GPT-6 Astra или Claude Fable 5.1: как выбрать и что дешевле
Тарифы равны, но у Fable 5.1 тот же текст занимает в 1,5 раза больше токенов: в тесте 26 октября 2026 года она дороже Astra. Дешевле она на вводе свыше 272K.
Содержание
У GPT-6 Astra и Claude Fable 5.1 одинаковые тарифы прямого API — $10 за миллион входных и $50 за миллион выходных токенов, но на коротких задачах агента и программирования дешевле выходит gpt-6-astra. Fable 5.1 насчитывает больше токенов на тот же текст и пишет более длинные ответы: в тесте 26 октября 2026 года обе модели решили все 8 задач со скрытыми тестами, а Fable обошлась в 1,49 и 1,61 раза дороже Astra; русский абзац у неё занял в 1,56 раза больше токенов. По сводной оценке качества впереди тоже Astra: в Artificial Analysis Intelligence Index v5.0 (девять тестов; эта версия 27–28 октября 2026 года заменила v4.3.2, где модели шли вровень) она набирает 57 баллов против 49 у Fable на уровне max и опережает её на 5–8 баллов на каждом уровне рассуждений.
claude-fable-5-1 выигрывает там, где у Astra срабатывает надбавка: если разовый запрос больше 272 тыс. входных токенов, у Astra ввод и кэш становятся вдвое дороже, а вывод — в 1,5 раза, причём для всего запроса, и Fable остаётся дешевле, пока насчитывает меньше чем в 1,93 раза больше токенов. При многократном чтении большого кэшированного префикса модели почти сравниваются: дешёвое чтение кэша у Fable ($0,25 против $1) съедает лишний счёт токенов, и на русском тексте Fable уже чуть дороже.
Прежде чем платить за любой из флагманов, проверьте соседей подешевле. OpenAI описывает GPT-6.1 Sol как модель, близкую к Astra, по цене $2 / $10, и 25 октября 2026 года на тех же 8 задачах она тоже решила всё, обойдясь в 5–6 раз дешевле Astra. Anthropic теперь советует для большинства задач начинать с Claude Opus 5.5, а Fable 5.1 брать для сложных рассуждений и долгих автономных задач. Все цены ниже — прямой API, стандартная обработка, в долларах США, по состоянию на 26 октября 2026 года.
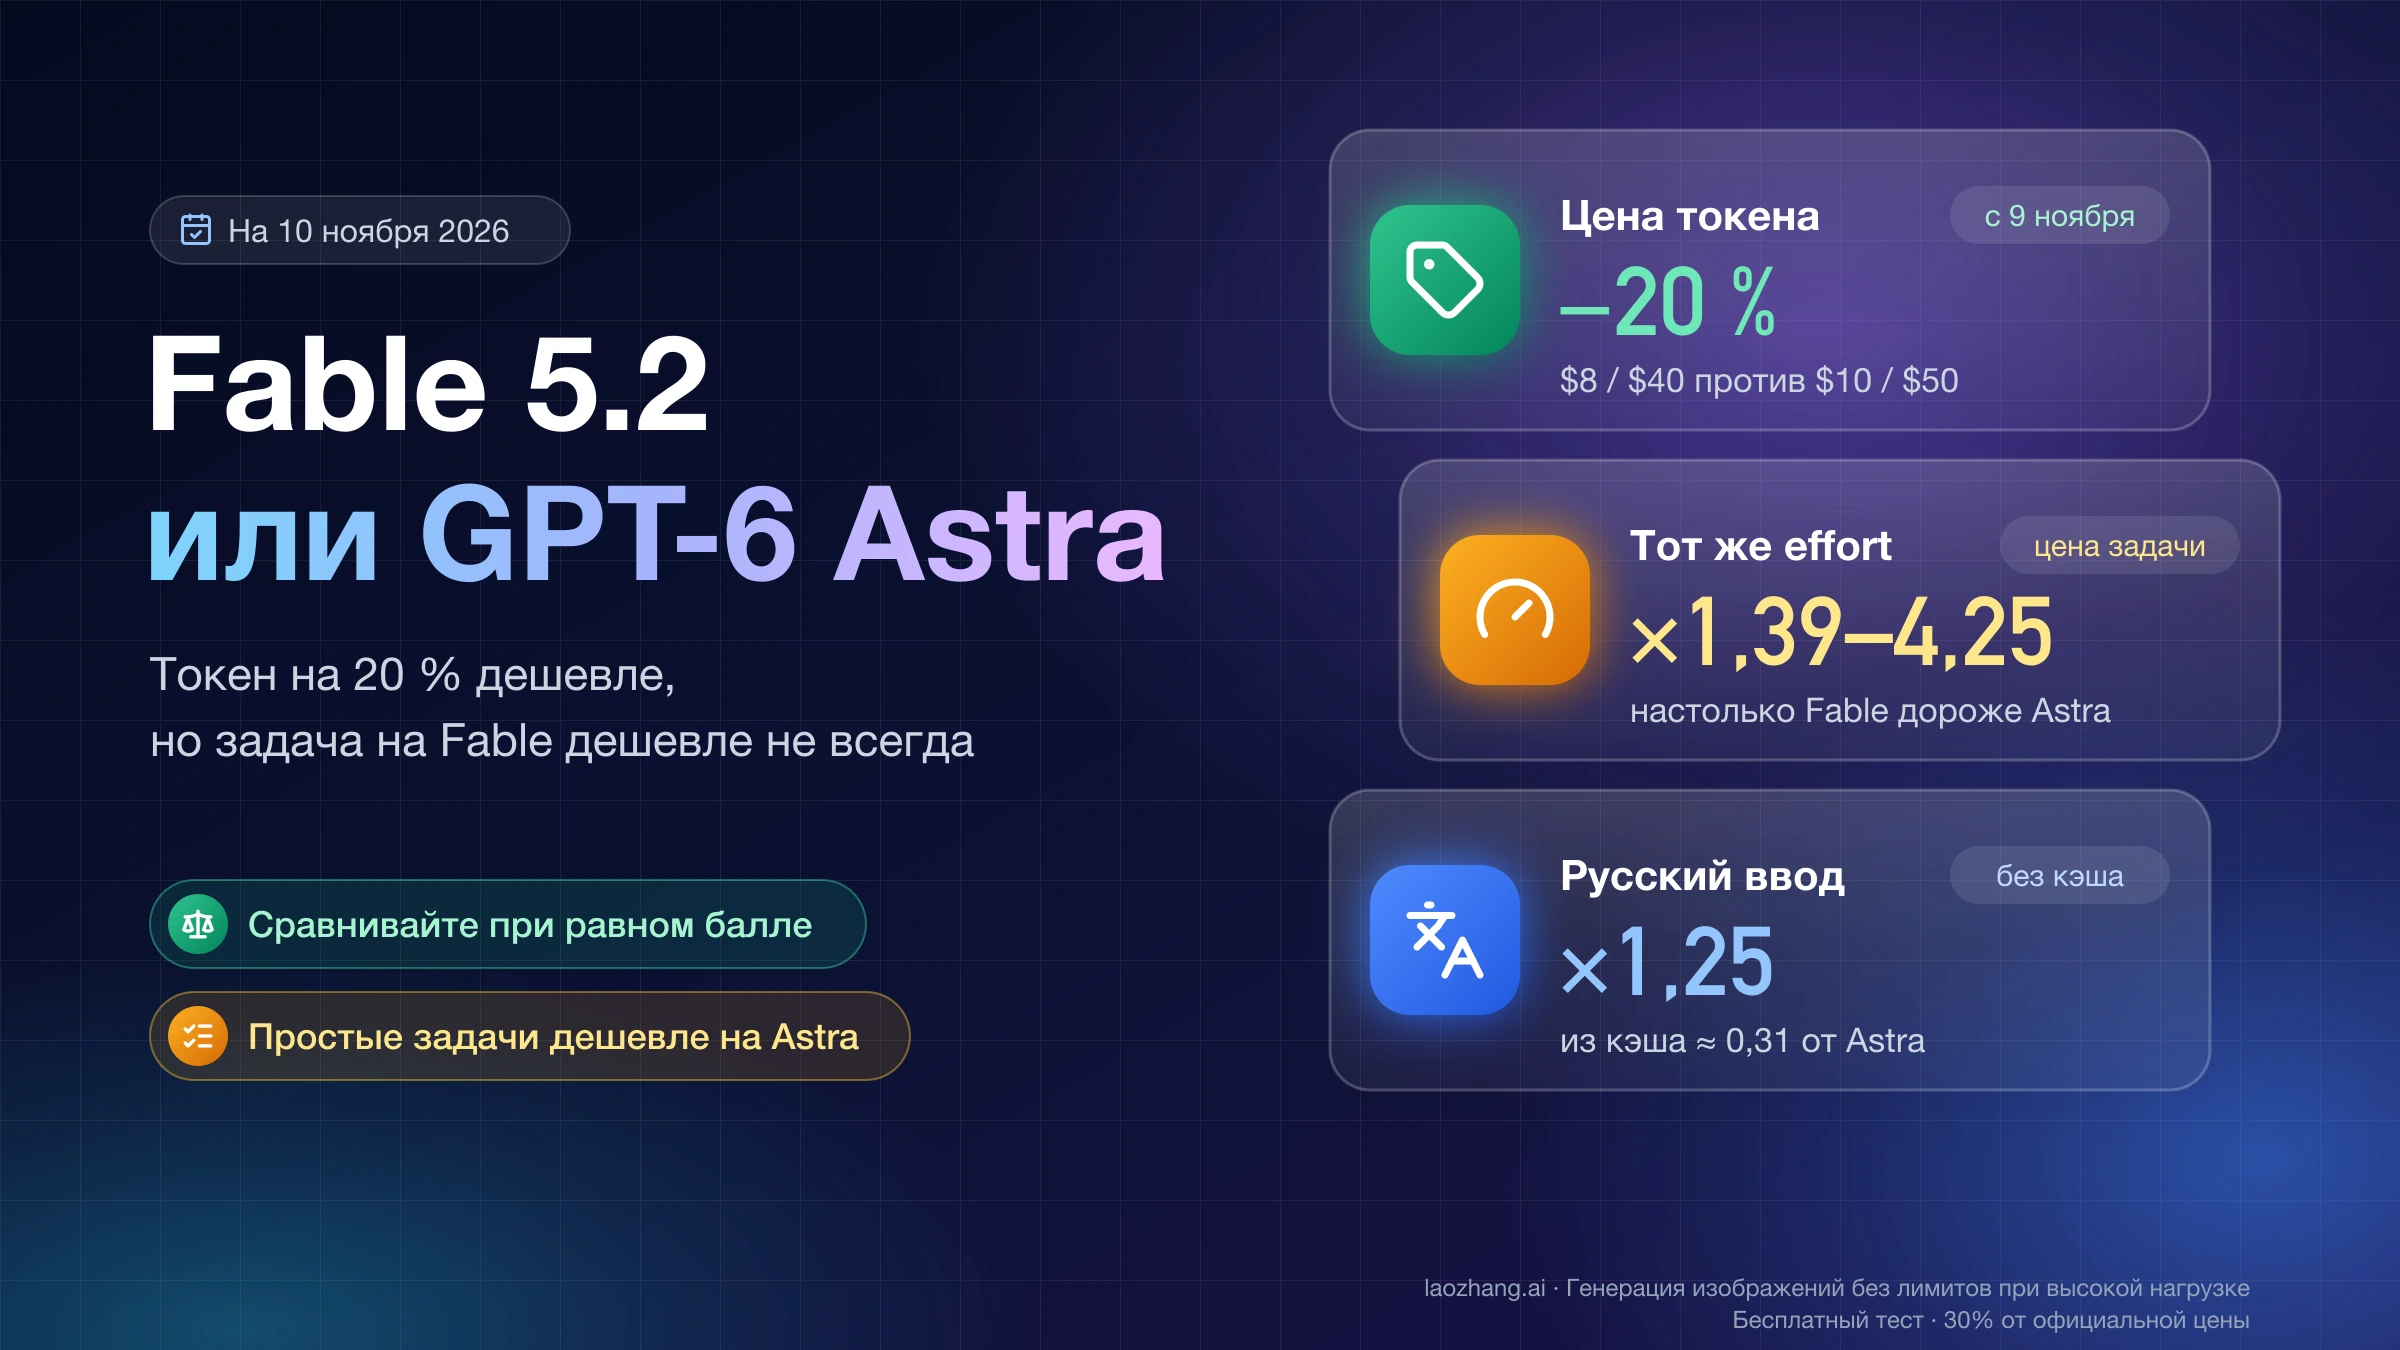
9 ноября 2026 года Anthropic выпустила Claude Fable 5.2 по цене $8 за миллион входных и $40 за миллион выходных токенов; Fable 5.1 по-прежнему доступна. Эта страница остаётся сравнением с Fable 5.1, а о новой модели — в статье Fable 5.2 или GPT-6 Astra: что выбрать и сколько стоит задача.
Сначала проверьте доступ, а не сравнивайте обещания
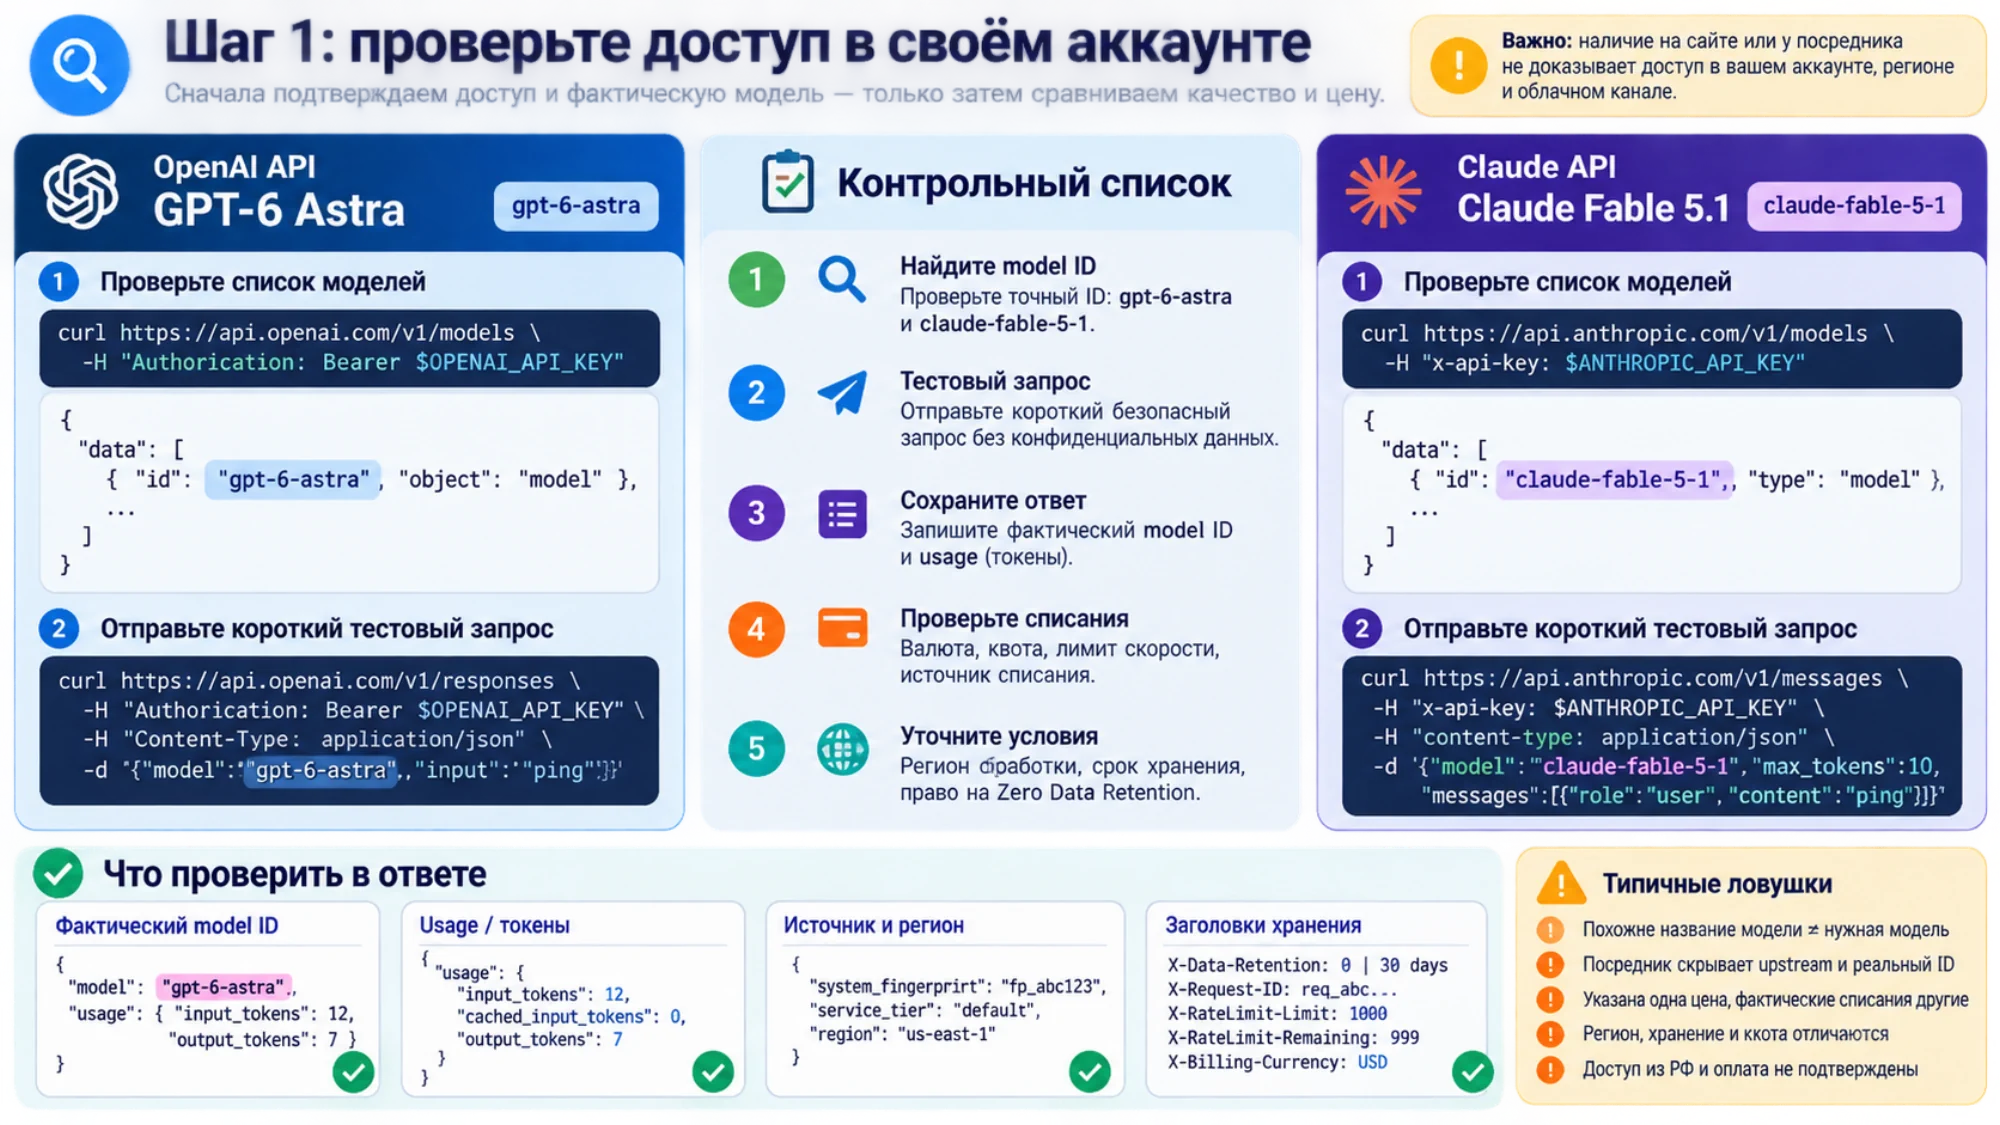
Точные идентификаторы API — gpt-6-astra и claude-fable-5-1, и до любого сравнения нужно убедиться, что запрос обслуживает именно эта модель в том канале, где будет работать нагрузка. Похожее название в интерфейсе, у посредника или в таблице тарифов ещё ничего не подтверждает. Минимальная проверка выглядит так:
- найдите точный model ID в списке моделей своего проекта;
- отправьте короткий безопасный запрос без конфиденциальных данных;
- сохраните идентификатор модели из ответа и запись usage;
- проверьте валюту, квоту, лимит скорости и фактический источник списания;
- уточните регион обработки, срок хранения и право на требуемый режим данных.
По состоянию на 26 октября 2026 года карточка GPT-6 Astra перечисляет Responses API, Chat Completions и Batch, причём вызов функций работает только через Responses. В ChatGPT доступ к Astra устроен отдельно от API: по справке OpenAI о моделях ChatGPT в Enterprise и Edu модель выключена, пока владелец рабочего пространства её не включит, и это не даёт доступа к API — он определяется организацией и проектом ключа. В Plus и стандартном Business таблица тарифов обещает примерно 5–45 локальных сообщений Astra за 5 часов в Codex. Какие тарифы получают Astra в обычном чате, OpenAI в открытой справке не расписывает; по сообщениям пользователей это Pro, Business и Enterprise. Первый запрос и типичные ошибки подключения разобраны в материале «Доступ к GPT-6 Astra API: ключ, первый запрос и ошибки подключения».
Fable 5.1 доступна через Claude API, Amazon Bedrock, Claude Platform on AWS, Microsoft Foundry и Google Cloud (обзор модели Anthropic). В приложениях Claude, по справке о моделях Fable на разных тарифах, она есть на всех платных тарифах: в Max на неё можно потратить до 50 % недельного лимита без доплаты, в Pro она с первого сообщения оплачивается кредитами использования, во Free её нет. Как устроены сами лимиты, сведено в материале «Лимиты Claude Pro и Max в неделю и за 5 часов: сводная таблица».
Доступность из конкретного региона и способ оплаты — отдельная проверка: открытые материалы OpenAI и Anthropic не дают на этот счёт универсального ответа для пользователей из России, поэтому не подменяйте её русскоязычной страницей или ценой посредника. Если сервис скрывает исходного провайдера, реальный model ID или политику хранения, его результат характеризует маршрут этого посредника, а не официальный API.
Похожие размеры контекста скрывают разные расходы
Окна у моделей почти одинаковые и цены за токен совпадают, но счёт расходится из-за трёх правил: у Astra свыше 272 тыс. входных токенов весь запрос идёт по повышенным ставкам (ввод и кэш вдвое дороже, вывод — в 1,5 раза), она по умолчанию сама записывает промпт в кэш, а Fable дешевле читает кэш, но записывает его только по явному запросу. Ставки ниже — за миллион токенов, по странице цен OpenAI API и тарифам Claude API на 26 октября 2026 года.
| Позиция | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Ввод | $10 | $10 |
| Чтение из кэша | $1 | $0,25 |
| Запись в кэш, короткий срок | $12,50 (30 минут) | $12,50 (5 минут) |
| Запись в кэш, длинный срок | $25 (12 часов, только Responses API) | $20 (1 час) |
| Вывод | $50 | $50 |
| Ввод свыше 272 тыс. токенов | весь запрос: $20 ввод, $2 кэш, $25 / $50 запись, $75 вывод | без надбавки до 1 млн |
| Batch | −50 % | −50 % |
| Контекст / максимум ввода | 1 050 000 / 922 000 | 1 000 000 |
| Максимальный вывод | 128 000 | 128 000 |
Надбавка Astra действует на весь запрос, а не на токены сверх порога: стоит входу перевалить за 272 тыс. токенов, как ввод и кэш дорожают вдвое, а вывод — в 1,5 раза. По документации Claude о контекстном окне Fable 5.1 держит стандартную ставку на всём окне в 1 млн токенов. Запись в кэш на 12 часов появилась у OpenAI 20 октября 2026 года; до этого у Astra была одна ставка записи, $12,50.
Кэш у моделей включается по-разному. В руководстве OpenAI по кэшированию промптов сказано, что кэширование включено по умолчанию, а запись для GPT-5.6 и новее стоит 1,25 от обычного ввода и заменяет его ставку; отказаться от неявной записи можно параметром prompt_cache_options.mode: "explicit", и без явно расставленных точек кэширования запрос тогда ничего не пишет. Fable кэширует только то, что помечено cache_control (документация Anthropic по кэшированию). В тесте 26 октября 2026 года это было видно напрямую: на промпте из 10 106 токенов без каких-либо настроек кэша Astra записала в кэш 10 103 токена по $12,50 за миллион, что добавило к счёту около $0,025, а Fable не записала ничего. На промптах короче примерно тысячи токенов записи у Astra не было.
Счёт по каждой модели отдельно разобран в материалах «GPT-6 Astra API: тарифы, кэш и стоимость длинного контекста» и «Цена Claude Fable 5.1 API: тарифы, кэш и расчёт счёта».
Один и тот же текст у Fable 5.1 занимает в 1,2–1,9 раза больше токенов
Одинаковая цена за токен не означает одинаковую цену за текст. 26 октября 2026 года один и тот же по смыслу абзац на шести языках Fable 5.1 посчитала в 1,23–1,90 раза большим числом входных токенов, чем GPT-6 Astra, а русский вариант — в 1,56 раза: 302 токена против 193. Это значит, что русский текст на вводе у Fable при равных тарифах стоит примерно в полтора раза дороже. Сама Anthropic в документации по подсчёту токенов пишет лишь, что токенизатор Fable 5.1 даёт примерно на 30 % больше токенов, чем модели Claude до Opus 4.7; официального сравнения с токенизатором OpenAI нет ни у одной из компаний.
| Текст | GPT-6 Astra, токенов | Claude Fable 5.1, токенов | Fable / Astra |
|---|---|---|---|
| Абзац на английском | 137 | 199 | 1,45 |
| Абзац на китайском | 165 | 247 | 1,50 |
| Абзац на японском | 254 | 312 | 1,23 |
| Абзац на корейском | 208 | 396 | 1,90 |
| Абзац на русском | 193 | 302 | 1,56 |
| Абзац на испанском | 162 | 304 | 1,88 |
| Статья на английском, 6 723 слова | 10 106 | 15 335 | 1,52 |
Абзацы — около 120–150 слов, одинаковые по смыслу; число токенов взято из поля usage каждого API при запросе через шлюз LaoZhang, за вычетом одной и той же короткой инструкции (23 токена у Astra и 34 у Fable). На каждый язык пришёлся один абзац, поэтому коэффициент для русского — оценка, а не константа: на коде, таблицах или другой тематике он может отличаться. Направление совпадает со сторонним замером Crazyrouter от 5 сентября 2026 года, где на английском тексте-заполнителе вышло 1,91.
Из коэффициента следуют и пределы окна. Порог 272 тыс. у Astra считается в токенах Astra, а миллион у Fable — в токенах Fable, поэтому русский текст, который помещается в окно Fable, по грубой оценке (1 000 000 / 1,56) соответствует примерно 640 тыс. токенов Astra. Максимальный ввод Astra — 922 тыс., так что на одном и том же русском документе у Astra запас по объёму больше, хотя свыше 272 тыс. весь запрос у неё дорожает: ввод и кэш вдвое, вывод в 1,5 раза.
Тест на 8 задачах: обе решили всё, Fable дороже в 1,5–1,6 раза
26 октября 2026 года обе модели получили одни и те же 8 задач со скрытыми тестами: текстовую задачу, merge_intervals, разбор длительности, подсчёт частых слов, сводку статьи на 6 723 слова, вычислитель выражений, разбор строки CSV и подсчёт по сумме цифр (последние три — по два прогона). Запросы шли через шлюз LaoZhang: Astra — через Chat Completions, Fable 5.1 — через Messages API, с потоковой выдачей, без системного промпта, инструментов и настроек кэша, с лимитом вывода 32 000 токенов и уровнями рассуждений по умолчанию. Все 22 ответа, по 11 на модель, прошли скрытые тесты, поэтому тест сравнивает стоимость и скорость при одинаковой доле успеха, а не «ум».
| Раунд | Модель | Решено | Ввод, токенов | Вывод, токенов | Стоимость по прайсу | Время, с |
|---|---|---|---|---|---|---|
| 1-й, 5 задач | GPT-6 Astra | 5/5 | 10 545 | 1 839 | $0,2227 | 50,3 |
| 1-й, 5 задач | Claude Fable 5.1 | 5/5 | 15 948 | 3 431 | $0,3310 | 43,3 |
| 2-й, 3 задачи × 2 | GPT-6 Astra | 6/6 | 862 | 3 656 | $0,1914 | 78,6 |
| 2-й, 3 задачи × 2 | Claude Fable 5.1 | 6/6 | 1 254 | 5 896 | $0,3073 | 72,4 |
Стоимость пересчитана по тарифам из таблицы выше на основе usage, который вернул каждый API. Для первого раунда у Fable это (15 948 × $10 + 3 431 × $50) / 1 000 000 = $0,331, у Astra — (10 545 × $10 + 1 839 × $50) / 1 000 000 = $0,197 плюс $0,025 за автоматическую запись кэша на сводке статьи, итого $0,2227. Разница в 1,49 и 1,61 раза складывается из двух причин: Fable насчитала больше входных токенов и выдала в 1,87 и 1,61 раза больше выходных. По общему времени раунда Fable была на 14 % и 8 % быстрее. Весь тест, 38 вызовов, стоил $1,10.
Выходные токены Fable на этом маршруте включают адаптивные рассуждения, которые не возвращаются в ответе: на просьбу ответить одним словом «ok» Fable выставила 132 выходных токена и думала 15,4 секунды, Astra — 5 токенов за 2,8 секунды. Astra отдельно показывает рассуждения в поле reasoning_tokens (например, 256 из 412 выходных токенов в текстовой задаче), у Fable их из общего счёта на этом маршруте не выделить. Для сравнения, 25 октября 2026 года те же 8 задач на GPT-6.1 Sol с настройками по умолчанию стоили $0,0387 и $0,0368 за раунд, тоже без единой ошибки: Astra оказалась дороже в 5,8 и 5,2 раза.
Ограничения теста стоит держать рядом с цифрами. Один шлюз, один день, по одному–два прогона на задачу, и задачи такие, что обе модели их решают. Astra шла через Chat Completions, а не через Responses API, и без явного уровня рассуждений: какой уровень у Astra по умолчанию, в документации OpenAI не указано, у Fable в API по умолчанию стоит high. Кэширование с повторным чтением и вводы свыше 272 тыс. токенов в тесте не проверялись — для них ниже приведён расчёт по прайсу.
Два расчёта, которые меняют порядок пилота
Если считать, что обе модели насчитывают одинаковое число токенов, Fable выигрывает оба расчёта ниже. С измеренным коэффициентом картина другая: при повторном чтении большого кэша русский текст на Fable уже чуть дороже, а на разовом длинном вводе Fable остаётся заметно дешевле. Обозначим r — во сколько раз больше токенов Fable насчитывает на тот же текст (для русского 1,56, для английского 1,45); все объёмы ниже выражены в токенах Astra, цены — по таблице выше, и предполагается, что r действует и на ввод, и на вывод.
Первый случай — агент снова и снова читает большой префикс: за ход 250 тыс. токенов из кэша, 10 тыс. новых входных и 5 тыс. выходных. У Astra такой ход стоит 0,25 × $1 + 0,01 × $10 + 0,005 × $50 = $0,60, у Fable 5.1 — r × (0,25 × $0,25 + 0,01 × $10 + 0,005 × $50) = r × $0,4125, поэтому безубыточность наступает при r = 0,60 / 0,4125 ≈ 1,455. На английском (1,45) ход стоит у обеих моделей около $0,60, на русском у Fable выходит примерно $0,64, на корейском (1,90) — $0,78. Если Astra по умолчанию допишет в кэш и эти 10 тыс. новых токенов, как в тесте, её ход подорожает до $0,625, а точка безубыточности сдвинется к 1,52 — русский текст на Fable всё равно чуть дороже. Первая запись того же префикса стоит у Astra 0,25 × $12,50 + 0,01 × $10 + 0,005 × $50 = $3,475, у Fable — r × $3,475, то есть на русском около $5,42. Учтите и срок жизни: короткая запись у Fable живёт 5 минут против 30 у Astra, поэтому при паузах между ходами Fable придётся писать кэш заново или брать часовую запись по $20.
Второй случай — разовый длинный ввод без кэша: 300 тыс. входных и 10 тыс. выходных токенов. Вход у Astra больше 272 тыс., поэтому запрос стоит 0,30 × $20 + 0,01 × $75 = $6,75, а у Fable 5.1 — r × (0,30 × $10 + 0,01 × $50) = r × $3,50. Безубыточность здесь при r = 6,75 / 3,50 ≈ 1,93: на русском Fable обходится примерно в $5,46, то есть дешевле, и выигрывает даже на корейском и испанском. Цифра $6,75 для Astra верна, только если неявная запись кэша отключена через prompt_cache_options.mode: "explicit". Если Astra по умолчанию запишет весь промпт, как на коротком тесте, его ввод будет стоить по ставке записи длинного контекста: 0,30 × $25 + 0,01 × $75 = $8,25, и безубыточность поднимется до 2,36.
Третий случай, короткие задачи без кэша, — это условия теста: стоимость равна ввод × $10 + вывод × $50, а у Fable больше и то и другое. Вывод здесь весит в пять раз больше ввода, поэтому решает то, насколько длиннее отвечает модель, и на задачах теста это дало Fable 1,49–1,61 раза. Ни в одном из расчётов не учтены инструменты, повторы, налоги и наценка облака или посредника, а реальная длина ответа зависит от модели и задачи сильнее, чем коэффициент r: в тесте Fable писала в 1,6–1,9 раза больше выходных токенов.
Поэтому рабочая метрика остаётся прежней:
стоимость принятого результата = все вызовы + кэш + инструменты + повторы + время проверки человека
Если дешёвый запуск дважды нарушает требования и требует ручной переделки, цена его токенов мало помогает. Неудачные попытки нельзя выбрасывать из расчёта.
Бенчмарки задают гипотезу, а не победителя
Сводный рейтинг теперь на стороне Astra, но и он лишь подсказывает, что проверять. В сравнении Artificial Analysis по Intelligence Index v5.0 Astra опережает Fable на каждом уровне рассуждений на 5–8 баллов: 57 против 49 на max, а лучший результат Fable, 50 баллов на xhigh, ниже, чем у Astra на medium (51). В прежней версии v4.3.2 обе модели набирали по 53 балла на max; с новыми цифрами её не сравнить, потому что 27–28 октября 2026 года AA сменила набор тестов. Цифры «66 против 61» в пользу Fable, которые появились в первую неделю после запуска, относятся к ещё более старому Index v4.1. Задача индекса при этом стоит у Fable в 2,0–3,2 раза дороже, так что Astra в этом рейтинге одновременно выше и примерно вдвое дешевле.
| Уровень рассуждений | Fable 5.1, баллы v5.0 | Astra, баллы v5.0 | Стоимость задачи индекса, Fable / Astra |
|---|---|---|---|
| max | 49 | 57 | $13,04 / $6,24 |
| xhigh | 50 | 55 | $10,89 / $3,66 |
| high | 47 | 55 | $7,56 / $3,24 |
| medium | 43 | 51 | $5,58 / $2,73 |
| low | 38 | 43 | $4,49 / $1,42 |
По отдельным тестам лидеры разные. В таблице анонса GPT-6 Astra на уровне max Astra впереди в Terminal-Bench 4.0 (57,9 % против 55,8 %), AutomationBench (41,4 % против 31,4 %) и DeepSWE v1.1 (74,1 % против 67,4 %), а Fable — в Humanity's Last Exam с инструментами (65,0 % против 57,2 %). Из девяти тестов Artificial Analysis v5.0 на уровне max Fable впереди только в AA-Briefcase (рейтинг 1669 против 1568) и AA-Omniscience (46 против 42), а Astra — во всех остальных: в собственном прогоне AA Terminal-Bench 4.0 (59,1 % против 52,0 %), AutomationBench-AA (68,5 % против 59,4 %), FrontierCode (42,4 % против 31,6 %), GDP.pdf (31,0 % против 26,2 %), HLE-Diamond (63,8 % против 60,1 %), CritPt (70,5 % против 51,0 %) и Terminal-Bench-Science (63,3 % против 43,3 %). GDPval-AA, SciCode и AA-LCR, где Fable прежде была выше (на длинном контексте — 85,3 % против 80,7 %), входили в v4.3.2 и в новый индекс не попали. Anthropic публикует собственные результаты и оценки экономии; страницы обоих поставщиков принадлежат заинтересованным сторонам, и в примечаниях к таблицам оговорены разные уровни effort, оболочки и защитные механизмы.
Сторонние замеры расходятся ещё сильнее. В тесте Crazyrouter от 5 сентября 2026 года Fable прошла 29 из 29 проверок, а Astra — 16, в том числе из-за неполных ответов на вопросы с тремя равнозначными вариантами и согласия с ложной посылкой. В публикации на VC.ru с собственным тестом Astra оказалась на 36 % дешевле, автор на X насчитал по 15 сценариям $26,61 у Fable против $12,14 у Astra при лучшем результате Fable, а пользователи r/codex пишут, что Fable сильнее в качестве кода, но быстрее расходует 5-часовой лимит. Это отдельные сообщения на собственных задачах, а не воспроизводимые замеры. По скорости вывода картина тоже зависит от площадки: OpenRouter показывает медиану 57 токенов в секунду у Fable против 36 у Astra, а у Artificial Analysis на уровне max, наоборот, быстрее Astra: 71 против 66 по замеру 28 октября 2026 года.
Из этого можно выбрать класс задач для проверки, но нельзя сложить разнородные проценты в универсальный рейтинг. Результат терминального агента предлагает проверить исправление реального репозитория, показатель работы с компьютером — сценарий с наблюдаемым конечным состоянием, экономия токенов — расчёт на вашей истории запросов. Уровень рассуждений, оболочка, права инструментов, время и допустимые повторы должны быть записаны рядом с результатом.
Инструменты и политика данных могут решить выбор до теста качества
Интеграция может отсеять одну из моделей раньше любого сравнения качества. У Astra вызов функций работает только через Responses API: в руководстве по последней модели OpenAI прямо сказано, что Chat Completions не поддерживает function calling с GPT-6 Astra и GPT-6.1 Sol. Уровни рассуждений (reasoning effort) — low, medium, high, xhigh и max; none возвращает HTTP 400. Какой уровень стоит по умолчанию, OpenAI не указывает, а справка Codex советует начинать Astra с Light, то есть low, поэтому в своём сравнении задавайте reasoning_effort явно. Если агент уже построен на Responses API, Astra встраивается в него без попытки повторить поведение Claude API.
Fable 5.1 работает с постоянно включённым адаптивным мышлением (adaptive thinking), уровень effort в API по умолчанию — high. По описанию изменений Fable 5.1 и release notes Anthropic HTTP 400 вернут tool_choice со значением any или tool, предзаполнение ответа ассистента, budget_tokens и отключение мышления, а также temperature, top_p и top_k; tool_choice: auto и none остаются допустимыми. Агент, который принудительно требует вызов функции, сначала нуждается в изменении оркестрации, а уже потом — в сравнении качества.
С политикой данных различие столь же практичное. По руководству OpenAI о данных в API режим Zero Data Retention настраивается для каждого эндпоинта после предварительного одобрения, /v1/responses и /v1/chat/completions для него подходят, но OpenAI оставляет за собой право сделать модели недоступными для отдельных клиентов. Fable 5.1 — модель с обязательным хранением данных 30 дней: по правилам Anthropic о хранении данных API ZDR для неё недоступен без явного разрешения Anthropic, организация, не выполняющая требование, получает HTTP 400, а организация с ZDR может включить 30-дневное хранение для одного рабочего пространства.
У Fable есть и защитные механизмы: в приложениях Claude помеченный запрос может получить ответ от другой модели, о чём сообщает справка Claude о переключении моделей. Если для аудита важна модель-исполнитель, сохраняйте в журнале модель из ответа, а не только запрошенное имя. Облачная площадка может иметь собственные регионы, журналы, наценки и договор, поэтому не переносите условия прямого Claude API или OpenAI API на Bedrock, Foundry либо посредника без проверки.
Как выбирать по рабочей нагрузке
Выбор по нагрузке сводится к трём вопросам: какой у вас типичный размер одного запроса, сколько раз читается один и тот же контекст и сколько текста модель пишет в ответ. Ниже — как ответы на них меняют порядок кандидатов.
Большие документы и повторно используемый контекст
Начните с Fable 5.1, если типичный разовый ввод регулярно превышает 272 тыс. токенов Astra: повышенные ставки Astra на весь такой запрос (ввод и кэш вдвое, вывод в 1,5 раза) перевешивают лишние токены Fable до коэффициента 1,93, а на русском он около 1,56. Затем проверьте качество извлечения важных ограничений: контекст, который поместился, но не повлиял на ответ, не создаёт ценности. В прежнем индексе Artificial Analysis v4.3.2 Fable была впереди на тесте длинного контекста AA-LCR, 85,3 % против 80,7 %, но в v5.0 этого теста нет, поэтому качество работы с длинными документами придётся проверять на своих данных.
Если один и тот же большой корпус многократно читается из кэша, преимущество Fable почти исчезает: на английском расчёт выходит в ничью, на русском Fable чуть дороже, а короткий срок её кэша требует частых перезаписей. Если вход можно надёжно разбить, извлечь релевантные части или сократить до порога, Astra снова становится полноценным кандидатом. Сравнивайте не максимальный размер окна, а весь способ подготовки данных и долю принятых результатов.
Агентная автоматизация и работа с компьютером
Astra логично поставить первой, когда процесс уже использует Responses API, асинхронные инструменты или управление во время выполнения; в таблицах OpenAI и Artificial Analysis она впереди и в AutomationBench. Устройство такого цикла разобрано в материале «GPT-6 Astra и управление компьютером: контролируемый цикл через API». Но заявленная пригодность к работе с компьютером не доказывает устойчивость в вашей среде: критерий должен проверять завершение всей операции — правильное состояние системы, отсутствие нежелательных действий и восстановление после ошибки инструмента.
Fable 5.1 стоит включить в тот же пилот, если оркестратор совместим с её правилами tool_choice. Учитывайте не только правильный финальный текст, но и число вызовов, зависания, повторные запросы, вмешательство человека и случаи защитной маршрутизации.
Программирование
На коротких задачах с тестами обе модели в тесте 26 октября 2026 года справились одинаково, и Astra вышла дешевле в 1,5–1,6 раза; в таблице OpenAI она впереди в DeepSWE и Terminal-Bench, а в сообщениях пользователей r/codex Fable хвалят за качество кода. Для настоящего выбора дайте обеим моделям один и тот же коммит, зависимости, доступные команды и тесты. Приёмка должна требовать не красивого объяснения, а проходящих тестов и изменения, которое не приходится переписывать на ревью; отдельно считайте попытки после неверной правки, потерю контекста между инструментами и минуты ручной проверки.
Если одна модель сильнее в коротких исправлениях, а другая — в длительной межфайловой переработке, это основание для двойной маршрутизации, а не для объявления общего победителя. Если вы сравнивали Fable с Sol для кода, учтите, что флагман OpenAI сейчас Astra, а GPT-6.1 Sol — более дешёвая модель близкого уровня; их сравнение — в материале «GPT-6.1 Sol, GPT-6 Astra и GPT-6 Sol: какую модель выбрать».
Исследование и аналитика
Здесь данные расходятся. В таблице OpenAI Fable впереди в Humanity's Last Exam с инструментами, а GDPval-AA и SciCode, где она была выше у Artificial Analysis, в индекс v5.0 больше не входят; в новых научных тестах AA — HLE-Diamond, CritPt и Terminal-Bench-Science — на уровне max впереди Astra. Зафиксируйте набор разрешённых источников, дату среза и список утверждений, которые обязаны иметь прямую ссылку. Принятым считается вывод, выдержавший выборочную проверку фактов и ограничений; большое число уверенных абзацев или высокий результат общего теста интеллекта не заменяют такую приёмку.
Проведите ограниченный сопоставимый пилот
Небольшой пилот на своих задачах ответит на вопрос точнее любой таблицы, и его можно провести за день. Порядок такой:
- Возьмите 6–10 недавних задач из настоящей очереди, а не демонстрационные запросы, и для каждой заранее запишите неизменный входной снимок, критерий приёмки, права на файлы, сеть и инструменты, лимит времени, бюджета и повторов.
- Измерьте свой коэффициент r. Отправьте один типичный промпт в обе модели и разделите входные токены Fable из usage на входные токены Astra. Подставьте r в расчёты выше, чтобы понять, какая модель дешевле на вашем профиле ещё до пилота.
- Задайте уровни рассуждений явно,
reasoning_effortдля Astra иeffortдля Fable. Добавьте третьим кандидатом GPT-6.1 Sol или Claude Opus 5.5 — по цене они заметно ниже флагманов. - Запускайте задачи в отдельных рабочих копиях и чередуйте порядок моделей, чтобы второй кандидат не получал более тёплый кэш или исправленную среду.
- Для каждого запуска сохраняйте запрошенный и фактический model ID, токены ввода, чтения и записи кэша, вывода и рассуждений, задержку, вызовы инструментов, повторы, итог приёмки и время проверки.
- Посчитайте стоимость принятого результата по формуле выше и сравните её, а не цену за токен.
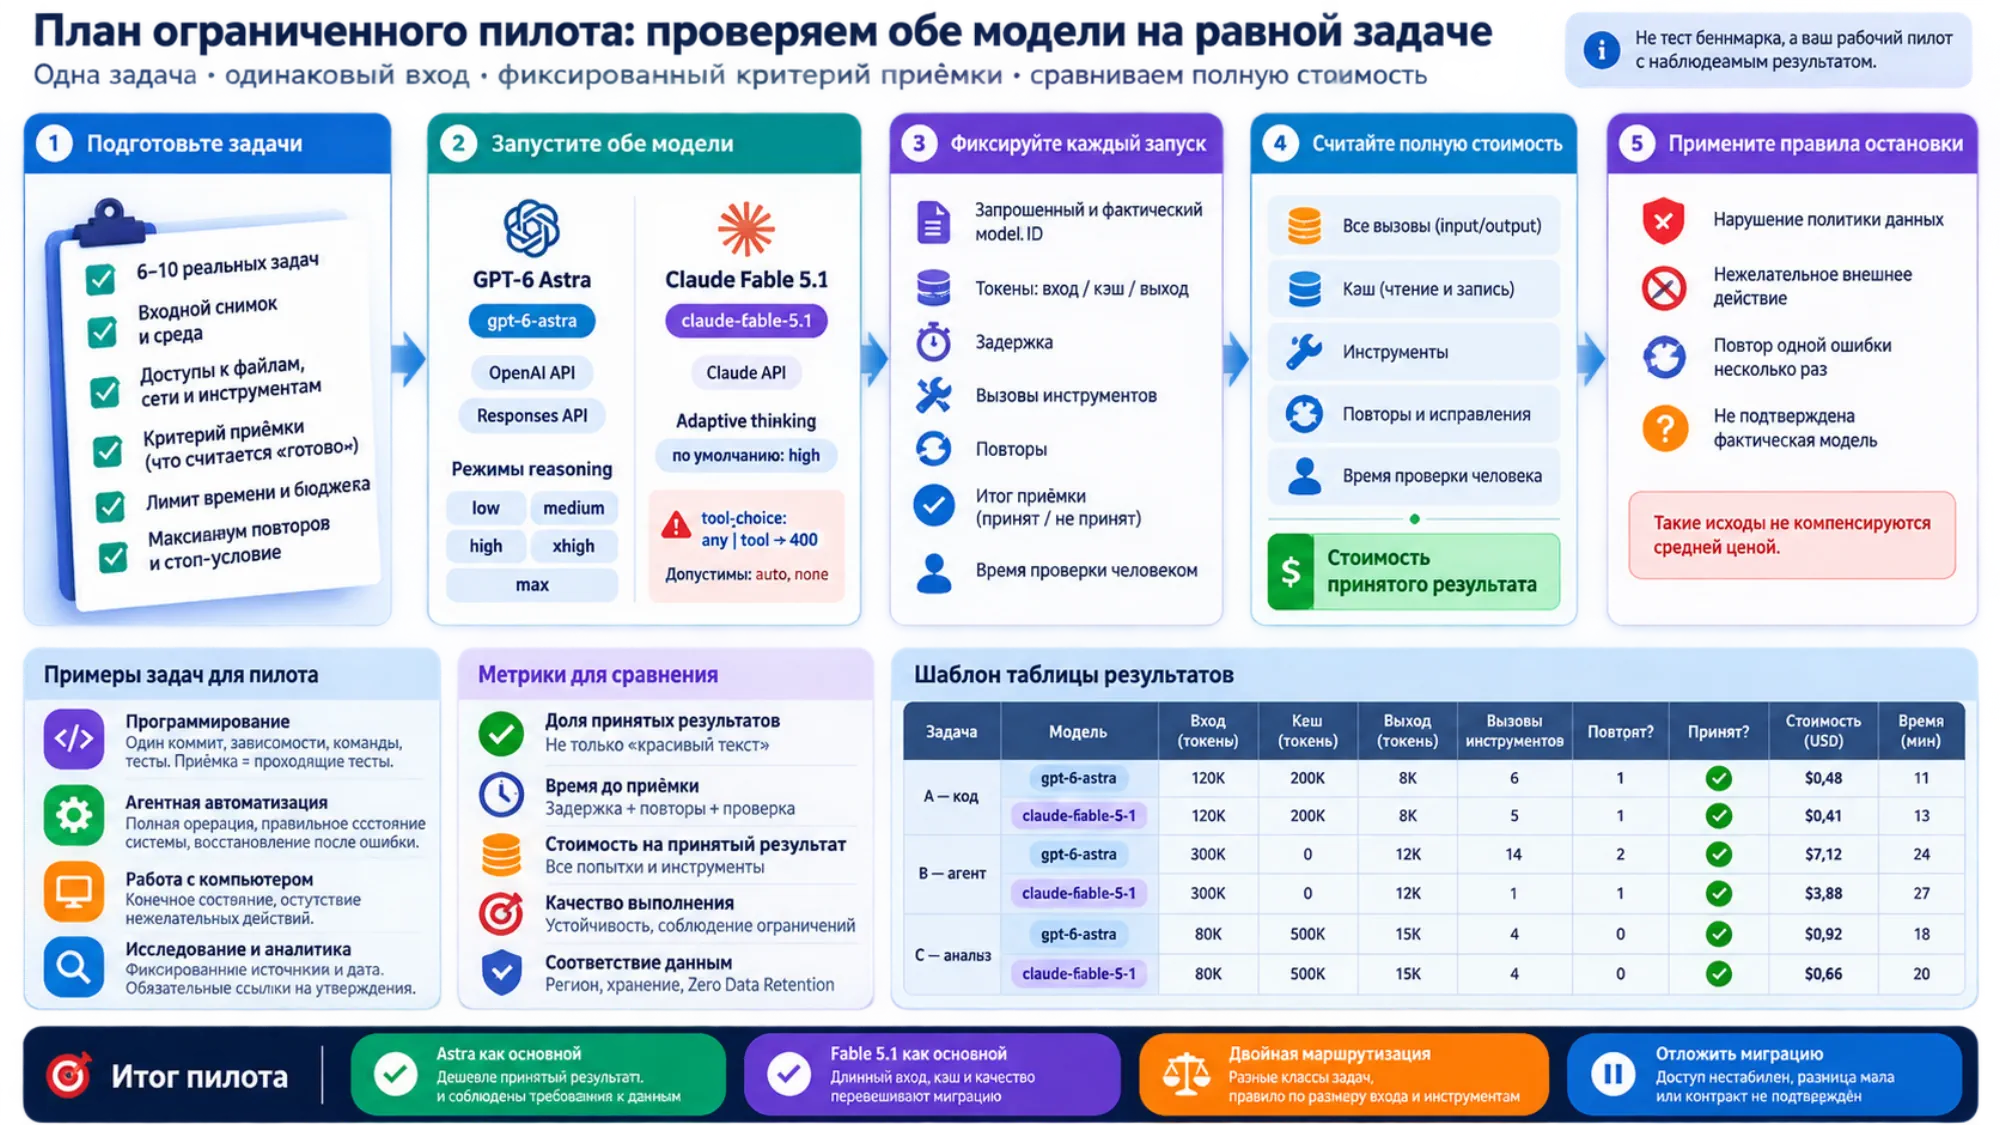
Полной симметрии между API нет: адаптивное мышление Fable не равно какому-либо уровню Astra, а наборы инструментов различаются. Не скрывайте это: цель, вход и критерий приёмки должны быть функционально одинаковыми, а различия исполнения — явно записанными. Остановите кандидата раньше лимита, если он нарушил политику данных, выполнил нежелательное внешнее действие, несколько раз повторил одну ошибку или фактическая модель не подтверждается. Такие исходы нельзя компенсировать средней ценой.
Решение может быть двойным — или никаким
После пилота возможны четыре здравых исхода, и один из них — не брать ни один из двух флагманов. Astra годится как основной маршрут, если она доступна, соблюдает требования к данным и устойчиво даёт более дешёвый принятый результат на главной нагрузке; судя по тесту и расчётам, так чаще всего выходит на коротких задачах, а для русского текста — и на повторном чтении кэша. Fable 5.1 стоит сделать основной, если на вашей нагрузке преобладают разовые вводы свыше 272 тыс. токенов или её качество окупает и миграцию оркестратора, и лишние токены.
Двойная маршрутизация оправдана, если кандидаты выигрывают в разных классах задач; тогда правило выбора должно опираться на размер входа, инструменты и требования к данным, а не на то, как модель сама классифицирует задачу. Отложить переход разумно, если доступ нестабилен, разница меньше обычного разброса, фактическая модель не подтверждается или новый маршрут не окупает стоимость перехода. Заранее задайте порог переключения и рабочий откат и не меняйте основную модель после одного удачного примера.
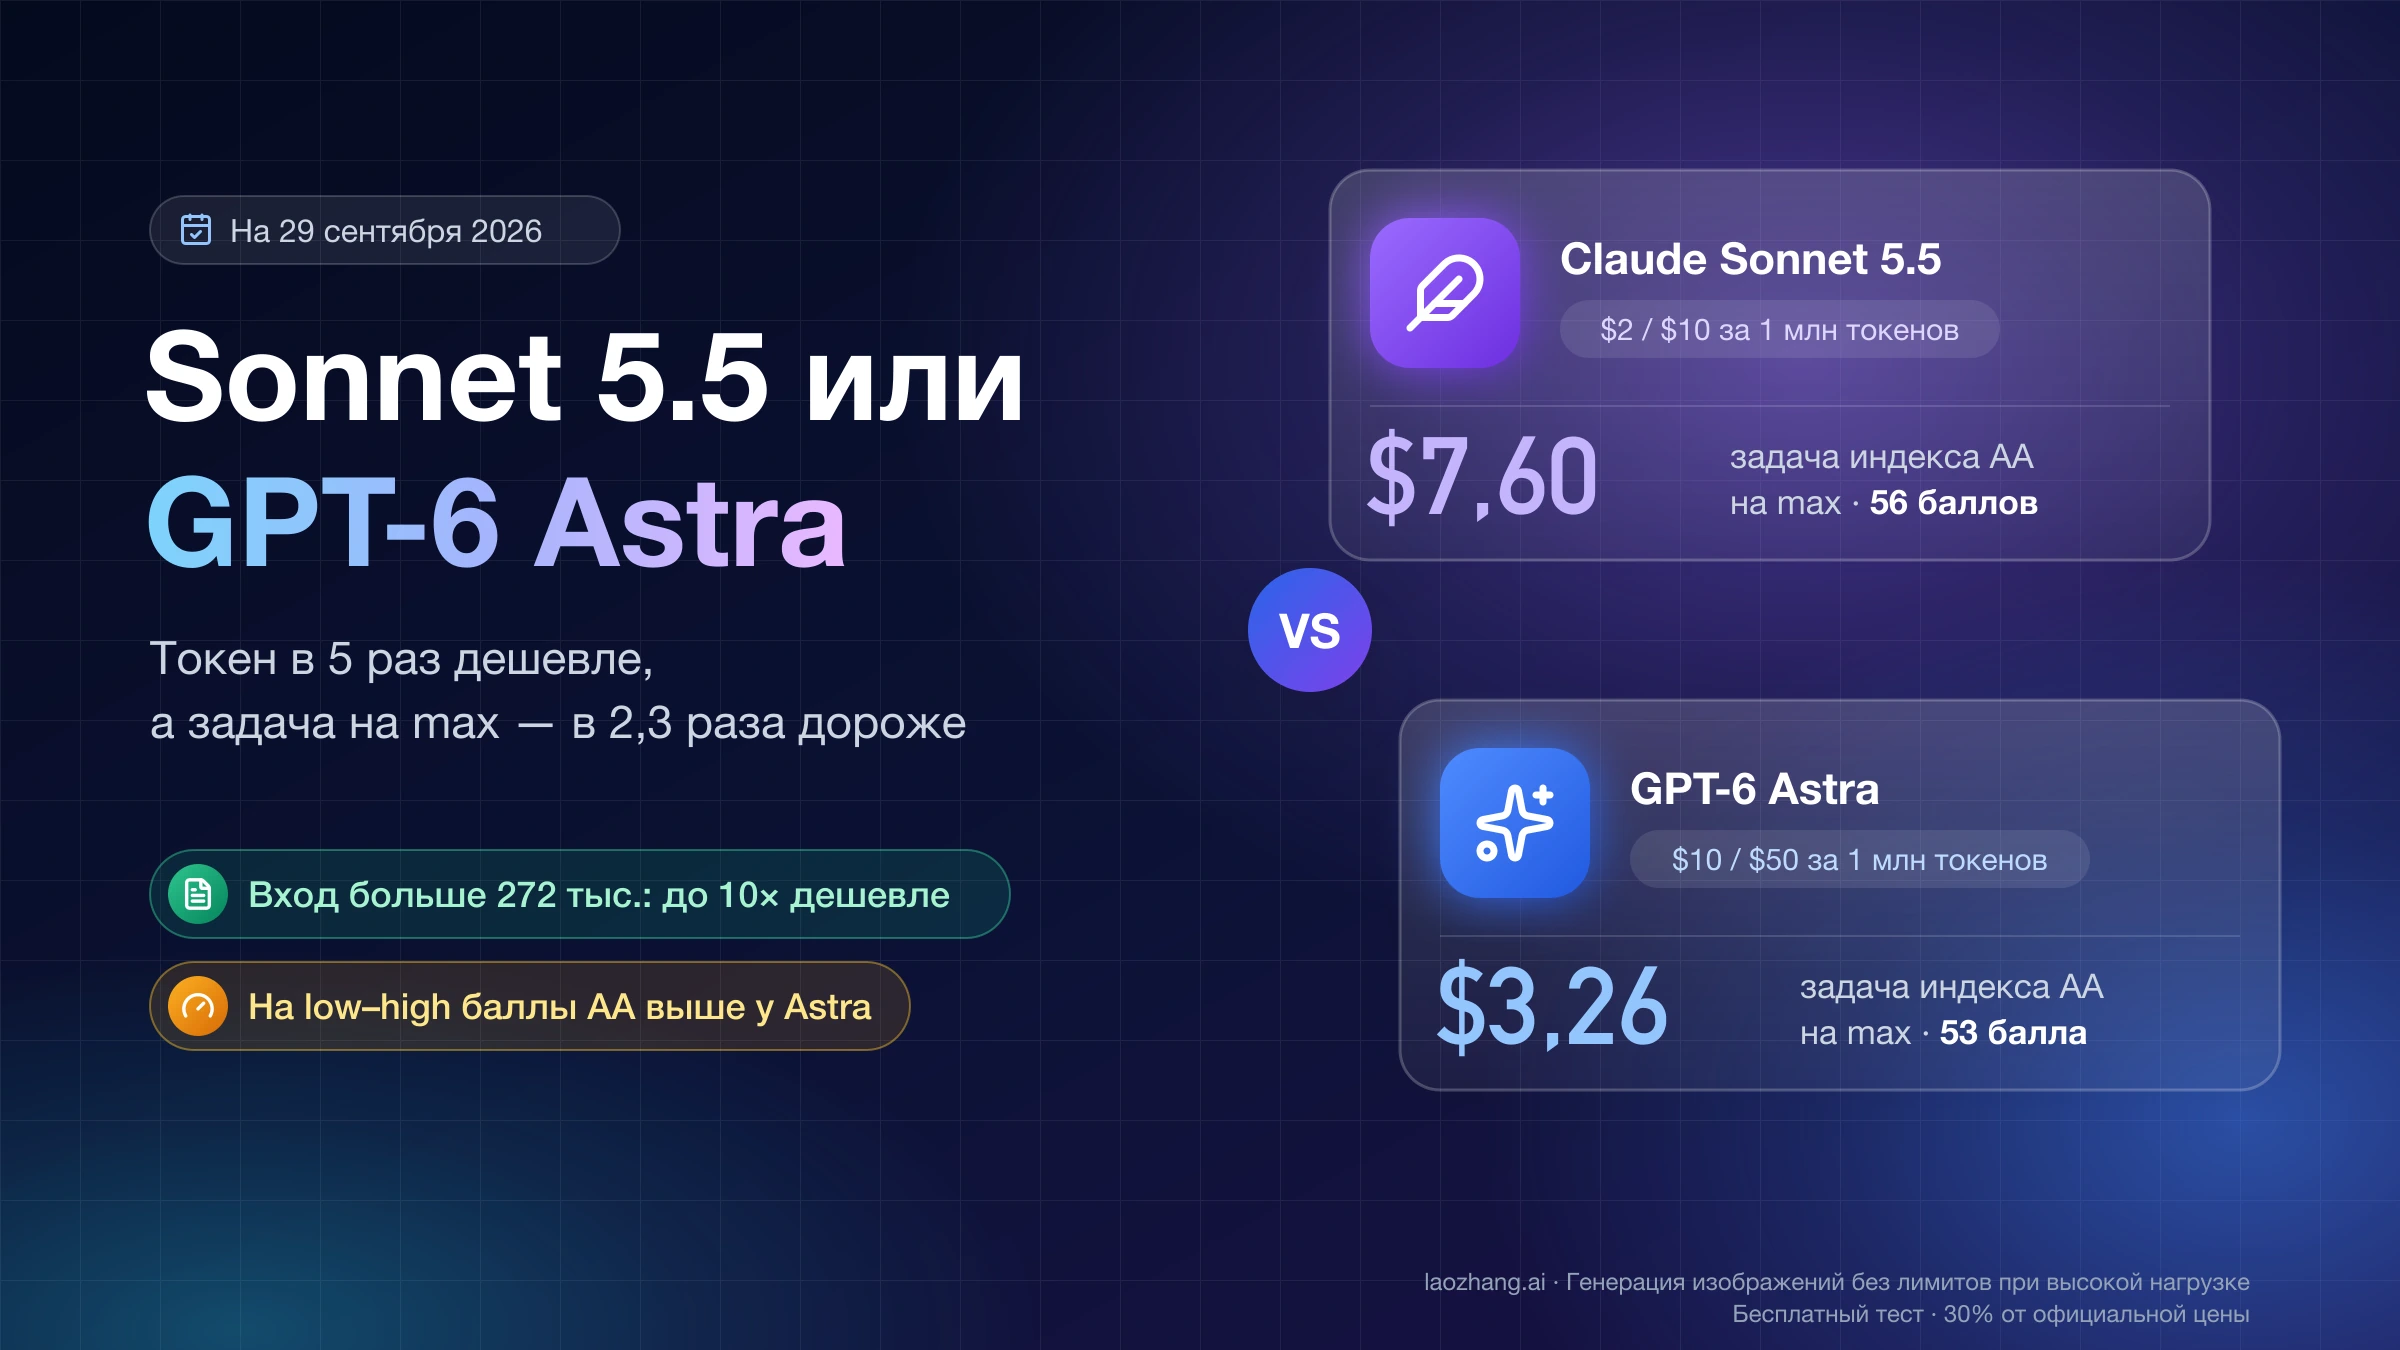
Часто выгоднее оказывается модель на ступень ниже. OpenAI называет GPT-6.1 Sol моделью близкой к Astra силы за $2 / $10 (страница GPT-6.1 Sol), а Anthropic в обзоре моделей Claude советует начинать с Opus 5.5, а Fable 5.1 брать для сложных рассуждений и долгой агентной работы или когда Opus 5.5 на высоком уровне рассуждений не справляется. Когда доплата за Fable оправдана, разобрано в материале «Claude Fable 5.1 или Opus 5.5: что выбрать и когда стоит доплатить», а более дешёвый Claude против Astra — в «Claude Sonnet 5.5 или GPT-6 Astra: стоит ли переходить». Если вы переходите на Fable с предыдущей версии Claude, отдельно проверьте материал «Claude Fable 5.1 или Opus 5: цены API и стоимость задачи».
Новых версий обеих моделей пока нет: по состоянию на 26 октября 2026 года Anthropic не публиковала Fable новее 5.1, а в журнале изменений OpenAI по последнюю запись от 22 октября нет версии новее GPT-6 Astra. Что известно о следующих моделях, собрано в материале «Сравнение Fable 5.5, Gemini 4 и GPT-6.1: Fable 5.2 вышла, 5.5 нет».
Источники24
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 окт. 2026 г..
Источники24
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 окт. 2026 г..
- 1.карточка GPT-6 Astradevelopers.openai.com/api/docs/models/gpt-6-astra
- 2.справке OpenAI о моделях ChatGPTlearn.chatgpt.com/docs/models.md
- 3.таблица тарифовlearn.chatgpt.com/docs/pricing.md
- 4.обзор модели Anthropicplatform.claude.com/docs/en/models/fable-5-1/overview
- 5.справке о моделях Fable на разных тарифахsupport.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- 6.странице цен OpenAI APIdevelopers.openai.com/api/docs/pricing
- 7.тарифам Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 8.документации Claude о контекстном окнеplatform.claude.com/docs/en/build-with-claude/context-windows
- 9.руководстве OpenAI по кэшированию промптовdevelopers.openai.com/api/docs/guides/prompt-caching
- 10.документация Anthropic по кэшированиюplatform.claude.com/docs/en/build-with-claude/prompt-caching
- 11.документации по подсчёту токеновplatform.claude.com/docs/en/build-with-claude/token-counting
- 12.Crazyrouter от 5 сентября 2026 годаcrazyrouter.com/zh/blog/gpt-6-astra-vs-claude-fable-5-1-benchmark-2026-zh
- 13.сравнении Artificial Analysisartificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-1
- 14.анонса GPT-6 Astraopenai.com/index/gpt-6-astra
- 15.Anthropic публикует собственные результаты и оценки экономииanthropic.com/claude-fable-and-mythos-5-1
- 16.OpenRouteropenrouter.ai/compare/anthropic/claude-fable-5.1/openai/gpt-6-astra
- 17.руководстве по последней модели OpenAIdevelopers.openai.com/api/docs/guides/latest-model
- 18.описанию изменений Fable 5.1platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- 19.release notes Anthropicplatform.claude.com/docs/en/release-notes/overview
- 20.руководству OpenAI о данных в APIdevelopers.openai.com/api/docs/guides/your-data.md
- 21.правилам Anthropic о хранении данных APIplatform.claude.com/docs/en/manage-claude/api-and-data-retention
- 22.справка Claude о переключении моделейsupport.claude.com/en/articles/15363606-why-claude-switched-models-in-your-conversation-with-fable-5-or-fable-5-1
- 23.страница GPT-6.1 Soldevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 24.обзоре моделей Claudeplatform.claude.com/docs/en/about-claude/models/overview