GLM-5.3, Kimi K3 или DeepSeek V4: какую модель проверять первой
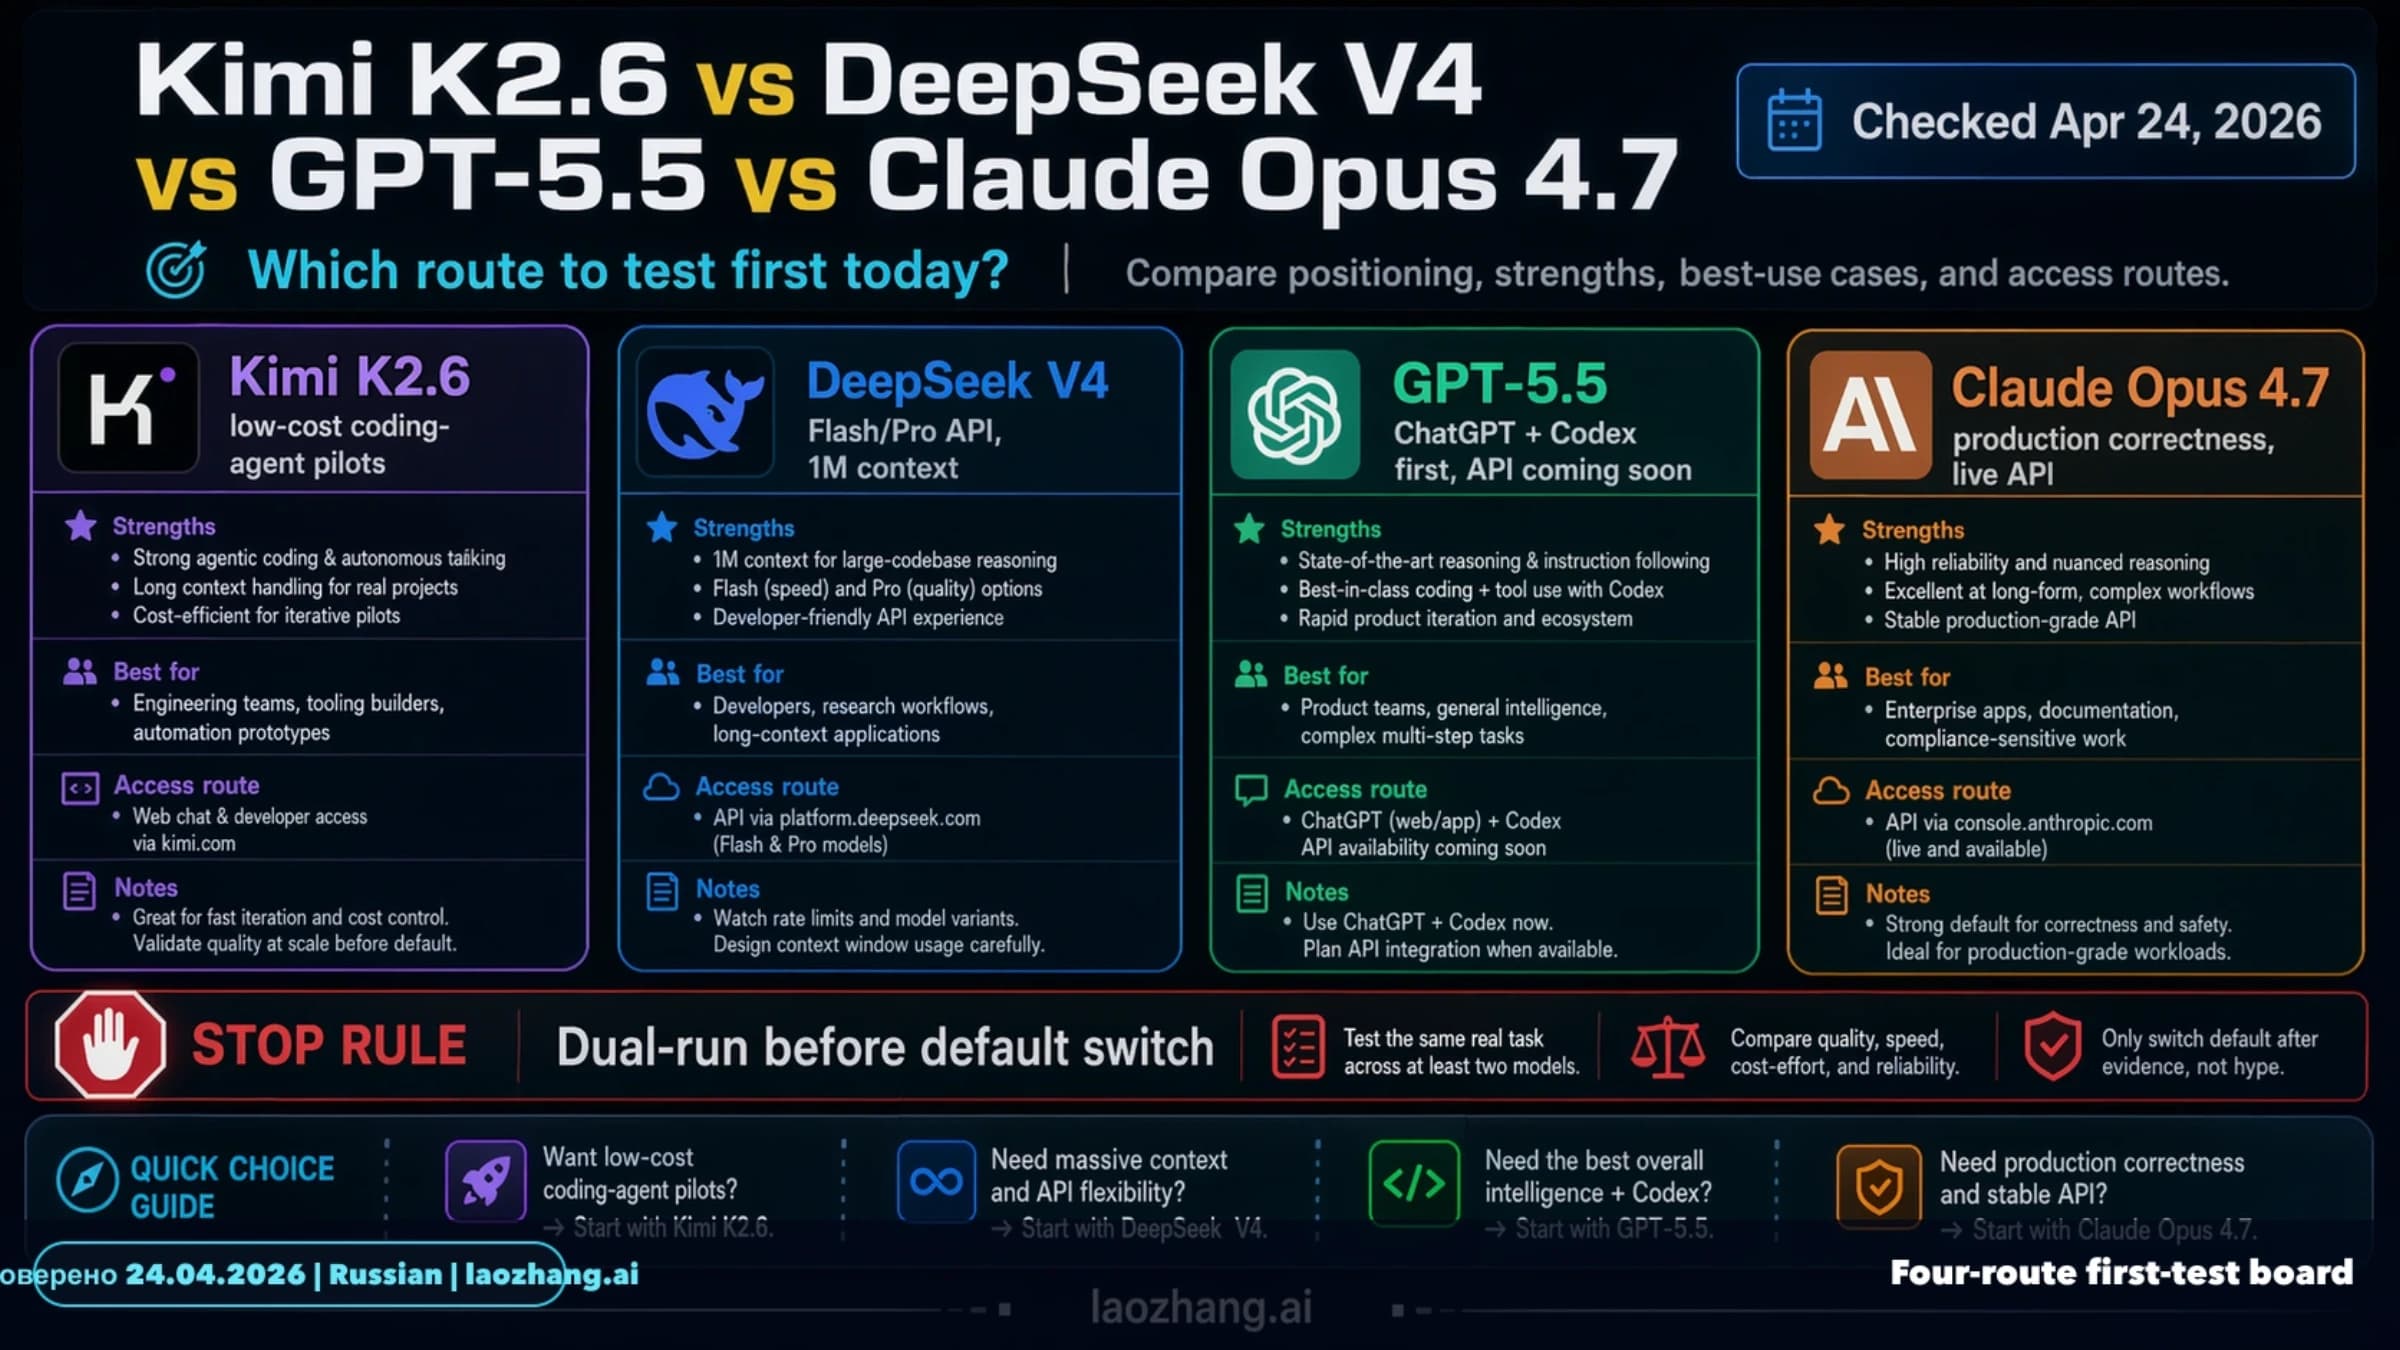
GLM-5.3 стоит первым проверить на долгих текстовых инженерных задачах, Kimi K3 — когда в цикле нужны изображения или видео, DeepSeek V4 Flash — для дешёвого покрытия, а Pro — для сложного контроля качества.
Содержание
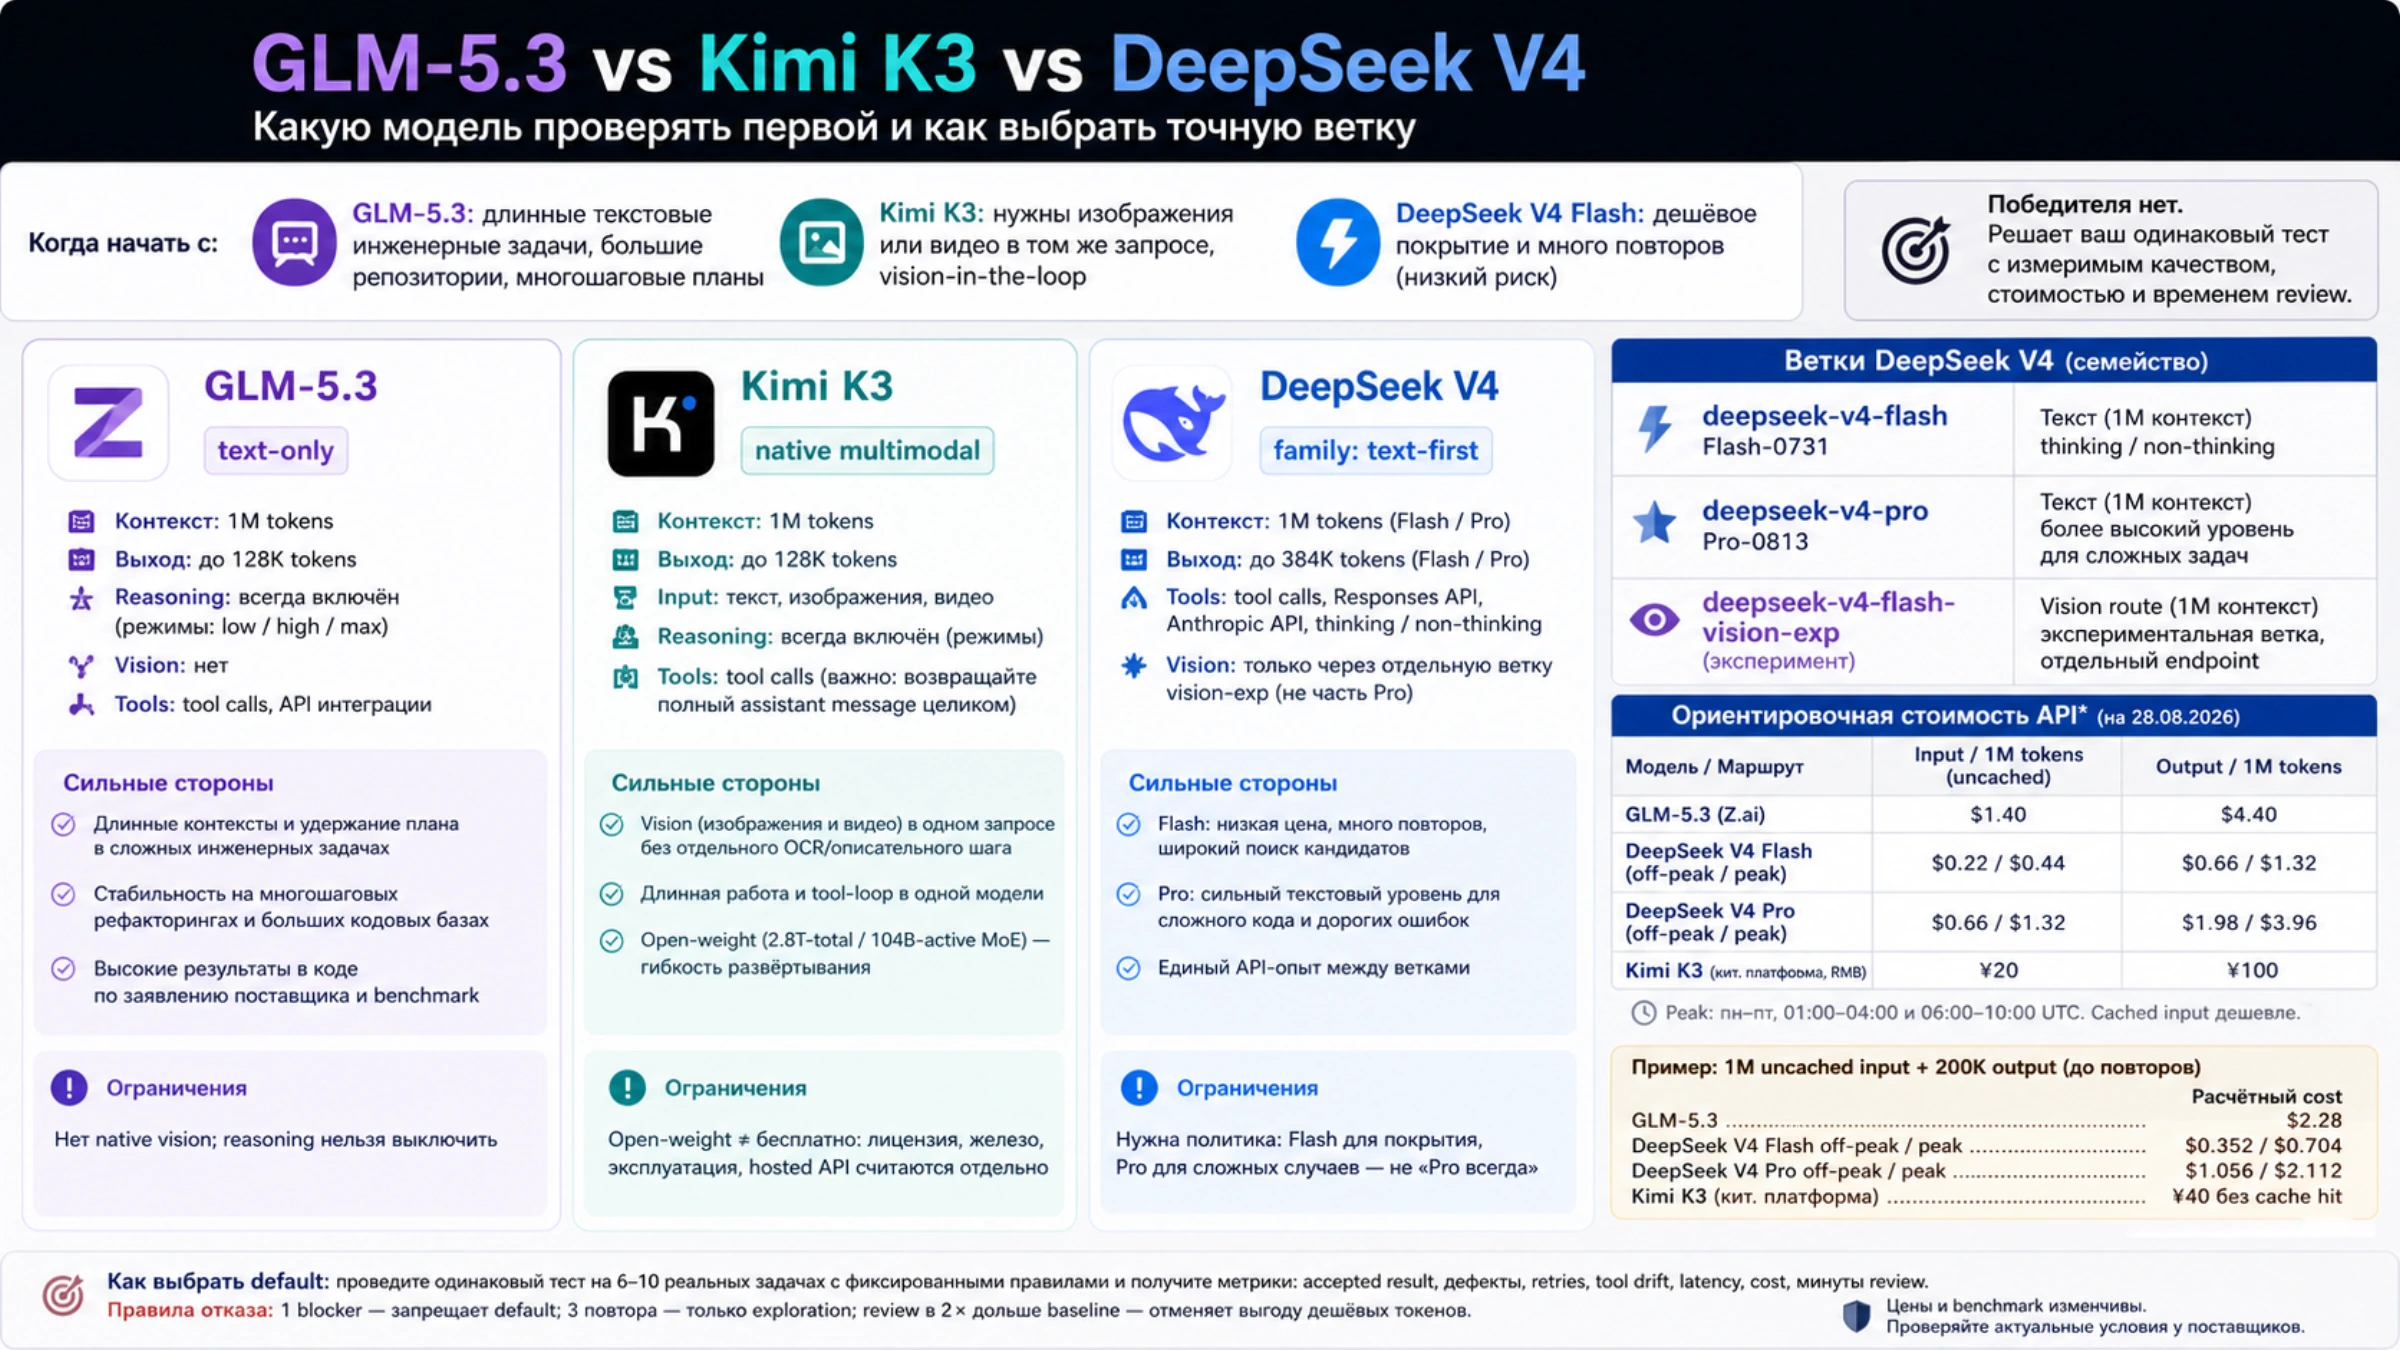
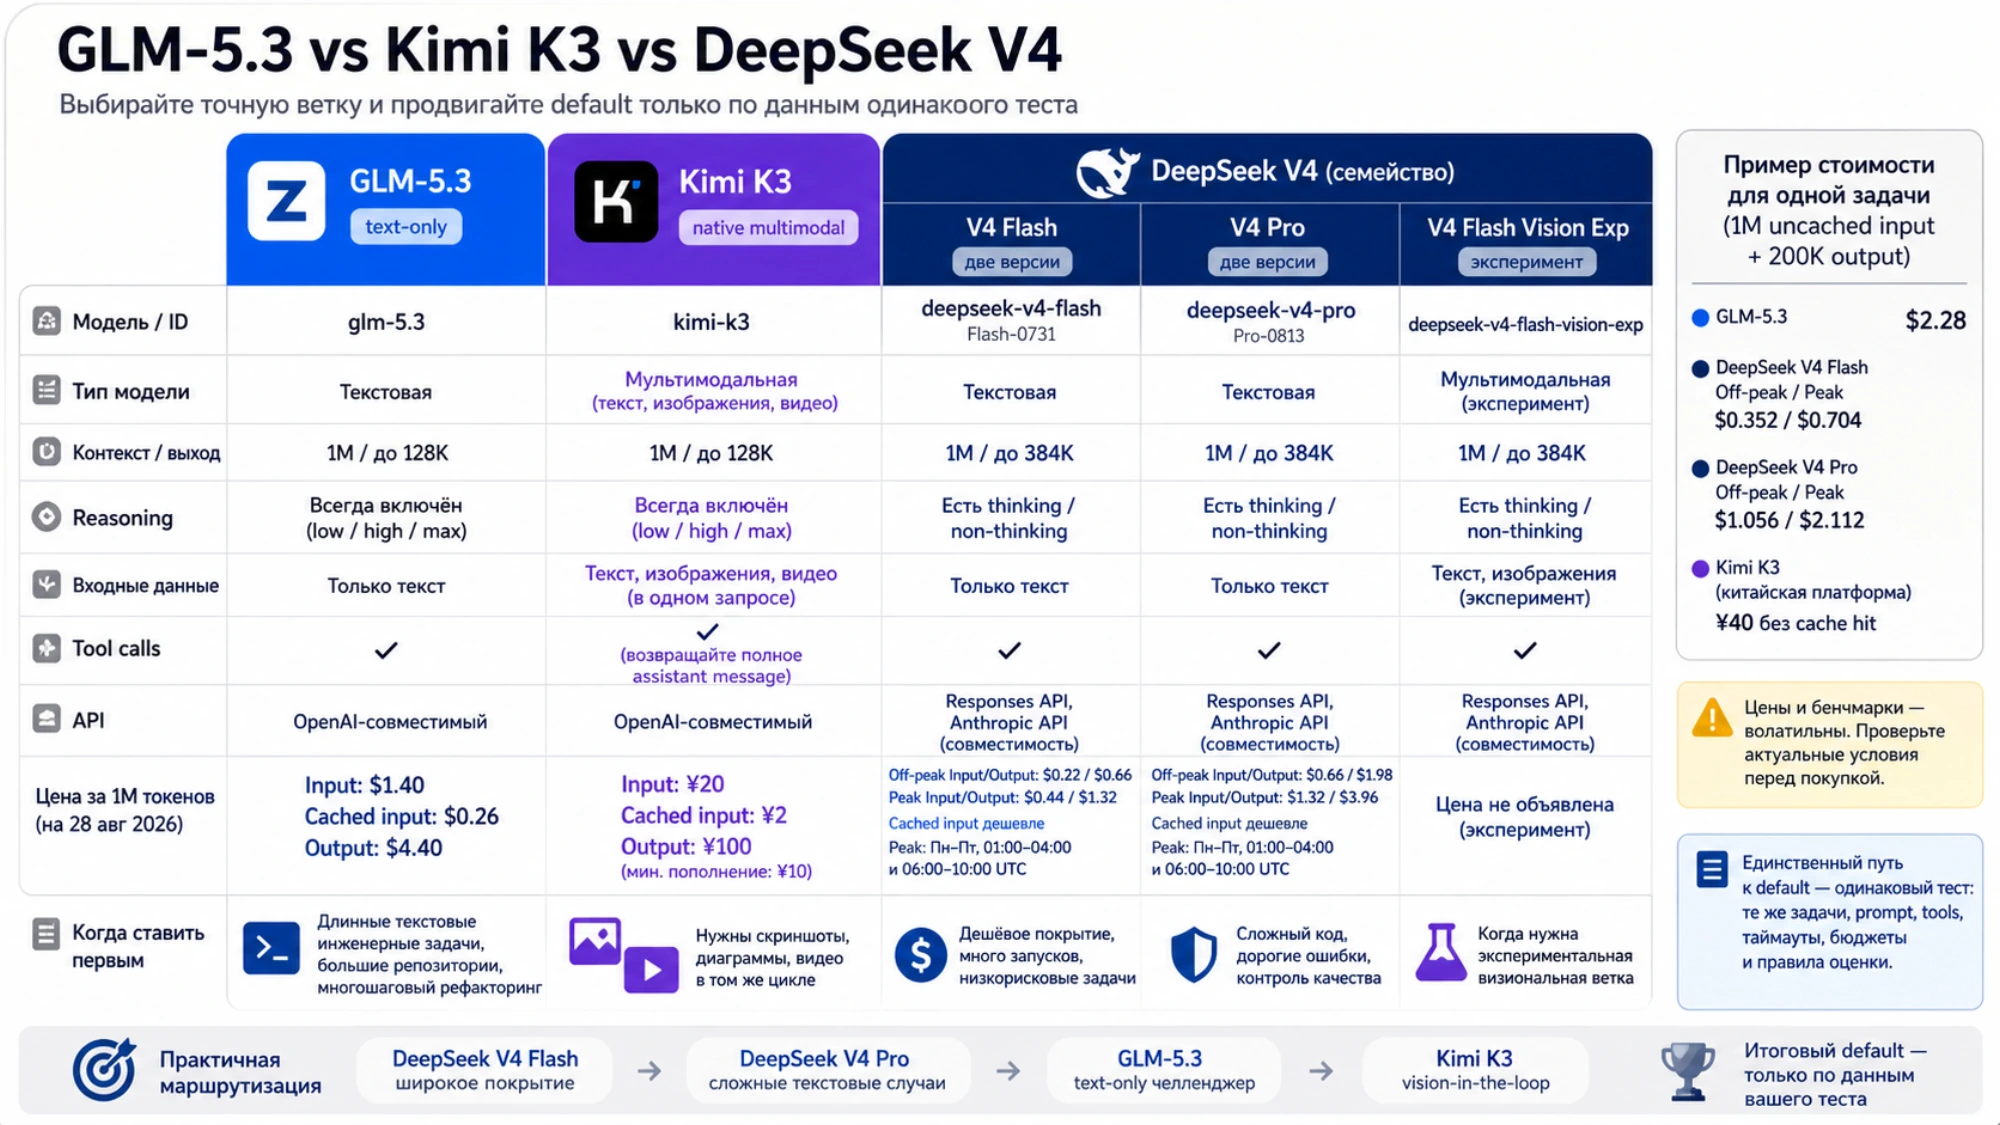
Выбор проще начать не с вопроса «кто сильнее», а с исключений. Если модели нужно видеть скриншоты или видео внутри того же запроса, у Kimi K3 есть прямое преимущество по контракту. Если задача текстовая и важна длинная инженерная сессия, в первую пару входят GLM-5.3 и DeepSeek V4 Pro. Если главная цель — дешёво повторить много запусков, первым кандидатом становится DeepSeek V4 Flash.
Такой порядок не назначает победителя. Он только сокращает число дорогих экспериментов. Финальный default должна определять одинаковая серия задач с измеримым качеством, стоимостью повторов и временем reviewer.
Сначала устраните ошибку в названии DeepSeek V4
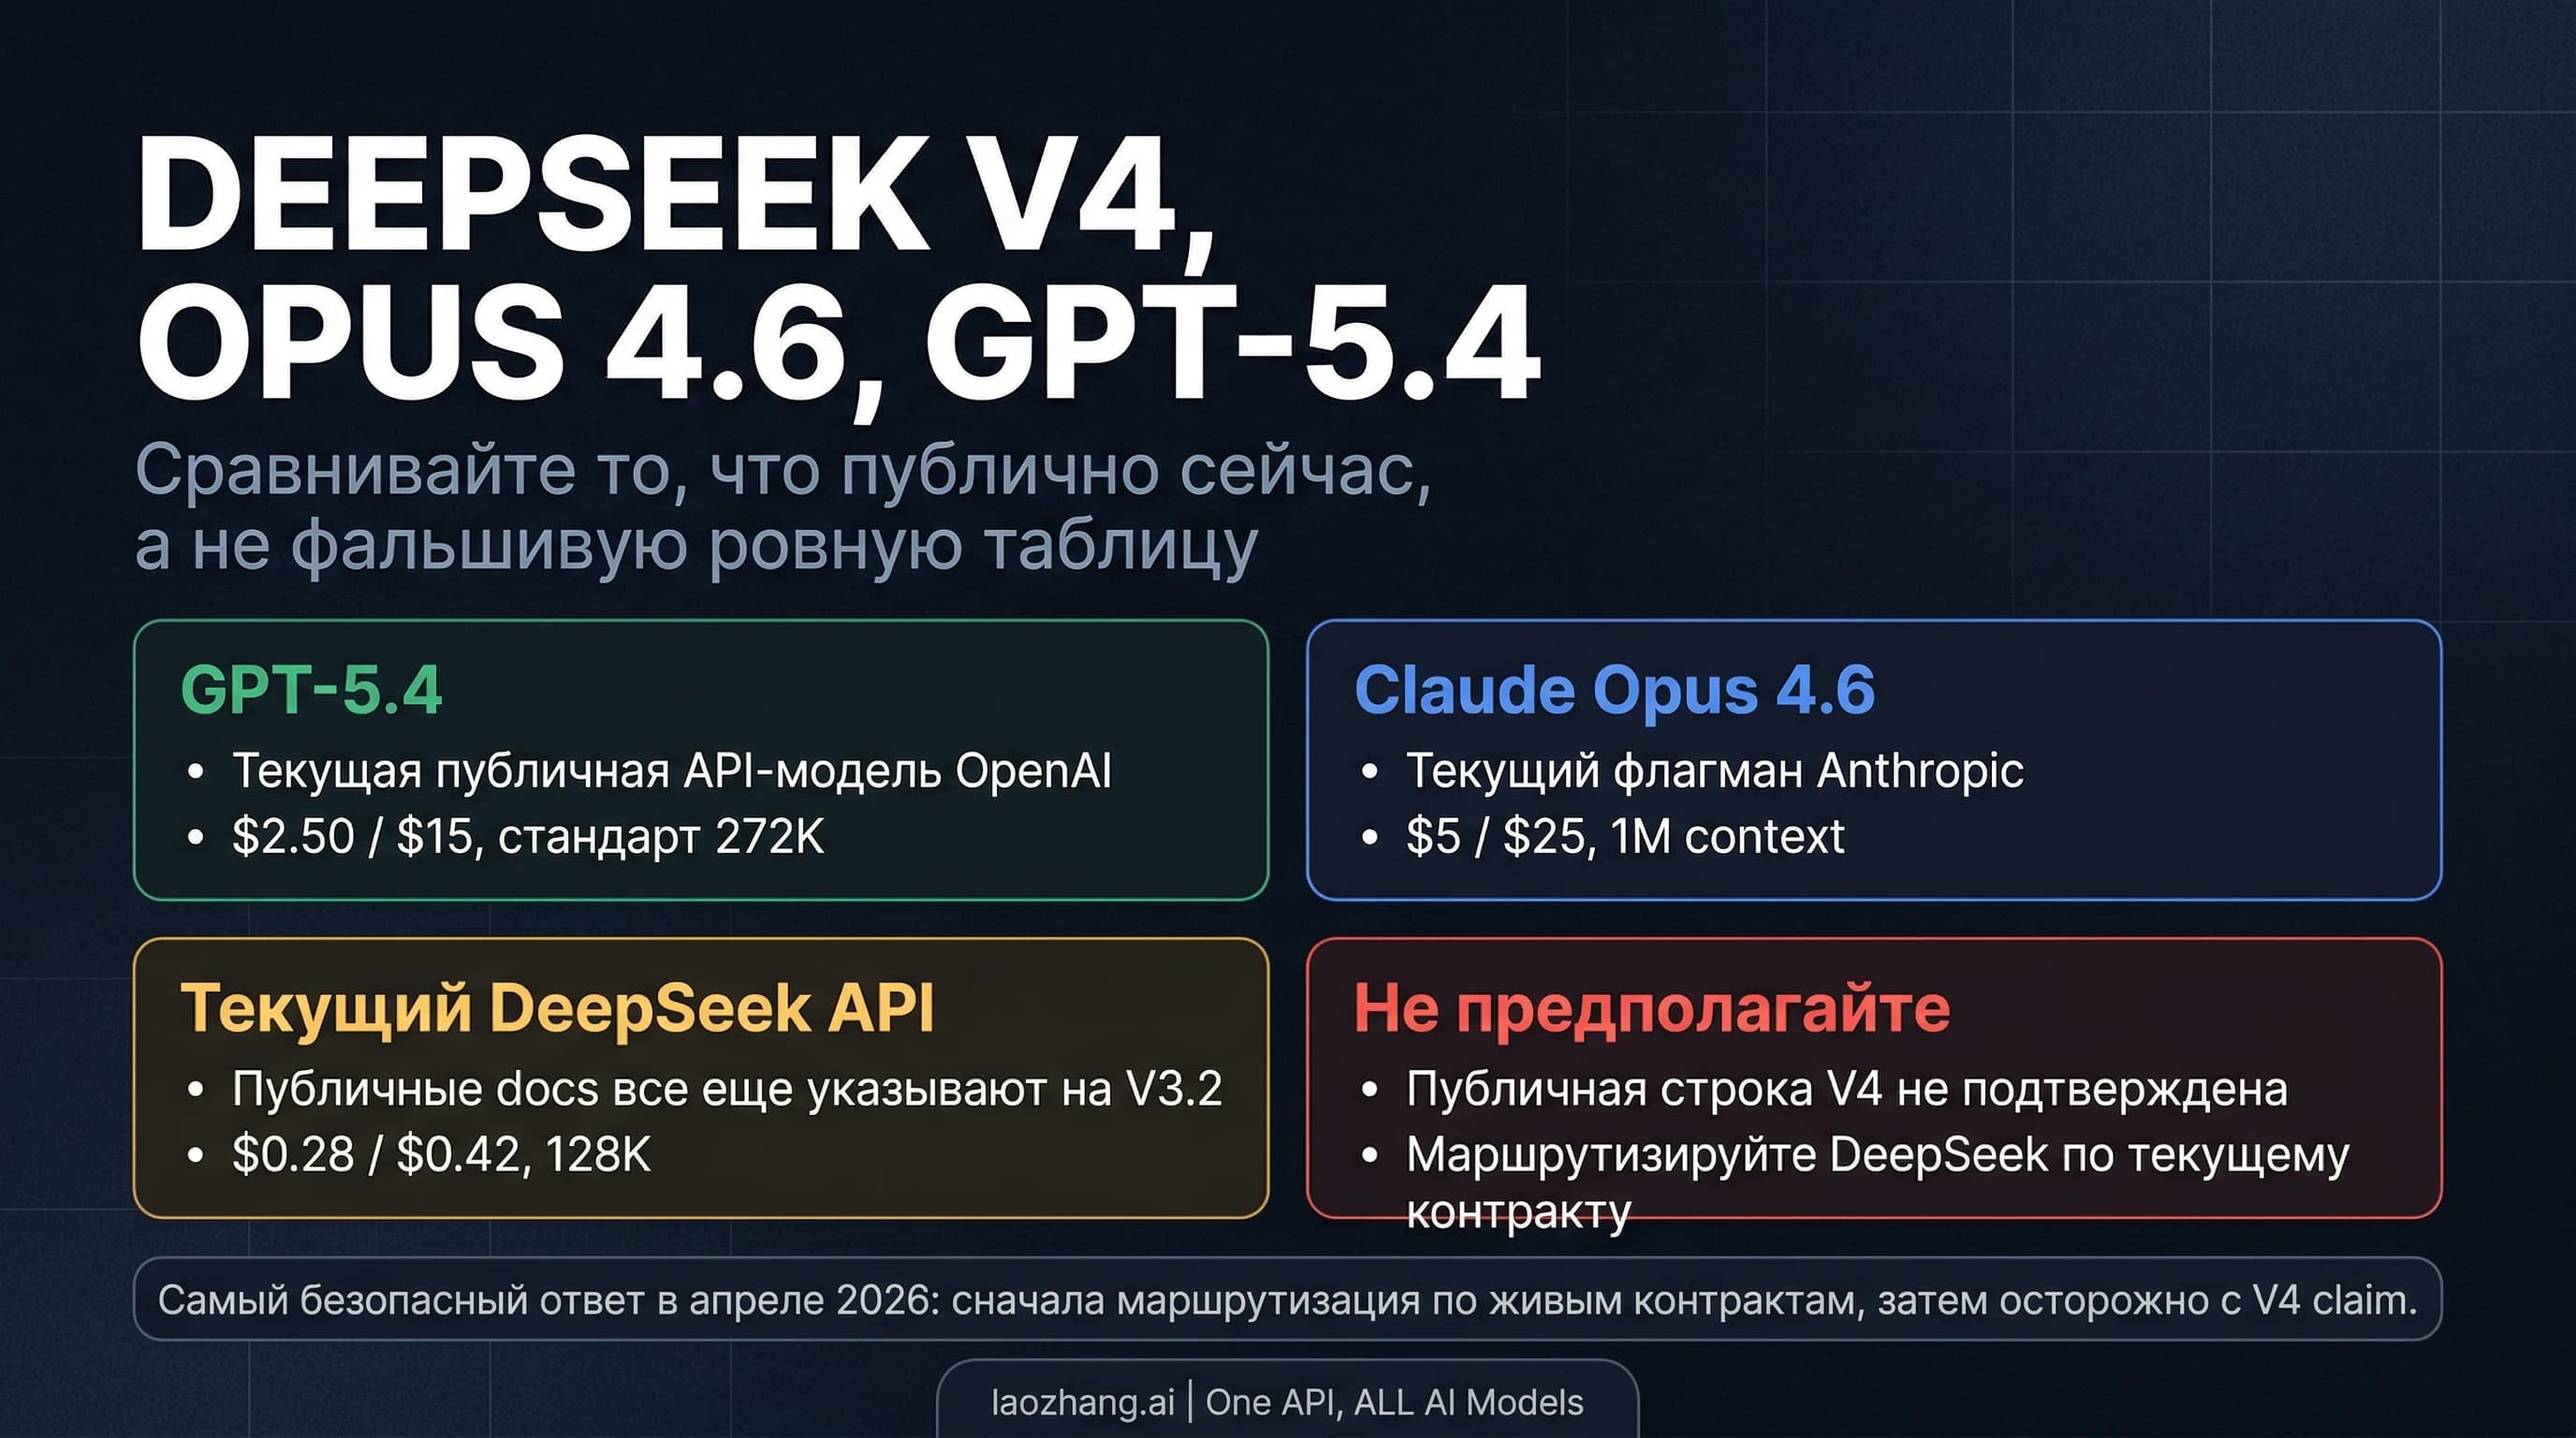
DeepSeek V4 — это семейство. В текущей официальной таблице есть deepseek-v4-flash версии Flash-0731 и deepseek-v4-pro версии Pro-0813. Отдельно указан экспериментальный deepseek-v4-flash-vision-exp. Обычные Flash и Pro поддерживают контекст 1M, выход до 384K, tool calls, Responses API, Anthropic API и thinking/non-thinking. Vision-ветка не превращает Pro в мультимодальную модель — это другой endpoint. Актуальные строки собраны на странице DeepSeek Models & Pricing.
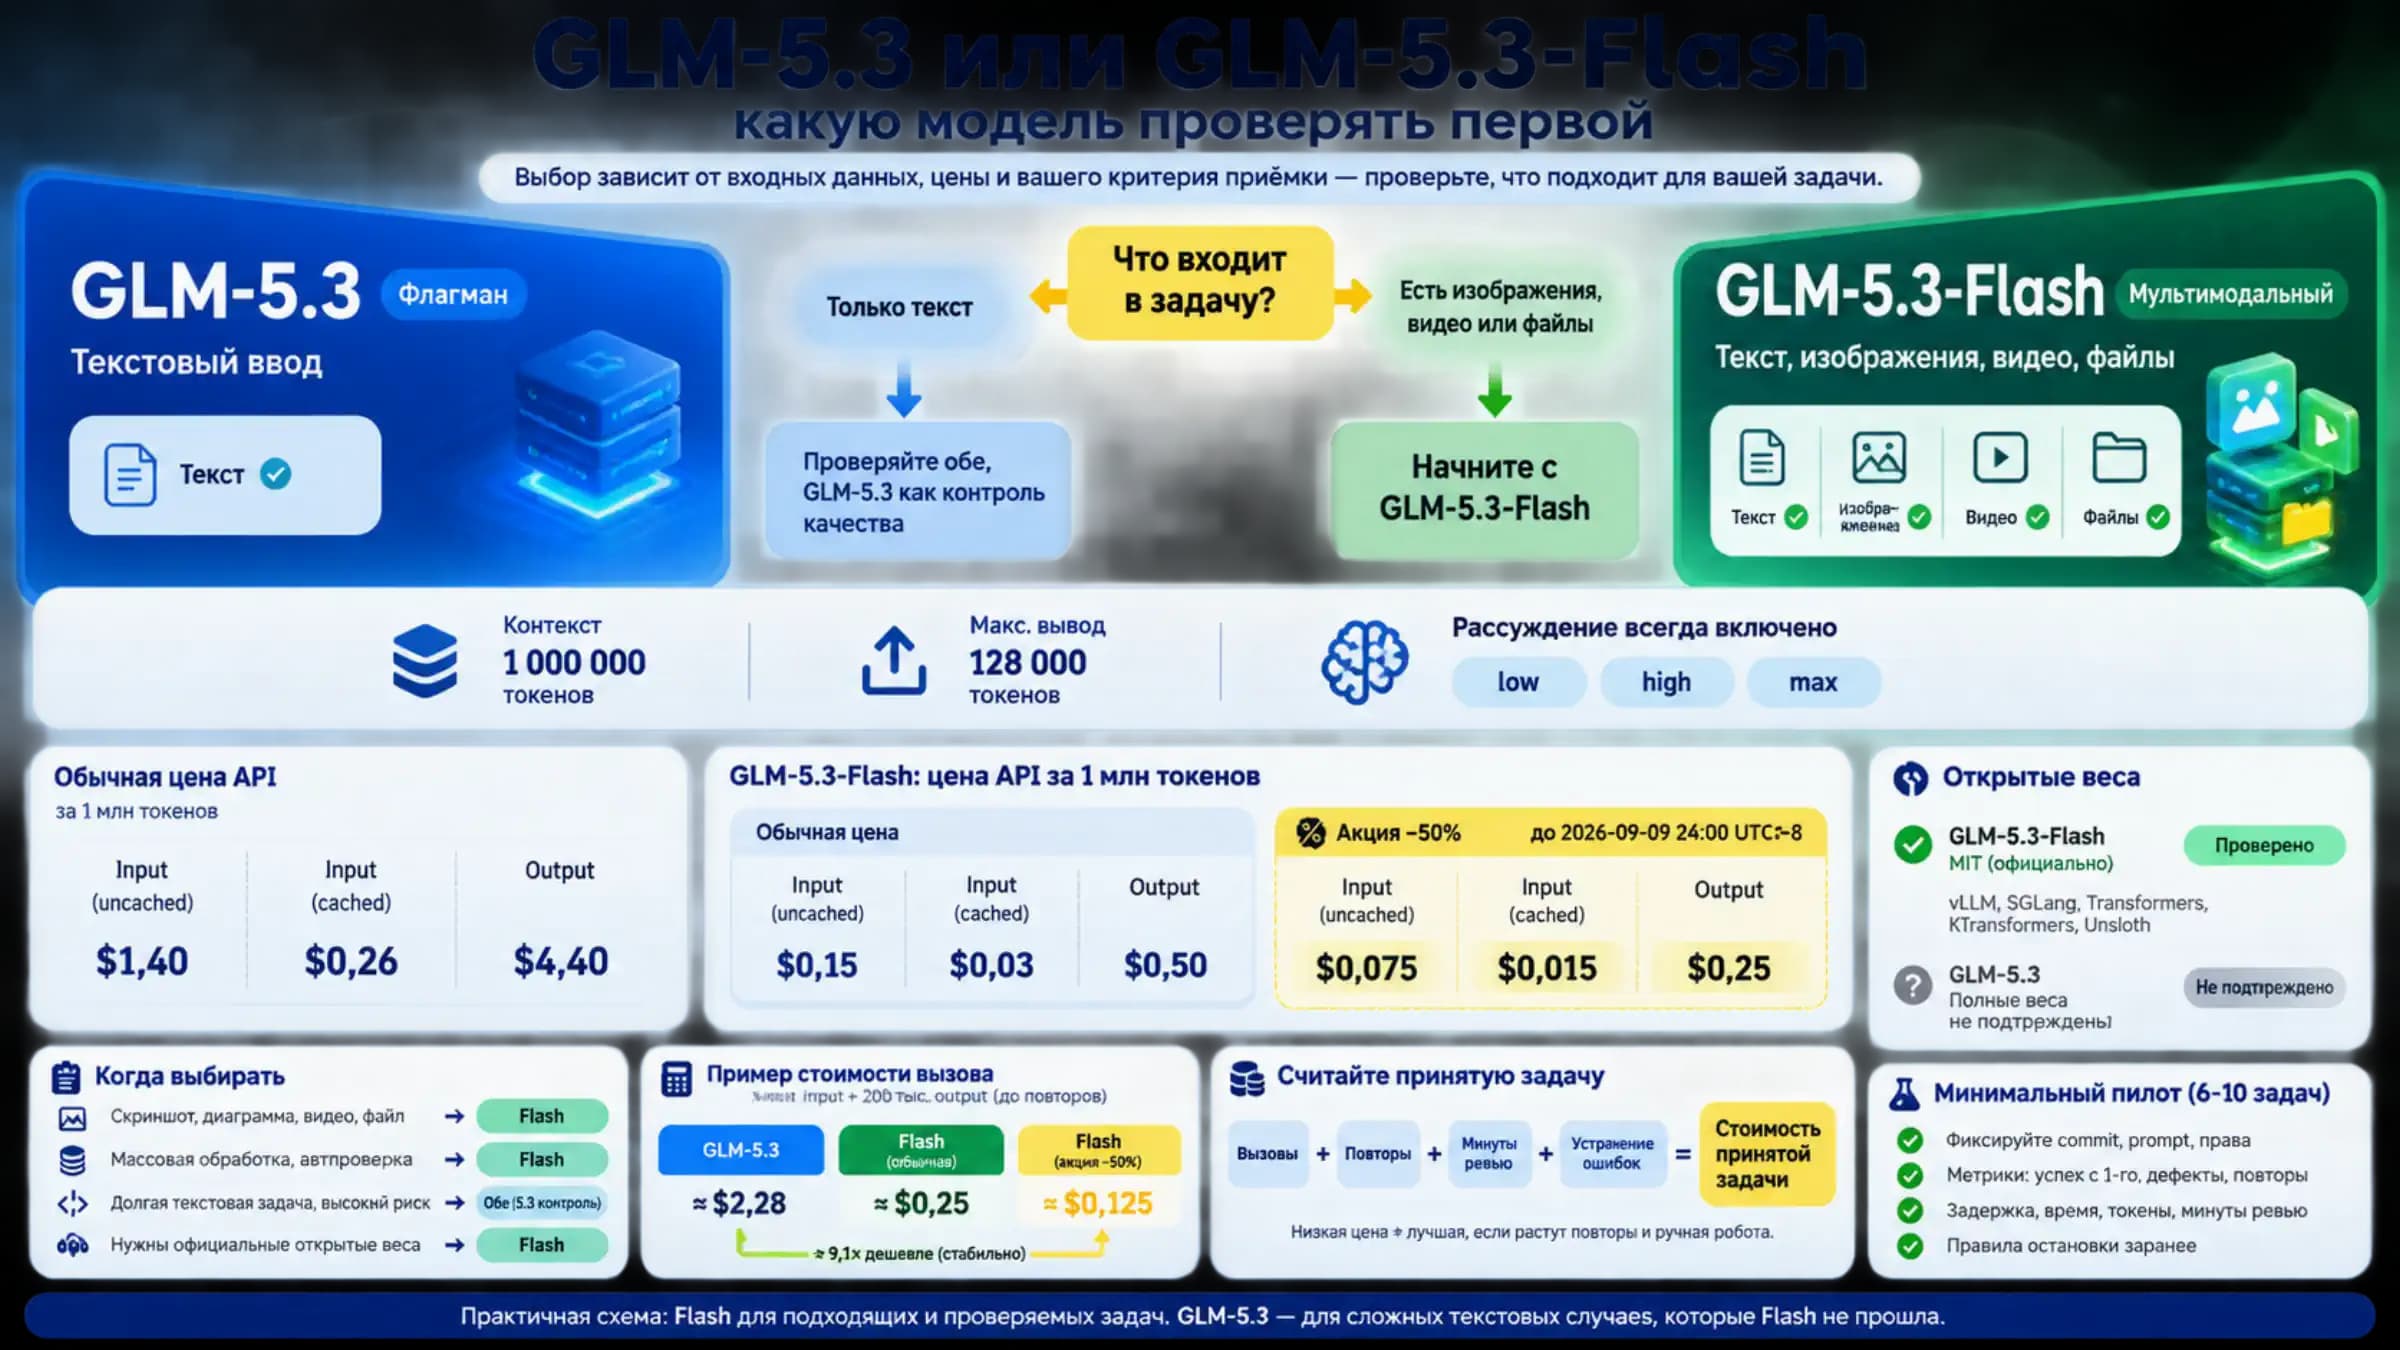
У GLM и Kimi граница устроена иначе. Документация GLM-5.3 описывает glm-5.3 как text-only модель с контекстом 1M и максимальным выходом 128K. Reasoning всегда включён; доступны low, high и max.
Kimi K3 API использует ID kimi-k3, принимает текст, изображения и видео, даёт 1M контекста и тоже всегда рассуждает. Для tool loop есть важное требование: в следующий запрос нужно возвращать полное assistant message, а не только финальный content.
Три «паспорта» кандидатов
GLM-5.3: текстовый инженерный challenger
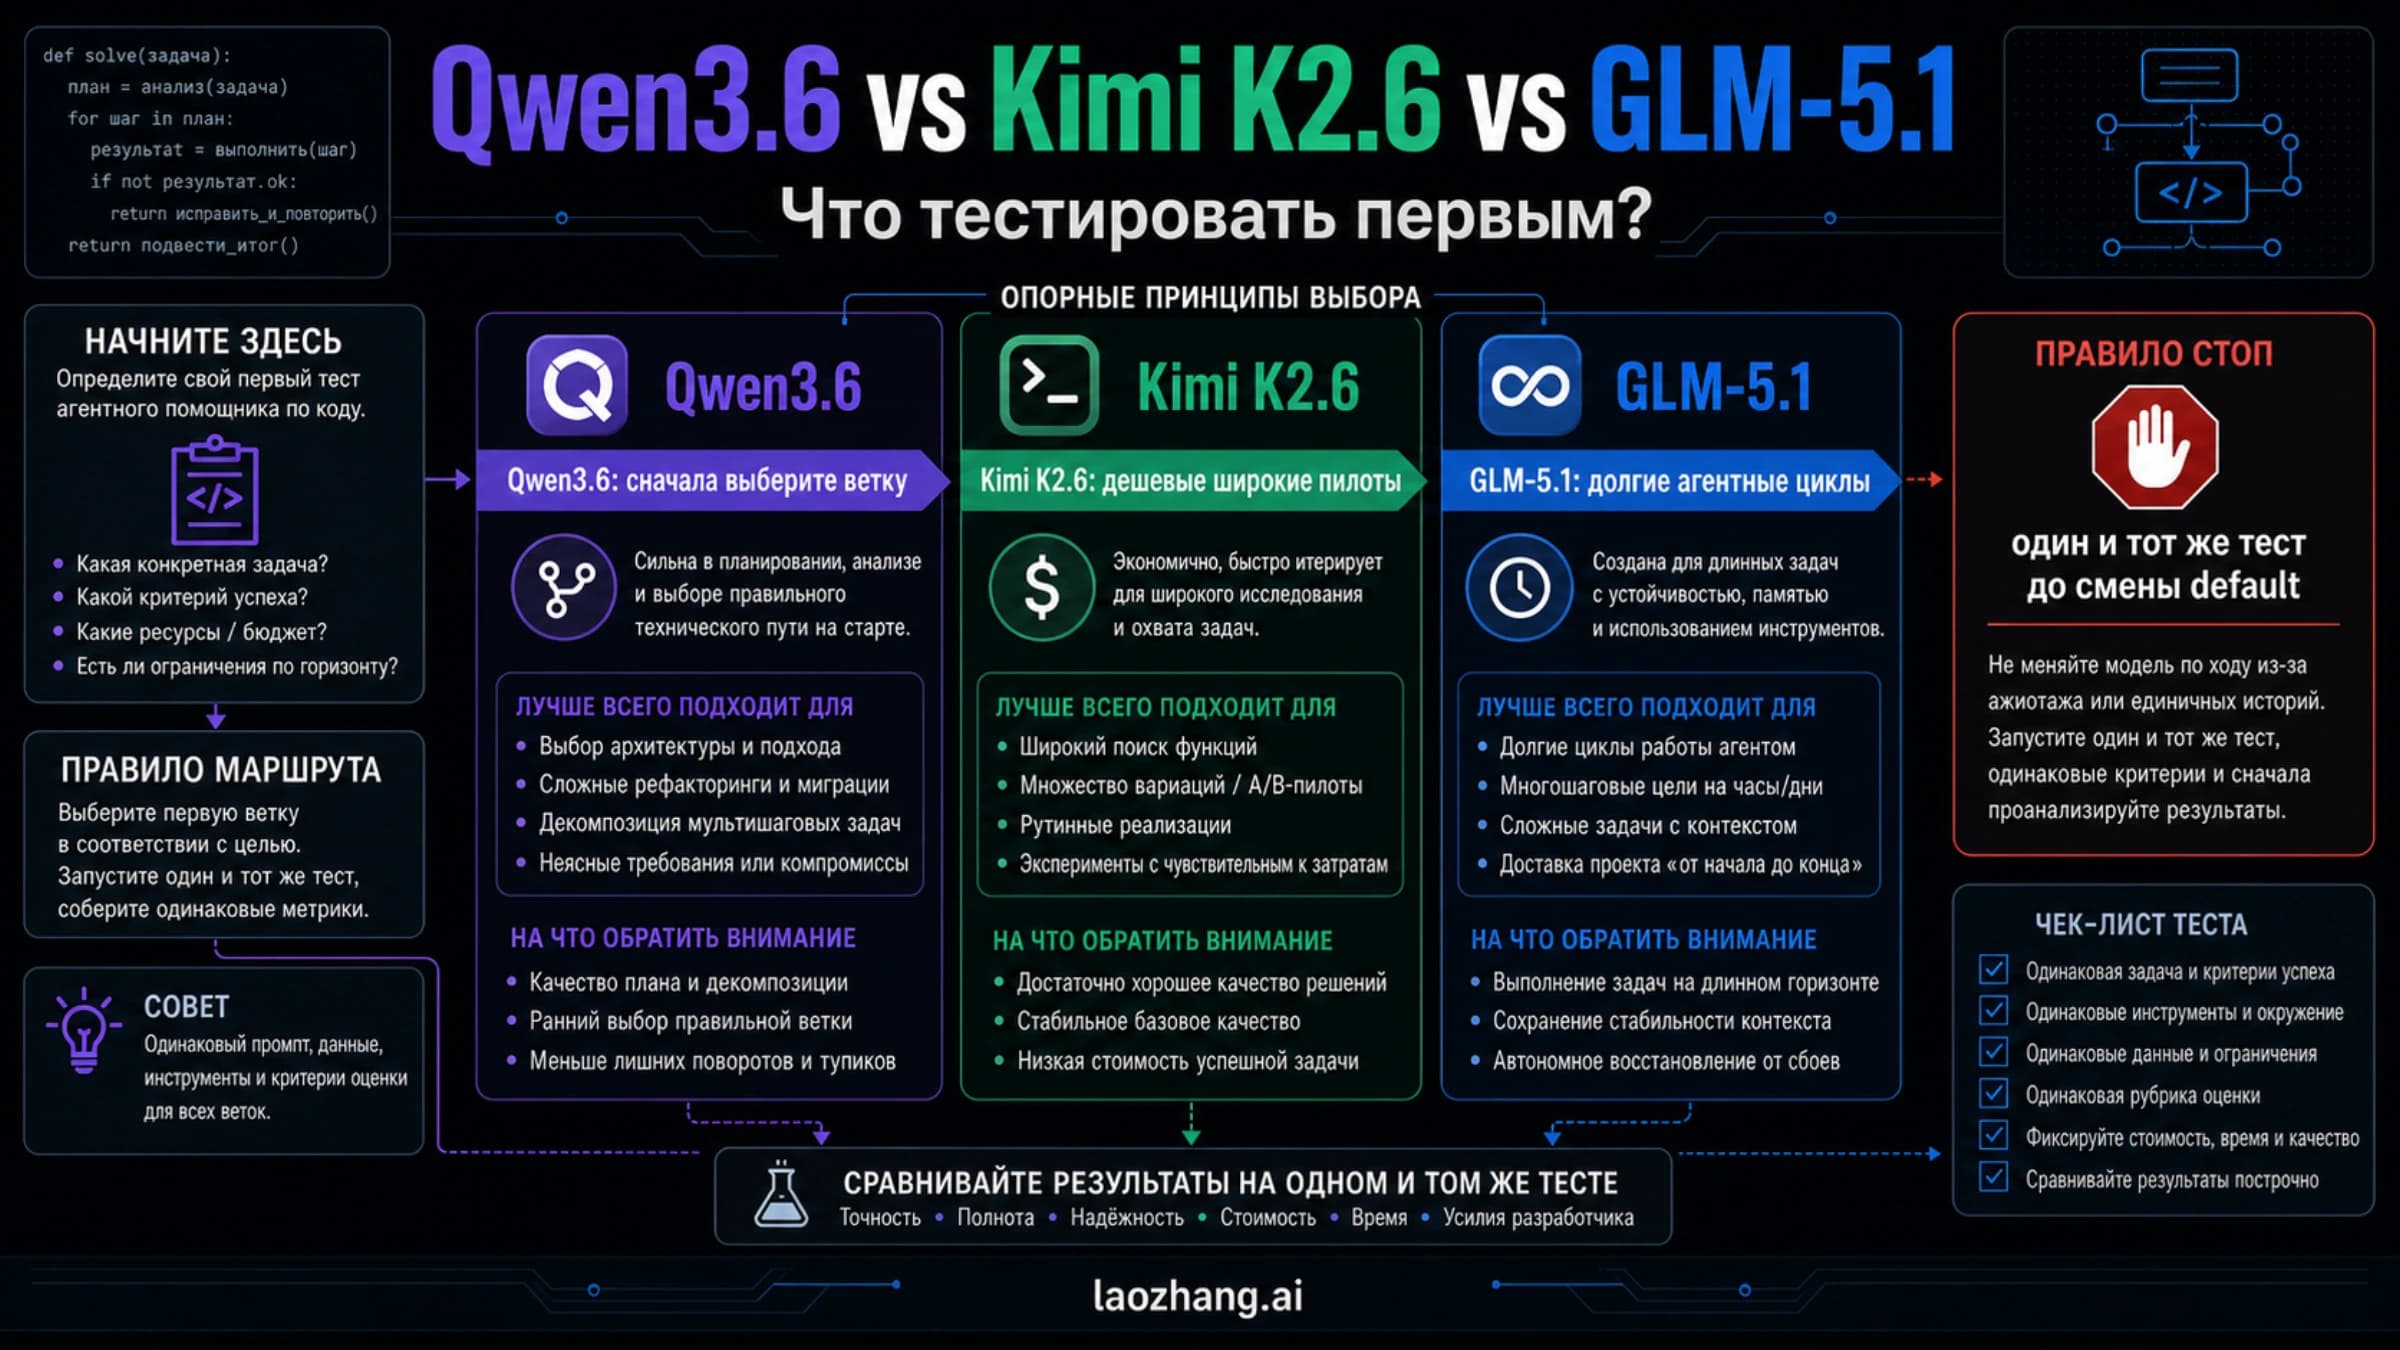
Его разумно ставить на длинные терминальные сессии, большие репозитории, многошаговые рефакторинги и задачи, где модель должна долго удерживать план. Ограничение видно заранее: native vision нет, выключить reasoning нельзя. Заявленный Z.ai прирост в кодинге и публичные benchmark — позиция поставщика, а не гарантия для вашего стека.
Kimi K3: vision и длинная работа в одной модели
Kimi называет K3 2.8T-total/104B-active open-weight MoE-моделью. Для выбора важнее не число параметров, а отсутствие отдельного OCR/описательного шага, когда агенту нужны скриншоты, диаграммы или видео. Open weights не означают бесплатный production: отдельно считаются лицензия Kimi K3, оборудование, эксплуатация и hosted API.
DeepSeek V4: две текстовые ступени
Flash подходит для широкого недорогого поиска кандидатов, повторных прогонов и низкорисковых задач. Pro стоит добавлять как более сильную DeepSeek-ступень для сложного кода и дорогих ошибок. Полезная policy: Flash создаёт покрытие, Pro проверяет трудные случаи, а не «Pro всегда заменяет Flash».
Цена меняется даже в течение недели
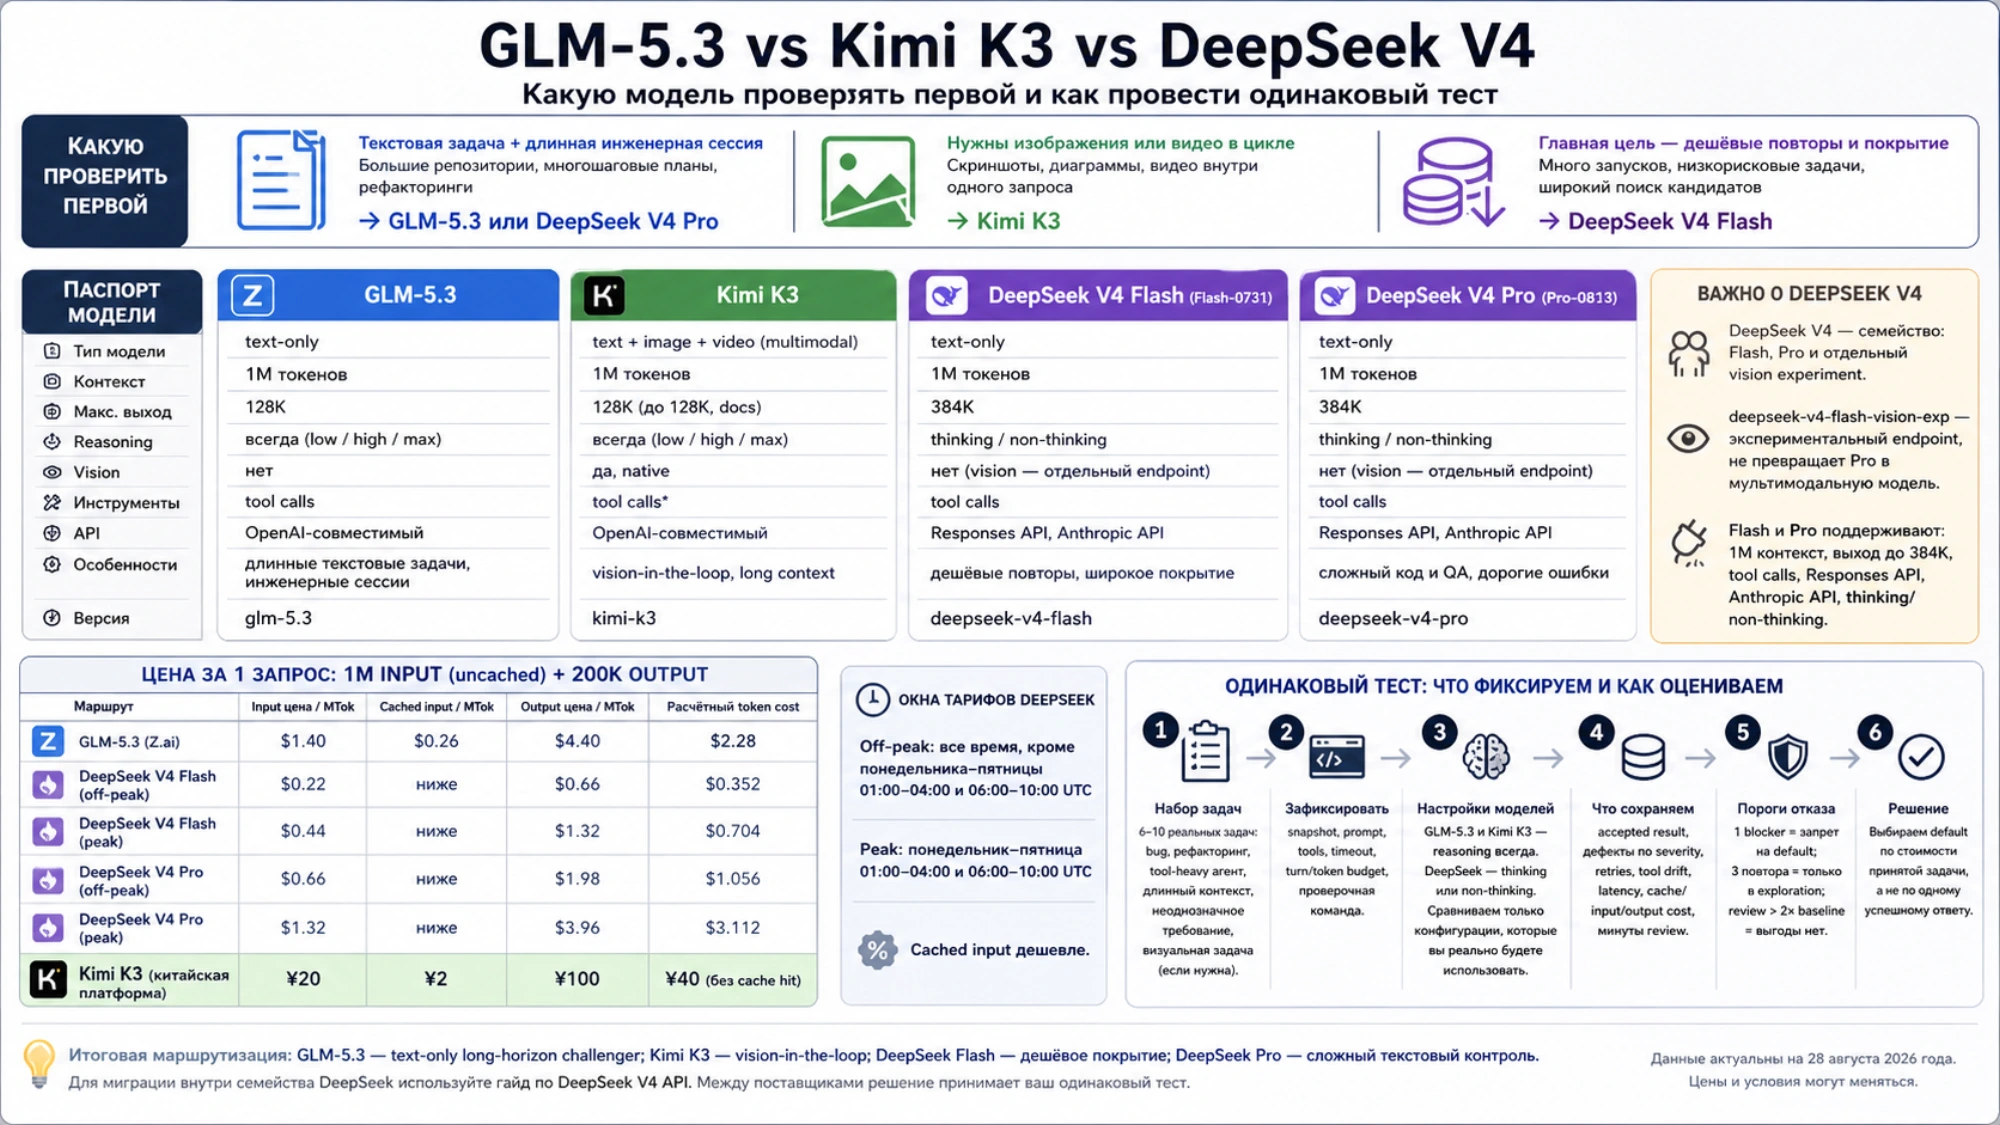
На 28 августа 2026 года Z.ai указывает для GLM-5.3 $1.40 за 1M input tokens, $0.26 за cached input и $4.40 за output.
Китайская платформа Kimi показывает для K3 ¥20 за input, ¥2 за cached input и ¥100 за output / MTok. Это цена конкретного RMB-маршрута; документация также требует минимум 10 юаней пополнения для доступа к K3. Нельзя молча переводить эту строку в доллары и считать её условиями любого международного provider.
У DeepSeek рабочие часы определяют тариф. Для V4 Flash off-peak input/output стоят $0.22/$0.66, peak — $0.44/$1.32 за 1M. Для Pro — $0.66/$1.98 и $1.32/$3.96. Peak: понедельник–пятница, 01:00–04:00 и 06:00–10:00 UTC. Cached input дешевле.
Для одной задачи с 1M uncached input и 200K output до повторов получится примерно:
| Маршрут | Расчётный token cost |
|---|---|
| GLM-5.3 | $2.28 |
| DeepSeek V4 Flash off-peak / peak | $0.352 / $0.704 |
| DeepSeek V4 Pro off-peak / peak | $1.056 / $2.112 |
| Kimi K3, китайская платформа | ¥40 без cache hit |
Эти числа не учитывают 429, очередь, неудачные tool loops, повторный запуск и review. Правильная единица сравнения — стоимость принятой задачи, а не один успешный ответ.
Почему один независимый тест не даёт общего чемпиона
В исследовании Aikido модели трижды искали 32 недавно раскрытые уязвимости с одинаковыми prompt, tools и политикой оценки. DeepSeek V4 Pro-0813 получил наибольший pooled recall. Kimi K3 показал лучшую pooled precision среди протестированных open-weight моделей. GLM-5.3 сочетал сильные recall и consistency.
Это хороший пример дизайна теста и плохой источник для фразы «модель X лучшая вообще». Поиск уязвимостей выигрывает от разных траекторий повторных запусков; фронтенд, документы или production automation могут ценить стабильность сильнее. Aikido также работала с Z.ai как ранний evaluation partner для GLM-5.3 — контекст источника стоит сохранять.
Проведите тест с заранее заданным отказом
Возьмите 6–10 реальных задач: bug в нескольких файлах, рефакторинг, tool-heavy agent, анализ длинного контекста, неоднозначное требование и визуальную задачу, если она нужна продукту. Зафиксируйте snapshot, prompt, tools, timeout, turn/token budget и проверочную команду.
Не выравнивайте только названия. Kimi K3 и GLM-5.3 всегда используют reasoning; DeepSeek может работать без него. Сравнивать Kimi max с DeepSeek non-thinking можно только тогда, когда именно эти production-конфигурации вы собираетесь покупать.
Для каждого запуска сохраните accepted result, дефекты по severity, число retries, tool drift, latency, cache/input/output cost и минуты review. До старта установите пороги: один blocker запрещает default; три повтора оставляют модель только в exploration; review дольше текущего baseline в два раза отменяет выгоду от дешёвых токенов.
Итоговая маршрутизация получается практичной: GLM-5.3 — text-only long-horizon challenger; Kimi K3 — кандидат для vision-in-the-loop; DeepSeek Flash — дешёвое покрытие; DeepSeek Pro — сложный текстовый контроль. Для миграции только внутри семейства DeepSeek используйте отдельный гайд по DeepSeek V4 API. Между поставщиками решение принимает ваш одинаковый тест.
Источники5
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 авг. 2026 г..
Источники5
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 28 авг. 2026 г..