Claude Opus 5.5 или GPT-6.1 Sol (и GPT-6 Sol): выбор для кода
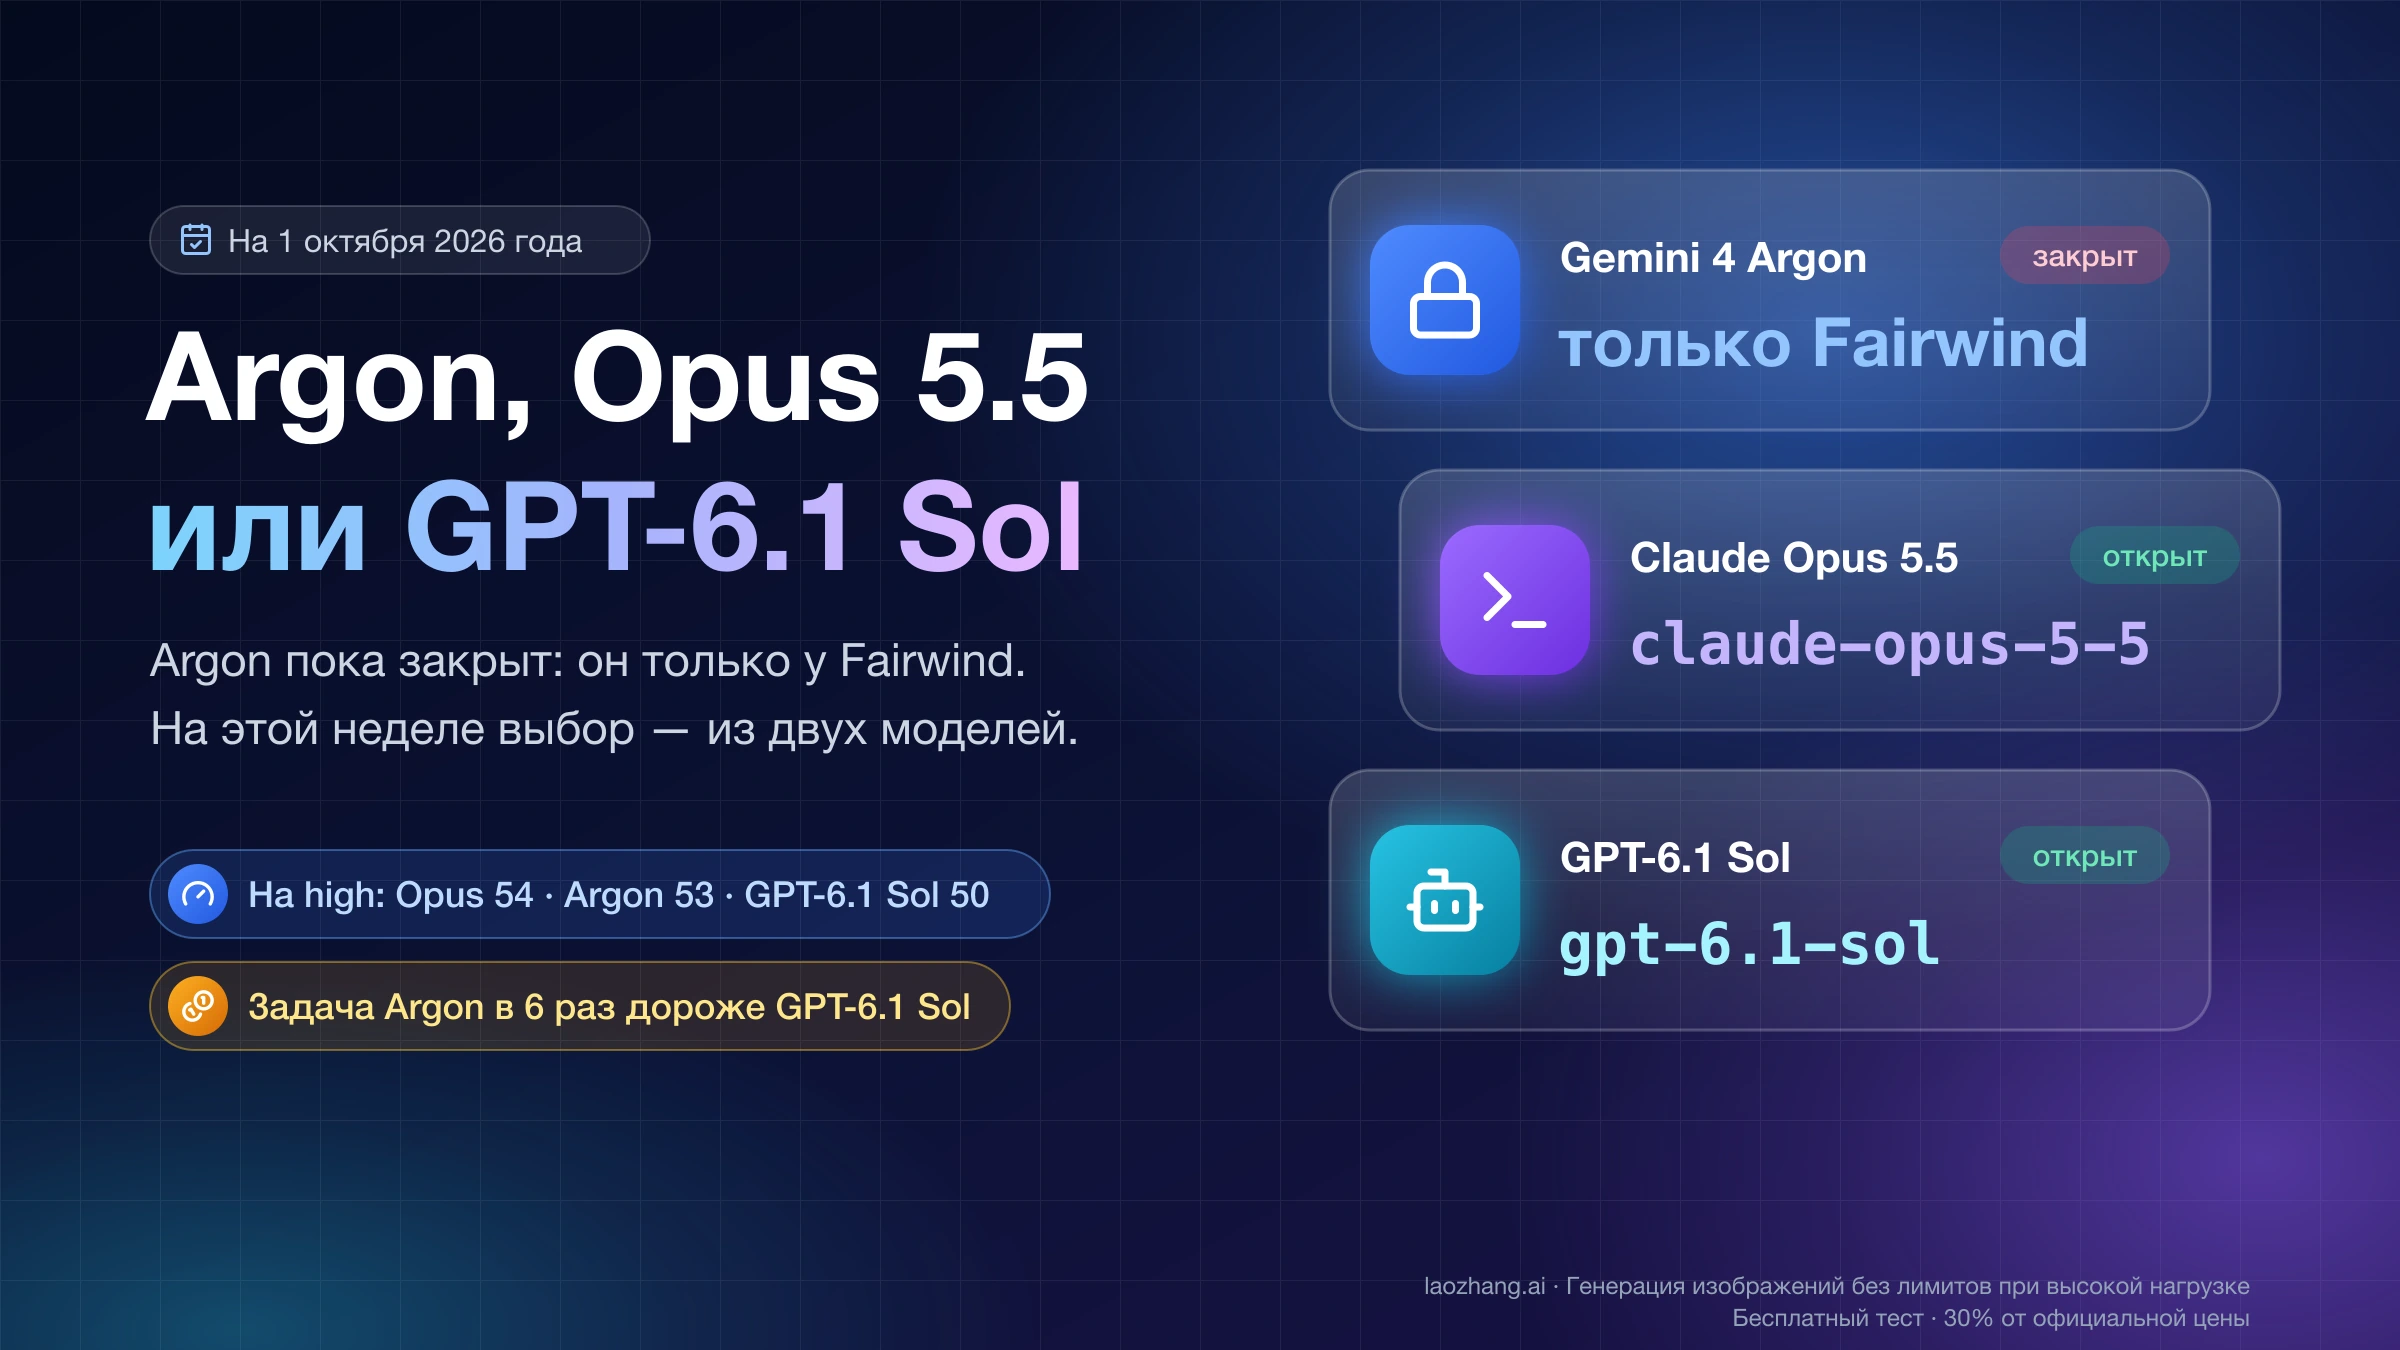
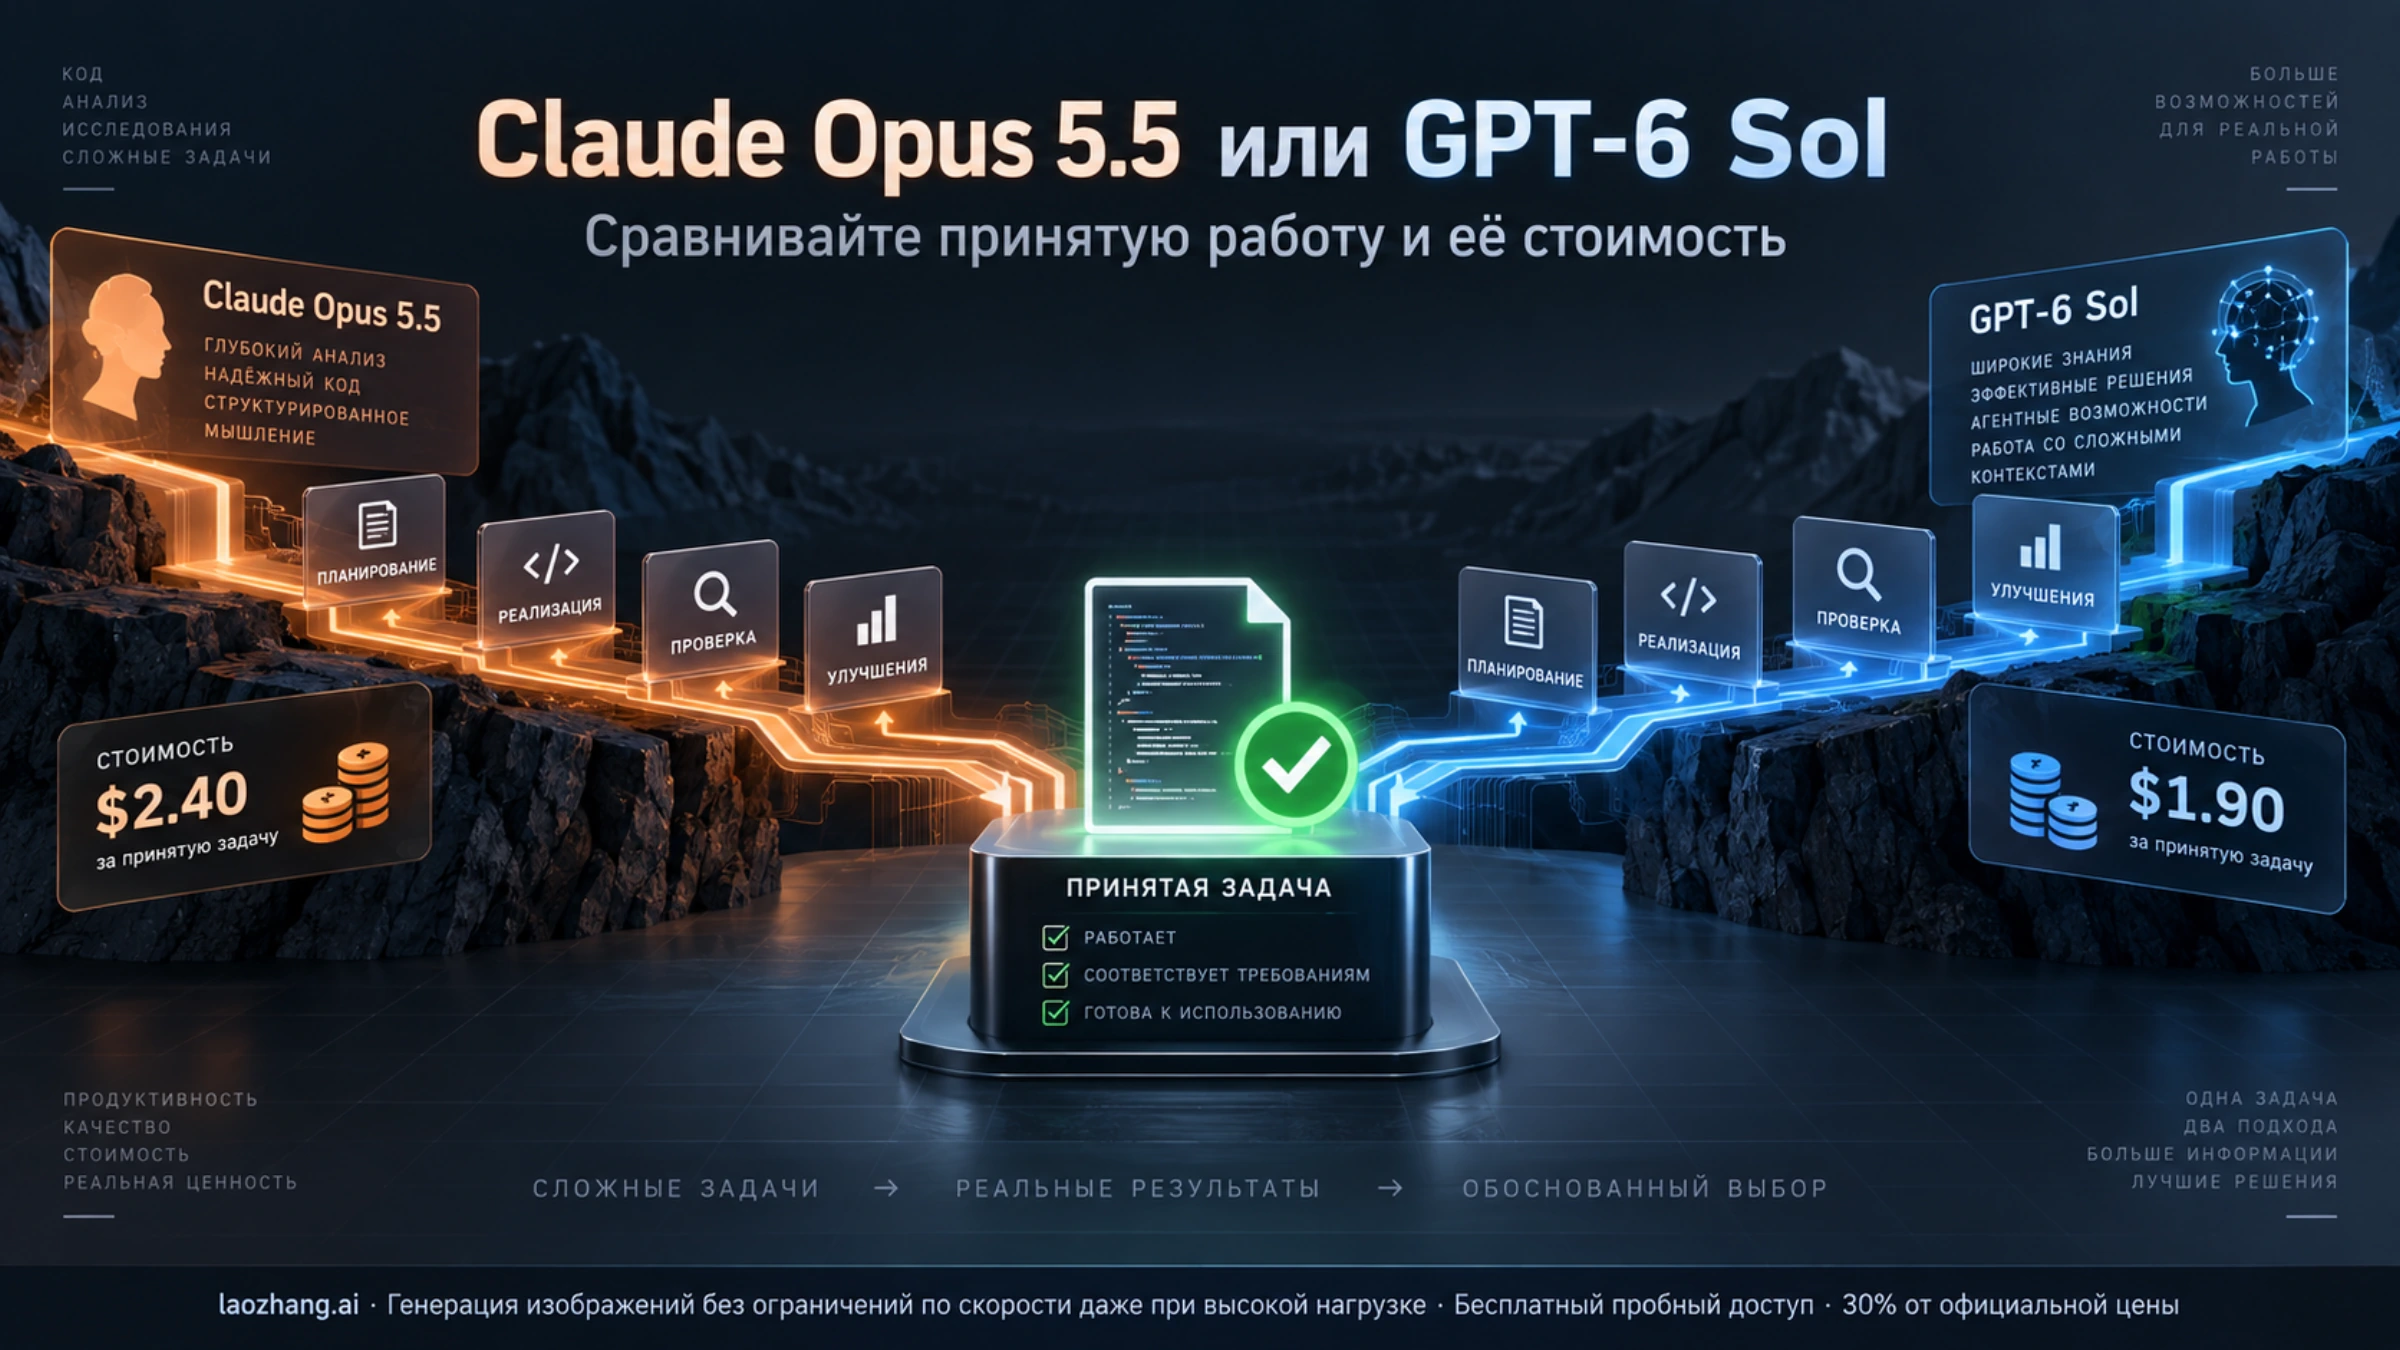
До 272 тыс. токенов GPT-6.1 Sol ровно вдвое дешевле Opus 5.5 по всем статьям, включая кэш. В замерах задача Opus дороже в 4–9 раз; решает цена принятой задачи.
Содержание
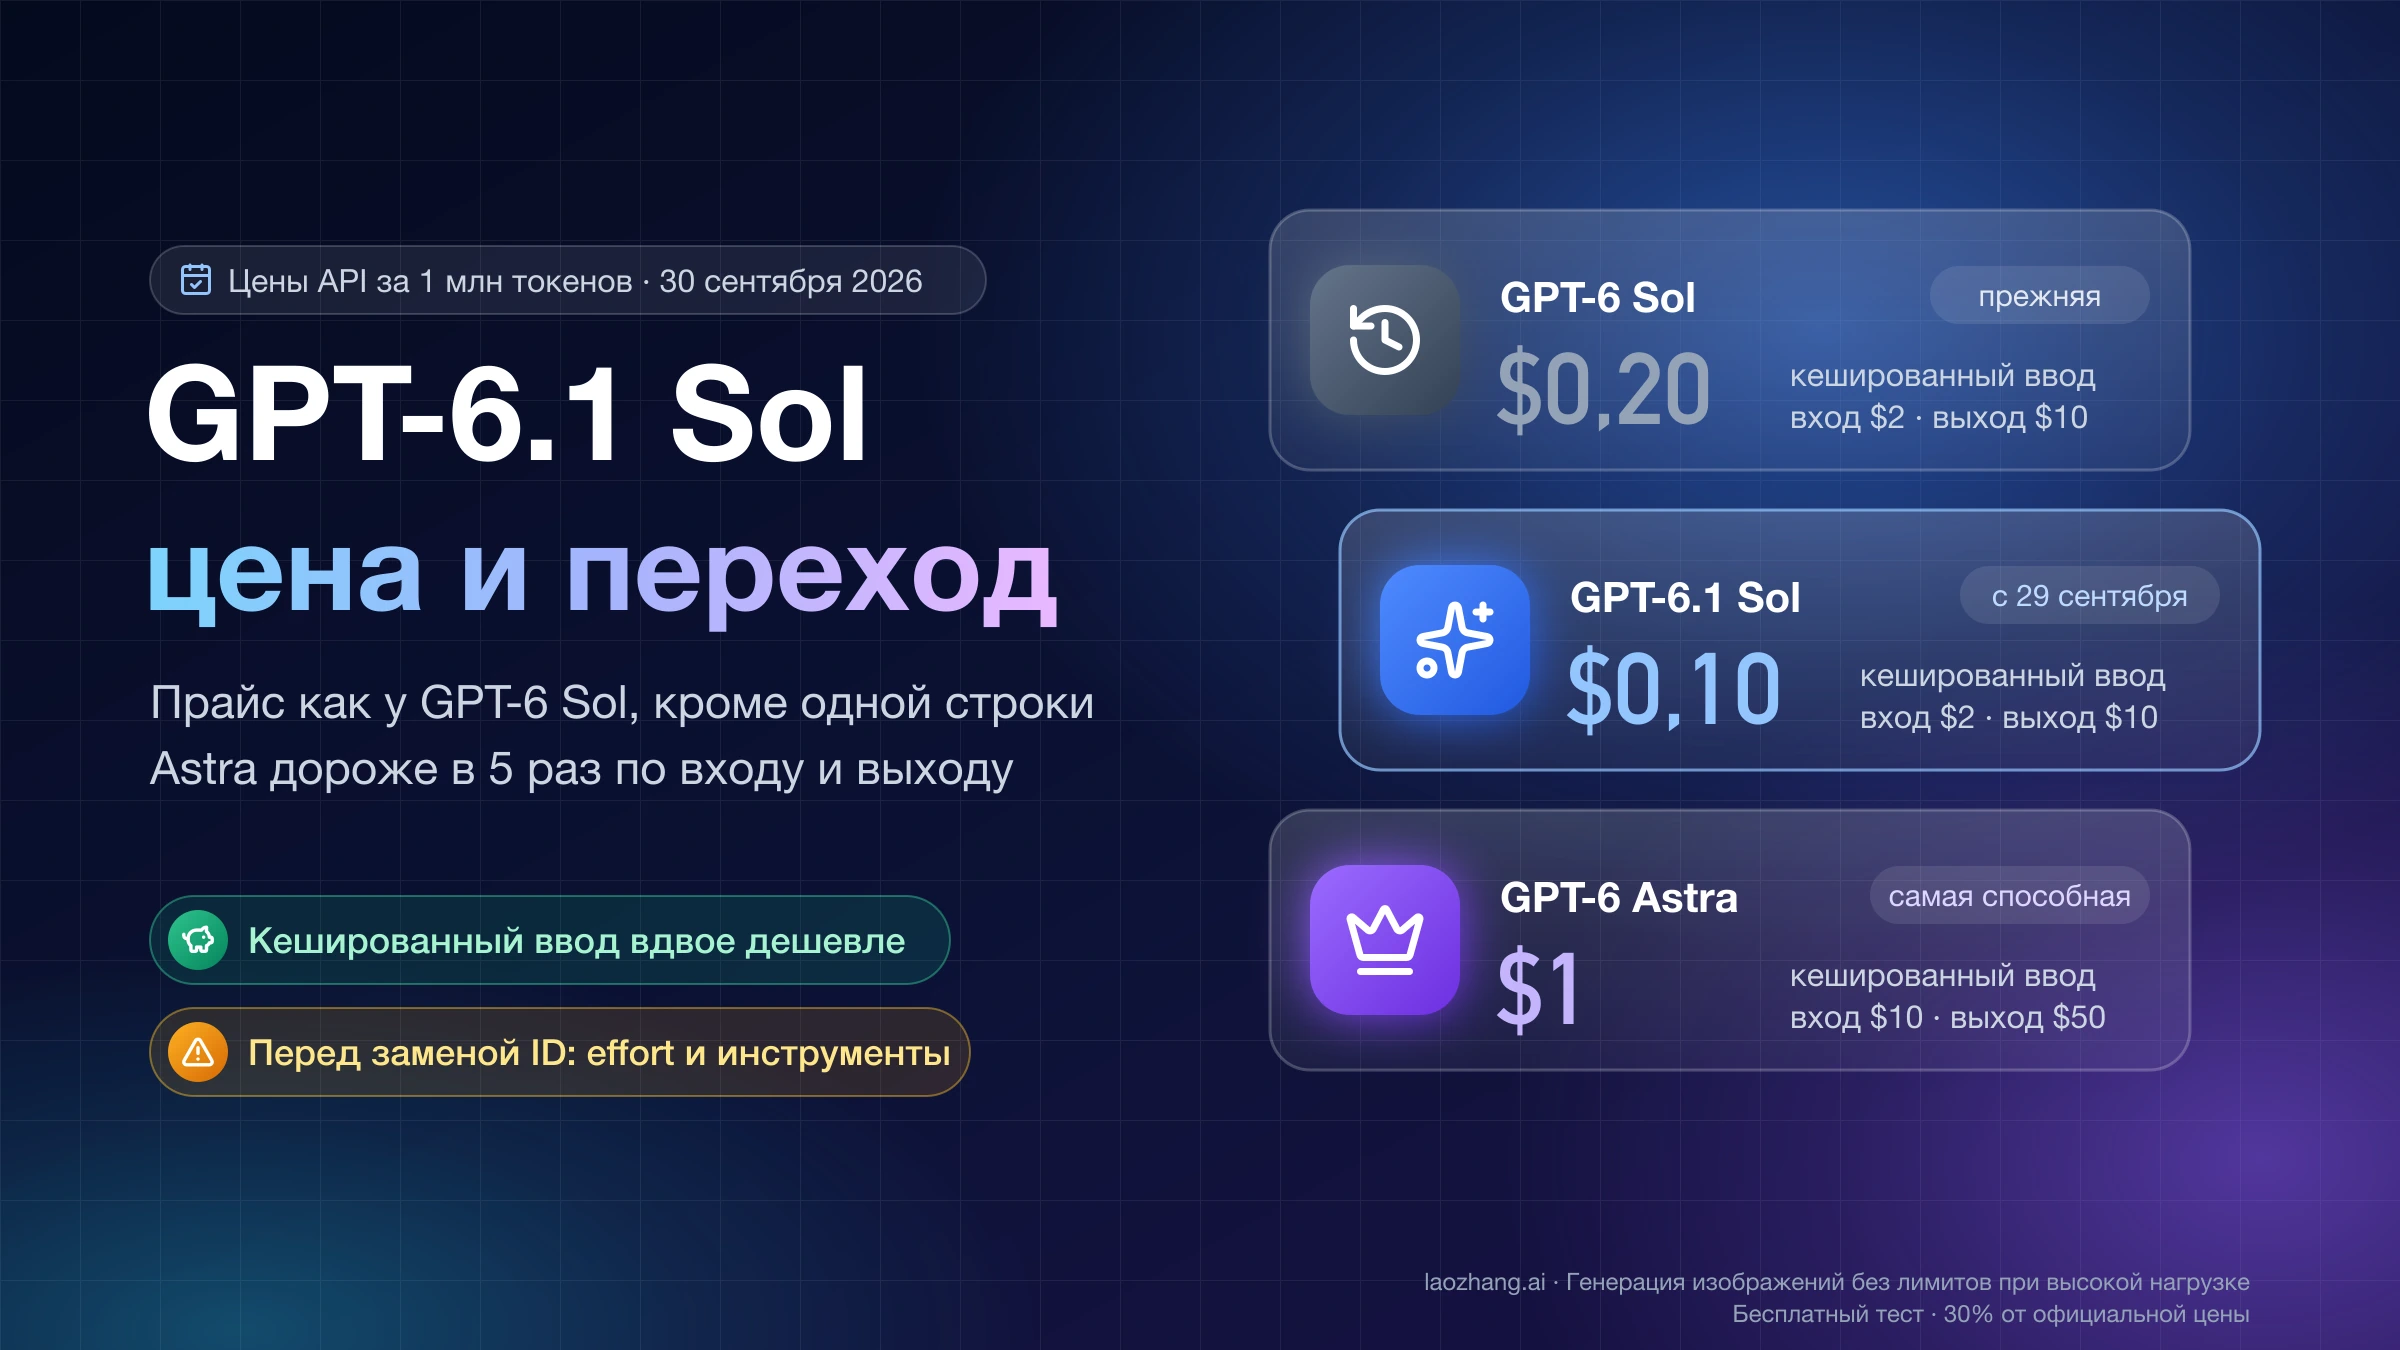
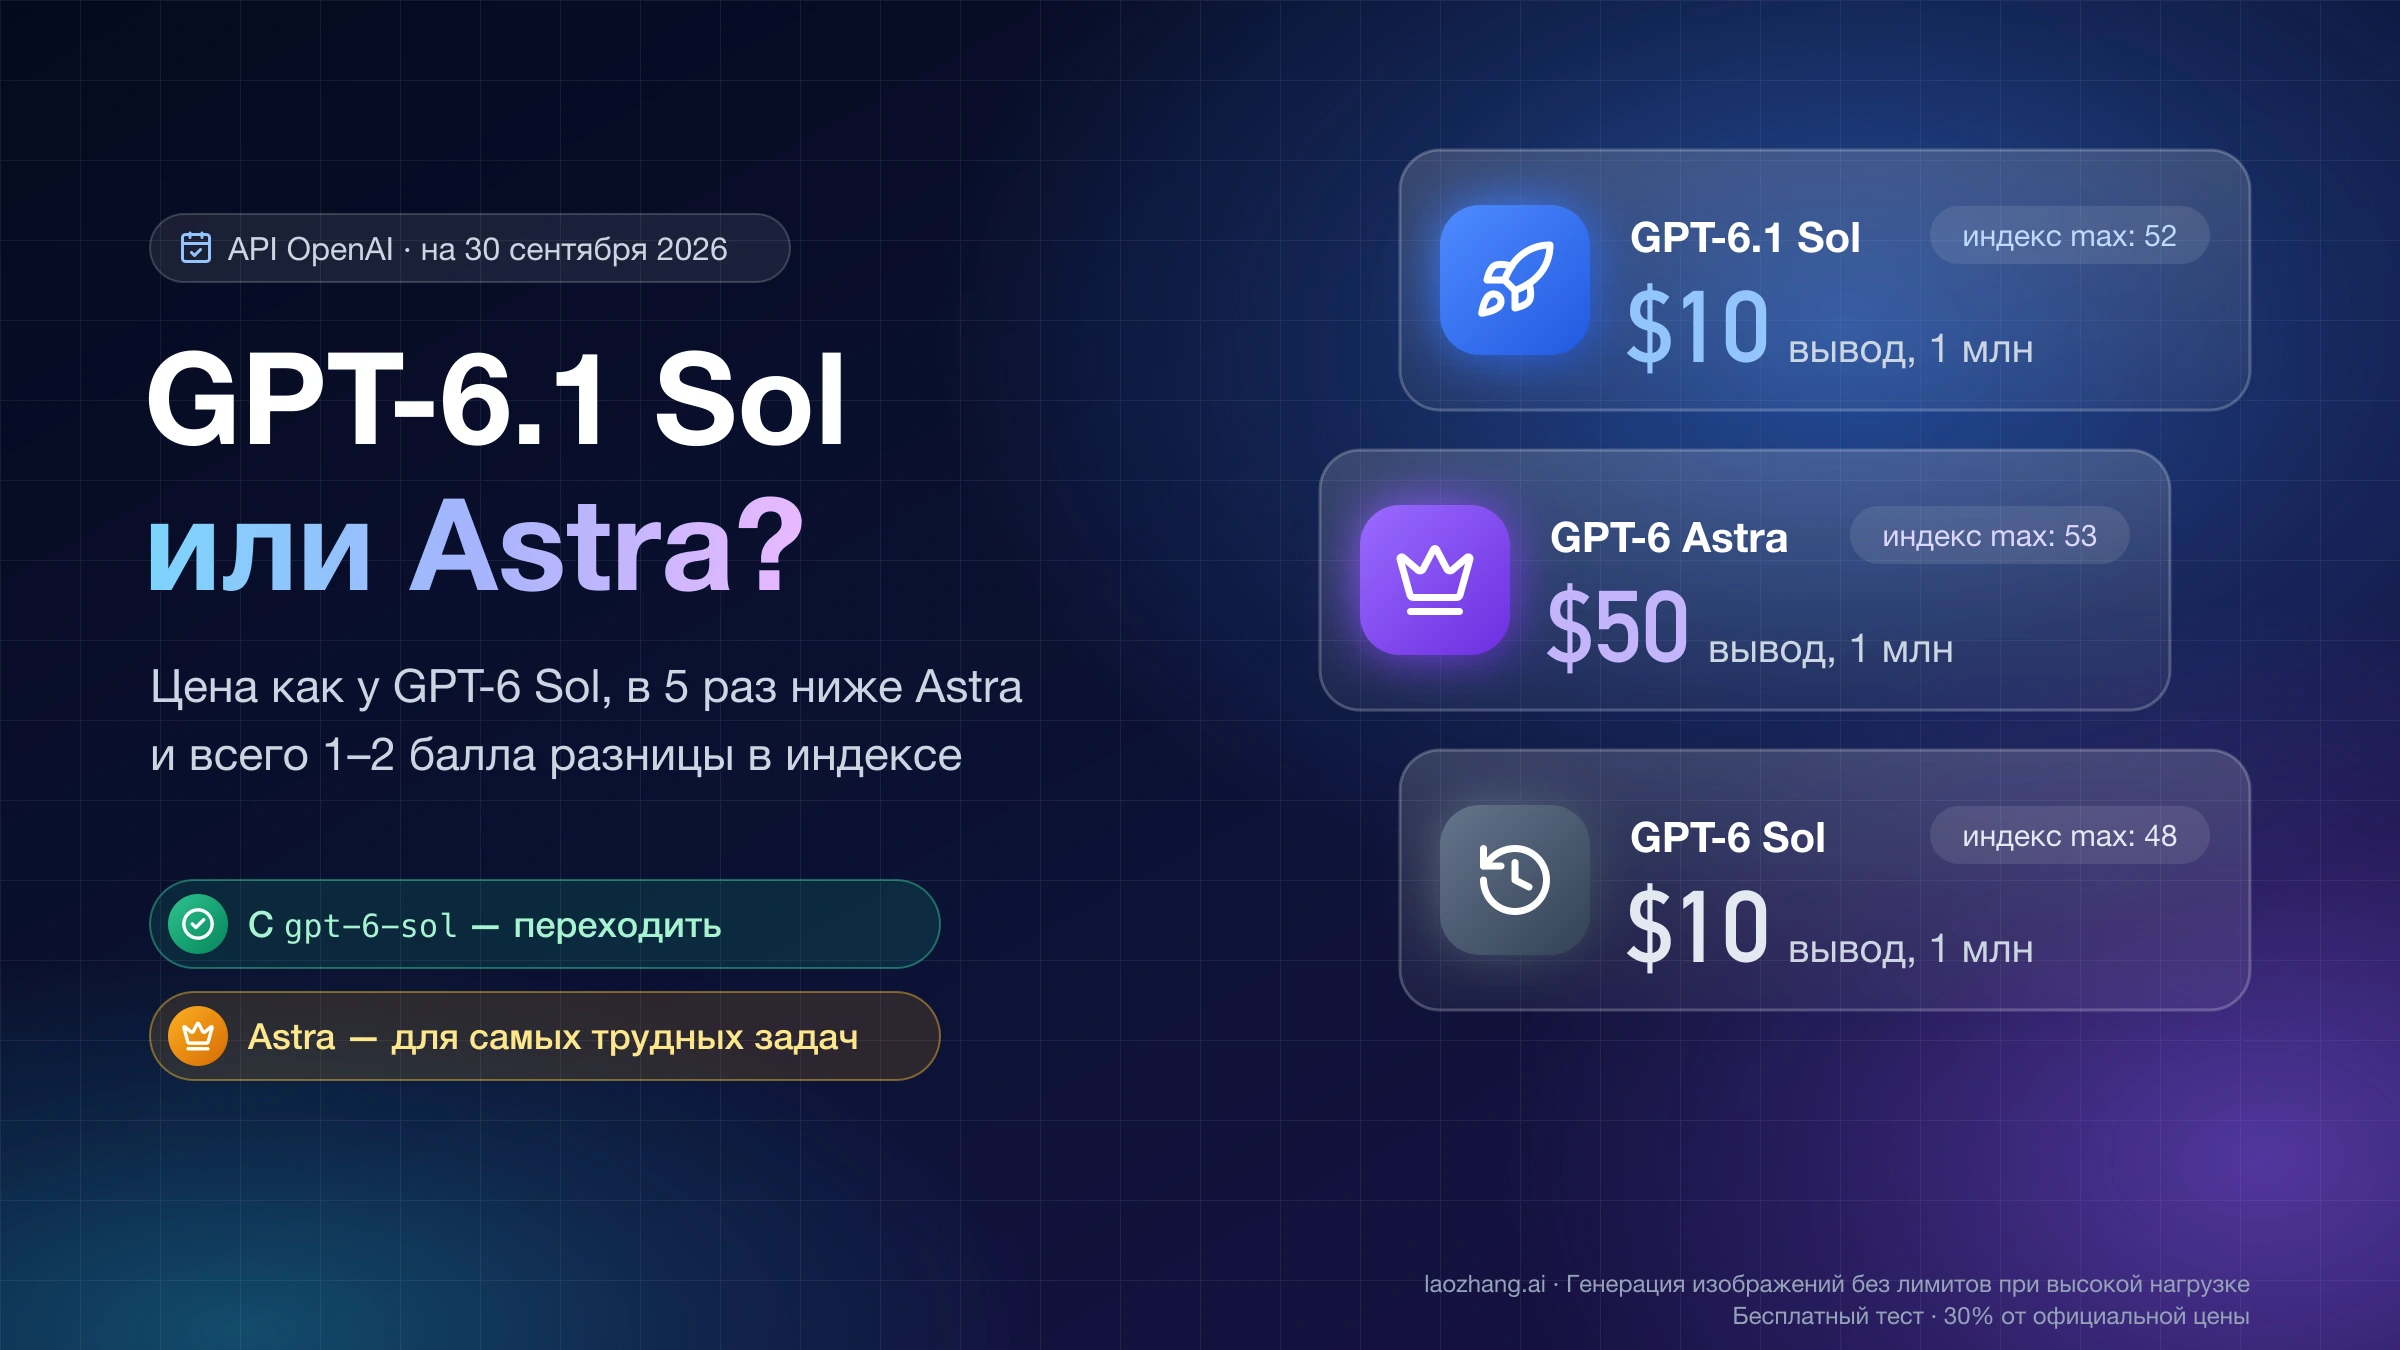
29 сентября 2026 года OpenAI выпустила GPT-6.1 Sol (gpt-6.1-sol) — обновление GPT-6 Sol с теми же ценами входа и выхода, но вдвое более дешёвым чтением кэша. Сравнивать Claude Opus 5.5 теперь имеет смысл именно с ней. В запросах до 272 тыс. входных токенов Opus ровно вдвое дороже по каждой статье счёта, включая кэш: $0,20 против $0,10 за миллион прочитанных токенов. В запросах длиннее 272 тыс. разница сводится к выходу, $20 против $15 за миллион, и при одинаковом числе токенов Opus не бывает дешевле. Прежние выводы о том, что кэш сжимает надбавку Opus до 1,3–1,6 раза, а длинный запрос из кэша у Opus выходит дешевле, верны только для GPT-6 Sol с кэшем по $0,20; ниже они оставлены как справка для тех, кто остаётся на gpt-6-sol.
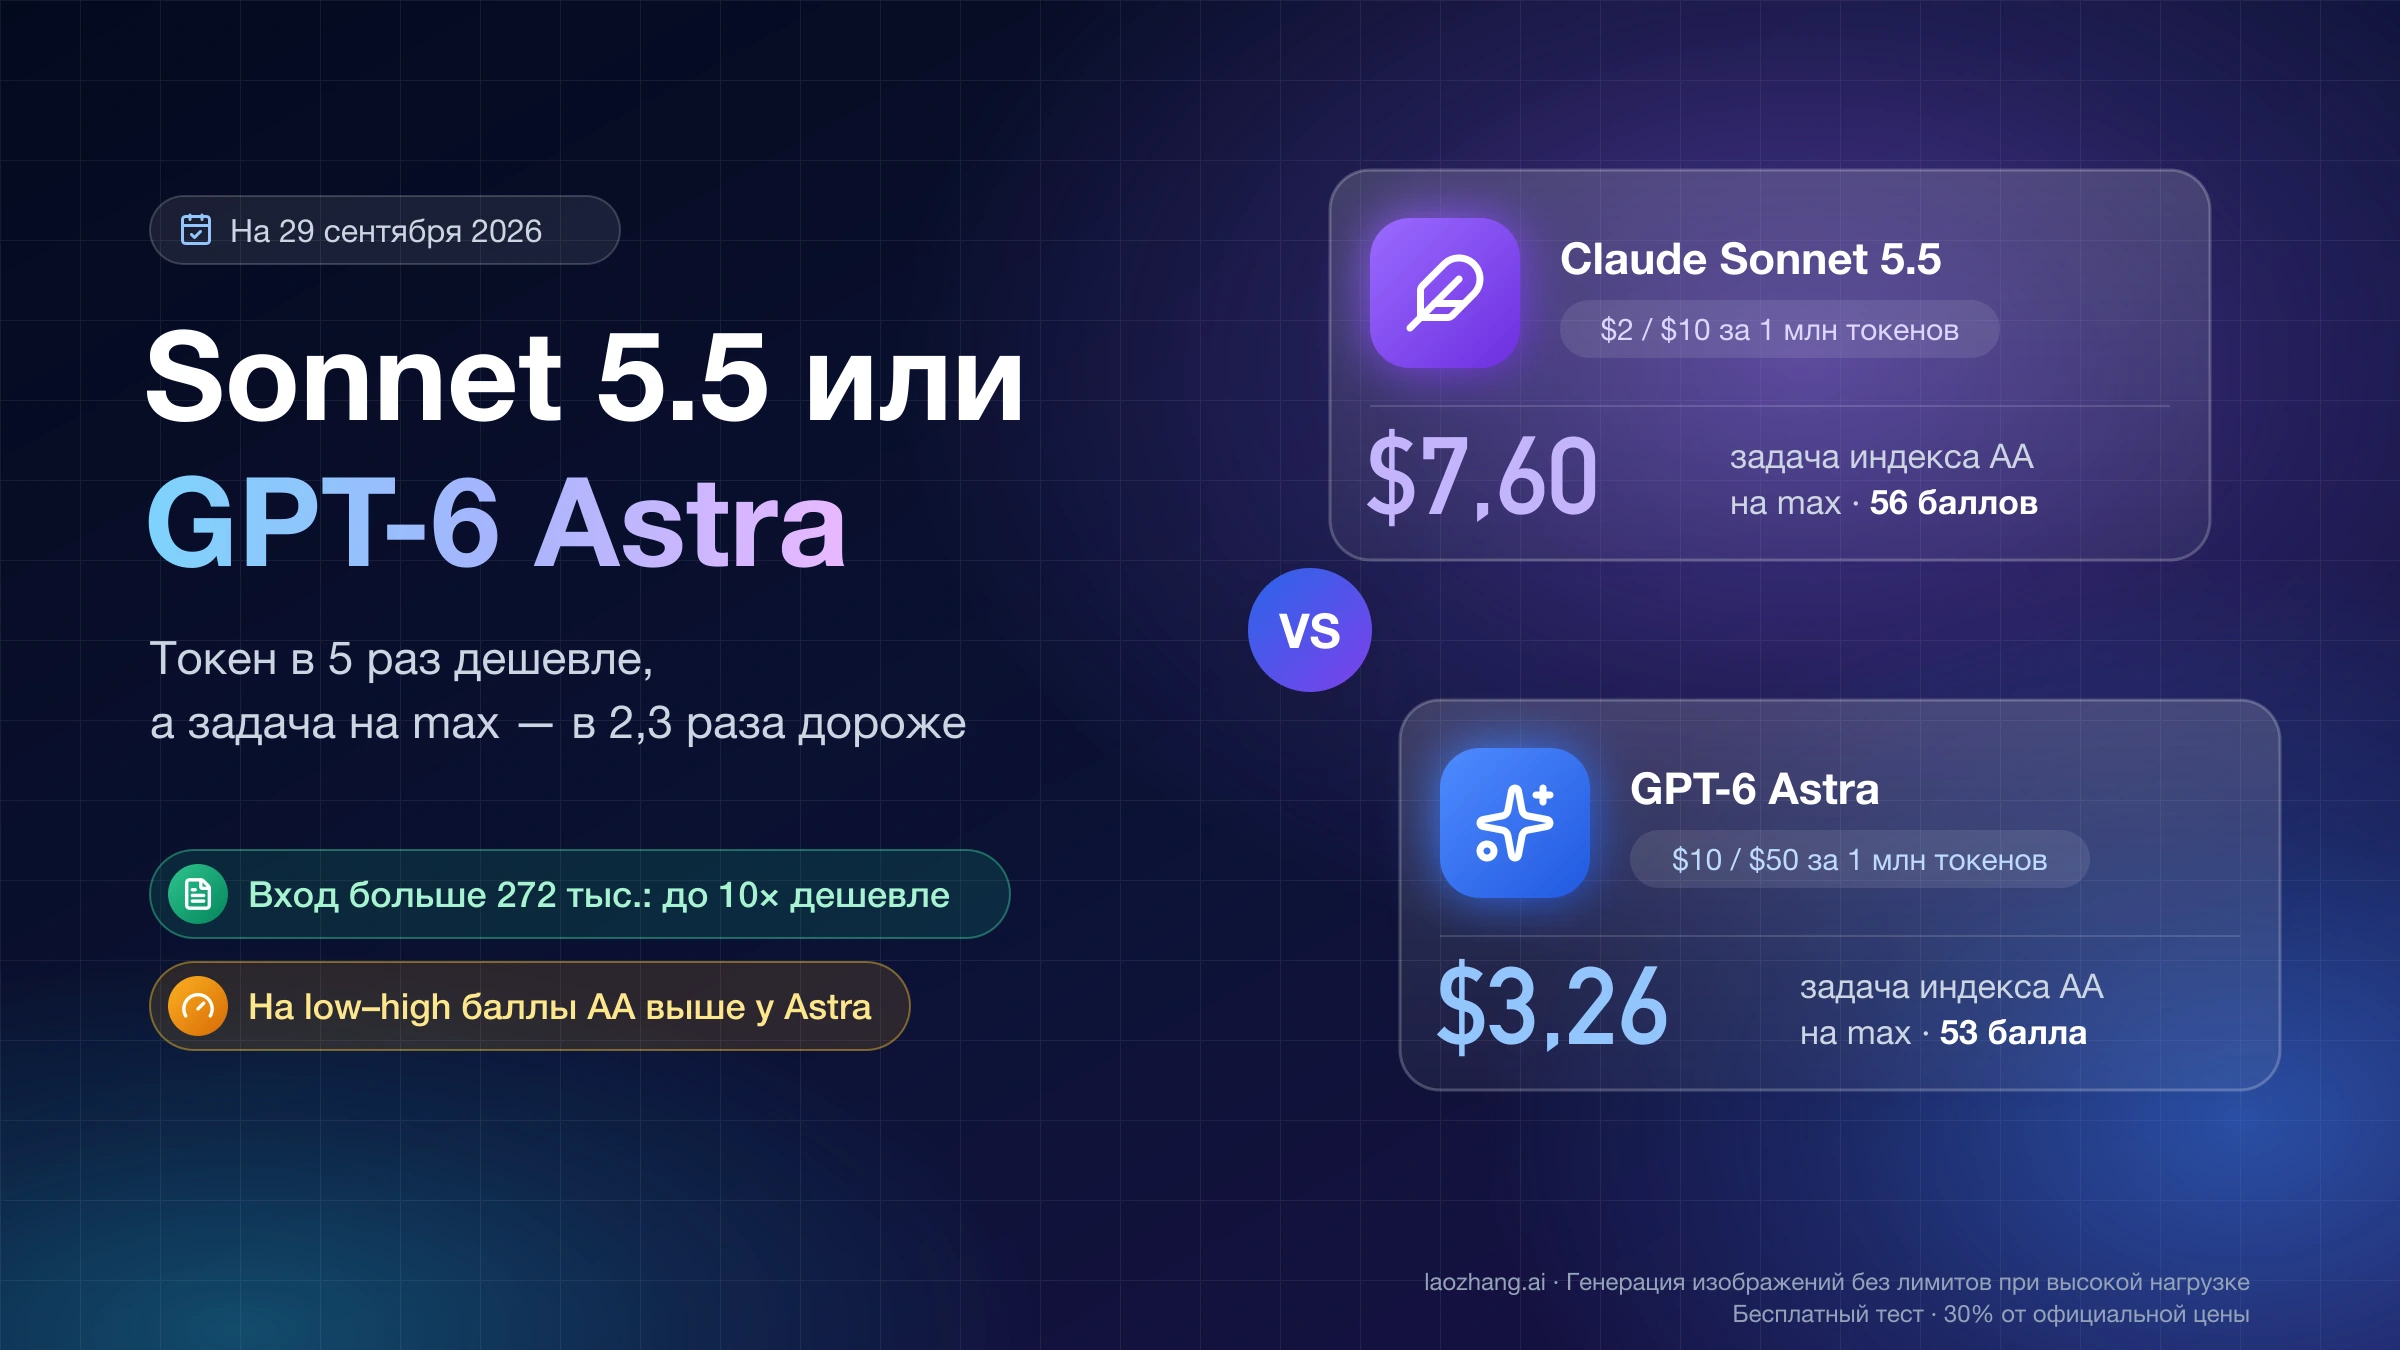
Реальный расход токенов у моделей разный. В замерах Artificial Analysis на 30 сентября 2026 года задача индекса у Opus 5.5 стоит в 4,2–8,9 раза дороже, чем у GPT-6.1 Sol на том же уровне рассуждения. Баллы у Opus выше на всех уровнях, кроме low: 51 против 48 на medium, 58 против 52 на max. Но GPT-6.1 Sol на max (52 балла, $0,72 за задачу) обходит Opus на medium (51 балл, $1,34). Рабочее правило такое: GPT-6.1 Sol подходит по умолчанию для массовых агентов, коротких и длинных вызовов и ограниченного бюджета; Opus 5.5 стоит своих денег там, где нужен верх шкалы качества, а неудачная попытка обходится дороже токенов. Кто выгоднее именно у вас, покажет стоимость принятой задачи на небольшом пилоте. Ниже формулы для вашего расхода токенов и порядок такого пилота.
Сколько стоит каждая статья счёта
Claude Opus 5.5 и GPT-6 Sol вышли 22 сентября 2026 года, GPT-6.1 Sol — 29 сентября. У claude-opus-5-5 контекстное окно 1 млн токенов и до 128 тыс. токенов выхода; адаптивное мышление у неё включено всегда, отключить его нельзя, уровень рассуждения (effort) по умолчанию medium (обзор модели у Anthropic). У gpt-6.1-sol окно 1 050 000 токенов, тоже до 128 тыс. токенов выхода, effort настраивается от low до max, по умолчанию medium. Значений none и minimal у новой модели нет, а вызов инструментов работает только через Responses API: Chat Completions поддерживается без инструментов (страница GPT-6.1 Sol у OpenAI).
GPT-6 Sol по-прежнему вызывается и в списке выводимых из эксплуатации моделей не значится, но из таблицы цен OpenAI уже убрана, а её страница отсылает к GPT-6.1 Sol как к более новой модели Sol (страница GPT-6 Sol). В отличие от 6.1 Sol, она поддерживает none.
Стандартные тарифы прямых API в долларах за 1 млн токенов; OpenAI — по состоянию на 30 сентября 2026 года, Anthropic — на 25 сентября:
| Статья счёта | Claude Opus 5.5 | GPT-6.1 Sol, запрос до 272 тыс. | GPT-6.1 Sol, запрос свыше 272 тыс. | Для справки: GPT-6 Sol, до / свыше 272 тыс. |
|---|---|---|---|---|
| Свежий вход | $4 | $2 | $4 | $2 / $4 |
| Запись в кэш | $5 (на 5 минут), $8 (на 1 час) | $2,50 | $5 | $2,50 / $5 |
| Чтение из кэша | $0,20 | $0,10 | $0,20 | $0,20 / $0,40 |
| Выход, включая токены рассуждения | $20 | $10 | $15 | $10 / $15 |
Источники: цены Claude API и цены OpenAI API.
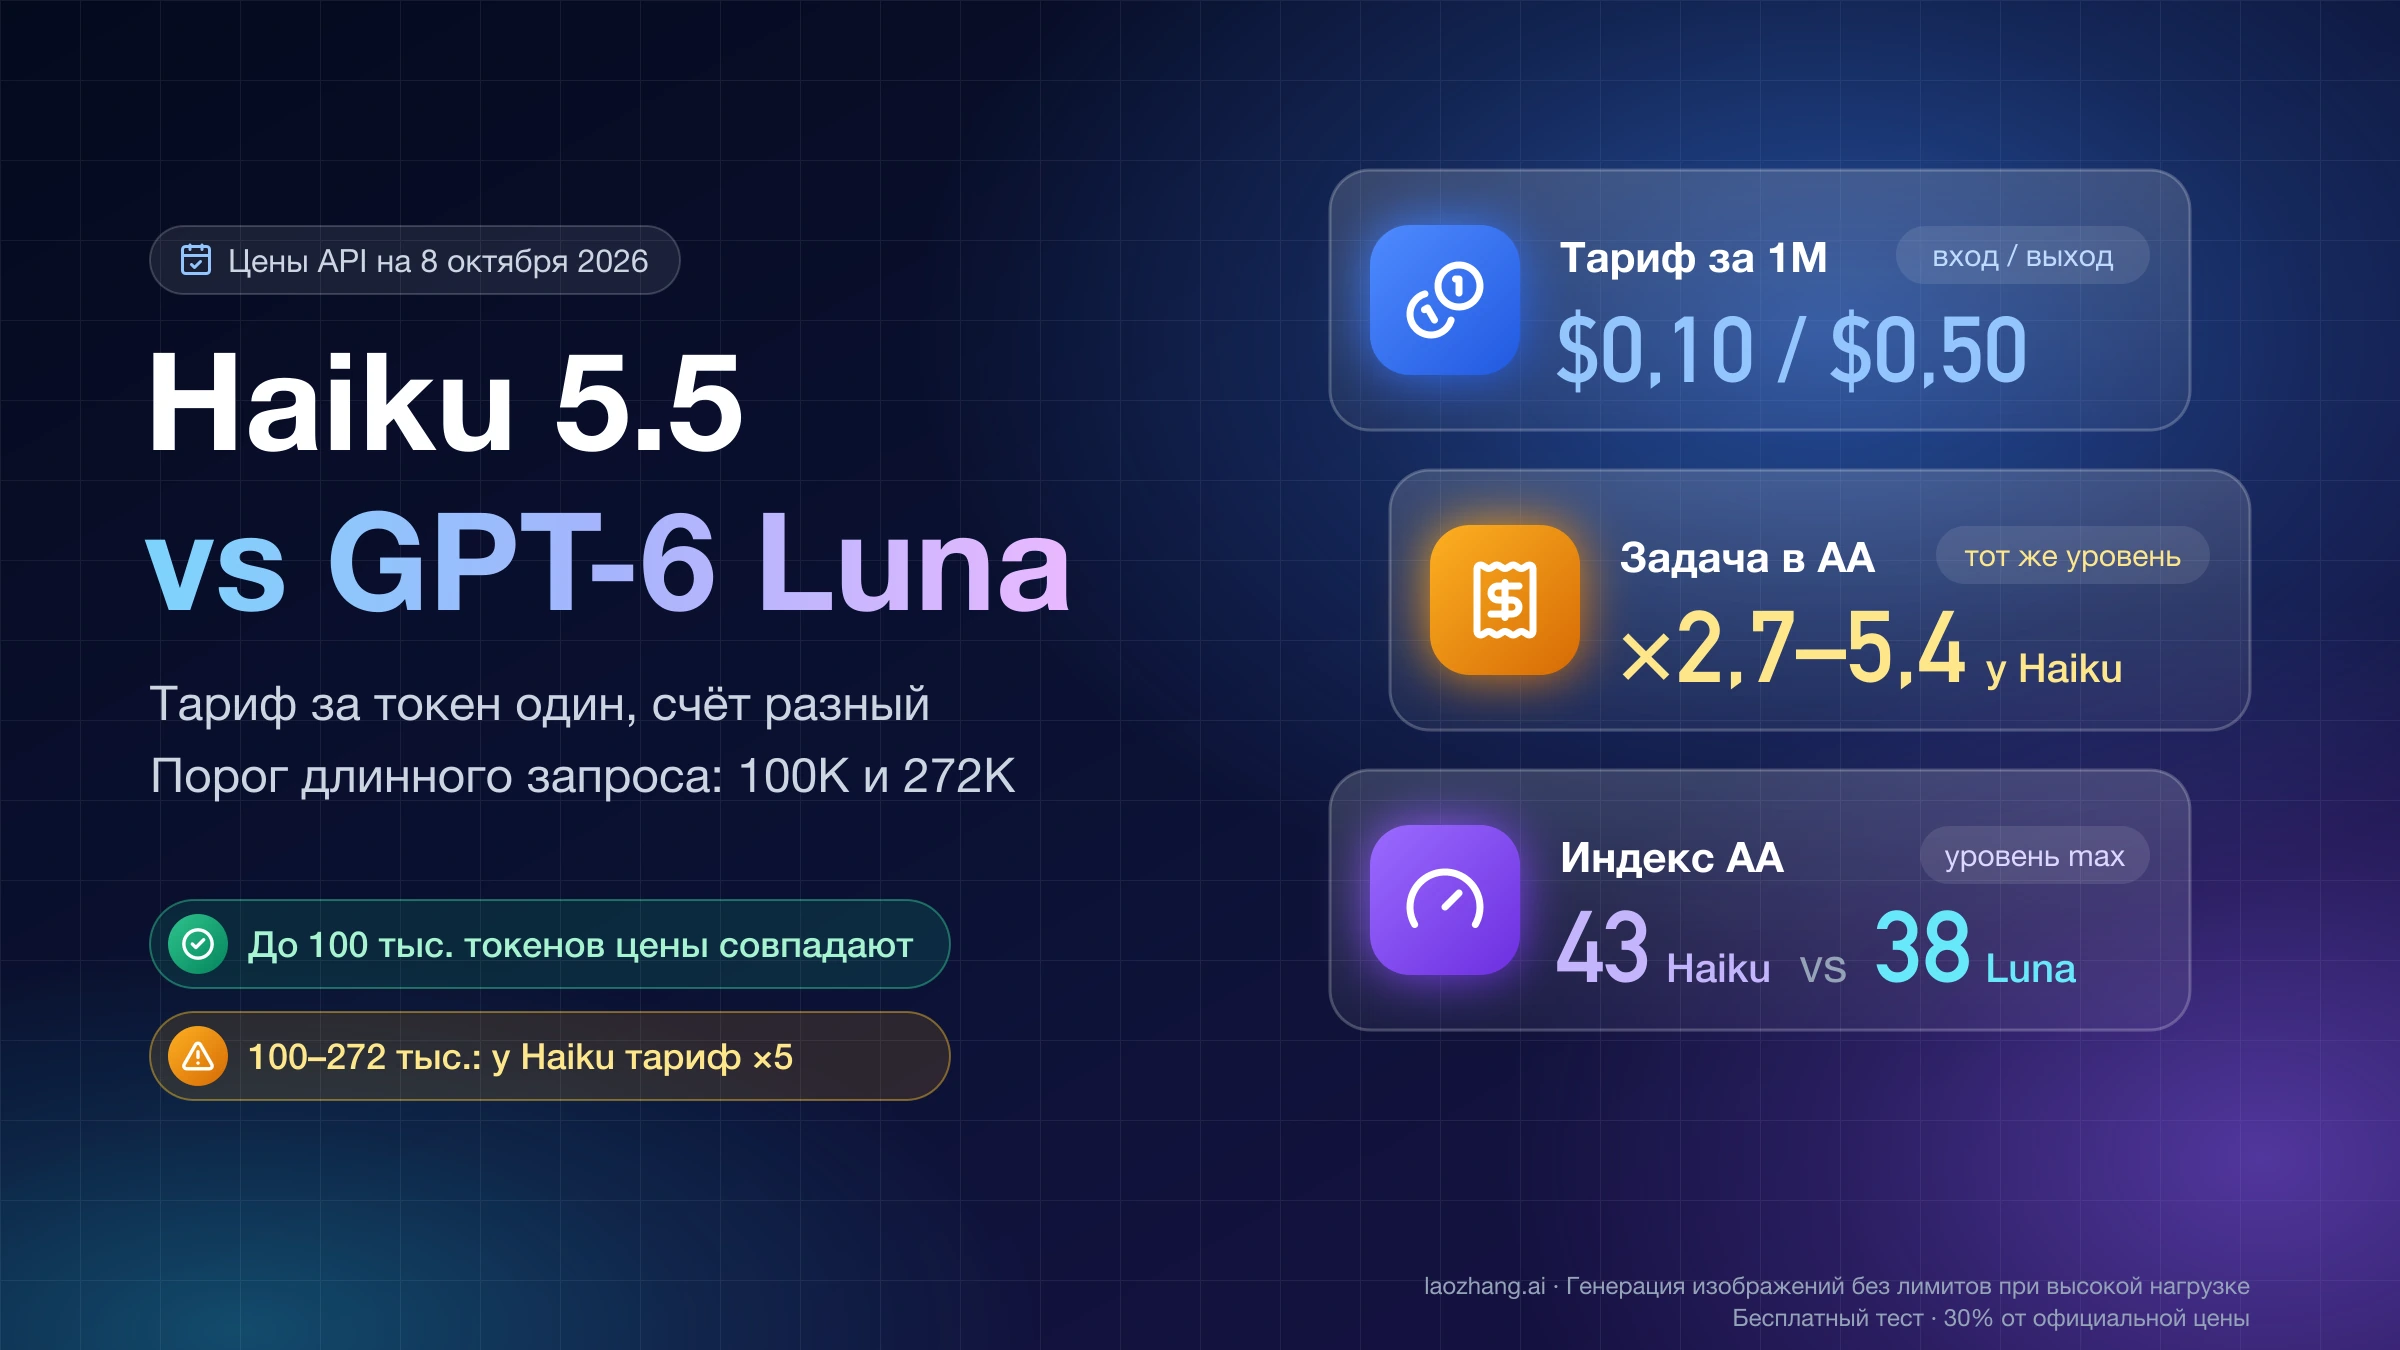
Две строки в этих прайсах устроены по-разному. У Opus 5.5 нет надбавки за длинный контекст: по словам Anthropic, запрос на 900 тыс. токенов оплачивается по той же ставке, что и запрос на 9 тыс. У GPT-6.1 Sol, как и у GPT-6 Sol, запрос, в котором больше 272 тыс. входных токенов, целиком переходит на длинные тарифы: вход и кэш вдвое дороже, выход в 1,5 раза.
Счёт меняют и режимы обслуживания:
- Пакетная обработка. Batch у Anthropic снижает на 50% цену входа и выхода. У OpenAI Batch и Flex стоят половину стандартного тарифа по всем статьям.
- Быстрый режим. Fast у GPT-6.1 Sol стоит вдвое дороже стандарта. Fast mode у Opus 5.5 обходится в $8 за вход и $40 за выход, работает только в собственном API Anthropic, пока в статусе research preview и с Batch не совмещается.
- Регион обработки. У OpenAI региональная обработка (data residency) добавляет 10%. У Anthropic параметр
inference_geo: "us"умножает все статьи на 1,1. - Инструменты. Встроенные инструменты OpenAI могут оплачиваться за вызов: веб-поиск, например, стоит $10 за 1000 вызовов.
Где двойная надбавка Opus сохраняется, а где сжимается
Удобнее всего считать по четырём статьям. Обозначим миллионы оплаченных токенов: U — свежий вход, W — запись в кэш, R — чтение из кэша, O — выход (вместе с рассуждением). Тогда при стандартных тарифах:
- Opus 5.5 = 4·U + 5·W + 0,2·R + 20·O (запись в кэш на 5 минут);
- GPT-6.1 Sol, запрос до 272 тыс. = 2·U + 2,5·W + 0,1·R + 10·O;
- GPT-6.1 Sol, запрос свыше 272 тыс. = 4·U + 5·W + 0,2·R + 15·O.
Из этих формул следуют два правила, которые проще запомнить, чем таблицу.
Короткие запросы. Opus = 2 × GPT-6.1 Sol, ровно и при любом составе счёта. Каждая статья у Opus вдвое дороже, поэтому доля кэша на соотношение не влияет: агентный цикл, который почти целиком читает контекст из кэша, стоит у Opus вдвое больше так же, как и короткий вызов без кэша.
Запросы свыше 272 тыс. Opus − GPT-6.1 Sol = 5·O. Свежий вход, запись в кэш и чтение кэша стоят одинаково, выход у Opus дороже на $5 за миллион. Разница никогда не бывает отрицательной, то есть при тех же токенах Opus в длинном запросе не дешевле, а дороже ровно на стоимость выхода. Если используется часовая запись в кэш у Anthropic ($8), к стороне Opus добавьте ещё 3·W.
С GPT-6 Sol, где чтение кэша стоит $0,20 в коротком запросе и $0,40 в длинном, правила были другими: Opus = 2 × Sol − 0,2·R, а в запросах свыше 272 тыс. Opus − Sol = 5·O − 0,2·R, и Opus выходил дешевле, когда токенов чтения из кэша было более чем в 25 раз больше, чем токенов выхода. Для gpt-6.1-sol оба правила уже не работают.
Пять гипотетических примеров при одинаковом числе оплаченных токенов у обеих моделей:
| Пример | U / R / O, млн токенов | Opus 5.5 | GPT-6.1 Sol | Отношение Opus / 6.1 Sol | Для справки: GPT-6 Sol |
|---|---|---|---|---|---|
| Короткие запросы без кэша | 0,1 / 0 / 0,02 | $0,80 | $0,40 | 2,00 | $0,40 |
| Агентный цикл из коротких вызовов | 0,1 / 2,0 / 0,05 | $1,80 | $0,90 | 2,00 | $1,10 |
| Цикл, где почти весь вход из кэша | 0,05 / 5,0 / 0,03 | $1,80 | $0,90 | 2,00 | $1,40 |
| Один запрос на 800 тыс., в основном кэш | 0,05 / 0,75 / 0,02 | $0,75 | $0,65 | 1,15 | $0,80 |
| Один запрос на 300 тыс. без кэша | 0,3 / 0 / 0,02 | $1,60 | $1,50 | 1,07 | $1,50 |
Запись в кэш в этих примерах не учитывается. С GPT-6 Sol запрос на 800 тыс. токенов выходил у Opus дешевле ($0,75 против $0,80); с GPT-6.1 Sol он на $0,10 дороже, и это ровно 5 × 0,02 млн токенов выхода. Главное допущение таблицы — одинаковое число токенов, а в жизни его нет: модели по-разному рассуждают и по-разному режут текст на токены, об этом раздел ниже. Поэтому таблица показывает устройство тарифов, а не ваш будущий счёт.
Из того же расчёта видно, почему промах кэша так бьёт по бюджету: токен, который должен был прийти из кэша, у Opus стоит $4 вместо $0,20, у GPT-6.1 Sol — $2 вместо $0,10, то есть у обеих в 20 раз дороже. Как это выглядит в реальных сессиях, разобрано в статье Claude Code cache miss и стоимость токенов.
Чтобы подставить собственные логи, достаточно короткого скрипта. Порог 272 тыс. проверяется для каждого запроса отдельно, поэтому считать нужно по запросам, а не по суммам за день:
# Стандартные тарифы, $ за 1 млн токенов: OpenAI на 30.09.2026, Anthropic на 25.09.2026
RATES = {
    "claude-opus-5-5": {"short": {"u": 4.00, "w": 5.00, "r": 0.20, "o": 20.00}},  # запись в кэш на 5 минут
    "gpt-6.1-sol": {
        "short": {"u": 2.00, "w": 2.50, "r": 0.10, "o": 10.00},
        "long": {"u": 4.00, "w": 5.00, "r": 0.20, "o": 15.00},  # весь запрос, если вход > 272 тыс.
    },
    "gpt-6-sol": {  # предыдущая модель, для сравнения
        "short": {"u": 2.00, "w": 2.50, "r": 0.20, "o": 10.00},
        "long": {"u": 4.00, "w": 5.00, "r": 0.40, "o": 15.00},
    },
}

def request_cost(rates, u, w, r, o):
    return (rates["u"] * u + rates["w"] * w + rates["r"] * r + rates["o"] * o) / 1_000_000

def bill(model, requests):
    """requests: список запросов с оплаченными токенами u, w, r, o из usage этой модели."""
    table = RATES[model]
    total = 0.0
    for q in requests:
        prompt = q["u"] + q["w"] + q["r"]  # допущение: кэш входит в порог 272 тыс.
        rates = table["long"] if "long" in table and prompt > 272_000 else table["short"]
        total += request_cost(rates, **q)
    return total

# Пример: один запрос на 800 тыс. токенов, в основном из кэша
q = [{"u": 50_000, "w": 0, "r": 750_000, "o": 20_000}]
for m in RATES:
    print(m, round(bill(m, q), 2))  # 0.75, 0.65, 0.8
Для реального сравнения передавайте каждой модели её собственные логи: одинаковые токены во всех вызовах bill нужны только для упражнения с тарифами.
Порог 272 тыс. токенов: почему «для длинных документов» не значит «Sol»
Рассуждение кажется очевидным: у GPT-6.1 Sol окно 1 050 000 токенов, значит, для длинных документов он подходит лучше. Разница в окне с Opus 5.5 — 50 тыс. токенов, около 5%. Для документа на 300–900 тыс. токенов важнее другое: как только вход одного запроса превышает 272 тыс., у Sol весь этот запрос оплачивается по длинным тарифам. Свежий вход, запись и чтение кэша сравниваются с Opus, а на треть дешевле остаётся только выход.
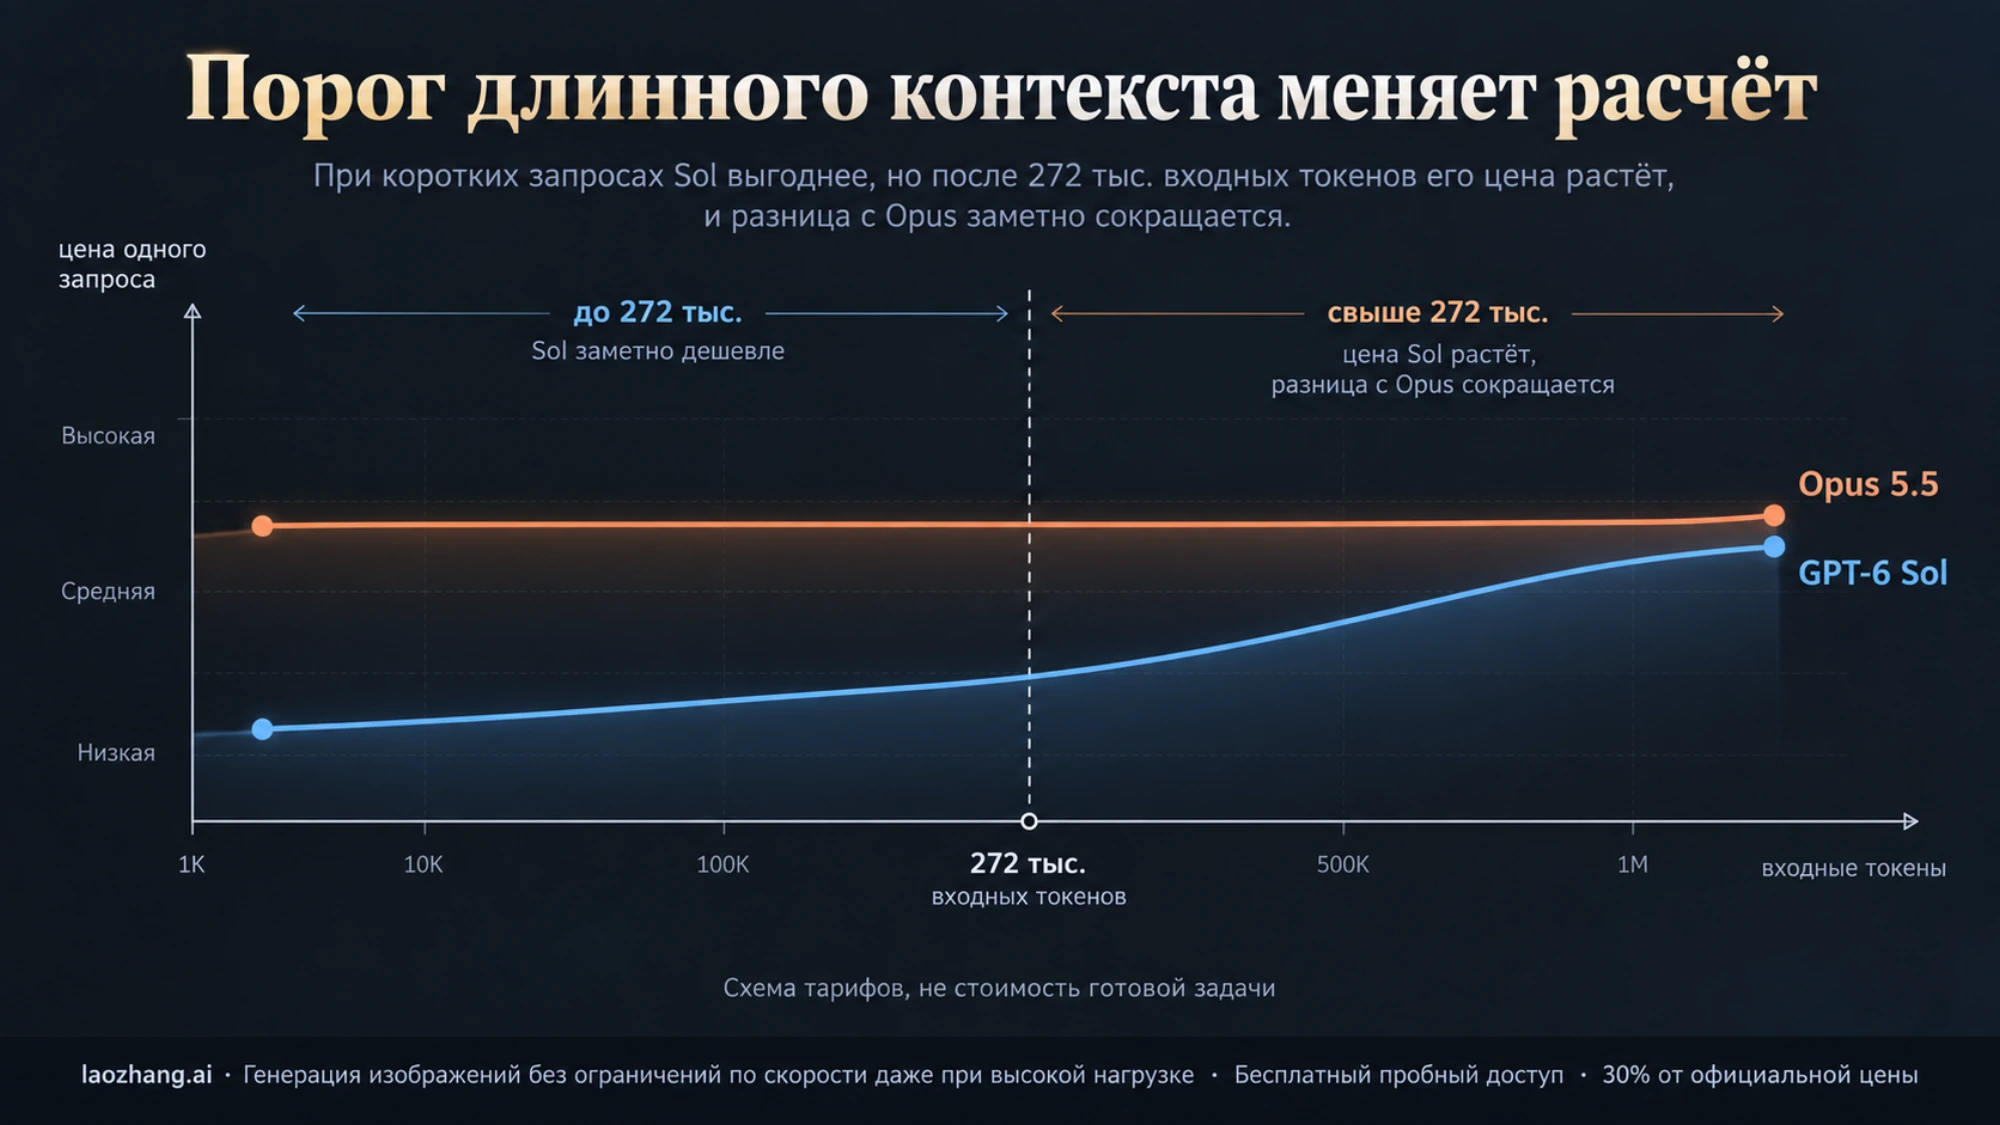
В таблице — тарифы GPT-6.1 Sol: до порога каждая статья счёта вдвое ниже, чем у Opus, после порога совпадает с ним во всём, кроме выхода. Оговорка о том, что длинный запрос с тяжёлым кэшем у Opus может оказаться дешевле, относится только к GPT-6 Sol: там чтение кэша за порогом стоило $0,40 против $0,20 у Opus. У 6.1 Sol за порогом оно те же $0,20.
Отсюда два практических вывода для работы с длинными документами:
- Если документ целиком лежит в каждом запросе и переиспользуется через кэш (анализ кодовой базы, длинный договор с десятками вопросов), тарифы у моделей почти сравнялись: запрос на 800 тыс. токенов из примера выше стоит $0,75 у Opus и $0,65 у GPT-6.1 Sol. Здесь выбор решают качество ответов и то, сколько токенов выхода и рассуждения тратит каждая модель. Ценового довода в пользу Opus в таких запросах больше нет.
- Если документ режется на фрагменты и каждый запрос остаётся меньше 272 тыс. токенов (поиск по базе, RAG), у GPT-6.1 Sol сохраняется двукратное преимущество по всем статьям, включая кэш. DataCamp приводит пример для GPT-6 Sol: 10 млн входа и 1 млн выхода запросами до порога стоят $30 у Sol и $60 у Opus, а запросами свыше порога — $55 и $60. Кэша в этом примере нет, а ставки свежего входа и выхода у 6.1 Sol те же, поэтому для неё цифры не меняются.
Одна оговорка про сам порог. OpenAI пишет, что для запросов длиннее 272 тыс. входных токенов вдвое дорожают «вход и кэш», то есть закэшированная часть длинного запроса тоже переоценивается. Из этой формулировки разумно заключить, что порог считается по всему входу запроса вместе с кэшированными токенами. Прямо это в документации не сказано, поэтому после первого длинного запроса сверьте начисление в консоли.
Почему стоимость задачи расходится с прайсом в разы
Artificial Analysis прогоняет модели через свой индекс (версия 4.3.2, десять наборов задач) на каждом уровне рассуждения и публикует балл и среднюю стоимость одной задачи индекса. Эта стоимость складывается из свежего входа, чтения и записи кэша, токенов рассуждения и ответа, то есть отражает реальный расход токенов. Opus измерен в режиме адаптивного рассуждения с резервной моделью по умолчанию. Данные на 30 сентября 2026 года (сравнение GPT-6.1 Sol и Claude Opus 5.5 у Artificial Analysis):
| Уровень рассуждения | Opus 5.5: балл / $ за задачу | GPT-6.1 Sol: балл / $ за задачу | Opus дороже в |
|---|---|---|---|
| low | 42 / $0,55 | 42 / $0,13 | ≈4,2 раза |
| medium | 51 / $1,34 | 48 / $0,21 | ≈6,4 раза |
| high | 54 / $1,82 | 50 / $0,32 | ≈5,7 раза |
| xhigh | 56 / $3,46 | 51 / $0,39 | ≈8,9 раза |
| max | 58 / $5,98 | 52 / $0,72 | ≈8,3 раза |
Для сравнения: у GPT-6 Sol в тех же замерах было 40 баллов за $0,25 на medium и 48 за $1,05 на max (страница GPT-6 Sol у Artificial Analysis). Новая модель на каждом из этих уровней и сильнее, и дешевле.
Баллы индекса — не доля решённых задач, а стоимость задачи индекса — не ваш производственный счёт. Но соотношение показательно. Тарифы у Opus в запросах до порога ровно вдвое выше, а задача дороже в 4–9 раз. Значит, на этих задачах Opus тратит примерно в 2–4,5 раза больше токенов в пересчёте на тарифы. Artificial Analysis показывает это и напрямую: на medium Opus выдаёт в среднем 26 тыс. токенов выхода на задачу против 8 тыс. у GPT-6.1 Sol, на max — 119 тыс. против 38 тыс. Реальная разница в цене задачи больше прайсовой, а не меньше.
Из этой таблицы полезно сделать два вывода.
Сравнивайте одинаковые уровни. Если в сравнении GPT-6.1 Sol на xhigh стоит рядом с Opus на medium, такая пара ничего не говорит ни о качестве, ни о цене: effort меняет и балл, и расход в несколько раз.
Посмотрите на равные деньги. Opus на low набирает 42 балла за $0,55, а GPT-6.1 Sol на xhigh — 51 за $0,39. Opus на medium даёт 51 балл за $1,34, GPT-6.1 Sol на max — 52 за $0,72, почти вдвое дешевле. При сопоставимом бюджете на задачу 6.1 Sol теперь впереди, тогда как у GPT-6 Sol при равном бюджете разница сводилась к нескольким баллам в ту или другую сторону. За Opus остаётся верх шкалы: 54–58 баллов на high, xhigh и max GPT-6.1 Sol не набирает ни на одном уровне, его потолок — 52.
Ту же механику показывает единичный тест DataCamp (23 сентября 2026 года), проведённый ещё с GPT-6 Sol: игра в духе тетриса в одном HTML-файле, уровень high, одна попытка. GPT-6 Sol сделал 6 ходов, потратил 120 226 токенов, из них 8 123 на рассуждение, и обошёлся в $0,26. Opus 5.5 уложился в 3 хода и 107 958 токенов, но 22 551 из них ушли на рассуждение по цене выхода, итог — $0,87. Это одна задача и другая версия Sol, но вывод о механике общий: меньше ходов не значит дешевле, если модель дольше думает.
Сравнивать «одинаковое число токенов» мешают и токенизаторы. Они у вендоров разные, и официального коэффициента пересчёта между Claude и OpenAI нет. Anthropic сообщает только, что начиная с Claude 4.7 её токенизатор выдаёт примерно на 30% больше токенов на тот же текст, чем Claude Sonnet 4.6 и более ранние модели; это сравнение внутри линейки Claude. Поэтому в пилоте сравнивайте оплаченные токены из ответов каждого API, а не пересчитывайте одни в другие.
Со скоростью картина двойственная. По замерам Artificial Analysis на 30 сентября Opus 5.5 генерирует текст быстрее: 72 токена в секунду на medium, 78 на xhigh и 92 на max против 59–66 у GPT-6.1 Sol. Но до ответа Opus дольше думает: первый токен ответа у него появляется через 12,7 с на low и 23 с на medium, у GPT-6.1 Sol — через 2,1 и 5,7 с. Целиком задачу индекса на medium 6.1 Sol проходит в среднем за 136 с, Opus — за 219 с. Для интерактивных подсказок в редакторе это заметно. Для многочасового автономного агента важнее число попыток до принятого результата.
GPT-5.6 Sol, GPT-6 Sol и «на 40% дешевле»: чьи это цифры
В анонсе Opus 5.5 есть таблица бенчмарков, которую легко принять за сравнение с GPT-6 Sol. Но в колонке OpenAI там стоит GPT-5.6 Sol, предыдущее поколение. Например, Terminal-Bench 4.0 — 66,4% у Opus на xhigh против 37,3% у GPT-5.6 Sol; CursorBench 4.0 — 57,8% против 41,7%; GDPval-AA v2.1 — 1846 против 1588 Elo; AutomationBench — 40,0% против 28,8%. Результаты Opus в этой таблице получены на уровне max, если не указано иное, и с защитными механизмами, которые при срабатывании переключают запрос на Opus 4.8 или Opus 5; цифры GPT взяты из отчётов OpenAI (анонс Anthropic). О GPT-6 Sol и GPT-6.1 Sol эти строки напрямую ничего не говорят. Сама Anthropic в том же анонсе признаёт, что разрыв в бенчмарках стал менее надёжным ориентиром для реальной работы.
У OpenAI в анонсе GPT-6.1 Sol есть собственное сравнение с Opus 5.5, и оно тоже выбрано вендором. По данным компании, в GDP.pdf GPT-6.1 Sol набирает больше, чем Opus 5.5 с резервными моделями, на всех проверенных уровнях усилий на рассуждения, при стоимости задачи более чем вдвое ниже. В AutomationBench 1.0.6 на medium она на 2,2 пункта выше при примерно трети стоимости, а в Terminal-Bench Science 0.1 на max средняя задача стоит $5,47 против $23,21 у Opus. Результаты Opus OpenAI взяла из публичных отчётов (анонс GPT-6.1 Sol). Сводный индекс Artificial Analysis выше ставит Opus на первое место по баллам и 6.1 Sol на первое по цене задачи. Оба утверждения могут быть верны одновременно: вендор выбирает наборы, где его модель сильнее, а индекс усредняет десять разных.
Так же легко неверно прочитать фразу «Opus 5.5 на 40% дешевле». Anthropic сравнивает его с Opus 5: по тестам компании на типичных нагрузках при настройках по умолчанию он обходится на 40% дешевле, вход и выход подешевели на 20%, чтение кэша — на 60%. К GPT-6 Sol и GPT-6.1 Sol эта экономия отношения не имеет.
Путаница поколений касается и выбора модели в инструментах. GPT-6 Sol и GPT-5.6 Sol остаются доступны, поэтому в Codex и API проверяйте точный идентификатор gpt-6.1-sol. Что меняется при переходе с gpt-6-sol, от уровней рассуждения до вызова инструментов, разобрано в статье GPT-6.1 Sol: цена, доступ и что менять при переходе с GPT-6 Sol. Если вы выбираете внутри линейки OpenAI, помогут материалы GPT-6.1 Sol, GPT-6 Astra и GPT-6 Sol: какую модель выбрать и, для более дешёвой Luna на однотипных задачах, GPT-6 Sol, Luna, Astra и GPT-5.6 Terra: что выбрать для работы. Если Opus 5.5 не справляется и вы думаете о более дорогой модели Anthropic, смотрите Claude Fable 5.1 или Opus 5.5: что выбрать и когда стоит доплатить.
Claude Code и Codex: лимиты подписки не следуют из цен API
Если вы работаете не через API, а по подписке, тарифы за токены на выбор влияют косвенно. OpenAI говорит об этом прямо: цены API не связаны с лимитами подписки, и оценивать по ним число включённых задач не стоит.
- GPT-6.1 Sol в ChatGPT доступен в Work и Codex на планах Plus, Pro, Business, Enterprise и Edu; в обычном чате его нет, на Free и Go тоже. В Enterprise и Edu модель выключена, пока её не включит администратор. В терминале —
codex --model gpt-6.1-sol. Выбор модели в интерфейсе не даёт доступа, если его нет у рабочего пространства (документация ChatGPT по моделям). - Opus 5.5 доступен в приложениях Claude на Pro, Max, Team и Enterprise и в Claude Code начиная с версии 2.1.280. Надёжнее указывать полный идентификатор
claude-opus-5-5: значение псевдонимаopusзависит от провайдера.
Лимиты считаются по-разному. Для Plus и Standard Business OpenAI публикует ориентиры в локальных сообщениях за пять часов: от 15 до 160 для GPT-6.1 Sol и от 15 до 150 для GPT-6 Sol. Pro теперь продаётся за $100, $200 или $500 в месяц, и пятичасового лимита на нём, по словам OpenAI, сейчас нет. Компания подчёркивает, что это оценки, а не фиксированные лимиты: расход зависит от модели и задачи, облачные задачи расходуют больше локальных сообщений, возможны и недельные ограничения (цены ChatGPT и Codex). В кредитах Codex GPT-6.1 Sol стоит 50, 2,5 и 250 кредитов за 1 млн входных, кэшированных и выходных токенов (у GPT-6 Sol кэш — 5 кредитов). Anthropic вместе с Opus 5.5 подняла пятичасовые лимиты на Pro, Max, Team и Enterprise с оплатой за место, но числа не опубликовала. Сопоставимой цифры сообщений для Opus в Claude Code нет, поэтому сказать по документации, какая подписка «растянется» дольше, нельзя: лимиты каждый продукт задаёт сам, из цен API они не выводятся.
Подробнее о том, как считать подписку против оплаты по токенам, — в статье Claude Code или Codex: стоимость подписки, лимиты и реальный счет API. Что делать, когда лимит Codex закончился, разобрано в материале Лимит Codex в ChatGPT Plus: 15–160 сообщений за 5 часов и credits, а о новой цене Opus и сбросе лимита подписки — в статье Claude Opus 5.5: цена API и как сбросить лимит подписки.
Пилот на своих задачах: стоимость принятой задачи
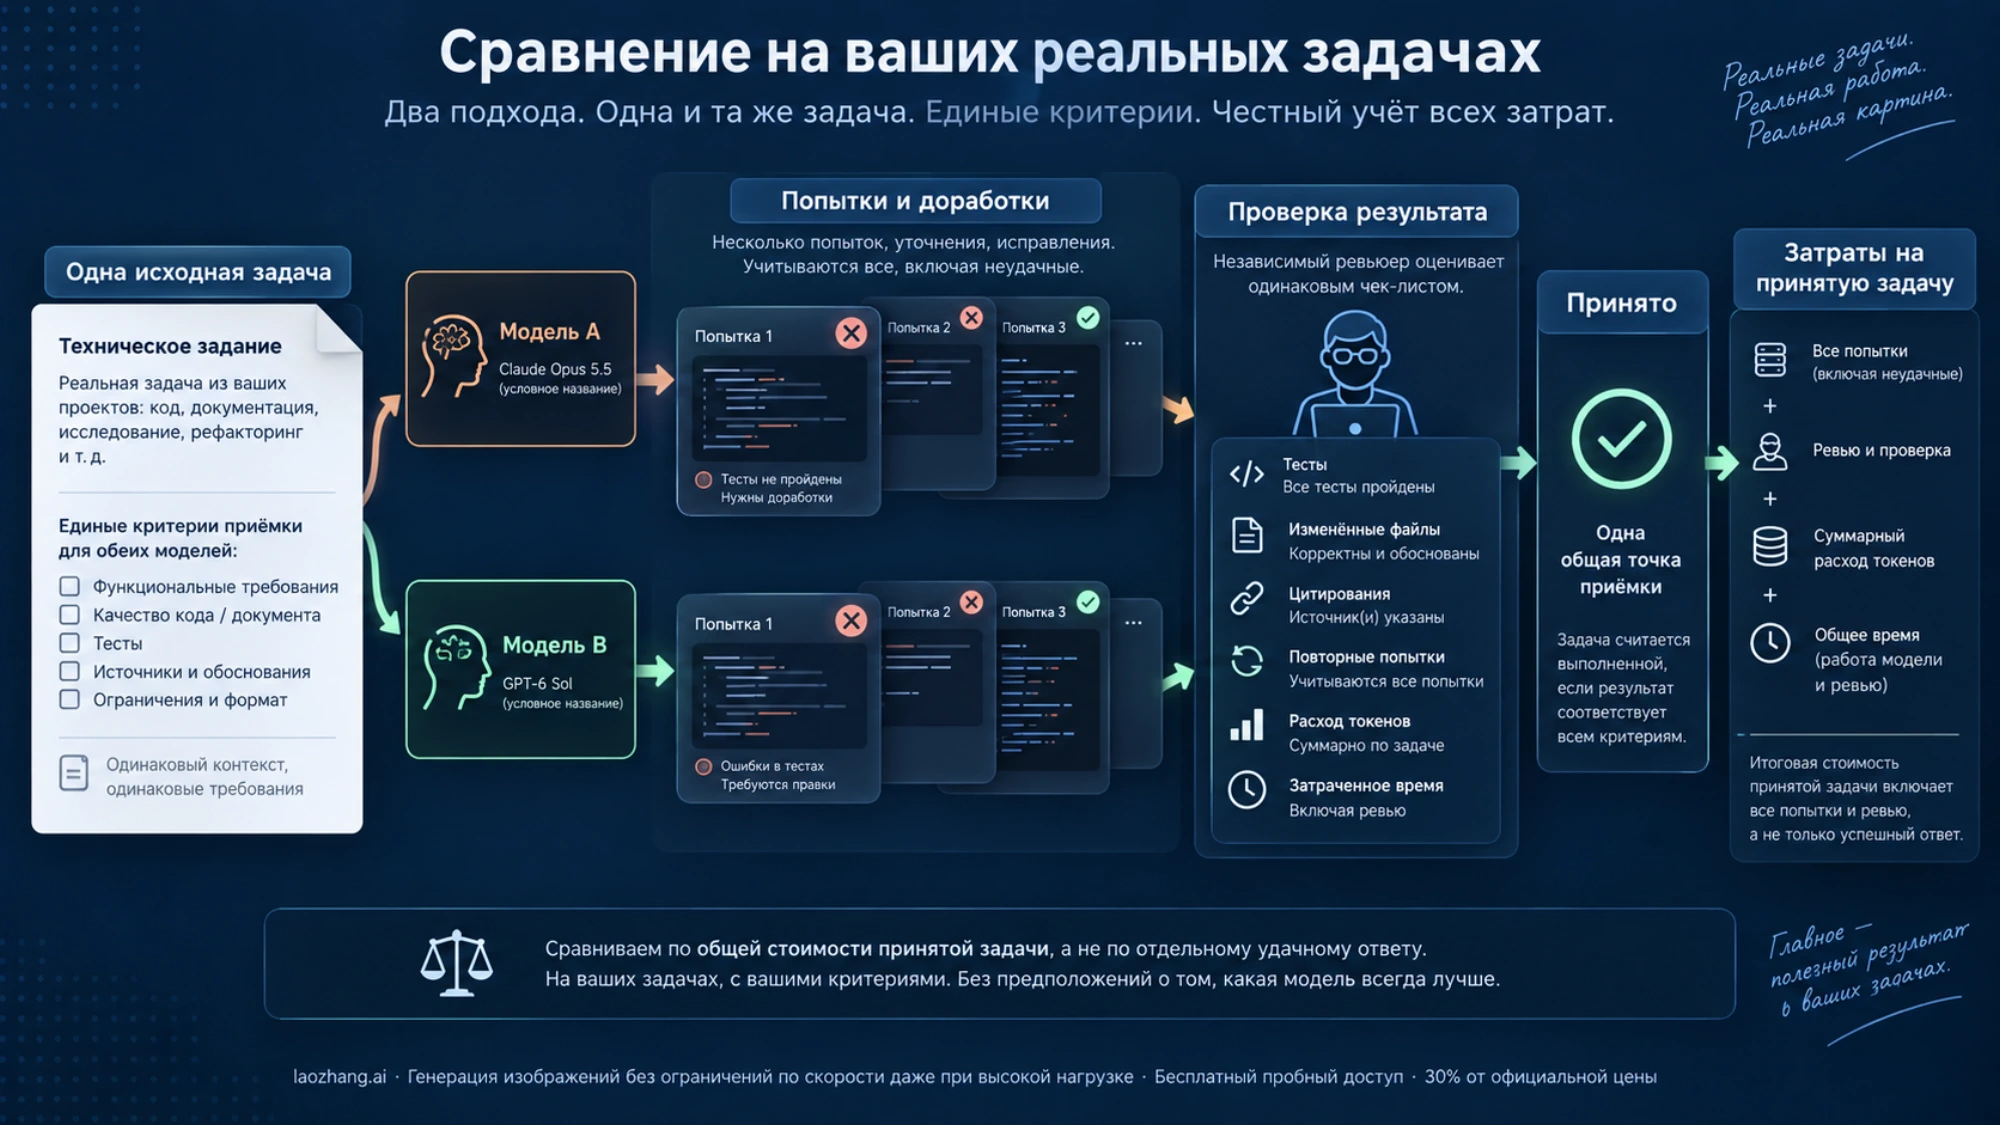
Ни прайс, ни индекс не скажут, сколько попыток понадобится каждой модели на вашем коде. Это измеряется только на своих задачах. Удобная единица — принятая задача: результат, который прошёл заранее записанные критерии приёмки (тесты зелёные, изменены только нужные файлы, требования и формат соблюдены). Её стоимость считается так:
стоимость принятой задачи = (оплата API за все попытки, включая неудачные повторы и платные вызовы инструментов + время ревью × ставка ревьюера) ÷ число принятых задач.
Порядок пилота:
- Задачи. Возьмите 10–20 реальных задач того класса, по которому принимаете решение: исправление бага с тестами, рефакторинг модуля, разбор длинного документа. Критерии приёмки запишите до запуска.
- Одинаковые условия. Тот же промпт, тот же снимок репозитория, те же инструменты, одинаковый уровень рассуждения (medium против medium, high против high), одинаковый лимит попыток, одна политика кэширования и один режим обслуживания (например, Standard без Batch и Fast, без региональной надбавки). У GPT-6.1 Sol нижний уровень —
low; если раньше вы гоняли GPT-6 Sol наnone, начните сlow. - Журнал по каждому вызову. Идентификатор модели, effort, дата, режим обслуживания и оплаченные токены из
usage: у Anthropic этоinput_tokens,cache_creation_input_tokens,cache_read_input_tokensиoutput_tokens, у OpenAI в Responses API —input_tokens,input_tokens_details.cached_tokens,input_tokens_details.cache_write_tokensиoutput_tokens(рассуждение входит в выход). Отмечайте запросы, где вход превысил 272 тыс. токенов. - Все попытки. Учитывайте неудачные запуски и платные вызовы инструментов, засекайте время ревью.
- Сверка. Посчитайте счёт по журналу скриптом выше и сравните с тем, что за этот день показала консоль каждого провайдера. Если цифры расходятся, ищите промахи кэша, запросы за порогом 272 тыс. или платные инструменты.
Что в результате должно поменять выбор по умолчанию:
- Стоимость принятой задачи у Opus не выше, чем у GPT-6.1 Sol. Надбавку за токены окупают меньшее число повторов и более короткое ревью. Для этого класса задач Opus 5.5 можно ставить по умолчанию.
- GPT-6.1 Sol дешевле, а принятых задач у обеих моделей примерно поровну. По умолчанию GPT-6.1 Sol, а Opus остаётся эскалацией для задач, которые Sol не закрыл за отведённые попытки.
- Opus закрывает задачи, которые Sol не принимает ни за какой бюджет попыток. Такой класс задач направляйте на Opus независимо от тарифа, остальные — на Sol.
- Opus тратит в разы больше токенов при сравнимом качестве. Прежде чем отказываться от него, повторите прогон на уровень ниже: по данным Artificial Analysis, задача Opus стоит от $0,55 на low до $5,98 на max, то есть effort меняет расход больше чем в десять раз.
- В нагрузке много длинных запросов свыше 272 тыс. Ставки там различаются только на выходе, поэтому сравнивайте фактический выход и рассуждение по журналу. Если вы остаётесь на GPT-6 Sol, для неё по-прежнему действует правило «чтения из кэша более чем в 25 раз больше, чем выхода», при котором Opus дешевле.
Что выбрать по умолчанию
| Ваша ситуация | С чего начать | Почему | Что может изменить выбор |
|---|---|---|---|
| Много коротких агентных вызовов, бюджет ограничен | GPT-6.1 Sol | По тарифам ровно вдвое дешевле при тех же токенах, включая кэш; по замерам разрыв в 4–9 раз | Sol требует заметно больше повторов и ревью |
| Длинная автономная разработка, дорогое ревью | Claude Opus 5.5 | Выше баллы индекса на одинаковом уровне рассуждения, а 54–58 баллов есть только у Opus | Пилот показал, что стоимость принятой задачи у Sol ниже |
| Длинный документ целиком в каждом запросе, через кэш | По пилоту, по цене — GPT-6.1 Sol | Свыше 272 тыс. ставки равны, кроме выхода: $15 против $20 | Качество ответов Opus проходит приёмку, а Sol нет |
| Документ по фрагментам, запросы до 272 тыс. | GPT-6.1 Sol | Двукратная разница по всем статьям счёта | Качество ответов Sol не проходит приёмку |
| Нужен быстрый интерактивный отклик | GPT-6.1 Sol на low или medium | 2,1–5,7 с до первого токена ответа против 12,7–23 с у Opus | Нужен ответ без рассуждения: у 6.1 Sol нет none, он остался у GPT-6 Sol |
| Работа по подписке | Модель того инструмента, за который уже платите | 6.1 Sol есть только в Codex и ChatGPT Work, Opus — в Claude Code и приложениях Claude | Лимиты подписки кончаются раньше, чем нужно |
Уже работаете на gpt-6-sol | Переход на gpt-6.1-sol | Те же ставки входа и выхода, вдвое дешевле кэш, выше баллы | Код использует none, minimal или инструменты через Chat Completions |
Если коротко: начинайте с GPT-6.1 Sol там, где задач много и каждая дешёвая, и с Opus 5.5 там, где нужен верх шкалы качества и одна неудачная попытка стоит больше, чем разница в токенах. А спор «кто умнее» решайте не по прайсу и не по чужой таблице бенчмарков, а по стоимости принятой задачи на своих данных.
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 1 окт. 2026 г..
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 1 окт. 2026 г..
- 1.обзор модели у Anthropicplatform.claude.com/docs/en/models/opus-5-5/overview
- 2.страница GPT-6.1 Sol у OpenAIdevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 3.страница GPT-6 Soldevelopers.openai.com/api/docs/models/gpt-6-sol
- 4.цены Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 5.цены OpenAI APIdevelopers.openai.com/api/docs/pricing
- 6.сравнение GPT-6.1 Sol и Claude Opus 5.5 у Artificial Analysisartificialanalysis.ai/models/releases/comparisons/gpt-6-1-sol-vs-claude-opus-5-5
- 7.страница GPT-6 Sol у Artificial Analysisartificialanalysis.ai/models/releases/gpt-6-sol
- 8.анонс Anthropicanthropic.com/claude-opus-5-5
- 9.анонс GPT-6.1 Solopenai.com/index/introducing-gpt-6-1-sol
- 10.документация ChatGPT по моделямlearn.chatgpt.com/docs/models
- 11.цены ChatGPT и Codexlearn.chatgpt.com/docs/pricing