Sonnet 5.5 vs GPT-6 Luna: сравнение — за что платить в 20 раз
Claude Sonnet 5.5 в 20 раз дороже GPT-6 Luna за токен. Luna закрывает массовые запросы и документы, Sonnet нужен выше 38 баллов AA и в агентных задачах.
Содержание
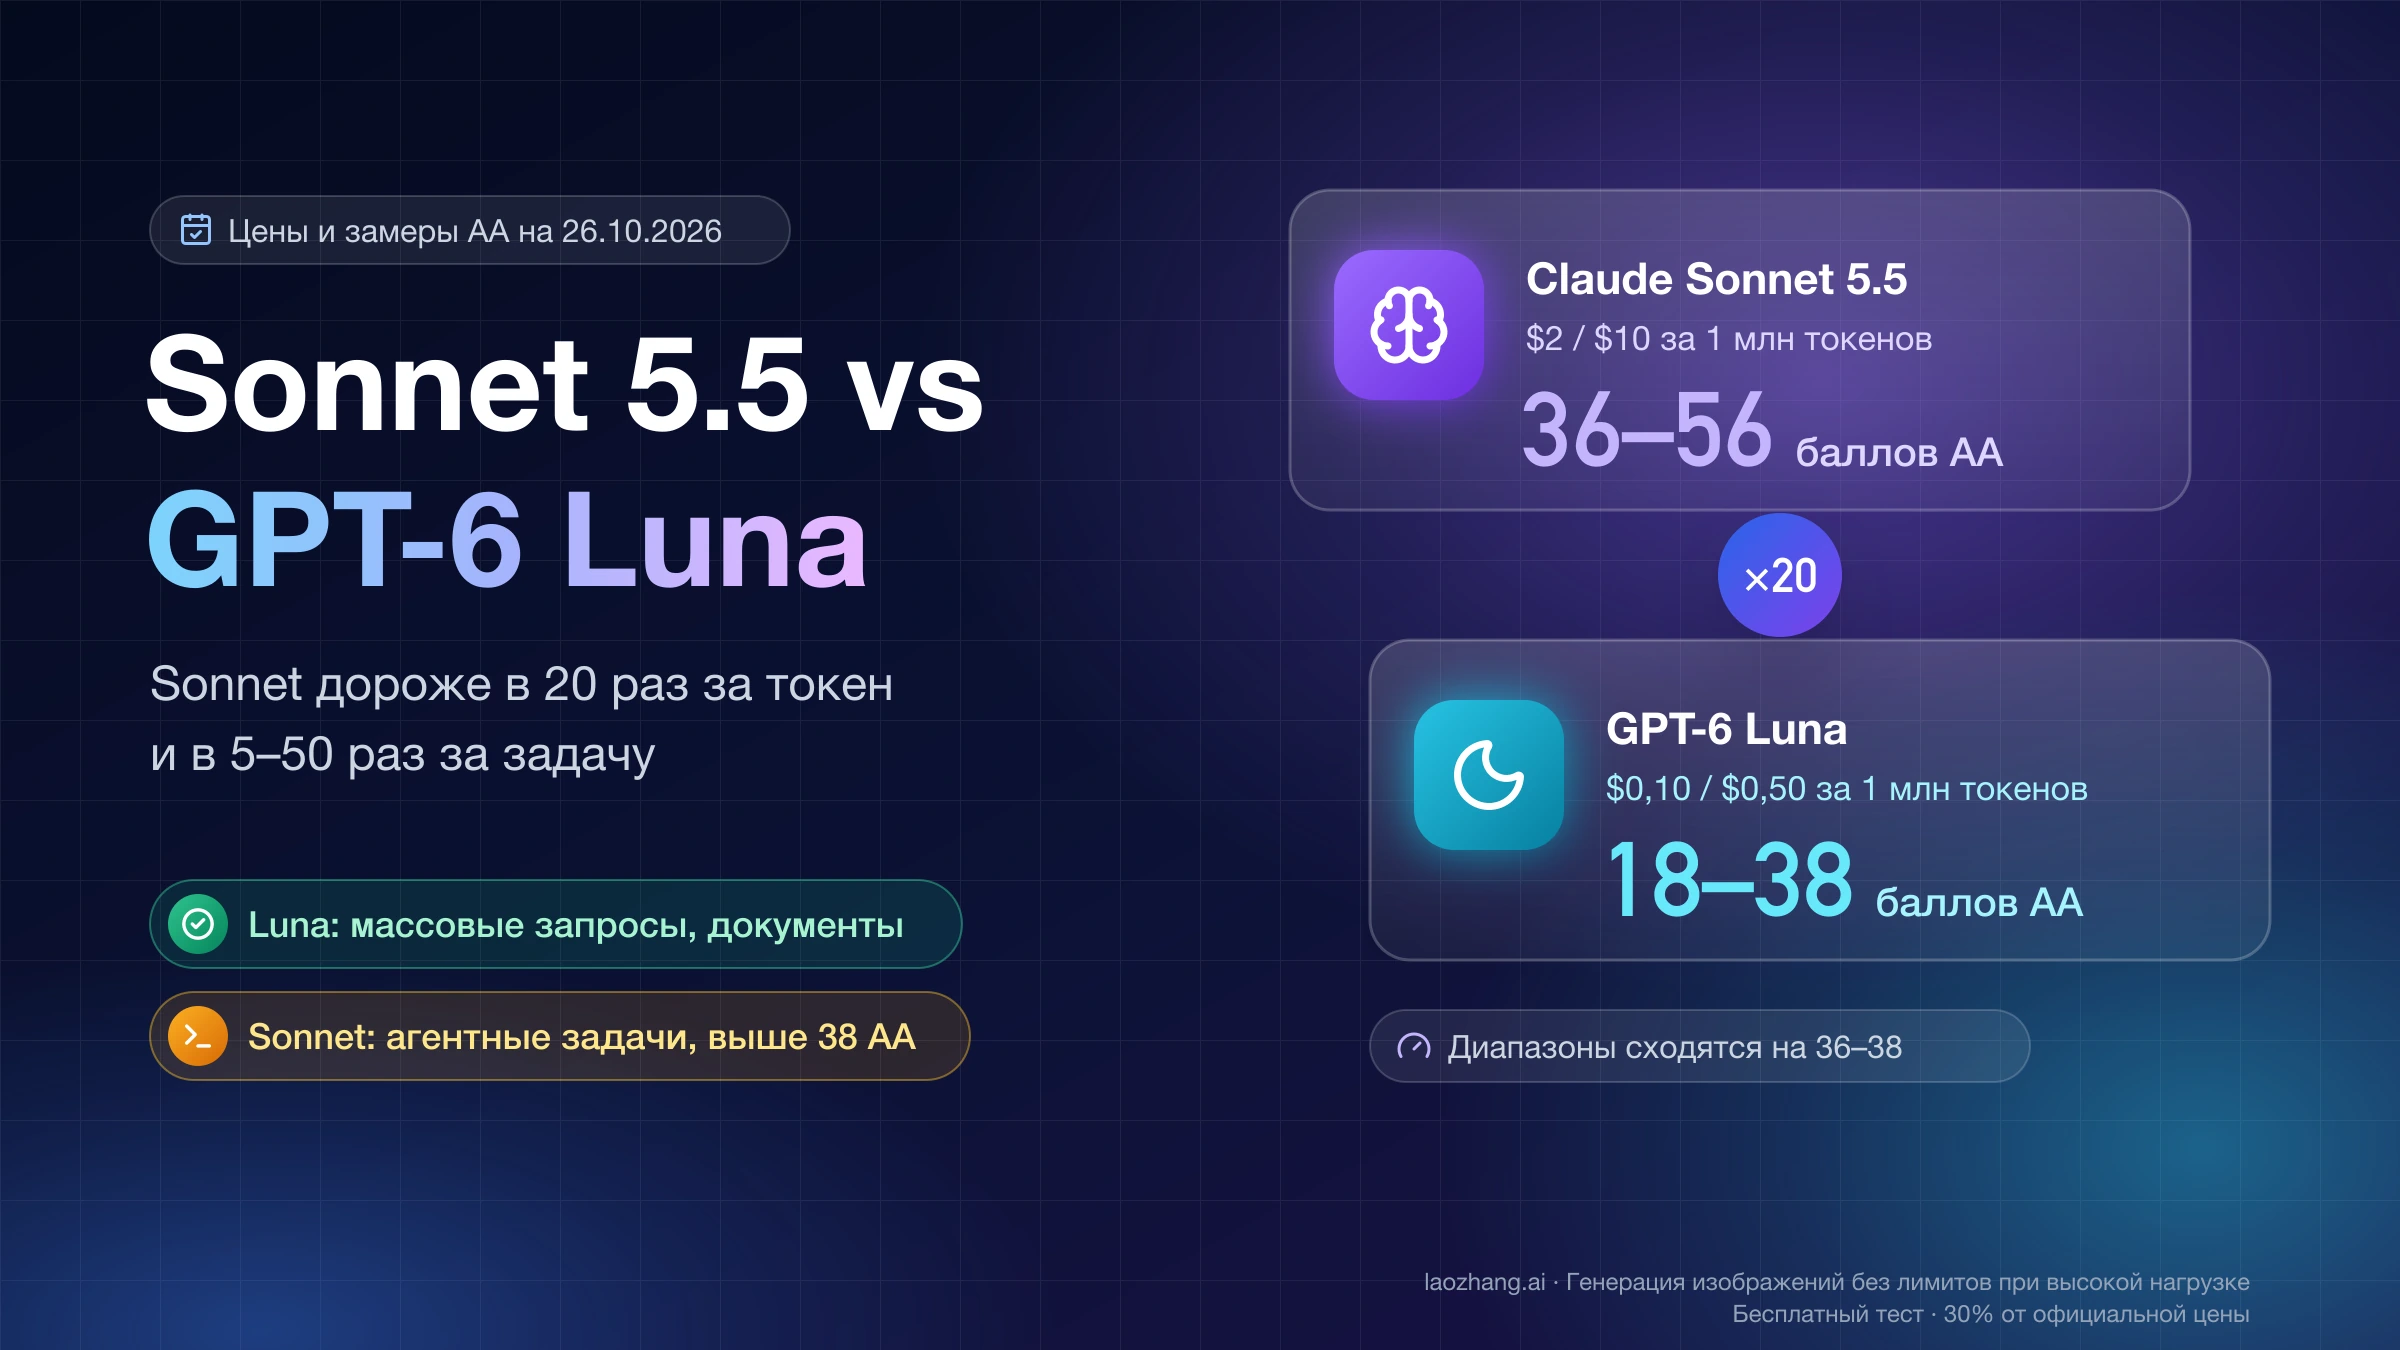
Если ваша нагрузка — короткие массовые запросы, извлечение полей, сводки и документы до 272 тыс. токенов, начинайте с GPT-6 Luna (gpt-6-luna): по прайсу на 26 октября 2026 года она в 20 раз дешевле Claude Sonnet 5.5 и за входной, и за выходной токен. Claude Sonnet 5.5 (claude-sonnet-5-5) окупается там, где Luna упирается в потолок: её максимум в индексе Artificial Analysis — 38 баллов, а Sonnet уже на уровне medium набирает 41, на max — 56. Сильнее всего разница видна в агентных задачах в терминале: в Terminal-Bench 4.0 Luna даже на max решает 12,6 %, Sonnet — от 20,7 % на low до 63,6 % на max.
Сам разрыв в цене не сводится к одному числу. За токен — 20 раз, за чтение из кэша — 10, а запрос длиннее 272 тыс. входных токенов Luna оплачивает целиком по повышенному тарифу, и разница сжимается до 10–13 раз. Один и тот же текст Sonnet разбивает на большее число токенов — в 1,52 раза для английской статьи и в 1,45 раза для русского текста, — поэтому за одинаковый ввод выходит около 29–30 раз. За задачу индекса AA при настройках по умолчанию Sonnet дороже в 50 раз, а если сравнивать уровни с близким баллом — Sonnet на low против Luna на xhigh или max, — в 5–8 раз, и Sonnet при этом быстрее.
В тесте 26 октября 2026 года через шлюз LaoZhang обе модели получили 9 одинаковых задач со скрытыми тестами: Sonnet с размышлениями на high решил 9 из 9 за $0,1119, Luna на medium — тоже 9 из 9, но за $0,0044. Такой тест показывает цену и задержку при равном результате, а не то, какая модель умнее, поэтому качество дальше оценивается по замерам AA. Прямые API Anthropic и OpenAI, вызов инструментов и другие уровни рассуждений в нём не проверялись. Перед переключением прогоните собственные задачи и считайте стоимость принятого ответа, а не цену токена.
Sonnet 5.5 или Luna: что выбрать под тип нагрузки
Выбор упирается в два вопроса: нужна ли вам планка качества выше 38 баллов AA и насколько задача агентная. Если оба ответа «нет», Luna решит её дешевле на любом уровне рассуждений; если хотя бы один «да», Luna не дотянет ни на одном. Между полюсами есть зона, где обе модели набирают близкие баллы, и там решают цена задачи и задержка.
| Нагрузка | С чего начать | Что решает |
|---|---|---|
| Короткие массовые запросы: классификация, извлечение полей, ответы по шаблону | Luna на none, low или medium | За короткий запрос Sonnet дороже в 20–25 раз, а качество Luna можно поднять уровнем рассуждений до 38 баллов |
| Документы до 272 тыс. входных токенов | Luna | В тесте AA-LCR на длинный контекст Luna начиная с medium не хуже Sonnet на том же уровне, а цена ниже в 20 раз |
| Документы длиннее 272 тыс. токенов | Luna, но со своим расчётом | Весь запрос Luna идёт по повышенному тарифу, разница падает примерно до 10–15 раз; вход Luna ограничен 922 тыс. токенов |
| Агентный цикл с длинным префиксом в кэше | Зависит от нужного качества | Чтение из кэша у Sonnet дороже всего в 10 раз, и цикл обходится примерно в 15 раз дороже, а не в 20 |
| Агентные задачи в терминале, многошаговая работа с кодом | Sonnet, начиная с medium | В Terminal-Bench 4.0 Sonnet на medium решает 29,8 %, Luna даже на max — 12,6 % |
| Фактические ответы без поиска и источников | Sonnet или Luna с подключённым поиском | В AA-Omniscience у Luna от −22 до 1 балла: неверных ответов больше или почти столько же, сколько верных |
| Batch-обработка | Luna, если хватает качества | Скидка 50 % есть у обеих, разница остаётся 20 раз |
| Интерактив с жёстким лимитом задержки и планкой 36–41 балл | Sonnet на low или medium | При близком балле Sonnet на low тратит на задачу 85 с, Luna на xhigh — 215 с |
| Смешанный поток с автоматической проверкой ответа | Сначала Luna, при провале проверки — Sonnet | Платите за Sonnet только на тех задачах, которые Luna не прошла |
Последняя строка — самый частый практический ответ: две модели не обязательно выбирать «или-или». Если у вас есть тест, схема или другой автоматический критерий приёмки, Luna становится первой попыткой, а Sonnet — резервом; как посчитать выгоду такого каскада, показано в разделе о проверке перед переключением.
Во сколько раз Sonnet 5.5 дороже: 20x за токен, от 5 до 50x за задачу
По прайсам Anthropic и OpenAI на 26 октября 2026 года Sonnet 5.5 стоит $2 за миллион входных токенов и $10 за миллион выходных, GPT-6 Luna — $0,10 и $0,50. Это ровно 20 раз, но счёт за реальную работу отличается от этого множителя в обе стороны, потому что токены у моделей разные, тарифы кэша и длинного контекста устроены по-разному, а на одну задачу модели тратят разное число токенов.
| Как считать | Claude Sonnet 5.5 | GPT-6 Luna | Sonnet дороже |
|---|---|---|---|
| Ввод, за 1 млн токенов | $2 | $0,10 | в 20 раз |
| Вывод, за 1 млн токенов | $10 | $0,50 | в 20 раз |
| Чтение из кэша, за 1 млн токенов | $0,10 | $0,01 | в 10 раз |
| Запись в кэш, за 1 млн токенов | $2,50 на 5 минут | $0,125 на 30 минут | в 20 раз |
| Запрос длиннее 272 тыс. входных токенов: ввод и вывод | $2 и $10 | $0,20 и $0,75 | в 10 и 13,3 раза |
| Один и тот же английский текст на входе | 15 335 токенов | 10 106 токенов | около 30 раз |
| Один и тот же русский текст на входе, 6 000 знаков | 2 967 токенов | 2 051 токен | около 29 раз |
| Задача индекса AA, уровни по умолчанию в API | $0,88 на high | $0,0175 на medium | в 50 раз |
| Задача индекса AA при близком балле | $0,35 на low, 36 баллов | $0,0422 на xhigh (35) и $0,0678 на max (38) | в 8,3 и 5,2 раза |
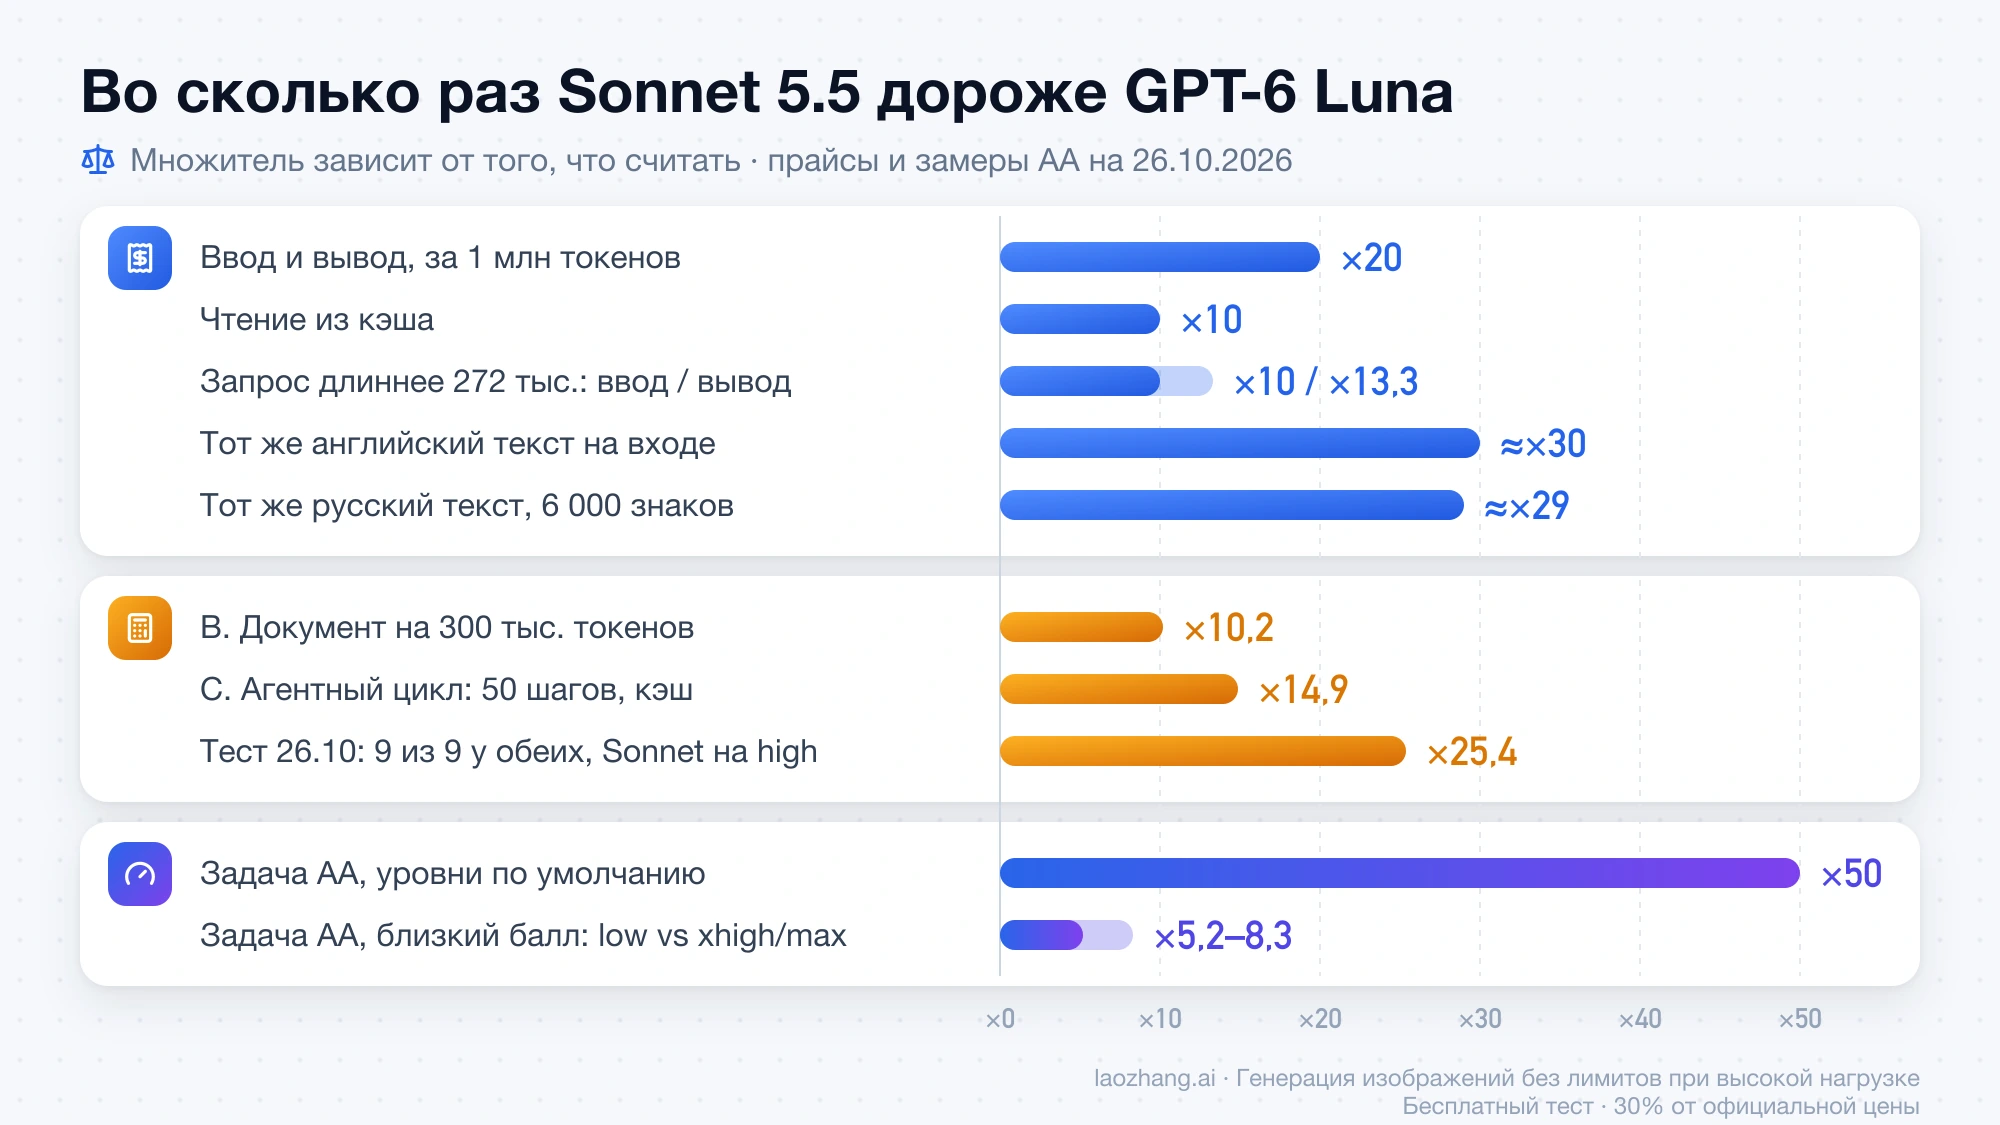
Цены за токены взяты из прайса Claude API и прайса OpenAI API, цены за задачу — из сравнения Claude Sonnet 5.5 и GPT-6 Luna на Artificial Analysis. Под чтением из кэша здесь понимается одно и то же у обоих поставщиков: у Anthropic это cache hits, у OpenAI — cached input. Anthropic берёт за него 5 % базовой цены ввода, OpenAI — 10 %, поэтому в агентных циклах с длинным общим префиксом разница меньше 20 раз. Цена $0,10 у Sonnet действует с 7 октября 2026 года, до этого было $0,20; как это меняет расчёт экономии, разобрано в статье Claude Sonnet 5.5: цена чтения кэша $0,10 — расчёт экономии.
Порог 272 тыс. токенов работает только в одну сторону. На странице GPT-6 Luna в документации OpenAI сказано, что запрос длиннее 272 тыс. входных токенов оплачивается по двойной цене ввода и кэша и полуторной цене вывода за весь запрос, а у Sonnet 5.5 одна цена на всё окно в 1 млн токенов. Batch-обработка у обоих поставщиков стоит половину обычной цены ($1 и $5 у Sonnet, $0,05 и $0,25 у Luna), так что соотношение там не меняется. Региональная обработка дорожает почти одинаково: у OpenAI на 10 %, у Anthropic обработка только в США (inference_geo) стоит в 1,1 раза дороже.
Строка про задачу AA при настройках по умолчанию требует оговорки. В API у Sonnet 5.5 по умолчанию уровень high, а в Claude Code и приложениях Claude — medium; у Luna по умолчанию medium. Значит, «по умолчанию против по умолчанию» — это сравнение 47 баллов с 30, и множитель 50 раз складывается из цены токена и объёма: на одну задачу индекса Sonnet на high пишет около 37,3 тыс. выходных токенов, Luna на medium — около 11,5 тыс., то есть в 3,2 раза меньше. Тот же разрыв в 20 раз по прайсу есть и внутри линейки Anthropic, между Haiku 5.5 и Sonnet 5.5, — он разобран в статье Claude Haiku 5.5 или Sonnet 5.5: что выбрать по цене задачи.
Уровни рассуждений: у Luna потолок 38 баллов, у Sonnet старт с 36
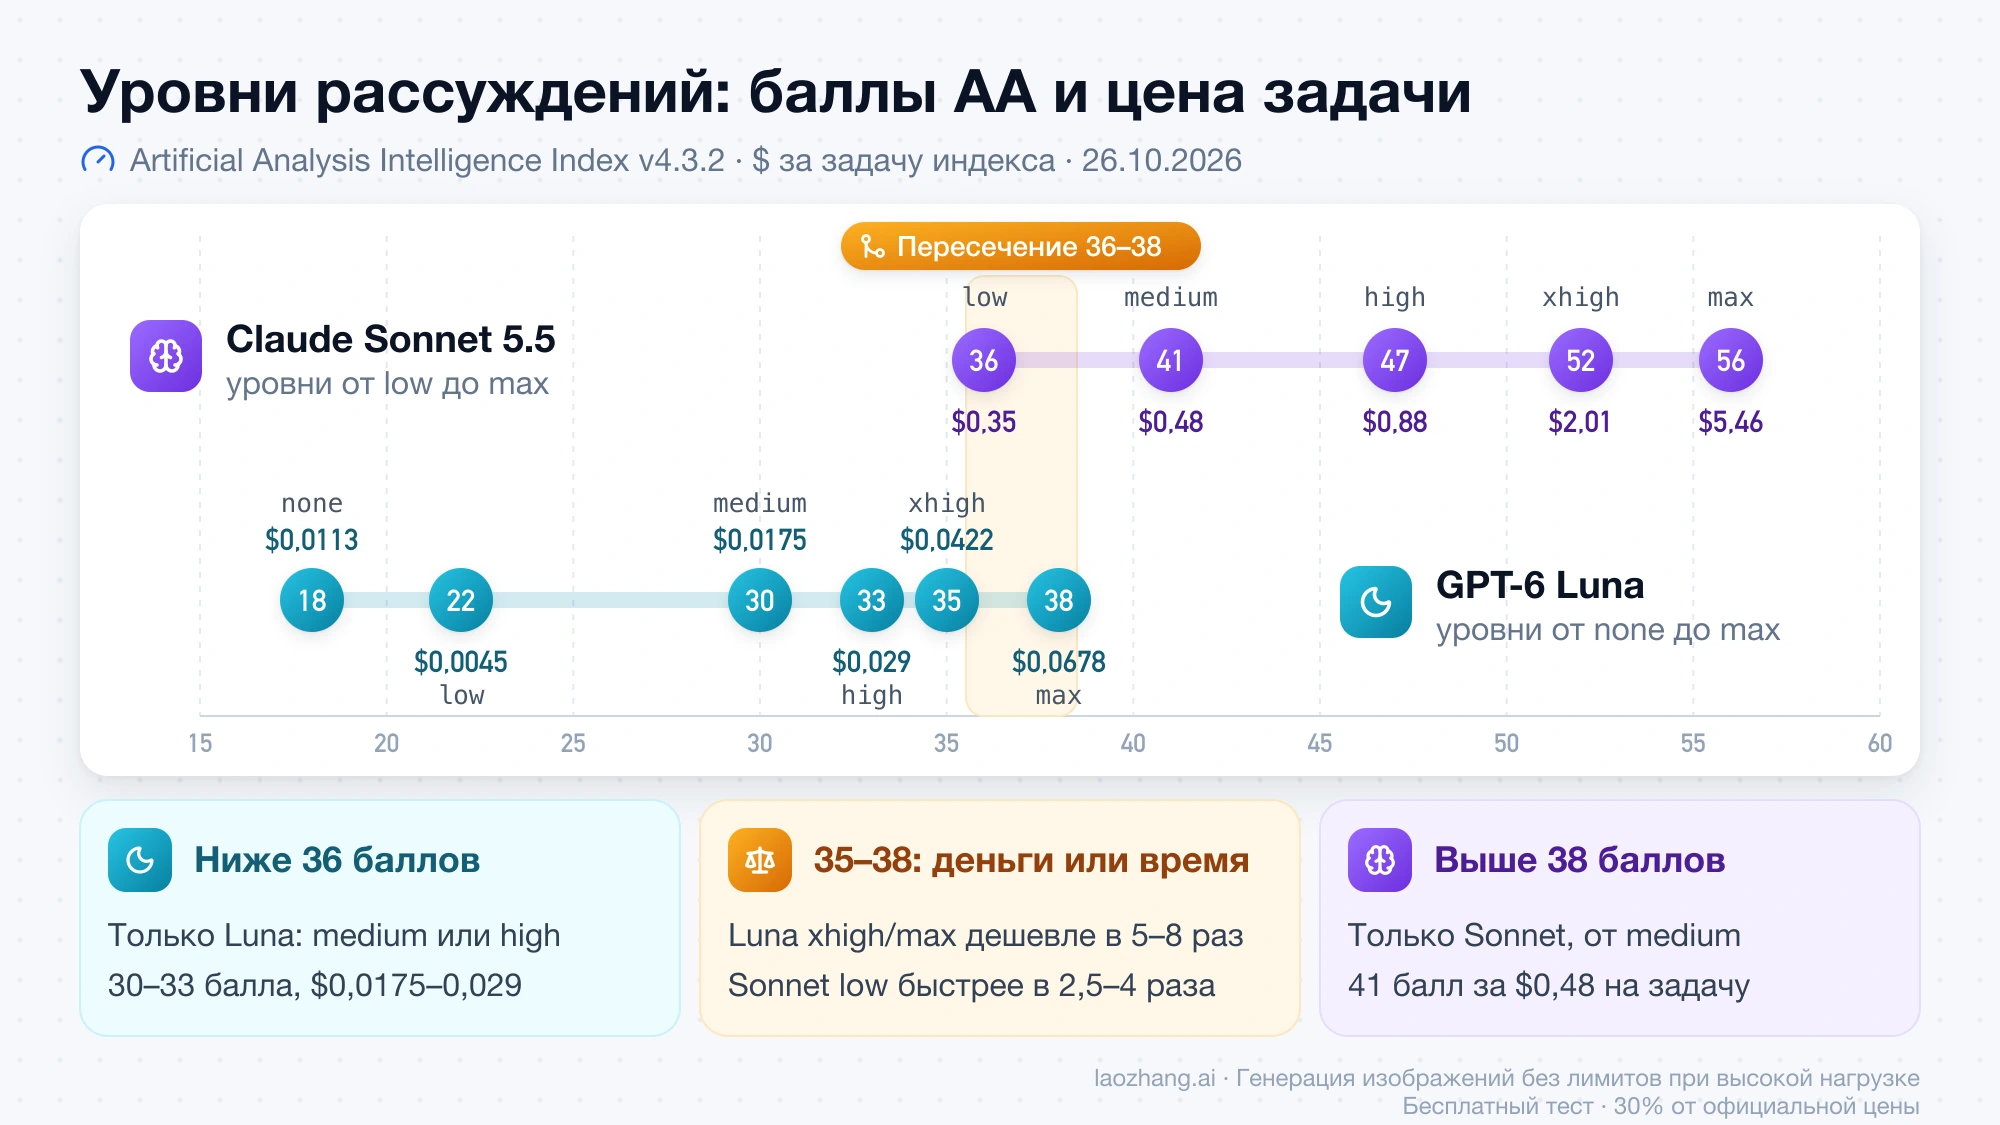
В индексе Artificial Analysis Intelligence Index v4.3.2 на 26 октября 2026 года самый слабый уровень Sonnet 5.5 (low, 36 баллов) почти совпадает с самым сильным уровнем GPT-6 Luna (max, 38). Поэтому «Sonnet против Luna» на деле означает выбор между двумя диапазонами, которые соприкасаются в одной точке: всё, что выше 38 баллов, есть только у Sonnet, всё, что ниже 36, — только у Luna.
| Уровень рассуждений | Sonnet 5.5: баллы | Sonnet 5.5: $ за задачу | Sonnet 5.5: время на задачу | GPT-6 Luna: баллы | GPT-6 Luna: $ за задачу | GPT-6 Luna: время на задачу |
|---|---|---|---|---|---|---|
none | нет такого уровня | — | — | 18 | $0,0113 | 31 с |
low | 36 | $0,35 | 85 с | 22 | $0,0045 | 18 с |
medium | 41 | $0,48 | 121 с | 30 | $0,0175 | 126 с |
high | 47 | $0,88 | 217 с | 33 | $0,029 | 164 с |
xhigh | 52 | $2,01 | 434 с | 35 | $0,0422 | 215 с |
max | 56 | $5,46 | 936 с | 38 | $0,0678 | 364 с |
Индекс AA собран из 10 тестов, а стоимость задачи — средневзвешенная цена одной задачи из него при прямых API поставщиков. Цифры Sonnet снизились после удешевления чтения из кэша 7 октября: до него AA оценивала задачу на high в $1,12, на max — в $7,67, так что более высокие суммы, которые ещё можно встретить, относятся к старой цене. Anthropic отдельно предупреждает, что уровни Sonnet 5.5 откалиброваны иначе, чем у Sonnet 5, поэтому при переходе со старой модели уровень стоит подбирать заново.
Из таблицы следуют три правила. Если вашей задаче нужно больше 38 баллов, выбора нет: минимальный подходящий вариант — Sonnet на medium за $0,48, что в 7 раз дороже Luna на max, зато втрое быстрее (121 с против 364 с). Если хватает 35–38 баллов, Luna на xhigh или max дешевле Sonnet на low в 5–8 раз, а Sonnet на low быстрее в 2,5–4 раза — здесь выбор между деньгами и задержкой. Если задача решается на 30–33 баллах, у Sonnet нет сопоставимого уровня, и Luna на medium или high остаётся единственным разумным вариантом.
Где Sonnet сильнее, а где Luna не уступает: подоценки AA
Разрыв в индексе неравномерен: в агентных задачах и проверке знаний Sonnet ушёл далеко вперёд, а в рассуждениях по длинному контексту Luna на том же уровне не хуже. Ниже — диапазоны от уровня low до max для обеих моделей по данным того же сравнения AA на 26 октября 2026 года.
| Тест AA | Sonnet 5.5, от low до max | GPT-6 Luna, от low до max |
|---|---|---|
| Terminal-Bench 4.0 | 20,7–63,6 % | 0,0–12,6 % |
| AutomationBench-AA | 49,4–71,8 % | 12,0–53,2 % |
| AA-LCR v1.1, рассуждения по длинному контексту | 76,0–82,7 % | 74,0–83,3 % |
| AA-Omniscience, надёжность знаний | от 19 до 32 | от −9 до 1 |
| SciCode | 49,1–61,0 % | 46,9–54,6 % |
| Humanity's Last Exam | 36,2–55,0 % | 20,3–38,5 % |
Для агентной работы в терминале разница принципиальная: Luna на максимальном уровне решает 12,6 % задач Terminal-Bench 4.0, тогда как Sonnet даже на low — 20,7 %, а на medium — 29,8 %. Если ваш сценарий — агент, который сам запускает команды, правит файлы и проверяет результат, Luna как основная модель не подходит ни на каком уровне.
С длинными документами картина обратная. В AA-LCR начиная с medium Luna на том же уровне набирает не меньше Sonnet: 78,3 % против 76,3 % на medium, 79,3 % против 78,0 % на high, 83,3 % против 82,7 % на max. Поиск ответа в большом документе, сверка нескольких файлов, извлечение фактов из отчёта — задачи, где Luna даёт сопоставимый результат за двадцатую часть цены, пока запрос не перевалил за 272 тыс. токенов.
Отдельный риск — фактические вопросы. В AA-Omniscience отрицательный балл означает, что неверных ответов больше, чем верных, и у Luna он от −22 без рассуждений до 1 на max, у Sonnet — от 19 до 32. Если модель должна отвечать на вопросы по памяти, без поиска и без переданных ей документов, Luna чаще даёт неверный ответ. Для таких задач либо берите Sonnet, либо передавайте Luna нужные факты в самом запросе — документами или результатами поиска.
Тест на одних промптах 26 октября: 9 из 9 у обеих, цена — в 25 раз
26 октября 2026 года обе модели решали 9 одинаковых задач через шлюз LaoZhang, и при одинаковом результате работа Sonnet обошлась в 25 раз дороже. Задачи небольшие и чётко сформулированные: текстовая задача на подсчёт, функции merge_intervals, parse_duration, top_words и eval_expr, разбор строки CSV, сравнение версий по SemVer 2.0.0, подсчёт чисел по сумме цифр и сводка английской статьи в 6 723 слова в пять пунктов. Все проверки были написаны до того, как читались ответы. Для функций это скрытые тесты, причём тесты к eval_expr, разбору CSV и сравнению версий SemVer дополнительно сверены с эталонной реализацией; текстовая задача и подсчёт по сумме цифр сравниваются с заранее известным ответом, а у сводки проверяется формат — пять пунктов не длиннее 25 слов. Каждая модель отвечала один раз, без системного промпта и инструментов; Sonnet вызывался через формат Anthropic Messages, Luna — через Chat Completions, стоимость считалась по прайсу из поля usage в ответах.
| Конфигурация | Решено | Входные токены | Выходные токены | Стоимость по прайсу | Суммарное время |
|---|---|---|---|---|---|
Sonnet 5.5, thinking: adaptive и effort: high | 9 из 9 | 16 957 | 7 802 | $0,1119 | 71 с |
Sonnet 5.5 без полей thinking и effort | 8 из 9 | 16 957 | 4 896 | $0,0829 | 50 с |
GPT-6 Luna, medium по умолчанию | 9 из 9 | 11 213 | 6 545, из них 3 897 на рассуждения | $0,0044 | 128 с |
Разница вышла 25,4 раза для Sonnet с размышлениями и 18,8 раза без них, а не ровно 20, по двум причинам. Входных токенов у Sonnet на тех же промптах в 1,51 раза больше, а выходных с размышлениями — 7 802 против 6 545: на этих задачах Luna на medium написала ненамного меньше, причём 60 % её вывода ушло на рассуждения. Единственный провал — у Sonnet без размышлений в merge_intervals: слово «касающиеся» модель поняла как «соседние целые» и слила интервалы (1, 2) и (3, 4) в (1, 4), а скрытый тест ожидал, что они останутся раздельными. Это промах в толковании неоднозначной формулировки, а не сбой; с включёнными размышлениями Sonnet объединил только пересекающиеся интервалы и интервалы с общей границей и тест прошёл.
На этом шлюзе Luna была медленнее на каждой из 9 задач: например, на eval_expr ответ занял 33,2 с против 13,0 с у Sonnet с размышлениями. Весь прогон обошёлся в $0,21 по прайсу. LaoZhang отдаёт обе модели по тем же ценам, что и прайсы Anthropic и OpenAI, с одним ключом на обе; у его маршрута Claude один ответ ограничен 32 768 выходными токенами, а Message Batches API нет.
Границы у теста узкие: 9 небольших задач, по одной попытке, один шлюз и один день. Обе модели решили почти всё, поэтому он сравнивает цену, число токенов и задержку при равной доле решённых задач. Качество на трудных задачах лучше видно по AA, где разрыв проявляется в агентных тестах, а не на коротких функциях с ясной спецификацией.
Токенизатор: тот же текст — в 1,45–1,52 раза больше токенов у Sonnet
Одна и та же английская статья в 6 723 слова вместе с однострочной инструкцией заняла 15 335 входных токенов у Sonnet 5.5 и 10 106 у GPT-6 Luna — в 1,52 раза больше. По всем 9 промптам вышло 16 957 против 11 213, то есть 1,51 раза; в коротких промптах сюда входит и служебная обёртка сообщений каждого API. Значит, за один и тот же английский ввод Sonnet обходится примерно в 20 × 1,52 ≈ 30 раз дороже Luna. Для русского текста соотношение измерено отдельно, тоже 26 октября 2026 года: первые 6 000 знаков русскоязычной статьи блога о Haiku 5.5 и GPT-6 Luna заняли 2 967 входных токенов у Sonnet и 2 051 у Luna — в 1,45 раза больше, так что за русский ввод Sonnet дороже примерно в 20 × 1,45 ≈ 29 раз. Файл на Python длиной 6 000 знаков дал 1,46 раза. Это по одному образцу на язык, и замер касается только ввода: сколько выходных токенов напишет каждая модель, зависит от ответа, поэтому для своих данных соотношение всё равно стоит проверить. Anthropic в документации пишет лишь, что токенизатор Sonnet 5 насчитывает примерно на 30 % больше токенов, чем модели поколения Claude 4.6; официального сравнения с токенизатором OpenAI нет.
Размышления Sonnet через шлюз: без поля thinking их не было
Через этот шлюз запросы к Sonnet без поля thinking и без уровня рассуждений вернулись без единого блока размышлений во всех 9 задачах. С явными thinking: {"type": "adaptive"} и output_config: {"effort": "high"} блоки размышлений пришли в 7 задачах из 9, а выходных токенов стало больше: 7 802 вместо 4 896. По документации Anthropic о размышлениях у Sonnet 5.5 без поля thinking должны включаться адаптивные размышления на уровне high; прямой API Anthropic в этом тесте не проверялся. Практический вывод: если вы обращаетесь к Sonnet через любой прокси или шлюз, задавайте thinking и уровень рассуждений явно, иначе можно незаметно получить другой режим и другой результат.
Сколько обойдётся ваша нагрузка: пять сценариев с расчётом
Для коротких запросов и batch-заданий разница остаётся около 20 раз, для длинного документа выше 272 тыс. токенов падает примерно до 10, для агентного цикла с кэшем — до 15. Расчёт ниже сделан 26 октября 2026 года по прайсам из таблицы выше; объёмы токенов в сценариях — допущения, а не замеры, и в основных строках каждая модель считается в собственных токенах.
| Сценарий | Claude Sonnet 5.5 | GPT-6 Luna | Sonnet дороже |
|---|---|---|---|
| A. Один запрос чата: 2 тыс. токенов на входе, 500 на выходе | $0,0090 | $0,00045 | в 20 раз |
| A с поправкой на токенизатор: вход Sonnet × 1,52 | $0,0111 | $0,00045 | в 24,6 раза |
| B. Документ на 300 тыс. токенов и 5 тыс. на выходе | $0,65 | $0,0638 | в 10,2 раза |
| B с поправкой: тот же документ у Sonnet около 456 тыс. токенов | $0,962 | $0,0638 | в 15,1 раза |
| B2. Документ на 250 тыс. токенов, ниже порога Luna | $0,55 | $0,0275 | в 20 раз |
| C. Агентный цикл: 50 шагов, префикс 100 тыс. токенов в кэше, на шаг 2 тыс. нового ввода и 1 тыс. вывода | $1,45 | $0,0975 | в 14,9 раза |
| D. Batch: 10 000 запросов по 3 тыс. ввода и 1 тыс. вывода, скидка 50 % у обеих | $80 | $4 | в 20 раз |
Каждую строку можно пересчитать. В сценарии B Sonnet берёт 300 000 × $2 / 1 млн = $0,60 за ввод и 5 000 × $10 / 1 млн = $0,05 за вывод, итого $0,65; у Luna запрос длиннее 272 тыс., поэтому весь он идёт по повышенному тарифу: 300 000 × $0,20 / 1 млн + 5 000 × $0,75 / 1 млн = $0,06 + $0,00375 ≈ $0,0638. В сценарии C у Sonnet один раз оплачивается запись префикса в кэш (100 тыс. × $2,50 / 1 млн = $0,25), а затем на каждом шаге чтение префикса, новый ввод и вывод: $0,01 + $0,004 + $0,01 = $0,024, за 50 шагов $1,20, итого $1,45. У Luna те же статьи дают $0,0125 + 50 × $0,0017 = $0,0975.
У расчёта три допущения, которые стоит заменить своими числами. Первое: объём вывода взят одинаковым, хотя на реальных задачах модели пишут разное количество токенов, особенно с размышлениями. Второе: в сценарии C кэш не истекает между шагами — у Sonnet запись живёт 5 минут и продлевается при каждом чтении, у Luna записывается на 30 минут. Третье: поправка на токенизатор 1,52 измерена на английской статье; для русского текста по одному образцу вышло 1,45, для кода на Python — 1,46, так что на ваших данных множитель может немного отличаться.
Что быстрее: Sonnet на low против Luna на высоких уровнях
Быстрее та модель, которой для нужного балла не приходится долго рассуждать. В замерах AA на 26 октября 2026 года Sonnet на low тратит на задачу индекса 85 с, а Luna на xhigh — 215 с, на max — 364 с, так что при близком балле Sonnet быстрее в 2,5–4 раза. На одинаковом уровне medium время почти равно (121 и 126 с), а Luna на low укладывается в 18 с, но и набирает там 22 балла. Скорость генерации у обеих в замерах AA одного порядка — 105–134 токена в секунду у Sonnet и 92–140 у Luna, а до первого токена на medium проходит 1,35 с у Sonnet и 2,79 с у Luna. В тесте 26 октября через шлюз LaoZhang Luna оказалась медленнее на каждой задаче (128 с суммарно против 71 с у Sonnet с размышлениями), но это один маршрут в один день, и задержка заметно зависит от провайдера и нагрузки. OpenRouter публикует собственную статистику по своим маршрутам — медиана 106 токенов в секунду у Sonnet 5.5 и 42 у Luna; это другой способ замера, и сопоставлять его с цифрами AA напрямую нельзя.
Что сломается при переезде: параметры API Sonnet 5.5 и GPT-6 Luna
Замены названия модели недостаточно в обе стороны: у моделей разные параметры уровня рассуждений, разные ограничения на вызов функций и разное поведение длинного контекста. Ниже — то, что придётся поменять в коде, по документации Anthropic и OpenAI на 26 октября 2026 года.
| Что проверить | Claude Sonnet 5.5 | GPT-6 Luna |
|---|---|---|
| ID и API | claude-sonnet-5-5, Messages API | gpt-6-luna; Responses, Chat Completions и Batch, без Realtime, дообучения и эмбеддингов |
| Уровень рассуждений | output_config.effort: от low до max; по умолчанию high в API и medium в Claude Code и приложениях | reasoning.effort в Responses или reasoning_effort в Chat Completions: от none до max; по умолчанию medium |
| Как выключить размышления | thinking: {type: "disabled"} возвращает ошибку 400; минимальная настройка — between_tools, она принимается только на уровне high и ниже | Уровень none |
| Вызов функций | tool_choice со значениями auto и none работает, принудительный вызов (any или tool) возвращает ошибку 400 | В Chat Completions — только при reasoning_effort: "none"; с рассуждениями и встроенными инструментами — через Responses API |
| Текст размышлений | По умолчанию не возвращается (display: "omitted"), но оплачивается полностью | Число токенов рассуждений видно в usage, в Chat Completions — в completion_tokens_details.reasoning_tokens |
| Длина запроса | Окно 1 млн токенов, одна цена на всю длину | Окно 1 050 000, вход не больше 922 000; выше 272 тыс. входных токенов весь запрос дороже |
| Максимальный вывод | 128 тыс. токенов | 128 тыс. токенов |
| Кэш | Запись на 5 минут или на 1 час; кэшируется промпт от 512 токенов | Запись на 30 минут или на 12 часов |
При переходе с Luna на Sonnet чаще всего ломаются две вещи. Код, который принудительно вызывает инструмент через tool_choice, получает ошибку 400, поэтому его придётся перевести на auto и описать нужный вызов в инструкции. Код, который отключал рассуждения через none, на Sonnet должен использовать between_tools; кроме того, стоит заложить больший max_tokens и бюджет, ведь размышления оплачиваются, даже когда их текст скрыт.
При переходе с Sonnet на Luna главное — вызов функций. Если агент работает через Chat Completions и при этом нужны рассуждения, функции там не вызвать, и запросы придётся перенести в Responses API. Второе — длина: агент, у которого контекст иногда перерастает 272 тыс. токенов, начнёт платить по повышенному тарифу за весь запрос, а всё, что длиннее 922 тыс., Luna не примет вовсе. В обоих направлениях через прокси или шлюз задавайте уровень рассуждений явно, а не полагайтесь на значение по умолчанию.
Как проверить перед переключением: стоимость принятой задачи
Сравнивайте не цену токена, а стоимость задачи, ответ на которую прошёл вашу проверку: в ней сразу учтены токенизатор, объём рассуждений, повторы и провалы. Небольшого прогона на собственных данных достаточно, чтобы увидеть, где ваша нагрузка находится между 5 и 50 разами.
- Соберите 30–50 реальных запросов из логов вместе с критерием приёмки: тестом, JSON-схемой или правилом ручной проверки. Запросы без критерия в сравнение не берите, на них нельзя посчитать, какой ответ принят.
- Задайте параметры явно в каждом запросе: для Sonnet —
thinkingиoutput_config.effort, для Luna —reasoning_effortилиreasoning.effort. Минимальный набор — Luna наmediumиmax, Sonnet наlowи на том уровне, который у вас сейчас. - Сохраняйте из каждого ответа
usage: входные, кэшированные и выходные токены, токены рассуждений. Деньги считайте по прайсу из этих чисел, а не по длине текста. - Разделите всё потраченное на прогон, включая повторы, на число ответов, прошедших проверку. Рядом запишите медианное время ответа и время самых медленных 10 % запросов.
- Разберите провалы вручную. Неверно понятую формулировку, как с «касающимися» интервалами в тесте выше, исправляет уточнение промпта, а ошибку в рассуждении — только более сильная модель или более высокий уровень.
- Если Luna проходит большую часть задач, а проверка автоматическая, прогоните каскад: сначала Luna, при провале проверки — Sonnet.
Ожидаемая цена задачи в каскаде равна цене попытки Luna плюс доля провалов, умноженная на цену попытки Sonnet. С ценами одной задачи из теста 26 октября ($0,0044 / 9 ≈ $0,00049 у Luna и $0,1119 / 9 ≈ $0,0124 у Sonnet) и допущением, что Luna проходит 80 % задач, выходит $0,00049 + 0,2 × $0,0124 ≈ $0,0030 — примерно вчетверо дешевле, чем отправлять всё на Sonnet. Без автоматической проверки каскад не работает, и он не подходит там, где задержка второй попытки неприемлема.
Sonnet 5.5 и GPT-6 Luna: другие вопросы
Существует ли GPT-6 Luna Pro или GPT-6.1 Luna?
По состоянию на 26 октября 2026 года в каталоге моделей и на странице цен OpenAI есть только gpt-6-luna: моделей «GPT-6 Luna Pro» и gpt-6.1-luna там нет. Цены, которые встречаются под названием «Luna Pro», — $0,10 за миллион входных и $0,50 за миллион выходных токенов при контексте 1 050 тыс. — совпадают с ценами gpt-6-luna. Как Luna соотносится с остальной линейкой OpenAI, разобрано в статье GPT-6 Sol, Luna, Astra и GPT-5.6 Terra: что выбрать для работы.
Есть ли у Anthropic модель по цене GPT-6 Luna?
Да, Claude Haiku 5.5: в запросах до 100 тыс. токенов её прайс совпадает с ценами Luna, а длиннее весь запрос стоит в пять раз дороже. Задача у Haiku при этом обходится дороже, потому что Haiku пишет больше токенов: по замерам AA — в 2,7 раза при уровнях по умолчанию. Подробности — в статье Haiku 5.5 vs GPT-6 Luna: сравнение — тариф один, счёт разный.
На каких моделях работают бесплатные ChatGPT и Claude?
Согласно объявлению OpenAI от 7 октября 2026 года, на тарифах Free и Go ChatGPT отвечает моделью GPT-6 Luna; развёртывание началось 8 октября. В бесплатном Claude, по таблице тарифов Claude, доступен Sonnet; версию таблица не называет, но текущая модель Sonnet — 5.5, и выключить размышления у Sonnet 5.5 в приложении Claude нельзя. Подробнее о бесплатном доступе к GPT-6 — в статье GPT-6 бесплатно в ChatGPT: на Free работает Luna, Astra — платно.
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 26 окт. 2026 г..
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 26 окт. 2026 г..
- 1.прайса Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 2.прайса OpenAI APIdevelopers.openai.com/api/docs/pricing
- 3.сравнения Claude Sonnet 5.5 и GPT-6 Luna на Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-luna
- 4.странице GPT-6 Luna в документации OpenAIdevelopers.openai.com/api/docs/models/gpt-6-luna
- 5.документации Anthropic о размышленияхplatform.claude.com/docs/en/build-with-claude/thinking
- 6.таблице тарифов Claudeclaude.com/pricing