DeepSeek V4.1 Flash vs GLM-5.3-Flash: сравнение цены по нагрузке
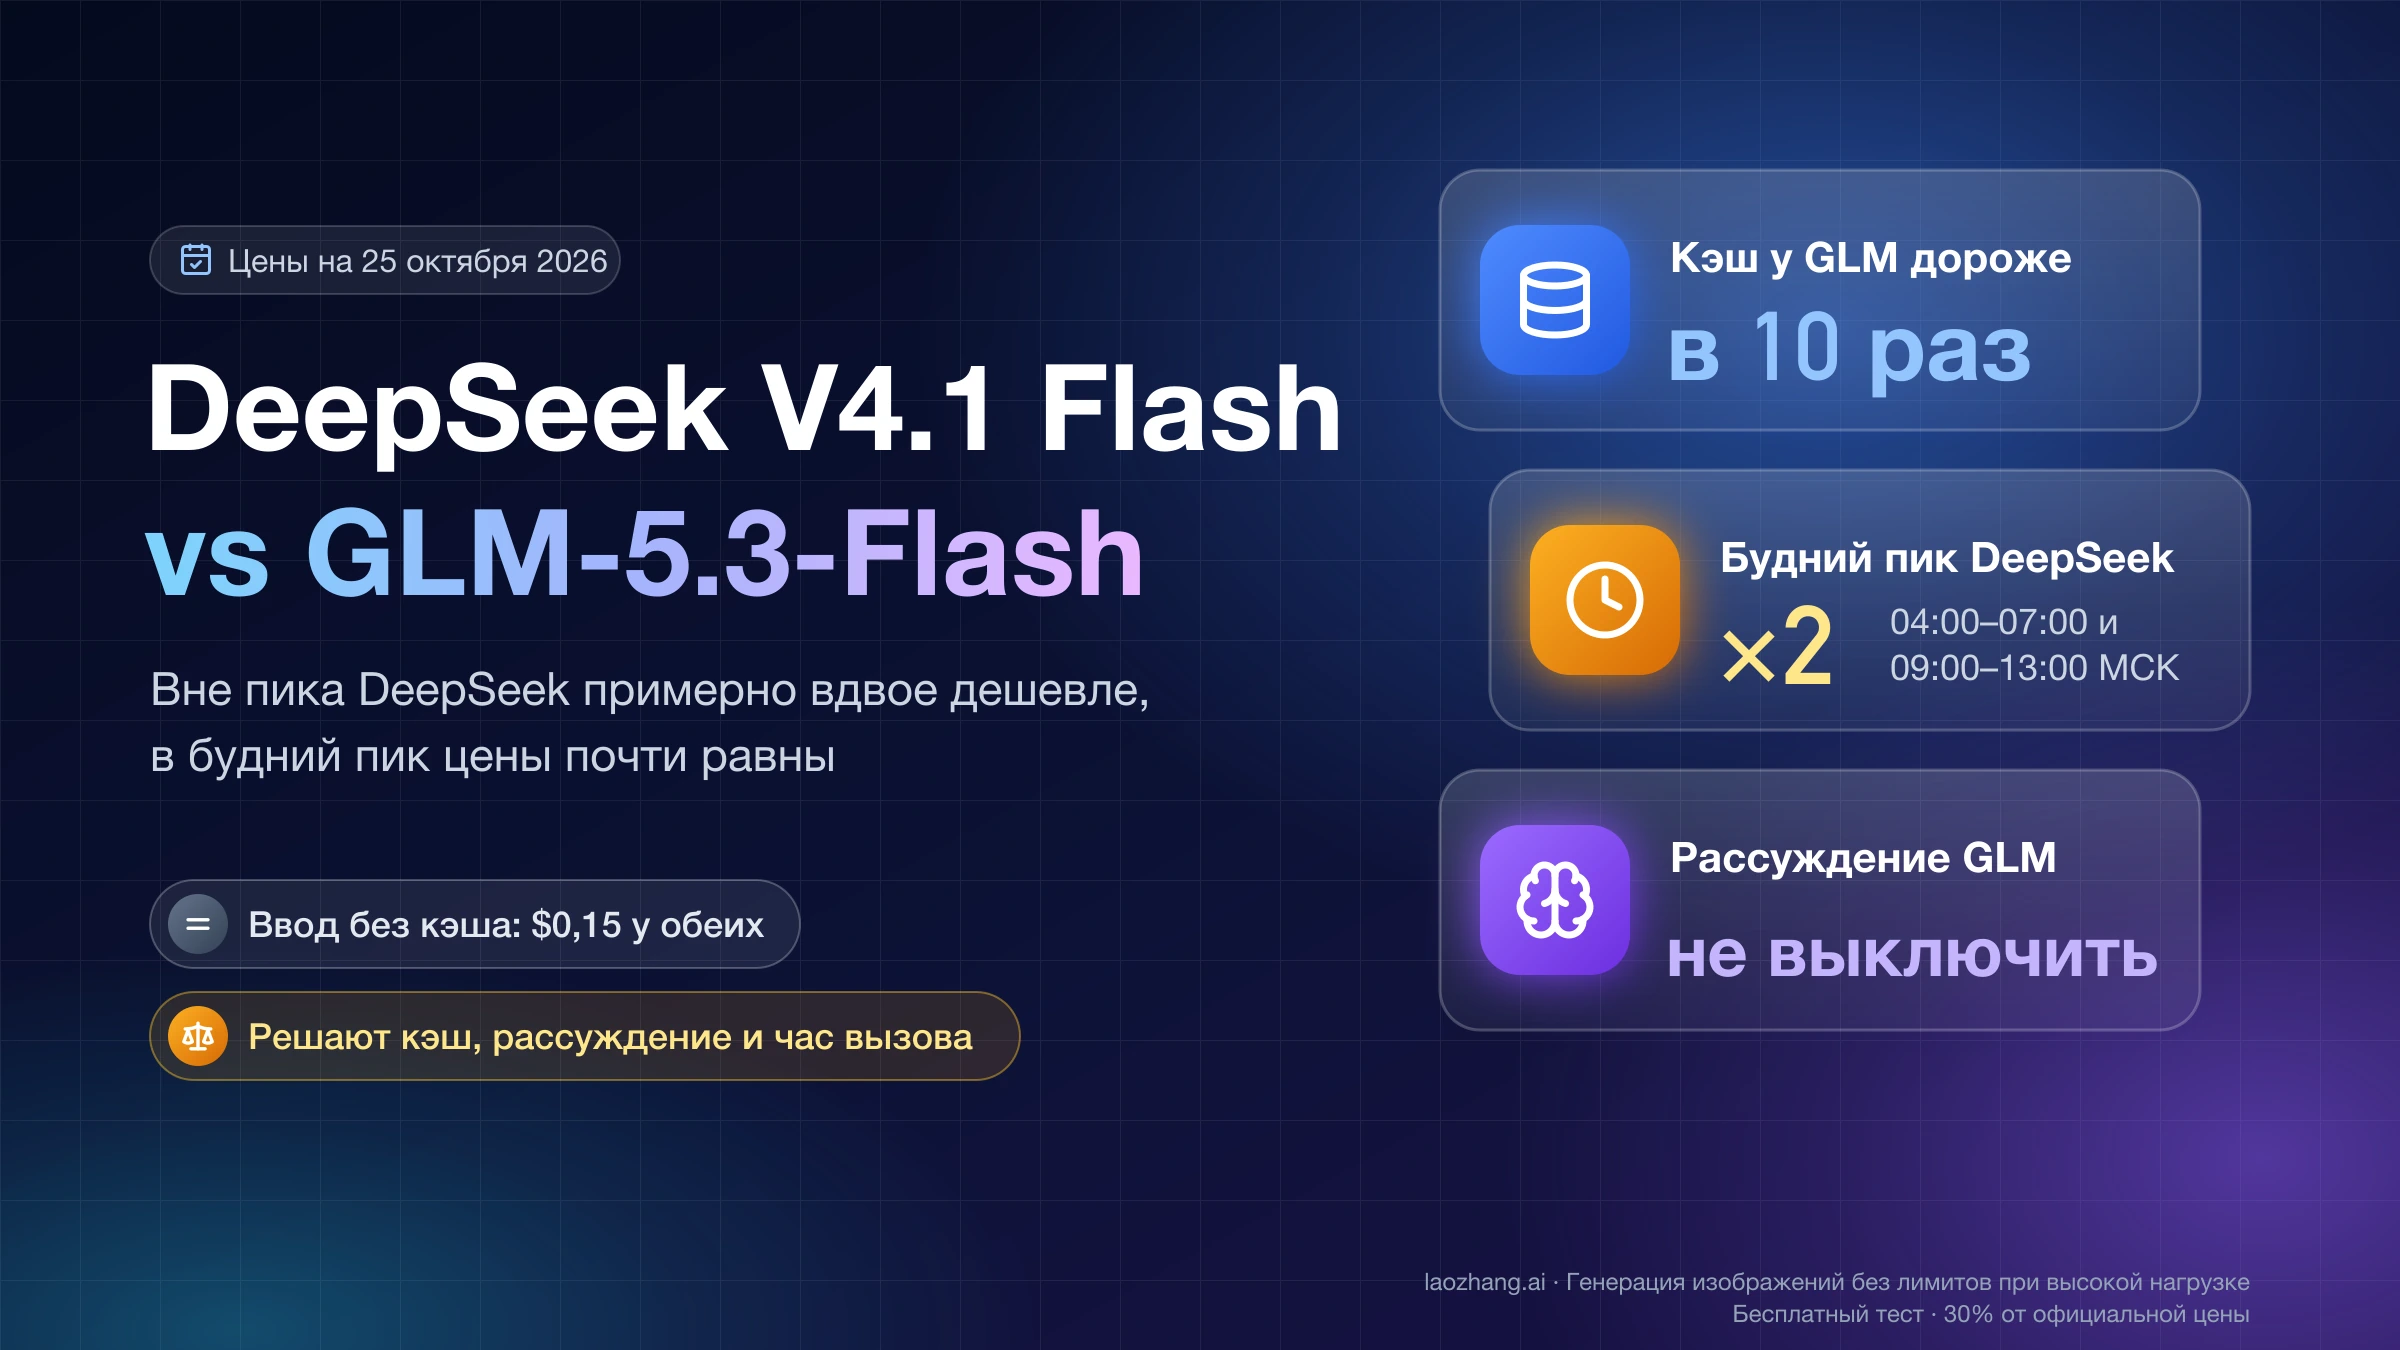
Вне будничного пика DeepSeek V4.1 Flash на той же задаче примерно вдвое дешевле GLM-5.3-Flash, в пик цены почти равны. Решают кэш, рассуждение и час вызова.
Содержание
Если нужна одна модель по умолчанию, начинайте с DeepSeek V4.1 Flash (deepseek-flash): вне будничных пиковых часов DeepSeek она на большинстве нагрузок дешевле GLM-5.3-Flash, отвечает быстрее и немного выше в независимом индексе Artificial Analysis. GLM-5.3-Flash (glm-5.3-flash) стоит проверить первой, если основная часть ваших вызовов приходится на пик DeepSeek и не опирается на длинный кэшированный префикс, если нужен видео- или файловый вход или если на ваших собственных задачах её ответы оказываются лучше.
Одинаковая цена обычного ввода, $0,15 за 1 млн токенов, здесь ничего не решает. У DeepSeek все тарифы удваиваются по будням с 04:00 до 07:00 и с 09:00 до 13:00 по Москве, кэшированный ввод у неё в 10 раз дешевле, чем у GLM, а у GLM-5.3-Flash рассуждение (thinking) выключить нельзя, поэтому даже короткий ответ тянет за собой оплачиваемые токены размышлений. При переходе в любую сторону меняется не только имя модели: у DeepSeek рассуждение отключается параметром thinking, у GLM такого переключателя нет, а максимальный вывод отличается втрое — 384 тыс. против 128 тыс. токенов.
25 октября 2026 года на одних и тех же текстах были посчитаны токены официальными токенизаторами обеих моделей, стоимость пересчитана по прейскурантам DeepSeek и Z.ai, прочитаны каталог OpenRouter и размеры весов на Hugging Face. Одинаковые задания на качество и скорость через обе модели не прогонялись, поэтому оценки качества и скорости ниже взяты у Artificial Analysis, а заявления самих вендоров приведены отдельно. Все цены — в долларах США с официальных страниц по состоянию на 25 октября 2026 года.
Какие модели стоят за названиями: V4.1-Flash-1017 и GLM-5.3-Flash
С 17 октября 2026 года под именем deepseek-flash в API DeepSeek работает DeepSeek-V4.1-Flash-1017. Число 1017 — дата чекпойнта (17 октября), а не номер версии: по журналу изменений DeepSeek API V4.1 Flash вышла 10 сентября, а 17 октября её заменили обновлённой моделью с более короткими ответами и более быстрым выполнением задач, сохранив имя и цену. Старые имена deepseek-v4-flash и deepseek-v4-flash-vision-exp API ещё принимает, но, согласно странице цен DeepSeek API, отвечает на них тот же 1017 по цене Flash.
Поэтому сравнения, сделанные летом и в сентябре, относятся к другим моделям: к снятой V4 Flash 0731 или к сентябрьской V4.1 Flash. Если для DeepSeek указаны 74,2 в DeepSWE или индекс 39 у Artificial Analysis, это сентябрьская версия. На роутерах старые идентификаторы живут отдельно: в каталоге OpenRouter на 25 октября 2026 года рядом с deepseek/deepseek-v4.1-flash-1017 остаются deepseek/deepseek-v4.1-flash и deepseek/deepseek-v4-flash-0731, так что выбирать нужно id с -1017.
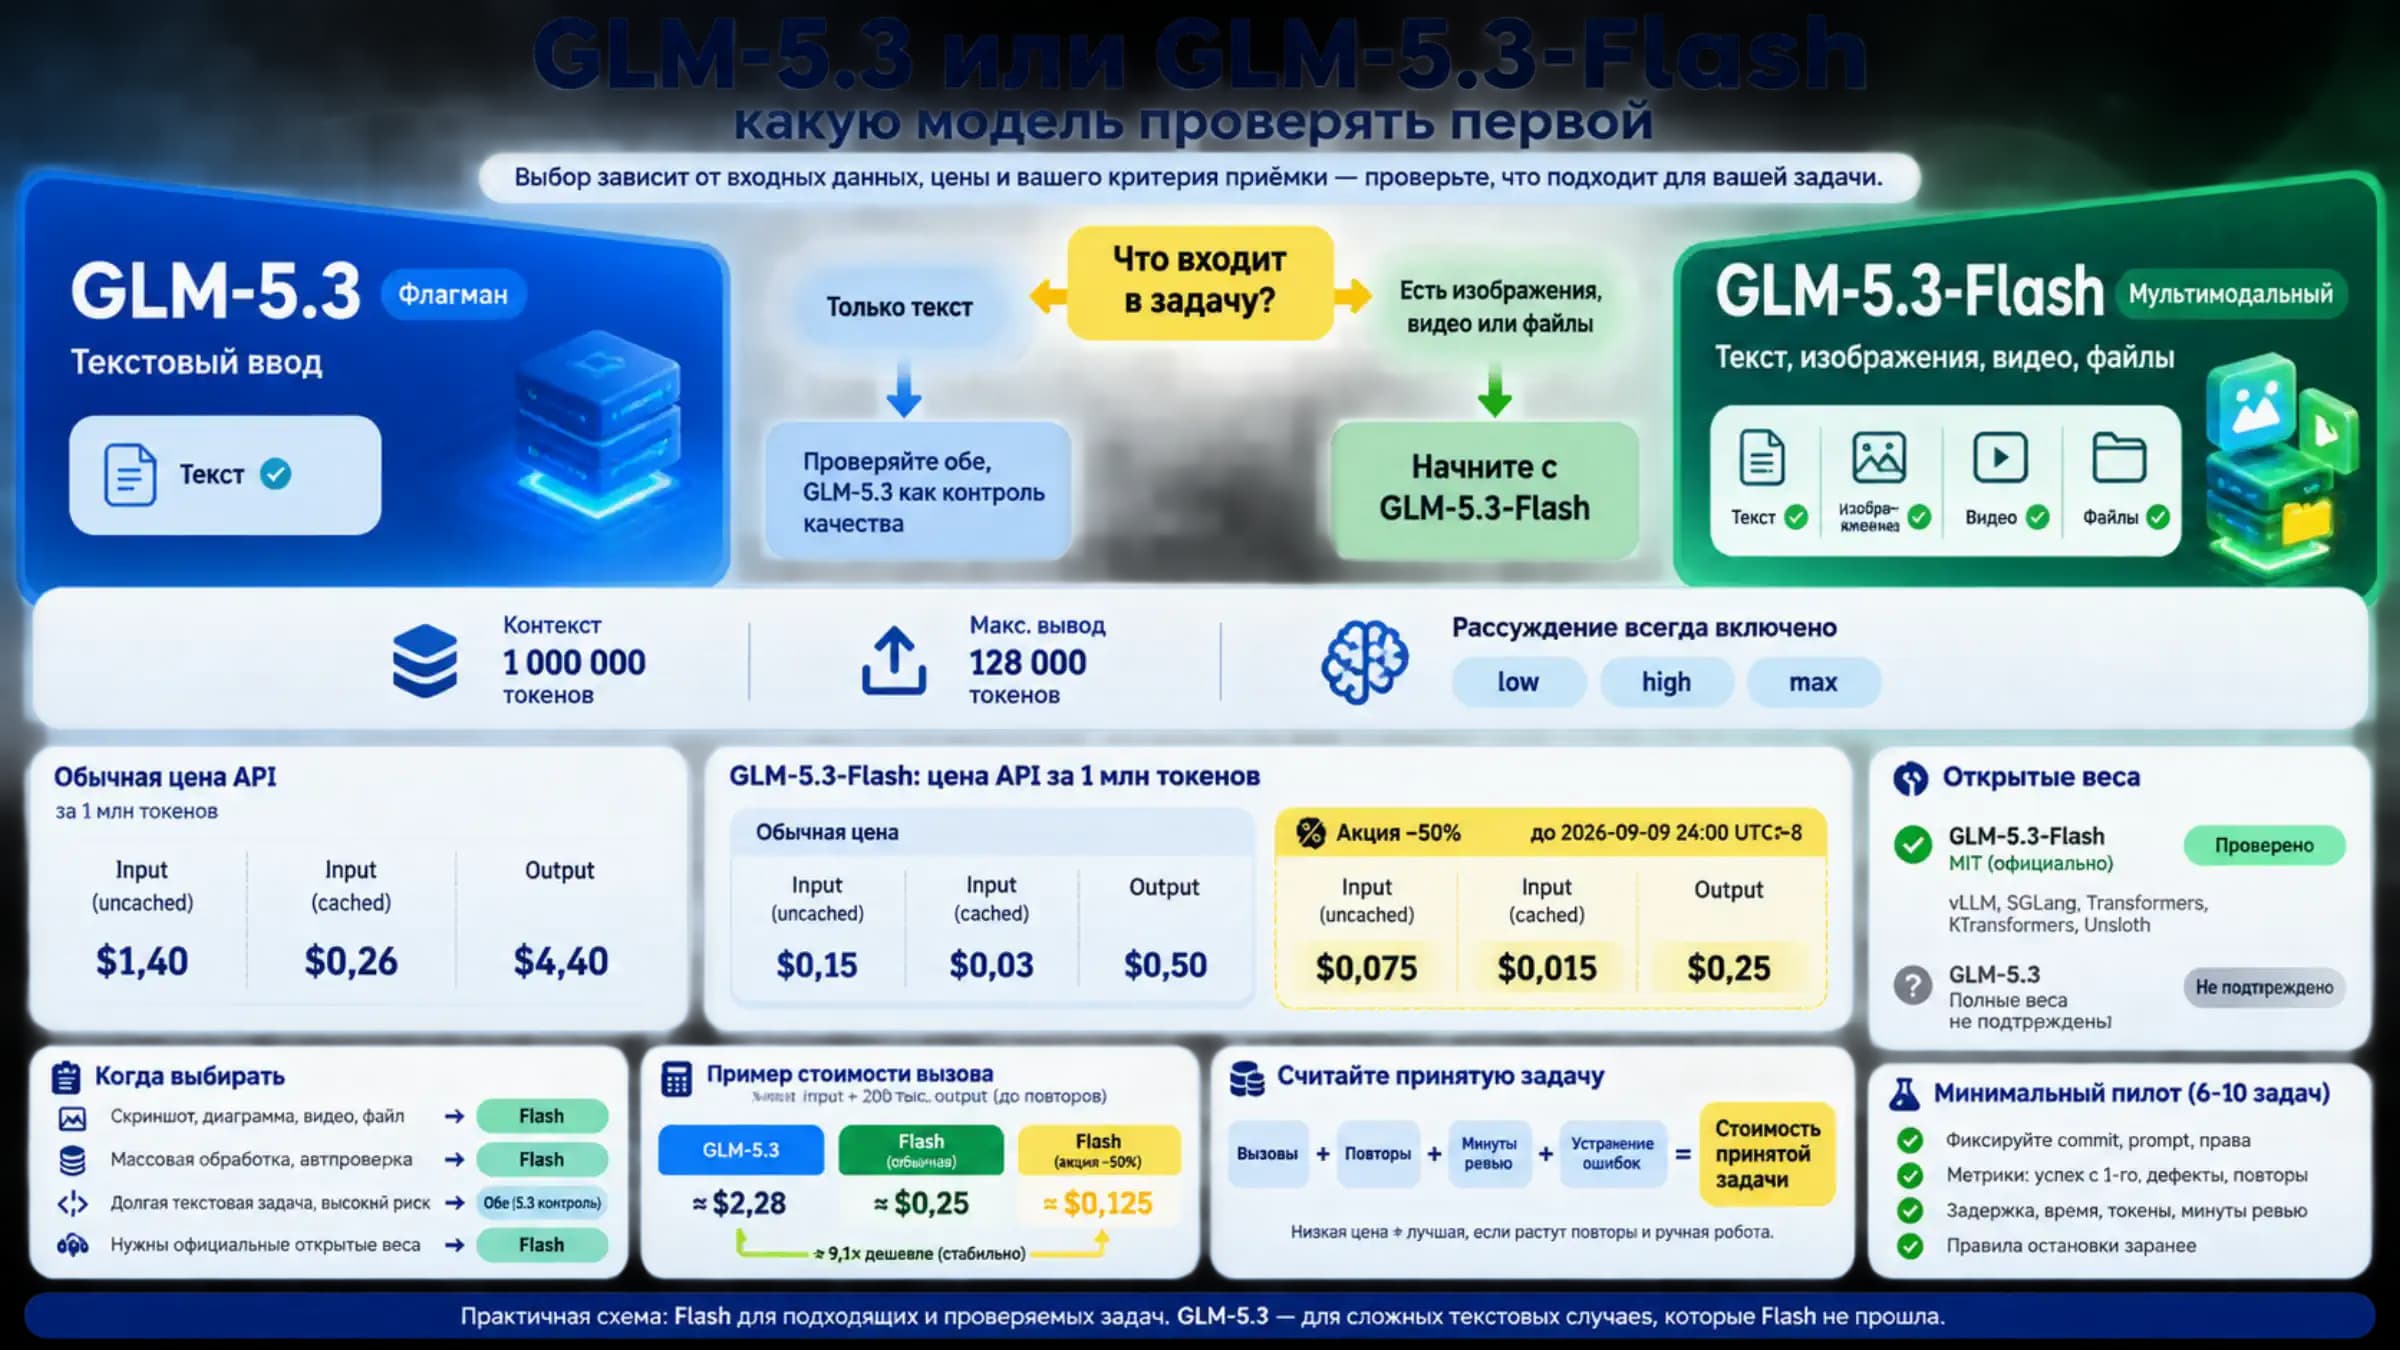
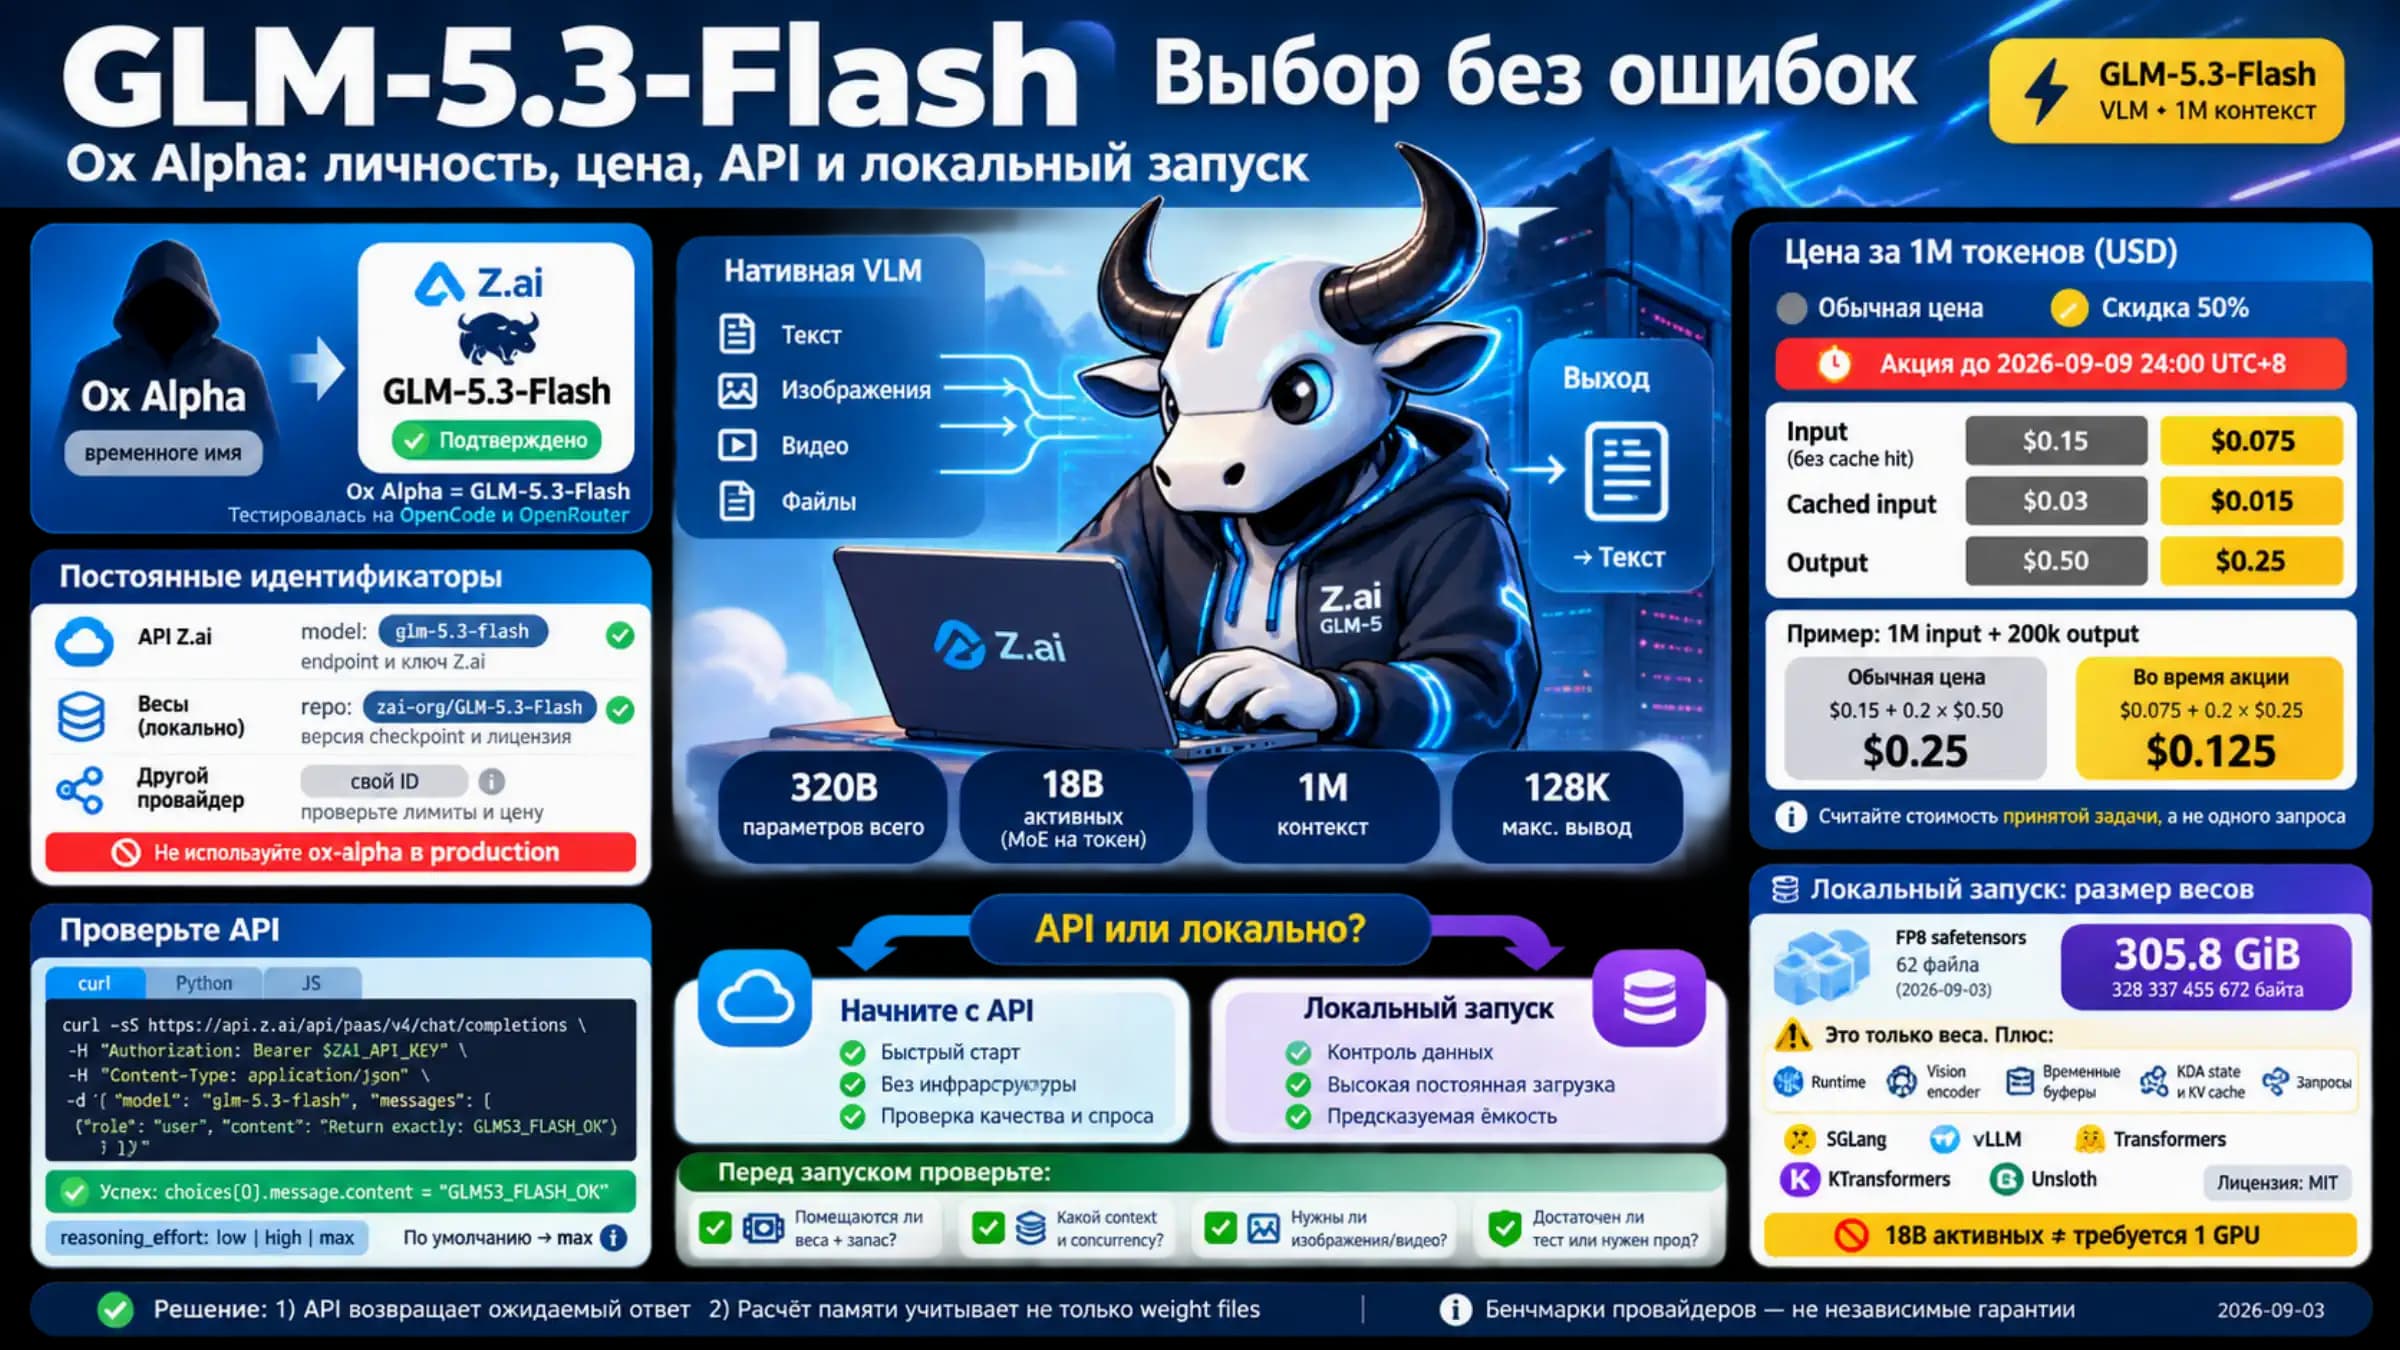
GLM-5.3-Flash от Z.ai вышла в августе 2026 года; до релиза её анонимно тестировали в OpenCode и OpenRouter под именем ox-alpha. В API у неё три кода: glm-5.3-flash, более быстрая и дорогая glm-5.3-flashx и glm-5.3-flashx-legal. «Маленькими» обе модели назвать трудно: у DeepSeek 552 млрд параметров, из которых при генерации активны 16 млрд, у GLM — 320 млрд и 18 млрд активных. Обе выложены с открытыми весами под лицензией MIT и принимают контекст до 1 млн токенов. Если вы выбираете внутри семейства GLM, это отдельный вопрос: GLM-5.3 или GLM-5.3-Flash: какую модель проверять первой.
Цены за 1 млн токенов: вход одинаковый, кэш и пик разные
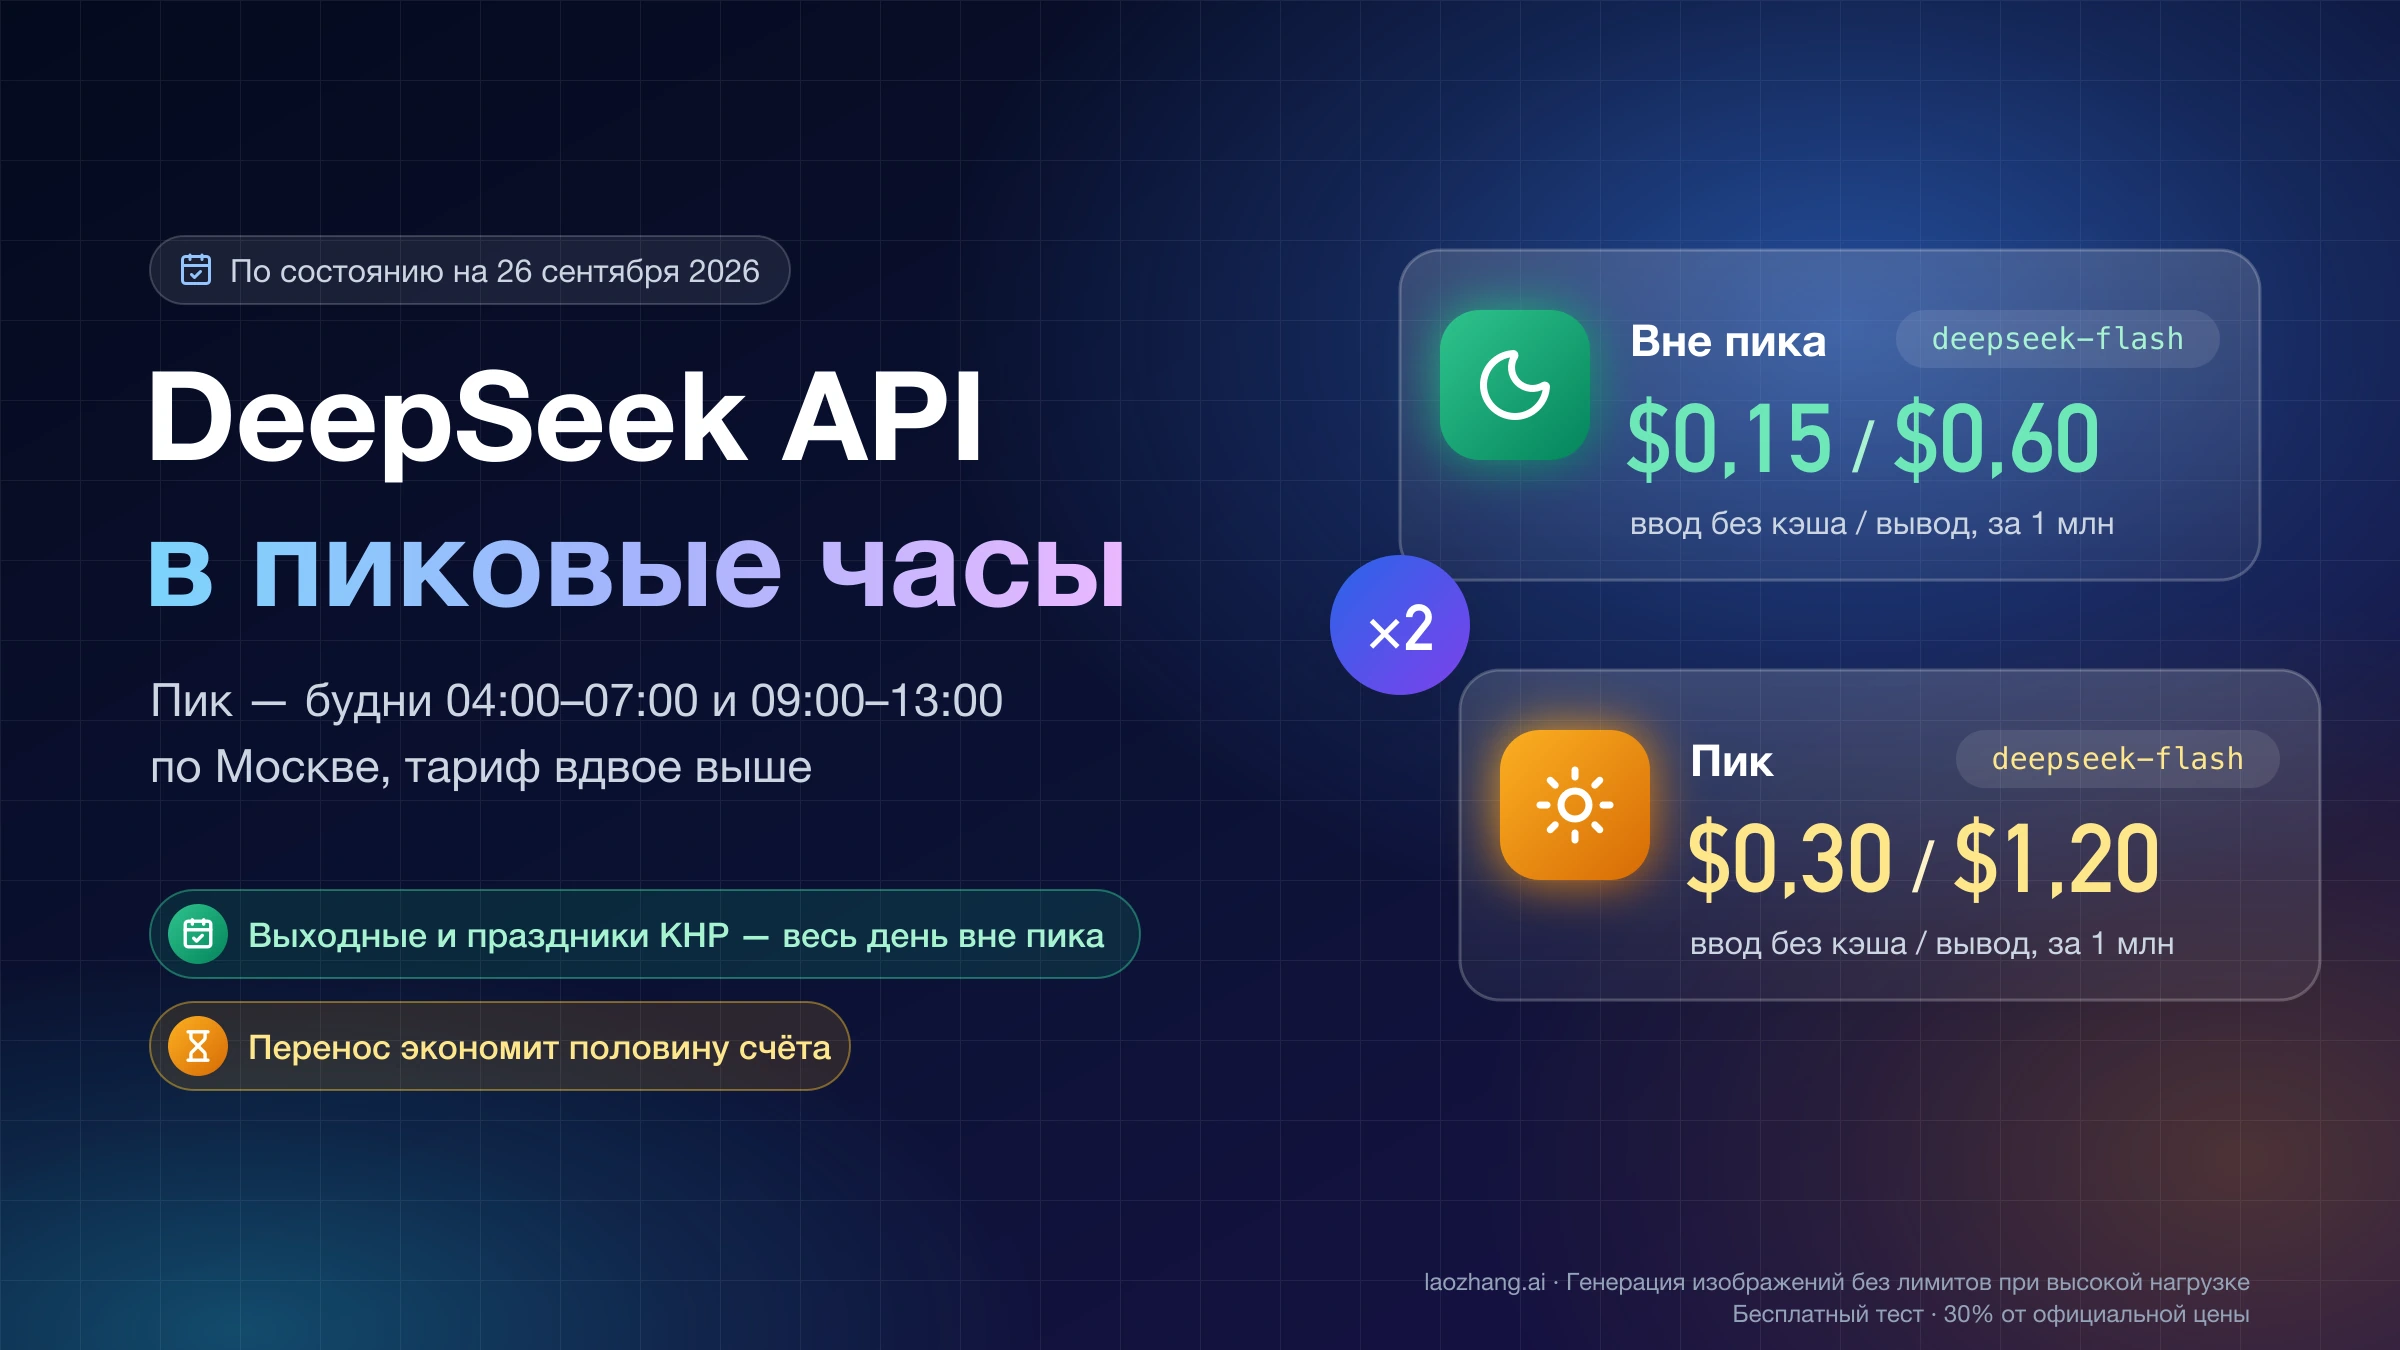
По прейскурантам на 25 октября 2026 года обычный ввод у обеих моделей стоит одинаково, но у DeepSeek только вне пика. В будни с 01:00 до 04:00 и с 06:00 до 10:00 UTC, кроме праздников Китая, DeepSeek берёт вдвое больше за всё сразу: за ввод, кэш и вывод. У GLM-5.3-Flash на странице цен Z.ai одна цена на все часы, без ступеней по длине контекста.
| За 1 млн токенов | DeepSeek V4.1 Flash, вне пика | DeepSeek V4.1 Flash, пик | GLM-5.3-Flash | GLM-5.3-FlashX |
|---|---|---|---|---|
| Ввод, попадание в кэш | $0,003 | $0,006 | $0,03 | $0,075 |
| Ввод без кэша | $0,15 | $0,30 | $0,15 | $0,37 |
| Вывод вместе с рассуждением | $0,60 | $1,20 | $0,50 | $1,25 |
В пересчёте на московское время (UTC+3, без перехода на летнее время) пик DeepSeek приходится на 04:00–07:00 и 09:00–13:00 по будням, то есть почти на всё утро рабочего дня. Это 35 из 168 часов недели, около 21 %, если не считать китайских праздников. Как планировать пакетные задачи под эти окна, разобрано в статье Цены DeepSeek API в пиковые часы: когда задачу стоит отложить.
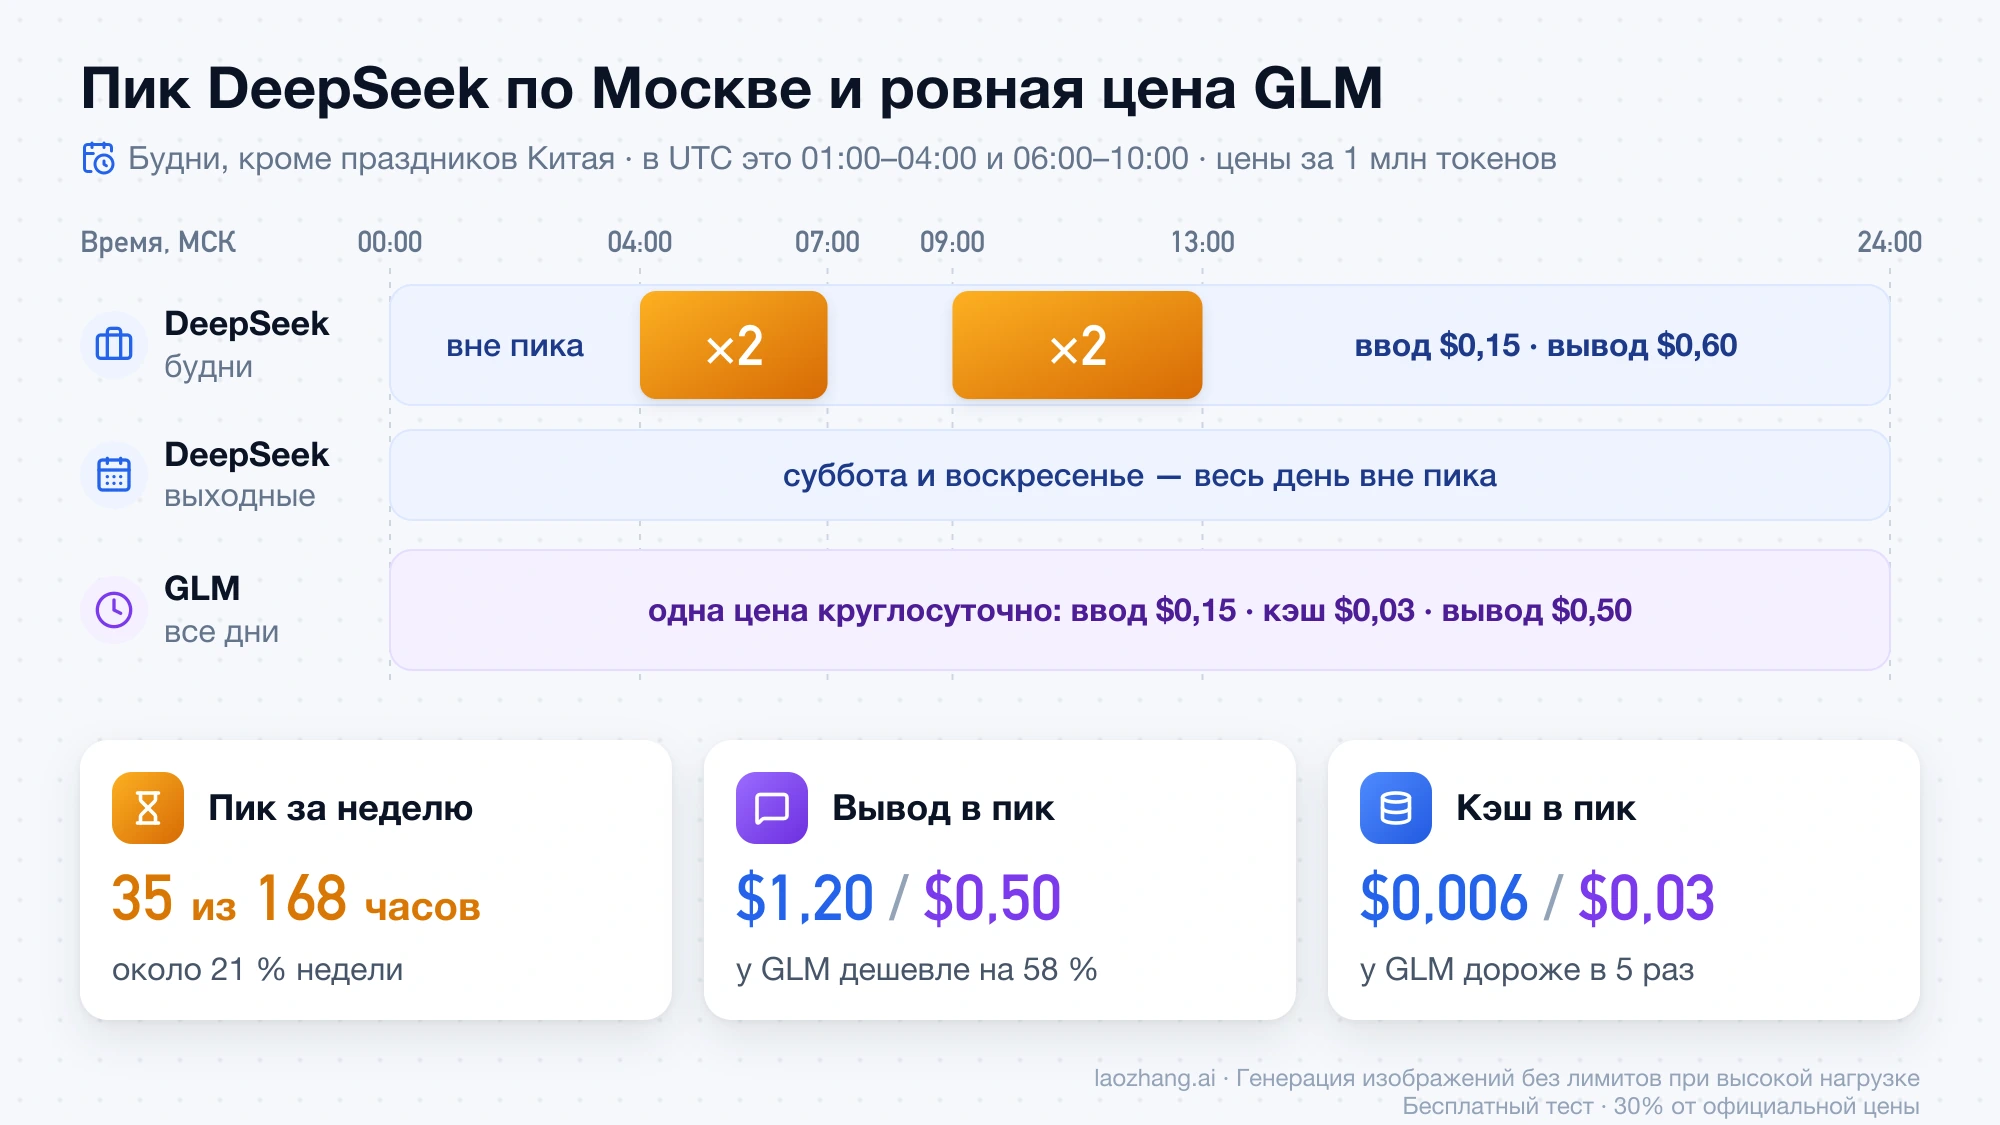
Самая большая разница в таблице — строка кэша. Попадание в кэш у GLM стоит в 10 раз дороже, чем у DeepSeek вне пика, и в 5 раз дороже, чем в пик. У агента, который на каждом шаге заново отправляет длинный системный промпт и историю, именно эта строка становится главной статьёй расходов. Вывод, наоборот, у GLM дешевле в любой час: на 17 % вне пика и на 58 % в пик. Хранение кэша Z.ai сейчас помечает как временно бесплатное (Limited-time Free), а сколько живёт кэш, не публикует ни один из двух вендоров.
Для тех, кто работает через агента для программирования по подписке, есть и другой путь к GLM: по руководству Z.ai по GLM-5.3-Flash модель входит в GLM Coding Plan с втрое большей квотой, чем GLM-5.3, а вызовы в непиковые часы и все выходные списывают половину баллов. FlashX в подписку пока не входит.
Сравнивать цены за токен напрямую можно и для русского текста. 25 октября 2026 года официальные файлы tokenizer.json обеих моделей с Hugging Face были прогнаны по одним и тем же текстам. Русская статья этого блога о ценах AI API длиной 14 860 символов дала 5 227 токенов у DeepSeek и 5 029 у GLM, то есть GLM на 4 % экономнее. На английском, китайском, японском и испанском тексте, на файле TypeScript и на JSON разница тоже не выходит за 5 %; заметное исключение одно — корейский, где GLM нужно примерно на 13 % больше токенов. Служебные токены шаблона чата и изображения в подсчёт не входили.
Что дешевле для вашей нагрузки: расчёт на пяти сценариях
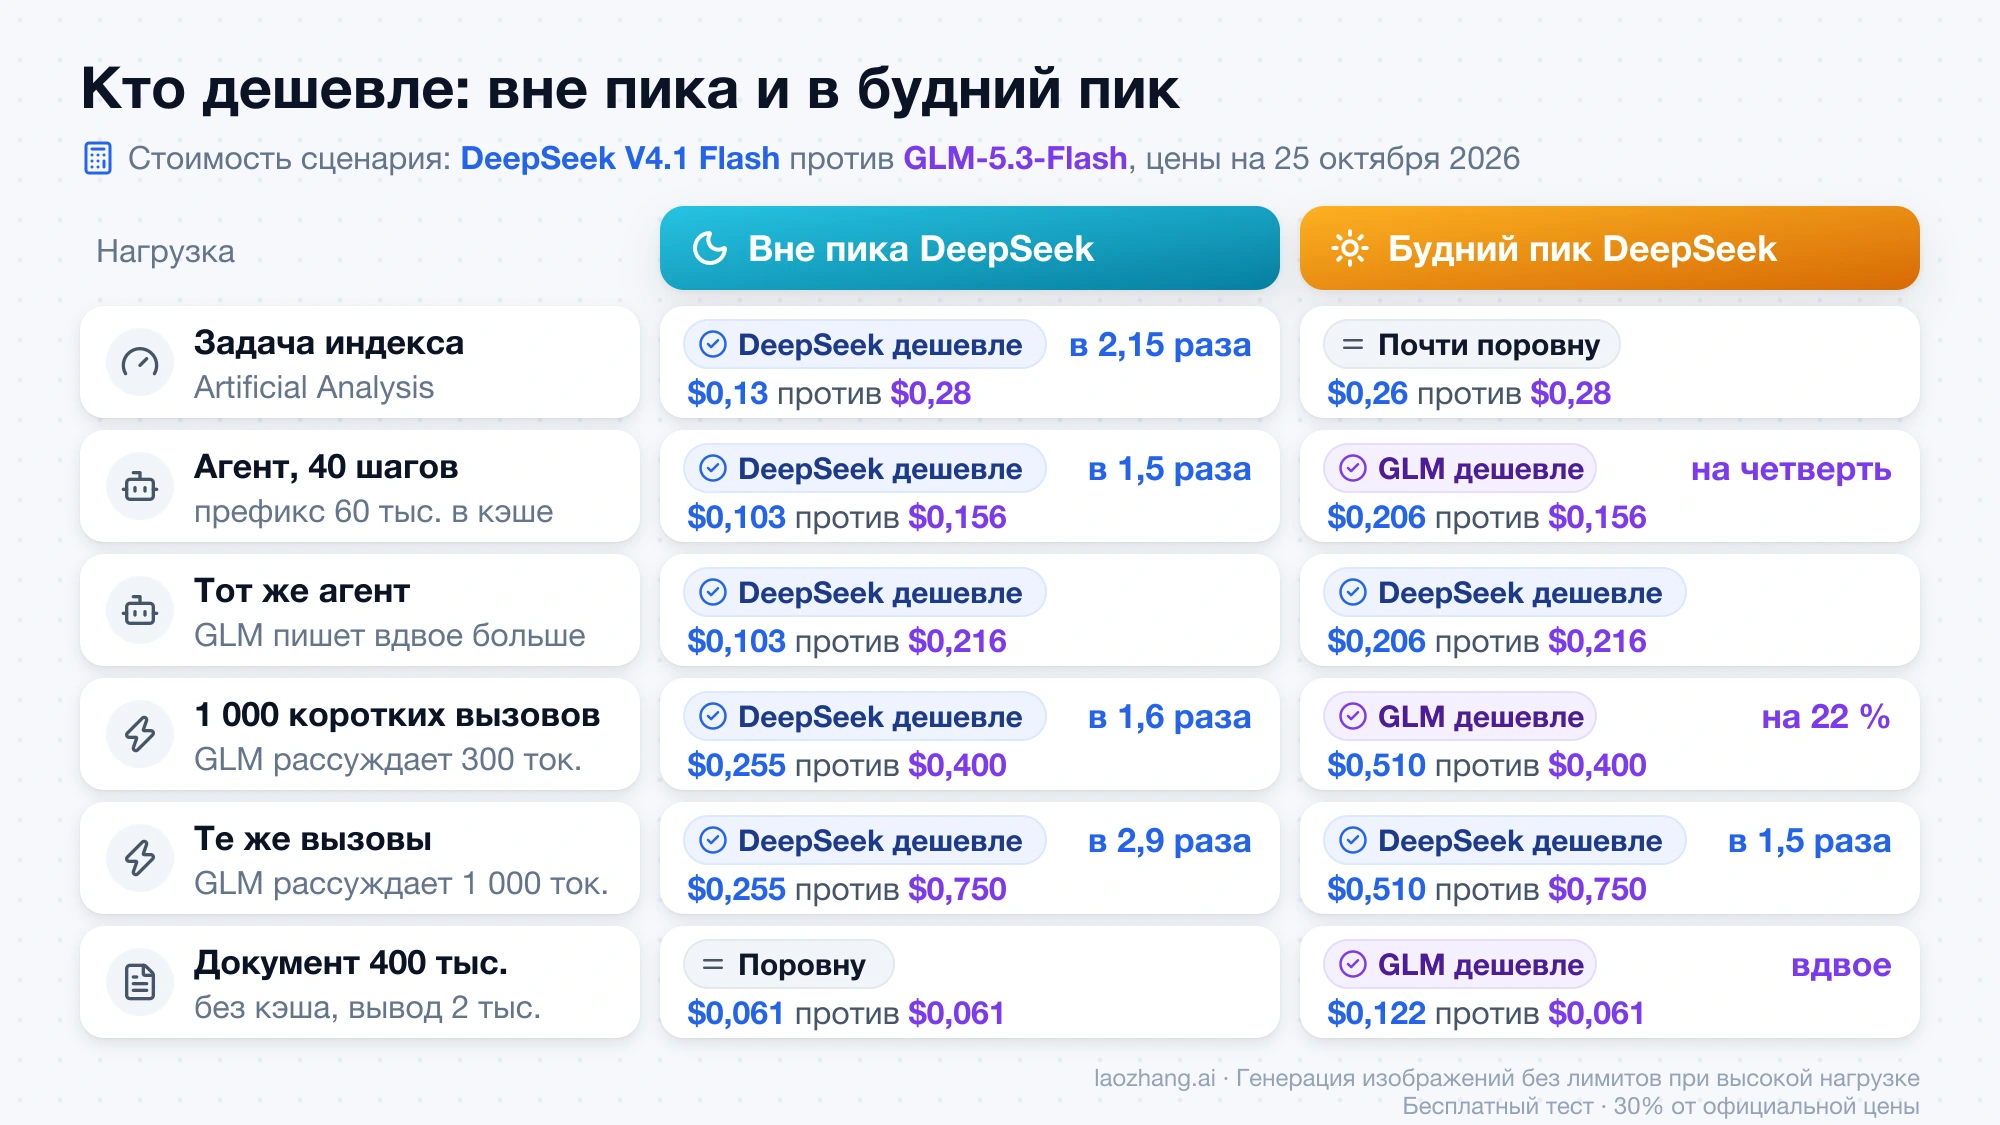
Вне пика DeepSeek V4.1 Flash дешевле или не дороже GLM-5.3-Flash во всех сценариях ниже, пересчитанных 25 октября 2026 года по прейскурантам из таблицы выше. В будний пик ответ зависит от двух вещей: сколько токенов пишет GLM и какая доля ввода идёт из кэша, где GLM даже против пиковой цены DeepSeek в 5 раз дороже. В расчётных сценариях агента и коротких вызовов GLM в пик дешевле на 22–24 %, на одном длинном документе без кэша — вдвое, но на задаче индекса Artificial Analysis она и в пик немного дороже, хотя пишет меньше DeepSeek.
| Нагрузка | DeepSeek вне пика | DeepSeek в пик | GLM-5.3-Flash | Что выходит |
|---|---|---|---|---|
| Задача индекса Artificial Analysis, по их подсчёту токенов | $0,13 | $0,26 | $0,28 | Вне пика GLM дороже в 2,15 раза, в пик почти поровну |
| Агент: 40 шагов, кэшированный префикс 60 тыс. токенов, на шаг 4 тыс. нового ввода и 3 тыс. вывода | $0,103 | $0,206 | $0,156 | Вне пика GLM дороже в 1,5 раза, в пик дешевле на четверть |
| Тот же агент, но GLM пишет вдвое больше токенов | $0,103 | $0,206 | $0,216 | GLM дороже и вне пика, и в пик |
| 1 000 коротких вызовов: 1,5 тыс. ввода, ответ 50 токенов; DeepSeek без рассуждения, GLM рассуждает 300 токенов | $0,255 | $0,510 | $0,400 | Вне пика GLM дороже в 1,6 раза, в пик дешевле на 22 % |
| То же, но GLM рассуждает 1 000 токенов | $0,255 | $0,510 | $0,750 | GLM дороже в 2,9 раза вне пика и в 1,5 раза в пик |
| Один документ на 400 тыс. токенов без кэша, вывод 2 тыс. | $0,061 | $0,122 | $0,061 | Вне пика поровну, в пик GLM вдвое дешевле |
Первая строка опирается на опубликованную стоимость задачи индекса на сравнении DeepSeek V4.1 Flash 1017 и GLM-5.3-Flash на Artificial Analysis: $0,26 у DeepSeek и $0,28 у GLM. Artificial Analysis считает DeepSeek по пиковым ценам, а вне пика каждая ставка вдвое ниже, поэтому та же задача вне пика обходится в $0,13.
Остальные строки считаются по одной формуле: токены × цена за 1 млн токенов, отдельно для попаданий в кэш, ввода без кэша и вывода, а токены рассуждения оплачиваются как вывод. Для одного шага агента у DeepSeek вне пика это (60 000 × 0,003 + 4 000 × 0,15 + 3 000 × 0,60) / 1 000 000 = $0,00258, за 40 шагов $0,103; у GLM (60 000 × 0,03 + 4 000 × 0,15 + 3 000 × 0,50) / 1 000 000 = $0,0039 за шаг и $0,156 за сессию. Объёмы токенов в сценариях — иллюстрация, а не замер реального трафика: в расчёте предполагается, что весь префикс агента попадает в кэш, а первый холодный запрос и сброс кэша не учитываются. Для своей оценки подставьте числа из поля usage ответов API.
Отсюда практическое правило. Если агент работает с длинным кэшированным контекстом, а запуски можно сдвинуть за пределы пика, берите DeepSeek. Если работа идёт в основном утром по Москве в будни, GLM-5.3-Flash может оказаться дешевле, но только при определённой форме нагрузки: в сценариях агента с умеренным выводом и коротких вызовов с рассуждением около 300 токенов выигрыш около 22–24 %, на холодном длинном документе — вдвое. Если GLM пишет вдвое больше DeepSeek, рассуждает на коротком вызове дольше 520 токенов или нагрузка похожа на задачу индекса Artificial Analysis, в пик она дороже, поэтому для пиковых часов решает замер доли кэша и длины вывода на ваших запросах. Ничто не мешает разделить поток: ночные и выходные пакеты и короткие вызовы без рассуждения отправлять в DeepSeek, а задачи, где GLM на вашей проверке отвечает лучше, — в GLM.
Рассуждение GLM-5.3-Flash нельзя выключить: когда это решает счёт
У GLM-5.3-Flash параметр thinking.type принимает только enabled: в документации Z.ai о режиме рассуждений прямо сказано, что GLM-5.3 и GLM-5.3-Flash рассуждают принудительно. DeepSeek V4.1 Flash по умолчанию тоже рассуждает, но, по руководству DeepSeek по режиму рассуждений, это выключается запросом с {"thinking": {"type": "disabled"}}. Для классификации, извлечения полей, маршрутизации и других вызовов с ответом в несколько десятков токенов эта разница переворачивает порядок цен.
В сценарии с 1 000 коротких вызовов DeepSeek без рассуждения тратит $0,000255 на вызов вне пика: 1 500 токенов ввода по $0,15 и 50 токенов ответа по $0,60 за миллион. Ввод у GLM стоит столько же, а вывод — $0,50 за миллион, поэтому GLM догоняет эту сумму, как только рассуждает больше 10 токенов на вызов, то есть практически всегда. Пиковую цену DeepSeek, $0,00051 за вызов, GLM превышает при рассуждении длиннее 520 токенов. Значит, для коротких вызовов вне пика выбор очевиден, а в пик всё зависит от того, сколько GLM думает над вашими запросами.
Для длинных задач, где рассуждают обе модели, заранее сказать, какая напишет больше, нельзя. На индексе Artificial Analysis больше пишет DeepSeek: 89 тыс. токенов вывода на задачу против 69 тыс. у GLM, из них рассуждения — 59 тыс. против 47 тыс. А на писательском бенчмарке ToneBench, по данным его автора (X, @Whats_AI, около 20 октября 2026 года), картина обратная: при практически одинаковых оценках (23-е и 24-е место из 134 конфигураций) GLM думала 37 тыс. токенов против 17 тыс. у DeepSeek, а сценарий обошёлся в $0,022 против $0,014. Поэтому строка «GLM пишет вдвое больше» в таблице — не крайний случай, а реальный вариант для части задач, и проверить его можно только на своих запросах.
Что лучше по качеству и скорости: 45 против 42 у Artificial Analysis
Единственное сравнение, где обе модели прогнаны одним методом, — страница Artificial Analysis по состоянию на 25 октября 2026 года. По ней DeepSeek V4.1 Flash 1017 на уровне рассуждения max набирает 45 баллов индекса, GLM-5.3-Flash — 42. Разрыв небольшой, и учтите, что по умолчанию DeepSeek работает на уровне high, а не max.
По отдельным тестам картина неравномерная. В работе агента в терминале (Terminal-Bench 4.0) модели почти равны, 34 % против 33 %. В автоматизации процессов (AutomationBench-AA) DeepSeek впереди заметнее, 67 % против 60 %, на длинном контексте (AA-LCR) — 83 % против 80 %, на научном коде (SciCode) — 56 % против 52 %, а самый большой отрыв — в CritPt: 24 % против 15 %. Выше GLM только в AA-Omniscience, 7 против 5.
Собственные цифры вендоров получены в разных обвязках, поэтому выводов о том, какая модель сильнее, по ним делать не стоит. DeepSeek сообщает для 1017 о 77,0 в DeepSWE v1.1 в обвязке Mini-SWE-V2 и 42,3 в Terminal-Bench 4.0 в Claude Code. Z.ai для GLM-5.3-Flash приводит 63,4 в DeepSWE v1.1 без указания обвязки и 29,0 в собственном Z.ai Code Bench v1.0. Балл 57 из руководства Z.ai относится к более старой версии индекса Artificial Analysis (v4.1.1) и к цене со скидкой на запуск, с нынешними оценками его сравнивать нельзя.
Отзывы пользователей подтверждают, что выбор зависит от задачи. В ветке r/opencode на Reddit (больше 80 комментариев, сентябрь 2026 года) один из участников пишет, что у DeepSeek заметно меньше задержка, но GLM, возможно, сильнее в дизайне интерфейсов; речь там ещё о сентябрьской версии DeepSeek.
По скорости разрыв больше, чем по качеству. По замерам Artificial Analysis на выбранных ею эндпойнтах DeepSeek выдаёт 195 токенов в секунду против 69 у GLM, первый токен приходит через 1,14 с против 3,29 с, а задача индекса занимает в среднем 358 с против 832 с. Если GLM устраивает по качеству, но тормозит, у Z.ai есть GLM-5.3-FlashX: по заявлению компании, 200 токенов в секунду, но по ценам из таблицы выше, примерно в 2,5 раза дороже обычной Flash, и в каталоге OpenRouter на 25 октября 2026 года её предлагает только сама Z.AI.
Что поменять в коде при переходе между DeepSeek и GLM-5.3-Flash
Обе модели работают через совместимый с OpenAI Chat Completions интерфейс, поэтому переход начинается с имени модели и базового URL, но на этом не заканчивается. Главное различие — рассуждение: код, который выключал его у DeepSeek ради коротких ответов, на GLM этого сделать не сможет, а лимит вывода у GLM втрое ниже.
| Параметр | DeepSeek V4.1 Flash | GLM-5.3-Flash |
|---|---|---|
| Имя модели | deepseek-flash; старые deepseek-v4-flash тоже принимаются | glm-5.3-flash; быстрее — glm-5.3-flashx |
| Базовый URL | https://api.deepseek.com, формат Anthropic — https://api.deepseek.com/anthropic | https://api.z.ai/api/paas/v4/ |
| Рассуждение | Включено по умолчанию, выключается {"thinking": {"type": "disabled"}} | Только enabled, выключить нельзя |
| Уровень рассуждения | reasoning_effort: low, high (по умолчанию), max | Z.ai рекомендует reasoning_effort: max |
| Сэмплирование | В режиме рассуждений temperature, presence_penalty и frequency_penalty игнорируются без ошибки, top_p действует в диапазоне 0,95–1,0 | Рекомендованы temperature: 1 и top_p: 0.95 |
| Рассуждение в истории диалога | При вызове инструментов reasoning_content прошлых ходов нужно возвращать, иначе ошибка 400 | При рекомендованном thinking.clear_thinking: false нужно возвращать полный неизменённый reasoning_content |
| Максимум вывода | 384K | 128K |
| Типы входа | Текст и изображения | Текст, изображения, видео и файлы; изображения — блоками image_url со ссылкой или Base64 |
| Прочие возможности | Responses API, JSON, вызов инструментов, FIM (бета, только без рассуждения), до 2 500 параллельных запросов на аккаунт | Вызов функций, структурированный вывод JSON, автоматический кэш контекста |
При переходе с DeepSeek на GLM чаще всего ломаются три вещи. Короткие вызовы, где рассуждение было выключено, начинают тратить токены размышлений и отвечать медленнее; ответы длиннее 128 тыс. токенов обрезаются; а код, который отбрасывал reasoning_content между ходами, нужно переписать, если вы включаете рекомендованное Z.ai сохранение рассуждений. Для потоковых запросов Z.ai советует включать вместе stream: true и tool_stream: true, а число кэшированных токенов показывает в usage.prompt_tokens_details.cached_tokens.
В обратную сторону проверьте другое. Видео и файлы DeepSeek не принимает, temperature в режиме рассуждений перестаёт действовать, хотя ошибки не будет, а значения minimal, medium, xhigh и ultra для reasoning_effort DeepSeek сводит к ближайшим из трёх своих уровней: minimal к low, medium и xhigh к high, ultra к max. Для агентов вроде Claude Code у DeepSeek есть адрес в формате Anthropic; маршруты и типичные ошибки подключения разобраны в статье Claude Code с OpenRouter и DeepSeek: маршруты, настройка и первые ошибки.
Свой сервер или сторонний провайдер: 475 и 306 ГиБ весов
Запустить у себя можно обе модели, но речь о серверах с несколькими ускорителями, а не о видеокарте в рабочей станции. 25 октября 2026 года через API Hugging Face были сложены размеры официальных весов: у DeepSeek-V4.1-Flash-1017 на Hugging Face 48 файлов .safetensors на 475,3 ГиБ (FP8, эксперты в FP4), у GLM-5.3-Flash на Hugging Face 62 файла на 305,8 ГиБ (FP8). Это только веса: память под KV-кэш, активации и запас нужна сверх них. Как выбрать способ запуска GLM и сколько памяти закладывать, разобрано в статье GLM-5.3-Flash: что скрывалось под именем Ox Alpha и как выбрать способ запуска.
Благодаря открытым весам обе модели держат десятки сторонних провайдеров. В каталоге OpenRouter на 25 октября 2026 года у deepseek/deepseek-v4.1-flash-1017 34 эндпойнта от 29 провайдеров, у z-ai/glm-5.3-flash — 38 от 34. Цены, квантизация (от FP8 до FP4) и лимит вывода у них разные: у DeepSeek максимальная длина ответа на разных эндпойнтах колеблется от 131 072 до 943 718 токенов. Поэтому для честного сравнения берите первоисточники или эндпойнты с одинаковой квантизацией у обеих моделей, а цены сторонних провайдеров перед запуском сверяйте отдельно. В каталоге laozhang.ai при повторной проверке 25 октября 2026 года уже есть deepseek-flash (старое имя deepseek-v4-flash тоже осталось), но нет glm-5.3-flash, так что сравнить обе модели через этот шлюз пока не получится.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Как сравнить DeepSeek V4.1 Flash и GLM-5.3-Flash на своих задачах
Индекс и расчёты выше сужают выбор, но окончательно его решает небольшой тест на ваших запросах: только в нём видно и качество, и то, сколько токенов каждая модель реально тратит на вашу работу. Достаточно нескольких десятков запросов, если они взяты из реальной работы, а не придуманы для теста.
- Соберите из логов 20–50 реальных запросов в той же пропорции, что и в рабочей нагрузке: длинные сессии агента, короткие вызовы, документы.
- Зафиксируйте настройки, которые пойдут в продакшен. Для DeepSeek выберите
reasoning_effortи для коротких вызовов добавьте вариант с выключенным рассуждением; для GLM поставьте рекомендованныеtemperature: 1,top_p: 0.95иreasoning_effort: max. - Прогоните оба набора через
api.deepseek.comиapi.z.aiили через эндпойнты одной квантизации на роутере, указав у DeepSeek id с-1017. - Для каждого ответа сохраните из
usageтокены ввода, попадания в кэш, вывод и рассуждение, а также время до первого токена и общее время ответа. - Посчитайте стоимость по ценам из таблицы выше: для DeepSeek дважды, по непиковой и пиковой цене, а затем взвесьте по доле ваших вызовов, которая приходится на пиковые часы.
- Сравните ответы вслепую: перемешайте их и скройте имена моделей до оценки.
Если разница в качестве на вашем наборе не видна, решает стоимость из шага 5. Если GLM заметно лучше в одной категории задач, отправляйте на GLM только эту категорию, а остальное оставьте на DeepSeek.
Источники9
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 25 окт. 2026 г..
Источники9
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 25 окт. 2026 г..
- 1.журналу изменений DeepSeek APIapi-docs.deepseek.com/updates
- 2.странице цен DeepSeek APIapi-docs.deepseek.com/quick_start/pricing
- 3.странице цен Z.aidocs.z.ai/guides/overview/pricing
- 4.руководству Z.ai по GLM-5.3-Flashdocs.z.ai/guides/vlm/glm-5.3-flash
- 5.сравнении DeepSeek V4.1 Flash 1017 и GLM-5.3-Flash на Artificial Analysisartificialanalysis.ai/models/comparisons/deepseek-v4-1-flash-1017-vs-glm-5-3-flash
- 6.документации Z.ai о режиме рассужденийdocs.z.ai/guides/capabilities/thinking-mode
- 7.руководству DeepSeek по режиму рассужденийapi-docs.deepseek.com/guides/thinking_mode
- 8.DeepSeek-V4.1-Flash-1017 на Hugging Facehuggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- 9.GLM-5.3-Flash на Hugging Facehuggingface.co/zai-org/GLM-5.3-Flash