最新发布
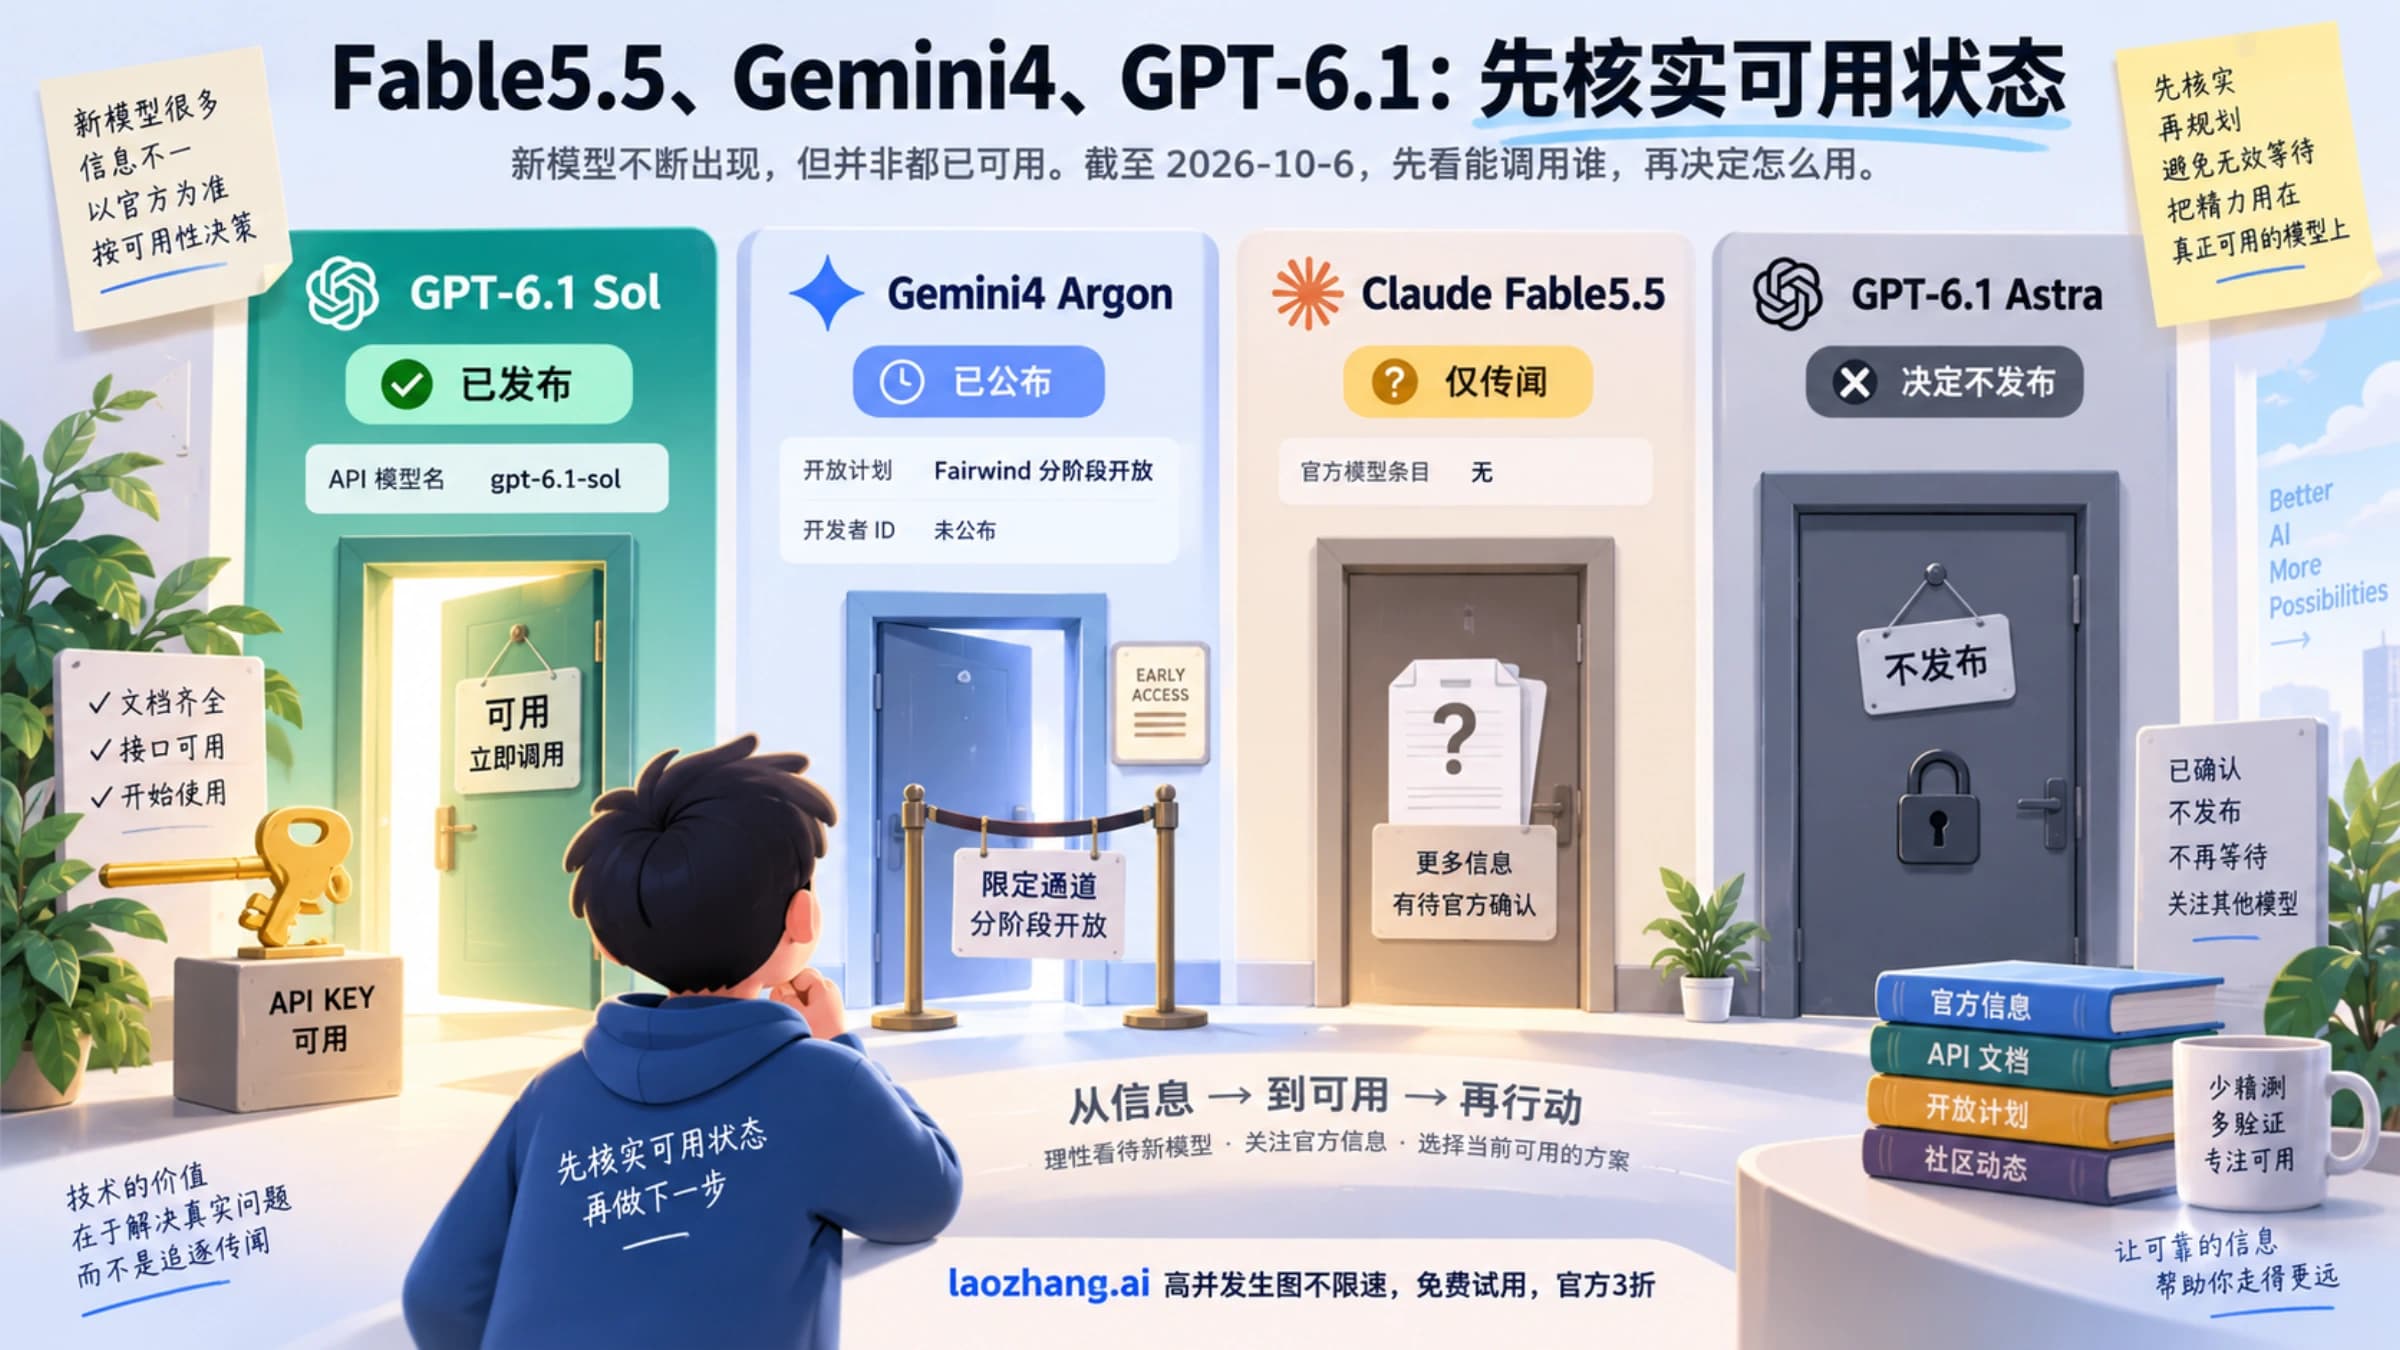
Fable 5.5、Gemini 4、GPT-6.1 对比:Argon 已开放,Fable 5.5 未出
截至 2026 年 10 月 14 日,GPT-6.1 Sol 和 Gemini 4 Argon 都能调用;Fable 5.5 仍未发布,GPT-6.1 Astra 被搁置。
22 分钟
截至 2026 年 10 月 14 日,GPT-6.1 Sol 和 Gemini 4 Argon 都能调用;Fable 5.5 仍未发布,GPT-6.1 Astra 被搁置。
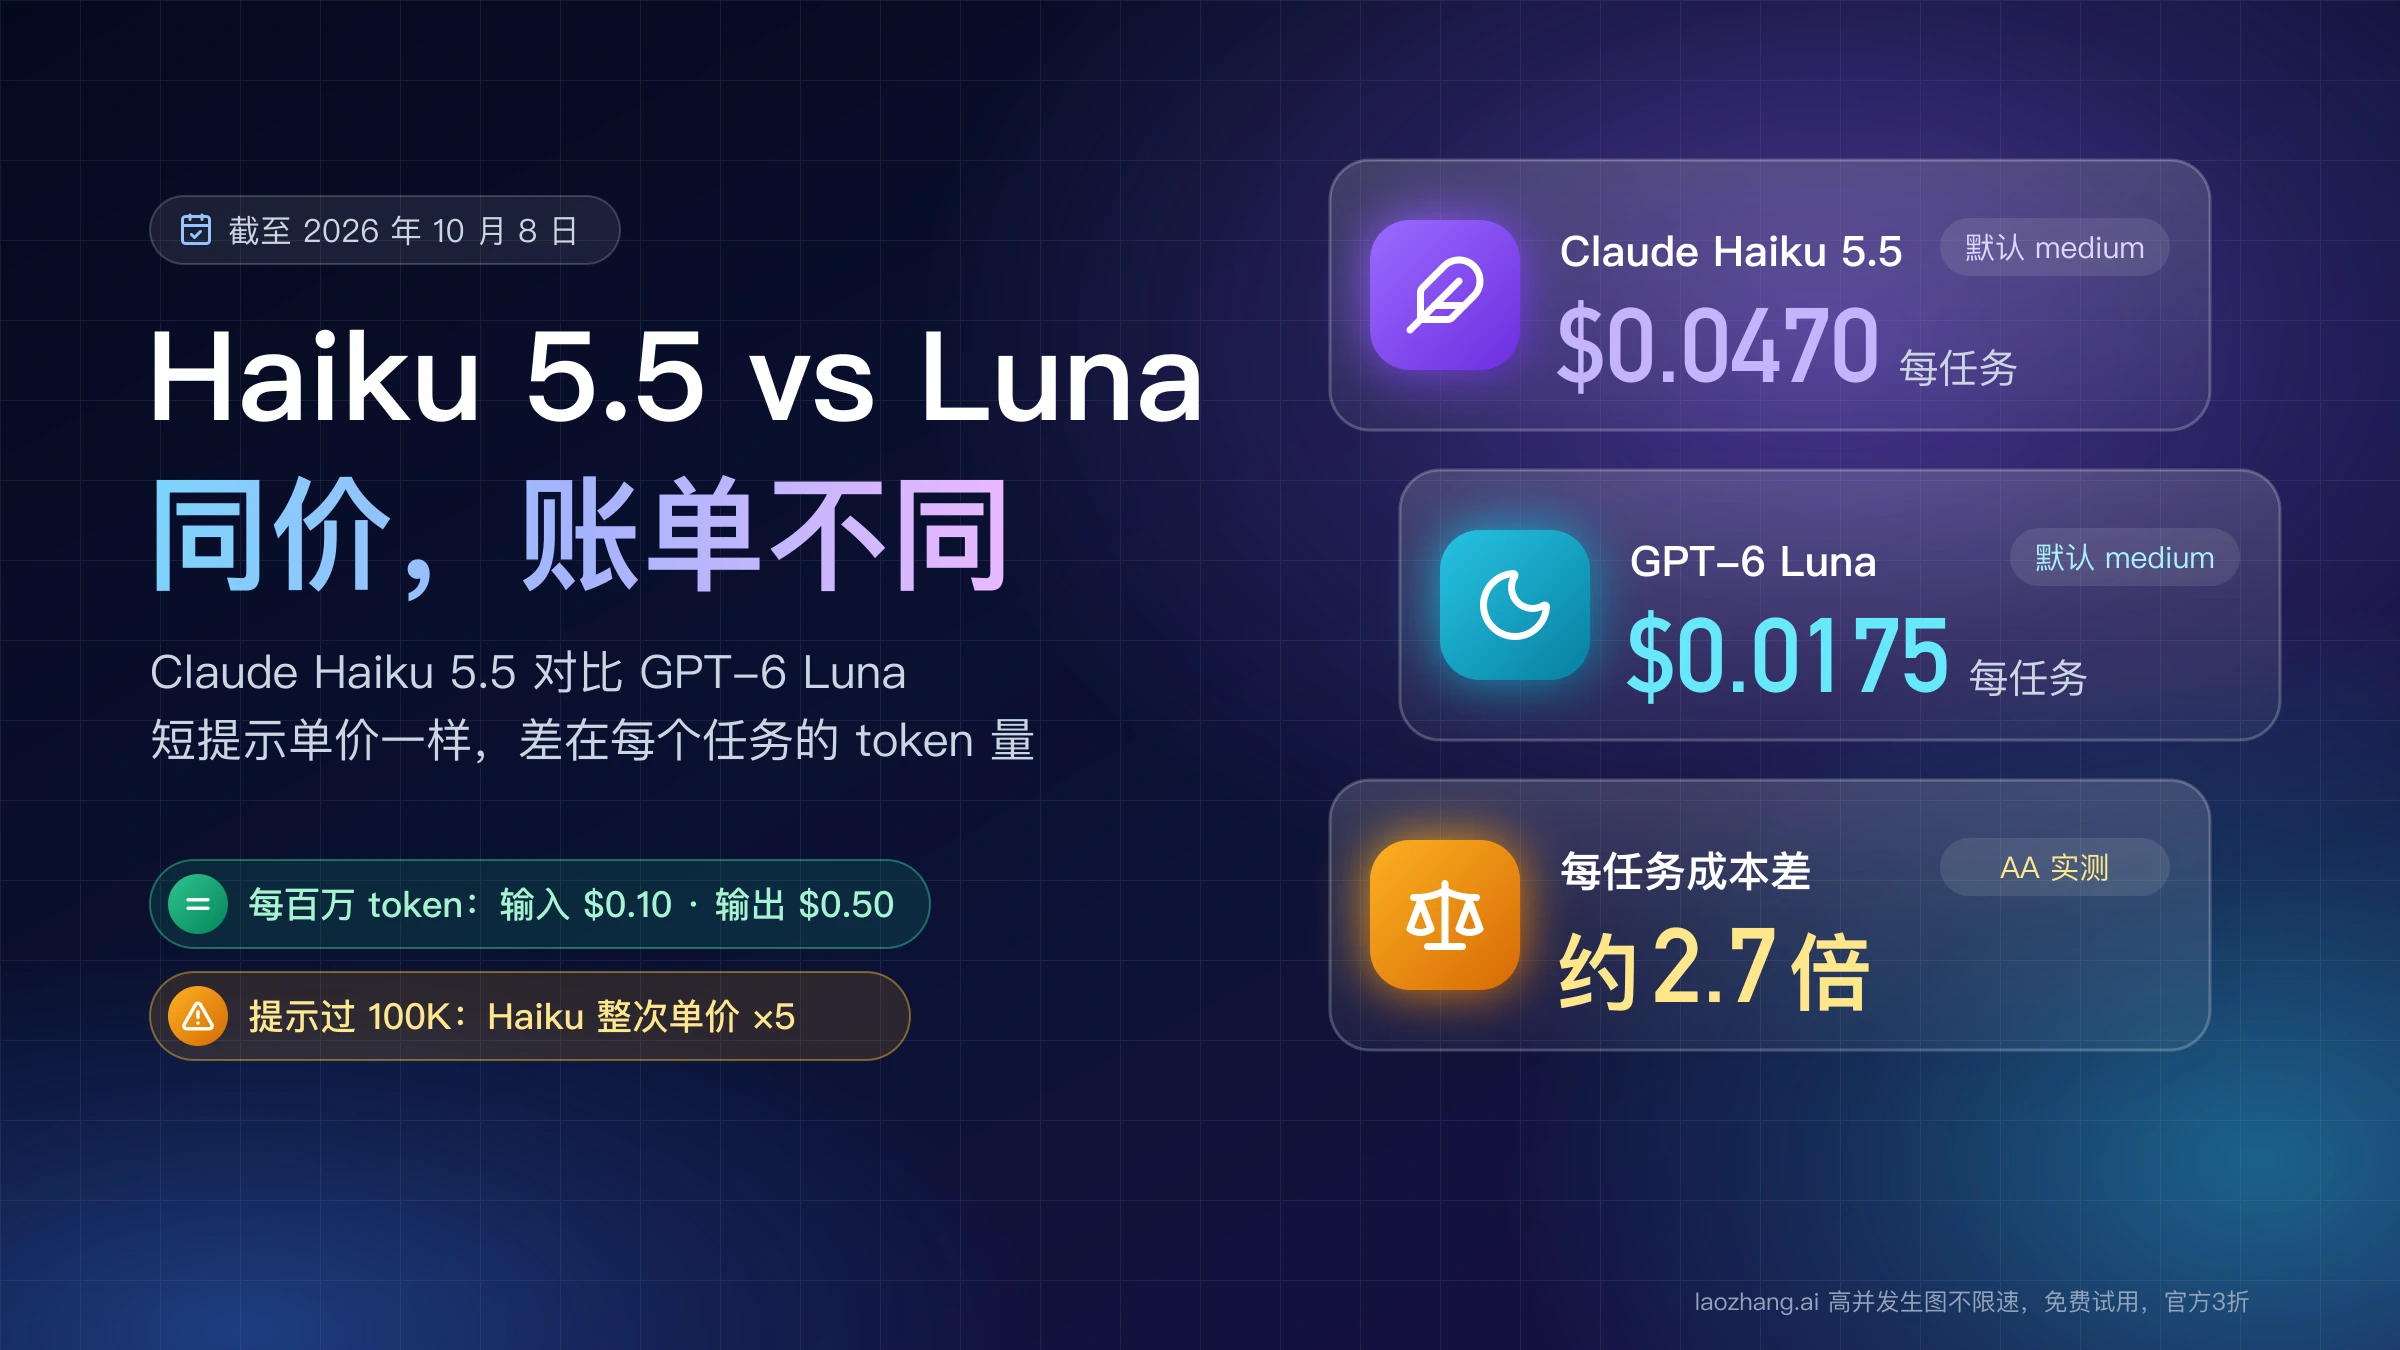
Claude Haiku 5.5 与 GPT-6 Luna 短提示同价;AA 数据中默认档 Haiku 每任务约贵 2.7 倍,提示过 100K 后整次单价再涨 5 倍。
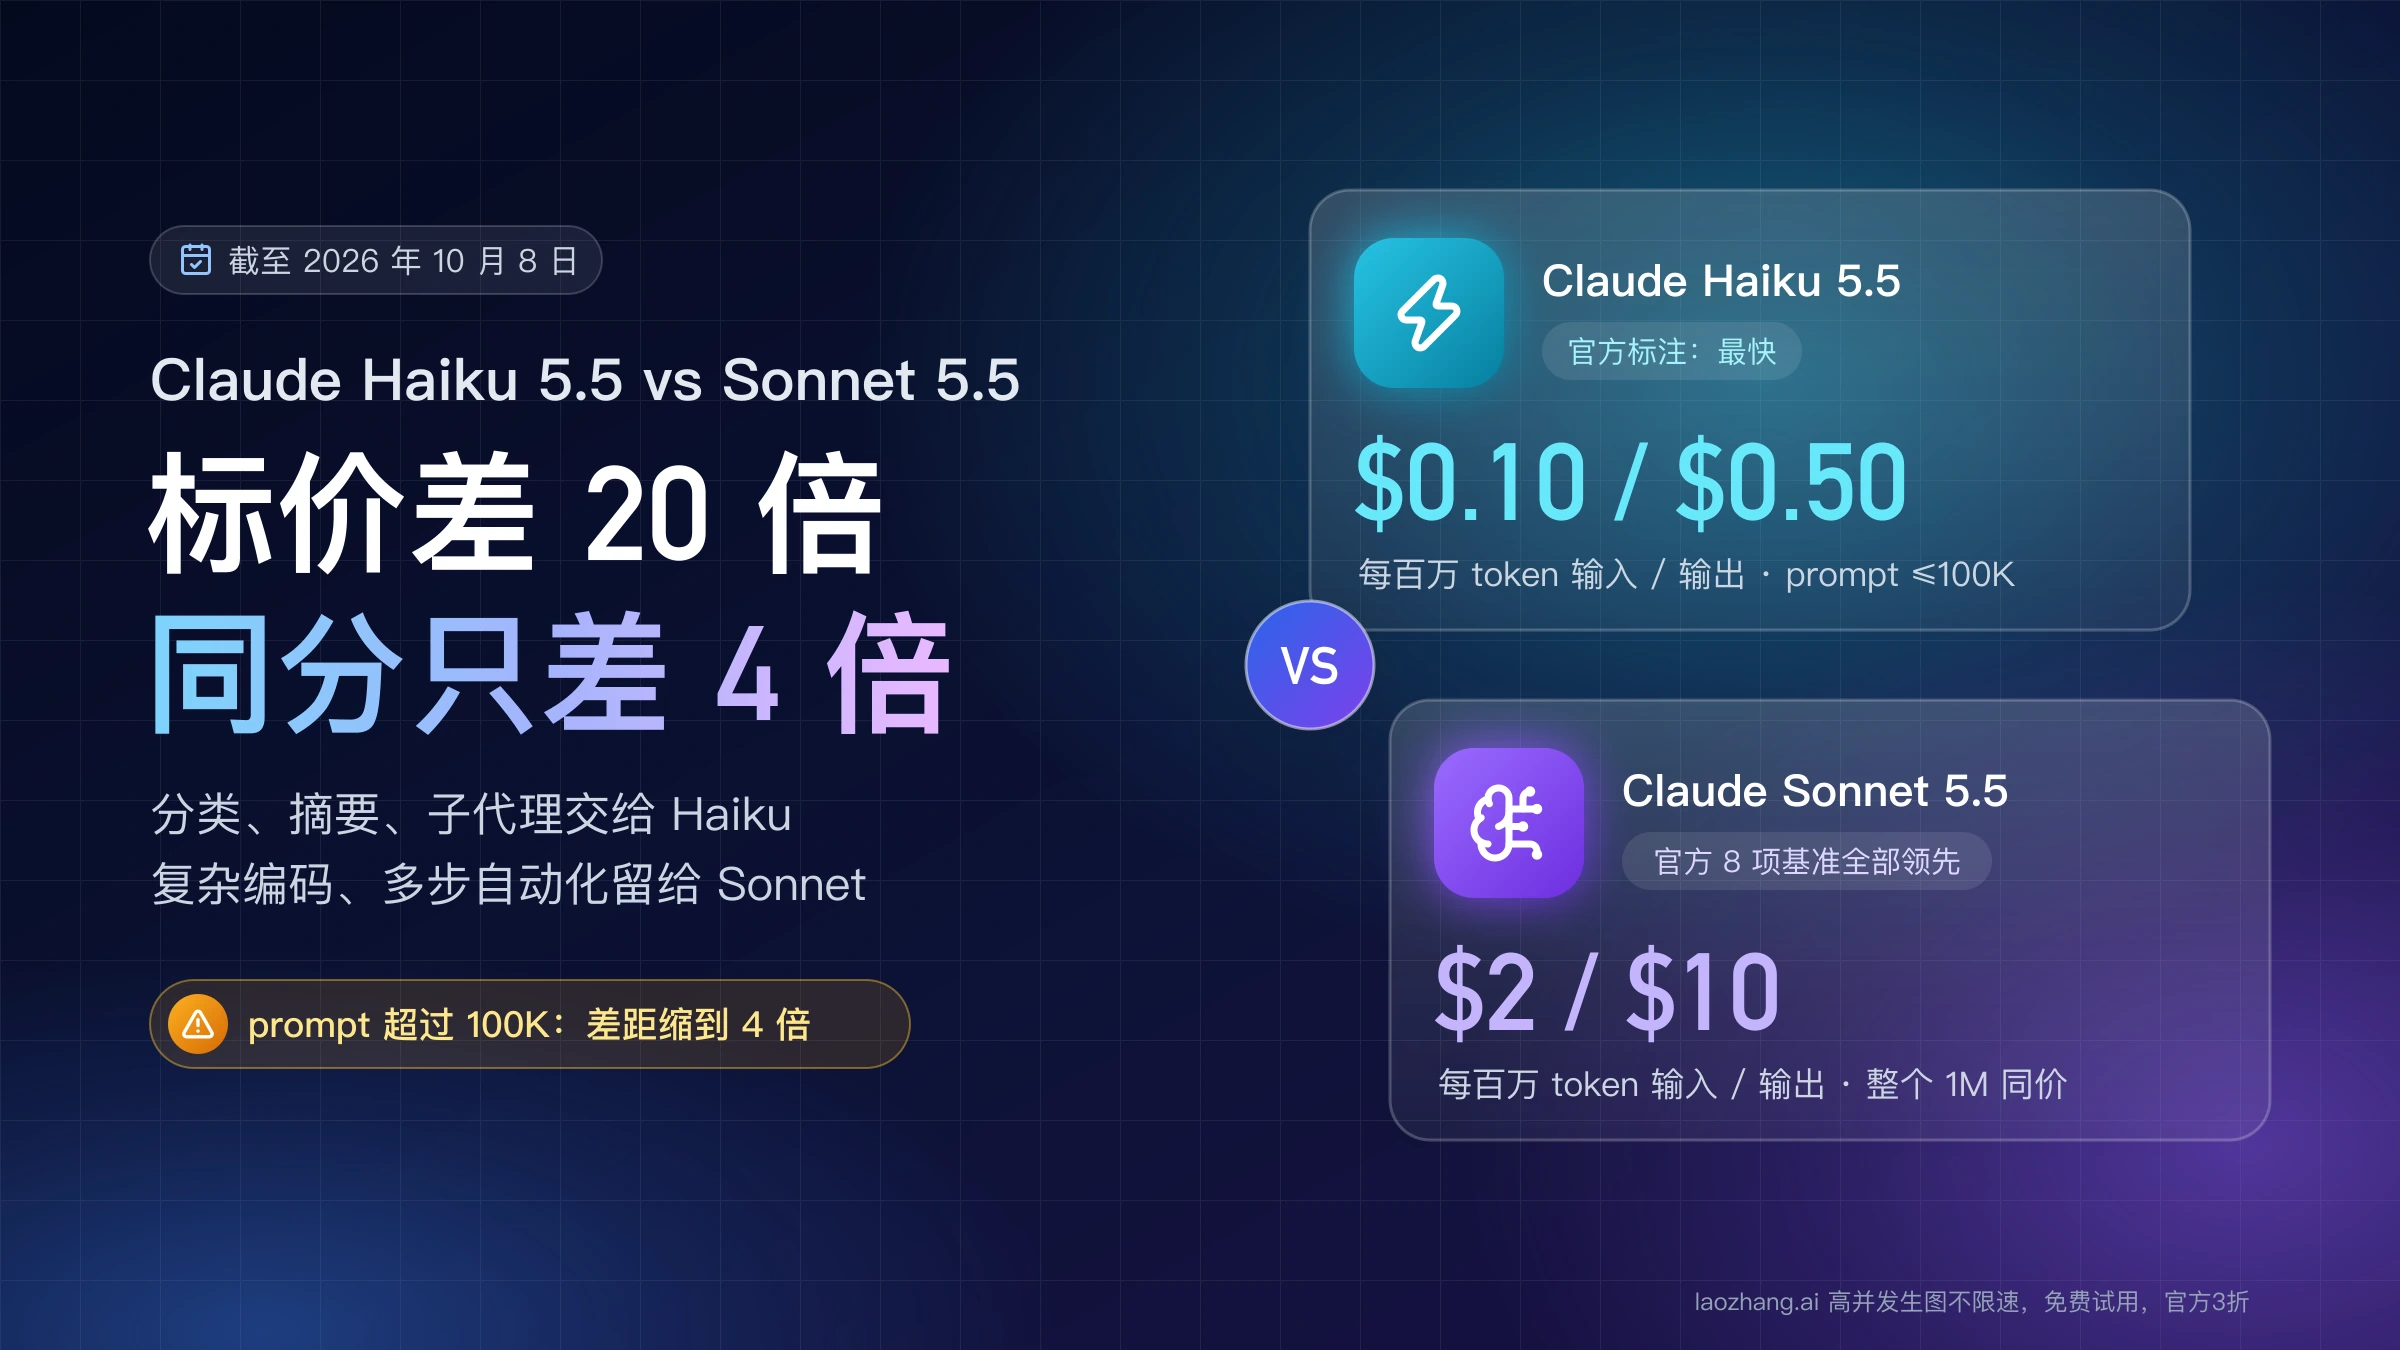
Haiku 5.5 单价约为 Sonnet 5.5 的二十分之一,但同等综合分下任务成本只低 4 倍、耗时更长。分类、摘要、子代理交给 Haiku,复杂编码留给 Sonnet。
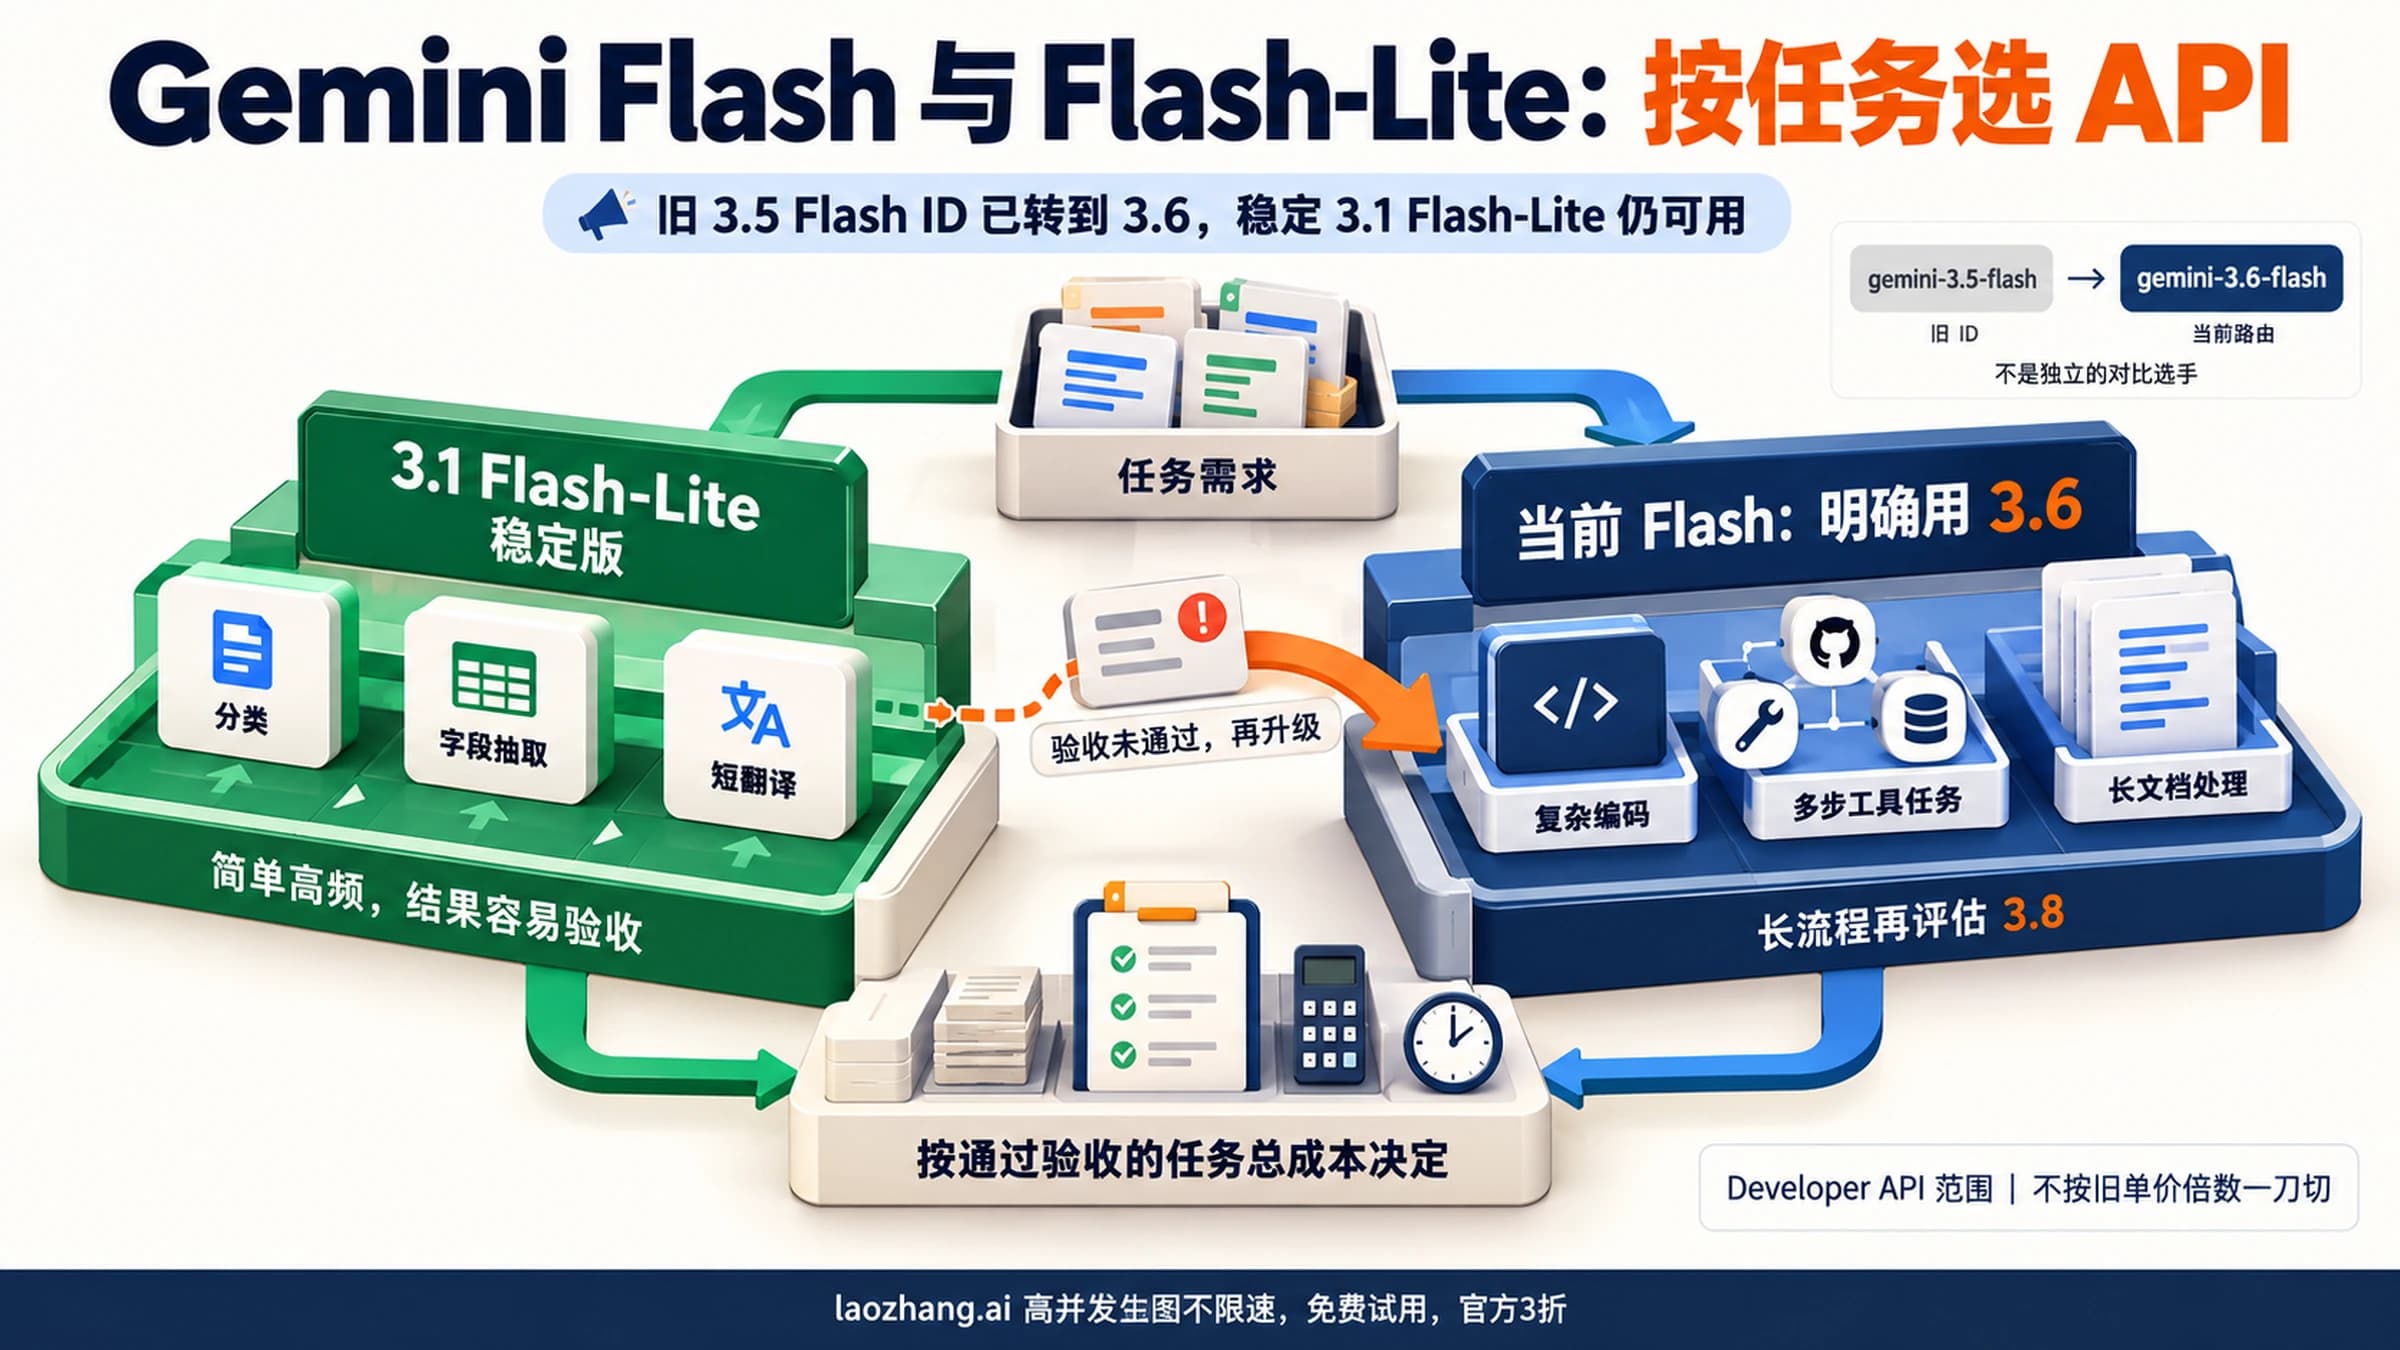
简单、高频且容易验收的任务可以保留 Gemini 3.1 Flash-Lite;原 Gemini 3.5 Flash 请求已由 3.6 响应,复杂编码和工具任务应以明确的当前模型 ID 做对照,再按成功任务的总成本决定迁移。
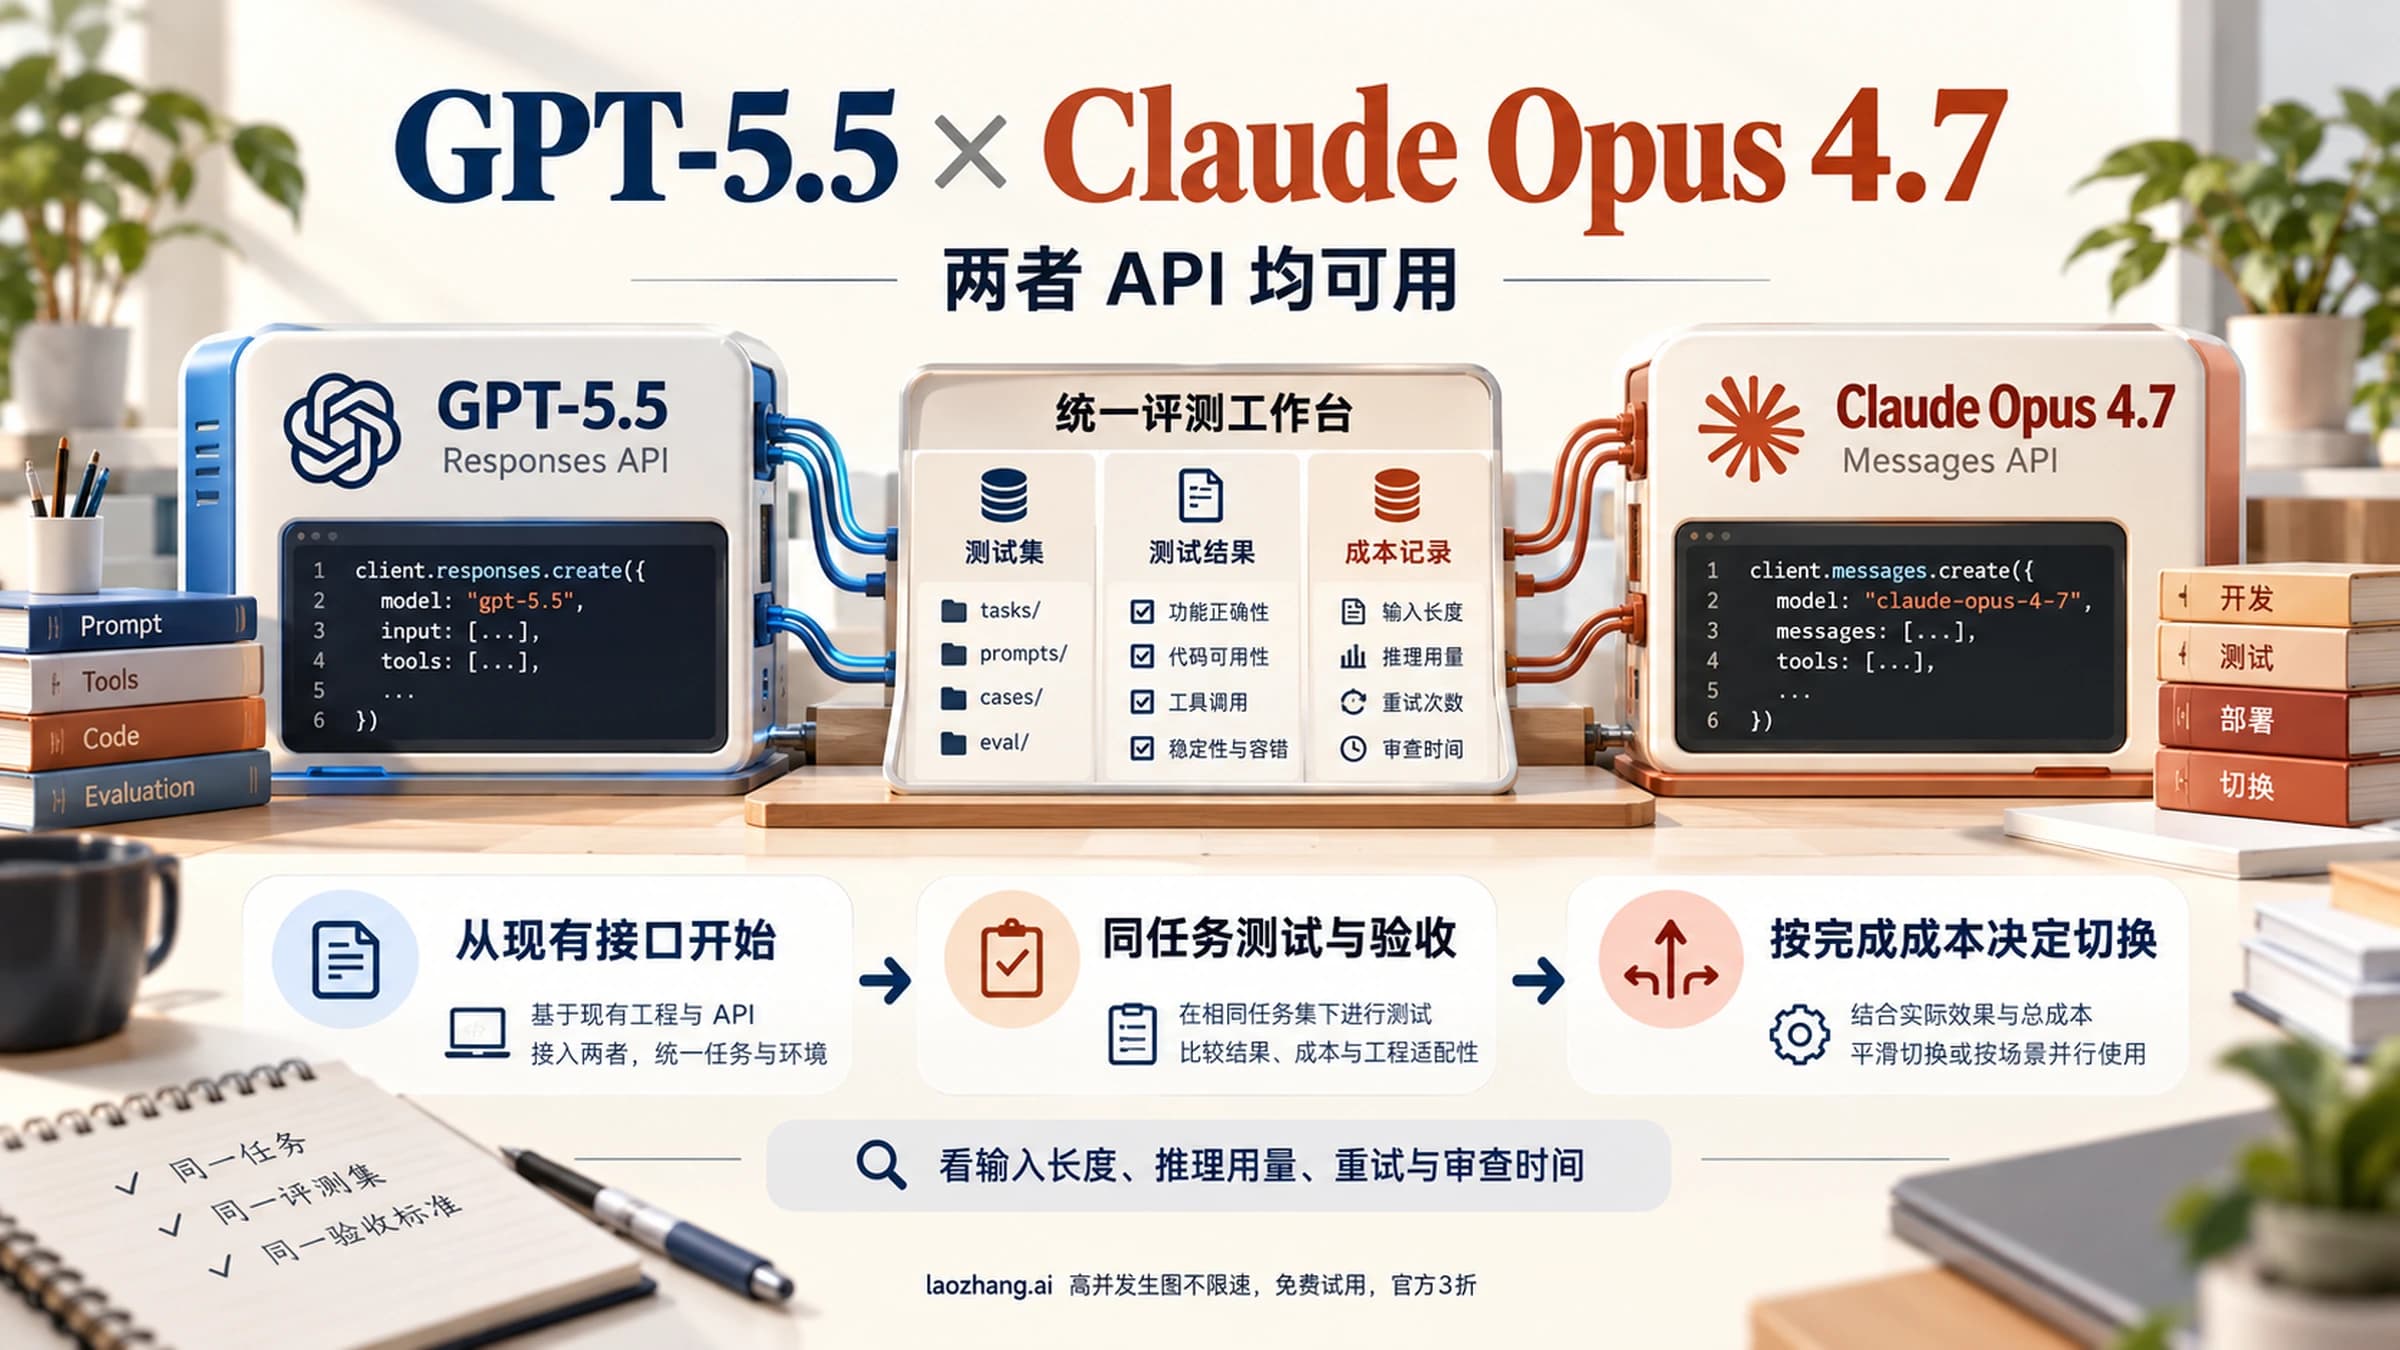
两者 API 均可用:已有 OpenAI 工具链先测 GPT-5.5,已有 Anthropic 工具链先测 Opus 4.7。超过 272K 的输入会触发 GPT-5.5 长上下文费率,编程任务则要按验收后的总成本决定是否切换。
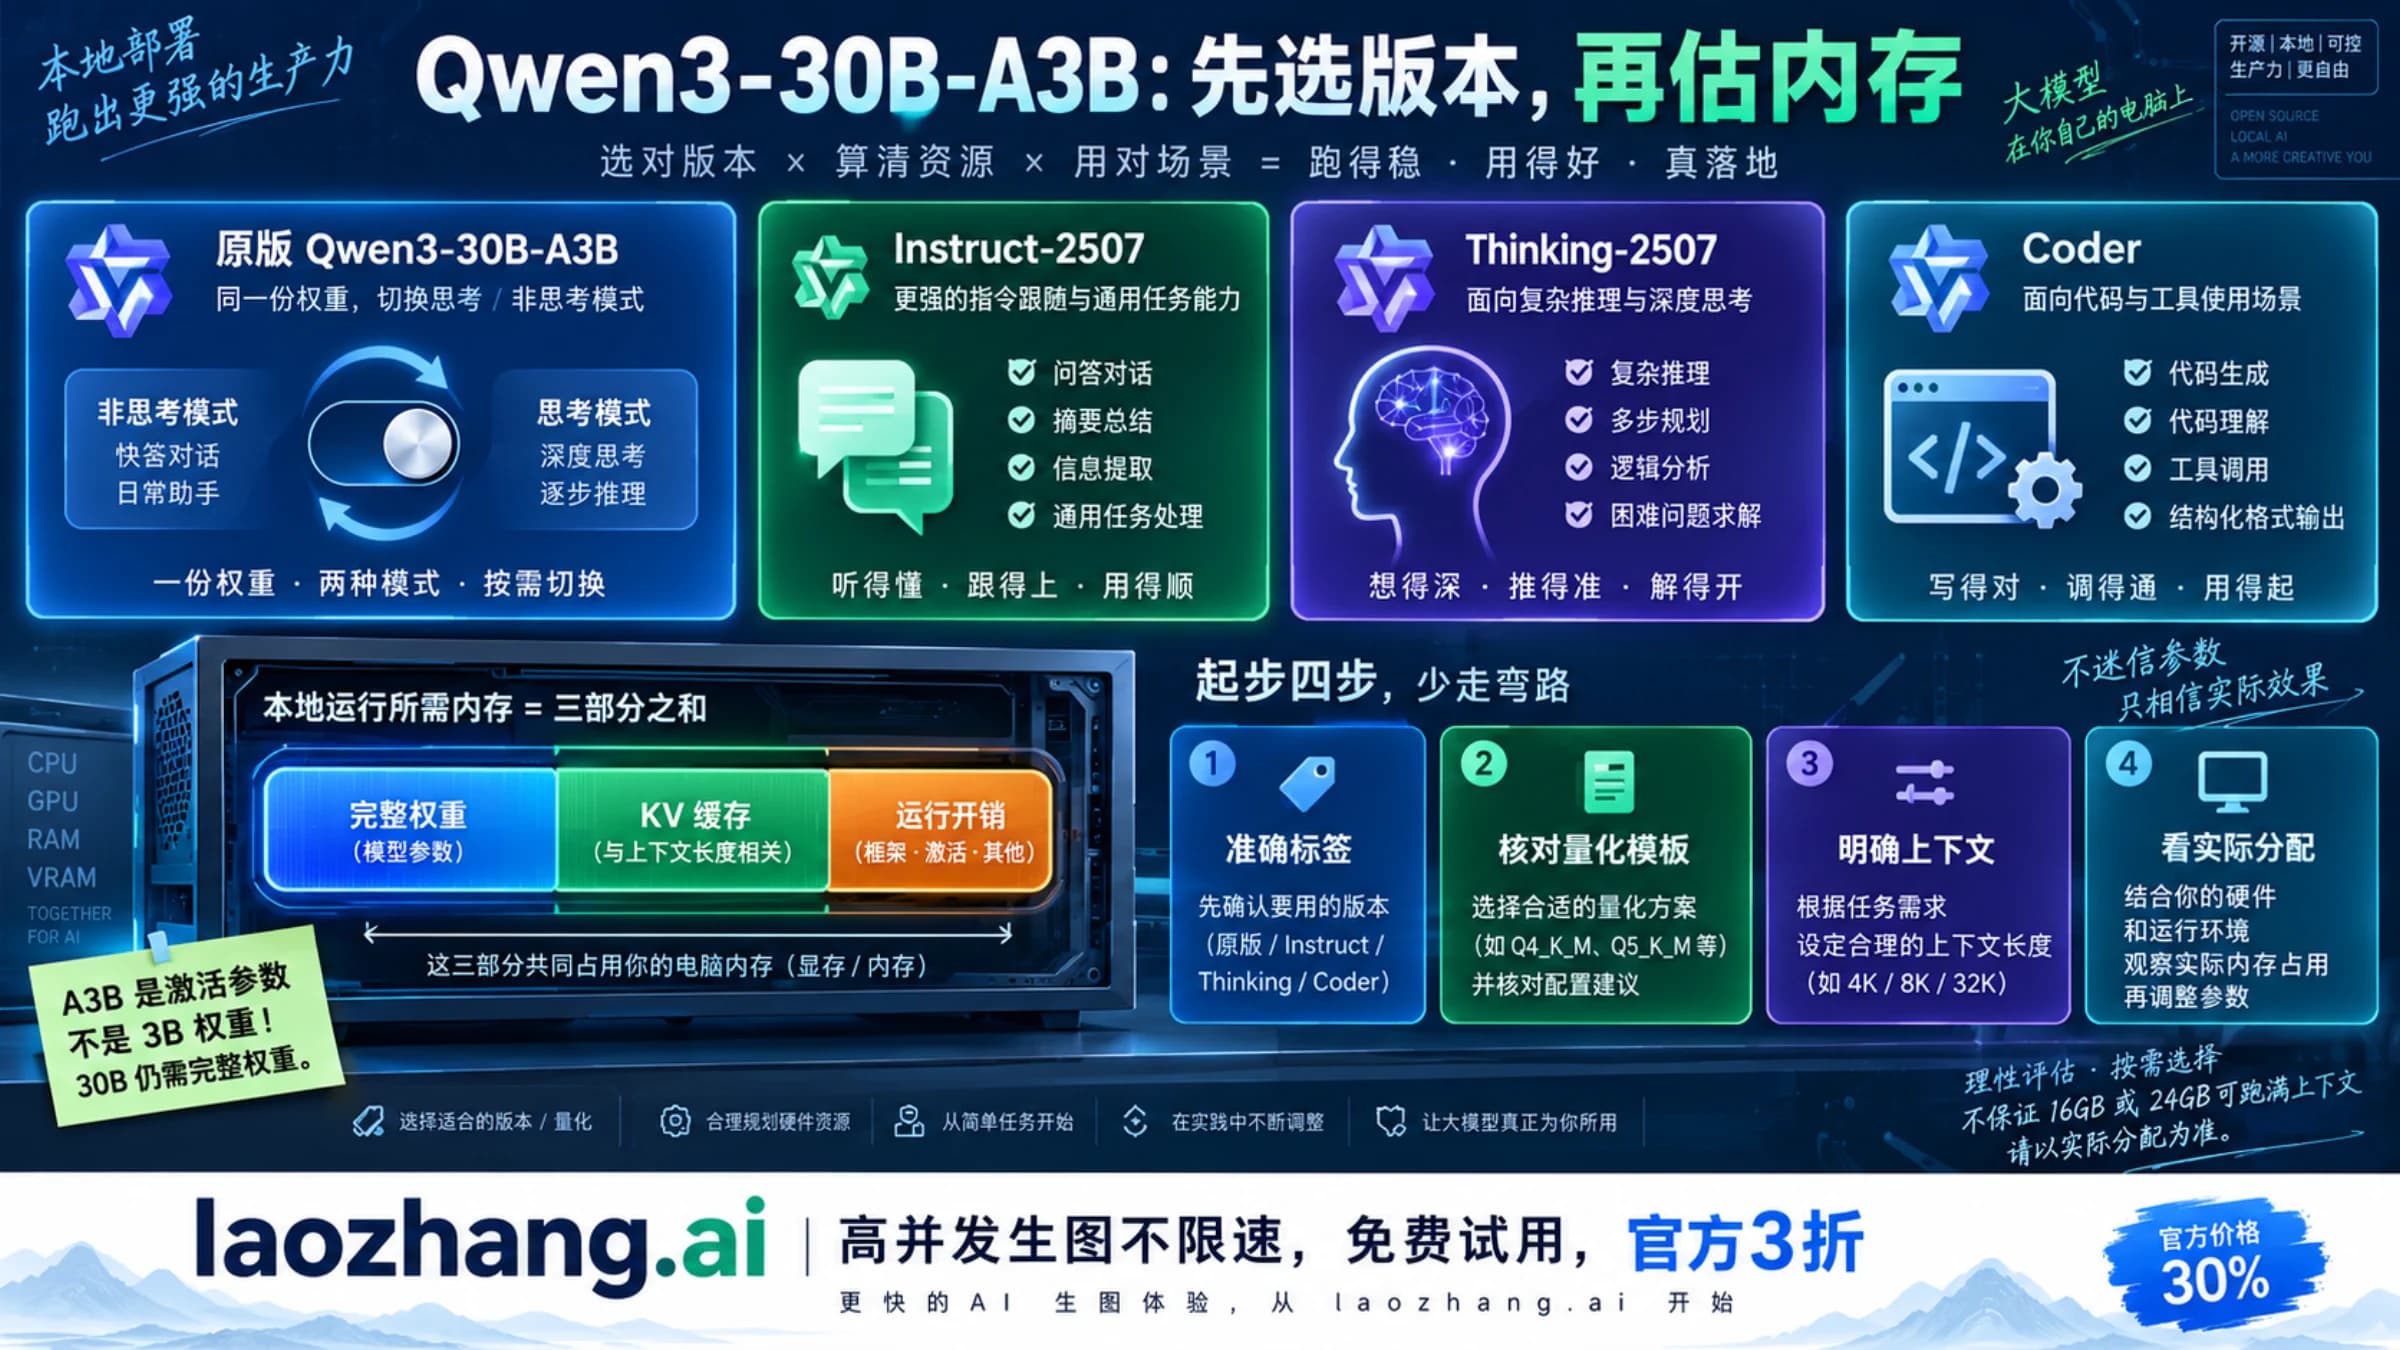
需要在同一模型中切换思考模式,选原版;普通问答选 Instruct-2507,复杂推理选 Thinking-2507,代码任务选 Coder。A3B 仍需保存 30.5B 权重,实际内存还要加上上下文缓存。
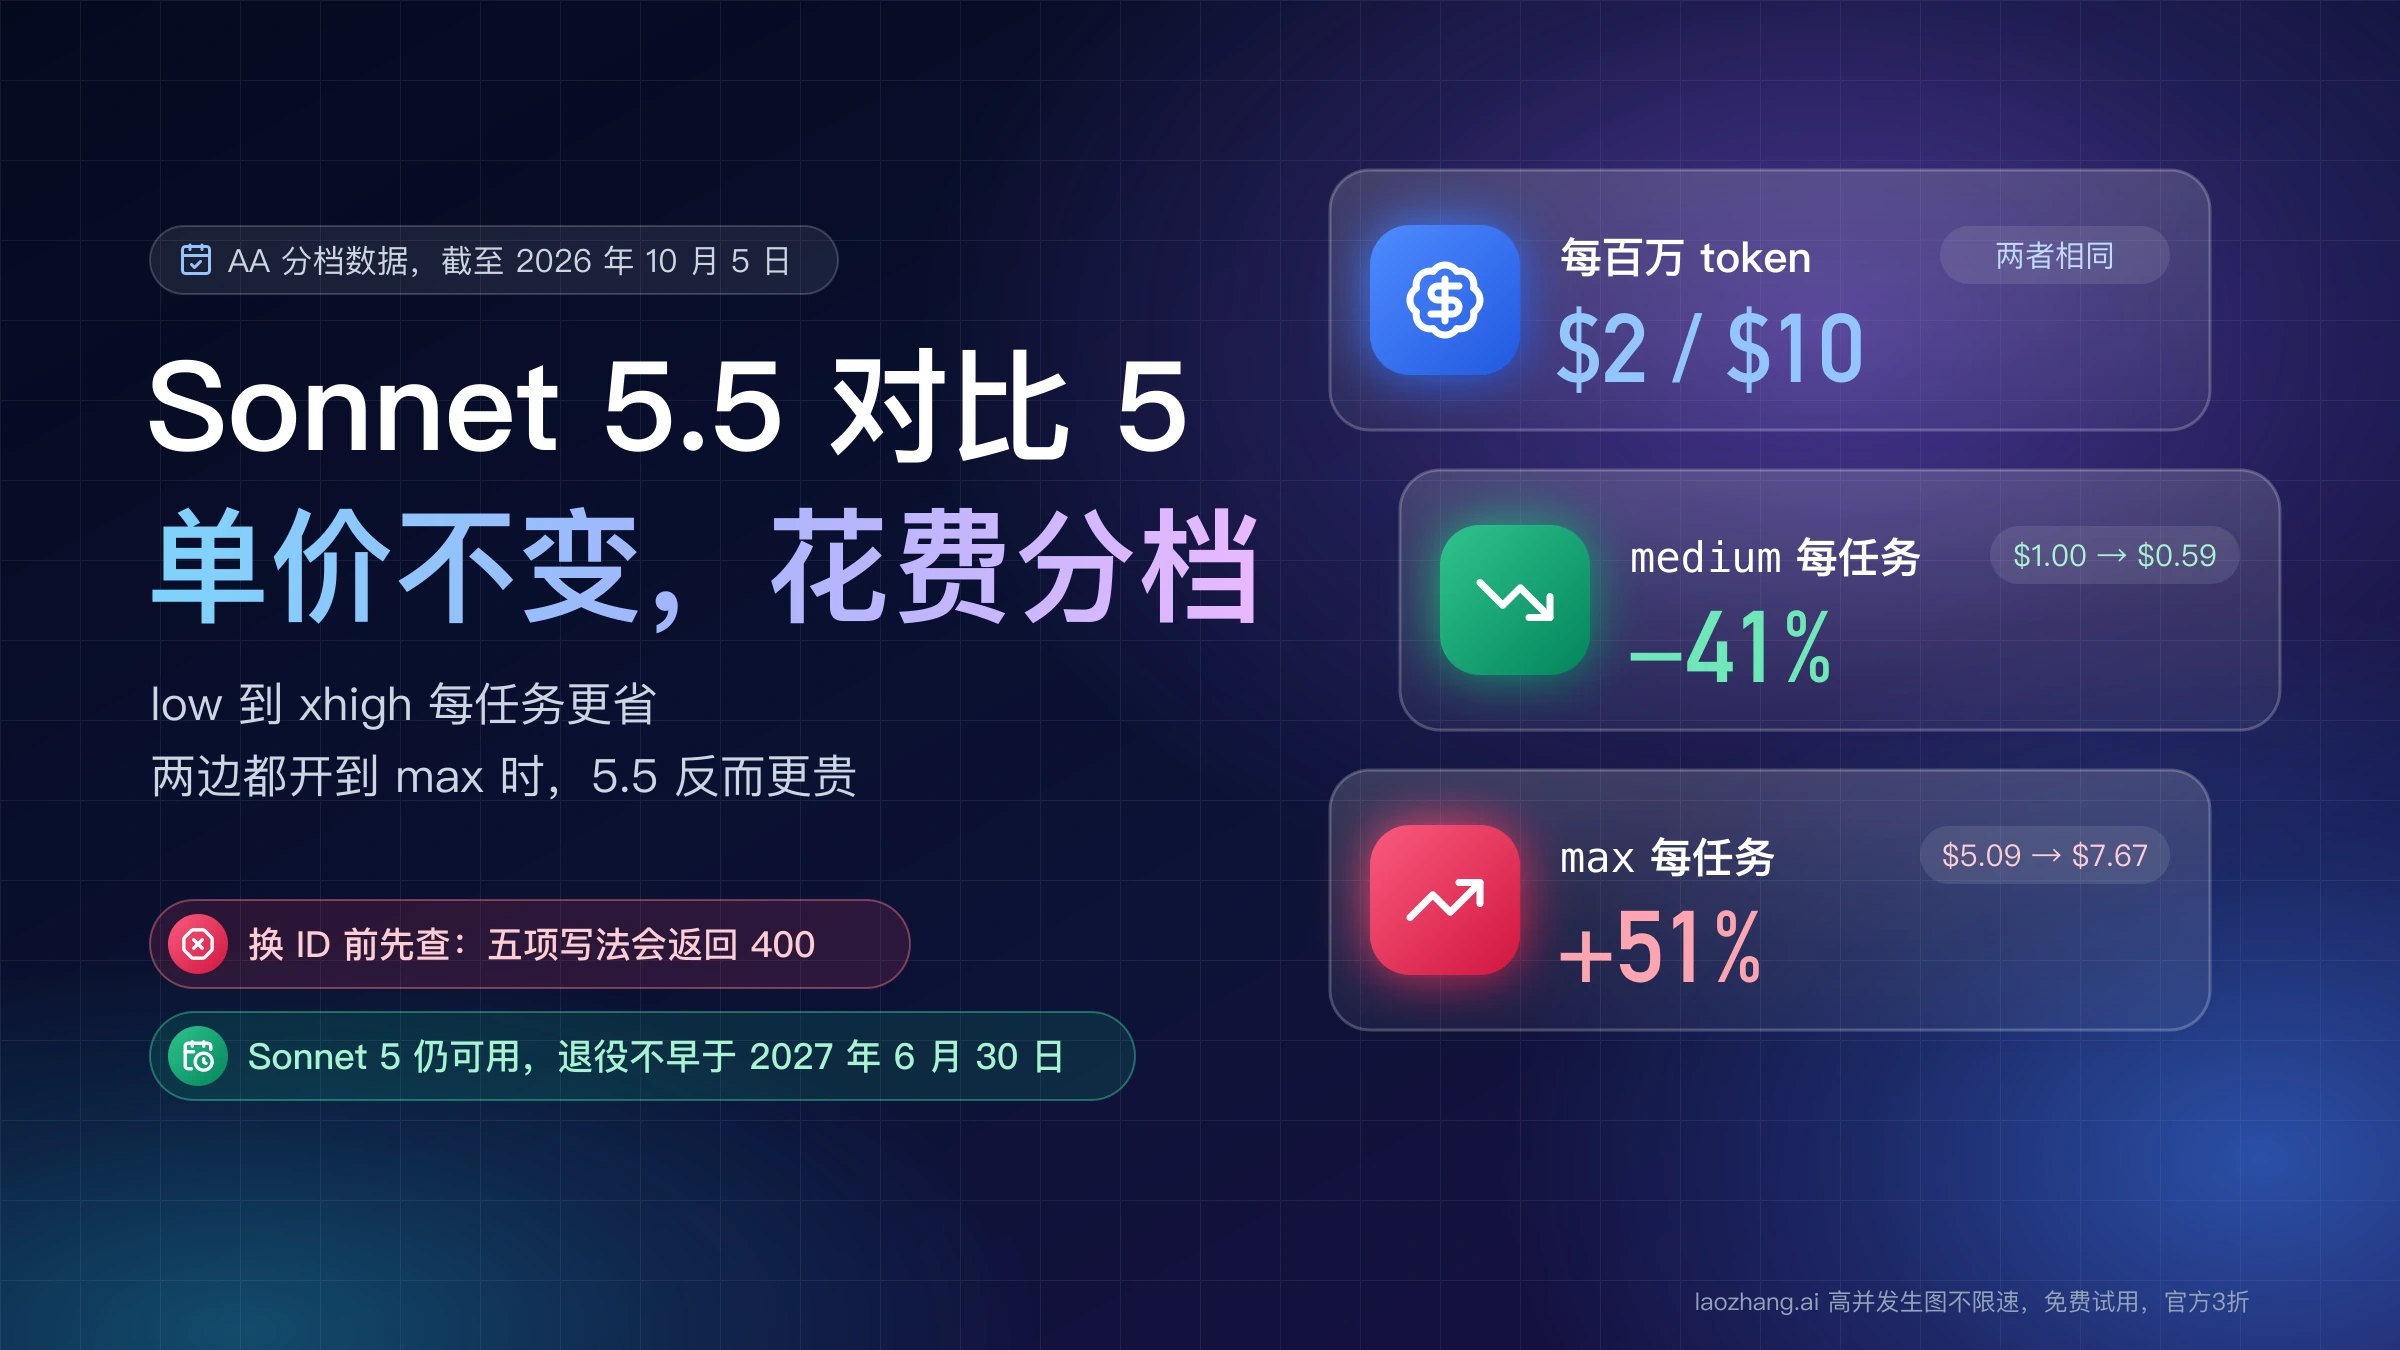
Claude Sonnet 5.5 与 Sonnet 5 单价相同。按第三方分档测试,low 到 xhigh 每任务更省,max 档贵约五成;改模型 ID 前先查五项破坏性变更。
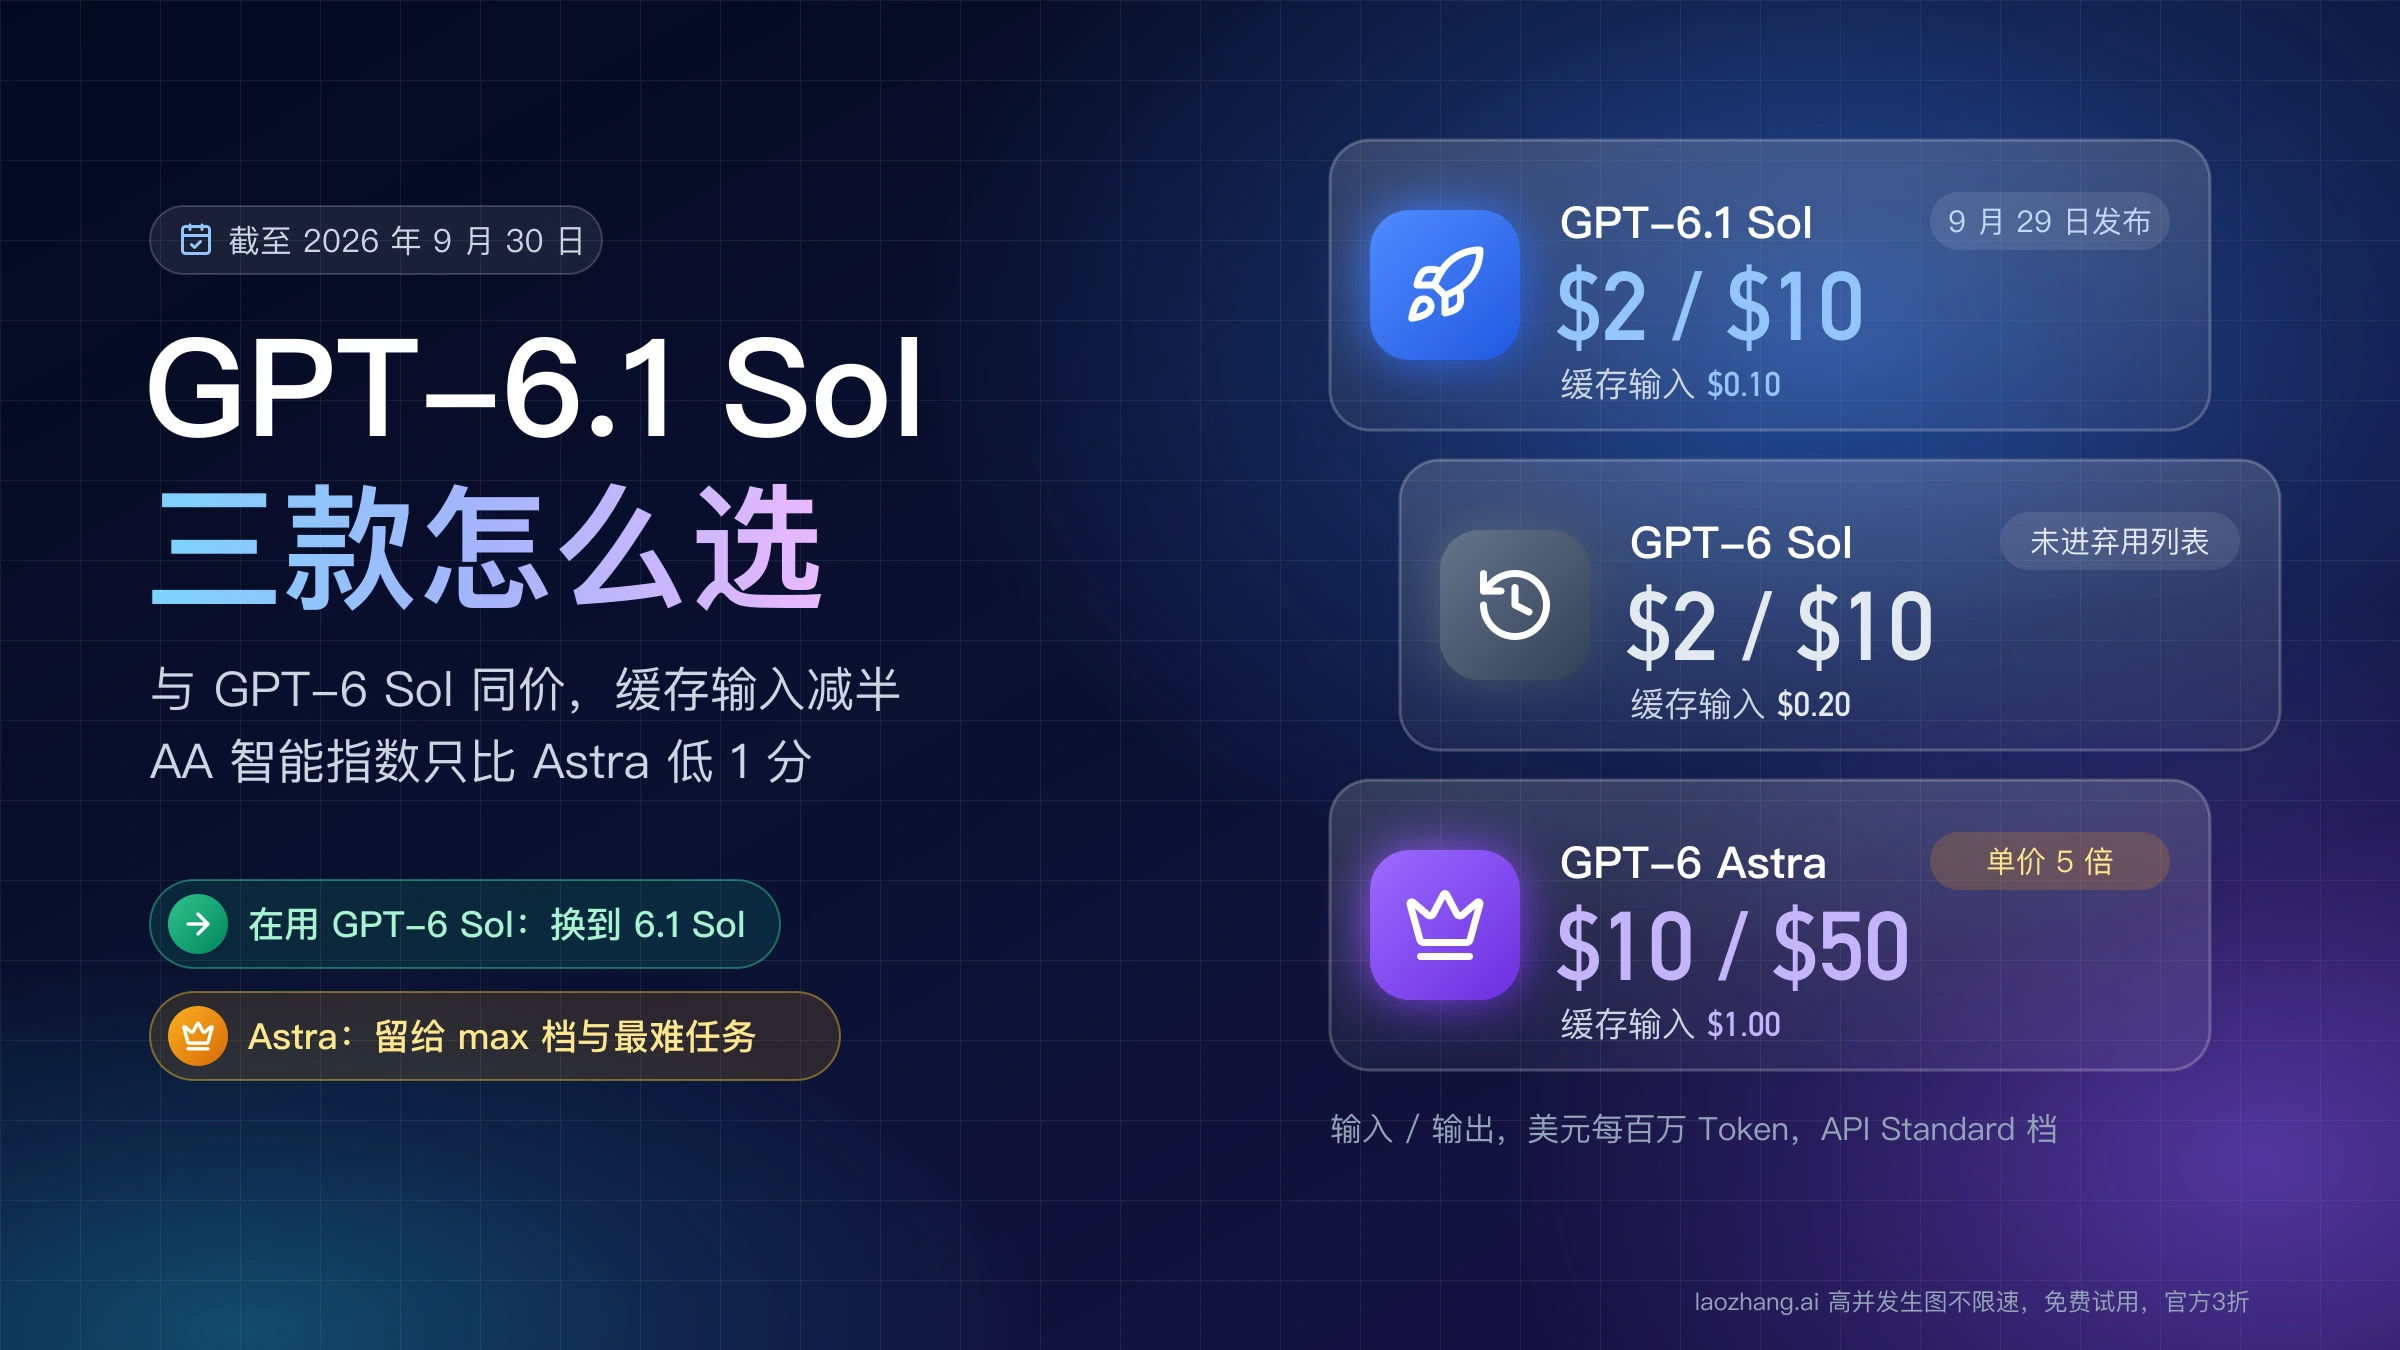
GPT-6.1 Sol 与 GPT-6 Sol 同价、各档更强,改好推理强度和工具调用就能换;Astra 单价高 5 倍,只在顶档能力、最难科学任务和 Ultrafast 上值得。
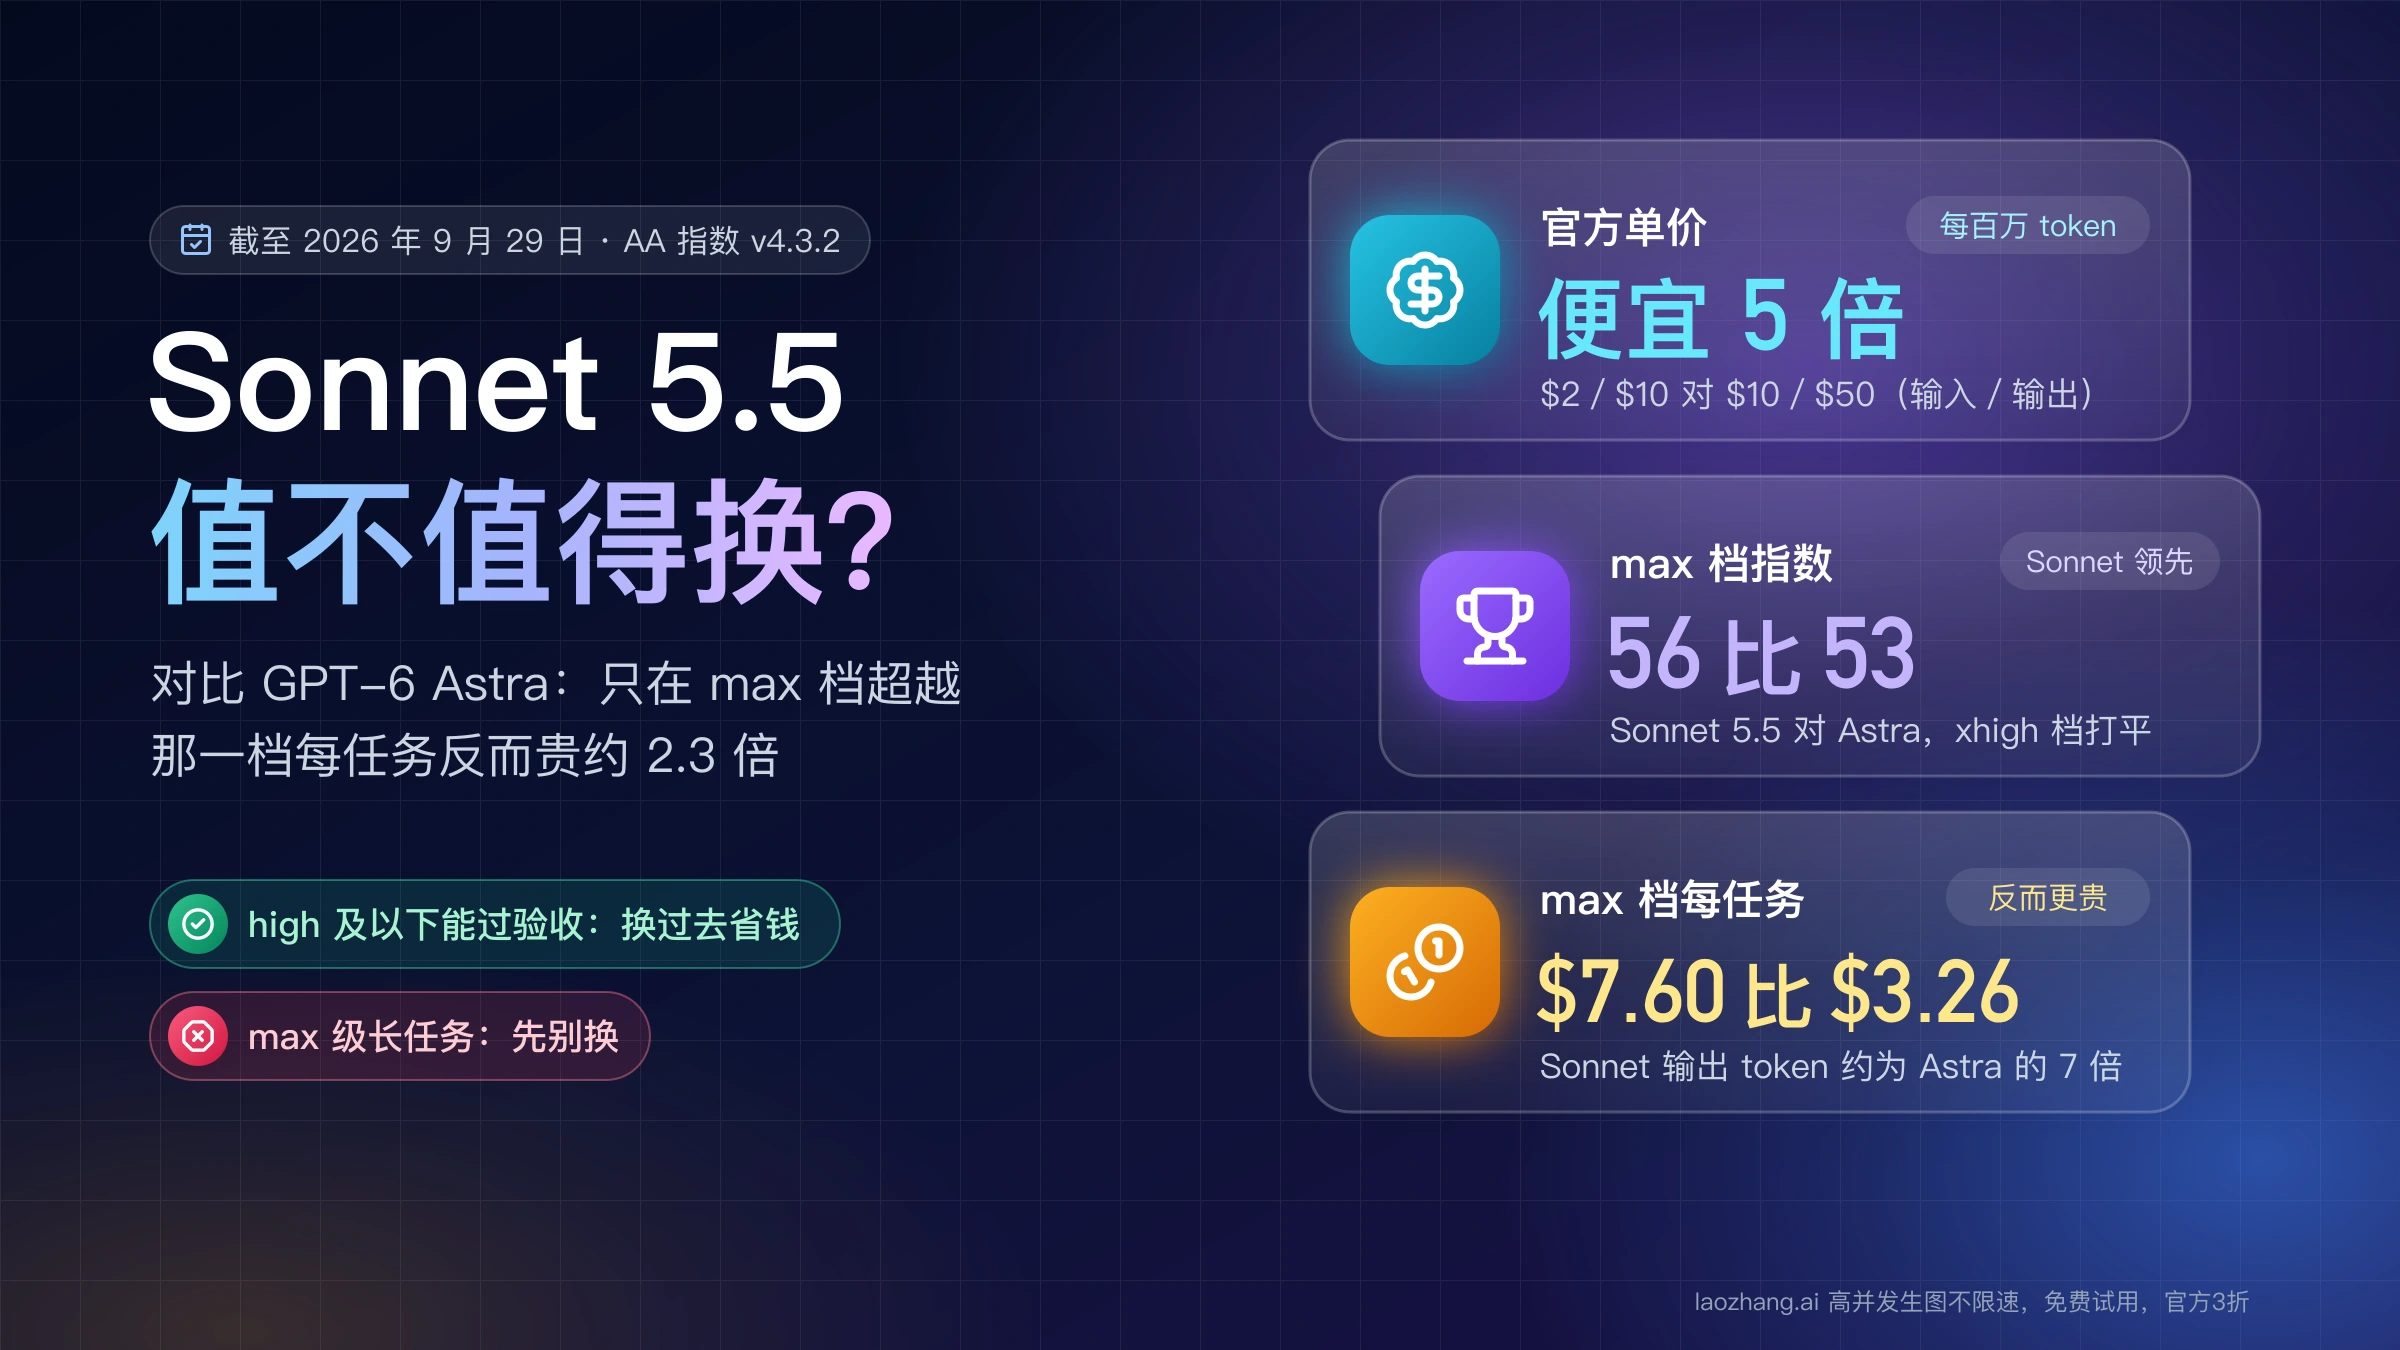
“超越 Astra”只在两边都开 max 时成立,这一档 Sonnet 5.5 每任务反而贵约 2.3 倍。high 及以下能过验收的任务换过去更省,max 级长任务先别换。
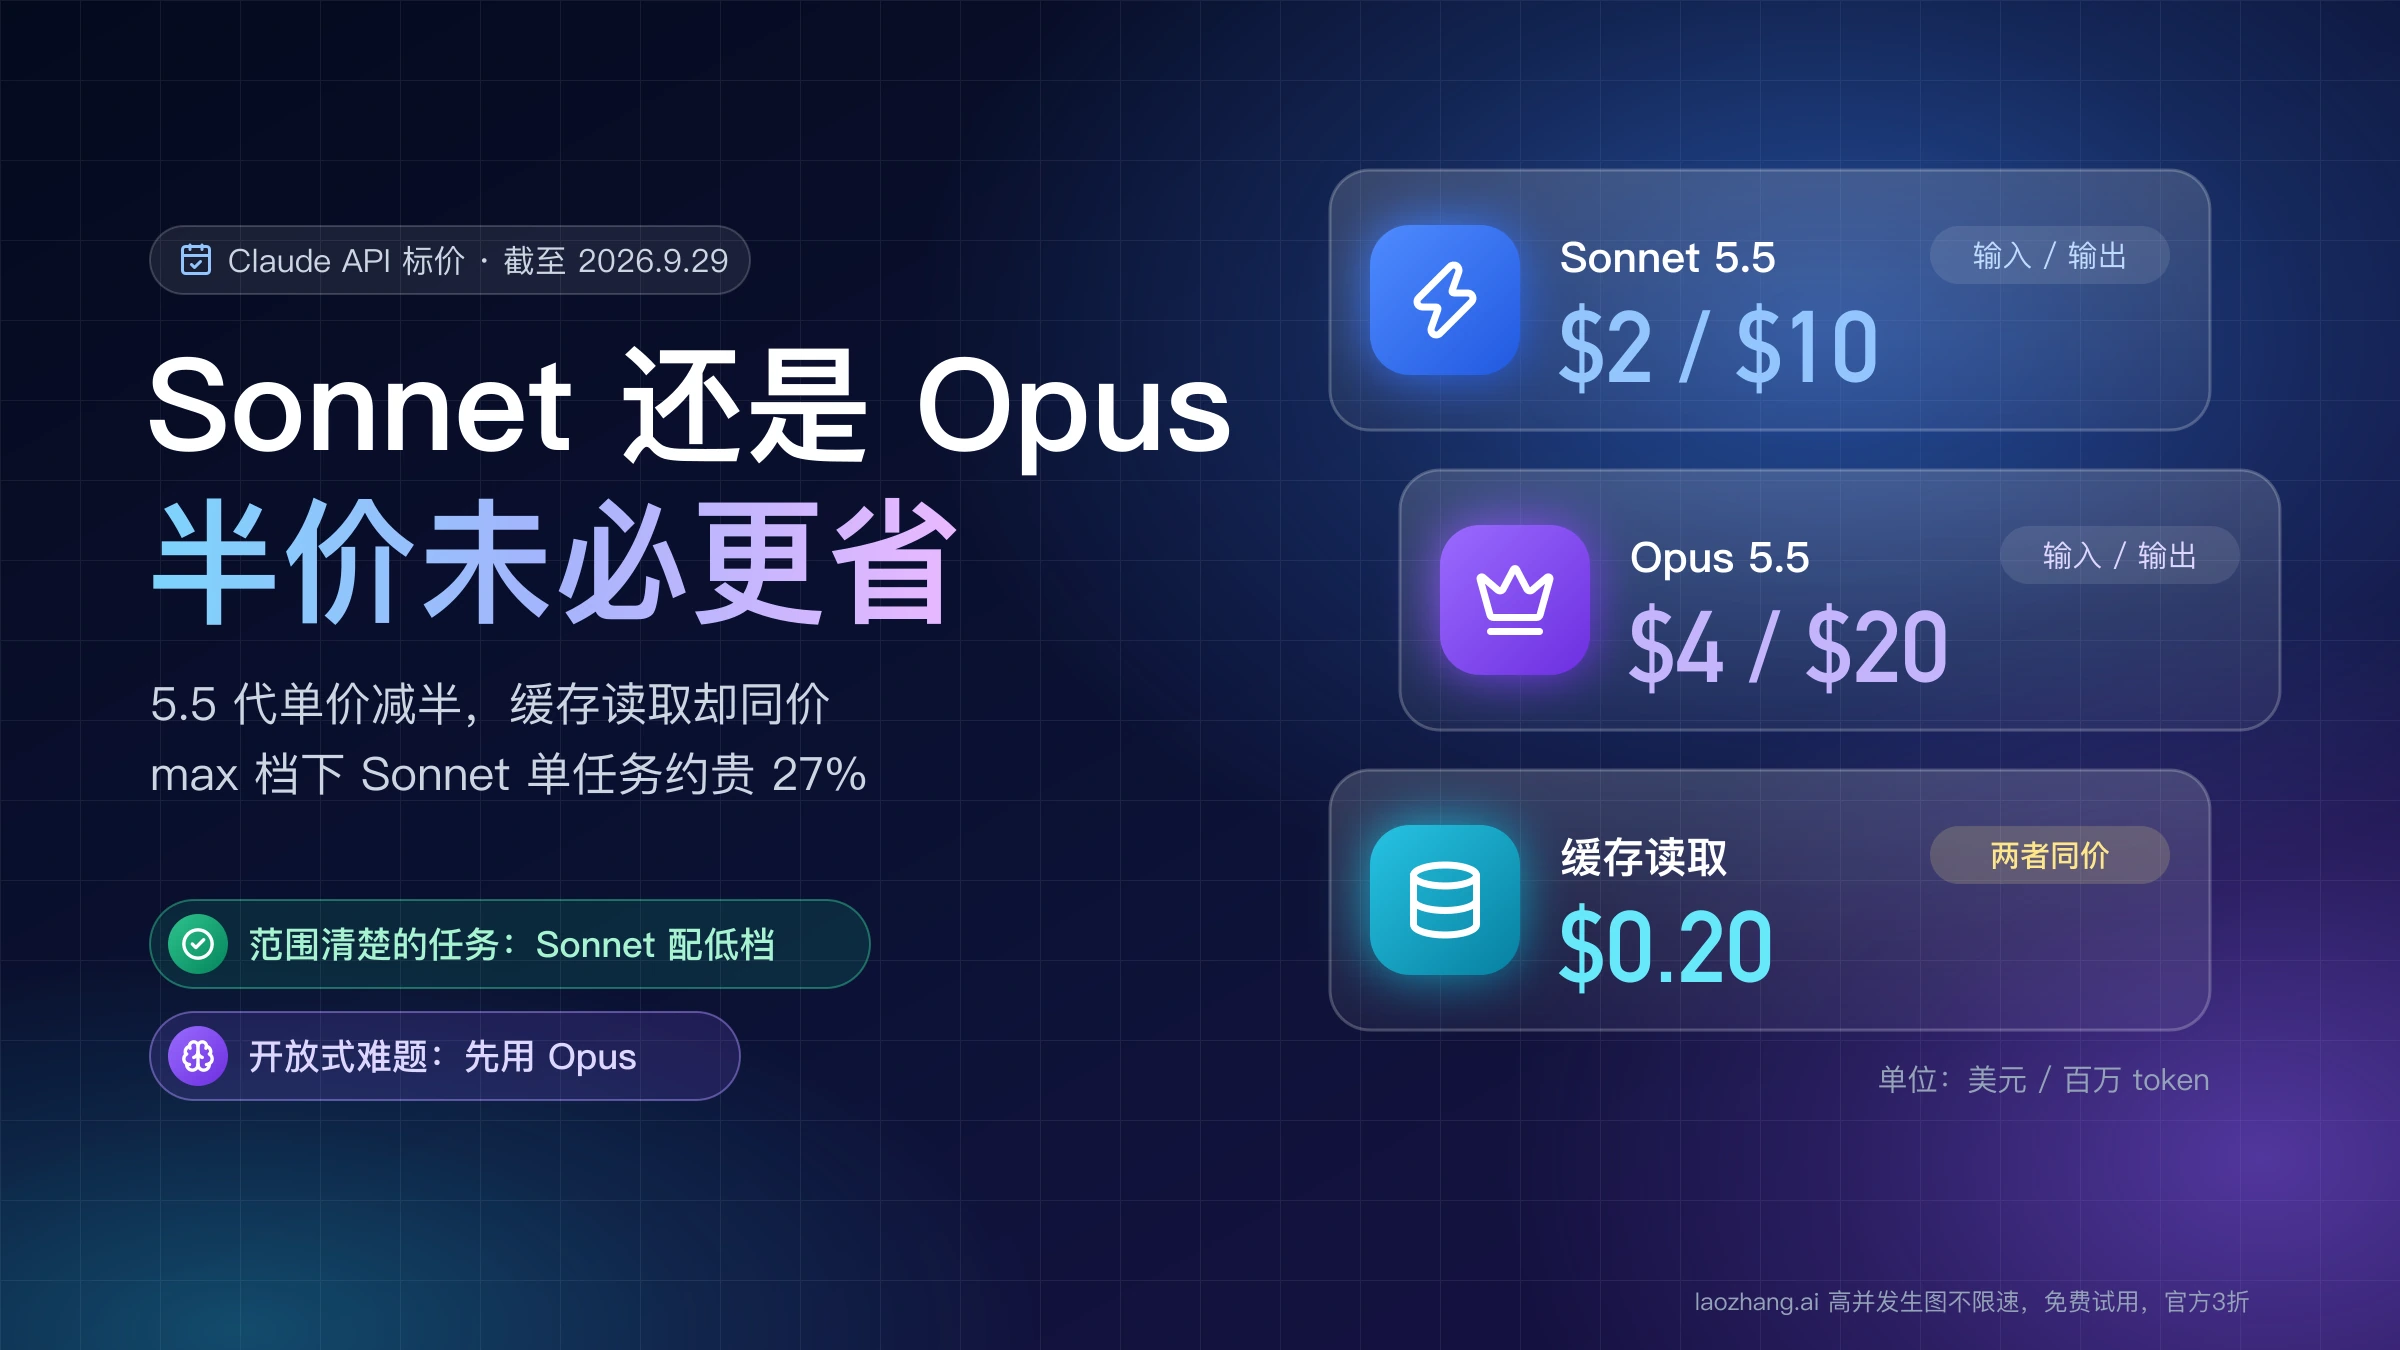
Sonnet 5.5 单价是 Opus 5.5 的一半,但缓存读取同价,max 档下单任务可能更贵。范围清楚的任务用 Sonnet 配低档,开放式难题先用 Opus。
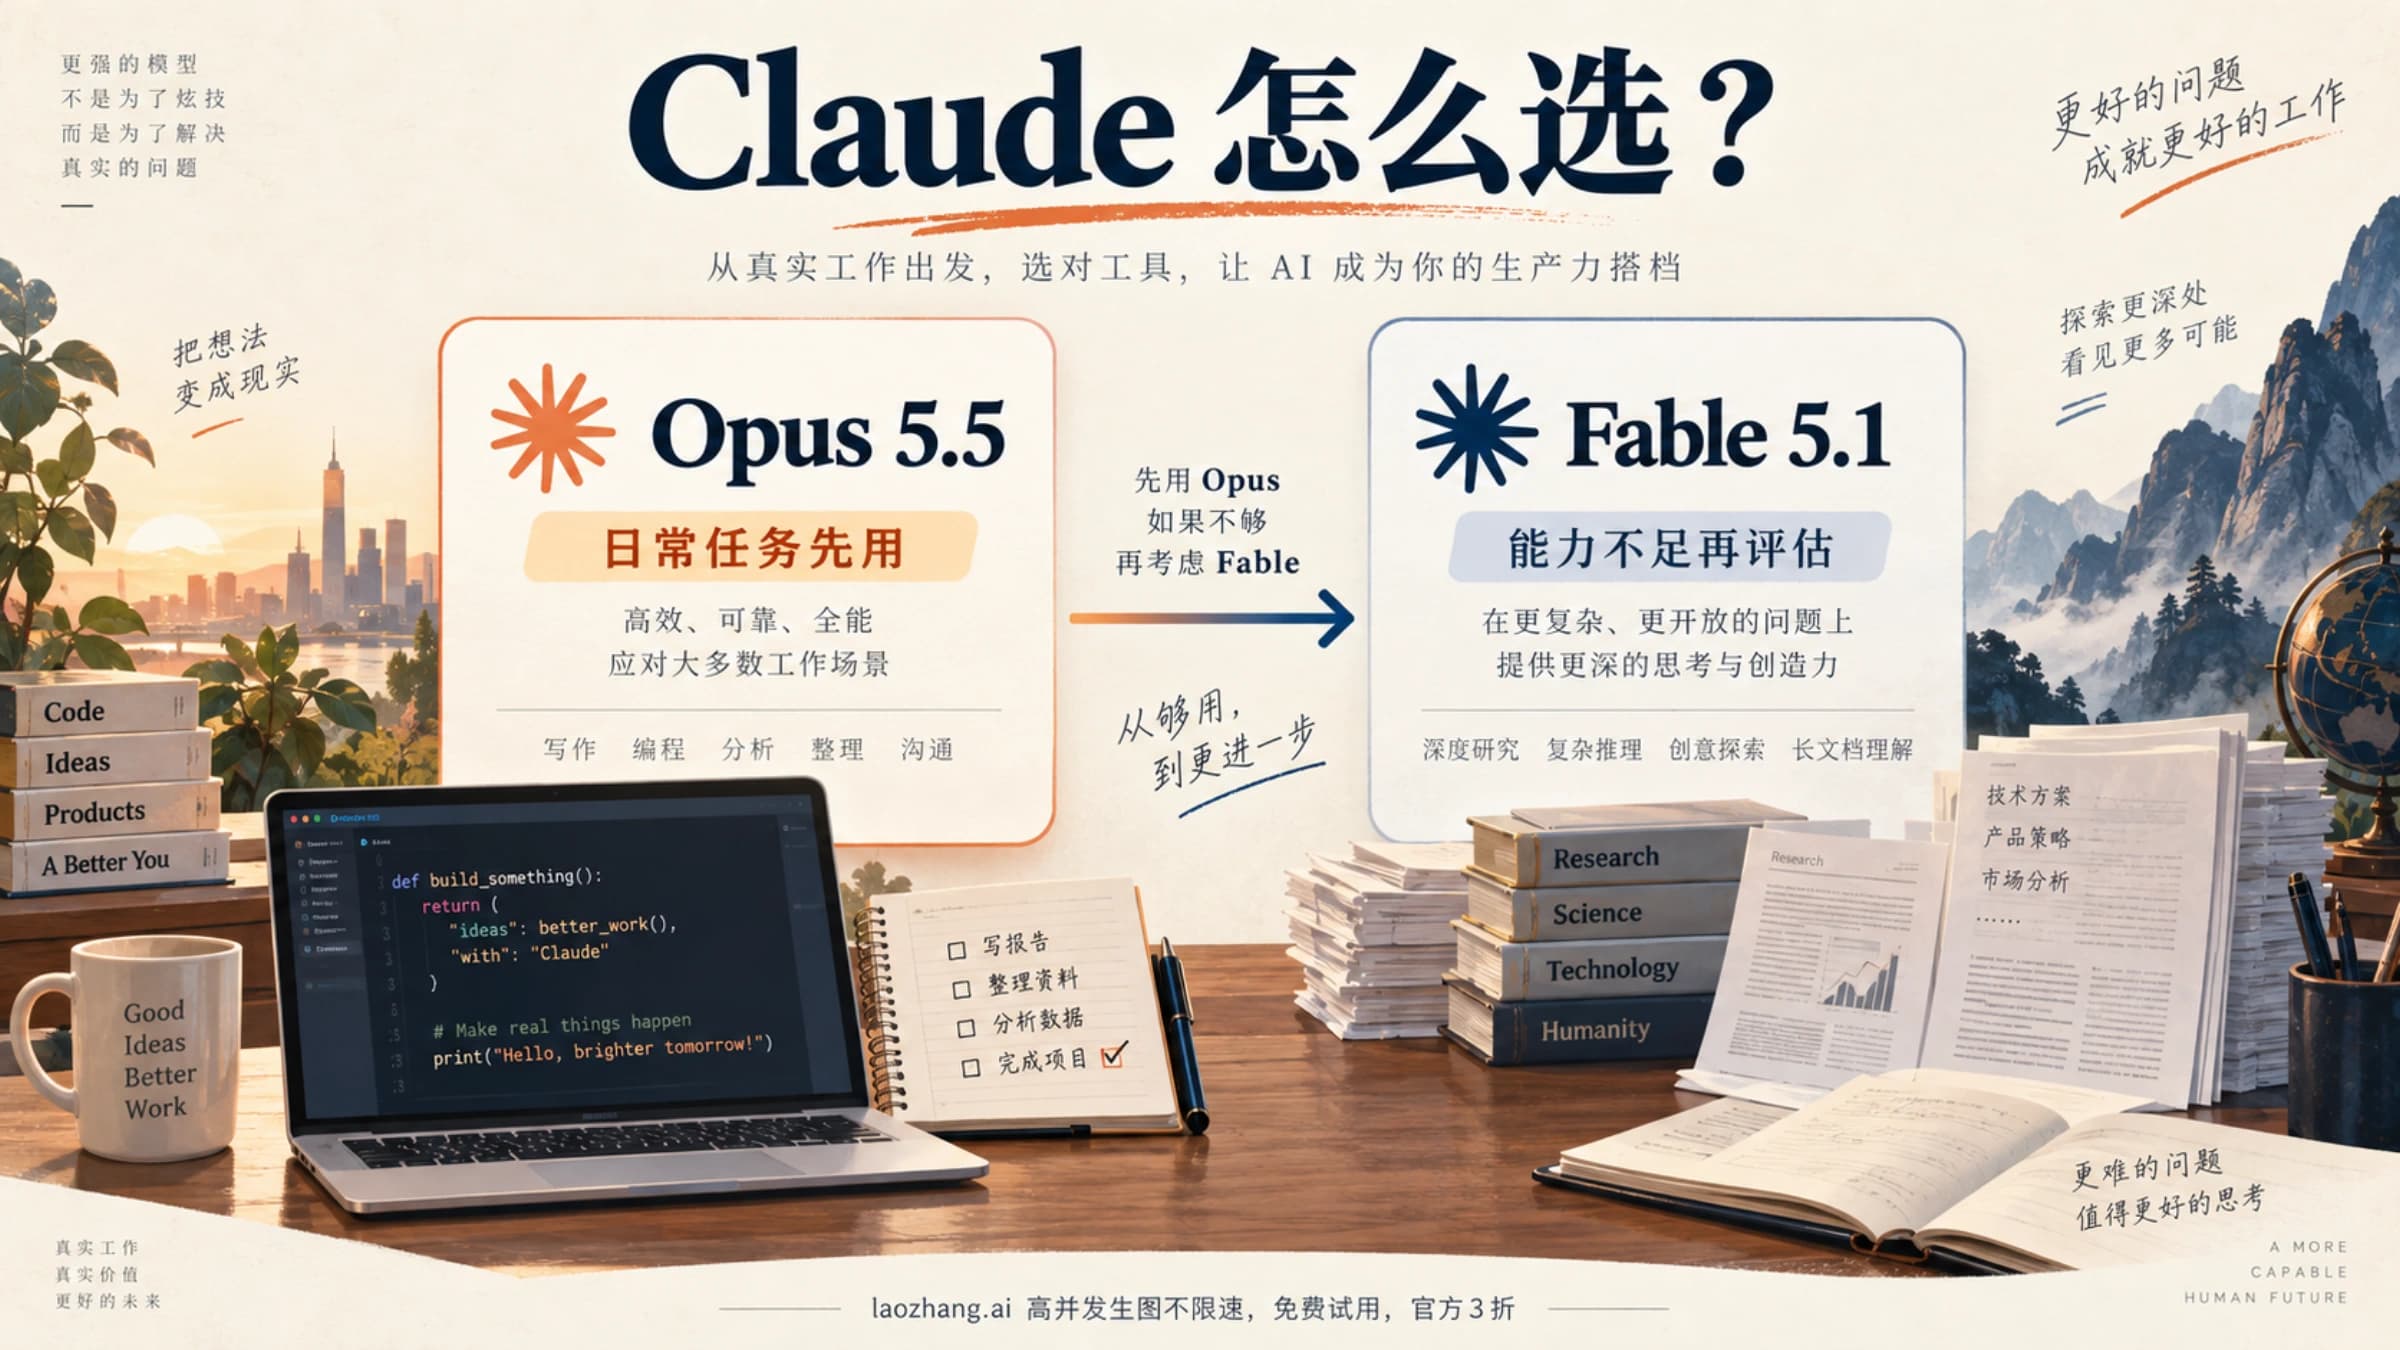
多数代码、研究和文档任务先用 Opus 5.5;Fable 5.1 留给提高思考强度后仍做不好的任务。对比当前价格、缓存费用、官方测试与会话切换限制。
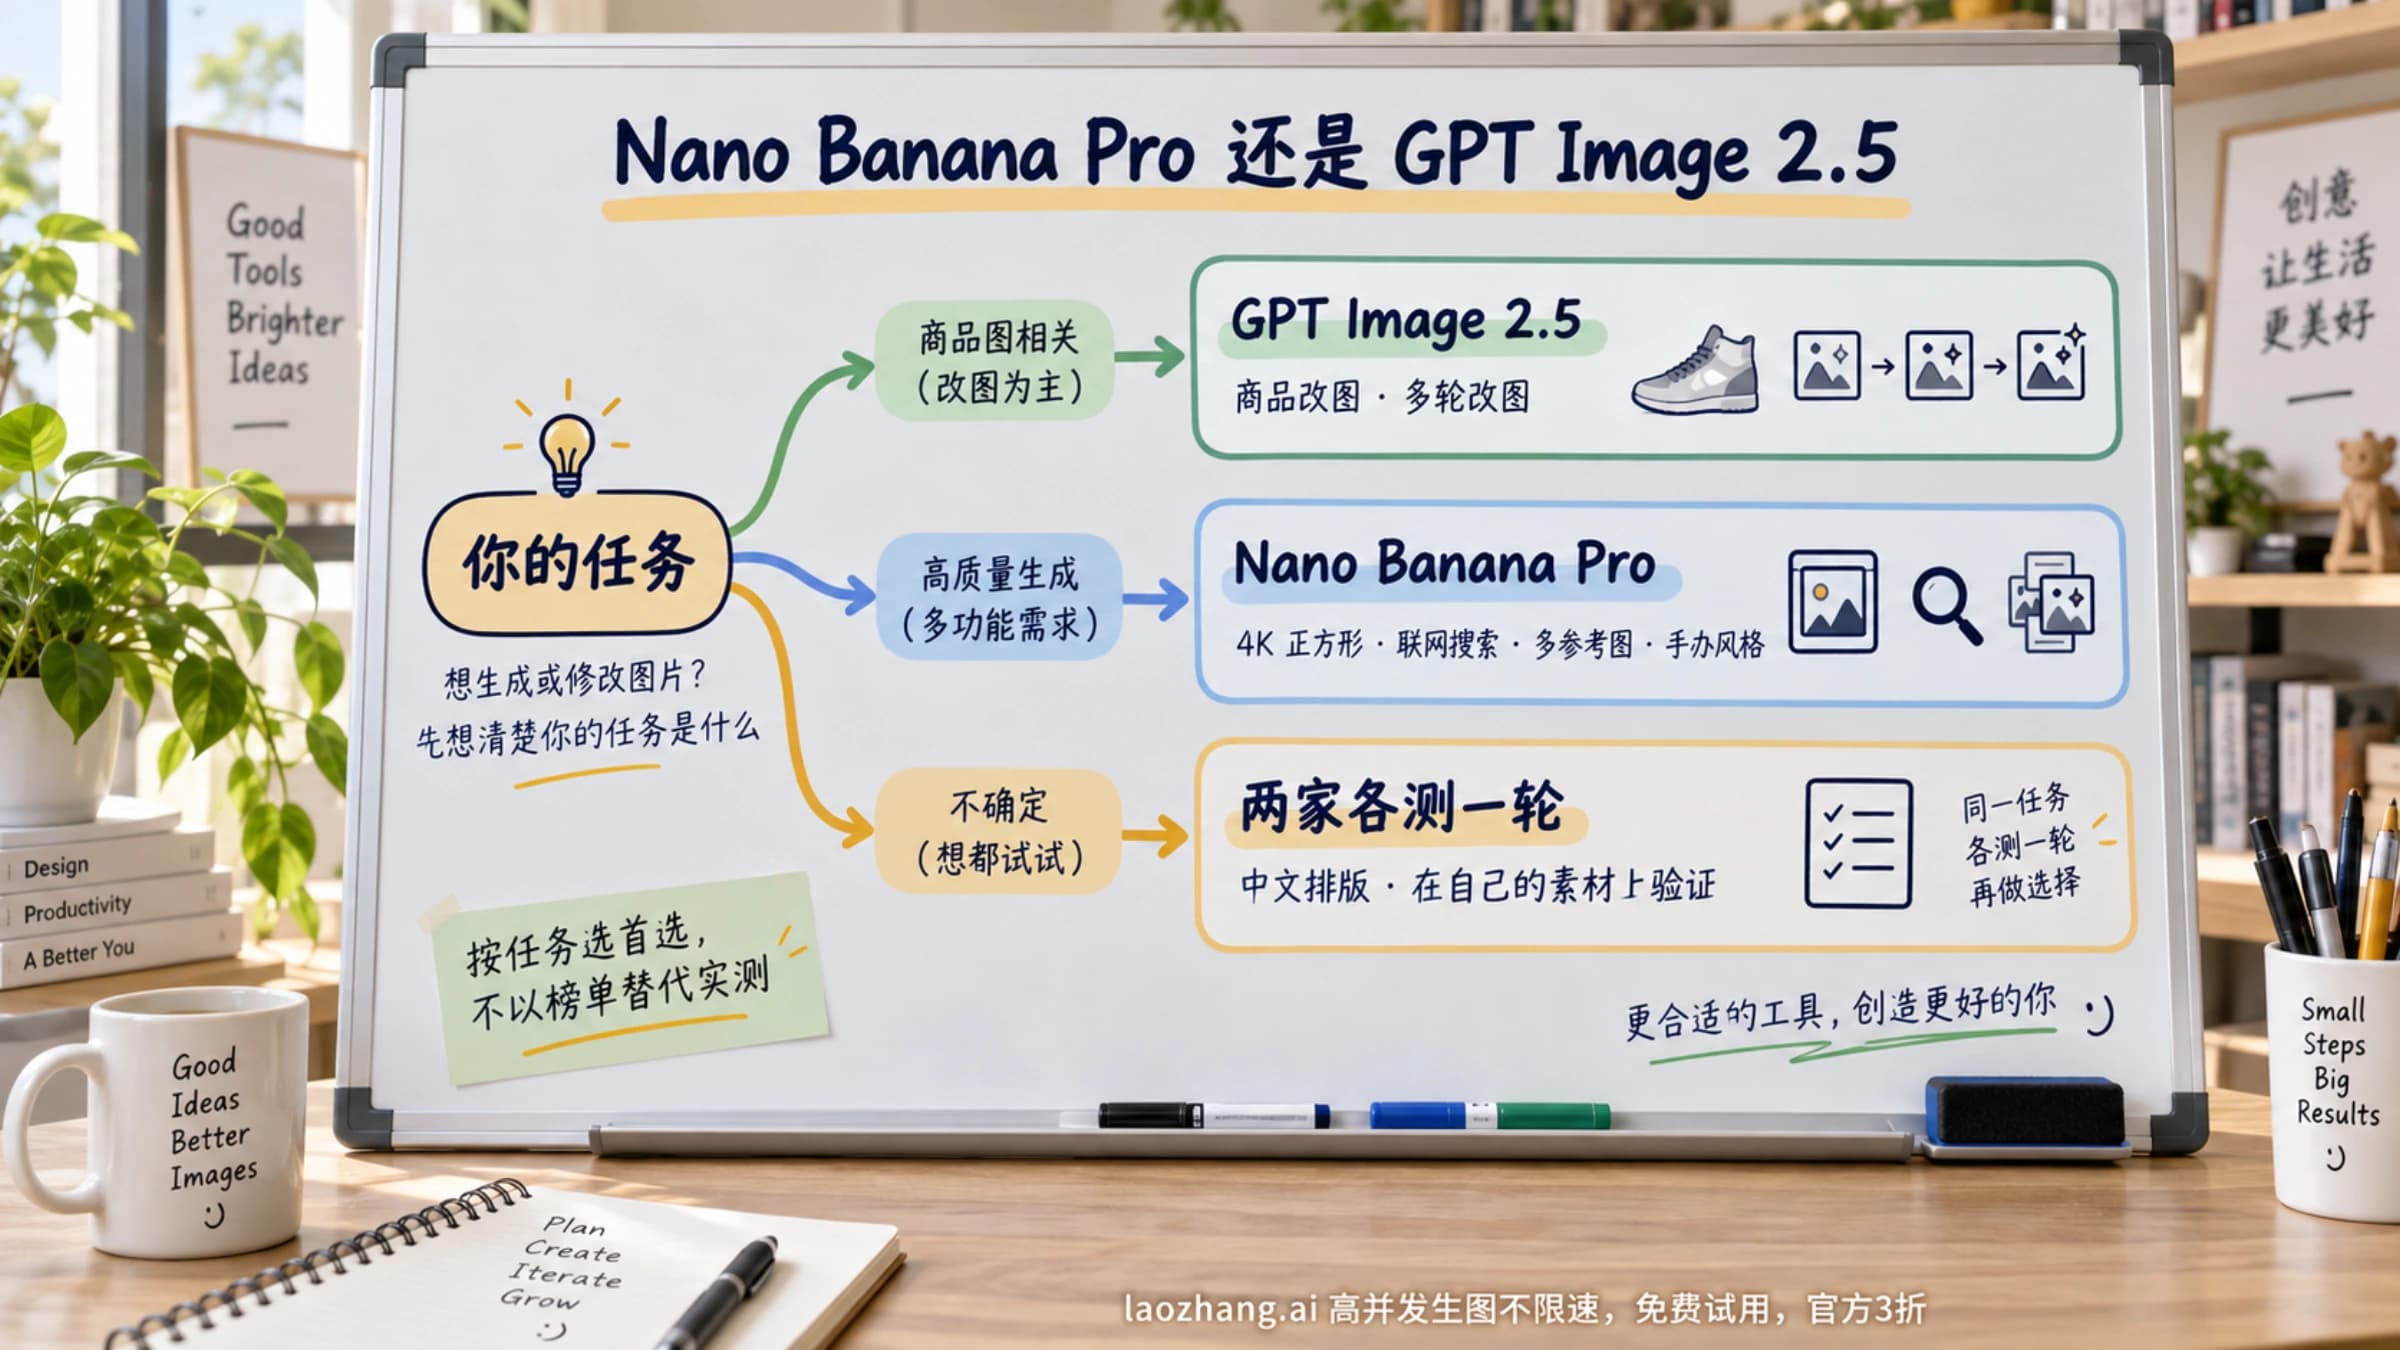
改商品图要保外形或多轮改图,先用 GPT Image 2.5;4K 正方形、联网核对、多参考图或手办风格先用 Nano Banana Pro。Pro 1K 一张 $0.134。
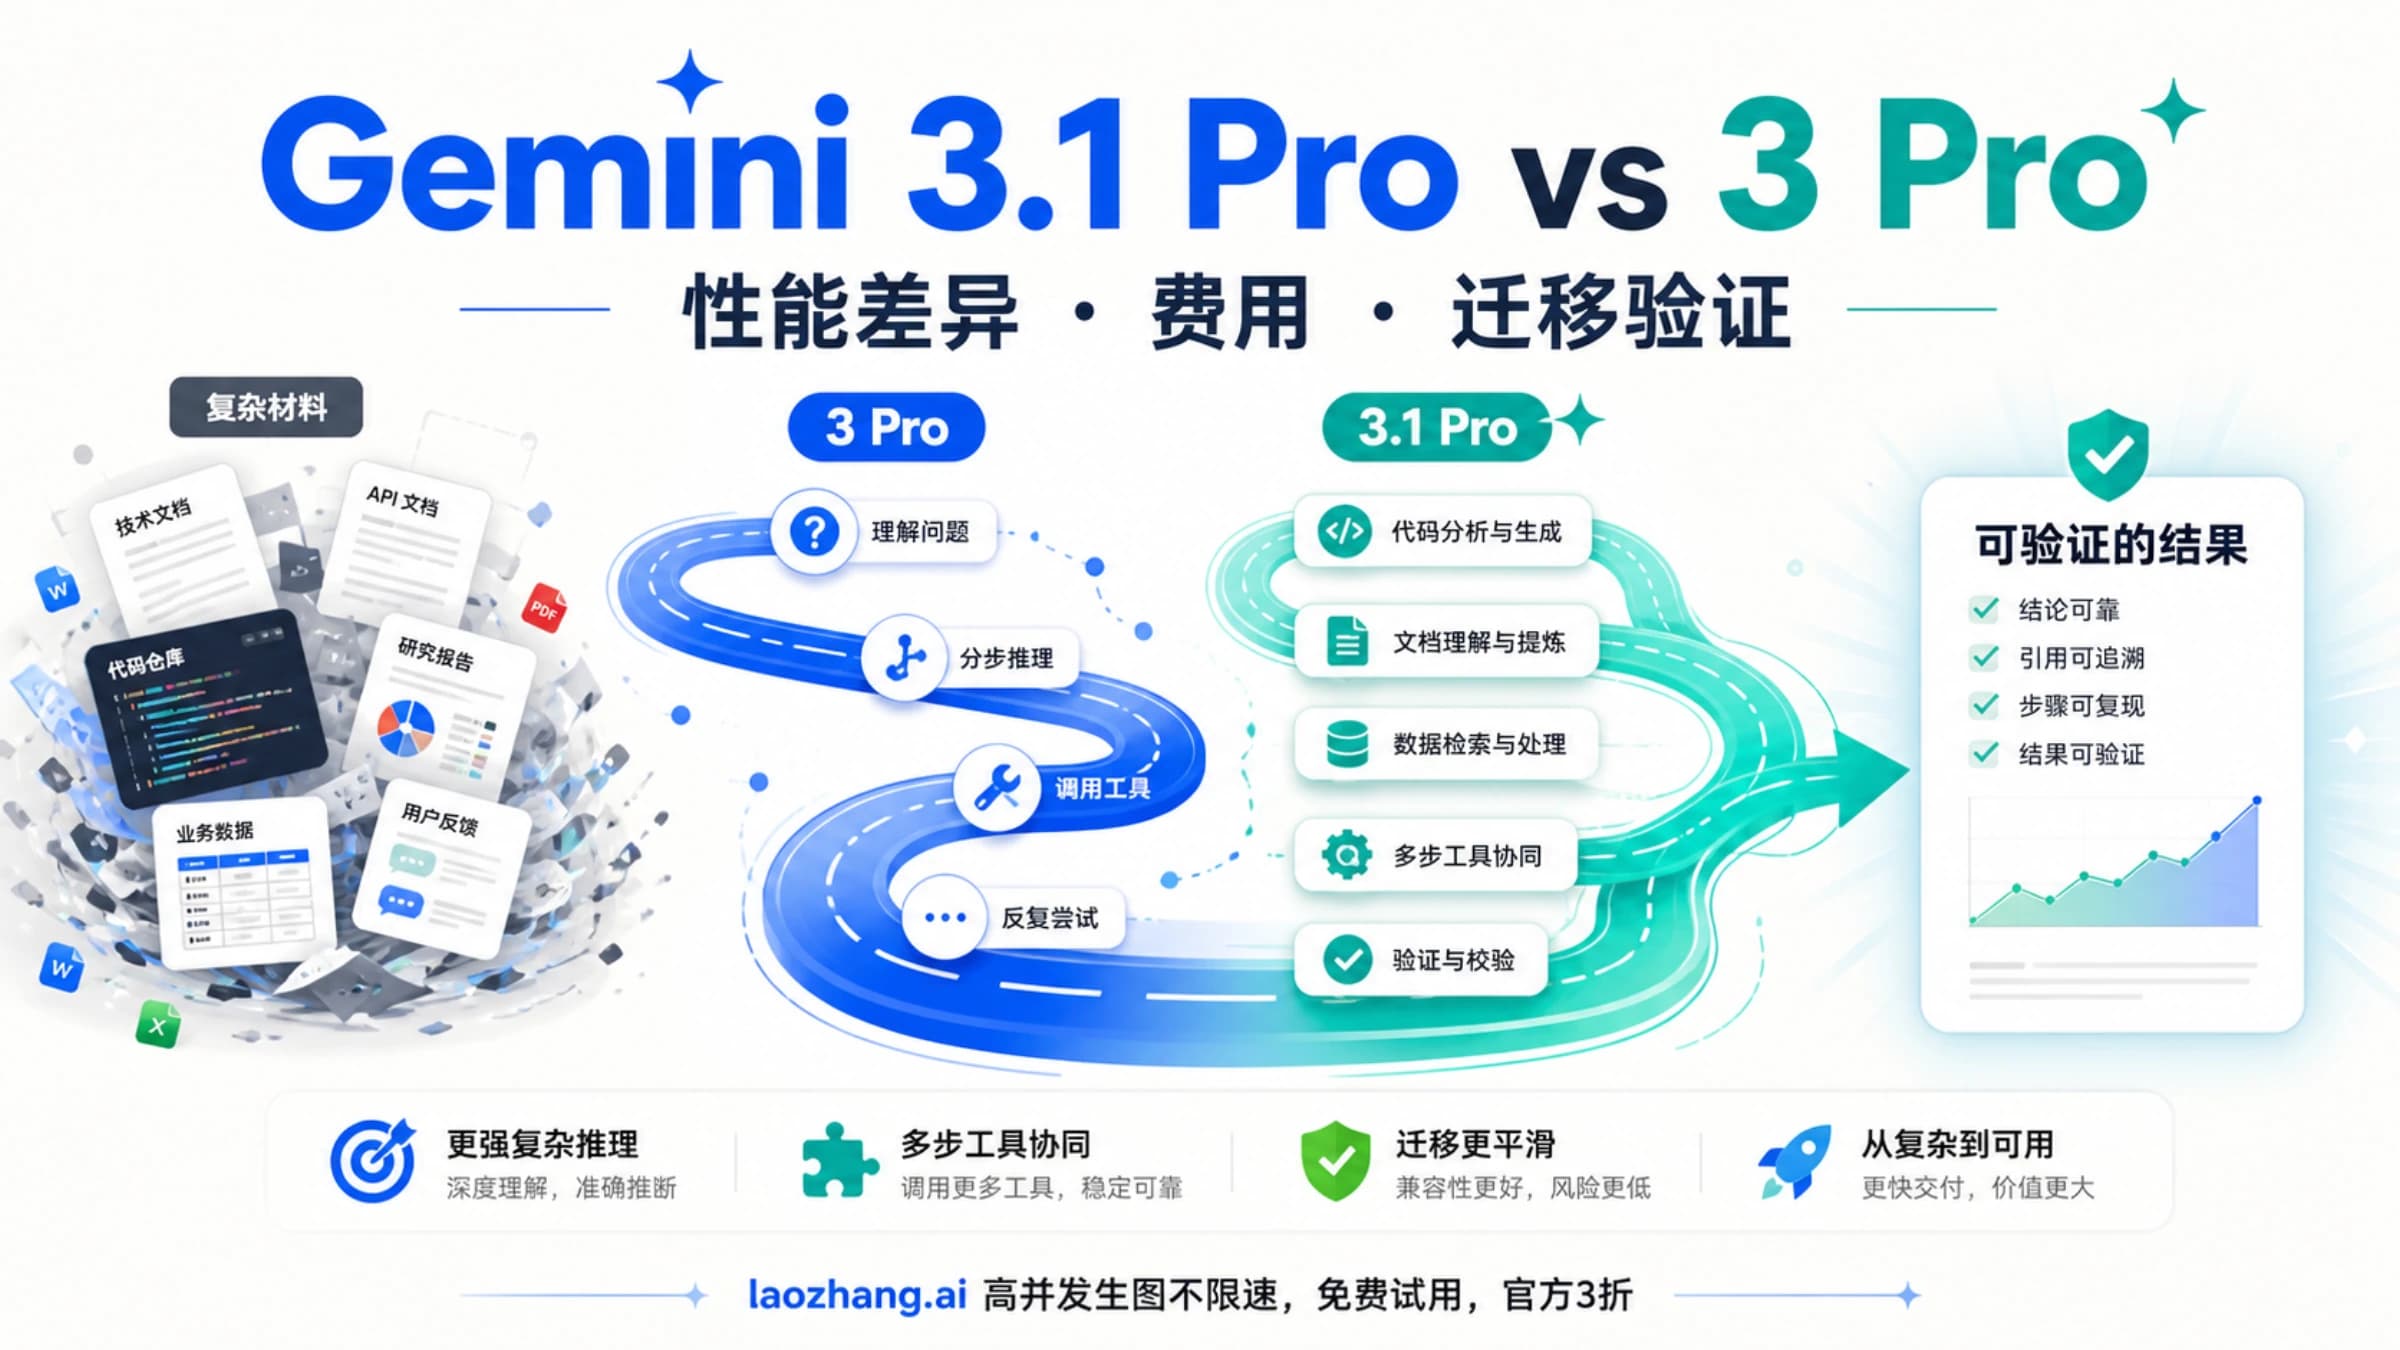
Gemini 3.1 Pro 的主要升级是复杂推理和多步工具操作,输入窗口并未扩大。本文解释官方性能结果、200K 费用分档,并提供可运行的迁移请求与输出校验;Gemini Developer API 的旧 3 Pro 已关闭。
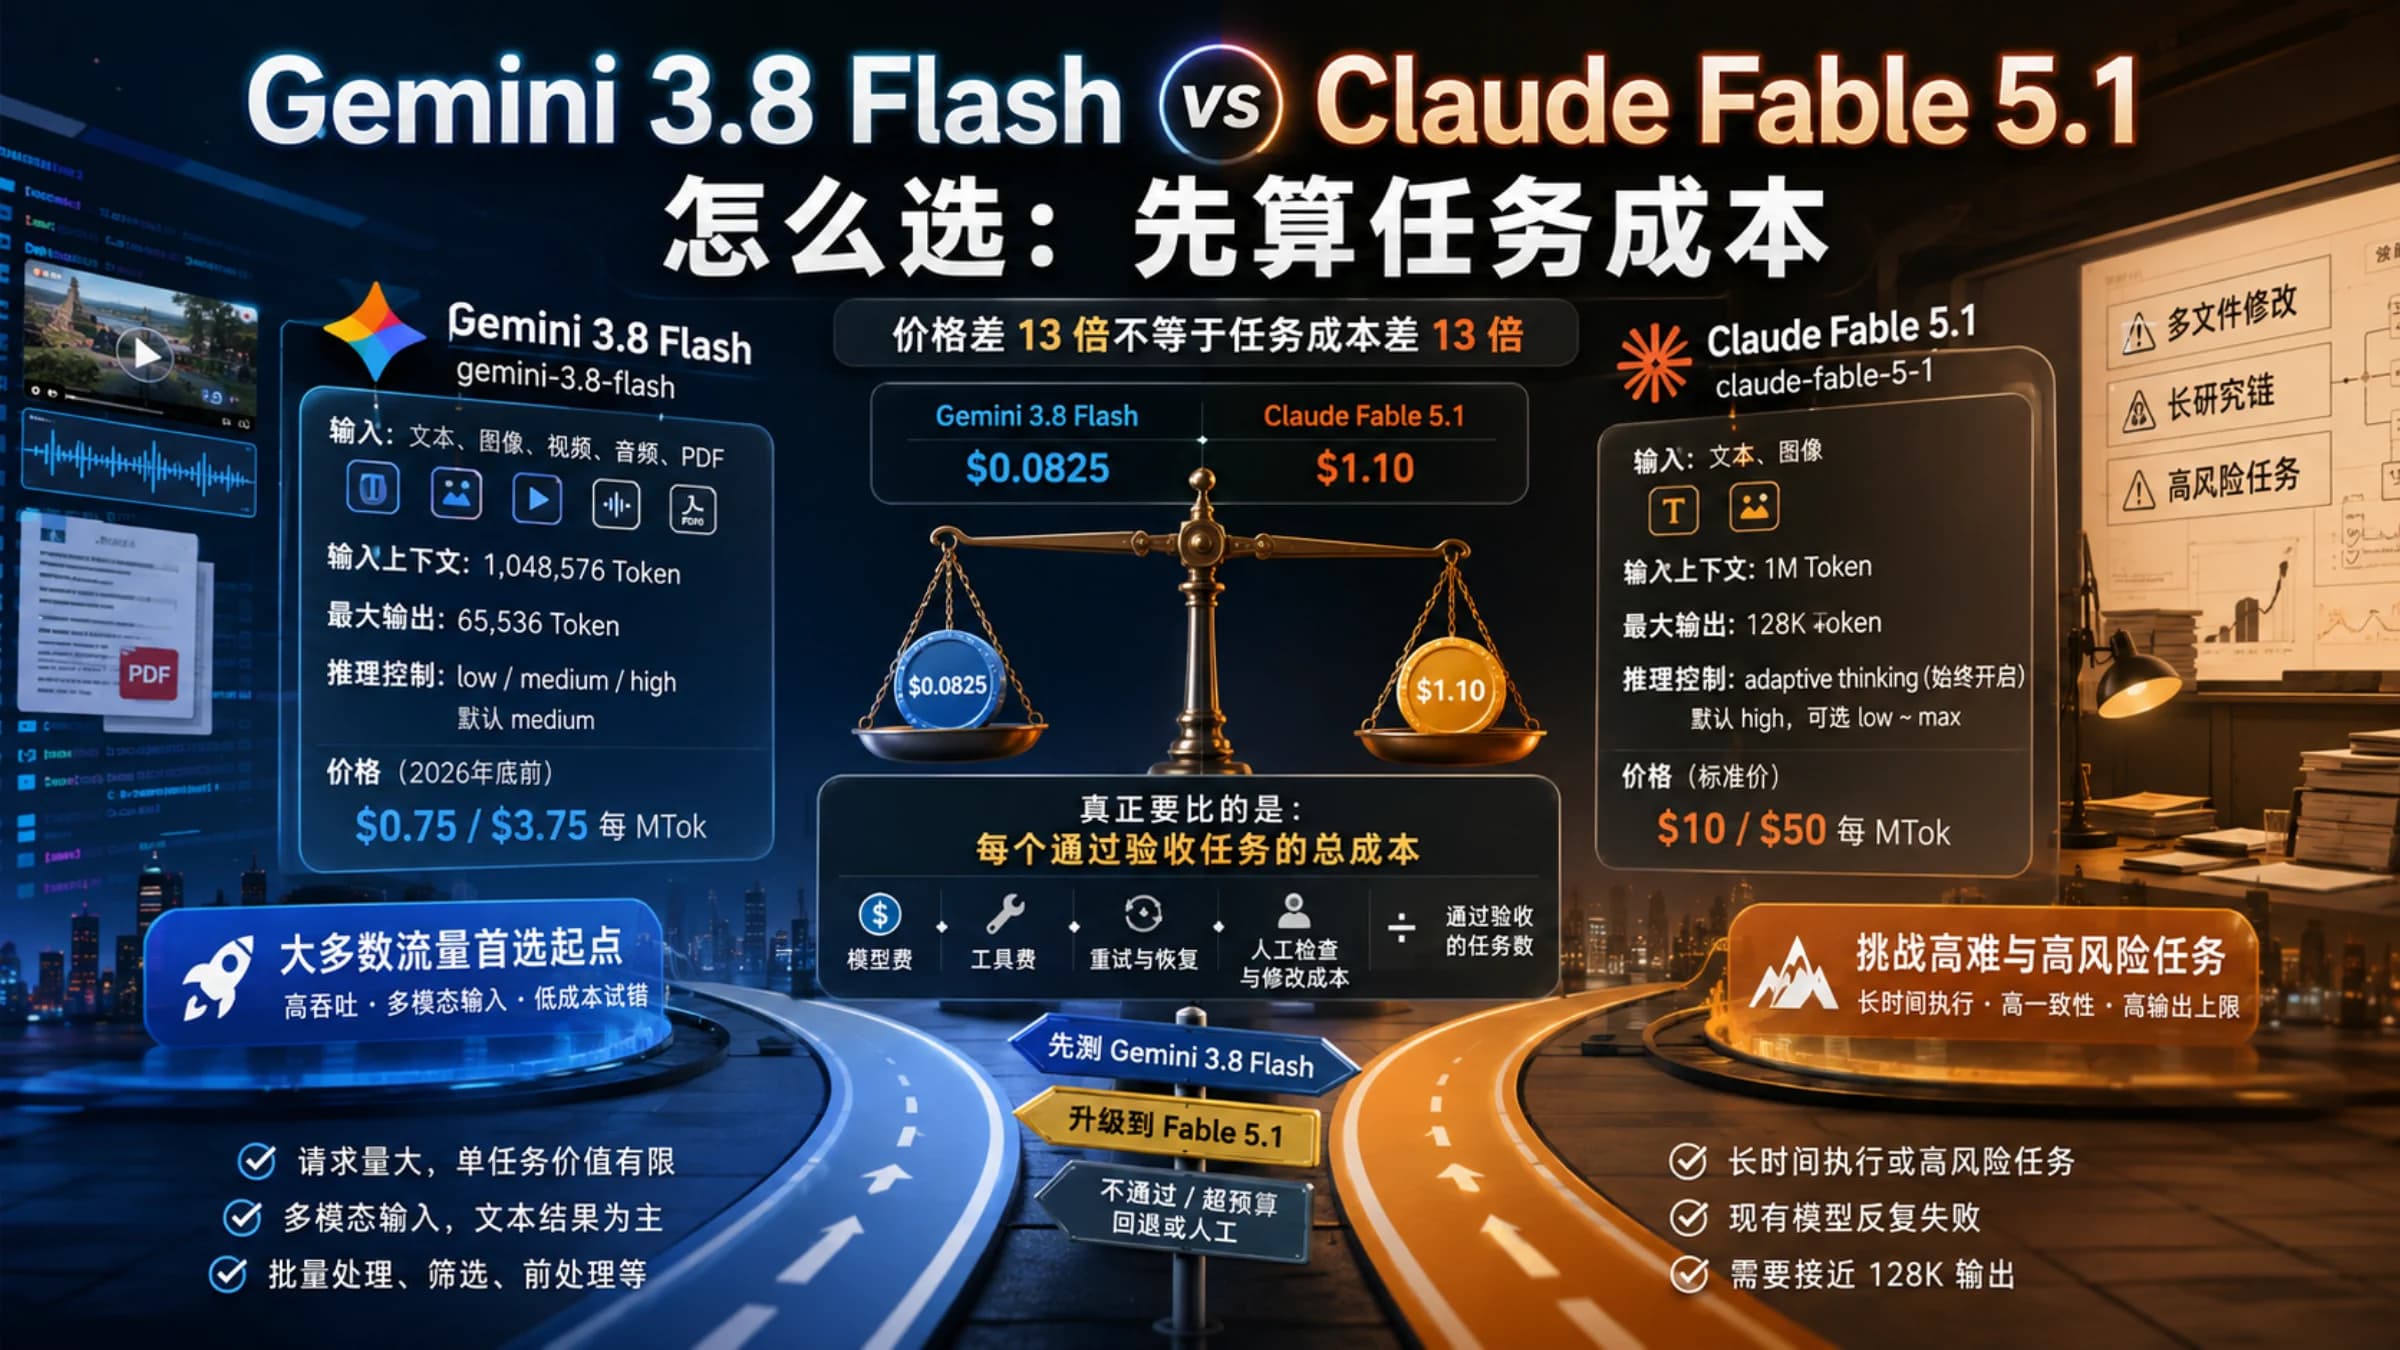
大多数流量可以先测 Gemini 3.8 Flash,最难的长任务再让 Claude Fable 5.1 挑战;最终不要看单次 Token 价,而要看通过验收的任务成本。
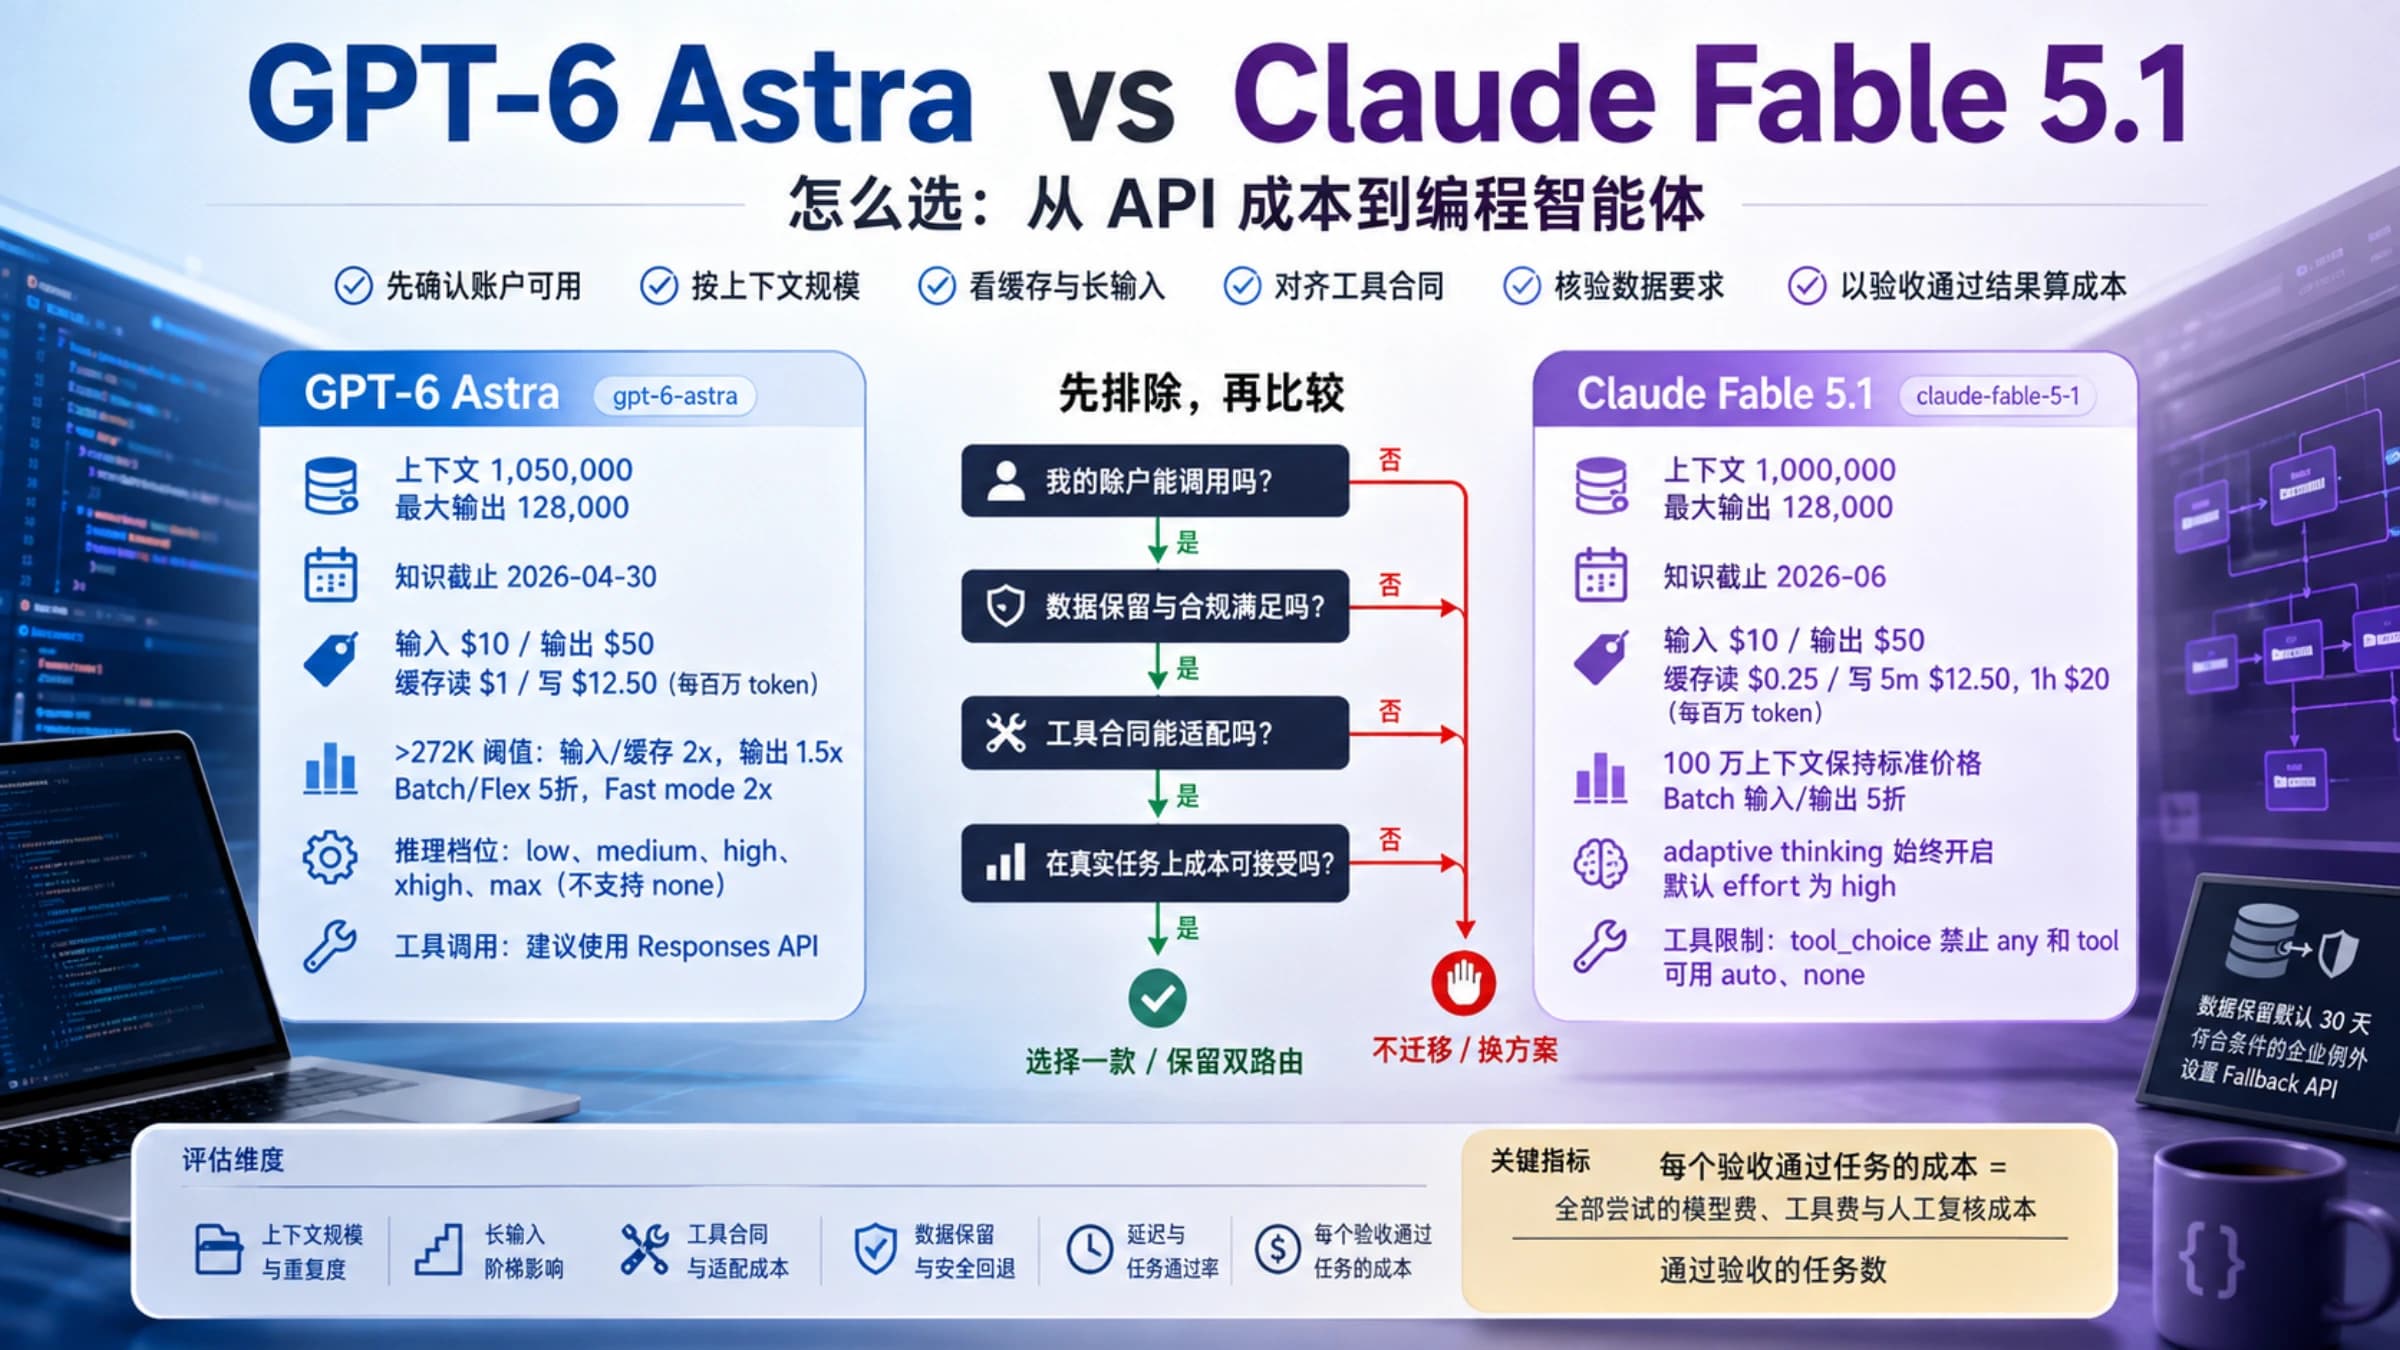
先确认账户确实能调用,再按重复上下文、长输入阶梯、工具配置、数据保留和真实验收结果决定首选;不同任务保留双路由,往往比押一个总冠军更稳。
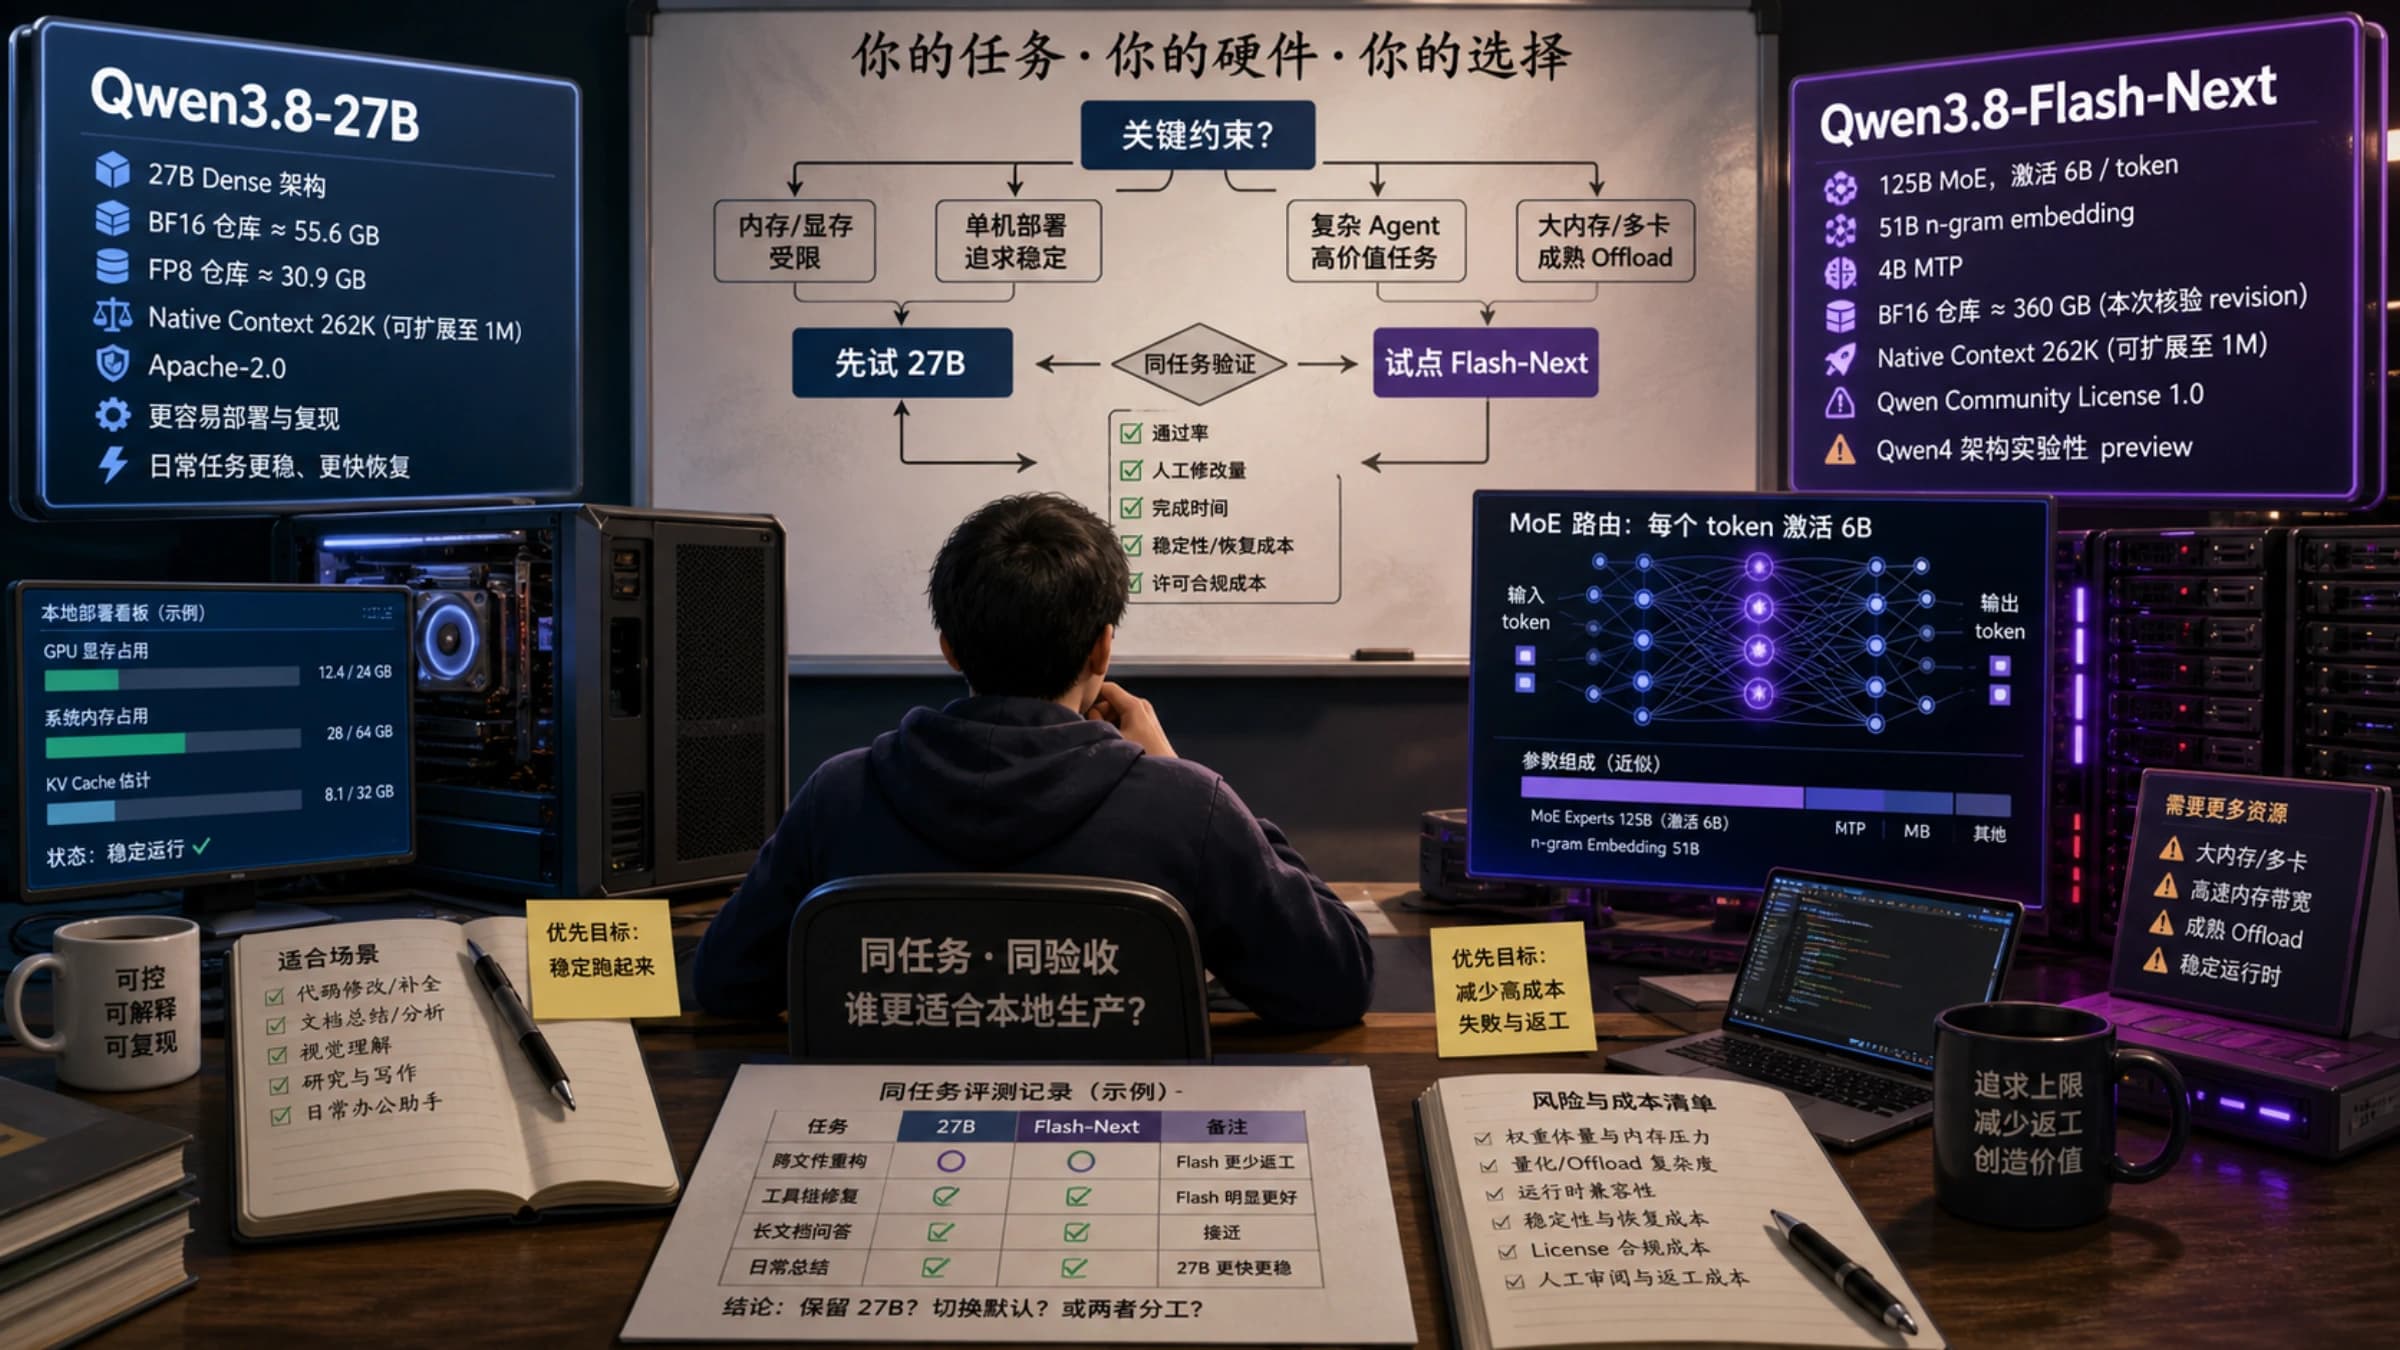
希望单机部署、控制权重占用,或优先采用 Apache-2.0 许可时,先测试 27B;有足够内存和多卡资源、复杂任务又经常返工时,再用同一批任务比较 Flash-Next。
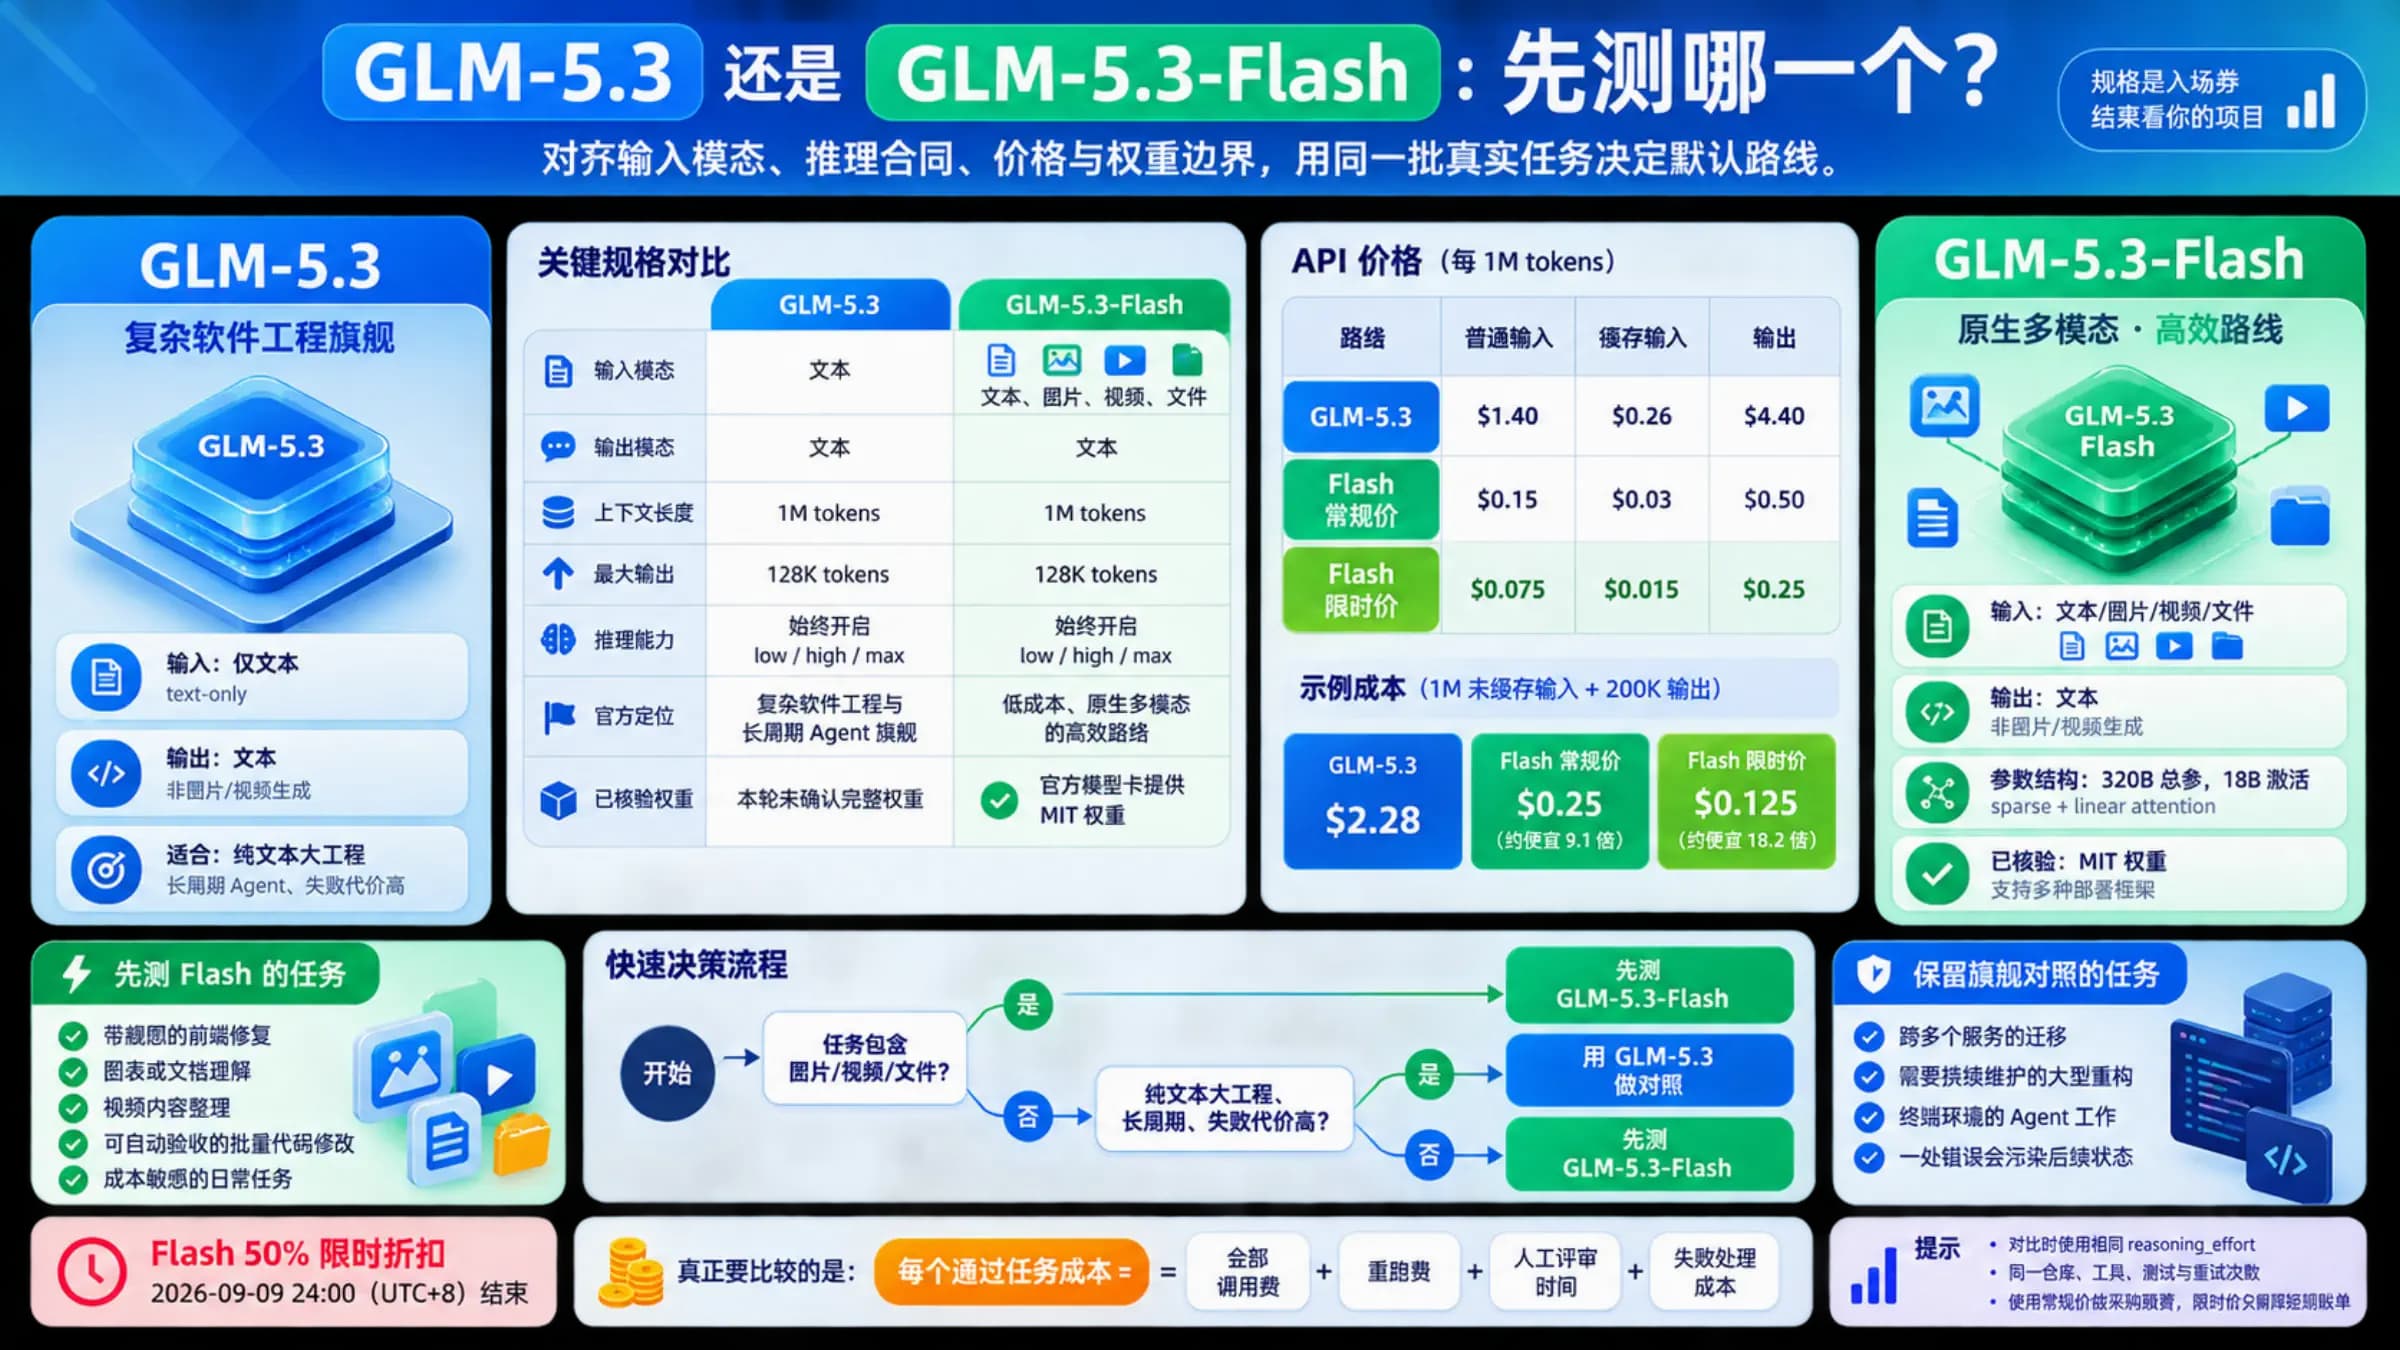
多数成本敏感或含图片的任务可先测 GLM-5.3-Flash;纯文本长周期工程、失败代价高的任务,再用 GLM-5.3 做复杂任务的对照模型。最终选择要看每个通过任务的总成本。
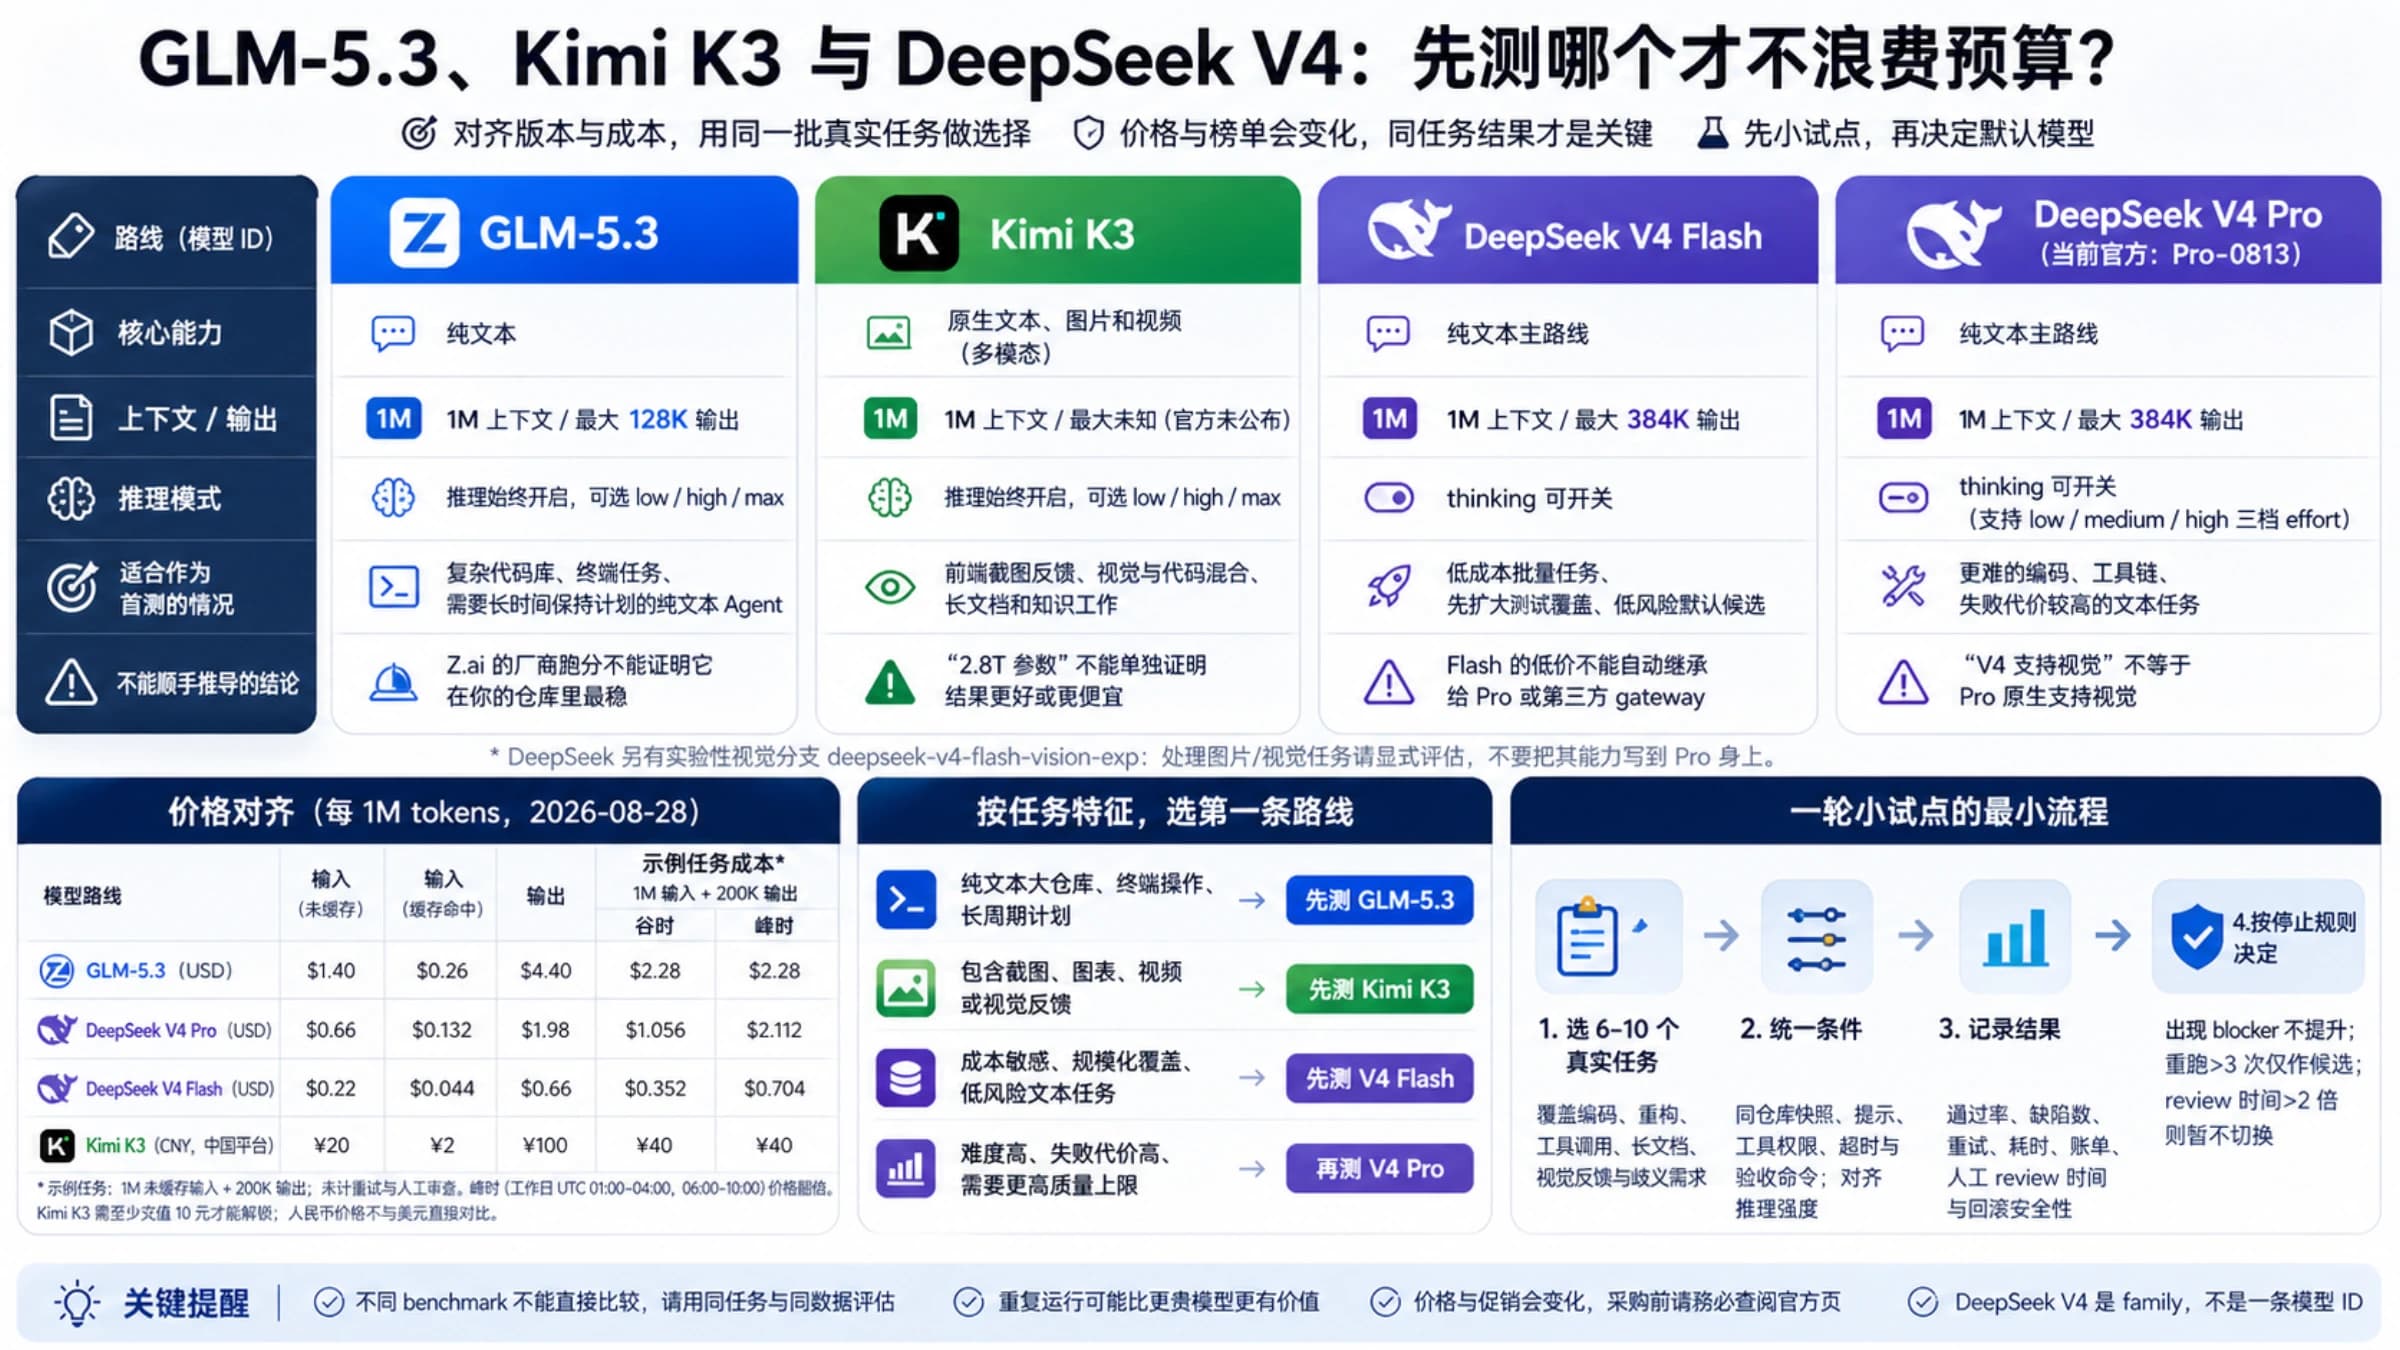
需要纯文本长周期编码,先把 GLM-5.3 放进候选;任务含图片或视频,Kimi K3 的原生多模态更直接;预算与吞吐优先,则先测 DeepSeek V4 Flash,再用 Pro 做质量上限。
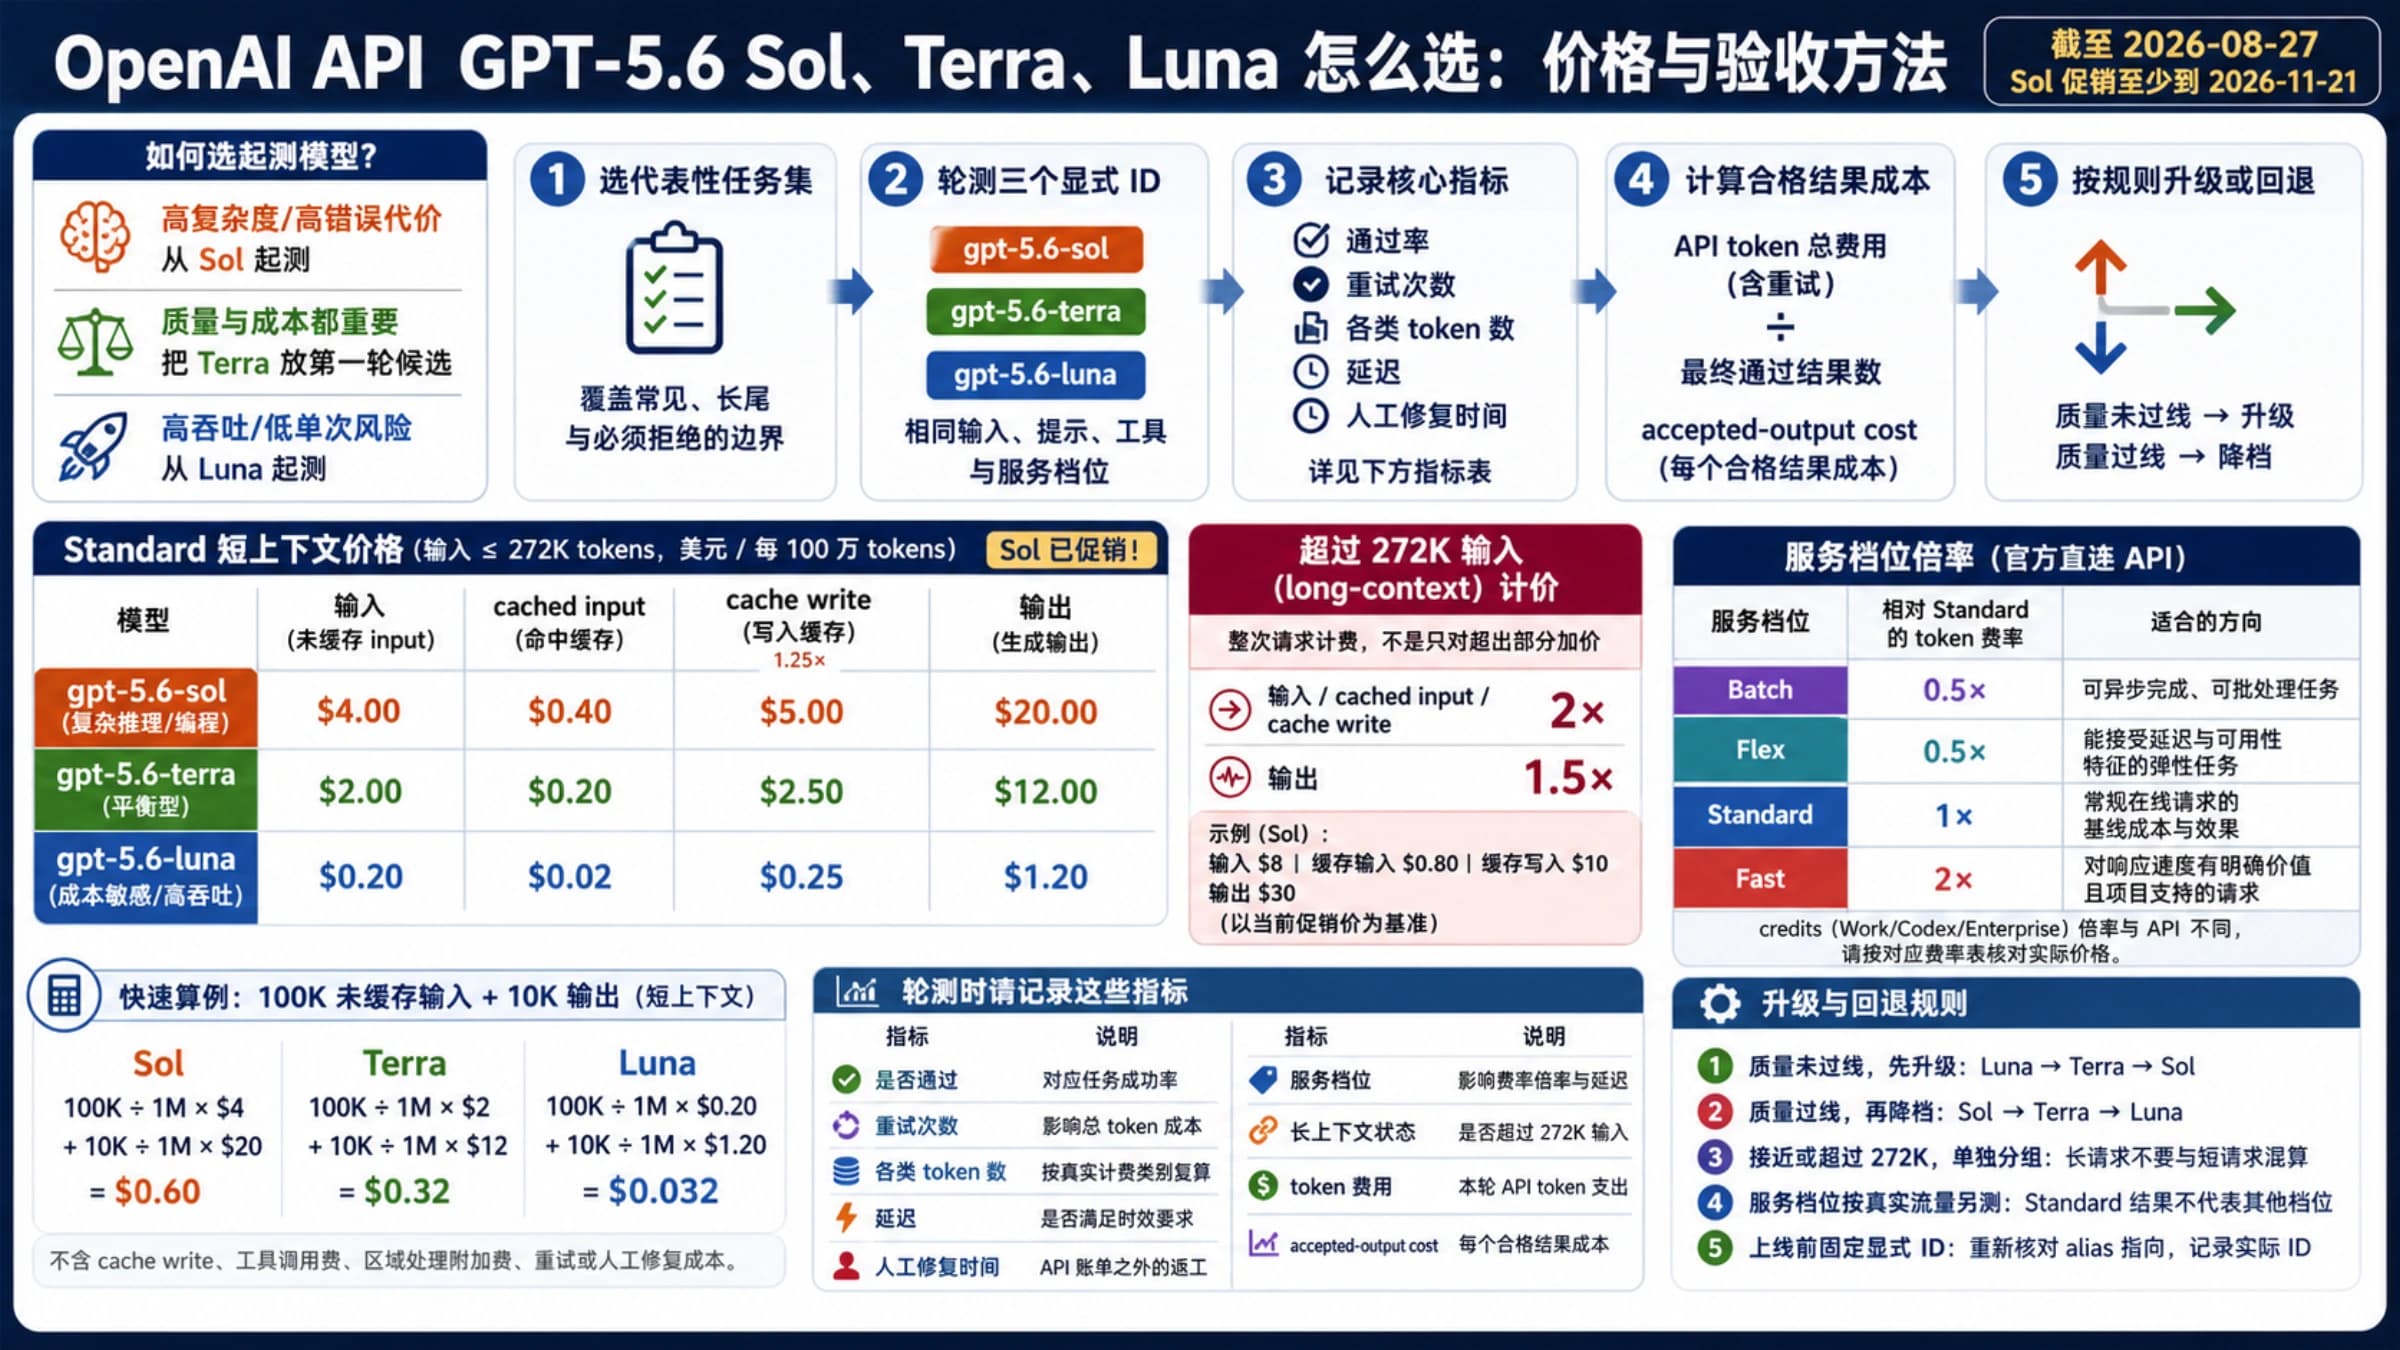
Sol 已启用临时促销价。先算清 API 与 credits 的适用边界,再用同一组任务比较三档模型的通过率、重试和返工成本。
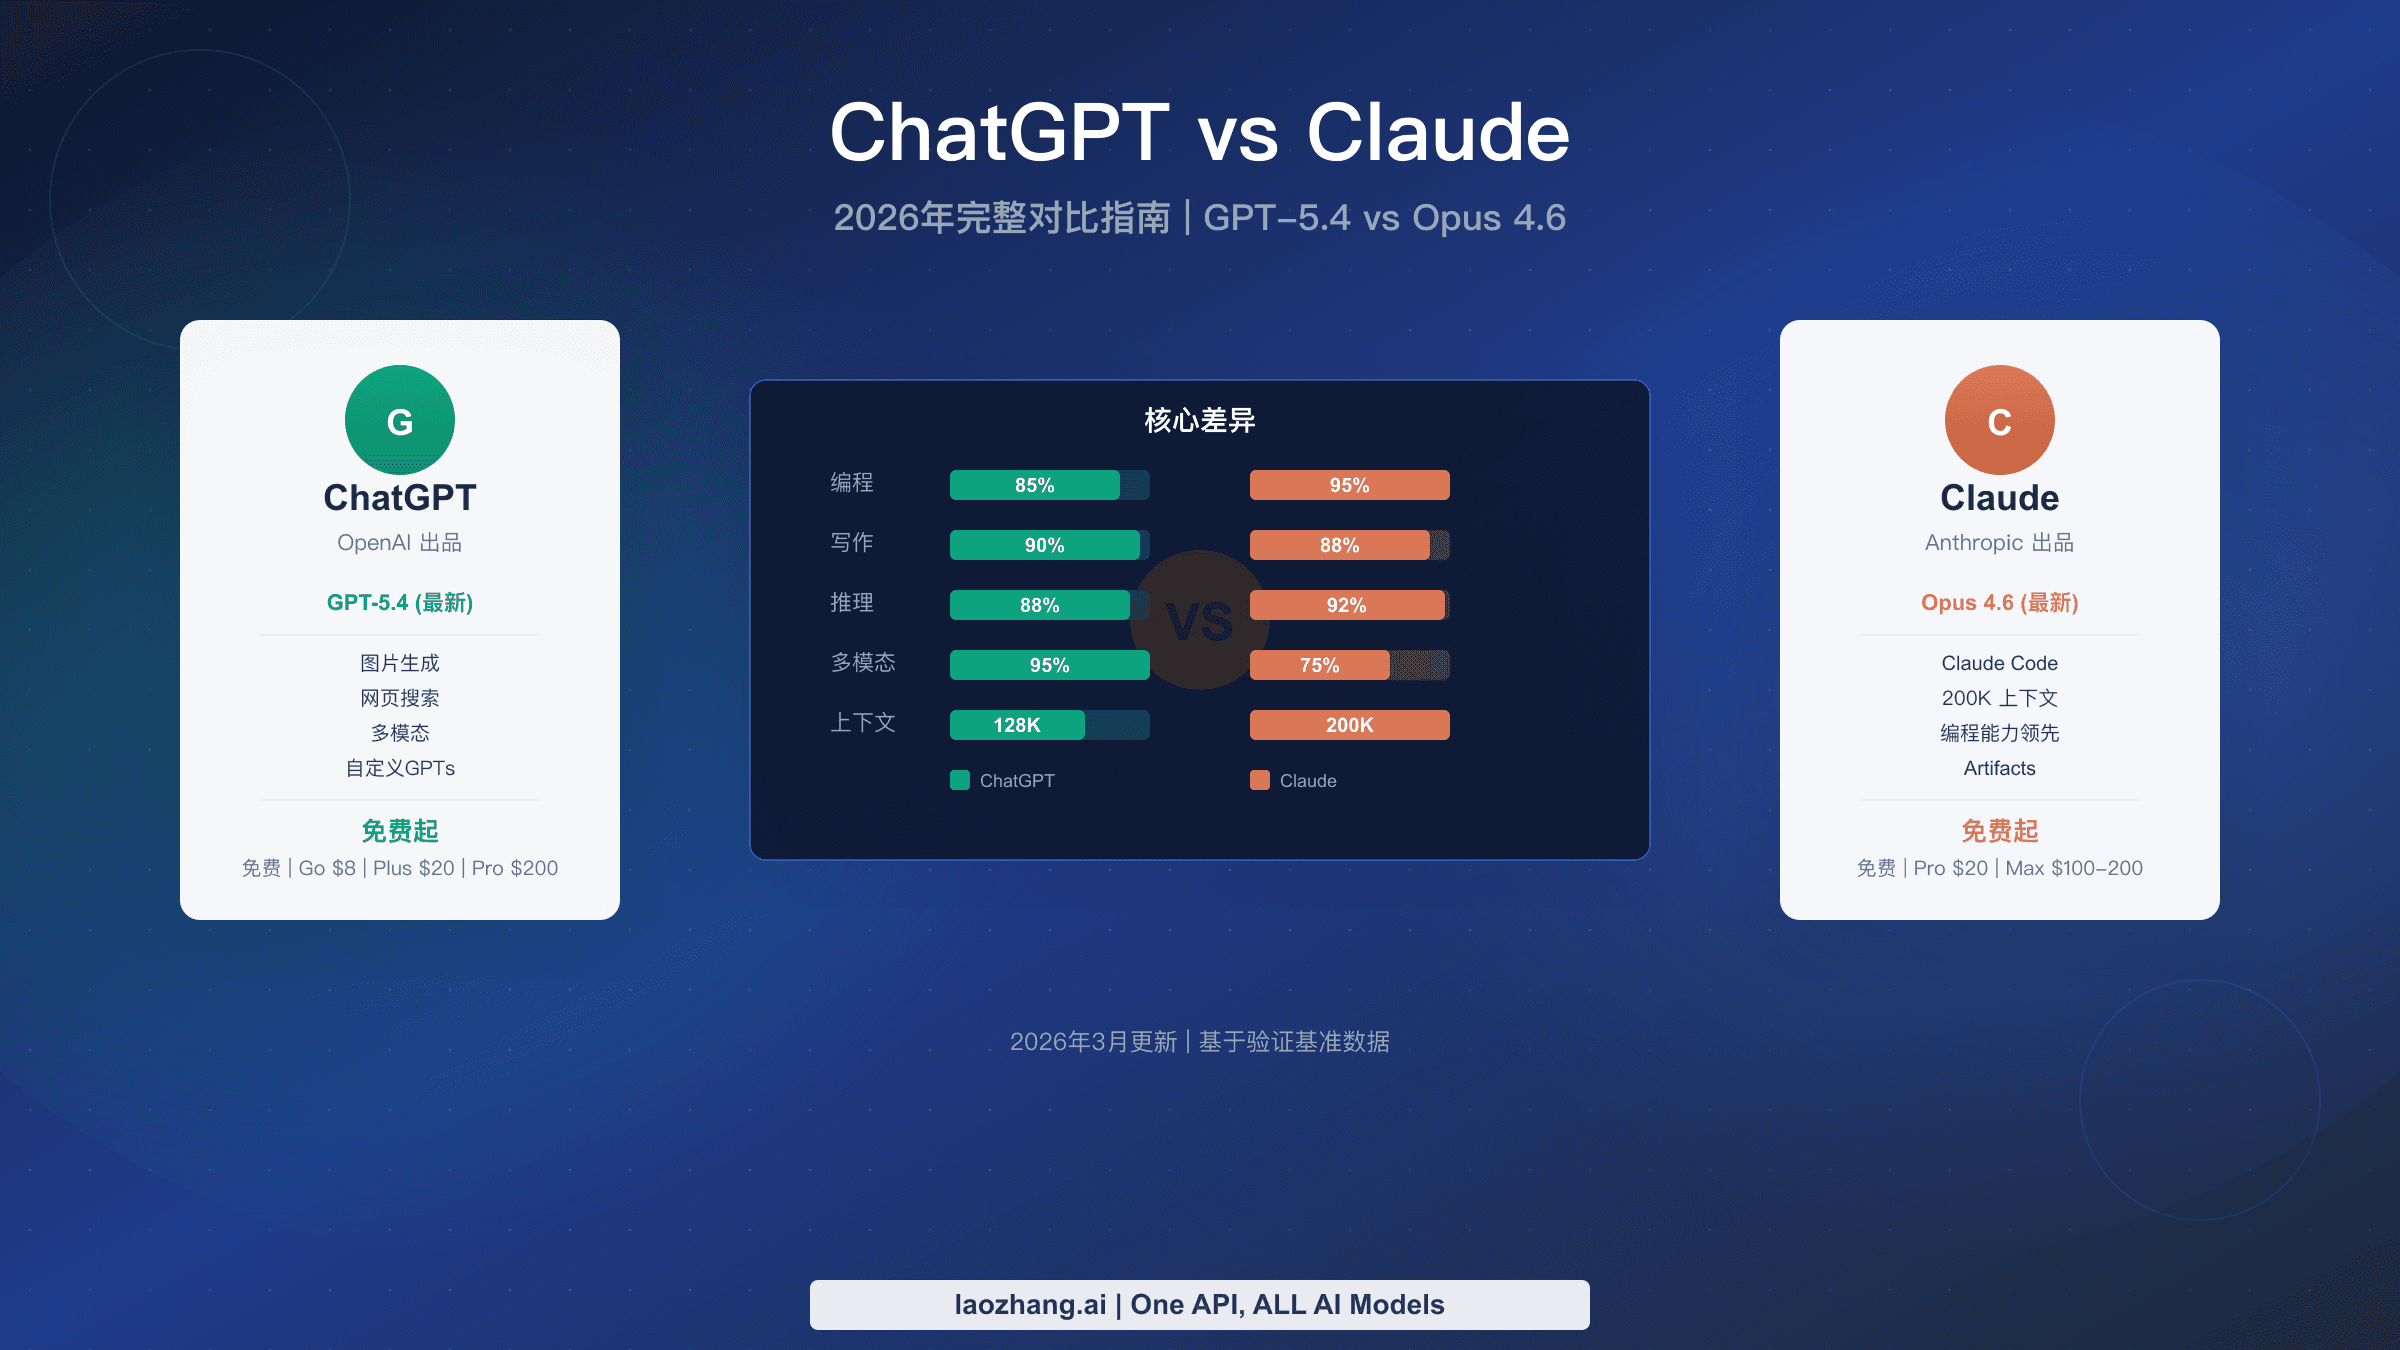
2026年3月,ChatGPT(GPT-5.4)和Claude(Opus 4.6)代表着两大顶尖AI助手,各有独特优势。ChatGPT擅长多模态任务、图片生成和网页搜索,而Claude在编程精度、长文档分析和开发者工具方面领先。两者均提供免费版和$20/月付费方案。本指南基于验证基准数据,从编程、写作、研究、定价和API能力等维度进行全面对比。
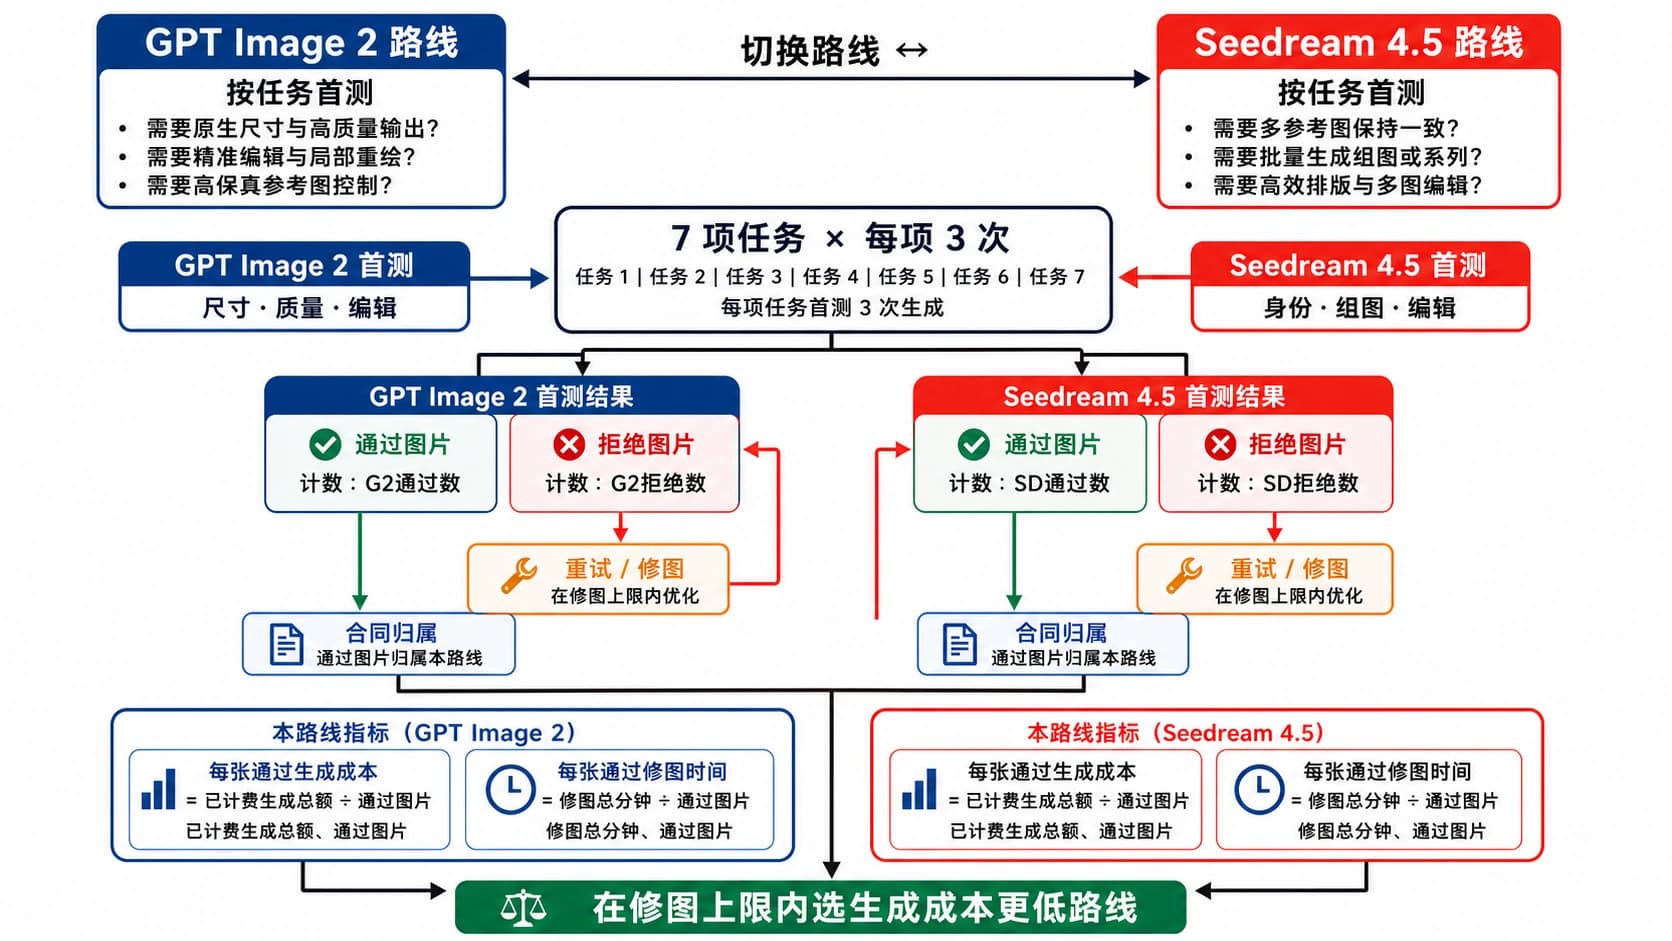
OpenAI 原生尺寸、质量、编辑和 inpainting 控制优先试 GPT Image 2;多参考图、海报排版和组图工作流优先试 Seedream 4.5。真正的胜负要同时比较中文文字、身份一致性、精确编辑、每张验收通过图片的生成成本与修图时间,而不是一次调用有多便宜。
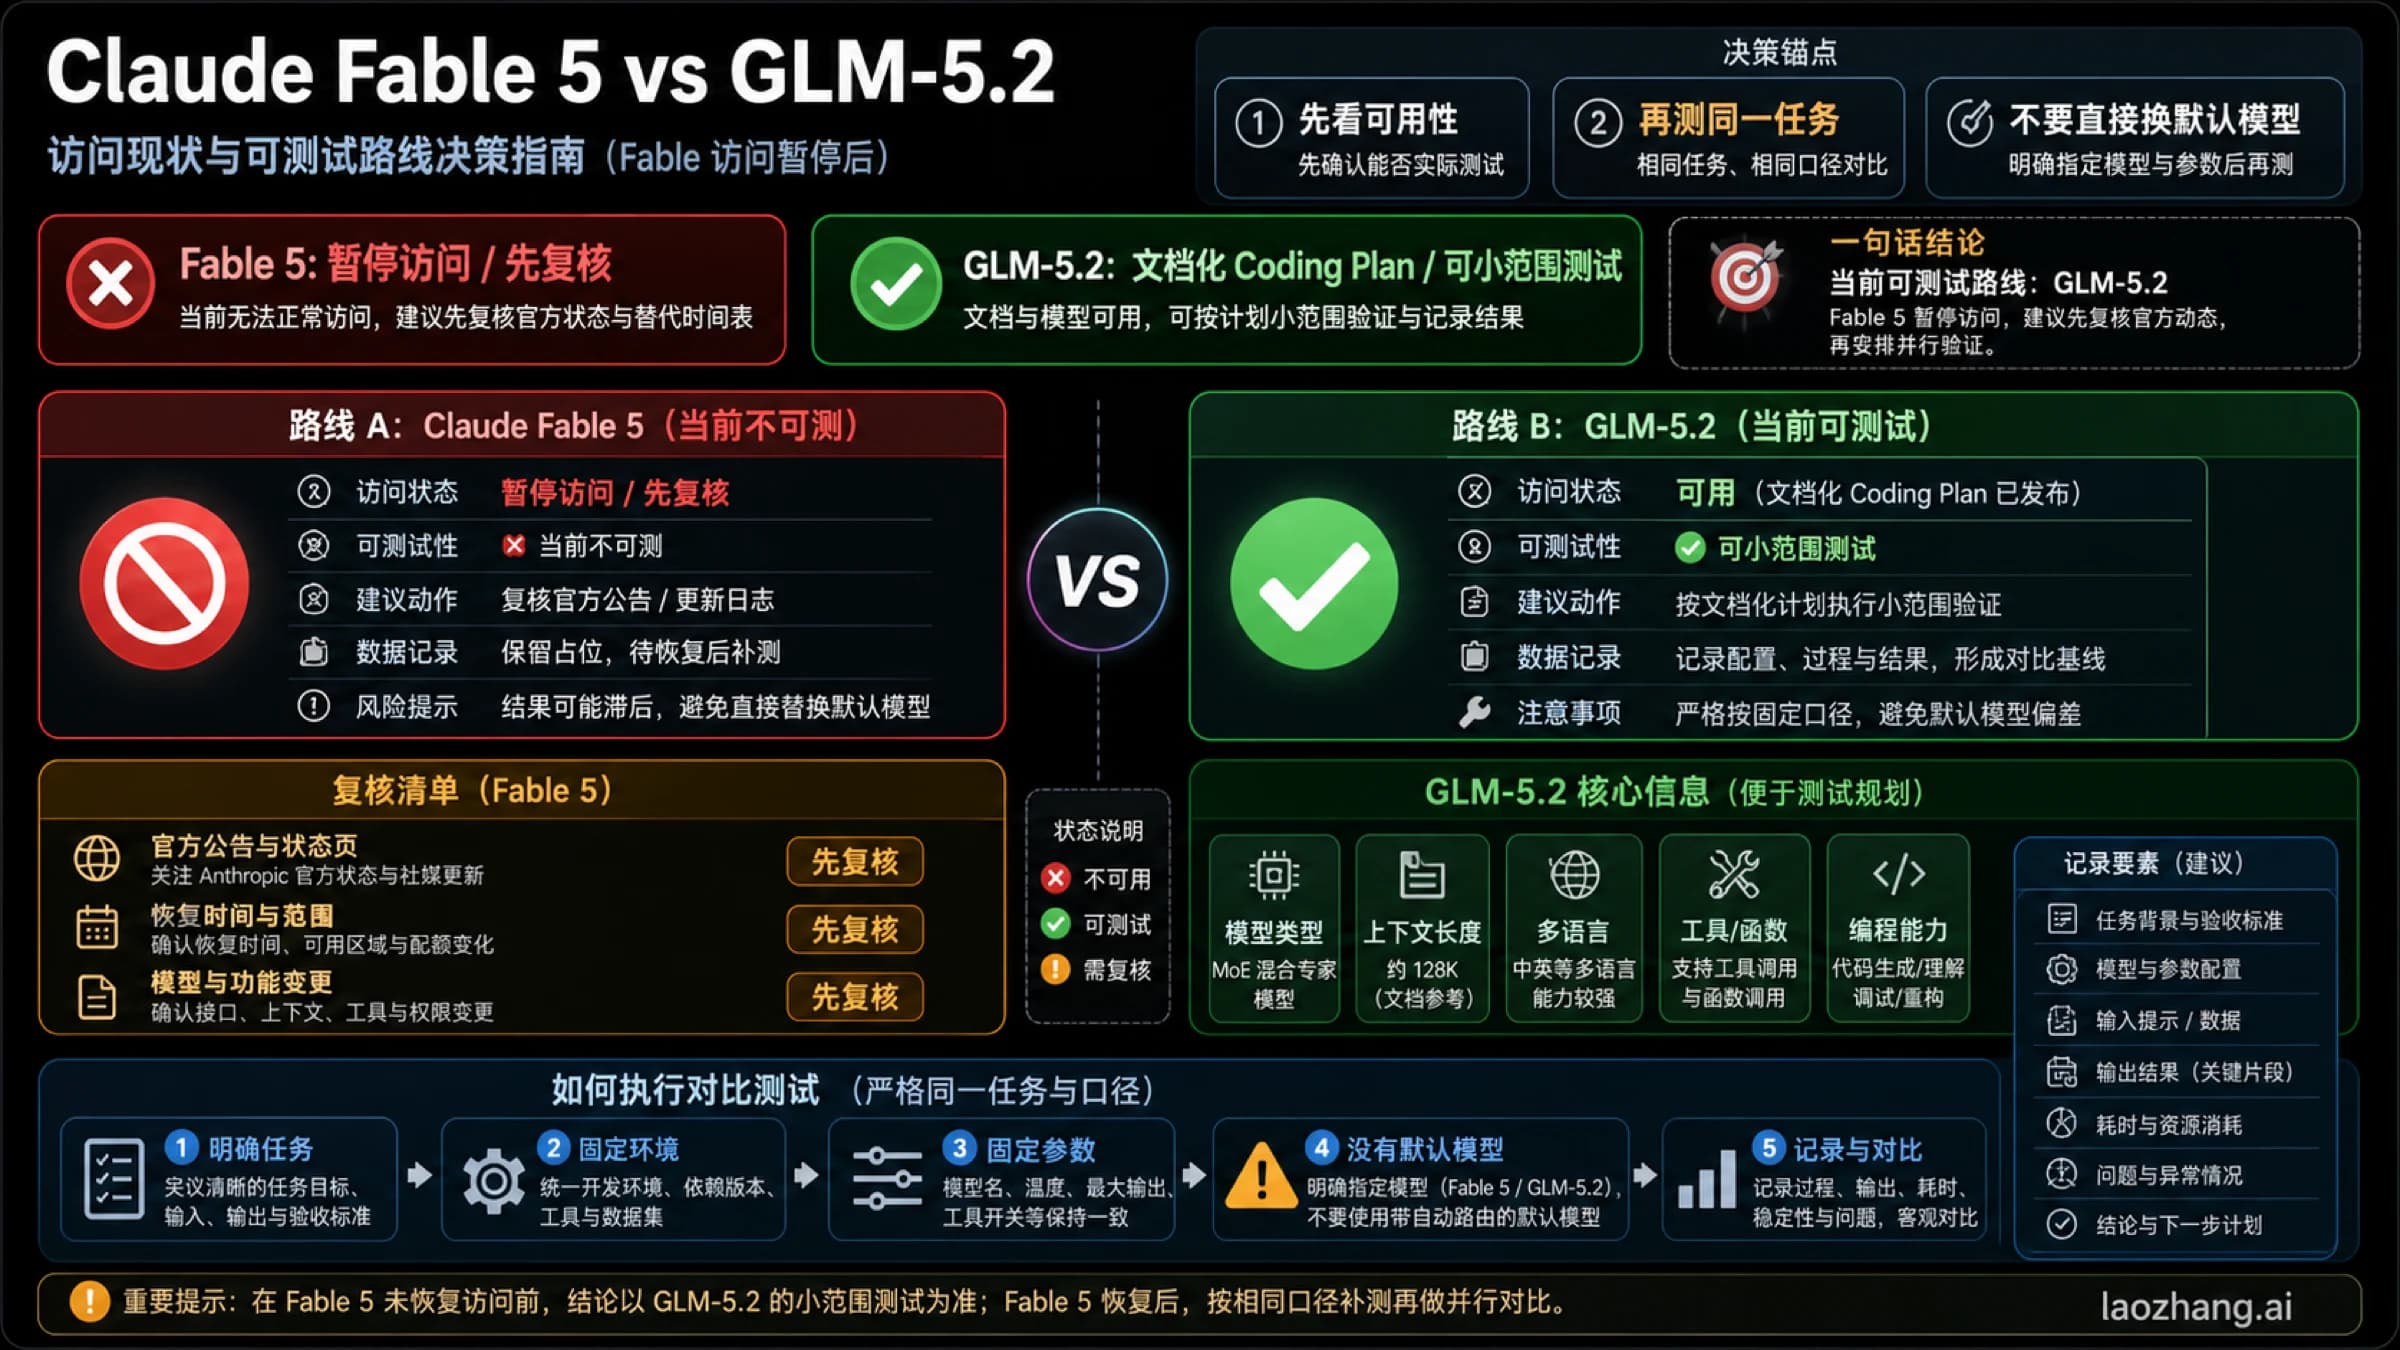
截至 2026 年 6 月 14 日,Fable 5 是等待复核路线,GLM-5.2 是可以按 Z.AI Coding Plan 做小范围测试的路线;不要在没有同一任务证据前替换默认模型。
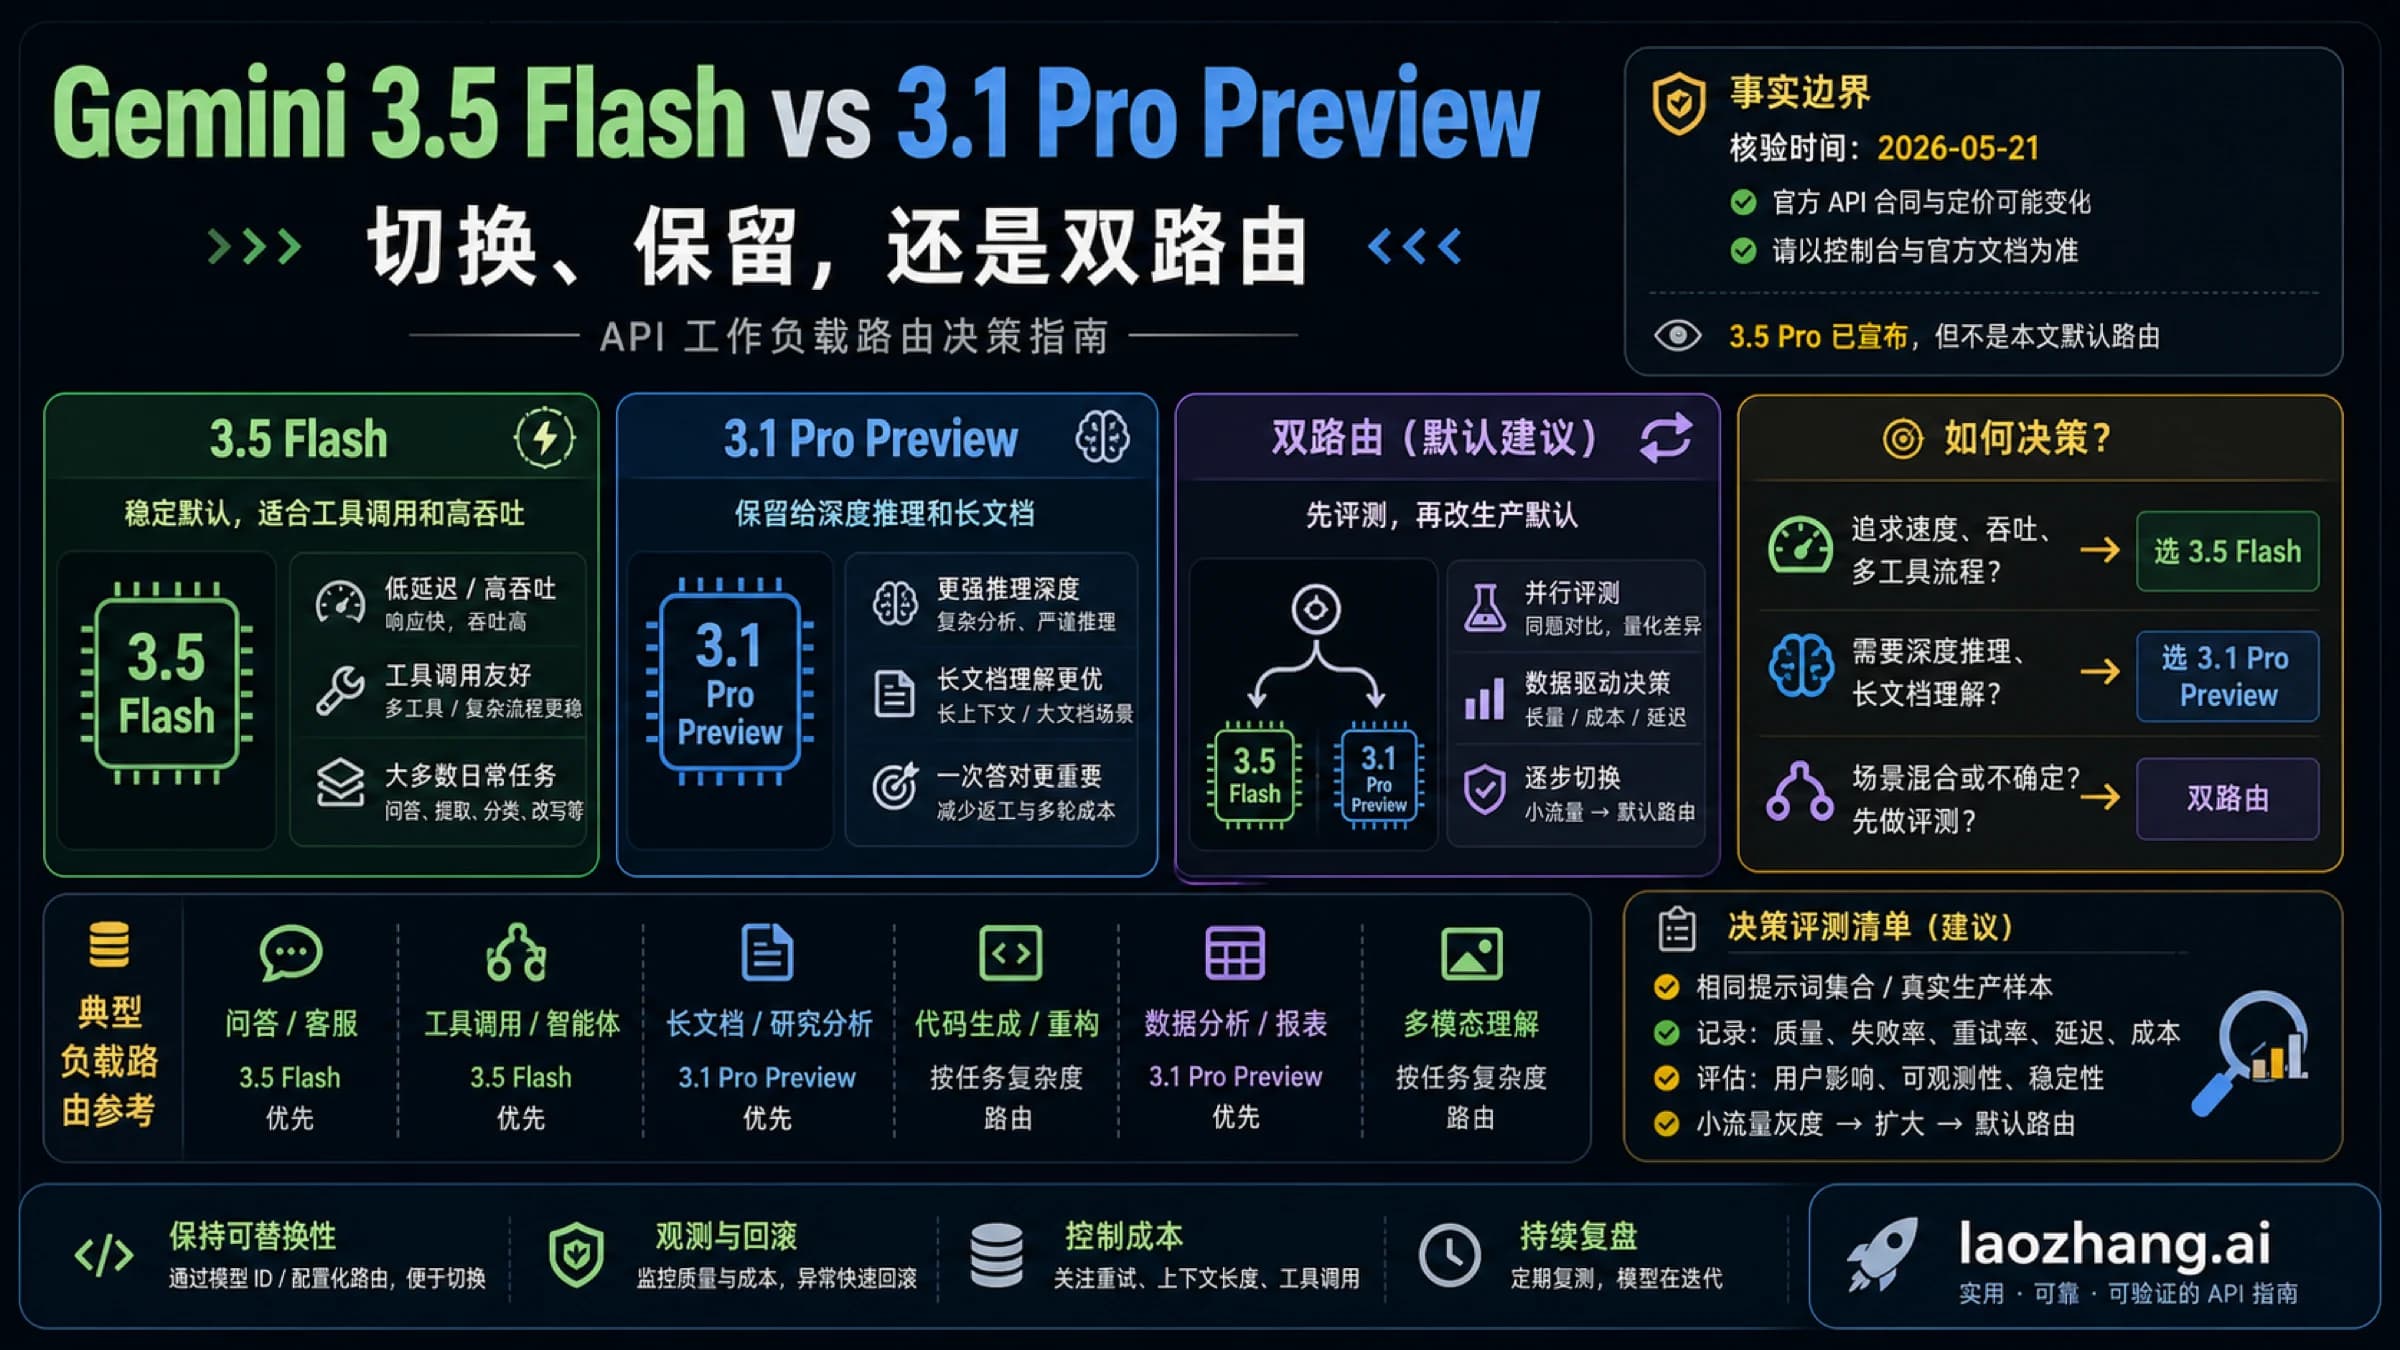
Gemini 3.5 Flash 适合先接管快节奏代理、编码和工具调用链路,但 Gemini 3.1 Pro Preview 仍应保留在深推理、长文档和 customtools 敏感任务里。
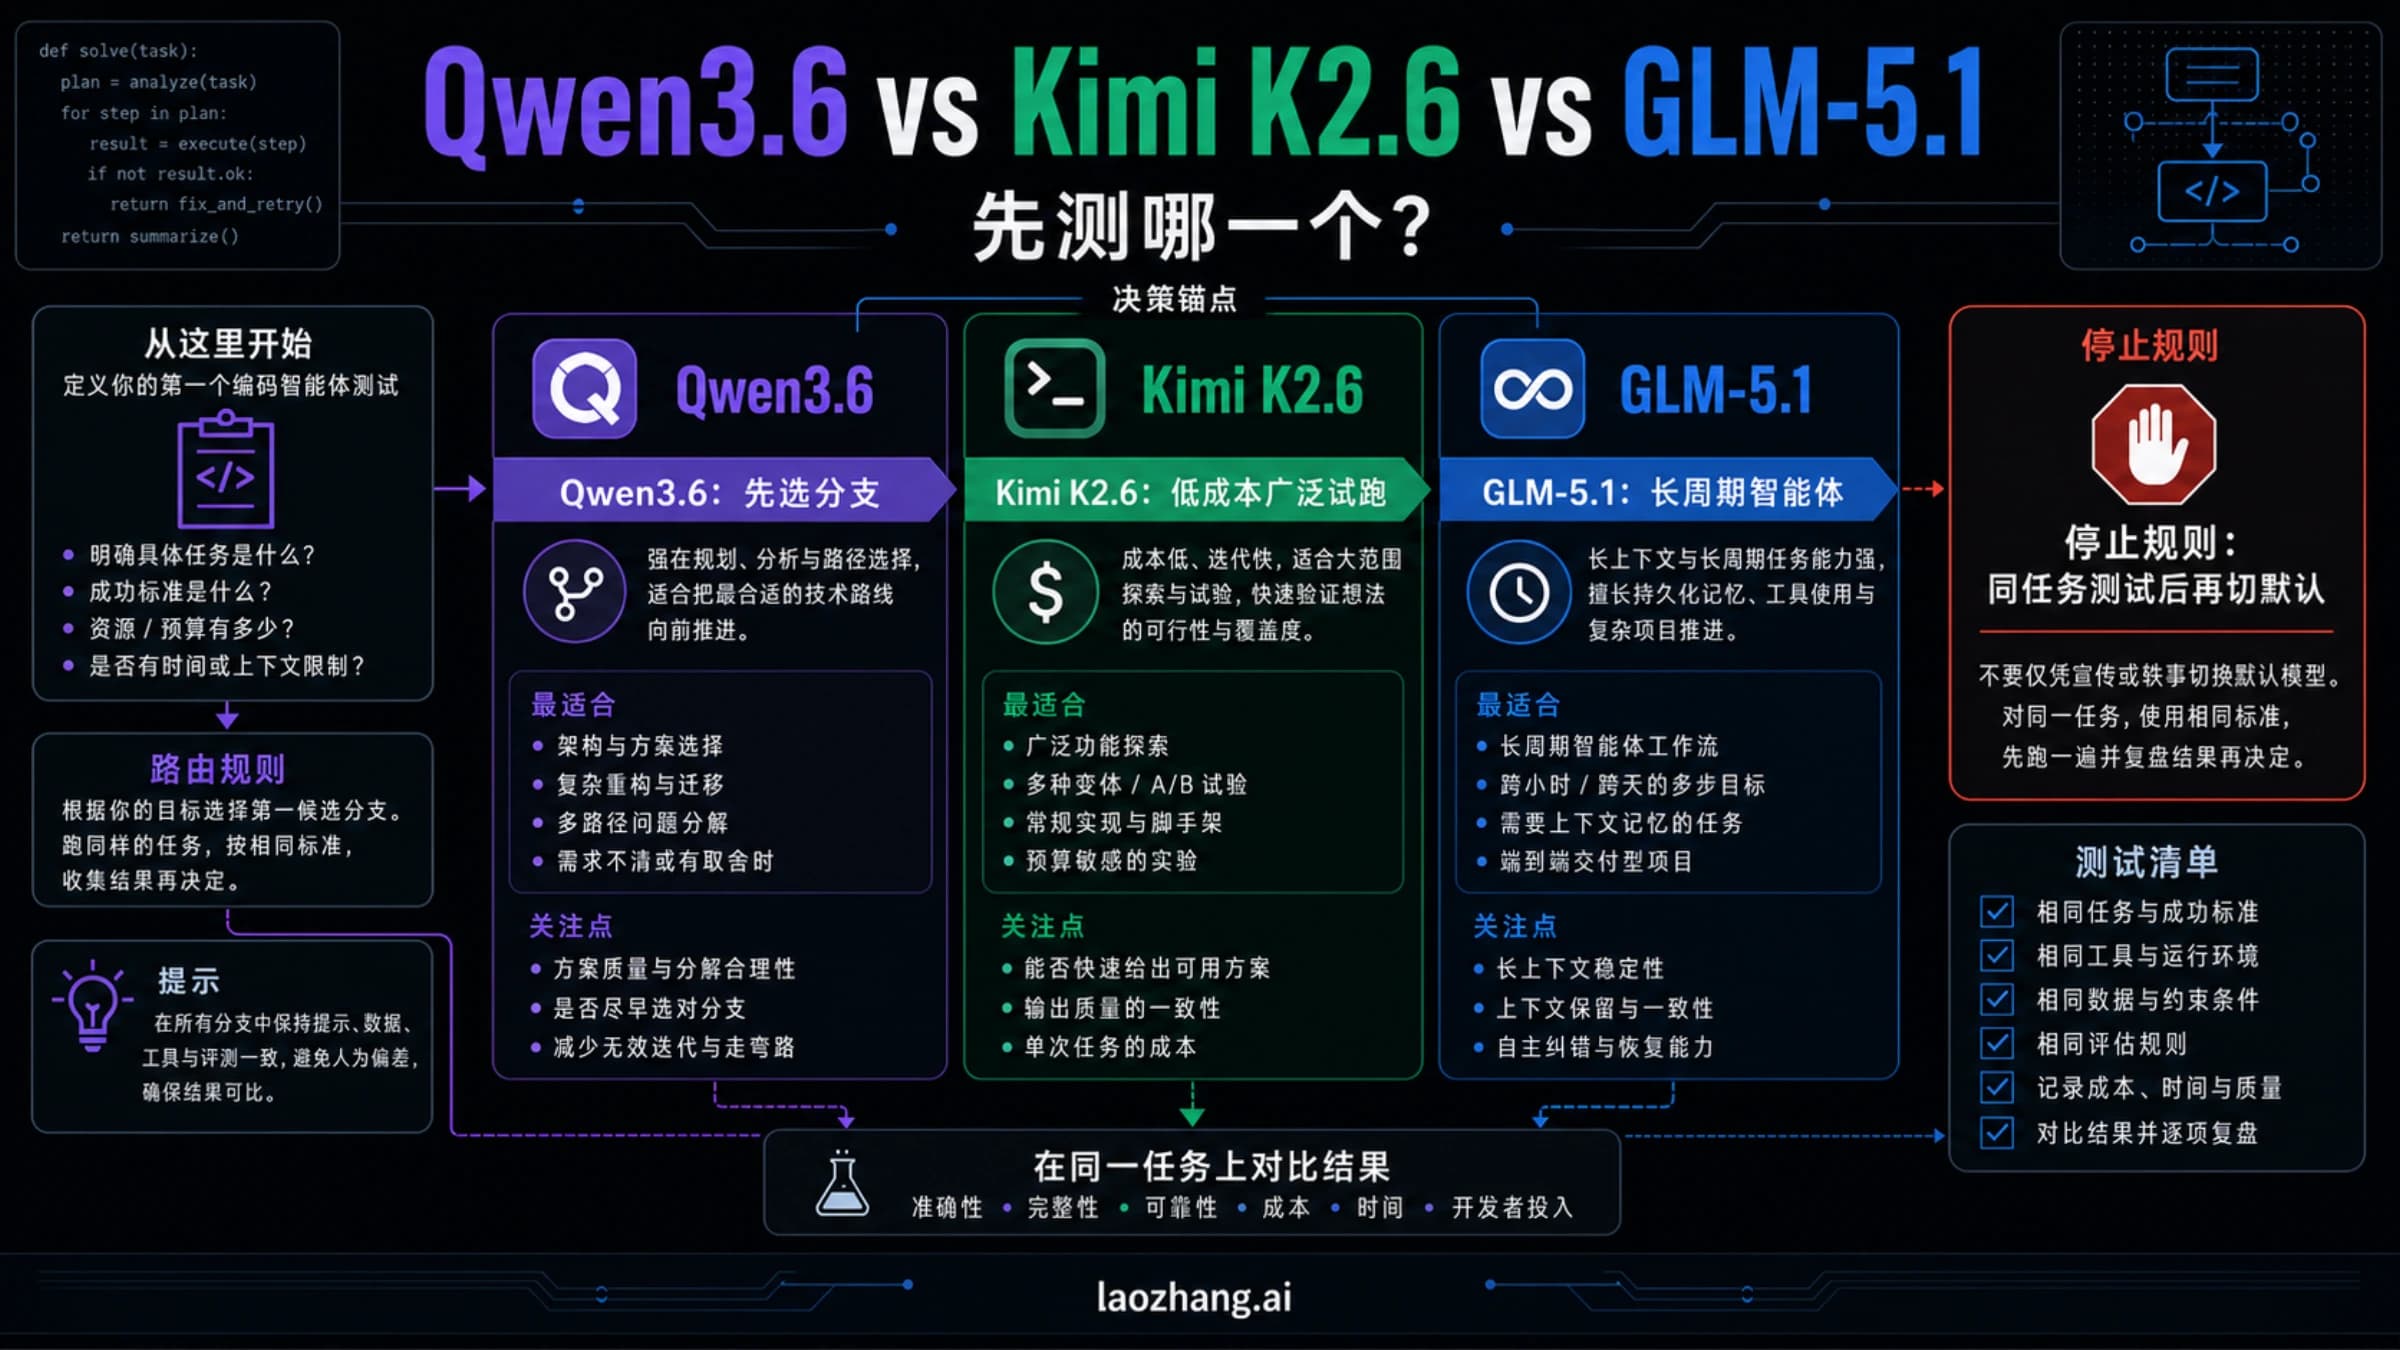
长周期自主编码先测 GLM-5.1,低成本批量试错先测 Kimi K2.6;Qwen3.6 必须先说明是 35B-A3B 开放权重分支还是托管分支。