GLM-5.3、Kimi K3 与 DeepSeek V4:先测哪个才不浪费预算?
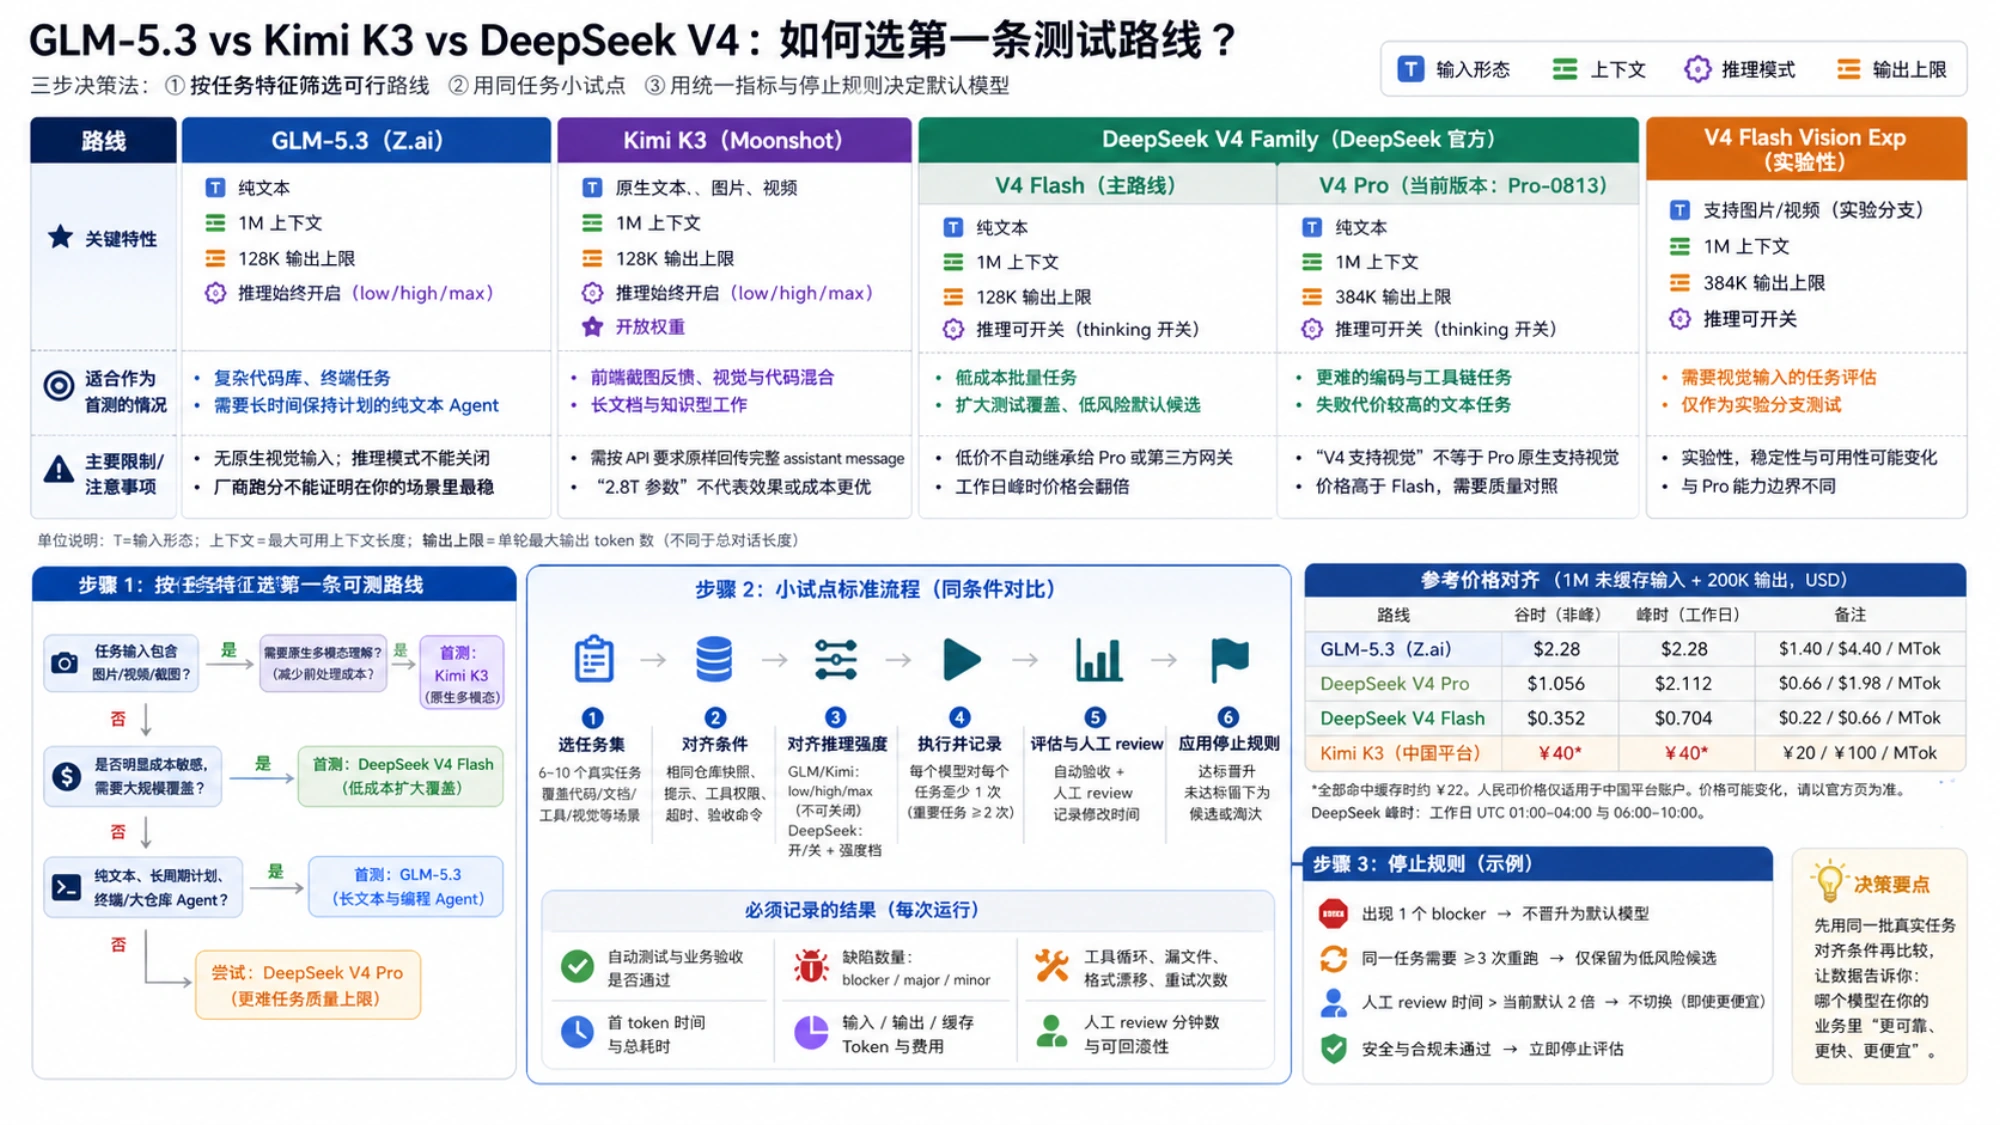
需要纯文本长周期编码,先把 GLM-5.3 放进候选;任务含图片或视频,Kimi K3 的原生多模态更直接;预算与吞吐优先,则先测 DeepSeek V4 Flash,再用 Pro 做质量上限。
文章目录
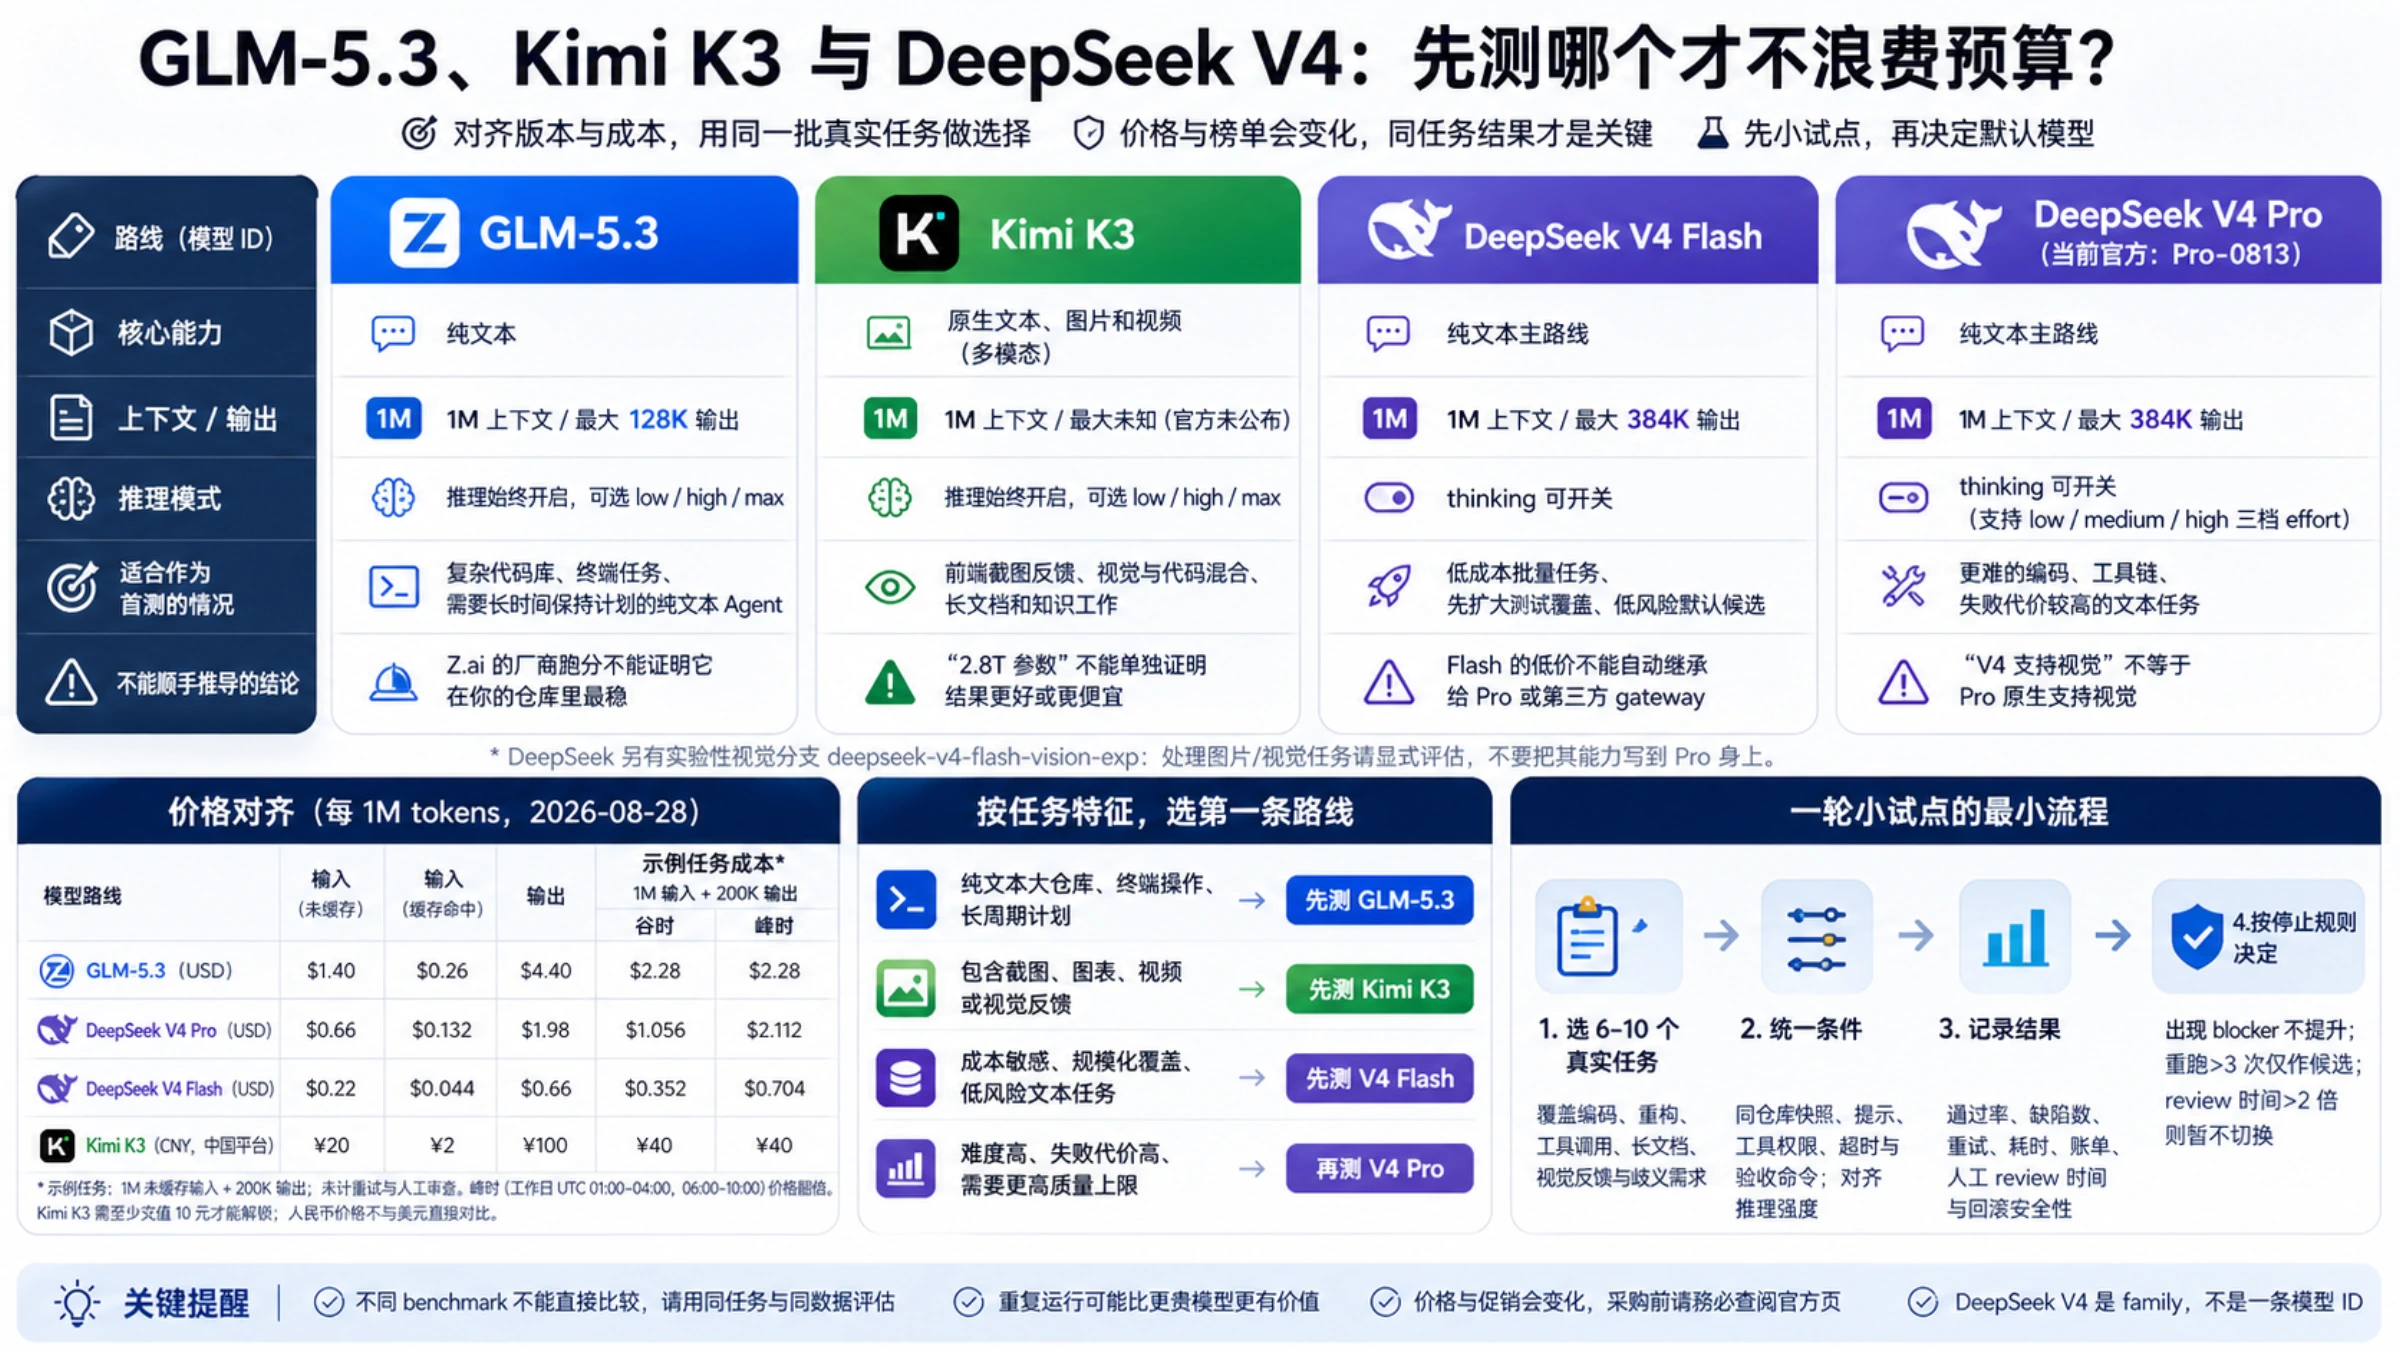
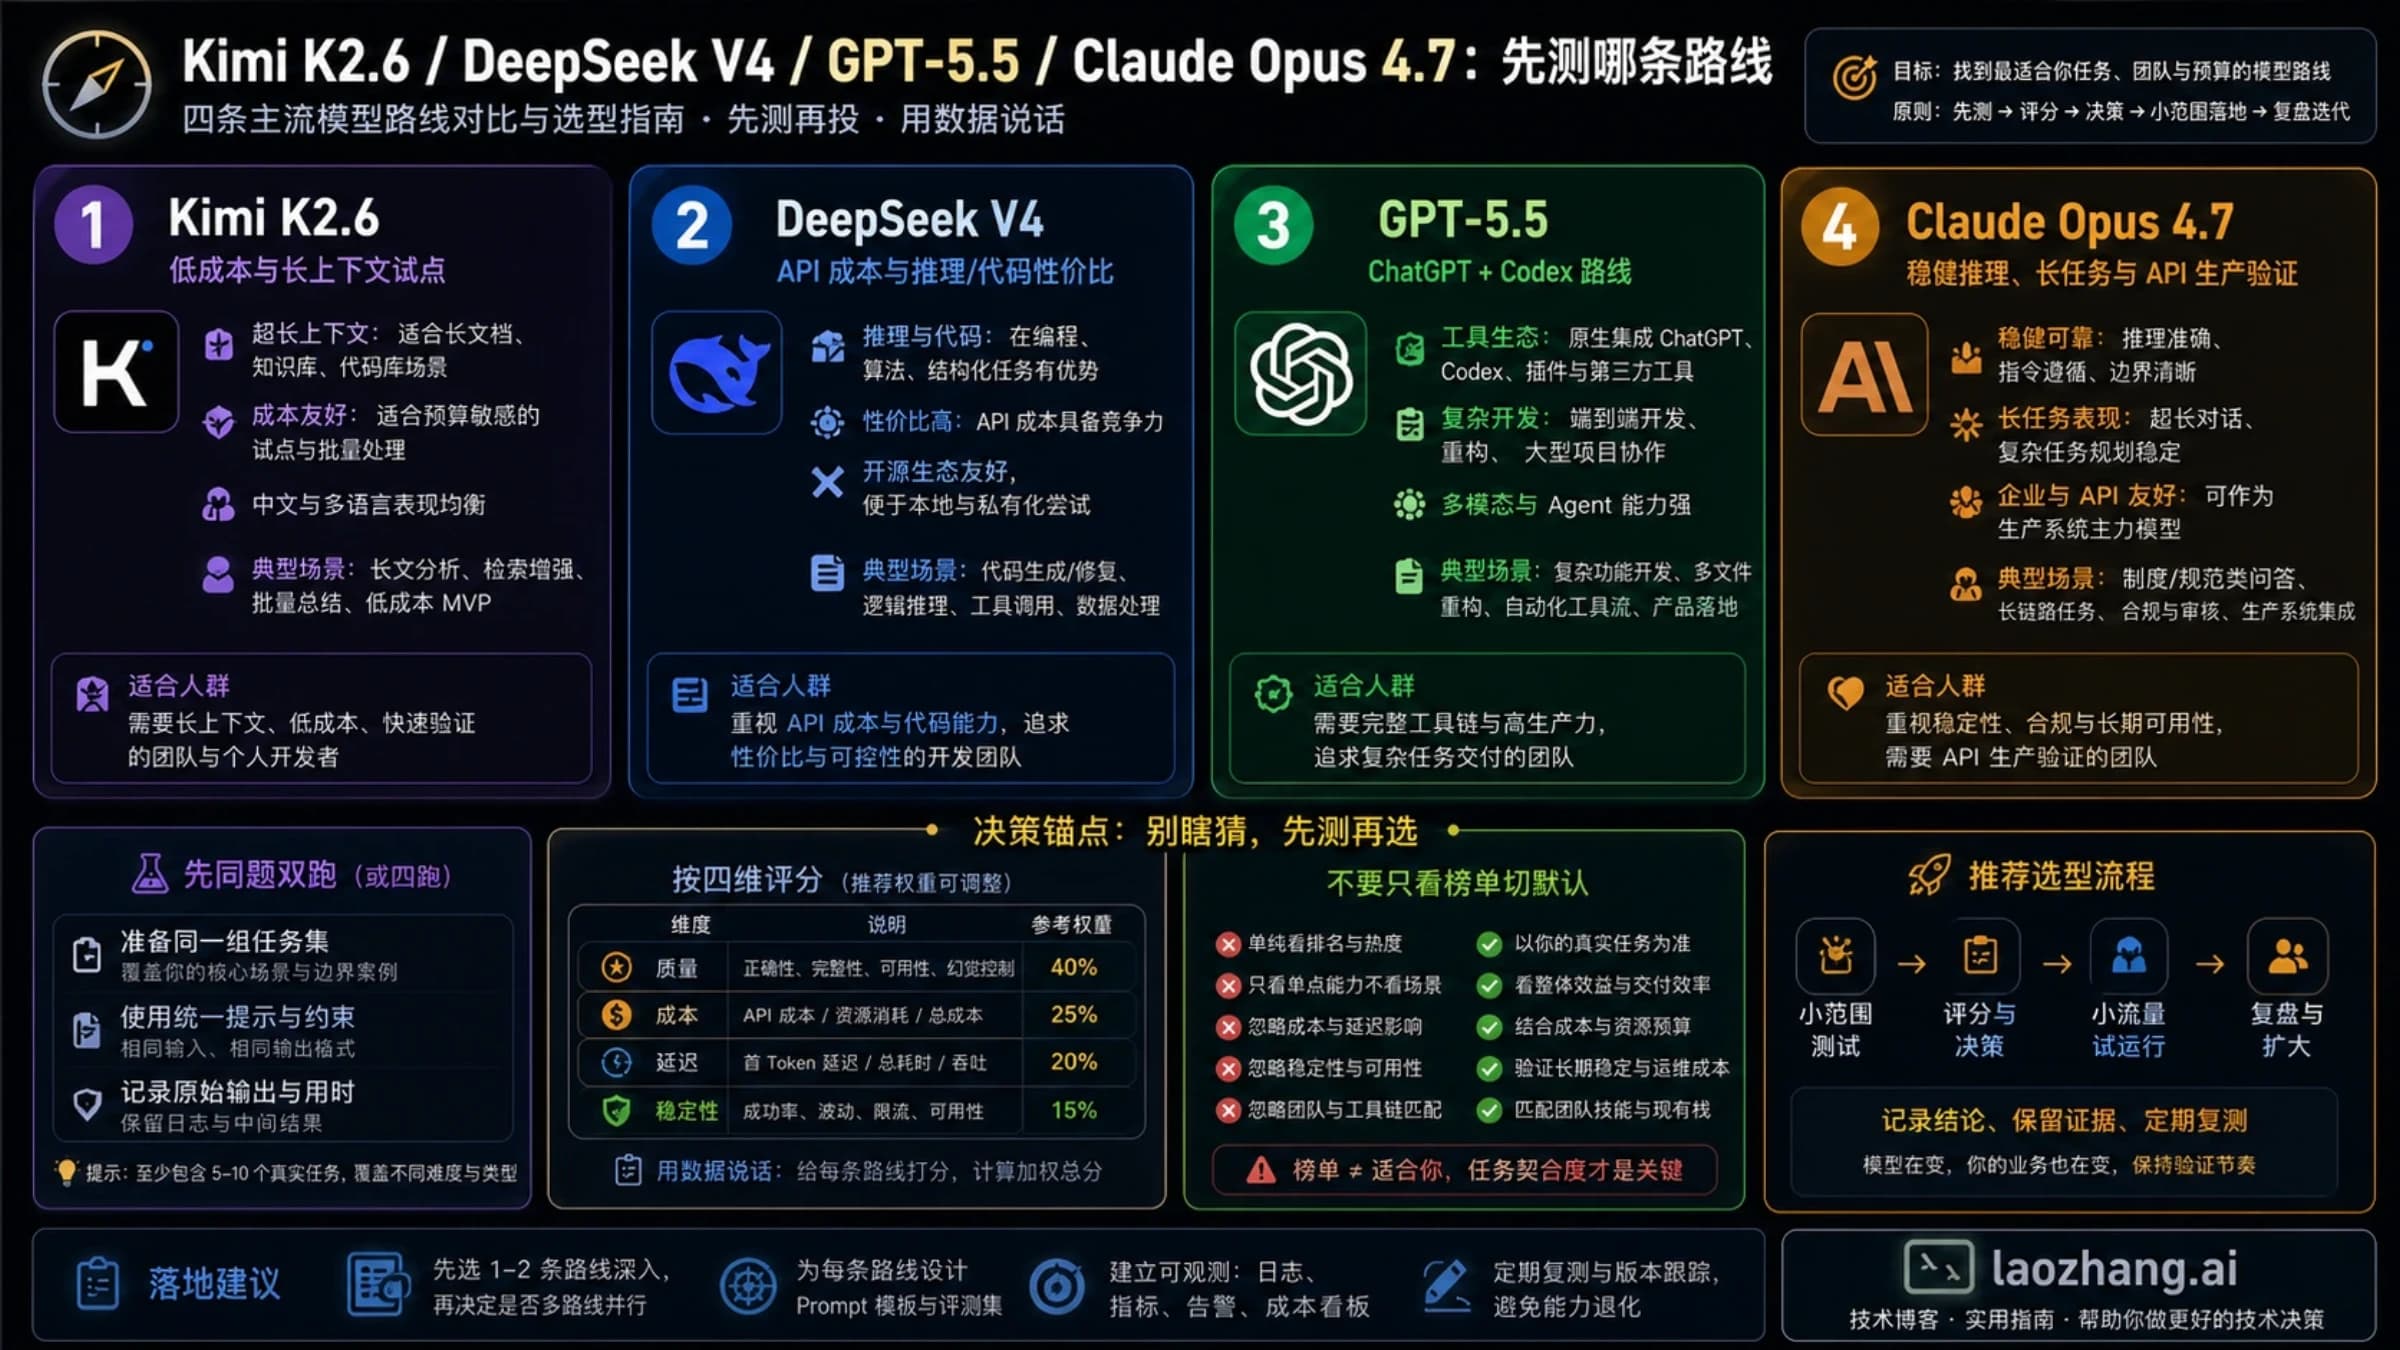
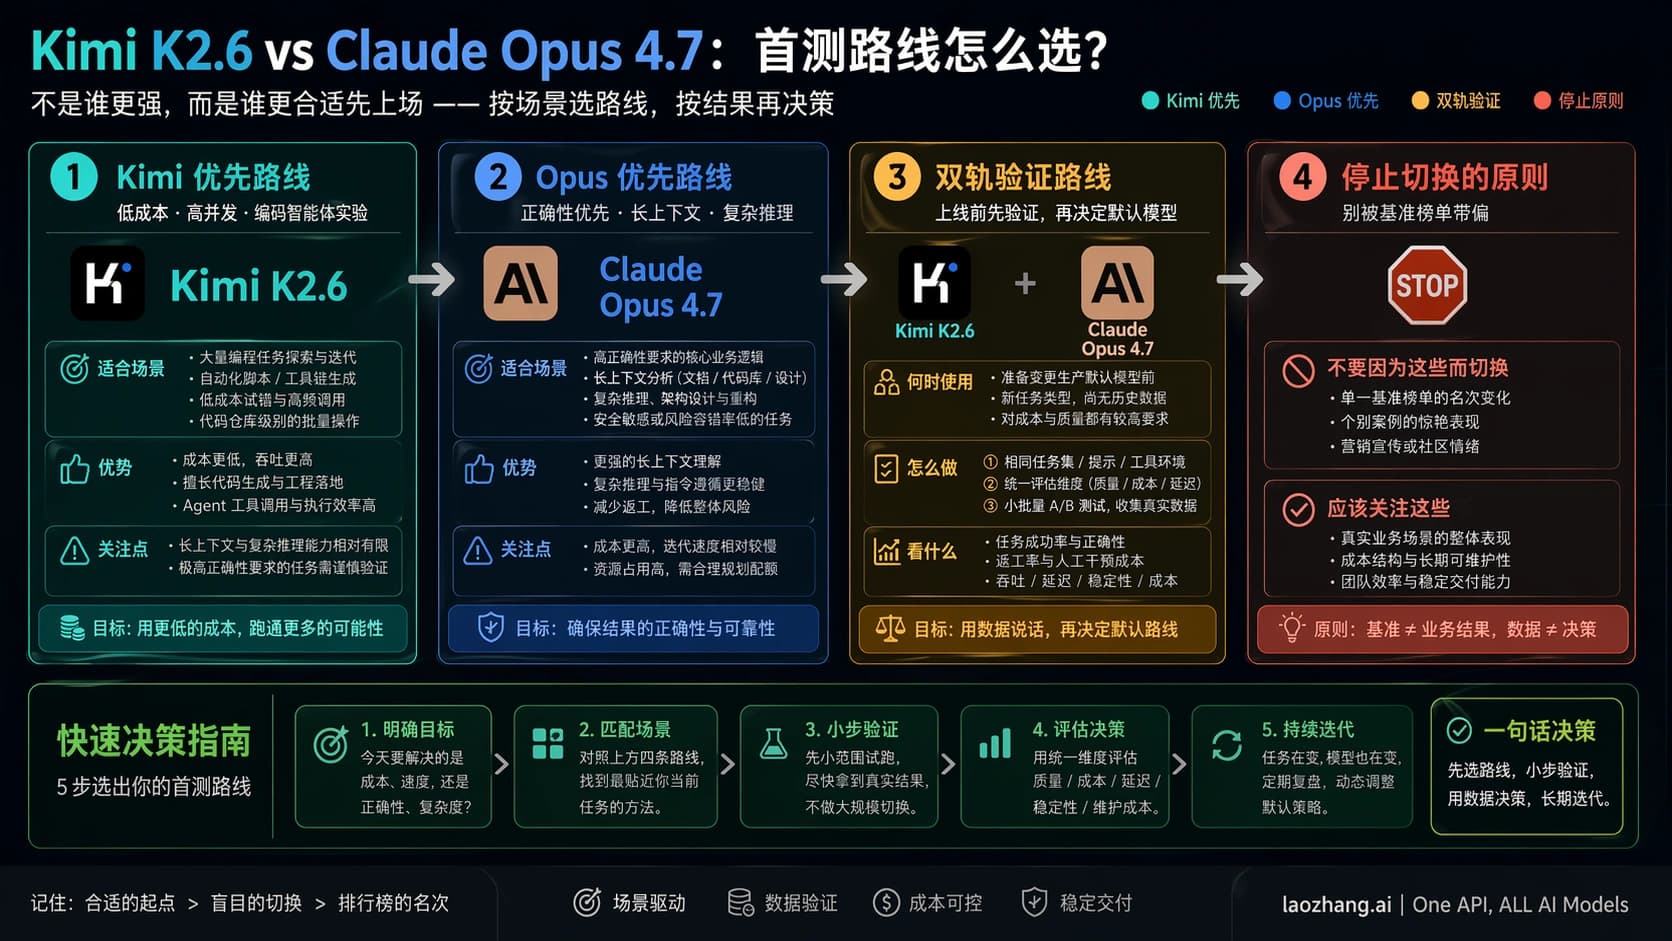
这三个名字不能直接排成一条“最强榜”。更实用的结论是:纯文本、长周期编码与终端 Agent 可以先测 glm-5.3;同一模型需要读图片或视频时,先测 kimi-k3;成本敏感的文本 API 先测 deepseek-v4-flash,难题再用 deepseek-v4-pro 做质量对照。
真正决定默认模型的,不是发布页上的最高分,而是同一批真实任务在质量、重试、延迟、人工 review 和总账单上的结果。尤其要先拆开 DeepSeek V4:它是一个 family,不是一条模型 ID。
先把四条可调用路线对齐
| 路线 | 当前合同里最重要的区别 | 适合作为首测的情况 | 不能顺手推导的结论 |
|---|---|---|---|
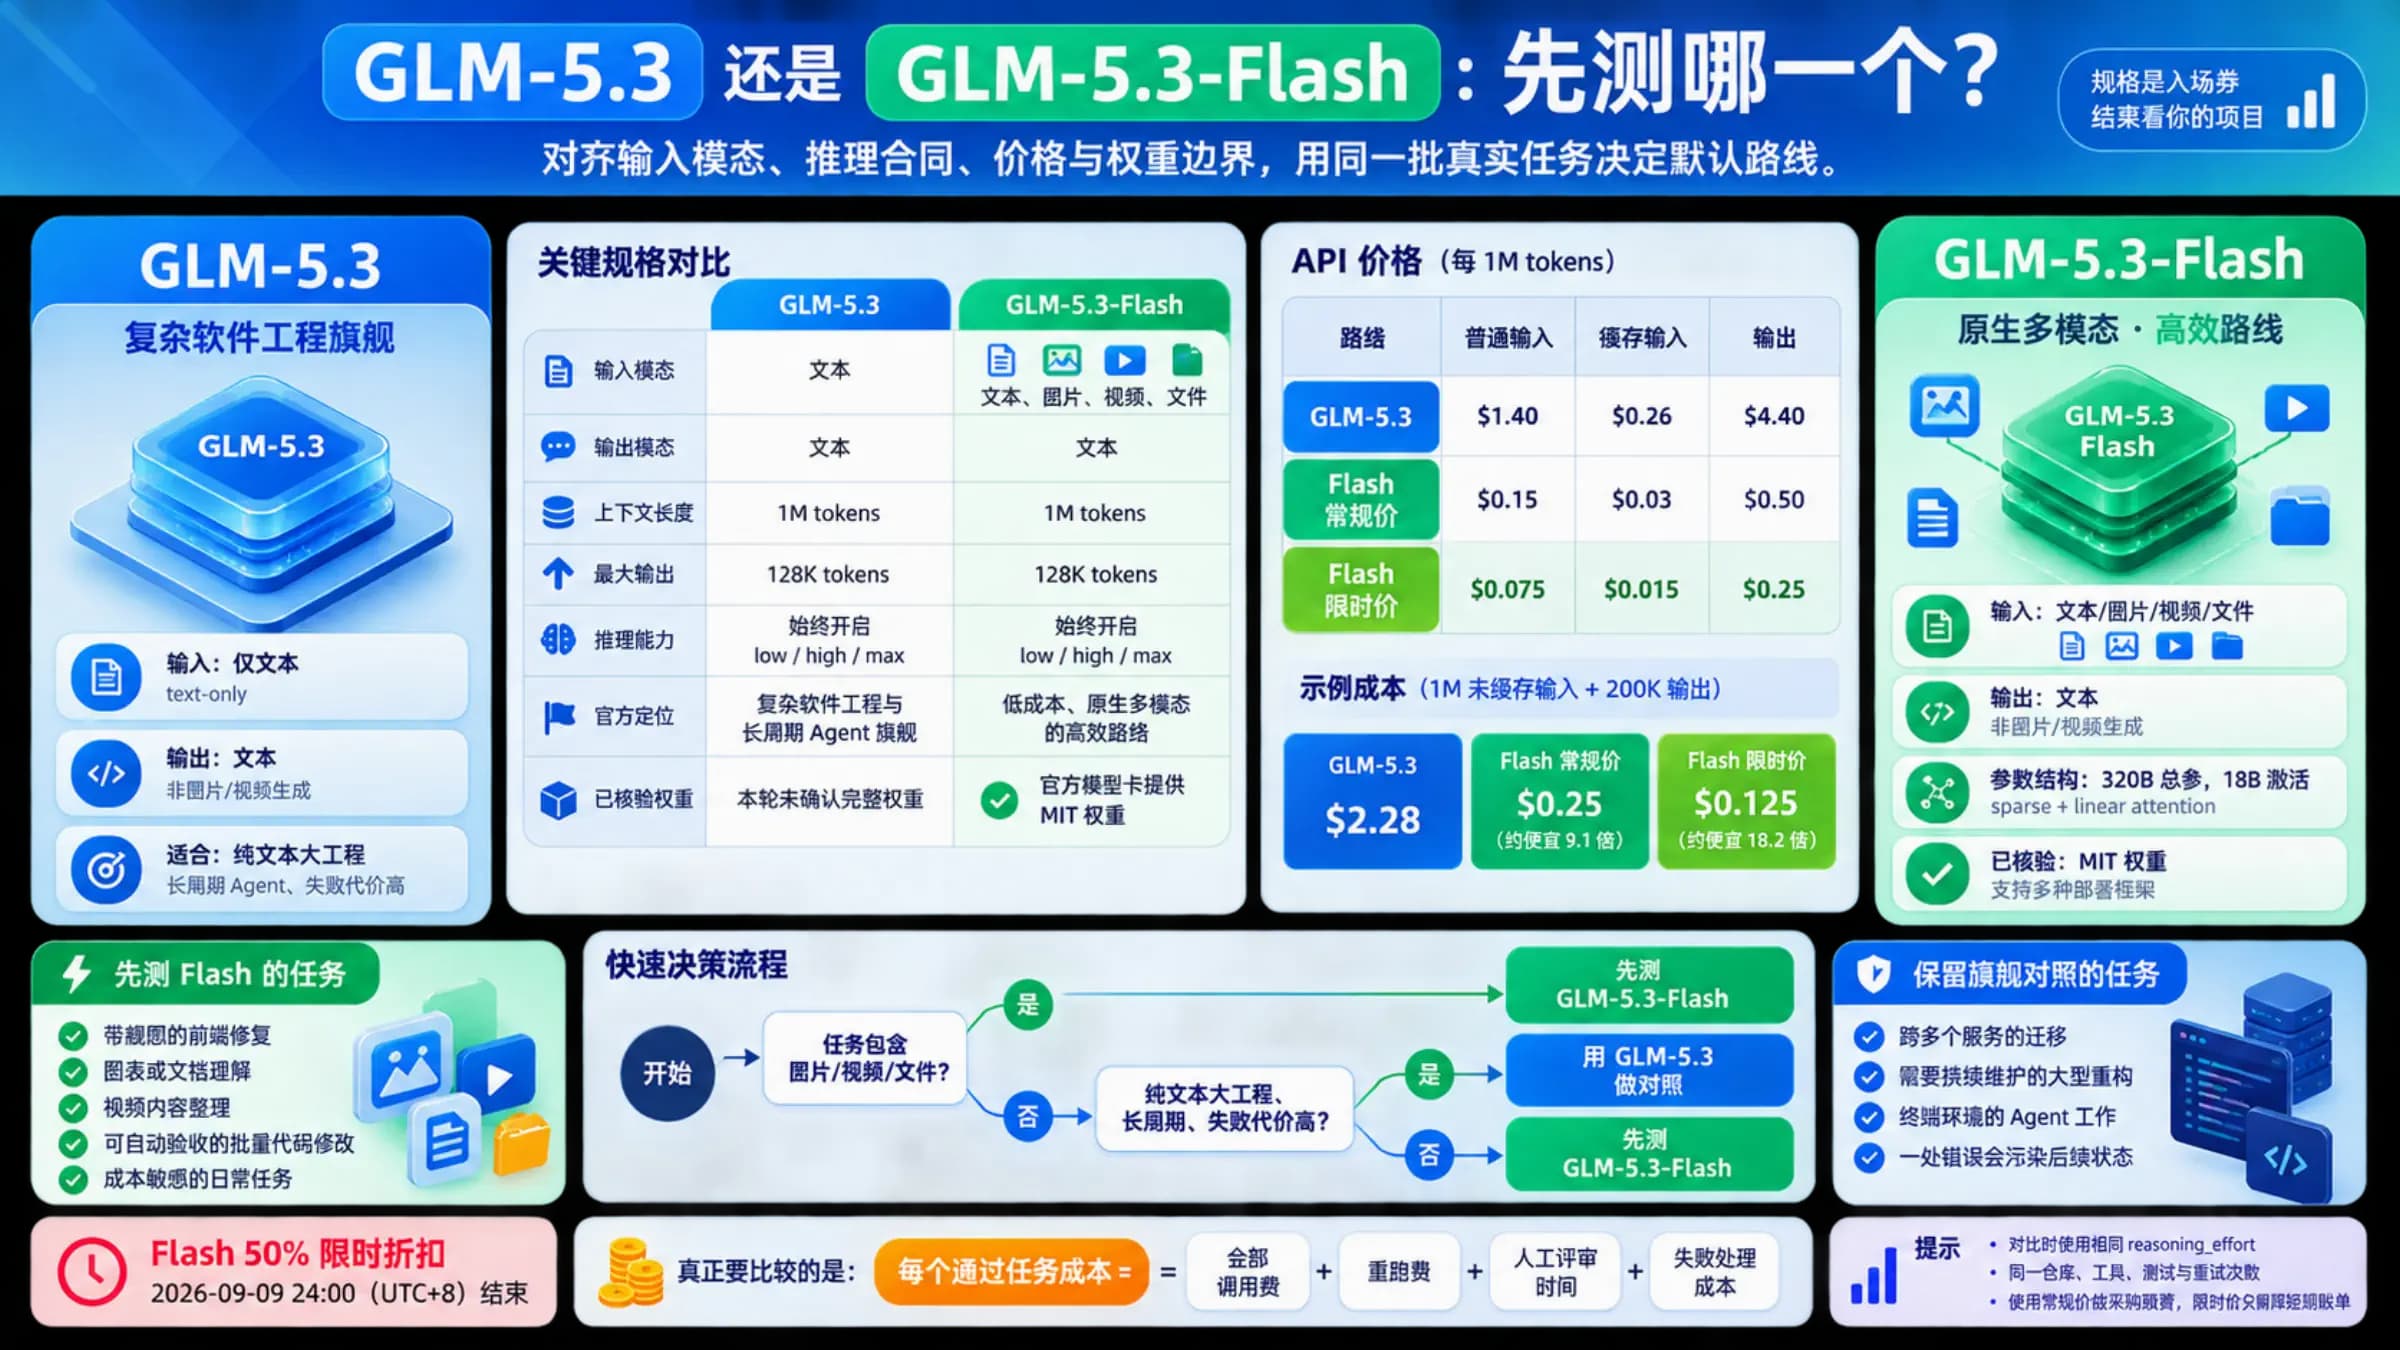
glm-5.3 | 纯文本;1M 上下文;最大 128K 输出;推理始终开启,可选 low/high/max | 复杂代码库、终端任务、需要长时间保持计划的纯文本 Agent | Z.ai 的厂商跑分不能证明它在你的仓库里最稳 |
kimi-k3 | 原生文本、图片和视频;1M 上下文;开放权重;推理始终开启 | 前端截图反馈、视觉与代码混合、长文档和知识工作 | “2.8T 参数”不能单独证明结果更好或更便宜 |
deepseek-v4-flash | 纯文本主路线;1M 上下文;最大 384K 输出;thinking 可开关 | 低成本批量任务、先扩大测试覆盖、低风险默认候选 | Flash 的低价不能自动继承给 Pro 或第三方 gateway |
deepseek-v4-pro | 当前官方版本为 Pro-0813;同样支持 thinking 开关和三档 effort | 更难的编码、工具链、失败代价较高的文本任务 | “V4 支持视觉”不等于 Pro 原生支持视觉 |
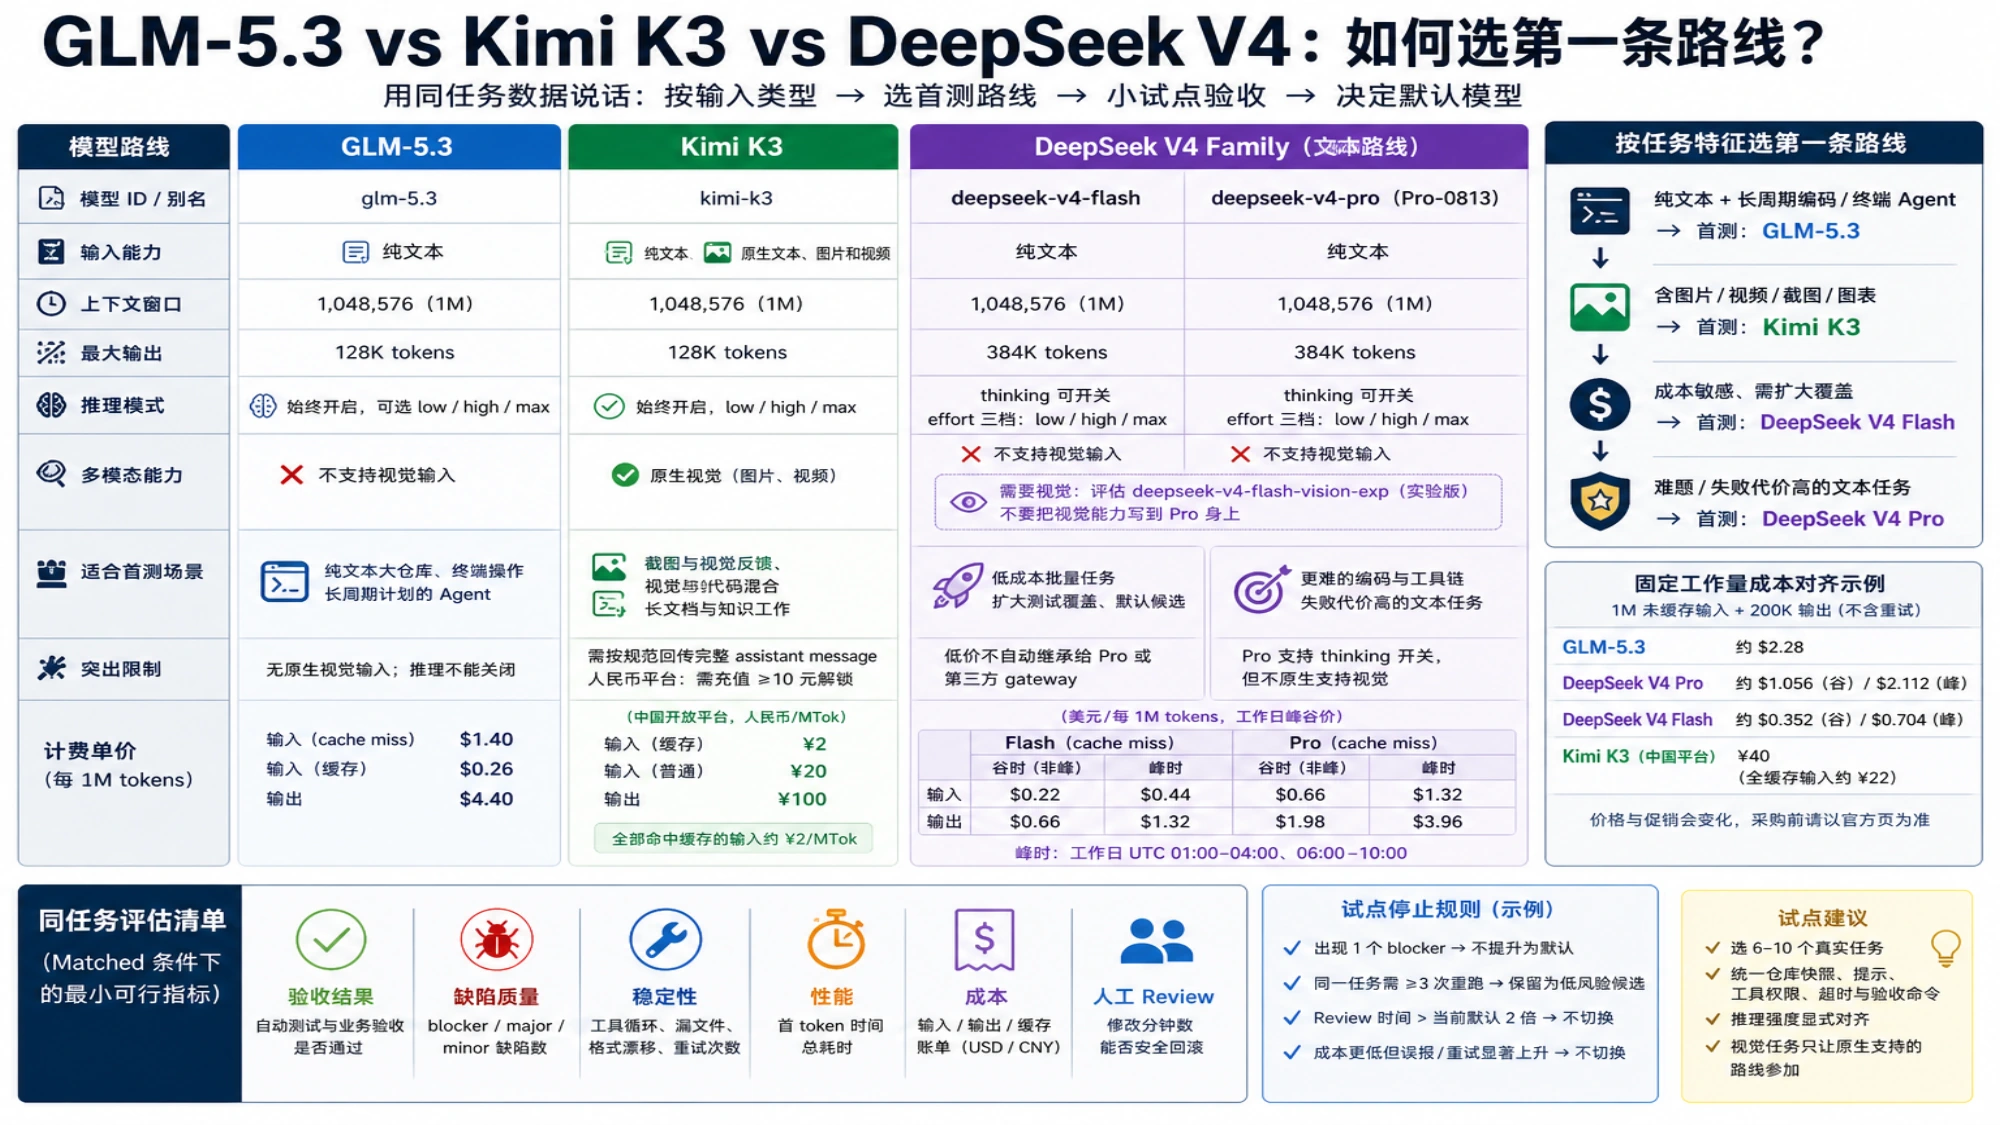
GLM-5.3 官方文档明确写的是纯文本、1M 上下文、128K 最大输出和始终开启推理。Kimi K3 官方 API 指南给出 kimi-k3、原生视觉、1M 上下文和 low/high/max 三档,但也要求多轮工具调用把完整 assistant message 原样回传。
DeepSeek 的边界更容易写错。当前价格与模型页把 deepseek-v4-pro、deepseek-v4-flash 与实验性的 deepseek-v4-flash-vision-exp 分成三行。要处理图片,应显式评估视觉实验分支;不要把它的能力写到 Pro 身上。
价格比较要先统一计费场景
截至 2026 年 8 月 28 日,Z.ai 价格页列出的 GLM-5.3 单价是每 1M tokens:输入 $1.40、缓存输入 $0.26、输出 $4.40。
Kimi 中国开放平台显示 K3 为缓存输入 ¥2、普通输入 ¥20、输出 ¥100 / MTok。这个价格属于人民币平台账户;官方指南还写明 K3 需要至少充值 10 元才能解锁,注册赠券不能解锁。它不能不经说明就和美元国际 provider 报价放进一列。
DeepSeek 采用工作日峰谷价。V4 Flash 的 cache-miss 输入/输出在谷时为 $0.22/$0.66,峰时为 $0.44/$1.32;V4 Pro 谷时为 $0.66/$1.98,峰时为 $1.32/$3.96,单位都是每 1M tokens。峰时是工作日 UTC 01:00–04:00 与 06:00–10:00。
可以用一笔固定工作量检查价格表是否对齐。假设一次任务有 1M 未缓存输入和 200K 输出,暂不计重试:
- GLM-5.3 约为 $1.40 + $0.88 = $2.28;
- DeepSeek V4 Pro 谷时约 $1.056,峰时约 $2.112;
- DeepSeek V4 Flash 谷时约 $0.352,峰时约 $0.704;
- Kimi K3 中国平台为 ¥20 + ¥20 = ¥40,若输入全部命中缓存则约 ¥22。
这只是 token 合同对齐,不是最终性价比。Agent 失败一次再重跑,或者便宜结果需要多出半小时 review,都会改变“每个被接受任务”的成本。价格与促销也会变化,采购前应重新打开官方页。
公开 benchmark 能回答什么
三家发布材料使用的 harness、工具、推理强度、token budget 和测试集并不一致。把几个最高分抄进同一张表,会制造精确但错误的比较。
更有参考价值的是同工作负载评测。Aikido 的安全模型评测冻结了 32 个近期漏洞、prompt、工具和评估规则,每个模型重复三次。在这个漏洞发现任务里,DeepSeek V4 Pro-0813 的三次合并召回最高;Kimi K3 在受测开放权重模型中有最高的合并精度;GLM-5.3 的召回与一致性都很强。
这并没有产生通用冠军。它反而说明了三个决策事实:
- 单次运行会遗漏,重复运行可能比换更贵模型更有价值;
- 高召回可能带来更多误报和后处理;
- 一个安全评测不能代表前端实现、长文档、视觉理解或你自己的工具链。
用一轮小试点决定默认模型
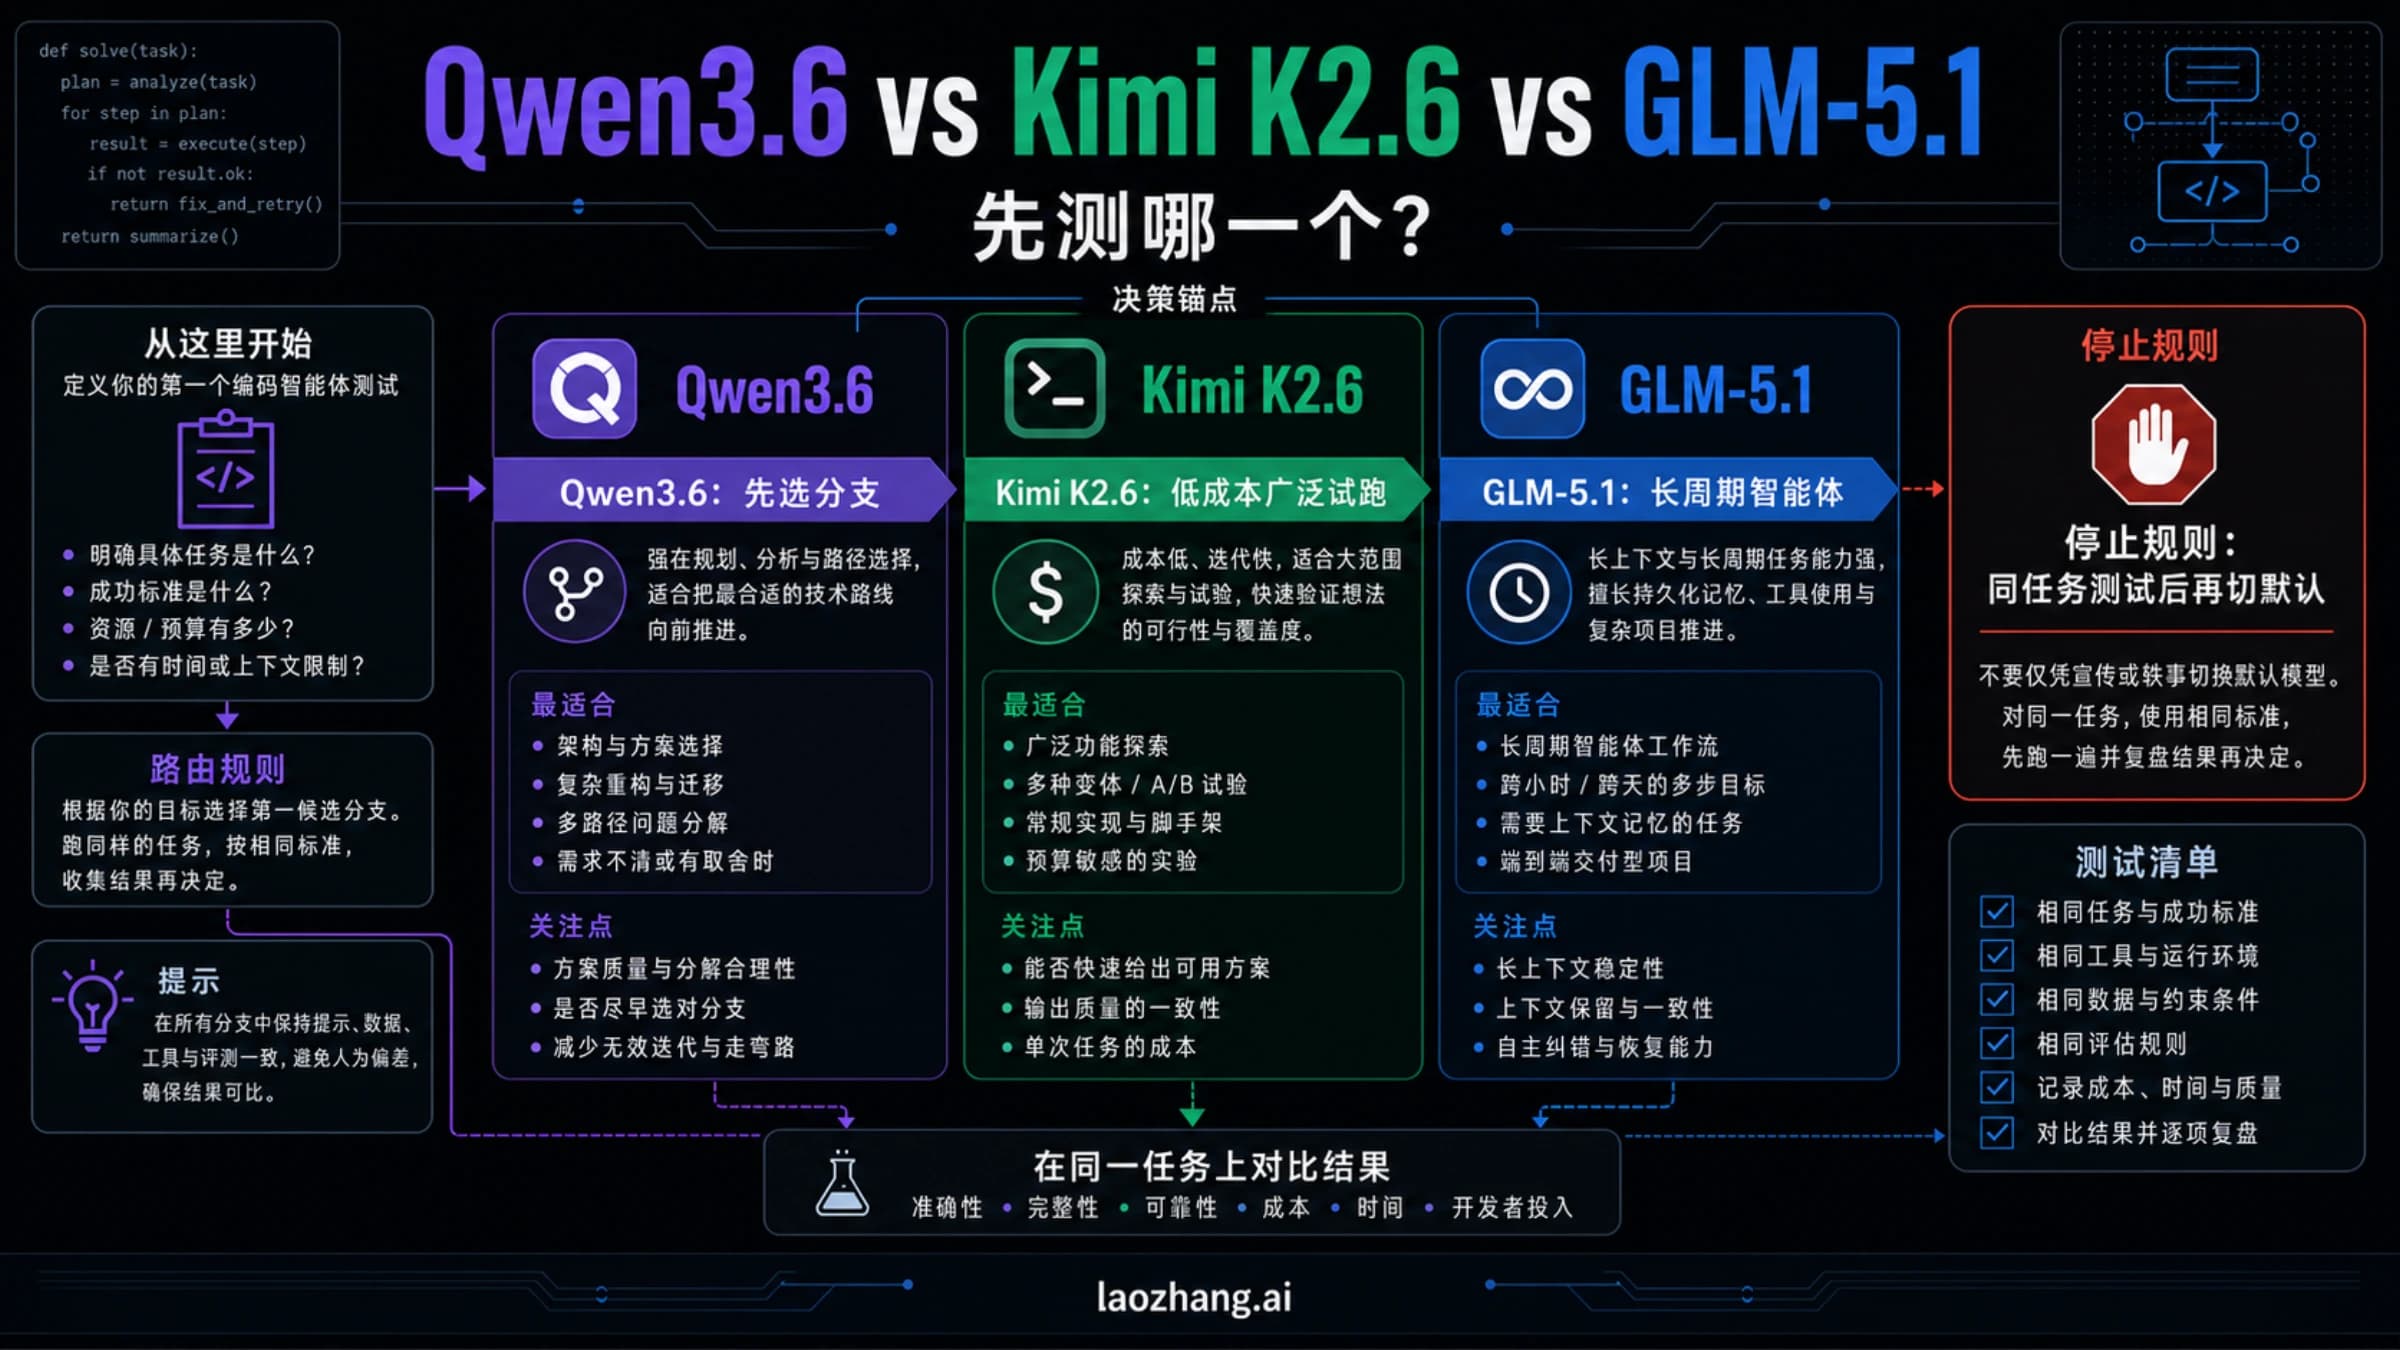
不要一开始就把整个生产流量切过去。先选 6–10 个会真实发生的任务,例如:一个跨文件 bug、一次中型重构、一条需要工具调用的 Agent 任务、一份长文档分析、一个带截图反馈的前端任务,以及一个故意保留歧义的需求。
对文本任务,让 glm-5.3、DeepSeek V4 Flash/Pro 与 Kimi K3 使用相同仓库快照、提示、工具权限、超时和验收命令。视觉任务只让实际支持该输入的路线参加,并把“为了参赛先人工转成文字”的成本单独记录。推理强度也要显式对齐:三家都能使用 low/high/max,但 Kimi K3 与 GLM-5.3 不能关闭 reasoning,DeepSeek 可以。
每次至少记录这些结果:
- 自动测试与业务验收是否通过;
- blocker、major、minor 缺陷数;
- 工具循环、漏文件、格式漂移和重试次数;
- 首 token、总耗时、输入/输出/缓存账单;
- reviewer 修改分钟数与能否安全回滚。
在试点前写停止规则。例如出现一个 blocker 就不提升默认;同一任务需要三次以上重跑,只保留为低风险候选;review 时间超过当前默认两倍,即使 token 更便宜也不切换。
按任务选择第一条路线
如果任务是纯文本大仓库、终端操作和长周期计划,GLM-5.3 是合理的第一条挑战者;它的限制也清楚:没有原生视觉输入,推理不能关闭。
如果输入天然包含截图、图表、视频或视觉反馈,Kimi K3 的原生多模态减少了前处理。它也适合评估开放权重部署,但硬件成本、Kimi K3 License 与官方托管单价是三件不同的事。
如果目标是用低价格扩大覆盖,先让 DeepSeek V4 Flash 跑大量低风险样本,再用 Pro 处理 Flash 未通过或失败代价更高的任务。工作日峰时会把价格翻倍,批处理是否能移到谷时会直接改变路线价值。
如果你现在只需要 DeepSeek family 内部的模型 ID、别名和迁移边界,继续看 DeepSeek V4 API 迁移指南。跨 provider 的默认选择,则保留这三条路线作为候选,用同任务数据做最后决定。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年8月28日。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年8月28日。