Gemini 3.1 Pro vs Gemini 3 Pro:性能差异、费用与迁移实用指南
Gemini 3.1 Pro 的主要升级是复杂推理和多步工具操作,输入窗口并未扩大。本文解释官方性能结果、200K 费用分档,并提供可运行的迁移请求与输出校验;Gemini Developer API 的旧 3 Pro 已关闭。
文章目录
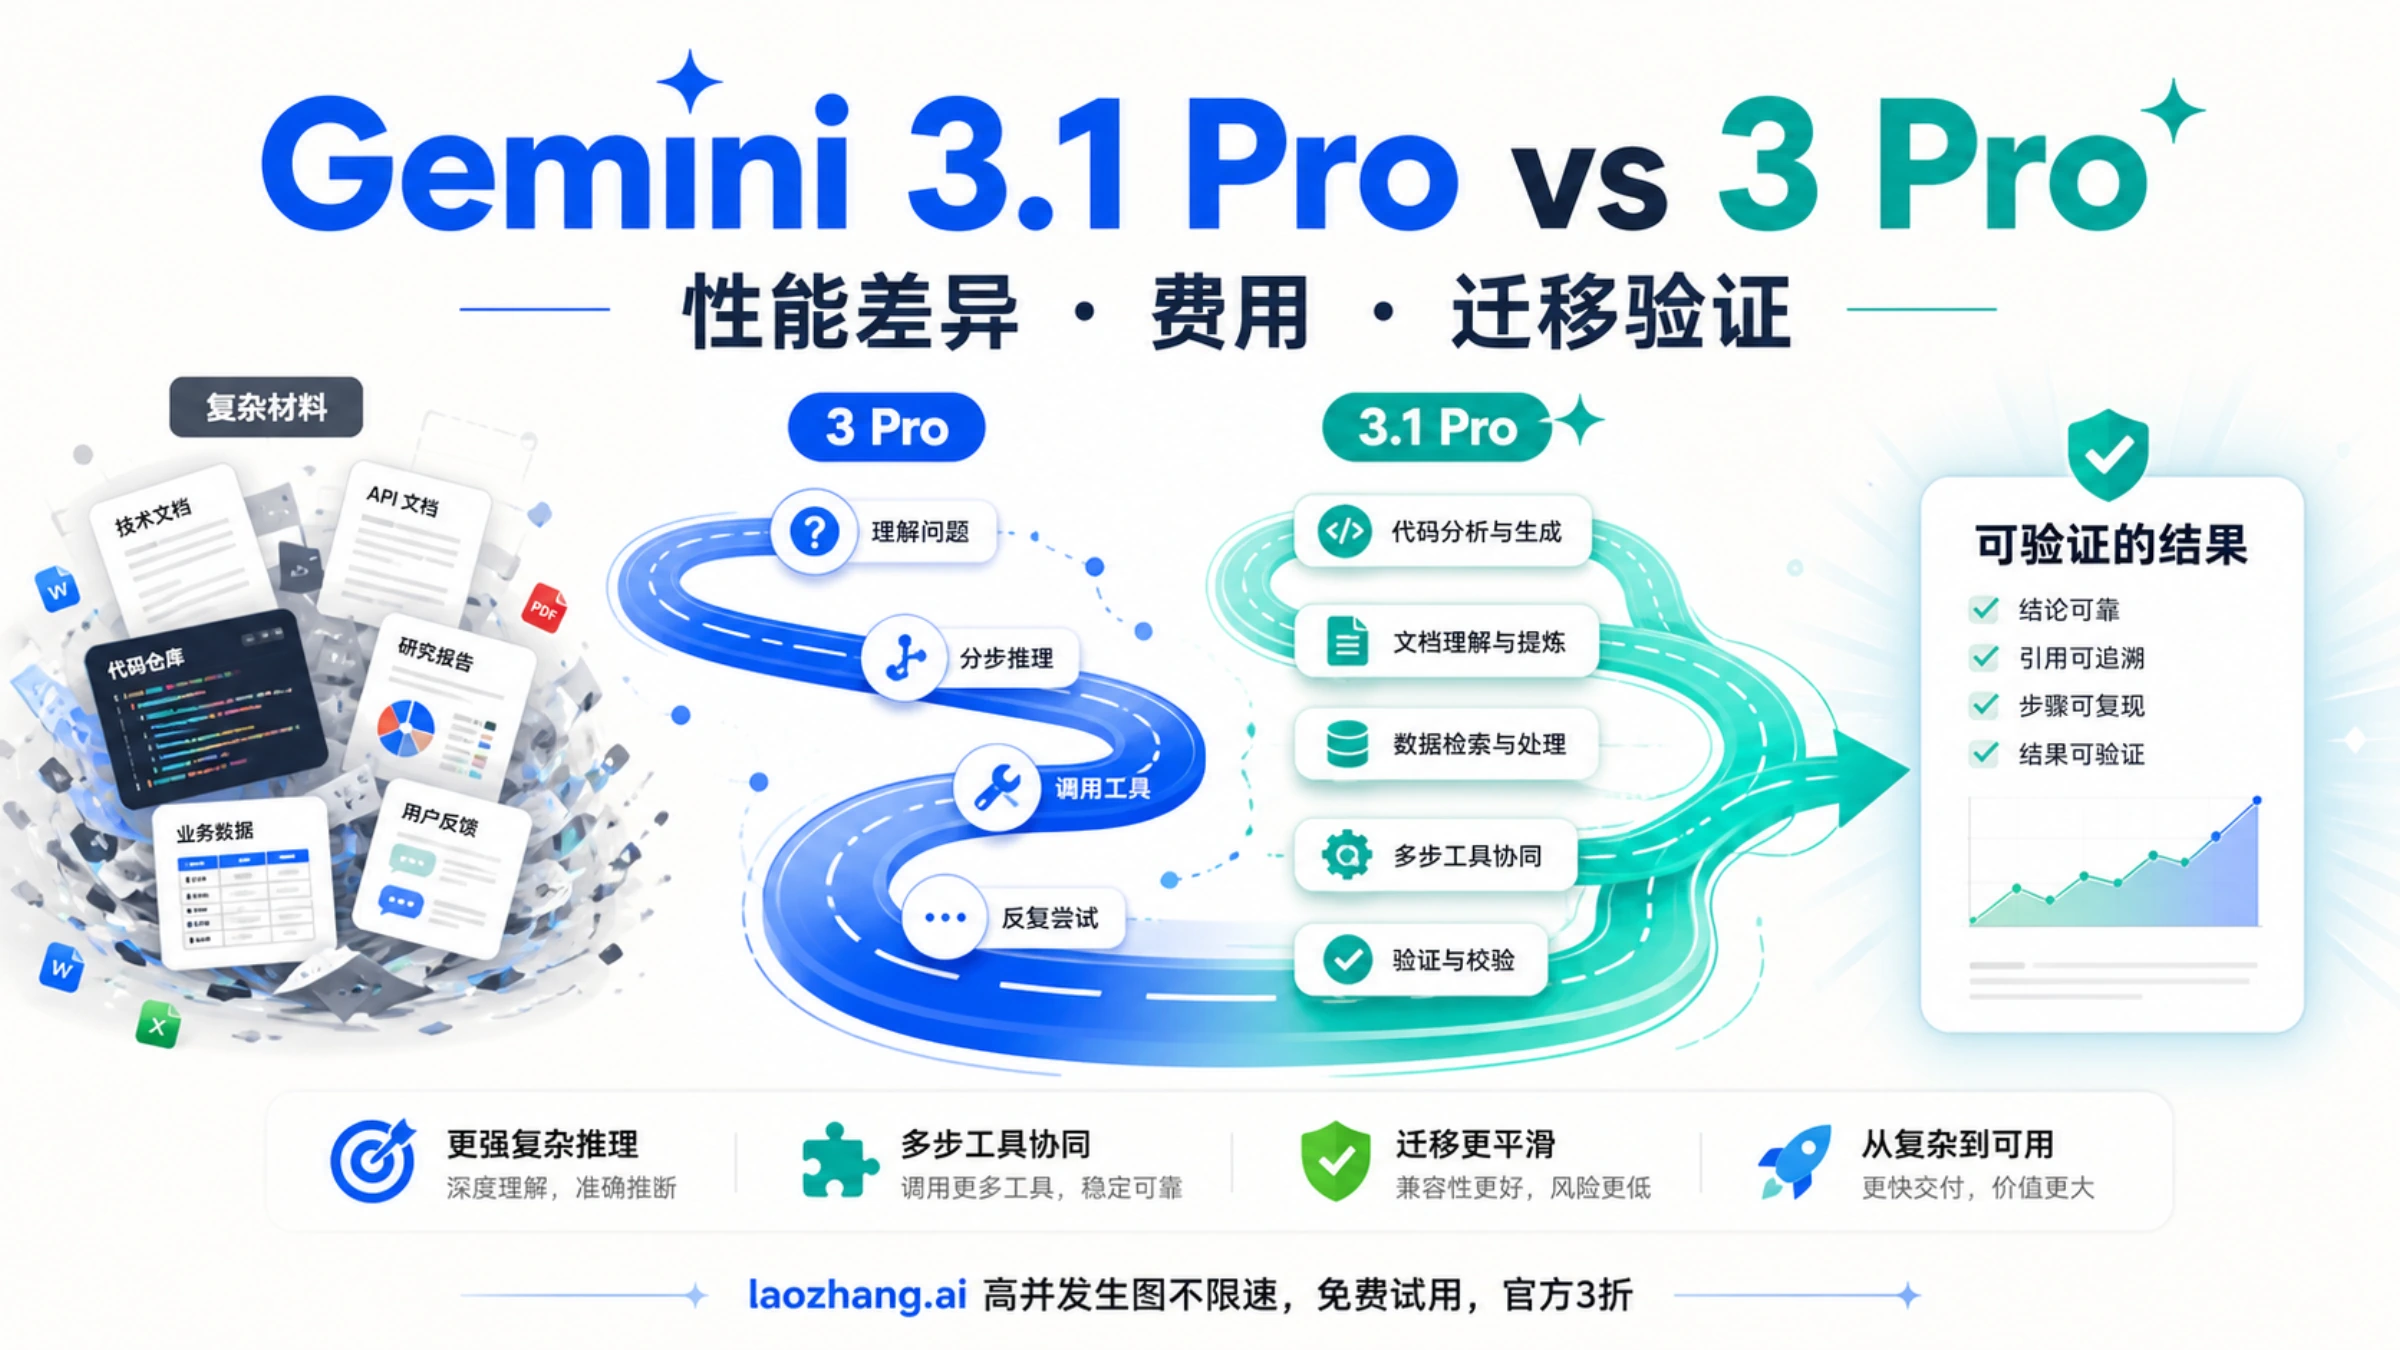
Gemini 3.1 Pro 相比 Gemini 3 Pro,主要升级的是复杂推理和多步工具操作,输入容量仍是约 100 万 token。 Google 公布的 ARC-AGI-2 推理测试得分达到 77.1%,超过旧版两倍;这个结果说明它处理陌生逻辑模式的能力有进步,不能直接换算成所有任务快两倍或准确两倍。Google 官方发布说明
现在做选择还要考虑可用性:在 Gemini Developer API 中,gemini-3-pro-preview 已于 2026 年 3 月 9 日关闭,官方指定的替代型号是 gemini-3.1-pro-preview。截至 2026 年 9 月 8 日,替代型号仍为预览版,未公告关闭日期。官方停用表
因此,已有应用的下一步是迁移并验证效果;新项目则应判断 3.1 Pro 是否适合自己的任务。本篇比较的是输出文本的 Pro 模型,生图用的 Gemini 3 Pro Image 属于另一条产品线。
Gemini 3.1 Pro 改进了什么,哪些规格没有变?
当前 3.1 Pro 模型页强调推理、token 使用效率、软件工程行为和多步工具执行的改进。与旧 3 Pro 历史模型页对照,开发者能直接用到的变化如下。
| 比较项 | Gemini 3 Pro Preview | Gemini 3.1 Pro Preview | 对应用的影响 |
|---|---|---|---|
| 输入上限 | 1,048,576 token | 相同 | 不能因为升级就多塞一倍文件 |
| 输出上限 | 65,536 token | 相同 | 长回复仍需处理截断和续写 |
| 输入与输出 | 文本、图片、视频、音频、PDF 输入;文本输出 | 相同 | 原有多模态理解任务可继续验证 |
| 思考等级 | low、high | 增加 medium | 可多比较一个质量与用量折中档 |
| Google Maps 工具 | 不支持 | 支持 | 地点任务可接地图来源,需单独配置 |
| 自定义工具专用型号 | 未列出 | 另有 -customtools 型号 | 混合 Bash 与自定义工具的程序可单独评估 |
| 图片生成、语音生成、Live API | 不支持 | 不支持 | 要生成这些媒体,应另选对应模型 |
“多模态”在这里指模型能读懂不同输入,不代表它会直接输出图片或声音。它能够写出 SVG、网页或动画代码,是代码生成能力;这与返回一张生成图片也不同。
官方推理成绩,如何对应到你的实际任务?
Google 的发布文章展示了代码动画、实时数据页面和交互式设计等案例。它们说明模型可以把较复杂的要求落实成代码,但展示案例没有给出你的仓库修复成功率,也没有证明中文回答速度一定提升。判断升级价值,最好把“模型更强”拆成任务中能观察到的结果。
| 你的任务 | 应重点观察的变化 | 可以直接检查的结果 |
|---|---|---|
| 修复现有项目的缺陷 | 是否读到关联代码并保持接口兼容 | 原有测试、新增边界测试、实际页面行为 |
| 分析多份合同、文档或表格 | 是否处理冲突条件,能否对应到具体材料 | 金额、日期、引用位置、遗漏条款 |
| 让智能体连续调用多个工具 | 是否选对工具,错误后能否继续完成任务 | 工具名称、参数、调用次数、最终产物 |
| 简单分类或字段提取 | 更高思考等级是否产生可见收益 | JSON 合法性、字段正确率、完成耗时 |
例如,“从两张订单提取金额”适合先检查结构和计算;“从几十份材料中解释预算超支原因”更依赖跨资料推理。两种任务都能使用 Pro,但需要的思考投入不同。比较时固定输入、工具权限、提示词和输出要求,才知道变化来自哪里。
旧版官方接口已经关闭,无法再现场做同条件双模型测试时,可以使用迁移前保存的任务、输出和用量记录作为历史基准。没有历史数据,就建立 3.1 Pro 当前基准,别把没有执行的对比写成测试结论。
费用为什么可能变化:输入分档与思考用量
当前官方价格表将普通 3.1 Pro 和 customtools 型号列在同一价格组。标准请求按以下费率计价,单位是美元/100 万 token。
| 单次提示输入长度 | 输入 | 输出,包含思考 token |
|---|---|---|
| 不超过 200,000 token | $2 | $12 |
| 超过 200,000 token | $4 | $18 |
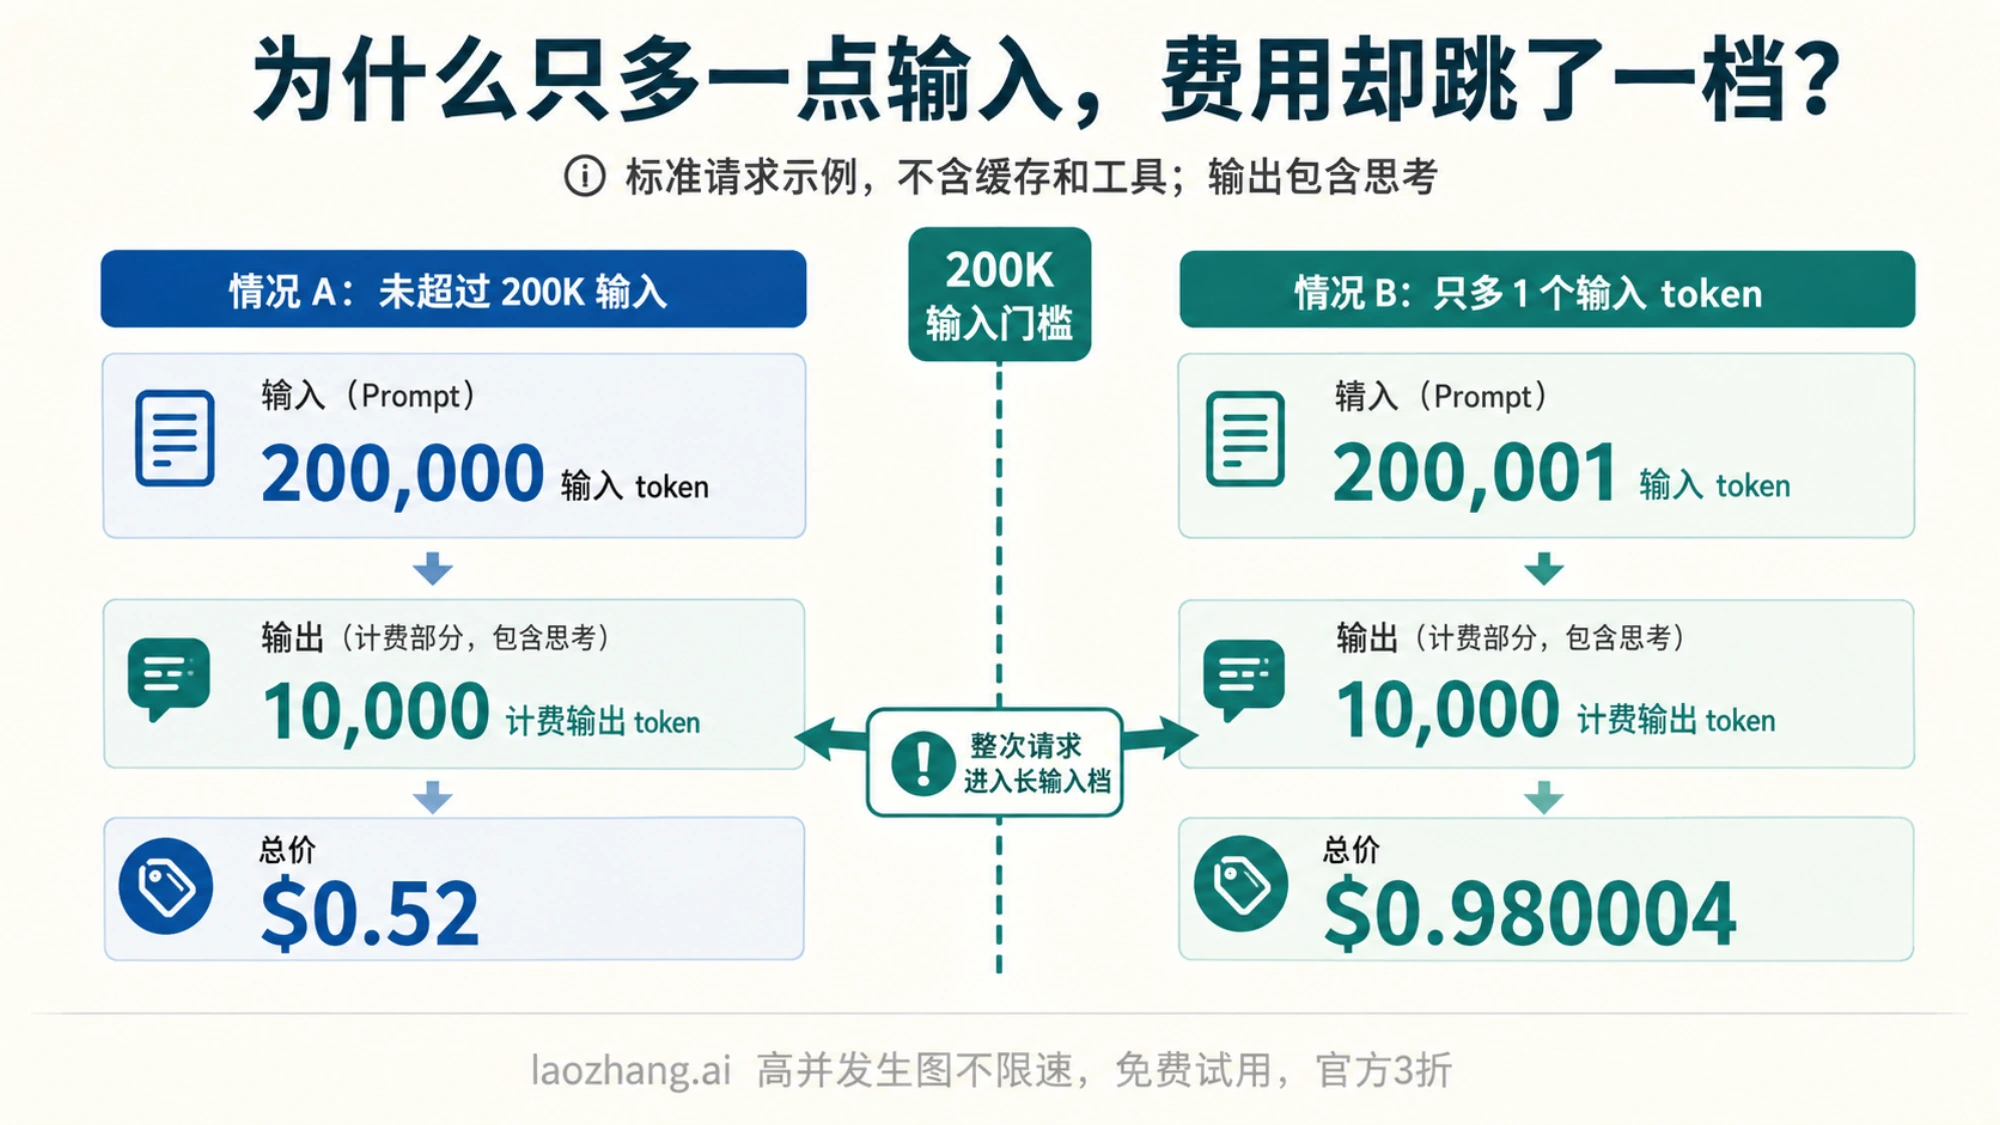
跨过 200K 后,整次请求按长输入档计价,并非只给超出的部分加价。 下表都是假设算例,没有缓存、搜索、Maps 或 Batch 用量,输出数量已包括思考。
| 输入 token | 计费输出 token | 计算 | 本次费用 |
|---|---|---|---|
| 100,000 | 10,000 | 0.1 × 2 + 0.01 × 12 | $0.32 |
| 200,000 | 10,000 | 0.2 × 2 + 0.01 × 12 | $0.52 |
| 200,001 | 10,000 | 0.200001 × 4 + 0.01 × 18 | $0.980004 |
| 250,000 | 10,000 | 0.25 × 4 + 0.01 × 18 | $1.18 |
这也是为什么长对话中“只多问了一句”,费用却可能明显变化:追加的历史消息让输入跨了档。删去无关历史、只检索当前任务需要的文件,比只缩短最终回答更可能减少这部分开销。
思考同样影响成本。假设输入都是 100,000 token,可见回答都是 2,000 token,一次另用了 3,000 思考 token,另一次用了 8,000。两次费用分别是 $0.20 + 0.005 × $12 = $0.26 和 $0.20 + 0.01 × $12 = $0.32。这是算术示例,不能据此认定 high 固定比 low 贵多少。
若使用缓存,读取费率是 $0.20/$0.40,还要考虑存储时间;工具与 Batch 则有单独规则。对迁移项目,应比较完成同一个任务的累计用量和重试次数,不能只比较模型名称或最后一段回答的字数。
用一条请求检查模型、JSON 输出和用量
已有 generateContent 集成可以保留接口,先改模型名。下面使用 Python 3 标准库发送一条独立请求,并检查一个有确定答案的订单提取任务。把代码保存为 check_gemini_migration.py,在自己的环境配置 GEMINI_API_KEY 后运行。它会产生实际 API 用量。
请求和响应字段对应官方 generateContent 参考。这里没有额外 SDK 自动重试,方便先看清一次请求的真实结果。
import json
import os
import time
import urllib.error
import urllib.request

model = "gemini-3.1-pro-preview"
payload = {
    "contents": [{"parts": [{"text": (
        "订单:拿铁2杯,每杯18元;美式1杯,每杯24元。"
        "只输出JSON对象,字段为subtotal和currency。"
        "subtotal是数字总金额,currency固定为CNY。"
    )}]}],
    "generationConfig": {
        "responseMimeType": "application/json",
        "thinkingConfig": {"thinkingLevel": "LOW"}
    }
}
request = urllib.request.Request(
    f"https://generativelanguage.googleapis.com/v1beta/"
    f"models/{model}:generateContent",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Content-Type": "application/json",
        "x-goog-api-key": os.environ["GEMINI_API_KEY"]
    },
    method="POST"
)
started = time.monotonic()
try:
    with urllib.request.urlopen(request, timeout=90) as response:
        result = json.load(response)
except urllib.error.HTTPError as error:
    print("HTTP", error.code)
    print(error.read().decode("utf-8", errors="replace"))
    raise SystemExit(1)

candidates = result.get("candidates", [])
if not candidates or candidates[0].get("finishReason") != "STOP":
    raise RuntimeError("生成未正常完成,请检查候选结果和结束原因")
parts = candidates[0].get("content", {}).get("parts", [])
answer = "".join(p.get("text", "") for p in parts if not p.get("thought"))
order = json.loads(answer)
if not isinstance(order, dict) or order != {"subtotal": 60, "currency": "CNY"}:
    raise ValueError(f"结果不符合订单要求:{order!r}")
print("订单校验通过:", order)
print("完成耗时(秒):", round(time.monotonic() - started, 2))
print("本次实际用量:", result.get("usageMetadata", {}))
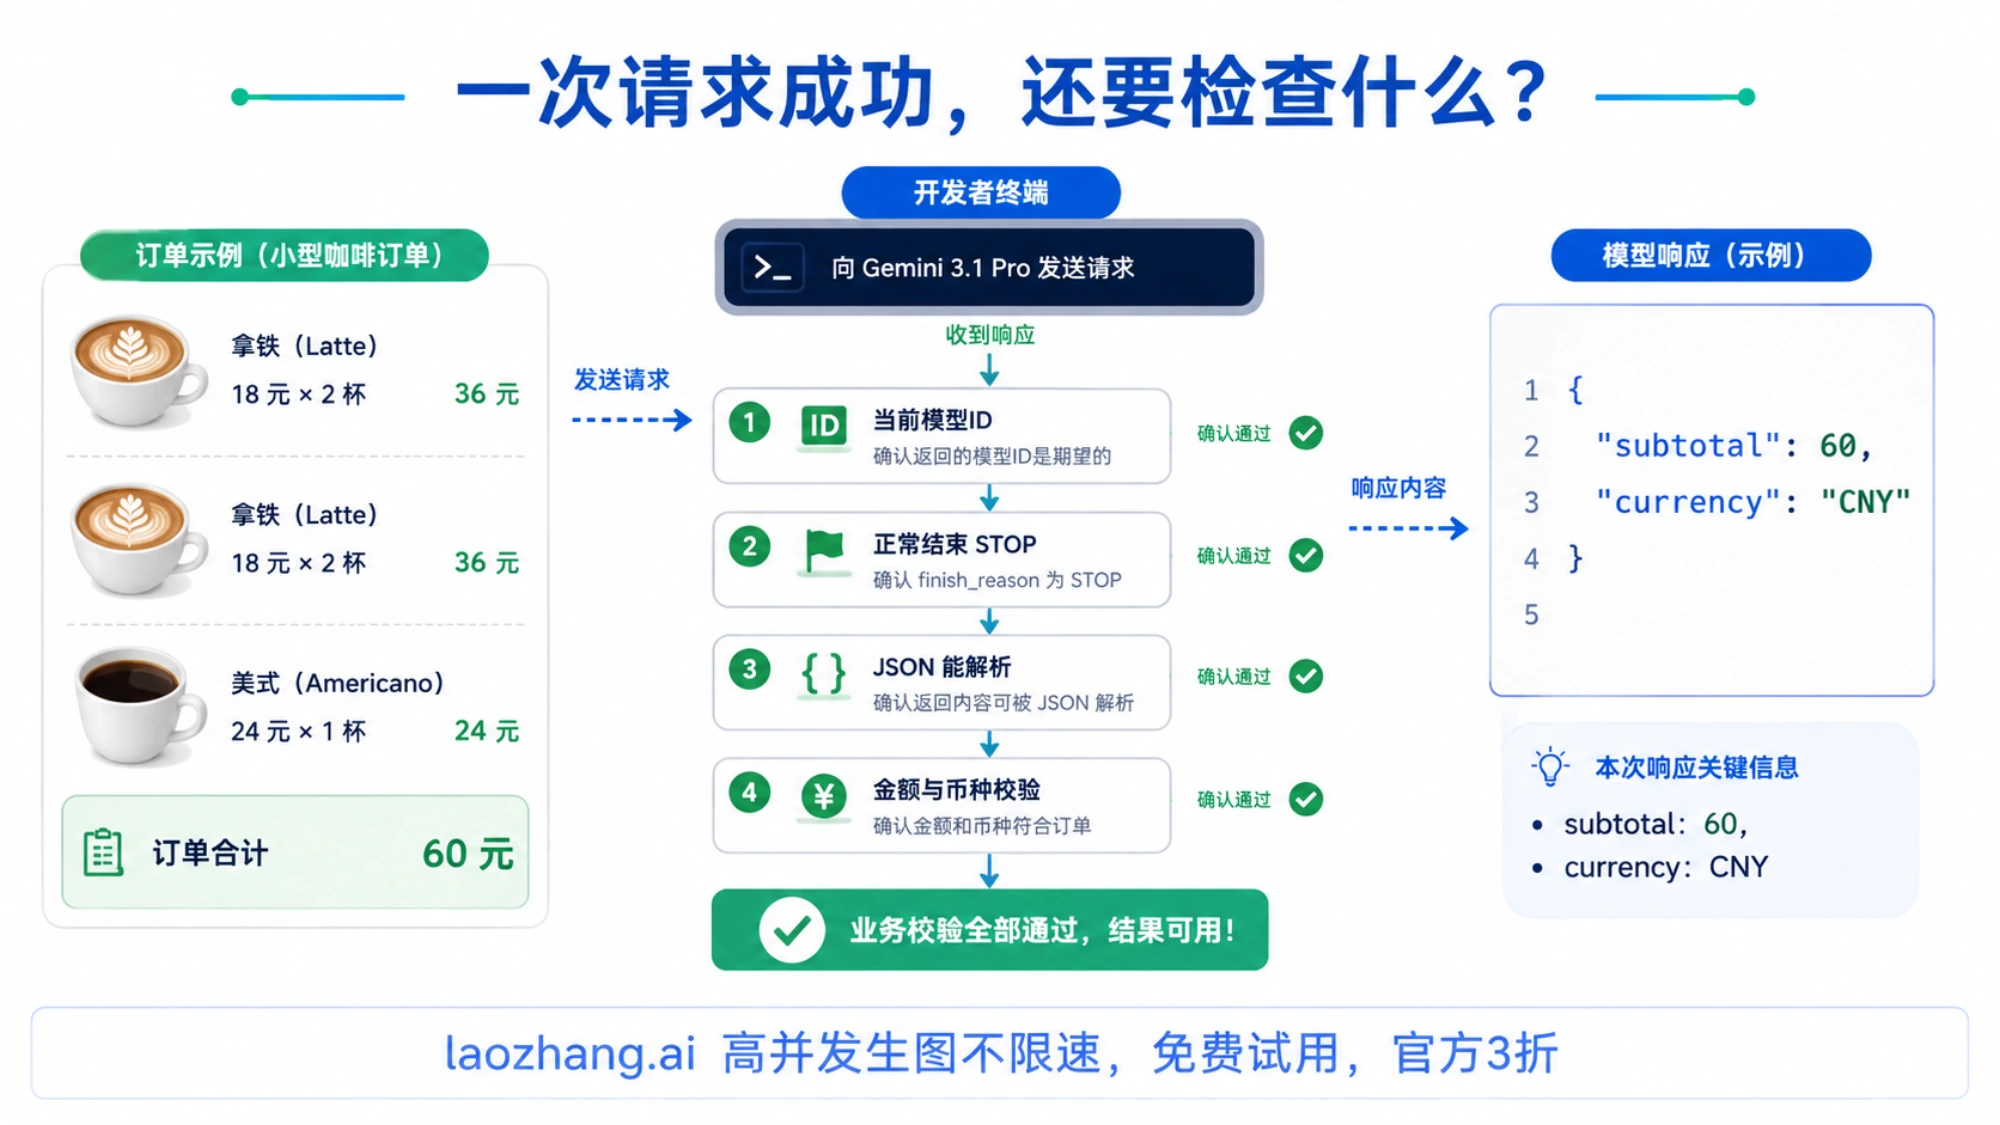
这个例子把“接口成功”进一步检查成“正常结束、可解析 JSON、金额和币种正确”。如果模型输出了多余字段或错误金额,程序会明确失败,便于发现下游兼容问题。本文只对示例做了离线响应校验,没有用它产生付费模型测试数据。
第一次通过后,逐项加回真实系统提示、文件和工具;同一组代表性任务分别试 LOW、MEDIUM、HIGH,保存完成率、耗时与 usageMetadata。普通中文聊天能回答,并不能替代你实际业务的验证。
迁移时最容易遗漏的参数与工具配置
思考参数按所用接口填写。 思考文档列出 3.1 Pro 支持 low、medium、high,默认 high。上例使用 REST 的 generationConfig.thinkingConfig.thinkingLevel;Interactions 使用 generation_config.thinking_level。不能把两种请求字段混用,也不要同时配置思考等级和旧的 token 预算。
先保留默认温度。 Gemini 3 指南建议保持 temperature 默认值 1.0,特别是复杂推理任务。不要沿用“温度越低就一定越准确”的旧经验作为升级依据。需要更细的配置说明,可以看思考等级指南。
多轮工具调用要保留签名。 手工拼接历史记录时,仅复制可见回答或工具参数可能丢掉思考签名。应按当前接口保存完整所需内容;使用 Interactions 的有状态对话,则按其会话机制继续。第一次文字请求通过,下一轮工具请求报错时,这项值得优先排查。
Maps 和 customtools 应按任务选择。 Maps 可为地点查询提供地图来源,但当前工具说明限定英语提示和回答,默认关闭,而且要求展示 Google Maps 来源链接。中文产品不能仅凭“支持 Maps”就承诺完整中文地点问答。
gemini-3.1-pro-preview-customtools 是单独的模型 ID,适合 Bash 与 view_file、search_code 等自定义工具混用的程序。Google 提醒,不依赖这些工具的任务可能出现质量波动。先让普通型号完成任务,再测试专用型号是否减少错误工具调用;具体注册方式见customtools 指南。
现在应该怎么选?
已有 Gemini 3 Pro 应用,应迁移到当前替代型号,先验证最小请求,再验证真实任务和全部旧模型引用,包括后台任务与失败后的备用配置。旧型号已关闭,不能继续充当可用的回退选项。
新建复杂分析、代码或多步工具应用,可以从 3.1 Pro 建立基准;做简单提取与分类,则先测试较低思考等级是否已达到要求。若更高等级没有改善任务结果,却增加等待或费用,就没有必要只因名称更强而给所有请求使用同样配置。
完成这一步后,需要文件上传、多轮对话和完整应用接入时,继续看 Gemini 3.1 Pro API 接入指南。