Gemini 3.8 Flash 和 Claude Fable 5.1 怎么选:先算任务成本
大多数流量可以先测 Gemini 3.8 Flash,最难的长任务再让 Claude Fable 5.1 挑战;最终不要看单次 Token 价,而要看通过验收的任务成本。
文章目录
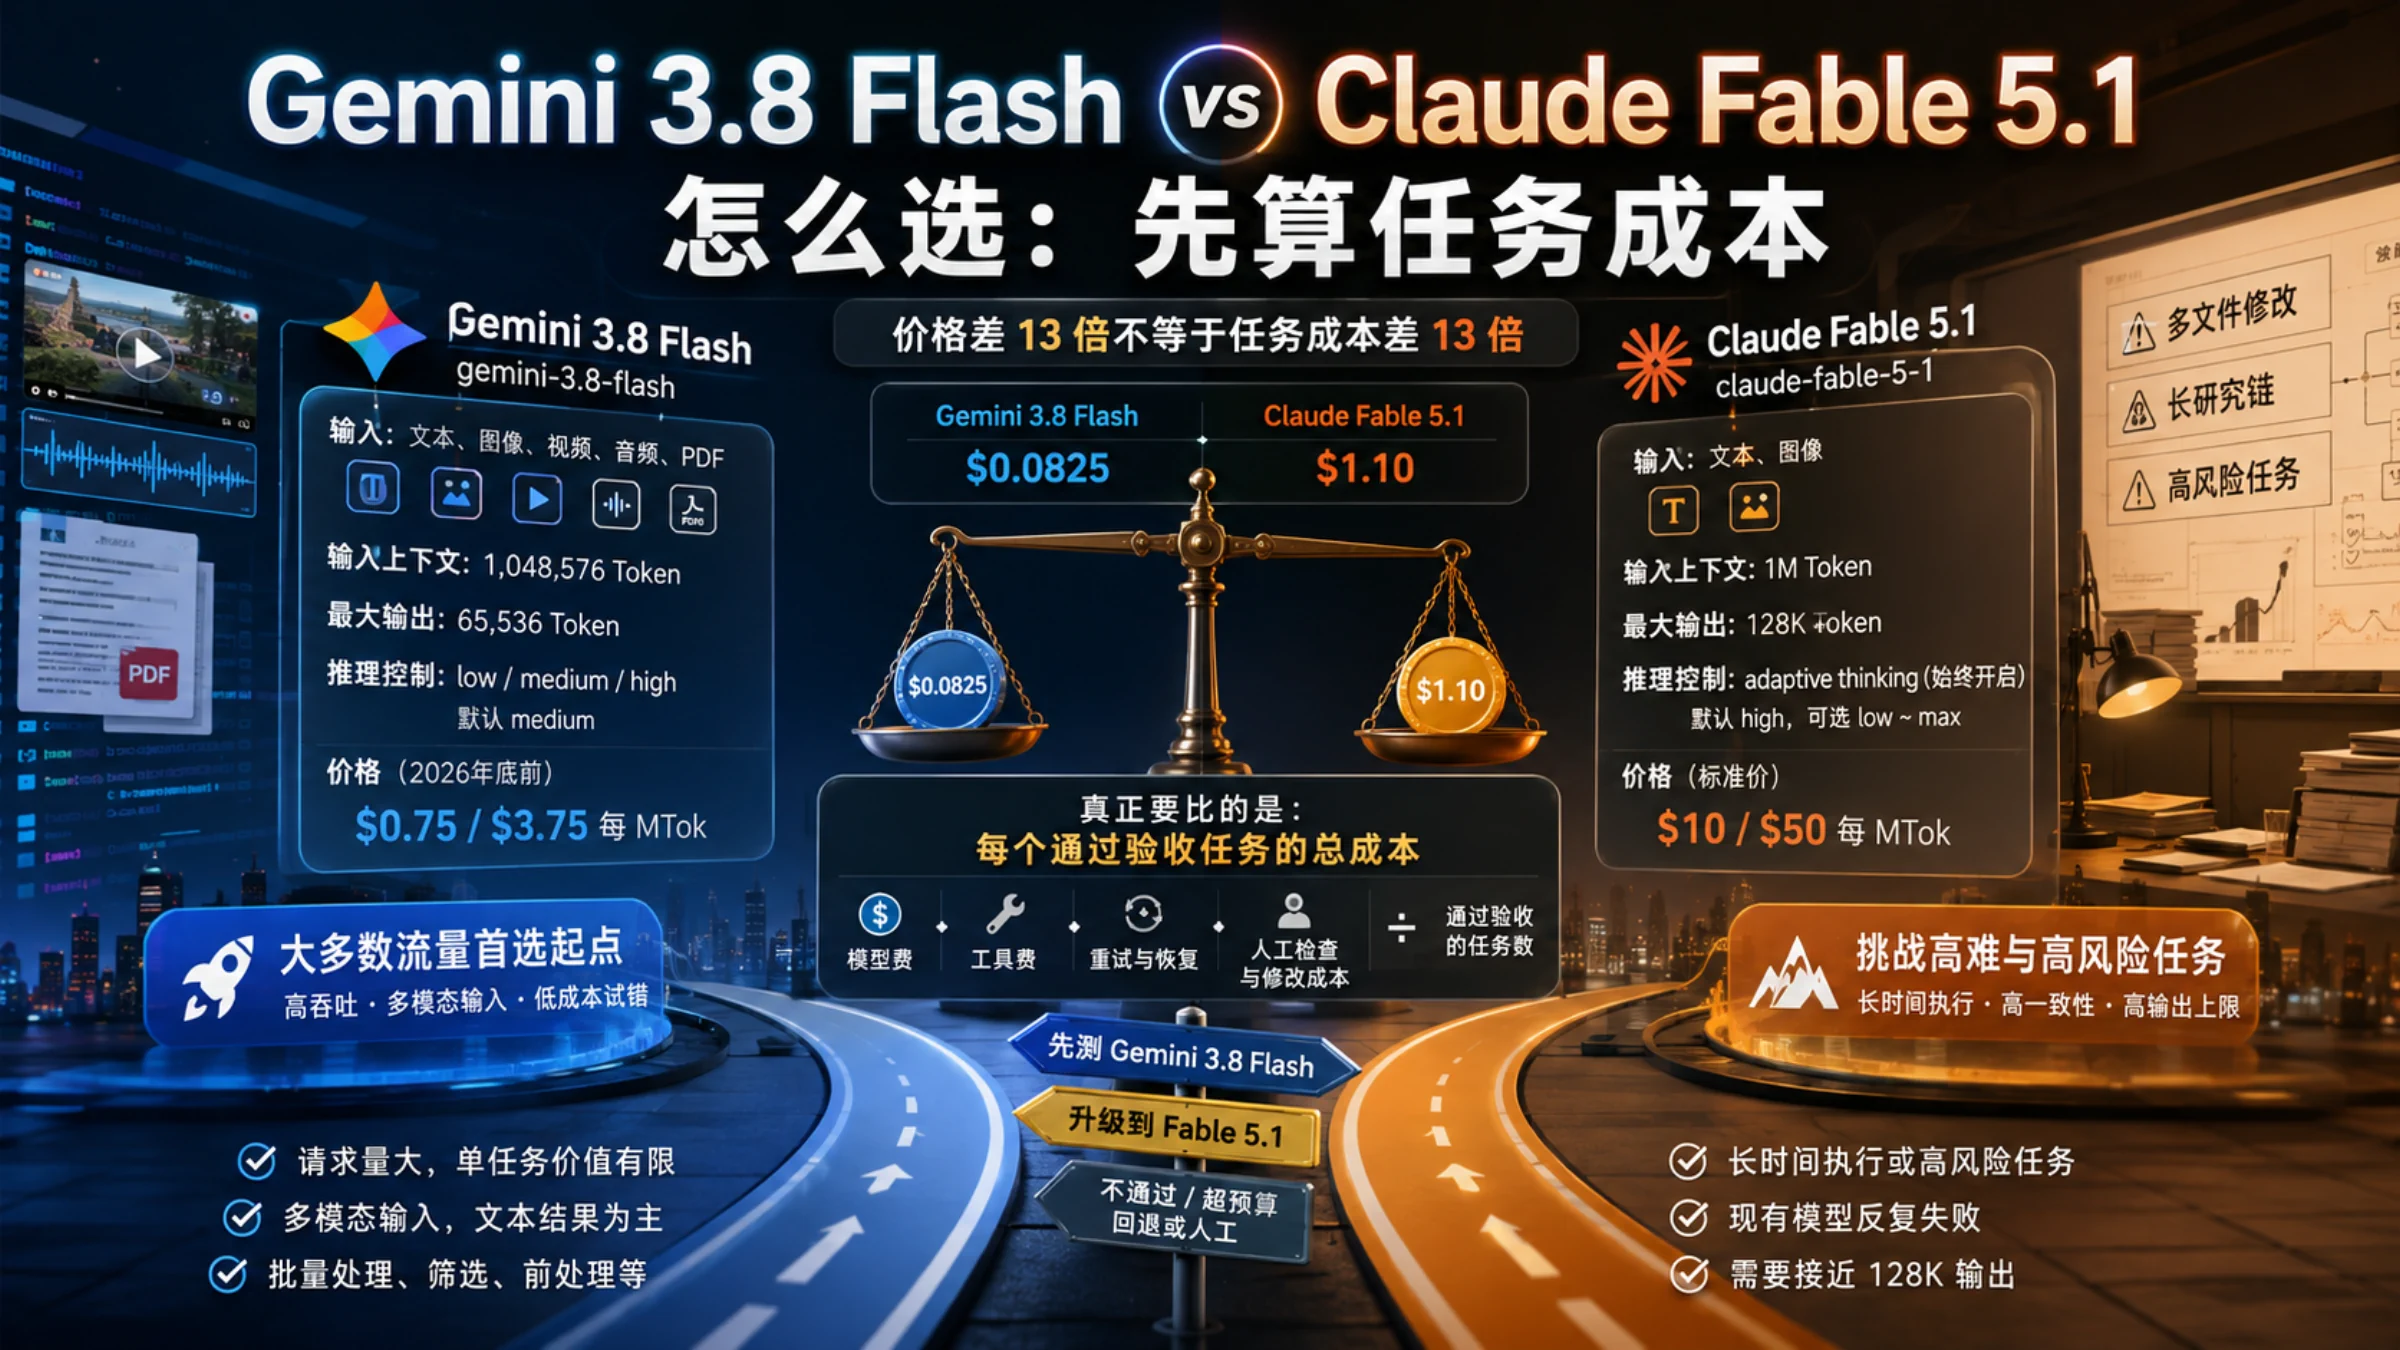
如果你现在要为编程、智能体或研究工作负载选一个起点,先测 Gemini 3.8 Flash,把 Claude Fable 5.1 作为高难任务的挑战者,通常是更容易控制预算的顺序。原因不是 Gemini 已经被证明“全面更强”,而是它当前每百万 Token 的输入、输出标价都只有 Fable 5.1 的约十三分之一。只有当 Fable 明显减少失败、重试或人工返工时,这笔溢价才可能值得。
反过来,如果一个任务失败一次就会让工程师返工数小时,或者现有高端模型在长时间执行中仍频繁丢失目标,那么从 Fable 5.1 开始做小规模评测也合理。两家没有公布一场设置、工具、预算和评分规则完全相同的直接对测,所以这不是一篇能替你宣布永久赢家的文章。它给你的是可执行的首测顺序、计费方法和切换门槛。
先确认你比较的是两个公开模型
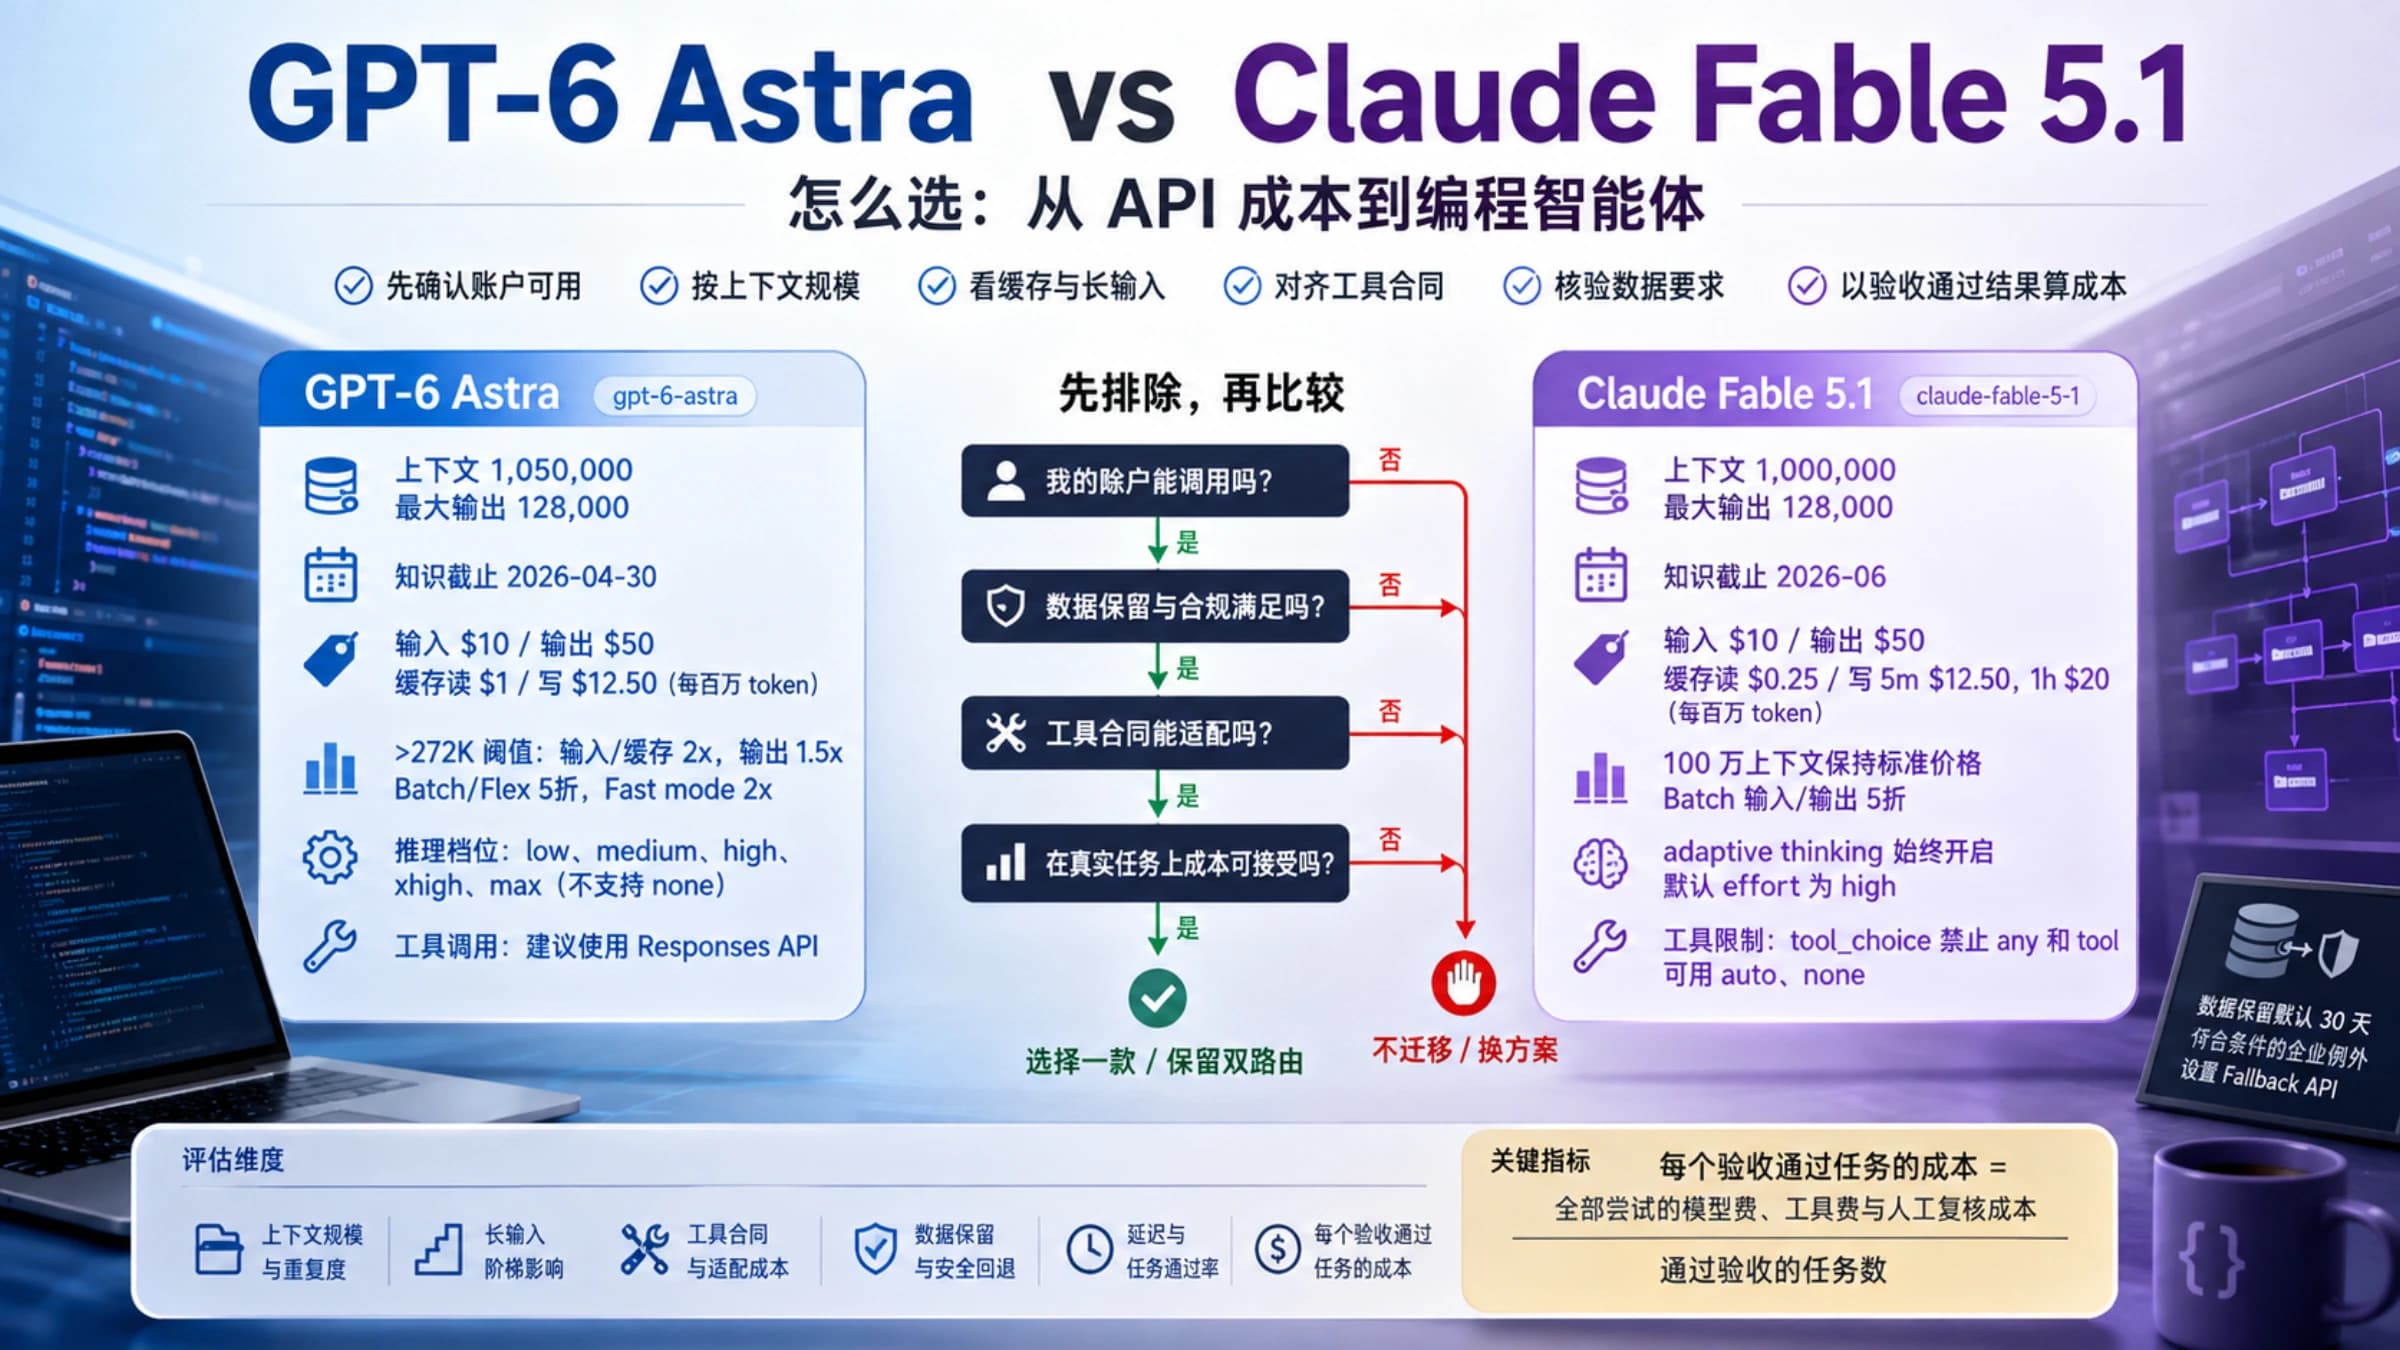
这里的对象是 Google 在 2026 年 9 月 2 日正式发布的 Gemini 3.8 Flash,以及 Anthropic 在前一天发布的 Claude Fable 5.1。对应的开发者 API 模型 ID 分别是:
gemini-3.8-flash
claude-fable-5-1不要把两个受限版本混进来。Gemini 3.8 Flash Cyber 面向 Fairwind Program 中获批的防御机构,不是公开 Flash 的另一个普通价格档;Claude Mythos 5.1 只提供给 Project Glasswing 参与者,也不是所有 Fable 用户都能调用的同义名称。
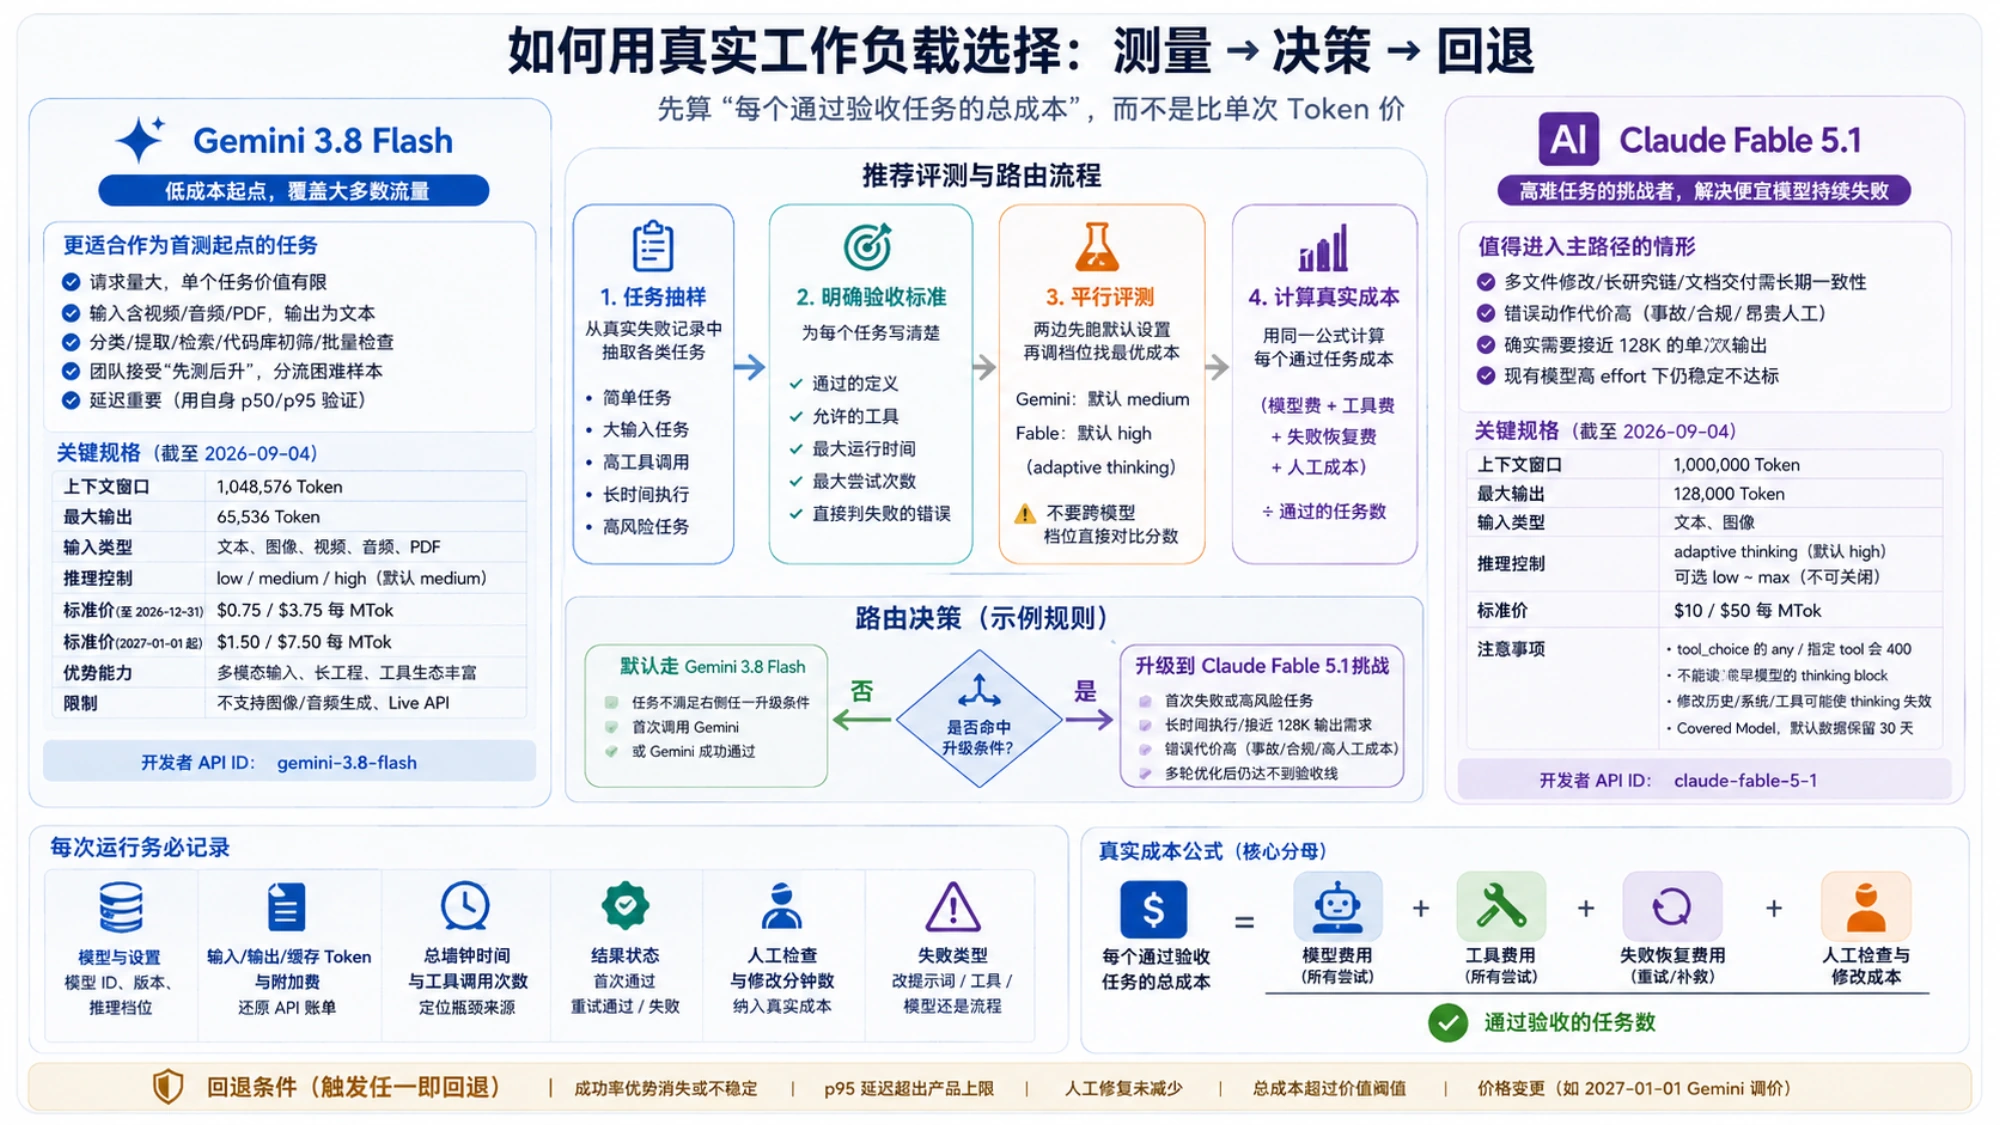
截至 2026 年 9 月 4 日,两款公开模型的关键规格如下:
| 项目 | Gemini 3.8 Flash | Claude Fable 5.1 |
|---|---|---|
| 状态 | GA / Stable | Active (latest) |
| 输入上下文 | 1,048,576 Token | 1M Token |
| 最大输出 | 65,536 Token | 128K Token |
| 输入 | 文本、图像、视频、音频、PDF | 文本、图像 |
| 输出 | 文本 | 文本 |
| 推理控制 | low、medium、high;默认 medium | adaptive thinking 始终开启;默认 high,可选 low 到 max |
| 标准输入/输出价 | 2026 年底前 $0.75 / $3.75 每 MTok | $10 / $50 每 MTok |
这些数据分别来自 Google 的 Gemini 3.8 Flash 规格页和 Anthropic 的 Fable 5.1 模型页。相近的百万级输入窗口不代表功能对等:Gemini 接受更多媒体输入;Fable 的最大文本输出更高;两家的推理控制、缓存计费和工具调用约束也不同。
十三倍只是等 Token 的价格基线
Google 的开发者 API 定价页显示,Gemini 3.8 Flash 的优惠价持续到 2026 年 12 月 31 日:输入 $0.75/MTok,输出 $3.75/MTok。2027 年 1 月 1 日起会变成 $1.50/$7.50。Anthropic 的定价表给 Fable 5.1 的标准价是输入 $10/MTok、输出 $50/MTok。
假设一次调用两边都使用 80,000 个输入 Token 和 6,000 个输出 Token,暂不计缓存、工具和其他费用:
Gemini:0.08 × $0.75 + 0.006 × $3.75 = $0.0825
Fable: 0.08 × $10   + 0.006 × $50   = $1.10
Fable 在这个等 Token 假设下正好贵约 13.33 倍。2027 年 Gemini 调价后,同样计算约为 6.67 倍。但真实任务不会保证两边生成相同 Token、调用相同次数或获得相同通过率。Google 还明确提醒,3.8 Flash 在复杂任务上可能采取更多推理步骤、反复调用工具,因此相同单价不等于相同账单。
真正有用的分母是“通过验收的任务”,而不是调用次数:
每个通过验收任务的总成本 =
(所有尝试的模型费 + 工具费 + 失败恢复费 + 人工检查与修改成本)
÷ 通过验收的任务数
如果 Fable 只把重试从两次降到一次,它仍然未必抵消十三倍的等量 Token 价差;如果它避免的是一次高风险错误和数小时人工修复,单纯的 API 倍率又会低估它的价值。结论必须由你的失败代价决定。
哪些任务更值得先测 Gemini
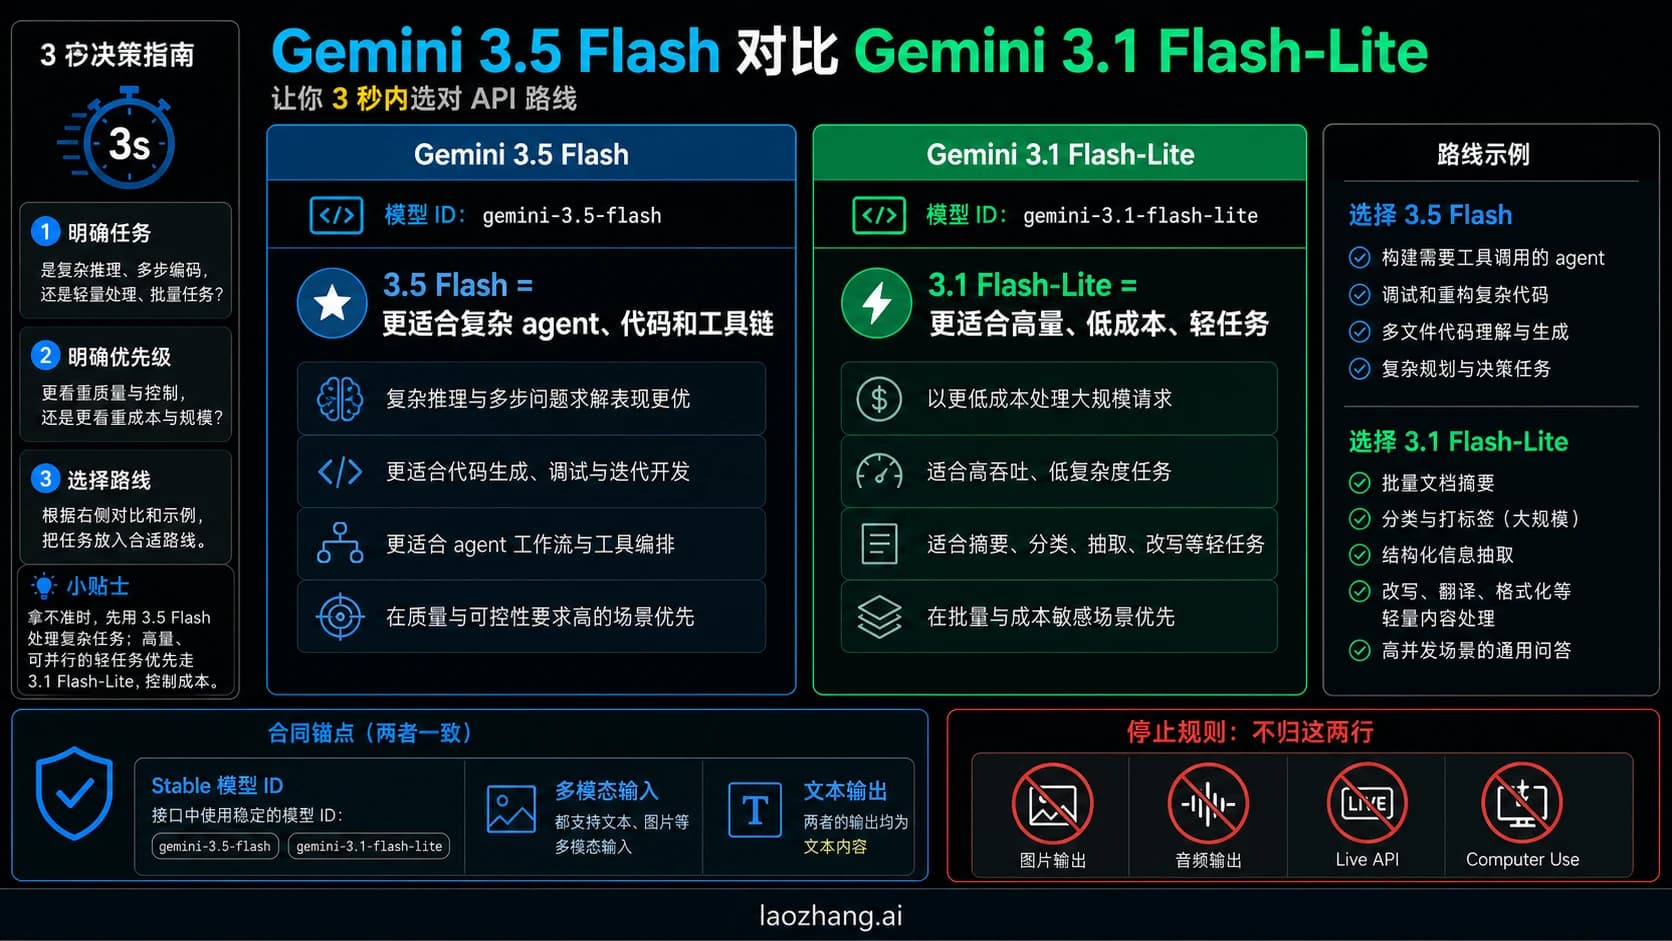
Gemini 3.8 Flash 更适合作为这些评测队列的低成本起点:
- 请求量大,单个任务价值有限,需要严格限制平均调用成本;
- 输入包含视频、音频或 PDF,而结果主要是文本分析;
- 工作以分类、提取、检索前处理、代码库初筛或批量检查为主;
- 团队愿意把困难样本升级到第二个模型,而不是要求一个模型解决全部流量;
- 延迟很重要,但团队会用自己的 p50/p95 数据验证,而不是把 “Flash” 名称当速度证明。
Google 将 3.8 Flash 定位为面向长时间软件工程、自主智能体和复杂企业流程的 Flash 模型。它支持函数调用、代码执行、文件搜索、结构化输出、URL context 以及 Search/Maps grounding,computer use 仍是 Preview。它不支持图像生成、音频生成或 Live API,因此“支持多模态输入”不能被理解成能输出所有媒体。
如果你正从 3.7 迁移,单独的 Gemini 3.8 Flash 迁移指南更适合核对 thinking_level、工具响应和兼容字段。本页的任务只是决定它是否该进入你的首轮对比。
Fable 5.1 什么时候才值得进入主路径
Anthropic 对 Fable 5.1 的建议比“所有任务都用最强模型”克制得多:大多数工作先从 Claude Opus 5 开始;只有高难推理、长时间智能体执行,或 Opus 在更高 effort 下仍达不到验收标准时,再使用 Fable 5.1。这也给跨厂商评测提供了一个可靠原则:Fable 应该靠解决便宜模型持续失败的样本赢得流量。
值得把它放进挑战队列的情形包括:
- 多文件修改、长研究链或文档交付需要长时间保持目标一致;
- 一个错误动作会触发生产事故、合规风险或昂贵人工复核;
- 任务确实需要接近 128K 的单次输出,而不是把可拆分工作硬塞进一条响应;
- 你的现有模型已经过提示词、工具和 effort 调整,仍稳定达不到验收线。
Fable 5.1 的 adaptive thinking 不能关闭,不能使用手动 budget_tokens。迁移时还要注意:tool_choice 的 any 和指定 tool 会返回 HTTP 400;较早模型不能继续读取 Fable 5.1 产生的 thinking block;修改前面的对话、system 或工具定义可能使后续 thinking block 失效。Anthropic 的迁移指南给出了完整边界。若要进一步比较 Fable 与 Opus 的缓存成本,可看 Fable 5.1 与 Opus 5 成本指南。
用同一批任务得到自己的答案
不要给两边各挑一条“擅长的 prompt”。从真实失败记录中抽取任务,保留简单、大输入、高工具调用、长时间执行和高风险样本。每个样本都要先写清楚:什么输出算通过、允许哪些工具、最大运行时间、最大尝试次数,以及哪些错误必须直接判失败。
两边的推理标签不能假装完全等价。Gemini 默认是 medium;Fable 默认是 high,且 adaptive thinking 始终开启。实用做法是先测试各自默认设置,得到“开箱成本”;再在第二轮用满足同一质量目标的较低或较高档位寻找最省的设置。不要把 Gemini high 对 Fable medium 的一轮分数包装成模型能力总排名。
每次运行至少保留这些字段:
| 记录项 | 为什么会改变决策 |
|---|---|
| 模型 ID 与推理设置 | 避免把版本或档位差异误认成厂商差异 |
| 输入、输出、缓存 Token 与附加费 | 还原实际 API 账单 |
| 总墙钟时间与工具调用次数 | 找出慢在推理、工具还是重试 |
| 首次通过、重试后通过、失败 | 计算真实完成率 |
| 人工检查与修改分钟数 | 把最容易被漏掉的成本纳入比较 |
| 失败类型 | 决定该改提示词、工具、模型还是流程 |
测试前冻结任务集与评分规则;测试后再决定路由。否则你很容易在看到结果后放宽喜欢模型的标准。
把选择写成可回退的规则
一个可执行的上线策略不需要“永久赢家”。它可以很简单:Gemini 3.8 Flash 先处理普通流量;命中高风险任务、长时间执行任务,或 Gemini 首次失败时,再升级到 Fable 5.1。只有当连续样本证明 Fable 的每个通过任务总成本更低,或者它解决了 Gemini 无法接受的失败类型,才扩大 Fable 流量。
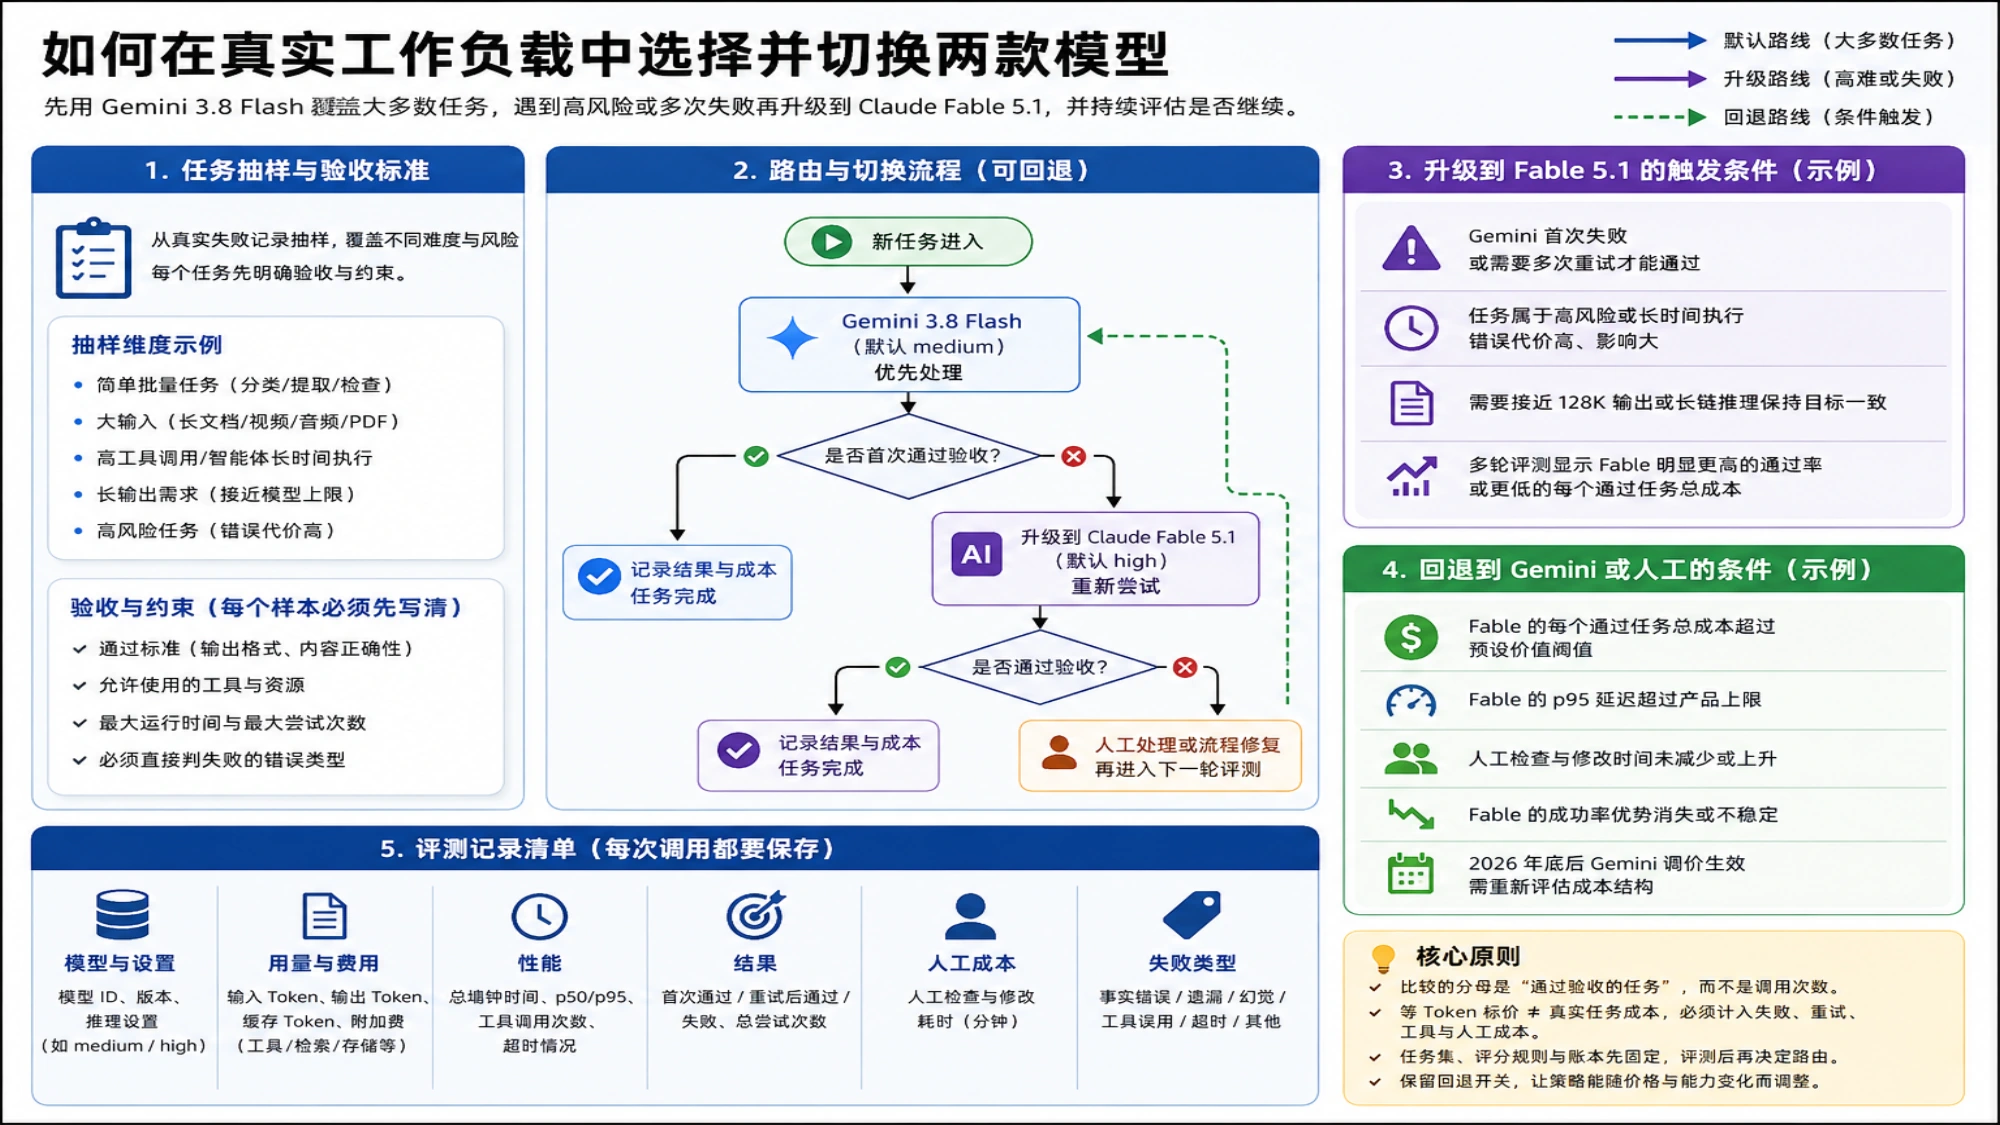
同时设置回退条件。例如 Fable 的成功率优势消失、p95 延迟超出产品上限、人工修复没有减少,或其总成本超过你预设的价值阈值,就回到 Gemini 或人工处理。Gemini 的优惠价在 2026 年底结束,因此任何依赖当前倍率的预算,都应在 2027 年价格生效前重算。
还有一个不该被价格掩盖的边界:Anthropic 当前把 Fable 5.1 列为 Covered Model,Claude API 默认数据保留期为 30 天;零数据保留需要明确获批的安排。敏感工作负载在评测前就要核对合同和数据路径,而不是模型表现合格后才补合规审查。
最终选择因此不是“便宜”对“聪明”的品牌投票。先用 Gemini 买到广泛覆盖,再让 Fable 在高价值失败样本上证明溢价,是一个合理起点;如果你的实测给出相反结果,就按数据反转顺序。只要任务集、账本和回退开关都还在,你的模型决策就能随着价格和能力变化,而不必重写整个系统。