Gemini 3.5 Flash 对比 Gemini 3.1 Flash-Lite:API 选型、价格与迁移
简单、高频且容易验收的任务可以保留 Gemini 3.1 Flash-Lite;原 Gemini 3.5 Flash 请求已由 3.6 响应,复杂编码和工具任务应以明确的当前模型 ID 做对照,再按成功任务的总成本决定迁移。
文章目录

简单、高频、结果容易检查的任务,先保留 Gemini 3.1 Flash-Lite;复杂编码、多步工具调用和难以自动验收的任务,评估当前 Flash。 但今天比较 Gemini 3.5 Flash 与 Gemini 3.1 Flash-Lite,必须先认清一个变化:截至 2026 年 10 月 13 日,Google Developer API 对 gemini-3.5-flash 的请求会自动转到 gemini-3.6-flash,旧 ID 的端点没有关闭。3.5 Flash 已不能在 AI Studio 中选择,新的配置应明确写 3.6,或在适合的复杂任务上评估 3.8。3.5 Flash 官方说明与弃用时间表都说明了这个区别。
选择取决于低价模型够不够用、较贵的模型能否减少返工,以及已有配置是否需要迁移。以下价格和能力以 Google Developer API 为范围;第三方网关、Gemini 应用和 Google Cloud 路线需要各自核对。
先确认模型:旧 3.5 Flash、稳定 Lite 和 Preview 是三种状态
如果日志里还写着 gemini-3.5-flash,不要据此认定请求仍由旧 3.5 模型执行;如果配置写着 Lite Preview,也不要把稳定版的可用性套上去。
| 配置中的模型 ID | 2026 年 10 月 13 日的 Developer API 状态 | 下一步 |
|---|---|---|
gemini-3.5-flash | 已弃用,端点继续存在,请求自动转到 3.6 Flash | 将配置改为明确的 gemini-3.6-flash,核对响应版本与结果 |
gemini-3.1-flash-lite | 稳定版,2026 年 5 月 7 日发布 | 现有简单任务通过验收时可继续保留,并安排后续迁移评估 |
gemini-3.1-flash-lite-preview | 2026 年 5 月 25 日已关闭 | 使用稳定版 ID,重新检查原有参数和输出 |
状态来源:Google 模型生命周期表。表中 3.1 Flash-Lite 的最早可能关闭日期是 2027 年 5 月 7 日,推荐替代为 gemini-3.5-flash-lite;这个日期不是保证服务到期的 SLA。另一个名字相近的 3.5 Flash-Lite 是独立模型,不能与 3.5 Flash 混用价格或能力。
尤其不要把“旧 3.5 ID”和“直接 3.6 ID”当作两个独立模型做质量胜负测试:按当前官方路由,两者指向同一个替代模型。更有用的对照是稳定 3.1 Flash-Lite 与明确的当前 Flash ID,并保存实际返回的模型版本。
哪些任务继续用 Lite,哪些任务值得评估当前 Flash?
3.1 Flash-Lite 的官方定位是低延迟、低成本的高频轻量任务,开发者指南列出了翻译、转写、抽取、文档处理和任务分类。3.6 Flash 侧重编码、智能体执行和快速迭代;3.8 Flash 则面向长流程软件工程、自主智能体和复杂企业工作流。这些定位可以帮助选择候选,不能替代你自己任务的验收结果。Lite 指南、3.6 模型页、3.8 模型页分别说明了适用方向。
| 实际任务 | 建议从哪里开始 | 什么情况下改变选择 |
|---|---|---|
| 工单分类、字段抽取、短文本翻译、固定格式摘要 | 稳定 3.1 Flash-Lite | 丢字段、误译或错误分类频繁触发人工处理时,比较当前 Flash 的完整成本 |
| 查代码、规划修改、调用多个工具后修复问题 | 直接 3.6 Flash | 长流程任务仍需要大量恢复或人工介入时,将 3.8 加入对照 |
| 长流程编码、自主智能体、复杂企业流程 | 将 3.8 作为候选,同时保留能完成任务的现有方案 | 看最终验收、工具失败和返工成本,不能只按版本号替换 |
| 一批可以等待的独立任务 | 先确定能通过验收的模型,再考虑 Batch | 任务之间存在依赖,或必须及时返回时,重新选择调用模式 |
分工可以很具体。例如客服工单先用 Lite 提取订单号和诉求,字段缺失或涉及多步调查时再交给 Flash。升级条件应来自业务规则或可检查的结果,不能只听模型自称“有信心”。不需要每条请求都先做一次昂贵的分类,也不需要为了新模型改掉已经准确、便宜的简单任务。
模态相同,不代表所有运行方式都相同
稳定 3.1 Flash-Lite 与当前 3.6、3.8 Flash 均接受文本、图片、视频、音频和 PDF,输出为文本;输入上限是 1,048,576 token,输出上限是 65,536 token。它们都支持函数调用、结构化输出、缓存、代码执行、文件检索、搜索与地图依据,以及 Batch、Flex、Priority。各模型能力表与当前 Flash 能力表给出了这些边界。
这意味着 Lite 可以接工具,并非只会普通聊天;但工具的调用权限、执行和错误处理仍要由应用完成。1M 输入也不代表一次能输出 1M token:长文档可以读进来,整本书的译文或超长报告仍需要分段生成和验收。
对运行方式的选择还要留意两点:
- 3.1 Flash-Lite 不支持 Computer Use;3.6、3.8 目前列为支持 Preview。旧 3.5 的当前归档页也已列出这一 Preview 能力,不能继续沿用“所有这些 Flash 都不支持”的旧判断。
- 这些文本输出模型都不支持图像生成、音频生成或 Live API。需要生成图片、实时语音对话时,应选择对应的专用模型,而不是仅因为它能读取图片、音频就直接调用。
当前价格怎么比:先选模式、输入模态和生效日期
在 Google Developer API 的付费 Standard 模式下,3.1 Flash-Lite 的文本、图片、视频输入是 0.25 美元/百万 token,音频输入是 0.50 美元/百万 token,输出含思考是 1.50 美元/百万 token。当前直接调用 3.6 或 3.8 Flash,两者 Standard 都是输入 0.75、输出含思考 3.75 美元/百万 token,有效期到 2026 年 12 月 31 日。官方价格页是这些数字的依据。
因此当前不能概括成“两个方向都贵六倍”:对文本、图片、视频,Flash 输入单价是 Lite 的 3 倍,输出单价是 2.5 倍;对音频输入则是 1.5 倍。单次请求的比例还会随输入输出占比变化。
下表全部为 付费层、美元/百万 token、截至 2026 年 10 月 13 日的官方报价,输出均包含思考 token。
| 模型与价格期间 | 模式 | 输入:文本/图片/视频 | 输入:音频 | 输出 |
|---|---|---|---|---|
| 3.1 Flash-Lite,当前报价 | Standard | 0.25 | 0.50 | 1.50 |
| 3.1 Flash-Lite,当前报价 | Batch / Flex | 0.125 | 0.25 | 0.75 |
| 3.1 Flash-Lite,当前报价 | Priority | 0.45 | 0.90 | 2.70 |
| 3.6 / 3.8 Flash,至 2026-12-31 | Standard | 0.75 | 0.75 | 3.75 |
| 3.6 / 3.8 Flash,至 2026-12-31 | Batch / Flex | 0.375 | 0.375 | 1.875 |
| 3.6 / 3.8 Flash,至 2026-12-31 | Priority | 1.35 | 1.35 | 6.75 |
| 3.6 / 3.8 Flash,2027-01-01 起 | Standard | 1.50 | 1.50 | 7.50 |
| 3.6 / 3.8 Flash,2027-01-01 起 | Batch / Flex | 0.75 | 0.75 | 3.75 |
| 3.6 / 3.8 Flash,2027-01-01 起 | Priority | 2.70 | 2.70 | 13.50 |
来源:Gemini Developer API 价格页。当前页没有单独的 3.5 Flash 价格区块;上表是明确的 3.6、3.8 ID 的报价,不能拿它冒充旧 3.5 别名的已核对账单,也不能把任何网关的结算价格直接等同于 Google 价格。
免费层要单独读。本次价格页中,3.1 Flash-Lite 的 Standard、Batch、Flex、Priority 输入输出栏均显示免费;3.6、3.8 的 Batch、Flex 免费栏显示不可用。价格栏说明并不保证你的项目拥有相应模式、额度或即时容量,实际限制需到 AI Studio 速率限制页确认。免费层输入输出还会用于改进 Google 产品,付费层则不会;这也会影响业务选择。价格页列出了数据使用条件。
算一次请求的费用,还要算完成一项任务的费用

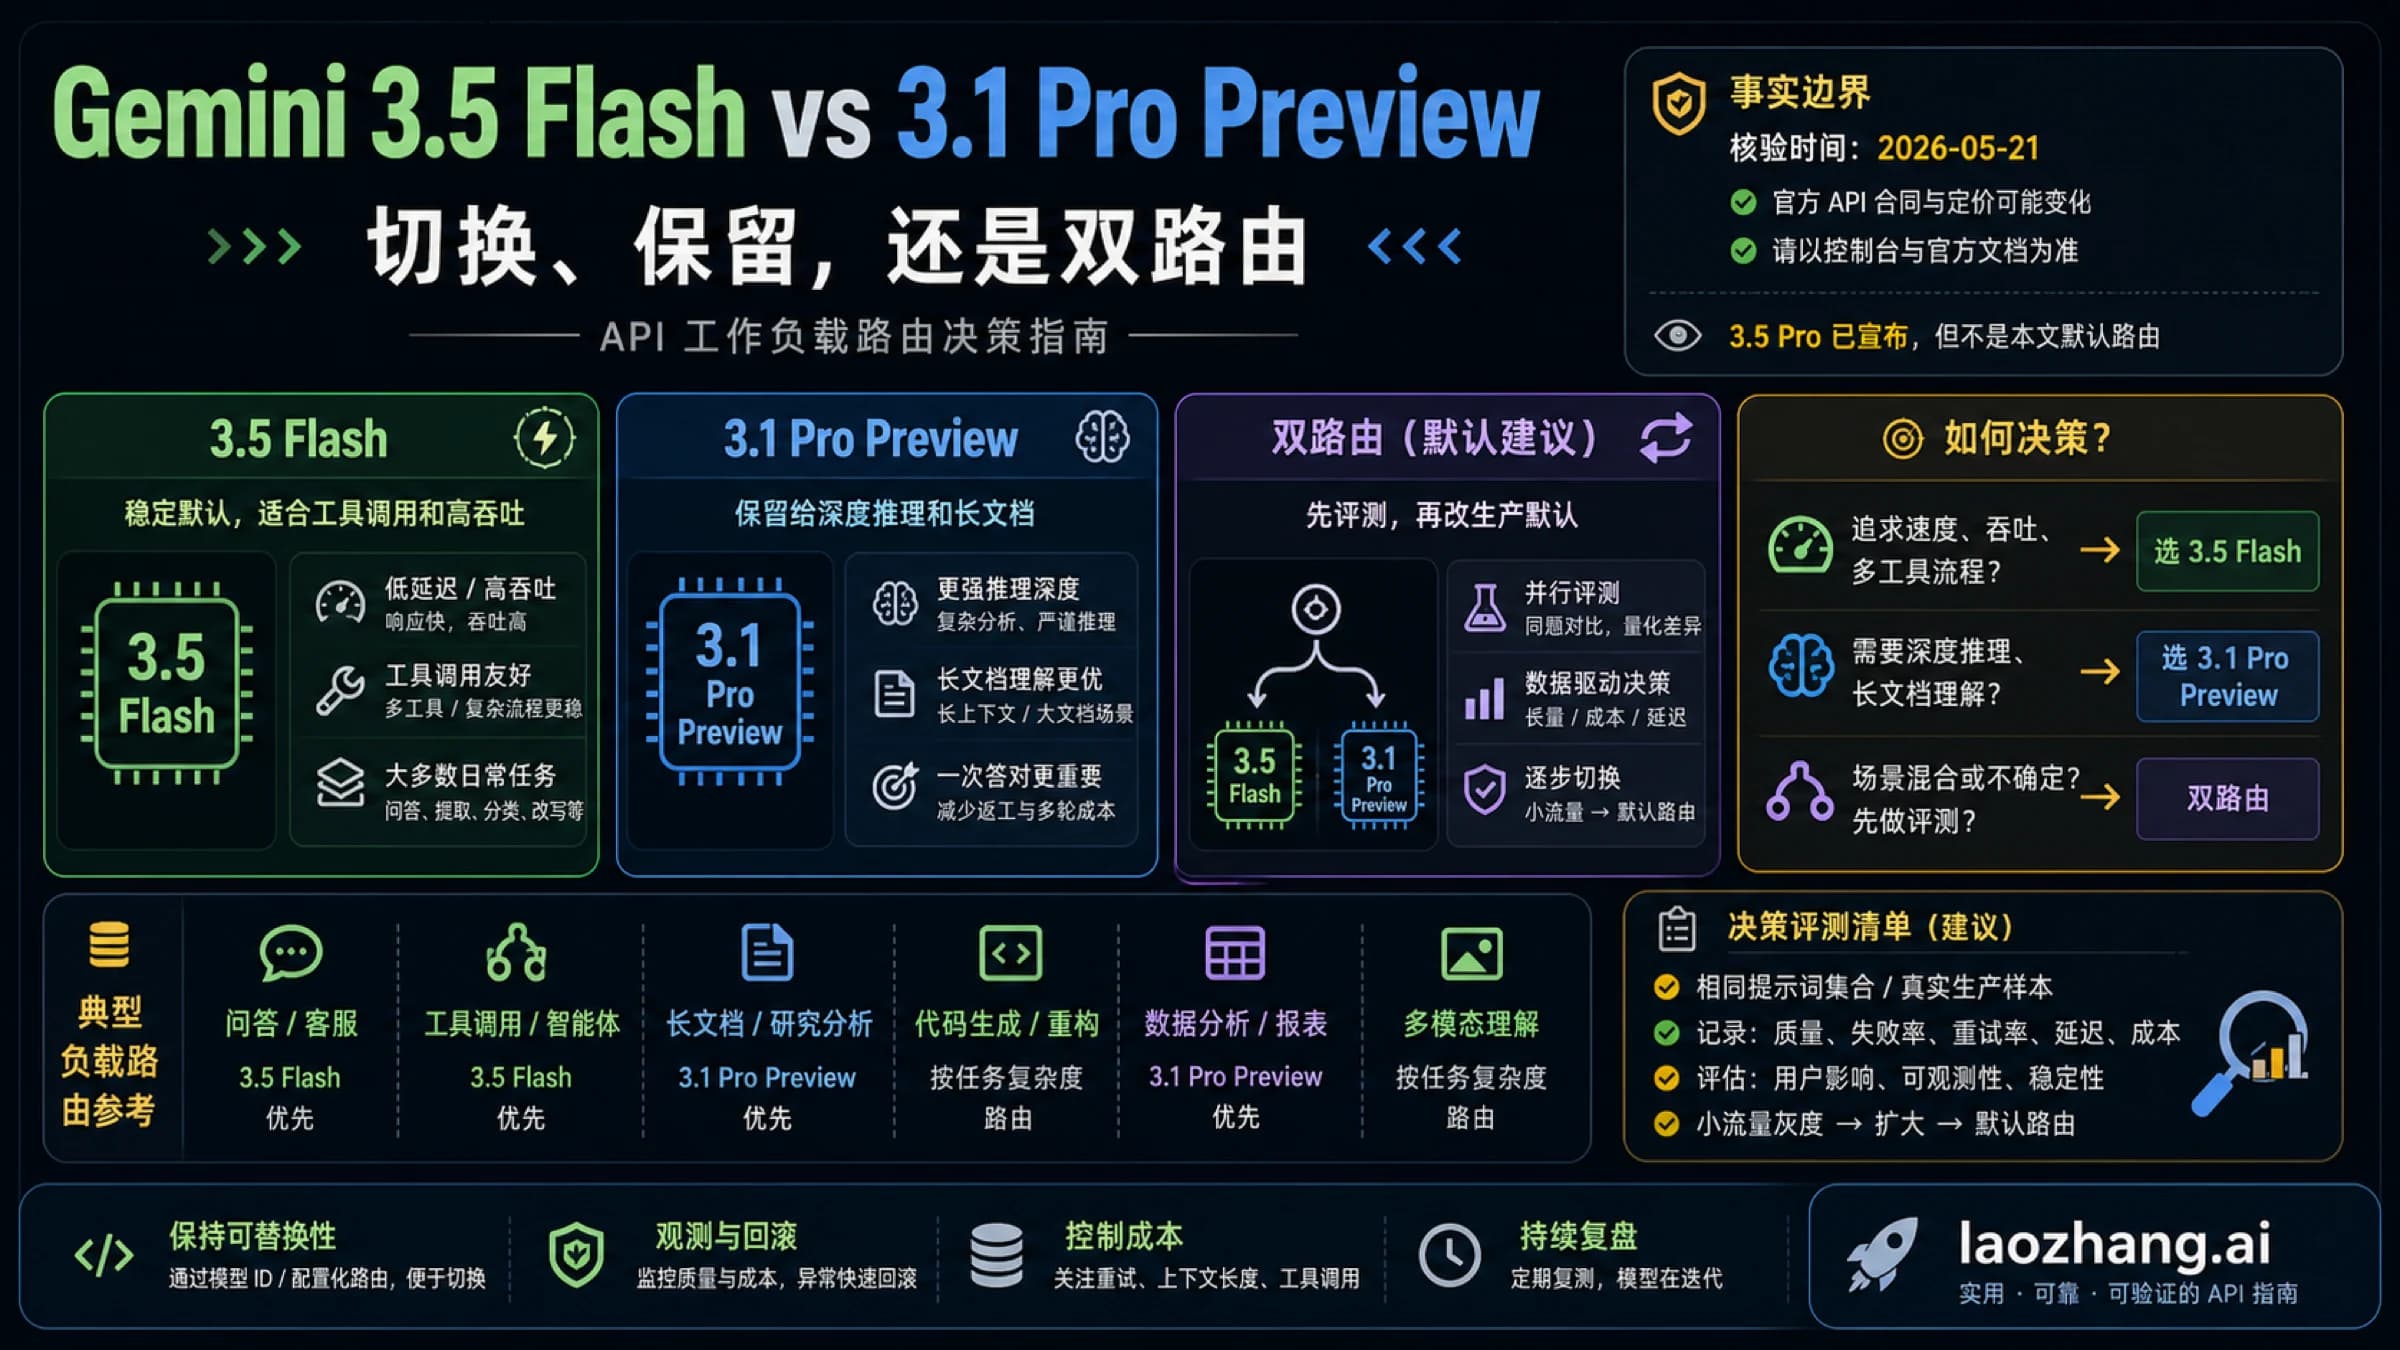
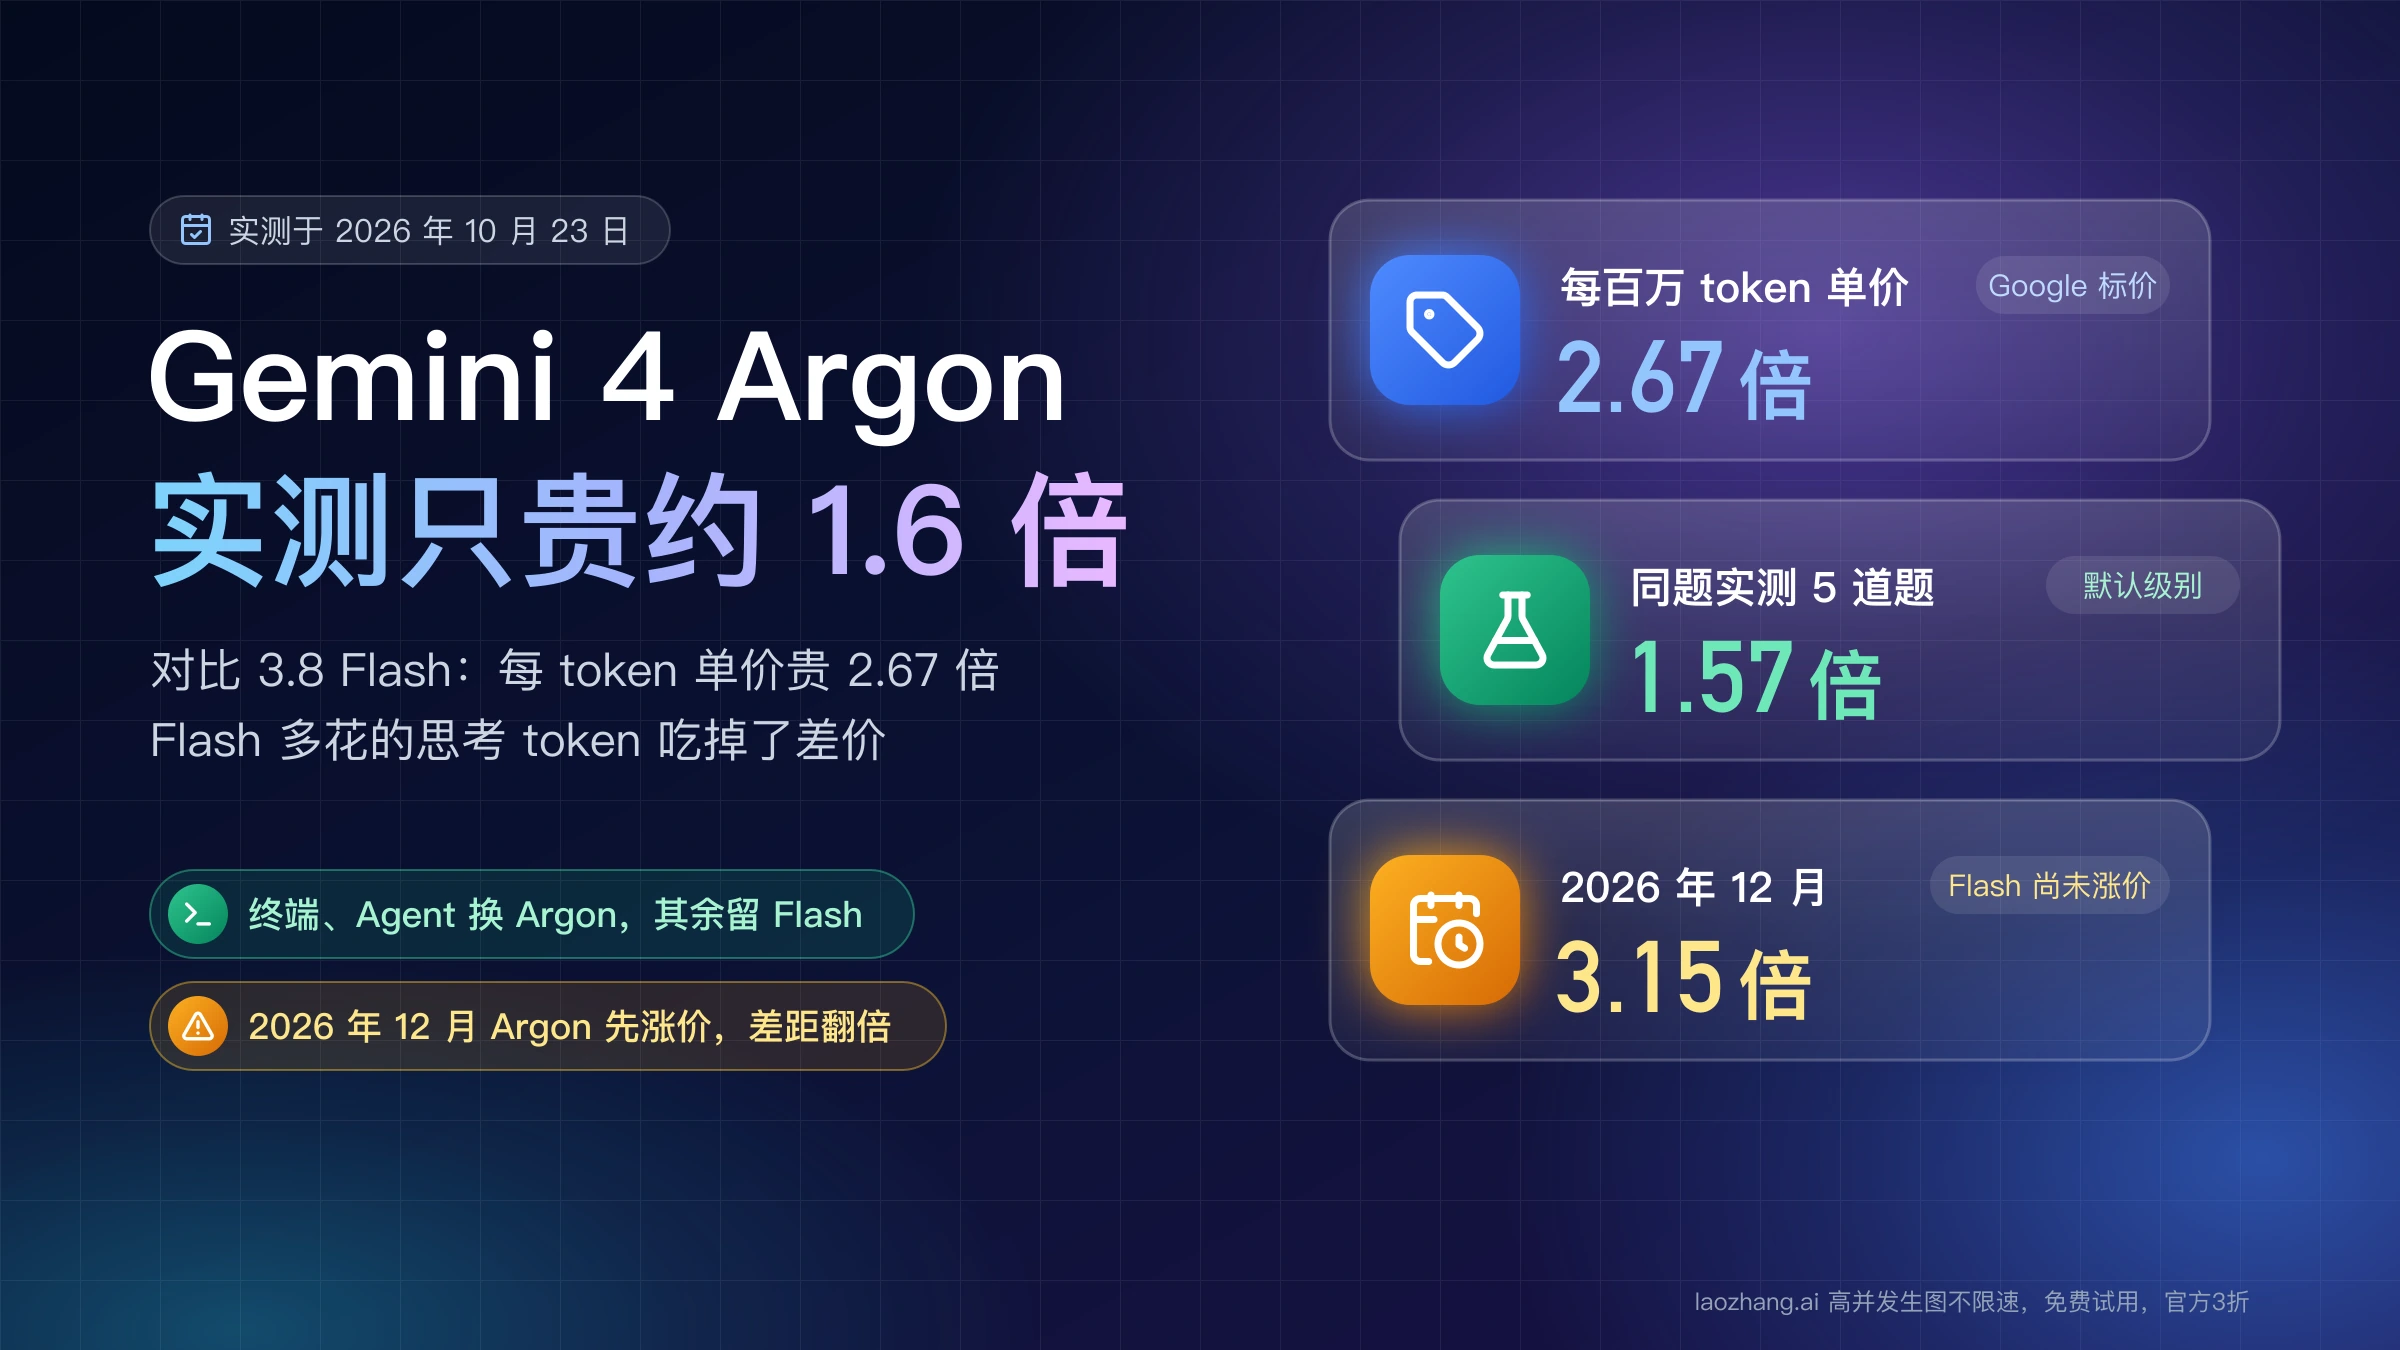
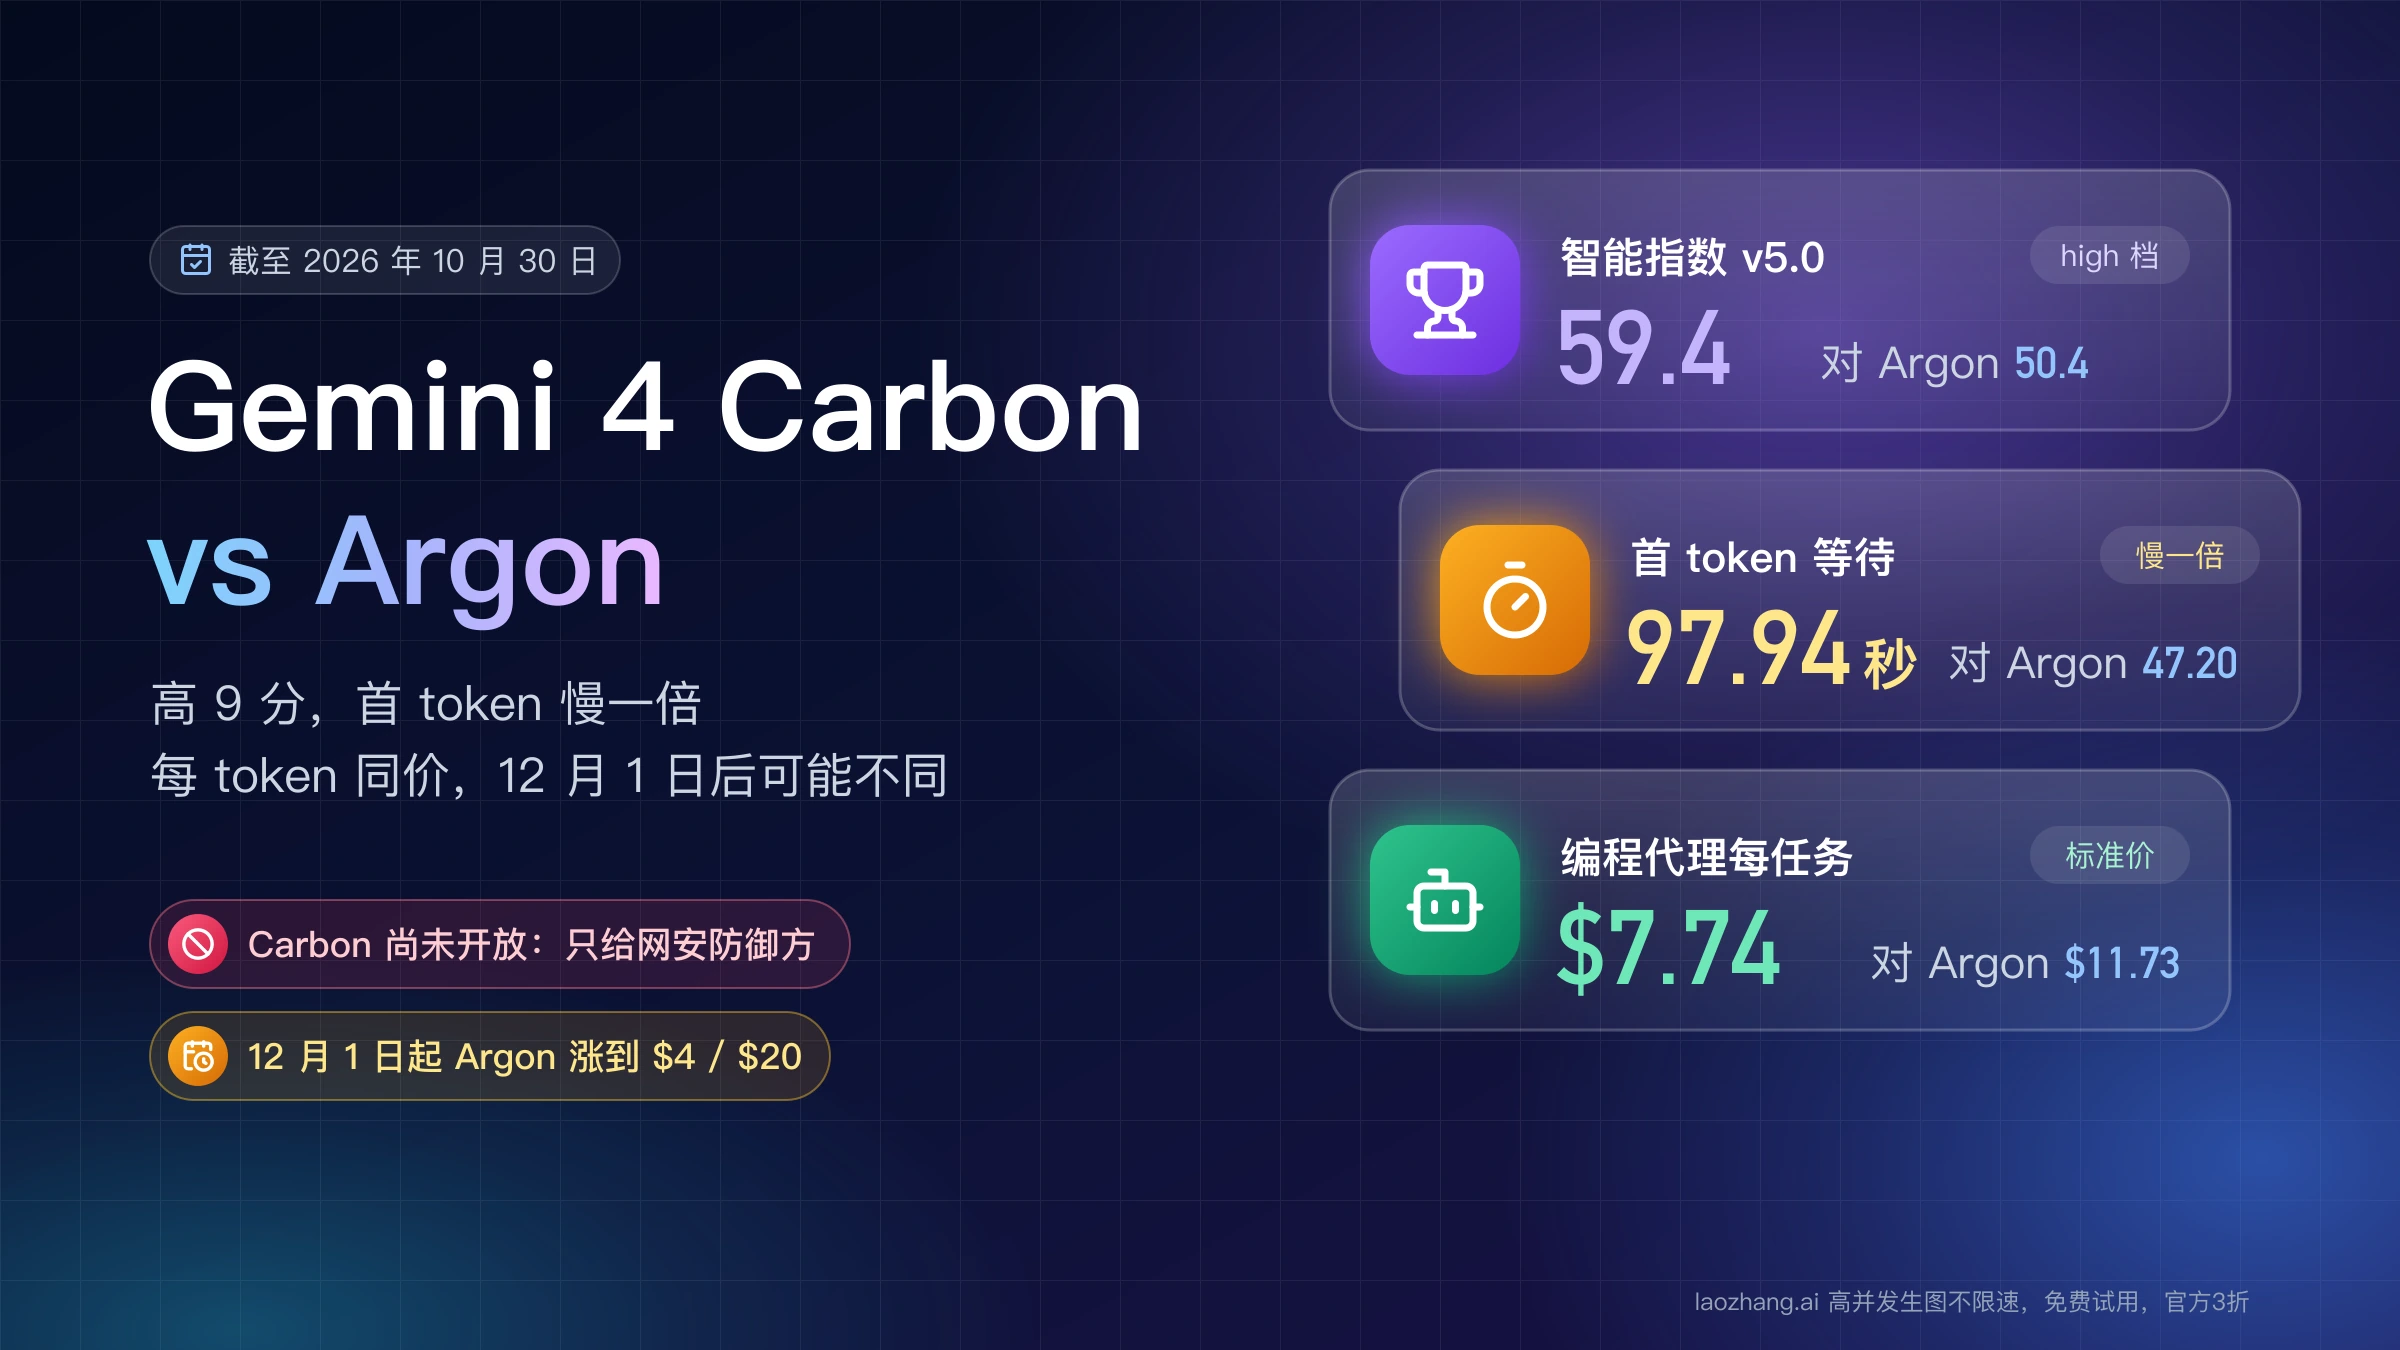
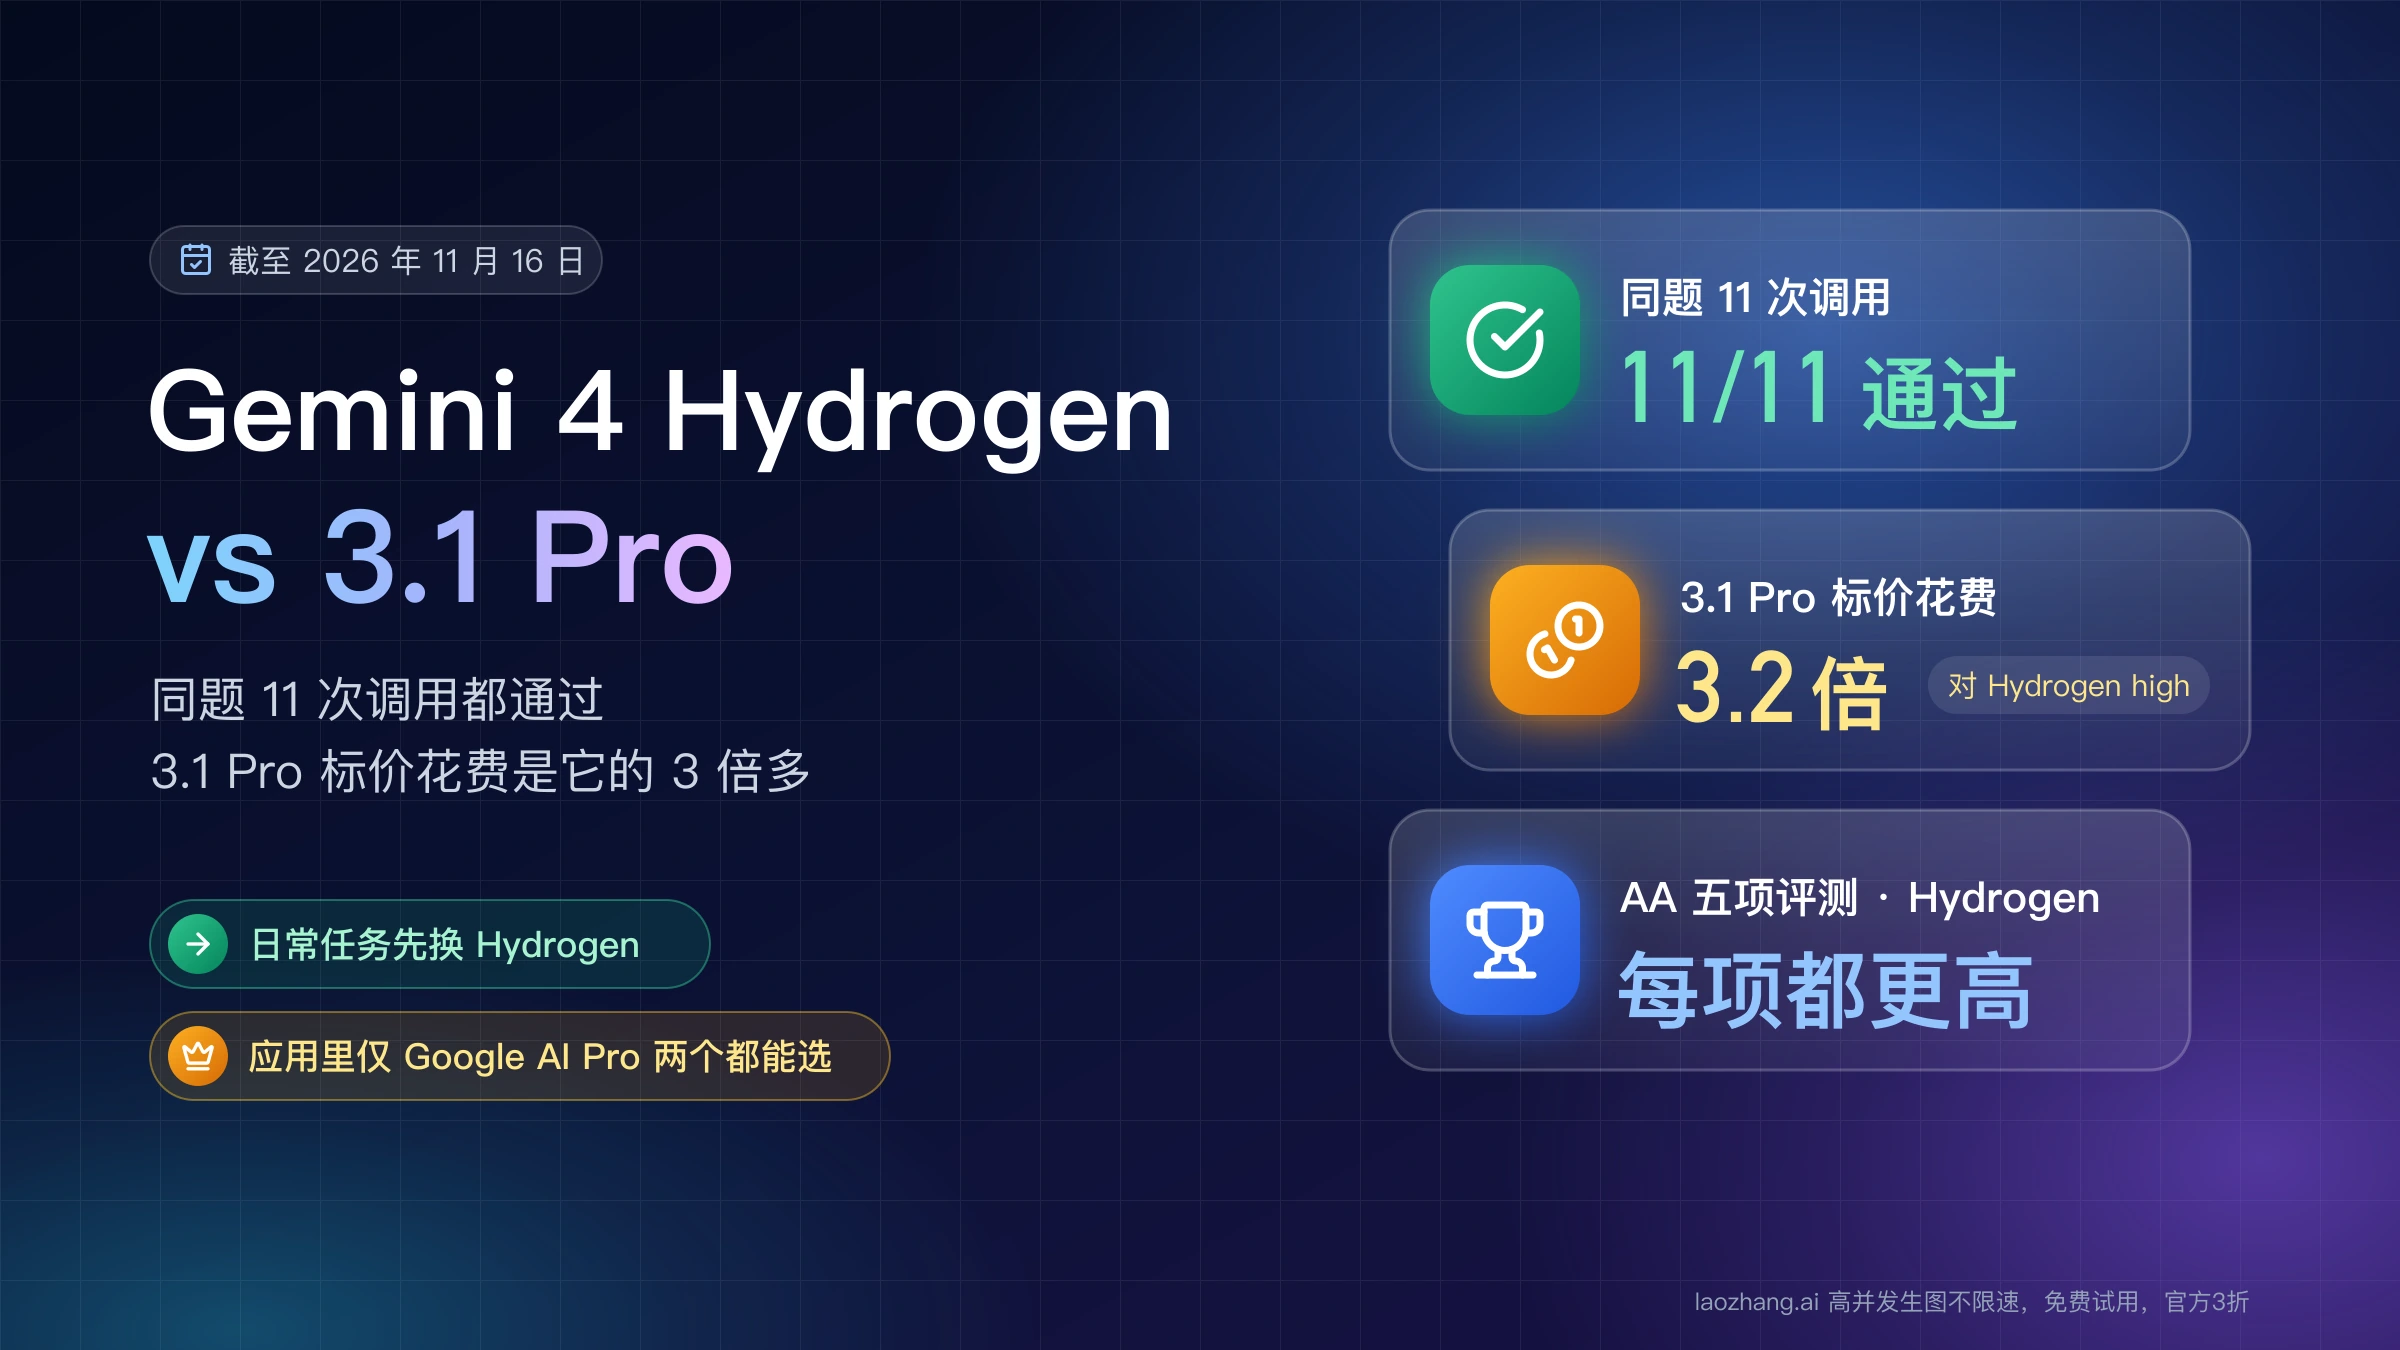
原稿的成本示意图保留作比较思路参考;当前模型状态与价格以本页文字和官方文档为准。
对不使用缓存或工具的纯文本请求,可以先按以下方式估算 token 费用:
token 费用 = 输入 token ÷ 1,000,000 × 输入单价
           +(答案 token + 思考 token)÷ 1,000,000 × 输出单价
例如,假设处理 10,000 条请求,每条都是 2,000 个文本输入 token、300 个答案 token 和 100 个思考 token。总输入是 2,000 万 token,计费输出是 400 万 token。仅按付费 Standard 演算:
| 方案 | 输入费用 | 输出与思考费用 | 合计 |
|---|---|---|---|
| 3.1 Flash-Lite,当前报价 | 20 × 0.25 = 5 美元 | 4 × 1.50 = 6 美元 | 11 美元 |
| 直接 3.6 / 3.8 Flash,2026 年内报价 | 20 × 0.75 = 15 美元 | 4 × 3.75 = 15 美元 | 30 美元 |
| 直接 3.6 / 3.8 Flash,2027-01-01 起报价 | 20 × 1.50 = 30 美元 | 4 × 7.50 = 30 美元 | 60 美元 |
这是按官方价格计算的假设案例,假定各模型 token 用量相同,未包含缓存、搜索、其他工具、重试、税费或人工处理;它不是实测用量或实际账单。实际思考和答案长度可能不同,因此 11 与 30 美元不能直接预测你的成本差距。
用于选型的分母应该是最终通过验收的任务数:把全部尝试的模型费用、失败后的重试与升级费用、工具和缓存费用,以及必要的人工处理成本加起来,再除以完成数量。便宜模型的初次调用即使只有 11 美元,只要大量结果需要补救,整体也可能更贵;当前 Flash 的首次成本更高,也只有在确实减少补救、或完成 Lite 无法完成的任务时才值得。
思考、缓存和搜索会改变计算
思考 token 按输出收费,不能只计算读者看到的答案或思考摘要。3.6 默认思考等级是 medium,支持 minimal、low、medium、high;3.8 默认也是 medium,但只支持 low、medium、high,传 minimal 会报错。Lite 的当前模型指南展示了 high 配置,但当前通用默认等级表未列出稳定 3.1 Flash-Lite,不能据此断言它默认关闭或默认 low。思考文档与3.8 能力表说明了这些条件。
缓存还分读取费用和存储时间。Standard 下,Lite 的文本/图片/视频缓存读取为 0.025 美元/百万 token,音频为 0.05,存储为 1 美元/百万 token·小时;3.6、3.8 到 2026 年底分别为读取 0.075、存储 0.50,2027 年起分别为 0.15、1 美元。缓存读取更便宜,不等于长期存储免费。价格页按模型和模式给出不同列。
Batch 缓存尤其不要直接套“所有费用都打五折”:当前 Batch 指南说命中缓存按 Standard 缓存价格,价格页的 Batch 列却列出不同数字。两处说明的适用口径尚需核对,缓存密集项目应按自己的账单确认,不能拿这个差异编出确定结算结果。
付费搜索与地图依据也有独立计量。价格页的两项工具行各列出每月 5,000 次免费请求,额度由 Gemini 3 及更新模型共享;搜索行超额报价为每 1,000 次请求 14 美元,但脚注进一步说明,一条 Gemini 请求可能触发多次搜索查询,计费按实际搜索查询数量计算。地图行的超额单位则写为搜索查询,每 1,000 次 14 美元。应按对应模型的 Grounding 行与脚注核对,不能把一条模型请求直接当成一次搜索,也不能自行认定两项工具共用同一个免费池。
Batch 和 Flex 的便宜,换来了什么?
Batch 适合独立、非紧急的大批任务;Flex 适合允许等待的同步任务链。 两者的 token 报价低于 Standard,但不能从单价推出实时服务更划算。
- Batch目前只适用于 generateContent,异步处理,目标周转时间为 24 小时,并非保证。任务提交成功不等于每条结果都成功;完成后仍需检查逐条响应与错误。创建任务不具备幂等性,重复提交会创建新的任务。
- Flex仍是 Preview,提供同步接口,目标延迟约 1–15 分钟,容量属于尽力提供。容量不足可返回 503,配额或资源耗尽可返回 429;服务端不会自动升级到 Standard。应用自行选择重试或升级时,要把等待与额外成本纳入预算。
用户正在等待的客服回答、交互式编码或短时超时的任务,不能只把模式改成 Flex 就认为完成了降本。先判断业务允许的等待时间和失败处理,再选择模式;Flex 还会占用普通速率配额,并不会给你额外的无限并发。
迁移时怎样确认实际响应模型和用量?
保留使用中的调用方式,先让模型 ID 和响应记录可追踪。下面是 Gemini 原生 generateContent 的单请求示例,使用 Python 标准库。它展示请求与记录方法,本文没有执行真实模型调用。
前提是服务端已有合法可用的 Gemini API Key,并通过安全方式提供 GEMINI_API_KEY;默认选稳定 3.1 Flash-Lite。要比较直接 3.6 或 3.8,可在自己的运行环境中选择对应的 GEMINI_MODEL。只在符合支持地区与年龄要求、项目权限和额度的环境中运行,Key 不应放进网页前端。当前地区列表未包含中国大陆,中文界面或中文请求不会改变服务资格。
import json
import os
import urllib.error
import urllib.request

model = os.environ.get("GEMINI_MODEL", "gemini-3.1-flash-lite")
allowed = {"gemini-3.1-flash-lite", "gemini-3.6-flash", "gemini-3.8-flash"}
if model not in allowed:
    raise SystemExit("请选择本例支持的稳定模型 ID")

payload = {
    "contents": [{"role": "user", "parts": [{"text":
        "只返回 JSON,包含 order_id 和 issue。"
        "工单:订单 A1042 的包裹还没收到,想查询物流。"
    }]}],
    "generationConfig": {"responseMimeType": "application/json"},
    "serviceTier": "standard"
}
request = urllib.request.Request(
    f"https://generativelanguage.googleapis.com/v1beta/models/{model}:generateContent",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json",
             "x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    method="POST"
)
try:
    with urllib.request.urlopen(request, timeout=120) as response:
        result = json.load(response)
except urllib.error.HTTPError as error:
    raise SystemExit(f"HTTP {error.code}: {error.read().decode('utf-8')}")
except urllib.error.URLError as error:
    raise SystemExit(f"连接失败:{error.reason}")

print(json.dumps({"requestedModel": model,
                  "modelVersion": result.get("modelVersion"),
                  "responseId": result.get("responseId"),
                  "usageMetadata": result.get("usageMetadata"),
                  "candidates": result.get("candidates", []),
                  "promptFeedback": result.get("promptFeedback")},
                 ensure_ascii=False, indent=2))
端点、请求字段和响应字段来自 generateContent API 参考,认证头来自密钥文档。代码里的 120 秒只是本例客户端等待上限,不是官方延迟保证;它没有自动重试或升级,避免让首次对照混入未记录的重复调用。
收到响应后,应同时判断 API 结果与业务结果:candidates 中是否有完成的文本,返回 JSON 是否能解析、订单号是否正确、诉求是否保留。HTTP 成功或返回合法 JSON,单独都不能证明业务已经完成;缺少候选时查看 promptFeedback,异常或未完成结果应记录,不能当作成功样本。
对于模型与成本,重点保存这些字段:
| 记录 | 怎样使用 |
|---|---|
请求的 ID、返回的 modelVersion、responseId | 区分你要求的模型与生成该响应的版本,定位同一次响应 |
promptTokenCount 与模态明细 | 看总输入量;包含缓存部分,不能再把缓存 token 全额加一次 |
cachedContentTokenCount | 区分缓存输入,按相应读取口径计算 |
candidatesTokenCount、thoughtsTokenCount | 分清答案与思考,计算输出费用 |
serviceTier、请求日期、端点 | 对应实际模式和价格期间 |
| 最终验收、重试、工具错误、人工处理时间 | 决定每项成功任务的总成本 |
字段定义见官方响应与 UsageMetadata 参考。totalTokenCount 是输入、思考与答案的总量,不能把它全部按输出单价计费。响应版本可帮助核对执行情况,但单凭网关返回的同名字段,不能证明其后端身份或结算账单。
Google 当前入门指南使用另一个原生接口 Interactions:请求为 /v1beta/interactions,使用 model、input、generation_config、service_tier,响应为 steps 和自己的 usage 字段。它与上例的 contents、generationConfig、serviceTier 不能直接混写。仅为迁移模型 ID,不必同时改端点、SDK 和响应解析;如果确需换接口,应单独验证状态处理、输出提取和用量计算。
上线前,把迁移结果和配额问题分开

先选一组能代表实际业务的任务,固定输入、检索材料、工具权限与验收标准,保留允许的参数配置。
对照 3.1 Flash-Lite 和直接调用的当前 Flash,记录质量、完成耗时及总成本,再决定哪些任务升级。思考等级不能机械照搬:例如原配置含 minimal 时,迁移到 3.8 必须处理这个不支持的选项。
放量前明确失败后的下一动作,并保留回退配置;回退到旧 gemini-3.5-flash 字符串不能恢复旧 3.5 模型,因为当前它仍会转到 3.6。达到业务验收要求且总成本可接受,才逐步改变生产分配。本文没有同任务模型对照结果,因此不宣称 3.8 一定更快、Lite 一定够准确,或任何方案有固定胜率。
如果遇到 429,先检查项目限额而不是宣布模型质量下降。Google 按项目共享 RPM、输入 TPM、RPD,任一限制触顶都可能失败;多建同项目 Key 不会增加额度。RPD 在太平洋时间午夜重置,具体数值在 AI Studio查看,公布或显示的限额也不等于保证容量。速率限制文档还列出可能适用的滚动 10 分钟消费限制:Tier 1 为 10 美元、Tier 2 为 50 美元、Tier 3 为 200 美元,是否适用取决于结算历史与账号状态,不能与月度层级上限混算。
如果是认证失败,核对已有 Key 的类型和限制:2026 年 5 月 28 日起 AI Studio 新建 Key 默认是绑定服务账号的 auth key;无限制的旧标准 Key 会被拒绝,明确加了限制的标准 Key 仍可使用。官方密钥文档说明了规则与权限要求。权限不足应找项目管理员处理;升级付费也涉及 Cloud Billing 和当前入门说明中的最低 5 美元或等值预付,并非买一个模型订阅就获得无限 API 容量。
需要比较 API Key 接入和云上治理时,可继续读同语言的 Gemini Developer API 与 Vertex AI 选择指南。这里的模型状态、端点和价格属于 Developer API,转到 Cloud 路线时需重新确认相应平台的模型、区域、认证和费用。
常见问题
Gemini 3.5 Flash 现在还能调用吗?
旧 gemini-3.5-flash 的 Developer API 端点没有关闭,但请求会自动转到 gemini-3.6-flash,也已不能在 AI Studio 中选择旧模型。新配置宜使用明确的当前 ID,不能把旧字符串当作仍在运行独立 3.5 模型的证据。官方状态与替代说明。
Gemini 3.1 Flash-Lite 还需要用 Preview 吗?
不需要。gemini-3.1-flash-lite 是稳定版,gemini-3.1-flash-lite-preview 已于 2026 年 5 月 25 日关闭。稳定版的最早可能关闭日期为 2027 年 5 月 7 日,Google 推荐后续替代为 3.5 Flash-Lite;这不等于固定 SLA。生命周期表。
Lite 是不是比 Flash 便宜六倍?
当前不能这样概括。按 2026 年 10 月 13 日 Developer API 付费 Standard 报价,稳定 3.1 Flash-Lite 为文本/图片/视频输入 0.25、音频输入 0.50、输出含思考 1.50 美元/百万 token;直接 3.6、3.8 Flash 到年底为输入 0.75、输出含思考 3.75。输入模态、模式、日期和实际用量都会改变费用比例。当前官方价格。
Gemini 3.1 Flash-Lite 的免费层可以无限调用吗?
不可以。当前价格页把 Lite 各模式的输入输出免费栏标为免费,但项目仍受模型与模式可用性、速率和容量限制。到 AI Studio 速率限制页核对自己的项目,多把 Key 不会扩大同项目配额。限额计算方式。
从 3.5 Flash 迁移到 3.8,只改模型名够吗?
不一定。保留原生接口时可先改为明确的模型 ID,但参数也要合法:3.8 不支持 minimal 思考等级。还需检查响应解析、工具流程、验收结果和实际用量;原 3.5 ID 当前已转到 3.6,不能用它代表旧 3.5 做独立比较。3.8 能力说明与3.5 路由说明。
同样支持多模态输入,为什么还要按任务分配模型?
支持某种输入,只说明模型能接收它,并不证明所有模型都能以相同质量、耗时和成本完成任务。简单抽取或翻译可以从 Lite 开始,复杂编码和多步工具任务值得评估当前 Flash;最终按业务验收和成功任务总成本决定。这个选择依据官方 Lite 定位与当前 Flash 定位,不代表本站已经做出普遍质量排名。
参考来源15
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月13日。
参考来源15
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月13日。
- 1.3.5 Flash 官方说明ai.google.dev/gemini-api/docs/models/gemini-3.5-flash
- 2.弃用时间表ai.google.dev/gemini-api/docs/deprecations
- 3.Lite 指南ai.google.dev/gemini-api/docs/models/gemini-3.1-flash-lite
- 4.3.6 模型页ai.google.dev/gemini-api/docs/models/gemini-3.6-flash
- 5.3.8 模型页ai.google.dev/gemini-api/docs/models/gemini-3.8-flash
- 6.官方价格页ai.google.dev/gemini-api/docs/pricing
- 7.AI Studio 速率限制页aistudio.google.com/rate-limit
- 8.思考文档ai.google.dev/gemini-api/docs/thinking
- 9.Batch 指南ai.google.dev/gemini-api/docs/batch-api
- 10.Flexai.google.dev/gemini-api/docs/flex-inference
- 11.支持地区与年龄要求ai.google.dev/gemini-api/docs/available-regions
- 12.generateContent API 参考ai.google.dev/api/generate-content
- 13.密钥文档ai.google.dev/gemini-api/docs/api-key
- 14.Interactionsai.google.dev/gemini-api/docs/get-started
- 15.速率限制文档ai.google.dev/gemini-api/docs/rate-limits