GPT-5.5 对比 Claude Opus 4.7:API 价格与编程选型
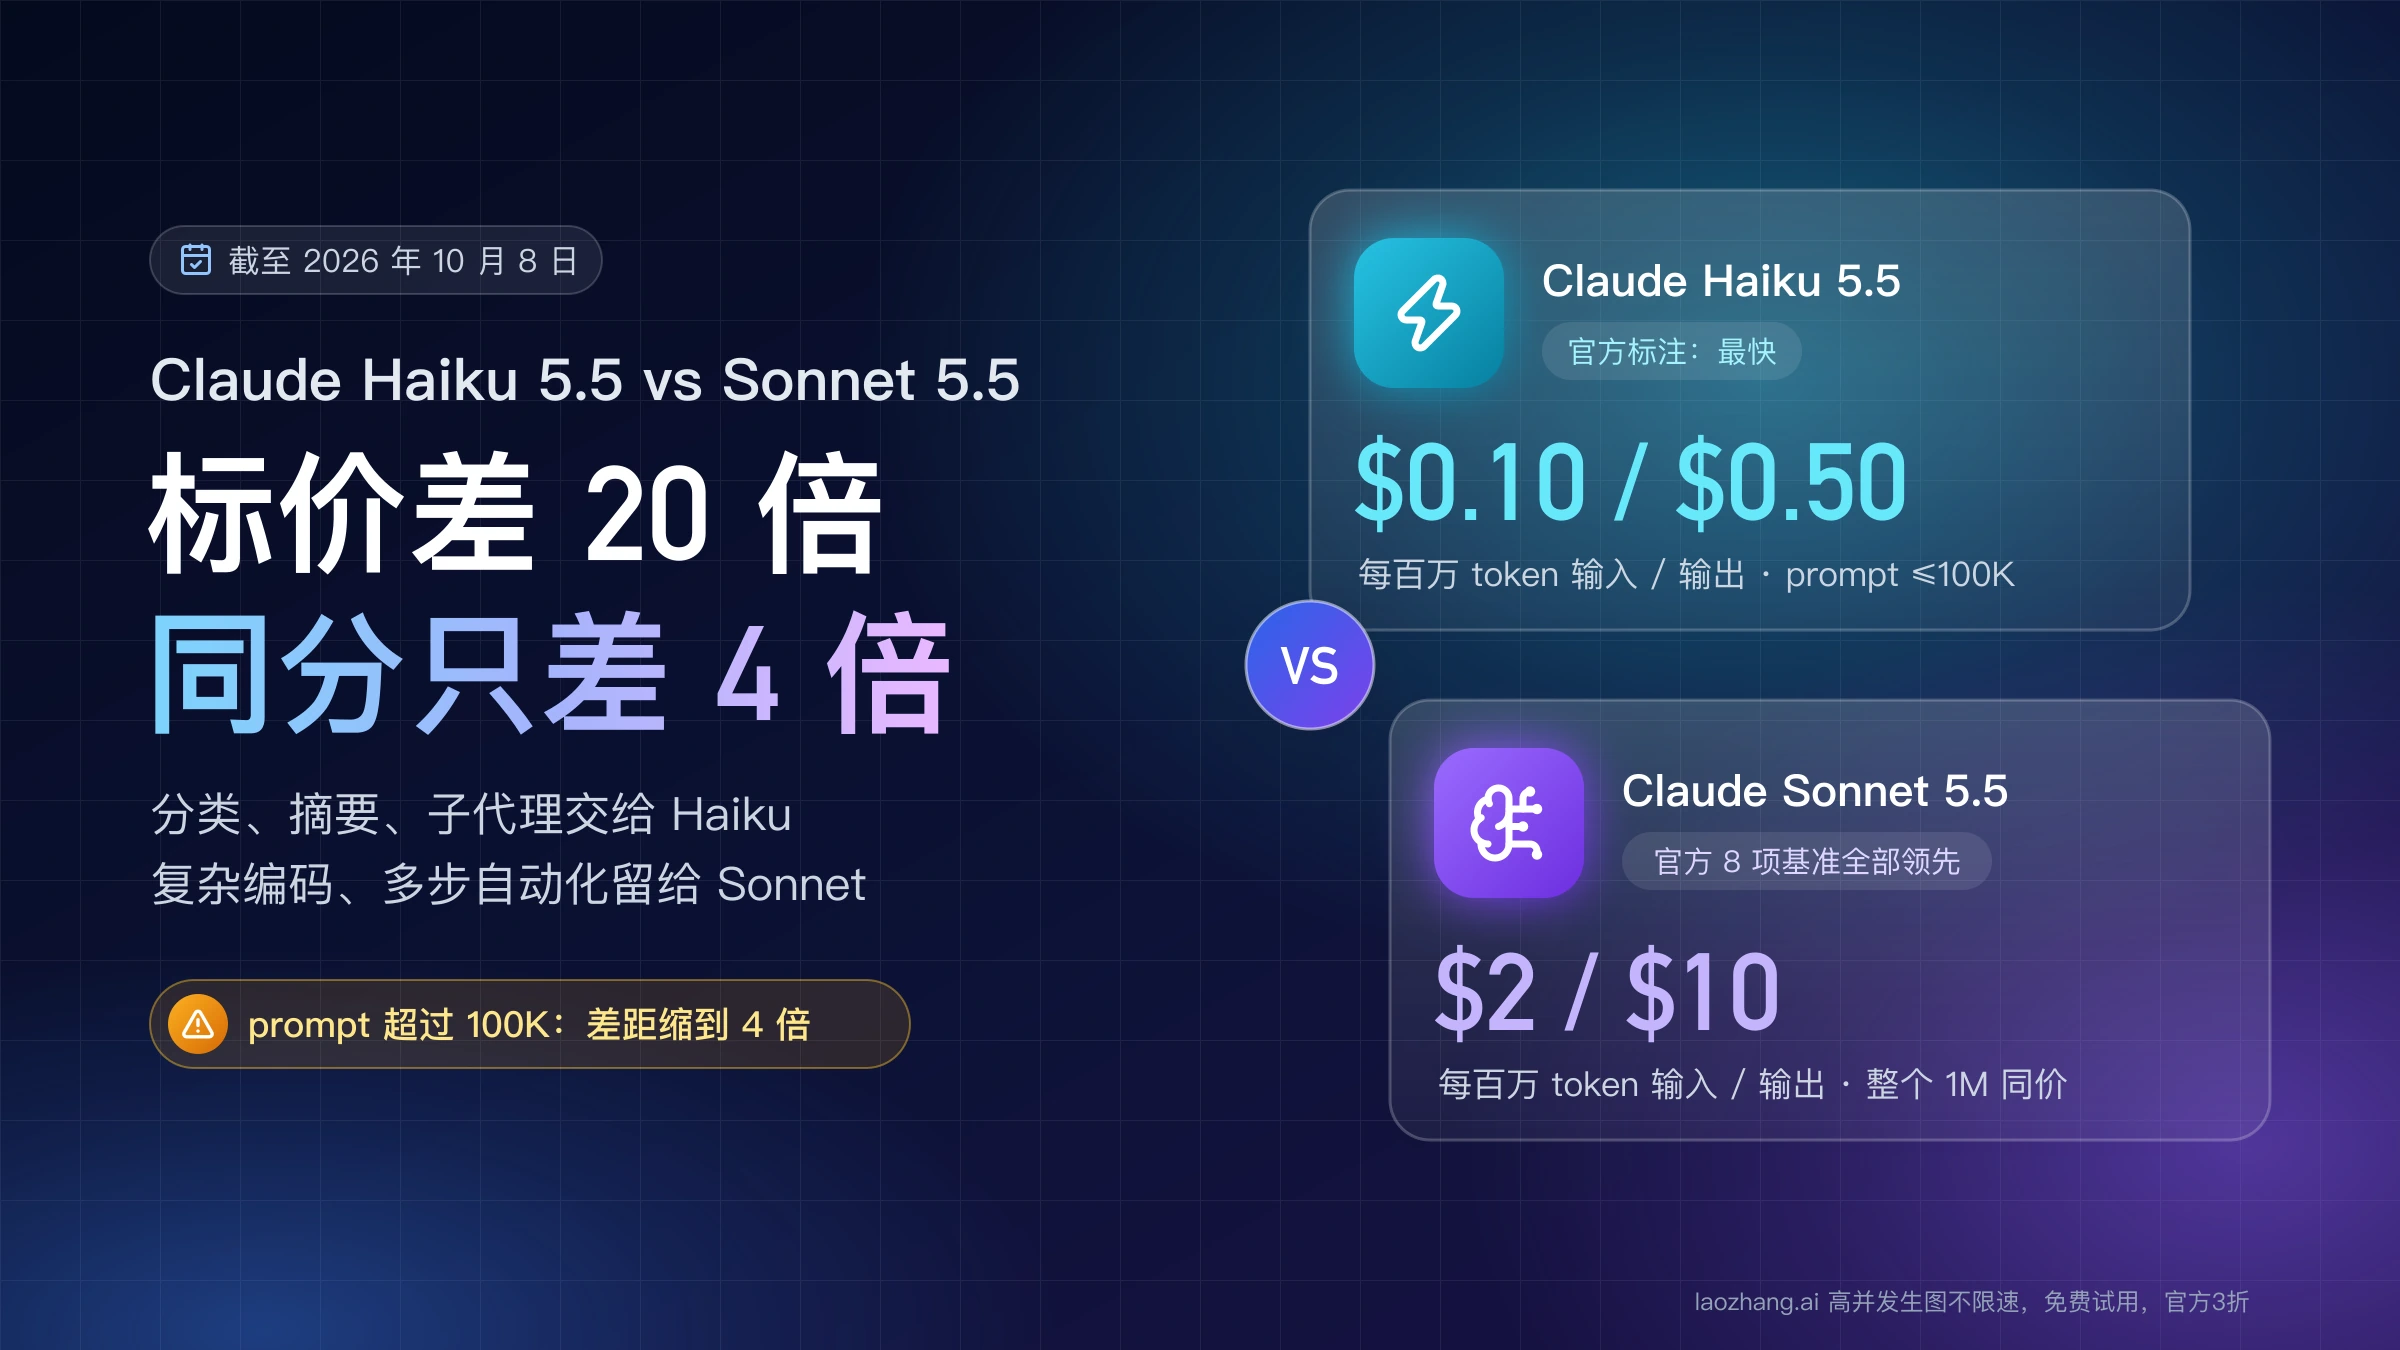
两者 API 均可用:已有 OpenAI 工具链先测 GPT-5.5,已有 Anthropic 工具链先测 Opus 4.7。超过 272K 的输入会触发 GPT-5.5 长上下文费率,编程任务则要按验收后的总成本决定是否切换。
文章目录
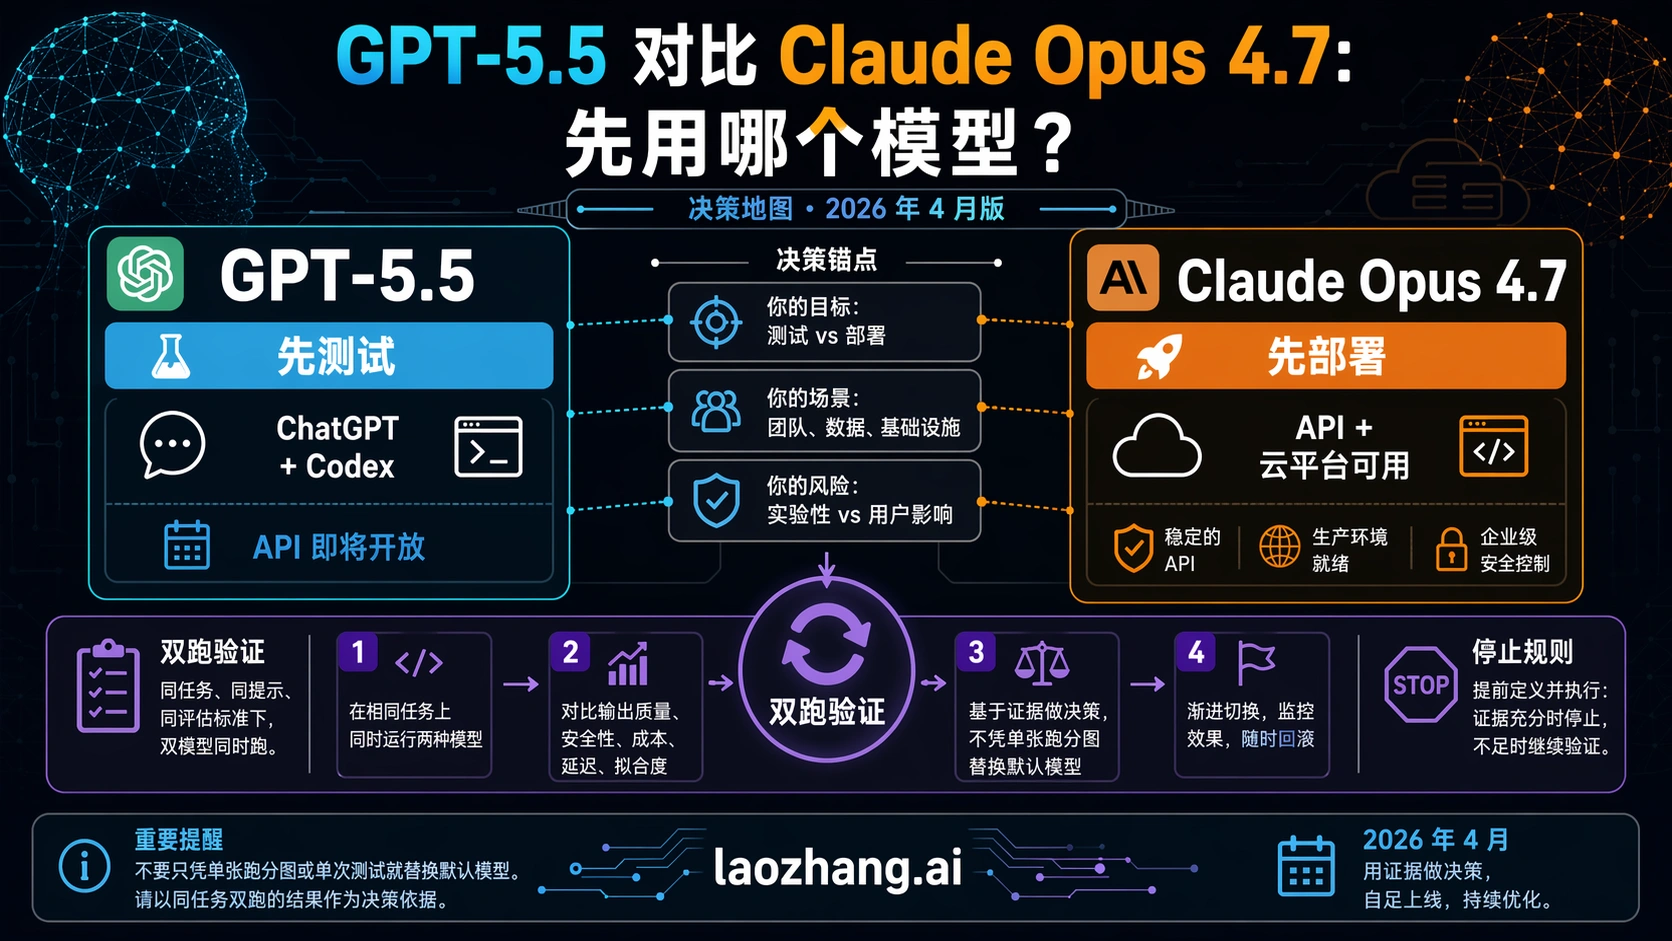
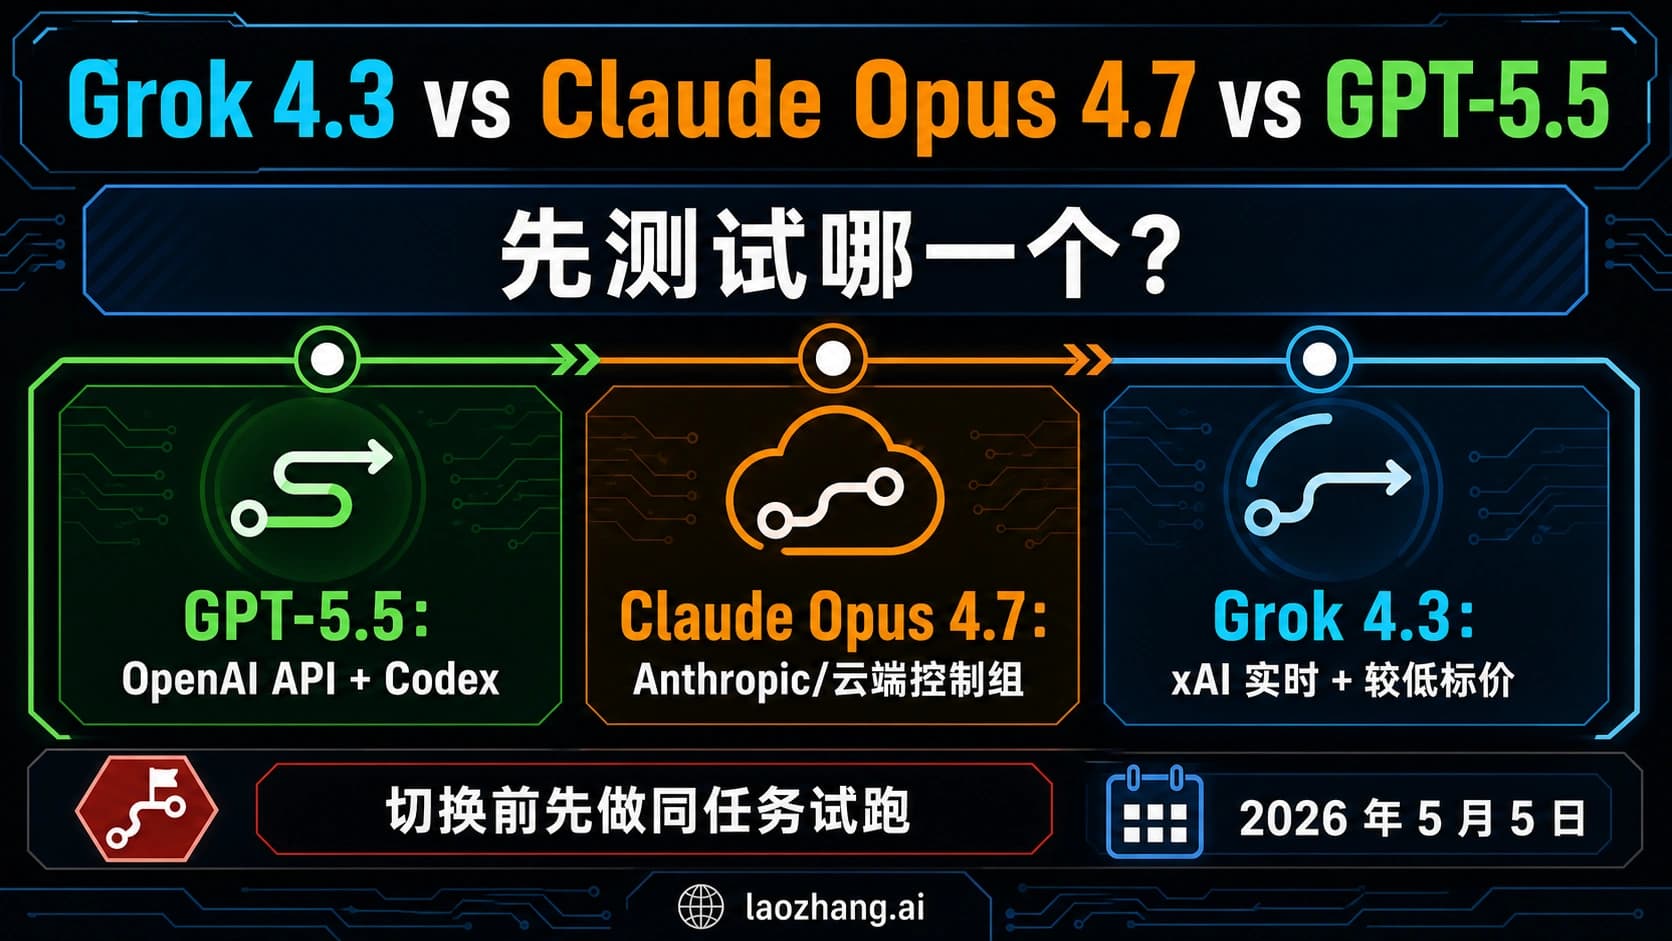
GPT-5.5 和 Claude Opus 4.7 现在都能通过官方 API 使用。 如果你的应用已经采用 OpenAI Responses API,先测 GPT-5.5,能减少接口迁移工作;如果已采用 Anthropic Messages API,先测 Opus 4.7,继续使用现有工具和消息处理。对于尚未绑定接口的新项目,输出较多或单次输入超过 272K token 的任务,可以优先以 Opus 4.7 建立成本基线,再用 GPT-5.5 做同任务对照。这是根据接口和费率作出的首测建议,最终选型还要看任务能否通过验收。GPT-5.5 模型资料、Opus 4.7 模型资料均已列出当前 API 规格。
另一个直接影响选择的变化是:GPT-5.5 将于 2026 年 10 月 14 日退出 ChatGPT、ChatGPT Work 和 Codex,官方明确说明此次退役不适用于 OpenAI API。 因此,使用这些产品界面的用户要选择可用替代模型;服务端调用 gpt-5.5 的应用不能把这条公告读成 API 停服。OpenAI 退役公告没有注明具体截止时刻。
本文的价格与状态依据核对到 2026 年 10 月 13 日。算例是按公开费率推导,代码是依据官方接口编写的调用示例;我们没有执行双模型调用或取得实际账单。
先测哪一个:让现有应用和任务成本决定起点
| 你要完成的工作 | 建议先测 | 首轮需要确认什么 |
|---|---|---|
| 已有 OpenAI Responses 应用,依赖结构化输出或托管工具 | GPT-5.5 | 保留现有接口,重新调推理力度,检查工具行为与最终产物 |
| 已有 Anthropic Messages 应用或 Claude API 编程代理 | Opus 4.7 | 按 4.7 支持的思考设置调用,正确处理内容块与停止原因 |
| 新建长文档流程,单次输入超过 272K token | Opus 4.7 作费用基线 | 标准费率覆盖完整 1M 上下文;随后比较两者检索正确性与总用量 |
| 新建输出密集型代码或报告流程 | Opus 4.7 作费用基线 | 输出单价较低,但节省是否成立还取决于推理、重试和审查 |
| 跨文件改代码、修 issue、执行多步工具任务 | 先从已接入的一方开始,再测试另一方 | 用同一仓库、验收测试和工具权限比较,避免把工具链差异算成模型优势 |
| 只打算在 ChatGPT 或 Codex 中使用 GPT-5.5 | 先处理产品界面迁移 | 10 月 14 日退出这些产品的公告与 API 选型是两件事 |
这里的“先测”意味着先建立可比较的结果。即使费率较低,一次修复要多重试、补测或人工重写,最终也可能更贵。反过来,如果现有应用已完成另一家的接口、日志和工具适配,为每百万输出 token 节省 5 美元而立即迁移,也未必划算。
两者 API 目前有哪些明确的可用边界?
GPT-5.5 的原生模型 ID 是 gpt-5.5,需要固定版本时可以使用 gpt-5.5-2026-04-23;支持 Responses、Chat Completions 和 Batch。官方模型资料列出 1,050,000 token 的上下文窗口及 128,000 token 的最大输出。模型卡的 API Free 层级标为不支持,付费层级的公开限额也不能代替你自己项目的实际权限与限额。GPT-5.5 模型卡
Opus 4.7 的 Claude API ID 是 claude-opus-4-7,普通请求的上下文窗口为 1M token,最大输出为 128K token。模型卡状态是 Active(legacy),生命周期表仍列为 Active;legacy 表示不再更新、未来可能弃用,并不表示已经停用。Anthropic 运营平台列出的退役时间为“不早于 2027 年 4 月 16 日”,这不是确定的关停日期。Bedrock 和 Google Cloud 等合作平台有自己的时间表。Opus 4.7 模型卡、模型生命周期说明
claude-opus-4-7 没有日期后缀,但它仍是固定模型快照,并非自动指向最新 Opus 的别名。模型权重固定也不代表周边服务设施永远不变,路由与安全分类等变化仍可能影响观察到的行为。Anthropic 模型 ID 说明
两者都接受文本与图片、输出文本。上下文窗口需要同时容纳输入和生成过程,不能把“百万上下文”理解为输入塞满百万 token 后,还能额外获得完整最大输出。文档存在模型也不证明每个账号、地区或第三方服务都能调用;采用云平台或聚合接口时,要确认该路线自己的模型标识、支持功能和计费规则。
API 价格:长输入会显著改变比较结果
以下均为官方直接 API 的美元价格,单位是 每百万 token,标准处理模式;没有计入区域加价、工具费用或个别商业折扣。
| 计费项目 | GPT-5.5:输入不超过 272K | GPT-5.5:输入超过 272K | Claude Opus 4.7 |
|---|---|---|---|
| 普通输入 | 5 美元 | 10 美元 | 5 美元 |
| 命中缓存的输入 | 0.50 美元 | 1 美元 | 0.50 美元 |
| 输出,包含计费的推理用量 | 30 美元 | 45 美元 | 25 美元 |
| 额外缓存写入费率 | 无额外写入费 | 无额外写入费 | 5 分钟写入 6.25 美元;1 小时写入 10 美元 |
GPT-5.5 官方说明:输入超过 272K token 时,Standard、Batch 和 Flex 的整个会话按输入 2 倍、输出 1.5 倍费率计价,不能只对超出的部分加价。Opus 4.7 的标准费率则覆盖完整 1M 上下文,没有旧版模型那种超过 200K 输入的长上下文溢价。OpenAI 价格表、GPT-5.5 长上下文说明、Anthropic 价格表
算例一:短输入下,输出单价差异有多大?
假设每次请求有 40,000 个未缓存输入 token、3,000 个计费输出 token,其中输出已经包含推理用量;两者恰好使用相同 token 数,没有重试、额外工具费或区域加价:
- GPT-5.5:
40,000 ÷ 1,000,000 × 5 + 3,000 ÷ 1,000,000 × 30 = 0.29 美元。 - Opus 4.7:
40,000 ÷ 1,000,000 × 5 + 3,000 ÷ 1,000,000 × 25 = 0.275 美元。
1,000 次这样的请求分别为 290 美元和 275 美元。Opus 4.7 的输出单价相对 30 美元低约 16.7%,但这个输入占比较高的完整请求仅便宜约 5.2%。“输出便宜”与“整个任务便宜”需要区分。
算例二:300K 输入时,价差从哪里来?
再假设一次请求有 300,000 个未缓存输入 token、10,000 个计费输出 token,其余条件相同:
- GPT-5.5:
0.3 × 10 + 0.01 × 45 = 3.45 美元。 - Opus 4.7:
0.3 × 5 + 0.01 × 25 = 1.75 美元。
这说明长输入费率足以改变首测顺序,但它没有证明 Opus 4.7 在同一长文档任务上的实际成功成本更低。同一段中文、代码或 PDF 由不同 tokenizer 处理,token 数不一定相同;生成的推理量和修正次数也不一定相同。预算应代入两边各自返回的用量,而不是用字数统一折算。
重复文档、批量任务和区域设置怎么计价?
重复使用同一文档时,把缓存命中与首次写入分开算。GPT-5.5 自动缓存、不支持显式断点且没有额外写入费;其 prompt_cache_retention 仅支持 24h,实际缓存寿命通常约 30 分钟、最长可到 24 小时,不能据参数名保证整整一天命中。OpenAI 缓存模型差异
Opus 4.7 支持缓存配置,但写入与读取是不同类别。例如把 100K 输入写入 5 分钟缓存一次并成功读取两次,仅这段输入的费用是 0.1 × 6.25 + 2 × 0.1 × 0.50 = 0.725 美元;三次均按未缓存输入计费则是 3 × 0.1 × 5 = 1.50 美元。这是假设缓存命中的输入部分算例,输出和其他新输入仍需另计。Anthropic 缓存价格
不需要同步交付的批量任务,可以再比较 Batch:GPT-5.5 短输入费率为输入 2.50、输出 15 美元,Opus 4.7 为输入 2.50、输出 12.50 美元。GPT-5.5 Flex 也列出短输入 2.50、输出 15 美元,但处理模式和服务条件要分别核对,不能把折扣当成免费提速。GPT-5.5 Fast 短输入则为 12.50、输出 75 美元;Opus 4.7 不支持 Fast,发送 speed: "fast" 会报错。OpenAI 模式价格、Anthropic Batch 与 Fast 价格
区域需求也会影响预算:GPT-5.5 区域处理端点有 10% 加价;Opus 4.7 在第一方 API 上指定 inference_geo: "us" 时,全部 token 计费类别乘以 1.1,默认 global 使用标准费率。合作云平台应按各自规则核对,价格资料不构成账号资格或合规保证。GPT-5.5 模型资料、Anthropic 数据驻留价格
编程能力与速度:哪些证据能用于选型?
不能把“某项基准领先”直接换算成你的 issue 修复成功率,更不能把发布周的不同测试环境拼成当前总榜。应同时查看测试版本、推理设置、工具环境与未公布的数据。
截至 10 月 13 日读取的 Artificial Analysis 对比页,比较的是 GPT-5.5 High 与 Opus 4.7 Max,并非两边默认设置;其 Intelligence Index v4.3.2 包含十项评估。页面显示 GPT-5.5 为 37、Opus 4.7 为 41,但 Opus 的 41 标为 估算,独立评估尚待完成。同页 AA-LCR v1.1 为 84% 与 79%,Humanity's Last Exam 为 45% 与 42%。这些结果适合帮助选择对照任务,不能推出某一模型在所有编程工作上更强。Artificial Analysis 原始对比
| 同页速度项目 | GPT-5.5 High | Opus 4.7 Max | 对交互体验的意义 |
|---|---|---|---|
| 输出生成速度 | 约 88 token/秒 | 约 51 token/秒 | 首段返回后,GPT 的输出生成更快 |
| 首 token 等待 | 30.53 秒 | 23.57 秒 | 该设置下,Opus 首段等待更短 |
| 500 token 端到端响应 | 36.20 秒 | 33.38 秒 | 短回复总时间不能只按输出速度判断 |
以上是 Artificial Analysis 的特定配置测量及计算口径,不是本站测量或固定延迟承诺。输出速度排除了首段等待;500 token 的端到端指标综合等待、思考和生成过程,方法使用多样化的 60 个提示。频繁的小修改与长篇代码生成可能看重不同指标,所以“输出更快”和“用户更早拿到结果”可以指向不同模型。测量口径与结果
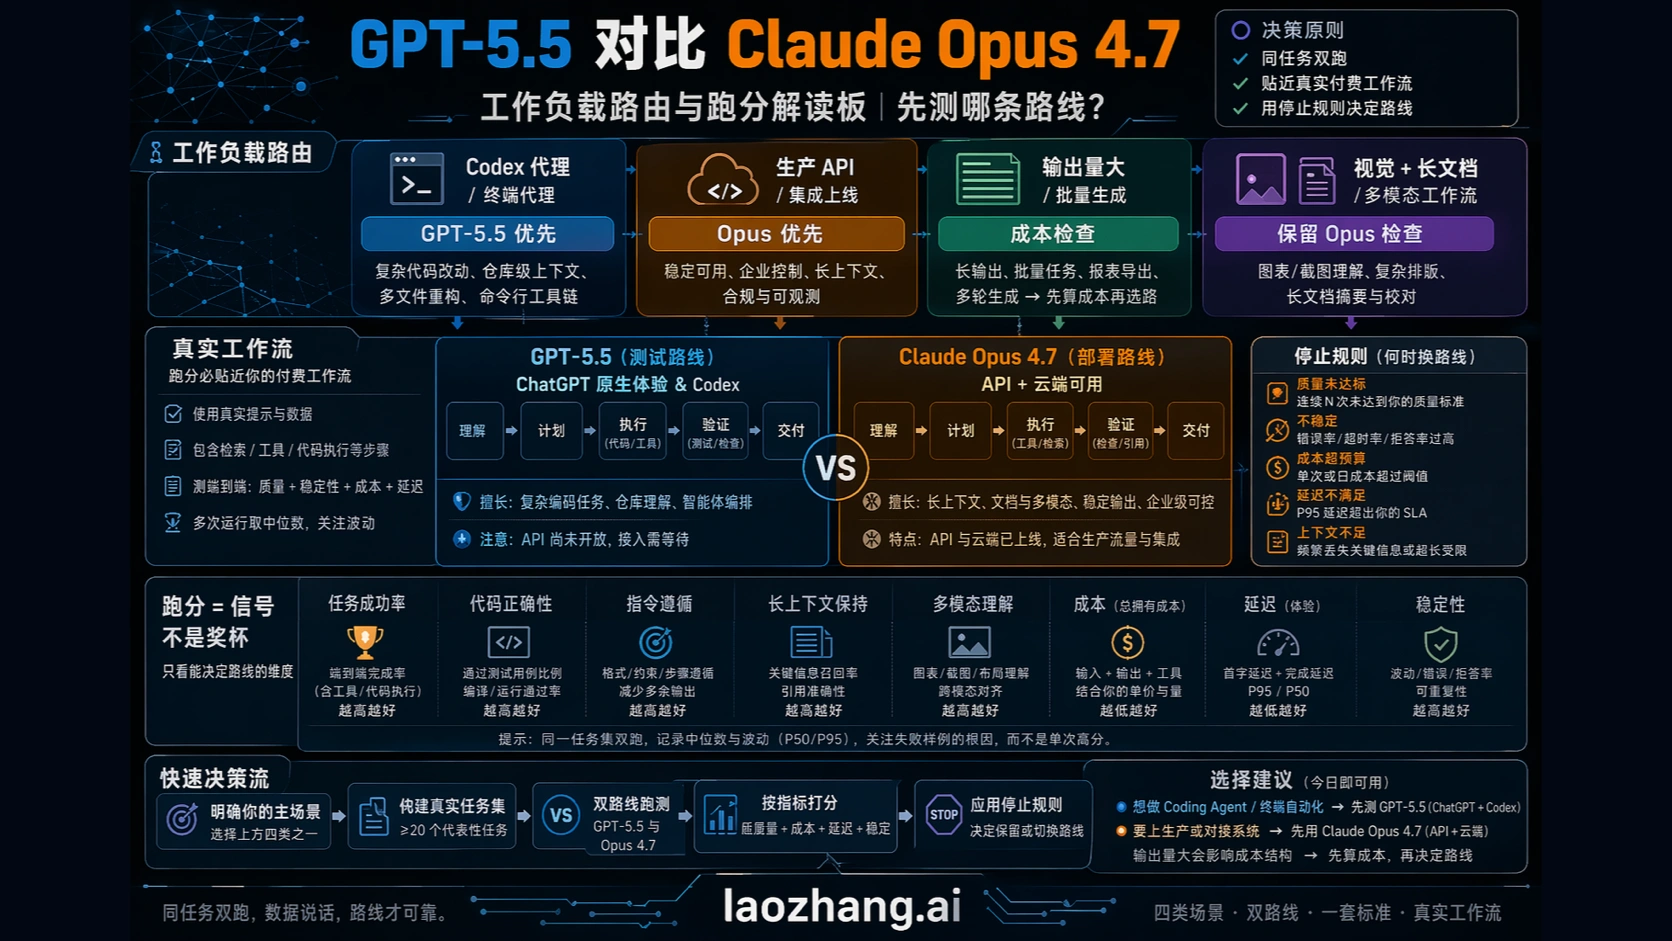
为自己的编程应用作决定,可以按下面的顺序组织对照:
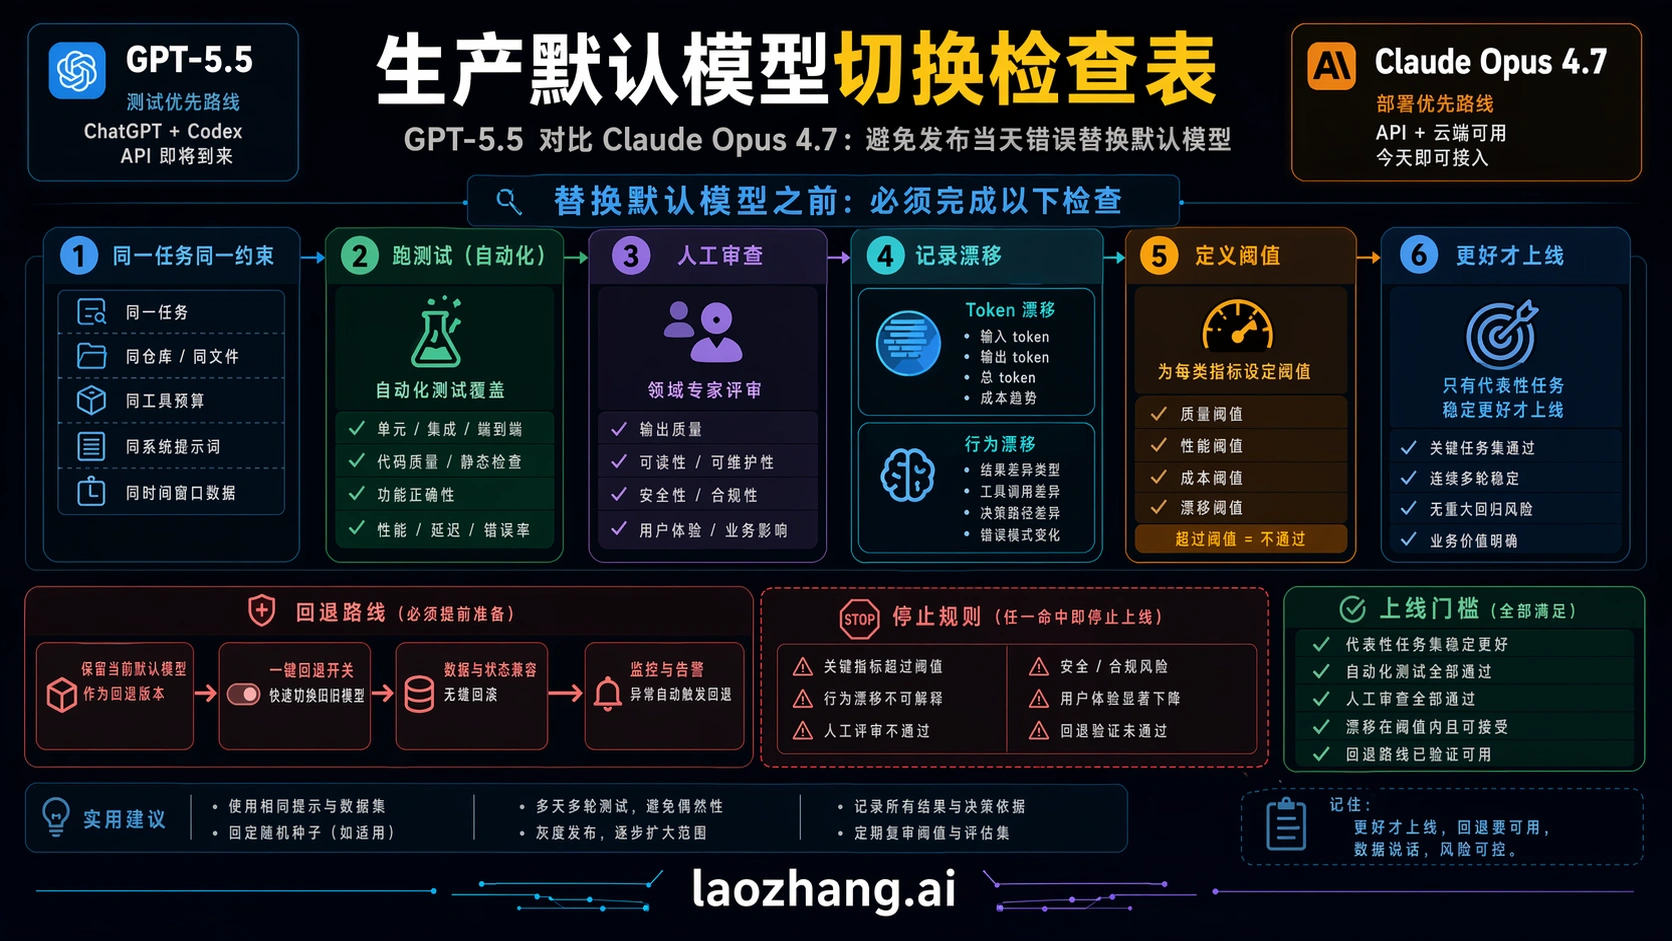
- 固定可验收任务。 从已关闭的 issue 里选取错误输入、边界条件、跨文件修改和历史回归任务;每个任务保留同一仓库版本,提前确定必须通过的测试与不允许改变的行为。
- 固定权限和交付要求。 两边拿到相同文件、工具与网络权限,禁止一边拥有额外检索结果。给出目标、约束和验收标准,再根据原生接口设置推理,不要求同名 effort 等于同等算力。
- 记录整个任务。 从开始到验收统计所有请求、重试、工具费用、人工审查分钟和失败原因;既记录首段时间,也记录真正可用补丁的完成时间。
- 按通过验收的产物比较。 模型调用总费用除以通过验收的任务数,才得到这批任务的每个成功产物成本。再单列人工审查负担,避免便宜的调用把成本转移给工程师。
对于会修改业务数据的代理,允许的副作用和停止条件也要在任务开始前写清。高 effort 并不会自动修复模糊的验收要求。OpenAI 建议 GPT-5.5 从 medium 建立基线、质量提升可测时才提高;Anthropic 对 Opus 4.7 编程代理建议从 xhigh 开始,max 留给评估确有增益的任务。GPT-5.5 调优说明、Opus 4.7 effort 建议
原生 API 示例:先正确调用,再记录用量
下面两个 Python 示例分别使用官方 SDK,完成相同的小型代码分析任务,打印文本、停止状态与原始用量。它们是文档支持的调用写法,未在本文执行,不含仓库工具循环或基准评测结果。
运行前需要可使用对应模型的 API 项目、密钥及计费或可用 credit,并在自己的服务端环境安装对应 SDK:python -m pip install openai anthropic。OpenAI SDK 读取 OPENAI_API_KEY,Anthropic SDK 读取 ANTHROPIC_API_KEY;不要把密钥写入浏览器端或公开代码。分别保存为 gpt_example.py、opus_example.py,准备好环境后使用 python 文件名.py 运行。OpenAI Python 入门、Claude API 入门
GPT-5.5:Responses、推理力度与完整输出状态
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-5.5-2026-04-23",
    reasoning={"effort": "medium"},
    text={"verbosity": "low"},
    max_output_tokens=25000,
    input=(
        "检查这段 Python:def average(xs): return sum(xs) / len(xs)。"
        "要求空列表返回 None,正常列表保持原结果。"
        "给出最小修改和覆盖空列表、负数及单元素列表的测试。"
    ),
)
print("status:", response.status)
print("usage:", response.usage)
if response.status == "incomplete":
    print("incomplete:", response.incomplete_details)
print(response.output_text)
max_output_tokens 同时限制推理、可见输出及不可见格式 token;incomplete 可能发生在最终文本出现之前。示例给 25K 的生成空间是参照推理指南的初测建议,不表示每次一定生成或收费 25K token。OpenAI 推理与输出限制
在 Responses 返回值中,缓存输入读取 usage.input_tokens_details.cached_tokens,推理用量读取 usage.output_tokens_details.reasoning_tokens。缓存用量已包含在 input_tokens 内,推理用量已包含在 output_tokens 内,不能重复加一遍。短输入标准费用按“未缓存输入 × 5 + 缓存输入 × 0.50 + 输出 × 30”计算,再除以百万;超过门槛时使用长输入费率。不要把 total_tokens 全部按输出价格收费。Responses 用量说明、缓存用量说明
Opus 4.7:Messages、自适应思考与内容块
import anthropic

client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=64000,
    thinking={"type": "adaptive"},
    output_config={"effort": "xhigh"},
    messages=[{
        "role": "user",
        "content": (
            "检查这段 Python:def average(xs): return sum(xs) / len(xs)。"
            "要求空列表返回 None,正常列表保持原结果。"
            "给出最小修改和覆盖空列表、负数及单元素列表的测试。"
        ),
    }],
)
print("stop_reason:", message.stop_reason)
print("usage:", message.usage)
for block in message.content:
    if block.type == "text":
        print(block.text)
这里的 xhigh 与 64K 上限参考 Opus 4.7 编程代理建议;小任务也可另测 high 或 medium,比较通过率和费用。两份示例的设置不同,适合展示各自的起点,不能据一次运行宣布公平胜负。max_tokens 包含思考与文本,达到上限时 stop_reason 为 max_tokens,需要检查结果是否完整。Anthropic effort 说明、思考故障排查
Opus 4.7 默认关闭 thinking,要启用时使用 adaptive;不要照搬旧模型的 thinking.type: "enabled" 和 budget_tokens,4.7 会拒绝这一组合。temperature 已弃用,只接受默认值。返回内容有不同类型的块,所以示例筛选 text,而不是假定 content[0] 一定是答案。后续加入工具循环时,Messages 的历史由客户端显式传递,上一条 assistant 的思考块也需按官方规则保留。Claude API 基础说明
Anthropic 用量中的普通输入、缓存读取、缓存创建及输出要按各自类别计价。第三方服务提供 OpenAI 格式的兼容入口,属于其适配层,不意味着原生 Claude API 就是 Chat Completions,也不自动保证工具字段、缓存统计和原生接口相同。
控制代理费用:单次生成上限还不够
Opus 4.7 的 Task Budgets 是 API beta 功能,需要 task-budgets-2026-03-13,最低 task_budget.total 为 20,000 token。它为一次代理循环提供包含思考、工具调用、工具结果与输出的预算提示;循环可能跨越多个请求。模型有时可以超出预算,响应 usage 也不返回服务器剩余额度。Task Budgets 官方说明
因此,Task Budgets 不能充当账单硬上限;max_tokens 只硬性限制单次请求的生成,同样无法包住全部输入、重试和后续调用。应用需要在发起下一次请求前,根据已经发生的各类费用检查任务总预算,并限制循环次数和总时间。这样既给模型留下完成任务的空间,也能让客户端决定什么时候停止继续花费。GPT-5.5 的 max_output_tokens 也只能约束对应请求的生成,不能代替这层任务管理。
常见问题
GPT-5.5 API 还需要等开放吗?
不需要等待。2026 年 10 月 13 日的官方模型资料已列出 gpt-5.5 与固定快照,支持 Responses、Chat Completions 和 Batch;具体项目权限和额度仍应在自己的 API 项目核对。10 月 14 日退出 ChatGPT、ChatGPT Work 和 Codex 的公告不适用于 API。模型卡、退役公告
Claude Opus 4.7 是不是已经过时到不能用了?
仍可通过 API 使用。模型卡标为 Active(legacy),生命周期表列为 Active,退役不早于 2027 年 4 月 16 日;该时间范围适用于 Anthropic 运营平台,合作平台另有安排。官方建议考虑 Opus 5.5,但它是另一个模型,不会通过 claude-opus-4-7 自动替换。Opus 4.7 模型卡、生命周期说明
哪个更适合修 GitHub issue 或大型代码库?
先以已经接入的 API 建立基线,再让另一模型修相同任务。需要检验的结果是补丁通过测试、保持既有行为并减少审查时间。当前所引用的第三方对比采用 High 与 Max 不同设置,且部分综合分数是估算,不能据此断言哪个必然更适合你的仓库。Artificial Analysis 对比及设置
输入超过 200K token,Opus 4.7 会加价吗?
不会因这一门槛触发旧版长上下文加价;官方价格说明给 Opus 4.7 的完整 1M 上下文标准费率。需要注意的是 GPT-5.5:输入超过 272K token 时使用长上下文费率,标准输入 10 美元、输出 45 美元/百万 token。Anthropic 长上下文价格、GPT-5.5 价格说明
Claude Max 或 Team 订阅包含 API 额度吗?
当前有附带条件的月度 API credit:Max 5x 为 100 美元,Max 20x 为 200 美元;Team 标准席位 20 美元、Premium 席位 100 美元,组织共享池上限 500 美元。Free、Pro 和 Enterprise 不适用。需要符合资格、计划生效至少七天,并由具备权限的人员把一个 Console 组织与计划关联;额度按周期到期、不滚存。它不覆盖交互式 Claude Code,也不等于无限 API 调用;是否已显示优惠、是否已关联及实际余额应看你的账号。Claude 月度 API credit 官方条件
GPT-5.5 Pro 值不值得直接替代 GPT-5.5?
先把普通 GPT-5.5 与 Opus 4.7 的任务对照做好,再评估 Pro 是否改善尚未通过的高价值任务。gpt-5.5-pro 是单独模型,支持 Responses 与 Batch,不提供缓存输入折扣;标准短输入价格为每百万输入 30 美元、输出 180 美元,一些请求可能耗时数分钟。不能将“Pro”当成免费增强开关,也不能与 Claude Pro 订阅混为一谈。GPT-5.5 Pro 模型资料、OpenAI 价格表
有必要长期同时使用两者吗?
只有对照结果证明分工有价值时才保留双模型。例如一方在某类任务上通过率更高,另一方在另一类任务上成功产物成本更低,就可以按任务选择;如果第二条接口只增加维护费用而没有改善交付,就保留单模型。将两者互相审查也应计入额外用量,不能把“多问一个模型”当成免费质量保证。
如果困扰你的是模型反复使用奇怪比喻,而非补丁正确率或调用费用,可以另读 GPT-5.5 哥布林问题的历史成因与行为判断。风格事件与这篇 API 选型的验收标准应分别判断。
参考来源20
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月13日。
参考来源20
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月13日。
- 1.GPT-5.5 模型资料developers.openai.com/api/docs/models/gpt-5.5
- 2.Opus 4.7 模型资料platform.claude.com/docs/en/models/opus-4-7/overview
- 3.OpenAI 退役公告learn.chatgpt.com/docs/models
- 4.模型生命周期说明platform.claude.com/docs/en/about-claude/model-deprecations
- 5.Anthropic 模型 ID 说明platform.claude.com/docs/en/about-claude/models/model-ids-and-versions
- 6.OpenAI 价格表developers.openai.com/api/docs/pricing
- 7.Anthropic 价格表platform.claude.com/docs/en/about-claude/pricing
- 8.OpenAI 缓存模型差异developers.openai.com/api/docs/guides/prompt-caching
- 9.Artificial Analysis 原始对比artificialanalysis.ai/models/comparisons/gpt-5-5-high-vs-claude-opus-4-7
- 10.GPT-5.5 调优说明developers.openai.com/api/docs/guides/latest-model
- 11.Opus 4.7 effort 建议platform.claude.com/docs/en/build-with-claude/effort
- 12.OpenAI Python 入门developers.openai.com/api/docs/quickstart
- 13.Claude API 入门platform.claude.com/docs/en/get-started
- 14.OpenAI 推理与输出限制developers.openai.com/api/docs/guides/reasoning
- 15.缓存用量说明developers.openai.com/api/docs/guides/prompt-caching/diagnostics
- 16.思考故障排查platform.claude.com/docs/en/build-with-claude/thinking-troubleshooting
- 17.Claude API 基础说明platform.claude.com/docs/en/claude_api_primer
- 18.Task Budgets 官方说明platform.claude.com/docs/en/build-with-claude/task-budgets
- 19.Claude 月度 API credit 官方条件support.claude.com/en/articles/17154008-monthly-api-credits-for-max-and-team-plans
- 20.GPT-5.5 Pro 模型资料developers.openai.com/api/docs/models/gpt-5.5-pro