OpenAI API GPT-5.6 Sol、Terra、Luna 怎么选:价格与验收方法
Sol 已启用临时促销价。先算清 API 与 credits 的适用边界,再用同一组任务比较三档模型的通过率、重试和返工成本。
文章目录

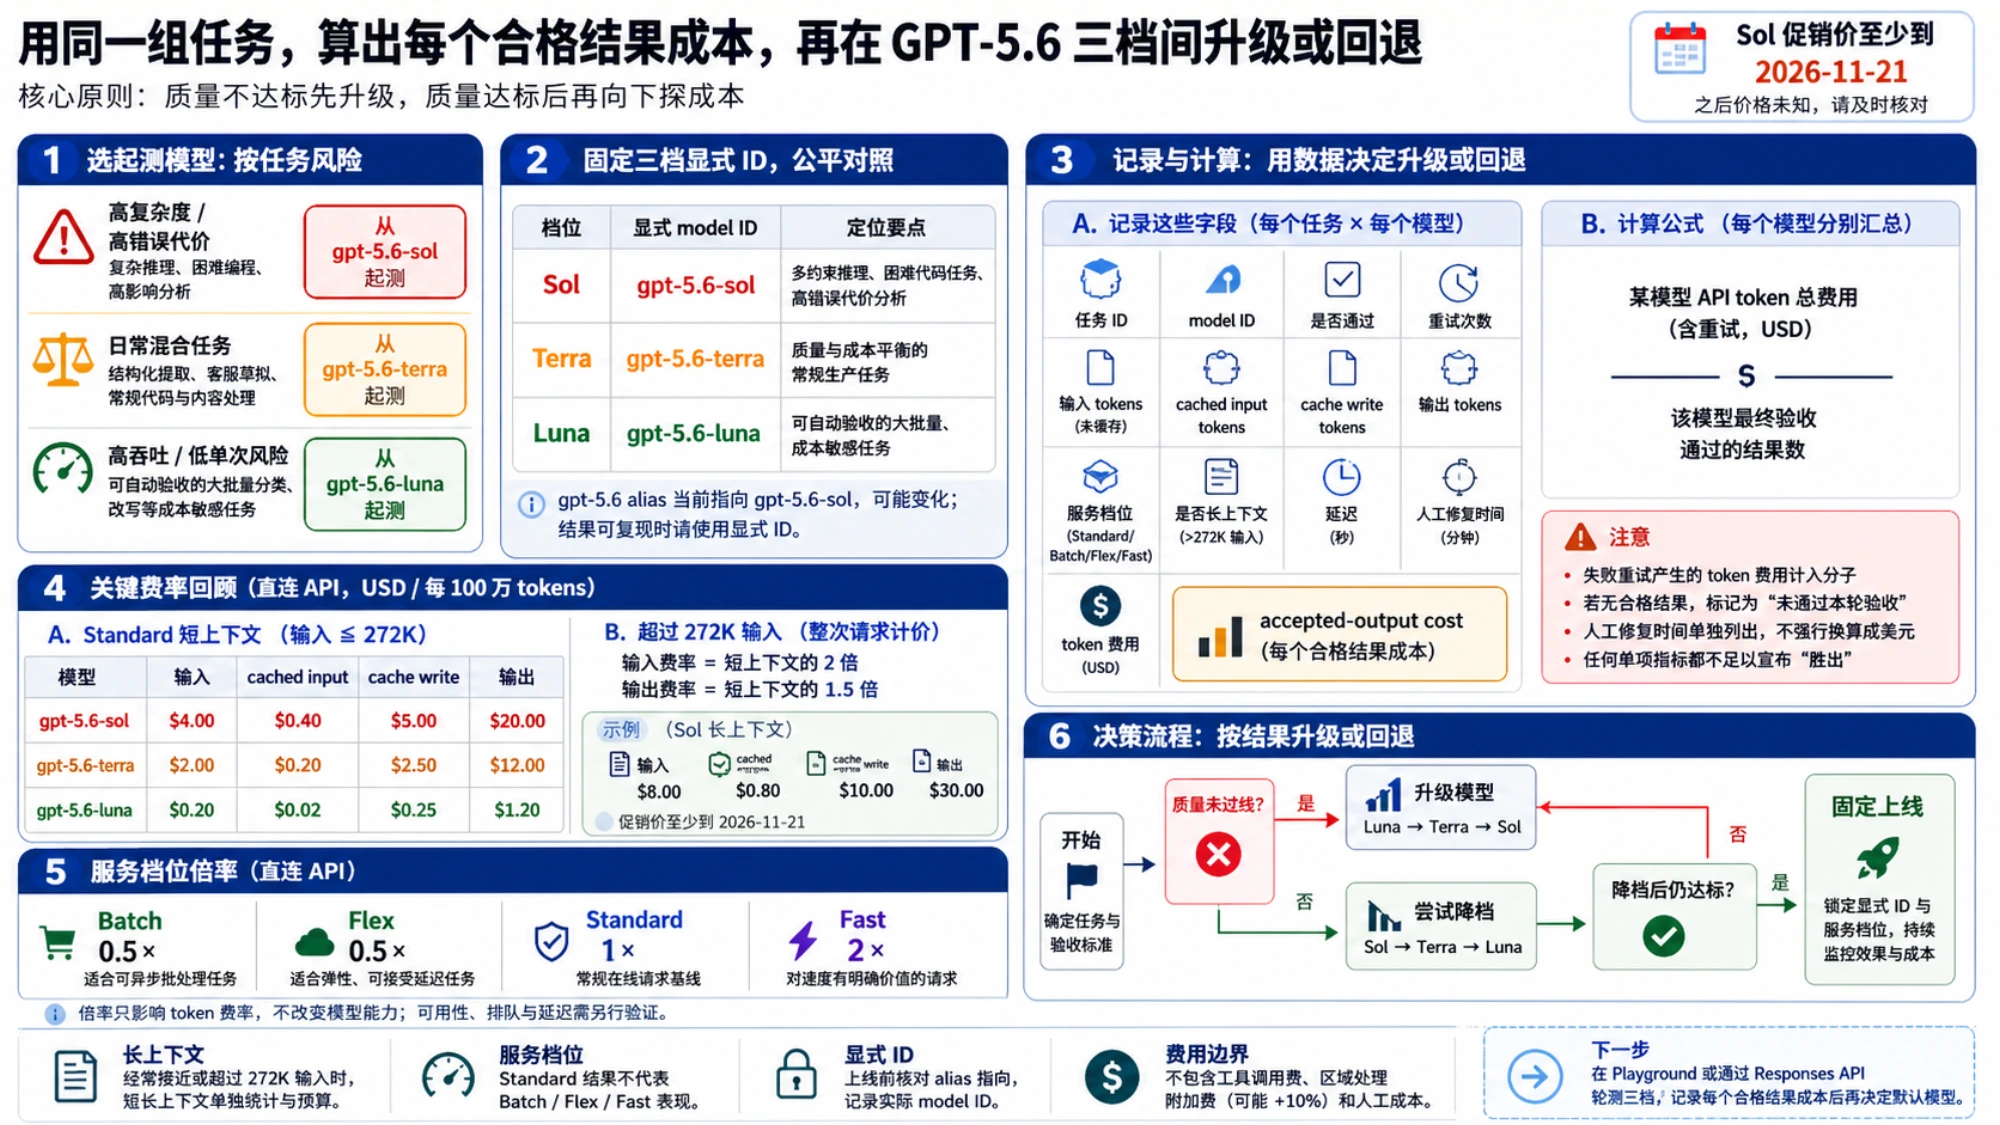
如果你正在为 OpenAI API 选择通用模型,可以先按任务风险确定起点:
- 复杂推理、困难编程或错误代价高:从
gpt-5.6-sol起测。 - 质量和成本都重要的常规生产任务:把
gpt-5.6-terra放在第一轮候选中。 - 高吞吐、单次任务价值较低且容易验收:从
gpt-5.6-luna起测。
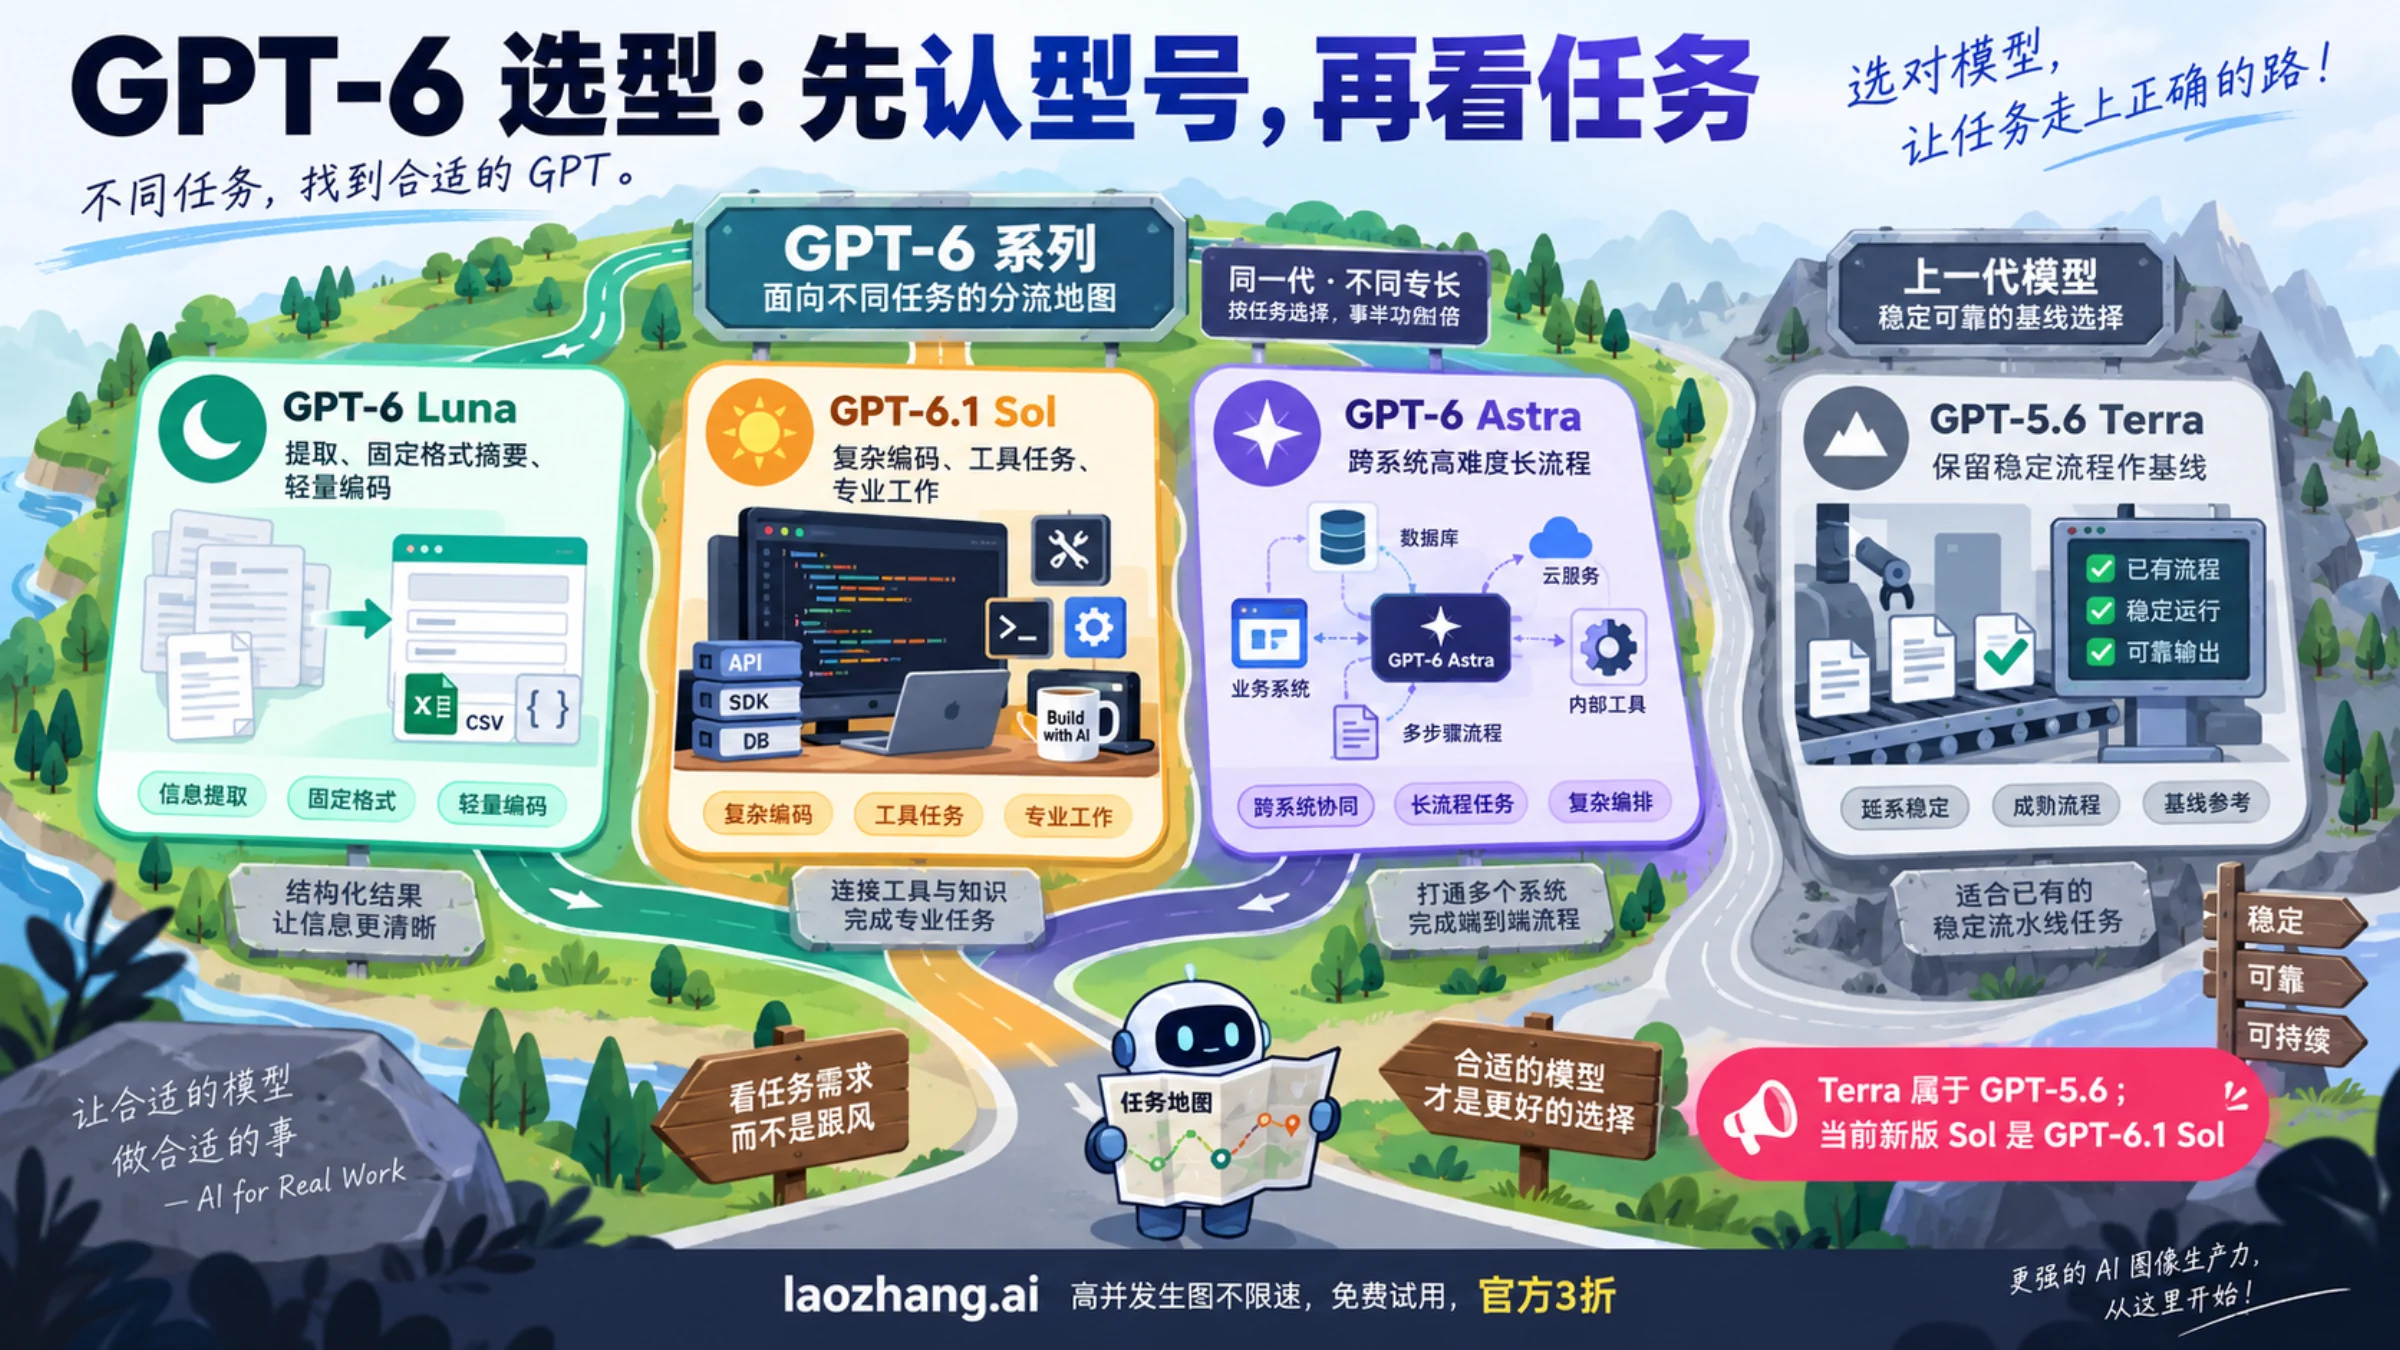
这是截至 2026 年 8 月 27 日,基于 OpenAI Models 页面给出的三档定位所做的起测建议,不是独立性能榜单。Sol 被定位于复杂推理和编程,Terra 强调智能与成本的平衡,Luna 面向成本敏感的大规模工作负载;这些描述不能证明某一档在你的任务上必然更准、更快或更便宜。
真正的决定应当来自同一组代表性任务:质量不达标就升级,质量达标后再向下探成本。本文比较的是 OpenAI API 当前推荐的三个 GPT-5.6 通用档位,不是完整模型目录,也不把 token 促销误写成 ChatGPT 订阅套餐降价。
先确认你调用的是哪个 model ID
API 中应该显式写出 model ID(模型标识):
| 档位 | 显式 model ID | 适合作为起测点的工作负载 |
|---|---|---|
| Sol | gpt-5.6-sol | 多约束推理、困难代码任务、高错误代价分析 |
| Terra | gpt-5.6-terra | 结构化提取、客服草拟、常规代码与内容处理等混合任务 |
| Luna | gpt-5.6-luna | 可自动验收的大批量分类、改写等成本敏感任务 |
当前 gpt-5.6 alias(会被平台重新指向具体版本的别名)指向 gpt-5.6-sol,这一点来自 OpenAI Latest model guide。alias 的目标会变化;如果线上结果需要可复现,部署前应重新核对,并优先使用经过验收的显式 ID。ChatGPT 界面里的名称、API alias 与 API 的显式 model ID 也不是同一层概念,不能只凭界面名称推断实际调用对象。
三档共享哪些能力,哪些不能靠规格推断
按 OpenAI 的模型对照页,三款均支持 Responses API、Chat Completions 和 Batch,context window(上下文窗口)为 1,050,000 tokens,最大输出为 128,000 tokens。各自的详细模型页还列出共同规格:最大输入 922,000 tokens、知识截止日期 2026-02-16,支持 text/image 输入和 text 输出,详见 GPT-5.6 Sol、GPT-5.6 Terra 与 GPT-5.6 Luna。
| 比较项 | Sol | Terra | Luna |
|---|---|---|---|
| context window | 1,050,000 tokens | 1,050,000 tokens | 1,050,000 tokens |
| 最大输入 | 922,000 tokens | 922,000 tokens | 922,000 tokens |
| 最大输出 | 128,000 tokens | 128,000 tokens | 128,000 tokens |
| 输入与输出形态 | text/image → text | text/image → text | text/image → text |
| 可用 API | Responses、Chat Completions、Batch | Responses、Chat Completions、Batch | Responses、Chat Completions、Batch |
这里有两个容易混淆的数字:1,050,000 是总上下文窗口,922,000 是最大输入;128,000 是最大输出。更重要的是,共同规格只说明接口容量相近,不能推出三款质量、延迟或吞吐相同。也不能据此断言 Luna 一定更快,或 Sol 一定能产生更好的可用结果。
先算 Standard 短上下文费用
以下是截至 2026 年 8 月 27 日的 OpenAI 官方直连 API 美元费率,单位均为每 100 万 tokens。根据 OpenAI Pricing 页面,Standard(标准处理档位)且输入不超过 272K tokens 时:
| 模型 | 输入 | cached input | cache write | 输出 |
|---|---|---|---|---|
gpt-5.6-sol | $4.00 | $0.40 | $5.00 | $20.00 |
gpt-5.6-terra | $2.00 | $0.20 | $2.50 | $12.00 |
gpt-5.6-luna | $0.20 | $0.02 | $0.25 | $1.20 |
cached input 是命中缓存的输入,cache write 是写入显式提示缓存的输入。两者与普通未缓存输入不是同一个计费类别;表中的 cache write 价格是相应未缓存输入价格的 1.25 倍。估算账单时,应按实际 usage 中的 token 分类分别相乘,不能把所有输入都套用最低价格。
8 月 Sol 降价和 7 月调价不是同一件事
OpenAI 的 GPT-5.6 发布页记录了两次更新:7 月 30 日下调 Terra 与 Luna,8 月 21 日才把 Sol 的 API 和适用 credits 价格降低 20% 以上。因此,7 月资料里“Sol 价格不变”在当时可能正确,却不能代表今天。
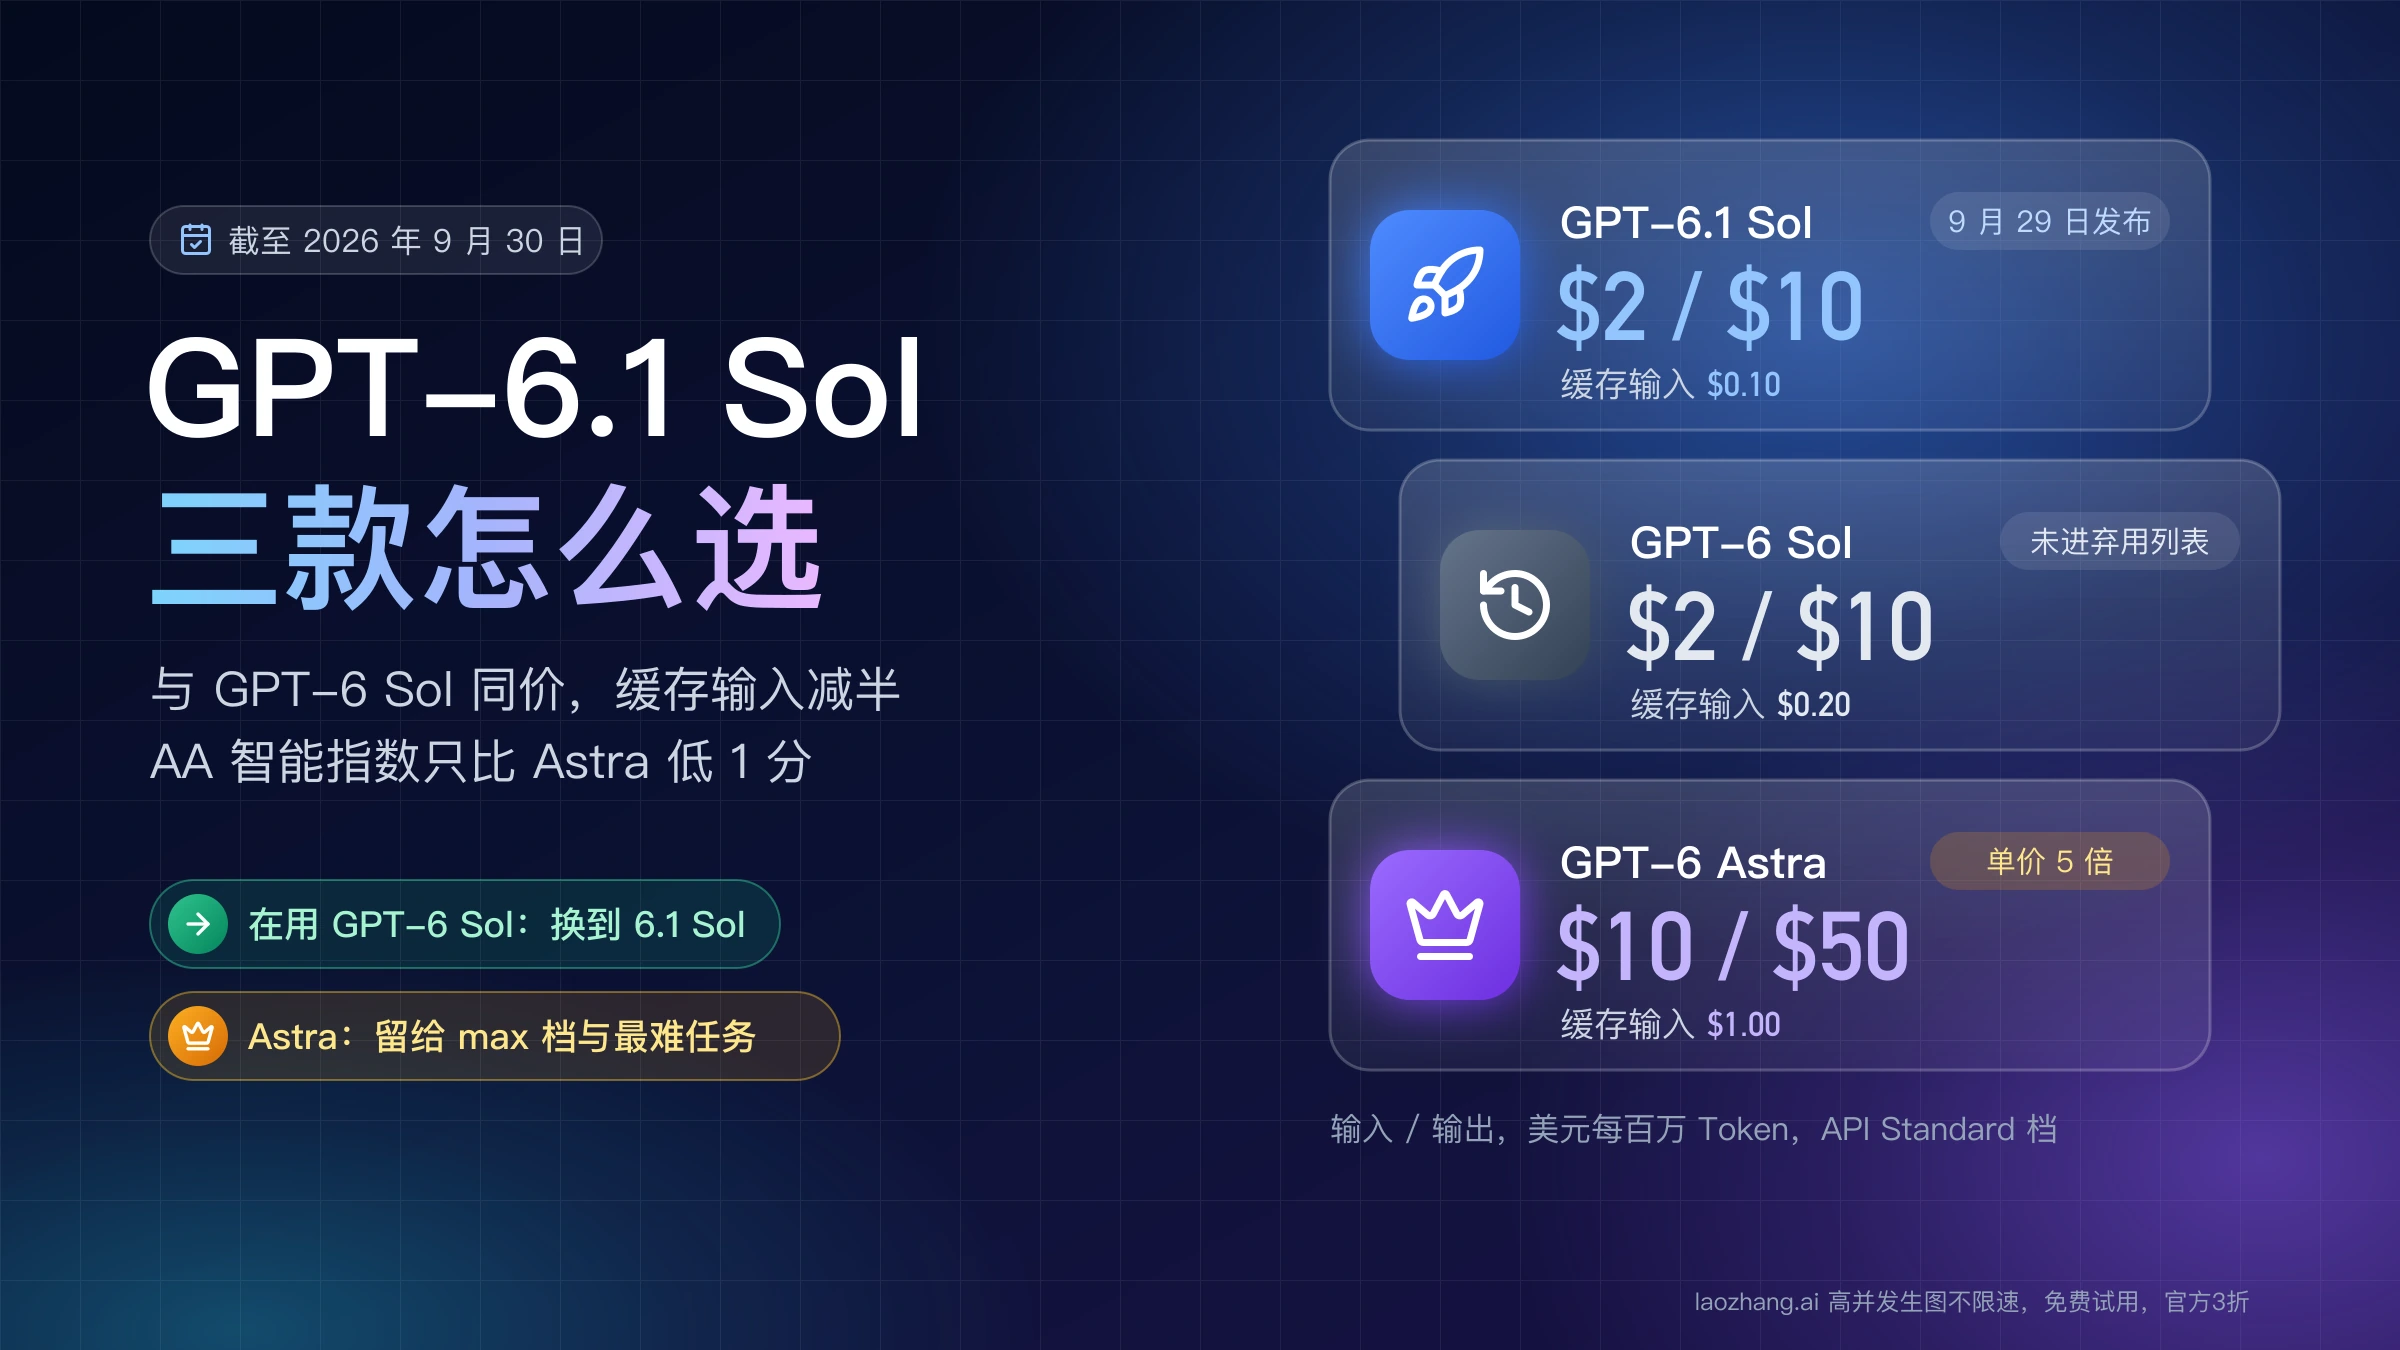
对官方直连 API 而言,Sol 短上下文输入从 $5 降到 $4,cached input 从 $0.50 降到 $0.40,cache write 从 $6.25 降到 $5,输出从 $30 降到 $20。输入降幅是 20%,输出降幅约 33%,不能统一写成一个模糊百分比。Sol 模型页将其明确标为促销价,并说明至少持续到 2026 年 11 月 21 日;OpenAI 尚未公布促销后的价格,因此不要直接把旧价写进 12 月预算。
适用的 ChatGPT Work/Codex purchased credits 或 Enterprise 按 token 美元结算也会反映促销,但这不代表订阅月费、方案内含用量、5 小时/每周限额或 legacy credit rate 改变。应按工作区实际采用的credits 费率表或企业按 token 费率表核对。AWS、OpenRouter、Vercel 等渠道有自己的账单,不应把其价格当作 OpenAI 官方直连价。
用 100K 输入和 10K 输出复算一次
假设一次调用使用 100K 未缓存输入和 10K 输出,采用 Standard、短上下文计价,且不发生 cache write:
- Sol:
100,000 ÷ 1,000,000 × $4 + 10,000 ÷ 1,000,000 × $20 = $0.60 - Terra:
100,000 ÷ 1,000,000 × $2 + 10,000 ÷ 1,000,000 × $12 = $0.32 - Luna:
100,000 ÷ 1,000,000 × $0.20 + 10,000 ÷ 1,000,000 × $1.20 = $0.032
这个算例只比较纯 token 费用,不包含缓存写入、工具调用费、区域处理附加费、失败重试或人工修复。它能说明单次请求的价格差距,却不能直接回答哪个模型完成任务最便宜。
超过 272K 输入后,不能只给超出部分加价
当一次请求的输入超过 272K tokens,三档模型都会进入 long-context(长上下文)计价:整次请求的输入费率变为短上下文的 2 倍,输出费率变为 1.5 倍,而不是只对超过 272K 的那一段加价。按当前促销价,Sol 的 long-context 输入、cached input、cache write、输出分别为 $8、$0.80、$10、$30。这一规则及费率以 OpenAI Pricing和各模型页的当前说明为准。
这意味着跨过阈值前后可能出现明显账单跳变。若工作负载经常靠近 272K,不要用平均输入长度估算;应从真实请求中统计跨过阈值的比例,并分别计算短、长上下文成本。也不要把“模型支持约 1.05M context”误解为“在整个窗口内都按短上下文单价收费”。
工具调用费用不属于上述 token 单价。对于 2026-03-05 及以后发布、且符合区域处理条件的模型,区域处理还可能增加 10% 费用;项目是否适用、支持哪些区域,应在部署时按当前 Pricing 页面和项目配置核对。
Batch、Flex、Fast 会怎样改变价格
理解 Standard 单价后,再看服务档位更容易:对官方直连 API,当前 GPT-5.6 的 Batch 与 Flex token 费率都是 Standard 的 0.5 倍,Fast 是 Standard 的 2 倍。Work/Codex credits 应使用对应费率表,不能直接套用 API 倍率。它们改变的不只是价格,还可能涉及可用性、排队方式和延迟,因此不能只看倍率就替线上流量选档。
| 服务档位 | 相对 Standard 的 token 费率 | 适合验证的方向 |
|---|---|---|
| Batch | 0.5× | 可异步完成、能够批处理的任务 |
| Flex | 0.5× | 能接受相应可用性和延迟特征的弹性任务 |
| Standard | 1× | 常规在线请求的成本与效果基线 |
| Fast | 2× | 对响应速度有明确价值、且项目支持的请求 |
OpenAI 在 2026-07-30 的 Changelog中用 Fast 取代了公开产品名 Priority Processing。兼容请求仍可携带 priority,响应也可能报告 priority;这不代表当前公开产品仍叫 Priority。通过 Responses API 请求时,service_tier 是服务档位字段,具体可用值、项目权限和有效响应应以 Responses API create reference及实际响应为准。
按任务风险选起测模型,而不是先选“冠军”
价格只是输入之一。更稳妥的顺序是先问:错误是否容易发现,失败是否能够自动重试,错误结果会造成多大损失?
高复杂度或高错误代价:从 Sol 起测
复杂代码迁移、跨文件调试、多约束规划,或一旦判断错误就会产生较高人工与业务成本的分析,可以先用 gpt-5.6-sol 建立质量基线。促销后 Sol 相对 Terra 的输出单价差从 2.5 倍缩小到约 1.67 倍,一些过去卡在成本边界的任务值得重新轮测;这仍不是 Sol 自动胜出的证据。
如果 Sol 在代表性任务上稳定通过,再用相同输入、工具和验收条件测试 Terra。只有 Terra 的通过率与错误类型仍可接受,降档才有意义。
日常混合任务:把 Terra 与相邻档一起测
结构化提取、客服草拟、常规代码辅助和内部内容处理等任务,通常同时在意质量和费用,可以先测 gpt-5.6-terra,再根据失败方向与 Sol 或 Luna 对照。
- 若失败集中在推理深度、多约束遵循或难以修复的边界条件,向 Sol 升级。
- 若大多数结果一次通过、错误容易自动检测,并且流量使 token 成本成为主要压力,向 Luna 回退测试。
不要把“平衡型定位”改写成“所有生产环境的默认赢家”。Terra 是否平衡,只能由你的合格结果和总投入来证明。
高吞吐、低单次风险:从 Luna 起测
大批量分类、格式受控的改写或其他可自动验收的低风险任务,可以从 gpt-5.6-luna 起测。它的官方定位和单价使它值得进入第一轮,但不保证更低延迟,也不保证最低总成本。
如果 Luna 需要多次重试,或失败结果占用大量人工修复时间,即使单次 token 费最低,每个合格结果的成本也可能高于 Terra。相反,如果验收规则清晰且一次通过率足够高,它才真正兑现成本优势。
用同一组代表性任务轮测三个显式 ID
先从真实流量中选一组代表性任务,覆盖常见输入、长尾难例和必须拒绝的边界情况。为每个任务写下相同的通过标准,然后在提示词、工具、输入和服务档位保持一致的前提下轮换三个显式 model ID。
下面的 Python 示例使用 Responses API 做最小轮测。它不替你决定胜负,只把同一个输入依次发送给三个模型;OpenAI 当前建议在 GPT-5.6 的推理、工具调用和多轮工作流中使用 Responses API,相关能力边界见 Latest model guide。
from openai import OpenAI

client = OpenAI()
models = ["gpt-5.6-sol", "gpt-5.6-terra", "gpt-5.6-luna"]
task = """把下面的工单归类为 billing、account 或 technical,并只返回 JSON。
工单:用户表示银行卡已经扣款,但 API 账户余额没有更新。"""

for model in models:
    response = client.responses.create(
        model=model,
        input=task,
    )
    print(model, response.output_text)
    print(response.usage)
如需测试 Fast,可在项目确认可用后加入 service_tier="fast",并检查响应中的有效档位;不要只因请求字段已发送就假定服务档位生效。fast、向后兼容的 priority 及响应值的当前行为以 Responses API create reference为准。
单个演示问题不足以选模型。每个任务至少记录以下字段,再由业务或产品验收人判断是否通过:
| 字段 | 为什么要记 |
|---|---|
| 任务 ID | 确保三个模型比较的是同一输入 |
| model ID | 避免 alias 变化或日志混淆 |
| 是否通过 | 直接对应任务成功率,而非主观“看起来不错” |
| 重试次数 | 暴露低单价背后的重复调用成本 |
| 输入、cached input、cache write、输出 tokens | 按真实计费类别复算 token 费用 |
| 服务档位与长上下文状态 | 解释费率倍率和延迟差异 |
| 延迟 | 判断响应时间是否满足实际场景 |
| 人工修复时间 | 显示 API 账单之外的返工负担 |
| token 费用 | 汇总本轮 API token 支出 |
| accepted-output cost | 计算每个最终合格结果分摊的 token 成本 |
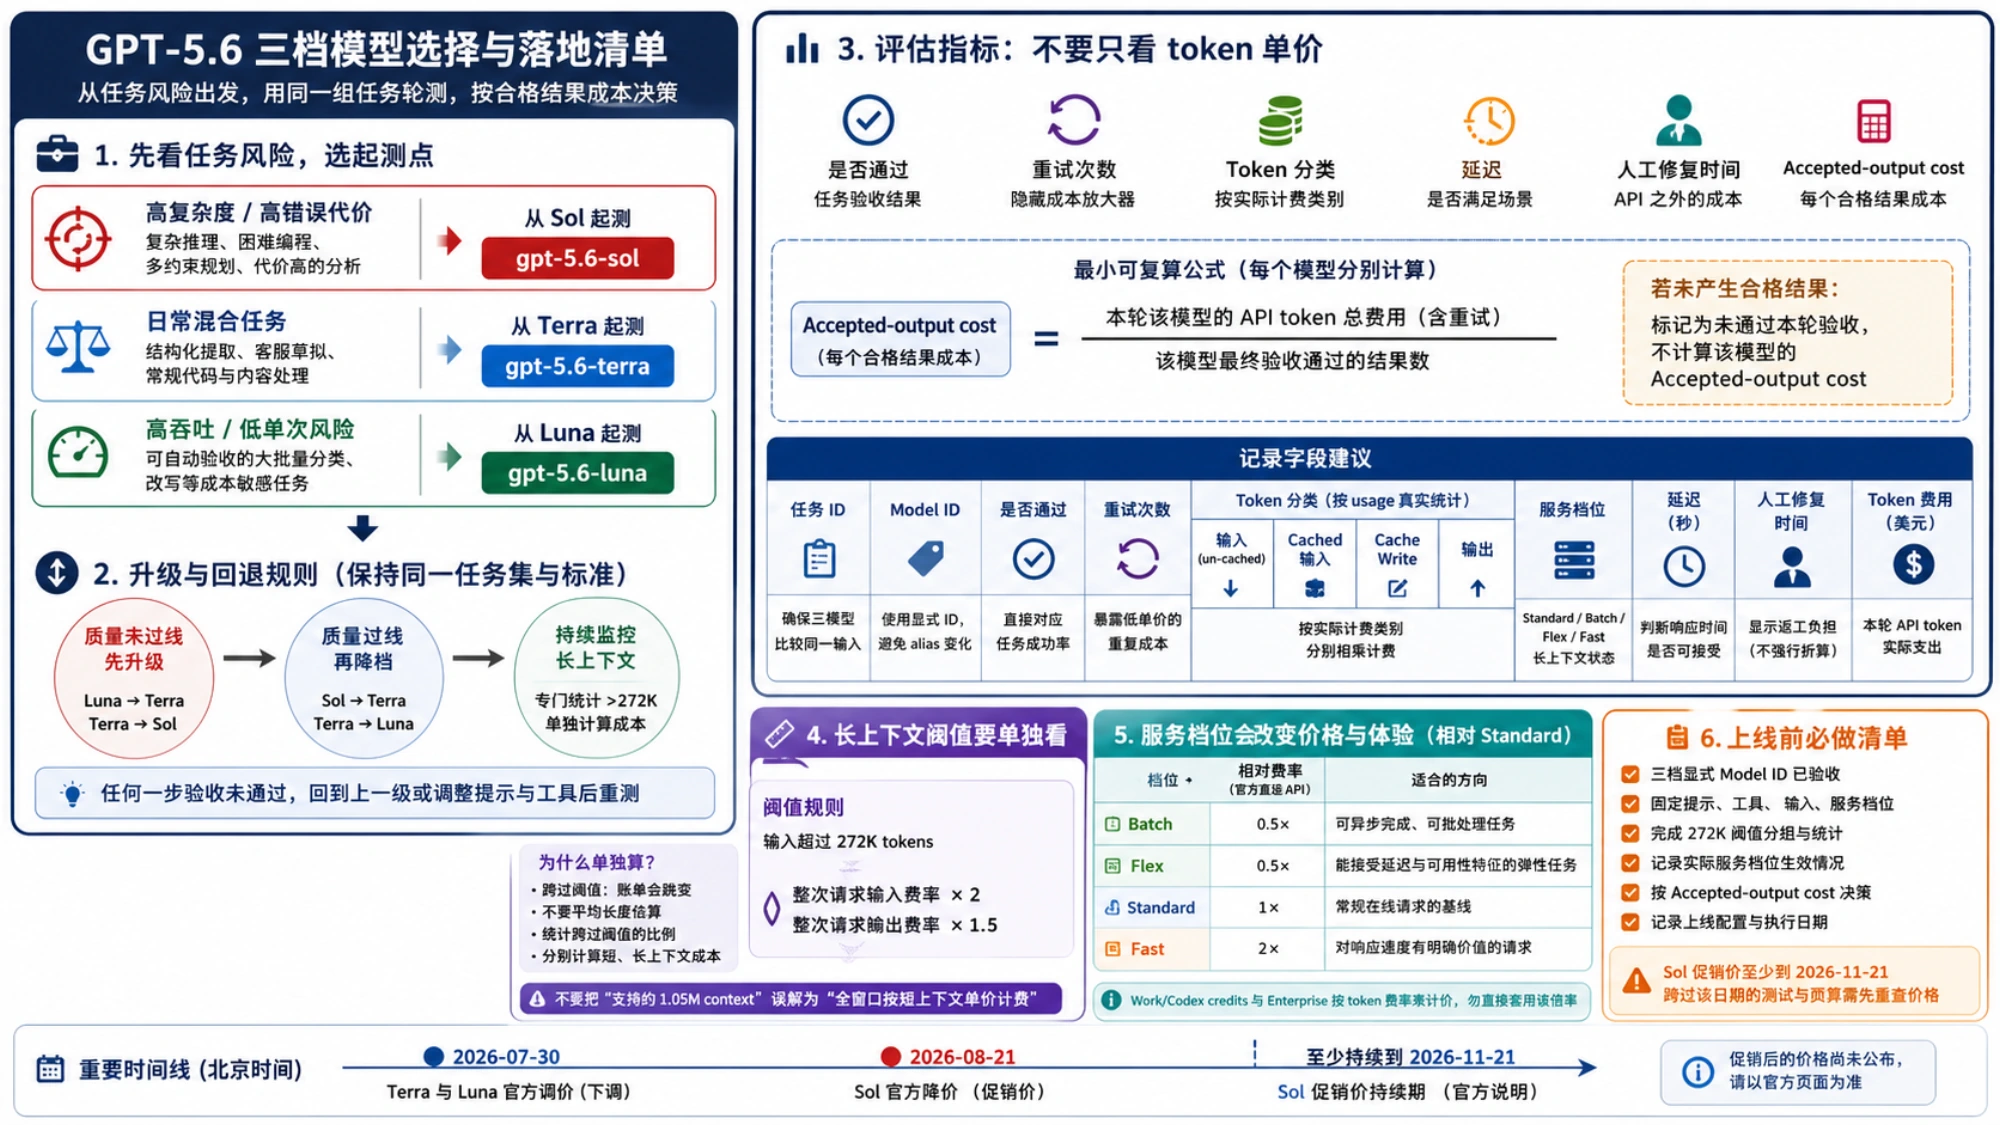
accepted-output cost 可理解为“每个合格结果的成本”。比较时应为每个模型分别汇总,且把失败重试产生的 token 费用计入分子。最小可复算公式是:
某模型在本轮的 API token 总费用(含重试)÷ 该模型最终验收通过的结果数如果某模型没有产生合格结果,就不能给它计算一个有限的 accepted-output cost,应直接标记为未通过本轮验收。人工修复时间应单独列出,不要在没有可靠人工成本口径时硬换算成一个看似精确的美元数字。最终至少一起看任务通过率、重试次数、人工修复时间、token 分类、延迟和 accepted-output cost;任何单项都不足以宣布普适赢家。
把选择固化成升级与回退规则
完成第一轮后,可以用下面的规则决定下一步:
- 质量未过线,先升级:Luna 不达标就测 Terra,Terra 不达标就测 Sol,同时保留相同任务集与验收标准。
- 质量过线,再降档:Sol 已达标时,用 Terra 重跑;Terra 已达标时,用 Luna 重跑。降档后的失败率和修复成本不能超过你的业务容忍线。
- 接近或超过 272K,单独分组:长上下文请求不要与短请求混算平均成本,避免掩盖整次请求的加价。
- 服务档位按真实流量另测:Standard 的结果不能直接代表 Batch、Flex 或 Fast 的可用性与延迟表现。
- 上线前固定显式 ID:如果结果可复现性重要,重新核对 alias 指向,并记录实际 model ID 和有效服务档位。
下一步是在官方 Playground 或 Responses API 中,用同一组代表性样本轮测 gpt-5.6-sol、gpt-5.6-terra、gpt-5.6-luna,记录每个合格结果的成本后再决定默认模型。若测试或预算跨过 11 月 21 日,应先重查 Sol 官方价格。若你的任务实际是图像生成、音频、Realtime、embedding,或你要比较 ChatGPT 套餐,请转到 OpenAI Models 目录选择对应的专用能力;那些需求不应被硬塞进这组三档通用模型比较。
参考来源12
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年8月27日。
参考来源12
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年8月27日。
- 1.OpenAI Models 页面给出的三档定位developers.openai.com/api/docs/models
- 2.OpenAI Latest model guidedevelopers.openai.com/api/docs/guides/latest-model
- 3.OpenAI 的模型对照页developers.openai.com/api/docs/models/compare
- 4.GPT-5.6 Soldevelopers.openai.com/api/docs/models/gpt-5.6-sol
- 5.GPT-5.6 Terradevelopers.openai.com/api/docs/models/gpt-5.6-terra
- 6.GPT-5.6 Lunadevelopers.openai.com/api/docs/models/gpt-5.6-luna
- 7.OpenAI Pricing 页面developers.openai.com/api/docs/pricing
- 8.OpenAI 的 GPT-5.6 发布页openai.com/zh-Hans-CN/index/gpt-5-6
- 9.credits 费率表help.openai.com/zh-hans-cn/articles/11481834
- 10.企业按 token 费率表help.openai.com/zh-hans-cn/articles/20001415
- 11.2026-07-30 的 Changelogdevelopers.openai.com/api/docs/changelog
- 12.Responses API create referencedevelopers.openai.com/api/reference/resources/responses/methods/create