模型对比
Claude Opus 4.7 vs Claude Opus 4.6:2026 年现在该不该升级
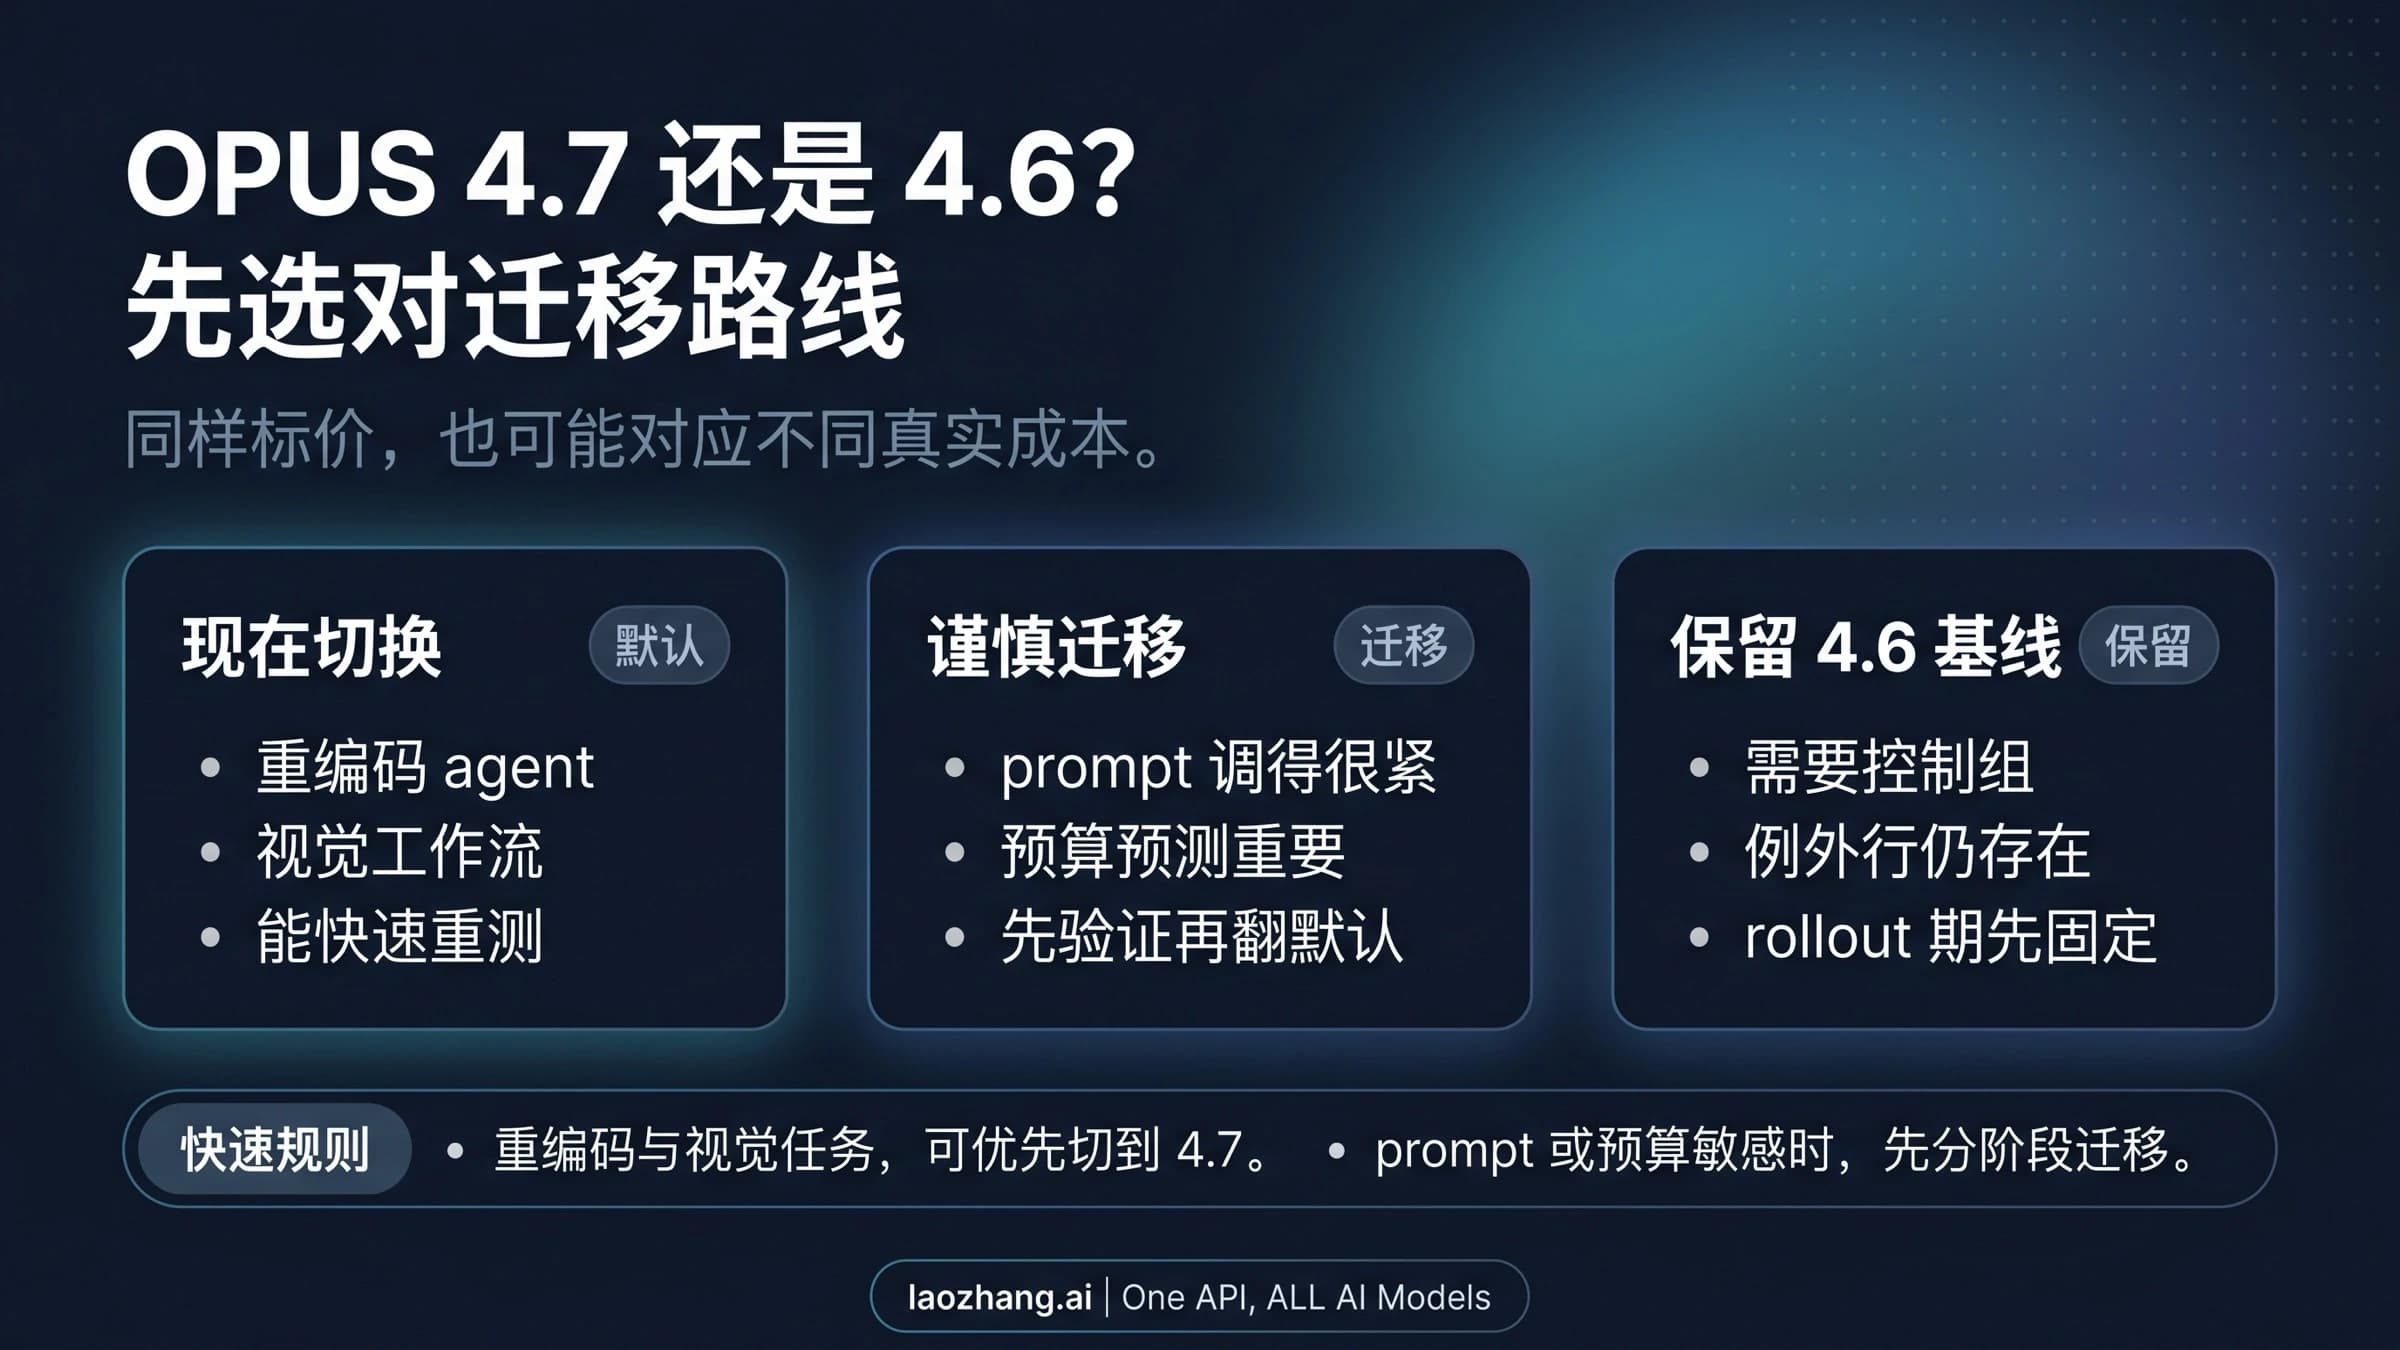
这不是一篇发布会复述,而是一篇升级决策指南:什么时候该把 Claude Opus 4.6 换成 Claude Opus 4.7,什么时候该分阶段迁移,什么时候又该继续把 4.6 留作稳定基线。
15 分钟
这不是一篇发布会复述,而是一篇升级决策指南:什么时候该把 Claude Opus 4.6 换成 Claude Opus 4.7,什么时候该分阶段迁移,什么时候又该继续把 4.6 留作稳定基线。
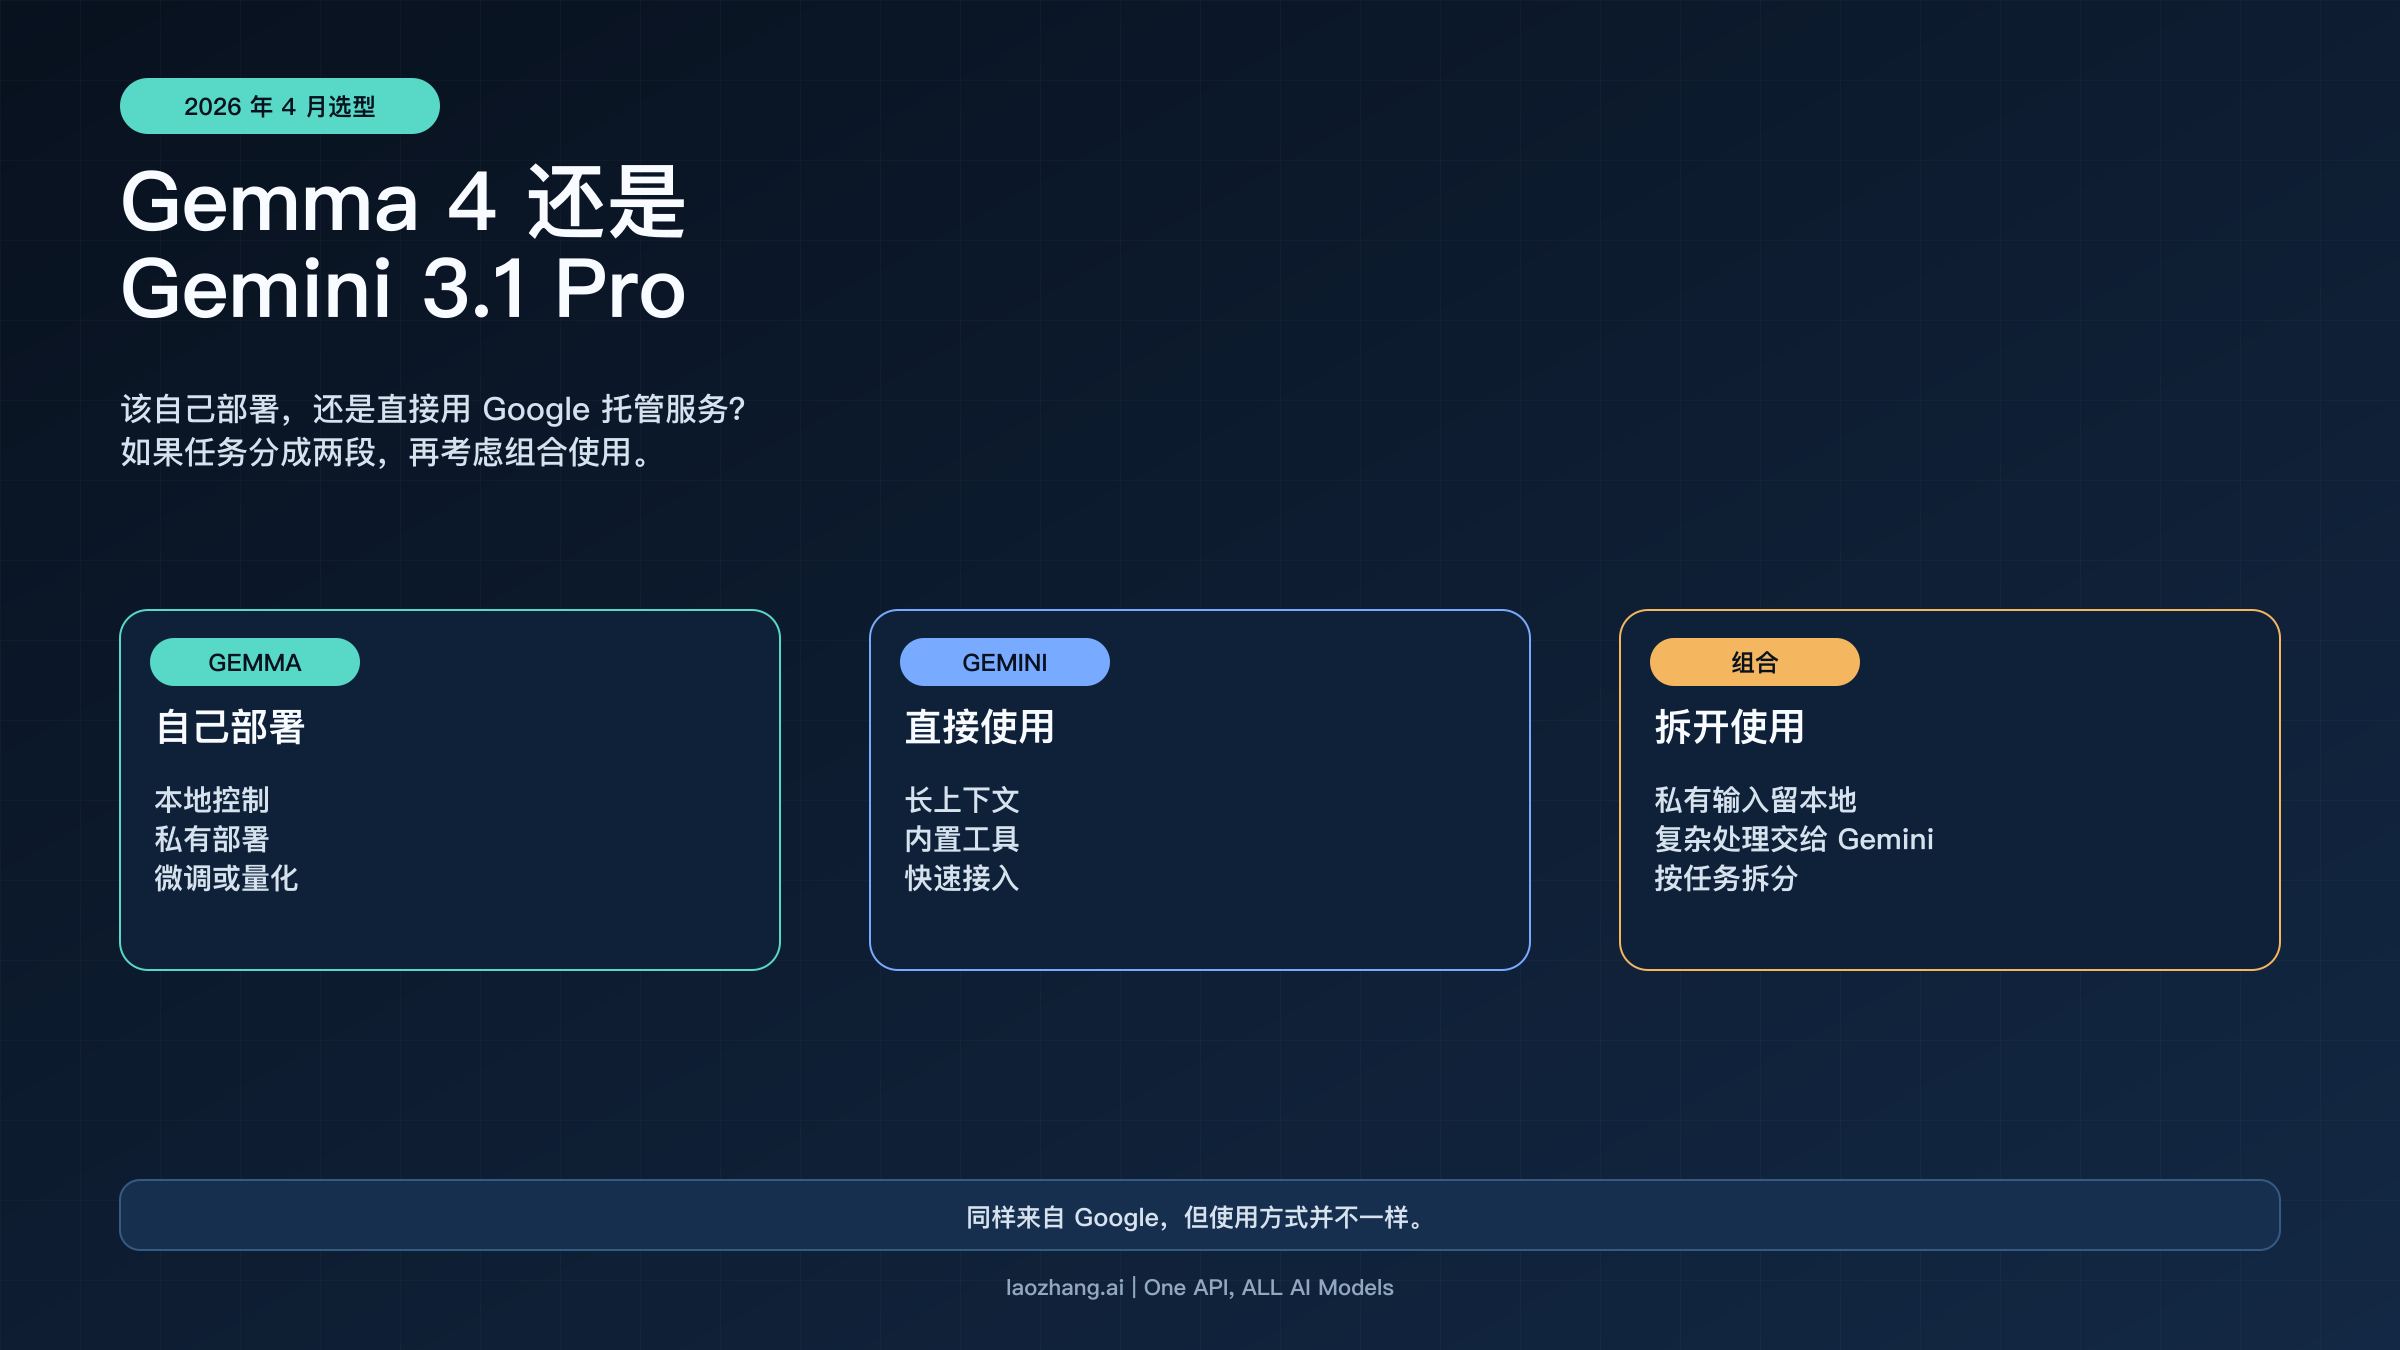
如果你需要开源权重、自主部署、隐私边界或定制能力,先看 Gemma 4;如果你需要托管长上下文、Google 工具链和更快上线,先看 Gemini 3.1 Pro;只有当任务本身分成两类时,组合使用才值得上。
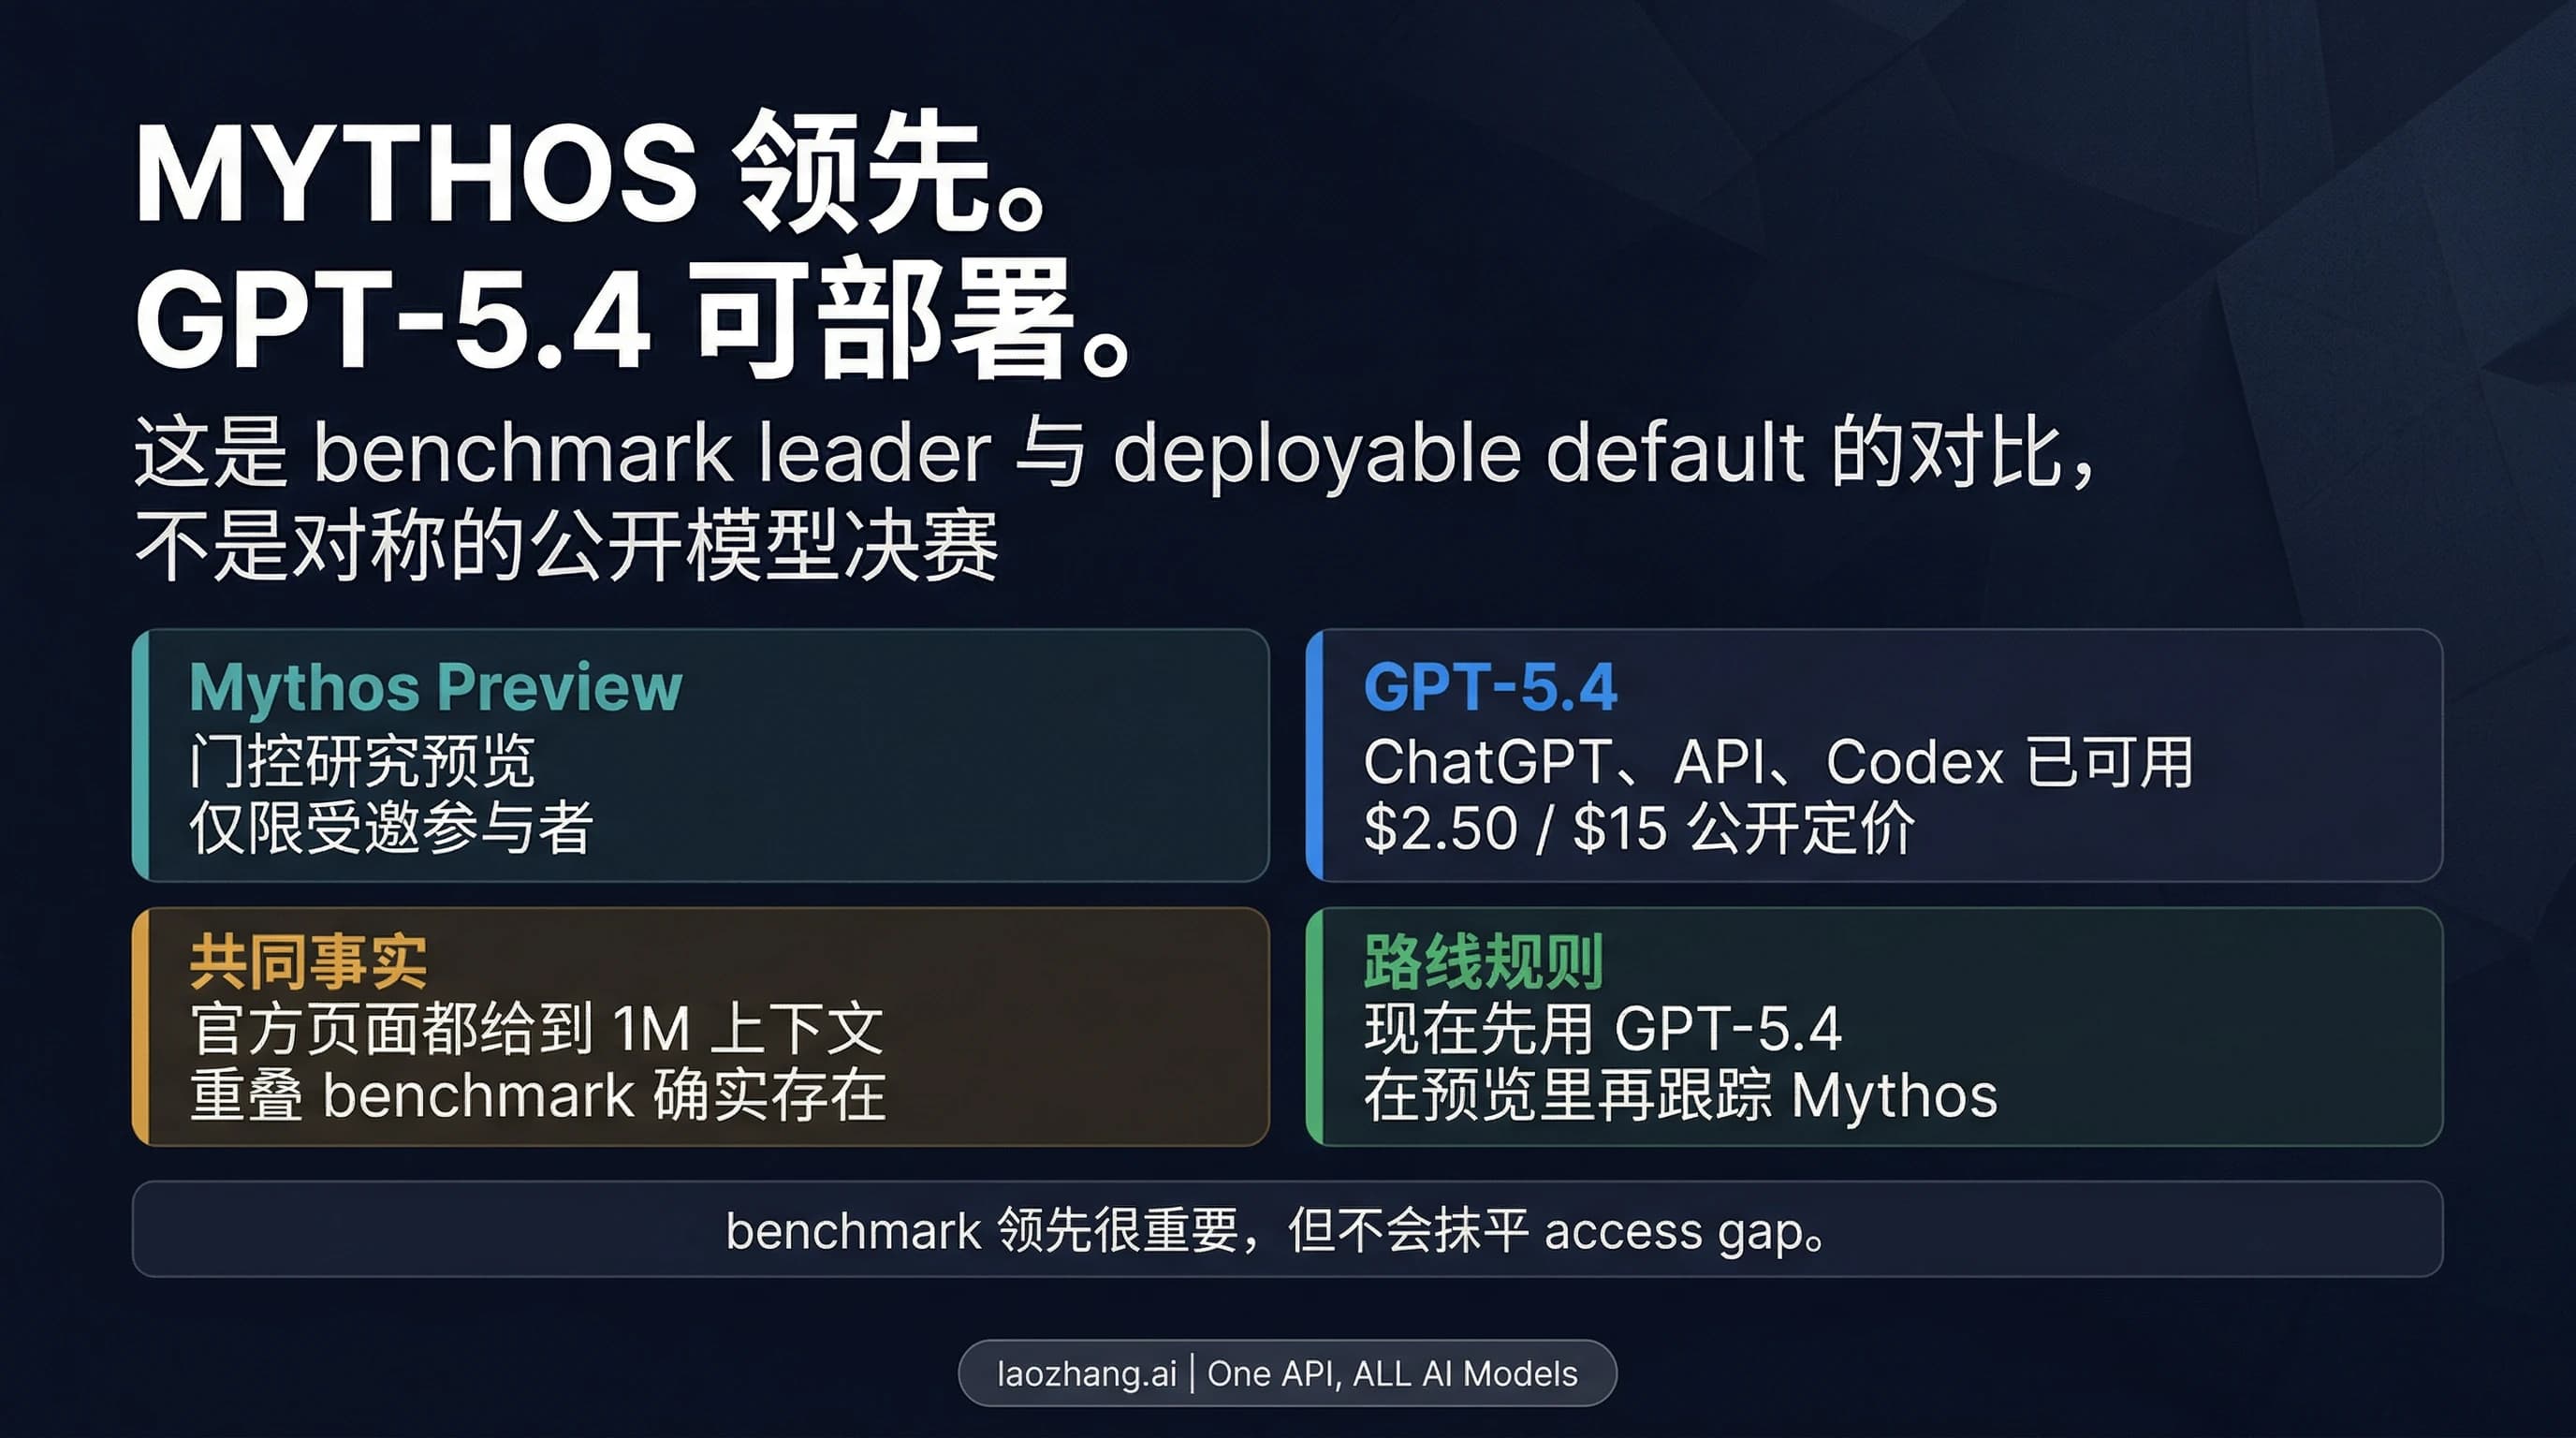
如果你今天就要用模型,答案仍然是 GPT-5.4。Claude Mythos Preview 之所以值得看,是因为 Anthropic 官方发布时给出的 benchmark 很强,但它仍是门控 research preview,而不是大多数人能直接切换过去的公开路线。
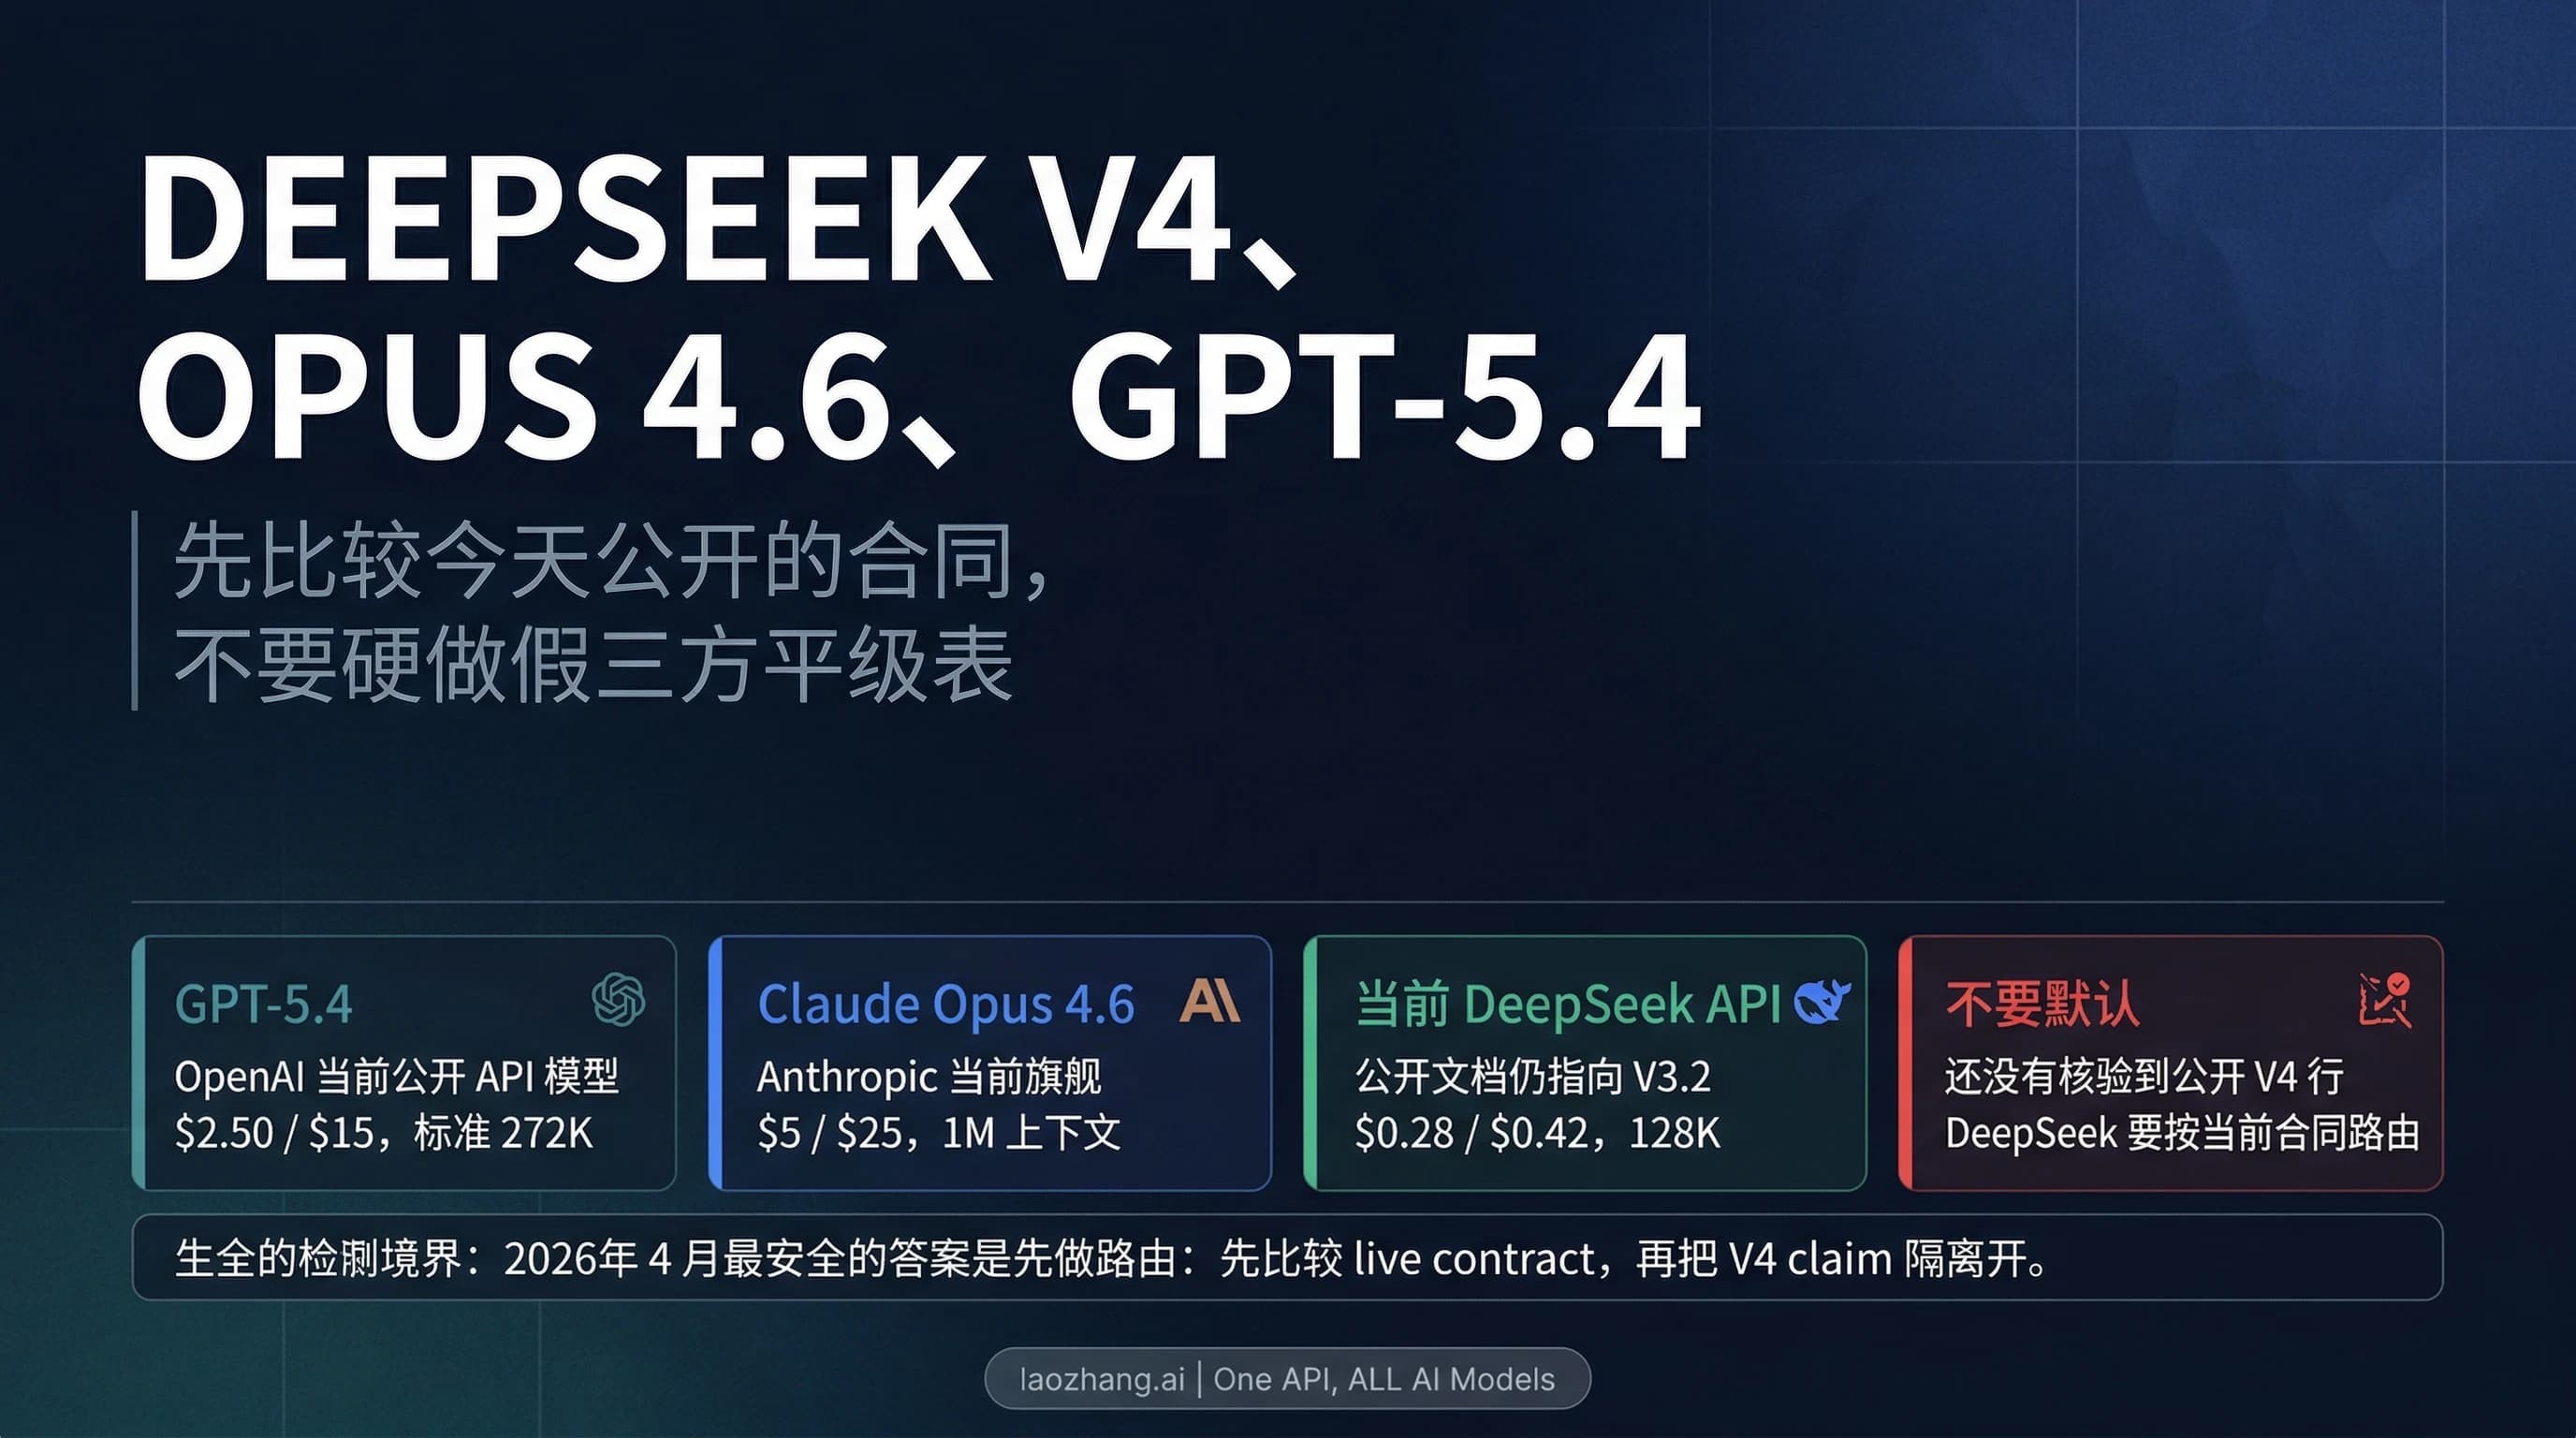
如果你今天就要做生产决策,不该先假设 DeepSeek V4、Claude Opus 4.6、GPT-5.4 是三条同等清晰的公开合同。更稳妥的做法是:先把 GPT-5.4 与 Claude Opus 4.6 作为两条当前公开 frontier contract 直接比较,再把 DeepSeek 放回当前 V3.2-backed 公共 API 这一层来判断。
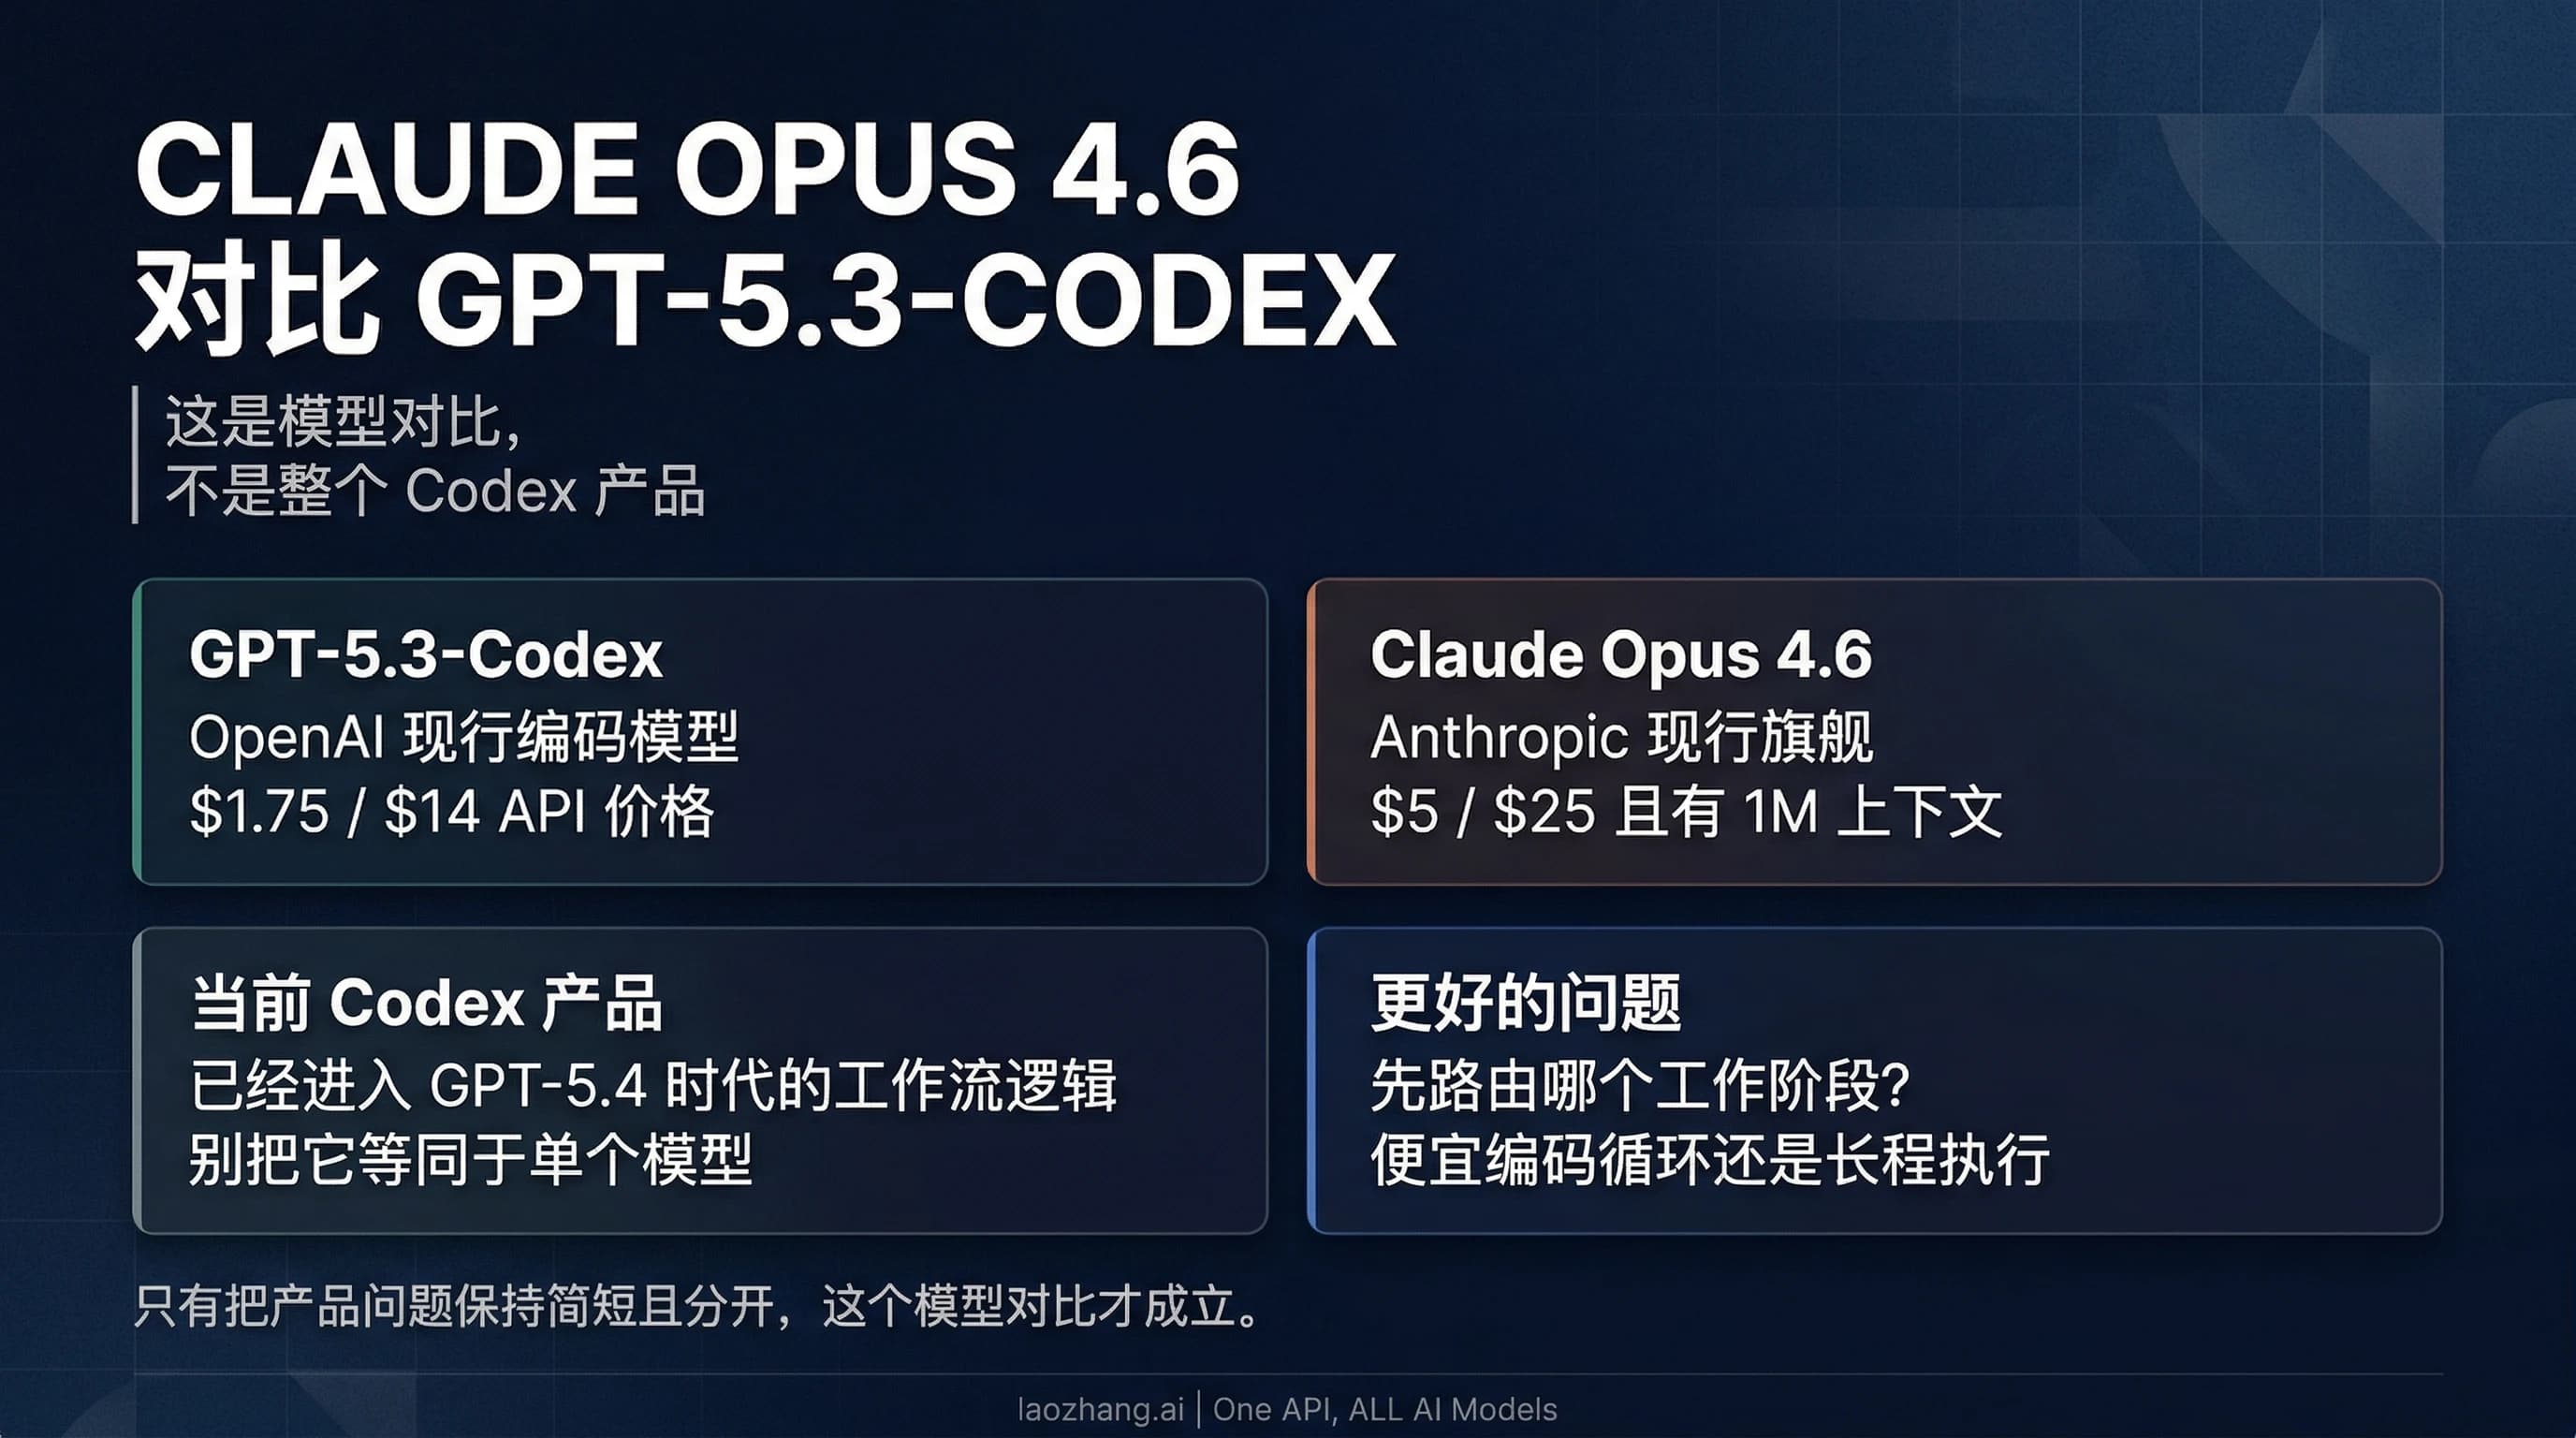
如果你想先跑一轮更便宜的编码代理测试,先看 GPT-5.3-Codex。若真正昂贵的是长链路任务里的返工、上下文深度和大输出稳定性,就先看 Claude Opus 4.6。关键前提是:GPT-5.3-Codex 仍是当前模型,但已经不能代指今天整个 Codex 产品。
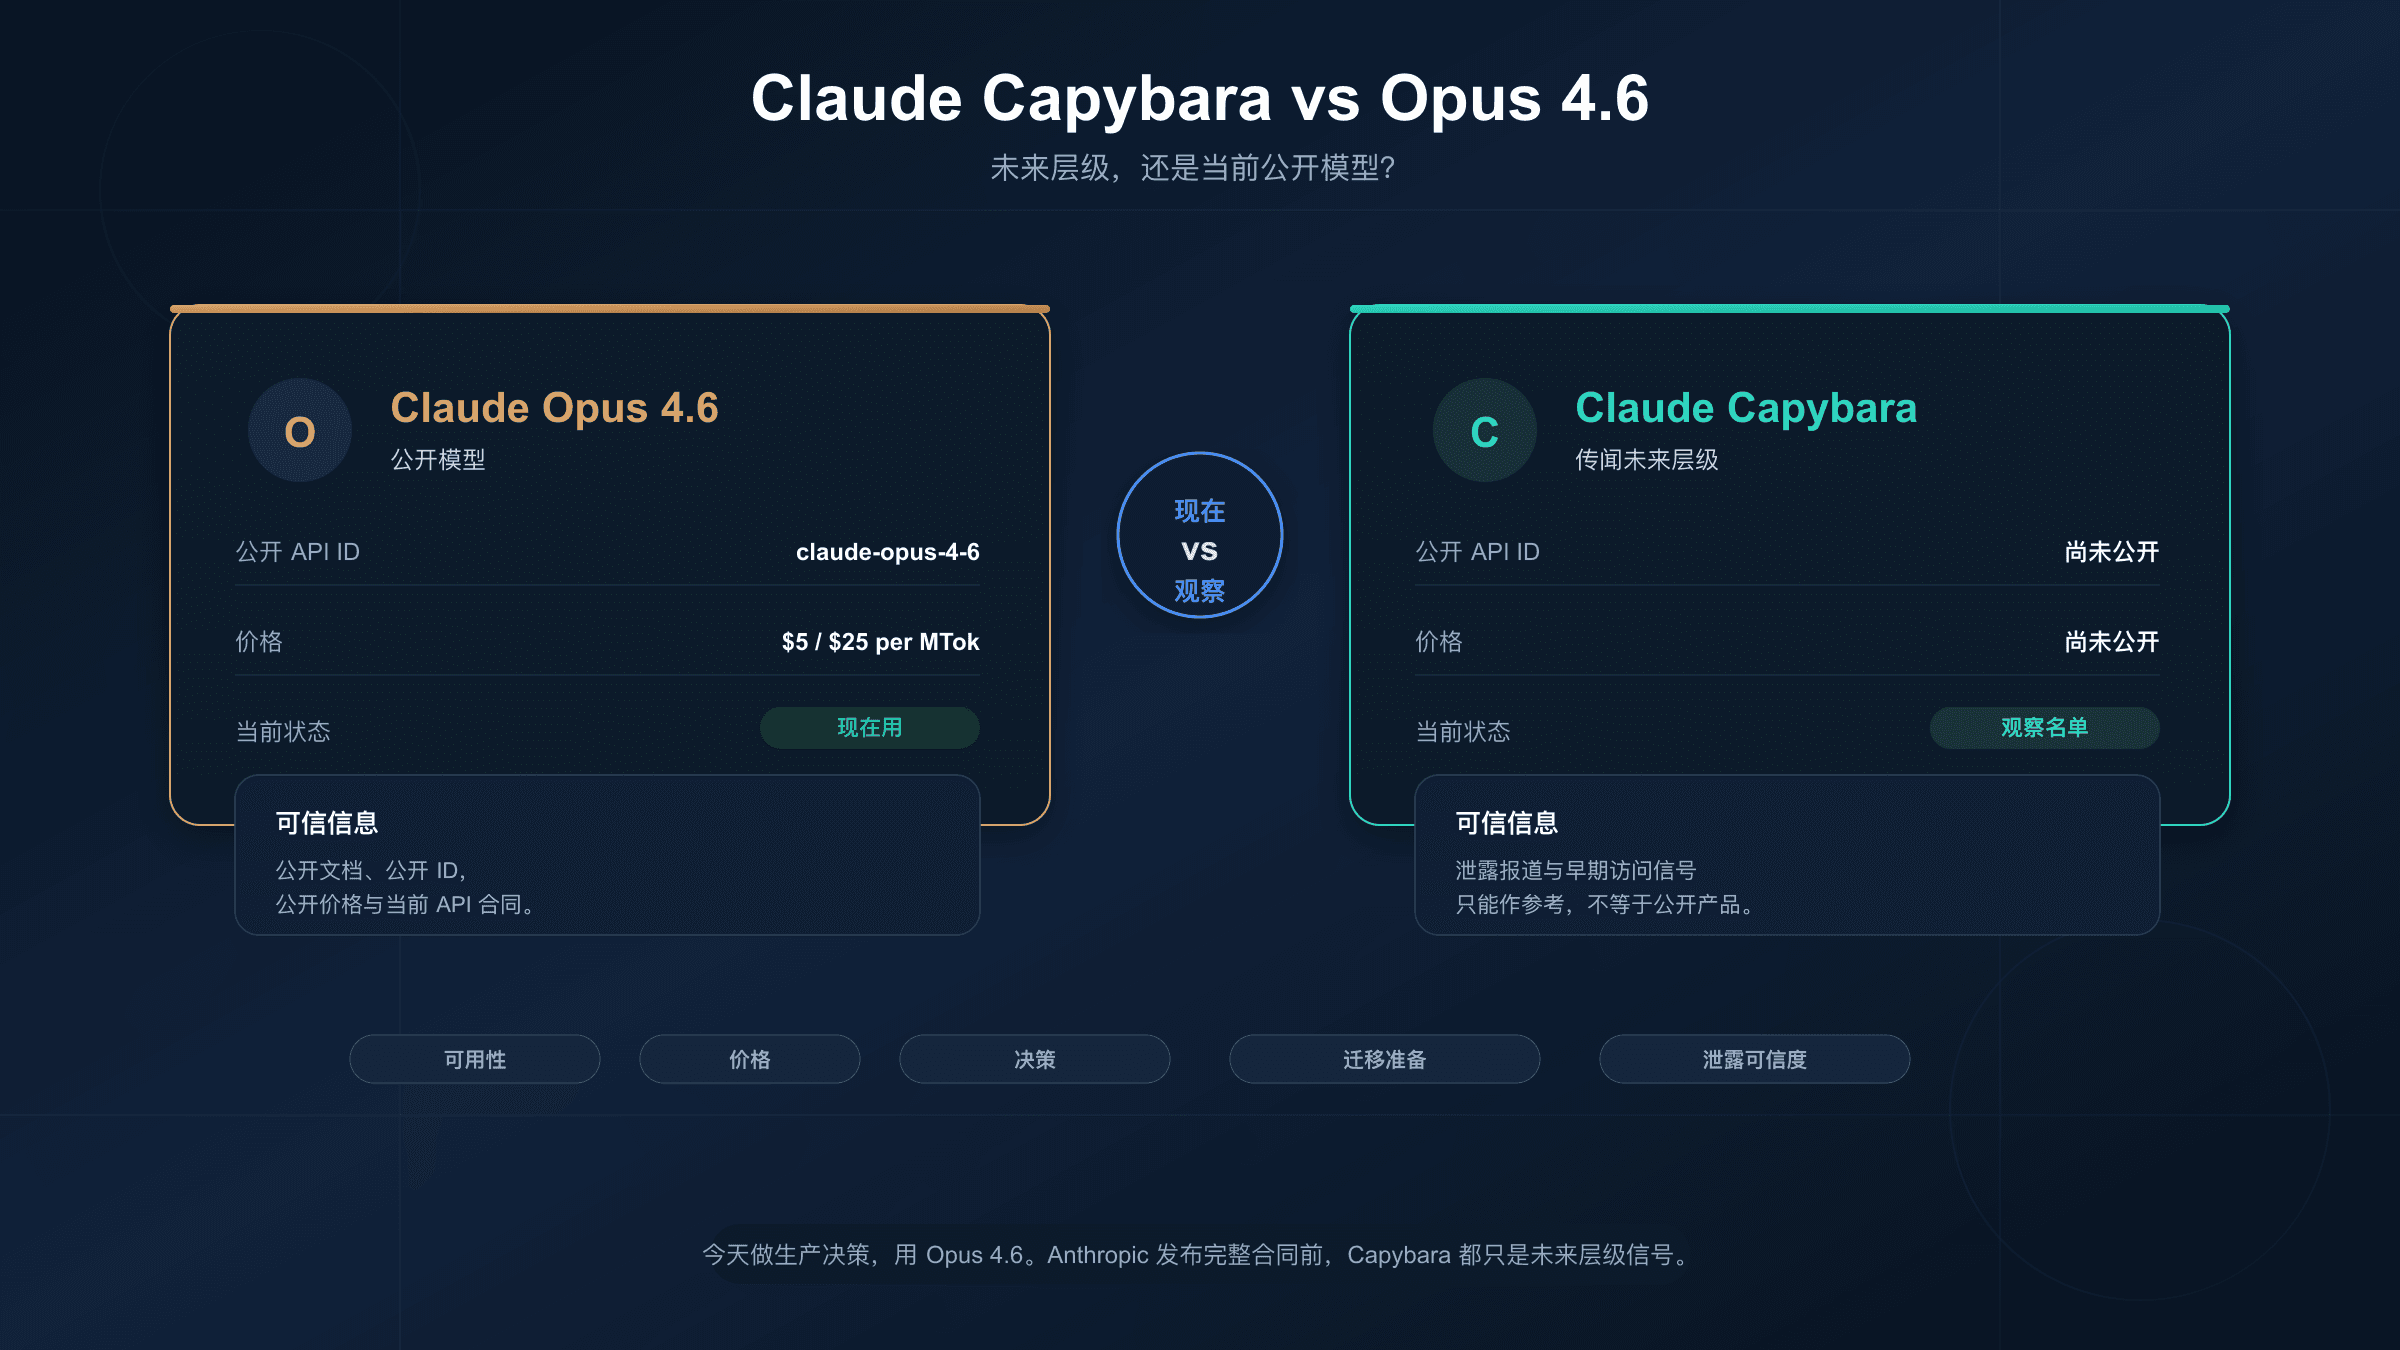
Claude Capybara 目前还不是一个可以直接选择的 Anthropic 公开模型合同。Anthropic 的公开文档仍然把 Claude Opus 4.6 作为当前最强的正式模型,而 Capybara 更像一个来自泄露线索的未来层级信号。本文告诉你现在该用什么,以及什么时候值得继续盯着 Capybara。
截至 2026 年 3 月 28 日,Gemini 3.1 Pro Preview 是这三个名字里唯一仍然属于现役旗舰选择的模型。Gemini 3 Pro Preview 已于 2026 年 3 月 9 日关闭,而 OpenAI 也把 GPT-4 Turbo 定义为较旧路线,并建议使用更新的 GPT-4o。
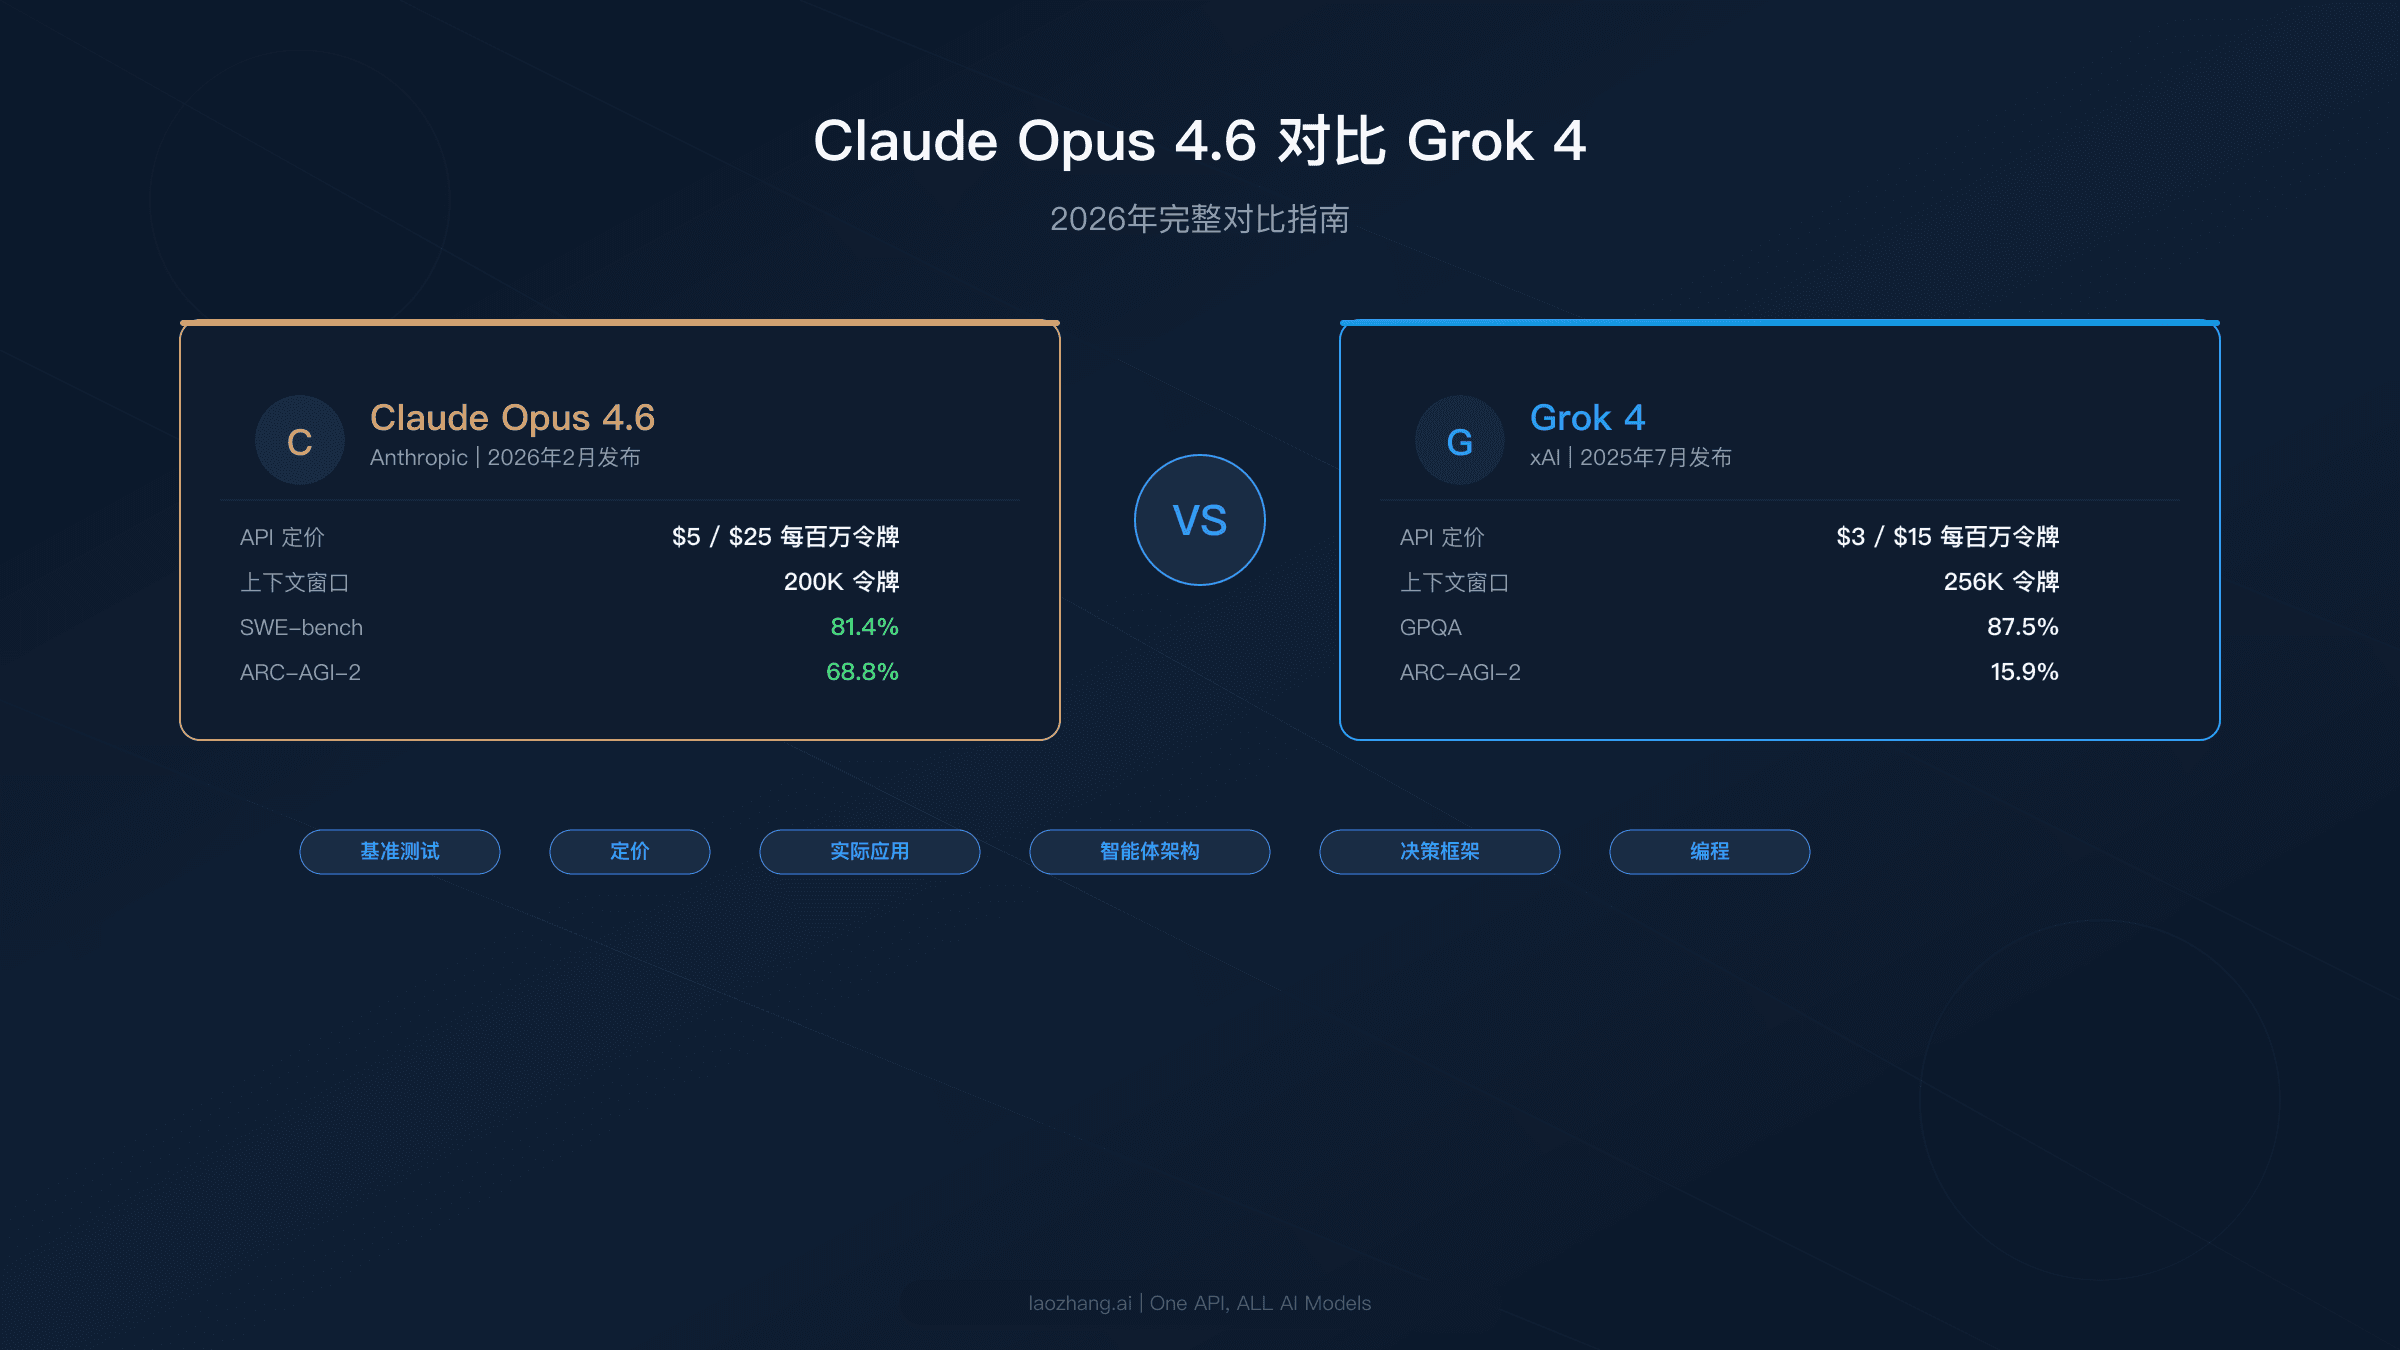
Claude Opus 4.6 在编程基准测试(SWE-bench 81.4% vs ~72%)和推理任务(ARC-AGI-2 68.8% vs 15.9%)上全面领先 Grok 4,而 Grok 4 以每百万令牌 $3/$15 的价格便宜 40%。本文全面对比基准测试、定价、编程能力、智能体架构,并提供场景化决策框架,帮你选择最适合的模型。
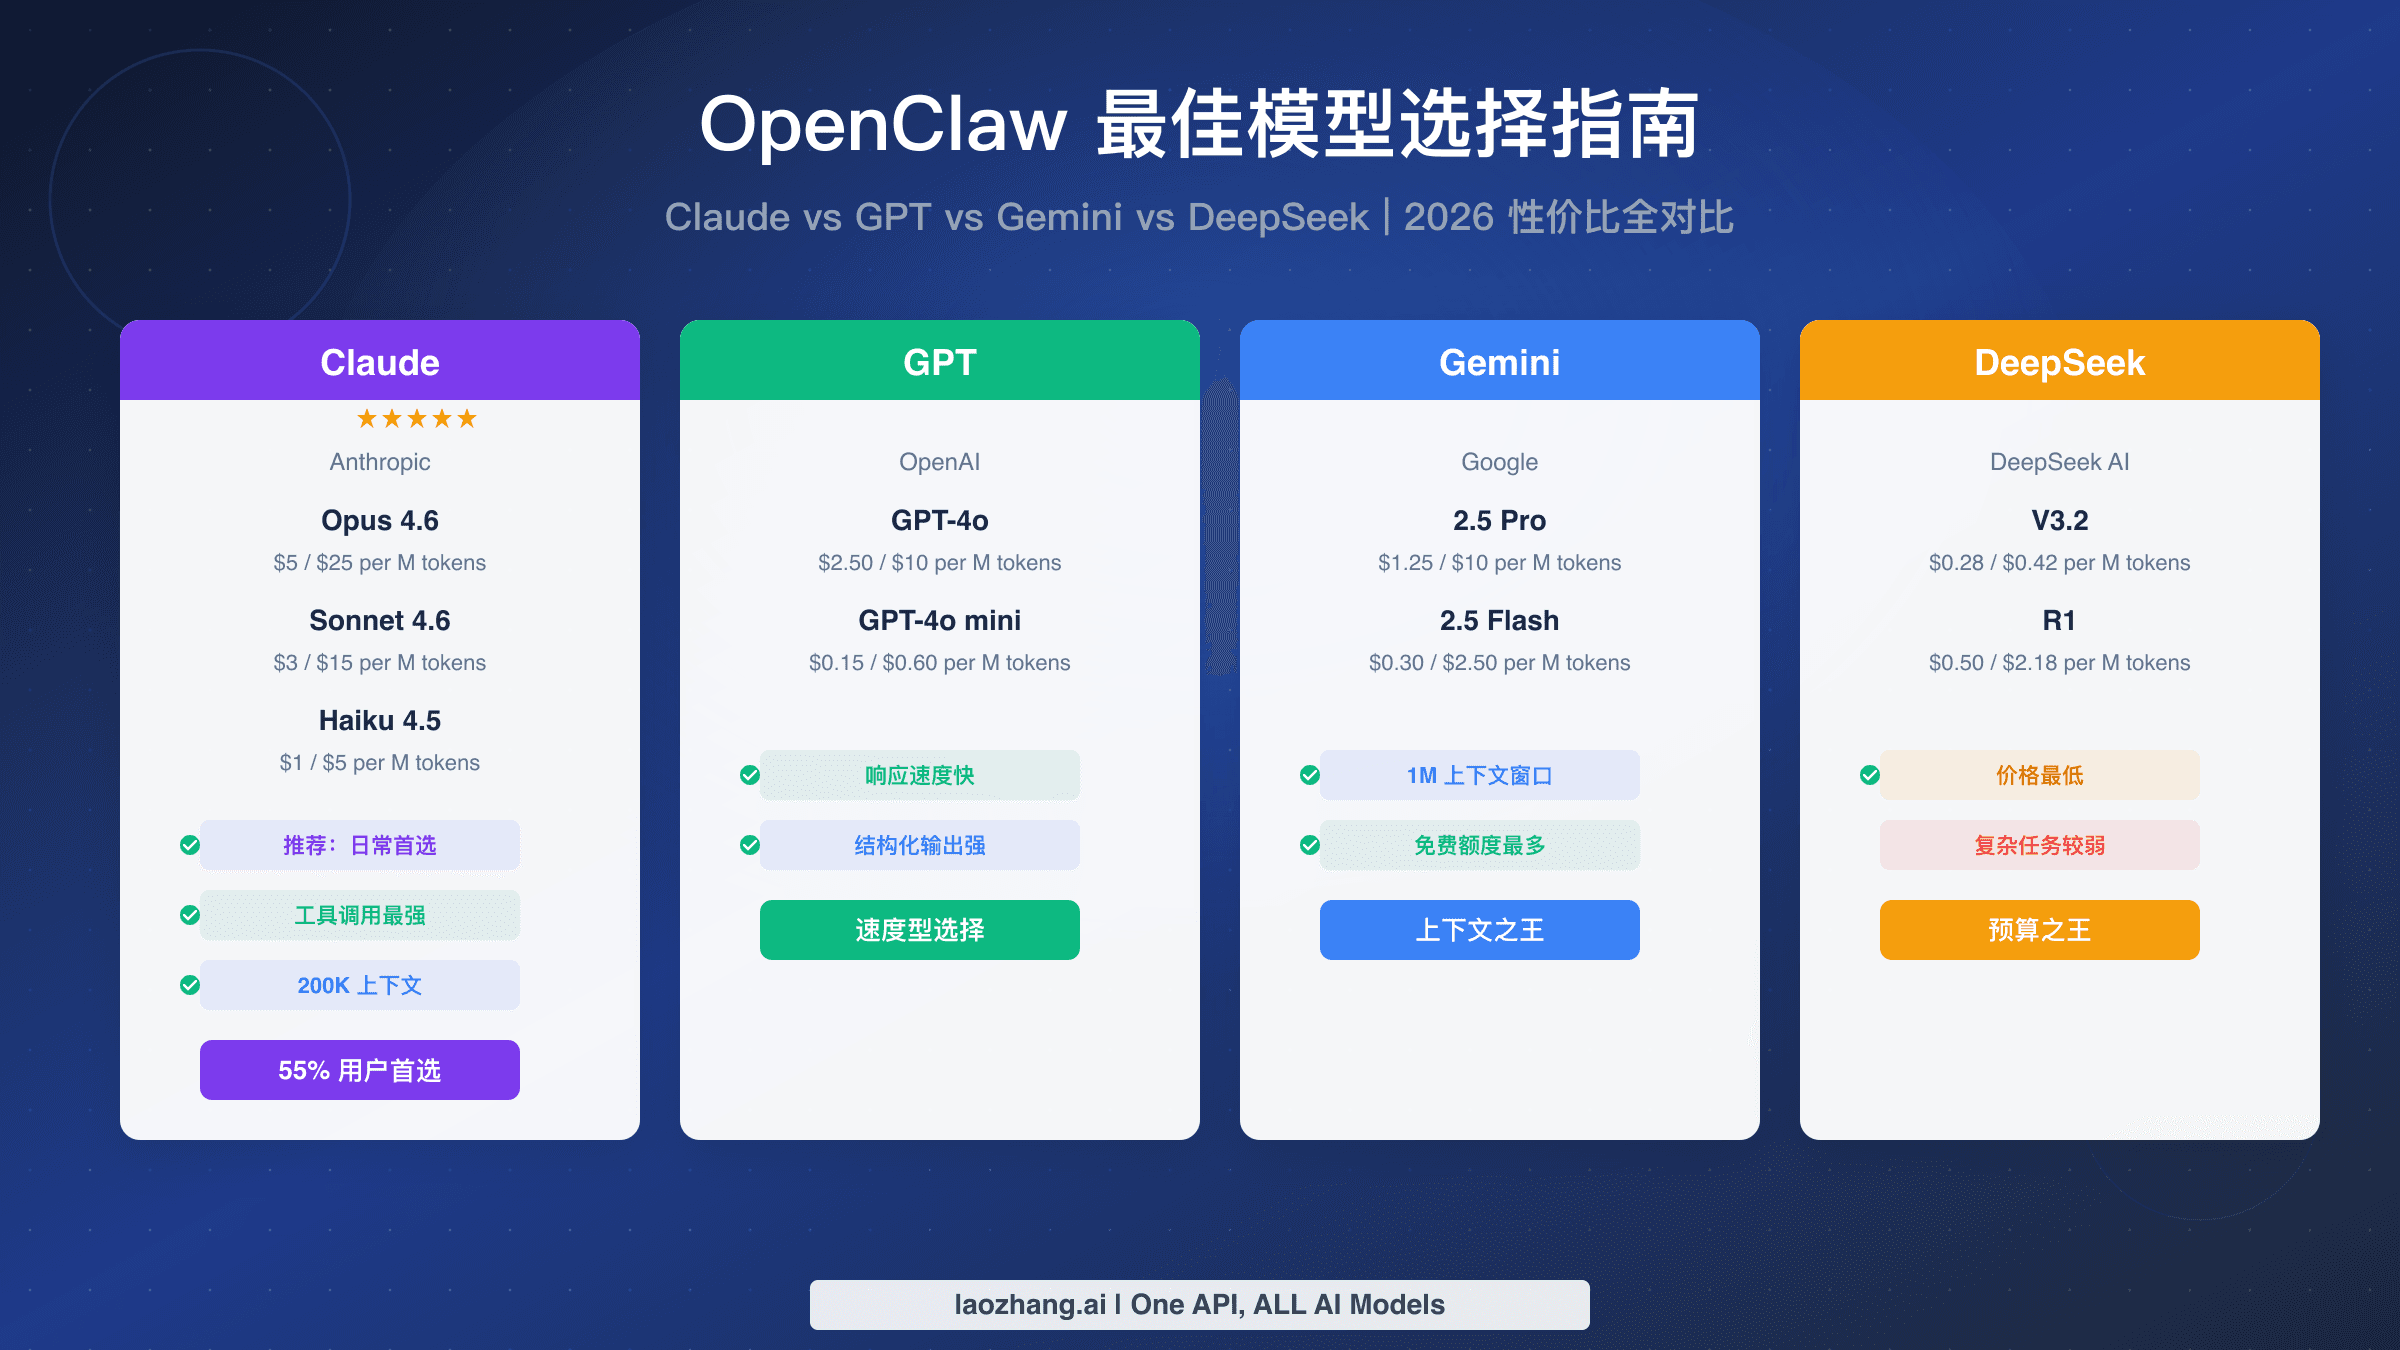
OpenClaw 支持 Claude、GPT、Gemini、DeepSeek 等十余种 AI 模型。Claude Sonnet 4.6($3/$15/M tokens)是多数用户的最佳起点,DeepSeek V3.2($0.28/$0.42)适合预算有限场景。本文对比 9 款主流模型的价格、性能与配置方法,并提供三层路由策略帮你节省 65-80% 的 API 成本。
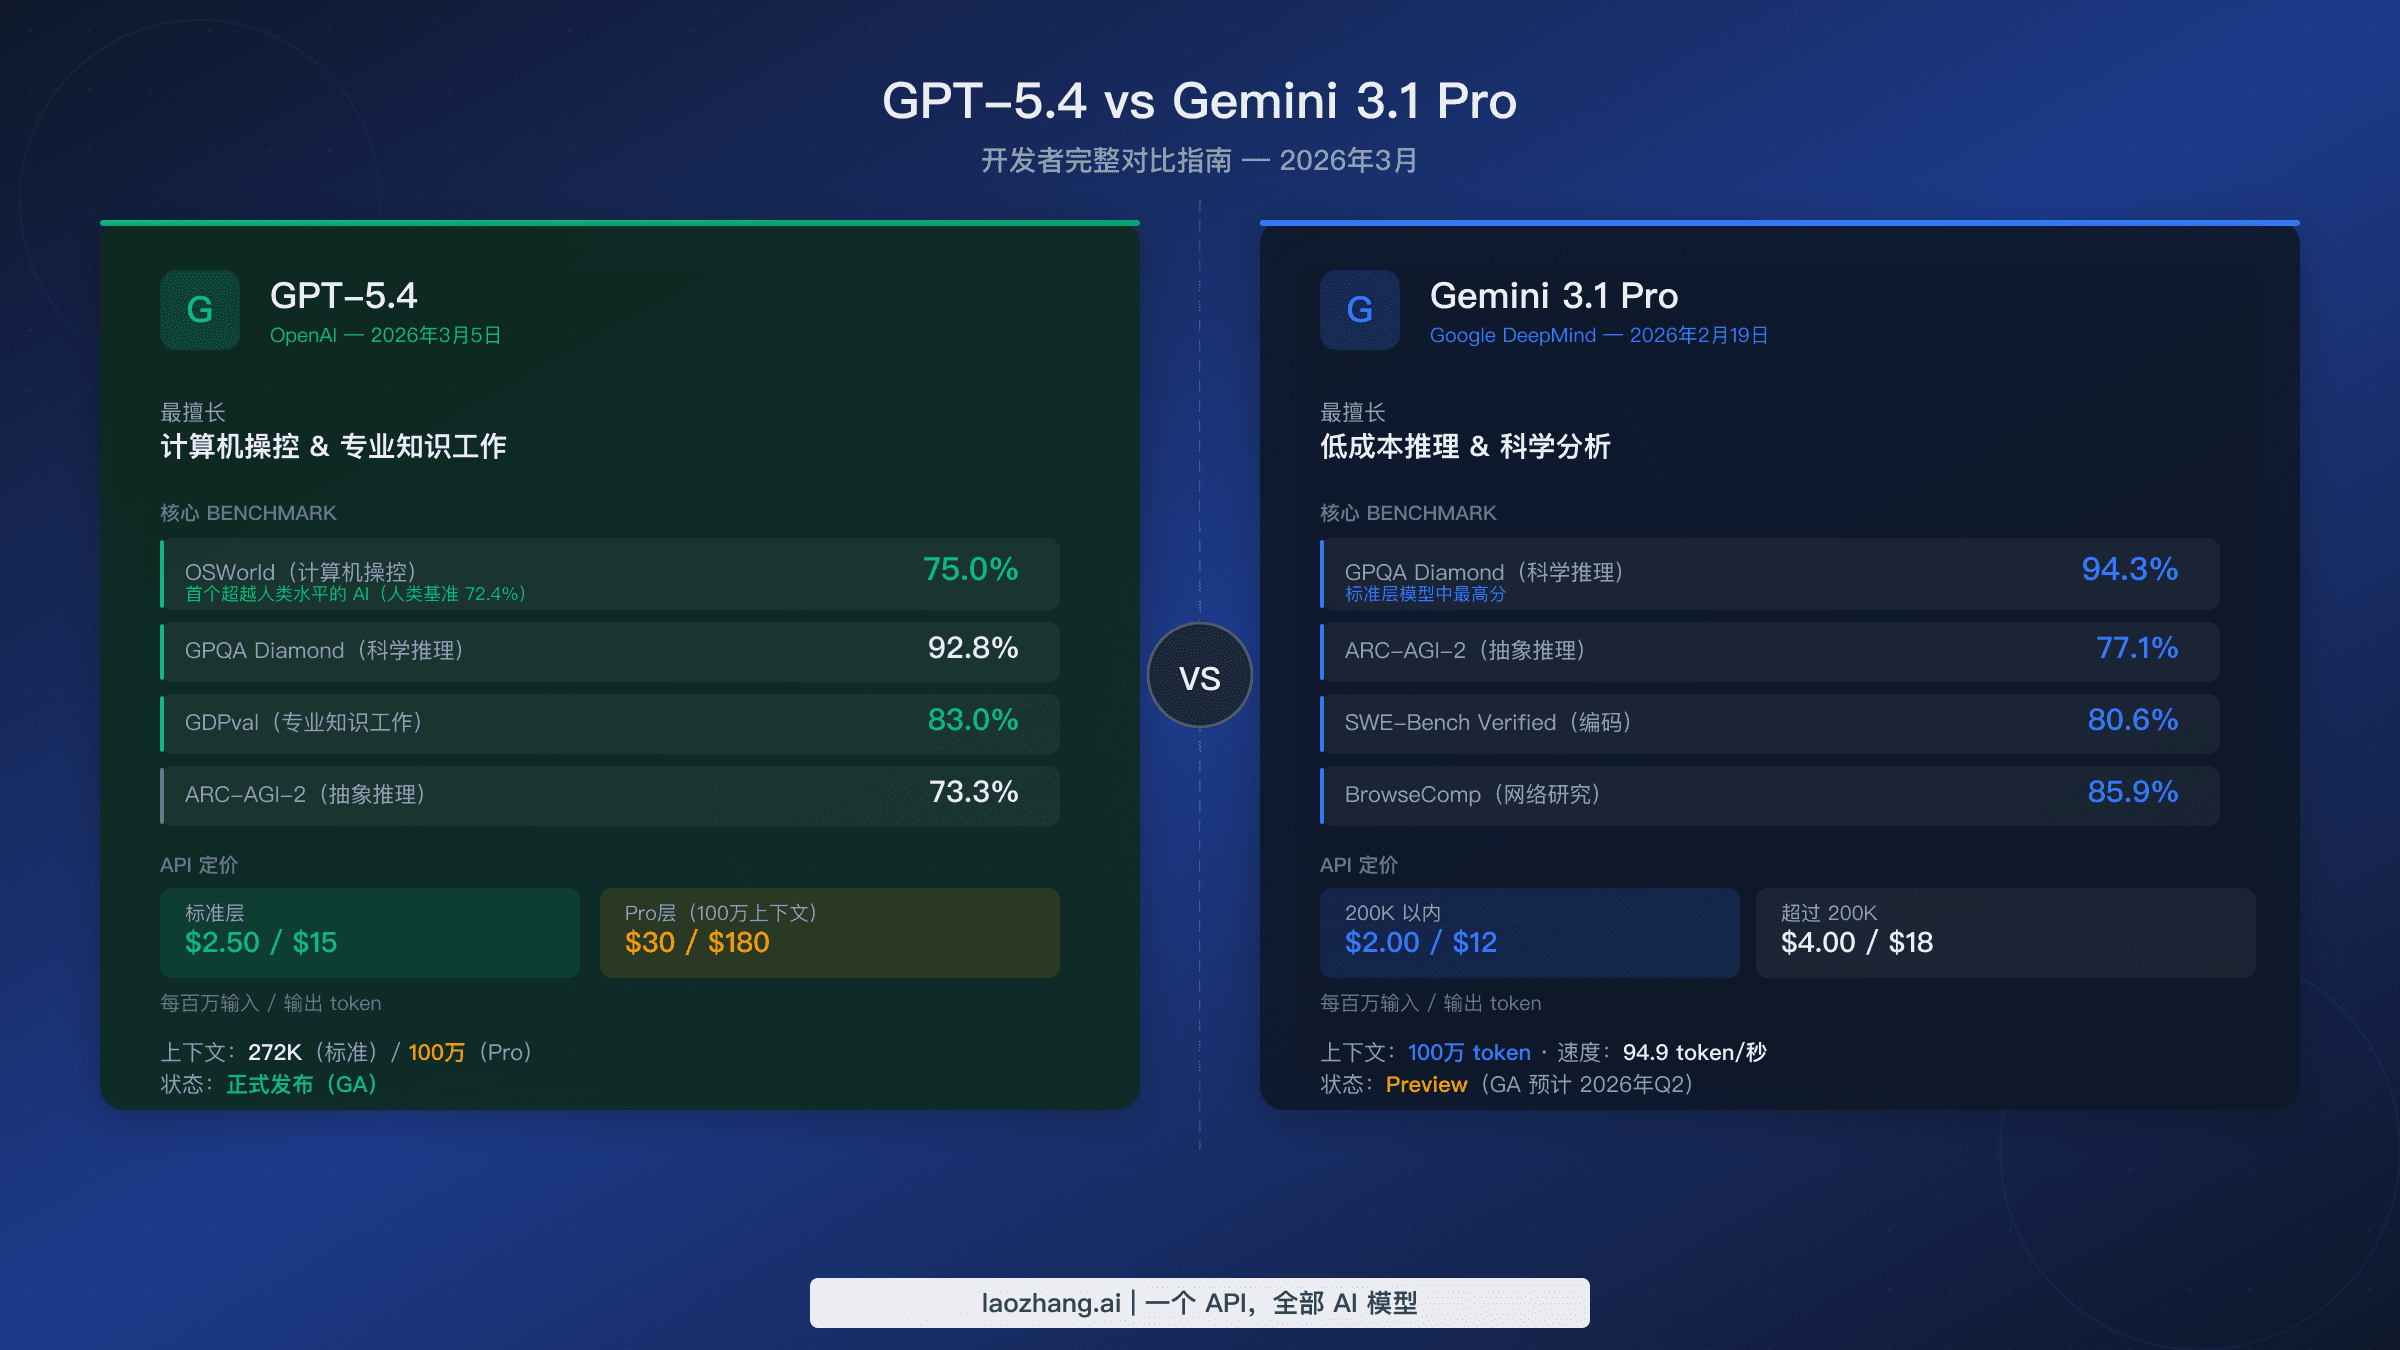
GPT-5.4 与 Gemini 3.1 Pro benchmark 得分几乎平分秋色。Gemini 在抽象推理上领先(GPQA Diamond 94.3%),标准层定价便宜约 20%,或比 GPT-5.4 Pro 便宜 15 倍。GPT-5.4 是首个在桌面计算机操控上超越人类的 AI(OSWorld 75%)。本文提供完整数据帮助你做出选择。
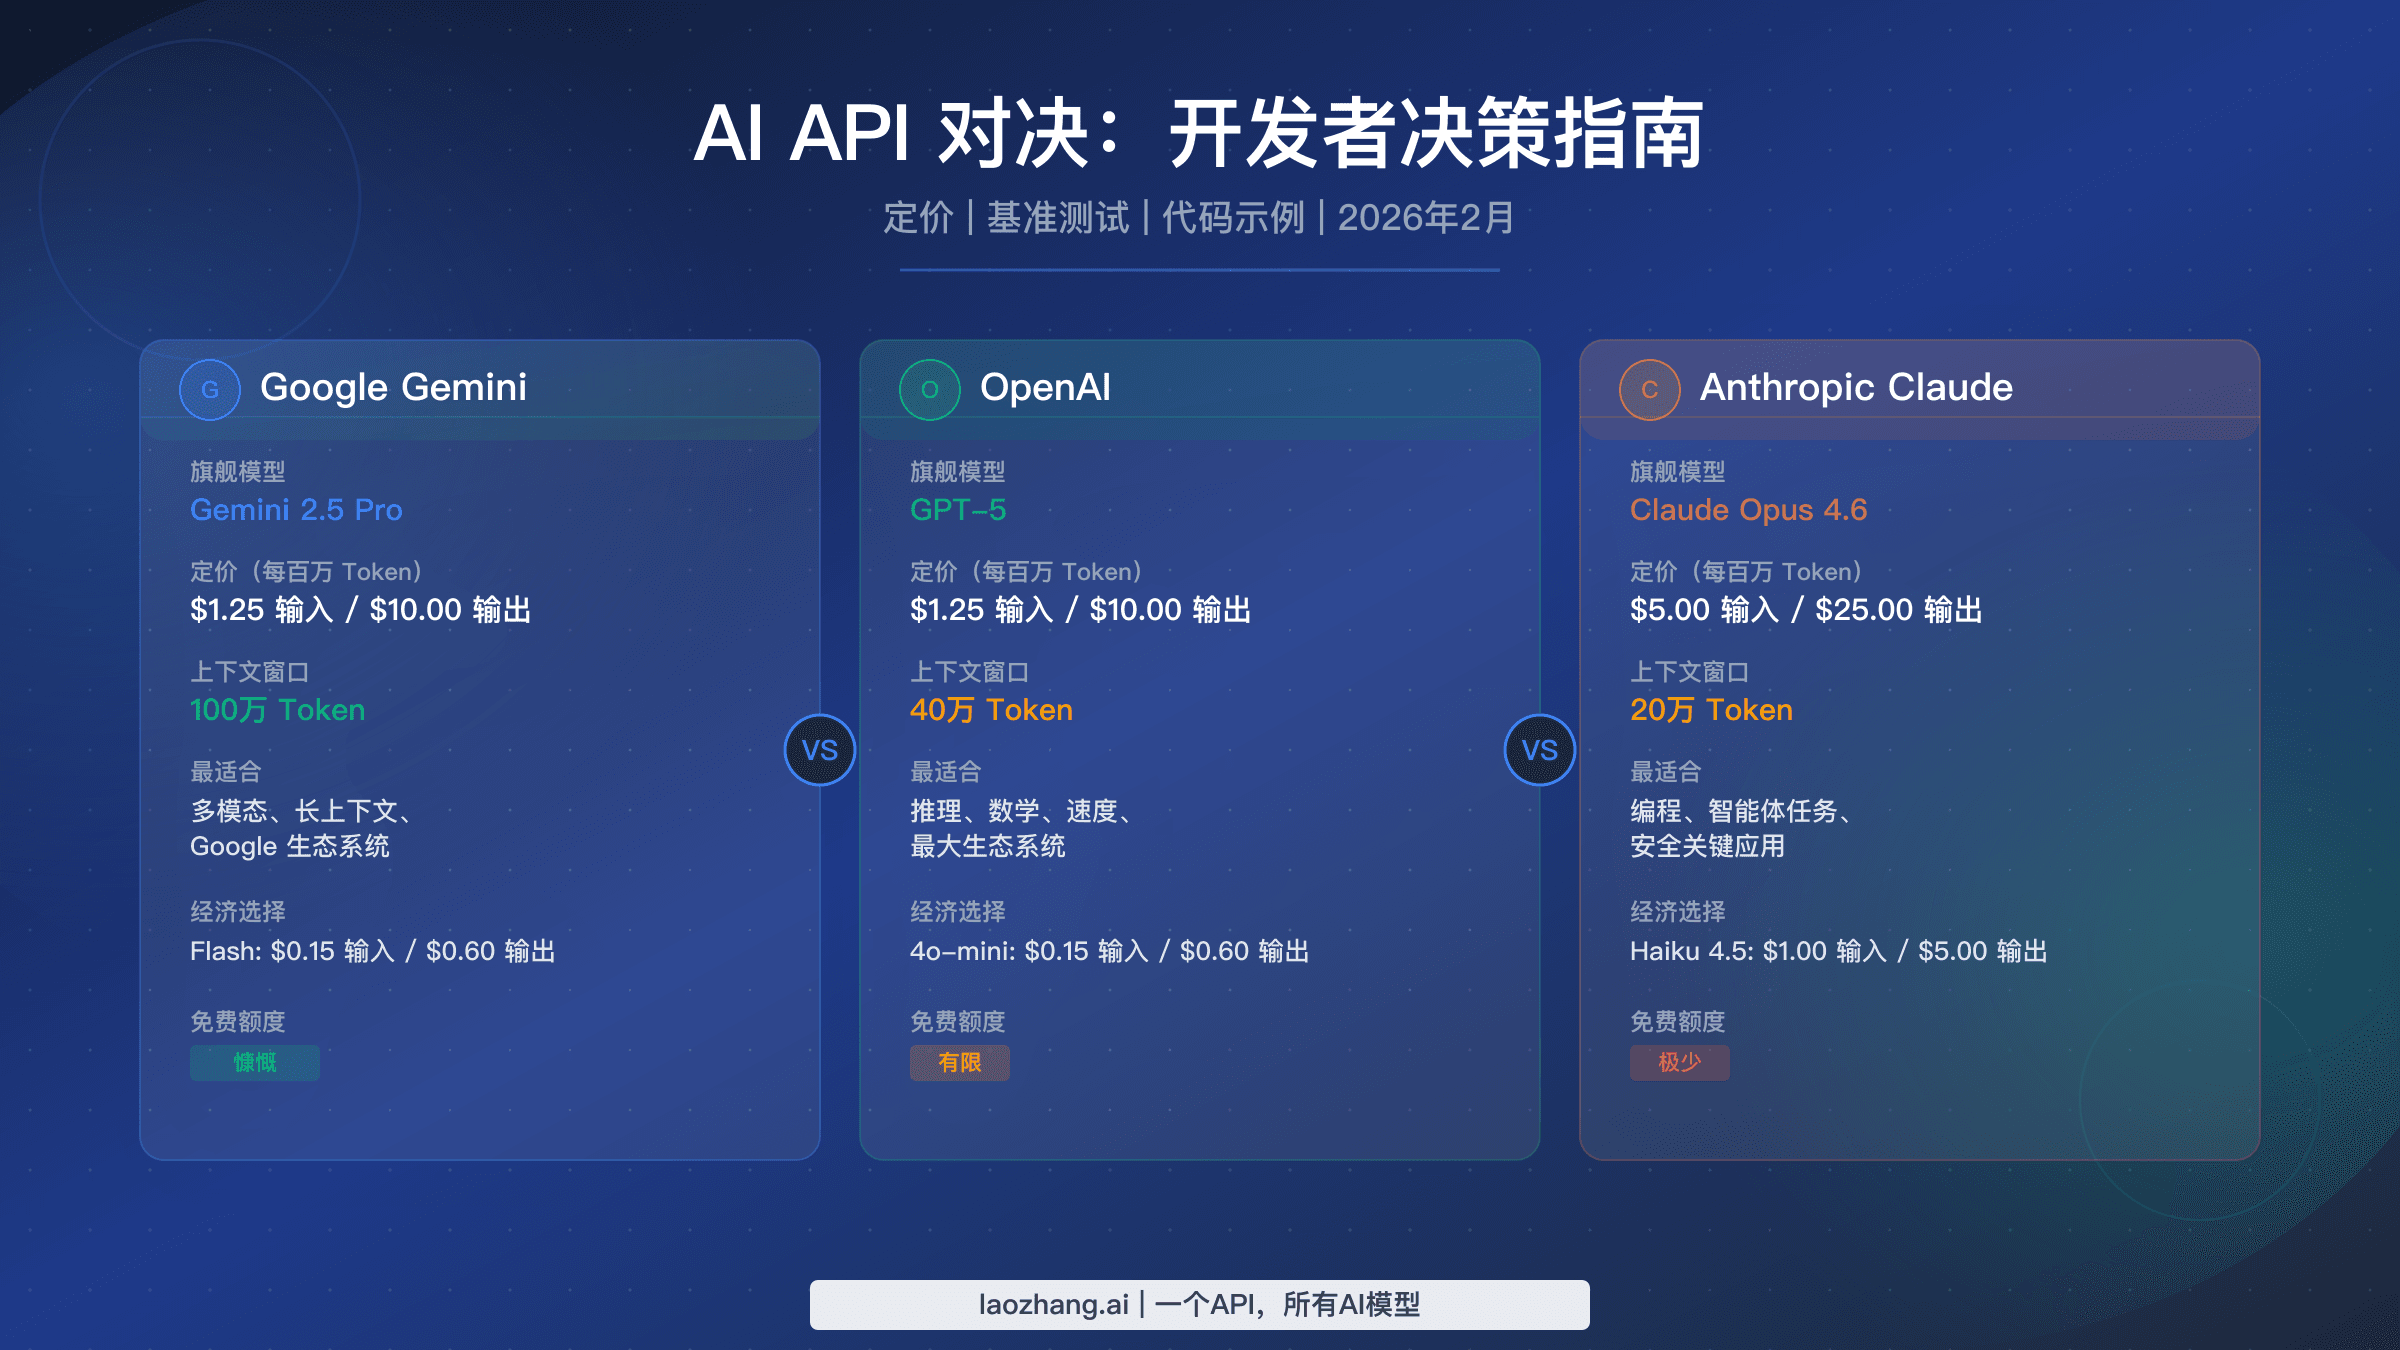
2026年2月三大主流 AI API 深度对比。涵盖 GPT-5、Gemini 2.5 Pro 和 Claude Opus 4.6 的官方验证定价,从独立开发者到企业团队的真实成本计算,SWE-bench 和 AIME 基准测试分析,并排代码示例,以及帮助你为项目选择最佳 API 的实用决策框架。
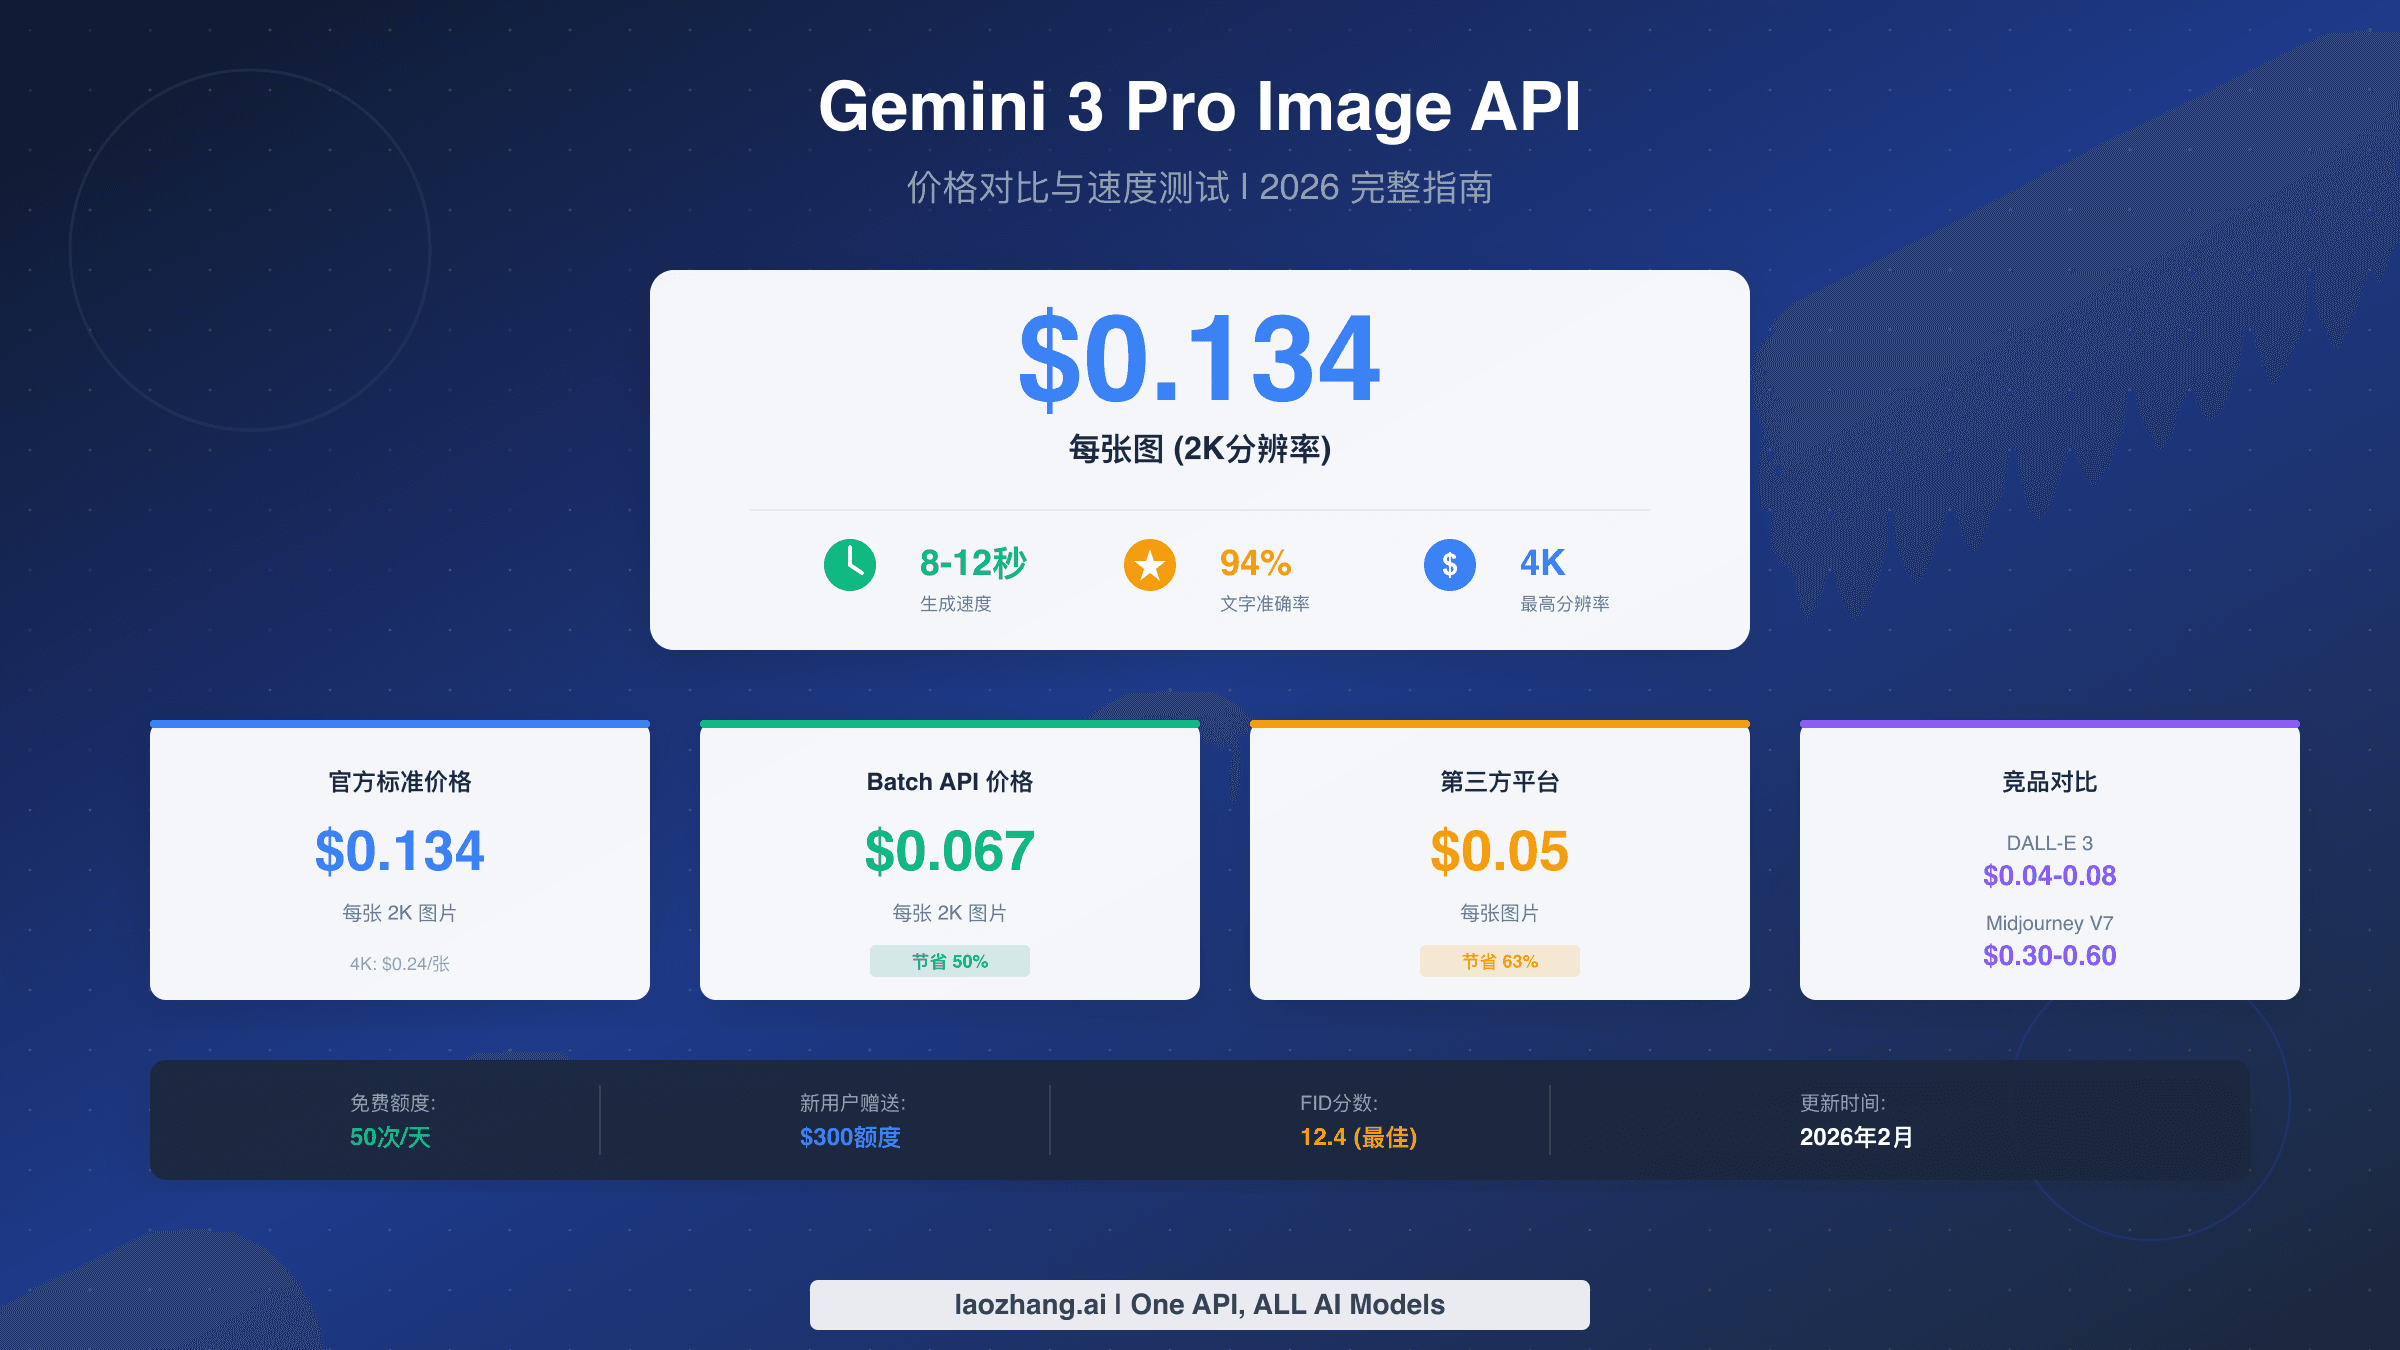
Gemini 3 Pro Image(Nano Banana Pro)官方定价为 $0.134/张(2K)至 $0.24/张(4K),生成速度 8-12 秒,文字渲染准确率达 94%。通过 Batch API 可享 50% 折扣,第三方平台更低至 $0.05/张,最高节省 63%。