GPT-6 Astra 与 Claude Fable 5.1 怎么选:实测 token 与 API 成本
标价同为 $10/$50,但中文在 Fable 5.1 上计 1.5 倍 token,实测花费是 Astra 的 1.5–1.6 倍;超过 272K 的长输入 Fable 仍省。
文章目录
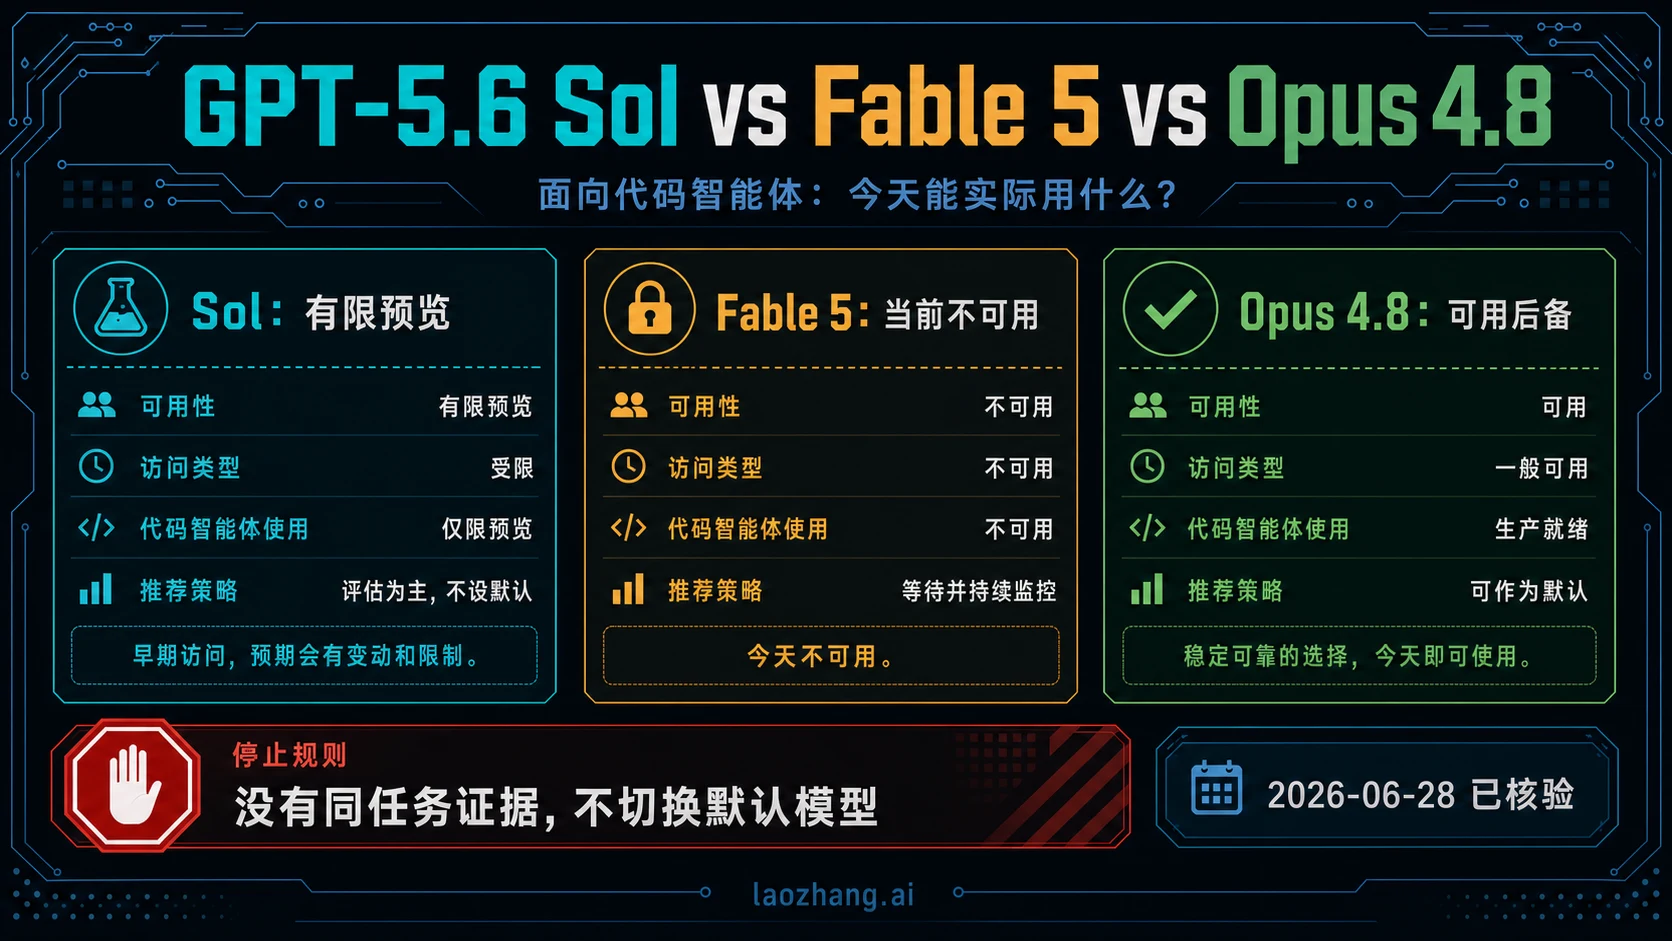
截至 2026 年 10 月 26 日,GPT-6 Astra(gpt-6-astra)和 Claude Fable 5.1(claude-fable-5-1)的标准 API 标价仍然相同:每百万输入 token $10、输出 token $50。同价却不等于同一笔账单。2026 年 10 月 26 日,用同一个 API 网关给两款模型发了同样的 8 道带隐藏测试的题,两边全部通过,按标价算 Fable 5.1 的花费是 Astra 的 1.49 倍(第一轮)和 1.61 倍(第二轮);同一段中文,Fable 计 247 个输入 token,Astra 计 165 个,是 1.50 倍。所以"同价、Fable 缓存更便宜"这笔账只在两家 token 数相同时成立,而实际并不相同。
因此要按负载形态来选。短任务、单次输入不到 272K 且很少复用上下文的调用,在两边都能做对的前提下 Astra 更便宜。反复读取同一个大前缀的编程智能体,中文提示下两者基本打平:一轮 25 万缓存读取、1 万新输入、5 千输出,Astra 约 $0.60,Fable 约 $0.62,缓存读取在费用里占得更多时 Fable 才开始占优。单次未缓存输入超过 272K 时,Astra 整次请求加价,Fable 仍然便宜,约 $5.25 对 $6.75。能力上,Artificial Analysis 在 2026 年 10 月 27–28 日把智能指数换成 9 项测试的 v5.0,新版在每个推理档位都给 Astra 高 5–8 分(max 档 57 对 49),而 Fable 跑一道指数题的成本是 Astra 的 2.0–3.2 倍;所以通过率没有把握时先从 Astra 试起,Fable 多出的花费要靠缓存、长输入或你自己的难题来证明。
有几种情况要先于成本处理。需要零数据保留时,Fable 5.1 默认要求 30 天保留,没有 Anthropic 明确授权就用不了;现有智能体依赖 tool_choice 的 any 或 tool,换到 Fable 会收到 400;在 Chat Completions 里做函数调用的,Astra 要改走 Responses API。另外,两家给的起点都变了:OpenAI 把 GPT-6.1 Sol 定位为接近 Astra、单价只有五分之一,Anthropic 现在建议多数场景先用 Opus 5.5。把这两款放进同一批题里一起测,往往比只在两款旗舰之间二选一更省钱。
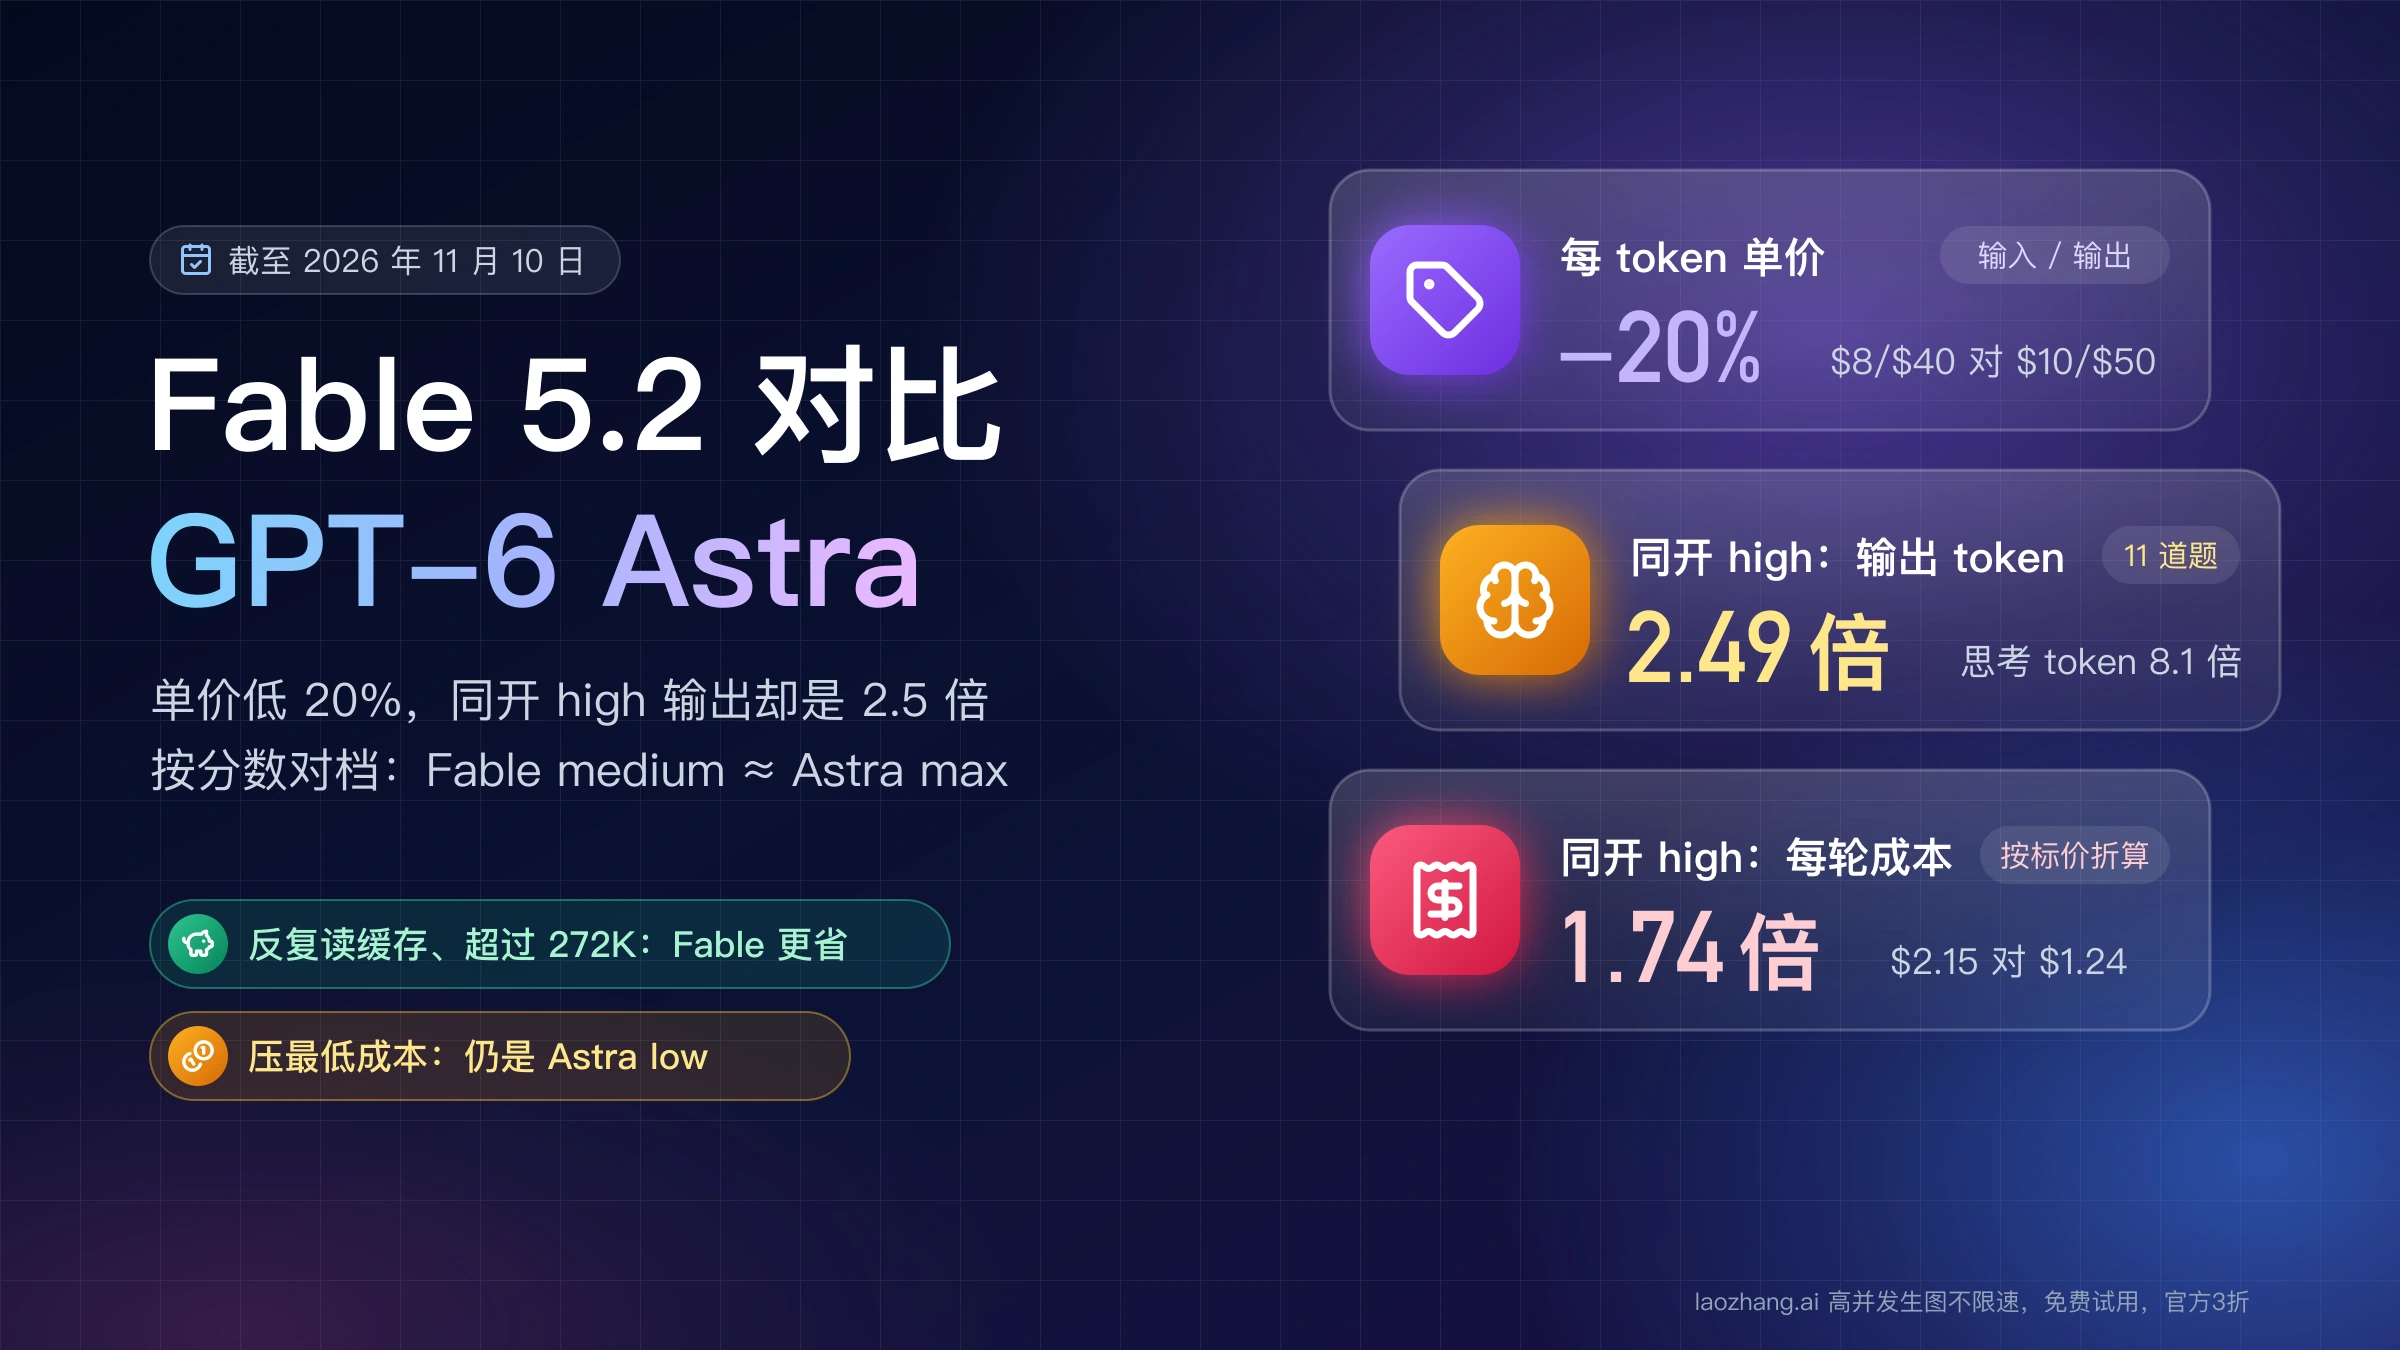
2026 年 11 月 9 日 Anthropic 发布了 Claude Fable 5.2,每百万 token 输入 $8、输出 $40,Fable 5.1 仍可调用。本页继续只讲 Fable 5.1;新模型的对比见 Fable 5.2 和 GPT-6 Astra 对比:单价低 20%,同题输出却是 2.5 倍。
先核对 API 合同,而不是先看谁的发布会分数高
两款模型的容量接近,真正影响选型的是推理配置、工具接口和计费规则。截至 2026 年 10 月 26 日,OpenAI 的 GPT-6 Astra 模型页与 Anthropic 的 Claude Fable 5.1 模型页给出的合同如下。
| 决策项 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 精确 API ID | gpt-6-astra,目前只有这一个快照 | claude-fable-5-1 |
| 发布日期 | 2026 年 9 月 3 日,见 OpenAI API 更新日志 | 2026 年 9 月 1 日 |
| 上下文 / 最大输出 | 1,050,000 / 128,000 token,最大输入 922,000 | 1,000,000 / 128,000 token |
| 知识截止 | 2026 年 4 月 30 日 | 2026 年 6 月 |
| 接口 | Responses、Chat Completions、Batch;函数调用只能走 Responses | Claude API(Messages),以及 Amazon Bedrock、Claude Platform on AWS、Microsoft Foundry、Google Cloud |
| 推理配置 | low、medium、high、xhigh、max,不支持 none;官方没有写默认档位 | 自适应思考始终开启;effort 从 low 到 max,API 默认 high |
| 提示缓存 | 默认自动写入 | 只有带 cache_control 才写入 |
| Standard 输入 / 输出 | $10 / $50 每百万 token | $10 / $50 每百万 token |
上下文上限要和计费阈值分开看。Astra 多出的 5 万容量并不自动构成优势:请求从 270K 增长到 300K,它跨过的不只是一个容量刻度,而是一条影响整次请求单价的边界。反过来,Fable 5.1 在 100 万上下文内都按标准价计费,也不证明它能更准确地利用每一个 token;而且两边的上限各按自己的分词器计数,同一份材料在 Fable 上占的 token 更多,下文的实测会给出比例。超长输入还会带来无关信息、较慢的响应和更难的失败恢复。
同为 $10/$50,为什么实际账单仍可能差一倍
会,而且不只发生在长输入上。2026 年 10 月 26 日的同题测试里,CSV 行解析那道题第一次采样,Fable 5.1 花了 $0.0628,Astra 花了 $0.0171,是它的约 3.7 倍;整轮平均下来是 1.5–1.6 倍。把账单拉开的是四件事:同一段文字算出多少 token、缓存怎么写、272K 以上的整次加价,以及输出和思考量。先看两家截至 2026 年 10 月 26 日的标价。
| 价格项(每百万 token) | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 输入 | $10 | $10 |
| 输出 | $50 | $50 |
| 缓存读取 | $1 | $0.25 |
| 缓存写入 | 30 分钟 $12.50;12 小时 $25 | 5 分钟 $12.50;1 小时 $20 |
| 单次输入超过 272K | 整次请求:输入 $20、缓存读取 $2、30 分钟写入 $25、12 小时写入 $50、输出 $75 | 不加价,100 万上下文都按标准价 |
| Batch | 半价,$5 / $25 | 半价,$5 / $25 |
价格来自 OpenAI API 定价页和 Anthropic 的 Claude API 定价页。Astra 的 12 小时缓存写入是 2026 年 10 月 20 日新增的一档,此前只有 30 分钟一种。OpenAI 另有半价的 Flex、2 倍价格的 Fast 和 6 倍价格的 Ultrafast,区域处理加价 10%;Fable 不提供 Fast 模式,限定美国境内推理加价 10%。这些路线要在延迟和合规条件匹配时单独比较,不能混进 Standard 的横向对照。单个模型的完整账单算法,可以看 GPT-6 Astra API 定价与成本计算:价格表、272K 与两档缓存写入 和 Claude Fable 5.1 API 价格:降了什么,省多少。
第一件事是分词器。Anthropic 的 token 计数文档只说 Fable 5.1 沿用 Opus 4.7 引入的分词器,同一段提示比更早的 Claude 模型多约 30%,具体取决于内容;它没有给出与 OpenAI 模型的比例。实测的比例在中文上是 1.50 倍,单价相同时,这就等于未缓存输入贵了一半。
第二件事是缓存写入的默认值。OpenAI 的提示缓存指南写明,支持的模型默认开启提示缓存,GPT-5.6 及之后的模型写入按普通输入的 1.25 倍计价,并且是替代而不是叠加输入价。实测里,一段 10,106 token 的提示没有带任何缓存设置,Astra 返回 cache_write_tokens: 10103,比按普通输入多付约 $0.025。一次性读完就丢的长文档不需要这笔写入,可以在请求里设 prompt_cache_options.mode: "explicit",不放断点就不会写缓存。Fable 正好相反,只有带 cache_control 才写缓存,最短可缓存前缀为 512 token;不加这个参数,$0.25 的读取价也就用不上。
第三件事是 272K 阈值。它按 Astra 自己的 token 计数,一旦越过,不是只对超出部分加价,而是整次请求的输入、缓存和输出都换成长上下文单价。第四件事是输出量。Fable 的自适应思考算在输出 token 里,实测中它的输出 token 是 Astra 的 1.61–1.87 倍,按 $50 的输出价计费,这部分在编程任务里往往比输入差价更大。
所以比价的单位应该是任务,而不是 token:
每个验收通过任务的成本 = 全部尝试的模型费、工具费与人工复核成本 ÷ 通过验收的任务数
如果某款模型在一批任务里没有任何结果通过,就把这一批记为失败,不要用生成字数、执行步骤或"看起来更聪明"来替代除数。
2026 年 10 月 26 日同题实测:两边全过,Fable 花费是 1.5–1.6 倍
在两边都能做对的题上,Fable 5.1 的花费稳定在 Astra 的 1.5–1.6 倍,完成时间差不多。测试于 2026 年 10 月 26 日通过 laozhang.ai 的 API 进行:Astra 走 OpenAI 兼容的 /v1/chat/completions,Fable 走 Anthropic Messages 格式的 /v1/messages,两边都流式返回,都不传推理档位参数,即使用各自的默认值,最大输出设为 32,000,没有系统提示、工具或缓存设置。题目共 8 道,带隐藏测试:应用题、区间合并、时长解析、词频统计、把一篇 6,723 词的英文文章总结成 5 条要点,以及表达式求值、CSV 行解析、数位和计数三道难题各采样两次。22 个评分答案两边全部通过。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 轮次 | 模型 | 通过 | 输入 token | 输出 token | 标价花费 | 总耗时 |
|---|---|---|---|---|---|---|
| 第一轮,5 道题 | GPT-6 Astra | 5/5 | 10,545 | 1,839 | $0.2227 | 50.3 秒 |
| 第一轮,5 道题 | Claude Fable 5.1 | 5/5 | 15,948 | 3,431 | $0.3310 | 43.3 秒 |
| 第二轮,3 道题 × 2 次 | GPT-6 Astra | 6/6 | 862 | 3,656 | $0.1914 | 78.6 秒 |
| 第二轮,3 道题 × 2 次 | Claude Fable 5.1 | 6/6 | 1,254 | 5,896 | $0.3073 | 72.4 秒 |
花费按各 API 返回的 usage 和官方标价计算,含 Astra 自动写入缓存的那一笔。第一轮 Fable 的花费是 Astra 的 1.49 倍,输出 token 是 1.87 倍;第二轮花费和输出 token 都是 1.61 倍。速度上 Fable 略快,两轮总耗时分别少 14% 和 8%,短题多数也是 Fable 先出第一段文字。38 次调用一共花费约 $1.10。作为参照,同一套 8 道题在 2026 年 10 月 25 日跑过 GPT-6.1 Sol,也全部通过,两轮分别花费 $0.0387 和 $0.0368,Astra 是它的 5.8 倍和 5.2 倍。
Fable 的输出 token 里包含看不到的思考。经过这条线路,Fable 没有流式返回任何思考文字,但只让它回复一个 "ok",也计了 132 个输出 token,用时 15.4 秒;Astra 同样的请求是 5 个 token、2.8 秒。Astra 会把推理 token 单独列在 reasoning_tokens 里,例如应用题那次 412 个输出 token 中有 256 个是推理。估算 Fable 的输出成本时,不能只看最终回复的长度。
这组数字的边界要一起看:只用了一个网关、一天、每道题 1–2 次采样,题目是两款模型都能做对的小题,所以它比较的是同等通过率下的花费和速度,不是谁更聪明。token 数取自网关返回的 usage 字段;Responses API、其他推理档位、缓存命中后的读取、272K 以上的输入和官方直连端点都没有测,下文涉及这些的金额是按标价复算。
同一段中文,Fable 5.1 的 token 数是 Astra 的 1.5 倍
同一段意思相同的文字,Fable 5.1 计出的 token 是 Astra 的 1.23–1.90 倍,中文是 1.50 倍。2026 年 10 月 26 日的测试用固定指令加一段文字发给两边,从返回的输入 token 中减去只发指令时的基数,Astra 为 23、Fable 为 34,剩下的就是这段文字的 token 数。六种语言的文字意思相同,各约 120–150 个英文词的篇幅。
| 语言 | 字符数 | GPT-6 Astra | Claude Fable 5.1 | Fable ÷ Astra |
|---|---|---|---|---|
| 中文 | 246 | 165 | 247 | 1.50 倍 |
| 英文 | 685 | 137 | 199 | 1.45 倍 |
| 日文 | 344 | 254 | 312 | 1.23 倍 |
| 韩文 | 363 | 208 | 396 | 1.90 倍 |
| 俄文 | 791 | 193 | 302 | 1.56 倍 |
| 西班牙文 | 799 | 162 | 304 | 1.88 倍 |
| 英文长文,6,723 词 | — | 10,106 | 15,335 | 1.52 倍 |
在这段中文里,Fable 差不多一个字符一个 token,Astra 约 0.67 个。一段代码风格的提示也是 1.46 倍,和英文接近。方向与其他来源一致:Crazyrouter 在 2026 年 9 月 5 日用英文填充文本做的拟合是 1.91 倍,用的文本不同,倍数也不同。每种语言只测了一段,你自己的提示最好用两家 API 各发一次,直接比返回的输入 token。
这个比例还会改变两边的有效容量。按 1.5 倍估算,Fable 的 100 万上下文大约只装得下 Astra 计数下 67 万 token 的中文或英文材料,韩文、西班牙文约 53 万,而 Astra 的最大输入是 922,000;这是由一段样本推出的估算,不是实测上限。反过来,Astra 计到 272K 的中文提示,在 Fable 上约为 408K,仍按标准价计费。
哪种负载 Fable 更便宜:看 token 比例是否越过盈亏点
Fable 便宜与否,取决于同一份文字在它那里多算的倍数有没有超过这类负载的盈亏点。设 r 为同一段文字在 Fable 上的 token 数除以 Astra 上的 token 数,所有数量都按 Astra 的计数写;Fable 的花费就是 r 乘以"按 Fable 单价、Astra token 数算出的金额",盈亏点等于 Astra 的花费除以这个金额。下面三种情况都按 2026 年 10 月 26 日的标价计算,假设输入和输出都放大 r 倍。
反复读取大前缀的编程智能体:中文下 Astra 略便宜
一轮读取 25 万缓存前缀、加 1 万新输入、输出 5 千,先不计首次写入:
Astra:     0.25 × $1 + 0.01 × $10 + 0.005 × $50 = $0.60
Fable 5.1: r × (0.25 × $0.25 + 0.01 × $10 + 0.005 × $50) = r × $0.4125
盈亏点:    r = 0.60 ÷ 0.4125 ≈ 1.455
按表中的比例,日文 1.23 倍时 Fable 约 $0.51,仍便宜;英文 1.45 倍约 $0.60,打平;中文 1.50 倍约 $0.62,已略贵;韩文、西班牙文接近 1.9 倍时约 $0.78。如果输出按实测里 Fable 约 1.8 倍的输出 token 算,中文这一轮会到 1.5 × $0.1625 + 1.8 × $0.25 ≈ $0.69。新输入也写进缓存时(Astra 默认如此,Fable 把断点放在末尾时也一样),两边的新输入都从 $10 变成 $12.50,Astra 为 $0.625,Fable 为 r × $0.4375,盈亏点约 1.43,结论不变。
缓存读取在一轮费用里占得越多,Fable 越有利。比如 50 万缓存、5 千新输入、2 千输出,Astra 为 0.5 × $1 + 0.005 × $10 + 0.002 × $50 = $0.65,Fable 为 r × $0.275,盈亏点升到约 2.36,这时中文提示下 Fable 明显便宜。还要算首次写入:同样 25 万前缀第一次写入,Astra 按 30 分钟写入为 0.25 × $12.50 + $0.35 = $3.475,Fable 按 5 分钟写入为 r × $3.475,中文约 $5.21。Fable 默认缓存只保留 5 分钟,智能体中途停顿超过这个时间就要重新写入,需要更长时可以付 $20 的 1 小时写入;Astra 默认是 30 分钟。
单次超过 272K 的长输入:Fable 仍便宜
一次 30 万未缓存输入、1 万输出,Astra 越过 272K,整次请求换成长上下文单价:
Astra:     0.30 × $20 + 0.01 × $75 = $6.75
Fable 5.1: r × (0.30 × $10 + 0.01 × $50) = r × $3.50
盈亏点:    r = 6.75 ÷ 3.50 ≈ 1.93
中文 1.50 倍时 Fable 约 $5.25,接近 1.9 倍的韩文、西班牙文约 $6.65,都还低于 Astra。Astra 默认会自动写缓存,如果这 30 万 token 也按长上下文的 30 分钟写入 $25 计费,Astra 会变成 0.30 × $25 + 0.01 × $75 = $8.25,差距更大;这一点是按默认缓存行为和标价推算的,272K 以上的请求没有实测。一次性的长输入在 Astra 上建议设 prompt_cache_options.mode: "explicit",或者把材料拆到 272K 以下。
短任务和一次性输入:同等通过率时 Astra 便宜
没有可复用的前缀时,Fable 的低缓存读取价用不上,剩下的就是 1.5 倍左右的 token 数和更多的输出,前面的同题实测就是这种情况。这类负载在两边都能做对时选 Astra;如果连 Astra 的单价都嫌高,同一套题上 GPT-6.1 Sol 的花费只有 Astra 的五分之一左右,值不值得多付钱见 GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选。
模型出现在文档里,不等于你的账户今天就能调用
模型页公开了 gpt-6-astra 和 claude-fable-5-1,只说明接口合同已经公开,不说明你的 API 项目、地区或组织已经有权限。截至 2026 年 10 月 26 日,Astra 的 API 权限跟着 API key 所属的组织和项目走,即使在 ChatGPT 企业工作区里开启了 Astra,也不会因此获得 API 访问。Fable 5.1 可以在 Claude API、Amazon Bedrock、Claude Platform on AWS、Microsoft Foundry 和 Google Cloud 上调用,但原生 API、各云平台和消费者套餐是不同的合同,地区、额度、价格和数据设置要分别确认。首次调用的条件和常见报错,见 GPT-6 Astra API 怎么开通?访问条件、首次调用与报错排查。
聊天产品里的情况也不一样。ChatGPT 的模型说明页写明,Enterprise 和 Edu 工作区默认关闭 Astra,要由工作区所有者开启;Plus 和标准 Business 在 Work 与 Codex 里每 5 小时约有 5–45 条 Astra 本地消息,Pro 没有 5 小时限制,部分付费套餐没有 Astra Extra High,Free 和 Go 用的是 GPT-6 Luna。哪些套餐能在普通聊天里选 Astra,官方帮助页无法直接读取,第三方的说法是 Pro、Business、Enterprise 可以,Plus 只在 Work 和 Codex 里可用。
Claude 这边,按 Claude 帮助中心关于 Fable 套餐权限的说明,所有付费套餐都能用 Fable 5.1,Free 不能用。Max、Team 高级席位和按席位计费的 Enterprise 高级席位把它算在套餐内,最多用掉每周额度的 50%,之后改用使用额度付费或换模型;Pro、Team 标准席位和 Enterprise 标准席位从第一条消息起就按使用额度付费。在 Claude Code 里用 Fable 5.1 需要 2.1.255 或更新版本。各套餐额度怎么算,见 Claude 用量限制总表:Free、Pro、Max 额度与重置,官方不公布条数。
正式花钱比较之前,先在实际生产账户完成一笔最小请求,并保存:请求的模型 ID、响应返回的模型标识、HTTP 状态、usage、错误正文、所在平台与计费层级。如果只能在聊天产品里选择模型,却没有 API 项目权限,这时还不能开始 API 成本对比。若通过云市场或聚合入口调用,也要使用该入口真实返回的模型与账单,不能套用原生 API 价格假定。
中国读者还需要特别注意:全球发布说明和网页可见性都不能证明中国境内可以注册、支付或稳定调用。账户资格、合同主体、可用地区和网络条件没有实际确认之前,"已发布"不能写进上线计划的可用性栏。
工具合同决定它是不是一次平滑迁移
对编程智能体来说,模型回答质量只是系统的一部分。工具选择、推理配置、长任务恢复和响应解析任何一项不兼容,都会把一次模型替换变成框架改造。
截至 2026 年 10 月 26 日,OpenAI 的最新模型指南写明 Chat Completions 不支持 GPT-6 Astra 和 GPT-6.1 Sol 的函数调用,要用工具就得走 Responses API。Astra 支持从 low 到 max 五个推理档位,不支持 none,官方文档没有写它的默认档位,ChatGPT 和 Codex 的说明建议从 Light(即 low)开始。旧系统如果把关闭推理当作低延迟路径,就要重新定义最低档位,不能把旧参数原样传过去。需要让 Astra 操作浏览器或桌面的,接入循环见 GPT-6 Astra 电脑操作 API:接入循环、安全确认与结果验收。
Fable 5.1 的限制在另一边。按 Anthropic 的 Fable 5.1 新特性说明,tool_choice 设为 {"type":"tool"} 或 {"type":"any"} 会返回 400,报错是 tool_choice: type "tool" and "any" are not supported for this model.,只能用 auto 和 none;助手消息预填充、budget_tokens 或关闭思考,以及 temperature、top_p、top_k 也都会返回 400。依赖强制工具调用的现有 Claude 客户端不能只换模型名就上线,要先改编排逻辑,并为模型没有按预期调用工具的情况留出可观察的失败分支。
两家的推理档位也不能当成相同的实验变量。Astra 的 high 与 Fable 默认的 high 不代表相同的计算量。更公平的做法是给两者相同的总费用上限、完成时间、最大尝试次数和验收规则,同时保存各自的实际配置,比较的是在同一业务约束下能不能完成任务,而不是参数名是否对称。
数据保留与安全回退可能直接否决候选
零数据保留是硬条件时,Fable 5.1 基本出局。按 Anthropic 的 API 数据保留说明,截至 2026 年 10 月 26 日,Fable 5.1 属于要求 30 天保留的模型,除非 Anthropic 明确授权,否则不提供零数据保留;不满足要求的组织调用会收到 HTTP 400,已开 ZDR 的组织可以单独给一个工作区开启 30 天保留来使用它。OpenAI 的零数据保留需要事先审批,按组织或项目设置,/v1/responses 和 /v1/chat/completions 都在适用范围内,没有看到针对 Astra 的排除;但 OpenAI 的数据控制说明保留了对特定客户把某些模型设为不适用的权利,所以"支持"不等于你的账户已经启用。
安全回退会改变实际回答你的模型。Fable 5.1 对每个请求运行安全分类器,网络攻击技术、部分生物学话题、提取思考内容和少数前沿模型开发任务会被拦下。API 里被拒的请求返回 HTTP 200 和 stop_reason: "refusal",stop_details.category 说明原因;设置 fallbacks: "default"(测试版,需要 server-side-fallback-2026-07-01 请求头)后,会改用 Claude Opus 4.8 或 Opus 5 重跑,按回退模型的价格计费。Anthropic 的 Fable 5.1 迁移指南写明,Amazon Bedrock、Google 托管的 Google Cloud 版本和 Microsoft Foundry 不提供这个参数,要在客户端自己实现回退。在 Claude 应用里,回退默认开启,界面会标出实际回答的模型,可以在设置中关闭"Switch models when a message is flagged",见 Claude 帮助中心关于 Fable 切换模型的说明。自 2026 年 9 月 24 日起,生物、前沿模型开发和提取思考这几类在输出前被拒的请求也开始计费。
因此,评测日志至少要保存请求的模型、响应返回的模型、stop_reason 和拒绝类别,以及是否发生了回退。只有 HTTP 200 不能证明预期的模型完成了任务;生成了结果,也不能证明数据条件符合内部政策。
公开基准能缩小测试范围,不能替代你的验收
论谁更强,截至 2026 年 10 月 28 日,第三方综合分数站在 Astra 一边。Artificial Analysis 在 10 月 27–28 日把智能指数从 v4.3.2 换成 v5.0,测试从 10 项改为 9 项;新版里 Astra 在每个推理档位都比 Fable 5.1 高 5–8 分,Fable 的最高分是 xhigh 档的 50 分,还低于 Astra medium 档的 51 分。跑一道指数题,Fable 的成本是 Astra 的 2.0–3.2 倍。旧版 v4.3.2 曾在 max 档给两者都是 53 分,发布周常被引用的"66 比 61"则是更早的 v4.1 结果,这些都已被取代,也不能和 v5.0 的分数逐分对比。
| 推理档位 | Claude Fable 5.1:v5.0 分数 / 每任务成本 | GPT-6 Astra:v5.0 分数 / 每任务成本 |
|---|---|---|
max | 49 / $13.04 | 57 / $6.24 |
xhigh | 50 / $10.89 | 55 / $3.66 |
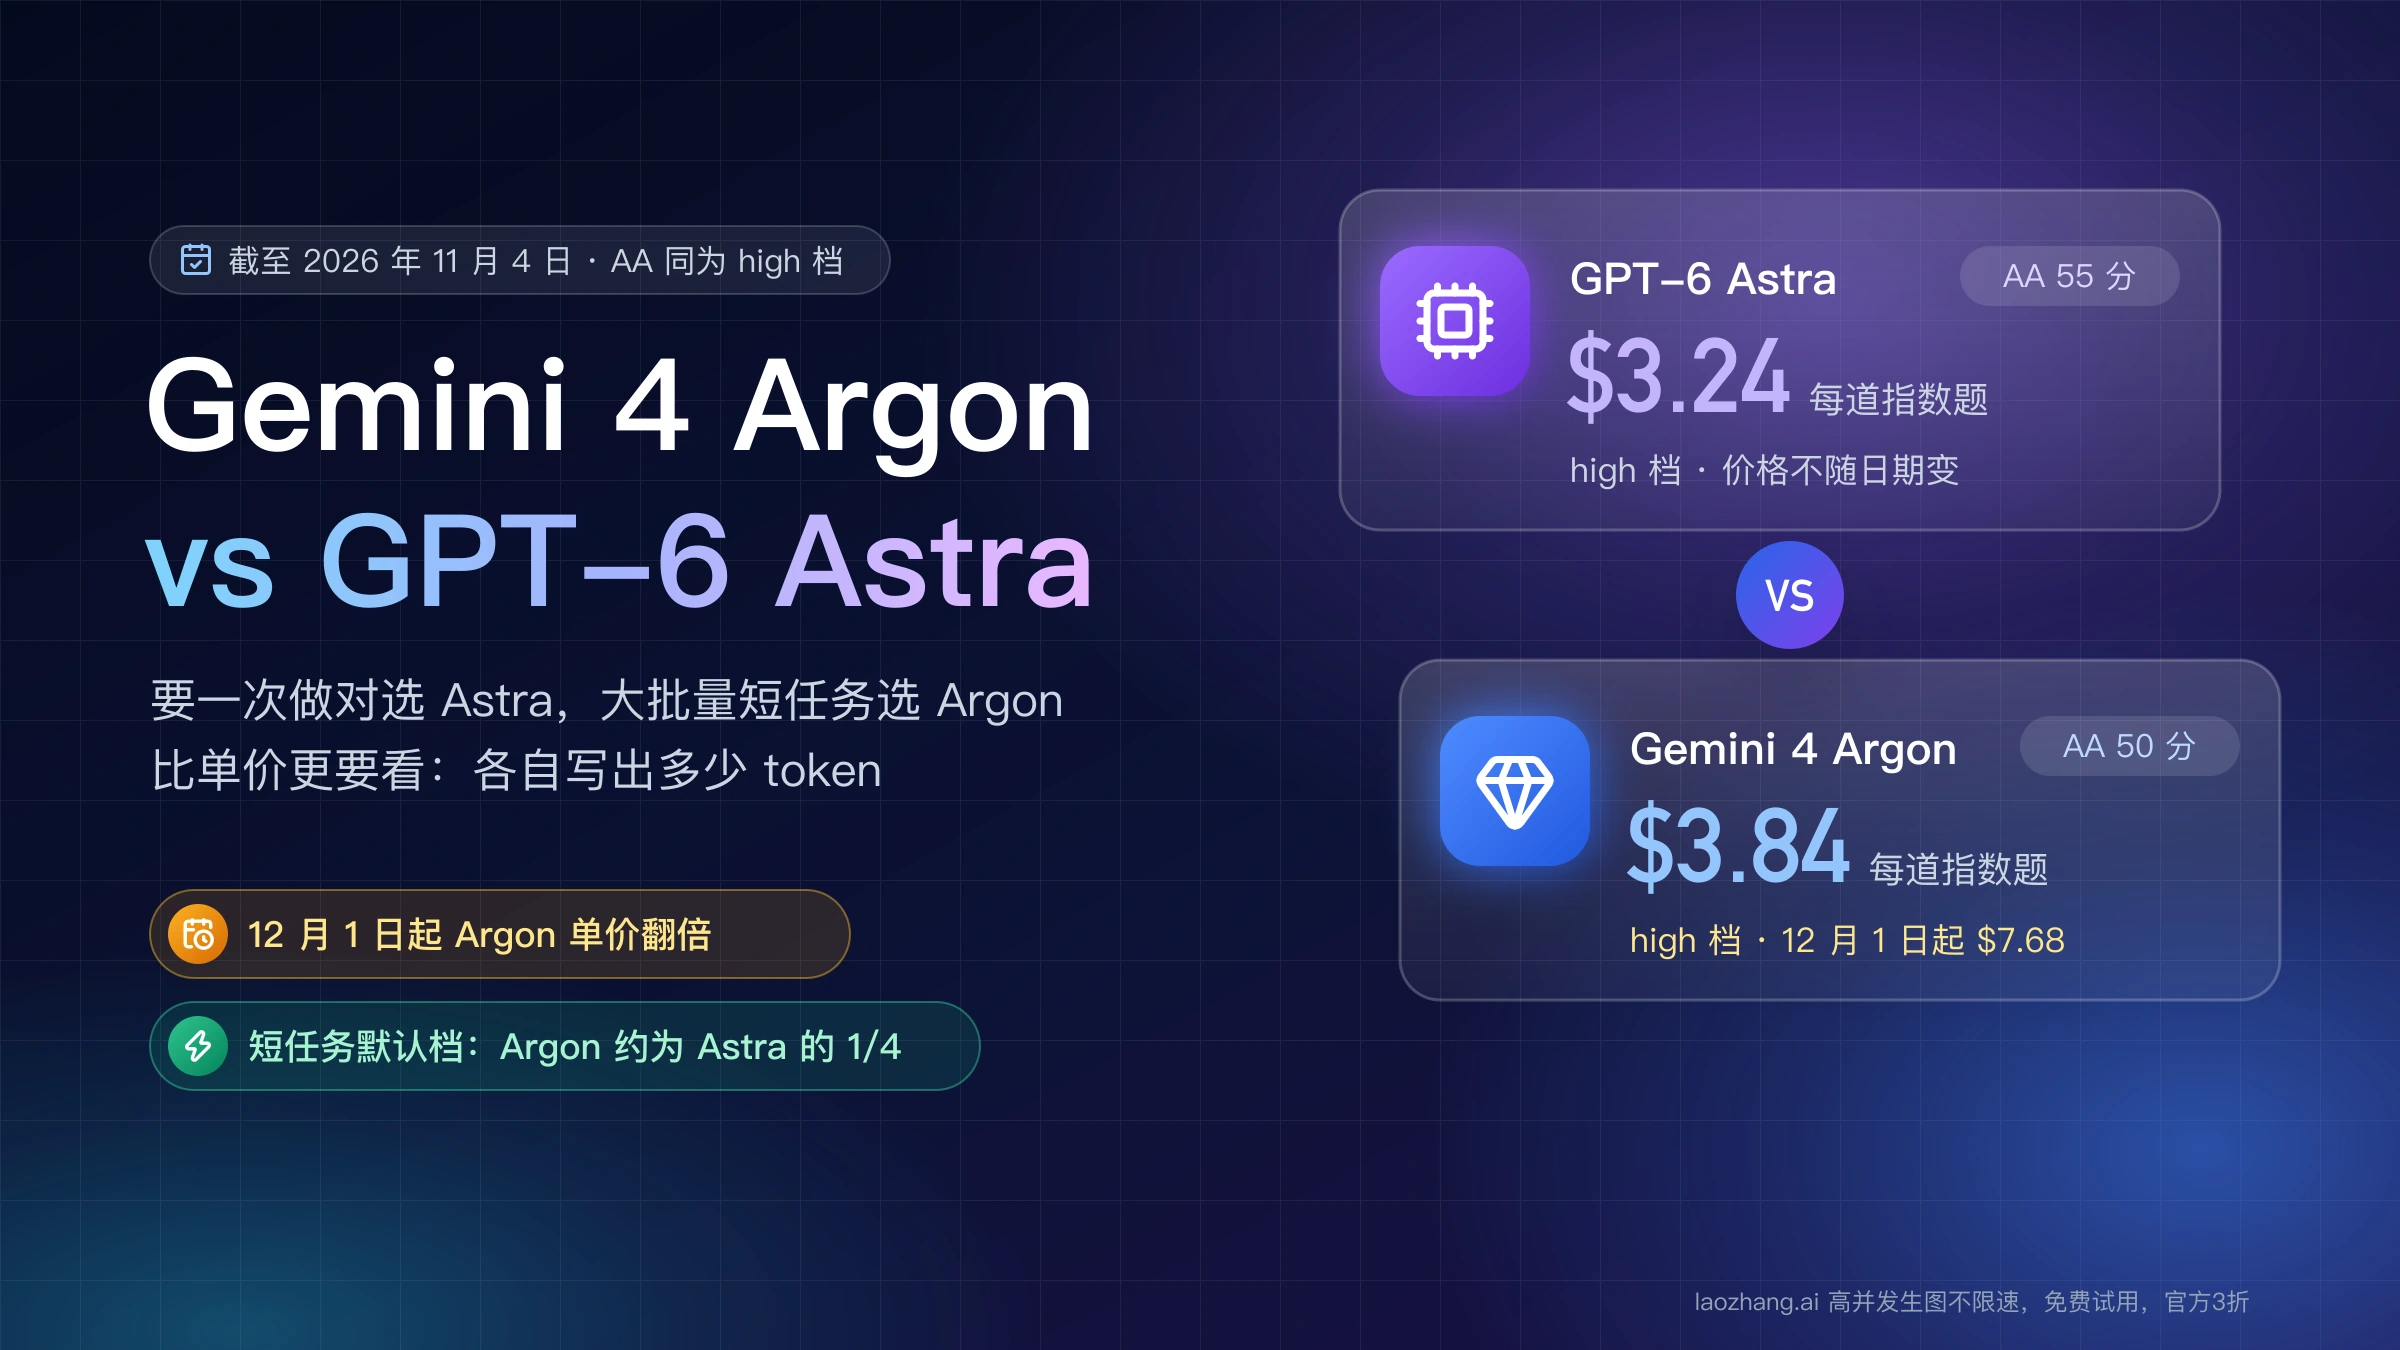
high | 47 / $7.56 | 55 / $3.24 |
medium | 43 / $5.58 | 51 / $2.73 |
low | 38 / $4.49 | 43 / $1.42 |
数据来自 Artificial Analysis 的 GPT-6 Astra 与 Claude Fable 5.1 对比页,截至 2026 年 10 月 28 日,Fable 一栏是带默认回退的成绩。每任务成本是按标价跑完整套测试摊到每道题的金额,反映的是这套测试的工作量,不是你的账单。同一页 10 月 28 日的 max 档输出速度为 Fable 每秒 66 个 token、Astra 71 个,Astra 到第一个回答 token 约 268.7 秒,Fable 在 10 月 26 日测得的首个 token 延迟是 180.5 秒;OpenRouter 上的中位吞吐量是 Fable 57.0、Astra 36.0 个 token 每秒,这些数字每天都在变。
分项上多数是 Astra 领先。OpenAI 发布页在 max 档、各自的测试框架下列出 Terminal-Bench 4.0 Astra 57.9% 对 Fable 55.8%,AutomationBench 41.4% 对 31.4%,DeepSWE v1.1 74.1% 对 67.4%,带工具的 Humanity's Last Exam 则是 Fable 65.0% 对 57.2%,这些是厂商自己公布的成绩。Artificial Analysis 的独立测试按 v5.0 的 max 档,Fable 只在 AA-Briefcase(1669 对 1568)和 AA-Omniscience(46 对 42)两项领先;Astra 在 Terminal-Bench 4.0(59.1% 对 52.0%)、AutomationBench-AA(68.5% 对 59.4%)、FrontierCode 2.0(42.4% 对 31.6%)、GDP.pdf(31.0% 对 26.2%)、HLE-Diamond(63.8% 对 60.1%)、CritPt(70.5% 对 51.0%)和 Terminal-Bench-Science(63.3% 对 43.3%)上领先。旧版 v4.3.2 里 Fable 领先的 GDPval-AA v2.1(1754 对 1573)、SciCode(63.1% 对 56.5%)和 AA-LCR 长上下文推理(85.3% 对 80.7%),已经不在 v5.0 指数里。
更难的题上,通过率可能拉开。Crazyrouter 在 2026 年 9 月 5 日的中文测试里设计了 29 个评分项,Fable 5.1 全部通过,Astra 通过 16 项,差距集中在三方并列的归因题和带错误前提的题上,短改写两边一样;这是第三方用自己的网关和构造题目做的小样本测试。也有博主报告 15 个用例里 Fable 的产出更好,但花了 $26.61、耗时 37 分钟,Astra 是 $12.14、23 分钟,只能当个人经验看。这正是要按通过任务算成本的原因:Fable 一次做对、Astra 需要重试时,单价上的差距可能被抵消。
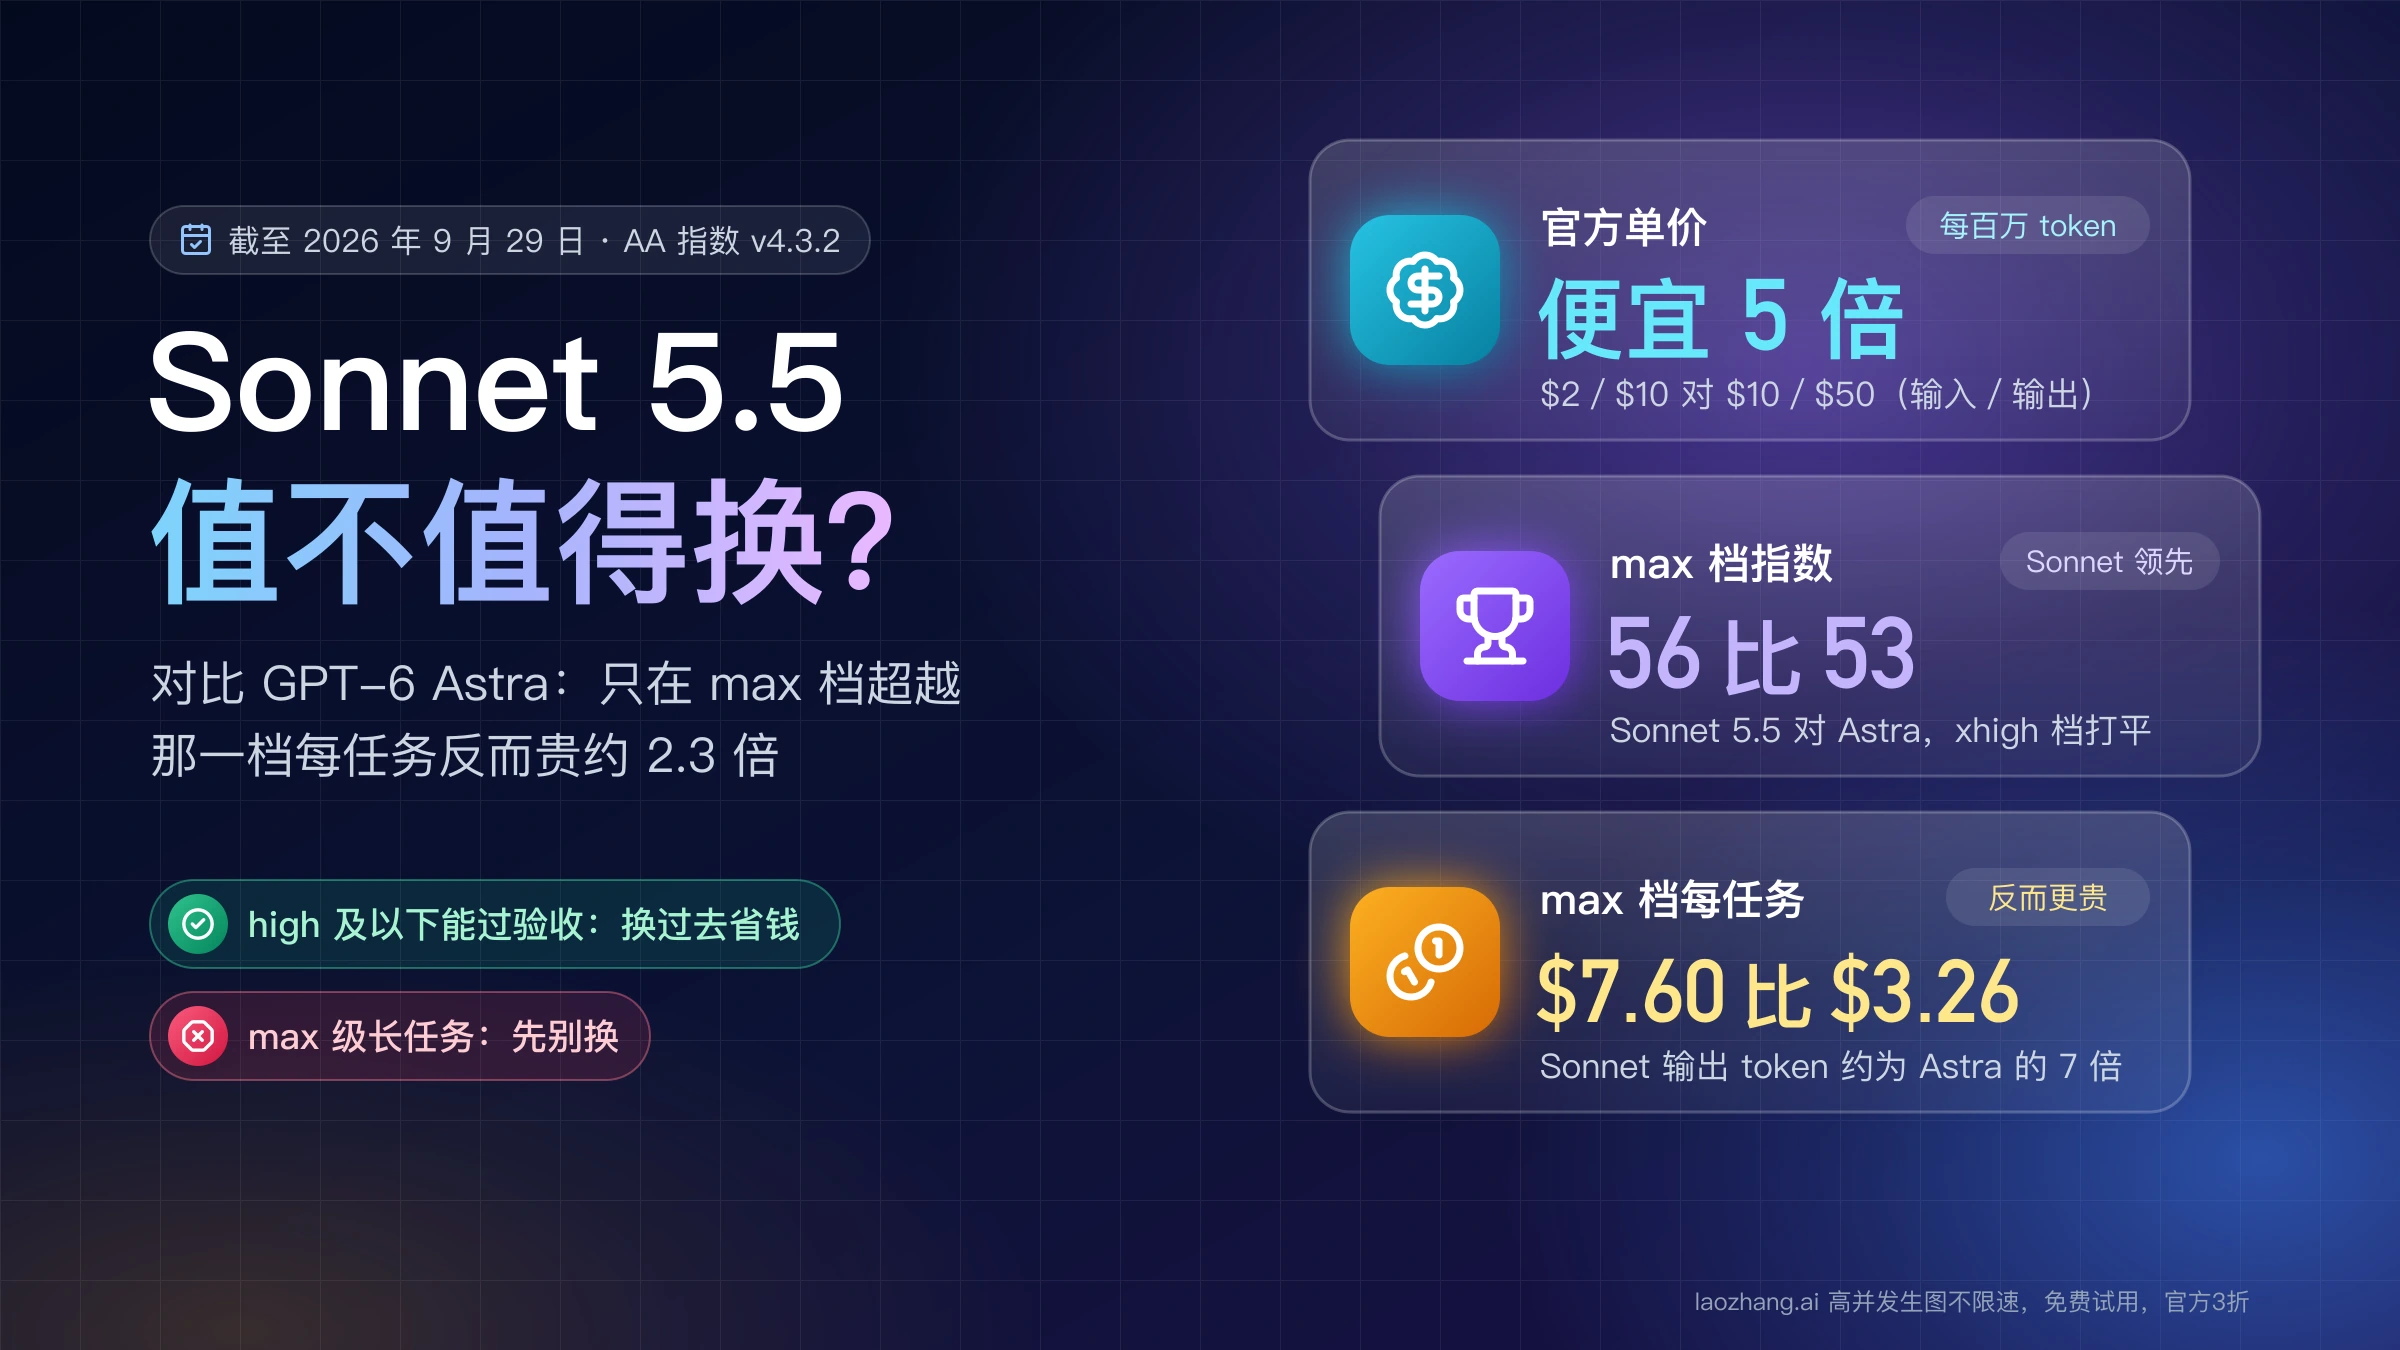
两家的推荐起点在发布后也都变了。OpenAI 在 2026 年 9 月 29 日推出 GPT-6.1 Sol,定位是接近 Astra 的表现、价格 $2/$10;Anthropic 的模型总览现在写的是多数工作负载先用 Opus 5.5,Fable 5.1 留给要求很高的推理和长时任务。Fable 值不值得比 Opus 5.5 多付钱,见 Claude Fable 5.1 和 Opus 5.5 怎么选?性能、价格与切换建议;想用更便宜的 Claude 对比 Astra,见 Sonnet 5.5 对比 GPT-6 Astra:值不值得换。截至 2026 年 10 月 26 日,Anthropic 没有发布 Fable 5.5 或更新的 Fable,传闻与已确认信息的区别见 Fable 5.5、Gemini 4、GPT-6.1 对比:Fable 5.2 已发布,5.5 未出。
公开基准最适合用来选择首轮任务:在意终端操作,就纳入真实仓库里可验收的修复;在意长时智能体,就测试多阶段任务中的中断恢复;在意研究工作,就要求来源、计算和最终交付都可核验。不要把榜单分数直接写成采购权重,也不要把不同测试框架下相邻的数字当成误差为零的比赛。
用自己的工作负载做一次可否决的比较
选少量但能覆盖真实失败代价的任务,并且一定放进几道你预计只有一边能做对的题。前面的同题测试两边全过,只能比出成本;要比出能力,题目必须能把两款模型分开。编程团队可以放入一个跨文件功能、一个带回归测试的缺陷修复、一个需要终端或浏览器工具的任务,以及一个大上下文代码审查;研究或专业工作团队可以换成长文档分析、数据核对和需要引用的交付物。
每项任务开始前固定这些条件:
- 用同一份输入快照,移除前一次模型留下的答案和评语,并把同一段代表性提示分别发给两边,记下各自的输入 token,算出你自己的 r。
- 给予等价的工具权限,记录不能等价的接口差异,例如 Astra 走 Responses、Fable 不能强制工具调用。
- 预先写明时间盒、总费用上限、最大尝试次数和停止条件。
- 预先写明验收标准,例如测试通过、关键事实正确、引用可打开、没有越权修改、核心方案无需人工重写。
- 保存所有尝试的 usage:Astra 的
cached_tokens、cache_write_tokens、reasoning_tokens,Fable 的cache_creation_input_tokens、cache_read_input_tokens和输出 token,以及完成时间、错误、回退和人工修正分钟数。
不要要求两款模型生成相同长度或遵循同一段思考过程。应该保持一致的是业务输入和合格结果,而不是供应商的内部实现。某款模型如果需要更少的输出、更少的重试或更短的人工复核,即使单次请求略贵,通过任务的成本也可能更低。
首轮完成后按任务组而不是总平均数做决定。重复读取稳定大前缀的任务,看缓存写入之后的连续命中和真实节省,Fable 要确认 cache_control 生效、停顿不超过缓存有效期;超过 272K 输入的任务,单独比较检索压缩、拆分执行和完整长上下文三种做法;多工具编程任务,看调用正确率、测试闭环、失败恢复和 tool_choice 的适配成本;有敏感数据的任务先查账户级数据设置,不合规的结果质量再高也不进入排名;对延迟敏感的任务比较完整任务时间和尾延迟,若试 Astra 的 Fast 模式,按 2 倍价格单独建组。
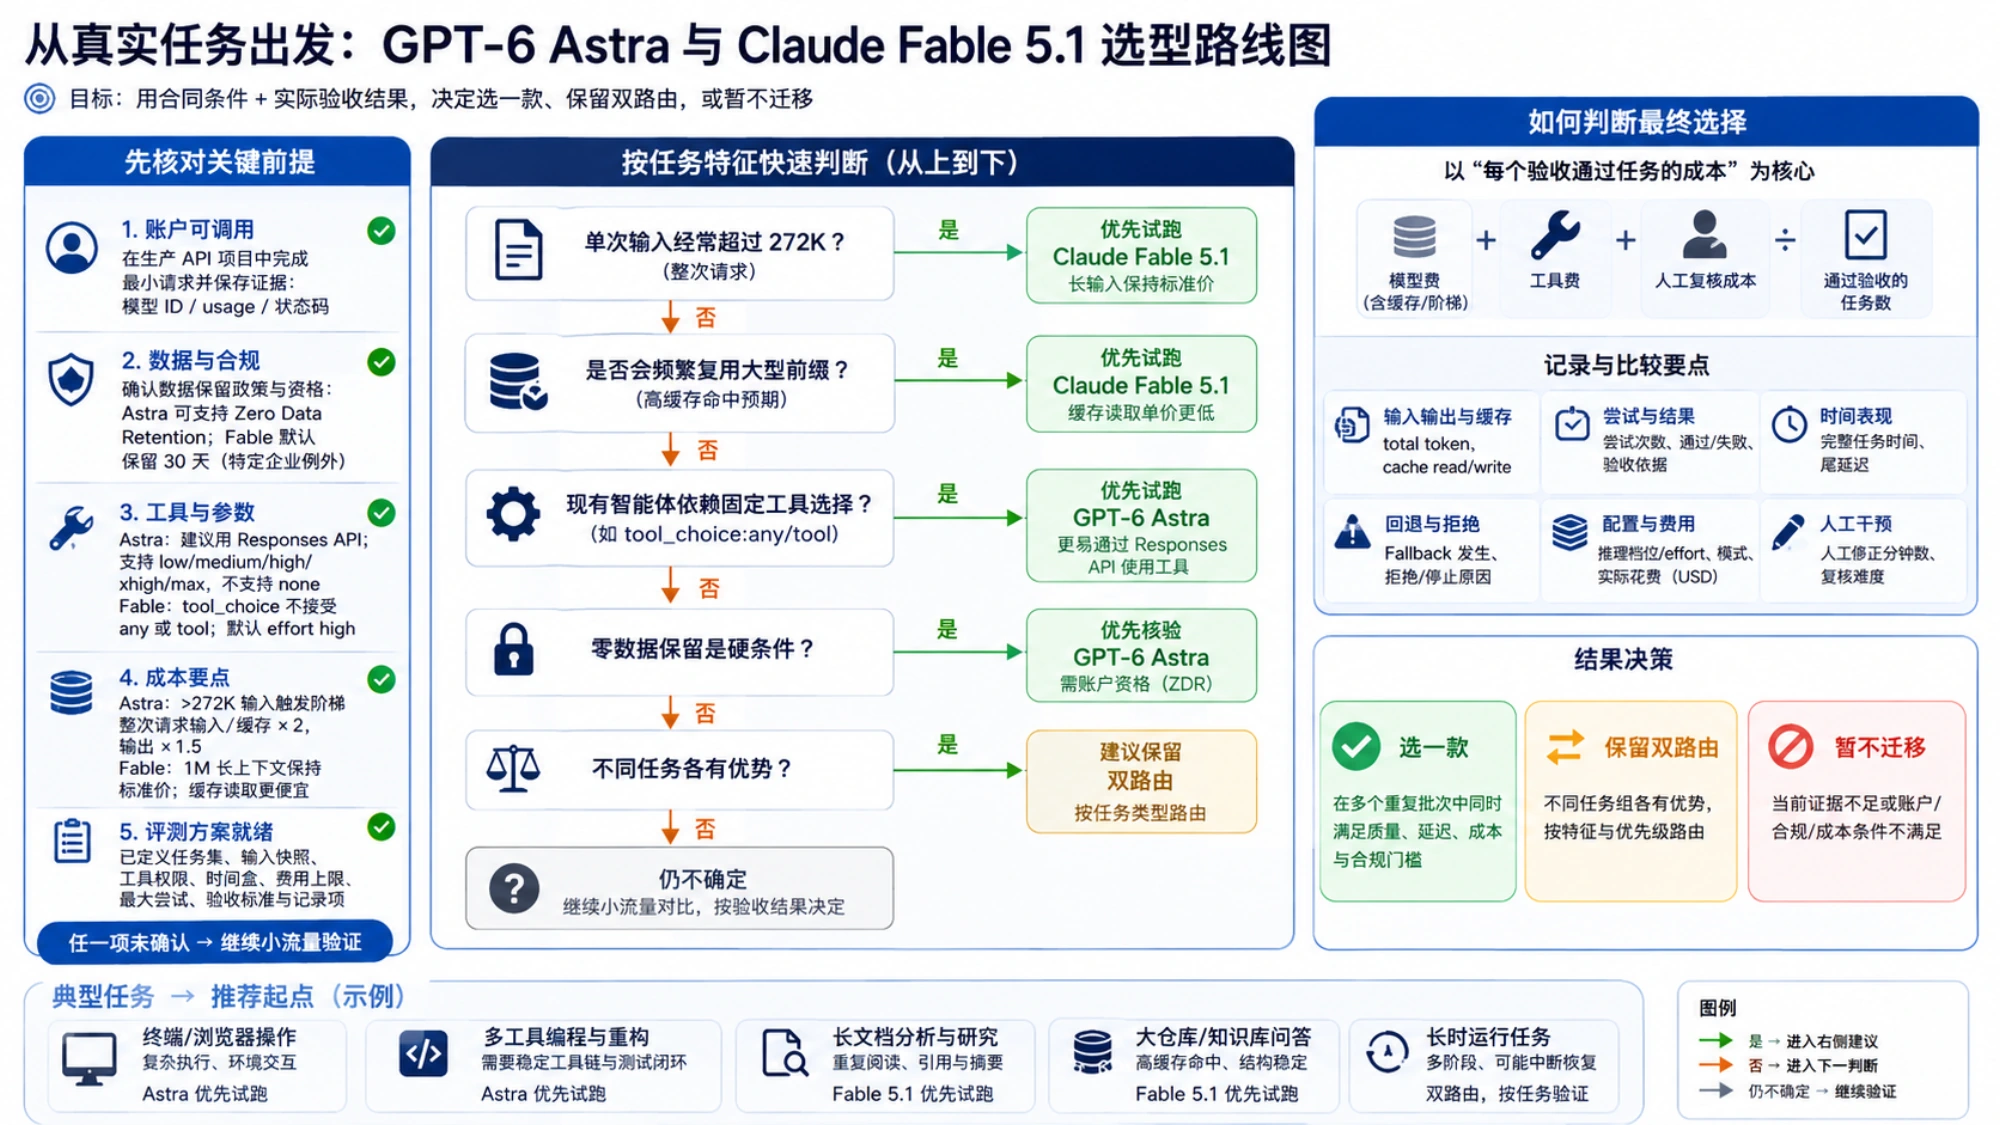
如果 Astra 在短任务和工具密集任务上通过率相同而花费更低,Fable 5.1 在高缓存或超长文档任务上成本更低、通过率更高,合理的结果就是双路由。只有一款模型在多个重复批次里同时达到质量、延迟、成本与合规门槛,才值得成为全局默认。
一份能直接落地的选择记录
正式迁移前,把决定压缩成一页记录:当前账户能调用的精确模型、适用的任务组、禁止处理的数据、标准与长输入价格、你实测的 token 比例 r、缓存设置与有效期、工具适配状态、通过率、每个通过任务的成本、回退模型和回滚触发条件。任何一个字段还是推测,就继续小流量验证,不要用发布期的热度填空。
如果团队已经在用 Claude,要处理模型 ID、缓存、effort 和工具选择的变化,可以继续看 Claude Fable 5.1 与 Opus 5:API 价格与任务成本怎么算。无论最后选哪款,扩流当天都要重新打开官方文档并核对实际账户;这里的价格、权限和接口行为截至 2026 年 10 月 26 日,之后可能变化。
最稳妥的结论不是"谁更强",而是先用合同排除不可用或不合规的候选,再用同一批真实任务和你自己的 token 比例,算出每个验收通过结果的总成本。能按任务保留第二条路线,就不必把所有工作负载押在一个名字上。
GPT-6 Astra 与 Claude Fable 5.1 的其他问题
GPT-6 Astra 是什么时候发布的,和 GPT-6 是一回事吗?
GPT-6 Astra 于 2026 年 9 月 3 日发布,是 OpenAI 目前能力最强的型号,但 GPT-6 是一个系列,还包括 Sol 和 Luna,2026 年 9 月 29 日又推出了 GPT-6.1 Sol,所以"GPT-6"不能单指 Astra。Claude Fable 5.1 早两天,于 2026 年 9 月 1 日发布,Anthropic 写明它的退役时间不早于 2027 年 9 月 1 日。
用 Batch 半价跑,结论会变吗?
截至 2026 年 10 月 26 日,两家的 Batch 都是标准价的一半,输入 $5、输出 $25,比例关系不变,所以上面的盈亏点同样适用。区别在功能上:Anthropic 在 Fable 5 的发布说明里写明,fallbacks 回退参数不支持 Message Batches API,批量任务被拒时要自己处理重跑。
通过 OpenAI 兼容接口调用 Fable,思考 token 会不会不计费?
会计费,只是看不到单独的数字。2026 年 10 月 26 日用 Messages 格式调用 Fable,没有返回任何思考文字,但一个 "ok" 也计了 132 个输出 token,思考就算在输出里;Crazyrouter 在 2026 年 9 月 5 日也观察到,兼容接口返回的 reasoning_tokens 为 0,思考被并进了 completion_tokens,原生 Messages 接口才会单独列出思考内容。比较成本时直接用总输出 token。
参考来源16
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
参考来源16
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
- 1.OpenAI 的 GPT-6 Astra 模型页developers.openai.com/api/docs/models/gpt-6-astra
- 2.Anthropic 的 Claude Fable 5.1 模型页platform.claude.com/docs/en/models/fable-5-1/overview
- 3.OpenAI API 更新日志developers.openai.com/api/docs/changelog
- 4.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 5.Anthropic 的 Claude API 定价页platform.claude.com/docs/en/about-claude/pricing
- 6.Anthropic 的 token 计数文档platform.claude.com/docs/en/build-with-claude/token-counting
- 7.OpenAI 的提示缓存指南developers.openai.com/api/docs/guides/prompt-caching
- 8.ChatGPT 的模型说明页learn.chatgpt.com/docs/models
- 9.Claude 帮助中心关于 Fable 套餐权限的说明support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- 10.OpenAI 的最新模型指南developers.openai.com/api/docs/guides/latest-model
- 11.Anthropic 的 Fable 5.1 新特性说明platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- 12.Anthropic 的 API 数据保留说明platform.claude.com/docs/en/manage-claude/api-and-data-retention
- 13.OpenAI 的数据控制说明developers.openai.com/api/docs/guides/your-data
- 14.Anthropic 的 Fable 5.1 迁移指南platform.claude.com/docs/en/models/fable-5-1/migration-guide
- 15.Claude 帮助中心关于 Fable 切换模型的说明support.claude.com/en/articles/15363606-why-claude-switched-models-in-your-conversation-with-fable-5-or-fable-5-1
- 16.Artificial Analysis 的 GPT-6 Astra 与 Claude Fable 5.1 对比页artificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-1