Qwen3-30B-A3B 本地部署:版本怎么选、显存怎么估?
需要在同一模型中切换思考模式,选原版;普通问答选 Instruct-2507,复杂推理选 Thinking-2507,代码任务选 Coder。A3B 仍需保存 30.5B 权重,实际内存还要加上上下文缓存。
文章目录
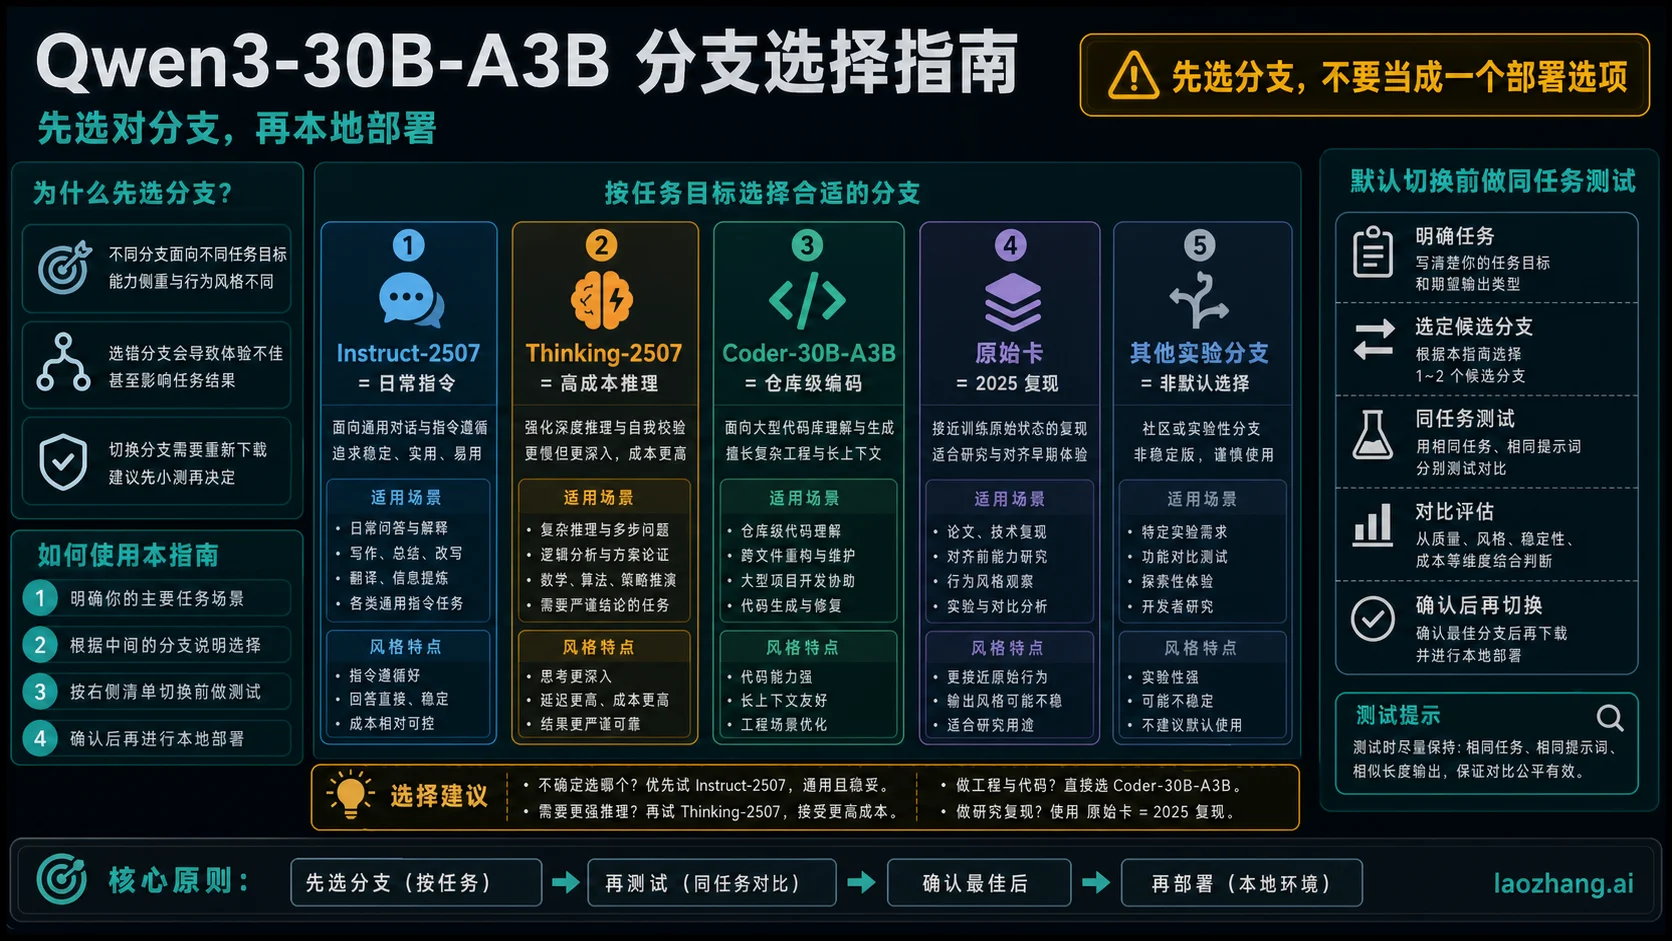
Qwen3-30B-A3B 本地部署,先按用途选版本:日常问答、摘要与结构化提取可从 Instruct-2507 开始;复杂推理考虑 Thinking-2507;代码与工具调用考虑 Coder;需要在同一个模型里切换思考和非思考模式,则选原版 Qwen3-30B-A3B。 原版现在仍有这种使用价值,并非只能用于复现旧评测。
硬件方面,A3B 指每个 token 激活约 3.3B 参数,模型总参数仍为 30.5B。当前 Ollama 的 30B Instruct-2507 Q4_K_M 包约为 19GB,不能按一个 3B 小模型准备内存;长上下文还会增加 KV 缓存。下面分别给出准确模型名、可用的本地启动步骤,以及选择上下文时的内存口径。命令按公开文档整理,本文没有运行模型,也没有测得速度或显存峰值。
先选版本:原版、2507 与 Coder 各适合什么?
四个模型的区别首先是输出方式和用途,其次才是名字相似。2507 是 2025 年 7 月的版本标记,不是 2026 年的新发布日期。
| 你需要的行为 | 准确的 Hugging Face 模型 ID | 模式与原生上下文 |
|---|---|---|
| 同一模型兼顾快速回答和需要展开的推理 | Qwen/Qwen3-30B-A3B | 可切换思考/非思考;原生 32,768 token,YaRN 扩展至 131,072 |
| 普通问答、摘要、分类、按格式提取信息 | Qwen/Qwen3-30B-A3B-Instruct-2507 | 固定非思考;原生 262,144 token |
| 多约束推理、数学、复杂问题分析 | Qwen/Qwen3-30B-A3B-Thinking-2507 | 固定思考;原生 262,144 token |
| 代码修改、代码理解、接入编码工具 | Qwen/Qwen3-Coder-30B-A3B-Instruct | 固定非思考;原生 262,144 token |
上述模式和长度分别来自原版模型卡、Instruct-2507 模型卡、Thinking-2507 模型卡与 Coder-30B 模型卡。表中的原生长度是模型能力边界,运行软件实际分配多少要另查。
如果主要处理短文摘要、工单分类或固定 JSON 输出,Instruct-2507 的非思考输出更便于直接接入应用。这是按输出需求作出的选择,不意味着它不能解推理题,也不意味着本文验证了它在你的机器上更快。
如果任务的难点是多步推导,可以选择 Thinking-2507,但要给思考过程和最终答案留出输出空间。它不能用 /no_think 变成 Instruct-2507。其模型卡明确写明固定思考,聊天模板会预先加入 <think>,因此生成文本有时只出现结束标记 </think>;这本身不是输出损坏。
如果任务围绕代码仓库、函数调用或编码助手,Coder 是更贴近用途的起点。不过模型提出工具调用,不代表工具已经执行。应用仍需要兼容的调用格式、解析器和实际工具实现;先让它解释小段代码或提出补丁,再接入能够修改文件的工具,比较容易分清模型问题和集成问题。
原版适合另一种明确需求:平时短答,遇到复杂题再开启思考,且希望保持同一套权重和聊天历史。例如本地知识助手可以先用非思考模式提取条款,再用思考模式分析相互冲突的条件。这样的切换需求没有因为 2507 出现就消失。
用 Ollama 开始:明确指定 30B 标签
如果已经安装并启动支持该模型的 Ollama,可先用下列两个已公布标签。前提是有足够的磁盘、内存和合适的 CPU/GPU 配置;首次运行会下载模型,以下命令是供你在自己的环境使用的文档示例。
普通问答与摘要:
ollama run qwen3:30b-a3b-instruct-2507-q4_K_M代码任务:
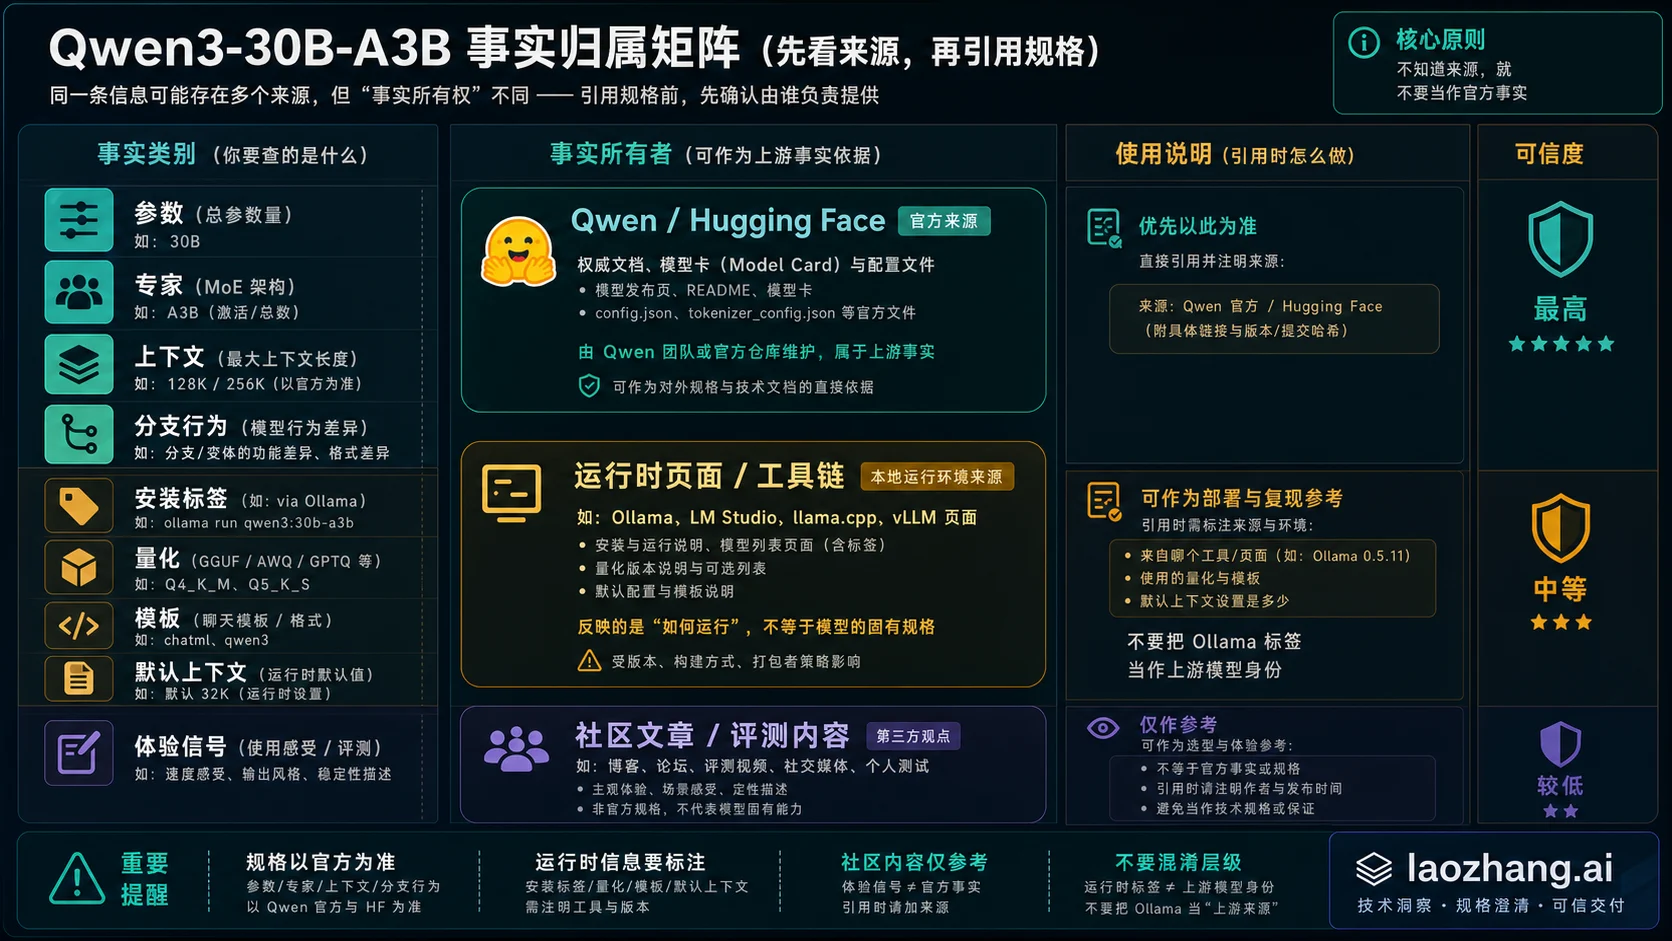
ollama run qwen3-coder:30b这两个标签分别有 Instruct-2507 的明确版本页面和 Coder-30B 页面。2026 年 10 月 7 日查到的包均为 Q4_K_M,显示大小约 19GB;下载文件大小不等于运行时内存峰值。
不要用 ollama run qwen3 来表示“运行 30B”。 当次查到的 qwen3 默认标签是 8B、约 5.2GB。另外,qwen3:30b 和 qwen3:30b-a3b 是较短的标签;它们的页面与通用家族介绍不能单独证明你取得的是上游原版双模式权重。需要 Instruct-2507 时,先选明确写出版本和量化方式的标签。
标签仍可能更新。安装后,在另一终端核对模型:
ollama show qwen3:30b-a3b-instruct-2507-q4_K_M
ollama show qwen3:30b-a3b-instruct-2507-q4_K_M --modelfile
前一条用于查看本地模型信息;后一条展开模板和参数。记录模型名称、量化、上下文信息以及模板。如果目标是长期复现,还应保存确切文件或仓库修订版本,不能只留下可变的短标签。Ollama 的模板与参数结构见 Modelfile 文档。
先配置 8K 上下文,再检查实际分配
进入上面的交互会话后,可以输入:
/set parameter num_ctx 8192然后再发送一个短任务。8,192 token 是这里主动选择的起步窗口,方便控制缓存预算;它不保证任意机器都能加载 30B,也不是这个模型的最大能力。Ollama 的上下文设置文档支持交互命令 /set parameter num_ctx,也支持 API 请求中的 options.num_ctx。
发送请求、模型仍驻留时,在另一终端运行:
ollama ps重点看 CONTEXT 和 PROCESSOR:前者是实际分配的上下文,后者表示 CPU/GPU 的分配情况。下载成功但大量放到 CPU,与模型完全驻留 GPU,是不同的运行条件。ps 的用途与字段见 Ollama 上下文文档。
不要把默认值当成常量。当前上下文文档按显存给出低于 24GiB 为 4K、24–48GiB 为 32K、至少 48GiB 为 256K 的默认规则,FAQ 则仍写 4,096。这两处说明存在差异,因此在自己的版本上明确设置 num_ctx,再以 ollama ps 的分配结果核对,比直接假定“默认就是 256K”可靠。
一个可以核对答案的中文本地任务
先用小任务确认输入、输出和版本选择,比一上来塞进整本手册更容易定位问题。下面的例子要求 Instruct-2507 从四条订单中提取已支付数量和金额,不涉及外部工具,也不需要长文推理。
Ollama 已在本机默认地址 127.0.0.1:11434 运行时,可发送以下请求;本文没有执行它,代码块也不是实际返回记录。
curl http://127.0.0.1:11434/api/chat \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen3:30b-a3b-instruct-2507-q4_K_M",
    "stream": false,
    "messages": [
      {
        "role": "user",
        "content": "请只返回 JSON,字段为 paid_orders 和 paid_total。只统计状态为 paid 的订单,金额保留两位小数。数据:O101,paid,12.50;O102,pending,8.00;O103,paid,7.50;O104,cancelled,9.00。不要把未支付或取消订单计入。"
      }
    ],
    "options": {
      "num_ctx": 8192,
      "num_predict": 512
    }
  }'
stream: false 让这次请求返回一个完整响应,最终回答在 message.content 中。num_ctx 控制上下文,num_predict 限制这次生成的 token 数;相应请求与参数结构见 Ollama API 源码定义。
人工可直接核对的标准是:已支付订单 2 条,合计 20.00,因为 12.50 + 7.50 = 20.00。这是从示例输入算出的验收标准,不是模型实际输出。如果返回带有额外解释、字段缺失或计入了 pending,就还没有满足这个任务的要求。应用接入时应再用 JSON 解析与业务校验处理输出,而不能只看文本像不像 JSON。
若接着比较 Coder,可以换成一个小函数任务:要求用 Python Decimal 编写 paid_total(rows),只累计 paid 行,明确遇到无效金额时抛出异常,并给出“全部未支付”“正常金额”“非法金额”三个测试。用自己的解释器执行生成代码和测试,才能判断代码是否可用。模型写出测试文本,与测试真实通过,是两件事。
思考模式怎么控制?先看你下载的是哪一版
原版、固定模式的 2507 和 Ollama 的控制字段不能混用。
原版 Hugging Face 聊天模板: enable_thinking=True 是默认设置;enable_thinking=False 可关闭思考。在开启设置下,用户或系统消息中的 /think、/no_think 可以作软切换;关闭设置后,/think 不能重新打开思考。下面只是原版已加载 tokenizer 的模板片段,不包含加载权重或推理步骤:
text = tokenizer.apply_chat_template(
    [{"role": "user", "content": "把会议记录整理为待办,列出负责人和截止日:小林周五交预算;小周下周一核对发票。/no_think"}],
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=True,
)
示例只展示模板控制,不是模型回答。要在模板层明确关闭,则把 enable_thinking 改成 False,无需再靠提示词要求少想。具体行为以原版模型卡的模式切换说明为准;此参数不能拿来把 Thinking-2507 改造成非思考模型。
Ollama 接口: 使用的字段是 think,并非 enable_thinking。先查询本地模型支持的控制值:
curl http://127.0.0.1:11434/api/show \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3:30b-a3b-instruct-2507-q4_K_M"}'
当前 Ollama 思考文档说明,可用 thinking.values 和 thinking.default 查看支持值与默认行为。只有模型允许时,think: false 才能用于关闭;缺少这段元数据也不能据此断言模型内部完全没有思考。支持思考的聊天响应会把 message.thinking 与 message.content 分开。
固定非思考的 Instruct-2507 无需为了得到普通回答额外添加 think: false。要用 Thinking-2507,就选择其准确的上游模型 ID 和兼容实现;本文没有核验到足以推荐的明确 Ollama Thinking-2507 标签,因此不拼出一个似乎合理的下载命令。若使用 Hugging Face Transformers,三个新分支的模型卡均提示低于 4.51.0 会出现 KeyError: 'qwen3_moe',应按对应卡的 Quickstart 检查兼容性。
另外,Ollama 的隐藏思考显示选项只改变显示,不等于停止生成思考。需要控制输出成本时,应核对模型模式与真正的生成控制,而不是仅把界面里的思考文字藏起来。
A3B 为什么仍需要较大的内存?
MoE 的优势是每次只激活部分专家参与计算,但下一步可能路由到其他专家,因此常规部署仍需保存完整模型权重。原版模型卡给出 30.5B 总参数、3.3B 激活参数、128 个专家和每次激活 8 个专家;2507 与 Coder-30B 也保留这一总参数和激活参数规模。
只计算理想 4bit 权重的数据部分:
30.5 × 10^9 参数 × 4 bit ÷ 8
= 15.25 GB
≈ 14.20 GiB
这不是完整量化文件大小。量化尺度、未量化部分、文件结构和运行时都会增加占用,所以实际 Ollama Q4_K_M 包约 19GB 并不与这个理想计算矛盾。加载后还需加入缓存、临时激活与框架开销,不能据此保证“16GB 显卡一定够”。CPU 分担权重可以改变显存需求,但也会改变延迟和吞吐,需在你的任务上测量。
上下文变长,KV 缓存也会增长
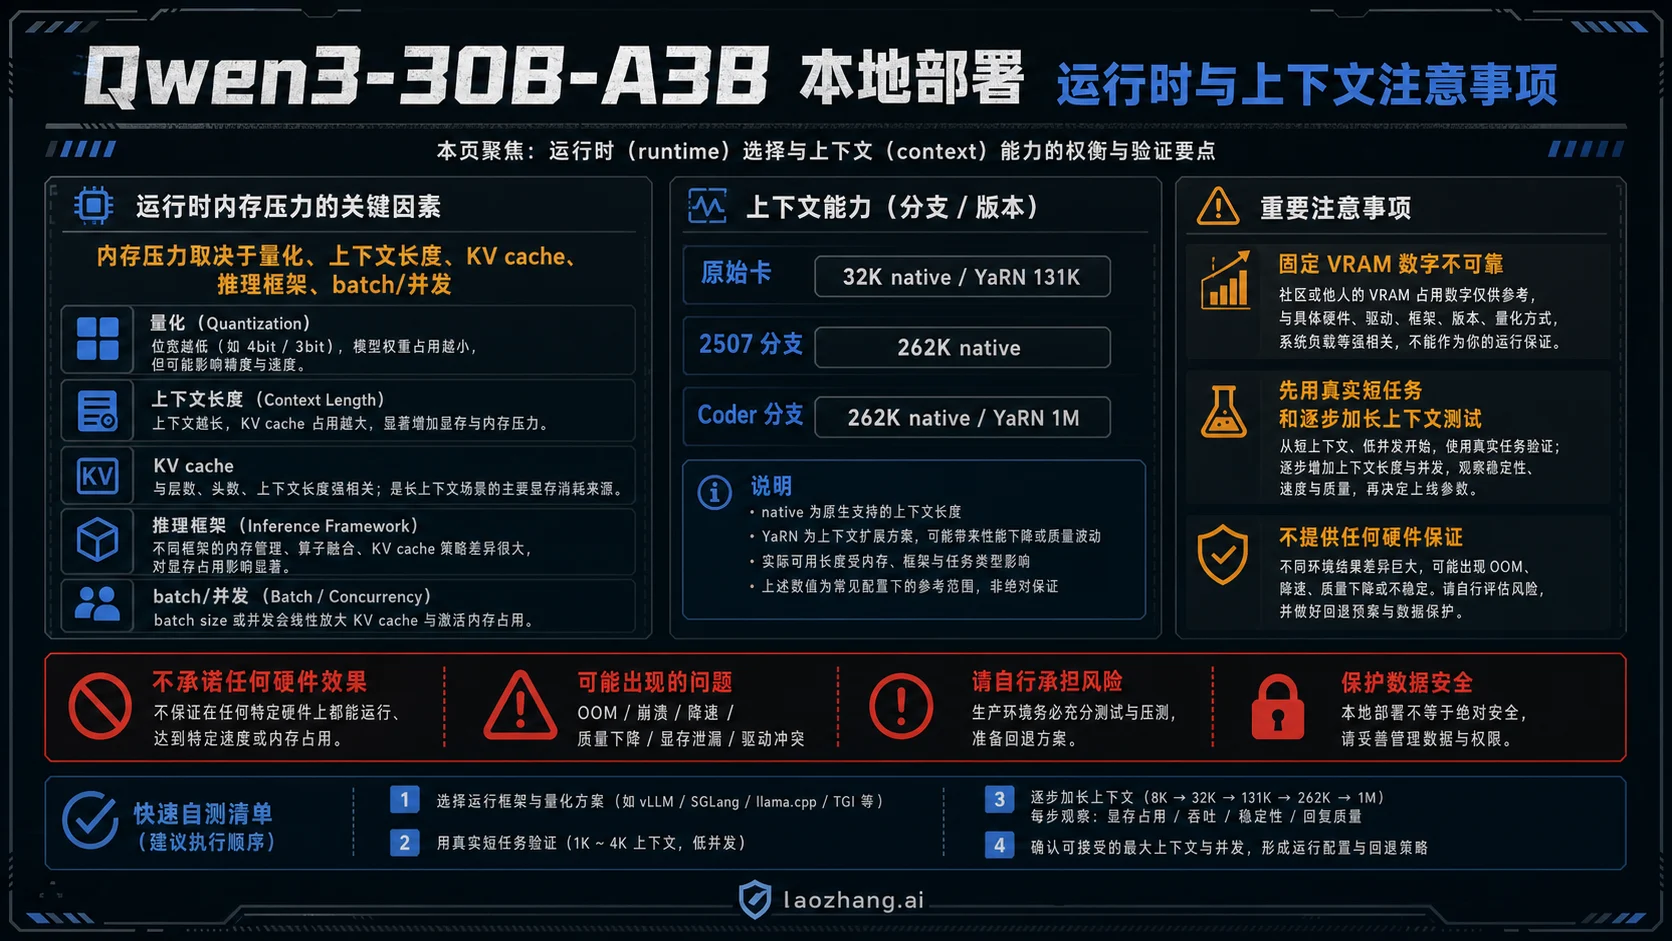
用 Coder-30B 的实际配置作一个有明确条件的估算:48 层、4 个 KV 头、每头维度 128,K 和 V 均用 F16,每个元素 2 字节。每个已存 token 的 KV 数据量为:
2(K 与 V)× 48 × 4 × 128 × 2 字节
= 98,304 字节
= 96 KiB| 单条序列存储的 token 数 | F16 KV 数据部分 |
|---|---|
| 8,192 | 0.75GiB |
| 32,768 | 3GiB |
| 65,536 | 6GiB |
| 262,144 | 24GiB |
这是离线算术,不是测量结果,且不含权重、临时激活、填充和运行时开销。实际实现可能提前分配缓存,也可能使用分页或缓存量化;多条并发序列还会增加总量。权重用 Q4,并不自动意味着 KV 也用 4bit。这个表的作用是解释:同一个 30B 模型,从短聊改成长文或多并发之后,为什么可能突然内存不足。
256K、1M 和实际可输入长度有什么区别?
先看上游模型:原版原生 32,768,YaRN 扩展至 131,072;两款 2507 与 Coder 的原生长度是 262,144。再看本地量化包与引擎设置:当前 Ollama 短 30B 标签的元数据也显示 262,144,但不能用它反过来修改原版 Hugging Face 模型卡的原生长度。
最后看请求预算。上下文需容纳系统提示、聊天模板、历史对话、用户材料以及生成内容。8K 设置不等于可以输入满 8K 材料后,再额外输出 512 token。 上面的请求主动留出生成预算;实际计算还要计入模板和历史,不能把中文字数直接当 token 数。Thinking 分支还要给生成的思考内容留出空间。
1M 也有不同条件。两款 2507 的模型卡提供 DCA、MInference 与 config_1m 的专门长文本方案,并说明约需 240GB 总 GPU 内存;那是该方案的条件,不是普通 30B 短聊要求。Coder 的模型卡则说明可用 YaRN 外推至 1M。两者都不能理解成普通 Q4 包下载完就能直接使用 1M,更不能把原生 256K、外推长度和当前 num_ctx 混为一谈。具体说明见 Instruct-2507 超长文本章节及 Coder 模型卡。
遇到内存不足时,先降低 num_ctx 并检查 ollama ps,再判断是否需要更低权重量化、CPU 分担或不同硬件。任务确实需要长文时,逐步增加窗口并测自己的材料;盲目把数字调到模型卡上限,不能证明长文答案可靠。
Qwen3.8 是这个 30B 模型的新名字吗?
不是。Qwen3.6-35B-A3B是另一个带视觉编码器的 MoE 模型;Qwen3.8-27B则是独立的 27B 稠密视觉语言模型,采用混合注意力。它们都不是 Qwen3-30B-A3B 的别名,不能把名称改成“Qwen3.8-30B”后沿用上述内存计算与下载标签。
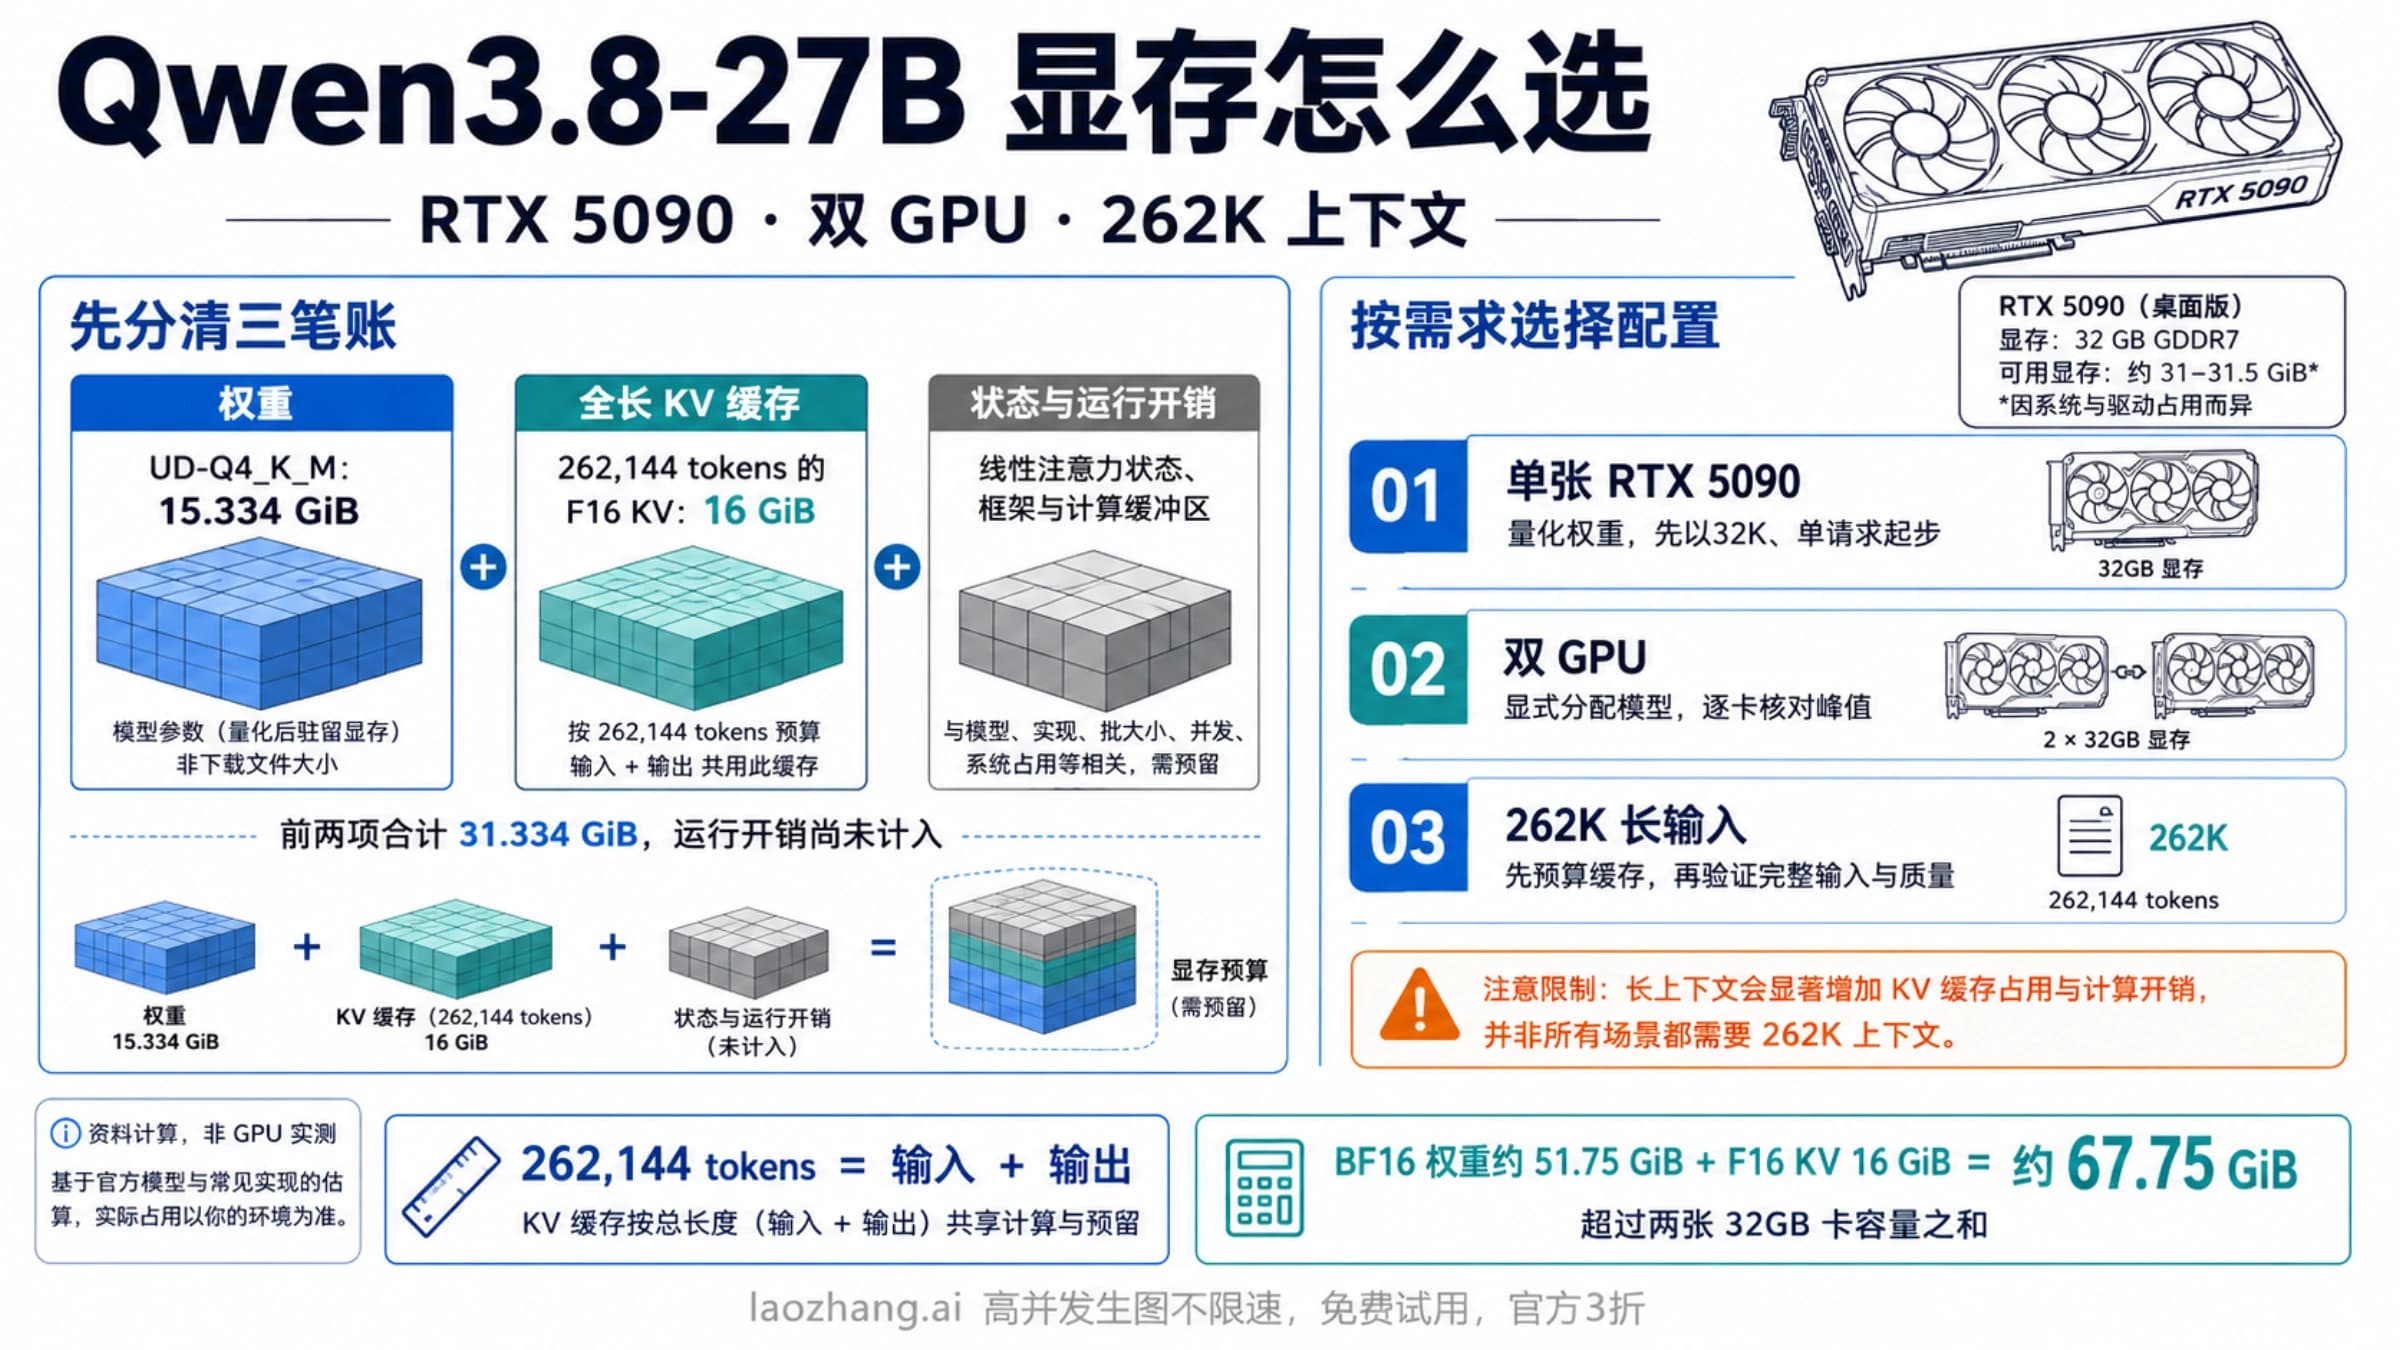
如果你的问题已变成 27B 视觉模型在 RTX 5090 上怎样安排量化、双卡和 262K 上下文,可继续看 Qwen3.8-27B 的显存与配置指南。那是另一种模型结构下的配置任务,不代表本页已经测得它比 30B 分支更快或更适合所有用途。
常见问题
Qwen3-30B-A3B 是 3B 模型吗?
不是。它有约 30.5B 总参数,每个 token 激活约 3.3B 参数。A3B 描述稀疏计算,常规部署仍需要保存完整权重;参数数值见原版模型卡。
原版现在还值得用吗?
如果需要在同一模型里切换思考与非思考,原版仍有明确用途。它的模板支持 enable_thinking 和开启条件下的软切换;固定模式的两款 2507 不能替代这个行为。原版的原生 32K 与 YaRN 扩展边界也应一并保留,见模式与上下文说明。
Instruct-2507 可以用 /think 开启思考吗?
不能把它切换成 Thinking-2507。官方把 Instruct-2507定义为固定非思考,Thinking-2507 是另一个固定思考模型。Instruct 仍能回答推理问题,但这不等于支持两种输出模式切换。
Ollama 的 qwen3 默认会下载 30B 吗?
当次核验不是:默认页指向 8B。需要 30B Instruct-2507,可明确使用 qwen3:30b-a3b-instruct-2507-q4_K_M;代码模型使用 qwen3-coder:30b。标签以后可能变化,使用前仍需核对默认页与具体版本页。
24GB 显卡能直接用 256K 吗?
不能仅凭显存容量保证。以 Coder-30B、单序列、F16 KV 为条件,262,144 token 的 KV 数据部分就约为 24GiB,还未加权重及运行开销。缓存量化、CPU 分担和引擎实现会改变条件;先用短窗口加载,再检查实际分配与自己的任务表现。
为什么模型显示支持 256K,我实际只能用较短上下文?
模型上限和引擎分配不是一个数字。Ollama 的 num_ctx 控制配置长度,ollama ps 的 CONTEXT 可核对实际分配;默认规则也随文档和版本存在差异。输入、历史与输出共同占用预算,详见 Ollama 上下文说明。
参考来源15
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
参考来源15
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
- 1.Ollama 的 30B Instruct-2507 Q4_K_M 包ollama.com/library/qwen3:30b-a3b-instruct-2507-q4_K_M
- 2.原版模型卡huggingface.co/Qwen/Qwen3-30B-A3B
- 3.Instruct-2507 模型卡huggingface.co/Qwen/Qwen3-30B-A3B-Instruct-2507
- 4.Thinking-2507 模型卡huggingface.co/Qwen/Qwen3-30B-A3B-Thinking-2507
- 5.Coder-30B 模型卡huggingface.co/Qwen/Qwen3-Coder-30B-A3B-Instruct
- 6.Coder-30B 页面ollama.com/library/qwen3-coder:30b
- 7.qwen3 默认标签ollama.com/library/qwen3
- 8.Modelfile 文档github.com/ollama/ollama/blob/main/docs/modelfile.mdx
- 9.上下文设置文档docs.ollama.com/faq
- 10.Ollama 上下文文档github.com/ollama/ollama/blob/main/docs/context-length.mdx
- 11.Ollama API 源码定义github.com/ollama/ollama/blob/main/api/types.go
- 12.Ollama 思考文档docs.ollama.com/capabilities/thinking
- 13.Coder-30B 的实际配置huggingface.co/Qwen/Qwen3-Coder-30B-A3B-Instruct/blob/main/config.json
- 14.Qwen3.6-35B-A3Bhuggingface.co/Qwen/Qwen3.6-35B-A3B
- 15.Qwen3.8-27Bhuggingface.co/Qwen/Qwen3.8-27B