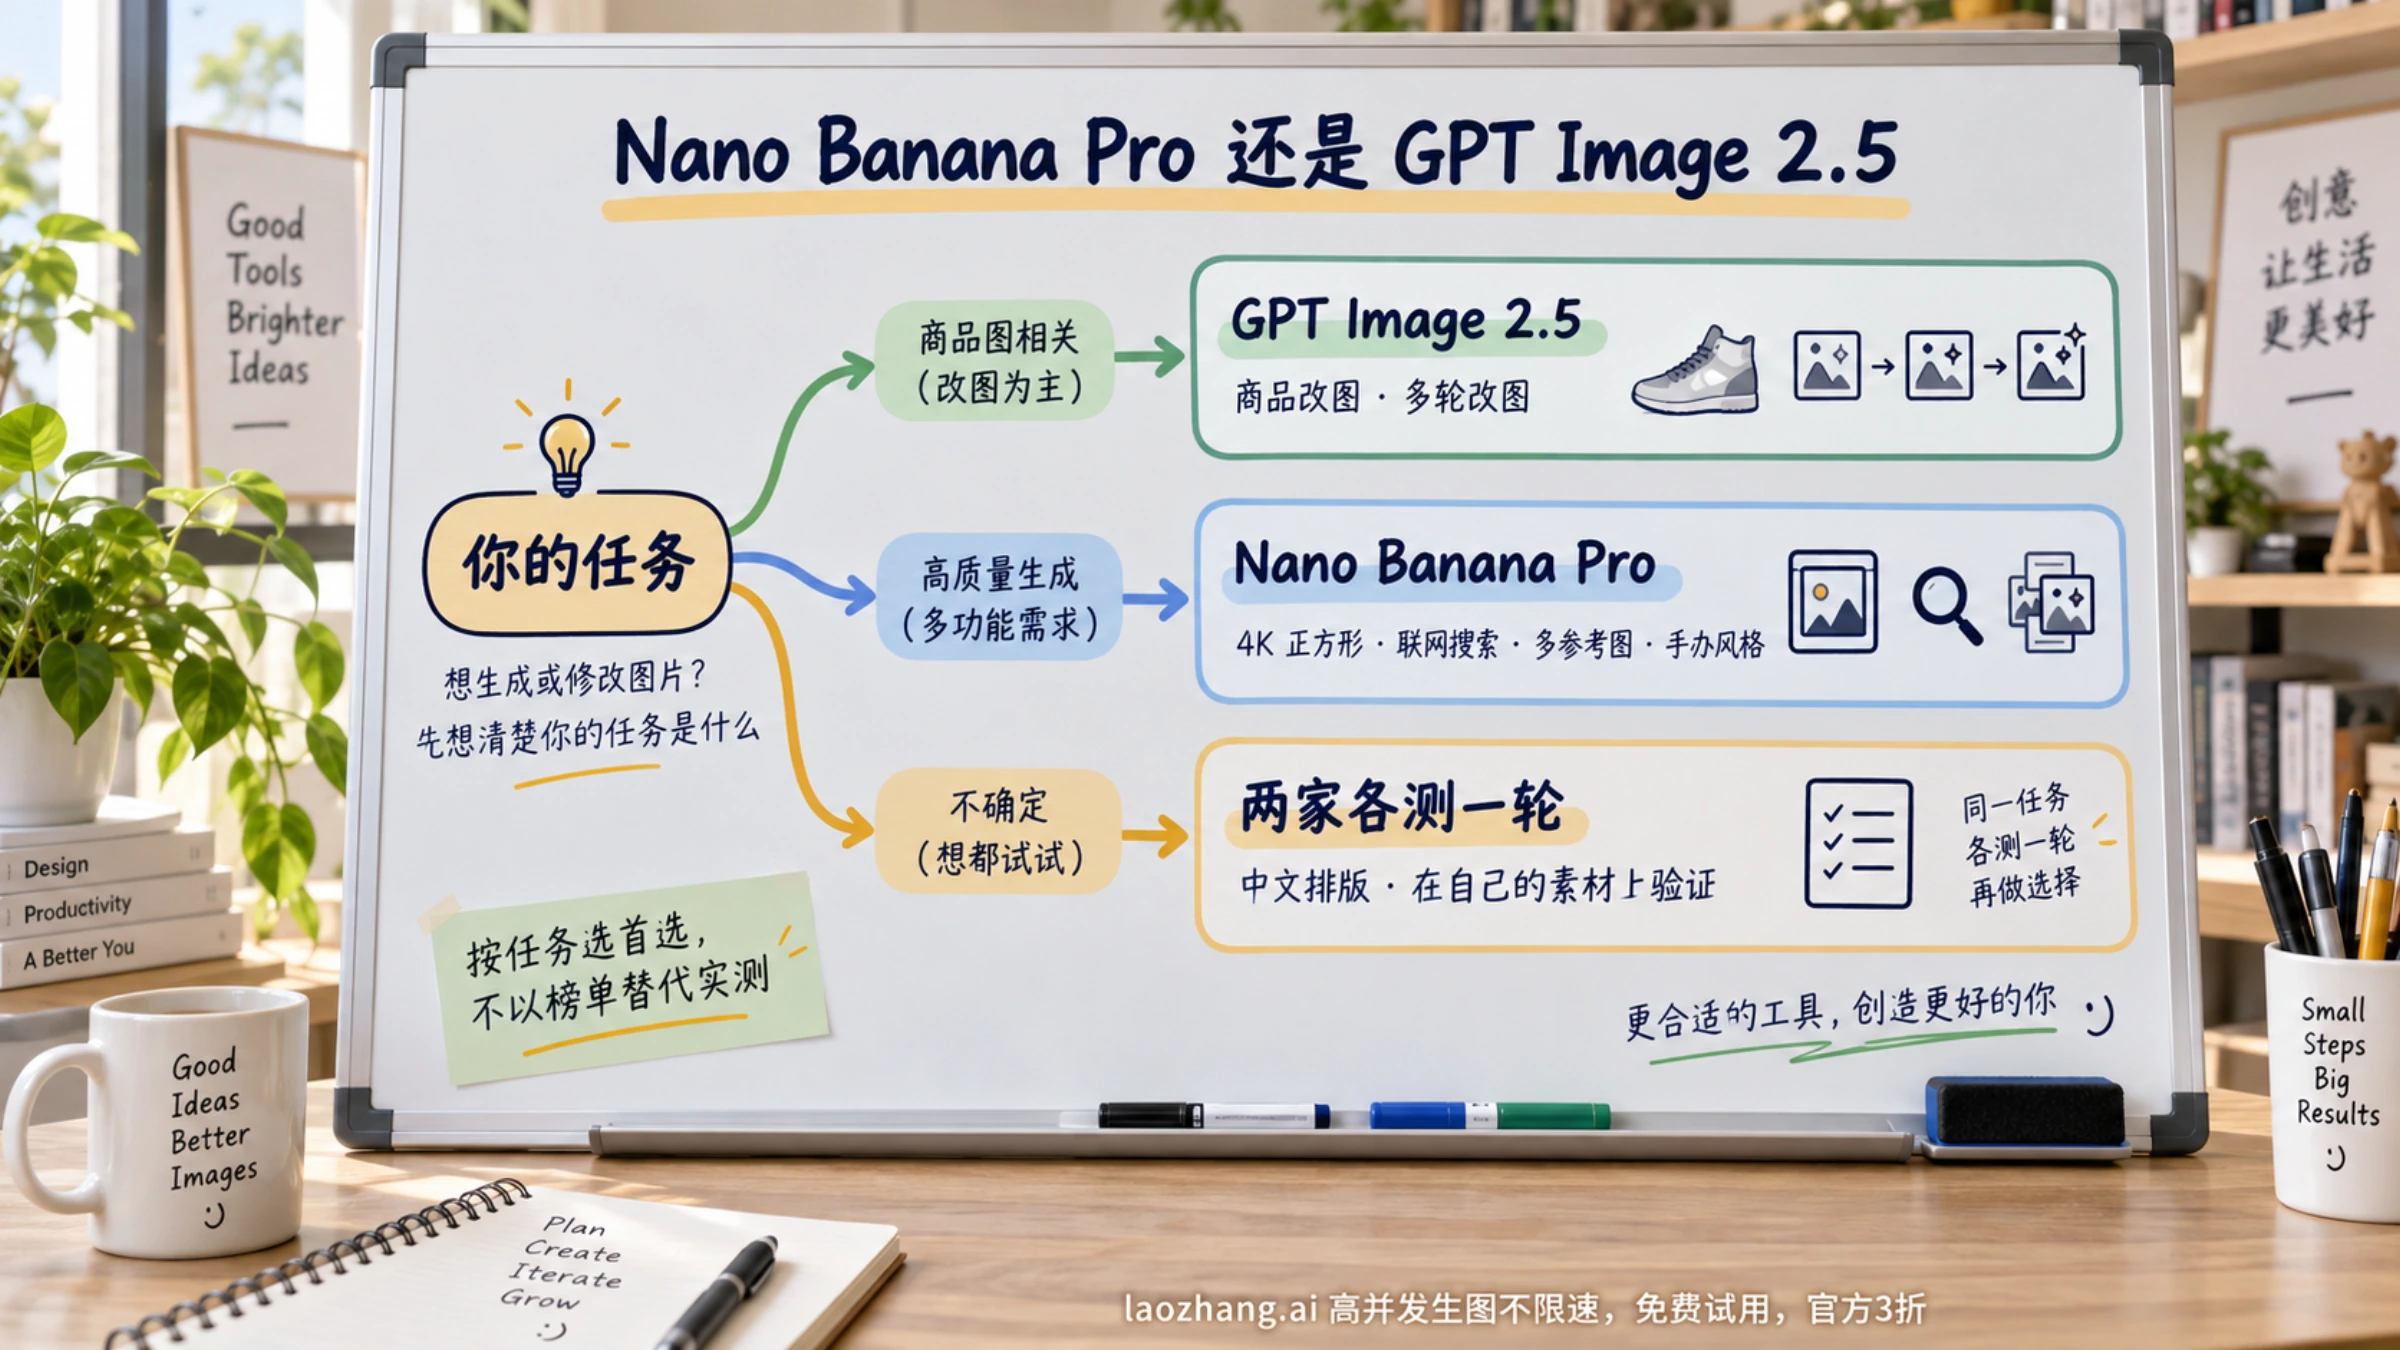
先说结论:两个模型没有谁全面领先,但每类任务都有一个说得出理由的首选。 改商品图要保住原有外形、要多轮连续改图,先用 GPT Image 2.5 Sunburst;要 4096×4096 的正方形 4K、要联网搜索核对事实(Google 搜索建立依据)、要一次喂进 5 张人物加 6 张物体参考图、要手办或立体化风格,先用 Nano Banana Pro。文字海报两家都能拼对英文和韩文,中文排版目前没有任何公开的同条件样本,只能自己测。这些判断来自两家官方文档和五份说明了测试条件的第三方实测,本站没有做模型实测,下文每条结论都标了出处和样本量。
价格上,按官方 Standard 费率(2026 年 9 月 22 日),Nano Banana Pro 生成一张 1K 或 2K 图的图片输出为 $0.134,4K 为 $0.24;GPT Image 2.5 在 1024×1024 下 high 估算 $0.05268、xhigh $0.09366、max $0.21072。Pro 的单价落在 2.5 的 xhigh 与 max 之间,但两家的档位名不对应同一画质,真正该比的是"每张合格图花多少钱",后面会给算法。Google Gemini API 定价、OpenAI 图片成本计算器
先对上名字:两个 2.5 模型、四个 Nano Banana、一个不存在的 2.5
"GPT Image 2.5"在 API 里是两个模型 ID,在 ChatGPT 里是一个功能名。API 侧是 gpt-image-2.5-flare(快照 gpt-image-2.5-flare-2026-09-08)与 gpt-image-2.5-sunburst(快照 gpt-image-2.5-sunburst-2026-09-08),不带后缀的 gpt-image-2.5 不是有效 ID。OpenAI 的提示词指南把 Flare 定位为"小模型,为速度优化,画质与 GPT Image 2 相当",Sunburst 为"基础模型,为质量优化,画质高于 GPT Image 2";但同一家的发布文章又说 Flare"比 GPT Image 2 画质更高且延迟低 50%"。两种说法都是官方原话,本文不替它们裁决,只提醒:这个 50% 是相对 GPT Image 2 的,从来不是相对 Google。ChatGPT 里的 Images 2.5 是功能名而不是某个 API ID,本文引用的两份应用端测试(韩国和日本)用的都是这个入口,作者都没有说明对应哪个模型。OpenAI 图片提示词指南、Images 2.5 发布说明
"Nano Banana"是 Google 四个模型的统称,本文对象只有 Nano Banana Pro = gemini-3-pro-image(GA 稳定版,模型页标注 2025 年 11 月更新)。另外三个是 Nano Banana 2(gemini-3.1-flash-image,1K $0.067)、Nano Banana 2 Lite(gemini-3.1-flash-lite-image,1K $0.0336)和已弃用、2026 年 10 月 2 日关闭的初代 gemini-2.5-flash-image。Google 自己的建议是 Nano Banana 2 作为"默认生图模型",Pro 留给"最复杂的视觉任务"。很多标题写着"GPT Image 2.5 vs Nano Banana 2"的对比文章,比的是那个便宜一半的兄弟模型,读的时候要看清对象。Gemini 图片生成指南
至于"Nano Banana 2.5":Google 的定价页、模型页、图片生成指南上都没有这个名字。它只是 9 月初出现在 Image Arena 里的匿名条目 spicy-mayo 被部分博客猜测的代号,没有公告、价格、发布日期和 API 规格,本文不把它当比较对象。
六类任务的首选与依据
下表是本文的核心判断。"首选"意味着先用它跑第一轮,不意味着另一家做不到;每一行的依据都注明了来源和样本规模,样本小的行请按"线索"而不是"定论"来读。
| 任务 | 先用 | 依据(来源、条件) |
|---|---|---|
| 要保住商品外形的改图(改色、换背景、加文案,多步串联) | 2.5 Sunburst | Ima Studio 9 月 14 日,一盏吊灯、每模型 3 条链 × 5 步共 30 张,Sunburst 1024×1024 high 对 Pro 1K:Sunburst 3/3 保住了扁宽灯罩,Pro 3/3 把灯罩改深成圆顶且偏差沿后续步骤延续 |
| 多轮连续改图 | 2.5 | 韩国 Danawa 9 月 17 日,ChatGPT Plus 对 Gemini 应用,5 轮连续编辑各一次:Pro 让已删除的行李箱重新出现,Images 2.5 保住了前几轮修改;与上一行的"偏差延续"方向一致 |
| 文字海报、中文排版 | 各测一轮,2.5 略先 | 英文标题两家都拼对(Ima Studio 30 张;JXP 咖啡馆招牌 1 张打平);韩文海报两家无错字(Danawa 1 张);日文 B2B 缩略图 Pro 出现"日文崩坏"两次未过作者门槛(HS 9 月 9 日,应用端);HiAPI 9 月 17 日 1 张海报 Pro 多写了一个 "SHIFT"。中文样本为零 |
| 多参考图人物/物体一致 | Pro(参考图多于 4 张时) | Google 文档明确 Pro 支持最多 6 张高保真物体 + 5 张人物 + 3 张风格参考;OpenAI 文档只给了 4 张输入的示例,没写上限。Danawa 3 人合成 1 张:2.5 统一成一幅动漫作品,Pro 变成粗线美漫风且加了参考图里没有的元素 |
| 4K 交付 | 按尺寸定:4096×4096 只有 Pro;3840×2160 两家都行 | 规格差异,不是画质结论:OpenAI 单边上限 3840 px、总像素 8,294,400;Google 4K = 4096 px。JXP 9 月 15 日 4K 微距对比拿到的正是 4096² 对 2880² |
| 风格化、手办/立体化 | Pro | 日本 note 作者てんねん 9 月 11 日,一条为 Pro 写的手办化提示词,6 模型 × 4 次取最佳,6 项 5 分制:Pro 30/30,2.5 24/30,作者评 2.5"保住了原图构图、脸型、体型和装甲信息"但"看起来像赛璐珞着色的 3DCG",换成为 2.5 优化的提示词仍是 24 |
来源:Ima Studio 中文版、韩国 Danawa DPG、JXP AI、HiAPI、日本 HSビルワーキングスペース、日本 note 作者てんねん。
几点必须跟表一起读的限定。第一,商品改图那一行是目前公开样本最大、条件最清楚的一组,但它只测了一个 SKU 和英文文案,作者自己声明不覆盖人像、试穿和多语言海报。第二,HiAPI 的两张样本(海报多字、鞋头方向与提示词相反)作者明说"四张图不能推算平均画质、速度、一致性或未来成功概率",本文也只当作线索。第三,手办那一行与前两行方向相反,说明"谁更强"确实随任务翻转,而不是一家全面领先。第四,两家的官方文档都强调:重复编辑仍可能改掉你想保留的细节,需要像素级不变的区域应把审核通过的编辑合成回原图,而不是靠提示词。
还有两类差异不需要测试,翻文档就能定:需要模型联网搜索核对事实(Google 搜索建立依据)的信息图、科普图,只有 Pro 有这项能力;需要带 alpha 通道的透明 PNG/WebP,OpenAI 文档明确支持 background: "transparent",Google 的 Pro 页面没有记载透明输出,这不等于做不到,但意味着你拿不到官方承诺。
硬性能力差异:文档写明的上限
下面这些是两家 2026 年 9 月 22 日文档里的规格,不是测试结果。
| 项目 | Nano Banana Pro(gemini-3-pro-image) | GPT Image 2.5(Flare / Sunburst) |
|---|---|---|
| 尺寸档位 | image_size 1K / 2K / 4K,4K = 4096 px;1:1 到 21:9 共 10 种比例 | WIDTHxHEIGHT 自定义,16 的倍数,比例 1:3 到 3:1,单边 ≤ 3840,总像素 655,360 到 8,294,400;2560×1440 以上标记为实验性 |
| 最大正方形 | 4096×4096 | 2880×2880(按上限推算) |
| 质量档 | 无质量参数 | low / medium / high / xhigh / max / auto,同一档名在不同模型上不代表同等画质 |
| 参考图 | 最多 14 张:6 张高保真物体 + 5 张人物一致 + 3 张风格 | image[] 多图输入,文档示例 4 张,未写上限;图 + 遮罩 ≤ 50 MB |
| 多轮编辑 | previous_interaction_id | Responses API previous_response_id,或把上一轮输出作为下一轮输入 |
| 透明背景 | 未记载 | background: "transparent" + PNG/WebP |
| 思考 | 默认开启且 API 中不可关闭,最多生成两张中间"思考图"(后台可见、不计费) | 无对应机制 |
| 联网搜索核对事实 | 支持(使用 Google 搜索建立依据) | 无 |
| 水印 | 所有输出含 SynthID | 无对应说明 |
| Batch | 支持,图片输出半价 | 两个 2.5 模型页均标记 v1/batch 不支持;Batch 价目表只有 gpt-image-2 |
来源:Gemini 图片生成指南、gemini-3-pro-image 模型页、OpenAI 图片生成指南、gpt-image-2.5-sunburst 模型页。
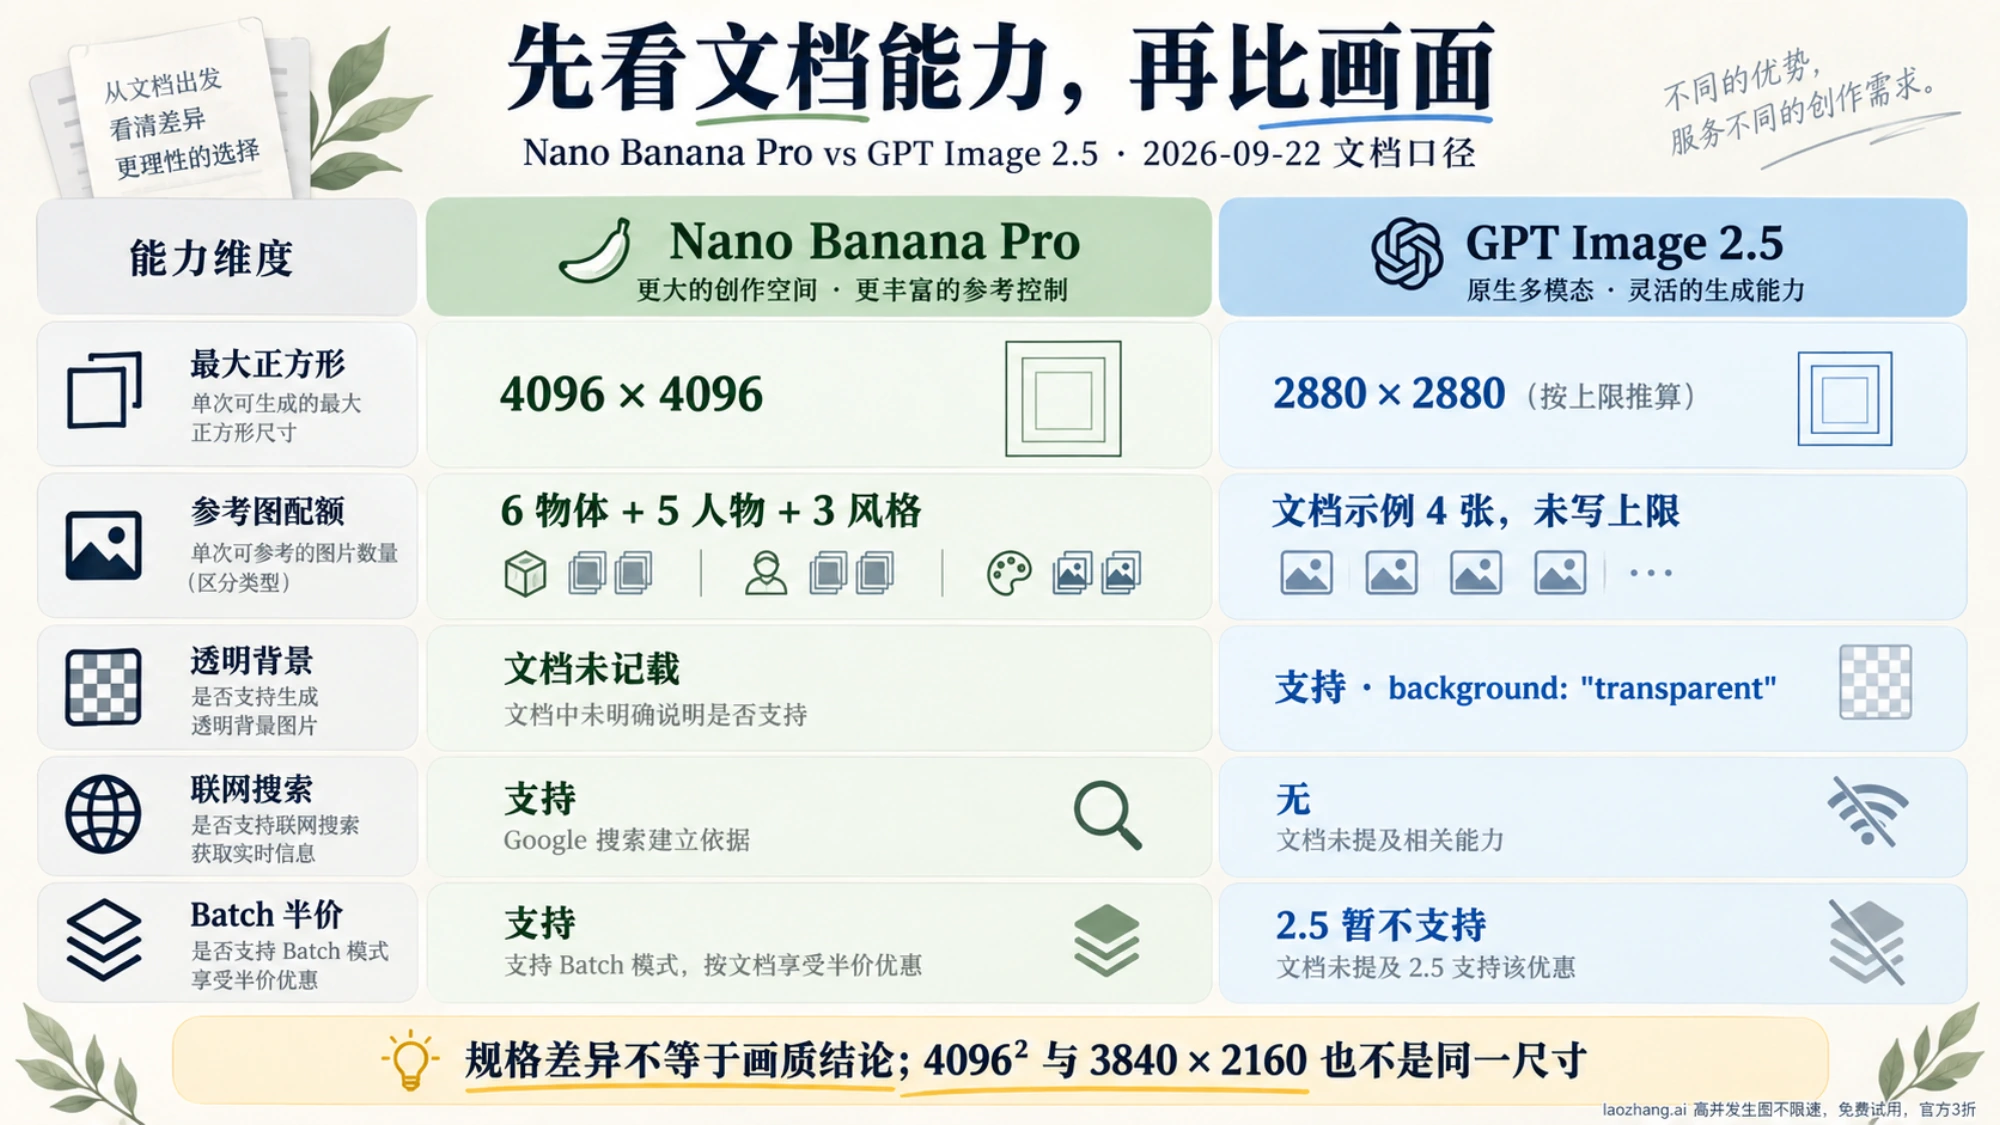
对国内电商和内容团队最常踩的两个坑:一是把 Pro 的"2K"和 2.5 的 2048×1152 当同一尺寸,前者是 2048 px 档位、后者是精确像素数;二是以为"4K"两家一样,正方形主图要 4096 只有 Google 能出,16:9 的 3840×2160 恰好卡在 OpenAI 8,294,400 总像素的上限上,两家都能出。4K 的实际用法见Nano Banana Pro 4K 指南。
同尺寸价格:把 2.5 的质量档对到 Pro 的 1K/2K/4K
Pro 按固定 token 数计费:1K 与 2K 图片各 1,120 个输出 token,4K 为 2,000 个,图片输出费率 $120/百万 token,所以单张为 $0.134 与 $0.24;Batch 半价($0.067 / $0.12)。2.5 的费率对 Flare、Sunburst、GPT Image 2 三者完全相同(图片输出 $30/百万 token,文本输入 $5,图片输入 $8),差别只在同一档位消耗多少 token。下表是 OpenAI 官方计算器 9 月 22 日的读数,只算图片输出,不含输入和流式部分图。
| 尺寸 | 2.5 medium | 2.5 high | 2.5 xhigh | 2.5 max | Nano Banana Pro |
|---|---|---|---|---|---|
| 1024×1024 vs Pro 1K | $0.01317(439 tok) | $0.05268(1,756) | $0.09366(3,122) | $0.21072(7,024) | $0.134(1,120) |
| 2048×1152 vs Pro 2K | $0.01101(367) | $0.04239(1,413) | $0.07533(2,511) | $0.16950(5,650) | $0.134(1,120) |
4K 一档没有并排:Pro 的 4096×4096 为 $0.24(2,000 token),OpenAI 计算器没有 3840×2160 的读数。来源:OpenAI 定价页、OpenAI 成本计算器、Google 定价页。
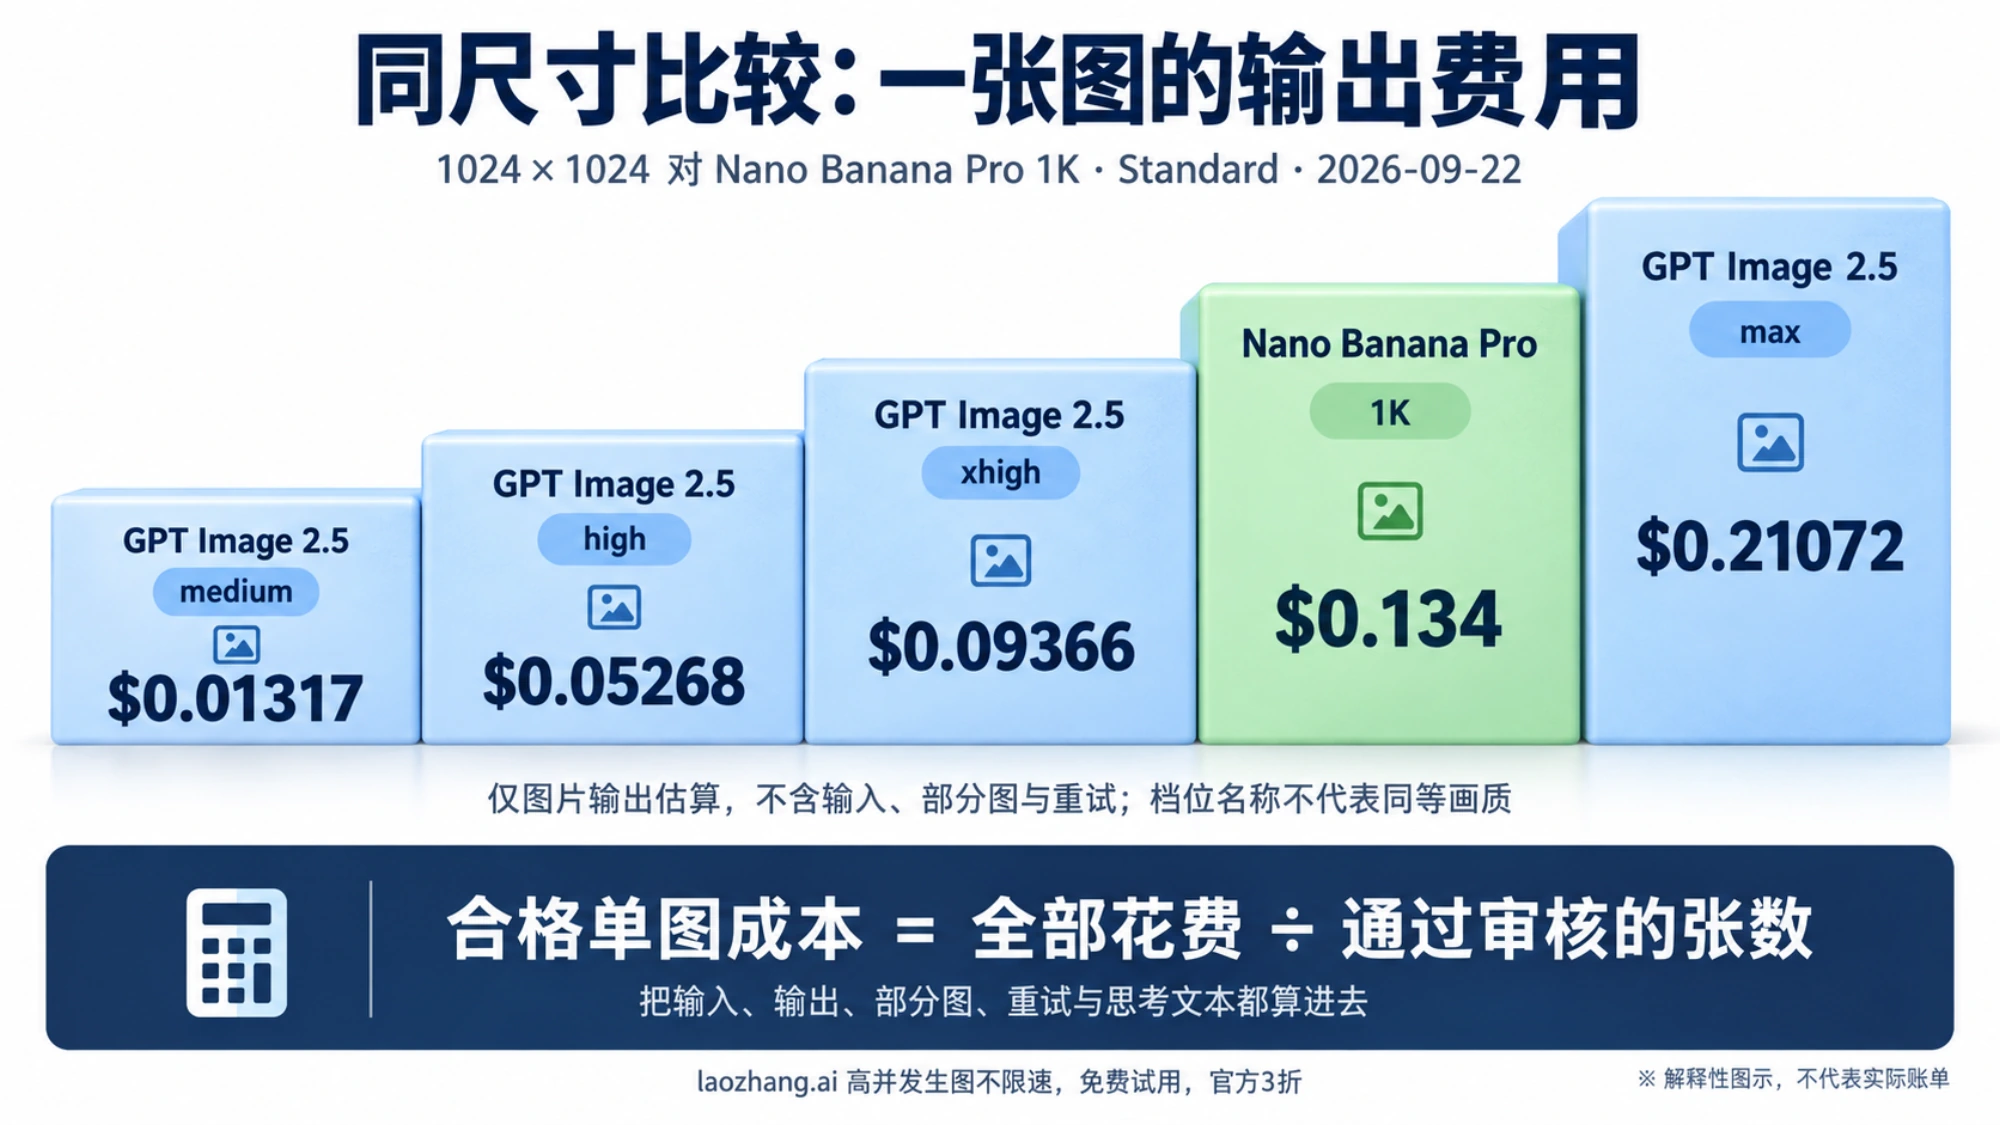
三个读法。其一,Pro 一张的钱可以买 2.5 high 两张半,或 xhigh 一张多一点;如果你的任务 high 就够,2.5 明显便宜,如果非 max 不可,2.5 反而比 Pro 贵。其二,Artificial Analysis 榜单里 2.5 的条目跑的是 max,它标的"每千张 $210.7"就是这么来的,别把那个数当 2.5 的日常成本。其三,4K 那一格只有第三方参考:Tosea 9 月 9 日在 2.5 high、3840×2160 下读到的实际 usage 为 3,336 个输出 token,约 $0.10。2.5 内部各档位怎么选,见GPT Image 2.5 API 定价拆解。
假设一个不含重试和输入的场景:10,000 次单图 1K 调用,Pro 官方 Standard $1,340、Batch $670;2.5 high 按计算器约 $527,max 约 $2,107。这只是算术演示,实际账单要看返回的 usage 与控制台。
真正该比的口径是合格单图成本:这一批的全部花费(输入、输出、部分图、重试、Pro 的思考文本)除以通过审核的张数。一家单价低 40% 但每三张要重做一张,另一家单价高但首轮通过,账算下来可能反过来。Ima Studio 那组 30 张里,平台积分 Pro 每步 10、Sunburst 每步 31,但 Pro 第一步就把灯罩改了形,后面每一步都要回头修,这就是单价与合格成本分道扬镳的例子。
盲评榜:2.5 领先,但票数和"Preliminary"标记要一起看
三个盲评榜单在 9 月 22 日的显示如下(Arena 页面标注"最后更新 Sep 7, 2026",早于 2.5 的 9 月 8 日发布,本文照录)。
| 榜单 | 2.5 Sunburst | 2.5 Flare | GPT Image 2 | Nano Banana Pro |
|---|---|---|---|---|
| Arena 文生图(78 模型) | #1,1421 ±13,3,149 票,Preliminary | #2,1399 ±13,2,856 票,Preliminary | #3,1381 ±4,78,731 票 | #14(2K 版)1246 ±3,152,220 票;#16(preview)1232 ±5 |
| Arena 图片编辑 | #1,1520 ±9,6,704 票,Preliminary | #2,1491 ±9,5,676 票,Preliminary | #3,1461 ±3,235,928 票 | #9(2K 版)1390 ±3,556,580 票 |
| Artificial Analysis 文生图 | #1(max)1197 ±9,13,401 次比较 | #2(max)1190 ±9 | #3(high)1171 ±9 | #10,1100 ±8,15,977 次 |
| Artificial Analysis 编辑 | #1(max)1180 ±8 | #2(max)1161 ±8 | #5(high)1122 ±9 | #13,1096 ±8 |
来源:Arena 文生图榜、Arena 编辑榜、Artificial Analysis 文生图、Artificial Analysis 编辑。
Arena 上两家差 130 到 175 分,Artificial Analysis 上差 80 到 100 分,都远大于置信区间,方向上没什么争议。但 2.5 的 Arena 条目只有三千到七千票,Pro 的 2K 条目在编辑榜有 55 万票,"Preliminary"就是在提醒分数还会动。另外榜单只回答"两张图并排时评审更喜欢哪张",不回答速度、成本,也不回答上一节那类"改了不该改的地方"的错误——手办测试里 2.5 输掉的原因是"看起来像 3DCG",这种审美判断恰恰是榜单会奖励也会惩罚的东西,取决于评审的题目分布。所以榜单结论与人工实测在个别任务上相反并不矛盾:一个是平均偏好,一个是你的具体任务。
在自己的素材上做对比:两家文档共同认可的方法
OpenAI 的提示词指南写了一套迁移评测流程,它同样适用于对 Google 的比较;Google 文档没有给方法,但 Ima Studio 的"不要只看最终图,把第一步和原图比"跟它是一回事。综合成五步:
- 固定变量。 同一提示词、同一批参考图、同一像素尺寸;2.5 侧显式指定
quality(不要用auto,它无法估算成本),Pro 侧指定image_size与aspect_ratio。先按像素对齐(1024² 对 1K,2048×1152 对 2K),不要按档名对齐。 - 第一步就和原图比。 商品、人脸、品牌几何在第一轮输出里有没有变形;后面每一步都以上一步通过的图为输入,测完整编辑链而不是单步。
- 看五项。 指令遵循、身份/商品保持、文字准确(要求的字放引号里,品牌名逐字母拼,小字比较
medium与high)、不该改的地方有没有改、需要透明时检查 alpha 通道的发丝、玻璃、阴影边缘。 - 重复跑。 同一请求跑 3 到 5 次看稳定性;记录典型与慢响应、失败与重试次数。
- 算合格单图成本。 每家的总账单除以通过的张数;OpenAI 提醒"确认当前价格,不要假设更快的模型就更便宜"。
把测试集限定在你真实的产线提示词上(难改的局部、精确文字、人脸、商品几何、透明素材),10 到 20 条就能看出方向。如果两家都过了质量线,再比延迟和价格;只有一家过线,价格就不是变量。这也是为什么本文不给"总体胜率":五份第三方测试各自只有 1 到 30 张样本,覆盖的任务互不重叠,没有一份能推出平均成功率。
今天能同时跑两家的通道(2026 年 9 月 22 日状态)
官方直连。 Google 的 gemini-3-pro-image 走 Gemini Developer API,Standard $0.134 / $0.24,Batch 半价,可在 AI Studio 试用。OpenAI 的两个 2.5 模型走 Images API 或 Responses API,按 token 计费,目前不在 Batch 里。两家分别开号、分别充值。
一把 key 跑两家。 如果你想在同一套代码里切换对比,laozhang.ai 的网关(https://api2.laozhang.ai/v1 )目前同时提供:
gpt-image-2.5-flare与gpt-image-2.5-sunburst的官方转发:用与官方转发gpt-image-2相同的/v1/images/generations和/v1/images/edits接口,可显式选 Flare 或 Sunburst、可用 2K/4K 尺寸;平台声明按与官方转发 GPT Image 2 相同的 token 费率计费,需要使用按量计费的令牌(API key),并在令牌设置里选Sora2Official或企业官方转发分组(分组不写在model字段)。LaoZhang GPT Image 2.5 文档gemini-3-pro-image按次 $0.09,含 4K,不分档;要选比例和imageSize: "4K"必须走 Google 原生形态/v1beta/models/gemini-3-pro-image:generateContent,OpenAI 兼容的/v1/chat/completions形态固定 1K 1:1;参考图上限同官方(6 物体 + 5 人物)。LaoZhang Nano Banana Pro 文档
需要说清的状态:LaoZhang 此前 $0.03/次 的 gpt-image-2.5-flare-vip 与 gpt-image-2.5-sunburst-vip 自 2026 年 9 月 16 日起因上游容量受限暂停,官方公告写明"没有确定的恢复时间",本文不把它当可用方案;另有按次计费的 gpt-image-2.5-web 路线,支持 size 但不能选 Flare/Sunburst,价格以控制台为准,本文不写固定数。暂停公告。新账号注册需 Gmail 或企业白名单,测试额度用于联调,不是长期免费产能;平台的并发、SLA 和退款本文不做任何承诺,扩量前先在控制台看实际扣费。
如果你只跑 Google 一家且能接受异步,官方 Batch 的 $0.067 比任何按次通道都低;只跑 OpenAI 一家且 medium 就够,官方 token 计费一张一分多美元,也没有比它更便宜的路。网关的价值在于同一把 key、同一份请求日志里能把两家并排跑,这正是上一节方法需要的条件。接入细节见Nano Banana Pro API 指南。
2.5 侧的最小请求如下,quality 与 size 显式写死,方便和 Pro 的 1K 对齐:
bashcurl "https://api2.laozhang.ai/v1/images/generations" \
  -H "Authorization: Bearer $LAOZHANG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"gpt-image-2.5-sunburst","prompt":"...","size":"1024x1024","quality":"high"}'
Pro 侧对应的是 /v1beta/models/gemini-3-pro-image:generateContent,请求体按 Google 原生格式在 imageConfig 里写 aspectRatio: "1:1" 与 imageSize: "1K",鉴权头与完整示例以 LaoZhang 的 Nano Banana Pro 文档为准。拿到两张图后,先做上一节的第二步:和原图比第一轮,再决定后面的链条交给谁。
常见问题
Nano Banana Pro 还是不是最强的生图模型?
按三个盲评榜单 9 月 22 日的显示不是:Arena 文生图榜它排第 14,编辑榜第 9,2.5 Sunburst 与 Flare 占据前两名,但 2.5 的条目只有几千票并带 Preliminary 标记。按任务看它仍有独占能力:4096×4096、联网搜索核对事实(Google 搜索建立依据)、文档写明的 14 张参考图配额,以及手办化那类风格任务上的第三方胜出。"最强"要先问是哪种任务。
预算有限,Nano Banana 2 能代替 Pro 吗?
Google 自己把 Nano Banana 2(gemini-3.1-flash-image,1K $0.067)列为默认生图模型,它还多了 0.5K 档、10 张物体参考,还能用 Google 图片搜索建立依据,价格是 Pro 的一半;Pro 独有的是 3 张风格参考图、Google 文档里"最高级别世界知识、品牌一致性、专业资产生产"的定位,物体参考反而只有 6 张。手办测试里 Nano Banana 2 拿了 29/30 只比 Pro 低 1 分。两者的完整差异见Nano Banana Pro 与 Nano Banana 2 对比。
GPT Image 2.5 该选 Flare 还是 Sunburst?
官方定位是 Flare 快、Sunburst 编辑精度高,两者费率相同、计算器 token 数也相同,所以差别不在价格。本文引用的商品改图测试用的是 Sunburst,HiAPI 与 JXP 用的是 Flare。OpenAI 的建议是:GPT Image 2 已够用就先试 Flare 看延迟收益,不够用就先用 Sunburst 过质量线再试 Flare。详见Sunburst 与 Flare 对比。
我还在用 GPT Image 2 的 Batch,要换吗?
GPT Image 2 目前不在弃用名单上,Batch 价目表也只有它(图片输出 $15/百万 token)。两个 2.5 模型不支持 Batch,切换意味着放弃半价。注意同一个 quality: "medium" 换到 2.5 后 token 数从 1,756 降到 439,画质不是同一档,要重新校准。见GPT Image 2.5 与 GPT Image 2 对比。
盲评榜说 2.5 强,为什么有人实测 Pro 赢?
因为测的是不同任务。榜单是评审对随机题目的平均偏好;手办化、日文排版、5 轮连续编辑这些单项测试各自只有一到几十张样本,任务分布和评审标准都不同。两者都是真实信息,都不能替代你自己素材上的对比。
ChatGPT 里的 Images 2.5 和 API 结果一样吗?
不保证。应用端没有 API 的模型 ID、quality 与像素尺寸参数,你不知道自己跑的是哪一档;本文引用的韩国与日本测试都是应用端结果,API 上未必复现。要在 ChatGPT 里用 2.5 的说明见ChatGPT Images 2.5 使用指南。