GLM-5.3 还是 GLM-5.3-Flash:先测哪一个?
多数成本敏感或含图片的任务可先测 GLM-5.3-Flash;纯文本长周期工程、失败代价高的任务,再用 GLM-5.3 做复杂任务的对照模型。最终选择要看每个通过任务的总成本。
文章目录
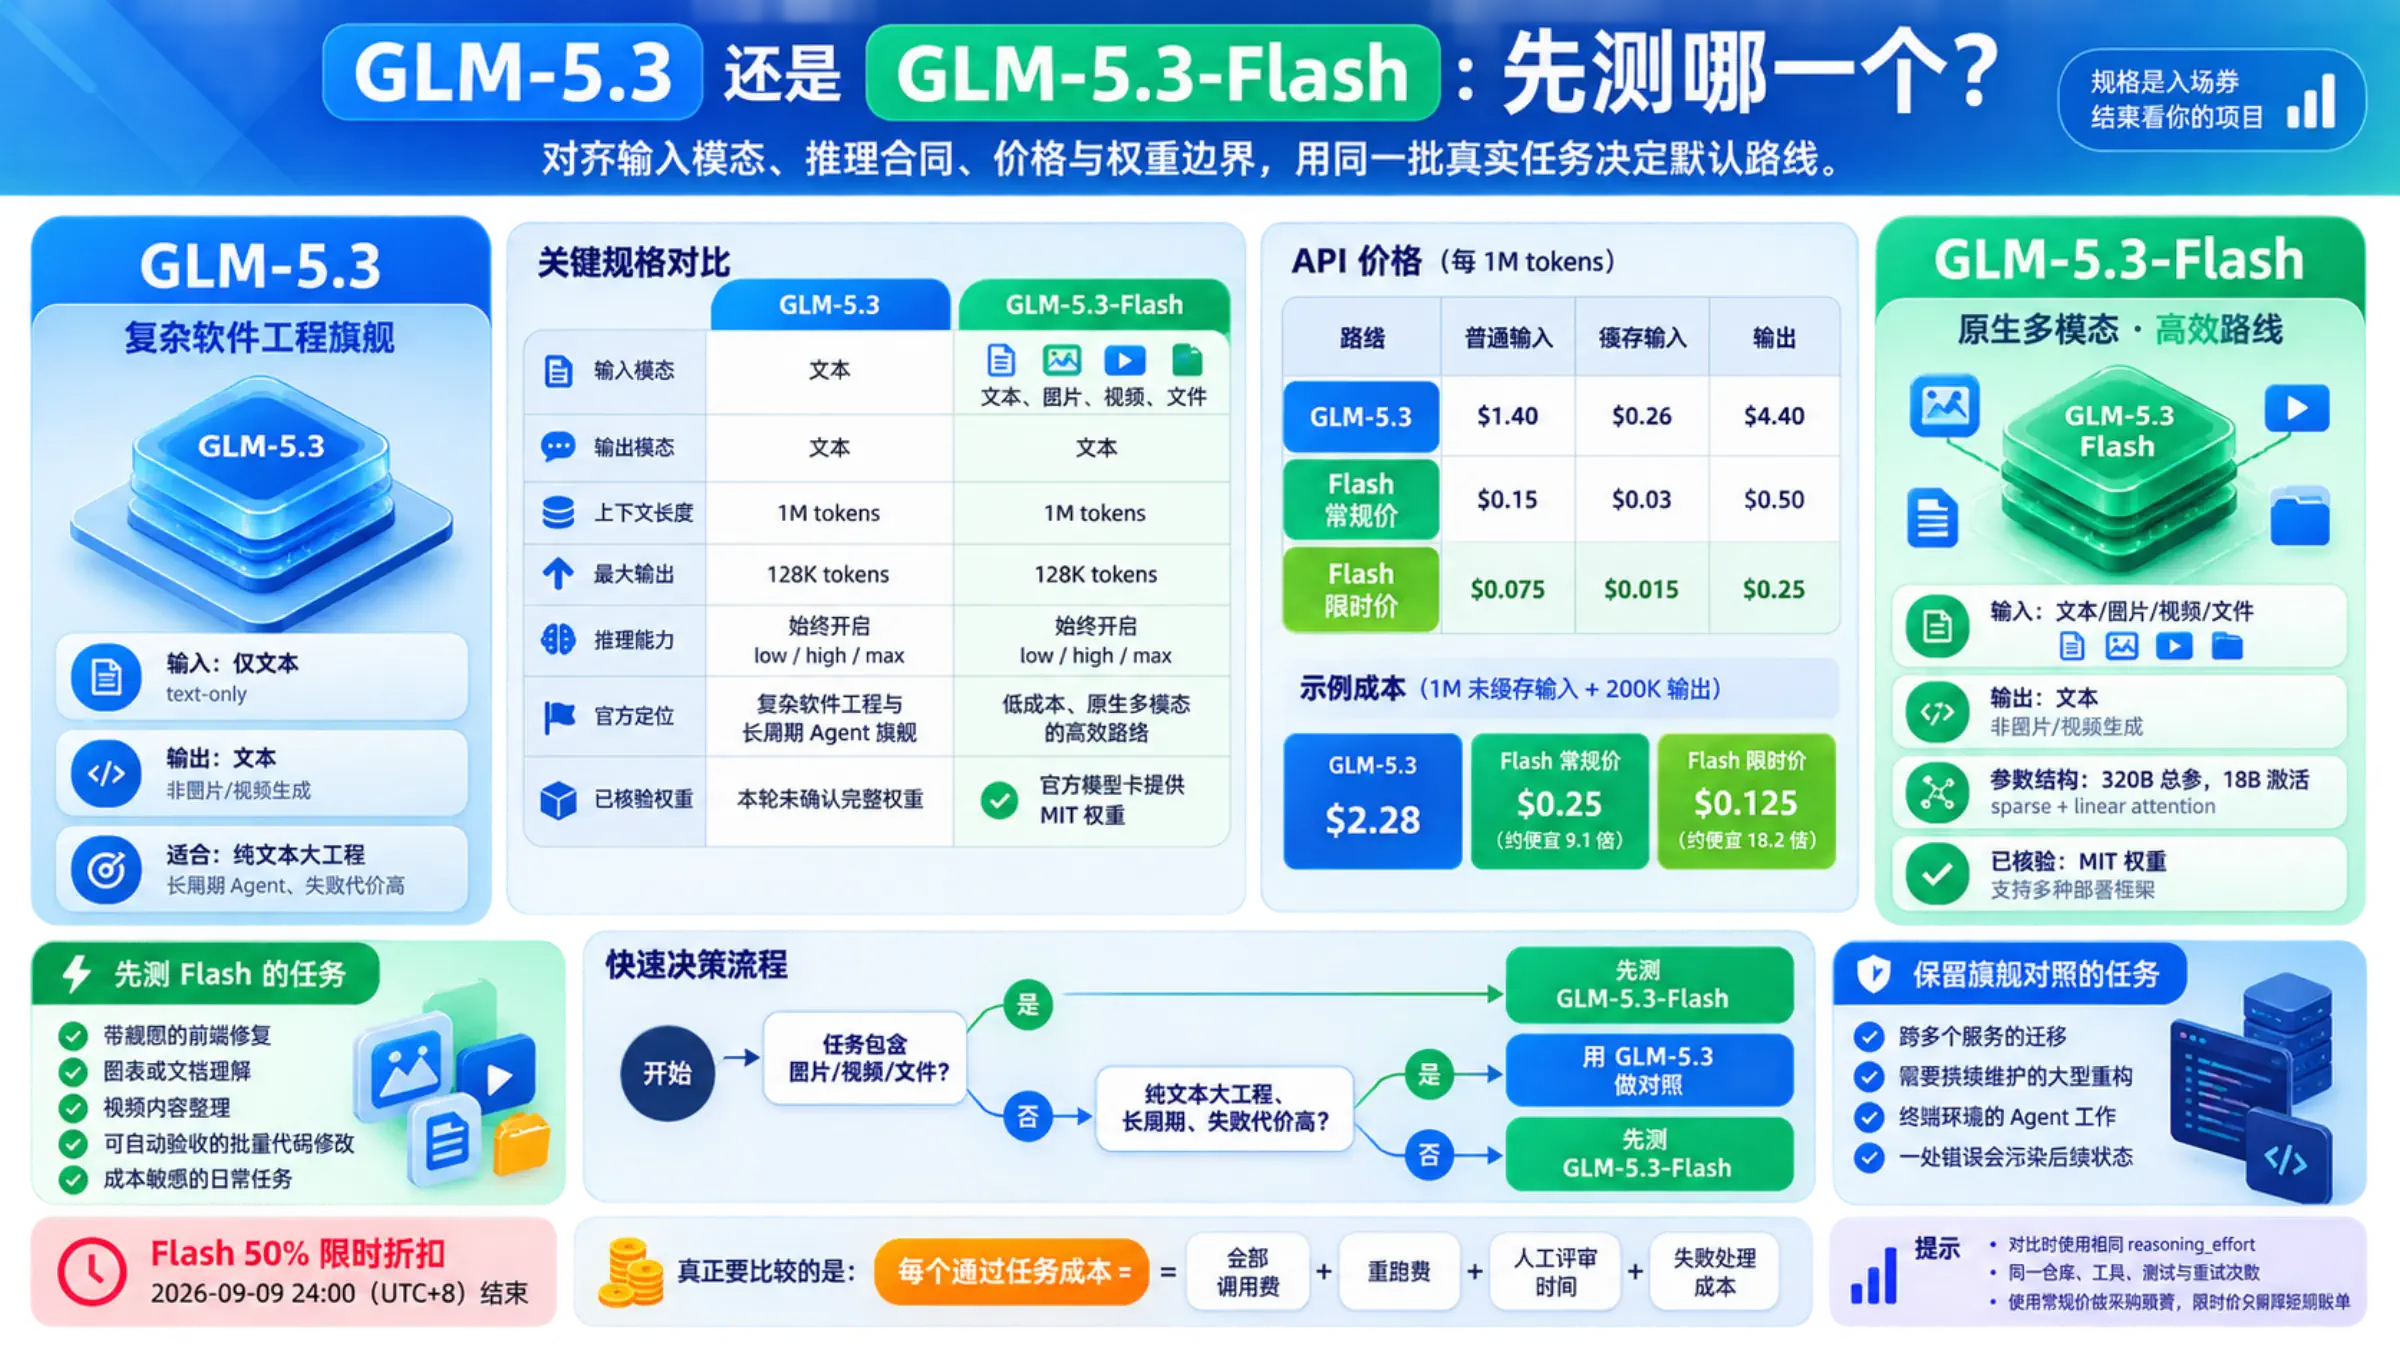
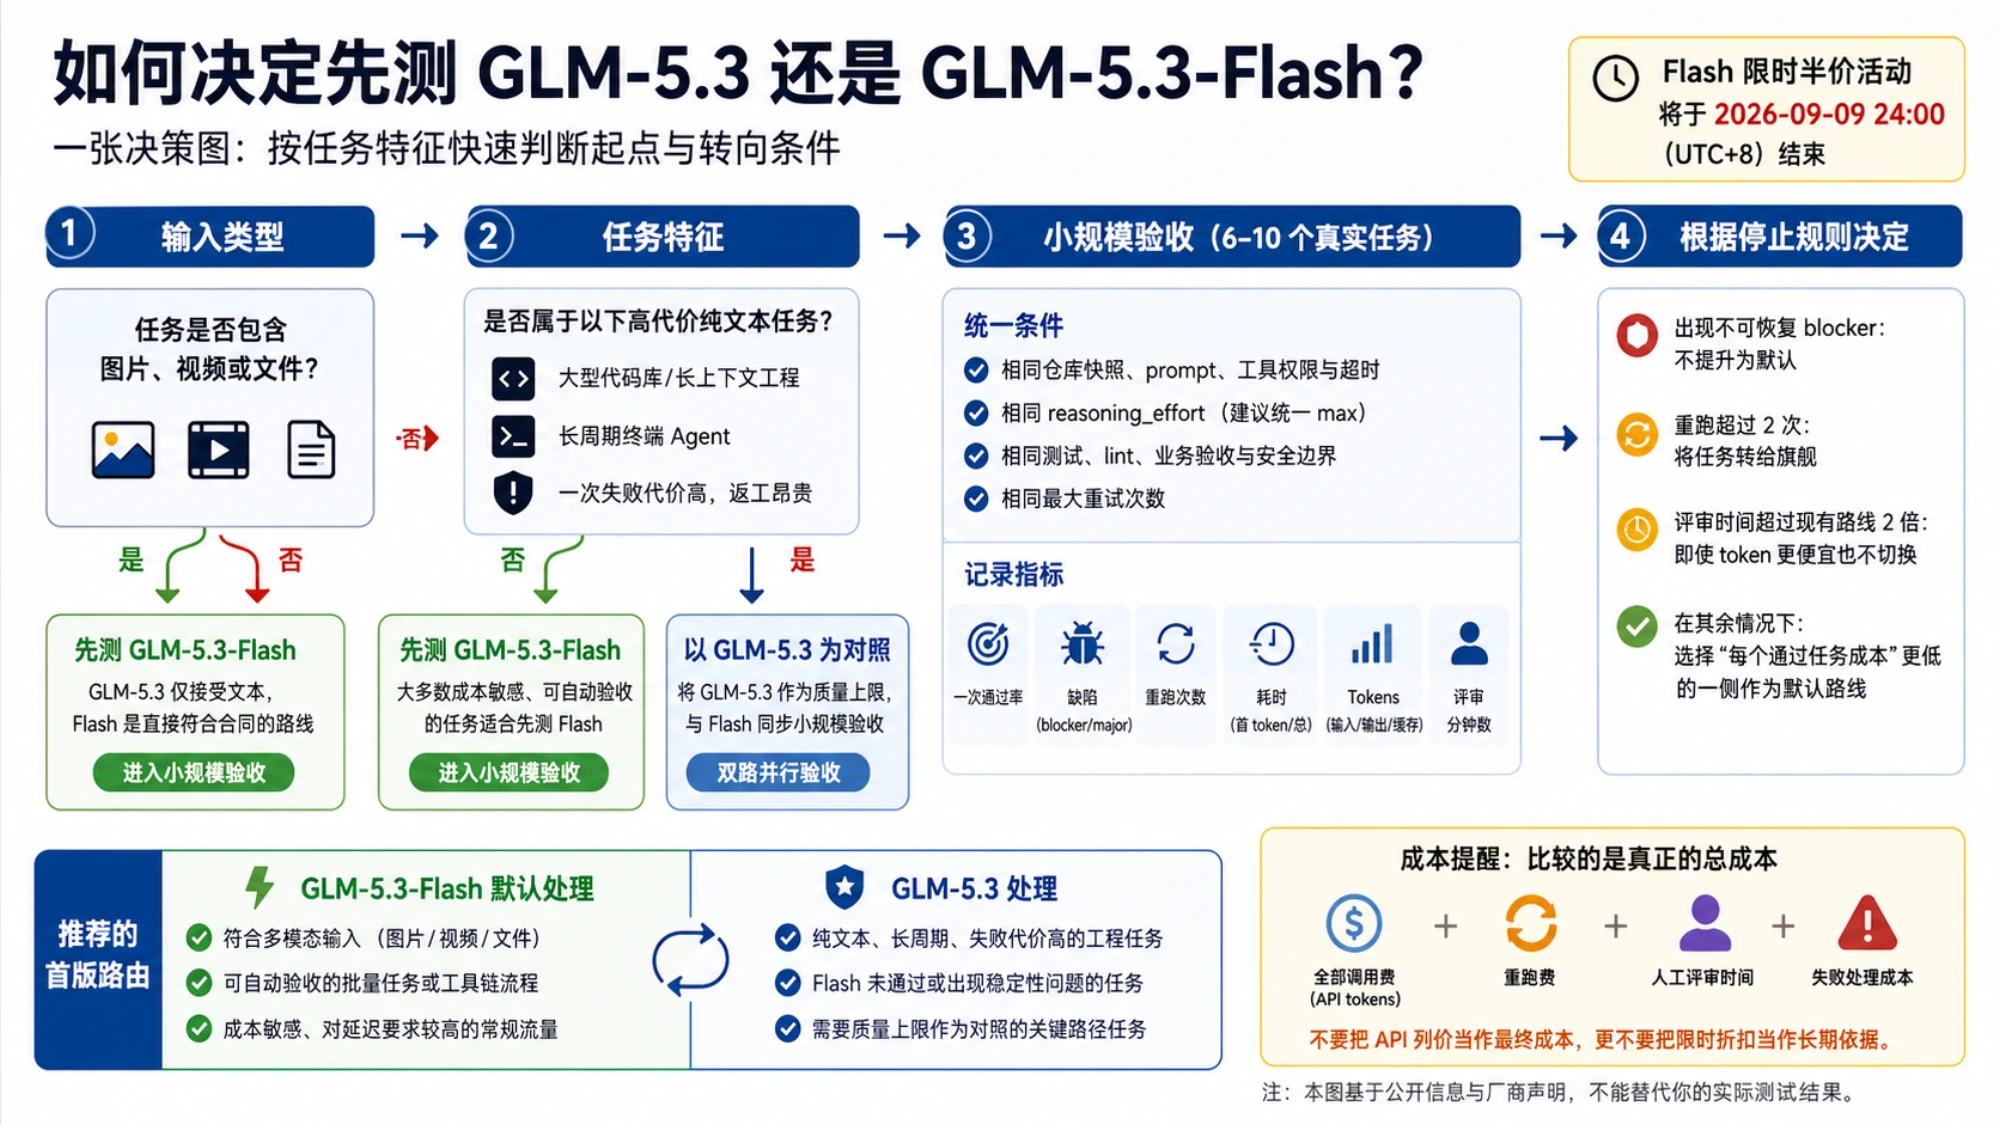
如果任务包含截图、视频或文件,先测 glm-5.3-flash,因为 glm-5.3 当前官方文档只列出文本输入。若任务是纯文本的大型代码库、长周期终端 Agent,且一次失败会造成昂贵返工,把 glm-5.3 作为复杂任务的对照模型更合理。其余大多数成本敏感任务,也应先让 Flash 参加小规模验收,而不是先为旗舰支付更高单价。
这不是“Flash 已经全面胜过旗舰”的结论。公开规格能决定谁有资格参加测试,却不能替代你自己的仓库、工具和验收命令。
先看两条路线是否都能接收任务
| 决策项 | glm-5.3 | glm-5.3-flash | 对选择的影响 |
|---|---|---|---|
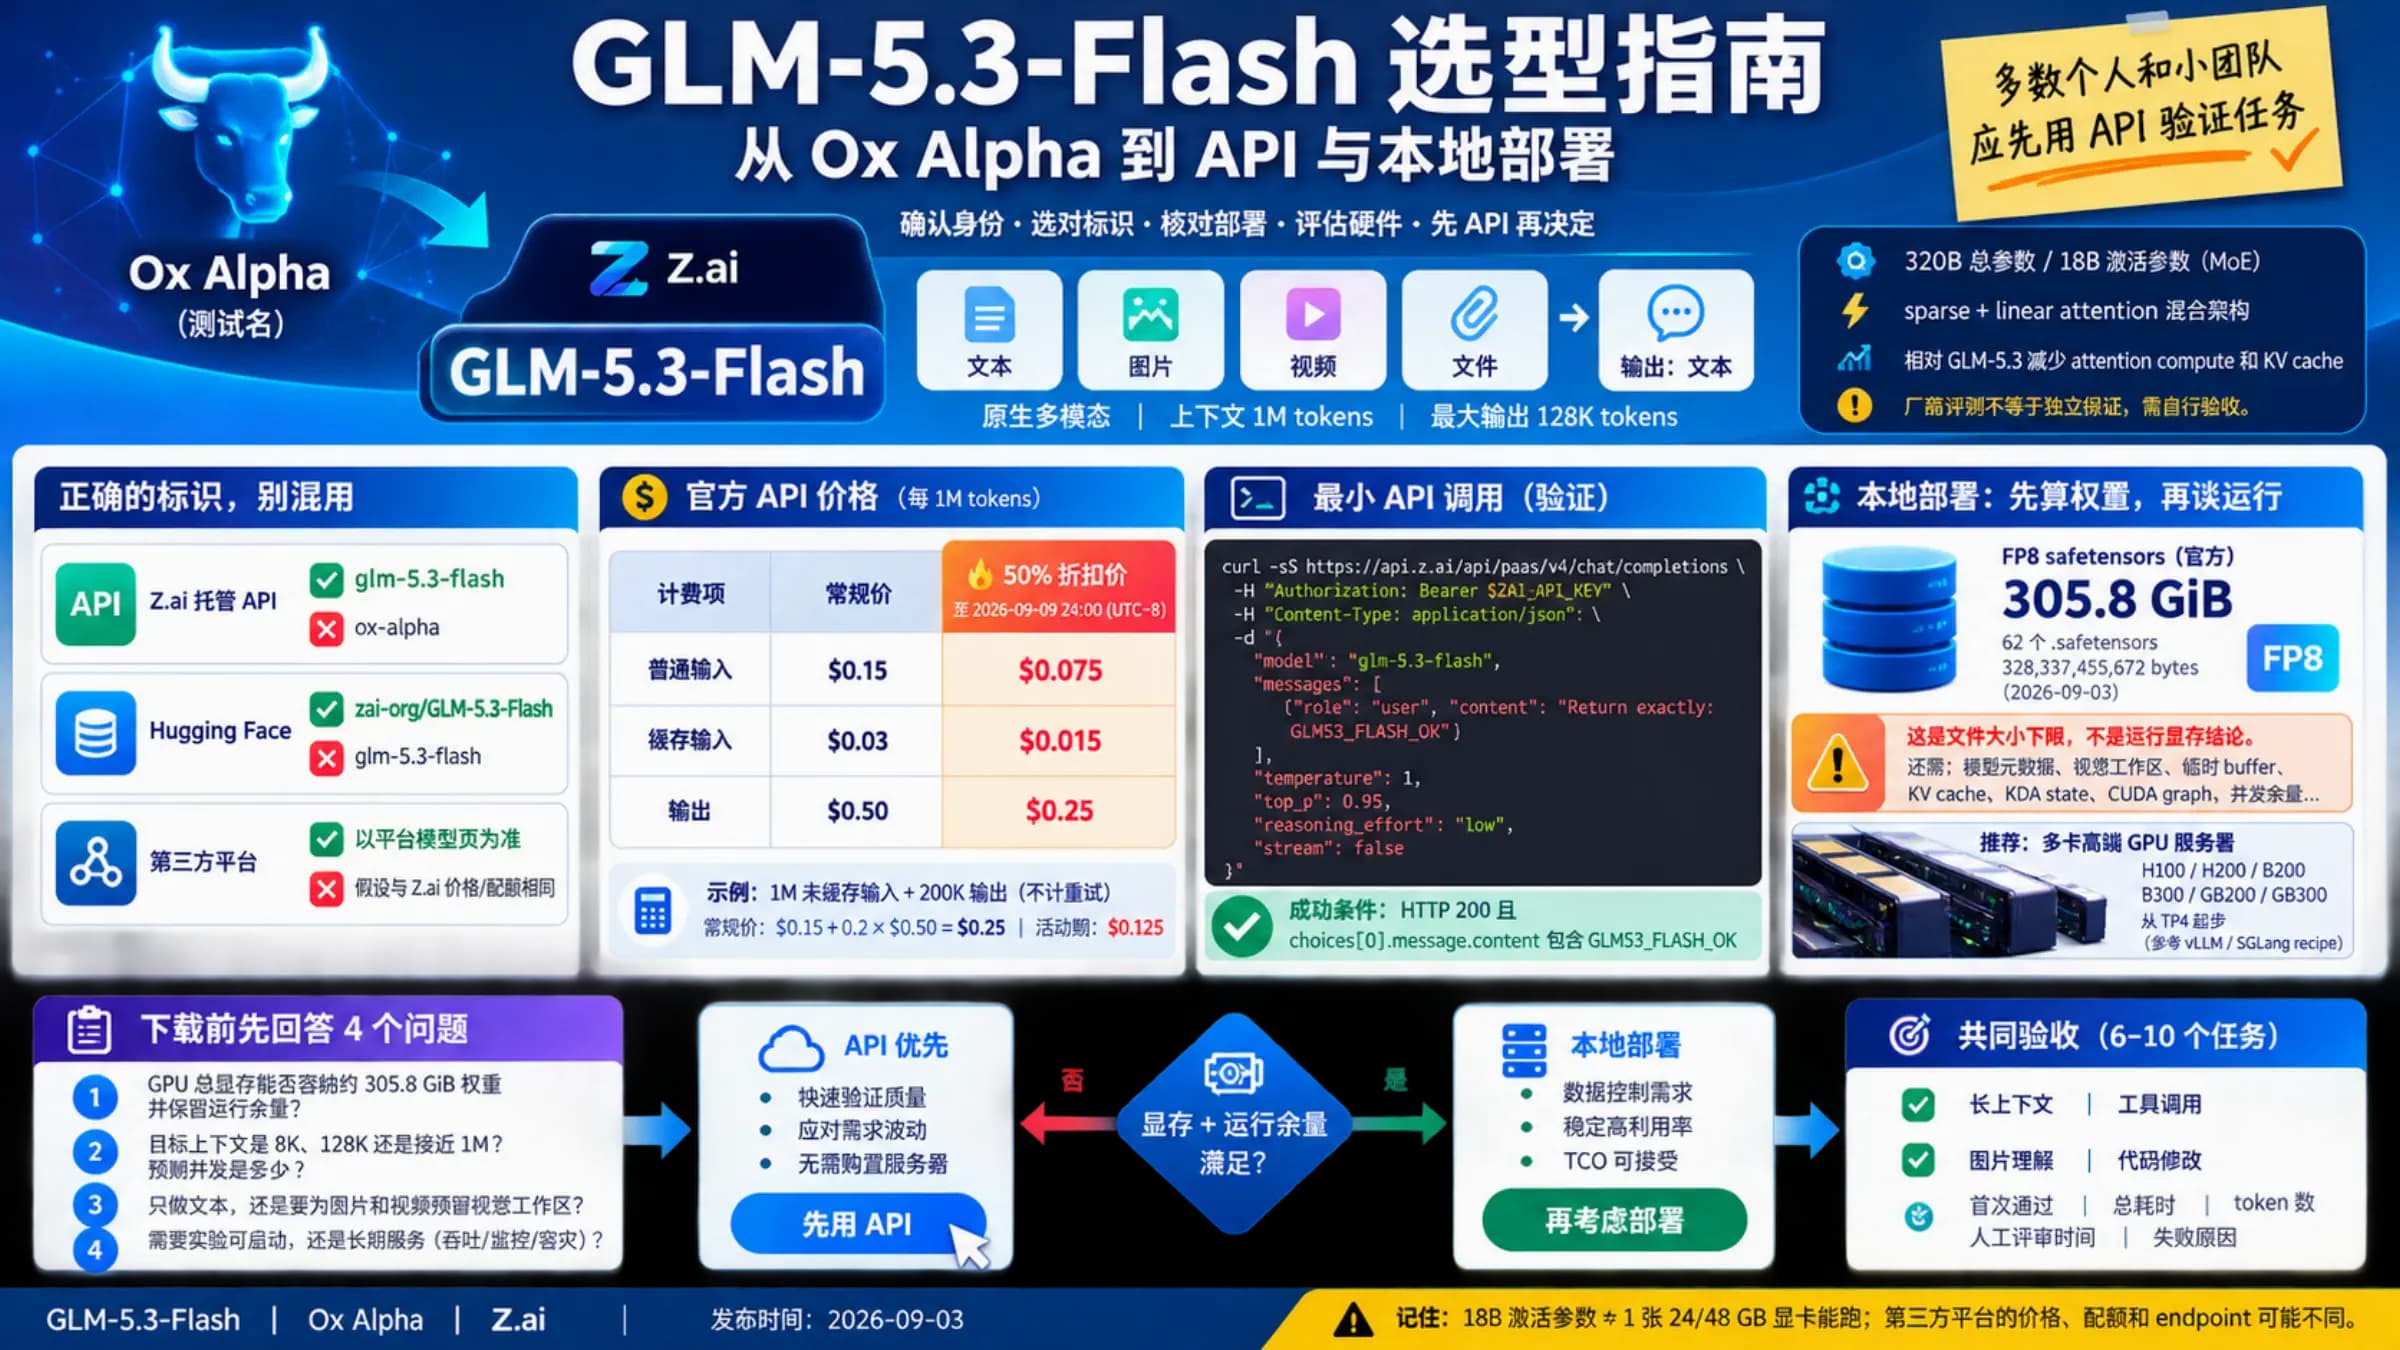
| 输入 | 文本 | 文本、图片、视频、文件 | 有视觉输入时,Flash 是两者中能够直接接收这些输入的模型 |
| 输出 | 文本 | 文本 | 两者都不是图片或视频生成模型 |
| 上下文 | 1M tokens | 1M tokens | 相同标称长度不代表相同长文准确率 |
| 最大输出 | 128K tokens | 128K tokens | 仍应为 Agent 设置业务级停止条件 |
| 推理 | 始终开启;low/high/max | 始终开启;low/high/max | 对比时必须使用相同推理强度 |
| 官方定位 | 复杂软件工程与长周期 Agent 的旗舰 | 低成本、原生多模态的高效路线 | 定位是首测线索,不是你的质量结果 |
| 已核验权重 | 官方模型卡提供 753B 权重,使用 GLM-5.3 license | 官方模型卡提供 321B、MIT 权重 | 两者都可研究本地部署,但许可证、容量与 TCO 不同 |
GLM-5.3 官方文档明确写出仅文本输入、1M 上下文、128K 最大输出,以及推理不可关闭。GLM-5.3-Flash 官方文档则列出视频、图片、文本和文件输入,模型 ID 为 glm-5.3-flash。
Flash 不是在旧模型上简单缩小。Z.ai 公布它有 320B 总参数、18B 激活参数,并采用稀疏注意力与线性注意力的混合架构。厂商还报告,相比 GLM-5.3,它将注意力计算量降至约 1/3.01、KV 缓存占用降至约 1/4.44。这些数字解释了服务成本设计,但不能单独证明某个真实项目的正确率或延迟。
用常规价做预算,再把促销当额外收益
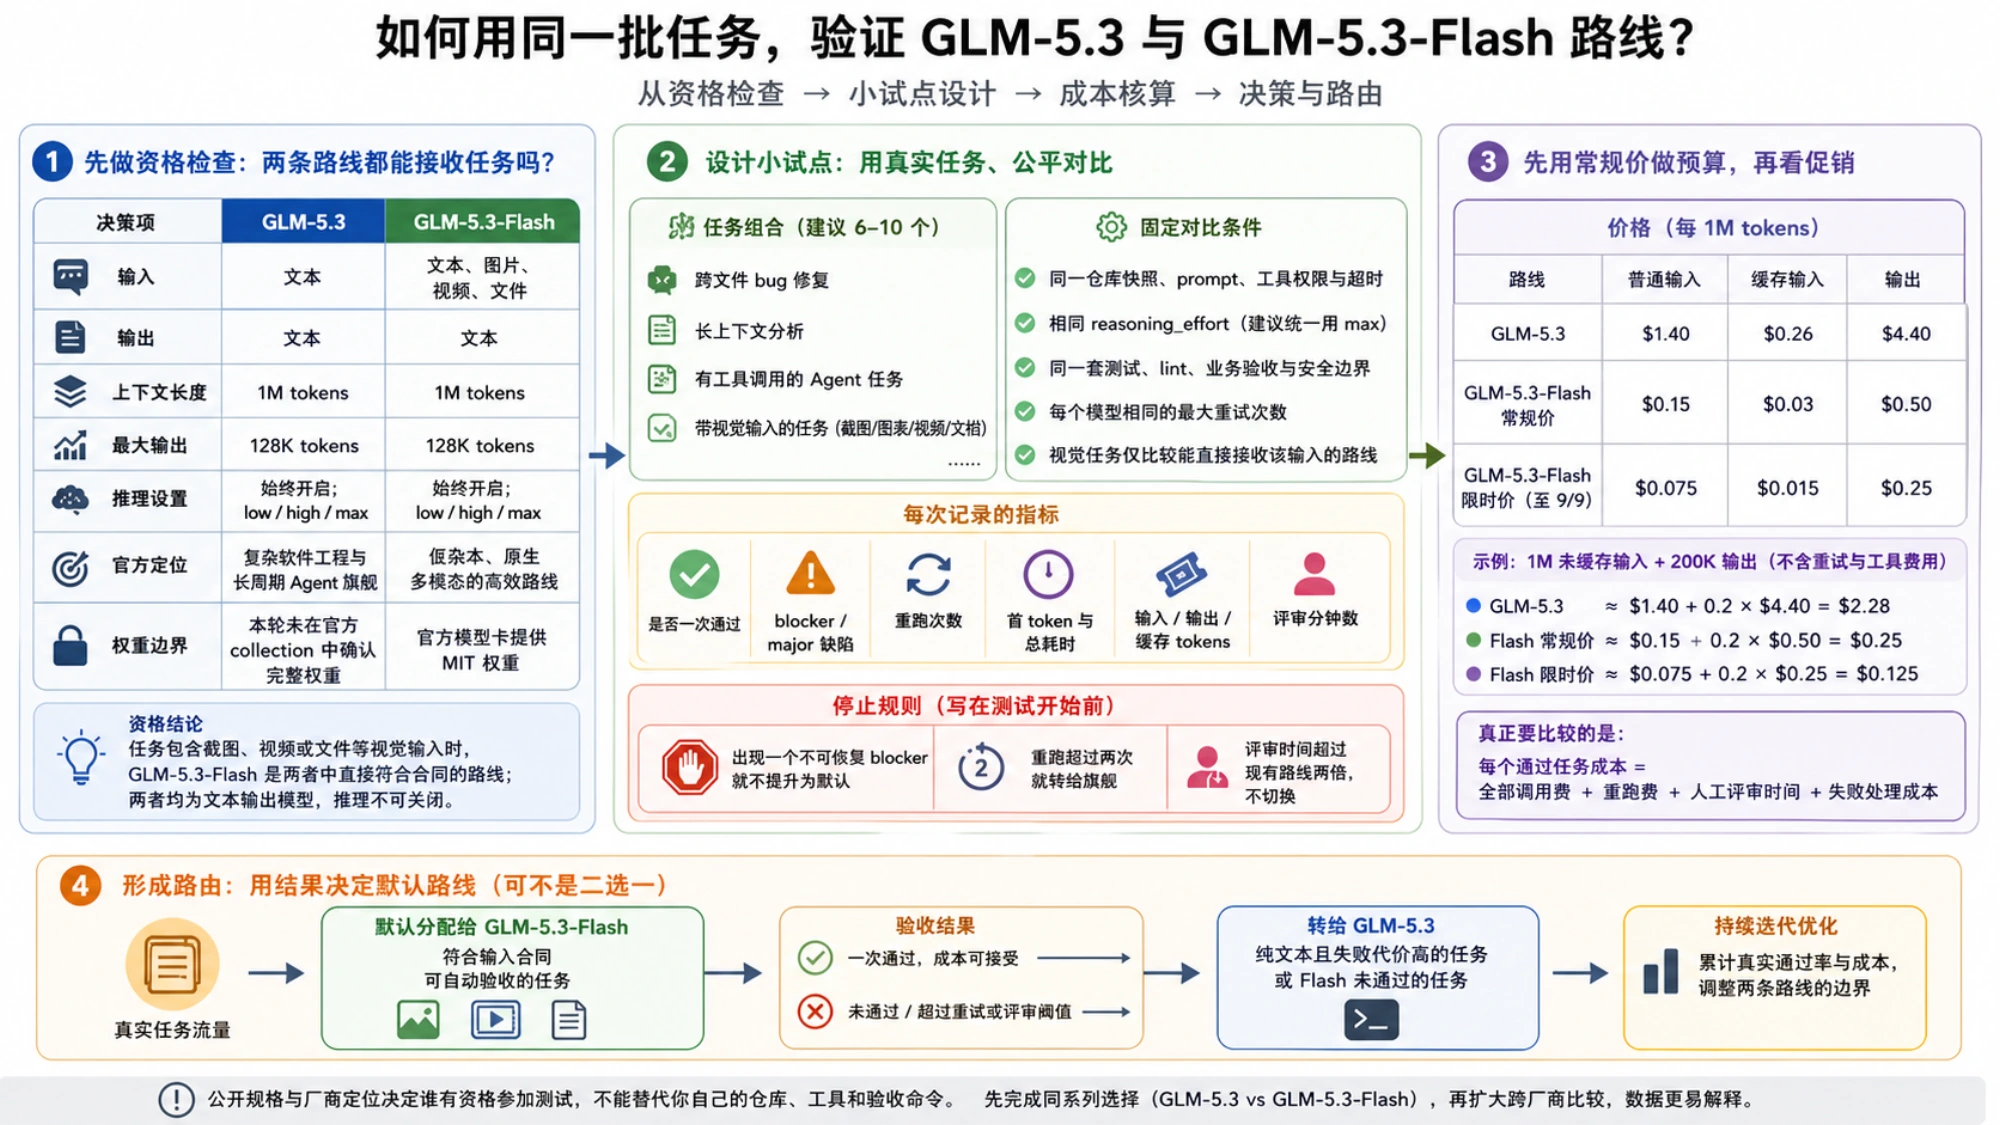
截至 2026 年 8 月 31 日,Z.ai 官方价格页按每 1M tokens 列出:
| 路线 | 普通输入 | 缓存输入 | 输出 |
|---|---|---|---|
| GLM-5.3 | $1.40 | $0.26 | $4.40 |
| GLM-5.3-Flash 常规价 | $0.15 | $0.03 | $0.50 |
| GLM-5.3-Flash 限时价 | $0.075 | $0.015 | $0.25 |
Flash 当时公布的半价活动原定于 2026 年 9 月 9 日 24:00(UTC+8)结束;此处保留活动价供核对历史费用,不能据此认定现在仍有折扣。采购或长期路由应使用常规价计算,限时价只适合解释短期账单。
假设一组请求累计消耗 1M 未缓存输入和 200K 输出,不含重试与工具费用:
- GLM-5.3 约为
$1.40 + 0.2 × $4.40 = $2.28; - Flash 常规价约为
$0.15 + 0.2 × $0.50 = $0.25; - Flash 限时价约为
$0.075 + 0.2 × $0.25 = $0.125。
因此,在这组假设用量下,Flash 常规费用约为 GLM-5.3 的 1/9.1,活动费用约为其 1/18.2。但真正要比较的是:
每个完成任务的总成本 =(全部 API 费用 + 人工评审小时数 × 每小时成本 + 其他失败处理费用)÷ 最终通过验收的任务数
全部 API 费用已包含重试,不再另加一次重跑费;人工时间要先折算为与账单相同的货币单位,其他处理费用也不能重复计算。若没有任务通过,记录失败及总支出,不计算平均完成成本。
如果 Flash 连续三次才通过,而旗舰一次通过,token 差距会缩小;若两者一次通过且评审时间接近,旗舰就需要用更低的失败率或更高的产出价值证明溢价。
哪些任务先交给 Flash
带截图的前端修复、图表或文档理解、视频内容整理、可自动验收的批量代码修改,都适合先测 Flash。它不仅价格低,而且支持的输入类型更多。官方 GLM-5.3-Flash 模型卡提供 321B、MIT 权重,并列出 vLLM、SGLang、Transformers、KTransformers 与 Unsloth 等部署入口。
官方 GLM-5.3 模型卡现在也提供 753B 权重,并列出 vLLM、SGLang、Transformers、KTransformers 与 Unsloth 等本地入口;其许可证标注为 GLM-5.3 license,而不是 Flash 的 MIT。开放或可下载权重都不等于“本地一定更便宜”:320B 与 753B 模型分别带来显存、量化、吞吐、运维和峰值容量成本。比较本地与托管 API 时,应把许可证和总拥有成本(TCO)写进同一张账单。
哪些任务值得保留旗舰对照
纯文本、长周期且失败代价高的工程任务值得让 GLM-5.3 参加:例如跨多个服务的迁移、需要持续维护计划的大型重构、终端环境中一处错误就会污染后续状态的 Agent 工作。
Z.ai 将 GLM-5.3 定位为复杂软件工程旗舰,并公布了多项编码与智能体评测提升。这些是选择候选的依据,不是直接把它设为生产默认的依据。公开评测的运行框架、工具、超时、token 预算和评分方式可能与你的环境不同;Flash 的发布材料也主要与 GLM-5.2 比较,而不是提供完整、独立的 5.3 对 5.3-Flash 胜负表。
一轮小试点就够做第一版决定
从真实工作里挑 6–10 个任务,不要专门为任何模型设计题目。至少包含一个跨文件 bug、一个长上下文分析、一个有工具调用的 Agent 任务,以及一个带视觉输入的任务。视觉任务只比较能直接接收该输入的路线,不要先由人工转成文字再假装条件相同。
文本任务需要固定:
- 同一仓库快照、提示词、工具权限与超时;
- 相同的
reasoning_effort,复杂任务可统一使用max; - 同一套测试、lint、业务验收与安全边界;
- 每个模型相同的最大重试次数。
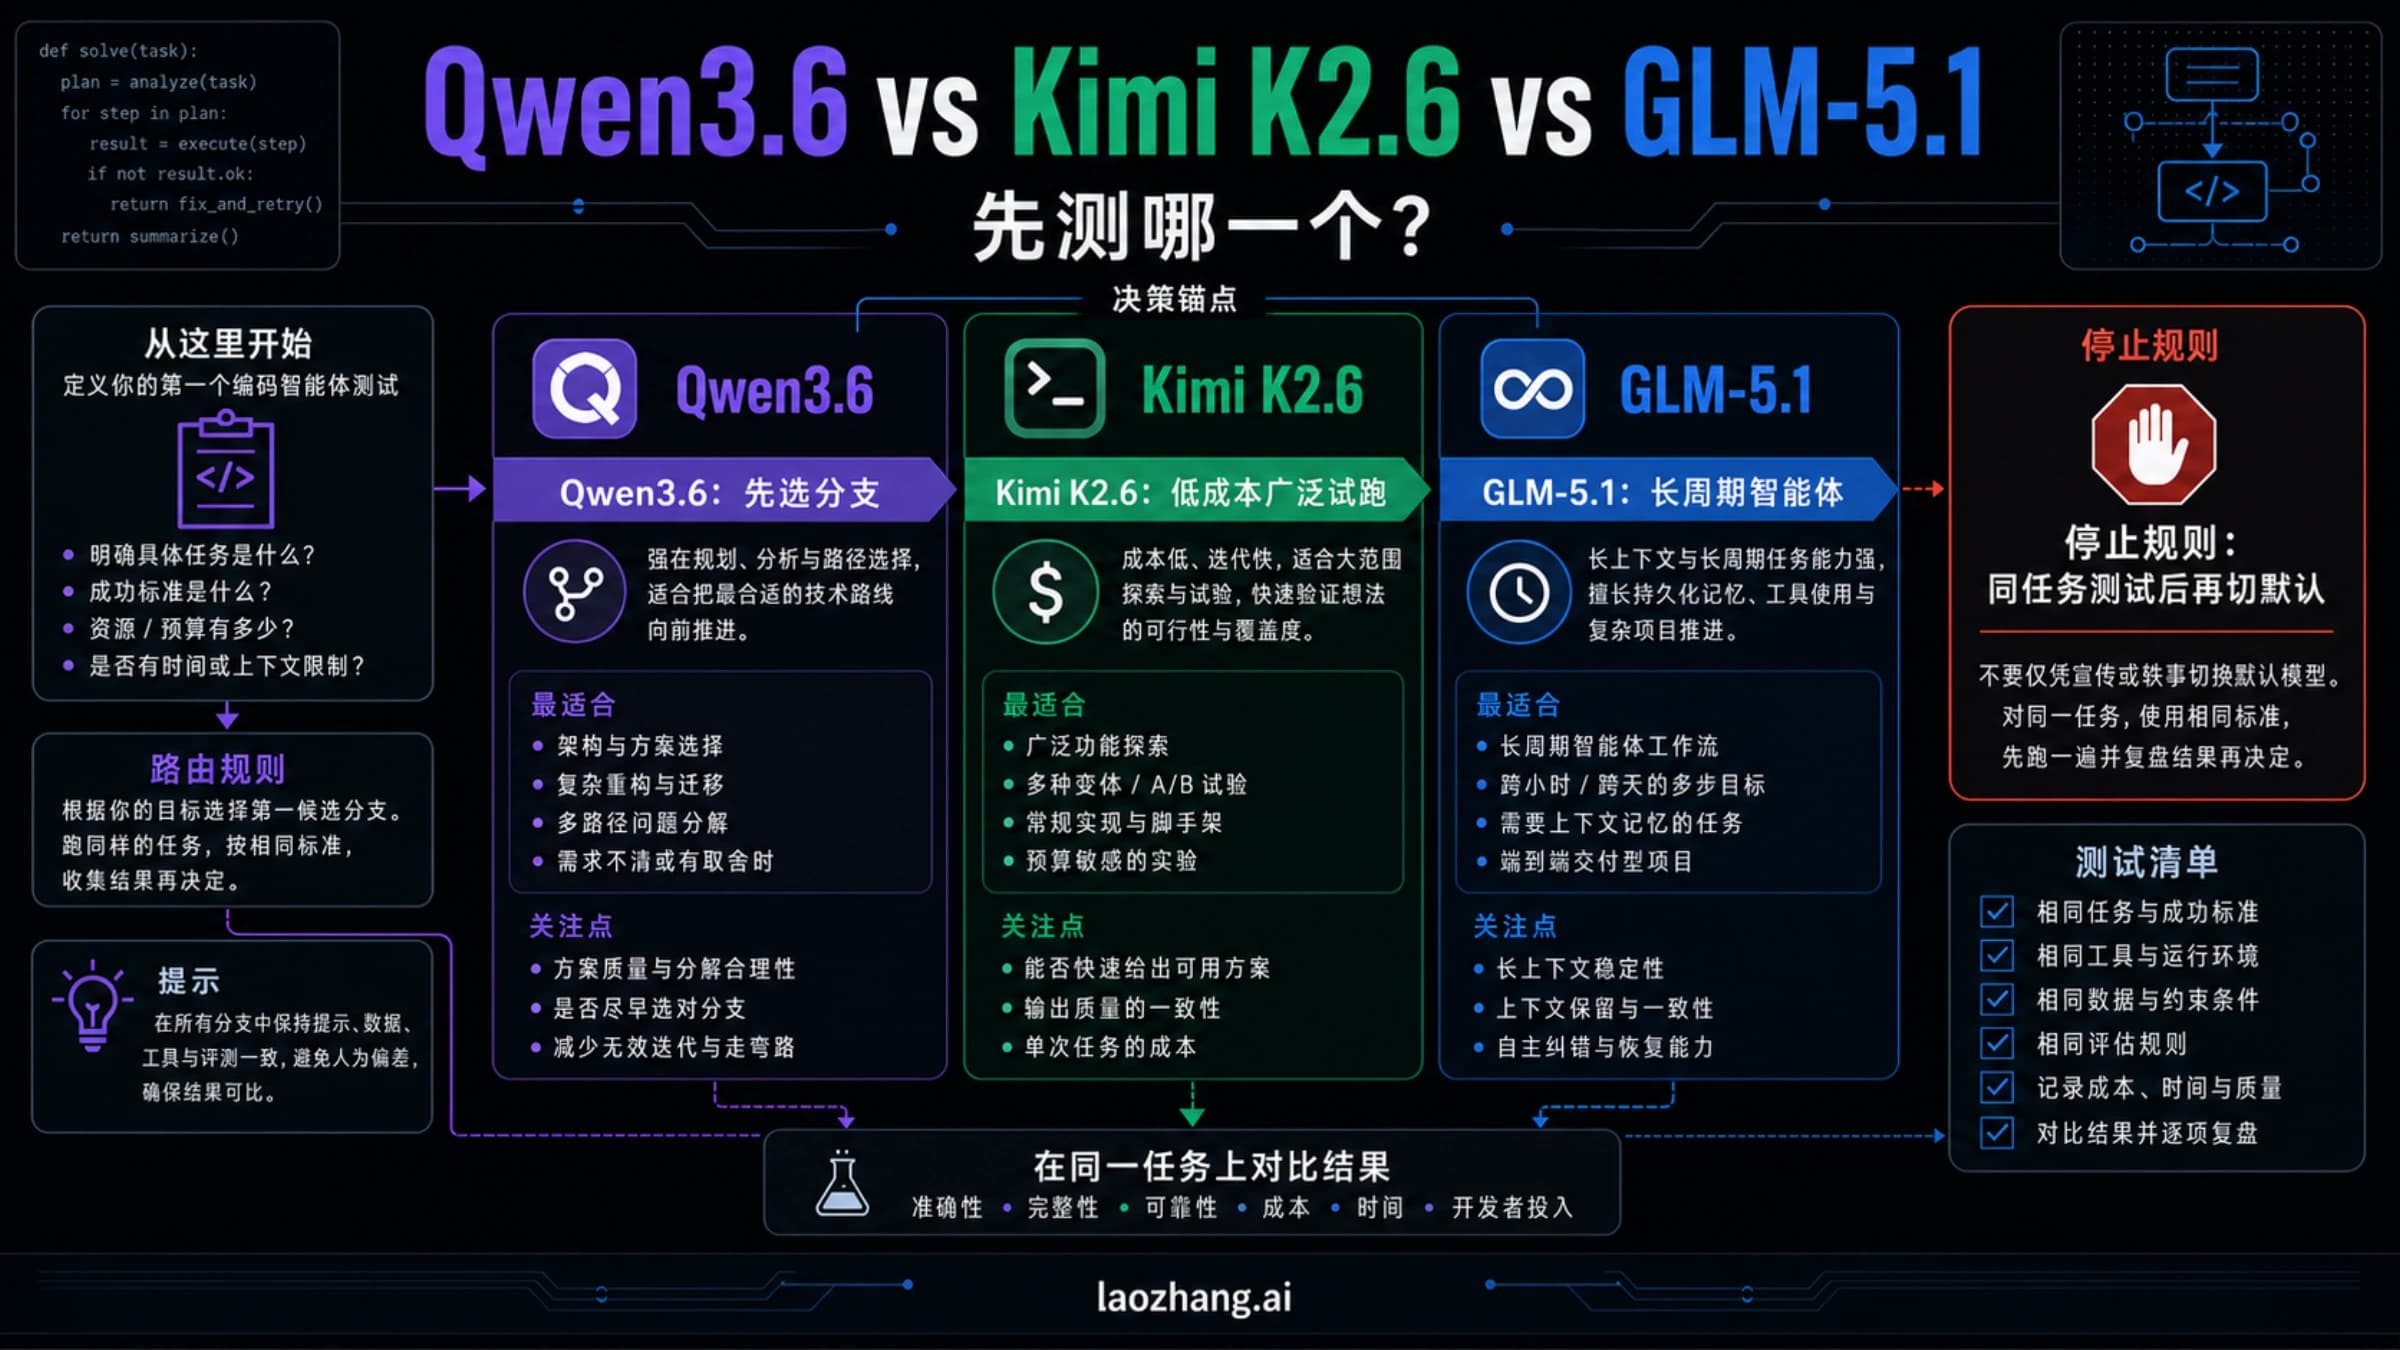
每次记录是否一次通过、阻断任务或影响结果的严重缺陷、重跑次数、首 token 与总耗时、输入/输出/缓存 tokens、评审分钟数。测试开始前写停止规则:例如,出现无法恢复的故障时不设为默认模型;重试次数和评审时间超过事先约定的业务预算时,停止当前尝试并比较其他方案。具体次数与时间应按任务确定,这些停止规则不代表任何模型的已测表现。
最终路由可以不是二选一。更稳妥的第一版通常是:Flash 处理输入类型受支持、能够自动验收的常规任务;GLM-5.3 处理 Flash 未通过、纯文本且失败代价高的任务。积累足够的真实通过率后,再调整边界。
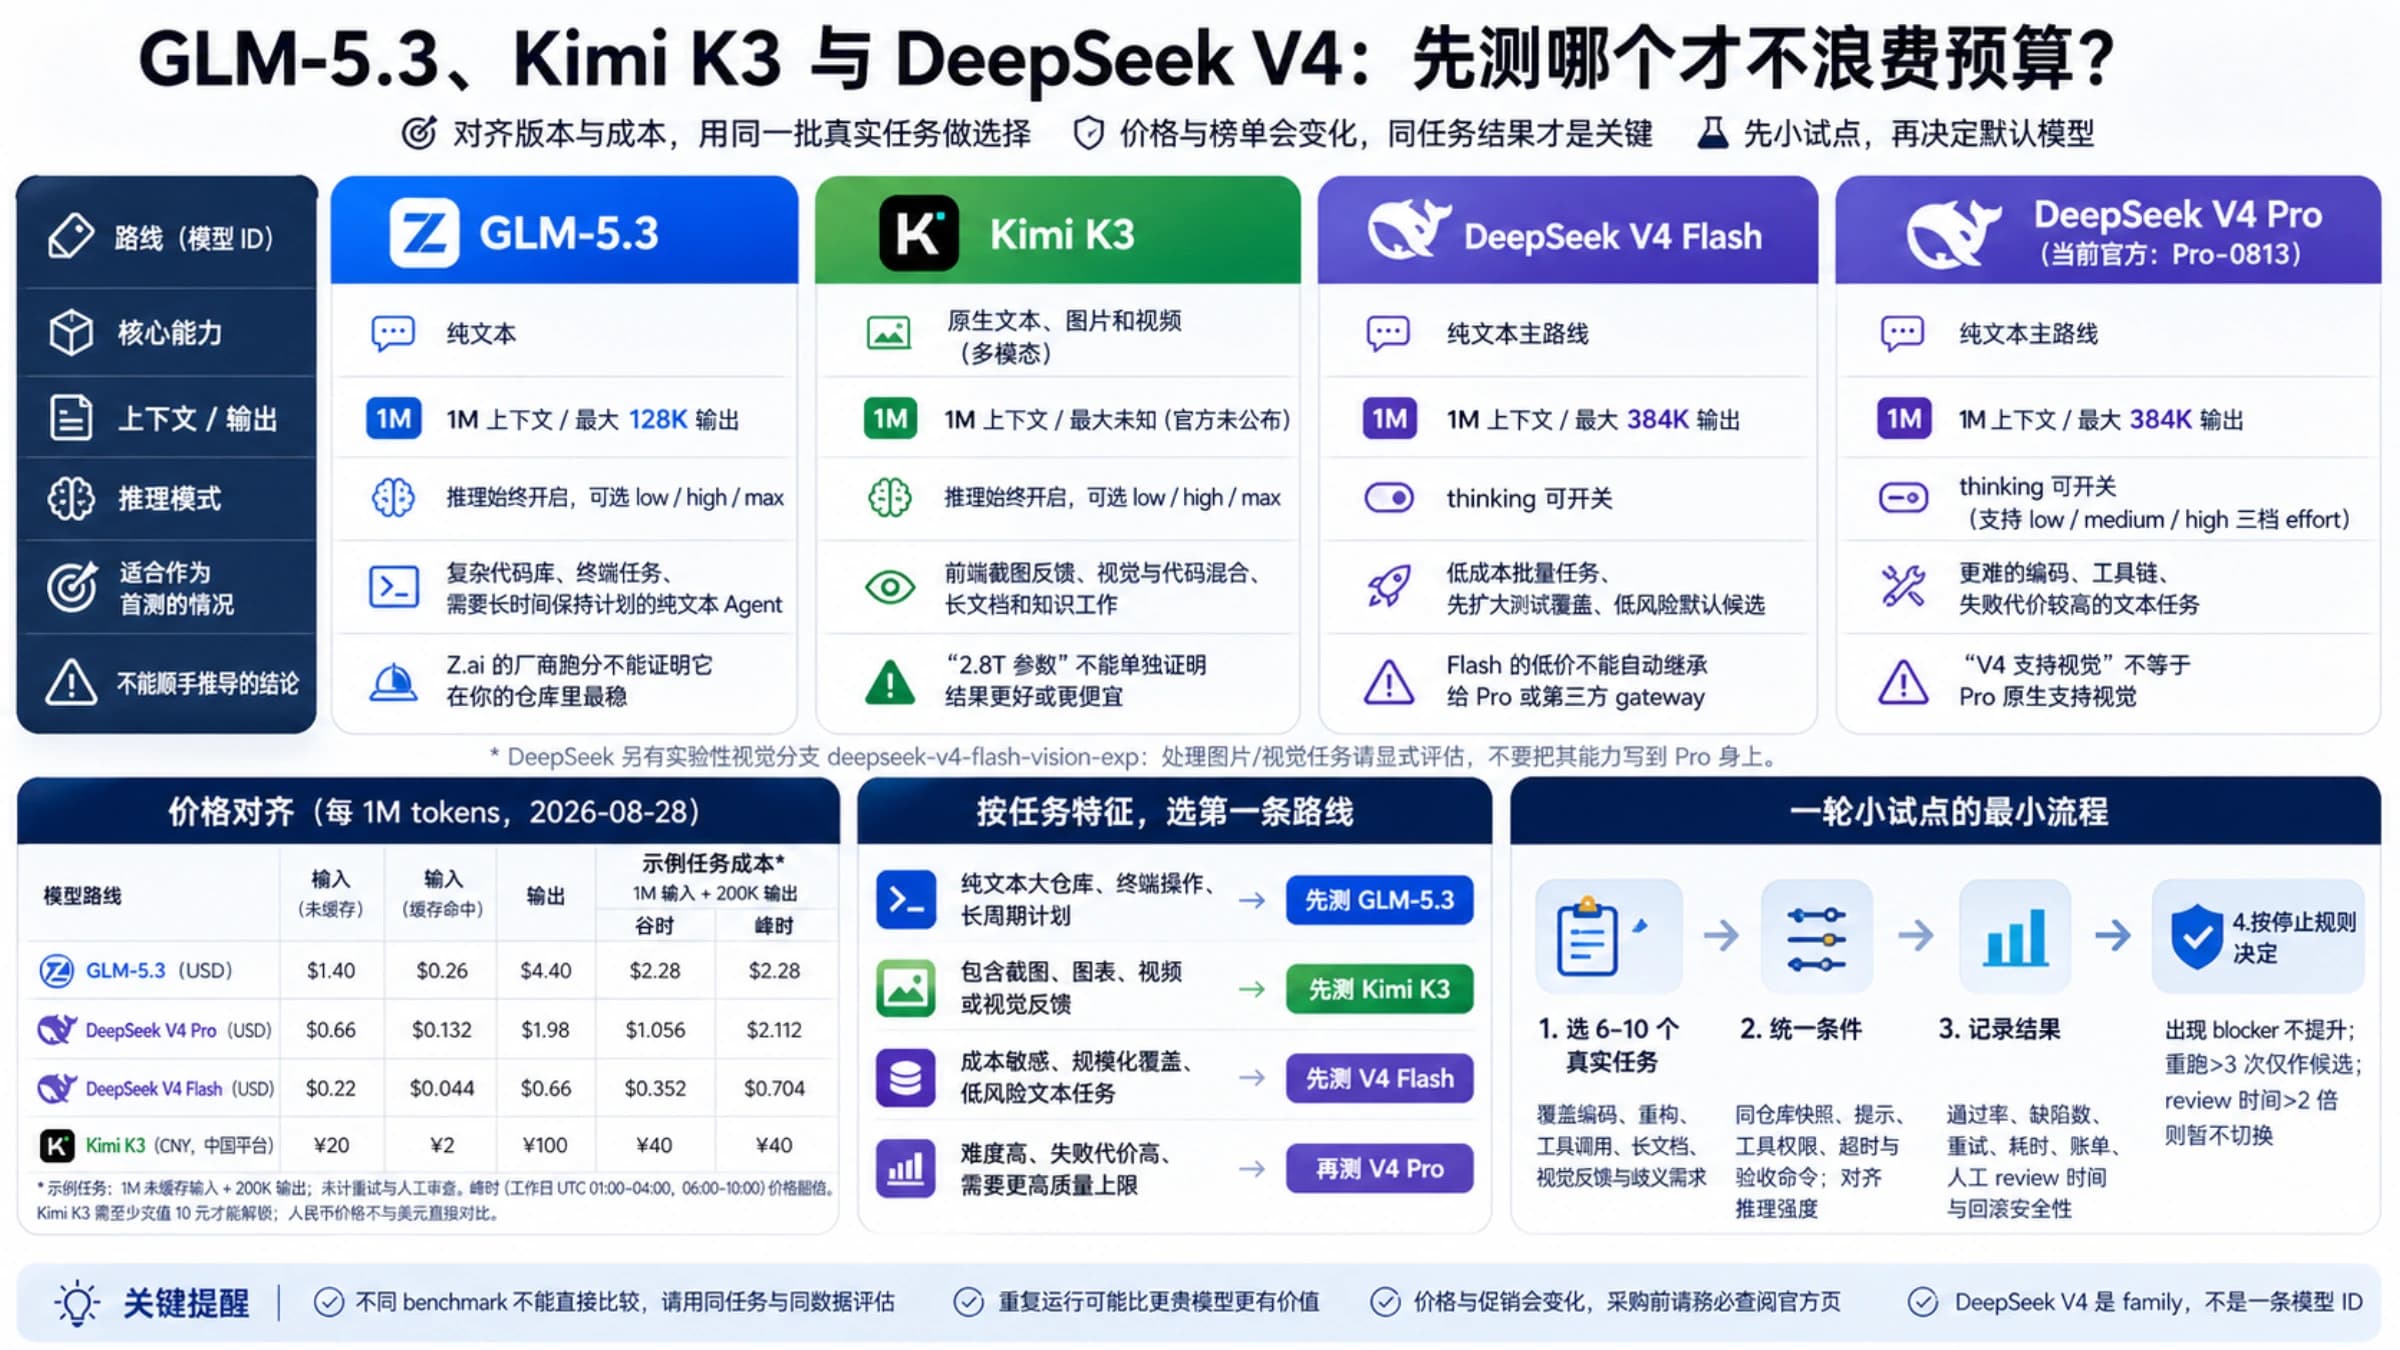
如果下一步要把这两条路线放进跨厂商候选池,可继续看 GLM-5.3、Kimi K3 与 DeepSeek V4 的首测路线。先完成同系列选择,再扩大比较,数据会更容易解释。