GLM-5.3 или GLM-5.3-Flash: какую модель проверять первой
Для мультимодальных и массовых задач первой проверяйте GLM-5.3-Flash. В текстовых задачах с дорогой ошибкой оставьте GLM-5.3 как контроль качества.
Содержание
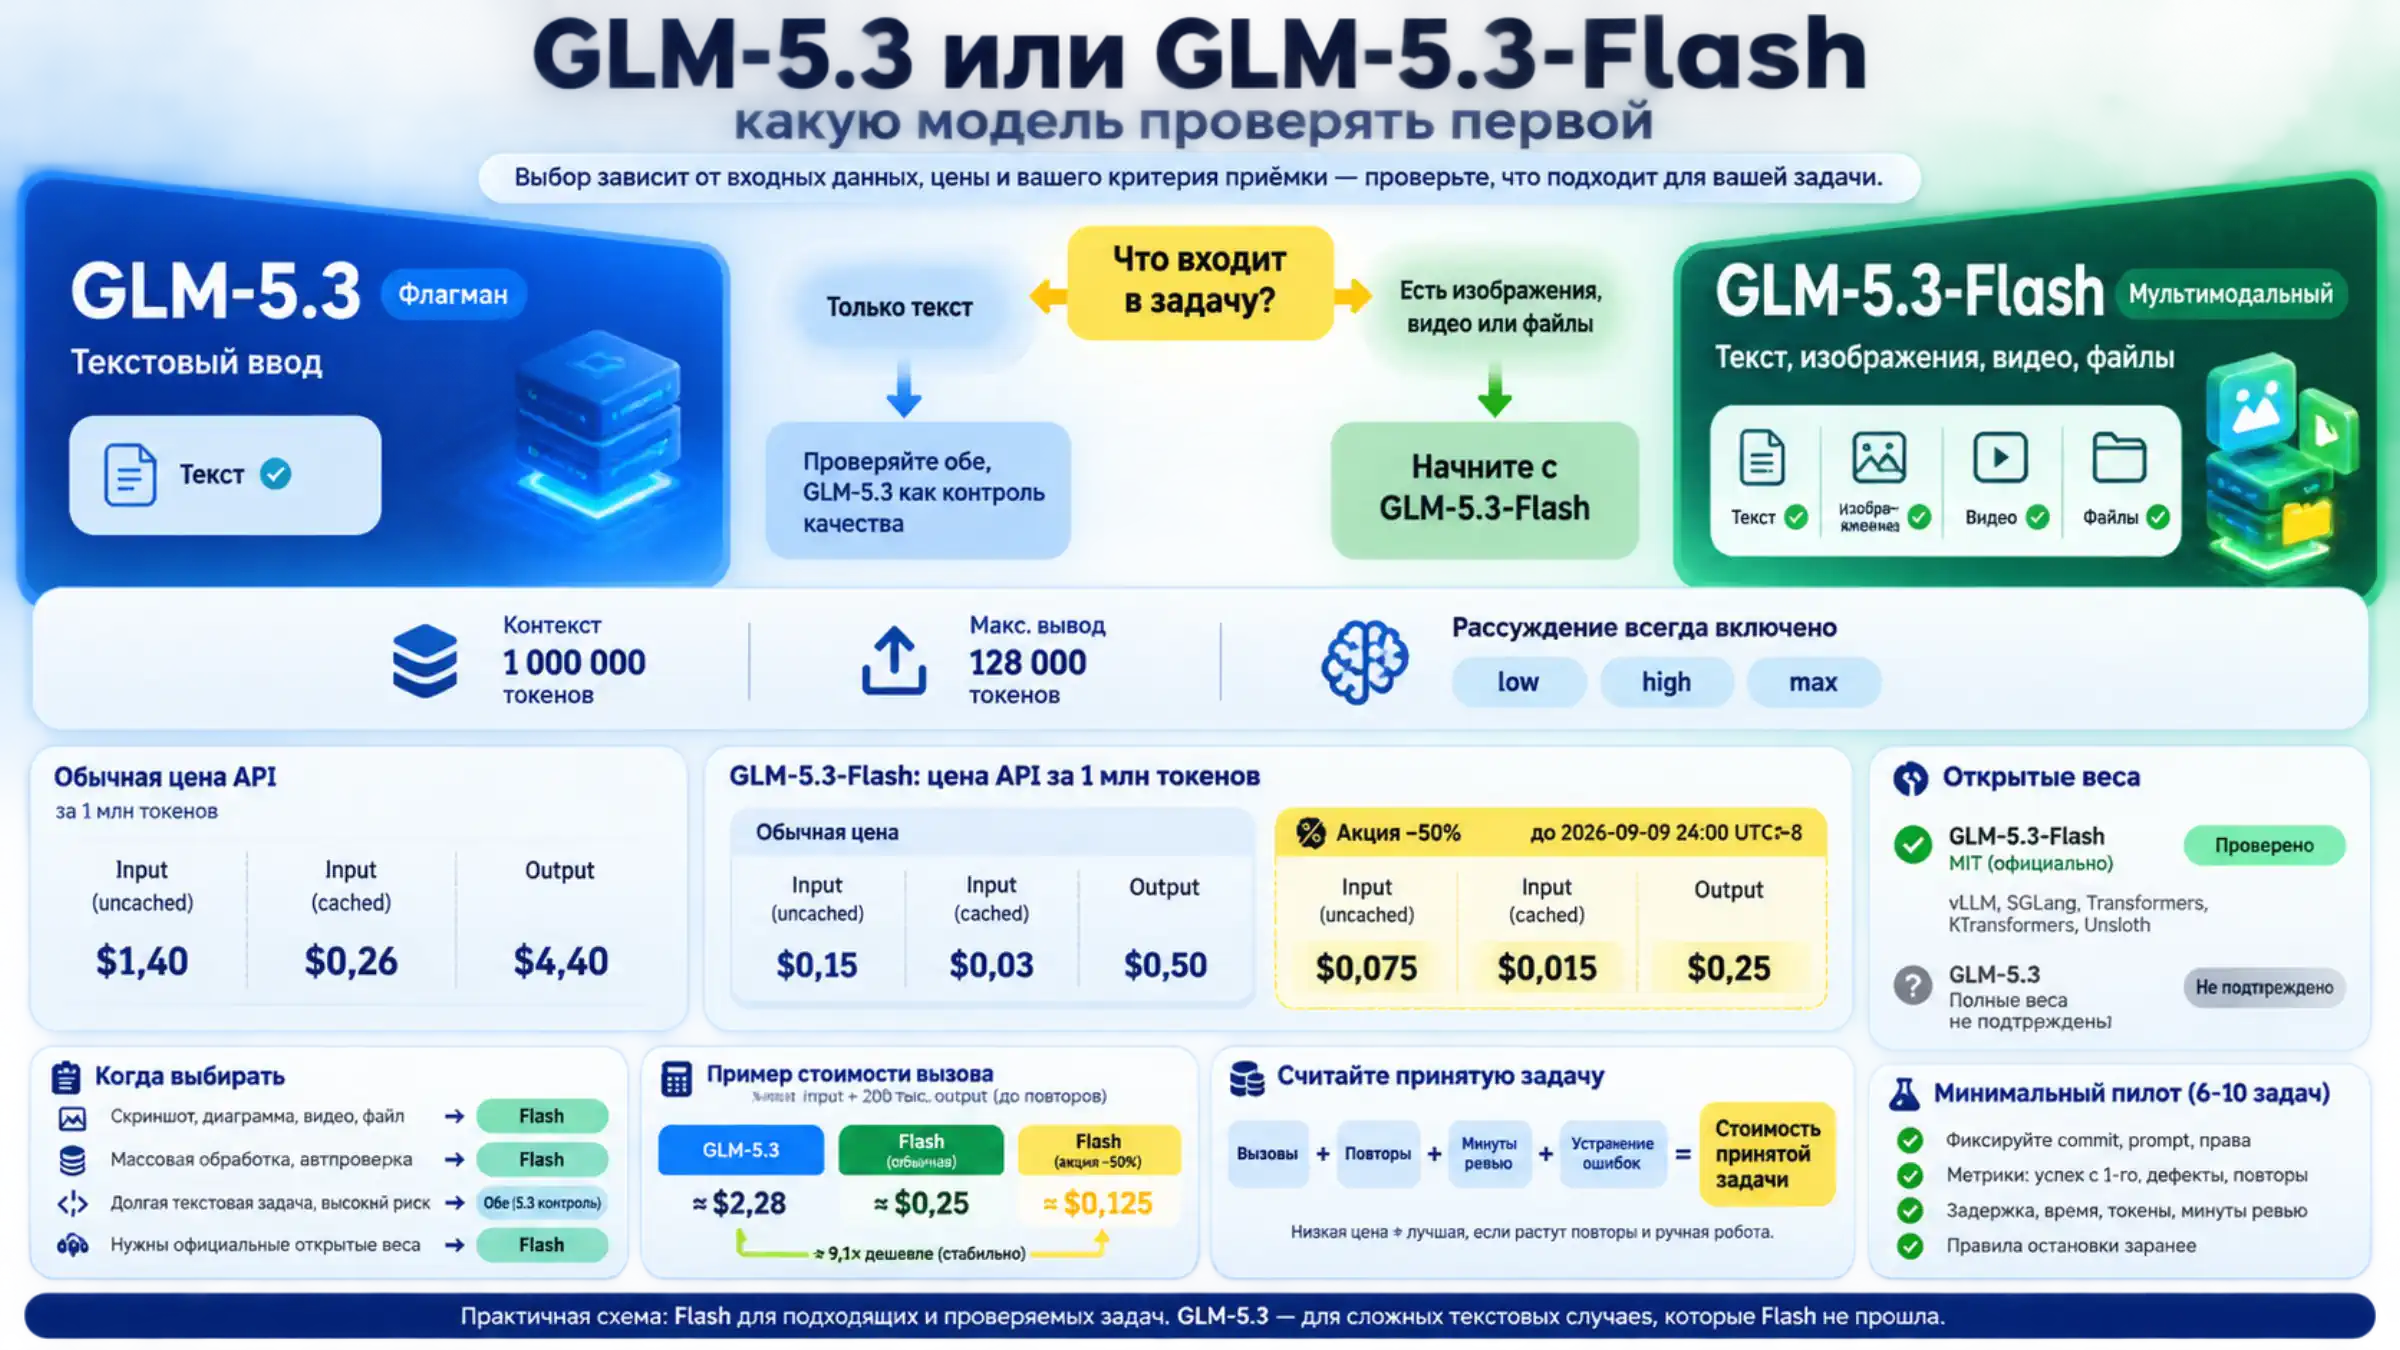
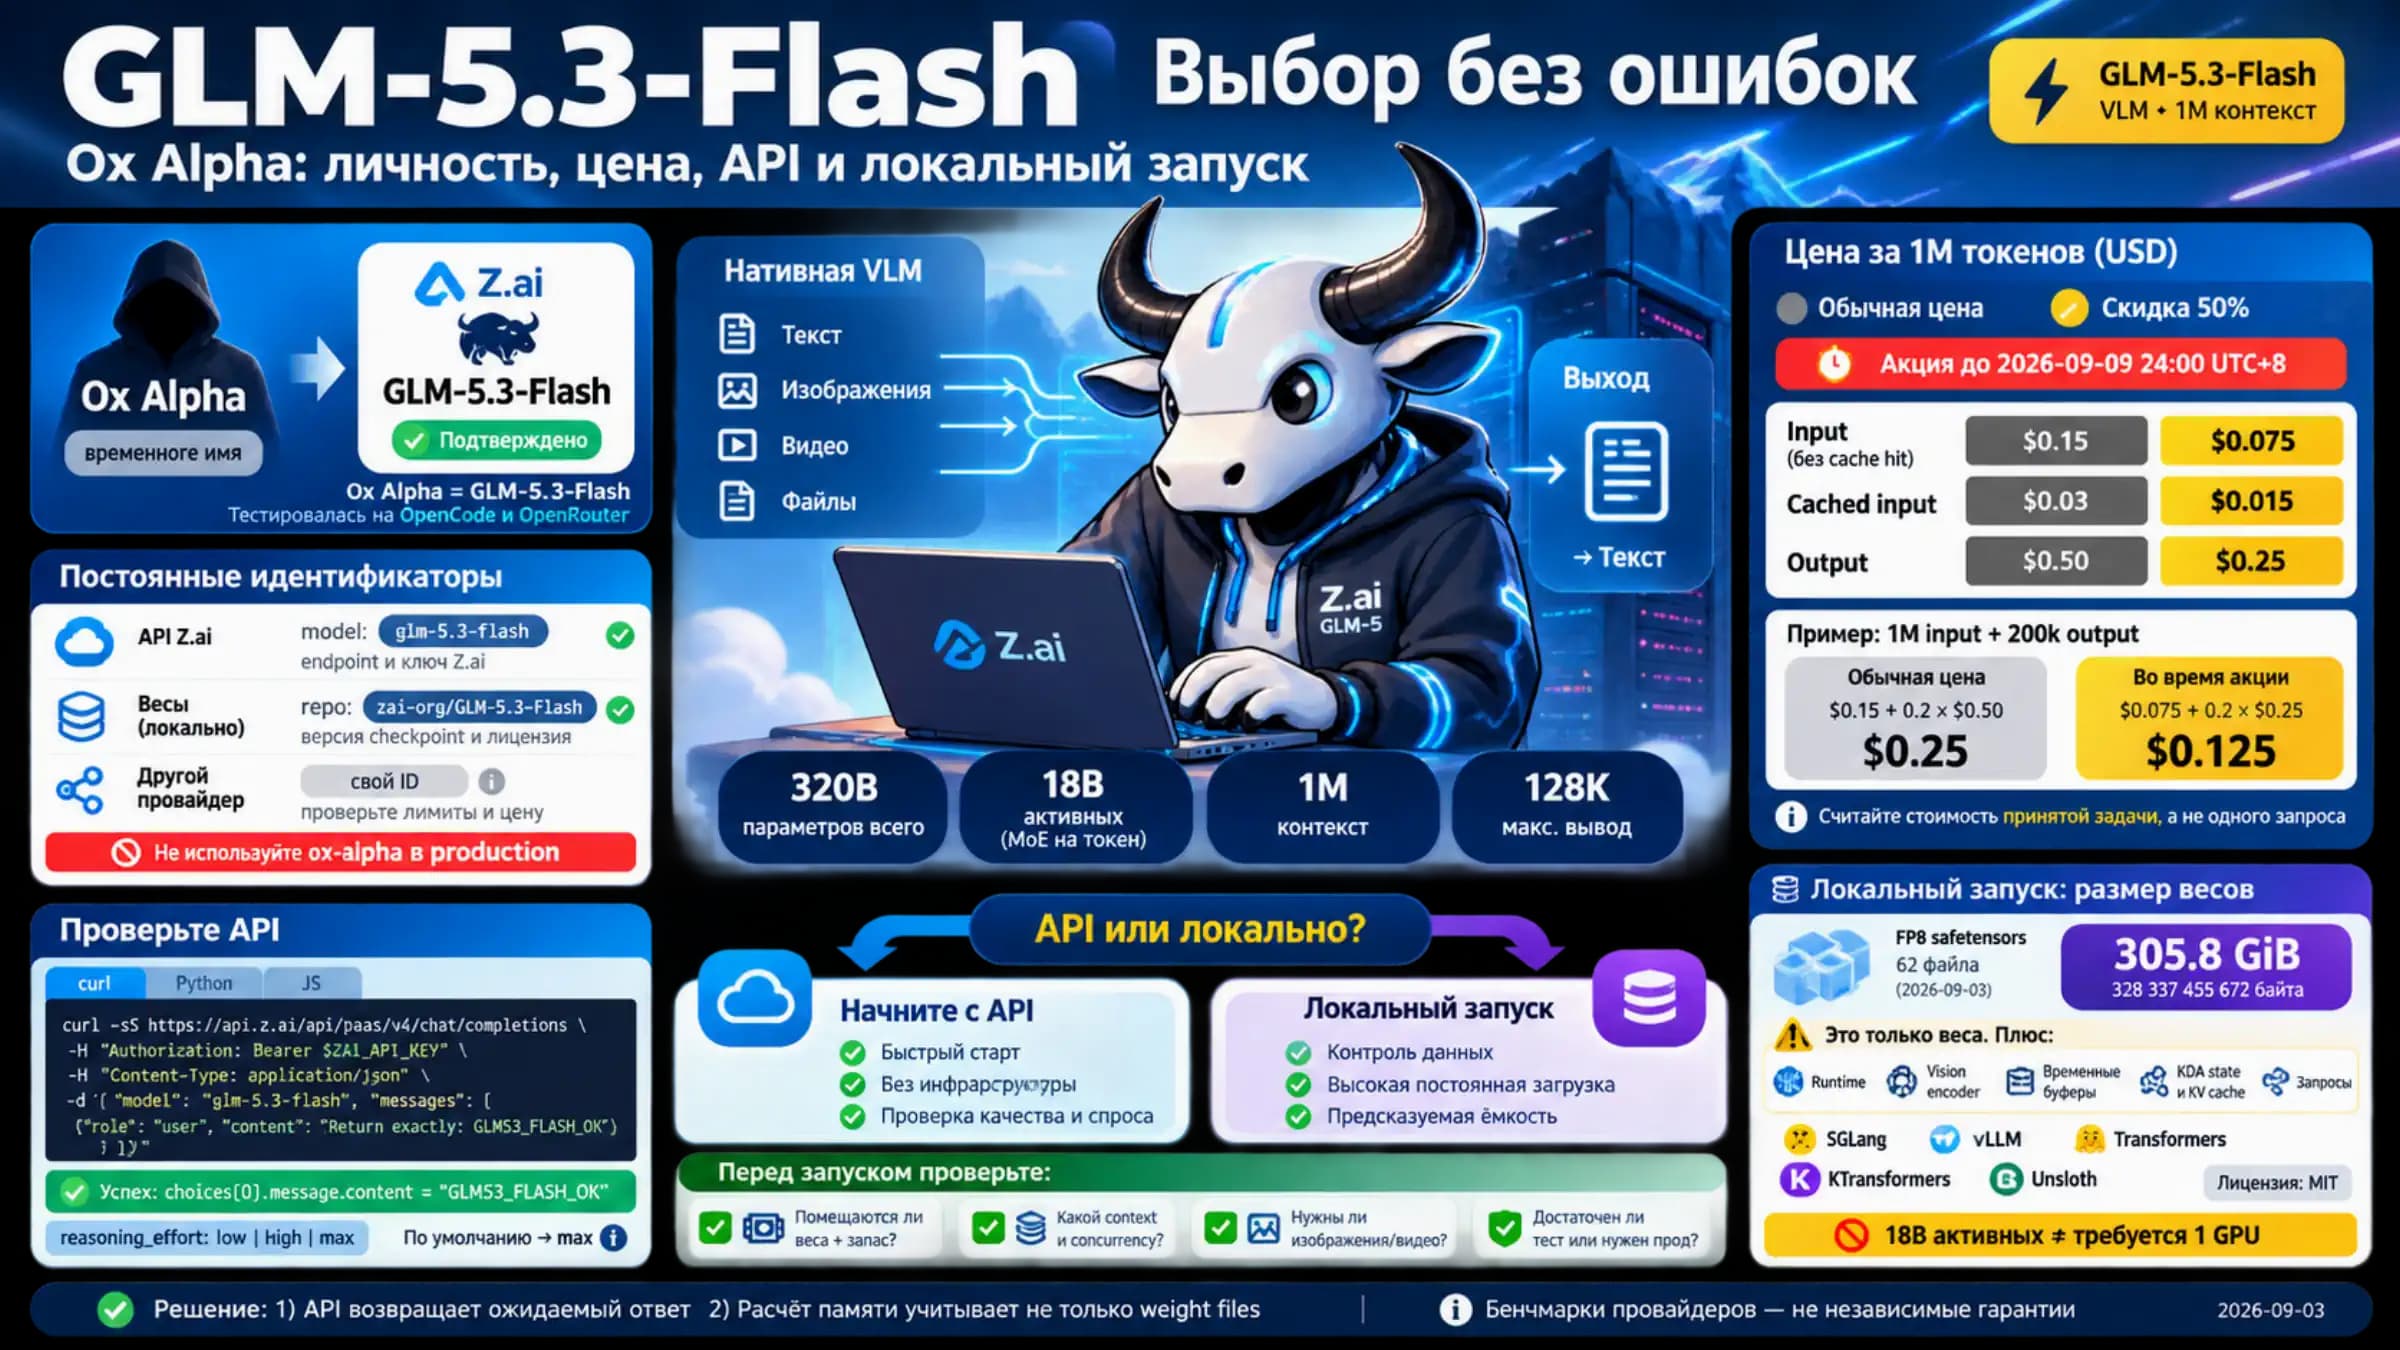
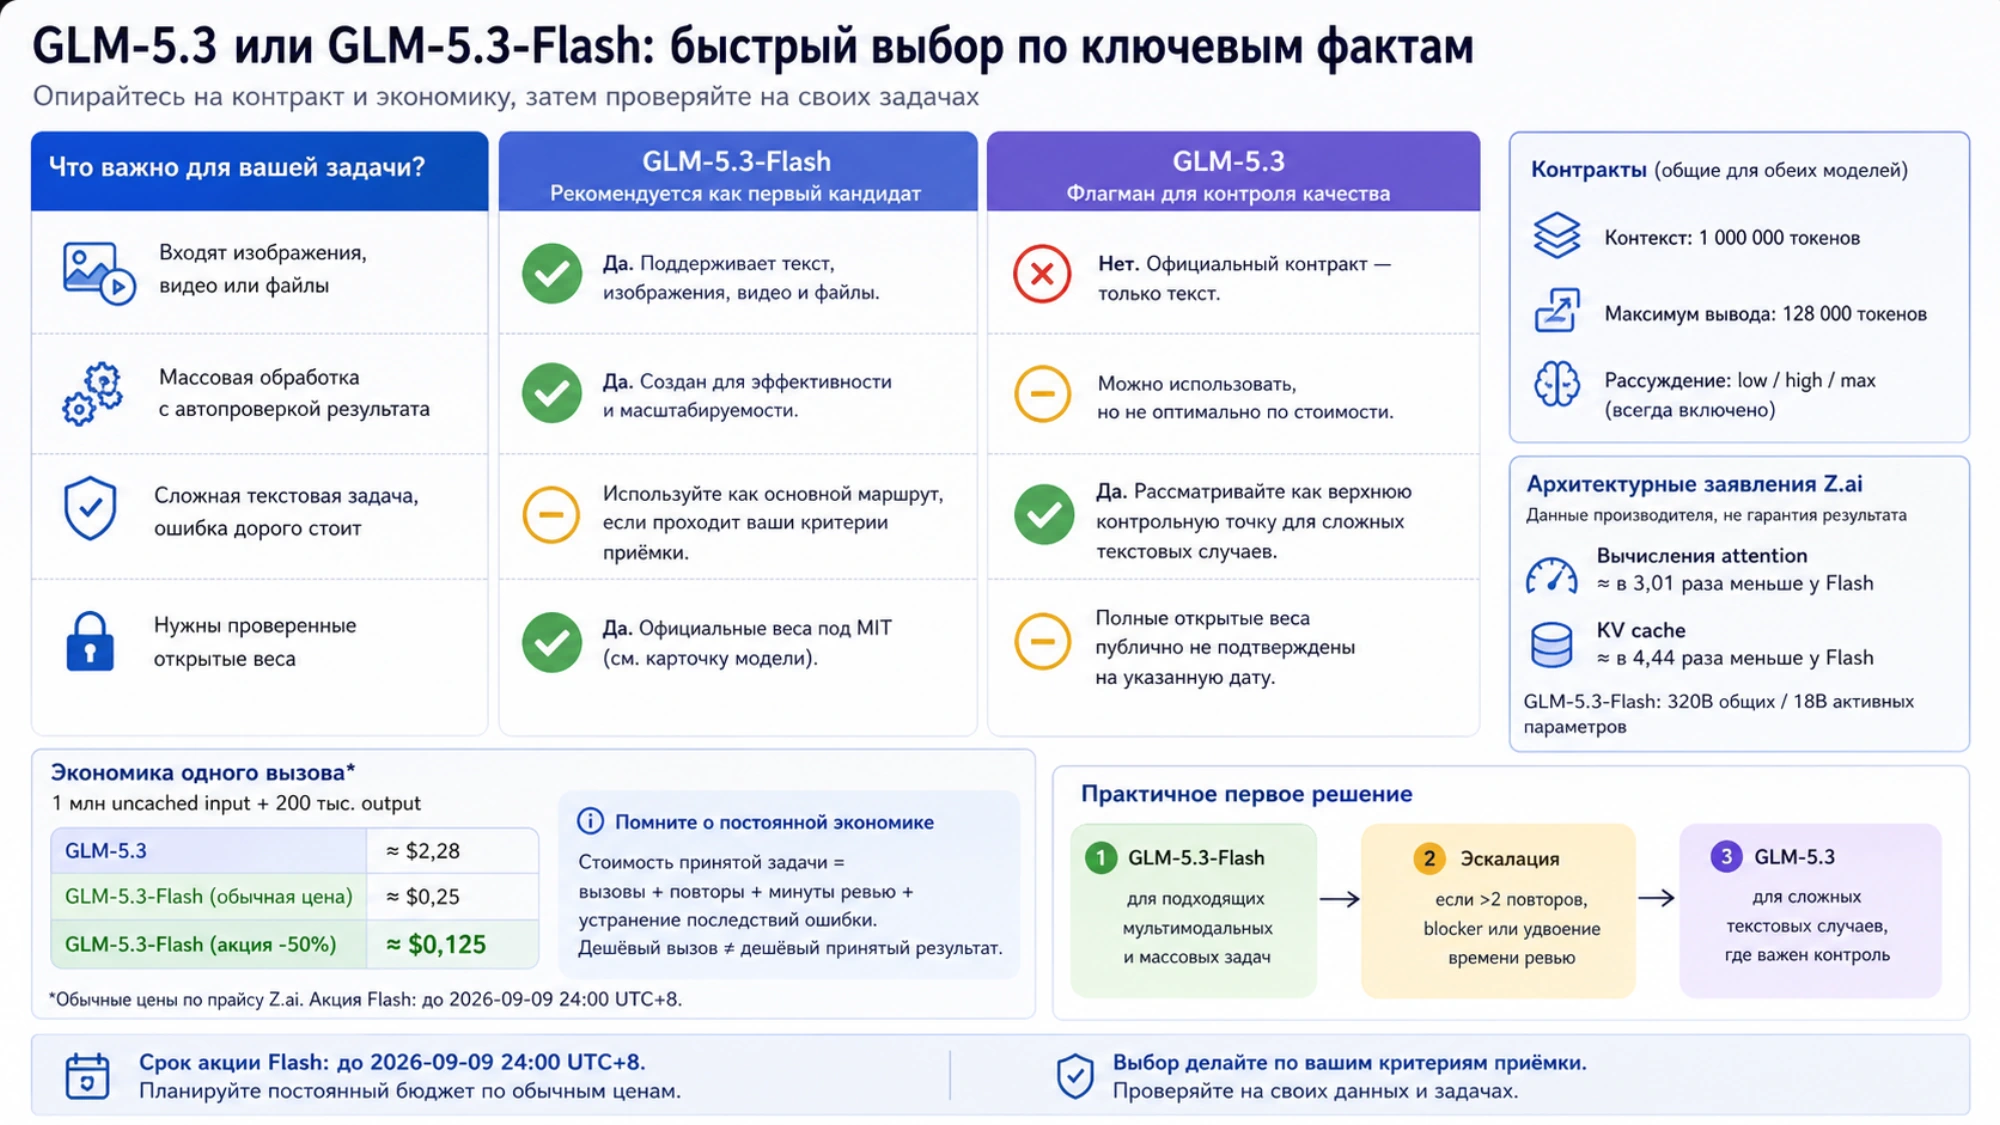
Начните с glm-5.3-flash, если в задаче есть изображения, видео или файлы: согласно документации, рассмотренной 31 августа 2026 года, glm-5.3 принимает только текст. Для сложных инженерных задач с текстом не выбирайте победителя по названию. Проверьте Flash как недорогой основной вариант, а GLM-5.3 — как кандидата для сравнения качества.
Такой порядок не означает, что Flash всегда сильнее. Спецификация позволяет отобрать модели, поддерживающие нужные данные. Для использования в приложении выбирайте модель по результатам проверки на своих задачах.
Какие данные принимают модели
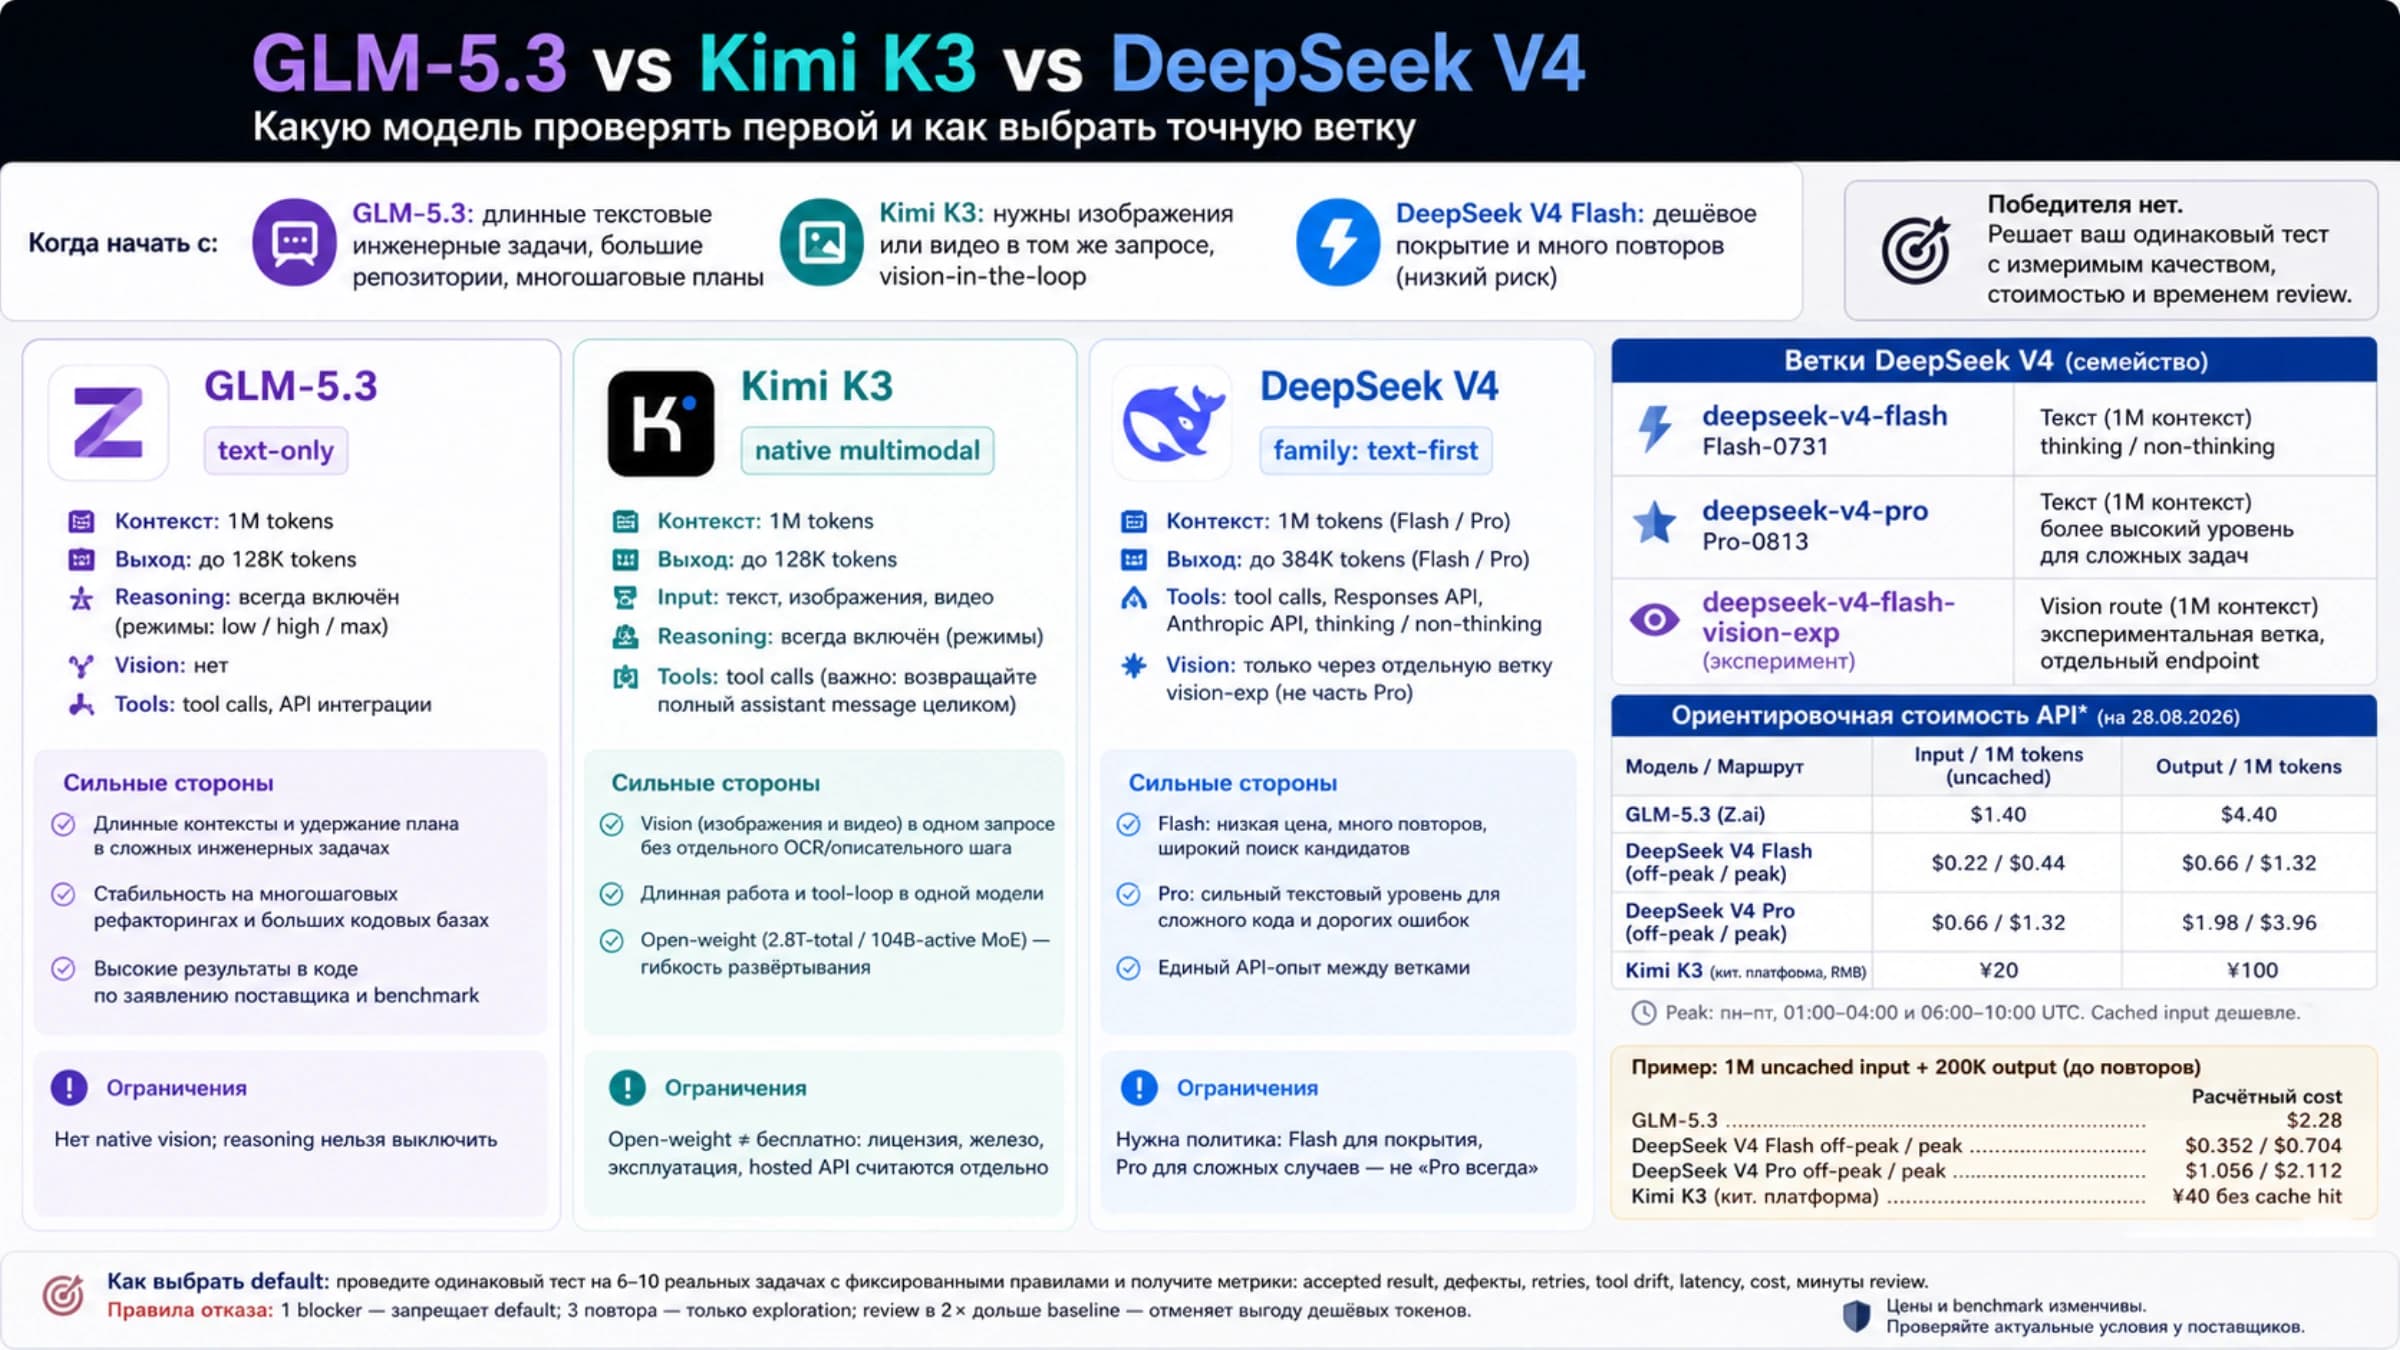
Обе модели имеют контекст 1 млн токенов, максимум 128 тыс. токенов вывода и постоянно включённое рассуждение с уровнями low, high, max. Но документация GLM-5.3 указывает только текстовый ввод и позиционирует модель как флагман для сложной разработки. Документация Flash добавляет изображения, видео и файлы.
| Условие | Первый кандидат |
|---|---|
| Скриншот, диаграмма, видео или файл должны входить напрямую | GLM-5.3-Flash |
| Массовая обработка с автоматической проверкой | GLM-5.3-Flash |
| Долгая текстовая задача, где ошибка портит состояние среды | Обе модели, GLM-5.3 как контроль |
| Нужны официальные веса для самостоятельного запуска | Обе модели; сверить лицензию и ёмкость |
Z.ai сообщает для Flash 320 млрд общих и 18 млрд активных параметров, а также снижение затрат на вычисление внимания примерно в 3,01 раза и объёма KV-кэша в 4,44 раза относительно GLM-5.3. Это данные производителя об архитектуре, а не гарантия скорости или точности в вашей системе.
Планируйте бюджет по стандартным тарифам
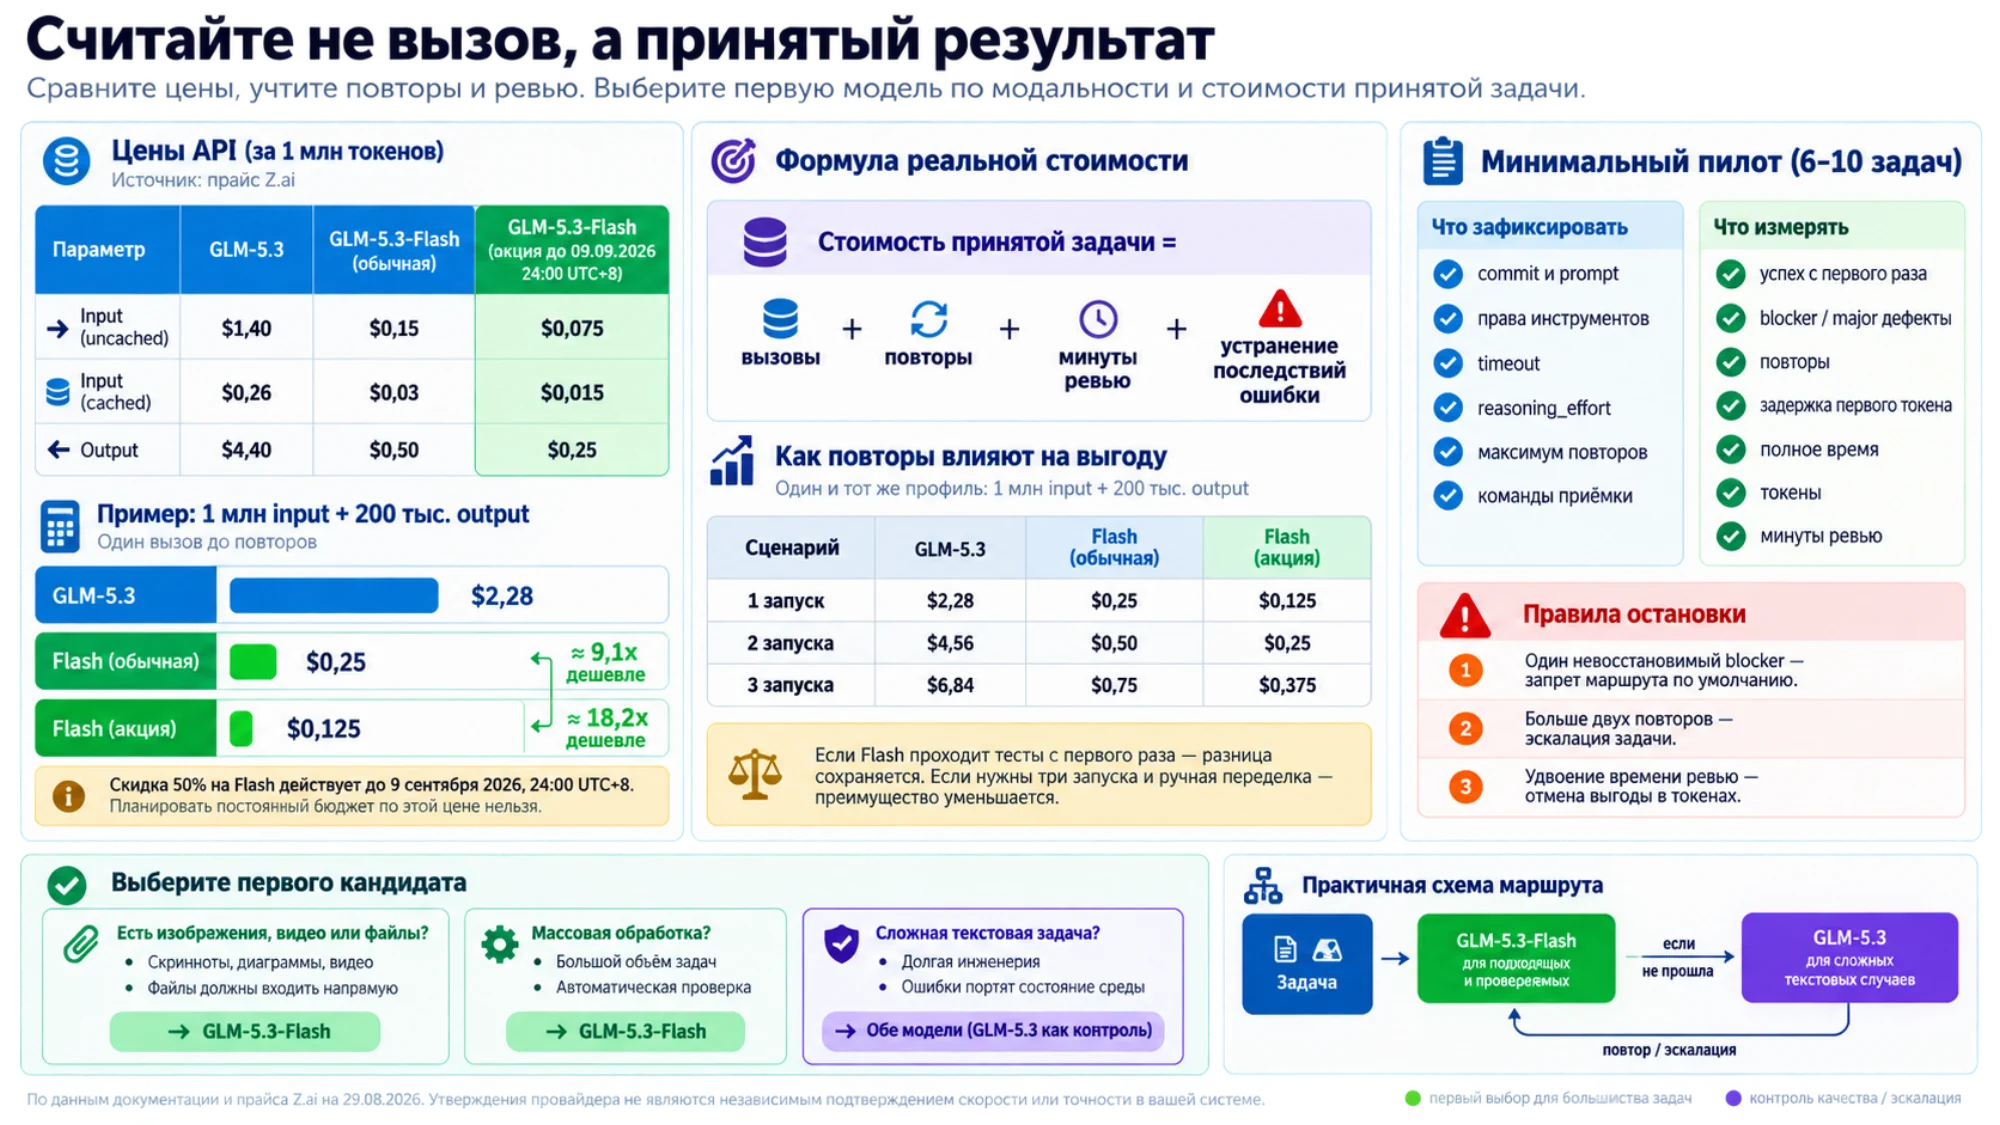
По прайсу Z.ai GLM-5.3 стоит $1,40 за 1 млн обычных входных токенов, $0,26 за кэшированный вход и $4,40 за выходные токены. Обычная цена Flash — $0,15, $0,03 и $0,50 соответственно.
По условиям на дату проверки скидка 50% для Flash — $0,075 / $0,015 / $0,25 — была запланирована до 9 сентября 2026 года, 24:00 UTC+8. Продлевалась ли акция, здесь не проверялось; для постоянного бюджета используйте стандартные ставки.
При 1 млн некэшированных входных и 200 тыс. выходных токенов один вызов до повторов обойдётся примерно в $2,28 для GLM-5.3, $0,25 для Flash по обычной цене и $0,125 по акции. Стабильная разница в таком профиле — около 9,1 раза.
Но бизнесу нужен не самый дешёвый вызов, а дешёвый принятый результат:
стоимость принятой задачи =
(все расходы API + часы ручной работы × стоимость часа
 + прочие расходы на устранение ошибок) / число принятых задач
Расходы API включают все оплаченные попытки, в том числе повторы: повторно прибавлять их не нужно. Время проверки и исправлений переводится в деньги по одной ставке, а прочие расходы не должны дублировать уже учтённую работу. Если принятых задач нет, показатель не рассчитывается.
Если Flash проходит тесты с первого раза, разница сохраняется. Если ей нужны три запуска и ручная переделка, преимущество уменьшается. Флагман оправдывает цену только измеримым снижением дефектов или риска.
Открытые веса — отдельное решение
Официальная карточка GLM-5.3-Flash публикует веса 321B под MIT и перечисляет vLLM, SGLang, Transformers, KTransformers и Unsloth.
Официальная карточка GLM-5.3 теперь также предоставляет веса модели на 753 млрд параметров и инструкции для тех же основных фреймворков; лицензия обозначена как GLM-5.3, а не MIT. Поэтому желание самостоятельно размещать модель само по себе не делает Flash единственным выбором. Нужно сравнить лицензию, модальность, память, квантование, пропускную способность, простой оборудования, мониторинг и обновления при расчёте полной стоимости владения.
Минимальный пилот для первого решения
Возьмите 6–10 настоящих задач: ошибку в нескольких файлах, большой анализ репозитория, цикл с инструментами, длинный документ и визуальную задачу. Для текстовой части зафиксируйте исходный коммит, текст запроса, права инструментов и тайм-аут, reasoning_effort, максимум повторов и команды приёмки.
Записывайте долю успеха с первого раза, критические и существенные дефекты, повторы, задержку первого токена, полное время, расход токенов и время проверки. Заранее определите недопустимые ошибки и предел повторов. Критический сбой должен останавливать внедрение, а увеличение ручной работы оценивайте в деньгах: само по себе удвоение времени проверки ещё не показывает, исчезла ли экономия на API.
Практичная первая схема — Flash для подходящих и проверяемых задач, GLM-5.3 для сложных текстовых случаев, которые Flash не прошла. Для сравнения с другими поставщиками используйте отдельную схему GLM-5.3, Kimi K3 и DeepSeek V4.
Источники5
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 31 авг. 2026 г..
Источники5
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 31 авг. 2026 г..