Gemini 3.8 Flash или Claude Fable 5.1: что выбрать для API-задач
Gemini заметно дешевле по прейскуранту, но это ещё не доказывает меньшую стоимость готовой работы. Выберите первую модель, проверьте обе на одинаковых задачах и заранее задайте условия переключения и отката.
Содержание
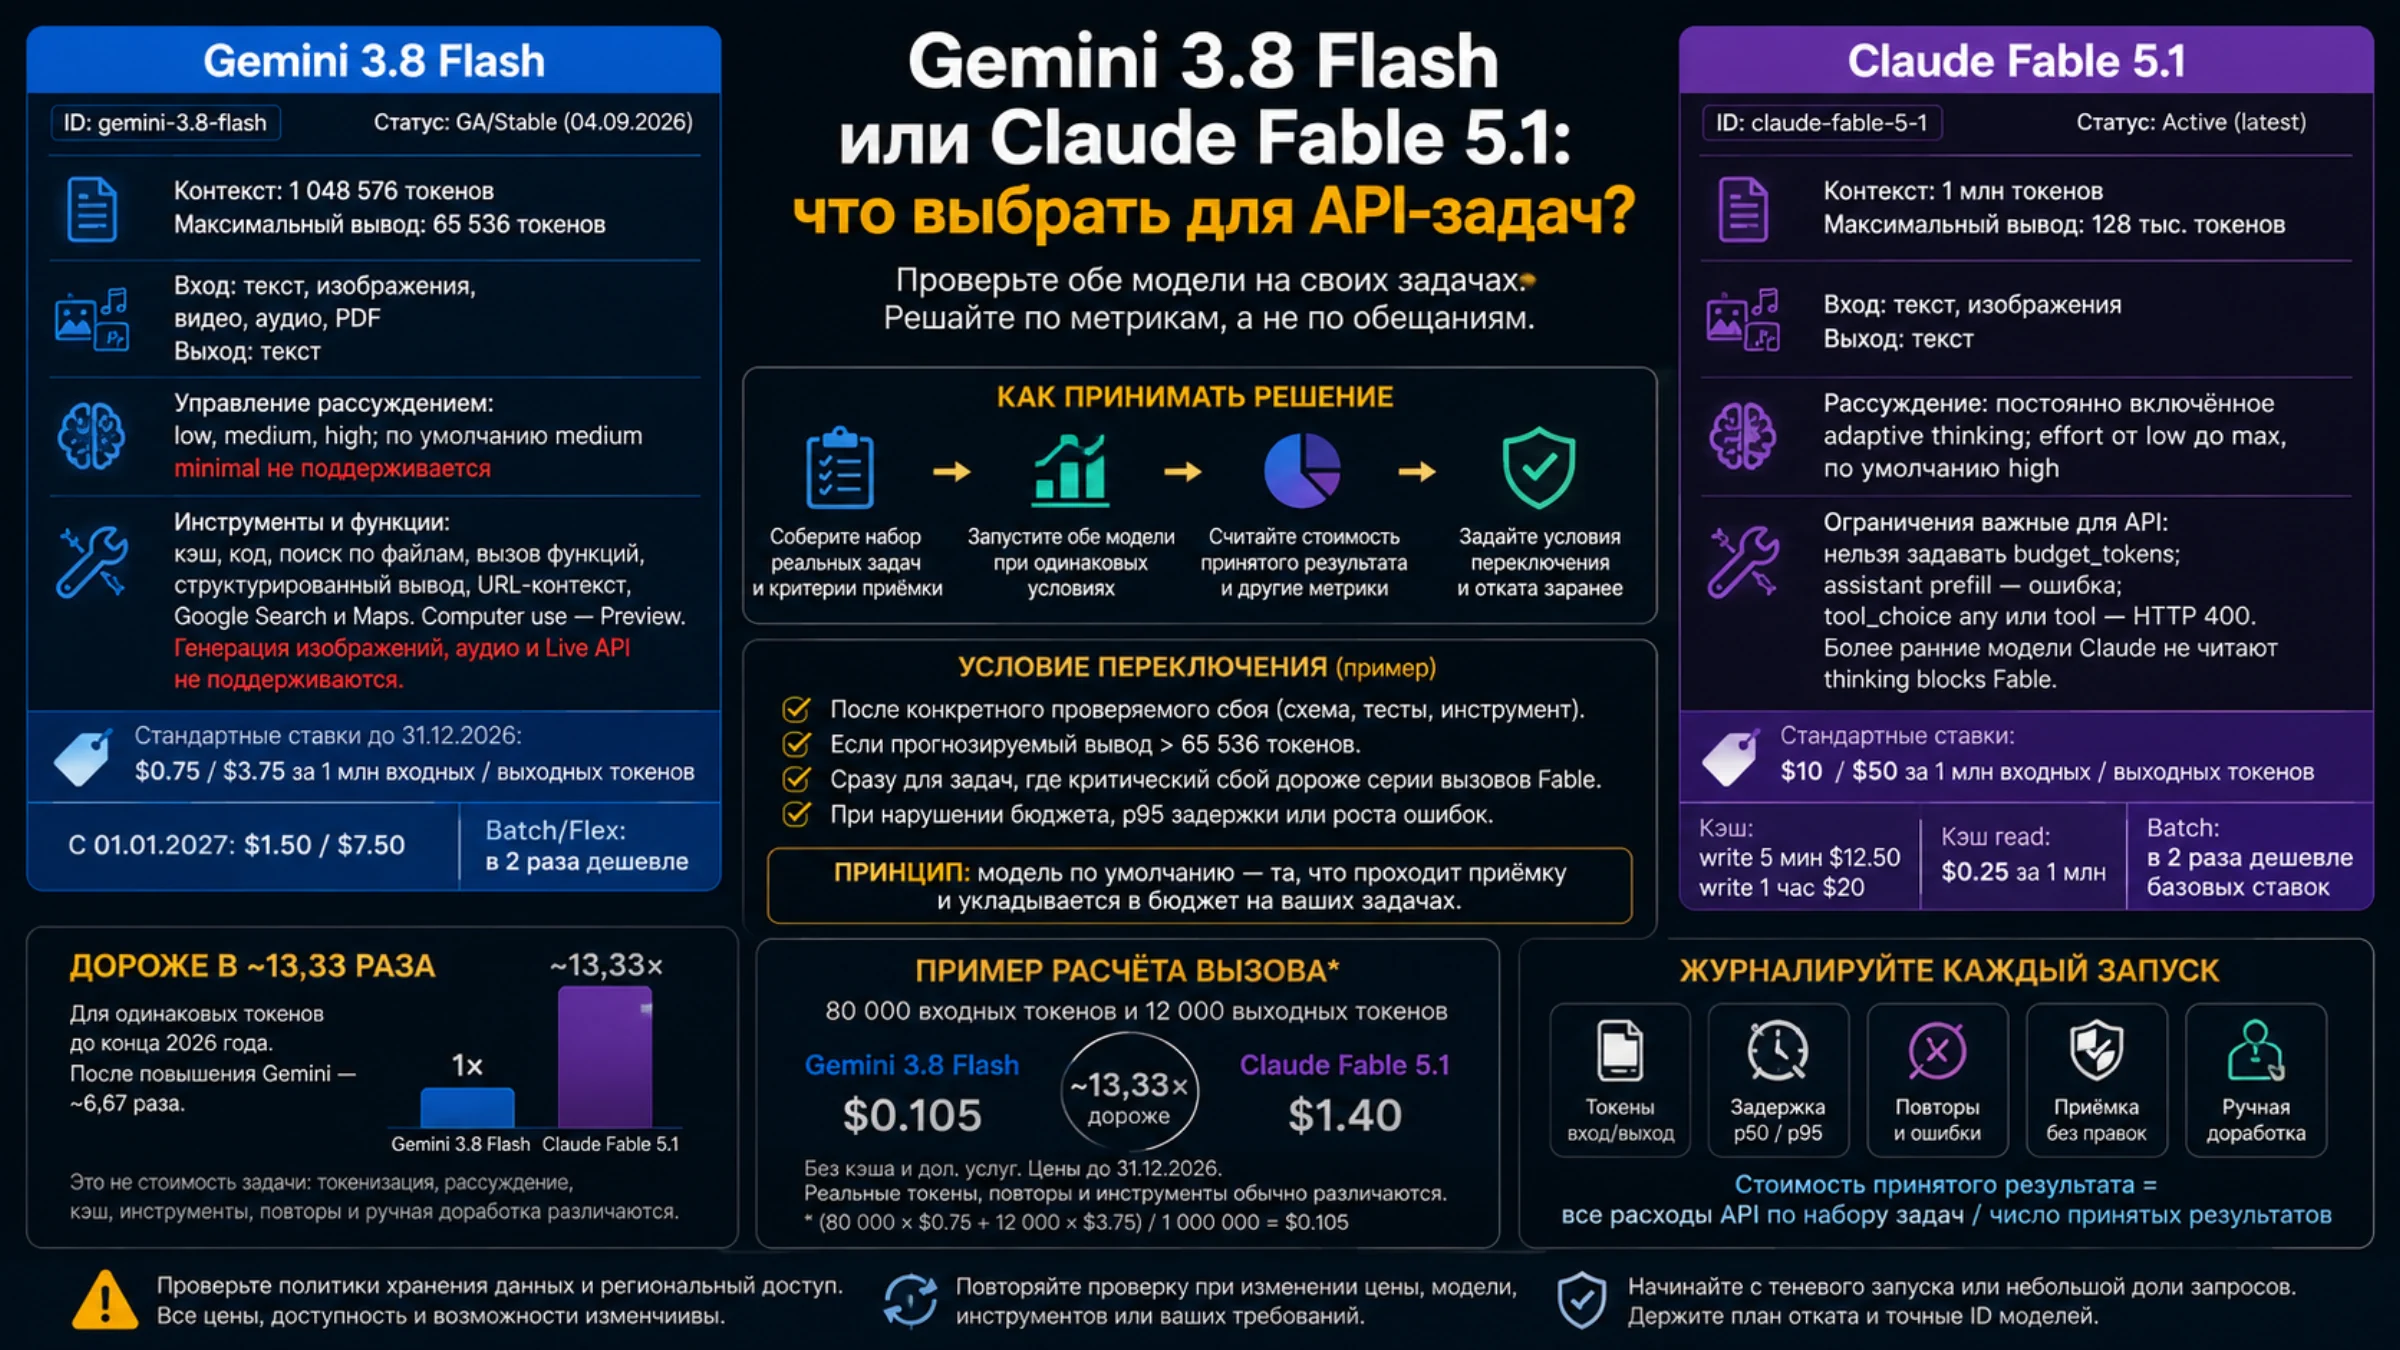
Если обе модели подходят по входным данным и функциям, разумная первая проверка для большинства массовых API-задач — Gemini 3.8 Flash. Причина измерима: до конца 2026 года её стандартные ставки за одинаковое число входных и выходных токенов примерно в 13,33 раза ниже ставок Claude Fable 5.1. Но это только порядок проверки, а не вердикт о качестве.
Fable стоит одновременно включить в проверку там, где один неудачный результат запускает дорогую ручную доработку, повторные вызовы инструментов или срыв долгой агентной задачи. Переходить на неё следует не потому, что поставщик называет модель более сильной, а когда ваша проверка показывает, что рост доли принятых результатов компенсирует разницу в расходах.
Ни один официальный источник не публикует независимое сопоставимое испытание этой пары при одинаковых заданиях, инструментах, настройках и критериях успеха. Поэтому честный ответ на вопрос «что лучше?» состоит из трёх частей: проверить точные публичные модели, посчитать стоимость принятого результата и заранее определить условия переключения и отката.
Сначала убедитесь, что сравниваете нужные модели
На 4 сентября 2026 года официальная карточка Google указывает для Gemini 3.8 Flash статус GA/Stable и ID gemini-3.8-flash. Модель принимает до 1 048 576 входных токенов, а максимальный вывод составляет 65 536 токенов. На вход можно передавать текст, изображения, видео, аудио и PDF; результат — текст.
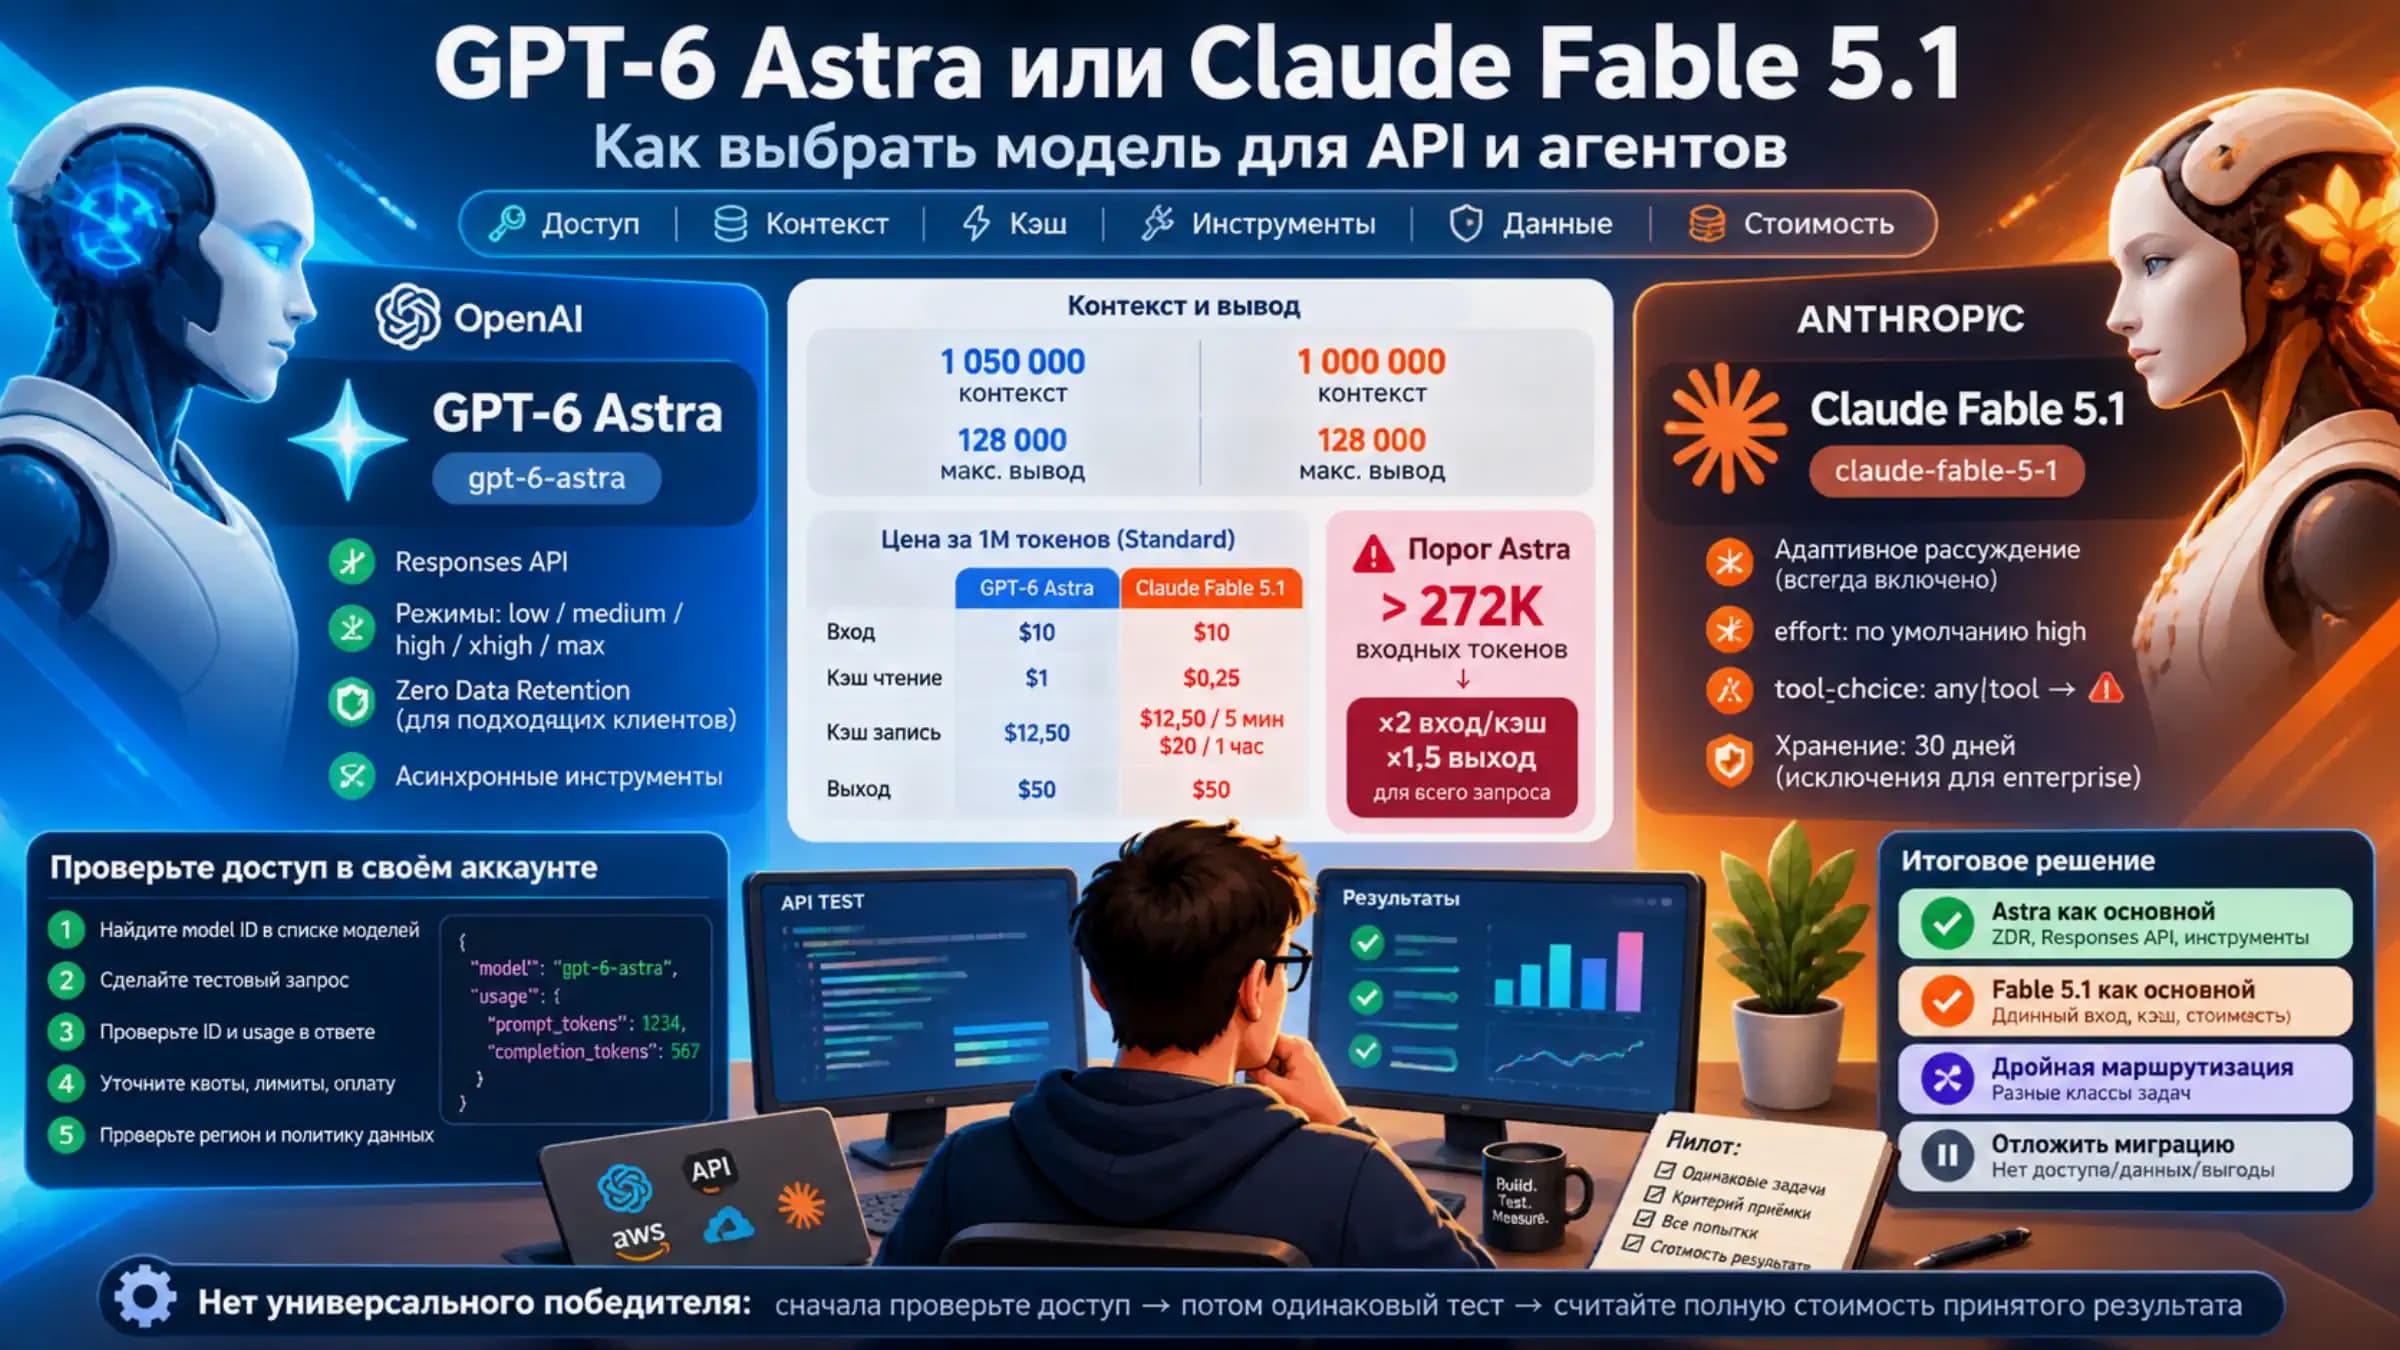
Anthropic описывает Claude Fable 5.1 как активную актуальную модель с ID claude-fable-5-1, контекстом 1 млн токенов и максимальным выводом 128 тыс. токенов. Она принимает текст и изображения, а возвращает текст.
Эти характеристики уже снимают две ложные развилки. Миллионный контекст теперь заявлен для обеих моделей, поэтому старое правило «Gemini для большого входа, Claude для малого» не работает. И наоборот, мультимодальный вход Gemini не означает, что эта модель генерирует изображения или аудио: соответствующие выходы у неё не поддерживаются.
| Что меняет решение | Gemini 3.8 Flash | Claude Fable 5.1 |
|---|---|---|
| Публичный ID | gemini-3.8-flash | claude-fable-5-1 |
| Состояние на 04.09.2026 | GA/Stable | Active (latest) |
| Максимальный входной контекст | 1 048 576 токенов | 1 млн токенов |
| Максимальный вывод | 65 536 токенов | 128 тыс. токенов |
| Входные форматы | текст, изображения, видео, аудио, PDF | текст, изображения |
| Управление рассуждением | low, medium, high; по умолчанию medium | постоянно включённое adaptive thinking; effort от low до max, по умолчанию high |
| Стандартные ставки до 31.12.2026 | $0.75 / $3.75 за 1 млн входных / выходных токенов | $10 / $50 |
Таблица помогает отсеять технически неподходящий вариант, но не ранжирует качество. Например, лимит вывода Fable важен, если один запрос должен вернуть очень большой отчёт или изменение кода. Поддержка аудио и видео на входе у Gemini важна, если иначе пришлось бы строить отдельный слой преобразования. Для обычной задачи программирования обе строки могут не повлиять на итог вообще.
Уровни рассуждения тоже нельзя сопоставлять по названию. high у Google и high у Anthropic — настройки разных систем, а не единая единица вычислений. Проверяйте те конфигурации, которые действительно собираетесь использовать, и сохраняйте их рядом с результатом каждого запуска.
Цена вызова — только нижняя граница полной стоимости
Согласно текущему прейскуранту Gemini Developer API, до 31 декабря 2026 года стандартный режим Gemini 3.8 Flash стоит $0.75 за 1 млн входных и $3.75 за 1 млн выходных токенов. С 1 января 2027 года ставки вырастут до $1.50 и $7.50. Режимы Batch и Flex стоят вдвое дешевле соответствующего стандартного режима. Токены рассуждения входят в оплачиваемый вывод.
Стандартные ставки Claude API для Fable 5.1 составляют $10 за 1 млн входных и $50 за 1 млн выходных токенов. Запись кэша на 5 минут стоит $12.50, на 1 час — $20, чтение кэша — $0.25 за 1 млн токенов. Пакетная обработка уменьшает базовые входную и выходную ставки на 50%.
Это цены в долларах США для указанных API, без налогов, договорных скидок, различий партнёрских облаков и дополнительных услуг. У Google отдельно оплачиваются некоторые обращения к поиску и картам для обоснования ответа, а также хранение кэша. Сравнение подписок на чат-продукты по этим цифрам невозможно.
Для проверки арифметики возьмём не результат испытания, а условный вызов с 80 000 входных и 12 000 выходных токенов, без кэша и дополнительных услуг:
Gemini: (80 000 × $0.75 + 12 000 × $3.75) / 1 000 000 = $0.105
Fable:  (80 000 × $10   + 12 000 × $50)   / 1 000 000 = $1.40
При строго одинаковом числе токенов разница действительно составляет около 13,33 раза. После повышения ставок Gemini в 2027 году она сократится примерно до 6,67 раза. Однако в реальном сравнении число токенов почти наверняка не совпадёт: различаются токенизация, объём рассуждений, поведение инструментов, повторы и длина ответа. Google прямо предупреждает, что сложная работа может потребовать больше шагов рассуждения и вызовов инструментов, поэтому прежняя ставка сама по себе не гарантирует прежний счёт или задержку.
Сначала считайте каждый вызов по фактически выставленным категориям:
стоимость вызова =
  входные токены × входная ставка
  + выходные токены × выходная ставка
  + запись и чтение кэша
  + платные инструменты и другие надбавки
Затем переходите к единице, которая имеет смысл для продукта:
стоимость принятого результата =
  все расходы API по набору задач / число результатов, прошедших приёмку
Если время разработчика заметно дороже вызова модели, ведите ещё одну метрику:
полная стоимость принятой работы =
  расходы API
  + минуты ручной доработки × стоимость минуты специалиста
  + заранее определённая цена критического сбоя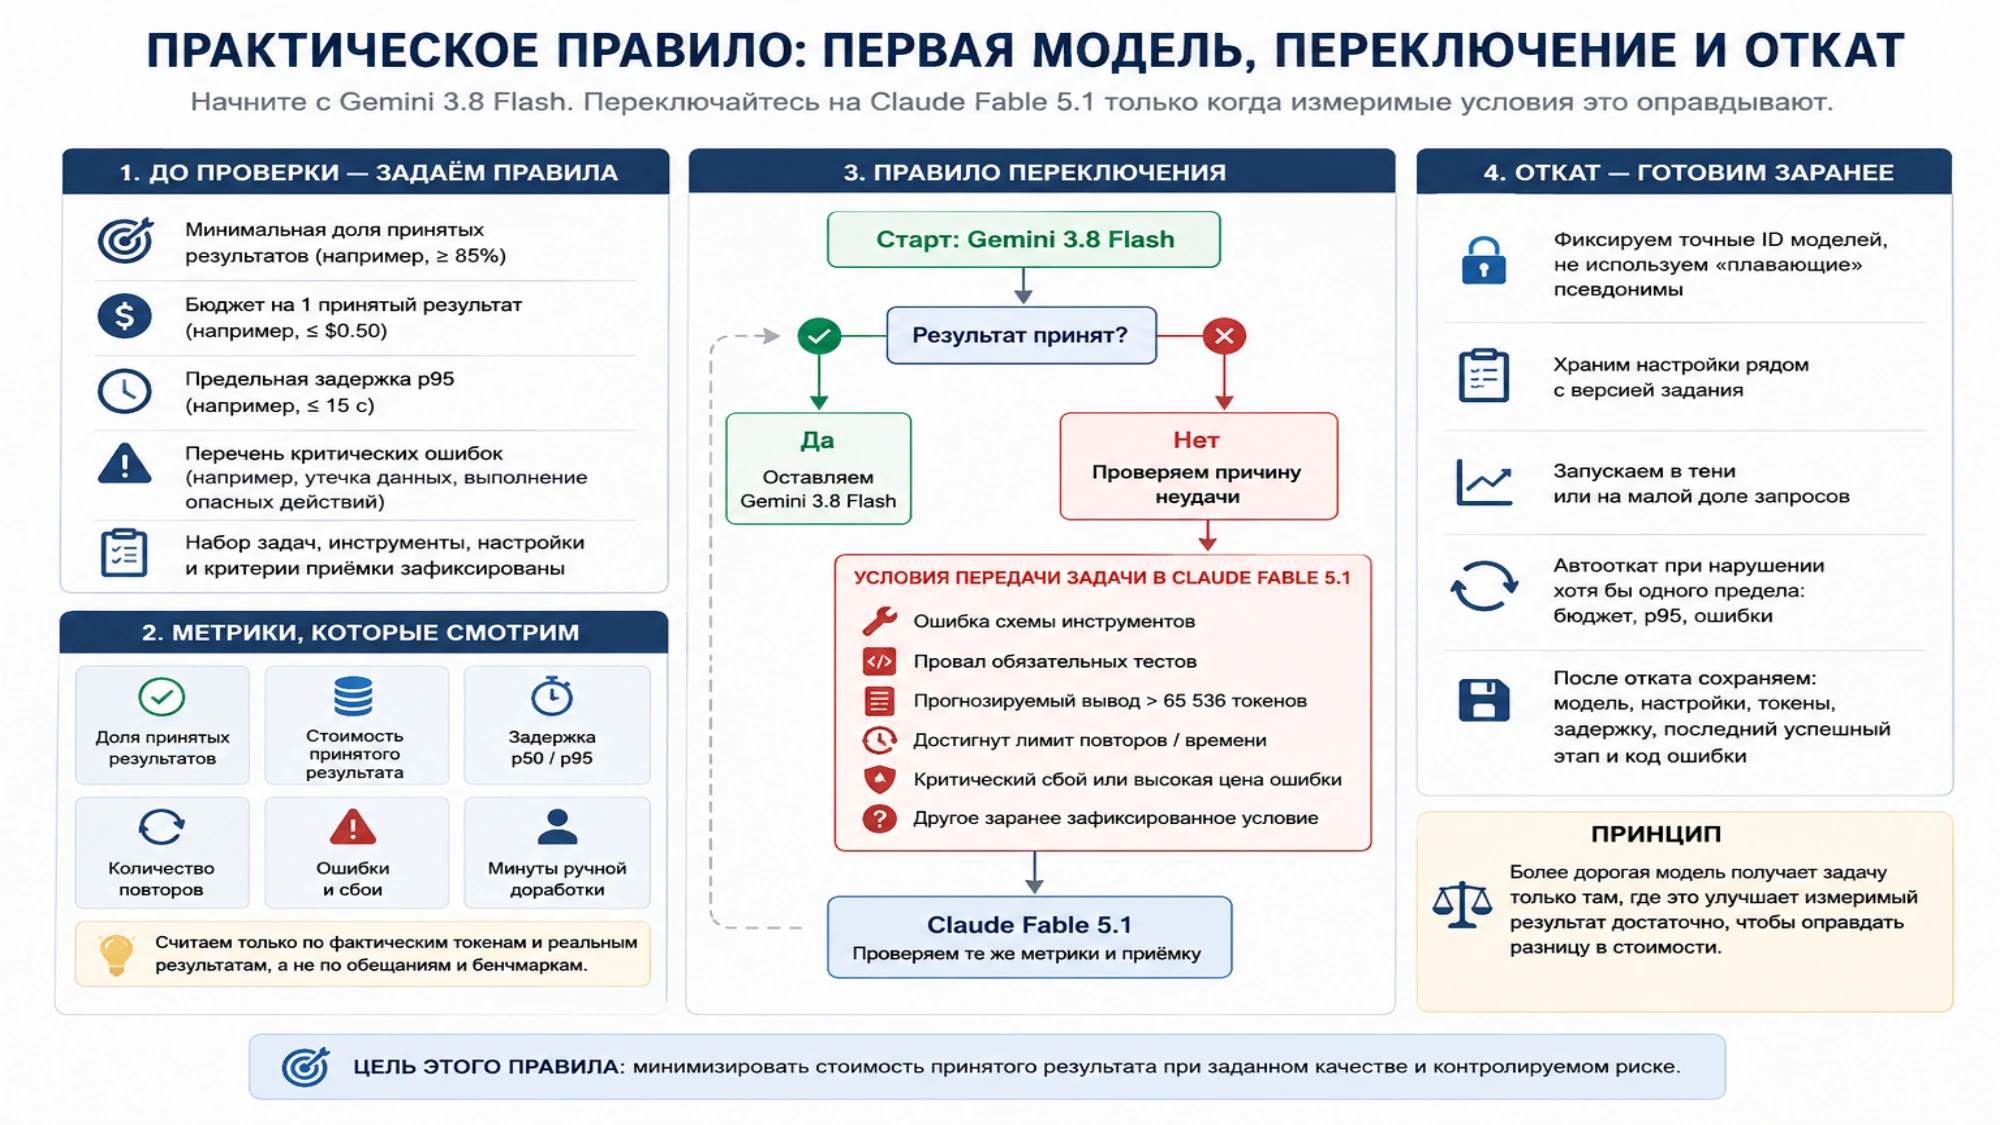
Последний член нужен не каждой команде. Главное — определить его до испытания, а не добавлять после того, как понравилась одна из моделей.
Как провести сопоставимую проверку
Начните не с эффектной демонстрации, а с небольшого набора настоящих работ. Возьмите обычные задачи, несколько недавних сбоев и критичные пограничные случаи. Для помощника программиста это могут быть исправление ошибки в нескольких файлах, обзор изменения, работа с инструментом и задача, где правильный ответ — отказаться от опасного действия. Для исследовательского процесса — извлечение фактов, проверка источников и синтез с заданными условиями приёмки.
До первого запуска зафиксируйте:
- исходные материалы и точную версию каждого задания;
- доступные инструменты, их схемы и разрешения;
- ограничение времени, число допустимых повторов и условие остановки;
- критерии функциональной приёмки, известные до просмотра ответа;
- используемый ID модели и все значимые настройки;
- правила подсчёта ручной доработки и критических ошибок.
Одинаковыми должны быть задача, данные, возможности инструментов и критерий успеха. Настройки рассуждения не нужно притворно уравнивать: у Gemini по умолчанию medium, у Fable — high effort и постоянно включённое adaptive thinking. Запишите фактическую конфигурацию и объясните, почему именно она соответствует предполагаемому применению. Если проверяете несколько уровней, считайте их отдельными вариантами.
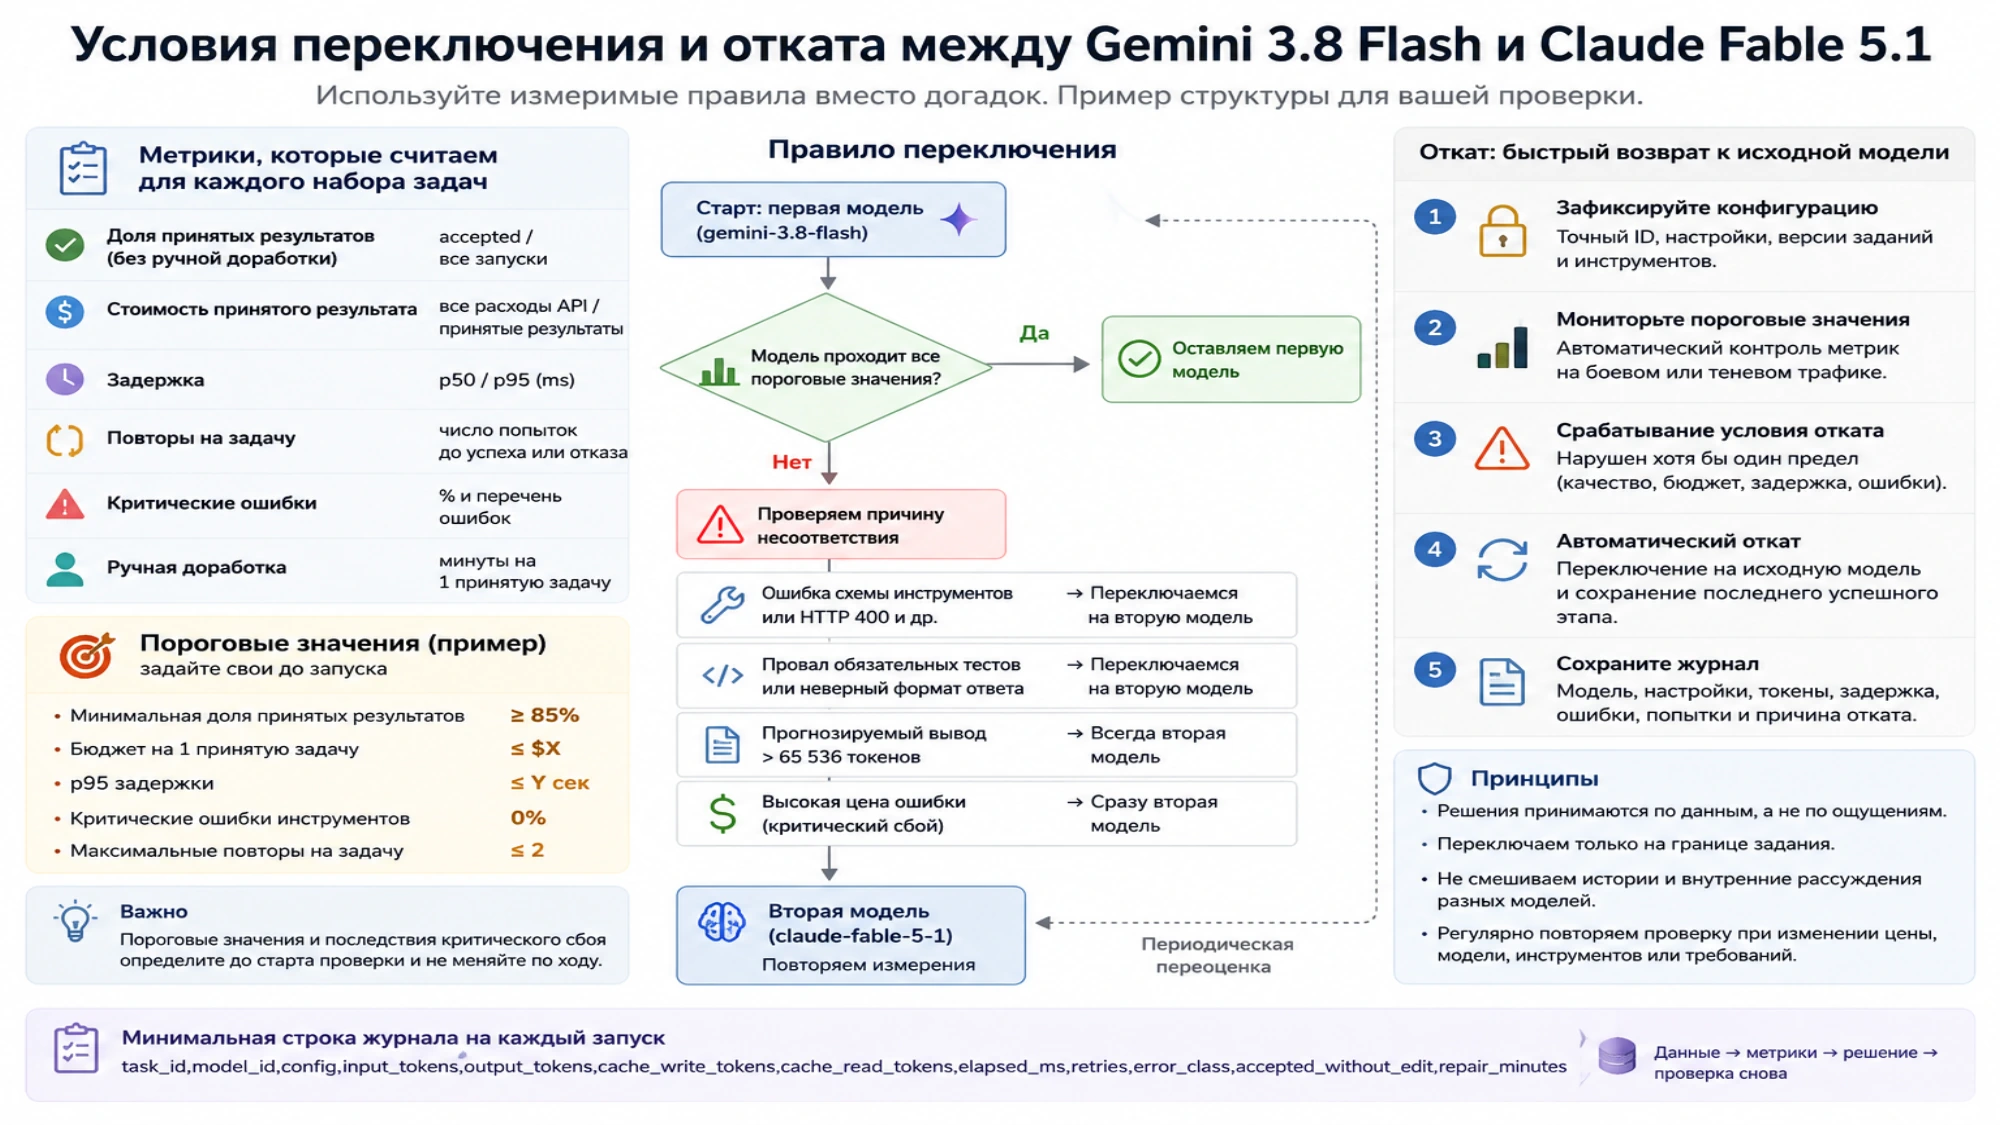
Для каждого запуска достаточно одной строки журнала:
task_id,model_id,config,input_tokens,output_tokens,cache_write_tokens,cache_read_tokens,elapsed_ms,retries,error_class,accepted_without_edit,repair_minutesПоле accepted_without_edit должно следовать проверяемому правилу. Изменение кода может считаться принятым только после тестов и проверки области изменений; структурированный ответ — после валидации схемы; исследовательская справка — после проверки обязательных источников и утверждений. Оценка «ответ кажется лучше» не годится.
Если запусков мало, показывайте медиану, диапазон и все критические сбои. p95 имеет смысл только при достаточном числе наблюдений; всегда сообщайте объём выборки. Не объединяйте в одно среднее быстрые классификации, длинные агентные задачи и анализ больших документов: более дешёвая модель на одном типе работы может оказаться неверным выбором на другом.
Чтобы уменьшить предвзятость, по возможности скрывайте от проверяющего имя модели до выставления оценки. Случайно меняйте порядок запуска и не разрешайте одной модели получать исправленное задание после ошибки другой. Если внешние данные успели измениться, такой результат нужно пометить, а не считать чистым сравнением.
Эта процедура не доказывает, что победитель сохранится навсегда. Она даёт воспроизводимую исходную точку, которую можно повторить после изменения цены, модели, инструментов или собственных требований.
Практическое правило: первая модель, переключение и откат
Для массовой нагрузки с приемлемой ценой ошибки начните с gemini-3.8-flash. Это редакционная рекомендация из подтверждённой разницы в тарифах, а не утверждение, что Gemini уже показала лучшее качество. Включите claude-fable-5-1 в тот же набор испытаний для задач, где неудачная попытка особенно дорога или где важен вывод объёмом свыше лимита Gemini.
Перед проверкой задайте минимальную допустимую долю принятых результатов, бюджет на один принятый результат, предельную задержку и перечень критических ошибок. После этого правило можно выразить без названий поставщиков:
- оставлять первую модель, пока она проходит приёмку, укладывается в бюджет и не превышает предел ошибок;
- передавать задачу второй модели после конкретного проверяемого сбоя, а не по расплывчатому признаку «она сложная»;
- закреплять более дорогую модель только за тем классом работ, где она уменьшает повторы или ручную доработку достаточно, чтобы оправдать доплату;
- возвращаться к исходной модели при превышении бюджета, ухудшении p95, росте ошибок инструментов или изменении условий обработки данных.
Подходящее условие переключения зависит от продукта. Например: после одной неудачной попытки с ошибкой схемы инструментов; после провала обязательных тестов; при прогнозируемом выводе свыше 65 536 токенов; либо сразу для задач, где критический сбой дороже всей серии вызовов Fable. Важно, чтобы условие можно было вычислить из журнала и воспроизвести.
Откат готовят до передачи трафика. Закрепите точные ID, не заменяйте их плавающими псевдонимами, храните настройки рядом с версией задания и не смешивайте историю разных моделей без адаптера. Начинайте с теневого запуска или небольшой доли запросов. Возвращайте предыдущую конфигурацию автоматически, если нарушен хотя бы один заранее заданный предел; после отката сохраняйте не только код ошибки, но и модель, настройки, токены, задержку и последний успешный этап.
Если команда переходит на Gemini 3.8 с предыдущей версии, отдельный русскоязычный разбор миграции и точного ID поможет не смешать выбор поставщика с заменой модели внутри Google. Для Claude аналогичную задачу — переход, кэш и уровни effort — подробнее разбирает руководство по Fable 5.1.
Ограничения API, которые могут изменить выбор
Gemini поддерживает кэширование, выполнение кода, поиск по файлам, вызов функций, структурированный вывод, контекст URL и обоснование ответа через Google Search и Maps. Computer use остаётся Preview; генерация изображений, генерация аудио и Live API у этой модели не поддерживаются. Уровень minimal возвращает ошибку. Проверять конкретную функцию нужно в том варианте API и на том аккаунте, где она будет использоваться: запись в общей карточке не гарантирует одинаковые квоты и региональный доступ.
У Fable 5.1 постоянно включено adaptive thinking, и руководство Anthropic по миграции перечисляет ограничения, которые способны сломать существующий адаптер. Нельзя задавать ручной budget_tokens; assistant prefill приводит к ошибке; tool_choice типов any и именованного tool возвращает HTTP 400. Более ранние модели Claude не могут продолжать работу с thinking blocks Fable, а изменение предыдущей истории может сделать эти блоки недействительными.
Эти различия особенно важны для переключения во время многошаговой задачи. Унифицированная схема инструментов ещё не делает истории ответов взаимозаменяемыми. Надёжнее переключать модель на границе задания с явным состоянием, чем передавать ей внутренние блоки рассуждения другого поставщика или другой версии Claude.
Для данных тоже нельзя предполагать симметрию. По текущей политике Anthropic Fable 5.1 относится к Covered Models: стандартное хранение данных Claude API составляет 30 дней, а нулевое хранение требует отдельно одобренного соглашения. Эта строка описывает только Claude API; считать режим Gemini таким же нельзя. Перед внедрением проверьте обе действующие политики, договор, регион и фактический путь запроса отдельно.
Для исследовательских задач учитывайте ещё одну границу: карточка Gemini 3.8 Flash указывает март 2026 года как основной срез знаний, но отмечает, что в отдельных областях он может оставаться на январе 2025 года. Это не замена поиску и проверке источников. Для Fable здесь нет подтверждённой сопоставимой даты, поэтому делать из неё сравнительное преимущество нельзя.
Не путайте публичные модели с закрытыми вариантами
Gemini 3.8 Flash Cyber — не ещё один публичный ID по обычному прайсу. Google предоставляет эту версию через ограниченную Fairwind Program. Аналогично Claude Mythos 5.1 связан с закрытым Project Glasswing и не равен обычному Fable 5.1. Нельзя переносить на эти варианты публичные цены, идентификаторы, доступность или функции.
Жизненный цикл также нужно проверять отдельно. В таблице Google для gemini-3.8-flash пока не объявлена дата отключения. Anthropic указывает, что Fable 5.1 будет выведена из эксплуатации не раньше 1 сентября 2027 года. Отсутствие близкой даты не означает бессрочную поддержку, поэтому точный ID, повторяемая проверка и рабочий откат остаются обязательными.
Что выбрать сегодня
Gemini 3.8 Flash — логичный первый кандидат, когда обе модели удовлетворяют техническим требованиям, запросов много, а качество можно проверить автоматически или недорогой приёмкой. Fable 5.1 — обоснованный второй кандидат для классов задач, где Gemini не проходит заранее установленный порог, где требуется более длинный вывод или где стоимость ошибки настолько высока, что дорогая попытка может быть дешевле ручного восстановления.
Это не постоянное распределение ролей. После сопоставимой проверки одна команда может оставить Gemini почти для всего, другая — сразу направлять критичные агентные задачи в Fable, третья — обнаружить, что ни одна модель не проходит её критерии. Все три результата полезнее универсального рейтинга, потому что их можно проверить по журналу.
Если решение уже выходит за пределы двух моделей, не раздувайте этот тест случайными третьими кандидатами: сформируйте новый короткий список по сравнению API основных поставщиков, а затем повторите ту же процедуру. Модель по умолчанию должна выигрывать не спор, а вашу приёмку; более дорогая модель — получать задачу только там, где измеримый результат оплачивает разницу.