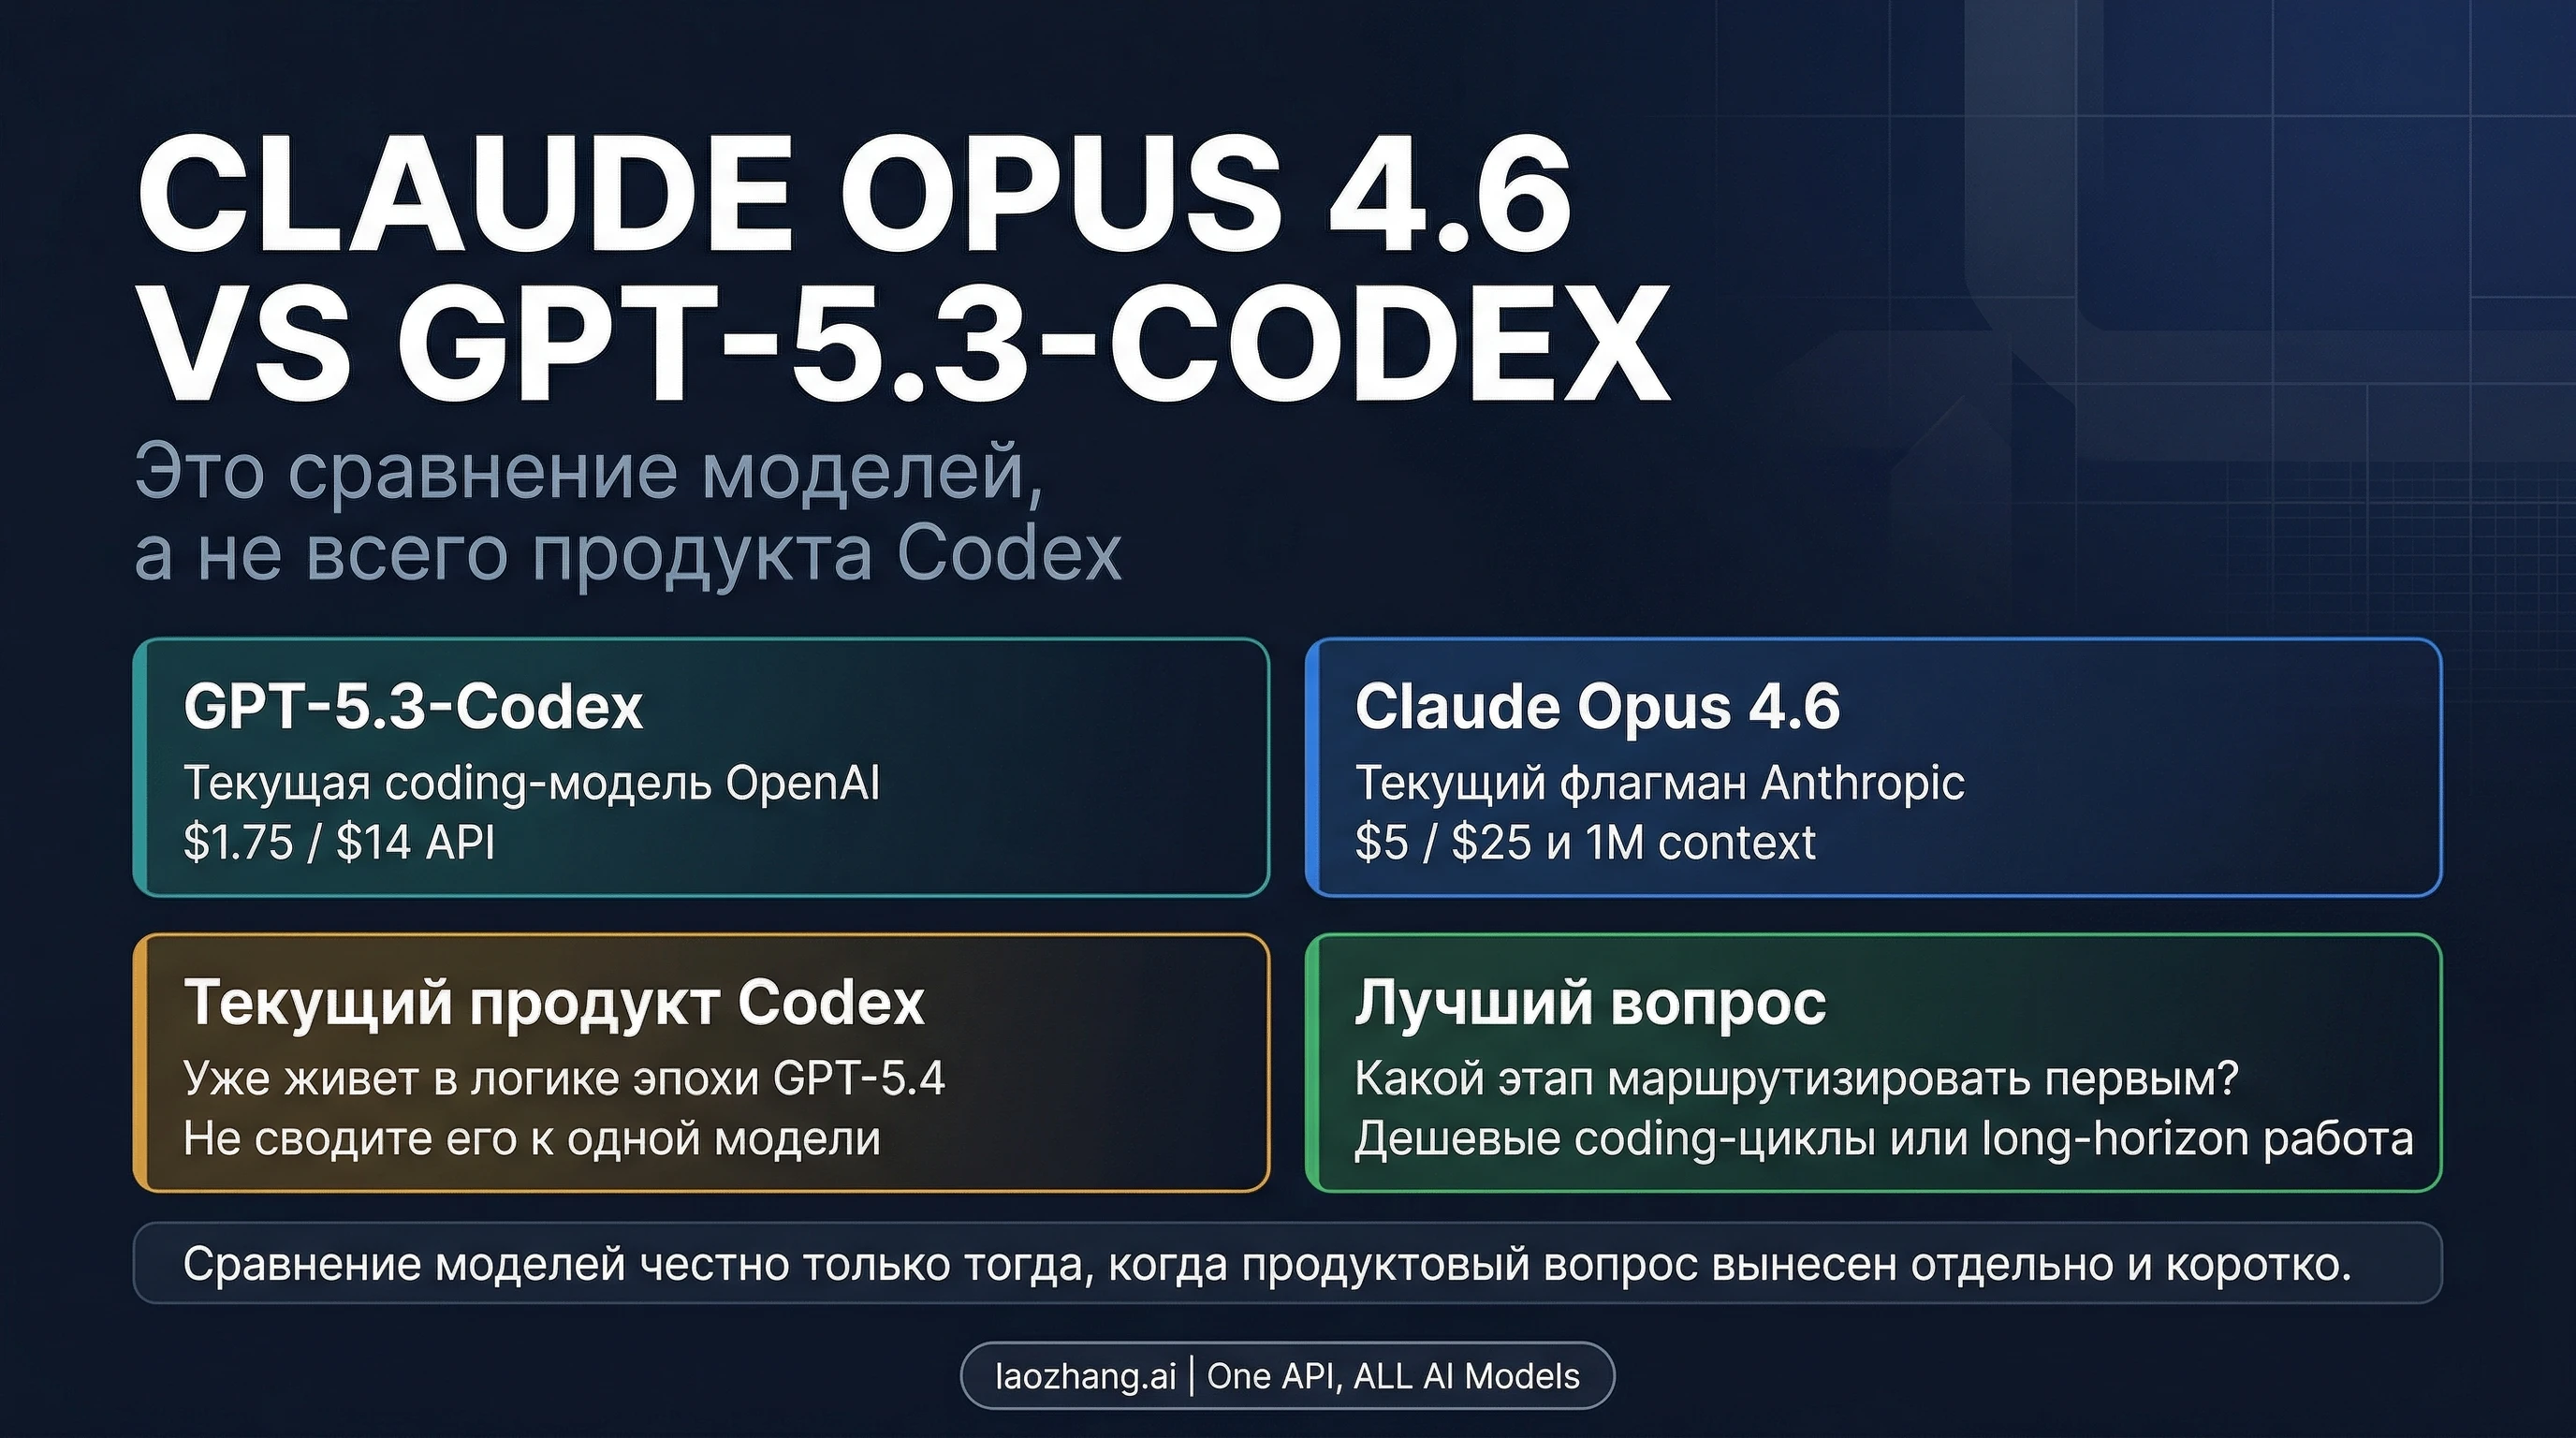
GPT-5.3-Codex дешевле по официальным тарифам API; Claude Opus 4.6 позволяет передать больше контекста. Но ни цена токена, ни размер окна не отвечают на главный вопрос разработчика: какая модель внесет нужное изменение и сколько времени займет его проверка. Если задача помещается в обе модели, выбирать стоит по стоимости принятого исправления, включая повторы и ручную доработку.
Ниже сравниваются именно gpt-5.3-codex и claude-opus-4-6 для существующего проекта. Характеристики и цены проверены 7 сентября 2026 года. Это разбор документации с расчетными примерами и предложенной методикой проверки; собственного сравнительного прогона моделей для этой статьи мы не проводили. Если вы выбираете приложение, терминальный инструмент или способ работы команды, перейдите к сравнению Claude Code и Codex.
Что различается в API
| Параметр | GPT-5.3-Codex | Claude Opus 4.6 |
|---|---|---|
| Идентификатор модели | gpt-5.3-codex | claude-opus-4-6 |
| Окно контекста | 400 000 токенов | 1 000 000 токенов |
| Максимальный обычный вывод | 128 000 токенов | 128 000 токенов |
| Управление рассуждением | low, medium, high, xhigh | Адаптивное рассуждение; по умолчанию уровень high |
| Вход / выход | Текст и изображения / текст | Текст и изображения / текст |
Параметры взяты из документации GPT-5.3-Codex и обзора Claude Opus 4.6. У Opus 4.6 есть отдельное исключение: до 300 000 токенов вывода в бета-режиме Batch API. Это не лимит обычного интерактивного запроса, поэтому он не заменяет 128 000 в таблице.
Окно контекста нельзя целиком считать местом для файлов. В него входят инструкции, история, результаты инструментов и генерируемый ответ. Для GPT-5.3-Codex указан предел входа 272 000 токенов; число 400 000 не означает, что можно отправить 400 000 токенов исходного кода и затем получить еще 128 000 токенов ответа.
Больший контекст Opus полезен как техническая возможность: например, когда необходимо одновременно передать спецификацию и много связанных модулей. Он сам по себе не доказывает, что модель найдет нужную связь, точнее изменит код или реже ошибется. Если агент умеет искать по репозиторию и читать нужные файлы, весь проект может вообще не понадобиться в одном запросе. Сначала измерьте объем действительно необходимого входа, затем решайте, является ли ограничение контекста препятствием.
Сколько стоит одинаковый объем работы
Сравнение ниже относится к стандартным прямым API и ценам в долларах США за миллион токенов. Подписки на приложения оплачиваются по другим правилам. Региональные условия и специальные режимы обработки могут менять итоговый счет.
| Оплачиваемая категория | GPT-5.3-Codex | Claude Opus 4.6 |
|---|---|---|
| Обычный вход | $1,75 | $5,00 |
| Чтение входа из кеша | $0,175 | $0,50 |
| Запись в кеш на 5 минут | Отдельная ставка записи не указана | $6,25 |
| Запись в кеш на 1 час | Отдельная ставка записи не указана | $10,00 |
| Выход | $14,00 | $25,00 |
У OpenAI таблица модели выделяет обычный вход, кешированный вход и выход. У Anthropic запись и чтение кеша тарифицируются отдельно; за токены записи не нужно дополнительно прибавлять обычный вход. Миллионное окно Opus 4.6 доступно по стандартным ставкам, без надбавки только за длину контекста. Источники: тарифы GPT-5.3-Codex и цены Anthropic, включая кеширование.
Возьмем условную задачу с 10 000 входных и 2 000 выходных токенов. При повторном обращении 8 000 входных токенов совпадают с сохраненным префиксом, а 2 000 — новые. Это специально одинаковые количества токенов для сравнения тарифов: один и тот же русский текст или файл модели могут разбить на разное число токенов.
| Сценарий одного запроса | GPT-5.3-Codex | Claude Opus 4.6 |
|---|---|---|
| Без кеша: 10 000 входа + 2 000 выхода | $0,0455 | $0,1000 |
| С попаданием в кеш: 8 000 из кеша + 2 000 нового входа + 2 000 выхода | $0,0329 | $0,0640 |
| Создание кеша Opus на 5 минут: 8 000 записи + 2 000 обычного входа + 2 000 выхода | — | $0,1100 |
| Создание кеша Opus на 1 час: те же объемы | — | $0,1400 |
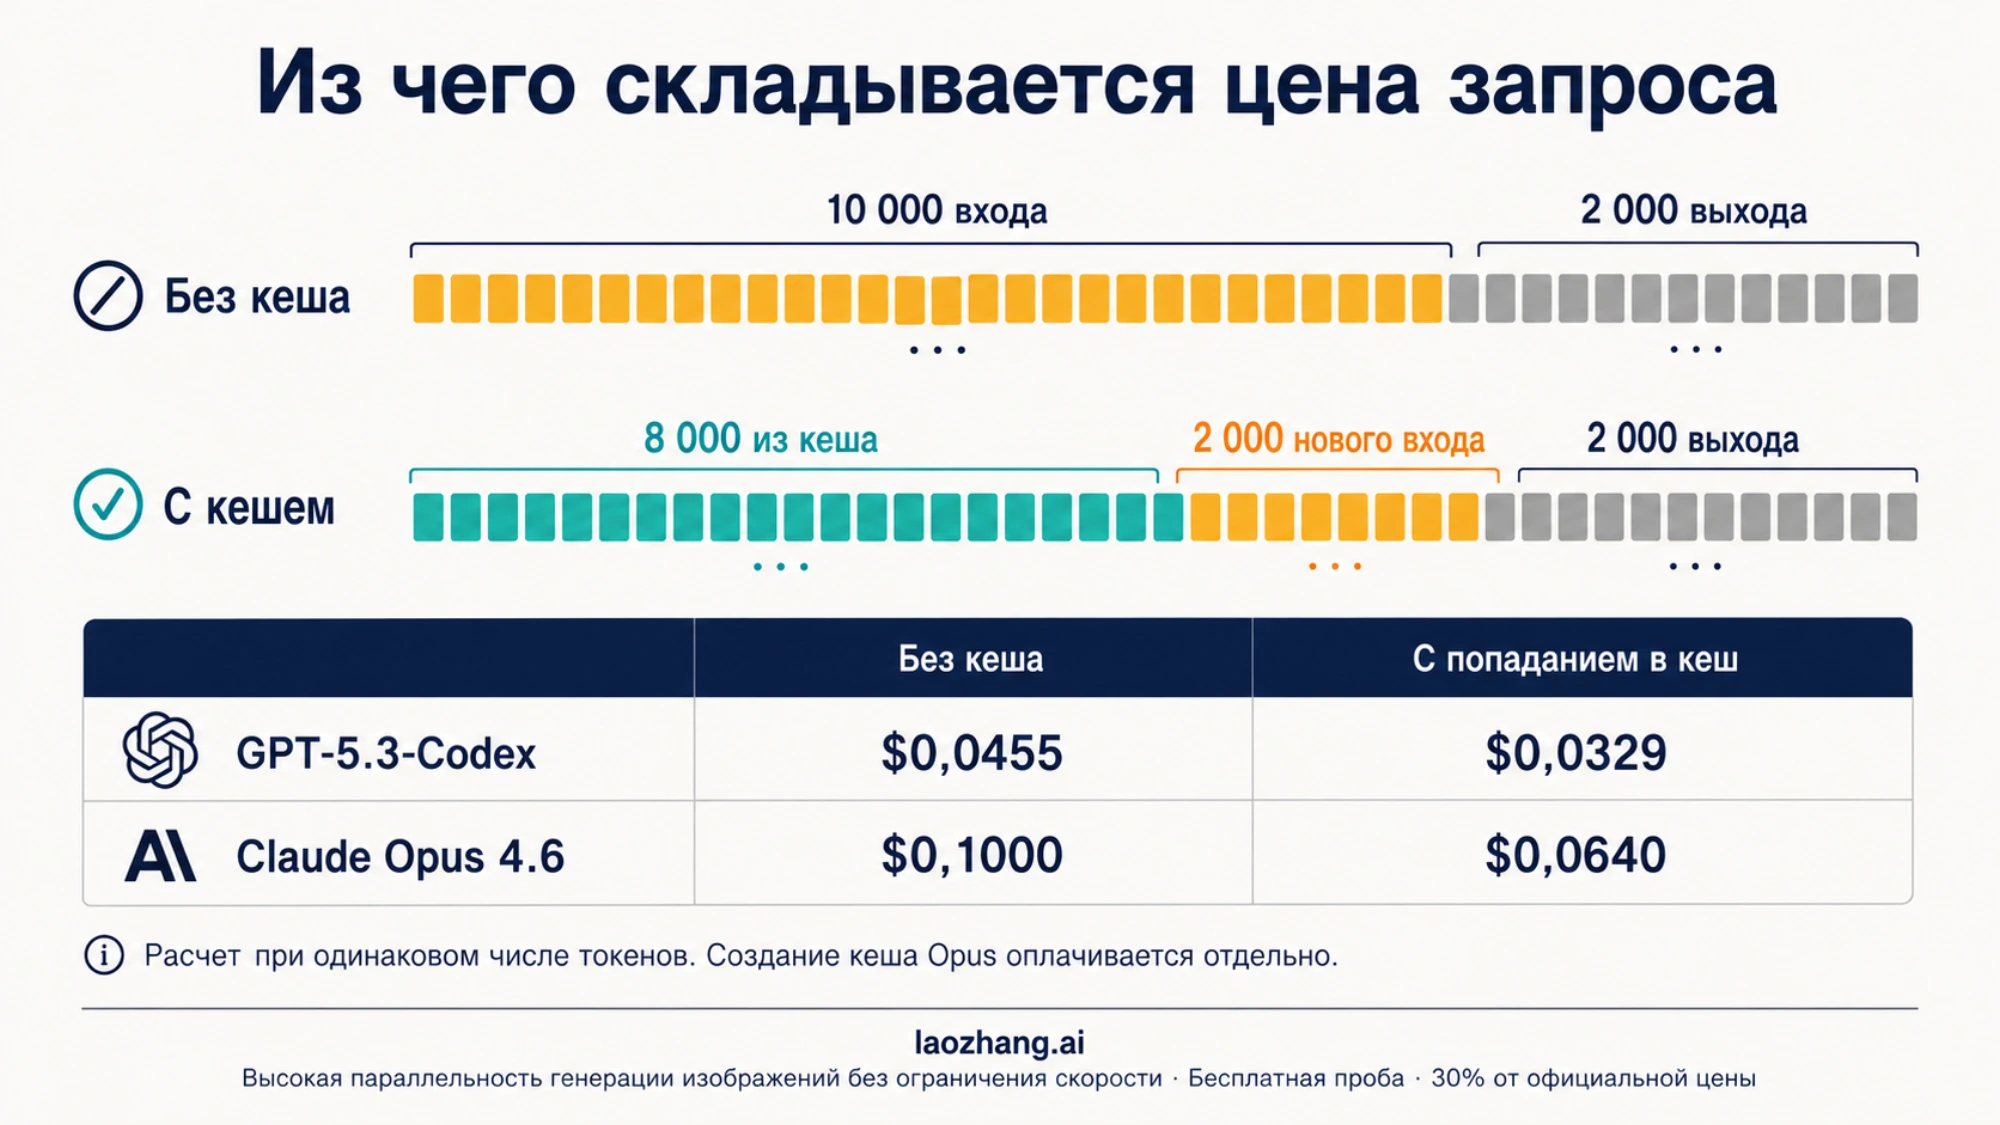
Для проверки первой строки достаточно умножить объемы на ставки и разделить на миллион. У GPT-5.3-Codex это (10 000 × 1,75 + 2 000 × 14) / 1 000 000 = $0,0455. Для теплого запроса Opus расчет другой: (8 000 × 0,50 + 2 000 × 5 + 2 000 × 25) / 1 000 000 = $0,0640.
При десяти таких обращениях, если первое создает кеш, а следующие девять гарантированно попадают в него, расчетная сумма для GPT-5.3-Codex составит $0,0455 + 9 × $0,0329 = $0,3416. Для Opus с пятиминутной записью — $0,1100 + 9 × $0,0640 = $0,6860. Здесь предполагается, что запросы выполняются в пределах срока действия кеша и его префикс не меняется. Это арифметический сценарий, а не обещание десяти автоматических попаданий.
Реальная задача агента обычно включает несколько обращений, чтение файлов, ошибки и новые ответы. Поэтому итоговую стоимость нужно брать из фактического учета использования по всему запуску. Приведенные суммы не учитывают дополнительные инструменты, инфраструктуру и работу человека; они показывают только разницу тарифов при фиксированном объеме.
Почему публичного рейтинга недостаточно
В публикации OpenAI от 5 февраля 2026 года для GPT-5.3-Codex приведены 77,3% на Terminal-Bench 2.0 и 64,7% на OSWorld-Verified. В приложении указано использование xhigh. Это результаты разработчика модели в определенном окружении, а не измеренная вероятность исправить ваш баг.
Анонс Anthropic той же даты также описывает работу с терминалом, компьютером и длинным контекстом. Сопоставлять отдельные столбцы можно только с учетом набора задач, версии агента, доступных инструментов, числа попыток и вычислительного бюджета. Уровень high одного поставщика не гарантирует равного бюджета с high другого.
OSWorld оценивает выполнение задач в графическом интерфейсе. Его результат не является прямой оценкой надежности изменений в Java-сервисе или TypeScript-приложении. Terminal-Bench ближе к терминальной работе, но также не заменяет проверку конкретного репозитория. Публичные тесты помогают выбрать кандидатов для прогона; приемочные проверки определяют, подходит ли результат вашему проекту.
Как сравнить модели на своем репозитории
Возьмите небольшое изменение с однозначно проверяемым поведением. Например: HTTP-обработчик должен отклонять отрицательный limit статусом 400 и не обращаться к базе данных. Это лучше задания «улучши качество кода»: обеим моделям можно предъявить одинаковые условия, а результат проверить независимо от объяснения в ответе.
- Зафиксируйте исходный коммит, версии зависимостей и команды запуска. Создайте две независимые рабочие копии от этого коммита, чтобы одна модель не увидела правки другой.
- Передайте одинаковое описание ошибки, ограничения изменения и способ воспроизведения. Начните новые сессии, дайте одинаковые права на файлы, сеть и команды. Зафиксируйте версии модели и используемого агента.
- Задайте общий предел времени и расходов. Запишите настройки рассуждения каждой модели; одинаковое название настройки еще не делает затраты равными.
- После завершения запустите заранее подготовленные проверки вне сессии агента. Проверьте diff, измененные тесты и реальное поведение приложения.
- Повторите сравнение на нескольких задачах разных типов. Чередуйте порядок запусков, сохраняйте неудачные попытки и учитывайте ручные подсказки.
Если сравнивать модели в разных инструментах с разными правилами чтения файлов и выполнения команд, измеряется связка «модель + инструмент». Такой эксперимент тоже полезен для выбора рабочего процесса, но его результат нельзя приписывать одной модели.
Проверка, которую зеленый тест может пропустить
В примере с limit модульный тест способен пройти, если он вызывает новую функцию проверки напрямую, а HTTP-маршрут продолжает использовать старую реализацию. Поэтому одной галочки в отчете недостаточно. Нужен запрос через тот же обработчик, которым пользуется клиент, и отдельная проверка отсутствия обращения к базе.
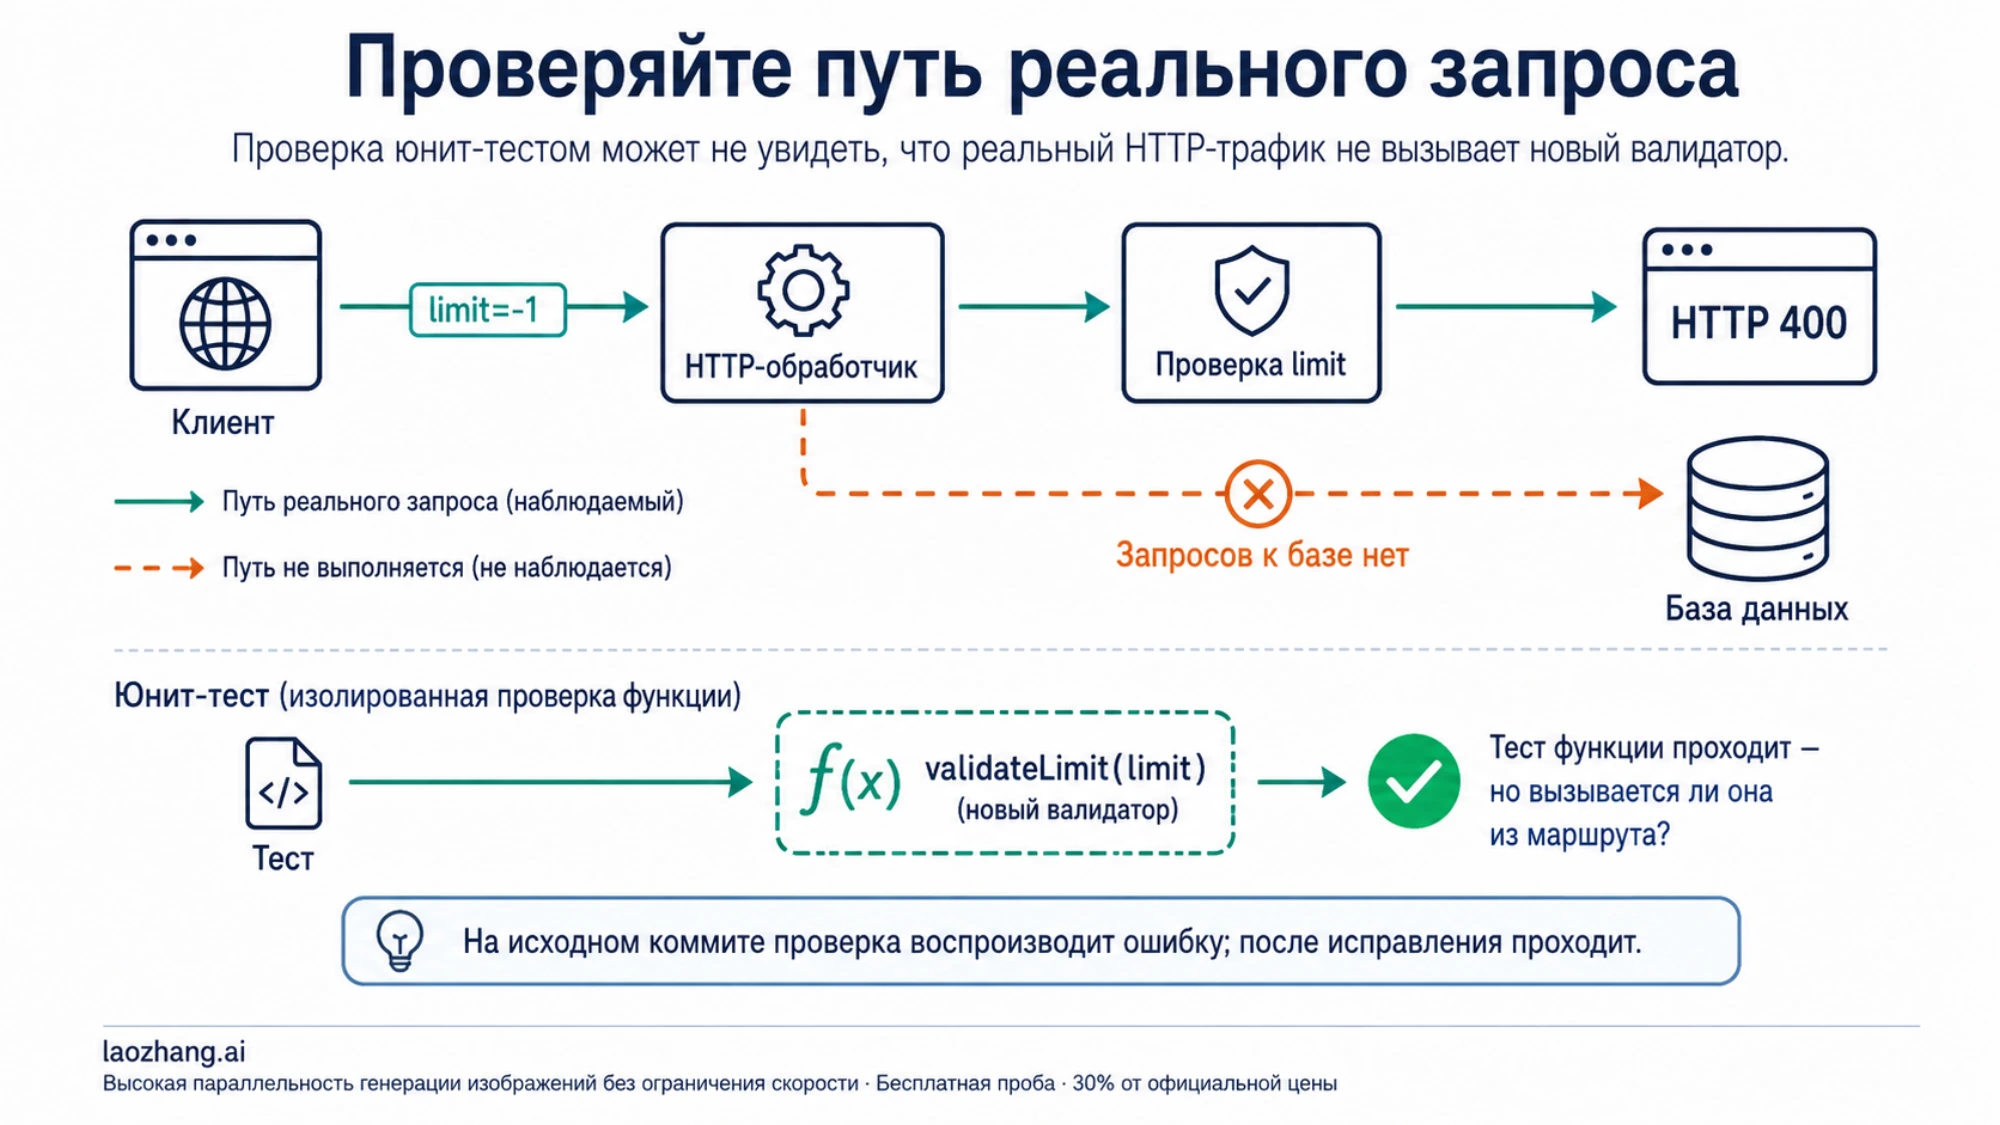
Приемочные условия можно записать до запуска моделей:
| Вход | Ожидаемое наблюдаемое поведение |
|---|---|
limit=-1 | HTTP 400; запросов к базе нет |
limit=0 | Поведение соответствует заранее согласованной спецификации |
limit=10 | Обычный успешный ответ; разрешенный запрос к базе выполняется |
Прежний сценарий без limit | Сохраняется документированное значение по умолчанию |
Проверка отрицательного значения должна воспроизводить ошибку на исходном коммите и проходить после исправления. Если она проходит и до изменения, она не подтверждает устранение этой ошибки. Заодно посмотрите, не ослабила ли модель существующие утверждения в тестах, не исключила ли неудобный случай и не оставила ли новую функцию без вызова из рабочего кода.
Это предложенный пример проверки, а не описание проведенного нами эксперимента. Для своей задачи замените входные данные и ожидаемый результат, сохранив принцип: проверяется пользовательское поведение и нужные побочные эффекты.
Как принять решение после прогона
Для каждой задачи запишите: выполнены ли приемочные условия, сколько было попыток, сколько стоил весь запуск, сколько минут заняли проверка и ручные правки, какие лишние файлы изменены. Неудачный результат тоже входит в расходы, даже если итоговый патч пришлось написать самостоятельно.
Полезный показатель для серии задач — суммарные расходы на API, деленные на число принятых решений. Время человека лучше сначала учитывать отдельно в минутах; если у команды есть согласованная стоимость часа, ее можно добавить к денежной оценке. Такой учет покажет, окупается ли более дорогой запуск сокращением реальной доработки, без предположения, что это обязательно произойдет.
Если обе модели проходят ваши проверки при сопоставимых затратах времени, меньшая стоимость GPT-5.3-Codex становится практическим преимуществом. Если обязательный вход не помещается в его пределы, больший контекст Opus 4.6 дает основание проверить этот вариант. Если одна модель требует меньше ручной работы, используйте измеренную разницу, а не размер контекста как объяснение по умолчанию.
Держать обе модели в постоянной схеме необязательно. Сначала выберите ту, которая надежно решает ваши задачи при приемлемой полной стоимости. Правило переключения имеет смысл добавлять лишь тогда, когда повторяющийся тип неудач и выигрыш второй модели уже видны в ваших результатах.