GPT-5.5 vs Claude Opus 4.7: выбор для кода, API и длинных документов
Обе модели доступны через API. Начните с существующей интеграции, сравните стоимость принятой задачи и учтите повышенный тариф GPT-5.5 после 272 000 входных токенов.
Содержание
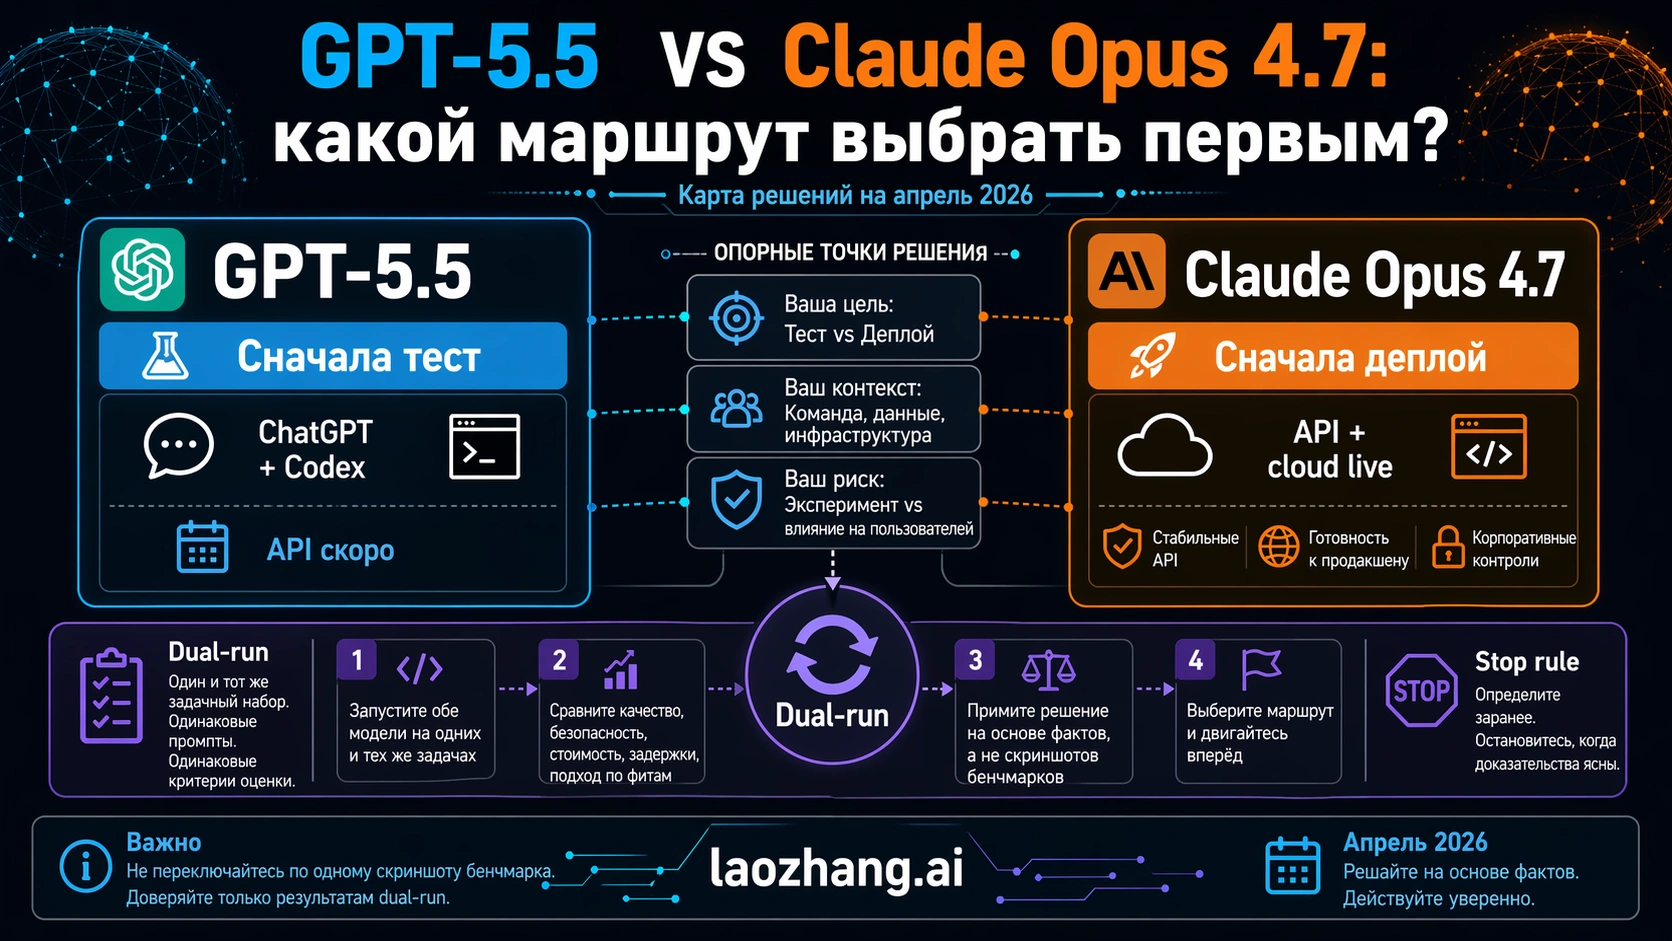
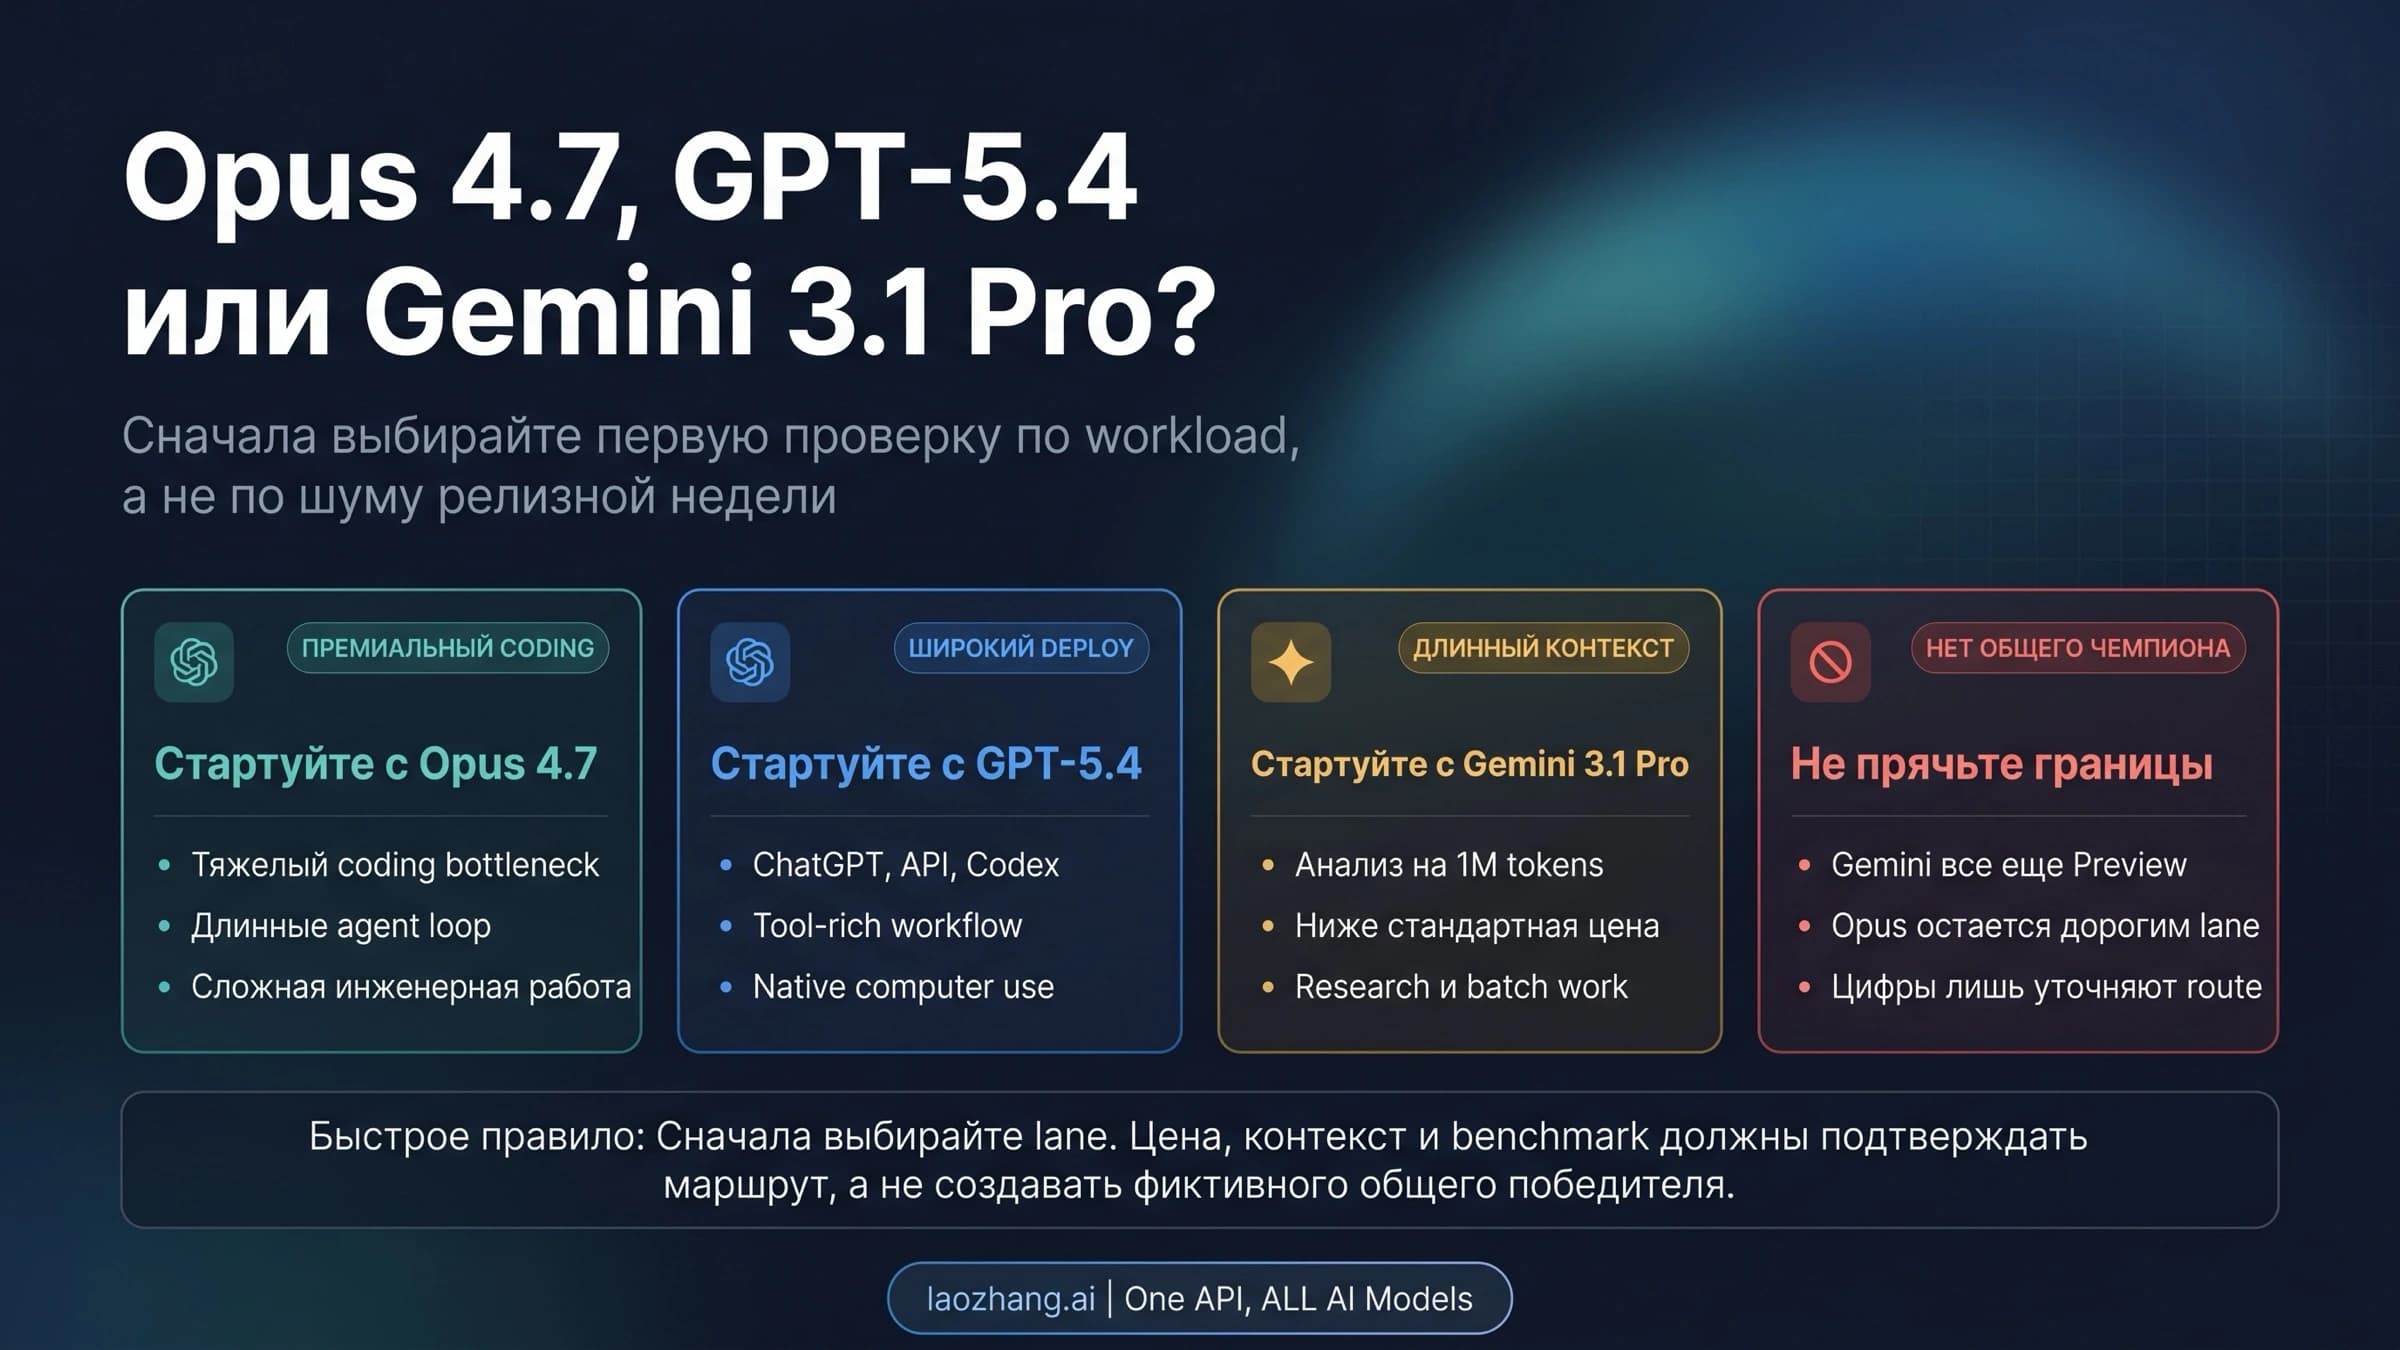
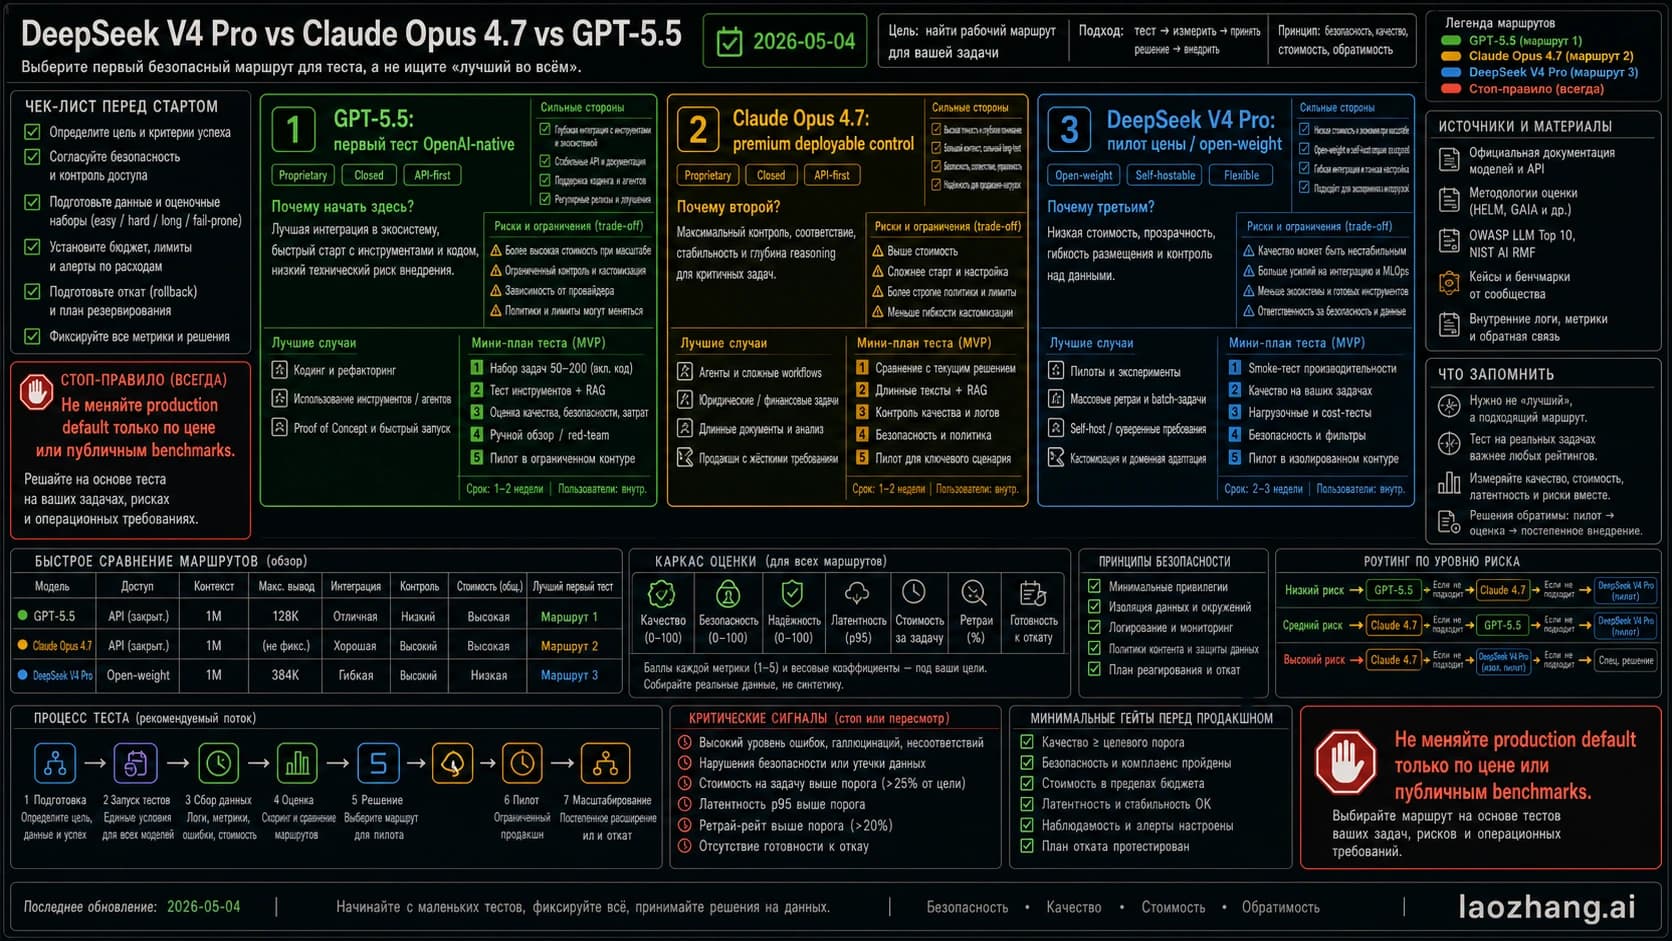
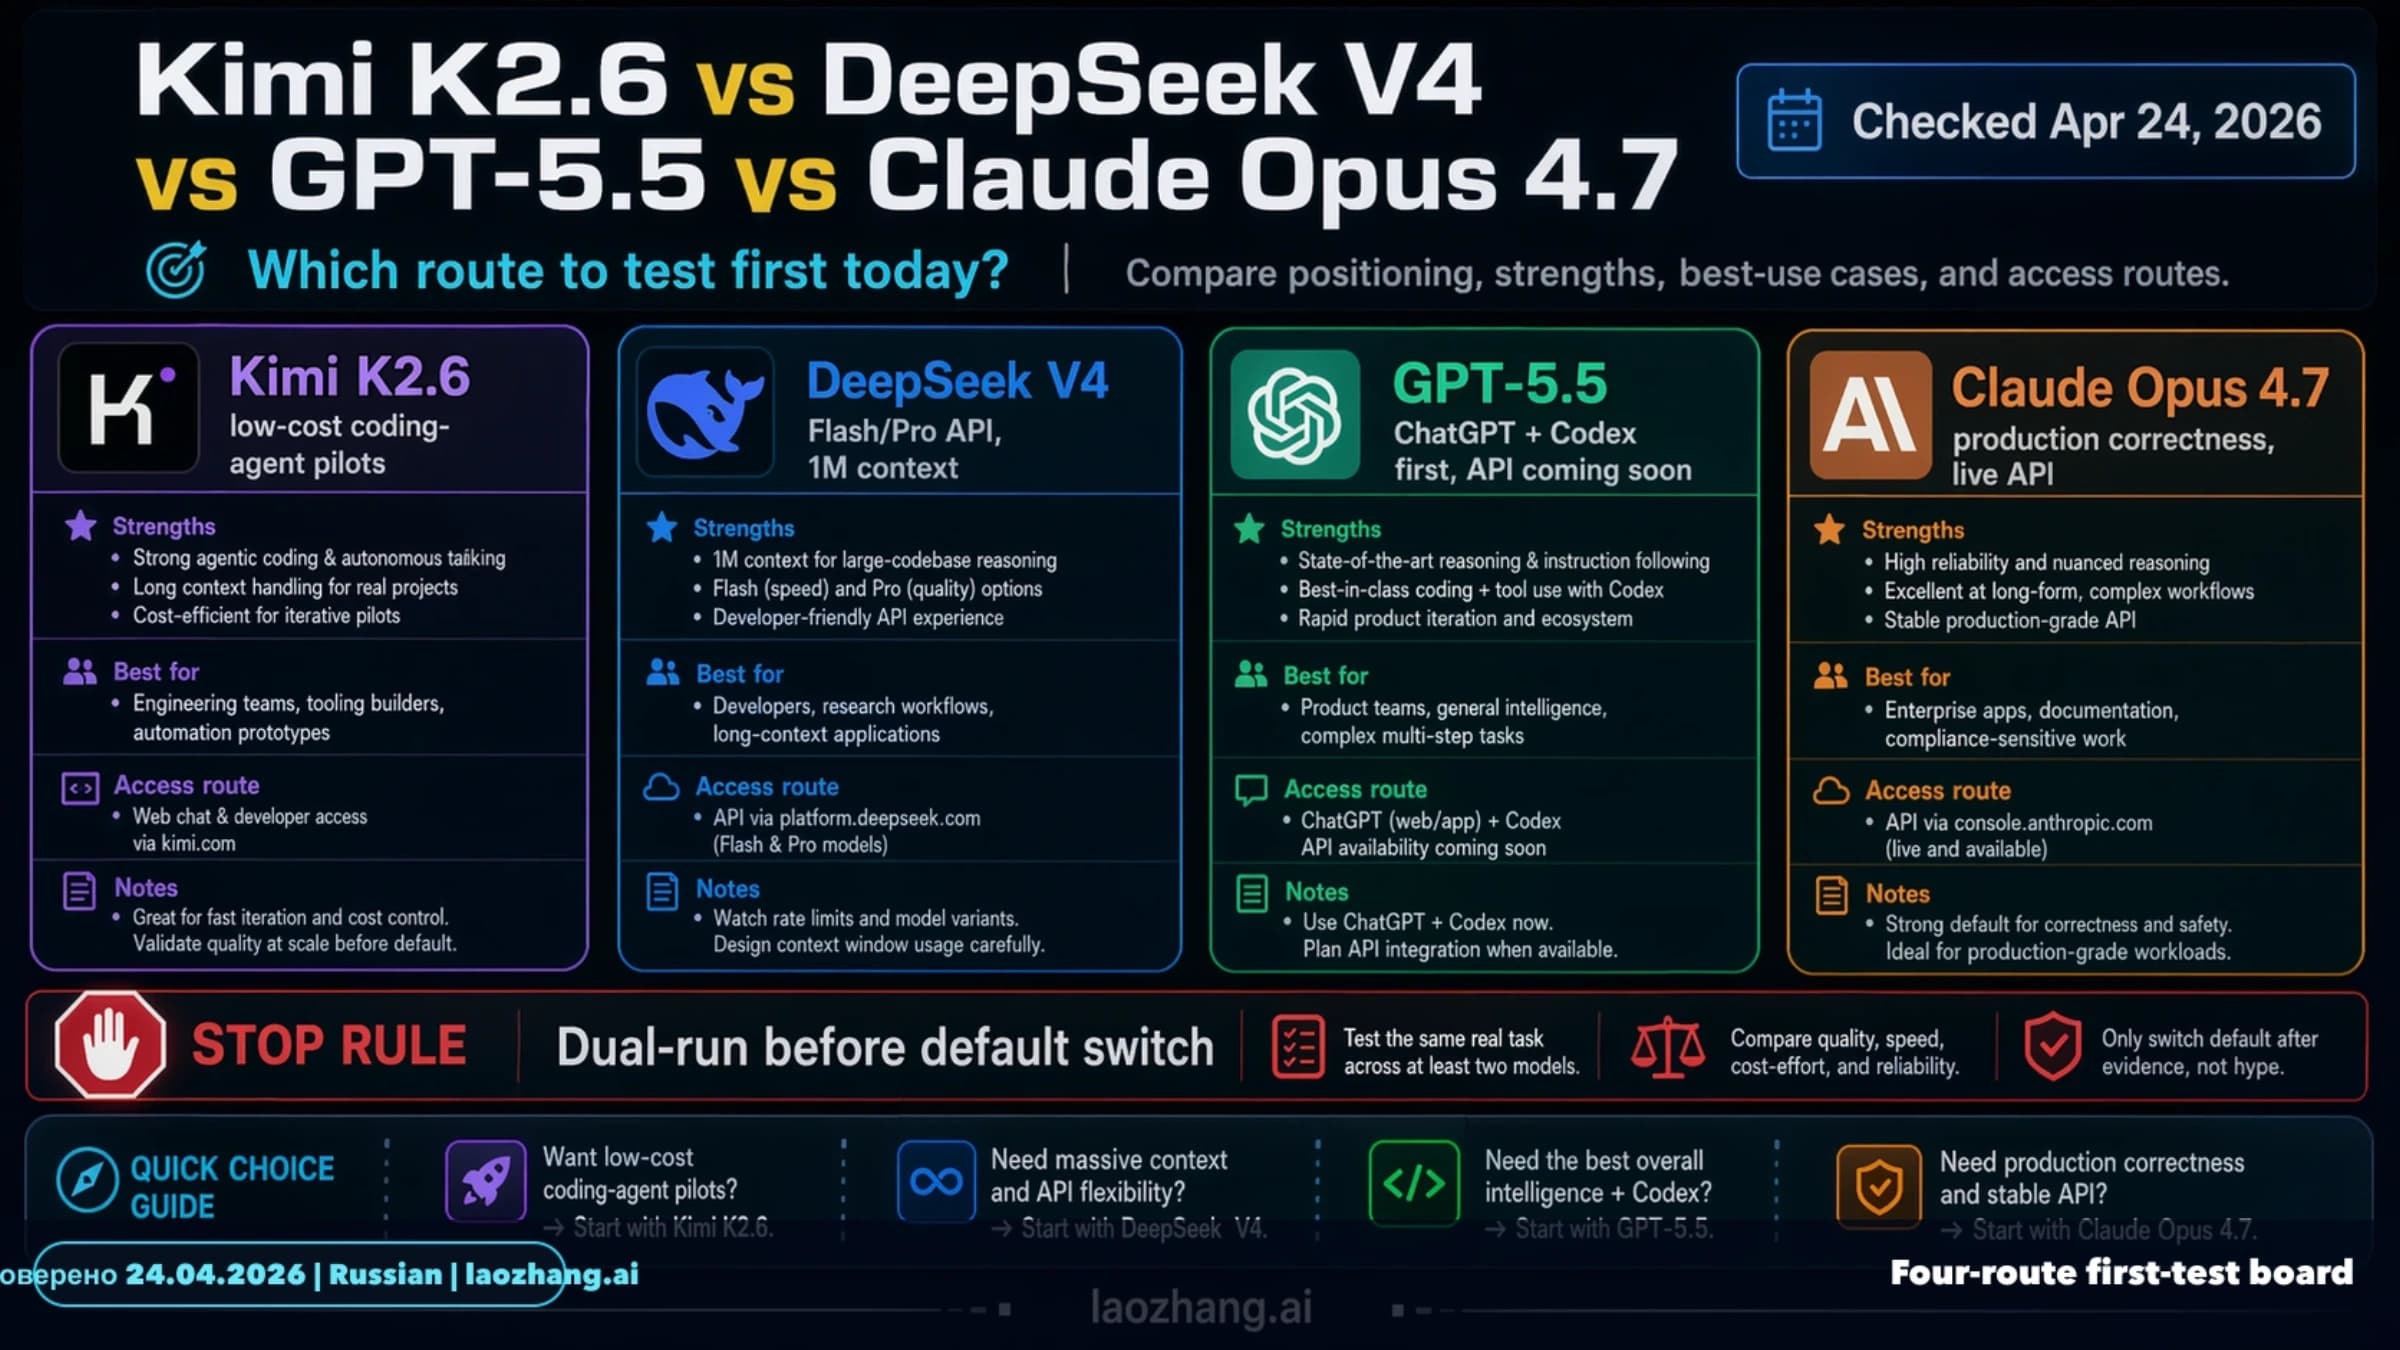
Если приложение уже использует OpenAI Responses, первым кандидатом для проверки будет GPT-5.5. Если оно построено на Claude Messages, начните с Opus 4.7. Для длинных документов свыше 272 000 входных токенов и большой генерации у Opus 4.7 есть ценовое преимущество; для программирования окончательный выбор должен определяться исправлениями, которые прошли ваши тесты и проверку человеком. Переход к другому поставщику имеет смысл, когда выигрыш на ваших задачах покрывает расходы на интеграцию и повторные попытки.
На 13 октября 2026 года обе модели доступны через API. Апрельское ожидание API GPT-5.5 больше не актуально. При этом 14 октября GPT-5.5 выводится из ChatGPT, ChatGPT Work и Codex на всех планах — OpenAI прямо указывает, что это не относится к API. Поэтому выбирать её для нового рабочего процесса с входом через ChatGPT и выбирать для серверного приложения — разные решения. Карточка GPT-5.5, официальное уведомление о выводе из интерфейсов.
Какие версии действительно можно сравнить через API
Для воспроизводимого сравнения укажите точный идентификатор модели, интерфейс и параметры. У GPT-5.5 есть датированный снимок; у Opus 4.7 отсутствие даты в имени уже означает закреплённую версию.
| Параметр | GPT-5.5 | Claude Opus 4.7 |
|---|---|---|
| Идентификатор | gpt-5.5; снимок gpt-5.5-2026-04-23 | claude-opus-4-7 |
| Основной интерфейс в примерах ниже | OpenAI Responses | Claude Messages |
| Опубликованное окно контекста | 1 050 000 токенов | 1 000 000 токенов |
| Максимальный обычный вывод | 128 000 токенов | 128 000 токенов |
| Вход и выход | Текст и изображения → текст | Текст и изображения → текст |
| Текущее положение | API доступен; вывод из перечисленных интерфейсов 14 октября | Active (legacy); API остаётся доступен |
Характеристики приведены для прямых API по OpenAI и Anthropic. Внутри указанного окна нужно оставить место для генерации и рассуждений; нельзя заполнить его входом целиком и затем рассчитывать на максимальный ответ.
Статус legacy у Opus 4.7 означает прекращение обновлений этой версии и возможность будущего вывода, а не отказ API уже сегодня. Anthropic указывает срок не раньше 16 апреля 2027 года для своих платформ; это нижняя граница, а не назначенный день отключения. У Amazon Bedrock и Google Cloud собственные графики. Правила жизненного цикла.
claude-opus-4-7 не переключается автоматически на Opus 5.5. Веса и конфигурация закреплены за ID, хотя обслуживающая инфраструктура может меняться. Сам Opus 5.5 — отдельный кандидат для миграции, который Anthropic сейчас предлагает рассмотреть; он не является другим названием Opus 4.7. Идентификаторы и версии Claude.
Что выбрать первым для вашей нагрузки
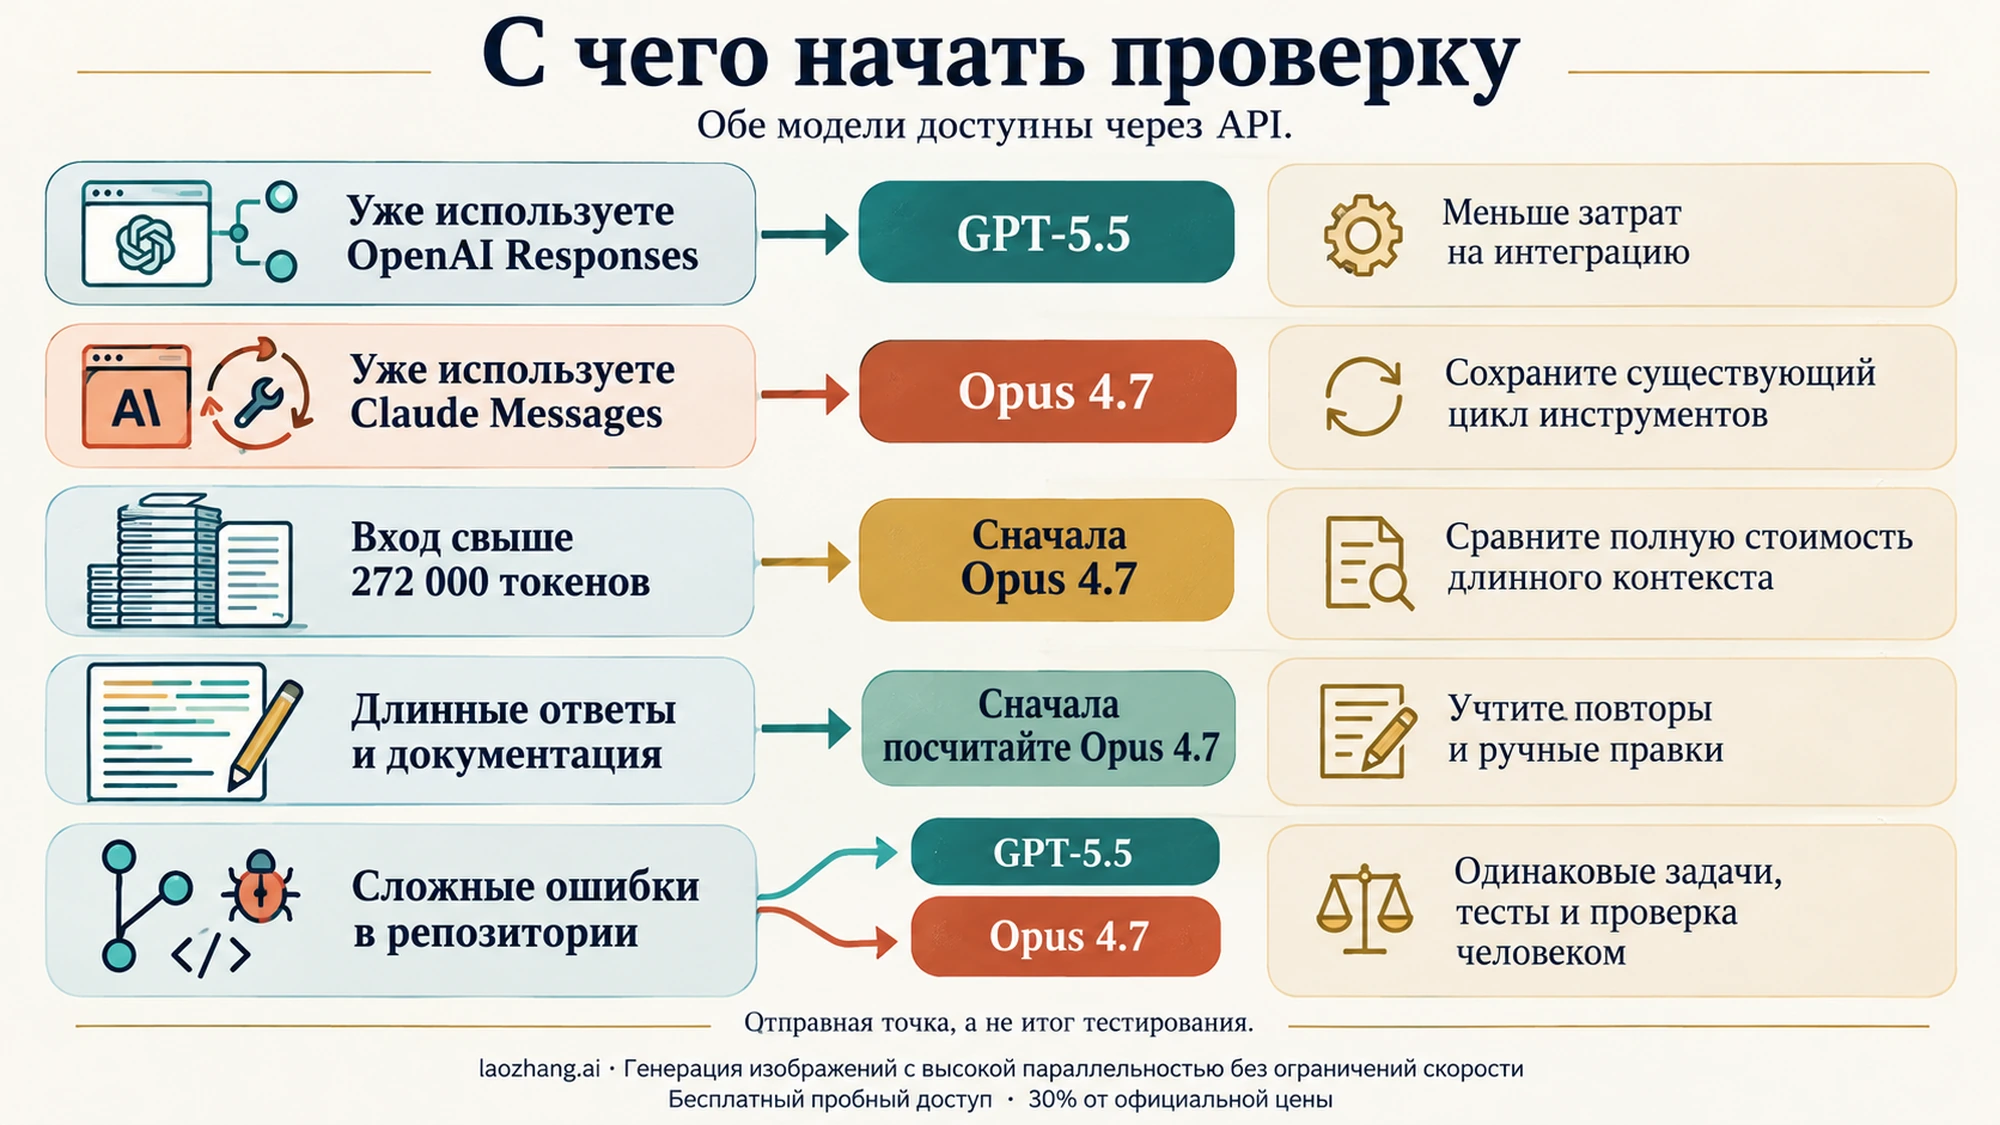
| Ваша ситуация | Разумная отправная точка | Что должно оправдать смену |
|---|---|---|
| Уже работают Responses, инструменты OpenAI и собственные проверки | GPT-5.5 | Opus снижает ошибки или полную стоимость настолько, чтобы окупить другой интерфейс |
| Уже работают Messages и цикл инструментов Claude | Opus 4.7 | GPT-5.5 заметно улучшает принятые результаты или время выполнения |
| Анализ больших документов с входом более 272 000 токенов | Opus 4.7 как первый ценовой кандидат | GPT-5.5 даёт нужный прирост точности, который покрывает повышенный тариф |
| Длинные ответы, документация, генерация кода | Сначала посчитать Opus 4.7 | Более дешёвый выход сохраняет смысл, только если не растут повторы и правки |
| Исправление сложных ошибок в репозитории | Проверить обе модели на одинаковых исходных задачах | Исправление проходит тесты, не ломает соседнее поведение и требует меньше проверки |
Это рекомендации по порядку проверки, основанные на интерфейсах и тарифах, а не результаты нашего сравнительного запуска. Мы не выполняли платные вызовы и не измеряли качество этих моделей на собственном репозитории.
Для анализа документов обе модели подходят по формату входа. Большое окно полезно, если нужные факты распределены по файлам, но само по себе не гарантирует правильную ссылку на источник. В проверку включите документы с противоречиями и вопросом, на который в них нет ответа. Успешный результат должен отделять найденное от предположений и указывать место в документе.
Для агента программирования поддержка инструментов — только часть решения. Агенту нужны разрешённые операции, сохранение истории вызовов и понятное условие завершения. Модель не получает файловую систему, память или право выполнять команды только потому, что в её карточке указан вызов инструментов.
Тарифы: где появляется разница в стоимости
В таблице — USD за миллион токенов, прямой стандартный API без региональных надбавок и отдельных инструментальных сборов. Кэшированный вход предполагает фактическое попадание в кэш.
| Категория | GPT-5.5: вход до 272 000 включительно | GPT-5.5: вход свыше 272 000 | Opus 4.7: весь контекст |
|---|---|---|---|
| Обычный вход | 5,00 | 10,00 | 5,00 |
| Чтение кэша | 0,50 | 1,00 | 0,50 |
| Оплачиваемый выход | 30,00 | 45,00 | 25,00 |
У GPT-5.5 порог длинного входа повышает ставки для всей сессии в Standard, Batch и Flex: вход вдвое, выход в полтора раза. У Opus 4.7 весь миллионный контекст тарифицируется по обычным ставкам; старую надбавку после 200 000 токенов переносить на него не следует. Цены OpenAI, условия GPT-5.5, цены Claude.
При одинаковом числе выходных токенов 25 USD вместо 30 USD — экономия 16,7 % относительно GPT-5.5. Это не означает такую же экономию на всей задаче: вход, рассуждения и число попыток могут отличаться.
Два расчёта для обычного и длинного запроса
Допустим, каждый API сообщает 18 000 обычных входных и 8 000 оплачиваемых выходных токенов. Без кэша и инструментов:
- GPT-5.5:
18 000 × 5 / 1 000 000 + 8 000 × 30 / 1 000 000 = 0,33 USD. - Opus 4.7:
18 000 × 5 / 1 000 000 + 8 000 × 25 / 1 000 000 = 0,29 USD.
Теперь предположим 320 000 входных и 10 000 выходных токенов в одной сессии. GPT-5.5 уже попадает в длинный тариф: 3,65 USD. Для Opus 4.7 расчёт даёт 1,85 USD. При таких условиях ценовая разница намного важнее, чем при коротком запросе.
Это арифметические примеры по опубликованным ставкам. Одинаковый текст не обязательно имеет одинаковое число токенов у двух поставщиков; оплачиваемый выход включает рассуждения, а не только видимый ответ. Реальные расходы следует считать по каждому ответу API.
Когда кэш меняет расчёт
GPT-5.5 кэширует подходящий повторяющийся префикс автоматически, без отдельной доплаты за запись. Для неё поддерживается prompt_cache_retention: "24h", но документация описывает обычное время около 30 минут и возможное хранение до 24 часов, а не гарантию попадания на протяжении суток. Стабильный prompt_cache_key помогает маршрутизации кэша. Различия кэширования по моделям.
У Opus 4.7 запись на пять минут стоит 6,25 USD, на час — 10 USD за миллион токенов; чтение — 0,50 USD. Тарифы кэша Claude.
Для иллюстрации возьмём неизменяемый префикс из 80 000 токенов и четыре обращения, причём последние три полностью читают его из кэша. Только обработка префикса обойдётся в 0,52 USD для GPT-5.5, 0,62 USD для Opus с пятиминутной записью или 0,92 USD с часовой. Без повторного использования — 1,60 USD у каждой модели. Динамический вход и генерация сюда не включены; временные условия и попадания должны действительно выполняться.
Если работа допускает асинхронную обработку, Batch снижает базовые ставки: для короткого входа GPT-5.5 — 2,50/15 USD, Opus 4.7 — 2,50/12,50 USD за вход/выход. GPT-5.5 также имеет Flex и более дорогой Fast; у Opus 4.7 speed: "fast" не поддерживается. Режим обработки нужно выбирать под срок получения результата, а не считать все скидки взаимозаменяемыми. Региональные настройки тоже меняют цену: для GPT-5.5 региональная обработка добавляет 10 %, для Opus 4.7 inference_geo: "us" — 10 % ко всем категориям токенов прямого API. OpenAI, Anthropic.
Параметры и минимальные примеры для двух API
Начните с небольшого одинакового задания и сохраните результат вместе с usage. Для обычной проверки кода ниже используется уровень high; для полноценного агента с длительной работой Anthropic рекомендует начать оценку Opus 4.7 с xhigh. Одинаковые названия уровней у поставщиков не означают одинаковое количество вычислений. Настройка GPT-5.5, effort Claude.
Примеры предназначены для Python с официальными пакетами openai и anthropic. Нужны разрешённый доступ к соответствующей модели, ключ своего API в OPENAI_API_KEY или ANTHROPIC_API_KEY и UTF-8-файл review-task.txt с заданием и проверяемым кодом. Каждый пример выполняется отдельно и создаёт платный запрос. Это примеры по документации, без нашего запуска. Предпосылки описаны в OpenAI quickstart и Claude get started.
GPT-5.5: Responses и учёт скрытых рассуждений
from pathlib import Path
from openai import OpenAI

task = Path("review-task.txt").read_text(encoding="utf-8")
client = OpenAI()
response = client.responses.create(
    model="gpt-5.5-2026-04-23",
    input=task,
    reasoning={"effort": "high"},
    text={"verbosity": "medium"},
    max_output_tokens=32768,
)

if response.usage is not None:
    Path("gpt55-usage.json").write_text(
        response.usage.model_dump_json(indent=2), encoding="utf-8"
    )
Path("gpt55-answer.txt").write_text(
    response.output_text or "", encoding="utf-8"
)
if response.status != "completed":
    raise RuntimeError(
        f"Ответ не завершён: {response.status}, "
        f"{response.incomplete_details}"
    )
print(response.output_text)
max_output_tokens ограничивает весь генерируемый объём, включая невидимые рассуждения. При incomplete и причине max_output_tokens запрос может уже стоить денег, даже если видимого ответа нет. Сначала посмотрите сохранённый результат и расход, затем решайте, снижать ли effort или увеличивать лимит. Работа reasoning-моделей.
Для расчёта в Responses берите input_tokens, input_tokens_details.cached_tokens и output_tokens; output_tokens_details.reasoning_tokens уже входит в выход. Кэшированные токены уже входят во вход. Не начисляйте их повторно и не умножайте total_tokens на выходной тариф. Поле prompt_tokens_details.cached_tokens относится к Chat Completions, а не к этому примеру. Документированный usage Responses.
Opus 4.7: Messages и adaptive thinking
from pathlib import Path
import anthropic

task = Path("review-task.txt").read_text(encoding="utf-8")
client = anthropic.Anthropic()
message = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=32768,
    thinking={"type": "adaptive"},
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": task}],
)

answer = "\n".join(
    block.text for block in message.content if block.type == "text"
)
Path("opus47-usage.json").write_text(
    message.usage.model_dump_json(indent=2), encoding="utf-8"
)
Path("opus47-answer.txt").write_text(answer, encoding="utf-8")
if message.stop_reason != "end_turn":
    raise RuntimeError(f"Проверьте завершение: {message.stop_reason}")
print(answer)
В Opus 4.7 thinking по умолчанию выключен; пример включает его явно. Старый thinking.type: "enabled" с budget_tokens для этой модели возвращает ошибку 400. temperature устарел, принимается только значение по умолчанию — поэтому параметр здесь отсутствует. Текст выбирается по типу блока: первый блок может содержать рассуждение. Claude API primer, поддержка thinking и ошибки.
Messages не хранит за приложение историю диалога. Для продолжения нужно отправлять необходимые предыдущие сообщения; в цикле инструментов сохраняйте возвращённые thinking-блоки. Если появился stop_reason: "max_tokens", ответ мог оборваться до готового текста: рассуждения тоже расходуют max_tokens. Пример выше проверяет завершение только простого запроса без инструментов. Правила Messages.
Бенчмарки и скорость: что можно заключить из цифр
Сравнительная страница Artificial Analysis, проверенная 13 октября, сопоставляет GPT-5.5 High и Opus 4.7 Max. В Intelligence Index v4.3.2 она показывает 37 и 41, однако значение Opus помечено как оценочное, с независимой проверкой в будущем. Поэтому эта строка не доказывает общую победу Opus в программировании. Часть отдельных результатов и стоимость задачи Opus на странице отсутствуют; пустое значение не означает нулевой результат. Сравнение Artificial Analysis.
Там же скорость вывода составляет примерно 88 и 51 токен/с, но время до первого токена — 30,53 и 23,57 с соответственно. Расчётное время ответа на 500 токенов — 36,20 и 33,38 с. Более высокая скорость генерации не обязательно даёт более быстрый короткий ответ: начальное ожидание может перевесить. Эти показатели относятся к настройкам и методике источника, а не к гарантированному времени вашего сервера. Метрики и пояснения AA.
Для интерактивного приложения измеряйте время до первого полезного ответа и полное время задачи, включая инструменты. Для массовой генерации — завершённые результаты в единицу времени. Апрельские таблицы Terminal-Bench 2.0 нельзя объединять с текущими результатами Terminal-Bench 4.0 в один рейтинг. Процент успешных задач также нельзя выдавать за процент галлюцинаций.
Как сравнить стоимость исправления, которое вы приняли
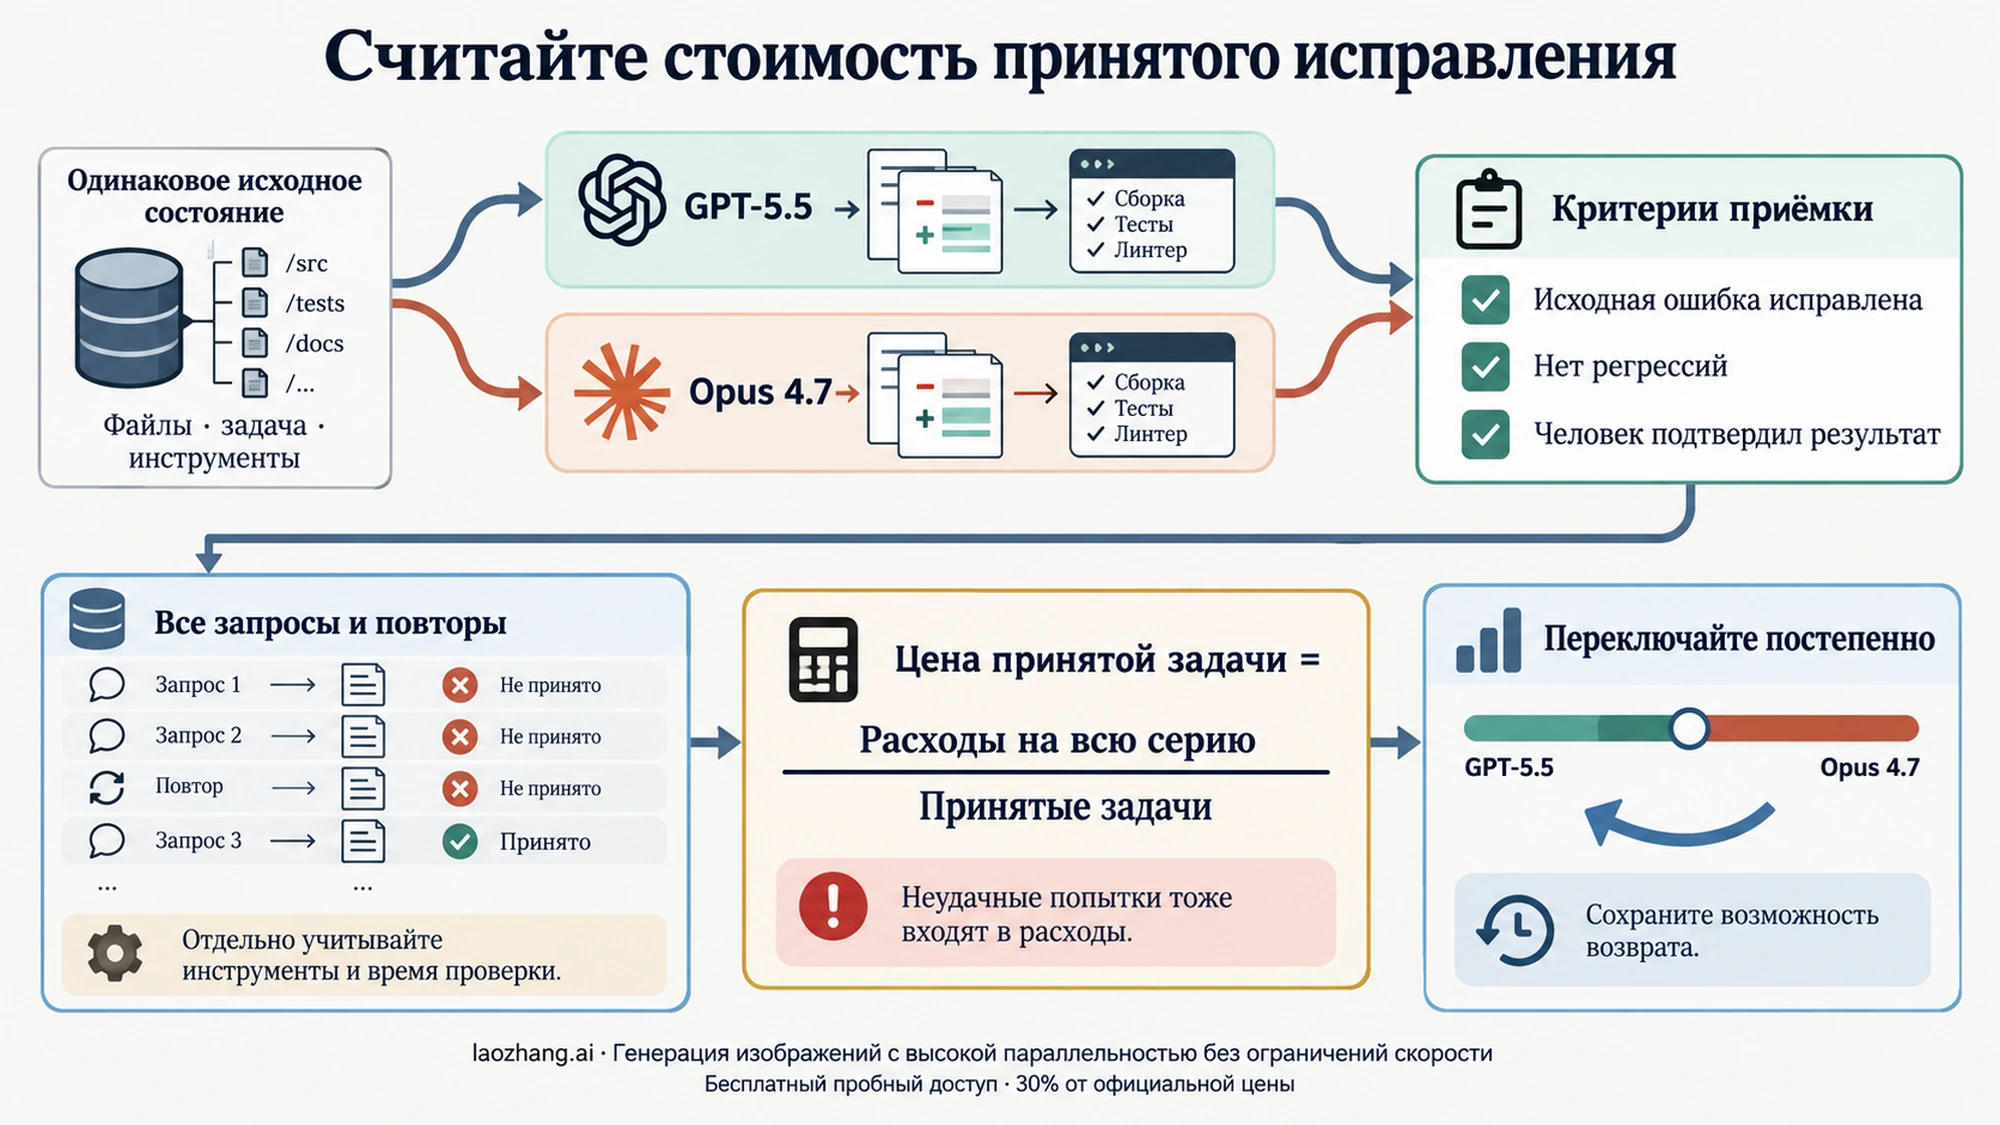
Подготовьте набор реальных ошибок с известным ожидаемым поведением: например, неверная обработка часового пояса, повторная запись после сетевого сбоя и нарушение совместимости формата данных. Перед каждым запуском восстановите одинаковое исходное состояние репозитория. Обе модели должны получить одинаковые файлы, требования, доступные инструменты и критерии приёмки; API-настройки адаптируются к каждому поставщику.
Заранее определите, когда исправление принято: проверка исходной ошибки проходит, связанные тесты не дают регрессий, формат результата пригоден для использования, а человек подтверждает соответствие задаче. Один убедительный ответ с кодом ещё не равен принятому исправлению.
Записывайте расходы всех запросов и повторов, время до результата и минуты ручной проверки. Полезная величина — суммарные расходы на серию / количество принятых задач. Задачи, которые не завершились, остаются в расходах.
Возьмём исключительно условную серию из 120 запросов с коротким входом из первого расчёта. Она стоит 39,60 USD у GPT-5.5 и 34,80 USD у Opus. Если принято 96 результатов GPT и 90 результатов Opus, цена принятого результата — около 0,413 и 0,387 USD. Если у Opus принято только 80, его показатель становится 0,435 USD, и более дешёвый выход уже не выигрывает. Числа приёмки здесь придуманы для демонстрации расчёта, а не получены в тесте. Инструментальные сборы и труд человека нужно прибавить отдельно.
Для длинного агента Opus 4.7 поддерживает beta Task Budgets с заголовком task-budgets-2026-03-13 и минимумом task_budget.total в 20 000 токенов. Это ориентир для саморегуляции на весь цикл, который модель может превысить; оставшийся бюджет не возвращается в usage. max_tokens ограничивает генерацию одного запроса. Для ограничения расходов всей задачи приложение должно отдельно учитывать запросы, инструменты и повторы и прекращать новые действия при достижении своего лимита. Условия Task Budgets.
Сначала сравните результаты без изменения рабочего трафика. Переключайте конкретный тип задач, где выигрыш подтверждён, сохранив возможность возврата. Если причина выбора — существующий API, не включайте в ту же оценку удобство чата или подписочные лимиты: это другой продуктовый сценарий.
Частые вопросы
Можно ли использовать GPT-5.5 API после 14 октября 2026 года?
Да: официальное уведомление о выводе GPT-5.5 из ChatGPT, ChatGPT Work и Codex прямо исключает OpenAI API. Доступ конкретного проекта и его квоты проверяются отдельно. Уведомление OpenAI.
Что дешевле: GPT-5.5 или Claude Opus 4.7?
При равном коротком входе базовая цена входа совпадает, а выход Opus дешевле. После 272 000 входных токенов у GPT-5.5 действует повышенный тариф всей сессии, поэтому ценовое преимущество Opus увеличивается. Полная стоимость зависит от фактических токенов, кэша, повторов и принятых результатов. OpenAI, Anthropic.
Есть ли бесплатный API у GPT-5.5 и включён ли API в подписку Claude?
В карточке именно GPT-5.5 уровень Free указан как неподдерживаемый; общая инструкция quickstart с другой моделью не доказывает бесплатную квоту для неё. Карточка GPT-5.5.
У Claude сейчас есть условные ежемесячные API-кредиты для Max и Team: Max 5x — 100 USD, Max 20x — 200 USD; Team — 20 USD за Standard-место и 100 USD за Premium-место, общий фонд до 500 USD. Требуются подходящая подписка, действующая не менее семи дней, необходимые роли и привязка одной организации Console с принятием условий. Free, Pro и Enterprise не участвуют. Неиспользованный остаток сгорает в конце цикла; это не безлимит и не увеличение лимитов чата. Кредиты покрывают Claude Platform API и предусмотренные сервисы, но не интерактивный Claude Code и партнёрские облачные вызовы. Наличие предложения и остатка в конкретном аккаунте нужно проверить отдельно. Условия кредитов Max и Team.
Достаточно ли заменить имя модели в одном SDK?
Для прямых API — нет: Responses и Messages имеют разные поля и формы ответа. Шлюз может предоставлять совместимый интерфейс; например, OrcaRouter заявляет единый OpenAI-совместимый endpoint. Это заявление конкретного сервиса, а не гарантия переноса thinking, инструментов, идентичности модели или тарифов во всех шлюзах. Перед переносом нужна документация выбранного провайдера. Страница OrcaRouter.
Чем GPT-5.5 Pro отличается от обычной GPT-5.5?
gpt-5.5-pro — отдельная API-модель, а не подписка ChatGPT Pro. У неё доступ через Responses и Batch; стандартная короткая обработка стоит 30 USD за миллион входных и 180 USD за миллион выходных токенов, без скидки на кэшированный вход. Запросы могут занимать несколько минут. Для данного сравнения сначала оцените обычную GPT-5.5 и Opus 4.7, а затем решайте, окупается ли дополнительное вычисление Pro. Карточка Pro, прайс.
Какая модель лучше пишет код?
Выберите ту, у которой на ваших задачах больше принятых исправлений при допустимых расходах и времени проверки. Для существующего OpenAI-приложения логично начать с GPT-5.5, для Claude-приложения — с Opus 4.7. Публичный индекс помогает выбрать кандидатов, но оценочный балл Opus и разные уровни High/Max не заменяют одинаковые задачи, тесты и проверку результата. Условия сравнения AA.
Источники20
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 13 окт. 2026 г..
Источники20
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 13 окт. 2026 г..
- 1.Карточка GPT-5.5developers.openai.com/api/docs/models/gpt-5.5
- 2.официальное уведомление о выводе из интерфейсовlearn.chatgpt.com/docs/models
- 3.Anthropicplatform.claude.com/docs/en/models/opus-4-7/overview
- 4.Правила жизненного циклаplatform.claude.com/docs/en/about-claude/model-deprecations
- 5.Идентификаторы и версии Claudeplatform.claude.com/docs/en/about-claude/models/model-ids-and-versions
- 6.Цены OpenAIdevelopers.openai.com/api/docs/pricing
- 7.цены Claudeplatform.claude.com/docs/en/about-claude/pricing
- 8.Различия кэширования по моделямdevelopers.openai.com/api/docs/guides/prompt-caching
- 9.Настройка GPT-5.5developers.openai.com/api/docs/guides/latest-model
- 10.effort Claudeplatform.claude.com/docs/en/build-with-claude/effort
- 11.OpenAI quickstartdevelopers.openai.com/api/docs/quickstart
- 12.Claude get startedplatform.claude.com/docs/en/get-started
- 13.Работа reasoning-моделейdevelopers.openai.com/api/docs/guides/reasoning
- 14.Claude API primerplatform.claude.com/docs/en/claude_api_primer
- 15.поддержка thinking и ошибкиplatform.claude.com/docs/en/build-with-claude/thinking-troubleshooting
- 16.Сравнение Artificial Analysisartificialanalysis.ai/models/comparisons/gpt-5-5-high-vs-claude-opus-4-7
- 17.Условия Task Budgetsplatform.claude.com/docs/en/build-with-claude/task-budgets
- 18.Условия кредитов Max и Teamsupport.claude.com/en/articles/17154008-monthly-api-credits-for-max-and-team-plans
- 19.Страница OrcaRouterorcarouter.ai/ru/compare/claude-opus-4.7-vs-gpt-5.5
- 20.Карточка Prodevelopers.openai.com/api/docs/models/gpt-5.5-pro