최신 글
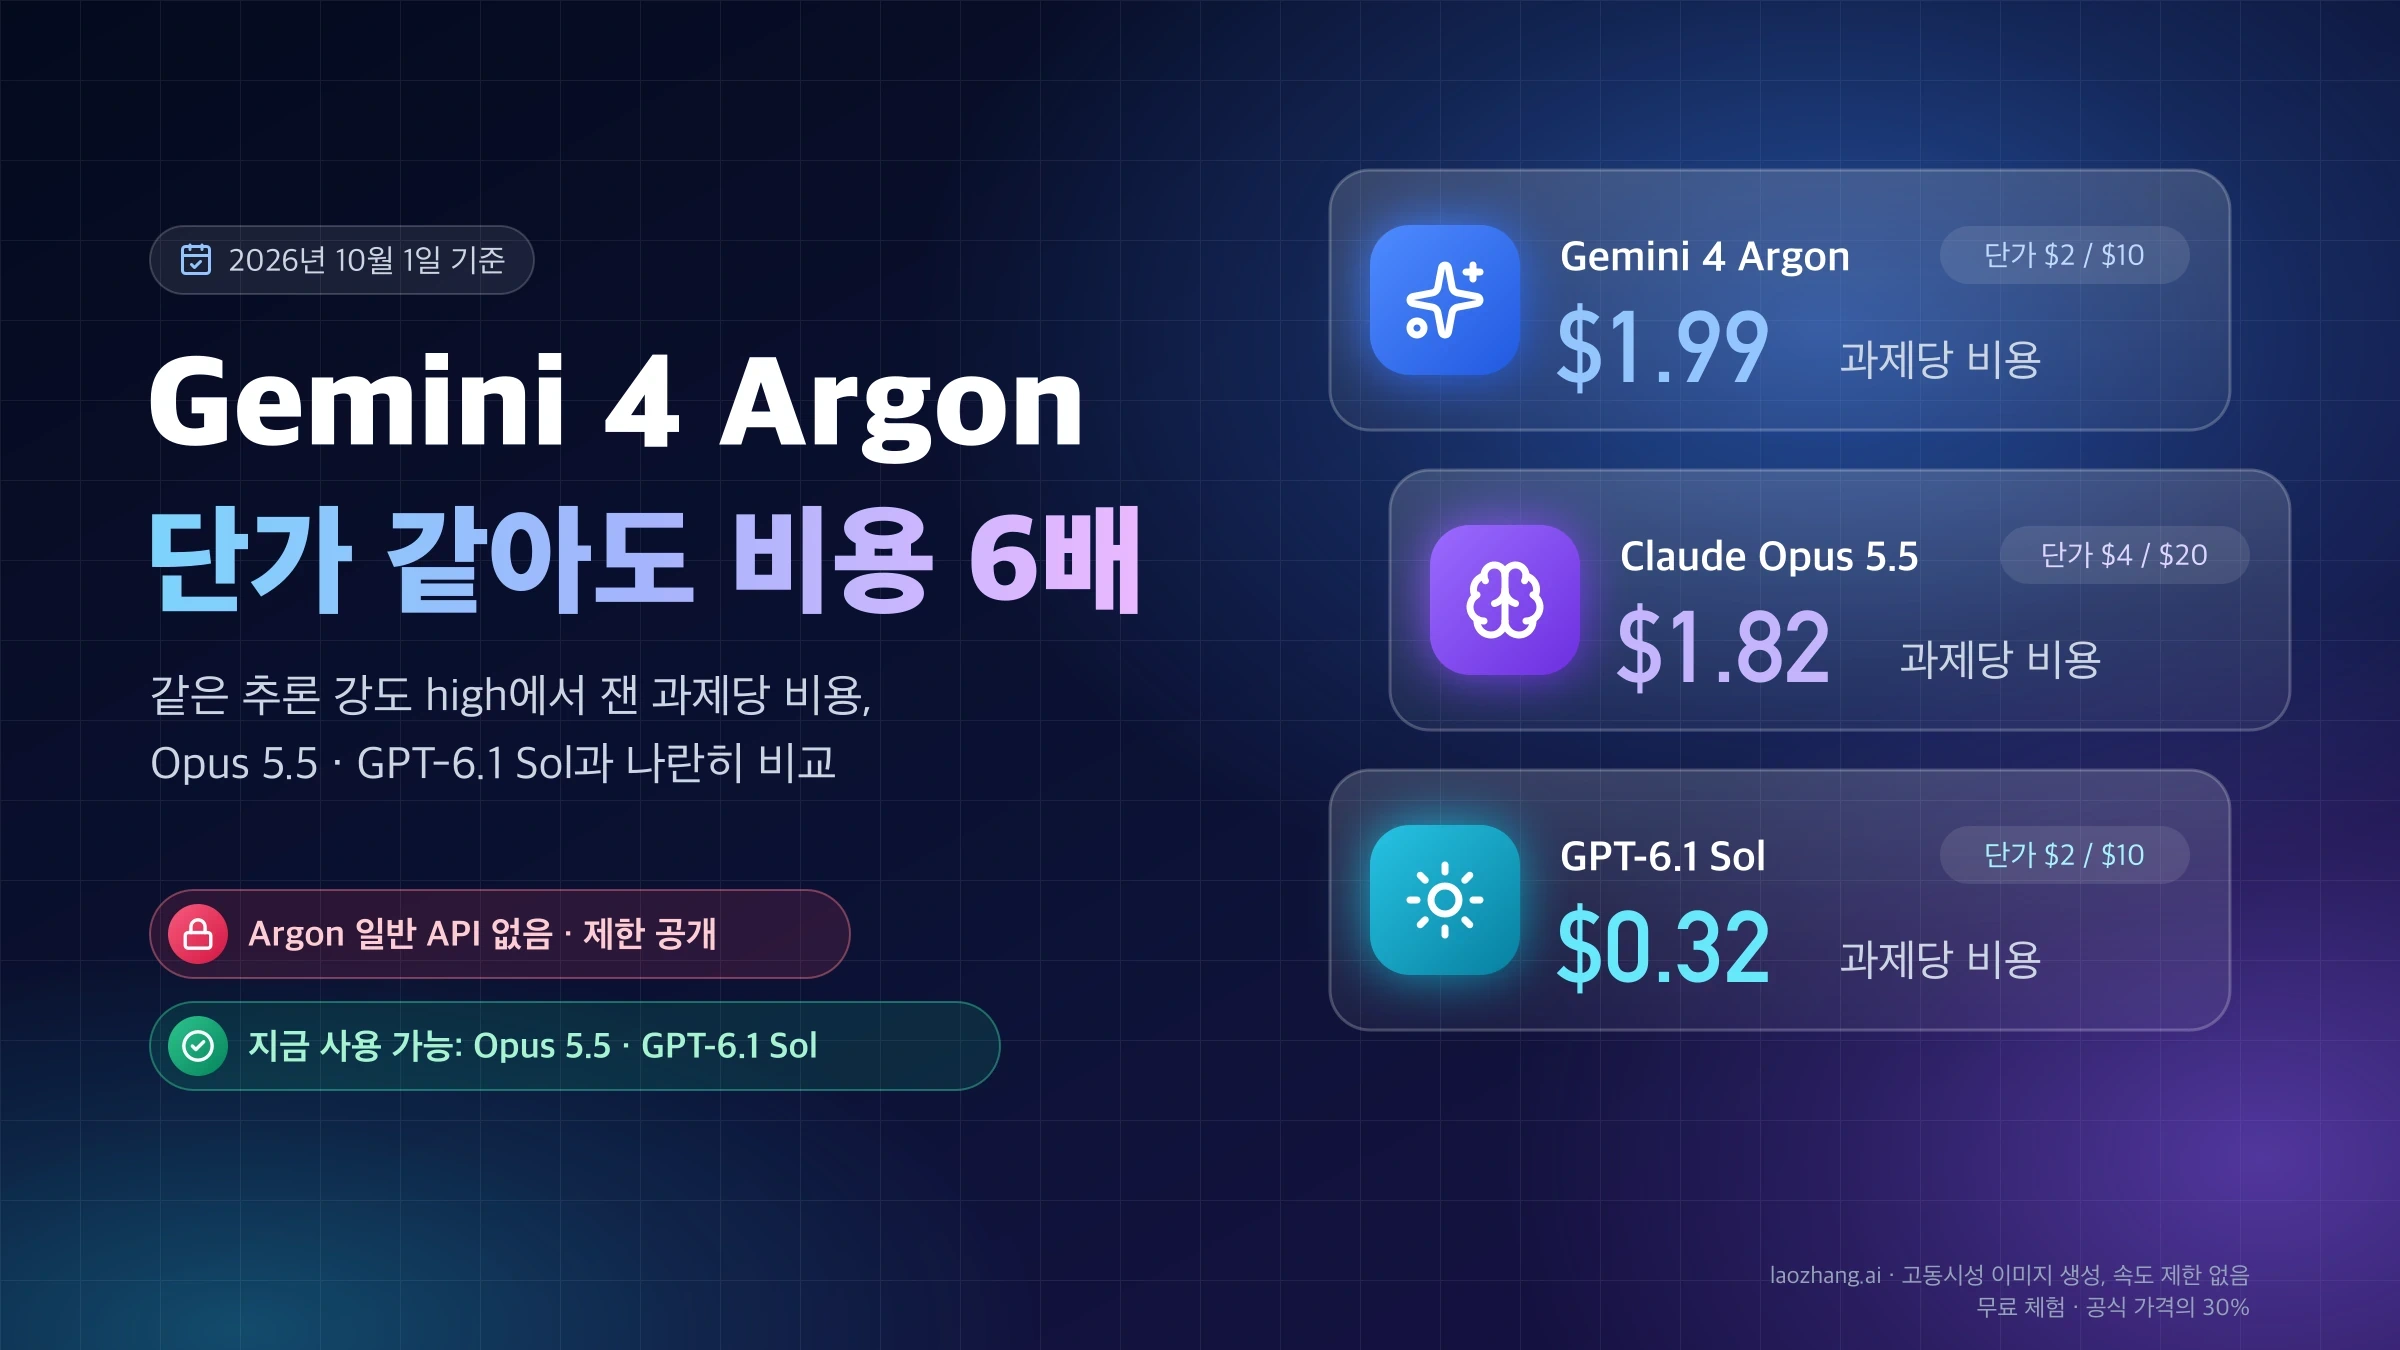
Gemini 4 Argon·Opus 5.5·GPT-6.1 Sol 비교: 작업당 비용 6배 차이
Gemini 4 Argon은 10월 13일 정식 출시돼 API 유료 등급에서 쓸 수 있고, 단가는 11월 30일까지 Sol과 같은 $2/$10, 12월 1일부터 Opus와 같은 $4/$20입니다.
16 분
Gemini 4 Argon은 10월 13일 정식 출시돼 API 유료 등급에서 쓸 수 있고, 단가는 11월 30일까지 Sol과 같은 $2/$10, 12월 1일부터 Opus와 같은 $4/$20입니다.
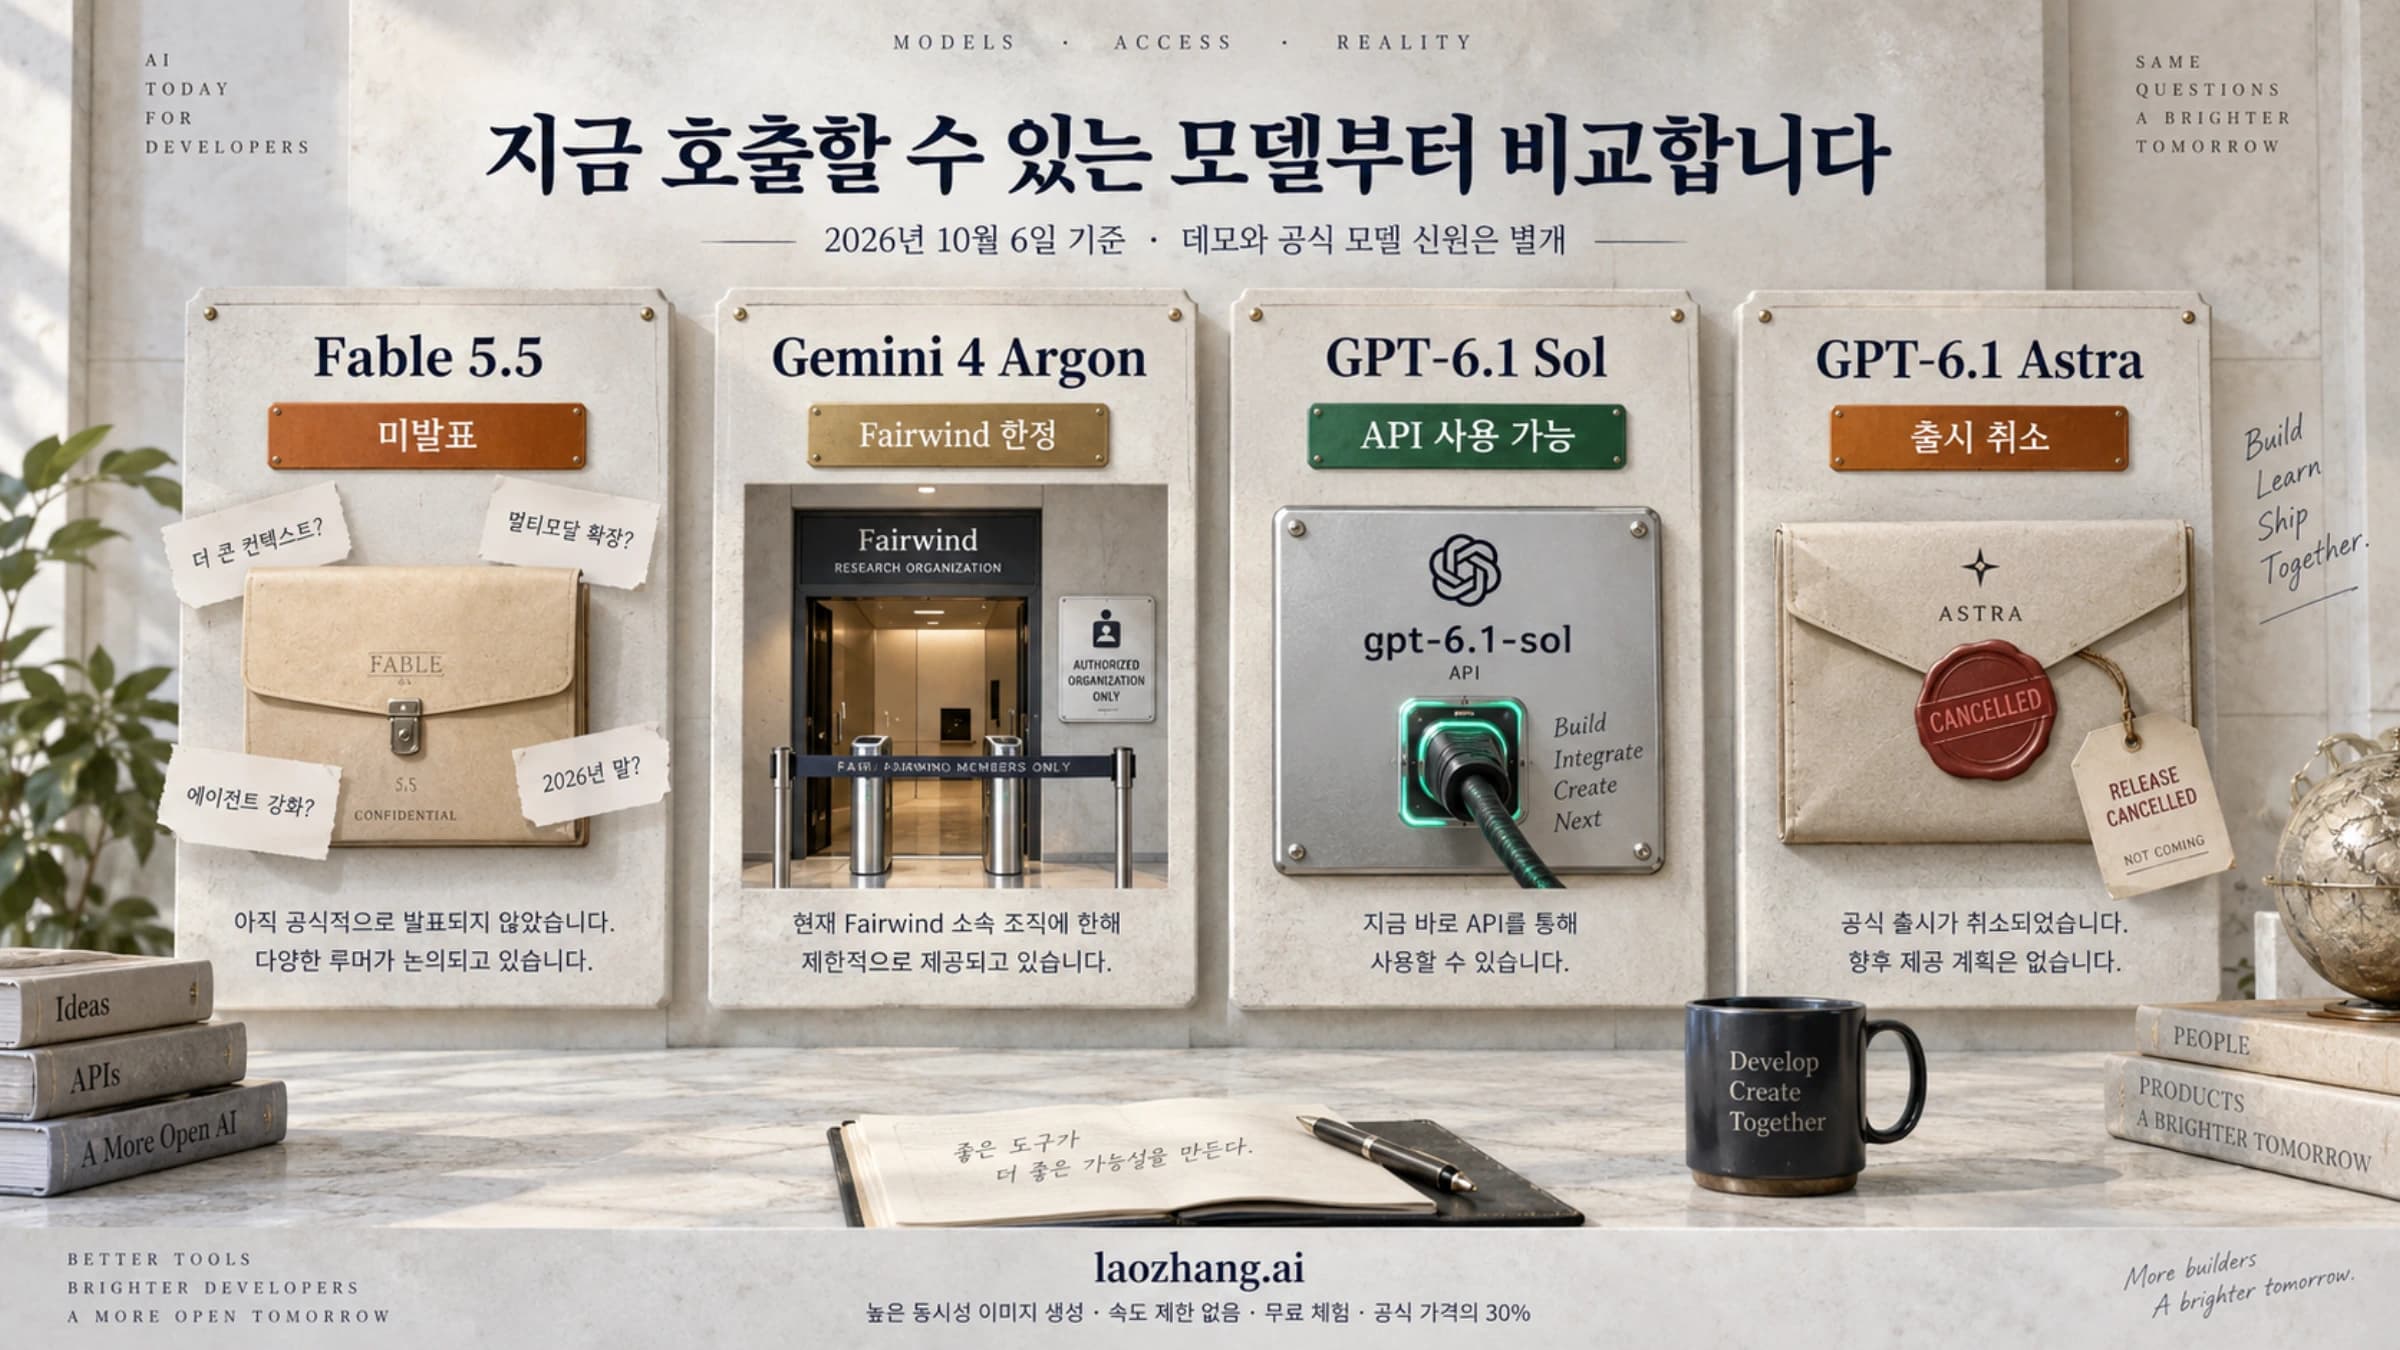
2026년 10월 14일 기준 GPT-6.1 Sol과 10월 13일 정식 공개된 Gemini 4 Argon은 쓸 수 있고, Fable 5.5는 미발표, GPT-6.1 Astra는 출시 보류입니다.
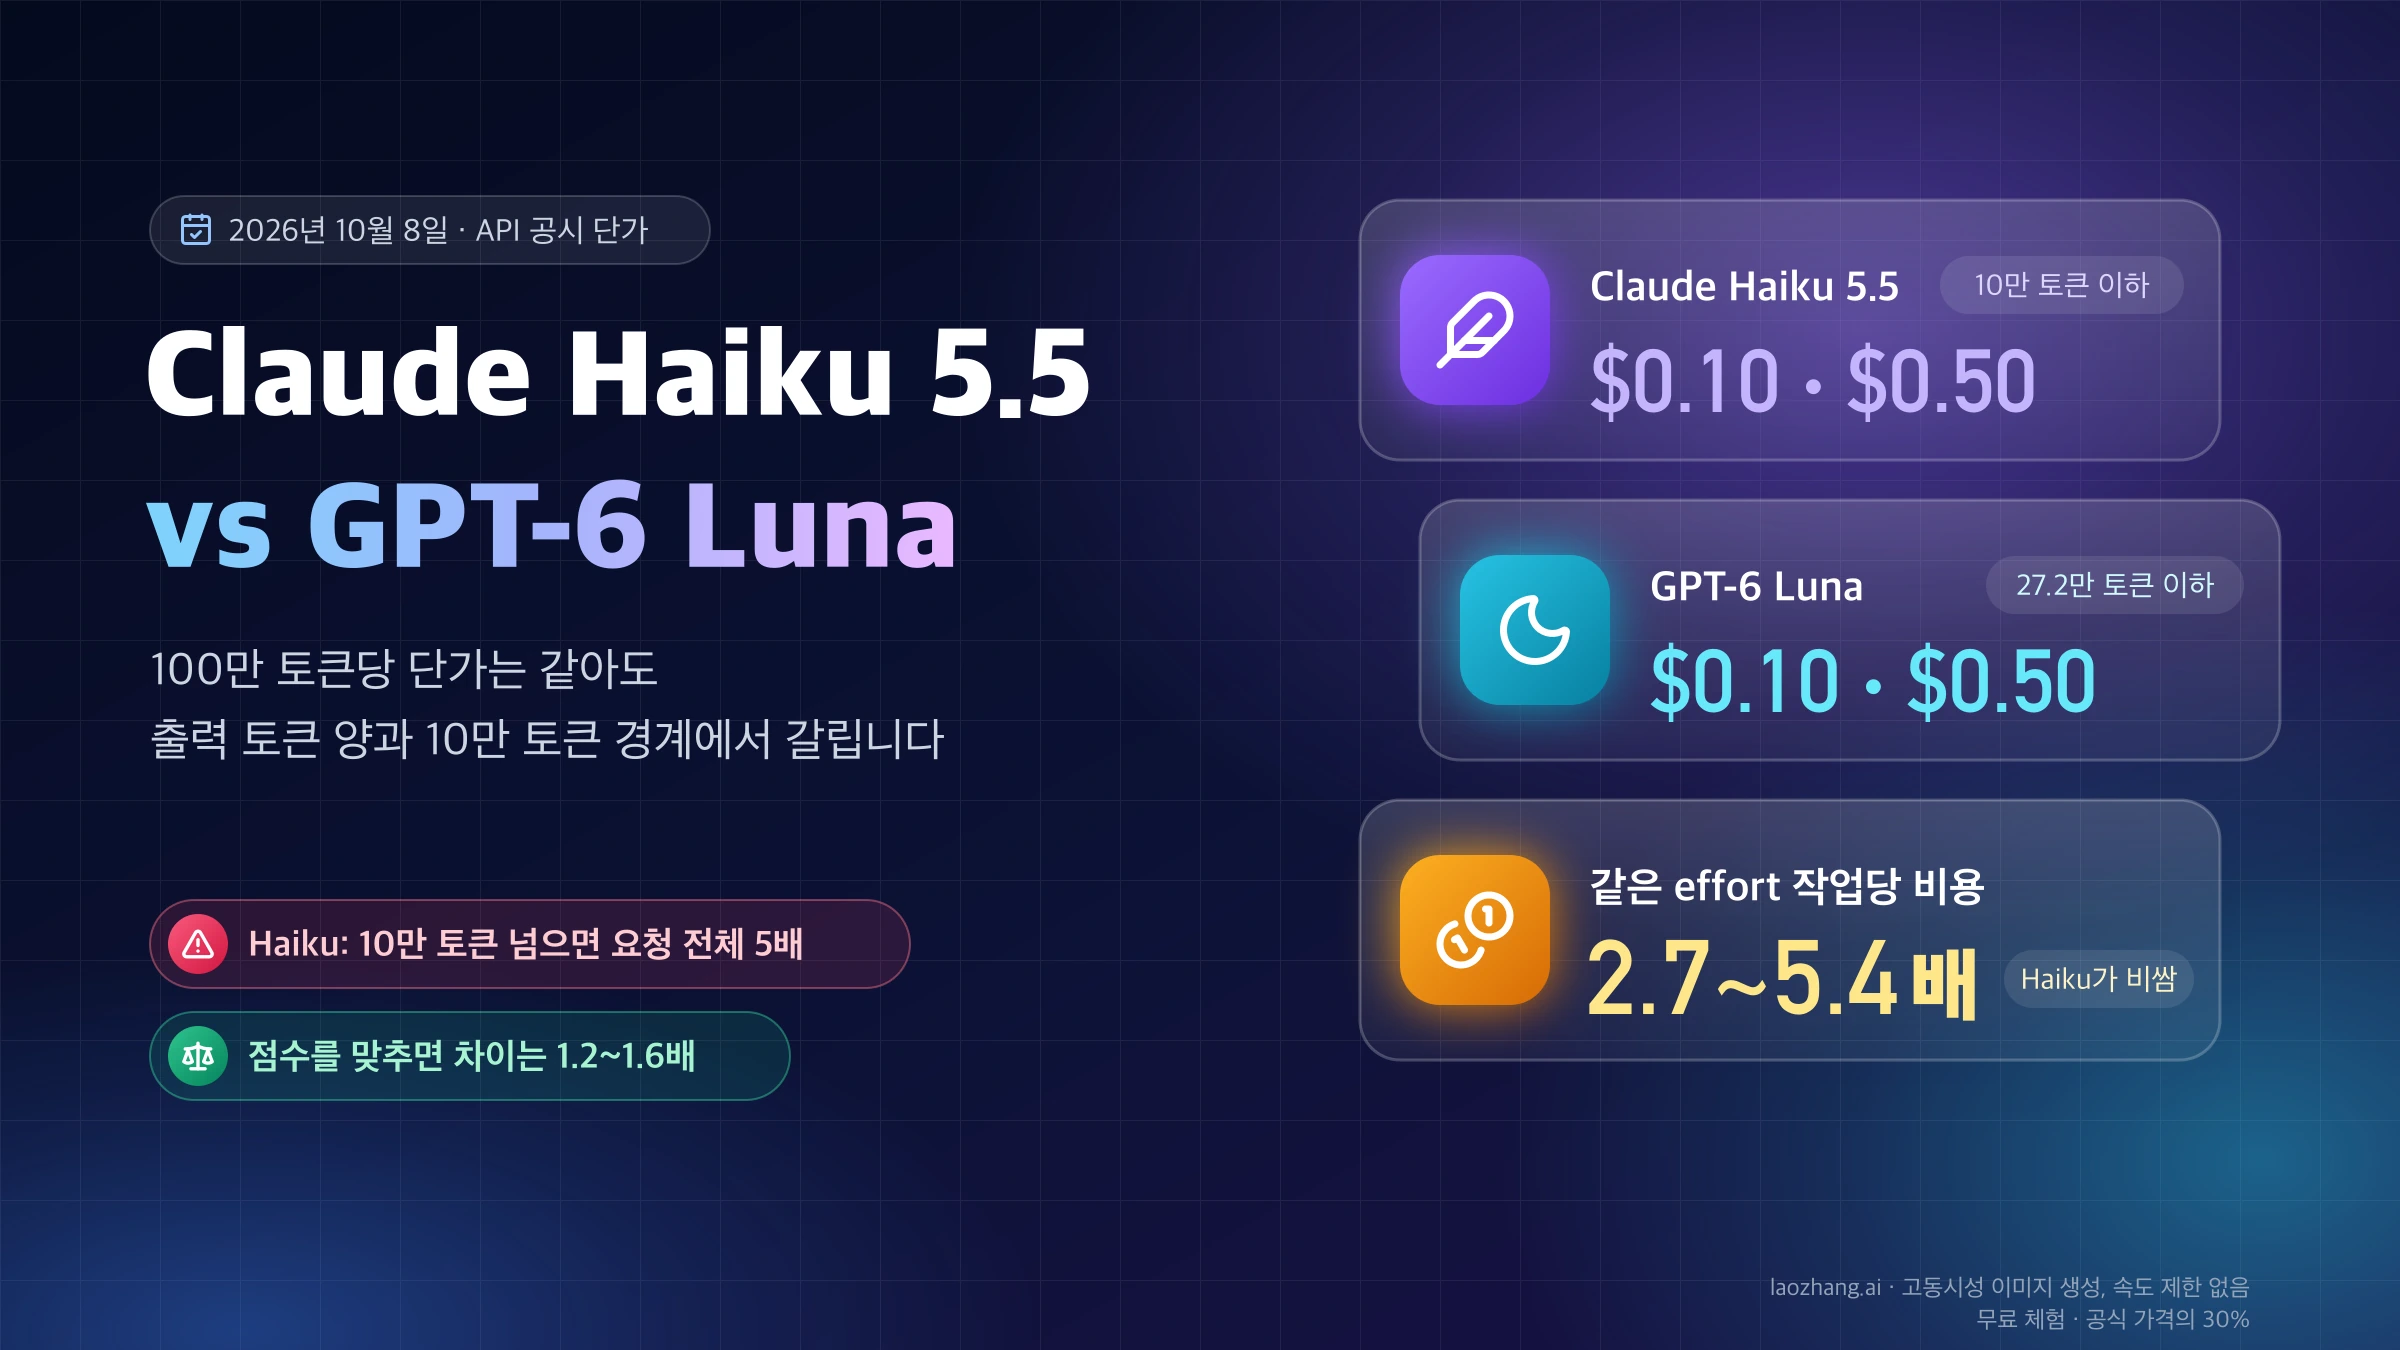
Claude Haiku 5.5와 GPT-6 Luna는 짧은 요청 단가가 같지만, 같은 effort의 작업당 비용은 Haiku가 2.7~5.4배입니다. 10만 토큰 넘는 요청은 Luna가 쌉니다.
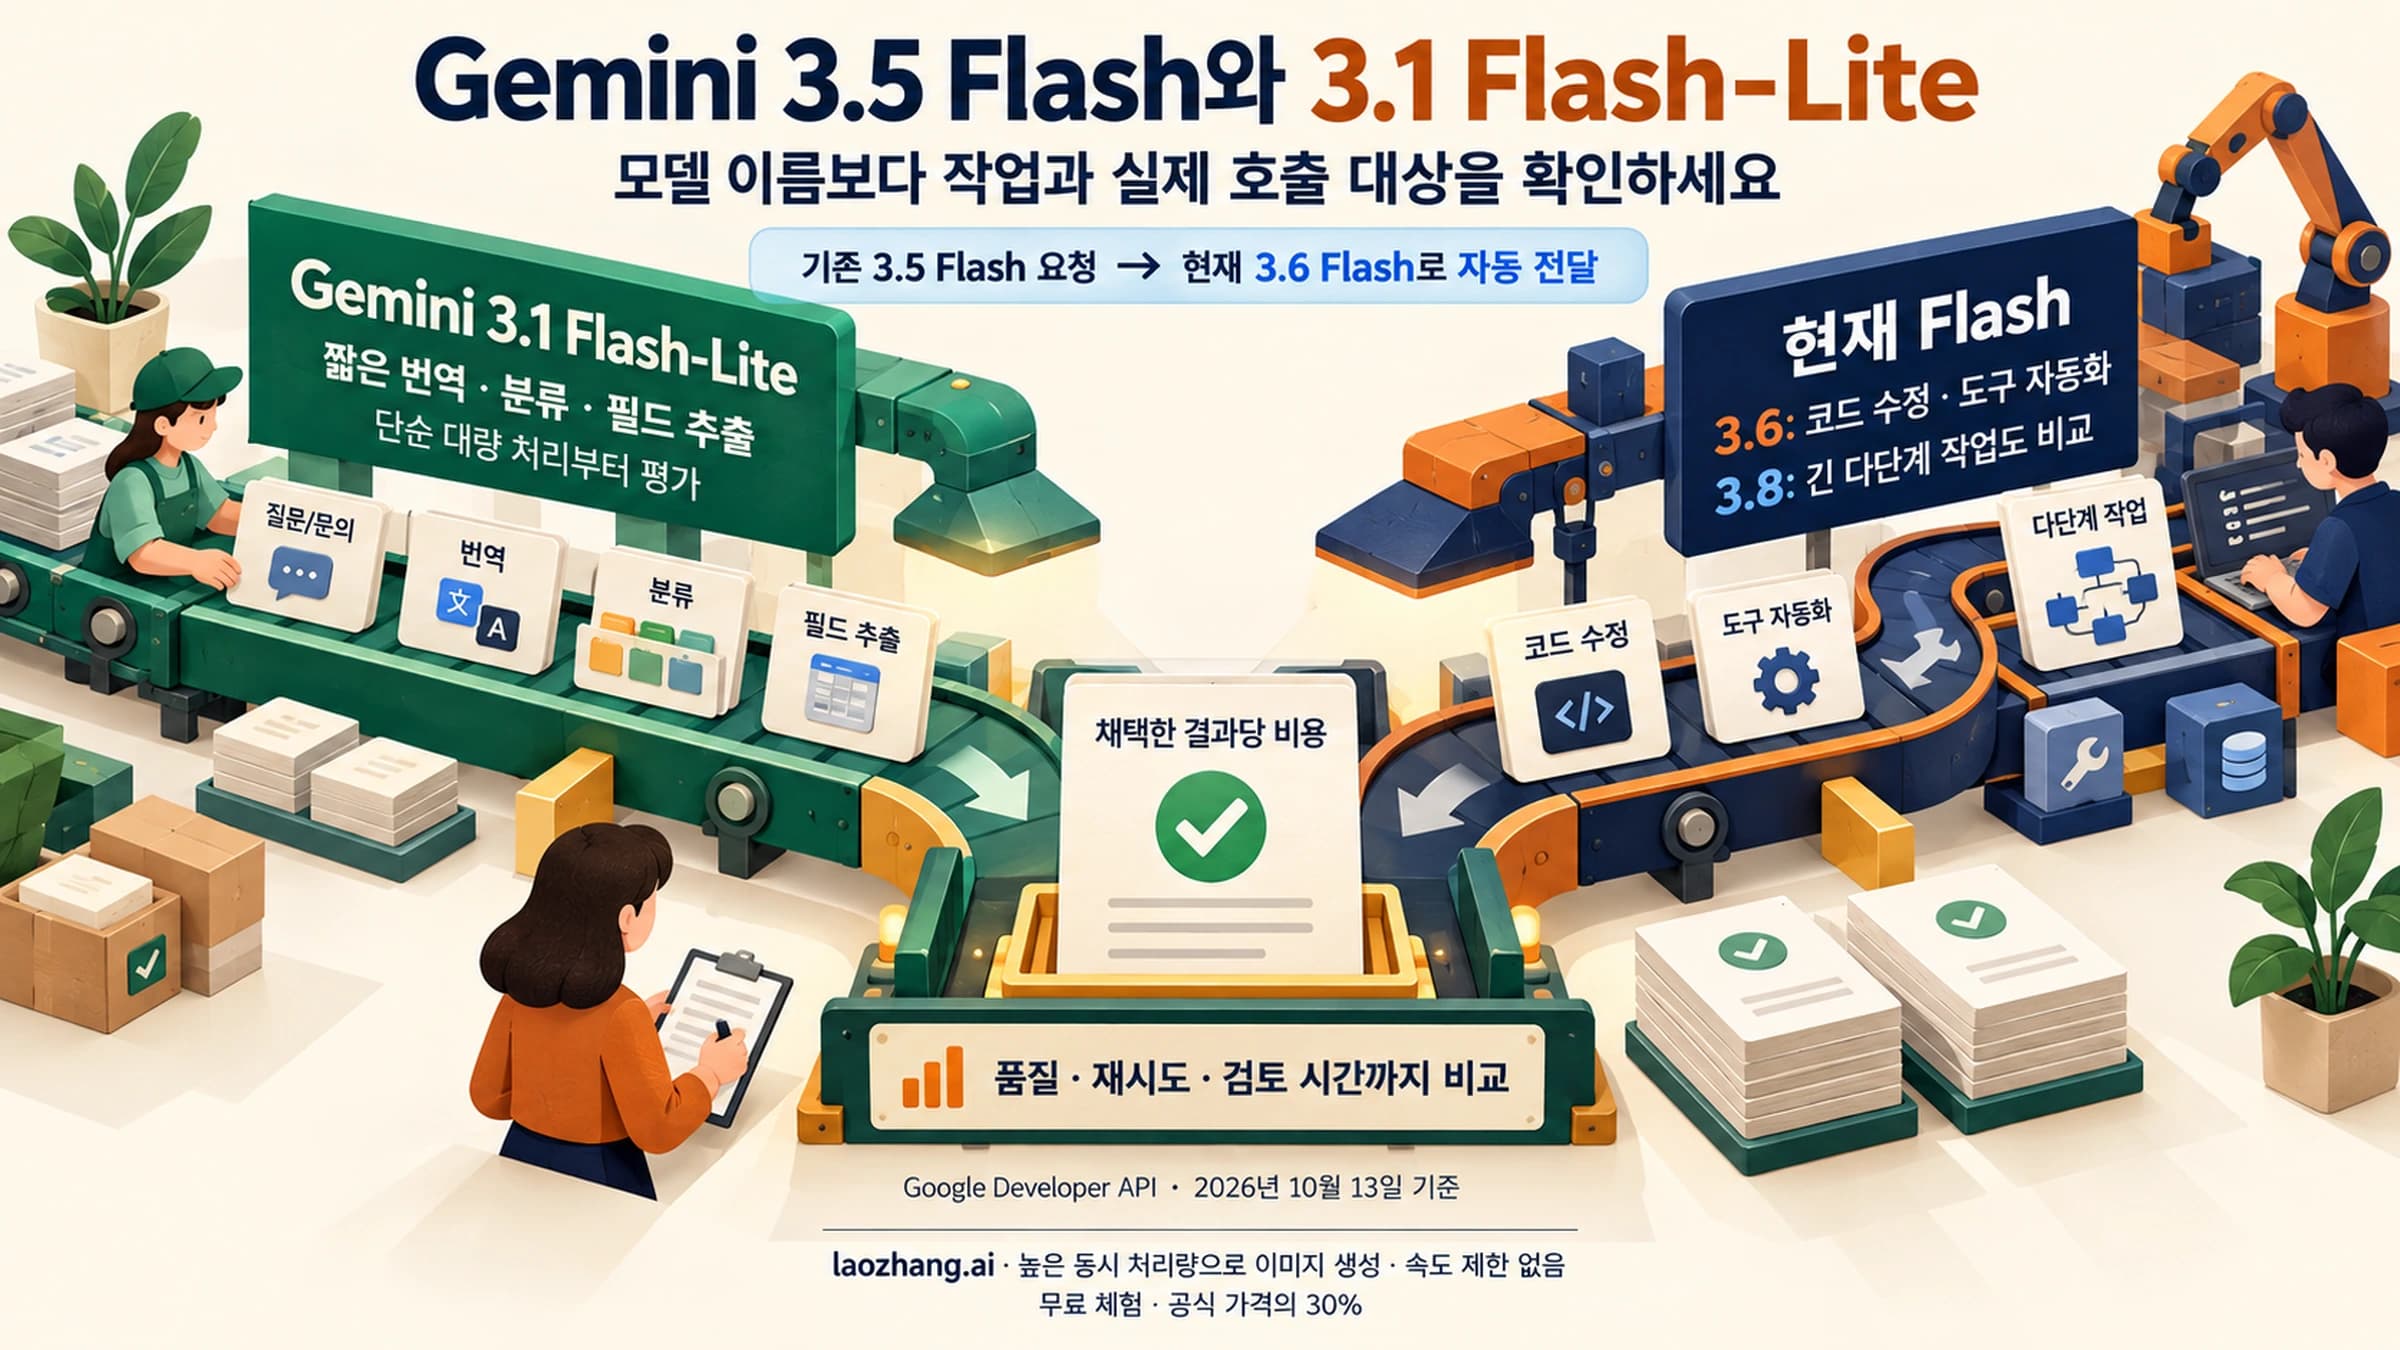
Gemini 3.5 Flash의 Developer API 요청은 현재 3.6 Flash로 전달됩니다. 단순 대량 처리에는 3.1 Flash-Lite를 먼저 평가하고, 복잡한 작업은 현재 Flash와 채택한 결과당 비용을 비교하세요.
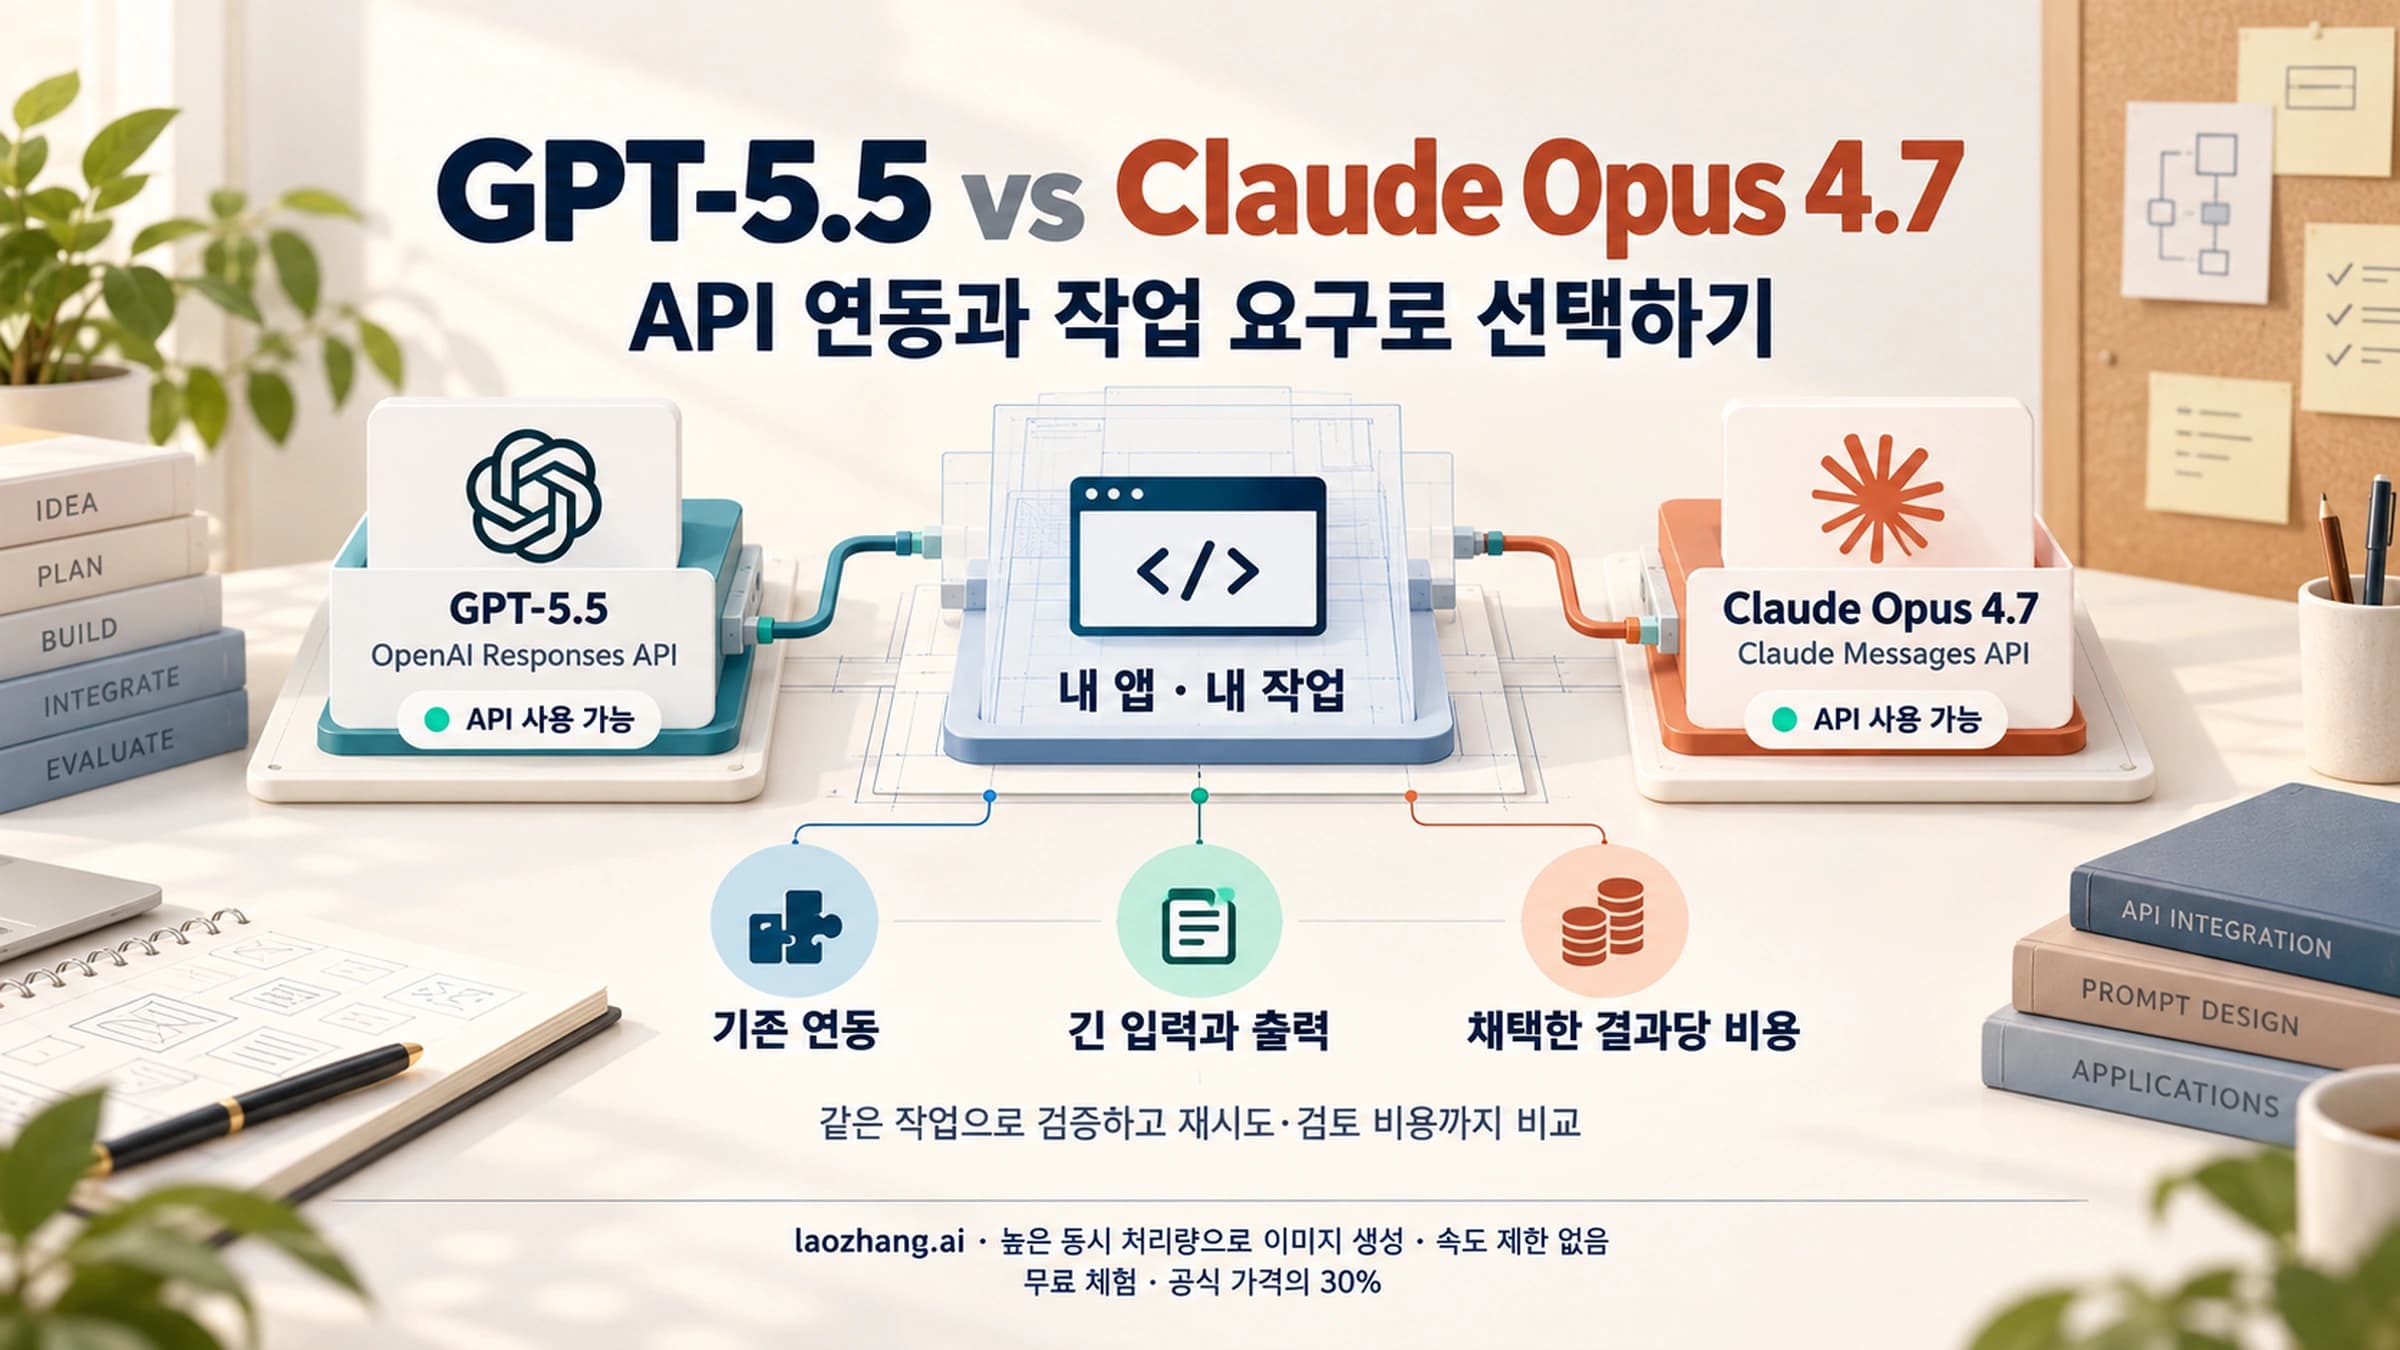
두 모델 모두 API로 사용할 수 있습니다. 기존 OpenAI 연동을 유지할 때는 GPT-5.5, 출력량과 긴 문서의 단가가 중요할 때는 Opus 4.7부터 비교하고, 재시도와 검토까지 포함한 작업당 비용으로 결정하세요.
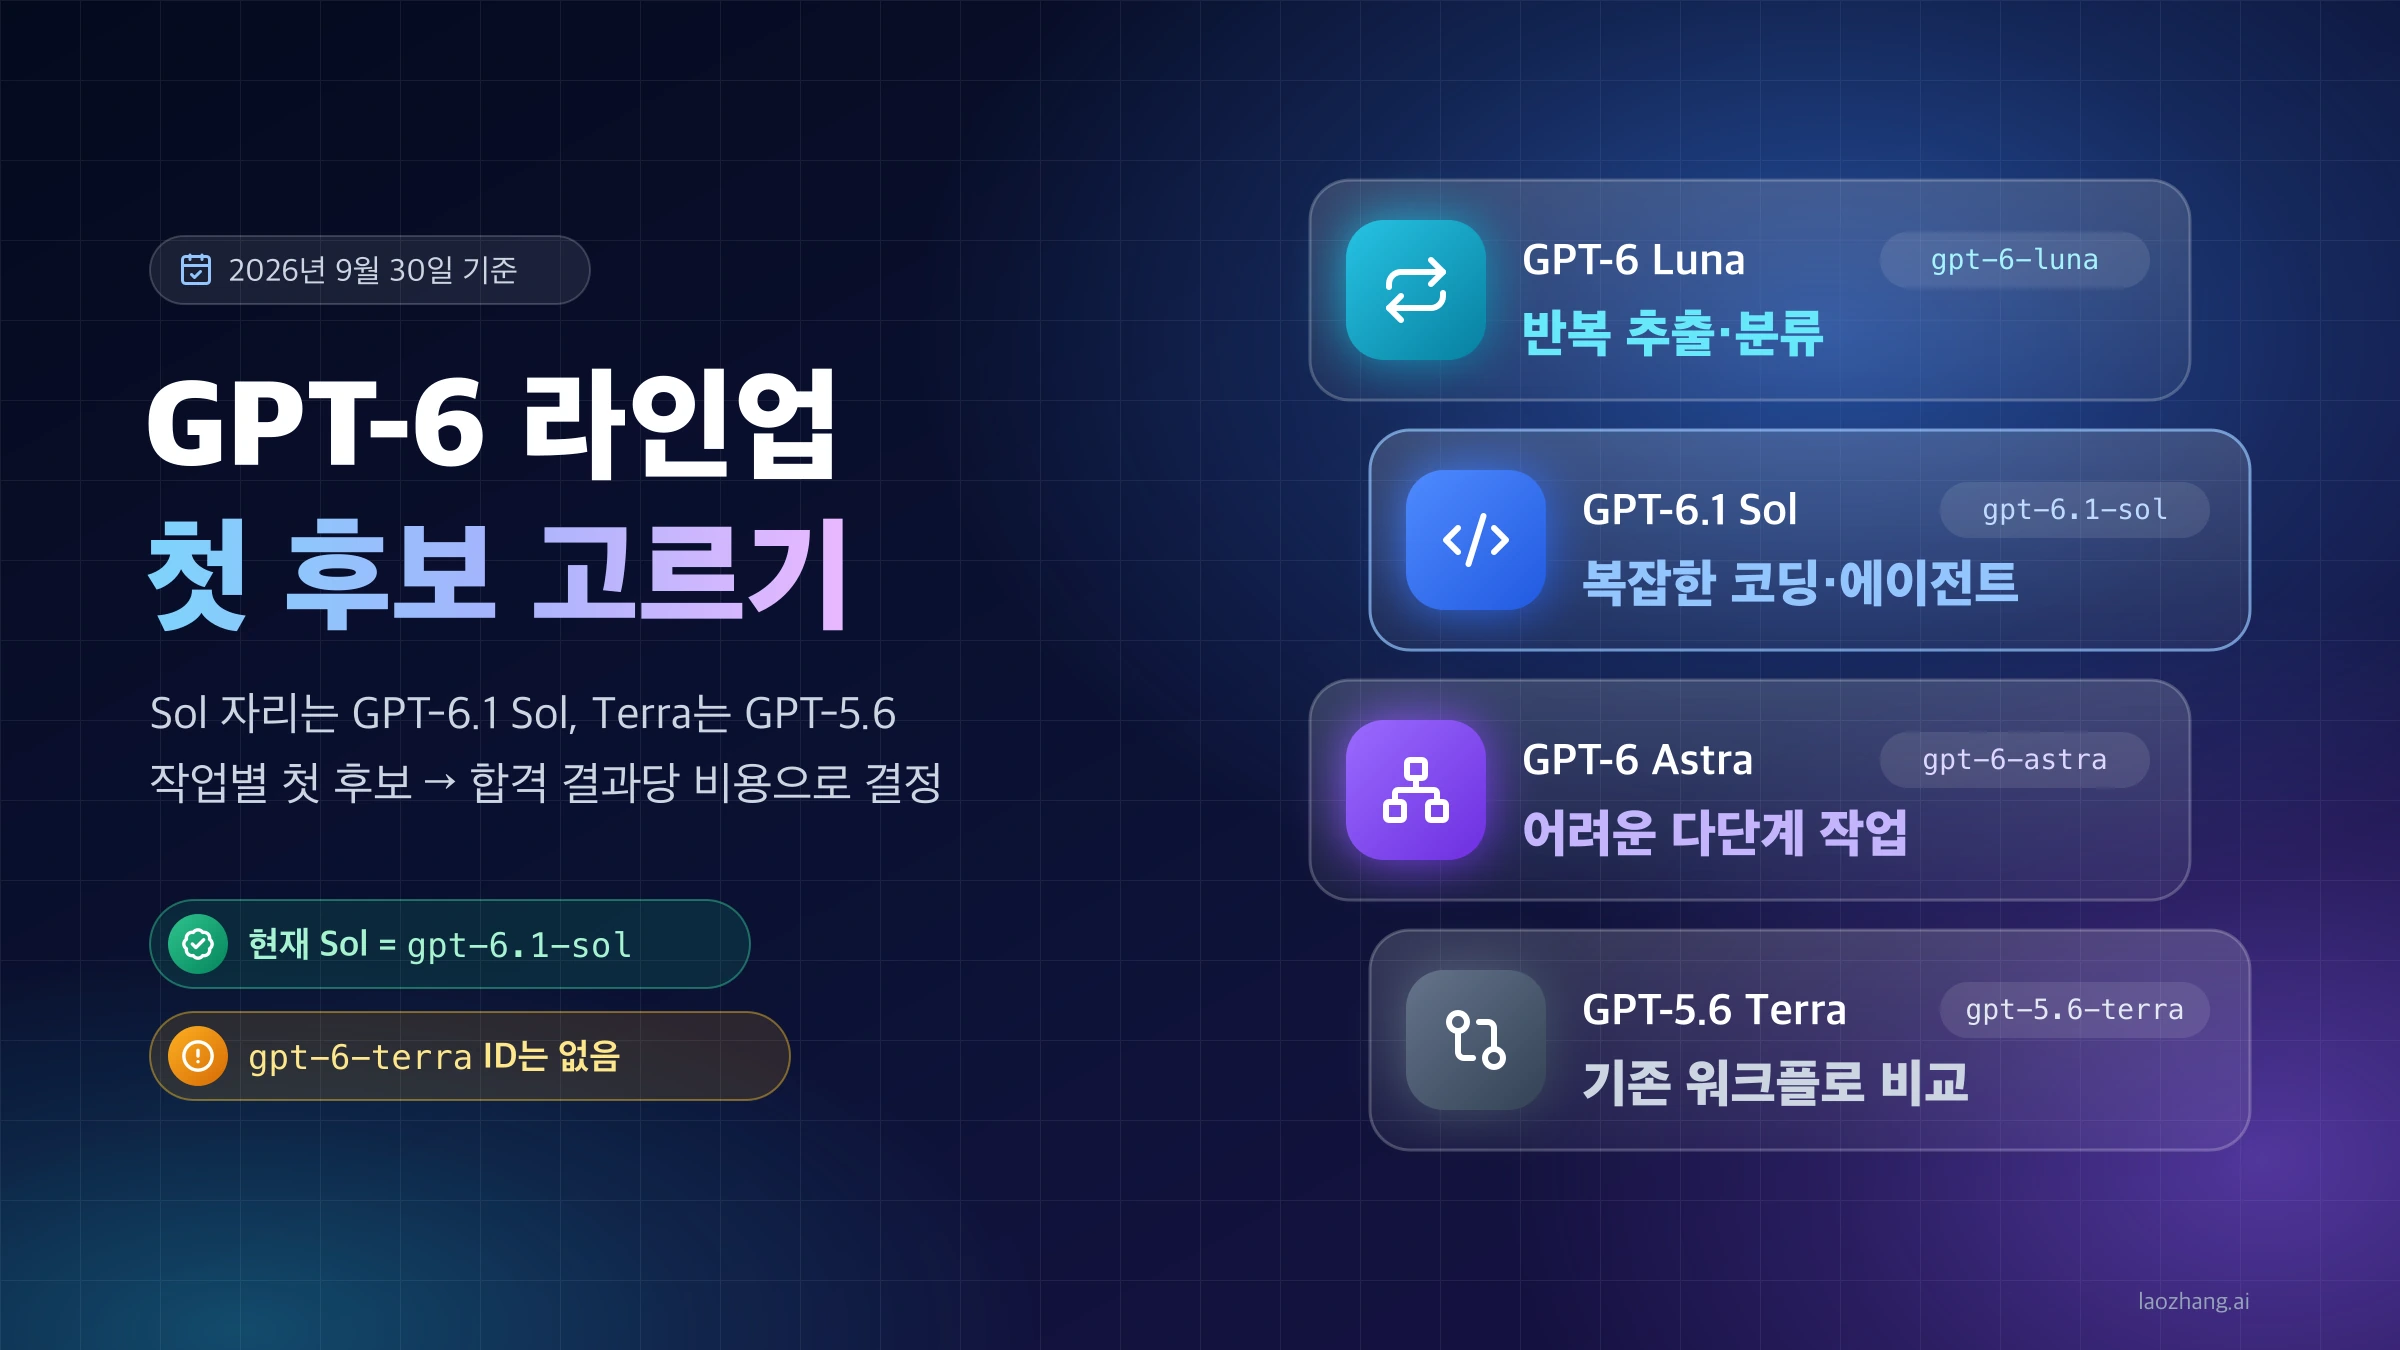
GPT-6 라인업은 Astra·GPT-6.1 Sol·Luna이고 Terra는 GPT-5.6입니다. 2026년 9월 30일 API 단가를 비교한 뒤 실제 작업의 합격률·재시도로 고르세요.

같은 모델에서 사고 모드를 전환하려면 Qwen3-30B-A3B 원본이 유효합니다. Instruct-2507과 Thinking-2507은 모드가 고정되어 있고, Coder는 코딩용 별도 모델입니다. 로컬 실행에서는 이름뿐 아니라 양자화와 실제 컨텍스트 설정도 확인해야 합니다.

GPT-6 Sol을 쓰고 있다면 단가가 같은 GPT-6.1 Sol로 바꾸는 편이 낫습니다. Astra는 점수를 맞추면 작업당 비용이 3~5배라 가장 어려운 작업에만 남기세요.
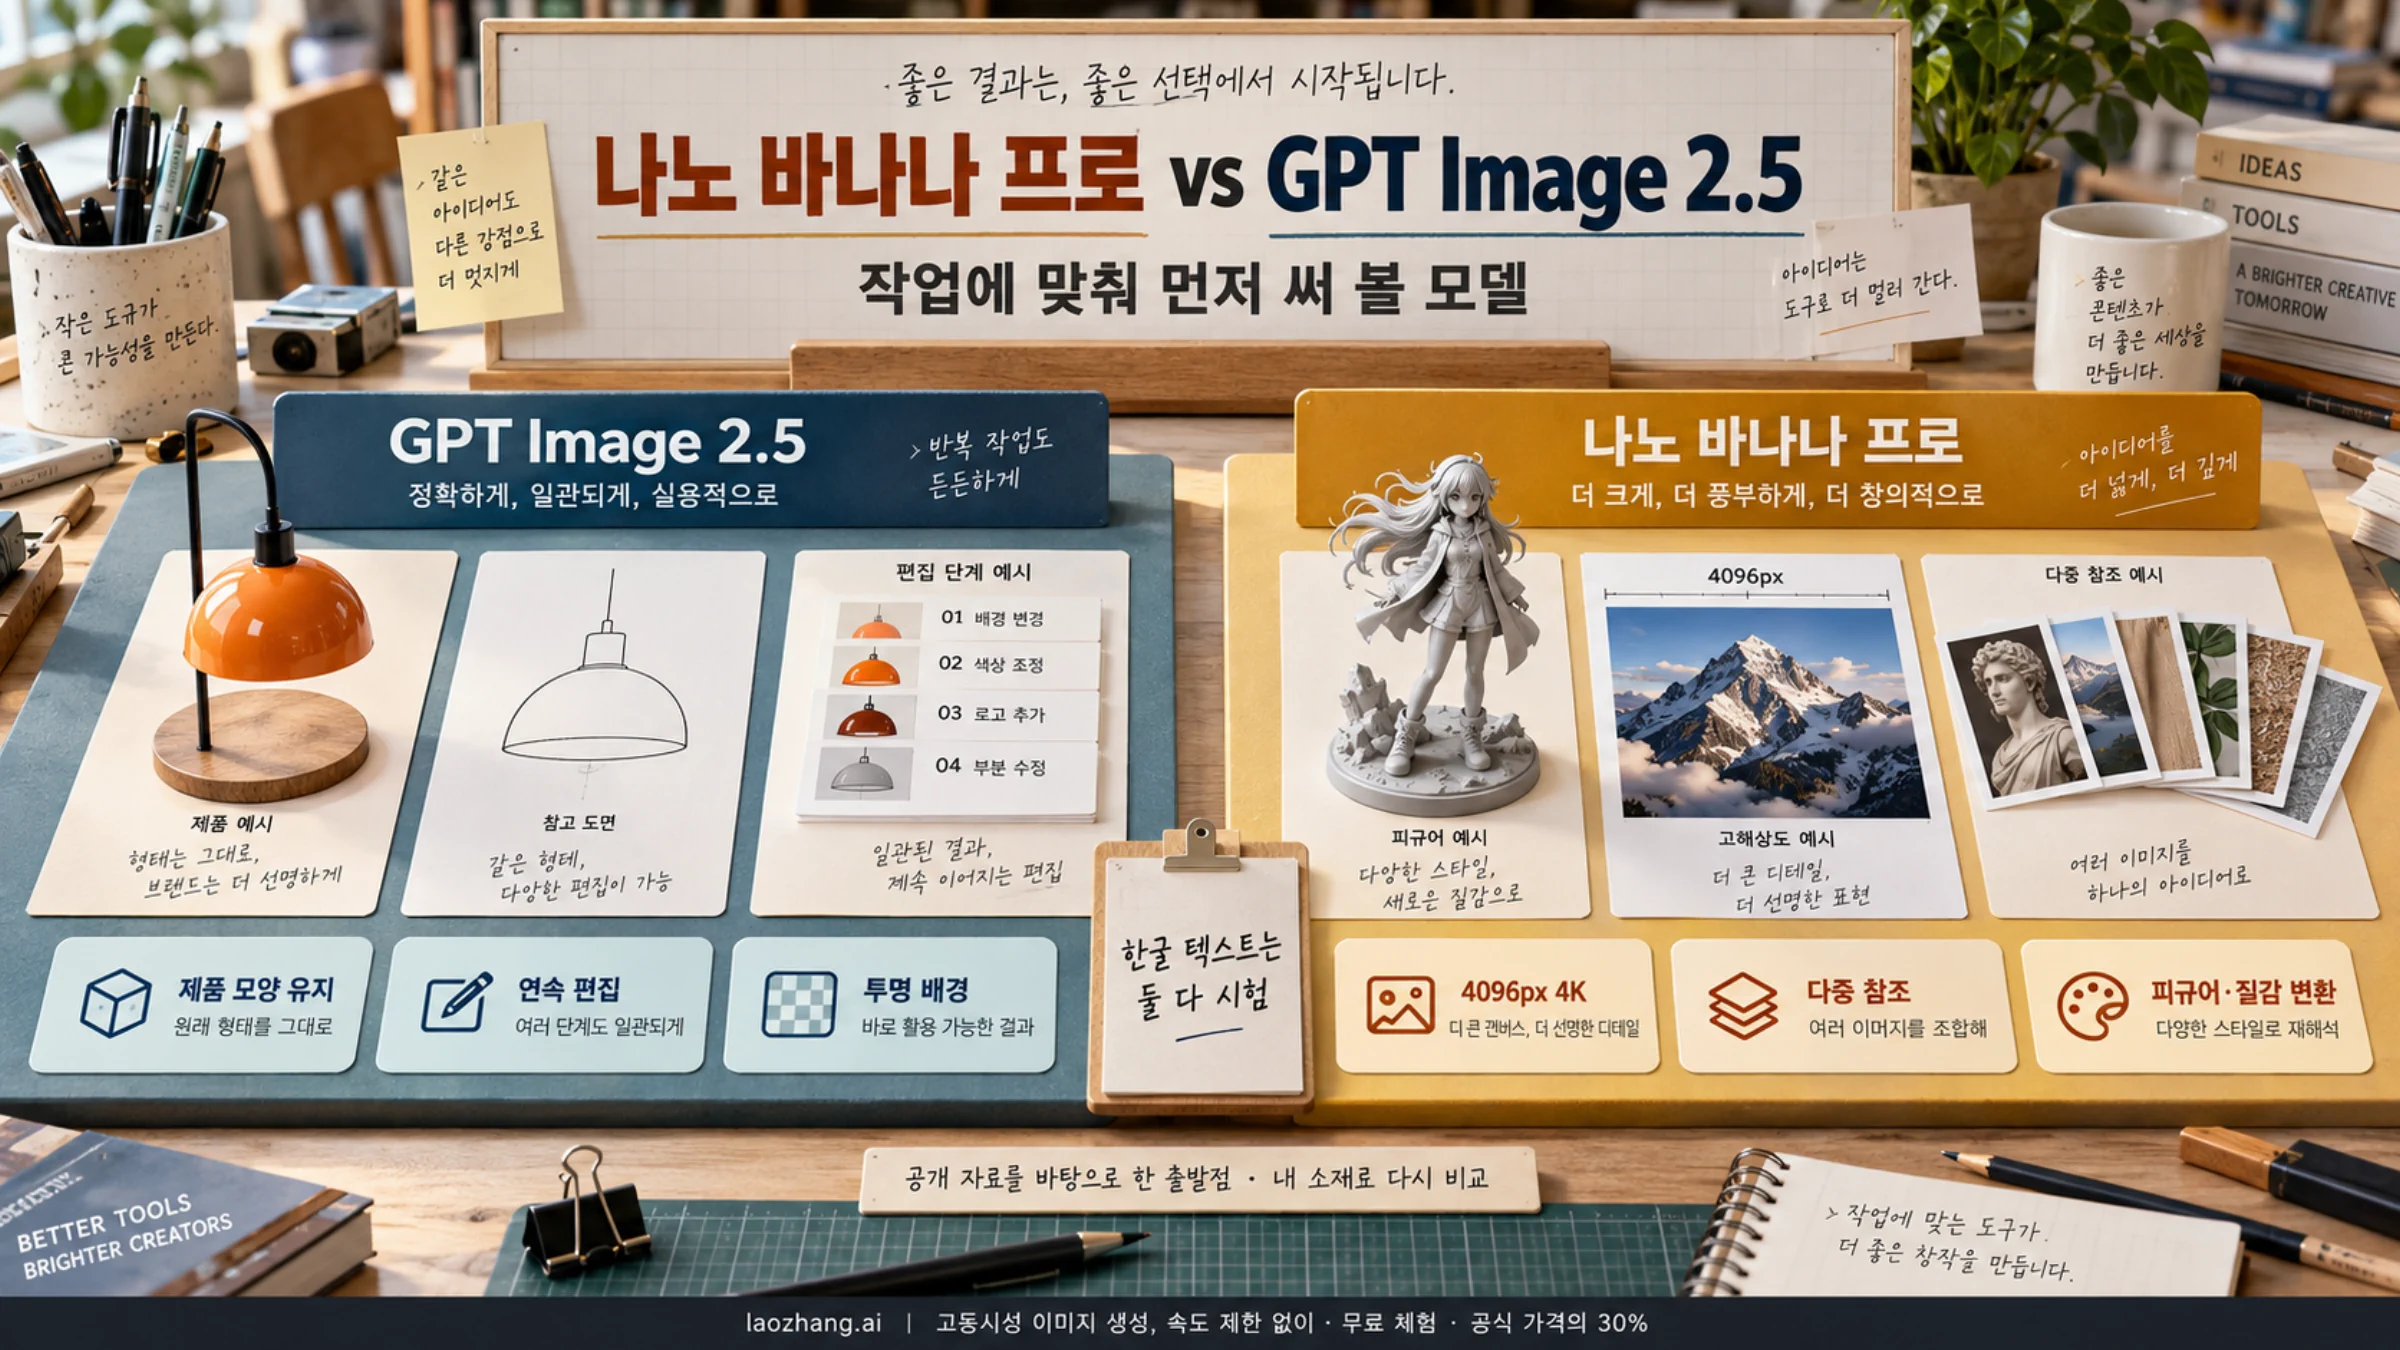
어느 한쪽이 항상 이기지는 않습니다. 제품 모양을 지키는 편집과 연속 편집은 GPT Image 2.5, 4096px 4K와 참조 5장 이상, 피규어 질감은 나노 바나나 프로가 먼저입니다.

GPT-5.3-Codex는 동일한 토큰 사용량에서 API 비용이 낮고, Claude Opus 4.6은 더 큰 컨텍스트를 제공합니다. 캐시 생성·조회 비용과 일반 출력 한도를 함께 비교하고, 같은 코딩 작업에서 성공률·총비용·수정 시간을 확인하는 방법을 설명합니다.
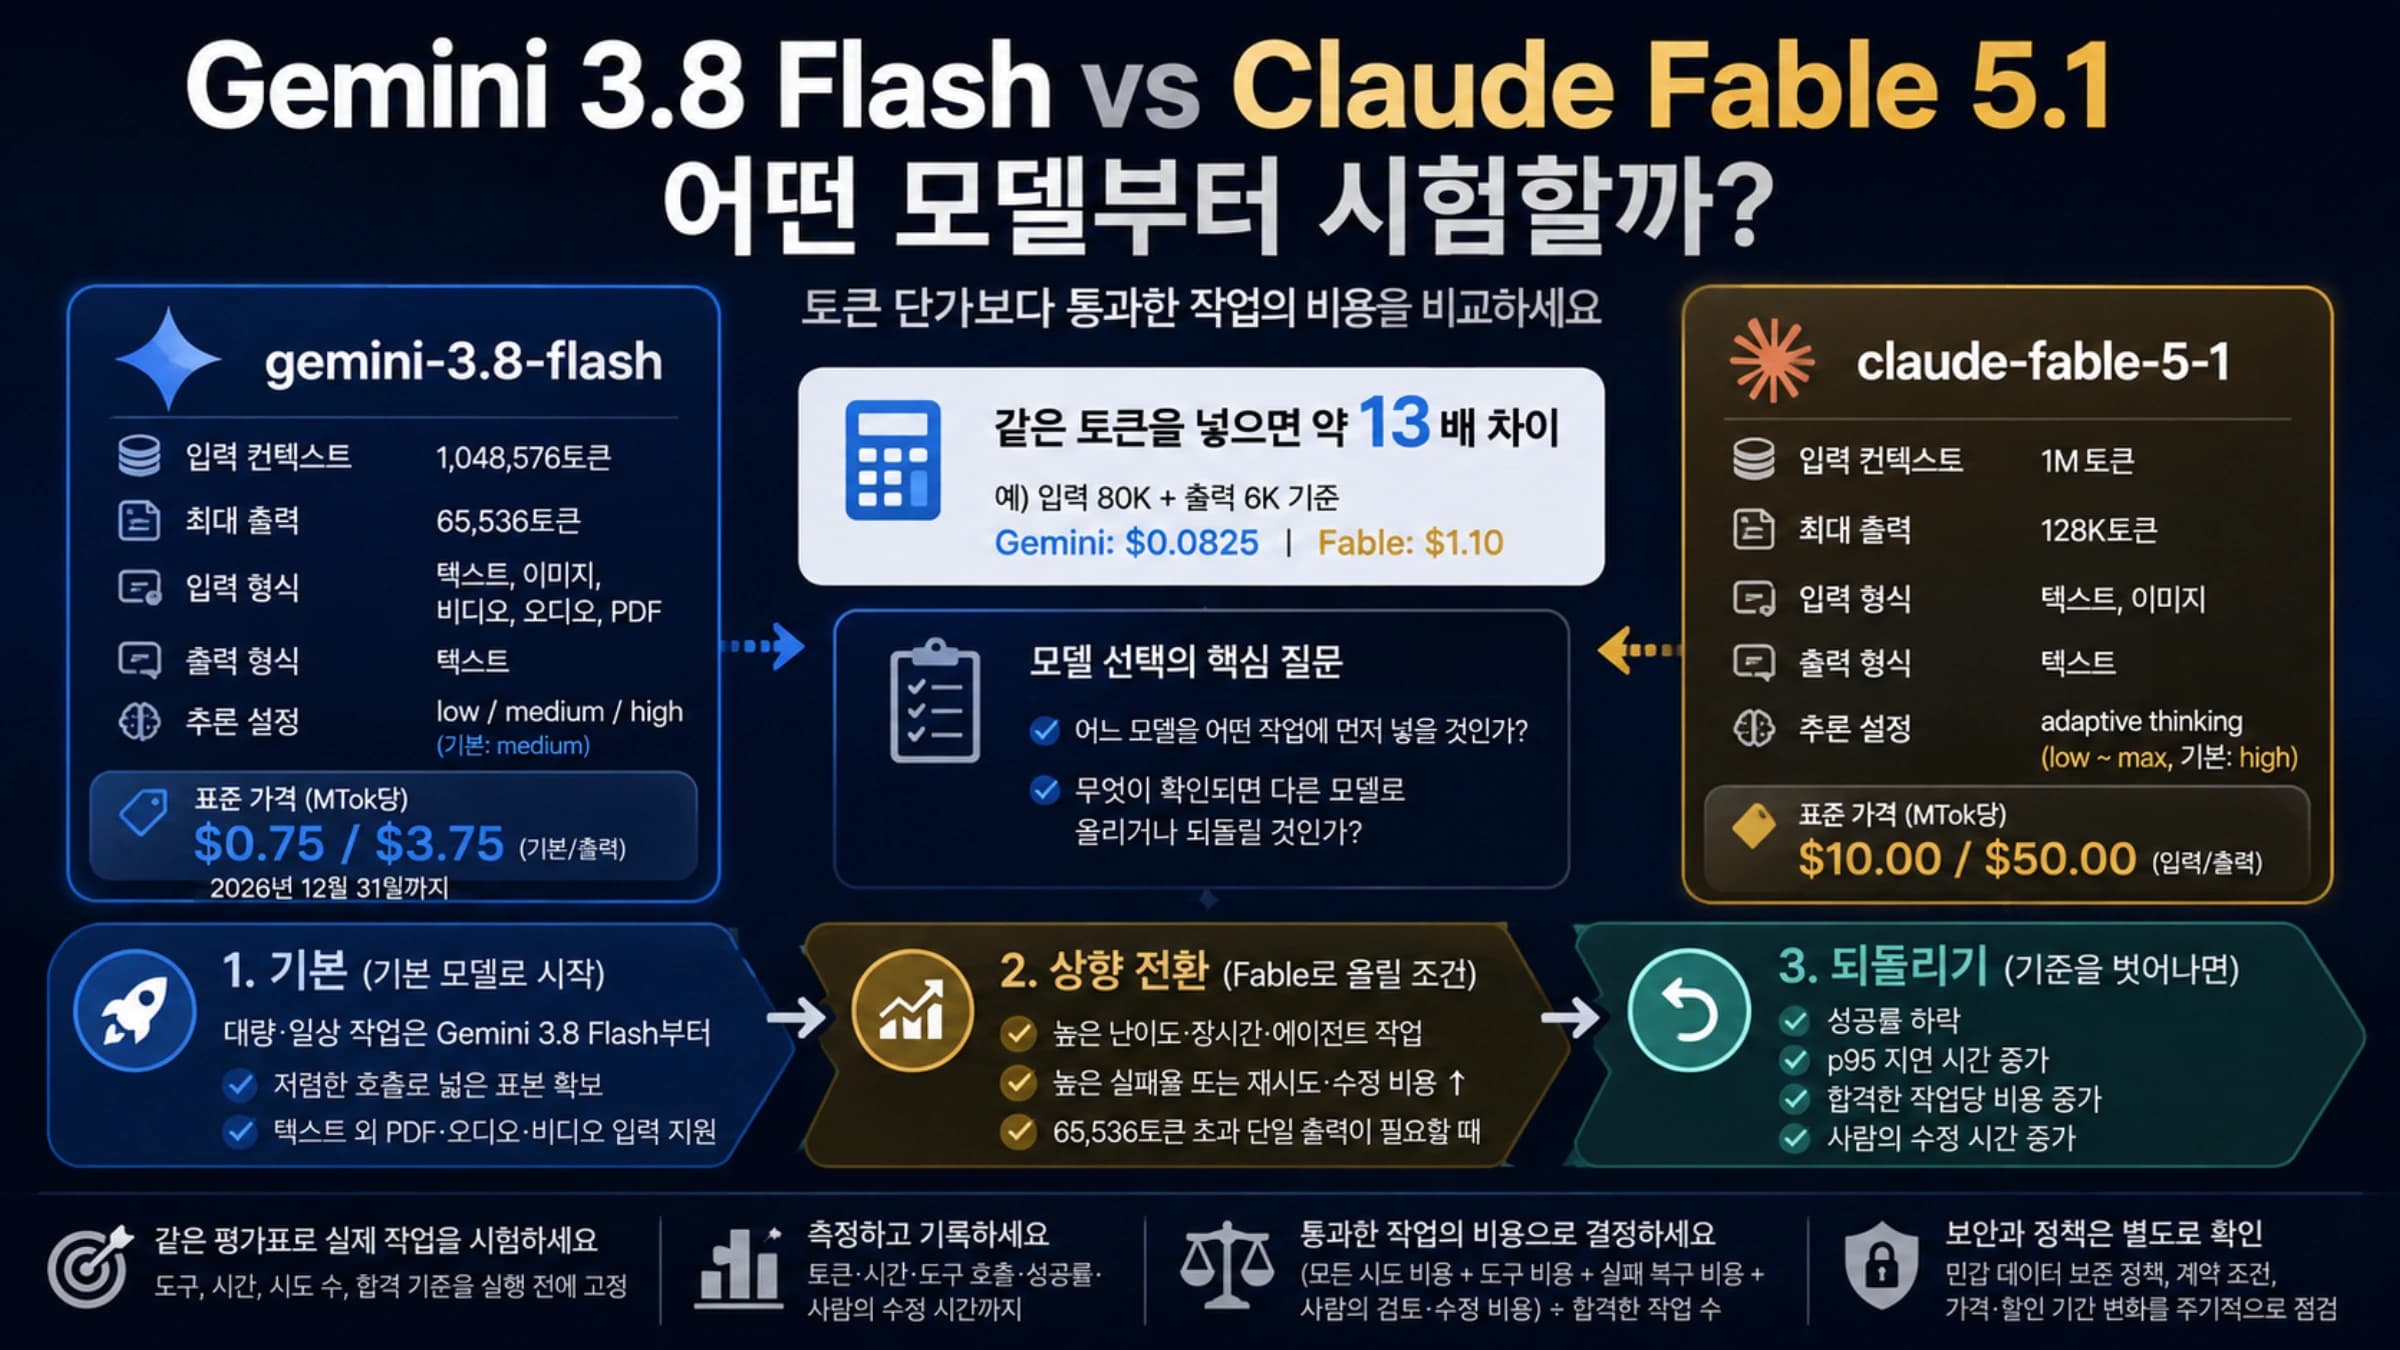
대량 작업은 Gemini 3.8 Flash부터, 가장 어려운 장시간 작업은 Claude Fable 5.1을 도전 모델로 시험하는 것이 합리적입니다. 단, 최종 선택은 동일한 작업의 성공률과 총비용으로 내려야 합니다.

GPT-6 Astra와 Claude Fable 5.1을 같은 업무 조건에서 비교하고, 호출 가능 여부와 실제 승인된 작업당 비용을 기준으로 도입 여부를 결정하는 한국어 가이드입니다.

한 대의 시스템에 안정적으로 맞추려면 27B부터, 큰 메모리와 복잡한 코딩·에이전트 작업의 완료율이 더 중요하면 Flash-Next를 동일 작업으로 테스트하세요.
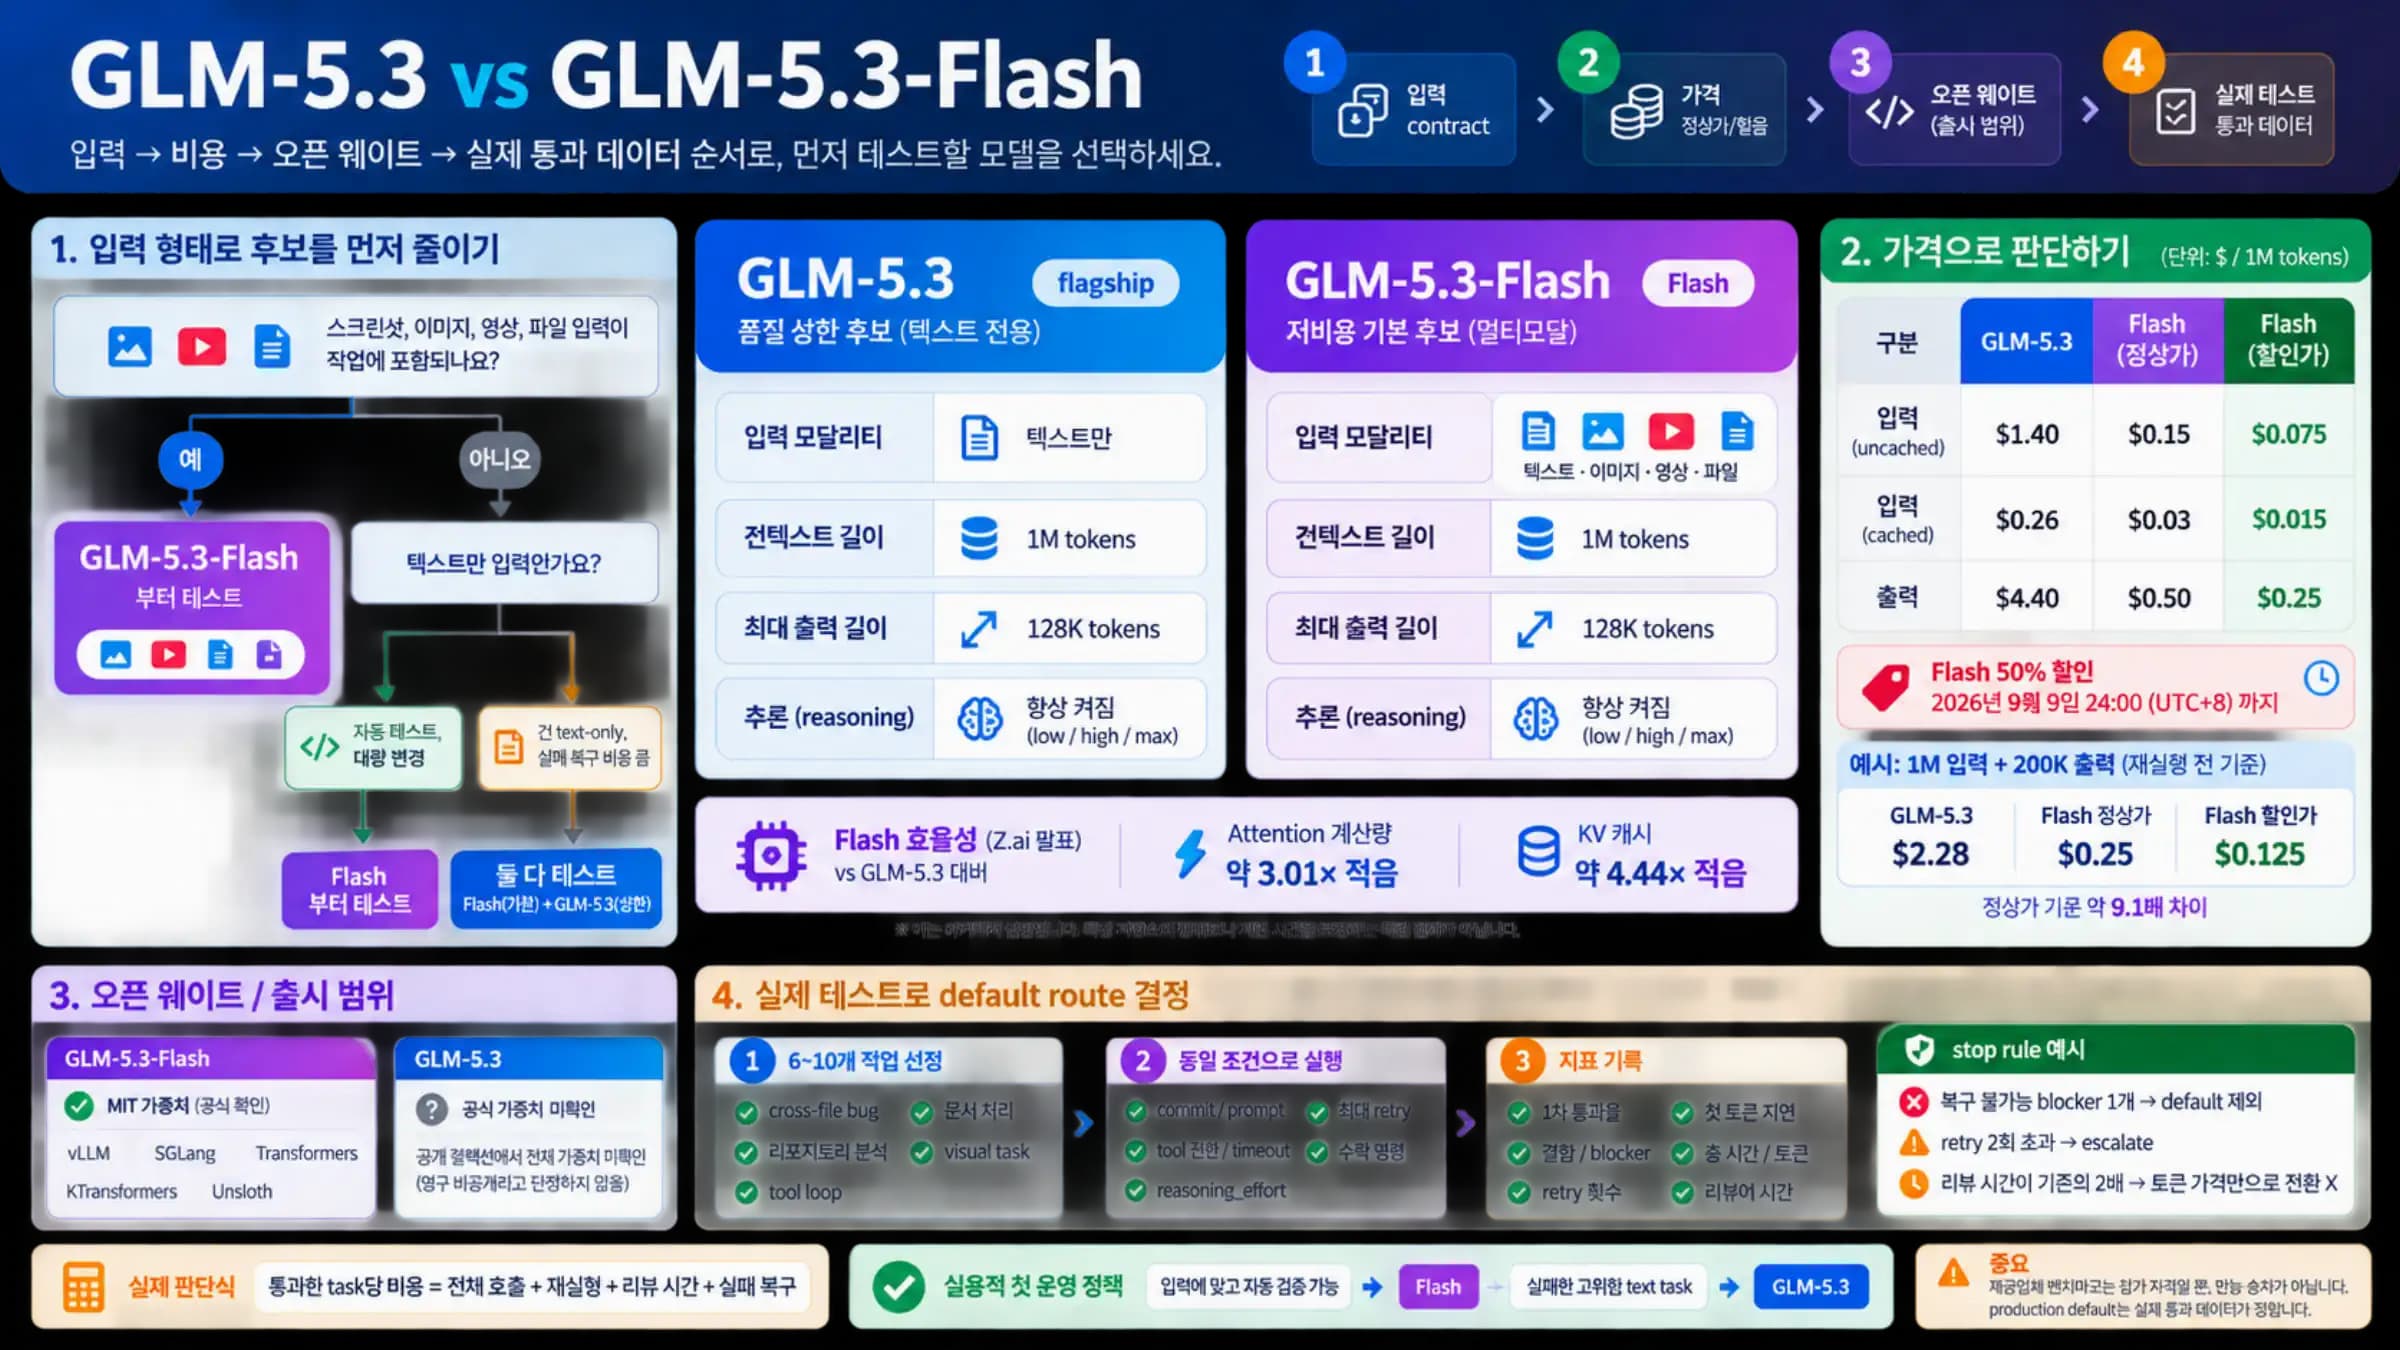
이미지 입력이 있거나 비용을 줄여야 하는 작업은 Flash부터 시험하세요. 실패 비용이 큰 텍스트 기반 개발 작업에서는 GLM-5.3도 같은 조건으로 비교하세요.

긴 텍스트 엔지니어링은 GLM-5.3, 이미지가 모델 루프 안에 있어야 하면 Kimi K3, 저비용 반복은 DeepSeek V4 Flash부터 시작하고 실패 비용이 큰 텍스트 작업은 Pro로 대조합니다.
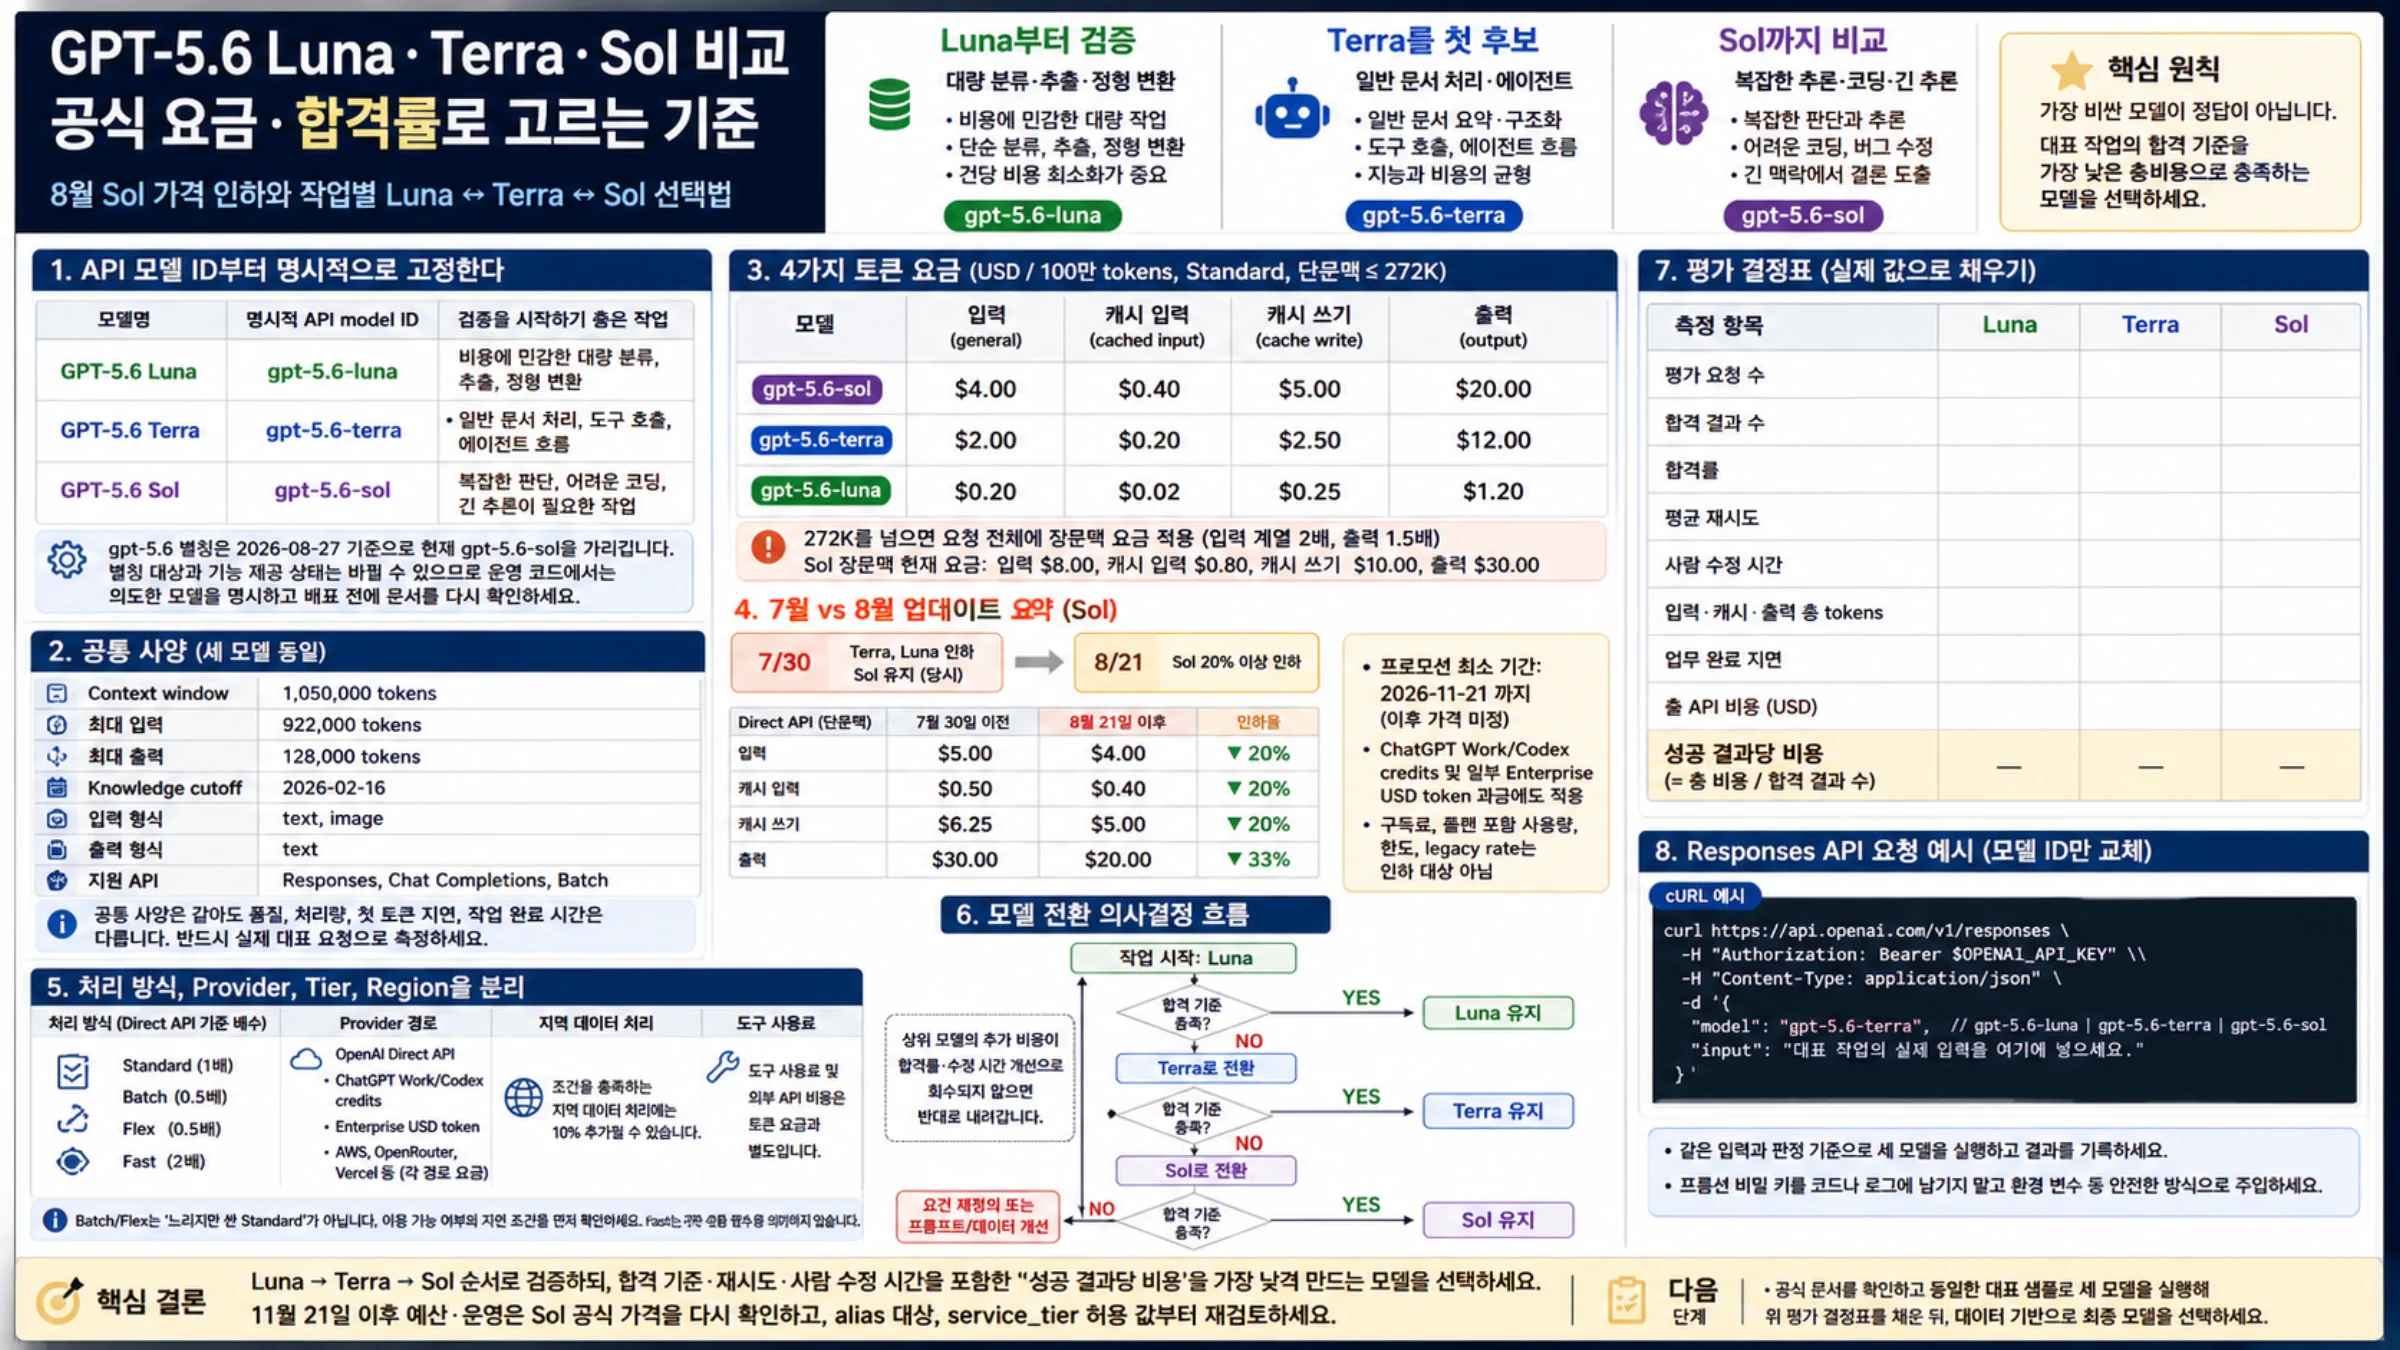
Sol은 기간 한정으로 저렴해졌습니다. API와 플랜 한도를 분리해 계산하고 같은 대표 작업의 합격률·재시도·수정 비용으로 선택하세요.

2026년 3월 기준, ChatGPT(GPT-5.4)와 Claude(Opus 4.6)는 각각 뚜렷한 강점을 가진 양대 AI 어시스턴트입니다. ChatGPT는 멀티모달, 이미지 생성, 웹 검색에 뛰어나고, Claude는 코딩 정확도, 장문 분석, 개발자 도구에서 앞서갑니다. 둘 다 무료 플랜과 월 $20 유료 플랜을 제공합니다. 본 가이드에서는 코딩, 글쓰기, 리서치, 가격, API까지 검증된 벤치마크 데이터로 비교합니다.
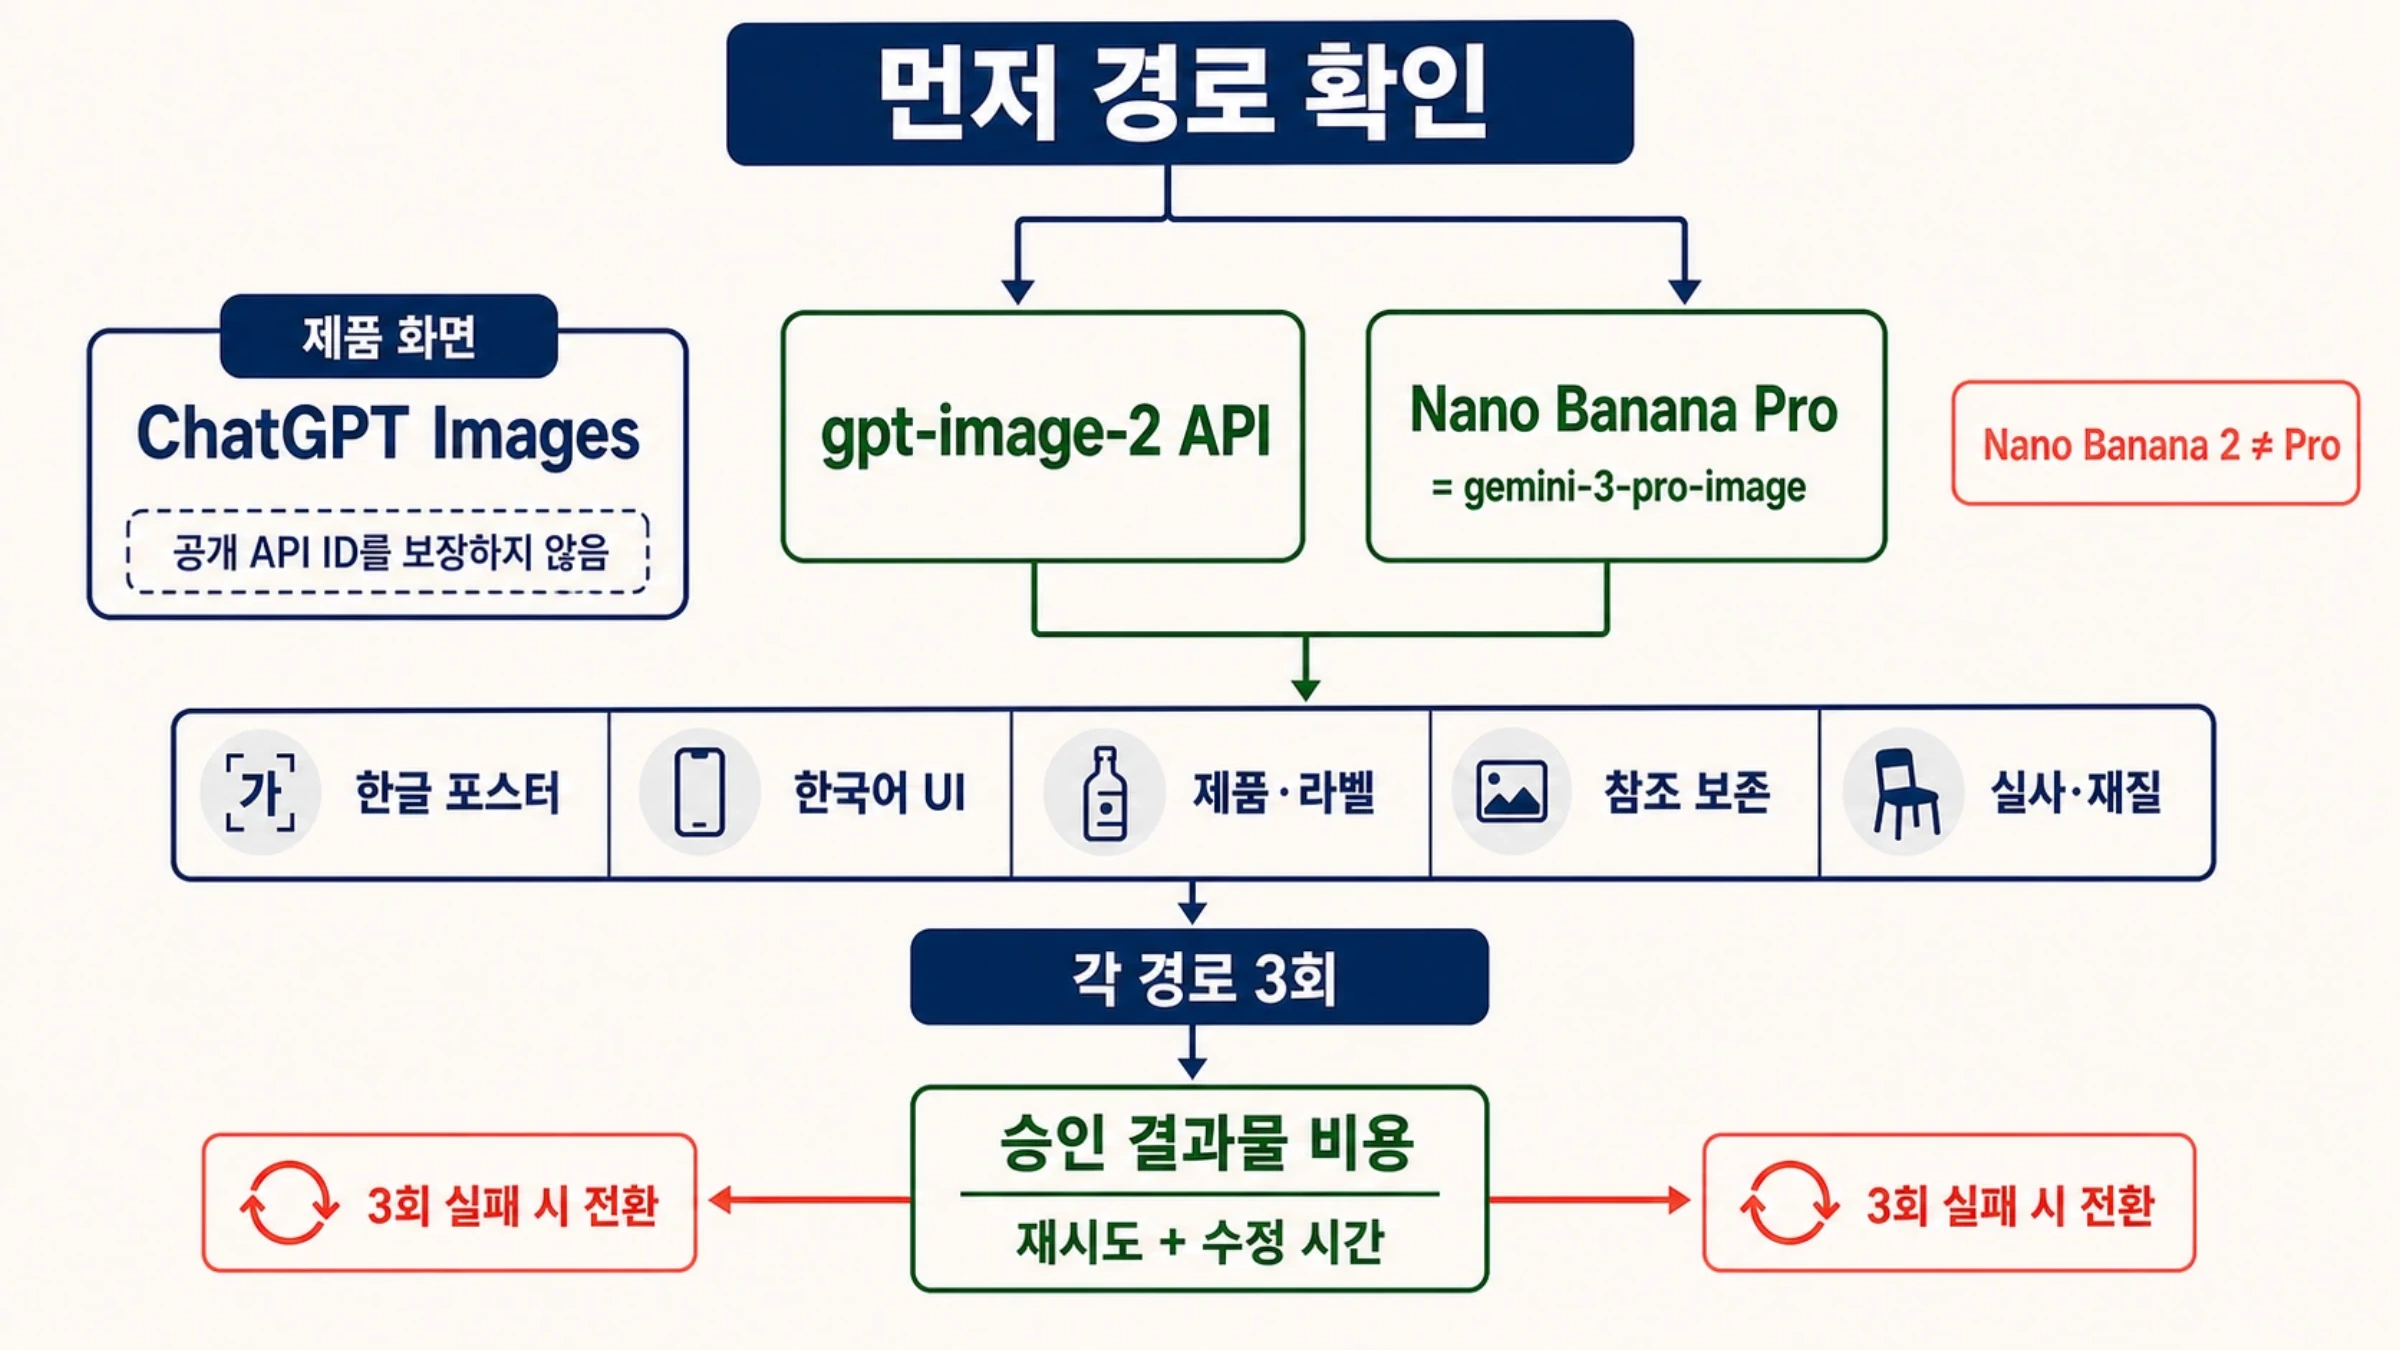
정확한 한글·레이아웃과 OpenAI API 제어가 핵심이면 GPT Image 2부터, 복잡한 디자인·제품 목업·검색 기반 시각화가 핵심이면 Nano Banana Pro부터 검증하세요. 최종 선택은 같은 과제를 3회씩 실행한 통과 결과 비용으로 합니다.
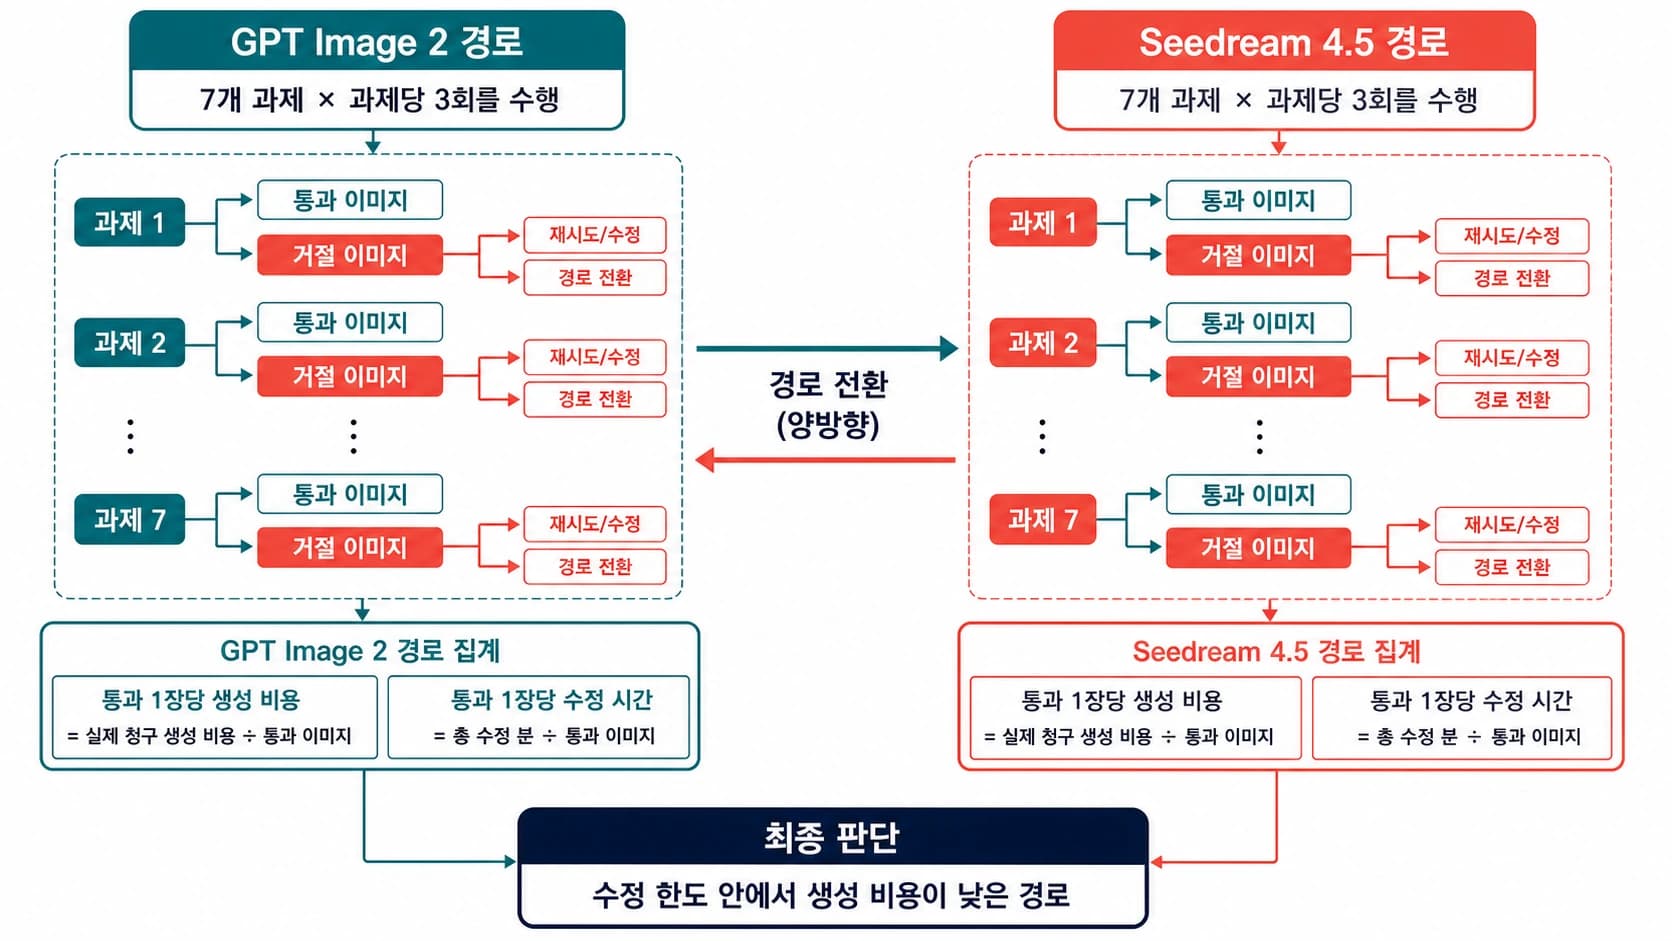
OpenAI 네이티브 제어가 중요하면 GPT Image 2, 다중 참조와 디자인 세트가 중요하면 Seedream 4.5부터 시험하세요. 최종 선택은 호출 가격이 아니라 통과 1장당 비용으로 합니다.
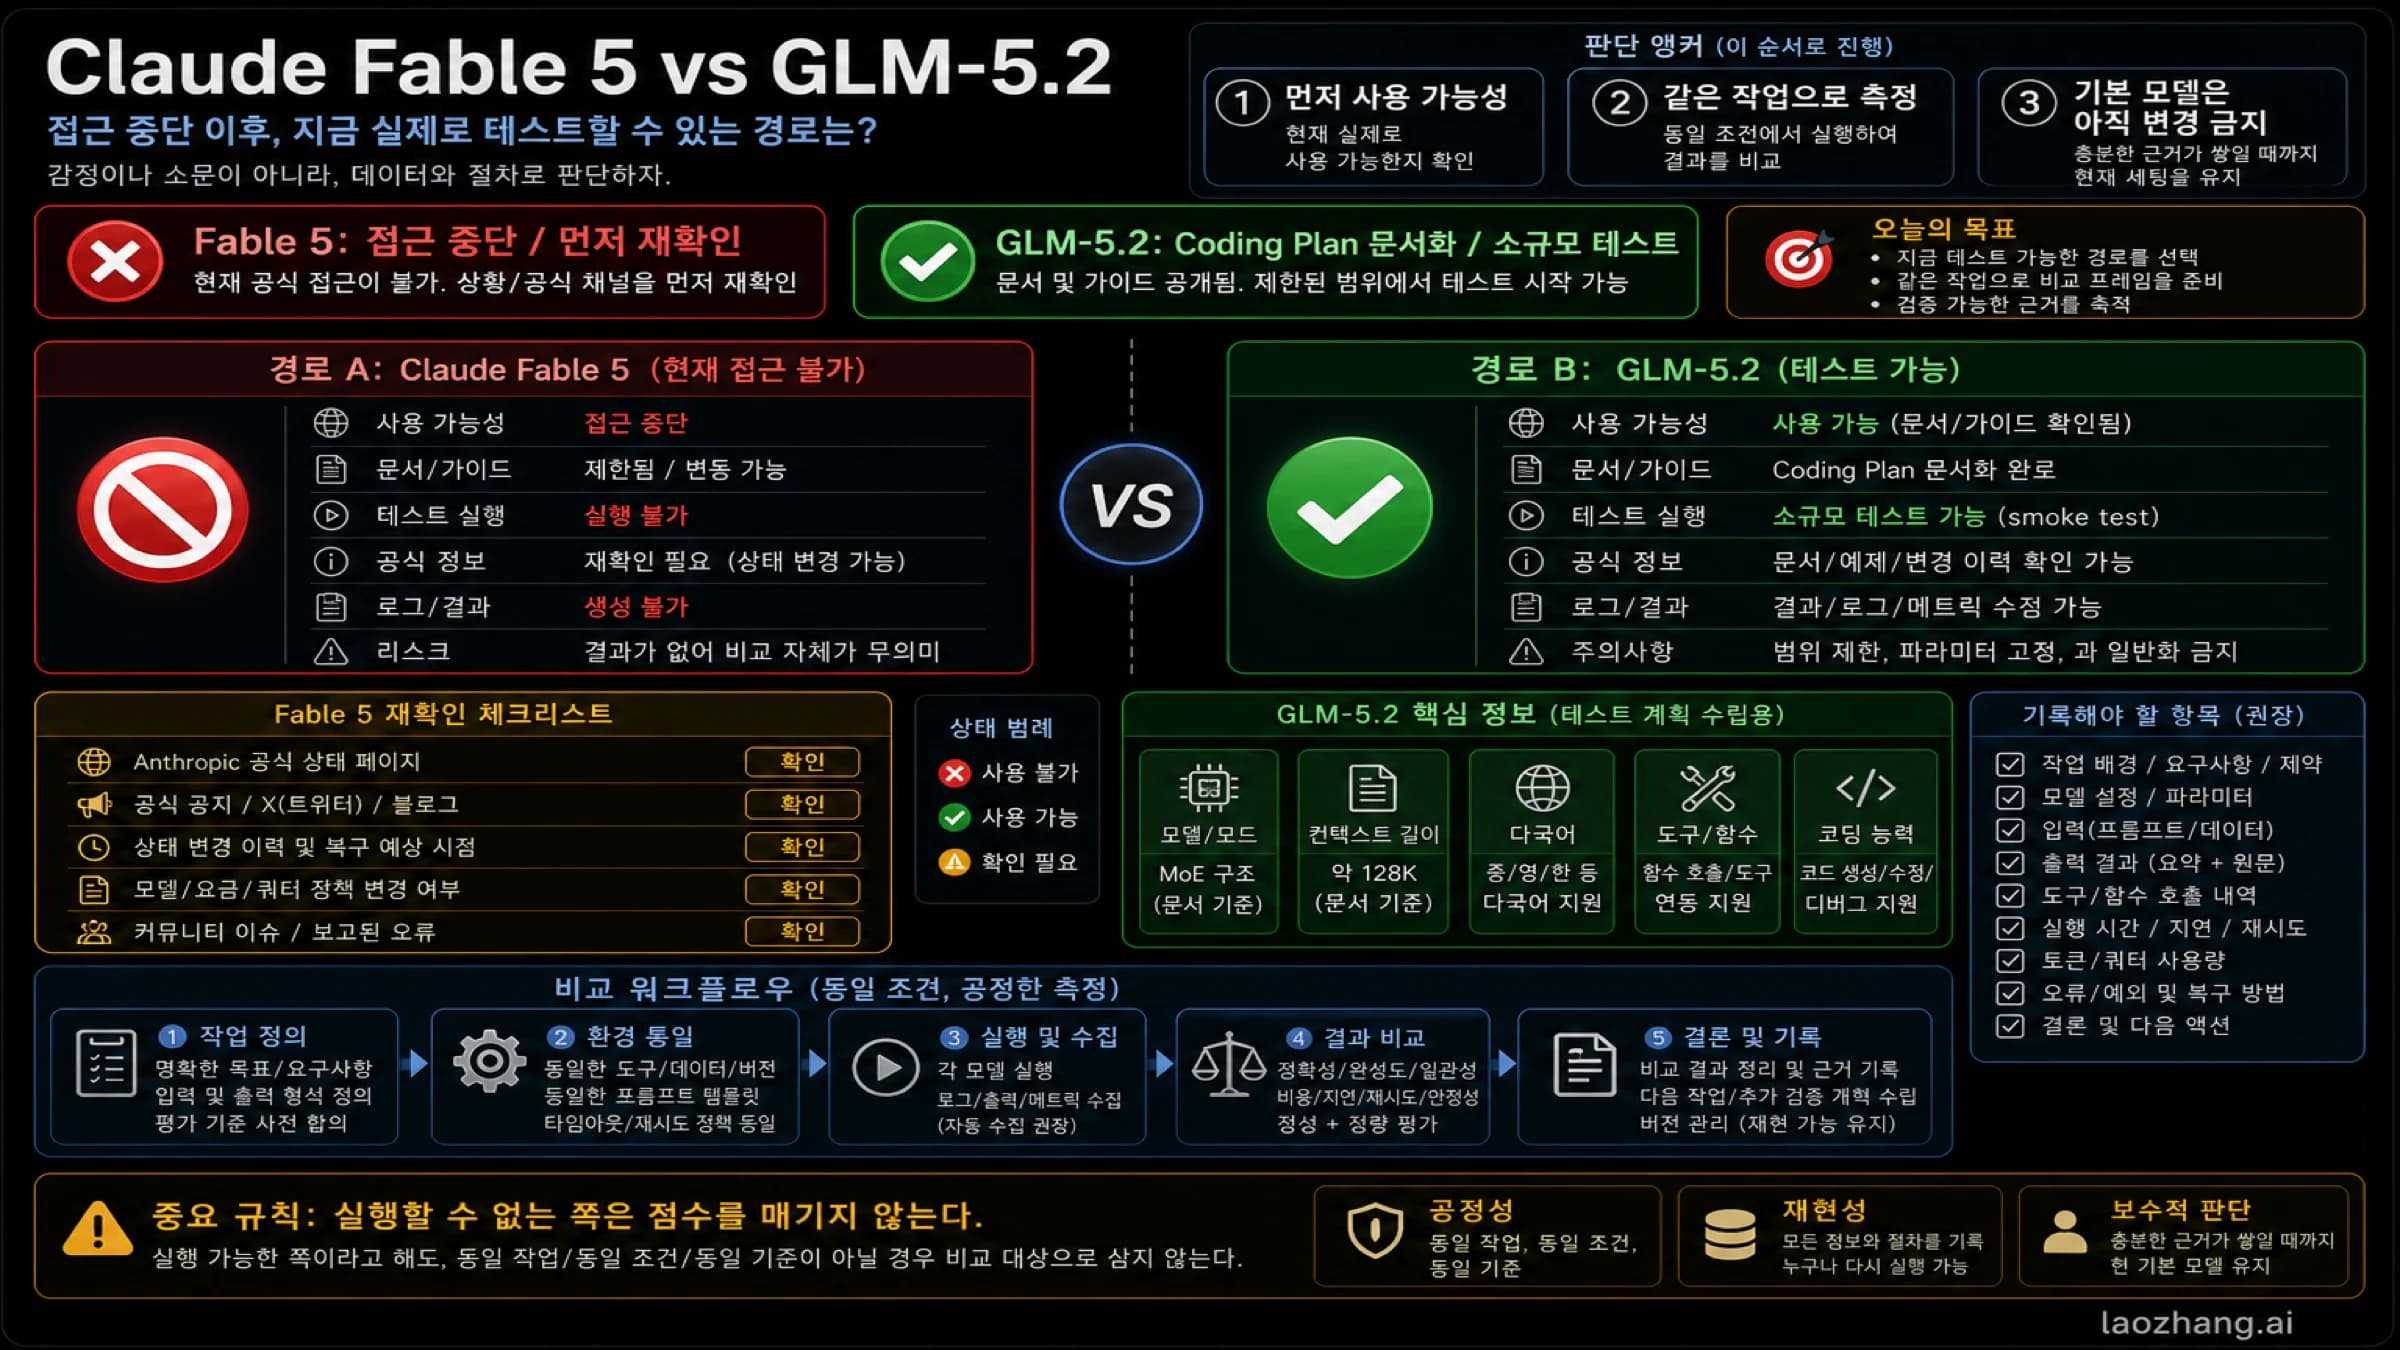
2026년 6월 14일 기준 Fable 5는 재확인 대기 경로이고, GLM-5.2는 Z.AI Coding Plan에서 작은 테스트를 먼저 할 수 있는 경로입니다. 같은 작업 증거 없이 기본 모델을 바꾸지 마세요.

Gemini 3.5 Flash는 빠른 코딩 에이전트와 도구 호출 API의 첫 테스트 대상이지만, Gemini 3.1 Pro Preview는 깊은 추론, 긴 문서, customtools 작업에 남겨둘 이유가 있습니다.
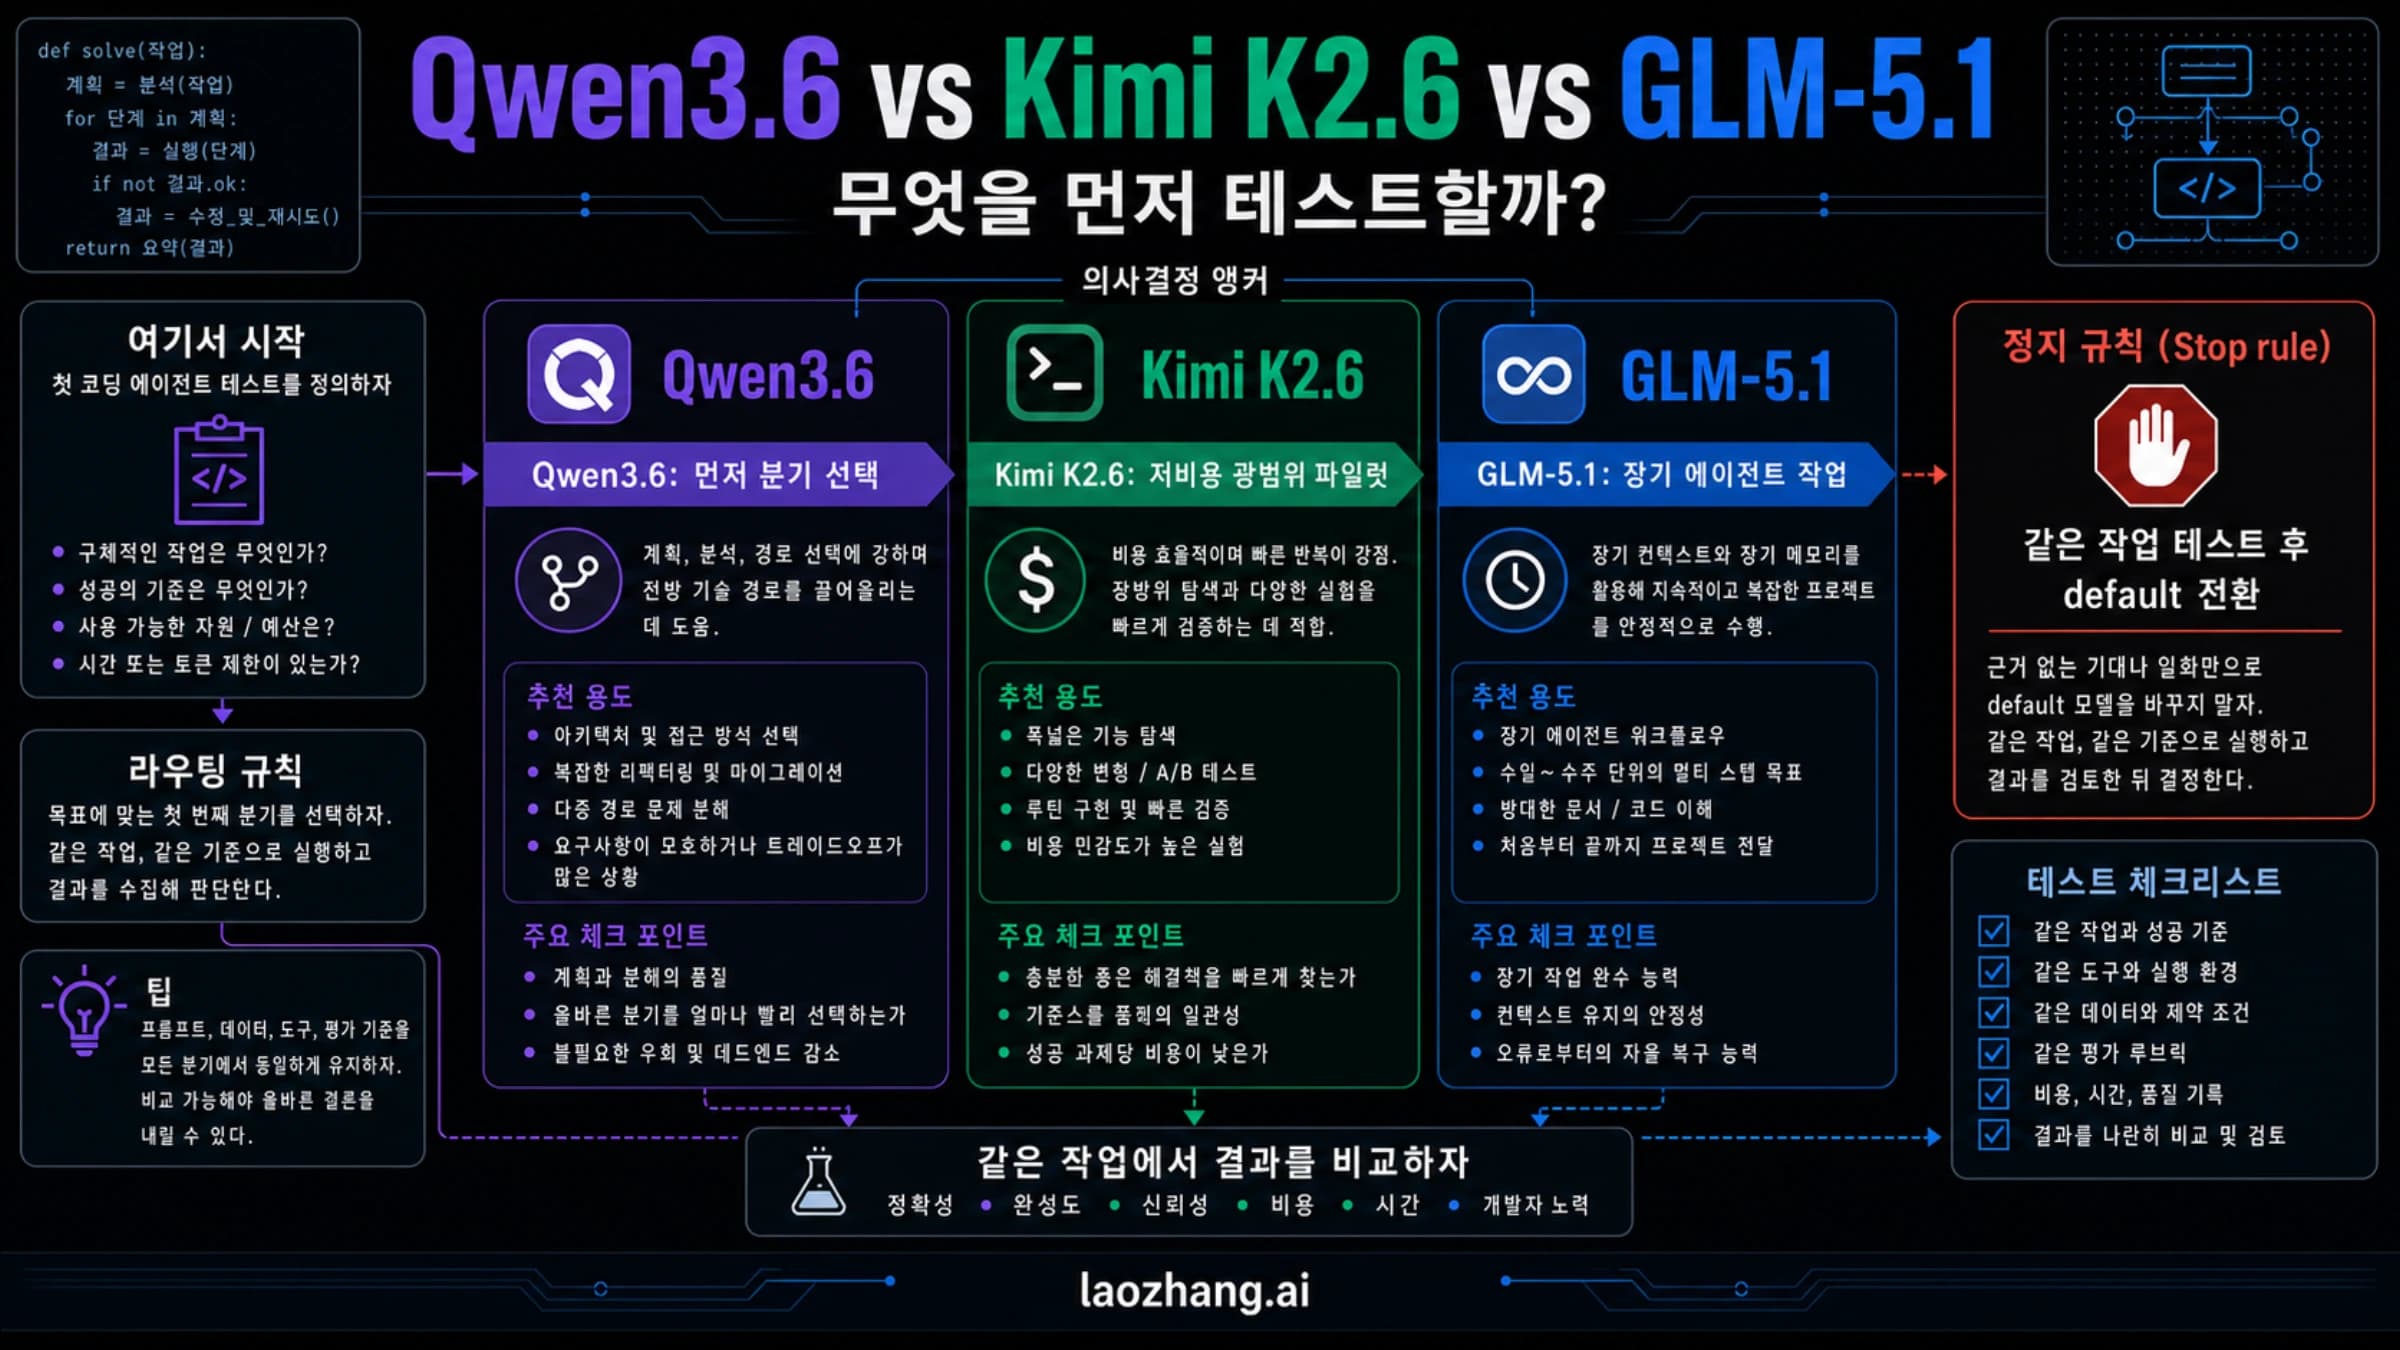
장시간 autonomous coding은 GLM-5.1, 저비용 파일럿은 Kimi K2.6을 먼저 봅니다. Qwen3.6은 35B-A3B 또는 hosted branch를 먼저 골라야 합니다.
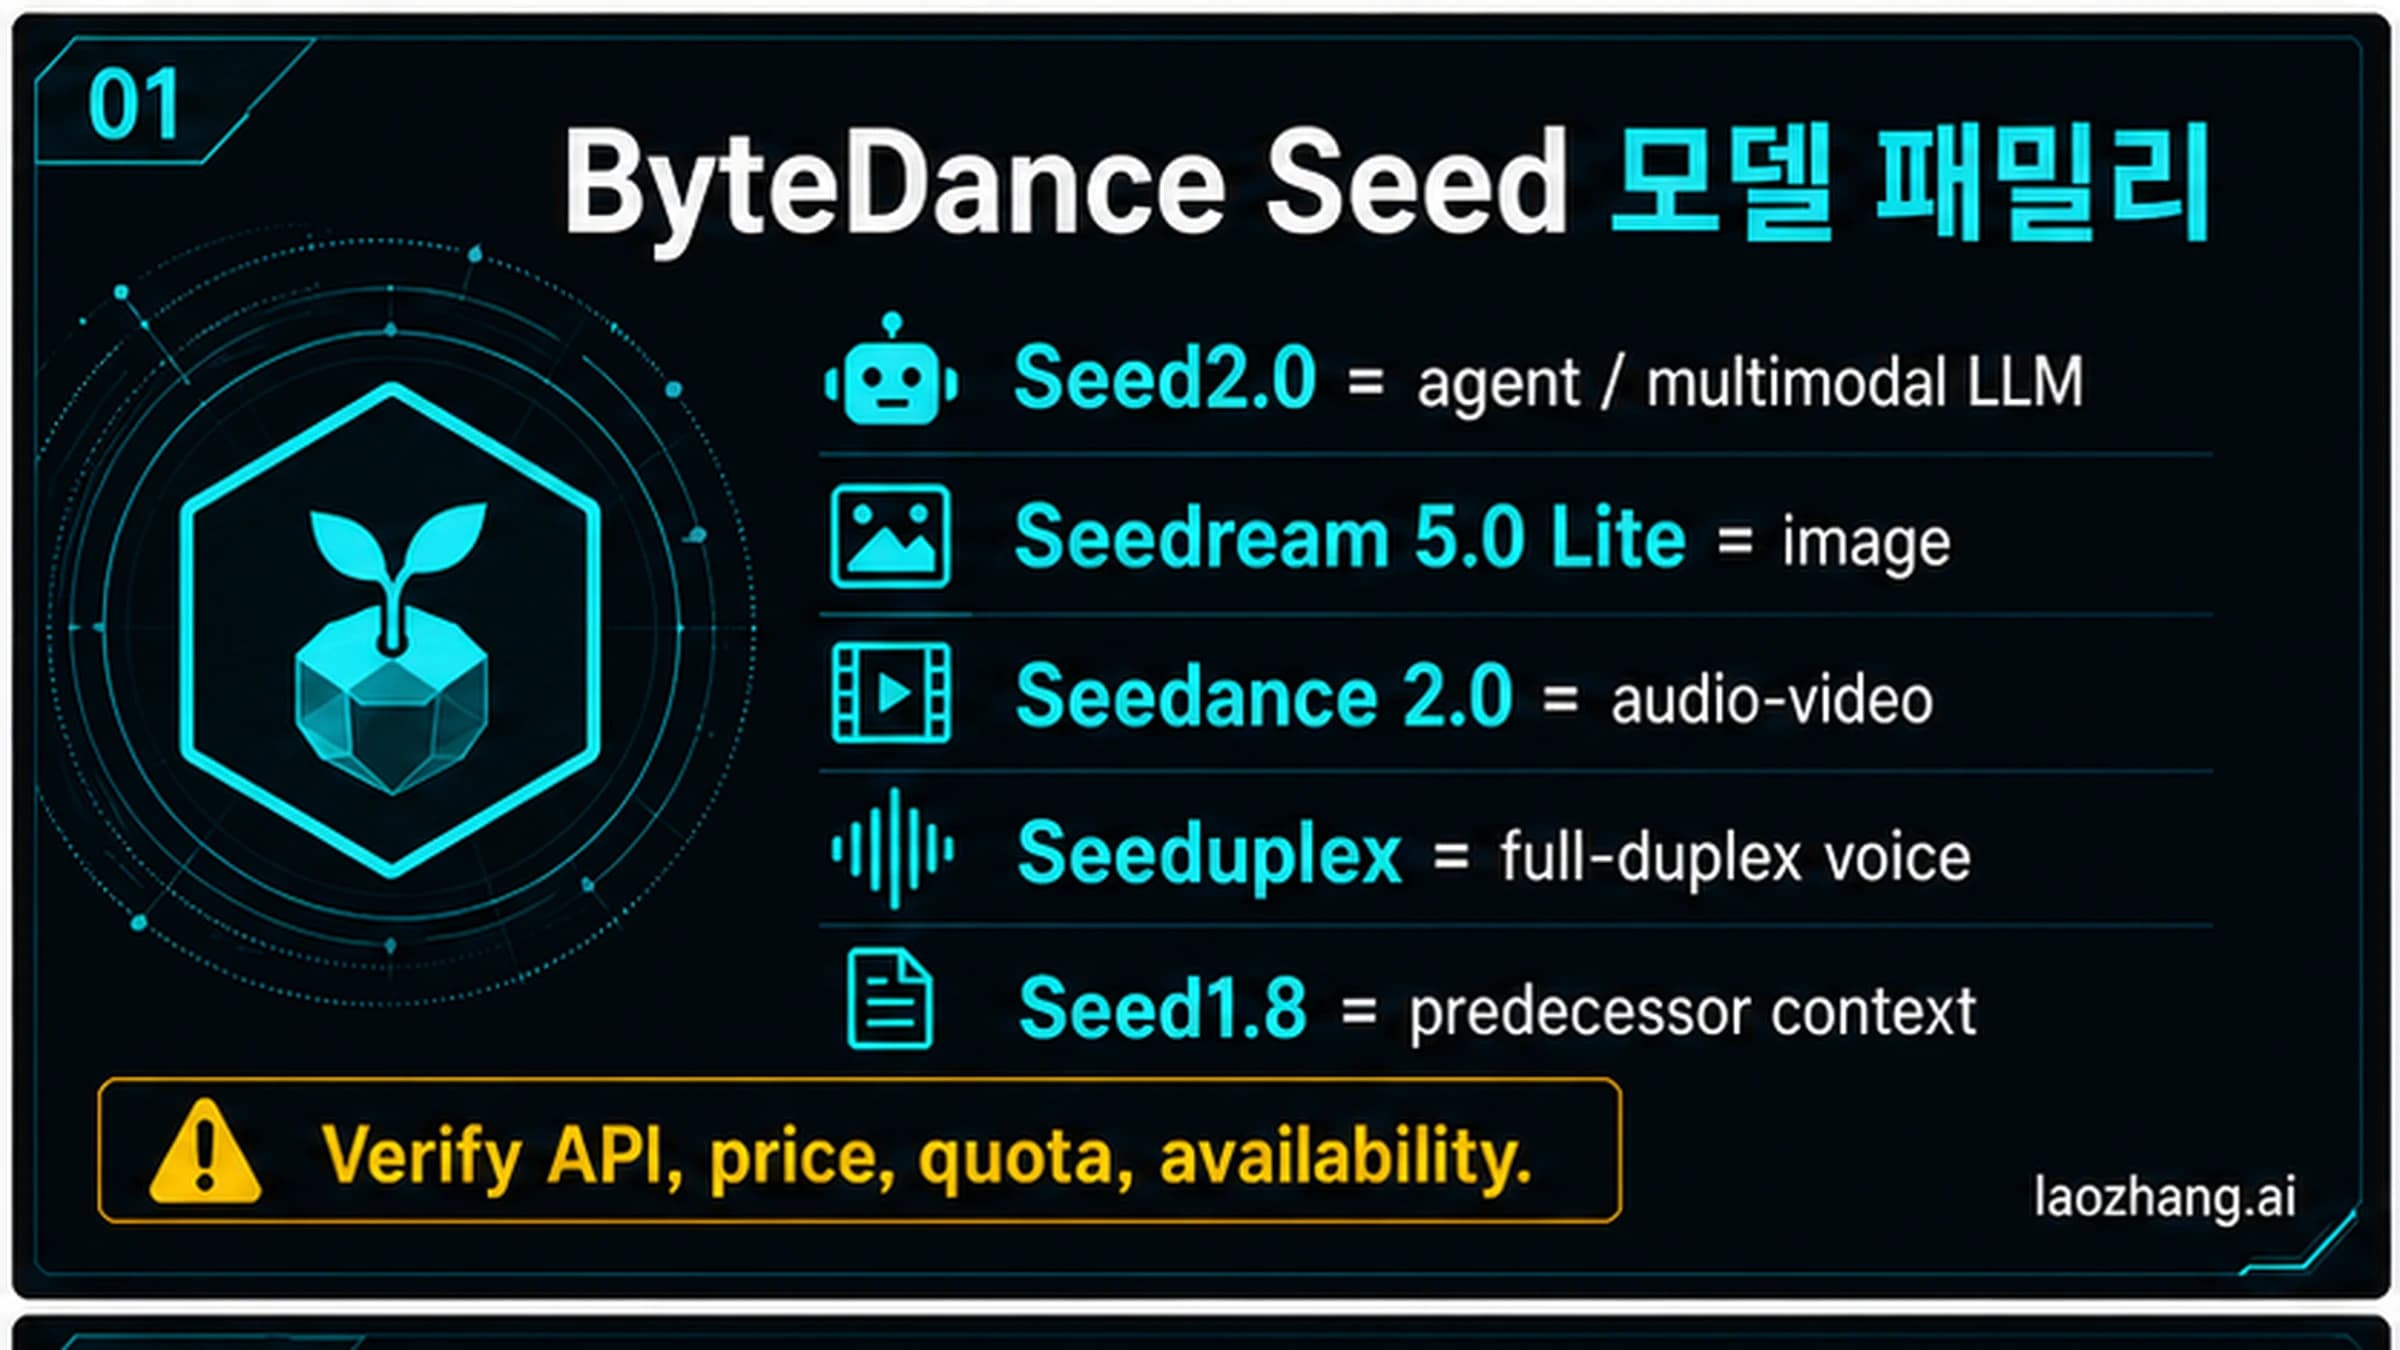
Agent와 멀티모달 이해는 Seed2.0, 이미지는 Seedream, 오디오 비디오는 Seedance, 실시간 음성은 Seeduplex, Seed1.8은 이전 세대 맥락입니다.
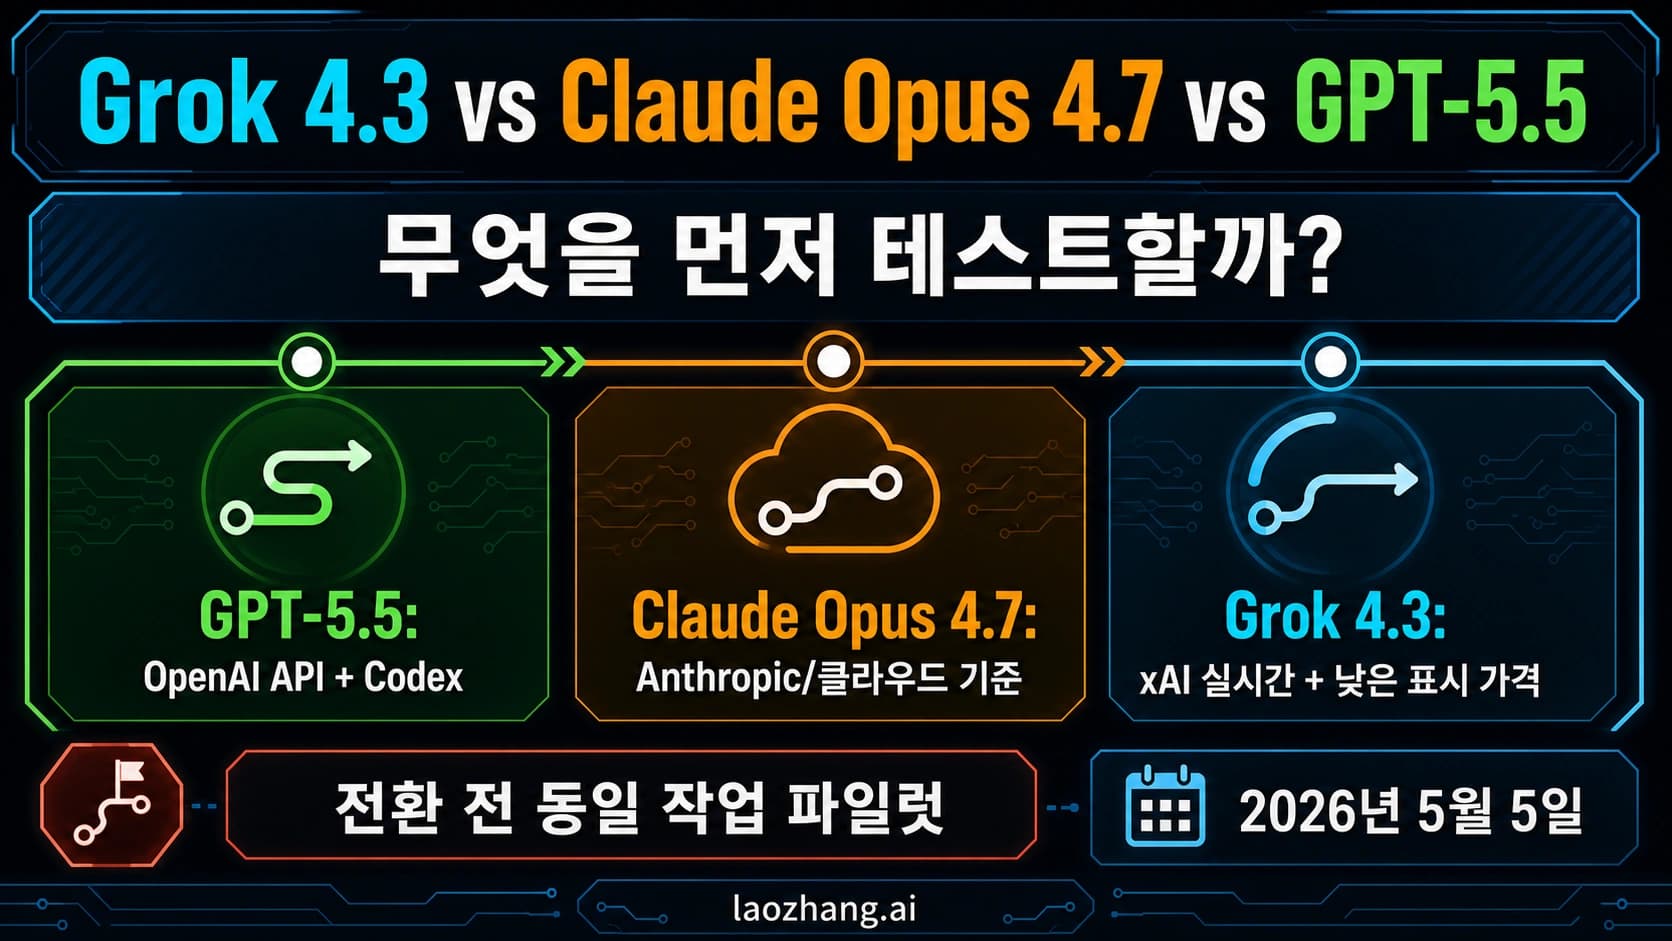
OpenAI-native 스택은 GPT-5.5부터, Anthropic/cloud 고위험 제어는 Claude Opus 4.7, xAI realtime/가격 pilot은 Grok 4.3부터 테스트합니다.