Claude Sonnet 5.5 vs GPT-6 Luna 비교: 단가 20배, 같은 점수면 5~8배
Sonnet 5.5의 토큰 단가는 GPT-6 Luna의 20배지만, AA 점수를 맞춘 작업당 비용은 5~8배입니다. 38점을 넘는 품질이나 에이전트 코딩이 아니면 Luna로 충분합니다.
목차
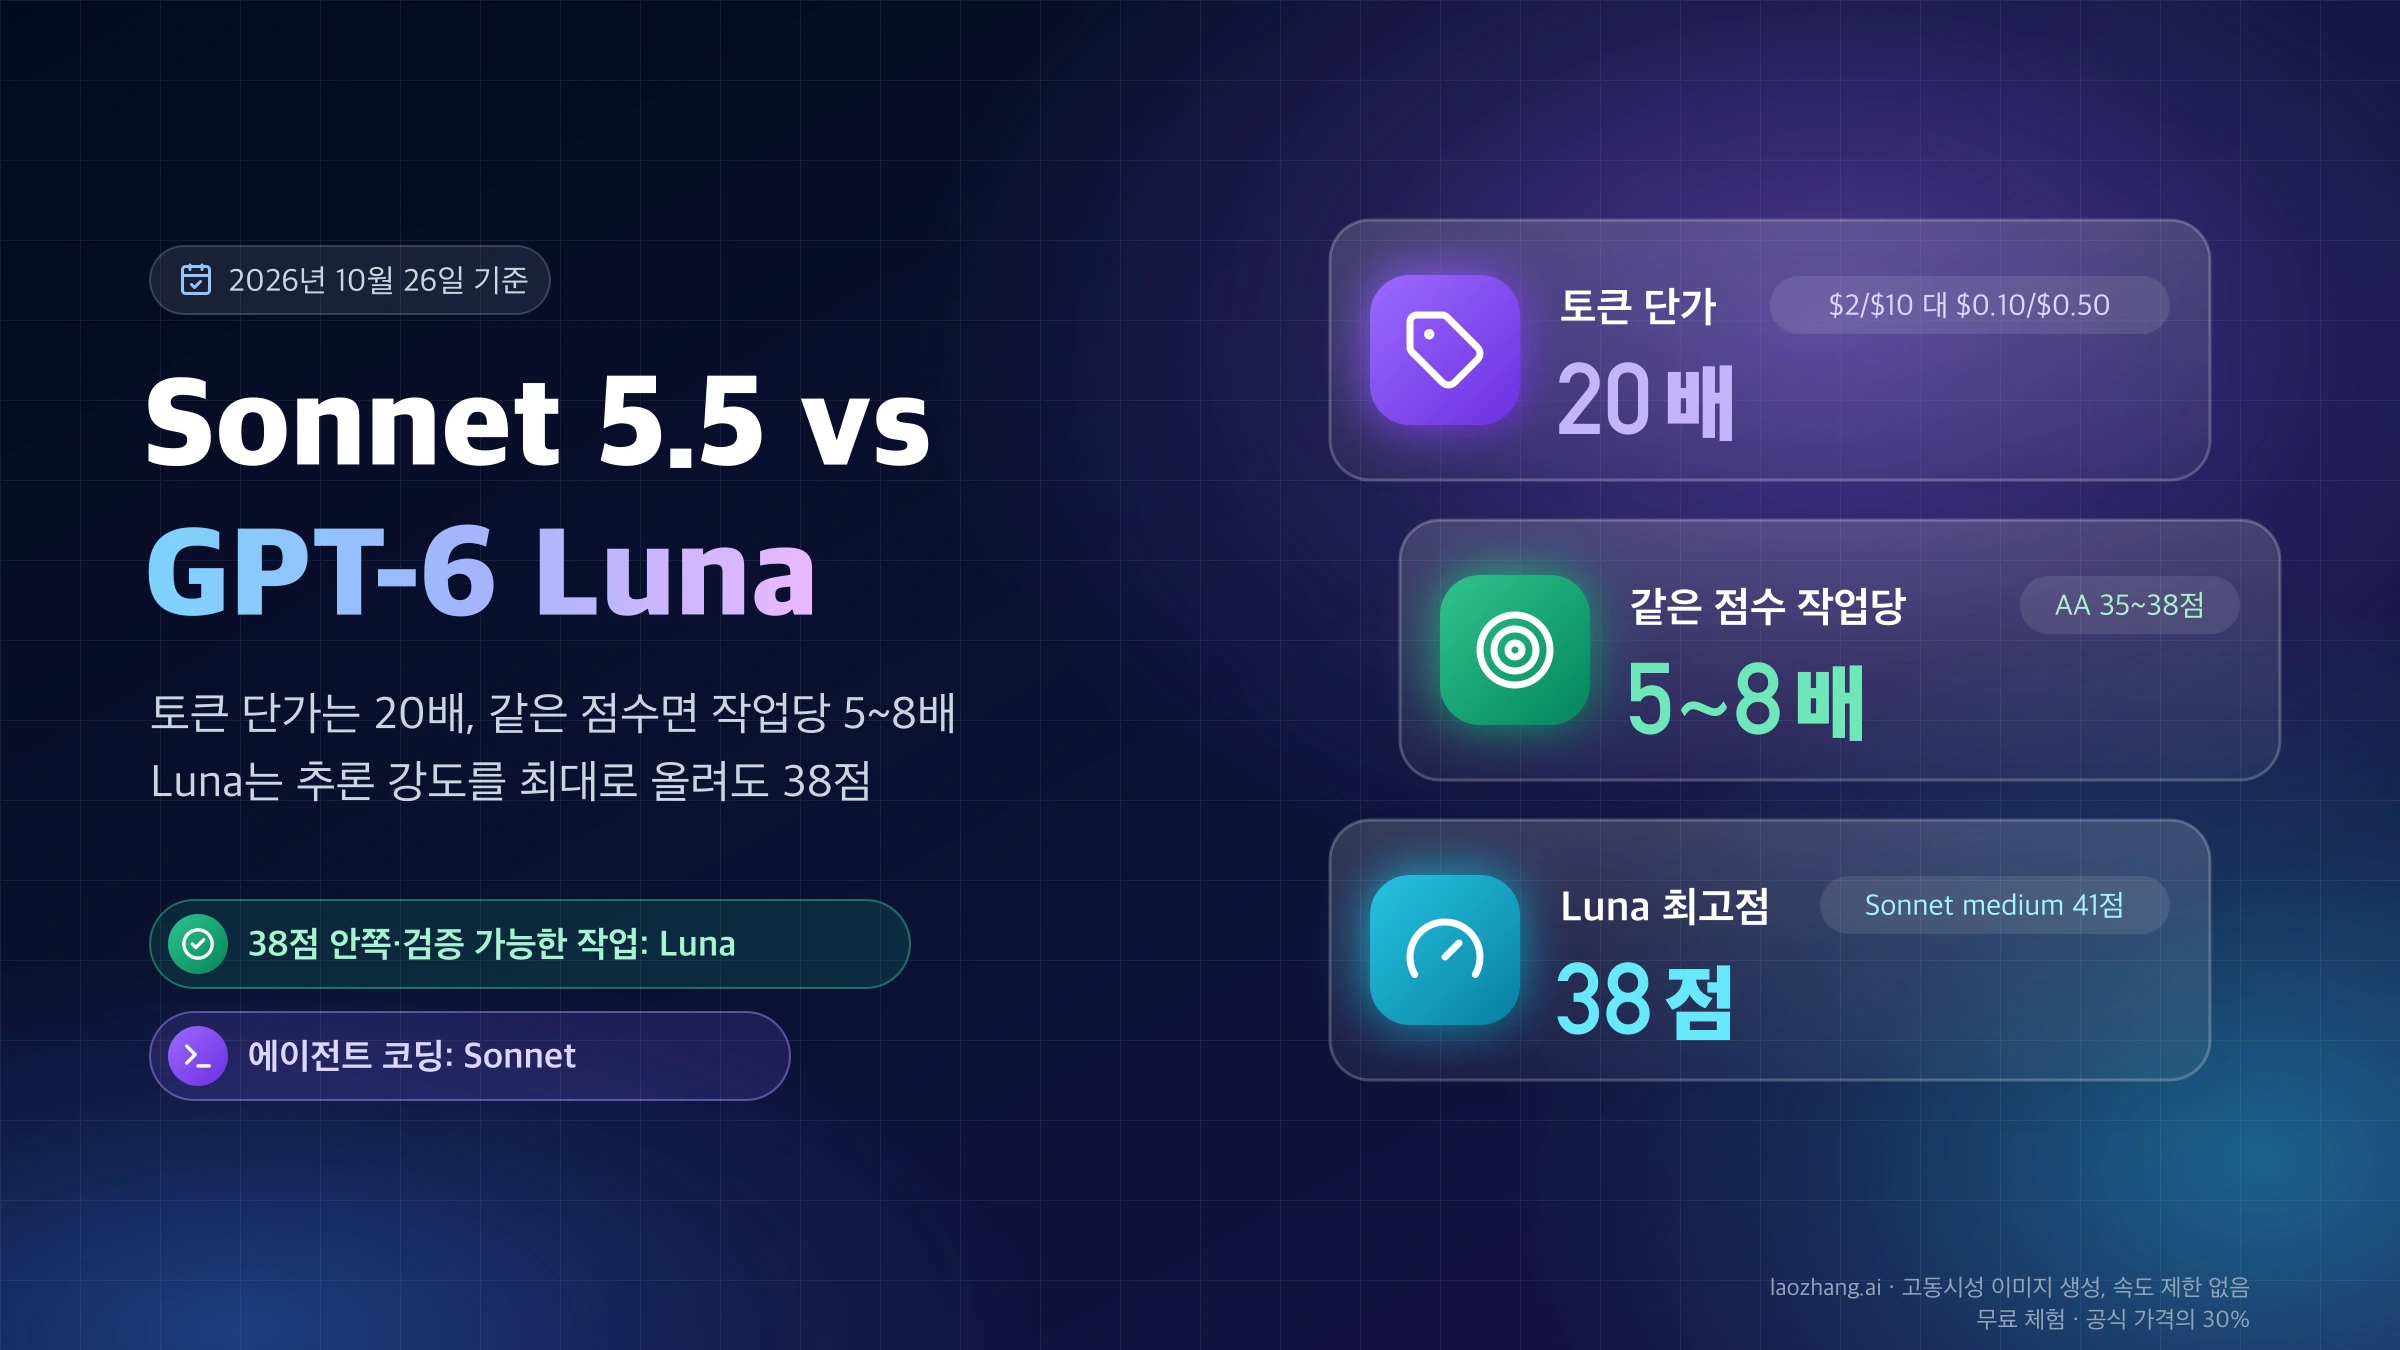
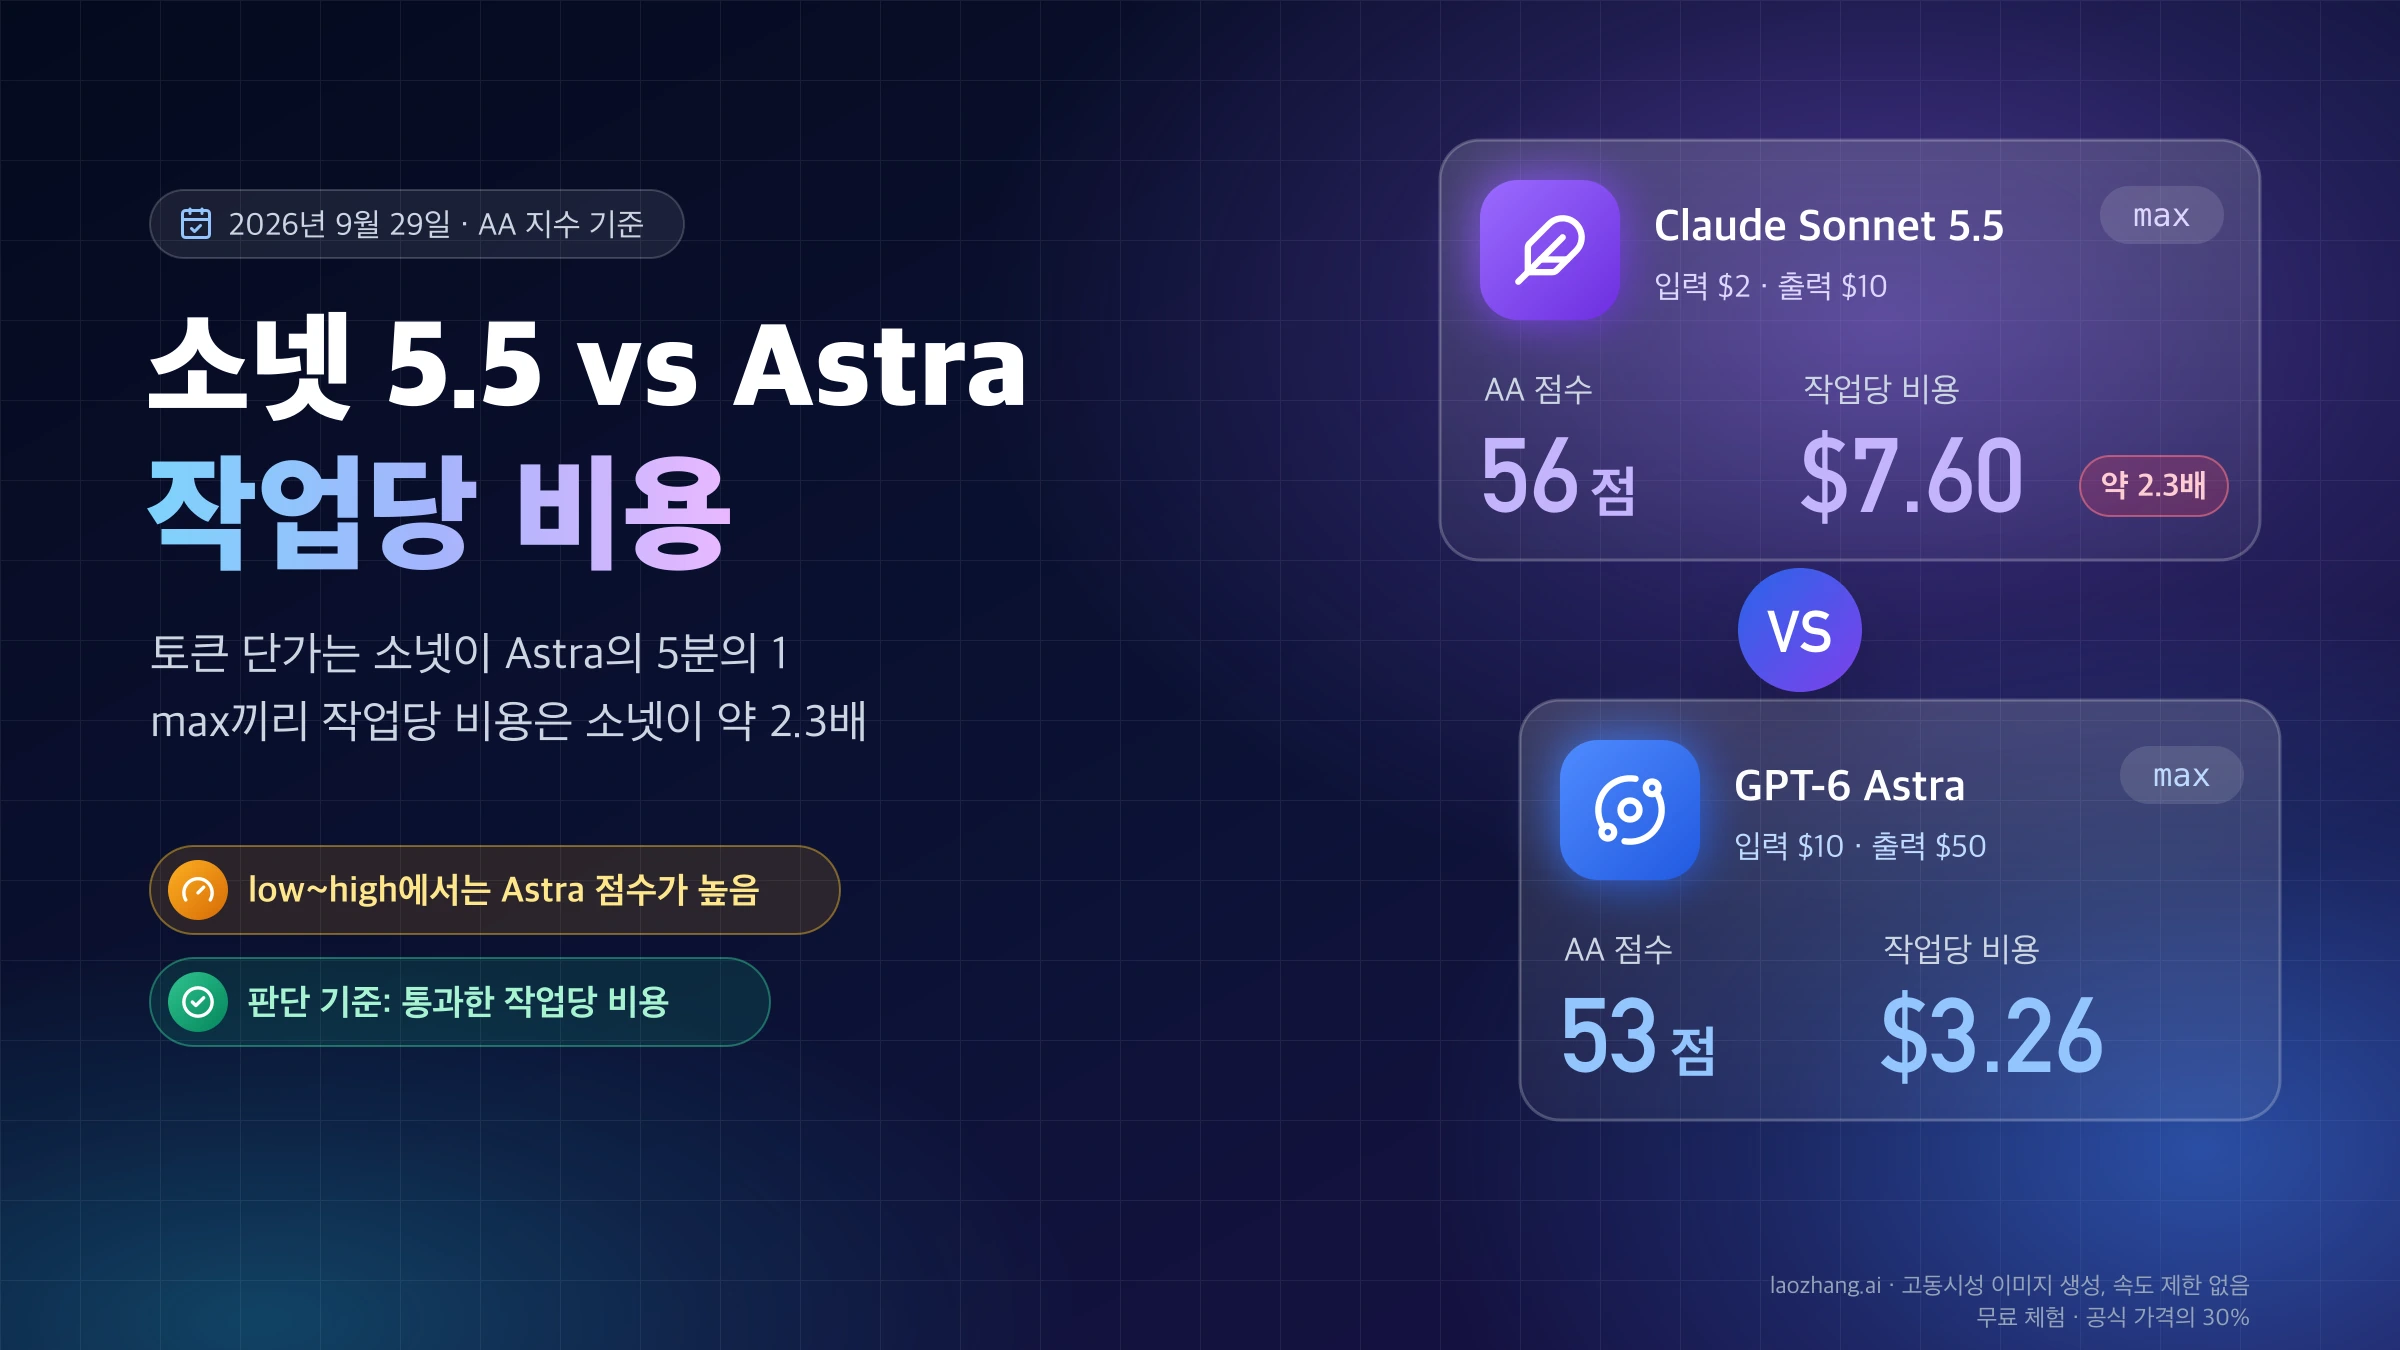
2026년 10월 26일 기준 Claude Sonnet 5.5(claude-sonnet-5-5)의 API 단가는 100만 토큰당 입력 $2, 출력 $10으로, GPT-6 Luna(gpt-6-luna)의 입력 $0.10, 출력 $0.50보다 20배 높습니다. 하지만 작업 하나를 끝내는 비용으로 보면 차이는 하나로 정해지지 않습니다. Artificial Analysis(AA) 지능 지수에서 점수가 비슷한 설정끼리 맞추면 5~8배, 각자 기본 설정끼리는 약 50배입니다. 또 Luna는 추론 강도(effort)를 최대로 올려도 38점에 그쳐, 41점인 Sonnet medium 이상의 품질에는 닿지 않습니다.
그래서 분류·추출·짧은 요약, 대량 배치, 긴 문서 질의처럼 결과를 검증할 수 있고 38점 안쪽 품질로 충분한 작업은 gpt-6-luna로 보내고, 터미널·에이전트 코딩과 그보다 높은 품질이 필요한 작업은 claude-sonnet-5-5에 남기는 편이 맞습니다. 옮길 때는 코드도 바꿔야 합니다. Luna는 Chat Completions에서 추론 강도가 none일 때만 함수 호출이 되므로 도구를 쓰는 요청은 Responses API로 보내야 하고, 프록시나 게이트웨이로 Sonnet을 부를 때는 thinking과 추론 강도를 직접 지정해야 합니다.
2026년 10월 26일 LaoZhang 게이트웨이로 두 모델에 숨은 테스트가 있는 같은 9문항을 보내 통과율·비용·소요 시간을 쟀고, 같은 영어 글의 토큰 수와 작업 유형별 비용도 계산했습니다. 각사 직접 API, 도구 호출, 다른 추론 강도는 실행하지 않았으므로 품질 비교는 AA의 측정을 근거로 합니다.
작업별로 고르기: Luna로 충분한 일과 Sonnet이 필요한 일
판단 기준은 두 가지입니다. 필요한 품질이 Luna의 최고점인 AA 38점 안에 있는지, 그리고 작업이 터미널 명령과 도구 호출을 여러 번 이어 가는 에이전트형인지입니다. 둘 다 아니라면 Luna로 시작하고, 하나라도 해당하면 Sonnet을 남기세요. 아래 표는 작업 형태별로 이 기준을 적용한 결과이며, 근거가 되는 수치는 뒤의 각 절에 있습니다.
| 작업 형태 | 먼저 쓸 모델 | 이유와 바꿀 조건 |
|---|---|---|
| 분류·추출·짧은 요약을 대량으로 | Luna low~medium | 토큰당 20배 차이가 그대로 청구됩니다. 출력 형식을 자동으로 검사할 수 있으면 불합격분만 Sonnet으로 다시 보내면 됩니다 |
| Batch API로 돌리는 오프라인 작업 | Luna | 두 회사 모두 50% 할인이라 차이는 20배로 유지됩니다 |
| 긴 문서 질의·요약 | Luna, 입력이 922K 토큰을 넘으면 Sonnet | 같은 추론 강도의 긴 문맥 평가에서 Luna가 같거나 높고, 272K를 넘으면 Luna 요금이 올라 차이가 약 10배로 줄어듭니다 |
| 캐시를 쓰는 에이전트 루프 | 필요한 품질로 결정 | 캐시 읽기 차이가 10배라 전체 차이는 약 15배입니다. 비용보다 작업 성공률이 판단을 좌우합니다 |
| 터미널·에이전트 코딩 | Sonnet | Terminal-Bench 4.0에서 Luna의 가장 높은 단계가 Sonnet의 가장 낮은 단계보다 낮습니다 |
| 사실 확인이 필요한 지식 답변 | Sonnet, 또는 근거 문서를 붙인 Luna | AA-Omniscience에서 Luna는 모를 때 틀린 답을 낼 가능성이 큽니다 |
| 응답 지연에 민감한 대화 | 자신의 호출 경로에서 측정 후 결정 | 추론 강도에 따라 순서가 바뀌고, AA의 직접 API 측정과 게이트웨이 측정도 다르게 나옵니다 |
둘을 나눠 쓰는 방법도 있습니다. Luna가 먼저 처리하고 자동 검사에서 떨어진 요청만 Sonnet으로 다시 보내면, 요청당 비용은 Luna 비용 + 불합격률 × Sonnet 비용입니다. 작업당 비용 차이가 20배라면 Luna 불합격률이 95% 미만일 때, 5배라도 80% 미만이면 처음부터 Sonnet에 보내는 것보다 쌉니다. 그래서 실제로 따질 것은 비용보다 불합격을 자동으로 가려낼 검사가 있는지, 그리고 두 번 왕복하는 요청의 지연을 감수할 수 있는지입니다.
Sonnet 5.5는 20배 값을 할까: 계산법에 따라 5배에서 50배
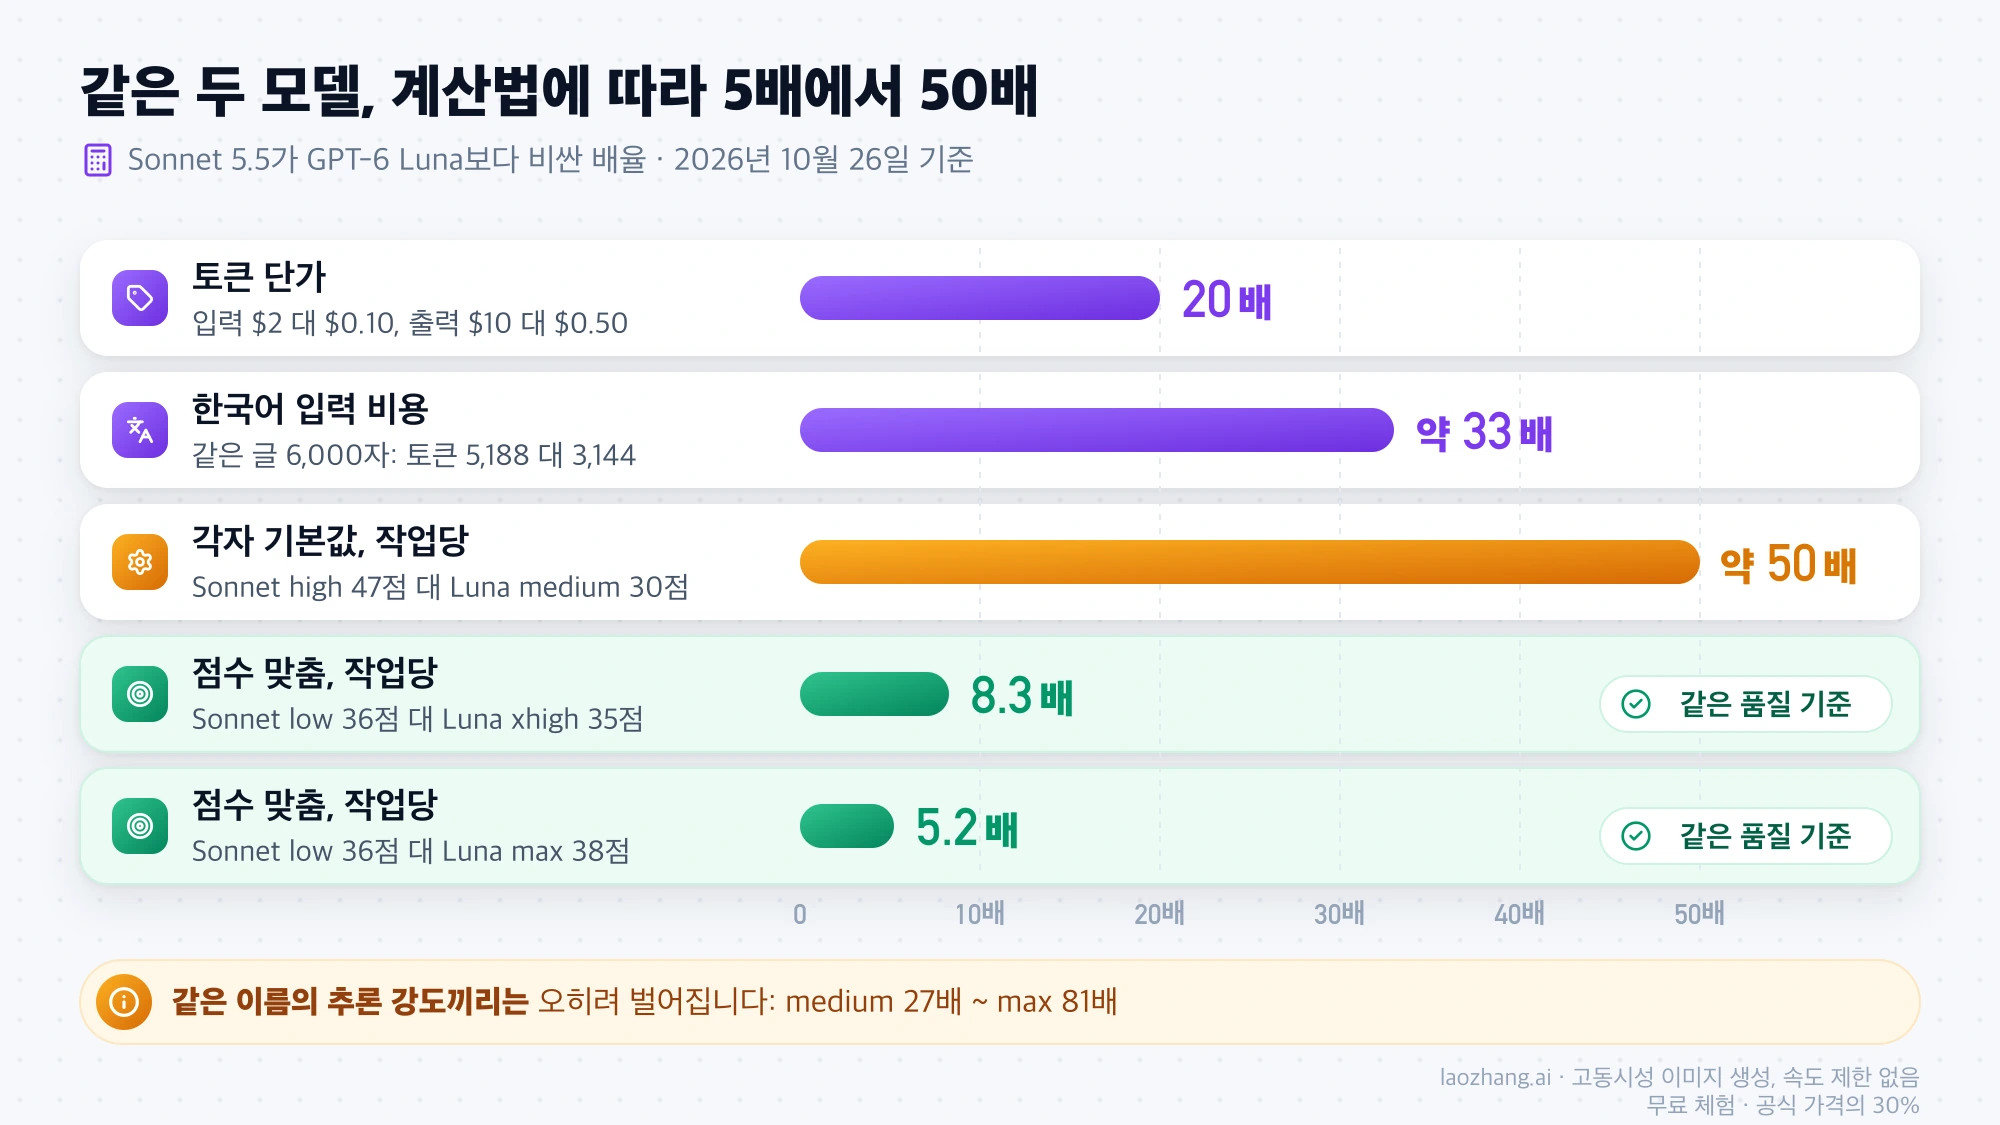
20배는 토큰 하나의 표시 가격 차이이고, 실제로 내는 돈의 차이는 무엇을 같게 놓고 비교하느냐에 따라 5배에서 50배까지 달라집니다. Luna가 닿는 점수 범위의 작업이라면 같은 점수에서 Luna가 5~8배 싸므로 Sonnet이 20배 값을 하지 못합니다. 반대로 38점을 넘는 품질이 필요하다면 Luna로는 그 점수에 도달할 수 없으니, 비용을 비교하기 전에 Sonnet을 써야 합니다.
| 비교 방법 | Claude Sonnet 5.5 | GPT-6 Luna | 차이 |
|---|---|---|---|
| 100만 토큰당 입력 / 출력 단가 | $2 / $10 | $0.10 / $0.50 | 20배 |
| 100만 토큰당 캐시 읽기 | $0.10 | $0.01 | 10배 |
| 같은 한국어 글(6,000자)의 입력 토큰 | 5,188 | 3,144 | 토큰 1.65배, 입력 비용 약 33배 |
| 같은 영어 글(6,723단어)의 입력 토큰 | 15,335 | 10,106 | 토큰 1.52배, 입력 비용 약 30배 |
AA 작업당 비용, 각자 기본값(Sonnet high 47점, Luna medium 30점) | $0.88 | $0.0175 | 약 50배 |
AA 작업당 비용, 점수 맞춤(Sonnet low 36점 대 Luna xhigh 35점, max 38점) | $0.35 | $0.0422 / $0.0678 | 8.3배 / 5.2배 |
단가는 2026년 10월 26일 기준 Anthropic Claude API 가격 페이지와 OpenAI API 가격 페이지의 Standard 처리 요금입니다. Anthropic의 cache hits와 OpenAI의 cached input은 저장해 둔 프롬프트 앞부분을 다시 읽는 같은 항목이라 아래에서는 둘 다 캐시 읽기라고 부릅니다. Sonnet 5.5의 캐시 읽기는 2026년 10월 7일 $0.20에서 지금 값으로 내려갔고, 인하 폭과 절감액 계산은 Claude Sonnet 5.5 캐시 가격: 캐시 읽기 $0.10로 반값, 청구액 계산법에서 다룹니다. 캐시 쓰기는 Sonnet이 5분 저장 $2.50, 1시간 저장 $4이고, Luna는 30분 저장 $0.125, 12시간 저장 $0.25입니다.
Luna에는 Sonnet에 없는 가격 경계가 하나 있습니다. OpenAI의 GPT-6 Luna 모델 페이지는 입력이 272K 토큰을 넘는 요청에 대해 요청 전체의 입력·캐시 단가를 2배, 출력 단가를 1.5배로 매긴다고 적고 있어, 이 경우 Luna는 입력 $0.20, 출력 $0.75가 되고 Sonnet과의 차이는 입력 10배, 출력 약 13배로 줄어듭니다. Sonnet은 100만 토큰 컨텍스트 전체를 같은 단가로 받습니다. Batch 처리는 두 회사 모두 Standard의 50%라 배율은 바뀌지 않습니다.
같은 글이라도 Sonnet이 토큰을 더 많이 세고, 그 차이는 한국어에서 가장 큽니다. 2026년 10월 26일 같은 한국어 글의 앞부분 6,000자를 두 API에 보냈을 때 응답의 usage에 찍힌 입력 토큰은 Sonnet 5,188, Luna 3,144로 1.65배였고, 같은 방식으로 잰 영어(1.45배), 일본어(1.29배), Python 코드(1.46배)보다 높았습니다. 그래서 한국어 입력은 같은 분량을 넣는 비용이 20 × 1.65 ≈ 33배입니다. 더 긴 6,723단어 영어 글에서는 15,335 대 10,106으로 1.52배, 약 30배였습니다. 언어마다 글 한 편씩만 잰 값이므로, 문체나 코드 비중이 다른 입력이라면 자신의 실제 요청을 두 API에 한 번씩 보내 usage를 비교해 보세요.
각자 기본값끼리의 약 50배는 같은 조건의 비교가 아닙니다. Sonnet 5.5의 API 기본 추론 강도는 high이고(Claude Code와 Claude 앱에서는 medium), Luna의 기본값은 medium이라, 이 비교는 17점 높은 결과를 50배 값에 사는 셈입니다. 이름이 같은 추론 강도끼리 맞춰도 medium 27배, high 30배, xhigh 48배, low 77배, max 81배로 오히려 벌어지는데, 같은 이름이어도 두 모델이 쓰는 연산량이 다르기 때문입니다. 점수를 맞춘 비교에서는 Luna가 5~8배 싸지만 걸리는 시간은 Sonnet low가 작업당 85초로, Luna xhigh의 215초나 max의 364초보다 2.5~4.3배 짧습니다.
추론 강도별 AA 점수: Luna 최고 38점은 Sonnet medium 아래
AA가 같은 평가 환경에서 두 모델의 모든 추론 강도를 측정한 결과, Sonnet 5.5는 low 36점에서 max 56점까지, Luna는 추론 없음 18점에서 max 38점까지 분포합니다. 두 범위가 겹치는 곳은 Sonnet low와 Luna xhigh·max 사이뿐이고, Sonnet medium부터 위의 네 단계는 모두 Luna의 어떤 설정보다 높습니다. 아래 수치는 2026년 10월 26일 기준 AA의 Claude Sonnet 5.5 vs GPT-6 Luna 비교 페이지에 실린 Intelligence Index v4.3.2(10개 평가 묶음) 결과를 점수 순으로 정렬한 것입니다.
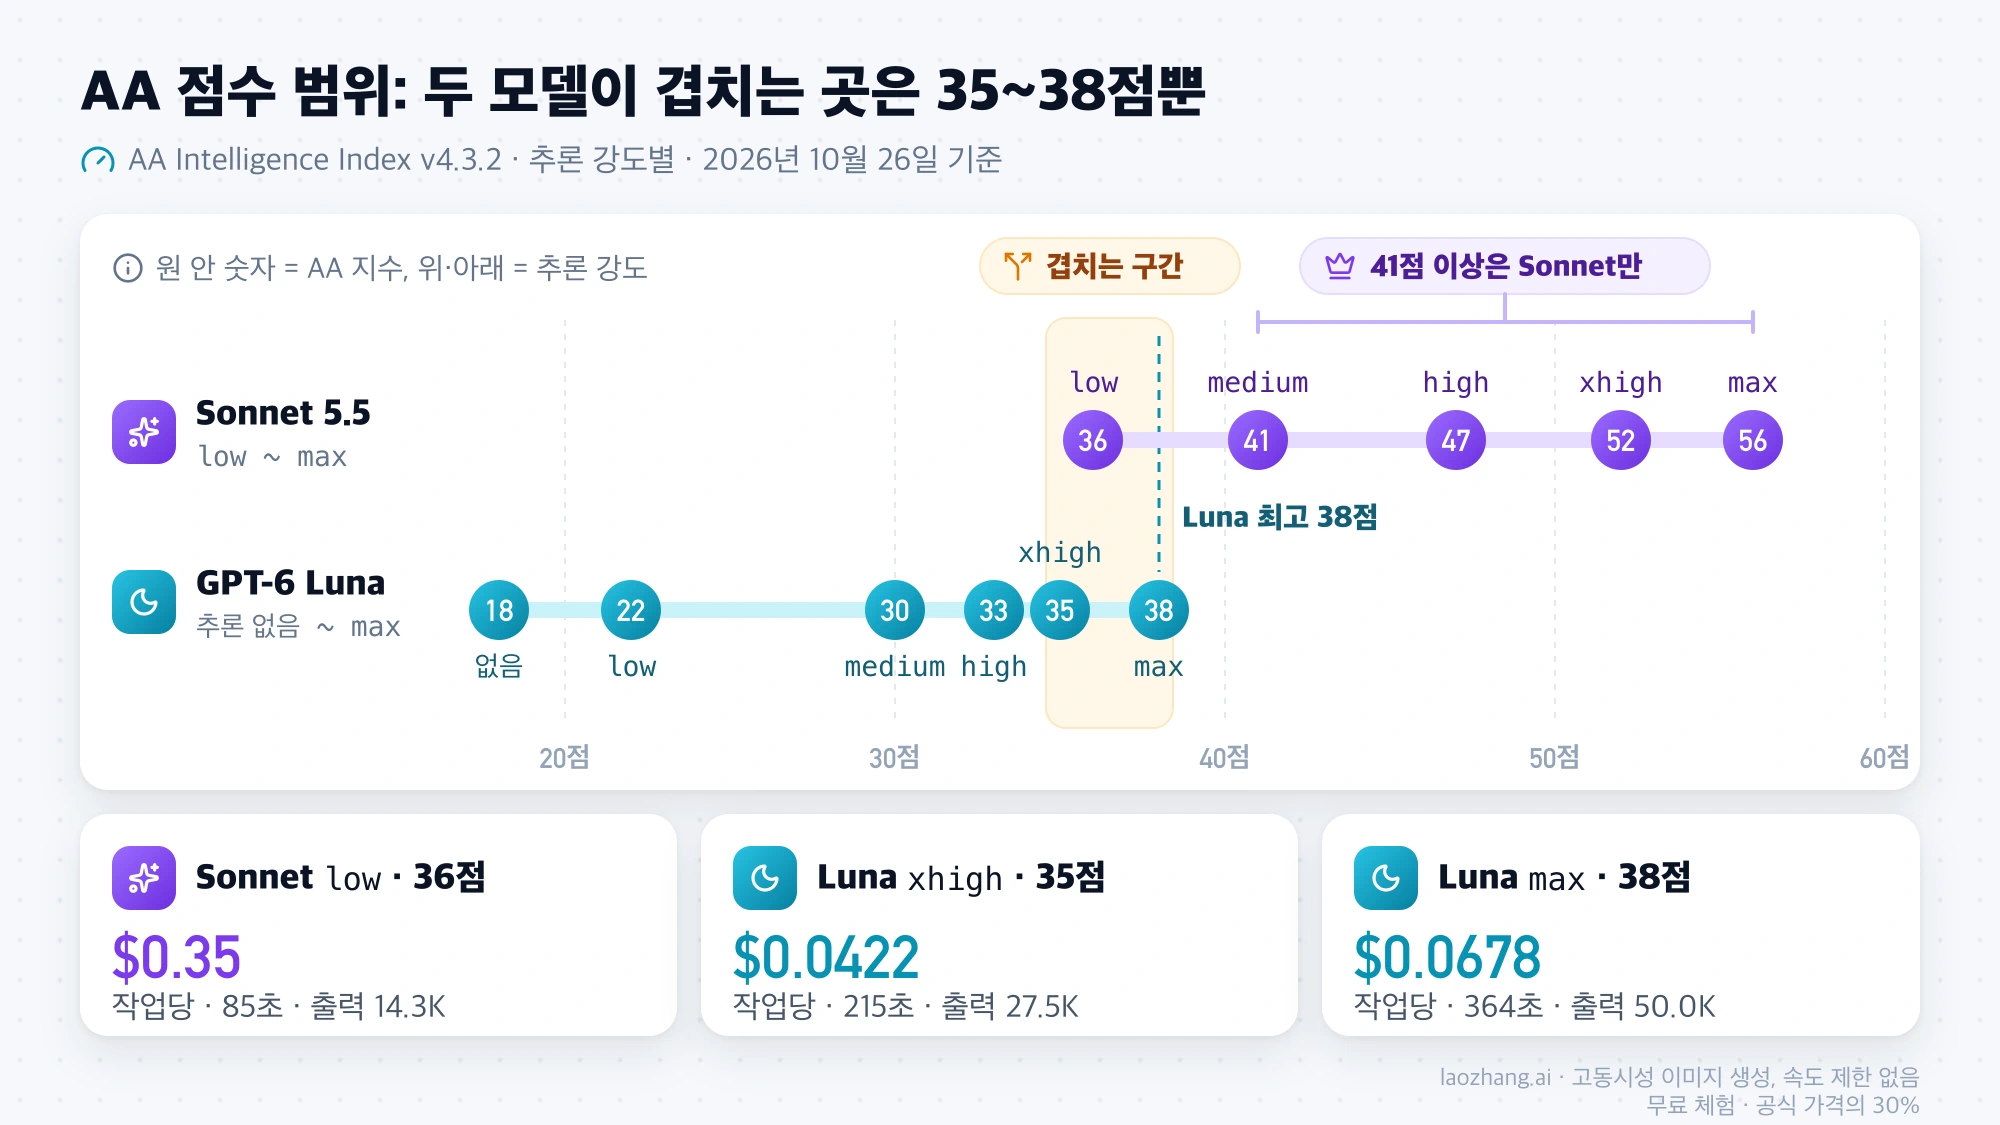
| 모델·추론 강도 | AA 지수 | 작업당 비용 | 작업당 시간 | 작업당 출력 토큰 |
|---|---|---|---|---|
Sonnet 5.5 max | 56 | $5.46 | 936초 | 197.4K |
Sonnet 5.5 xhigh | 52 | $2.01 | 434초 | 74.8K |
Sonnet 5.5 high(API 기본값) | 47 | $0.88 | 217초 | 37.3K |
Sonnet 5.5 medium | 41 | $0.48 | 121초 | 20.9K |
Luna max | 38 | $0.0678 | 364초 | 50.0K |
Sonnet 5.5 low | 36 | $0.35 | 85초 | 14.3K |
Luna xhigh | 35 | $0.0422 | 215초 | 27.5K |
Luna high | 33 | $0.029 | 164초 | 19.7K |
Luna medium(기본값) | 30 | $0.0175 | 126초 | 11.5K |
Luna low | 22 | $0.0045 | 18초 | 2.1K |
| Luna 추론 없음 | 18 | $0.0113 | 31초 | 3.8K |
같은 이름의 단계에서 작업당 비용 차이가 단가 차이인 20배보다 커지는 이유는 출력 토큰 양에 있습니다. max에서 Sonnet은 작업당 197.4K 토큰을 써 Luna의 50.0K보다 약 4배 많고, 그만큼 비용 배율이 81배까지 올라갑니다. 반대로 low에서는 Luna가 2.1K 토큰만 쓰고 끝내 점수가 22점으로 떨어지므로, 비용이 가장 낮은 설정이 곧 쓸 만한 설정은 아닙니다.
Sonnet의 작업당 비용은 10월 7일 캐시 읽기 인하 뒤 내려갔습니다. AA의 2026년 10월 5일 측정에서 Sonnet high는 작업당 $1.12, max는 $7.67이었고 지금은 각각 $0.88, $5.46입니다. Sonnet max를 작업당 $7대로 적은 수치는 인하 전 측정이라는 뜻입니다. AA는 시점마다 다시 측정하는 제3자 평가이므로, 결정에 쓰기 전에 같은 페이지의 최신 값을 한 번 더 보는 편이 안전합니다.
세부 평가: 터미널 작업은 Sonnet, 긴 문서는 Luna도 대등
종합 점수의 차이는 평가마다 고르게 나지 않습니다. 터미널 작업과 지식 신뢰도에서는 Sonnet이 크게 앞서고, 긴 문서 추론에서는 같은 추론 강도의 Luna가 Sonnet과 같거나 높습니다. 아래는 같은 AA 비교 페이지의 세부 평가로, 각 모델의 가장 낮은 단계부터 가장 높은 단계까지의 범위입니다.
| AA 세부 평가 | Sonnet 5.5(low~max) | GPT-6 Luna(추론 없음~max) | 작업에 주는 의미 |
|---|---|---|---|
| Terminal-Bench 4.0(터미널 작업) | 20.7~63.6% | 0.0~12.6% | 셸 명령을 이어 가는 코딩 에이전트는 Sonnet |
| AutomationBench-AA(업무 자동화) | 49.4~71.8% | 9.1~53.2% | Luna max가 Sonnet low와 medium 사이 |
| AA-LCR v1.1(긴 문맥 추론) | 76.0~82.7% | 39.7~83.3% | medium 이상 같은 단계에서 Luna가 같거나 높음 |
| AA-Omniscience(지식 신뢰도) | 19~32 | −22~1 | Luna는 max를 빼면 모두 음수 |
| SciCode(과학 계산 코딩) | 49.1~61.0% | 43.1~54.6% | 함수 단위 구현은 격차가 작음 |
| GDPval-AA v2.1(지식 업무, Elo) | 1,177~1,838 | 1,032~1,433 | Luna max가 Sonnet medium과 high 사이 |
에이전트 코딩에서 차이가 가장 큽니다. Terminal-Bench 4.0에서 Luna는 max로 올려도 12.6%로, Sonnet의 가장 낮은 low가 낸 20.7%에 못 미칩니다. 저장소를 오가며 명령을 실행하고 결과를 보고 다시 고치는 작업은 단가를 보기 전에 Sonnet으로 정하는 편이 맞습니다. 반면 SciCode처럼 명세가 분명한 함수 하나를 짜는 일은 Luna medium(50.9%)이 Sonnet low(49.1%)보다 높을 만큼 격차가 작습니다.
AA-Omniscience는 맞힌 답에 점수를 주고 틀린 답에서 점수를 빼는 지식 신뢰도 평가라, 음수는 틀린 답이 맞힌 답보다 많다는 뜻입니다. Luna는 max의 1점을 빼면 모든 단계가 음수이고 Sonnet은 19~32점이므로, 사실 질문에서 Luna는 모른다고 답하는 대신 그럴듯한 오답을 낼 가능성이 큽니다. 고객 응대나 문서 질의에 Luna를 쓴다면 검색 결과나 원문을 함께 넣어 답의 근거를 붙이는 구성이 필요합니다.
긴 문서는 Luna에 유리한 쪽입니다. AA-LCR에서 medium 이상은 같은 단계의 Luna가 Sonnet과 같거나 높습니다. 다만 Luna는 컨텍스트 창이 1,050,000토큰이어도 최대 입력이 922,000토큰이고 272K를 넘는 순간 요청 전체가 할증되므로, 두 모델 모두 컨텍스트가 100만 토큰급이라는 사실만으로 같은 조건이라고 보면 안 됩니다.
같은 9문항 테스트 결과: 둘 다 통과, 비용은 25배 차이
2026년 10월 26일 LaoZhang 게이트웨이로 같은 9문항을 보냈을 때 Sonnet 5.5(thinking adaptive와 추론 강도 high)와 Luna(기본값 medium)는 9문항을 모두 통과했고, 비용은 Sonnet $0.1119, Luna $0.0044로 약 25배 차이였습니다. 두 모델이 거의 모든 문항을 풀었으므로 이 결과는 어느 쪽이 더 똑똑한지가 아니라, 같은 통과율에서 비용·토큰·시간이 얼마나 다른지를 보여 줍니다.
| 설정 | 통과 | 입력 토큰 | 출력 토큰 | 공시가 기준 비용 | 총 소요 시간 |
|---|---|---|---|---|---|
Sonnet 5.5, thinking adaptive + 추론 강도 high | 9/9 | 16,957 | 7,802 | $0.1119 | 71초 |
Sonnet 5.5, thinking과 추론 강도 생략 | 8/9 | 16,957 | 4,896 | $0.0829 | 50초 |
GPT-6 Luna, 기본값 medium | 9/9 | 11,213 | 6,545(추론 3,897 포함) | $0.0044 | 128초 |
문항은 구간 병합, 기간 문자열 파싱, 단어 빈도, 수식 계산기, CSV 한 줄 파싱, SemVer 비교를 구현하는 Python 함수 6개와 답이 하나로 정해지는 계산 문제 2개, 6,723단어 영어 글을 5줄로 요약하는 과제 1개입니다. 채점용 숨은 테스트는 답을 보기 전에 작성했고, 문항마다 한 번씩만 실행했으며 시스템 프롬프트와 도구는 쓰지 않았습니다. Sonnet은 Anthropic Messages 형식(/v1/messages), Luna는 /v1/chat/completions로 호출했고 비용은 응답의 usage에 각사 공시가를 곱해 계산했습니다. LaoZhang은 2026년 10월 26일 기준 두 모델을 각사 공시가와 같은 단가로 제공하며, Claude 쪽은 1회 출력이 32,768토큰으로 제한되고 Message Batches API를 지원하지 않습니다.
25배라는 차이는 대부분 단가에서 나옵니다. Luna는 medium에서도 출력 토큰의 60%를 추론에 써서 출력량이 Sonnet과 비슷했고(6,545 대 7,802), 입력은 같은 프롬프트를 Sonnet이 1.51배 많게 셌습니다. 20배 단가에 이 토큰 차이가 조금 더해진 것이 25배입니다.
thinking을 빼고 보낸 Sonnet은 9문항 중 하나를 틀렸습니다. 구간 병합 문제에서 "맞닿은(touching)" 구간을 정수로 이웃한 구간으로 해석해 (1, 2)와 (3, 4)를 (1, 4)로 합쳤는데, 숨은 테스트는 두 구간을 따로 두도록 되어 있었습니다. 애매한 단어를 다르게 읽은 실수이고, adaptive 사고를 켠 Sonnet은 겹치거나 끝점을 공유하는 구간만 합쳐 통과했습니다.
이 게이트웨이에서는 thinking을 생략한 요청 9건 모두 응답에 사고 블록이 없었고, thinking: {"type": "adaptive"}와 추론 강도 high를 명시하자 9건 중 7건에서 사고 블록이 돌아오며 출력 토큰이 4,896에서 7,802로 늘었습니다. Anthropic의 thinking 문서는 Sonnet 5.5에서 thinking을 생략하면 기본 추론 강도 high의 adaptive 사고가 켜진다고 설명하지만, 각사 직접 API에서는 이 차이를 시험하지 않았습니다. 어떤 프록시나 게이트웨이를 거치든 사고 설정이 그대로 전달된다고 가정하지 말고 thinking과 추론 강도를 요청에 직접 넣으세요.
내 작업은 얼마 드나: 긴 문서 10배, 캐시 루프 15배, 배치 20배
같은 양의 토큰을 쓴다고 가정하면 짧은 요청과 배치는 20배 그대로이고, Luna의 272K 경계를 넘는 긴 문서는 약 10배, 캐시를 쓰는 에이전트 루프는 약 15배로 차이가 줄어듭니다. 아래는 2026년 10월 26일 공시가로 다시 계산한 값이며, 사례의 토큰 양은 측정값이 아니라 가정입니다.
| 사례(가정) | Sonnet 5.5 | GPT-6 Luna | 차이 |
|---|---|---|---|
| A. 대화 1턴: 입력 2K + 출력 500 | $0.0090 | $0.00045 | 20.0배 |
| A를 영어 토큰 차이 1.52배로 보정 | $0.0111 | $0.00045 | 24.6배 |
| B. 문서 1건: 입력 300K + 출력 5K | $0.65 | $0.0638 | 10.2배 |
| B를 토큰 차이로 보정(Sonnet 기준 약 456K) | $0.962 | $0.0638 | 15.1배 |
| B와 같은 작업, 입력 250K(272K 이하) | $0.55 | $0.0275 | 20.0배 |
| C. 에이전트 50턴: 100K 캐시 1회 저장, 턴마다 새 입력 2K + 출력 1K | $1.45 | $0.0975 | 14.9배 |
| D. 배치 10,000건 × (입력 3K + 출력 1K), 양쪽 50% 할인 | $80 | $4 | 20.0배 |
보정하지 않은 행은 각 모델이 자기 토크나이저로 같은 수의 토큰을 쓴다고 본 값이고, 보정한 행은 영어 기준 실측 배율 1.52를 Sonnet 입력에만 곱했습니다. 입력이 한국어라면 한국어 실측 배율 1.65를 곱해 사례 A는 (3.3K × 2 + 500 × 10) ÷ (2K × 0.10 + 500 × 0.50)으로 약 25.8배, 사례 B는 Sonnet 기준 약 495K가 되어 $1.04 ÷ $0.0638로 약 16.3배입니다. 출력 토큰은 모델이 얼마나 길게 쓰고 생각하느냐에 따라 달라지므로 보정하지 않았습니다. 사례 B는 300K가 Luna의 272K 경계를 넘기 때문에 Luna에 장문 단가가 붙어 차이가 10배로 줄고, 같은 문서를 250K 이하로 줄이면 다시 20배가 됩니다. 문서를 나눠 보낼 수 있는 작업이라면 Luna 쪽은 272K 안쪽으로 자르는 것만으로 요청당 비용이 절반 아래로 내려갑니다.
사례 C는 캐시 읽기 차이가 10배라서 배율이 낮아집니다. 계산식은 Sonnet이 100K × 2.50 + 50 × (100K × 0.10 + 2K × 2 + 1K × 10), Luna가 100K × 0.125 + 50 × (100K × 0.01 + 2K × 0.10 + 1K × 0.50)이고 단가는 100만 토큰당 달러입니다. 턴 사이 간격이 캐시 유지 시간(Sonnet 5분, Luna 30분) 안에 있다고 가정했으며, 간격이 길어 캐시가 만료되면 다시 저장하는 비용이 붙습니다.
Sonnet과 Luna를 바꿀 때 고쳐야 할 API 설정
모델 ID만 바꾸면 깨지는 곳이 있습니다. Luna로 옮길 때는 도구 호출 경로를, Sonnet으로 옮길 때는 사고 설정과 tool_choice를 먼저 확인하세요. 아래 표의 Luna 열은 2026년 10월 26일 기준 OpenAI GPT-6 Luna 모델 페이지의 사양입니다. Sonnet 열의 사고 설정과 display 항목은 같은 날 Anthropic thinking 문서로 다시 확인했고, tool_choice 제한, 최대 출력, 지식 기준일은 2026년 10월 5일 기준 Anthropic 모델 문서의 내용입니다.
| 항목 | Claude Sonnet 5.5 | GPT-6 Luna |
|---|---|---|
| 모델 ID | claude-sonnet-5-5 | gpt-6-luna |
| 추론 강도 지정 | output_config.effort, low~max, API 기본 high(Claude Code·앱은 medium) | Responses는 reasoning.effort, Chat Completions는 reasoning_effort, none~max, 기본 medium |
| 사고·추론 끄기 | thinking: {type: "disabled"}는 400 오류, 가장 낮은 설정은 between_tools(추론 강도 high 이하에서만) | 추론 강도 none |
| 함수 호출 | tool_choice는 auto·none만 가능, any·tool로 강제하면 400 오류 | Chat Completions는 추론 강도 none일 때만 가능, 그 밖의 강도와 내장 도구는 Responses API |
| 사고 내용 반환 | 기본 display: "omitted"라 사고 텍스트는 빈 값이지만 사고 토큰은 전부 과금 | 추론 토큰 수가 usage에 표시되고 출력 토큰으로 과금 |
| 컨텍스트와 최대 입력 | 100만 토큰, 전 구간 같은 단가 | 컨텍스트 1,050,000토큰, 최대 입력 922,000토큰, 272K 초과 요청은 할증 |
| 최대 출력 | 128K 토큰(동기 Messages API) | 128,000토큰 |
| 지식 기준일 | 2026년 6월 | 2026년 5월 18일 |
Sonnet에서 Luna로 옮길 때 가장 흔히 걸리는 곳은 함수 호출입니다. Chat Completions에 tools를 넣고 추론 강도를 none 외의 값으로 두면 함수 호출을 쓸 수 없으므로, 도구를 쓰는 요청은 Responses API로 바꾸고 추론 강도는 reasoning.effort로 넘깁니다. 922,000토큰을 넘는 입력은 Luna가 받지 않으므로 나눠 보내거나 Sonnet에 남겨야 합니다. 아래는 Responses API에 함수 하나를 넘기는 요청 본문의 형식 예시입니다.
{
  "model": "gpt-6-luna",
  "reasoning": { "effort": "medium" },
  "input": "주문 A-1042의 배송 상태를 알려 줘",
  "tools": [
    {
      "type": "function",
      "name": "get_order_status",
      "description": "주문 번호로 배송 상태를 조회합니다",
      "parameters": {
        "type": "object",
        "properties": { "order_id": { "type": "string" } },
        "required": ["order_id"]
      }
    }
  ]
}
Luna나 다른 모델에서 Sonnet으로 옮길 때는 사고를 끄던 코드부터 확인하세요. Sonnet 5.5는 thinking: {type: "disabled"}를 400 오류로 거부하므로, 미리 생각하는 단계를 없애려면 {type: "between_tools"}를 보내야 하고 이 설정은 추론 강도 high 이하에서만 받습니다. tool_choice로 특정 도구를 강제하던 코드도 auto로 바꾸고 지시문에서 도구 사용을 요구해야 합니다. 게이트웨이를 거친다면 사고 설정을 생략하지 말고 아래처럼 명시합니다.
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": { "type": "adaptive" },
  "output_config": { "effort": "high" },
  "messages": [{ "role": "user", "content": "..." }]
}
사고 텍스트가 빈 값으로 돌아와도 사고 토큰은 출력 단가로 청구됩니다. 비용을 줄이려면 display 설정이 아니라 추론 강도를 낮춰야 하고, Anthropic은 Sonnet 5.5에서 추론 강도의 기준이 이전 Sonnet과 달라졌으니 단계별로 다시 시험해 보라고 권합니다.
전환 전에 통과한 작업당 비용을 재는 순서
비교할 값은 토큰 단가가 아니라 기준을 통과한 작업 하나에 든 비용입니다. 단가가 20분의 1이어도 불합격이 많아 재시도와 사람 손이 늘면 절감 폭이 줄고, 반대로 Luna가 같은 기준을 통과한다면 그 작업에 Sonnet을 쓸 이유가 사라집니다. 실제 요청 표본으로 아래 순서를 따르세요.
- 운영 중인 요청에서 작업 유형별로 수십 건을 뽑고, 테스트 통과·JSON 스키마 검사·사람 검수 기준 중 무엇으로 합격을 판정할지 결과를 보기 전에 정해 둡니다.
- 점수가 겹치는 추론 강도끼리 짝을 지어 돌립니다. Luna는
medium·xhigh·max, Sonnet은low·medium을 함께 시험하고, 게이트웨이를 거치면 Sonnet의thinking과 추론 강도를 명시합니다. - 응답의
usage에서 입력·캐시 읽기·캐시 쓰기·출력 토큰을 나눠 공시가를 곱하고, 입력이 272K를 넘은 Luna 요청에는 장문 단가를 적용합니다. - 총비용을 합격 건수로 나눠 통과한 작업당 비용을 구하고, 불합격 건을 사람이 고치는 데 든 시간도 함께 적습니다.
- Luna 결과 중 불합격만 Sonnet으로 다시 보냈을 때의 총비용과 총 소요 시간을 Sonnet 단독 실행과 비교합니다.
Sonnet 5.5와 Luna 속도: 추론 강도와 호출 경로에 따라 다름
어느 쪽이 빠른지는 무엇을 같게 놓고 비교하느냐에 따라 답이 바뀝니다. AA가 각사 직접 API로 잰 출력 속도는 Sonnet 초당 105~134토큰, Luna 초당 92~140토큰으로 비슷하고, 차이는 얼마나 오래 생각하느냐에서 납니다. 같은 이름의 추론 강도끼리 보면 작업당 시간은 high 이상에서 Luna가 짧고(high 164초 대 217초, xhigh 215초 대 434초, max 364초 대 936초), medium은 Luna 126초 대 Sonnet 121초로 비슷하며, low는 Luna가 18초로 Sonnet의 85초보다 훨씬 빠릅니다.
첫 토큰까지의 시간은 단계에 따라 갈립니다. AA 측정에서 low와 medium은 Sonnet이 0.98초와 1.35초로 Luna의 2.45초와 2.79초보다 짧고, high는 두 모델 모두 약 10.5초로 같으며, xhigh와 max는 Luna가 19.84초와 78.46초로 Sonnet의 27.33초와 371.62초보다 짧습니다. 반면 같은 이름이 아니라 같은 점수로 맞추면 결과가 뒤집혀, AA 지수 36점인 Sonnet low가 35~38점인 Luna xhigh·max보다 작업당 시간이 짧습니다.
2026년 10월 26일 LaoZhang 게이트웨이에서 순서대로 호출했을 때는 9문항 모두 Luna가 더 오래 걸렸습니다. 9문항의 소요 시간 합은 Luna 128초, Sonnet(adaptive, high) 71초였고, 수식 계산기 문항에서는 Luna 33.2초, Sonnet 13.0초였습니다. 하나의 경로에서 하루 동안 잰 값이라 경로와 부하에 따라 달라질 수 있으므로, 지연이 중요한 서비스라면 실제로 호출할 경로에서 첫 토큰 시간과 전체 응답 시간을 직접 재 보세요.
Sonnet 5.5와 GPT-6 Luna에 관한 다른 질문
GPT-6 Luna Pro나 GPT-6.1 Luna라는 모델이 있나요?
2026년 10월 26일 기준 OpenAI의 모델 목록과 가격 페이지에는 gpt-6-luna 하나만 있고, GPT-6 Luna Pro나 gpt-6.1-luna라는 모델은 없습니다. 일부 게시물이 Luna Pro라는 이름과 함께 인용하는 입력 $0.10, 출력 $0.50, 컨텍스트 1,050K는 gpt-6-luna의 공시 사양과 같습니다. OpenAI GPT-6 계열의 이름과 모델 ID는 GPT-6 Sol·Luna·Astra와 Terra 비교: 모델 ID, API 요금, 선택 기준에서 볼 수 있습니다.
Luna와 단가가 비슷한 Anthropic 모델은 없나요?
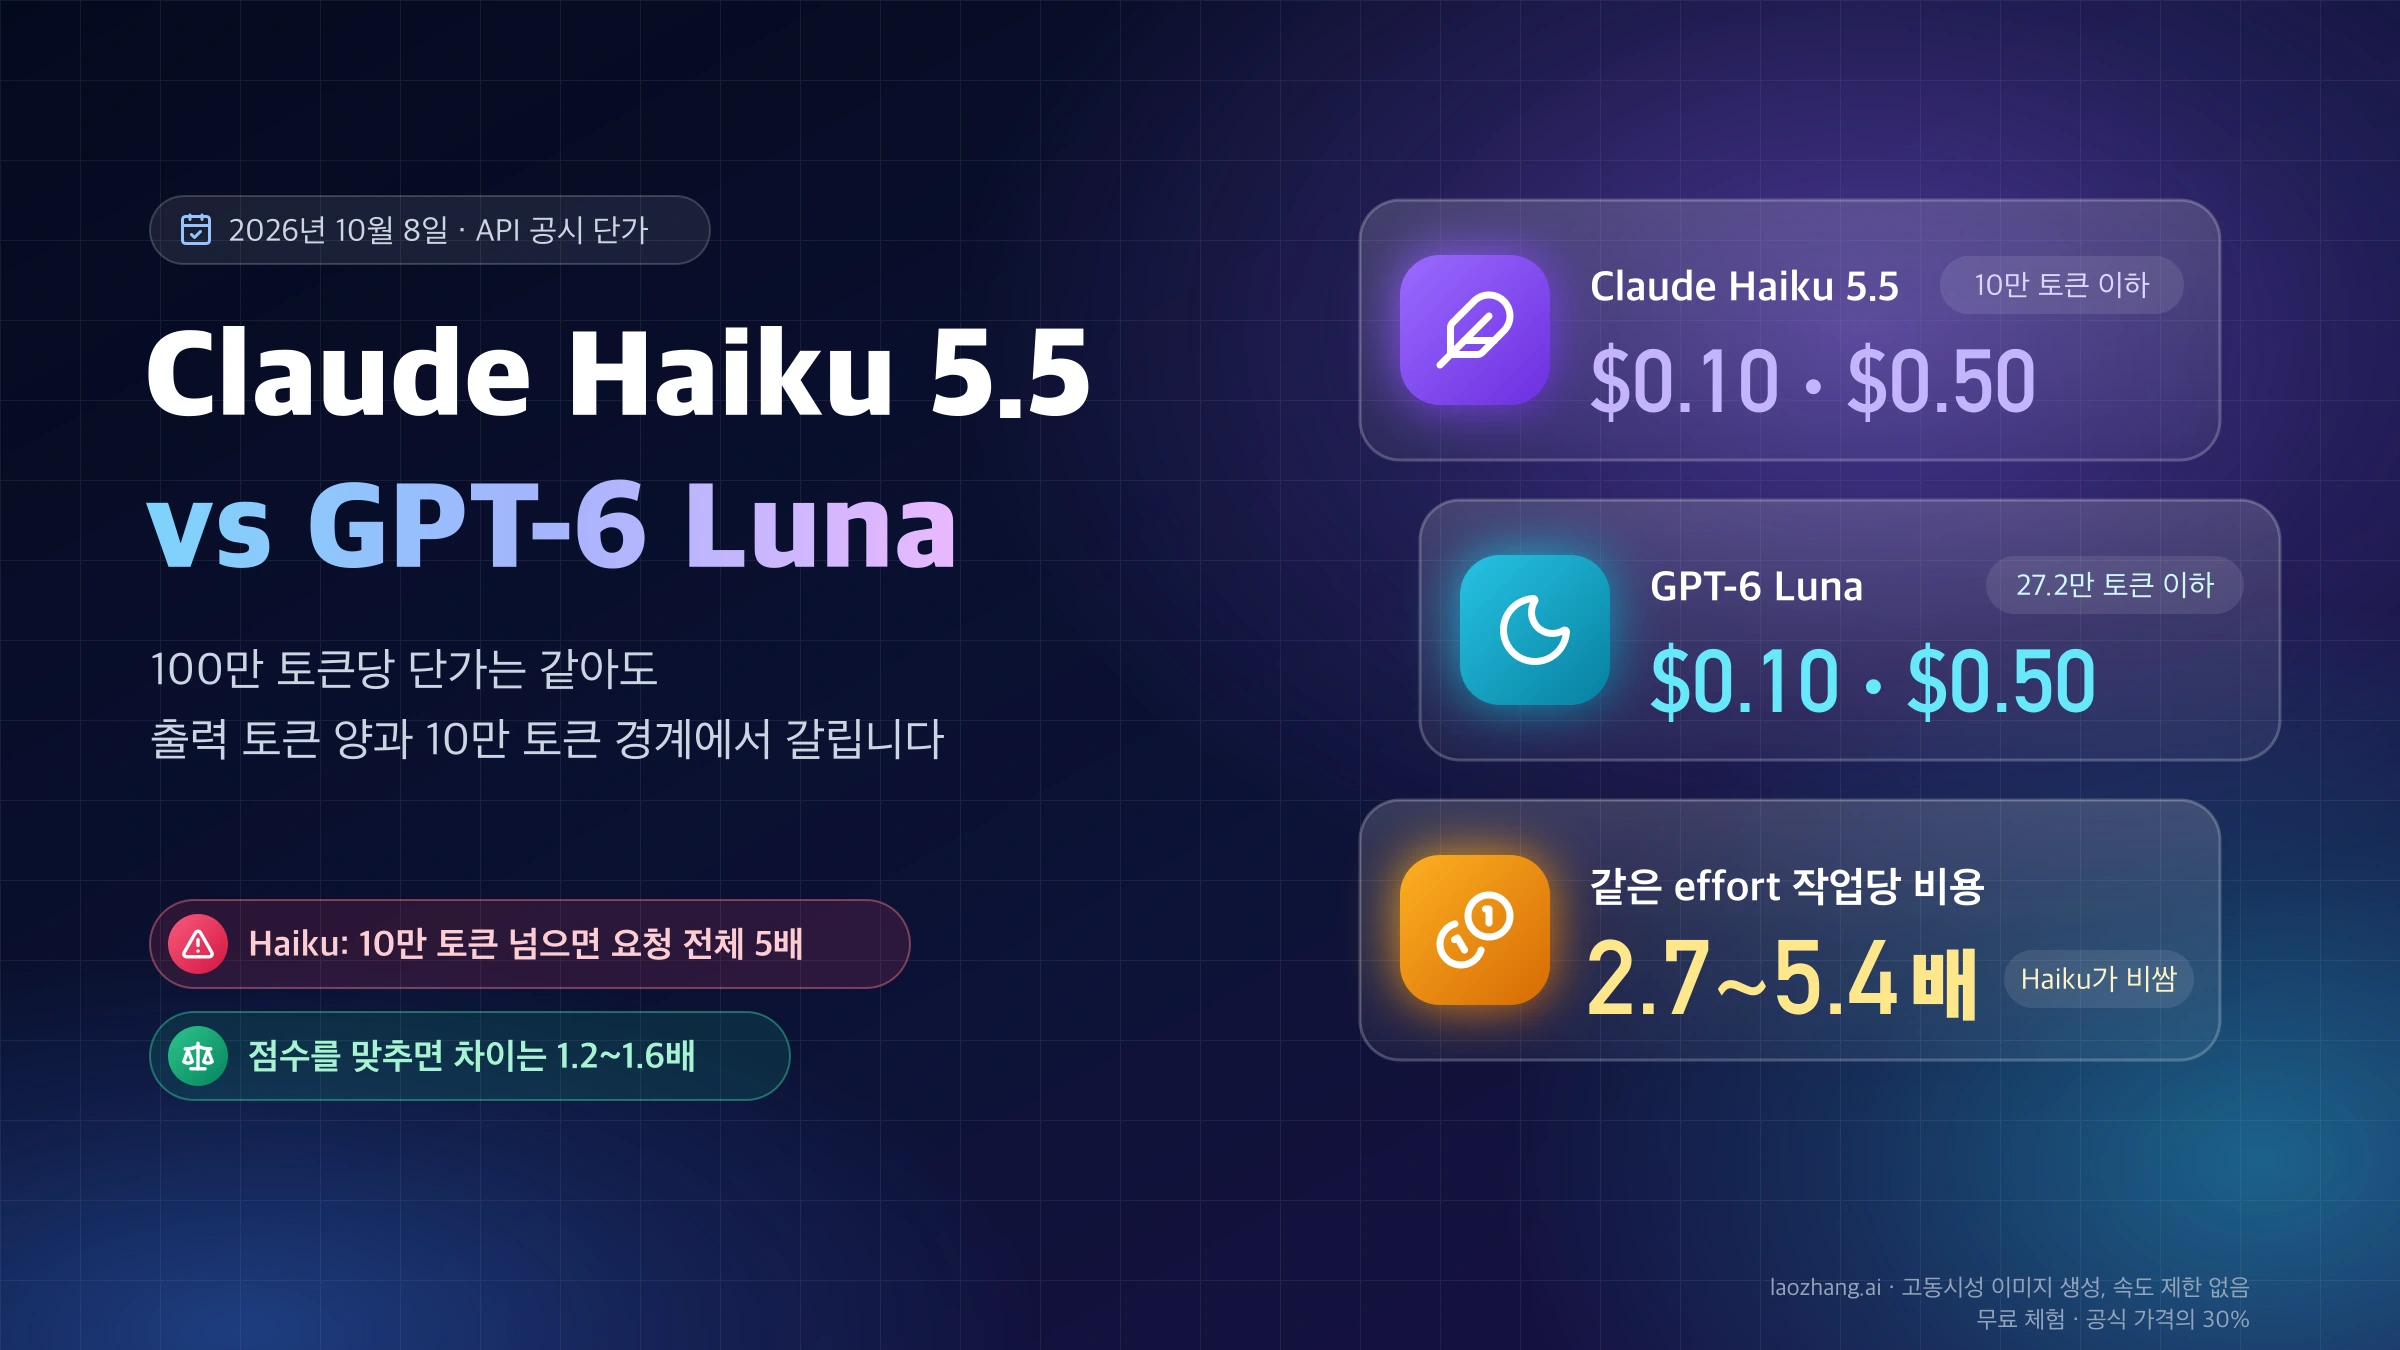
Claude Haiku 5.5가 있습니다. 2026년 10월 15일 기준 Haiku 5.5는 프롬프트 10만 토큰까지 Luna와 같은 입력 $0.10, 출력 $0.50을 받고, 10만 토큰을 넘으면 요청 전체가 5배가 됩니다. 기본 설정끼리의 작업당 비용은 Haiku가 Luna의 약 2.7배이며 자세한 비교는 Claude Haiku 5.5 vs GPT-6 Luna 비교: 단가 같고 작업당 비용 2.7~5.4배에, Anthropic 안에서 같은 20배 차이를 다룬 내용은 Claude Haiku 5.5 vs Sonnet 5.5 차이: 단가는 20배, 어떤 작업을 옮길까에 있습니다.
ChatGPT 무료 Luna와 Claude 무료 Sonnet도 같은 차이인가요?
앱 요금제에는 토큰 단가가 적용되지 않으므로 이 비교를 그대로 옮길 수 없습니다. OpenAI는 2026년 10월 7일 ChatGPT의 Free와 Go 요금제에 GPT-6 Luna를 쓴다고 발표했고, Claude 요금제 표는 Free 플랜에서 Sonnet을 쓸 수 있다고만 적고 버전은 밝히지 않습니다. ChatGPT 무료 사용 범위는 GPT-6 무료 사용: 무료 플랜은 GPT-6 Luna, Sol·Astra는 유료 요금제에서 확인할 수 있습니다.
참고 자료5
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 26일.
참고 자료5
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 26일.
- 1.Anthropic Claude API 가격 페이지platform.claude.com/docs/en/about-claude/pricing
- 2.OpenAI API 가격 페이지developers.openai.com/api/docs/pricing
- 3.OpenAI의 GPT-6 Luna 모델 페이지developers.openai.com/api/docs/models/gpt-6-luna
- 4.AA의 Claude Sonnet 5.5 vs GPT-6 Luna 비교 페이지artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-luna
- 5.Anthropic의 thinking 문서platform.claude.com/docs/en/build-with-claude/thinking