Claude Sonnet 5.5 vs GPT-6.1 Terra 비교: 실측 Sonnet 비용 2.8배
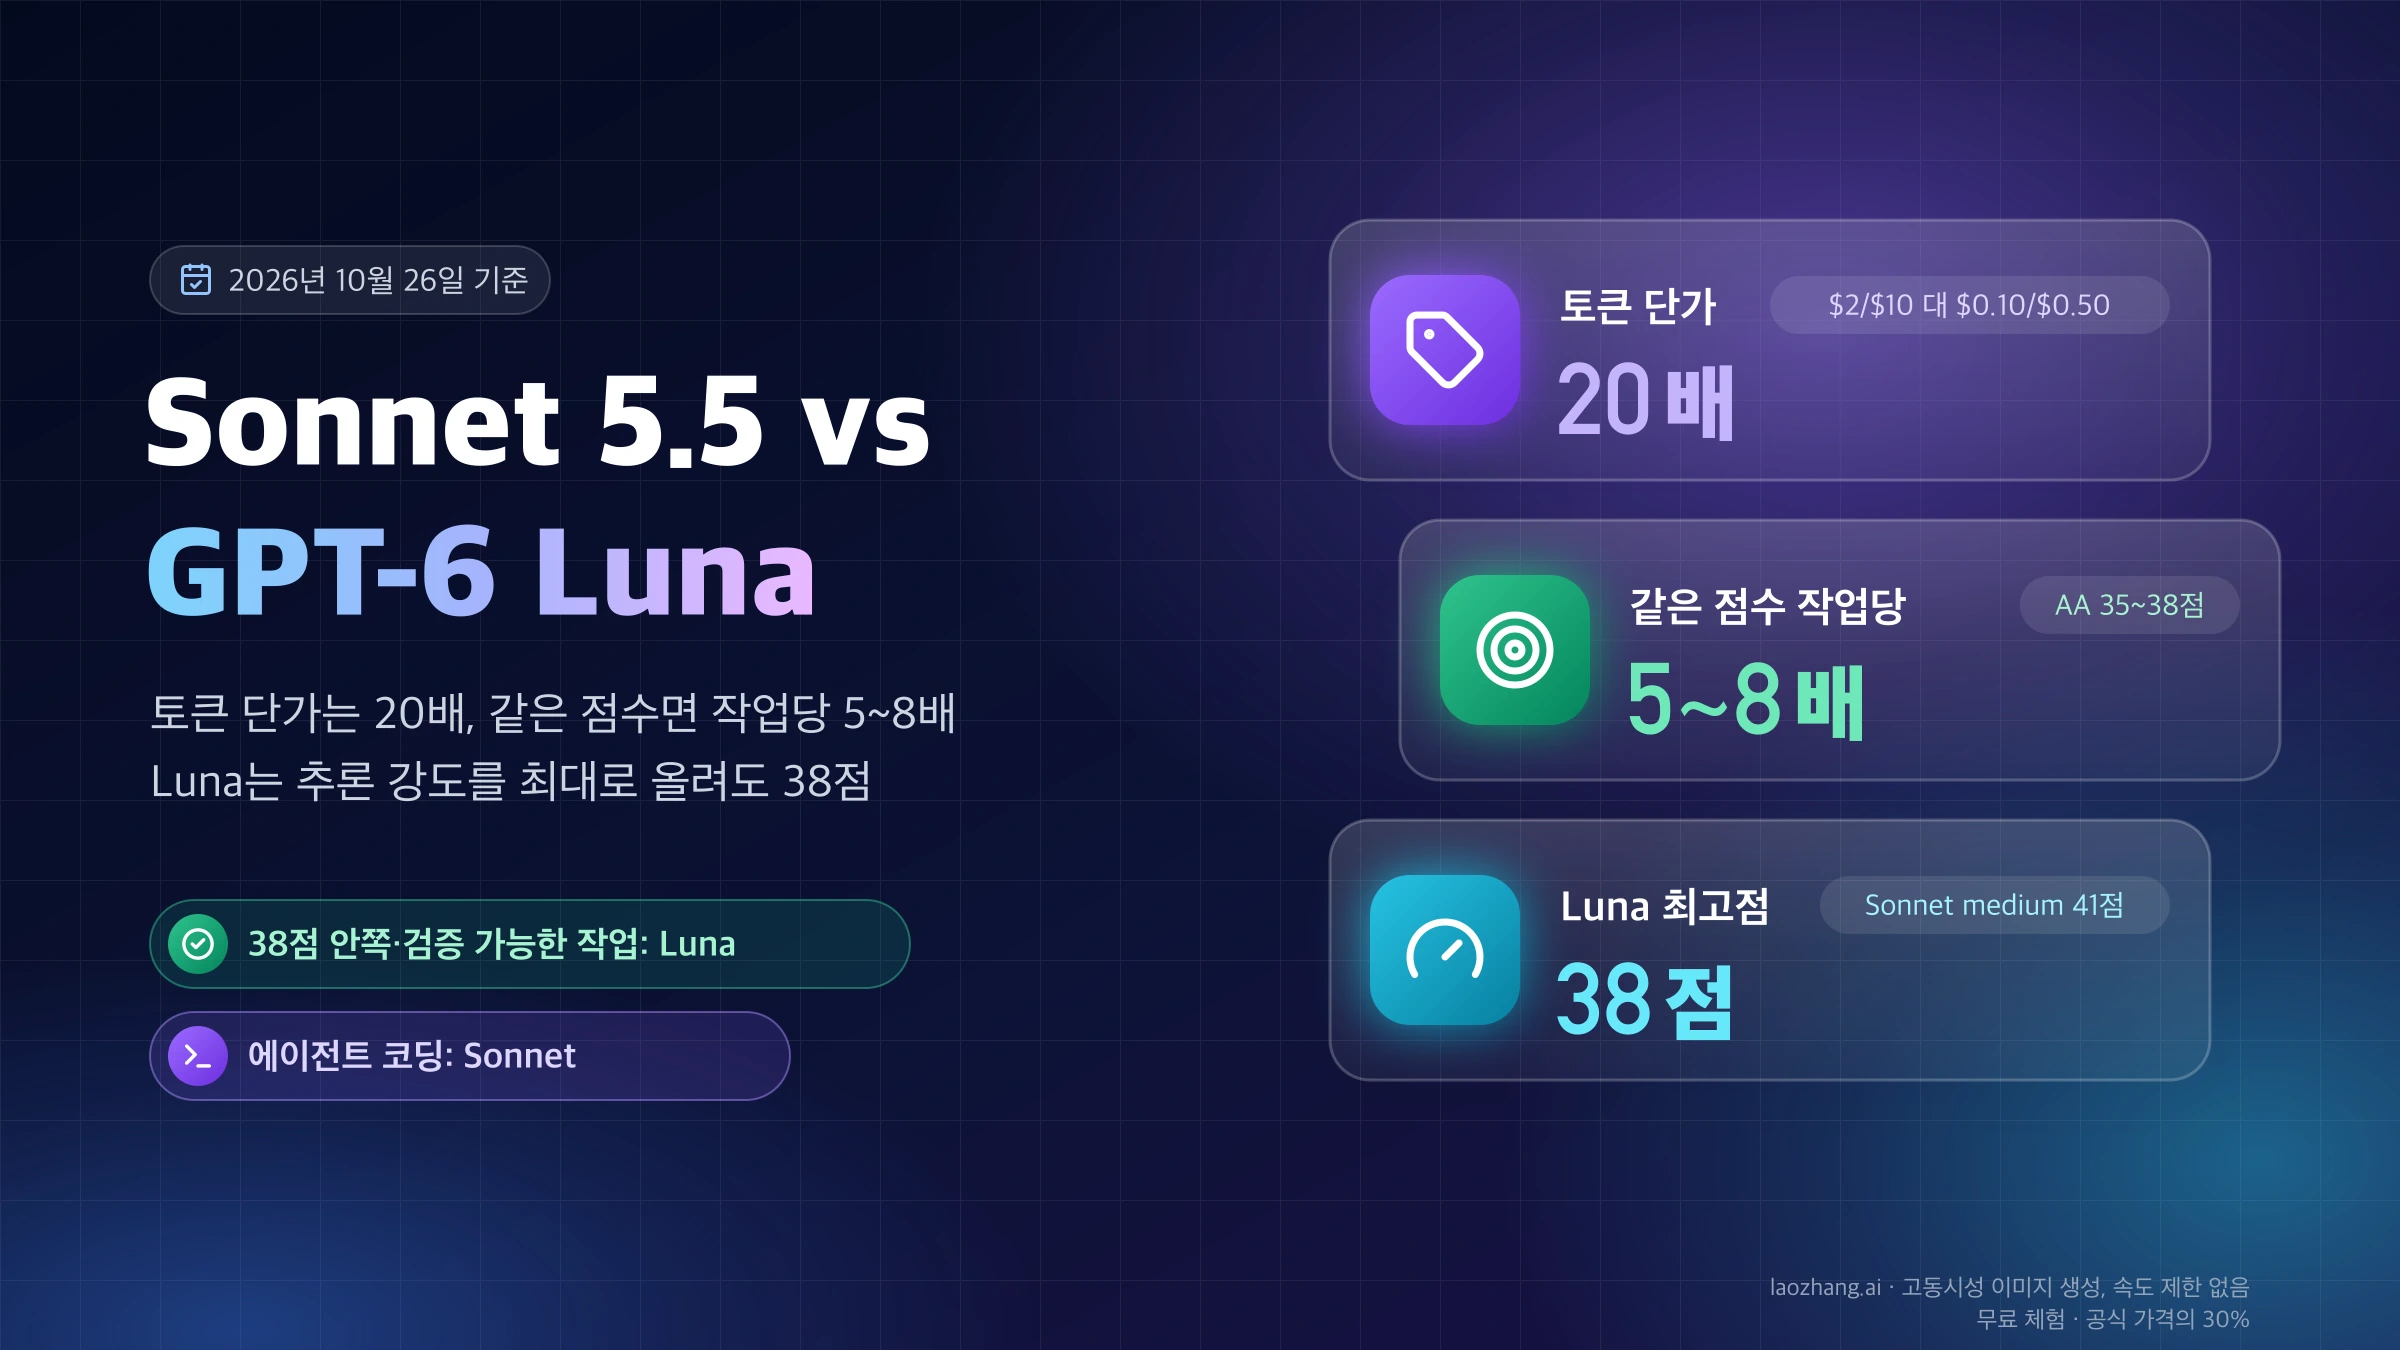
Claude Sonnet 5.5와 GPT-6.1 Terra를 같은 12개 작업으로 돌리면 Sonnet 비용이 2.84배였습니다. 채점 가능한 작업은 Terra medium부터 옮기세요.
목차
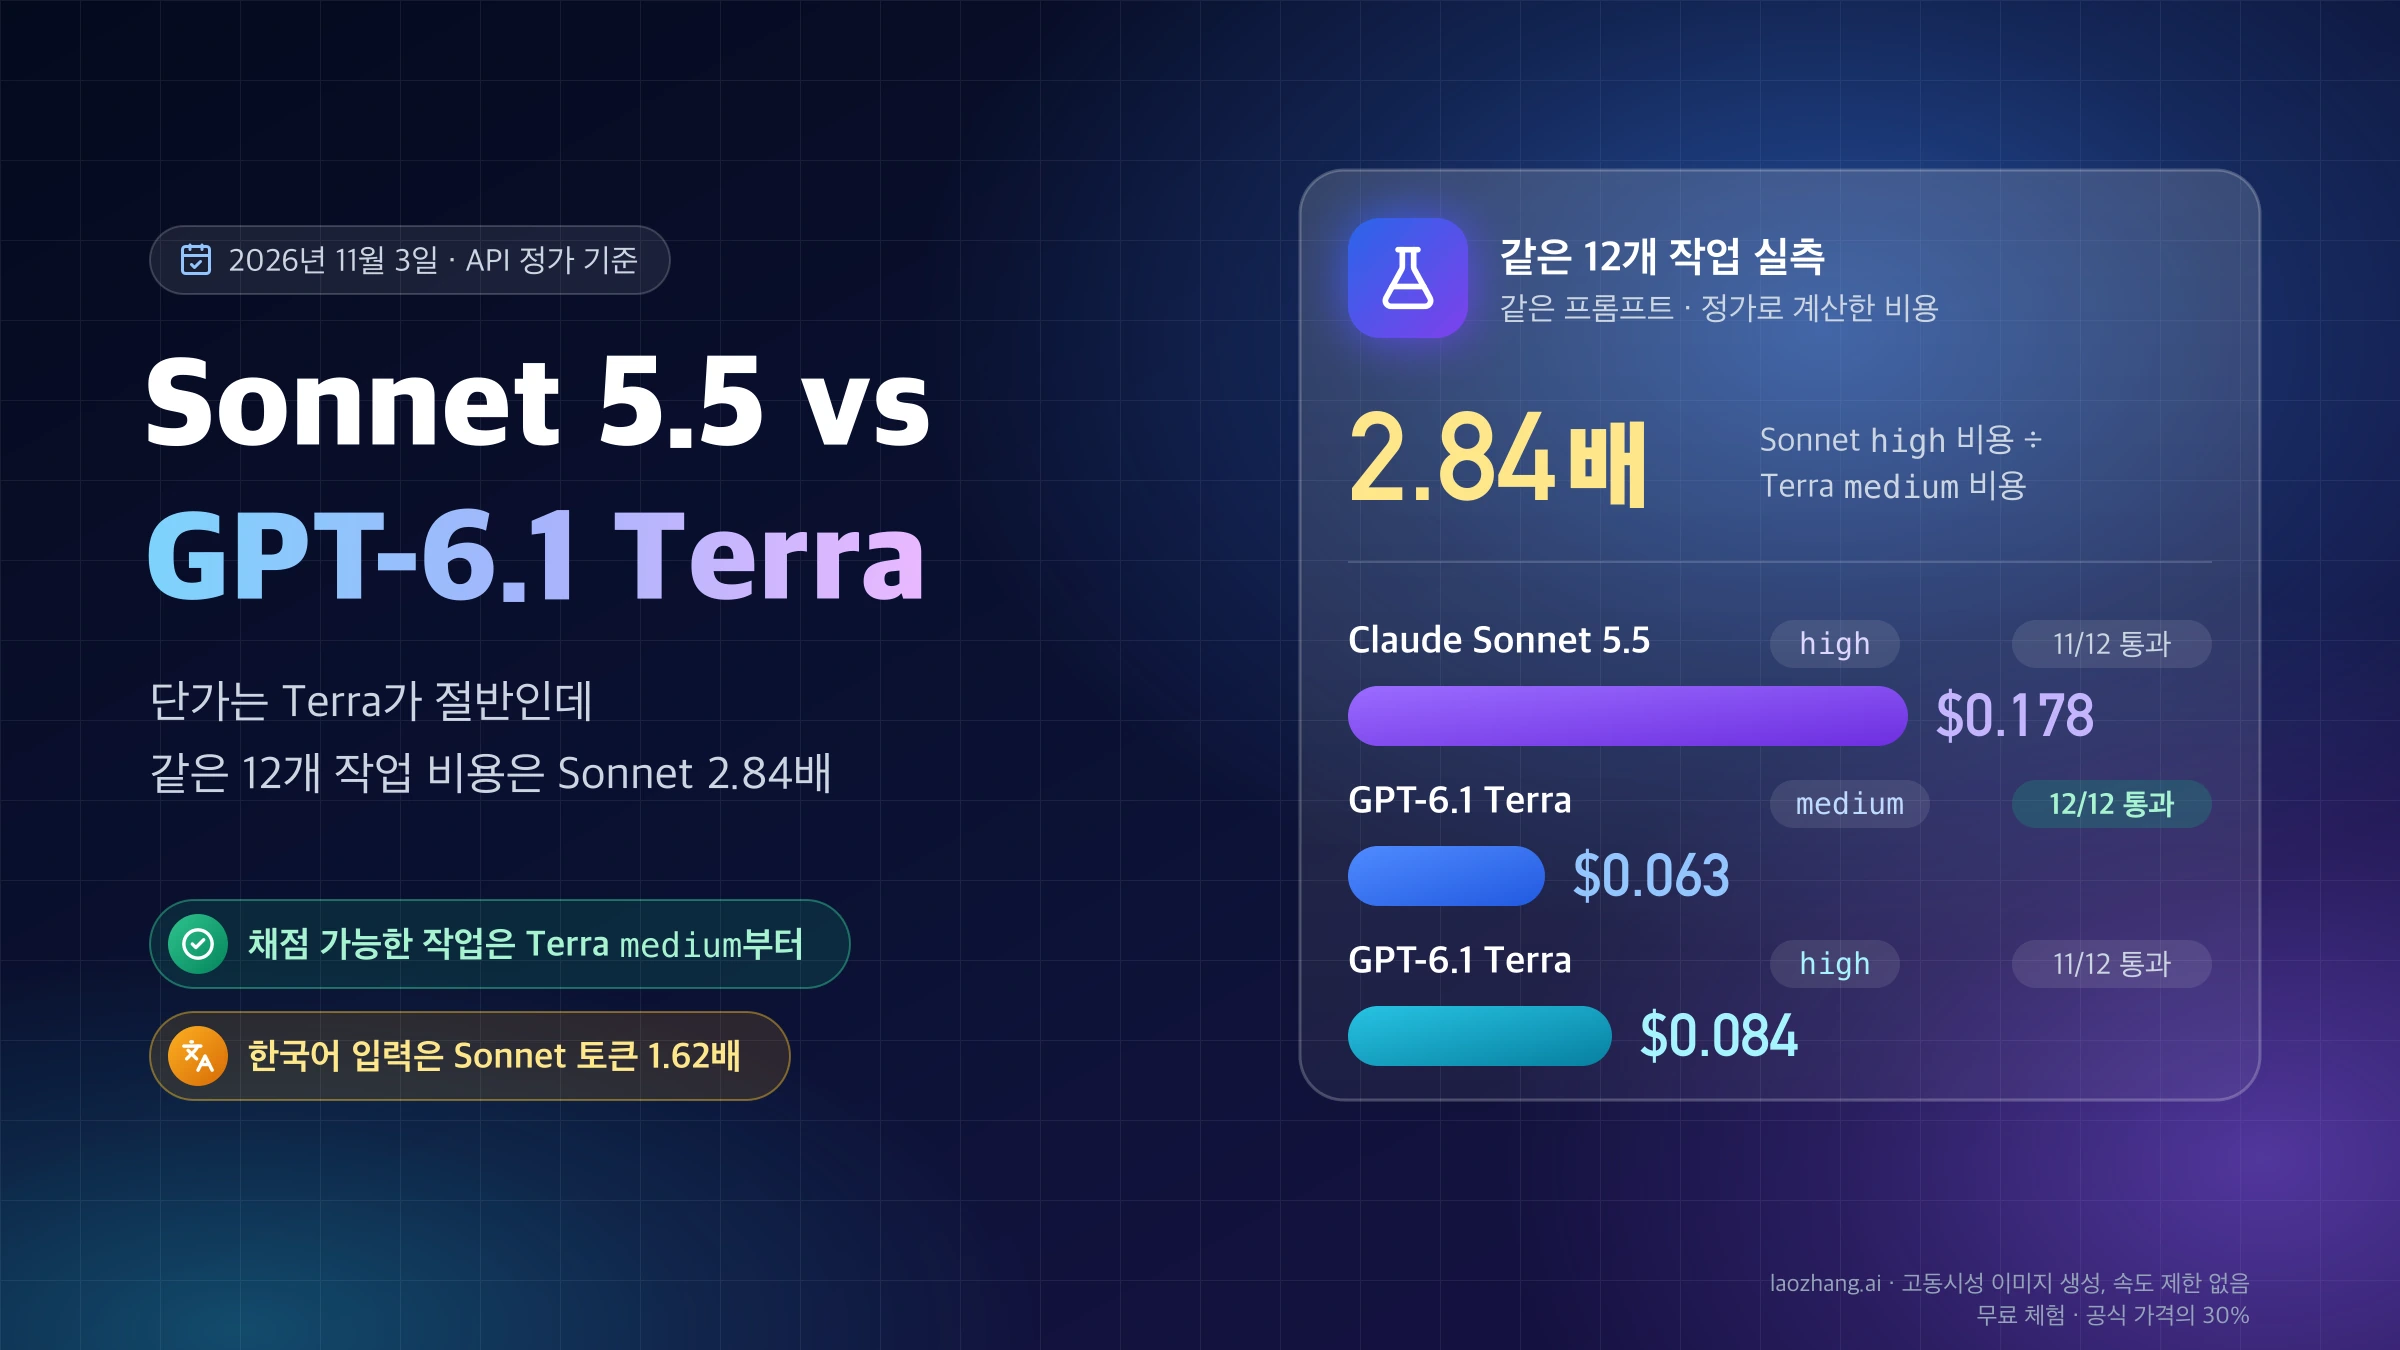
GPT-6.1 Terra(gpt-6.1-terra, 2026년 10월 26일 출시)의 100만 토큰당 단가는 입력 $1, 출력 $5로 Claude Sonnet 5.5(입력 $2, 출력 $10)의 절반입니다. 그런데 청구서는 절반에서 끝나지 않습니다. 2026년 11월 3일 숨은 테스트가 있는 12개 작업을 같은 프롬프트로 보냈을 때 Sonnet 5.5 high는 11개를 통과하며 $0.178, Terra medium은 12개를 통과하며 $0.063이 들어 Sonnet 쪽이 2.84배였습니다. 한국어로 쓴 같은 글은 Sonnet에서 토큰이 1.62배로 세어지므로, 단가 2배와 곱하면 한국어 입력만으로도 약 3.2배가 청구됩니다.
그래서 사양이 분명한 단발 코딩, 요약, 문서 질의처럼 결과를 채점할 수 있는 작업은 GPT-6.1 Terra를 medium으로 놓고 먼저 옮겨 보는 것이 맞습니다. Artificial Analysis 인텔리전스 지수(Intelligence Index) v5.0(2026년 11월 3일 기준)에서도 같은 이름의 추론 강도(effort)끼리는 high까지 Terra 점수가 Sonnet 이상이고, 작업당 비용은 4.6~7.3배 낮습니다. Sonnet 5.5에 남길 것은 터미널·업무 자동화처럼 여러 단계를 이어 가는 에이전트 작업과, Terra의 최고 설정으로도 닿지 않는 Sonnet max 수준이 필요한 작업입니다.
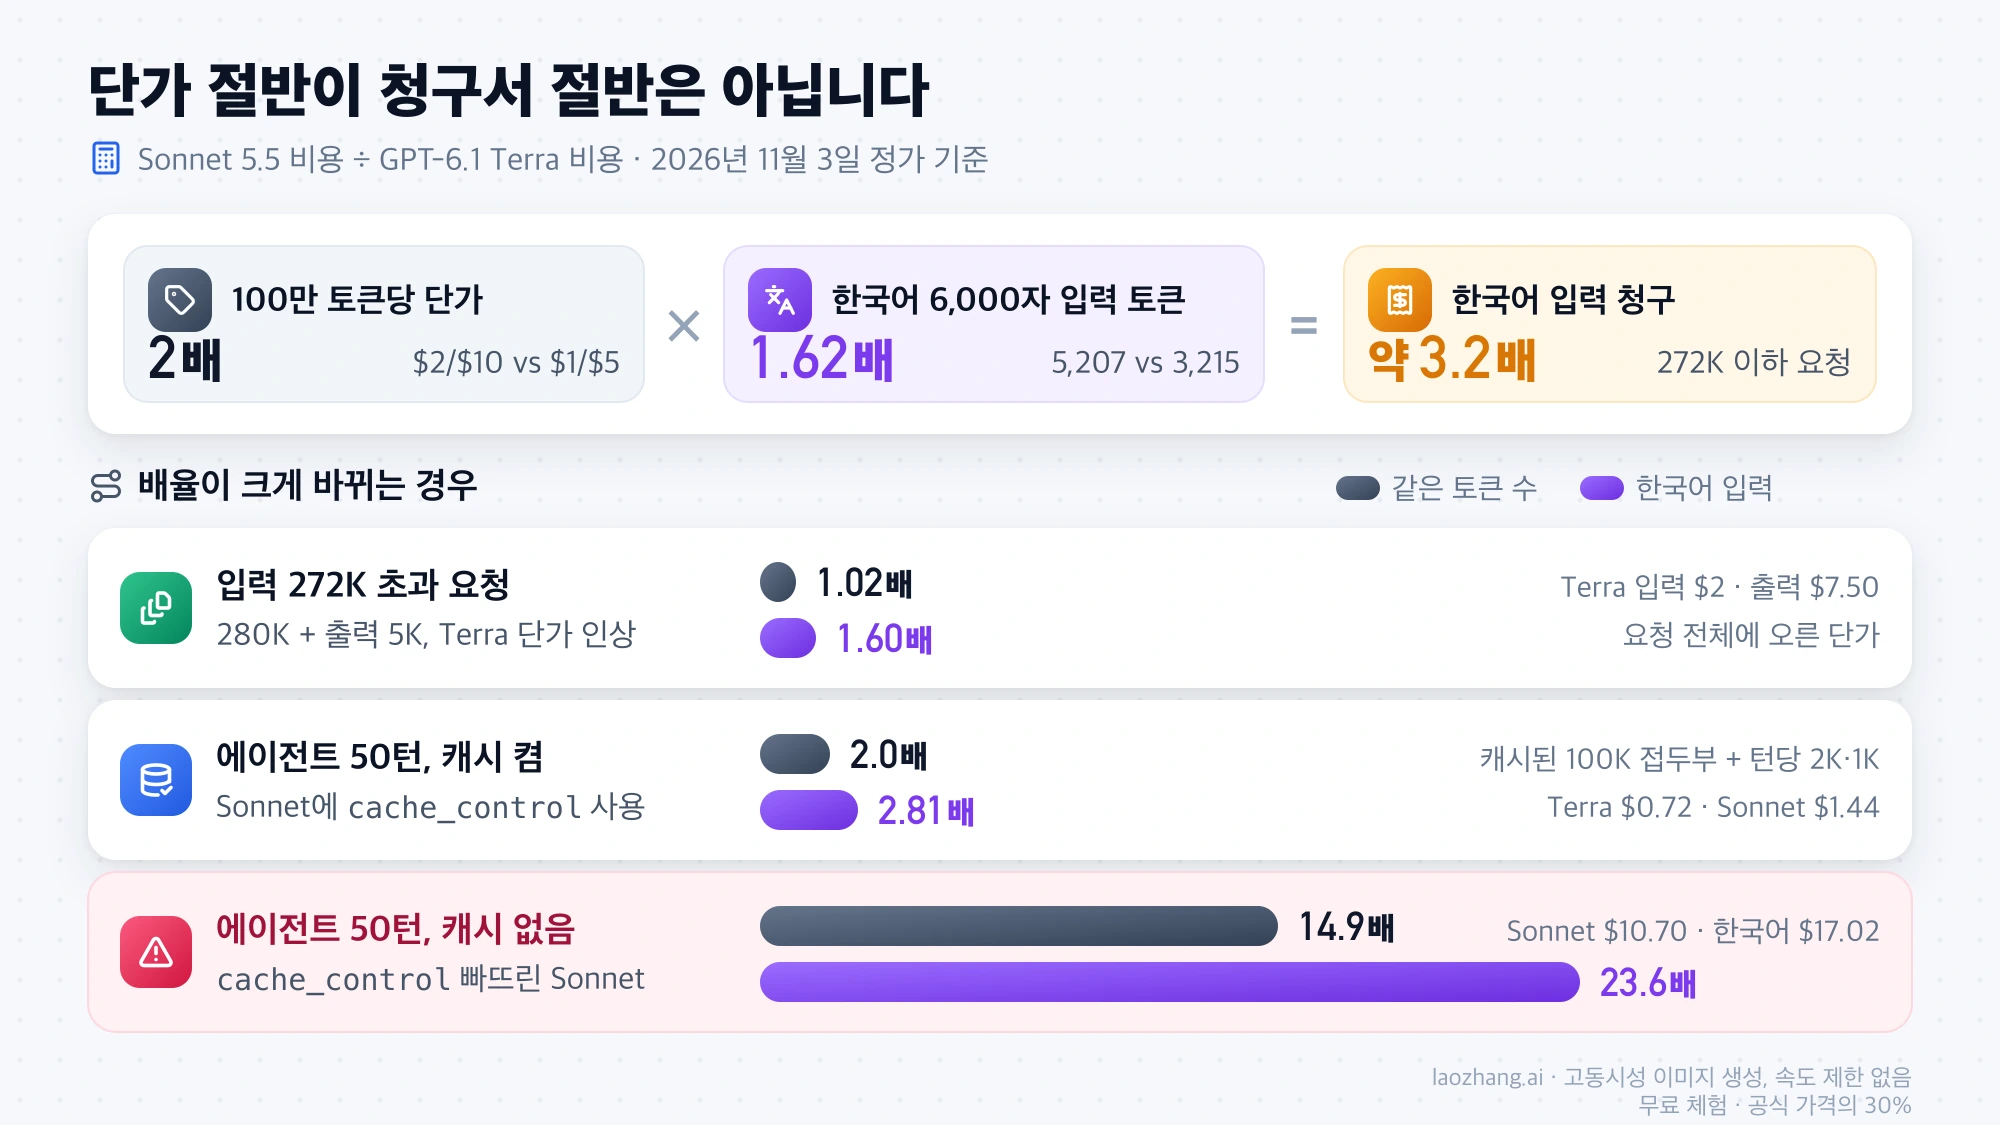
예외도 있습니다. 한 요청의 입력이 272K 토큰을 넘으면 Terra 단가가 올라 토큰당 가격 차이가 거의 사라지고, 에이전트 루프에서 Sonnet 요청에 cache_control을 넣지 않았다면 차이는 15배 안팎까지 벌어집니다. 도구 호출이나 Terra max를 쓰려면 Chat Completions가 아니라 Responses API로 요청해야 합니다.
Sonnet 5.5 작업 중 GPT-6.1 Terra로 옮길 것과 남길 것
옮길지 말지는 모델 이름보다 지금 Sonnet을 어떤 작업에, 어느 추론 강도로 쓰고 있느냐로 정해집니다. Anthropic의 Claude Sonnet 5.5 출시 발표에 따르면 Claude API의 기본 추론 강도는 high이고 Claude Code와 Claude 앱은 medium이므로, 같은 "Sonnet 5.5"라도 비교 기준이 다릅니다. 아래 표는 그 출발점별로 먼저 시험할 Terra 설정을 정리한 것이고, 판단 근거의 수치는 이어지는 절에서 설명합니다.
| 지금 Sonnet 5.5로 하는 일 | 먼저 시험할 GPT-6.1 Terra 설정 | 판단 근거 |
|---|---|---|
Claude Code·Claude 앱에서 medium으로 하는 코딩·문서 작업 | medium | AA 지수에서 Terra medium이 점수는 높고 작업당 비용은 낮음 |
API에서 high로 돌리는 단발 코딩·요약·추출 | medium, 기준에 못 미치면 high | 같은 12개 작업에서 세 설정 모두 11~12개 통과 |
| 분류·요약 같은 대량 일괄 처리 | low 또는 medium, Batch | 단가 절반에 한국어 입력 토큰 차이까지 더해짐 |
xhigh로 올려야 풀리던 어려운 문제 | max(Responses API) | 지수가 거의 같은 구간에서 작업당 비용이 약 4분의 1 |
| 터미널·업무 자동화 에이전트 | 둘 다 시험하되 기본은 Sonnet 유지 | Terminal-Bench·AutomationBench·Briefcase에서 Sonnet 우위 |
Sonnet max 점수가 필요한 작업 | 해당하는 Terra 설정 없음 | Terra 최고 지수가 Sonnet max보다 낮음 |
마지막 두 줄은 Terra를 쓰지 말라는 뜻이 아니라, 옮기기 전에 직접 비교해야 할 범위라는 뜻입니다. OpenAI도 GPT-6.1 Terra 출시 글에서 가장 복잡한 코딩 작업에는 GPT-6.1 Sol과 GPT-6 Astra가 더 낫다고 밝혔기 때문에, Terra는 반복 작업의 비용을 줄이는 쪽에 두는 것이 제조사 설명과도 맞습니다.
단가 절반이 청구서 절반일까: 한국어 입력은 같은 글에 약 3.2배
아닙니다. 청구액은 단가 × 토큰 수인데, 같은 텍스트라도 두 모델이 세는 토큰 수가 다르고 추론 강도에 따라 출력 토큰도 달라지기 때문입니다. 2026년 11월 3일 같은 한국어 본문 6,000자를 두 API에 보내 입력 토큰을 세자 Sonnet 5.5는 5,207개, GPT-6.1 Terra는 3,215개로 1.62배였습니다. 같은 방식으로 잰 영어는 1.43배, Python 코드는 1.46배였고, 측정한 6개 언어 가운데 한국어 차이가 가장 컸습니다. 단가가 2배이니 272K 이하 요청에서 같은 한국어 입력은 Sonnet 쪽이 약 3.2배(1.62 × 2)로 청구됩니다.
두 회사의 표준 API 단가는 다음과 같습니다(2026년 11월 3일 기준, 100만 토큰당 USD). 출처는 OpenAI API 요금 페이지와 Anthropic Claude API 요금 페이지입니다.
| 과금 항목 | Claude Sonnet 5.5 | GPT-6.1 Terra, 입력 272K 이하 | GPT-6.1 Terra, 입력 272K 초과 |
|---|---|---|---|
| 입력 | $2 | $1 | $2 |
| 출력(추론 토큰 포함) | $10 | $5 | $7.50 |
| 캐시 읽기 | $0.10 | $0.05 | $0.10 |
| 캐시 쓰기 | 5분 $2.50, 1시간 $4 | 30분 $1.25, 12시간 $2.50 | 30분 $2.50, 12시간 $5 |
Sonnet 5.5는 100만 토큰 창 전체를 같은 단가로 받지만, Terra는 입력이 272K를 넘으면 그 요청 전체에 오른 단가가 붙습니다. Batch는 두 모델 모두 절반이어서 Sonnet $1/$5, Terra(272K 이하) $0.50/$2.50입니다.
출력 쪽 차이는 추론 강도가 좌우합니다. 같은 12개 작업에서 같은 high로 맞추면 출력 토큰은 Sonnet 11,155개, Terra 11,375개로 거의 같았지만, Terra의 기본값인 medium은 7,149개로 Terra high보다 37% 적었습니다. Claude API에서 Sonnet을 기본 high로 쓰다가 Terra를 기본 medium으로 바꾸면 단가와 입력 토큰 차이에 출력량 차이까지 겹치기 때문에, 실제 청구 배율이 단가 비율 2배보다 커집니다.
추론 강도별 점수와 비용: 같은 점수면 Sonnet 4.3배
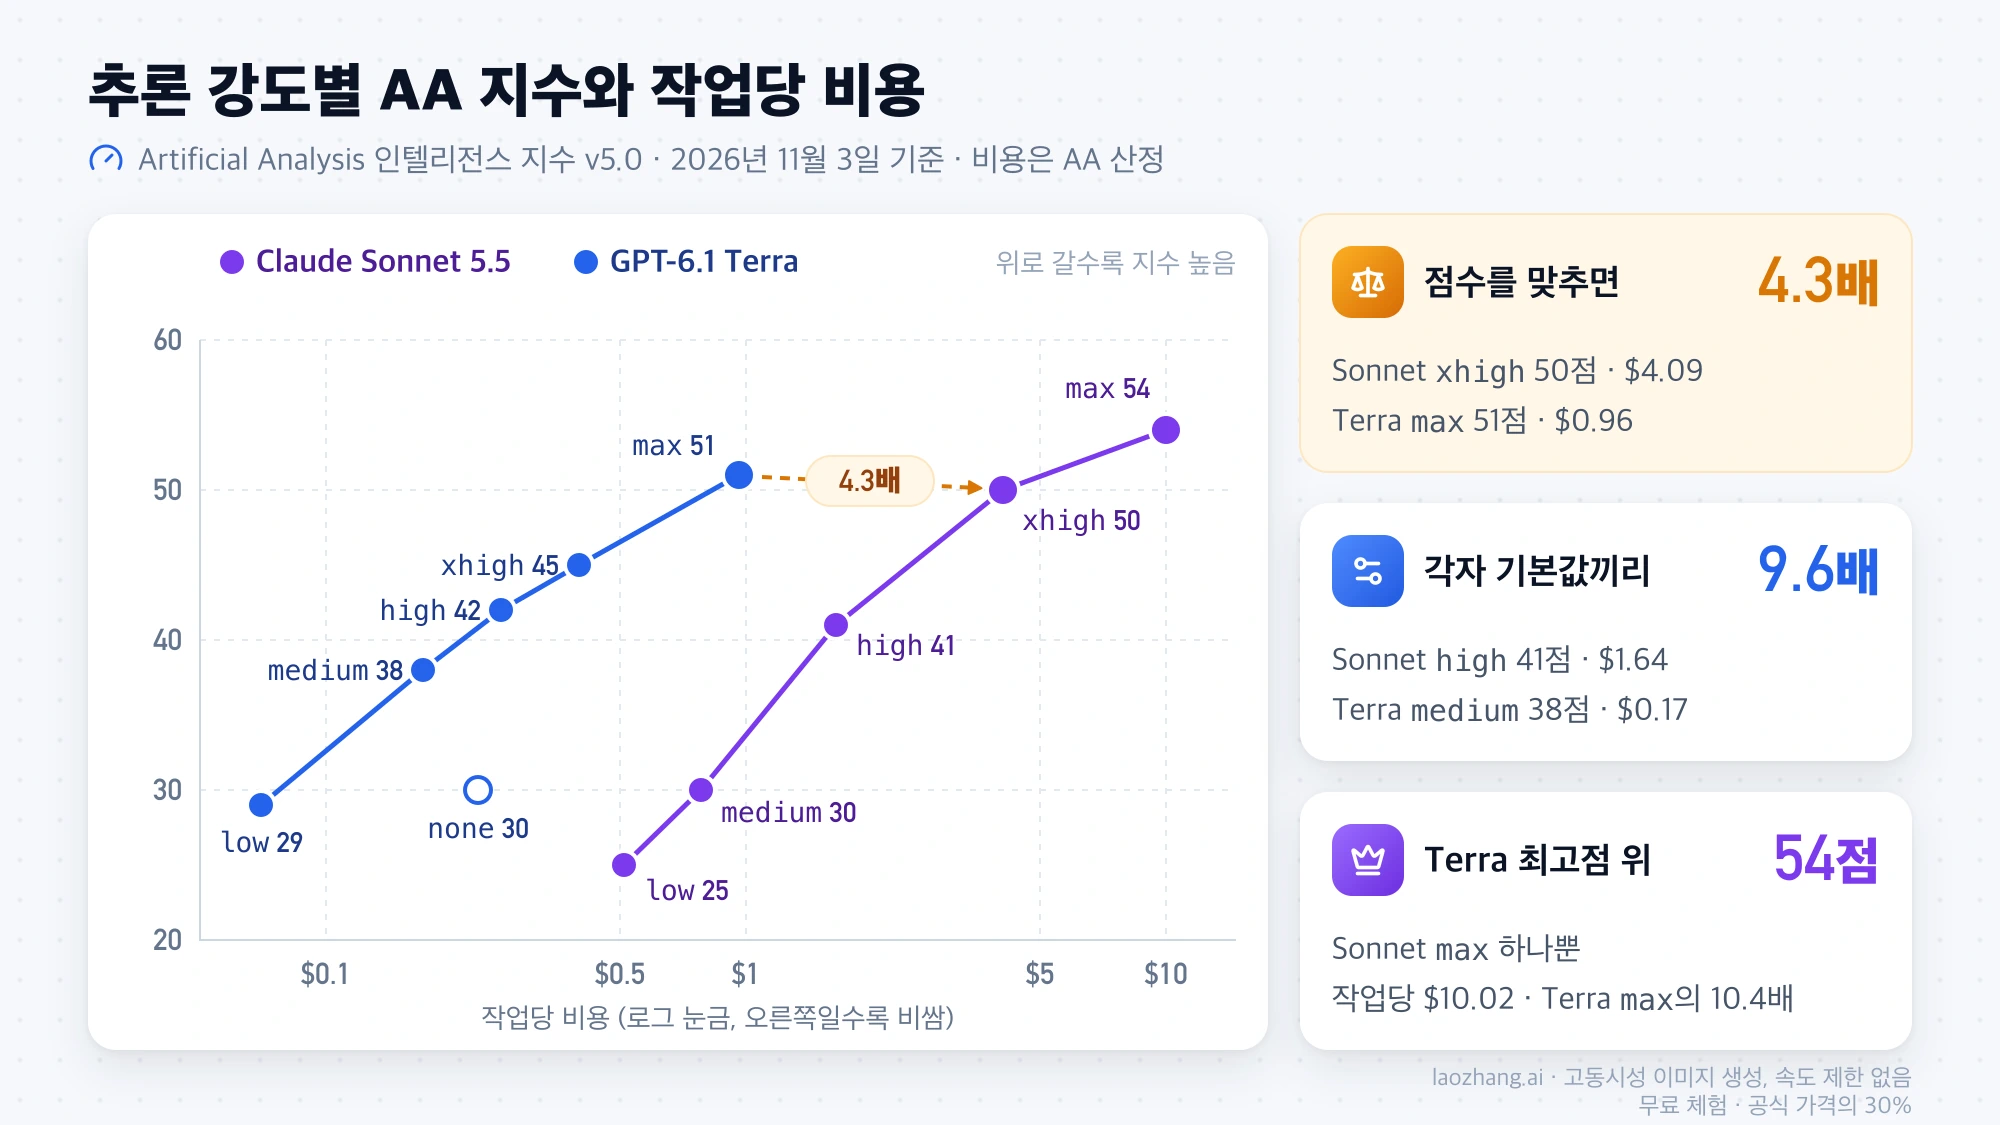
Artificial Analysis 인텔리전스 지수 v5.0(2026년 11월 3일 기준)으로 보면 같은 이름의 단계에서는 low부터 high까지 GPT-6.1 Terra 점수가 더 높고, xhigh와 max에서는 Sonnet 5.5가 앞섭니다. 다만 두 회사의 추론 강도 이름은 같은 연산량을 뜻하지 않으므로, 이름이 같은 칸보다 점수가 비슷한 칸끼리 비교해야 판단이 정확합니다. 아래 수치는 Artificial Analysis의 두 모델 단계별 비교이며, 작업당 비용은 AA가 자체 평가에서 쓴 토큰을 정가로 계산한 값(AA 산정), 시간은 AA의 작업당 소요 시간입니다.
| 추론 강도 | Claude Sonnet 5.5: 지수 / 작업당 비용 / 시간 | GPT-6.1 Terra: 지수 / 작업당 비용 / 시간 | 비용 배율 (Sonnet ÷ Terra) |
|---|---|---|---|
추론 없음(none) | 해당 없음 | 30 / $0.23 / 104초 | – |
low | 25 / $0.51 / 127초 | 29 / $0.07 / 48초 | 7.3배 |
medium | 30 / $0.78 / 190초 | 38 / $0.17 / 118초 | 4.6배 |
high | 41 / $1.64 / 344초 | 42 / $0.26 / 172초 | 6.3배 |
xhigh | 50 / $4.09 / 719초 | 45 / $0.40 / 248초 | 10.2배 |
max | 54 / $10.02 / 1,263초 | 51 / $0.96 / 533초 | 10.4배 |
각자의 기본값끼리 놓으면 차이가 더 분명합니다. Claude API의 Sonnet 기본값 high(41점, $1.64)와 Terra 기본값 medium(38점, $0.17)은 점수가 3점 차인데 작업당 비용은 9.6배, 시간은 2.9배입니다. Claude Code와 Claude 앱의 Sonnet 기본값 medium(30점, $0.78)은 Terra medium보다 8점 낮으면서 비용이 4.6배라, 이 출발점에서는 Terra로 옮겨도 점수가 내려가지 않습니다.
점수를 맞추면 Sonnet xhigh(50점, $4.09, 719초)에 대응하는 것은 Terra max(51점, $0.96, 533초)이고, Sonnet 쪽 작업당 비용이 4.3배, 시간이 1.35배입니다. Terra가 닿지 못하는 구간은 Sonnet max(54점) 하나뿐이며, 이 설정은 작업당 $10.02로 Terra max의 10.4배, 시간은 2.4배가 듭니다. 여기서 max는 각 모델의 설정 이름일 뿐 "최고 품질 보장"이라는 뜻은 아닙니다. 또 Terra max는 Chat Completions에서 받지 않으므로 Responses API로 보내야 합니다.
AA는 2026년 10월 27~28일 지수를 v4.3.2에서 v5.0으로 바꿨습니다. 옛 지수에서는 두 모델이 low(36점)와 medium(41점)에서 동점이고 xhigh가 52 대 45였지만, v5.0에서는 같은 이름의 단계에서 동점이 없고 모든 수치가 달라졌습니다. AA 점수를 인용할 때는 지수 버전과 기준 날짜를 함께 봐야 하는 이유입니다. 각 설정은 AA가 한 번씩 측정한 결과라는 점도 감안해야 합니다.
Sonnet 5.5가 앞서는 평가와 GPT-6.1 Terra가 앞서는 평가
지수가 거의 같은 Sonnet xhigh(50점)와 Terra max(51점)를 놓고 보면, Sonnet 5.5는 터미널 작업과 업무 자동화 평가에서, GPT-6.1 Terra는 코드 생성과 과학 문제 평가에서 앞섭니다. 총점이 같아도 강한 영역이 갈리므로, 내 작업이 어느 쪽에 가까운지에 따라 같은 지수에서도 결과가 달라질 수 있습니다. 수치는 위와 같은 AA v5.0 비교(2026년 11월 3일 기준)입니다.
| AA v5.0 평가 | Sonnet 5.5 xhigh (지수 50) | GPT-6.1 Terra max (지수 51) |
|---|---|---|
| Terminal-Bench 4.0 | 57.1% | 55.6% |
| AutomationBench-AA | 65.5% | 60.2% |
| AA-Briefcase v1.1 | 1744 | 1402 |
| HLE-Diamond | 44.1% | 47.3% |
| FrontierCode 2.0 | 35.6% | 42.3% |
| CritPt v2 (Hard) | 54.0% | 64.5% |
| Terminal-Bench-Science 0.1 | 52.4% | 57.6% |
Terminal-Bench는 이 구간에서 1.5%포인트 차이로 작지만, 양쪽 모두 max로 올리면 63.6% 대 55.6%로 벌어집니다. 여러 도구를 오가며 업무를 끝내는 AutomationBench와 Briefcase는 Sonnet 우위가 뚜렷하고, 코드 문제인 FrontierCode와 물리 연구 문제인 CritPt는 Terra 우위가 뚜렷합니다. 재무·전략·법률·의료·엔지니어링·경제 분야별 지수는 이 구간에서 0~4점 차이로 비슷하고, Sonnet을 max로 올리면 Terra max보다 4~9점 높아집니다. 그러니 에이전트형 업무 자동화가 주력이라면 Sonnet을 남길 근거가 있고, 채점 기준이 있는 코드·분석 작업이라면 Terra로 옮길 근거가 더 큽니다.
2026년 11월 3일 같은 프롬프트 테스트: 정답 수는 비슷, 비용은 2.84배
2026년 11월 3일 LaoZhang API 게이트웨이(laozhang.ai)의 API 키 하나로 두 모델에 같은 12개 작업을 한 번씩 보냈습니다. Sonnet 5.5는 Anthropic Messages 형식에 thinking: {"type":"adaptive"}와 output_config.effort: "high"를 넣었고, GPT-6.1 Terra는 Chat Completions에 reasoning_effort를 medium과 high로 바꿔 가며 max_completion_tokens 32,000으로 보냈습니다. 시스템 프롬프트와 도구 없이 사용자 메시지 하나만 보냈고, 비용은 각 응답의 사용량에 제조사 정가를 곱해 계산했습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
작업은 문장형 계산 문제, 구간 병합, 기간 문자열 파서(숨은 테스트 18개), 수식 계산기(25개), CSV 한 줄 파서(16개), 시맨틱 버전 비교(30개), npm 방식 버전 범위(36개), 6,700여 단어 글을 25단어 이하 5개 항목으로 요약하기, 긴 문서에 흩어진 메모 3개로 $76.80을 계산하기, 존재하지 않는 CPython 함수를 묻는 문제 등입니다.
| 설정 | 통과 | 정가 기준 비용 | 출력 토큰(그중 추론) | 입력 토큰 | 호출 시간 합계 |
|---|---|---|---|---|---|
Claude Sonnet 5.5 high | 11/12 | $0.1782 | 11,155 | 33,300 | 103초 |
GPT-6.1 Terra medium | 12/12 | $0.0628 | 7,149 (3,740) | 21,977 | 130초 |
GPT-6.1 Terra high | 11/12 | $0.0839 | 11,375 (7,816) | 21,977 | 176초 |
이 테스트가 보여 주는 것은 비용입니다. 같은 작업에 Sonnet high는 Terra medium의 2.84배, Terra high의 2.12배가 들었고, 작업별로는 Terra medium 대비 2.0~5.8배였습니다. 같은 high끼리는 출력량이 비슷했으므로 이 차이는 대부분 단가 2배와 입력 토큰 1.52배(작업 대부분이 영어 프롬프트)에서 나옵니다. 또 Terra는 캐시 설정을 하나도 넣지 않았는데도 약 10.1K 토큰짜리 긴 문서 프롬프트 두 개에서 캐시 쓰기 토큰 10,103개와 10,195개를 기록했고, cache_control을 보내지 않은 Sonnet에는 캐시 기록이 없었습니다.
반대로 이 테스트는 어느 모델이 더 똑똑한지를 보여 주지 않습니다. 빠진 두 개는 모두 같은 요약 작업에서 한 항목이 26단어로 제한을 1단어 넘긴 서식 실수였고, Sonnet은 2026년 10월 28일 같은 작업에서도 같은 실수를 했지만 표본이 하나씩이라 순위를 매길 근거가 되지 않습니다. 이 경로에서는 Sonnet이 12개 중 11개 작업에서 Terra medium보다 응답이 빨랐는데, AA의 작업당 시간과는 반대 방향입니다. 작업 종류와 측정 방식이 다르므로 어느 쪽이 일반적으로 빠르다고 말할 수는 없습니다. 도구 호출, 여러 턴의 에이전트, 이미지 입력, Responses API, 제조사 직접 엔드포인트, Sonnet의 다른 추론 강도와 Terra xhigh·max는 시험하지 않았으므로 그 부분의 판단은 AA 지수와 제조사 문서를 따릅니다.
내 청구서는 몇 배가 될까: 계산식과 한국어 입력 예시
자기 사용량으로 배율을 어림하려면 입력을 두 모델의 토큰 수로 따로 세고 단가를 곱하면 됩니다. Terra 기준 토큰 수에 언어별 배율(한국어 1.62, 영어 1.43, Python 코드 1.46)을 곱하면 Sonnet이 세는 입력 토큰이 나오고, 출력은 실제로 같은 프롬프트를 돌려 본 값을 쓰는 것이 가장 정확합니다. 100만 토큰 단위로 쓰면 계산식은 다음과 같습니다.
Sonnet 5.5          = 2 × 새 입력 + 2.5 × 5분 캐시 쓰기 + 0.1 × 캐시 읽기 + 10 × 출력   (100만 토큰까지 동일)
GPT-6.1 Terra ≤272K = 1 × 새 입력 + 1.25 × 30분 캐시 쓰기 + 0.05 × 캐시 읽기 + 5 × 출력
GPT-6.1 Terra >272K = 2 × 새 입력 + 2.5 × 30분 캐시 쓰기 + 0.1 × 캐시 읽기 + 7.5 × 출력 (요청 전체)
아래 예시는 출력 토큰을 양쪽에서 같다고 놓고, Terra 기준 토큰 수로 사용량을 적은 계산입니다(2026년 11월 3일 정가 기준).
| 사용 예 (Terra 기준 토큰) | GPT-6.1 Terra | Sonnet 5.5, 같은 토큰 수 | Sonnet 5.5, 한국어 입력(×1.62) |
|---|---|---|---|
| 채팅 1턴: 입력 2K + 출력 500 | $0.0045 | $0.0090 (2.0배) | $0.0115 (2.55배) |
| 문서 1건: 입력 270K + 출력 5K | $0.295 | $0.590 (2.0배) | $0.925 (3.13배) |
에이전트 50턴: 캐시된 100K 접두부 + 턴당 새 입력 2K·출력 1K, Sonnet에 cache_control 사용 | $0.72 | $1.44 (2.0배) | $2.02 (2.81배) |
| Batch 10,000건 × (입력 3K + 출력 1K) | $40 | $80 (2.0배) | $98.60 (2.47배) |
문서 1건을 예로 들면 Terra는 270K × $1 + 5K × $5 = $0.295이고, Sonnet은 한국어 입력이 270K × 1.62 = 437,400토큰이 되어 437,400 × $2 + 5K × $10 = $0.925입니다. 출력이 짧은 일에서는 입력 토큰 차이가 배율을 키우고, 출력이 긴 일에서는 2배에 가까워집니다. 실제로는 Terra medium이 Sonnet high보다 출력을 적게 쓰는 경우가 많아, 앞의 테스트처럼 표보다 배율이 커질 수 있습니다.
272K를 넘는 프롬프트, 캐시 없는 에이전트 루프에서는 배율이 바뀝니다
두 경우는 위 표에서 크게 벗어납니다. 첫째, GPT-6.1 Terra는 한 요청의 입력이 272K 토큰을 넘으면 요청 전체에 입력 $2, 출력 $7.50이 붙어 토큰당 가격이 Sonnet 5.5와 거의 같아집니다. 입력 280K + 출력 5K라면 Terra $0.5975, 같은 토큰 수의 Sonnet $0.61로 1.02배이고, 한국어 입력으로 계산해도 Sonnet $0.957로 1.60배에 그칩니다. 남는 차이는 토큰 수 차이뿐이고, 272K라는 경계는 Terra 기준이므로 같은 한국어 글이라면 Sonnet 기준으로 약 44만 토큰에 해당합니다.
둘째, 캐시 규칙이 다릅니다. Anthropic 프롬프트 캐싱 문서에 따르면 Claude는 요청에 cache_control(최상위 필드의 자동 지정이나 명시적 구간 지정)을 넣어야 캐시하고, 넣지 않으면 아무것도 캐시하지 않습니다. 반면 Terra는 설정 없이도 자동으로 캐시하고 캐시 쓰기를 청구합니다. 그래서 100K 접두부를 50턴 동안 다시 보내는 에이전트 루프에서 Sonnet 요청에 cache_control이 없으면 Sonnet은 같은 토큰 수 기준 $10.70으로 Terra $0.72의 14.9배, 한국어 입력 기준 $17.02로 23.6배가 됩니다. 두 모델을 비교하기 전에 Sonnet 쪽 캐시 설정부터 켜 두어야 공정한 비교가 됩니다.
한 번만 쓰는 긴 프롬프트에서는 반대로 Terra의 자동 캐시 쓰기가 조금 더 붙습니다. 앞의 테스트에서는 이 비용이 설정당 $0.0063 정도였으니 판단을 바꿀 크기는 아니지만, 정가 계산과 실제 청구가 맞지 않을 때 확인할 항목입니다.
어느 Terra인가: GPT-6.1 Terra와 GPT-5.6 Terra
이 비교의 Terra는 2026년 10월 26일 나온 GPT-6.1 Terra(gpt-6.1-terra)입니다. 이전 세대인 GPT-5.6 Terra(gpt-5.6-terra)도 2026년 11월 3일 기준 OpenAI 모델 페이지에 입력 $2, 출력 $12로 남아 있고 종료 일정도 없습니다. 이 모델은 단가가 Sonnet 5.5보다 낮지 않으므로 "Terra가 절반 가격"이라는 말은 6.1에만 해당합니다. 두 Terra와 GPT-6 라인업 전체의 차이는 GPT-6 Sol·Luna·Astra와 Terra 비교: 6.1 Terra 모델 ID·API 요금·선택 기준에 정리돼 있습니다.
ChatGPT·Codex의 Terra와 Claude 요금제의 Sonnet
구독으로 쓸 때는 두 모델이 열리는 자리가 다릅니다. GPT-6.1 Terra는 ChatGPT의 일반 채팅에는 없고 Work와 Codex에서만 고를 수 있으며, 출시 글 기준 Plus, Pro, Enterprise, Edu가 대상이고 Codex 문서에는 Business도 들어 있습니다. Claude Sonnet 5.5는 Claude 앱과 Claude Code에서 쓸 수 있고, 여기서는 기본 추론 강도가 medium이므로 앞의 AA 표에서 medium 줄과 비교해야 합니다. Claude Code에서 모델별로 어떤 추론 강도가 실제로 전송되는지는 Claude Code effort 설정과 차이: Opus 5.5 기본값 medium, 안 먹힐 때 해결을 참고하세요.
요금제 사용량은 API 단가와 따로 정해지는데, OpenAI Codex 요금 안내는 Plus 기준 5시간마다 Terra 로컬 메시지 35~285개(고정 한도 아님)를 제시하고, Anthropic은 요금제별 Sonnet 5.5 메시지 수를 공개하지 않습니다.
GPT-6.1 Terra로 바꾸기 전에 내 프롬프트로 확인하는 순서
옮길 후보를 정했다면 실제로 쓰는 프롬프트 몇 개로 작게 다시 확인하세요. 비용은 몇 센트에서 끝나고, 출력 형식이나 파라미터 차이처럼 표로는 드러나지 않는 문제를 먼저 잡을 수 있습니다.
- 지금 Sonnet 5.5에 자주 보내는 요청 10~20개를 고르고, 통과 기준을 먼저 적어 둡니다. 코드는 테스트, 요약은 길이와 항목 수, 계산은 정답 숫자처럼 기계적으로 판정할 수 있는 기준이 좋습니다.
- Sonnet 쪽 추론 강도를 명시합니다. API라면
high, Claude Code에서 쓰던 작업이라면medium으로 실제 쓰던 값과 맞추고, 반복되는 긴 접두부가 있으면cache_control도 넣습니다. - 같은 요청을 GPT-6.1 Terra
medium으로 보내고, 기준에 못 미치는 작업만high로 다시 보냅니다. Chat Completions에서는max_tokens대신max_completion_tokens를 쓰고, 도구 호출이나max가 필요하면 Responses API로 보냅니다. - 응답의 사용량에서 입력, 출력(추론 포함), 캐시 쓰기 토큰을 기록하고 위 계산식으로 정가 비용을 냅니다.
- 통과한 결과 1건당 비용으로 비교합니다. Terra가 몇 개 작업에서 계속 떨어지면 그 작업만 Sonnet에 남기면 됩니다.
요청 본문은 다음 형태로 2026년 11월 3일(Terra max는 2026년 10월 28일) 게이트웨이에서 HTTP 200을 받았습니다. 같은 경로에서 Terra에 max_tokens를 넣거나 Chat Completions에 reasoning_effort: "max"를 넣으면 HTTP 400이 돌아왔고, 지원 값은 none, low, medium, high, xhigh였습니다.
// GPT-6.1 Terra, POST /v1/chat/completions
{"model": "gpt-6.1-terra", "reasoning_effort": "medium", "max_completion_tokens": 32000,
 "messages": [{"role": "user", "content": "..."}]}

// GPT-6.1 Terra max, POST /v1/responses
{"model": "gpt-6.1-terra", "reasoning": {"effort": "max"}, "input": "..."}

// Claude Sonnet 5.5, POST /v1/messages
{"model": "claude-sonnet-5-5", "max_tokens": 32000,
 "thinking": {"type": "adaptive"}, "output_config": {"effort": "high"},
 "messages": [{"role": "user", "content": "..."}]}
게이트웨이를 거쳐 Sonnet을 부를 때는 thinking과 output_config.effort를 직접 넣는 편이 안전합니다. 2026년 10월 26일 같은 경로에서 thinking을 빼고 보낸 Sonnet 5.5 요청은 사고 블록 없이 답했기 때문에, 비교 대상이 의도한 설정과 달라질 수 있습니다. LaoZhang API로 Claude를 부르면 한 번의 출력이 32,768토큰으로 제한되고 Batch와 Files API는 쓸 수 없으므로, 긴 생성이나 일괄 처리를 비교할 때는 제조사 API에서 확인하세요.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
Sonnet 대 Sol, Opus 대 Terra 등 다른 조합이 궁금하다면
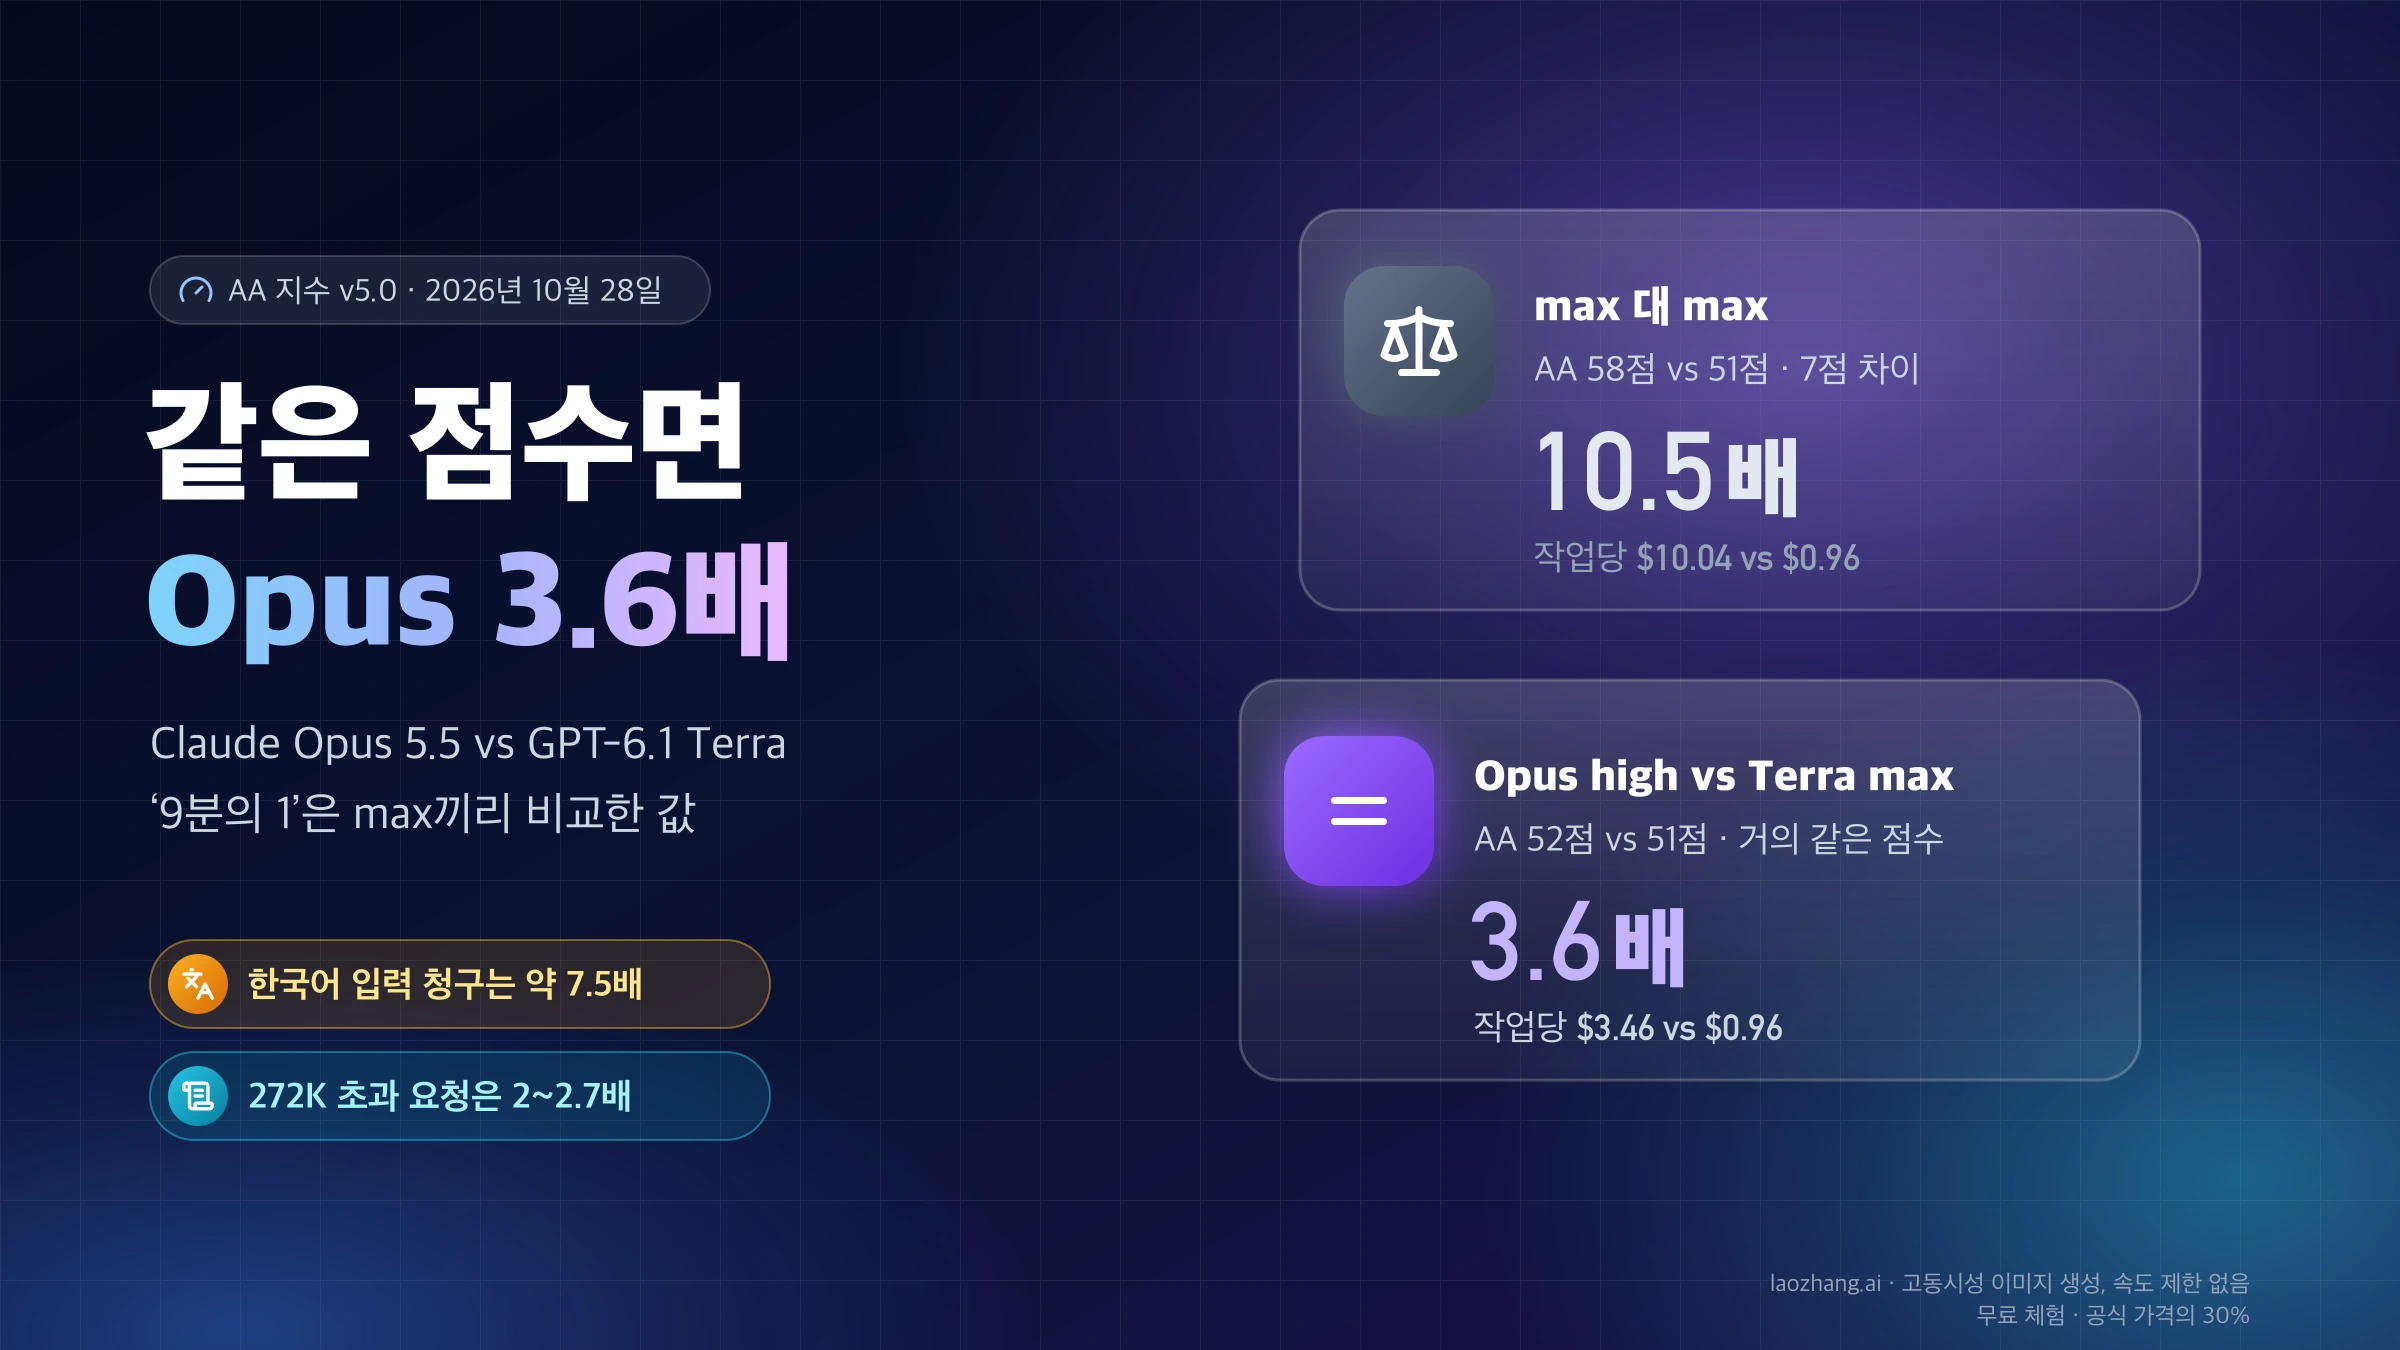
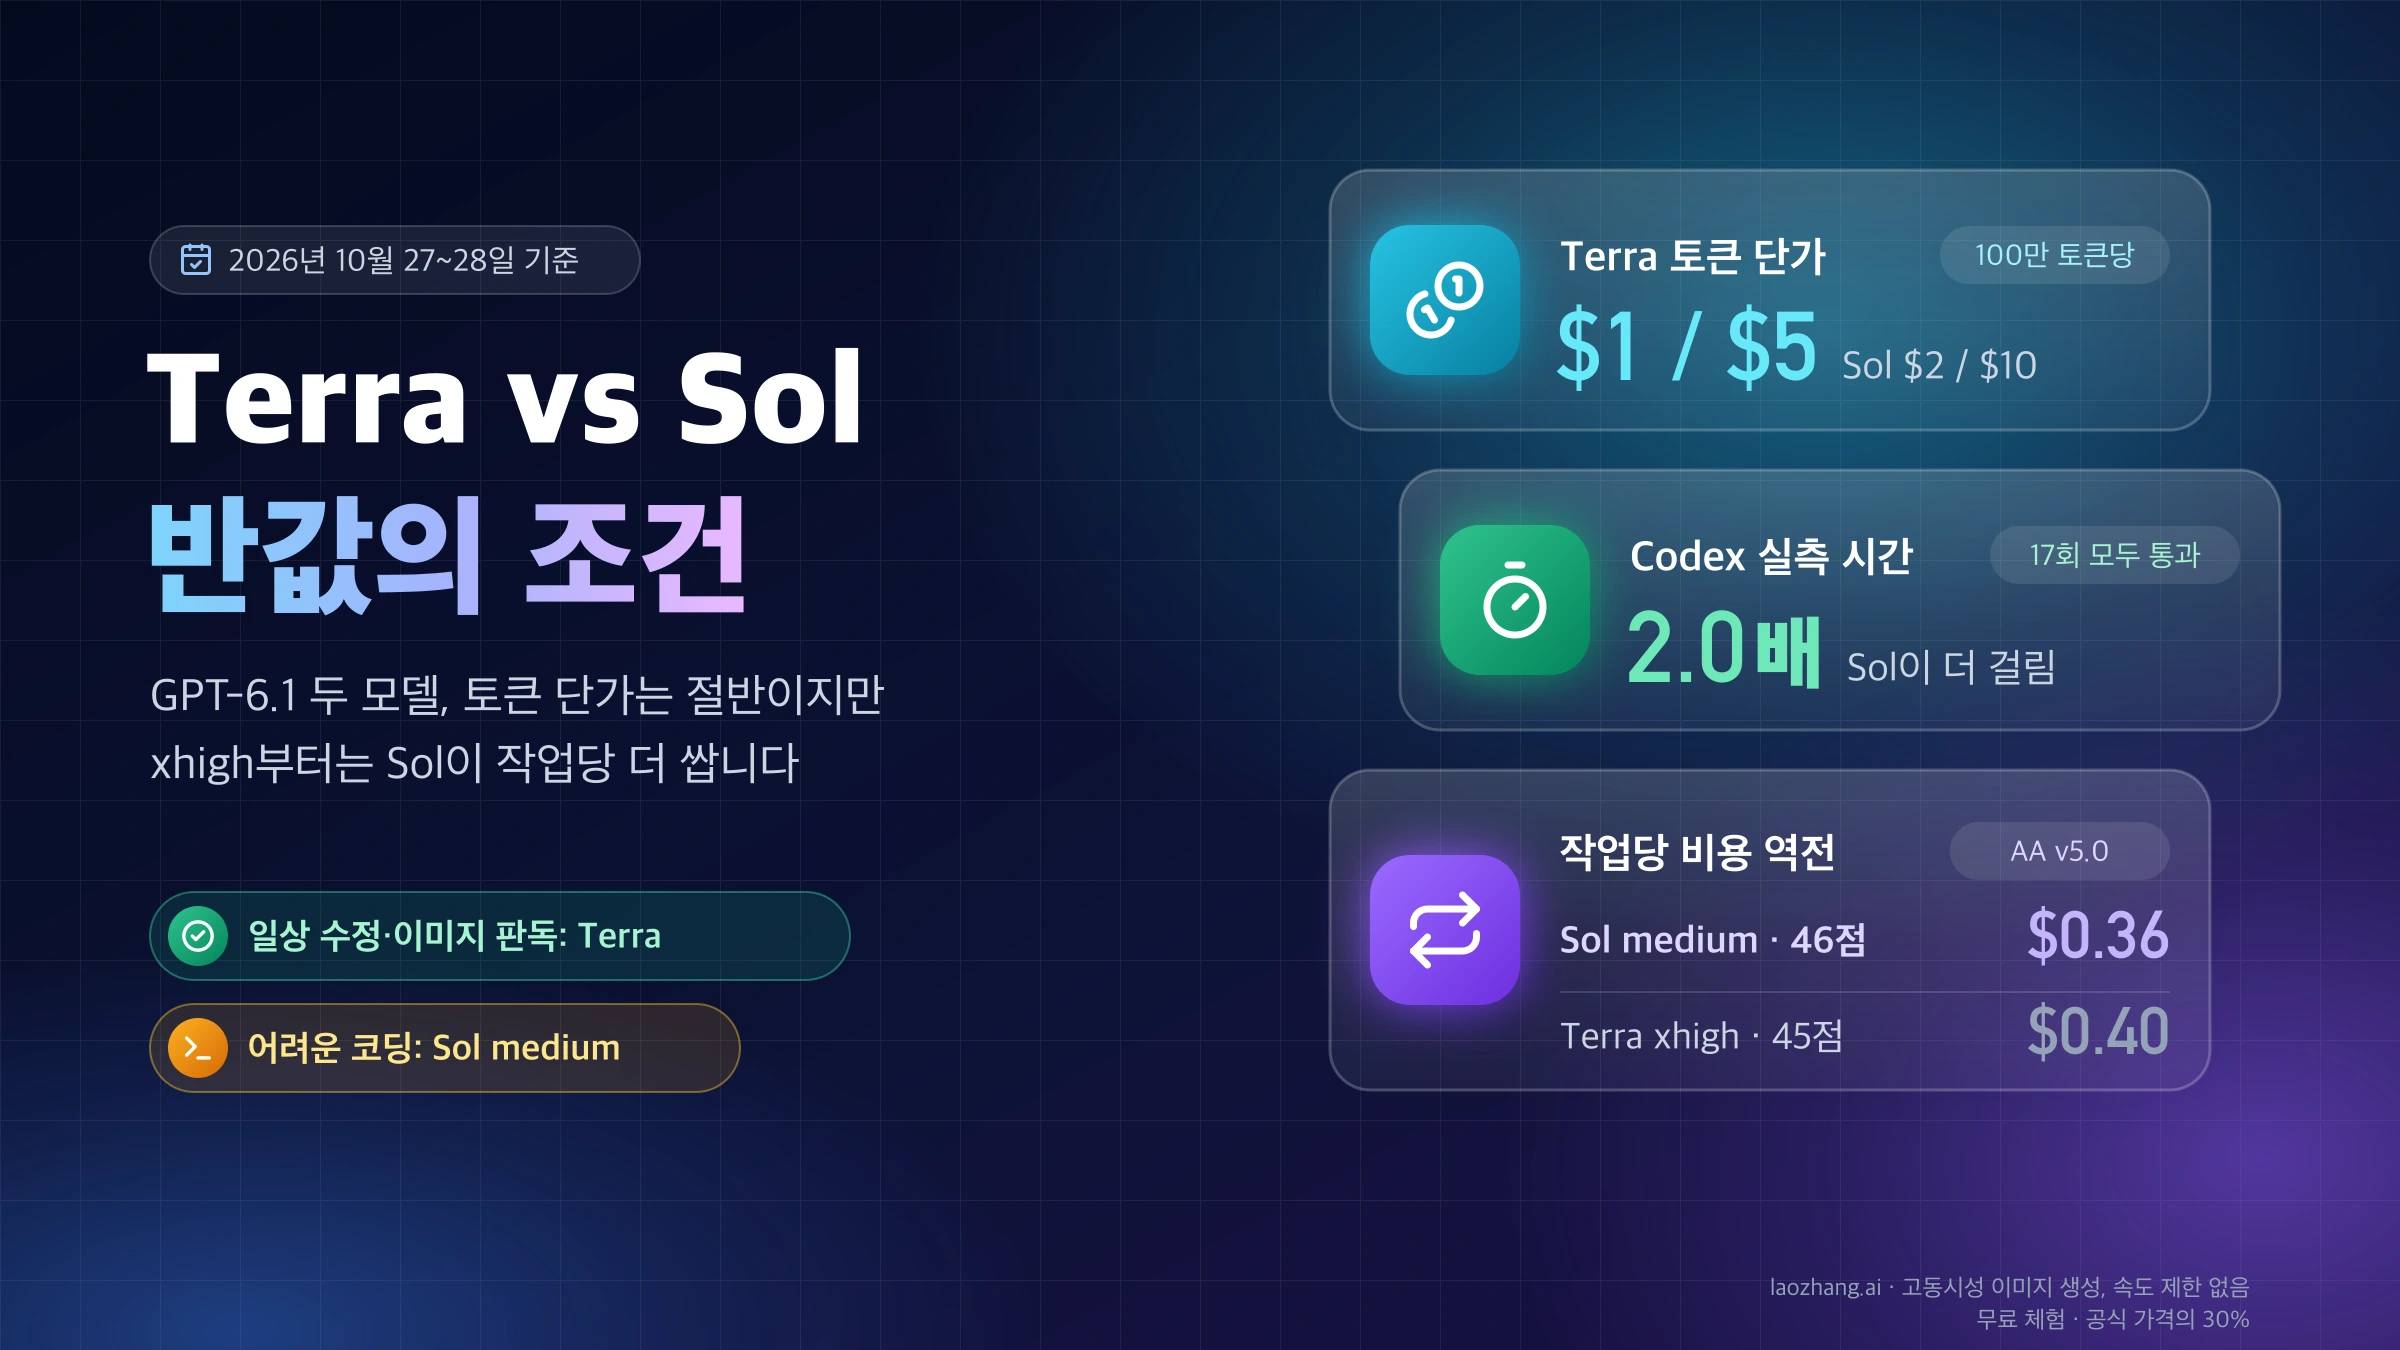
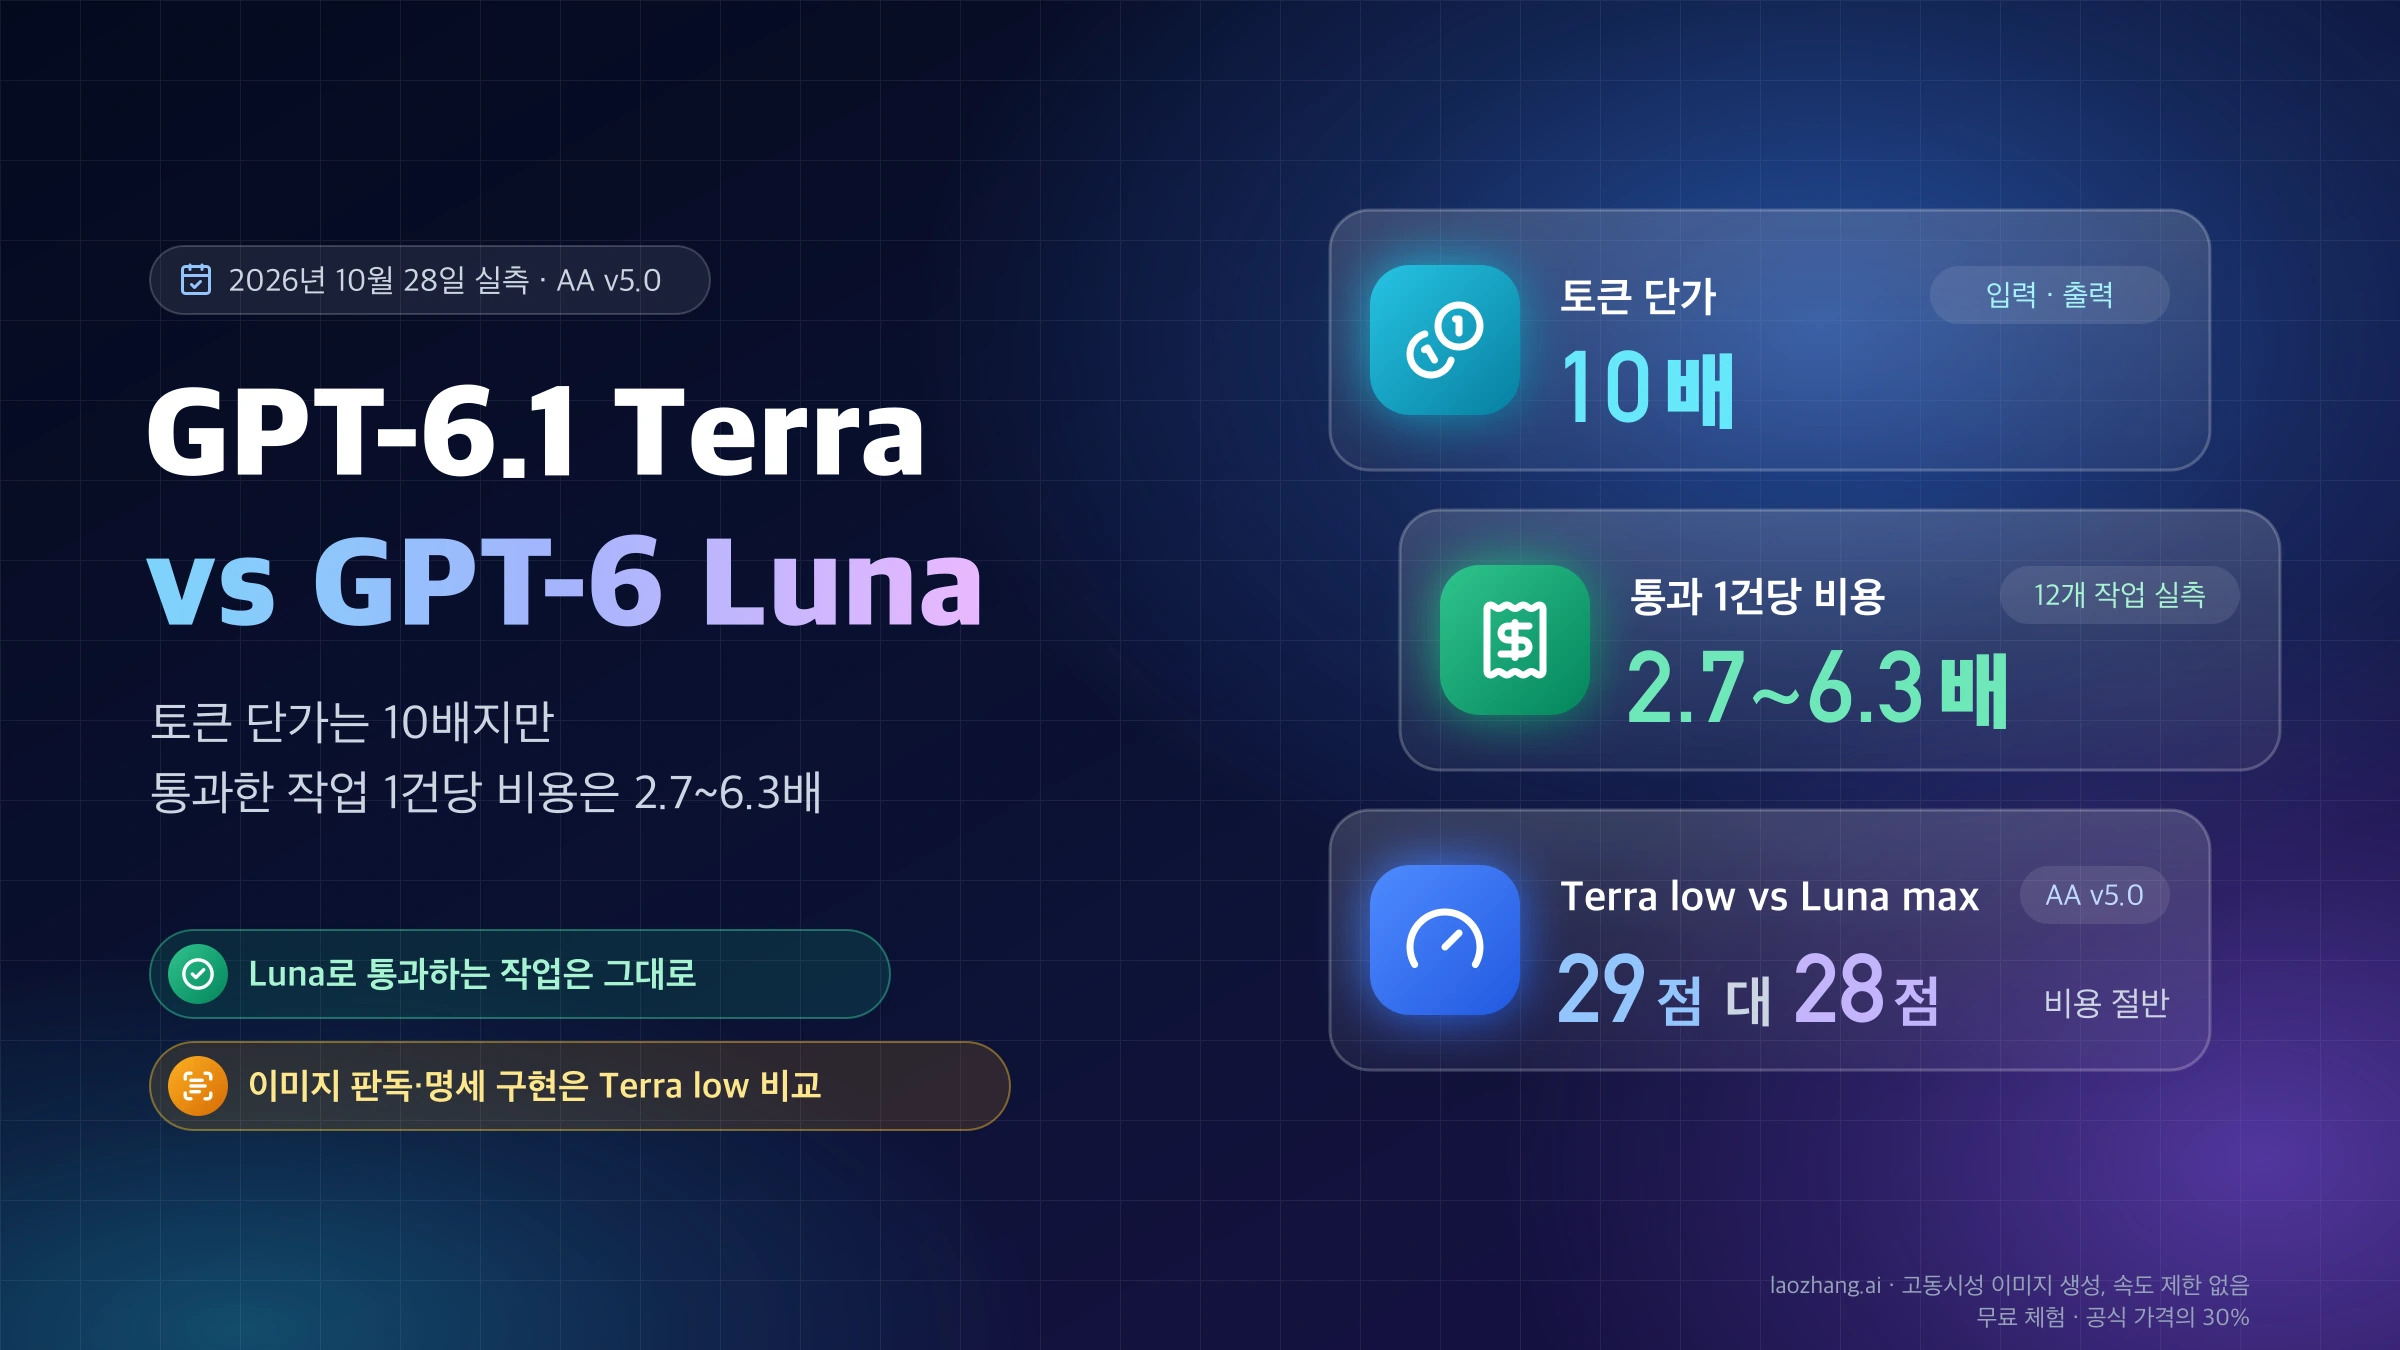
비교 대상이 바뀌면 단가 비율부터 달라지므로 각 조합은 따로 보는 편이 정확합니다. Sonnet 5.5와 단가가 같은 GPT-6.1 Sol과의 비교는 Claude Sonnet 5.5 vs GPT-6.1 Sol 비교: 같은 단가, 같은 점수면 7~8배에 있습니다. OpenAI가 출시 글에서 내세운 "작업당 비용 약 9분의 1"은 Sonnet이 아니라 Opus 5.5와 비교한 주장이며, 그 조건은 Claude Opus 5.5 vs GPT-6.1 Terra 비교: 같은 점수면 Opus 비용 3.6배에서 다룹니다. OpenAI 안에서 한 단계 위인 Sol과의 차이는 GPT-6.1 Terra vs GPT-6.1 Sol 비교: 가격 절반, Codex 실측 2배 빠름, 더 싼 Luna와의 차이는 GPT-6.1 Terra vs GPT-6 Luna 비교: 단가 10배, 실측 작업당 2.7~6.3배를 보세요. Sonnet 5.5가 이전 Sonnet 5와 비교해 추론 강도별로 얼마나 달라졌는지는 Claude Sonnet 5.5 가격과 성능: Sonnet 5 대비 effort별 비용, 전환 방법에 정리돼 있습니다.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 3일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 3일.
- 1.Claude Sonnet 5.5 출시 발표anthropic.com/news/claude-sonnet-5-5
- 2.GPT-6.1 Terra 출시 글openai.com/index/introducing-gpt-6-1-terra
- 3.OpenAI API 요금 페이지developers.openai.com/api/docs/pricing
- 4.Anthropic Claude API 요금 페이지platform.claude.com/docs/en/about-claude/pricing
- 5.Artificial Analysis의 두 모델 단계별 비교artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-1-terra
- 6.Anthropic 프롬프트 캐싱 문서platform.claude.com/docs/en/build-with-claude/prompt-caching
- 7.OpenAI Codex 요금 안내learn.chatgpt.com/docs/pricing