모델 비교
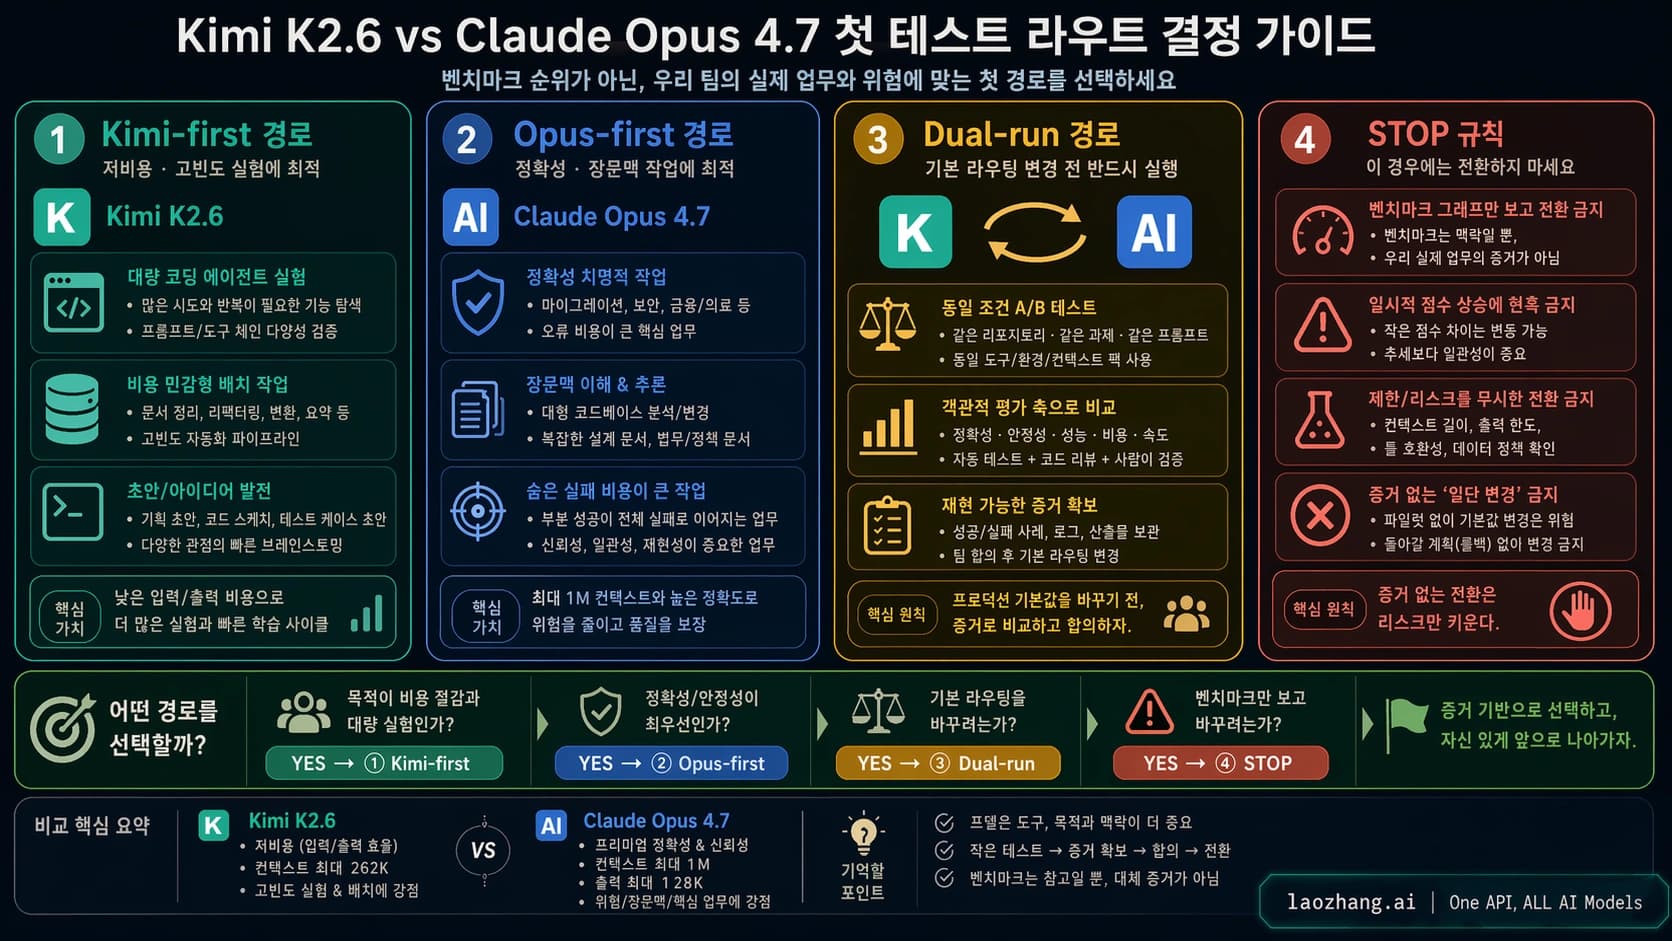
Kimi K2.6 vs Claude Opus 4.7: 먼저 테스트할 모델
대량 저비용 실험은 Kimi부터, 고위험 production coding은 Opus부터, default 변경 전에는 반드시 dual-run입니다.
12 분
대량 저비용 실험은 Kimi부터, 고위험 production coding은 Opus부터, default 변경 전에는 반드시 dual-run입니다.
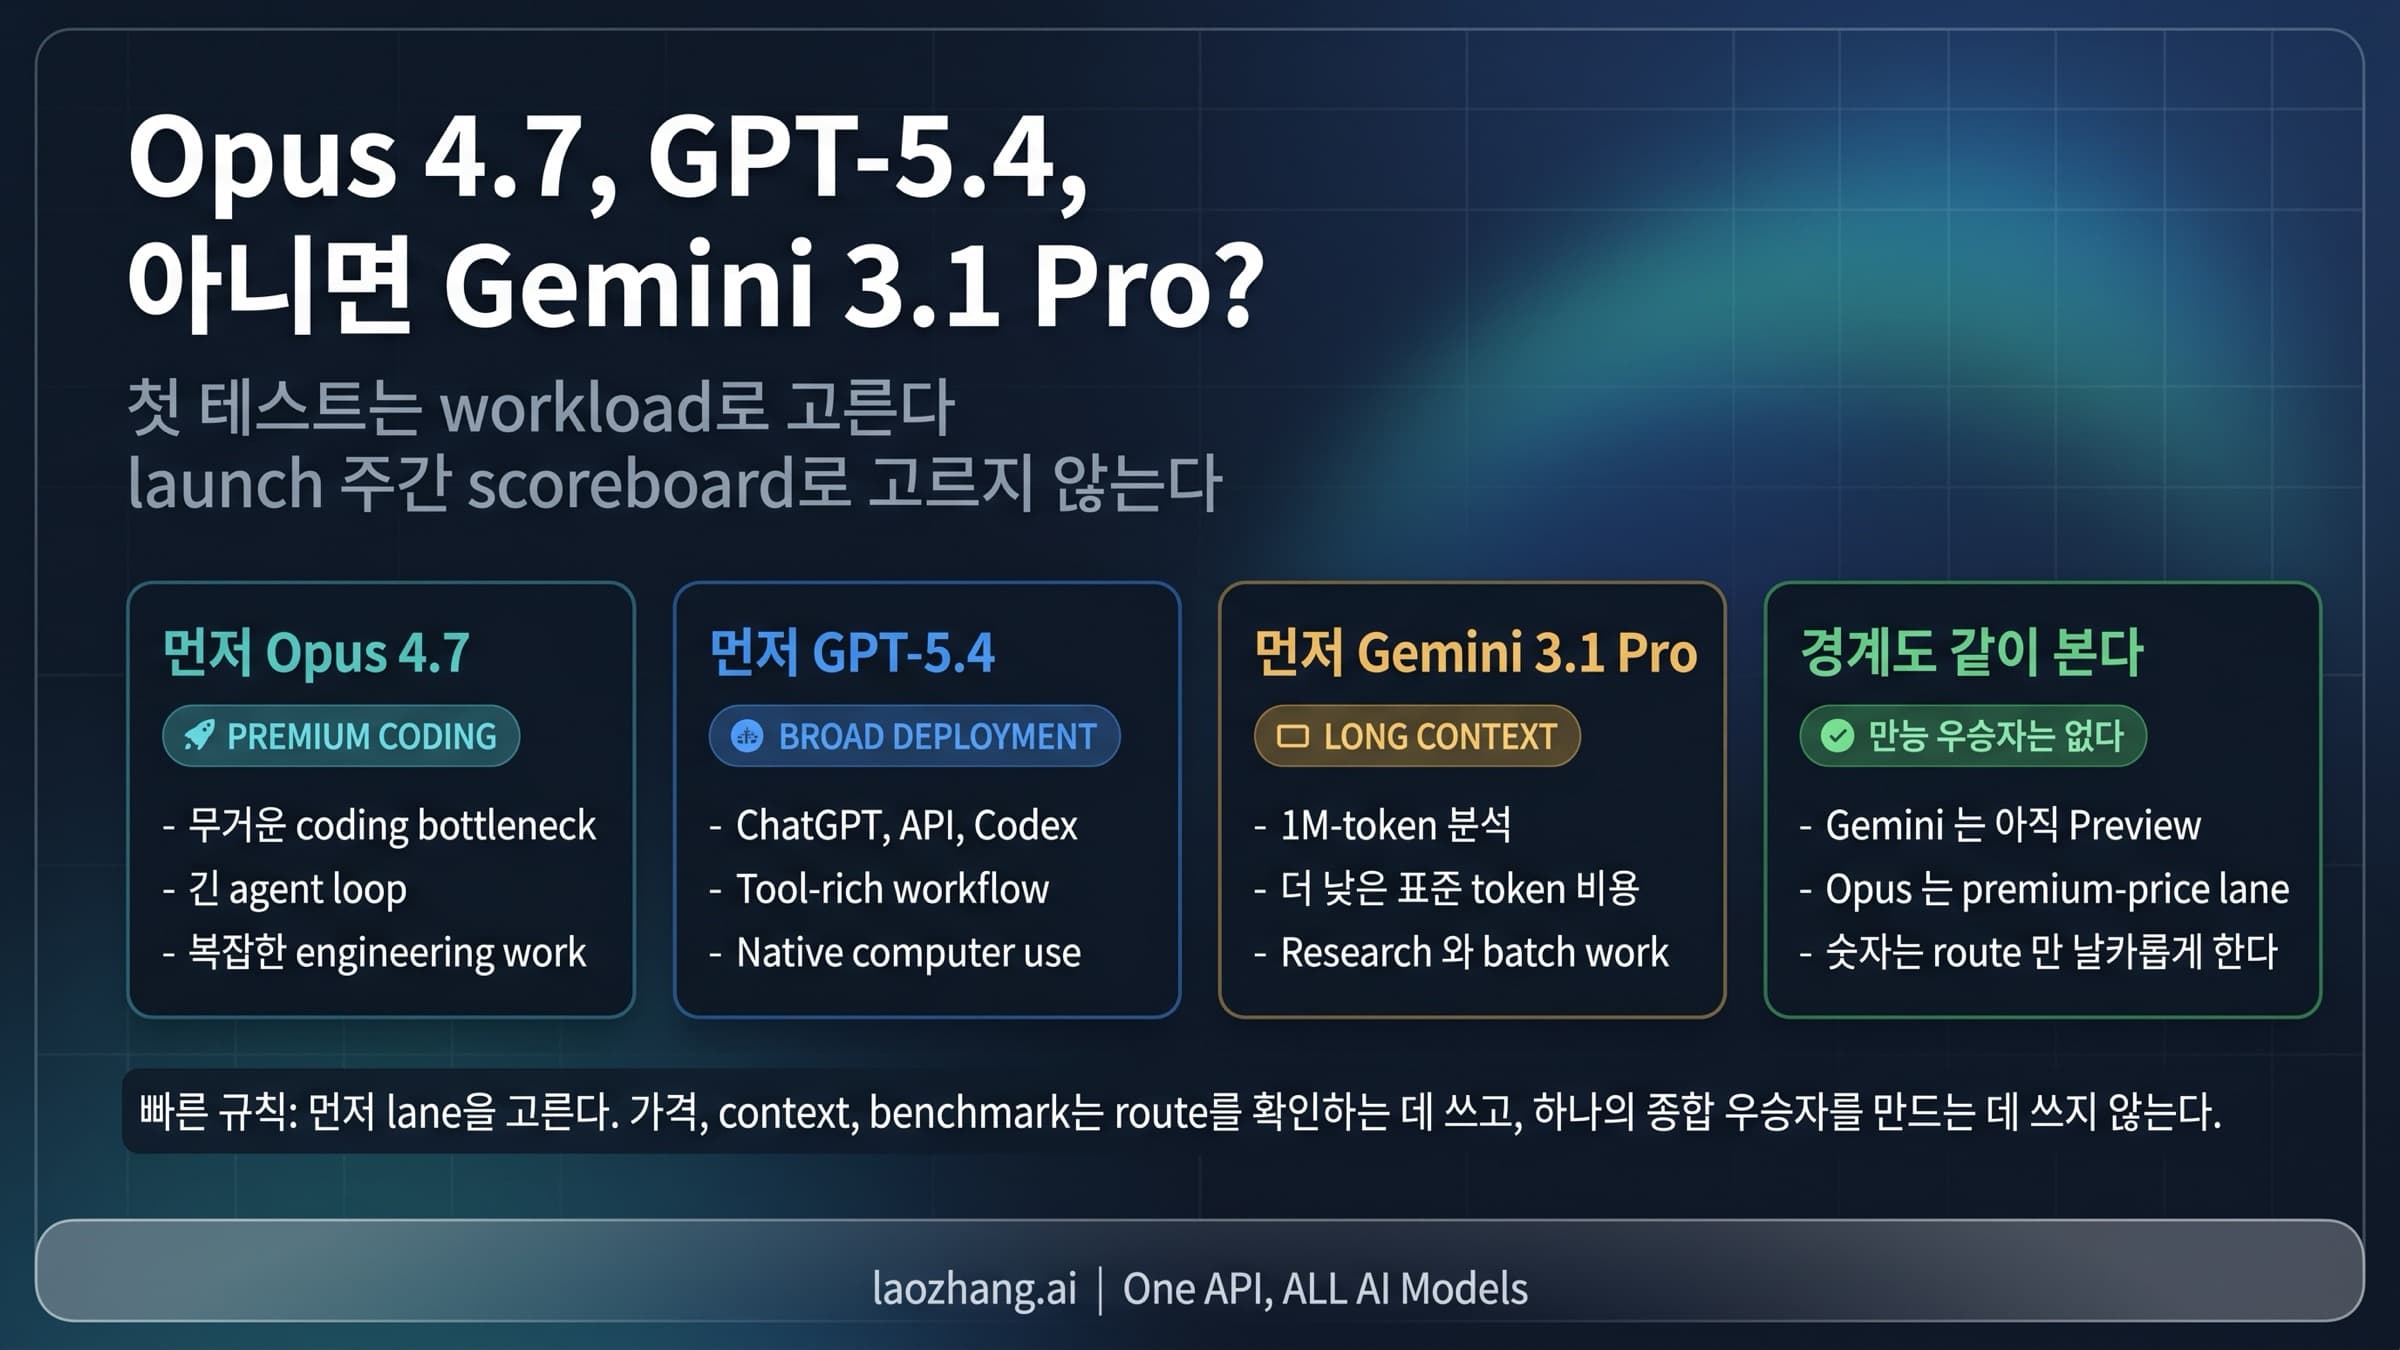
첫 테스트를 어디서 시작할지 고민 중이라면, premium coding은 Opus 4.7, 넓은 실배포 route는 GPT-5.4, 백만 token 문맥과 token economics는 Gemini 3.1 Pro로 읽는 편이 가장 실무적이다.
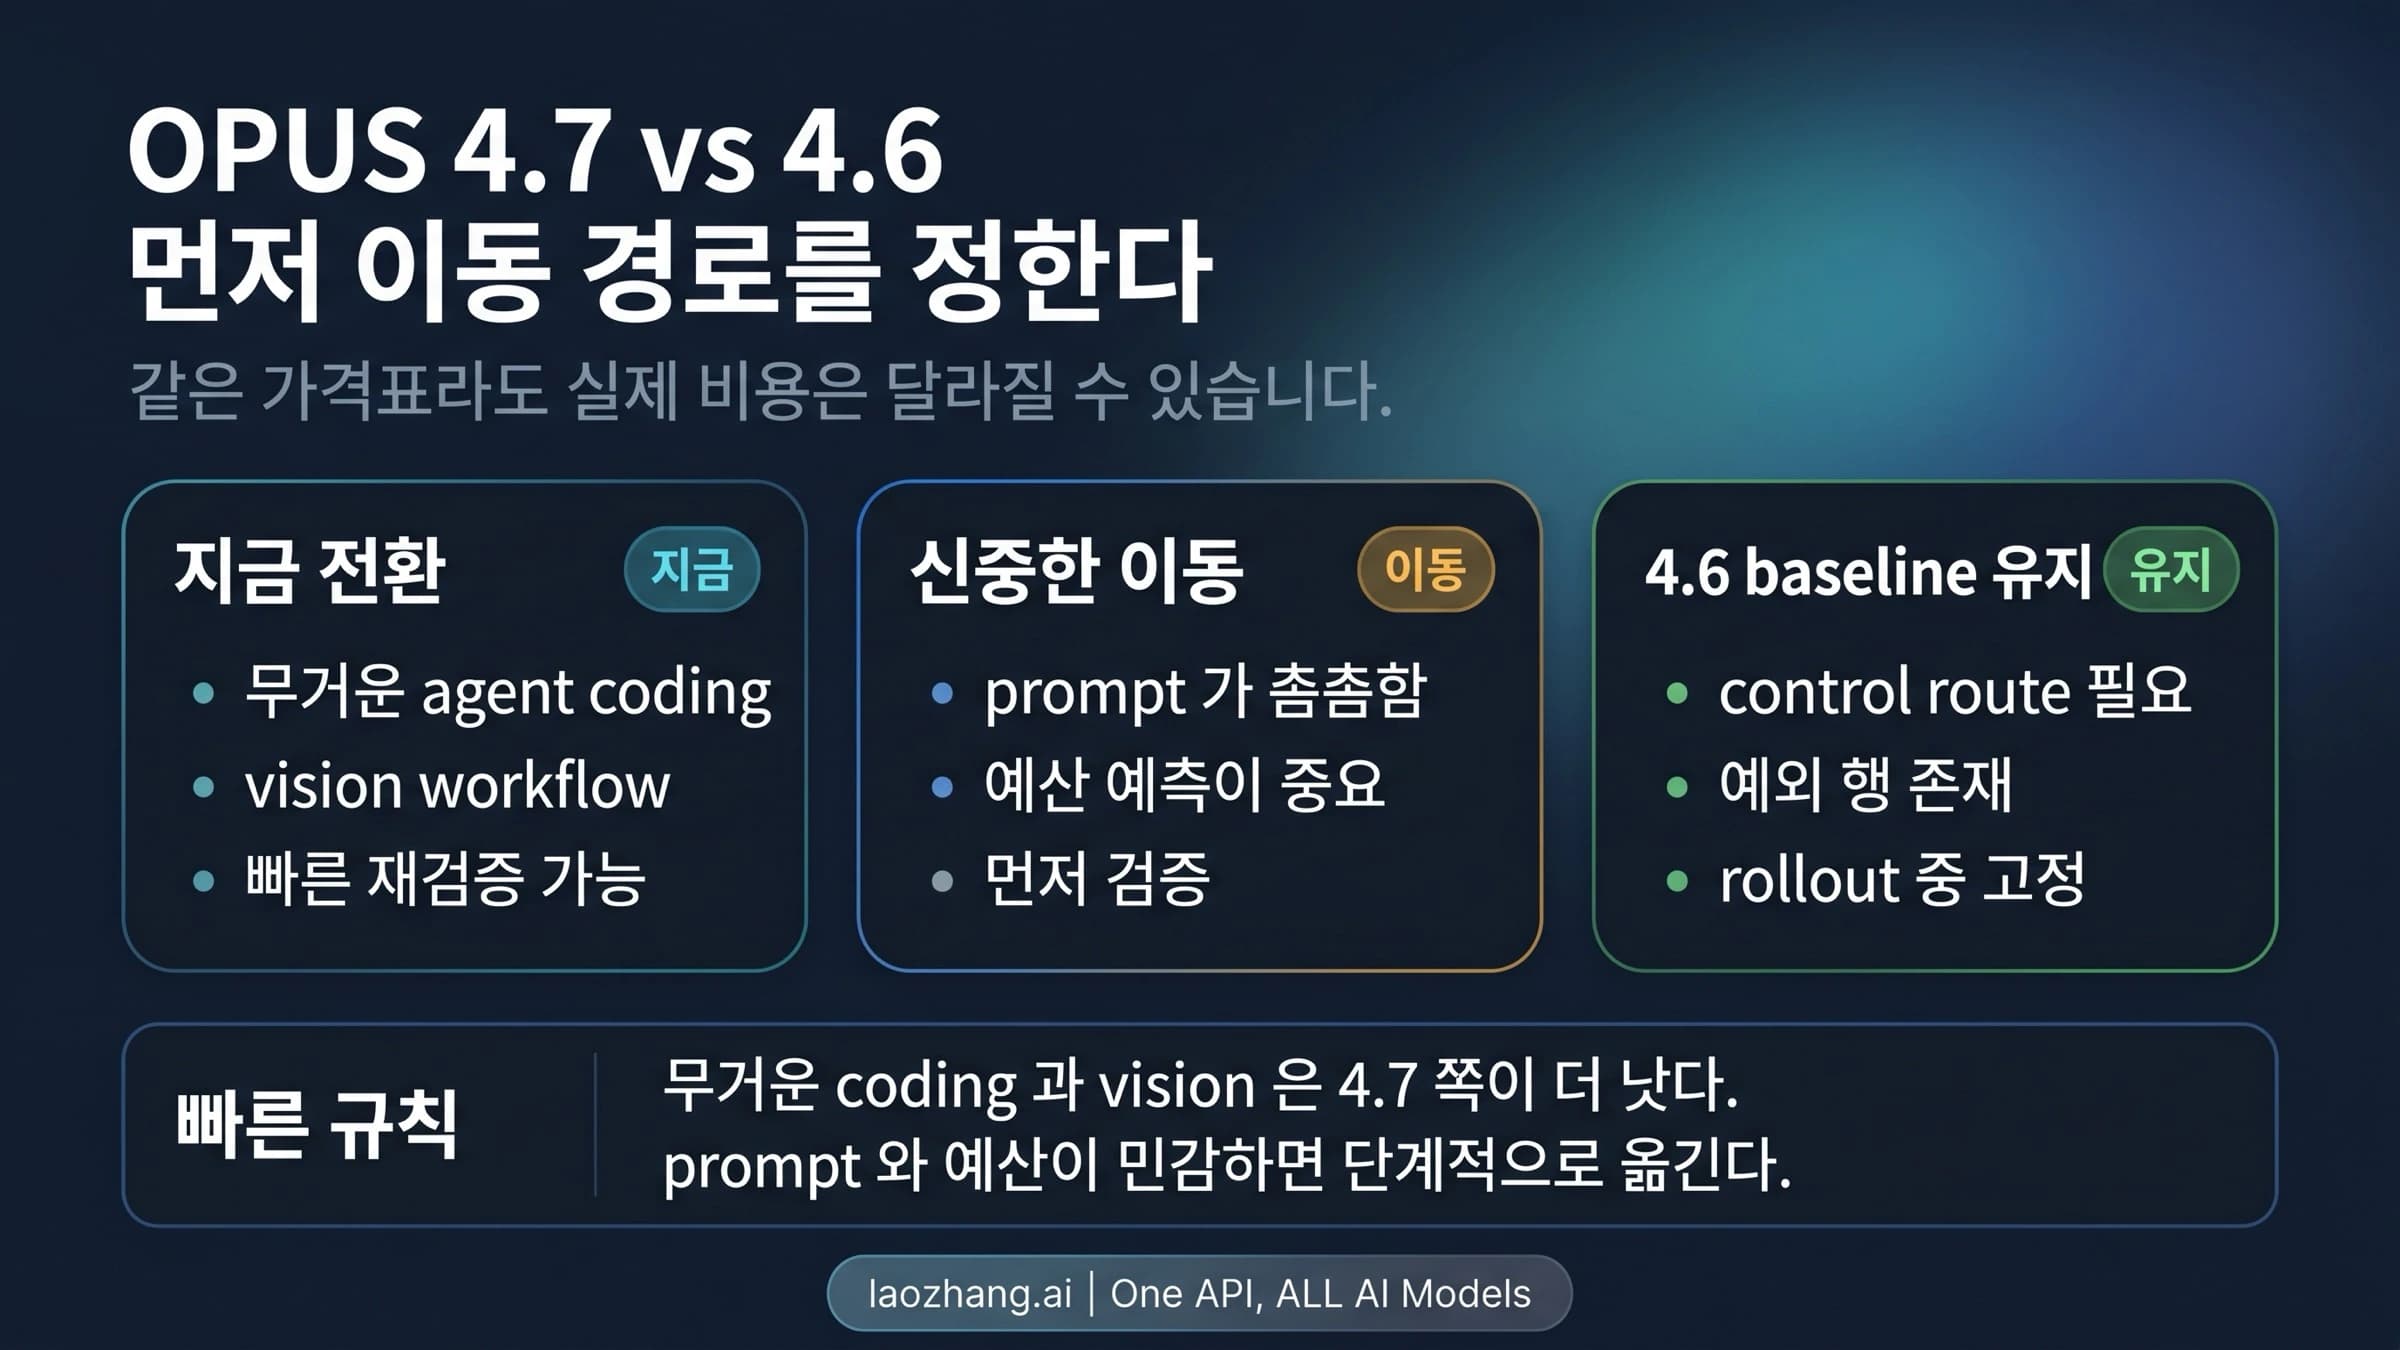
이 글은 출시 소식 요약이 아니라 업그레이드 판단 가이드다. Claude Opus 4.7을 새 default로 삼아야 하는 경우, 단계적으로 옮겨야 하는 경우, 그리고 Claude Opus 4.6을 control route로 남겨야 하는 경우를 나눠 본다.
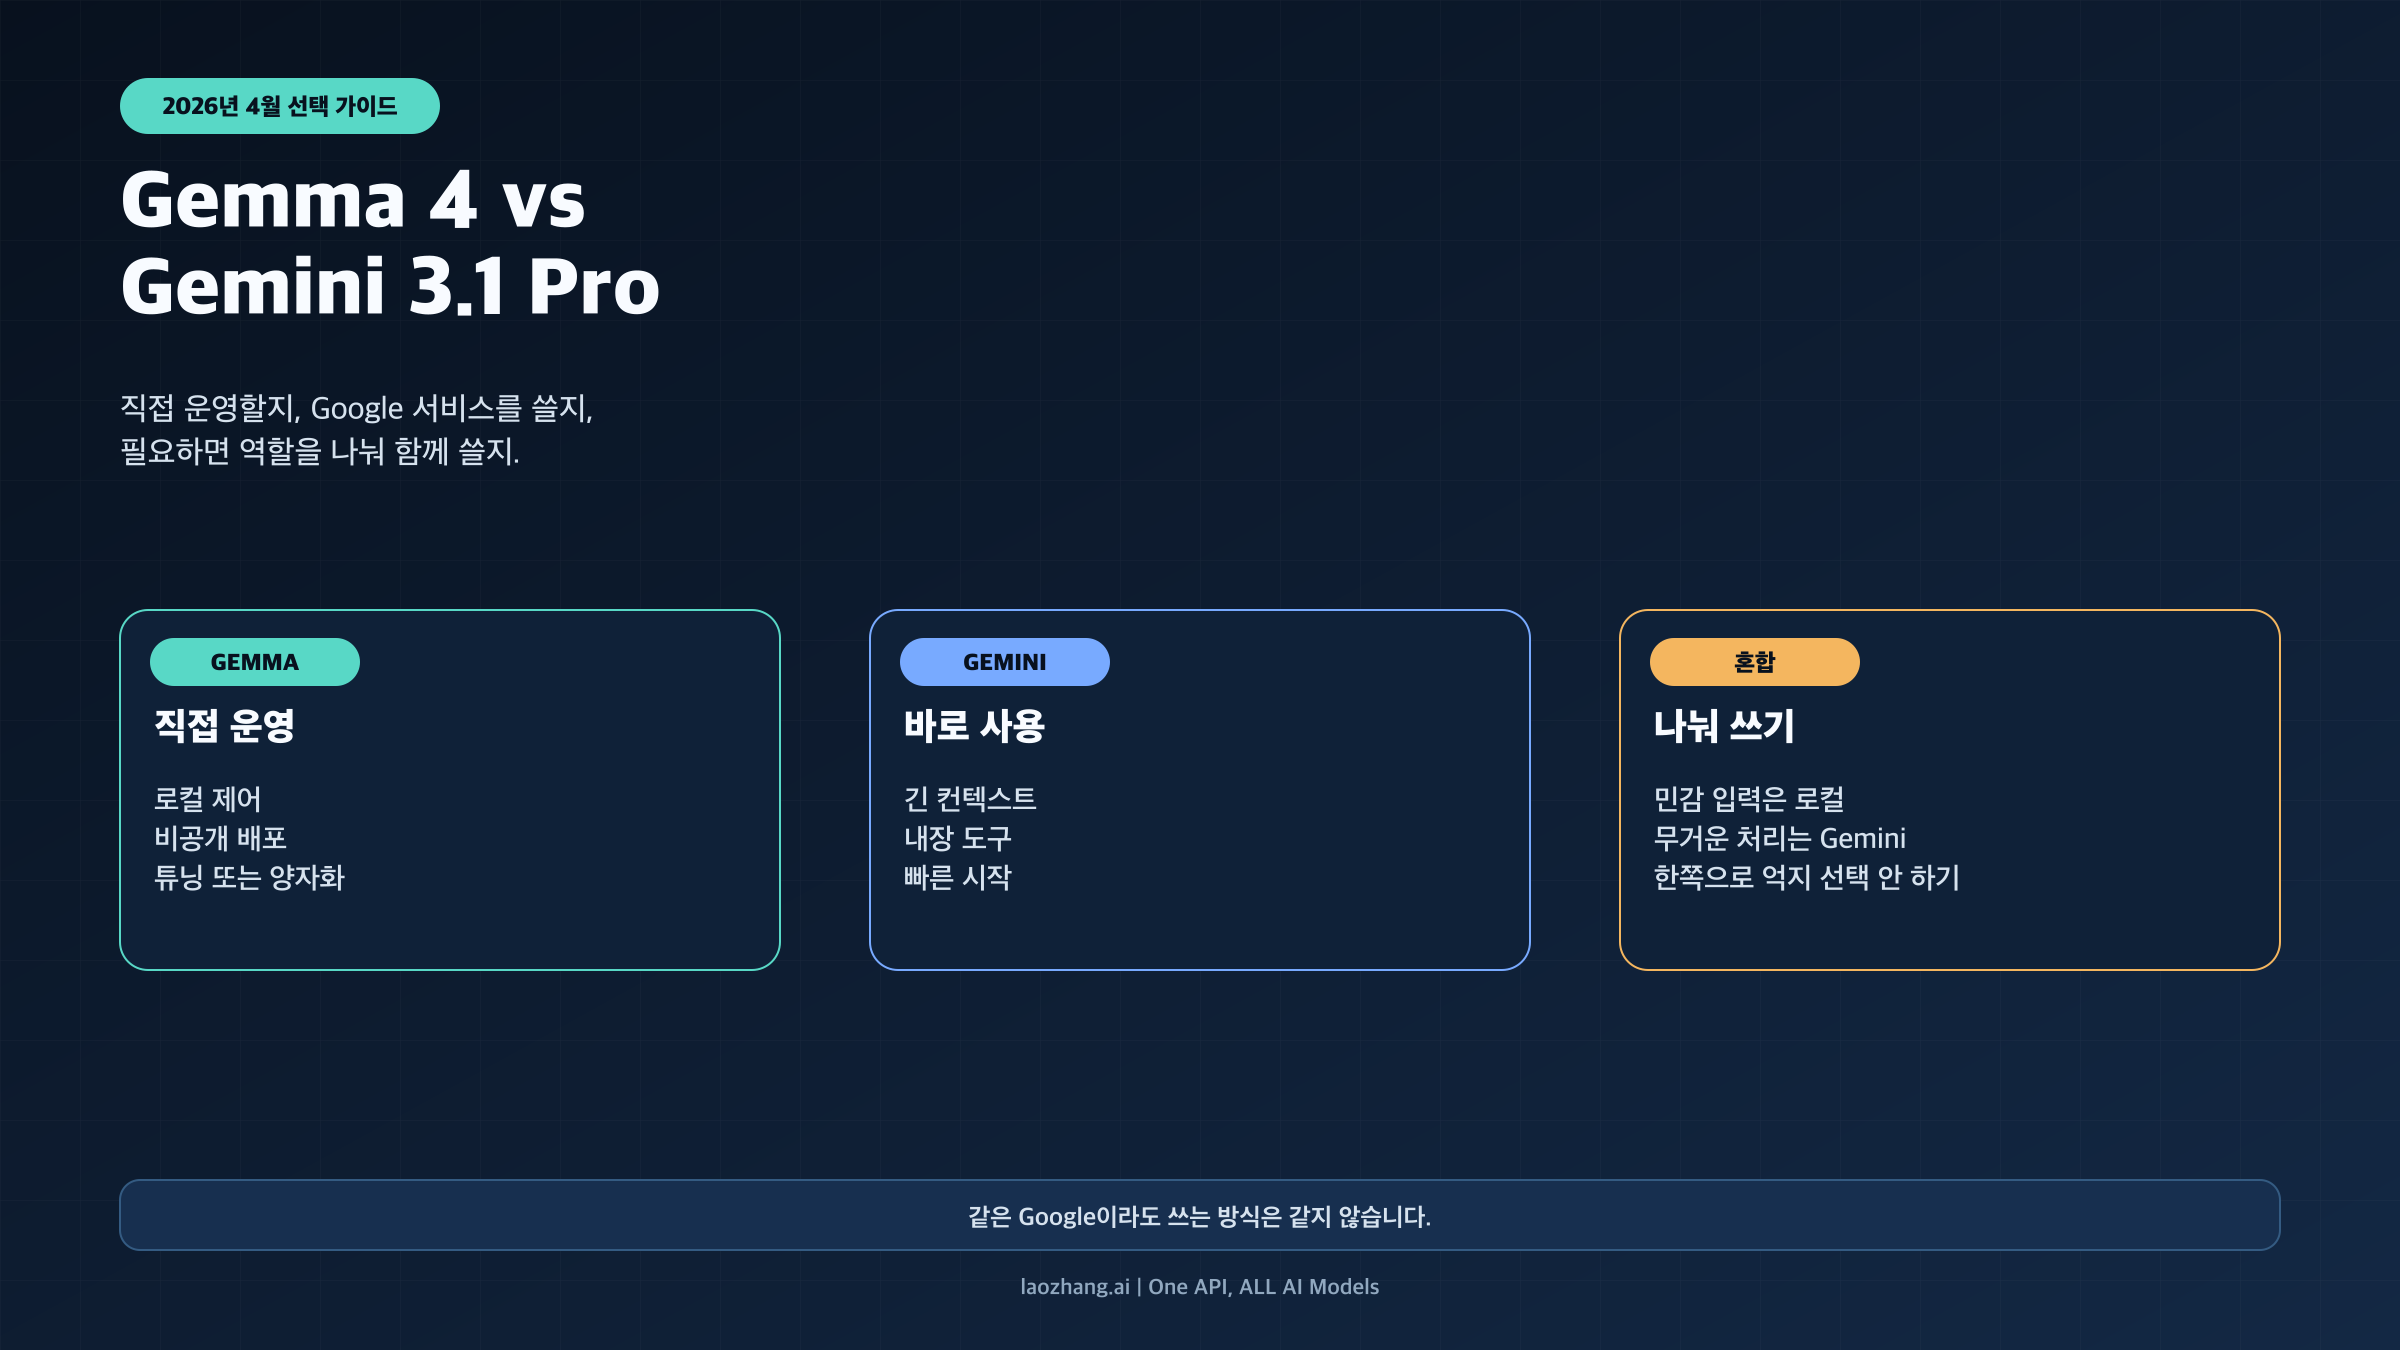
자체 배포, 프라이버시 경계, 커스터마이징이 중요하면 Gemma 4부터 보세요. 긴 컨텍스트, Google 도구, 빠른 도입이 더 중요하면 Gemini 3.1 Pro가 맞습니다. 작업이 실제로 둘로 갈릴 때만 병행 구성이 값어치를 합니다.
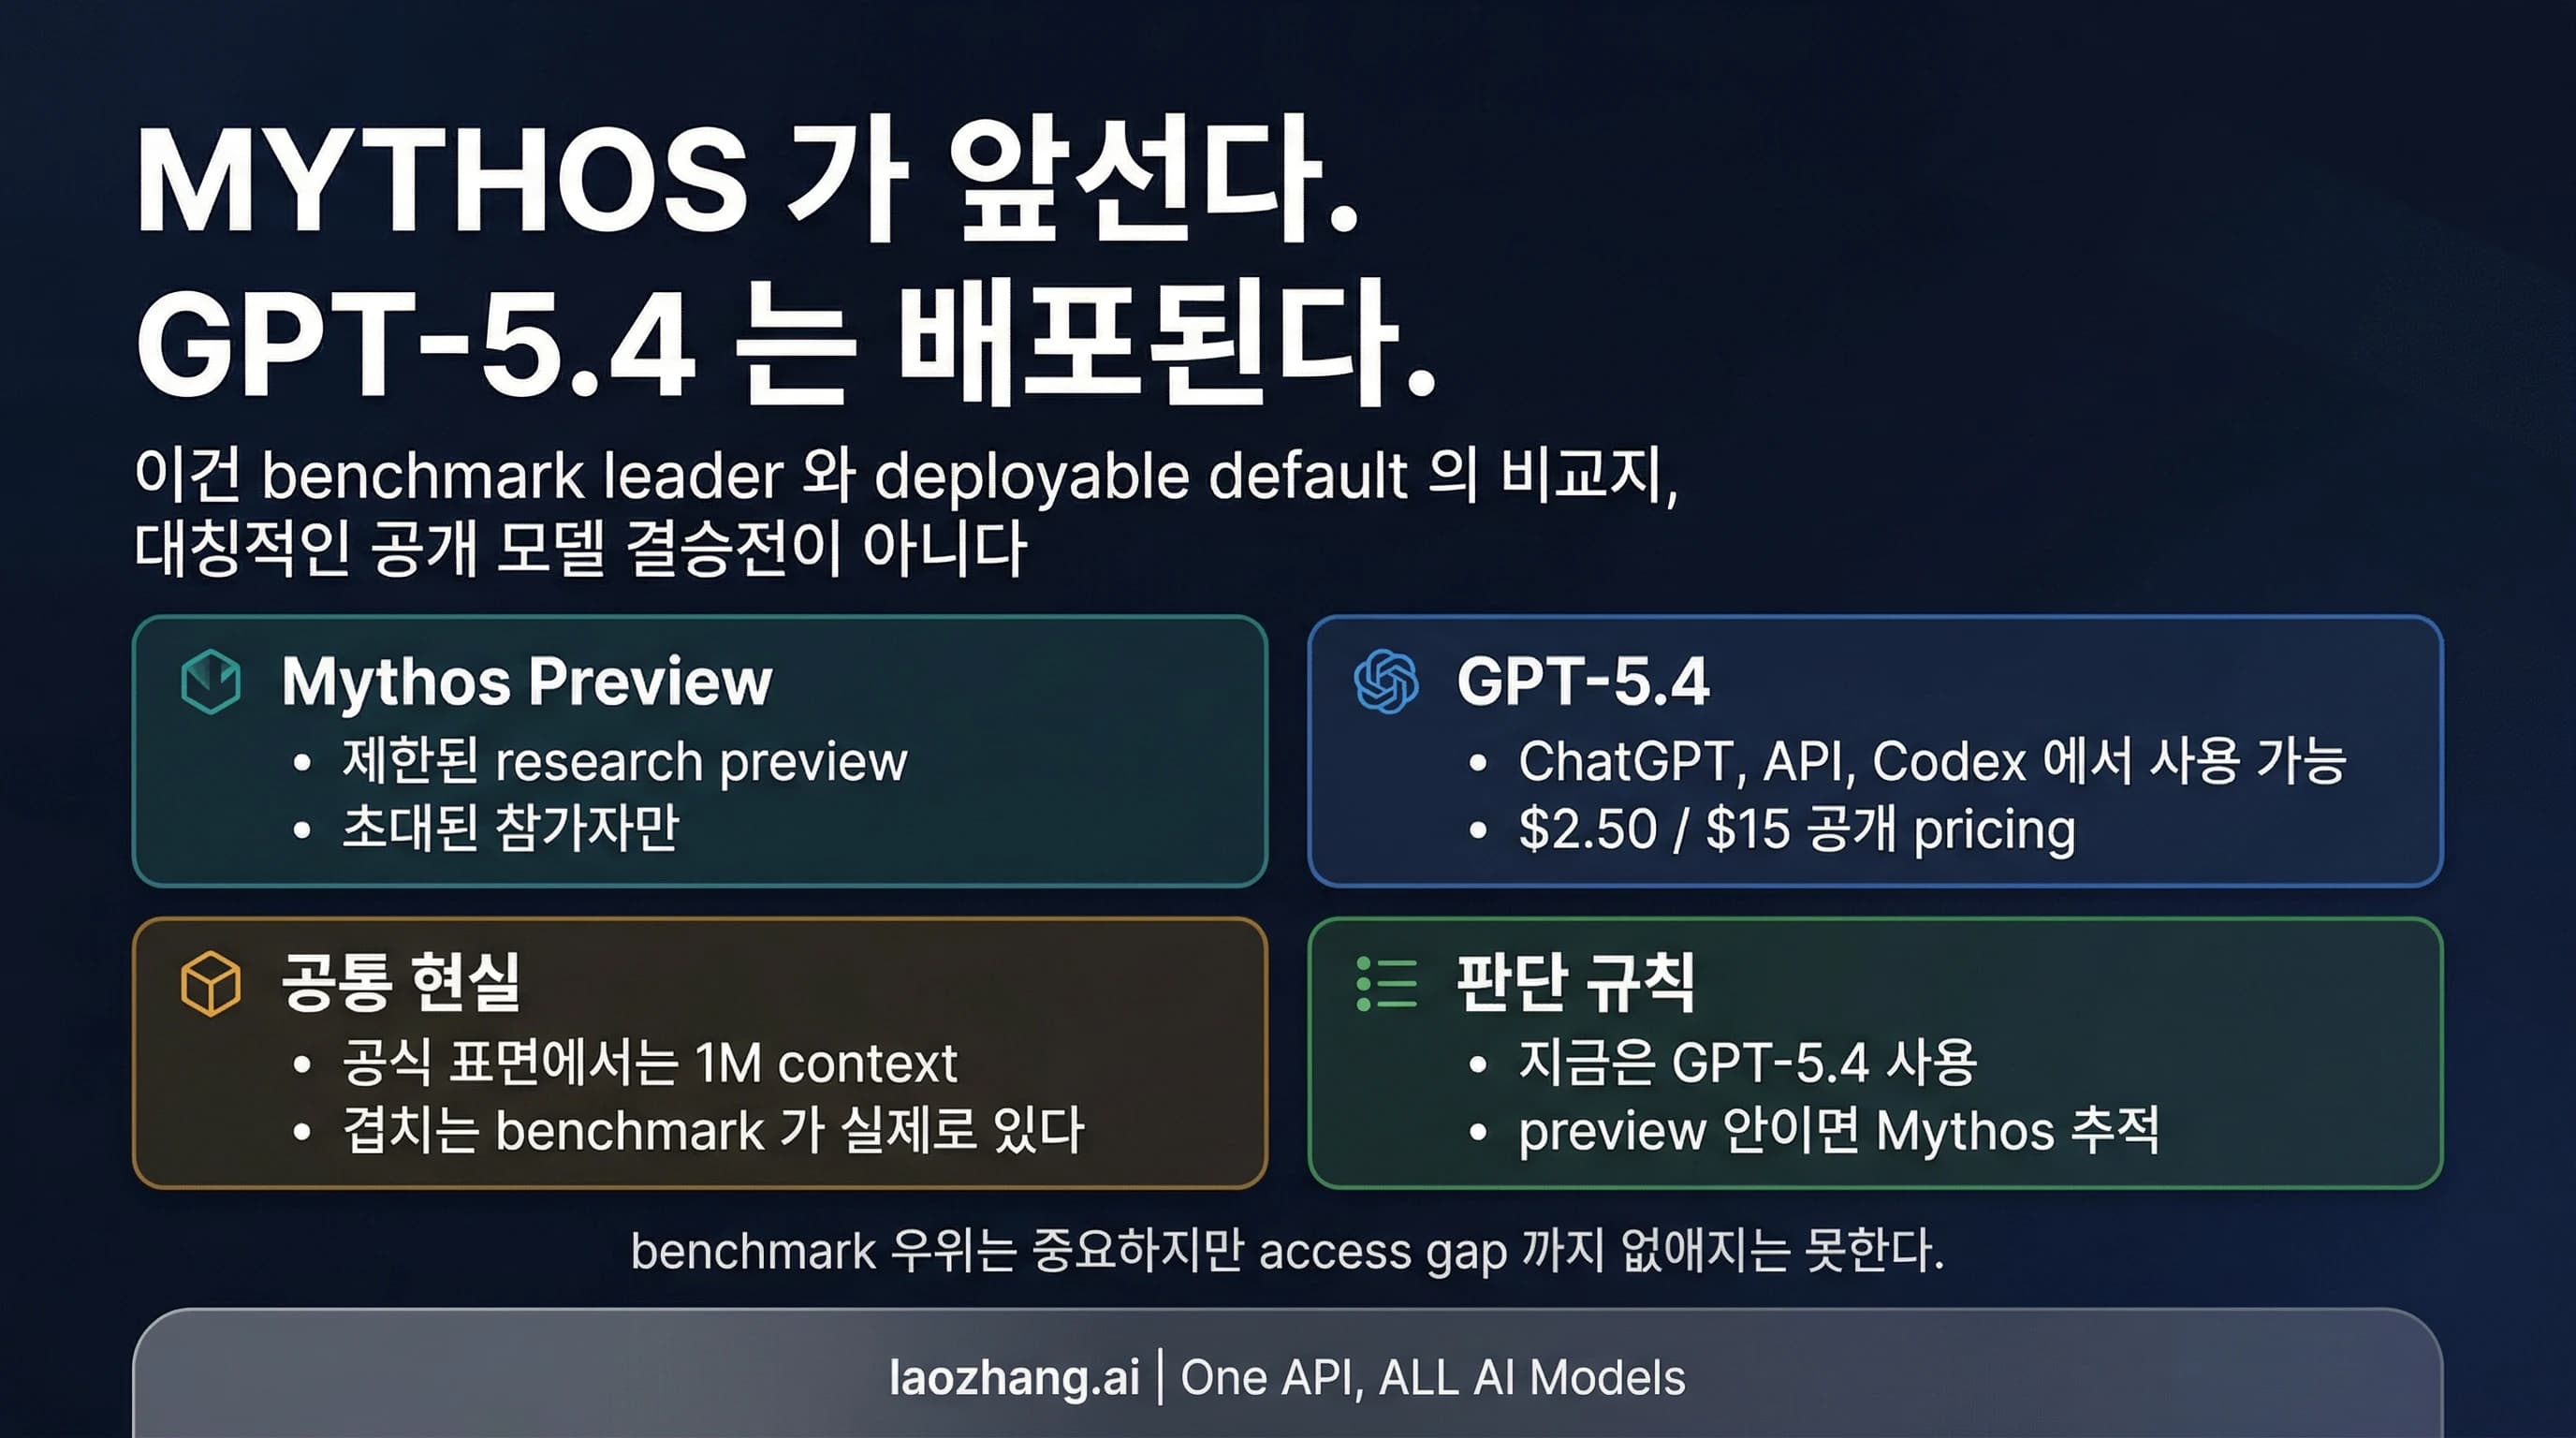
지금 당장 모델이 필요하다면 실전 답은 아직 GPT-5.4입니다. Claude Mythos Preview가 주목받는 이유는 Anthropic의 공식 런치 벤치마크가 강하기 때문이지만, 현재로서는 누구나 고를 수 있는 공개 모델이 아니라 초대제 research preview에 가깝습니다.
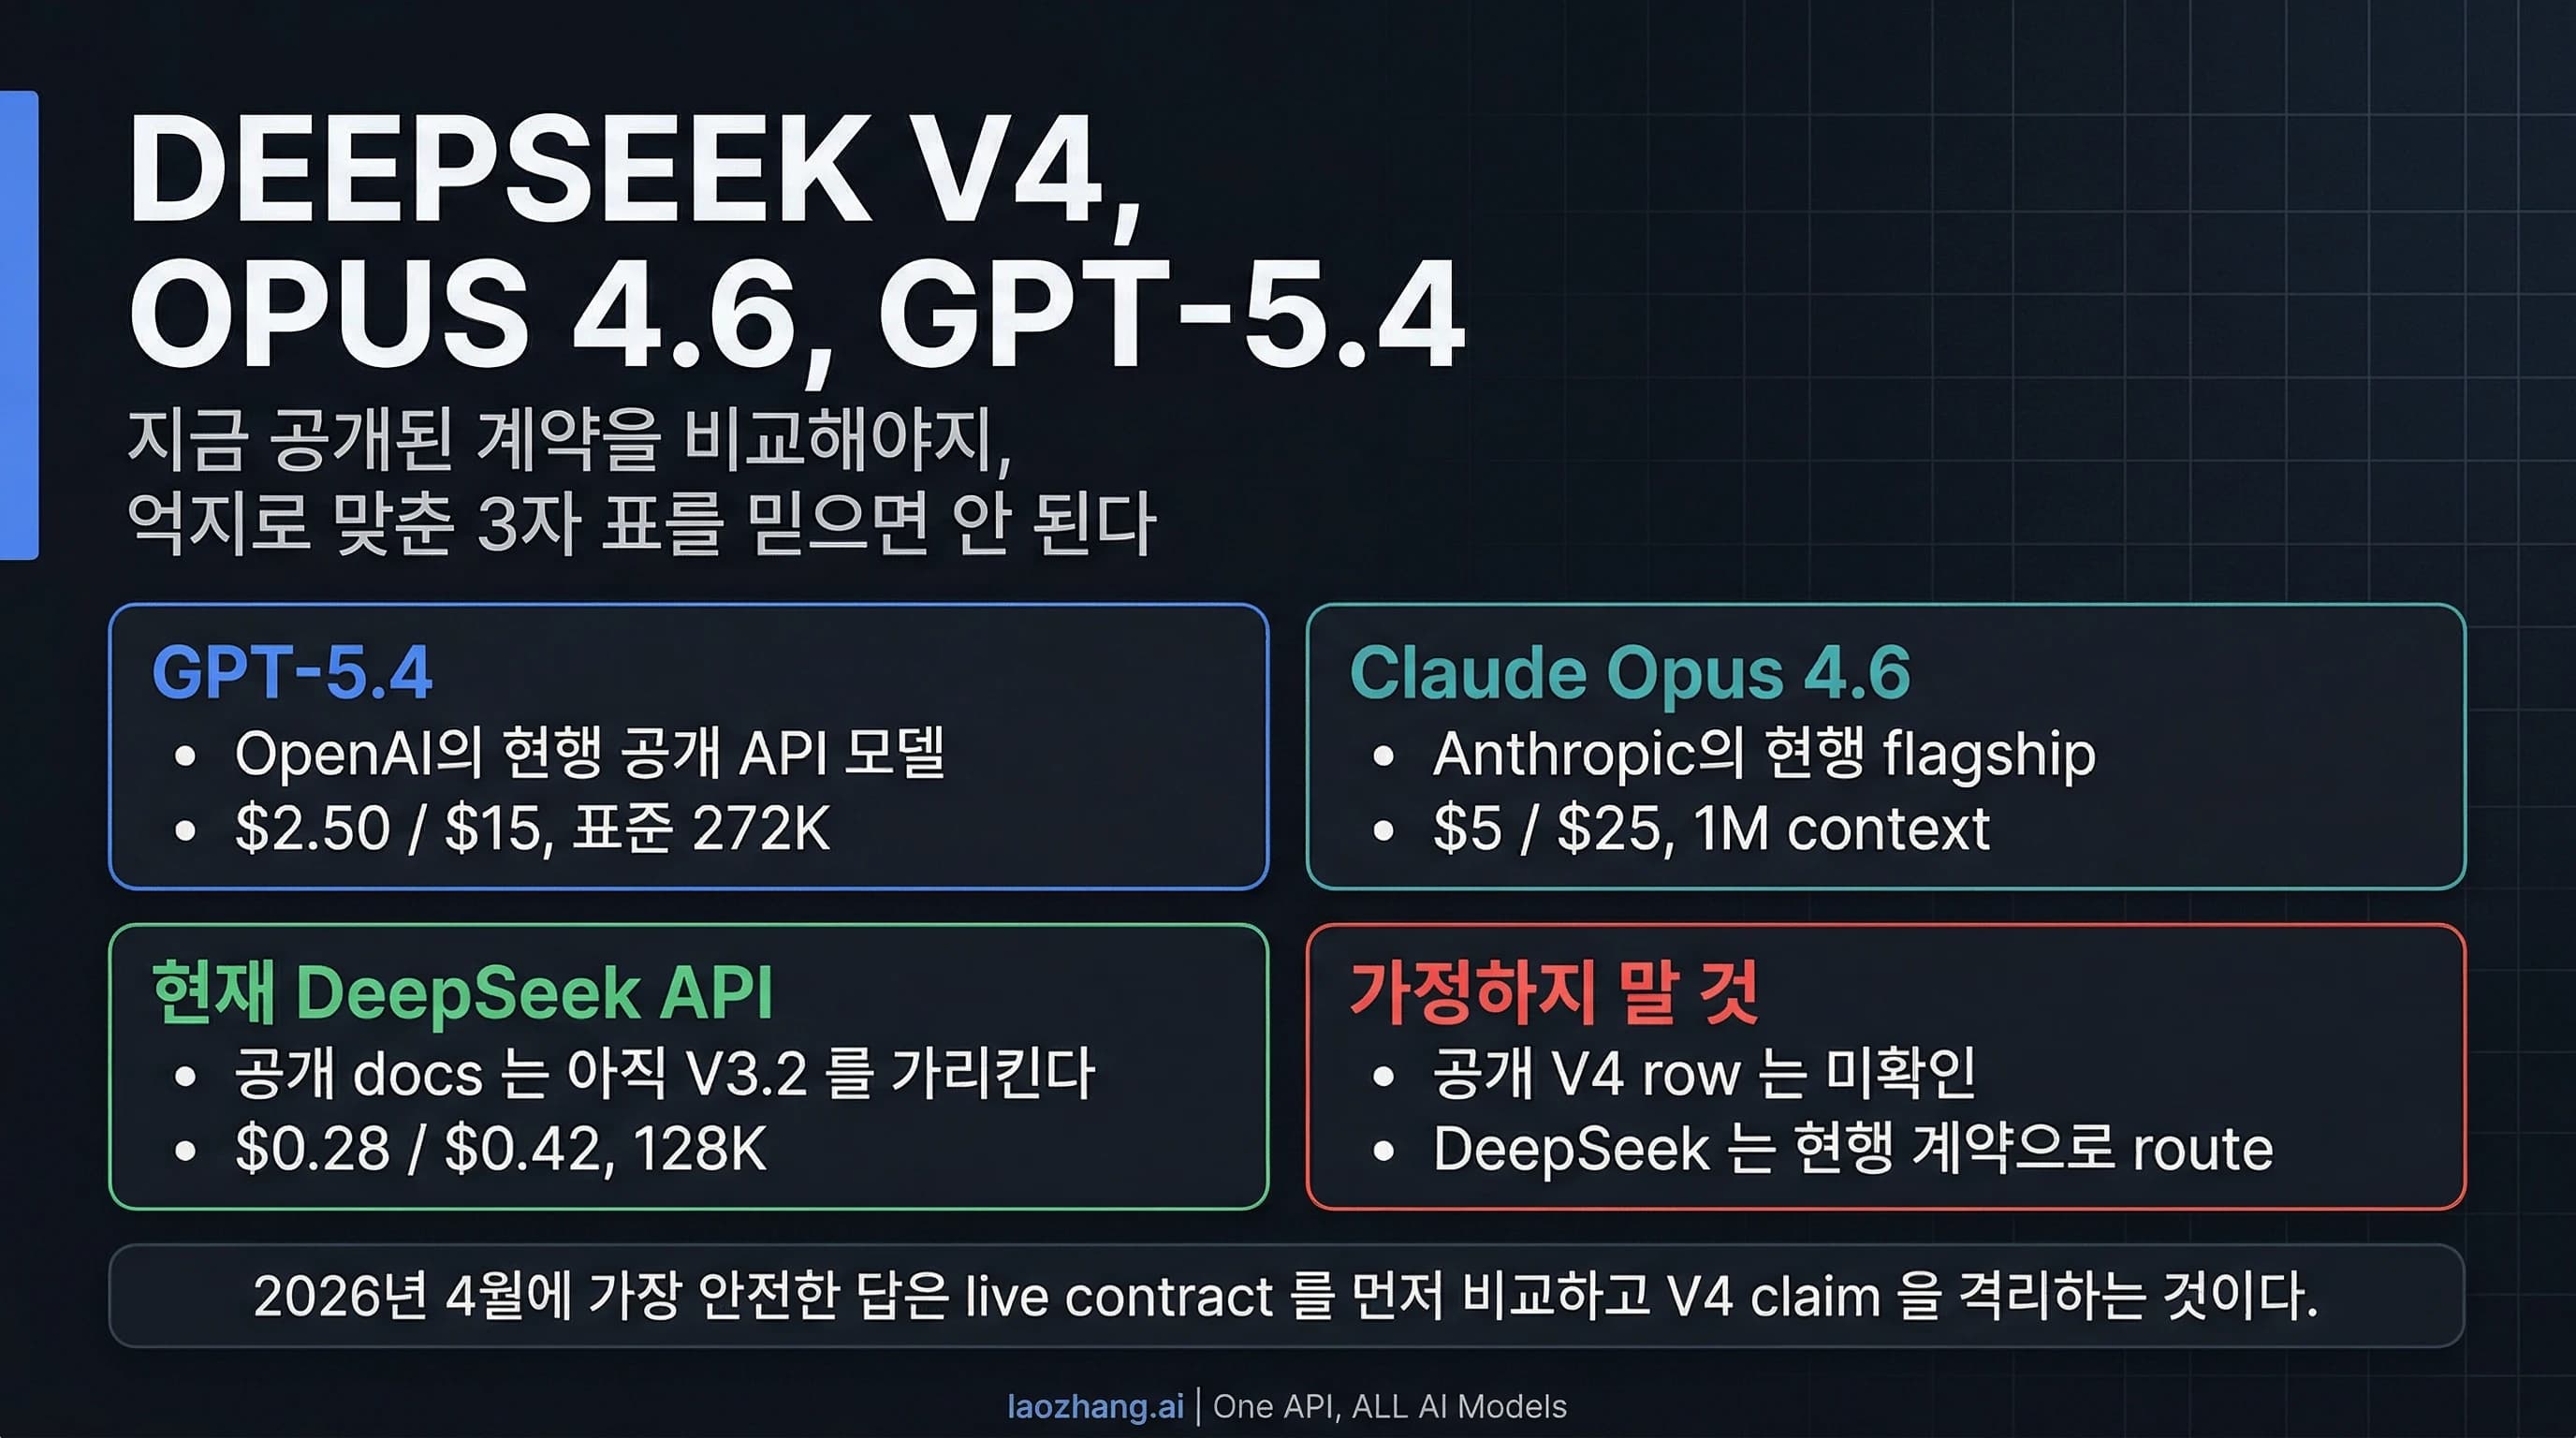
지금 당장 운영 결정을 내려야 한다면 DeepSeek V4, Claude Opus 4.6, GPT-5.4를 처음부터 동급의 공개 계약으로 놓고 비교하면 안 됩니다. 먼저 GPT-5.4와 Claude Opus 4.6을 현재 공개된 frontier contract로 직접 비교하고, 그 다음 DeepSeek는 현행 V3.2 기반 public API의 위치에서 판단하는 것이 더 안전합니다.
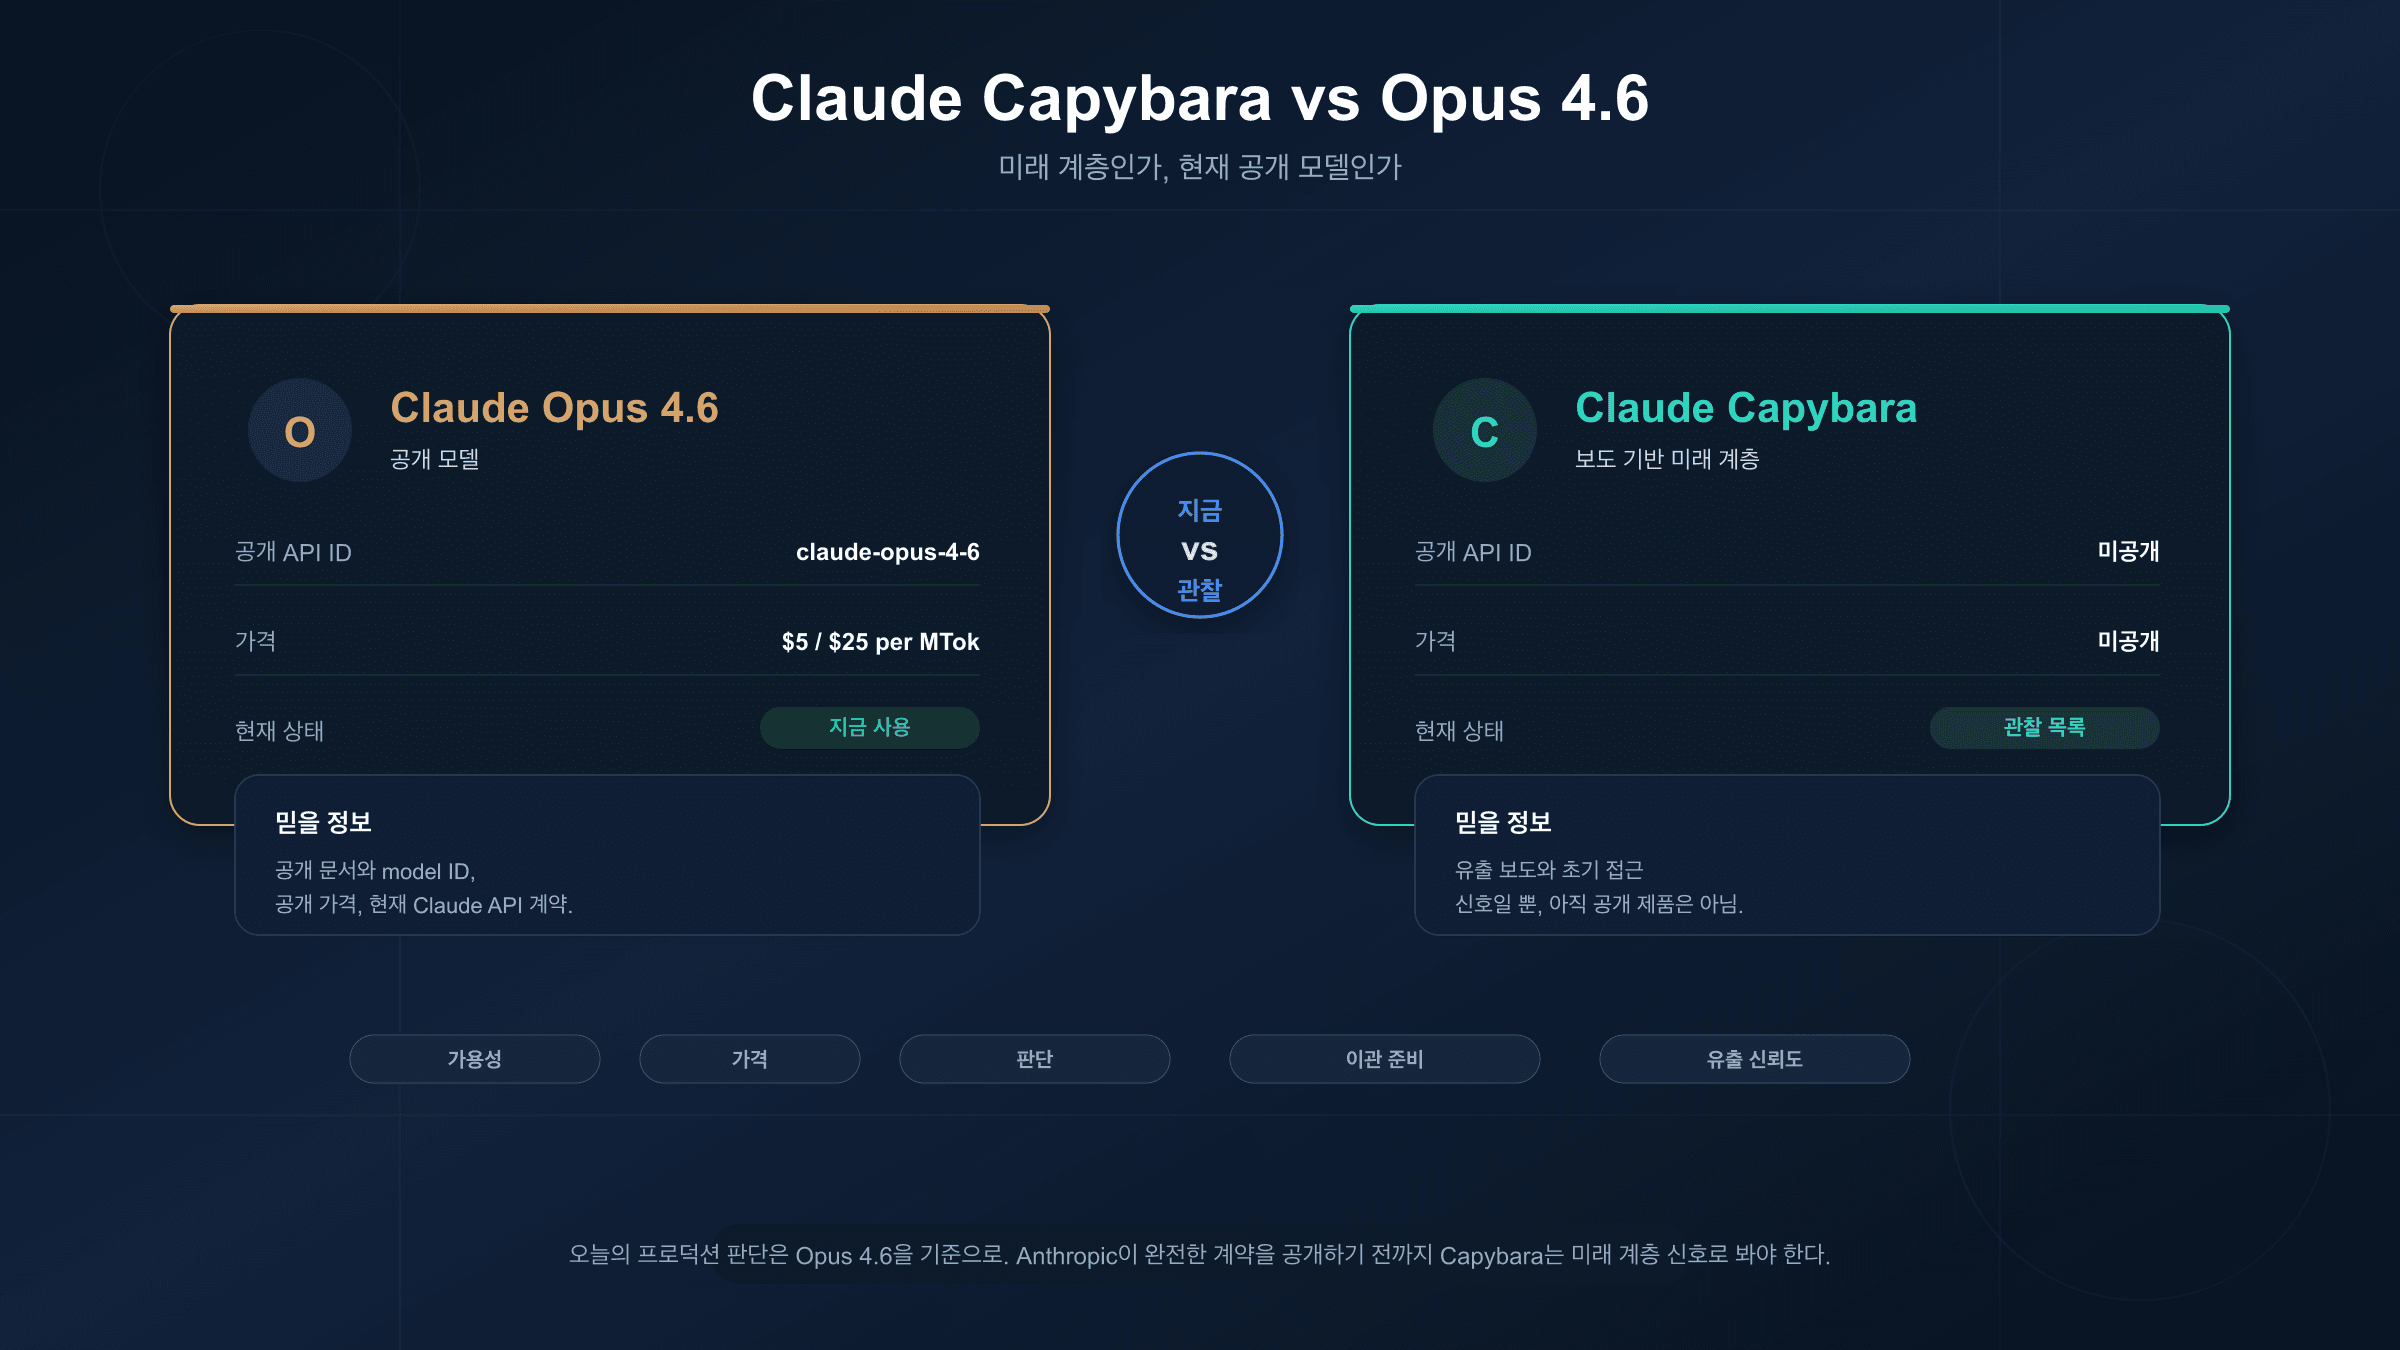
Claude Capybara는 아직 오늘 바로 선택할 수 있는 Anthropic의 공개 모델 계약이 아닙니다. Anthropic의 공개 문서는 여전히 Claude Opus 4.6을 현재 최상위 공개 모델로 가리키고 있으며, Capybara는 미래 상위 계층을 암시하는 신호에 더 가깝습니다.
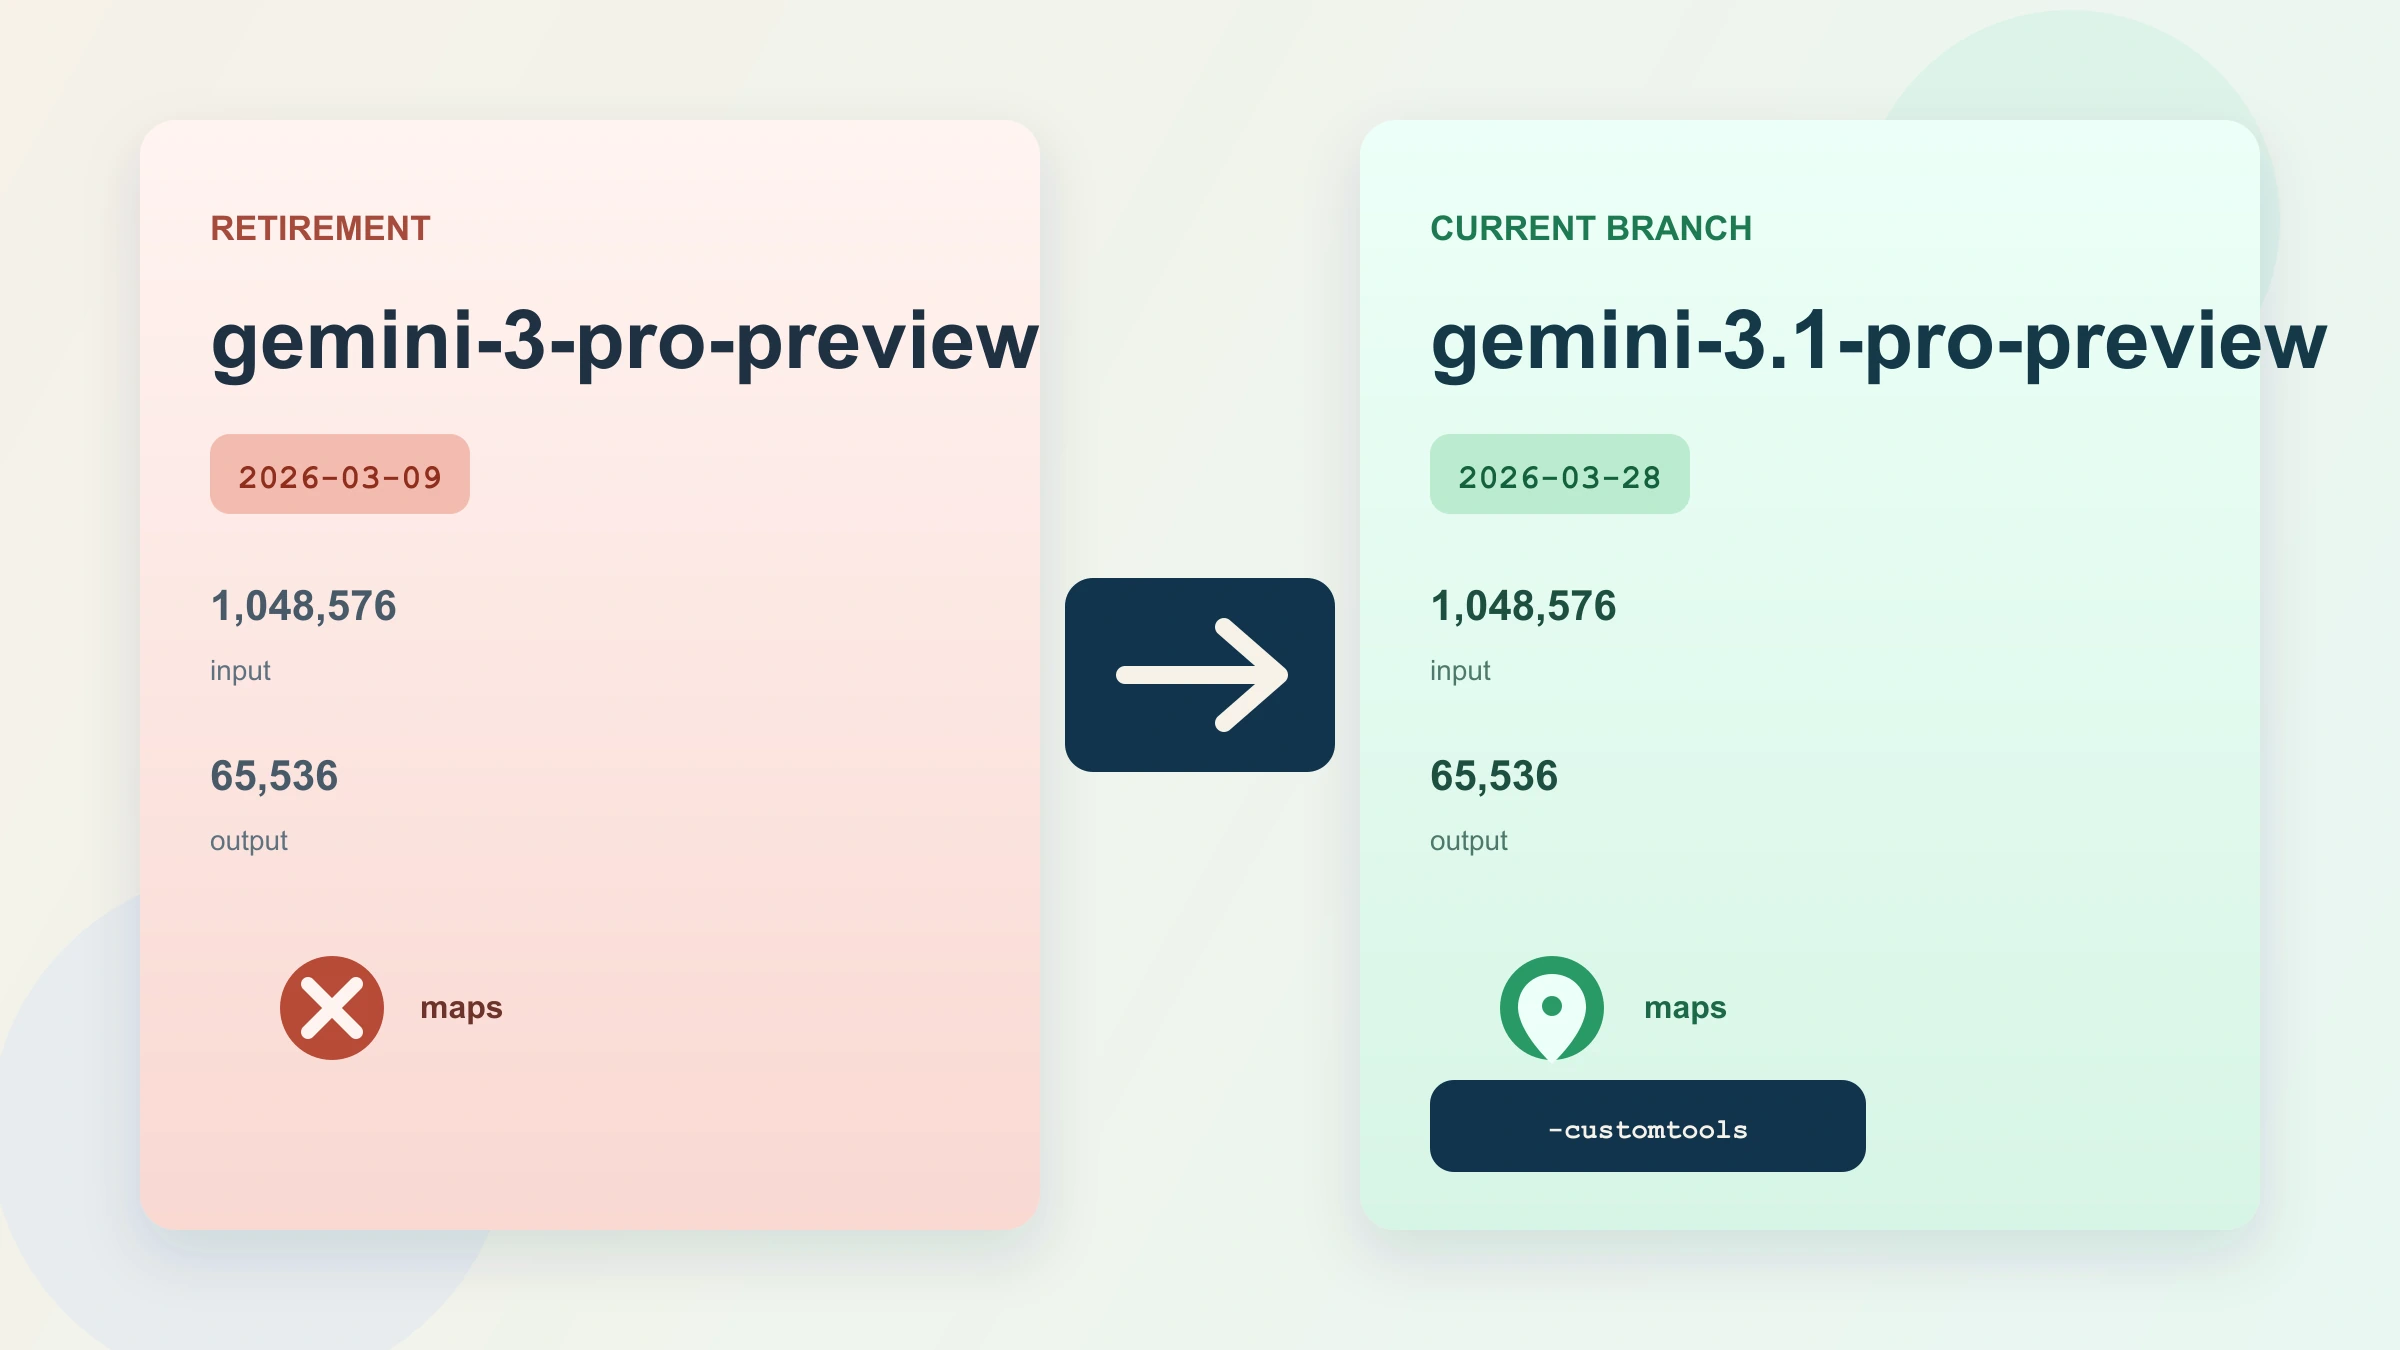
Gemini 3 Pro는 이미 종료됐기 때문에, 이 글은 더 이상 일반적인 정면 비교가 아니다. 핵심은 Gemini 3.1 Pro에서 무엇이 달라졌고 무엇이 그대로이며, 마이그레이션 시 무엇을 다시 검증해야 하는지다.
2026년 3월 28일 기준으로 이 세 이름 가운데 현역 플래그십 선택지라고 부를 수 있는 것은 Gemini 3.1 Pro Preview뿐입니다. Gemini 3 Pro Preview는 2026년 3월 9일 종료됐고, OpenAI도 GPT-4 Turbo를 더 오래된 계열로 설명하며 GPT-4o 같은 더 새로운 모델을 권합니다.
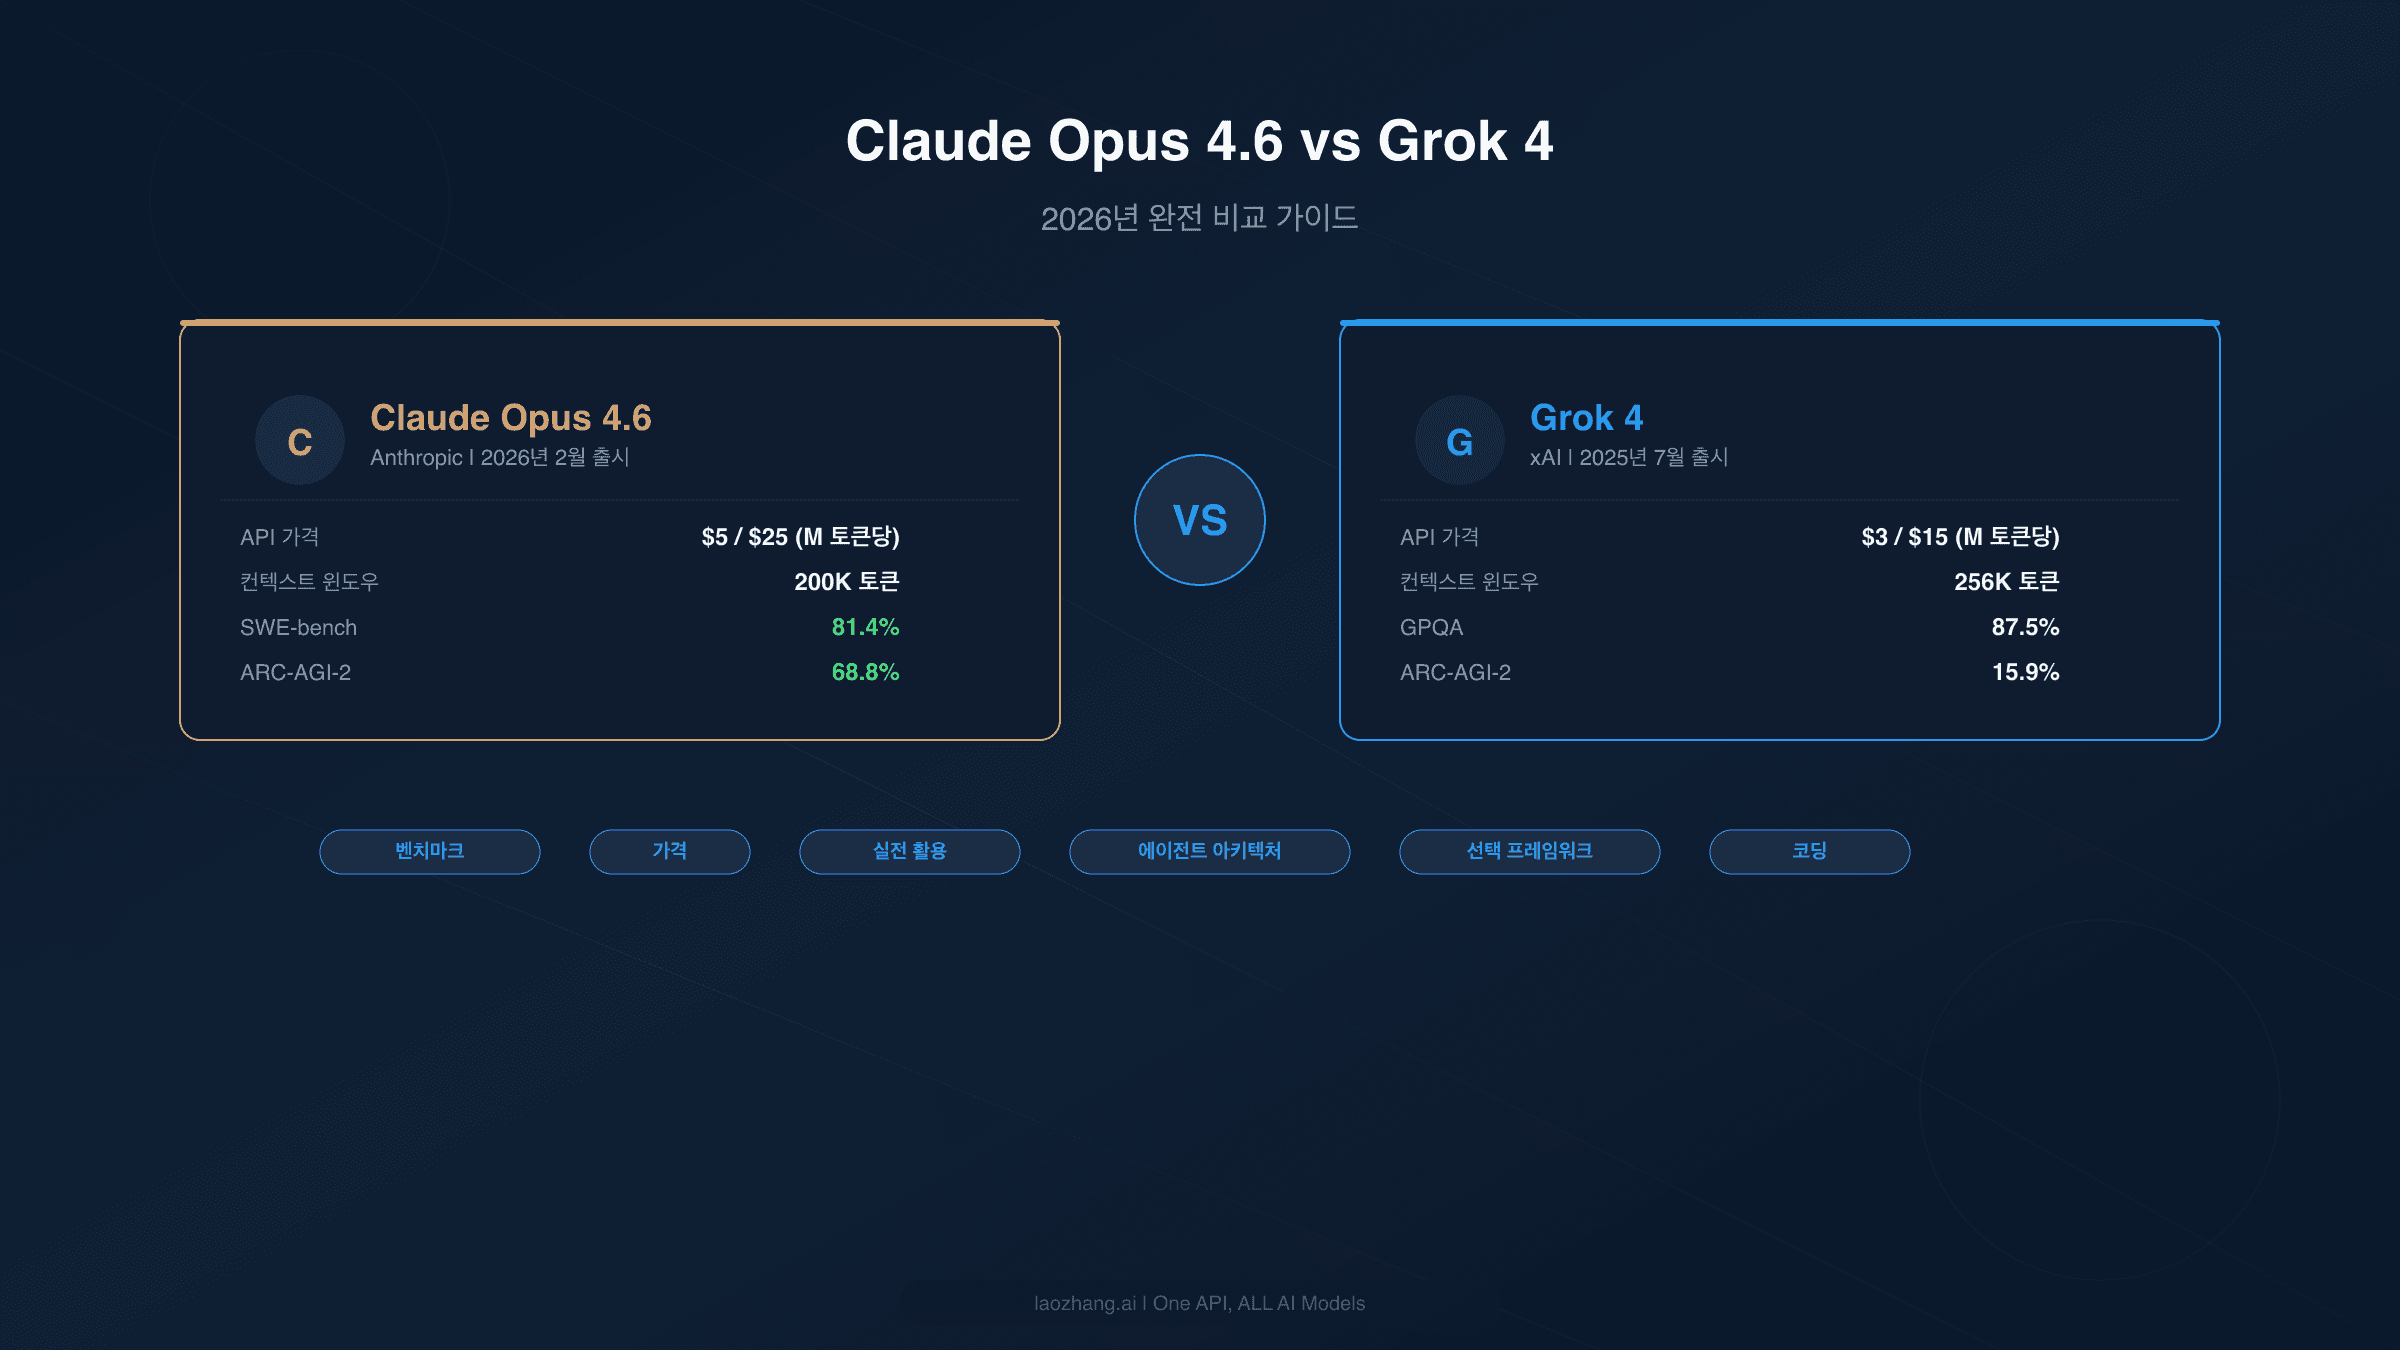
Claude Opus 4.6는 코딩 벤치마크(SWE-bench 81.4% vs ~72%)와 추론 작업(ARC-AGI-2 68.8% vs 15.9%)에서 Grok 4를 앞서지만, Grok 4는 백만 토큰당 $3/$15로 40% 저렴합니다. 이 종합 비교에서는 벤치마크, 가격, 코딩 능력, 에이전트 아키텍처를 다루고, 올바른 모델 선택을 위한 시나리오별 의사결정 프레임워크를 제공합니다.
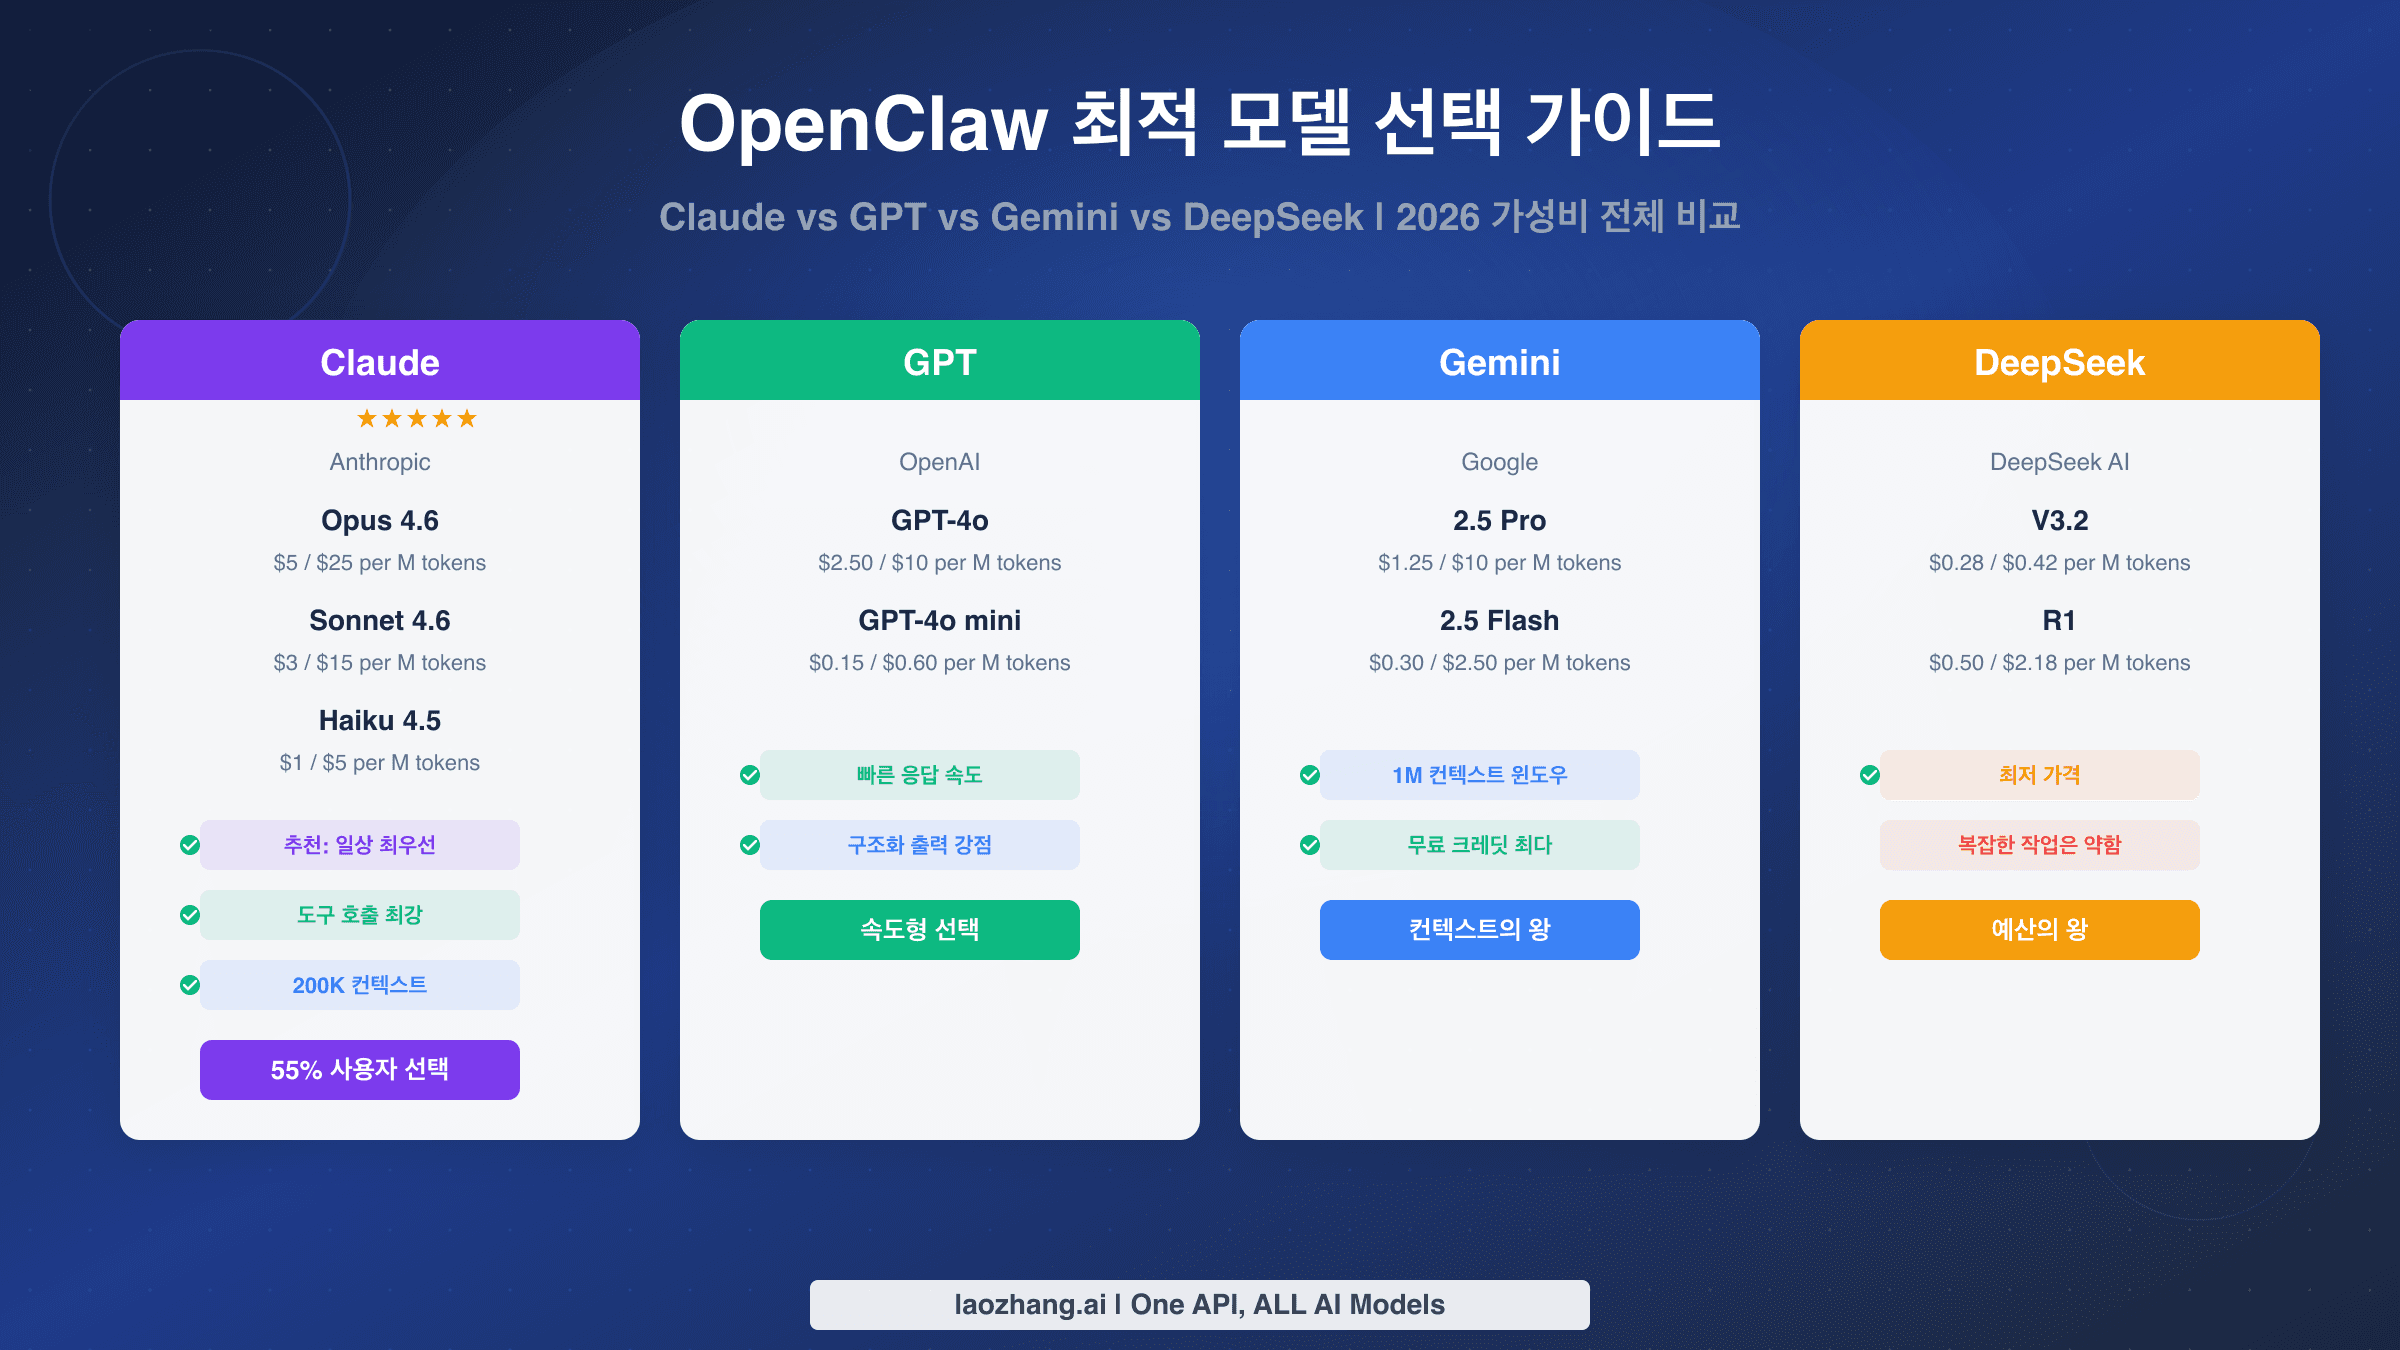
OpenClaw는 Claude, GPT, Gemini, DeepSeek 등 10여 종의 AI 모델을 지원합니다. Claude Sonnet 4.6($3/$15/M tokens)은 대부분의 사용자에게 최적의 시작점이며, DeepSeek V3.2($0.28/$0.42)는 예산이 제한된 상황에 적합합니다. 본 가이드에서는 9개 주요 모델의 가격, 성능, 설정 방법을 비교하고 3단계 라우팅 전략으로 API 비용을 65-80% 절감하는 방법을 소개합니다.
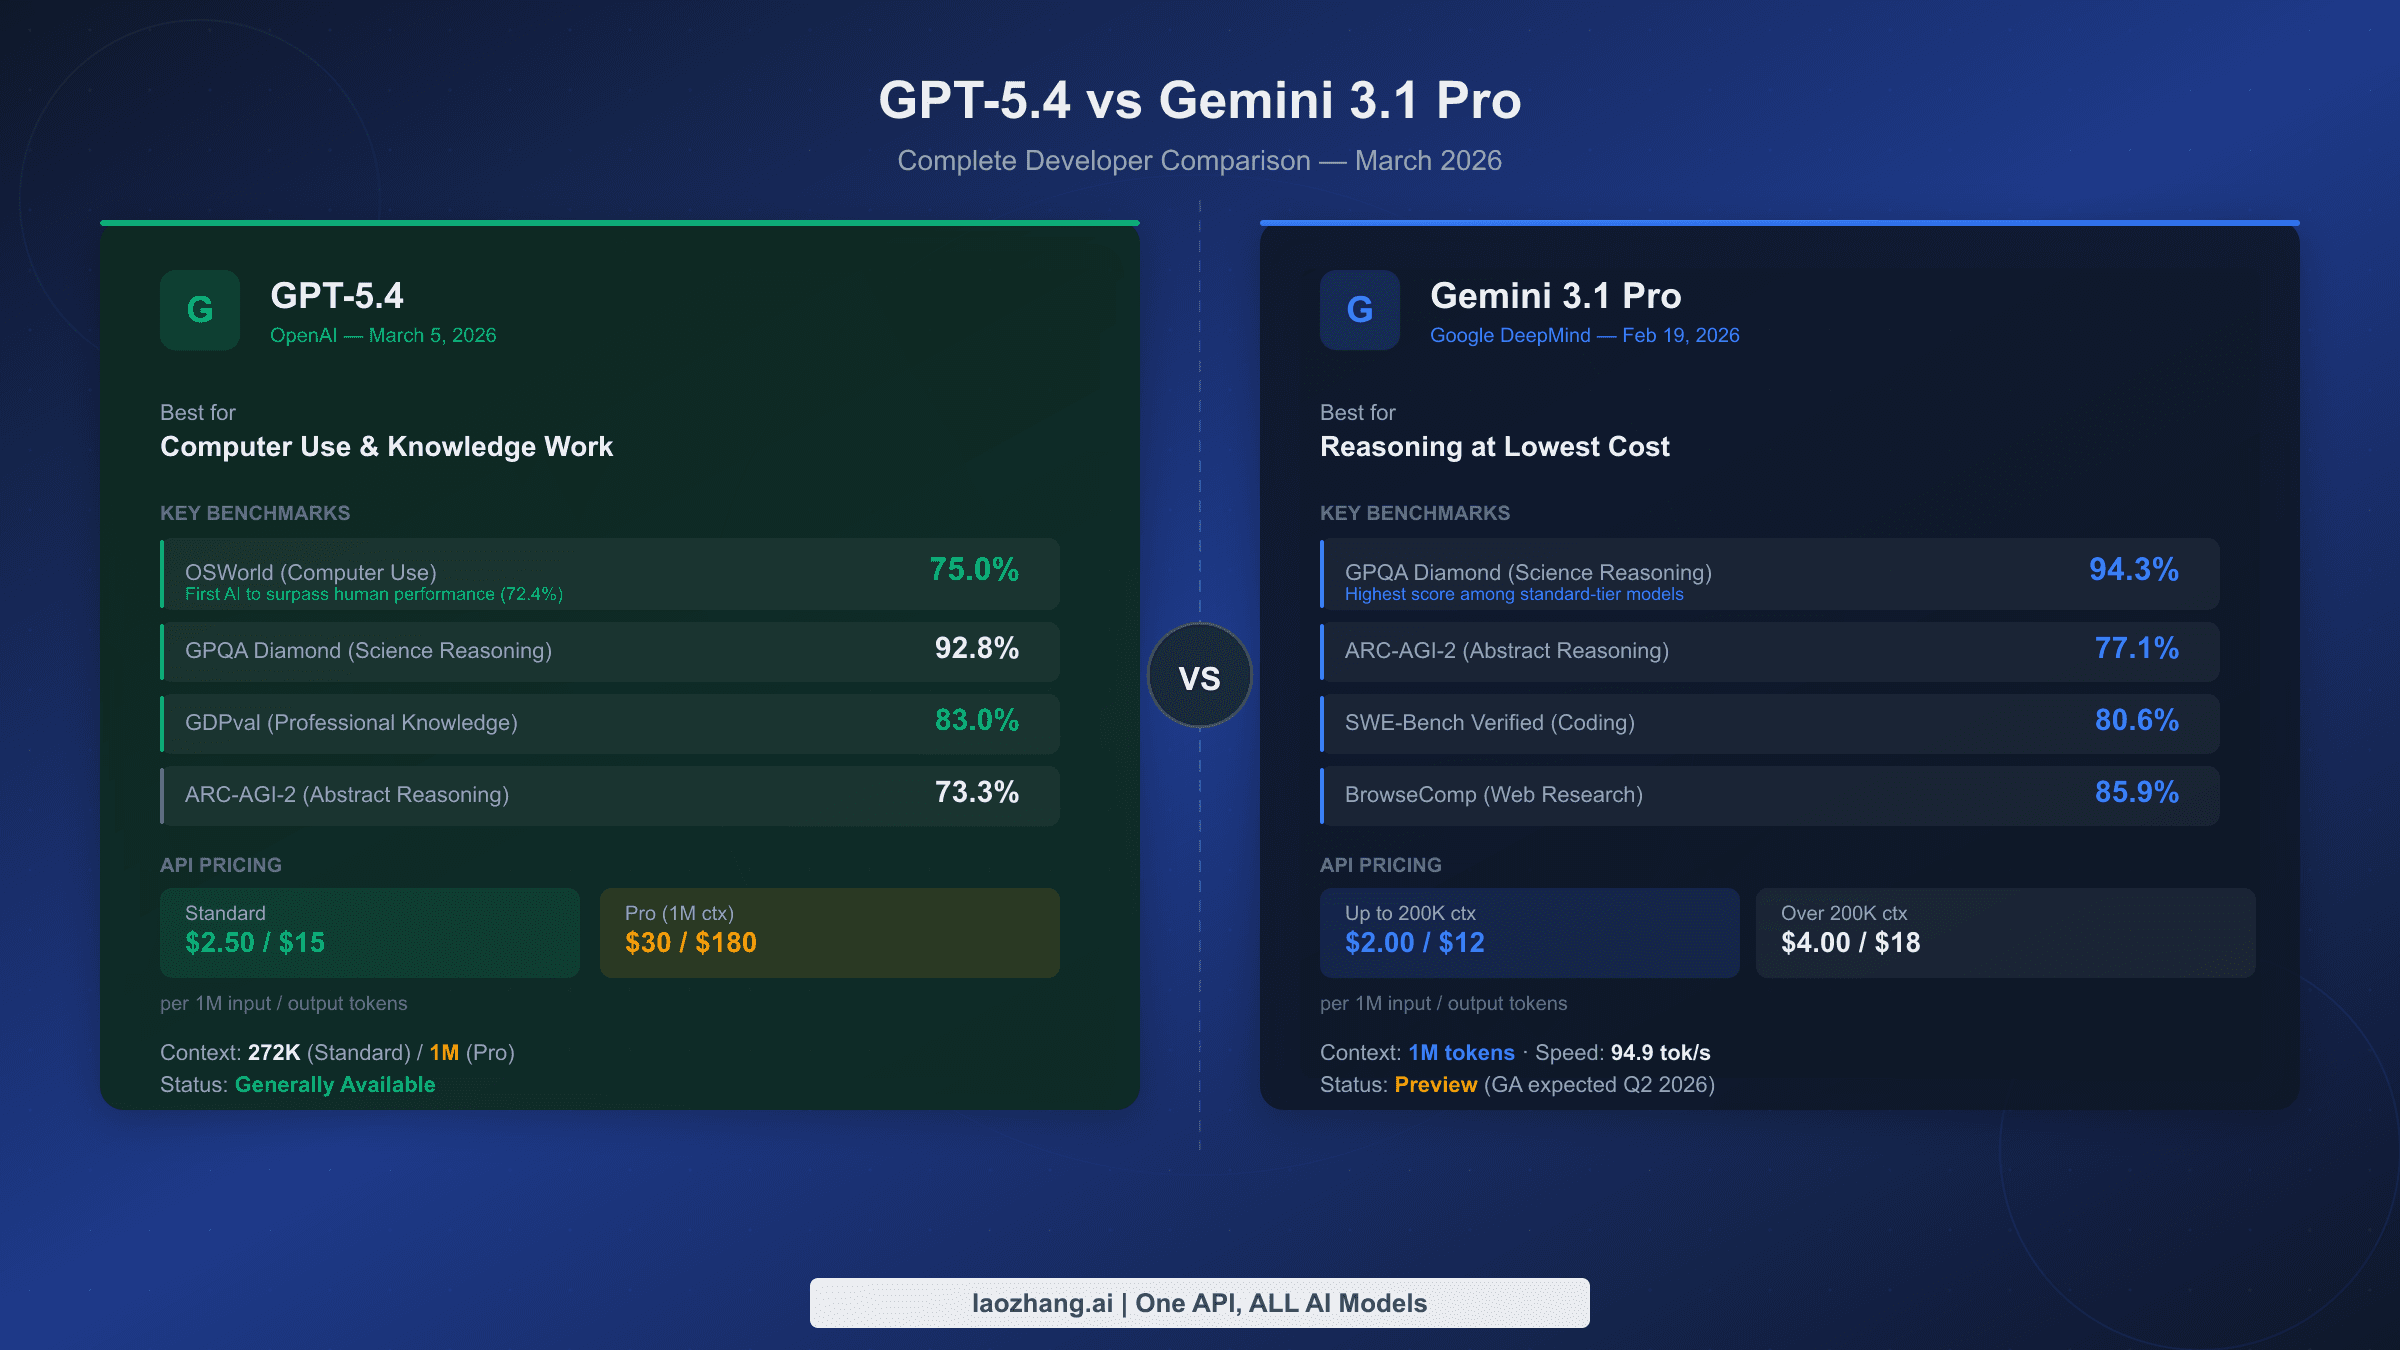
GPT-5.4와 Gemini 3.1 Pro는 벤치마크를 거의 동등하게 나눕니다. GPT-5.4는 컴퓨터 제어(OSWorld 75%), 터미널 작업(75.1%), 전문 지식 업무(GDPval 83%)를 선도합니다. Gemini 3.1 Pro는 과학적 추론(GPQA 94.3%), 코딩(SWE-Bench 80.6%), 웹 연구(BrowseComp 85.9%)에서 앞섭니다. 가격은 표준 레이어에서 거의 같습니다—진정한 15배 차이는 GPT-5.4 Pro($30/M) 대 Gemini 표준($2/M)을 비교할 때만 나타납니다.