GPT-6 Astra와 Claude Fable 5.1 비교: 같은 단가, 한국어 토큰은 1.9배
같은 $10/$50 단가에도 한국어 문장은 Fable 5.1에서 Astra보다 토큰이 1.9배입니다. 짧은 작업은 Astra가, 272K 넘는 영어·코드 단발 입력은 Fable이 쌉니다.
목차
2026년 10월 26일 기준으로 GPT-6 Astra와 Claude Fable 5.1의 API 정가는 둘 다 입력 100만 토큰당 $10, 출력 $50입니다. 그런데 같은 문장을 두 회사가 세는 토큰 수가 다릅니다. 같은 날 직접 재 보니 같은 뜻의 한국어 문단을 Fable은 Astra보다 1.90배, 영어 문단은 1.45배 많은 토큰으로 셌고, 숨은 테스트가 있는 8문제를 두 모델 모두 전부 통과한 상태에서 Fable의 비용은 Astra의 1.49~1.61배였습니다. "단가는 같고 캐시는 Fable이 싸다"는 계산은 토큰 수가 같다는 전제 위에서만 맞습니다.
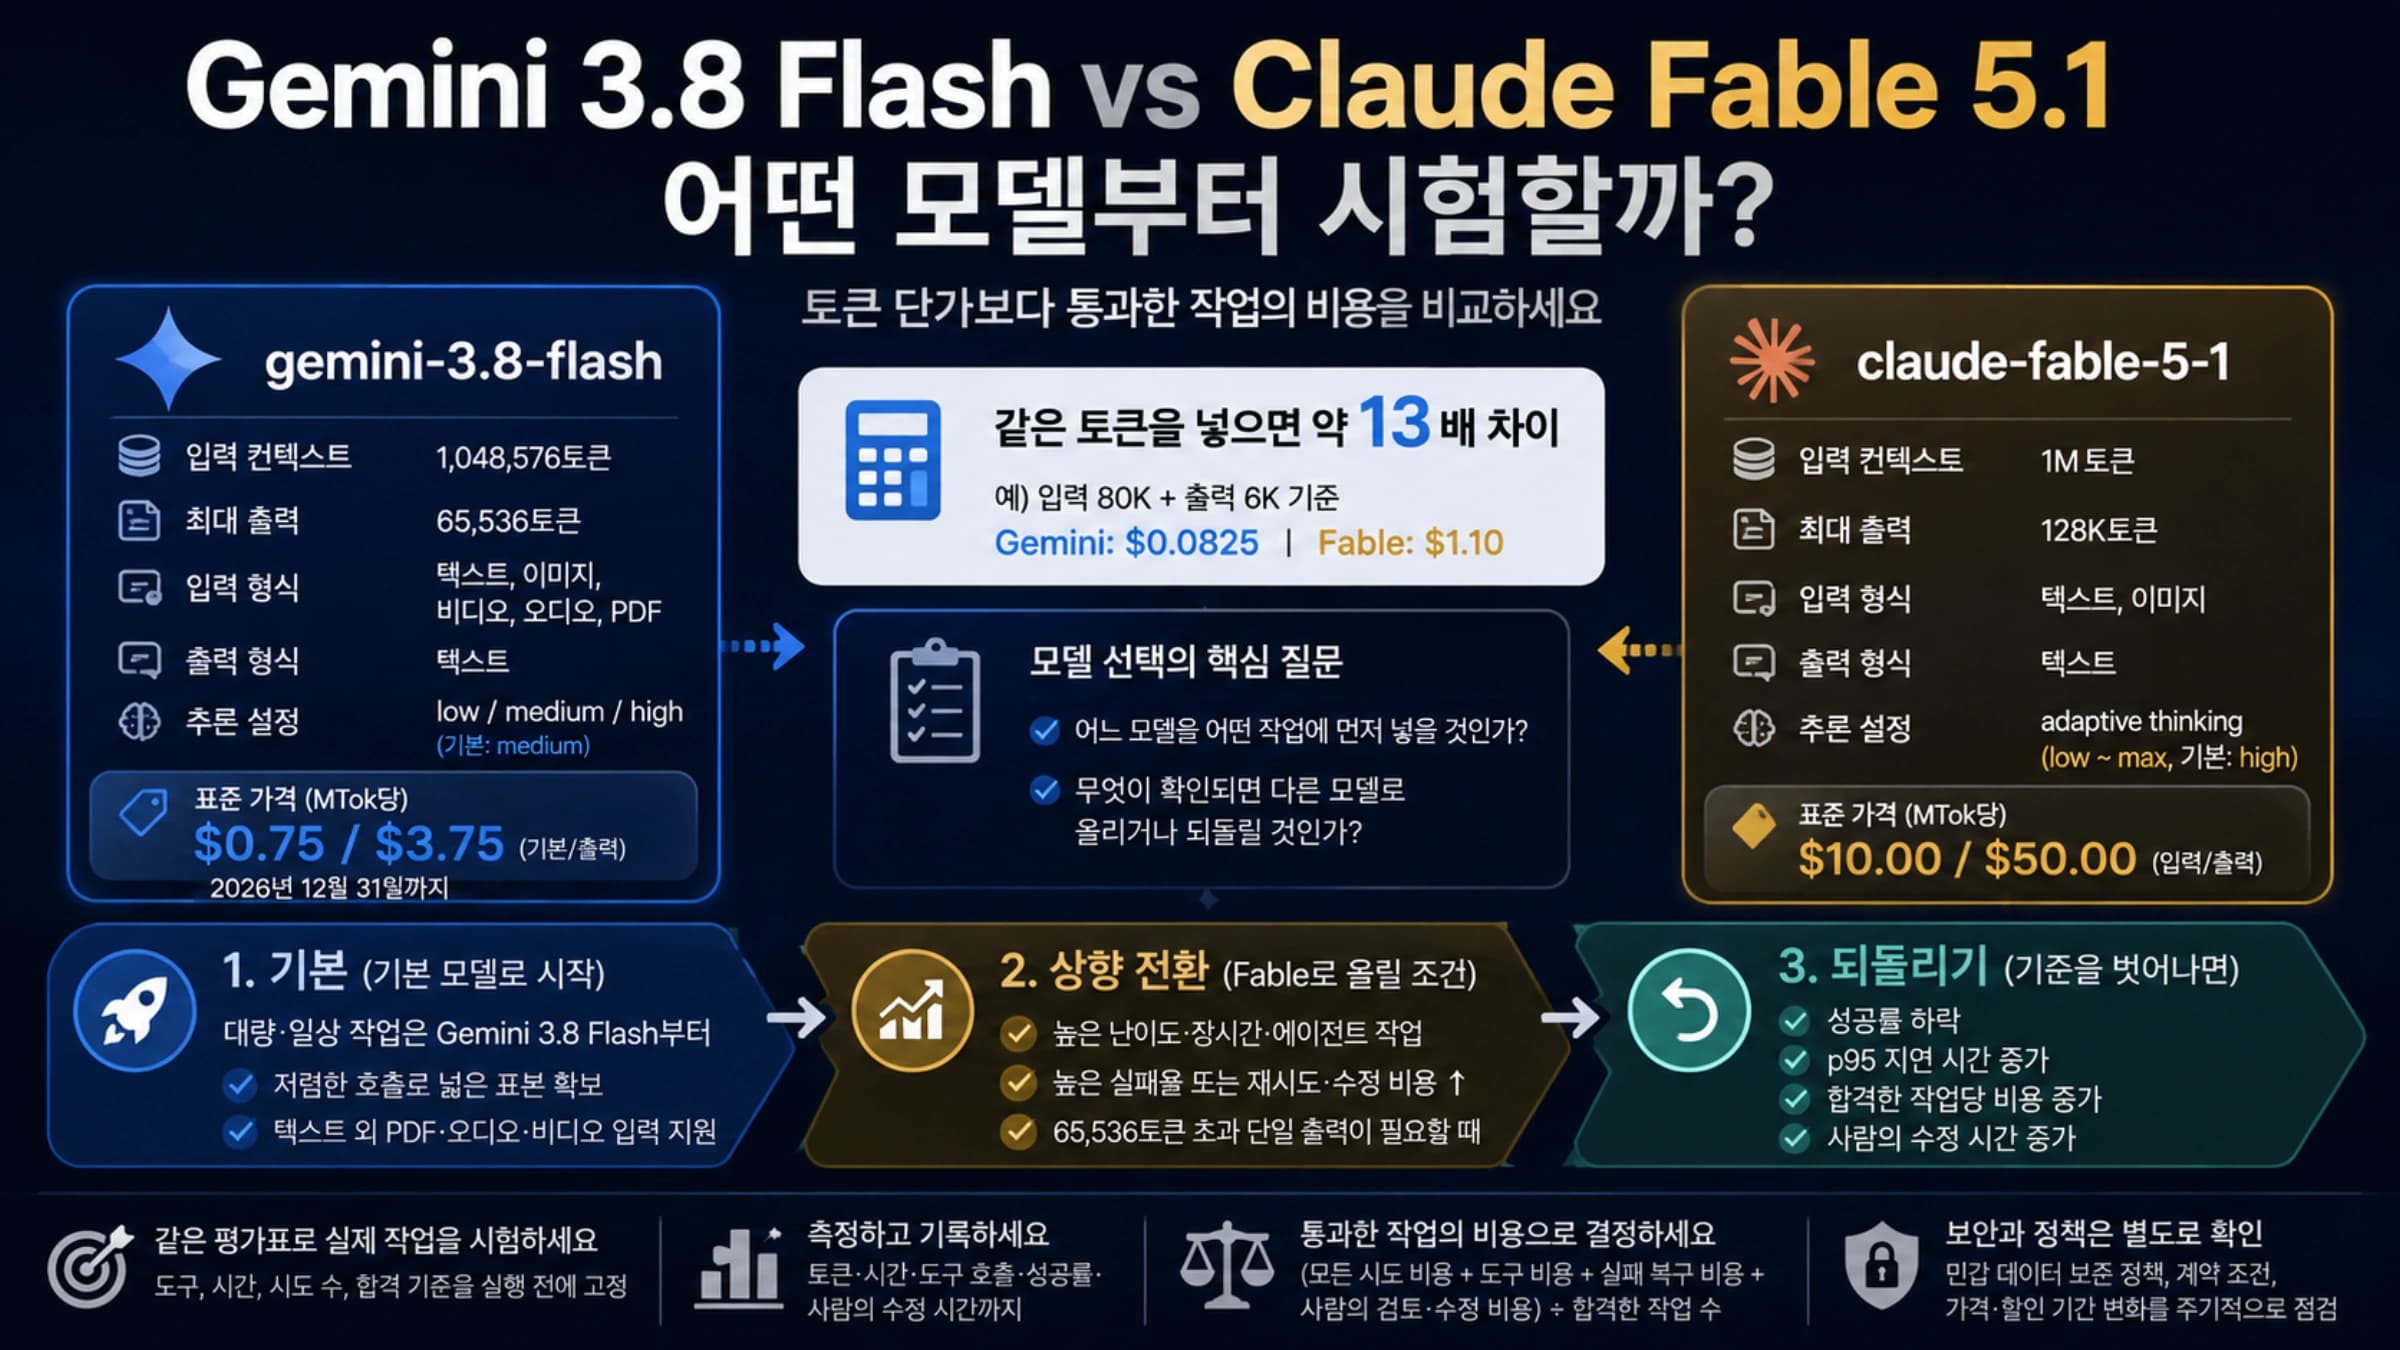
그래서 짧은 코딩 작업과 한국어 비중이 큰 프롬프트라면 gpt-6-astra를 먼저 시험하는 편이 비용상 유리합니다. claude-fable-5-1이 돈을 아껴 주는 경우는 캐시 없이 272K 토큰을 넘는 영어·코드 입력을 한 번에 보낼 때, 일본어처럼 토큰 비율이 낮은 텍스트를 캐시로 반복해 읽을 때, 그리고 Astra가 반복해서 실패하는 작업을 Fable이 통과할 때입니다. 둘 다 정하기 전에 더 싼 형제 모델도 확인하세요. Anthropic은 대부분의 작업을 claude-opus-5-5부터 시작하라고 안내하고, OpenAI는 gpt-6.1-sol을 Astra에 가까운 성능의 저렴한 모델로 소개합니다. 같은 8문제를 GPT-6.1 Sol로 풀면 비용이 Astra의 약 5분의 1이었습니다.
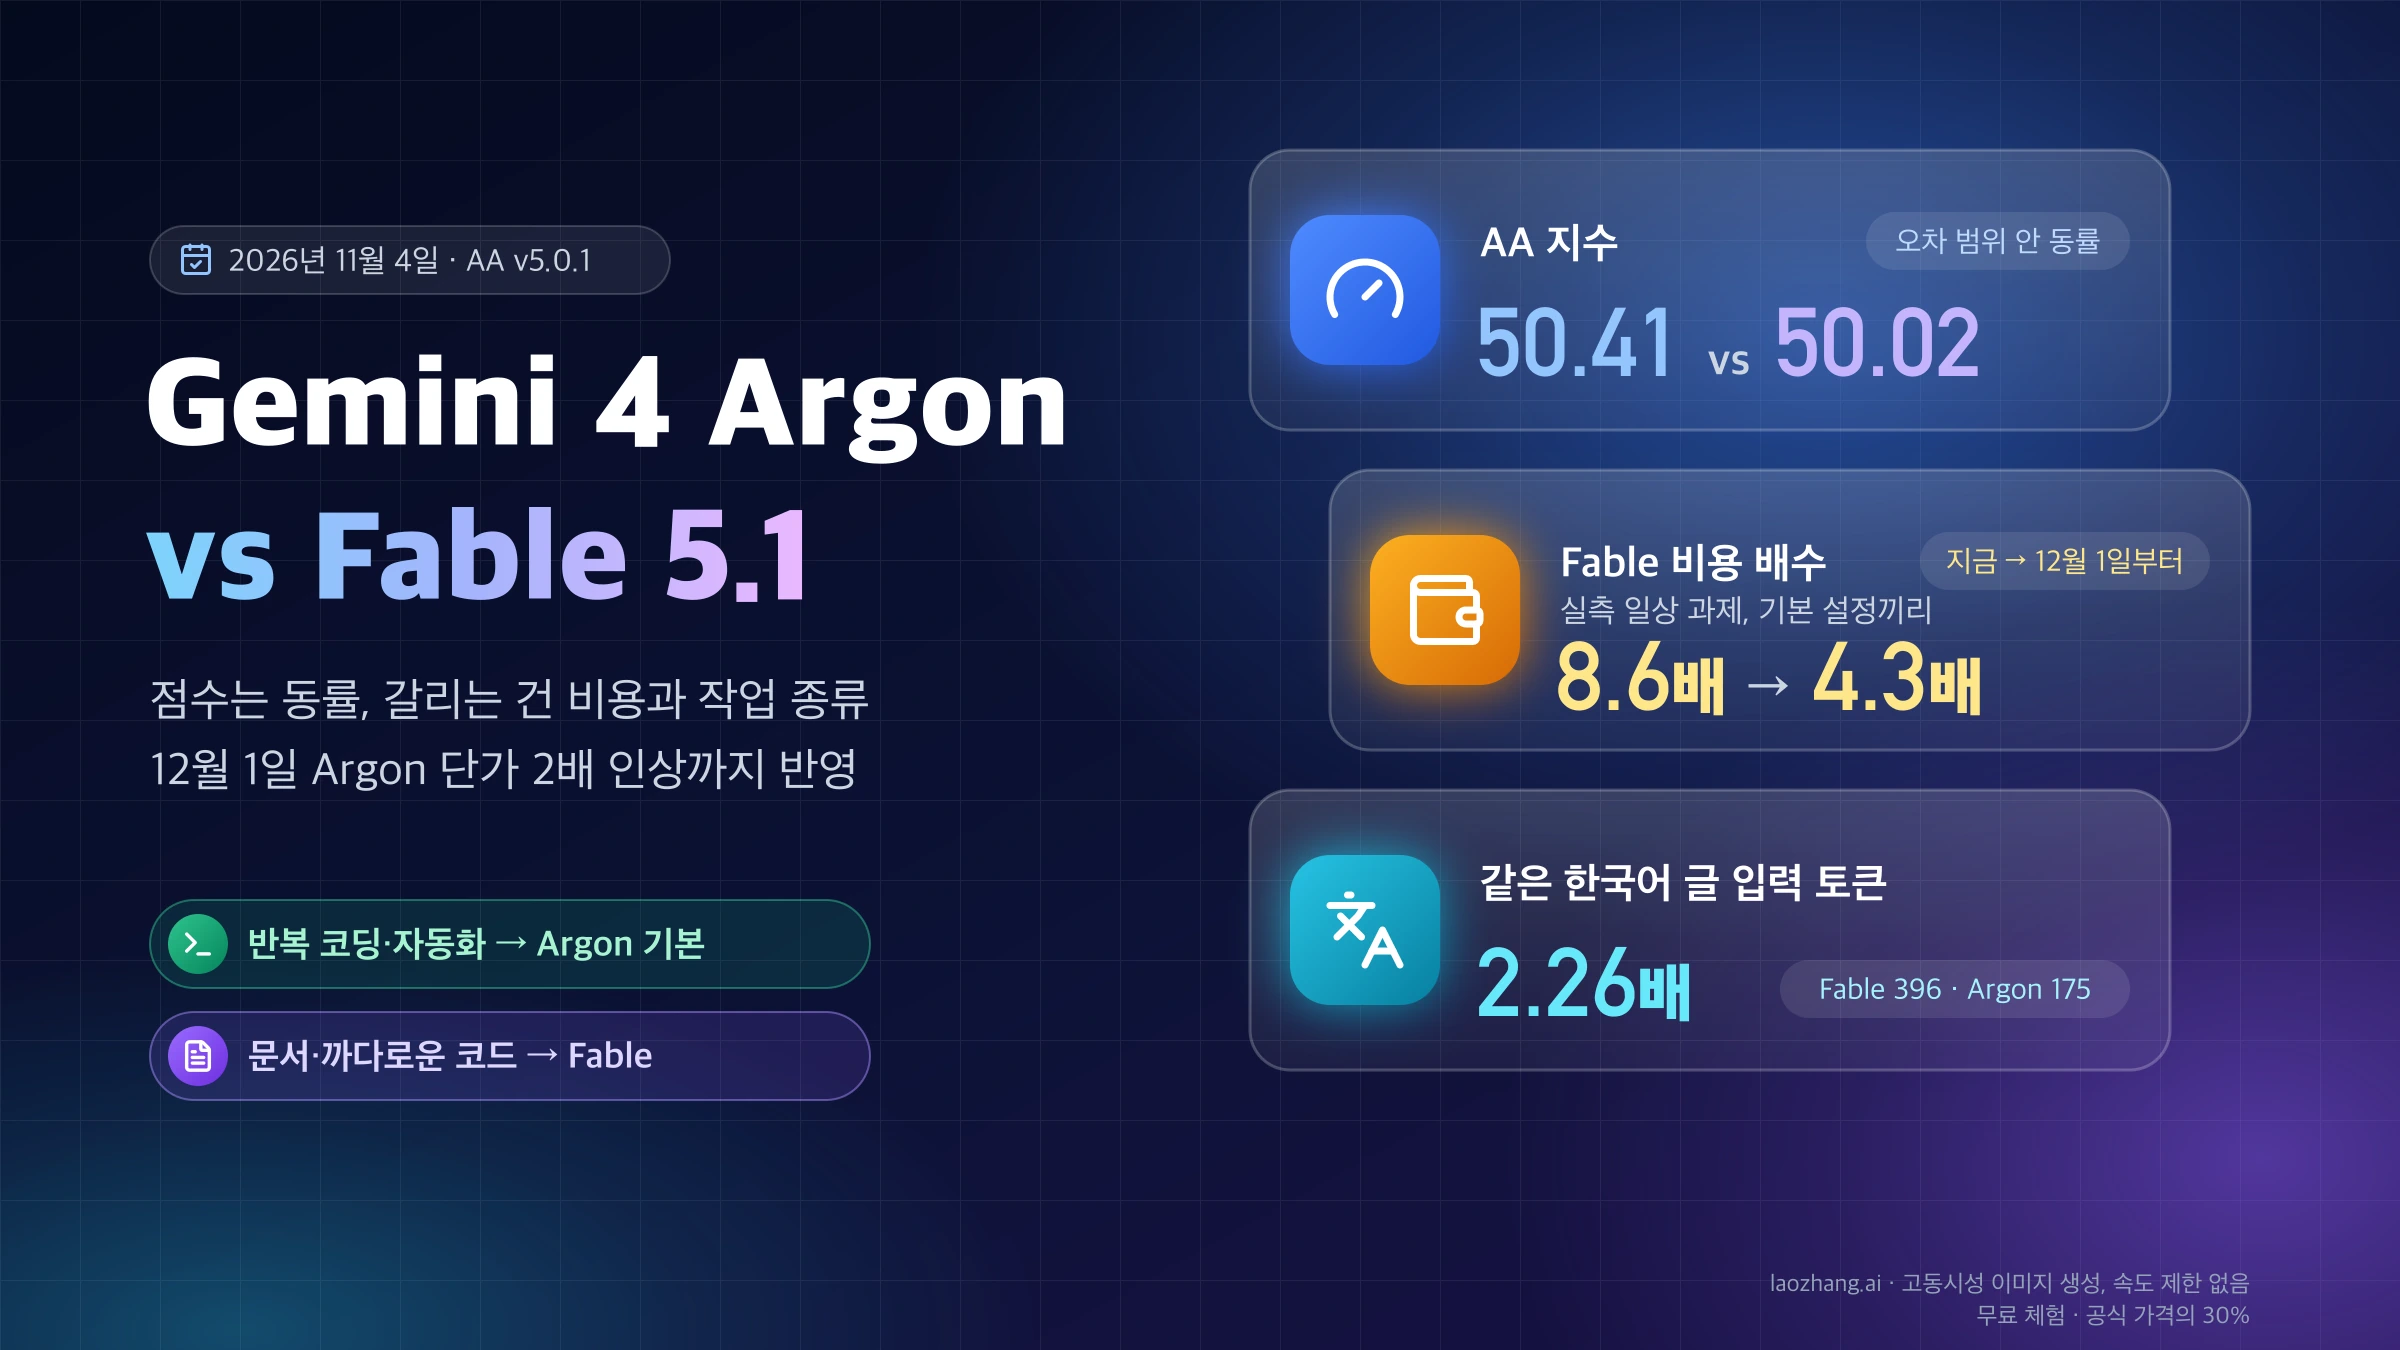
독립 평가의 종합 점수는 Astra 쪽입니다. 2026년 10월 27~28일 v4.3.2를 대체한 Artificial Analysis 지능 지수 v5.0(9개 평가)에서 Astra는 모든 추론 강도에서 Fable보다 5~8점 높고(max 57 대 49), 지수 과제당 비용은 Fable이 2.0~3.2배입니다. 그래서 Fable을 고를 이유는 점수보다 위의 비용 조건과 내 작업에서의 통과 여부에 있습니다. 데이터를 저장하지 않는 계약(ZDR)이 꼭 필요하다면 Fable 5.1은 Anthropic의 별도 승인 없이는 후보가 되지 않으므로, 비용 계산보다 그 조건을 먼저 확인해야 합니다.
Anthropic은 2026년 11월 9일 Claude Fable 5.2를 출시했습니다. 가격은 100만 토큰당 입력 $8, 출력 $40이고, Fable 5.1도 계속 쓸 수 있습니다. 이 글은 Fable 5.1 기준 그대로이며, 새 모델은 Fable 5.2 vs GPT-6 Astra 비교: 추론 강도 대응표와 실측 토큰 2.5배에서 다룹니다.
공식 API 계약에서 갈리는 부분
두 모델의 API 계약은 컨텍스트 크기보다 캐시가 켜지는 방식, 긴 입력 할증, 추론 설정에서 더 크게 갈립니다. 아래 가격은 2026년 10월 26일 기준 직접 API의 Standard 요금이며, MTok은 100만 토큰입니다.
| 항목 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| API 모델 ID | gpt-6-astra | claude-fable-5-1 |
| 컨텍스트 / 최대 입력 / 최대 출력 | 1,050,000 / 922,000 / 128,000 토큰 | 1,000,000 / 별도 공개 없음 / 128,000 토큰(출력·사고 토큰도 창에 포함) |
| 지식 기준일 | 2026-04-30 | 2026년 6월 |
| 추론 설정 | low~max, none은 400 오류, 기본값은 문서에 없음 | 적응형 사고 항상 켜짐, low~max, API 기본값 high |
| 기본 입력 / 출력 | $10 / $50 | $10 / $50 |
| 캐시 읽기 | $1 | $0.25 |
| 캐시 쓰기 | 30분 $12.50, 12시간 $25 | 5분 $12.50, 1시간 $20 |
| 캐시가 켜지는 조건 | 기본으로 자동 기록, prompt_cache_options.mode: "explicit"로 끔 | cache_control을 넣었을 때만 |
| 긴 입력 할증 | 입력이 272K를 넘으면 요청 전체 $20 / $2 / $75 | 없음, 1M 전체 표준 가격 |
| Batch | 50% 할인 | 50% 할인 |
GPT-6 Astra의 사양과 가격은 OpenAI GPT-6 Astra 모델 문서와 OpenAI API 가격표에 있습니다. 2026년 10월 20일부터 캐시 쓰기가 두 가지로 나뉘어, 기본 30분은 입력 단가의 1.25배, Responses API에서 고를 수 있는 12시간은 2.5배입니다. 272K 할증은 넘은 부분만이 아니라 요청 전체에 붙습니다. Astra의 기본 추론 강도는 OpenAI 문서에 적혀 있지 않고, Codex 문서는 Astra를 Light(low)부터 시작하라고 권합니다.
Claude Fable 5.1의 사양은 Anthropic Fable 5.1 모델 개요에, 단가는 Claude API 가격 문서에 있으며, 컨텍스트 창 문서는 1M 창 전체에 표준 가격을 적용한다고 설명합니다. 한 모델의 청구액만 깊게 계산하려면 GPT-6 Astra API 가격: 272K 기준과 캐시·서비스 티어 계산법과 Claude Fable 5.1 API 가격: 내 청구액은 얼마나 줄까를 참고하세요.
같은 기본 단가도 실제 비용은 달라진다
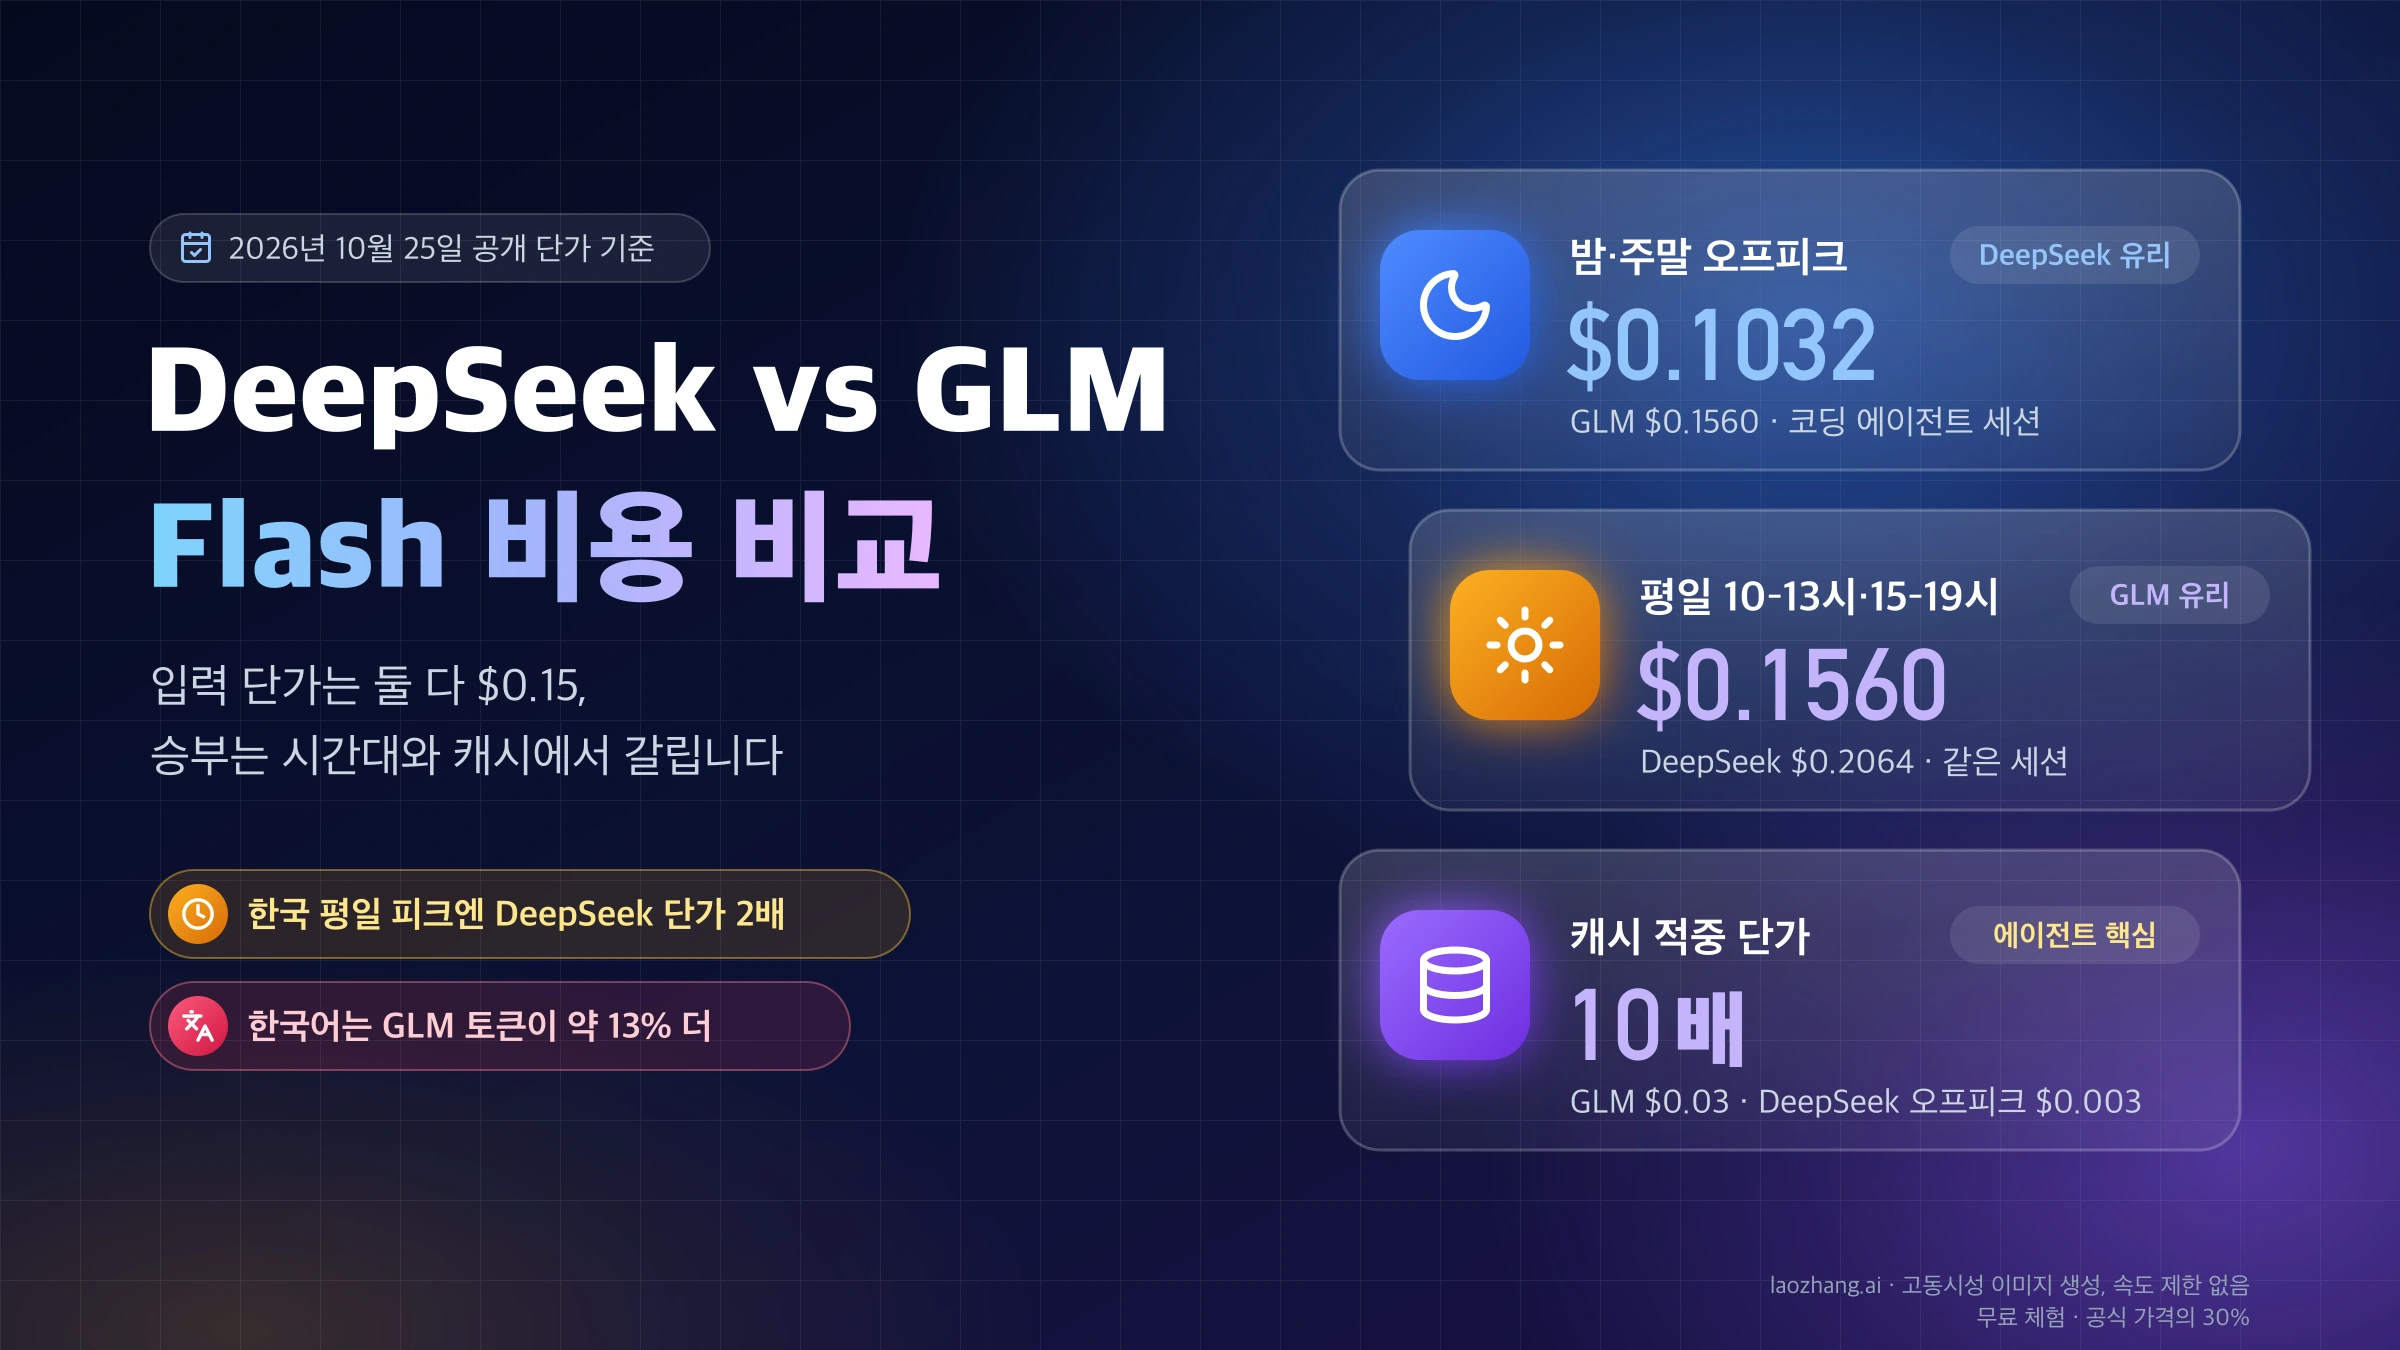
같은 $10/$50인데 청구액이 달라지는 이유는 네 가지입니다. 같은 텍스트가 Fable에서 더 많은 토큰이 되고, Astra는 아무 설정 없이도 긴 프롬프트를 캐시에 기록하면서 쓰기 단가를 받으며, Astra만 272K 초과 요청 전체에 할증이 붙고, Fable은 보이지 않는 사고 토큰까지 출력으로 청구합니다. 이 가운데 가장 큰 변수는 토크나이저이고, 한국어에서 차이가 가장 컸습니다.
Anthropic은 토큰 계산 문서에서 Fable 5.1의 토크나이저가 Opus 4.7 이전 Claude보다 약 30% 많이 센다고만 밝히고, OpenAI 모델과의 비율은 어느 회사도 공개하지 않습니다. 그래서 2026년 10월 26일 같은 뜻의 문단을 6개 언어로 써서 두 API가 돌려준 입력 토큰 수를 비교했습니다. 숫자는 각 모델의 지시문만 보낸 기준값(Astra 23, Fable 34)을 뺀 문단 토큰입니다.
| 언어 | 글자 수 | GPT-6 Astra | Claude Fable 5.1 | Fable / Astra |
|---|---|---|---|---|
| 한국어 | 363 | 208 | 396 | 1.90배 |
| 스페인어 | 799 | 162 | 304 | 1.88배 |
| 러시아어 | 791 | 193 | 302 | 1.56배 |
| 중국어 | 246 | 165 | 247 | 1.50배 |
| 영어 | 685 | 137 | 199 | 1.45배 |
| 일본어 | 344 | 254 | 312 | 1.23배 |
긴 영어 기사(6,723단어)에서는 Astra 10,106 대 Fable 15,335토큰으로 1.52배였고, 코드가 섞인 프롬프트 하나는 1.46배였습니다. 한국어 지시문에 코드를 붙이는 개발 프롬프트라면 실제 비율은 대략 1.46배와 1.90배 사이에 놓일 가능성이 큽니다. 한국어 비율은 문단 하나에서 잰 값이라 문체와 내용에 따라 달라질 수 있지만, Crazyrouter가 영어 채움 텍스트로 얻은 1.91배와 방향이 같습니다.
이 비율은 컨텍스트 크기에도 영향을 줍니다. Fable의 1M 창은 Fable 토큰으로 세기 때문에, 위 비율로 단순 환산하면 한국어 텍스트(1.90배)는 Astra 기준 약 53만 토큰, 영어(약 1.5배)는 약 67만 토큰 분량이 들어간다는 추정이 나옵니다. 반대로 Astra의 272K 할증 기준은 Astra 토큰으로 세므로 같은 문서가 할증선을 넘는 시점은 Astra 쪽이 더 늦습니다.
2026년 10월 26일 같은 프롬프트로 돌린 결과: Fable 비용 1.49~1.61배
같은 문제를 두 모델 모두 전부 맞힌 상태에서 비용은 Fable이 Astra의 1.49배(1차)와 1.61배(2차)였습니다. 2026년 10월 26일 laozhang.ai API 게이트웨이를 통해 Astra는 Chat Completions, Fable 5.1은 Messages 형식으로 같은 프롬프트를 보냈습니다. 시스템 프롬프트·도구·캐시 설정 없이 스트리밍으로, 추론 강도는 지정하지 않고 각 모델 기본값을 썼으며, 최대 출력은 32,000토큰입니다. 비용은 응답의 usage 값에 공식 정가를 곱해 계산했고, 게이트웨이 표시 가격도 같은 날 공식 Standard 가격과 같았습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
| 회차 | 모델 | 통과 | 입력 토큰 | 출력 토큰 | 정가 기준 비용 | 걸린 시간 |
|---|---|---|---|---|---|---|
| 1차, 5문제 | GPT-6 Astra | 5/5 | 10,545 | 1,839 | $0.2227 | 50.3초 |
| 1차, 5문제 | Claude Fable 5.1 | 5/5 | 15,948 | 3,431 | $0.3310 | 43.3초 |
| 2차, 3문제×2회 | GPT-6 Astra | 6/6 | 862 | 3,656 | $0.1914 | 78.6초 |
| 2차, 3문제×2회 | Claude Fable 5.1 | 6/6 | 1,254 | 5,896 | $0.3073 | 72.4초 |
문제는 문장형 계산, 구간 병합, 시간 문자열 파싱, 단어 빈도, 6,723단어 기사 5줄 요약, 수식 계산기, CSV 한 줄 파서, 자릿수 합 세기의 8개이고, 채점은 미리 만든 숨은 테스트로 했습니다. 두 모델이 모두 통과했으므로 이 결과는 어느 쪽이 더 똑똑한지가 아니라 같은 통과율에서 비용과 속도가 어떻게 다른지를 보여 줍니다. Fable의 출력 토큰은 1.87배와 1.61배로 입력보다 더 크게 늘었고, 회차 전체 시간은 Fable이 8~14% 짧았습니다. 38번 호출한 총비용은 정가 기준 $1.10입니다.
출력이 늘어나는 이유 중 하나는 보이지 않는 사고입니다. 이 경로에서 Fable에게 "ok" 한 단어만 답하게 했더니 출력 132토큰이 청구됐고 15.4초가 걸렸습니다. Astra는 5토큰, 2.8초였습니다. Astra는 사고 토큰을 reasoning_tokens로 따로 알려 주지만(첫 문제에서 412토큰 중 256), Fable은 사고 내용이 스트림으로 돌아오지 않아 출력 토큰에서 분리할 수 없었습니다.
캐시 동작도 확인됐습니다. 아무 캐시 설정 없이 보낸 10,106토큰짜리 프롬프트에서 Astra는 10,103토큰을 캐시에 기록했고, 이 부분이 일반 입력 $10 대신 쓰기 단가 $12.50로 계산돼 약 $0.025가 더 나왔습니다. 1,000토큰 미만의 짧은 프롬프트에서는 기록이 없었는데, OpenAI가 밝힌 최소 캐시 길이 1,024토큰과 맞습니다. Fable은 cache_control 없이는 아무것도 기록하지 않았습니다. 같은 8문제를 2026년 10월 25일 GPT-6.1 Sol로 풀었을 때도 모두 통과했고 비용은 1차 $0.0387, 2차 $0.0368로 Astra의 약 5분의 1이었습니다.
이번 측정의 한계도 분명합니다. 게이트웨이 하나에서 하루, 문제당 1~2회만 돌렸고, 두 모델 모두 푸는 문제만 들어 있습니다. 토큰 수는 게이트웨이가 돌려준 usage 값이며 Anthropic의 count_tokens로 따로 확인하지 못했습니다. Astra의 Responses API, 다른 추론 강도, 캐시 읽기, 272K를 넘는 입력은 돌리지 않았으므로, 아래 손익분기 계산의 캐시·긴 입력 부분은 정가로 계산한 값입니다.
내 사용 방식에서는 어느 쪽이 싼가: 손익분기 비율 1.455와 1.93
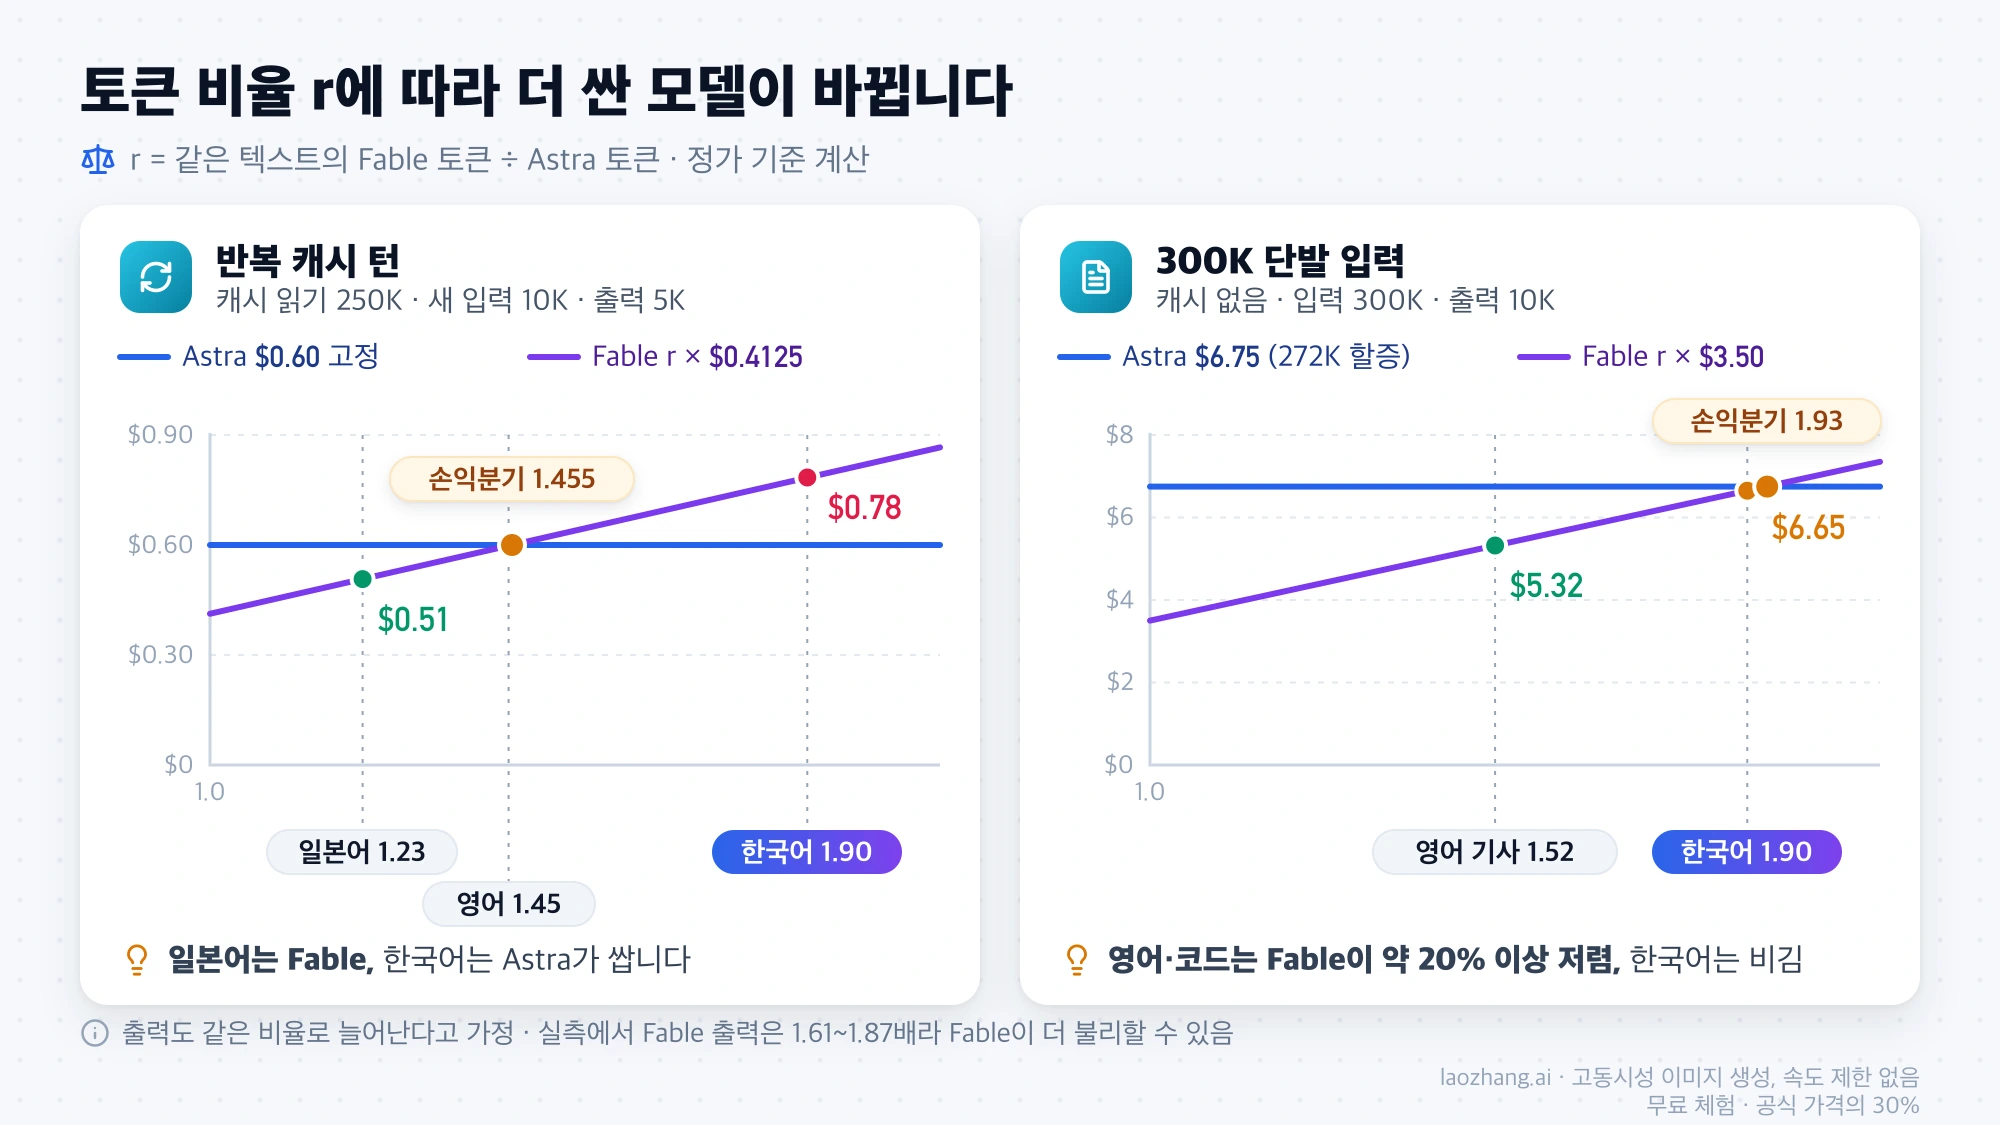
어느 쪽이 싼지는 내 텍스트의 토큰 비율 r(같은 텍스트의 Fable 토큰 ÷ Astra 토큰)이 손익분기점보다 높은지 낮은지로 정해집니다. 아래 계산은 모든 양을 Astra 토큰으로 적고 Fable 비용에 r을 곱했으며, 출력도 같은 비율로 늘어난다고 가정한 정가 계산입니다. 실제로는 Fable이 출력을 더 길게 쓰는 경향이 있어(위 실측에서 1.61~1.87배) Fable 쪽 결과가 아래보다 불리해질 수 있습니다.
같은 큰 앞부분을 반복해서 읽는 에이전트 한 턴을 캐시 읽기 250K, 새 입력 10K, 출력 5K로 잡으면 다음과 같습니다.
- GPT-6 Astra:
0.25 × $1 + 0.01 × $10 + 0.005 × $50 = $0.60 - Claude Fable 5.1:
r × (0.25 × $0.25 + 0.01 × $10 + 0.005 × $50) = r × $0.4125
두 값이 같아지는 r은 0.60 ÷ 0.4125 = 1.455입니다. 일본어(1.23배)면 Fable이 약 $0.51로 싸고, 영어나 코드(1.45~1.46배)면 $0.60 안팎으로 거의 같으며, 한국어(1.90배)면 Fable이 약 $0.78로 오히려 비쌉니다. 캐시 읽기 단가가 4분의 1이라는 장점은 한국어 텍스트에서 토큰 수 차이에 거의 다 상쇄됩니다. 캐시를 처음 쓰는 턴은 더 불리합니다. 30분 쓰기와 5분 쓰기 단가가 $12.50로 같아 Astra 0.25 × $12.50 + 0.01 × $10 + 0.005 × $50 = $3.475, Fable은 r × $3.475이므로 한국어 기준 약 $6.60입니다. 게다가 Fable의 기본 캐시 수명은 5분이라 작업 사이 간격이 길면 1시간 쓰기($20)를 써야 합니다.
캐시 없이 300K 입력과 10K 출력을 한 번에 보내는 긴 단발 작업은 결과가 반대입니다.
- GPT-6 Astra: 272K를 넘어 요청 전체에 할증,
0.30 × $20 + 0.01 × $75 = $6.75 - Claude Fable 5.1:
r × (0.30 × $10 + 0.01 × $50) = r × $3.50
손익분기 r은 6.75 ÷ 3.50 = 1.93입니다. 긴 영어 기사 비율(1.52배)이면 Fable이 약 $5.32로 확실히 싸고, 한국어(1.90배)면 약 $6.65 대 $6.75로 거의 같습니다. 한국어 문서가 주된 입력이라면 272K 할증만 보고 Fable을 고를 근거는 약하고, 검색이나 요약으로 Astra 입력을 272K 아래로 줄이는 쪽도 같은 기준으로 비교할 가치가 있습니다.
272K 아래의 짧은 작업에서는 할증도 캐시도 작동하지 않으므로 Fable 비용은 입력에서 r배, 출력에서 출력 토큰 비율만큼 늘어납니다. 위 실측이 바로 이 경우입니다. 어느 경우든 비교 단위는 호출 한 번이 아니라 통과한 작업 한 건입니다.
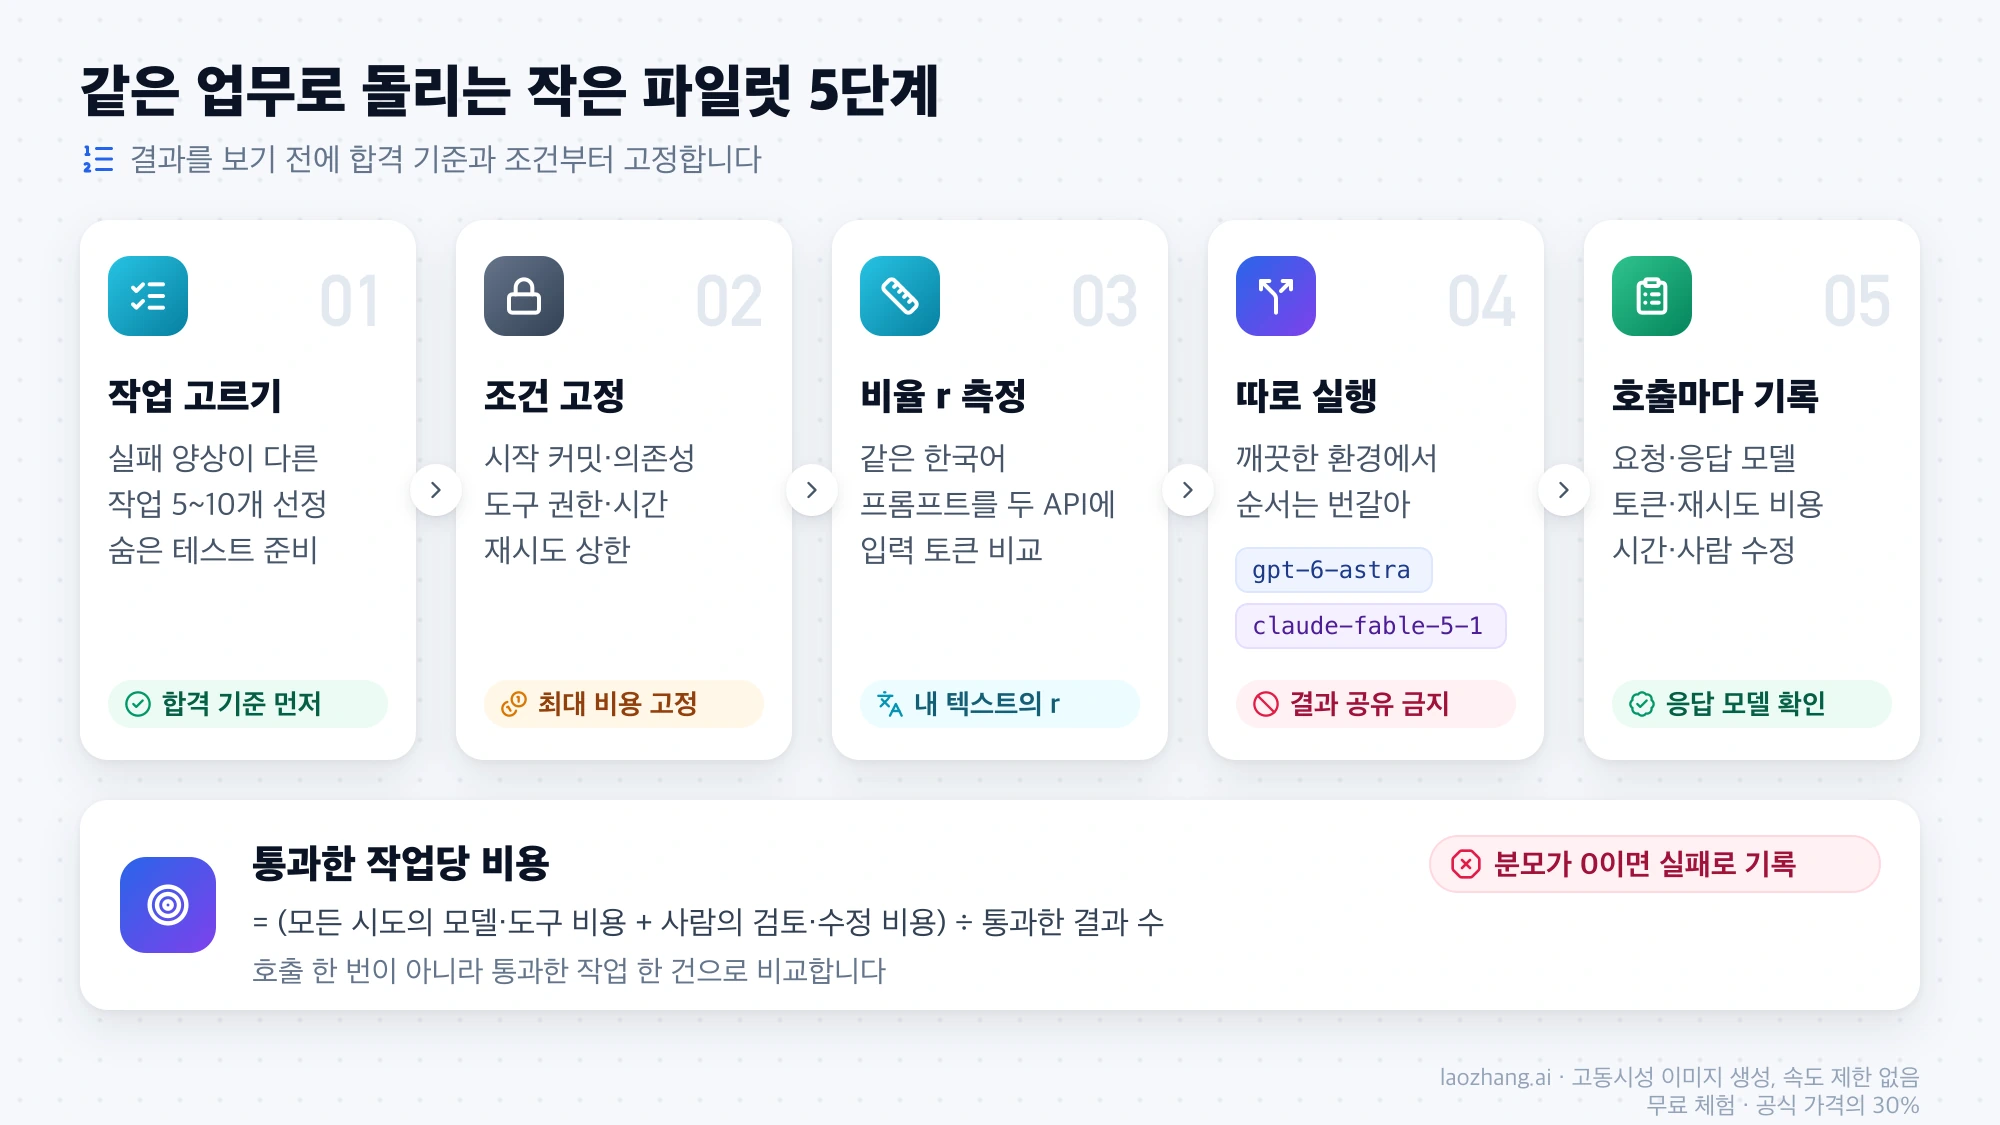
통과한 작업당 비용 = (모든 시도의 모델·도구 비용 + 사람의 검토·수정 비용) ÷ 통과한 결과 수
Fable이 Astra보다 적은 재시도로 통과한다면 토큰 비용이 1.5배라도 이 값은 Fable이 낮을 수 있습니다. 분모가 0인 작업군은 평균을 내지 말고 실패로 기록해, 모델·도구·권한·데이터 조건 중 어디서 막혔는지 나눠 봐야 합니다.
공급사 벤치마크는 시험 항목을 고르는 자료다
2026년 10월 28일 기준 독립 평가의 종합 점수는 Astra가 앞섭니다. Artificial Analysis 지능 지수 v5.0에서 Astra 대 Fable 점수는 max 57 대 49, xhigh 55 대 50, high 55 대 47, medium 51 대 43, low 43 대 38로 모든 추론 강도에서 Astra가 5~8점 높고, Fable의 최고점인 xhigh 50점도 Astra medium 51점에 못 미칩니다. 10월 26일까지 쓰이던 v4.3.2에서는 두 모델이 max 53점으로 같았지만, 평가 구성이 바뀐 두 판의 점수는 직접 비교할 수 없습니다. 출시 주에 널리 인용된 "Fable 66, Astra 61"도 지수 v4.1 기준이라 마찬가지입니다.
비용 차이도 같은 방향입니다. Artificial Analysis의 GPT-6 Astra 대 Claude Fable 5.1 비교 페이지에서 지수 과제 하나당 비용은 max에서 Fable $13.04 대 Astra $6.24, low에서 $4.49 대 $1.42였고, 추론 강도에 따라 Fable이 2.0~3.2배였습니다. 점수가 더 낮은데도 Fable이 과제마다 돈을 더 쓴다는 뜻이며, 비용 방향은 직접 돌린 결과와 같습니다. 속도는 측정처마다 다릅니다. OpenRouter의 실시간 비교에서는 Fable 57 대 Astra 36토큰/초로 Fable이 빨랐지만, Artificial Analysis의 max 설정에서는 출력 속도가 Fable 66, Astra 71토큰/초로 비슷하고 지수 과제 하나에 걸린 시간은 Fable 1,177.6초, Astra 711.1초였습니다. 첫 토큰까지 시간은 10월 26일 측정에서 Fable 180.5초, Astra 278.3초로 Fable이 빨랐습니다.
항목별로는 우위가 갈립니다. OpenAI의 GPT-6 Astra 출시 페이지는 max 설정에서 Terminal-Bench 4.0 57.9% 대 55.8%, DeepSWE v1.1 74.1% 대 67.4%로 Astra가 앞서고, 도구를 쓴 Humanity's Last Exam은 Fable이 65.0% 대 57.2%로 앞선다고 적었습니다. Artificial Analysis v5.0의 max 설정 세부 항목에서는 Fable이 AA-Briefcase(1669 대 1568)와 지식 신뢰도 지표인 AA-Omniscience(46 대 42)에서만 앞서고, Terminal-Bench 4.0(59.1% 대 52.0%), AutomationBench(68.5% 대 59.4%), FrontierCode, GDP.pdf, HLE-Diamond, CritPt, Terminal-Bench-Science는 모두 Astra가 높습니다. 예전 v4.3.2에서 Fable이 앞서던 GDPval-AA, SciCode, 긴 문맥 추론(AA-LCR)은 v5.0 지수에서 빠졌습니다. Crazyrouter의 29문항 자체 시험에서는 Fable이 29개를 모두 맞히고 Astra는 16개였는데, Astra는 세 갈래 동점 처리와 잘못된 전제 문제에서 주로 틀렸습니다. X 사용자 @nateherk는 15가지 활용 사례를 비교해 Fable의 결과물이 낫지만 37분 12초에 $26.61, Astra는 23분 30초에 $12.14가 들었다고 보고했습니다.
이 숫자들의 쓸모는 영원한 승자를 정하는 데 있지 않고 내 파일럿에 넣을 실패 유형을 고르는 데 있습니다. 터미널 작업과 자동화가 중심이라면 Astra 쪽 근거가 많고 종합 점수도 Astra가 높습니다. Fable 쪽 근거는 AA-Briefcase와 AA-Omniscience, Crazyrouter의 잘못된 전제 문제처럼 좁은 영역에 남아 있으므로, 사실 정확도나 까다로운 전제 확인이 중요한 작업이라면 Fable이 통과하는지 직접 확인할 이유가 생깁니다.
비교 전에 실제 호출 가능 여부부터 확인한다
API에서는 두 모델 모두 공개돼 있지만, 내 키가 어느 조직·프로젝트에 속하는지에 따라 실제 호출 여부가 달라집니다. OpenAI 문서에 따르면 API 키로 쓰는 Astra 권한은 그 키의 조직과 프로젝트를 따르며, ChatGPT 워크스페이스에서 Astra를 켜도 API 권한이 생기지는 않습니다. Fable 5.1은 Claude API, Amazon Bedrock, Claude Platform on AWS, Microsoft Foundry, Google Cloud에 올라와 있지만, 플랫폼 목록에 있다고 내 계정과 리전에서 바로 호출된다는 뜻은 아닙니다. 첫 요청을 보내 응답의 모델명을 기록하는 과정은 GPT-6 Astra API 사용 방법: 프로젝트 권한 확인부터 첫 응답까지에 정리돼 있습니다.
구독으로 쓸 때는 조건이 더 복잡합니다. 2026년 10월 26일 기준 OpenAI 문서는 Plus와 표준 Business에서 Work·Codex의 Astra 사용량을 5시간당 약 5~45회로 안내하고, Pro에는 5시간 한도가 없으며, 일부 유료 요금제에서는 Astra Extra High가 빠진다고 적고 있습니다. Free와 Go는 Luna로 안내되고, Enterprise·Edu는 관리자가 켜기 전까지 Astra가 꺼져 있습니다. Chat 화면에서 요금제별로 Astra를 쓸 수 있는지는 공식 문서에 나와 있지 않고, Pro·Business·Enterprise만 가능하다는 사용자 보고가 있습니다. Codex와 ChatGPT Work에서 "Sol"은 아직 고를 수 있는 GPT-6.1 Sol, GPT-6 Sol, GPT-5.6 Sol 중 하나일 수 있고, 셋 모두 Astra와는 다른 모델입니다. Sol과 Astra의 차이는 GPT-6.1 Sol·Astra·GPT-6 Sol 비교와 전환 기준에서 다룹니다.
Claude 쪽은 Free에서 Fable 5.1을 쓸 수 없습니다. Anthropic 도움말의 요금제별 Fable 모델 안내에 따르면 Max와 Team·Enterprise 프리미엄 좌석은 주간 사용량 한도의 최대 50%까지 추가 비용 없이 쓰고, Pro와 표준 좌석은 첫 메시지부터 종량제 사용 크레딧으로 결제됩니다. Claude Code에서 쓰려면 2.1.255 이상이 필요합니다. 요금제별 한도 전체는 Claude 요금제별 사용량 한도: Ultra(구 Max 20배) 인증 시 5시간 한도 없음을 보세요.
도구를 많이 쓰는 업무에서는 API 차이가 먼저 드러난다
GPT-6 Astra로 도구를 호출하려면 Responses API를 써야 합니다. OpenAI의 최신 모델 사용 가이드는 Astra가 Chat Completions도 지원하지만 함수 호출은 지원하지 않는다고 적고 있어, Chat Completions 기반 하네스에서 모델 ID만 바꾸면 도구가 필요한 작업은 비교 자체가 되지 않습니다. 추론 강도에 none을 넣으면 400 오류가 나므로 가장 가벼운 설정은 low입니다. 화면 조작까지 맡길 계획이라면 GPT-6 Astra로 컴퓨터 작업 구현하기: API 경로와 안전한 실행 루프에서 실행 루프를 확인할 수 있습니다.
Claude Fable 5.1은 요청 형식 제약이 많습니다. Anthropic의 Fable 5.1 변경 사항 문서에 따르면 tool_choice의 tool과 any, 응답 앞부분 미리 채우기(prefill), budget_tokens나 사고 끄기, temperature·top_p·top_k는 모두 400 오류를 돌려주고, auto와 none만 남습니다. 특정 도구를 강제로 고르게 만든 에이전트는 품질을 시험하기 전에 하네스부터 고쳐야 합니다.
두 모델에 완전히 같은 JSON을 보내는 것이 공정한 비교는 아닙니다. 맞춰야 하는 것은 업무 목표, 입력 자료, 쓸 수 있는 도구와 권한, 시간 제한, 합격 기준이고, 각 공급사의 공식 API 형식에 맞게 구현하되 한쪽에만 힌트나 복구 기회를 더 주지 않아야 합니다.
데이터 조건은 성능 시험보다 앞선 탈락 기준이다
요청·응답을 저장하지 않는 ZDR이 필수라면 Fable 5.1은 기본적으로 후보에서 빠집니다. Anthropic의 API 데이터 보존 문서는 Fable 5.1을 30일 보존이 필요한 대상 모델로 분류하고, Anthropic이 명시적으로 승인하지 않는 한 ZDR을 적용하지 않습니다. 이 조건을 갖추지 않은 조직의 요청은 HTTP 400을 받고, ZDR 조직은 워크스페이스 하나에만 30일 보존을 켜서 쓸 수 있습니다.
OpenAI는 ZDR을 엔드포인트 단위로 사전 승인하며, /v1/responses와 /v1/chat/completions가 대상입니다. Astra만 따로 제외한다는 문구는 OpenAI 데이터 관리 문서에 없지만, OpenAI는 특정 고객에게 모델을 제외할 권리를 남겨 두고 있으므로 자격은 조직·프로젝트별로 확인해야 합니다.
모델 귀속도 조건입니다. Fable의 안전장치가 요청을 걸러 내면 Claude 앱은 다른 모델로 답을 바꿀 수 있고 알림에 답한 모델이 표시됩니다. API로 비교할 때도 요청 모델뿐 아니라 응답에 기록된 모델을 매번 남겨야 합니다. 영업비밀·개인정보·규제 대상 데이터가 들어가거나 처리 리전이 정해져 있다면 계약과 실제 설정으로 이 조건을 증명할 수 있는 경로만 평가하고, 증명할 수 없다면 비민감 합성 자료로 기능만 시험합니다. Fable 도입 시 캐시와 추론 설정이 함께 바뀌는 부분은 Claude Fable 5.1 vs Opus 5 가격 비교: 실제 작업 비용에서 더 볼 수 있습니다.
업무별로 첫 시험 후보를 좁힌다
업무 유형마다 먼저 시험할 모델이 다릅니다. 기준은 입력 언어의 토큰 비율, 272K를 넘는지, 캐시를 반복해서 읽는지, 도구 호출 방식입니다.
큰 고정 입력을 반복해서 읽는 코딩 에이전트
같은 저장소 스냅샷이나 긴 규칙을 여러 턴에 걸쳐 다시 읽는다면 Fable의 $0.25 캐시 읽기가 매력적으로 보이지만, 손익분기 비율이 1.455라 영어·코드 위주면 거의 같고 한국어 규칙 문서가 크면 Astra가 쌉니다. 캐시 수명도 따져야 합니다. Astra는 아무 설정 없이 30분 캐시가 기록되고, Fable은 cache_control을 넣어야 5분 또는 1시간 캐시가 생깁니다. Fable을 고르게 하는 것은 가격이 아니라 같은 작업에서의 재시도 횟수입니다.
272K를 넘는 단일 입력이 잦은 리서치·저장소 작업
한국어 텍스트(r≈1.90)라면 Fable이 정가로 앞서거나 거의 비기는 곳은 이 구간입니다. 반복 캐시 턴에서는 한국어 비율이 손익분기 1.455를 넘기 때문입니다. 영어·코드 입력이면 Fable이 약 20% 이상 싸고, 한국어 문서면 두 모델의 비용이 거의 같아집니다. 전체 자료를 한 번에 넣는 경로와, 검색이나 단계별 요약으로 Astra 입력을 272K 아래로 줄이는 경로를 같은 합격 기준으로 비교하고, 요약 과정의 누락과 지연도 비용에 넣으세요.
도구 호출과 실행 중 조정이 많은 작업
Responses API로 이미 도구를 다루고 있다면 Astra의 통합 비용이 낮고, 벤치마크에서도 터미널·자동화 항목은 Astra가 앞섰습니다. Anthropic 하네스에 익숙하다면 Fable이 덜 바꿔도 되지만 tool_choice 강제 선택이 막혀 있다는 점을 먼저 확인해야 합니다. 인증, 로깅, 재시도, 도구 스키마 변경까지 파일럿 비용으로 기록하세요.
민감 데이터와 엄격한 모델 귀속이 필요한 작업
보존 기간은 앞의 데이터 조건에서 먼저 걸러지므로 여기서 남는 질문은 모델 귀속입니다. Fable의 30일 보존을 받아들일 수 있더라도 안전장치에 따른 모델 전환이 허용되지 않는 업무라면, 응답 모델을 매번 기록하고 전환이 생긴 요청을 결과에서 분리할 수 있는지부터 확인합니다. Astra로 좁히는 경우에도 쓰려는 엔드포인트의 ZDR 승인을 조직 단위로 받아 두어야 합니다.
같은 업무로 작은 파일럿을 설계한다
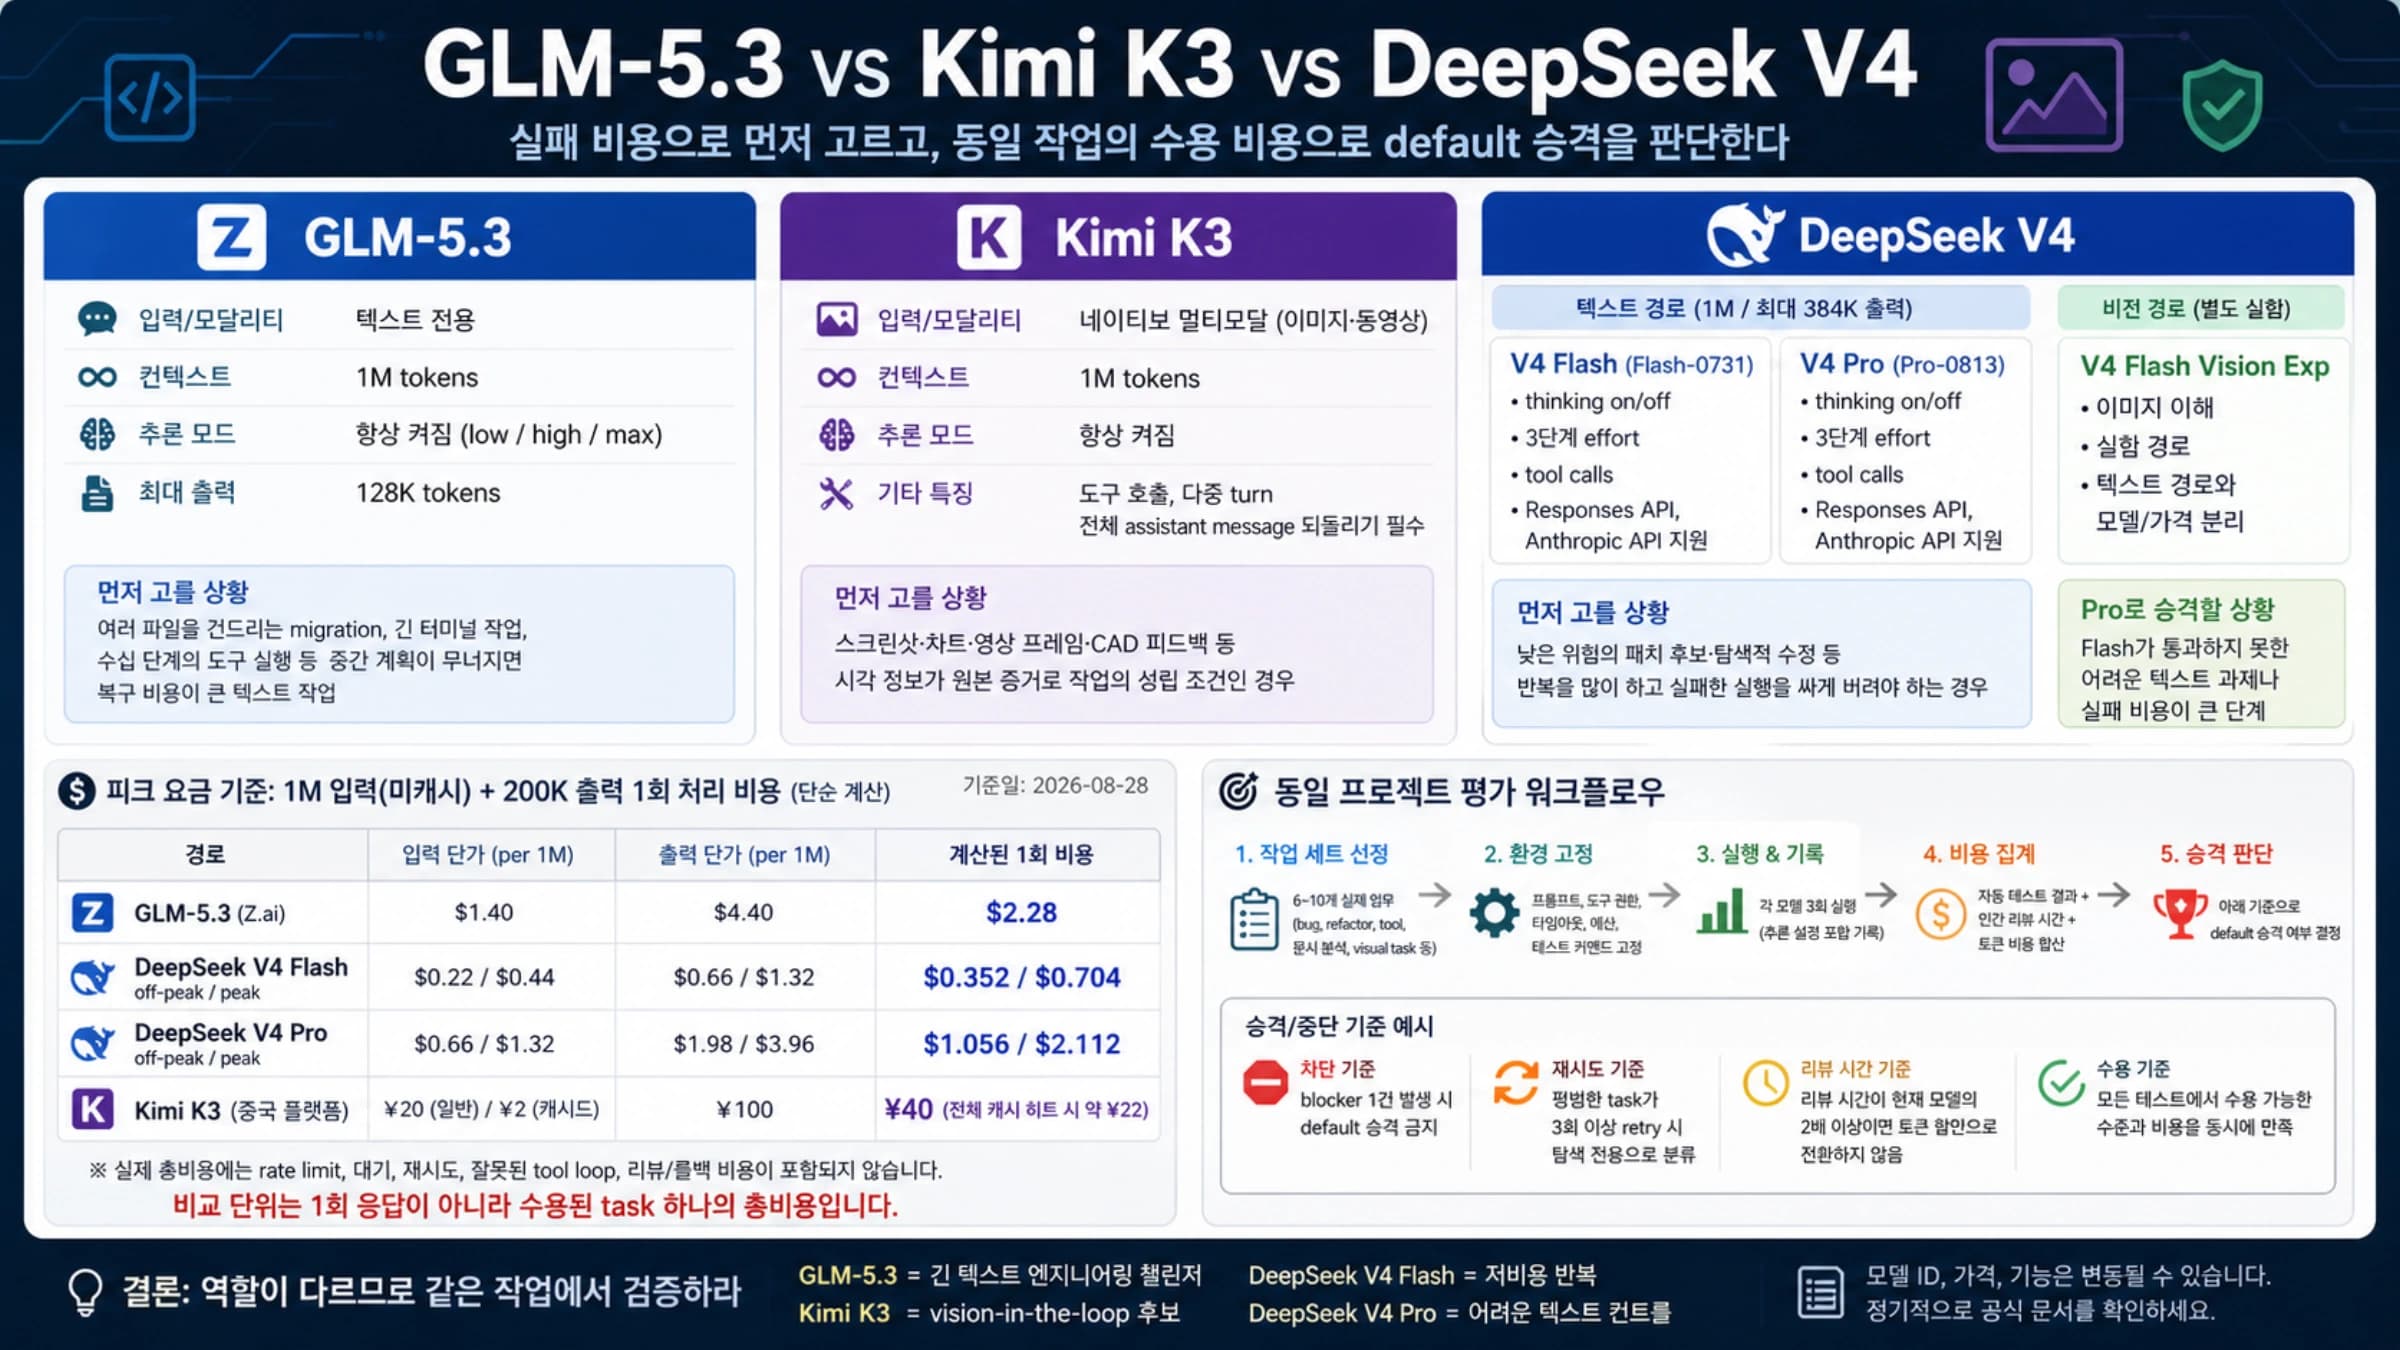
결과를 자동으로 채점할 수 있는 작업 몇 개면 충분합니다. 앞의 실측도 숨은 테스트가 있는 8문제만으로 두 모델의 비용 구조를 드러냈습니다. 다만 그 문제들은 두 모델 모두 풀 수 있어 품질 차이는 보여 주지 못했으므로, 직접 돌릴 때는 지금 쓰는 모델이 실제로 실패했던 작업을 섞어야 합니다.
- 최근 대기열에서 여러 파일 버그 수정, 긴 문서 분석, 도구 실패 뒤 복구처럼 실패 양상이 다른 작업을 5~10개 고르고, 결과를 보기 전에 숨은 테스트나 합격 기준을 정합니다.
- 시작 커밋, 의존성, 지시문, 도구 권한, 시간 제한, 재시도 상한, 모델별 최대 비용을 고정합니다. 추론 강도는 요청에 넣지 않은 기본 상태와 한 단계 높인 값 두 가지로 돌립니다.
- 한국어 프롬프트와 첨부 문서를 두 API에 각각 보내 입력 토큰 수를 기록하고, 내 텍스트의 비율 r을 구합니다.
- 각 모델을 깨끗한 환경에서 따로 실행하고 실행 순서를 번갈아 바꿉니다. 한 모델의 수정 내역이나 리뷰 의견을 다른 모델에 넘기지 않습니다.
- 매 호출마다 요청 모델과 응답 모델, 새 입력·캐시 읽기·캐시 쓰기·출력 토큰, 재시도를 포함한 비용, 걸린 시간, 사람의 수정 시간을 남깁니다. Astra는
cache_write_tokens가, Fable은cache_creation_input_tokens가 캐시 기록 여부를 알려 줍니다. - 캐시를 쓰는 작업은 캐시 없는 실행과 따로 돌려, 반복 횟수에 따라 통과한 작업당 비용이 어떻게 바뀌는지 비교합니다.
단일 승자 대신 세 가지 운영 결론을 허용한다
파일럿이 끝나면 한 모델을 기본값으로 정하거나, 업무별로 나눠 쓰거나, 지금은 옮기지 않는 세 결론 중 하나를 고를 수 있습니다. 어느 쪽이든 승격과 중단 기준은 시작 전에 숫자나 명확한 사건으로 정해 둡니다.
여러 핵심 작업군에서 통과율이 같거나 높고 통과한 작업당 비용이 낮으며, 계정 권한·데이터 조건·롤백이 확인됐다면 한 모델을 기본값으로 올립니다. 짧은 작업과 한국어 중심 작업은 Astra, 272K를 넘는 영어·코드 단발 입력은 Fable처럼 작업군마다 이점이 반복해서 갈린다면 업무별로 나눠 씁니다. 지금 모델보다 통과율이나 비용이 나아지지 않거나, 호출 권한·응답 모델·데이터 조건을 확인할 수 없다면 옮기지 않는 것이 맞는 결론입니다. 보존 정책 위반, 응답 모델 불명, 되돌릴 수 없는 외부 변경, 비용 상한 반복 초과는 평균 점수로 상쇄하지 말고 원인을 고칠 때까지 해당 작업군의 시험을 멈춥니다.
두 모델 모두 같은 회사의 더 싼 모델과 먼저 비교할 가치가 있습니다. Opus 5.5로 충분한지 따져 보려면 Claude Fable 5.1 vs Opus 5.5: 코딩·업무용으로 무엇을 선택할까?를, Astra보다 싼 Claude 모델과 비교하려면 소넷 5.5 vs GPT-6 Astra: 추론 강도별 성능과 작업당 비용을 보세요. 다음 세대 모델 소식 때문에 비교 대상을 다시 고르고 있다면 Fable 5.5·Gemini 4·GPT-6.1 비교: Fable 5.2는 출시, 5.5는 미발표에서 지금 호출할 수 있는 모델부터 확인할 수 있습니다.
참고 자료13
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 28일.
참고 자료13
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 28일.
- 1.OpenAI GPT-6 Astra 모델 문서developers.openai.com/api/docs/models/gpt-6-astra
- 2.OpenAI API 가격표developers.openai.com/api/docs/pricing
- 3.Anthropic Fable 5.1 모델 개요platform.claude.com/docs/en/models/fable-5-1/overview
- 4.Claude API 가격 문서platform.claude.com/docs/en/about-claude/pricing
- 5.컨텍스트 창 문서platform.claude.com/docs/en/build-with-claude/context-windows
- 6.토큰 계산 문서platform.claude.com/docs/en/build-with-claude/token-counting
- 7.Artificial Analysis의 GPT-6 Astra 대 Claude Fable 5.1 비교 페이지artificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-1
- 8.GPT-6 Astra 출시 페이지openai.com/index/gpt-6-astra
- 9.Anthropic 도움말의 요금제별 Fable 모델 안내support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- 10.최신 모델 사용 가이드developers.openai.com/api/docs/guides/latest-model
- 11.Fable 5.1 변경 사항 문서platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- 12.API 데이터 보존 문서platform.claude.com/docs/en/manage-claude/api-and-data-retention
- 13.OpenAI 데이터 관리 문서developers.openai.com/api/docs/guides/your-data