DeepSeek V4.1 Flash vs Gemini 3.8 Flash 비교: 제미나이 비용 2.2~4.3배
같은 작업 실측에서 Gemini 3.8 Flash 기본값은 DeepSeek V4.1 Flash보다 2.2~4.3배 비쌌습니다. 텍스트 작업은 DeepSeek, 오디오·영상·PDF는 제미나이입니다.
목차
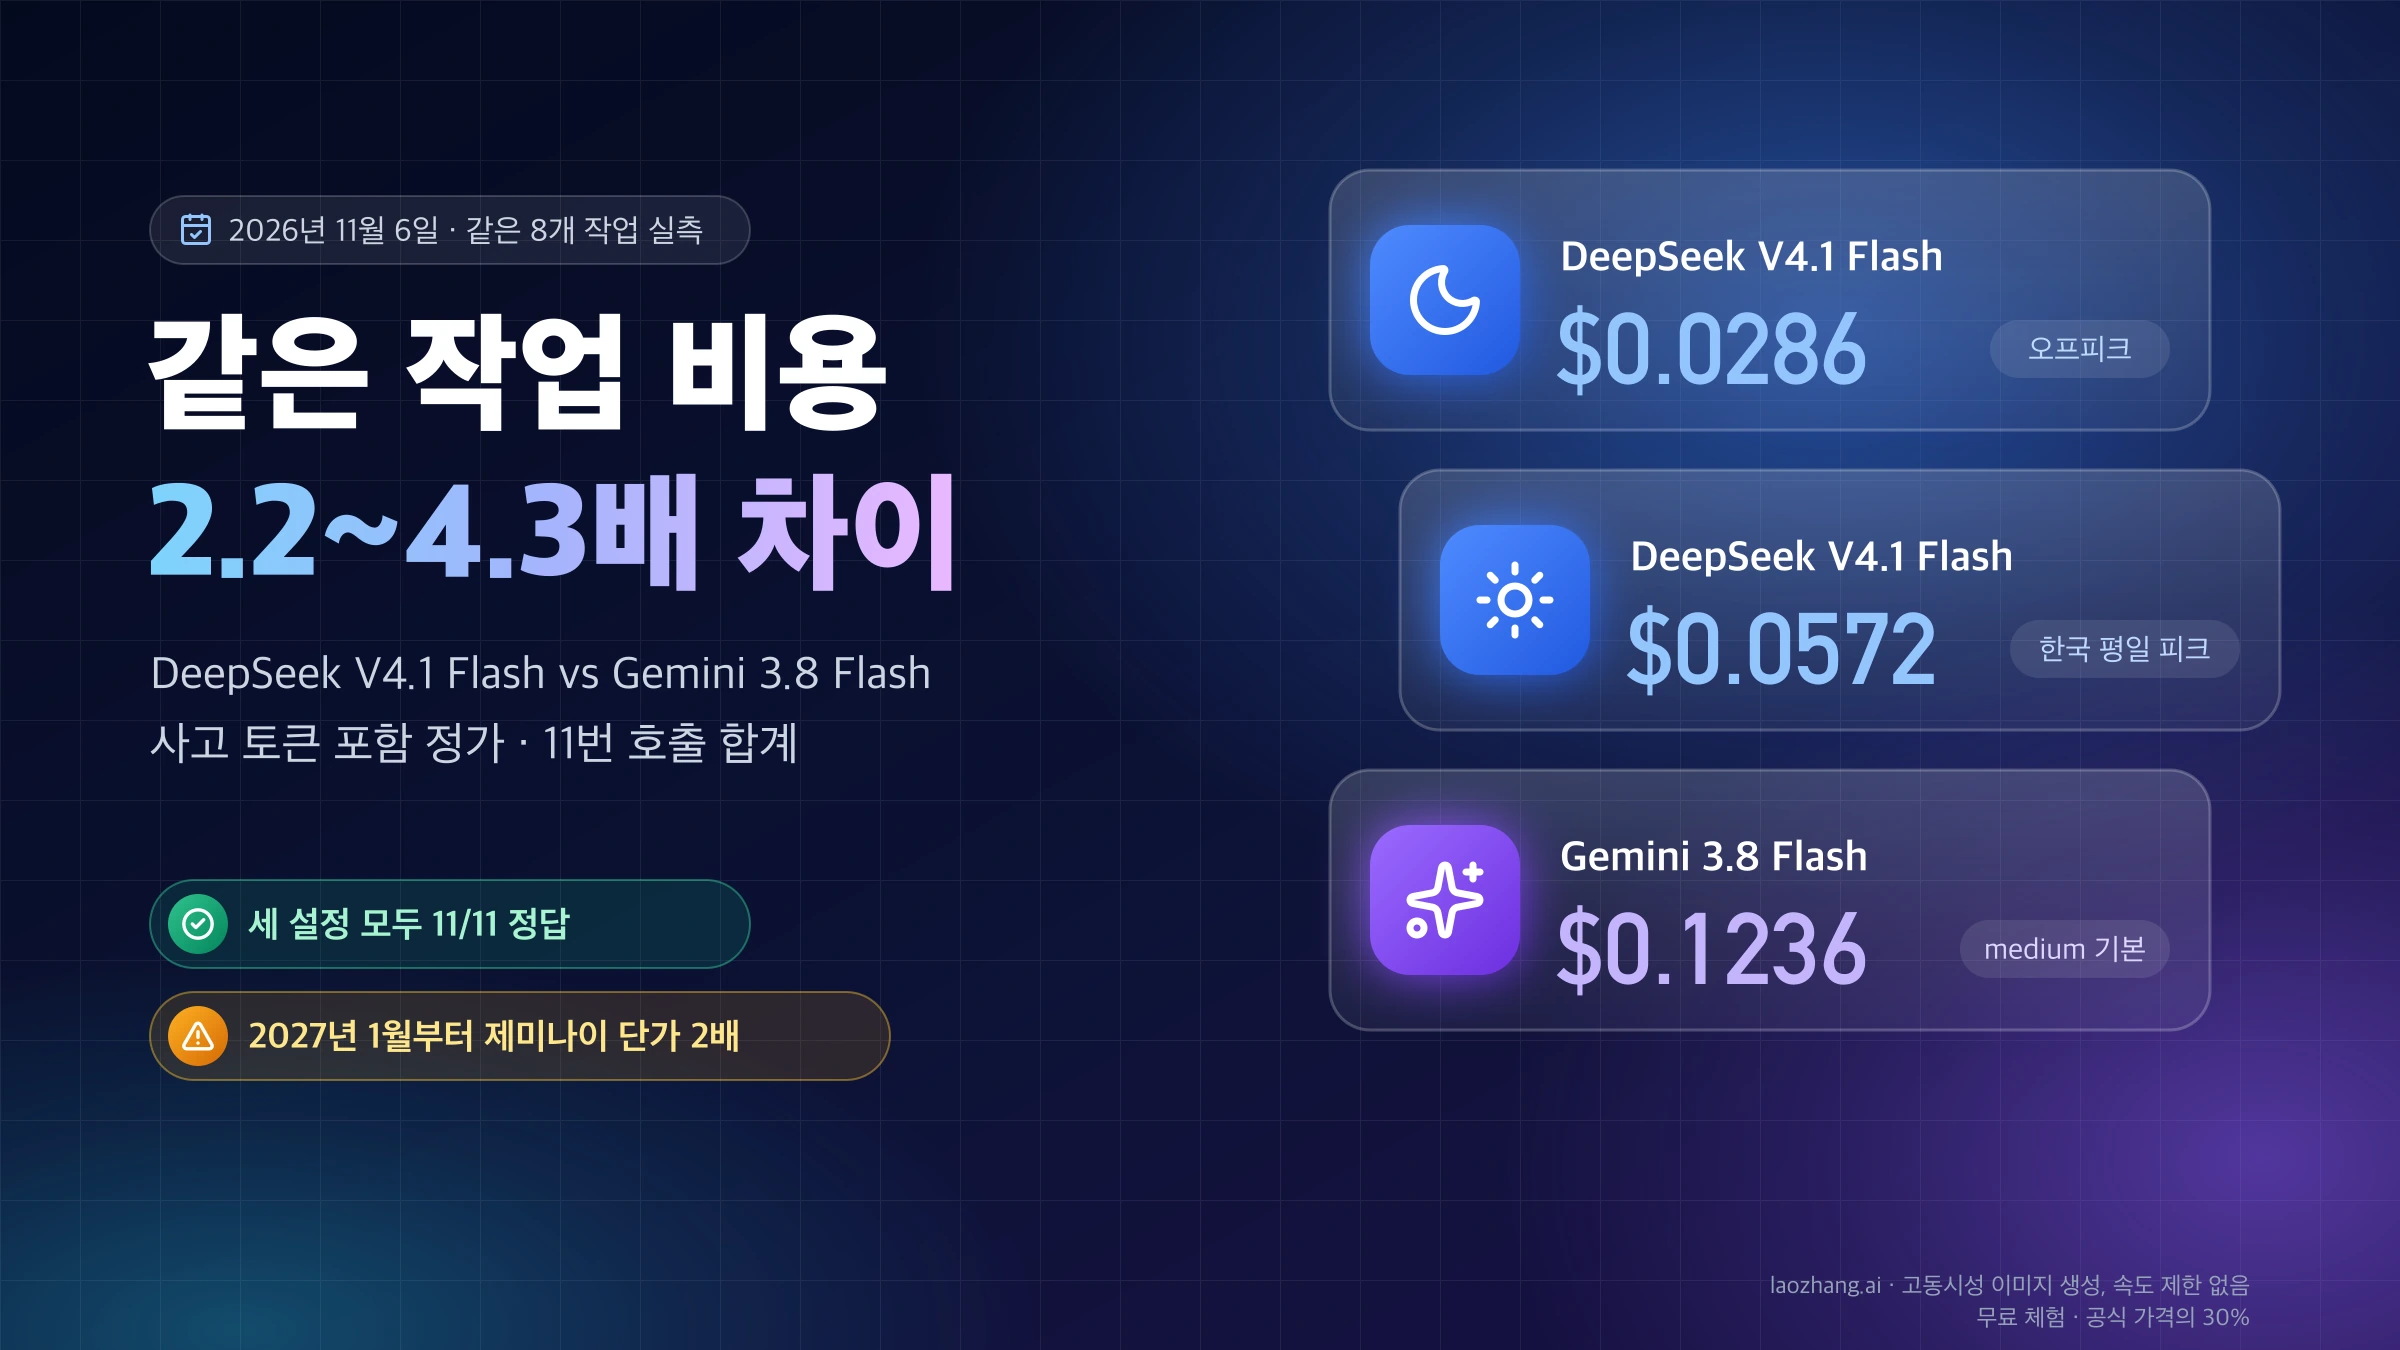
텍스트만 주고받는 채팅 백엔드, 코딩 도우미, 대량 요약이라면 DeepSeek V4.1 Flash(deepseek-flash, 현재 1017 스냅샷)부터 쓰세요. 2026년 11월 6일 LaoZhang 게이트웨이에서 키 하나로 두 모델에 같은 8개 작업을 11번씩 보냈더니 세 설정 모두 11개를 전부 맞혔고, 사고 토큰까지 포함한 정가 비용은 DeepSeek 기본값(high)이 $0.0286, Gemini 3.8 Flash 기본값(medium)이 $0.1236이었습니다. DeepSeek를 한국 시간 평일 피크에 호출하면 $0.0572가 되므로 차이는 2.2~4.3배입니다.
Gemini 3.8 Flash(gemini-3.8-flash)를 고를 이유는 기능과 지식 문항에 있습니다. 오디오·비디오·PDF를 그대로 입력해야 하거나 과학·사실 지식을 묻는 비중이 큰 작업이라면 제미나이 쪽이 맞습니다. 다만 2027년 1월 1일부터 단가가 두 배가 되어 같은 작업의 차이가 8.6배까지 벌어지고, 어려운 작업에서는 사고 토큰이 출력 한도를 먼저 채우므로 maxOutputTokens를 모델 상한인 65,536 가까이 열어 두어야 합니다.
어려운 코딩 작업에서도 결론은 바뀌지 않았습니다. npm 방식 semver 범위 해석 문제(숨은 테스트 36개)에서 Gemini 3.8 Flash는 출력 한도 32,000 토큰일 때 4번 중 3번을 생각만 하다 잘렸지만, 한도를 65,536으로 올리자 4번 모두 통과했습니다. 실패 원인은 코드가 아니라 출력 예산이었고, 대신 통과한 호출의 비용은 DeepSeek V4.1 Flash 오프피크의 약 8배(medium)와 약 12배(high)였습니다.
같은 8개 작업 실측: 세 설정 모두 11/11 정답
같은 요청을 세 설정에 보냈을 때 정답률은 모두 11/11로 같았고, 차이는 사고 토큰 수와 첫 답변까지의 대기 시간에서 났습니다. 측정은 2026년 11월 6일 한국 시간 21시 50분~22시(금요일, DeepSeek 오프피크)에 LaoZhang 게이트웨이의 사용량 과금 키 하나로 진행했고, 모든 호출을 스트리밍으로 받았습니다. 시스템 메시지, 도구, temperature는 넣지 않았고 출력 한도는 양쪽 모두 32,000 토큰입니다.
DeepSeek는 OpenAI 호환 /v1/chat/completions에 deepseek-flash, reasoning_effort: "high"(DeepSeek 기본값)로 보냈고, 응답 모델명은 매번 deepseek-v4-1-flash-261017이었습니다. Gemini 3.8 Flash는 제미나이 네이티브 streamGenerateContent에 thinkingLevel을 medium(Google 기본값)과 high로 나눠 보냈으며, 응답의 모든 조각에 modelVersion: gemini-3.8-flash가 찍힌 호출만 집계했습니다. 작업은 숨은 테스트로 채점하는 Python 함수 5개(구간 병합 8개, 기간 문자열 파싱 18개, 단어 빈도 10개, eval 없이 수식 계산 25개, CSV 한 줄 파싱 16개), 문장형 산수 1개, 6,723단어 영어 문서를 25단어 이하 5개 항목으로 요약하기, 자릿수 합이 27인 100만 미만 자연수 세기(정답 55,252)입니다. 어려운 3개는 두 번씩 보내 설정마다 11번을 호출했습니다.
| 설정 | 정답 | 출력 토큰(그중 사고) | 첫 답변 토큰 중앙값 | 호출당 전체 시간 중앙값 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash, high(기본) | 11/11 | 44,807 (41,674) | 10.9초 | 12.3초 |
| Gemini 3.8 Flash, medium(기본) | 11/11 | 30,467 (25,476) | 22.0초 | 24.1초 |
| Gemini 3.8 Flash, high | 11/11 | 78,258 (72,699) | 27.9초 | 30.1초 |
입력 토큰은 DeepSeek 11,836개, Gemini 3.8 Flash 12,486개였습니다. 첫 답변 토큰 시간은 이 게이트웨이와 이 8개 작업에서 DeepSeek가 빨랐지만, Artificial Analysis 측정(DeepSeek high 24.11초, Gemini 3.8 Flash medium 10.01초)에서는 반대였습니다. 세 설정이 모두 만점이었으므로 이 8개 작업은 품질 차이가 아니라 같은 결과를 얻는 데 드는 토큰과 시간의 차이를 보여 줍니다. Gemini 3.8 Flash를 high로 올리면 출력 토큰이 medium의 약 2.6배로 늘었지만 맞힌 개수는 그대로였습니다.
같은 요청을 두 번 보내도 사고 길이는 크게 흔들립니다. eval 없이 수식을 계산하는 작업에서 DeepSeek는 8,708개와 19,986개, Gemini 3.8 Flash high는 16,326개와 22,490개를 썼습니다. 반면 설정 전체의 합계는 안정적이어서, 2026년 10월 26일 같은 8개 작업을 Gemini 3.8 Flash high로 보냈을 때 출력 80,277개에 정가 $0.3104가 나왔고 11월 6일에는 78,258개에 $0.3028로 3% 안쪽에서 다시 나왔습니다.
이 결과는 게이트웨이 한 곳, 하루, 작업당 1~2개 표본에서 얻은 것이며 벤치마크가 아닙니다. 이미지·오디오·비디오 입력, 도구 호출, 긴 컨텍스트, DeepSeek max, Gemini 3.8 Flash low는 측정하지 않았고, DeepSeek 공식 API와 Google AI Studio 엔드포인트에 직접 보낸 호출도 없습니다. 대기 시간은 게이트웨이의 영향을 받을 수 있습니다.
작업당 비용: 출력 단가는 6.25배인데 실측 배수는 4.3배
토큰 단가 차이가 그대로 작업 비용 차이가 되지 않는 이유는 두 모델이 같은 작업에 쓰는 사고 토큰 수가 다르기 때문입니다. 100만 토큰당 정가는 DeepSeek V4.1 Flash가 오프피크 입력 $0.15·출력 $0.60(피크 $0.30·$1.20), Gemini 3.8 Flash가 2026년 12월 31일까지 입력 $0.75·출력 $3.75입니다. 두 회사 모두 사고 토큰을 출력으로 과금하므로 출력 단가만 보면 6.25배, 입력은 5배 차이입니다. 그런데 기본 설정의 Gemini 3.8 Flash는 DeepSeek보다 출력 토큰을 0.68배만 썼기 때문에 작업 비용 차이는 4.3배로 줄었고, high로 올리면 1.75배를 써서 10.6배로 커졌습니다. 가격 출처는 DeepSeek API 가격 문서와 제미나이 API 가격표(Google AI Studio 문서)입니다.
비용은 반환된 사용량에 정가를 곱해 계산했습니다. 식은 (입력 − 캐시 적중) × 입력 단가 + 캐시 적중 × 캐시 단가 + 출력(사고 포함) × 출력 단가를 100만으로 나눈 값입니다. DeepSeek는 같은 요청이 반복된 두 호출에서 128토큰씩 자동 캐시 적중을 보고해 그만큼 캐시 단가(오프피크 $0.003)로 계산했습니다. 같은 11번 호출의 사용량을 다섯 가지 가격 기준으로 다시 계산하면 다음과 같습니다.
| 가격 기준 | DeepSeek V4.1 Flash high | Gemini 3.8 Flash medium | Gemini 3.8 Flash high | medium ÷ DeepSeek |
|---|---|---|---|---|
| DeepSeek 오프피크, 제미나이 2026년 정가 | $0.0286 | $0.1236 | $0.3028 | 4.3배 |
| DeepSeek 피크, 제미나이 2026년 정가 | $0.0572 | $0.1236 | $0.3028 | 2.2배 |
| DeepSeek 오프피크, 제미나이 2027년 정가 | $0.0286 | $0.2472 | $0.6057 | 8.6배 |
| DeepSeek 피크, 제미나이 2027년 정가 | $0.0572 | $0.2472 | $0.6057 | 4.3배 |
| LaoZhang 게이트웨이 가격(시간대 구분 없음) | $0.0643 | $0.1236 | $0.3028 | 1.9배 |
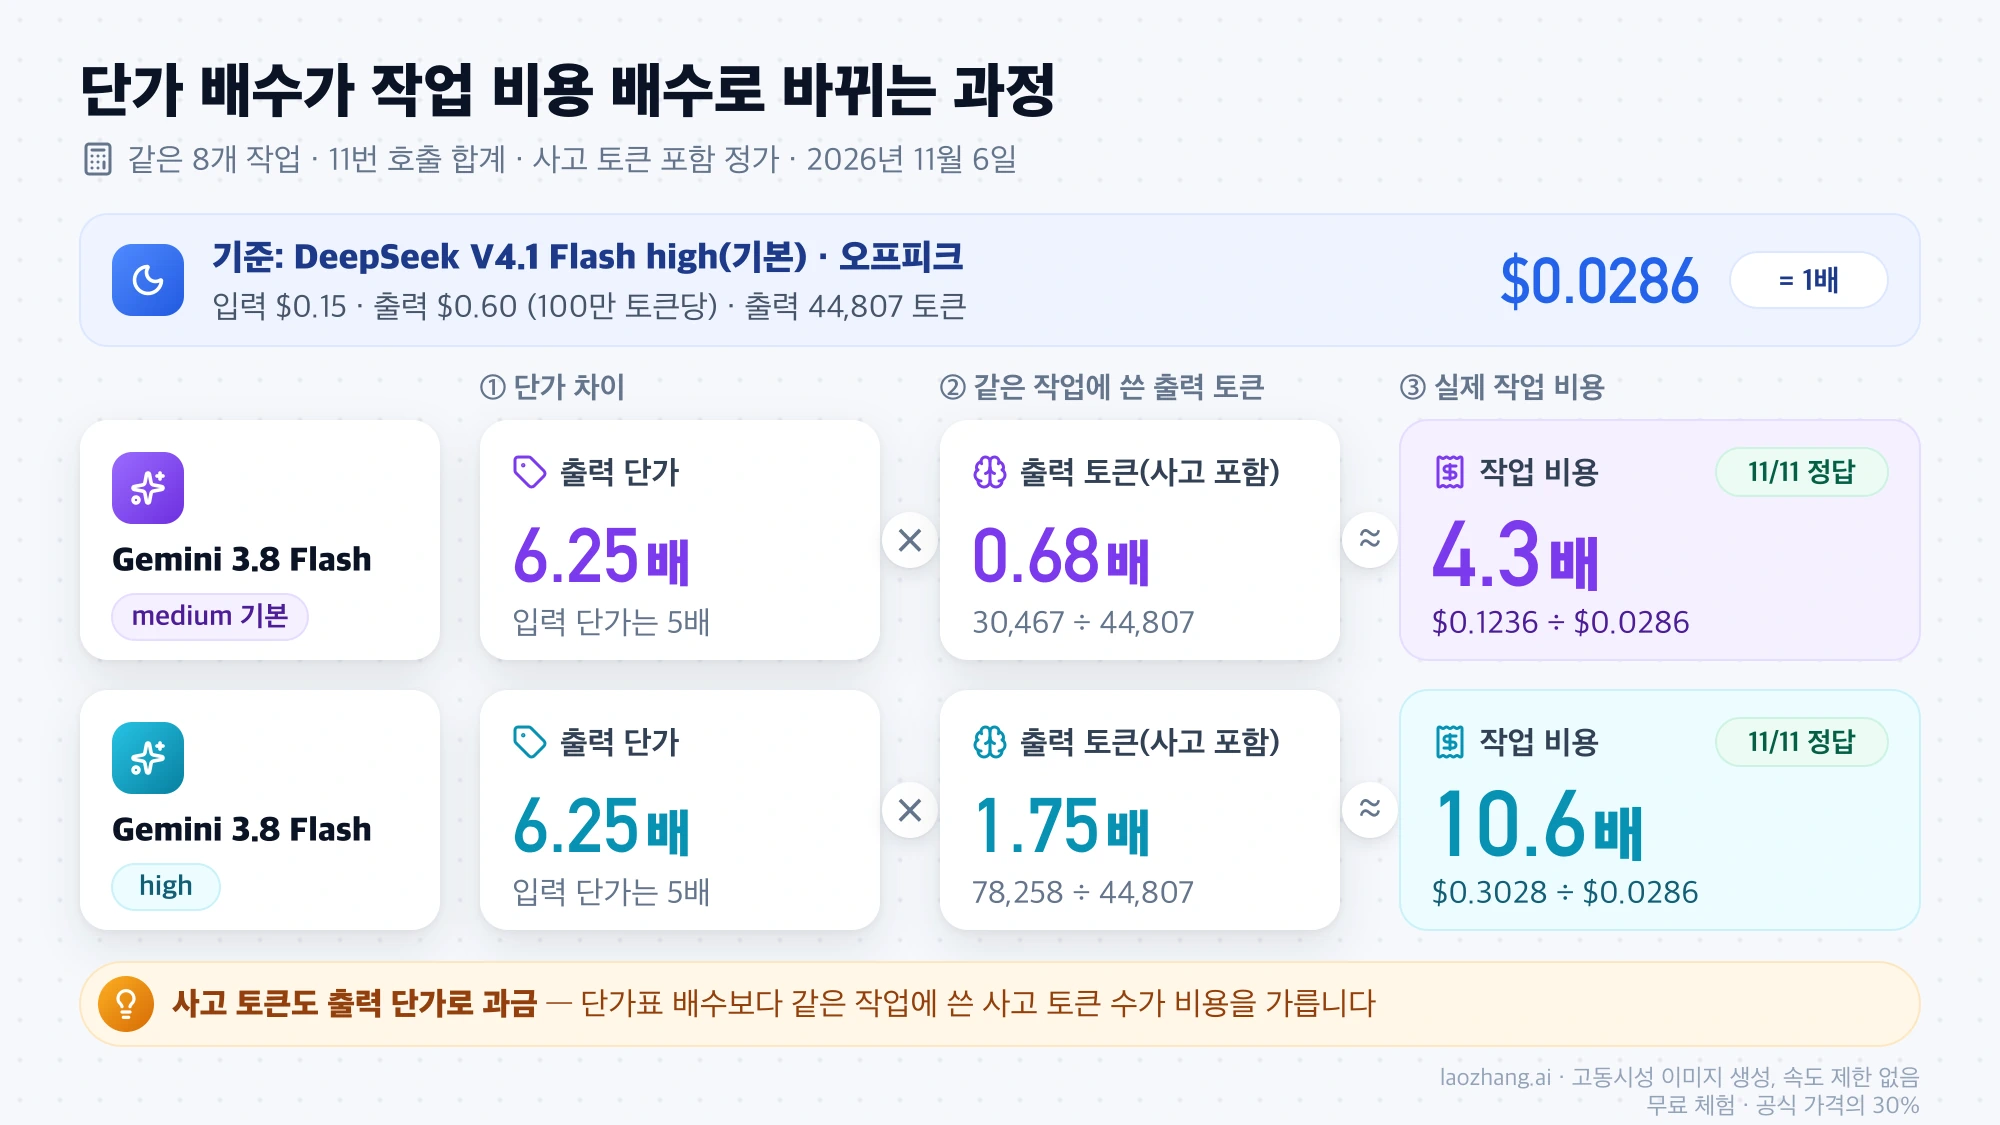
LaoZhang 게이트웨이의 2026년 11월 6일 가격은 deepseek-flash가 시간대 구분 없이 입력 $0.44·출력 $1.32로 DeepSeek 직접 요금의 피크 단가보다 높고, gemini-3.8-flash는 Google 정가와 같은 $0.75·$3.75입니다. 그래서 이 경로에서는 배수가 1.9배로 줄어듭니다. 이 가격은 플랫폼 표시 가격이며, 표에서는 모델 간 배수 비교용으로만 썼습니다.
작업 종류에 따라서도 배수가 달라집니다. 입력이 긴 작업일수록 입력 단가 차이 5배가 그대로 반영되어, 6,723단어 문서 요약은 DeepSeek $0.0025, Gemini 3.8 Flash medium $0.0176으로 7배였습니다. 반대로 사고가 길어지는 수식 계산 작업은 DeepSeek가 $0.0053과 $0.0120, Gemini 3.8 Flash medium이 $0.0156과 $0.0274로 2~3배 사이였습니다.
토크나이저 차이는 결론을 바꾸지 않습니다. 같은 한국어 3,000자를 넣었을 때 입력 토큰은 DeepSeek 1,692개, Gemini 3.8 Flash 1,694개로 사실상 같았고, 영어 6,723단어 문서에서도 제미나이 쪽이 8.8% 많은 정도였습니다. 한국어 입력이라면 단가표의 입력 배수를 그대로 써도 됩니다.
어려운 semver 작업: 제미나이 실패는 출력 예산 32,000 토큰 탓
8개 작업이 너무 쉬워 차이를 가리지 못했기 때문에, 같은 날 밤(한국 시간, DeepSeek 오프피크) 모델 차이가 드러나도록 만든 작업 3개를 두 번씩 더 보냈습니다. 가장 어려운 것은 caret·tilde·하이픈·OR 범위와 프리릴리스 규칙까지 포함한 npm 방식 semver 범위 판정 함수로, 숨은 테스트 36개를 모두 통과해야 정답입니다. DeepSeek V4.1 Flash는 출력 한도 32,000에서 두 번 모두 36/36을 맞혔고, Gemini 3.8 Flash는 같은 한도에서 medium 1/2, high 0/2였습니다. 놓친 세 번은 모두 finishReason: MAX_TOKENS로, 30,719~31,898개의 사고 토큰을 쓰는 동안 한도에 닿아 코드가 없거나 중간에 잘렸습니다.
| semver 작업(2번씩) | 통과 | 호출당 출력 토큰 | 호출당 정가 비용 | 호출당 시간 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash high, 한도 32,000 | 2/2 | 24,531 / 23,154 | $0.0148 / $0.0139 | 150초 / 141초 |
| Gemini 3.8 Flash medium, 한도 32,000 | 1/2 | 31,996 / 22,468 | $0.1203 / $0.0846 | 210초 / 193초 |
| Gemini 3.8 Flash high, 한도 32,000 | 0/2 | 31,898 / 31,996 | $0.1199 / $0.1203 | 255초 / 237초 |
| Gemini 3.8 Flash medium, 한도 65,536 | 2/2 | 30,421 / 30,794 | $0.1144 / $0.1158 | 199초 / 218초 |
| Gemini 3.8 Flash high, 한도 65,536 | 2/2 | 55,224 / 38,875 | $0.2074 / $0.1461 | 308초 / 300초 |
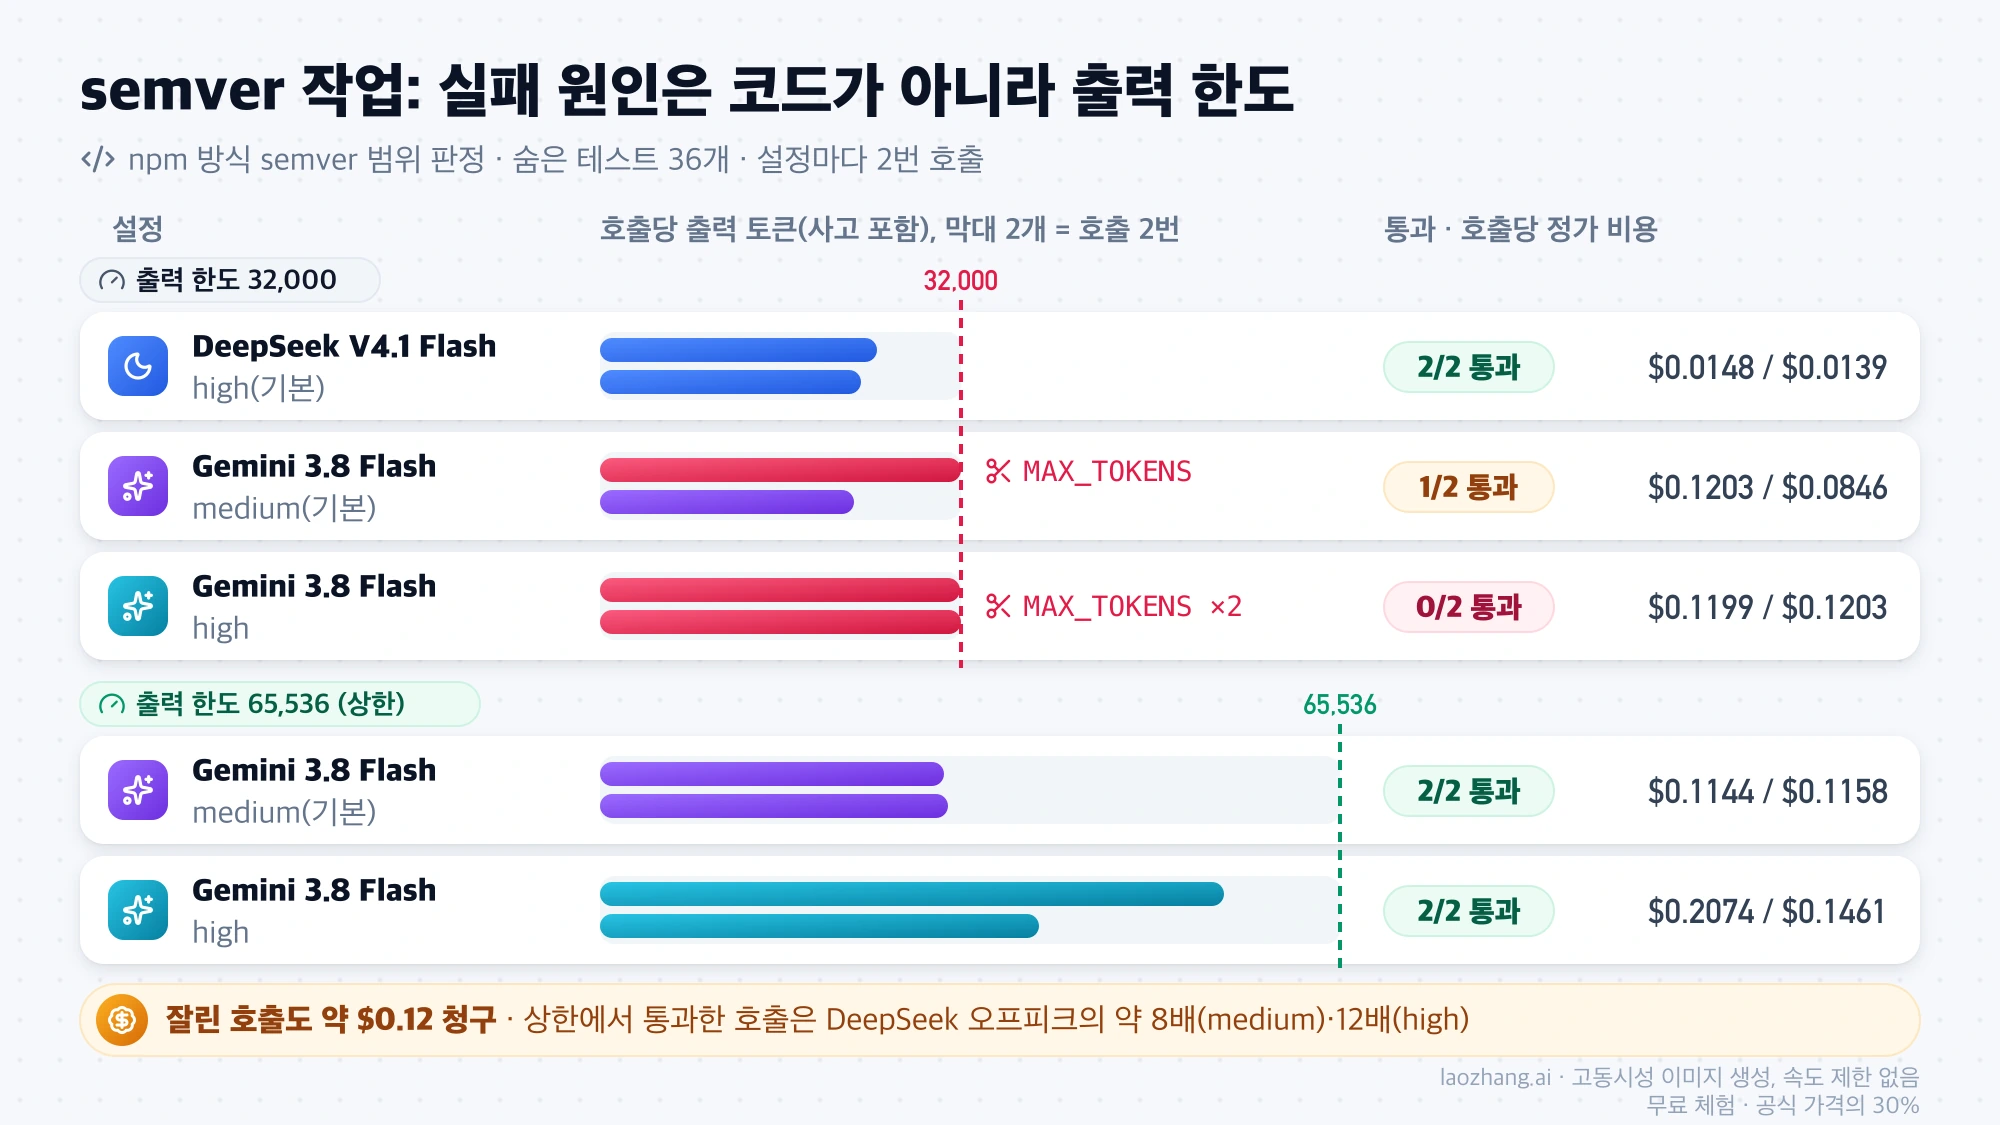
한도를 문서상 상한까지 올려 다시 보낸 4번은 모두 36/36으로 통과했습니다. 따라서 이 작업에서 Gemini 3.8 Flash가 틀린 코드를 낸 적은 없고, 필요한 만큼 생각할 공간이 없었을 뿐입니다. 비용은 다른 이야기입니다. 상한까지 올려 통과한 호출을 DeepSeek와 비교하면 Gemini 3.8 Flash medium이 DeepSeek 오프피크의 약 8배, high가 약 12배였고(DeepSeek 피크 기준으로는 그 절반), 시간도 141~150초 대 199~308초로 더 걸렸습니다. 32,000에서 잘린 호출도 각각 약 $0.12가 청구됐습니다. 제미나이 API 사고(thinking) 문서도 사고 중 출력 한도에 닿으면 잘리거나 빈 결과를 돌려주면서 이미 생성한 사고 토큰은 과금한다고 설명합니다.
실무에서는 어려운 코딩 작업을 Gemini 3.8 Flash에 맡길 때 maxOutputTokens를 상한까지 열어 두고, finishReason이 MAX_TOKENS인 응답은 코드가 잘렸을 수 있으므로 그대로 쓰지 말고 걸러 내도록 처리해 두는 편이 안전합니다. DeepSeek V4.1 Flash는 최대 출력 한도가 훨씬 커서 같은 문제가 생길 여지가 적고, 이 작업에서는 23,000~25,000개로 끝났습니다.
나머지 두 작업에서는 차이가 없었습니다. 6,723단어 문서 속 세 개의 'PROJECT NOTE' 문단(예산, 사용량, 나중에 덧붙은 +25% 정정)을 읽고 금액을 계산하는 문제는 DeepSeek 2/2, Gemini 3.8 Flash 4/4가 모두 $76.80을 맞혔습니다. 존재하지 않는 Python 3.13 함수 statistics.winsorized_mean과 functools.memoize_method를 섞은 질문에도 모든 응답이 "존재하지 않는다"고 답했습니다. 이 긴 문서 작업을 반복 호출하자 DeepSeek는 10,387개 입력 중 10,368개를 캐시 적중으로 보고해 호출 비용이 $0.0019에서 $0.0004로, Gemini 3.8 Flash는 11,300개 중 8,168개를 암묵적 캐시로 보고해 $0.0107에서 $0.0054로 내려갔습니다. 둘 다 별도 캐시 설정 없이 자동으로 적용됐습니다.
Gemini 3.8 Flash가 더 똑똑한가: 기본 설정끼리 AA 지수 30 대 29
기본 설정끼리 비교하면 종합 점수는 거의 같고, 분야에 따라 앞서는 쪽이 갈립니다. 2026년 11월 6일 기준 Artificial Analysis의 DeepSeek V4.1 Flash 1017 vs Gemini 3.8 Flash 비교 페이지(Intelligence Index v5.0.1)에서 Gemini 3.8 Flash는 medium 30, high 31, low 23이고, DeepSeek V4.1 Flash 1017은 high 29, max 33, 사고 없음 19입니다. 가장 높은 점수는 DeepSeek의 max 설정이 냈습니다.
세부 항목을 보면 용도가 나뉩니다. 터미널 작업을 보는 Terminal-Bench 4.0은 DeepSeek max 33.8%, high 28.8%로 Gemini 3.8 Flash high 19.7%보다 높습니다. 반대로 과학 추론 HLE-Diamond는 DeepSeek max 25.3% 대 Gemini 3.8 Flash high 33.1%, 물리 연구 문제 CritPt v2는 25.0% 대 46.5%, 사실 지식을 보는 AA-Omniscience는 DeepSeek 1~2 대 제미나이 23~24로 Gemini 3.8 Flash가 크게 앞섭니다. 코딩·에이전트 작업은 DeepSeek V4.1 Flash, 과학 지식과 사실 확인이 많은 질의응답은 Gemini 3.8 Flash 쪽으로 기우는 셈입니다.
AA가 계산한 지수 작업 1회당 비용은 DeepSeek high $0.46, Gemini 3.8 Flash medium $6.26입니다. AA는 DeepSeek를 피크 가격($0.30·$1.20)으로 계산하므로, 오프피크에 호출한다면 DeepSeek 쪽 비용은 대략 그 절반으로 보면 됩니다.
비교 수치가 서로 다른 이유: 1017 이전 데이터, 중개 가격, 사고 수준
DeepSeek V4.1 Flash와 Gemini 3.8 Flash의 비교 수치가 자료마다 다르다면 대개 세 가지 중 하나가 원인입니다. 첫째는 데이터 시점입니다. DeepSeek는 2026년 10월 17일 1017 스냅샷을 내면서 호출 방식과 가격은 그대로 두고 작업 시간과 출력 길이를 줄였다고 DeepSeek API 업데이트 기록에 밝혔습니다. 같은 기록에서 DeepSeek가 직접 발표한 Terminal-Bench 4.0 점수는 9월 10일 첫 버전 31.2에서 42.3으로 올랐습니다. 10월 초 aimlapi가 X에 올린 3D 장면 6개 테스트에서 DeepSeek가 출력 토큰 168k, Gemini 3.8 Flash가 21k를 쓴 것도 1017 이전 스냅샷이고, 11월 6일 1017로 측정한 8개 작업에서는 그 차이가 44,807개 대 30,467개였습니다.
둘째는 가격 출처입니다. 다른 중개 업체가 파는 가격을 DeepSeek 가격처럼 적거나 캐시 적중 단가를 입력 단가 자리에 넣으면 배수가 크게 달라집니다. 입력 단가가 $0.006으로 보인다면 그것은 DeepSeek의 피크 캐시 적중 단가입니다. DeepSeek 직접 요금은 피크와 오프피크 두 줄로 확인해야 합니다. 셋째는 사고 수준입니다. DeepSeek max와 Gemini 3.8 Flash high를 맞붙이면 실제로 쓸 기본값(DeepSeek high, 제미나이 medium)과는 다른 결과가 나옵니다. 최대 출력도 DeepSeek 가격 문서에 적힌 공식 값보다 크게 적혀 있다면 다른 모델이나 다른 경로의 수치입니다.
첫 글자까지 몇 초: DeepSeek는 사고 과정을 먼저 스트리밍합니다
11월 6일 8개 작업에서 DeepSeek V4.1 Flash는 첫 토큰이 중앙값 2.59초에 도착했지만, 이것은 사고 과정(reasoning_content)이 바로 흘러나오기 때문입니다. 실제 답변의 첫 토큰은 중앙값 10.9초였고, Gemini 3.8 Flash는 medium 22.0초, high 27.9초였습니다. 이때 제미나이 쪽은 사고 요약을 요청하지 않아 답변이 시작될 때까지 아무것도 보내지 않았습니다.
같은 날 어려운 작업 3개에서 Gemini 3.8 Flash에 includeThoughts: true를 켜자, 사고 요약이 먼저 흘러나와 첫 토큰 중앙값이 medium 4.78초, high 3.97초로 짧아졌습니다. 과금은 달라지지 않습니다. 채팅 화면처럼 사용자가 기다리는 곳이라면 두 모델 모두 사고 내용을 먼저 보여 주는 방식으로 체감 대기 시간을 줄일 수 있습니다.
답변 시작 시간 자체는 작업과 경로에 따라 뒤집힙니다. Artificial Analysis가 자체 평가 작업으로 잰 값에서는 오히려 Gemini 3.8 Flash medium이 첫 답변 토큰 10.01초로 DeepSeek high의 24.11초보다 빨랐고, 출력 속도는 DeepSeek high 초당 175토큰, Gemini 3.8 Flash medium 116토큰이었습니다. 지연 시간이 중요한 서비스라면 자기 요청으로 첫 답변 토큰 시간을 직접 재 보고 결정하는 편이 맞습니다.
한국 시간 평일 피크와 2027년 1월 인상 후 비용 차이
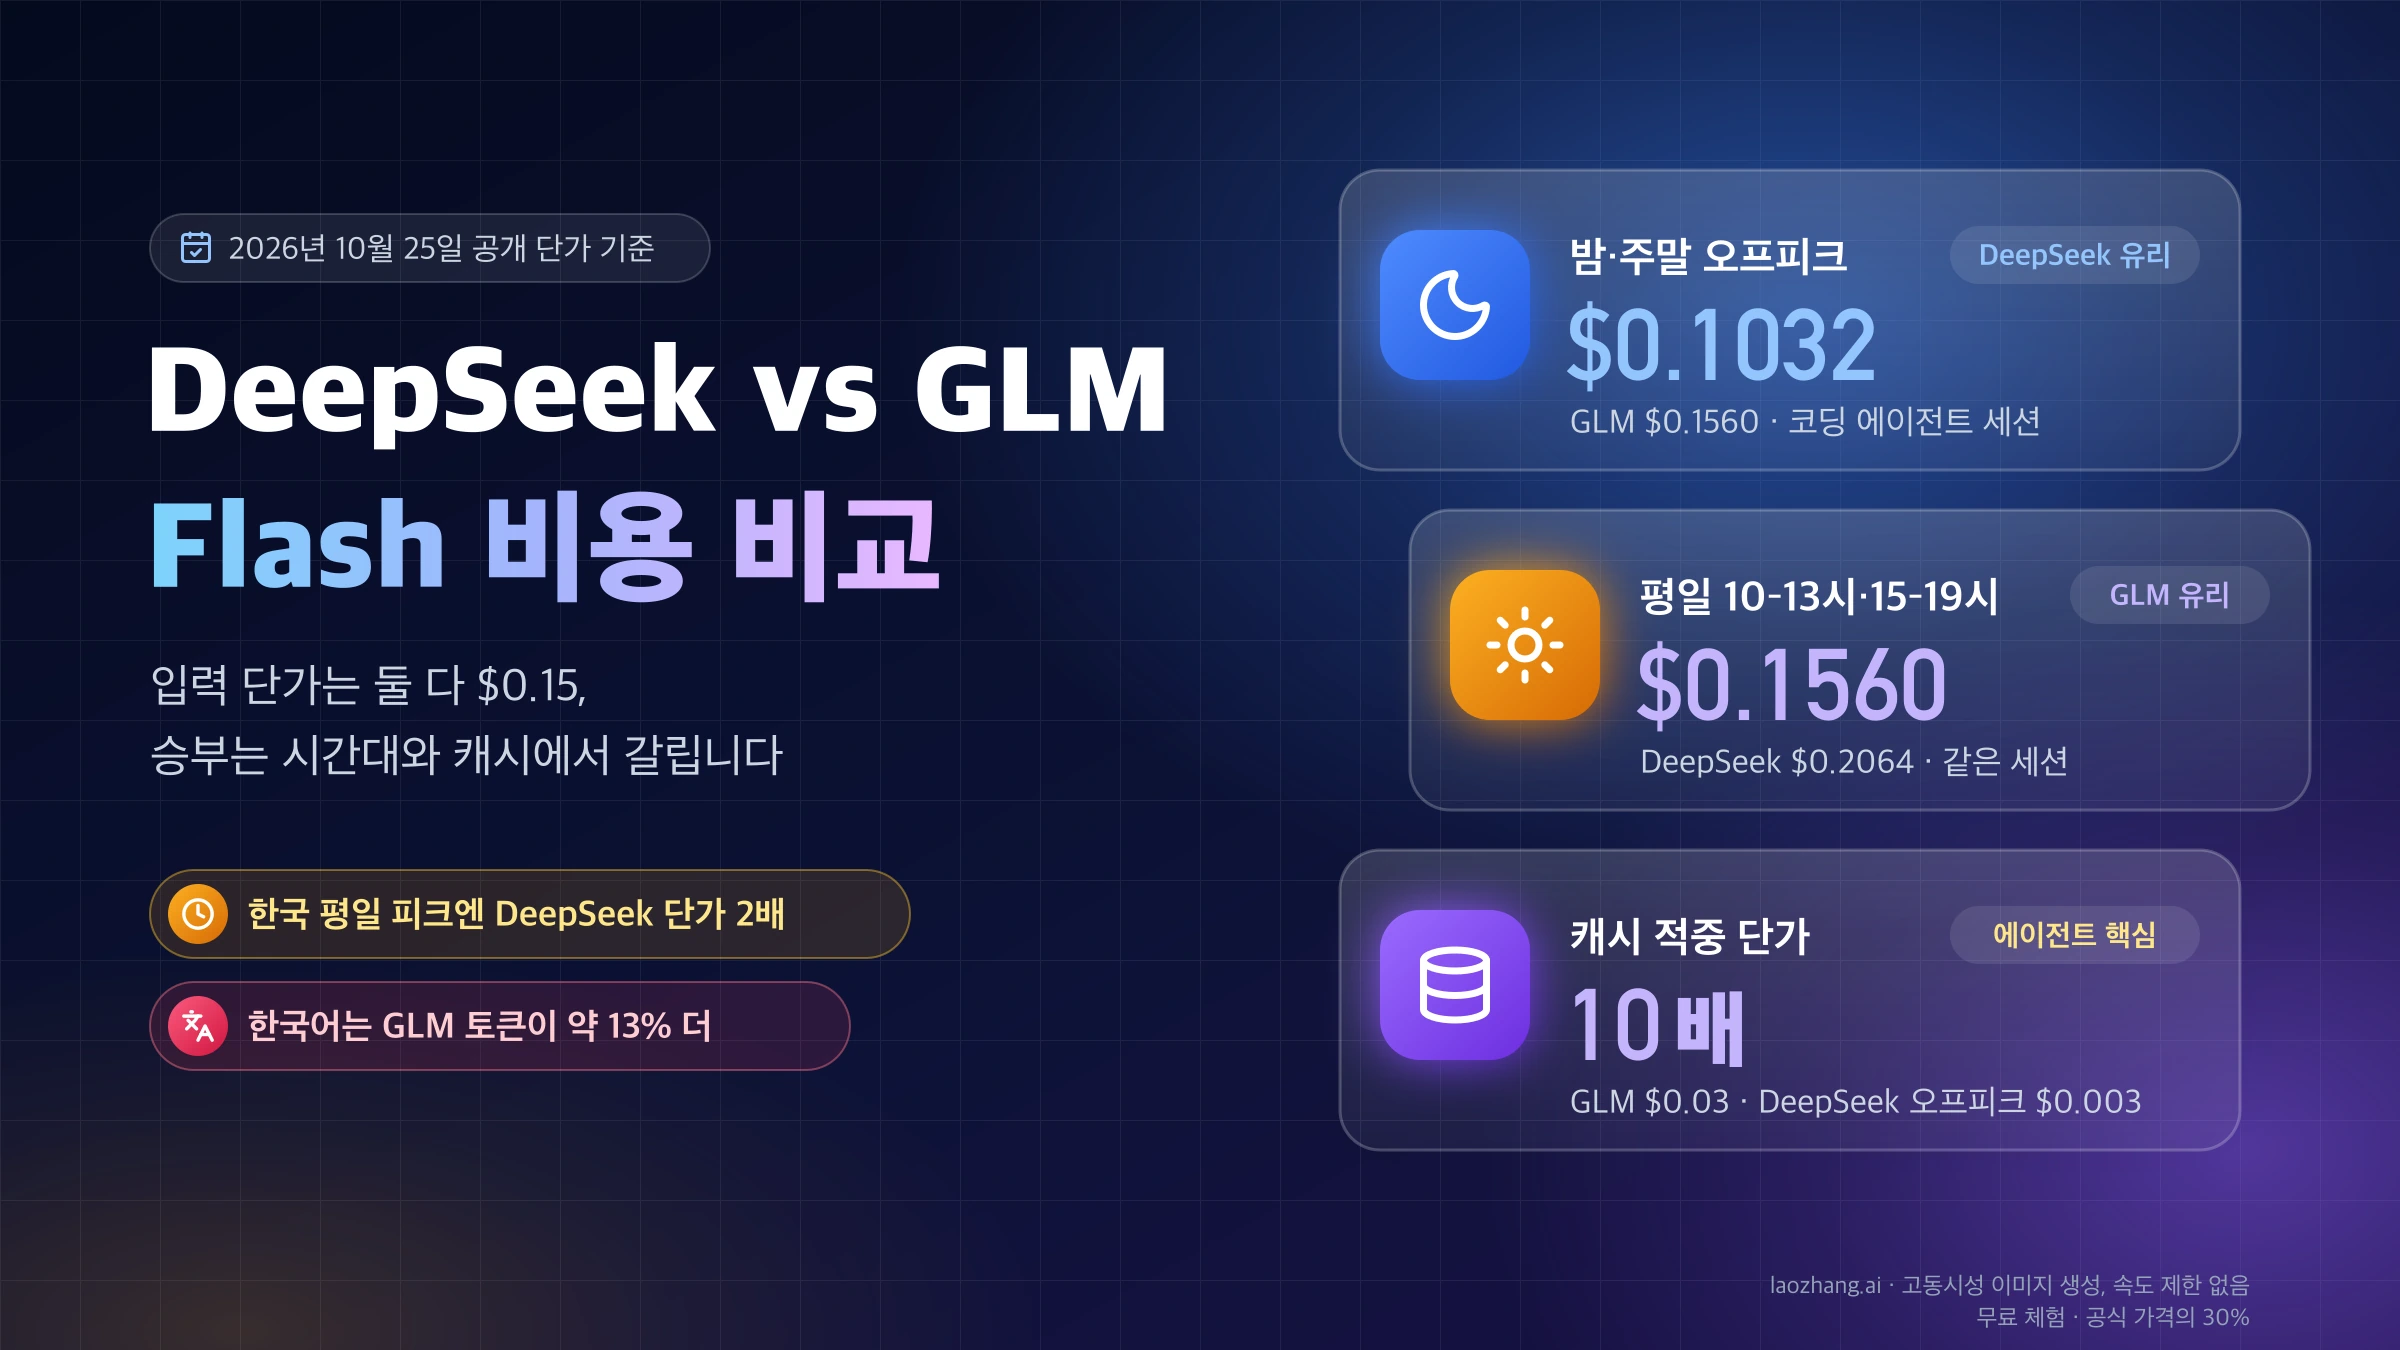
한국에서 낮에 호출하는 서비스라면 비교 기준은 DeepSeek 피크 가격입니다. DeepSeek 피크는 UTC 기준 평일 01:00~04:00와 06:00~10:00로, 한국 시간으로는 월~금 10:00~13:00와 15:00~19:00입니다. 이 시간에는 오프피크의 두 배를 내며, 주말과 중국 공휴일은 하루 종일 오프피크입니다. DeepSeek는 오프피크를 피크 가격의 절반으로 정의하고 있습니다. 업무 시간 채팅 백엔드라면 위 비용 표의 피크 줄, 밤에 돌리는 대량 작업이라면 오프피크 줄이 현실적인 비교 기준입니다. 시간대별 단가 계산은 DeepSeek API 피크 요금: 한국 시간과 현재 단가 계산에 정리돼 있습니다.
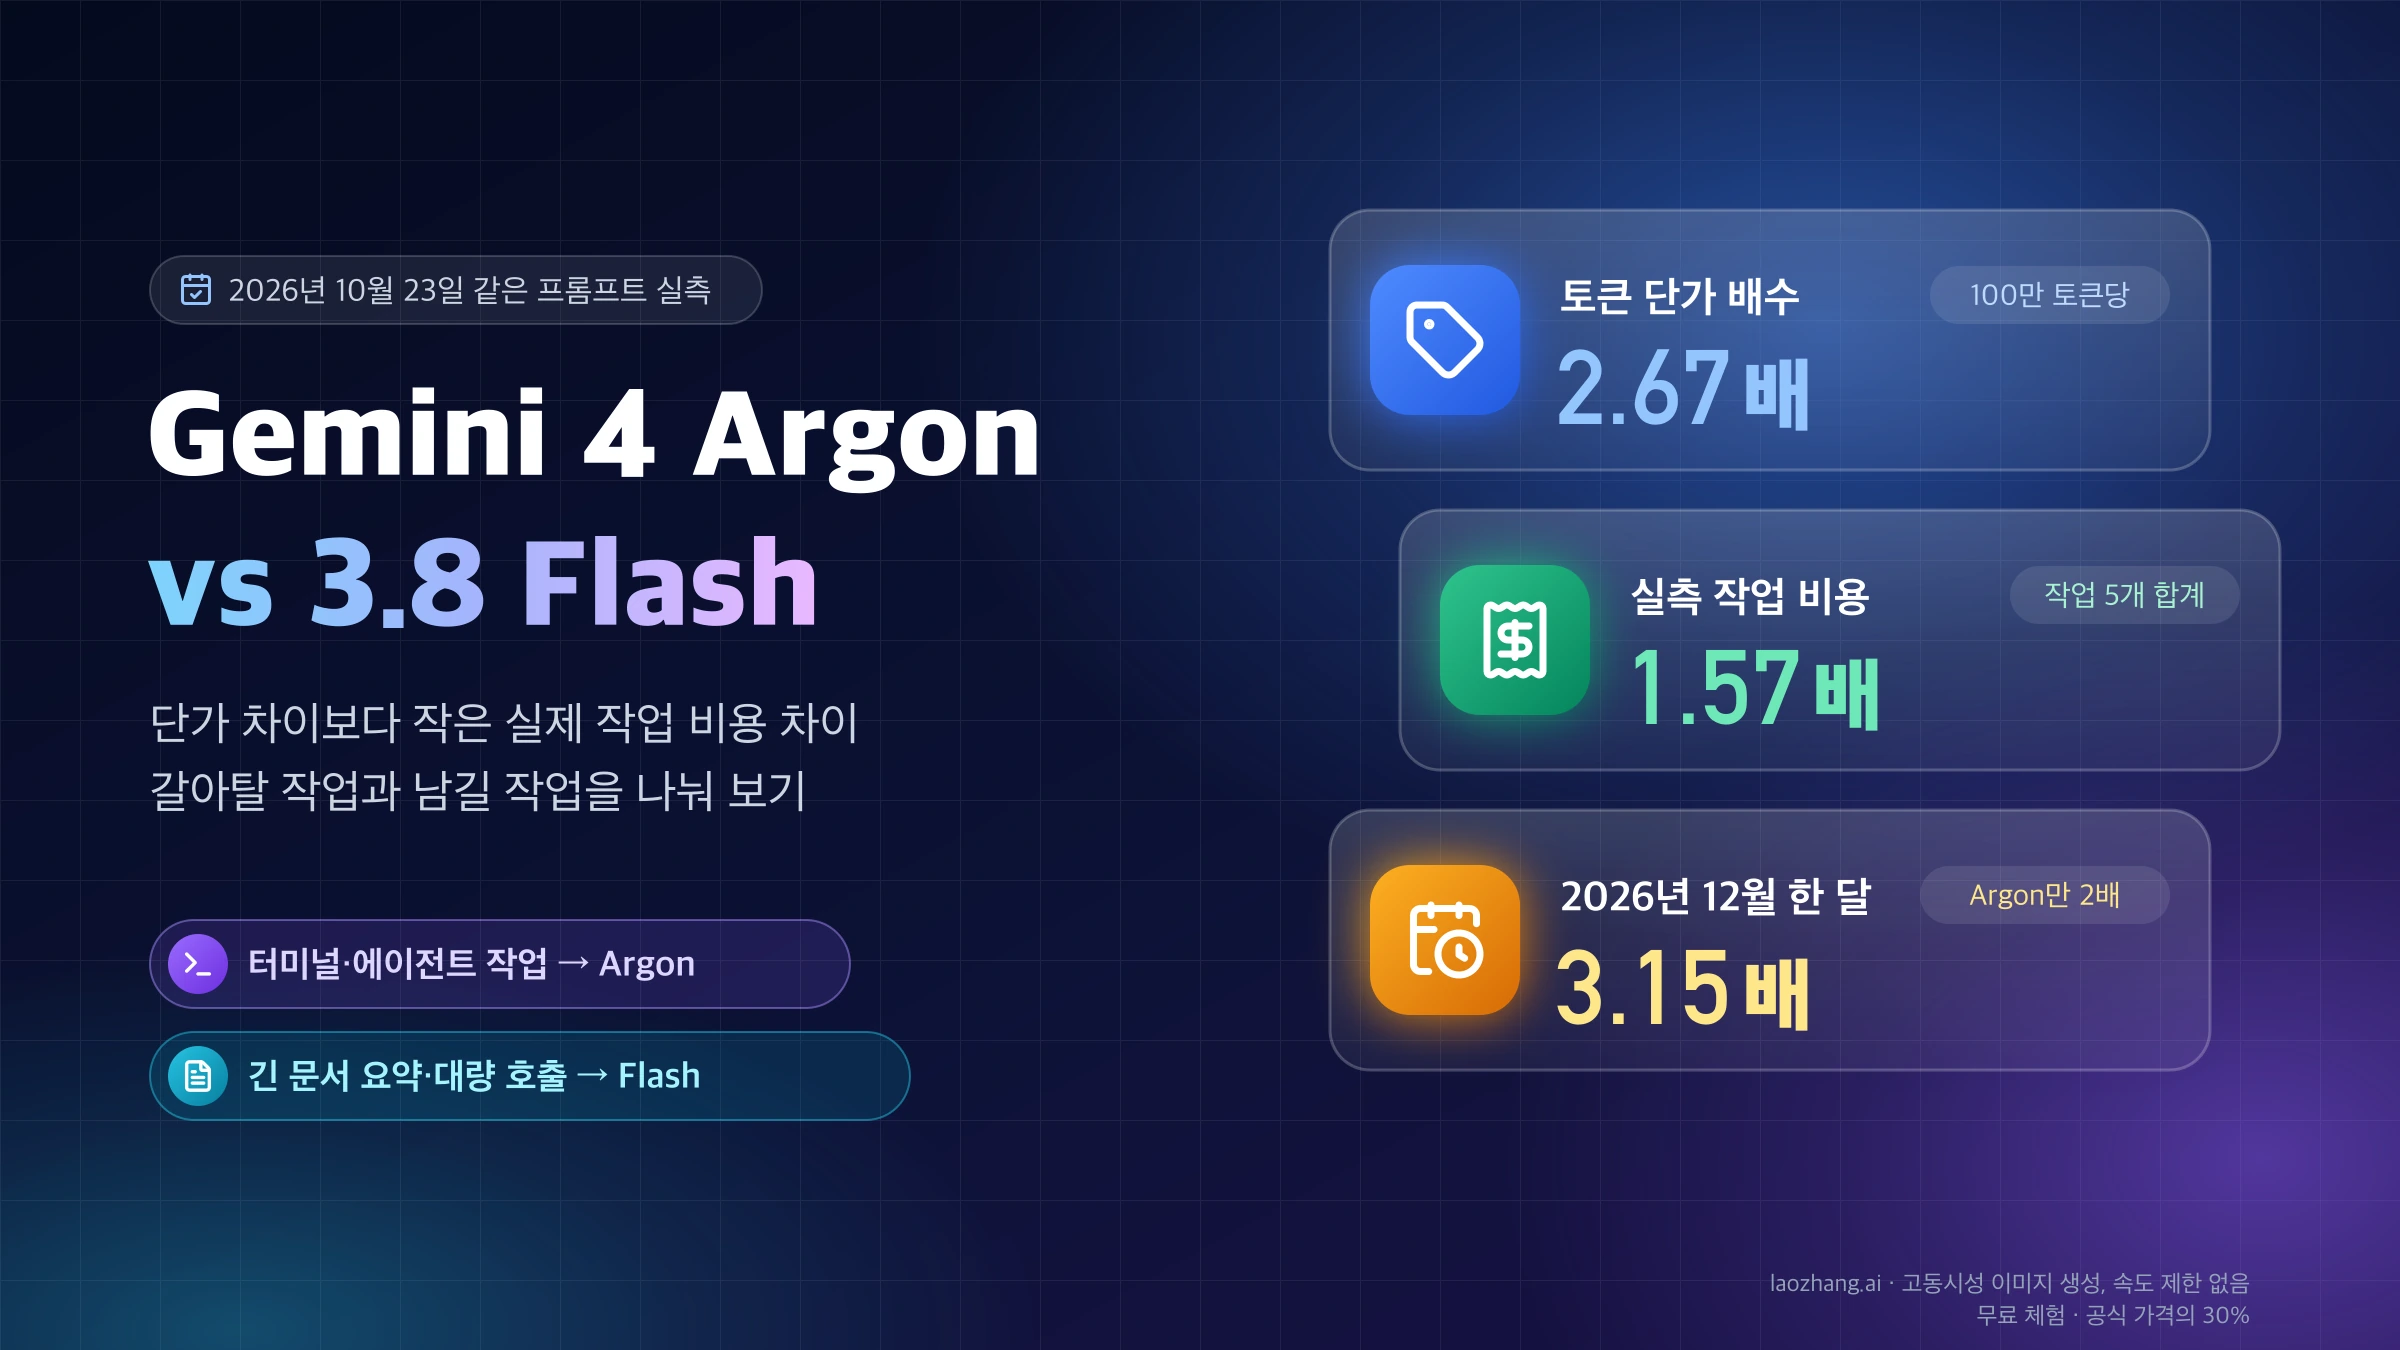
Gemini 3.8 Flash는 2027년 1월 1일부터 입력 $1.50, 출력 $7.50, 컨텍스트 캐시 $0.15(보관 시간당 100만 토큰당 $1.00)로 오릅니다. 내년에도 쓸 계획이라면 같은 사용량의 예산을 두 배로 잡아야 하며, 위 비용 표의 2027년 줄이 그 기준입니다. 일괄 처리라면 Batch와 Flex가 표준 가격의 절반(현재 $0.375·$1.875)이라 같은 사용량을 가정하면 위 8개 작업의 Gemini 3.8 Flash medium 비용은 $0.0618로 DeepSeek 오프피크의 2.2배가 되지만, Batch·Flex 가격도 2027년 1월 1일부터 두 배가 됩니다. 제미나이 쪽 가격표 전체는 Gemini API 키 발급과 가격·결제: 키는 무료, 3.8 Flash 단가 2027년 2배에서 볼 수 있습니다.
오디오·비디오·PDF 입력은 제미나이, 65,536 토큰을 넘는 출력은 DeepSeek
입력 형식과 출력 길이가 걸리면 가격보다 기능이 먼저 결정합니다. Gemini 3.8 Flash 모델 카드에 따르면 입력은 텍스트·이미지·비디오·오디오·PDF, 출력은 텍스트이고, 입력 한도 1,048,576, 출력 한도 65,536 토큰입니다. Batch, 컨텍스트 캐시, 코드 실행, 함수 호출, 파일 검색, Google 검색·지도 그라운딩도 지원하며, Google 검색 그라운딩은 월 5,000건까지 무료이고 이후 1,000건당 $14입니다. 대한민국은 제미나이 API 사용 가능 지역 목록에 들어 있습니다.
DeepSeek V4.1 Flash는 DeepSeek API 가격 문서 기준 컨텍스트 1M, 최대 출력 384K이며 이미지 입력(Vision), JSON 출력, 도구 호출, Responses API, Anthropic API 형식을 지원합니다. FIM 코드 완성은 사고 모드를 끈 상태에서만 됩니다. 오디오·비디오·PDF 입력은 이 문서에 기재돼 있지 않습니다. 그래서 회의 녹음이나 영상, PDF 원본을 그대로 넣는 작업은 Gemini 3.8 Flash, 사고를 포함해 6만 토큰을 넘는 긴 코드나 문서를 한 번에 생성해야 하는 작업은 DeepSeek V4.1 Flash가 맞습니다. 무료로 먼저 시험하려면 제미나이 API 무료 등급에서 Gemini 3.8 Flash 입력·출력이 무료로 표시돼 있으며, 한도는 Gemini API 무료 사용 한도(Free Tier) 2026: 무료 모델과 실시간 한도 확인에서 확인할 수 있습니다.
기본 사고 수준 high와 medium, 바꿀 때 확인할 파라미터
두 API 모두 사고가 기본으로 켜져 있고, 기본 수준은 DeepSeek V4.1 Flash가 high, Gemini 3.8 Flash가 medium입니다. 11월 6일 실측에서는 Gemini 3.8 Flash를 medium에서 high로 올리면 비용이 2.45배, 첫 답변 토큰 시간이 22.0초에서 27.9초로 늘었지만 8개 작업의 정답 수는 같았습니다. 어려운 작업에서 실패가 나면 수준을 올리기 전에 출력 한도부터 확인하세요. DeepSeek의 low와 max는 측정하지 않았고, AA 기준으로는 max가 지수 33으로 high보다 4점 높고 작업당 비용은 $0.60 대 $0.46입니다.
| 확인 항목 | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| 모델 ID | deepseek-flash (예전 이름 deepseek-v4-flash도 1017로 응답) | gemini-3.8-flash |
| 요청 형식 | OpenAI 호환 Chat Completions, Anthropic 형식, Responses API | 제미나이 네이티브 generateContent |
| 사고 수준 파라미터 | reasoning_effort: low / high / max | thinkingLevel: low / medium / high |
| 기본값 | 사고 켜짐, high | 사고 켜짐, medium |
| 가장 낮은 설정 | thinking: {"type": "disabled"}로 사고 끄기 | low (minimal 없음) |
| 사고 내용 받기 | 응답의 reasoning_content | includeThoughts: true로 사고 요약 |
| 최대 출력(사고 포함) | 384K | 65,536 |
DeepSeek는 다른 이름의 수준도 받아 주지만 내부에서 바꿉니다. medium과 xhigh는 high로, minimal은 low로, ultra는 max로 처리되므로, 제미나이용 코드에서 쓰던 medium을 그대로 넘기면 DeepSeek에서는 기본값과 같은 high가 됩니다. 사고 모드에서는 temperature, presence_penalty, frequency_penalty가 오류 없이 무시되고, 도구를 쓰는 대화에서는 이전 턴의 reasoning_content를 다시 넘겨야 합니다. 자세한 규칙은 DeepSeek API 사고 모드 문서에 있습니다. DeepSeek 공식 API에 OpenAI SDK로 보낼 때는 아래처럼 thinking을 extra_body에 넣습니다. 엔드포인트 주소는 DeepSeek 문서의 예시이며, 11월 6일 실측은 같은 파라미터를 LaoZhang 게이트웨이로 보냈습니다.
from openai import OpenAI

client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "..."}],
    reasoning_effort="high",                       # low / high / max
    extra_body={"thinking": {"type": "enabled"}},  # 끄려면 "disabled"
    max_tokens=32000,
)
print(resp.choices[0].message.reasoning_content)   # 사고 과정
print(resp.choices[0].message.content)             # 답변
Gemini 3.8 Flash는 models/gemini-3.8-flash:generateContent 요청 본문의 generationConfig에서 수준과 출력 한도를 함께 정합니다. 아래 본문 구조는 11월 6일 실측(LaoZhang 게이트웨이의 streamGenerateContent)에 쓴 것과 같으며, 출력 한도는 사고 토큰을 포함한 값이라 어려운 작업에서는 상한까지 열어 둡니다.
{
  "contents": [{ "role": "user", "parts": [{ "text": "..." }] }],
  "generationConfig": {
    "maxOutputTokens": 65536,
    "thinkingConfig": { "thinkingLevel": "medium", "includeThoughts": true }
  }
}
GLM-5.3-Flash·Sonnet 5.5·Gemini 4 Argon과도 비교하려면
DeepSeek V4.1 Flash를 다른 저가 Flash 모델과 견주려면 DeepSeek V4.1 Flash vs GLM-5.3-Flash 비교: 시간대·캐시가 가르는 비용을, Gemini 3.8 Flash를 더 비싼 모델과 같은 작업으로 비교한 결과는 Claude Sonnet 5.5 vs Gemini 3.8 Flash 비교: 실측 비용은 Flash가 2.4배를 보세요. Gemini 3.8 Flash로 부족해 상위 모델을 검토한다면 Gemini 4 Argon vs 3.8 Flash 차이: 같은 프롬프트 실측 비용과 갈아탈 작업이, 다섯 회사의 등급별 단가를 한꺼번에 보려면 AI API 가격 비교: 5개사 등급별 요금과 가장 싼 모델이 맞습니다.
참고 자료8
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 6일.
참고 자료8
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 6일.
- 1.DeepSeek API 가격 문서api-docs.deepseek.com/quick_start/pricing
- 2.제미나이 API 가격표(Google AI Studio 문서)aistudio.google.com/docs/pricing
- 3.제미나이 API 사고(thinking) 문서aistudio.google.com/docs/thinking
- 4.Artificial Analysis의 DeepSeek V4.1 Flash 1017 vs Gemini 3.8 Flash 비교 페이지artificialanalysis.ai/models/releases/comparisons/deepseek-v4-1-flash-1017-vs-gemini-3-8-flash
- 5.DeepSeek API 업데이트 기록api-docs.deepseek.com/updates
- 6.Gemini 3.8 Flash 모델 카드aistudio.google.com/docs/models/gemini-3.8-flash
- 7.제미나이 API 사용 가능 지역 목록aistudio.google.com/docs/available-regions
- 8.DeepSeek API 사고 모드 문서api-docs.deepseek.com/guides/thinking_mode