Gemini 4 Argon·Opus 5.5·GPT-6.1 Sol 비교: 같은 과제 실측과 12월 비용
Argon이 Opus 5.5의 반값인 것은 11월 30일까지의 단가뿐입니다. 같은 과제 실측에서 기본값은 Argon이 쌌고, high는 Argon이 지금 1.3배, 12월부터 2.6배 비쌌습니다.
목차
Gemini 4 Argon과 Claude Opus 5.5 중 API 개발에 쓸 모델을 고른다면, 2026년 11월 11일 기준으로 답은 추론 강도와 12월 1일 단가 인상에 따라 갈립니다. 같은 프롬프트로 8개 과제(채점한 답 11개)를 LaoZhang 게이트웨이에 보낸 실측에서 각자의 기본값은 Argon이 11개 중 10개, Opus 5.5가 11개를 맞혔고, 비용은 Argon이 $0.09로 Opus($0.29)의 약 3분의 1이었습니다. 각자의 high에서는 둘 다 11개를 모두 맞혔지만 Argon이 출력 토큰을 3.3배 써서 지금 단가로도 $0.40 대 $0.31로 더 비쌌고, 12월 1일부터는 Argon이 $0.81로 Opus의 약 2.6배가 됩니다(Argon 11월 4일, Opus 11월 11일 측정).
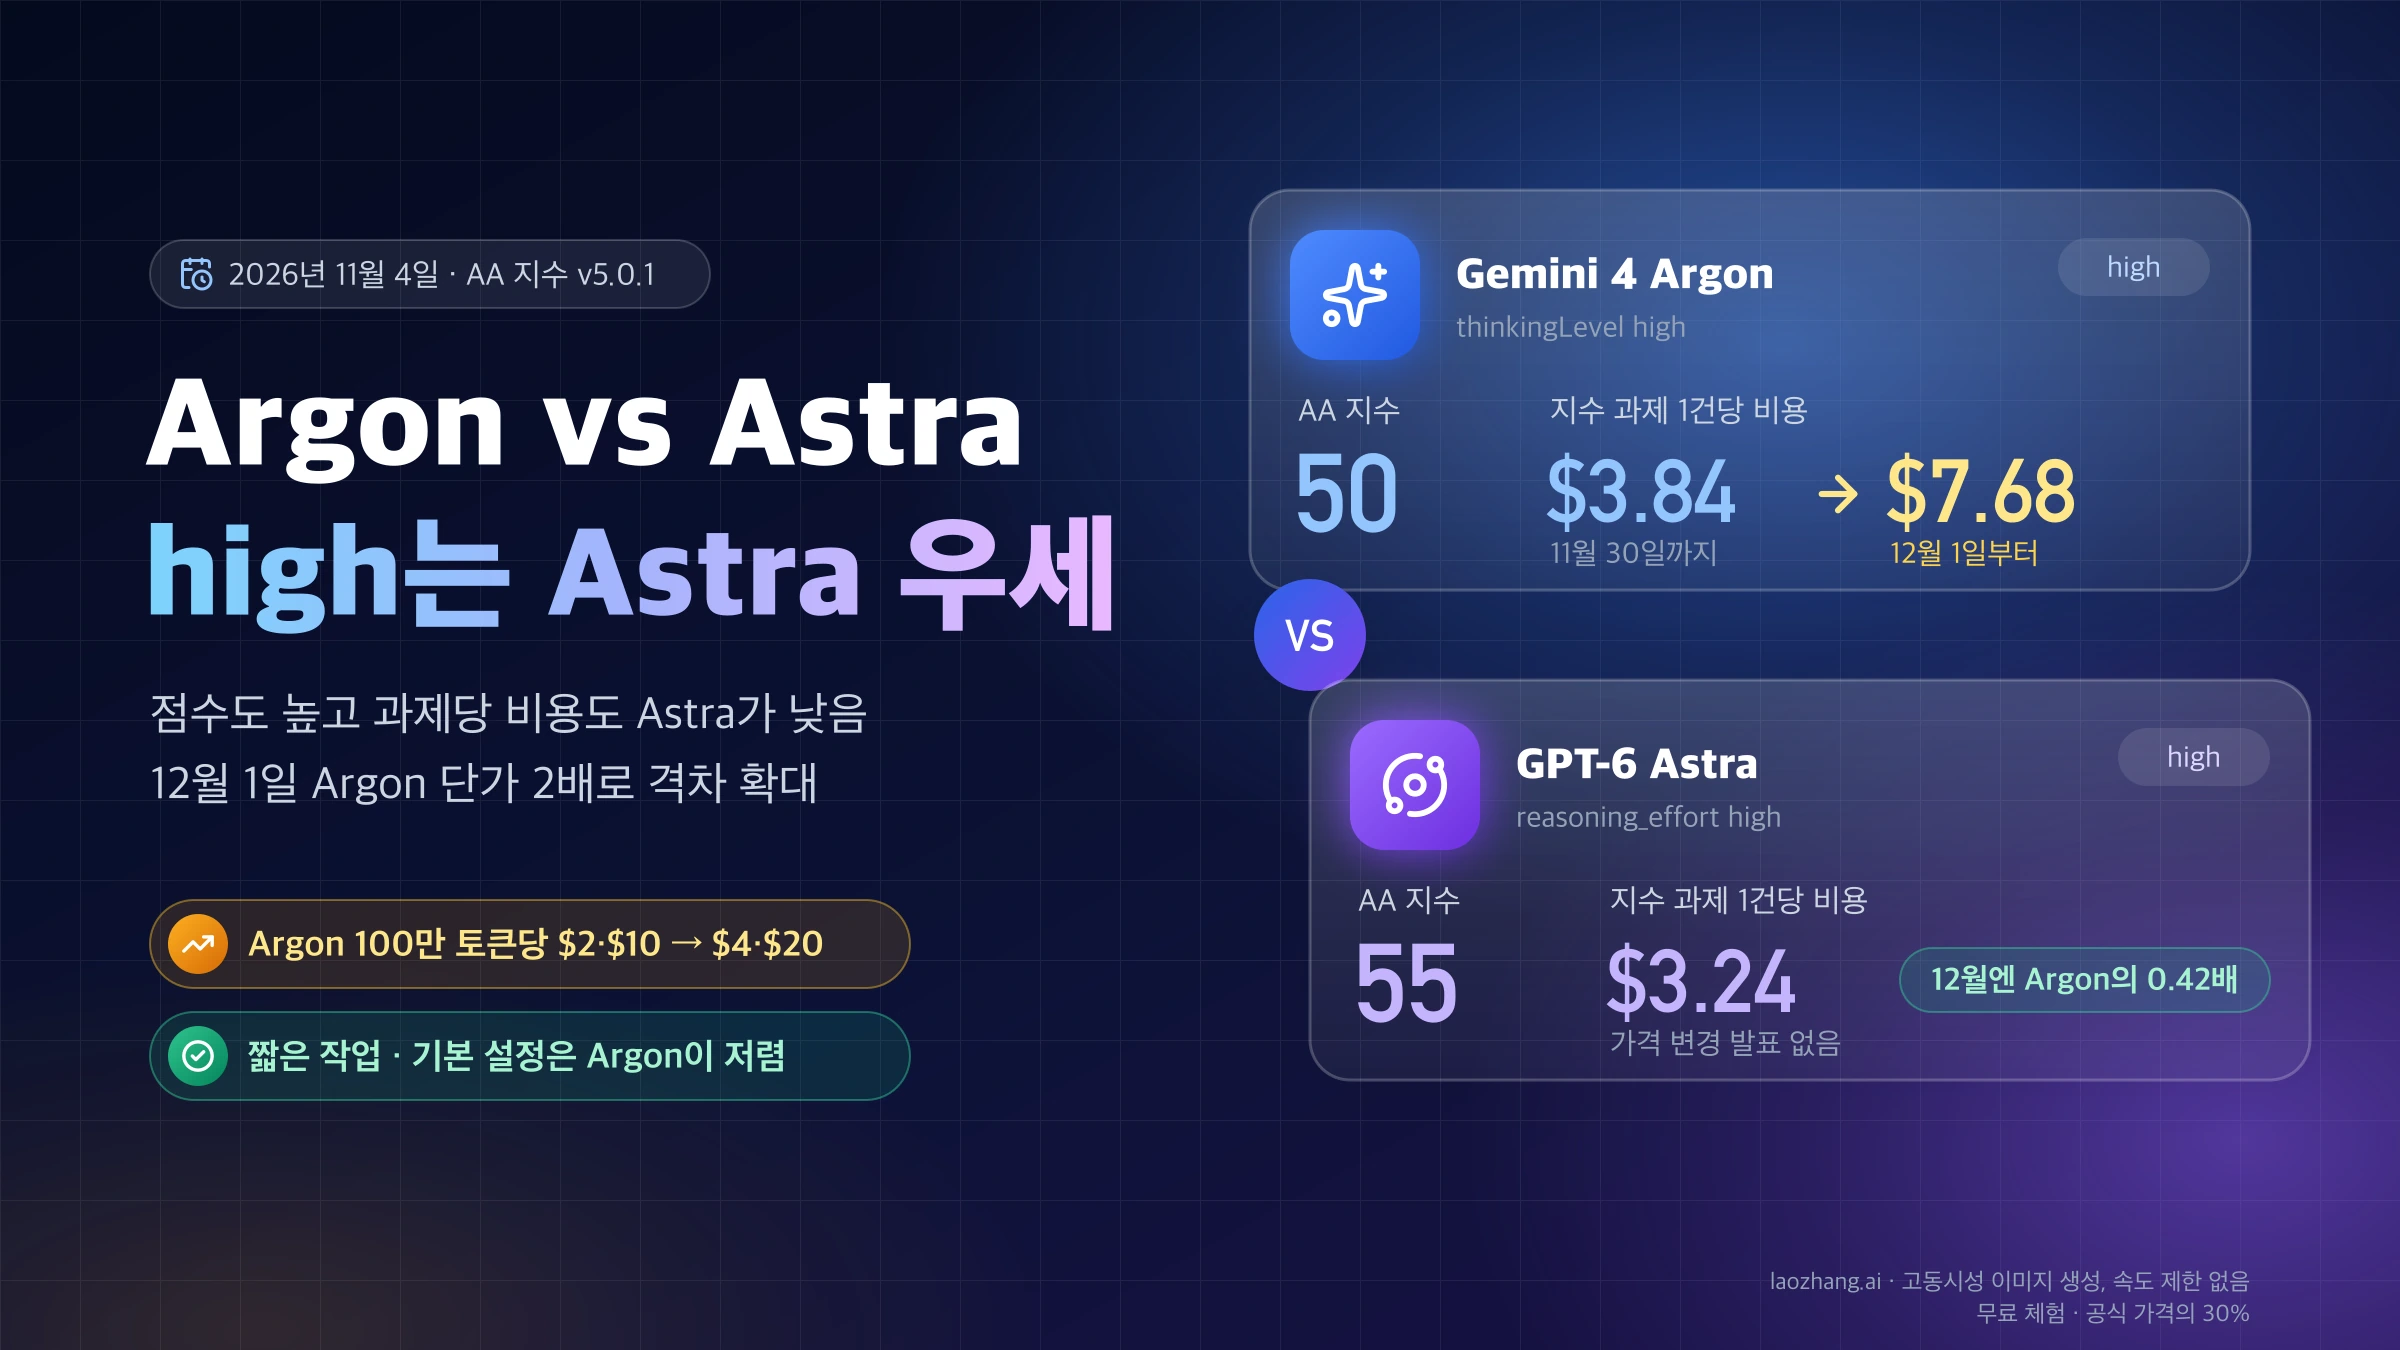
"Argon은 Opus의 반값"이라는 말은 11월 30일까지의 토큰 단가 이야기입니다. Argon은 입력 $2·출력 $10, Opus 5.5는 $4·$20이고, 12월 1일부터는 두 모델의 단가가 같아집니다. Artificial Analysis(AA)가 high 단계로 잰 과제당 비용으로는 반값이 성립한 적이 없습니다. 11월 11일 기준 AA는 Argon high를 과제당 $9.95(12월 단가 기준)로 표시하는데, 11월 4일의 $7.68에서 점수 변화 없이 올라간 값입니다. 도입가로 환산한 약 $4.98도 Opus high($3.46)의 1.44배이고, 12월부터는 2.88배입니다.
그래서 코딩 에이전트처럼 길고 정확해야 하는 작업은 Opus 5.5의 API 기본값(effort medium)에서 시작하는 편이 안전합니다. 146 KB 로그를 정확히 세는 과제에서 Opus는 medium과 high로 4번 모두 맞혔지만, Argon은 기본값으로 2번 모두 틀렸고 high에 스트리밍까지 켜야 맞혔습니다. Argon은 기본값으로 충분한 짧은 작업, 그리고 Google 표에서 앞선 금융·법률·긴 컨텍스트 작업에 한해 11월 30일 전에 자기 과제로 재 보고 12월 단가로 판단합니다. 한국어 프롬프트는 같은 문단도 Opus에서 토큰이 2.26배로 세어지므로, 단가가 같아지는 12월 이후에도 입력 비용은 Opus 쪽이 큽니다. 비용이 가장 중요하다면 AA에서 Argon high와 같은 50점에 과제당 $0.59인 GPT-6.1 Sol이 기준점입니다.
같은 과제 실측: 기본값은 Argon, high는 Opus가 쌉니다
같은 프롬프트를 두 모델에 보내면, 각자의 기본값에서는 Argon이 Opus 5.5보다 싸고 맞힌 답 수는 거의 같았으며, 각자의 high에서는 Opus가 같은 정답 수로 더 싸고 빨랐습니다. 호출은 모두 LaoZhang 게이트웨이(api.laozhang.ai)에서 사용량 과금 키 하나로 했습니다. Argon은 2026년 11월 4일 제미나이 네이티브 generateContent(비스트리밍)로, Opus 5.5는 11월 11일 Anthropic Messages API(스트리밍, thinking: adaptive)로 불렀고, 비용은 실제 토큰 수에 각 회사의 공개 정가를 곱해 다시 계산한 값입니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
과제는 8개입니다. 단어 문제 1개, 숨은 테스트로 채점하는 함수 구현 3개(merge_intervals, parse_duration, top_words), 6,723단어 영어 기사를 정확히 5개 항목으로 요약하기, 그리고 어려운 과제 3개(eval 없이 수식 계산기, csv 모듈 없이 CSV 한 줄 파서, 답이 55,252인 자릿수 합 세기)입니다. 어려운 3개는 두 번씩 돌려 설정마다 채점한 답이 11개입니다. Argon의 기본값은 thinkingConfig를 넣지 않은 호출(Google 기본값 medium)이고 high는 thinkingLevel high입니다. Opus는 effort medium(API 기본값)과 high입니다. 두 회사의 추론 강도 단계는 같은 기준이 아니므로 "각자의 기본값", "각자의 high"로 나눠 봐야 합니다.
| 설정 | 맞힌 답 | 입력 토큰 | 출력 토큰 | 비용 (11월 30일까지) | 비용 (12월 1일부터) | 걸린 시간 |
|---|---|---|---|---|---|---|
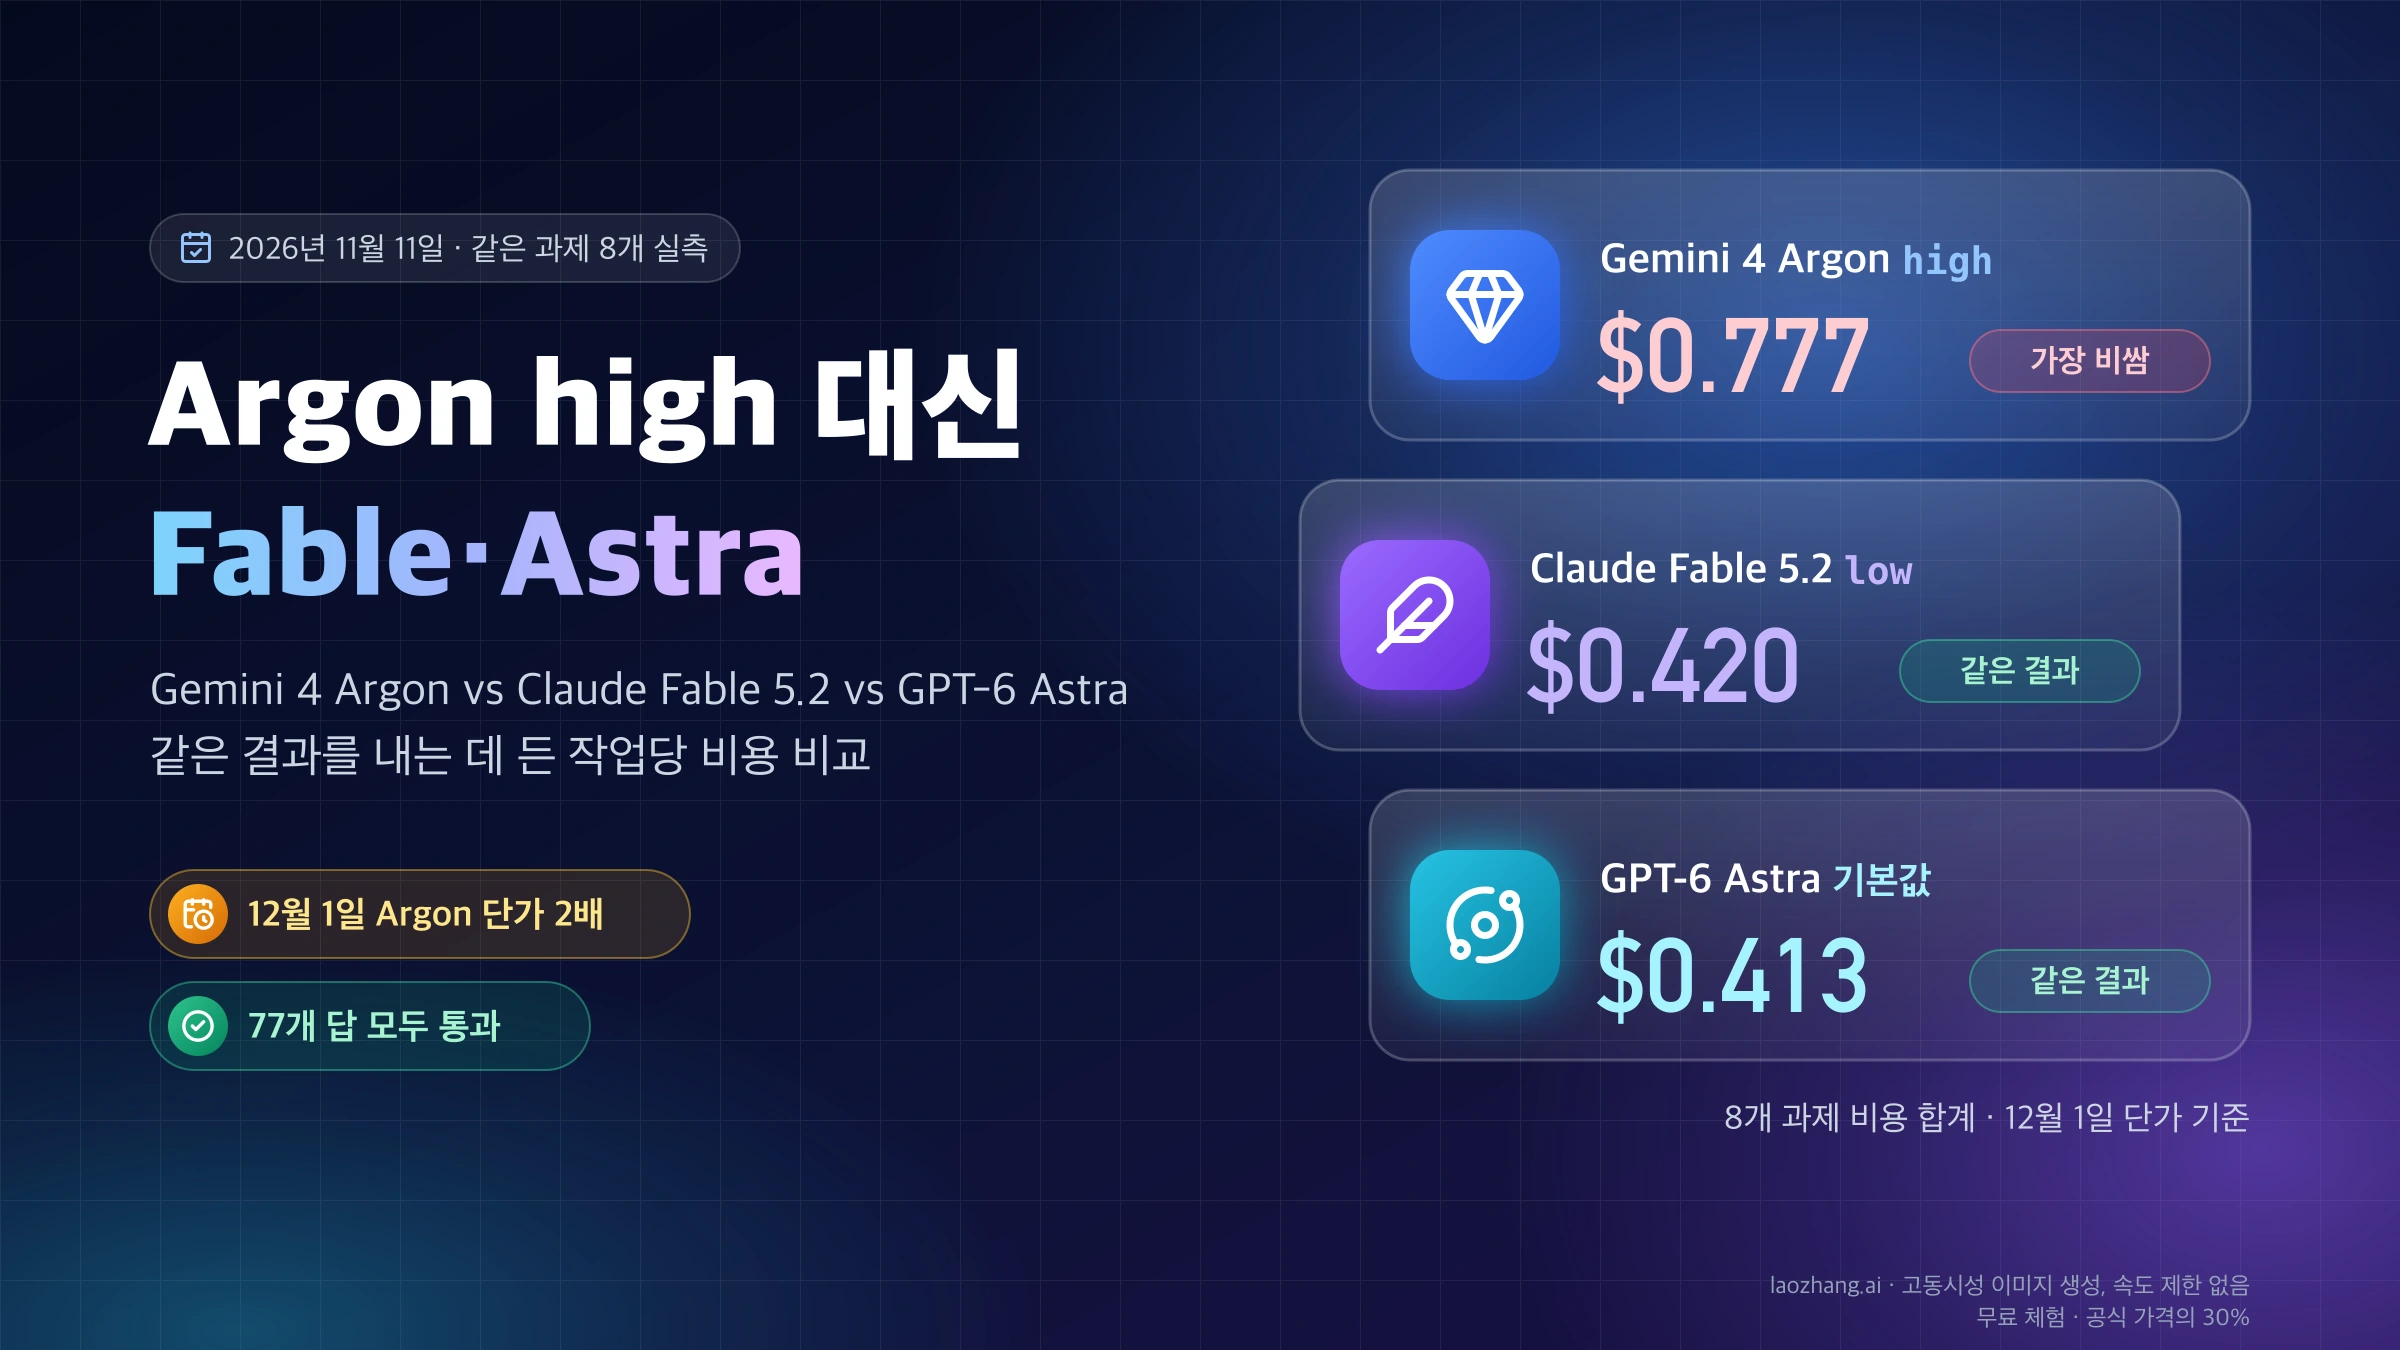
| Argon 기본값 | 10/11 | 12,712 | 6,782 (생각 1,727) | $0.093 | $0.187 | 163초 |
| Argon high | 11/11 | 12,712 | 39,514 (생각 33,105) | $0.403 | $0.807 | 463초 |
| Opus 5.5 medium (기본값) | 11/11 | 17,202 | 11,056 | $0.290 | $0.290 | 126초 |
| Opus 5.5 high | 11/11 | 17,202 | 11,968 | $0.308 | $0.308 | 147초 |
기본값끼리는 Opus가 지금 3.11배, 12월 1일부터 1.55배 비쌉니다. Argon의 출력이 짧았기 때문인데(Opus가 1.63배), 대신 Argon 기본값은 수식 계산기 첫 시도에서 공백이 겹친 " 1 + 2 "를 받자 ValueError를 내며 실패했습니다. 같은 날 따로 돌린 기본값 실행에서는 11개를 모두 맞혀, 기본값 Argon은 두 번 합쳐 22개 중 21개를 맞혔습니다. high끼리는 방향이 뒤집힙니다. Argon high는 생각 토큰 33,105개를 포함해 출력 토큰을 Opus high의 3.3배 썼고, 그래서 비용이 지금 Opus의 1.31배, 12월 1일부터 2.62배입니다. Opus high의 merge_intervals 답은 함수와 테스트를 두 파일로 나눠 출력해 그대로는 실행되지 않았고, 파일을 분리해 실행하자 숨은 테스트 8개와 자체 테스트 6개를 모두 통과했습니다. 표의 11/11은 이렇게 분리해 실행한 결과입니다.
Opus 5.5가 더 빠르냐는 질문의 답도 설정에 따라 다릅니다. 이 실측에서 기본값끼리는 Opus가 126초로 Argon(163초)보다 약간 빨랐고, high끼리는 147초 대 463초로 3배 넘게 벌어졌습니다. Argon은 비스트리밍 호출이었으므로 시간은 참고용이지만, AA의 과제당 시간도 Argon high 28.6분, Opus high 9.5분으로 같은 방향입니다.
이 표의 한계도 분명합니다. 게이트웨이 하나를 거친 결과이고, 칸마다 표본이 1~2개이며, 두 모델의 측정일은 일주일 떨어져 있습니다. 과제가 작고 조건이 분명해서 두 모델 모두 대부분 맞혔기 때문에, 이 표는 품질 순위가 아니라 같은 일을 시켰을 때 토큰과 비용이 어떻게 달라지는지를 보여 줍니다. 어느 모델이 더 어려운 문제를 푸는지는 아래의 AA와 Google 표를 함께 봐야 합니다.
146 KB 로그 집계: Argon은 high와 스트리밍이 필요했습니다
긴 입력을 정확히 세는 작업에서는 차이가 더 분명했습니다. 1,500줄(ERROR 326줄)짜리 146 KB 합성 애플리케이션 로그를 주고 오류 코드 5개의 ERROR 개수, E503 오류를 낸 사용자 수, retry 값이 가장 큰 요청을 물었습니다. 정답은 스크립트로 생성하고 grep으로 맞춰 본 값입니다. 측정 날짜와 경로는 위 실측과 같습니다(Argon 11월 4일, Opus 11월 11일, LaoZhang 게이트웨이).
| 설정 (실행 횟수) | 정답 | 걸린 시간 | 1회 비용 (11월 30일까지) | 1회 비용 (12월 1일부터) |
|---|---|---|---|---|
| Opus 5.5 medium·high (4회) | 4/4 모두 정답 | 56~59초 | $0.47~0.48 | $0.47~0.48 |
| Argon 기본값 (2회) | 0/2, 개수 20~37% 적음 | 약 7초 | $0.16 | $0.32 |
| Argon high, 비스트리밍 (1회) | 답 없음, 출력 상한 도달 | — | $0.49 | 약 $0.97 |
| Argon high, 스트리밍 (2회) | 2/2 모두 정답 | 271~402초 | $0.53~0.55 | $1.06~1.09 |
Argon 기본값은 7초 만에 답했지만 E503 94건을 59건으로, E503 사용자 78명을 46명으로 세는 식으로 개수가 크게 모자랐습니다. high로 올려 비스트리밍으로 부르면 생각하는 도중 출력 상한 32,768토큰에 걸려 답 없이 $0.49가 청구됐고, 스트리밍으로 바꾸자 두 번 모두 맞혔습니다. 그 대가로 271~402초가 걸렸고 비용은 Opus의 약 1.1배, 12월 1일부터 약 2.3배입니다. 같은 로그의 입력 토큰은 Opus 78,537개, Argon 79,312개로 거의 같았으므로, 이 차이는 단가가 아니라 출력과 생각 토큰에서 나옵니다. 긴 입력을 정확히 다뤄야 하는 에이전트라면 Argon은 high와 스트리밍을 전제로 예산을 잡아야 하고, Opus는 기본값으로 충분했습니다.
토큰 단가: Argon은 11월 30일까지 Sol과 같고, 이후 Opus와 같습니다
Argon의 토큰 단가는 11월 30일까지 GPT-6.1 Sol과 같고 Opus 5.5의 절반이며, 12월 1일부터는 Opus 5.5와 같아집니다. 아래는 1M 토큰당 정가로, Argon은 2026년 11월 11일, Opus 5.5는 11월 10일, GPT-6.1 Sol은 10월 14일 기준입니다.
| 항목 | Argon (11월 30일까지) | Argon (12월 1일부터) | GPT-6.1 Sol (입력 272K 이하) | GPT-6.1 Sol (272K 초과) | Opus 5.5 |
|---|---|---|---|---|---|
| 입력 | $2 | $4 | $2 | $4 | $4 |
| 캐시된 입력 | $0.10 | $0.20 | $0.10 | $0.20 | $0.20 |
| 출력 (추론 토큰 포함) | $10 | $20 | $10 | $15 | $20 |
| 캐시 쓰기 | 별도 요금 없음 (암시적 캐시만) | 별도 요금 없음 (암시적 캐시만) | $2.50 | $5 | $5 (5분 캐시), $8 (1시간 캐시) |
| Batch | $1 / $5 | $2 / $10 | $1 / $5 | 50% 할인 | $2 / $10 |
Argon의 $2 / $10는 Google이 "출시 초기 가격(introductory price)"이라고 부른 값입니다. Google 발표문은 "초기 기간이 2026년 11월 30일에 끝나면 입력 $4, 출력 $20가 적용된다"고 적었고, 제미나이 API 가격 페이지도 11월 30일까지와 12월 1일부터를 나눠 싣고 있습니다(11월 11일에도 같은 내용). 캐시된 입력도 $0.10에서 $0.20로 함께 오르므로 입력가 대비 95% 할인 비율은 그대로입니다. Flex는 Batch와 같은 가격이고, 우선 처리(Priority)는 $3.60 / $18에서 12월 1일부터 $7.20 / $36입니다. 긴 프롬프트용 별도 가격 구간은 없습니다. 생각 토큰을 포함해 모델이 처리한 모든 토큰이 과금됩니다.
Argon의 캐시는 암시적 캐시(implicit caching)만 지원하고 명시적 캐시는 지원하지 않습니다. 캐시 쓰기나 저장 요금이 없는 대신, 어떤 입력이 캐시 단가로 계산될지를 호출하는 쪽에서 직접 지정할 수는 없습니다. Google 검색과 지도를 이용한 그라운딩(grounding)은 Gemini 3 이후 모델 전체를 합쳐 월 5,000건까지 무료이고, 그 뒤로는 1,000건당 $14입니다. 가격과 날짜는 Google이 바꾸거나 연장할 수 있으므로, 예산은 가격 페이지의 당일 표시를 기준으로 잡습니다.
새 입력을 U, 캐시 읽기를 R, 출력(추론 토큰 포함)을 O라고 하고 단위를 100만 토큰으로 두면 요청 한 건의 비용은 다음과 같습니다.
- Argon, 11월 30일까지: 2U + 0.10R + 10O
- Argon, 12월 1일부터: 4U + 0.20R + 20O
- GPT-6.1 Sol, 입력 272K 이하: 2U + 0.10R + 10O (캐시 쓰기 100만 토큰당 $2.50 별도)
- GPT-6.1 Sol, 입력 272K 초과: 4U + 0.20R + 15O
- Opus 5.5: 4U + 0.20R + 20O (5분 캐시 쓰기 100만 토큰당 $5 별도)
새 입력 100K 토큰에 출력 20K 토큰인 요청을 넣어 보면 11월 30일까지의 Argon은 0.1 × 2 + 0.02 × 10 = $0.40, GPT-6.1 Sol도 $0.40, Opus 5.5는 0.1 × 4 + 0.02 × 20 = $0.80, 12월 1일부터의 Argon도 $0.80입니다. 토큰 수가 같다는 전제에서는 "Argon은 Sol과 같고 Opus의 절반"이 맞지만, 이 관계는 11월 30일에 끝납니다. 12월 1일부터 Argon의 단가 공식은 Opus 5.5와 같아지고, Argon에는 캐시 쓰기 요금이 없다는 차이만 남습니다. 그때도 $2 / $10로 남는 것은 GPT-6.1 Sol의 272K 이하 요청뿐이고, Sol도 입력이 272K를 넘으면 요청 전체가 높은 구간으로 계산된다는 점은 같이 봐야 합니다.
다만 "토큰 수가 같다"는 전제는 한국어에서 특히 맞지 않습니다. 같은 한국어 문단을 넣었을 때 Opus 5.5의 입력 토큰은 Argon의 2.26배였고, 같은 방식으로 잰 영어 문단은 1.45배, 6,723단어 영어 기사는 1.38배, 숫자와 ID가 대부분인 로그는 0.99배였습니다(같은 지시문만 넣었을 때의 토큰을 빼고 계산, Opus 11월 11일·Argon 11월 4일, LaoZhang 게이트웨이). 그래서 12월 1일에 단가가 같아져도 한국어 프롬프트의 입력 비용은 Opus 쪽이 두 배 이상입니다. Gemini 4 Carbon vs Opus 5.5 비교: 단가 같아도 한국어는 Opus 토큰 1.94배의 1.94배는 요청 전체 토큰으로 나눈 값이라 측정 방식이 다릅니다.
Opus와 Sol 두 모델 사이의 캐시·긴 요청 계산은 Claude Opus 5.5 vs GPT-6 Sol·6.1 Sol 비용에, Opus 5.5 단가로 요청 비용을 계산하는 방법은 Claude Opus 5.5 가격과 사용량 초기화권: 토큰 비용 계산부터 사용 시점까지에 더 자세히 있습니다.
작업당 비용: 단가가 같아도 8배 넘게 차이가 납니다
Artificial Analysis의 high 단계 측정에서 Gemini 4 Argon과 GPT-6.1 Sol은 지수 점수(50)도, 11월 30일까지의 토큰 단가도 같지만 과제 하나에 드는 비용은 Argon이 약 8.4배입니다. 같은 과제를 풀 때 추론과 출력에 쓰는 토큰 수가 모델마다 다르고, 청구서는 단가가 아니라 단가에 토큰 수를 곱한 값으로 나오기 때문입니다. AA의 Intelligence Index(현재 v5.0.1)는 9개 평가를 묶은 종합 지수이고, 과제 하나를 끝내는 데 든 평균 비용을 함께 공개합니다. AA는 2026년 10월 27~28일에 지수를 v4.3.2에서 v5.0으로 바꿨으므로 그 전에 인용된 점수·비용과는 값이 다르고, 11월의 v5.0.1은 그중 CritPt 한 항목만 다시 채점했습니다.
| 모델·추론 강도 | 지수 점수 | 과제당 비용 (11월 30일까지) | 과제당 비용 (12월 1일부터) |
|---|---|---|---|
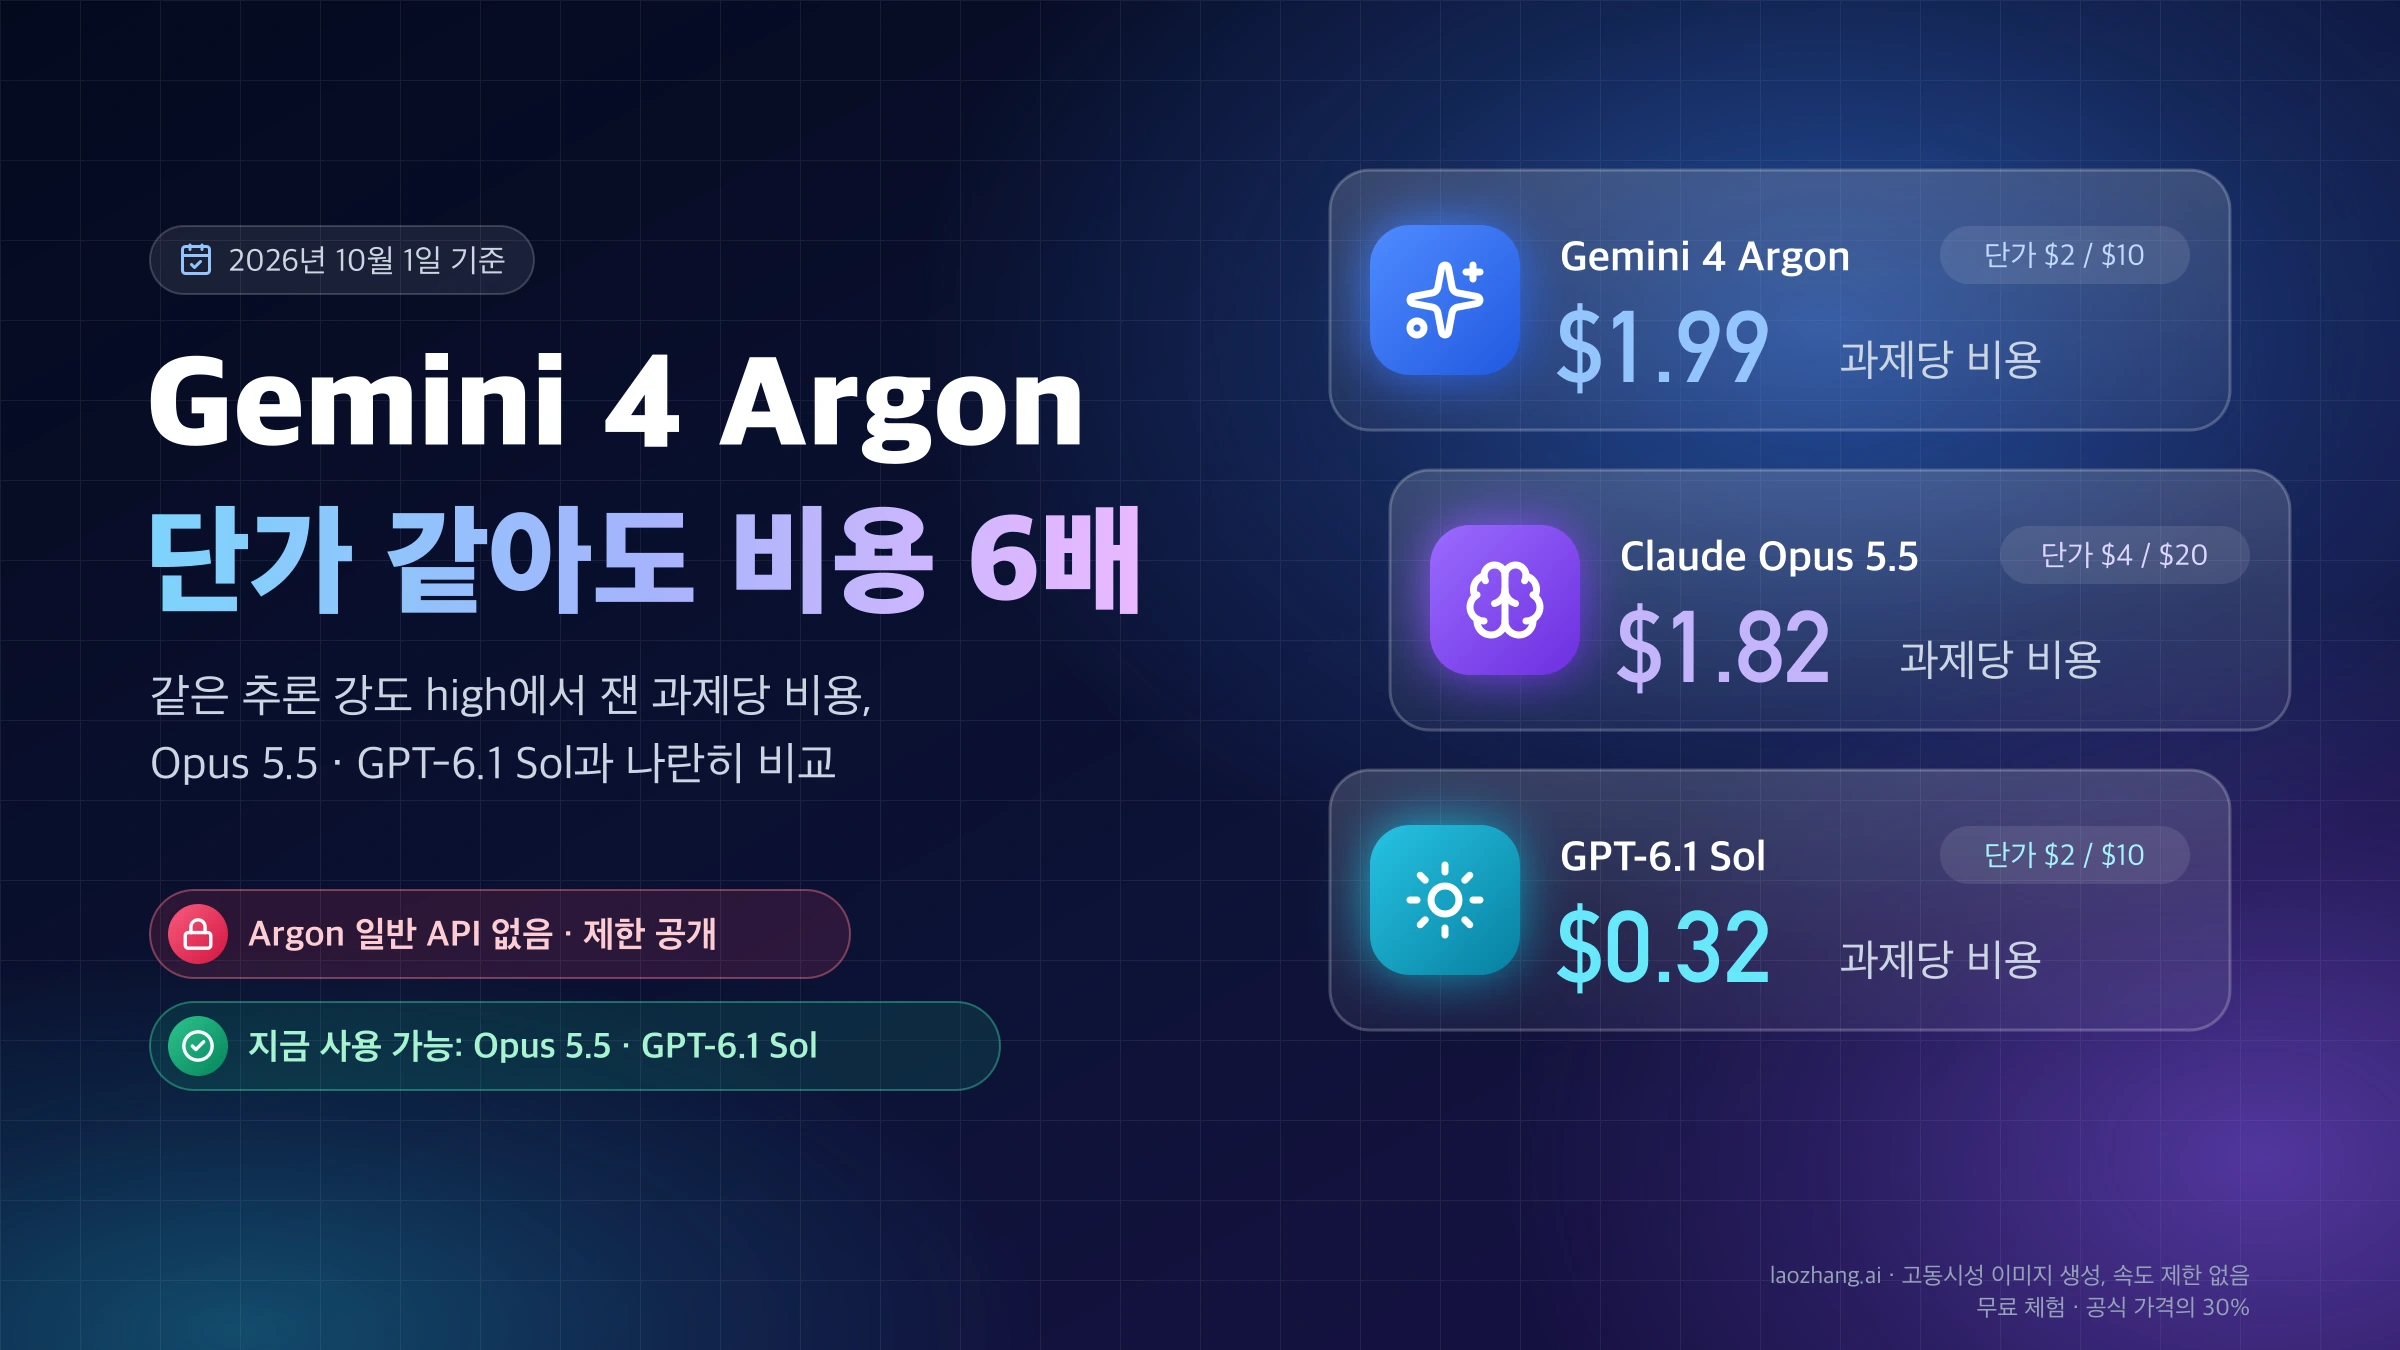
| Gemini 4 Argon high | 50 | 약 $4.98 (AA 표시값의 절반) | $9.95 (AA 표시값, $4 / $20) |
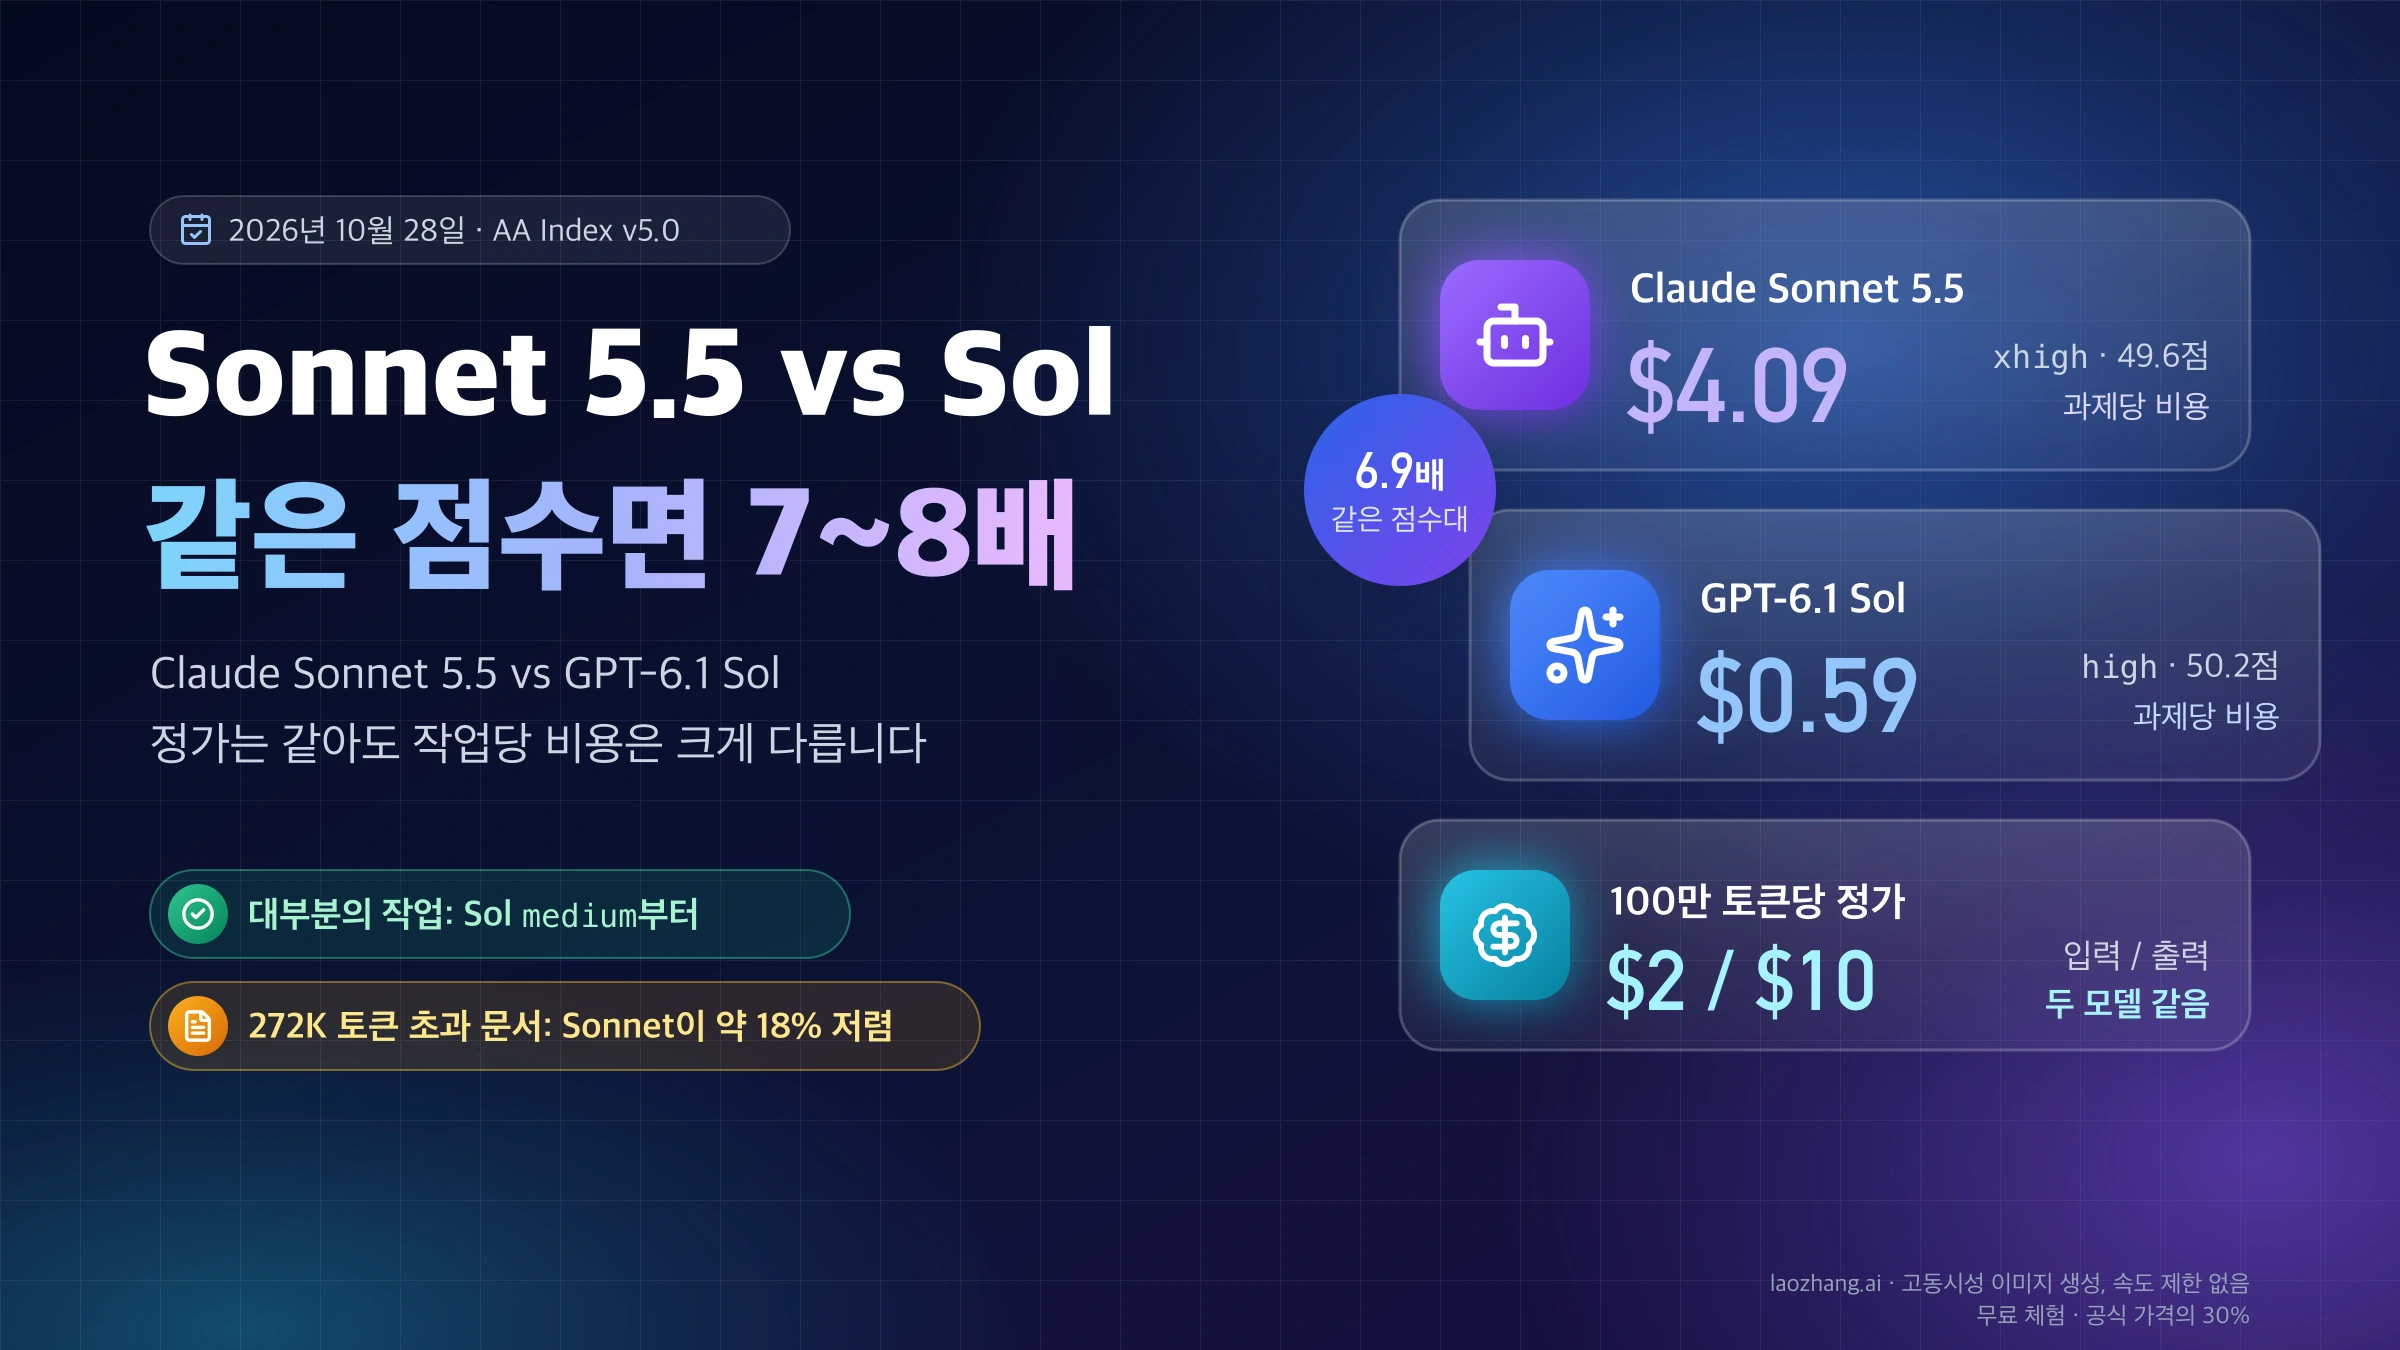
| Claude Opus 5.5 medium (API 기본값) | 48 | $2.45 | $2.45 |
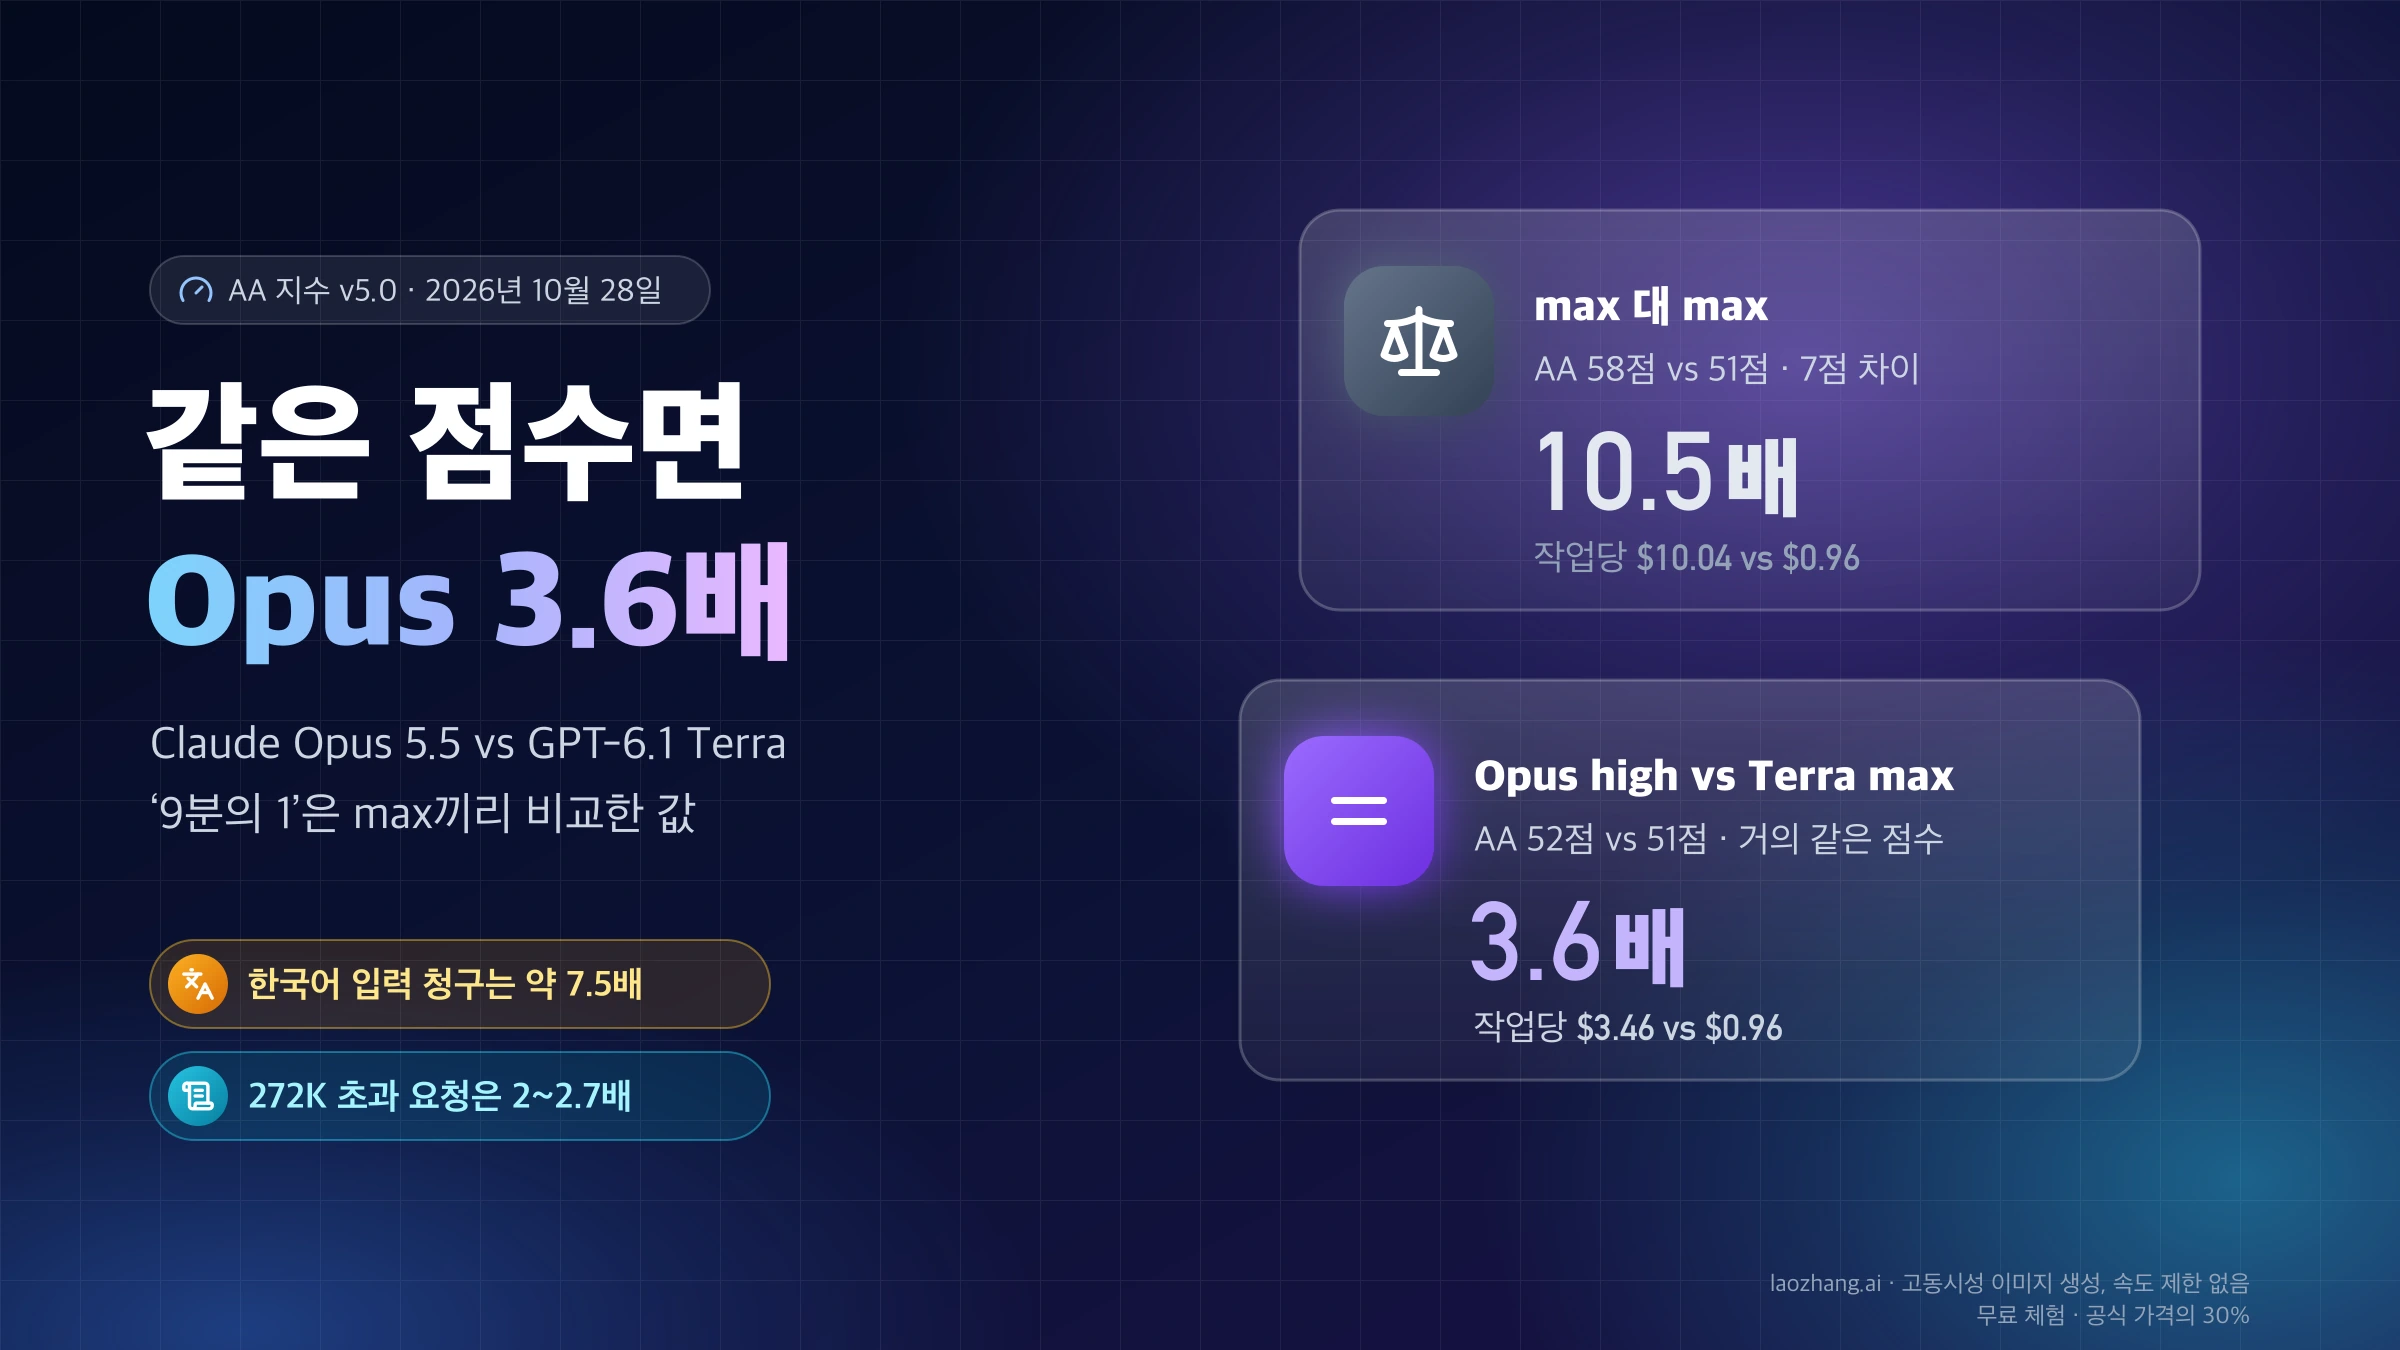
| Claude Opus 5.5 high | 52 | $3.46 | $3.46 |
| Claude Opus 5.5 xhigh | 57 | $6.05 | $6.05 |
| Claude Opus 5.5 max | 59 | $10.04 | $10.04 |
| GPT-6.1 Sol high | 50 | $0.59 | $0.59 |
| GPT-6.1 Sol max | 55 | $1.27 | $1.27 |
출처는 Artificial Analysis의 Gemini 4 Argon 페이지와 AA의 Gemini 4 Argon vs Claude Opus 5.5 비교 페이지이며, Argon과 Opus max·Sol max는 2026년 11월 11일, Opus의 나머지 단계는 11월 10일, Sol high는 11월 4일 기준 v5.0.1 값입니다. AA는 Argon을 high 하나로만 공개하고 이미 12월 단가로 계산합니다. Argon의 모든 단가는 11월 30일까지 정확히 절반이므로, 왼쪽 열의 약 $4.98은 $9.95를 반으로 나눈 계산값이지 AA가 공개한 수치가 아닙니다.
AA의 Argon 수치는 11월 4일과 11월 11일 사이에 바뀌었습니다. 지수 점수와 9개 하위 평가 점수는 그대로인데, 과제당 비용이 $7.68에서 $9.95로 약 30%, 과제당 시간이 22.7분에서 28.6분으로 늘었고, 페이지에는 이유가 적혀 있지 않습니다. 다시 측정한 결과로 보이지만 추정일 뿐이고, 11월 4일 값($7.68)이나 그 절반인 $3.84로 계산한 배수는 이제 맞지 않습니다.
Argon과 Sol의 8.4배는 $4.98 ÷ $0.59이고, 점수와 단가가 같으므로 이 차이는 전부 토큰 사용량에서 나옵니다. Argon이 지수 전체를 도는 데 쓴 출력 토큰은 1억 1천3백만 개, 과제당 출력 토큰은 11만 6천 개였습니다. 12월 1일부터는 $9.95 ÷ $0.59로 약 16.9배가 됩니다.
Argon과 Opus는 단가가 절반인 지금도 $4.98 대 $3.46으로 Argon이 1.44배 더 들고 점수는 2점 낮습니다. 12월 1일부터는 2.88배입니다. 그때는 Opus를 xhigh로 올려도(57점, $6.05) Argon high보다 7점 높으면서 39% 싸고, Opus max(59점, $10.04)가 Argon high의 12월 비용과 거의 같습니다. Opus의 API 기본값인 medium(48점, $2.45)은 Argon high보다 2점 낮지만 비용은 지금도 절반 이하입니다. 과제당 시간도 Argon high 28.6분, Opus high 9.5분으로 Argon이 3배 깁니다. 모두 실제 청구서가 아니라 AA의 토큰 사용량으로 계산한 값입니다.
합격한 결과 1건 기준으로 바꾸면 판단이 더 분명해집니다. 합격 1건당 비용은 과제당 비용을 통과율로 나눈 값이므로, Argon high가 Opus high보다 싸려면 내 작업에서 Argon의 통과율이 Opus의 1.44배(12월부터 2.88배)를 넘어야 합니다. Opus가 35% 넘게 통과하는 작업이라면 12월부터는 Argon이 전부 통과해도 뒤집을 수 없습니다(1 ÷ 2.88 ≈ 0.35). 반대로 Sol high는 통과율이 Argon의 11.9%(12월부터 5.9%)만 넘으면 Argon high보다 쌉니다. 검토 시간과 재시도 비용은 이 계산에 들어 있지 않습니다.
추론 강도를 바꾸면 선택지가 더 생깁니다. GPT-6.1 Sol을 max로 올리면 55점에 $1.27로, Argon high보다 5점 높으면서 비용은 도입가 기준 Argon의 약 4분의 1, 12월 1일 이후 값의 약 8분의 1입니다. Argon의 API는 low·medium·high 세 단계를 제공하지만 AA가 공개한 값은 high 하나뿐입니다. 앞의 실측에서는 기본값(medium)의 비용이 high의 약 4분의 1이었으므로, Argon을 쓸 거라면 기본값으로 통과하는 작업인지부터 확인하는 것이 비용을 가장 크게 바꿉니다.
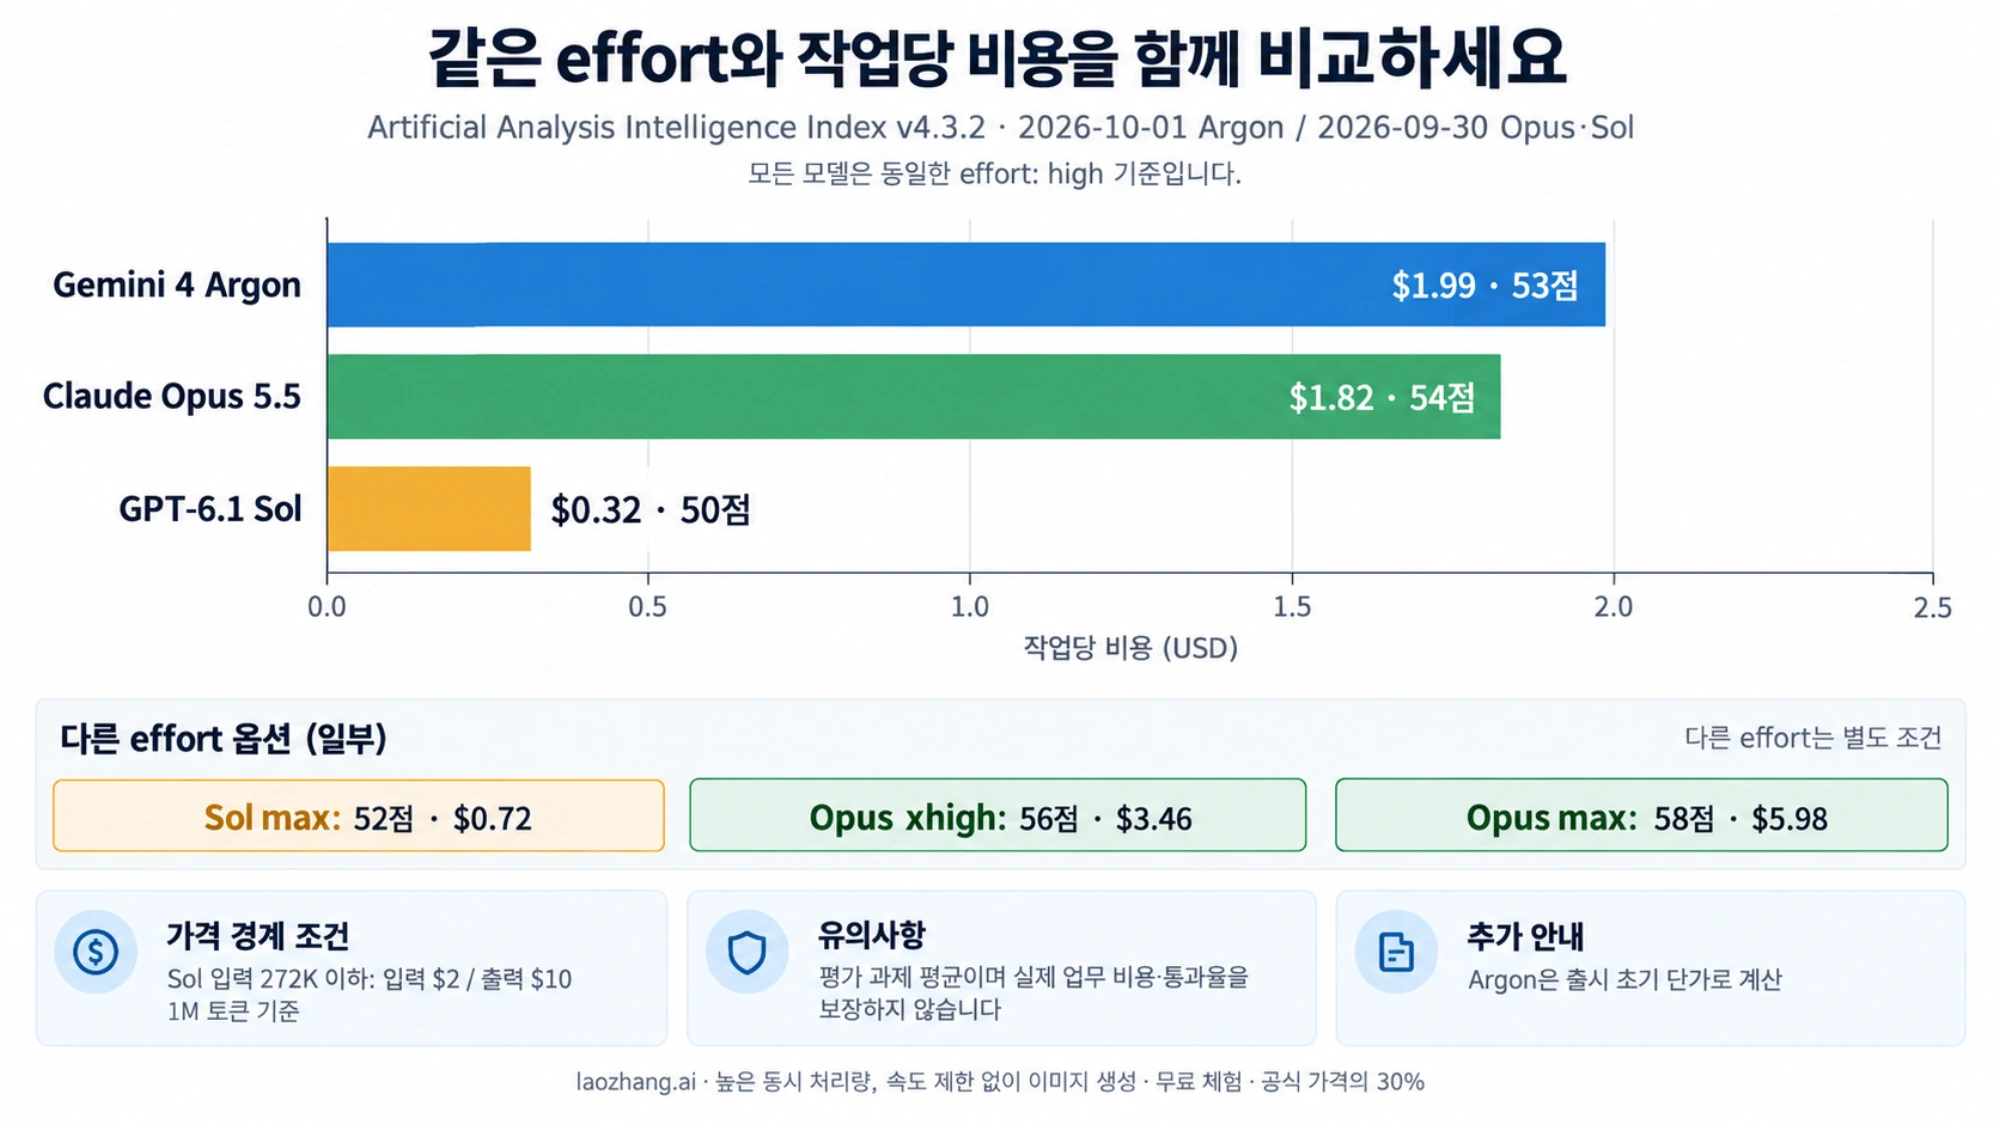
위 그래프는 이전 시점(Artificial Analysis 지수 v4.3.2)의 점수와 과제당 비용으로 그린 것입니다. 현재 수치는 본문 표를 참고하세요.
AA의 두 모델 비교 페이지는 Argon high와 Opus max를 맞대어 50점 대 59점, 과제당 $9.95 대 $10.04로 보여 줍니다. 12월 단가로는 비용이 거의 같고 Opus가 9점 높은 조합이지만, 도입가 기준으로는 Opus max가 Argon high(약 $4.98)의 약 2배입니다. 페이지에 나오는 "Opus 5.5 (Max, Default Fallback)"은 AA의 설정 표기이지 별도 제품 이름이 아니므로, 점수 차이를 인용할 때는 어느 단계끼리의 비교인지와 그 단계의 비용을 같이 봐야 합니다.
한 가지 한계가 있습니다. 이 수치는 AA의 과제 묶음에서 나온 평균이지 실제 청구서가 아니고, 점수당 비용이 좋다는 것이 내 작업을 통과한다는 뜻도 아닙니다. 다만 "단가가 같으니 비용도 같다"는 추론이 성립하지 않는다는 것은 이 표만으로 충분히 확인됩니다.
Google 표의 수치와 제3자 측정은 따로 읽어야 합니다
Google이 직접 낸 표에서는 Argon이 Opus 5.5보다 앞선 항목이 훨씬 많지만, 독립 측정에서는 두 모델의 종합 점수가 약 2점 안에 붙어 있습니다. 누가 어떤 조건으로 잰 값인지에 따라 결론이 달라지므로 출처별로 나눠 봐야 합니다.
Google 발표 표: Opus 5.5와는 14 대 4, GPT-6.1 Sol은 열이 없습니다
Google이 9월 30일 Gemini 4 Argon 발표문에 실은 벤치마크 표의 비교 대상은 GPT-6 Astra, Claude Fable 5.1, Claude Opus 5.5입니다. GPT-6.1 Sol 열은 없으므로 이 표로는 Argon과 Sol을 비교할 수 없습니다. Opus 5.5와 점수가 함께 있는 18개 항목 가운데 Argon이 14개, Opus가 4개에서 앞섭니다. 차이가 큰 항목과 Opus가 앞선 항목만 추리면 다음과 같습니다(단위 %).
| 벤치마크 | Gemini 4 Argon | Claude Opus 5.5 | 앞선 쪽 |
|---|---|---|---|
| Vals Index | 68.9 | 67.0 | Argon |
| AutomationBench | 51.3 | 42.5 | Argon |
| Vals Finance Agent v2 | 65.4 | 58.6 | Argon |
| Harvey Legal Agent | 19.6 | 3.8 | Argon |
| DeepSWE v1.1 | 77.9 | 74.2 | Argon |
| LABBench 2 | 88.8 | 73.1 | Argon |
| GraphWalks 256k~1M | 84.2 | 66.8 | Argon |
| LVBench | 91.7 | 83.7 | Argon |
| FrontierSWE v2 | 55.0 | 62.3 | Opus |
| Terminal-bench 4.0 | 57.4 | 66.4 | Opus |
| PostTrainBench | 45.3 | 49.3 | Opus |
| Terminal-Bench Science 0.1 | 57.6 | 63.3 | Opus |
패턴은 비교적 뚜렷합니다. Argon은 금융·법률 같은 지식 업무, 긴 컨텍스트, 영상·차트 이해에서 앞서고, Opus 5.5는 터미널에서 오래 돌아가는 에이전트 코딩과 ML 후처리 학습, 과학 계산 터미널 작업에서 앞섭니다. 코딩 에이전트용 모델을 고르는 팀이라면 "14 대 4"보다 Opus가 앞선 4개 항목이 자기 작업과 얼마나 닮았는지가 더 중요합니다. 10월 13일 정식 출시 발표문은 이 표를 다시 싣지 않았고, 경쟁 모델 점수 없이 Vals Index 1위와 ERQA 87% 같은 Argon 단독 수치만 추가했습니다.
이 표는 Google이 직접 돌리거나 모은 수치이고 독립적으로 재현된 것이 아닙니다. Kingy AI는 Google의 평가 방법 문서를 읽고, 모델을 최고 추론 단계로 돌렸다는 점과 DeepSWE에 mini-swe 하네스를 썼다는 점, Terminal-Bench Science에서 검증 시간 제한이 6배였다는 점, LVBench에서 모델마다 영상 프레임 수가 달랐다는 점을 지적했습니다. 이는 Kingy AI의 해석이며, 표의 1~2점 차이를 순위로 받아들이기 전에 감안할 조건입니다.
프롬프트 인젝션 방어에 대해 Google은 10월 13일 발표문에서 Gray Swan의 적응형 공격 15회 기준 Argon의 공격 성공률을 0.7%로 적었습니다. VentureBeat가 9월 30일 발표문의 Gray Swan 차트에서 옮긴 Opus 5.5의 값은 1.0%이고, 여기에도 GPT-6.1 Sol의 값은 없습니다.
Vals와 Arena: 독립 측정에서 Argon이 1위였지만 조건을 봐야 합니다
Vals AI의 Gemini 4 Argon 페이지에 실린 Vals Index는 금융·코딩·법률·세무 과제를 묶은 지수이고, 2026년 10월 1일 기준(Vals Index v2.1) Argon은 41개 모델 중 1위였습니다. Vals는 10월 19일 Finance Agent를 갱신한 v2.2를 내놓았고, 10월 30일 기준 현재 리더보드에서 Argon은 69.24%(테스트당 $13.37)로 32개 모델 중 4위입니다. 앞선 모델은 Claude Sonnet 5.5(70.85%), Gemini 4 Carbon(70.45%), Claude Opus 5.5(70.18%, $28.12)이고 GPT-6.1 Sol은 63.94%($3.61)로 8위입니다(2026년 11월 4일 기준). 아래 표는 v2.1 값이며 v2.2 값과 섞어 비교하면 안 됩니다.
| 모델 | Vals Index | 테스트당 비용 |
|---|---|---|
| Gemini 4 Argon | 68.90% | $15.68 |
| Claude Sonnet 5.5 | 67.04% | $21.34 |
| Claude Opus 5.5 | 66.97% | $32.14 |
| GPT-6.1 Sol | 61.15% | $3.24 |
읽을 때 세 가지를 붙여야 합니다. 첫째, Vals는 Argon을 초기 가격이 아니라 $4 / $20로 계산했고 추론 강도는 high로 돌렸습니다. 이 단가는 12월 1일 이후 가격과 같으므로, Argon의 $15.68은 12월 이후 기준에 가까운 값입니다. Kingy AI에 따르면 Opus와 Sonnet 행은 max 단계입니다. 둘째, v2.1에서 Argon과 Opus의 차이는 약 2점이었고(v2.2에서는 Opus가 약 1점 앞섭니다) OrcaRouter가 리더보드에서 읽은 오차 범위는 ±0.9~1.0입니다. 셋째, GPT-6.1 Sol의 61.15%와 $3.24는 Vals 페이지가 아니라 Kingy AI가 Vals 리더보드에서 옮겨 적은 2차 수치입니다. 그 수치대로라면 Sol은 Argon보다 약 8점 낮고 테스트당 비용은 5분의 1 수준입니다.
Vals는 Argon의 약점도 함께 적었습니다. 컴퓨터 조작을 재는 CUA-bench에서는 4.83%로 8개 모델 중 7위였고, 긴 에이전트 과제에서 비용이 올라가 CUA-bench는 테스트당 $193.78, Code Migration은 $57.82였습니다. 지수 평균으로는 Claude 세 모델보다 싸지만, 오래 도는 작업 하나의 비용은 평균과 크게 다를 수 있습니다.
사람이 두 답변 중 나은 쪽을 고르는 Arena에서는 Kingy AI가 옮긴 9월 30일 텍스트 순위 기준으로 Argon high가 1,525점(±9, 4,942표)으로 1위, Opus 5.5 high가 1,504점(±10)입니다. GPT-6.1 Sol은 그 표에 없었습니다. Arena 점수는 선호 투표이지 과제를 맞혔는지를 재는 값이 아닙니다.
세 측정을 합치면 "Argon이 Opus 5.5보다 나은가"에 대한 답은 이렇게 정리됩니다. 지식 업무와 긴 컨텍스트에서는 Google 표와 Vals가 같은 방향으로 Argon의 우위를 보여 줍니다. 종합 점수에서는 두 모델이 약 2점 안에 붙어 있습니다. 같은 강도의 AA v5.0.1에서는 Opus가 2점 앞서고, Vals Index에서는 v2.1에서 Argon이 약 2점 앞섰다가 현재 v2.2에서는 Opus가 약 1점 앞섭니다. GPT-6.1 Sol은 AA에서 Argon과 같은 50점이고 Vals에서는 두 모델보다 몇 점 낮지만, 비용은 AA 과제당 비용으로 Argon의 약 8분의 1, Vals v2.2 테스트당 비용으로 약 4분의 1입니다.
코딩에는 어느 쪽인가: 근거 세 가지가 다르게 말합니다
코딩 에이전트용으로 Argon과 Opus 5.5 중 하나를 고를 때는 Google 표, AA의 독립 평가, 같은 과제 실측이 서로 조금씩 다른 이야기를 하므로 하나로 합치지 말고 나눠 봐야 합니다. Google 자체 표(9월 30일)에서는 Opus가 Terminal-bench 4.0(66.4 대 57.4), FrontierSWE v2(62.3 대 55.0), Terminal-Bench Science, PostTrainBench에서 앞서고, Argon은 DeepSWE v1.1(77.9 대 74.2)과 Vibe Code Bench(91.9 대 90.3)에서 앞섭니다. 터미널에서 오래 도는 작업은 Opus, 저장소 이슈 해결과 웹앱 생성은 Argon이라는 그림입니다.
AA의 독립 평가는 이 그림을 일부만 확인해 줍니다. 2026년 11월 10~11일 기준 Terminal-Bench 4.0은 Argon high 57.1%, Opus high 56.6%, Opus max 59.6%로 Google 표보다 차이가 훨씬 작습니다. 반대로 코드 작성 평가인 FrontierCode 2.0은 Argon high 25.7%, Opus high 35.9%, Opus max 46.4%로 Opus 쪽 차이가 큽니다. 같은 실측에서는 숨은 테스트가 있는 작은 함수 구현과 수식 계산기·CSV 파서를 두 모델 모두 high에서 전부 통과했고, 차이는 146 KB 로그처럼 긴 입력을 정확히 처리하는 작업에서 났습니다. Opus는 기본값으로 충분했고 Argon은 high와 스트리밍이 필요했습니다.
그래서 조건별로 정리하면 이렇습니다. 테스트가 분명한 짧은 코딩 작업을 대량으로 돌린다면 Argon 기본값이 두 모델 중 가장 싸고(실측 $0.09, 12월부터 $0.19 대 Opus $0.29), 실패한 답을 다시 돌리는 비용을 감안해도 비교해 볼 만합니다. 긴 로그나 여러 파일을 읽고 정확히 고쳐야 하는 에이전트 작업, 터미널 작업은 Opus 5.5의 기본값부터 시작하는 편이 비용과 정답률 모두에서 유리했습니다. Argon을 high로 올려야 하는 작업이라면 12월 1일부터는 Opus보다 싸게 만들기 어렵습니다.
1M 토큰 한도: 입력과 출력이 함께 쓰고, 일반 호출의 출력은 65,536
제미나이 API의 Gemini 4 Argon 모델 페이지는 컨텍스트 창을 "입력과 출력을 합친 토큰 한도" 1,048,576으로 적고 있습니다. 최대 출력은 두 가지로 나뉩니다. 일반 동기 호출은 65,536 토큰까지이고, long decode 모드에서만 최대 1,048,576 토큰까지 출력할 수 있습니다. 9월 30일 발표 때 Google은 출력 한도를 기존 64K에서 "1M"으로 늘렸다고 했는데, 정식 출시 문서에서는 이 1M이 입력과 출력이 함께 쓰는 한도로 바뀌었습니다. VentureBeat는 이 한도가 한 번의 끊기지 않은 응답 길이와 어떤 관계인지 Google이 설명하지 않았다고 지적했습니다.
평소 요청의 출력 상한은 65,536 토큰으로, Opus 5.5와 GPT-6.1 Sol의 최대 출력(각각 128K)보다 작습니다. 이보다 긴 출력이 필요할 때만 long decode를 쓰는데, 이 모드를 켜는 요청 방식은 모델 페이지의 한도 표에 나와 있지 않으므로 해당 모드의 API 문서를 따로 확인해야 합니다. 입력이 길면 출력 여유도 줄어듭니다. 입력에 900,000 토큰을 넣으면 남는 출력 여유는 1,048,576 − 900,000 = 148,576 토큰입니다.
호출 방식도 중요합니다. 2026년 11월 4일 기준 Google API 문서는 스트리밍이 아닌 호출의 출력 상한을 32,768 토큰으로 적고 있고(스트리밍은 65,536), 생각 토큰도 이 안에 들어갑니다. 그래서 high로 오래 생각하는 작업을 비스트리밍으로 부르면 답이 나오기 전에 상한에 걸려 답 없이 과금될 수 있고, 앞의 로그 실측에서 $0.49가 이렇게 청구됐습니다. 긴 작업은 스트리밍으로 호출합니다.
출력은 가장 비싼 항목이기도 합니다. 동기 호출 한 번이 출력 상한 65,536 토큰을 다 쓰면 11월 30일까지는 0.065536 × $10 ≈ $0.66, 12월 1일부터는 약 $1.31입니다. long decode로 출력 500K 토큰을 쓰면 0.5 × $10 = $5, 12월 1일부터는 $10입니다.
Vals 모델 페이지에 적힌 최대 출력 262k는 정식 출시 전 Vals가 평가에 쓴 엔드포인트의 값이며, 현재 API 한도는 위의 모델 페이지 수치입니다. 입력은 텍스트·이미지·영상·오디오·PDF를 받고 출력은 텍스트뿐이며, 함수 호출, 구조화된 출력, 코드 실행, 컴퓨터 사용(프리뷰)을 지원합니다. 이미지·오디오 생성과 Live API는 지원하지 않습니다.
오늘 쓸 수 있는 곳과 못 쓰는 곳: Argon은 10월 13일 정식 출시
세 모델 모두 지금 API로 프로젝트에 붙일 수 있습니다. Gemini 4 Argon은 9월 30일(미국 시간) 발표 뒤 Google의 Fairwind 프로그램 참여 조직에만 제한 공개되다가, 10월 13일 모델 ID gemini-4-argon으로 정식 출시됐습니다. 제미나이 API 유료 등급에서 호출할 수 있고 무료 등급에서는 쓸 수 없습니다. 검색어에 흔히 쓰이는 "GPT 6.1"은 OpenAI가 9월 29일에 내놓은 GPT-6.1 Sol을 가리킵니다.
| Gemini 4 Argon | Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|---|
| 발표·출시 | 2026-09-30 발표, 2026-10-13 정식 출시 | 2026-09-22 출시 | 2026-09-29 출시 |
| 개발자 API | 사용 가능 (유료 등급만) | 사용 가능 | 사용 가능 |
| 모델 ID | gemini-4-argon | claude-opus-5-5 | gpt-6.1-sol |
| 쓸 수 있는 곳 | 제미나이 API 유료 등급, AI Studio (Google AI Pro·Ultra 요금제 한도 포함), Google Cloud의 Gemini platform, Gemini for business, Google Antigravity (Google AI Ultra, 유료 Google AI Pro 또는 대상 프리미엄 기기의 Pro 체험판), 제미나이 앱과 검색 AI 모드 (Google AI Pro·Ultra) | Claude 앱(Pro·Max·Ultra·Team·Enterprise), Claude Code, Claude API, AWS·Google Cloud·Azure | OpenAI API, ChatGPT Work와 Codex(Plus·Pro·Business·Enterprise·Edu) |
| 쓸 수 없는 곳 | 제미나이 API 무료 등급, 제미나이 앱 무료·Google AI Plus | Claude Free | ChatGPT Free·Go, ChatGPT 일반 채팅 |
| 컨텍스트 / 최대 출력 | 입력·출력 합산 1,048,576 / 일반 동기 호출 65,536, long decode 최대 1,048,576 | 1M / 128K | 1,050,000 / 128,000 |
Google은 10월 13일 Gemini 4 Argon 정식 출시 발표문에서 Argon이 개발자와 기업에게 AI Studio와 Gemini platform의 API로 "오늘부터 전 세계에 제공된다"고 밝혔습니다. 같은 날 제미나이 API 모델 목록에도 gemini-4-argon이 "Gemini 4 > Stable" 항목에 올라왔습니다. Google Cloud 블로그의 Argon 출시 글은 같은 모델 ID로 Gemini platform, AI Studio, Antigravity에서 쓸 수 있고, Gemini for business에서는 웹·데스크톱·모바일로 제공된다고 적었습니다. Google 발표문은 유료 등급 API로 AI Studio와 Android Studio에서 개발할 수 있다고 안내합니다.
구독과 API는 따로 봐야 합니다. 2026년 11월 6일 기준 AI Studio의 Google AI 요금제 안내는 AI Studio 웹 화면에서 Google AI Pro에 "더 높은 한도"로, Ultra에 "가장 높은 한도"로 Argon을 쓸 수 있다고 적고 있고, 예전 가격 페이지에 있던 "Google AI Pro 요금제에서 제공되지 않는다"는 문구는 사라졌습니다. 다만 이것은 AI Studio 화면에서 쓰는 한도이고, 코드에서 API 키로 호출하는 비용은 어떤 구독에도 포함되지 않아 유료 등급 결제가 따로 필요합니다. 제미나이 앱과 검색의 AI 모드에서는 Google AI Pro·Ultra 구독자가 Argon을 쓸 수 있고, 무료 앱과 Google AI Plus에는 Argon이 없습니다. Antigravity는 출시 때 개인 사용자 중 Google AI Ultra 구독자만 대상이었지만, 2026년 10월 23일 기준 Antigravity 모델 페이지는 유료 Google AI Pro 구독, 또는 대상 프리미엄 기기에 딸려 오는 Pro 체험판에서도 Argon을 쓸 수 있다고 적고 있습니다(대상 기기 목록은 공개되지 않았고, 일반 무료 체험이 포함된다는 말은 없습니다). Antigravity 앱, Antigravity CLI, IDE 확장 프로그램에서 쓸 수 있고 Antigravity IDE에서는 제공되지 않습니다. Argon의 속도 제한(rate limit)은 가격 페이지와 모델 페이지 어디에도 공개돼 있지 않습니다.
Claude 쪽은 2026년 11월 6일 기준 Free 요금제에 Opus가 없고 Claude Code도 쓸 수 없으며, Pro($20, 연간 결제 시 월 $17), Max($100), Ultra($200), Team, Enterprise에서 Opus 5.5를 쓸 수 있습니다. Ultra는 10월 30일 기존 Max 20x가 이름을 바꾼 요금제이고, Max 5x는 Max가 됐습니다. 무료로 쓸 수 있는 경로와 조건은 Gemini 4 Argon 무료 사용 방법: 0원 경로 조건과 1회 실측 비용에, Opus 5.5를 앱·Claude Code·API에서 쓰는 조건은 Claude Opus 5.5 사용법과 무료 경로: 게스트 패스 조건과 막힌 방법에 정리돼 있습니다.
Fairwind는 Google이 보안 방어 조직을 대상으로 운영하는 프로그램입니다. 정식 출시 뒤에도 Fairwind는 사이버 가드레일이 없는 Argon 버전에만 관련이 있고, Google은 이 버전을 "수백 곳의 추가 파트너"에게 순차적으로 넓힌다고 밝혔습니다. 어떤 조직이 대상인지는 Gemini 3.8 Flash Cyber 신청 가이드: Fairwind 자격과 준비 조건에 정리돼 있는데, 이 가이드는 3.8 Flash Cyber를 기준으로 쓰인 것이어서 Argon 신청 절차로 그대로 읽을 수는 없습니다. 일반 개발에는 Fairwind가 필요 없습니다.
GPT-6.1 Sol에도 조건이 하나 있습니다. ChatGPT에서는 일반 채팅이 아니라 Work와 Codex에서만 제공되고 Free·Go 요금제는 제외되며, API에서 도구 호출을 쓰려면 Responses API여야 합니다. 이전 모델에서 옮겨 올 때 걸리는 지점은 GPT-6.1 Sol 가격과 사용법: 모델 ID만 바꾸면 안 되는 이유에서 다룹니다.
지금 쓸 모델과 11월 30일 전에 Argon으로 시험할 것
12월 1일 전에 정해야 한다면, 코딩 에이전트의 기본 모델은 Opus 5.5의 API 기본값(medium)으로 두고, 비용이 가장 중요한 대량 작업은 GPT-6.1 Sol을 기준으로 삼고, Argon은 기본값으로 통과하는 작업과 Argon이 앞선 영역에서만 시험하는 순서가 무난합니다. Opus 5.5 medium은 AA에서 48점에 과제당 $2.45로 Argon high(50점, 12월부터 $9.95)보다 훨씬 싸고, 같은 과제 실측에서도 짧은 과제 11개와 긴 로그 과제를 모두 맞혔습니다. 강도를 올릴수록 점수와 비용이 함께 올라가므로(high $3.46, xhigh $6.05, max $10.04) 단계는 작업별로 정합니다.
GPT-6.1 Sol은 AA에서 Argon high와 같은 50점이고 Opus high보다 2점 낮지만, 과제당 비용이 $0.59로 Opus high의 약 6분의 1이고 12월 1일에도 단가가 바뀌지 않습니다. 대부분의 문서·분석 작업과 단순한 코딩은 Sol에서 시작해 실패율을 재고, Sol이 실패하는 터미널·장기 코딩 작업을 Opus로 올리는 구성이 비용 면에서 유리합니다. Claude 안에서 더 싼 대안을 찾는다면 Sonnet 5.5 vs Opus 5.5 차이: 작업당 비용과 선택 기준이 기준이 됩니다. Anthropic은 11월 9일 더 비싼 플래그십 Claude Fable 5.2(입력 $8, 출력 $40)를 내놨지만 대부분의 작업은 Opus 5.5에서 시작하라고 안내하며, 두 모델의 차이는 Claude Fable 5.2 vs Opus 5.5 비교: 실측 비용 1.86배와 effort 고르는 법에 있습니다.
Argon은 금융·법률 문서 처리, 수십만 토큰 이상의 긴 컨텍스트, 영상 이해처럼 Google 표와 Vals가 모두 우위를 보여 준 영역에서 시험할 가치가 있습니다. 다만 AA 종합 지수에서는 Opus high보다 2점 낮고 Sol과 같으며, high의 과제당 비용은 도입가로 계산해도 Opus high의 1.44배, 12월 1일부터 2.88배입니다. 11월 30일까지의 초기 가격 기간은 같은 예산으로 더 많은 과제를 돌려 볼 수 있는 기간이지, 그 가격을 전제로 전환할 기간이 아닙니다.
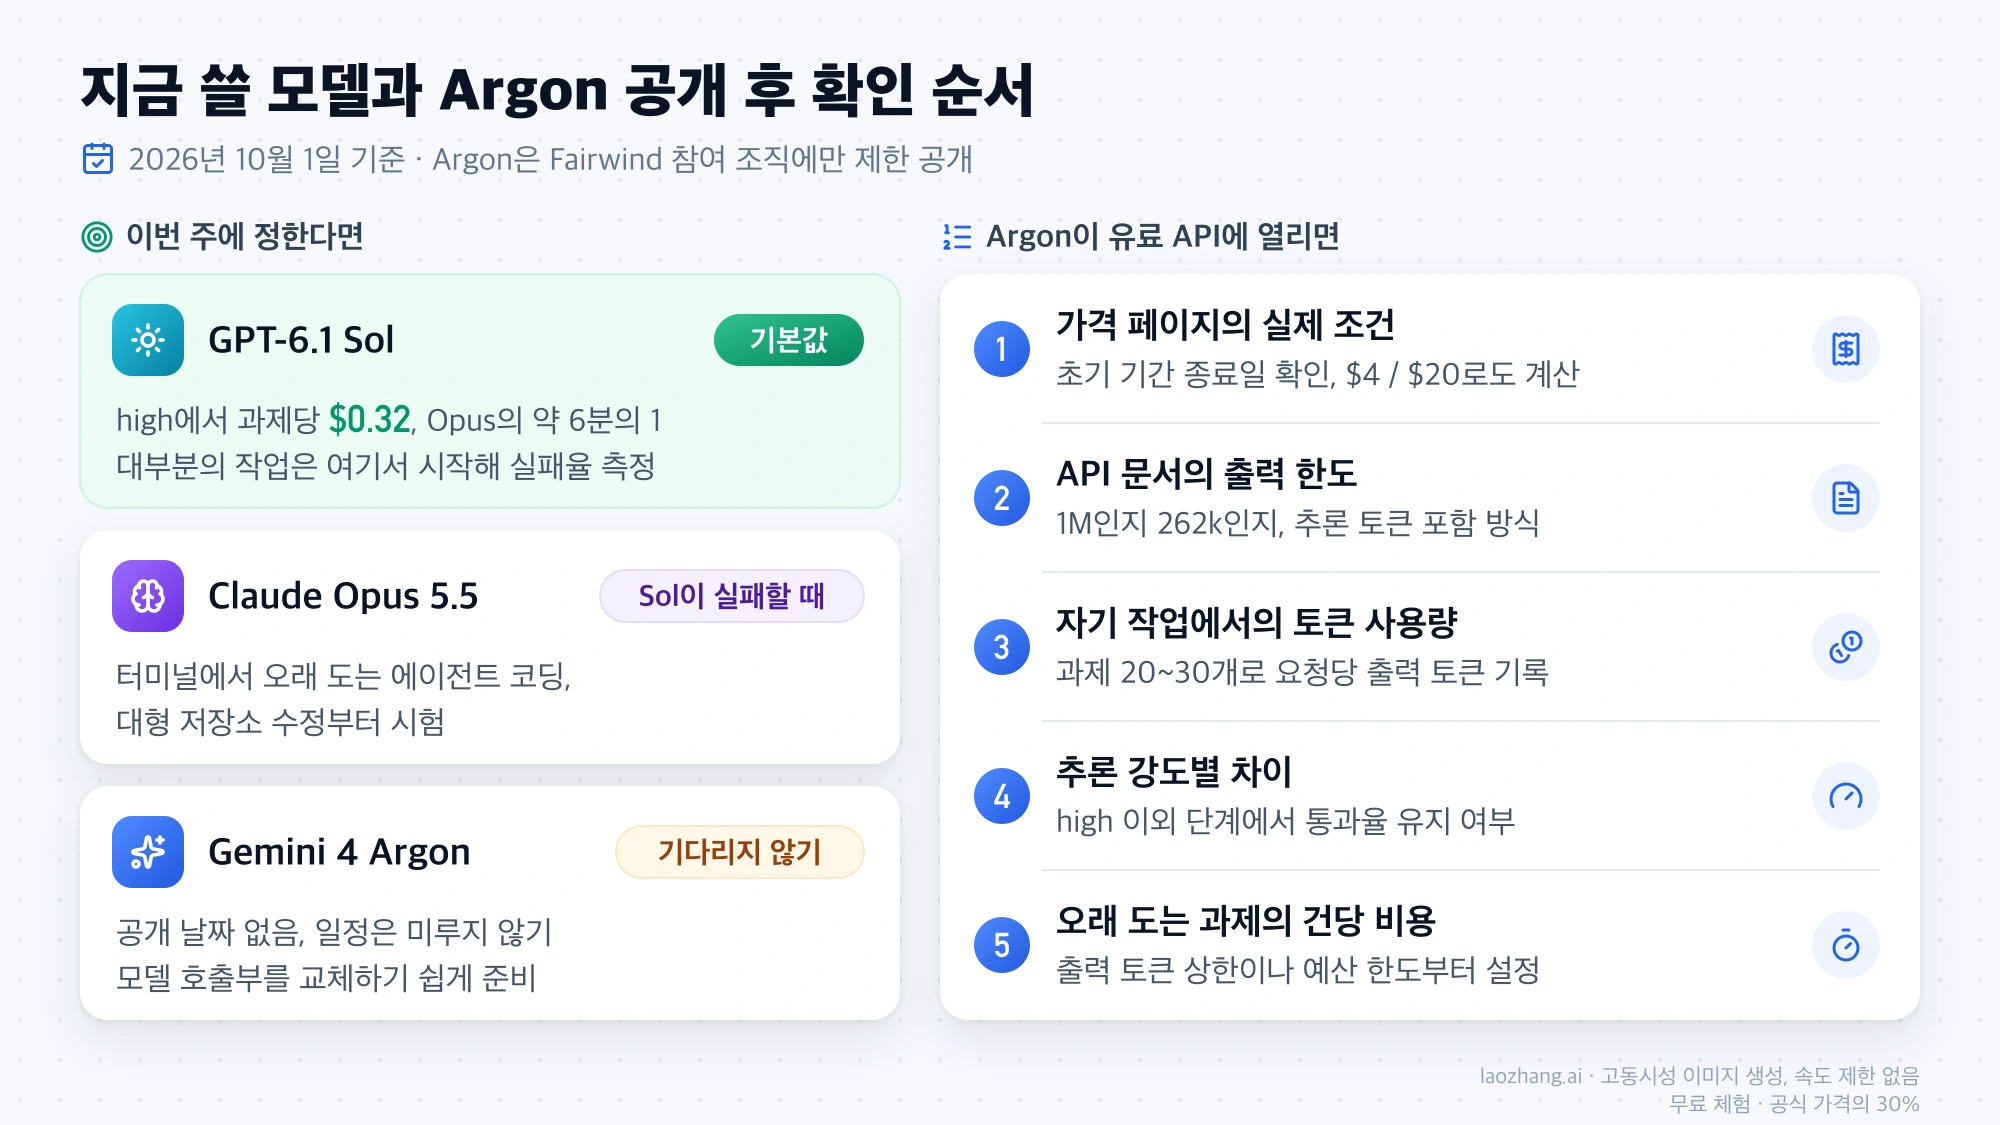
위 그림은 Argon 정식 출시 전인 2026년 10월 1일 시점 기준으로 그린 것이며, 그림 속 과제당 비용도 이전 지수 값입니다. 현재 수치와 선택 기준은 본문 표와 이 절의 내용을 참고하세요.
Argon으로 전환을 결정하기 전에, 11월 30일 전까지 다음 순서로 확인합니다.
- 12월 1일 이후 단가로 예산 계산. 시험은 $2 / $10로 돌리더라도 예산표는 $4 / $20로도 만들어 둡니다. 캐시는 암시적 캐시뿐이라 캐시 적중 비율을 직접 정할 수 없으므로, 시험 기간에 청구된 캐시 입력 비율을 함께 기록합니다. 한국어 프롬프트라면 Opus와 입력 토큰 수가 2배 넘게 다르므로 단가가 아니라 실제 토큰 수로 비교합니다. 비동기로 돌려도 되는 작업은 Batch나 Flex(절반 가격)로 계산합니다.
- 출력 한도와 호출 방식. 일반 호출의 출력 상한 65,536 토큰 안에서 작업이 끝나는지, 긴 입력을 넣었을 때 입력·출력 합산 한도 1,048,576에 걸리지 않는지 봅니다. high로 오래 생각하는 작업은 비스트리밍 상한 32,768 토큰에 걸리지 않도록 스트리밍으로 부릅니다.
- 자기 작업에서의 토큰 사용량. 지금 쓰는 모델에서 실패하거나 비싼 과제 20~30개를 골라 같은 입력으로 돌리고, 통과율과 함께 요청당 출력 토큰 수를 기록합니다. Argon의 비용은 단가가 아니라 이 숫자가 결정합니다.
- 기본값으로 통과하는지. 같은 과제 실측에서 Argon 기본값의 비용은 high의 약 4분의 1이었지만, 긴 로그 집계에서는 기본값이 두 번 모두 틀렸습니다. 기본값으로 통과하는 작업과 high가 필요한 작업을 나눠 각각 12월 단가로 계산합니다.
- 오래 도는 과제의 건당 비용과 한도. Vals에서 테스트당 $193.78까지 올라간 유형이 있었으므로, 에이전트 작업에는 요청별 출력 토큰 상한이나 예산 한도를 걸고 시작합니다. 속도 제한이 공개돼 있지 않으니 부하가 큰 작업을 옮기기 전에 자기 프로젝트에 걸리는 한도부터 확인합니다.
Sol 계열 안에서 어느 모델로 갈지는 GPT-6.1 Sol·Astra·GPT-6 Sol 비교와 전환 기준에서, 최상위 모델이 필요 없는 작업의 더 싼 선택지는 AI API 가격 비교: 5개사 등급별 요금과 가장 싼 모델에서 이어 볼 수 있습니다.
Gemini 4 Argon 자주 묻는 질문
Gemini 4 Argon은 언제부터 쓸 수 있나요?
2026년 10월 13일부터 쓸 수 있습니다. 개발자는 모델 ID gemini-4-argon으로 제미나이 API 유료 등급에서 호출할 수 있고, 기업은 Gemini for business와 Google Cloud의 Gemini platform에서 쓸 수 있습니다. 2026년 11월 기준 Google AI Pro·Ultra 구독자는 제미나이 앱, 검색의 AI 모드, AI Studio 웹 화면, Antigravity(IDE 제외)에서도 쓸 수 있지만, API 키로 호출하는 비용은 구독에 포함되지 않습니다. 제미나이 API 무료 등급과 Google AI Plus에서는 제공되지 않습니다. 9월 30일 발표부터 10월 12일까지는 Fairwind 프로그램 참여 조직에만 제한 공개됐습니다.
Gemini 4 Argon 도입가 $2는 GPT-6.1 Sol 가격과 같은가요?
11월 30일까지의 토큰 단가는 같지만 작업당 비용은 같지 않습니다. Argon의 출시 초기 가격(도입가)은 1M 토큰당 입력 $2, 출력 $10로, 입력 272K 이하인 GPT-6.1 Sol 요청과 같습니다. 그러나 Artificial Analysis가 두 모델을 high로 돌린 과제당 비용은 도입가로 환산해 Argon 약 $4.98, Sol $0.59로 약 8.4배 차이이고(2026년 11월 11일 기준 v5.0.1, 점수는 둘 다 50점), 12월 1일 Argon 단가가 $4 / $20로 오르면 약 16.9배가 됩니다. 차이는 Argon이 쓰는 토큰 수에서 나옵니다.
Gemini 4 Argon은 Opus 5.5의 절반 가격이 맞나요?
2026년 11월 30일까지의 토큰 단가로만 맞습니다. Argon은 입력 $2, 출력 $10이고 Claude Opus 5.5는 입력 $4, 출력 $20이며, 12월 1일부터는 같은 단가가 됩니다. 과제당 비용으로는 반값이 아닙니다. AA의 high 단계 기준으로 Argon이 지금도 Opus의 1.44배, 12월부터 2.88배이고, LaoZhang 게이트웨이로 같은 8개 과제를 돌린 실측(Argon 11월 4일, Opus 11월 11일)에서는 기본값끼리만 Argon이 쌌습니다.
Gemini 4 Argon이 Claude Opus 5.5보다 성능이 좋은가요?
작업 유형에 따라 다릅니다. Google이 발표한 벤치마크 표에서는 두 모델의 점수가 함께 있는 18개 항목 중 Argon이 14개에서 앞서고, 금융·법률 같은 지식 업무와 긴 컨텍스트에서 차이가 큽니다. Opus 5.5는 Terminal-bench 4.0과 FrontierSWE v2처럼 터미널에서 오래 도는 코딩 작업에서 앞섭니다. 독립 측정으로는 Artificial Analysis 종합 지수(v5.0.1, 2026년 11월 11일 기준)가 같은 high 단계에서 Argon 50점, Opus 5.5 52점이고, Vals Index는 10월 30일 기준 v2.2에서 Opus 70.18%, Argon 69.24%로, 종합 점수로는 두 모델이 약 2점 안에 붙어 있습니다.
지금 Gemini 4 Argon으로 전환을 준비해야 하나요?
2026년 10월 13일부터 유료 API로 호출할 수 있으므로, 이제는 준비가 아니라 시험 단계입니다. 금융·법률 문서 처리, 수십만 토큰 이상의 긴 컨텍스트, 영상 이해가 핵심인 제품이라면 11월 30일까지 자기 과제 20~30개로 통과율과 요청당 출력 토큰 수를 재고, 12월 1일 이후 단가($4 / $20)로 계산한 비용이 지금 모델보다 나은지로 정합니다. 코딩 에이전트처럼 high가 필요한 작업은 12월부터 Argon이 Opus 5.5보다 싸지기 어렵습니다.
참고 자료11
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 11일.
참고 자료11
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 11일.
- 1.제미나이 API 가격 페이지aistudio.google.com/docs/pricing
- 2.Artificial Analysis의 Gemini 4 Argon 페이지artificialanalysis.ai/models/gemini-4-argon
- 3.AA의 Gemini 4 Argon vs Claude Opus 5.5 비교 페이지artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-opus-5-5
- 4.9월 30일 Gemini 4 Argon 발표문blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 5.Vals AI의 Gemini 4 Argon 페이지vals.ai/models/google_gemini-4-argon
- 6.현재 리더보드vals.ai/benchmarks/vals_index
- 7.제미나이 API의 Gemini 4 Argon 모델 페이지ai.google.dev/gemini-api/docs/models/gemini-4-argon
- 8.Gemini 4 Argon 정식 출시 발표문blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon
- 9.제미나이 API 모델 목록ai.google.dev/gemini-api/docs/models
- 10.Google Cloud 블로그의 Argon 출시 글cloud.google.com/blog/products/ai-machine-learning/gemini-4-argon-available-on-google-cloud
- 11.Antigravity 모델 페이지antigravity.google/docs/models