Gemini 4 Carbon vs Argon 차이: 9점 높고 첫 토큰은 2배 느리다
Gemini 4 Carbon은 AA 지수에서 Argon보다 9점 높지만 2026년 10월 30일 기준 일반 공개 전입니다. 지금은 Argon을 쓰고 12월 1일 단가 2배 인상을 예산에 넣으세요.
목차
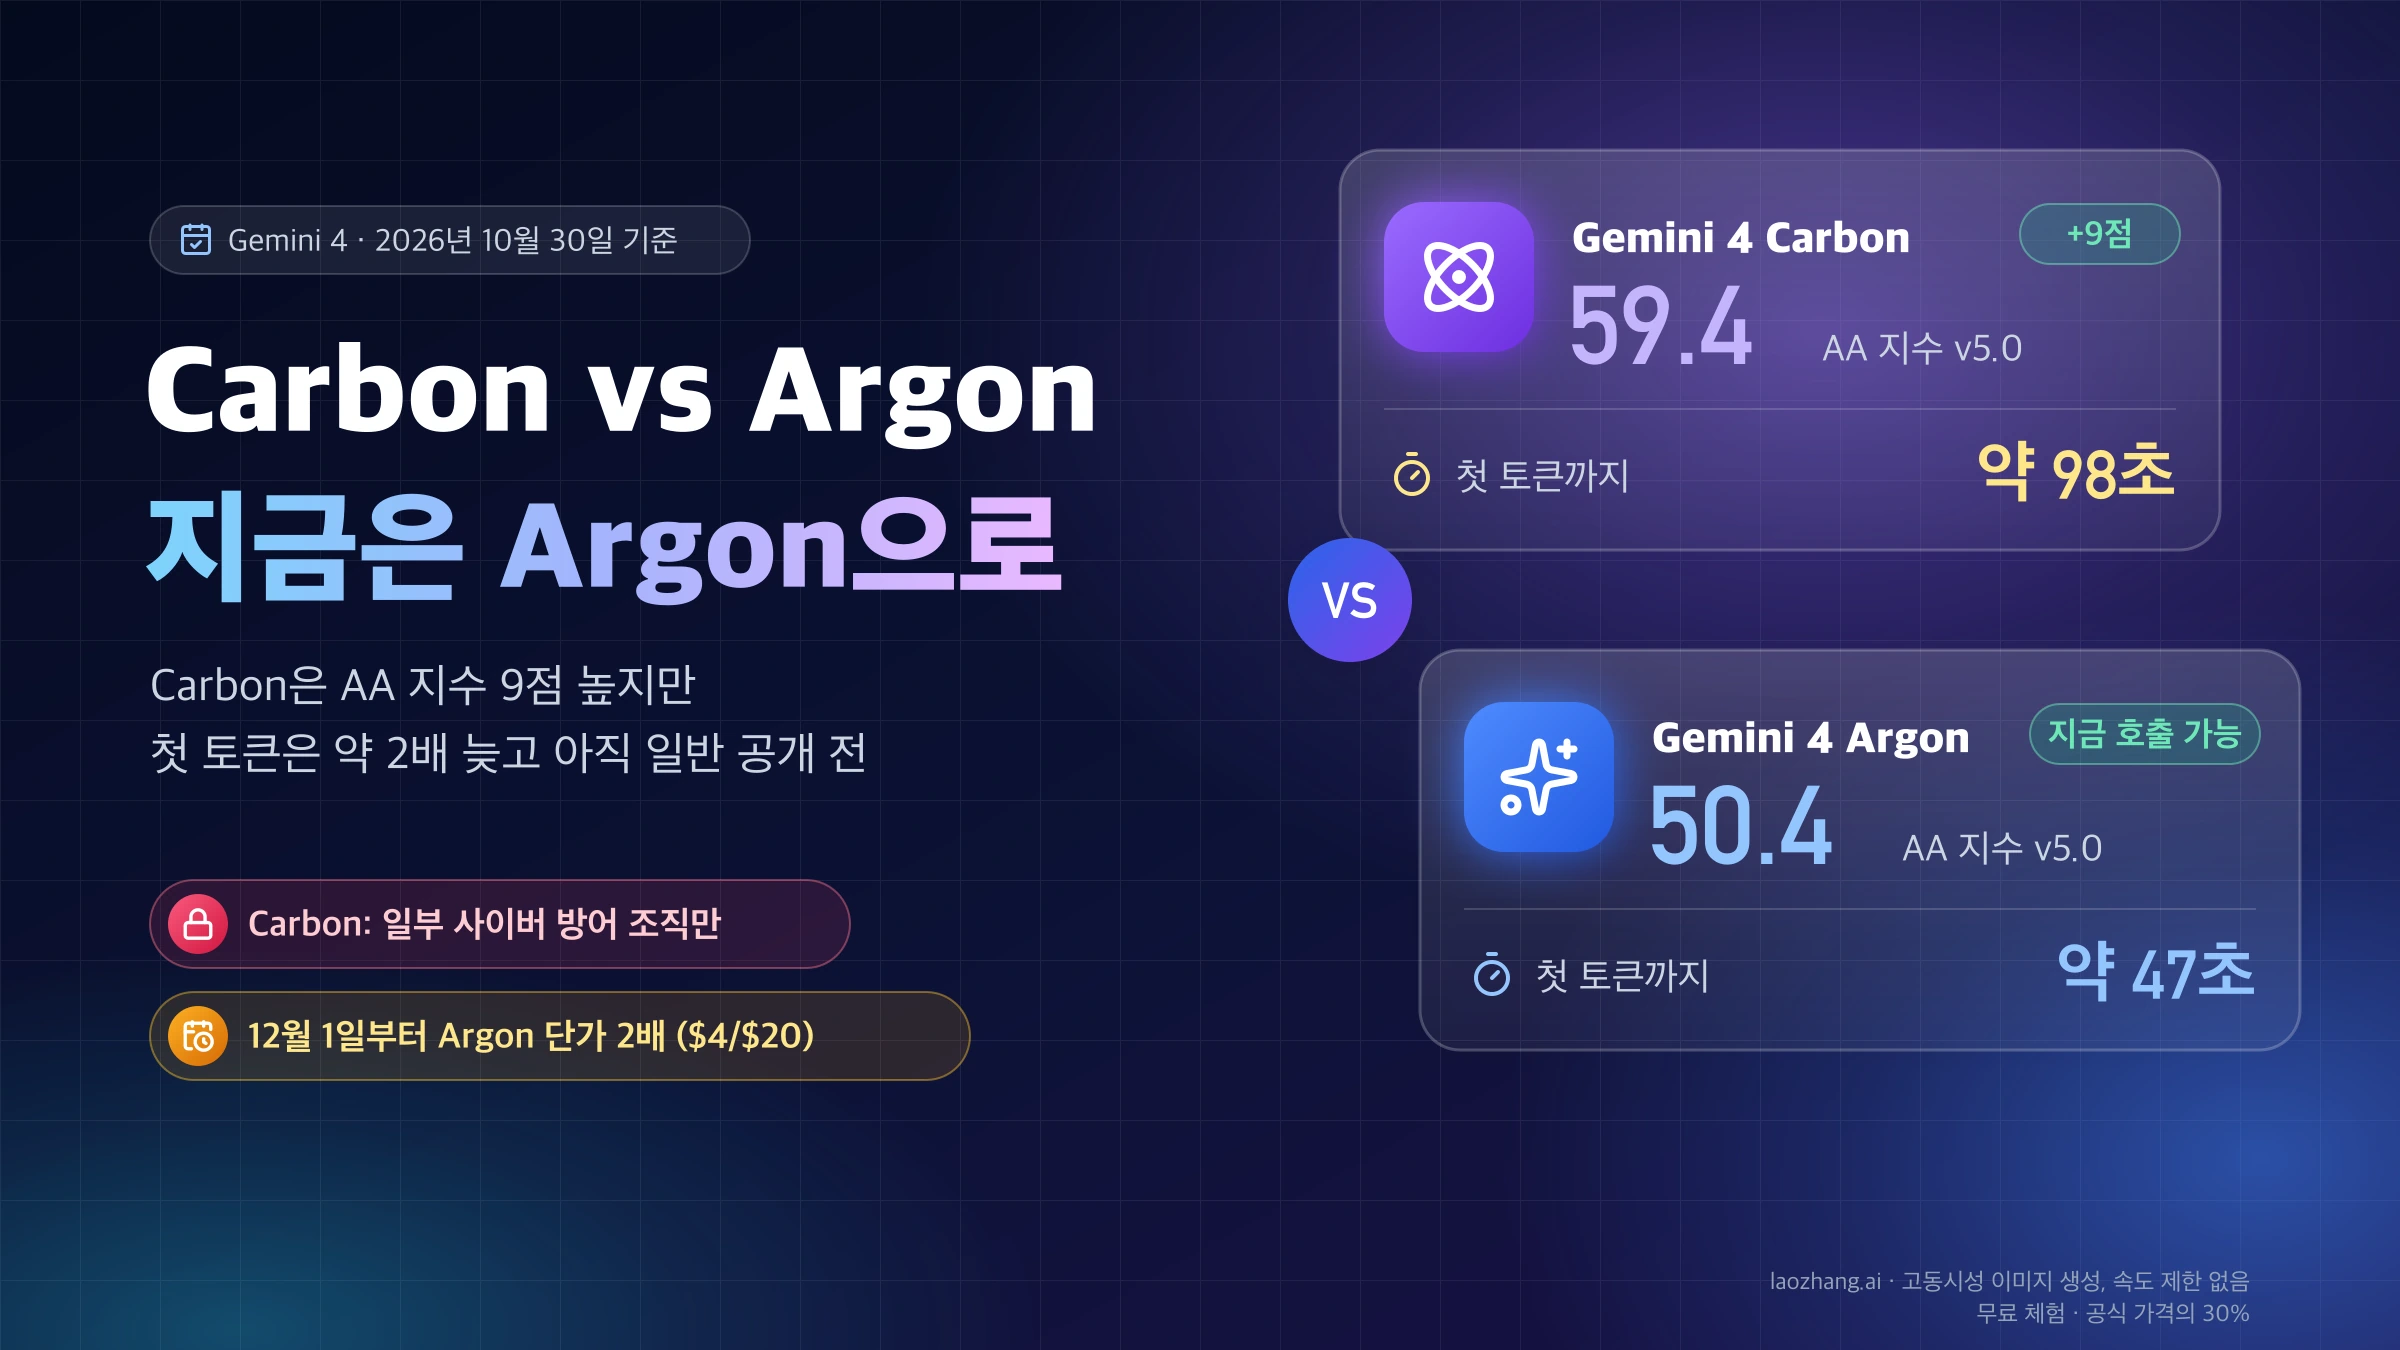
Google이 2026년 10월 28일 발표한 Gemini 4 Carbon은 독립 평가 기관 Artificial Analysis(AA)의 지능 지수 v5.0에서 59.4점으로, 2주 전 나온 Gemini 4 Argon(50.4점)보다 9점 높습니다(두 모델 모두 추론 설정 high). 앞서는 폭은 작업마다 다릅니다. 오픈소스 저장소에서 코딩 에이전트로 일하는 평가 FrontierCode 2.0에서는 40.6% 대 25.7%로 크게 벌어지지만, SaaS 업무 자동화를 재는 AutomationBench-AA에서는 77.8% 대 77.5%로 사실상 같습니다. 반대로 첫 토큰이 나오기까지는 Carbon이 약 98초, Argon이 약 47초로 두 배가 걸렸습니다(Artificial Analysis의 Gemini 4 Argon·Carbon 비교 페이지, 2026년 10월 30일 측정).
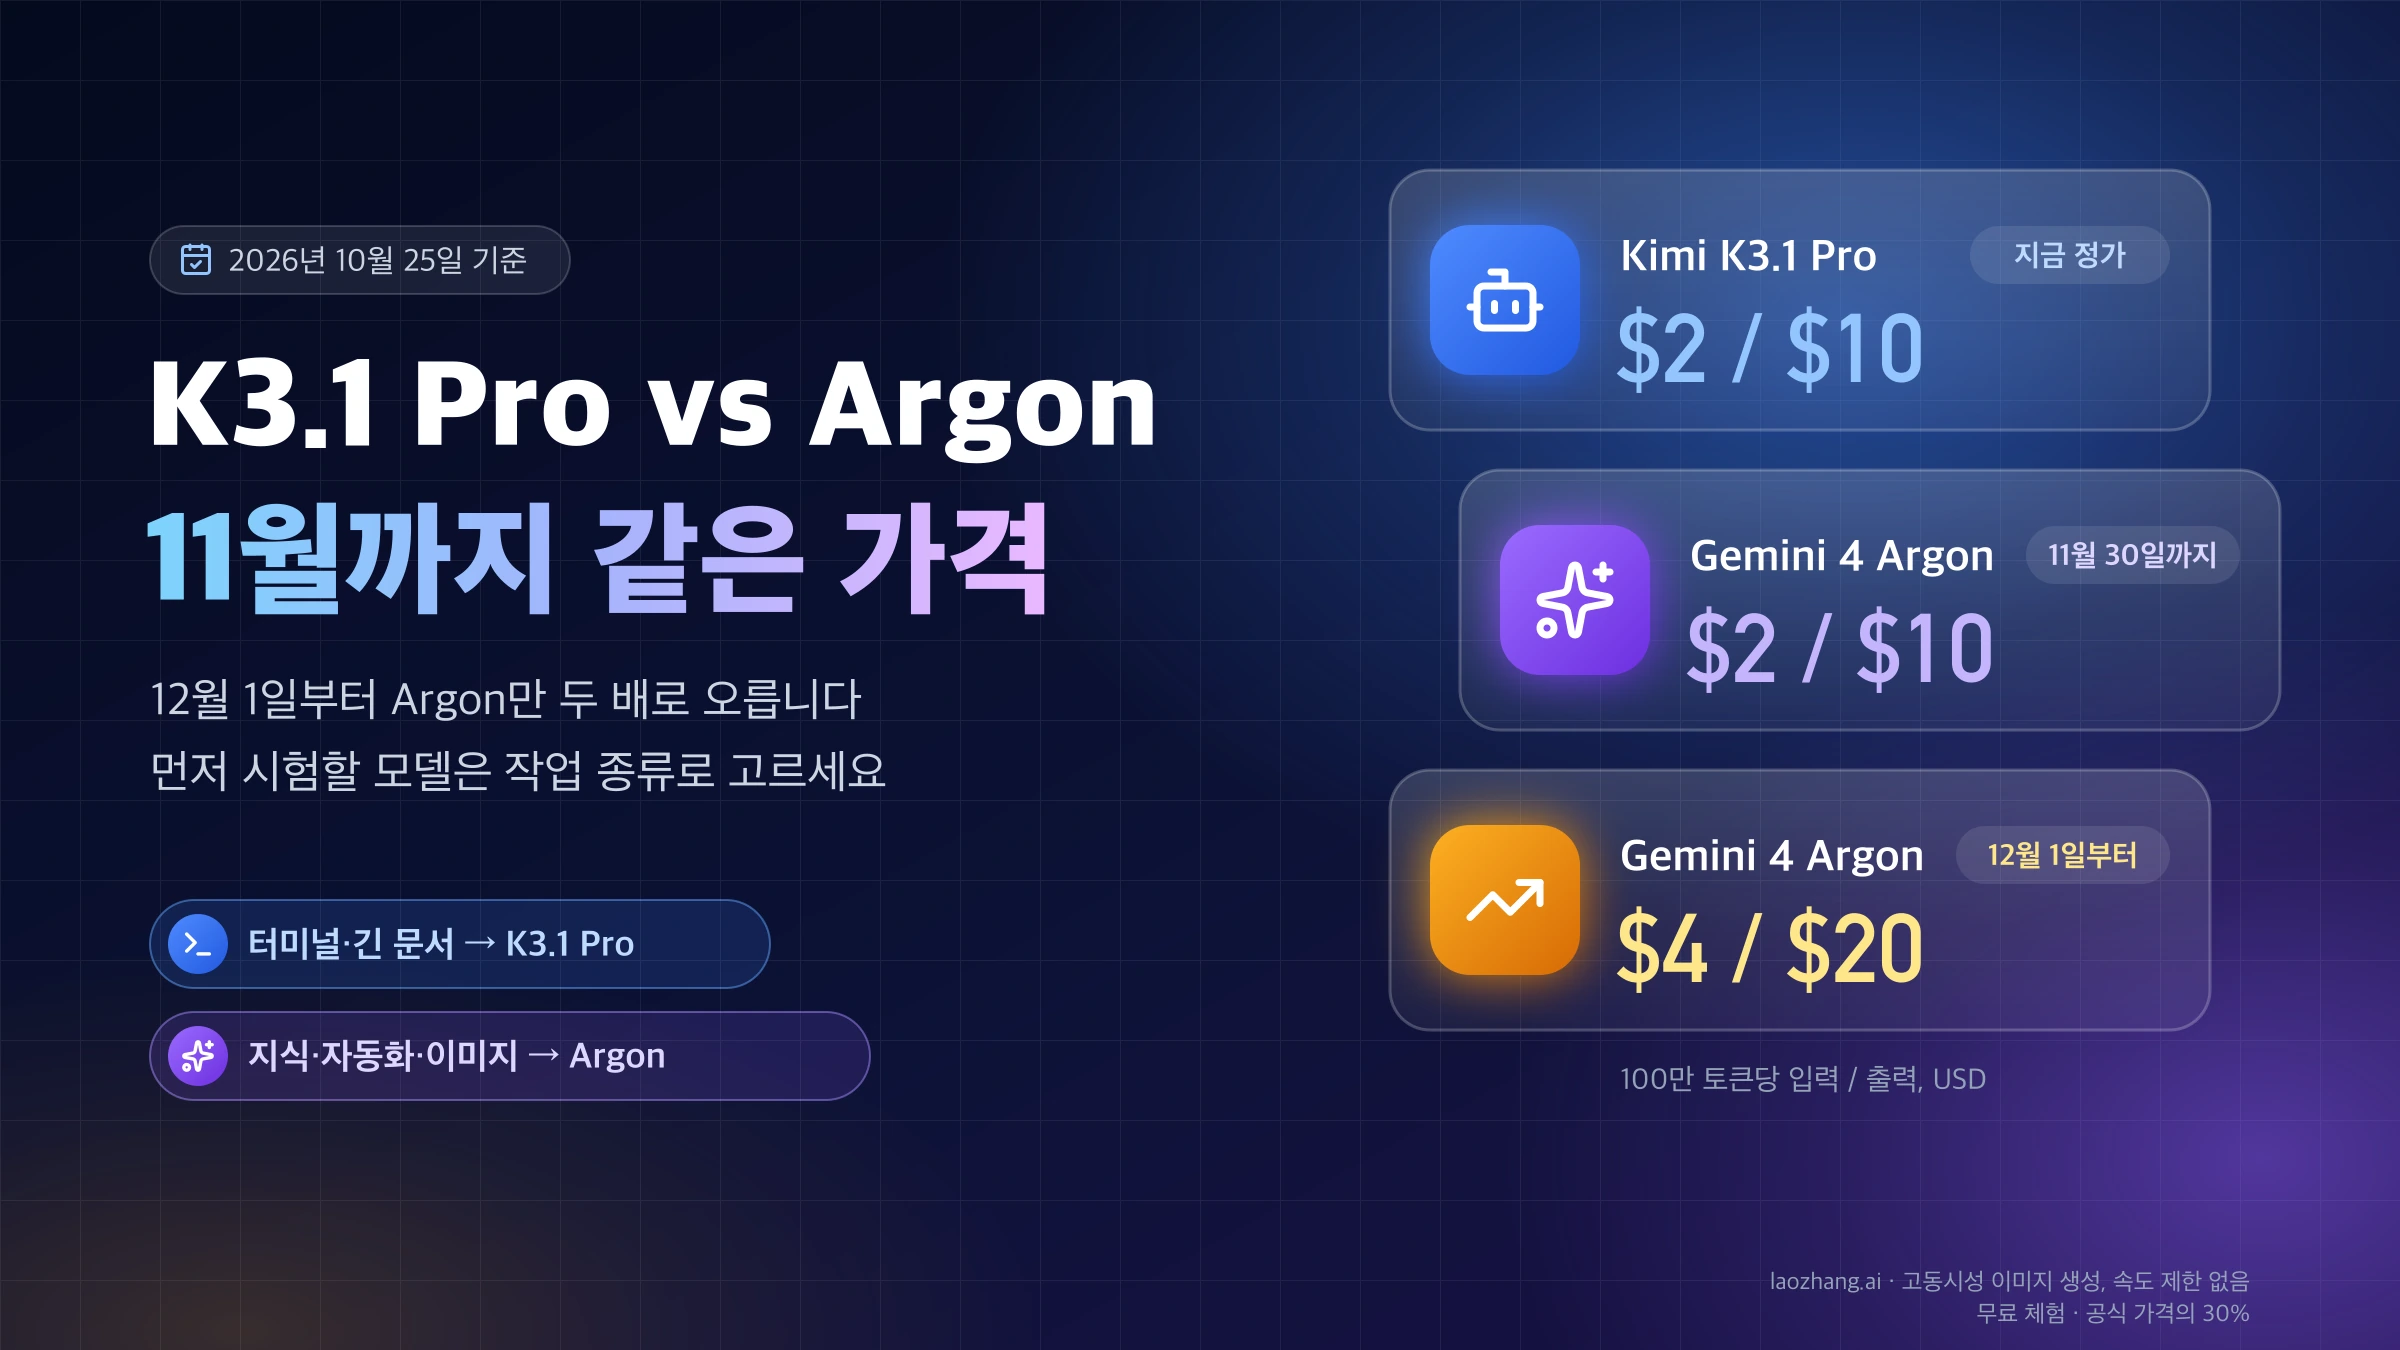
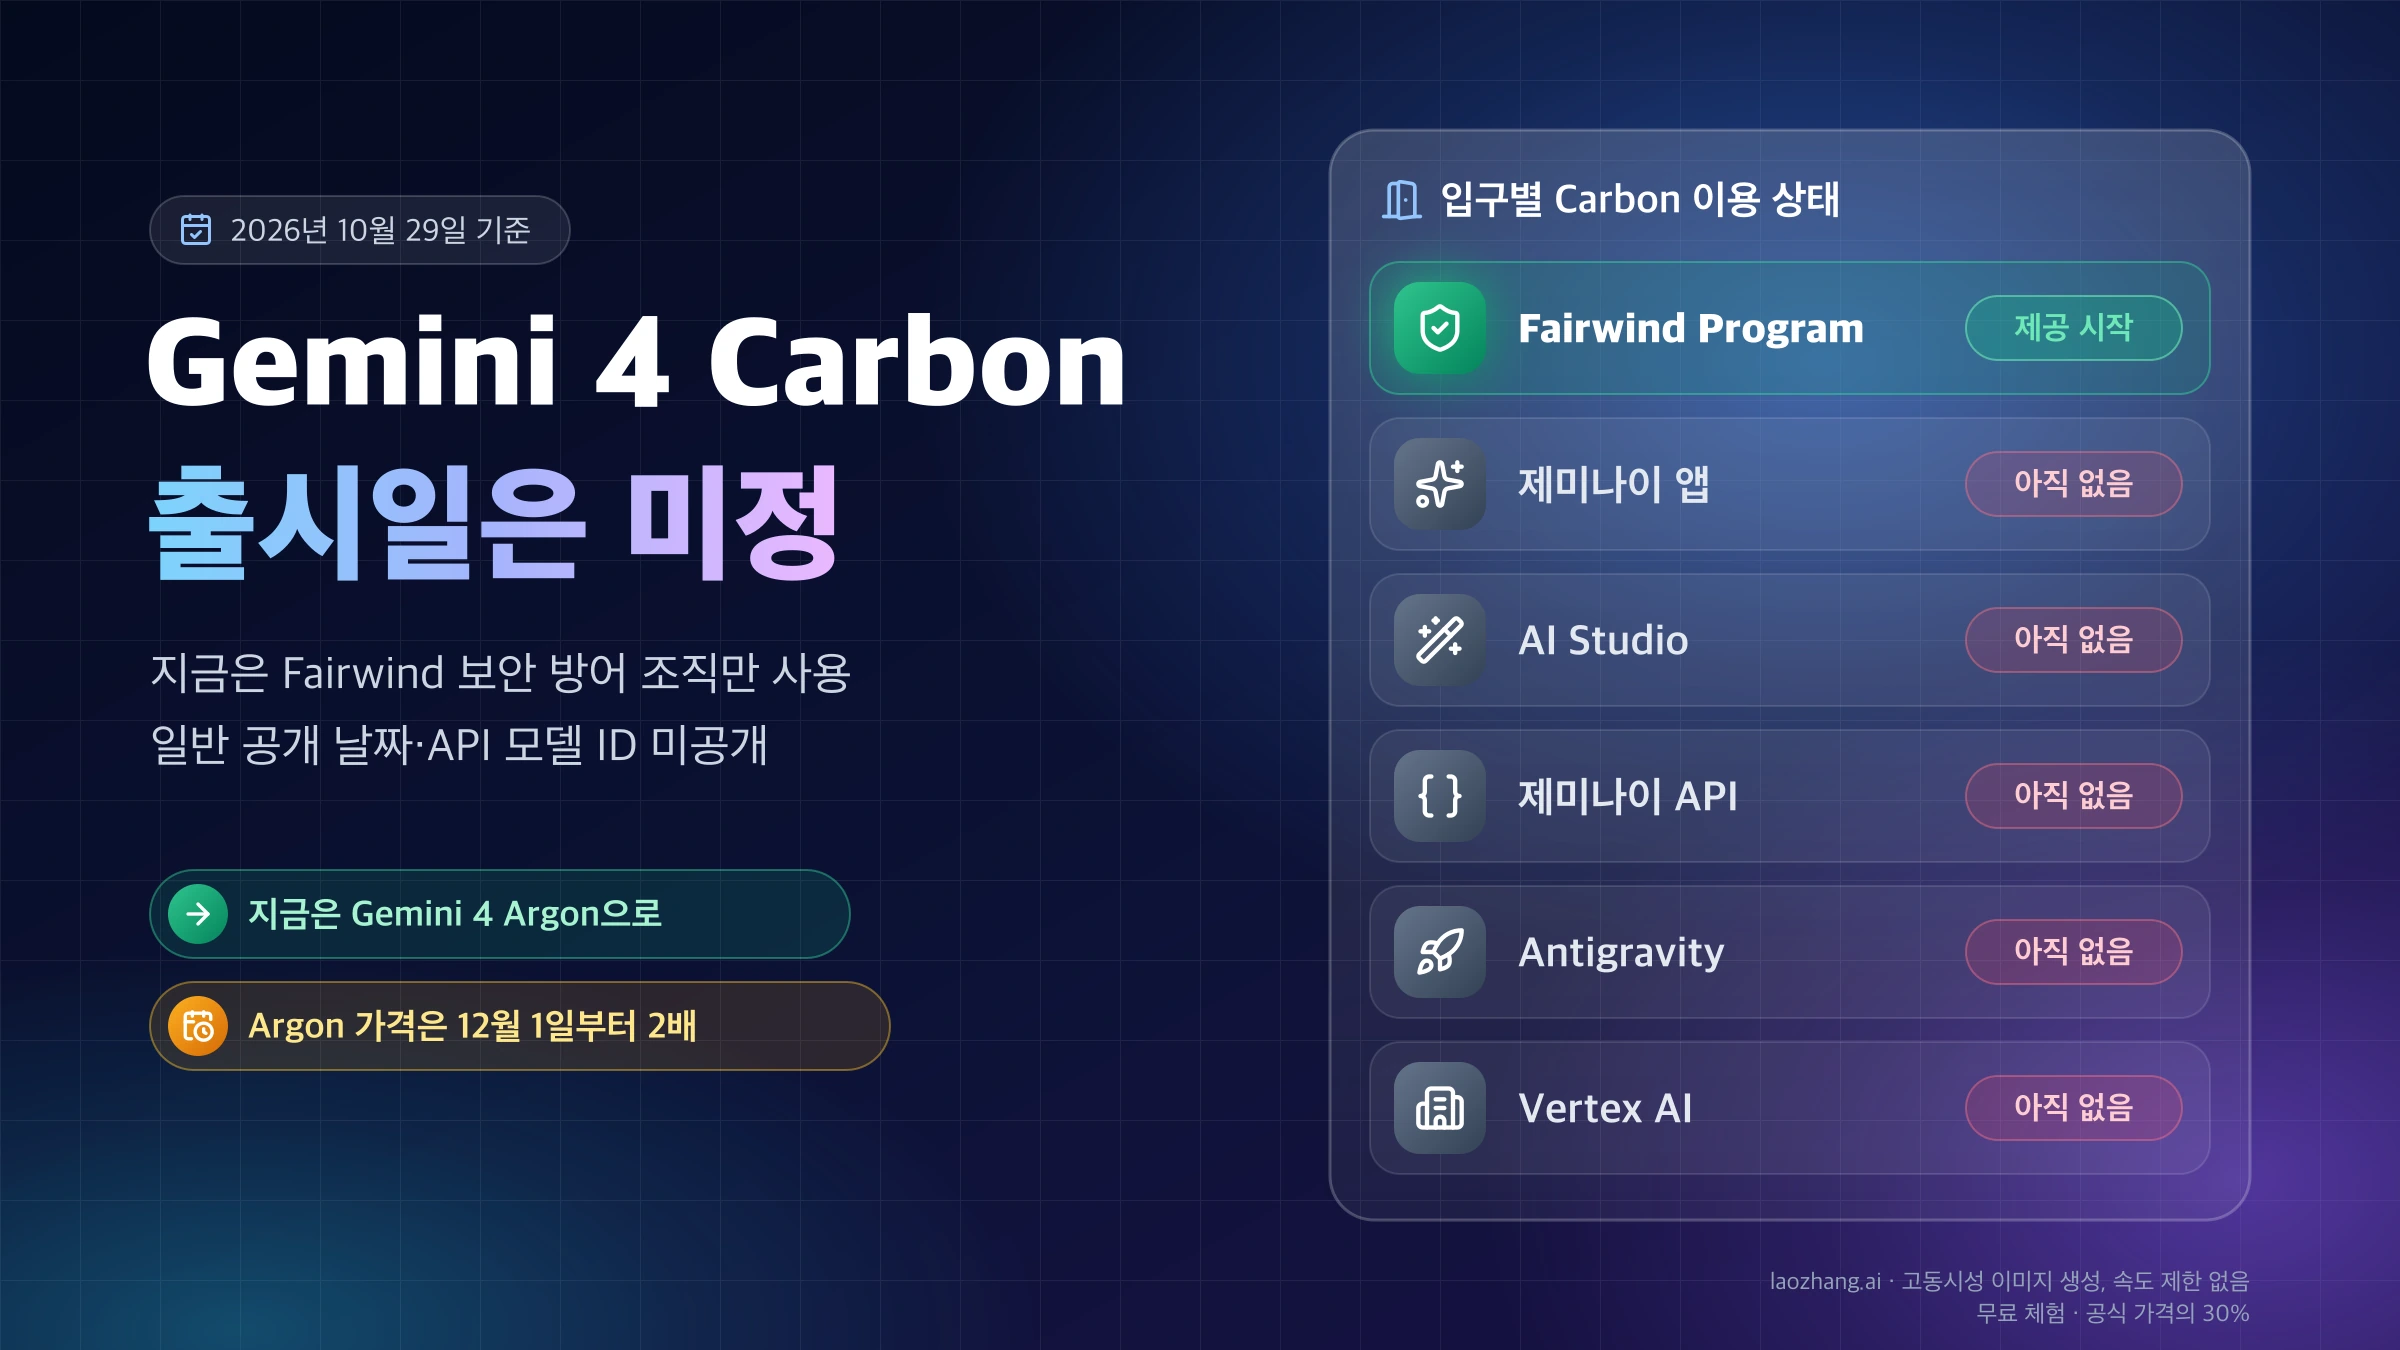
하지만 2026년 10월 30일 기준 Carbon은 일부 사이버 방어 조직에만 제공되고 있어 일반 개발자와 기업은 호출할 수 없습니다. 누가 언제 쓸 수 있는지는 Gemini 4 Carbon 출시일: 지금은 보안 조직만, 일반 공개 날짜 미정에서 다룹니다. 그러니 오늘은 gemini-4-argon으로 계속 출시하고, 모델 이름을 설정값 한 곳에 모아 두고, 11월 30일에 끝나는 Argon 도입가(100만 토큰당 입력 $2·출력 $10)가 12월 1일부터 입력 $4·출력 $20으로 오르는 것을 예산에 반영하세요. 토큰 단가는 두 모델이 같지만, 12월 1일 이후에도 Carbon이 도입가 기간이라면 같은 작업 비용이 Carbon 쪽에서 절반 수준으로 내려갈 수 있습니다.
Carbon이 열리는 날 바로 비교해 볼 가치가 큰 쪽은 코딩 에이전트와 과학·추론 작업입니다. SaaS 자동화가 중심이거나 사용자가 첫 응답을 기다리는 대화형 기능이라면 Argon을 유지하고 Carbon은 측정만 해도 충분합니다. 사실 확인형 Q&A는 AA 측정에서 Carbon의 환각률이 4.3%에서 11.4%로 올랐기 때문에, 바꾸기 전에 자체 질문 세트로 먼저 시험해야 합니다.
Carbon이 앞서는 작업: 코딩·과학은 크게, 자동화는 동점
AA 지능 지수 v5.0을 이루는 9개 평가 가운데 Carbon은 8개에서 Argon보다 앞서고, AutomationBench-AA 하나에서만 동점입니다. 가장 크게 오른 것은 에이전트형 코딩(FrontierCode 2.0, 14.9포인트)과 과학·학술 추론(HLE-Diamond 12.4포인트, Terminal-Bench-Science 11.9포인트)이고, 문서 중심 지식 업무는 그보다 작게 올랐습니다. AA는 Carbon을 공개 API가 아닌 사전 제공 접근으로 측정했고 두 모델 모두 high 설정 결과만 있으며, 아래 숫자는 Artificial Analysis의 Gemini 4 Carbon 평가 기사와 비교 페이지의 2026년 10월 30일 값입니다.
| 작업 종류 | AA 평가 (무엇을 재나) | Carbon | Argon | 차이 |
|---|---|---|---|---|
| 코딩 에이전트 | FrontierCode 2.0 (오픈소스 저장소에서의 에이전트형 소프트웨어 개발) | 40.6% | 25.7% | +14.9 |
| 코딩 에이전트 | Terminal-Bench 4.0 (터미널에서 수행하는 에이전트 작업) | 65.2% | 57.1% | +8.1 |
| 과학·추론 | HLE-Diamond (최고 난도 학술 문제) | 69.1% | 56.7% | +12.4 |
| 과학·추론 | Terminal-Bench-Science (터미널 기반 과학 연구 작업) | 64.8% | 52.9% | +11.9 |
| 과학·추론 | CritPt v2 Hard (연구 수준 물리 문제) | 63.0% | 52.5% | +10.5 |
| 지식·문서 업무 | AA-Briefcase (에이전트형 지식 업무, Elo 점수) | 1609.5 | 1483.3 | +126.2 |
| 지식·문서 업무 | AA-Omniscience v1.1 (맞히면 가점, 틀리면 감점하는 지식 평가) | 53.5 | 46.1 | +7.4 |
| 지식·문서 업무 | GDP.pdf (전문 문서 작성, 모든 기준 통과율) | 28.4% | 21.8% | +6.6 |
| SaaS 자동화 | AutomationBench-AA (여러 SaaS를 오가는 업무 흐름 처리) | 77.8% | 77.5% | +0.3 |
AA가 분야별로 묶은 역량 지수도 같은 방향입니다. 금융·회계 62.6 대 55.9, 법률 62.0 대 54.6, 엔지니어링 64.7 대 57.3, 경제 61.0 대 54.0으로 7점 안팎 앞서지만, 전략·운영은 60.9 대 57.2로 3.7점 차이에 그칩니다. 의료 분야는 Carbon 점수가 아직 발표되지 않았습니다.
같은 Terminal-Bench 4.0이라도 출처에 따라 숫자가 조금 다릅니다. Google 발표표와 AA의 모델 측정은 65.2% 대 57.1%이고, AA가 Antigravity CLI라는 코딩 에이전트 도구 안에서 잰 코딩 에이전트 지수의 구성 항목으로는 63.6% 대 56.1%입니다. 또 AA 지수 v5.0 점수는 그 이전 버전(v4.3.2) 기준으로 인용된 Argon 점수와 직접 비교할 수 없습니다.
내 작업에는 Carbon인가 Argon인가: 작업별 판단 기준
코딩 에이전트와 과학·연구 작업이라면 Carbon 전환을 지금부터 준비할 가치가 있습니다. 위 표에서 가장 크게 오른 영역이고, AA 코딩 에이전트 지수(Antigravity CLI 기준)에서도 Carbon 59.4점 대 Argon 53.2점으로 앞서면서 작업당 비용은 오히려 Carbon이 낮게 측정됐습니다. Google도 Carbon을 큰 코드베이스에서 버그의 근본 원인을 찾아 고치는 것 같은 장시간 엔지니어링 작업용으로 소개합니다.
문서 중심 지식 업무(보고서, 금융·법률 문서 작성, 리서치 정리)는 비교해 볼 만하지만 서두를 이유는 약합니다. AA-Briefcase에서 126 Elo, GDP.pdf에서 6.6포인트 올랐어도 GDP.pdf의 전체 기준 통과율은 Carbon도 28.4%에 그쳐 사람의 검토가 여전히 필요하고, 전략·운영 업무는 역량 지수 차이가 3.7점으로 가장 작기 때문입니다.
SaaS 자동화(CRM 갱신, 티켓 분류처럼 여러 SaaS를 오가는 업무 흐름)는 Argon을 유지하세요. AutomationBench-AA 차이가 0.3포인트라 바꿔서 얻는 것은 거의 없고 첫 토큰 대기만 길어집니다. 사용자가 화면 앞에서 답을 기다리는 대화형 기능도 같은 판단입니다. 다만 AA는 두 모델 모두 high 설정만 측정했으므로, 낮은 추론 설정에서 대기 시간 차이가 얼마나 될지는 Carbon이 공개된 뒤 직접 재 봐야 합니다.
사실 확인형 Q&A(고객 지원 답변 봇, 사내 지식 검색 답변)는 정답률이 오른 대신 모를 때도 답하는 경향이 커졌으므로, 아래 환각 절의 방식으로 시험한 뒤 결정하세요. 지금 Argon 자체가 필요 이상인 작업인지는 Gemini 4 Argon vs 3.8 Flash 차이: 같은 프롬프트 실측 비용과 갈아탈 작업에서, 오늘 바로 쓸 수 있는 다른 회사 플래그십과의 비교는 Gemini 4 Argon·Opus 5.5·GPT-6.1 Sol 비교에서 확인할 수 있습니다.
Carbon이 더 비싼가: 단가는 같고 12월 1일부터 갈린다
토큰 단가만 보면 두 모델은 같습니다. Google 공식 블로그의 Gemini 4 Carbon 발표문에 따르면 Carbon은 Argon과 같은 도입가(캐시 입력은 입력 단가의 95% 할인인 $0.10)로 시작하고, 도입 기간이 끝나면 표준가(캐시 입력 $0.20)가 적용됩니다. 다른 것은 기간입니다. Argon의 도입가는 제미나이 API 요금 문서 기준 2026년 11월 30일까지인데, Carbon의 도입가가 언제 끝나는지는 공개되지 않았습니다. 그래서 "요금이 같다"는 말은 같은 기간, 같은 토큰 수일 때만 맞고, 실제 작업당 비용은 두 모델이 쓰는 토큰 수와 캐시 적중률에 따라 달라집니다.
아래 표는 AA가 측정한 두 종류의 작업, 즉 지능 지수 평가 작업 1건과 Antigravity CLI 코딩 에이전트 작업 1건의 비용을 요금 기간별로 다시 계산한 것입니다(2026년 10월 30일 계산, high 설정).
| 요금 기간 | 지수 작업: Argon | 지수 작업: Carbon | 코딩 에이전트: Argon | 코딩 에이전트: Carbon |
|---|---|---|---|---|
| 지금부터 2026년 11월 30일까지 | $3.84 | 호출 불가 | $5.87 | 호출 불가 |
| 두 모델 모두 도입가일 때 | $3.84 | $3.88 | $5.87 | $3.87 |
| 두 모델 모두 표준가일 때 | $7.68 | $7.76 | $11.73 | $7.74 |
| 만약 12월 1일 이후 Carbon이 도입가로 열린다면 | $7.68 | $3.88 | $11.73 | $3.87 |
지수 작업에서 Carbon은 출력 토큰을 약 5.5% 더 써서(122,768 대 116,368) 같은 단가라면 1% 정도 비쌉니다. 점수 1점당 비용으로 보면 표준가 기준 $0.131 대 $0.152로 Carbon이 낮습니다. 코딩 에이전트 작업은 반대로 표준가끼리도 Carbon이 34% 쌉니다. AA 측정에서 Carbon의 캐시 적중률이 95.2%로 Argon(87.0%)보다 높고 작업당 입력 토큰이 1,244만 대 1,376만으로 적었기 때문으로 보이며, 토큰이 싸서가 아니라 덜 쓰고 더 많이 재사용한 결과라는 해석입니다.
결론이 뒤집히는 시점은 12월 1일입니다. Argon은 표준가로 넘어가는데 Carbon이 그 뒤에 도입가로 열린다면 같은 지수 작업이 Carbon에서 절반, 코딩 에이전트 작업은 약 3분의 1 비용이 됩니다. Carbon 도입가 종료일이 발표되지 않은 상태의 가정이므로 예산은 Argon 표준가로 잡고, Carbon이 열리는 날 요금 문서에서 종료일을 확인하세요. Argon은 Batch·Flex 처리가 표준 처리의 절반 가격이지만, Carbon의 Batch·Flex·Priority 요금은 아직 공개되지 않았습니다.
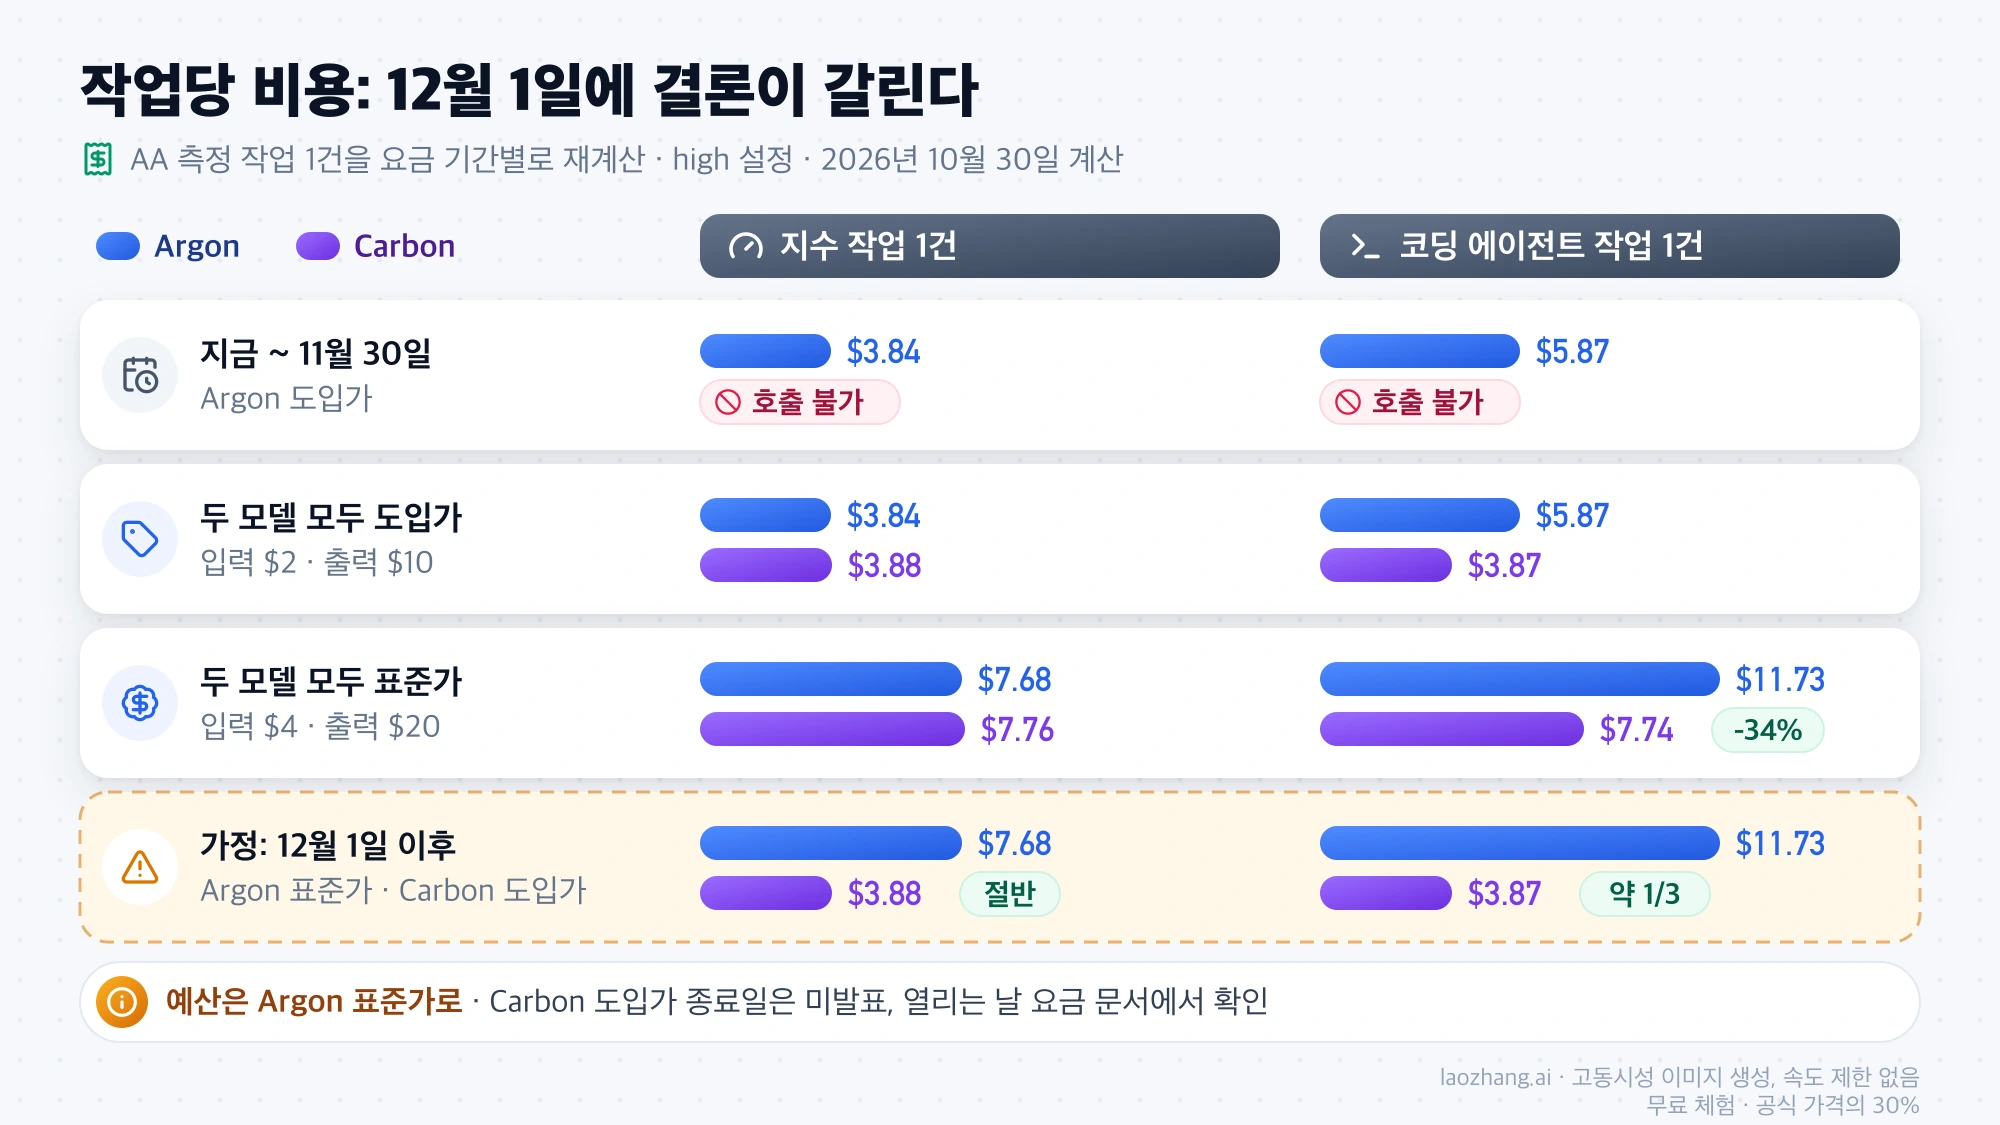
표의 숫자는 AA가 공개한 작업당 비용 내역에서 토큰 수를 역산해 기간별 단가로 다시 곱한 값이며, 표준가로 계산하면 AA가 표시한 $7.68과 $7.76이 그대로 재현됩니다. Argon의 지수 작업 1건은 출력 116,368토큰, 캐시 읽기 약 1,035.7만 토큰, 일반 입력 단가로 과금되는 입력 약 82.1만 토큰이어서, 도입가로는 출력 $1.16 + 캐시 읽기 $1.04 + 일반 입력 $1.64 = $3.84이고 표준가는 모든 단가가 두 배라 $7.68입니다. Carbon은 출력 122,768토큰, 캐시 읽기 약 1,019.6만 토큰, 일반 입력 약 81.5만 토큰으로, 같은 방식으로 더하면 출력 $1.23 + 캐시 읽기 $1.02 + 일반 입력 $1.63 = 도입가 $3.88, 표준가 $7.76입니다. 캐시에 처음 쓰이는 입력은 일반 입력 단가로 계산했고, 코딩 에이전트 작업의 도입가 열은 AA의 표준가 비용을 절반으로 나눈 값입니다.
Carbon은 느린가: 첫 토큰은 2배, 생성 속도는 같다
"Carbon이 느리다"는 말은 어떤 시간을 재느냐에 따라 맞기도 하고 틀리기도 합니다. AA가 2026년 10월 30일 측정한 값으로 첫 토큰까지 걸린 시간은 Carbon 97.94초, Argon 47.20초로 약 2배이고, 추론 과정을 포함해 500토큰 답변을 다 받기까지는 103.82초 대 53.23초로 역시 약 2배입니다. 그런데 토큰이 나오기 시작한 뒤의 생성 속도는 초당 85토큰 대 83토큰으로 거의 같습니다. Carbon은 답이 시작되기까지의 대기가 길 뿐, 글자를 내보내는 속도가 느린 것은 아닙니다.
에이전트 작업 전체 시간은 또 다릅니다. Artificial Analysis 코딩 에이전트 지수 페이지에서 작업 하나가 끝나기까지 Carbon은 29.8분, Argon은 34.7분이 걸려 Carbon이 더 짧았습니다. 실행 단계는 Carbon이 178번으로 Argon(166번)보다 많았는데도 전체 작업은 먼저 끝났습니다. AA 비교 페이지의 작업당 시간(Time per Task) 1452.93초 대 1364.94초는 첫 토큰 대기와 부가 시간을 빼고 생성 시간만 가중 합산한 값이라 실제 소요 시간으로 읽으면 안 됩니다.
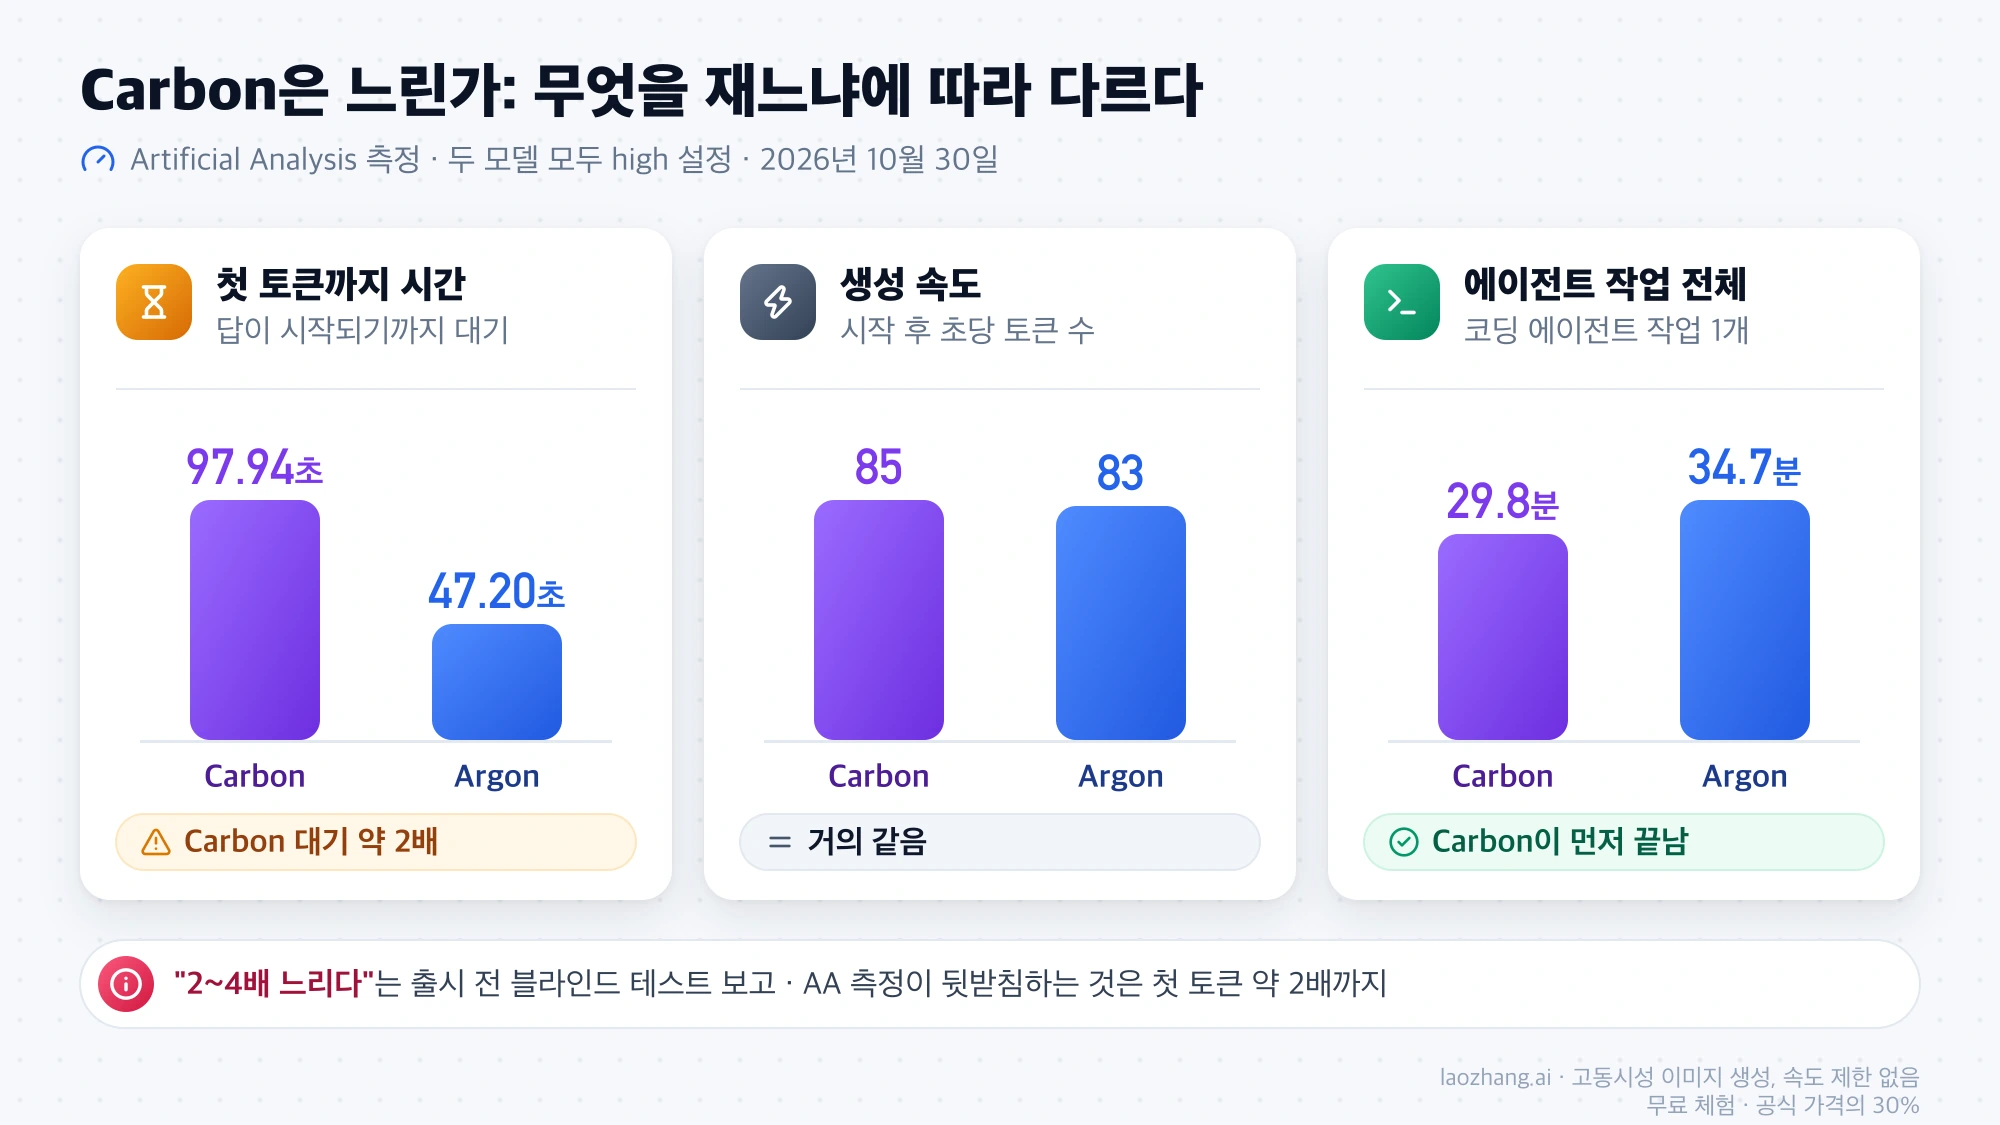
"Carbon이 Argon보다 2~4배 느리다"는 말은 출시 전 블라인드 테스트에서 나온 보고입니다. letslearngenai의 Gemini 4 Carbon vs Argon 기사(2026년 10월 28일)는 Arena 블라인드 테스트 보고를 인용해 작업에 따라 2~4배 느리고 복잡한 작업은 30분 가까이 걸렸다고 전하면서, 표준화된 지연 시간 측정이 아니라 사전 접근과 블라인드 테스트에서 나온 관찰이라고 스스로 밝힙니다. AA 측정이 뒷받침하는 것은 첫 토큰 기준 약 2배까지이고, 2~4배는 아닙니다.
실무 판단으로 옮기면 작업 단위에 따라 결론이 갈립니다. 사용자가 첫 글자를 기다리는 기능은 물론, 요청 하나하나를 따로 처리하는 배치 작업도 AA 측정상 500토큰 답변 한 건에 약 2배 시간이 걸리므로 처리량 계획을 그만큼 넉넉히 잡아야 합니다. 반면 여러 단계를 이어 가는 코딩 에이전트 작업은 AA 측정에서 작업 전체가 Carbon 쪽에서 더 일찍 끝났으므로, 이 경우에는 Carbon이 느리다고 볼 근거가 없습니다. AA의 Carbon 생성 속도는 10월 29일 초당 99.8토큰에서 10월 30일 85토큰으로 하루 만에 바뀌었을 만큼 변동이 크고 공개 전 접근 기준이라, 공개 API가 열리면 숫자가 달라질 수 있습니다.
Carbon은 환각이 늘었나: AA 11.4%와 Google 주장의 차이
환각이 늘었다는 측정과 줄었다는 주장이 함께 있는데, 재는 대상이 달라서 둘 다 성립합니다. AA-Omniscience v1.1 지식 평가에서 Carbon의 정답률은 48.3%에서 58.3%로 10포인트 올랐지만, 정답을 모를 때 답을 거절하지 않고 틀린 답을 내는 환각률도 4.3%에서 11.4%로 올랐습니다. Carbon이 답을 더 자주 시도하면서 맞히는 답과 틀리는 답이 함께 늘어난 셈입니다. 그래도 11.4%는 AA가 측정한 모든 모델 가운데 Argon 다음으로 낮고, Claude Opus 5.5(max)와 GPT-6 Astra(max)는 약 50%입니다.
Google의 주장은 다른 장면을 다룹니다. Google은 내부 테스트에서 Carbon이 Argon보다 근거 없는 주장을 약 절반으로 줄였고, 근거가 부족하면 지어내는 대신 결과물 안에 한계를 적거나 막힌 작업을 남은 요건 목록과 함께 보류한다고 밝혔습니다. 에이전트가 만든 결과물 속 주장을 본 것이고, Google이 직접 잰 수치이며 측정 방법은 공개되지 않았습니다. 정리하면 근거 자료를 주고 일을 시키는 작업에서는 Google 주장대로 나아졌을 수 있고, 자료 없이 지식으로만 답하는 질문에서는 모를 때도 답하는 쪽으로 움직였다는 것이 AA 측정입니다.
그래서 사실 확인형 기능을 Carbon으로 옮기기 전에는 정답률보다 오답 수를 보세요. 실제 질문에 더해 답이 문서에 없는 질문을 섞은 세트를 만들고, 두 모델의 결과를 정답, 오답, "모름"으로 나눠 셉니다. Carbon의 오답이 늘었다면 시스템 지시에 "확실하지 않으면 모른다고 답하라"는 규칙을 넣거나 근거 문서를 함께 넣는 방식으로 바꾼 뒤 다시 재 보는 것이 순서입니다.
Google 자체 측정 보안 점수: SEC-bench Pro 88.2%
보안팀에는 Google이 발표한 보안 평가가 가장 직접적인 숫자지만, 모두 Google이 직접 돌린 벤더 측정입니다. Google은 사이버 보안 평가를 가장 높은 추론 설정에서 안전장치(guardrails) 없이 실행했다고 밝혔고, Argon 비교값은 Google 발표 비교표를 정리한 VentureBeat 보도를 따랐습니다.
| 평가 (Google 측정) | 무엇을 재나 | Carbon | Argon |
|---|---|---|---|
| SEC-bench Pro | 실제 소프트웨어에서 취약점 찾기 | 88.2% | 83.4% |
| ExploitGym | 취약점이 실제로 악용 가능한지 검증 | 54.8% | 42.0% |
| CWE-bench | 근본 원인을 고치는 패치 작성 | 71.0% | 68.0% |
| Gray Swan 간접 프롬프트 인젝션 | 공격 성공률 (낮을수록 좋음) | 0.0% | 0.7% |
같은 발표표의 다른 항목도 대체로 Carbon이 앞섭니다. 긴 컨텍스트를 다루는 GraphWalks는 96.2% 대 84.2%, 컴퓨터 화면 조작 평가 OSWorld-2.1(오프라인 부분)은 81.5% 대 74.7%입니다. 가장 작은 차이는 여러 업무 분야를 묶은 Vals Index v2.2(70.4% 대 69.2%)와 CWE-bench(3.0포인트)였고, 안전한 코드 생성 성공률은 Google 내부 평가에서 Argon의 2배가 넘는다고 발표됐습니다.
Carbon 호출해 보니: 2026년 10월 30일 HTTP 503
2026년 10월 30일 00시 12분(UTC) API 게이트웨이 laozhang.ai(api.laozhang.ai)에 사용량 과금 키로 보낸 요청에서 Carbon은 호출되지 않았습니다. 모델 목록 요청(GET /v1/models)은 정상 응답(200)으로 모델 192개를 돌려줬고, 그중 Gemini 4 계열은 gemini-4-argon 하나뿐이었습니다. OpenAI 호환 방식(POST /v1/chat/completions)으로 gemini-4-carbon을 지정하면 1.08초 만에 HTTP 503과 "no available channels for model gemini-4-carbon" 메시지가 돌아왔고, gemini-4-carbon-preview(1.11초)와 제미나이 네이티브 방식의 gemini-4-carbon:generateContent(1.07초)도 같은 503이었습니다. 세 요청 모두 과금되지 않았으며, 10월 29일 01시 36분과 03시 00분(UTC)에 보낸 같은 요청도 결과가 같았습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
이 결과가 보여 주는 것은 그 시각 이 게이트웨이로는 Carbon에 요청을 보낼 경로가 없다는 것까지입니다. Google 키로 Google의 제미나이 API를 직접 부른 요청은 포함되지 않습니다. 다만 같은 날 제미나이 API 모델 문서와 요금 문서, 변경 기록 어디에도 Carbon 모델 ID가 없어, 공개 API에서도 부를 수 있는 이름이 아직 없는 상태입니다. 같은 게이트웨이에서 gemini-4-argon은 제미나이 네이티브 방식과 OpenAI 호환 방식으로 제공됩니다.
Carbon 전환 준비: 모델 이름 분리부터 첫날 측정까지
Carbon이 언제 열릴지 모르는 지금 할 수 있는 일은 나중에 바꾸는 비용을 미리 줄여 두는 것입니다. 아래 순서로 준비하면 Carbon이 열린 날 설정값 하나와 평가 한 번으로 전환 여부를 정할 수 있습니다.
- 모델 이름을 코드 곳곳에 직접 쓰지 말고 환경 변수나 설정 파일 한 곳(예:
GEMINI_MODEL=gemini-4-argon)에서 읽게 바꿉니다. Carbon 모델 ID가 공개되면 그 값 하나만 바꾸면 됩니다. - 12월 1일부터 Argon 작업당 비용이 두 배가 되는 것을 12월 예산에 넣습니다. 결과를 바로 받지 않아도 되는 작업은 지금 Batch 처리로 옮겨 두면 인상 폭을 줄일 수 있습니다.
- 자주 반복하는 실제 작업으로 합격 기준이 있는 평가 세트를 만들고, Argon의 결과와 비용을 지금 기록해 둡니다. 사실 확인형 기능이라면 답이 문서에 없는 질문도 섞습니다.
Carbon이 열린 첫날에는 모델 문서에서 모델 ID를, 요금 문서에서 도입가 종료일을 확인한 뒤 같은 평가 세트를 Carbon으로 돌려 다섯 가지를 비교하세요. 첫 토큰까지의 시간과 작업 전체가 끝나는 시간을 따로 재고, 청구액을 작업 수로 나눈 작업당 비용과 캐시 적중률, 합격 기준 통과율, 사실 질문에서 나온 오답과 "모름"의 비율입니다. AA 수치는 공개 전 접근에서 high 설정만 잰 것이므로, 공개 API의 속도와 낮은 추론 설정에서의 결과는 이 첫날 숫자가 판단 기준이 됩니다.
Gemini 4 Carbon과 Argon에 관한 그 밖의 질문
보안 조직이라면 지금 Carbon을 받을 수 있나요?
Google은 Carbon을 먼저 일부 사이버 방어 조직에 제공하고, Fairwind Program을 통해 신뢰할 수 있는 파트너로 단계적으로 넓힌다고 밝혔습니다. Fairwind는 정부, 의료 기관, 통신 서비스처럼 핵심 인프라를 지키는 방어 조직을 위한 신청형 프로그램이라, 2026년 10월 30일 기준 보안 조직이 아닌 개발자에게는 해당하지 않습니다. 자격과 준비 조건은 Gemini 3.8 Flash Cyber 신청 가이드: Fairwind 자격과 준비 조건에 정리돼 있습니다.
Carbon이 나오면 Argon은 종료되나요?
Google은 2026년 10월 30일 기준 Argon의 종료나 Carbon으로의 대체를 발표하지 않았습니다. 발표문은 Carbon을 Argon을 "기반으로 한(building on)" 모델로 소개할 뿐이고, gemini-4-argon은 제미나이 API 요금 문서에 그대로 올라 있습니다.
Gemini 4 Carbon과 Claude Opus 5.5 중 어느 쪽이 나은가요?
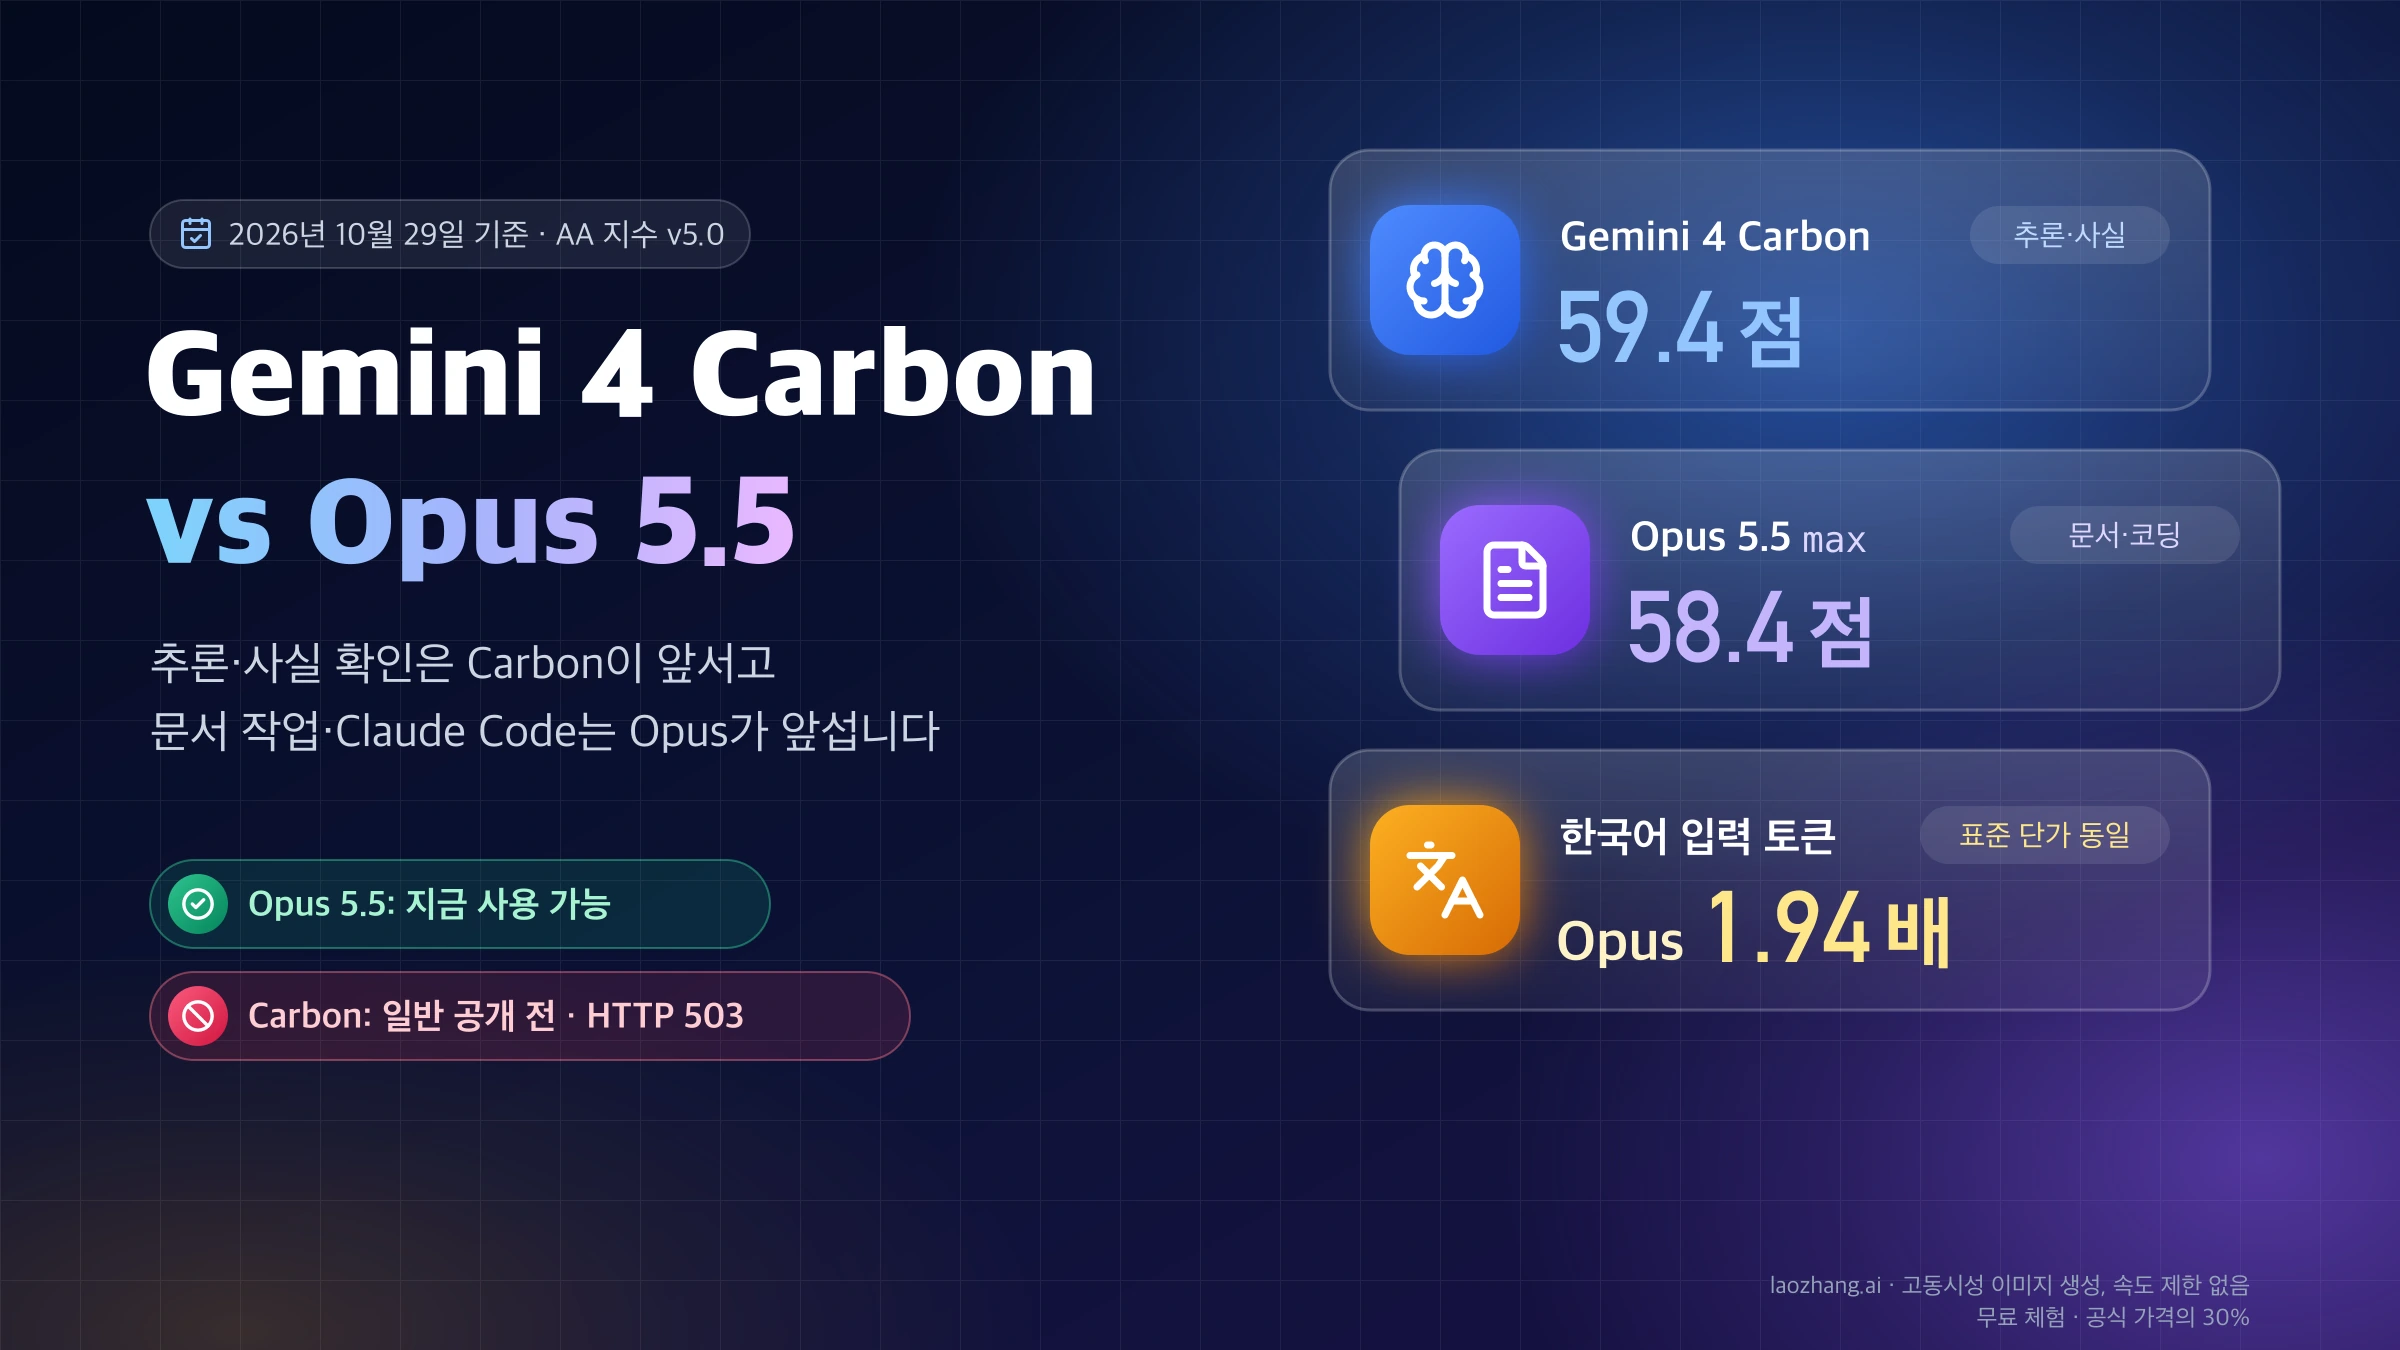
AA 지능 지수 v5.0에서는 Carbon이 1위이지만, AA 코딩 에이전트 지수에서는 Claude Code와 Opus 5.5(max) 조합이 61.7점으로 Antigravity CLI와 Carbon(high) 조합의 59.4점보다 높습니다(2026년 10월 30일 기준). 단가와 한국어 토큰 수까지 넣은 비교는 Gemini 4 Carbon vs Opus 5.5 비교: 단가 같아도 한국어는 Opus 토큰 1.94배에 있습니다.
Carbon의 컨텍스트 길이와 입력 형식은 Argon과 같나요?
Google은 2026년 10월 30일 기준 Carbon의 컨텍스트 길이, 최대 출력, 지원하는 입력 형식을 공개하지 않았습니다. Argon은 모델 문서에 100만 토큰 컨텍스트가 명시돼 있지만 Carbon은 공식 사양이 없으므로, AA 모델 목록의 표시만으로 같다거나 다르다고 판단하지 말고 Carbon 모델 문서가 올라온 뒤 확인하세요.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
- 1.Artificial Analysis의 Gemini 4 Argon·Carbon 비교 페이지artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-4-carbon
- 2.Artificial Analysis의 Gemini 4 Carbon 평가 기사artificialanalysis.ai/articles/gemini-4-carbon-new-number-1
- 3.Google 공식 블로그의 Gemini 4 Carbon 발표문blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- 4.제미나이 API 요금 문서ai.google.dev/gemini-api/docs/pricing
- 5.Artificial Analysis 코딩 에이전트 지수 페이지artificialanalysis.ai/agents/coding-agents
- 6.letslearngenai의 Gemini 4 Carbon vs Argon 기사letslearngenai.com/articles/gemini-4-carbon-vs-gemini-4-argon-a-faster-flagship-becomes-a-harder-working-one-2026-10-28
- 7.제미나이 API 모델 문서ai.google.dev/gemini-api/docs/models