Kimi K3.1 Pro vs GPT-6.1 Sol 비교: 같은 정가, 작업당 비용은 3배 차이
Kimi K3.1 Pro와 GPT-6.1 Sol은 정가가 같지만 AA 작업당 비용은 K3.1 Pro가 Sol max의 약 3배입니다. 272K 넘는 프롬프트에서는 K3.1 Pro가 절반입니다.
목차
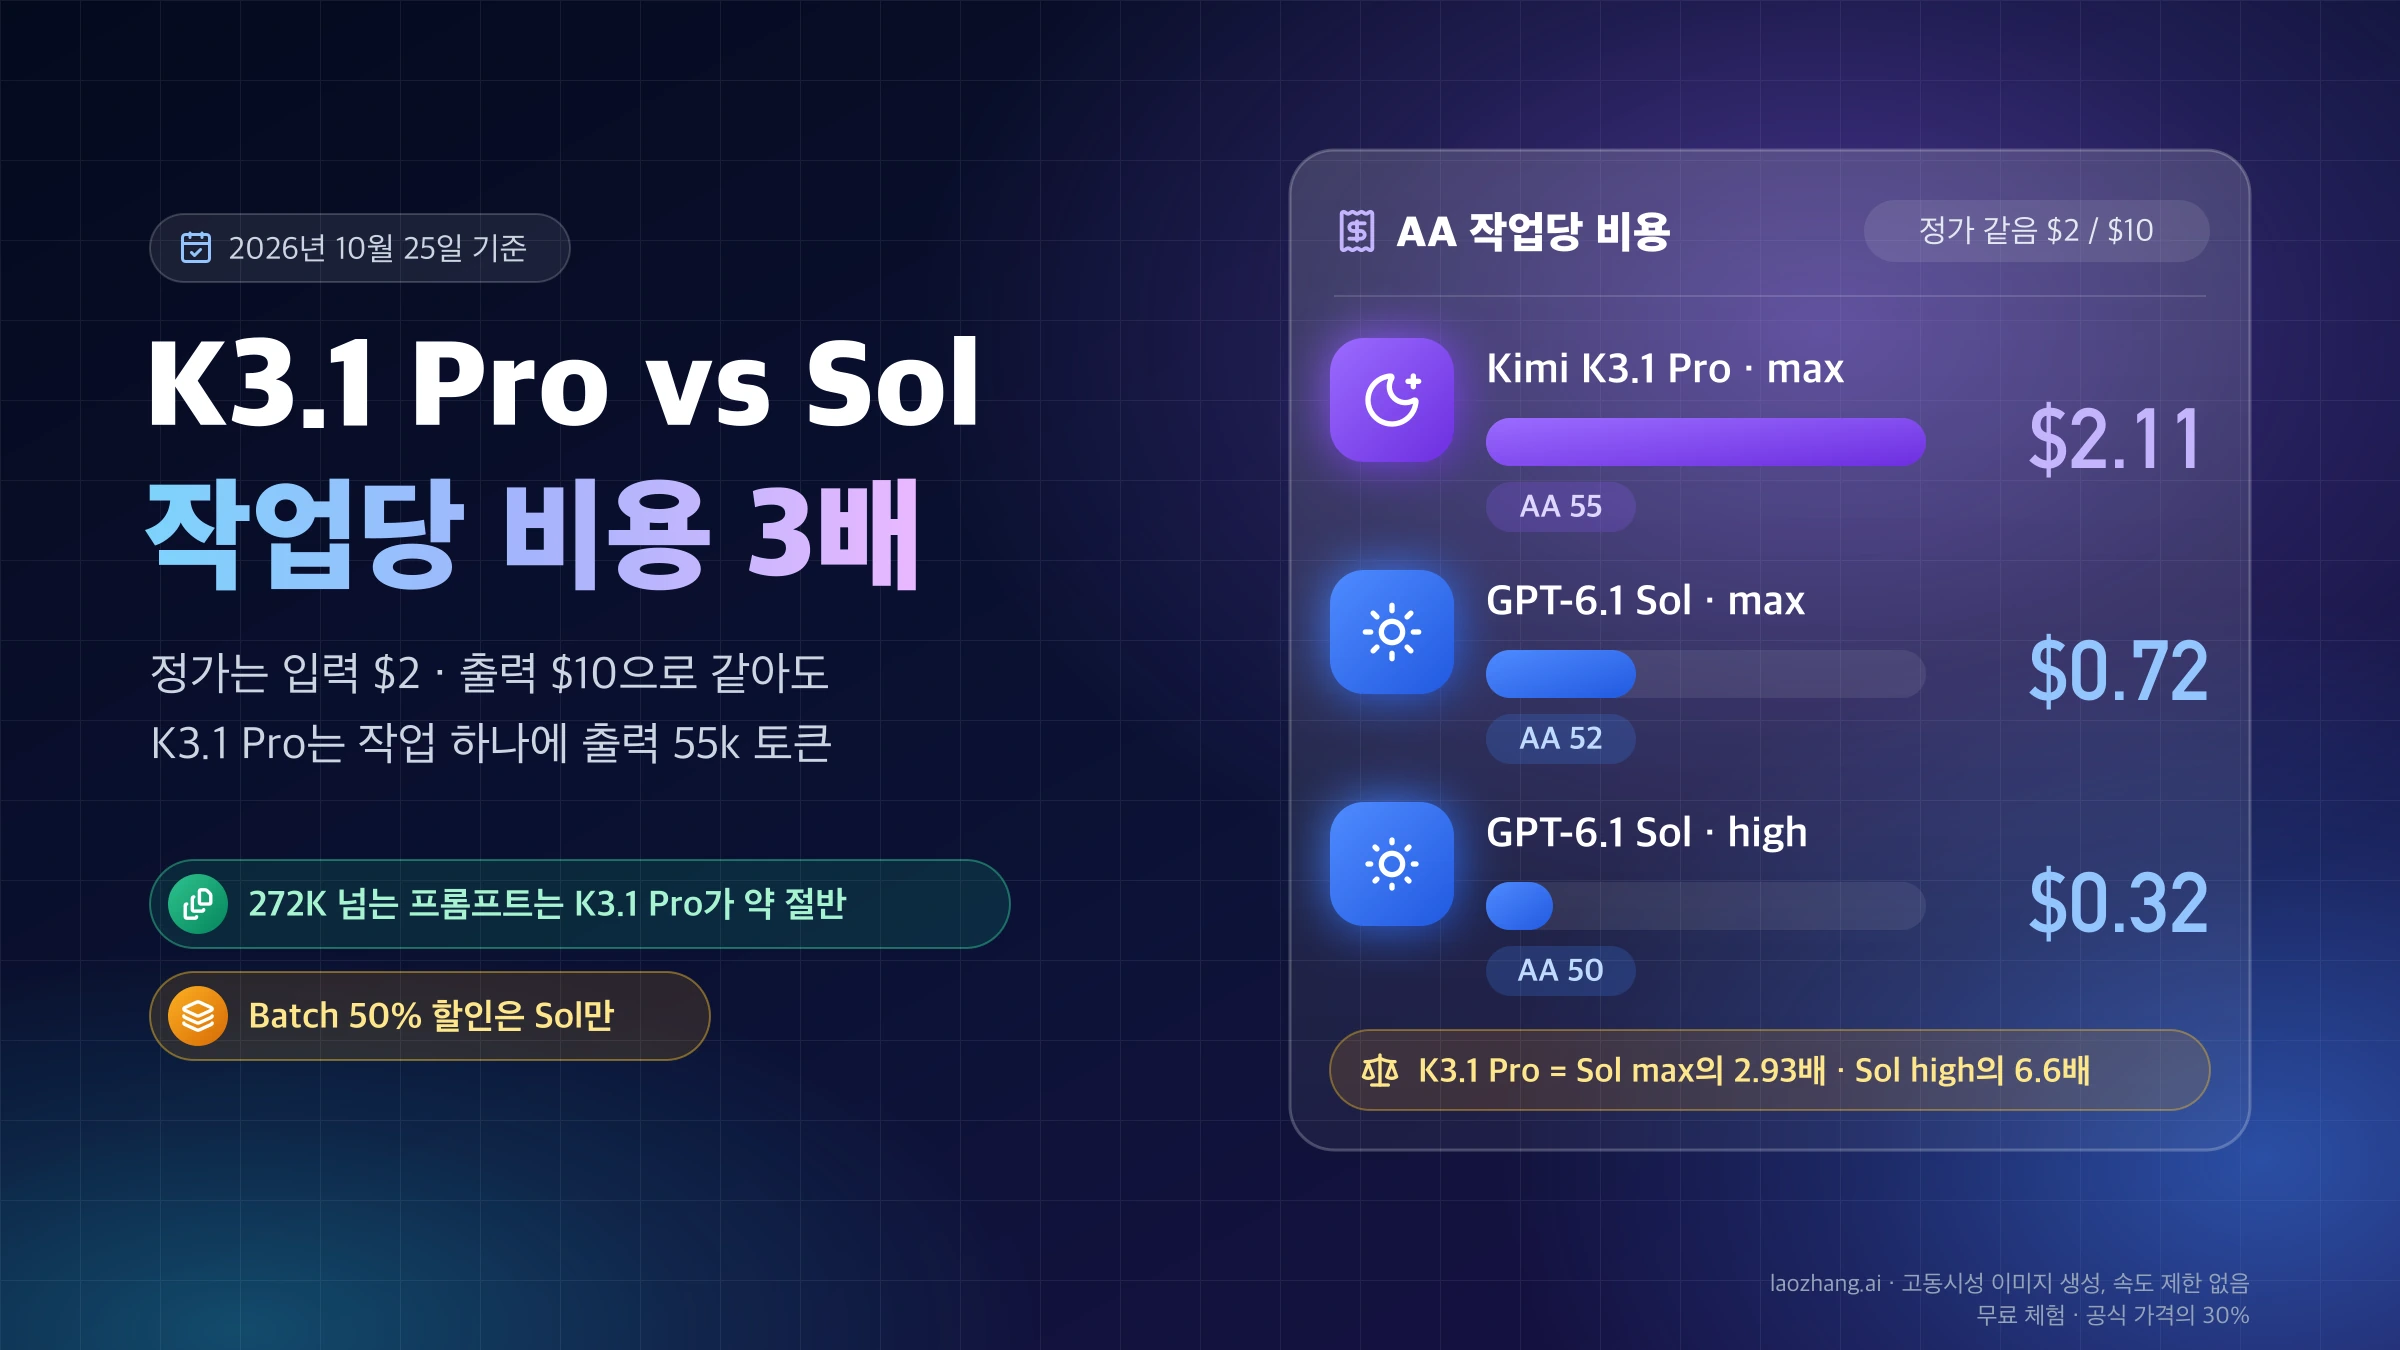
Kimi K3.1 Pro(kimi-k3.1-pro)와 GPT-6.1 Sol(gpt-6.1-sol)은 2026년 10월 25일 기준 100만 토큰당 입력 $2, 출력 $10으로 정가가 같습니다. 그래도 청구액은 같지 않습니다. Artificial Analysis(AA)의 Intelligence Index에서 K3.1 Pro는 기본 추론 강도인 max로 55점을 받았지만 작업 하나에 $2.11을 썼고, Sol은 max 설정에서 52점에 $0.72, high 설정에서 50점에 $0.32였습니다. 3점을 더 얻는 대가가 작업당 약 3배(2.93배), high와 견주면 6.6배입니다.
그래서 지금 Sol을 쓰고 있다면 기본은 gpt-6.1-sol을 그대로 두고, 결과가 모자랄 때 추론 강도를 high로 올리는 쪽이 먼저입니다. K3.1 Pro는 두 경우에 자기 작업으로 시험해 볼 만합니다. 터미널 조작이나 업무 문서 작성처럼 여러 단계를 스스로 진행하는 에이전트형 작업에서 Sol max로도 통과율이 부족할 때, 그리고 입력이 272K 토큰을 넘는 긴 프롬프트를 자주 보낼 때입니다. Sol은 272K를 넘으면 요청 전체에 할증 요금을 매기기 때문에 같은 500K 프롬프트를 K3.1 Pro가 약 절반 가격에 처리합니다. 반대로 오프라인 일괄 처리는 Sol의 Batch 50% 할인이 있고 K3.1 Pro는 Kimi Batch API를 쓸 수 없어서 Sol이 낫습니다.
2026년 10월 25일 직접 실행한 것은 API 목록 조회와 비용 재계산입니다. OpenRouter 공개 API 등으로 두 모델을 제공하는 엔드포인트와 모델 목록을 확인했고, 두 회사의 공식 정가로 작업 형태별 비용을 다시 계산했습니다. 같은 프롬프트로 두 모델을 나란히 돌린 품질·속도 시험은 없으며, 아래의 품질 점수와 지연 시간은 모두 AA의 측정값입니다.
정가가 같으면 비용도 같나: 작업당 비용은 K3.1 Pro가 2.9배
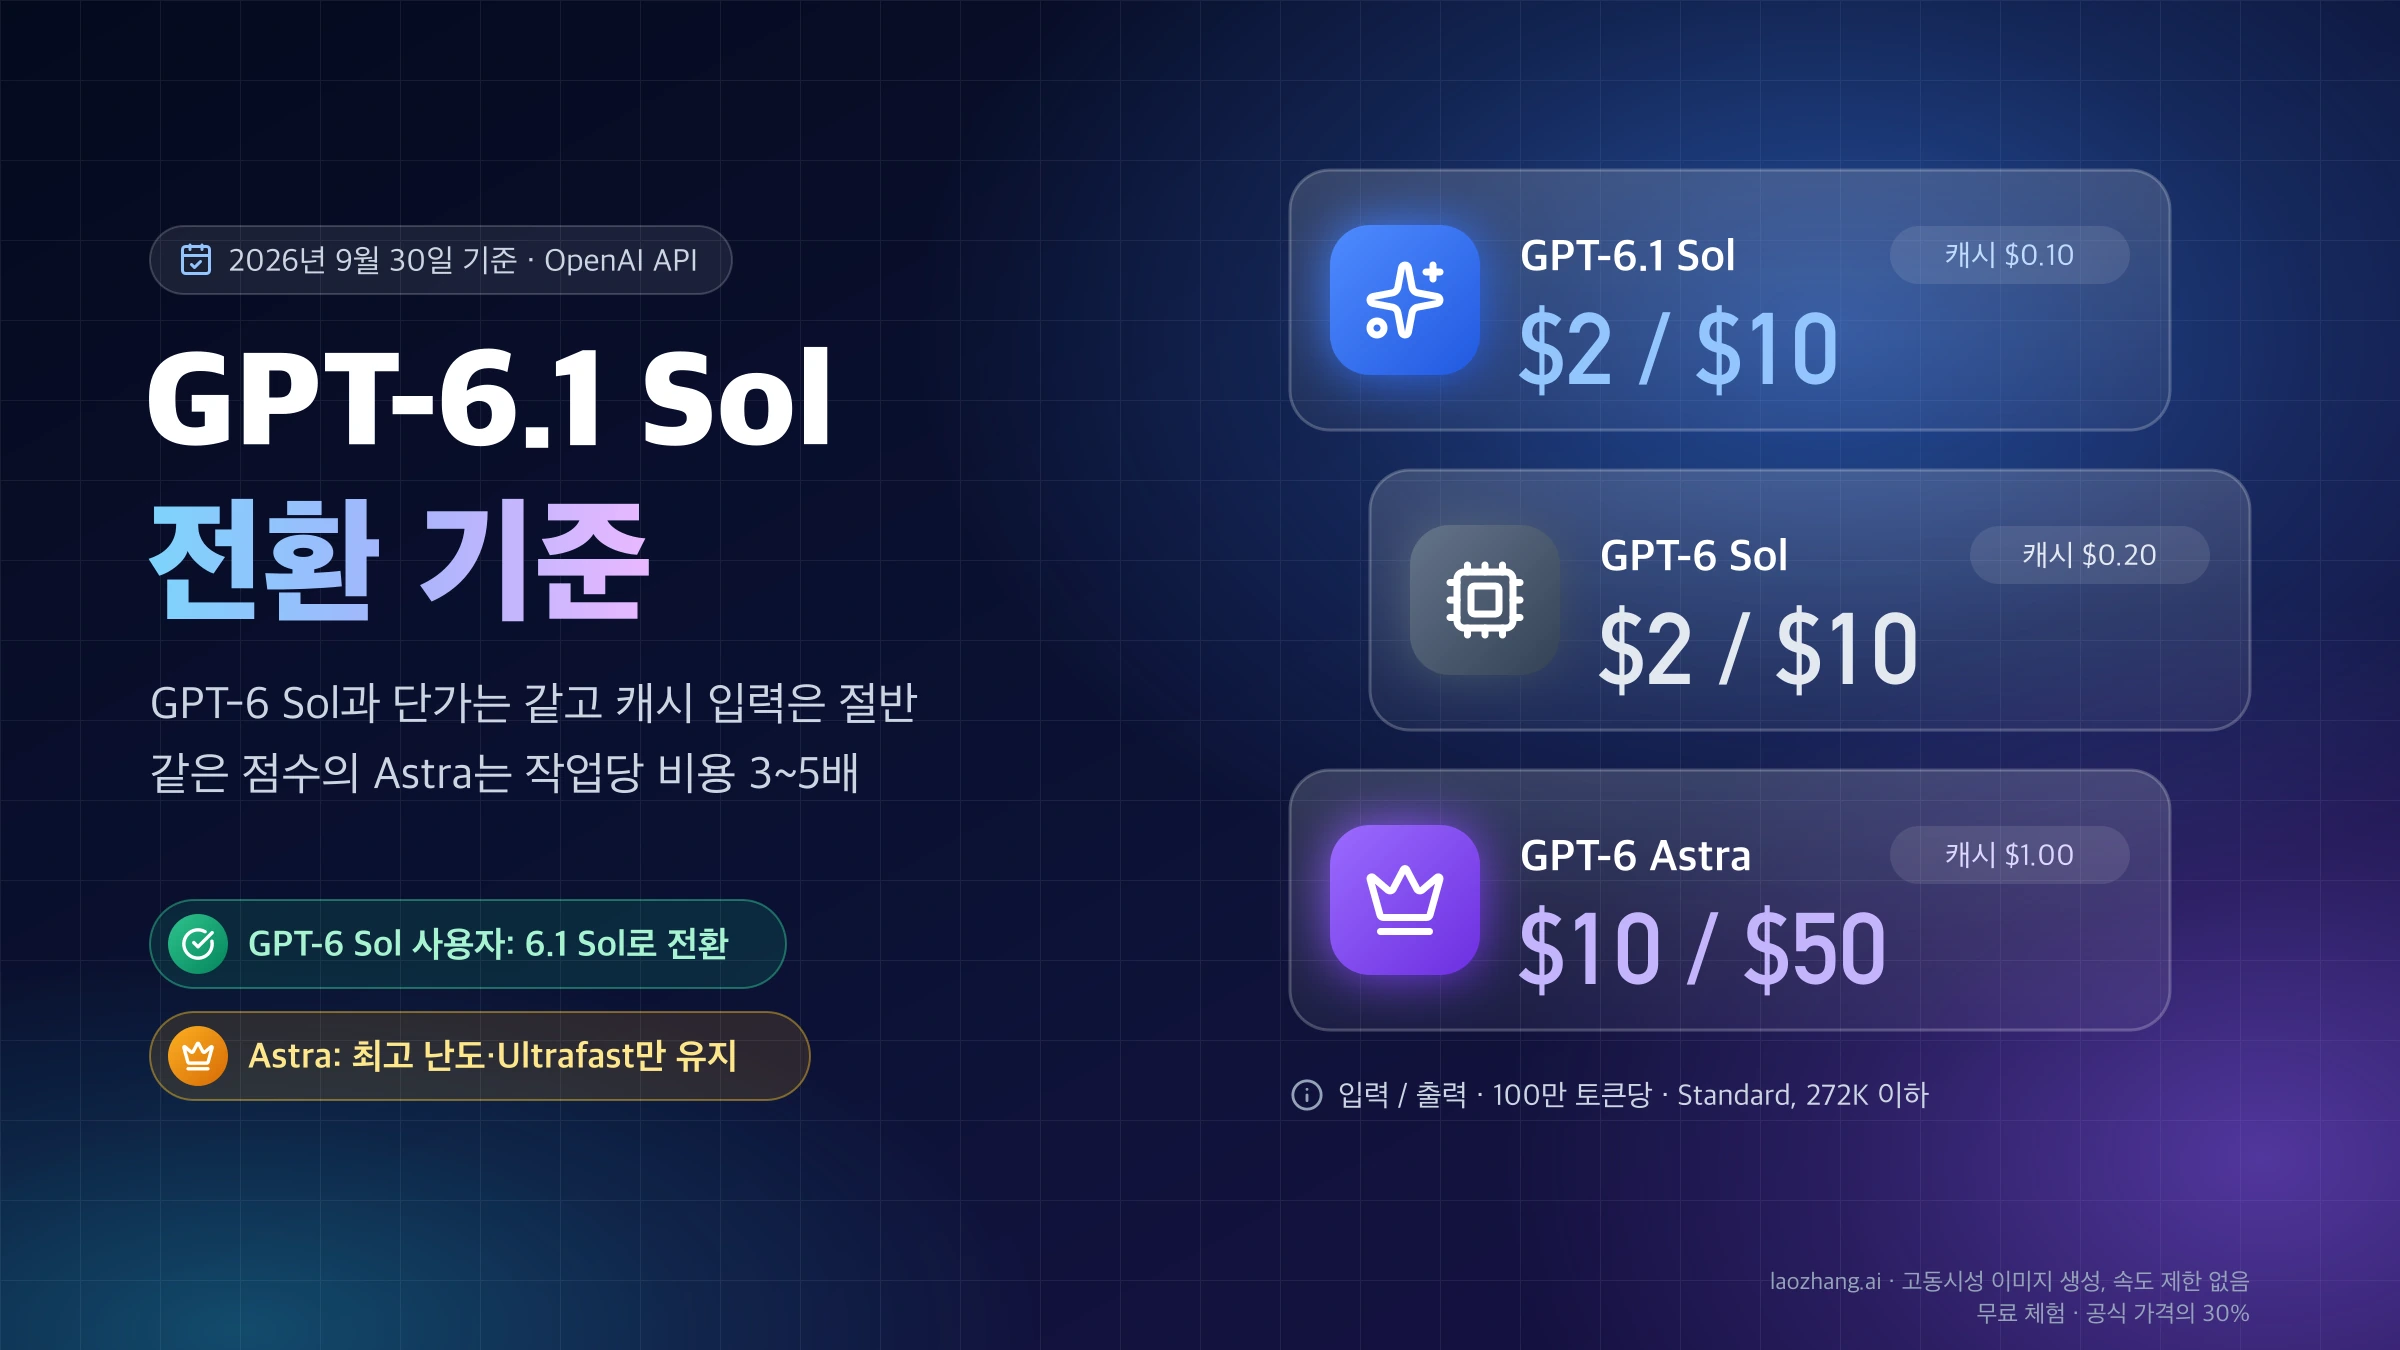
정가가 같아도 작업당 비용이 벌어지는 이유는 작업 하나에 쓰는 출력 토큰 수입니다. 이전 모델 Kimi K3는 입력 $3, 출력 $15로 Sol보다 1.5배 비쌌지만, K3.1 Pro는 입력 $2, 출력 $10, 캐시 읽기 $0.20로 내려와 일반 단가가 Sol과 같아졌습니다(Kimi API 요금표, 국제 플랫폼, 세금 별도). K3를 쓰던 사람이라면 같은 토큰에 3분의 1을 덜 냅니다. 하지만 두 모델 모두 출력 요금에 추론 토큰이 포함되는데, AA 측정에서 K3.1 Pro는 작업 하나에 평균 55k 토큰(그중 추론 35k)을 출력했고 Sol은 max에서도 38k, 기본값인 medium에서는 8k였습니다.
| 설정 | AA 지수 | 작업당 비용 | 작업당 출력 토큰 | 작업당 시간 |
|---|---|---|---|---|
| K3.1 Pro, 기본값 max | 55 | $2.11 | 55k | 618초 |
| Sol low | 42 | $0.13 | 4k | 83초 |
| Sol medium(기본값) | 48 | $0.21 | 8k | 168초 |
| Sol high | 50 | $0.32 | 13k | 257초 |
| Sol xhigh | 51 | $0.39 | 18k | 342초 |
| Sol max | 52 | $0.72 | 38k | 680초 |
출처: Artificial Analysis의 Kimi K3.1 Pro vs GPT-6.1 Sol 비교 페이지와 추론 강도별 페이지, Intelligence Index v4.3.2, 공식 정가 기준, 2026년 10월 25일 기준. AA가 다시 측정하면 값이 바뀝니다.
이 표에서 읽을 판단 기준은 하나입니다. Sol의 어떤 설정도 55점에 닿지 않으므로 K3.1 Pro를 고르는 것은 Sol max보다 3점 높은 결과에 작업당 $1.39($2.11 − $0.72)를, Sol high보다 5점 높은 결과에 $1.79를 더 내는 선택입니다. 실패한 작업을 다시 돌리거나 사람이 고치는 비용이 그보다 크면 K3.1 Pro가 이득이고, 작업 대부분이 Sol high로 통과한다면 Sol이 훨씬 쌉니다.
"기본값끼리" 비교가 같은 추론 강도 비교는 아니라는 점도 기억해야 합니다. K3.1 Pro의 기본값은 max, Sol의 기본값은 medium입니다. AA는 K3.1 Pro를 기본값으로만 측정했기 때문에 low·high 설정의 점수와 작업당 비용은 공개된 값이 없습니다. K3.1 Pro를 high로 낮추면 비용이 줄 가능성은 있지만, 얼마나 줄고 점수가 얼마나 떨어지는지는 직접 재 봐야 알 수 있습니다.
속도에서도 같은 구조가 보입니다. AA 측정에서 K3.1 Pro는 요청 후 2.97초 만에 추론 토큰을 내보내기 시작하지만 첫 답변 토큰까지는 30.19초가 걸렸고, Sol high는 31.33초, Sol max는 162.10초였습니다. 사용자가 화면 앞에서 기다리는 대화형 서비스라면 작업당 시간이 83초·168초인 Sol low·medium이 훨씬 짧습니다. Moonshot의 kimi-k3.1-pro-highspeed는 설정 스위치가 아니라 별도 모델 ID로, K3.1 Pro보다 2~3배 빠른 대신 입력 $4, 출력 $20으로 단가가 두 배입니다.
K3.1 Pro가 정말 낫나: 에이전트 작업은 K3.1, 지식 신뢰도는 Sol
AA 세부 지표를 보면 K3.1 Pro의 우위는 고르게 퍼져 있지 않습니다. K3.1 Pro가 앞서는 곳은 업무 산출물·자동화·터미널 조작처럼 여러 단계를 스스로 진행하는 에이전트형 평가와 과학 코딩(SciCode), 긴 문서 읽기(AA-LCR)입니다. Sol max는 지식 질문에서 틀린 답을 덜 내는 AA-Omniscience와 연구 수준 물리 문제 CritPt에서 앞서고, HLE와 GDP.pdf는 사실상 같습니다.
| AA 세부 지표 | K3.1 Pro (max) | Sol max | 앞선 쪽 |
|---|---|---|---|
| GDPval-AA | 1846 | 1596 | K3.1 Pro |
| AA-Briefcase | 1678 | 1555 | K3.1 Pro |
| AutomationBench | 73% | 65% | K3.1 Pro |
| Terminal-Bench 4.0 | 67% | 56% | K3.1 Pro |
| SciCode | 61% | 54% | K3.1 Pro |
| AA-LCR | 86% | 83% | K3.1 Pro |
| HLE | 52% | 53% | 비슷함 |
| GDP.pdf | 31% | 31% | 같음 |
| CritPt | 25% | 32% | Sol |
| AA-Omniscience | 30 | 42 | Sol |
출처: AA 비교 페이지(max 설정), 2026년 10월 25일 기준.
용도로 옮기면 이렇습니다. 코딩 에이전트나 업무 자동화가 주 용도라면 Terminal-Bench 4.0에서 11%p 차이는 K3.1 Pro를 시험해 볼 충분한 이유가 됩니다. 반면 사실 확인이 중요한 질의응답이나 리서치 요약이라면 AA-Omniscience에서 12점 앞선 Sol이 더 안전한 기본값입니다.
두 모델을 같은 방법으로 잰 공개 수치는 현재 AA뿐입니다. Moonshot의 출시 발표 표는 GPT-6 Astra, Claude Opus 5.5와 비교했을 뿐 GPT-6.1 Sol은 넣지 않았기 때문에 두 모델의 직접 비교 근거가 되지 못합니다. 커뮤니티 글에 도는 "K3.1 Pro 55점, GPT-6 Sol 52점"의 52점도 구형 GPT-6 Sol이 아니라 max 설정의 GPT-6.1 Sol 점수입니다. K3.1 Pro를 Opus 5.5와 견주는 경우는 같은 작업당 비용 방식으로 비교한 Kimi K3.1 Pro vs Claude Opus 5.5 비교: 절반 가격은 토큰 단가일 뿐에서 다룹니다.
작업별 비용 재계산: 캐시 루프는 Sol, 272K 초과는 K3.1 Pro
출력 토큰 수를 똑같이 맞춰도 요금 규칙이 달라서 작업 형태에 따라 더 싼 쪽이 바뀝니다. 아래는 2026년 10월 25일 Kimi 국제 플랫폼과 OpenAI Standard 처리의 공식 정가로 다시 계산한 결과입니다. 토큰 구성은 예시이고, 출력에는 두 모델 모두 추론 토큰이 포함됩니다. 계산식은 (새 입력 × 입력 단가 + 캐시 적중 × 캐시 읽기 단가 + 캐시 쓰기 × 쓰기 단가 + 출력 × 출력 단가) ÷ 100만입니다.
| 작업 형태 | K3.1 Pro | GPT-6.1 Sol | Sol ÷ K3.1 |
|---|---|---|---|
| 짧은 요청: 새 입력 20K, 출력 2K | $0.060 | $0.060 | 1.00배 |
| 에이전트 한 턴: 새 입력 10K, 캐시 적중 140K, 출력 3K | $0.078 | $0.064 | 0.82배 |
| 첫 턴에 140K 접두부를 캐시에 씀(Kimi 5분, Sol 30분), 새 입력 10K, 출력 3K | $0.330 | $0.400 | 1.21배 |
| 긴 프롬프트: 새 입력 500K, 출력 5K | $1.050 | $2.075 | 1.98배 |
| 긴 프롬프트와 캐시: 새 입력 50K, 캐시 적중 450K, 출력 5K | $0.240 | $0.365 | 1.52배 |
| 50턴 세션, 턴당 출력 3K로 동일 | $4.15 | $3.54 | 0.85배 |
| 50턴 세션, Sol 출력을 AA 비율로 줄임(max 38/55, high 13/55) | $4.15 | $3.07 / $2.39 | 0.74배 / 0.58배 |
| 일괄 처리 1만 건, 건당 입력 20K와 출력 2K | $600 | $600, Batch·Flex는 $300 | 1.00배 / 0.50배 |
50턴 세션은 첫 턴에 140K 접두부를 캐시에 쓰고, 2~50턴은 140K 캐시 적중과 새 입력 10K를 보내는 에이전트 루프를 가정했습니다. Sol 출력을 줄인 줄은 AA에서 관찰된 작업당 출력량 비율을 빌려 온 가정일 뿐 실제 작업의 측정값이 아닙니다. 턴당 출력이 같아도 Sol이 15% 싸고, 이 가정을 적용하면 26~42% 쌉니다.
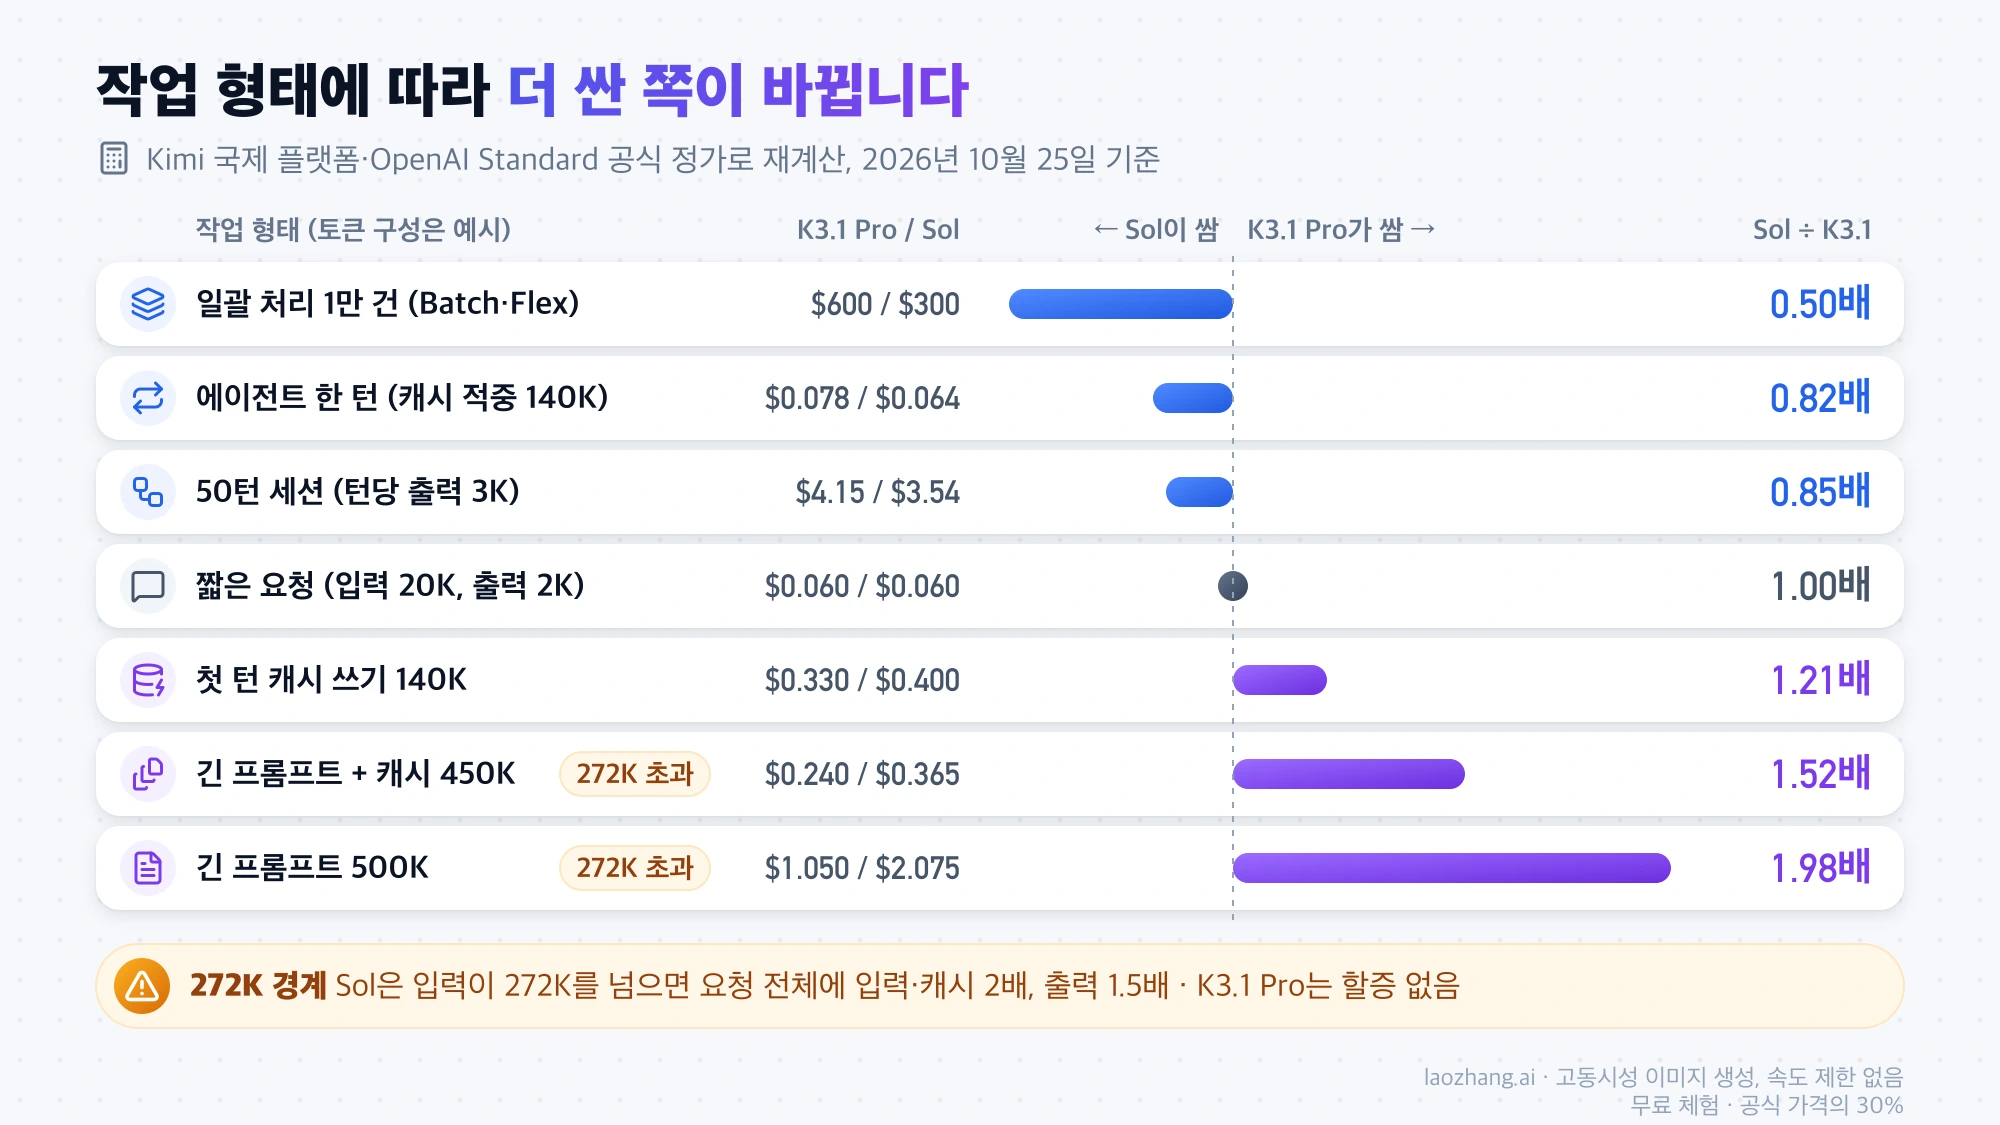
캐시를 쓰는 에이전트 루프에서 Sol이 유리한 것은 캐시 읽기 단가 때문입니다. Sol은 $0.10로 K3.1 Pro($0.20)의 절반이라 턴이 길어질수록 차이가 쌓입니다. 첫 턴만은 반대인데, Kimi의 5분 캐시 쓰기는 입력 단가와 같은 $2이고 Sol의 기본 30분 캐시 쓰기는 입력의 1.25배인 $2.50이기 때문입니다. 더 긴 캐시를 고르면 쓰기 요금이 Kimi 1시간 $4(2배), Sol 12시간 $5(2.5배)로 오르고, 기본 유지 시간이 Kimi 5분, Sol 30분이라 턴 사이 간격이 5분을 넘는 루프에서는 Kimi 쪽 캐시가 먼저 만료될 수 있습니다(Kimi 컨텍스트 캐시 문서, OpenAI 프롬프트 캐싱 문서).
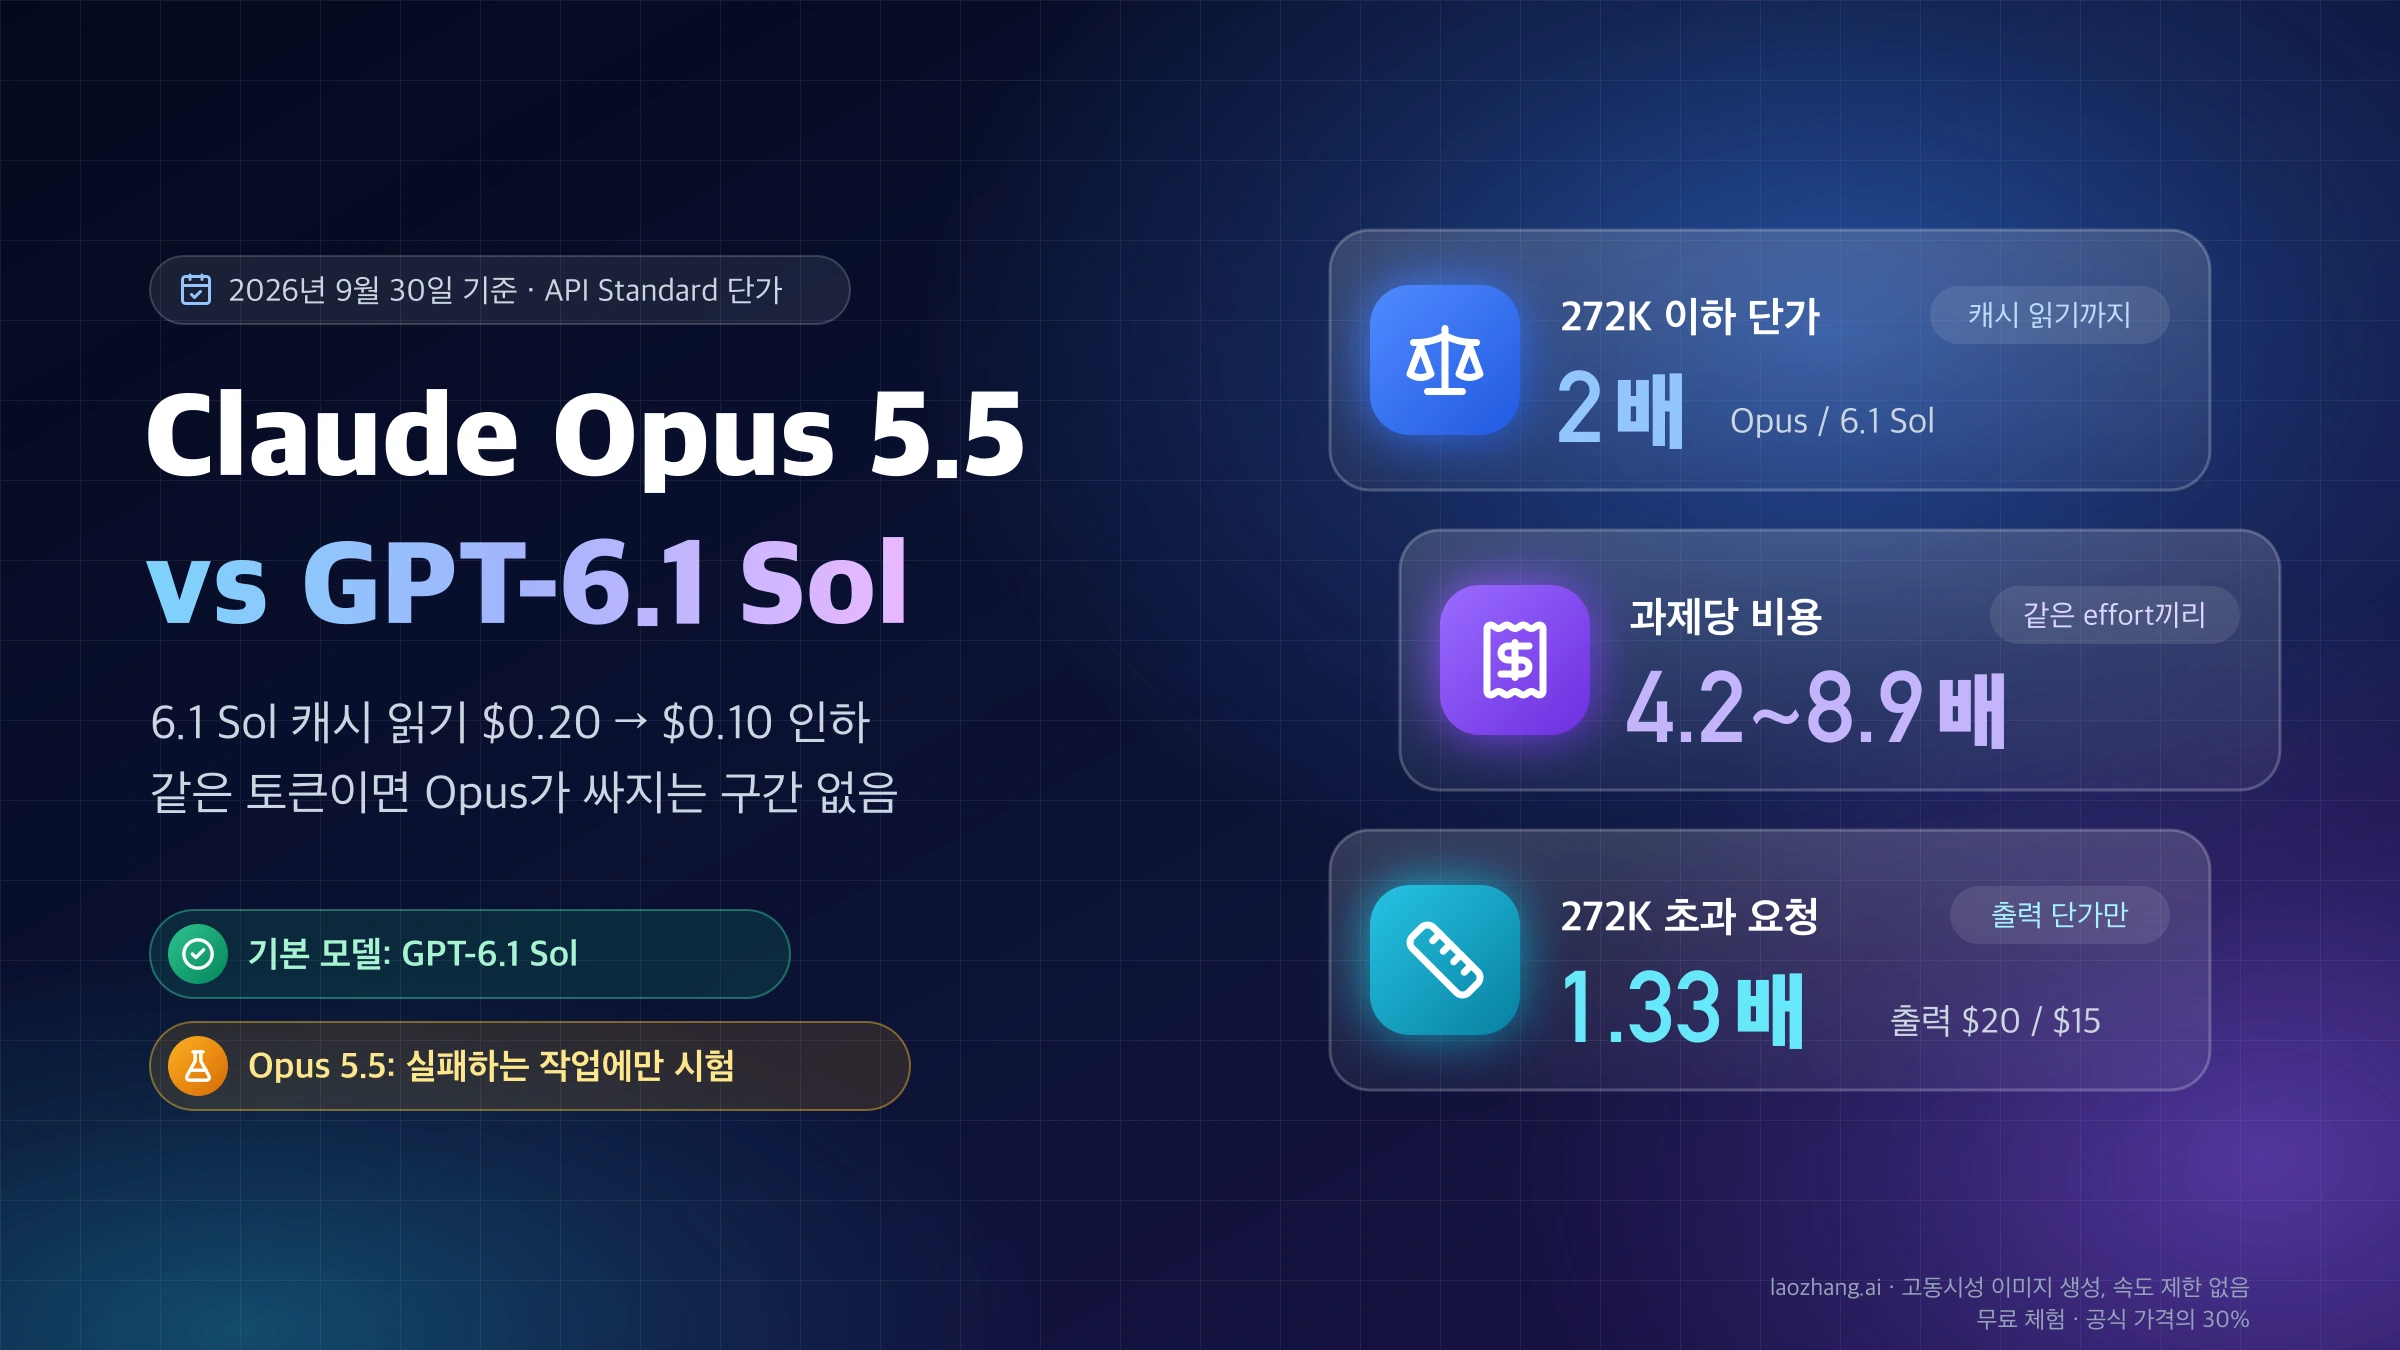
긴 프롬프트에서는 K3.1 Pro가 확실히 쌉니다. Sol은 입력이 272K 토큰을 넘으면 요청 전체에 입력·캐시 2배, 출력 1.5배 요금을 매기고(OpenAI API 요금 페이지), K3.1 Pro는 1,048,576 토큰까지 단일 요금입니다. 그래서 새 입력 500K에 출력 5K라면 K3.1 Pro는 500K × $2 + 5K × $10으로 $1.05, Sol은 500K × $4 + 5K × $15로 $2.075가 됩니다. Sol 요금 구간과 272K 계산은 GPT-6.1 Sol 가격과 사용법: 모델 ID만 바꾸면 안 되는 이유에 자세히 있습니다.
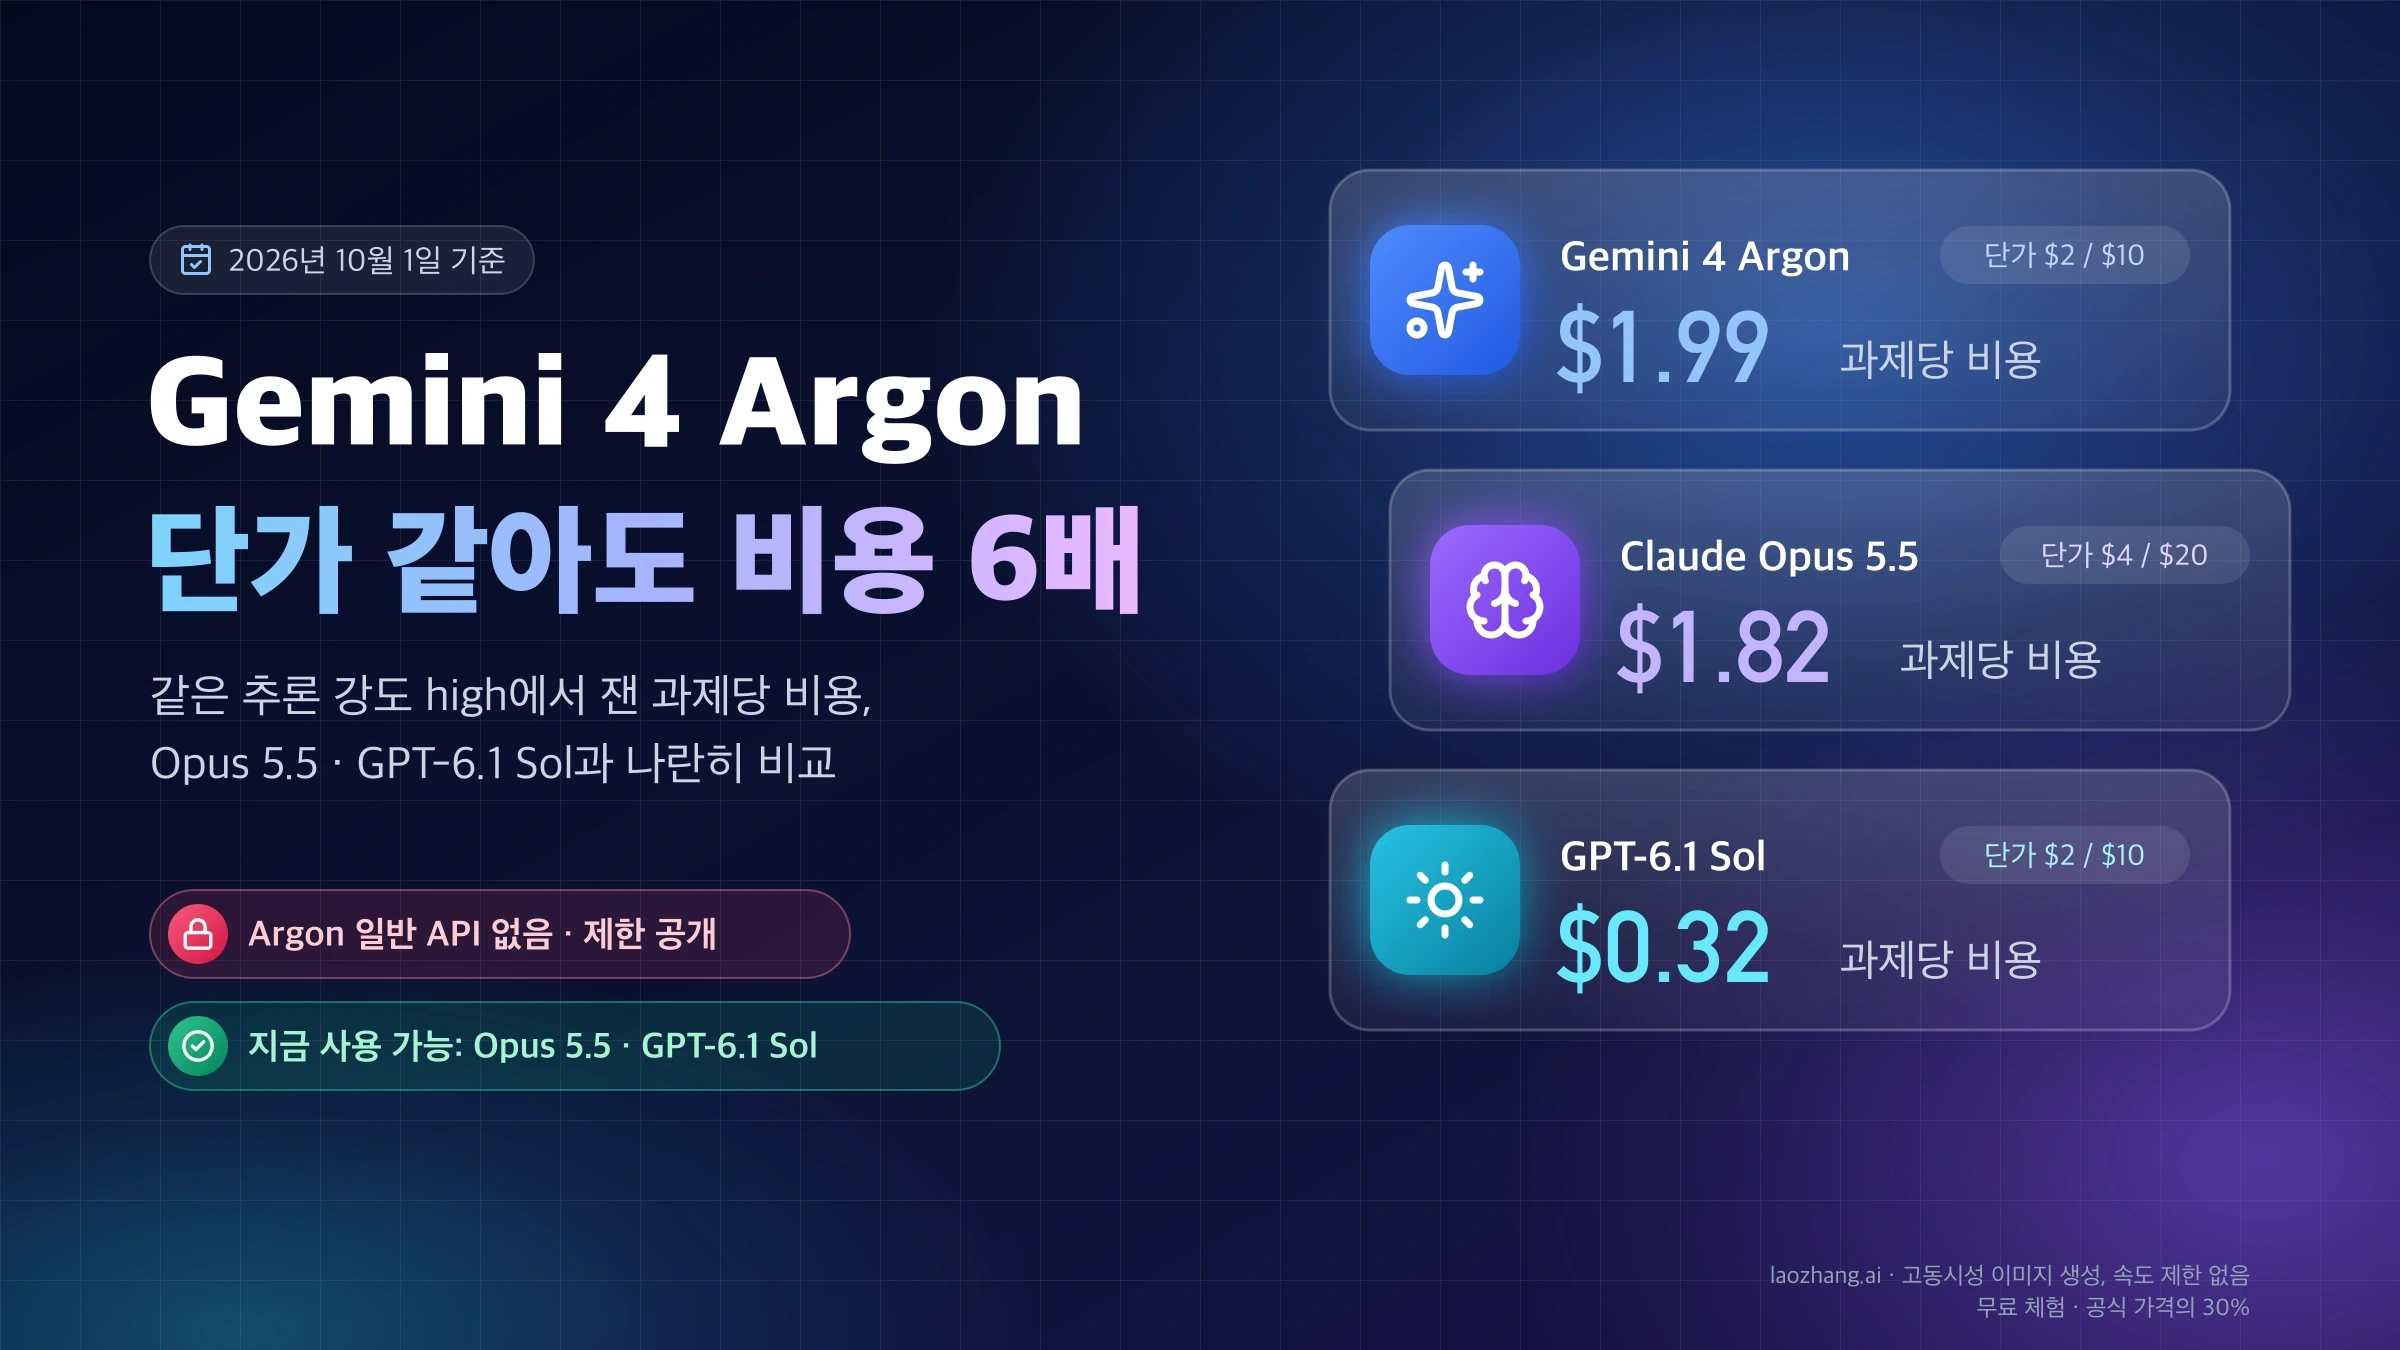
오프라인 일괄 처리는 Sol 쪽이 절반입니다. OpenAI는 Batch와 Flex 처리를 50% 싸게 받지만, Kimi Batch API는 정가의 60%로 받는 대신 지원 모델이 kimi-k2.7-code와 kimi-k2.6뿐이고 K3.1 Pro는 빠져 있습니다. K2 시리즈마저 2026년 10월 31일부터 신규 사용자에게 막히고 12월 말 종료 예정이라, Kimi에서 일괄 할인을 기대하기는 어렵습니다. 다른 플래그십 모델과 Sol의 작업당 비용은 Gemini 4 Argon·Opus 5.5·GPT-6.1 Sol 비교: 작업당 비용 6배 차이에서 비교할 수 있습니다.
K3.1 Pro 시작 조건: $1 충전 직후엔 동시 1건·RPM 3
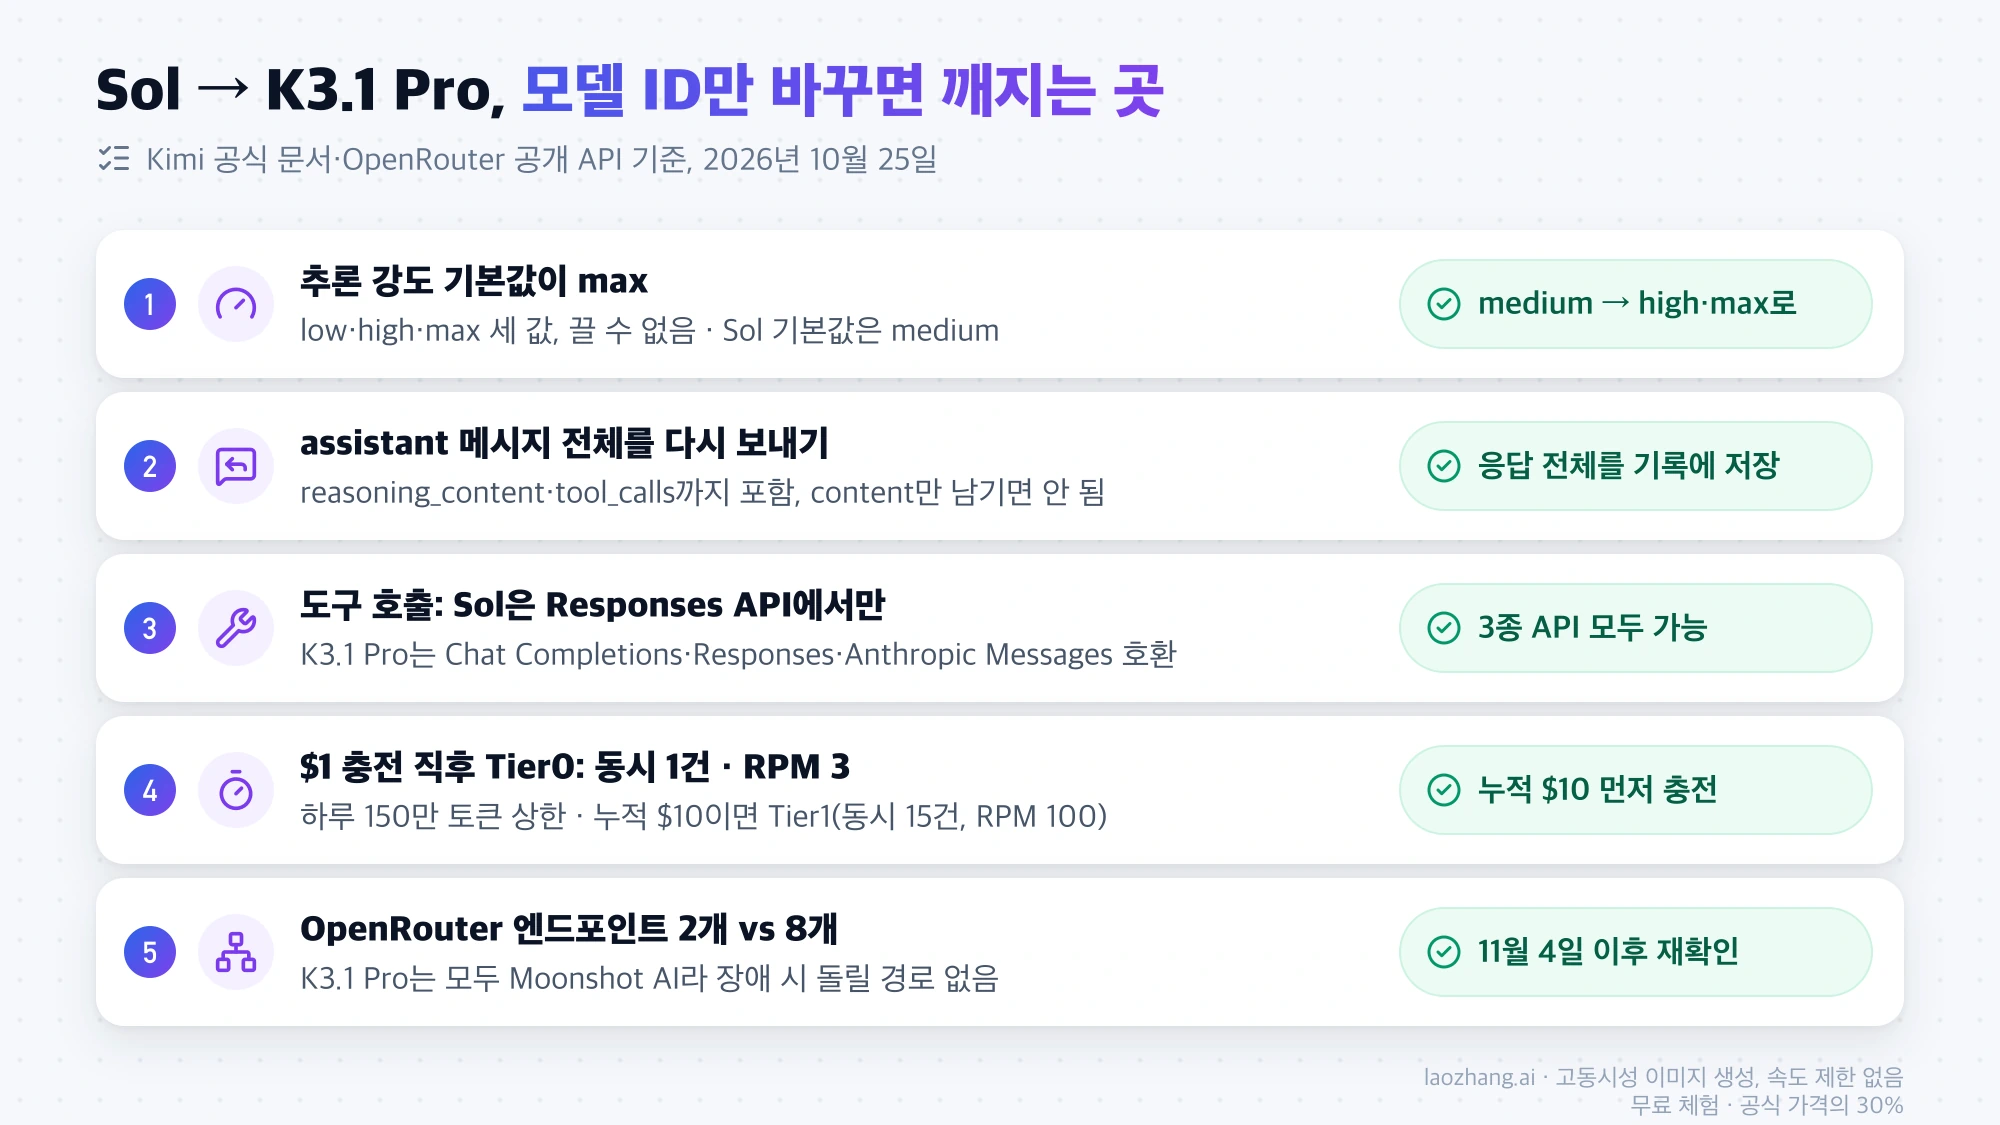
K3.1 Pro는 Kimi 국제 플랫폼에서 최소 $1을 충전해야 열리고, 누적 충전액으로 정해지는 등급에 따라 속도 제한이 크게 다릅니다. $1만 충전한 Tier0은 동시 요청 1건, 분당 3건(RPM), 분당 50만 토큰, 하루 150만 토큰이 상한입니다. 하루 150만 토큰을 AA 작업 하나의 출력 55k 토큰으로 나누면 입력을 빼고도 약 27개 작업 분량이라, 병렬로 도는 에이전트나 시험 배치에는 모자랍니다. 누적 $10이면 Tier1(동시 15건, RPM 100, 분당 200만 토큰, 하루 제한 없음)로 올라갑니다(Kimi 속도 제한 문서). Sol은 OpenAI API 무료 등급에서는 쓸 수 없고, Build 등급부터 5,000 RPM, 분당 100만 토큰입니다.
누적 $5를 충전하면 $5 쿠폰을 주지만 쿠폰은 등급을 정하는 누적 충전액에 들어가지 않습니다. 결제 수단은 Kimi 계정 FAQ가 개인 온라인 충전으로 WeChat Pay와 Alipay QR 결제를 안내하고, 이용약관은 신용·체크카드를 결제 수단 예시로 듭니다. 한국에서 발급한 카드로 결제가 되는지는 공개 문서에 나와 있지 않으므로 $1~$10 소액 충전으로 먼저 확인하는 편이 안전합니다.
옮길 때 바뀌는 것: 추론 강도 기본값, 메시지 재전송, 도구 호출
모델 ID만 바꾸면 깨지는 곳은 주로 추론 강도와 대화 기록 처리입니다. K3.1 Pro는 생각 모드가 항상 켜져 있고 끌 수 없으며, 추론 강도(reasoning_effort)는 low, high, max 세 값에 기본값이 max입니다. Sol의 기본값인 medium을 명시해 보내던 코드는 값을 바꿔야 하고, 아무 값도 보내지 않으면 가장 비싼 max로 실행됩니다. 여러 턴 대화와 도구 호출에서는 API가 돌려준 assistant 메시지 전체를 reasoning_content와 tool_calls까지 포함해 다음 요청에 넣어야 하며, content만 남기면 안 됩니다(Kimi 추론 강도 문서).
| 항목 | Kimi K3.1 Pro | GPT-6.1 Sol |
|---|---|---|
| 모델 ID | kimi-k3.1-pro, 고속판은 별도 ID kimi-k3.1-pro-highspeed | gpt-6.1-sol |
| 출시일 | 2026년 10월 23일 | 2026년 9월 29일 |
| 컨텍스트 | 1,048,576 토큰 | 1,050,000 토큰 |
| 최대 출력(OpenRouter 표기) | 943,718 토큰 | 128,000 토큰 |
| 추론 강도 값 | low, high, max. 기본 max, 끌 수 없음 | low, medium, high, xhigh, max. 기본 medium, none·minimal 미지원 |
| 추론 강도 지정 위치 | 요청 최상위 reasoning_effort | reasoning.effort |
| 도구 호출 | Chat Completions, Responses API, Anthropic Messages 호환 엔드포인트 | Responses API에서만. Chat Completions는 도구 호출 없이 지원 |
| 샘플링 파라미터 | OpenRouter 엔드포인트에 temperature·top_p·seed 없음 | 2026년 10월 5일 게이트웨이 경유 테스트에서 Chat Completions가 temperature: 0.2 거부 |
| 캐시 유지 시간 지정 | prompt_cache_options의 ttl 1h, 생략 시 5분 | Responses API prompt_cache_options.ttl의 12h, 기본 30분 |
| 272K 초과 입력 | 할증 없음 | 요청 전체 할증 |
| 일괄 처리 할인 | 없음(Kimi Batch API 미지원) | Batch·Flex 50% |
| OpenRouter 엔드포인트(2026년 10월 25일) | 2개, 모두 Moonshot AI | 8개: OpenAI 4종, Azure 3종, Amazon Bedrock |
| 가중치 | 비공개, 11월 4일까지 공개 예정 | 비공개 |
출처: Kimi K3.1 Pro 빠른 시작, OpenAI GPT-6.1 Sol 모델 페이지, OpenRouter 엔드포인트 API.
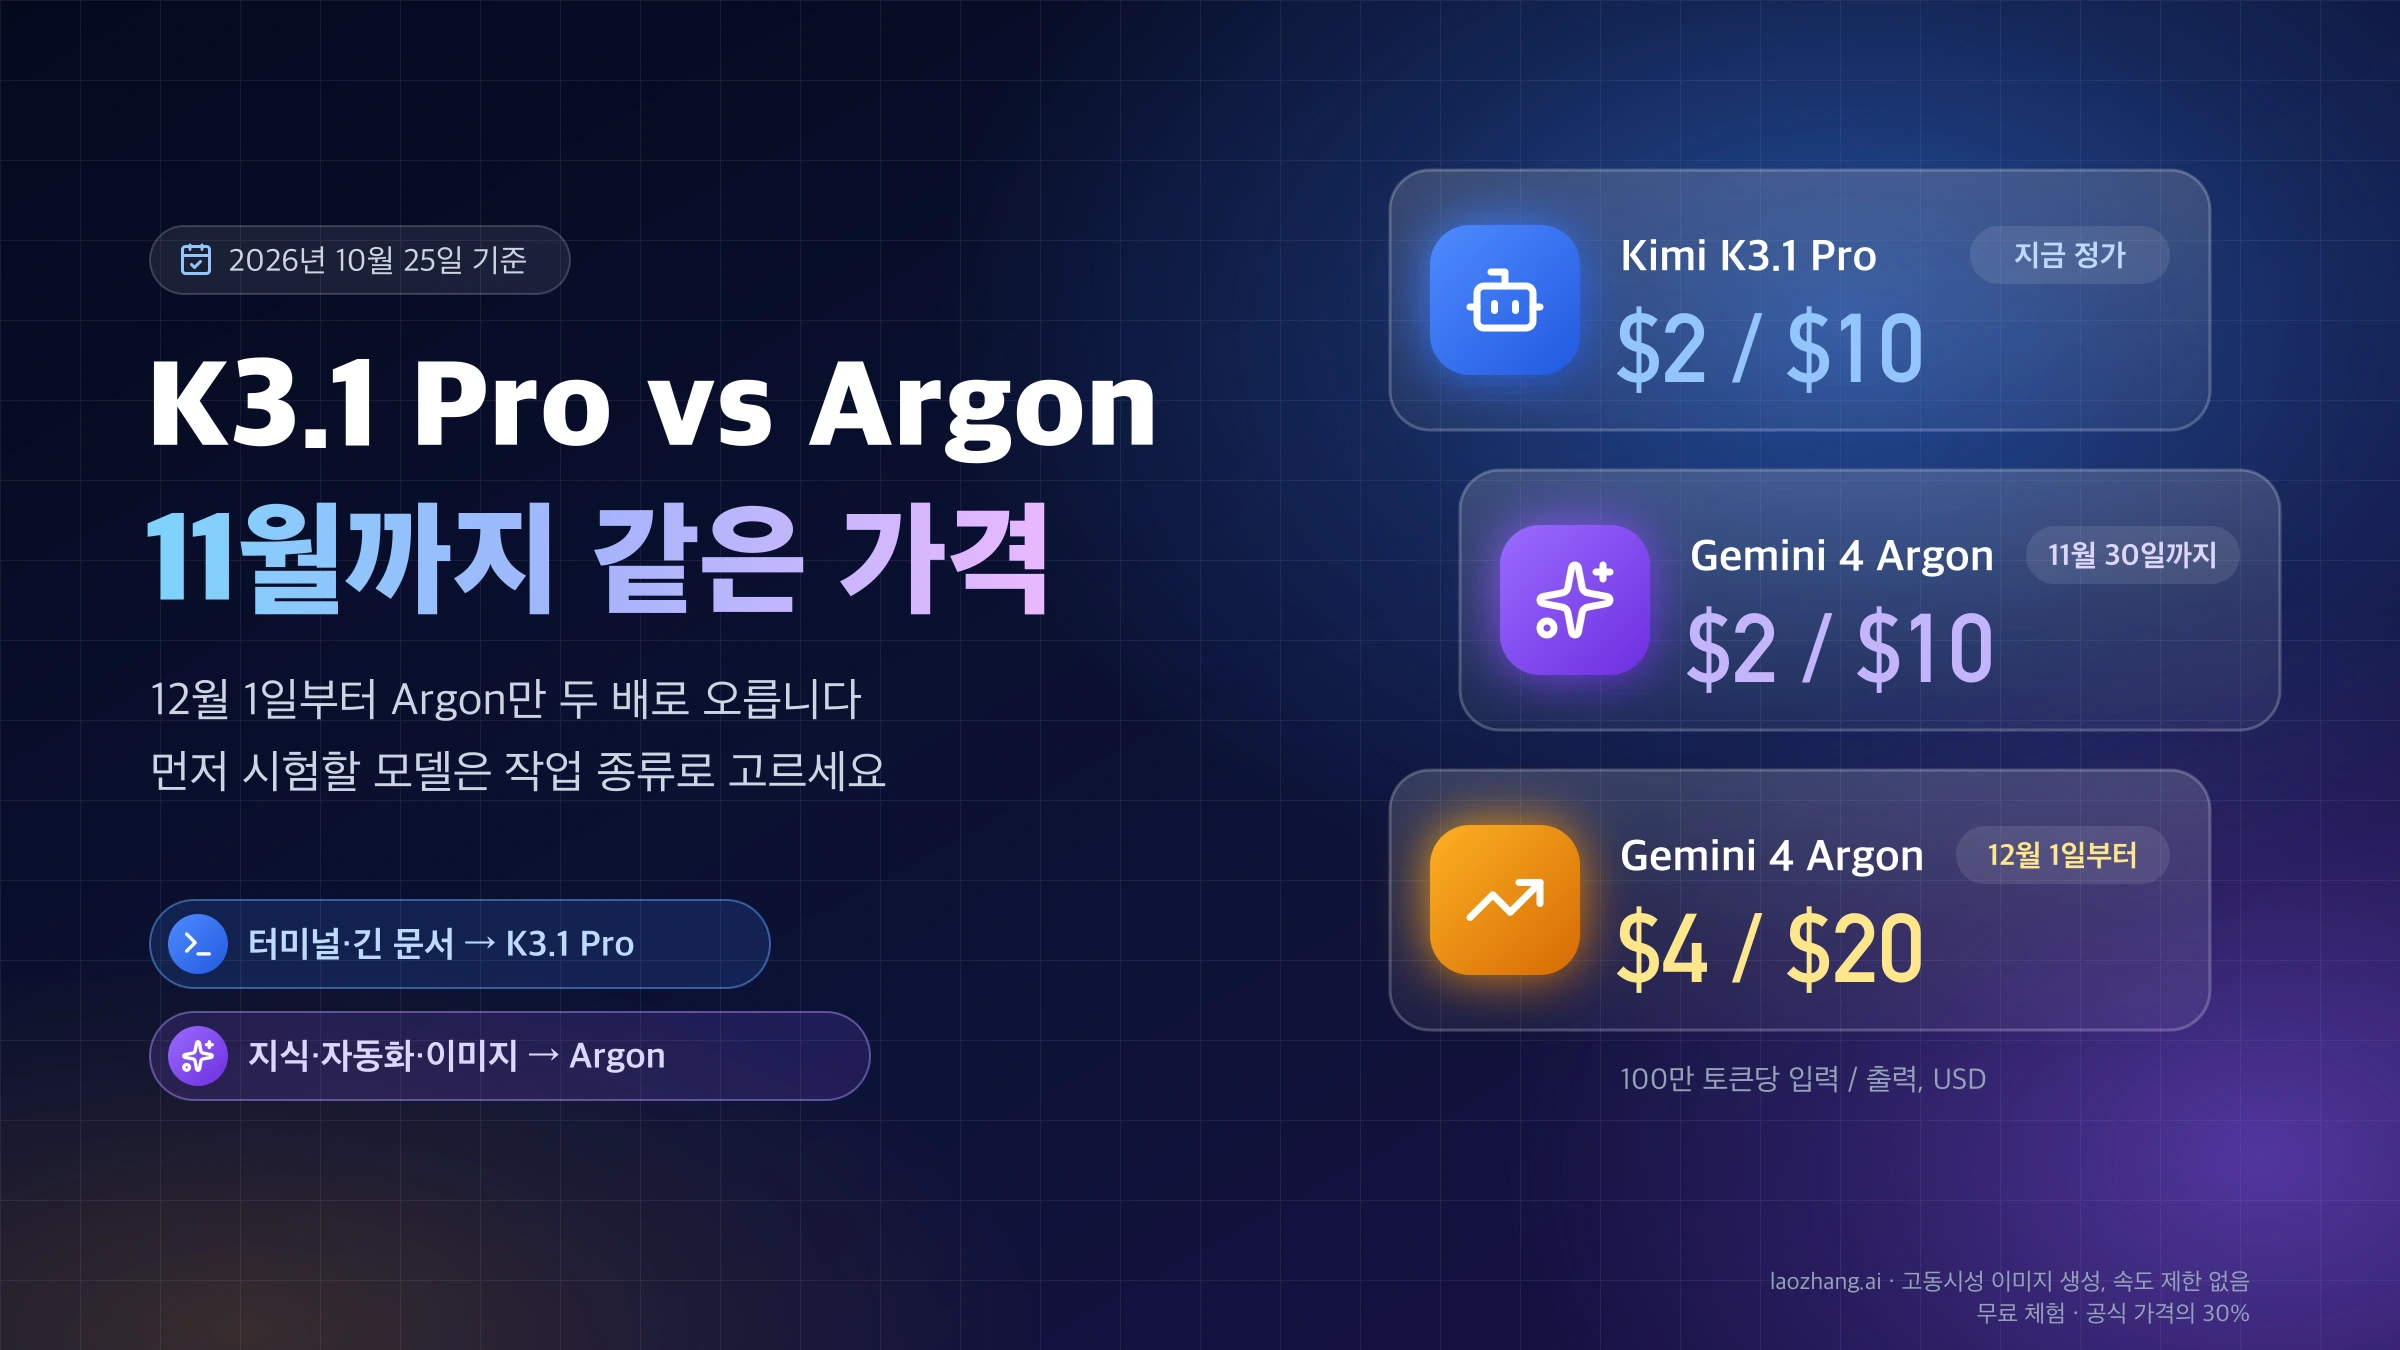
2026년 10월 25일 OpenRouter 공개 API(/api/v1/models/{id}/endpoints)를 키 없이 조회한 결과, OpenRouter의 Kimi K3.1 Pro 페이지에 연결된 엔드포인트는 Moonshot AI의 표준판과 highspeed 두 개뿐이었습니다. Sol은 OpenAI의 standard·flex·fast·ultrafast, Azure 일반·EU·US, Amazon Bedrock us-east-1까지 8개였습니다. K3.1 Pro는 Moonshot에 장애가 나면 다른 회사로 돌릴 경로가 아직 없다는 뜻입니다. Moonshot은 전체 가중치를 11월 4일까지 공개하겠다고 밝혔지만 AA는 현재 비공개 모델로 분류하므로, 오픈 웨이트로 자체 호스팅하거나 다른 제공업체로 옮기는 계획은 실제 공개 이후에 세우는 편이 맞습니다. LaoZhang API(laozhang.ai)의 모델 목록에는 gpt-6.1-sol이 있고, 2026년 10월 25일에는 kimi-k3.1-pro와 kimi-k3.1-pro-highspeed도 Kimi 정가(100만 토큰당 각각 입력 $2·출력 $10, 입력 $4·출력 $20, 캐시 읽기 $0.20, 캐시 쓰기 5분 $2·1시간 $4)로 추가돼 Chat Completions로 호출할 수 있습니다. 키 하나로 두 모델을 모두 시험할 수 있다는 뜻입니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
Codex에서 K3.1 Pro 쓰기: config.toml에 kimi 프로바이더 추가
Kimi 공식 가이드 Use Kimi K3.1 Pro in Codex에 따르면 Kimi 플랫폼이 Codex가 쓰는 Responses API를 직접 지원하므로, 변환 프록시 없이 ~/.codex/config.toml에 프로바이더를 추가하고 API 키를 KIMI_API_KEY 환경 변수에 넣으면 됩니다. Codex와 Kimi 연결은 직접 실행해 보지 않았으므로 아래는 Kimi 문서의 설정 그대로입니다.
model = "kimi-k3.1-pro"
model_provider = "kimi"
model_context_window = 1048576

[model_providers.kimi]
name = "Kimi"
base_url = "https://api.moonshot.ai/v1"
env_key = "KIMI_API_KEY"
wire_api = "responses"
Kimi 문서는 데스크톱 앱에서 모델 이름이 "Custom"으로 보일 수 있고, "Model metadata for kimi-k3.1-pro not found" 경고는 정상이라고 설명합니다. platform.kimi.ai에서 만든 키는 https://api.moonshot.ai/v1에서만 동작하고, 429 오류는 등급별 속도·동시 요청 제한에 걸렸다는 뜻입니다. 도구를 연달아 호출하는 Codex 세션은 Tier0의 동시 1건·RPM 3에 금방 막히므로 누적 $10(Tier1)을 먼저 채워 두세요. Codex에서 추론 강도를 medium으로 지정해 두었다면 K3.1 Pro에는 그 값이 없으니 high나 max로 바꾸는 편이 안전합니다.
ChatGPT 구독으로 Codex에서 Sol을 쓰던 사람은 과금 구조도 바뀝니다. Sol은 ChatGPT Plus·Pro·Business·Enterprise·Edu 플랜의 Codex에서 구독 한도 안에서 쓰지만, K3.1 Pro는 Kimi API 키로 토큰마다 청구됩니다. Codex 세션은 캐시 적중이 많은 에이전트 루프라 토큰 단가로 따져도 Sol이 불리하지 않습니다. 구독과 API 키의 손익은 Codex API 키와 ChatGPT 구독 차이: 크레딧 환산 비용과 손익분기점, 일반적인 커스텀 프로바이더 설정과 인증 오류는 Codex Custom Provider 설정: API 키와 Base URL 연결법에서 다룹니다.
내 업무로 확인하는 법: 성공한 작업당 비용으로 비교
AA 지수는 여러 평가의 평균이라, K3.1 Pro의 3점 우위가 자기 작업에서도 나타날지는 직접 돌려 봐야 압니다. 판단 기준은 토큰 단가가 아니라 성공한 작업 하나당 비용으로 잡는 것이 정확합니다. 순서는 다음과 같습니다.
- 실제 로그에서 자주 반복되는 작업 20~30개를 고르고, 테스트 통과나 수치 일치처럼 합격 기준을 먼저 정합니다.
- Kimi 계정을 누적 $10 이상 충전해 Tier1로 올립니다. Tier0에서는 동시 1건 제한 때문에 시험이 오래 걸리고 429로 자주 끊깁니다.
- 같은 작업을 Sol은 지금 쓰는 설정과 한 단계 위(예: medium과 high)로, K3.1 Pro는 기본값 max와 high로 실행합니다. K3.1 Pro high의 비용은 공개된 값이 없으니 이 단계에서 직접 잽니다.
- 응답의 usage에서 작업마다 새 입력, 캐시 적중, 캐시 쓰기, 출력(추론 포함) 토큰을 기록하고 각 회사 정가로 비용을 계산합니다. Sol 요청 가운데 입력이 272K를 넘은 것은 입력·캐시 2배, 출력 1.5배로 계산합니다.
- 총비용을 합격한 작업 수로 나눠 성공한 작업당 비용을 비교합니다. 대화형 용도라면 첫 답변 토큰까지 걸린 시간도 함께 적습니다.
결과가 작업마다 갈리면 하나로 정할 필요 없이 나눠 쓰면 됩니다. 기본은 Sol high로 돌리고, Sol이 합격 기준을 넘지 못한 에이전트 작업과 입력이 272K를 넘는 요청만 K3.1 Pro로 보내는 식입니다. 11월 4일 이후 가중치가 공개되어 OpenRouter에 다른 제공업체가 붙으면 K3.1 Pro의 가격과 속도 선택지도 달라질 수 있으니, 그때 엔드포인트 목록을 다시 확인하세요.
참고 자료12
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 25일.
참고 자료12
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 25일.
- 1.Kimi API 요금표platform.kimi.ai/docs/pricing/chat
- 2.Artificial Analysis의 Kimi K3.1 Pro vs GPT-6.1 Sol 비교 페이지artificialanalysis.ai/models/comparisons/kimi-k3-1-pro-vs-gpt-6-1-sol
- 3.Kimi 컨텍스트 캐시 문서platform.kimi.ai/docs/guide/context-caching
- 4.OpenAI 프롬프트 캐싱 문서developers.openai.com/api/docs/guides/prompt-caching
- 5.OpenAI API 요금 페이지developers.openai.com/api/docs/pricing
- 6.Kimi Batch APIplatform.kimi.ai/docs/pricing/batch
- 7.Kimi 속도 제한 문서platform.kimi.ai/docs/pricing/limits
- 8.Kimi 추론 강도 문서platform.kimi.ai/docs/guide/use-reasoning-effort
- 9.Kimi K3.1 Pro 빠른 시작platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- 10.OpenAI GPT-6.1 Sol 모델 페이지developers.openai.com/api/docs/models/gpt-6.1-sol
- 11.OpenRouter의 Kimi K3.1 Pro 페이지openrouter.ai/moonshotai/kimi-k3.1-pro
- 12.Use Kimi K3.1 Pro in Codexplatform.kimi.ai/docs/guide/codex-kimi