Kimi K3.1 Pro vs Gemini 4 Argon 비교: 11월까지 같은 가격, 작업별 선택
두 모델은 100만 토큰당 입력 $2·출력 $10으로 같지만 Argon은 12월 1일부터 두 배입니다. 터미널 코딩·긴 문서는 K3.1 Pro, 지식·자동화·이미지는 Argon부터 시험하세요.
목차
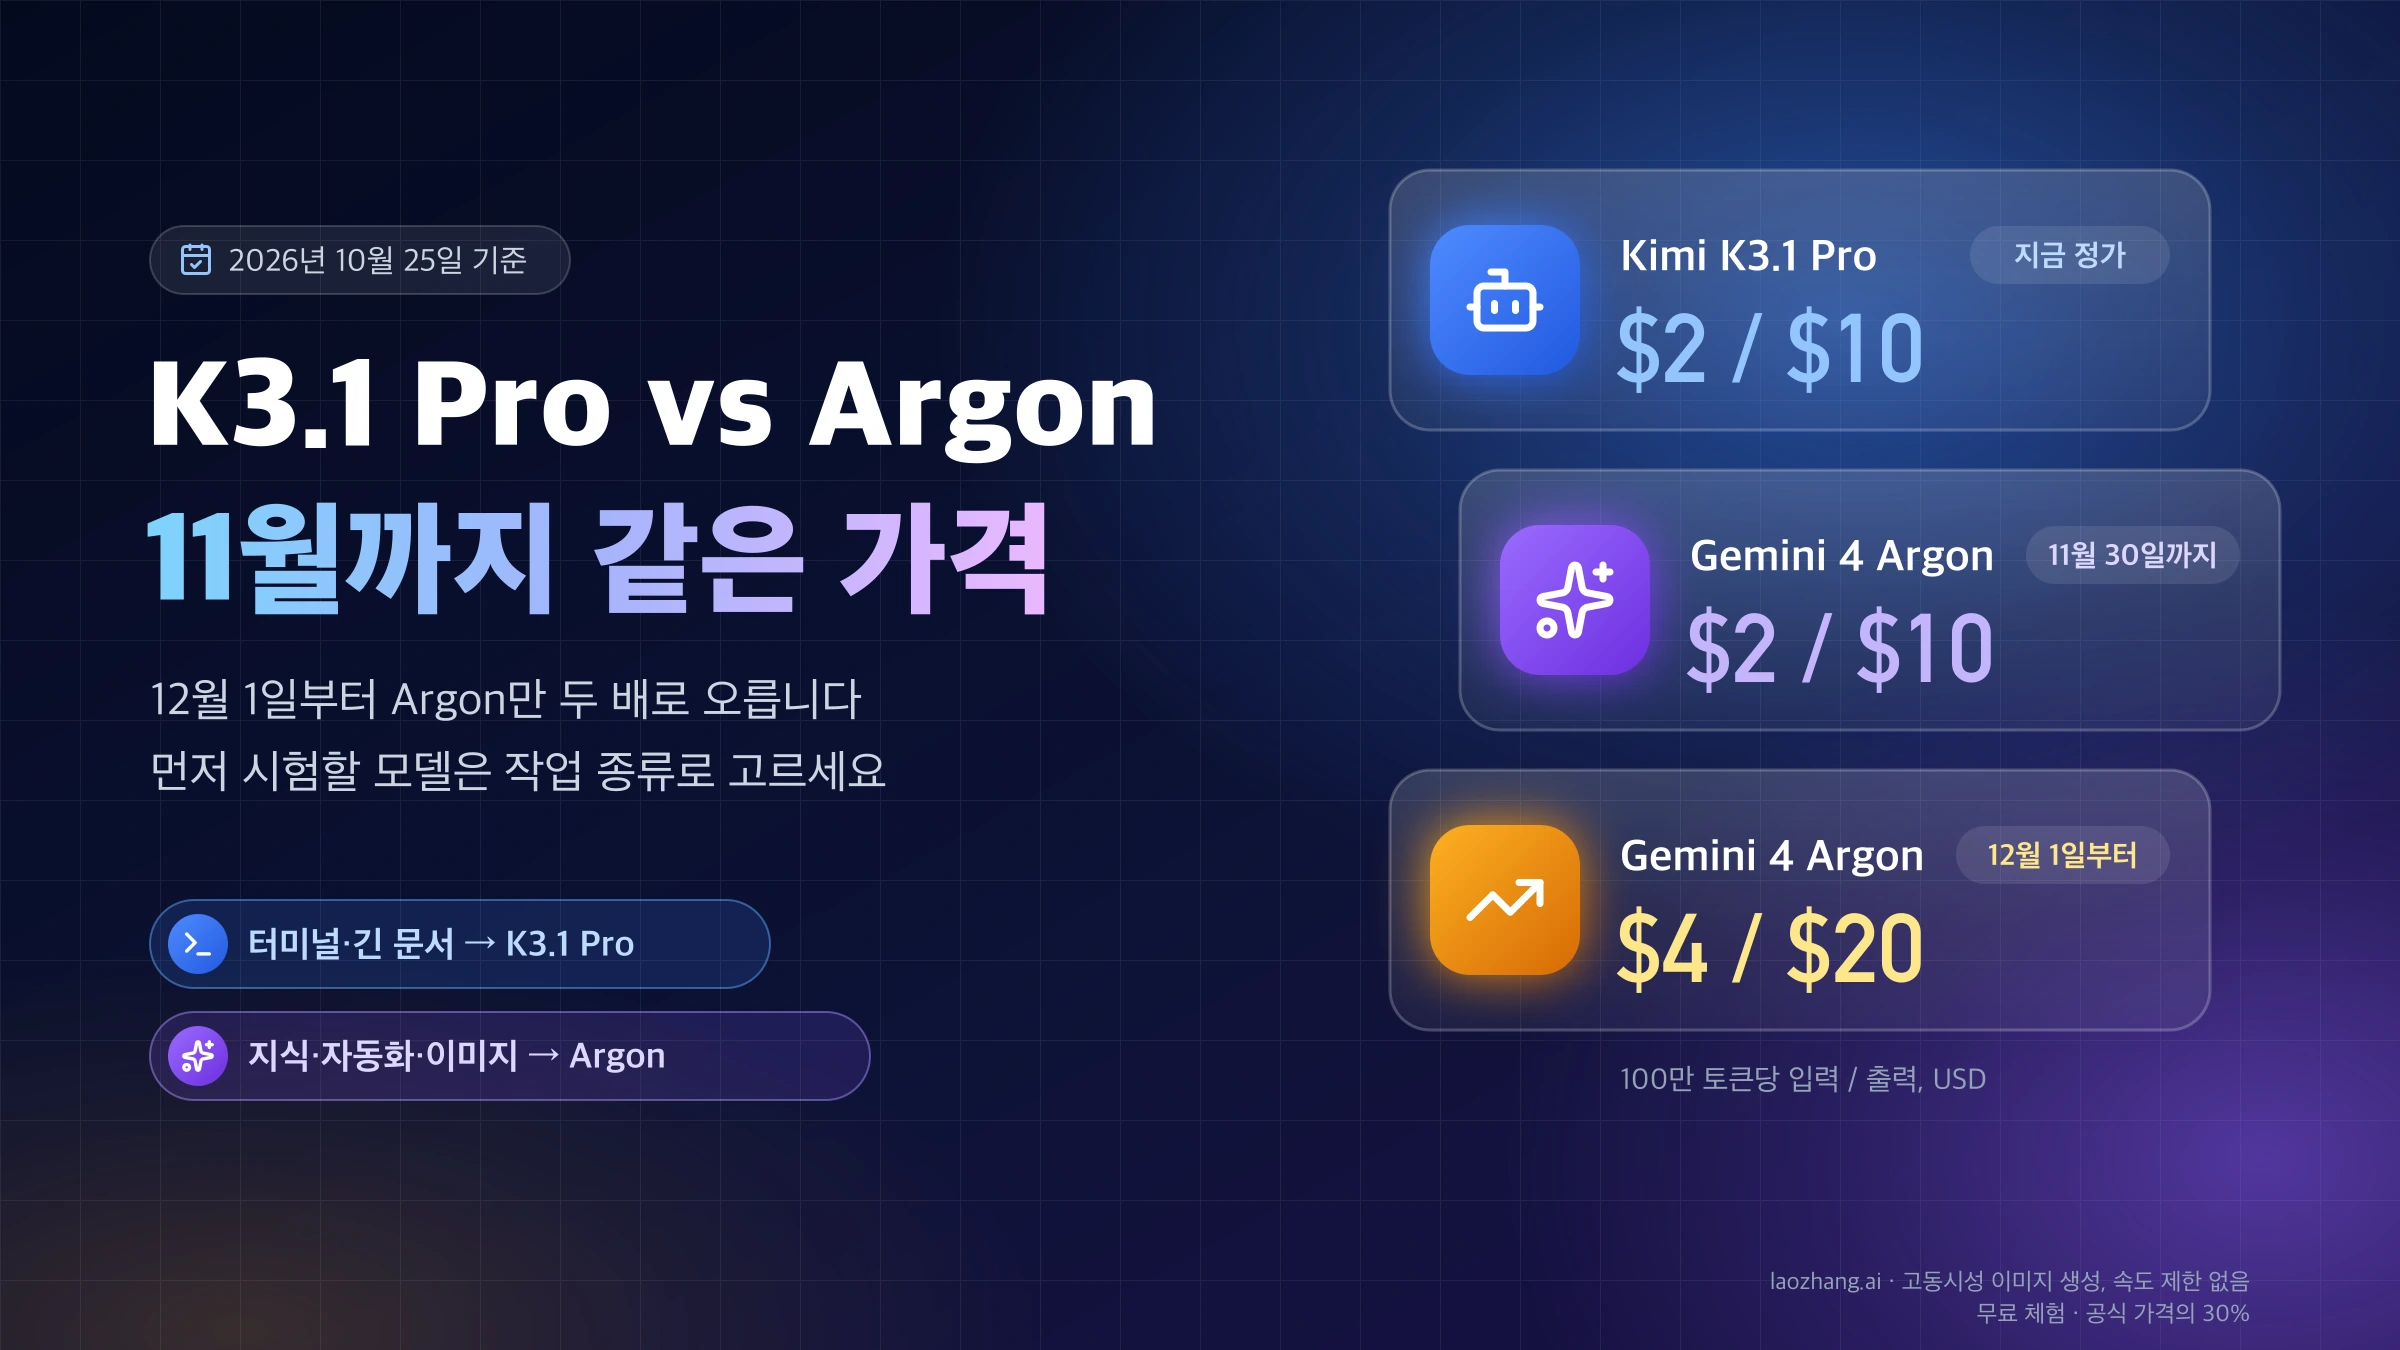
Kimi K3.1 Pro(kimi-k3.1-pro, 2026년 10월 23일 공개)와 Gemini 4 Argon(gemini-4-argon, 2026년 10월 13일 정식 출시)의 API 정가는 2026년 10월 25일 기준 100만 토큰당 입력 $2, 출력 $10으로 같습니다. 다만 Argon의 이 가격은 2026년 11월 30일까지만 적용되고, 12월 1일부터는 입력 $4, 출력 $20으로 두 배가 됩니다. 그 단가는 Kimi가 2~3배 빠르다고 소개하는 K3.1 Pro Highspeed와 같습니다.
무엇을 먼저 테스트할지는 작업 종류로 정하세요. 터미널·에이전트 코딩, 긴 문서를 읽고 추론하는 질의, 보고서처럼 문서 산출물을 만드는 업무라면 kimi-k3.1-pro부터 시험할 만합니다. Artificial Analysis 항목별 점수에서 Terminal-Bench 4.0은 67% 대 57%, 긴 컨텍스트 추론(AA-LCR)은 86% 대 80%로 K3.1 Pro가 앞섰습니다. 반대로 사실 정확도가 중요한 지식 질의, 어려운 과학 문제, 업무 자동화, 이미지 속 객체에 박스를 그리는 작업은 gemini-4-argon이 먼저입니다. Argon은 지식 신뢰도 지표와 업무 자동화 평가에서 앞섰고, Ultralytics의 객체 탐지 벤치마크에서는 정확도·비용·속도 모두 우세했습니다.
비용으로 고른다면 12월 단가로 계산해야 합니다. 캐시를 많이 쓰는 코딩 에이전트 세션을 가정해 정가로 계산하면 11월까지는 Argon이 K3.1 Pro의 0.89배지만 12월부터는 1.78배가 되고, Argon의 암묵적 캐시가 맞지 않으면 지금 가격으로도 약 3배입니다. 지금 당장 직접 호스팅하거나 파인튜닝할 모델이 필요하다면 K3.1 Pro도 아직 답이 아닙니다. 웨이트는 11월 4일까지 공개될 예정이고, 그 전까지 API 제공처는 개발사 Moonshot 한 곳뿐입니다.
정말 같은 가격인가: 2026년 11월 30일까지만 입력 $2·출력 $10
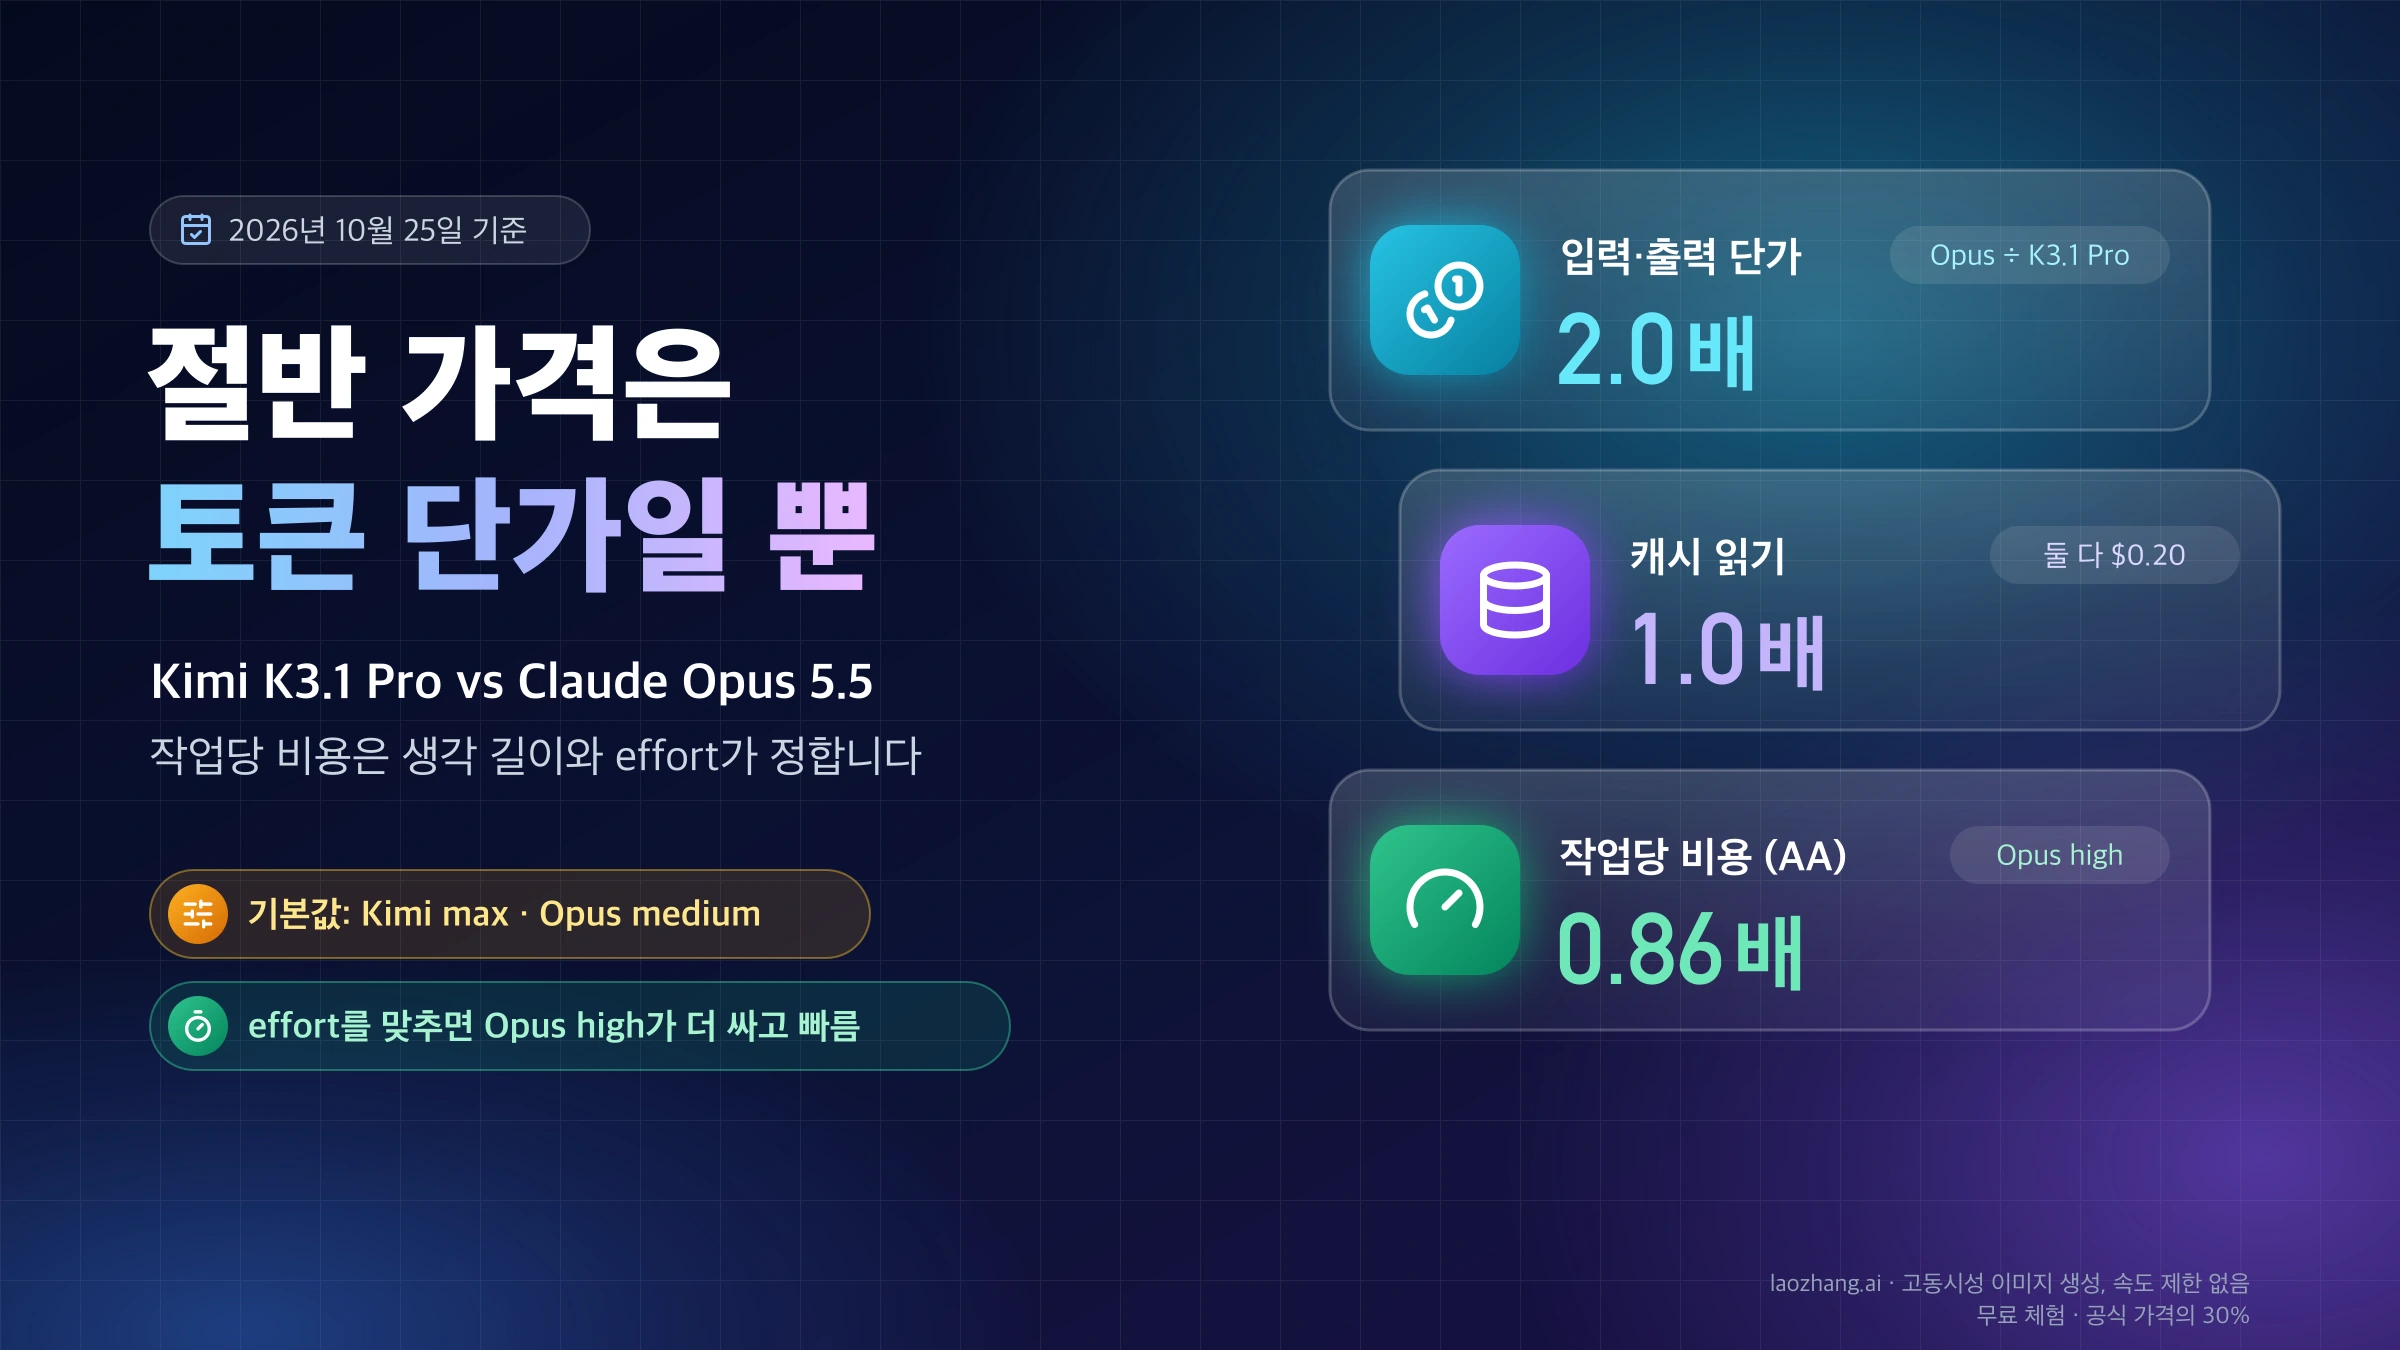
토큰 단가가 같은 것은 Argon의 출시 가격 기간인 2026년 11월 30일까지, 그것도 입력과 출력에 한해서입니다. 캐시 적중 입력은 지금 Argon이 $0.10으로 K3.1 Pro($0.20)의 절반이고, 12월 1일부터는 Argon의 입력·출력·캐시 적중 단가가 모두 K3.1 Pro Highspeed와 같아집니다. 아래는 Google 제미나이 API 가격 페이지의 Standard 가격과 Kimi API 가격 페이지의 달러 가격입니다.
| 100만 토큰당 정가 (USD) | K3.1 Pro | K3.1 Pro Highspeed | Argon (11월 30일까지) | Argon (12월 1일부터) |
|---|---|---|---|---|
| 입력 | $2.00 | $4.00 | $2.00 | $4.00 |
| 출력(사고 토큰 포함) | $10.00 | $20.00 | $10.00 | $20.00 |
| 캐시 적중 입력 | $0.20 | $0.20 | $0.10 | $0.20 |
| 캐시 쓰기 | 5분 $2.00, 1시간 $4.00 | 5분 $4.00, 1시간 $8.00 | 별도 요금 없음 | 별도 요금 없음 |
Google은 Argon 출력 요금에 사고 토큰이 포함된다고 밝혔습니다. Kimi는 이 점을 명시하지 않지만 OpenRouter와 Artificial Analysis는 사고 토큰을 출력으로 계산하므로, 아래 비용 계산도 같은 전제를 따릅니다. 두 모델 모두 컨텍스트 길이에 따른 가격 구간은 없습니다.
Argon에는 Standard 외에 Batch·Flex(11월 30일까지 입력 $1, 출력 $5)와 Priority(입력 $3.60, 출력 $18) 가격도 있고, 이 역시 12월 1일부터 두 배가 됩니다. 응답을 기다릴 필요가 없는 대량 작업이라면 Argon Batch가 같은 기간 K3.1 Pro 정가의 절반이라는 점도 계산에 넣을 만합니다. 이전 모델 Kimi K3는 입력 $3, 출력 $15로 K3.1 Pro와 가격이 다르므로, K3 기준으로 쓰인 가격 비교를 볼 때는 모델 ID부터 확인하세요.
작업당 비용: 캐시 많은 에이전트 작업은 12월부터 Argon 1.78배
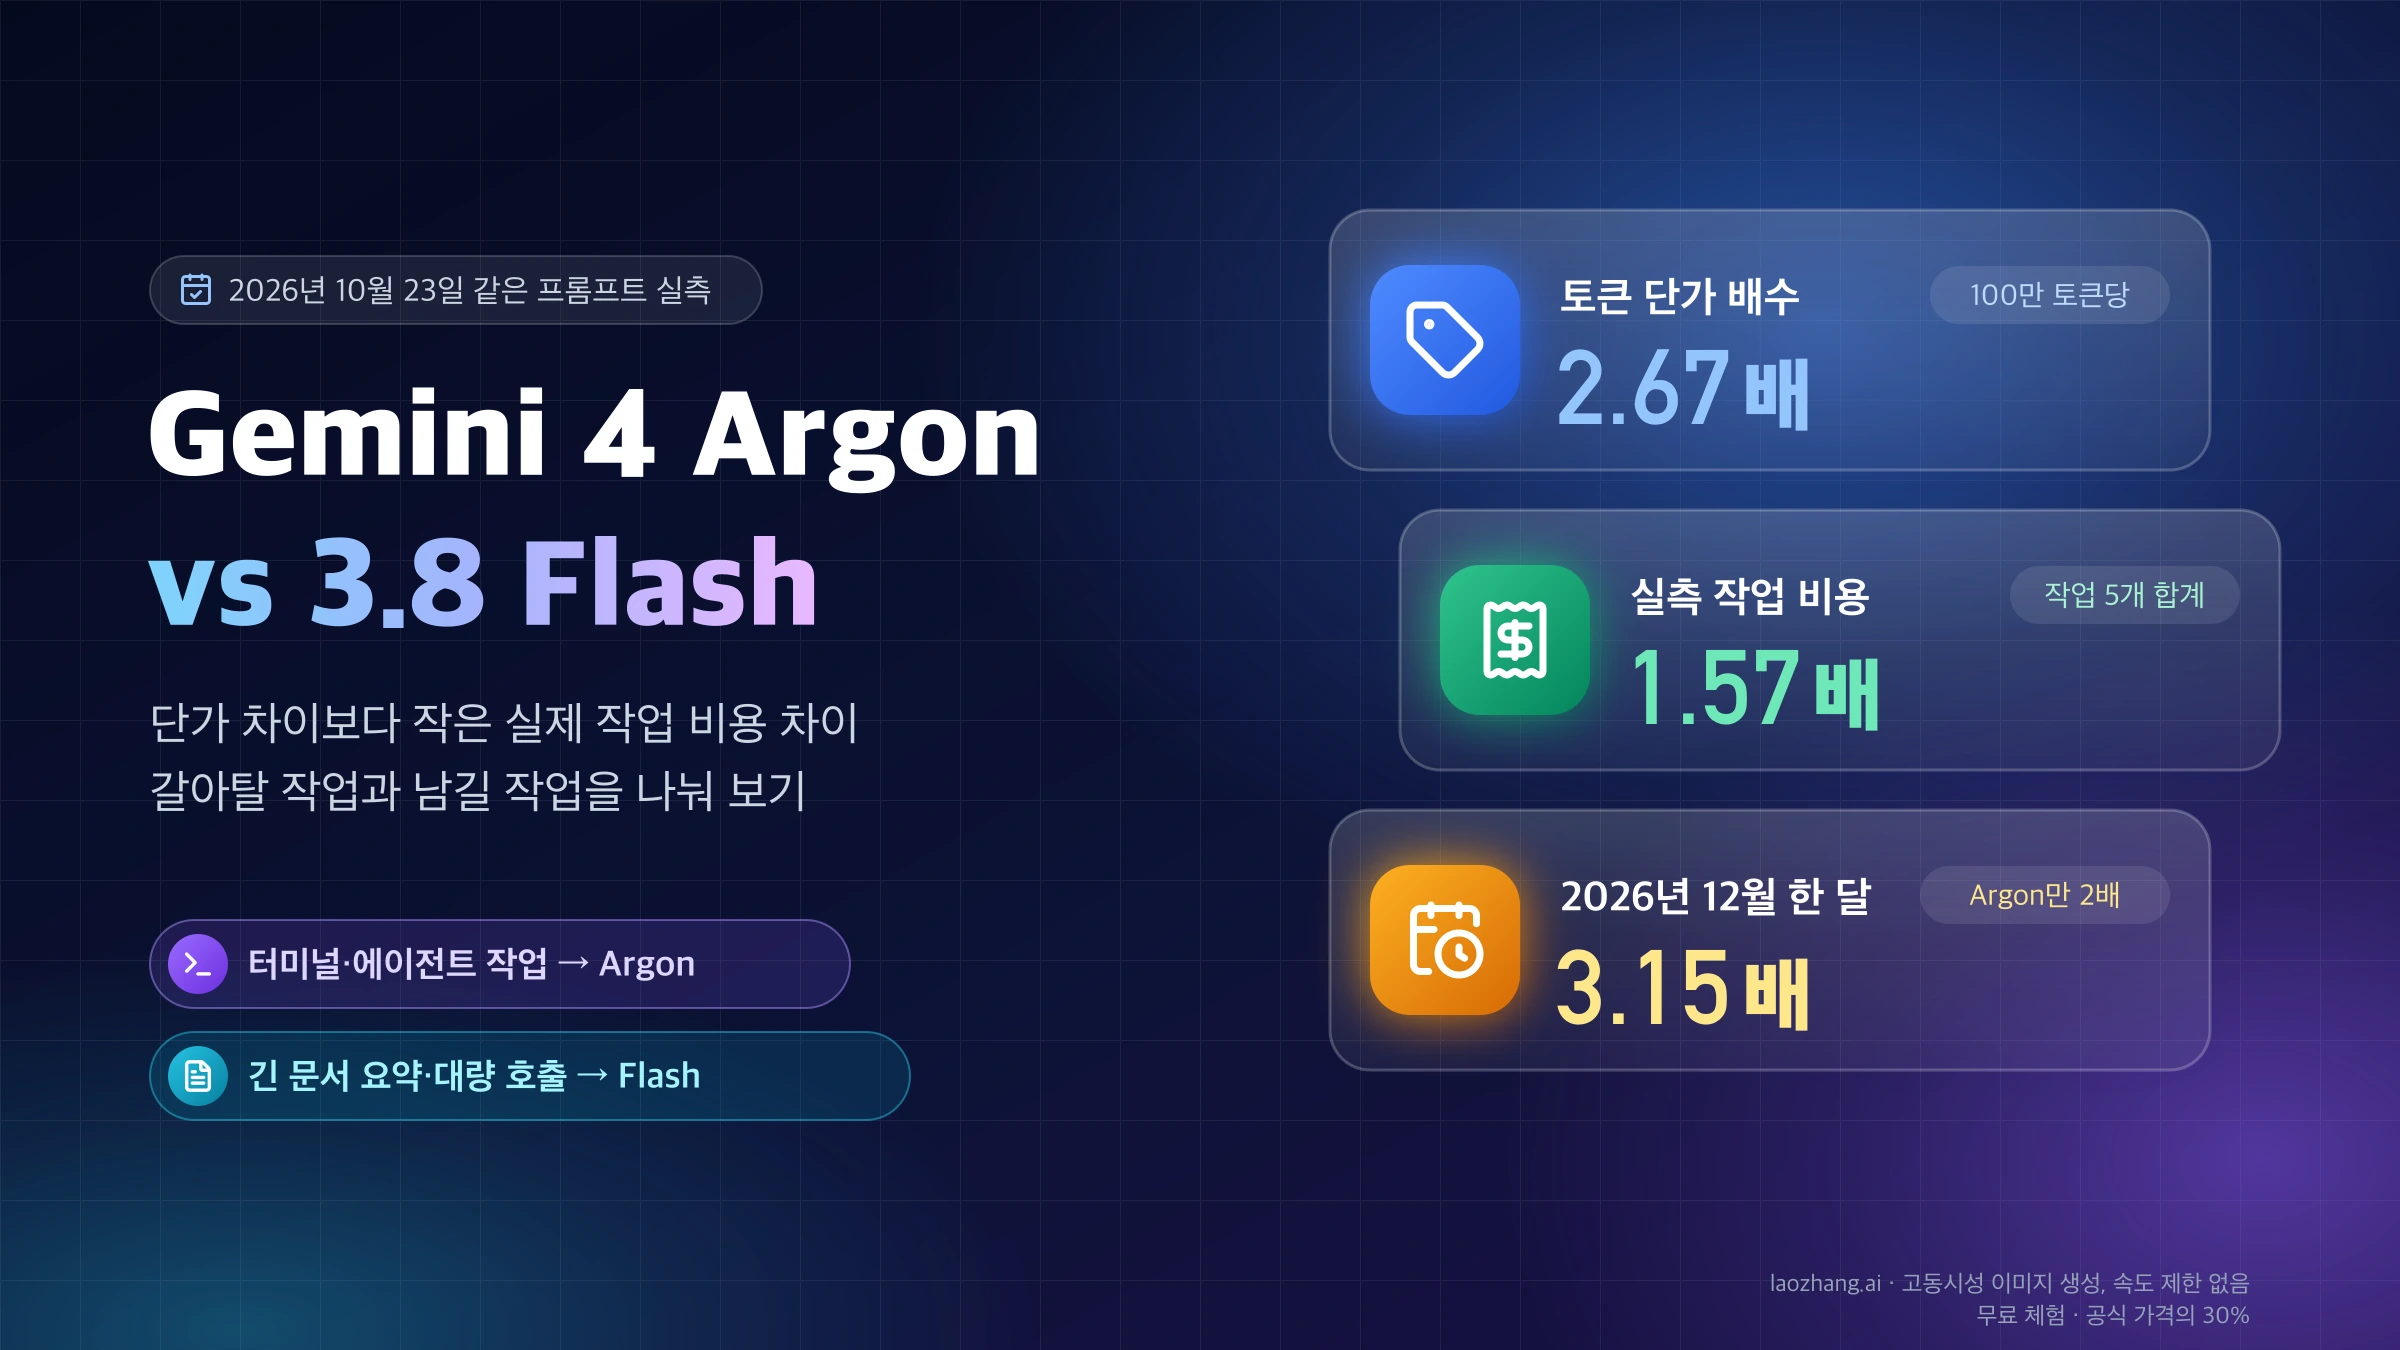
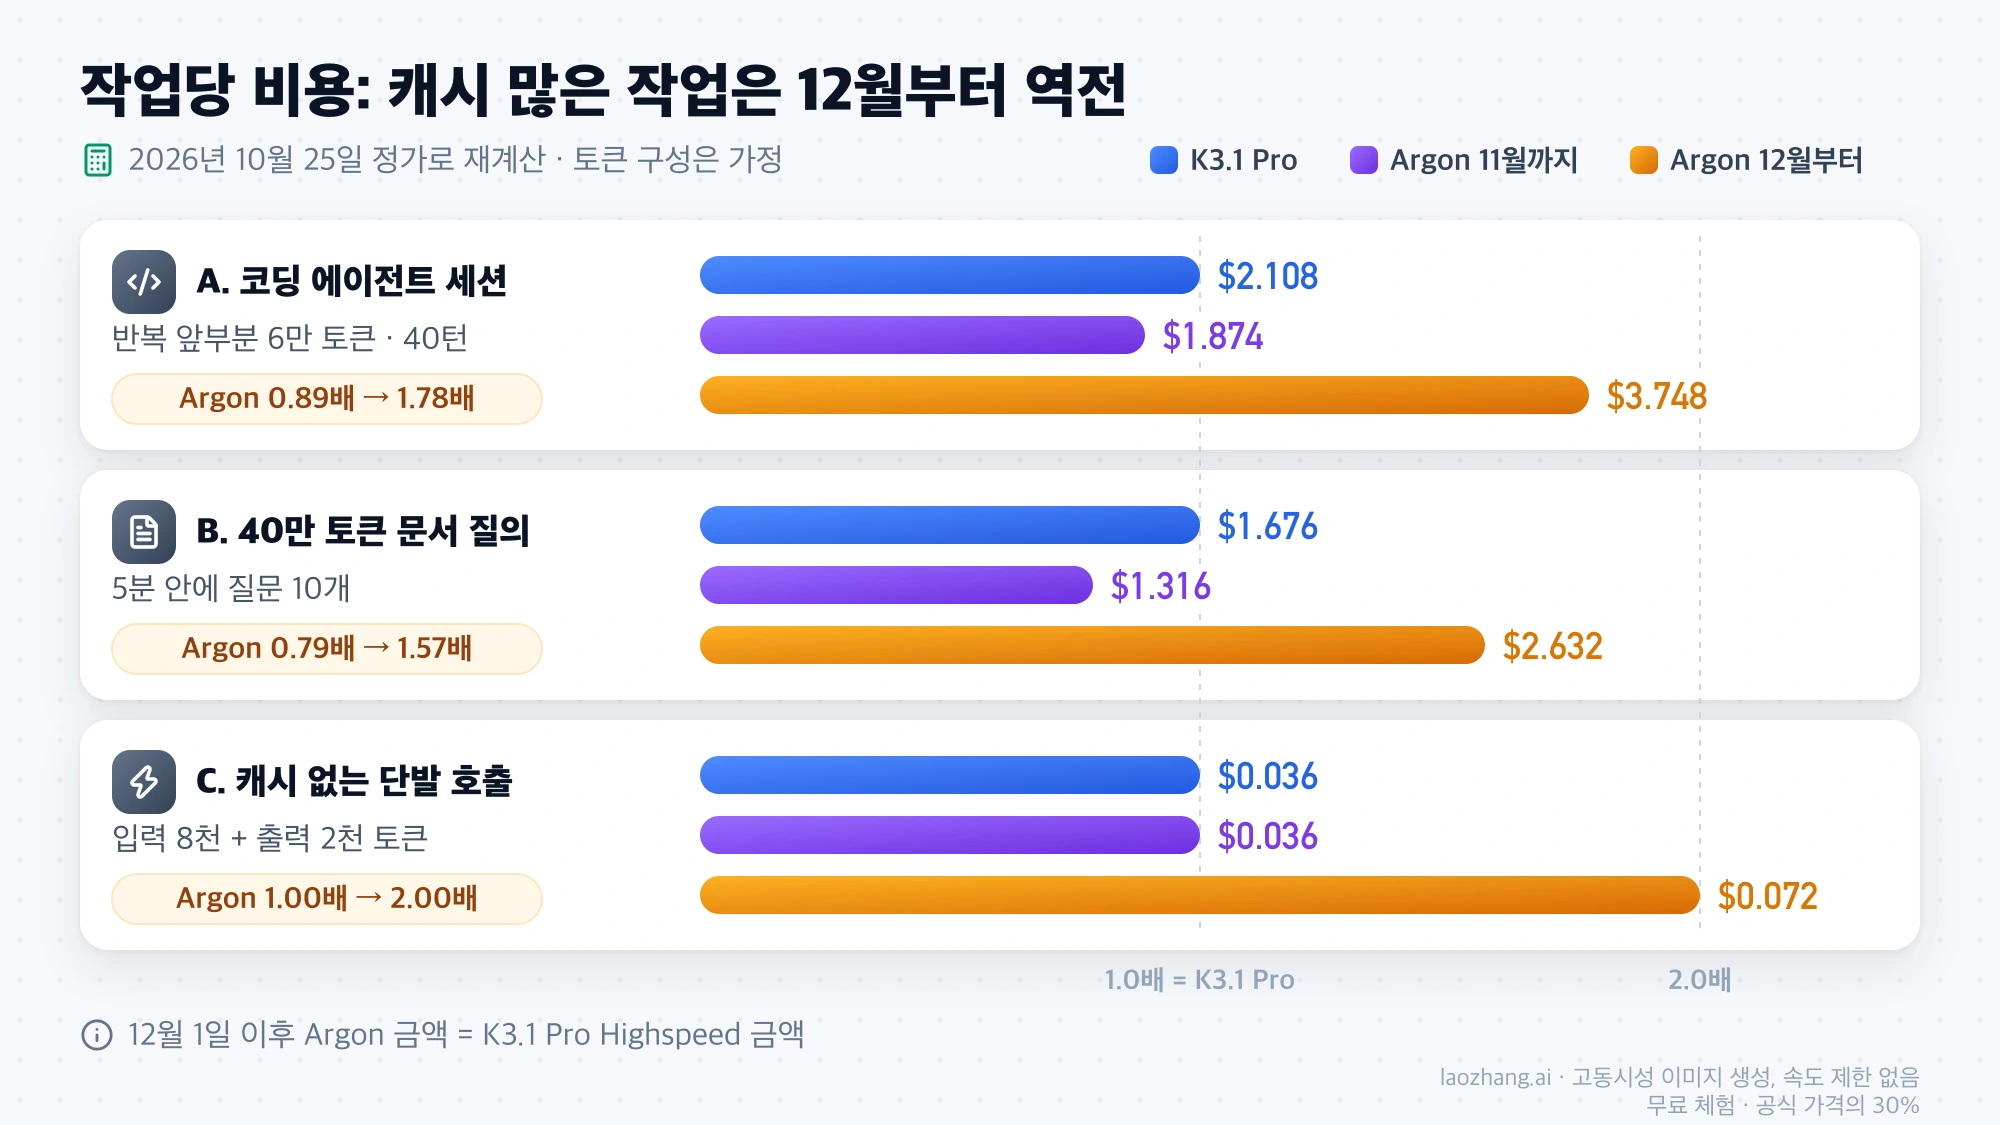
토큰당 가격이 같아도 작업당 비용은 캐시를 얼마나 쓰느냐와 가격 기간에 따라 달라집니다. 2026년 10월 25일 두 모델의 정가로 세 가지 토큰 구성을 재계산한 결과, 캐시 비중이 큰 작업은 11월까지 Argon이 10~20% 싸고 12월부터는 1.57~1.78배 비쌉니다. 캐시가 없는 단발 호출은 지금 같고, 12월부터 정확히 두 배입니다.
이 계산에 쓴 토큰 수는 실제 트래픽이 아니라 가정입니다. K3.1 Pro는 반복되는 앞부분(시스템 프롬프트, 도구 정의, 문서 등)을 5분 TTL 쓰기 가격으로 한 번 쓰고 이후 캐시 가격으로 읽는다고 보았고, Argon은 첫 턴에 그 부분을 정가로 낸 뒤 이후 턴은 캐시 가격으로 계산했습니다. 같은 날 실행한 것은 이 재계산과 OpenRouter 공개 카탈로그 조회 두 가지이며, 같은 프롬프트로 두 모델의 품질과 속도를 비교하는 테스트는 실행하지 않았습니다. 품질과 지연 수치는 모두 아래에 출처를 밝힌 제3자 측정과 개발사 발표입니다.
| 토큰 구성 (가정) | K3.1 Pro | K3.1 Pro Highspeed | Argon (11월 30일까지) | Argon (12월 1일부터) | Argon ÷ K3.1 Pro |
|---|---|---|---|---|---|
| A. 코딩 에이전트 세션: 반복되는 앞부분 6만 토큰, 40턴, 턴마다 새 입력 4천 + 출력 3천 토큰 | $2.108 | $3.748 | $1.874 | $3.748 | 0.89배 → 1.78배 |
| B. 40만 토큰 문서에 5분 안에 질문 10개, 질문마다 입력 300 + 출력 1,500 토큰 | $1.676 | $2.632 | $1.316 | $2.632 | 0.79배 → 1.57배 |
| C. 캐시 없는 단발 호출, 입력 8천 + 출력 2천 토큰 | $0.036 | $0.072 | $0.036 | $0.072 | 1.00배 → 2.00배 |
A 행의 K3.1 Pro는 앞부분 쓰기 0.06M × $2 = $0.12, 캐시 읽기 39턴 × 0.06M × $0.20 = $0.468, 새 입력 40 × 0.004M × $2 = $0.32, 출력 40 × 0.003M × $10 = $1.20을 더한 $2.108입니다. 11월까지의 Argon은 캐시 읽기만 39 × 0.06M × $0.10 = $0.234로 바뀌어 $1.874가 됩니다. 출력이 비용의 절반 이상을 차지하므로, 출력 단가가 두 배가 되는 12월부터는 캐시 할인으로 그 차이를 메우지 못합니다. 세 행 모두 12월 1일 이후의 Argon 금액이 K3.1 Pro Highspeed와 똑같다는 점도 눈여겨볼 만합니다.
Argon의 캐시는 4,096토큰 이상인 프롬프트에 자동으로 걸리는 암묵적 캐시뿐이고, 적중하면 95% 할인되지만 적중이 보장되지는 않으며 cachedContents로 명시적으로 만들 수도 없습니다. 캐시가 한 번도 맞지 않는 최악의 경우 A는 11월까지 $6.32, 12월부터 $12.64이고, B는 $8.156에서 $16.312가 됩니다. 지금 가격으로도 K3.1 Pro의 약 3배와 약 4.9배입니다. Kimi 쪽에도 변수가 있습니다. 질문 사이가 5분을 넘으면 캐시를 다시 써야 하고, 1시간 TTL을 고르면 쓰기 단가가 100만 토큰당 $4로 올라 B 같은 문서 작업의 비용 구조가 달라집니다.
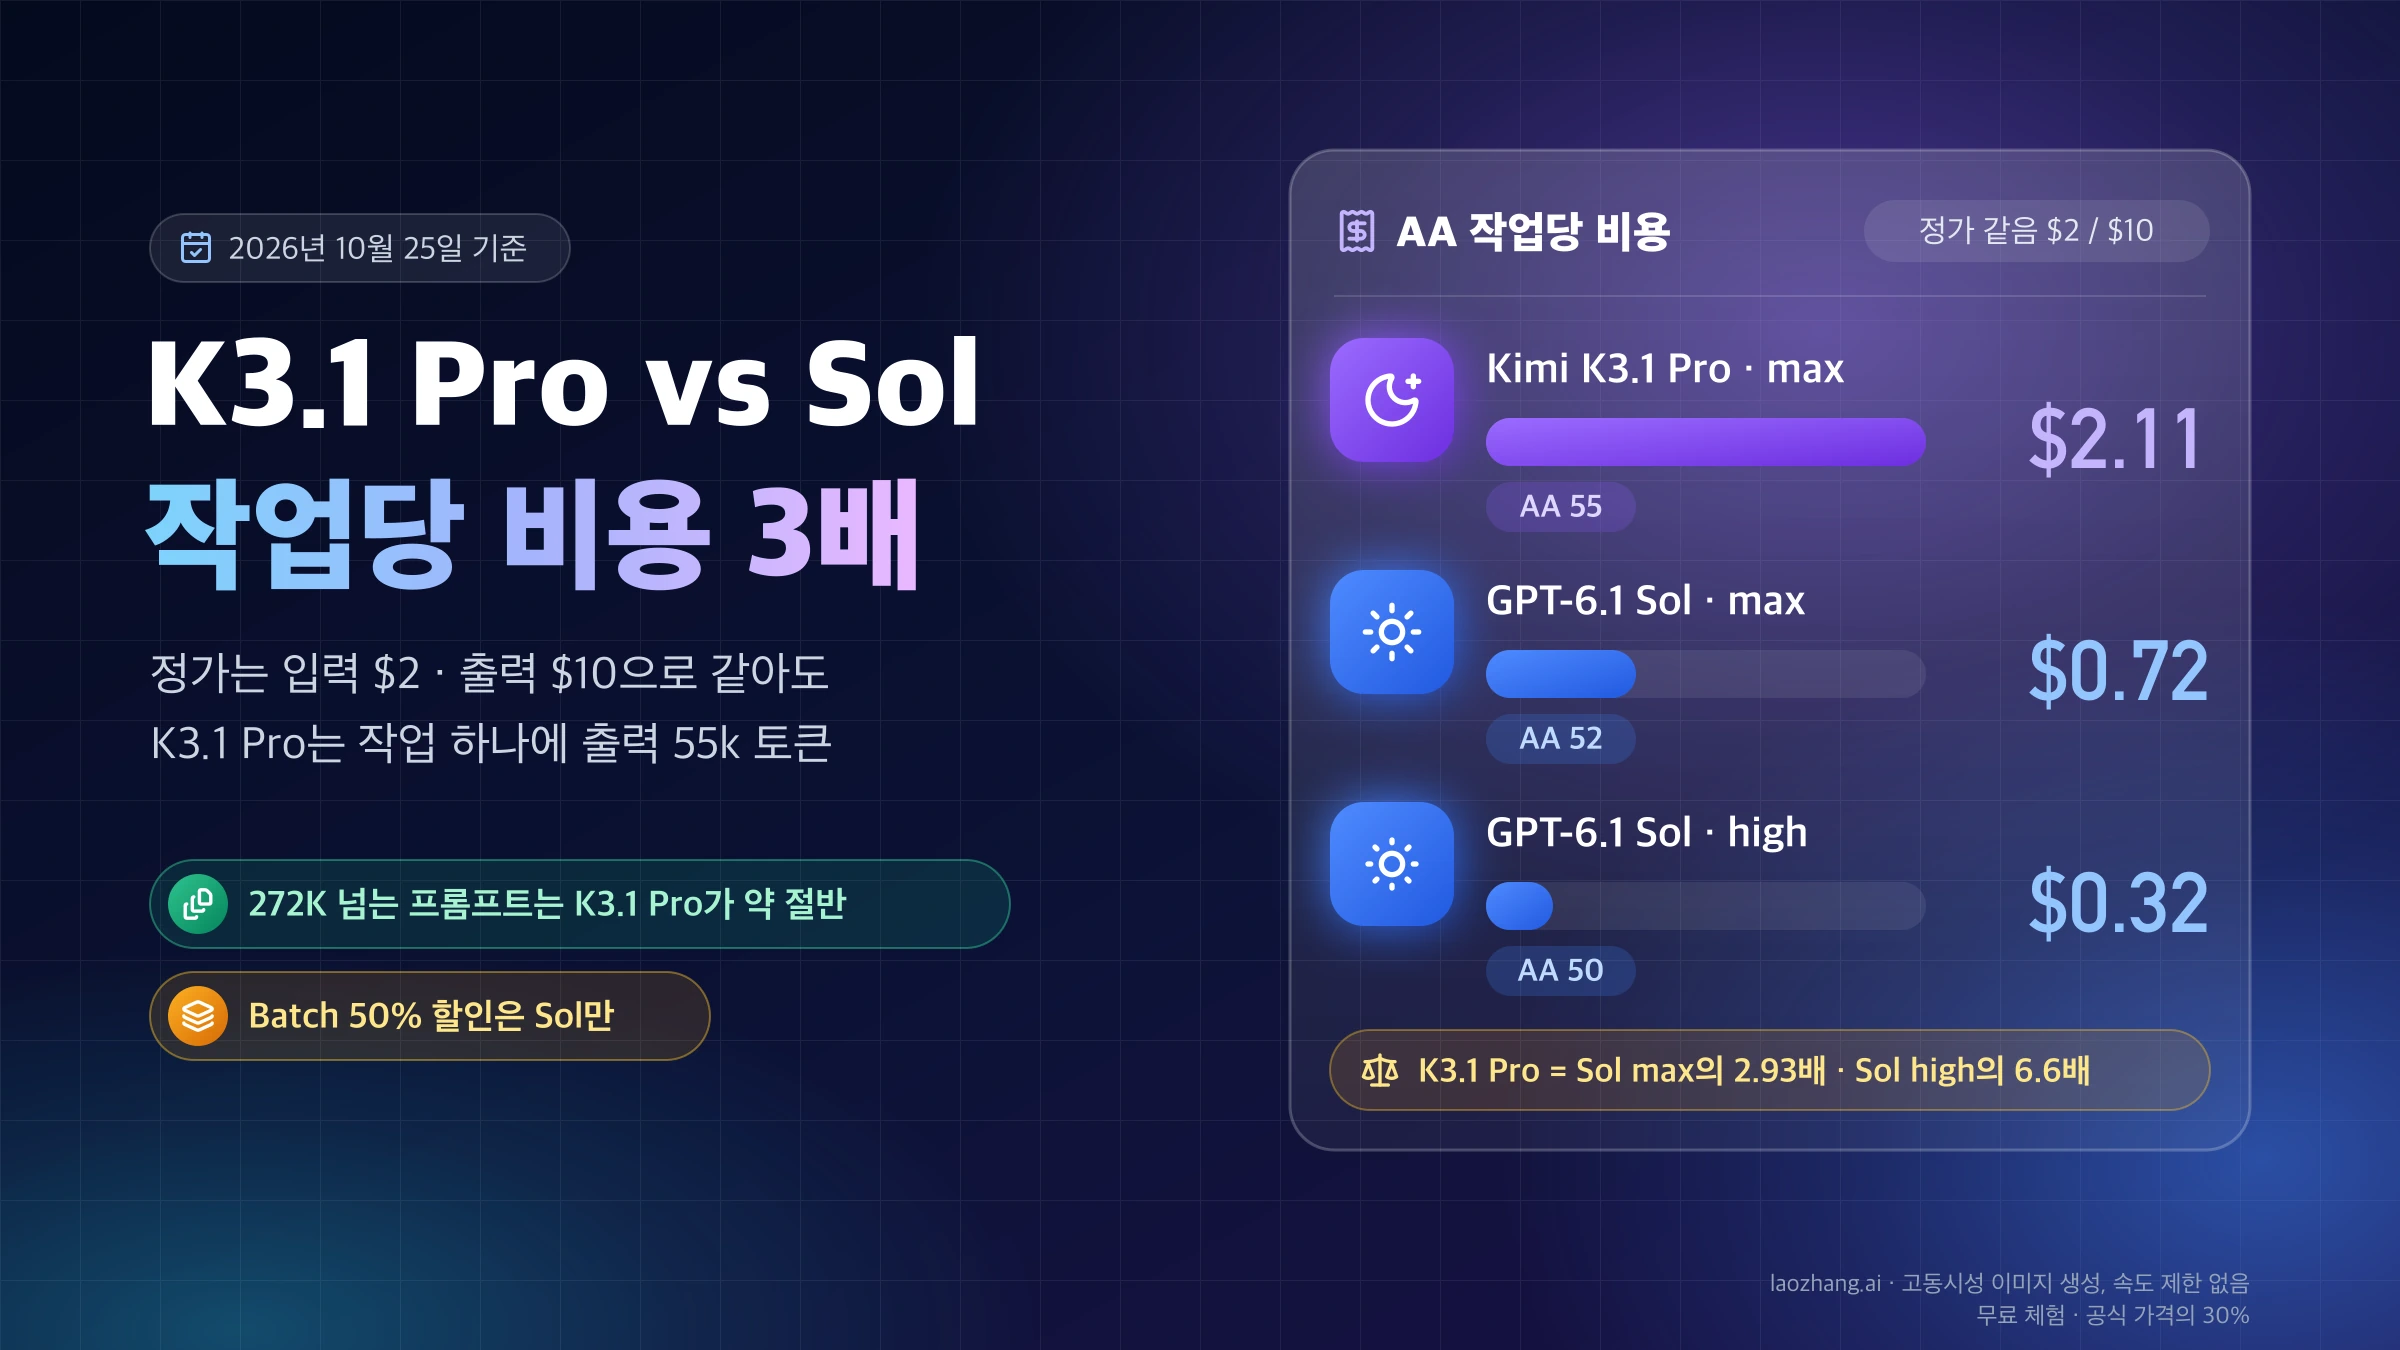
같은 작업에서 두 모델이 쓰는 사고 토큰의 양도 다릅니다. Artificial Analysis의 두 모델 비교 페이지에서 지수 작업 하나당 출력 토큰은 K3.1 Pro 55k, Argon(High) 62k였고, 작업당 비용은 Argon 출시 가격 기준 $2.11 대 $1.99로 Argon이 조금 쌌습니다. 토큰 사용량이 그대로라면 12월 1일부터 Argon은 약 $3.98로 K3.1 Pro의 1.89배가 됩니다. 이미지 1,000장에 박스를 그리는 Ultralytics 벤치마크에서는 K3.1 Pro 약 $22.50, Argon 약 $7.60이었는데, Argon 단가가 두 배가 돼도 약 $15.20으로 여전히 Argon이 쌉니다. 12월 금액은 두 출처의 수치에 가격 변화만 반영해 계산한 값입니다.
벤치마크 항목별: 터미널·긴 문서는 K3.1 Pro, 지식·자동화는 Argon
Artificial Analysis의 종합 지수(Intelligence Index v4.3.2)는 2026년 10월 25일 기준 K3.1 Pro 55, Argon 53으로 2점 차이입니다. 이 차이만으로는 고를 수 없고, 10개 항목을 나눠 보면 앞서는 쪽이 작업 종류에 따라 갈립니다. Argon은 High 설정으로 측정됐는데 API 기본값은 medium이고, K3.1 Pro는 설정 표기가 없지만 Artificial Analysis의 K3.1 Pro 페이지 기준으로는 기본값인 max입니다. K3.1 Pro 공개 이틀 뒤의 측정이라 수치가 수정될 수 있습니다.
Artificial Analysis 10개 항목과 응답 속도
| 평가 항목 | K3.1 Pro | Argon (High) | 앞선 쪽 |
|---|---|---|---|
| Terminal-Bench 4.0 | 67% | 57% | K3.1 Pro |
| AA-LCR v1.1 (긴 컨텍스트 추론) | 86% | 80% | K3.1 Pro |
| AA-Briefcase v1.1 (에이전트형 지식 업무) | 1678 | 1486 | K3.1 Pro |
| GDPval-AA v2.1 | 1846 | 1624 | K3.1 Pro |
| GDP.pdf | 31% | 22% | K3.1 Pro |
| AA-Omniscience (지식 신뢰도) | 30 | 42 | Argon |
| Humanity's Last Exam | 52% | 57% | Argon |
| AutomationBench-AA | 73% | 78% | Argon |
| CritPt | 25% | 27% | 비슷함 |
| SciCode | 61% | 62% | 비슷함 |
K3.1 Pro가 앞선 쪽은 터미널 작업, 긴 컨텍스트 추론, 그리고 보고서·문서 같은 업무 산출물을 평가하는 항목들입니다. Argon이 앞선 AA-Omniscience는 정답에 점수를 주고 틀린 답(환각)에 감점을 주는 지식 신뢰도 지표여서, 그럴듯한 문서를 만드는 능력과 사실을 틀리지 않는 능력이 두 모델에서 엇갈린다고 볼 수 있습니다. 과학 계열은 Humanity's Last Exam에서 Argon이 5점 앞섰지만 SciCode와 CritPt는 1~2점 차이라, 과학 문제에서는 Argon이 근소하게 앞선다고 보는 편이 정확합니다.
Kimi도 자체 수치를 발표했습니다. Kimi K3.1 Pro 빠른 시작 문서 중국어판은 Terminal-Bench 4.0 65.7%를 제시하지만 측정 환경은 밝히지 않았고, 2026년 10월 25일 기준 영문판의 같은 문장은 아직 "[xx.x%]"로 비어 있습니다. 일부러 어렵게 만든 테스트에서 주장 단위 환각률이 K3의 23.35%에서 6.85%로 줄었다는 수치도 개발사 발표이며, Argon과 비교한 수치는 없습니다.
응답 속도는 체감과 총 소요 시간이 다르게 나옵니다. Artificial Analysis에서 첫 토큰까지 걸린 시간은 K3.1 Pro 2.97초, Argon 57.01초였고, 전체 응답 시간도 37.00초 대 63.33초, 지수 작업 하나당 시간은 618초 대 723초로 K3.1 Pro가 짧았습니다. 생성 속도 자체는 초당 79토큰인 Argon이 73토큰인 K3.1 Pro보다 조금 빠릅니다. Argon의 첫 토큰이 늦은 것은 사고 과정이 스트리밍되지 않기 때문으로 보이며 High 설정에서는 1분 가까이 화면에 아무것도 나오지 않을 수 있으므로, 사용자가 화면을 보고 기다리는 대화형 서비스라면 이 점을 따로 시험해야 합니다.
Ultralytics 객체 탐지: Argon 0.537 대 K3.1 Pro 0.444
이미지에서 객체 위치를 박스로 찾는 작업은 Argon을 먼저 쓰는 편이 맞습니다. Ultralytics가 2026년 10월 24일 공개한 Kimi K3.1 Pro 자동 라벨링 벤치마크는 실제 탐지 데이터셋 36개에서 10장씩, 모두 360장을 쓰고 SAM 3.1로 박스를 다듬어 mAP50을 쟀습니다. 여기서 Argon은 0.537, K3.1 Pro는 0.444로 29개 모델 중 7위였고, 이미지 한 장의 중앙값 지연은 4.6초 대 약 22초로 Argon이 약 4.8배 빨랐습니다.
K3.1 Pro가 이긴 데이터셋도 6개 있습니다. 테니스, 축구, 밀 이삭, 갑상선 초음파가 여기에 들어가고, 스포츠 분야 평균은 0.68 대 0.60으로 K3.1 Pro가 높았습니다. 다만 이 벤치마크는 박스 그리기라는 한 종류의 작업이고, Kimi는 추론 강도 high로 측정됐습니다. Ultralytics는 max로 돌리면 Kimi K3 이미지의 약 40%가 115초 제한을 넘었다고 밝혔습니다.
작업별로 먼저 테스트할 모델과 맞춰야 할 추론 강도
작업 종류를 정했다면 아래 표에서 먼저 테스트할 모델을 고르고, 오른쪽 열의 조건에 해당하면 다른 쪽도 함께 시험하세요. 근거는 앞의 Artificial Analysis와 Ultralytics 측정이며, 표의 순서는 출발점일 뿐 결과는 자기 작업의 통과율로 판단해야 합니다.
| 작업 | 먼저 테스트 | 근거 | 함께 시험할 조건 |
|---|---|---|---|
| 터미널·에이전트 코딩 | K3.1 Pro | Terminal-Bench 4.0 우세 | 11월 안에 끝나고 캐시 적중이 확실하면 Argon 비용이 더 낮음 |
| 긴 문서 질의·추론 | K3.1 Pro | AA-LCR 우세 | 질문 간격이 5분을 넘으면 Kimi 캐시 쓰기 비용이 반복됨 |
| 보고서·문서 산출물 | K3.1 Pro | AA-Briefcase, GDPval-AA, GDP.pdf 우세 | 수치·사실 오류가 치명적인 문서는 Argon으로 교차 검증 |
| 사실 정확도가 중요한 지식 질의 | Argon | AA-Omniscience 우세 | K3.1 Pro를 쓴다면 출처 확인 단계를 둘 것 |
| 과학 문제 | Argon (근소) | Humanity's Last Exam 우세, SciCode·CritPt는 비슷 | 차이가 작아 비용과 가격 기간으로 결정 |
| 업무 자동화 | Argon | AutomationBench-AA 우세 | 12월 이후 비용은 K3.1 Pro의 1.5~2배를 전제로 계산 |
| 이미지 객체 탐지 | Argon | Ultralytics 정확도·비용·속도 우세 | 스포츠처럼 K3.1 Pro가 앞선 유형의 데이터 |
| 화면을 보며 기다리는 대화형 응답 | K3.1 Pro | 첫 토큰까지 시간이 훨씬 짧음 | Argon을 medium이나 low로 두면 달라질 수 있음 |
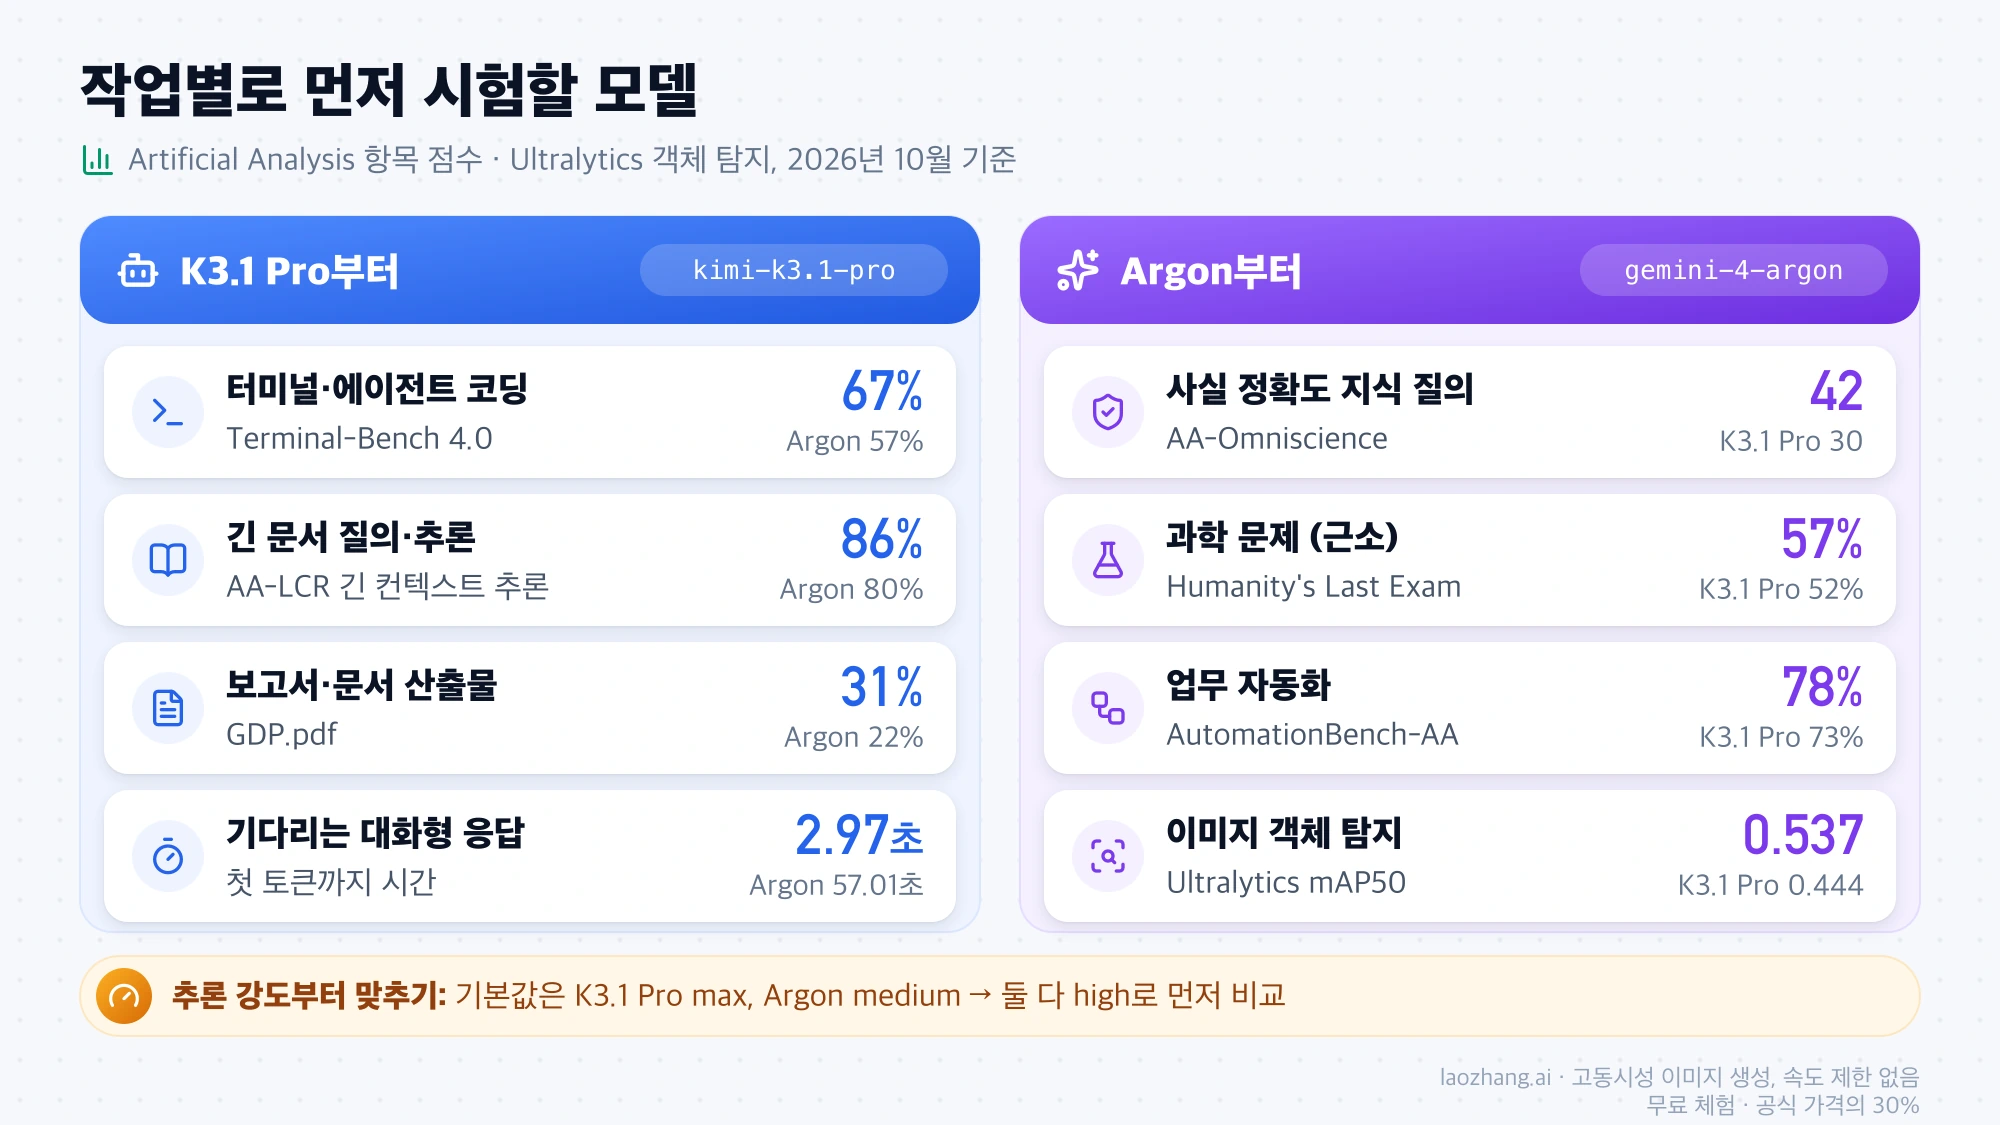
추론 강도는 처음부터 맞춰 두세요. K3.1 Pro는 사고 기능이 항상 켜져 있고 reasoning_effort 기본값이 가장 높은 max라서, 설정 없이 첫 테스트를 하면 비용과 지연이 크게 나옵니다. Argon은 기본값이 medium인데 Artificial Analysis 점수는 High 기준입니다. 공개 점수와 비슷한 조건을 원한다면 K3.1 Pro high와 Argon high로 먼저 비교하고, 그다음 각자 한 단계 낮춘 설정을 시험해 통과한 작업 하나당 비용을 12월 단가로 계산하면 됩니다.
모델을 바꾸면 달라지는 코드: 추론 강도·샘플링·캐시·이미지 입력
두 모델 모두 컨텍스트는 약 100만 토큰이지만, 모델 ID만 바꾸면 그대로 동작하지 않는 부분이 많습니다. 특히 샘플링 파라미터, 이미지 입력 형식, 출력 한도는 요청 코드를 고쳐야 하고, 추론 강도와 캐시 방식은 비용에 직접 영향을 줍니다. 아래 내용은 Gemini 4 Argon 모델 문서와 Kimi K3.1 Pro 빠른 시작 문서 기준입니다.
| 항목 | Kimi K3.1 Pro | Gemini 4 Argon |
|---|---|---|
| 모델 ID | kimi-k3.1-pro, kimi-k3.1-pro-highspeed | gemini-4-argon |
| 호출 방식 | OpenAI SDK 호환, base URL https://api.moonshot.ai/v1 | 제미나이 API (AI Studio, Vertex AI) |
| 추론 강도 | 항상 켜짐, reasoning_effort low·high·max, 기본 max | low·medium·high, 기본 medium |
| 샘플링 파라미터 | temperature 1.0, top_p 0.95 등 고정, 요청에서 빼야 함 | temperature·top_p·top_k를 보내도 무시 |
| 최대 출력 | max_completion_tokens 기본 131,072, 최대 1,048,576 | 동기 호출 65,536, 1,048,576은 background=True 장문 생성에서만 |
| 캐시 | 반복 앞부분 자동 캐시, 기본 TTL 5분, 1시간 선택 가능, 쓰기 요금 있음 | 4,096토큰 이상에서 암묵적 캐시만, cachedContents 미지원 |
| 이미지 입력 | 공개 이미지 URL 불가, base64 또는 ms://<file-id> | 텍스트·이미지·동영상·오디오·PDF 입력 |
| 사용 시작 조건 | 최소 $1 충전 후 잠금 해제, 누적 충전액으로 등급과 속도 제한 결정 | 유료 등급만, 무료 등급 없음 |
| 이용 지역 | 공개된 국가 목록 없음 | 한국 포함 (Google 이용 가능 지역 목록) |
| 웨이트 | 2026년 11월 4일까지 공개 예정 | 비공개 |
K3.1 Pro로 옮길 때는 멀티턴 대화와 도구 호출에서 어시스턴트 메시지 전체를 수정하지 않고 다음 요청에 그대로 돌려줘야 합니다. 구조화 출력은 json_schema strict를 지원하고, Kimi는 공식 웹 검색 기능을 운영 환경에 쓰는 것을 권하지 않습니다. Argon으로 옮길 때는 Google의 마이그레이션 안내대로 max_output_tokens를 32,768 이상으로 올리고, 어려운 프롬프트에 대비해 클라이언트 타임아웃을 15분 이상으로 잡아 두는 편이 안전합니다.
제공처도 다릅니다. 2026년 10월 25일 OpenRouter 공개 모델 API(/api/v1/models와 모델별 엔드포인트 목록)를 키 없이 조회한 결과, moonshotai/kimi-k3.1-pro의 엔드포인트는 표준과 highspeed 두 개였고 둘 다 Moonshot AI가 제공했습니다. google/gemini-4-argon은 AI Studio, AI Studio Flex, Vertex 글로벌, Vertex US, 두 개의 Priority까지 엔드포인트 6개와 :batch 변형이 있었는데 모두 Google이었습니다. 가격은 개발사 정가와 같았고, Vertex US만 입력 $2.20, 출력 $11에 최대 출력 65,536이었습니다.
같은 조회에서 K3.1 Pro의 지원 파라미터 목록에는 temperature, top_p, seed가 없었고, Argon 엔드포인트에는 temperature, top_p, seed가 들어 있었습니다. OpenRouter가 이 값을 받아 주더라도 Google 문서상 Argon은 이를 무시하므로 출력이 달라지지는 않습니다. 결국 지금은 두 모델 모두 사실상 개발사 한 곳에서만 쓸 수 있고, 장애나 혼잡이 생겨도 다른 회사의 호스팅으로 돌릴 수 없다는 점은 같습니다.
제미나이 API 이용 가능 지역에는 한국이 들어 있어 Google API를 바로 쓸 수 있고, Google 결제 계정 없이 쓰는 경로로는 LaoZhang API에도 gemini-4-argon이 등록돼 있고, 2026년 10월 25일부터는 kimi-k3.1-pro(입력 $2·출력 $10, 캐시 적중 $0.2)와 kimi-k3.1-pro-highspeed($4·$20)도 OpenAI 호환 엔드포인트로 올라와 있습니다. Kimi 플랫폼은 공개된 지원 국가 목록이 없어 실제로는 해외 결제로 충전이 되는지가 관건입니다. 앱으로 쓰는 경우 제미나이 앱의 Argon은 Google AI Pro와 Ultra 요금제에서만 고를 수 있고, Kimi 앱에서 K3.1 Pro를 고를 수 있는지는 Kimi 멤버십 안내에 모델명이 없어 공개 정보로는 알 수 없습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
K3.1 Pro 직접 호스팅·파인튜닝: 웨이트는 11월 4일까지 공개 예정
2026년 10월 25일 기준으로는 할 수 없습니다. Kimi는 빠른 시작 문서에서 전체 모델 웨이트를 "11월 4일까지" 공개하겠다고 밝혔고, 지금은 Artificial Analysis도 두 모델을 모두 웨이트 비공개로 표시하며 OpenRouter의 K3.1 Pro 제공처도 Moonshot뿐입니다. 웨이트가 실제로 공개되면 직접 호스팅이나 파인튜닝, 다른 공급자의 API가 가능해지지만, 그 가격과 품질은 공개 이후에야 알 수 있습니다.
K3.1 Pro는 Kimi K3를 후속 학습한 K3.1 시리즈의 첫 모델입니다. 직접 호스팅 규모를 가늠할 때 자주 인용되는 총 2.8T·활성 104B 파라미터는 K3의 수치이며, K3.1 Pro 문서는 파라미터 수를 따로 밝히지 않았습니다. Argon은 웨이트 공개 계획이 없으므로 자체 호스팅이 필수 조건이라면 11월 4일 이후 K3.1 Pro의 공개 상태를 보고 판단하면 됩니다.
Argon을 Opus 5.5·GPT-6.1 Sol·3.8 Flash와 비교하려면
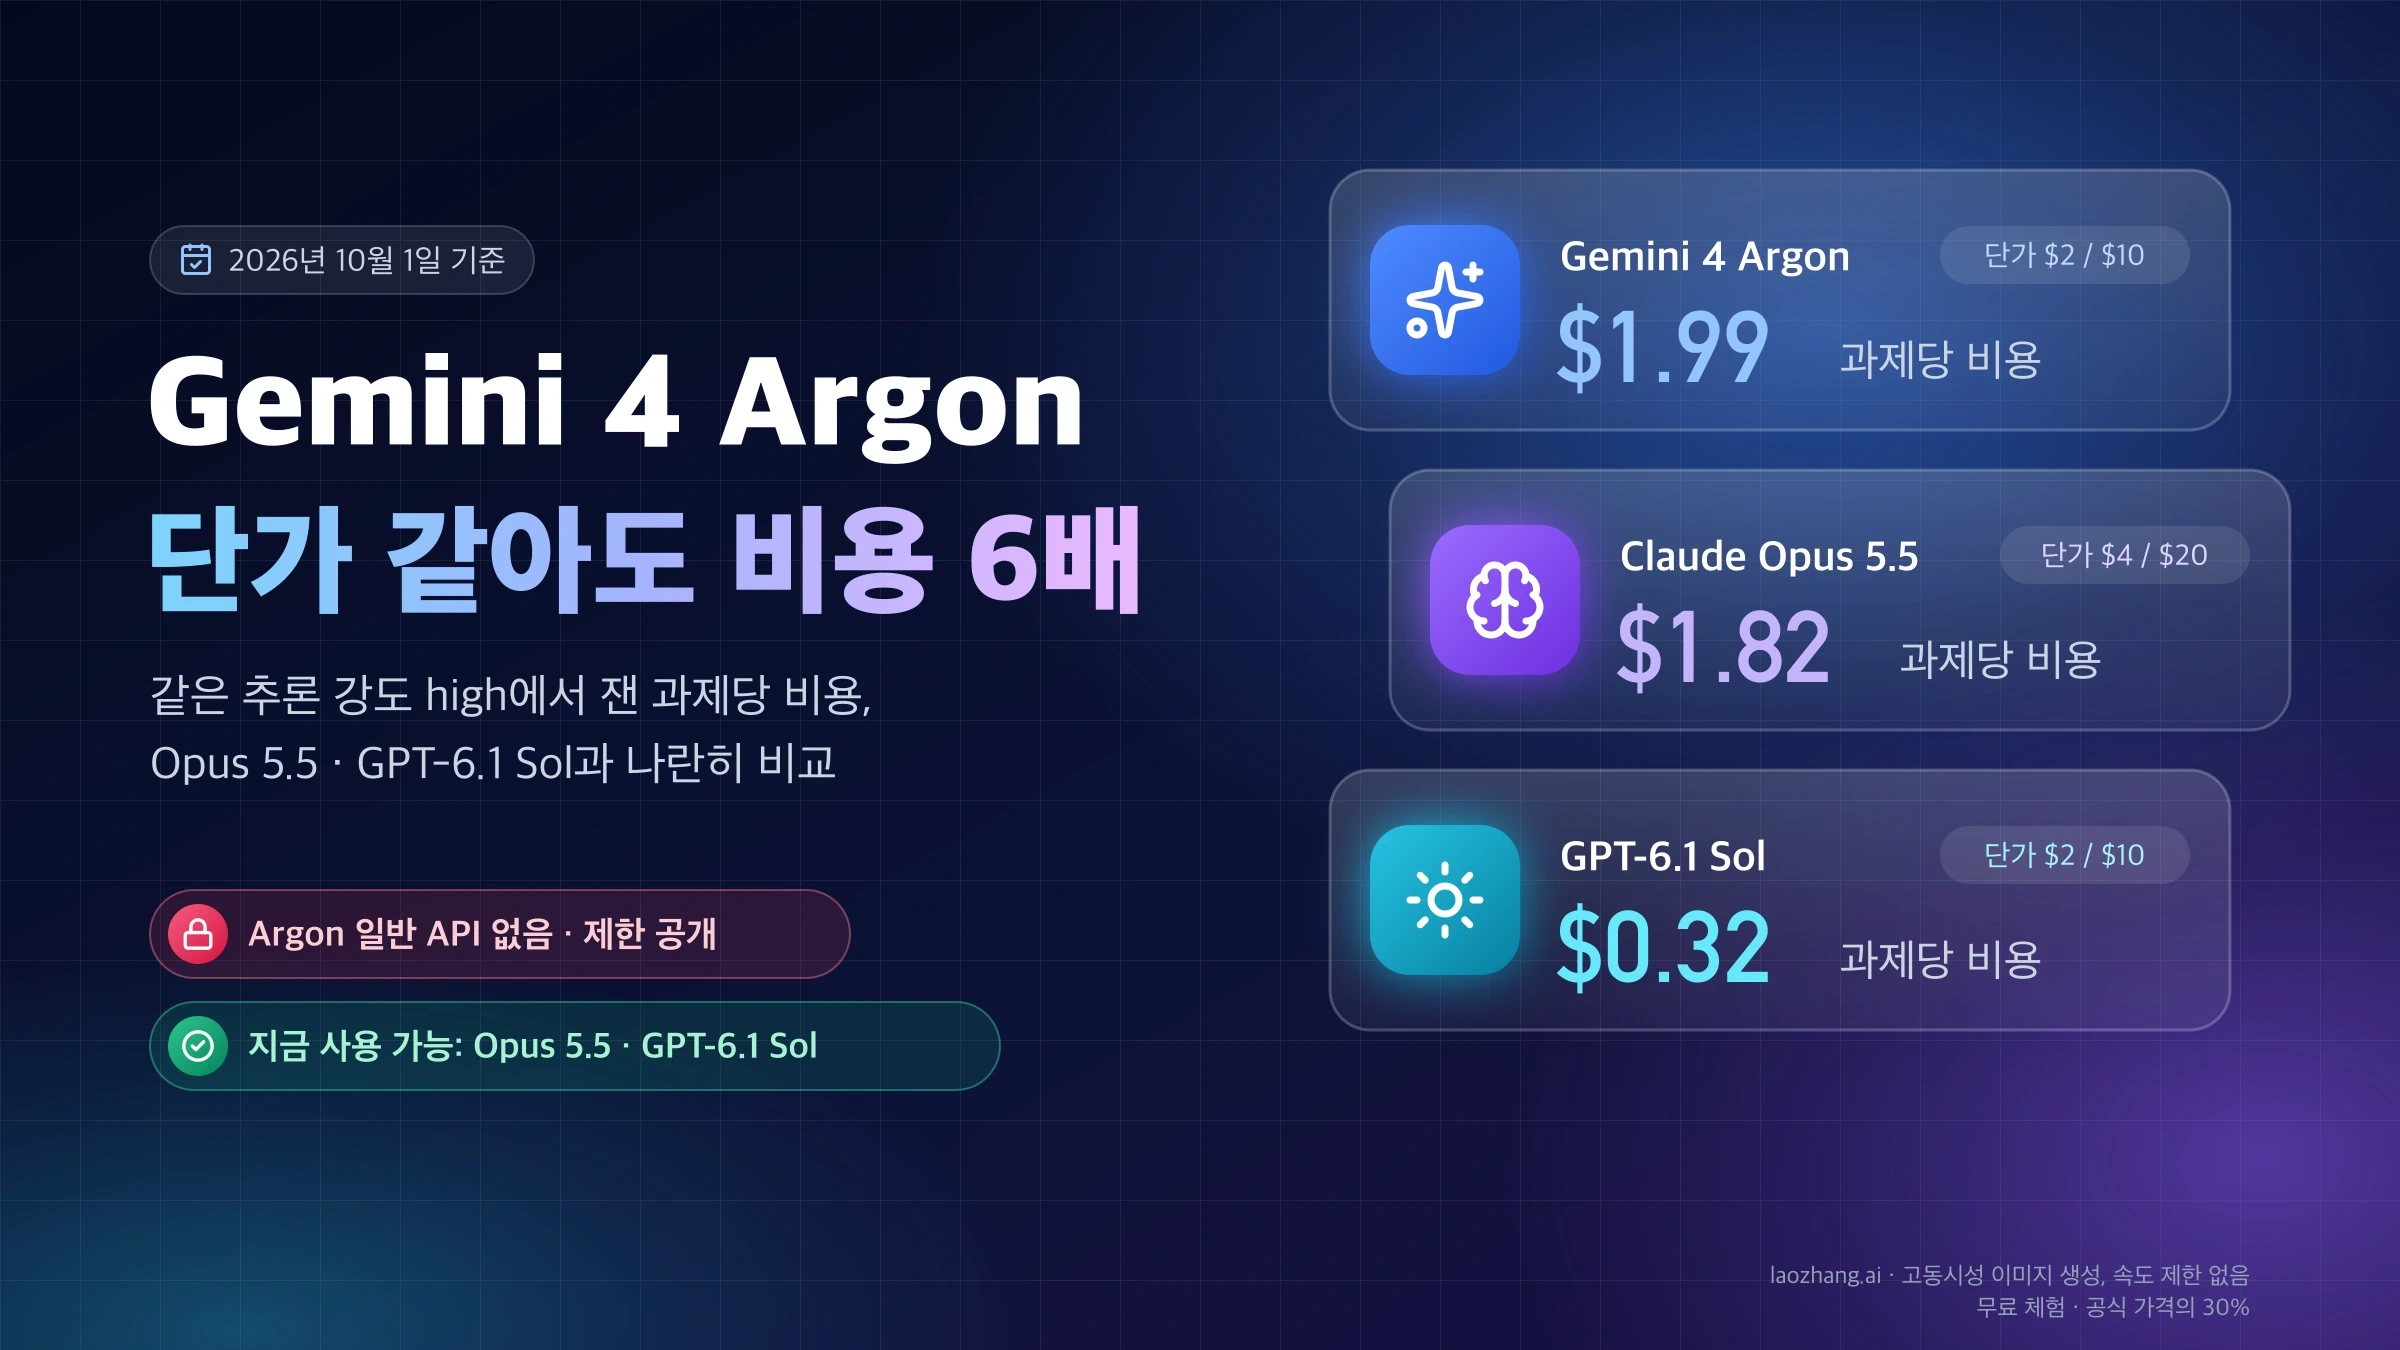
Argon을 다른 폐쇄형 플래그십과 견주고 있다면 Gemini 4 Argon·Opus 5.5·GPT-6.1 Sol 비교: 작업당 비용 6배 차이에서 작업당 비용 차이를 볼 수 있습니다. Google 안에서 더 싼 모델로 충분한지 따지고 있다면 Gemini 4 Argon vs 3.8 Flash 차이: 같은 프롬프트 실측 비용과 갈아탈 작업이 같은 프롬프트로 잰 비용을 다룹니다. 신세대 모델 가운데 지금 실제로 쓸 수 있는 것이 무엇인지는 Fable 5.5·Gemini 4·GPT-6.1 비교: 지금 쓸 수 있는 건 Sol과 Argon에 정리돼 있습니다.
Google이 Argon 외에 다른 Gemini 4 모델을 낼지는 아직 공식 정보가 없습니다. Business Insider는 2026년 10월 9일 Google 직원들이 "Carbon"이라는 코드명의 내부 Gemini 4 빌드를 시험 중이라고 보도했지만, Google의 발표나 모델 ID, 출시일은 없으므로 지금의 선택에 반영할 근거는 되지 않습니다.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 25일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 25일.
- 1.Google 제미나이 API 가격 페이지ai.google.dev/gemini-api/docs/pricing
- 2.Kimi API 가격 페이지platform.kimi.ai/docs/pricing/chat
- 3.Artificial Analysis의 두 모델 비교 페이지artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-kimi-k3-1-pro
- 4.Kimi K3.1 Pro 빠른 시작 문서platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- 5.Kimi K3.1 Pro 자동 라벨링 벤치마크ultralytics.com/zh/blog/kimi-k3-1-pro-auto-annotation
- 6.Gemini 4 Argon 모델 문서ai.google.dev/gemini-api/docs/models/gemini-4-argon
- 7.제미나이 API 이용 가능 지역ai.google.dev/gemini-api/docs/available-regions