Gemini 4 Argon vs Claude Fable 5.1 비교: 비용 8.6배, 12월부터 4.3배
AA 지수 v5.0.1에서 두 모델은 동률이고, 같은 일상 과제 비용은 Fable 5.1이 Argon 기본 설정의 8.6배입니다. 12월 1일 Argon 단가가 2배가 돼도 4.3배입니다.
목차
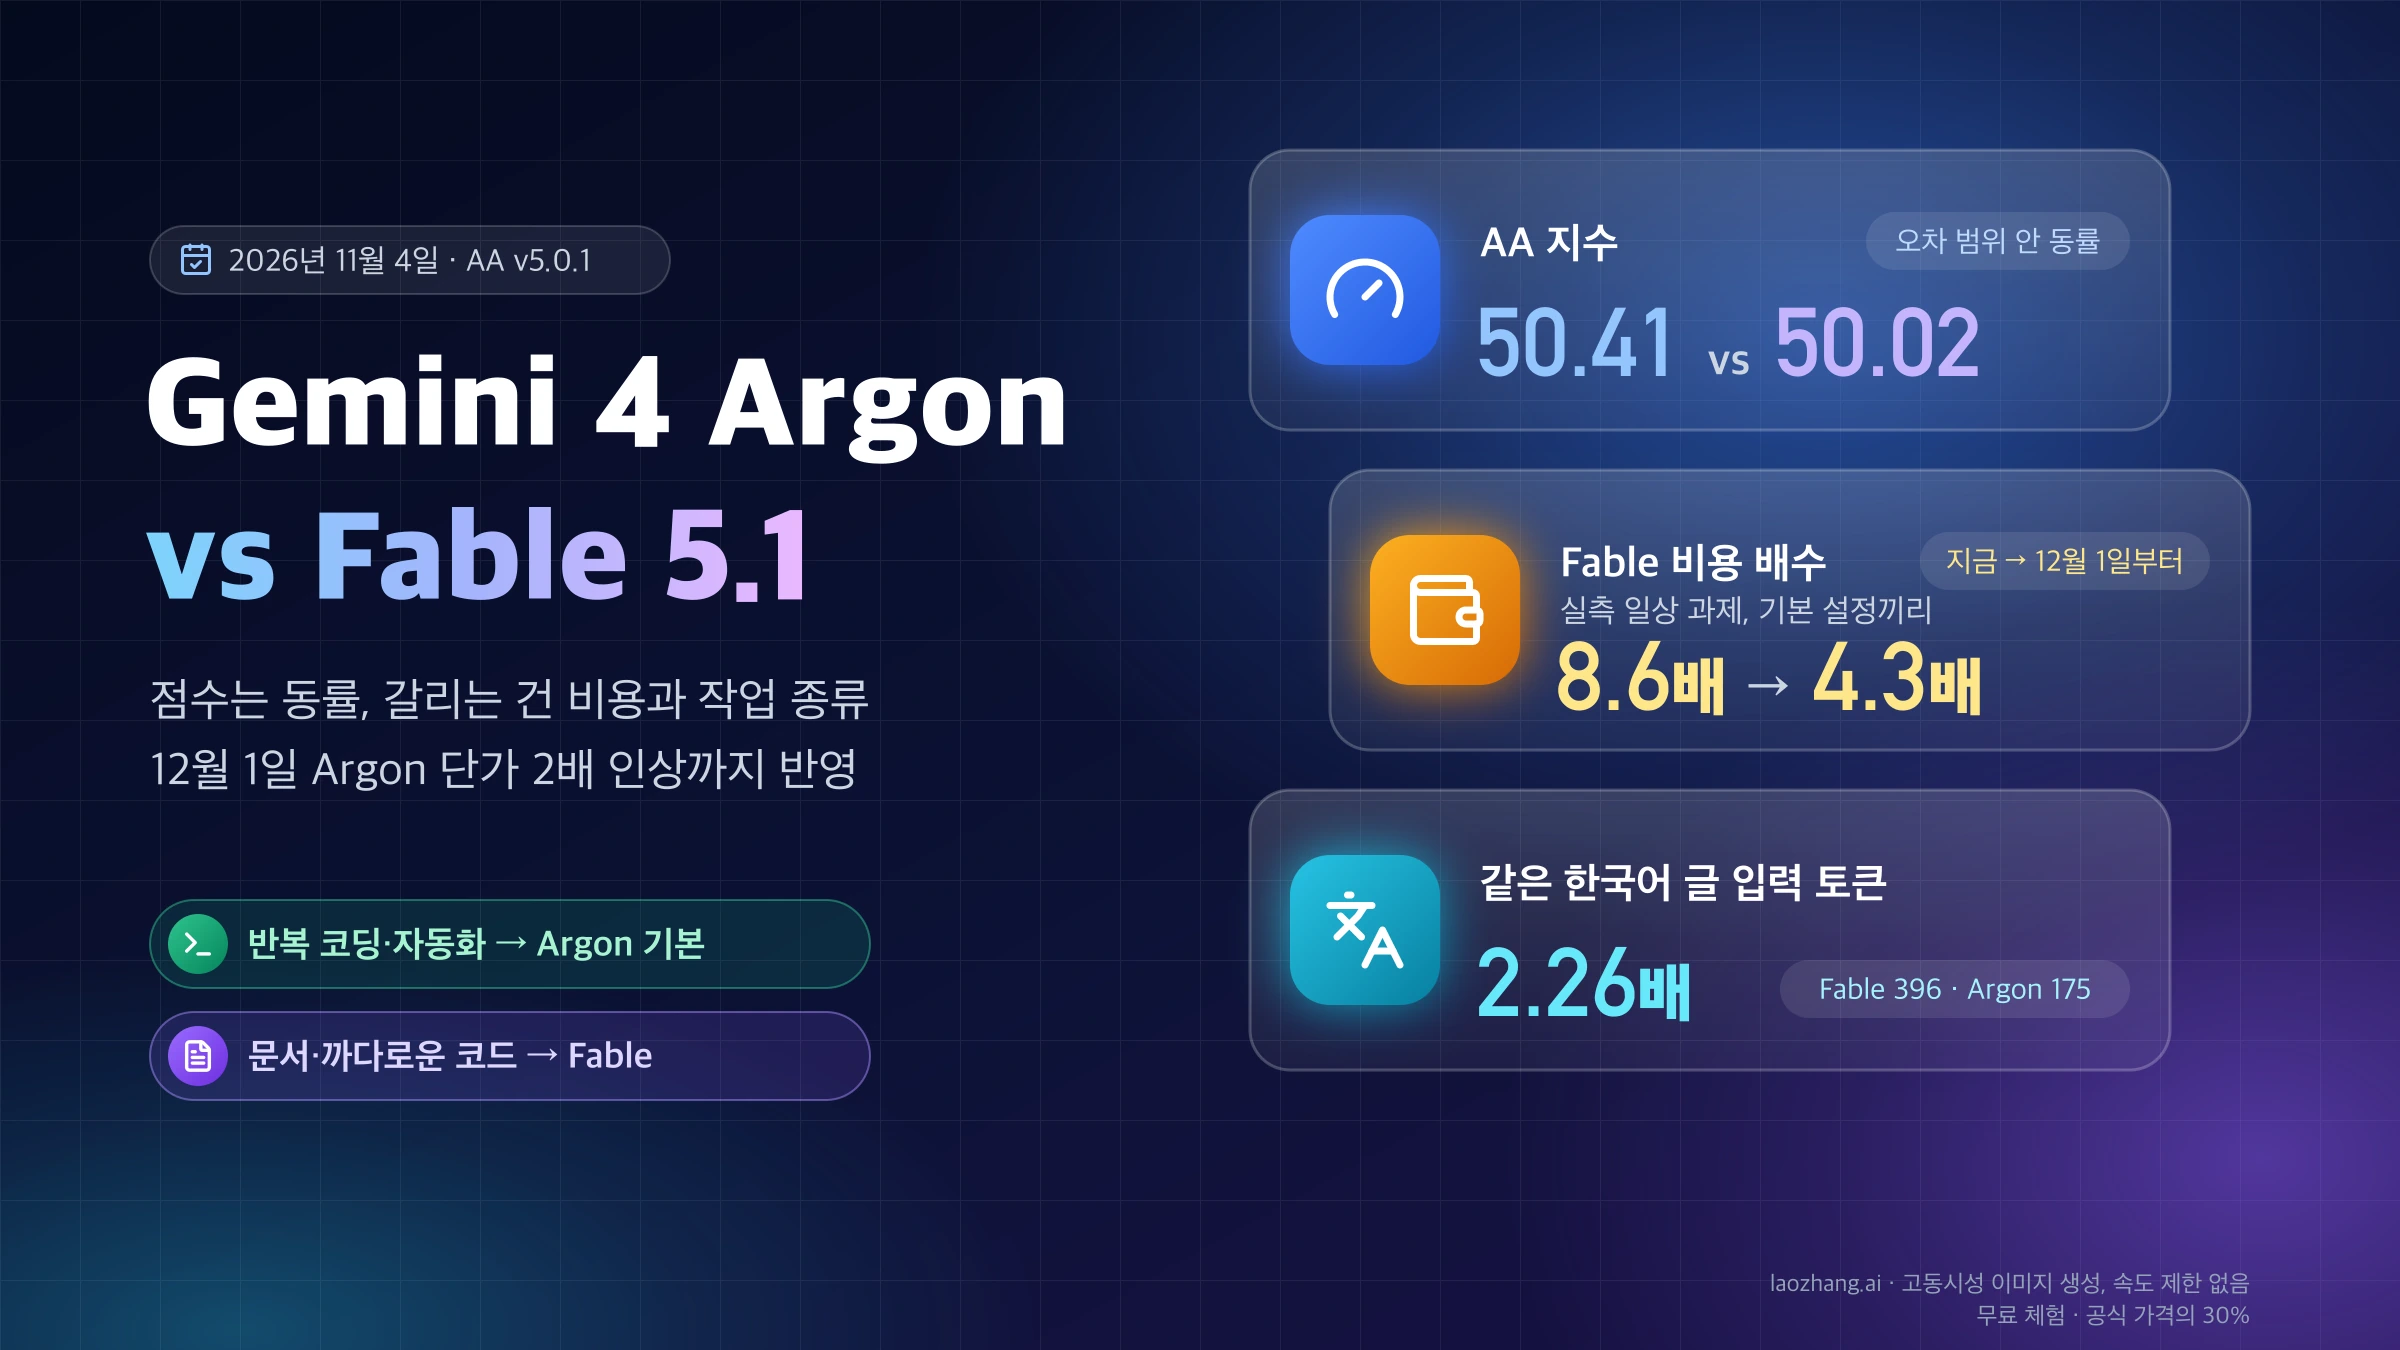
Gemini 4 Argon(gemini-4-argon)과 Claude Fable 5.1(claude-fable-5-1)은 품질만으로는 고르기 어렵고, 비용과 작업 종류에서 갈립니다. 2026년 11월 4일 기준 Artificial Analysis(AA) 지수 v5.0.1에서 Argon(High)은 50.41점, Fable 5.1은 가장 점수가 높은 xhigh 설정에서 50.02점으로 오차 범위 안의 동률입니다. 반면 100만 토큰당 단가는 Argon이 입력 $2·출력 $10, Fable이 입력 $10·출력 $50으로 5배 차이가 나고, Argon이 입력 $4·출력 $20으로 오르는 2026년 12월 1일부터는 2.5배로 줄어듭니다.
그래서 지금 Fable로 돌리는 반복 코딩, 요약, 터미널·브라우저 자동화는 gemini-4-argon을 기본 사고 수준(medium) 그대로 두고 옮겨 시험해 볼 만합니다. 같은 API 게이트웨이로 같은 8개 과제를 돌렸을 때(Argon 2026년 11월 4일, Fable 10월 26일) 두 모델 모두 숨은 테스트를 전부 통과했고, 일상 과제 5개의 비용은 Fable이 Argon 기본 설정의 8.6배, 12월 1일 단가로는 4.3배였습니다. 한국어 입력이라면 차이가 더 커집니다. 같은 한국어 글을 Fable이 2.26배 많은 토큰으로 세기 때문에 캐시 없는 입력 청구액은 지금 약 11.3배입니다.
예외도 분명합니다. 사무 문서·보고서 작업과 명세가 까다로운 코드는 AA 세부 평가에서 Fable이 앞서므로 claude-fable-5-1에 남기는 편이 맞습니다. Argon을 high로 올리면 사고 토큰이 크게 늘어, 12월 1일부터는 어려운 과제에서 오히려 Fable 기본 설정보다 비싸집니다. 아직 Anthropic 모델 안에서 고르는 중이라면 Anthropic 스스로 대부분의 작업은 Opus 5.5부터 시작하라고 안내하므로 Claude Fable 5.1 vs Opus 5.5: 코딩·업무용으로 무엇을 선택할까?를 먼저 확인하세요.
Fable 5.1이 얼마나 더 좋은가: AA v5.0.1에서는 50.41 대 50.02 동률
현재 종합 지수로는 Fable 5.1이 Gemini 4 Argon보다 낫다고 말할 근거가 없습니다. AA는 2026년 10월 지수를 v5.0으로 바꿨고, 11월에 CritPt v2 재채점을 반영한 v5.0.1을 냈습니다. 평가 9개와 가중치는 v5.0과 같습니다(AA 지수 방법론). AA는 1점 안팎의 차이를 측정 오차로 보므로 50.41 대 50.02는 승패가 아니라 동률입니다.
비교할 때 주의할 점은 AA가 Argon을 High 한 가지 설정으로만 측정했다는 것입니다. 이는 API 기본값(medium)보다 한 단계 높은 설정입니다. Fable 5.1은 다섯 단계를 모두 측정했고, 최고 단계인 max가 xhigh보다 점수가 낮게 나왔습니다. 그래서 두 회사의 설정 이름끼리 맞추기보다 비용이 같은 지점과 점수가 같은 지점에서 비교하는 편이 정확합니다.
| 설정 (2026년 11월 4일, AA v5.0.1) | AA 지수 | AA 과제 1건당 비용 | 과제 1건당 시간 | 첫 토큰까지 |
|---|---|---|---|---|
| Gemini 4 Argon High | 50.41 | $7.68 | 1,362.9초 | 41.5초 |
Fable 5.1 max | 49.16 | $12.99 | 1,066.4초 | 252.5초 |
Fable 5.1 xhigh | 50.02 | $10.85 | 965.7초 | 79.5초 |
Fable 5.1 high (API 기본값) | 47.17 | $7.54 | 719.8초 | 18.3초 |
Fable 5.1 medium | 43.17 | $5.56 | 537.1초 | 14.7초 |
Fable 5.1 low | 38.68 | $4.47 | 421.3초 | 2.6초 |
출처는 Artificial Analysis의 Gemini 4 Argon vs Claude Fable 5.1 비교 페이지이고, "과제 1건당 비용"은 AA 지수 과제 하나를 푸는 데 든 평균 비용입니다. AA는 Argon 비용을 이미 12월 단가($4/$20)로 계산합니다. 이 기준에서 Fable 기본값 high($7.54)는 Argon($7.68)과 비용이 거의 같은데 점수는 Argon이 약 3점 높고, 점수를 맞추려면 Fable을 xhigh($10.85)까지 올려야 합니다. 대신 첫 토큰까지 걸리는 시간은 Fable high가 18.3초로 Argon High의 41.5초보다 짧습니다.
다른 제3자 지수도 결론이 비슷합니다. 2026년 11월 3일 갱신된 Epoch Capabilities Index에서 Fable 5.1은 166.36, Argon은 166.07이고 신뢰 구간이 겹쳐 통계적으로 동률입니다. Vals Index는 10월 19일 v2.2로 바뀐 뒤 Argon을 69.24%로 32개 모델 중 4위에 올렸지만, 현재 순위표에는 Fable 5.1이 없고 Vals는 그 이유를 밝히지 않았습니다. 예전 v2.1의 Fable 65.83%는 새 지수와 나란히 놓을 수 없는 값입니다.
같은 이유로 9~10월의 AA 수치도 지금 점수와 맞지 않습니다. 두 모델이 0.79점 차이라거나 Argon이 약 53점이라는 값은 AA가 v5.0 이전에 쓰던 v4.3.2 지수 기준이라 현재 점수와 비교할 수 없습니다. Argon은 2026년 10월 13일 정식 출시돼 지금은 API로 바로 호출할 수 있고, 출시 전 소문에 돌던 "Gemini 4 Pro"는 Argon의 정식 이름이 아닙니다.
평가별로 누가 앞서나: 자동화는 Argon, 문서·코드는 Fable
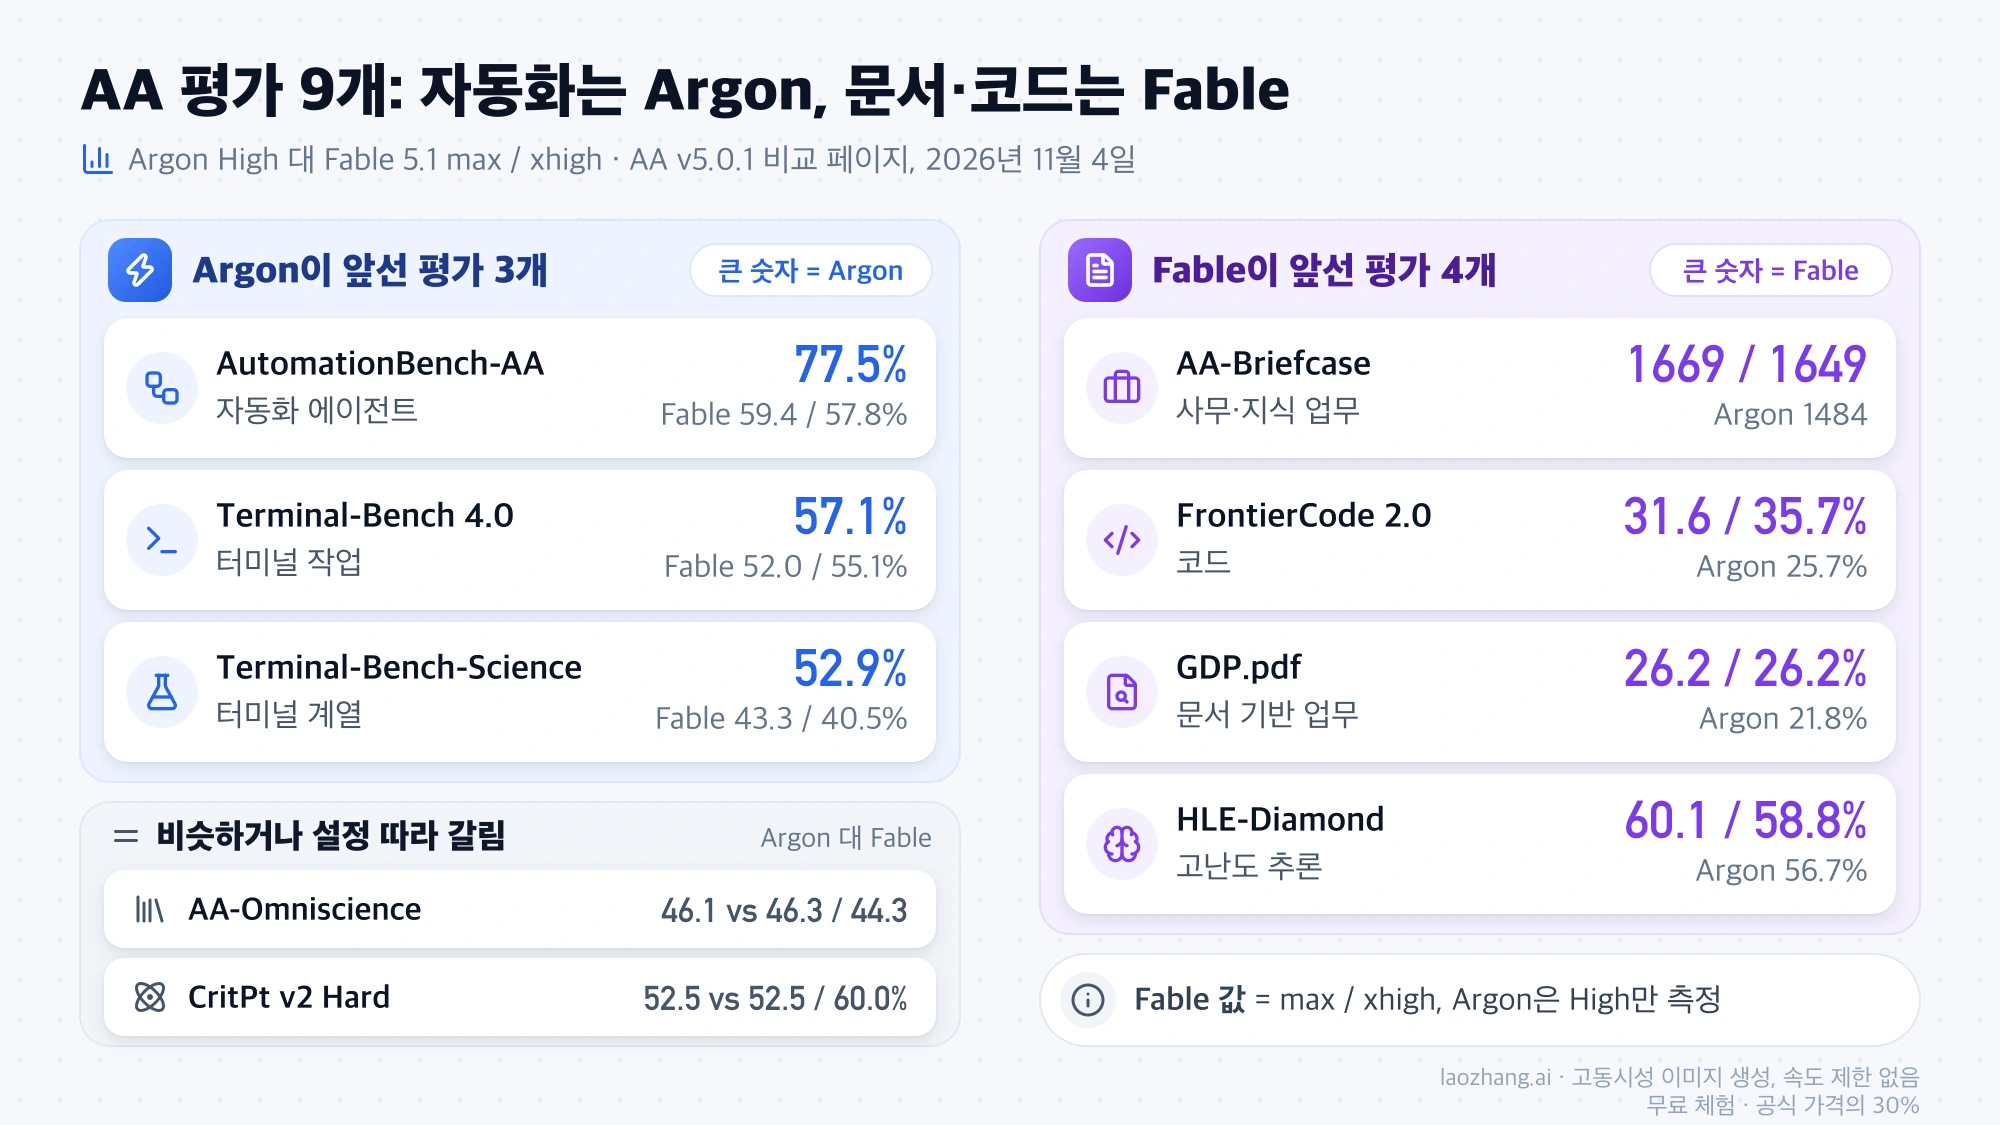
평가를 하나씩 보면 두 모델의 강점이 뚜렷하게 나뉩니다. AA v5.0.1의 9개 평가 중 Argon은 자동화 에이전트(AutomationBench)와 터미널 계열 두 개에서 앞서고, Fable은 사무·지식 업무(AA-Briefcase), 코드(FrontierCode), 문서 기반 업무(GDP.pdf), 고난도 추론(HLE-Diamond)에서 앞섭니다. 종합 점수가 같아도 어떤 일을 맡기느냐에 따라 결과가 달라지는 이유입니다.
| AA v5.0.1 평가 | Argon High | Fable 5.1 max | Fable 5.1 xhigh |
|---|---|---|---|
| AutomationBench-AA | 77.5% | 59.4% | 57.8% |
| Terminal-Bench 4.0 | 57.1% | 52.0% | 55.1% |
| Terminal-Bench-Science | 52.9% | 43.3% | 40.5% |
| AA-Briefcase | 1484 | 1669 | 1649 |
| FrontierCode 2.0 | 25.7% | 31.6% | 35.7% |
| GDP.pdf | 21.8% | 26.2% | 26.2% |
| HLE-Diamond | 56.7% | 60.1% | 58.8% |
| AA-Omniscience | 46.1 | 46.3 | 44.3 |
| CritPt v2 Hard | 52.5% | 52.5% | 60.0% |
2026년 11월 4일 기준 AA 비교 페이지의 값입니다. AA-Omniscience는 사실상 같고, CritPt v2 Hard는 max에서 같지만 xhigh에서는 Fable이 앞섭니다. 지수 전체를 한 번 돌리는 데 든 비용은 Argon $6,103, Fable max $13,327이었습니다.
Google이 2026년 9월 30일 Gemini 4 Argon 출시 글에 실은 표는 Argon 쪽으로 더 기웁니다. 두 모델이 함께 실린 17개 항목 중 Fable이 앞선 것은 FrontierSWE v2(56.3 대 55.0)와 Terminal-bench 4.0(57.9 대 57.4) 두 개뿐이고, AutomationBench(51.3 대 31.4), Harvey Legal Agent(19.6 대 6.7), GraphWalks 256k~1M(84.2 대 65.0)처럼 격차가 큰 항목은 모두 Argon 쪽입니다. 다만 이 표는 Google이 Argon을 가장 높은 사고 수준으로 놓고 양쪽을 직접 돌린 자체 측정이라, 같은 Terminal-Bench 4.0에서 AA 결과와 순서가 뒤바뀌는 것처럼 독립 평가와 어긋나는 부분이 있습니다.
Fable은 작업당 몇 배 비싼가: 12월 1일부터 배수가 절반으로
토큰 단가는 2026년 11월 30일까지 5배, 12월 1일부터 2.5배 차이입니다. 제미나이 API 가격표에서 Gemini 4 Argon은 입력 $2, 출력 $10, 캐시 입력 $0.10이고 12월 1일부터 각각 $4, $20, $0.20이 됩니다. Batch·Flex는 $1/$5에서 $2/$10으로 오릅니다. Claude API 가격표의 Fable 5.1은 입력 $10, 출력 $50, 캐시 읽기 $0.25, 5분 캐시 쓰기 $12.50, Batch $5/$25로 변동이 없습니다. 두 모델 모두 사고 토큰은 출력으로 청구됩니다. Google은 인하 가격을 연장할지 밝히지 않았습니다.
실제 청구액 배수는 단가 배수에 토큰 배수를 곱한 값이고, 입력과 출력을 따로 계산합니다. 같은 일을 시켜도 Fable이 입력을 더 많은 토큰으로 세고, 출력 토큰은 사고 수준에 따라 어느 쪽이든 많아질 수 있어서 단가 배수 5배가 그대로 청구액 배수가 되지 않습니다. 아래는 Argon 대비 Fable 청구액을 조건별로 정리한 것입니다.
| 비교 조건 (Fable ÷ Argon) | 11월 30일까지 | 12월 1일부터 |
|---|---|---|
AA 과제 1건, Fable high ÷ Argon High (비용이 같은 지점) | 약 2.0배 | 약 1.0배 |
AA 과제 1건, Fable xhigh ÷ Argon High (점수가 같은 지점) | 약 2.8배 | 약 1.4배 |
| 실측 일상 과제 5개, Fable 기본 ÷ Argon 기본 | 8.6배 | 4.3배 |
실측 일상 과제 5개, Fable 기본 ÷ Argon high | 2.4배 | 1.2배 |
| 실측 어려운 과제 3개×2회, Fable 기본 ÷ Argon 기본 | 5.5배 | 2.8배 |
실측 어려운 과제 3개×2회, Fable 기본 ÷ Argon high | 1.2배 | 0.60배 |
| 같은 한국어 글 입력, 캐시 없음 | 약 11.3배 | 약 5.7배 |
AA 행의 11월 값은 AA 공식 값이 아닙니다. AA가 12월 단가로 계산한 Argon $7.68을 단가가 절반인 지금 기간에 맞춰 약 $3.84로 낮춰 잡고 Fable의 $7.54와 $10.85를 나눈 환산값이며, 12월 값은 $7.54 ÷ $7.68, $10.85 ÷ $7.68입니다. 실측 행은 아래 실측 결과의 정가 비용에서, 한국어 행은 다음 절의 토큰 배수 2.26에 단가 배수 5와 2.5를 곱해 나왔습니다.
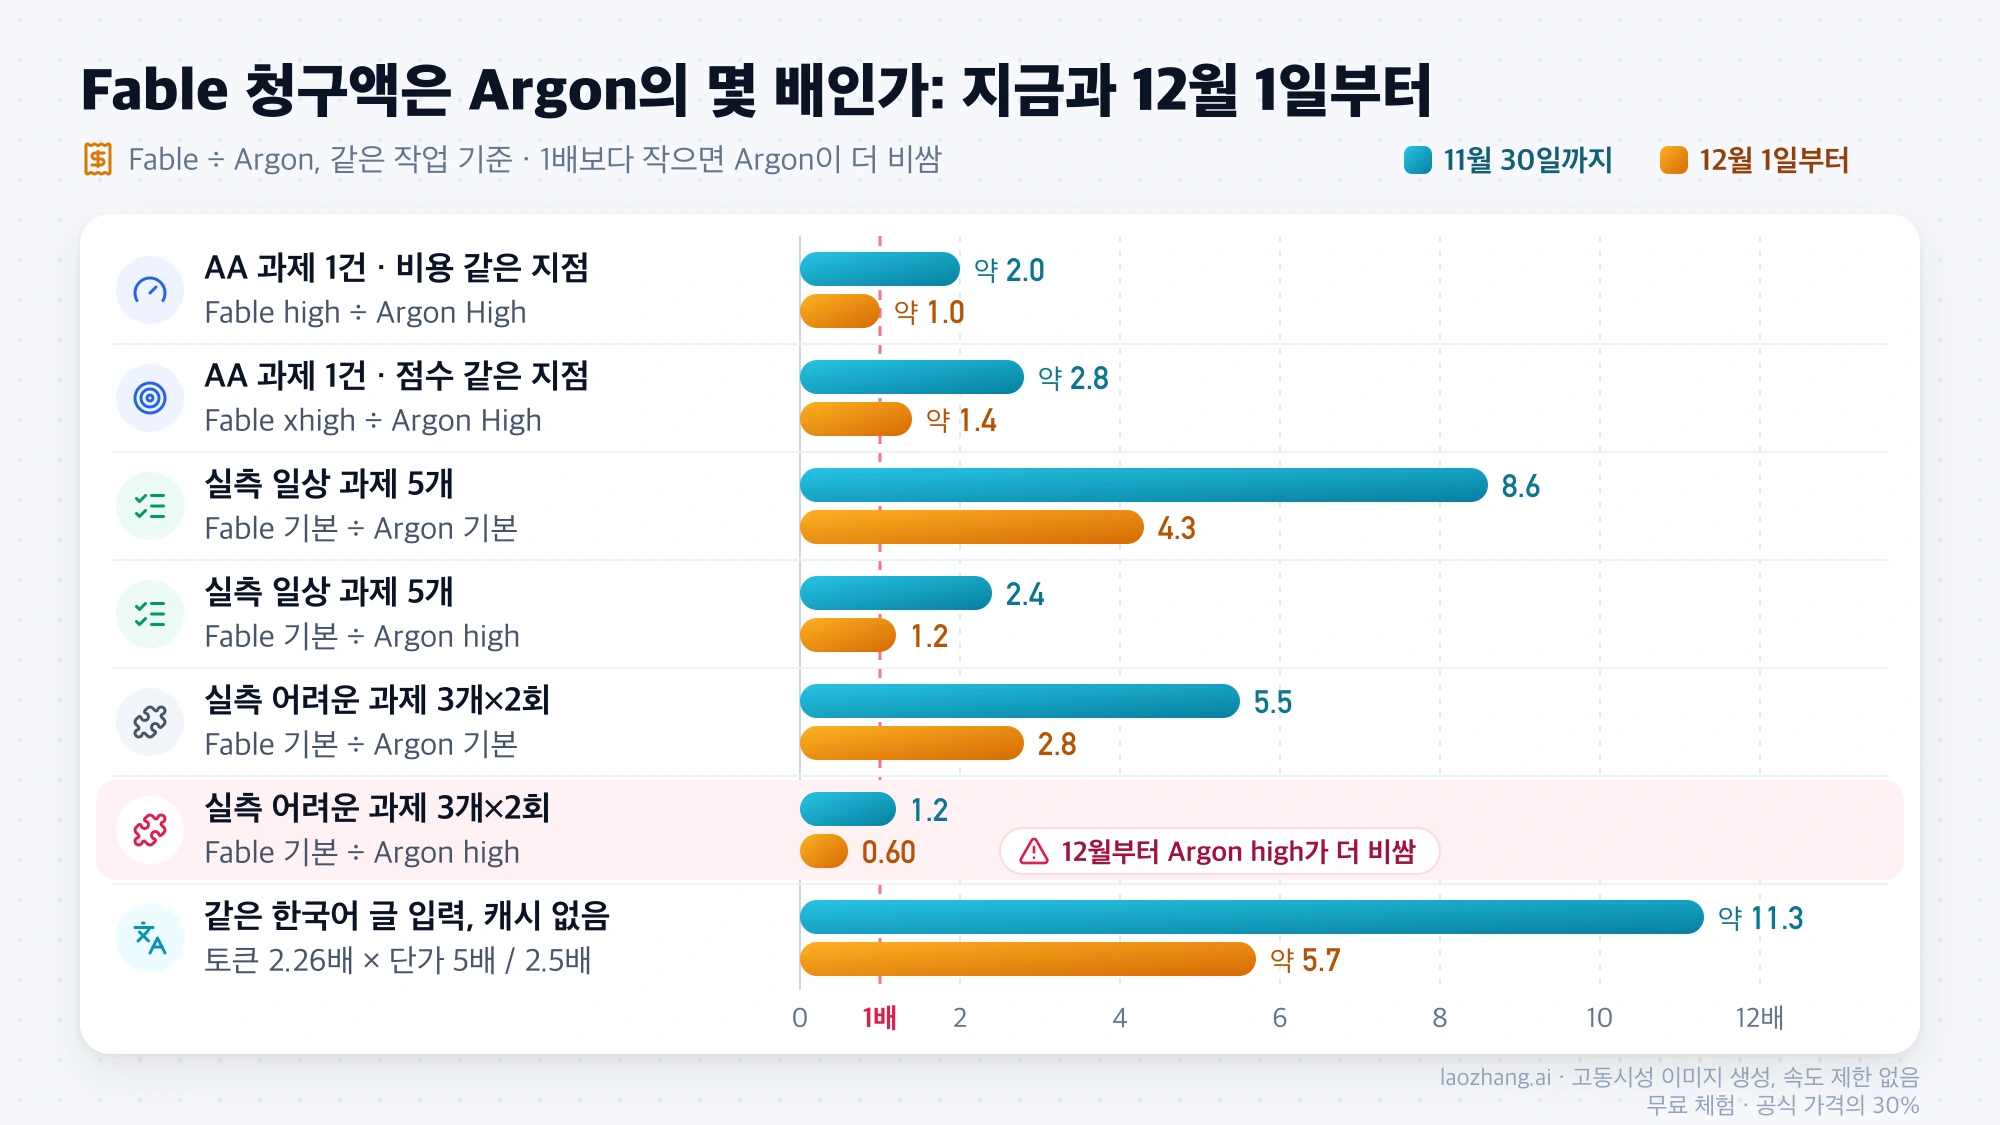
표에서 가장 중요한 줄은 마지막에서 두 번째 실측 행입니다. Argon을 high로 올리면 어려운 과제에서 사고 토큰이 크게 늘어, 12월 1일부터는 Fable 기본 설정의 청구액이 Argon의 0.60배, 즉 Argon이 더 비쌉니다. 캐시를 많이 쓰는 에이전트라면 격차가 더 좁아집니다. 캐시 읽기 단가는 Fable $0.25 대 Argon $0.10으로 지금 2.5배, 12월부터 $0.20과 비교해 1.25배뿐입니다. 실제 청구서는 캐시 적중률, 재시도, 에이전트 반복 횟수에 따라 달라지므로 이 배수는 계산 기준으로만 쓰세요. Fable 과금 세부는 Claude Fable 5.1 API 가격: 내 청구액은 얼마나 줄까, 제미나이 쪽 결제 구조는 Gemini API 키 발급과 가격·결제: 키는 무료, 3.8 Flash 단가 2027년 2배에 정리돼 있습니다.
같은 8개 과제 실측: 셋 다 전부 통과, 갈린 것은 비용과 시간
2026년 11월 4일 LaoZhang API 게이트웨이(laozhang.ai)를 거쳐 Gemini 4 Argon에 8개 과제를 기본 설정(thinkingConfig 없음, Google 기본값 medium)과 thinkingLevel high 두 가지로 실행했습니다. Claude Fable 5.1은 2026년 10월 26일 같은 게이트웨이에서 같은 과제를 기본 설정(effort high)으로 돌린 결과이고, 11월 4일 같은 과제 하나를 다시 호출해 모델 ID와 입력 토큰 수(86개)가 그대로인 것을 확인했습니다. 과제는 일상 과제 5개(단가 계산 문제, 구간 병합 함수, 기간 문자열 파서, 단어 빈도 함수, 영어 6,723단어 기사 5줄 요약)와 어려운 과제 3개(eval 없이 사칙연산 계산기, csv 모듈 없이 CSV 한 줄 파서, 자릿수 합이 27인 수 세기)를 각 2회씩입니다. 코드 답안은 모델에게 보여 주지 않은 pytest 테스트로 채점했습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
| 설정 | 통과 | 일상 과제 5개 비용 (11/30까지 → 12/1부터) | 어려운 과제 3개×2회 비용 (11/30까지 → 12/1부터) | 출력 토큰 (그중 사고) | 11회 전체 시간 |
|---|---|---|---|---|---|
Argon 기본 (medium) | 11/11 | $0.0384 → $0.0768 | $0.0556 → $0.1112 | 6,859 (1,531) | 128초 |
Argon high | 11/11 | $0.1364 → $0.2728 | $0.2565 → $0.5130 | 36,746 (31,016) | 532초 |
Fable 5.1 기본 (high) | 11/11 | $0.3310 | $0.3073 | 9,327 (사고 포함, 별도 표시 없음) | 116초 |
비용은 각 API가 돌려준 사용량에 정가를 곱한 값이고, 캐시와 도구 호출은 쓰지 않았습니다. 11회 전체로 보면 Argon 기본은 $0.094(12월부터 $0.188), Argon high는 $0.393($0.786), Fable은 $0.638이었습니다.
결과에서 읽을 수 있는 것은 세 가지입니다. 첫째, Argon은 기본 설정에서 11회 중 9회 사고 토큰을 하나도 쓰지 않았고, 자릿수 합 퍼즐에서만 651개와 880개를 썼습니다. 사고 수준이 medium이어도 쉬운 요청에서는 모델이 거의 생각하지 않고 답하기 때문에 출력이 짧고 쌉니다. 둘째, high로 올리면 모든 호출에서 926~4,213개씩 사고해 사고 토큰만 31,016개가 됐고, 그만큼 비용이 4배 이상 늘었습니다. 출력 토큰으로 보면 Fable은 Argon 기본의 약 1.4배, Argon high의 약 0.25배였습니다. 셋째, 시간은 Argon 기본(128초)과 Fable(116초)이 비슷했지만 Argon high는 532초로 Fable보다 약 4.6배 느렸습니다.
이 실측이 보여 주지 못하는 것도 분명합니다. 셋 다 모든 답이 통과했으니 이 과제들로는 품질 차이를 가를 수 없고, 품질 판단은 앞의 AA와 Google 표에 기대야 합니다. 과제가 작고 요구사항이 명확하며, 일상 과제는 1회, 어려운 과제는 2회씩만 돌렸습니다. 에이전트 반복, 도구 호출, 아주 긴 출력, 캐싱은 들어가지 않았습니다. Fable의 같은 과제 출력이 10월 26일 773토큰, 11월 4일 674토큰으로 달랐듯 같은 요청도 매번 결과가 조금씩 다릅니다. 테스트에 쓴 비용은 정가 기준 약 $0.53이었습니다.
한국어로 쓰면 더 비싼가: 같은 글을 Fable이 2.26배 토큰으로 셉니다
한국어 입력이라면 Fable 5.1의 청구액은 단가 차이보다 훨씬 커집니다. 2026년 11월 4일(Argon)과 10월 26일(Fable) 같은 게이트웨이에 같은 363자 한국어 문단을 보냈을 때 Argon은 175토큰, Fable은 396토큰으로 셌습니다. Fable이 2.26배 많은 셈이고, 같은 뜻의 문단을 6개 언어로 잰 결과 중 가장 큰 차이입니다. 영어는 1.45배, 일본어 1.85배, 중국어 1.78배였고, 영어 6,723단어 기사 전체는 Argon 11,110토큰, Fable 15,335토큰으로 1.38배였습니다. 문단 토큰은 요청 전체에서 지시문만 보낸 요청의 토큰(Argon 47, Fable 34)을 뺀 값입니다.
이 토큰 배수에 단가 배수를 곱하면 같은 한국어 입력의 캐시 없는 청구액은 2.26 × 5 = 약 11.3배, 12월 1일부터 2.26 × 2.5 = 약 5.7배입니다. 출력 쪽 배수는 사고량에 따라 달라 이 계산에 들어가지 않습니다. Anthropic은 Fable 5.1이 쓰는 토크나이저가 이전 Claude 모델보다 대략 30% 많은 토큰을 센다고 토큰 계산 문서에서 밝히지만, 두 회사 모두 Claude와 제미나이를 직접 비교한 수치는 내놓지 않았습니다.
그래서 한국어 문서를 길게 넣고 짧게 답을 받는 작업, 예를 들어 사내 문서 요약이나 검색 결과 정리처럼 입력이 청구액 대부분을 차지하는 일일수록 Argon으로 옮겼을 때 줄어드는 폭이 큽니다. 문단 하나로 잰 값이라 문체와 전문 용어에 따라 달라질 수 있으니, 실제로 넣을 한국어 원문으로 두 API의 입력 토큰을 한 번씩 세어 보는 것이 가장 확실합니다.
API로 옮길 때 달라지는 조건: 사고 수준, 캐싱, 최대 출력
모델 ID만 바꿔서는 같은 조건이 되지 않습니다. 두 모델은 추론 설정의 이름과 기본값, 캐싱 방식, 한 번에 받을 수 있는 출력 길이가 다르고, 양쪽 모두 high라는 값이 있지만 같은 단계가 아닙니다. 2026년 11월 4일 기준 공식 문서(Gemini 4 Argon 모델 문서, Argon 사고 설정 문서, Fable 5.1 모델 문서, Claude effort 문서)의 차이는 다음과 같습니다.
| 항목 | Gemini 4 Argon | Claude Fable 5.1 |
|---|---|---|
| 추론 설정 | 사고 수준(thinkingLevel) low·medium·high, 기본 medium, 끌 수 없음 | 추론 강도(effort) low·medium·high·xhigh·max, 기본 high |
| 캐싱 | 암묵적 캐싱만, 약 4,000~6,000토큰 이상 요청부터 (문서에 따라 4,096 또는 6,144) | cache_control을 붙인 경우만, 읽기 $0.25 |
| 최대 출력 | 동기 요청 65,536토큰, 비스트리밍 한 번 32,768토큰, 긴 디코딩으로 최대 1,048,576토큰 | 128K 토큰 |
| 컨텍스트 | 1,048,576토큰 (입력과 출력 공유) | 100만 토큰 |
| 입력 형식 | 텍스트·이미지·동영상·오디오·PDF | 텍스트·이미지 |
캐싱은 청구액을 크게 바꿉니다. Fable의 $0.25 캐시 읽기는 요청에 cache_control을 넣었을 때만 적용되고, Argon은 명시적 캐시 API가 없어 조건이 맞으면 자동으로 캐시가 적용됩니다. 구조 차이는 Claude(클로드) 프롬프트 캐싱 적용법: 캐시 읽기 0.05배, 최소 512토큰과 Gemini 컨텍스트 캐싱: 암시적·명시적 차이와 비용, 실측 적중은 3번에 1번에서 확인할 수 있습니다.
긴 출력과 데이터 조건도 미리 봐야 합니다. Argon을 비스트리밍으로 호출하면 한 번에 32,768토큰에서 끊기므로 긴 코드나 문서를 생성한다면 스트리밍이나 긴 디코딩을 써야 하고, 응답이 중간에 끝날 때의 처리는 Gemini 4 Argon API finish_reason: CONTINUATION·빈 응답 대처에 정리돼 있습니다. Fable 5.1은 30일 데이터 보관이 필수라 무보관 조건으로 계약한 조직은 먼저 확인이 필요합니다. 게이트웨이를 거친다면 그쪽 제한도 따로 있습니다. 2026년 10월 하순 기준 LaoZhang API는 Claude 응답 한 번의 출력을 32,768토큰으로 제한하고, OpenAI 호환 경로로 Argon을 부르면 reasoning_effort를 무시하므로 사고 수준은 제미나이 네이티브 형식의 thinkingConfig.thinkingLevel로 지정해야 합니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
작업별로 무엇을 쓸까: Argon으로 옮길 일, Fable에 남길 일
통과 기준이 분명하고 자주 반복하는 일은 Argon 기본 설정으로, 사무 문서와 까다로운 코드는 Fable로 나누는 것이 지금 숫자에 가장 맞는 배치입니다. 12월 1일 이후에는 Argon 쪽 비용이 두 배가 되지만, 기본 설정끼리 비교하면 여전히 Fable이 몇 배 비쌉니다.
Argon으로 먼저 옮길 일은 테스트나 체크리스트로 결과를 확인할 수 있는 반복 코딩, 요약, 분류입니다. 실측에서 기본 설정이 전부 통과했고 비용 차이가 8.6배에서 12월 이후 4.3배이기 때문입니다. 터미널·브라우저 자동화처럼 도구를 많이 쓰는 에이전트도 AutomationBench(77.5% 대 59.4%)와 Terminal-Bench 계열에서 Argon이 앞서므로 Argon 기본부터 시험하고, 부족할 때만 high로 올린 뒤 12월 단가로 비용을 다시 계산하세요. 한국어 장문을 넣고 짧게 받는 작업은 입력 청구액 차이(약 11.3배, 12월부터 5.7배)만으로도 옮길 이유가 충분합니다.
Fable 5.1에 남길 일은 보고서와 사무 문서, PDF를 근거로 하는 업무입니다. AA-Briefcase(1669 대 1484)와 GDP.pdf(26.2% 대 21.8%)에서 Fable이 앞서기 때문입니다. 명세가 까다로운 코드와 고난도 추론은 FrontierCode(Fable xhigh 35.7% 대 Argon 25.7%)와 HLE-Diamond 결과를 보면 Fable xhigh를 쓸 만한 영역입니다. 첫 응답 속도가 중요한 대화형 작업이라면 AA 기준 첫 토큰까지 Fable high가 18.3초, Argon High가 41.5초라 Argon을 high로 올리지 않는 것이 좋습니다.
Fable을 꼭 써야 하는지부터 의심해 볼 필요도 있습니다. Anthropic의 모델 개요 문서는 어떤 모델을 쓸지 확실하지 않으면 대부분의 작업을 Opus 5.5로 시작하고, Fable 5.1은 까다로운 추론과 오래 이어지는 에이전트 작업, 또는 Opus 5.5를 높은 추론 강도로 돌려도 평가 기준에 못 미칠 때 쓰라고 안내합니다. 지금 Fable을 쓰는 이유가 "가장 좋은 모델이라서"뿐이라면 Argon과 Opus 5.5를 함께 시험할 만합니다.
제미나이 앱·Antigravity·Claude Code에서 쓰려면 필요한 요금제
API가 아니라 앱이나 코딩 도구로 쓴다면 요금제가 먼저 갈립니다. Gemini 4 Argon은 2026년 10월 13일부터 제미나이 앱의 Google AI Pro(미국 기준 월 $19.99)와 Google AI Ultra(월 $99.99 또는 $199.99)에서 쓸 수 있고, 월 $4.99인 Google AI Plus는 Flash 모델만 제공합니다(제미나이 요금제 페이지). AI Studio 웹에서도 Pro와 Ultra에만 Argon 사용량이 주어지고, 어떤 요금제도 API 호출 비용은 포함하지 않습니다. 10월 말 기준 코딩 에이전트 Antigravity에서는 유료 Google AI Pro와 Ultra 사용자가 별도 주간 한도로 Argon을 쓸 수 있고, 제미나이 CLI는 Argon에 최적화돼 있지 않아 Google이 Antigravity를 권합니다.
Claude 쪽은 Free에서 Fable 5.1을 쓸 수 없습니다. Pro(월 $20)는 첫 메시지부터 사용 크레딧으로 결제하고, Max(월 $100)와 Ultra(월 $200)는 주간 한도의 절반까지 Fable에 쓸 수 있으며 그 뒤에는 사용 크레딧이나 다른 모델로 넘어갑니다(Claude 요금제 페이지, Fable 요금제별 이용 안내). Max와 Ultra는 2026년 10월 30일 예전 Max 5x와 Max 20x에서 이름이 바뀐 요금제이고, Claude Code에서 Fable 5.1을 쓰려면 2.1.255 이상이 필요합니다. 제미나이 앱의 Argon 한도는 Google이 메시지 개수를 공개하지 않고 5시간마다 갱신되는 사용량과 주간 상한으로만 설명하며, Claude 요금제별 Fable 조건은 Claude Fable 5.1 vs Opus 5.5: 코딩·업무용으로 무엇을 선택할까?에서 더 자세히 다룹니다.
Fable에서 Argon으로 바꾸기 전에 내 작업으로 확인하는 순서
벤치마크와 위 실측은 출발점일 뿐이라, 실제로 옮길 작업으로 한 번 비교해 보는 것이 가장 확실합니다. 순서는 다음과 같습니다.
- 자주 반복하는 실제 요청 몇 개를 고르고, 각 요청의 통과 기준을 먼저 정합니다. 코드라면 테스트, 문서라면 빠지면 안 되는 수치와 결론 목록이 기준이 됩니다.
- Argon은 사고 설정 없이 한 번,
thinkingLevelhigh로 한 번 호출하고, Fable 5.1은 effort를 지정하지 않은 기본값(high)으로 호출합니다. 게이트웨이의 OpenAI 호환 경로를 쓴다면 Argon의 사고 수준이 실제로 적용되는지 응답의 사고 토큰 수로 확인합니다. - 응답마다 입력 토큰, 출력 토큰, 사고 토큰을 기록합니다. Argon은
usageMetadata의promptTokenCount,candidatesTokenCount,thoughtsTokenCount를 보고, Fable은usage의input_tokens와output_tokens를 봅니다. Fable의 출력 토큰에는 사고 토큰이 포함돼 있습니다. - 같은 사용량에 11월 단가와 12월 1일 단가를 각각 곱해, 통과한 결과 1건당 비용을 계산합니다. 실패해서 다시 돌린 호출도 비용에 넣습니다.
- 한국어 요청은 실제 한국어 원문으로, 캐시를 쓰는 요청은 두 번째 호출의 캐시 토큰까지 확인합니다. 긴 출력이 필요한 작업이라면 Argon의 32,768토큰 비스트리밍 상한에 걸리지 않는지도 봅니다.
Argon 쪽 사고 수준은 제미나이 네이티브 generateContent 요청의 generationConfig에 다음처럼 넣습니다. thinkingConfig를 빼면 기본값 medium으로 동작합니다.
{
  "contents": [{ "role": "user", "parts": [{ "text": "..." }] }],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "high" },
    "maxOutputTokens": 32000
  }
}
통과율이 같다면 비용이 낮은 쪽으로 옮기고, Argon이 기준을 못 넘는 작업만 Fable에 남기면 됩니다. Argon을 high로 올려야만 통과하는 작업이라면 12월 1일 단가로 다시 계산했을 때 Fable 기본 설정이 더 쌀 수 있으니, 그 작업은 옮기지 않는 편이 낫습니다.
Opus 5.5·GPT-6 Astra·Fable 5.5·Gemini 4 Carbon과도 비교하려면
Argon을 Anthropic의 Opus 5.5나 OpenAI의 GPT-6.1 Sol과 견주고 있다면 Gemini 4 Argon·Opus 5.5·GPT-6.1 Sol 비교: 작업당 비용 6배 차이에서 세 모델을 함께 다룹니다. Fable을 OpenAI 최상위 모델과 비교하려면 GPT-6 Astra와 Claude Fable 5.1 비교: 같은 단가, 한국어 토큰은 1.9배를 보세요. 그 제목의 1.9배는 Astra 대비 값이라, Argon 대비 2.26배와는 다른 비교입니다.
기다릴 만한 새 모델도 아직은 없습니다. 2026년 11월 4일 기준 Anthropic 문서와 릴리스 노트에 Fable 5.5는 없고 Fable 5.1이 최신 모델로 표시돼 있으며, 출시 소문의 경과는 Fable 5.5·Gemini 4·GPT-6.1 비교: 지금 쓸 수 있는 건 Sol과 Argon에 있습니다. 10월 28일 발표된 Gemini 4 Carbon은 일부 보안 방어 조직에만 열려 있고 공개 모델 ID, API, 일반 공개 날짜가 모두 없으며, Google은 Argon을 종료한다고 밝히지 않았습니다. Carbon과 Argon의 차이는 Gemini 4 Carbon vs Argon 차이: 9점 높고 첫 토큰은 2배 느리다, 공개 일정은 Gemini 4 Carbon 출시일: 지금은 보안 조직만, 일반 공개 날짜 미정에서 확인하세요.
참고 자료16
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 4일.
참고 자료16
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 4일.
- 1.AA 지수 방법론artificialanalysis.ai/methodology/intelligence-benchmarking
- 2.Artificial Analysis의 Gemini 4 Argon vs Claude Fable 5.1 비교 페이지artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-fable-5-1
- 3.Epoch Capabilities Indexepoch.ai/benchmarks/eci
- 4.Vals Indexvals.ai/benchmarks/vals_index
- 5.Gemini 4 Argon 출시 글blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 6.제미나이 API 가격표aistudio.google.com/docs/pricing
- 7.Claude API 가격표platform.claude.com/docs/en/about-claude/pricing
- 8.토큰 계산 문서platform.claude.com/docs/en/build-with-claude/token-counting
- 9.Gemini 4 Argon 모델 문서aistudio.google.com/docs/models/gemini-4-argon
- 10.Argon 사고 설정 문서aistudio.google.com/docs/thinking
- 11.Fable 5.1 모델 문서platform.claude.com/docs/en/models/fable-5-1/overview
- 12.Claude effort 문서platform.claude.com/docs/en/build-with-claude/effort
- 13.모델 개요 문서platform.claude.com/docs/en/about-claude/models/overview
- 14.제미나이 요금제 페이지gemini.google/us/subscriptions
- 15.Claude 요금제 페이지claude.com/pricing
- 16.Fable 요금제별 이용 안내support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan