Claude Sonnet 5.5 vs GPT-6.1 Sol 비교: 같은 단가, 같은 점수면 7~8배
단가는 같지만 AA 지수에서 같은 점수를 내는 비용은 Sonnet 5.5가 7~8배입니다. 대부분은 GPT-6.1 Sol, 272K 토큰을 넘는 문서는 Sonnet이 유리합니다.
목차
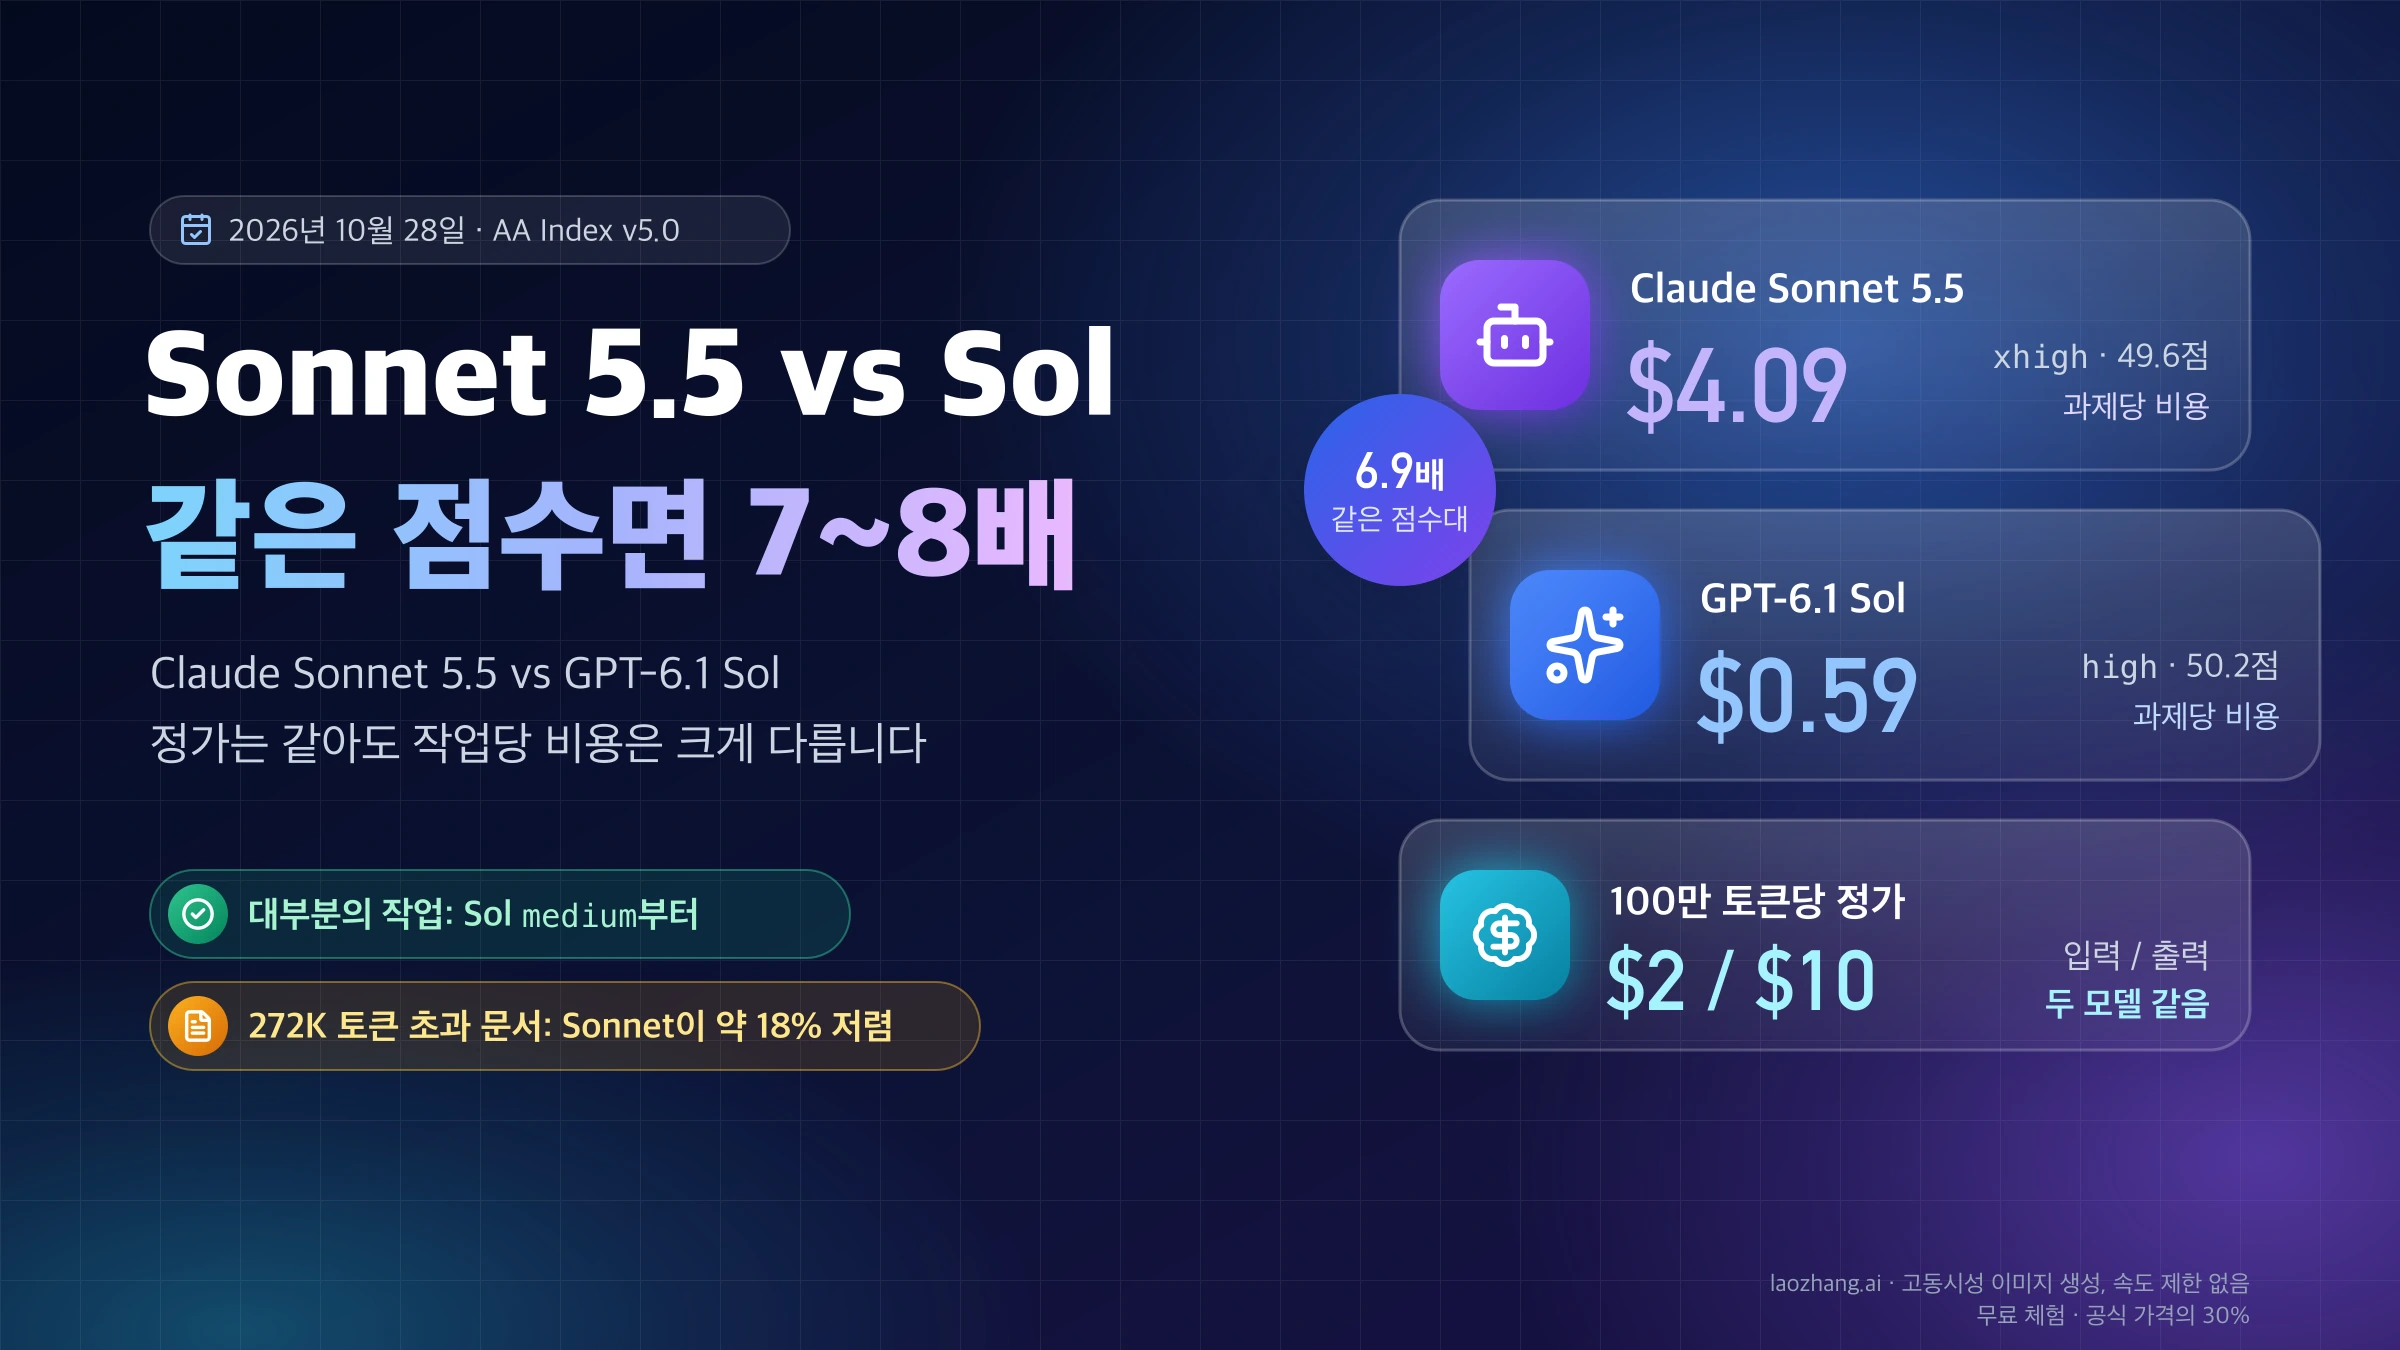
Claude Sonnet 5.5와 GPT-6.1 Sol은 2026년 10월 28일 기준 API 정가가 같습니다. 100만 토큰당 입력 $2, 출력 $10, 캐시 읽기 $0.10입니다. 그래도 대부분의 API 작업은 GPT-6.1 Sol(gpt-6.1-sol)을 기본 effort(추론 강도) medium으로 먼저 시험하는 편이 낫습니다. Artificial Analysis(AA) Intelligence Index v5.0에서 Sonnet 5.5가 Sol high(50.2점)와 비슷한 점수를 내려면 xhigh(49.6점)가 필요하고 이때 작업당 비용은 약 6.9배, 최고 단계 max끼리(54.2점 대 54.5점)는 약 7.9배입니다.
Claude Sonnet 5.5(claude-sonnet-5-5)를 먼저 고를 만한 경우는 두 가지입니다. 입력이 272K 토큰을 넘는 긴 문서에서는 Sol의 요청 전체 단가가 입력 $4·출력 $15로 오르기 때문에, 같은 한국어 글을 Sonnet이 1.65배 많은 토큰으로 세어도 Sonnet 쪽이 약 18% 쌉니다. 또 Terminal-Bench 4.0 같은 터미널 작업 점수가 가장 중요하고 xhigh·max의 비용을 감수할 수 있다면 Sonnet이 앞섭니다.
어느 쪽으로 옮기든 모델 ID만 바꾸면 깨지는 부분이 있습니다. Sol에서 도구를 호출하려면 Responses API를 써야 하고, Sonnet은 cache_control을 넣지 않으면 캐시를 쓰지 않아 긴 에이전트 루프 비용이 10배 넘게 불어날 수 있습니다. 2026년 10월 28일 같은 12문제를 직접 실행해 보니 통과는 Sonnet high 11개, Sol 12개로 거의 같았고 비용은 Sonnet이 Sol 기본 설정의 1.52배였습니다. 이 실행에는 도구 호출, 여러 턴의 에이전트 작업, 각 회사 API 직접 호출이 들어가지 않았으므로 품질 비교는 AA 수치를 기준으로 합니다.
작업별로 어느 모델부터 쓸까: 대부분 Sol, 272K 초과 문서는 Sonnet
선택을 가르는 조건은 입력 길이, 캐시 사용 방식, 그리고 어느 평가에서 높은 점수가 필요한지입니다. 아래 표는 2026년 10월 28일 기준 정가와 AA Intelligence Index v5.0, 같은 날 직접 실행한 결과를 바탕으로 작업별로 먼저 시험할 설정을 정리한 것입니다. 실제 작업으로 합격률을 확인하기 전까지는 출발점으로만 보세요.
| 작업 | 먼저 시험할 설정 | 이유 |
|---|---|---|
| 짧은 채팅·분류·추출 요청 | GPT-6.1 Sol medium | 정가가 같아 한국어 토큰 수 차이가 그대로 청구액 차이가 됨 |
| 272K 토큰 이하의 긴 문서 | GPT-6.1 Sol medium | 할증 구간 전이라 토큰을 적게 세는 Sol이 유리 |
| 272K 토큰을 넘는 긴 문서 | Claude Sonnet 5.5 high | Sol은 요청 전체가 할증 단가로 바뀜 |
| 같은 앞부분을 반복하는 에이전트 루프 | Sol medium, Sonnet이면 cache_control 필수 | Sol은 자동 캐시, Sonnet은 지정해야 캐시 |
| 터미널·코딩 에이전트 | Sol high부터, 최고 점수가 필요하면 Sonnet xhigh·max | Terminal-Bench 4.0은 xhigh 이상에서 Sonnet이 앞서지만 작업당 비용이 훨씬 큼 |
| 지식·과학 문제 | Sol high 이상 | AA-Omniscience, HLE-Diamond, CritPt에서 모든 단계 Sol 우세 |
| 첫 응답이 빨라야 하는 대화 | Sonnet low·medium 또는 Sol Fast | 출력 속도는 Sonnet이 빠르고, Sol은 유료 Fast·Ultrafast 등급이 있음 |
| 대량 배치 | Sol Batch 또는 Flex | 둘 다 50% 할인이지만 토큰 수 차이는 그대로 남음 |
두 API를 아무 설정 없이 부르면 서로 다른 단계를 비교하게 된다는 점도 기억하세요. Claude API에서 Sonnet 5.5의 기본 effort는 high이고(Claude Code와 Claude 앱은 medium), GPT-6.1 Sol의 기본값은 medium입니다. Sonnet 5.5의 effort별 동작과 Sonnet 5에서 바뀐 점은 Claude Sonnet 5.5 가격과 성능: Sonnet 5 대비 effort별 비용, 전환 방법에 정리돼 있습니다.
두 모델의 API 정가: 272K 토큰 이하에서는 항목마다 같습니다
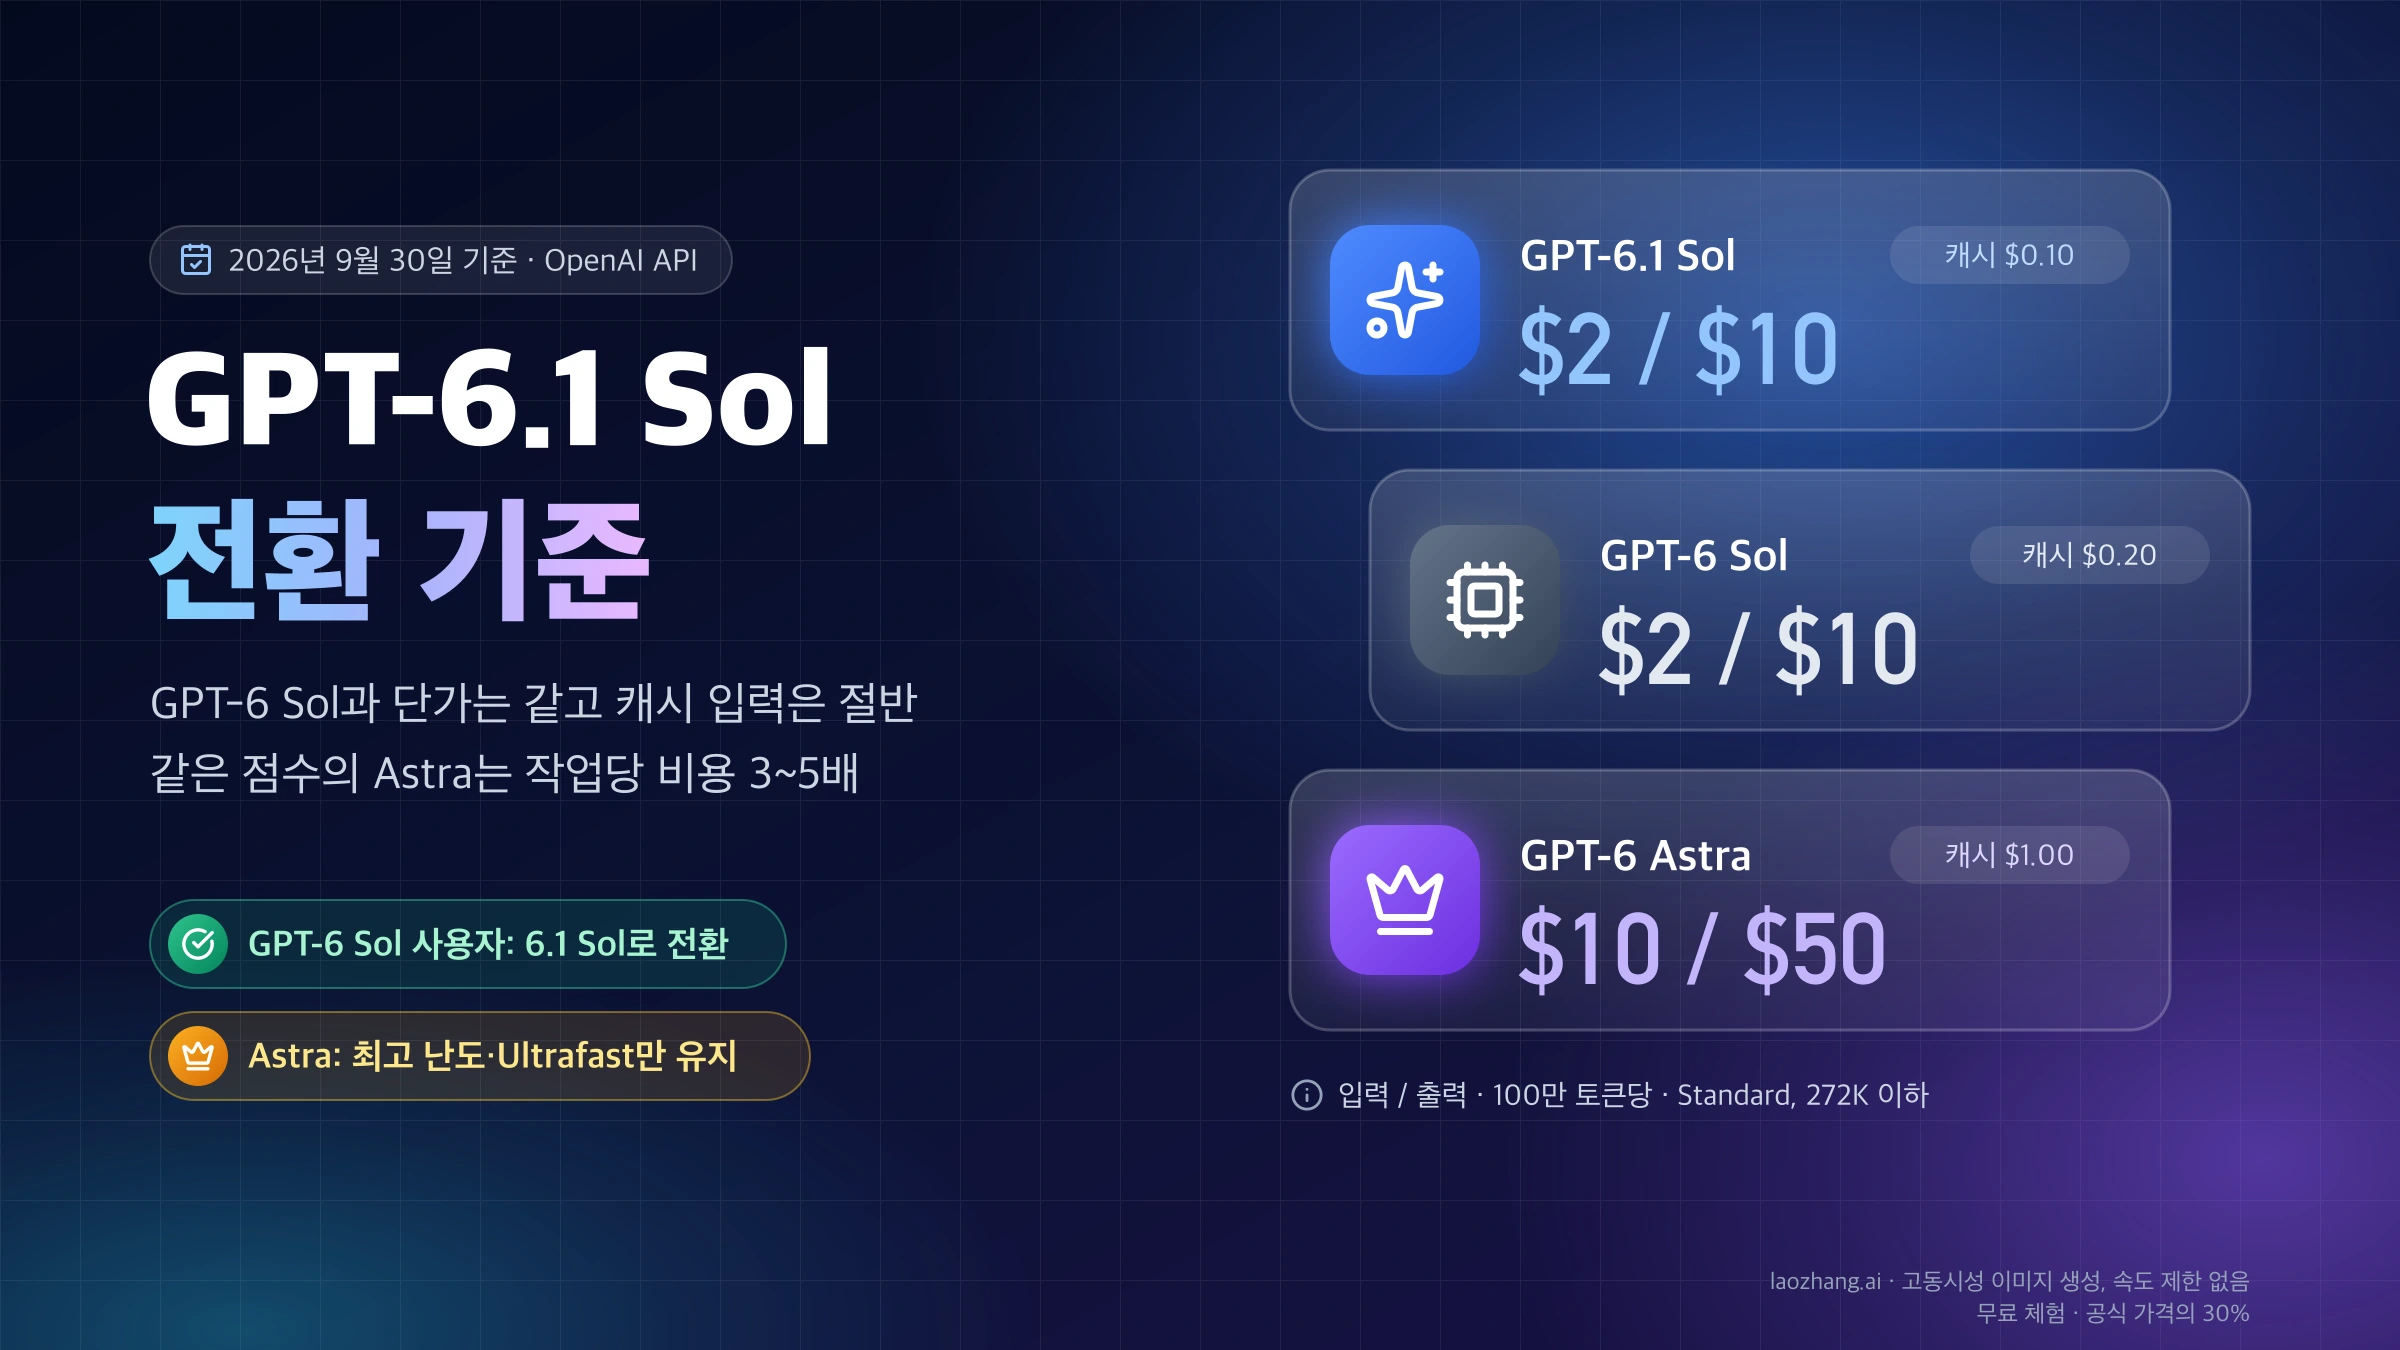
2026년 10월 28일 기준 Anthropic Claude API 요금표와 OpenAI API 요금표를 나란히 놓으면, Sol 입력이 272K 토큰 이하인 요청에서는 입력, 출력, 캐시 읽기, 짧은 캐시 기록 단가가 모두 같습니다. 차이는 272K를 넘는 요청, 긴 캐시의 유지 시간과 가격, 그리고 Sol에만 있는 Fast·Flex 같은 처리 등급에서 생깁니다. 아래는 모두 표준 등급, 100만 토큰당 미국 달러입니다.
| 과금 항목 | Claude Sonnet 5.5 (1M까지 동일) | GPT-6.1 Sol (272K 이하) | GPT-6.1 Sol (272K 초과) |
|---|---|---|---|
| 입력 | $2 | $2 | $4 |
| 출력 | $10 | $10 | $15 |
| 캐시 읽기 | $0.10 | $0.10 | $0.20 |
| 짧은 캐시 기록 | $2.50 (5분) | $2.50 (30분) | $5 |
| 긴 캐시 기록 | $4 (1시간) | $5 (12시간, Responses API 전용) | $10 |
| Batch 입력 / 출력 | $1 / $5 | $1 / $5 (Flex도 같음) | $2 / $7.50 |
| 빠른 처리 등급 | 없음 | Fast $4 / $20, Ultrafast $12 / $60 | 별도 단가 |
GPT-6.1 Sol 모델 페이지는 272K 토큰을 넘는 프롬프트에 입력·캐시 단가 2배, 출력 1.5배가 "요청 전체"에 적용된다고 적고 있습니다. 넘은 부분만 비싸지는 구조가 아니라는 뜻입니다. Claude 요금표는 Sonnet 5.5를 포함한 Claude 4.6 이후 모델(Haiku 5.5 제외)이 1M 토큰 컨텍스트 전체를 표준 단가로 쓴다고 밝히고 있어 긴 입력 할증이 없습니다. 미국 내 처리(inference_geo: "us")를 고르면 Sonnet은 모든 항목이 1.1배가 되고, Sol의 지역 처리(data residency)는 10%가 붙습니다.
GPT-6.1 Sol의 캐시 읽기가 Sonnet의 절반이라는 설명은 2026년 10월 7일 이전에만 맞았습니다. 그날부터 Sonnet 5.5의 캐시 읽기가 $0.20에서 $0.10으로 내려가 지금은 두 모델이 같습니다. 인하 내용과 청구액 계산은 Claude Sonnet 5.5 캐시 가격: 캐시 읽기 $0.10로 반값, 청구액 계산법에서 볼 수 있습니다.
단가는 같아도 캐시가 켜지는 방식은 정반대입니다. OpenAI 프롬프트 캐싱 가이드에 따르면 GPT-5.6 이후 모델은 캐시가 기본으로 켜져 1,024토큰 이상의 앞부분을 30분 동안 저장하고, 그 기록에 입력 단가의 1.25배를 받습니다. 12시간 보존(prompt_cache_options.ttl: "12h")은 Responses API에서만 되고 2.5배입니다. Claude는 Anthropic 프롬프트 캐싱 문서대로 cache_control이나 자동 캐싱 설정을 켜야 캐시하며, Sonnet 5.5의 최소 캐시 길이는 512토큰, 유지 시간은 기본 5분에 1시간 옵션이 있습니다.
단가가 같은데 왜 몇 배 차이가 날까: 계산 방식별 배수
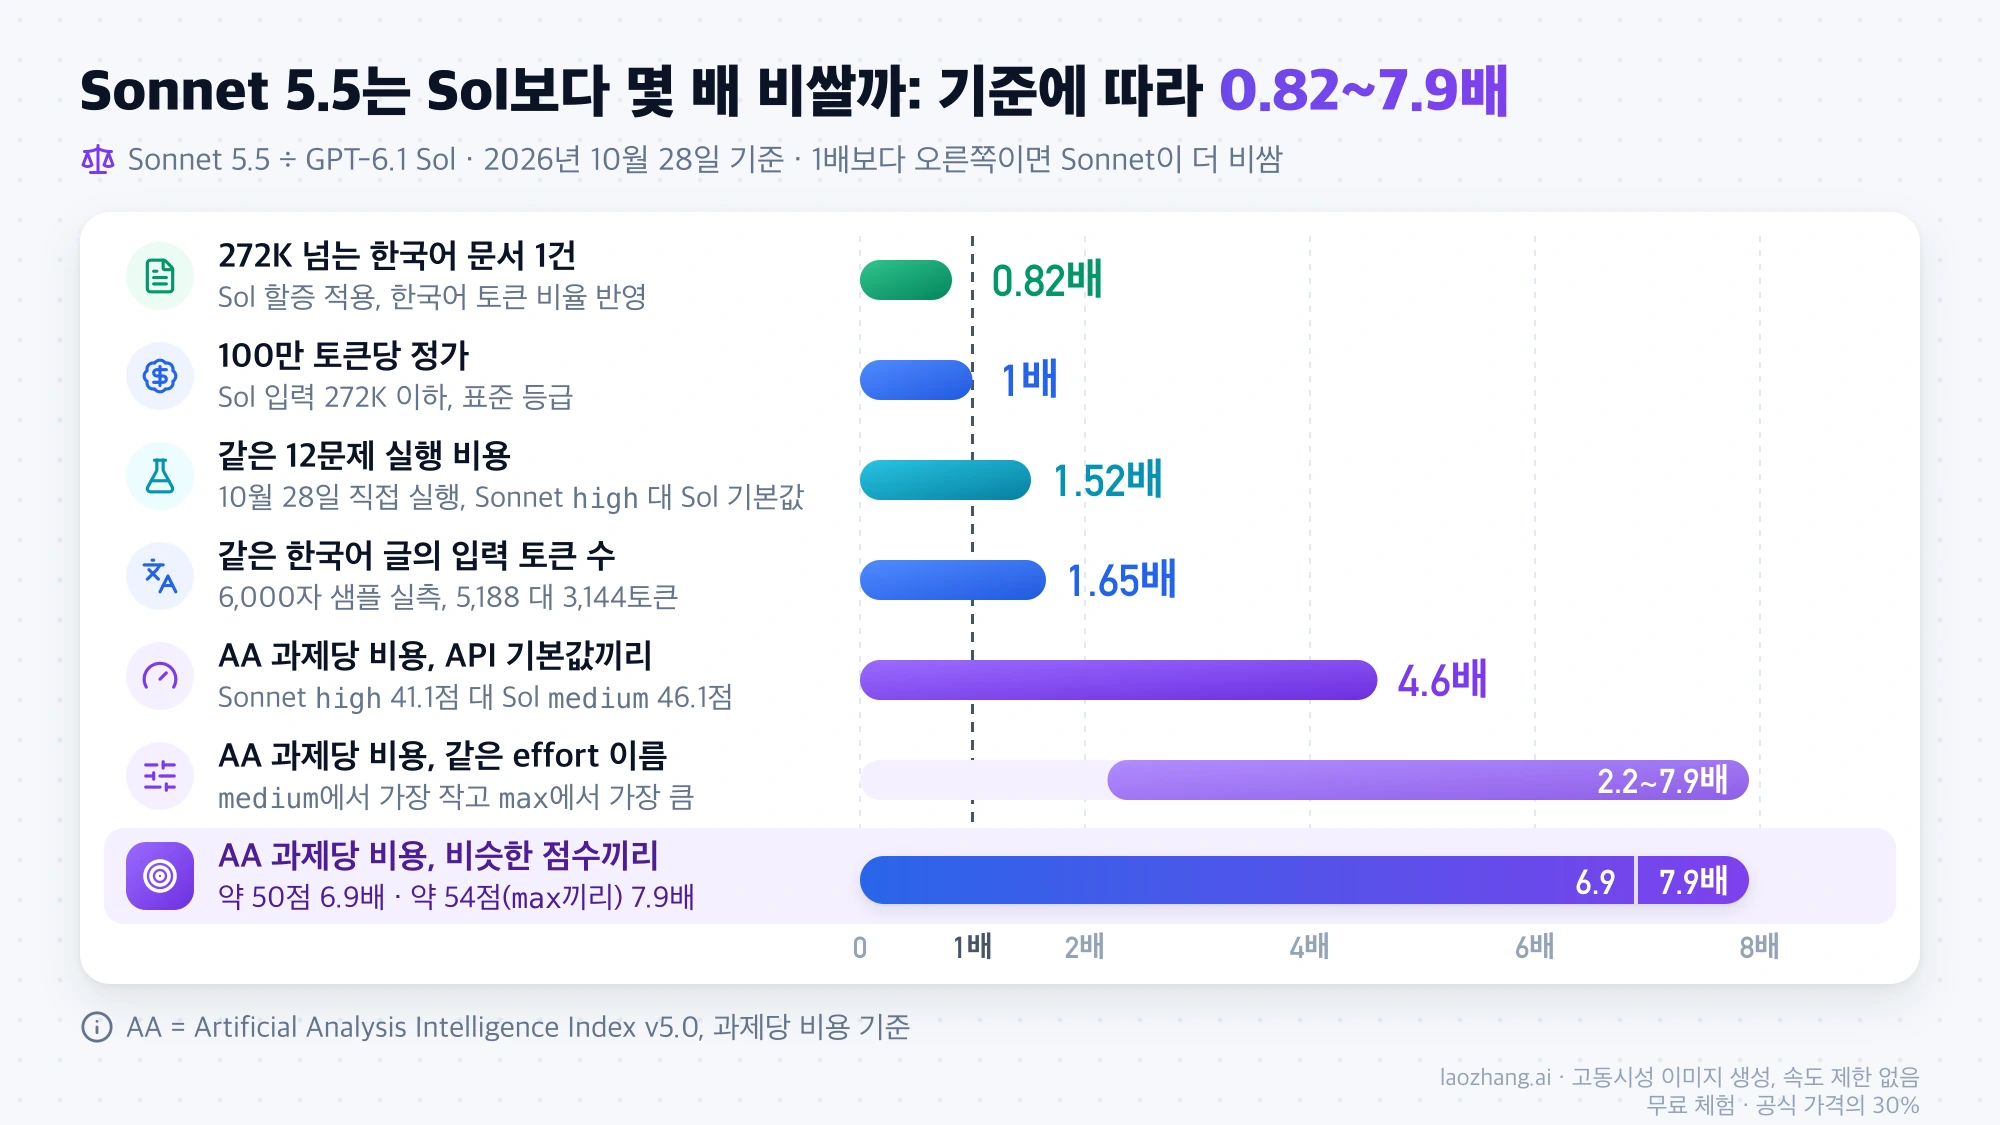
100만 토큰당 가격이 같아도 청구액이 같지 않은 이유는 세 가지입니다. 같은 글을 Sonnet이 더 많은 토큰으로 세고, 같은 effort 이름에서도 Sonnet이 작업 하나에 훨씬 많은 토큰을 쓰며, 입력이 272K를 넘으면 거꾸로 Sol의 단가가 올라갑니다. 그래서 "몇 배 비싸다"는 숫자는 무엇을 기준으로 재느냐에 따라 1배 아래부터 8배 가까이까지 달라집니다.
| 비교 기준 | Sonnet 5.5 ÷ GPT-6.1 Sol | 조건 |
|---|---|---|
| 100만 토큰당 정가 | 1배 | Sol 입력 272K 이하, 표준 등급 |
| 같은 한국어 글의 입력 토큰 수 | 1.65배 | 2026년 10월 28일 실측, 6,000자 샘플 |
| 같은 12문제를 실행한 비용 | 1.52배 | Sonnet high 대 Sol 기본값, 2026년 10월 28일 |
| AA 과제당 비용, 같은 effort 이름 | 2.2~7.9배 | medium에서 가장 작고 max에서 가장 큼 |
| AA 과제당 비용, API 기본값끼리 | 4.6배 | Sonnet high 41.1점 대 Sol medium 46.1점 |
| AA 과제당 비용, 비슷한 점수끼리 | 6.9배 / 7.9배 | 약 50점 / 약 54점 |
| 272K 토큰을 넘는 한국어 문서 1건 | 0.82배 | Sol 할증 적용, 한국어 토큰 비율 반영 |
토큰 수 차이는 2026년 10월 28일에 직접 잰 값입니다. 각 언어로 따로 쓴 같은 주제의 기사 앞부분 6,000자를 두 모델에 보내고, 지시문만 보냈을 때의 토큰 수를 뺐습니다. 한국어는 Sonnet 5.5가 5,188토큰, GPT-6.1 Sol이 3,144토큰으로 1.65배였고, 영어 1.45배, 중국어 1.41배, 일본어 1.29배, 스페인어 1.52배, Python 코드 1.46배보다 격차가 컸습니다. GPT-6 Luna는 모든 샘플에서 Sol과 똑같은 수를 세었습니다.
두 회사 모두 상대 모델과의 토큰 수 비교를 공개하지 않습니다. OpenAI는 GPT-6.x의 토크나이저 이름을 밝히지 않고 tiktoken에도 gpt-6 계열 매핑이 없어, 정확한 수는 OpenAI의 입력 토큰 계산 엔드포인트로 확인하라고 안내합니다. Anthropic은 Claude 4.7 이후 토크나이저가 이전 모델보다 약 30% 많이 센다고만 설명합니다. 자기 문서의 비율을 알고 싶다면 실제 문서를 양쪽 토큰 계산 기능에 넣어 보는 수밖에 없습니다.
레딧 r/ClaudeAI의 "Sonnet 5.5 30x more expensive than GPT 6.1 Sol on 3D tasks"라는 글 제목은 특정 작업에서 나온 숫자이고, 위 어떤 기준으로 계산해도 30배는 나오지 않습니다. 작업이 길고 반복 호출이 많을수록 배수가 커지는 경향은 AA 수치에도 보이지만, 개별 사례의 배수를 두 모델의 일반적인 가격 차이로 읽으면 판단이 어긋납니다.
effort 단계별 점수와 작업당 비용: AA Intelligence Index v5.0
AA Intelligence Index v5.0(2026년 10월 28일 기준)에서 GPT-6.1 Sol은 low부터 xhigh까지 모든 단계에서 같은 이름의 Sonnet 5.5보다 점수가 높고 작업당 비용은 낮습니다. 최고 단계 max에서만 두 모델의 점수가 거의 같아집니다. 아래 값은 Artificial Analysis의 Claude Sonnet 5.5 vs GPT-6.1 Sol 비교 페이지에 실린 단계별 측정치이며, 각 칸은 지수 점수 · 과제당 비용 · 과제당 시간 · 과제당 출력 토큰 순서입니다.
| effort | Claude Sonnet 5.5 | GPT-6.1 Sol | 과제당 비용 (Sonnet ÷ Sol) |
|---|---|---|---|
low | 25.3점 · $0.51 · 121초 · 20.9k | 34.5점 · $0.16 · 104초 · 5.8k | 3.2배 |
medium | 30.3점 · $0.78 · 178초 · 30.7k | 46.1점 · $0.36 · 231초 · 13.5k | 2.2배 |
high | 41.1점 · $1.64 · 332초 · 58.4k | 50.2점 · $0.59 · 322초 · 22.6k | 2.8배 |
xhigh | 49.6점 · $4.09 · 691초 · 122.2k | 52.3점 · $0.76 · 436초 · 30.2k | 5.4배 |
max | 54.2점 · $10.02 · 1,326초 · 285.4k | 54.5점 · $1.27 · 858초 · 67.8k | 7.9배 |
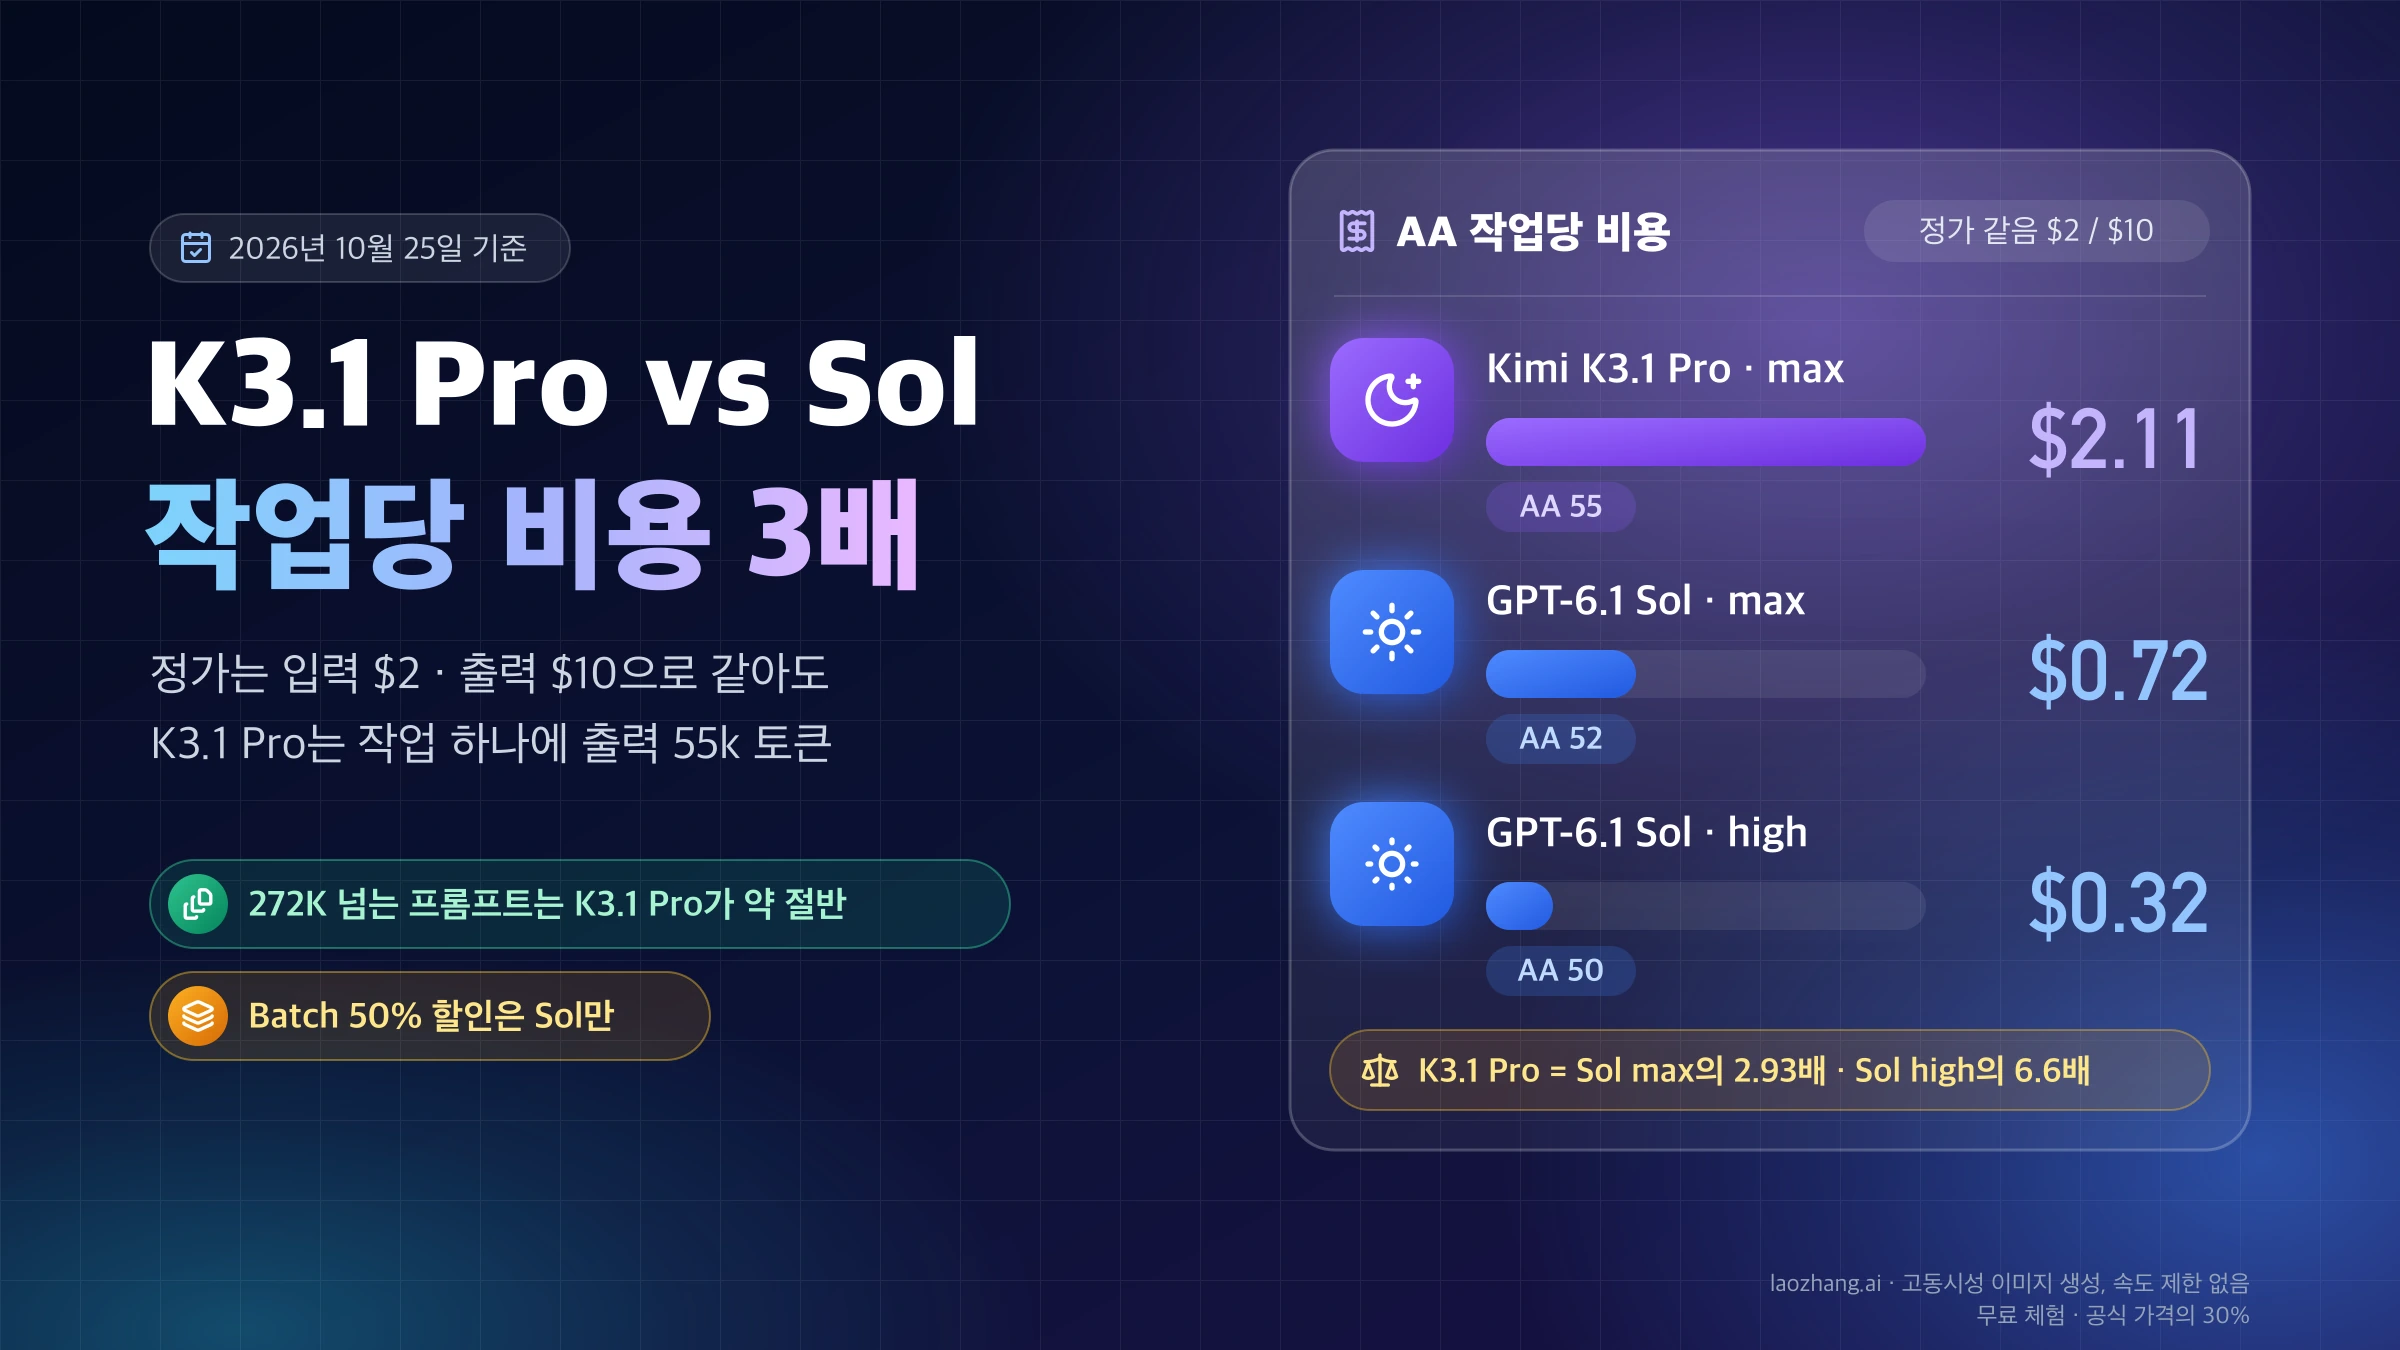
점수를 맞춰 보면 차이가 더 벌어집니다. Sol high(50.2점)와 비슷한 점수는 Sonnet xhigh(49.6점)에서 나오는데, 이때 과제당 비용은 $4.09 대 $0.59, 시간은 691초 대 322초입니다. 두 API를 기본값으로 부르면 Sonnet high와 Sol medium을 비교하는 셈이어서, Sol이 점수는 5점 높으면서 과제당 비용은 $0.36으로 Sonnet의 $1.64보다 적습니다.
Sonnet의 과제당 비용이 커지는 원인은 출력 단가가 아니라 토큰 양입니다. max에서 Sonnet은 과제 하나에 출력 토큰 285.4k를 쓰고 Sol은 67.8k를 씁니다. AA의 비용 내역을 보면 Sonnet max의 과제당 $10.02 가운데 $7.17이 입력 쪽(캐시 읽기 $4.88, 캐시 기록 $2.27)이어서, 여러 차례 이어지는 에이전트 실행에서 긴 맥락을 더 많은 턴에 걸쳐 다시 읽는 비용이 대부분입니다. Sol max는 $1.27 중 입력 쪽이 $0.59입니다.
다른 글에서 본 AA 점수가 위 표와 다르다면 지수 버전이 다를 가능성이 큽니다. AA는 2026년 10월 지수를 v4.3.2에서 v5.0으로 바꾸면서 HLE-Diamond, FrontierCode 2.0, Terminal-Bench-Science를 넣고 GDPval-AA, SciCode, AA-LCR, HLE를 뺐습니다. 그 결과 이전 지수에서 Sonnet max가 Sol max보다 높았던 순위가 뒤집혔으므로, 두 버전의 점수와 비용은 섞어서 비교하면 안 됩니다.
Sonnet 5.5가 앞서는 평가와 GPT-6.1 Sol이 앞서는 평가
같은 AA 페이지의 세부 평가에서 Sonnet 5.5가 앞서는 곳은 높은 단계의 터미널·자동화 작업과 AA-Briefcase입니다. 지식과 과학 문제에서는 Sol이 모든 단계에서 앞서고, low·medium에서는 AA-Briefcase를 뺀 모든 항목에서 Sol이 앞섭니다. Sonnet의 강점은 대부분 xhigh·max 비용을 낼 때 드러난다는 뜻입니다.
| AA 세부 평가 | medium Sonnet / Sol | xhigh Sonnet / Sol | max Sonnet / Sol | 앞서는 쪽 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 29.8% / 48.0% | 57.1% / 54.0% | 63.6% / 56.1% | xhigh 이상 Sonnet |
| AutomationBench-AA | 54.9% / 62.6% | 65.5% / 66.6% | 71.8% / 64.9% | max만 Sonnet |
| AA-Briefcase (Elo) | 1438 / 1361 | 1743 / 1502 | 1812 / 1555 | 모든 단계 Sonnet |
| FrontierCode 2.0 | 11.0% / 33.4% | 35.6% / 38.5% | 41.7% / 40.6% | max만 Sonnet, 근소 |
| AA-Omniscience | 18.6 / 40.2 | 20.6 / 42.4 | 30.5 / 42.0 | 모든 단계 Sol |
| CritPt v2 Hard | 28.5% / 65.0% | 54.0% / 68.0% | 56.0% / 68.5% | 모든 단계 Sol |
표에 없는 평가도 같은 방향입니다. HLE-Diamond와 GDP.pdf는 모든 단계에서 Sol이 높고(max 기준 HLE-Diamond 53.3% 대 58.8%), Terminal-Bench-Science는 xhigh(52.4% 대 50.5%)를 빼면 Sol이 앞섭니다. 그래서 터미널 명령을 오래 이어 가는 작업에서 최고 점수가 꼭 필요하다면 Sonnet xhigh·max를 시험할 가치가 있지만, 사실 지식을 묻는 질문이나 과학 계산이 중심이라면 Sol에 머무는 편이 점수와 비용 모두 유리합니다.
코딩 에이전트에서도 비슷한 그림이 보입니다. AA가 2026년 10월 초 공개한 Coding Agent Index 게시물에서 Claude Code의 Sonnet 5.5 max는 68점으로 1위였지만 과제당 비용도 $14.19로 가장 높았고, Codex의 GPT-6.1 Sol xhigh는 63점에 $1.04였습니다.
10월 28일 12문제 실측: 통과율은 비슷, 비용은 Sonnet이 더 듦
2026년 10월 28일, laozhang.ai 게이트웨이를 거쳐 정답이나 숨은 테스트를 미리 정해 둔 12개 단일 턴 과제를 세 가지 설정으로 한 번씩 실행했습니다. Sonnet 5.5는 Anthropic Messages 형식(/v1/messages)에 thinking: {"type": "adaptive"}와 effort high를, Sol은 Chat Completions에 기본값(medium)과 reasoning_effort: "high"를 썼고 도구와 시스템 프롬프트는 쓰지 않았습니다. 세 설정 모두 거의 다 풀었기 때문에 이 결과는 어느 모델이 더 똑똑한지가 아니라 비슷한 통과율에서 비용·토큰·시간이 얼마나 다른지를 보여 줍니다. 비용은 응답의 usage 값에 공식 정가를 곱해 계산했습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
| 설정 | 통과 | 정가 기준 비용 | 출력 토큰 (그중 추론) | 호출 시간 합계 | 호출 시간 중앙값 |
|---|---|---|---|---|---|
Claude Sonnet 5.5 high | 11/12 | $0.1761 | 10,945 (별도 집계 없음) | 101초 | 7.6초 |
GPT-6.1 Sol 기본값 (medium) | 12/12 | $0.1157 | 6,162 (2,423) | 187초 | 14.0초 |
GPT-6.1 Sol high | 12/12 | $0.1581 | 10,398 (6,311) | 442초 | 21.2초 |
Sonnet이 놓친 한 문제는 6,723단어 영어 기사를 25단어 이하 글머리표 5개로 요약하는 과제였고, 첫 줄이 26단어여서 형식 조건에 걸렸습니다. 그 호출에서는 adaptive thinking이 쓰이지 않았고, 사고 블록은 12개 과제 중 8개에서만 돌아왔습니다. 존재하지 않는 표준 라이브러리 함수 두 개를 묻는 문제에는 세 설정 모두 "없다"고 답했고, 테스트 36개가 걸린 npm 버전 범위 과제도 모두 통과했습니다. 같은 12문제 비용은 Sonnet이 Sol high보다 1.11배 많았고, 긴 문서 과제 두 개를 빼면 Sol 기본값의 1.83배였습니다.
Sol은 캐시 설정을 하나도 넣지 않았는데도 약 1만 토큰짜리 문서 프롬프트 두 개에서 cache_write_tokens가 10,103과 10,195로 돌아왔고, 이 기록은 입력 단가의 1.25배인 $2.50로 계산됐습니다. 같은 문서 프롬프트를 약 5분 30초 뒤 reasoning_effort: "high"로 다시 보냈을 때는 캐시에서 읽은 토큰이 0이었고 캐시를 다시 기록했는데, effort 설정이 달라서인지 게이트웨이나 상위 경로 때문인지는 이 결과만으로 가릴 수 없습니다. cache_control을 넣지 않은 Sonnet은 아무것도 캐시하지 않았습니다.
이번 실행에 들어가지 않은 것은 각 회사 API 직접 호출, Responses API, 도구 호출, 여러 턴의 에이전트 작업, Sol xhigh·max, Sonnet의 high 외 단계입니다. 이 부분에 대한 판단은 위 AA 수치와 공식 문서를 근거로 합니다. 또 2026년 10월 26일 같은 게이트웨이에서 Sonnet 5.5 요청에 thinking과 effort를 빼고 보냈을 때는 9개 과제 모두 사고 블록이 돌아오지 않았습니다. Anthropic 문서는 thinking을 생략하면 adaptive와 기본값 high가 적용된다고 설명하지만, 중계 서비스를 거칠 때는 두 값을 요청에 명시해 두는 편이 안전합니다.
내 작업이면 얼마일까: 한국어 기준 사례별 비용
한국어 텍스트로 계산하면 Sol 기준 272K 토큰 이하의 사례에서는 Sol이 1.2~1.6배 저렴하고, 272K를 넘는 긴 문서에서만 Sonnet이 약 18% 저렴합니다. 아래 표는 2026년 10월 28일 정가로 계산했습니다. 토큰 수는 Sol 기준이고, Sonnet 입력은 그 1.65배(앞에서 잰 한국어 비율), 출력 토큰은 두 모델이 같다고 가정했습니다. 실제로는 Sonnet이 출력도 더 많이 쓰는 경우가 많아 표의 Sonnet 금액은 낮게 잡힌 쪽입니다.
| 사례 (Sol 토큰 기준) | GPT-6.1 Sol | Claude Sonnet 5.5 | Sonnet ÷ Sol |
|---|---|---|---|
| 채팅 1회: 입력 2K + 출력 500 | $0.0090 | $0.0116 | 1.29배 |
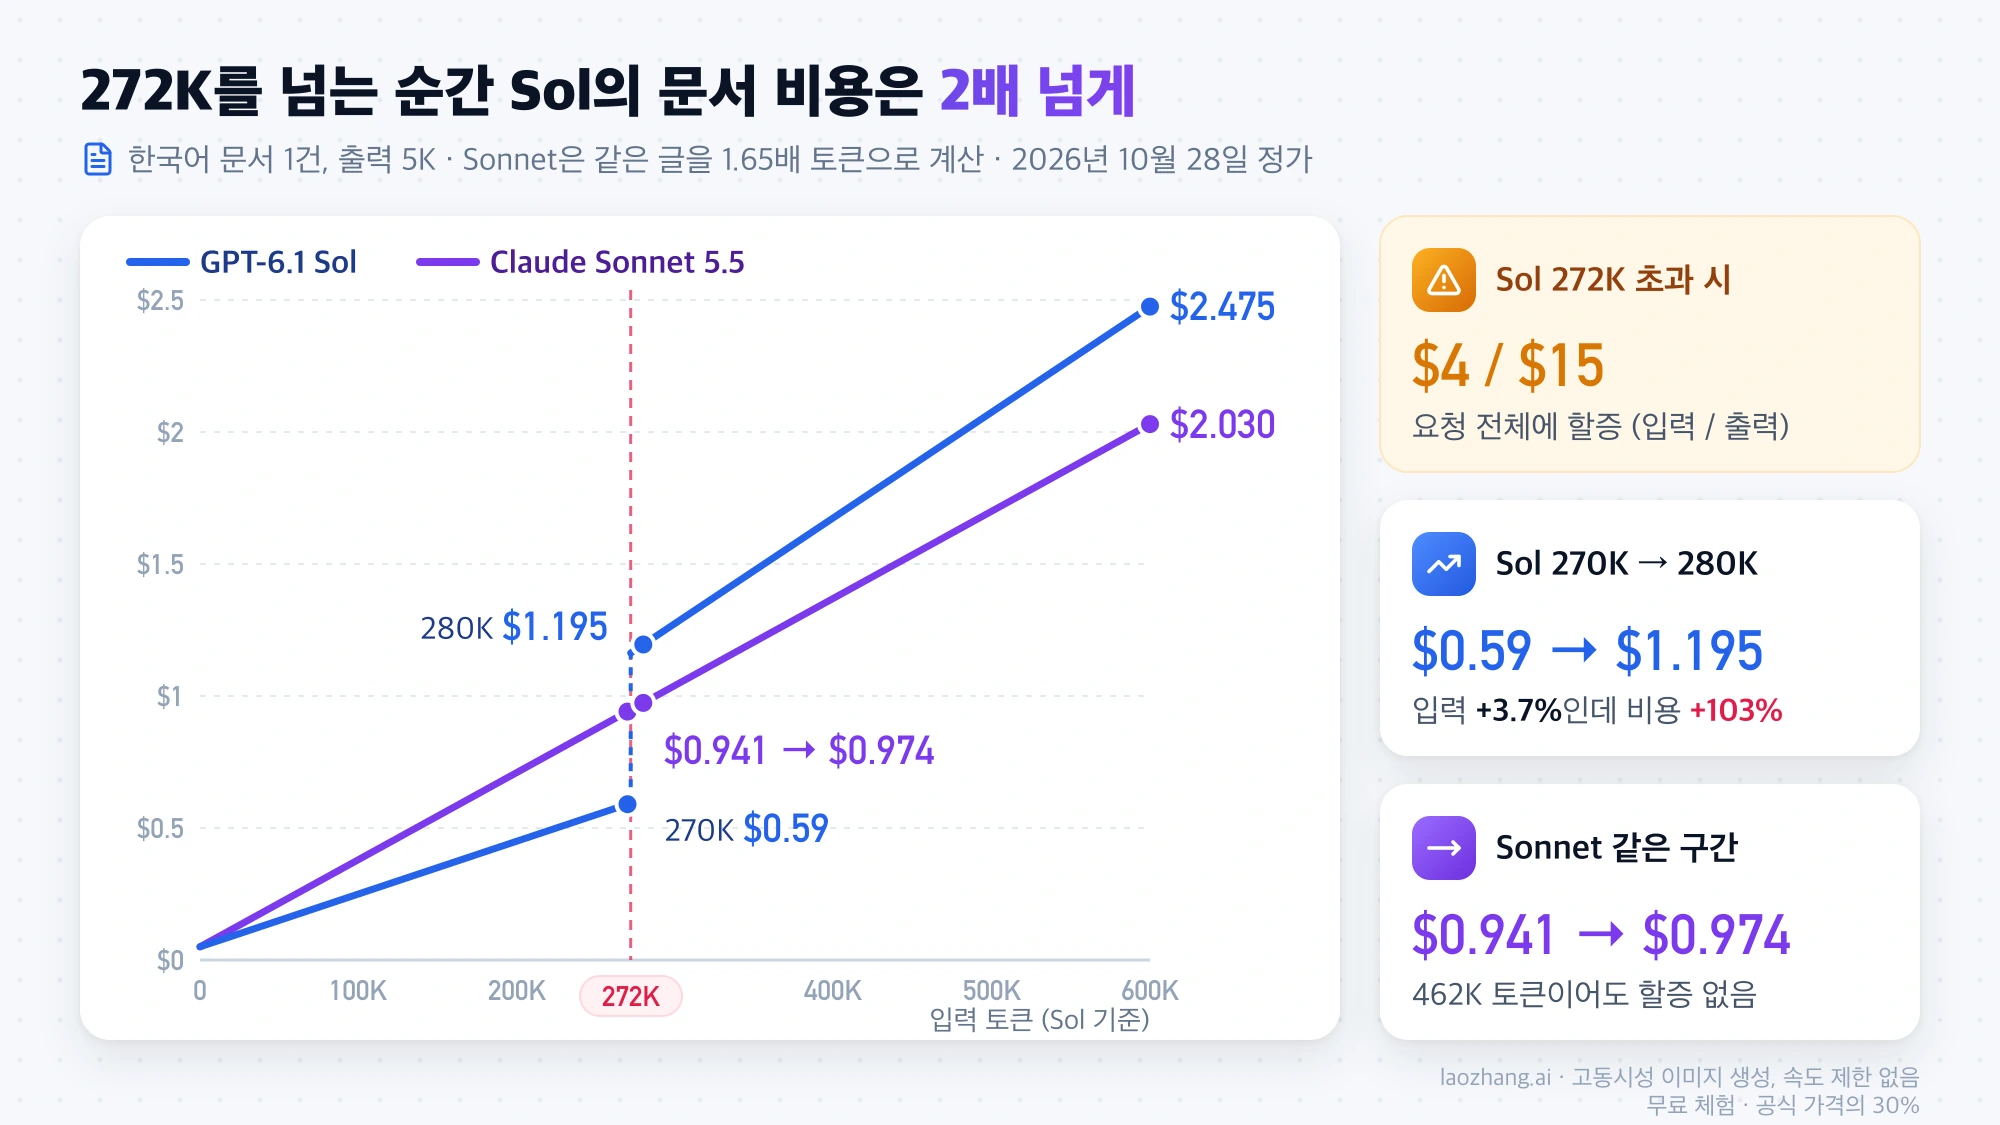
| 문서 1건: 입력 270K + 출력 5K | $0.590 | $0.941 | 1.59배 |
| 문서 1건: 입력 280K + 출력 5K (Sol 272K 초과) | $1.195 | $0.974 | 0.82배 |
| 문서 1건: 입력 600K + 출력 5K | $2.475 | $2.030 | 0.82배 |
| 에이전트 50턴: 100K 앞부분 캐시, 턴마다 새 입력 2K + 출력 1K | $1.44 | $2.051 | 1.42배 |
같은 루프에서 Sonnet에 cache_control 없음 | $1.44 | $17.33 | 12.03배 |
| 배치 10,000건 × (입력 3K + 출력 1K), 둘 다 50% 할인 | $80.00 | $99.50 | 1.24배 |
272K 단차가 얼마나 큰지는 두 번째와 세 번째 줄에서 드러납니다. Sol은 입력 270K라면 0.27 × $2 + 0.005 × $10 = $0.59이지만, 280K가 되면 요청 전체에 할증이 붙어 0.28 × $4 + 0.005 × $15 = $1.195가 됩니다. 입력은 3.7% 늘었을 뿐인데 비용은 103% 오른 것입니다. Sonnet은 같은 글을 462K 토큰(280K × 1.65)으로 세어도 0.462 × $2 + 0.005 × $10 = $0.974입니다. 272K를 넘는 구간에서는 Sonnet의 토큰 비율이 2배 미만인 한 Sonnet 입력이 더 쌉니다. 다만 Sol 기준 600K 토큰인 한국어 문서는 Sonnet에서 약 990K 토큰이 되어 1M 컨텍스트에 거의 닿고, Sol 쪽은 최대 입력이 922K 토큰이라는 한도가 있습니다.
가장 비싼 실수는 Sonnet에서 캐시 지정을 빠뜨리는 것입니다. Sol은 앞부분을 자동으로 캐시하므로 설정 없이도 표의 $1.44에 가깝게 나오지만, Sonnet은 cache_control이 없으면 50턴 동안 165K 토큰(100K × 1.65)의 앞부분을 매번 정가로 다시 읽어 $17.33이 됩니다. 반대로 Sol에서는 원하지 않아도 캐시 기록 요금이 붙는다는 점을 계산에 넣어야 합니다. 표의 에이전트 계산은 두 모델 모두 턴 간격이 캐시 유지 시간(Sonnet 5분, Sol 30분) 안에 있다고 가정했습니다.
어느 쪽이 빠른가: 출력은 Sonnet, 과제 시간은 effort별로 다름
초당 출력 속도는 Sonnet 5.5가 빠릅니다. AA 측정에서 Sonnet은 단계별로 109~140 t/s, Sol은 59~81 t/s입니다. 하지만 Sonnet은 높은 단계에서 훨씬 많은 토큰을 쓰기 때문에 AA 과제 하나를 끝내는 시간은 xhigh에서 691초 대 436초, max에서 1,326초 대 858초로 Sol이 짧습니다. medium에서는 반대로 Sonnet 178초, Sol 231초입니다.
첫 답변 토큰까지의 시간(AA)은 low 1.3초 대 2.4초, high 11.1초 대 40.8초로 Sonnet이 빠르고, max에서는 455초 대 278초로 Sol이 빠릅니다. 2026년 10월 28일 게이트웨이 실측에서도 짧은 과제의 호출 시간 중앙값은 Sonnet이 가장 짧았고, Sol high의 한 호출은 출력 514토큰에 150.6초가 걸렸습니다. 이런 시간은 경로와 부하에 따라 달라지고, 다른 라우터나 서비스가 공개한 t/s 수치는 측정 방법이 달라 AA 값과 나란히 놓고 비교할 수 없습니다.
응답 속도를 돈으로 살 수 있는 쪽은 Sol입니다. Sol에는 정가의 2배인 Fast와 6배인 Ultrafast 등급이 있지만, Claude의 Fast 모드는 Opus 계열에만 있고 Sonnet 5.5에는 없습니다. Sol이 느릴 때의 원인과 effort·Fast 설정은 GPT-6.1 Sol 느림 원인과 해결: effort·Fast 설정과 10월 26일 실측을 참고하세요.
Sonnet 5.5와 GPT-6.1 Sol 사이를 옮길 때 깨지는 API 설정
두 모델 사이를 옮길 때는 모델 ID보다 요청 형식이 먼저 문제가 됩니다. Sol은 Chat Completions에서 함수 호출을 지원하지 않아 도구를 쓰려면 Responses API로 옮겨야 하고, Sonnet 5.5는 사고를 끌 수 없으며 tool_choice를 강제하면 400 오류를 돌려줍니다. 아래 표는 2026년 10월 28일 기준 Claude 모델 개요와 GPT-6.1 Sol 모델 페이지의 내용입니다.
| 항목 | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| 모델 ID | claude-sonnet-5-5 | gpt-6.1-sol |
| API 기본 effort | high (Claude Code·Claude 앱은 medium) | medium |
| effort 값 | low~max, thinking: {type: "disabled"}는 거부되고 최저 설정은 between_tools | low~max, none·minimal 없음 |
| 도구 호출 | Messages API, tool_choice를 any·tool로 강제하면 400 | Responses API 필수, Chat Completions에서는 함수 호출 불가 |
| 캐시 | cache_control로 지정, 최소 512토큰, 5분 또는 1시간 | 기본으로 자동 기록(1.25배 과금), 최소 1,024토큰, 30분 또는 12시간 |
| 컨텍스트와 입력 | 1M 토큰, 같은 단가 | 컨텍스트 1,050,000, 최대 입력 922,000, 272K 초과 시 요청 전체 할증 |
| 최대 출력 | 128K (Batch는 베타 헤더로 300K) | 128K |
| 사고 내용 | 기본으로 텍스트를 생략하지만 사고 토큰은 과금 | 추론 토큰은 출력 토큰에 포함해 과금 |
| 빠른 처리와 할인 | Fast 모드 없음, Batch 50% | Fast·Ultrafast, Batch·Flex 50% |
Sol로 옮길 때는 temperature를 바꾸는 코드도 확인하세요. 2026년 10월 5일 게이트웨이를 거친 Chat Completions 호출에서 Sol은 temperature: 0.2를 "기본값(1)만 지원한다"는 오류로 거부했습니다. laozhang.ai에서는 2026년 10월 28일 기준 두 모델 모두 공식 정가와 같은 단가로 표시되지만, Sol은 Chat Completions로만 연결되므로 그 경로에서는 Sol의 도구 호출을 쓸 수 없습니다. GPT-6 Sol에서 6.1 Sol로 옮기는 경우의 세부 사항은 GPT-6.1 Sol 가격과 사용법: 모델 ID만 바꾸면 안 되는 이유에 있습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
바꾸기 전에 합격 작업당 비용을 재는 순서
토큰당 가격이 같은 두 모델은 단가표로는 고를 수 없으므로, 실제 작업으로 합격한 결과 하나에 든 비용을 재는 것이 가장 정확합니다. 실패한 실행과 재시도 비용까지 넣어야 싸 보이는 설정이 정말 싼지 알 수 있습니다. 아래 순서로 20~50개 정도의 과제를 돌려 보면 한국어 토큰 비율과 effort 차이가 내 작업에서 얼마인지 드러납니다.
- 실제 업무에서 과제를 고르고, 테스트·정답·형식 조건처럼 통과 여부를 기계적으로 가릴 기준을 실행 전에 정합니다.
- 같은 이름의 단계와 점수가 비슷한 단계를 함께 돌립니다. 예를 들어 Sol은
medium과high, Sonnet은high와xhigh를 비교합니다. - effort를 요청에 명시합니다. Sonnet에는
thinking: {"type": "adaptive"}와 effort를, Sol에는reasoning.effort(Chat Completions는reasoning_effort)를 넣어 중계 서비스를 거쳐도 설정이 바뀌지 않게 합니다. - 캐시 조건을 맞춥니다. Sonnet에는 반복되는 앞부분에
cache_control을 넣고, 두 모델 모두 응답 usage의 캐시 기록·읽기 토큰을 기록해 Sol의 자동 기록 요금까지 비용에 넣습니다. - 한국어 입력은 OpenAI의 입력 토큰 계산 엔드포인트와 Anthropic의 토큰 계산 API로 미리 세어, 272K 경계에 걸리는 문서가 있는지 확인합니다.
- 실패를 포함한 총비용을 합격 수로 나누고, 과제당 시간과 사람이 고친 횟수를 함께 비교합니다.
구독, Opus 5.5, Terra, Astra와 비교하려면
월 20달러 구독으로 Claude와 ChatGPT를 쓸 때의 한도와 실제 청구 비교는 Claude Code vs Codex 비용 비교: 구독, 한도, 실제 API 청구에서 다룹니다. Sol의 절반 가격인 OpenAI 모델이 궁금하다면 GPT-6.1 Terra vs GPT-6.1 Sol 비교: 가격 절반, Codex 실측 2배 빠름을, Anthropic의 한 단계 위 모델을 Sol과 견주려면 Claude Opus 5.5 vs GPT-6 Sol·6.1 Sol 비용을 보세요. Sonnet 5.5를 OpenAI의 저가 모델과 비교하는 경우는 Claude Sonnet 5.5 vs GPT-6 Luna 비교: 단가 20배, 같은 점수면 5~8배에 정리돼 있습니다. GPT-6.1 Sol과 OpenAI 상위 모델 GPT-6 Astra의 차이와 전환 기준은 GPT-6.1 Sol·Astra·GPT-6 Sol 비교와 전환 기준에서, Sonnet 5.5를 Astra와 직접 견주는 경우는 소넷 5.5 vs GPT-6 Astra: 추론 강도별 성능과 작업당 비용에서 확인하세요. 이 가운데 일부 글은 이전 지수 v4.3.2 기준의 AA 점수를 싣고 있으므로, 위 v5.0 표와 점수를 견줄 때는 각 글에 적힌 지수 버전부터 확인하세요.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 28일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 28일.
- 1.Anthropic Claude API 요금표platform.claude.com/docs/en/about-claude/pricing
- 2.OpenAI API 요금표developers.openai.com/api/docs/pricing
- 3.GPT-6.1 Sol 모델 페이지developers.openai.com/api/docs/models/gpt-6.1-sol
- 4.OpenAI 프롬프트 캐싱 가이드developers.openai.com/api/docs/guides/prompt-caching
- 5.Anthropic 프롬프트 캐싱 문서platform.claude.com/docs/en/build-with-claude/prompt-caching
- 6.Artificial Analysis의 Claude Sonnet 5.5 vs GPT-6.1 Sol 비교 페이지artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-1-sol
- 7.Claude 모델 개요platform.claude.com/docs/en/about-claude/models/overview