GPT-6.1 Terra vs GPT-6.1 Sol 비교: 가격 절반, Codex 실측 2배 빠름
GPT-6.1 Terra는 토큰 단가가 Sol의 절반이고 10월 27일 Codex 실측에서 약 2배 빨랐습니다. 단, 같은 점수를 맞추면 Sol medium이 Terra max보다 싸고 빠릅니다.
목차
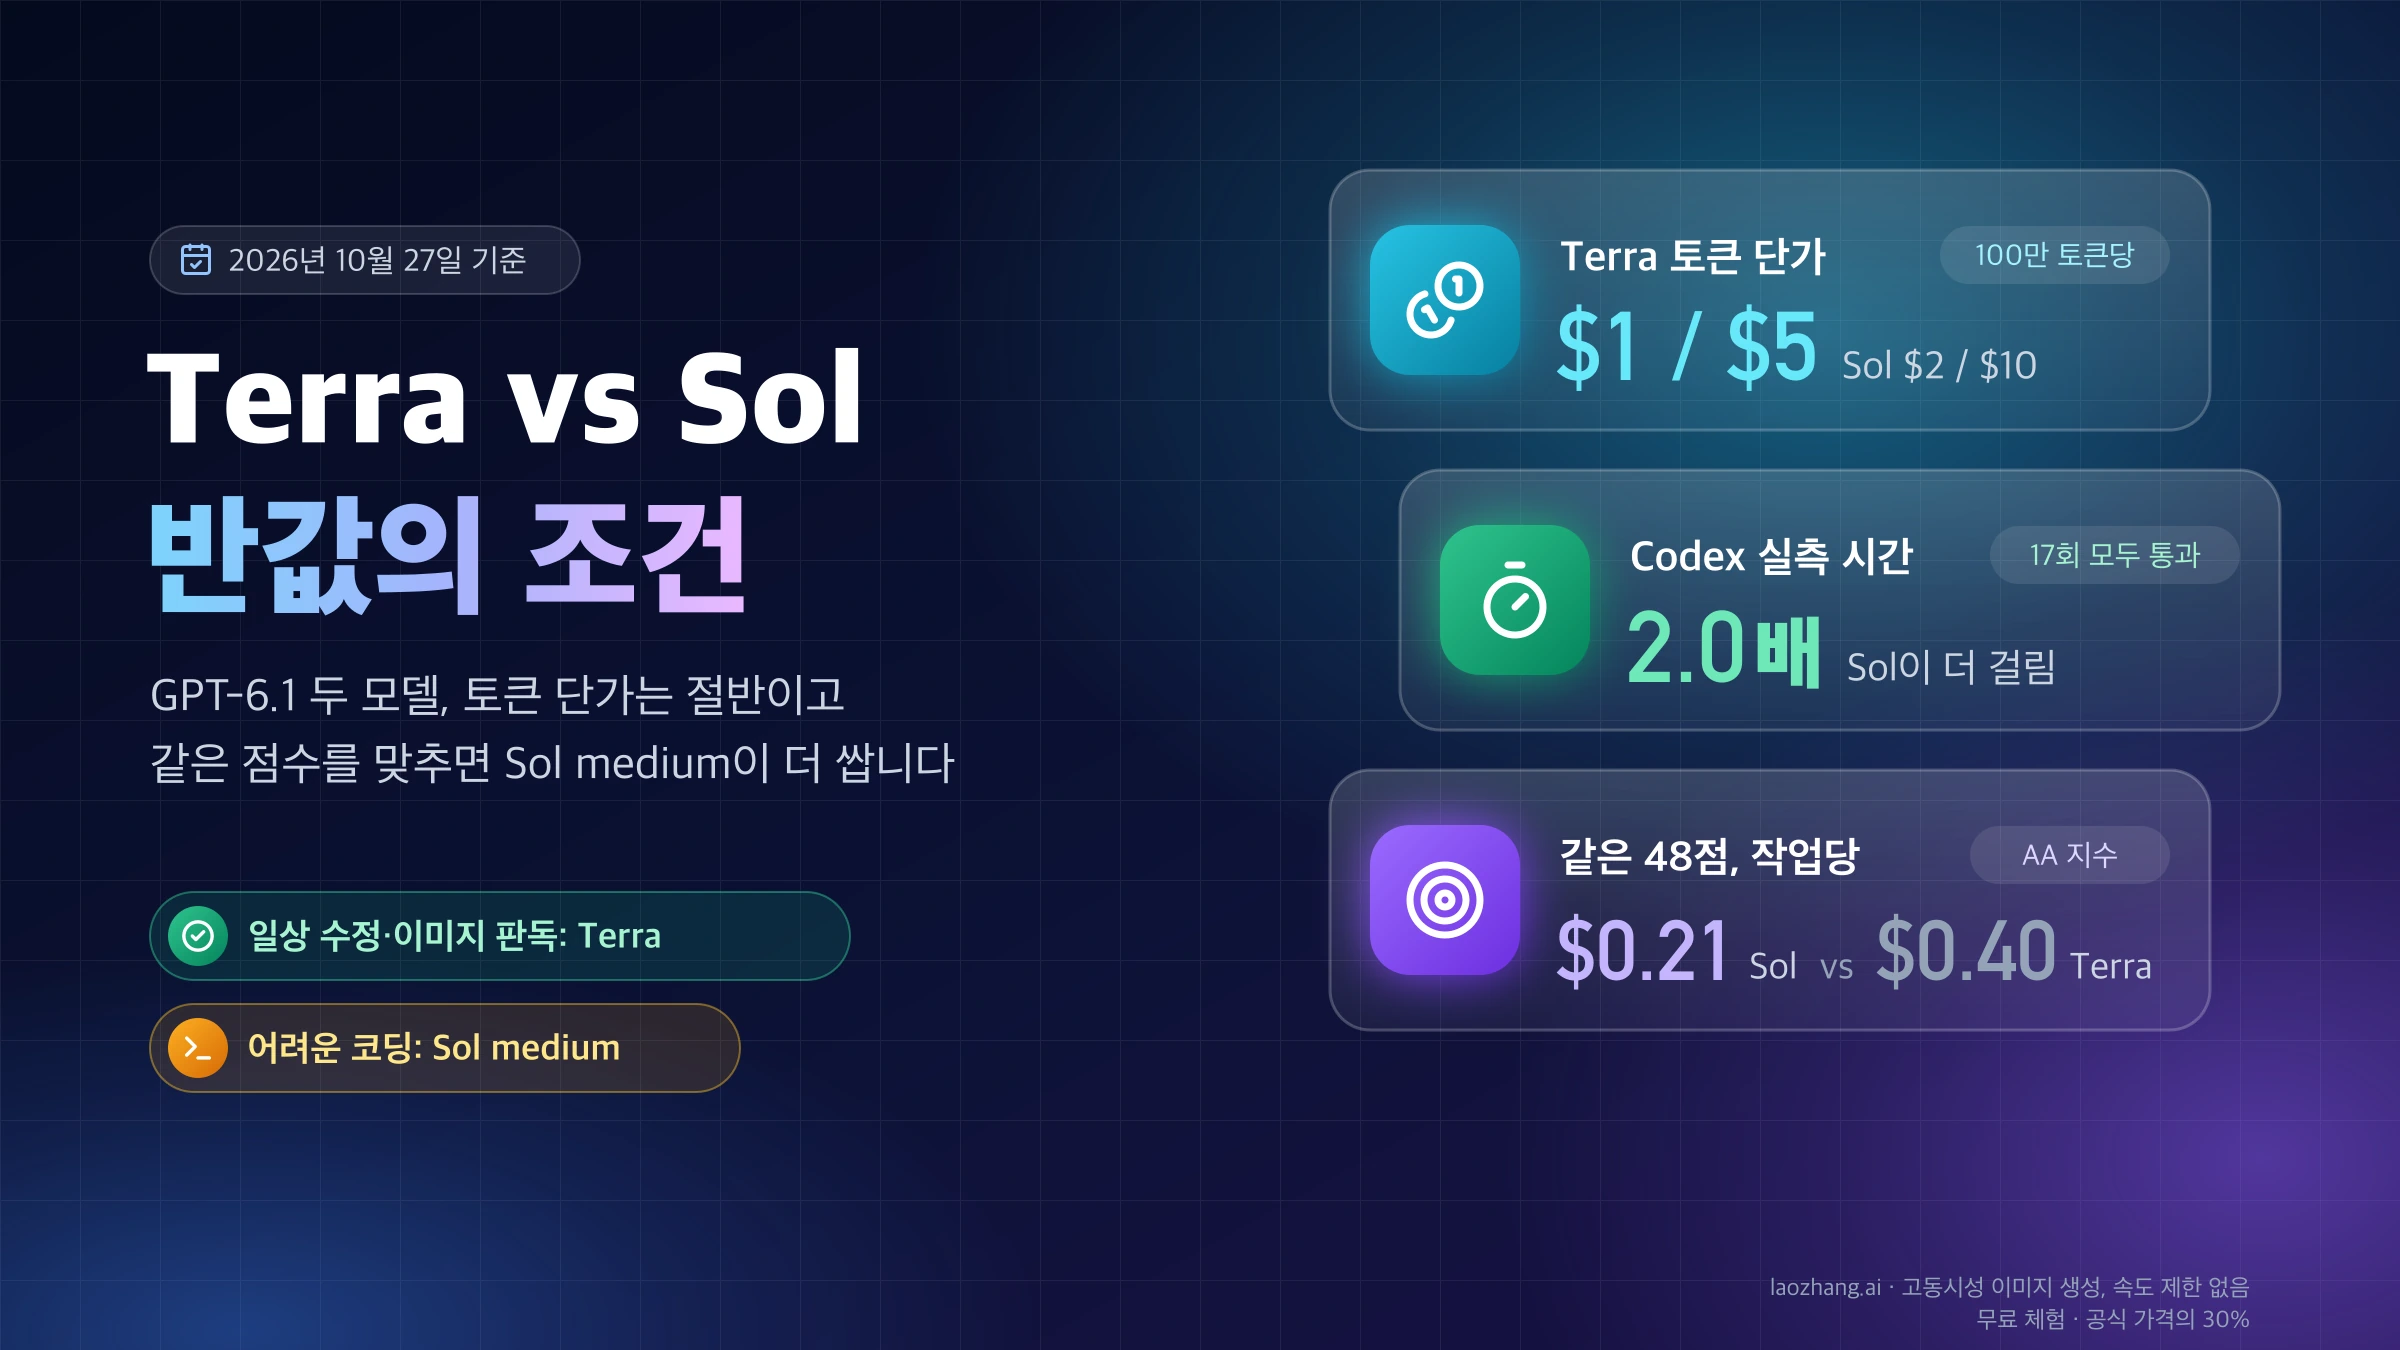
2026년 10월 26일 공개된 GPT-6.1 Terra(gpt-6.1-terra)는 OpenAI API 토큰 단가가 모든 항목에서 GPT-6.1 Sol(gpt-6.1-sol)의 정확히 절반입니다. 100만 토큰당 입력 $1 대 $2, 출력 $5 대 $10입니다. 일상적인 코드 수정, 청구서·차트 같은 이미지 판독, 폼 입력과 화면 조작, Codex 한도가 빠듯한 작업이라면 Codex에서 codex -m gpt-6.1-terra로 바꾸고 추론 강도(reasoning effort) low나 medium부터 써 보세요. 반대로 여러 단계에 걸친 어려운 코딩은 gpt-6.1-sol의 medium을 유지하는 편이 낫습니다. Artificial Analysis(AA) 지수에서 Terra는 최고 단계인 max까지 올려야 Sol medium과 같은 점수가 나오는데, 그 지점에서는 작업당 비용도 시간도 Terra 쪽이 더 듭니다.
2026년 10월 27일 Codex CLI에서 세 가지 작업(청구 코드 수정, 청구서·그래프 이미지 판독, semver 사양 구현)을 두 모델로 17회 실행했더니 모든 실행이 통과했고, 같은 medium끼리 비교하면 Sol이 시간은 2.0배, Codex 크레딧은 2.4배를 썼습니다. 작은 작업에서는 품질 차이가 나지 않았다는 뜻이며, 어려운 작업에서 벌어지는 격차는 터미널 코딩 벤치마크에서 드러납니다.
선택을 바로 정해 버리는 제약도 있습니다. 두 모델 모두 ChatGPT의 일반 채팅(Chat)에는 없고 ChatGPT Work, Codex, API에서만 쓸 수 있습니다. Terra는 Ultrafast 모드와 UAE 추론 데이터 상주를 지원하지 않고, Sol은 추론 강도 none을 지원하지 않으므로, 이 중 하나가 꼭 필요하다면 성능을 비교할 것도 없이 모델이 정해집니다.
작업별로 먼저 쓸 모델과 추론 강도
대부분의 일상 작업은 GPT-6.1 Terra low~medium에서 시작하고, 테스트를 반복해서 못 넘기거나 단계가 많은 코딩일 때 GPT-6.1 Sol medium으로 올리는 순서가 비용 대비 효율이 가장 좋습니다. 2026년 10월 27일 기준 공개된 가격, AA 측정, OpenAI 발표와 Codex 실측을 합쳐 작업 유형별 출발점을 정리하면 다음과 같습니다.
| 맡길 작업 | 먼저 쓸 설정 | 근거 | 바꿀 시점 |
|---|---|---|---|
| 버그 수정, 테스트 맞추기, 사양대로 함수 구현 | Terra low~medium | 10월 27일 Codex 실측에서 두 작업 모두 36/36, 시간은 Sol의 절반 안팎 | 같은 테스트를 계속 통과하지 못하면 Sol medium |
| 청구서·차트·도면 판독, 폼 입력, 앱 화면 조작 | Terra medium (none도 시험) | 실측 이미지 판독 전 실행 정답, OpenAI가 Terra의 주력 용도로 제시 | 숫자나 항목을 반복해서 잘못 읽을 때 |
| 여러 파일·여러 단계에 걸친 어려운 코딩, 터미널 작업 | Sol medium | AA Terminal-Bench 4.0 medium 기준 Sol 48.0% 대 Terra 32.3% | Sol 높은 강도로도 부족하면 GPT-6 Astra 검토 |
| 검색 없이 사실 지식으로 답해야 하는 질문 | Sol, 또는 Terra에 웹 검색 도구 연결 | AA-Omniscience에서 Sol 38~42 대 Terra 4~30 | — |
| Plus·Business에서 Codex 한도가 빠듯한 경우 | Terra | 5시간당 예상 메시지 수와 크레딧 요율 모두 Terra 쪽이 약 2배 여유 | — |
| 응답 지연이 가장 중요한 실시간 처리 | none이 필요하면 Terra, Ultrafast가 필요하면 Sol | Terra만 none 지원, Ultrafast는 Sol만 제공 | — |
이 표는 시작점이지 결론이 아닙니다. 같은 이름의 추론 강도라도 두 모델이 쓰는 토큰과 도달하는 점수가 다르기 때문에, 자주 반복하는 작업이라면 마지막 절의 방법으로 "채택된 결과 1건당 비용"을 직접 재 보고 정하는 것이 가장 확실합니다.
API 가격 비교: 모든 항목에서 Terra가 Sol의 정확히 절반
OpenAI 가격 페이지 기준(2026년 10월 27일), GPT-6.1 Terra의 API 단가는 짧은 컨텍스트, 272K 초과 긴 컨텍스트, Batch·Flex, Fast 어느 처리 방식에서든 GPT-6.1 Sol의 정확히 절반입니다. 차이가 나는 곳은 Ultrafast 하나로, 이 처리 방식에는 Sol만 있고 Terra 행이 없습니다. 아래는 모두 100만 토큰당 미국 달러입니다. OpenAI API 가격 페이지
| 과금 항목 (100만 토큰당) | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| Standard 입력 (272K 이하) | $1.00 | $2.00 |
| 캐시 입력 | $0.05 | $0.10 |
| 캐시 쓰기 30분 / 12시간 | $1.25 / $2.50 | $2.50 / $5.00 |
| 출력 | $5.00 | $10.00 |
| 272K 초과 입력 / 캐시 입력 / 출력 | $2.00 / $0.10 / $7.50 | $4.00 / $0.20 / $15.00 |
| 272K 초과 캐시 쓰기 30분 / 12시간 | $2.50 / $5.00 | $5.00 / $10.00 |
| Batch·Flex 입력 / 출력 | $0.50 / $2.50 | $1.00 / $5.00 |
| Fast 입력 / 출력 | $2.00 / $10.00 | $4.00 / $20.00 |
| Ultrafast 입력 / 출력 | 제공하지 않음 | $12.00 / $60.00 |
272K 초과 단가는 입력이 272K 토큰을 넘는 순간 그 요청 전체에 적용되고, 지역 처리 엔드포인트를 쓰면 두 모델 모두 10%가 더 붙습니다. 캐시 쓰기 비용과 긴 컨텍스트 요금을 실제 요청에 대입하는 계산 순서는 GPT-6 Astra API 가격: 272K 기준과 캐시·서비스 티어 계산법에 정리된 방식이 두 모델에도 그대로 적용됩니다. Sol 자체의 가격 구조와 이전 시 주의점은 GPT-6.1 Sol 가격과 사용법: 모델 ID만 바꾸면 안 되는 이유에서 다룹니다.
작업당으로도 싼가: Terra high까지만 그렇습니다
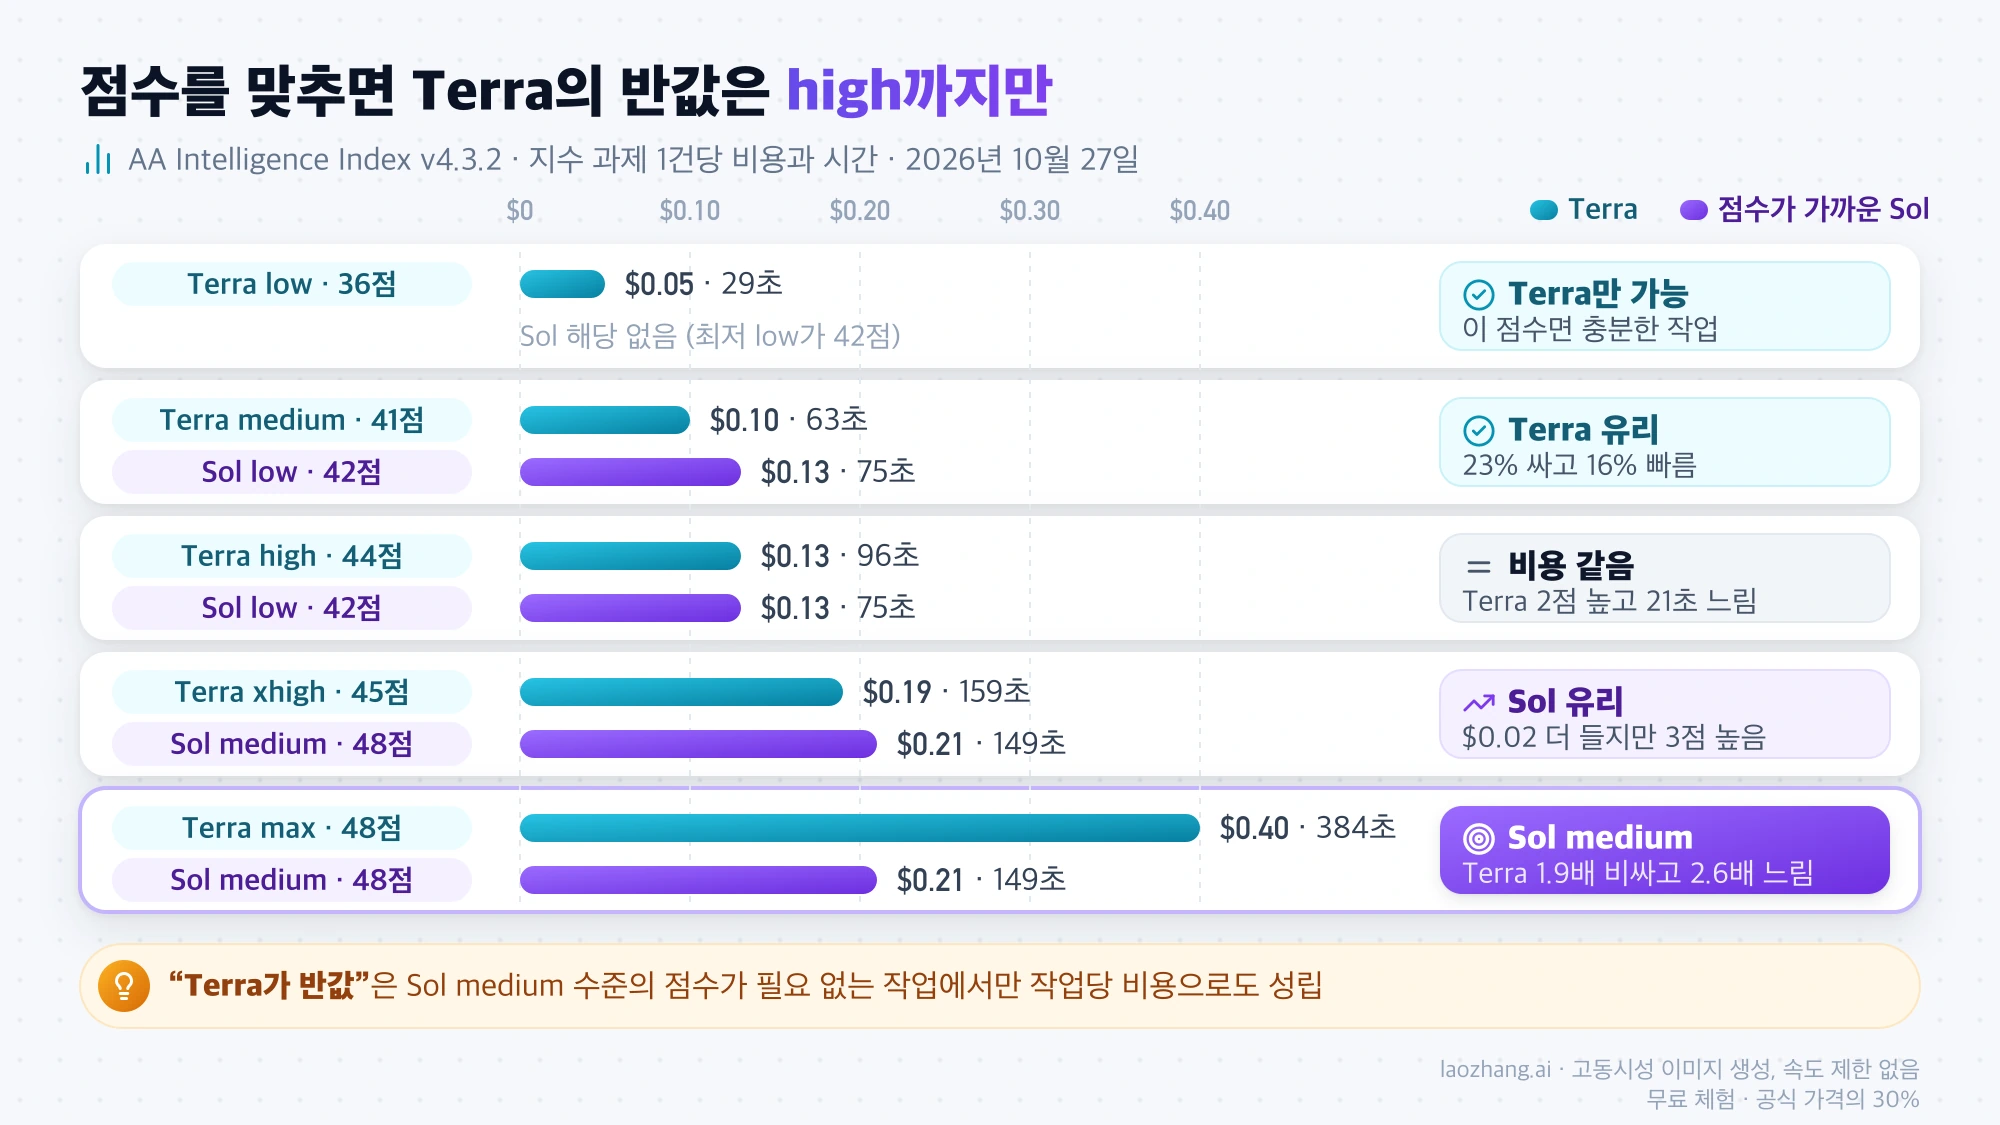
토큰 단가가 절반이라고 작업 1건 비용도 늘 절반인 것은 아닙니다. 작업 비용은 단가에 실제로 쓴 토큰을 곱한 값이고, 두 모델은 같은 추론 강도에서도 도달하는 점수가 다르기 때문입니다. 그래서 점수가 비슷한 설정끼리 맞춰 놓고 보면, Terra는 high까지는 작업당 비용이 같거나 낮고 xhigh 이상에서는 Sol medium보다 비싸거나 점수가 낮아집니다. 아래 수치는 2026년 10월 27일 기준 Artificial Analysis의 GPT-6.1 Terra vs GPT-6.1 Sol 비교 페이지에 실린 Intelligence Index v4.3.2 점수, 지수 과제 1건당 비용과 시간입니다.
| Terra 설정 (점수 / 작업당 비용 / 시간) | 점수가 가까운 Sol 설정 | 판단 |
|---|---|---|
low 36점 / $0.05 / 29초 | 해당 없음 (Sol 최저 low가 42점) | 이 수준이면 충분한 작업은 Terra만 가능 |
medium 41점 / $0.10 / 63초 | low 42점 / $0.13 / 75초 | 점수는 거의 같고 Terra가 23% 싸고 16% 빠름 |
high 44점 / $0.13 / 96초 | low 42점 / $0.13 / 75초 | 비용 같음, Terra가 2점 높고 21초 느림 |
xhigh 45점 / $0.19 / 159초 | medium 48점 / $0.21 / 149초 | Sol이 $0.02 더 들지만 3점 높고 더 빠름 |
max 48점 / $0.40 / 384초 | medium 48점 / $0.21 / 149초 | 같은 점수에서 Terra가 1.9배 비싸고 2.6배 느림 |
비율은 표의 값으로 직접 계산한 것입니다. medium 대 low는 (0.13 − 0.10) ÷ 0.13 ≈ 23%, (75 − 63) ÷ 75 = 16%이고, max 대 medium은 0.40 ÷ 0.21 ≈ 1.9배, 384 ÷ 149 ≈ 2.6배입니다. 결국 "Terra가 반값"이라는 말은 Sol medium 이상의 점수가 필요 없는 작업에서만 작업당 비용으로도 성립합니다. AA 지수는 여러 과제를 합친 종합 점수이므로 특정 업무에서는 순서가 달라질 수 있다는 점도 함께 기억해 두세요.
"Terra가 토큰을 더 써서 절약분을 까먹지 않나"라는 걱정은 같은 추론 강도끼리라면 해당하지 않았습니다. 2026년 10월 27일 Codex 실측에서 출력 토큰은 오히려 Sol이 더 많았는데, 청구 코드 수정 medium에서 Sol 1,821개 대 Terra 1,245개, semver 구현 medium 두 번에서 Sol 2,696·2,308개 대 Terra 1,392·1,384개였습니다. 토큰이 문제가 되는 것은 Terra의 강도를 xhigh·max까지 올릴 때입니다.
"3배 빠르다"는 정말인가: 작업 시간·출력 속도·실측은 다른 숫자입니다
"3배 빠르다"는 OpenAI가 발표 글에서 Agents' Last Exam 평가를 설명하며 쓴 표현으로, GPT-6.1 Terra가 GPT-6 Astra와 GPT-6.1 Sol보다 작업을 3배 이상 빨리 끝낸다는 뜻입니다. OpenAI 자체 평가에서의 작업 완료 시간이지 초당 토큰 수가 아니고, 모든 작업에서 3배라는 말도 아닙니다. OpenAI GPT-6.1 Terra 발표
출력 속도는 AA가 따로 잽니다. 2026년 10월 27일 기준 AA 측정에서 Terra는 모든 추론 강도에서 초당 91토큰, Sol은 강도에 따라 초당 54~73토큰이었습니다. 지수 과제 1건 시간으로 보면 같은 강도에서 Terra medium 63초 대 Sol medium 149초(약 2.4배), Terra low 29초 대 Sol low 75초(약 2.6배)로 차이가 더 커집니다. Sol은 출력 속도가 느린 데다 같은 강도에서 토큰도 더 많이 쓰기 때문입니다. 다만 앞 절에서 본 것처럼 점수를 맞춰 Terra를 max로 올리면 이 속도 우위는 사라집니다.
2026년 10월 27일 Codex CLI 실측에서는 같은 작업·같은 강도 7쌍에서 Sol이 1.45~2.28배 오래 걸렸습니다. 3배에 못 미친 것은 작업이 짧아서 Codex 에이전트의 파일 읽기, 명령 실행 같은 고정 시간이 차지하는 비중이 크기 때문으로 보입니다. OpenAI Codex 팀의 @victornunez가 발표 당일인 2026년 10월 26일 X에 올린 폼 입력 화면 조작 1회 시연에서는 Fast 모드 기준 Terra 53.5초, Sol 3분 21.7초로 약 3.8배 차이가 났지만, 단 한 번의 실행입니다. Sol이 유난히 느리게 느껴진다면 모델 문제보다 설정 문제일 수 있으니 GPT-6.1 Sol 느림 원인과 해결: effort·Fast 설정과 10월 26일 실측을 먼저 확인해 보세요.
2026년 10월 27일 Codex CLI 실측: 17회 모두 통과, 시간은 Sol이 약 2배
2026년 10월 27일 UTC 03:55~04:08에 macOS 컴퓨터 한 대에서, ChatGPT 구독 계정 하나로 로그인한 Codex CLI 0.164.0-alpha.11.1(ChatGPT 앱 동봉판)을 Standard 속도로 실행했습니다. 실행마다 작업 폴더를 새로 복사하고 codex exec --ephemeral --ignore-user-config --skip-git-repo-check -s workspace-write -m <모델> -c model_reasoning_effort=<강도> -c service_tier="default" --json으로 돌렸으며, 두 모델을 번갈아 실행했습니다. 시간은 실행부터 종료까지의 실제 경과 시간이고, 토큰은 turn.completed 이벤트의 사용량입니다. 크레딧은 이 사용량에 Codex 크레딧 요율을 곱해 계산한 값으로, 계정에서 실제로 차감된 잔액이 아닙니다.
작업은 세 가지입니다. 청구 코드 수정은 버그가 있는 billing.py를 7개 규칙의 사양서대로 고치는 과제로, 숨겨진 테스트 36개를 씁니다(수정 전 파일은 13/36). 이미지 판독은 SKU가 헷갈리게 생긴 12줄짜리 청구서와 데이터 라벨 없는 12개 막대그래프 PNG 두 장을 주고, 청구서 한 줄의 금액을 일부러 틀리게 적어 그 오류를 찾는지 봤습니다. semver 구현은 npm의 프리릴리스 규칙을 포함한 긴 사양서대로 satisfies()를 만드는 과제로, 역시 숨겨진 테스트 36개를 씁니다.
| 작업 | 모델·추론 강도 | 시간 | 출력 토큰 | 크레딧 환산 | 결과 |
|---|---|---|---|---|---|
| 청구 코드 수정 | Terra low | 29.2초 | 1,138 | 0.42 | 36/36 |
| 청구 코드 수정 | Terra medium | 31.9초 | 1,245 | 0.44 | 36/36 |
| 청구 코드 수정 | Terra high | 34.0초 | 1,571 | 0.52 | 36/36 |
| 청구 코드 수정 | Sol medium | 51.5초 | 1,821 | 1.32 | 36/36 |
| 청구 코드 수정 | Sol high | 62.0초 | 2,829 | 1.35 | 36/36 |
| 이미지 판독 | Terra none | 28.8초 | 859 | 0.87 | 숫자 40/40, 그래프 12/12, 오류 발견 |
| 이미지 판독 | Terra medium | 36.4초 | 1,461 | 0.81 | 숫자 40/40, 그래프 12/12, 오류 발견 |
| 이미지 판독 | Terra high | 38.1초 | 1,376 | 0.86 | 숫자 40/40, 그래프 12/12, 오류 발견 |
| 이미지 판독 | Sol medium | 78.8초 | 2,202 | 1.69 | 숫자 40/40, 그래프 12/12, 오류 발견 |
| 이미지 판독 | Sol high | 55.4초 | 1,810 | 1.47 | 숫자 40/40, 그래프 12/12, 오류 발견 |
| semver 구현 | Terra low | 27.5초 | 1,321 | 0.58 | 36/36 |
| semver 구현 | Terra medium 2회 | 28.1초 / 25.1초 | 1,392 / 1,384 | 0.60 / 0.45 | 36/36, 36/36 |
| semver 구현 | Terra high | 36.9초 | 2,047 | 1.10 | 36/36 |
| semver 구현 | Sol low | 44.2초 | 1,745 | 1.33 | 36/36 |
| semver 구현 | Sol medium 2회 | 59.1초 / 57.2초 | 2,696 / 2,308 | 1.47 / 1.08 | 36/36, 36/36 |
medium끼리 짝지은 4쌍을 더하면 Terra는 31.9 + 36.4 + 28.1 + 25.1 = 121.5초와 0.44 + 0.81 + 0.60 + 0.45 = 2.30크레딧, Sol은 51.5 + 78.8 + 59.1 + 57.2 = 246.6초와 1.32 + 1.69 + 1.47 + 1.08 = 5.56크레딧입니다. Sol이 시간은 2.0배, 크레딧은 2.4배를 쓴 셈이고, 같은 사용량을 API Standard 단가로 환산하면 Terra $0.0917 대 Sol $0.2222입니다. 같은 작업·같은 강도 7쌍 하나하나로 보면 크레딧 차이는 1.7~3.0배였습니다.
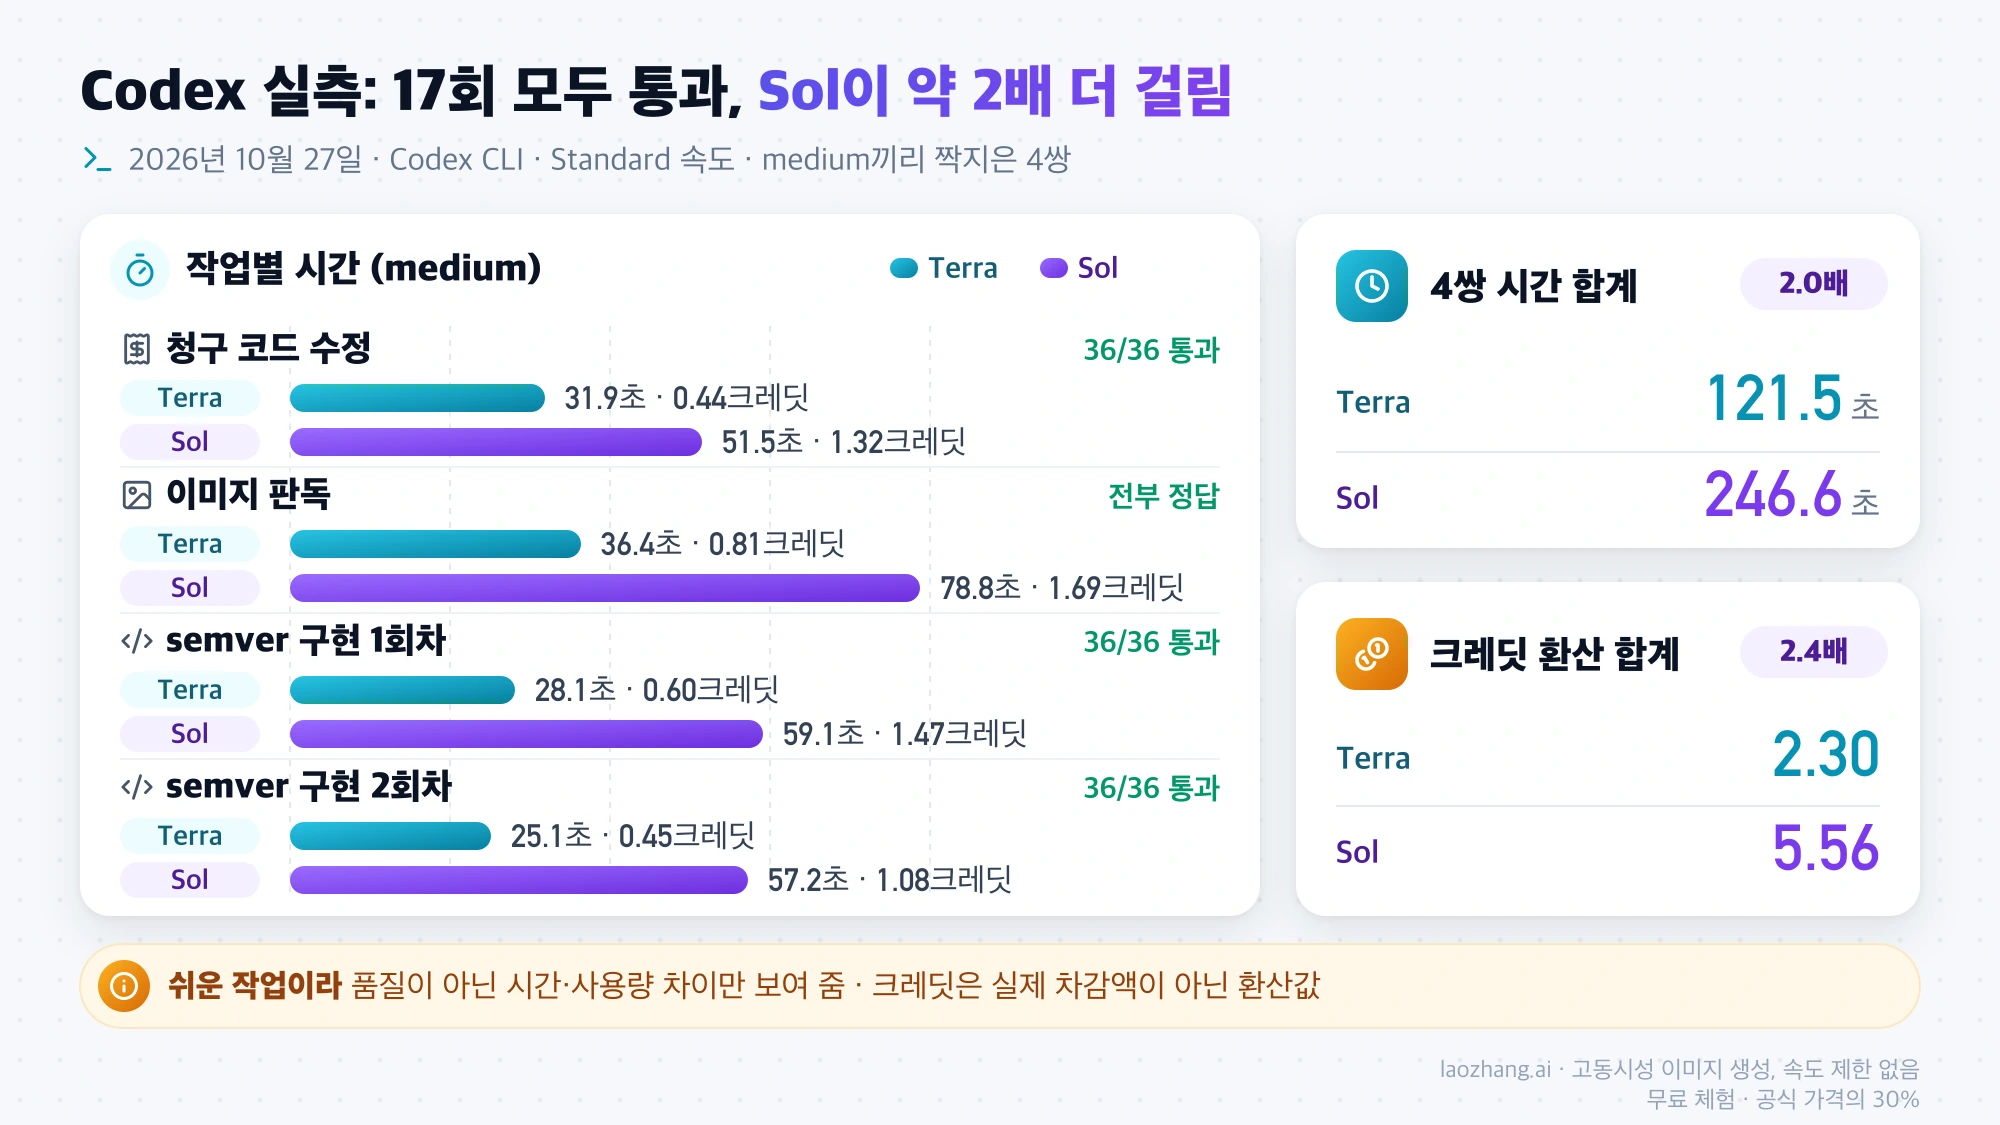
크레딧 차이가 요율 차이인 2배보다 큰 것은 Sol이 출력 토큰을 더 많이 썼고, 이미지 판독에서는 단계도 더 밟았기 때문입니다. 이미지 판독 Sol medium은 명령을 6번 실행하며 입력 토큰 19만 6천 개(그중 캐시 18만 3천 개)를 썼고, Terra medium은 2번이었습니다. 두 모델 모두 답하기 전에 Python PIL로 이미지를 잘라 확대해 봤고, 소문자 l·대문자 I·숫자 1이 거의 같게 보이는 SKU 두 개는 모든 실행이 똑같이 잘못 읽어 채점에서 뺐습니다. Terra none은 가장 빨랐지만 입력 토큰을 더 써서 크레딧은 medium보다 많았으므로, 에이전트 작업에서 none이 늘 가장 싼 것은 아닙니다.
이 측정의 한계도 분명합니다. 세 작업 모두 두 모델이 매번 통과할 만큼 쉬웠기 때문에 품질 차이가 아니라 시간과 사용량 차이만 보여 줍니다. 계정 하나, 컴퓨터 한 대에서 설정마다 대부분 한 번씩만 돌렸고, Standard 속도만 썼으며 Fast·Ultrafast는 재지 않았습니다. Codex 에이전트를 거친 결과라 API를 직접 호출했을 때의 시간·토큰과도 다를 수 있습니다.
Terra가 코딩에서 밀리나: 쉬운 수정은 같고, 어려운 터미널 작업에서 차이
범위가 정해진 수정이나 사양 구현에서는 Terra도 Sol과 같은 결과를 냈지만, 터미널에서 여러 단계를 거치는 어려운 코딩에서는 같은 추론 강도일 때 Sol이 확실히 앞섭니다. 2026년 10월 27일 기준 AA의 Terminal-Bench 4.0 측정에서 low는 Terra 15.2% 대 Sol 30.8%, medium은 32.3% 대 48.0%였고, max에서야 55.6% 대 56.1%로 거의 같아졌습니다. 최고 강도에서 따라잡기는 하지만 그 설정의 작업당 비용과 시간은 앞에서 본 대로 Sol medium보다 불리합니다.
OpenAI도 같은 방향으로 설명합니다. 발표 글에서 Terra는 max 강도의 Terminal-Bench 4.0에서 50.3%를 기록했다고 밝혔는데, 이는 OpenAI 자체 측정이라 AA 수치와 측정 환경이 다릅니다. 그러면서 "가장 복잡한 코딩 작업에는 GPT-6.1 Sol과 GPT-6 Astra가 여전히 더 나은 선택"이라고 직접 적었습니다. GitHub도 Copilot 변경 기록에서 Terra를 Sol보다 저렴하게 쓰는 일상적 에이전트 코딩·터미널 작업용으로 소개하며, 범위가 잘 정해진 작업에서 짧게 정리된 단계로 일한다고 설명합니다. GitHub Copilot의 GPT-6.1 Terra 변경 기록
출시 첫날 커뮤니티 반응도 비슷합니다. 2026년 10월 27일 기준 Reddit r/codex의 출시 스레드(댓글 370개 이상)에서는 특정 작업 흐름에서는 Terra가 강하지만 어려운 코딩은 Sol이 낫다는 의견이 많았고, r/OpenAI에는 "Do GPT 6.1 Terra even make sense?"라는 회의적인 스레드도 올라왔습니다. 개별 사용자 보고이니, 테스트로 결과를 확인할 수 있는 수정 작업은 Terra로, 무엇을 고쳐야 할지부터 찾아야 하는 열린 작업은 Sol medium으로 나누는 정도로 참고하면 됩니다.
이미지 판독·폼 입력·화면 조작은 Terra로 충분한가
깨끗한 이미지에서 숫자를 읽고 오류를 찾는 정도라면 Terra로 충분했습니다. 2026년 10월 27일 Codex 실측의 이미지 판독 과제에서 Terra는 none, medium, high 세 설정 모두 청구서 숫자 40개, 그래프 값 12개를 전부 맞히고 일부러 틀리게 적은 금액도 찾아냈으며, 걸린 시간은 28.8~38.1초로 Sol의 55.4~78.8초보다 짧았습니다. 다만 합성한 깨끗한 이미지였고 설정마다 한 번씩만 돌렸으므로, 스캔본이나 손글씨처럼 판독이 어려운 자료는 따로 확인해야 합니다.
화면 조작과 시각 추론은 OpenAI가 Terra의 주력 용도로 내세운 영역입니다. OpenAI 자체 평가에 따르면 Terra는 MMMU-Pro(시각 추론)에서 훨씬 낮은 비용으로 GPT-6 Astra와 GPT-6.1 Sol에 가까운 점수를 냈고, OSWorld 2.1(데스크톱 앱 다단계 조작)에서는 medium 강도만으로 GPT-5.6 Terra의 최고 점수를 넘었습니다. 발표 글의 그래프는 이미지라 Sol의 정확한 수치가 텍스트로 공개되지 않았는데, X 사용자 @rezoundous가 발표 당일인 2026년 10월 26일 그래프를 읽어 올린 값으로는 MMMU-Pro 약 85.5 대 86.3, OSWorld 2.1 약 78 대 79, Agents' Last Exam 약 60 대 59로 두 모델이 거의 붙어 있습니다. 눈으로 읽은 근사치이니 차이가 "거의 없다" 정도로만 받아들이는 것이 안전합니다.
예외는 검색 없이 사실 지식으로 답해야 하는 일입니다. OpenAI 내부 평가에서 Terra의 오답률은 low 16.7%, max 4.3%로 Astra와 Sol에 가까워졌다고 하지만, 2026년 10월 27일 기준 AA의 지식·환각 지표(AA-Omniscience)에서는 Sol이 38~42점, Terra가 4~30점으로 차이가 큽니다. 문서 내용을 근거로 쓰는 작업이라면 Terra에 원문이나 웹 검색을 붙이고, 모델의 기억에 기대는 답변이 필요하다면 Sol을 쓰는 편이 안전합니다.
어디서 쓸 수 있나: ChatGPT Work·Codex·API, 일반 채팅은 둘 다 불가
두 모델 모두 ChatGPT의 일반 채팅(Chat)에서는 고를 수 없고, ChatGPT Work와 Codex, 그리고 OpenAI API에서 씁니다. 2026년 10월 27일 기준 OpenAI의 Codex 요금 문서와 API 모델 페이지에 적힌 입구와 사양은 다음과 같습니다.
| 항목 | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| ChatGPT 일반 채팅(Chat) | 없음 | 없음 |
| ChatGPT Work·Codex | Plus, Pro, Business, Enterprise, Edu | Work와 Codex에서 제공, Enterprise·Edu는 관리자가 켜야 사용 가능 |
| Free·Go 요금제 | 목록에 없음 | 목록에 없음 |
| API 모델 ID | gpt-6.1-terra | gpt-6.1-sol |
| 추론 강도 | none, low, medium(기본), high, xhigh, max | low, medium, high, xhigh, max |
| Ultrafast | 없음 | API, Codex(Pro $500 요금제와 일부 Enterprise·Edu) |
| UAE 추론 데이터 상주 | 지원하지 않음 | 문서에 제한 표기 없음 |
| 컨텍스트 창 / 최대 출력 | 1.05M / 128K 토큰 | 1.05M / 128K 토큰 |
| 지식 기준일 | 2026년 6월 1일 | 2026년 4월 30일 |
OpenAI 발표 글은 Terra 제공 요금제를 Plus, Pro, Enterprise, Edu로 적어 Business가 빠져 있지만, 더 구체적인 Codex 요금 문서에는 Business가 포함되어 있습니다. Business 워크스페이스에서 보이지 않는다면 순차 배포나 관리자 설정을 먼저 확인하세요. API에서 함수 호출 같은 도구를 쓰려면 두 모델 모두 Responses API가 필요합니다.
OpenAI 밖에서는 GitHub Copilot이 2026년 10월 26일부터 Copilot Pro, Pro+, Max, Business, Enterprise 사용자에게 Terra를 순차 제공하고 있으며, 사용량 기반 과금에서 OpenAI 정가로 청구합니다. laozhang.ai API의 모델 목록에는 2026년 10월 27일 기준 gpt-6.1-sol은 있지만 gpt-6.1-terra는 없습니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
Plus·Business에서 얼마나 더 쓸 수 있나: 5시간당 35~285회 대 15~160회
같은 Plus나 Business 요금제 한도로 Terra는 Sol보다 대략 두 배 가까이 많은 작업을 돌릴 수 있습니다. OpenAI Codex 요금 문서는 2026년 10월 27일 기준 Plus와 Standard Business에서 5시간마다 보낼 수 있는 로컬 메시지를 GPT-6.1 Terra 35~285회, GPT-6.1 Sol 15~160회로 추정합니다. 작업 크기에 따라 달라지는 범위일 뿐 고정 한도가 아니고, 주간 한도가 따로 걸릴 수 있으며 클라우드 작업은 더 많이 소모합니다. Pro 요금제에는 현재 5시간 한도가 없습니다.
포함된 한도를 다 쓰거나 유연 요금제 워크스페이스라면 Codex 크레딧이 차감되는데, 100만 토큰당 Terra는 입력 25, 캐시 입력 1.25, 출력 125크레딧이고 Sol은 50, 2.5, 250크레딧으로 역시 절반입니다. Codex 크레딧에는 캐시 쓰기 요금이 따로 없습니다. 요금제에 포함된 사용량, Codex 크레딧, API 달러 청구는 서로 다른 계량이라서, OpenAI도 크레딧 요율만으로 구독 사용량이 정해지지 않는다고 적고 있습니다. 주간 한도가 언제 초기화되는지는 Codex 주간 한도 초기화: 복구 시각 확인부터 유료 즉시 재설정까지에서 확인할 수 있습니다.
Codex에서 GPT-6.1 Terra로 바꾸는 법: CLI 0.159.0 이상과 -m 옵션
OpenAI Codex 모델 문서에 따르면 GPT-6.1 Terra를 쓰려면 Codex CLI 0.159.0 이상이 필요하고, 실행할 때 codex -m gpt-6.1-terra로 모델을 지정합니다. 입구별로 순서는 다음과 같습니다. OpenAI Codex 모델 문서
- 터미널에서
codex --version을 실행해 0.159.0 이상인지 확인하고, 낮으면 먼저 업데이트합니다. - 새 세션을
codex -m gpt-6.1-terra로 시작합니다. 추론 강도까지 정하려면codex -m gpt-6.1-terra -c model_reasoning_effort="low"처럼 붙입니다. - 이미 열려 있는 대화형 세션에서는
/model을 입력해 모델과 추론 강도를 바꿉니다. - ChatGPT 데스크톱 앱이나 웹의 ChatGPT Work에서는 Power 설정의 Advanced를 열고 모델 목록에서 GPT-6.1 Terra를 고릅니다. 요금제와 워크스페이스에 따라 목록이 다를 수 있습니다.
- API에서는 Responses API 요청의
model을gpt-6.1-terra로 바꿉니다. 반대로 Terra에서 Sol로 옮길 때reasoning.effort가none이면 Sol이 지원하지 않으므로low로 바꿔야 합니다.
바꾸기 전에 내 작업으로 재는 법: 채택된 결과 1건당 비용
모델을 바꿀지는 "채택된 결과 1건당 비용"으로 판단하는 것이 가장 정확합니다. 실패한 실행과 재시도까지 포함한 전체 비용을 채택한 결과 수로 나눈 값입니다. 예를 들어 가정으로, Terra가 10번 실행에 회당 0.5크레딧을 쓰고 8건이 채택되면 5.0 ÷ 8 = 0.625크레딧, Sol이 회당 1.3크레딧으로 10건 모두 채택되면 13 ÷ 10 = 1.3크레딧입니다. 이 경우 Terra가 두 건을 더 실패해도 여전히 절반 수준이지만, 실패한 결과를 사람이 고치는 시간까지 생각하면 판단이 달라질 수 있습니다.
- 최근에 실제로 맡긴 작업 5~10개를 고르고, 테스트·정답표·검토 체크리스트처럼 채택 여부를 기계적으로 가를 기준을 먼저 정합니다.
- 같은 작업을 Terra
low, Terramedium, Solmedium으로 실행합니다. 매번 작업 폴더를 새로 복사하고, 모델 순서를 번갈아 돌려 시간대 영향을 줄입니다. codex exec --json출력의turn.completed이벤트에서 입력·캐시 입력·출력 토큰을 기록하고, 실행 시작부터 종료까지의 시간을 잽니다.- 토큰에 Codex 크레딧 요율이나 API 단가를 곱해 실행별 비용을 계산합니다. 요금제 포함 사용량의 소모는 사용량 대시보드에서 따로 확인합니다.
- 채택된 결과 1건당 비용과 시간을 비교해, Terra의 채택률이 Sol과 같은 작업 유형은 Terra로 옮기고 떨어지는 유형만 Sol에 남깁니다.
2026년 10월 27일 실측에 쓴 명령의 형태는 다음과 같습니다. 모델 ID와 추론 강도만 바꿔 같은 작업을 반복하면 됩니다.
codex exec --ephemeral --skip-git-repo-check -s workspace-write \
  -m gpt-6.1-terra -c model_reasoning_effort="medium" \
  --json "SPEC.md대로 billing.py를 고치고 테스트를 통과시켜" > terra-medium.jsonl
GPT-6.1 Terra와 Sol에 관한 다른 질문
GPT-6.1 Terra는 GPT-5.6 Terra와 같은 모델인가요?
다른 세대의 모델입니다. GPT-5.6 Terra(gpt-5.6-terra)는 2026년 10월 27일 기준 API 입력 $2, 출력 $12, Codex 크레딧 입력 50·출력 300으로 계속 판매되고 있고, GPT-6.1 Terra는 그보다 단가가 낮습니다. OpenAI 발표에 따르면 max 강도 Terminal-Bench 4.0 점수도 GPT-5.6 Terra의 21.5%에서 50.3%로 올랐습니다. 두 모델이 함께 판매되고 있으므로 가격표나 모델 선택 화면에서는 "Terra" 뒤의 버전 번호까지 확인하세요.
GPT-6.1 Sol이 느린 건 원래 그런 건가요?
같은 강도에서 Terra보다 오래 추론하는 것은 사실이지만, 추론 강도와 Fast 설정에 따라 체감 속도가 크게 달라집니다. 원인별 점검과 설정 방법은 GPT-6.1 Sol 느림 원인과 해결: effort·Fast 설정과 10월 26일 실측에서 다룹니다.
Terra와 Sol 대신 GPT-6 Astra로 올리는 게 낫나요?
Sol의 높은 추론 강도로도 해결되지 않는 최고 난도 작업이 아니라면 대개 그럴 필요가 없습니다. 점수를 맞췄을 때의 작업당 비용 차이와 Astra를 남길 경우는 GPT-6.1 Sol·Astra·GPT-6 Sol 비교와 전환 기준에 정리되어 있습니다.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 27일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 27일.
- 1.OpenAI API 가격 페이지developers.openai.com/api/docs/pricing
- 2.Artificial Analysis의 GPT-6.1 Terra vs GPT-6.1 Sol 비교 페이지artificialanalysis.ai/models/releases/comparisons/gpt-6-1-terra-vs-gpt-6-1-sol
- 3.OpenAI GPT-6.1 Terra 발표openai.com/index/introducing-gpt-6-1-terra
- 4.GitHub Copilot의 GPT-6.1 Terra 변경 기록github.blog/changelog/2026-10-26-gpt-6-1-terra-in-github-copilot
- 5.Codex 요금 문서learn.chatgpt.com/docs/pricing
- 6.API 모델 페이지developers.openai.com/api/docs/models/gpt-6.1-terra
- 7.OpenAI Codex 모델 문서learn.chatgpt.com/docs/models