Claude Haiku 5.5 vs GPT-6 Luna 비교: 단가 같고 작업당 비용 2.7~5.4배
Claude Haiku 5.5와 GPT-6 Luna는 짧은 요청 단가가 같지만, 같은 effort의 작업당 비용은 Haiku가 2.7~5.4배입니다. 10만 토큰 넘는 요청은 Luna가 쌉니다.
목차
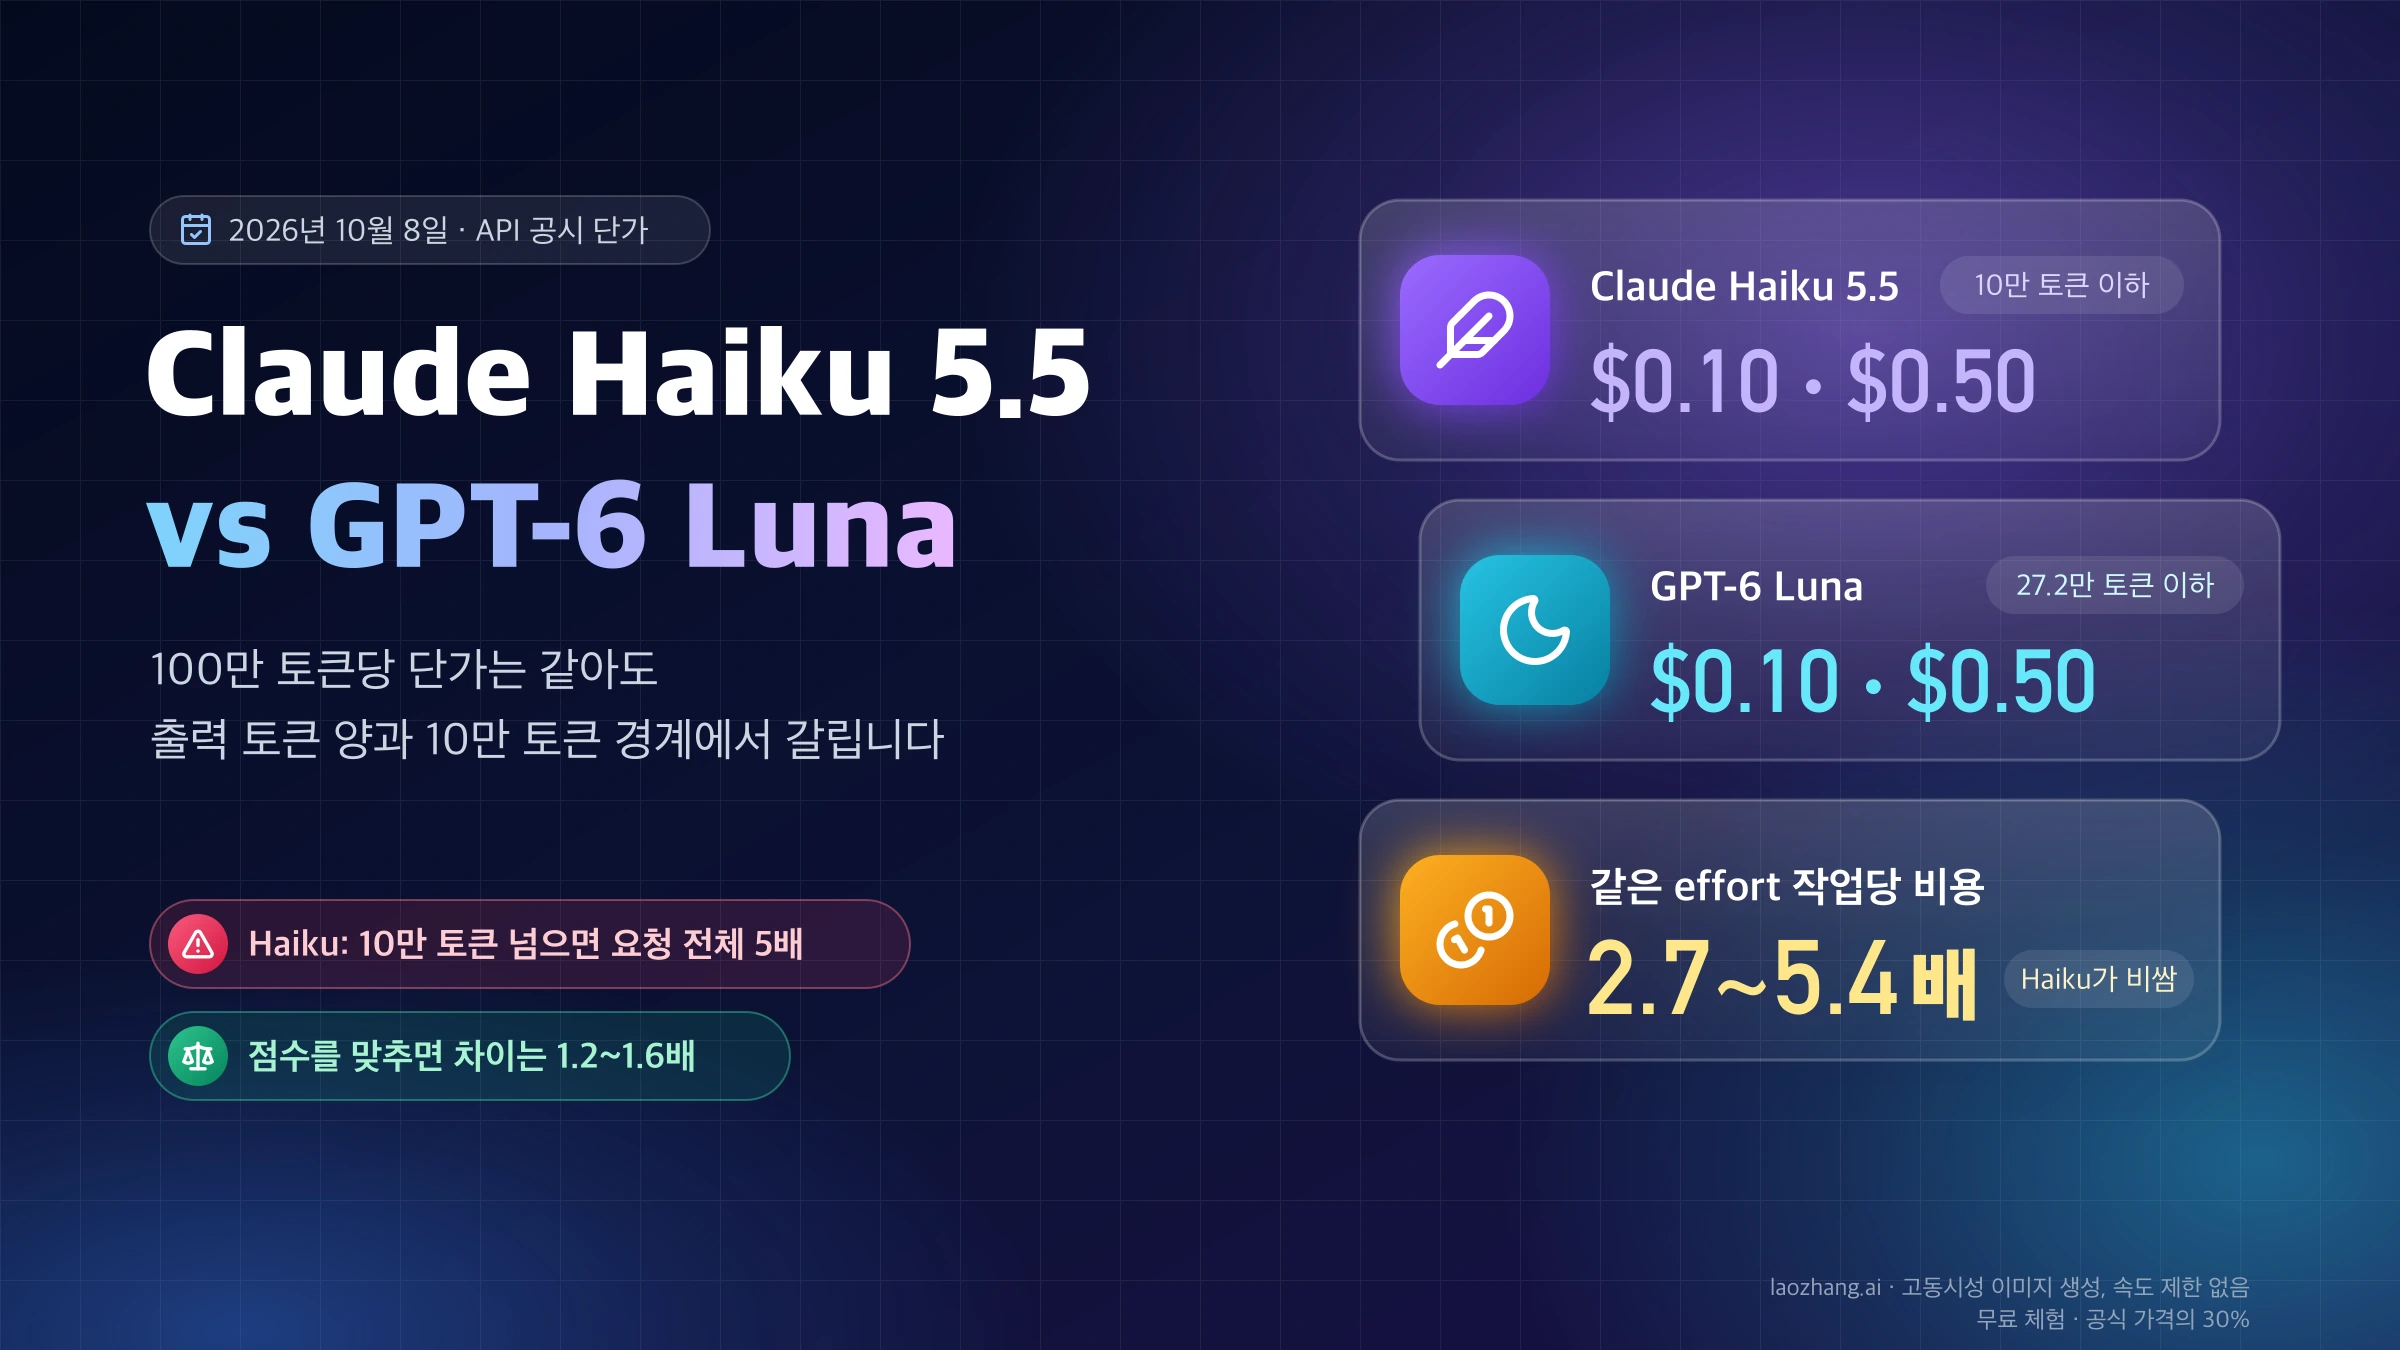
Claude Haiku 5.5(2026년 10월 7일 출시)와 GPT-6 Luna(API 2026년 9월 22일 출시)는 짧은 요청에서 100만 토큰당 입력 $0.10, 출력 $0.50, 캐시 읽기 $0.01로 단가가 같습니다. 그런데도 청구서가 같게 나오지는 않습니다. 차이는 두 곳에서 생깁니다.
첫째, 같은 일을 시키면 Haiku 5.5가 출력·추론 토큰을 훨씬 많이 씁니다. Artificial Analysis가 같은 추론 강도(effort)끼리 잰 작업당 비용은 Haiku 5.5가 GPT-6 Luna의 2.7~5.4배였습니다. 둘째, Haiku 5.5는 프롬프트가 10만 토큰을 넘으면 그 요청의 모든 단가가 5배가 되고, GPT-6 Luna는 입력이 27.2만 토큰을 넘어야 입력 2배·출력 1.5배가 됩니다.
다만 Haiku 5.5는 effort마다 점수가 더 높습니다. 점수가 비슷한 설정끼리 맞추면 작업당 비용 차이는 1.2~1.6배로 줄고, Artificial Analysis 지수 41점 이상은 두 모델 중 Haiku 5.5만 냅니다. 그래서 답은 작업에 따라 갈립니다.
- 10만 토큰 이하의 대량 분류·라우팅·추출: GPT-6 Luna의
none또는low를 먼저 시험합니다. - 프롬프트가 10만 토큰을 넘는 요청: GPT-6 Luna가 같은 토큰 수에서 확실히 쌉니다.
- 컴퓨터·브라우저 사용, Claude 상위 모델 밑의 서브에이전트, Luna max로도 품질이 모자란 작업: Haiku 5.5를 먼저 시험합니다.
요금은 2026년 10월 8일 기준 Anthropic API 요금 문서와 OpenAI API 요금 문서의 공시 단가이고, 성능과 작업당 비용은 Artificial Analysis, 각 회사, kingy.ai가 공개한 측정값입니다. 측정 조건은 수치마다 옆에 적었습니다.
Haiku 5.5·GPT-6 Luna 요금: 같은 단가, 경계는 10만·27.2만 토큰
두 모델의 기본 단가는 항목별로 같고, 높은 단가가 붙는 경계와 배율만 다릅니다. 가격은 모두 100만 토큰당 미국 달러입니다.
| 항목 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 낮은 단가가 적용되는 범위 | 프롬프트 10만 토큰 이하 | 입력 27.2만 토큰 이하 |
| 입력 | $0.10 | $0.10 |
| 캐시 읽기 | $0.01 | $0.01 |
| 캐시 쓰기 | $0.125 (5분), $0.20 (1시간) | $0.125 |
| 출력 (추론 토큰 포함) | $0.50 | $0.50 |
| 경계를 넘은 요청 | 입력 $0.50, 캐시 읽기 $0.05, 출력 $2.50 (모든 항목 5배) | 입력 $0.20, 캐시 읽기 $0.02, 출력 $0.75 (입력·캐시 2배, 출력 1.5배) |
| 배치 처리 | 50% 할인: 입력 $0.05, 출력 $0.25 | Batch·Flex 50%: 입력 $0.05, 출력 $0.25 |
| 빠른 처리 옵션 | Priority Tier 미지원 | Fast 모드 2배 (입력 $0.20, 출력 $1.00) |
| 컨텍스트 / 최대 출력 | 100만 토큰 / 12.8만 토큰 | 105만 토큰 (입력 최대 92.2만) / 12.8만 토큰 |
Anthropic 요금표는 "10만 토큰 초과 프롬프트" 행에 입력뿐 아니라 캐시와 출력 단가까지 따로 두고 있습니다. 경계를 넘은 토큰만 비싸지는 것이 아니라 그 요청 전체가 높은 단가로 계산된다고 보고 예산을 잡아야 합니다. OpenAI는 GPT-6 Luna 모델 페이지에 27.2만 토큰 초과 요청은 "요청 전체"에 높은 단가를 적용한다고 명시합니다.
한 가지는 공개 문서로 확인되지 않습니다. 캐시에서 읽은 토큰이 Haiku 5.5의 10만 토큰 계산에 들어가는지 Anthropic 문서에 정의가 없습니다. 예산은 들어간다고 보고 보수적으로 잡는 편이 안전하며, 아래 계산 예시에는 두 경우를 모두 적었습니다.
OpenAI의 Fast 모드는 2026년 7월 30일 Priority processing에서 이름이 바뀐 것입니다. Anthropic 쪽은 Haiku 5.5에서 Priority Tier를 지원하지 않으므로, Haiku 4.5에 Priority Tier 약정이 있는 조직은 용량 계획을 따로 세워야 합니다.
"같은 가격"·"75%"·"12배"·"5배"는 각각 무엇을 잰 숫자인가
네 숫자는 서로 다른 것을 잽니다. 자기 청구서에 맞는 숫자를 고르려면 무엇과 무엇을 비교했는지부터 봐야 합니다.
| 들리는 말 | 실제로 잰 것 | 내 청구서에 맞는 경우 |
|---|---|---|
| "같은 가격" | 100만 토큰당 공시 단가 (Haiku 10만 이하, Luna 27.2만 이하) | 두 모델이 같은 일에 같은 토큰 수를 쓸 때만 맞습니다 |
| "75% 저렴" | Anthropic이 Haiku 4.5 대비로 낸 평균 추정치 | Haiku 4.5에서 옮겨 오는 경우. GPT-6 Luna와는 관계없습니다 |
| "작업당 2.7~5.4배" | Artificial Analysis 지수 과제를 같은 effort로 돌린 작업당 비용 | 출력과 추론이 많은 에이전트·추론 작업 |
| "12배" | 서로 다른 effort를 맞댄 비율 (Haiku max 대 Luna medium) | 같은 조건 비교로는 나오지 않습니다 |
| "10만 토큰 넘으면 5배" | Haiku 5.5의 프롬프트 길이별 단가 | 프롬프트가 10만 토큰을 넘는 요청 |
"75% 저렴"은 Anthropic의 Haiku 5.5 발표문에 나오는 평균입니다. 각주에 따르면 Haiku 5.5는 10만 토큰 이하 요청에서 Haiku 4.5(입력 $1, 출력 $5)보다 90%, 10만 토큰 초과 요청에서 50% 쌉니다. Haiku 4.5 요청의 약 90%가 10만 토큰 이하였고, 새 토크나이저 때문에 같은 일에 토큰을 조금 더 쓴다는 점까지 반영한 값이라고 설명합니다. 요청 하나하나에 보장되는 할인율이 아닙니다.
12배는 같은 effort끼리의 측정에서는 나오지 않습니다. Artificial Analysis 공개 수치로 계산하면 같은 effort의 작업당 비용 비율은 2.7~5.4배입니다. 10배가 넘는 비율은 Haiku max 대 Luna medium(0.2128 ÷ 0.0175 = 12.2배)이나 Haiku medium 대 Luna low(0.0470 ÷ 0.00452 = 10.4배)처럼 Haiku 쪽 effort를 더 높게 잡은 경우에만 나옵니다.
5배는 Haiku 5.5 요금표 그대로입니다. 입력 15만 토큰에 출력 2천 토큰이면 Haiku 5.5는 $0.080, GPT-6 Luna는 $0.016입니다. 계산 과정은 아래 계산 절에 있습니다.
작업당 비용은 같은 effort에서 Haiku 5.5가 2.7~5.4배: 출력 토큰 차이
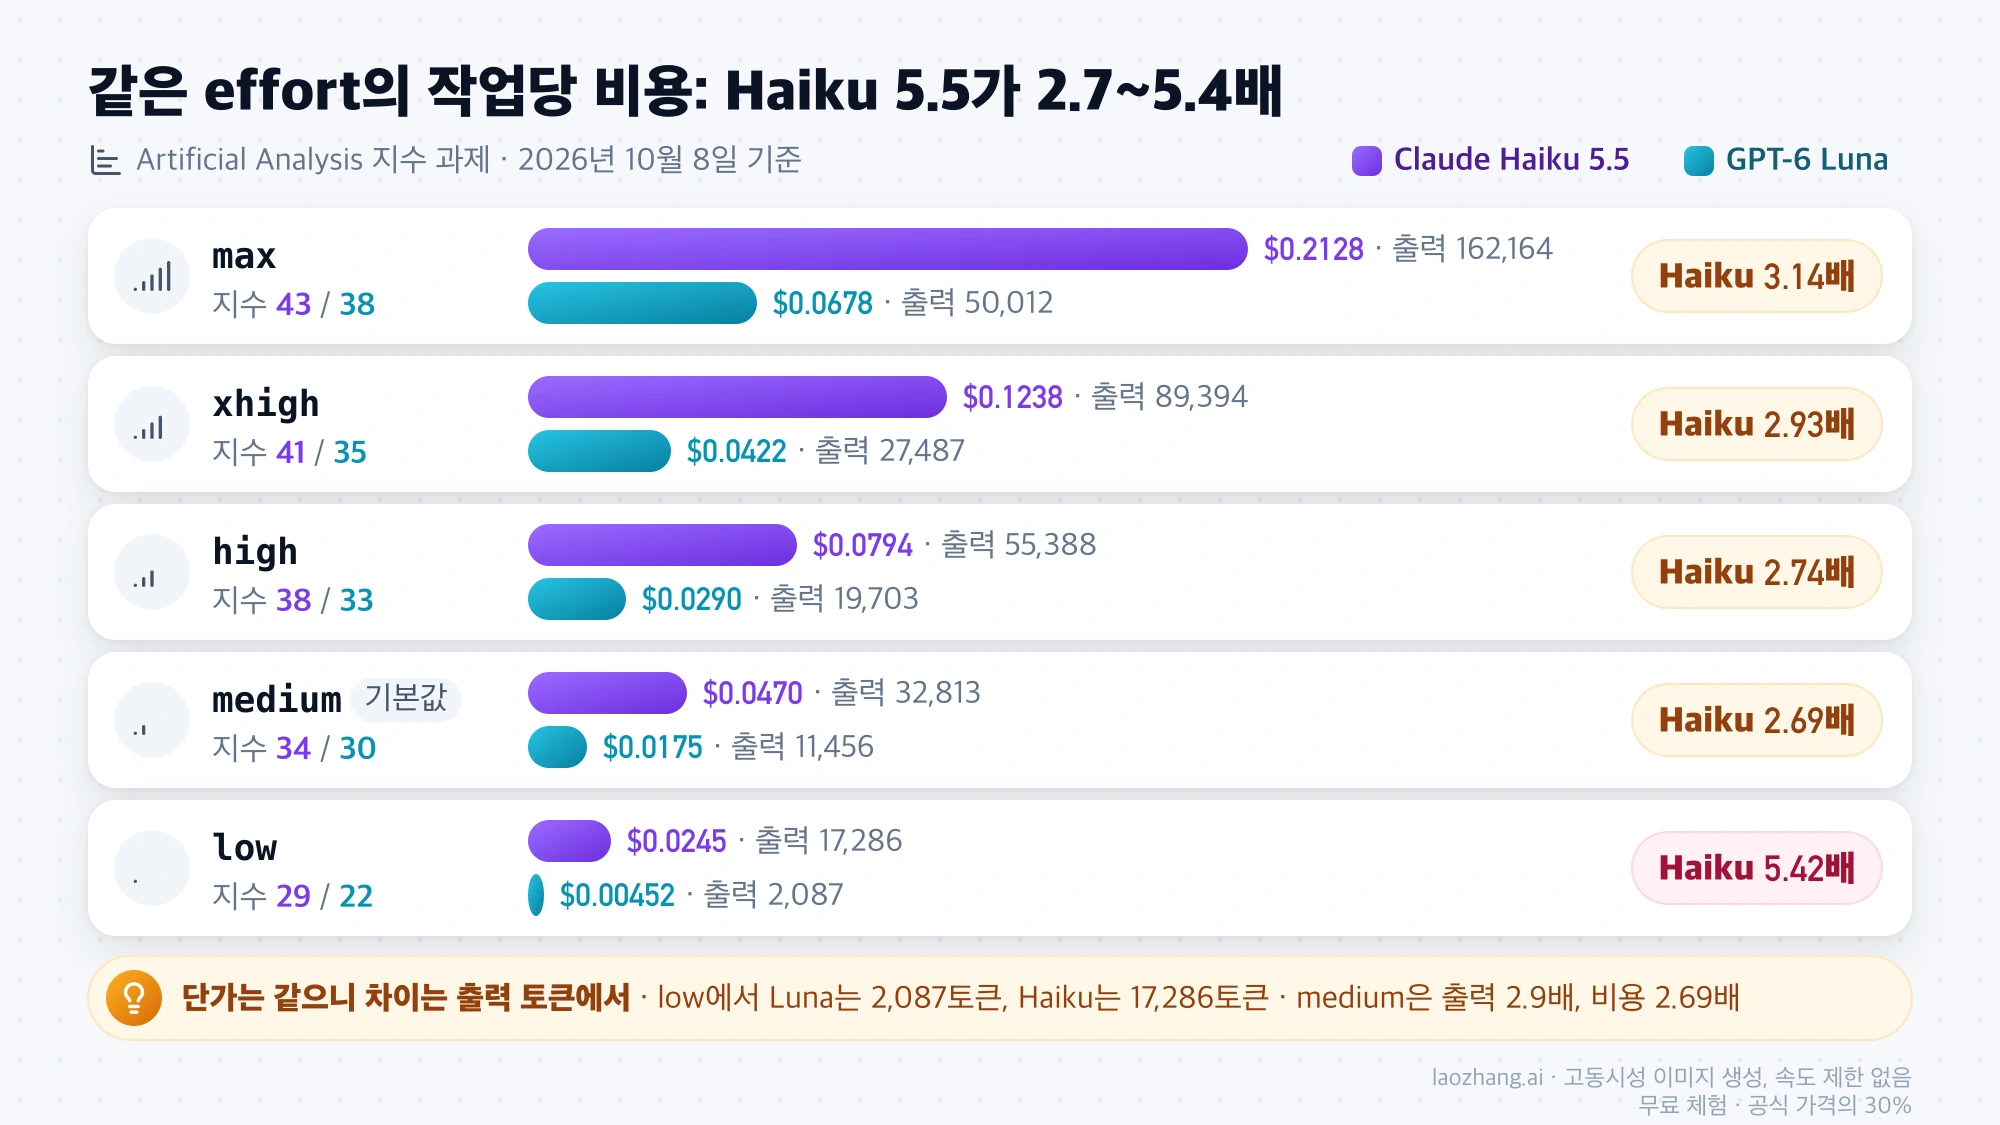
단가가 같으니 작업당 비용 차이는 토큰 양에서 나옵니다. Artificial Analysis의 Haiku 5.5·GPT-6 Luna 비교 페이지에 공개된 2026년 10월 8일 기준 수치는 다음과 같습니다.
| effort | 지수 점수 (Haiku / Luna) | 작업당 비용 Haiku 5.5 | 작업당 비용 GPT-6 Luna | 비용 비율 | 작업당 출력 토큰 (Haiku / Luna) |
|---|---|---|---|---|---|
| max | 43 / 38 | $0.2128 | $0.0678 | 3.14배 | 162,164 / 50,012 |
| xhigh | 41 / 35 | $0.1238 | $0.0422 | 2.93배 | 89,394 / 27,487 |
| high | 38 / 33 | $0.0794 | $0.0290 | 2.74배 | 55,388 / 19,703 |
| medium (둘 다 기본값) | 34 / 30 | $0.0470 | $0.0175 | 2.69배 | 32,813 / 11,456 |
| low | 29 / 22 | $0.0245 | $0.00452 | 5.42배 | 17,286 / 2,087 |
| none (Luna만) | — / 18 | — | $0.0113 | — | — / 3,758 |
비용 비율은 Haiku 값을 Luna 값으로 나눈 것입니다(예: 0.0470 ÷ 0.0175 = 2.69). 기본 설정인 medium끼리면 Haiku 5.5가 출력 토큰을 2.9배(32,813 ÷ 11,456) 쓰고, 비용은 2.69배가 됩니다. 비용에는 출력 외에 입력·캐시 비용도 들어가므로 비용 비율이 출력 토큰 비율보다 조금 낮게 나옵니다. low에서 차이가 5.42배로 커지는 이유는 GPT-6 Luna가 low에서 출력을 2,087토큰까지 줄이는 반면 Haiku 5.5는 17,286토큰을 쓰기 때문입니다.
지수 전체를 max로 돌린 총비용도 같은 방향입니다. Haiku 5.5는 $330, GPT-6 Luna는 $122였고, 출력 토큰은 4억 3,500만 대 1억 4,400만이었습니다. 두 모델이 푼 과제 수가 달라 이 비율(2.71배)은 과제당 비율(3.14배)과 일치하지 않습니다.
이 수치를 쓸 때 주의할 점이 두 가지 있습니다.
- Artificial Analysis는 Haiku 5.5를 모든 effort에서 10만 토큰 이하 단가($0.10/$0.50)로만 계산합니다. 과제 프롬프트가 10만 토큰을 넘은 경우가 있었다면 Haiku 쪽 실제 비용은 표보다 높습니다.
- 지수 과제에서는 비용 대부분이 출력에서 나옵니다. Haiku 5.5 max의 지수 총비용 $330 중 출력이 $217.59이고, 그중 $198.79가 추론 토큰 비용입니다. 입력이 길고 출력이 짧은 분류 작업에서는 차이가 줄어들며, 아래 계산 절에 예시가 있습니다.
속도는 기준에 따라 엇갈립니다. 초당 출력 토큰은 Haiku 5.5가 137~243으로 GPT-6 Luna의 112~127보다 빠릅니다. 하지만 토큰을 더 많이 쓰기 때문에 low 기준 작업당 시간은 Haiku 5.5 61.8초, GPT-6 Luna 17.2초였고, 첫 토큰까지 걸린 시간도 12.0초 대 3.2초였습니다. 추론을 끈 GPT-6 Luna의 첫 토큰 시간은 0.87초입니다. GPT-6 Luna medium의 속도와 지연 수치는 공개되지 않았습니다.
점수를 맞추면 차이는 1.2~1.6배, 41점 이상은 Haiku 5.5만
같은 effort끼리 비교하면 Haiku 5.5는 비싸지만 점수도 높습니다. 그래서 "같은 품질을 얻는 데 얼마가 드는가"를 보려면 점수가 비슷한 설정끼리 맞대야 합니다. 위 표의 Artificial Analysis 수치를 다시 묶으면 이렇습니다.
| 점수대 (Artificial Analysis 지수) | Claude Haiku 5.5 | GPT-6 Luna | 작업당 비용 비율 | 작업당 시간 (Haiku / Luna) |
|---|---|---|---|---|
| 약 30점 | low 29점, $0.0245 | medium 30점, $0.0175 | Haiku 1.40배 | 61.8초 / 공개 안 됨 |
| 33~34점 | medium 34점, $0.0470 | high 33점, $0.0290 | Haiku 1.62배 | 134.4초 / 172.8초 |
| 38점 | high 38점, $0.0794 | max 38점, $0.0678 | Haiku 1.17배 | 193.6초 / 393.6초 |
| 41~43점 | xhigh 41점, max 43점 | 도달하지 못함 (최고 38점) | — | — |
이 표에서 판단 규칙 세 가지가 나옵니다.
- GPT-6 Luna로 필요한 품질이 나오면 Luna가 쌉니다. 점수를 맞춰도 Haiku 5.5가 1.2~1.6배 비쌉니다.
- 38점대에서는 시간이 변수입니다. Haiku 5.5 high는 GPT-6 Luna max보다 17% 비싸지만 작업당 시간은 절반 수준입니다. 사용자가 기다리는 에이전트라면 Haiku 5.5 high가 합리적일 수 있습니다.
- Luna max로도 부족하면 두 모델 중에서는 Haiku 5.5밖에 없습니다. 다만 Anthropic은 Haiku 5.5의 xhigh·max를 평가에서 품질 향상이 확인될 때만 쓰고 Claude Sonnet 5.5와 성능·비용·속도를 비교하라고 권합니다. Haiku 5.5와 Sonnet 5.5 사이의 선택은 별도로 따져야 할 문제입니다.
지수 하나가 내 작업의 품질을 대신하지는 않습니다. 위 규칙은 "어느 쪽을 먼저 시험할지"를 정하는 데 쓰고, 최종 결정은 자기 데이터로 내려야 합니다.
Anthropic 벤치마크 표의 OSWorld 72.4% 대 48.9%
Anthropic의 Haiku 5.5 발표문에는 GPT-6 Luna와 나란히 놓은 표가 있습니다. Anthropic이 직접 돌린 결과이고, 칸마다 어떤 effort를 썼는지는 표에 적혀 있지 않습니다.
| 평가 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| OSWorld 2.1 (컴퓨터 사용, 오프라인 서브셋) | 72.4% | 48.9% |
| Terminal-Bench 4.0 (에이전트 코딩) | 39.2% | 16.4% |
| FrontierCode 1.1 Main (에이전트 코딩) | 46.4% | 42.4% |
| GDPval-AA v2.1 (지식 작업) | 1620 | 1437 |
| Chartography, 도구 없음 (시각 추론) | 46.4% | 29.1% |
차이가 가장 큰 곳은 컴퓨터 사용입니다. 다만 OSWorld 수치는 전체가 아닌 "오프라인 서브셋" 기준입니다. Terminal-Bench 4.0은 Artificial Analysis가 max로 따로 잰 값이 32.8% 대 12.6%로, 숫자는 다르지만 방향은 같습니다. FrontierCode는 차이가 4%포인트에 그칩니다. 코딩 작업에서는 이 정도 점수 차이가 2.7배 이상의 작업당 비용 차이를 상쇄하는지 자기 과제로 확인해야 합니다.
통과율까지 넣은 합격 결과 1건당 비용
실무에서 중요한 것은 요청 1회 비용이 아니라 쓸 만한 결과 1건의 비용입니다.
합격 1건당 비용 = 시도 1회 비용 ÷ 통과율

Haiku 5.5가 더 싼 조건:
(Haiku 통과율 ÷ Luna 통과율) > (Haiku 시도 비용 ÷ Luna 시도 비용)
실패한 결과를 사람이 고치거나 다시 돌리는 비용이 크다면 그 비용도 시도 비용에 더합니다.
참고할 만한 소규모 사례가 하나 있습니다. kingy.ai의 Haiku 5.5·GPT-6 Luna 160개 응답 테스트는 40개 과제를 모델마다 두 번씩, Claude Max와 ChatGPT Pro 구독의 명령줄 클라이언트 기본 설정으로 돌렸습니다. 입력은 모두 2만 토큰 미만이었고 effort는 맞추지 않았습니다. 모든 검사를 통과한 비율은 Haiku 5.5 75.0%(60/80), GPT-6 Luna 63.75%(51/80)였고, 클라이언트 기준 완료 시간 중앙값은 6.83초 대 2.92초였습니다.
통과율 비율은 75.0 ÷ 63.75 = 1.18입니다. 이 사례에 공식을 대입하면, Haiku 5.5의 시도 비용이 Luna의 1.18배 이하일 때만 합격 1건당 Haiku가 쌉니다. 같은 effort 기준 비용 비율 2.7배와 비교하면 그 조건을 맞추기는 어렵습니다. 범주별로 보면 JSON 추출과 코드 수정은 두 모델 모두 10/10이었고, 계산(8/10 대 4/10)과 글 편집(8/10 대 5/10)에서 차이가 났습니다. 두 모델이 모두 통과하는 유형이라면 GPT-6 Luna가 그대로 쌉니다.
요청당 비용 계산: 공식과 1만·15만 토큰, 캐시, 100만 건 예시
요청 하나의 비용은 다음 식으로 구합니다. 출력에는 추론(thinking) 토큰이 포함됩니다.
요청 비용($) = (새 입력 × 입력 단가
             + 캐시 읽기 × 캐시 읽기 단가
             + 캐시 쓰기 × 캐시 쓰기 단가
             + 출력(추론 포함) × 출력 단가) ÷ 1,000,000

단가 구간: Haiku 5.5는 프롬프트가 100,000토큰을 넘으면 높은 구간
GPT-6 Luna는 입력이 272,000토큰을 넘으면 높은 구간| 예시 (캐시 쓰기 없음) | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 입력 1만 + 출력 1천 | $0.0015 | $0.0015 |
| 입력 9.9만 + 출력 2천 | $0.0109 | $0.0109 |
| 입력 15만 + 출력 2천 | $0.080 | $0.016 |
| 15만 중 14만 캐시 읽기 + 새 입력 1만 + 출력 2천 | $0.017 (캐시 포함 가정) / $0.0034 (미포함 가정) | $0.0034 |
| 분류 100만 건 (요청당 입력 2천 + 출력 300) | $350, 배치 $175 | $350, Batch·Flex $175 |
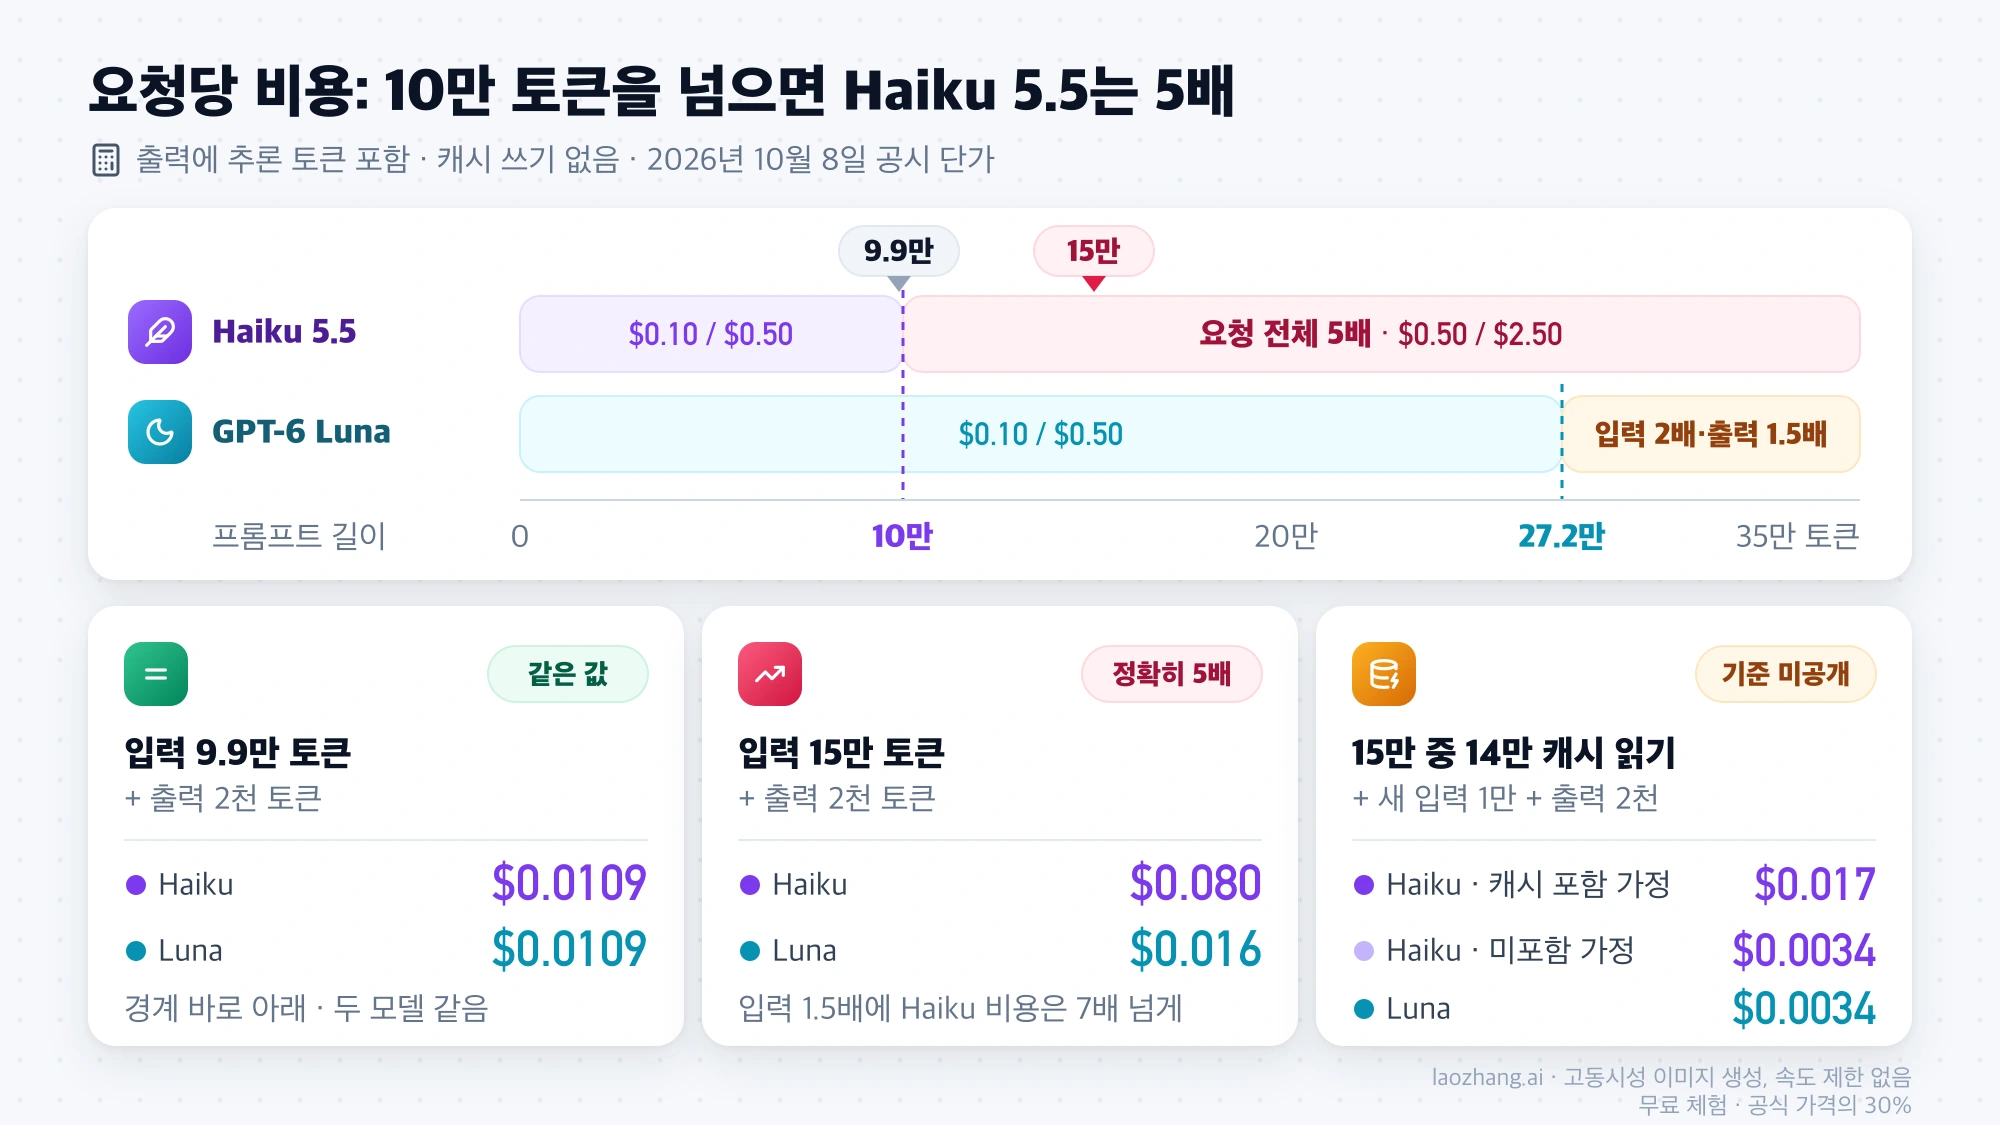
계산 과정은 다음과 같습니다.
- 입력 1만 + 출력 1천: 10,000 × $0.10 + 1,000 × $0.50 = $1,500을 100만으로 나누면 $0.0015. 두 모델 같습니다.
- 입력 15만 + 출력 2천: Haiku 5.5는 높은 구간이라 150,000 × $0.50 + 2,000 × $2.50 = $80,000 → $0.080. GPT-6 Luna는 27.2만 이하라 150,000 × $0.10 + 2,000 × $0.50 = $16,000 → $0.016. 정확히 5배입니다. 9.9만 토큰 요청($0.0109)과 비교하면 입력이 1.5배 늘었을 뿐인데 Haiku 5.5 비용은 7배가 넘습니다.
- 캐시 읽기가 섞인 15만 토큰: 캐시가 10만 계산에 들어간다면 Haiku 5.5는 140,000 × $0.05 + 10,000 × $0.50 + 2,000 × $2.50 = $17,000 → $0.017. 들어가지 않는다면 140,000 × $0.01 + 10,000 × $0.10 + 2,000 × $0.50 = $3,400 → $0.0034로 Luna와 같습니다. Anthropic이 기준을 밝히기 전까지는 $0.017로 예산을 잡는 편이 안전합니다.
- 분류 100만 건: 요청당 2,000 × $0.10 + 300 × $0.50 = $350 → $0.00035, 100만 건이면 $350입니다. 배치 단가($0.05/$0.25)로는 $175입니다. 같은 작업을 Haiku 4.5로 돌리면 2,000 × $1 + 300 × $5 = $3,500 → 요청당 $0.0035, 100만 건에 $3,500입니다.
위 예시는 두 모델이 같은 토큰 수를 쓴다는 가정입니다. 실제로는 두 가지가 달라집니다.
출력 토큰 양. 분류 예시의 출력 300토큰에는 추론 토큰이 들어가야 합니다. Haiku 5.5는 기본 effort가 medium이고 적응형 사고(adaptive thinking)가 기본으로 켜져 있어, 짧은 답을 시켜도 추론 토큰이 붙을 수 있습니다. 예를 들어 입력 1만에 GPT-6 Luna가 출력 1천을 쓰고 Haiku 5.5가 Artificial Analysis medium 비율대로 2.86배인 2,860토큰을 쓴다고 가정하면, Haiku 5.5는 10,000 × $0.10 + 2,860 × $0.50 = $2,430 → $0.00243, Luna는 $0.0015로 1.62배입니다. 지수 과제의 2.69배보다 작은 이유는 비용에서 입력이 차지하는 몫이 크기 때문입니다. 입력이 길고 답이 짧은 작업일수록 두 모델의 차이는 줄어듭니다.
토큰 수 자체. Haiku 5.5는 새 토크나이저를 써서 같은 텍스트가 Haiku 4.5보다 약 30% 많은 토큰으로 계산되며, 정확한 증가 폭은 내용에 따라 다릅니다. 이 30%는 Haiku 4.5와 비교한 값이고, Haiku 5.5와 GPT-6 Luna의 토큰 수 비율은 공개되지 않았습니다. Haiku 4.5에서 약 7.7만 토큰이던 프롬프트는 30% 늘면 10만 토큰 경계에 닿습니다(77,000 × 1.3 = 100,100). 자기 프롬프트 표본을 Anthropic 토큰 카운팅 API(model을 claude-haiku-5-5로 지정)와 OpenAI 응답의 usage 값으로 각각 세어 보고 계산에 넣으세요.
작업 유형별로 먼저 시험할 모델과 나눠 보내는 규칙
| 작업 | 먼저 시험할 모델 | 근거 | 확인할 점 |
|---|---|---|---|
| 대량 분류·라우팅·짧은 추출 (10만 토큰 이하) | GPT-6 Luna none 또는 low | 단가가 같고 low 출력 토큰이 Haiku의 8분의 1 수준 (2,087 대 17,286) | 형식 오류율. Haiku 5.5 low를 대조군으로 |
| 프롬프트 10만 토큰 초과 (긴 문서, 긴 대화 기록, 큰 검색 결과) | GPT-6 Luna | 27.2만 토큰까지 낮은 단가 유지, Haiku는 요청 전체 5배 | 27.2만 초과 시 Luna도 입력 2배·출력 1.5배 |
| 컴퓨터·브라우저 사용 에이전트 | Claude Haiku 5.5 | Anthropic 표 OSWorld 2.1 오프라인 서브셋 72.4% 대 48.9% | computer_toolset_20260801로 이전 필요 |
| Claude Opus 5.5·Sonnet 5.5 밑의 서브에이전트, 요약·압축 | Claude Haiku 5.5 | Anthropic이 코딩 작업의 서브에이전트와 요약·압축을 주 용도로 제시 | 기본 medium의 추론 토큰 양 |
| 실시간 상담 등 첫 응답이 중요한 작업 | GPT-6 Luna none/low | 첫 토큰 시간 0.87초(none), 3.2초(low) 대 Haiku low 12.0초 | 답이 길면 Haiku의 초당 출력이 더 빠름 |
| Luna max로도 품질이 모자란 작업 | Claude Haiku 5.5 xhigh·max | 지수 41~43점은 Haiku만 도달 | Sonnet 5.5와 비용 비교 |
| 대량 비동기 처리 | 둘 다 | Haiku 배치, Luna Batch·Flex 모두 50% | Haiku 배치도 10만 토큰 초과 시 $0.25/$1.25 |
두 모델을 같이 쓴다면 다음 순서로 나눠 보내는 방식이 비용을 가장 쉽게 통제합니다.
- 요청을 보내기 전에 프롬프트 토큰을 셉니다. 10만 토큰을 넘으면 Haiku 5.5로 보내지 않습니다. 같은 텍스트라도 Haiku 5.5 쪽 토큰 수가 더 많을 수 있으니 Haiku 기준으로 셉니다.
- 기본 처리는 GPT-6 Luna의 낮은 effort로 합니다. 형식 검사나 규칙 검사를 통과하지 못한 결과만 Haiku 5.5(또는 Luna의 더 높은 effort)로 다시 보냅니다. 이렇게 하면 비싼 호출이 실패분에만 붙습니다.
- 컴퓨터·브라우저 사용처럼 유형 자체에서 차이가 큰 작업은 처음부터 Haiku 5.5로 보냅니다.
- 자기 데이터로 확인합니다. 실제 요청 표본을 두 모델에 effort 두 단계씩 돌려 통과율, 출력 토큰, 시간을 기록하고 위의 합격 1건당 비용 공식에 넣습니다.
OpenAI 모델 안에서 GPT-6 Luna와 다른 모델(GPT-6.1 Sol, GPT-6 Astra 등)을 고르는 문제는 GPT-6 Sol·Luna·Astra와 Terra 비교: 모델 ID, API 요금, 선택 기준에서, 상위 모델끼리의 비용 비교는 Claude Opus 5.5 vs GPT-6 Sol·6.1 Sol 비용에서 다룹니다.
Haiku 5.5로 갈아탈 때 400 오류와 비용이 바뀌는 설정
Haiku 4.5나 GPT-6 Luna 코드를 Haiku 5.5로 옮기면 모델 ID만 바꿔서는 실패하는 요청이 생깁니다. Anthropic의 Haiku 5.5 마이그레이션 가이드와 OpenAI의 GPT-6 Luna 모델 문서 기준으로 정리하면 이렇습니다.
| 항목 | Claude Haiku 5.5 (claude-haiku-5-5) | GPT-6 Luna (gpt-6-luna) |
|---|---|---|
| 기본 effort | medium, 적응형 사고 기본 켜짐 | medium |
| 추론 끄기 | none 없음. thinking: {"type": "disabled"}는 high 이하에서만, xhigh·max에서는 400 | reasoning.effort: "none" 지원 |
| 샘플링 파라미터 | 기본값이 아닌 temperature·top_p·top_k는 400 | effort가 none이 아니면 temperature·top_p·top_logprobs 제거 |
| 어시스턴트 프리필 | 400. 구조화 출력이나 enum 필드가 있는 도구로 대체 | 해당 없음 |
| 추론 예산 지정 | budget_tokens는 400, 적응형 사고 + effort로 대체 | effort로 조절 |
| 컴퓨터 사용 | Claude API·Google Cloud에서 computer_toolset_20260801만, computer_20250124는 400 | Responses API의 computer_use 도구 |
| 함수 호출 | tool_choice를 any나 특정 도구로 강제하면 사고 없이 바로 도구 호출 | Chat Completions는 none일 때만, 추론과 도구를 함께 쓰려면 Responses API |
| 빠른 처리 | Priority Tier 미지원 | Fast 모드 (예전 Priority), 2배 단가 |
| 안전 거절 | stop_reason: "refusal" 반환 가능, 서버 쪽 대체 처리 없음 | — |
비용과 동작이 바뀌는 점도 있습니다.
max_tokens에 추론 토큰이 포함됩니다. Haiku 4.5용으로 작게 잡아 둔max_tokens는 Haiku 5.5에서 사고 토큰만 쓰다가 답 없이 끝날 수 있습니다. 값을 올리거나 effort를 낮춥니다.- Haiku 4.5에서 추론 없이 쓰던 작업은 낮은 effort로 옮깁니다. 기본값 medium을 그대로 두면 출력 토큰, 즉 비용이 늘어납니다. Anthropic은 단순 대량 요청에
low를 권합니다. 다만 추론을 완전히 끄고 JSON 출력과 도구를 함께 요구하면 필요한 도구 호출을 건너뛸 수 있다고 문서에 적혀 있습니다. - 토큰 수와 비용 추정을 다시 계산합니다. 같은 텍스트가 약 30% 많은 토큰으로 계산되므로, Haiku 4.5 기준의 예산과 10만 토큰 경계 판단을 그대로 쓰면 안 됩니다.
- 사고(thinking) 블록은 대화를 덧붙이는 방식으로만 유지됩니다. 이전 턴의
system·tools·messages를 바꾼 뒤 사고 블록을 다시 보내면 400 오류가 납니다.
Anthropic의 모델 폐기 일정표에는 Haiku 4.5의 폐기 시점이 "빨라도 2026년 10월 15일"로 적혀 있습니다. 당장 끊기지는 않지만 옮길 일정을 잡아 둘 때입니다.
Claude Code·Claude.ai·ChatGPT 무료에서 쓰는 Haiku 5.5와 GPT-6 Luna
Claude.ai. Free, Pro, Max, Team, Enterprise 사용자 모두 웹·iOS·Android에서 Haiku 5.5를 고를 수 있습니다.
Claude Code. Claude Code 모델 설정 문서에 따르면 Haiku 5.5는 v2.1.293 이상에서 써야 하며, claude update로 올릴 수 있습니다. haiku 별칭이 Haiku 5.5를 가리키는 것은 Anthropic API로 연결했을 때뿐입니다. Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS에서는 haiku가 아직 Haiku 4.5로 연결되므로, Haiku 5.5를 쓰려면 전체 모델 이름을 지정해야 합니다.
ChatGPT. OpenAI의 2026년 10월 7일 GPT-6 출시 발표에 따르면 10월 8일부터 Free·Go 요금제의 Chat 탭 GPT-6은 GPT-6 Luna로 동작합니다(순차 적용). Plus 이상은 GPT-6 Sol입니다. 이 Luna는 일상 대화용으로 조정된 버전이며, API의 gpt-6-luna와 같은 모델이라는 설명은 없습니다. Work와 Codex에서 쓰는 모델은 이번 발표로 바뀌지 않았습니다.
한국에서의 이용. Anthropic과 OpenAI 모두 공식 지원 국가 목록에 한국이 들어 있어, 한국에서 두 API를 직접 쓸 수 있습니다.
laozhang.ai로 GPT-6 Luna를 호출하는 경우. laozhang.ai 모델·요금 문서에는 gpt-6-luna가 OpenAI 호환 엔드포인트로, OpenAI 공식과 같은 단가(27.2만 토큰 이하 입력 $0.1, 출력 $0.5, 캐시 읽기 $0.01)에 올라 있습니다. 요청 전체에 한 구간 단가가 적용되고 호출 로그에 적용 구간이 표시됩니다. 2026년 10월 8일 기준 laozhang.ai의 Claude 모델은 용량 문제로 일시 중단된 상태라 Haiku 5.5는 이 경로로 쓸 수 없습니다.
Haiku 5.5와 GPT-6 Luna 자주 묻는 질문
GPT-6 Luna가 Claude Haiku 5.5보다 싼가요?
토큰 단가는 같습니다(10만 토큰 이하 기준). 같은 일을 시키면 Haiku 5.5가 출력 토큰을 더 많이 써서, Artificial Analysis 기준 같은 effort의 작업당 비용은 GPT-6 Luna가 2.7~5.4배 쌉니다. 프롬프트가 10만 토큰을 넘으면 Haiku 5.5 단가가 5배가 되므로 차이는 더 커집니다.
Claude Haiku 5.5와 GPT-6 Luna 중 어느 쪽이 더 똑똑한가요?
공개된 측정에서는 Haiku 5.5가 높습니다. Artificial Analysis 지수는 max 기준 43점 대 38점이고, effort마다 Haiku 5.5가 4~7점 앞섭니다. Anthropic 표의 컴퓨터 사용(OSWorld 2.1 오프라인 서브셋)은 72.4% 대 48.9%입니다. 다만 점수가 비슷한 설정끼리 맞춰도 Haiku 5.5가 1.2~1.6배 비싸므로, Luna로 충분한 작업에서는 Luna가 유리합니다.
Claude Haiku 5.5가 GPT-6 Luna보다 12배 비싸다는 말은 맞나요?
같은 조건에서는 맞지 않습니다. 같은 effort의 작업당 비용 차이는 2.7~5.4배입니다. 12배는 Haiku 5.5 max와 GPT-6 Luna medium처럼 서로 다른 effort를 맞댈 때 나오는 숫자입니다.
Claude Code에서 Haiku 5.5를 쓸 수 있나요?
v2.1.293 이상이면 쓸 수 있습니다. Anthropic API로 연결하면 haiku 별칭이 Haiku 5.5를 가리키고, Bedrock·Google Cloud·Foundry·Claude Platform on AWS에서는 haiku가 Haiku 4.5로 연결되므로 전체 모델 이름을 지정해야 합니다.
ChatGPT 무료 요금제는 이제 GPT-6 Luna인가요?
2026년 10월 8일부터 Free·Go 요금제의 Chat 탭에서 GPT-6이 GPT-6 Luna로 순차 적용됩니다. 대화용으로 조정된 버전이라 API의 gpt-6-luna와 같다고 볼 근거는 없고, Work·Codex 모델은 바뀌지 않았습니다.
참고 자료9
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 8일.
참고 자료9
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 8일.
- 1.Anthropic API 요금 문서platform.claude.com/docs/en/about-claude/pricing
- 2.OpenAI API 요금 문서developers.openai.com/api/docs/pricing
- 3.Anthropic의 Haiku 5.5 발표문anthropic.com/claude-haiku-5-5
- 4.Artificial Analysis의 Haiku 5.5·GPT-6 Luna 비교 페이지artificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-gpt-6-luna
- 5.kingy.ai의 Haiku 5.5·GPT-6 Luna 160개 응답 테스트kingy.ai/blog/claude-haiku-5-5-vs-gpt-6-luna-benchmark
- 6.Anthropic의 Haiku 5.5 마이그레이션 가이드platform.claude.com/docs/en/models/haiku-5-5/migration-guide
- 7.OpenAI의 GPT-6 Luna 모델 문서developers.openai.com/api/docs/models/gpt-6-luna
- 8.Claude Code 모델 설정 문서code.claude.com/docs/en/model-config
- 9.OpenAI의 2026년 10월 7일 GPT-6 출시 발표openai.com/index/gpt-6-for-everyone