Precio de la API de Claude vs OpenAI: qué nivel sale más barato
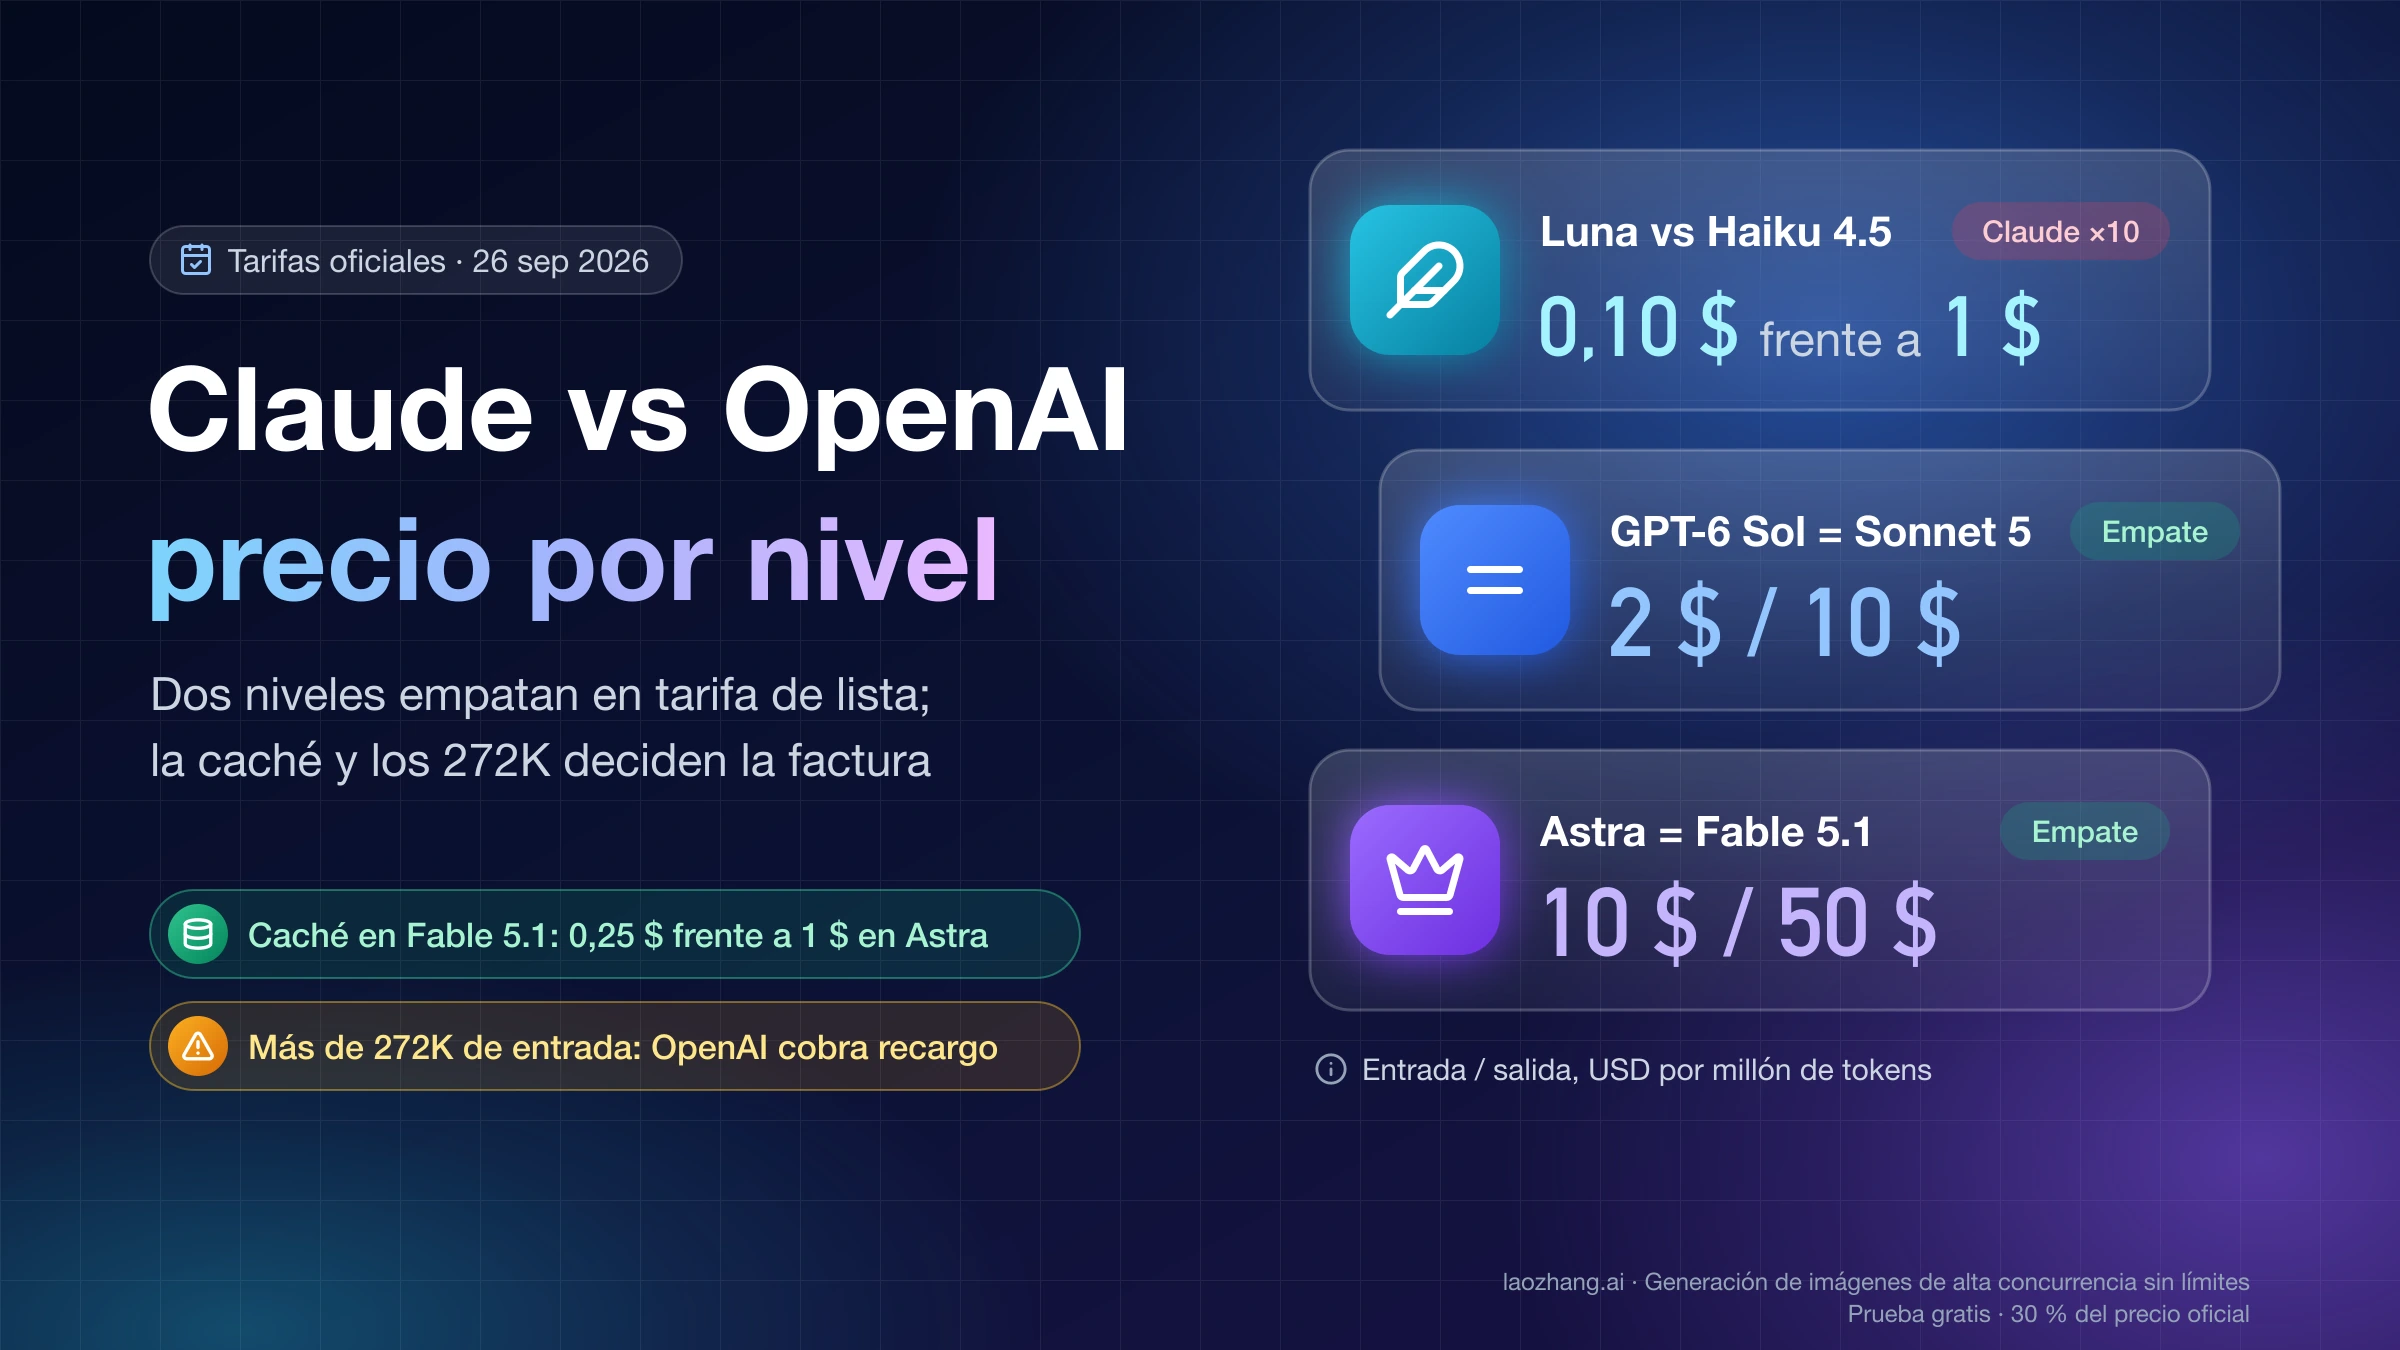
GPT-6 Sol y Claude Sonnet 5 cobran lo mismo por token, igual que Astra y Fable 5.1; la diferencia la marcan la caché y los prompts de más de 272K tokens.

GPT-6 Sol y Claude Sonnet 5 cobran lo mismo por token, igual que Astra y Fable 5.1; la diferencia la marcan la caché y los prompts de más de 272K tokens.

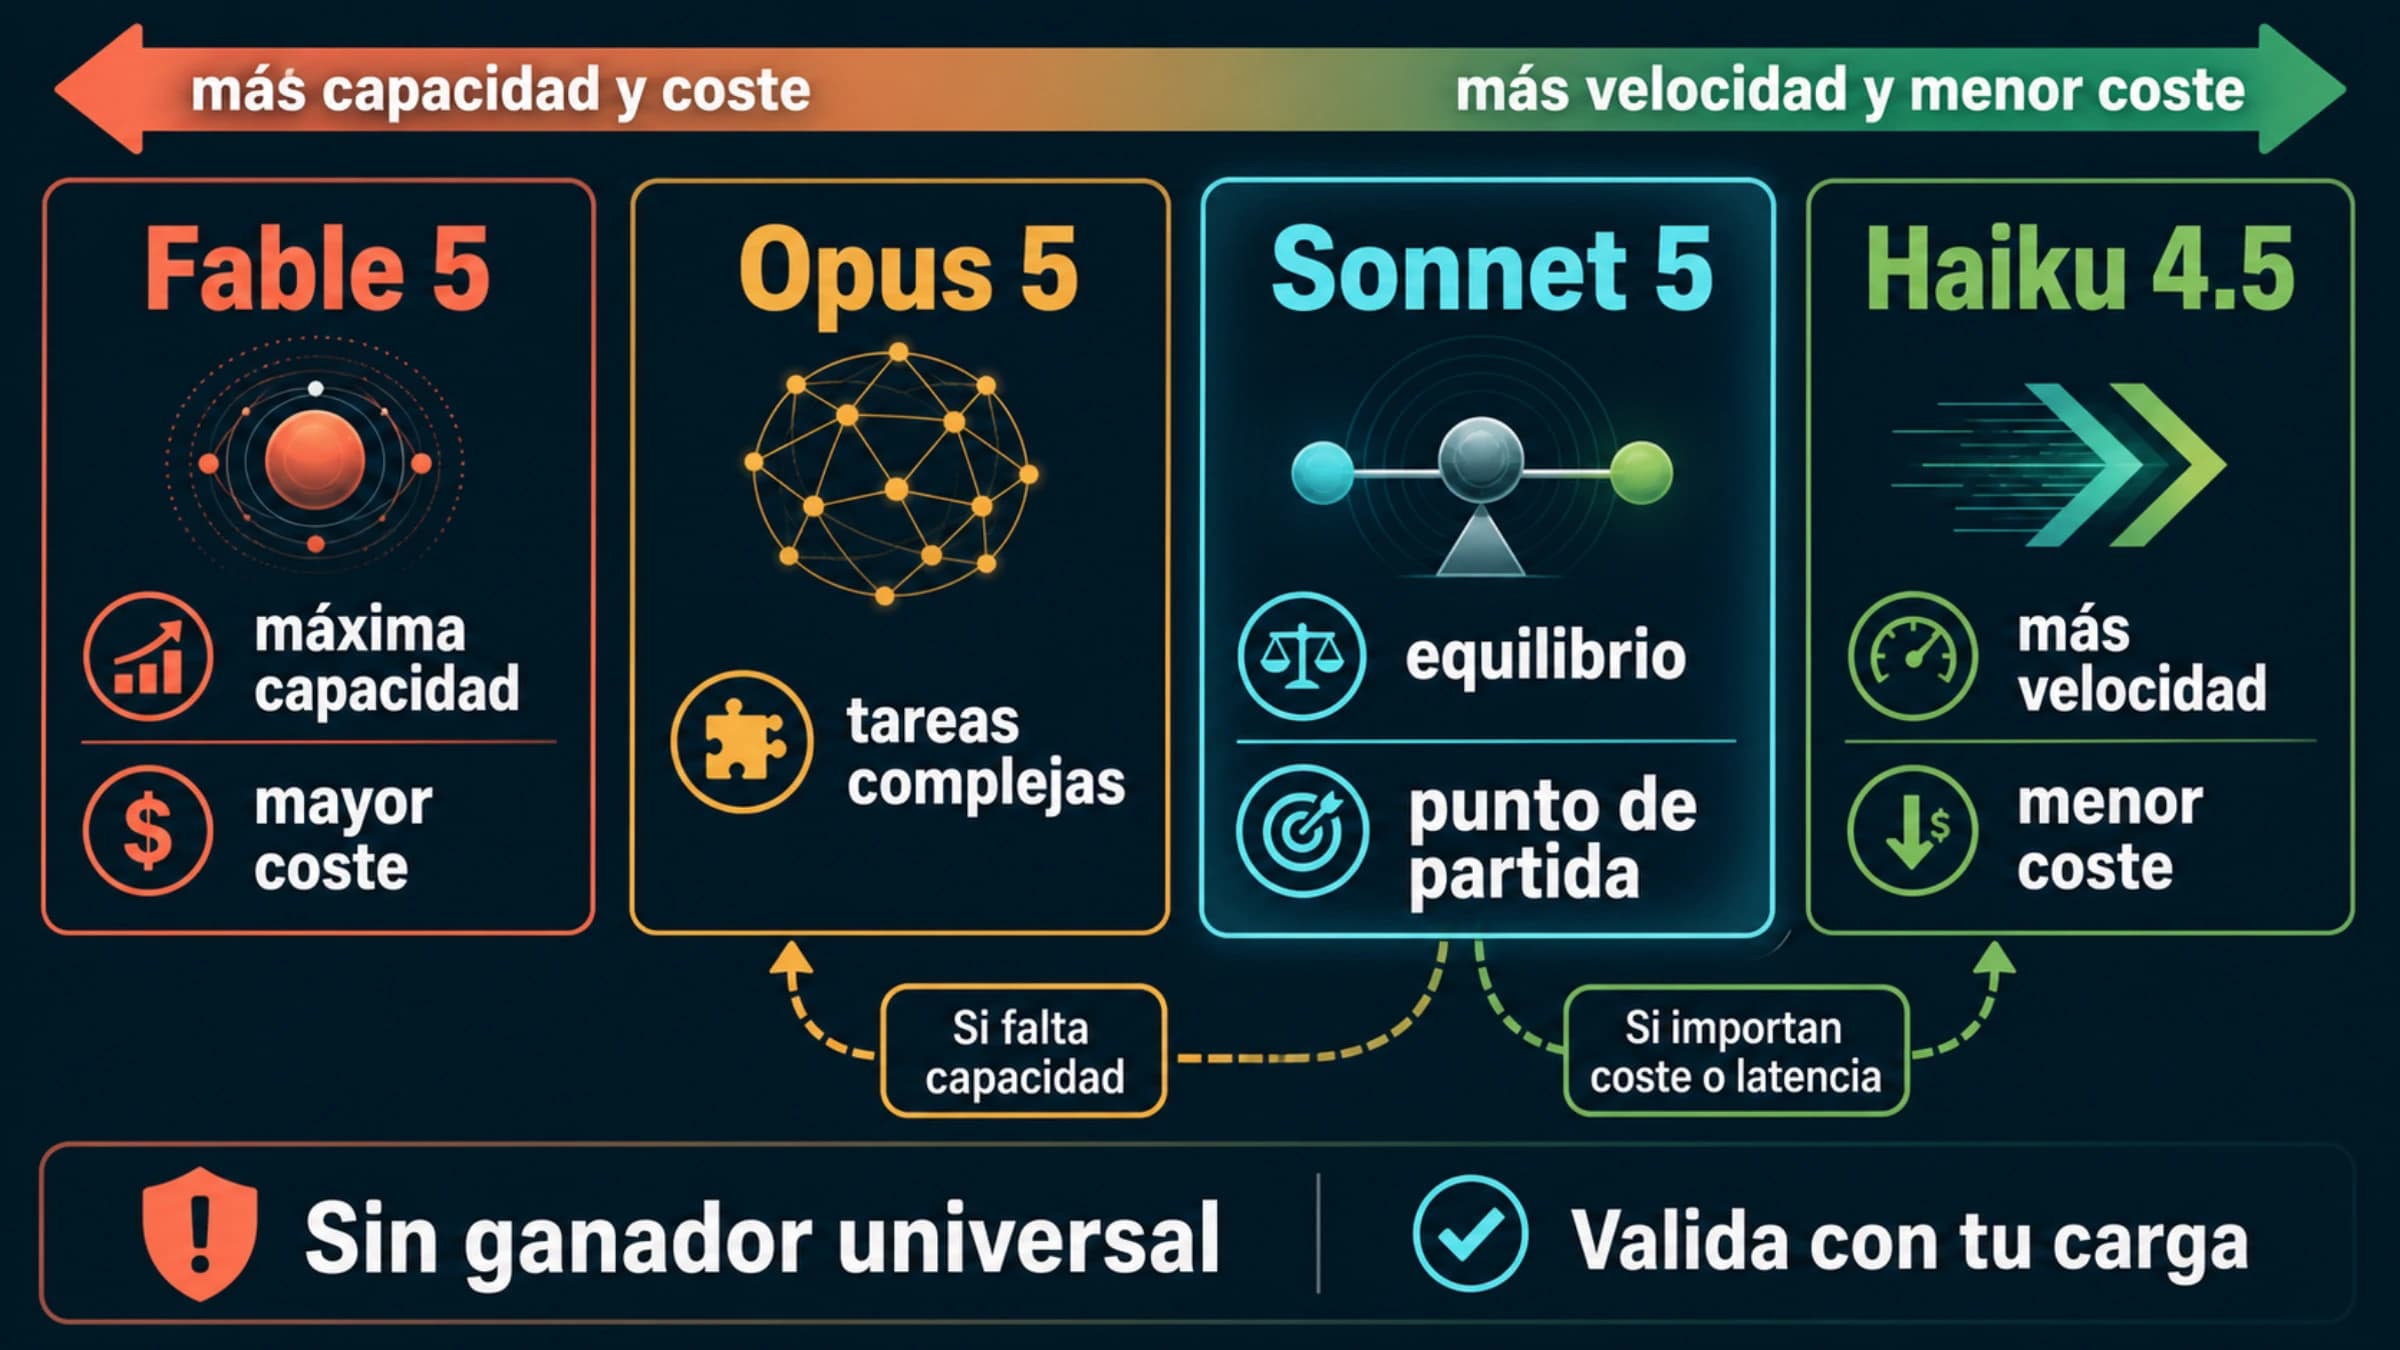
En las apps de Claude, empieza por Sonnet 5.5; en la API, Anthropic aconseja Opus 5.5. Sonnet 5.5 releva a Sonnet 5 al mismo precio, y Haiku 5.5 a Haiku 4.5.

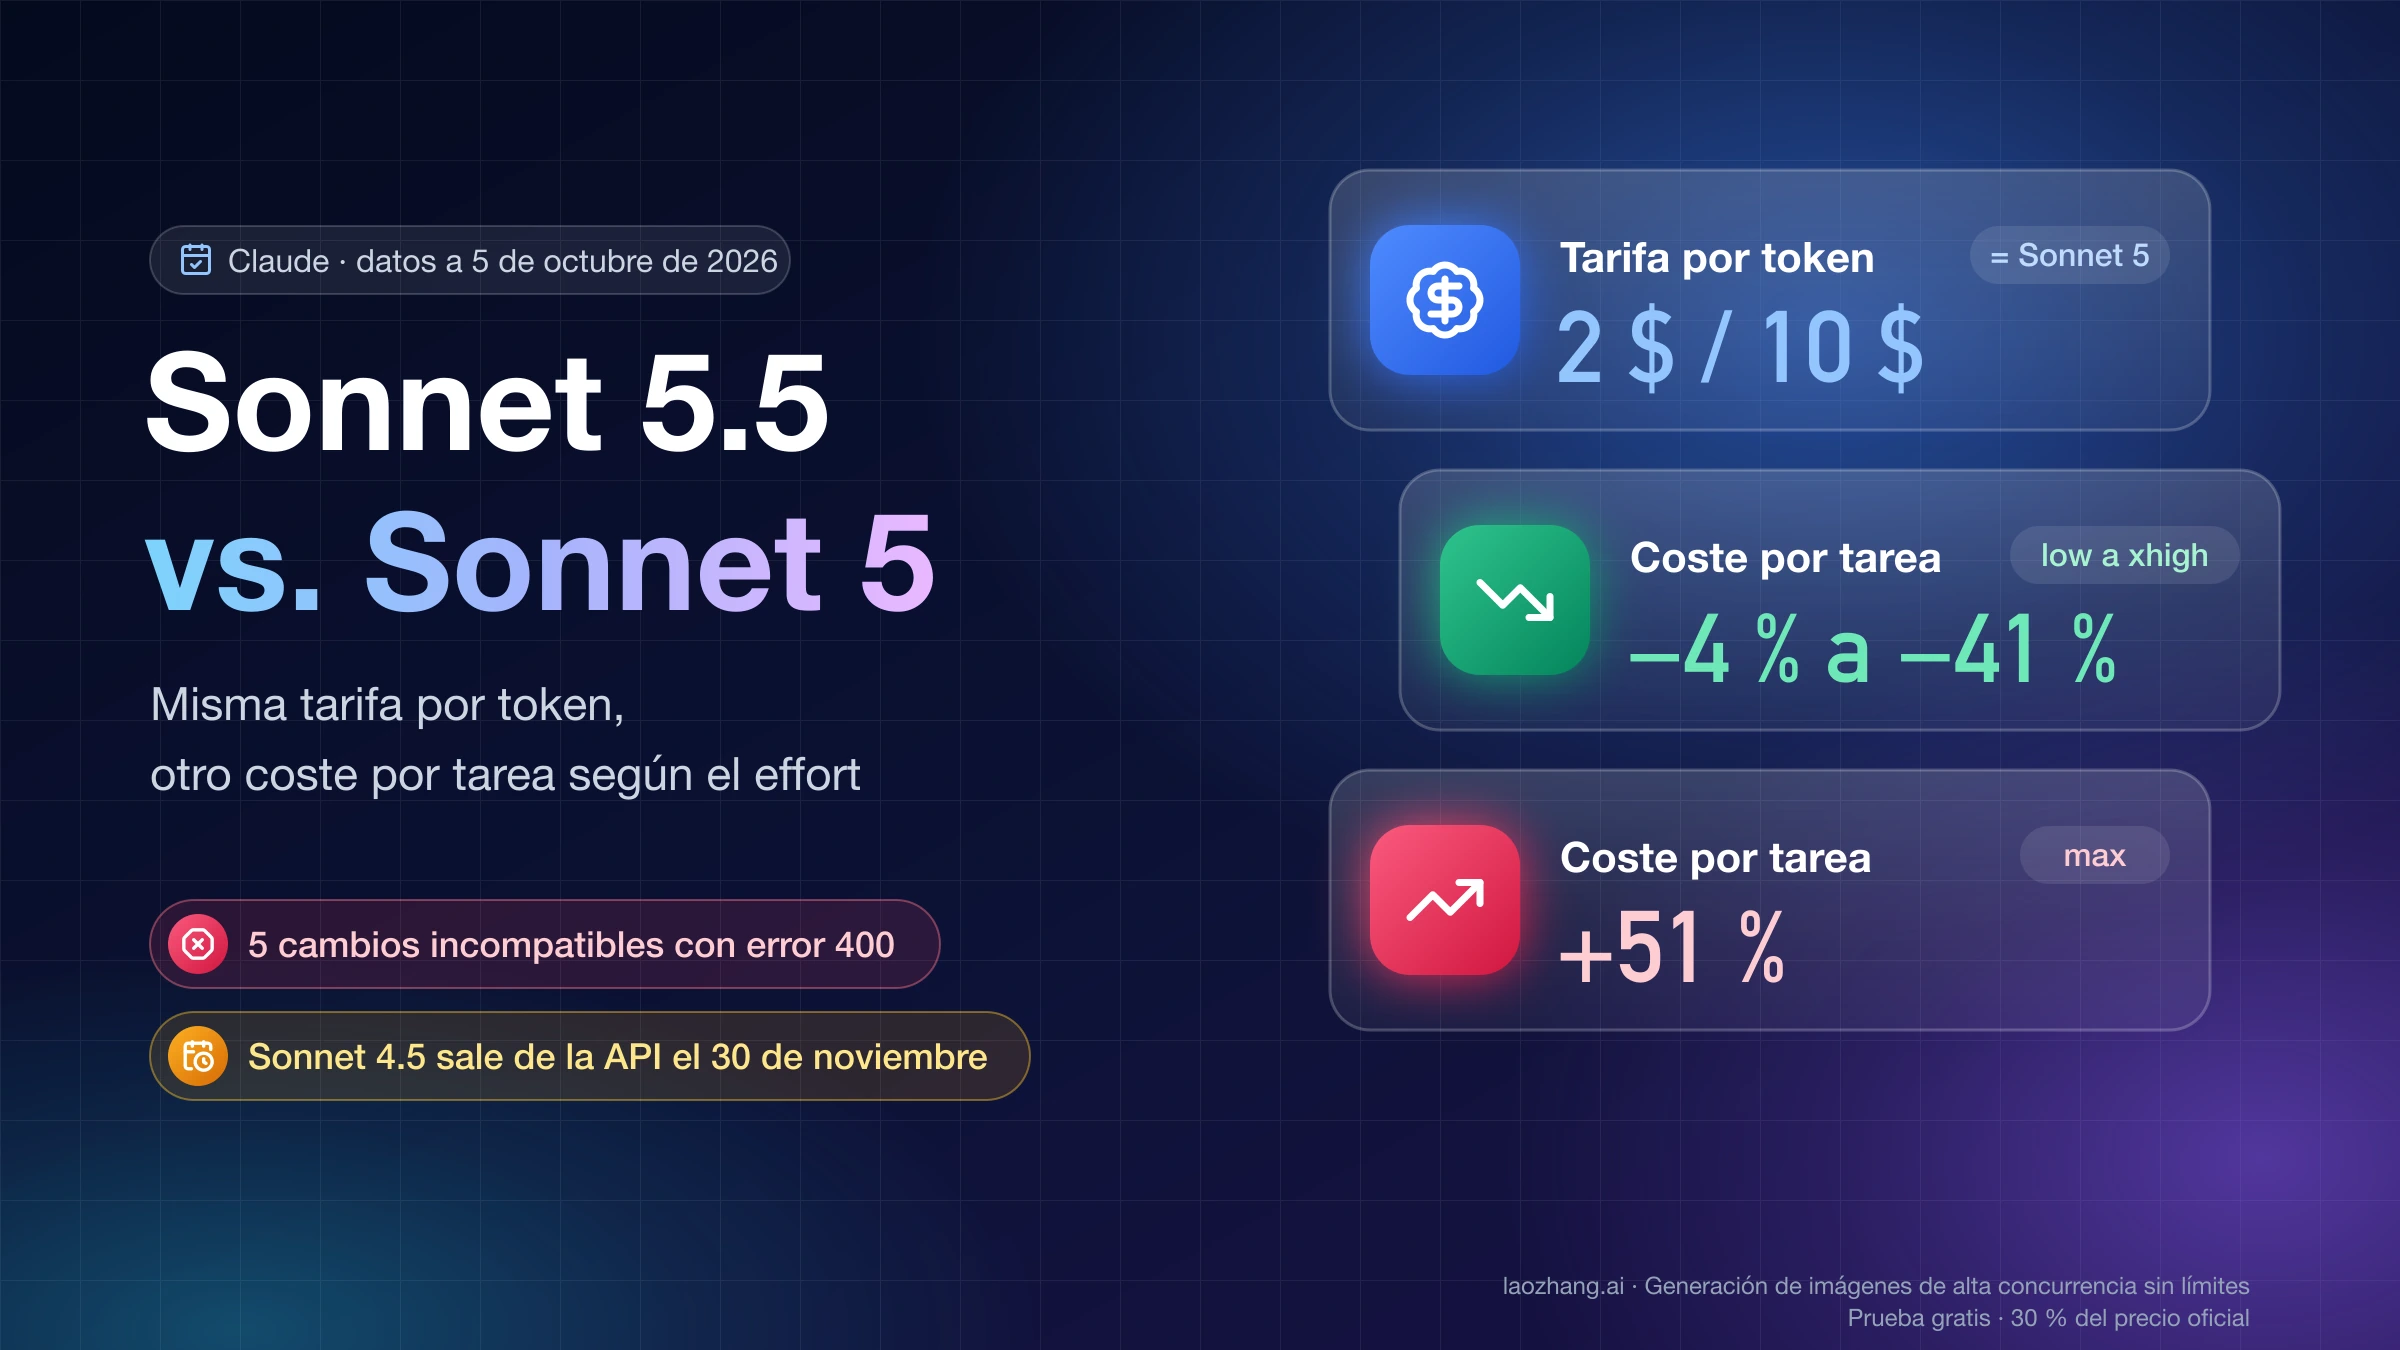
Claude Sonnet 5.5 cobra lo mismo que Sonnet 5 por token. Con datos de Artificial Analysis, por tarea sale más barato de low a xhigh y un 51 % más caro en max.

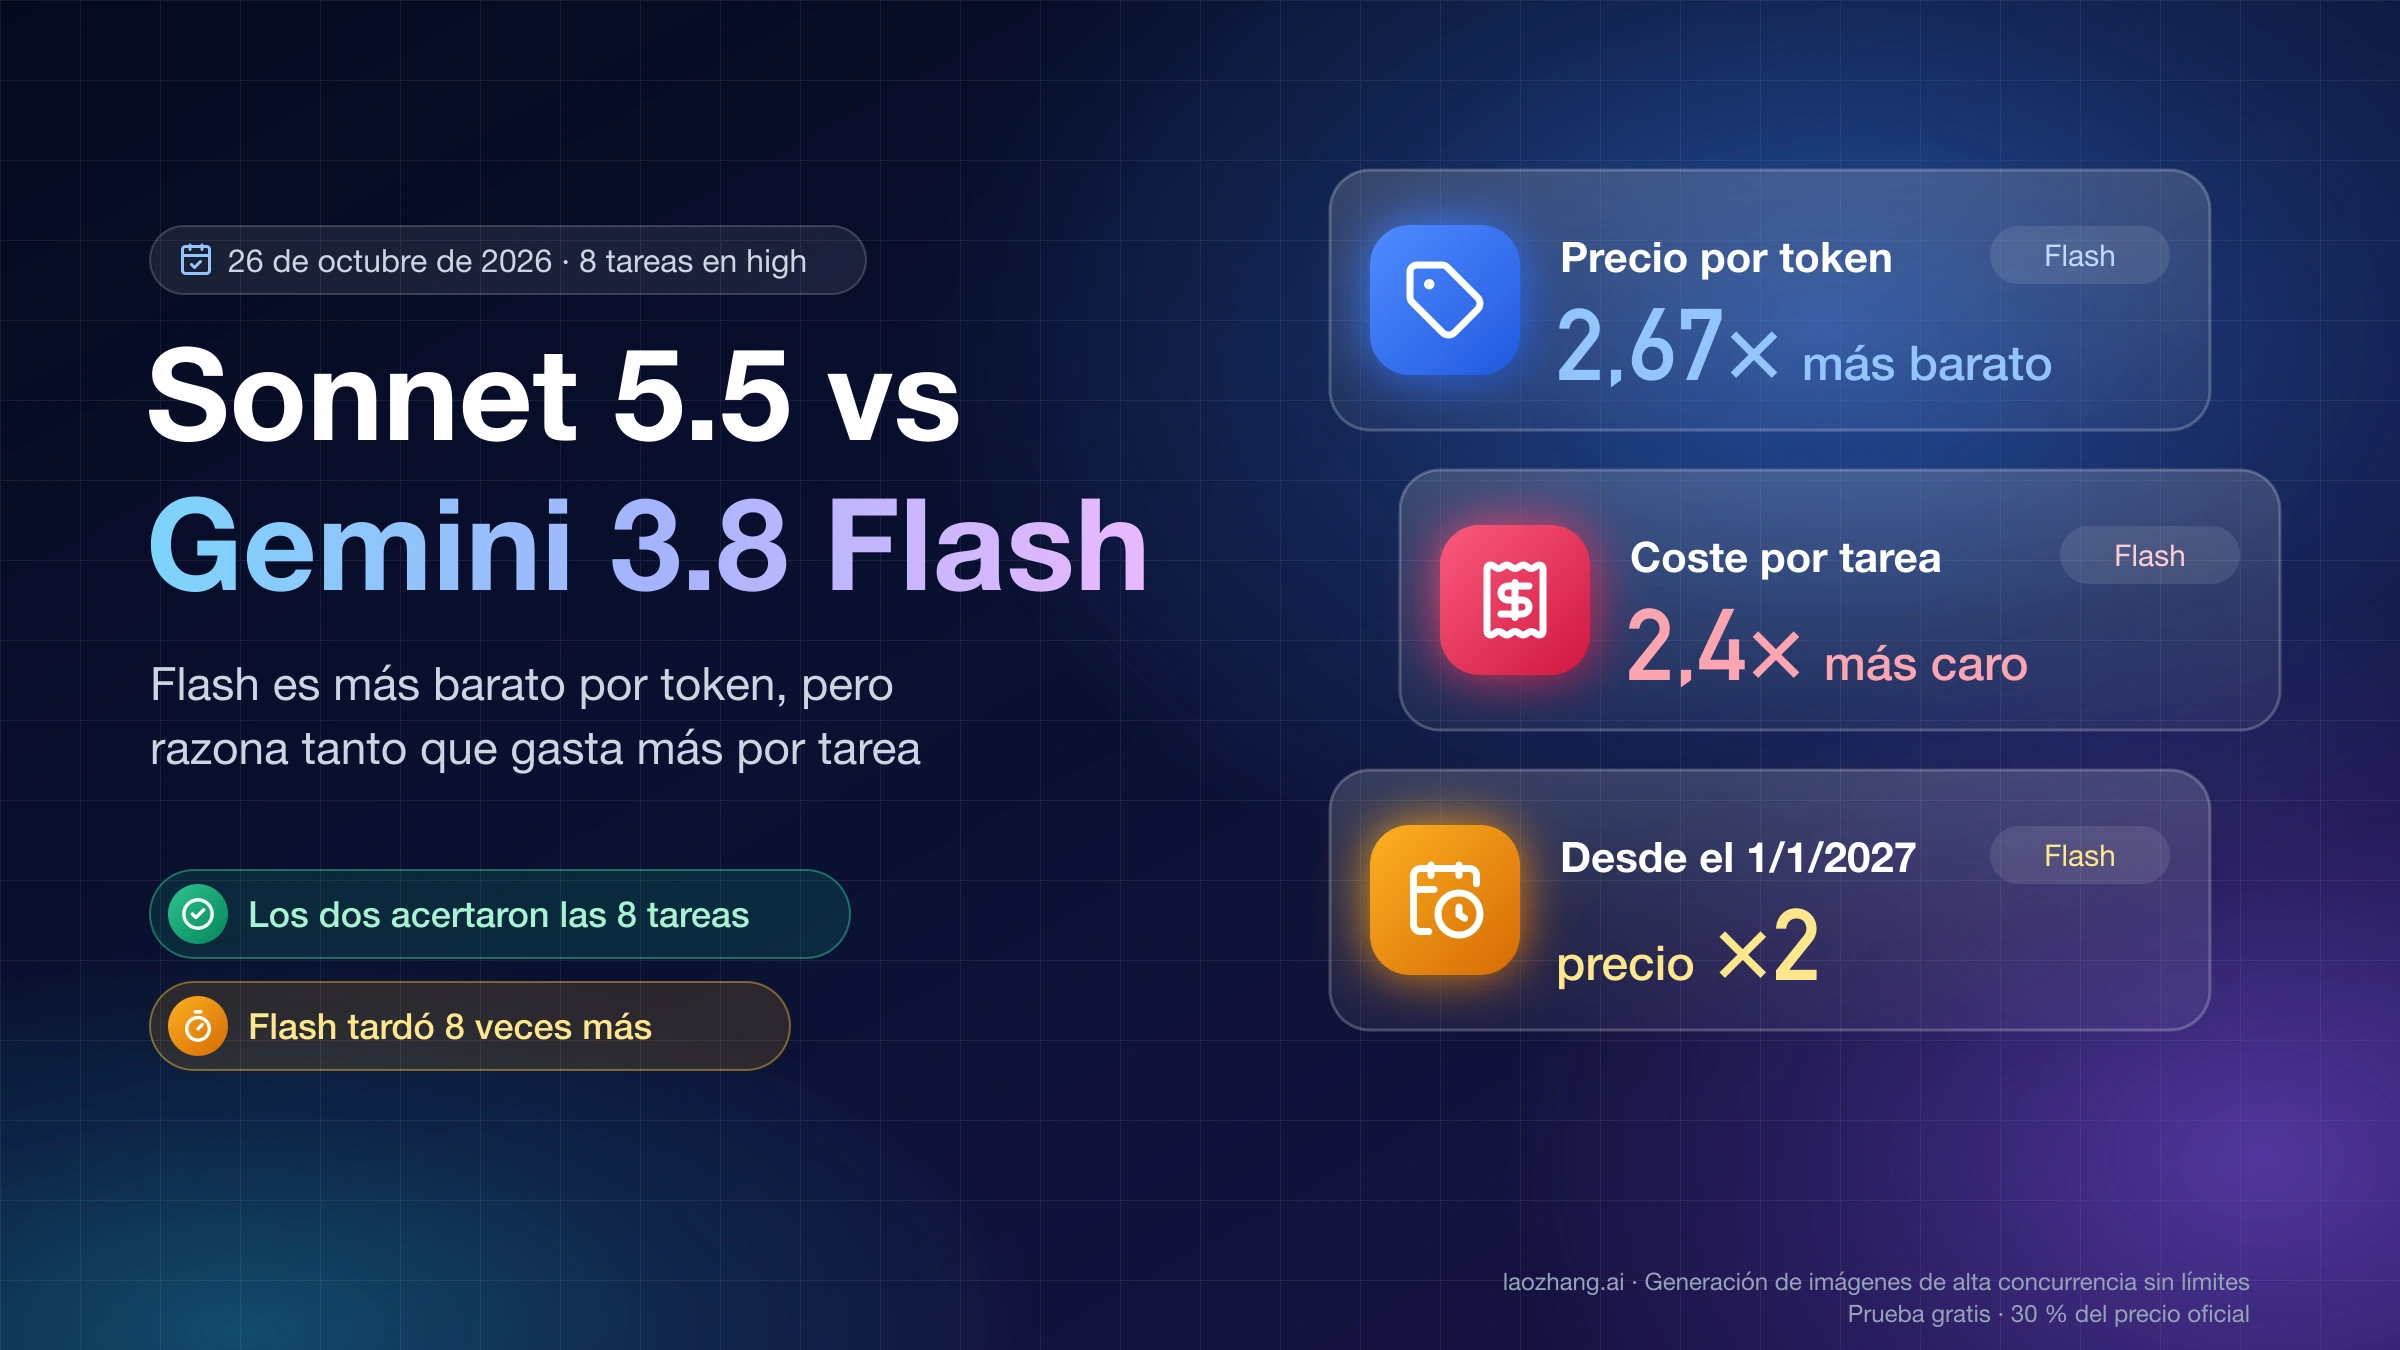
Gemini 3.8 Flash es 2,67 veces más barato por token, pero en 8 tareas en high costó 2,4 veces más que Sonnet 5.5. Solo ganó en 2, como resumir un documento.

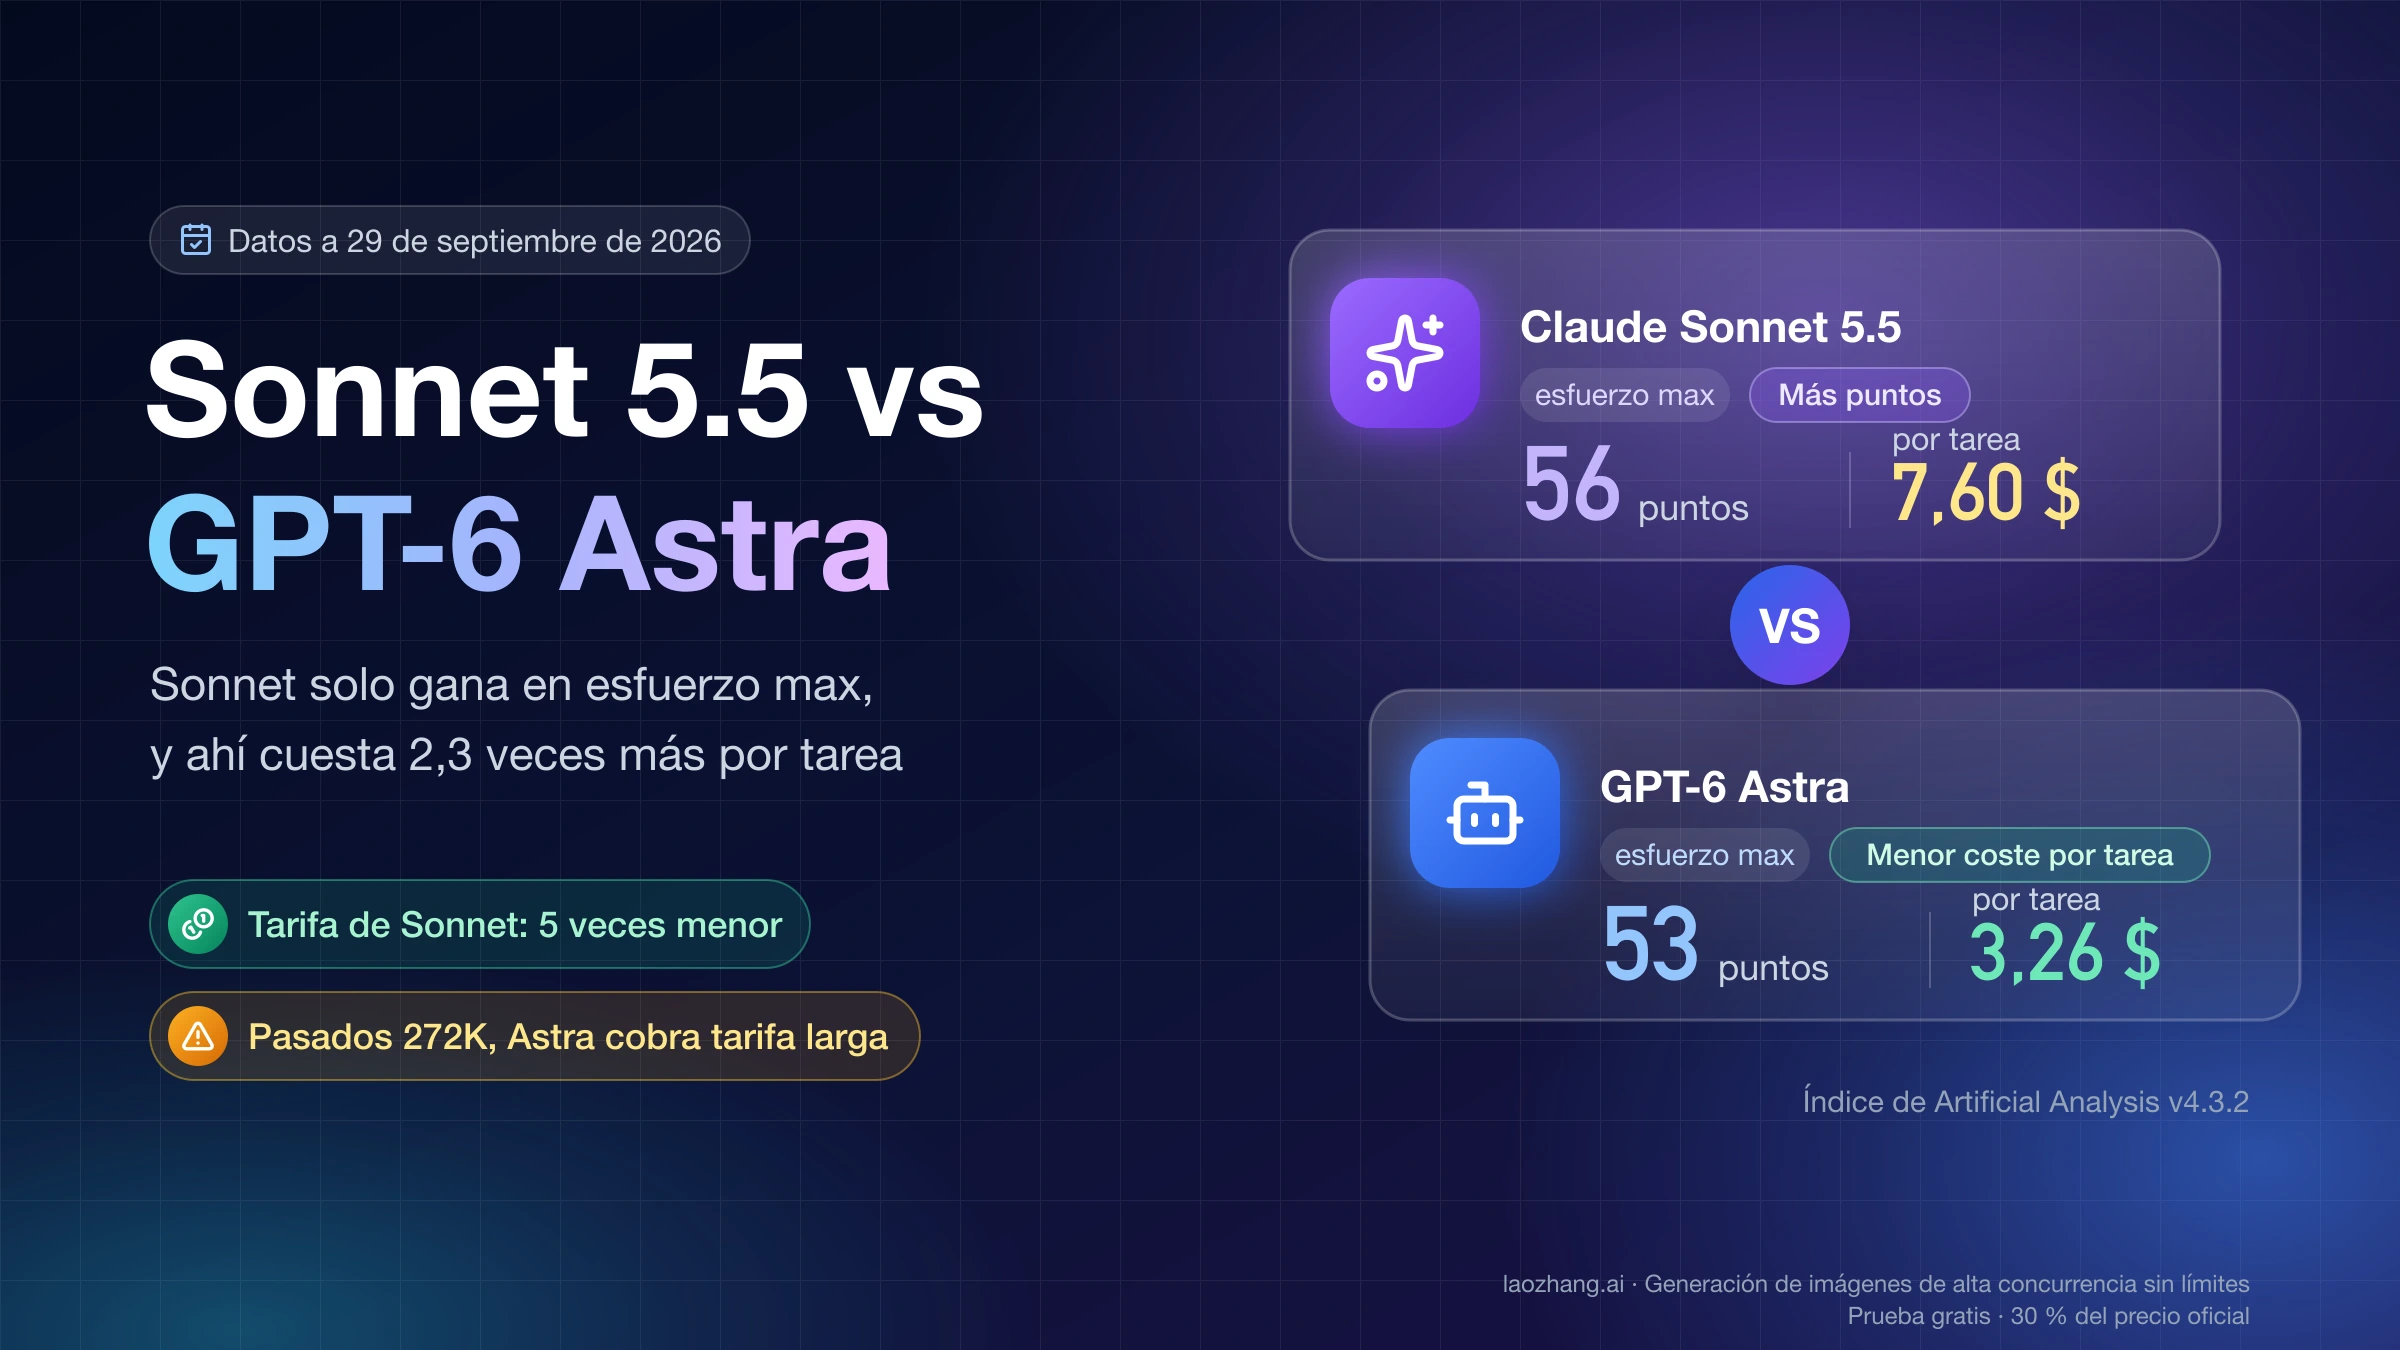
Sonnet 5.5 solo supera a GPT-6 Astra en esfuerzo max, donde cuesta unas 2,3 veces más por tarea. Su tarifa es 5 veces menor y la brecha crece pasados 272K.

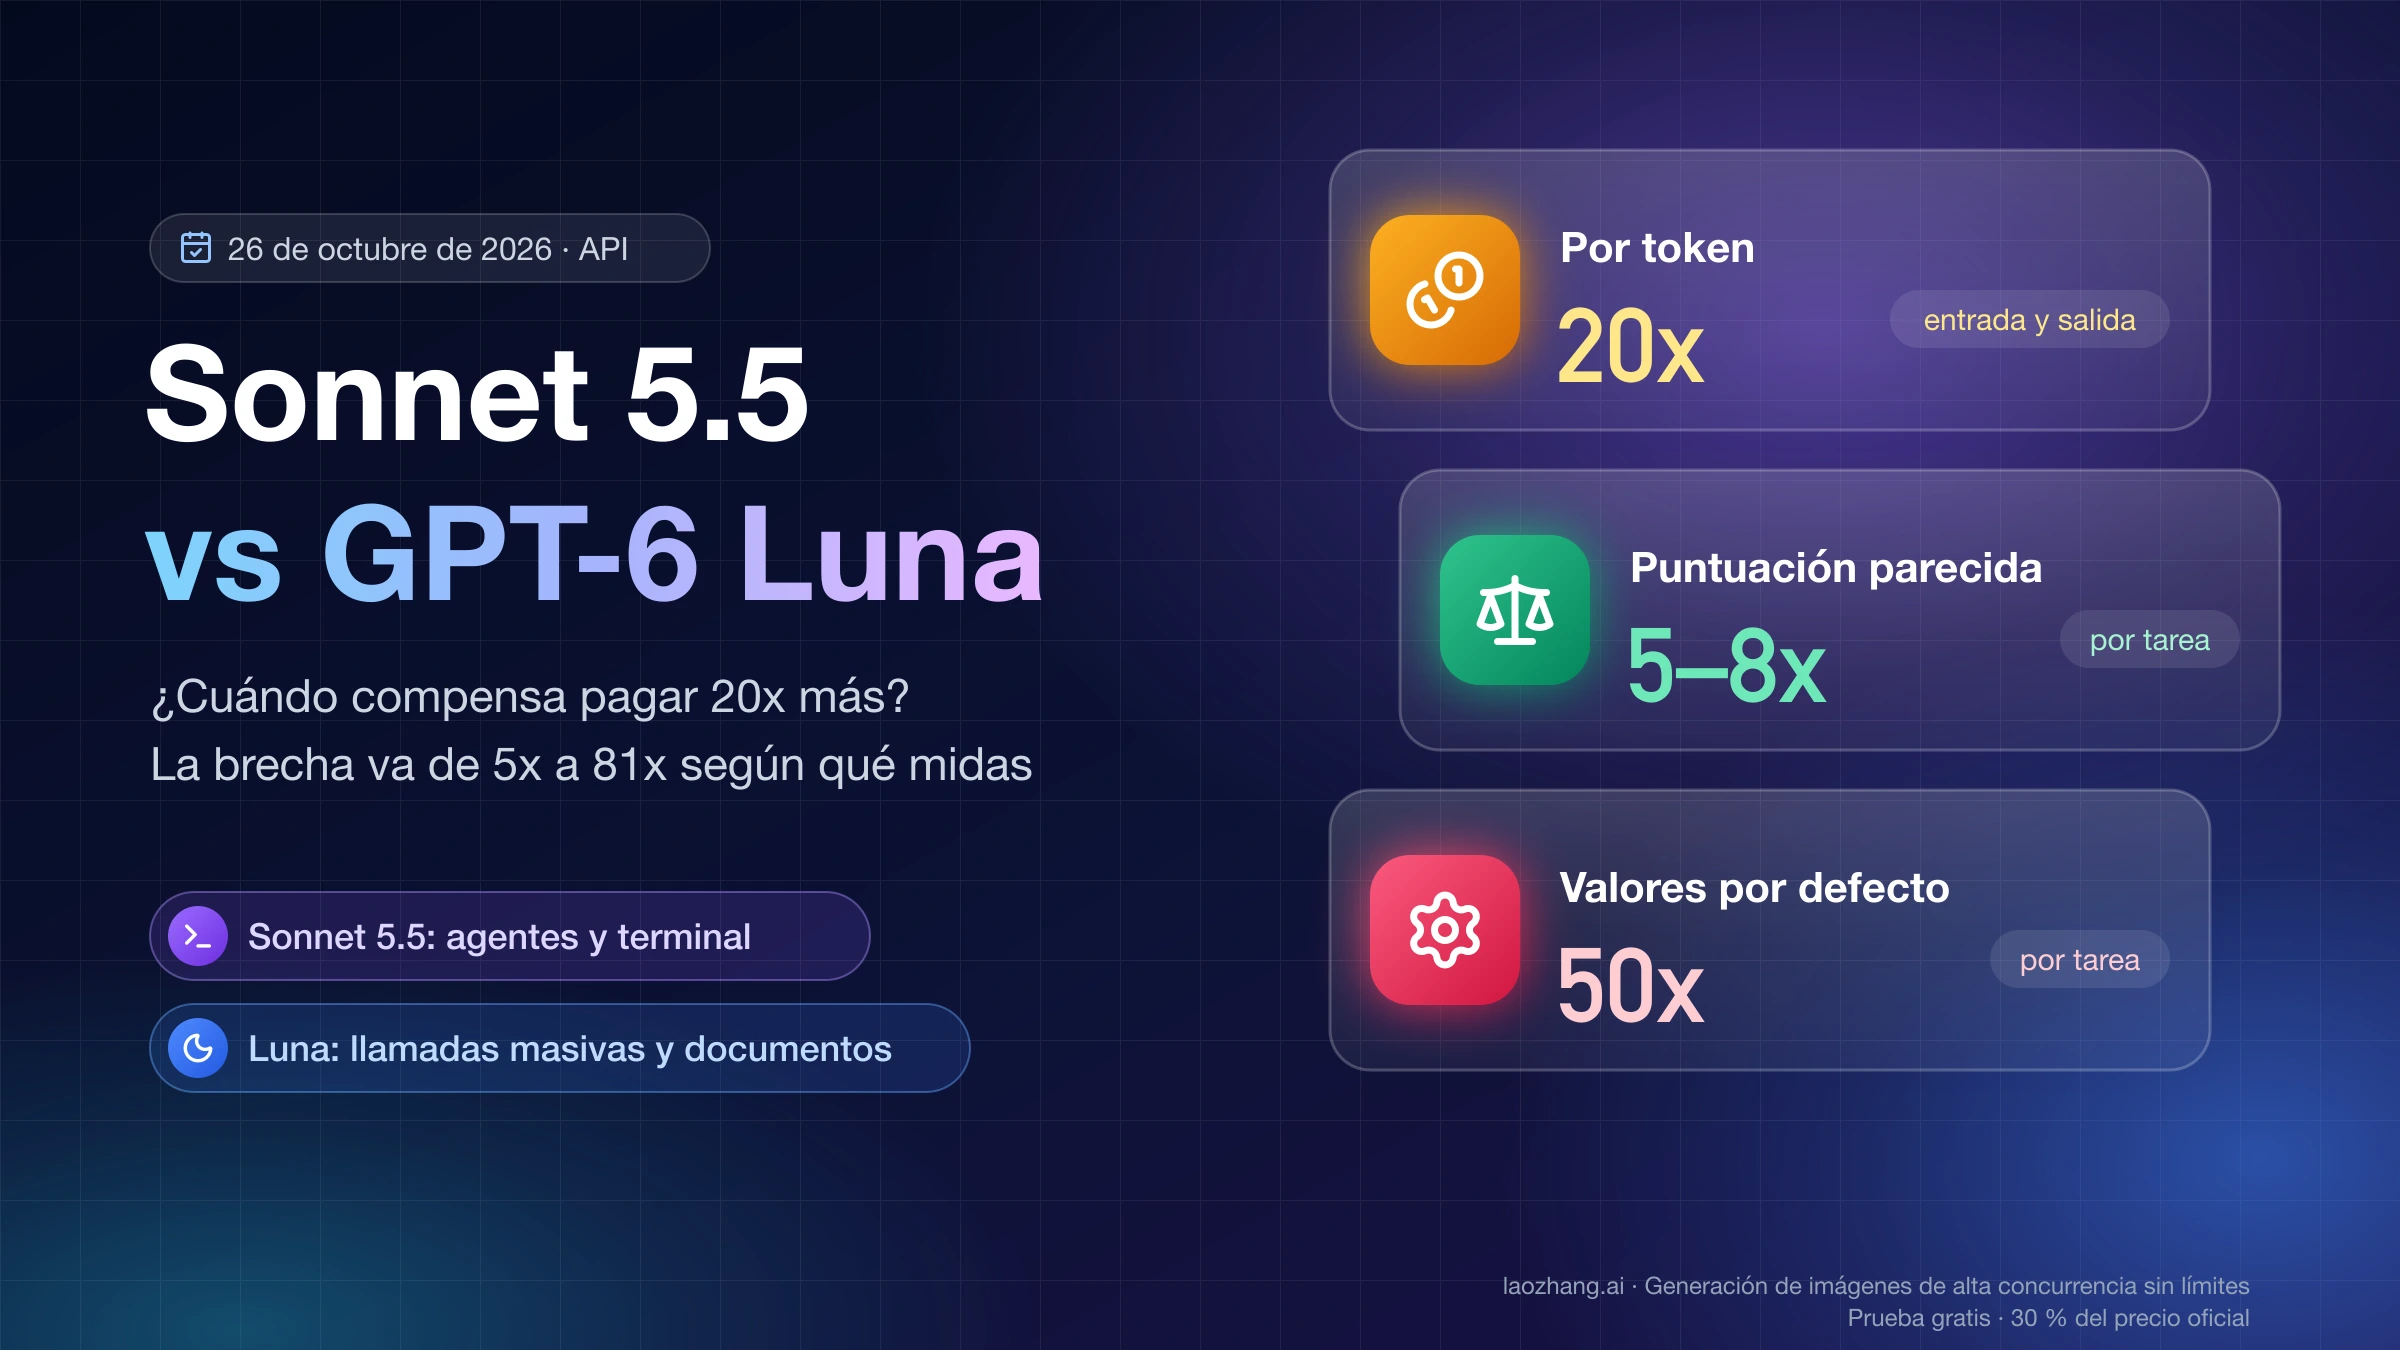
GPT-6 Luna cuesta 20 veces menos por token y basta para llamadas masivas y documentos largos; Sonnet 5.5 compensa en agentes y por encima de 38 en AA.

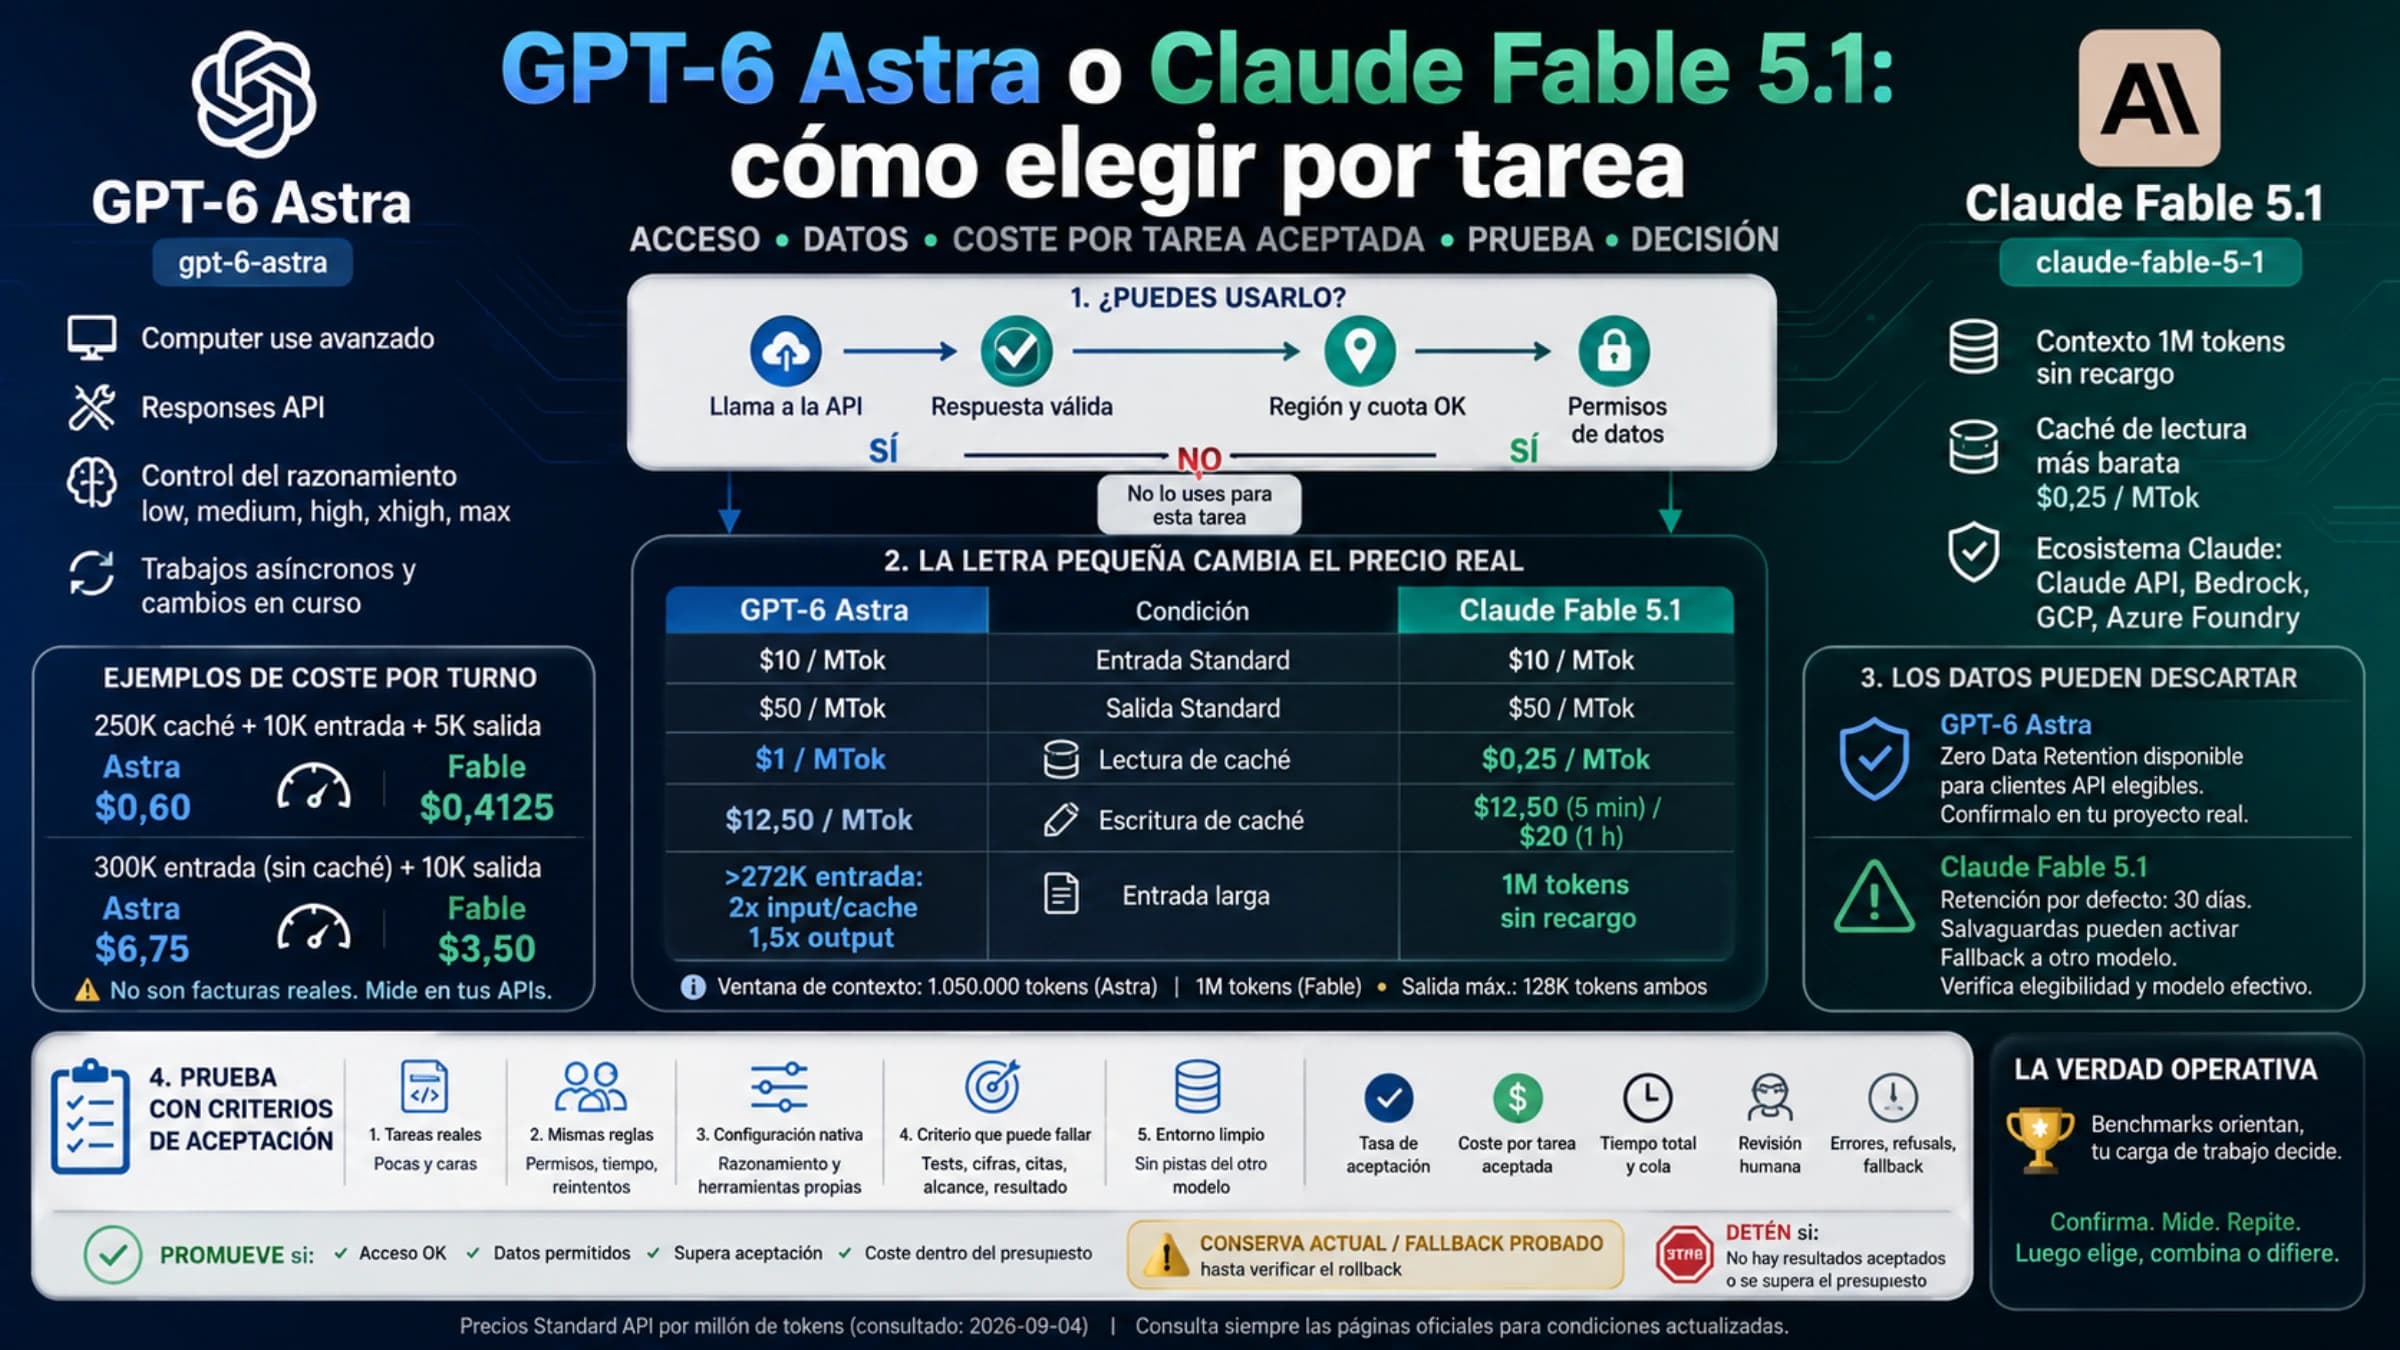
Misma tarifa, distinta factura: en una prueba del 26 de octubre de 2026, Fable 5.1 contó 1,88 veces más tokens en español y costó 1,5–1,6 veces lo que Astra.

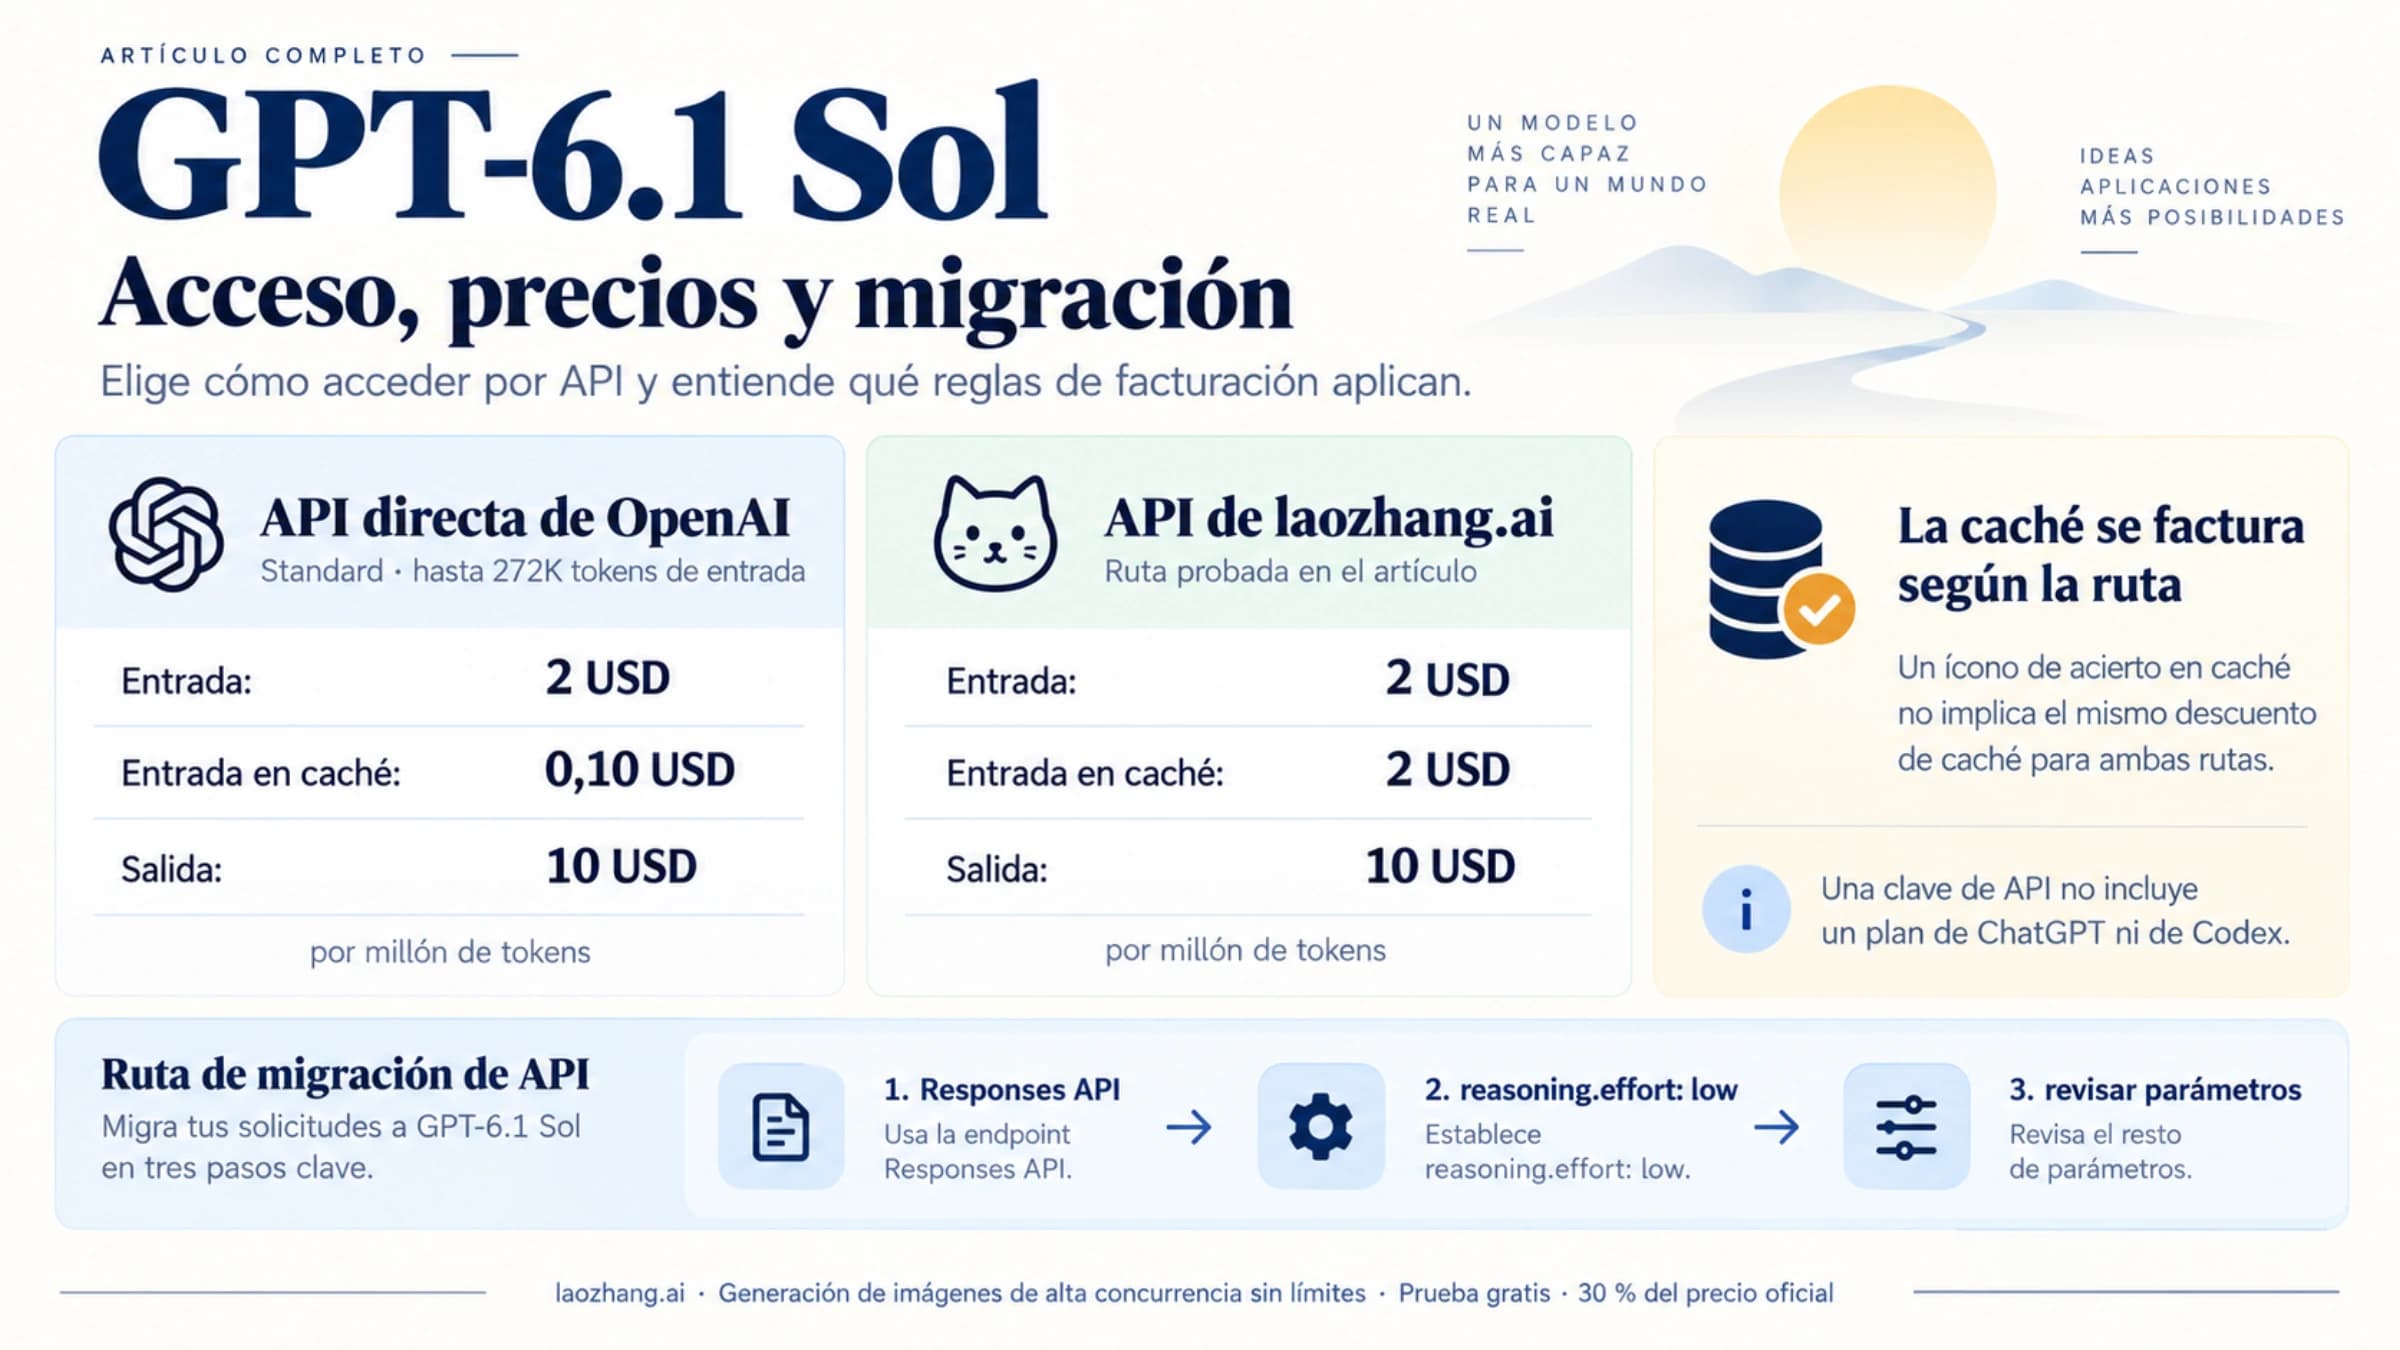
Mismo precio que GPT-6 Sol salvo la entrada en caché, que baja a la mitad. Antes de cambiar el ID, pasa none a low y lleva las herramientas a Responses API.

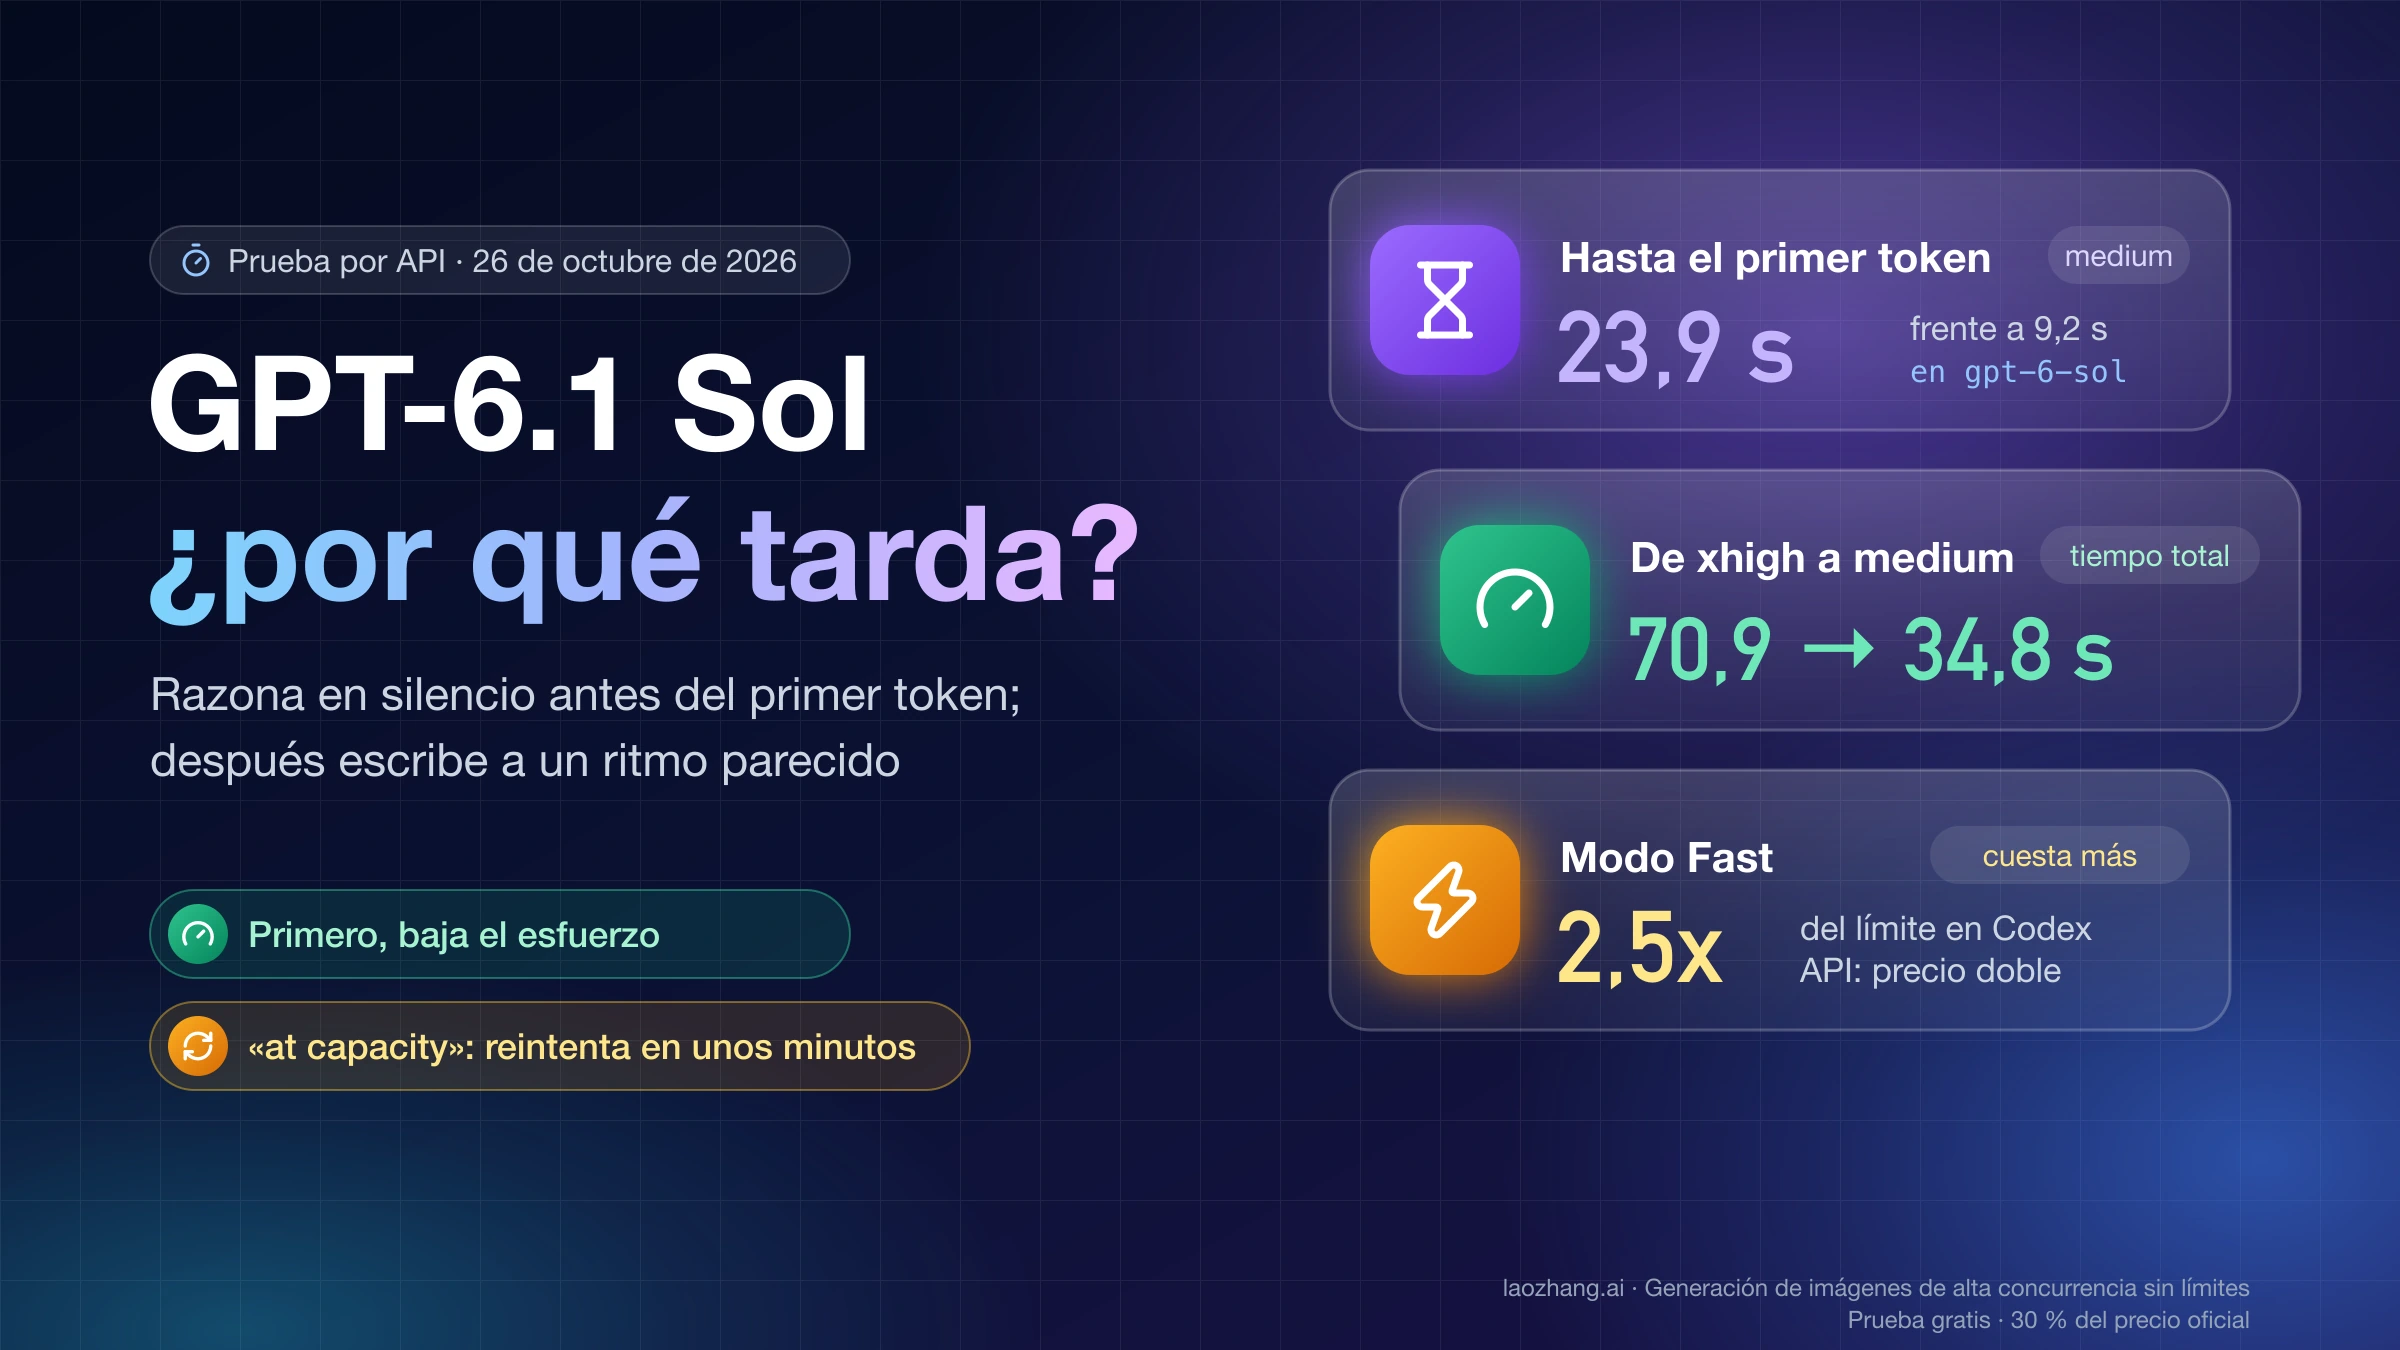
GPT-6.1 Sol tarda sobre todo antes del primer token, mientras razona. Bajar el esfuerzo o activar Fast lo acorta; «at capacity» se arregla reintentando.

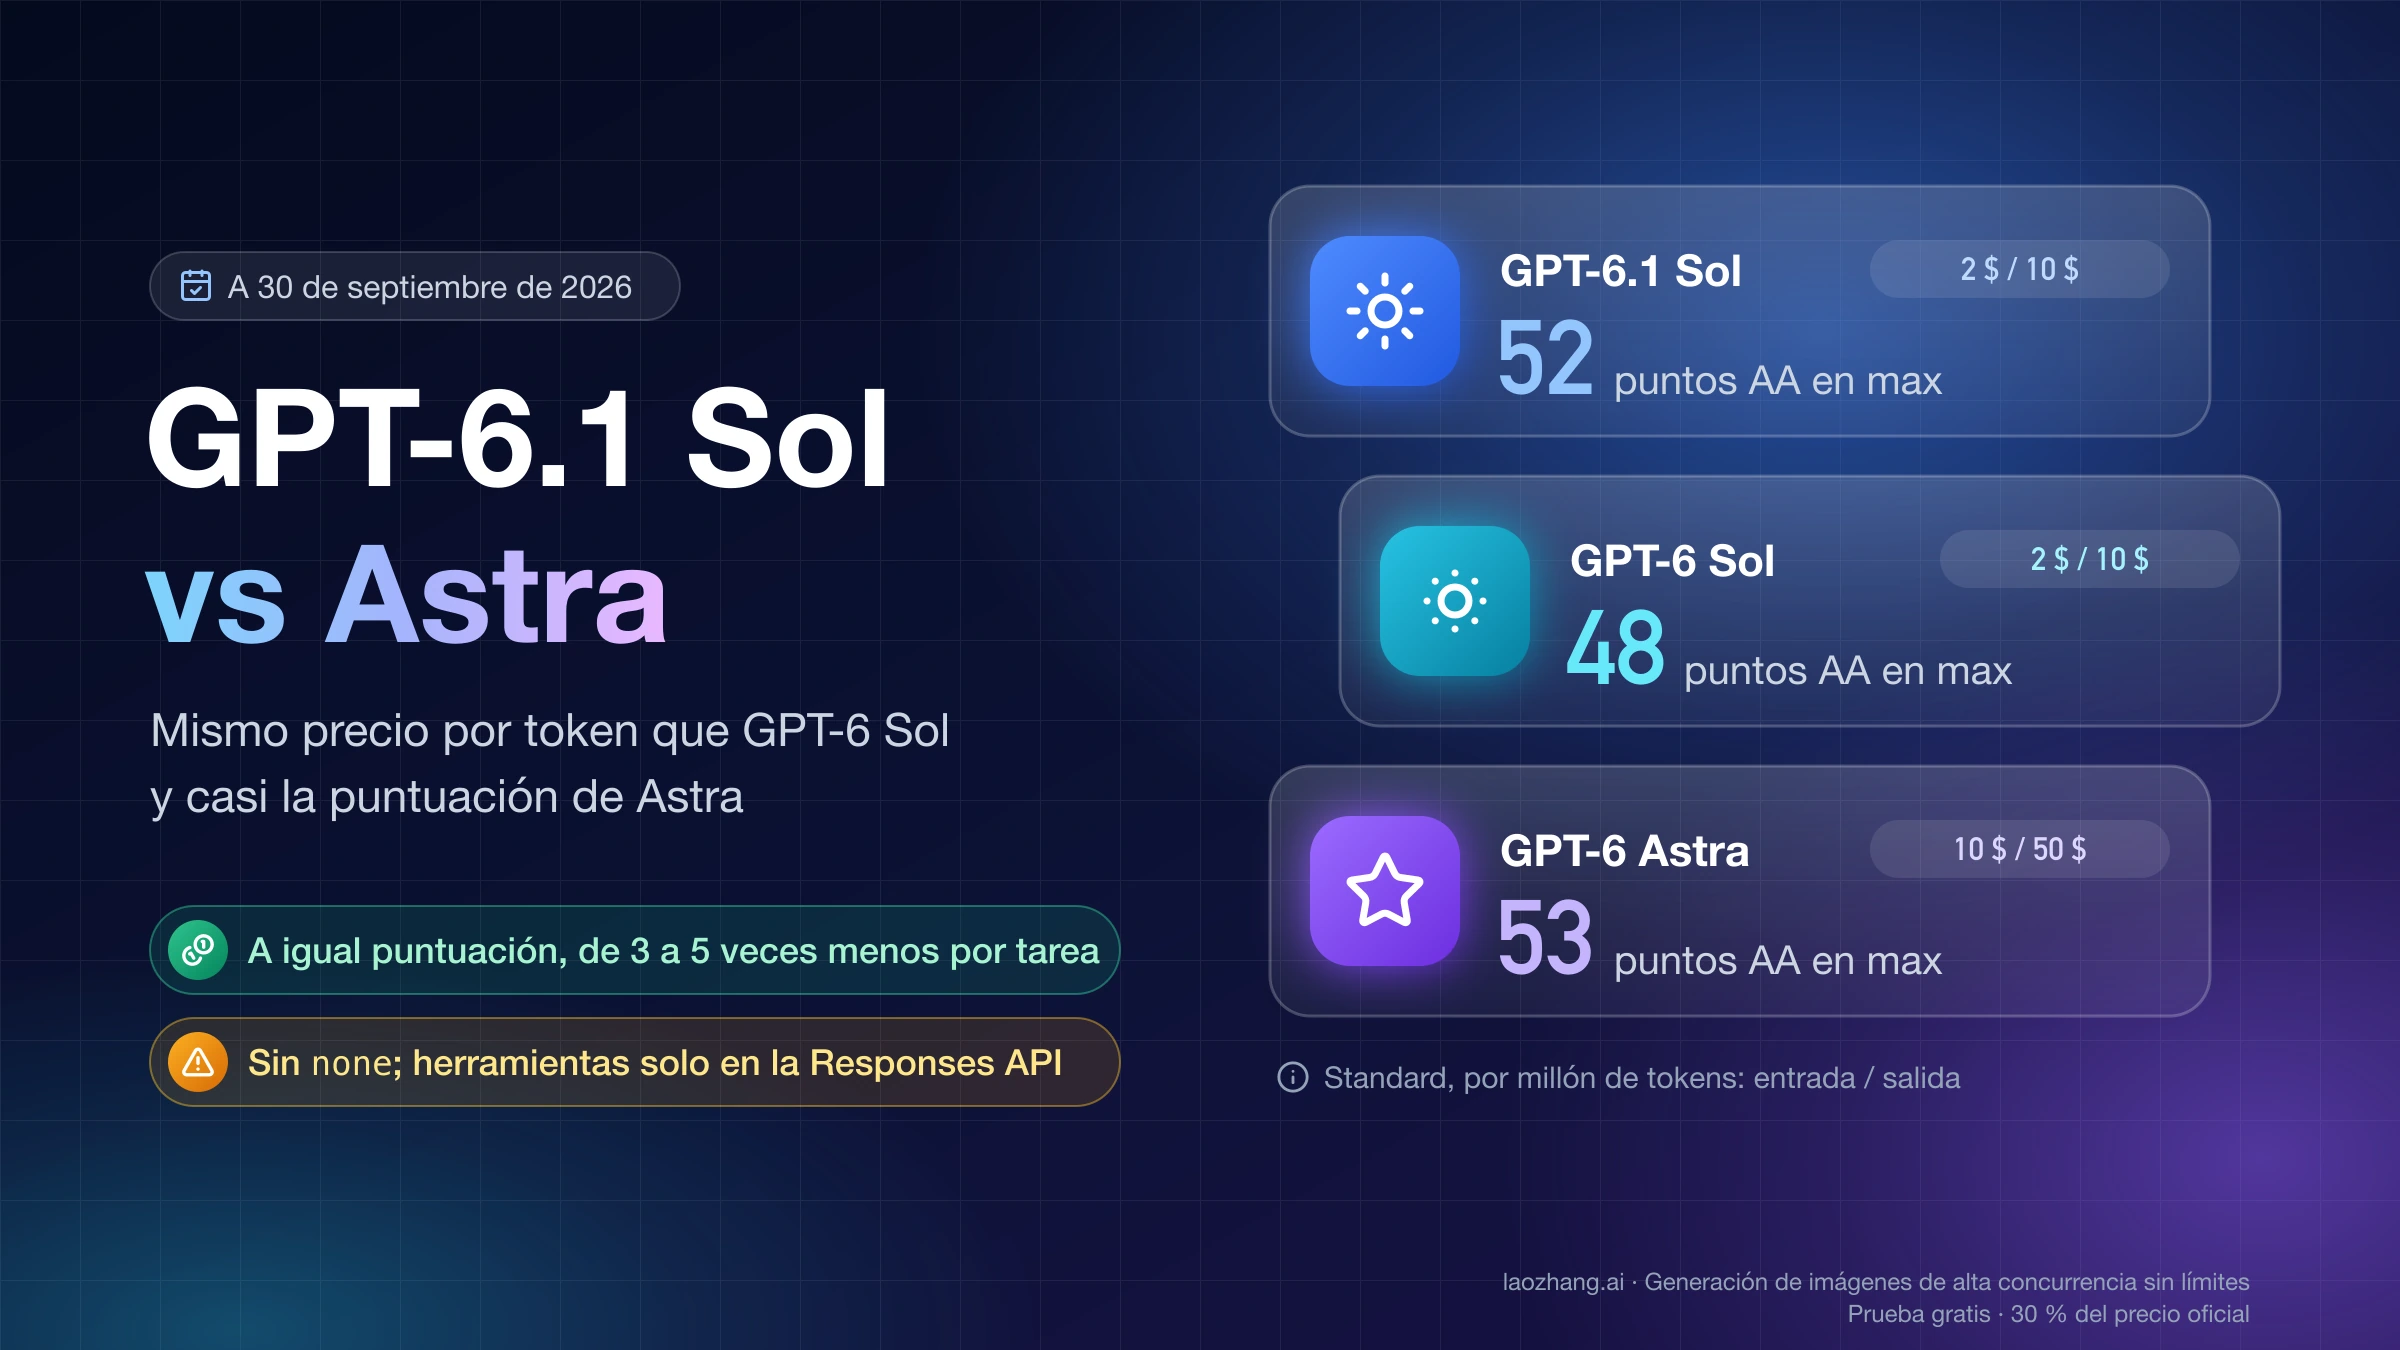
GPT-6.1 Sol cuesta lo mismo que GPT-6 Sol y rinde casi como Astra por 3 a 5 veces menos por tarea. Antes de cambiar, revisa none y las herramientas.

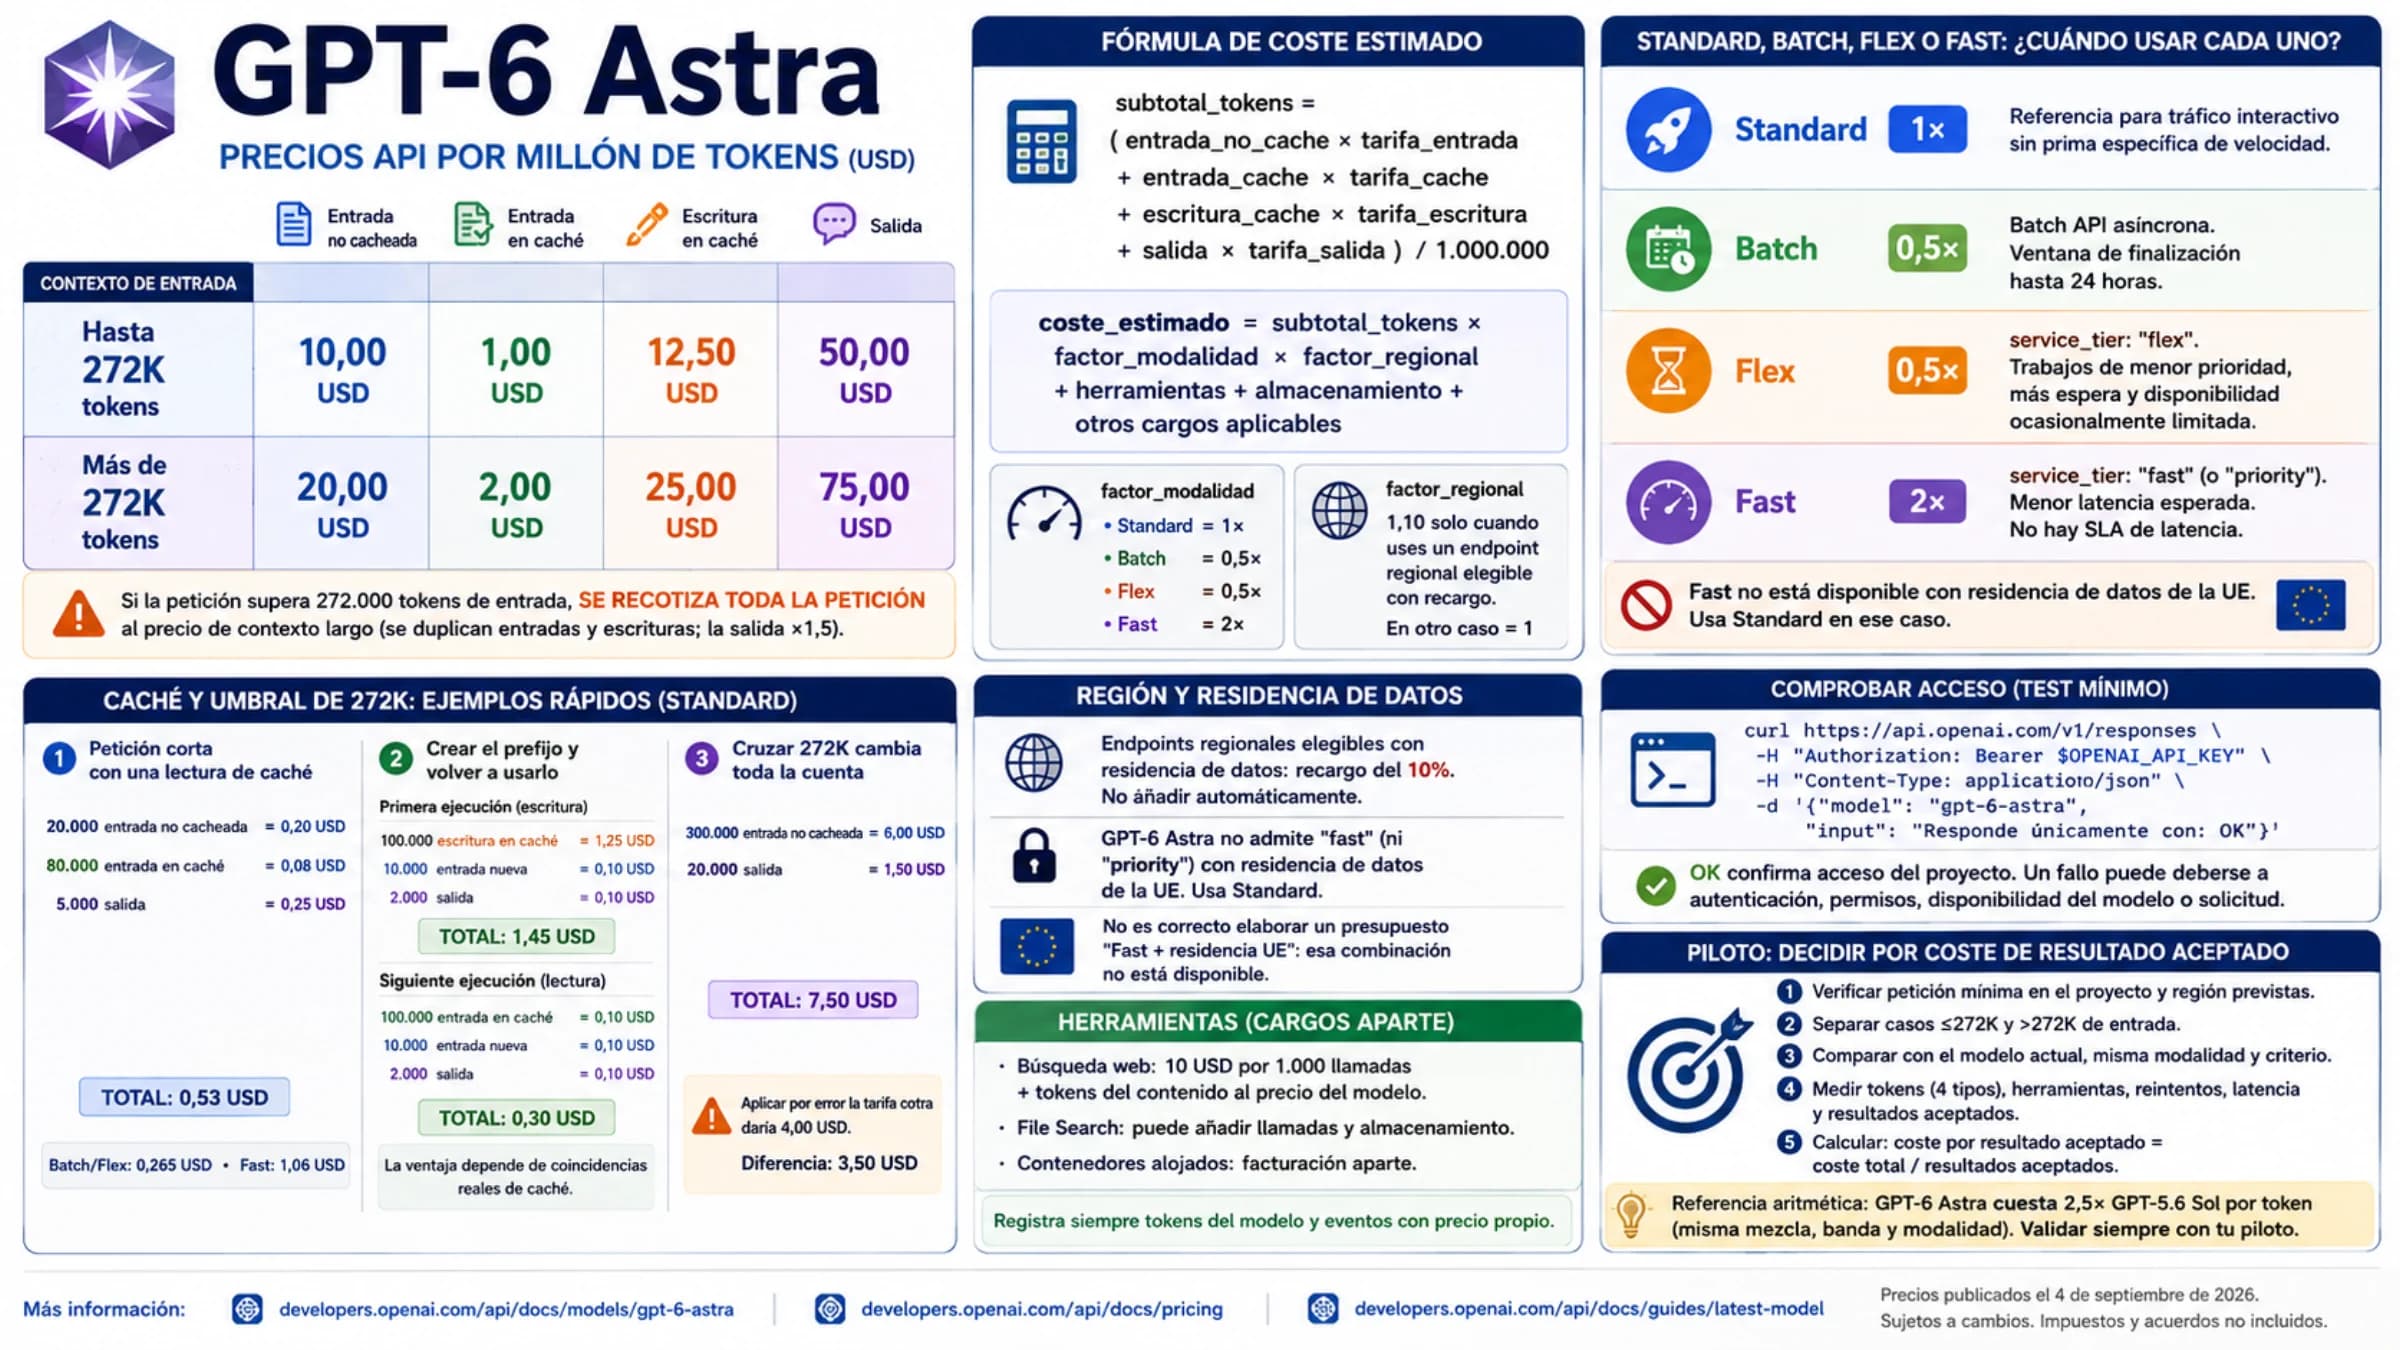
GPT-6 Astra cuesta 10 USD de entrada y 50 USD de salida por millón hasta 272K tokens, y su caché activada por defecto cobra cada escritura a 12,50 USD (30 min).

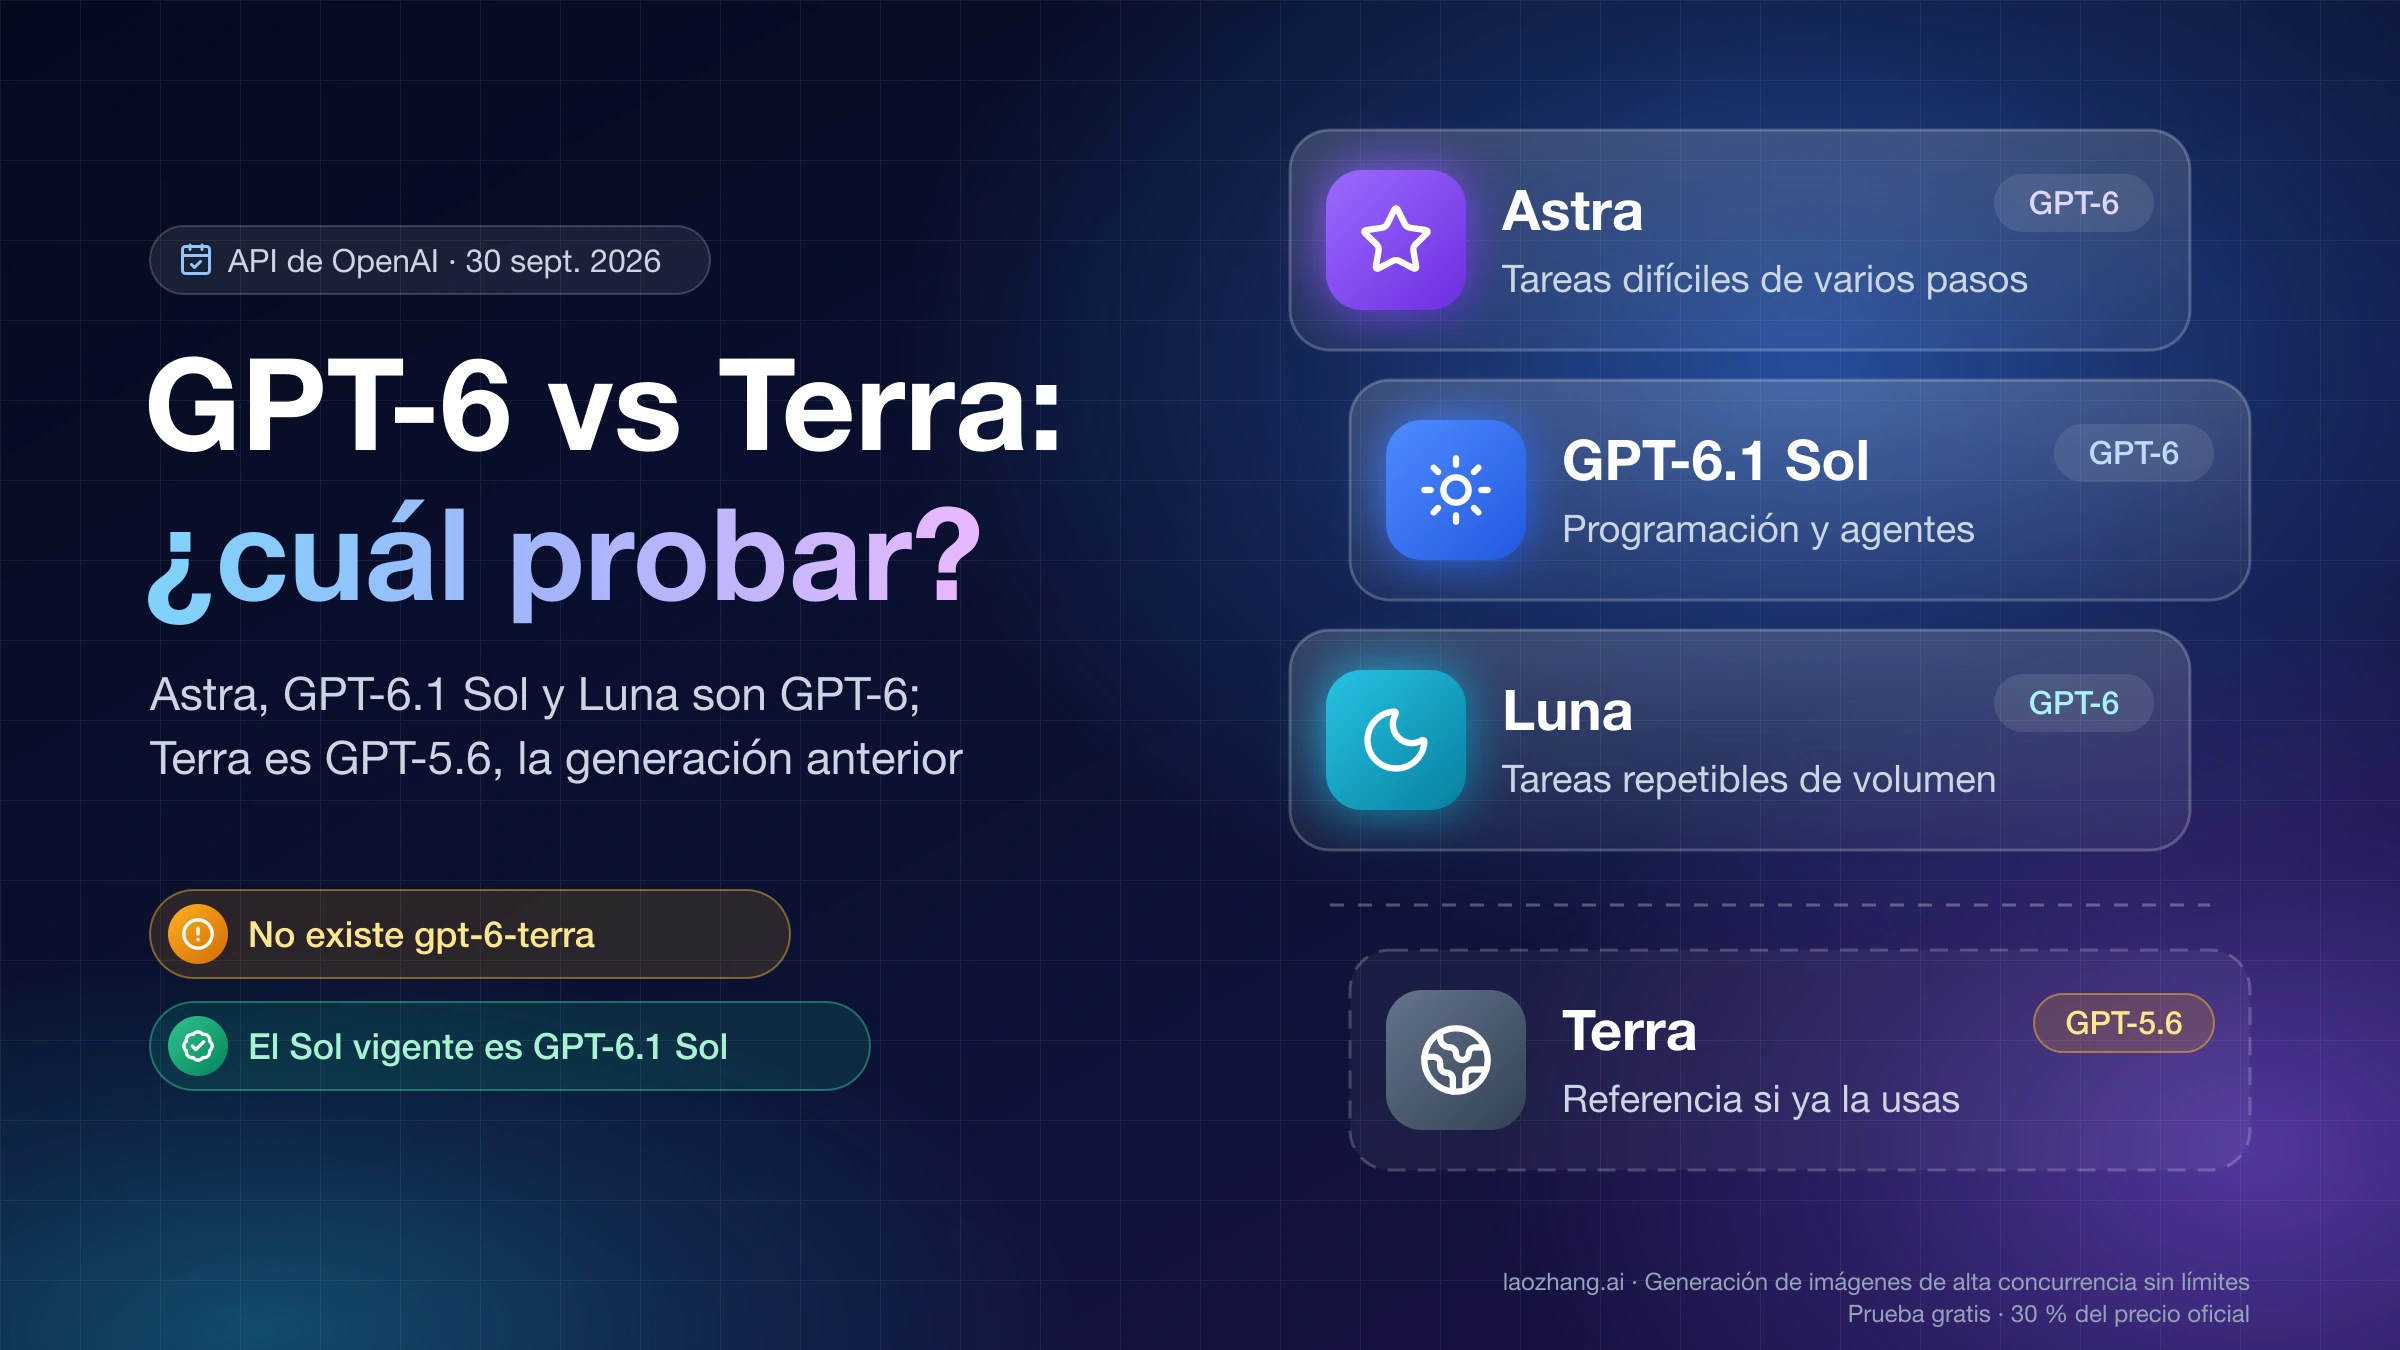
Astra, Sol y Luna son GPT-6 y el Sol vigente es GPT-6.1 Sol; Terra es GPT-5.6. Compara sus tarifas de API y mide cuánto cuesta cada resultado válido.

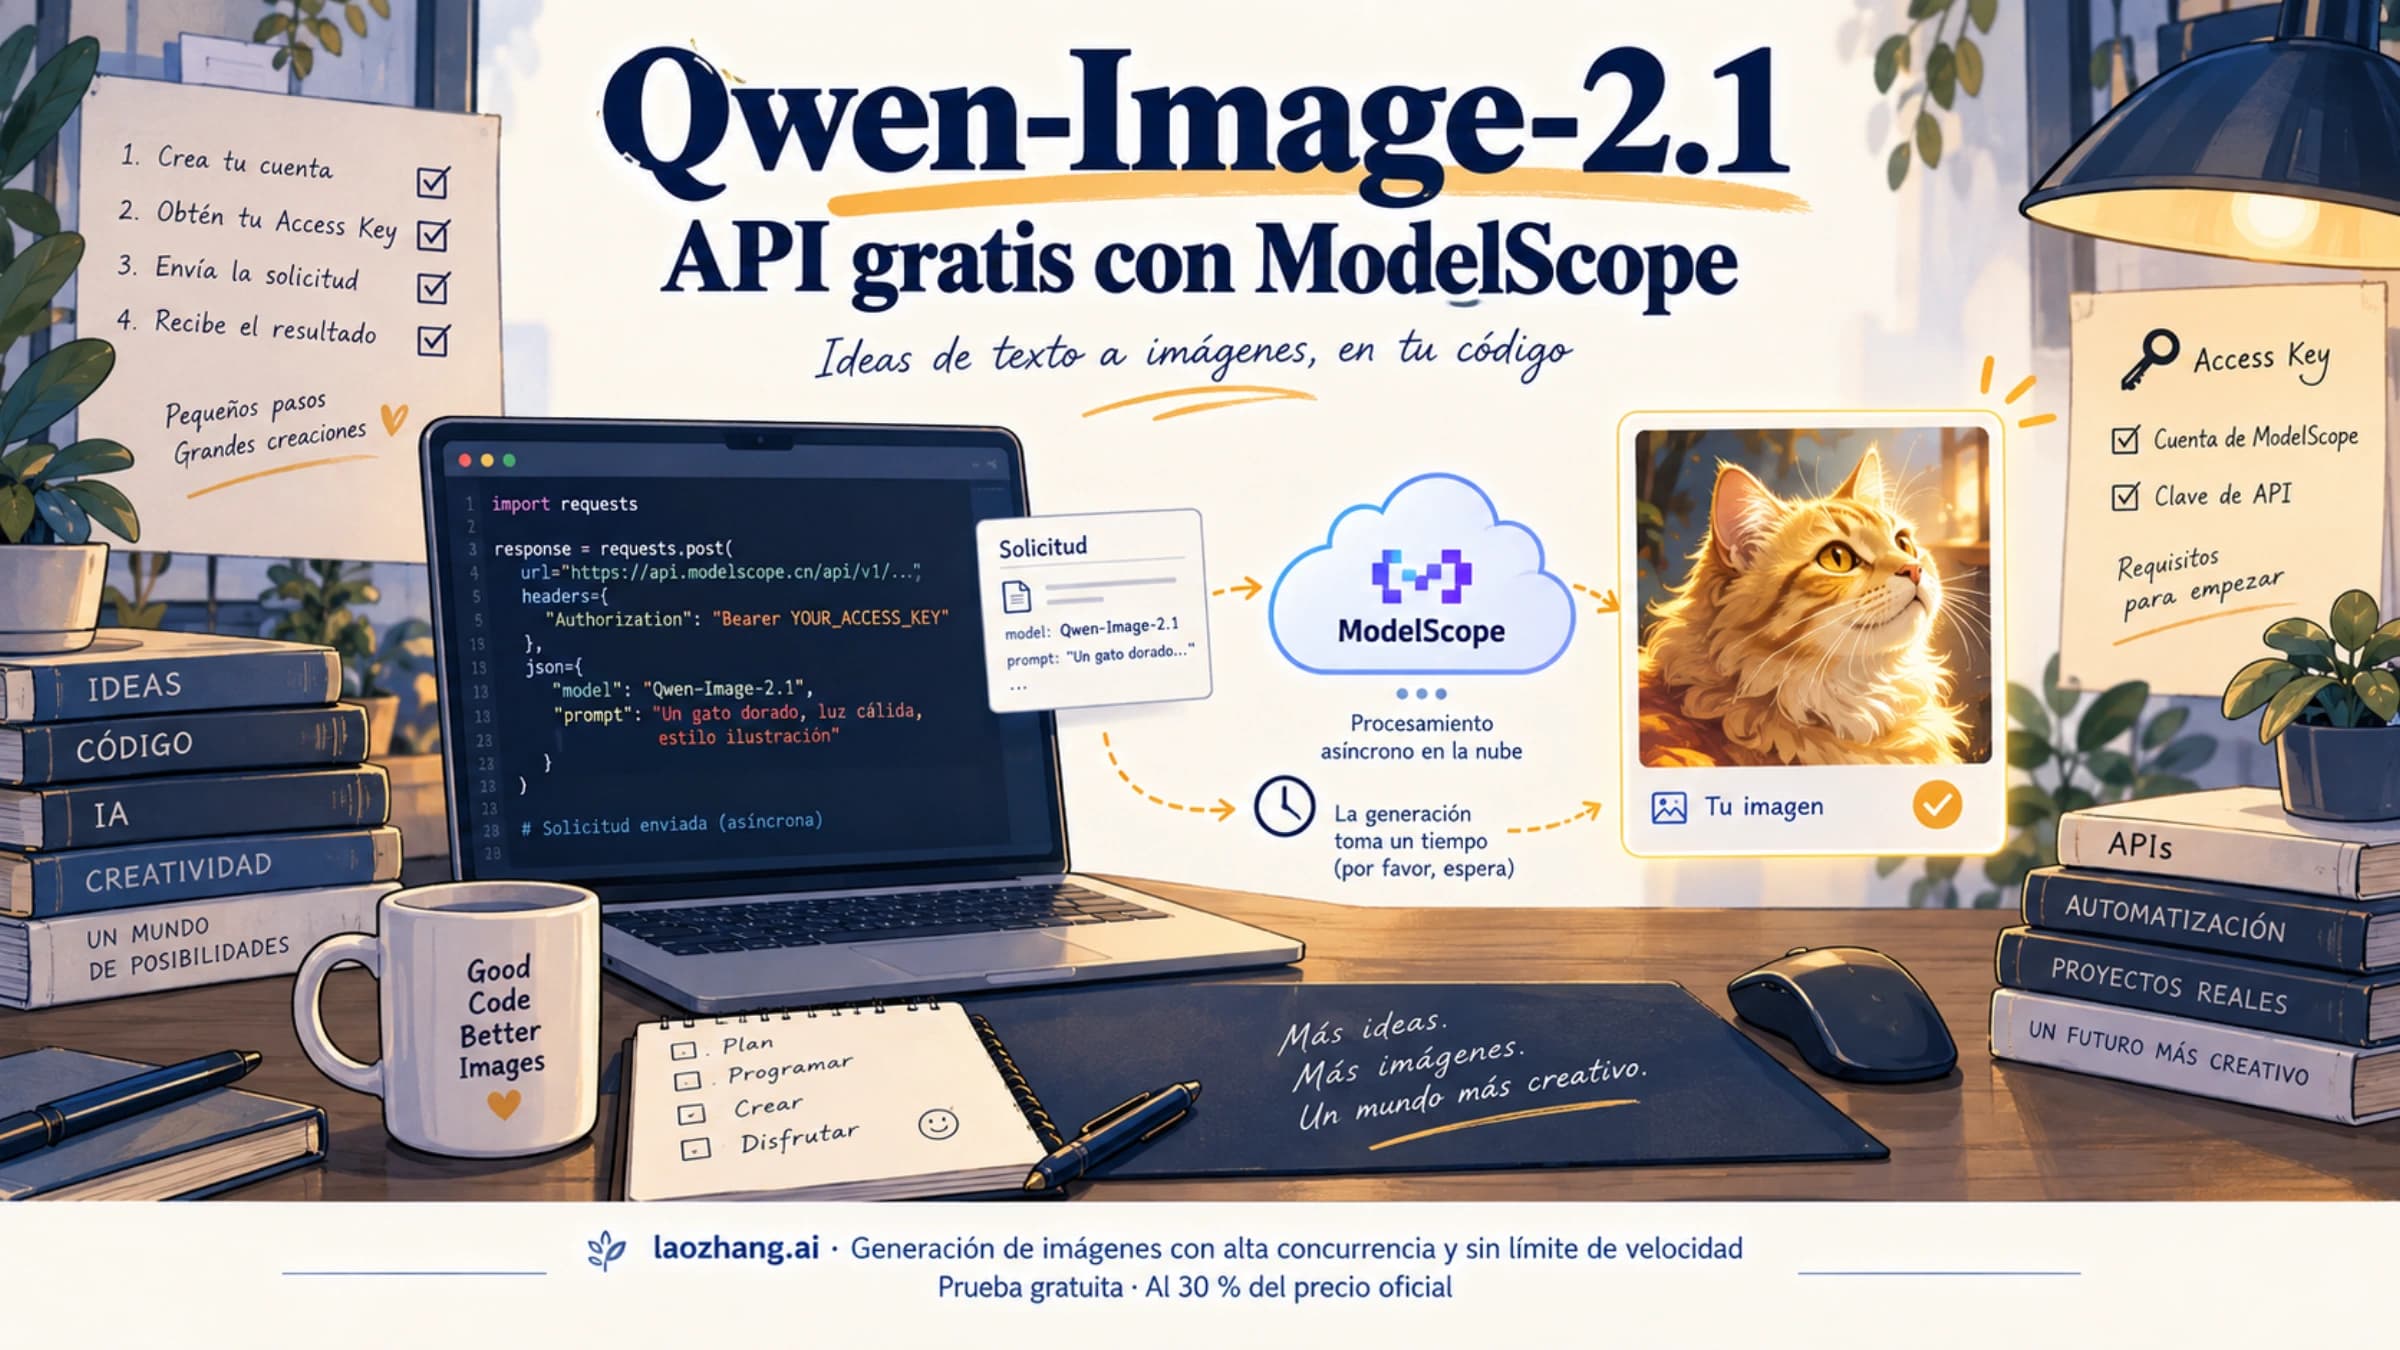
Sí: ModelScope da API gratis para Qwen-Image-2.1, a 1 crédito por llamada y con techo de unas 250 al día, si vinculas una cuenta de Alibaba Cloud verificada.

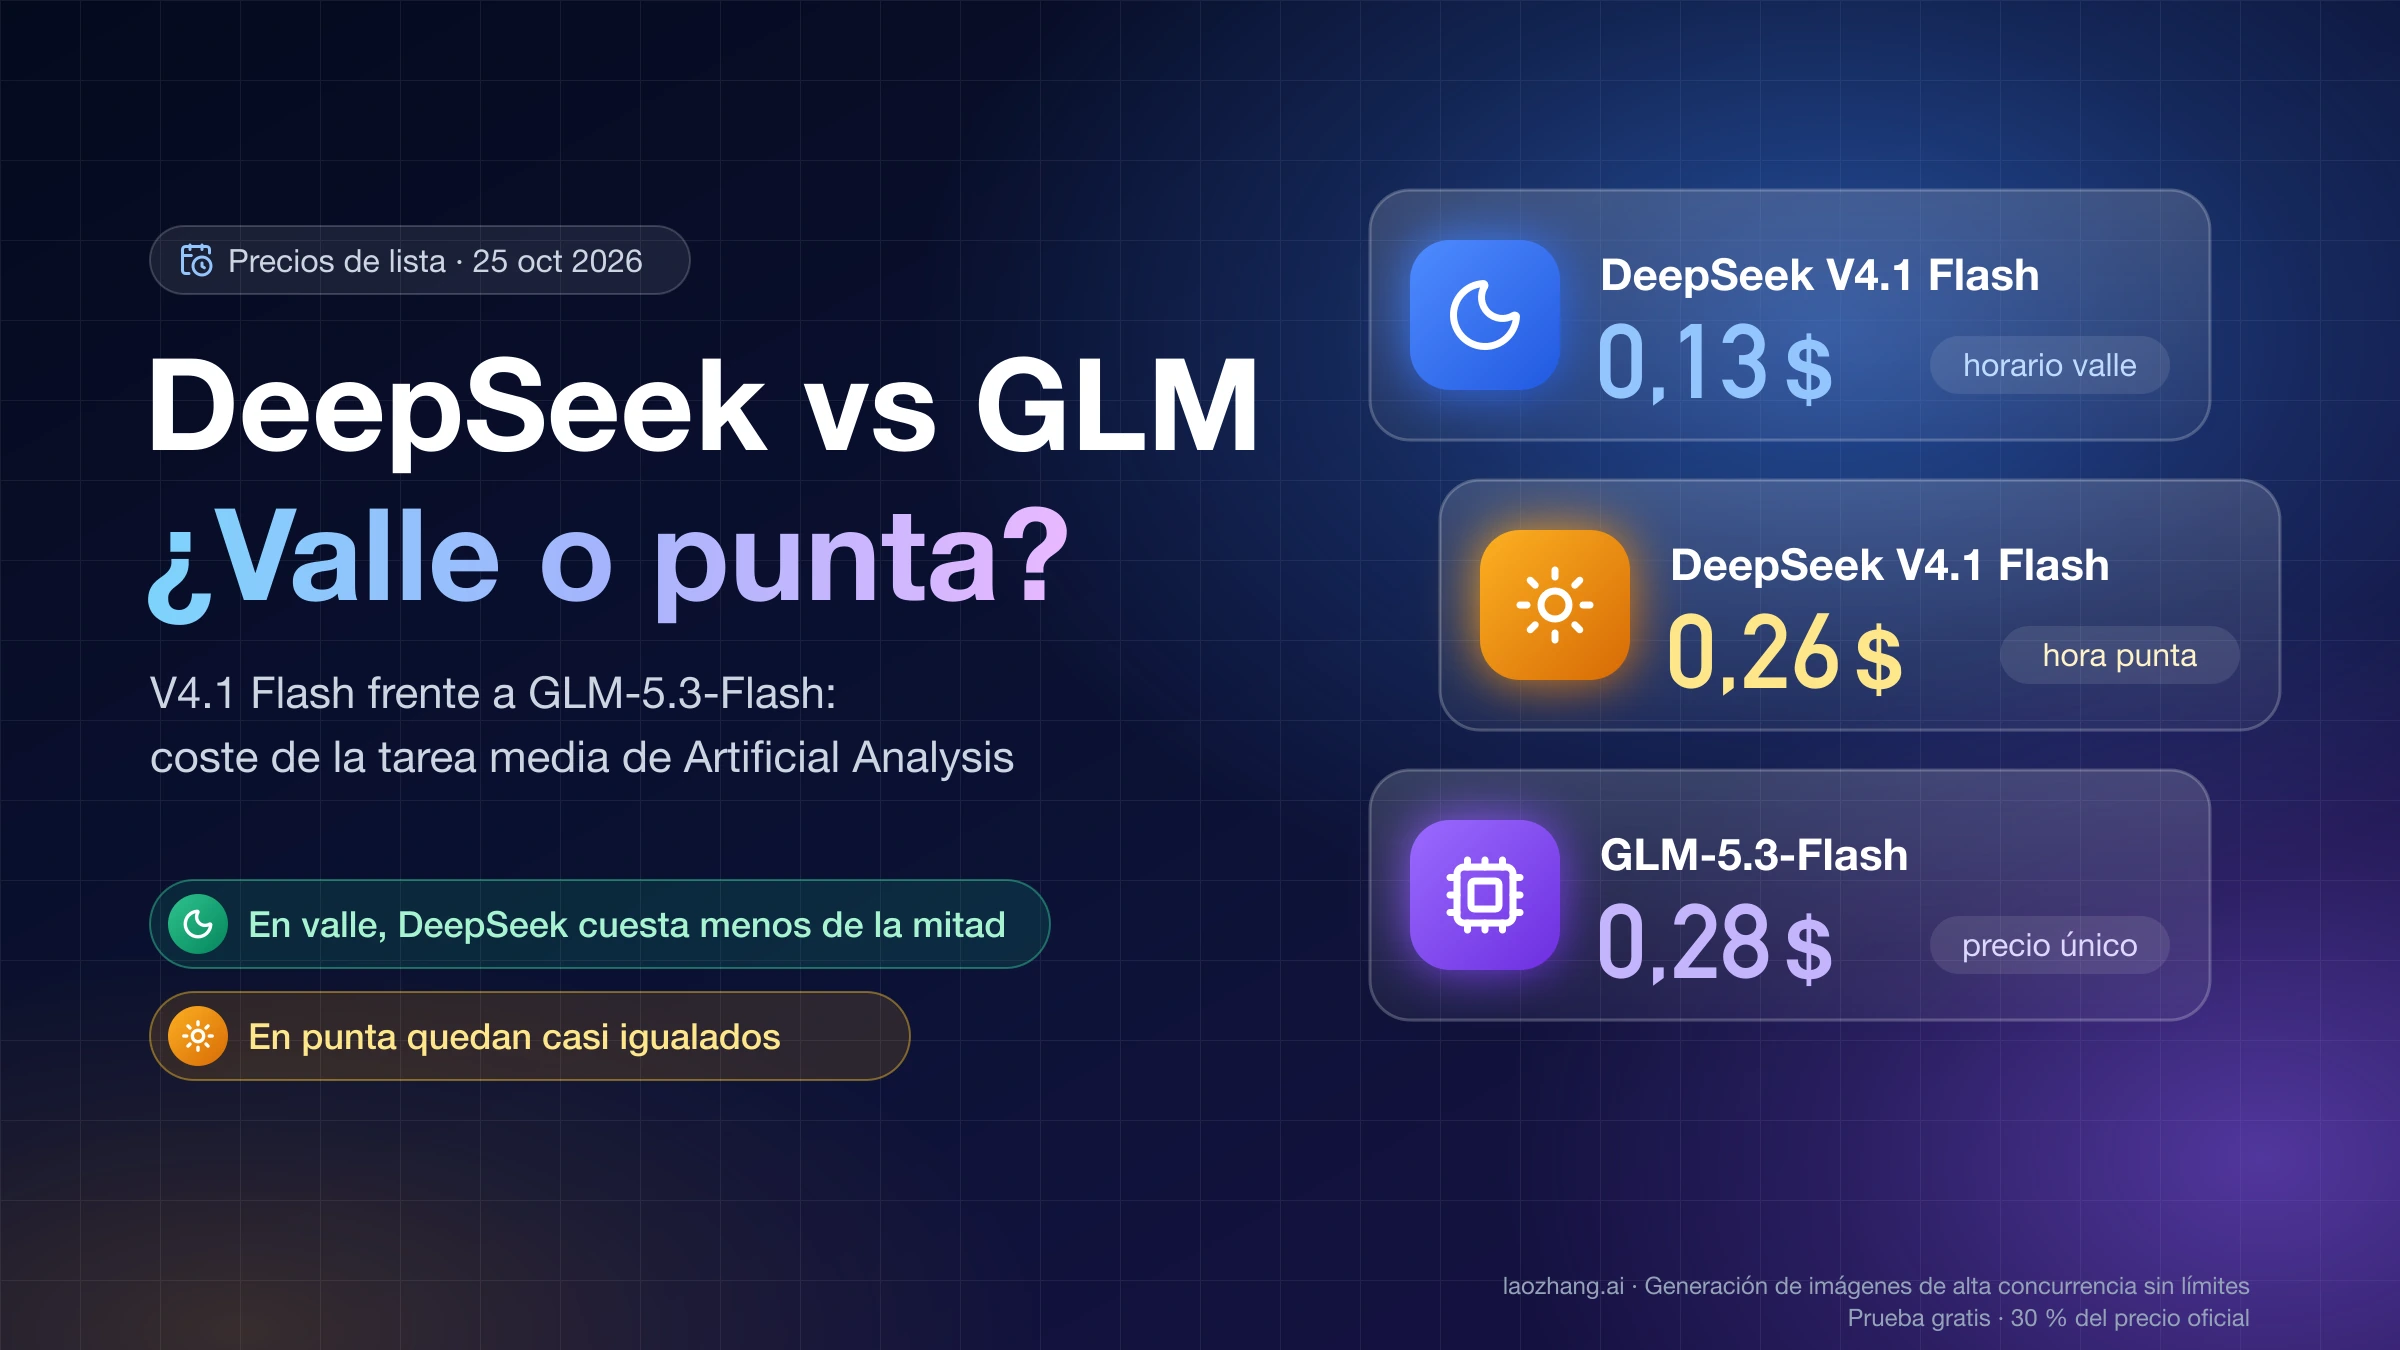
En la tarea media de Artificial Analysis, DeepSeek V4.1 Flash cuesta en horario valle menos de la mitad que GLM-5.3-Flash; en hora punta quedan casi igualados.

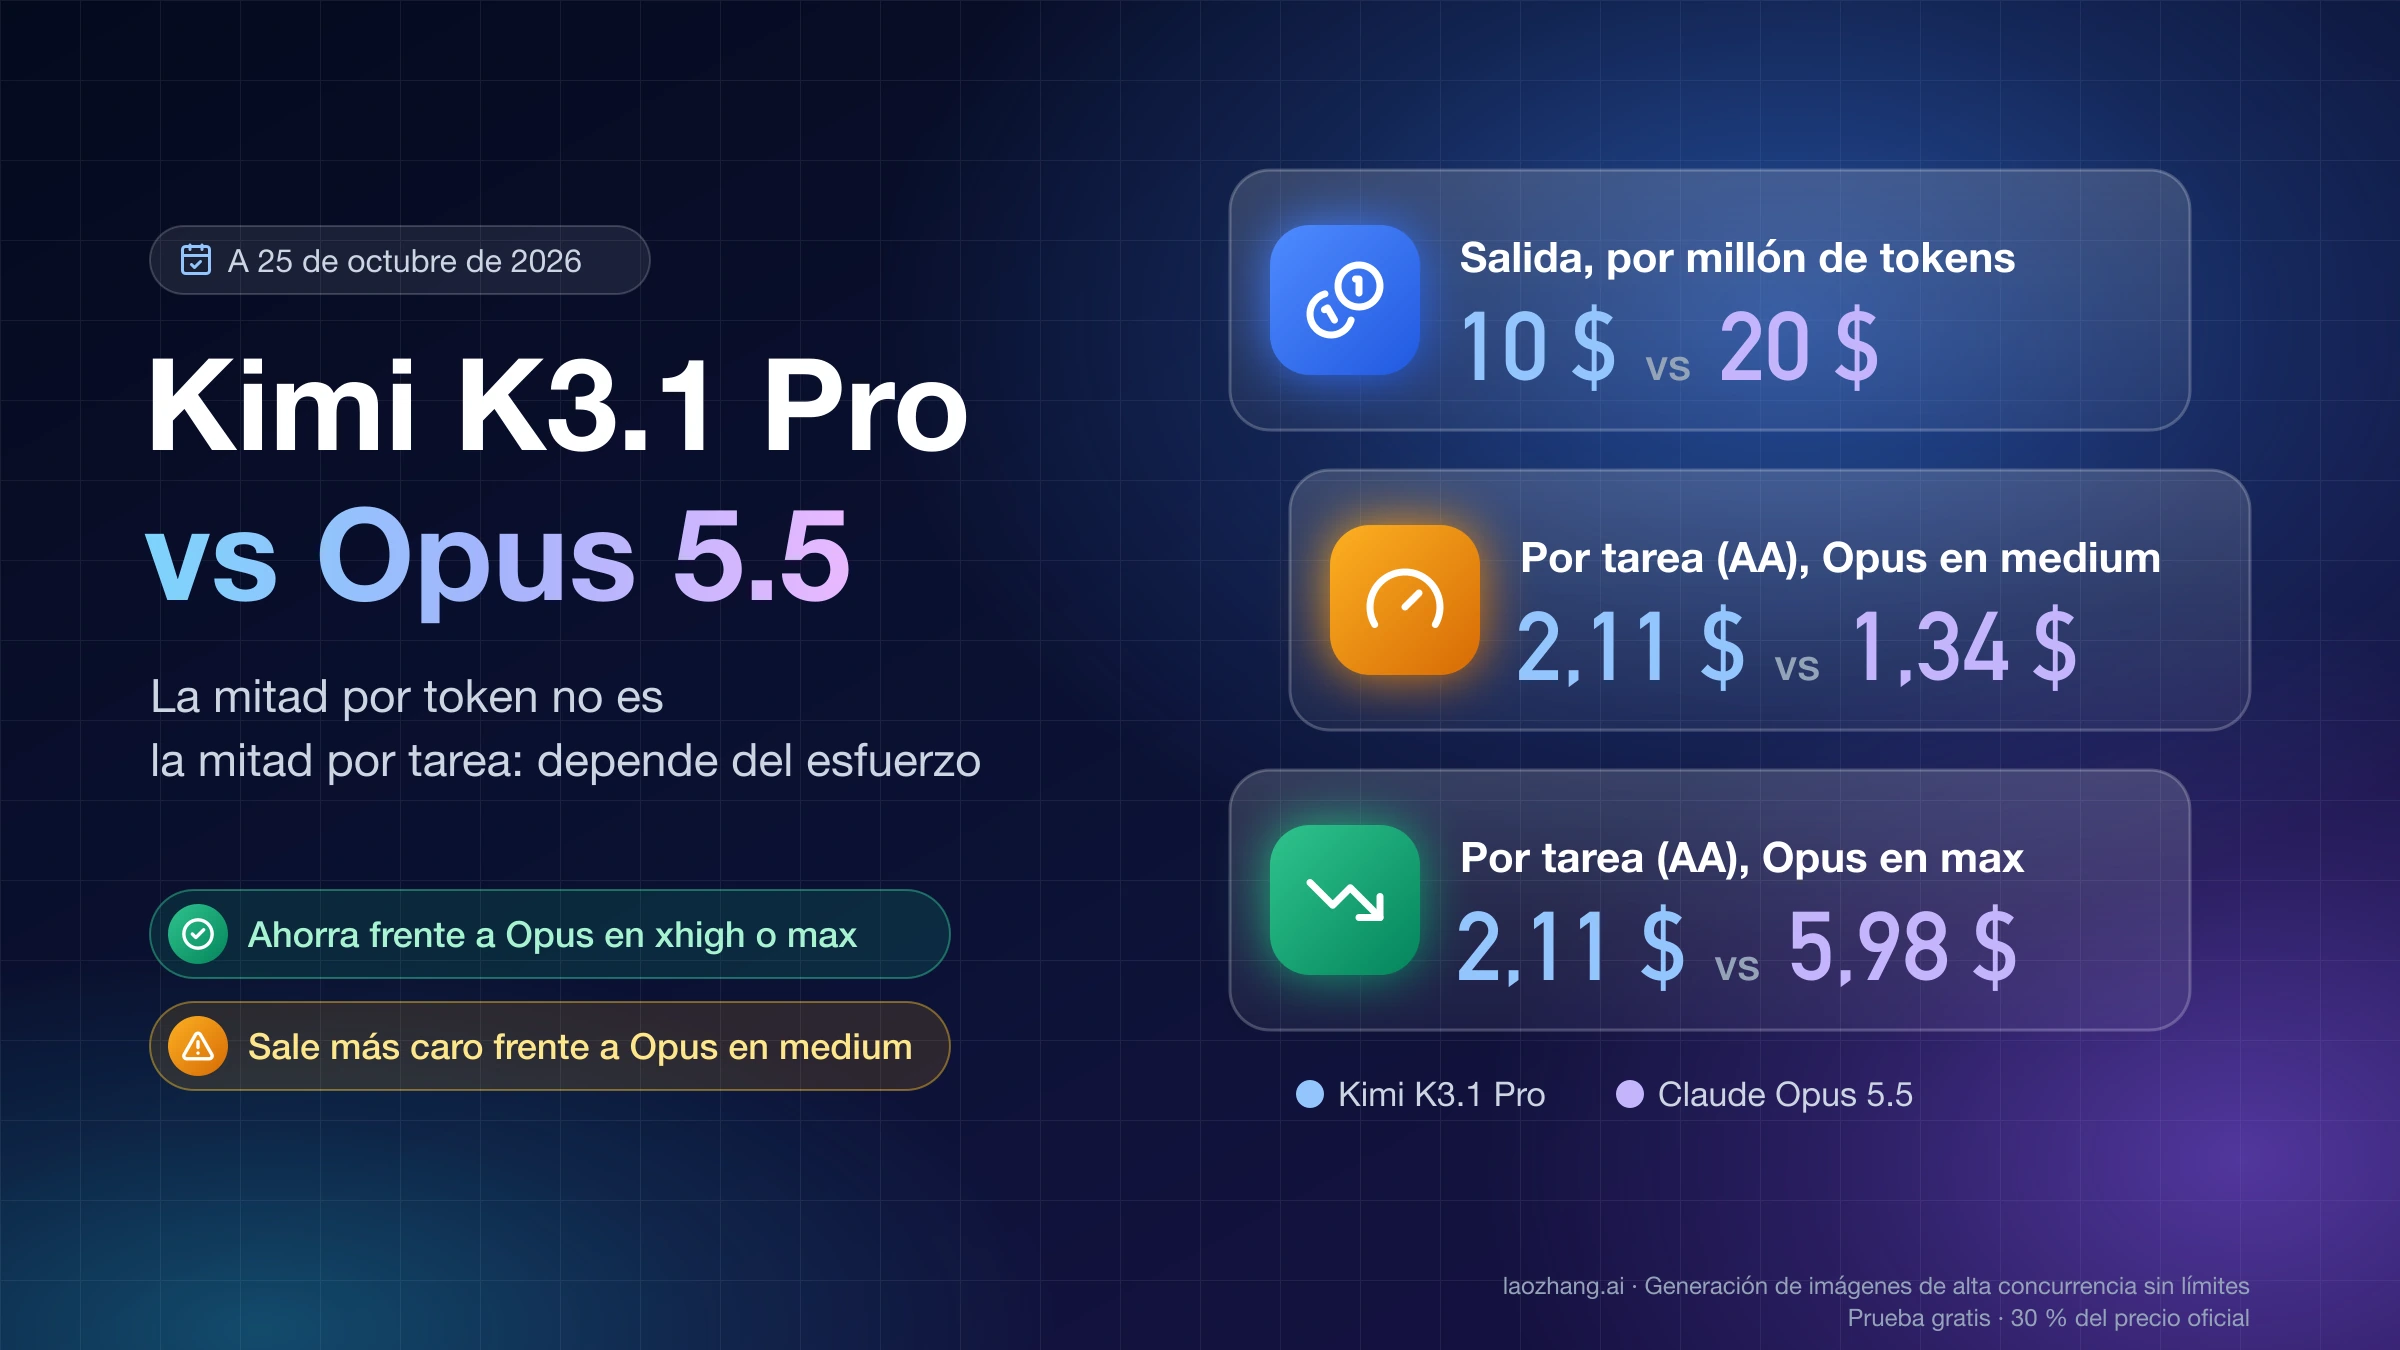
Por token, Kimi K3.1 Pro cuesta la mitad que Opus 5.5. Por tarea depende del esfuerzo: frente a Opus en medium sale más caro y frente a xhigh o max, más barato.

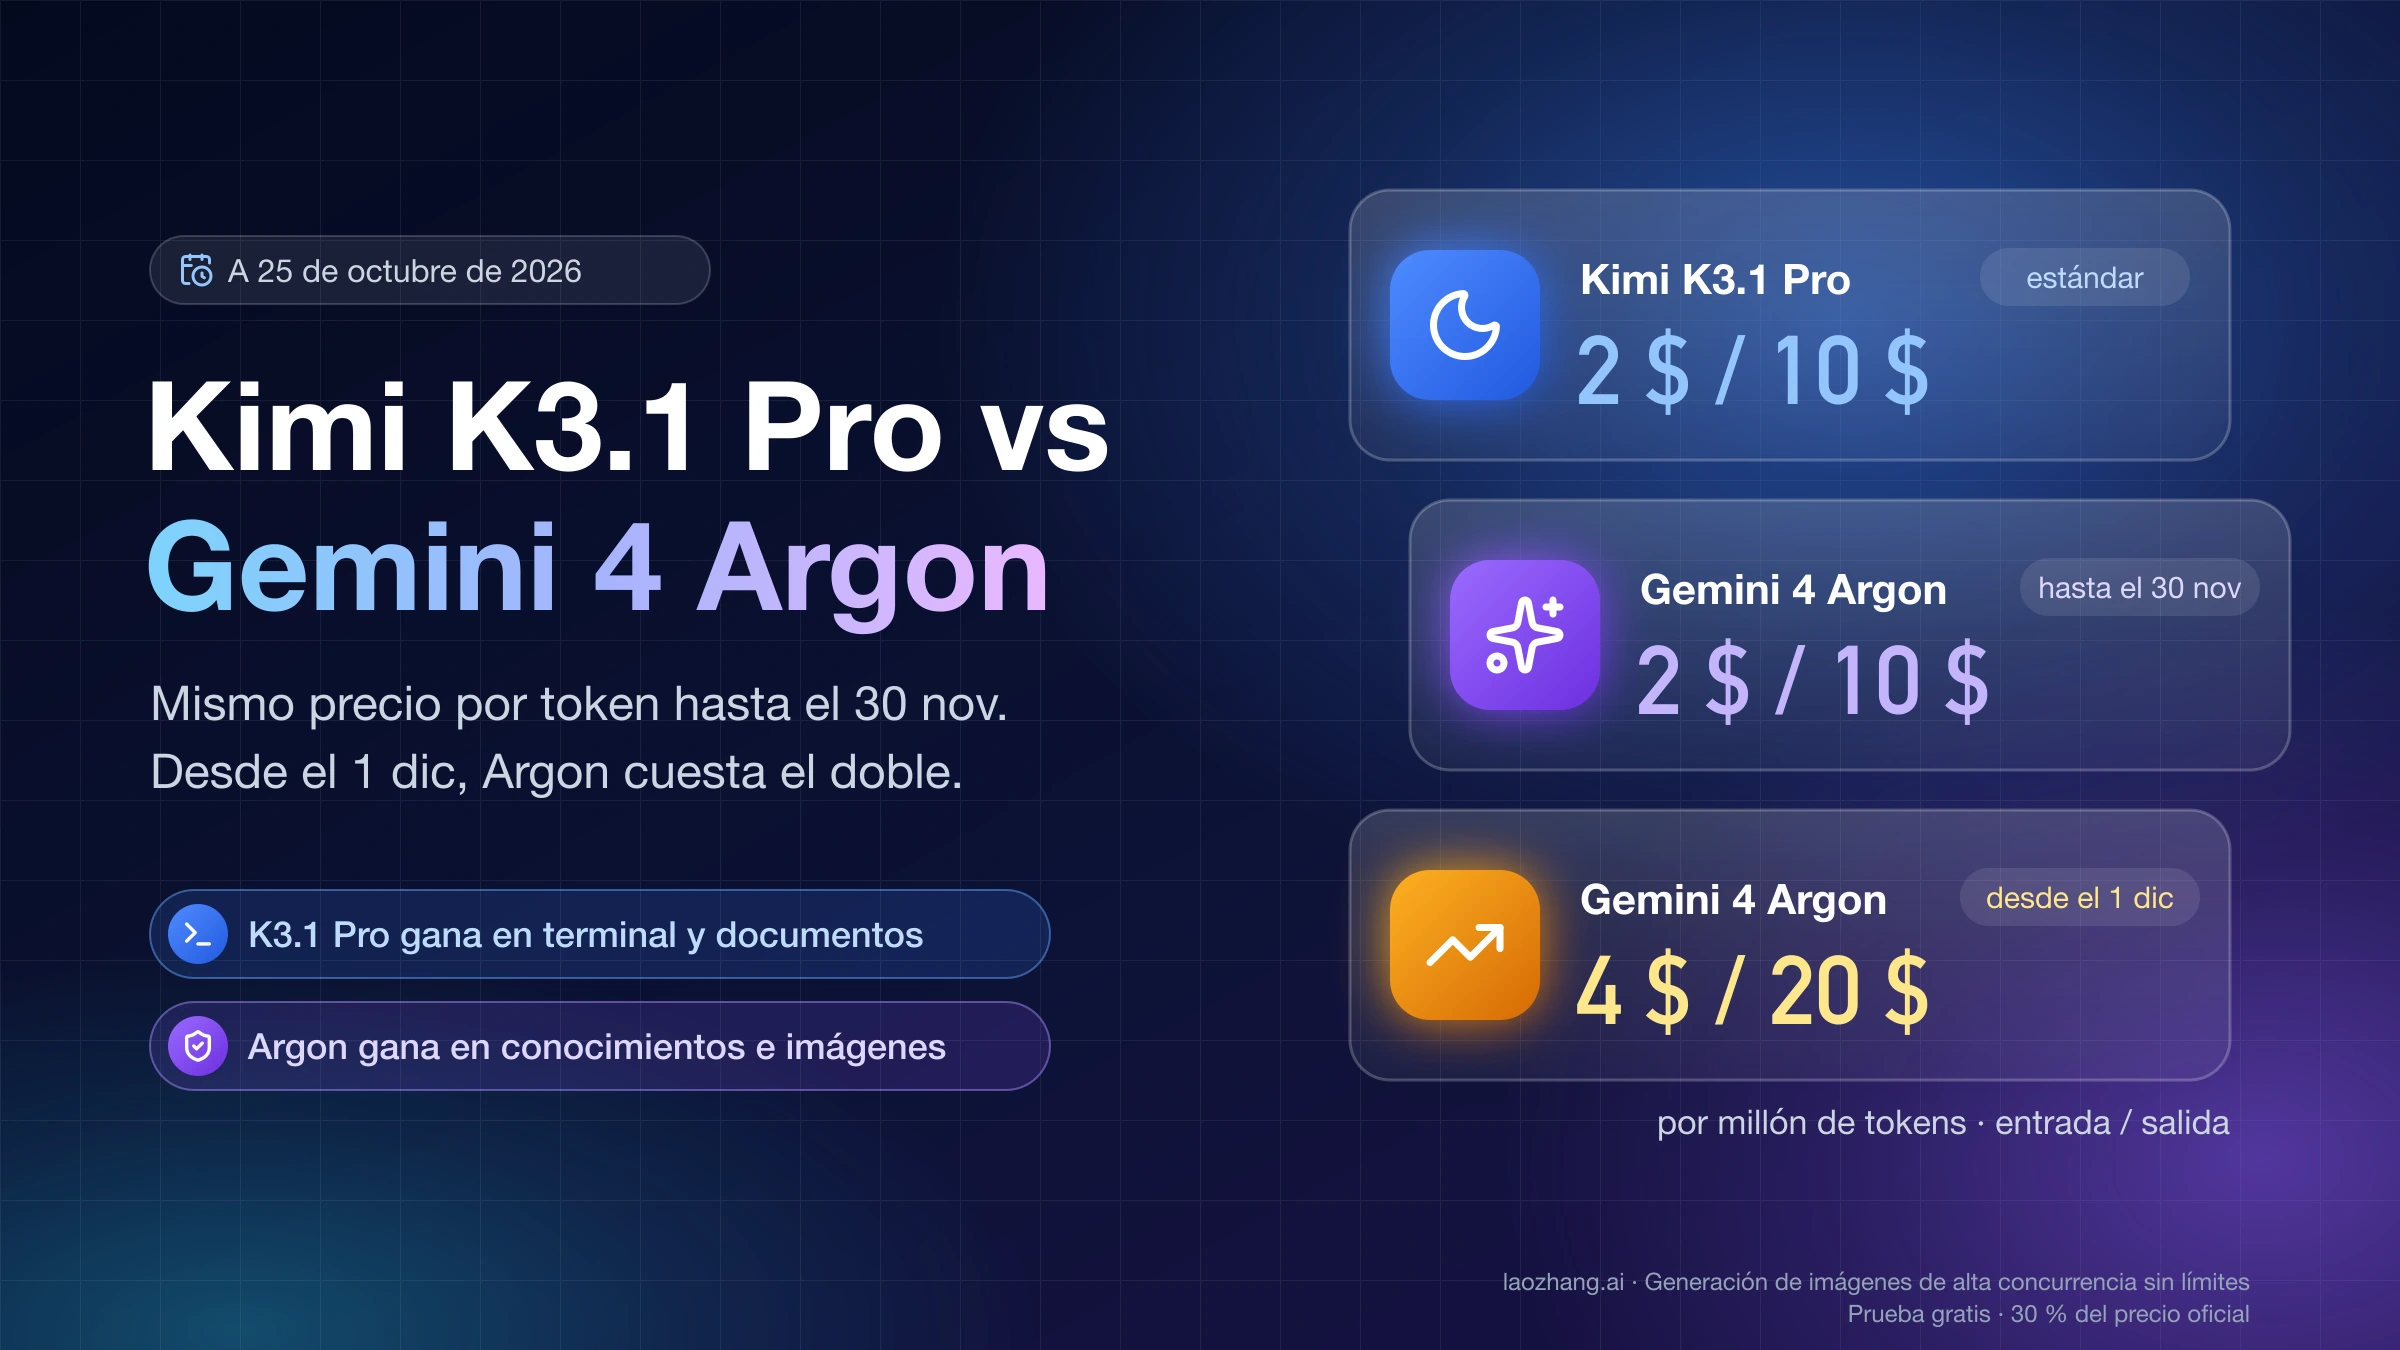
Mismo precio por token hasta el 30 de noviembre; luego Argon cuesta el doble. K3.1 Pro gana en terminal y documentos; Argon, en conocimientos e imágenes.

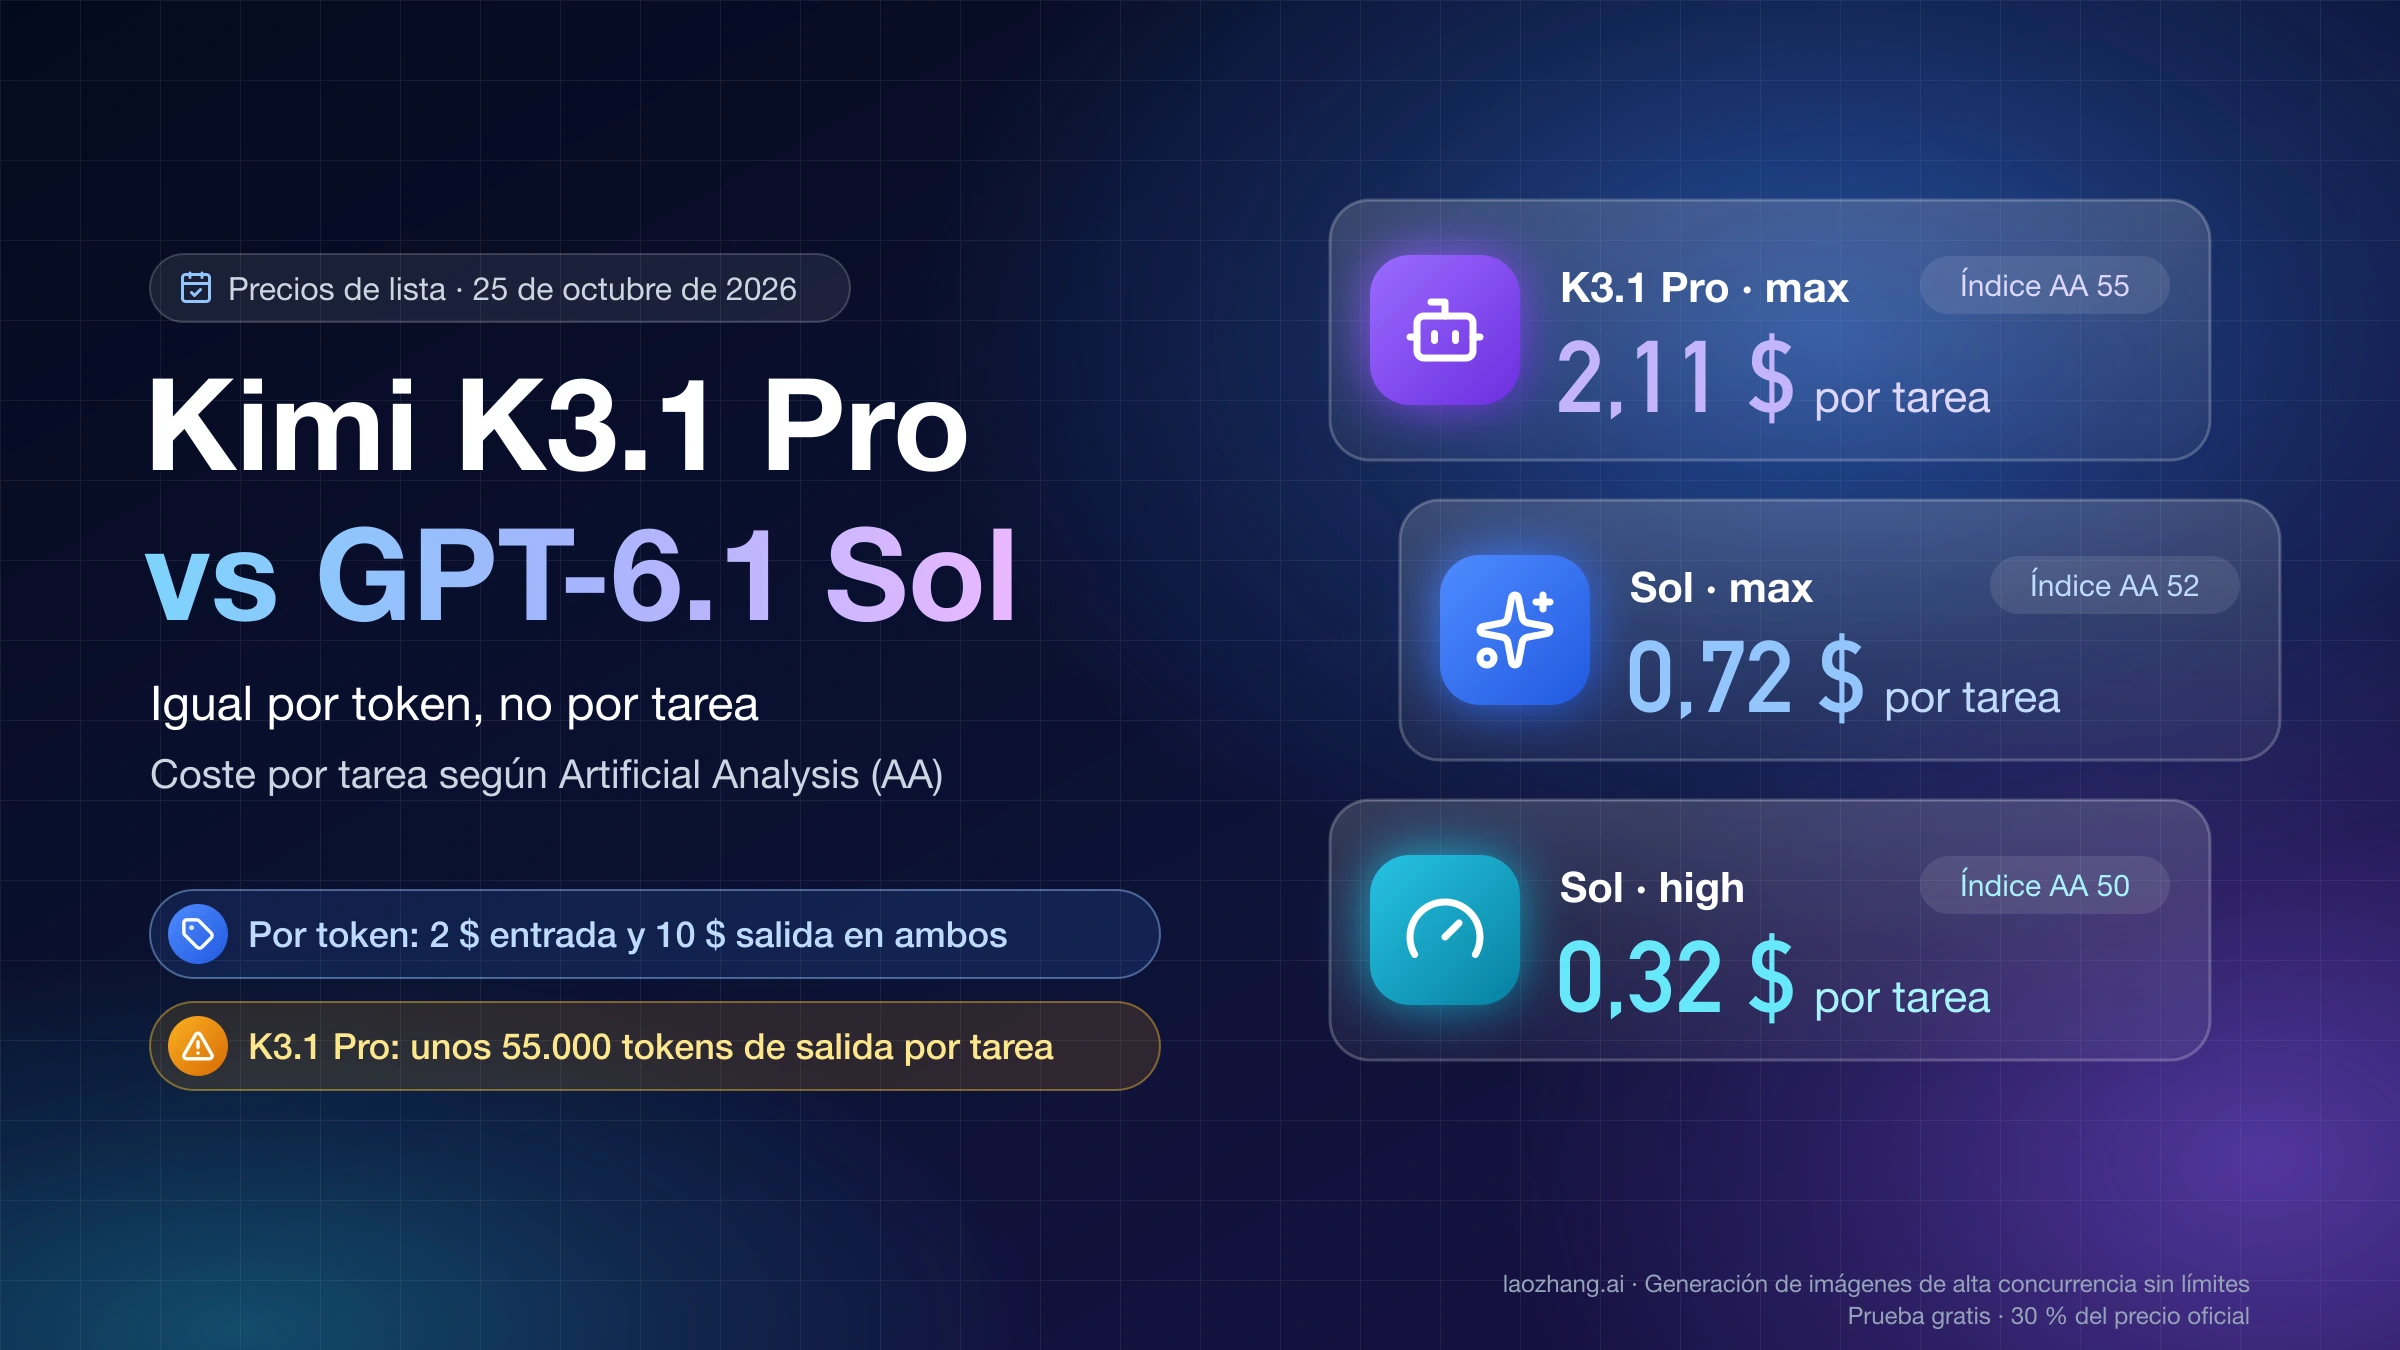
Ambos cobran 2 $ y 10 $ por millón de tokens, pero en Artificial Analysis K3.1 Pro gasta 2,11 $ por tarea y Sol en max, 0,72 $. Cuándo compensa cada uno.

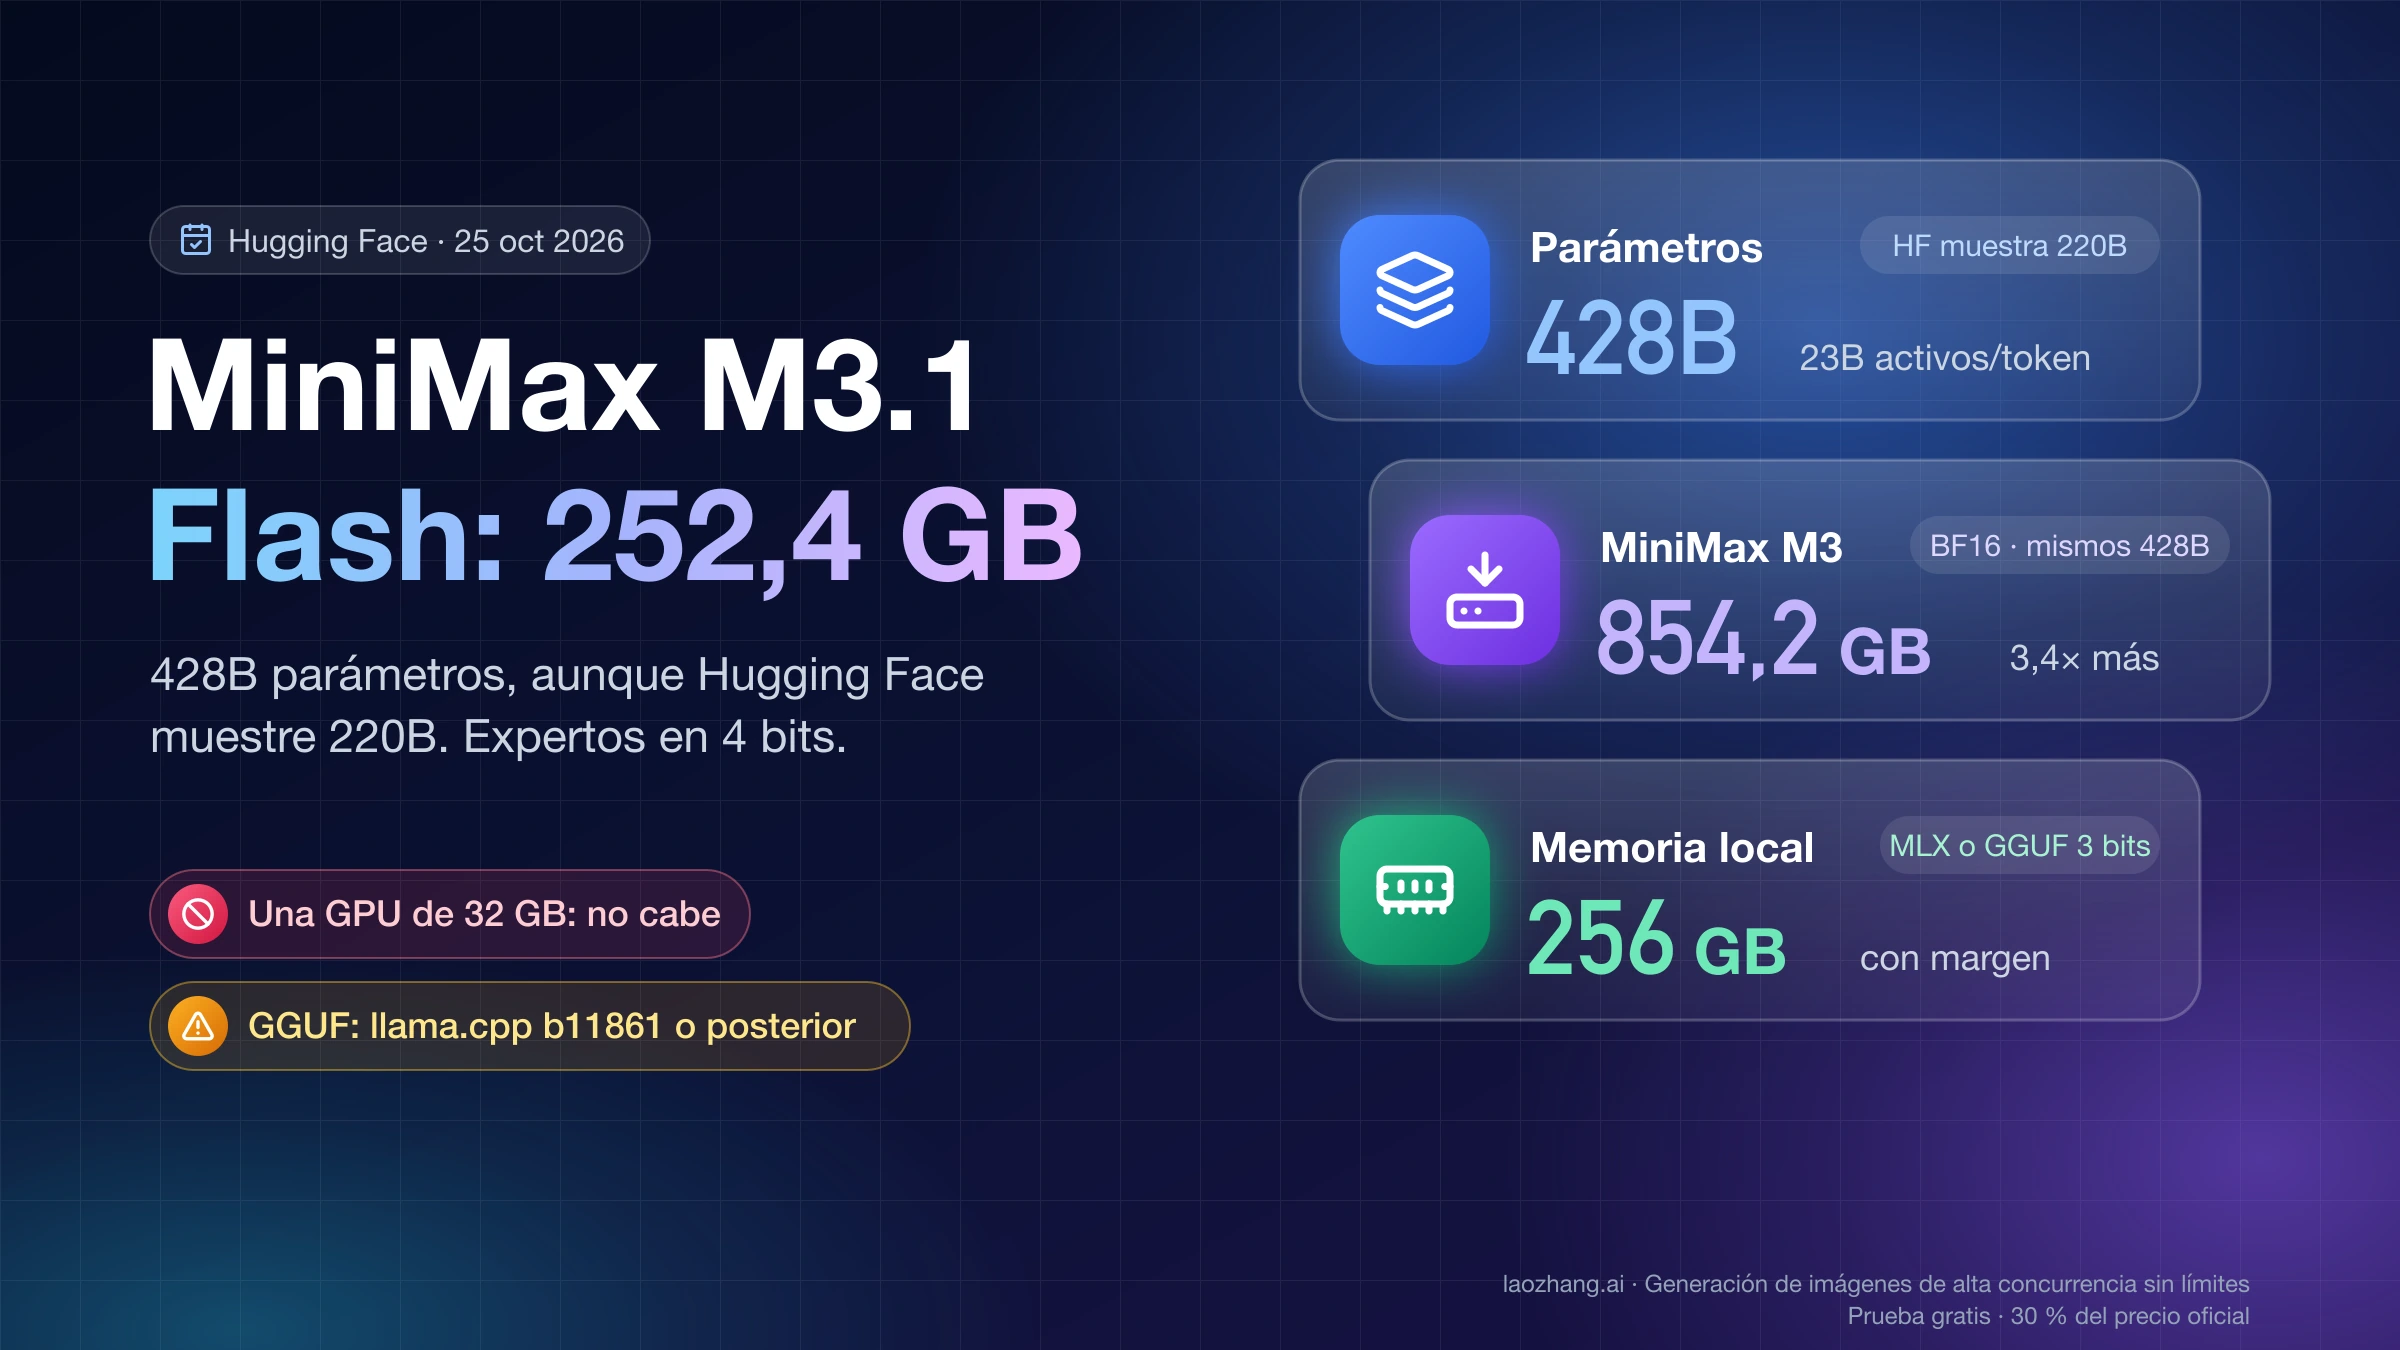
MiniMax M3.1 Flash tiene unos 428.000 millones de parámetros y 252,4 GB de pesos oficiales. Con menos de 256 GB de memoria, solo caben versiones de 1–3 bits.

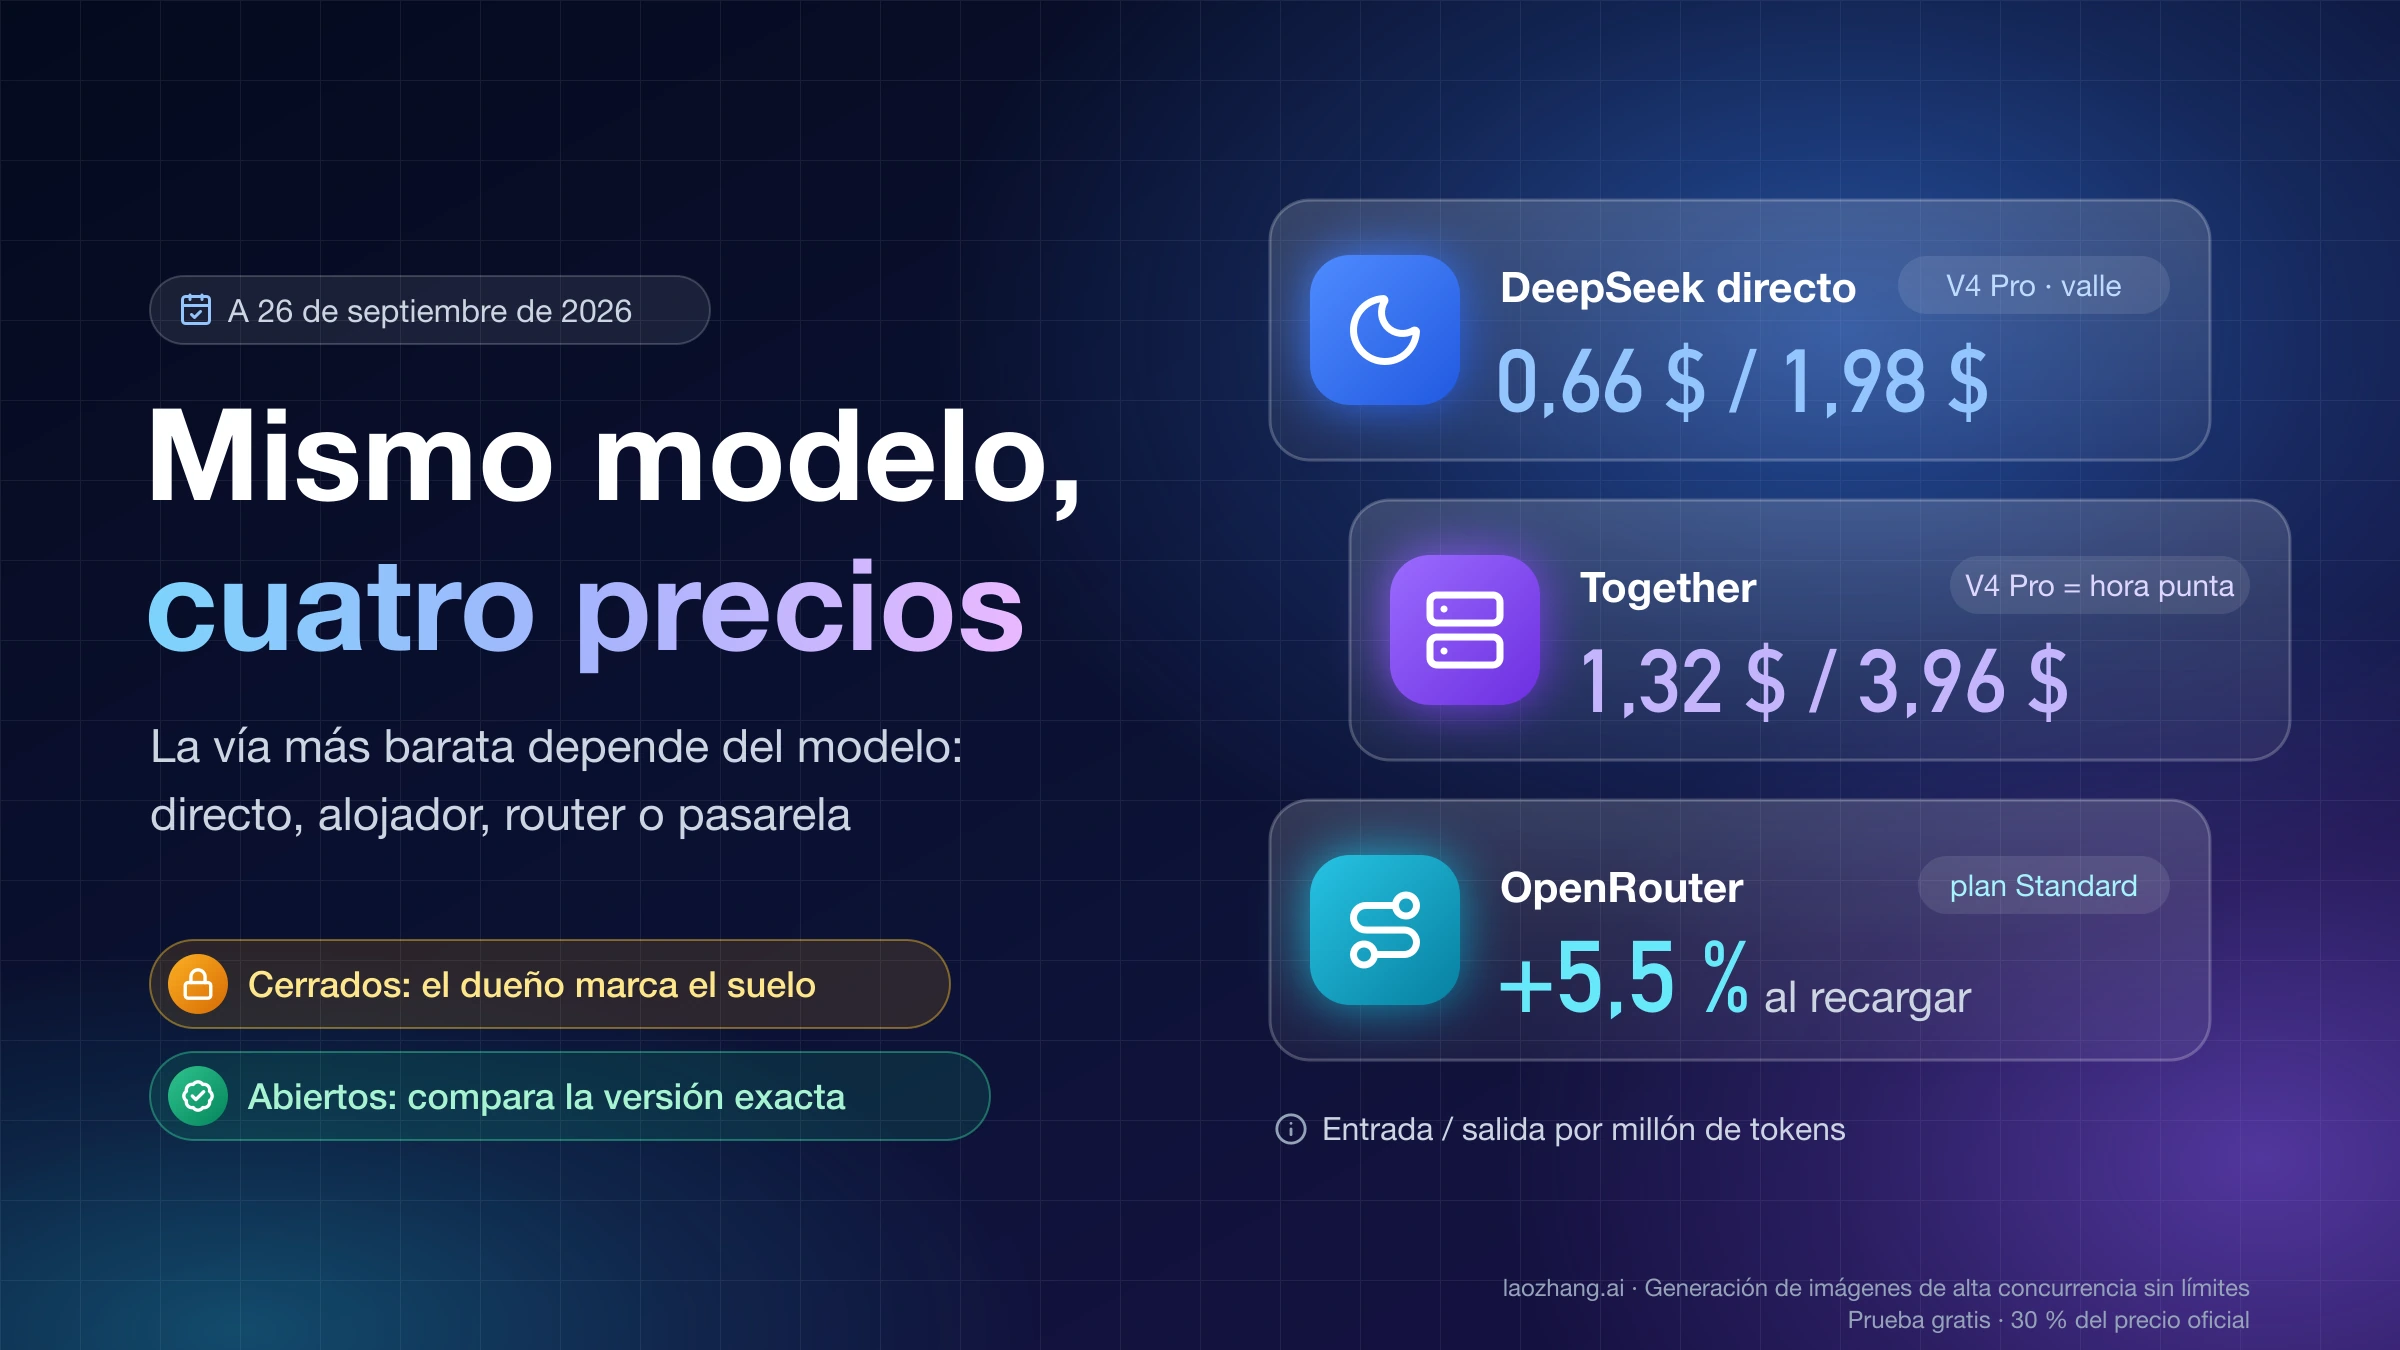
DeepSeek V4 Pro sale a mitad de precio en DeepSeek directo en horas valle; en GPT, Claude o Gemini el dueño marca el suelo y los routers suman su comisión.

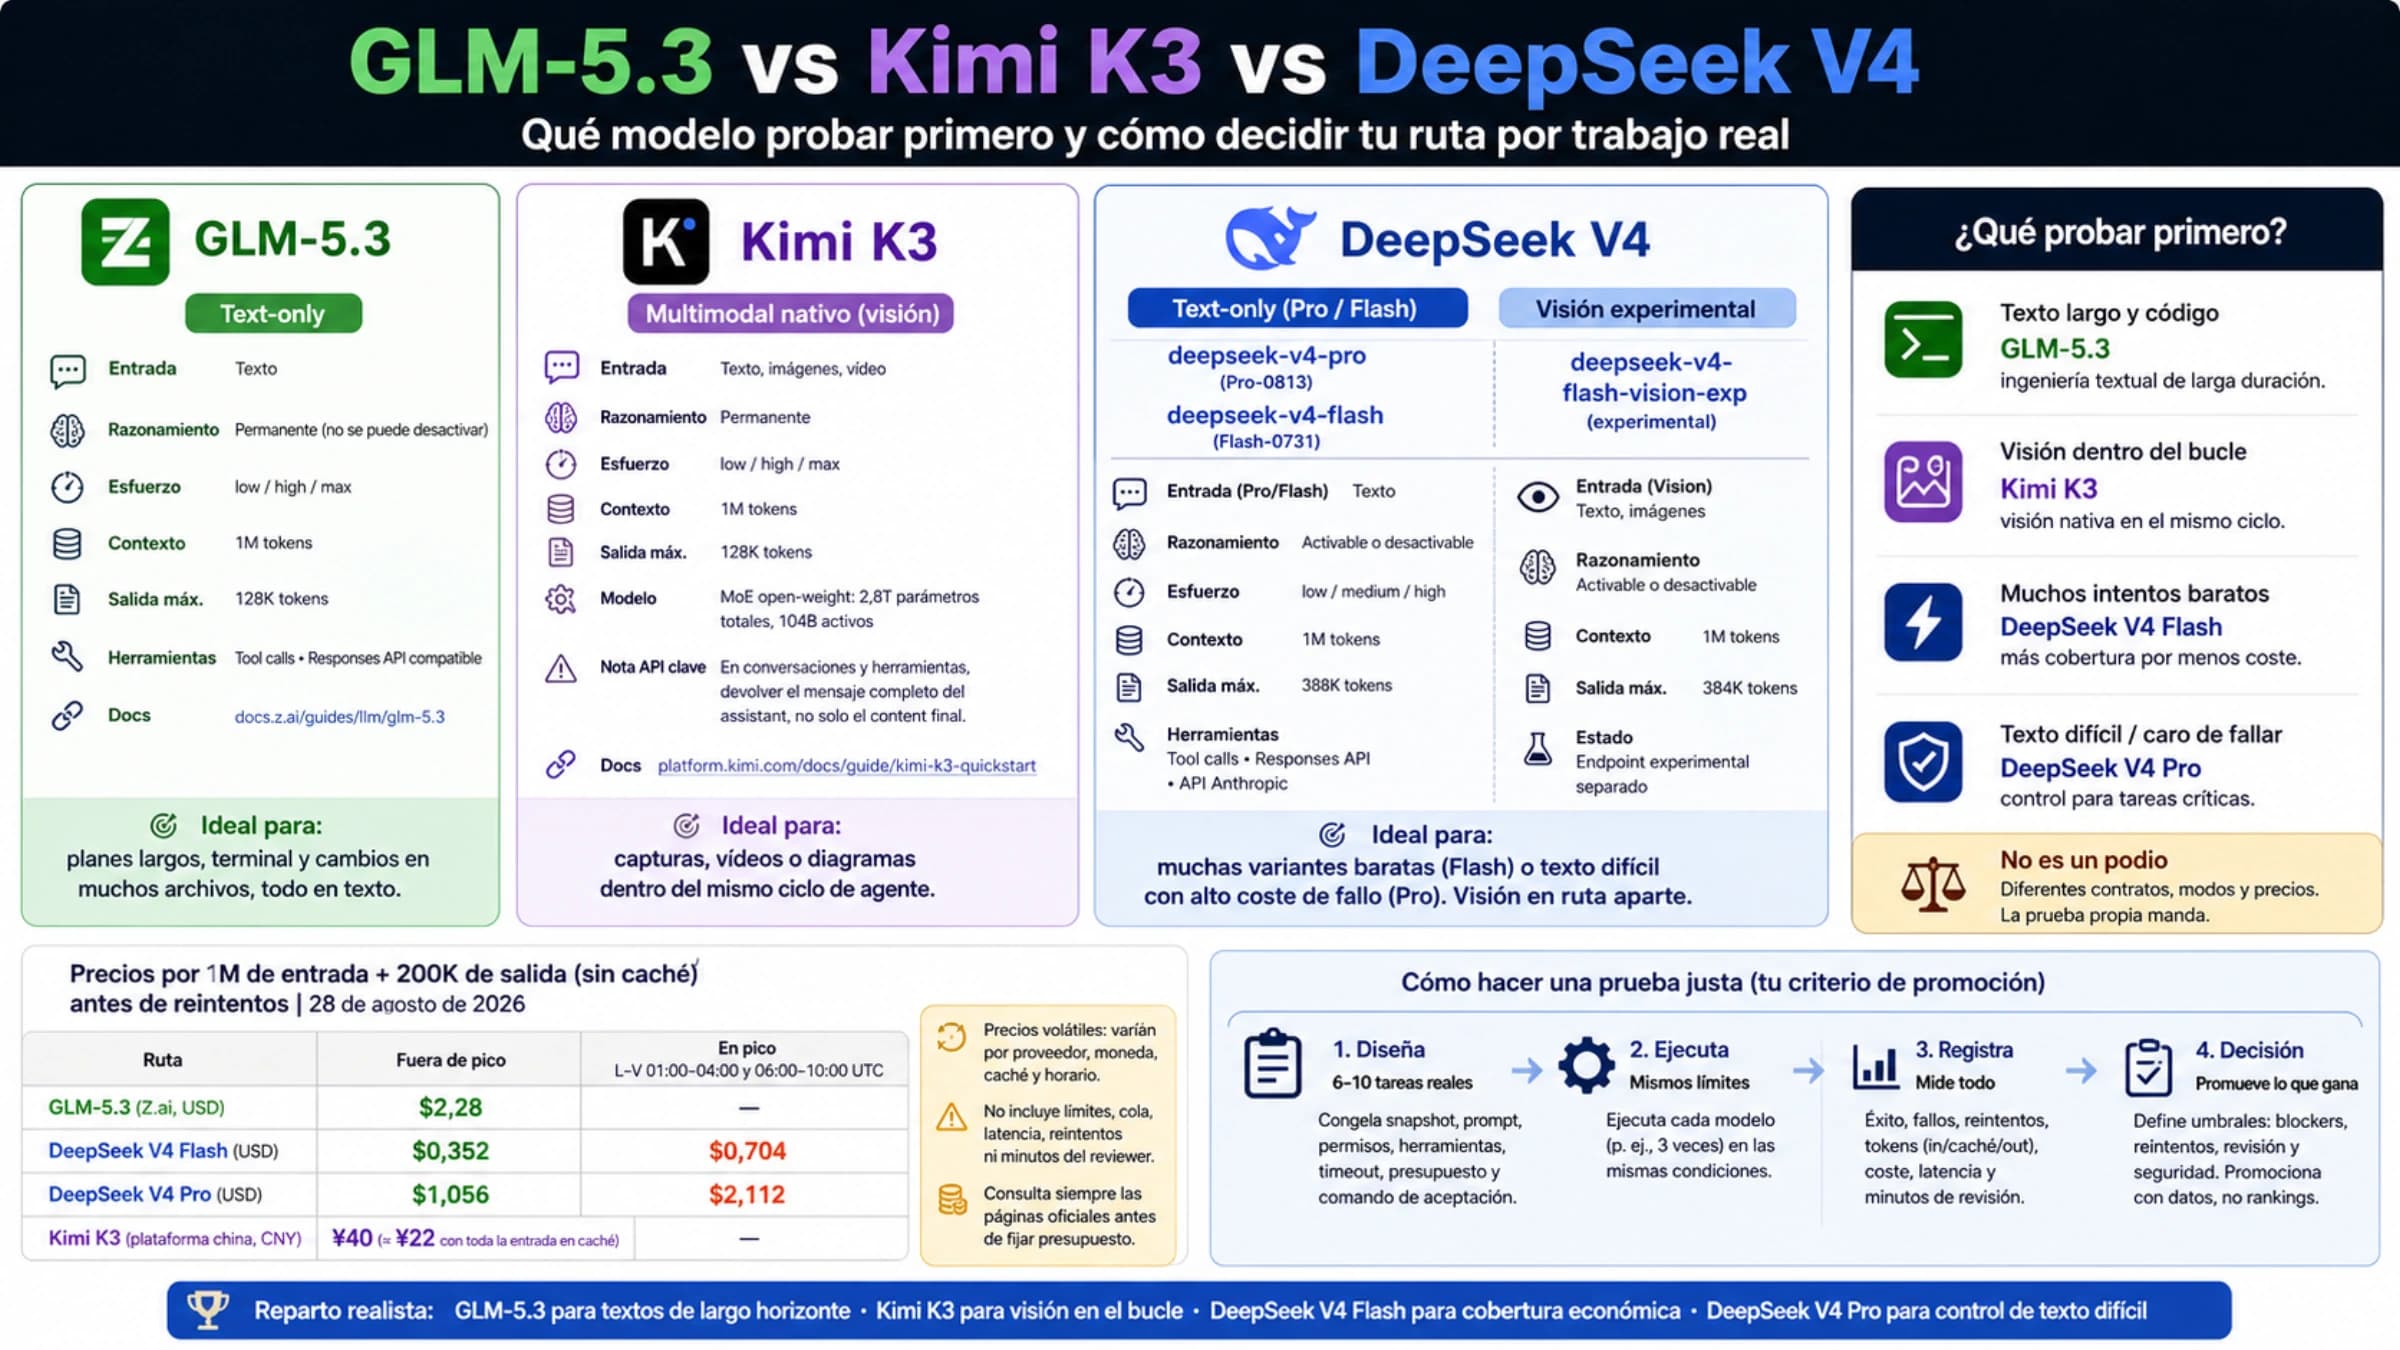
Empieza por GLM-5.3 en ingeniería larga solo de texto, por Kimi K3.1 Pro si la visión entra en el bucle y por deepseek-flash (V4.1) para intentos baratos.

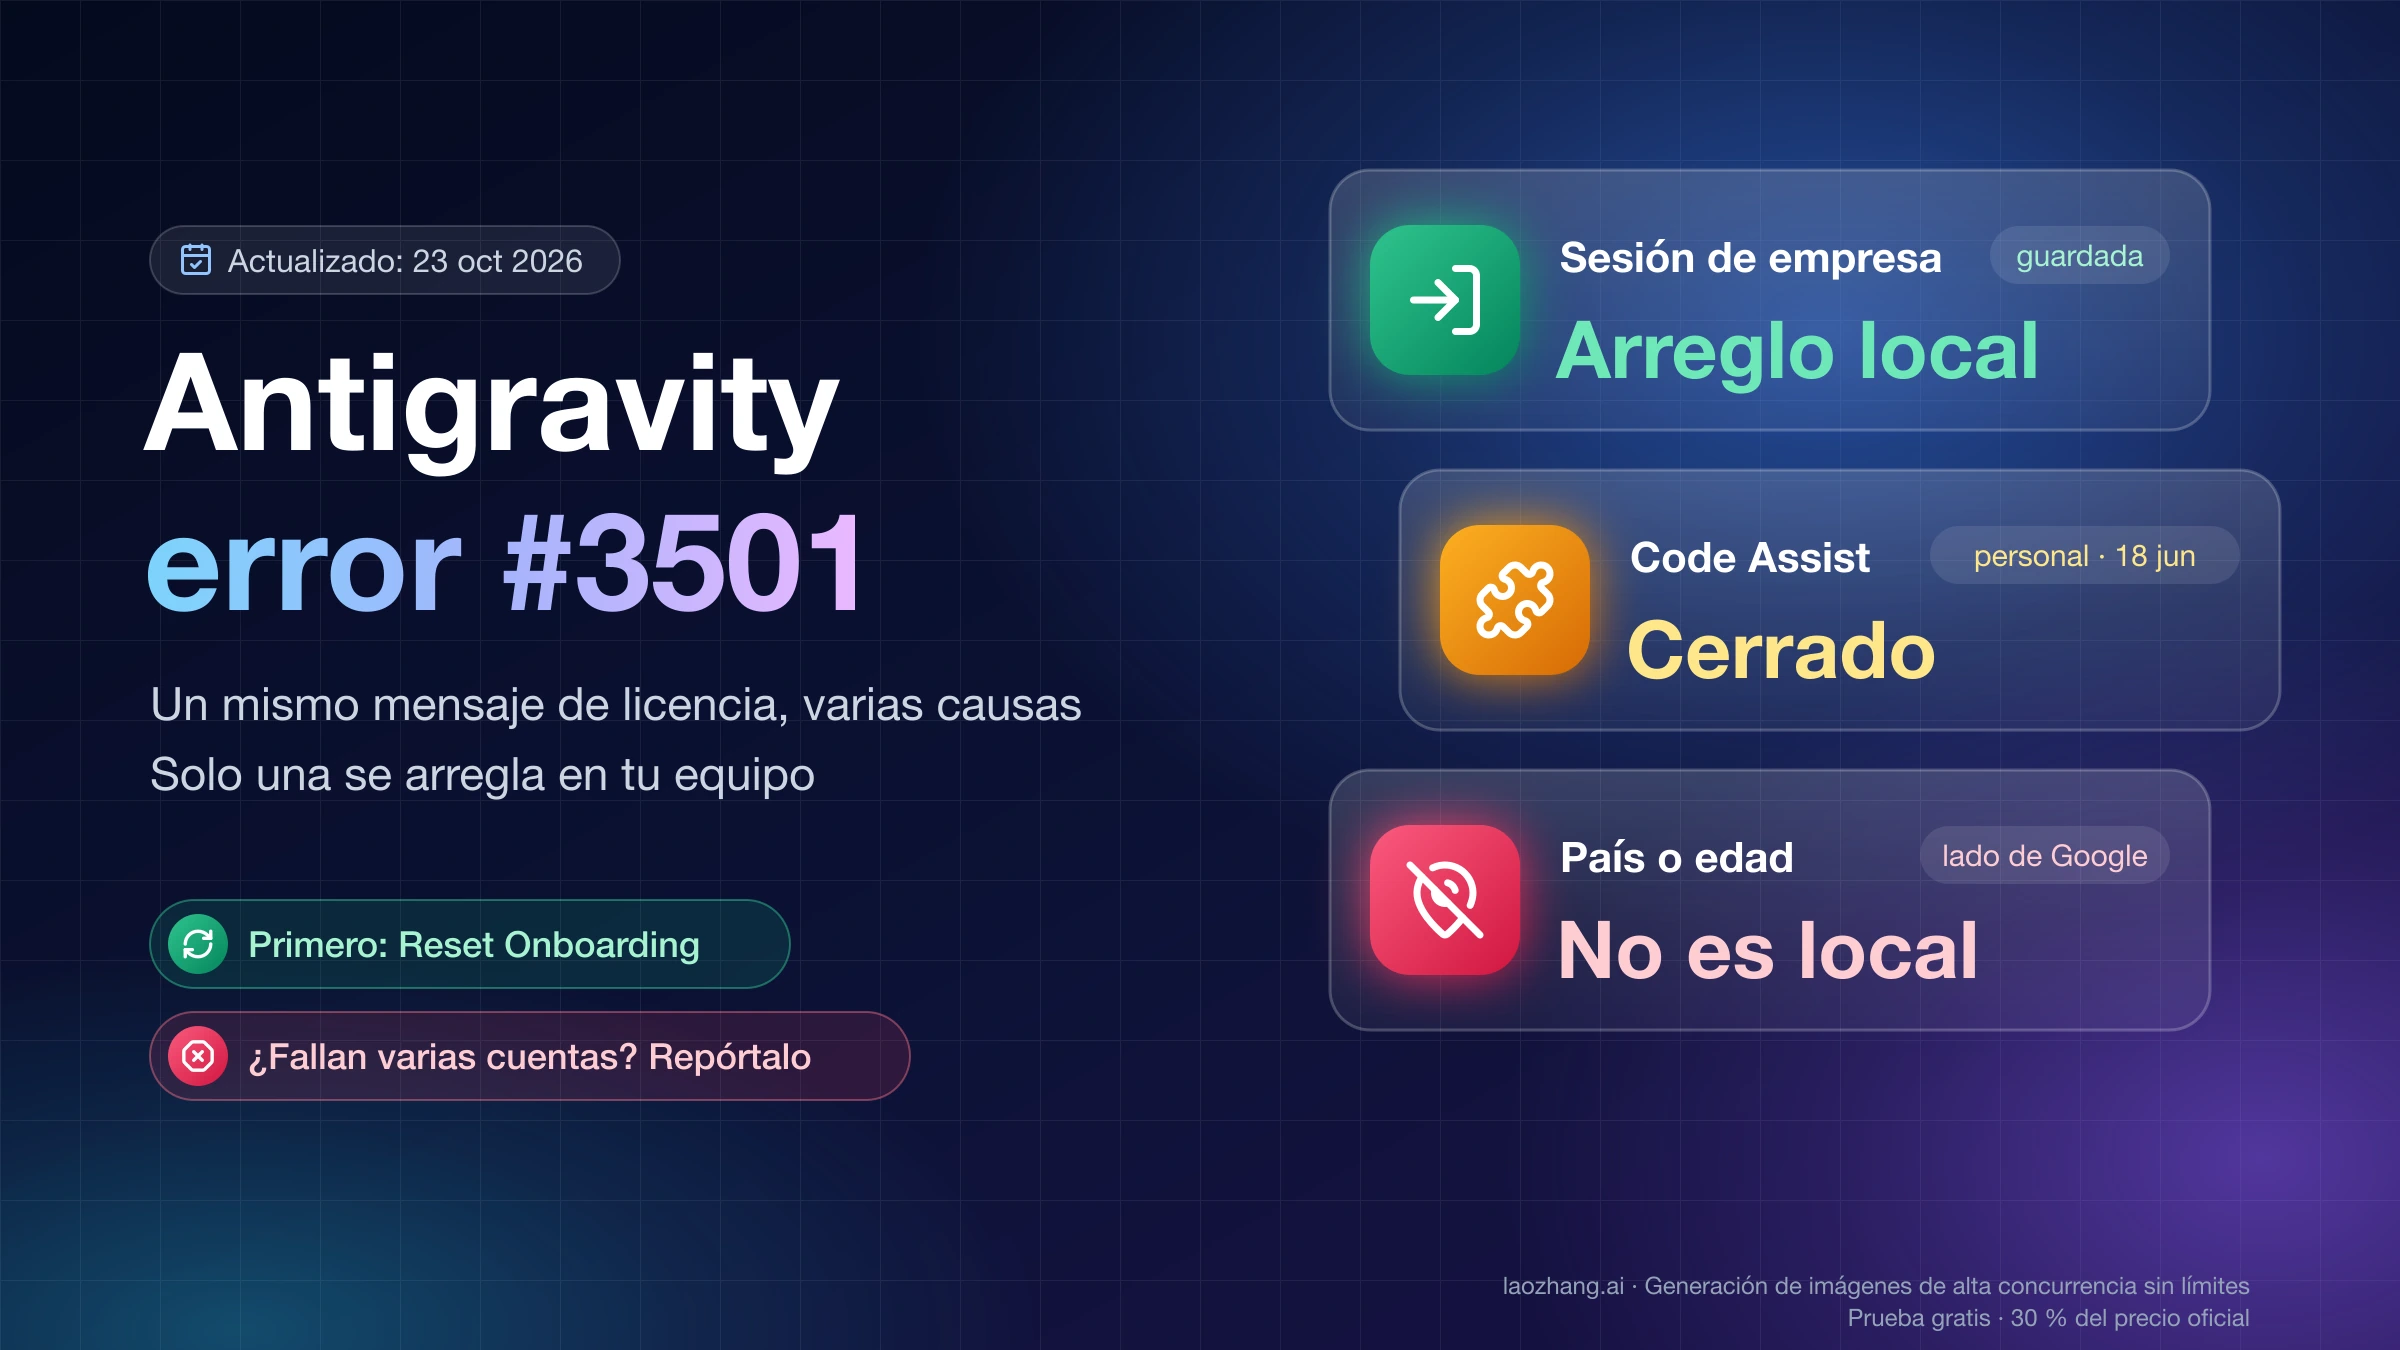
El #3501 de Antigravity sale por sesión empresarial en caché, país o VPN, edad o fin de Gemini Code Assist personal. Solo la primera se arregla en tu equipo.

La app de Claude solo exige Git en sesiones con Worktree. Si en Windows te lo pide siempre, es anterior a la 1.49585.0: actualízala antes de reinstalar Git.

En el equipo de Claude Code cada cambio pasa por siete capas y 0, 1 o 2 personas según su riesgo. Con /code-review, las reglas van a CLAUDE.md, no a REVIEW.md.

Codex de escritorio lo lanza en modo Work si entras con clave de API o un intermediario: vuelve al modo Codex o pon STEPS_COMMANDS en config.toml.