Claude Sonnet 5.5: precio, effort y qué cambia frente a Sonnet 5
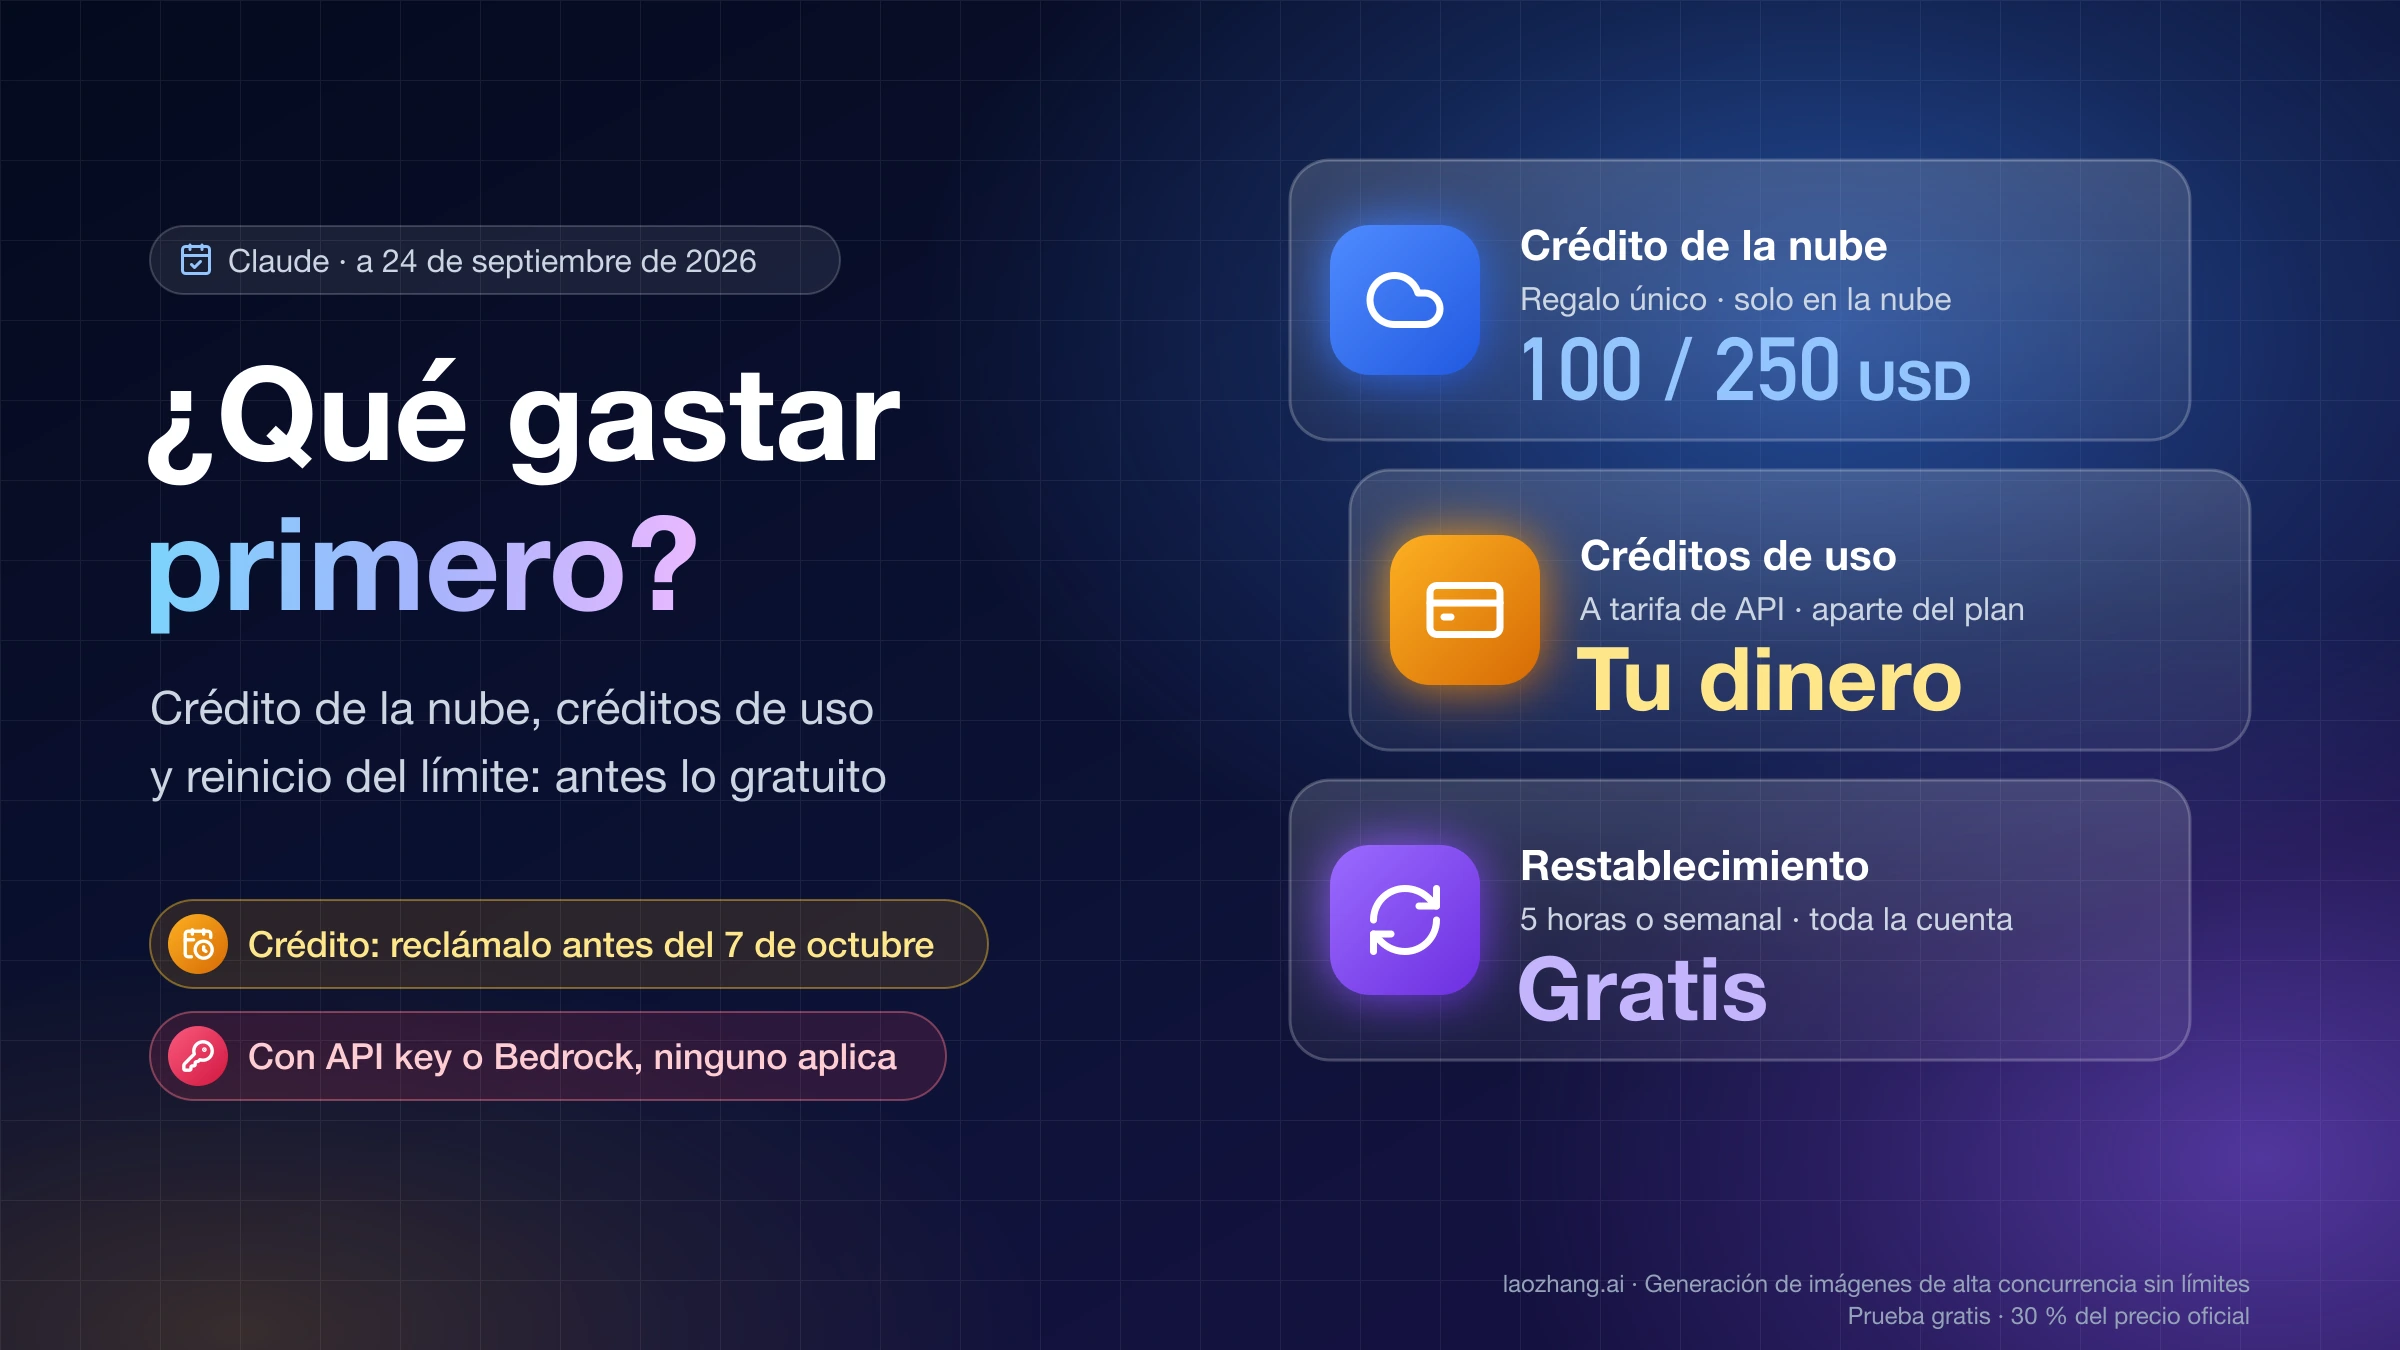
Claude Sonnet 5.5 cobra lo mismo que Sonnet 5 por token. Con datos de Artificial Analysis, por tarea sale más barato de low a xhigh y un 51 % más caro en max.
En esta página
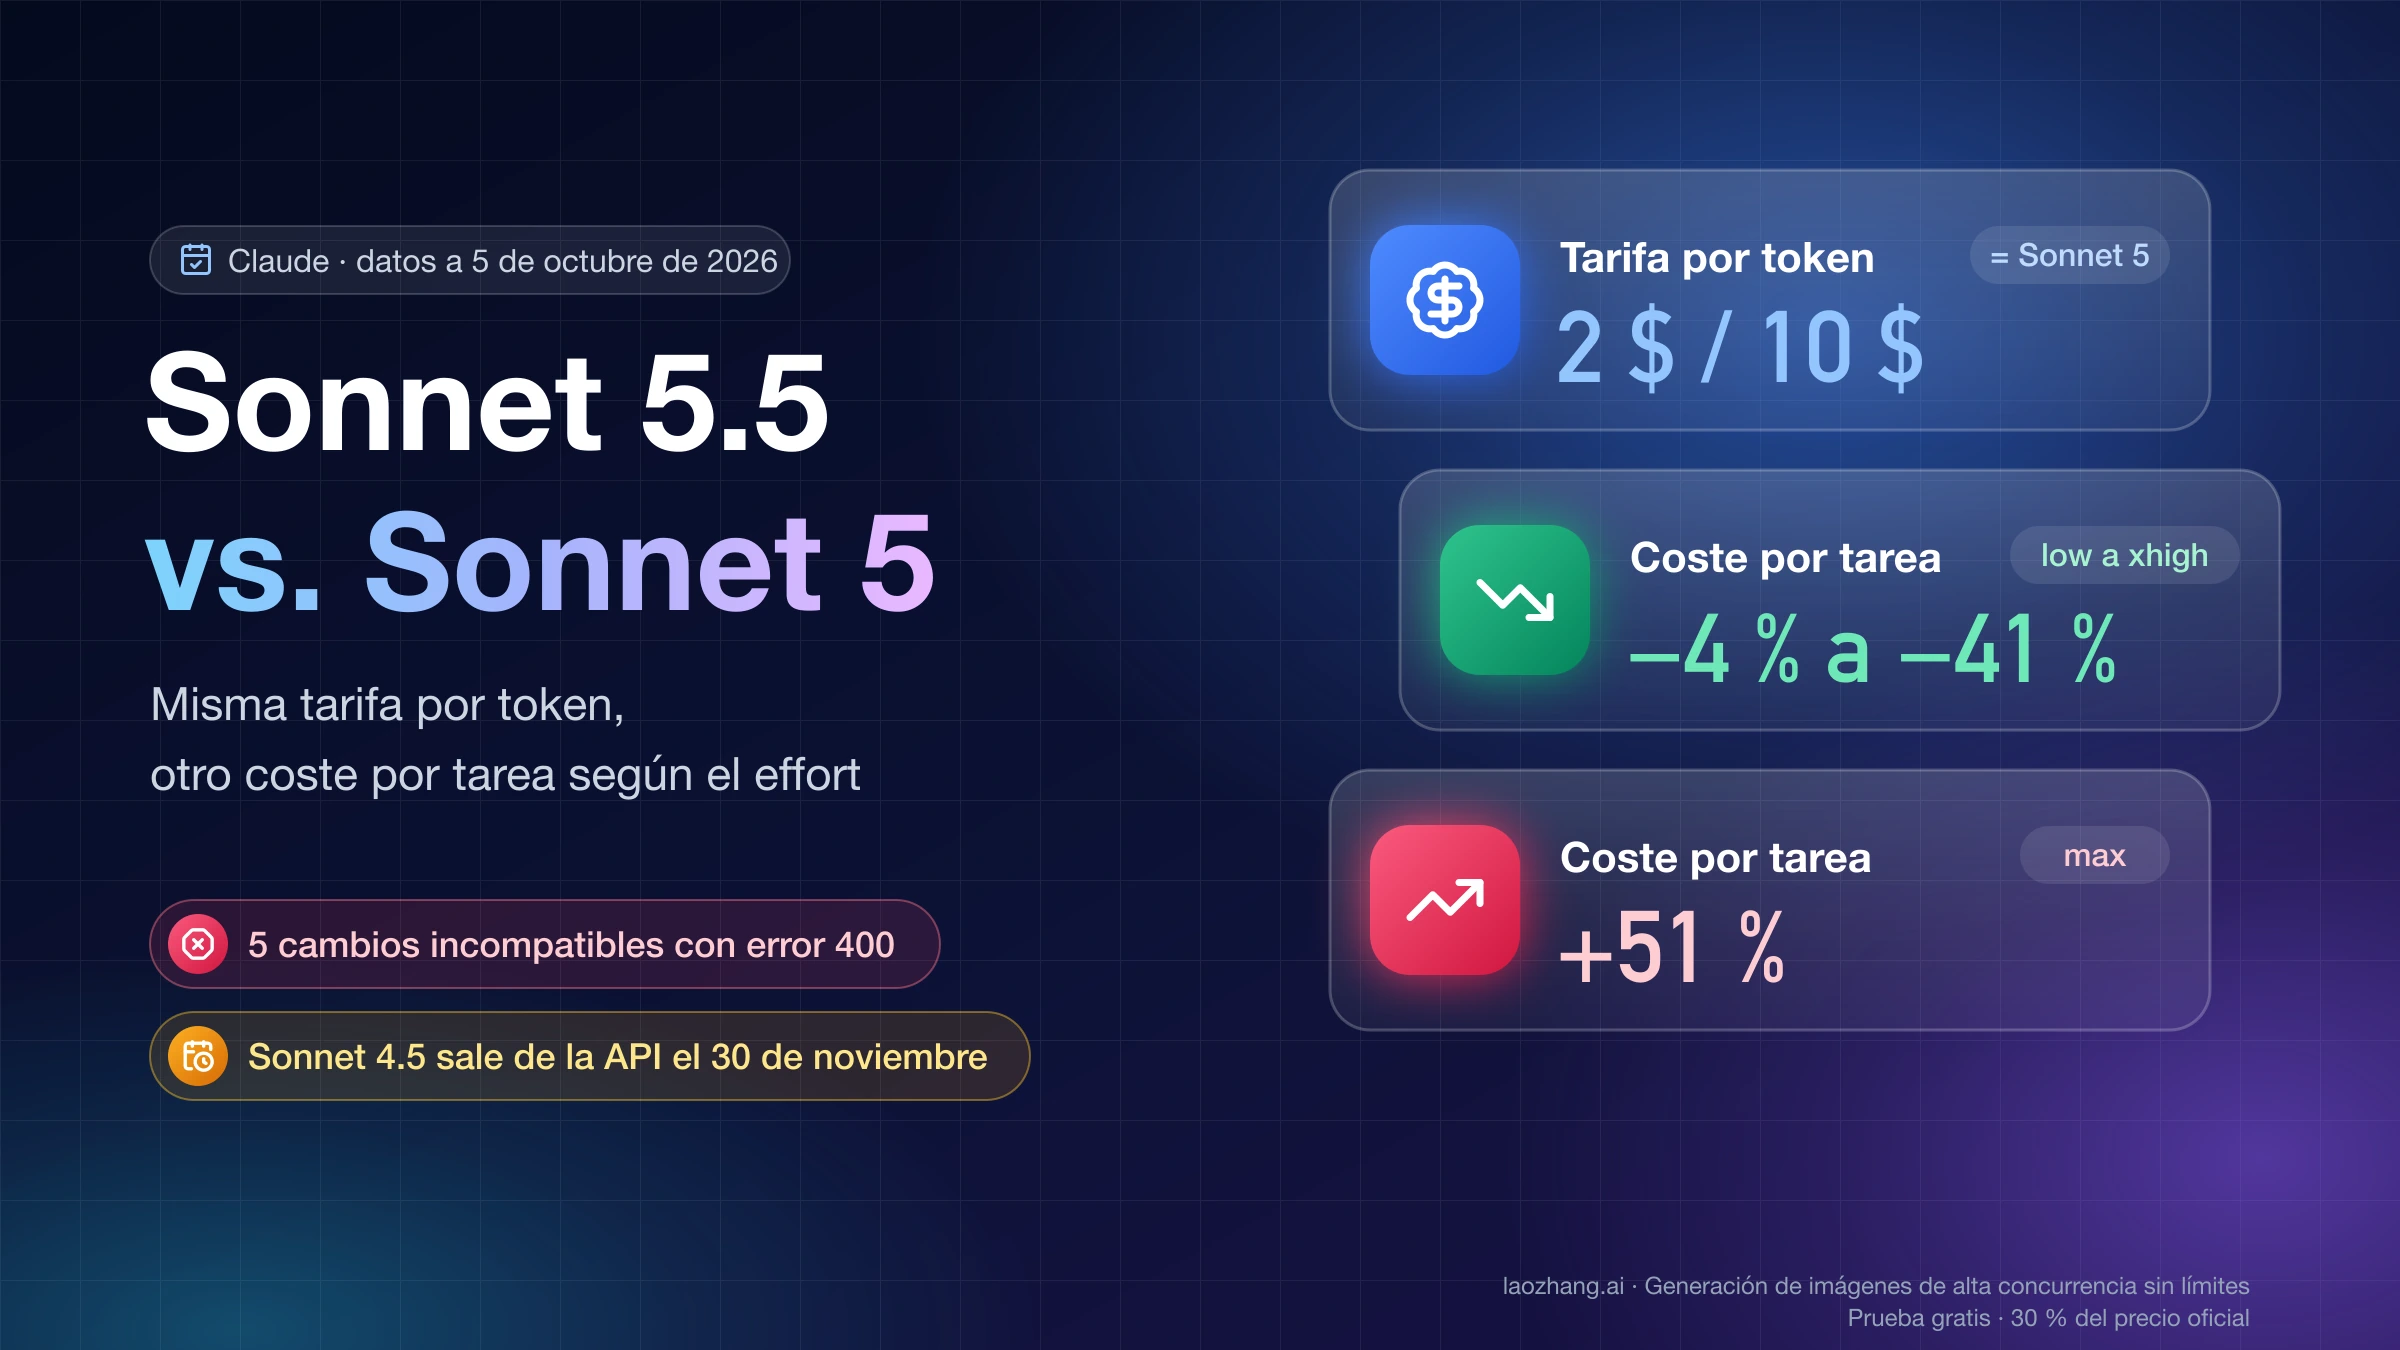
Claude Sonnet 5.5 (claude-sonnet-5-5) es el Sonnet que Anthropic publicó el 28 de septiembre de 2026 y el que ahora recomienda en lugar de Sonnet 5. Cuesta exactamente lo mismo por token: 2 $ por millón de tokens de entrada y 10 $ por millón de salida, con las mismas tarifas de caché y el mismo descuento por lotes. También usa el mismo tokenizador, así que un mismo texto cuenta los mismos tokens. Lo que cambia es cuántos tokens necesita para resolver una tarea, y eso depende del nivel de effort con el que lo ejecutes.
Con los datos de Artificial Analysis (AA) a 5 de octubre de 2026, y comparando la misma etiqueta de effort, Sonnet 5.5 gasta por tarea entre un 4 % y un 41 % menos que Sonnet 5 en low, medium, high y xhigh, y un 51 % más en max, siempre con más puntuación. Por eso son ciertas a la vez las dos cifras que circulan: el «hasta un 30 % menos por tarea» de Anthropic y el «~50 % más caro» de AA, que compara max con max. «Un 30 % más barato» no significa que haya bajado el precio.
Si usas Sonnet 5 por API, el cambio suele compensar, pero no basta con tocar el ID: cinco cambios incompatibles devuelven un error 400 y un sexto deja tu interfaz en silencio sin dar error. Tampoco conviene copiar tu ajuste de effort, porque los niveles están recalibrados. Y si sigues en Sonnet 4.5, Anthropic lo retira de la API de Claude el 30 de noviembre de 2026.
Qué es Claude Sonnet 5.5 y cuánto vale: la misma tarifa que Sonnet 5
Sonnet 5.5 es el segundo modelo de la familia Claude 5.5, después de Opus 5.5; Haiku 5.5 llegará «en las próximas semanas», sin fecha publicada. Anthropic lo describe como «la mejor combinación de velocidad e inteligencia» y lo orienta a tareas cotidianas bien acotadas, corrección de errores y documentos, presentaciones u hojas de cálculo. Sonnet 5 no desaparece: pasa a ser un modelo heredado (legacy), todavía disponible.
| Claude Sonnet 5.5 | Claude Sonnet 5 | |
|---|---|---|
| ID en la API de Claude | claude-sonnet-5-5 | claude-sonnet-5 |
| ID en Amazon Bedrock | anthropic.claude-sonnet-5-5 | anthropic.claude-sonnet-5 |
| Lanzamiento | 28 de septiembre de 2026 | 30 de junio de 2026 |
| Estado | Activo; retirada no antes del 28 de septiembre de 2027 | Heredado, disponible; retirada no antes del 30 de junio de 2027 |
| Corte de conocimiento | Junio de 2026 | Enero de 2026 |
| Contexto / salida máxima | 1M / 128K tokens | 1M / 128K tokens |
| Entrada / salida (por millón de tokens) | 2 $ / 10 $ | 2 $ / 10 $ |
| Caché: escritura 5 min / 1 h / lectura | 2,50 $ / 4 $ / 0,20 $ | 2,50 $ / 4 $ / 0,20 $ |
| Procesamiento por lotes | 50 % de descuento | 50 % de descuento |
| Prompt mínimo que se puede cachear | 512 tokens | 1.024 tokens |
| Effort por defecto en la API | high | high |
Precios de lista de la API de Claude en dólares, según la página de precios de Anthropic a 5 de octubre de 2026. Si quieres saber por qué Sonnet 5 sigue en esa tarifa y cómo cuadrar los cargos de caché, lo tienes en Anthropic cancela la subida de Sonnet 5: tarifas y cálculo del coste.
La mejora de capacidad es grande, aunque las cifras de Anthropic hay que leerlas con sus salvedades. En su tabla de lanzamiento, Sonnet 5.5 marca un 70,6 % en Terminal-Bench 4.0 frente al 10,3 % de Sonnet 5, pero esa base de Sonnet 5 es anormalmente baja: en la medición de AA en max la distancia es de 63,6 % frente a 14,1 %. Dos de las pruebas de su tabla (GDPval-AA y AA-Briefcase) se ejecutaron sobre una versión previa con un fallo en las salidas estructuradas que Anthropic ya ha corregido.
¿Es Sonnet 5.5 más barato que Sonnet 5? Hasta xhigh, sí; en max, no
AA publica su índice de inteligencia (versión 4.3.2, diez evaluaciones) para cada nivel de effort. El coste por tarea es lo que le cuesta a AA, a precios de lista, resolver cada tarea de esa batería. Estos son los datos a 5 de octubre de 2026, con las puntuaciones redondeadas:
| Effort | Sonnet 5: puntos | Sonnet 5: coste por tarea | Sonnet 5.5: puntos | Sonnet 5.5: coste por tarea | Diferencia de coste |
|---|---|---|---|---|---|
low | 24 | 0,51 $ | 36 | 0,42 $ | −18 % |
medium | 28 | 1,00 $ | 41 | 0,59 $ | −41 % |
high | 32 | 1,79 $ | 47 | 1,12 $ | −37 % |
xhigh | 34 | 2,87 $ | 52 | 2,75 $ | −4 % |
max | 38 | 5,09 $ | 56 | 7,67 $ | +51 % |
Fuente: ficha de Claude Sonnet 5.5 en Artificial Analysis. La última columna es un cálculo sobre esas cifras, no una factura medida: (coste de Sonnet 5.5 ÷ coste de Sonnet 5) − 1. En high, por ejemplo, 1,12 ÷ 1,79 − 1 = −0,37.
Lo que explica el salto en max son los tokens de salida. Como el precio por token es el mismo, el coste sigue sobre todo a lo que genera el modelo, y en max Sonnet 5.5 produce unos 197.400 tokens de salida por tarea frente a unos 117.800 de Sonnet 5, cerca de 1,7 veces más. En medium ocurre lo contrario: 20.900 frente a 27.300. También tarda más en max (968 segundos por tarea frente a 852), mientras que en high termina antes (238 frente a 375).
De ahí salen las dos cifras que parecen contradecirse:
- Anthropic dice que Sonnet 5.5 «cuesta hasta un 30 % menos por tarea» en sus pruebas. Es un máximo, no una media: el anuncio lo aplica a «la mayor parte del trabajo».
- AA escribió el 28 de septiembre que Sonnet 5.5 costaba «~50 % más por tarea» que Sonnet 5. Esa comparación es entre los dos modelos en
max, la fila en la que Sonnet 5.5 sí sale más caro.
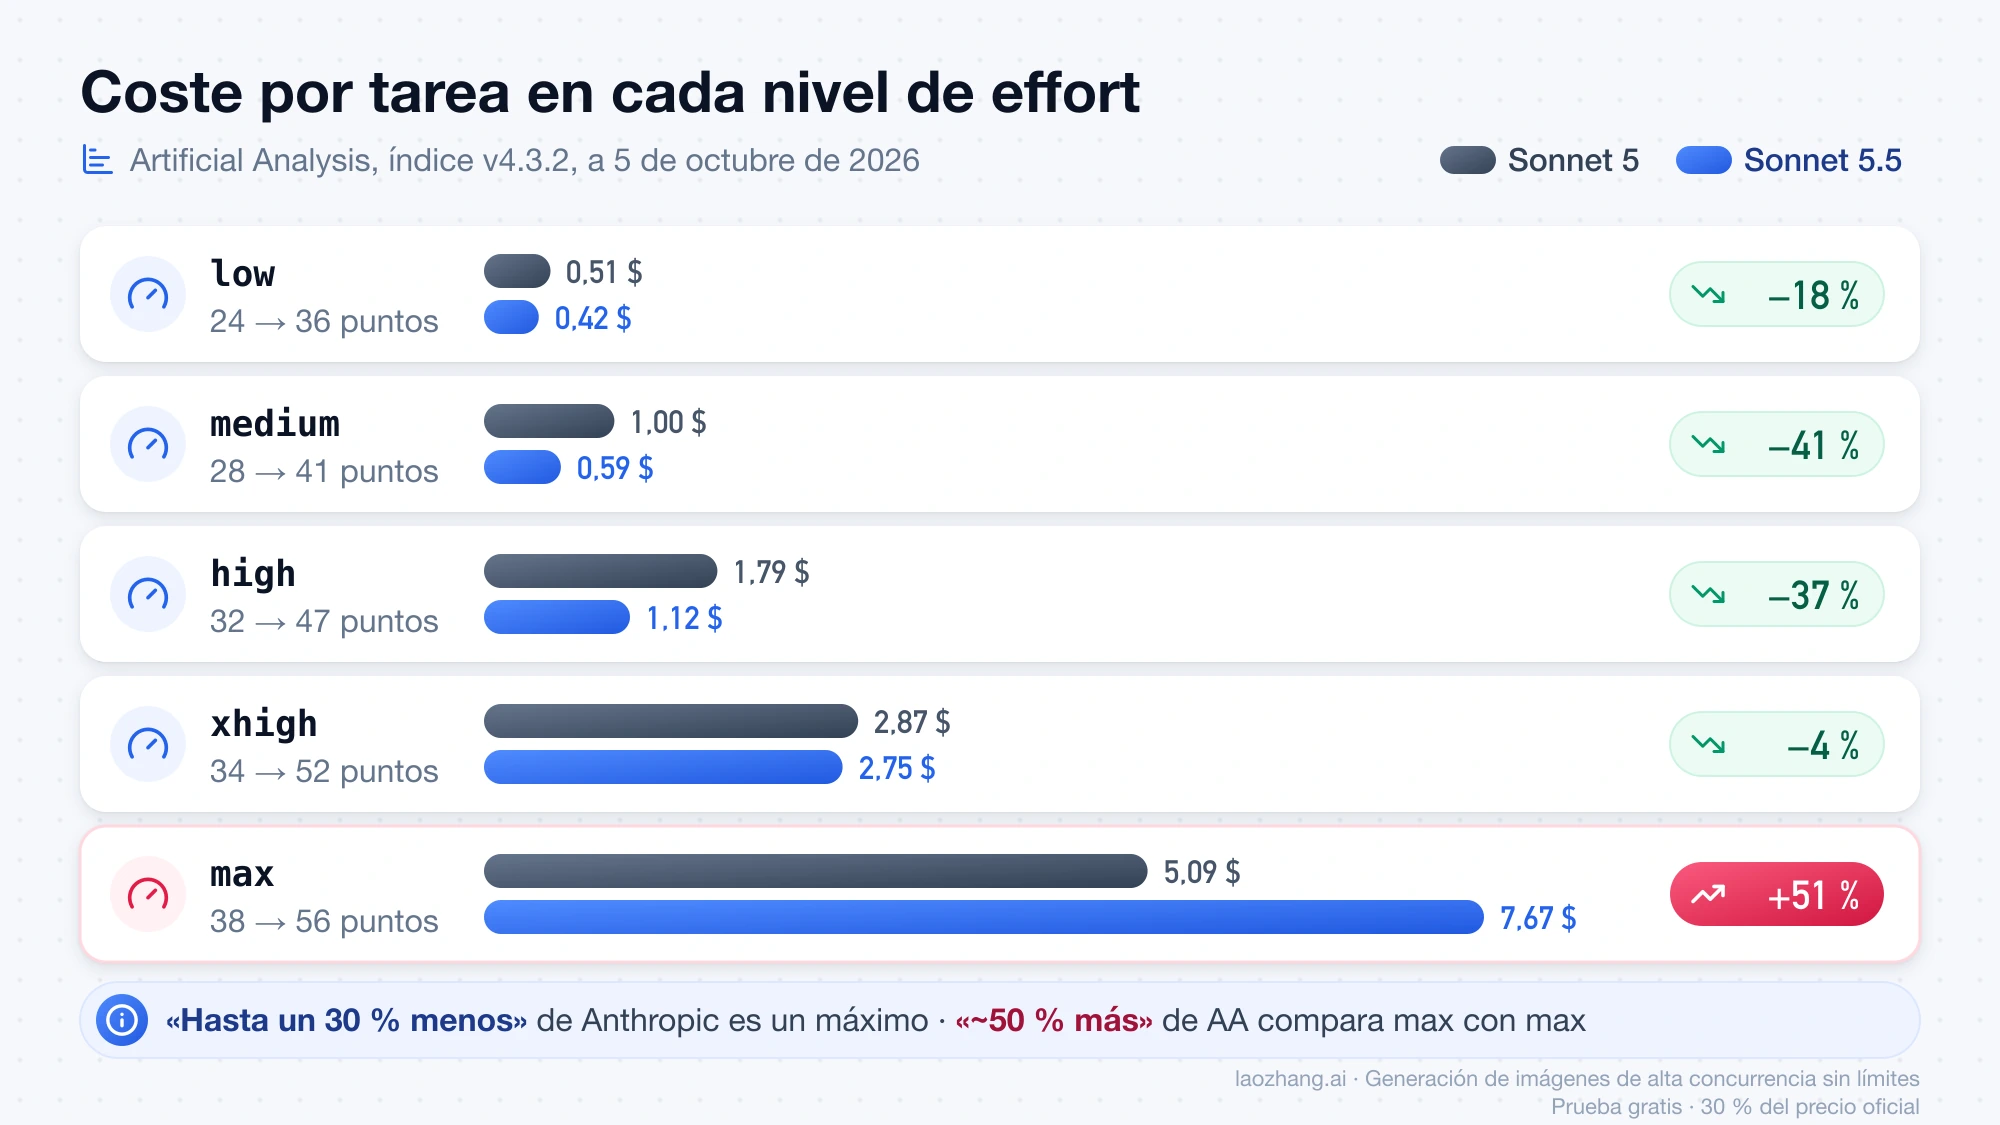
La comparación entre niveles distintos es todavía más clara. Sonnet 5.5 en low (36 puntos, 0,42 $) supera a Sonnet 5 en xhigh (34 puntos, 2,87 $) por cerca de una séptima parte del coste (2,87 ÷ 0,42 ≈ 6,8). Sonnet 5.5 en medium (41 puntos, 0,59 $) supera a Sonnet 5 en max (38 puntos, 5,09 $) por cerca de una novena parte (5,09 ÷ 0,59 ≈ 8,6). Encaja con lo que afirma Anthropic en su anuncio: en varias pruebas, Sonnet 5.5 en low o medium bate la mejor puntuación de Sonnet 5 por una décima parte del coste por tarea.
Un dato de un uso concreto apunta en la misma dirección. En la prueba de revisión de código de CodeRabbit con Sonnet 5.5, sobre 13 casos difíciles con errores conocidos, Sonnet 5.5 detectó 6 frente a 4 de Sonnet 5, con una precisión similar (41,2 % frente a 40,0 %), en la mitad de tiempo y con un coste por revisión cerca de un 60 % menor a precios de lista. La propia CodeRabbit avisa de que 13 casos indican una dirección, no una prueba.
Ninguna de estas cifras predice tu factura: dependen de la mezcla de tareas, del número de turnos y de cuánto aprovechas la caché. Para saber qué pasará con tu coste, lanza una muestra de tus tareas reales con los dos modelos y suma los campos usage de cada respuesta. Si además dudas entre Sonnet 5.5 y un modelo de OpenAI, en Claude Sonnet 5.5 vs GPT-6 Astra: cuándo cambiar y qué pagas tienes el coste por nivel de ambos.
Qué effort usar en Sonnet 5.5 según el que usabas en Sonnet 5
No copies el ajuste de Sonnet 5. Anthropic avisa de que los niveles están recalibrados: el mismo nivel no produce la misma cantidad de razonamiento que en Sonnet 5, y pide repetir el barrido de effort con tus evaluaciones. Sus puntos de partida para Sonnet 5.5 son estos:
- Por defecto,
high, salvo que tu carga sea agéntica o sensible a la latencia. - Código agéntico y uso de herramientas en varios pasos:
mediumpara tareas bien especificadas yhighpara las más difíciles o largas. - Chat y trabajo sensible a la latencia:
mediumolow. xhighymax: solo donde tus evaluaciones muestren una mejora de calidad.
Los datos de AA dicen hasta dónde puedes bajar si vienes de Sonnet 5: en su índice, Sonnet 5.5 dos niveles por debajo puntúa más que Sonnet 5 en el nivel original, y a una fracción del coste. Si combinas esa regla con el mínimo de medium que Anthropic propone para agentes de código, sale este punto de partida para tu barrido:
| En Sonnet 5 usabas | Empieza en Sonnet 5.5 con | Puntos y coste por tarea en AA (Sonnet 5 → Sonnet 5.5) |
|---|---|---|
low | low | 24 y 0,51 $ → 36 y 0,42 $ |
medium | low en chat; medium en agentes de código | 28 y 1,00 $ → 36 y 0,42 $ o 41 y 0,59 $ |
high | low en chat; medium en agentes de código | 32 y 1,79 $ → 36 y 0,42 $ o 41 y 0,59 $ |
xhigh | medium; high en tareas largas | 34 y 2,87 $ → 41 y 0,59 $ o 47 y 1,12 $ |
max | high; xhigh si tus evaluaciones lo justifican | 38 y 5,09 $ → 47 y 1,12 $ o 52 y 2,75 $ |
El índice de AA es una batería de pruebas, no tu carga de trabajo, así que la tabla es un punto de partida: baja un nivel si tus evaluaciones aguantan y sube uno si pierdes calidad. Para trabajo que no es agéntico ni de chat, Anthropic propone empezar en high; si en Sonnet 5 usabas high o menos, prueba también el nivel de la tabla y quédate con el más barato que supere tus evaluaciones. Con lo que conviene tener cuidado es con trasladar max sin probar. Es el único nivel en el que Sonnet 5.5 cuesta más que Sonnet 5, tarda más por tarea y no siempre puntúa mejor: en FrontierCode, la tabla de Anthropic le da un 52,1 % en xhigh y un 46,2 % en max. La documentación de Claude Code también advierte de que max tiende a pensar de más y da rendimientos decrecientes.
Si en la API no envías output_config.effort, Sonnet 5.5 trabaja en high. En Claude Code y en las apps de Claude, el nivel por defecto es medium. Y si con Sonnet 5 desactivabas el razonamiento, el equivalente en Sonnet 5.5 es between_tools, que solo se acepta en low, medium y high (lo ves en la sección siguiente).
Cinco cambios incompatibles al pasar a claude-sonnet-5-5
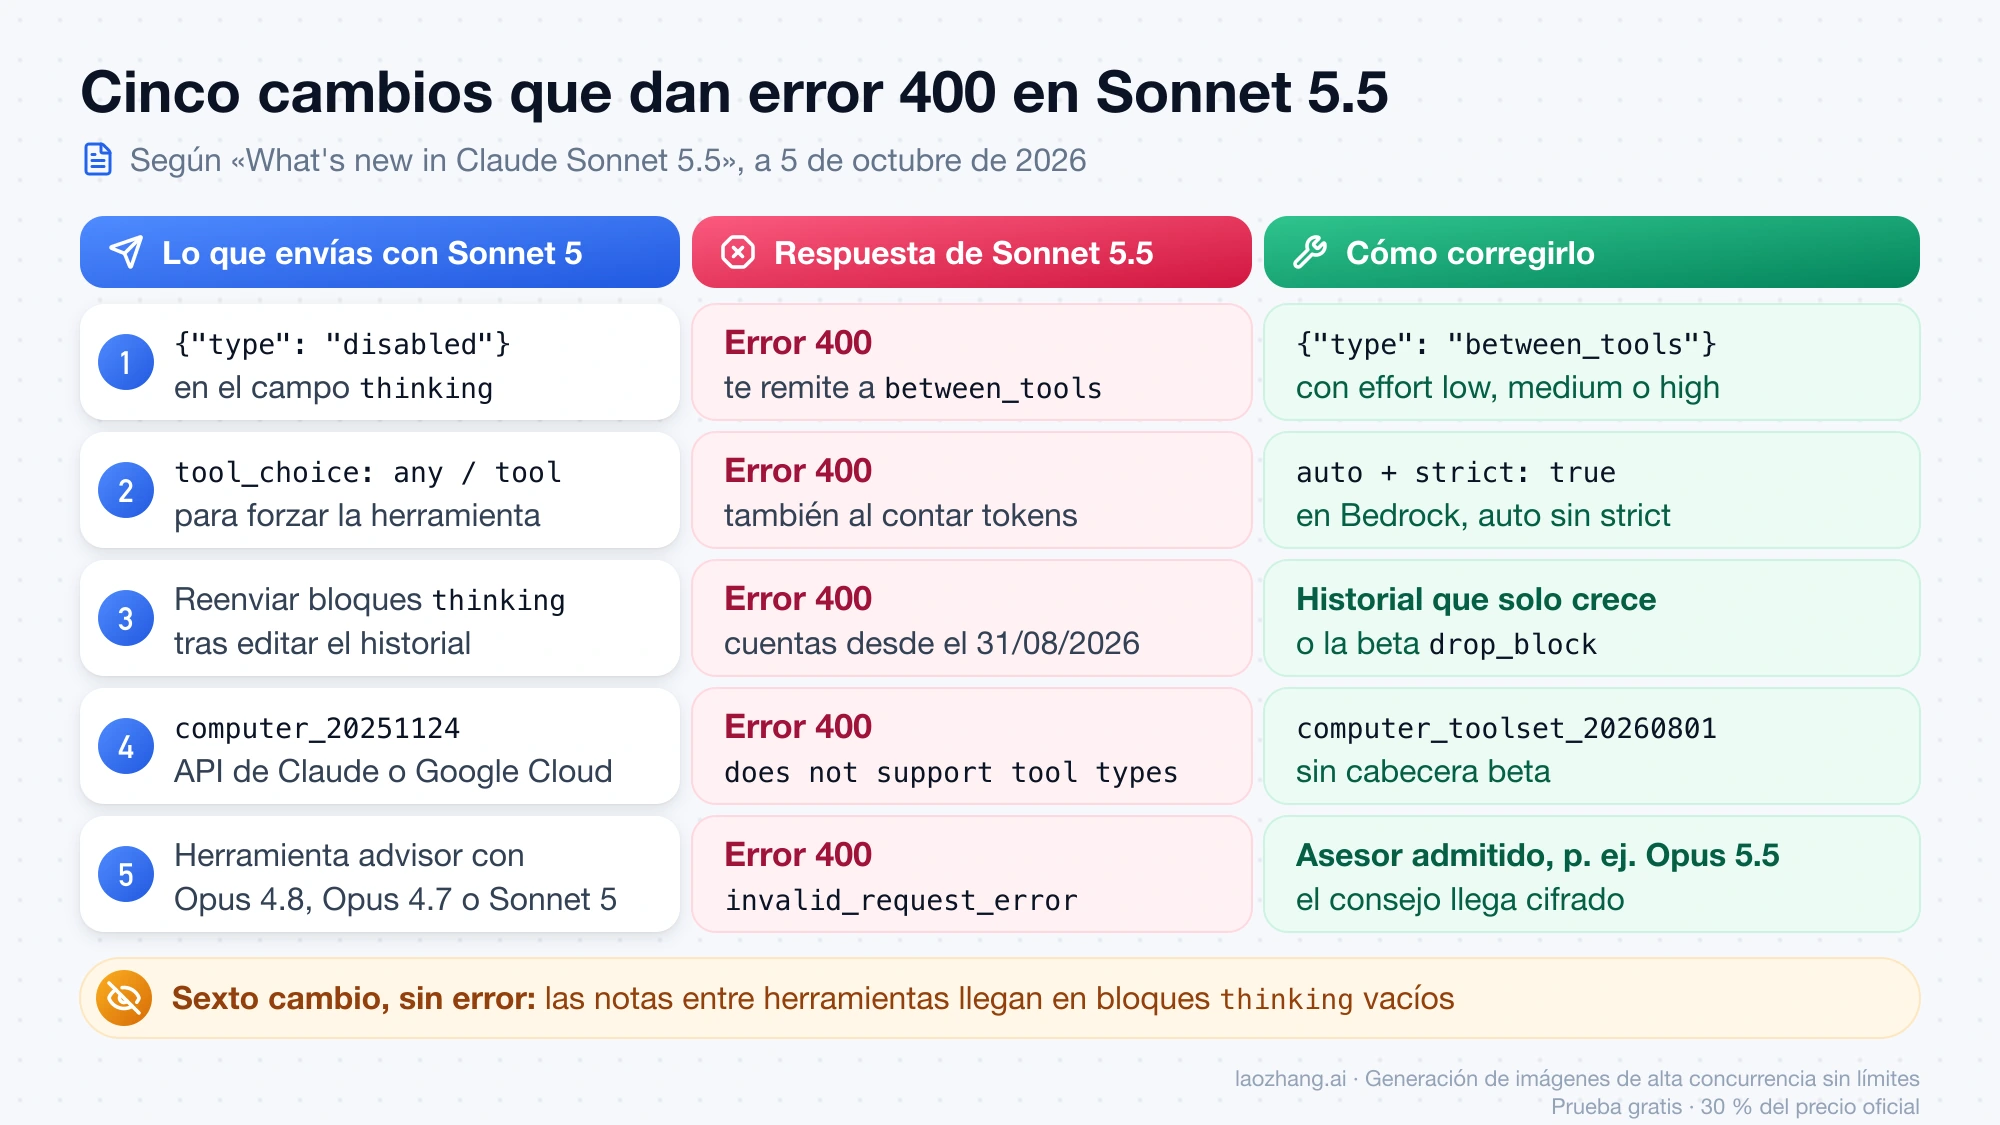
La documentación de Anthropic los llama cambios incompatibles (breaking changes): código que funciona con Sonnet 5 y falla con Sonnet 5.5. Esta matriz resume qué envías hoy, qué te devuelve el modelo nuevo y cómo corregirlo, según la página What's new in Claude Sonnet 5.5 a 5 de octubre de 2026:
| Lo que envías con Sonnet 5 | Qué pasa con Sonnet 5.5 | Cómo corregirlo |
|---|---|---|
thinking: {"type": "disabled"} | Error 400 invalid_request_error que te remite a between_tools | Envía {"type": "between_tools"} con effort low, medium o high; para xhigh o max, usa el razonamiento adaptativo |
tool_choice de tipo any o tool | Error 400, también en el endpoint de conteo de tokens | tool_choice: {"type": "auto"} con strict: true, o salidas estructuradas; en Amazon Bedrock, auto sin strict |
Reenviar bloques thinking de Sonnet 5.5 tras editar system, tools o un mensaje anterior | Error 400 en cuentas creadas desde el 31 de agosto de 2026 (API de Claude, Bedrock y Google Cloud) | Historial que solo crece; cambios con mensajes de sistema a mitad de conversación, o la beta drop_block |
Herramienta computer_20251124 en la API de Claude o Google Cloud | Error 400: 'claude-sonnet-5-5' does not support tool types: computer_20251124. | {"type": "computer_toolset_20260801"} sin cabecera beta; Bedrock sigue aceptando la versión antigua |
| Herramienta advisor (beta) con Opus 4.8, Opus 4.7 o Sonnet 5 como asesor | Error 400 invalid_request_error | Asesor Opus 5, Opus 5.5, Sonnet 5.5, Fable 5 o 5.1, Mythos 5 o 5.1; el consejo llega cifrado como advisor_redacted_result |
Si buscas en tu código "disabled", tool_choice, computer_20251124 y advisor, localizas cuatro de los cinco; el tercero depende de cómo gestiona tu aplicación el historial. Las dos primeras filas son las que más integraciones tocan.
thinking disabled devuelve error 400: usa between_tools
Este es el texto exacto del error a 5 de octubre de 2026:
To turn thinking off on this model, send "thinking": {"type": "between_tools"} instead of {"type": "disabled"}. The model does not think before responding. The short updates it writes between tool calls come back as thinking blocks.between_tools desactiva el razonamiento previo a la respuesta, pero las notas breves que el modelo escribe entre llamadas a herramientas siguen llegando como bloques thinking; devuélvelos sin cambios con el resto del turno. Si tus peticiones no usan herramientas, la respuesta solo trae texto, como con disabled en Sonnet 5. No admite ningún otro campo (display, budget_tokens o block_binding devuelven 400) y, con él, el effort no puede cambiar a mitad de conversación.
El caso que más confunde es una petición de Sonnet 5 que combinaba disabled con xhigh. Antes:
{
  "model": "claude-sonnet-5",
  "max_tokens": 16000,
  "thinking": {"type": "disabled"},
  "output_config": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}
Después, bajando el effort a high para poder usar between_tools:
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": {"type": "between_tools"},
  "output_config": {"effort": "high"},
  "messages": [{"role": "user", "content": "..."}]
}
La alternativa es mantener xhigh y quitar el campo thinking (o enviar {"type": "adaptive"}), con lo que el modelo vuelve a razonar antes de responder. Los presupuestos manuales ({"type": "enabled", "budget_tokens": N}) también devuelven 400.
tool_choice "any" o "tool" ya no fuerza la herramienta
El error es tool_choice: type "tool" and "any" are not supported for this model. Solo se aceptan auto (el valor por defecto) y none. Para que la entrada de la herramienta cumpla el esquema, márcala como estricta y di en el prompt cuándo debe usarse, porque con auto el modelo puede contestar sin llamarla:
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 1024,
  "tools": [{
    "name": "get_weather",
    "description": "Get the current weather in a given location",
    "input_schema": {
      "type": "object",
      "properties": {"location": {"type": "string"}},
      "required": ["location"],
      "additionalProperties": false
    },
    "strict": true
  }],
  "tool_choice": {"type": "auto"},
  "messages": [{"role": "user", "content": "¿Qué tiempo hace en París? Usa la herramienta get_weather."}]
}
El modo estricto necesita additionalProperties: false en cada objeto del esquema. En Amazon Bedrock las salidas estructuradas (que incluyen el modo estricto) no están disponibles para Sonnet 5.5: allí envía auto sin strict y valida la entrada en tu código.
Bloques thinking ligados al modelo y a la conversación
Cada bloque thinking registra qué modelo lo produjo. Sonnet 5.5 lee los de Sonnet 5, Opus 4.8, Haiku 4.5 y modelos anteriores, pero no los de Opus 5, Opus 5.5, Fable ni Mythos. En la API de Claude y Google Cloud, Opus 5.5 sí lee los bloques de Sonnet 5.5, y ningún otro modelo lo hace. En la práctica:
- Pasar una conversación de Sonnet 5 a Sonnet 5.5 conserva el razonamiento.
- Subirla de Sonnet 5.5 a Opus 5.5 en la API de Claude o Google Cloud también lo conserva.
- Cualquier otro cambio desde Sonnet 5.5 sigue sin él: la API descarta los bloques que el modelo de destino no puede leer, la petición funciona y esos bloques no se facturan.
El error 400 aparece por otro motivo: la API comprueba que nada de lo anterior a un bloque de Sonnet 5.5 (el prompt de sistema, las herramientas o un mensaje previo) haya cambiado desde que se generó. En cuentas creadas desde el 31 de agosto de 2026 a las 00:00 UTC lo hace por defecto. Mantén el historial de forma que solo crezca y cambia instrucciones o herramientas con mensajes de sistema a mitad de conversación. Si prefieres que la API descarte los bloques afectados en vez de fallar, envía la cabecera anthropic-beta: thinking-binding-controls-2026-08-01 y este campo (solo con razonamiento adaptativo):
"thinking": {
  "type": "adaptive",
  "block_binding": {"prefix_mismatch_behavior": "drop_block"}
}
Además, los bloques de Sonnet 5.5 solo sirven en la cuenta que los produjo o en una vinculada; si otra cuenta los envía, se descartan sin error.
Uso del ordenador y herramienta advisor
Si usas el uso del ordenador (computer use) con computer_20251124 en la API de Claude o Google Cloud, sustituye la entrada de tools por {"type": "computer_toolset_20260801"}, quita la cabecera beta y adapta tu bucle de agente a los bloques tool_use de miembro, las acciones por lotes y el campo toolset_name de los resultados. Sonnet 5 ya acepta ese conjunto de herramientas en la API de Claude, así que puedes migrar esa parte antes de cambiar de modelo. Si envías la cabecera fine-grained-tool-streaming-2025-05-14, retírala junto con el cambio: con el conjunto de herramientas da error 400, y su sustituto es eager_input_streaming: true en cada herramienta que lo necesite.
Con la herramienta advisor cambia qué asesores puedes emparejar: un ejecutor Sonnet 5.5 no acepta como asesor a Opus 4.8, Opus 4.7 ni Sonnet 5, y todo asesor aceptado devuelve el consejo cifrado, así que tu cliente ya no puede leer ese texto.
El cambio sin error: notas entre herramientas en bloques thinking
En Sonnet 5, todo el texto que el modelo escribía entre llamadas a herramientas llegaba como bloques text. En Sonnet 5.5, las notas de más de una o dos frases llegan como bloques thinking de progreso, y con el valor por defecto display: "omitted" esos bloques vienen vacíos. Ninguna petición falla, pero una aplicación que mostraba esas notas a sus usuarios deja de mostrar nada entre una herramienta y la siguiente.
Con razonamiento adaptativo, pide las notas con display. "updates" devuelve solo las notas de progreso y necesita la cabecera anthropic-beta: thinking-display-updates-2026-08-18; "summarized" las mezcla con resúmenes del razonamiento:
"thinking": {"type": "adaptive", "display": "updates"}Muestra cada bloque thinking no vacío antes del bloque tool_use que lo sigue. Con between_tools, el texto vuelve sin necesidad de display (y enviarlo junto con between_tools da error 400).
Rechazos con stop_reason "refusal" y vuelta a Sonnet 5
Sonnet 5.5 rechaza peticiones en más categorías que Sonnet 5. Un rechazo llega con HTTP 200, stop_reason: "refusal" y un objeto stop_details con la categoría: cyber, bio, frontier_llm, reasoning_extraction o general_harms. La última puede saltar también con trabajo inofensivo, así que tu código debe tratar el rechazo como un resultado posible y no como un fallo de red.
La reserva en el servidor (fallbacks: "default", beta y solo en la API de Claude) reintenta en Sonnet 5 los rechazos cyber y frontier_llm, pero no los de bio, reasoning_extraction ni general_harms. Anthropic presenta Sonnet 5.5 como el primer Sonnet con salvaguardas de ciberseguridad: el desarrollo de software habitual no se ve afectado, pero las tareas de seguridad de mayor riesgo pasan de forma visible a Sonnet 5. Que un rechazo se facture depende de su categoría, y en cualquier caso cuenta para tus límites de frecuencia (rate limits).
Si sigues en Sonnet 4.5: se retira de la API el 30 de noviembre
Anthropic avisó el 30 de septiembre de 2026 de que claude-sonnet-4-5-20250929 queda en desuso y se retira de la API de Claude el 30 de noviembre de 2026, y propone claude-sonnet-5-5 como sustituto, según su tabla de retirada de modelos. Sonnet 4.6 sigue activo hasta, como pronto, el 17 de febrero de 2027. En Bedrock, Google Cloud y Foundry, cada proveedor fija sus propias fechas.
Desde Sonnet 4.5 te tocan todos los cambios anteriores y, además, estos:
- El razonamiento viene activado por defecto: lee los bloques de la respuesta por su
type(no porcontent[0].text), devuelve los bloquesthinkingsin cambios y revisamax_tokens, porque incluye el razonamiento y este se factura como salida. - Quita los valores no predeterminados de
temperature,top_pytop_k, y fijaoutput_config.effortde forma explícita (Sonnet 4.5 no tenía effort). - El mismo texto ocupa en torno a un 30 % más de tokens que en Sonnet 4.5, y las imágenes llegan a 2576 píxeles en el lado largo: una de 2000×1500 cuesta unas 2,5 veces más tokens. Recalcula tu coste aunque la tarifa por token sea conocida.
- El relleno previo de la respuesta del asistente (prefill) devuelve
This model does not support assistant message prefill. The conversation must end with a user message. - Retira las cabeceras de ventana de contexto y
interleaved-thinking-2025-05-14, cambiafine-grained-tool-streaming-2025-05-14poreager_input_streamingy mueveoutput_formataoutput_config.format.
La lista completa por modelo de origen está en la guía de migración a Claude Sonnet 5.5. Si trabajas con Claude Code, la propia guía propone automatizar buena parte con /claude-api migrate this project to claude-sonnet-5-5, que aplica el cambio de ID y los parámetros incompatibles y te deja una lista de puntos que revisar a mano.
Cómo usar Sonnet 5.5 en Claude Code y comprobar el modelo y el effort
Claude Code necesita la versión 2.1.284 o posterior para Sonnet 5.5; actualiza con claude update. Después tienes varias formas de elegirlo:
/model sonneto/model claude-sonnet-5-5dentro de la sesión. ConEnteren el selector se guarda como predeterminado; cons, solo para esa sesión.claude --model claude-sonnet-5-5al arrancar, o la variableANTHROPIC_MODEL, que solo afectan a la sesión que lanzas con ellas.
La trampa está en el alias sonnet, que no apunta al mismo modelo en todos los proveedores. Según la documentación de configuración de modelos de Claude Code a 5 de octubre de 2026:
| Proveedor | sonnet apunta a |
|---|---|
| API de Anthropic | Sonnet 5.5 |
| Claude Platform on AWS | Sonnet 4.6 |
| Amazon Bedrock y Agent Platform de Google Cloud | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
Si trabajas con Bedrock o Google Cloud y escribes /model sonnet, estás usando Sonnet 4.5, el modelo que Anthropic retira de su propia API en noviembre. Fija la versión con el nombre completo del modelo o con ANTHROPIC_DEFAULT_SONNET_MODEL. Tampoco des por hecho que ya usas Sonnet: desde la versión 2.1.280, el ajuste default resuelve a Opus 5.5 en Pro, Max, Team, Enterprise y la API de Anthropic.
El effort por defecto de Sonnet 5.5 en Claude Code es medium, igual que el de Opus 5.5; la mayoría de los demás modelos parte de high. Lo cambias con /effort, con --effort al arrancar o con CLAUDE_CODE_EFFORT_LEVEL, y Claude Code guarda el nivel por modelo. Para comprobar qué tienes de verdad, /status muestra el modelo activo junto con tu cuenta, y la cabecera de la sesión enseña el nivel de effort al lado del nombre del modelo.
Dos detalles más. Cambiar de modelo con /model a mitad de sesión invalida la caché del prompt, así que el siguiente turno vuelve a leer todo el contexto sin descuento: si puedes, empieza una sesión nueva. Y si una petición activa el clasificador de ciberseguridad, Claude Code la repite en Sonnet 5 y lo indica en la transcripción; las de biología terminan en rechazo, porque Sonnet 5.5 no tiene modelo de reserva para esa categoría. En Bedrock, Google Cloud y Foundry, esa reserva solo funciona si Claude Code puede resolver un Sonnet 5 (con ANTHROPIC_DEFAULT_SONNET_MODEL o una entrada de Sonnet 5 en tu proveedor) y además tienes un Opus configurado con ANTHROPIC_DEFAULT_OPUS_MODEL o una entrada de Opus 4.8.
¿Es gratis Claude Sonnet 5.5? Lo que se sabe de la app de Claude
En la API pagas por token: 2 $ por millón de tokens de entrada y 10 $ por millón de salida. En las apps de Claude, el anuncio de Anthropic fija el effort por defecto en Medium, frente a High en Claude Platform.
A 29 de septiembre de 2026, la tabla de modelos de la página de planes de Claude marca Sonnet como disponible en el plan gratuito y Opus solo en Pro y Max, pero no indica versiones. Como Sonnet 5.5 es el Sonnet actual, es probable que el plan gratuito lo use, aunque Anthropic no lo dice de forma explícita. Si lo usas gratis, lo haces dentro de los límites de uso del plan gratuito.
Cuándo quedarte en Sonnet 5 por ahora
Quedarte en Sonnet 5 es una opción legítima: es un modelo heredado, todavía disponible, sin aviso de retirada y con fecha no anterior al 30 de junio de 2027. Anthropic recomienda plantearse la migración, no la impone. Tiene sentido esperar si:
- tu integración depende de
tool_choiceforzado y todavía no puedes rehacerla conautoy modo estricto; - usas
computer_20251124en la API de Claude o Google Cloud y no has adaptado el bucle del agente al conjunto de herramientas nuevo; - usas la herramienta advisor con Sonnet 5, Opus 4.7 u Opus 4.8 como asesor, o necesitas leer el texto del consejo;
- tu aplicación edita el historial y reenvía bloques
thinking, y aún no has pasado a un historial que solo crece; - trabajas fijo en
maxy no puedes bajar de nivel: es la fila en la que Sonnet 5.5 cuesta un 51 % más por tarea en los datos de AA; - haces trabajo de seguridad ofensiva que activará el clasificador
cyber, con lo que muchas peticiones acabarían en Sonnet 5 de todos modos.
Si no te ves en esa lista, el orden razonable es: cambia el ID en un entorno de pruebas, corrige lo que marque la matriz de cambios incompatibles, repite el barrido de effort con la tabla de arriba como punto de partida y compara coste y calidad con tus propias tareas antes de mover todo el tráfico.
Preguntas frecuentes sobre Claude Sonnet 5.5
¿Cuánto vale Claude Sonnet 5.5?
En la API de Claude, 2 $ por millón de tokens de entrada y 10 $ por millón de salida, igual que Sonnet 5; la lectura de caché cuesta 0,20 $ por millón y los lotes tienen un 50 % de descuento. El coste por tarea depende del nivel de effort: en el índice de AA va de 0,42 $ en low a 7,67 $ en max (a 5 de octubre de 2026).
¿Qué es mejor para programar, Sonnet 5.5 u Opus 5.5?
Opus 5.5 cuesta el doble por token (4 $ y 20 $ por millón) y, según Anthropic, sigue siendo claramente mejor en trabajo complejo y abierto que exige criterio sostenido. Sonnet 5.5 está pensado para tareas acotadas del día a día y cuesta la mitad: en max quedó a 2 puntos de Opus 5.5 en el índice de AA el día del lanzamiento, aunque se queda atrás en conocimiento factual (54 % frente a 66 % en AA-Omniscience).
¿Está disponible Claude Sonnet 5.5 en España?
Sí. España figura en la lista de países admitidos por Anthropic a 29 de septiembre de 2026, y Sonnet 5.5 está en la API de Claude para todos los clientes, además de en Amazon Bedrock, Claude Platform on AWS, Google Cloud y Microsoft Foundry.
¿Cuándo sale Claude Haiku 5.5?
Anthropic solo ha dicho que llegará «en las próximas semanas» como modelo para aplicaciones de alto volumen y sensibles al coste; no hay fecha ni precio publicados a 6 de octubre de 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 oct 2026.
- 1.página de precios de Anthropicplatform.claude.com/docs/en/about-claude/pricing
- 2.ficha de Claude Sonnet 5.5 en Artificial Analysisartificialanalysis.ai/models/claude-sonnet-5-5
- 3.prueba de revisión de código de CodeRabbit con Sonnet 5.5coderabbit.ai/blog/sonnet-5-5-model-review
- 4.What's new in Claude Sonnet 5.5platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- 5.tabla de retirada de modelosplatform.claude.com/docs/en/about-claude/model-deprecations
- 6.guía de migración a Claude Sonnet 5.5platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- 7.documentación de configuración de modelos de Claude Codecode.claude.com/docs/en/model-config