Tamaño de MiniMax M3.1 Flash: 252 GB, VRAM y qué versión te cabe
MiniMax M3.1 Flash tiene unos 428.000 millones de parámetros y 252,4 GB de pesos oficiales. Con menos de 256 GB de memoria, solo caben versiones de 1–3 bits.
En esta página
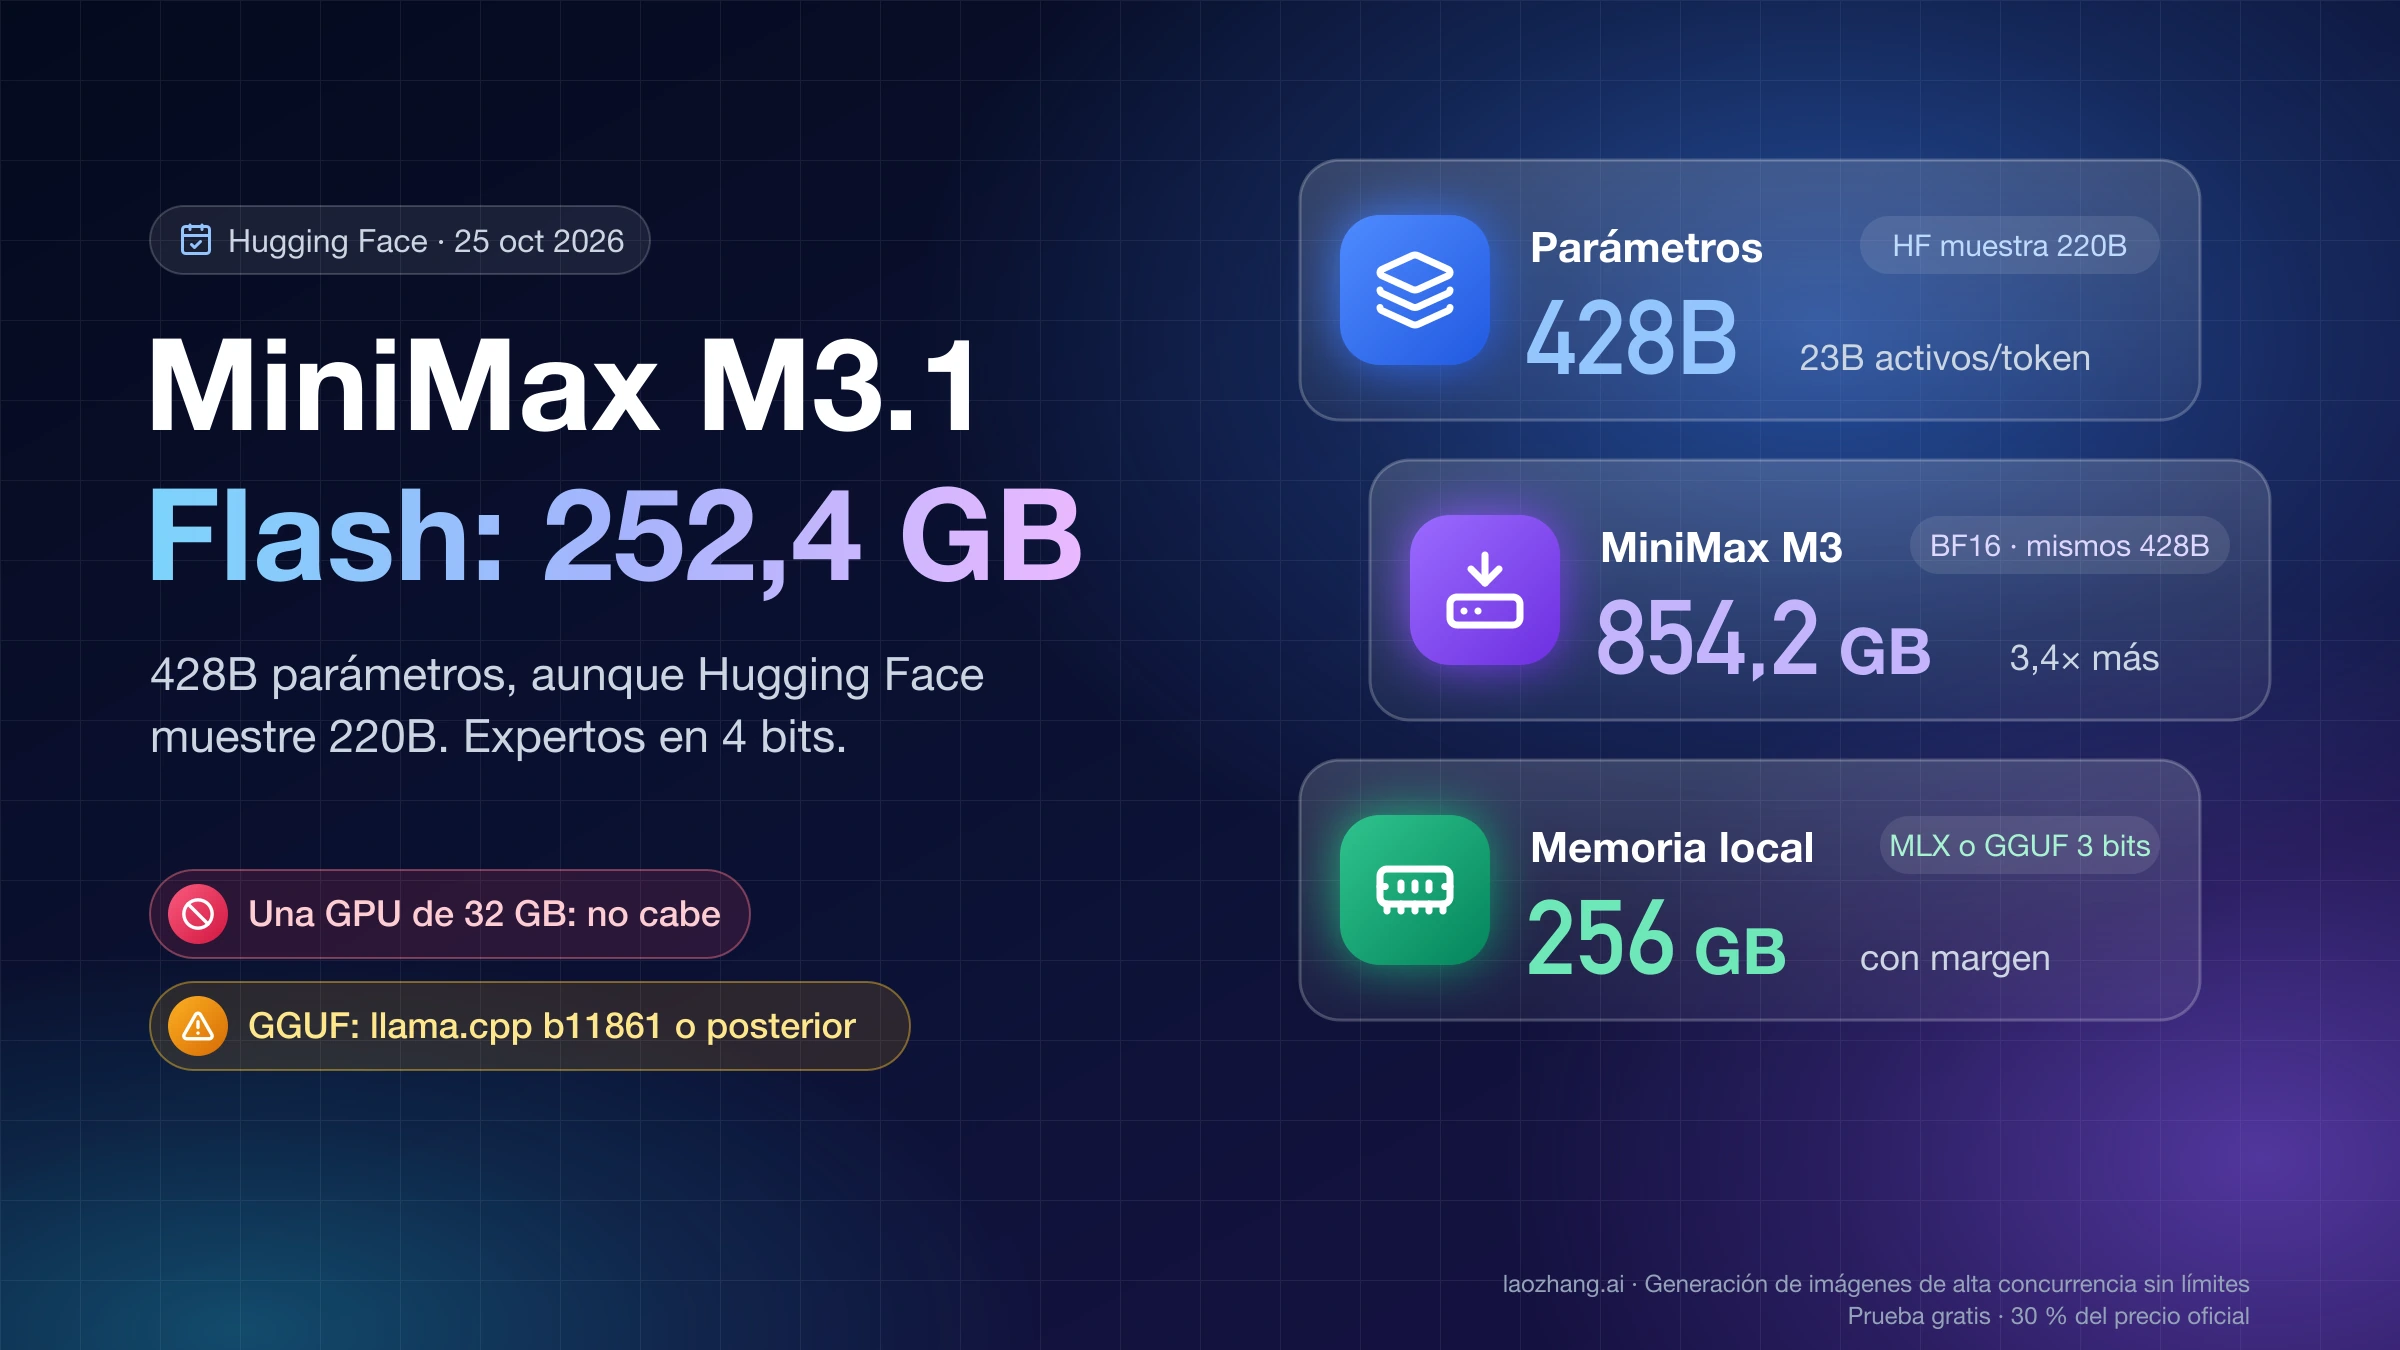
MiniMax M3.1 Flash no es un modelo pequeño: tiene unos 428.000 millones de parámetros en total (428B), de los que se activan unos 23.000 millones por token, y el repositorio oficial MiniMaxAI/MiniMax-M3.1-Flash ocupa 252,4 GB en Hugging Face. «Flash» quiere decir que es más barato y rápido de servir, porque sus expertos se entrenaron directamente en 4 bits, no que tenga menos parámetros: MiniMax M3 tiene los mismos y su repositorio en BF16 pesa 854,2 GB. Los «220B params» que enseña la página de Hugging Face salen de cómo se cuentan esos pesos de 4 bits empaquetados.
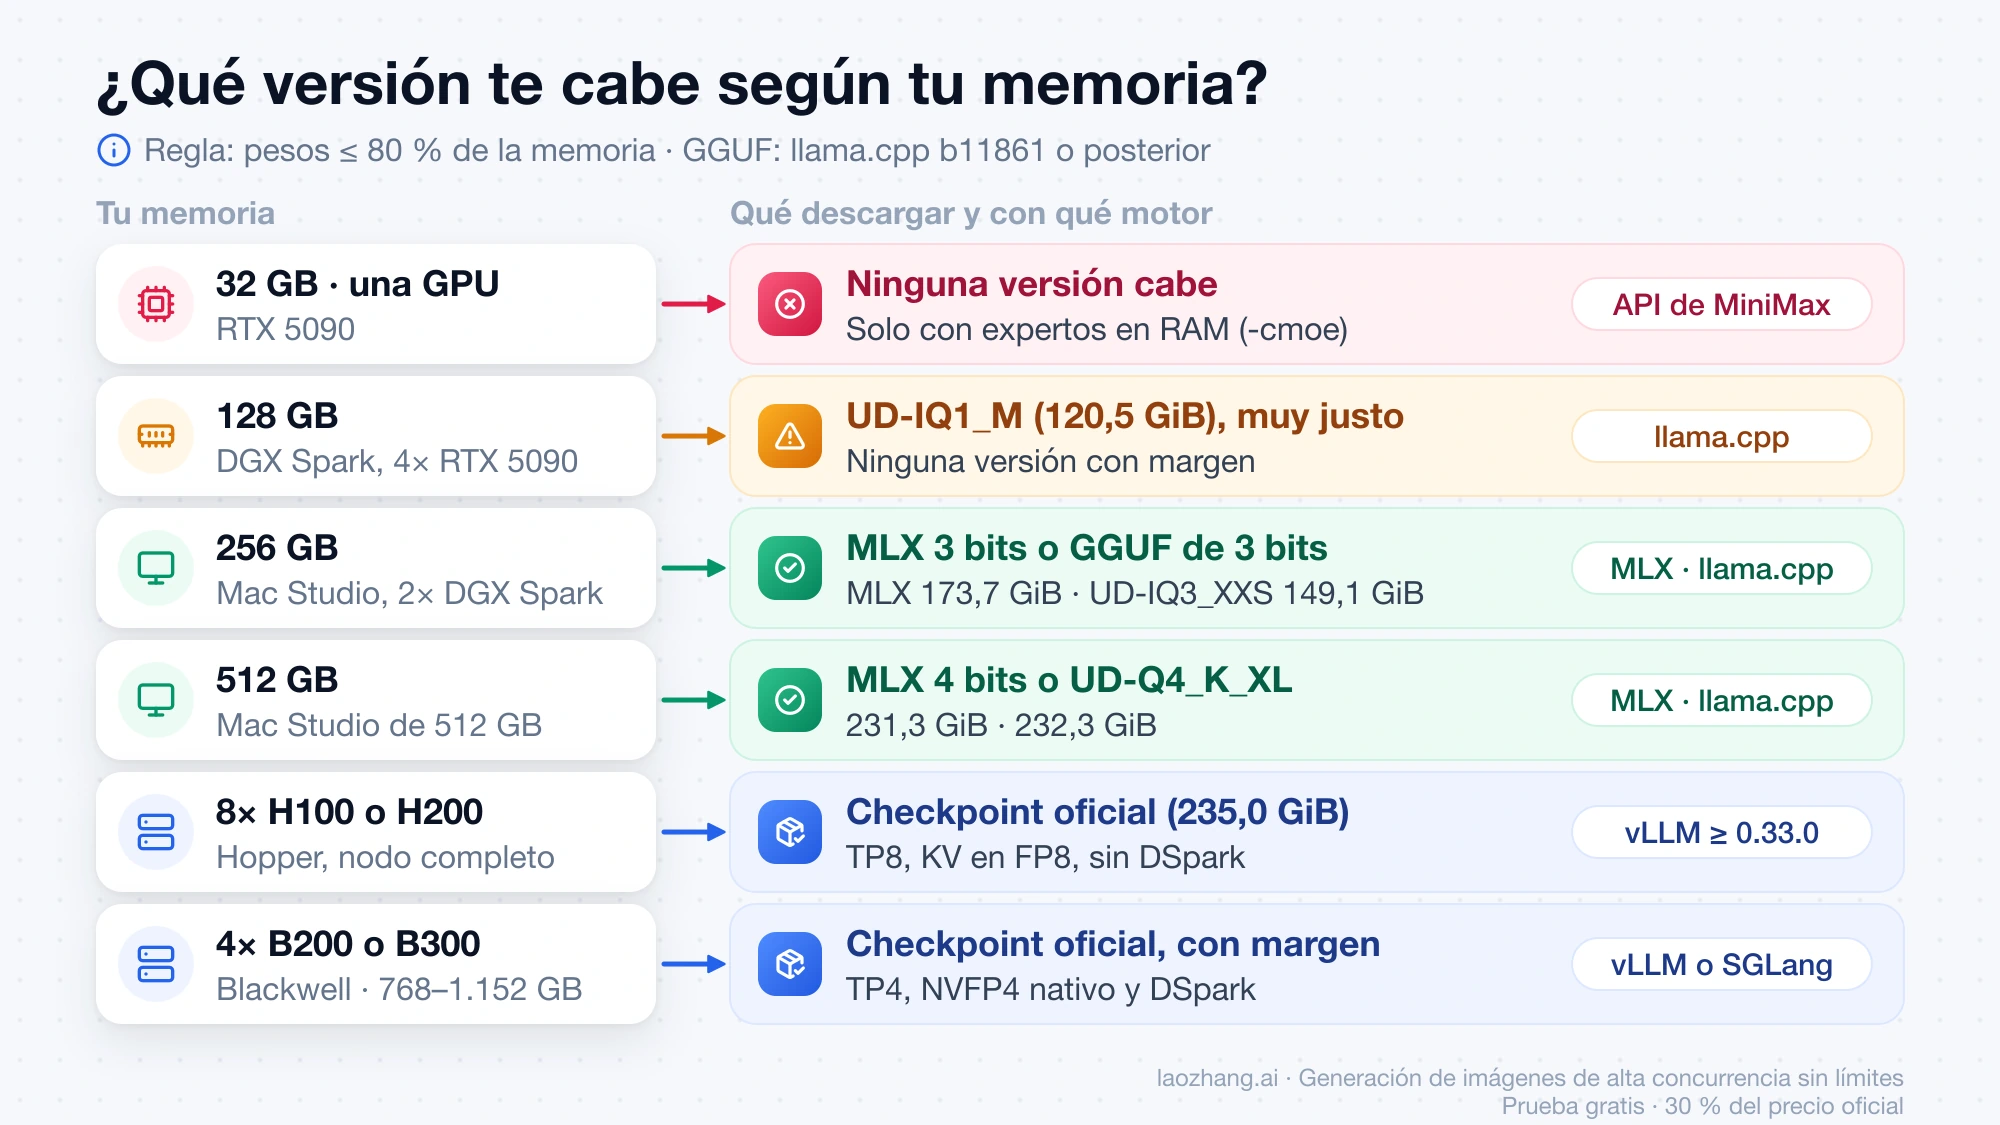
Qué descargar depende de la memoria que tengas. Con un nodo de cuatro GPU Blackwell (B200, B300) u ocho H100 o H200, usa el checkpoint oficial con vLLM 0.33.0 o posterior. En un Mac Studio de 512 GB cabe mlx-community/MiniMax-M3.1-Flash-Text-4bit; con 256 GB de memoria unificada, la versión MLX de 3 bits o un GGUF de 3 bits de unsloth/MiniMax-M3.1-Flash-GGUF, siempre con llama.cpp b11861 o posterior, porque las compilaciones anteriores devuelven texto sin sentido. Con 128 GB solo entra el GGUF UD-IQ1_M y sin margen, y en una sola GPU de 32 GB no cabe ninguna versión: ahí lo realista es la API de MiniMax, a USD 0,15 por millón de tokens de entrada y USD 0,60 por millón de salida.
Todos los tamaños proceden de la API pública de Hugging Face, consultada el 25 de octubre de 2026, y del recuento de parámetros hecho a partir del config.json oficial. El modelo no se descargó ni se ejecutó, así que no hay medidas propias de velocidad ni de calidad; las que aparecen llevan su fuente. Si lo vas a usar en un producto de pago, ten en cuenta que la licencia MiniMax Community exige mostrar «Built with MiniMax M3.1-Flash» y avisar a MiniMax.
Qué ocupa la descarga oficial: pesos, carpeta DSpark y configuración
El 25 de octubre de 2026, una consulta sin iniciar sesión a la API de Hugging Face (/api/models/MiniMaxAI/MiniMax-M3.1-Flash?blobs=true) devolvió 72 archivos que suman 252.446.157.295 bytes, es decir, 252,4 GB en las unidades decimales que usa Hugging Face o 235,1 GiB si lo piensas como memoria. De ese total, 250,1 GB (232,9 GiB) son los 48 fragmentos de pesos model-*.safetensors, 2,3 GB son la carpeta dspark/ y el resto son el tokenizador y los archivos de configuración. La ficha oficial de MiniMax-M3.1-Flash en Hugging Face lo describe como un MoE multimodal nativo, con texto, imagen y vídeo de entrada, salida de texto, «aproximadamente 428B en total; 23B activados por token» y contexto de hasta 1.000.000 de tokens.
La carpeta dspark/ es un modelo borrador para decodificación especulativa (speculative decoding). vLLM y SGLang la cargan por su cuenta cuando activas el método dspark, pero no hace falta para generar texto, y en GPU Hopper vLLM no la usa. El resto del checkpoint mezcla precisiones, según el config.json: los expertos enrutados están en NVFP4 (4 bits), la atención y las capas densas en MXFP8 (8 bits), y los embeddings, la cabeza de salida, el codificador visual y los routers siguen en BF16. MiniMax entrenó el modelo ya cuantizado (quantization-aware training) y aclara en la ficha que sus resultados son para estos pesos oficiales, y que las cuantizaciones de terceros pueden comportarse de otra forma.
La comparación con M3 deja claro qué significa «Flash». La misma consulta para MiniMaxAI/MiniMax-M3, publicado en junio de 2026, da 427.040.140.160 parámetros en BF16 y F32 y un repositorio de 854,2 GB, y su ficha habla de «~428B parámetros y ~23B activados». M3.1 Flash tiene, por tanto, el mismo número de parámetros, y su descarga es unas 3,4 veces menor (854,2 ÷ 252,4 = 3,38) solo porque los expertos son de 4 bits. MiniMax no publica una versión BF16 de M3.1 Flash: el checkpoint de 4 bits es el original, así que no tiene sentido buscar un archivo «completo» más grande.
Por qué Hugging Face muestra «220B params» si el modelo tiene 428B
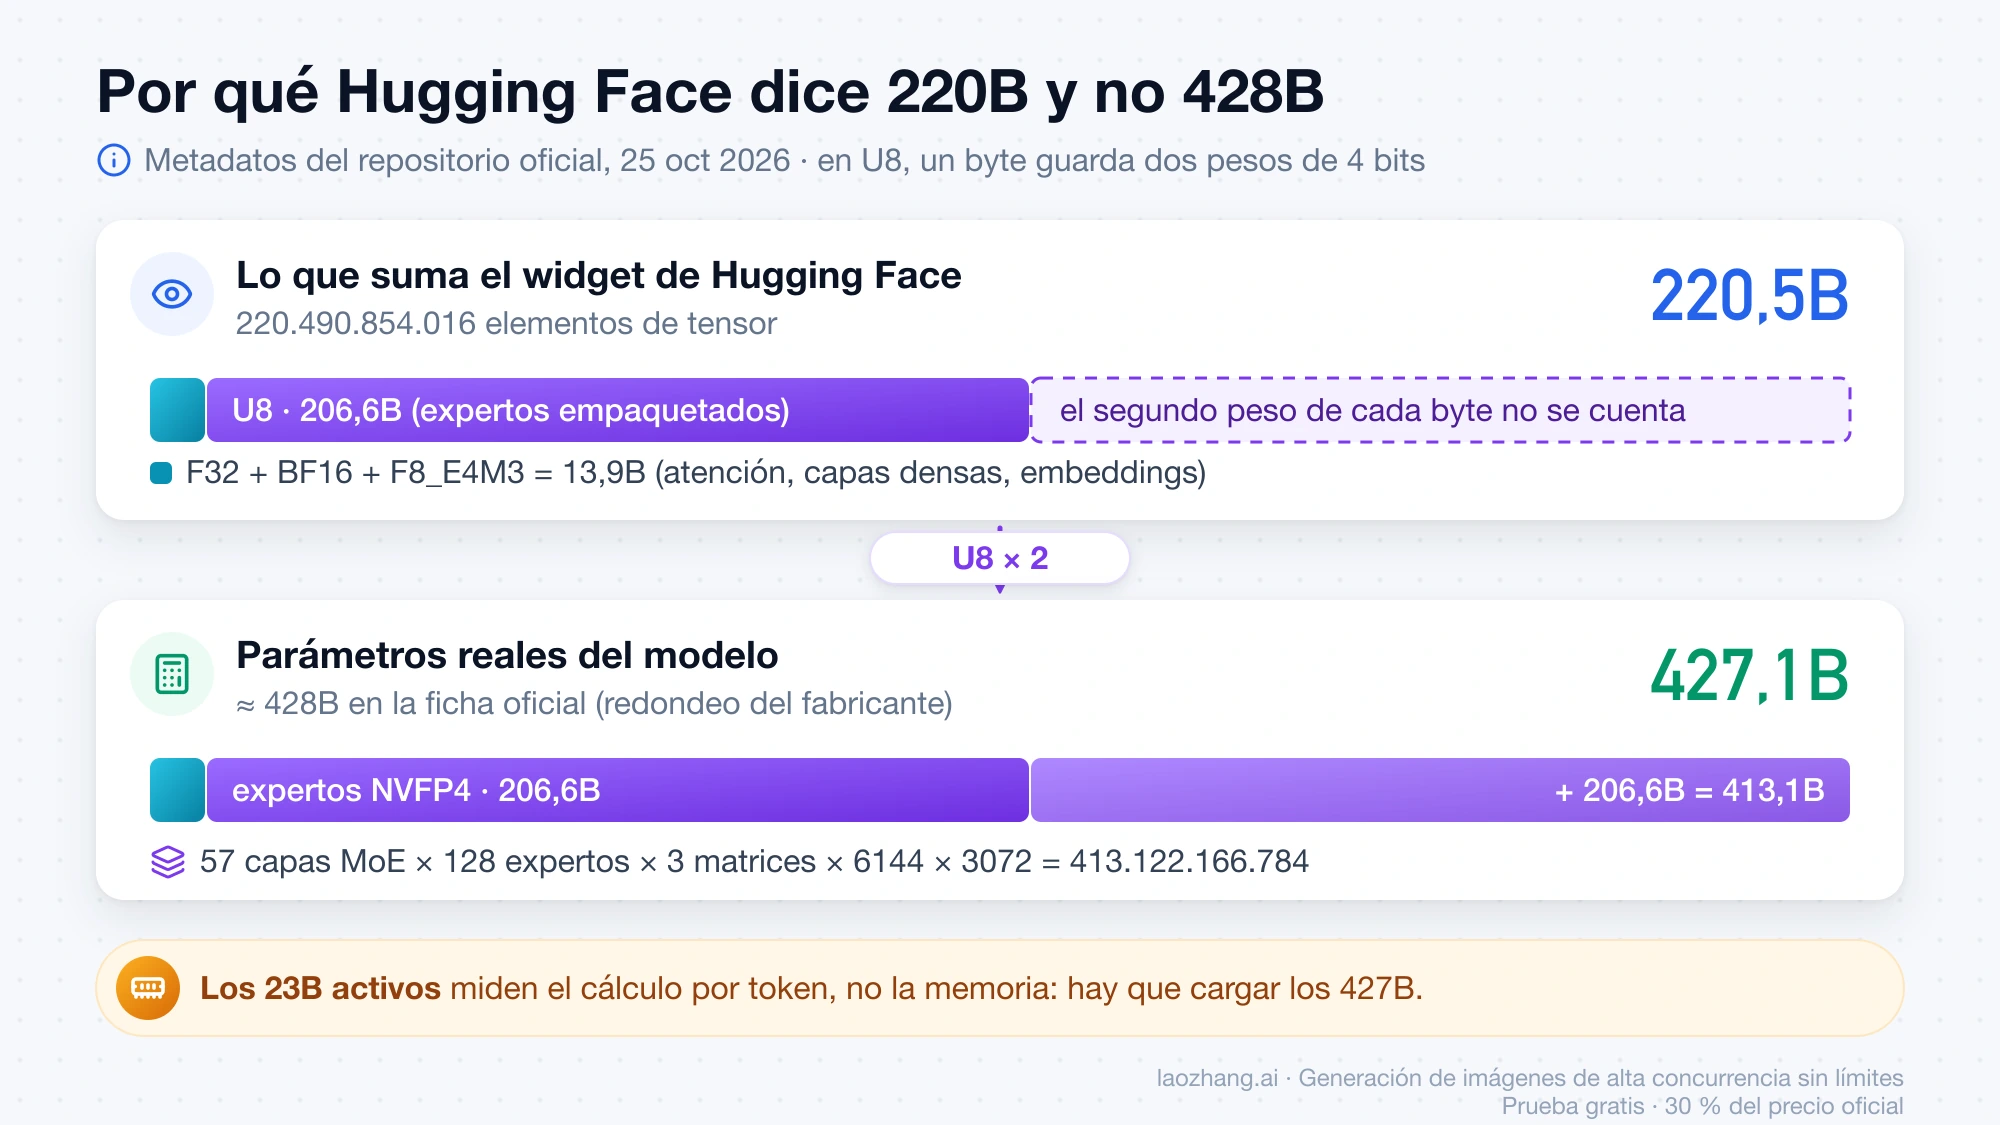
Hugging Face cuenta los elementos de cada tensor según su tipo de dato, y en este checkpoint dos pesos de 4 bits ocupan un solo byte U8. Los metadatos del repositorio oficial suman F32 46.339.200, BF16 3.323.222.528, F8_E4M3 10.560.208.896 y U8 206.561.083.392, en total 220.490.854.016 elementos, que es el «220B» del widget. Esos U8 son los expertos empaquetados: los tensores se llaman experts.N.w1/w2/w3.weight_packed y el config.json declara moe_quant_format: "nvfp4-pack-quantized".
Si doblas la parte U8, salen 413.122.166.784 parámetros, y esa cifra coincide exactamente con el recuento de los expertos a partir de la configuración:
57 capas MoE × 128 expertos × 3 matrices × 6144 × 3072 = 413.122.166.784
46.339.200 + 3.323.222.528 + 10.560.208.896 + 2 × 206.561.083.392 = 427.051.937.408
El total corregido, 427,1B, encaja con los «428B aproximados» de la ficha; la pequeña diferencia viene del redondeo del fabricante. El espejo unsloth/MiniMax-M3.1-Flash muestra el mismo 220B por la misma razón. El recuento de activos da unos 23,3B por token sin contar la cabeza de salida (24,5B contándola), en línea con los 23B oficiales, pero ese número describe el cálculo por token, no la memoria que necesitas.
Qué versión de MiniMax M3.1 Flash descargar de Hugging Face y cuánto pesa
El checkpoint oficial es para servidores con GPU NVIDIA o AMD; en un Mac necesitas una versión MLX o GGUF, y por debajo de 256 GB de memoria solo te sirven las versiones de 1 a 3 bits, GGUF o MLX. Estos son los tamaños de los archivos de pesos de cada versión publicada, medidos con la API de Hugging Face a 25 de octubre de 2026 (GB decimales, como los muestra Hugging Face, y GiB para compararlos con la memoria):
| Repositorio o variante | Formato | Pesos | Dónde corre |
|---|---|---|---|
MiniMaxAI/MiniMax-M3.1-Flash (oficial) | NVFP4 + MXFP8 | 250,1 GB / 232,9 GiB, más 2,3 GB de DSpark | GPU NVIDIA Blackwell o Hopper y AMD MI355X, con vLLM o SGLang |
unsloth/MiniMax-M3.1-Flash | Copia del oficial | 250,1 GB / 232,9 GiB, más 2,3 GB de DSpark | Igual que el oficial |
amd/MiniMax-M3.1-Flash-Quark-MXFP4 | MXFP4 | 237,2 GB / 220,9 GiB, más 2,3 GB de DSpark | AMD MI350X o MI355X con SGLang |
FlagRelease/MiniMax-M3.1-Flash-W8A8-nvidia-FlagOS-Express | W8A8 (8 bits) | 430,9 GB / 401,3 GiB, más 2,3 GB de DSpark | Pila FlagOS; hay compilaciones para otros fabricantes de chips |
mlx-community/MiniMax-M3.1-Flash-Text-4bit | MLX 4 bits, solo texto | 248,4 GB / 231,3 GiB | Mac con Apple Silicon |
mlx-community/MiniMax-M3.1-Flash-Text-3bit | MLX 3 bits, solo texto | 186,5 GB / 173,7 GiB | Mac con Apple Silicon |
unsloth/MiniMax-M3.1-Flash-GGUF UD-Q8_K_XL | GGUF | 259,1 GB / 241,3 GiB | llama.cpp |
| Ídem UD-Q4_K_XL | GGUF | 249,4 GB / 232,3 GiB | llama.cpp |
| Ídem UD-Q3_K_XL | GGUF | 194,0 GB / 180,6 GiB | llama.cpp |
| Ídem UD-IQ3_S | GGUF | 175,5 GB / 163,4 GiB | llama.cpp |
| Ídem UD-IQ3_XXS | GGUF | 160,0 GB / 149,1 GiB | llama.cpp |
| Ídem UD-Q2_K_XL | GGUF | 143,9 GB / 134,0 GiB | llama.cpp |
| Ídem UD-IQ2_XXS | GGUF | 134,9 GB / 125,7 GiB | llama.cpp |
| Ídem UD-IQ1_M | GGUF | 129,4 GB / 120,5 GiB | llama.cpp |
La trampa más habitual está en las filas de 4 y 8 bits. El GGUF UD-Q4_K_XL (249,4 GB) apenas es más pequeño que el checkpoint oficial, y el UD-Q8_K_XL (259,1 GB) es incluso más grande, porque los expertos oficiales ya vienen en 4 bits: pasarlos a un formato de 8 bits no recupera precisión que nunca tuvieron. Si buscas ahorrar memoria, el salto real empieza en los GGUF de 3 bits. La versión W8A8 de FlagOS va en sentido contrario, ocupa casi el doble y solo tiene sentido si tu acelerador lo pide; según la documentación de FlagOS en el repositorio oficial, son compilaciones para nueve fabricantes (entre ellos Huawei Ascend, Hygon, Moore Threads o Kunlunxin) convertidas desde los pesos NVFP4 originales.
El repositorio GGUF de Unsloth empieza su README con «Work in progress» y se modificó por última vez el 25 de octubre a las 05:13 UTC, así que la lista de cuantizaciones y sus tamaños todavía puede cambiar. Incluye además un mmproj-F32.gguf de 3,5 GB, el proyector de visión, aunque no está documentado si la parte visual y la atención dispersa funcionan ya en llama.cpp. La única guía de Unsloth publicada es la de MiniMax M3, no la de M3.1 Flash, y para aquel modelo calificaba el GGUF de experimental, solo texto y sin soporte de la atención dispersa MSA, con UD-IQ3_XXS como cuantización recomendada. En Hugging Face hay decenas de repositorios más, desde otros GGUF comunitarios y versiones EXL3 hasta una poda a 272B en NVFP4 (primitive-ai/MiniMax-M3.1-Flash-pruned-272B-NVFP4, 162,9 GB), y ninguno trae evaluaciones de MiniMax. Las variantes «uncensored» o «abliterated» modifican además los pesos, así que los resultados oficiales no les aplican y no conviene usarlas.
¿Cabe en tu equipo? Memoria para MiniMax M3.1 Flash según el hardware
Lo que tiene que caber en memoria son los pesos completos, no los 23B activos: cada token elige 4 de los 128 expertos de cada capa, y en el siguiente token pueden ser otros, así que todos tienen que estar a mano. La tabla compara el tamaño de cada archivo en GiB con la memoria nominal de cada equipo y aplica una regla prudente: que los pesos no pasen del 80 % de la memoria, para dejar sitio a la caché KV, las activaciones y el sistema. Ese 80 % es una suposición de cálculo, no una cifra de MiniMax ni de los motores.
| Memoria disponible | Ejemplos | Versiones que caben con margen | Con qué motor |
|---|---|---|---|
| 32 GB en una GPU | RTX 5090 | Ninguna; solo dejando la mayor parte de los expertos en la RAM del sistema | llama.cpp con -cmoe |
| 128 GB | Un DGX Spark, 4× RTX 5090 | Ninguna con margen; UD-IQ1_M (120,5 GiB) y UD-IQ2_XXS (125,7 GiB) entran muy justos, con 7,5 y 2,3 GiB libres | llama.cpp |
| 256 GB | Mac Studio de 256 GB, 2× DGX Spark | MLX 3 bits (173,7 GiB), UD-Q3_K_XL (180,6), UD-IQ3_XXS (149,1), UD-Q2_K_XL (134,0) | MLX en Mac, llama.cpp |
| 512 GB | Mac Studio de 512 GB | MLX 4 bits (231,3 GiB), UD-Q4_K_XL (232,3), UD-Q8_K_XL (241,3) | MLX o llama.cpp |
| 564–640 GB | 4× H200, 8× H100 | Oficial (235,0 GiB con DSpark), FlagOS W8A8 (403,4 GiB) | vLLM, que en Hopper pide 8 GPU |
| 768–1.152 GB | 4× B200, 4× B300 | Oficial, con mucho margen | vLLM o SGLang, NVFP4 nativo |
Que un archivo quepa no significa que el motor lo ejecute. El checkpoint oficial necesita vLLM o SGLang sobre CUDA o ROCm, de modo que un Mac de 512 GB tiene memoria de sobra para él pero no puede usarlo y debe tirar de MLX o GGUF. En equipos de 256 GB, el oficial (235,0 GiB) solo entra sin margen, y en la práctica no es una opción. Con cuatro H200 hay capacidad, pero la receta de vLLM para Hopper está pensada para un nodo completo de ocho GPU. Repartir el modelo entre dos DGX Spark tampoco tiene una receta oficial; kie.ai cita un informe comunitario con cuatro DGX Spark y vLLM en TP4.
La tabla solo cuenta pesos. La caché KV crece con el contexto y con las peticiones simultáneas, y no hay una cifra publicada por token para la atención dispersa MSA de este modelo. Como referencia de servidor, el cookbook de SGLang habla de unos 10,4 millones de tokens de caché KV repartidos entre todas las peticiones en cuatro B300 con mem-fraction 0,8, y el ejemplo de vLLM para Hopper limita el contexto a 262.144 tokens y desactiva el vídeo. Si dejas parte del modelo en la RAM del sistema, puede arrancar, pero cada token tendrá que leer expertos a través de un bus mucho más lento que la memoria de la GPU; la misma cuenta para otro modelo Flash de pesos abiertos está en Guía de GLM-5.3-Flash: Ox Alpha, precio de la API y ejecución local.
Cómo servir el checkpoint oficial en GPU NVIDIA y AMD con vLLM o SGLang
El checkpoint oficial es el mismo para todas las GPU; lo que cambia es el número de GPU y los parámetros. Según la receta de vLLM para MiniMax-M3.1-Flash, actualizada el 23 de octubre de 2026, en Blackwell (B200, B300, GB200, GB300) se sirve en TP4 con los expertos NVFP4 ejecutados de forma nativa y DSpark activado; en AMD MI355X, también en TP4 con ROCm 7.2 o posterior, los expertos se recuantizan a MXFP8 al cargar; y en Hopper (H100, H200) hace falta TP8 en un nodo completo. Como estas GPU no tienen núcleos FP4, en Hopper la caché KV va en FP8, los expertos corren con el kernel Marlin y DSpark no se activa.
- Comprueba que tienes vLLM 0.33.0 o posterior (
vllm --version); las versiones anteriores no traen el soporte de este modelo. - Reserva disco para el repositorio entero y descárgalo con
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash. - Arranca con el comando de tu generación de GPU, sin quitar
--block-size 128: la atención dispersa MSA lo exige y sin él vLLM falla conNo common block size for 16. - Da tiempo al primer arranque. La receta avisa de que un arranque en frío puede pasar de 10 minutos, y en configuraciones con paralelismo de datos recomienda
VLLM_ENGINE_READY_TIMEOUT_S=3600.
Este es el ejemplo de la receta para un nodo de ocho H100 o H200:
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 262144 \
  --max-num-seqs 80 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
En Blackwell, el comando de la receta cambia a -tp 4, --kv-cache-dtype nvfp4 y añade --speculative-config con "method":"dspark", que carga el borrador de la carpeta dspark/ sin indicar ruta. La propia receta recomienda temperature 1,0 y top_p 0,95, y el nivel de razonamiento se fija por petición con reasoning_effort (low, medium, high, xhigh o max).
El cookbook de SGLang para MiniMax M3.1 propone cuatro B300 en TP4 para baja latencia, ocho B200 en TP8 para rendimiento y AMD MI350X o MI355X en TP4 con ROCm 7.2, y no incluye receta para Hopper. El soporte todavía no está en ninguna versión publicada de SGLang a 25 de octubre de 2026: el cookbook indica instalarlo desde la PR de soporte, que la página todavía no enlaza con número, o usar la imagen Docker de desarrollo lmsysorg/sglang:dev-minimax-m31-flash. Ojo con el CUDA toolkit: los kernels de MSA necesitan la versión 13.4 o posterior, y con una más antigua SGLang no falla, sino que pasa sin avisar a un camino más lento. En su prueba con cuatro B300 y su MonoKernel, SGLang obtuvo 1.028 tokens/s con 1K de contexto y 723 tokens/s con 1M; son cifras de SGLang, no medidas independientes. Para aceleradores que no son NVIDIA ni AMD, la vía documentada son las compilaciones W8A8 de FlagOS con vLLM-plugin-FL.
llama.cpp y Mac: por qué las compilaciones antiguas dan texto sin sentido
llama.cpp ya reconoce la arquitectura de MiniMax M3, pero hasta el 24 de octubre de 2026 su código ignoraba la escala NVFP4 de cada experto, y cualquier GGUF de M3.1 Flash producía una sopa de tokens. Lo describe la incidencia #31063 de llama.cpp, abierta por alguien con una RTX 5090 de 32 GB y 128 GB de RAM que convirtió el modelo a Q2_K (146 GiB): cargaba sin errores y respondía basura a cualquier pregunta. La corrección, la PR #31097 de llama.cpp, se fusionó el 24 de octubre a las 14:09 UTC, y la primera versión publicada que la incluye es la b11861. Con cualquier compilación anterior, también la que lleve dentro una aplicación de escritorio sin actualizar, el texto saldrá corrupto y no será culpa de la cuantización.
Si compilas tú mismo, comprueba que tu copia contiene el commit de la corrección antes de descargar 130–260 GB:
git merge-base --is-ancestor 73adf89 HEAD && echo "corrección incluida"
hf download unsloth/MiniMax-M3.1-Flash-GGUF --include "*UD-IQ3_XXS*" --local-dir MiniMax-M3.1-Flash-GGUF
Cambia UD-IQ3_XXS por la cuantización que te quepa según la tabla anterior. Si tu GPU tiene poca VRAM y mucha RAM, la opción -cmoe de llama.cpp deja los expertos en la memoria del sistema. Es lo que usaba quien abrió la incidencia: con su parche, que es la corrección que luego se fusionó, su Q2_K de 146 GiB con las 60 capas respondió de forma coherente en la RTX 5090 con 128 GB de RAM, a 3,59 tokens/s de prefill y 5,12 tokens/s de generación. Es una sola prueba comunitaria, con una cuantización hecha en local y no con los archivos de Unsloth, pero da una idea del orden de magnitud cuando la mayor parte del modelo vive en la RAM.
En un Mac, el checkpoint oficial no sirve, porque NVFP4 depende de motores para CUDA o ROCm. Las versiones de mlx-community (4 bits para 512 GB, 3 bits para 256 GB) son solo de texto, como indica el Text de su nombre, y los GGUF de Unsloth también funcionan con llama.cpp en macOS si la versión es b11861 o posterior. El modelo minimax-m3.1-flash:cloud que aparece en Ollama se ejecuta en los servidores de Ollama, no en tu equipo. Y bajar a 1 o 2 bits para que quepa tiene un coste en calidad que no aparece medido en ninguna fuente pública para este modelo; si lo quieres para programar con agentes, revisa antes ¿Falla tu coding agent local? Diagnostica cuantización, contexto o harness.
¿Es gratis MiniMax M3.1 Flash? La licencia y el umbral de 20 millones de dólares
Descargar los pesos es gratis y el repositorio no pide permiso de acceso, pero la licencia MiniMax Community del repositorio oficial no es una licencia de código abierto aprobada por la OSI: lo correcto es hablar de pesos abiertos con condiciones. El uso no comercial es libre. El uso comercial incluye ofrecer a terceros productos o servicios de pago basados en el modelo, usar comercialmente APIs que lo sirvan y desplegar con fines comerciales versiones ajustadas (fine-tuning) o modificadas.
Para ese uso comercial, la licencia pide dos cosas. Primero, mostrar de forma visible «Built with MiniMax M3.1-Flash» en la web, la interfaz, un artículo, la página «acerca de» o la documentación del producto. Después, si el producto factura 20 millones de dólares al año o menos, basta con enviar una sola vez un aviso a api@minimax.io con el asunto «M3.1-Flash licensing — notice»; por encima de esa cifra necesitas una autorización previa por escrito, que se pide a la misma dirección con el asunto «M3.1-Flash licensing - authorization request». Un anexo prohíbe, entre otros, los usos militares, los que dañen a menores y la desinformación con intención de causar daño. Si hay dinero de por medio, lee el texto completo, porque esto es un resumen y no asesoramiento legal.
API o local: con menos de 256 GB de memoria, usa la API de MiniMax
Si no tienes al menos 256 GB de memoria rápida para un GGUF de 3 bits, o un nodo de cuatro GPU Blackwell u ocho Hopper para el checkpoint oficial, la API sale mucho más a cuenta que comprar hardware. A 25 de octubre de 2026, la página de precios de MiniMax cobra por MiniMax-M3.1-Flash USD 0,15 por millón de tokens de entrada, USD 0,60 por millón de salida y USD 0,015 por millón leído de caché, sin tramos por longitud de contexto; MiniMax M3 estándar cuesta el doble (USD 0,30 y USD 1,20 hasta 512K). Un día con 10 millones de tokens de entrada y 2 millones de salida cuesta 10 × 0,15 + 2 × 0,60 = USD 2,70.
Cuenta con que el razonamiento también se factura como salida. Según el análisis de kie.ai, el modo de razonamiento no se puede desactivar (enviar thinking.type="disabled" devuelve un error 400) y, si no indicas nada, el esfuerzo es max, así que bajar reasoning_effort es la forma de controlar el gasto. Además de la API oficial, el modelo aparece alojado en Together AI y OpenRouter, cada uno con sus propios precios. Si dudas entre pagar por tokens o montar un servidor para tus agentes de código, la comparación de costes está en LLM local para coding agents: cuándo supera a Claude/Codex.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
- 1.ficha oficial de MiniMax-M3.1-Flash en Hugging Facehuggingface.co/MiniMaxAI/MiniMax-M3.1-Flash
- 2.documentación de FlagOS en el repositorio oficialhuggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/blob/main/docs/FlagOS-Multi-Chip-Support-and-Downloads.md
- 3.receta de vLLM para MiniMax-M3.1-Flashrecipes.vllm.ai/MiniMaxAI/MiniMax-M3.1-Flash
- 4.cookbook de SGLang para MiniMax M3.1docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3.1
- 5.incidencia #31063 de llama.cppgithub.com/ggml-org/llama.cpp/issues/31063
- 6.PR #31097 de llama.cppgithub.com/ggml-org/llama.cpp/pull/31097
- 7.licencia MiniMax Community del repositorio oficialhuggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/blob/main/LICENSE
- 8.página de precios de MiniMaxplatform.minimax.io/docs/guides/pricing