Claude Sonnet 5.5 vs GPT-6 Luna: cuándo compensa pagar 20x más
GPT-6 Luna cuesta 20 veces menos por token y basta para llamadas masivas y documentos largos; Sonnet 5.5 compensa en agentes y por encima de 38 en AA.
En esta página
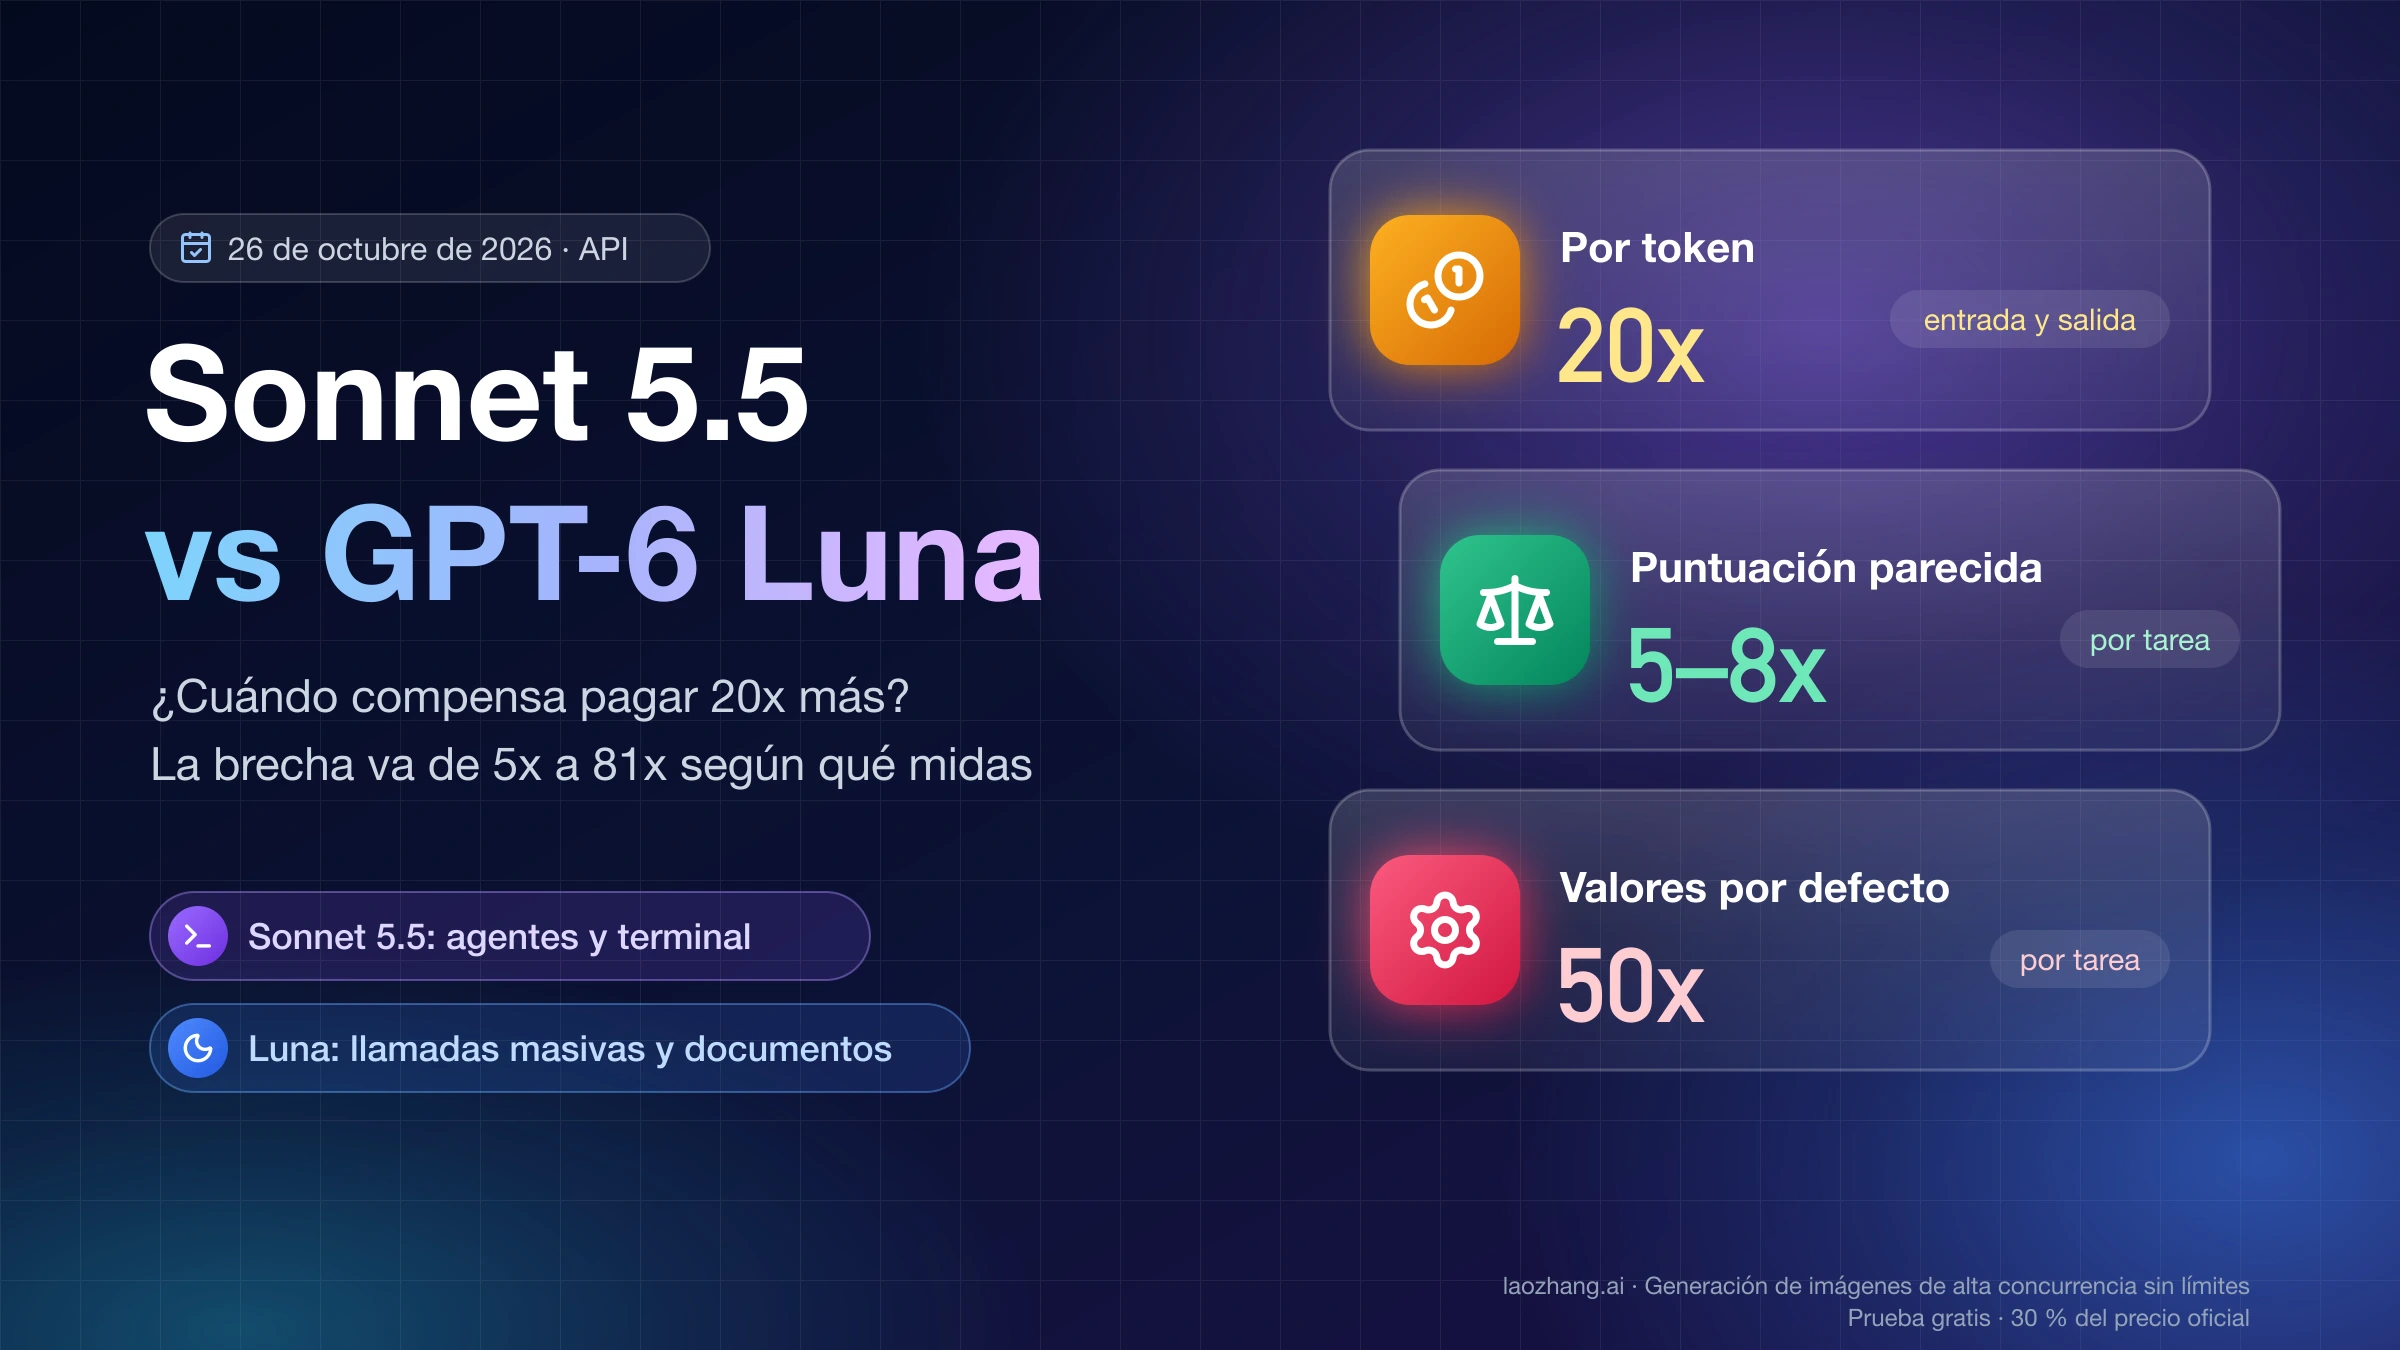
A 26 de octubre de 2026, empieza por GPT-6 Luna (gpt-6-luna) si tu carga son llamadas cortas y masivas, extracción, clasificación o lectura de documentos largos, y reserva Claude Sonnet 5.5 (claude-sonnet-5-5) para programación agéntica, trabajo en terminal y tareas que necesiten más calidad de la que Luna puede dar. Luna llega como máximo a 38 puntos en el Intelligence Index de Artificial Analysis (AA), y Sonnet 5.5 supera esa cifra desde su nivel medium (41) hasta los 56 de max, según la comparativa de Claude Sonnet 5.5 y GPT-6 Luna en Artificial Analysis.
La diferencia de precio no es un único número. Por token, Sonnet 5.5 cuesta 20 veces más que Luna en entrada y en salida; con el mismo texto en español la factura de entrada se acerca a 30 veces, porque Sonnet cuenta un 52 % más de tokens, y por tarea de AA la brecha va de unas 5 veces, con puntuaciones parecidas, a unas 50 veces si comparas la configuración por defecto de cada modelo. Antes de mover tráfico, revisa dos puntos del código: en Luna, la llamada a funciones con razonamiento activado exige la Responses API, y Sonnet 5.5 rechaza thinking: {"type": "disabled"} y el tool_choice forzado.
Lo que hay detrás de estas cifras: el 26 de octubre de 2026 se pasaron las mismas 9 tareas, con comprobaciones escritas antes de ver las respuestas, por los dos modelos a través de la pasarela de LaoZhang. Ambos resolvieron 9 de 9 y Sonnet costó 25 veces más. No se probaron las API directas de Anthropic y OpenAI, el uso de herramientas ni otros niveles de esfuerzo, así que las conclusiones sobre calidad salen de AA y no de esa prueba.
Cuál elegir según tu carga: masiva, documentos, agentes o terminal
La forma de tu carga decide más que el precio por token. Luna es suficiente cuando la tarea está bien definida y puedes comprobar el resultado de forma automática; Sonnet 5.5 compensa cuando un fallo cuesta más que la factura, cuando el trabajo encadena pasos en un terminal o cuando necesitas un nivel de calidad que Luna no alcanza en ningún nivel de esfuerzo. Las cifras que sostienen cada fila están en las secciones siguientes.
| Tu carga | Empieza por | Qué te haría cambiar |
|---|---|---|
| Llamadas cortas y masivas: clasificar, extraer, reescribir | Luna en medium o low | Que los errores que se escapan a tu validación te cuesten más que la diferencia de precio |
| Documentos largos, hasta 272.000 tokens de entrada | Luna desde medium | Que necesites respuestas con datos que el modelo debe saber, no leer en el documento |
| Documentos de más de 272.000 tokens | Luna, aunque la tarifa larga reduce su ventaja | Que la entrada pase de 922.000 tokens, el máximo de Luna; Sonnet admite 1M al mismo precio por token |
| Bucles de agente que reutilizan contexto en caché | Luna si los pasos son simples | Que el agente ejecute comandos o edite código: ahí Luna se queda muy atrás |
| Programación agéntica y trabajo en terminal | Sonnet 5.5, desde medium | Nada en los datos actuales: Luna no pasa del 12,6 % en Terminal-Bench 4.0 |
| Lotes sin prisa | Luna con Batch | Que el lote necesite la calidad de Sonnet; ambos rebajan Batch a la mitad |
| Turnos sensibles a la latencia | Luna en low o none si la tarea es sencilla | Que necesites unos 36 puntos de calidad: ahí Sonnet low termina antes que Luna xhigh o max |
| Preguntas sobre hechos sin documento de apoyo | Sonnet 5.5 | Que puedas darle la fuente: con el texto delante, Luna rinde bien |
También puedes repartir el tráfico: manda cada petición primero a Luna, valida la respuesta con tus tests, un esquema JSON o una regla de negocio, y reenvía a Sonnet solo las que fallen. Con la diferencia de 20 veces por token, una petición en Luna cuesta 0,05 veces lo que costaría en Sonnet, así que mandarlo todo a Luna y escalar una parte p a Sonnet cuesta 0,05 + p veces lo que pagarías usando solo Sonnet. Con un 20 % de escalado pagas en torno a una cuarta parte; con más del 95 % el reparto ya no ahorra nada. Es una cuenta aproximada, porque cada modelo escribe una cantidad distinta de tokens de salida.
Precios por millón de tokens: Sonnet 5.5, Luna y la línea de 272.000
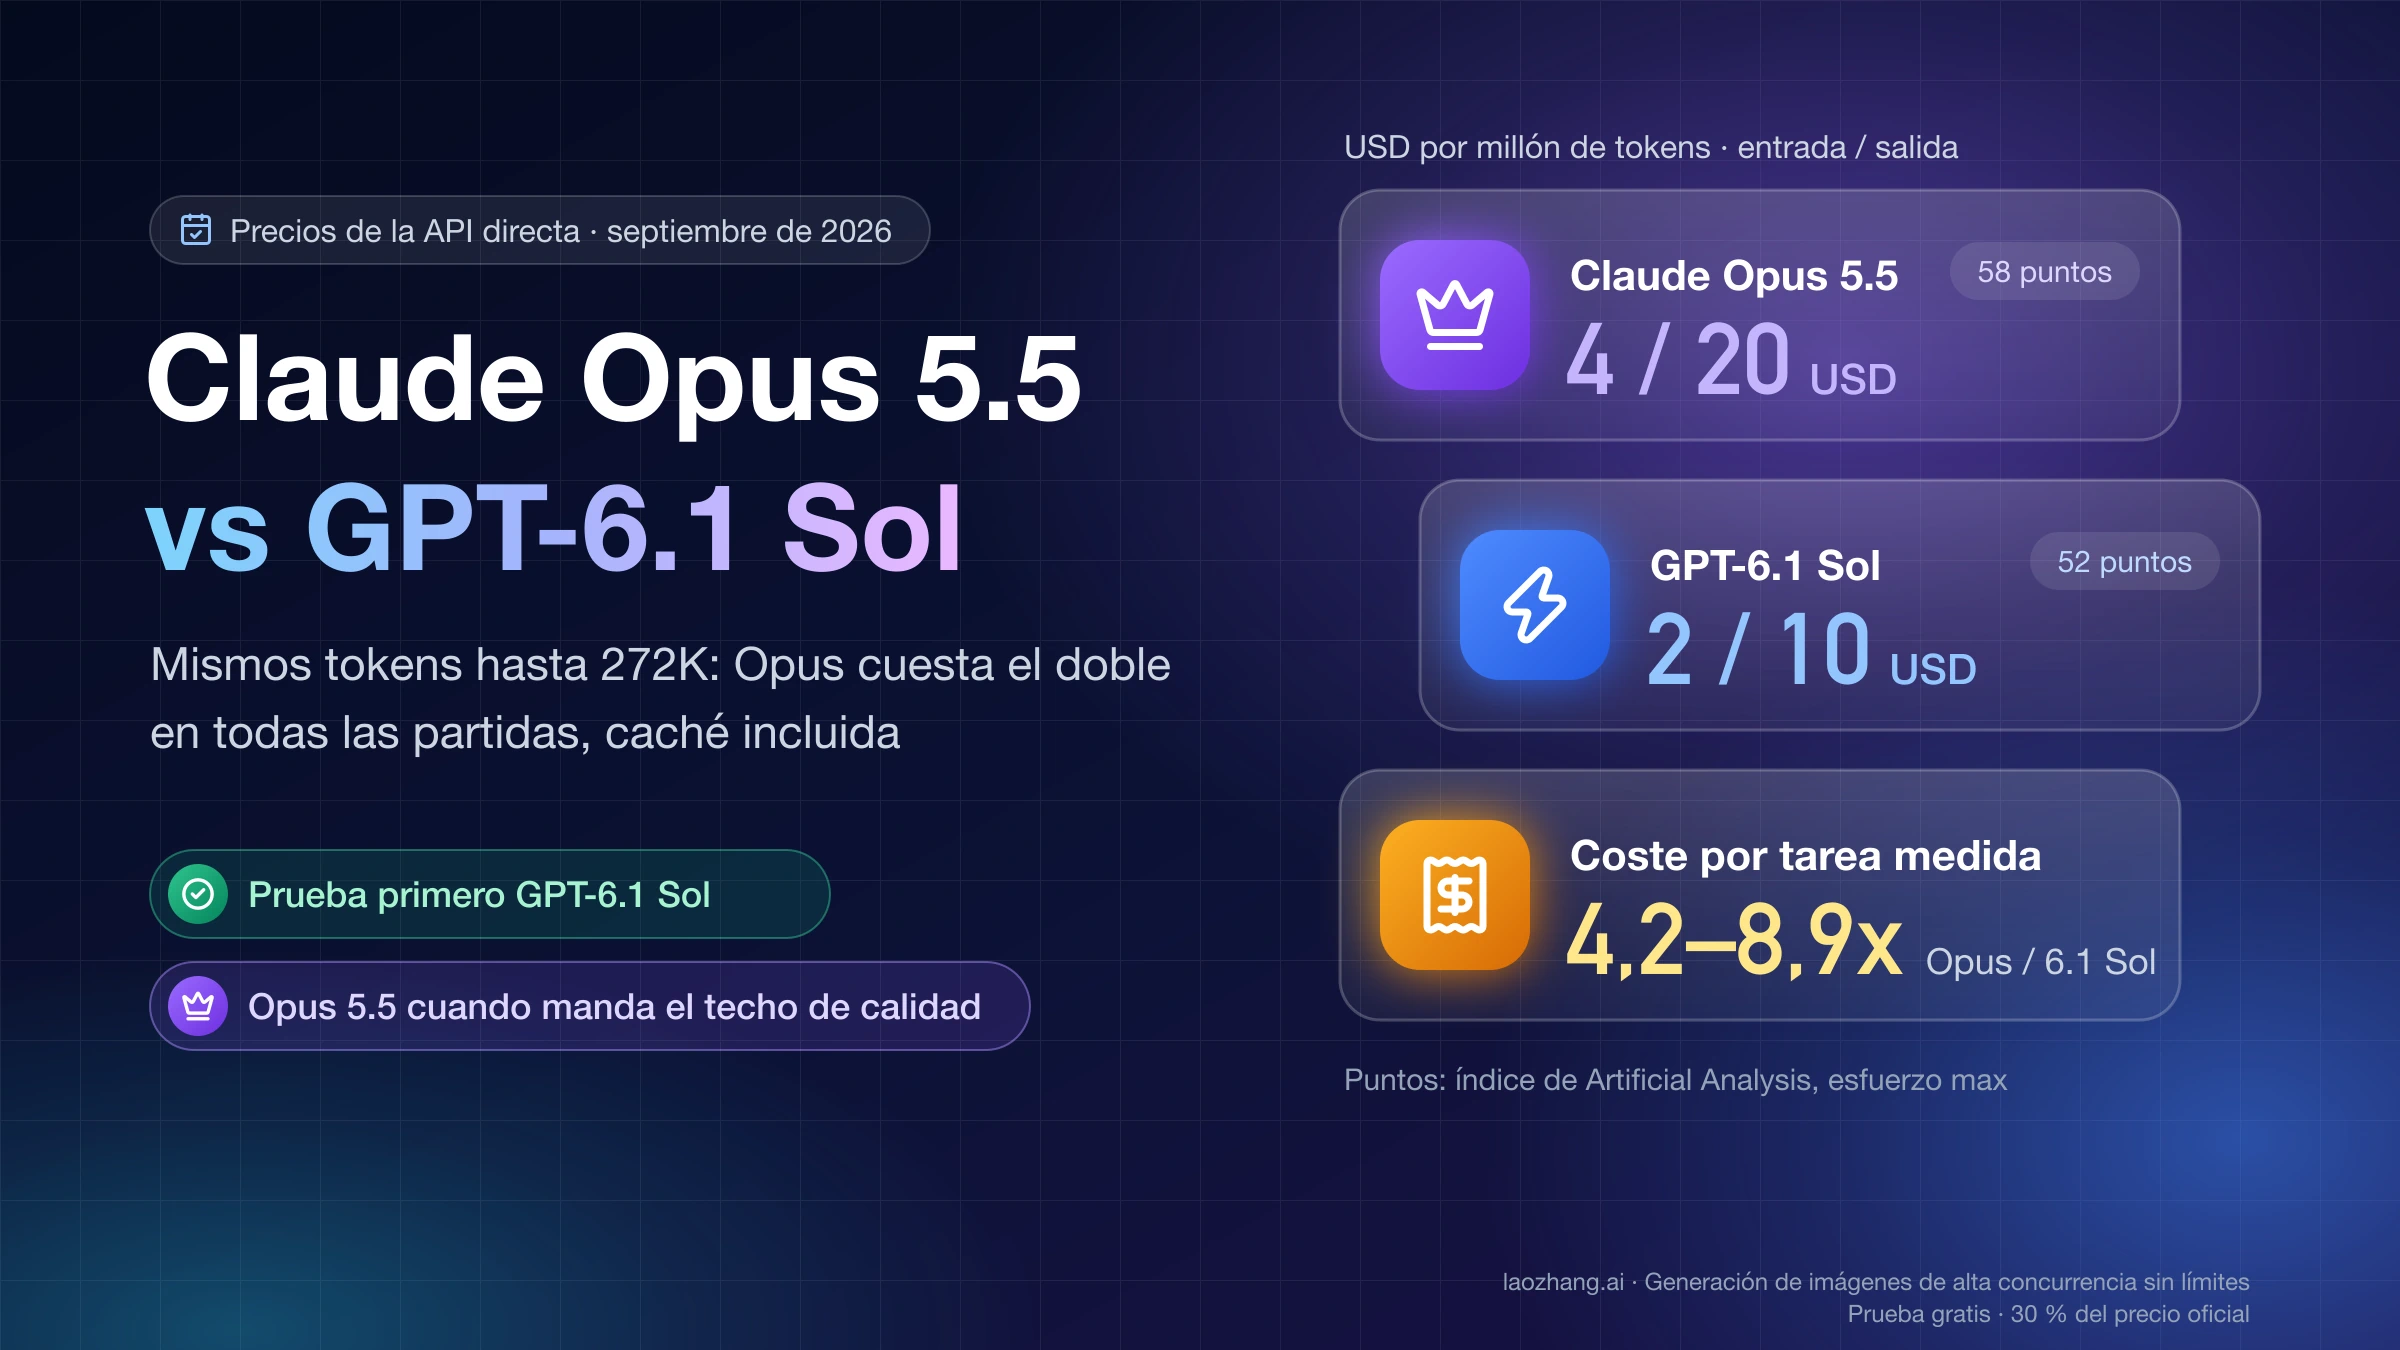
En la API estándar, a 26 de octubre de 2026, Sonnet 5.5 cobra 2 $ por millón de tokens de entrada y 10 $ por millón de salida, y GPT-6 Luna cobra 0,10 $ y 0,50 $ mientras la petición no pase de 272.000 tokens de entrada. Anthropic llama a las lecturas de caché «cache hits» y OpenAI habla de «cached input»: son lo mismo, la parte repetida del contexto que se cobra con descuento; en adelante, lecturas de caché. Fuentes: precios de la API de Claude, precios de la API de OpenAI y la página del modelo GPT-6 Luna.
| Por millón de tokens | Claude Sonnet 5.5 | GPT-6 Luna, hasta 272.000 de entrada | GPT-6 Luna, más de 272.000 | Sonnet ÷ Luna |
|---|---|---|---|---|
| Entrada | 2,00 $ | 0,10 $ | 0,20 $ | 20x, o 10x por encima de 272.000 |
| Lectura de caché | 0,10 $ | 0,01 $ | 0,02 $ | 10x, o 5x |
| Escritura de caché | 2,50 $ (5 min), 4,00 $ (1 h) | 0,125 $ (30 min), 0,25 $ (12 h) | 0,25 $ (30 min), 0,50 $ (12 h) | 20x en la escritura corta |
| Salida | 10,00 $ | 0,50 $ | 0,75 $ | 20x, o 13,3x |
| Batch | 1 $ / 5 $ | 0,05 $ / 0,25 $ | la mitad de la tarifa larga | 20x |
La línea de 272.000 tokens solo existe en Luna y afecta a toda la petición: si la entrada la supera, OpenAI cobra el doble por la entrada y la caché y 1,5 veces por la salida, también por los primeros 272.000 tokens. Sonnet 5.5 cobra la ventana completa de 1M al mismo precio por token. En ambos hay recargos aparte: el procesamiento regional de OpenAI añade un 10 %, y la inferencia solo en Estados Unidos de Anthropic (inference_geo) multiplica por 1,1.
La lectura de caché de Sonnet 5.5 está en 0,10 $ desde el 7 de octubre de 2026; antes costaba 0,20 $. El detalle de esa rebaja y cómo calcular lo que ahorras está en Claude Sonnet 5.5: precio de caché a 0,10 $ y cuánto ahorras.
¿Vale la pena pagar 20 veces más? Cinco formas de medir la brecha
La respuesta depende de qué mides, porque la misma pareja de modelos sale entre 5 y 81 veces más cara en Sonnet según la comparación. El precio por token solo cuenta una parte: cada modelo trocea el texto de forma distinta, escribe una cantidad distinta de tokens por tarea y llega a puntuaciones distintas en cada nivel de esfuerzo (effort).
| Forma de medir | Sonnet 5.5 ÷ Luna | Qué hay detrás |
|---|---|---|
| Por token, entrada y salida | 20x (10x en caché; de 10x a 13,3x por encima de 272.000) | Tarifas de lista de la tabla anterior |
| Mismo texto en español, solo entrada | Unas 30x | Sonnet cuenta 1,52 veces más tokens: 20 × 1,52 ≈ 30 |
| Por tarea de AA, valores por defecto | 50x | Sonnet high (0,88 $, 47 puntos) frente a Luna medium (0,0175 $, 30 puntos) |
| Por tarea de AA, mismo nombre de nivel | De 27x (medium) a 81x (max) | low 77x, medium 27x, high 30x, xhigh 48x, max 81x |
| Por tarea de AA, puntuación parecida | De 5x a 8x | Sonnet low (36 puntos) frente a Luna xhigh (35) o max (38) |
El dato del tokenizador se midió el 26 de octubre de 2026 enviando el mismo texto a los dos modelos: los primeros 6.000 caracteres de un artículo en español ocuparon 2.937 tokens de entrada en Sonnet 5.5 y 1.926 en Luna, 1,52 veces más. Con un archivo de Python de 6.000 caracteres la proporción fue de 1,46, y un artículo en inglés de 6.723 palabras dio 15.335 frente a 10.106 tokens, también 1,52. Es una muestra por idioma y solo cubre la entrada, así que para un presupuesto ajustado mide unas cuantas peticiones tuyas.
La comparación «por defecto contra por defecto» mezcla dos niveles distintos. En la API de Claude, Sonnet 5.5 usa high si no indicas nada; en Claude Code y en las apps de Claude usa medium; Luna usa medium en la API. Por eso el 50x compra 17 puntos de índice, y la comparación útil es la de puntuación parecida o la de un nivel concreto que ya uses.
Sonnet 5.5 y Luna en cada nivel de esfuerzo: puntuación, coste y tiempo
Luna tiene un techo de 38 puntos en el Intelligence Index de AA: si tu trabajo necesita más, solo Sonnet 5.5 llega, desde medium. Por debajo de ese techo, Luna consigue la misma puntuación por mucho menos dinero pero tardando más. La tabla ordena las 11 configuraciones de la comparativa de Artificial Analysis por puntuación, a 26 de octubre de 2026 (índice v4.3.2, diez evaluaciones, API de cada proveedor):
| Modelo y nivel | Índice AA | Coste por tarea | Tiempo por tarea | Tokens de salida por tarea |
|---|---|---|---|---|
Sonnet 5.5 max | 56 | 5,46 $ | 936 s | 197.400 |
Sonnet 5.5 xhigh | 52 | 2,01 $ | 434 s | 74.800 |
Sonnet 5.5 high, defecto en la API | 47 | 0,88 $ | 217 s | 37.300 |
Sonnet 5.5 medium, defecto en Claude Code | 41 | 0,48 $ | 121 s | 20.900 |
Luna max | 38 | 0,0678 $ | 364 s | 50.000 |
Sonnet 5.5 low | 36 | 0,35 $ | 85 s | 14.300 |
Luna xhigh | 35 | 0,0422 $ | 215 s | 27.500 |
Luna high | 33 | 0,0290 $ | 164 s | 19.700 |
Luna medium, defecto | 30 | 0,0175 $ | 126 s | 11.500 |
Luna low | 22 | 0,0045 $ | 18 s | 2.100 |
Luna none, sin razonamiento | 18 | 0,0113 $ | 31 s | 3.800 |
La pareja que más ayuda a decidir es Sonnet low frente a Luna xhigh o max. Con 35–38 puntos, Luna es entre 5 y 8 veces más barata por tarea (0,35 $ ÷ 0,0678 $ ≈ 5,2; 0,35 $ ÷ 0,0422 $ ≈ 8,3), pero Sonnet low termina entre 2,5 y 4,3 veces antes (85 s frente a 215 s o 364 s). Si el usuario espera la respuesta, esa diferencia de tiempo puede pesar más que la de coste.
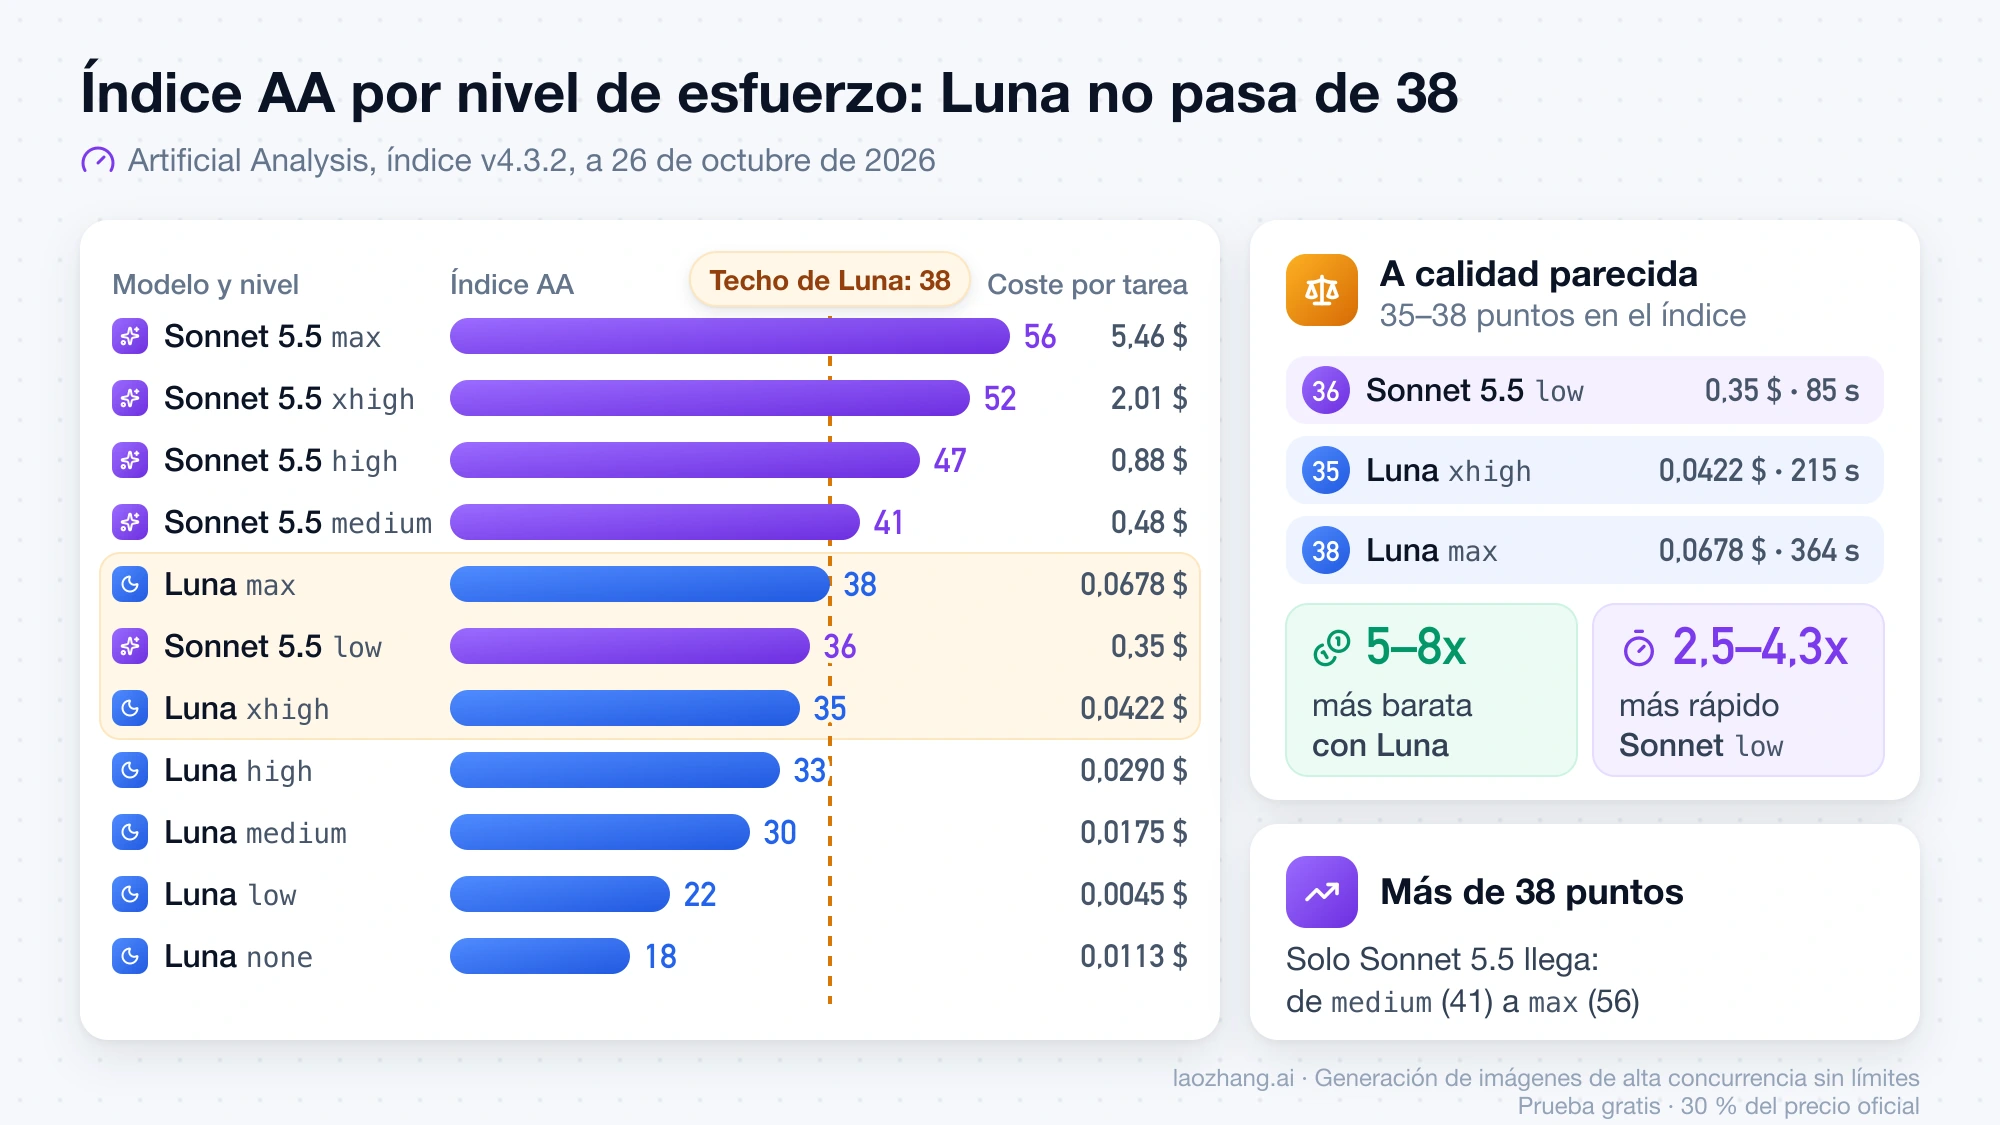
Fíjate también en el final de la tabla: Luna none puntúa 18 y sale más cara por tarea que low en la medición de AA. Esto importa porque es el único nivel con el que Luna acepta llamada a funciones en Chat Completions. Los costes de Sonnet 5.5 en AA bajaron tras la rebaja de la caché del 7 de octubre: max pasó de 7,67 $ a 5,46 $ por tarea y high de 1,12 $ a 0,88 $, así que una cifra de 7,60 $ por tarea corresponde a la medición anterior.
Dónde gana Sonnet 5.5 y dónde Luna: terminal frente a contexto largo
El índice global esconde diferencias grandes según el tipo de tarea. En las mismas mediciones de AA, Sonnet 5.5 domina el trabajo en terminal y la fiabilidad de los datos que sabe de memoria, mientras que Luna iguala o supera a Sonnet en razonamiento sobre contexto largo. La tabla compara las dos parejas que sirven para decidir: puntuación parecida (Sonnet low y Luna max) y valores por defecto (Sonnet high en la API y Luna medium).
| Evaluación de AA | Sonnet low | Luna max | Sonnet high | Luna medium |
|---|---|---|---|---|
| Terminal-Bench 4.0, tareas en terminal | 20,7 % | 12,6 % | 43,9 % | 2,5 % |
| AutomationBench-AA, automatización con herramientas | 49,4 % | 53,2 % | 59,4 % | 40,5 % |
| AA-LCR v1.1, razonamiento con contexto largo | 76,0 % | 83,3 % | 78,0 % | 78,3 % |
| AA-Omniscience, fiabilidad del conocimiento | 19 | 1 | 21 | −5 |
| SciCode, programación científica | 49,1 % | 54,6 % | 53,7 % | 50,9 % |
| Humanity's Last Exam | 36,2 % | 38,5 % | 45,8 % | 28,3 % |
En terminal la diferencia no se cierra con más esfuerzo: Sonnet va del 20,7 % en low al 63,6 % en max, y Luna no pasa del 12,6 % ni en su nivel máximo. Para agentes de programación que ejecutan comandos, Sonnet 5.5 es la opción aunque cueste más.
AA-Omniscience premia acertar y penaliza inventar: un valor negativo significa más respuestas equivocadas que correctas. Sonnet va de 19 a 32 según el nivel y Luna de −22 a 1, así que en preguntas sobre hechos, sin un documento delante, Luna tiende más a equivocarse que a decir que no lo sabe. Si le das la fuente, el panorama cambia: en AA-LCR Luna iguala o supera a Sonnet en el mismo nivel desde medium (78,3 % frente a 76,3 % en medium; 83,3 % frente a 82,7 % en max).
Para documentos largos hay dos límites que no aparecen en «contexto de 1M»: la entrada máxima de Luna es 922.000 tokens dentro de una ventana de 1.050.000, y por encima de 272.000 de entrada toda la petición se encarece. Lo que cuesta un documento a uno y otro lado de esa línea está en el caso B del cálculo de costes.
Prueba del 26 de octubre con 9 tareas: 9 de 9 en ambos modelos
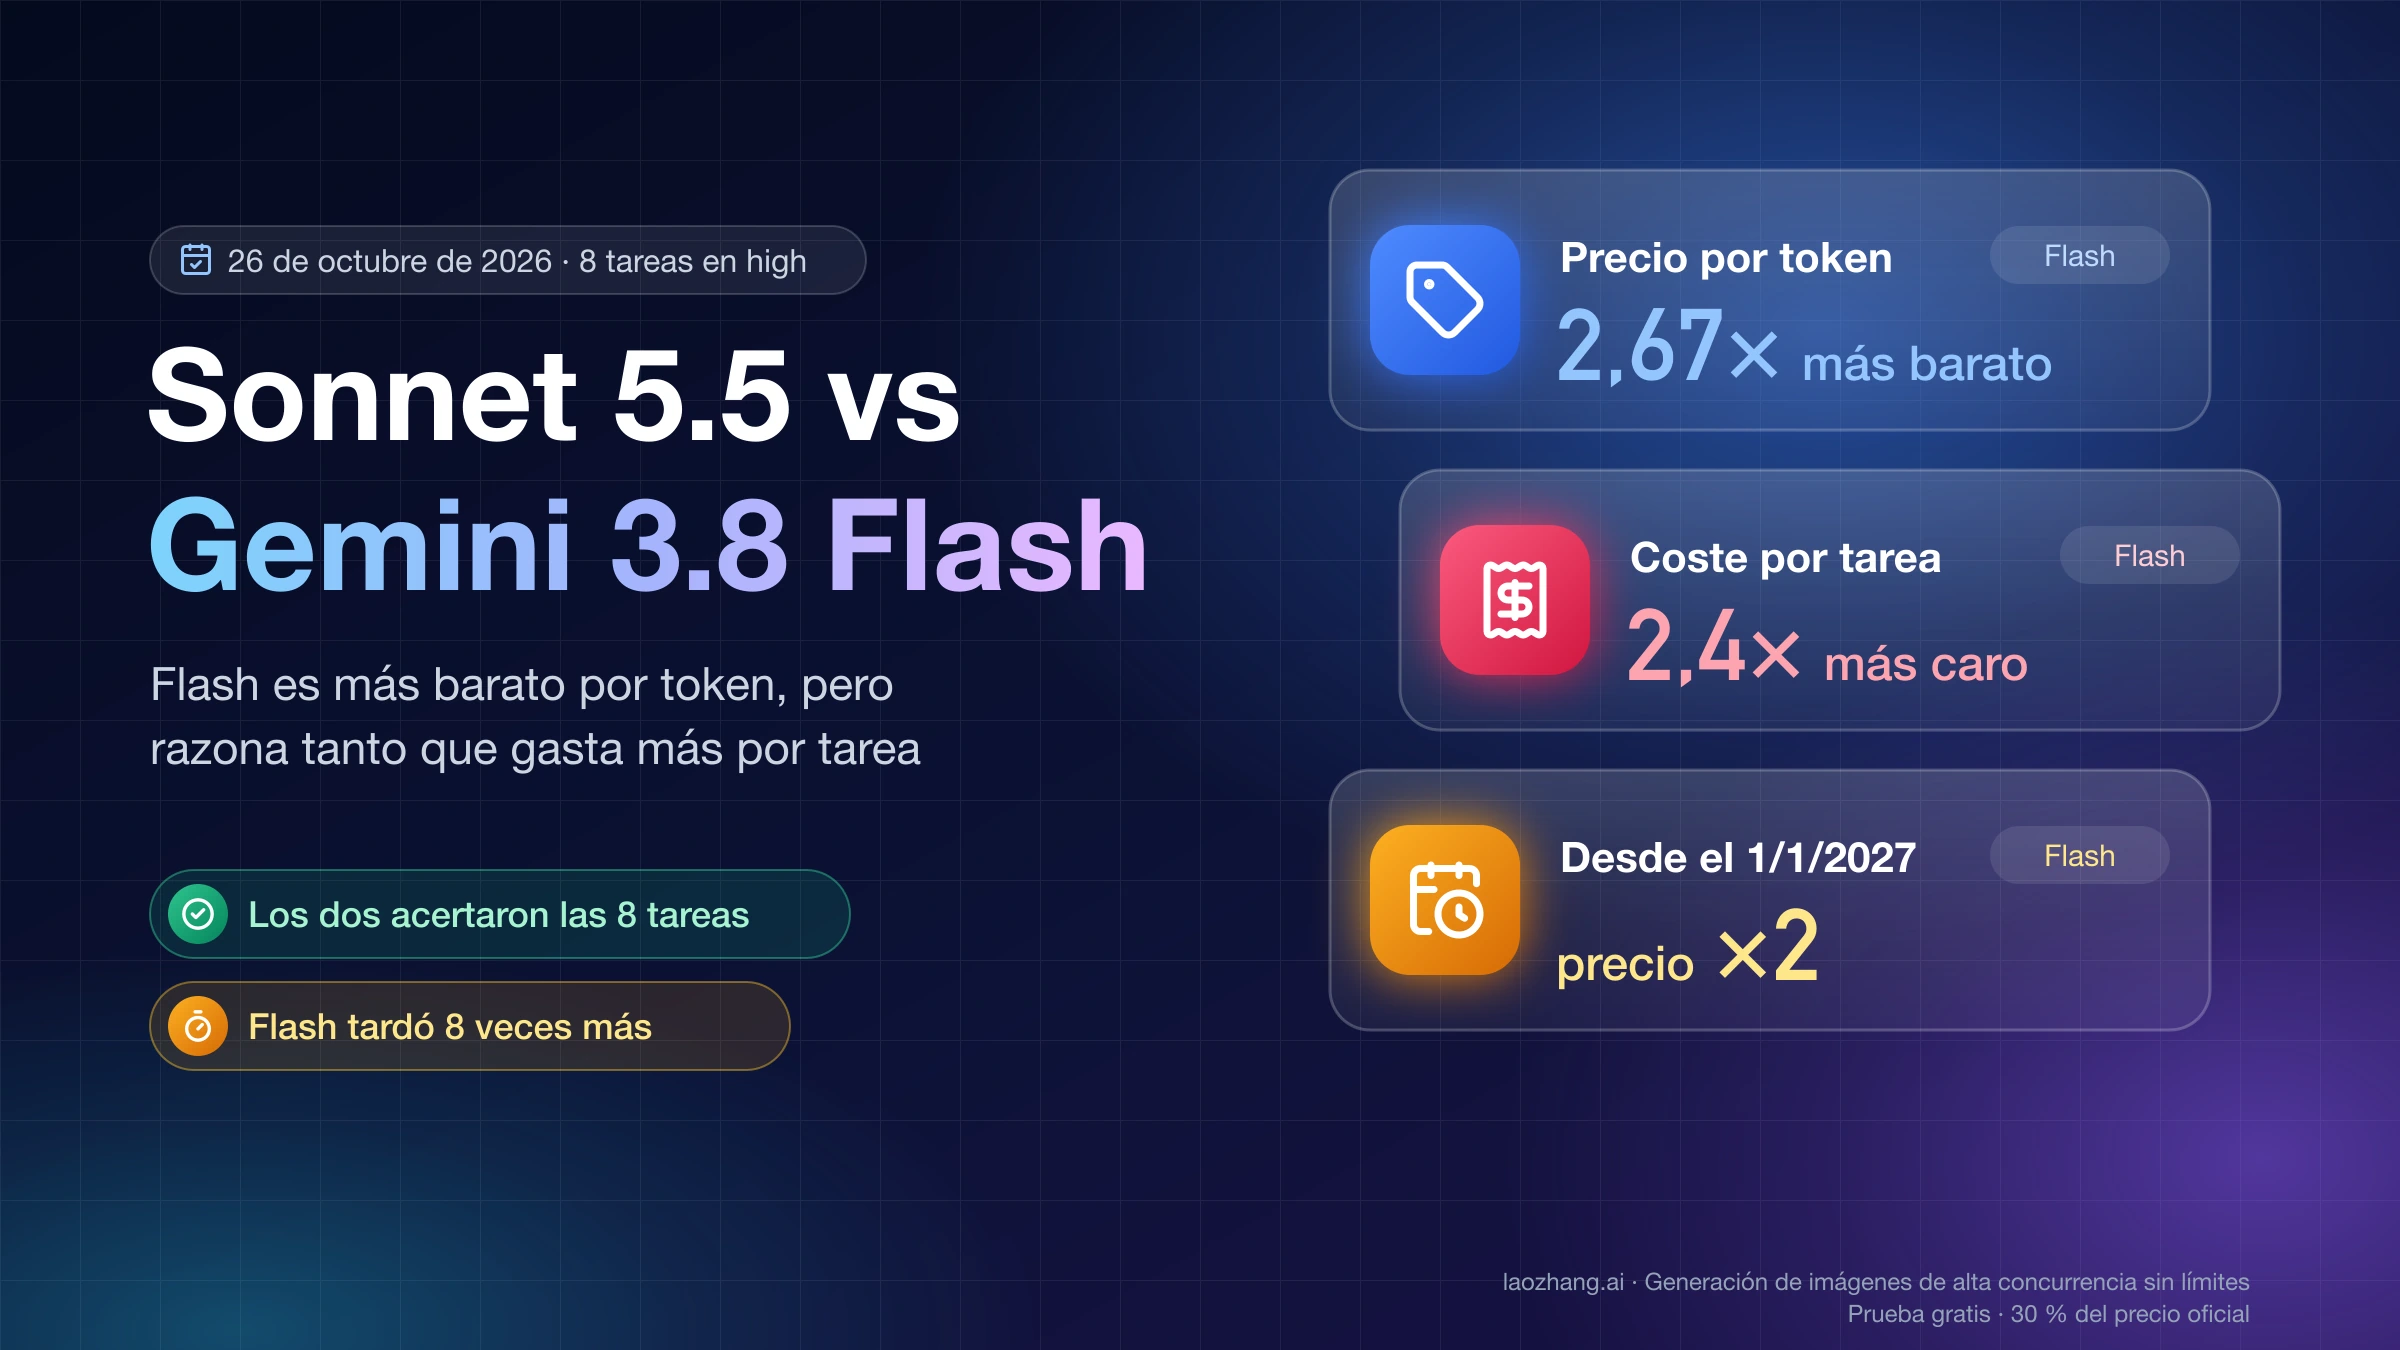
Con tareas pequeñas y bien especificadas, los dos modelos resolvieron todo y lo que cambió fue el coste, los tokens y el tiempo. El 26 de octubre de 2026 se pasaron 9 tareas con comprobaciones escritas antes de ver las respuestas: un problema de aritmética, fusionar intervalos, interpretar duraciones, contar las palabras más frecuentes, resumir en cinco puntos un artículo en inglés de 6.723 palabras, evaluar expresiones, leer una línea CSV, contar sumas de dígitos y comparar versiones SemVer. Cada tarea se lanzó una vez por configuración, sin instrucciones de sistema ni herramientas, a través de la pasarela de LaoZhang: Sonnet 5.5 por /v1/messages (formato Messages de Anthropic) y Luna por /v1/chat/completions.
| Configuración | Aprobadas | Tokens de entrada | Tokens de salida | Coste a precio de lista | Tiempo total |
|---|---|---|---|---|---|
Sonnet 5.5, thinking adaptativo + effort high | 9/9 | 16.957 | 7.802 | 0,1119 $ | 71 s |
| Sonnet 5.5 sin campos de razonamiento | 8/9 | 16.957 | 4.896 | 0,0829 $ | 50 s |
GPT-6 Luna por defecto (medium) | 9/9 | 11.213 | 6.545, de ellos 3.897 de razonamiento | 0,0044 $ | 128 s |
Por el mismo trabajo, Sonnet con razonamiento costó 25,4 veces más que Luna y, sin razonamiento, 18,8 veces más. El único fallo fue de Sonnet sin razonamiento en la fusión de intervalos: interpretó «intervalos que se tocan» como enteros consecutivos y unió (1, 2) con (3, 4), mientras que el test esperaba mantenerlos separados. Con razonamiento adaptativo lo resolvió bien. En esta ruta Luna fue más lenta en todas las tareas; en el evaluador de expresiones tardó 33,2 s frente a 13,0 s de Sonnet con razonamiento.
La prueba no dice cuál es más inteligente: con tareas así, los dos aciertan casi todo, y la distancia aparece en las evaluaciones más difíciles de AA. Tampoco cubre la API directa de cada proveedor, la Responses API, otros niveles de esfuerzo ni el uso de herramientas. LaoZhang sirve los dos modelos con una misma clave a precio de lista; su ruta de Claude limita la salida a 32.768 tokens y no ofrece Batches API.
Cuánto costará tu carga: cinco casos calculados con precios de lista
En casi todos los casos la proporción se queda en 20 veces, y solo dos situaciones la cambian: superar los 272.000 tokens de entrada en Luna y repetir mucho contexto en caché. Los casos se calcularon el 26 de octubre de 2026 con las tarifas de la tabla de precios y los tokens de cada proveedor; las cantidades de tokens son supuestos, no mediciones, y ambos modelos escriben la misma salida en cada caso.
| Caso | Sonnet 5.5 | GPT-6 Luna | Sonnet ÷ Luna |
|---|---|---|---|
| A. Un turno de chat: 2.000 tokens de entrada y 500 de salida | 0,0090 $ | 0,00045 $ | 20x |
| B2. Un documento de 250.000 tokens y 5.000 de salida | 0,55 $ | 0,0275 $ | 20x |
| B. Un documento de 300.000 tokens y 5.000 de salida | 0,65 $ | 0,0638 $ | 10,2x |
| C. Agente de 50 turnos con 100.000 tokens en caché, 2.000 nuevos y 1.000 de salida por turno | 1,45 $ | 0,0975 $ | 14,9x |
| D. Lote de 10.000 peticiones de 3.000 + 1.000 tokens, con Batch | 80,00 $ | 4,00 $ | 20x |
Para comprobar el caso C: en Sonnet son 0,1 millones de tokens de escritura de caché a 2,50 $ (0,25 $), 50 lecturas de 0,1 millones a 0,10 $ (0,50 $), 0,1 millones de entrada nueva a 2 $ (0,20 $) y 0,05 millones de salida a 10 $ (0,50 $), en total 1,45 $. En Luna, las mismas cantidades dan 0,0125 $ + 0,05 $ + 0,01 $ + 0,025 $ = 0,0975 $. La brecha baja a 14,9 veces porque la lectura de caché solo es 10 veces más cara, y el cálculo supone que cada turno llega antes de que caduque la caché (5 minutos en Sonnet, 30 en Luna).
Si ajustas la entrada de Sonnet por el 1,52 del tokenizador, medido tanto en español como en inglés, el caso A sube a 24,6 veces. En el caso B, un documento que Luna cuenta como 300.000 tokens ocupa unos 456.000 en Sonnet, que pasa a costar 0,962 $ frente a 0,0638 $, 15,1 veces más. La salida no se ajusta, porque depende de cuánto escribe cada modelo y no del tokenizador.
¿Cuál es más rápido, Sonnet 5.5 o GPT-6 Luna?
Ninguno es más rápido en todos los casos: depende del nivel de esfuerzo y de la ruta por la que llamas. En las mediciones de AA, que usan la API de cada proveedor, la velocidad de salida es parecida (Sonnet 5.5 entre 105 y 134 tokens por segundo según el nivel, Luna entre 92 y 140), así que el tiempo total depende sobre todo de cuántos tokens escribe cada uno. Luna en low es la configuración más rápida de las dos familias, con 18 s por tarea, pero puntúa 22; a calidad parecida, Sonnet low gana con 85 s frente a los 215 s de Luna xhigh.
Para la primera respuesta, Luna sin razonamiento tarda 0,87 s en devolver el primer token en AA y Sonnet low, 0,98 s, prácticamente lo mismo. En la prueba del 26 de octubre por la pasarela de LaoZhang, Luna medium fue más lenta que Sonnet en todas las tareas, al contrario que en AA, donde Luna medium (126 s por tarea) termina antes que Sonnet high (217 s). OpenRouter publica otra cifra en su propia plataforma (una mediana de 106 tokens por segundo para Sonnet 5.5 y 42 para Luna), con otro método y otros proveedores, así que no se puede sumar a las anteriores. Si la latencia te importa, mídela en el endpoint que vas a usar.
Qué cambiar en el código al pasar de Sonnet 5.5 a Luna o al revés
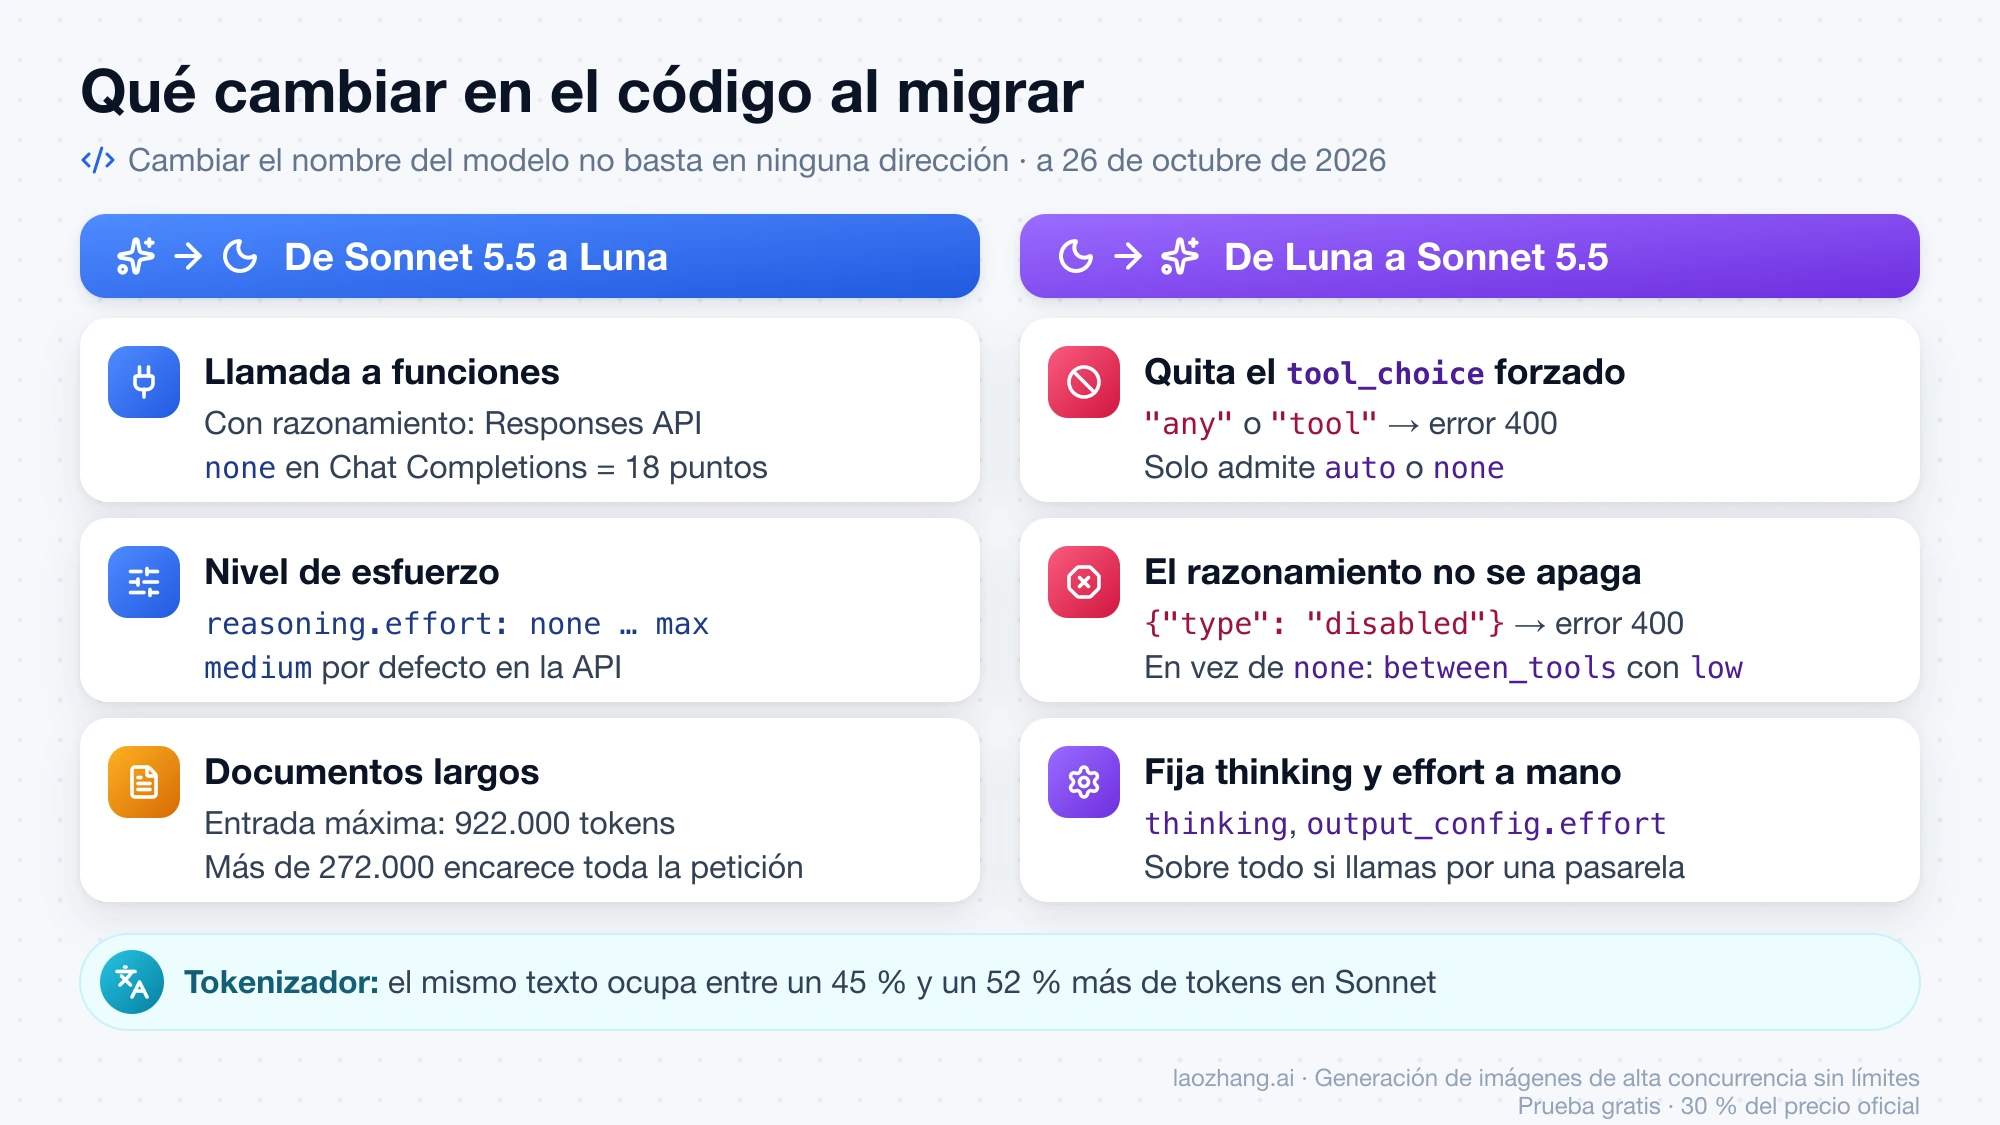
Cambiar el nombre del modelo no basta en ninguna dirección, porque las dos API tratan el razonamiento y las herramientas de forma distinta. Los contratos de GPT-6 Luna y la documentación de razonamiento extendido de Claude fijan estas diferencias:
| Aspecto | Claude Sonnet 5.5 | GPT-6 Luna |
|---|---|---|
| ID y API | claude-sonnet-5-5, Messages API | gpt-6-luna, Chat Completions, Responses y Batch; sin Realtime ni ajuste fino |
| Nivel de esfuerzo | output_config.effort: low a max; high por defecto en la API | reasoning.effort (reasoning_effort en Chat Completions): none a max; medium por defecto |
| Apagar el razonamiento | thinking: {"type": "disabled"} devuelve error 400; lo mínimo es {"type": "between_tools"}, con effort high o inferior | none |
| Llamada a funciones | tool_choice en auto o none; el forzado (any o tool) devuelve error 400 | En Chat Completions, solo con reasoning_effort: "none"; con razonamiento, Responses API |
| Texto del razonamiento | display es "omitted" por defecto: no se devuelve, pero se cobra | Los tokens de razonamiento aparecen en usage |
| Contexto y salida | 1M de contexto al mismo precio; 128.000 de salida | Ventana de 1.050.000, entrada máxima de 922.000; 128.000 de salida |
| Caché | Escritura de 5 min o 1 h; mínimo de 512 tokens cacheables | Escritura de 30 min o 12 h |
| Fecha de corte del conocimiento | Junio de 2026 | 18 de mayo de 2026 |
Si vas de Sonnet a Luna y tu código usa herramientas, pasa esas llamadas a la Responses API. Mantenerlas en Chat Completions con none funciona, pero te deja en el nivel de 18 puntos de la tabla de esfuerzo. Si vas de Luna a Sonnet, quita cualquier tool_choice forzado; si usabas reasoning_effort: "none", lo más parecido es thinking: {"type": "between_tools"} con effort low. Revisa además el tamaño de contexto y los presupuestos de tokens, porque el mismo texto de entrada, en español, inglés o código, ocupa entre un 45 % y un 52 % más de tokens en Sonnet (45 % en inglés, 46 % en código, 52 % en español).
Si llamas a Sonnet 5.5 a través de un proxy o una pasarela, fija thinking y el nivel de esfuerzo de forma explícita. El 26 de octubre de 2026, por la pasarela de LaoZhang, las peticiones a Sonnet sin el campo thinking no devolvieron bloques de razonamiento en ninguna de las 9 tareas; con thinking: {"type": "adaptive"} y output_config: {"effort": "high"} aparecieron en 7 de 9 y los tokens de salida subieron de 4.896 a 7.802. Anthropic documenta que omitir el campo equivale a razonamiento adaptativo con high, y la API directa no se probó, así que no dependas del valor por defecto cuando hay un intermediario entre tu código y Anthropic.
Cómo probar el coste por tarea aceptada antes de cambiar
El número que decide es cuánto pagas por cada resultado que aceptarías sin corregirlo, no el precio por token. Una prueba pequeña con tus propias peticiones te lo da en una tarde:
- Reúne unas decenas de peticiones reales de producción, incluidas las que hoy fallan o necesitan reintento, y escribe para cada una una comprobación automática (tests, esquema, respuesta esperada) antes de ver ninguna salida.
- Fija los parámetros de forma explícita en cada llamada: en Sonnet,
thinkingyoutput_config.effort; en Luna,reasoning.effort. Prueba al menos dos niveles por modelo, por ejemplo Sonnetlowyhighy Lunamediumyxhigh. - Guarda de cada respuesta los tokens de entrada, de caché, de salida y de razonamiento que devuelve
usage, el tiempo total y si pasó la comprobación. - Calcula el coste con las tarifas de lista y divide el total, reintentos incluidos, entre el número de tareas aceptadas. Ese es tu coste por tarea aceptada para cada configuración.
- Elige la configuración más barata que cumpla tu listón de aciertos y de latencia; si Luna falla en un grupo concreto de peticiones, enruta solo ese grupo a Sonnet.
Preguntas frecuentes sobre Sonnet 5.5 y GPT-6 Luna
¿Existe GPT-6 Luna Pro o GPT-6.1 Luna?
No. A 26 de octubre de 2026, el índice de modelos y la página de precios de OpenAI solo incluyen gpt-6-luna; no aparecen «GPT-6 Luna Pro» ni gpt-6.1-luna. Las cifras que circulan con el nombre de Luna Pro (0,10 $ de entrada, 0,50 $ de salida, contexto de 1.050.000 tokens) coinciden con las de gpt-6-luna. Para ver cómo encaja Luna en la gama, consulta GPT-6 Sol, Luna y Astra frente a Terra: precios y cuál probar primero.
¿Hay un modelo de Anthropic al precio de GPT-6 Luna?
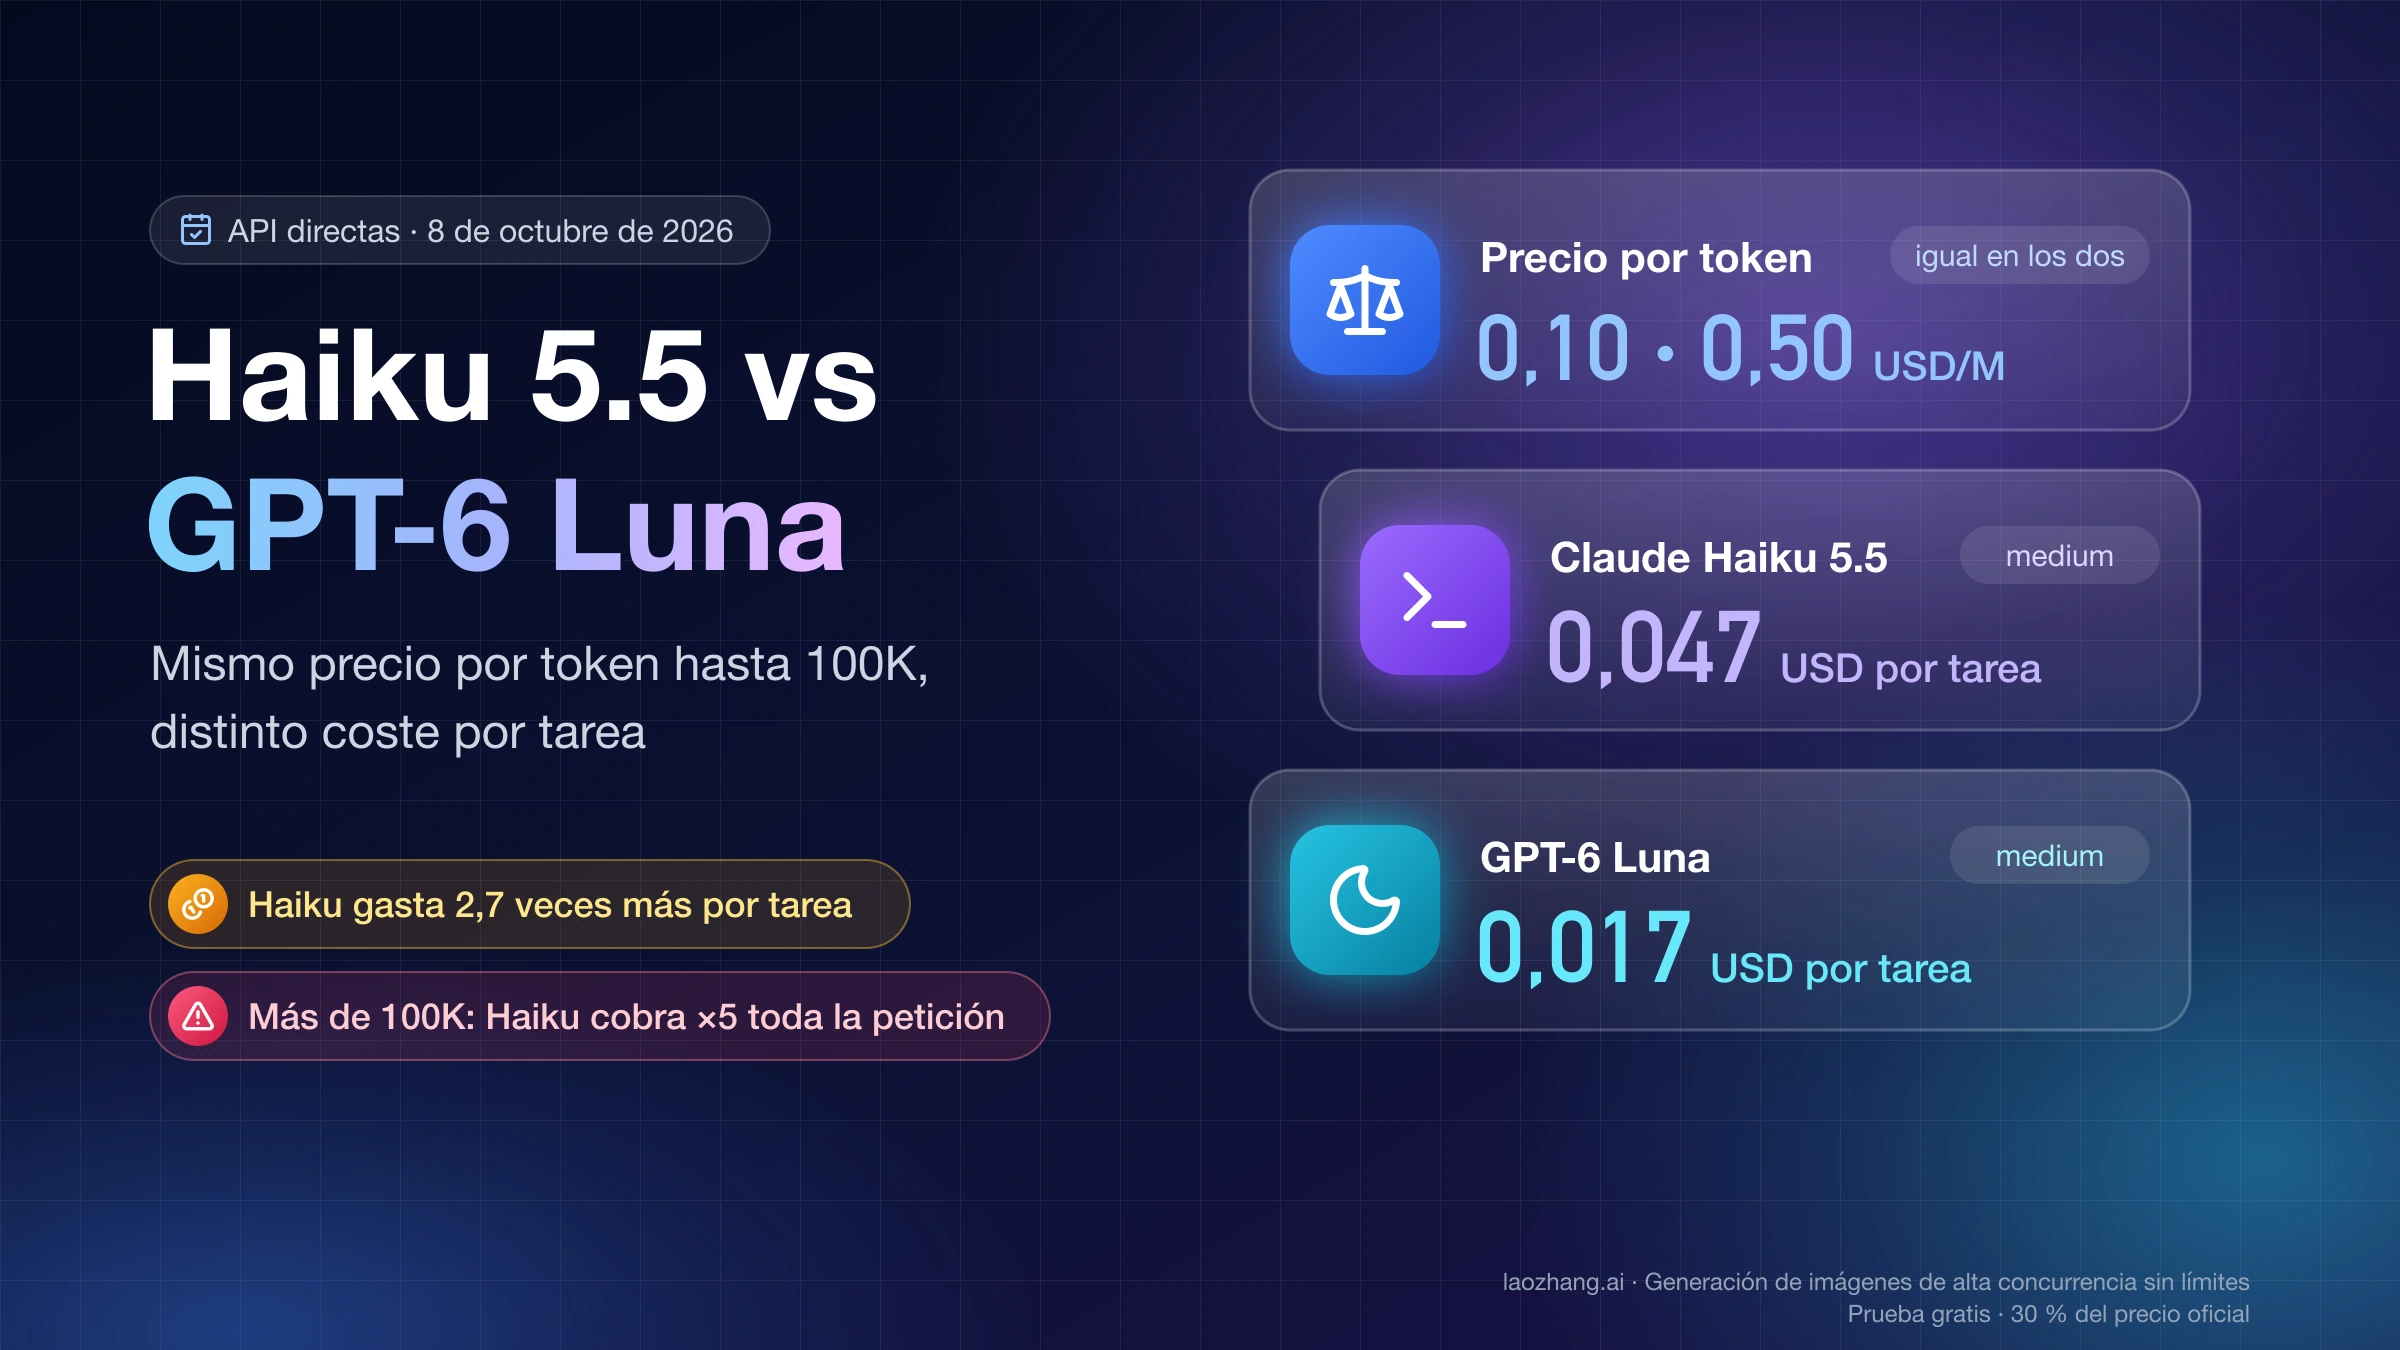
Sí, Claude Haiku 5.5 tiene la misma tarifa de lista que Luna (0,10 $ y 0,50 $ por millón de tokens) hasta 100.000 tokens de entrada, y a partir de ahí multiplica por 5 toda la petición. La comparación por tarea está en Claude Haiku 5.5 vs GPT-6 Luna: mismo precio, coste por tarea no, y la brecha de 20 veces dentro de Anthropic, en Claude Haiku 5.5 vs Sonnet 5.5: cuál elegir y coste por tarea.
¿Qué modelo usan ChatGPT gratis y Claude gratis?
Desde el 8 de octubre de 2026, los planes Free y Go de ChatGPT usan GPT-6 Luna, según el anuncio de OpenAI. El plan gratuito de Claude incluye Sonnet sin precisar la versión; la versión actual de Sonnet es la 5.5. Los detalles del lado de OpenAI están en GPT-6 gratis en ChatGPT: el plan Free usa Luna, no Sol ni Astra.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 26 oct 2026.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 26 oct 2026.
- 1.comparativa de Claude Sonnet 5.5 y GPT-6 Luna en Artificial Analysisartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-luna
- 2.precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 3.precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 4.página del modelo GPT-6 Lunadevelopers.openai.com/api/docs/models/gpt-6-luna
- 5.documentación de razonamiento extendido de Claudeplatform.claude.com/docs/en/build-with-claude/thinking