DeepSeek V4.1 Flash vs GLM-5.3-Flash: precio en valle y punta
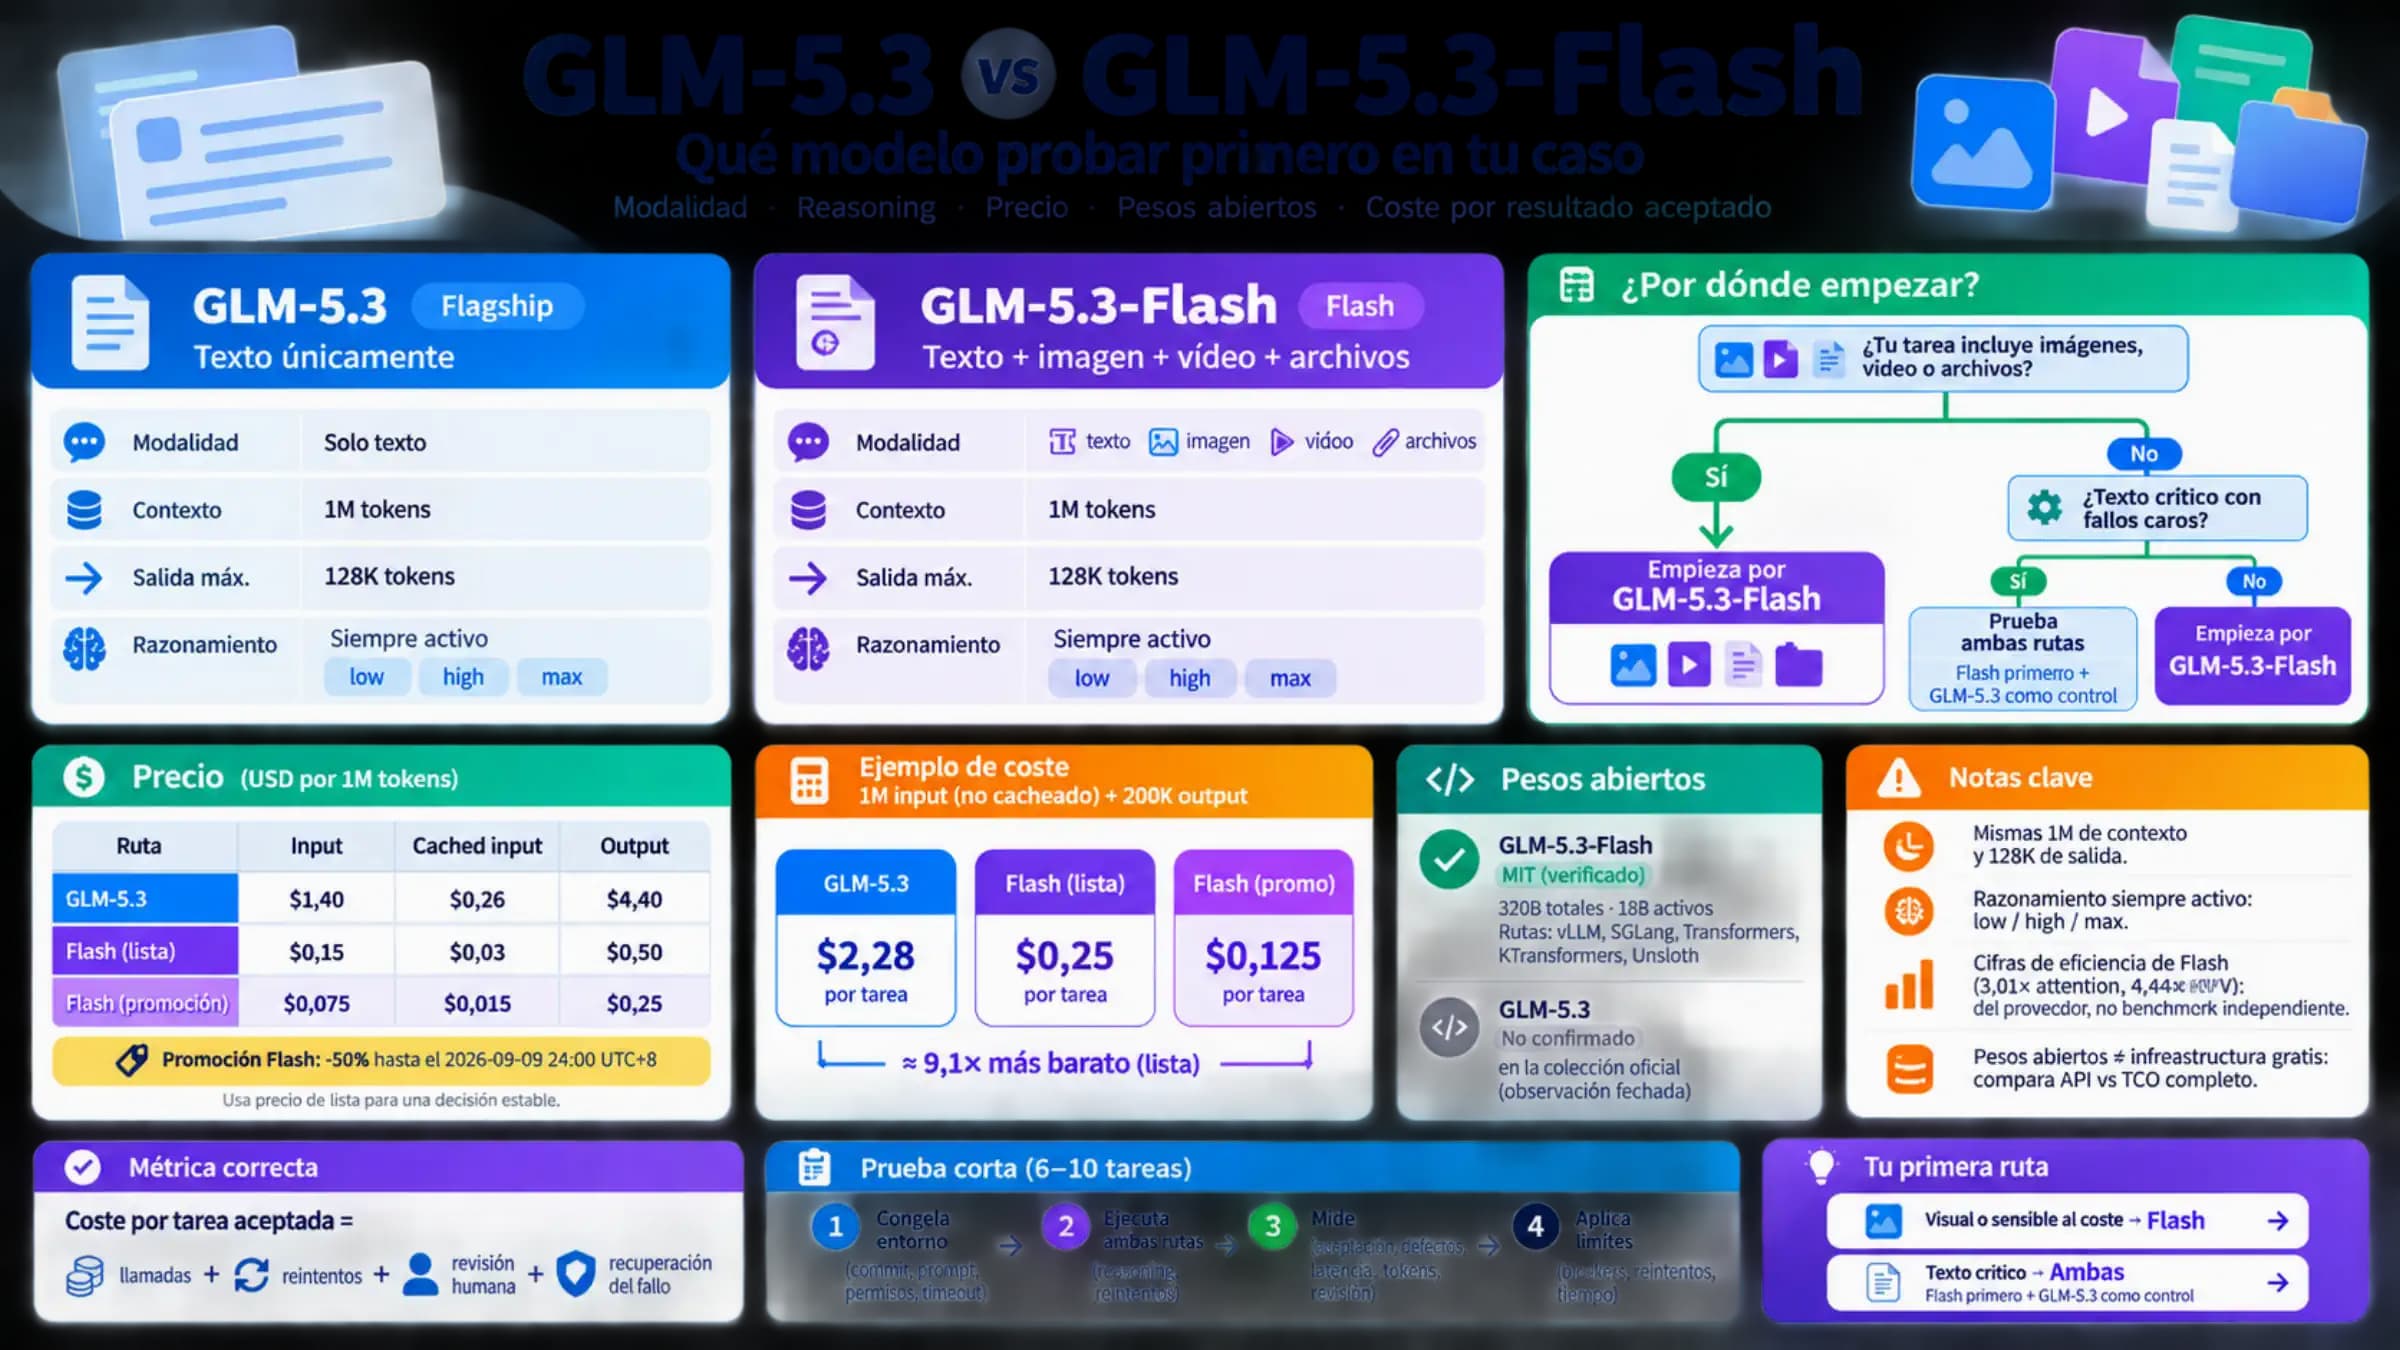
En la tarea media de Artificial Analysis, DeepSeek V4.1 Flash cuesta en horario valle menos de la mitad que GLM-5.3-Flash; en hora punta quedan casi igualados.
En esta página
Si vas a usar uno de los dos por API, empieza por deepseek-flash, el nombre de API de DeepSeek-V4.1-Flash-1017, y lanza fuera de su hora punta todo el trabajo que puedas. Con los precios de lista a 25 de octubre de 2026, la tarea media del índice de Artificial Analysis cuesta 0,13 $ con DeepSeek en horario valle frente a 0,28 $ con glm-5.3-flash, y en esa misma evaluación DeepSeek puntúa 45 frente a 42 y genera texto casi tres veces más rápido. Además, dos detalles que la tabla de precios por token no enseña favorecen a DeepSeek en muchas cargas: el acierto de caché de DeepSeek cuesta la décima parte que el de GLM-5.3-Flash y, a diferencia de GLM, DeepSeek permite desactivar el razonamiento.
GLM-5.3-Flash pasa por delante en tres situaciones. En la hora punta de DeepSeek, de 01:00 a 04:00 y de 06:00 a 10:00 UTC de lunes a viernes, DeepSeek duplica todas sus tarifas, y entonces GLM sale un 24 % más barato en una sesión de agente de código como la calculada más abajo y cuesta la mitad con un documento largo sin caché. También es la opción si necesitas enviar vídeo o archivos como entrada, porque DeepSeek solo acepta texto e imagen. Y si piensas alojar el modelo en tus máquinas, sus pesos ocupan 305,8 GiB frente a 475,3 GiB, aunque los dos exigen cientos de GiB de memoria solo para cargarlos.
El 25 de octubre de 2026 se hicieron cuatro comprobaciones: se contaron los tokens de los mismos textos con los tokenizadores oficiales de ambos modelos, se recalcularon los costes con los precios de lista, se leyó el catálogo público de OpenRouter y se sumó el tamaño de los pesos publicados en Hugging Face. No se ejecutó ninguna prueba con el mismo prompt para medir calidad, velocidad o factura real; esas cifras proceden de Artificial Analysis, que evalúa los dos modelos con un mismo método.
Qué modelos hay hoy detrás de deepseek-flash y glm-5.3-flash
Desde el 17 de octubre de 2026, deepseek-flash sirve DeepSeek-V4.1-Flash-1017. El «1017» es la fecha de ese checkpoint, no un número de versión: sustituyó al V4.1 Flash del 10 de septiembre con el mismo nombre de API y el mismo precio, y según el registro de cambios de la API de DeepSeek puntúa más, termina antes las tareas y escribe respuestas más cortas. Los nombres antiguos deepseek-v4-flash y deepseek-v4-flash-vision-exp se siguen aceptando y también responden con 1017. Es un modelo de mezcla de expertos (MoE) de 552.000 millones de parámetros que activa 8.000 millones para leer la entrada y 16.000 millones para generar la salida.
GLM-5.3-Flash, con el id glm-5.3-flash, tiene 320.000 millones de parámetros y activa 18.000 millones; combina atención dispersa y lineal para abaratar los contextos largos, admite 1M de tokens de contexto, según la guía de GLM-5.3-Flash en la documentación de Z.ai. Z.ai ofrece además glm-5.3-flashx, una variante del mismo modelo más rápida y más cara. Los dos modelos se publican con pesos abiertos y licencia MIT. Si tu duda es otra, elegir entre GLM-5.3 y su versión Flash, la tienes resuelta en GLM-5.3 o GLM-5.3-Flash: qué modelo probar primero.
Esa sustitución de checkpoints explica muchas cifras contradictorias que circulan. El índice 39 que algunos resúmenes atribuyen a «DeepSeek V4.1 Flash (Max)» y el 74,2 en DeepSWE corresponden al checkpoint de septiembre, no al actual. El 57 que Z.ai cita para GLM-5.3-Flash viene de una versión anterior del índice de Artificial Analysis (v4.1.1) y de los precios con descuento del lanzamiento; esa promoción del 50 % terminó el 9 de septiembre. En OpenRouter elige el id exacto deepseek/deepseek-v4.1-flash-1017, porque a 25 de octubre todavía aparecen por separado deepseek/deepseek-v4.1-flash, anterior a 1017, y deepseek-v4-flash-0731.
¿Cuál es más barato? Coste por carga en valle y en punta
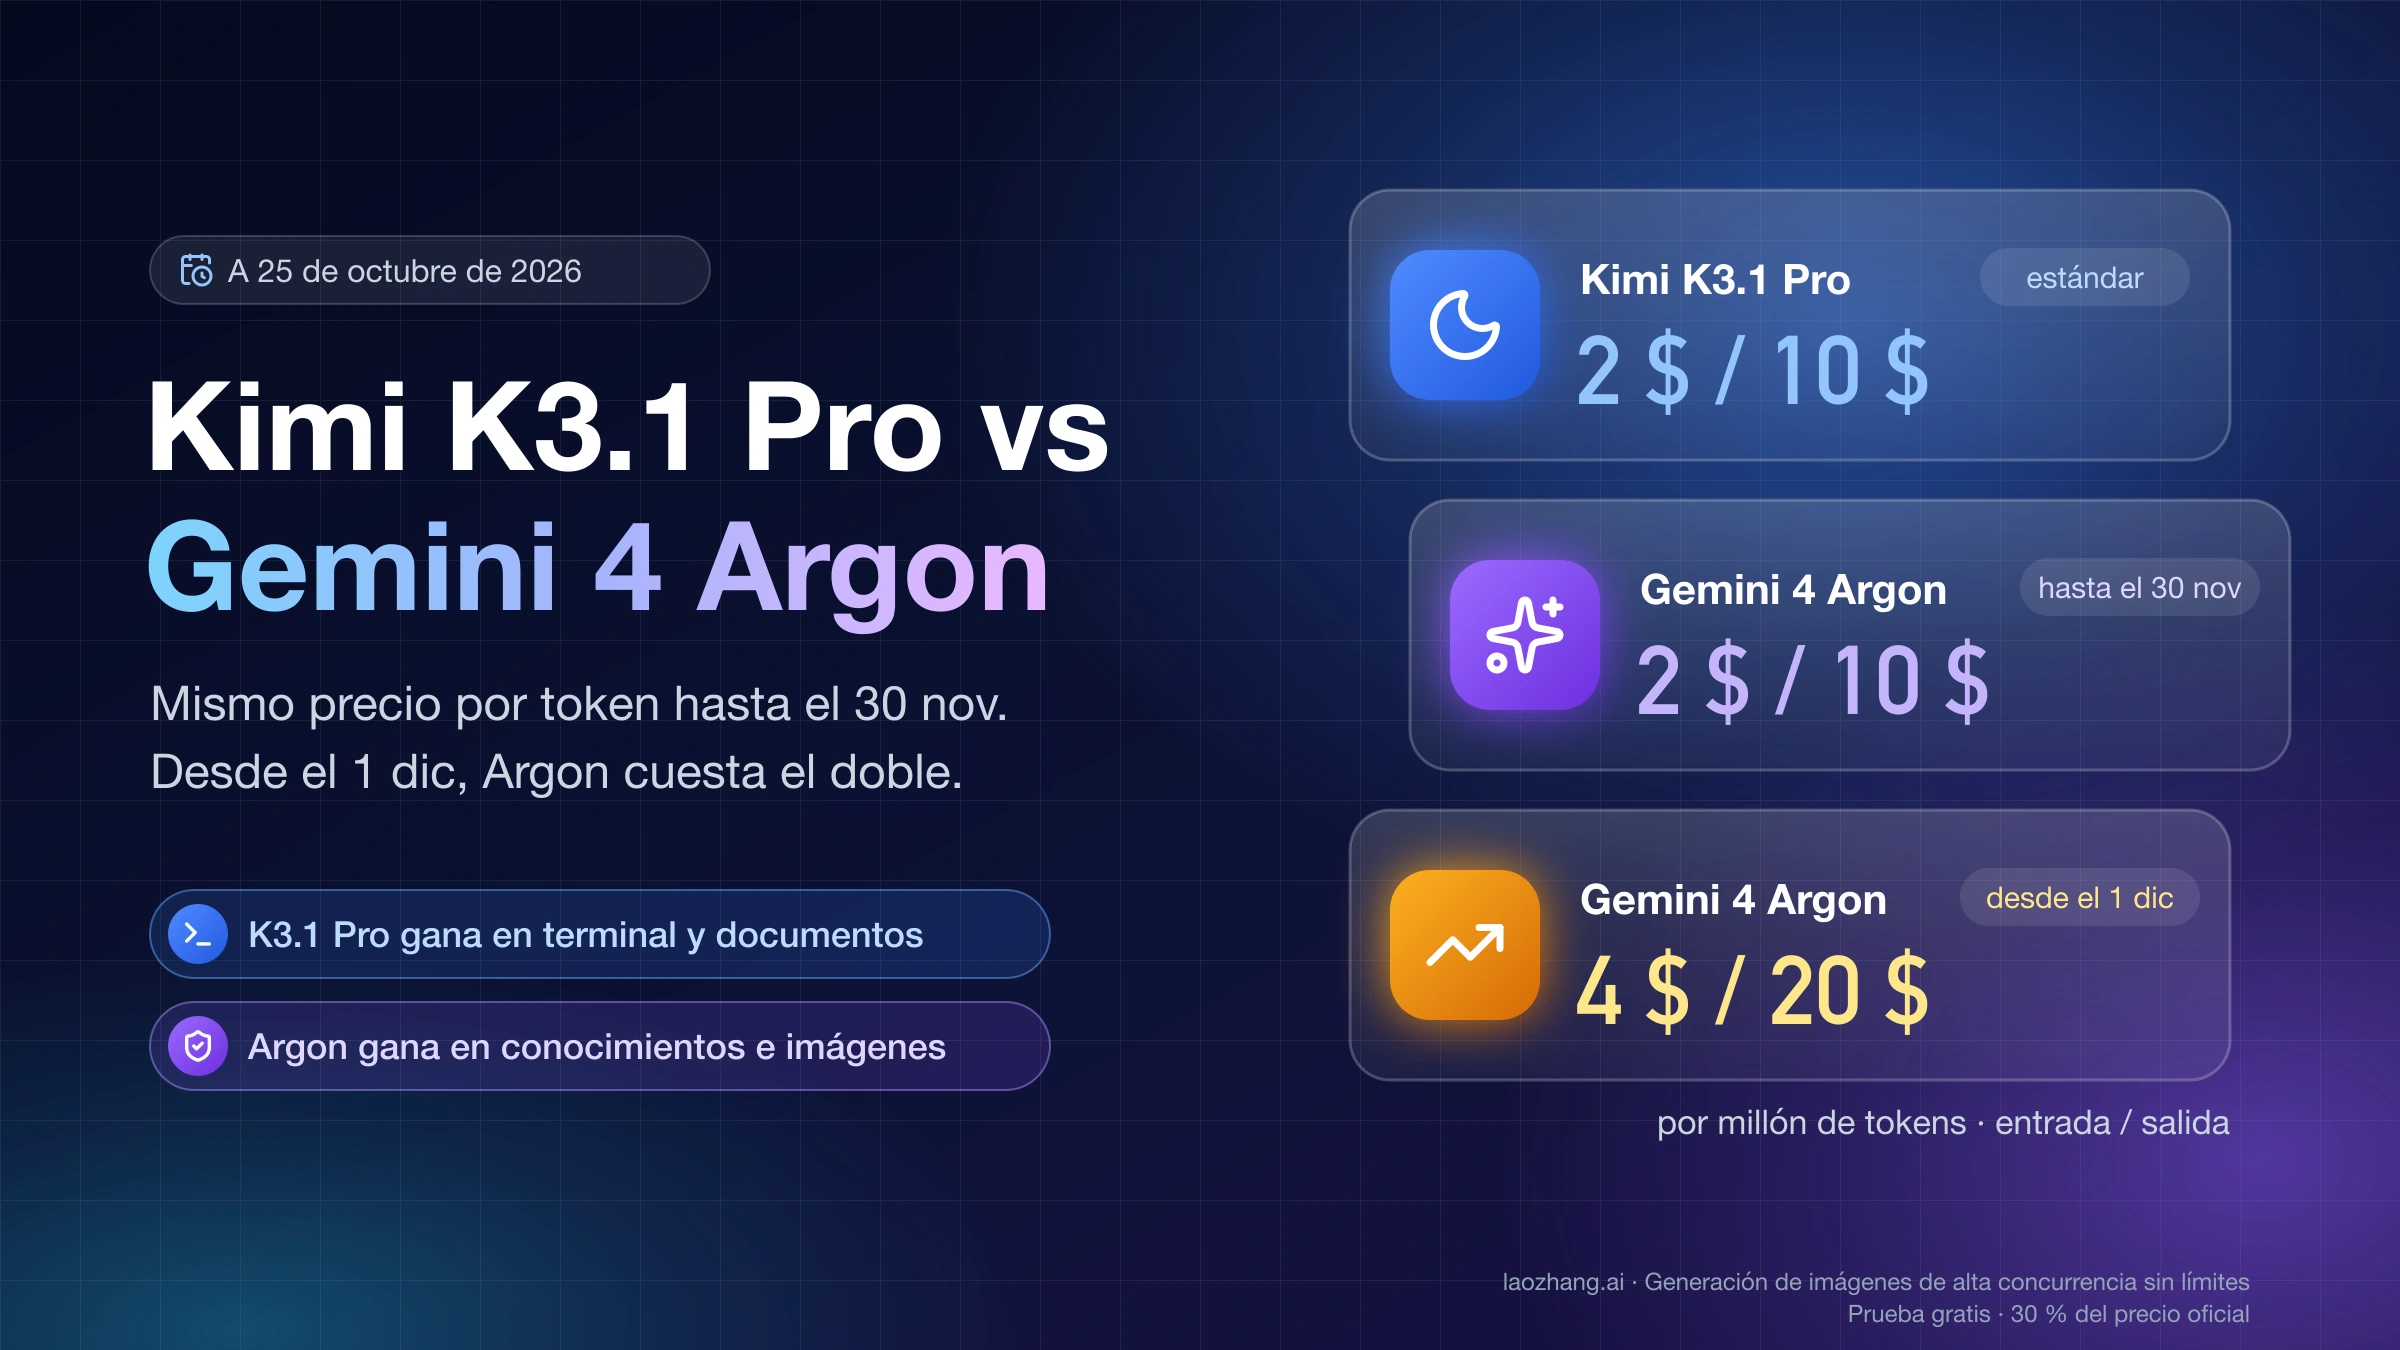
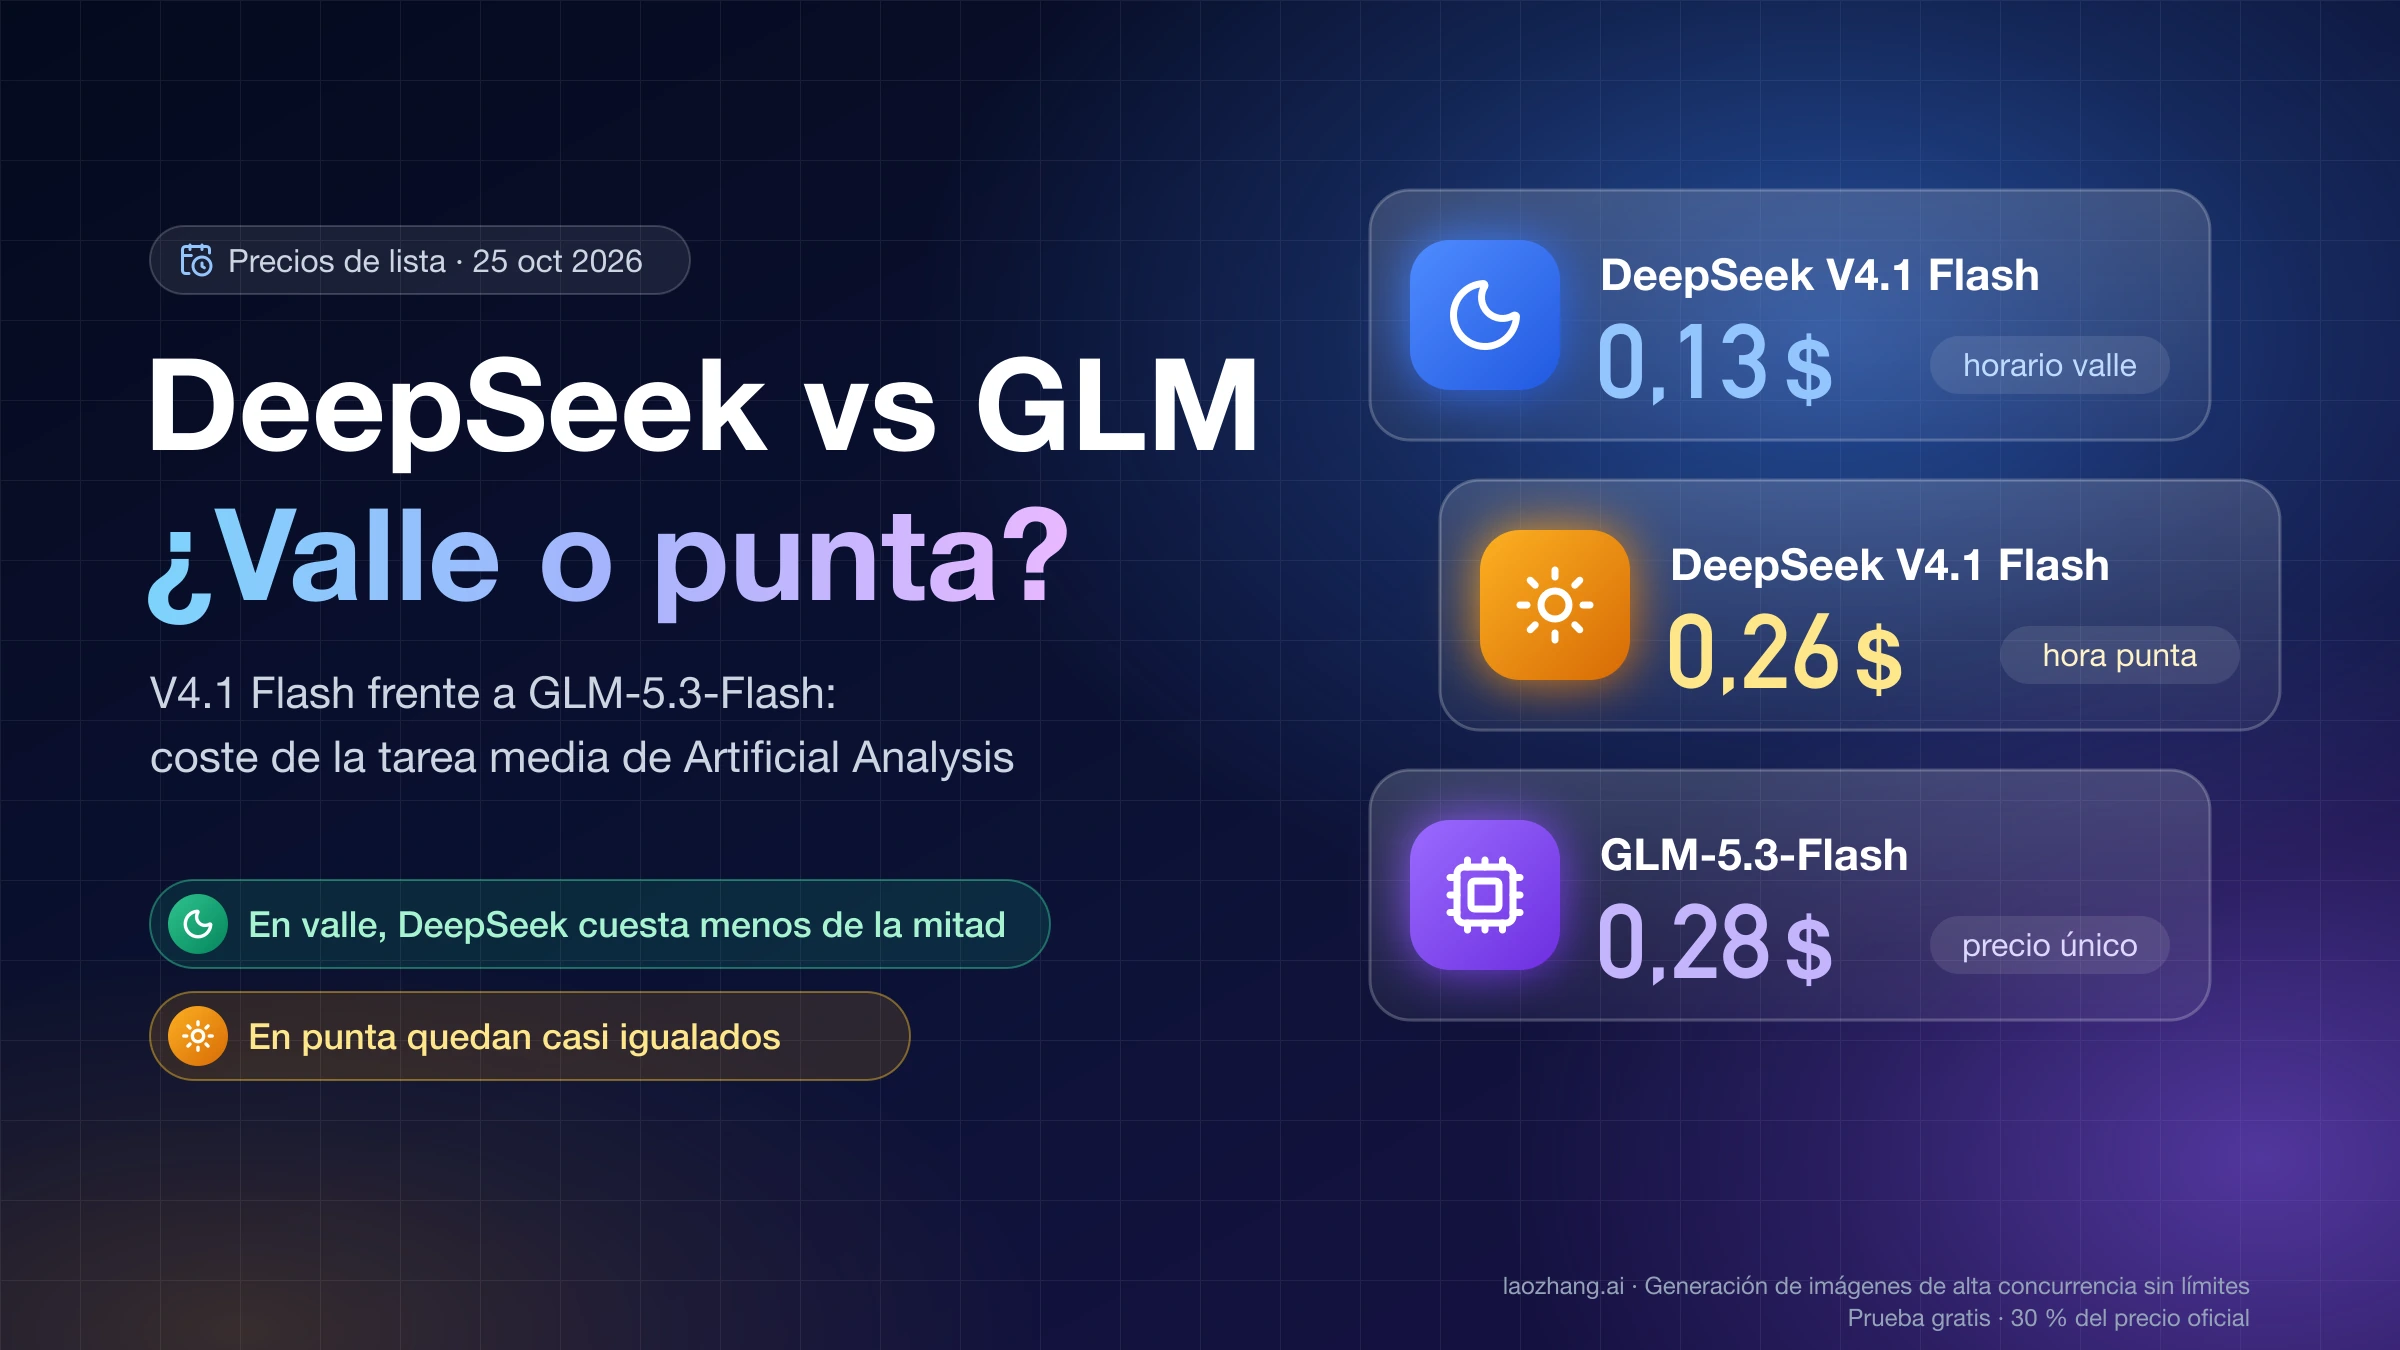
DeepSeek es más barato en horario valle en todas las cargas calculadas salvo el documento largo sin caché, donde empatan. En hora punta quedan cerca: en las cargas supuestas de la tabla, GLM-5.3-Flash sale más barato en la sesión de agente, en las llamadas cortas si razona unos 300 tokens y en el documento largo, pero pierde si escribe el doble o razona 1.000 tokens por llamada, y en la tarea media de Artificial Analysis quedan casi igualados. Estos son los precios de lista por millón de tokens a 25 de octubre de 2026, tomados de la página de precios de la API de DeepSeek y de la tabla de precios de Z.ai:
| Por millón de tokens | DeepSeek V4.1 Flash, valle | DeepSeek V4.1 Flash, punta | GLM-5.3-Flash |
|---|---|---|---|
| Entrada con acierto de caché | 0,003 $ | 0,006 $ | 0,03 $ |
| Entrada sin caché | 0,15 $ | 0,30 $ | 0,15 $ |
| Salida, razonamiento incluido | 0,60 $ | 1,20 $ | 0,50 $ |
GLM-5.3-Flash tiene un precio único, sin franjas horarias, y el almacenamiento de su caché figura como gratuito por tiempo limitado. DeepSeek aplica la tarifa de punta en dos ventanas de lunes a viernes, que se detallan en el apartado siguiente, y la de valle el resto del tiempo.
Con esos precios, el recálculo del 25 de octubre de 2026 da estos costes por carga:
| Carga | DeepSeek valle | DeepSeek punta | GLM-5.3-Flash | GLM ÷ DeepSeek, valle / punta |
|---|---|---|---|---|
| Tarea media del índice de Artificial Analysis | 0,13 $ | 0,26 $ | 0,28 $ | 2,15× / 1,08× |
| Sesión de agente de código: 40 turnos, prefijo de 60.000 tokens en caché, 4.000 tokens nuevos y 3.000 de salida por turno | 0,1032 $ | 0,2064 $ | 0,1560 $ | 1,51× / 0,76× |
| La misma sesión, pero GLM escribe el doble de salida | 0,1032 $ | 0,2064 $ | 0,2160 $ | 2,09× / 1,05× |
| 1.000 llamadas cortas de 1.500 tokens con respuesta de 50; DeepSeek sin razonamiento, GLM razona 300 tokens por llamada | 0,255 $ | 0,510 $ | 0,400 $ | 1,57× / 0,78× |
| Las mismas 1.000 llamadas, GLM razona 1.000 tokens por llamada | 0,255 $ | 0,510 $ | 0,750 $ | 2,94× / 1,47× |
| Un documento de 400.000 tokens sin caché y 2.000 tokens de salida | 0,0612 $ | 0,1224 $ | 0,0610 $ | 1,00× / 0,50× |
La primera fila sale de Artificial Analysis, que calcula el coste de DeepSeek con la tarifa de punta; la cifra de valle es esa misma tarea con todas las tarifas de DeepSeek a la mitad. Las demás filas son cargas supuestas para ilustrar el cálculo, no tráfico medido: los recuentos de tokens son ejemplos, la salida incluye los tokens de razonamiento, en la sesión de agente se supone que el prefijo acierta en caché en los 40 turnos y no se cuentan impuestos. Si todavía no has reducido la lista a estos dos modelos, la Comparativa de precios de API de IA: qué modelo sale más barato cubre más opciones.
Por qué el precio por token no decide la factura
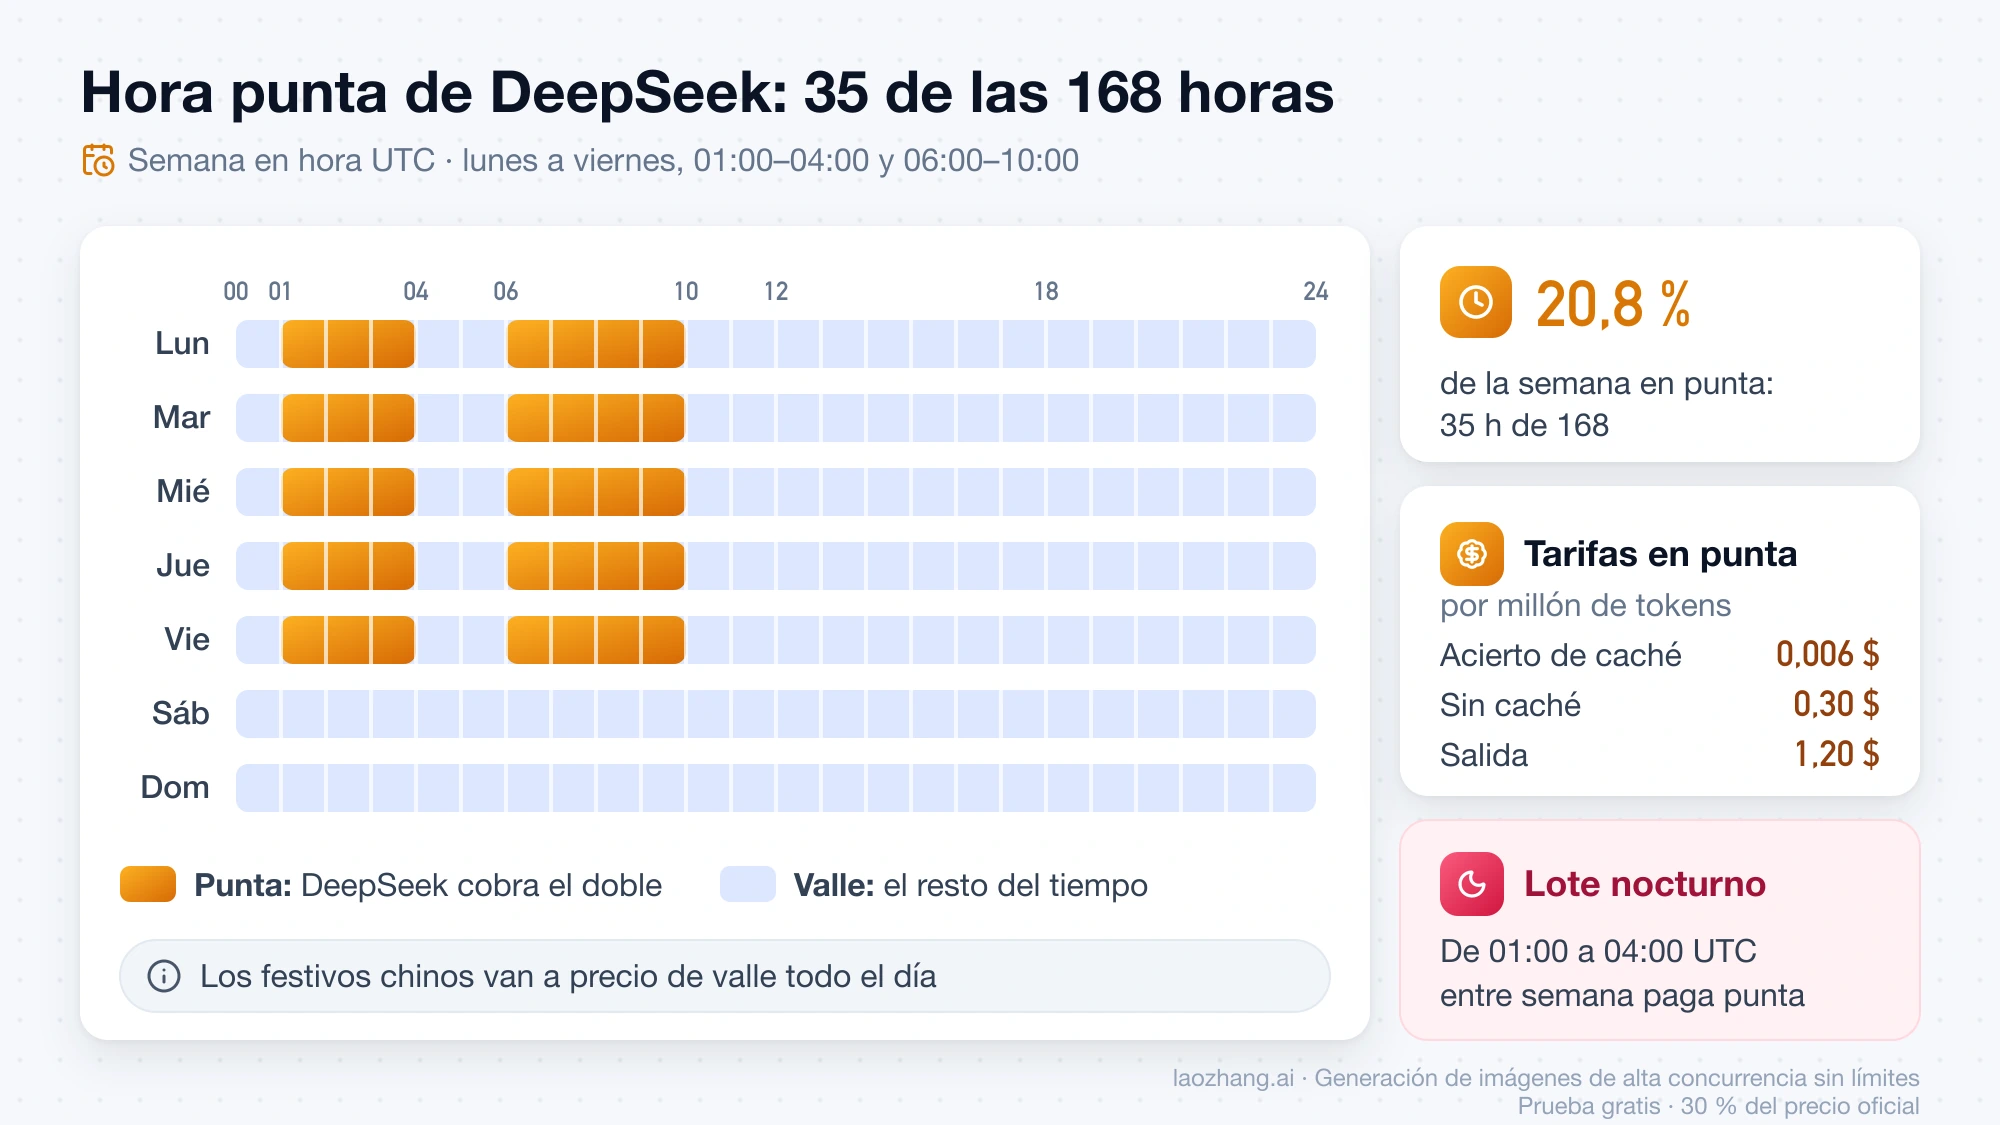
Los dos modelos cobran lo mismo por la entrada sin caché en valle y GLM es algo más barato en la salida, pero esa coincidencia esconde cuatro diferencias que mueven la factura más que la tarifa. La primera es la hora. DeepSeek cobra el doble de 01:00 a 04:00 y de 06:00 a 10:00 UTC de lunes a viernes, salvo festivos chinos: 35 de las 168 horas de la semana, un 20,8 %. Solo pagan valle los fines de semana, los festivos chinos y las horas laborables fuera de esas dos ventanas, así que un lote nocturno entre semana no es barato por definición: si cae en la ventana de 01:00 a 04:00 UTC, paga punta. Para pasar las dos ventanas a la hora peninsular, que cambia con el horario de invierno desde el 25 de octubre, consulta Precio de la API de DeepSeek en hora punta y valle desde España.
La segunda es la caché. Un acierto de caché cuesta 10 veces más en GLM-5.3-Flash que en DeepSeek en valle y 5 veces más en punta, y en un agente de código que reenvía el mismo prefijo en cada turno esa es la línea más voluminosa. En la sesión de la tabla, los 40 turnos leen 2,4 millones de tokens de caché: 0,0072 $ con DeepSeek en valle frente a 0,072 $ con GLM. Las 160.000 entradas nuevas cuestan 0,024 $ en los dos, y los 120.000 tokens de salida, 0,072 $ en DeepSeek frente a 0,060 $ en GLM; sumando, 0,1032 $ frente a 0,156 $. Ninguno de los dos fabricantes publica cuánto tiempo conserva la caché, así que la proporción real de aciertos tienes que medirla en tus propias llamadas.
La tercera es el razonamiento obligatorio. La guía de modo de razonamiento de Z.ai indica que GLM-5.3-Flash no permite desactivarlo, mientras que DeepSeek responde sin pensar con {"thinking":{"type":"disabled"}}. Para tareas cortas como clasificar, extraer campos o etiquetar, eso da ventaja a DeepSeek: en el ejemplo de 1.000 llamadas, GLM ya cuesta más que DeepSeek en valle en cuanto razona más de 10 tokens por llamada, y más que DeepSeek en punta a partir de 520.
La cuarta es cuánto escribe cada modelo, y eso depende de la tarea. En el índice de Artificial Analysis, DeepSeek genera 89.000 tokens de salida por tarea, 59.000 de ellos de razonamiento, frente a 69.000 y 47.000 de GLM. En cambio, en el benchmark de redacción ToneBench que publicó @Whats_AI en X hacia el 20 de octubre, GLM razonó 37.000 tokens por guion frente a 17.000 de DeepSeek y salió más caro, 0,022 $ frente a 0,014 $ por guion. Por eso la fila «GLM escribe el doble» de la tabla no es un caso extremo, sino un escenario que conviene comprobar.
Los tokens en español cuentan casi igual en los dos modelos
El mismo texto en español ocupa prácticamente los mismos tokens en DeepSeek y en GLM, así que puedes comparar sus precios por token tal cual. El 25 de octubre de 2026 se pasaron por el tokenizer.json oficial de cada modelo, publicado en Hugging Face, los mismos textos sin plantilla de chat: un artículo de este blog en español dio 5.828 tokens con DeepSeek y 5.700 con GLM, un 2,2 % menos con GLM.
En código la diferencia también es pequeña y a favor de GLM: un archivo TypeScript pasó de 5.309 a 5.060 tokens (un 4,7 % menos) y un JSON de configuración, de 848 a 784 (un 7,5 % menos). Con márgenes así, lo que separa la factura de los dos modelos es la longitud del razonamiento, no el tokenizador. La única excepción relevante apareció en coreano, donde GLM necesitó un 13 % más de tokens para el mismo texto.
¿Cuál es mejor para programar? Lo que mide Artificial Analysis
Con un mismo método de evaluación, DeepSeek V4.1 Flash 1017 queda por delante en casi todo, pero por poco en las pruebas que más se parecen a programar con un agente. En la comparación de Artificial Analysis entre DeepSeek V4.1 Flash 1017 y GLM-5.3-Flash, con DeepSeek en esfuerzo máximo, Terminal-Bench 4.0, que mide tareas de agente en terminal, da 34 % frente a 33 %, y SciCode, 56 % frente a 52 %. La diferencia crece en AutomationBench-AA, 67 % frente a 60 %, y el índice compuesto queda en 45 frente a 42. GLM-5.3-Flash solo puntúa más en AA-Omniscience, 7 frente a 5.
Para analizar documentos largos, la prueba de razonamiento con contexto largo AA-LCR da 83 % frente a 80 %. Es una distancia corta, de modo que en ese uso suele pesar más el coste, y con un documento sin caché la tabla de costes favorece a GLM en hora punta. Las cifras que publica cada fabricante no sirven para enfrentarlos, porque usan entornos de prueba distintos. DeepSeek declara 77,0 en DeepSWE v1.1 para el checkpoint 1017, medido con el marco Mini-SWE-V2. La guía de Z.ai da 63,4 para GLM-5.3-Flash en esa prueba sin indicar el marco.
Las opiniones de usuarios van en otra dirección y conviene leerlas como lo que son. En un hilo de r/opencode con más de 80 comentarios, de septiembre y por tanto anterior a 1017, un usuario resume que DeepSeek tiene menos latencia pero que GLM quizá sea mejor en diseño, y la respuesta más valorada prefiere GLM «para su caso». Si tu trabajo es sobre todo interfaz o estilo, ese matiz justifica incluir a GLM en tu propia prueba aunque pierda en las cifras agregadas.
¿Cuál es más rápido? 195 frente a 69 tokens por segundo
DeepSeek V4.1 Flash 1017 es claramente más rápido. Según Artificial Analysis, genera 195 tokens por segundo frente a 69 de GLM-5.3-Flash, entrega el primer token en 1,14 s frente a 3,29 s y tarda de media 357,60 s por tarea de su índice frente a 831,77 s, es decir, unos 6 minutos frente a casi 14. Son mediciones de Artificial Analysis sobre los endpoints que elige; un proveedor concreto de OpenRouter puede ir más rápido o más lento.
Si prefieres GLM y la velocidad es tu problema, Z.ai ofrece glm-5.3-flashx, para el que declara 200 tokens por segundo. Cuesta 0,37 $ por millón de entrada, 0,075 $ de caché y 1,25 $ de salida, más del doble que GLM-5.3-Flash y más que DeepSeek en hora punta en las tres líneas. A 25 de octubre de 2026, en OpenRouter solo lo sirve Z.AI y no está incluido en el GLM Coding Plan, donde GLM-5.3-Flash sí está disponible con el triple de cuota que GLM-5.3.
¿Local o por API? 475 GiB frente a 306 GiB solo en pesos
Para ejecutarlos en tus máquinas, lo que decide primero es el tamaño, y ahí GLM-5.3-Flash es bastante más manejable. Según la suma hecha el 25 de octubre de 2026 con la API de Hugging Face, los pesos oficiales ocupan 475,3 GiB en DeepSeek-V4.1-Flash-1017, 48 archivos .safetensors en FP8 con los expertos en FP4, y 305,8 GiB en GLM-5.3-Flash, 62 archivos en FP8. Eso es solo lo que ocupan los pesos: la caché KV, las activaciones y el margen del motor de inferencia van aparte y crecen mucho con contextos cercanos a 1M, y Z.ai reconoce que la caché KV de GLM-5.3-Flash sigue siendo algo mayor que la del DeepSeek-V4-Flash anterior. Los ejemplos de despliegue de GLM con vLLM reparten el modelo entre cuatro GPU. Los pasos concretos están en Guía de GLM-5.3-Flash: Ox Alpha, precio de la API y ejecución local.
Si no vas a alojarlos, la oferta de proveedores no te obliga a elegir. A 25 de octubre de 2026, el catálogo público de OpenRouter listaba 29 proveedores para deepseek/deepseek-v4.1-flash-1017 y 34 para z-ai/glm-5.3-flash. Esas copias no son idénticas a la oficial: muchas están cuantizadas a FP4 o FP8, y la salida máxima de DeepSeek varía entre 131.072 y 943.718 tokens según el proveedor, mientras que la ruta oficial de DeepSeek admite 393.216 y la de Z.AI, 131.072. Si vas a comparar calidad, hazlo contra el endpoint de cada fabricante y deja los proveedores de terceros para cuando ya hayas decidido el modelo.
Qué cambia en tu código al pasar de deepseek-flash a glm-5.3-flash
Cambiar el nombre del modelo no basta: el razonamiento, los parámetros de muestreo y el manejo del historial funcionan de forma distinta. Esta tabla resume las diferencias documentadas por DeepSeek en su guía de modo de razonamiento y su página de precios, y por Z.ai en la guía de GLM-5.3-Flash y su documentación de caché de contexto:
| Aspecto | DeepSeek V4.1 Flash (deepseek-flash) | GLM-5.3-Flash (glm-5.3-flash) |
|---|---|---|
| Razonamiento | Activado por defecto; se desactiva con {"thinking":{"type":"disabled"}} | Obligatorio: thinking.type solo admite enabled |
| Nivel de esfuerzo | reasoning_effort: low, high (predeterminado) o max | Z.ai recomienda reasoning_effort: max |
| Muestreo | Con razonamiento, temperature, presence_penalty y frequency_penalty se ignoran sin error; top_p solo actúa entre 0,95 y 1,0 | Recomendados temperature: 1 y top_p: 0.95 |
| Historial con herramientas | Hay que devolver reasoning_content de los turnos anteriores o la API responde 400 | Con thinking.clear_thinking: false, que Z.ai recomienda, hay que devolver reasoning_content completo y sin modificar |
| Salida máxima | 384K tokens | 128K tokens |
| Entrada | Texto e imagen | Texto, imagen, vídeo y archivos; las imágenes van en bloques image_url |
| Caché de contexto | Precio de acierto propio, distinto en valle y punta | Automática; los aciertos aparecen en usage.prompt_tokens_details.cached_tokens |
| Formatos de API | Formato OpenAI, Responses API y formato Anthropic en https://api.deepseek.com/anthropic | Chat Completion API de Z.ai; en streaming, stream: true y tool_stream: true |
| Otras funciones | Completado FIM solo sin razonamiento; completado con prefijo en beta; 2.500 peticiones simultáneas por cuenta | Llamada a funciones y salida JSON estructurada |
Al pasar de DeepSeek a GLM, lo que suele romperse es el código pensado para llamadas sin razonamiento: hay que quitar {"thinking":{"type":"disabled"}}, reservar en max_tokens espacio para el razonamiento, que ahora siempre existe, y partir cualquier tarea que genere más de 128K tokens. En sentido contrario, si enviabas vídeo o archivos a GLM tendrás que convertirlos en texto o imágenes, y si ajustabas temperature para variar las respuestas, DeepSeek la ignora mientras razona. Para usar DeepSeek como modelo de un agente de código, el formato Anthropic es el camino más corto; los detalles están en Claude Code con OpenRouter y DeepSeek: rutas, configuración y primeros errores.
Cómo hacer una prueba justa con tus propias tareas
Las cifras de Artificial Analysis y los cálculos anteriores te dicen por dónde empezar, pero quién escribe más y quién acierta más depende de tu carga, así que la decisión final sale de una prueba pequeña con tus propias tareas. Bastan unas horas si la preparas así:
- Reúne entre 20 y 30 tareas reales de tu trabajo, cada una con un criterio de aceptación comprobable: pasa los tests, el JSON valida, el resumen no inventa cifras.
- Llama a los dos con el mismo prompt y un esfuerzo comparable,
reasoning_effort: maxen ambos, el nivel que Z.ai recomienda para GLM y el que usa Artificial Analysis para DeepSeek. Si en producción usarías DeepSeek sin razonamiento, añade esa configuración como tercera columna. - Usa los endpoints oficiales,
deepseek-flashen DeepSeek yglm-5.3-flashen Z.ai, para no mezclar el modelo con la cuantización de un proveedor de terceros. - Guarda en cada llamada los tokens de entrada, los aciertos de caché, los tokens de salida con el razonamiento incluido y el tiempo total.
- Calcula el coste con tres precios, DeepSeek en valle, DeepSeek en punta y GLM, y pondera los dos de DeepSeek según la parte de tus llamadas que caiga en la franja de punta.
- Divide el coste total de cada modelo entre las tareas que cumplieron el criterio: el coste por resultado aceptado es la cifra que compara de verdad.
No tienes por qué quedarte con un solo modelo. Un reparto razonable es enviar a DeepSeek las sesiones de agente con prefijo largo en caché, las llamadas cortas sin razonamiento y los lotes que puedas programar en valle, y reservar GLM-5.3-Flash para el trabajo que no puedes sacar de la franja de punta de DeepSeek, las entradas de vídeo o archivos y las tareas en las que gane tu prueba. Si alguna vez quieres alojar uno de los dos, repite la prueba contra tu propio despliegue, porque la cuantización que elijas también cambia el resultado.
Fuentes10
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
Fuentes10
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
- 1.registro de cambios de la API de DeepSeekapi-docs.deepseek.com/updates
- 2.guía de GLM-5.3-Flash en la documentación de Z.aidocs.z.ai/guides/vlm/glm-5.3-flash
- 3.página de precios de la API de DeepSeekapi-docs.deepseek.com/quick_start/pricing
- 4.tabla de precios de Z.aidocs.z.ai/guides/overview/pricing
- 5.guía de modo de razonamiento de Z.aidocs.z.ai/guides/capabilities/thinking-mode
- 6.comparación de Artificial Analysis entre DeepSeek V4.1 Flash 1017 y GLM-5.3-Flashartificialanalysis.ai/models/comparisons/deepseek-v4-1-flash-1017-vs-glm-5-3-flash
- 7.DeepSeek-V4.1-Flash-1017huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- 8.GLM-5.3-Flashhuggingface.co/zai-org/GLM-5.3-Flash
- 9.guía de modo de razonamientoapi-docs.deepseek.com/guides/thinking_mode
- 10.caché de contextodocs.z.ai/guides/capabilities/cache