Claude Sonnet 5.5 vs Gemini 3.8 Flash: coste real por tarea
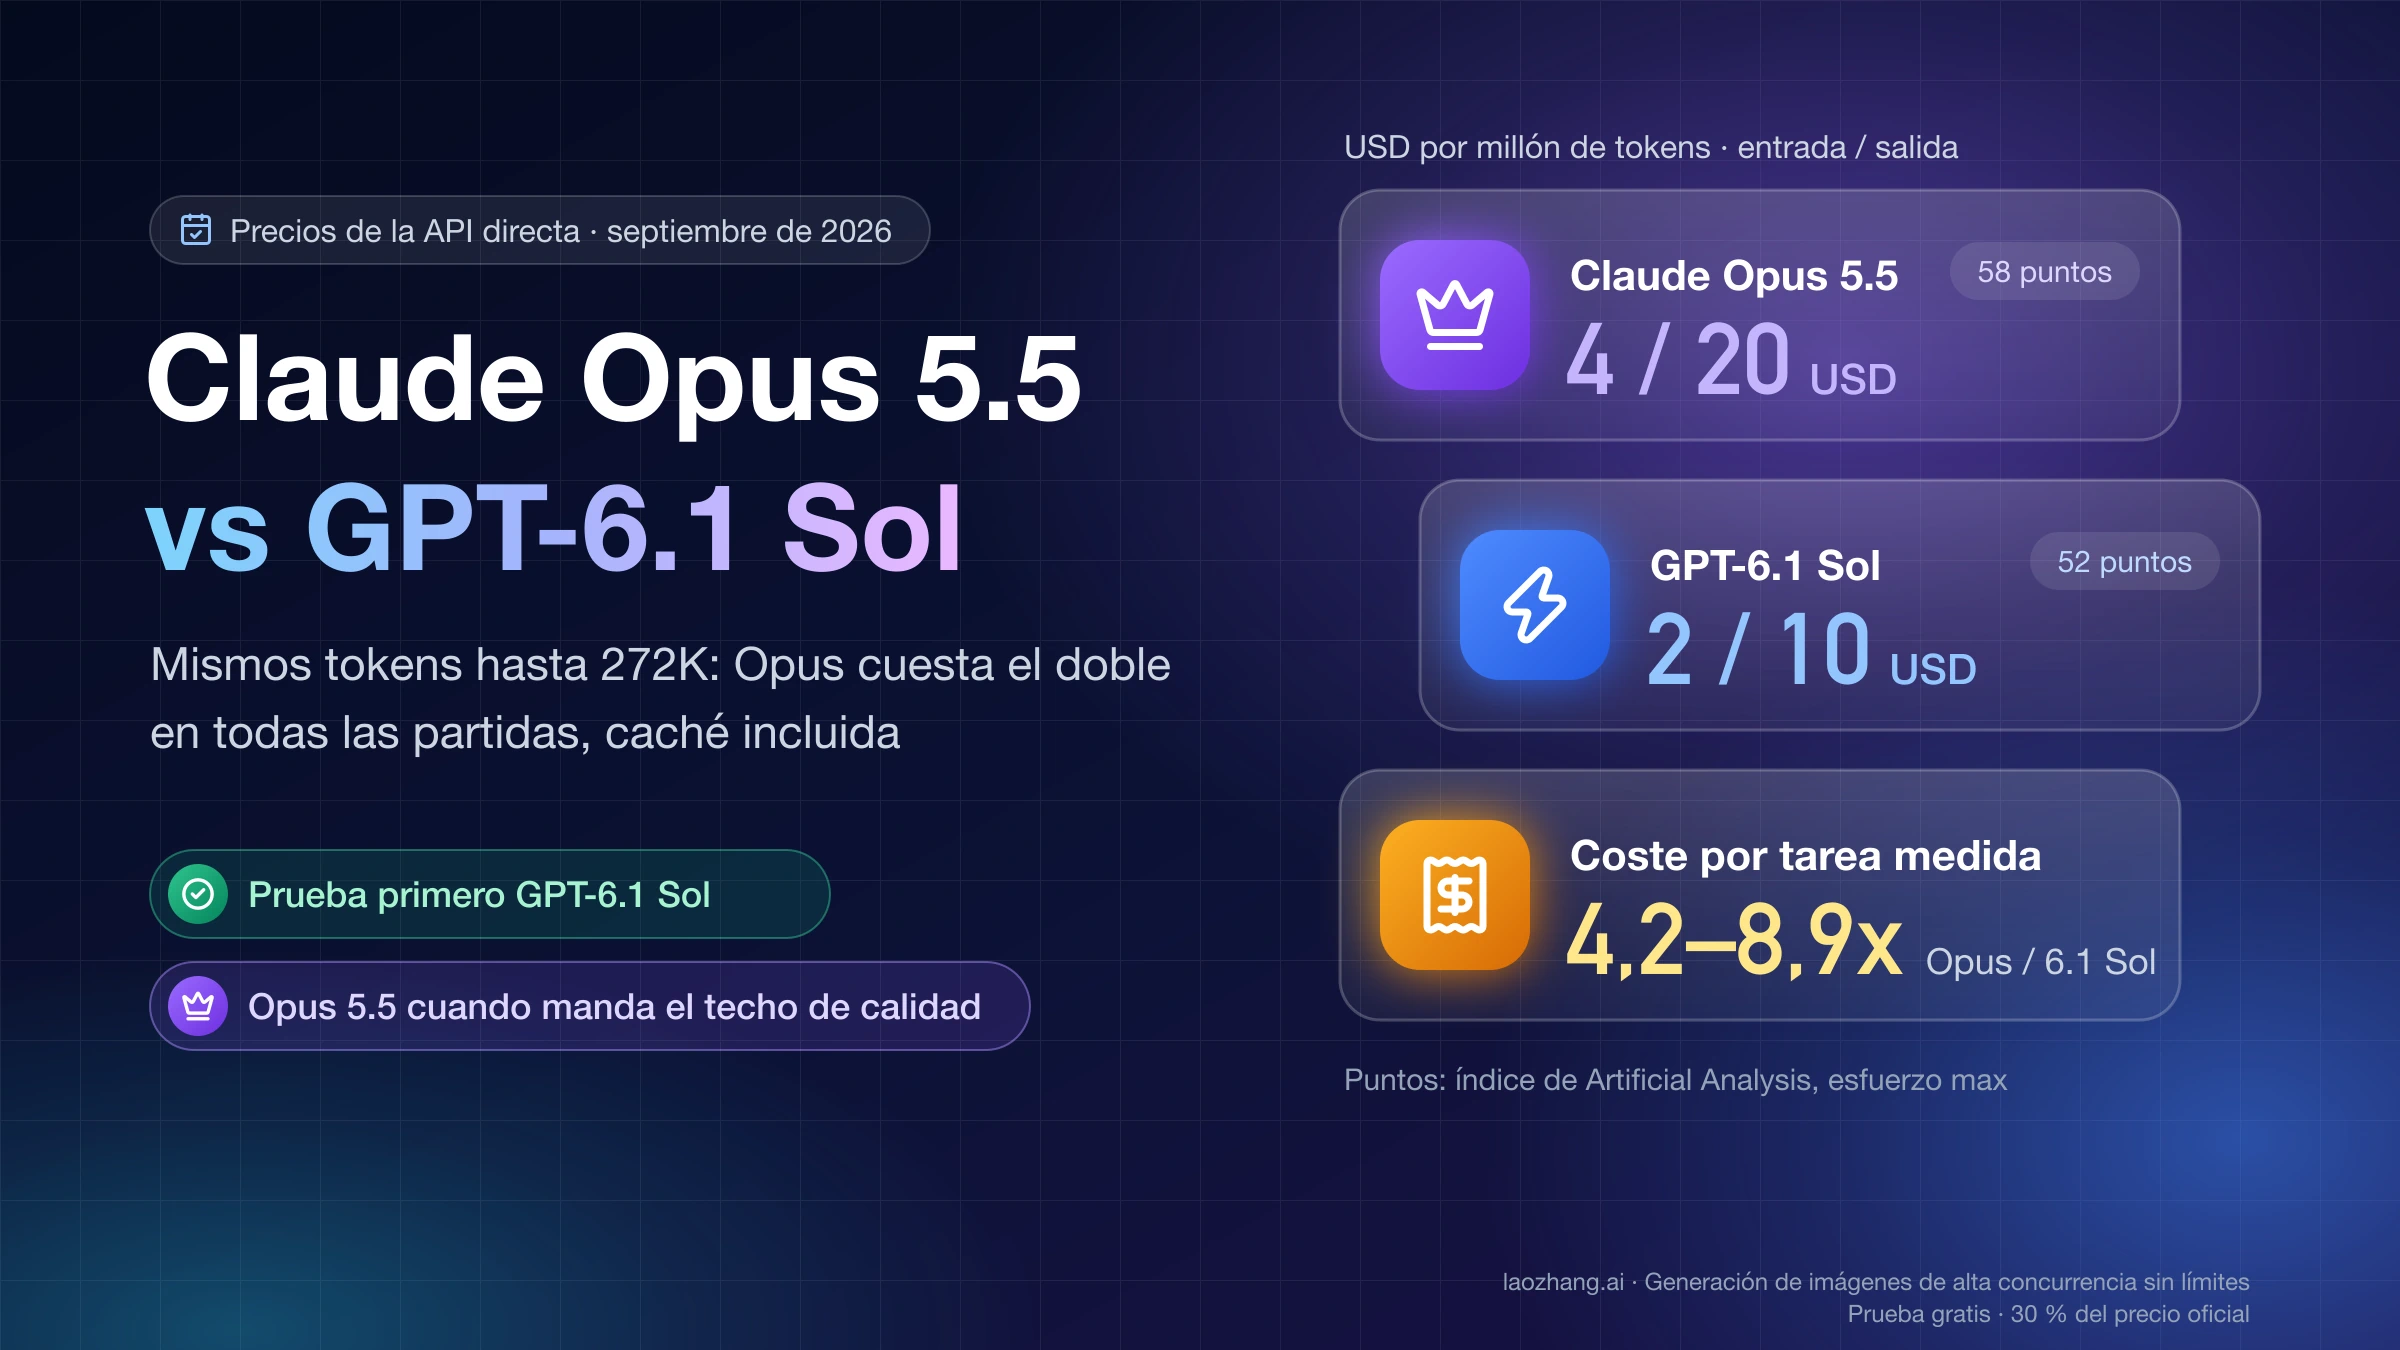
Gemini 3.8 Flash es 2,67 veces más barato por token, pero en 8 tareas en high costó 2,4 veces más que Sonnet 5.5. Solo ganó en 2, como resumir un documento.
En esta página
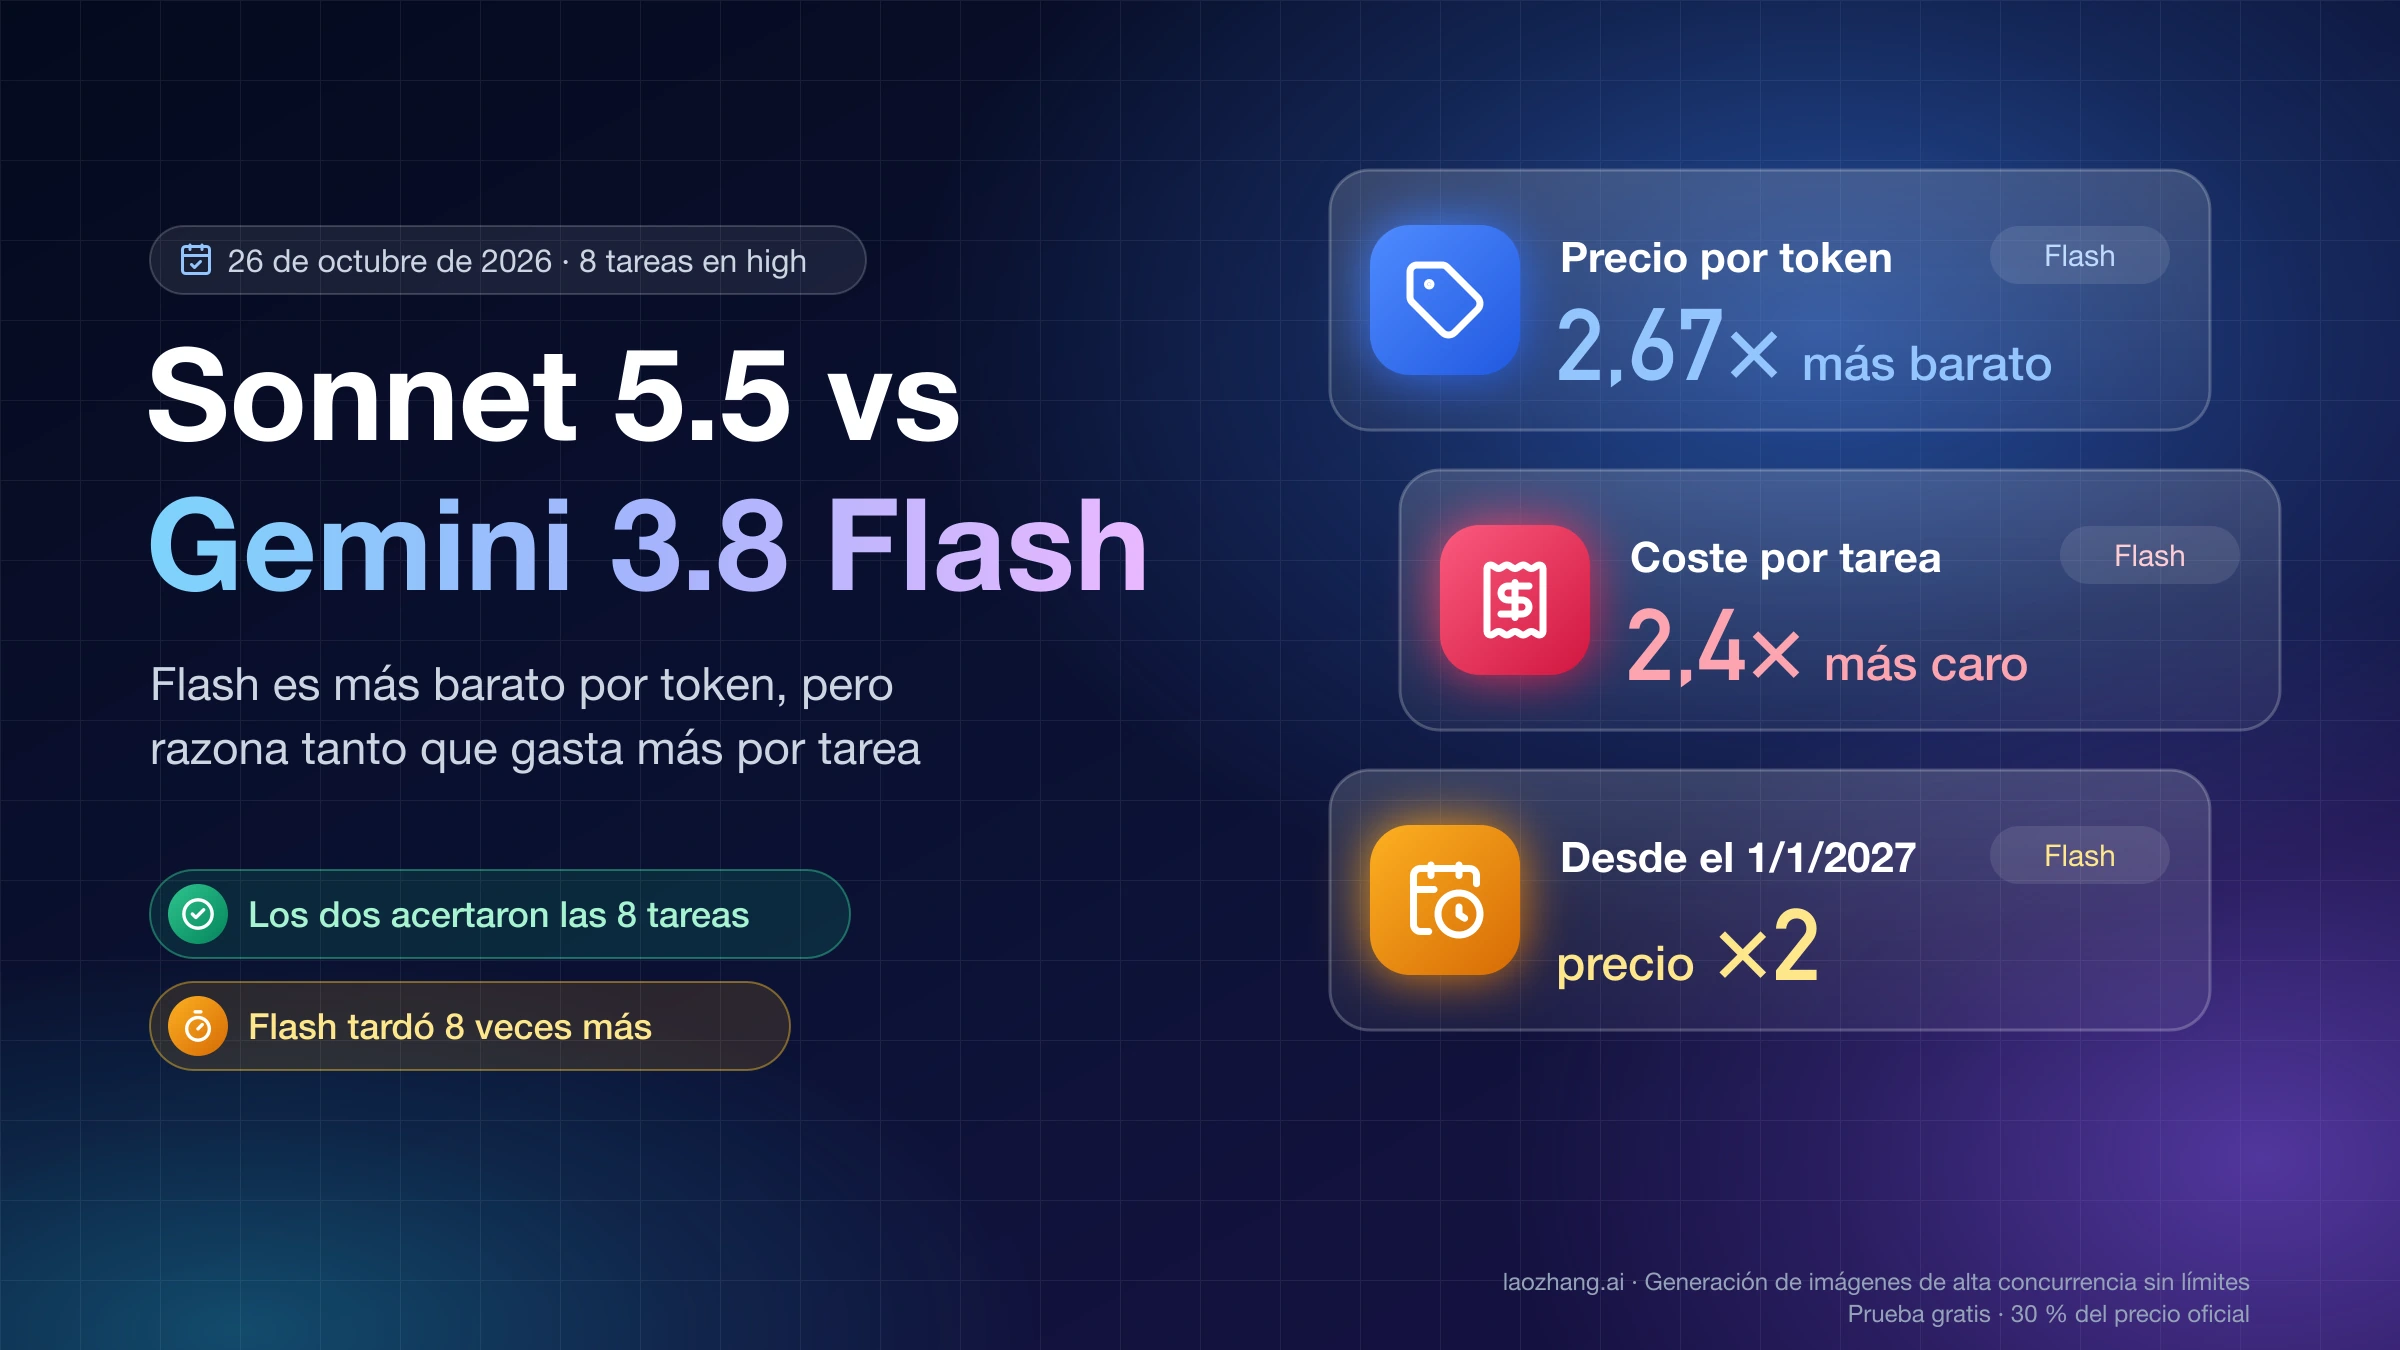
Si tienes que elegir el modelo por defecto para una API o un agente de código, deja Claude Sonnet 5.5 (claude-sonnet-5-5) y manda a Gemini 3.8 Flash (gemini-3.8-flash) los documentos largos de los que solo necesitas una respuesta corta. Flash es 2,67 veces más barato por token, pero el 26 de octubre de 2026, con las mismas 8 tareas y los dos modelos en nivel high, Flash costó 2,4 veces más que Sonnet y tardó ocho veces más en terminar. Los dos resolvieron bien todas las tareas.
La diferencia está en lo que el precio por token no cuenta. Flash generó 8,6 veces más tokens de salida que Sonnet, y el 93 % eran razonamiento interno que Google factura como salida. En sentido contrario, el tokenizador de Anthropic contó un 37 % más de tokens con el mismo texto en inglés, así que Flash gana cuando la entrada es larga y la respuesta corta: resumir un artículo de 6.723 palabras le costó 0,0155 $ frente a 0,0334 $ de Sonnet, y en cambio un intérprete de expresiones le salió 4,7 veces más caro.
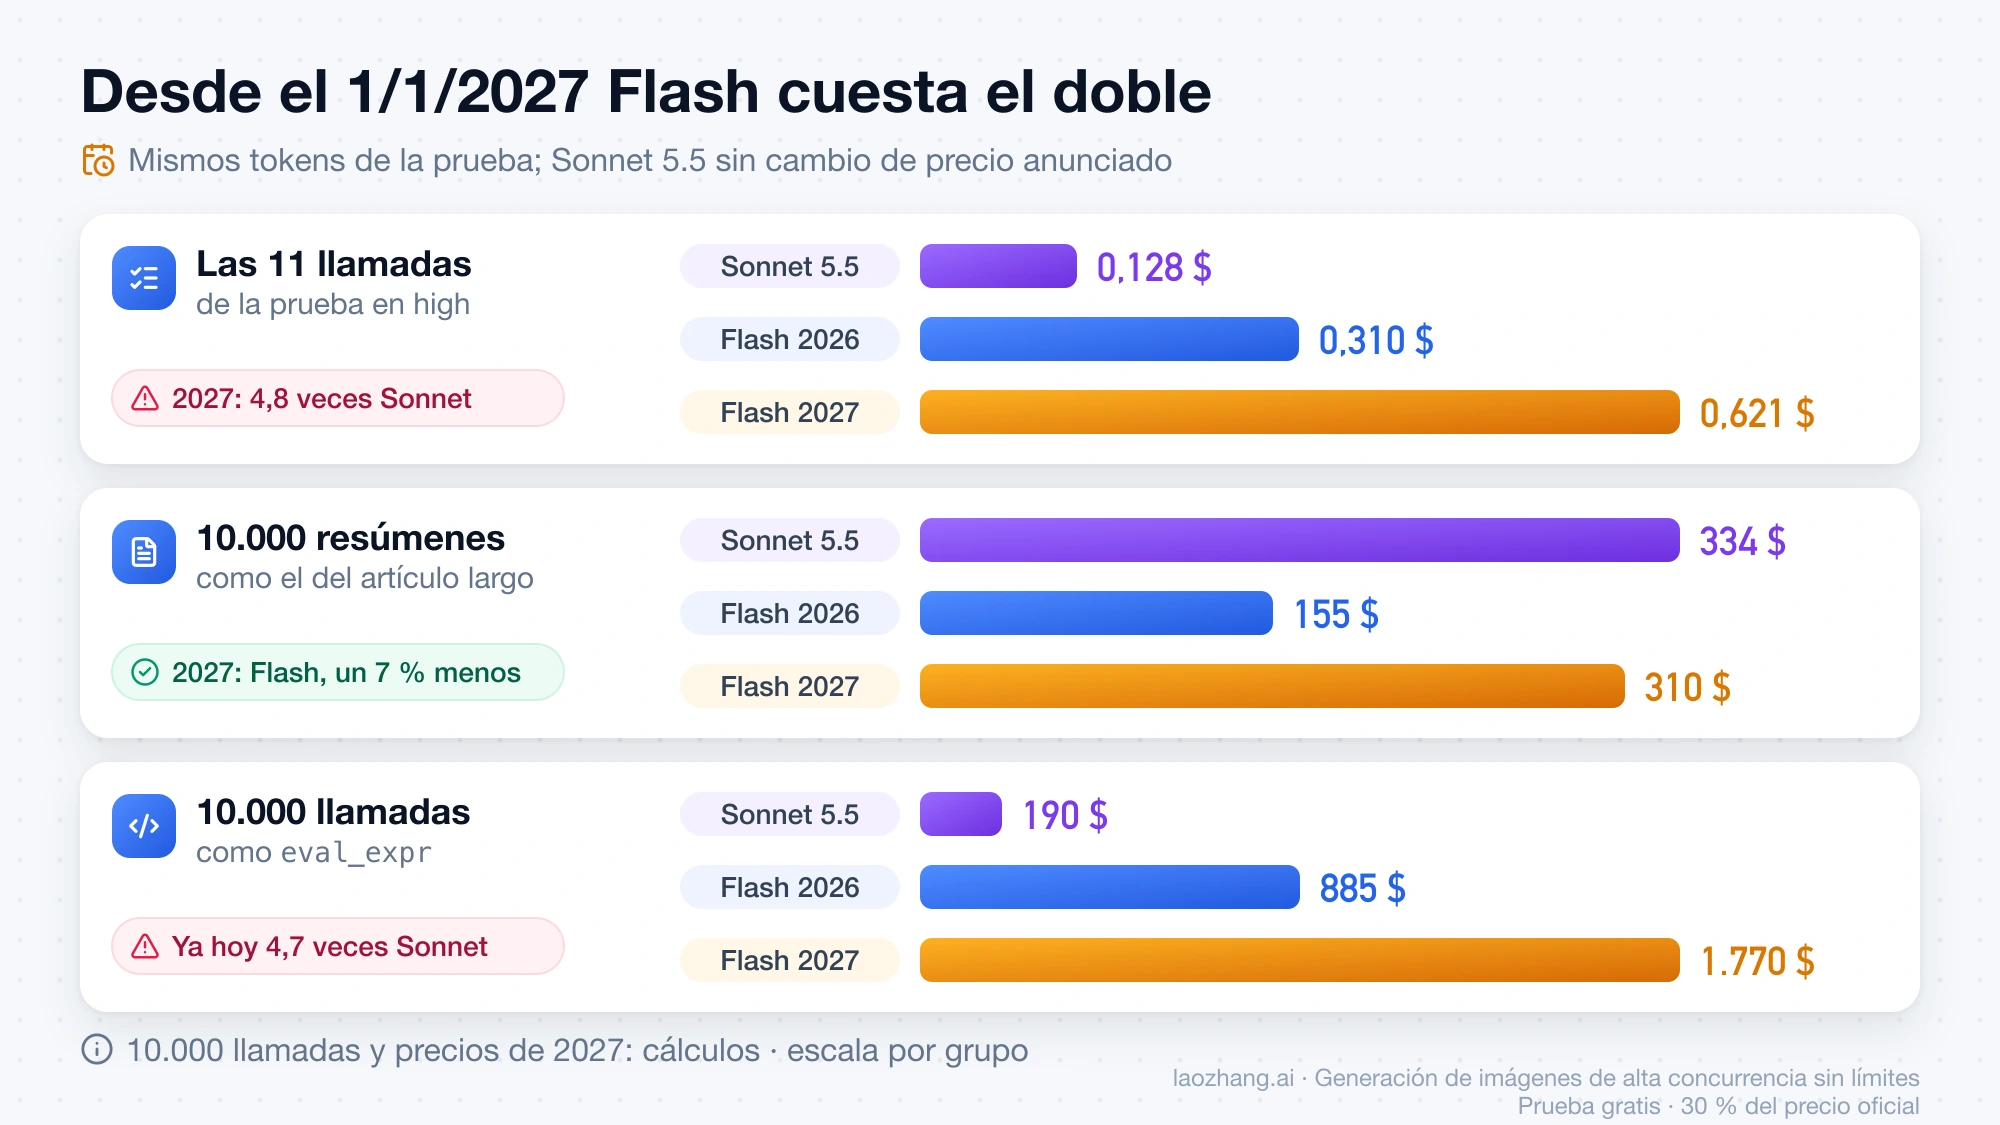
La cuenta empeora para Flash el 1 de enero de 2027, cuando Google duplica su precio por token. Con los mismos tokens, esas 11 llamadas de Flash pasarían a costar 4,8 veces lo de Sonnet, y su ventaja con documentos largos se queda en un 7 %. Flash sigue siendo la opción lógica si necesitas audio o vídeo como entrada, o el nivel gratuito de la API para prototipos.
Mismas 8 tareas en high: Flash costó 2,4 veces más y tardó 8 veces más
El 26 de octubre de 2026, con las mismas 8 tareas y los dos modelos en high, Gemini 3.8 Flash y Claude Sonnet 5.5 acertaron todas, pero Flash gastó 2,4 veces más y tardó 8,2 veces más. Las peticiones se enviaron a través de la API de laozhang.ai, un servicio del mismo equipo que publica este blog, con la misma clave para ambos. Sonnet 5.5 recibió las peticiones por la API Messages de Anthropic con output_config.effort: "high", que es su valor por defecto en la API, y sin campo thinking, de modo que el modelo decidió cuánto razonar. Flash las recibió por la API nativa de Gemini (generateContent) con thinkingConfig.thinkingLevel: "high". No hubo instrucciones de sistema ni herramientas, el límite de salida fue de 32.000 tokens y ninguna llamada falló ni hubo que repetirla.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Las cinco tareas sencillas se lanzaron una vez y las tres difíciles dos veces, así que cada modelo hizo 11 llamadas. El coste es el uso que devolvió cada API multiplicado por el precio de lista: 2 $ / 10 $ por millón de tokens para Sonnet y 0,75 $ / 3,75 $ para Flash. En las tareas difíciles, el coste y el tiempo de la tabla son la media de las dos muestras; el total suma las 11 llamadas.
| Tarea y comprobación | Salida de Sonnet 5.5 (tokens) | Salida de Flash: razonamiento + respuesta | Coste Sonnet | Coste Flash | Tiempo Sonnet | Tiempo Flash |
|---|---|---|---|---|---|---|
| Problema de packs de bolígrafos (41,50 $) | 704 | 1.716 + 355 | 0,0072 $ | 0,0078 $ | 7,1 s | 78,5 s |
merge_intervals, 8 tests ocultos | 1.217 | 974 + 522 | 0,0124 $ | 0,0057 $ | 9,3 s | 25,6 s |
parse_duration, 18 tests ocultos | 723 | 4.463 + 318 | 0,0077 $ | 0,0181 $ | 7,5 s | 30,5 s |
top_words, 10 tests ocultos | 160 | 1.115 + 130 | 0,0019 $ | 0,0047 $ | 3,0 s | 27,2 s |
| Resumir un artículo de 6.723 palabras en 5 viñetas | 277 | 1.733 + 154 | 0,0334 $ | 0,0155 $ | 5,0 s | 14,3 s |
eval_expr sin eval, 25 tests (2 muestras) | 1.816 y 1.849 | 14.876 + 730 y 30.721 + 809 | 0,0190 $ | 0,0885 $ | 13,7 s | 156,9 s |
parse_csv_line sin csv, 16 tests (2 muestras) | 880 y 432 | 4.175 + 371 y 6.167 + 371 | 0,0070 $ | 0,0209 $ | 6,1 s | 34,2 s |
| Números menores de 1.000.000 cuyos dígitos suman 27 (2 muestras) | 678 y 647 | 4.831 + 847 y 4.034 + 865 | 0,0068 $ | 0,0199 $ | 7,0 s | 71,9 s |
| Total, 11 llamadas | 9.383 | 74.805 + 5.472 | 0,128 $ | 0,310 $ | 86 s | 702 s |
Las 22 respuestas pasaron su comprobación: el problema de los bolígrafos dio 41,50 $ en los dos modelos, todo el código superó el 100 % de los tests ocultos, el resumen tuvo exactamente 5 viñetas de 25 palabras o menos y la cuenta de dígitos dio 55.252 en las cuatro respuestas. Con la calidad empatada en estas tareas, la prueba solo separa coste y tiempo. Flash fue más barato en dos casos, el resumen y merge_intervals, casi igual en el problema de los bolígrafos y entre 2,3 y 4,7 veces más caro en el resto. En las cinco tareas sencillas gastó un 17 % menos que Sonnet (0,0518 $ frente a 0,0627 $); en las tres difíciles, 3,95 veces más (0,2586 $ frente a 0,0655 $).
Estas cifras tienen límites claros. Solo se probó el nivel high, con una o dos muestras por tarea, a través de una sola pasarela y en un solo día; no se midieron medium, low, xhigh ni max, ni las APIs directas de Google y Anthropic, Batch, caché, herramientas, sesiones de agente de varios pasos, textos en otros idiomas o entradas de imagen y audio. El ruido entre muestras es grande: la segunda respuesta de Flash a eval_expr usó 31.530 tokens, el doble que la primera y casi todo el límite de 32.000. Además, high es el nivel máximo de Flash y Sonnet tiene dos por encima, así que es el ajuste más parecido, no uno idéntico.
Qué trabajos mandar a Sonnet 5.5 y cuáles a Gemini 3.8 Flash
Deja Sonnet 5.5 por defecto en todo lo que exija razonar antes de contestar, como programar, depurar o resolver un problema con un único resultado correcto, y usa Flash cuando la entrada pese mucho más que la salida o cuando necesites un tipo de entrada que Sonnet no acepta. La tabla resume en qué se apoya cada elección, a 26 de octubre de 2026.
| Tipo de trabajo | Modelo por defecto | En qué se basa |
|---|---|---|
| Programar, depurar y agentes de código en terminal | Sonnet 5.5 en high, o medium si la tarea está bien especificada | En las tres tareas difíciles de la prueba Flash costó 3,95 veces más; en Terminal-Bench 4.0 de Artificial Analysis, 43,9 % frente a 19,7 % |
| Tareas cortas en volumen (funciones pequeñas, cálculos, clasificación) | Cualquiera de los dos: mide con tus propias instrucciones | En las cinco tareas sencillas Flash gastó un 17 % menos en total, pero solo fue más barato en dos de cinco y más lento en todas; con el precio de 2027 pasaría a costar 1,65 veces más |
| Resumir o extraer datos de documentos largos con respuesta corta | Flash | Resumir el artículo largo le costó menos de la mitad que a Sonnet; mejor nota en razonamiento con contexto largo (AA-LCR) en Artificial Analysis |
| Audio o vídeo como entrada | Flash | Sonnet 5.5 no acepta audio ni vídeo; los PDF sí los lee en la API de Claude, como bloques document |
| Prototipos sin pagar | Flash en el nivel gratuito de la API | Entrada y salida gratis, pero Google usa esos datos para mejorar sus productos |
| Chat interactivo donde importa la primera palabra | Sonnet 5.5 en medium o low | 1,35 s y 0,98 s hasta el primer token de respuesta según Artificial Analysis, frente a 27,26 s de Flash en high |
Si ya usas Flash y no quieres cambiar de proveedor, prueba primero el nivel medium, que en Artificial Analysis saca 40 puntos frente a 41 en high y cuesta un 25 % menos por tarea, aunque sigue por encima de Sonnet en medium. En cualquier caso, vigila el campo thoughtsTokenCount de cada respuesta de Gemini, porque es el que dispara la factura.
Por qué 2,67 veces más barato por token no sale más barato por tarea
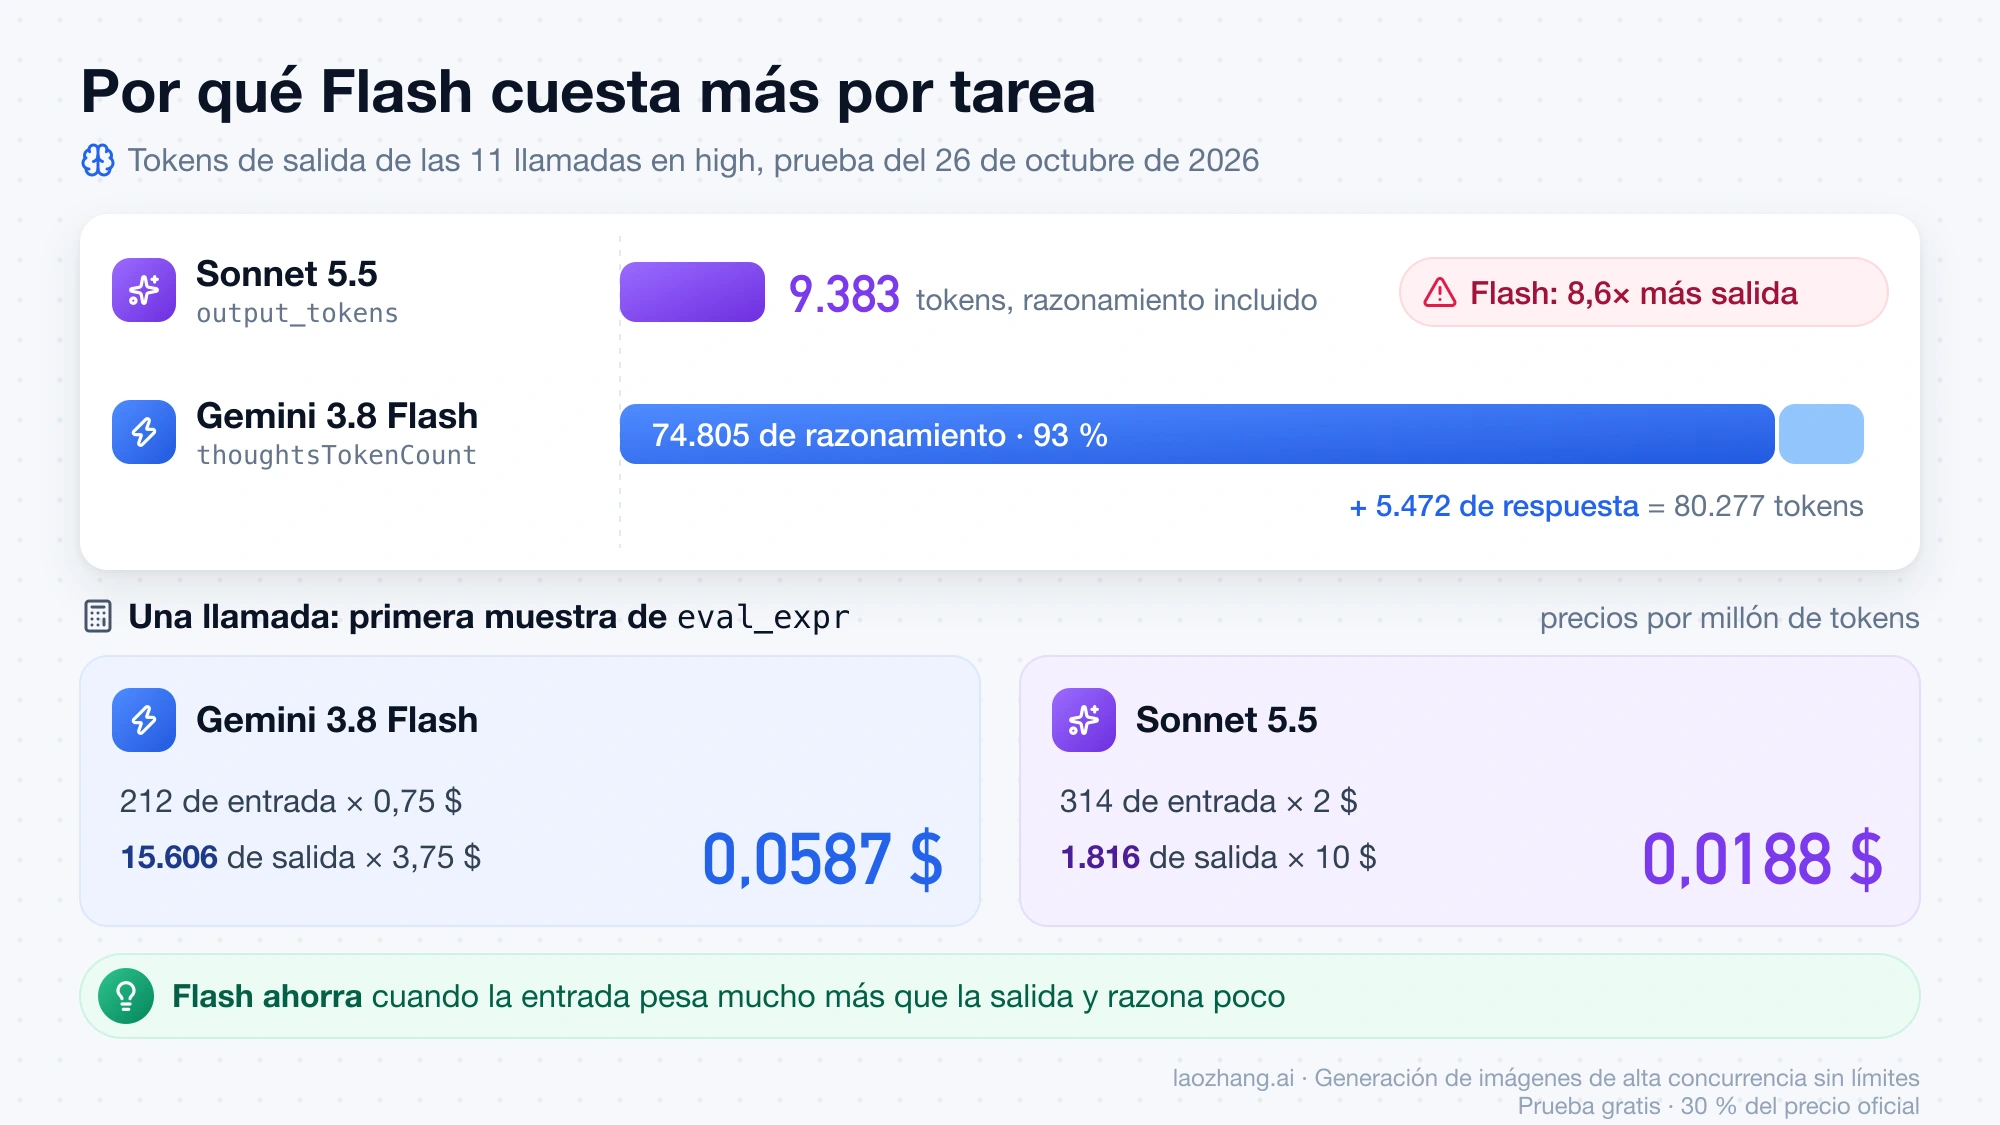
El precio por token solo dice cuánto pagas por cada token; lo que pagas por tarea depende de cuántos tokens necesita cada modelo para llegar a la misma respuesta. La cuenta es tokens de entrada por precio de entrada más tokens de salida por precio de salida, dividido entre un millón. En la primera muestra de eval_expr, Flash usó 212 tokens de entrada y 15.606 de salida: 212 × 0,75 + 15.606 × 3,75 da 0,0587 $. Sonnet usó 314 y 1.816: 314 × 2 + 1.816 × 10 da 0,0188 $. Flash pagaba 2,67 veces menos por token, pero escribió 8,6 veces más.
La primera causa son los tokens de razonamiento. Los dos modelos los cobran como salida, pero los informan de forma distinta: Gemini los separa en thoughtsTokenCount, y en la prueba fueron 74.805 de sus 80.277 tokens de salida, el 93 %. Sonnet los suma en un único output_tokens y no devuelve el texto del razonamiento salvo que pidas thinking: {"type": "adaptive", "display": "summarized"}, según la documentación de razonamiento de Claude. Por eso de Sonnet solo se conoce el total, 9.383 tokens para las 11 respuestas con el razonamiento incluido, menos de lo que Flash gastó en una sola respuesta a eval_expr.
La segunda causa favorece a Flash. Con el mismo artículo en inglés de 6.723 palabras, Anthropic contó 15.335 tokens de entrada y Google 11.198; es decir, Anthropic contó un 37 % más para el mismo texto. En ese texto la diferencia real de precio de entrada fue de 2,67 × 1,37, unas 3,65 veces, y por eso Flash ganó donde pesa la entrada: el resumen le costó menos de la mitad aunque dedicó 1.733 tokens a razonar. La medición se hizo con un solo texto en inglés, y con código u otros idiomas la proporción puede cambiar.
La regla que sale de todo esto es sencilla: Flash es más barato cuando la entrada pesa mucho más que la salida y la tarea exige poco razonamiento; cuando hay que pensar, sus tokens de razonamiento se comen la diferencia de precio.
¿Rinde igual Flash? En Artificial Analysis, 41 puntos frente a 47 en high
En la prueba los dos acertaron todo, así que no dice dónde falla cada uno. Para eso sirve el índice de Artificial Analysis comparando Sonnet 5.5 y Gemini 3.8 Flash, una batería de tareas largas y difíciles que publica nota, coste y tiempo para cada nivel. A 26 de octubre de 2026, con los dos en high, Sonnet 5.5 saca 47 puntos con 0,88 $ y 217 segundos por tarea, y Flash 41 puntos con 1,24 $ y 498 segundos. En esa batería, Sonnet en high puntúa más, cuesta un 29 % menos por tarea y tarda menos de la mitad.
A igual nota la distancia crece. Sonnet en medium también tiene 41 puntos y cuesta 0,48 $ y 121 segundos por tarea, de modo que Flash en high cuesta 2,6 veces más y tarda 4,1 veces más para el mismo resultado en el índice. La comparación destacada de la propia página enfrenta a Sonnet en low (0,35 $) con Flash en medium (0,93 $), pero esos niveles tienen notas distintas, 36 y 40, así que la comparación útil es la de igual puntuación. Flash en medium tampoco cambia el cuadro: cuesta 0,93 $ por tarea, casi el doble que Sonnet en medium con una nota parecida.
| Prueba de Artificial Analysis | Sonnet 5.5 en high | Gemini 3.8 Flash en high |
|---|---|---|
| Terminal-Bench 4.0 | 43,9 % | 19,7 % |
| AA-Briefcase | 1.635 | 1.202 |
| GDPval-AA | 1.548 | 1.436 |
| AutomationBench-AA | 59,4 % | 59,9 % |
| SciCode | 53,7 % | 56,6 % |
| Humanity's Last Exam | 45,8 % | 47,8 % |
| AA-LCR v1.1, razonamiento con contexto largo | 78,0 % | 81,3 % |
| AA-Omniscience | 21 | 30 |
El reparto encaja con la prueba. Flash puntúa más en razonamiento con contexto largo (en medium llega al 84,0 %, la mejor nota de las ocho configuraciones), en conocimiento y en ciencia, mientras que Sonnet saca más del doble en Terminal-Bench 4.0, la prueba más cercana a un agente de código, y puntúa más en GDPval-AA y AA-Briefcase. Los informes de usuarios van en la misma dirección, con la cautela de que son casos sueltos: en el foro linux.do, un usuario comparó Flash en high y Sonnet 5.5 el 11 de octubre y contó que Flash, desde una suscripción de Gemini, dejó a medias un gráfico dinámico tras tres o cuatro intentos, mientras que Sonnet 5.5 en el plan gratuito de Claude lo terminó; otro participante prefería Flash para redactar con naturalidad.
¿Flash es más rápido? Depende de si mides tokens por segundo o la tarea entera
Flash solo es más rápido en una de las tres cosas que se suelen llamar velocidad. Mientras escribe, Artificial Analysis le mide 137 tokens por segundo en high, frente a 106 de Sonnet en high. Pero hasta el primer token de respuesta tarda 27,26 segundos, porque razona antes de contestar, frente a 10,46 s de Sonnet en high y 1,35 s en medium; y para terminar una tarea del índice necesita 498 segundos frente a 217. En la prueba del 26 de octubre, Flash tardó en total ocho veces más que Sonnet, con tiempos medidos de punta a punta a través de la pasarela, que no es un banco de pruebas de velocidad.
La comparación de OpenRouter entre Sonnet 5.5 y Gemini 3.8 Flash da incluso lo contrario en tokens por segundo: 108 para Sonnet y 52 para Flash en la mediana, con latencias parecidas (2,39 s y 2,14 s), según datos actualizados el 5 de octubre de 2026. No es una contradicción con Artificial Analysis, porque OpenRouter mide el tráfico real de sus usuarios con el nivel que cada uno elige. Para decidir, la medida útil es cuánto tardas en tener la respuesta terminada, y ahí Flash pierde porque escribe muchos más tokens antes de contestar. Si notas esa espera dentro de Antigravity, la explicación está en Gemini 3.8 Flash va lento en Antigravity: qué está esperando.
Desde el 1 de enero de 2027 Flash cuesta el doble: así queda la cuenta
Google publica ya dos tarifas para Gemini 3.8 Flash en su página de precios de la API de Gemini. Hasta el 31 de diciembre de 2026 cobra los precios usados en la prueba, con el razonamiento incluido en la salida; desde el 1 de enero de 2027, el doble: 1,50 $ por millón de tokens de entrada y 7,50 $ de salida. Los precios de Sonnet 5.5 no tienen cambio anunciado en la tabla de precios de Claude. Con los mismos tokens de la prueba, así quedan los números:
| Escenario, con los mismos tokens | Sonnet 5.5 | Flash hasta el 31/12/2026 | Flash desde el 1/1/2027 |
|---|---|---|---|
| Las 11 llamadas de la prueba | 0,128 $ | 0,310 $ | 0,621 $ |
| Las cinco tareas sencillas | 0,0627 $ | 0,0518 $ | 0,1036 $ |
| Las tres tareas difíciles, 6 llamadas | 0,0655 $ | 0,2586 $ | 0,5172 $ |
| 10.000 resúmenes como el del artículo largo | 334 $ | 155 $ | 310 $ |
10.000 llamadas como eval_expr | 190 $ | 885 $ | 1.770 $ |
| Tarea media del índice de Artificial Analysis, a 41 puntos (Sonnet en medium, Flash en high) | 0,48 $ | 1,24 $ | 2,48 $ |
Las filas de 10.000 llamadas multiplican el coste de una llamada medida y la de Artificial Analysis supone que el número de tokens por tarea no cambia; son cálculos, no mediciones. El caso en el que Flash ganaba con claridad, el documento largo con respuesta corta, queda en 310 $ frente a 334 $, un 7 % menos, y en merge_intervals pasa de costar menos de la mitad a un 9 % menos. Si eliges Flash por precio, repite la cuenta con tus propias instrucciones antes de enero. Si mandas el mismo documento muchas veces, la caché cambia el resultado en los dos modelos: la lectura de caché de Sonnet 5.5 cuesta 0,10 $ por millón desde el 7 de octubre de 2026, como se explica en Claude Sonnet 5.5: precio de caché a 0,10 $ y cuánto ahorras, y la de Flash 0,075 $ (0,15 $ desde 2027) más el almacenamiento. El resto de cambios de Gemini para 2027 está en Clave de API de Gemini gratis y precio: qué sube en 2027.
Contexto, salida máxima y entradas: solo Flash acepta audio y vídeo
Los dos tienen alrededor de un millón de tokens de contexto, pero Flash acepta más tipos de entrada y Sonnet permite respuestas casi el doble de largas y dos niveles de razonamiento por encima de high. Los datos son de la ficha de modelos de Claude y de la página de Gemini 3.8 Flash, a 26 de octubre de 2026.
| Característica | Claude Sonnet 5.5 | Gemini 3.8 Flash |
|---|---|---|
| ID en la API | claude-sonnet-5-5 | gemini-3.8-flash |
| Precio por millón de tokens, entrada / salida | 2 $ / 10 $ | 0,75 $ / 3,75 $; 1,50 $ / 7,50 $ desde 2027 |
| Caché | Lectura 0,10 $; escritura 2,50 $ (5 minutos) o 4 $ (1 hora) | Lectura 0,075 $ más 0,50 $ por millón de tokens y hora de almacenamiento; el doble desde 2027 |
| Batch, entrada / salida | 1 $ / 5 $ | 0,375 $ / 1,875 $; 0,75 $ / 3,75 $ desde 2027; también Flex |
| Contexto | 1 millón de tokens, al mismo precio en toda la ventana | 1.048.576 tokens, sin tramo de precio para entradas largas |
| Salida máxima | 128.000 tokens (300.000 en Batch con cabecera beta) | 65.536 tokens |
| Entradas | Texto, imagen y PDF (en la API, como bloques document, hasta 600 páginas y 32 MB por petición) | Texto, imagen, vídeo, audio y PDF |
| Control del razonamiento | effort: low, medium, high, xhigh, max; high por defecto en la API | thinkingLevel: low, medium, high; medium por defecto, minimal da error |
| Razonamiento en el uso devuelto | Incluido en output_tokens, sin desglose | Aparte, en thoughtsTokenCount |
| Uso gratuito | Chat con Sonnet 5.5 en Claude.ai para cualquier usuario | Nivel gratuito de la API; Google usa esos datos para mejorar sus productos (en el de pago, no) |
| Lanzamiento | 28 de septiembre de 2026 | Disponible para todos desde el 2 de septiembre de 2026 |
El esfuerzo (effort) de Claude y el nivel de razonamiento (thinkingLevel) de Gemini no son el mismo parámetro aunque compartan nombres. Cada uno se mide en su propia escala, y high es el techo de Flash pero el tercer escalón de cinco en Sonnet, así que poner los dos en high no garantiza el mismo esfuerzo. Tampoco confundas Sonnet 5.5 con Claude Sonnet 5: es un modelo anterior con el mismo precio de 2 $ / 10 $ pero lectura de caché a 0,20 $, y las notas y costes por tarea que se publiquen de Sonnet 5 frente a Flash no sirven para 5.5. Los límites de peticiones del nivel gratuito de Flash están en Gemini API free tier 2026: modelos gratis, límites y API key.
Sin API: Claude.ai, app de Gemini, Claude Code y Antigravity
Si no usas la API, no pagas tokens sino un plan, y cada superficie ofrece solo uno de los dos modelos, salvo Antigravity, donde Sonnet 5.5 exige un plan de pago. A 26 de octubre de 2026 la disponibilidad es esta, según el centro de ayuda de Claude sobre esfuerzo y razonamiento, la ayuda de Gemini sobre modelos por plan y la tabla de modelos de Antigravity:
| Dónde | Claude Sonnet 5.5 | Gemini 3.8 Flash |
|---|---|---|
| Claude.ai | Cualquier usuario, también sin pagar; selector de esfuerzo de Low a Max; el razonamiento no se puede apagar | No |
| App de Gemini | No | Sin plan, modo Auto (la mayoría de respuestas usan Flash-Lite y las que piden más razonamiento pueden usar Flash o Pro) o Flash-Lite; Flash disponible en Google AI Plus, Pro y Ultra |
| Claude Code | Sí, con esfuerzo medium por defecto | No |
| Antigravity | Solo Google AI Pro de pago (no en periodo de prueba), Ultra y Enterprise | Todos los planes, también Free y Google AI Plus |
La ayuda de Claude no dice con qué nivel de esfuerzo funciona Sonnet 5.5 en el plan gratuito; el usuario de linux.do citado antes decía que era low, y es un dato sin confirmar. Google AI Plus pierde el acceso a Pro a partir del 13 de noviembre de 2026, pero conserva Flash. Si usas Sonnet sobre todo en Claude Code, la pregunta es más bien de límites de uso de la suscripción, y se responde en Claude Pro vs Max: precios, límites de uso y cuándo compensa Max.
¿Subir o bajar de modelo? Haiku 5.5, Opus 5.5 y Gemini 4 Argon
Si tu duda ya no es Sonnet frente a Flash sino un escalón por encima o por debajo, cada cambio tiene su propia cuenta. Para llamadas sencillas donde Sonnet 5.5 te parece caro, compara antes con Claude Haiku 5.5 vs Sonnet 5.5: cuál elegir y coste por tarea; si Sonnet se queda corto en tareas largas, mira Claude Sonnet 5.5 vs Opus 5.5: cuál gasta menos por tarea. Dentro de Google, el paso por encima de Flash es Gemini 4 Argon, y si Flash te basta por sí solo se analiza en Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar. La alternativa de OpenAI frente a Sonnet está en Claude Sonnet 5.5 vs GPT-6 Astra: cuándo cambiar y qué pagas.
Preguntas frecuentes sobre Sonnet 5.5 y Gemini 3.8 Flash
¿Se puede apagar el razonamiento de Sonnet 5.5 para que gaste menos?
No del todo. En la API, thinking: {"type": "between_tools"} desactiva el razonamiento previo a la respuesta cuando el esfuerzo es high o inferior, mientras que "disabled" y "enabled" con budget_tokens devuelven un error 400 en Sonnet 5.5, según la documentación de razonamiento de Claude a 26 de octubre de 2026. En Claude.ai y las demás apps de Claude no se puede apagar; lo que sí puedes hacer es bajar el esfuerzo.
¿Puedo poner Gemini 3.8 Flash en minimal para que razone menos?
No. En Gemini 3.8 Flash, thinkingLevel: "minimal" no está admitido y devuelve un error; el nivel más bajo es low. Artificial Analysis le da 33 puntos en low, pero a 26 de octubre de 2026 no publica su coste ni su velocidad en ese nivel, así que tendrías que medirlo con tus propias instrucciones.
¿Qué pasa si mi código todavía llama a gemini-3.7-flash?
Google dejó obsoleto gemini-3.7-flash el 8 de octubre de 2026 y desde entonces redirige esas peticiones a Gemini 3.8 Flash, según el registro de cambios de la API de Gemini. Es decir, ya estás pagando y usando 3.8 Flash, con su razonamiento y su precio, y el 1 de enero de 2027 también te afectará la subida.
Fuentes12
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 26 oct 2026.
Fuentes12
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 26 oct 2026.
- 1.documentación de razonamiento de Claudeplatform.claude.com/docs/en/build-with-claude/thinking
- 2.índice de Artificial Analysis comparando Sonnet 5.5 y Gemini 3.8 Flashartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gemini-3-8-flash
- 3.linux.do, un usuario comparó Flash en high y Sonnet 5.5linux.do/t/topic/3010438
- 4.comparación de OpenRouter entre Sonnet 5.5 y Gemini 3.8 Flashopenrouter.ai/compare/anthropic/claude-sonnet-5.5/google/gemini-3.8-flash
- 5.página de precios de la API de Geminiai.google.dev/gemini-api/docs/pricing
- 6.tabla de precios de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 7.ficha de modelos de Claudeplatform.claude.com/docs/en/about-claude/models/overview
- 8.página de Gemini 3.8 Flashai.google.dev/gemini-api/docs/models/gemini-3.8-flash
- 9.centro de ayuda de Claude sobre esfuerzo y razonamientosupport.claude.com/en/articles/8664678-change-the-model-effort-and-thinking-settings
- 10.ayuda de Gemini sobre modelos por plansupport.google.com/gemini/answer/18648722
- 11.tabla de modelos de Antigravityantigravity.google/docs/models
- 12.registro de cambios de la API de Geminiai.google.dev/gemini-api/docs/changelog