Claude API: cómo elegir entre Haiku, Sonnet, Opus 5.5 y Fable 5.1
En las apps de Claude, empieza por Sonnet 5.5; en la API, Anthropic aconseja Opus 5.5. Sonnet 5.5 releva a Sonnet 5 al mismo precio, y Haiku 5.5 a Haiku 4.5.
En esta página

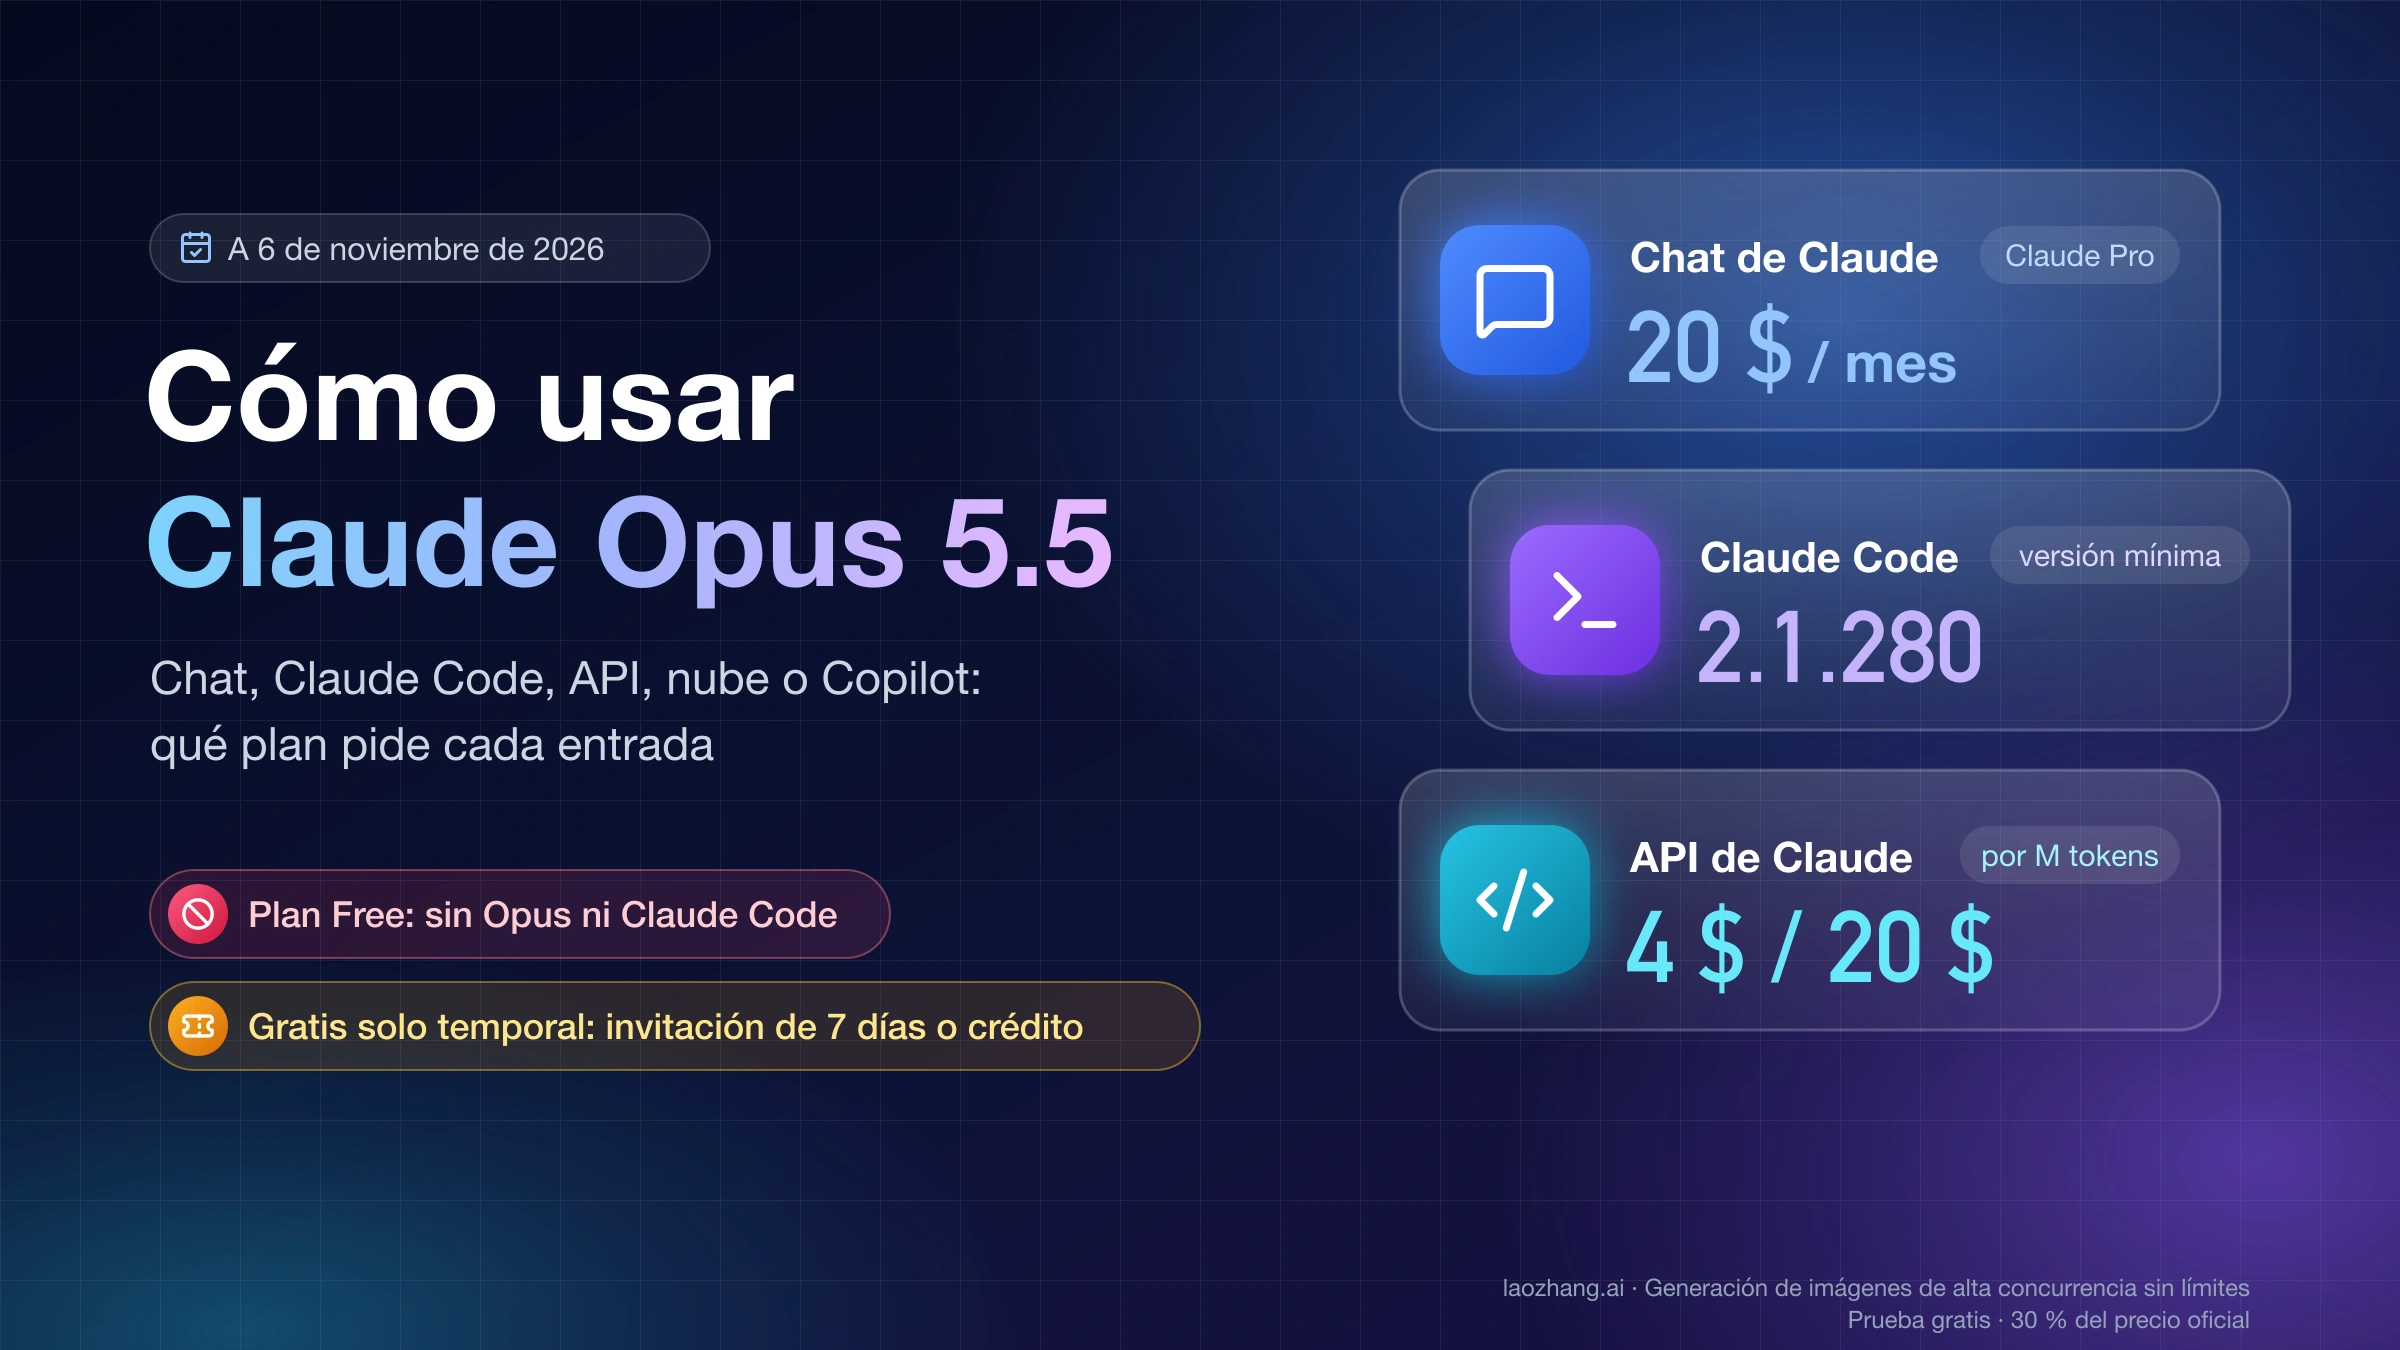
A 26 de octubre de 2026, la gama actual de Claude tiene cuatro modelos: Haiku 5.5, Sonnet 5.5, Opus 5.5 y Fable 5.1. Si usas Claude en la web, el escritorio o el móvil, empieza por Sonnet 5.5: es el punto de partida que da la guía de Anthropic para elegir modelo en las apps de Claude, gasta menos límite de uso que Opus y está incluido en el plan Free. Si llamas a la API, la documentación de modelos de Claude aconseja empezar por Opus 5.5 (claude-opus-5-5) en la mayoría de cargas y bajar a Sonnet 5.5 o Haiku 5.5 cuando tus pruebas muestren que bastan.
Haiku 5.5 sirve para trabajo acotado y de mucho volumen, como clasificar, extraer datos, enrutar peticiones o hacer de subagente. Fable 5.1 solo compensa cuando Opus 5.5 con el nivel de razonamiento (effort) en xhigh o max sigue sin resolver tu tarea, porque con la misma puntuación en el índice de Artificial Analysis cuesta 2,92 veces más por tarea. Desde el 9 de noviembre de 2026, ese papel lo ocupa Claude Fable 5.2, que sustituye a Fable 5.1 a 8 $ / 40 $ por millón de tokens; la comparación está en Claude Fable 5.2 vs Opus 5.5: cuál es mejor y con qué effort. Antes de cambiar de modelo, prueba a subir o bajar el effort del que ya usas.
Si llegas con los nombres antiguos, Sonnet 5 corresponde hoy a Sonnet 5.5, al mismo precio, y Haiku 4.5 a Haiku 5.5, diez veces más barato por token en peticiones de hasta 100.000 tokens. La respuesta a «¿Sonnet 5 o Haiku 4.5?» no cambia con los nombres nuevos: Haiku para tareas cortas y repetitivas, Sonnet para programar y encadenar pasos.
¿Sonnet 5 o Haiku 4.5? Qué modelo corresponde hoy a cada nombre
Fable 5, Opus 5, Sonnet 5 y Haiku 4.5 eran la gama vigente en agosto de 2026 y ahora figuran como modelos heredados en la documentación de modelos de Claude. Siguen respondiendo con sus IDs, pero cada uno tiene un sucesor del mismo nivel que cuesta lo mismo o menos. Precios por millón de tokens en la API de Anthropic, según la tabla oficial de precios de Claude a 26 de octubre de 2026:
| Nombre antiguo | Modelo actual e ID | Entrada / salida antes | Entrada / salida ahora | Qué cambia en la factura |
|---|---|---|---|---|
| Haiku 4.5 | Haiku 5.5, claude-haiku-5-5 | 1 $ / 5 $ | 0,10 $ / 0,50 $ con prompts de hasta 100.000 tokens; 0,50 $ / 2,50 $ por encima | 10 veces menos por token en peticiones cortas, solo 2 veces menos en las largas |
| Sonnet 5 | Sonnet 5.5, claude-sonnet-5-5 | 2 $ / 10 $ | 2 $ / 10 $ | La lectura de caché baja de 0,20 $ a 0,10 $ |
| Opus 5 | Opus 5.5, claude-opus-5-5 | 5 $ / 25 $ | 4 $ / 20 $ | Un 20 % menos por token |
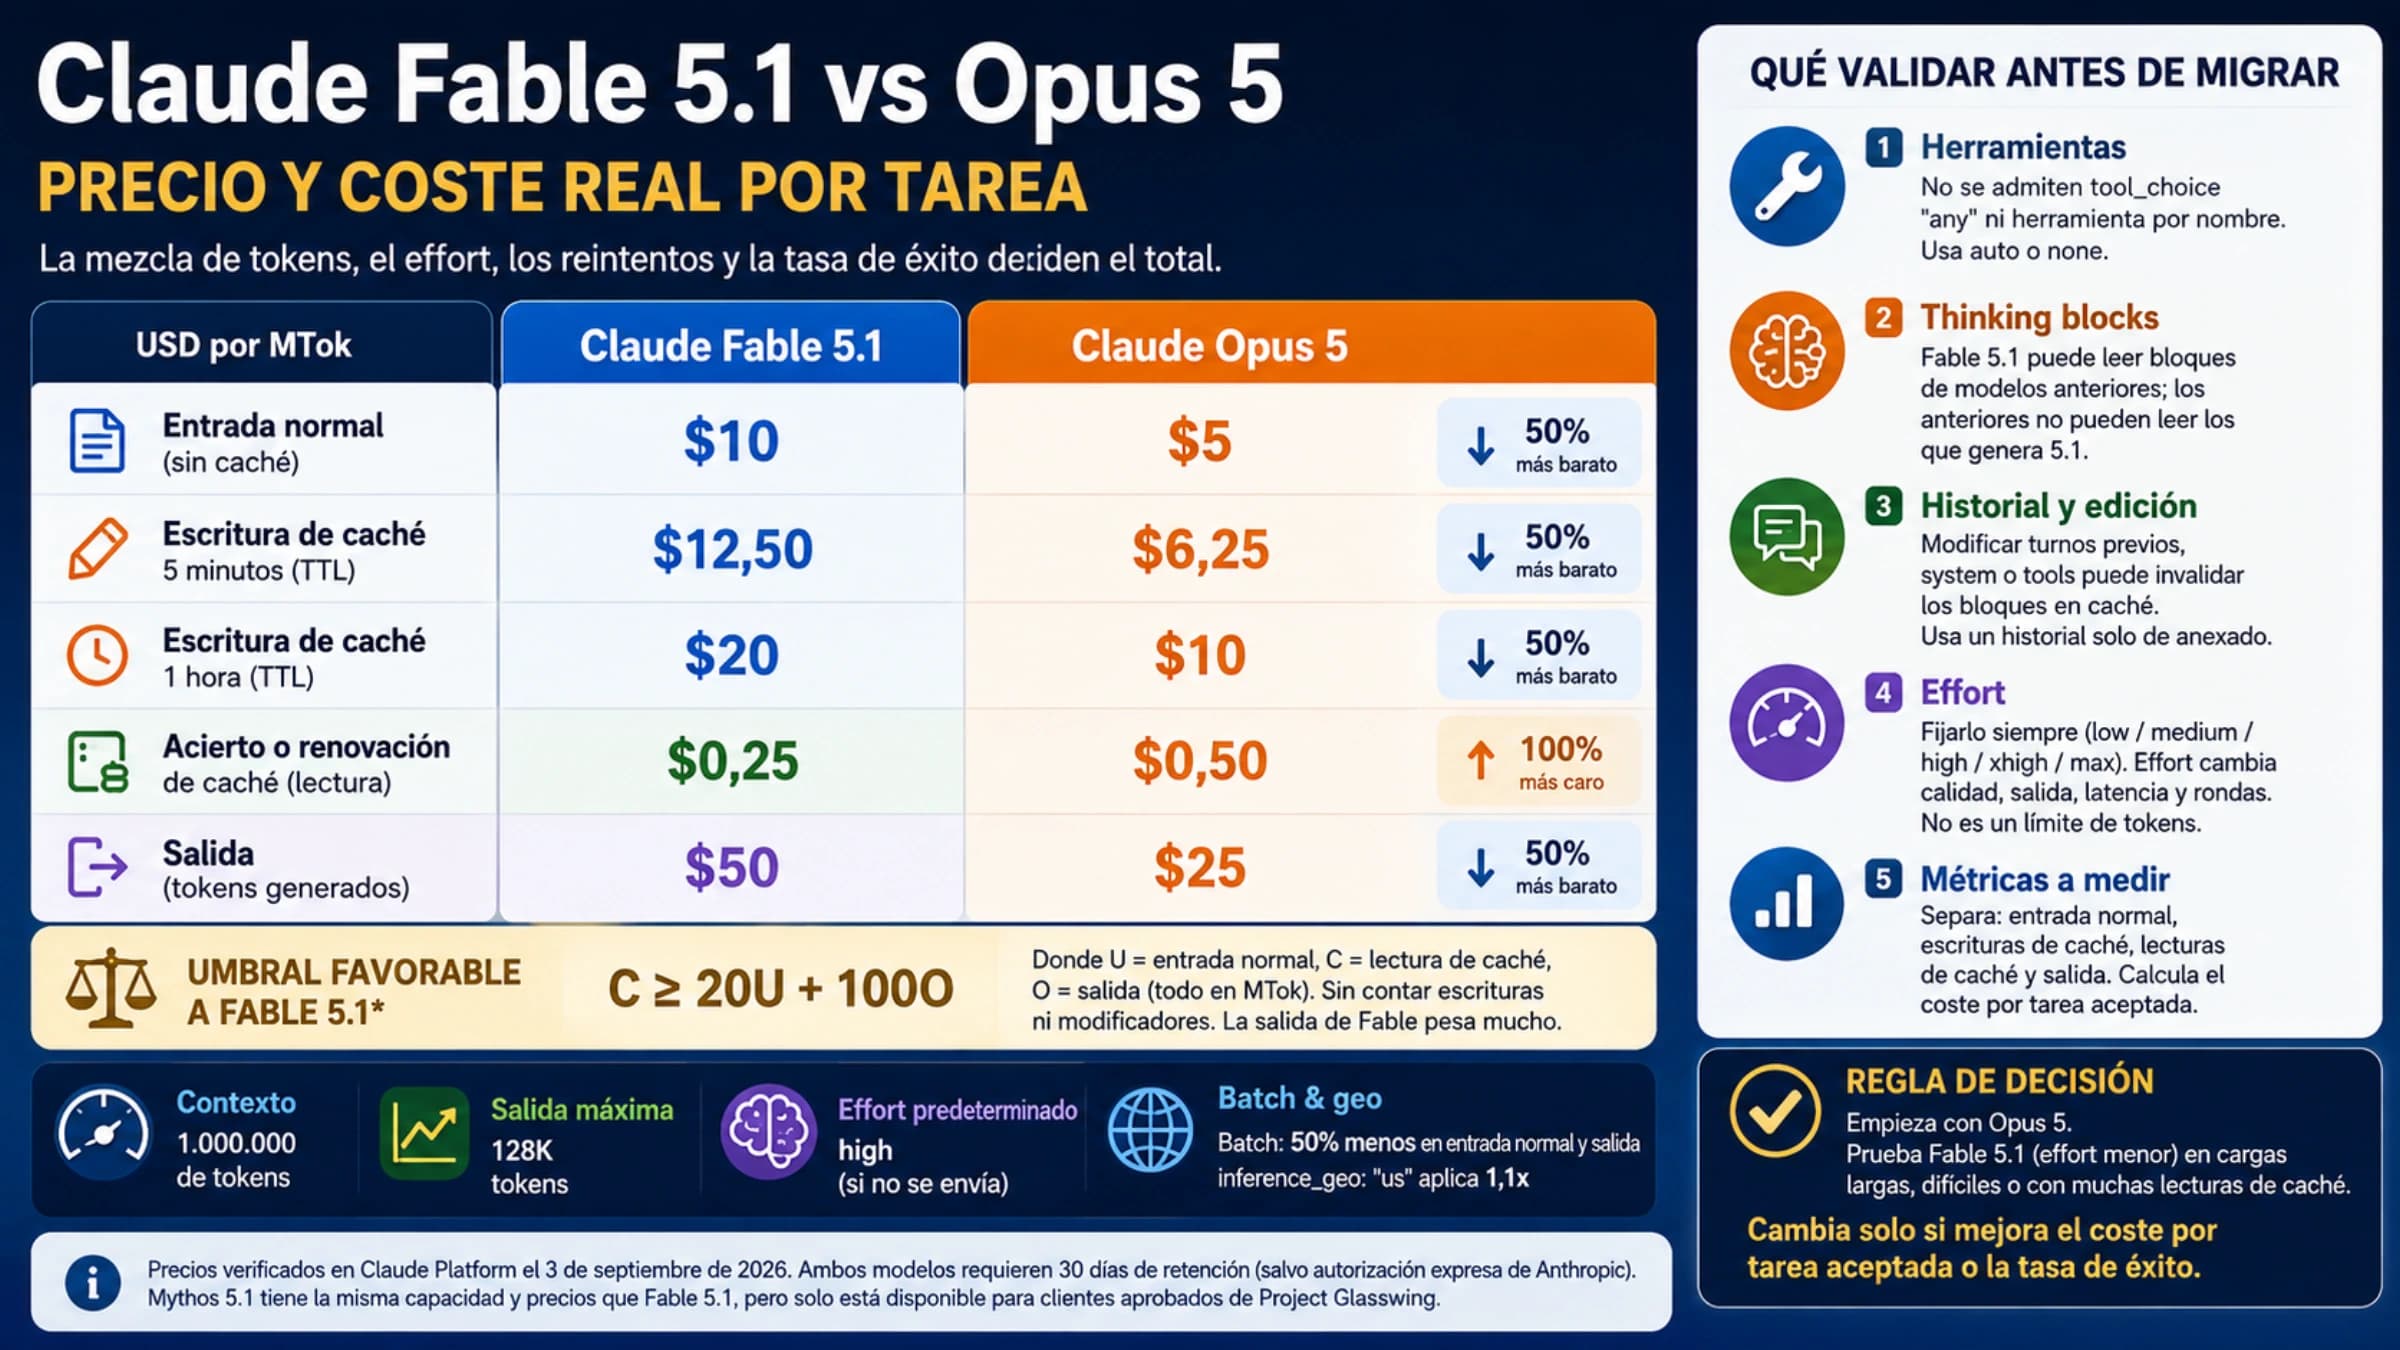
| Fable 5 | Fable 5.1, claude-fable-5-1 | 10 $ / 50 $ | 10 $ / 50 $ | La lectura de caché baja de 1 $ a 0,25 $ |
Así que «¿Sonnet 5 o Haiku 4.5?» hoy es «¿Sonnet 5.5 o Haiku 5.5?», y la regla de fondo es la misma. Haiku 5.5 es para trabajo estrecho y fácil de comprobar (clasificar, extraer, resumir, enrutar, hacer de subagente); Sonnet 5.5 es para programar, analizar y encadenar varios pasos con herramientas. Sonnet cuesta 20 veces más por token, pero en la prueba de 9 tareas descrita más abajo costó 9,9 veces más por tarea, porque Haiku escribió muchos más tokens para llegar a la misma respuesta. Si sigues llamando a claude-haiku-4-5, pagas la tarifa antigua por el mismo nivel; el detalle de qué trabajo pasar a Haiku está en Claude Haiku 5.5 vs Sonnet 5.5: cuál elegir y coste por tarea.
Dos aclaraciones para quien busca otros nombres. Anthropic no ha publicado ningún Haiku 5: después de Haiku 4.5 llegó directamente Haiku 5.5. Y la subida de Sonnet 5 a 3 $ / 15 $ anunciada para el 1 de septiembre de 2026 no se produjo; el precio de lanzamiento de 2 $ / 10 $ pasó a ser el definitivo. Opus 4.8, 4.7, 4.6 y 4.5 y Sonnet 4.6 también están en la lista de heredados, de modo que preguntas como «¿Opus 4.6 o Sonnet 5?» hoy se responden comparando Opus 5.5 con Sonnet 5.5.
Por qué Anthropic aconseja Sonnet en las apps y Opus 5.5 en la API
Las dos recomendaciones están vigentes y no se contradicen: se refieren a sitios distintos donde pagas de forma distinta. En las apps de Claude pagas con el límite de uso de tu plan, y Opus lo consume mucho más que Sonnet; en la API pagas por token, y la guía para desarrolladores prefiere empezar con el modelo capaz y abaratar después.
En las apps, la guía de Anthropic sobre Haiku, Sonnet, Opus y Fable llama a Sonnet 5.5 «your versatile default» y dice que, si no sabes qué elegir, empieces por él. El motivo es práctico: el plan Free solo incluye Haiku y Sonnet, Pro y Max añaden Opus y Fable, y el gasto de límite va de ligero en Haiku a moderado en Sonnet, alto en Opus y máximo en Fable. La propia guía reserva Opus para los problemas en los que Sonnet ya se quedó corto en una prueba, y Fable para los que tampoco resolvió Opus. Anthropic no publica cuántos mensajes de Sonnet equivalen a uno de Opus; los límites de cada plan se explican en Claude Pro vs Max: precios, límites de uso y cuándo compensa Max. En algunos temas de biología y seguridad, Claude puede pasar a otro modelo distinto del elegido y te avisa cuando lo hace.
En la API, la guía de Anthropic para elegir modelo propone dos caminos. El de capacidad primero empieza con Opus 5.5, ajusta los prompts y después baja el effort o cambia a un modelo más barato cuando las pruebas lo permiten; si Opus en xhigh o max sigue sin bastar en razonamiento exigente o en trabajo agéntico largo, pasa a Fable 5.1. El de eficiencia primero empieza con Haiku 5.5 y sube solo ante una carencia concreta, y la guía lo recomienda para prototipos, latencia ajustada, presupuestos estrictos y tareas sencillas de mucho volumen. La tabla de la misma página resume la gama así: Fable 5.1 para la máxima capacidad, Opus 5.5 para programación agéntica compleja y trabajo empresarial, Sonnet 5.5 para velocidad y capacidad en el trabajo diario, Haiku 5.5 para la menor latencia y precio.
En la práctica, si usas Claude con un plan Pro, deja Sonnet 5.5 como modelo habitual y cambia a Opus en la conversación concreta donde Sonnet falle. Si integras la API y la tarea es compleja, empieza por claude-opus-5-5 y mide si Sonnet o Haiku dan el mismo resultado; si es una tarea de volumen con respuesta comprobable, empieza por claude-haiku-5-5.
Diferencias entre Haiku 5.5, Sonnet 5.5, Opus 5.5 y Fable 5.1
Los cuatro modelos comparten contexto de un millón de tokens, salida síncrona de hasta 128.000 tokens y fecha de conocimiento fiable de junio de 2026. Lo que los separa es el precio, el effort con el que arrancan por defecto, la latencia relativa que les asigna Anthropic y el plan de las apps en el que aparecen.
| Modelo e ID | Para qué lo posiciona Anthropic | Entrada / salida por millón de tokens | Lectura de caché | Latencia (etiqueta de Anthropic) | Effort por defecto en la API | En las apps |
|---|---|---|---|---|---|---|
Haiku 5.5, claude-haiku-5-5 | Tareas de mucho volumen y sensibles a la latencia: clasificación, extracción, enrutado | 0,10 $ / 0,50 $ hasta 100.000 tokens; 0,50 $ / 2,50 $ por encima | 0,01 $ (0,05 $ por encima) | Fastest | medium | Free y de pago; gasto de límite ligero |
Sonnet 5.5, claude-sonnet-5-5 | La mejor combinación de velocidad e inteligencia | 2 $ / 10 $ | 0,10 $ | Fast | high | Free y de pago; gasto moderado |
Opus 5.5, claude-opus-5-5 | Programación agéntica larga y trabajo de conocimiento | 4 $ / 20 $ | 0,20 $ | Moderate | medium | Pro y Max; gasto alto |
Fable 5.2, claude-fable-5-2 | — | 8 $ / 40 $ | 0,20 $ | — | high; razonamiento adaptativo siempre activo | Max y Ultra, hasta el 50 % del límite semanal; Pro, con créditos de uso |
Fable 5.1, claude-fable-5-1 | Razonamiento exigente y trabajo agéntico de horizonte largo | 10 $ / 50 $ | 0,25 $ | Slower | high | Planes de pago; gasto máximo |
Fuentes: comparativa de modelos de Anthropic, precios de la API de Claude y la guía de las apps citada arriba, a 26 de octubre de 2026; la fila de Fable 5.2 recoge los datos de Anthropic a 10 de noviembre de 2026. La API por lotes descuenta un 50 % y fijar el procesamiento solo en EE. UU. multiplica todas las tarifas por 1,1.
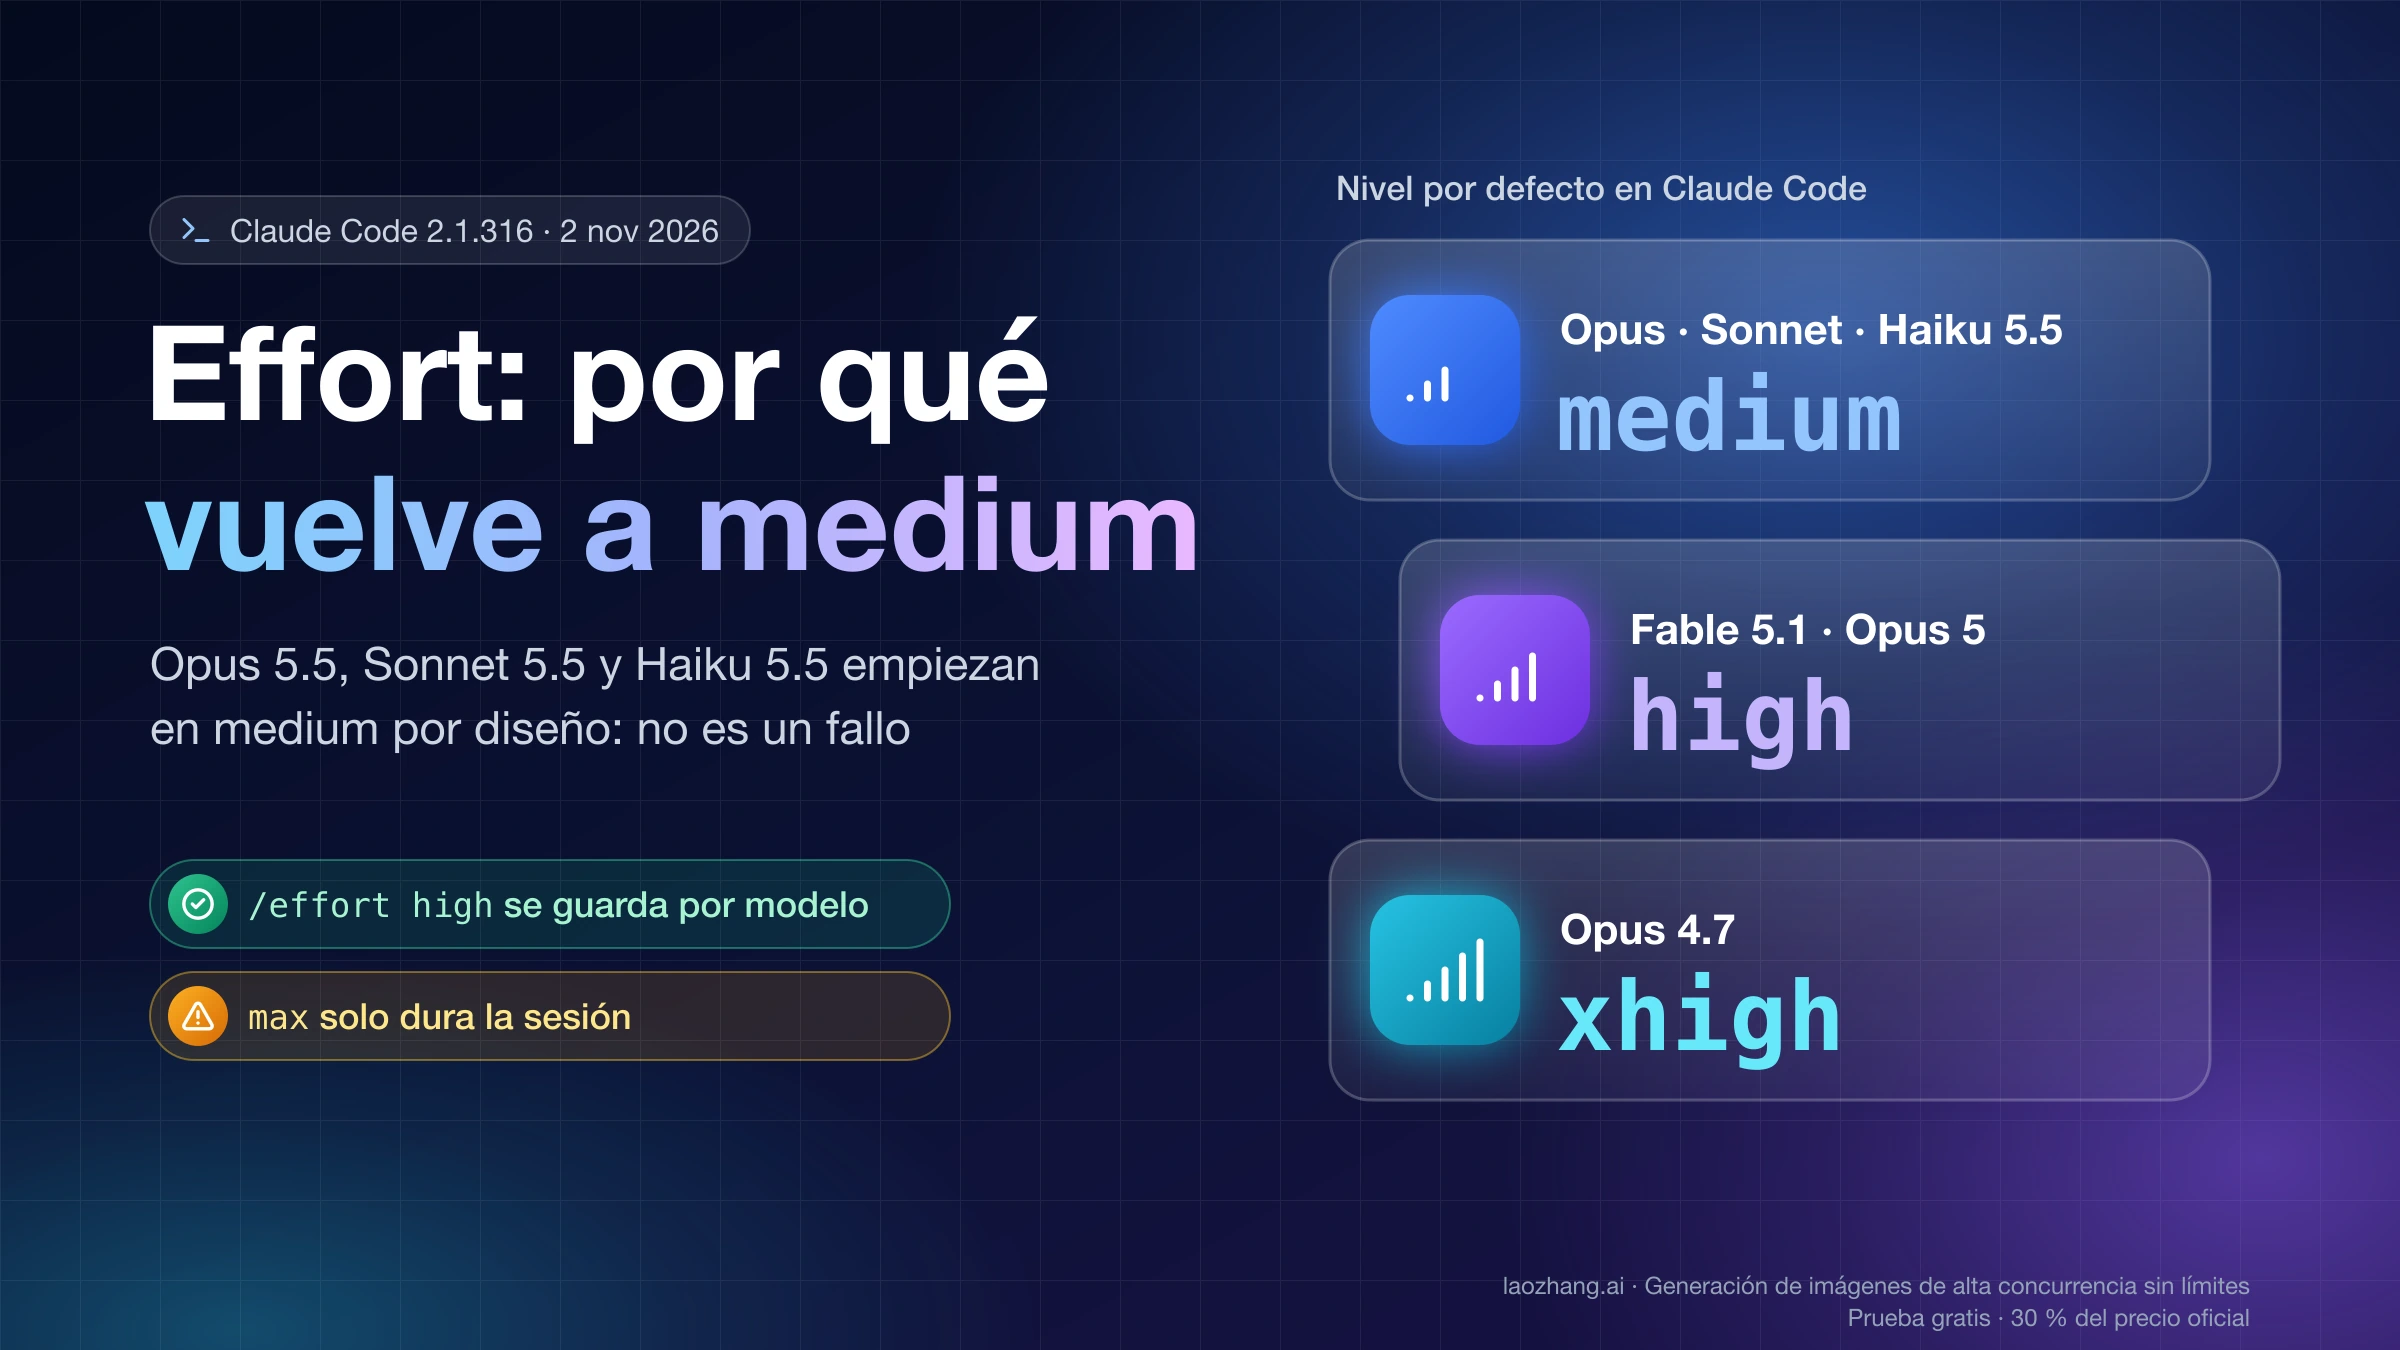
El effort es el ajuste con el que decides cuánto razona el modelo antes de responder; admite low, medium, high, xhigh y max, y dejarlo en el valor por defecto equivale a no enviarlo. Importa porque Sonnet arranca en high y Opus en medium: comparar los dos «tal cual» no es comparar el mismo esfuerzo. En Claude Code, los tres modelos 5.5 arrancan en medium.
Las etiquetas de latencia son relativas y Anthropic advierte que la velocidad real depende de la longitud del prompt, de la salida y del effort. Haiku genera más tokens por segundo (de 173 a 234 según Artificial Analysis, frente a 105–134 de Sonnet), pero en tareas cortas puede tardar más porque escribe más: en la prueba del 26 de octubre, Sonnet terminó primero en 8 de las 9 tareas.
La franja cara de Haiku 5.5 merece atención aparte. El umbral de 100.000 tokens cuenta toda la entrada de la petición, incluidas las lecturas y escrituras de caché, y cada petición que lo supera paga el precio alto completo aunque parte del prompt venga de la caché. En un agente que acumula historial, Haiku cruza ese umbral antes de lo que parece.
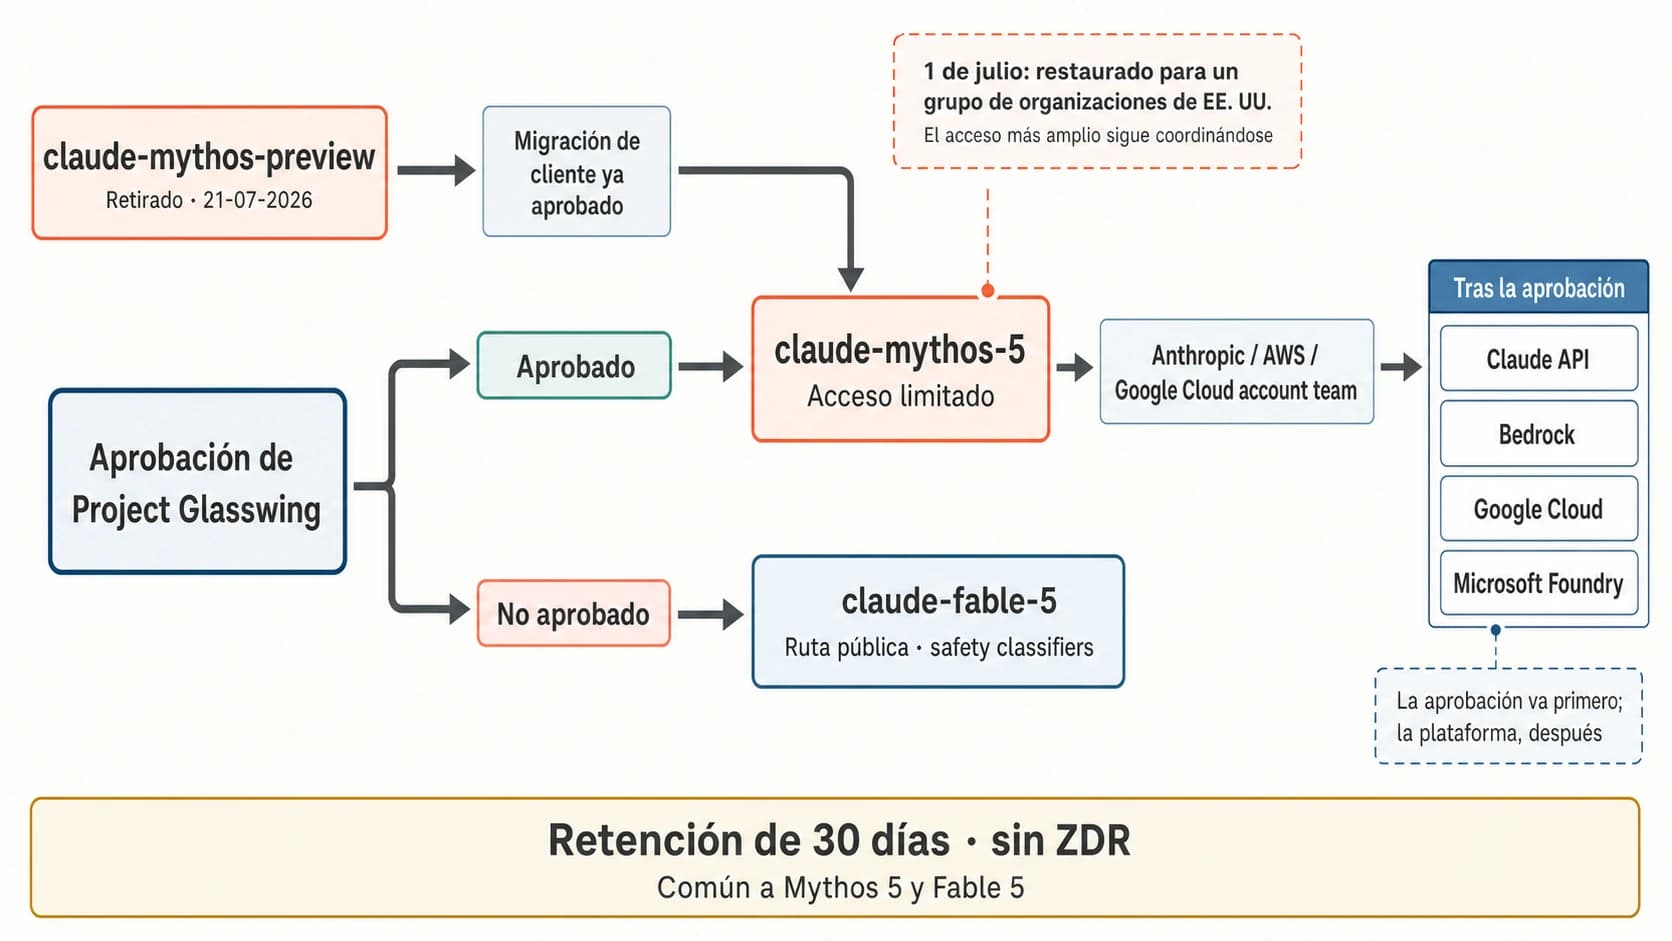
Junto a Fable 5.1 existe Claude Mythos 5.1, con las mismas capacidades, pero solo para organizaciones verificadas por los programas de Anthropic; no es una opción de autoservicio.
¿Qué es mejor, Sonnet u Opus, y cuál consume más?
Opus 5.5 rinde más que Sonnet 5.5 en tareas difíciles y también consume más, tanto en las apps como en la API. En el índice de Artificial Analysis, Opus con su effort por defecto puntúa 51 frente a 47 de Sonnet; en una prueba con 9 tareas ejecutada el 26 de octubre de 2026, Opus generó 9.875 tokens de salida frente a 5.061 de Sonnet y costó 3,11 veces más, con el mismo resultado en todas las comprobaciones.
La prueba usó el mismo prompt en Haiku 5.5, Sonnet 5.5 y Opus 5.5, cada uno con el effort por defecto de la API (sin parámetros de effort ni de thinking, sin prompt de sistema ni herramientas), a través de la pasarela LaoZhang API en formato Messages de Anthropic. Las 9 tareas tenían comprobaciones fijadas antes de leer ninguna respuesta: un problema de cálculo, cinco funciones de Python con baterías de tests ocultas, un artículo de 6.723 palabras que había que resumir en exactamente 5 viñetas de 25 palabras como máximo, un conteo combinatorio y la reparación de un billing.py con 5 errores plantados y 2 funciones ausentes, validada con 36 tests. El coste se calculó con los tokens devueltos y el precio de lista de Anthropic.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Modelo (effort por defecto) | Comprobaciones superadas | Coste de las 9 tareas | Tiempo total | Tokens de salida | Coste frente a Haiku |
|---|---|---|---|---|---|
Haiku 5.5 (medium) | 9 de 9 | 0,0087 $ | 74,9 s | 13.843 | 1 vez |
Sonnet 5.5 (high) | 9 de 9 | 0,0866 $ | 50,6 s | 5.061 | 9,9 veces |
Opus 5.5 (medium) | 9 de 9 | 0,2695 $ | 103,5 s | 9.875 | casi 31 veces |
Los 27 resultados fueron correctos, así que estas tareas no separan a los modelos por calidad; lo que muestran es cuánto cuesta y cuánto tarda cada uno cuando los tres aciertan. Por token, Opus cuesta 2 veces lo que Sonnet; por tarea costó bastante más, porque escribió 1,95 veces más tokens de salida. En la tarea de entrada larga (15.335 tokens), donde pesa la entrada, los costes fueron 0,0024 $, 0,0335 $ y 0,0916 $. Hay que leerlo con sus límites: una muestra por tarea, un solo día, una sola pasarela, tareas pequeñas y bien definidas, sin caché ni ajustes de effort, y sin probar las apps ni el endpoint propio de Anthropic. Fable 5.1 no se probó. Para la calidad en tareas difíciles, la referencia sigue siendo Artificial Analysis.
Un caso de terceros apunta en la misma dirección: según un artículo de MindStudio del 9 de octubre de 2026 sobre las pruebas de un creador, en una tarea de contabilidad forense los tres modelos encontraron los 8 fraudes plantados y Opus costó unas 4 o 5 veces más. Es una prueba sin repetir y sin datos de effort ni de tokens. En las apps, la respuesta a «¿qué consume más?» es directa: la guía de Anthropic clasifica el gasto de límite de Opus como alto y el de Sonnet como moderado.
Cuánto cuesta subir o bajar un nivel con la misma puntuación
El precio por millón de tokens dice que Sonnet cuesta 20 veces lo que Haiku y Opus 40 veces, pero esos múltiplos no son lo que pagas por tarea. Para comparar niveles con la misma calidad hay que fijar una puntuación y buscar la configuración más barata de cada modelo que la alcanza.
La tabla siguiente sale de recalcular, el 26 de octubre de 2026, las 20 configuraciones (4 modelos × 5 niveles de effort) que publica Artificial Analysis en sus comparativas de Haiku 5.5 y Sonnet 5.5, Sonnet 5.5 y Opus 5.5 y Opus 5.5 y Fable 5.1. Para cada puntuación mínima del índice de inteligencia, indica qué configuración la alcanza con el menor coste por tarea del índice.
| Puntuación mínima en AA | Configuración más barata | Coste por tarea | Tiempo por tarea |
|---|---|---|---|
| 34 | Haiku 5.5, medium (por defecto) | 0,05 $ | 119 s |
| 41 | Haiku 5.5, xhigh | 0,12 $ | 291 s |
| 47 | Sonnet 5.5, high (por defecto) | 0,88 $ | 217 s |
| 51 | Opus 5.5, medium (por defecto) | 1,34 $ | 198 s |
| 54 | Opus 5.5, high | 1,82 $ | 282 s |
| 56 | Opus 5.5, xhigh | 3,46 $ | 494 s |
| 58 | Opus 5.5, max | 5,98 $ | 791 s |
Fable 5.1 no es la opción más barata en ninguna fila. Con su effort por defecto (high) puntúa 51 a 3,91 $ por tarea, lo mismo que Opus en medium por 1,34 $: 2,92 veces el coste y 2,09 veces el tiempo. Su techo en max es 53, por debajo de los 56 de Sonnet y los 58 de Opus, aunque el índice promedia 10 evaluaciones y puede esconder tareas concretas en las que Fable sí gana. Entre los niveles por defecto, subir de Haiku a Sonnet da 13 puntos más por 17,6 veces el coste, y subir de Sonnet a Opus da 4 puntos más por 1,52 veces el coste. El salto caro es el primero; el segundo, en proporción, cuesta poco si la tarea lo necesita.
Dos precauciones al usar esta tabla. El índice mide la mezcla de tareas de Artificial Analysis, no la tuya, y es un tercero que vuelve a medir con el tiempo. Además, Artificial Analysis calcula Haiku solo con la tarifa de prompts de hasta 100.000 tokens.
Calcula la factura con la proporción real de entrada y salida
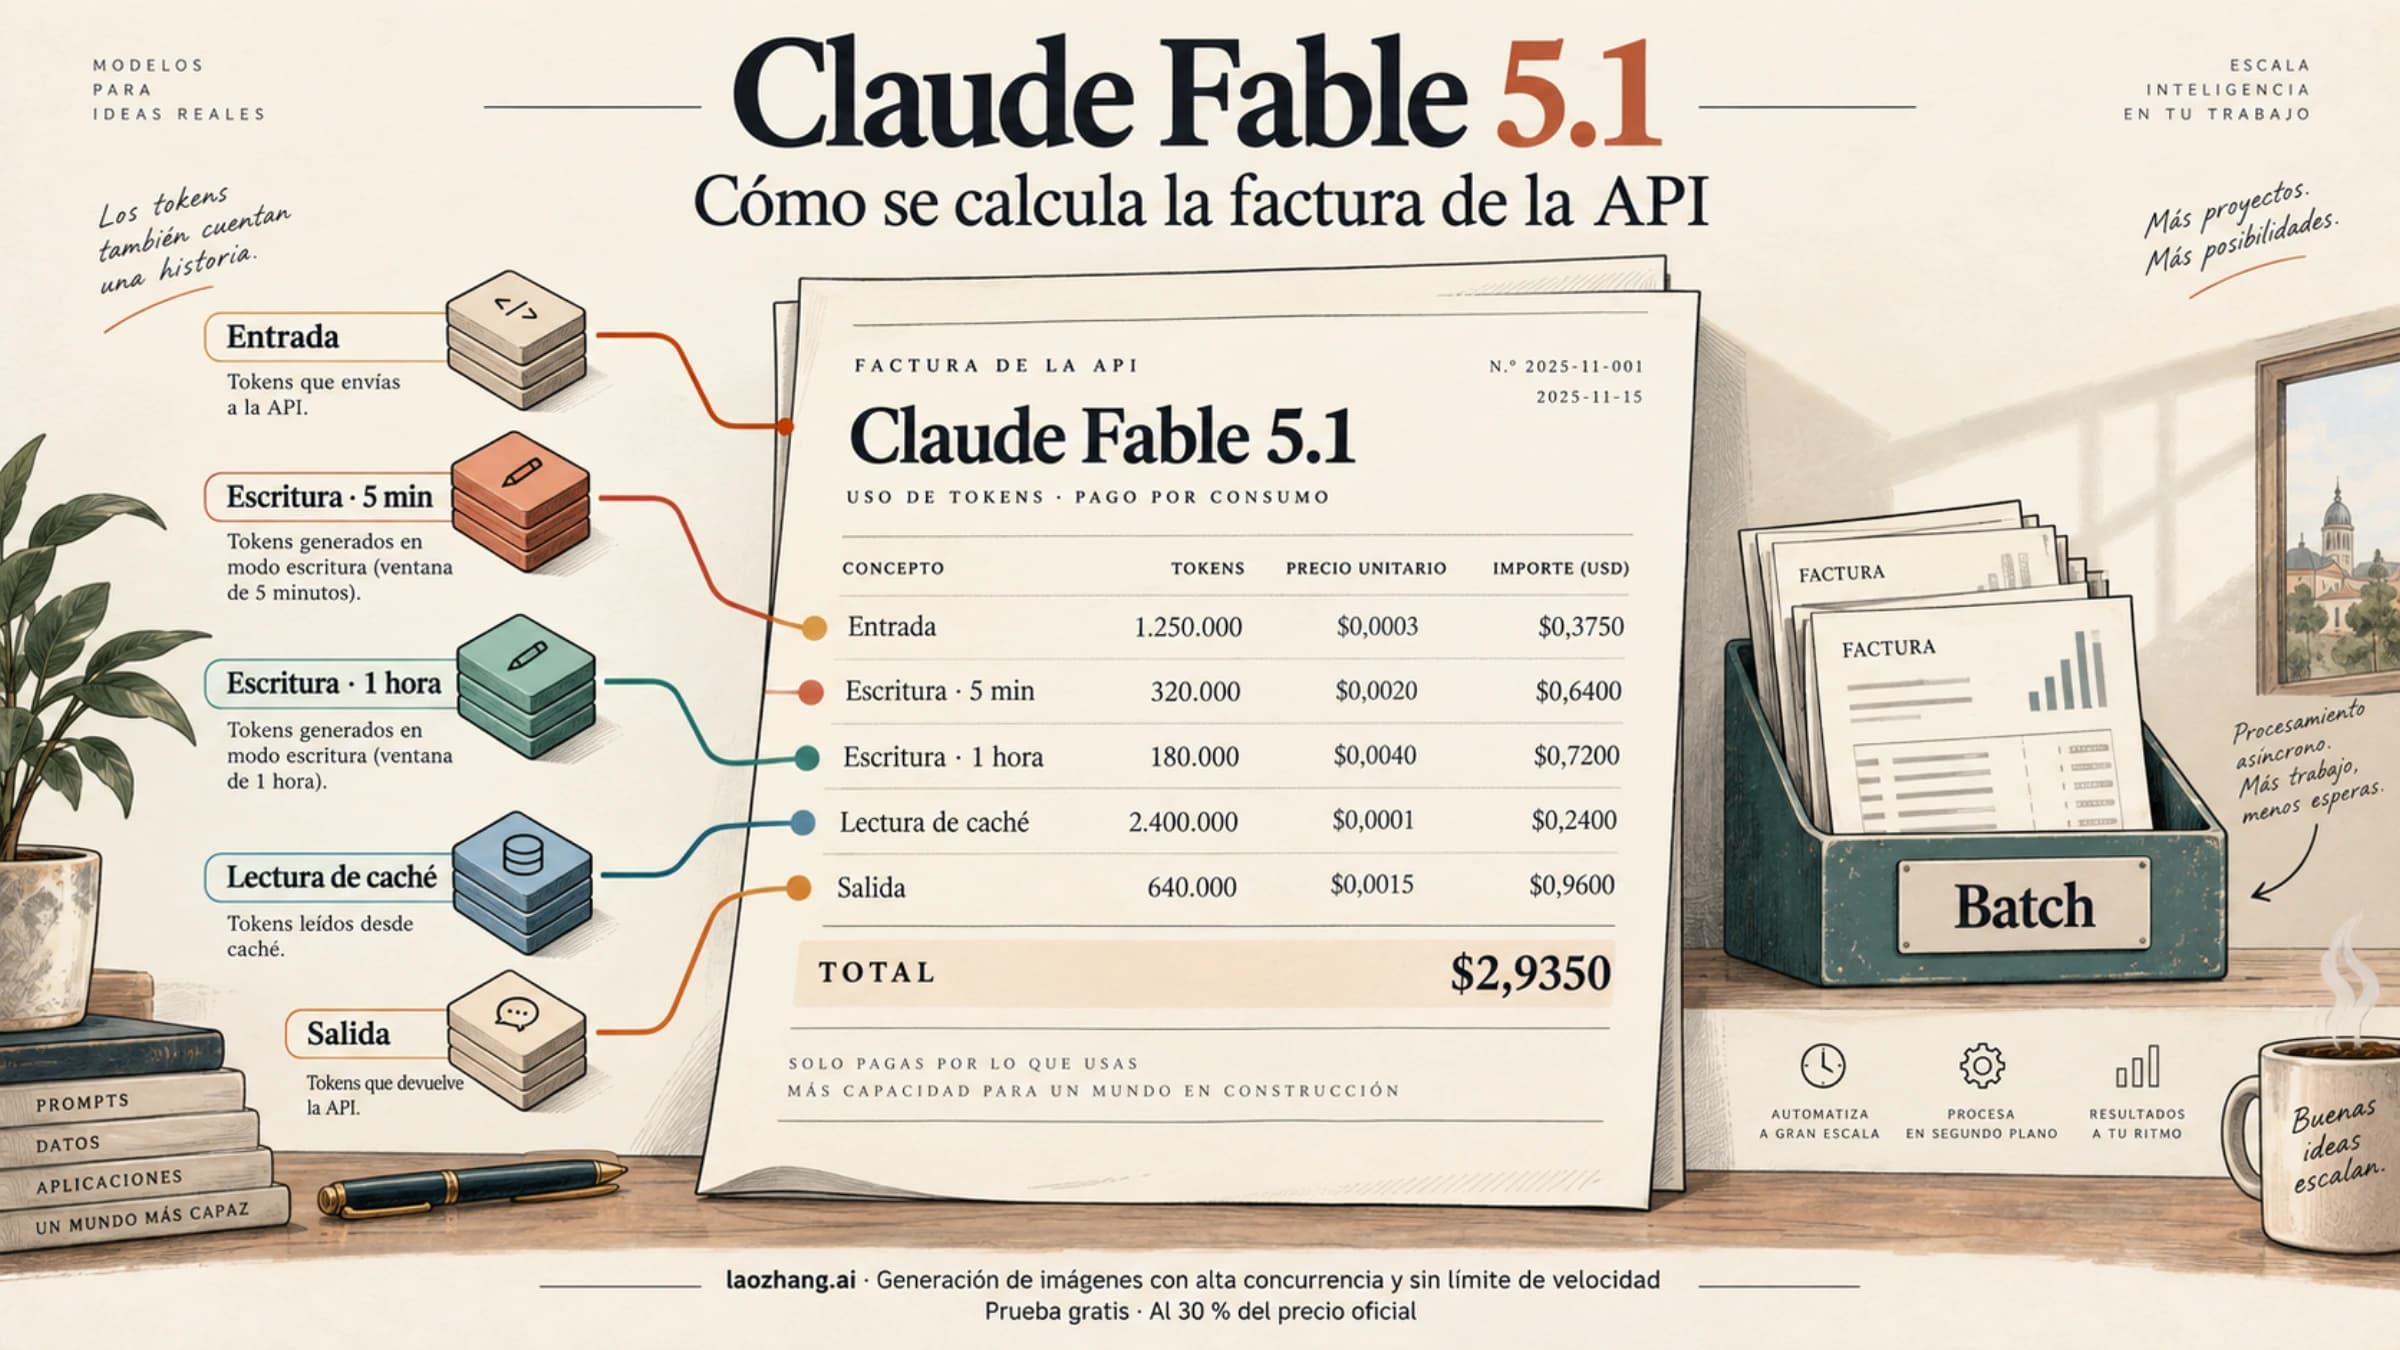
Para una petición concreta, el cálculo es la suma de cada tipo de token por su tarifa: coste = Σ tokens × precio por millón ÷ 1.000.000. Estas cuatro peticiones tipo, con precios de lista de la API y sin lotes, suponen el mismo número de tokens en los cuatro modelos, cosa que en tareas reales no ocurre (la salida incluye el razonamiento y varía de un modelo a otro, como mostró la prueba anterior).
| Petición | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| A. 10.000 de entrada + 1.000 de salida, sin caché | 0,0015 $ | 0,030 $ | 0,060 $ | 0,150 $ |
| B. Turno de agente: 90.000 leídos de caché + 5.000 nuevos + 2.000 de salida | 0,0024 $ | 0,039 $ | 0,078 $ | 0,1725 $ |
| C. El mismo turno con 150.000 leídos de caché | 0,015 $ | 0,045 $ | 0,090 $ | 0,1875 $ |
| D. Un millón de clasificaciones de 2.000 de entrada + 300 de salida | 350 $ | 7.000 $ | 14.000 $ | 35.000 $ |
La fila C muestra la franja de Haiku: al pasar de 95.000 a 155.000 tokens de entrada, el turno de Haiku pasa a costar más de 6 veces lo que costaba, mientras que en Sonnet solo sube un 15 %. En B, Sonnet cuesta 16 veces lo que Haiku; en C, 3 veces. La fila D es el caso que más favorece a Haiku: con un millón de llamadas cortas, la diferencia con Sonnet son 6.650 $. Las cifras B y C excluyen la escritura de caché del primer turno. Si tu caché se mantiene, la rebaja de Sonnet 5.5 a 0,10 $ por millón en lectura cuenta mucho en agentes largos; el cálculo detallado está en Claude Sonnet 5.5: precio de caché a 0,10 $ y cuánto ahorras.
Elige según la tarea: cuándo bajar a Haiku y cuándo subir a Opus o Fable
La gama funciona como una escalera en la que cambias de peldaño por una razón concreta, no por defecto. Bajas a Haiku cuando el trabajo es acotado y fácil de comprobar, subes a Opus cuando Sonnet falla de forma repetible, y pruebas Fable solo cuando Opus con effort alto tampoco basta.

El gráfico muestra la gama de agosto de 2026; el texto recoge la gama vigente a 26 de octubre de 2026, en la que Haiku 5.5, Sonnet 5.5, Opus 5.5 y Fable 5.1 ocupan esos mismos puestos.
Haiku 5.5 para volumen, subagentes y respuestas acotadas
Haiku 5.5 encaja en clasificación, extracción, enrutado, resúmenes y compactación de contexto, y como subagente de un modelo mayor. En el anuncio de Haiku 5.5, Anthropic dice que Sonnet 5.5 y Opus 5.5 siguen siendo mejores para la programación agéntica compleja y que Haiku rinde mejor en tareas de alcance estrecho. Así que, a la pregunta de si es mejor Sonnet o Haiku, la respuesta es Sonnet para trabajo abierto y Haiku cuando el resultado se puede comprobar de forma automática y el volumen hace que el precio pese. En Claude Code, la documentación de costes recomienda poner model: haiku en la configuración de los subagentes simples; en Bedrock, Google Cloud y Foundry ese alias apunta a una versión anterior, así que allí conviene fijar claude-haiku-5-5. Si solo necesitas elegir entre opciones cerradas sin generar texto, hay modelos de clasificación específicos como Jev de TypeSafe: qué es, cuándo gana a un LLM y cómo usarlo.
Sonnet 5.5 como opción inicial en las apps y para programar a diario
Sonnet 5.5 es el modelo por defecto razonable para asistentes, generación de código, análisis de datos y automatizaciones con herramientas. En las apps es el que Anthropic recomienda si no sabes cuál usar, y en la API es el primer peldaño por debajo de Opus cuando tus pruebas con Opus pasan y quieres pagar menos. Fue el más rápido en 8 de las 9 tareas de la prueba del 26 de octubre, con su effort por defecto high.
Opus 5.5 cuando Sonnet se queda corto
Prueba Opus 5.5 cuando puedas señalar un fallo repetible de Sonnet: un agente que pierde el plan a mitad de una tarea larga, una refactorización que rompe dependencias o un análisis que necesita varias rondas de corrección. El sobrecoste por tarea frente a Sonnet fue de 1,52 veces en Artificial Analysis y de 3,11 veces en la prueba de 9 tareas, así que la mejora tiene que ahorrar más en reintentos o revisión de lo que añade en tokens.
Fable 5.1 solo después de una prueba con Opus en xhigh o max
Anthropic presenta Fable 5.1 como su modelo más capaz abierto a todos los clientes y lo reserva para sesiones de agente de horas, investigación de varios pasos y trabajos que terminan en un documento, una hoja de cálculo o una presentación. Las mediciones publicadas no lo sitúan por delante en todo: en el índice de Artificial Analysis su techo es de 53 puntos frente a 58 de Opus 5.5, y en Terminal-Bench 4.0, según los anuncios de Anthropic, Opus 5.5 en xhigh marca 66,4 % frente a 55,8 % de Fable 5.1. Pruébalo cuando Opus en xhigh o max siga fallando en tu caso; cuándo compensa su sobreprecio se analiza en Claude Fable 5.1 vs Opus 5.5: cuál compensa y cuándo pagar más.
¿Cambiar de modelo de Claude o subir el effort?
Ajustar el effort suele ser la palanca más barata, y la guía de elección de modelo de Anthropic lo dice así: «Tuning effort is often a better lever than switching models». La señal para cambiar de modelo es que ni el effort por defecto ni el siguiente nivel resuelven tus casos de prueba, y que el nivel siguiente de effort cuesta más que el modelo de arriba con la misma puntuación.
Los datos de Artificial Analysis muestran las dos situaciones. Si Haiku en medium no llega, subirlo a xhigh alcanza 41 puntos por 0,12 $ por tarea, mientras que Sonnet en medium llega a esos mismos 41 por 0,48 $; aquí subir el effort cuesta la cuarta parte que cambiar de modelo. En cambio, si Sonnet en high no basta, subirlo a xhigh da 52 puntos por 2,01 $, mientras que Opus en high da 54 por 1,82 $; aquí cambiar a Opus sale más barato y puntúa más. Y en la parte alta, Opus en high (54 puntos, 1,82 $) supera a Fable en max (53 puntos, 7,63 $).
Para Haiku, la guía de Anthropic pide usar xhigh o max solo donde tus pruebas muestren una mejora y compararlo con Sonnet 5.5 en rendimiento, coste y velocidad. Bajar el effort funciona igual en sentido contrario: si Opus en medium acierta siempre, prueba low antes de cambiar a Sonnet. En las apps de Claude, el selector de modelo también tiene ajuste de effort: el nivel por defecto sirve para la mayoría del trabajo, uno más bajo responde antes y gasta menos límite, y el más alto conviene dejarlo para los problemas más difíciles.
Migrar implica más que cambiar el ID: qué devuelve un error 400
Cambiar claude-sonnet-5 por claude-sonnet-5-5 o claude-haiku-4-5 por claude-haiku-5-5 puede devolver HTTP 400 aunque el ID sea correcto, porque los modelos 5.5 rechazan parámetros que los anteriores aceptaban. Revisa estos puntos en la petición antes de cambiar el ID:
tool_choicede tipoanyotooldevuelve 400 en Opus 5.5 y Sonnet 5.5, con el mensajetool_choice: type "tool" and "any" are not supported for this model.; usaautocon uso estricto de herramientas.thinking: {"type": "disabled"}devuelve 400 en Opus 5.5, que razona siempre, y en Sonnet 5.5, donde la alternativa es{"type": "between_tools"}con effortlow,mediumohigh. Haiku 5.5 sí permite desactivarlo con efforthigho inferior.budget_tokensmanual devuelve 400 en los cuatro modelos actuales.- Al pasar de Haiku 4.5 a Haiku 5.5, los valores no predeterminados de
temperature,top_potop_kdevuelven 400, y prellenar el turno del asistente da error. - Opus 5.5 rechaza la herramienta de uso del ordenador
computer_20251124.

El gráfico muestra la gama de agosto de 2026; los parámetros que hoy devuelven 400 son los de la lista anterior.
Cambiar de nivel a mitad de una conversación tiene otro efecto. En la API de Claude y en Google Cloud, Opus 5.5 lee los bloques de razonamiento que generaron Haiku 5.5 o Sonnet 5.5, de modo que subir de nivel conserva ese razonamiento. Al bajar se pierde: Haiku 5.5 no lee los bloques de Opus 5.5 y Sonnet 5.5 no lee los de Opus ni Fable; la petición funciona, pero esos bloques se descartan sin aviso y sin cobrarse. En Claude Code, cambiar de modelo con /model a mitad de sesión vuelve a leer toda la conversación sin aciertos de caché.
Las fechas también difieren por plataforma. Anthropic no retirará los modelos actuales antes del 1 de septiembre de 2027 en Fable 5.1, del 22 de septiembre en Opus 5.5, del 28 de septiembre en Sonnet 5.5 y del 7 de octubre de 2027 en Haiku 5.5. Bedrock usa IDs como anthropic.claude-sonnet-5-5, y cada plataforma asociada fija su propio calendario de retirada, así que si no llamas directamente a la API de Anthropic, comprueba el catálogo de la plataforma que te factura.
Lista de comprobación antes de desplegar o cambiar de modelo
Un nombre de modelo no decide por ti; lo decide una prueba con tus propios casos, en la que mides si el resultado se acepta sin corrección y cuánto cuesta cada resultado aceptado. En las apps basta con algo sencillo: la guía de Anthropic propone pasar el mismo encargo por Haiku y por Sonnet (por ejemplo, resumir un informe en cinco viñetas y señalar la afirmación para la que más querrías una segunda fuente) y fijarte en dónde difieren las respuestas, no en cuál es más larga. En la API conviene medir algo más:
- Sustituye cualquier ID heredado (
claude-haiku-4-5,claude-sonnet-5,claude-opus-5,claude-fable-5) por su sucesor 5.5 o 5.1 y limpia los parámetros que devuelven 400. - Prepara casos fáciles, frecuentes y difíciles, con la comprobación de cada uno fijada antes de ver las respuestas.
- Ejecuta cada caso con el effort por defecto y apunta tokens de entrada y de salida, no solo el precio por millón.
- Si un modelo falla, prueba el siguiente nivel de effort antes que el modelo de arriba y compara el coste por resultado aceptado.
- En Haiku, comprueba cuántas peticiones superan los 100.000 tokens de entrada contando la caché.
- Despliega de forma gradual y deja el modelo caro solo para los casos que de verdad lo necesitan.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 10 nov 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 10 nov 2026.
- 1.guía de Anthropic para elegir modelo en las apps de Claudeacademy.claude.com/tutorials/choosing-the-right-claude-model
- 2.documentación de modelos de Claudeplatform.claude.com/docs/en/about-claude/models/overview
- 3.tabla oficial de precios de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 4.guía de Anthropic para elegir modeloplatform.claude.com/docs/en/about-claude/models/choosing-a-model
- 5.Haiku 5.5 y Sonnet 5.5artificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-claude-sonnet-5-5
- 6.Sonnet 5.5 y Opus 5.5artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-claude-opus-5-5
- 7.Opus 5.5 y Fable 5.1artificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-claude-fable-5-1