Kimi K3.1 Pro vs Claude Opus 5.5: ¿cuesta la mitad por tarea?
Por token, Kimi K3.1 Pro cuesta la mitad que Opus 5.5. Por tarea depende del esfuerzo: frente a Opus en medium sale más caro y frente a xhigh o max, más barato.
En esta página
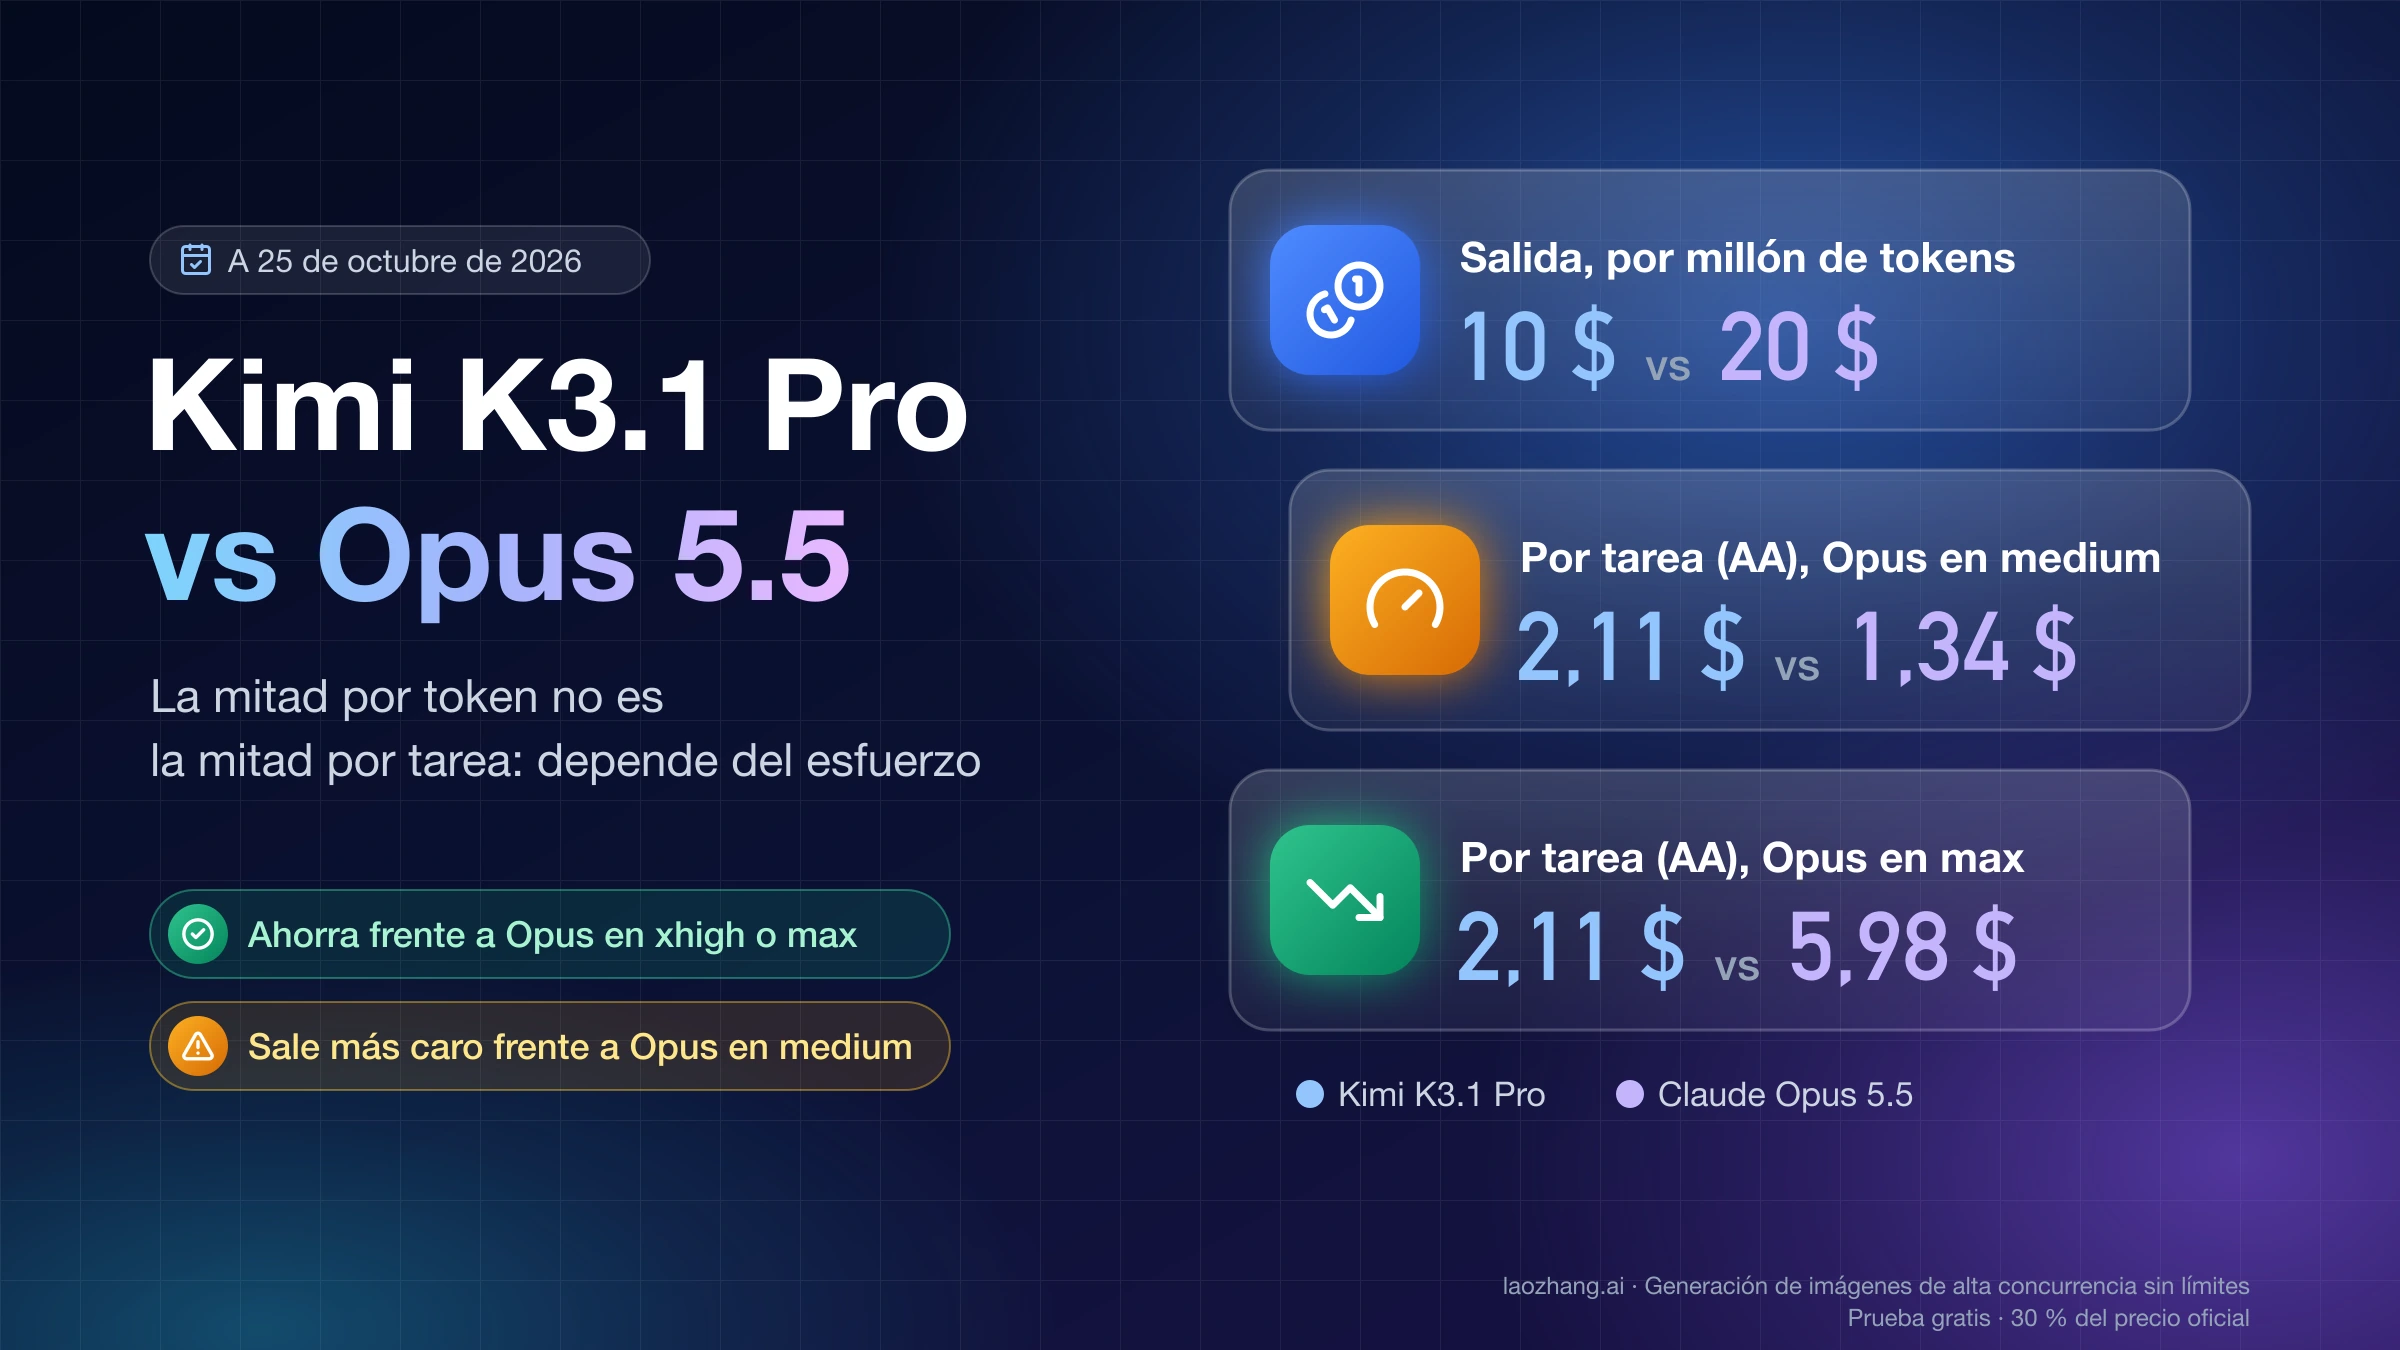
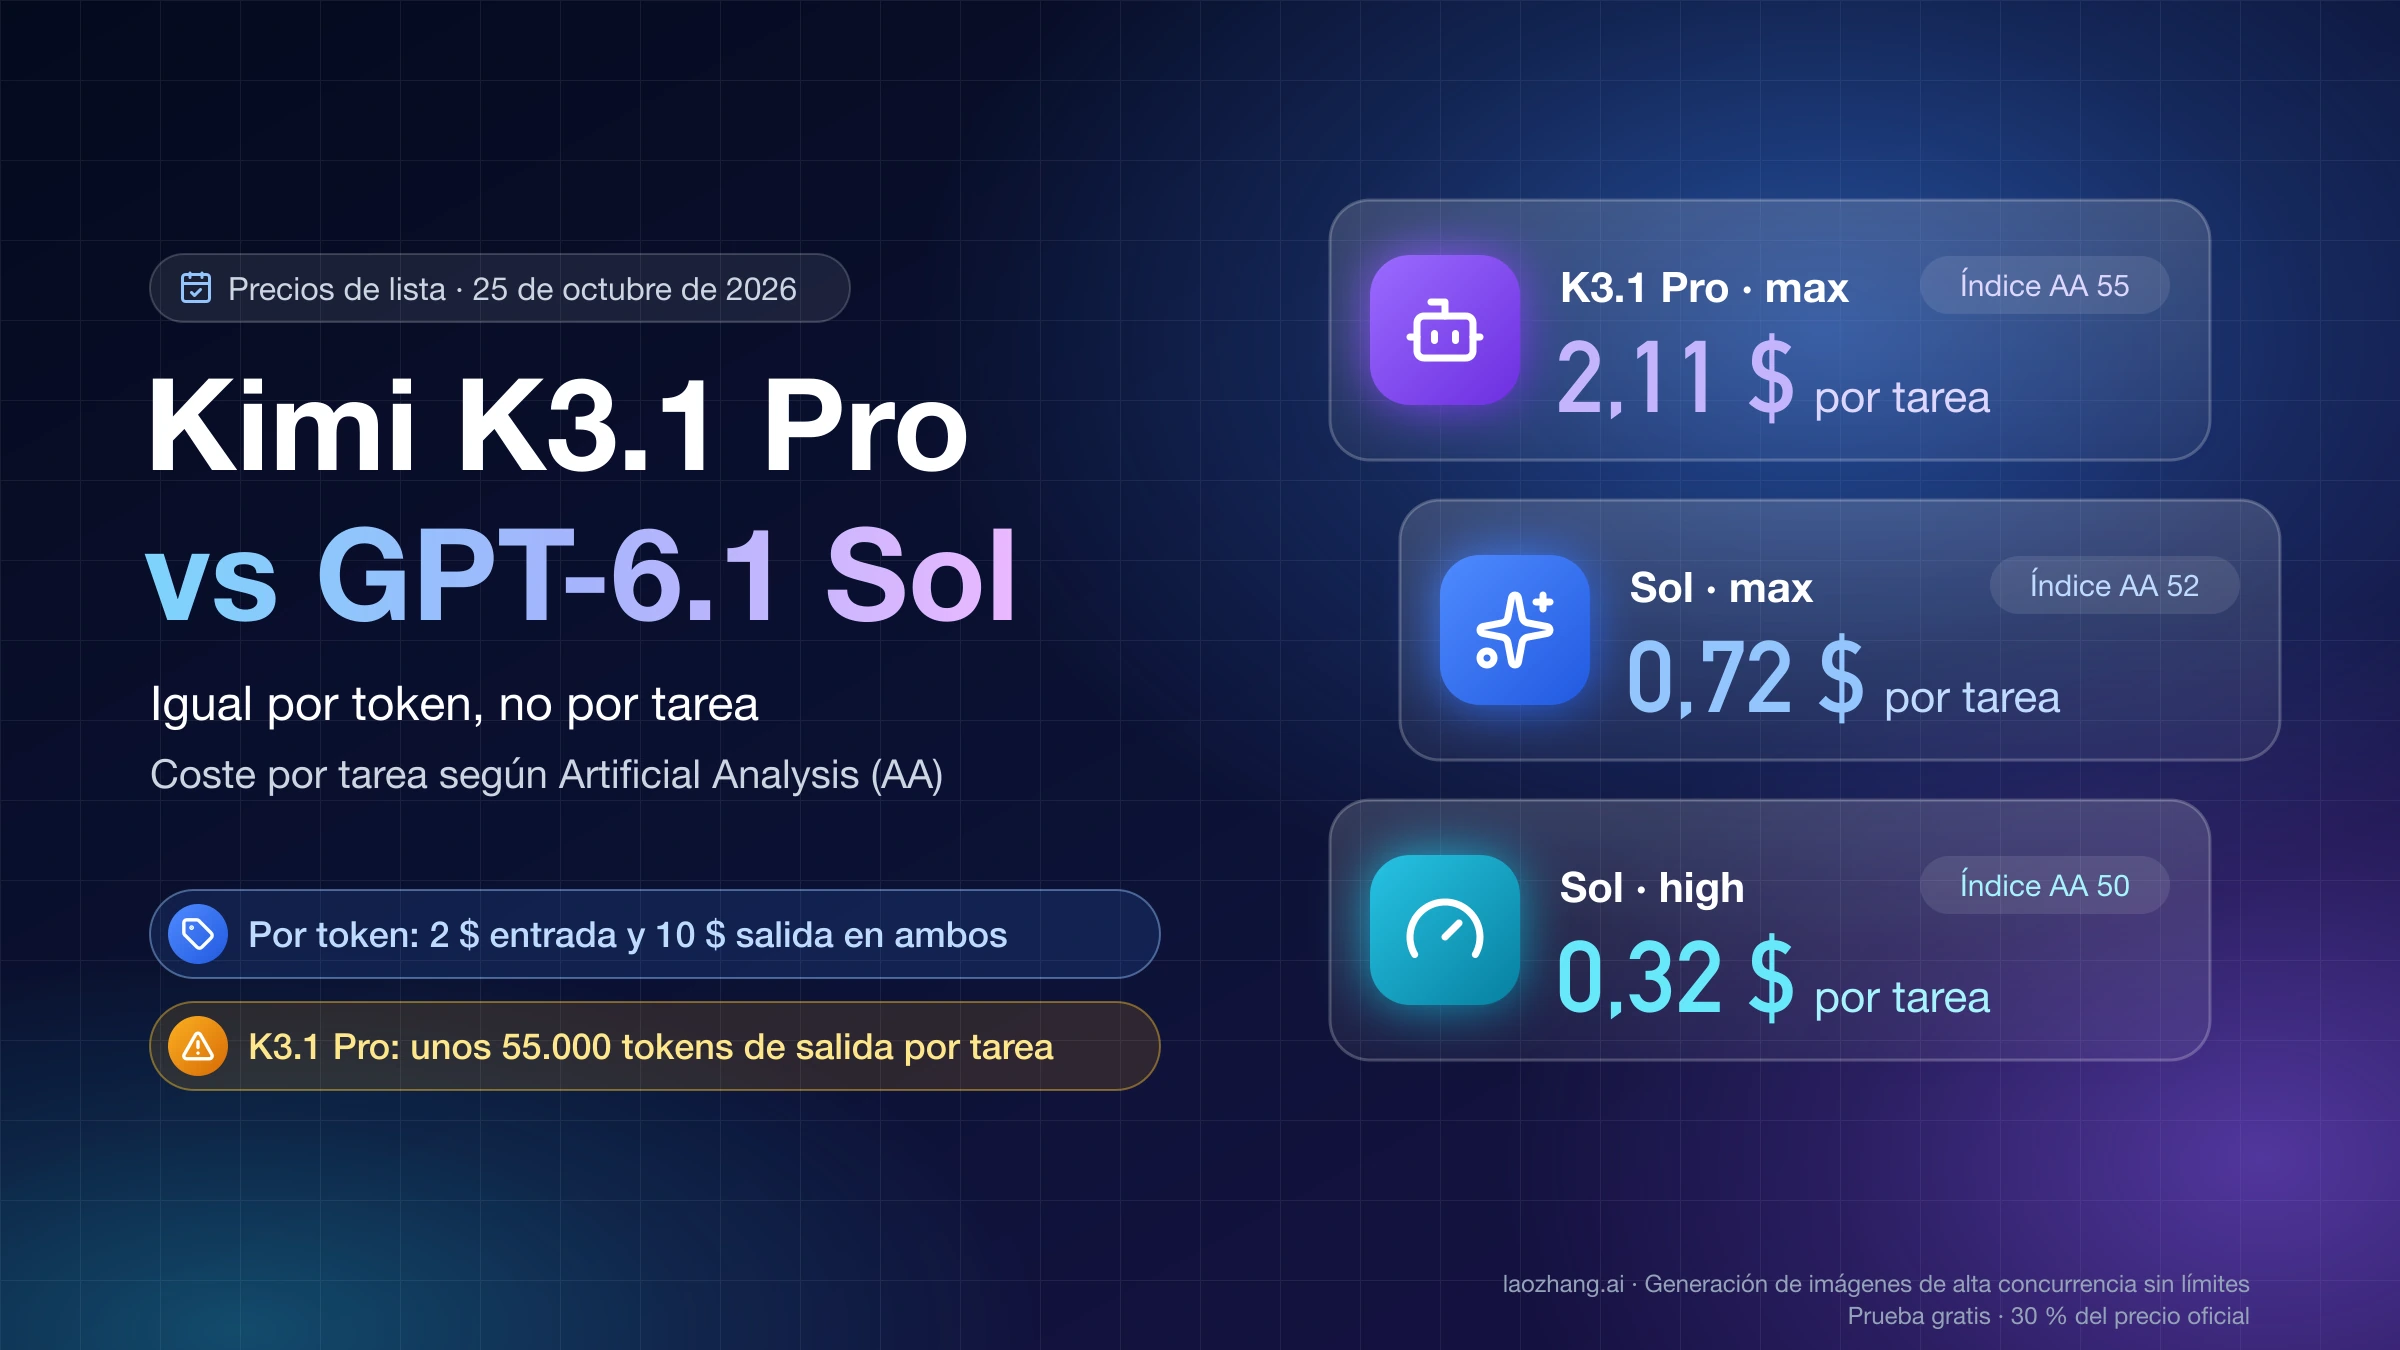
A 25 de octubre de 2026, Kimi K3.1 Pro (kimi-k3.1-pro) cobra exactamente la mitad que Claude Opus 5.5 por token de entrada y de salida: 2 $ y 10 $ por millón, frente a 4 $ y 20 $. La lectura de caché, en cambio, cuesta lo mismo en los dos (0,20 $ por millón), y K3.1 Pro genera mucho más razonamiento en cada tarea, así que esa mitad no llega entera a la factura. En las mediciones de Artificial Analysis (AA), una tarea de su índice cuesta 2,11 $ con K3.1 Pro, 1,34 $ con Opus en medium, que es su nivel por defecto en la API, y 5,98 $ con Opus en max.
Por eso, antes de decidir si Kimi es mejor que Claude para tu trabajo, iguala el nivel de esfuerzo: la API de Kimi funciona por defecto en max y la de Opus en medium. Si hoy usas Opus en xhigh o max para agentes de programación largos, prueba kimi-k3.1-pro en max con tus propias tareas, porque según AA queda a uno o tres puntos de Opus en su índice y cuesta entre un 39 % y un 65 % menos por tarea. Si usas Opus en medium o high, el cambio no ahorra y además es más lento; quédate en Opus o prueba Kimi en low solo para tareas sencillas y bien especificadas.
Las cifras de calidad que siguen proceden de Moonshot, de Anthropic y de terceros (AA, tbench.ai y atomicagent); los costes son un recálculo con las tarifas oficiales hecho el 25 de octubre de 2026. Ninguna cifra de calidad sale de una ejecución propia del mismo prompt en los dos modelos; la única comparación directa citada es la de atomicagent. Ten en cuenta también que, hasta que Moonshot publique los pesos, prometidos como tarde para el 4 de noviembre, K3.1 Pro solo lo sirve Moonshot.
Precio por token: la mitad en entrada y salida, lo mismo en caché
La relación de «la mitad» es exacta en entrada y salida, pero no en todas las partidas de la factura. Estas son las tarifas estándar por millón de tokens, en dólares y sin impuestos, según la guía de inicio de Kimi K3.1 Pro y la tabla de precios de la API de Claude:
| Por millón de tokens | Kimi K3.1 Pro | K3.1 Pro Highspeed | Claude Opus 5.5 |
|---|---|---|---|
| Entrada | 2,00 $ | 4,00 $ | 4,00 $ |
| Salida (incluido el razonamiento) | 10,00 $ | 20,00 $ | 20,00 $ |
| Lectura de caché | 0,20 $ | 0,20 $ | 0,20 $ |
| Escritura de caché de 5 minutos | 2,00 $ | 4,00 $ | 5,00 $ |
| Escritura de caché de 1 hora | 4,00 $ | 8,00 $ | 8,00 $ |
En una sesión de agente, el agente vuelve a enviar el mismo prefijo en cada turno, y esa lectura de caché cuesta igual en los dos modelos, así que diluye la diferencia; aun así, la salida sigue siendo la partida mayor. En la sesión de agente del recálculo de más abajo, la salida suma 1,20 $ de 2,108 $ en Kimi y 2,40 $ de 3,808 $ en Opus, frente a 0,468 $ de lectura de caché en los dos. En la escritura de caché de 5 minutos Opus cuesta 2,5 veces más, y en la de 1 hora, el doble. La variante Highspeed de Kimi, que según Moonshot es entre 2 y 3 veces más rápida, cuesta lo mismo que Opus en entrada y salida, así que pagar por velocidad elimina la ventaja de precio. En el lado de Anthropic, la API Batch cobra 2 $ y 10 $, el mismo precio que K3.1 Pro estándar, si tu trabajo puede esperar; los endpoints regionales de Bedrock, Vertex y Azure que lista OpenRouter cuestan 1,1 veces más (4,40 $ y 22 $). Ninguno de los dos modelos tiene recargo por contexto largo dentro de su millón de tokens. El detalle de tarifas y límites de Opus está en Claude Opus 5.5: precio de la API y restablecimiento de límites.
Mismos tokens, distinta proporción: de 2,00 a 1,05 veces
El 25 de octubre de 2026 se recalcularon cuatro cargas de trabajo con las tarifas de la tabla anterior, suponiendo que ambos modelos consumen exactamente los mismos tokens. Las cantidades de tokens son ejemplos, no tráfico medido, y sirven para ver cuánto se diluye la proporción a medida que crece la caché.
| Carga de trabajo (mismos tokens en ambos) | Kimi K3.1 Pro | Opus 5.5 | Opus / Kimi |
|---|---|---|---|
| Petición en frío: 8.000 de entrada + 2.000 de salida | 0,036 $ | 0,072 $ | 2,00 |
| Sesión de agente: prefijo de 60.000 en caché, 40 turnos de 4.000 de entrada nueva + 3.000 de salida | 2,108 $ | 3,808 $ | 1,81 |
| Documento de 400.000 tokens, 10 preguntas dentro de la caché de 5 minutos | 1,676 $ | 3,032 $ | 1,81 |
| 1 millón de tokens leídos de caché + 1.000 de salida | 0,210 $ | 0,220 $ | 1,05 |
Puedes rehacer la primera fila a mano: en Kimi, 8.000 × 2 $ / 1.000.000 + 2.000 × 10 $ / 1.000.000 = 0,016 $ + 0,020 $ = 0,036 $; en Opus, con 4 $ y 20 $, sale 0,072 $. En la última, la lectura de caché cuesta 0,200 $ en ambos y solo los 1.000 tokens de salida marcan la diferencia. El cálculo trata el razonamiento como salida, que es como lo facturan OpenRouter y AA (Kimi no lo detalla en su página de precios) y deja fuera reglas finas de cada caché.
Coste por tarea en cada nivel de esfuerzo de Opus 5.5
Con tareas reales, lo que decide la factura es cuántos tokens de salida genera cada modelo, y K3.1 Pro genera muchos. AA lo describe como «muy verboso»: en su índice produce 55.000 tokens de salida por tarea, más que Opus en high y menos que en xhigh. El nivel de esfuerzo es el parámetro effort en la API de Claude y reasoning_effort en la de Kimi; ninguno de los dos modelos permite apagar el razonamiento, así que no hay forma de cobrar solo la respuesta.
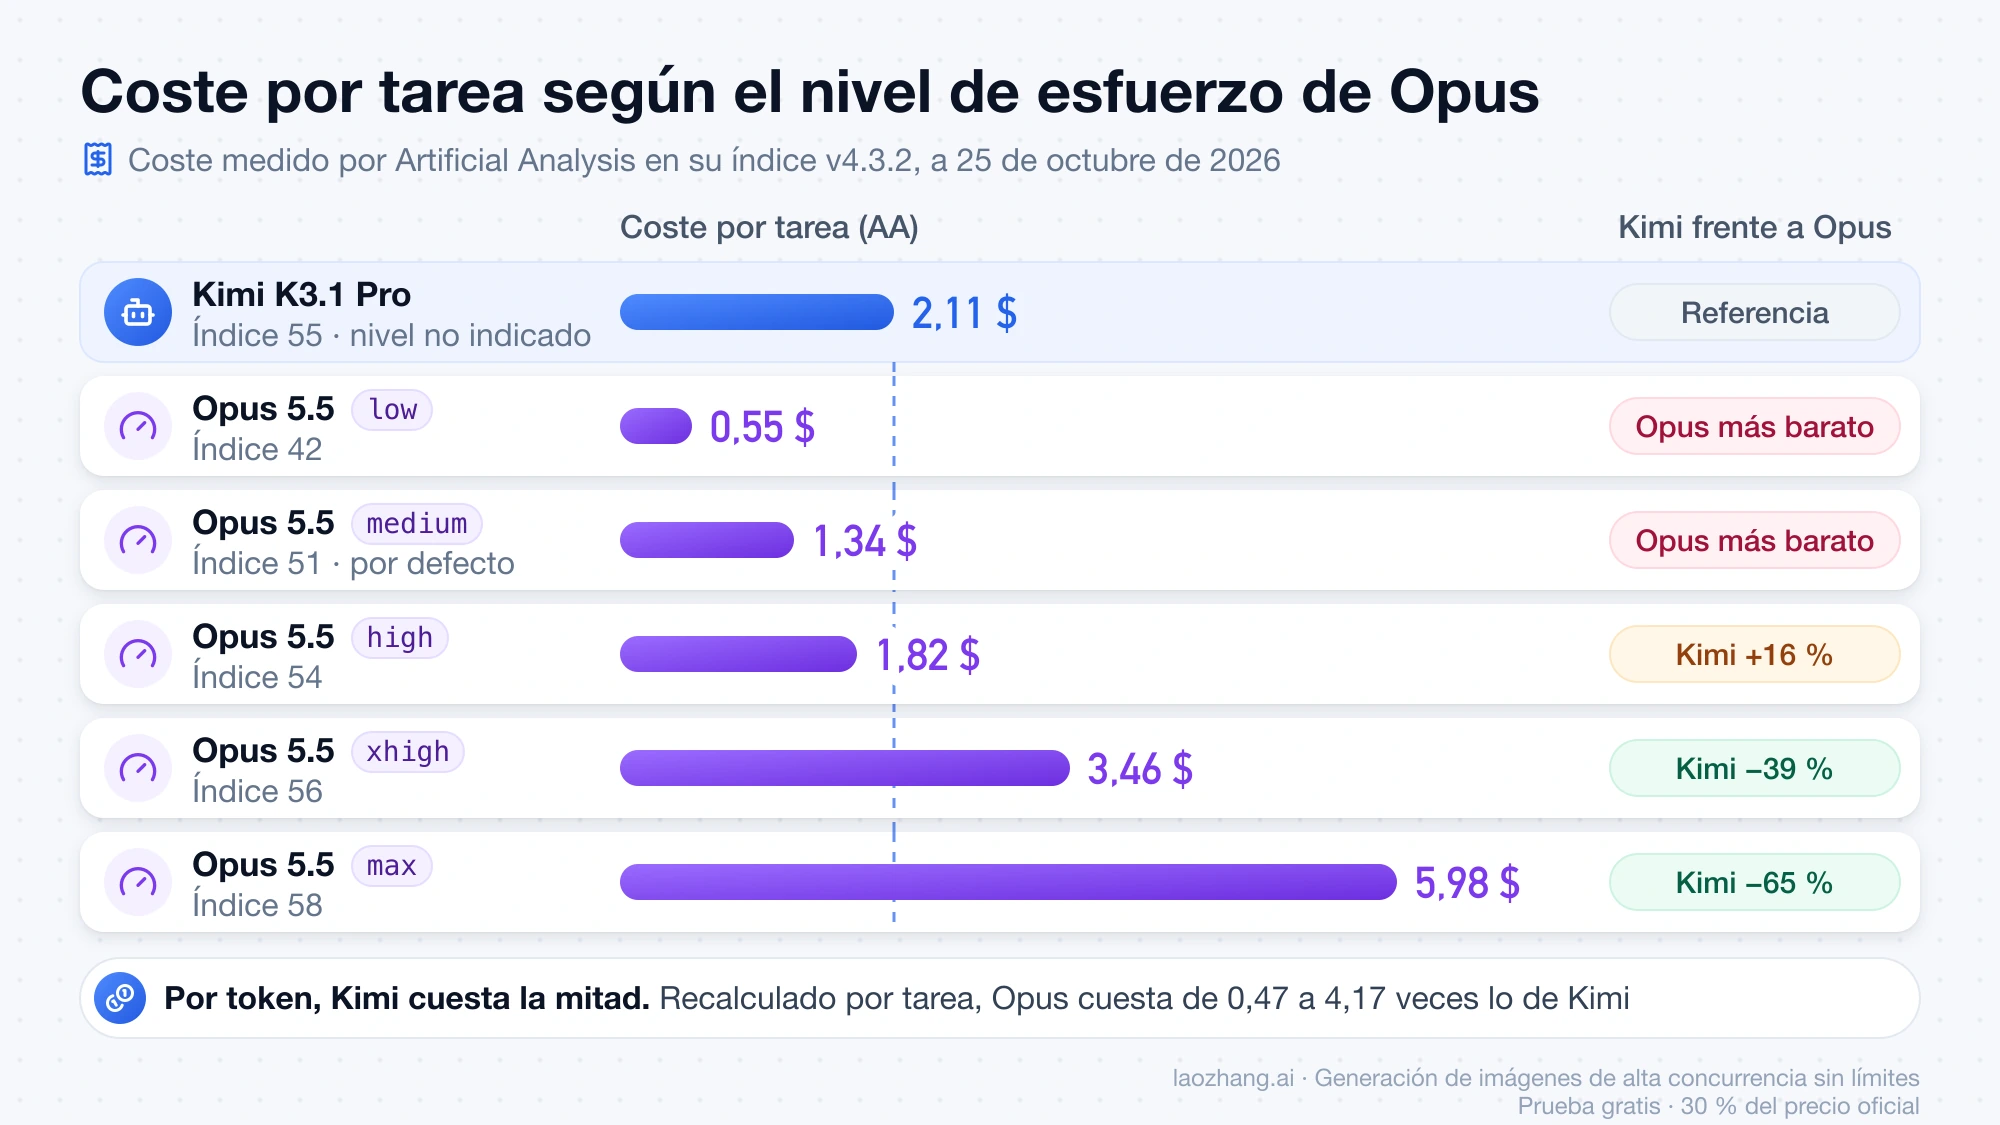
La tabla junta dos cosas: lo que AA midió por tarea en su Intelligence Index v4.3.2 a 25 de octubre de 2026 y el recálculo de ese mismo día con una petición de 20.000 tokens de entrada nueva más la longitud de salida medida por AA. La fila de K3.1 Pro es la ejecución que publica AA, sin nivel indicado; el valor por defecto de la API de Kimi es max.
| Modelo y nivel | Índice AA | Salida por tarea (AA) | Coste por tarea (AA) | Tiempo por tarea (AA) | Recálculo, Opus / Kimi |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | 55 | 55.000 | 2,11 $ | 618 s | 0,59 $ (base) |
Opus 5.5 low | 42 | 10.000 | 0,55 $ | 80 s | 0,47 |
Opus 5.5 medium (por defecto) | 51 | 26.000 | 1,34 $ | 195 s | 1,02 |
Opus 5.5 high | 54 | 36.000 | 1,82 $ | 272 s | 1,36 |
Opus 5.5 xhigh | 56 | 66.000 | 3,46 $ | 493 s | 2,37 |
Opus 5.5 max | 58 | 119.000 | 5,98 $ | 796 s | 4,17 |
El recálculo explica el patrón: con la longitud de salida de AA, K3.1 Pro cuesta 0,04 $ de entrada más 0,55 $ de salida, y Opus en medium 0,08 $ más 0,52 $, prácticamente lo mismo. En los costes medidos por AA, Opus en high cuesta 0,86 veces lo de K3.1 Pro, con un punto menos en el índice y en 0,44 veces el tiempo; en max cuesta 2,83 veces más. Las fuentes de la tabla son la comparativa de Artificial Analysis entre Kimi K3.1 Pro y Claude Opus 5.5 y sus variantes por nivel. Un punto del índice no es un porcentaje de tareas resueltas, y el coste de una tarea de AA no es tu factura: sirve para ver la tendencia, no para presupuestar.
La única prueba de terceros con el mismo encargo en el mismo agente apunta en la misma dirección. En la prueba de Kimi K3.1 Pro de atomicagent, un paquete de Python con cinco errores plantados, dos funciones pendientes y pruebas ocultas, con tres ejecuciones por configuración, todos superaron todas las pruebas. K3.1 Pro en max, su valor por defecto, costó entre 0,35 $ y 0,46 $ por tarea frente a 0,37 $ de Opus 5.5, con 28 llamadas al modelo por ejecución frente a 7 y unos 12.000 tokens de razonamiento frente a 700. Con reasoning_effort: "low" bajó a 0,16–0,21 $, la mitad de Opus, pero tardó unos 2,2 minutos frente a 69 segundos. Sus autores lo resumen así: el precio por token más bajo solo se convierte en una tarea más barata si bajas el razonamiento. Es una sola tarea pequeña, el día del lanzamiento, y no indica con qué nivel corrió Opus.
Qué nivel de esfuerzo probar primero en cada modelo
Compara niveles equivalentes, no nombres iguales. Kimi ofrece tres (low, high y max) y Opus cinco (low, medium, high, xhigh y max), y max no significa lo mismo en los dos: el max de Kimi es su configuración por defecto, mientras que el de Opus es el extremo más caro de su escala, según la documentación de effort de Claude. Si cambias de modelo sin tocar nada, comparas Kimi en max con Opus en medium.
Si trabajas con Opus en low o medium, Opus ya es más barato y bastante más rápido por tarea que K3.1 Pro en su configuración por defecto. Cambiar te da algunos puntos de índice a cambio de más coste y de unas tres veces más espera que medium (casi ocho veces más que low), así que solo tiene sentido probar K3.1 Pro en low o high con tareas sencillas, como hizo atomicagent.
Si usas Opus en high, estás casi en empate: K3.1 Pro saca un punto más en el índice de AA, cuesta un 16 % más por tarea y tarda más del doble. Aquí la decisión depende del tipo de tarea, no del precio; mira la sección sobre programación más abajo.
Si usas Opus en xhigh o max, es donde K3.1 Pro en max ahorra de verdad, un 39 % por tarea frente a xhigh y un 65 % frente a max, con uno y tres puntos menos en el índice. Frente a max, además, termina antes (618 frente a 796 segundos). No bajes Kimi de nivel para ahorrar más sin medirlo: en el propio gráfico de costes de Kimi sobre Terminal-Bench 4.0, K3.1 Pro en high cae a cerca del 53 %, frente al 65,7 % en max, y la tarea solo baja de unos 5,2 $ a unos 4,2 $.
En Opus puedes cambiar el nivel a mitad de conversación con un output_config por mensaje sin perder la caché del prompt, lo que permite subir solo los turnos difíciles. Kimi recomienda max también cuando se usa dentro de Claude Code.
¿A qué benchmark hacer caso? Terminal-Bench 4.0 tiene tres cifras
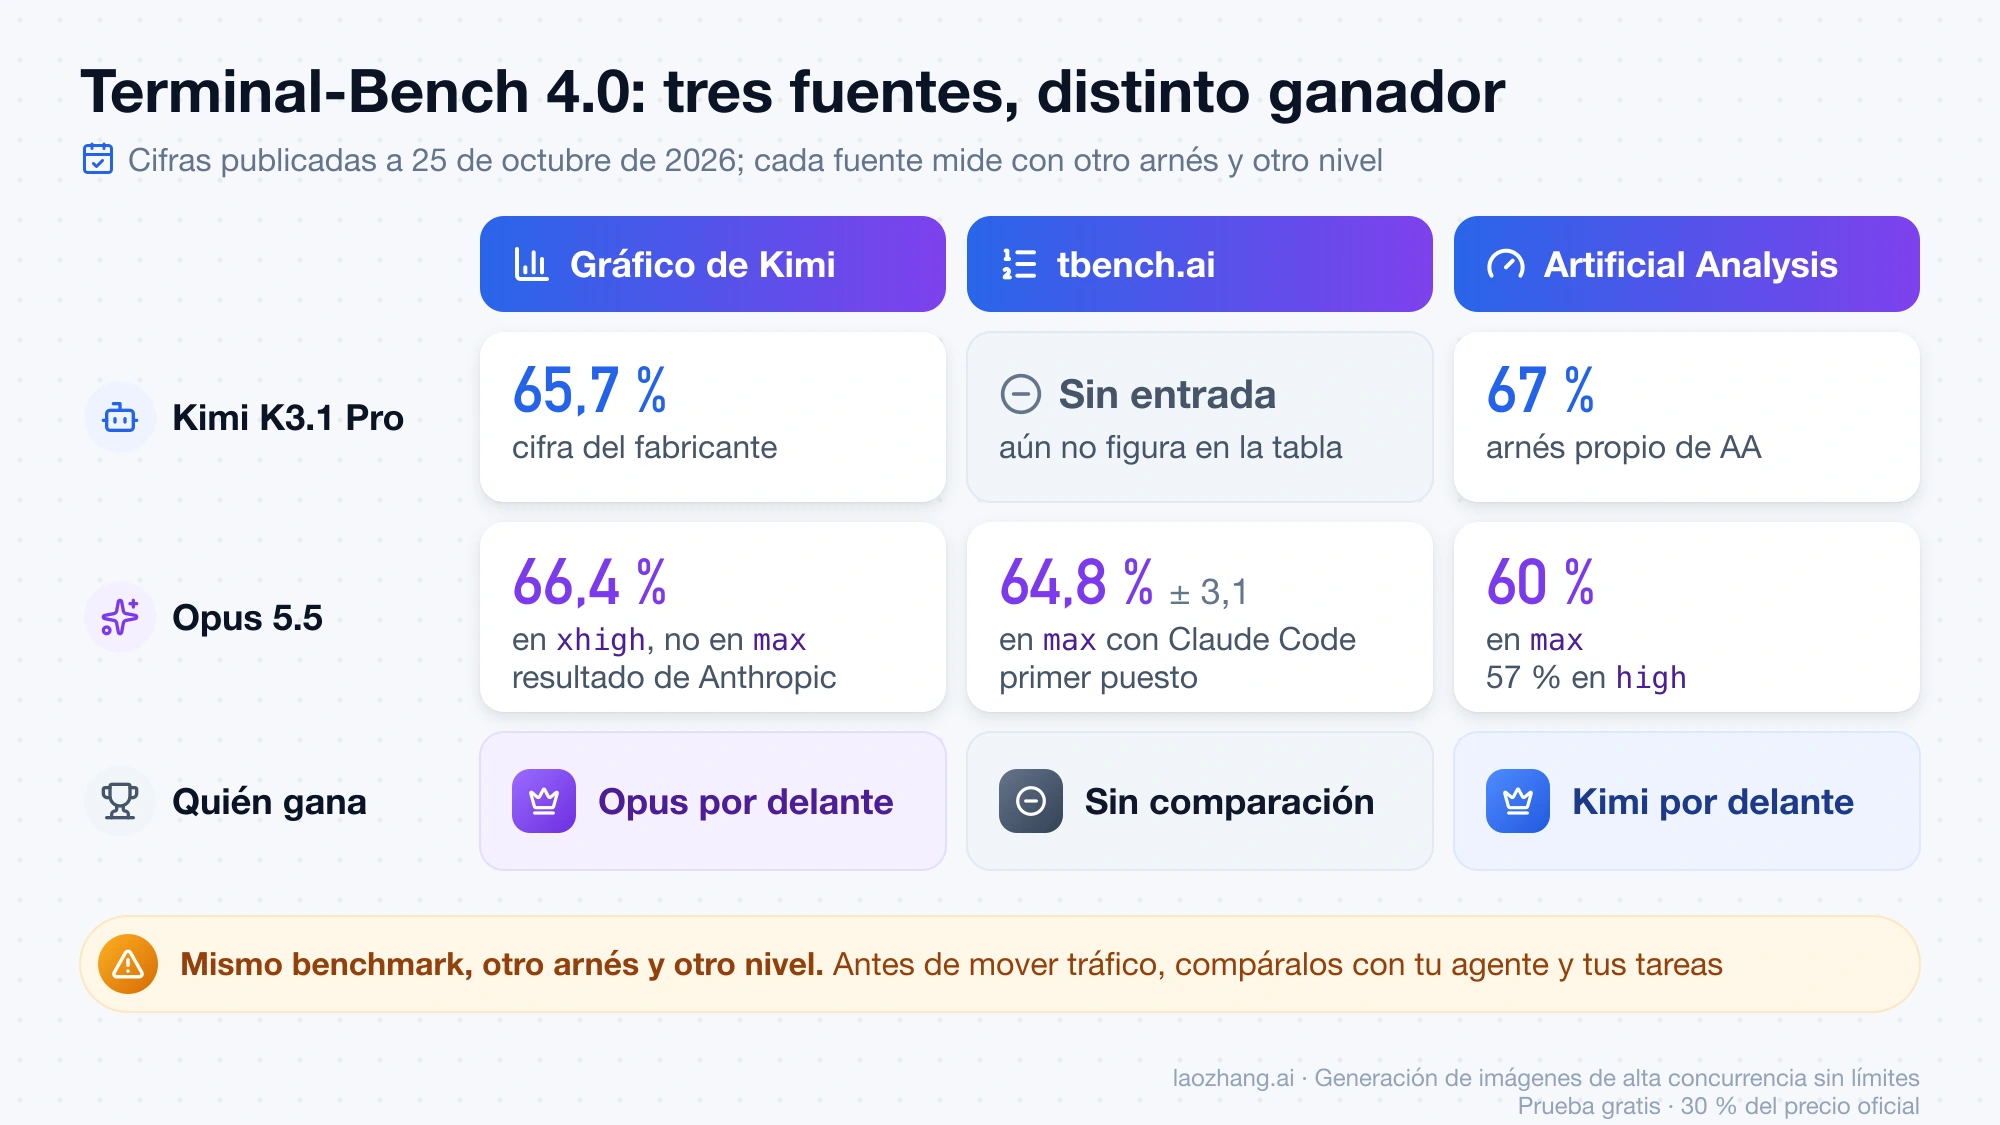
Ninguna de las tres cifras que circulan para Terminal-Bench 4.0 es falsa; miden con distinto arnés y distinto nivel, y por eso cambia el ganador. La que dice «65,7 frente a 66,4» viene del gráfico de lanzamiento de Kimi; «67 frente a 60» es de AA, y «64,8» es la tabla pública de tbench.ai, donde K3.1 Pro todavía no aparece.
| Fuente, a 25 de octubre de 2026 | Kimi K3.1 Pro | Opus 5.5 | Cómo se midió |
|---|---|---|---|
| Gráfico de lanzamiento de Kimi | 65,7 % | 66,4 % | El 66,4 % de Opus es el resultado propio de Anthropic en xhigh, no en max |
| Clasificación de Terminal-Bench 4.0 en tbench.ai | sin entrada | 64,8 % ± 3,1 | Opus en max con el arnés de Claude Code, primer puesto |
| Artificial Analysis | 67 % | 60 % en max, 57 % en high | Arnés propio de AA |
Fuera de Terminal-Bench, el gráfico de Kimi con 14 pruebas pone a K3.1 Pro por delante en 9 y a Opus en 5: Terminal-Bench 4.0, Terminal-Bench Science (38,1 frente a 63,3), GDPval-AA, BenchCAD y OSWorld. Moonshot indica que todos los modelos corrieron con el máximo esfuerzo, pero la columna de Opus mezcla configuraciones, como muestra el 66,4 %. Son cifras del fabricante, no independientes. El «un tercio del coste» que se repite en vídeos sale de otro gráfico de Kimi, el de puntuación frente a coste por tarea en Terminal-Bench 4.0, que sitúa a K3.1 Pro en max en unos 5,2 $ por tarea y a Opus 5.5 en unos 14,3 $, con datos de tbench.ai según su nota al pie.
En el índice de AA, Opus 5.5 en max saca 58 puntos y K3.1 Pro 55. Opus va por delante en HLE (61 % frente a 52 %), SciCode (67 % frente a 61 %), CritPt (32 % frente a 25 %), AA-Omniscience (46 frente a 30) y AA-Briefcase (1.801 frente a 1.678); K3.1 Pro gana en Terminal-Bench 4.0, AutomationBench-AA (73 % frente a 70 %) y GDP.pdf (31 % frente a 26 %). La propia Anthropic advierte en el lanzamiento de Opus 5.5 que los márgenes en benchmarks se han vuelto una guía menos fiable de las diferencias reales.
Las pruebas de usuarios apuntan en ambas direcciones y son muestras únicas. Una publicación en r/ClaudeAI cuenta que, en su tarea, Kimi costó 3,5 veces menos y terminó antes; otra en r/ClaudeCode dice que K3.1 Pro en high superó a Opus 5.5 en su banco interno, y en ese mismo subreddit hay quien acusa de promoción coordinada el día del lanzamiento.
¿Cuál es mejor para programar? Qué probar en K3.1 Pro y qué dejar en Opus
Para programar no hay un ganador general: K3.1 Pro compite donde el trabajo es largo, agéntico y tolera la espera, y Opus 5.5 sigue siendo la opción segura cuando importa la latencia, el conocimiento científico o tener varios proveedores. En cargas que hayas validado con tus propias pruebas, K3.1 Pro puede sustituir a Opus; sin esa validación, solo puedes comparar cifras ajenas.
Prueba primero en K3.1 Pro las tareas de terminal y los agentes de programación de larga duración que hoy ejecutas con Opus en xhigh o max, porque ahí coinciden su mejor resultado en AA (67 % en Terminal-Bench 4.0) y el mayor ahorro por tarea. También encajan los trabajos por lotes que no necesitan respuesta inmediata, aunque en ese caso compara con la API Batch de Opus, que cuesta lo mismo por token que K3.1 Pro estándar.
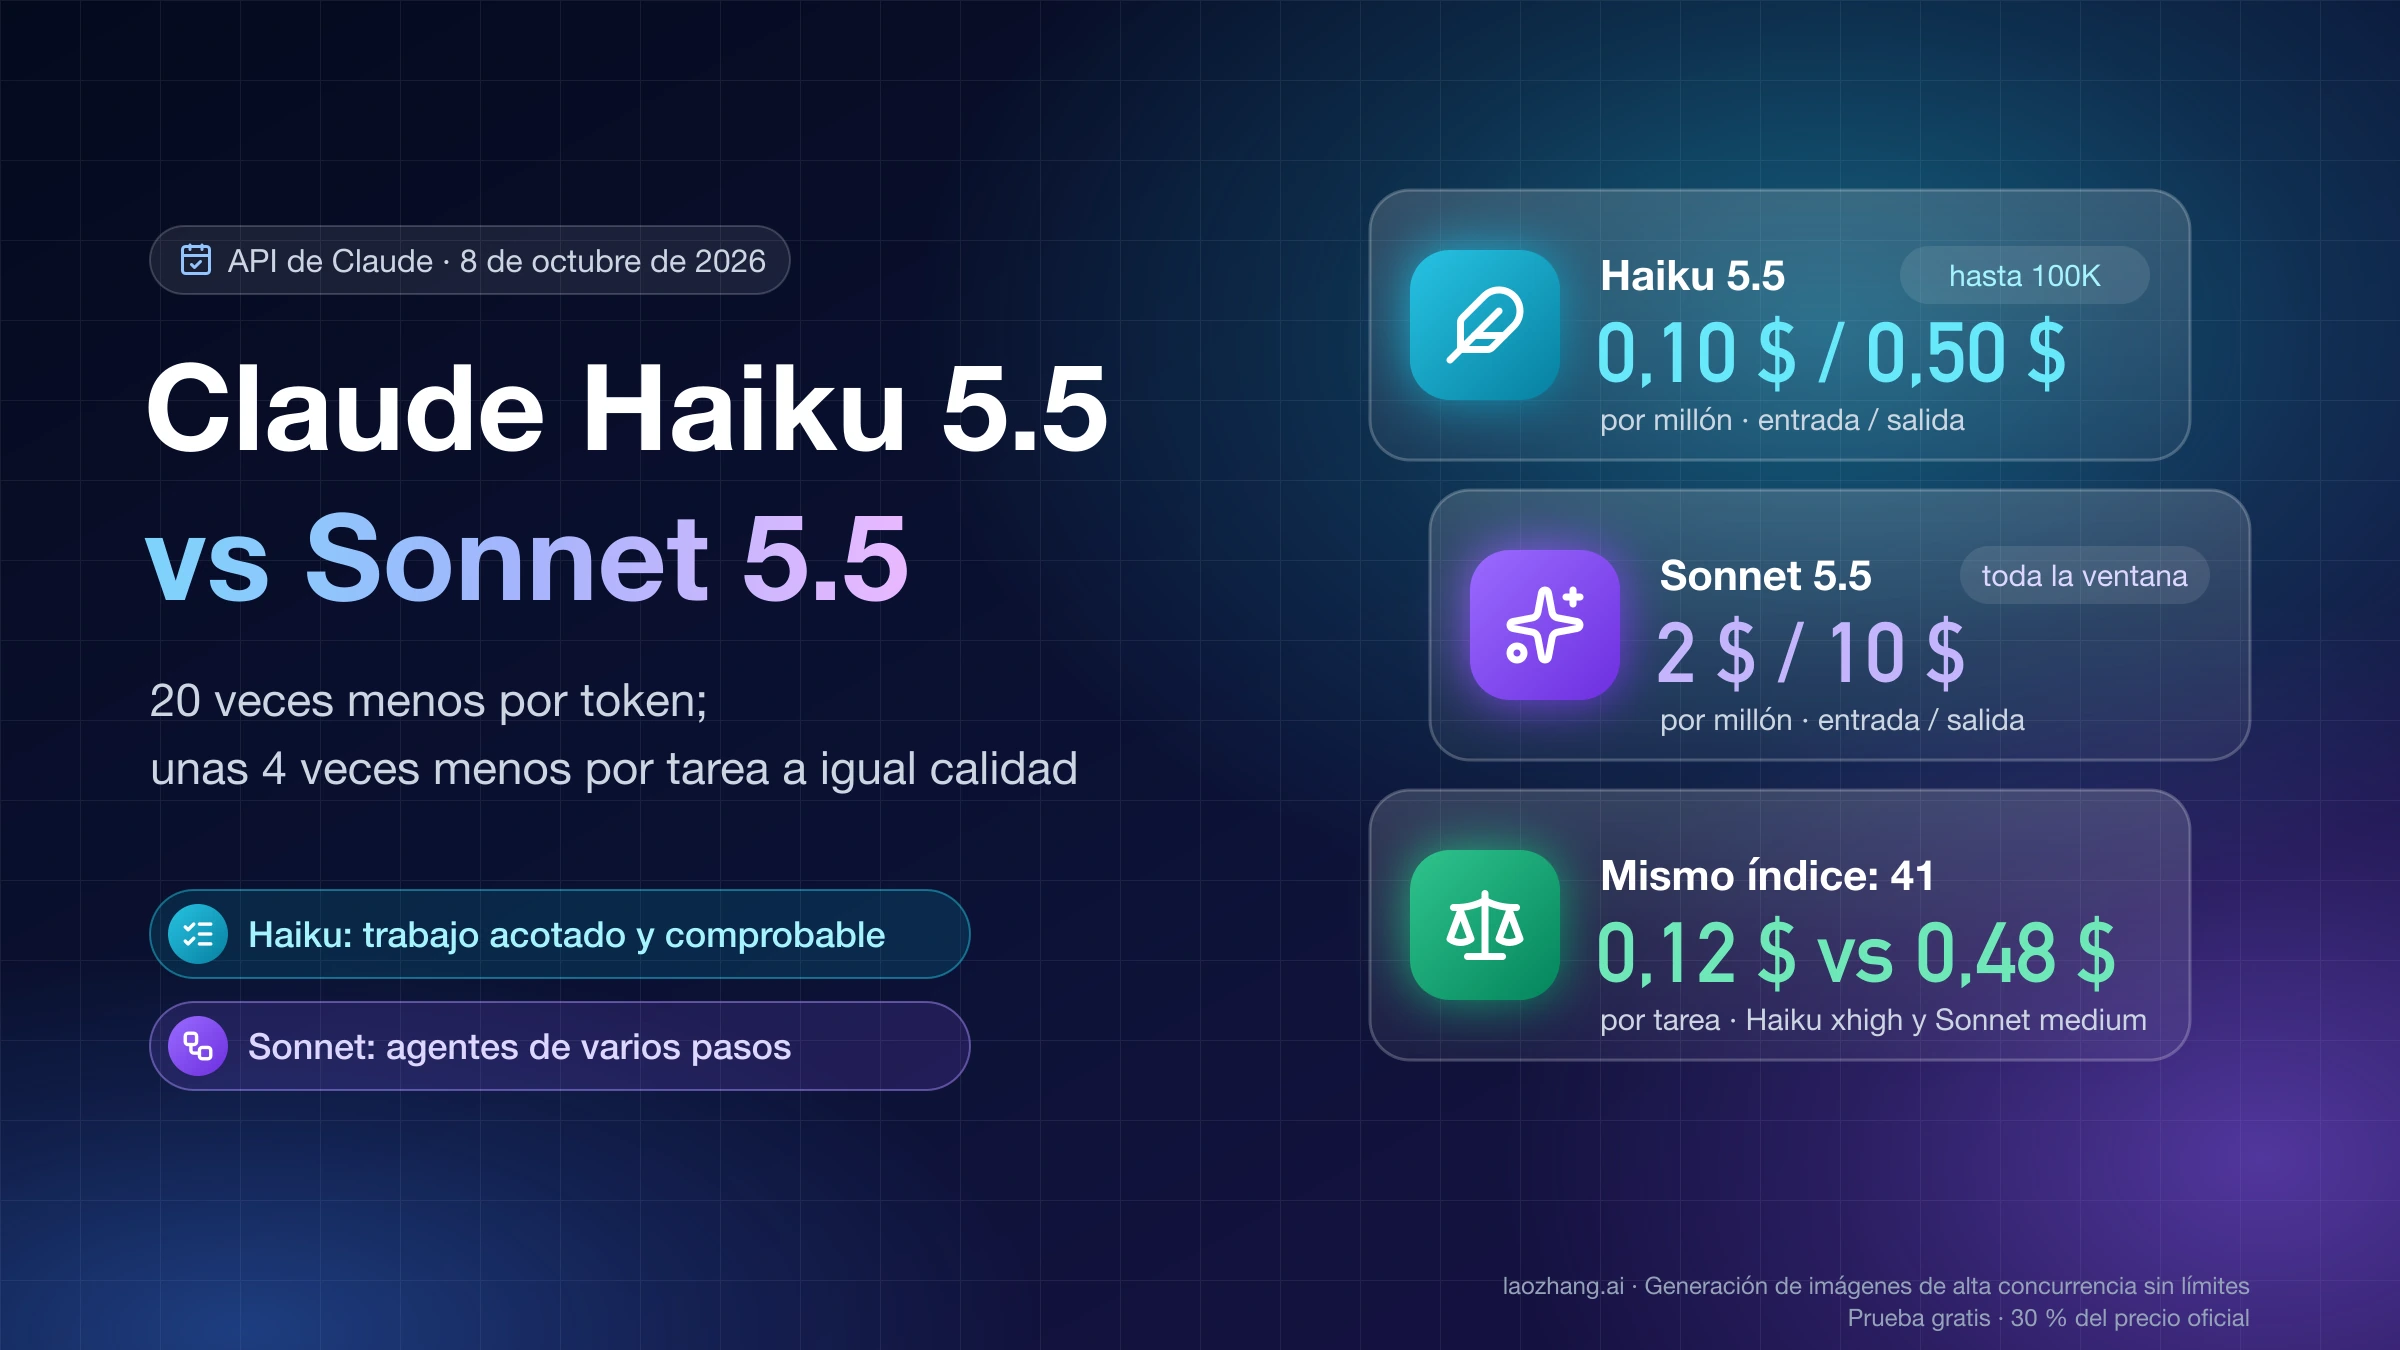
Deja en Opus el trabajo interactivo, en el que esperar dos o tres veces más por cada respuesta te cuesta más que la diferencia de tokens; las tareas que dependen de conocimiento científico o de recordar hechos, donde Opus saca ventaja en HLE, SciCode y AA-Omniscience; y cualquier despliegue que necesite Bedrock, Vertex o Azure, o un segundo proveedor por si el primero falla. Si lo que buscas es el precio por token de K3.1 Pro sin salir de Claude, Sonnet 5.5 cuesta lo mismo en entrada y salida; está comparado en Claude Sonnet 5.5 vs Opus 5.5: cuál gasta menos por tarea. Fuera de Anthropic, GPT-6.1 Sol también cobra 2 $ de entrada y 10 $ de salida por millón; por qué ese mismo precio no da el mismo coste por tarea frente a K3.1 Pro está en Kimi K3.1 Pro vs GPT-6.1 Sol: igual por token, no por tarea.
Qué se rompe al cambiar claude-opus-5-5 por kimi-k3.1-pro
Cambiar el nombre del modelo es lo de menos; lo que falla son los parámetros que uno de los dos no acepta o fija por su cuenta. Este es el contrato de la API de cada uno, según la guía de inicio de Kimi K3.1 Pro y la visión general de modelos de Claude, con el número de proveedores leído en el catálogo público de OpenRouter el 25 de octubre de 2026:
| Aspecto | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| ID y API | kimi-k3.1-pro y kimi-k3.1-pro-highspeed; https://api.moonshot.ai/v1, compatible con OpenAI, y https://api.moonshot.ai/anthropic | claude-opus-5-5 en la API de Claude, Vertex, Foundry y Claude Platform on AWS; anthropic.claude-opus-5-5 en Bedrock |
| Niveles de esfuerzo | reasoning_effort: low, high, max; por defecto max | effort: low, medium, high, xhigh, max; por defecto medium |
| Apagar el razonamiento | No se puede | No se puede; thinking: {"type": "disabled"} devuelve un error 400 |
| Parámetros que debes quitar | temperature (fija en 1,0), top_p (0,95), n (1) y las penalizaciones (0) están fijados; omítelos | El bloque thinking desactivado |
| Salida máxima | max_completion_tokens 131.072 por defecto, hasta 1.048.576 | 128.000 tokens; 300.000 en Message Batches con la cabecera beta output-300k-2026-03-24 |
| Contexto | 1 millón de tokens | 1 millón de tokens |
| Proveedores en OpenRouter | 2 endpoints, ambos de Moonshot AI | 11 endpoints: Anthropic, Amazon Bedrock, Google Vertex, Azure y Claude Platform on AWS |
Hay tres detalles de Kimi que suelen romper un agente heredado de Claude. En conversaciones de varios turnos y con herramientas debes devolver el mensaje completo del asistente sin modificarlo; las imágenes no se aceptan por URL pública, solo en base64 o con un identificador de archivo ms://; y Moonshot desaconseja su búsqueda web oficial en producción. La caché es automática, con 5 minutos por defecto y 1 hora si lo pides con prompt_cache_options.ttl. Para acceder a K3.1 Pro en la plataforma internacional hace falta una recarga mínima de 1 $, y lo que hayas recargado en total fija tus límites de uso.
La dependencia de un solo proveedor es temporal pero real. Hasta que salgan los pesos, prometidos como tarde para el 4 de noviembre de 2026, solo Moonshot sirve K3.1 Pro, y AA lo sigue marcando como modelo sin pesos abiertos; los 2 endpoints de OpenRouter son de Moonshot y no listan temperature ni top_p entre los parámetros admitidos. Opus 5.5, en cambio, tiene 11 endpoints repartidos entre Anthropic y tres nubes. En laozhang.ai, la lista de modelos de su API del 25 de octubre de 2026 incluye claude-opus-5-5, a precio de lista de Anthropic, y esa misma tarde añadió kimi-k3.1-pro y kimi-k3.1-pro-highspeed a los precios de lista de Kimi (2 $/10 $ y 4 $/20 $ por millón de tokens, lectura de caché 0,20 $); además limita cada respuesta de Claude a 32.768 tokens de salida, algo que se nota en xhigh y max.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Cómo usar Kimi K3.1 Pro dentro de Claude Code
Kimi documenta un endpoint compatible con Anthropic para usar su API dentro de Claude Code, así que puedes conservar el mismo arnés y cambiar solo el modelo. Los pasos siguientes resumen la guía de Kimi para usar su API en Claude Code y no se han ejecutado en una cuenta real. El ejemplo de esa guía todavía asigna el modelo anterior, kimi-k3[1m], aunque su comprobación con curl ya usa kimi-k3.1-pro.
- Crea una clave en la plataforma internacional de Kimi y recarga al menos 1 $ para desbloquear K3.1 Pro.
- Si antes configuraste otro proveedor, elimina las variables de endpoint, clave, modelo y esfuerzo (
ANTHROPIC_*,CLAUDE_CODE_SUBAGENT_MODEL,CLAUDE_CODE_EFFORT_LEVEL) que queden en el bloqueenvde~/.claude/settings.jsony en tu~/.zshrco~/.bashrc, porque el archivo de ajustes se impone a las variables del terminal. - Añade al bloque
envde~/.claude/settings.jsonlas variables siguientes. La guía advierte que los niveles que dejes sin definir fallan sin avisar, así que rellena todos; aquíkimi-k3.1-proocupa el lugar de todos los modelos del ejemplo, incluidokimi-k2.7-code, que la guía usa para el nivel Haiku.
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.moonshot.ai/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "TU_CLAVE_DE_MOONSHOT",
    "ANTHROPIC_MODEL": "kimi-k3.1-pro",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "kimi-k3.1-pro",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "kimi-k3.1-pro",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "kimi-k3.1-pro",
    "ANTHROPIC_DEFAULT_FABLE_MODEL": "kimi-k3.1-pro",
    "CLAUDE_CODE_SUBAGENT_MODEL": "kimi-k3.1-pro",
    "CLAUDE_CODE_EFFORT_LEVEL": "max"
  }
}- Comprueba la clave y el endpoint con la petición curl de la guía (modelo
kimi-k3.1-pro,max_tokens1). Una respuesta JSON normal confirma ambos; un 401 indica que la clave no es válida o no corresponde a esa plataforma. - Reinicia Claude Code y escribe
/status: la URL base debe serhttps://api.moonshot.ai/anthropicy el modelo, el que hayas puesto. Si aparece otro, revisa el paso 2.
El archivo guarda la clave en texto plano, así que no lo subas a git. Para volver a Opus basta con quitar esas variables y reiniciar.
Prueba justa con tus tareas antes de mover tráfico a K3.1 Pro
Una comparación justa usa tus tareas, el mismo arnés y niveles de esfuerzo elegidos a propósito, y mide el coste por tarea aceptada, no por token. El orden importa, porque cada paso elimina una diferencia que no tiene que ver con el modelo.
- Elige tareas que ya hayas resuelto y que tengan un criterio de aceptación comprobable, como pruebas que deben pasar o un resultado que puedes verificar. Así no dependes de tu impresión sobre una respuesta convincente.
- Fija en Opus el nivel que usas en producción y ejecuta K3.1 Pro al menos en
maxy en uno más bajo. Si solo pruebas los valores por defecto, comparasmaxconmedium. - Quita
temperature,top_py las penalizaciones de las peticiones a Kimi, y no envíesthinkingdesactivado a Opus. - Usa el mismo agente, las mismas herramientas y el mismo prompt en los dos. Cambiar de arnés cambia el resultado, como muestran las tres cifras de Terminal-Bench 4.0.
- Repite cada configuración varias veces; atomicagent hizo tres por configuración y aun así dio el coste de Kimi como rango.
- Anota por tarea el coste real que te cobran, el tiempo hasta el resultado, las llamadas al modelo, los reintentos y la proporción de entrada servida desde caché. Divide el coste total entre las tareas aceptadas.
- Mueve a K3.1 Pro solo las categorías de tareas en las que gane con ese cálculo y deja el resto en Opus.
Kimi K3.1 Pro y Claude Opus 5.5: otras preguntas
¿Y si comparo la suscripción Claude Max con un plan de Kimi en lugar de la API?
Es otra cuenta. Los planes se miden en cupos de sesión y no en precio por token. Un usuario de X informó de que la misma tarea de escena 3D consumió el 62 % de su sesión de 5 horas en el plan de Claude de 100 $ y el 0,53 % de la sesión de su plan Kimi Vivace; es un único informe y depende de cómo cada plan reparte su cupo.
¿Puedo usar Claude Opus 5.5 y Kimi K3.1 Pro desde España o Latinoamérica?
Según la política de regiones admitidas de Anthropic, España, México y Argentina figuran entre los países donde están disponibles la API, Claude Code y los modelos de Claude en nubes; los demás países conviene comprobarlos en esa lista. Kimi ofrece una plataforma internacional, platform.kimi.ai, que cobra en dólares, separada de su sitio para China.
¿Cuándo pueden cambiar estas cifras?
Hay tres fechas o hechos a vigilar. Cuando Moonshot publique los pesos, como tarde el 4 de noviembre de 2026, pueden aparecer otros proveedores con otros precios y velocidades; cuando K3.1 Pro entre en la clasificación de tbench.ai, habrá una cifra de Terminal-Bench 4.0 medida igual que la de Opus; y AA puede revisar sus mediciones en los primeros días de un modelo. Si tu decisión se apoya en una de esas cifras, vuelve a mirarla antes de mover tráfico.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
- 1.guía de inicio de Kimi K3.1 Proplatform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- 2.tabla de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 3.comparativa de Artificial Analysis entre Kimi K3.1 Pro y Claude Opus 5.5artificialanalysis.ai/models/comparisons/kimi-k3-1-pro-vs-claude-opus-5-5
- 4.prueba de Kimi K3.1 Pro de atomicagentatomicagent.io/blog/kimi-k3-1-pro
- 5.documentación de effort de Claudeplatform.claude.com/docs/en/build-with-claude/effort
- 6.Clasificación de Terminal-Bench 4.0 en tbench.aitbench.ai/leaderboard/terminal-bench/4.0
- 7.visión general de modelos de Claudeplatform.claude.com/docs/en/models/overview
- 8.guía de Kimi para usar su API en Claude Codeplatform.kimi.ai/docs/guide/claude-code-kimi
- 9.política de regiones admitidas de Anthropicanthropic.com/legal/supported-regions