Kimi K3.1 Pro vs GPT-6.1 Sol: igual por token, no por tarea
Ambos cobran 2 $ y 10 $ por millón de tokens, pero en Artificial Analysis K3.1 Pro gasta 2,11 $ por tarea y Sol en max, 0,72 $. Cuándo compensa cada uno.
En esta página
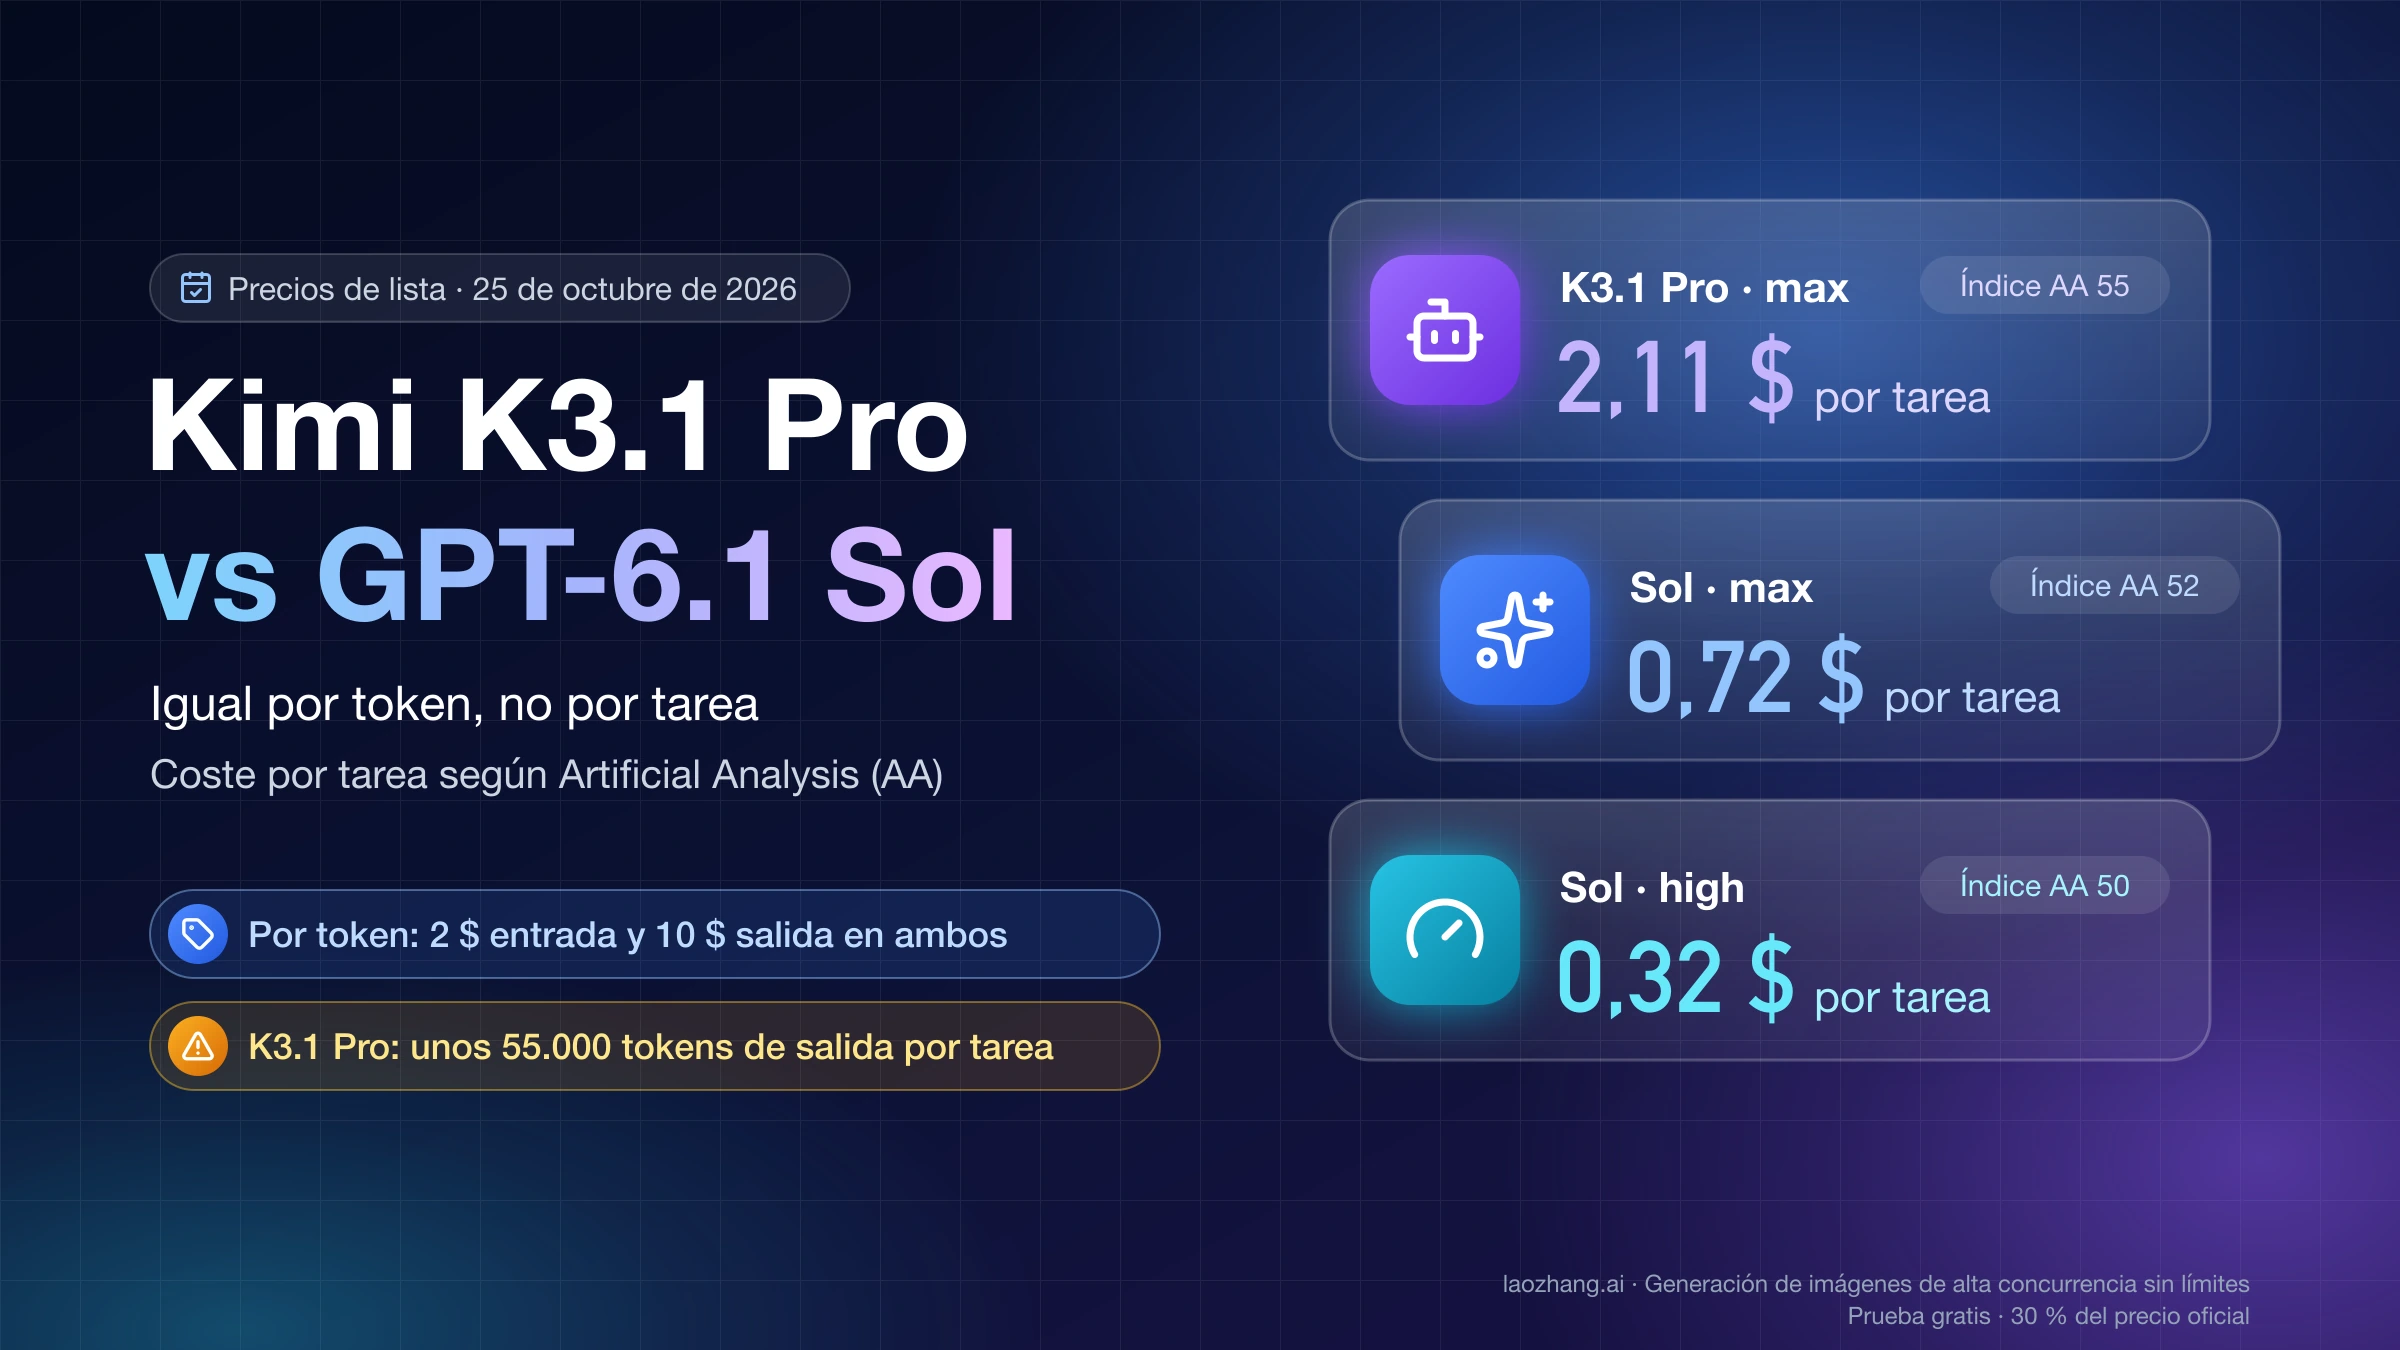
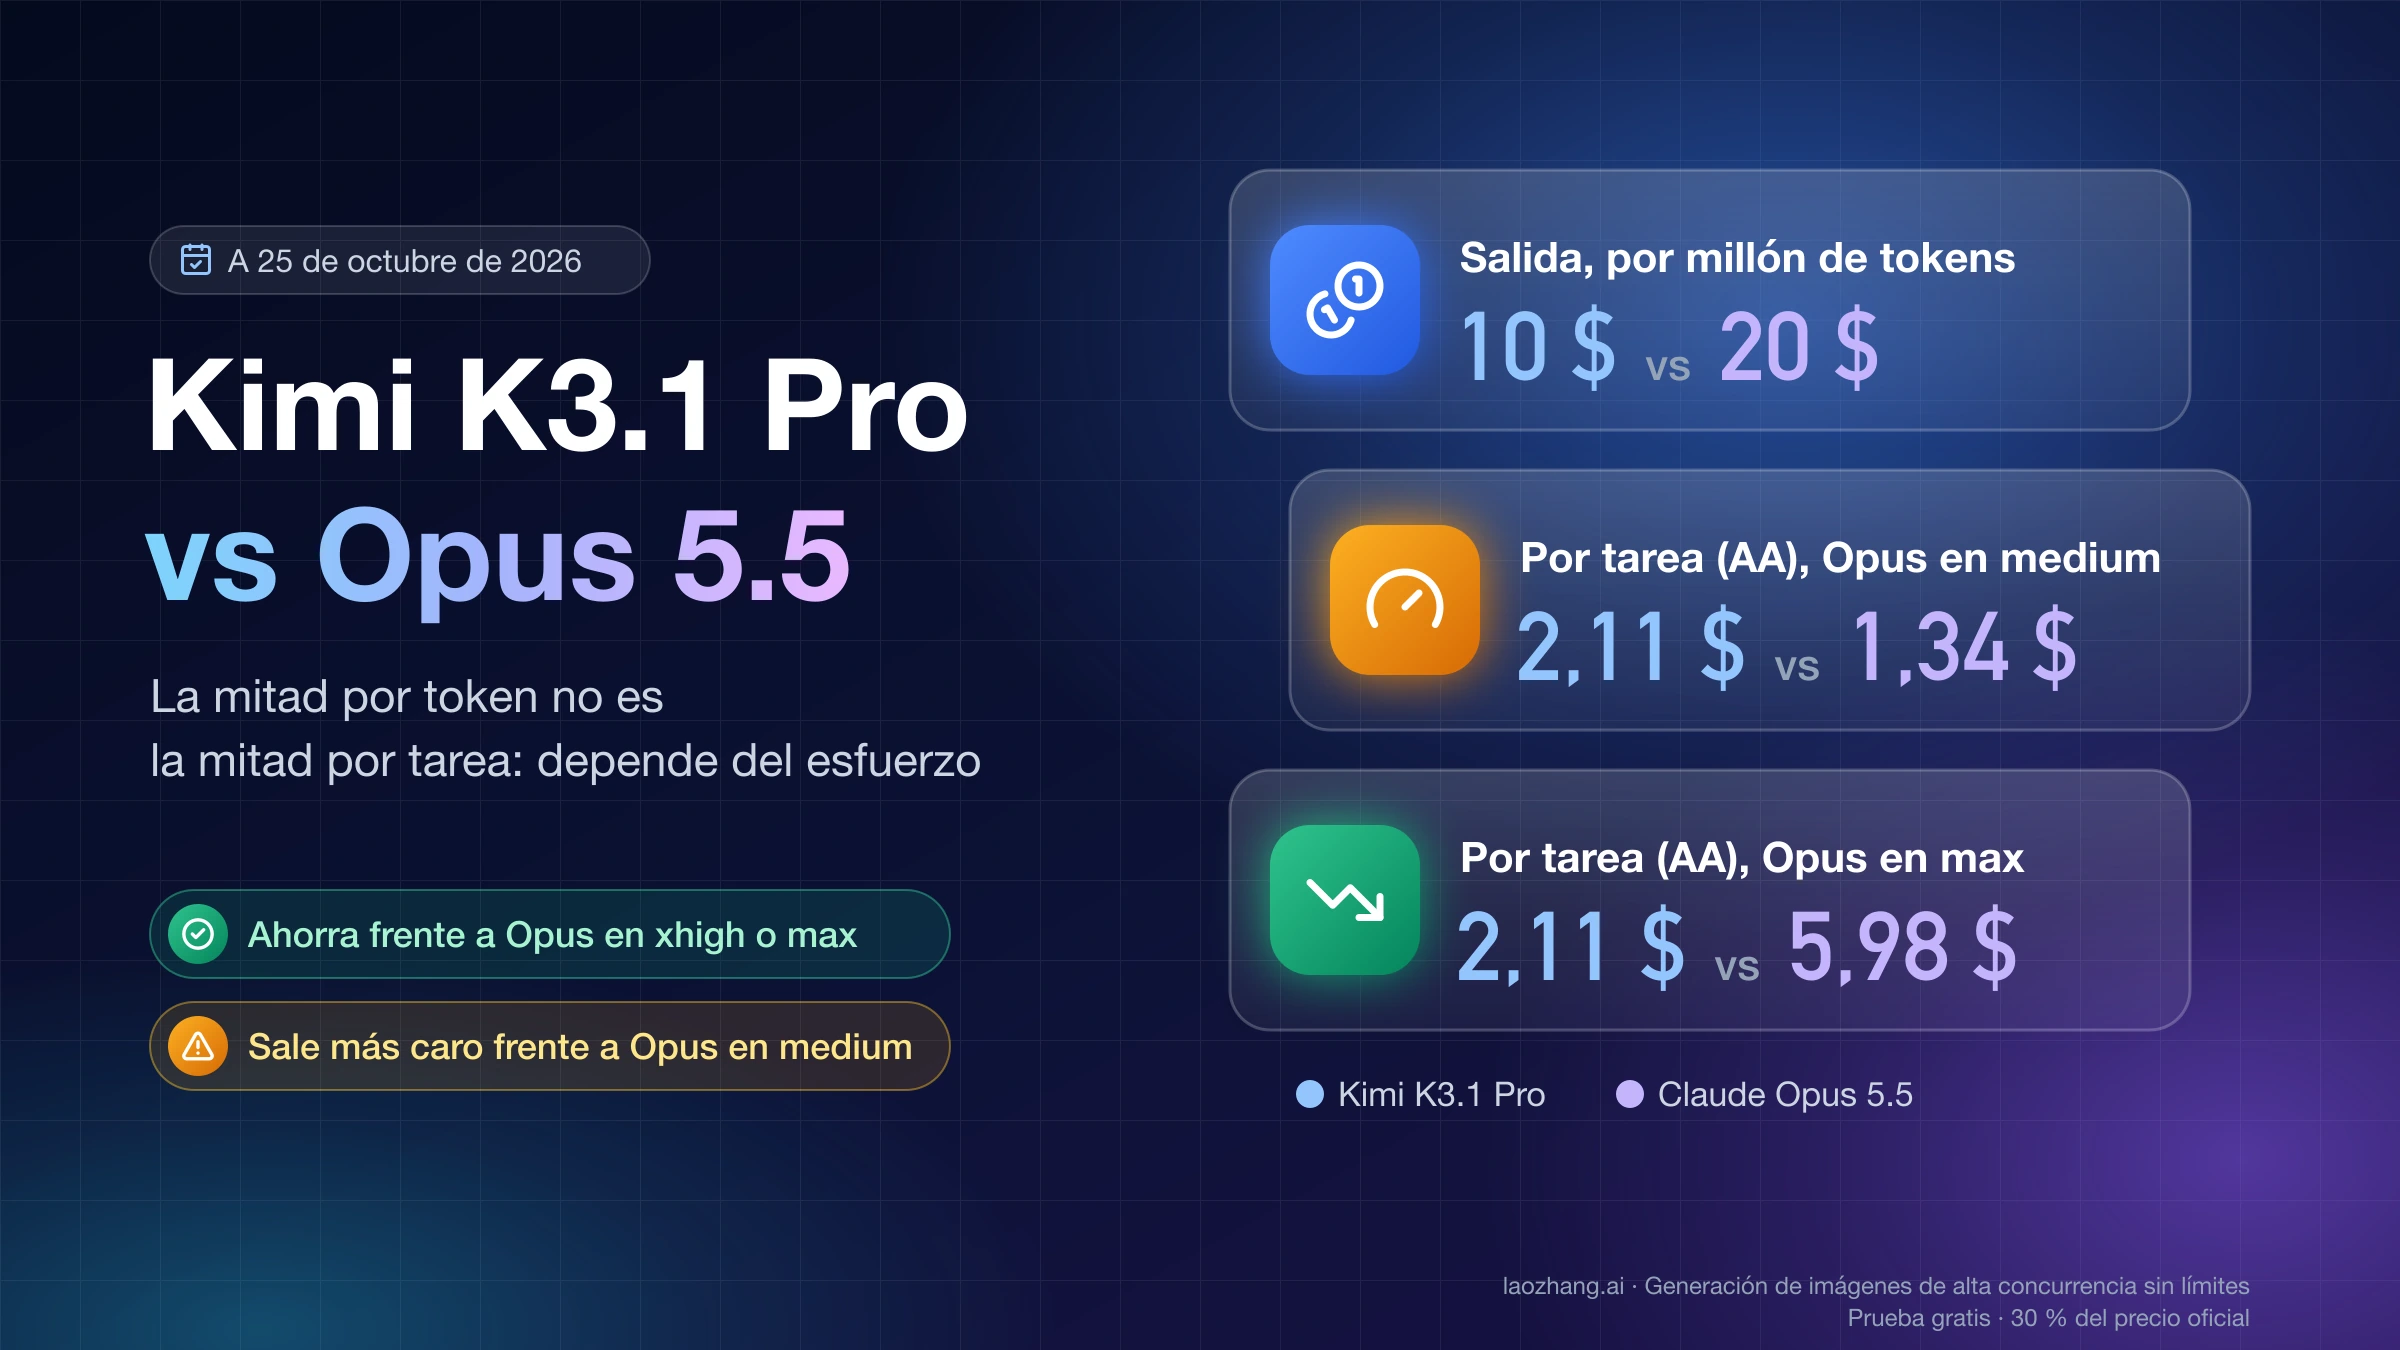
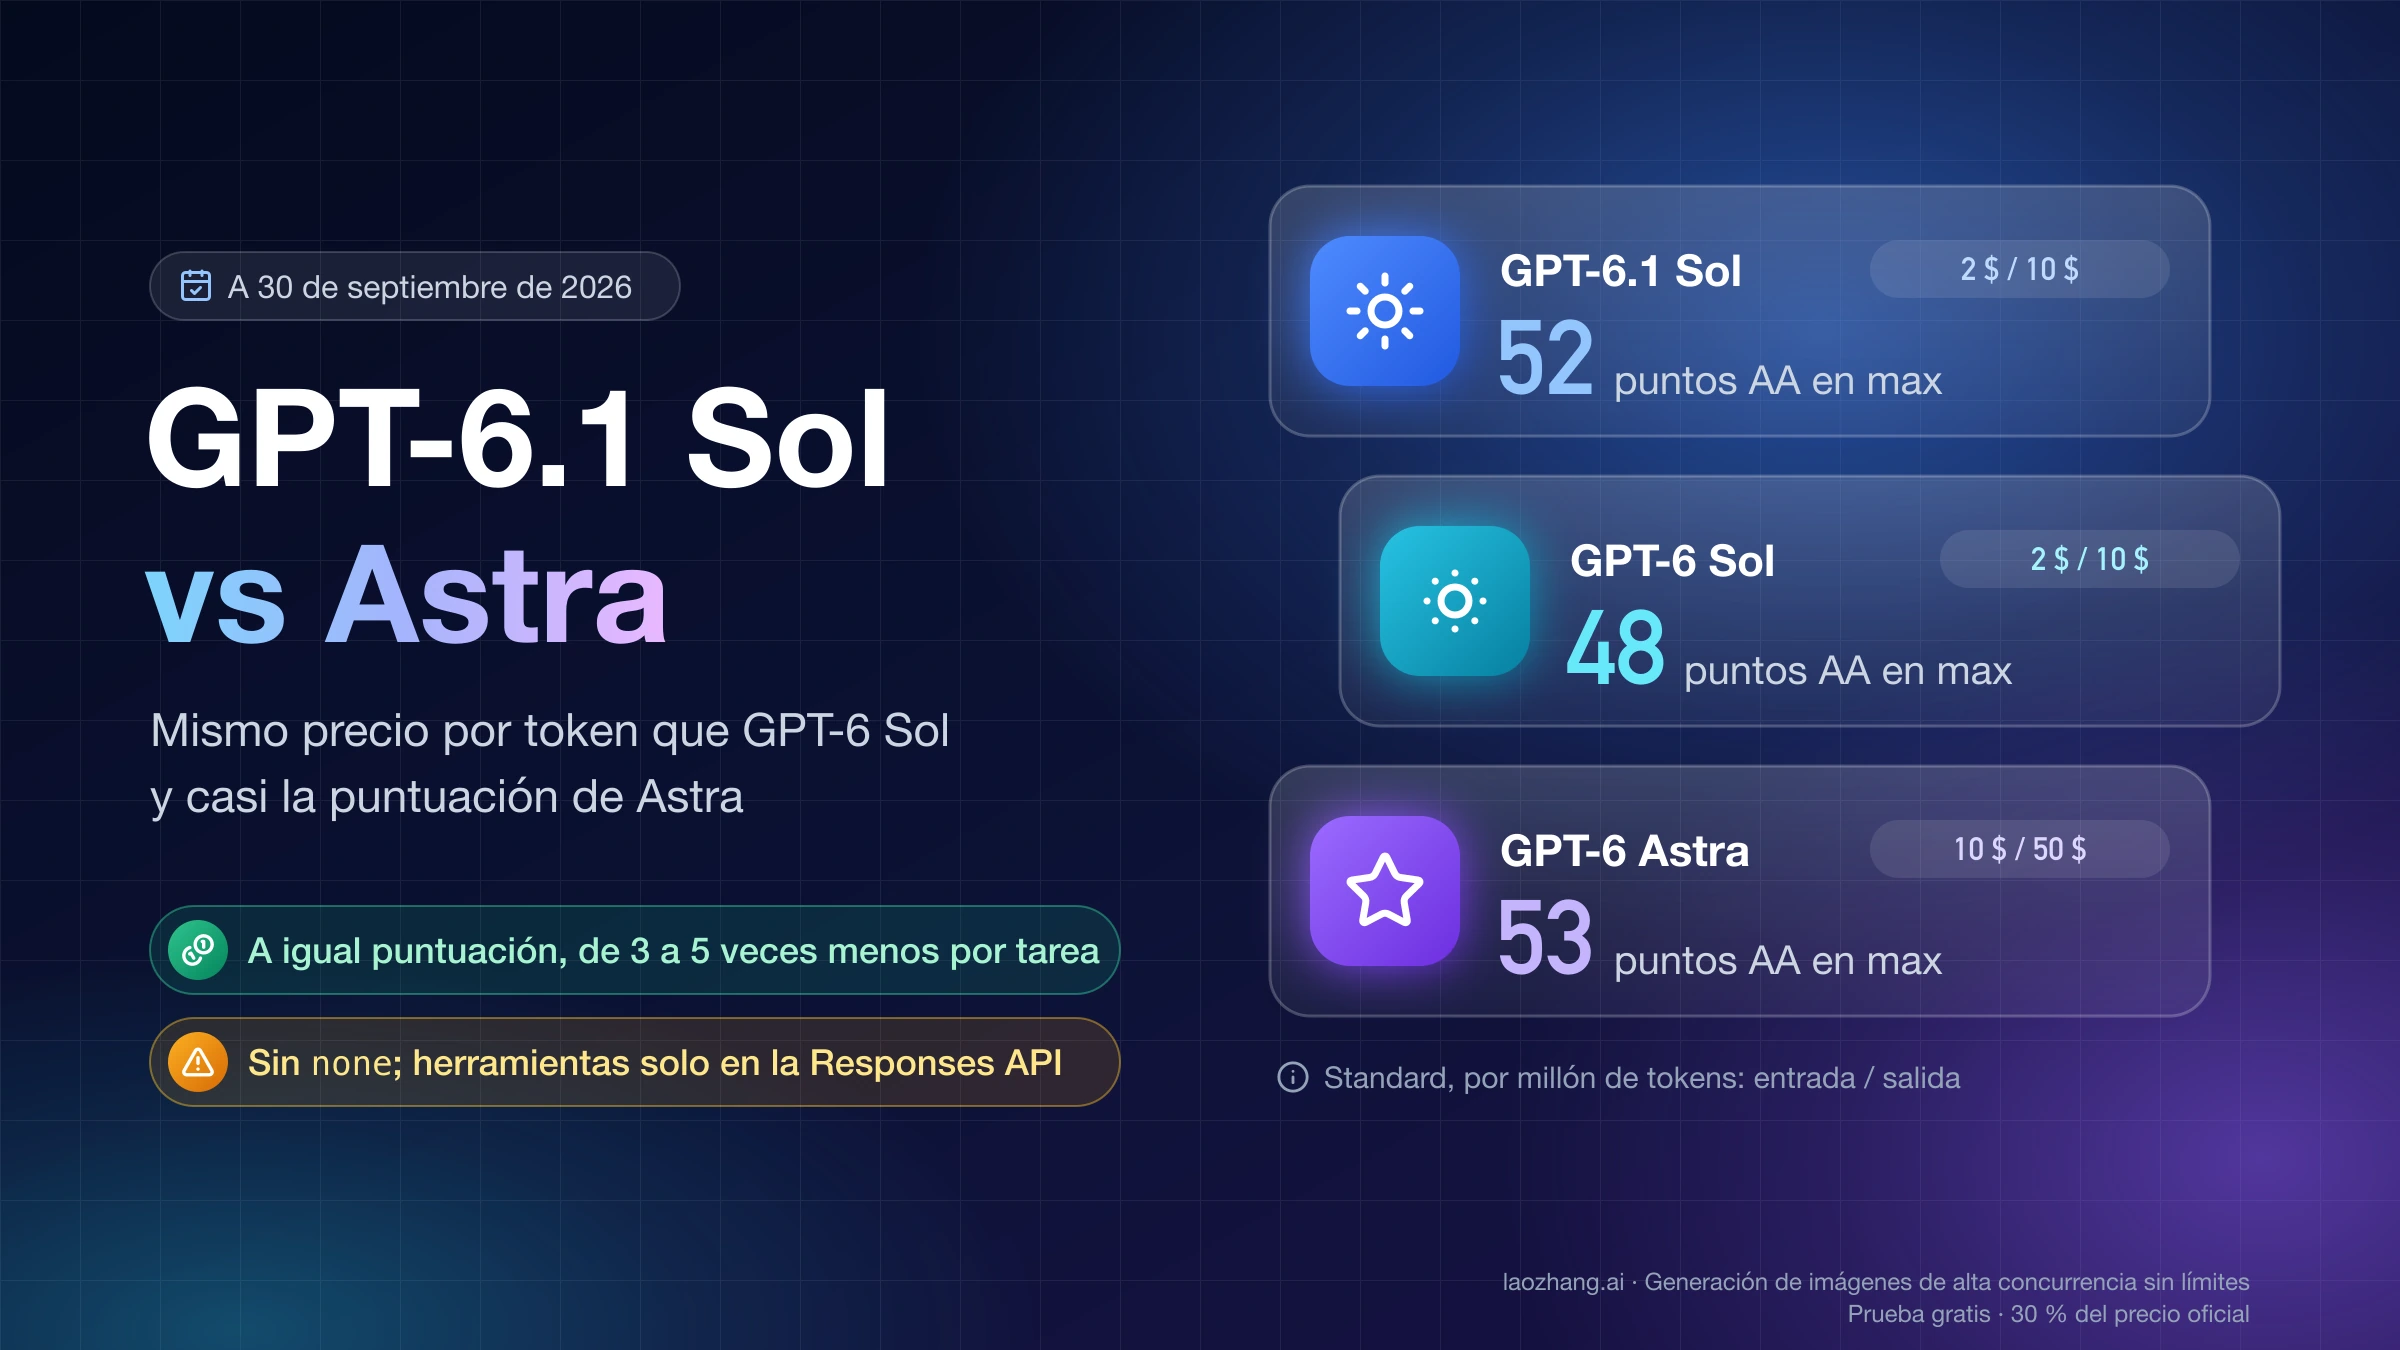
Kimi K3.1 Pro (kimi-k3.1-pro, lanzado el 23 de octubre de 2026) y GPT-6.1 Sol (gpt-6.1-sol) tienen hoy el mismo precio de lista: 2 $ por millón de tokens de entrada y 10 $ por millón de salida. La factura no sale igual. En el índice de Artificial Analysis (AA), K3.1 Pro obtiene 55 puntos y cuesta 2,11 $ por tarea con su esfuerzo de razonamiento (reasoning_effort) por defecto, max; Sol en max obtiene 52 por 0,72 $ y en high, 50 por 0,32 $. Ningún ajuste de Sol llega a 55, pero K3.1 Pro escribe muchos más tokens para conseguirlo.
Si ya trabajas con gpt-6.1-sol, no lo sustituyas entero. Mantenlo para el chat, el procesamiento por lotes (Batch o Flex a mitad de precio) y los bucles de agente que leen mucho de caché, porque ahí sale más barato. Prueba kimi-k3.1-pro en dos casos: prompts de más de 272K tokens de entrada, donde Sol cobra toda la petición con recargo y K3.1 Pro cuesta más o menos la mitad, y tareas agénticas largas en las que un fallo te sale más caro que los 1,39 $ de diferencia por tarea frente a Sol en max. Antes de llevar un agente a Kimi, acumula al menos 10 $ de recarga: con 1 $ la cuenta queda en Tier0, con una sola petición simultánea y 3 por minuto.
Las comprobaciones propias, hechas el 25 de octubre de 2026, se limitan a leer los catálogos públicos de proveedores (la API de endpoints de OpenRouter y la lista de modelos de un agregador) y a recalcular costes con los precios oficiales. No se ejecutó la misma batería de prompts en ambos modelos, así que las cifras de calidad y velocidad que siguen son de AA a esa fecha, con la configuración indicada en cada caso.
Coste por tarea: 2,11 $ en K3.1 Pro frente a 0,32–0,72 $ en Sol
K3.1 Pro cuesta más por tarea porque genera más tokens de salida, y los tokens de razonamiento se cobran como salida. En las tareas del índice de AA produce unos 55.000 tokens de salida por tarea, de los que 35.000 son razonamiento; Sol produce 38.000 en max y 13.000 en high. Con el mismo precio por token, esa diferencia de volumen es la diferencia de factura: por tarea, K3.1 Pro cuesta 2,93 veces lo que Sol en max y 6,6 veces lo que Sol en high.
| Configuración | Índice AA | Coste por tarea | Tokens de salida por tarea | Segundos por tarea |
|---|---|---|---|---|
K3.1 Pro, max (por defecto) | 55 | 2,11 $ | 55.000 | 618 |
Sol, low | 42 | 0,13 $ | 4.000 | 83 |
Sol, medium (por defecto) | 48 | 0,21 $ | 8.000 | 168 |
Sol, high | 50 | 0,32 $ | 13.000 | 257 |
Sol, xhigh | 51 | 0,39 $ | 18.000 | 342 |
Sol, max | 52 | 0,72 $ | 38.000 | 680 |
Datos del comparador de Artificial Analysis entre Kimi K3.1 Pro y GPT-6.1 Sol (Intelligence Index v4.3.2) a 25 de octubre de 2026, con precios de lista. AA solo ha medido K3.1 Pro en su valor por defecto.
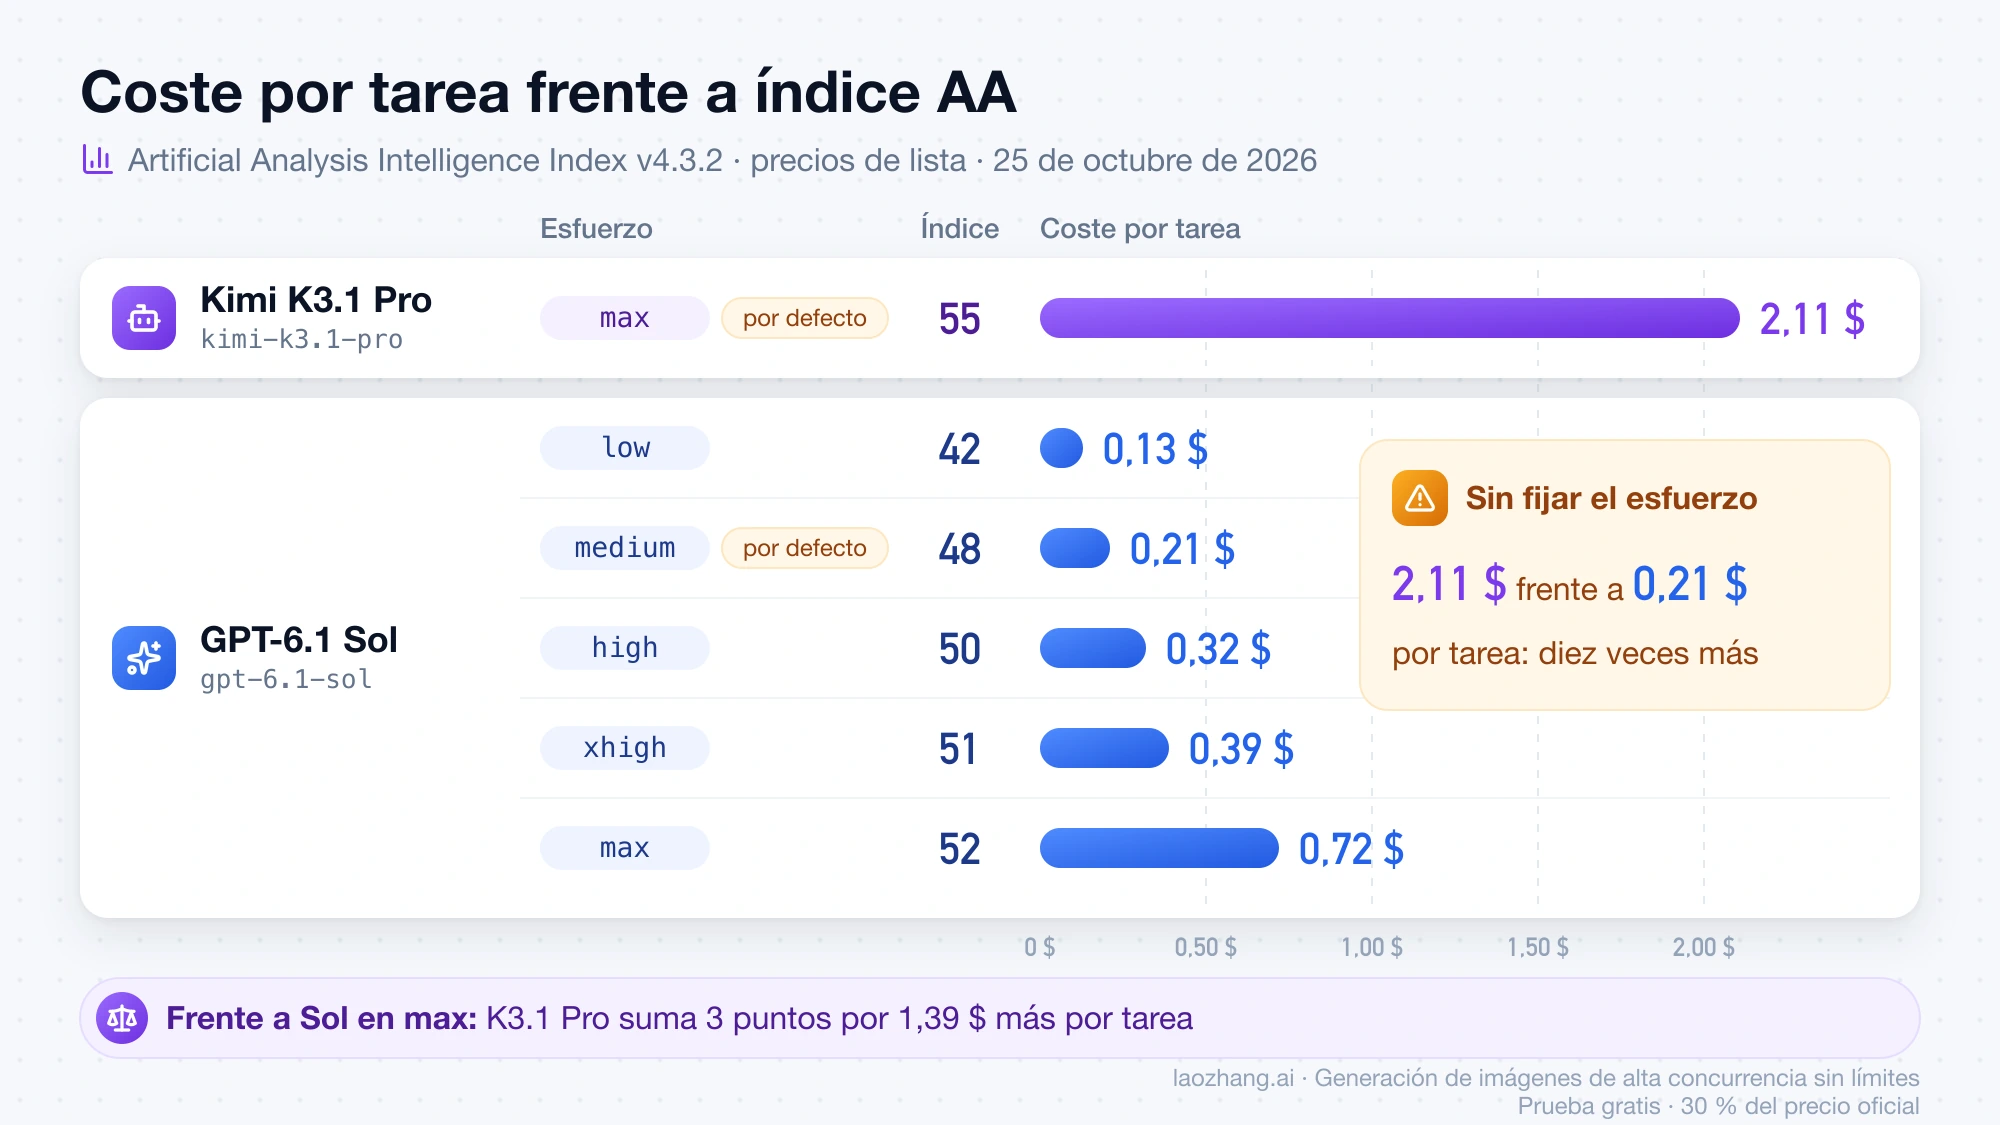
Comparar «por defecto contra por defecto» engaña. El esfuerzo de razonamiento de K3.1 Pro empieza en max y el de Sol en medium, así que si llamas a los dos sin fijarlo comparas 2,11 $ contra 0,21 $ por tarea, diez veces más. K3.1 Pro acepta también low y high, que deberían reducir los tokens, pero AA no ha publicado ni su coste ni su puntuación en esos niveles: esa cifra solo la obtendrás midiendo con tus propias peticiones.
La pregunta útil es si 3 puntos de índice compensan. Frente a Sol en max, K3.1 Pro suma 3 puntos por 1,39 $ más por tarea (2,11 − 0,72); frente a Sol en high, 5 puntos por 1,79 $ más (2,11 − 0,32). En 1.000 tareas al mes son 2.110 $ frente a 720 $ o 320 $. Compensa cuando cada tarea que Sol no resuelve te cuesta más que esa diferencia en revisión, reintentos o trabajo perdido, y eso ocurre sobre todo en el tipo de tareas donde K3.1 Pro saca más ventaja.
¿De verdad superó a Sol? Dónde gana cada uno en las pruebas de AA
En el índice global de AA, K3.1 Pro (55) supera a GPT-6.1 Sol en su mejor ajuste (52). El hilo de Reddit que circula, «Kimi K3.1 Pro Just Beat GPT-6 Sol…», llama «GPT-6 Sol» a ese modelo de 52 puntos, pero es GPT-6.1 Sol en max; GPT-6 Sol es un modelo anterior distinto. La ventaja de K3.1 Pro no es uniforme: se concentra en el trabajo agéntico, mientras que Sol gana en fiabilidad del conocimiento.
| Prueba de AA | K3.1 Pro | Sol max | Ventaja |
|---|---|---|---|
| AA-Briefcase (Elo) | 1.678 | 1.555 | K3.1 Pro |
| GDPval-AA (Elo) | 1.846 | 1.596 | K3.1 Pro |
| AutomationBench-AA | 73 % | 65 % | K3.1 Pro |
| Terminal-Bench 4.0 | 67 % | 56 % | K3.1 Pro |
| SciCode | 61 % | 54 % | K3.1 Pro |
| AA-LCR (lectura de contexto largo) | 86 % | 83 % | K3.1 Pro |
| Humanity's Last Exam | 52 % | 53 % | Empate |
| GDP.pdf | 31 % | 31 % | Empate |
| CritPt | 25 % | 32 % | Sol |
| AA-Omniscience (índice) | 30 | 42 | Sol |
Si tu agente ejecuta comandos en una terminal, modifica repositorios o encadena herramientas para entregar un documento, las pruebas que se parecen a tu trabajo son Terminal-Bench 4.0 (programación agéntica y uso de terminal), AA-Briefcase (trabajo de conocimiento agéntico) y GDPval-AA, y en las tres K3.1 Pro saca una ventaja clara. Si tus respuestas dependen de datos que el modelo debe saber sin buscarlos, como soporte o preguntas sobre hechos, pesa más AA-Omniscience, que premia acertar y penaliza inventar: ahí Sol saca 42 frente a 30.
La tabla de lanzamiento de Moonshot no sirve para este duelo, porque compara K3.1 Pro con GPT-6 Astra y Claude Opus 5.5, no con Sol. Su 65,7 % en Terminal-Bench 4.0 sale de la configuración de pruebas del fabricante y no debe ponerse al lado del 56 % de Sol en AA como si fueran la misma medición. Si lo que quieres es enfrentar K3.1 Pro a Opus 5.5, la misma cuenta por tarea está en Kimi K3.1 Pro vs Claude Opus 5.5: ¿cuesta la mitad por tarea?.
Velocidad: K3.1 Pro tarda 30 s en dar el primer token de respuesta
En las mediciones de AA, K3.1 Pro empieza a emitir razonamiento a los 2,97 s, pero el primer token de la respuesta llega a los 30 s y una tarea del índice tarda 618 s de media, a unos 73 tokens por segundo. Sol en max no muestra el primer token hasta los 162 s y tarda 680 s por tarea; en high baja a 257 s y en medium, a 168 s. Para un chat donde el usuario espera, ninguno de los dos en max es razonable: Sol en low o medium es la opción rápida, y si necesitas K3.1 Pro con menos espera existe kimi-k3.1-pro-highspeed, un modelo aparte que según Moonshot es 2–3 veces más rápido y cuesta el doble (4 $ de entrada y 20 $ de salida por millón).
Mismos tokens, distinta factura: dónde K3.1 Pro sale más barato
Con exactamente los mismos tokens, K3.1 Pro solo sale más barato cuando el prompt supera los 272K tokens de entrada o cuando escribe un prefijo nuevo en caché. En peticiones cortas empatan y en los turnos que leen mucho de caché gana Sol. Es el resultado de un recálculo local hecho el 25 de octubre de 2026 con las tarifas oficiales de precios de Kimi y de precios de la API de OpenAI:
| Caso (mismos tokens en ambos) | K3.1 Pro | GPT-6.1 Sol | Sol / K3.1 Pro |
|---|---|---|---|
| Petición corta: 20K de entrada + 2K de salida | 0,060 $ | 0,060 $ | 1,00× |
| Turno de agente: 10K nuevos + 140K leídos de caché + 3K de salida | 0,078 $ | 0,064 $ | 0,82× |
| Primer turno que escribe 140K en caché + 10K nuevos + 3K de salida | 0,330 $ | 0,400 $ | 1,21× |
| Prompt largo: 500K de entrada sin caché + 5K de salida | 1,050 $ | 2,075 $ | 1,98× |
| Prompt largo con caché: 50K nuevos + 450K leídos + 5K de salida | 0,240 $ | 0,365 $ | 1,52× |
Los supuestos son los precios por millón de tokens de cada plataforma. K3.1 Pro cobra 2 $ de entrada, 10 $ de salida, 0,20 $ por lectura de caché y 2 $ por escritura con duración de 5 minutos, sin recargo hasta su contexto de 1.048.576 tokens. Sol cobra 2 $ y 10 $, 0,10 $ por lectura y 2,50 $ por escritura de 30 minutos, pero si la entrada pasa de 272K tokens toda la petición se cobra con entrada y caché al doble y salida a 1,5 veces. Por eso el prompt largo de Sol sale a 500.000 × 4 $/M + 5.000 × 15 $/M = 2,075 $. En ambos casos la salida incluye los tokens de razonamiento. El resto de las tarifas de Sol, incluidas las de más de 272K, están en GPT-6.1 Sol: qué cambia, cuánto cuesta y qué revisar al migrar.
Caché: Sol lee más barato y Kimi escribe más barato
La lectura de caché de Sol cuesta la mitad (0,10 $ frente a 0,20 $), pero su escritura por defecto, de 30 minutos, cuesta 1,25 veces la entrada, mientras que la escritura por defecto de Kimi, de 5 minutos, cuesta lo mismo que la entrada. Las opciones largas siguen la misma lógica: 1 hora en Kimi a 2 veces la entrada (4 $) y 12 horas en Sol a 2,5 veces (5 $). En un bucle de agente que escribe el prefijo una vez y lo lee muchas veces, la lectura barata de Sol acaba pesando más. En una sesión simulada de 50 turnos (el primero escribe un prefijo de 140K y los 49 siguientes leen esos 140K, añaden 10K nuevos y generan 3K de salida), K3.1 Pro cuesta 4,15 $ y Sol 3,54 $. Si además Sol genera menos salida en la proporción que mide AA, la sesión baja a 3,07 $ en max y a 2,39 $ en high; es una ilustración, no una medición de tu carga.
Los tiempos de vida también cambian la cuenta. Si entre turno y turno pasan más de 5 minutos, por ejemplo porque alguien revisa cada paso, la caché por defecto de Kimi caduca y vuelves a pagar la escritura, salvo que pidas 1 hora con prompt_cache_options: {"mode": "implicit", "ttl": "1h"}; la de Sol dura 30 minutos sin tocar nada. Según la guía de caché de contexto de Kimi, la duración queda fijada en la primera escritura y no se puede cambiar hasta que la entrada caduque. En Sol, la duración de 12 horas se pide con prompt_cache_options.ttl en la Responses API, según la guía de prompt caching de OpenAI.
Lotes: Sol a mitad de precio, K3.1 Pro sin Batch API
Para trabajo que no necesita respuesta inmediata, Sol tiene Batch y Flex con un 50 % de descuento. Procesar 10.000 documentos de 20K tokens de entrada y 2K de salida cuesta 600 $ en ambos modelos a precio estándar y 300 $ en Sol por lotes. La Batch API de Kimi cobra el 60 % del precio normal, pero solo admite kimi-k2.7-code y kimi-k2.6, no K3.1 Pro, y la serie K2 deja de estar disponible para usuarios nuevos el 31 de octubre de 2026 y se retira a finales de diciembre.
Qué elegir según tu carga: Sol por defecto, K3.1 Pro en prompts largos
La elección por defecto razonable es Sol, con K3.1 Pro como segunda ruta para dos tipos de trabajo: prompts de más de 272K y tareas agénticas donde Sol falla y el fallo es caro. La tabla resume cada forma de carga con lo que decide su factura:
| Forma de carga | Qué decide la factura | Más barato | Elección |
|---|---|---|---|
| Bucle de agente con caché, turnos seguidos | Lecturas de caché y tokens de salida por turno | Sol | Sol; K3.1 Pro solo donde Sol falla y cada fallo cuesta más que la diferencia por tarea |
| Prompts de más de 272K tokens | Recargo de Sol sobre toda la petición | K3.1 Pro, cerca de la mitad | K3.1 Pro, que además saca 86 % frente a 83 % en contexto largo |
| Lotes sin prisa | Descuento por lotes | Sol con Batch o Flex | Sol |
| Chat sensible a la latencia | Tiempo hasta el primer token | Sol en low o medium | Sol; K3.1 Pro en max tarda 30 s en responder |
| Sesiones de Codex | Plan de ChatGPT o pago por token | Sol si ya pagas un plan que lo incluye | Sol en el plan; K3.1 Pro como proveedor aparte para tareas de terminal difíciles |
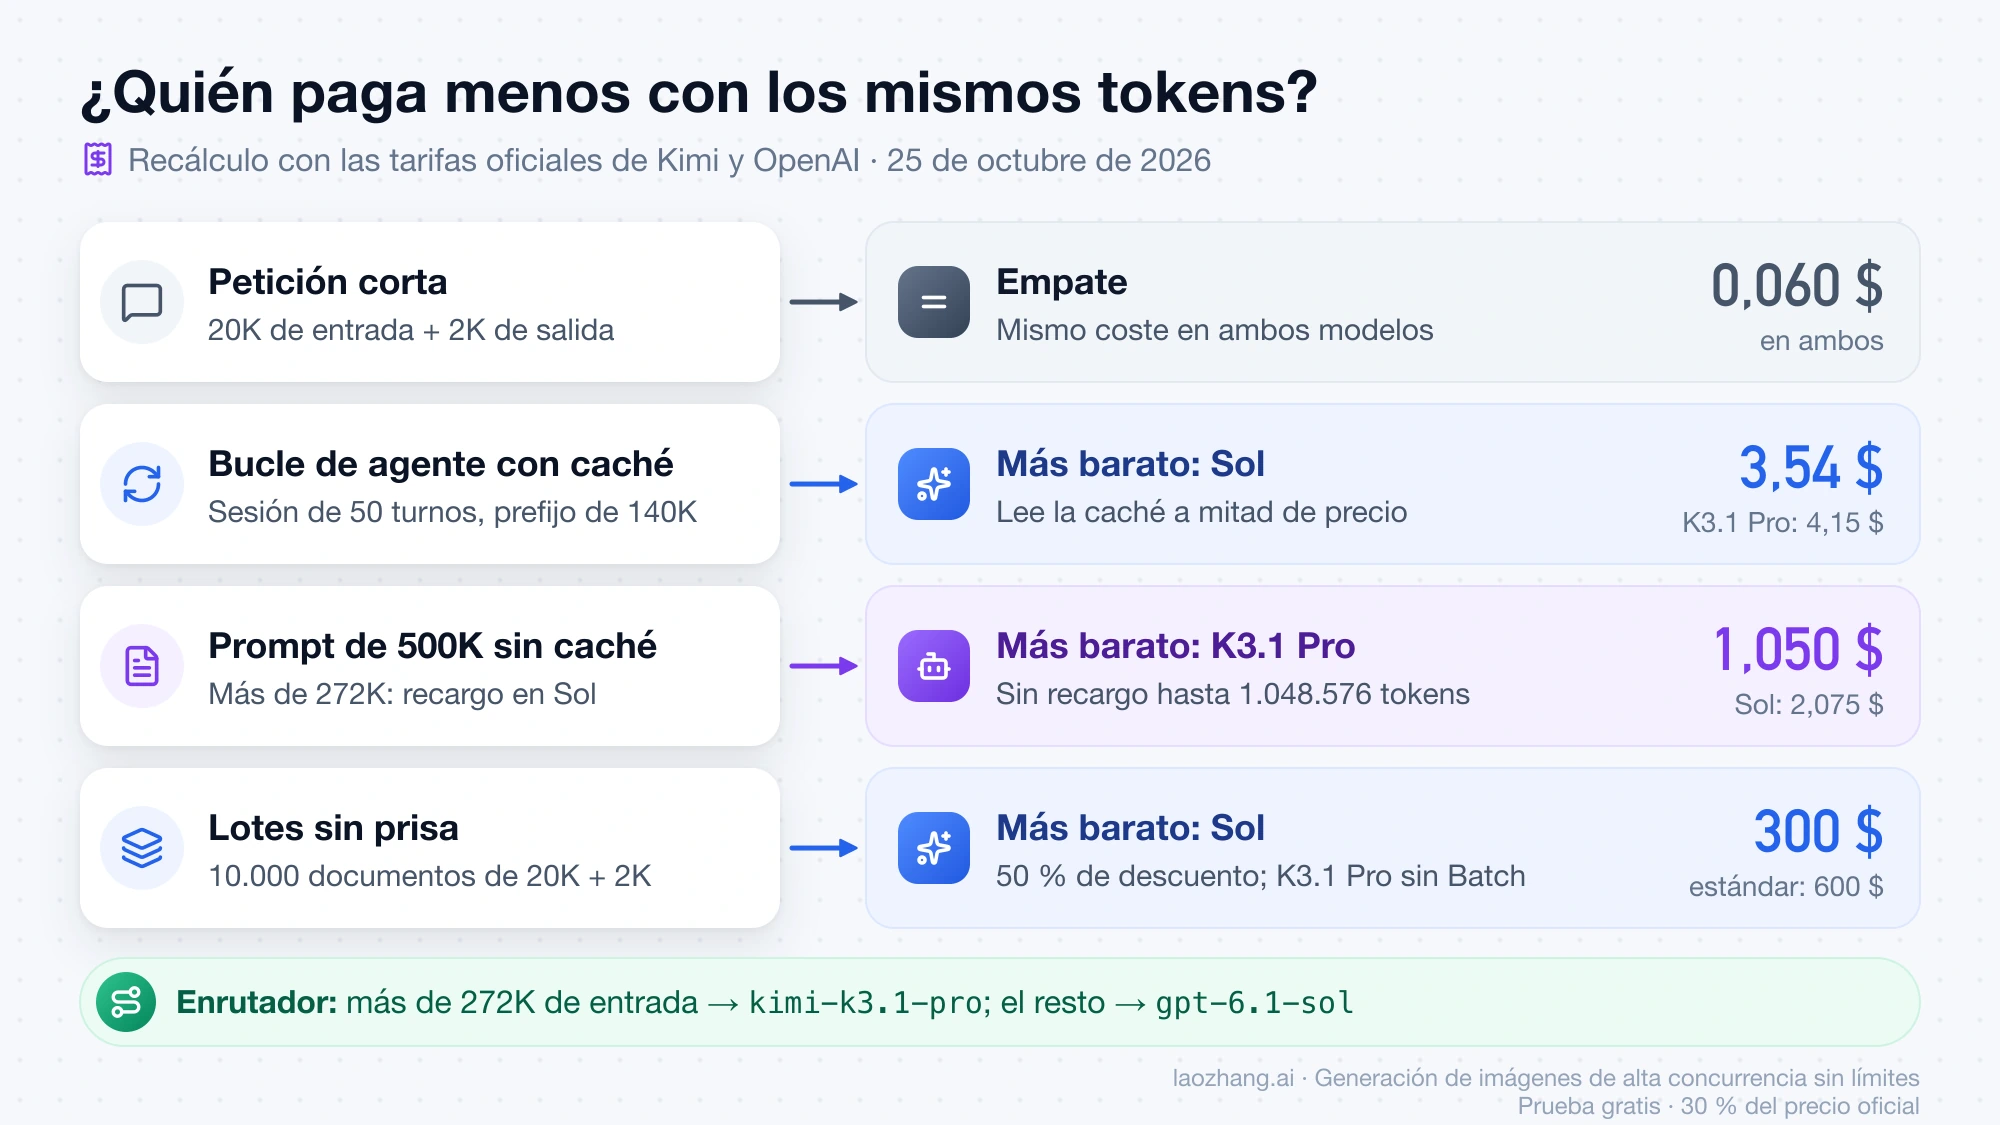
Repartir la carga suele ganar a cambiar del todo. Un enrutador sencillo que mande a kimi-k3.1-pro las peticiones con más de 272K tokens de entrada y deje el resto en gpt-6.1-sol aprovecha la diferencia de precio más clara sin pagar la verbosidad de K3.1 Pro en las peticiones cortas. Para otros buques insignia frente a Sol con el mismo criterio de coste por tarea, consulta Gemini 4 Argon vs Claude Opus 5.5 vs GPT-6.1 Sol: cuál usar hoy.
Migrar de gpt-6.1-sol a kimi-k3.1-pro: qué cambia en tu código
Los cambios que rompen código son tres: el esfuerzo de razonamiento tiene otros valores y otro valor por defecto, en conversaciones de varios turnos debes reenviar el mensaje del asistente completo, y las herramientas funcionan en APIs distintas. La guía de esfuerzo de razonamiento de Kimi y la ficha de GPT-6.1 Sol en la documentación de OpenAI recogen los detalles:
| Aspecto | kimi-k3.1-pro | gpt-6.1-sol |
|---|---|---|
| Esfuerzo de razonamiento | low, high, max; por defecto max; sin medium y sin forma de desactivar el razonamiento | low, medium, high, xhigh, max; por defecto medium; none y minimal no admitidos |
| Dónde se fija | Campo reasoning_effort en el primer nivel de la petición | reasoning.effort en la Responses API |
| Varios turnos y herramientas | Reenviar el mensaje del asistente completo, con reasoning_content y tool_calls, no solo content | Herramientas solo en la Responses API; Chat Completions funciona sin herramientas |
| APIs disponibles | Chat Completions (https://api.moonshot.ai/v1), Responses y un endpoint compatible con Anthropic Messages | Responses y Chat Completions |
| Parámetros de muestreo | El endpoint de OpenRouter no expone temperature, top_p ni seed | En una prueba anterior, del 5 de octubre de 2026, Chat Completions rechazó temperature: 0.2 y solo aceptó 1 |
| Contexto y salida máxima | 1.048.576 tokens; salida de hasta 943.718 según OpenRouter | 1.050.000 tokens; salida de hasta 128.000 |
| Caché | Automática; 5 minutos por defecto, 1 hora a petición | Automática; 30 minutos por defecto, 12 horas a petición |
| Lotes | La Batch API no admite K3.1 Pro | Batch y Flex con un 50 % de descuento |
| Acceso | Se desbloquea con una recarga mínima de 1 $ | Sin acceso en el nivel Free; nivel Build con 5.000 RPM |
La variante rápida es otro identificador, kimi-k3.1-pro-highspeed, no un parámetro: para usarla cambias el nombre del modelo. Tampoco des por hecho que K3.1 Pro tiene pesos abiertos: Moonshot ha prometido publicarlos antes del 4 de noviembre de 2026, pero hoy AA lo clasifica como modelo propietario.
Quién sirve cada modelo: 2 endpoints frente a 8
Una lectura de la API pública de endpoints de OpenRouter el 25 de octubre de 2026 devolvió 2 endpoints para moonshotai/kimi-k3.1-pro, ambos de Moonshot AI (el estándar y el highspeed), y 8 para openai/gpt-6.1-sol: OpenAI en sus modos estándar, flex, fast y ultrafast, Azure, Azure EU, Azure US y Amazon Bedrock en us-east-1. En la práctica, si el servicio de Moonshot tiene una incidencia, hoy no hay otro proveedor de K3.1 Pro al que desviar el tráfico; eso puede cambiar cuando se publiquen los pesos. En el catálogo de LaoZhang aparece gpt-6.1-sol, y el 25 de octubre de 2026 se añadieron kimi-k3.1-pro y kimi-k3.1-pro-highspeed a los precios de Kimi (2 $ y 10 $, y 4 $ y 20 $ por millón de tokens; lectura de caché a 0,20 $; escritura a 2 $ por 5 minutos y 4 $ por 1 hora), con llamadas por Chat Completions, de modo que una misma clave sirve para probar los dos modelos.
Recargar 1 $ no basta para un agente: niveles de cuenta de Kimi
K3.1 Pro se desbloquea tras una recarga de al menos 1 $, pero esa cuenta queda en Tier0: 1 petición simultánea, 3 peticiones por minuto, 500.000 tokens por minuto y 1.500.000 tokens al día. Si cada tarea genera unos 55.000 tokens de salida, como en AA, el tope diario da para unas 27 tareas (1.500.000 ÷ 55.000), contando solo la salida. Con 10 $ de recarga acumulada pasas a Tier1, con 15 peticiones simultáneas, 100 por minuto, 2 millones de tokens por minuto y sin tope diario, según la tabla de límites de Kimi. El vale de 5 $ que se recibe al acumular 5 $ no cuenta para subir de nivel.
En el lado de OpenAI, Sol no está disponible en el nivel gratuito y el nivel Build, que empieza tras 5 $ pagados, ya permite 5.000 peticiones por minuto. Para pagar en Kimi, la ayuda de cuentas menciona WeChat Pay y Alipay para particulares y los términos de servicio hablan de tarjeta de crédito o débito; comprueba qué método te ofrece la consola antes de planificar la migración. Los precios de Kimi no incluyen impuestos.
Cómo usar K3.1 Pro en Codex en lugar de Sol
Codex puede usar K3.1 Pro directamente, sin proxy, porque la plataforma de Kimi implementa la Responses API que Codex utiliza. La guía de Kimi para usar K3.1 Pro en Codex pide guardar la clave en la variable de entorno KIMI_API_KEY y añadir esto a ~/.codex/config.toml:
model = "kimi-k3.1-pro"
model_provider = "kimi"
model_context_window = 1048576

[model_providers.kimi]
name = "Kimi"
base_url = "https://api.moonshot.ai/v1"
env_key = "KIMI_API_KEY"
wire_api = "responses"
Es la configuración tal como la publica Kimi, sin una ejecución propia con Codex. Según esa guía, Codex Desktop puede mostrar el modelo como «Custom», el aviso «Model metadata for kimi-k3.1-pro not found» es esperable, las claves creadas en platform.kimi.ai solo funcionan con api.moonshot.ai y Codex solo relee el archivo al arrancar. El riesgo práctico es el error 429: un agente de Codex en una cuenta Tier0 choca con el límite enseguida, así que sube a Tier1 antes de probar. La configuración general de proveedores propios está en Custom Provider en Codex: API Key, Base URL y config.toml. Si hoy usas Sol en Codex con un plan de ChatGPT, pasar a Kimi te lleva al pago por token; las diferencias están en Codex con API key o suscripción ChatGPT: coste, límites y cloud.
Cómo probar K3.1 Pro con tus tareas antes de cambiar
El índice de AA te dice dónde buscar, no cuánto pagarás tú. Una prueba pequeña con tu carga real responde a las dos preguntas que importan, el coste por tarea aceptada y en qué tipo de tareas gana cada modelo, y se hace en este orden:
- Sube la cuenta de Kimi a Tier1 (10 $ acumulados) para que los límites de Tier0 no alteren los tiempos ni provoquen errores 429.
- Elige entre 20 y 30 tareas que ya resuelves con Sol y que tengan un criterio de aceptación comprobable: los tests pasan, el dato es correcto o el documento cumple la plantilla.
- Ejecútalas en
gpt-6.1-solcon el esfuerzo que usas hoy y enmax, y enkimi-k3.1-proenmaxy enhigh, fijando siemprereasoning_effortde forma explícita. - Guarda de cada respuesta los tokens de entrada, de caché y de salida (con el razonamiento incluido), el tiempo total y si la tarea quedó aceptada.
- Divide el coste total de cada configuración entre las tareas aceptadas y suma el tiempo de revisión o los reintentos que hicieron falta.
- Decide por tipo de tarea: manda a K3.1 Pro solo las categorías donde su coste por tarea aceptada es menor o donde Sol no llega, y deja el resto en Sol.
Preguntas frecuentes sobre Kimi K3.1 Pro y GPT-6.1 Sol
¿Kimi K3.1 Pro es open source?
Todavía no. A 25 de octubre de 2026, Moonshot dice en la guía de inicio de Kimi K3.1 Pro que publicará los pesos completos antes del 4 de noviembre, y AA lo lista como modelo propietario. Hasta que los pesos estén disponibles, solo puedes usarlo a través de la API de Moonshot o de servicios como OpenRouter que enrutan hacia ella.
¿Qué tan potente es Kimi K3.1 Pro frente a Kimi K3?
K3.1 Pro es una versión de K3 con mucho más entrenamiento posterior, según Moonshot, y además es más barato: K3 cuesta 3 $ de entrada y 15 $ de salida por millón de tokens, frente a 2 $ y 10 $. Moonshot afirma que, en un conjunto de prueba con casos señalados por usuarios, la proporción de afirmaciones alucinadas baja del 23,35 % de K3 al 6,85 %; es una cifra del fabricante. Por eso las comparativas con Sol hechas con K3 llegan a otra conclusión: K3 era más caro que Sol también por token.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 oct 2026.
- 1.comparador de Artificial Analysis entre Kimi K3.1 Pro y GPT-6.1 Solartificialanalysis.ai/models/comparisons/kimi-k3-1-pro-vs-gpt-6-1-sol
- 2.precios de Kimiplatform.kimi.ai/docs/pricing/chat
- 3.precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 4.guía de caché de contexto de Kimiplatform.kimi.ai/docs/guide/context-caching
- 5.guía de prompt caching de OpenAIdevelopers.openai.com/api/docs/guides/prompt-caching
- 6.Batch API de Kimiplatform.kimi.ai/docs/pricing/batch
- 7.guía de esfuerzo de razonamiento de Kimiplatform.kimi.ai/docs/guide/use-reasoning-effort
- 8.ficha de GPT-6.1 Sol en la documentación de OpenAIdevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 9.tabla de límites de Kimiplatform.kimi.ai/docs/pricing/limits
- 10.guía de Kimi para usar K3.1 Pro en Codexplatform.kimi.ai/docs/guide/codex-kimi
- 11.guía de inicio de Kimi K3.1 Proplatform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart