GPT-6.1 Sol: qué cambia, cuánto cuesta y qué revisar al migrar
Mismo precio que GPT-6 Sol salvo la entrada en caché, que baja a la mitad. Antes de cambiar el ID, pasa none a low y lleva las herramientas a Responses API.
En esta página
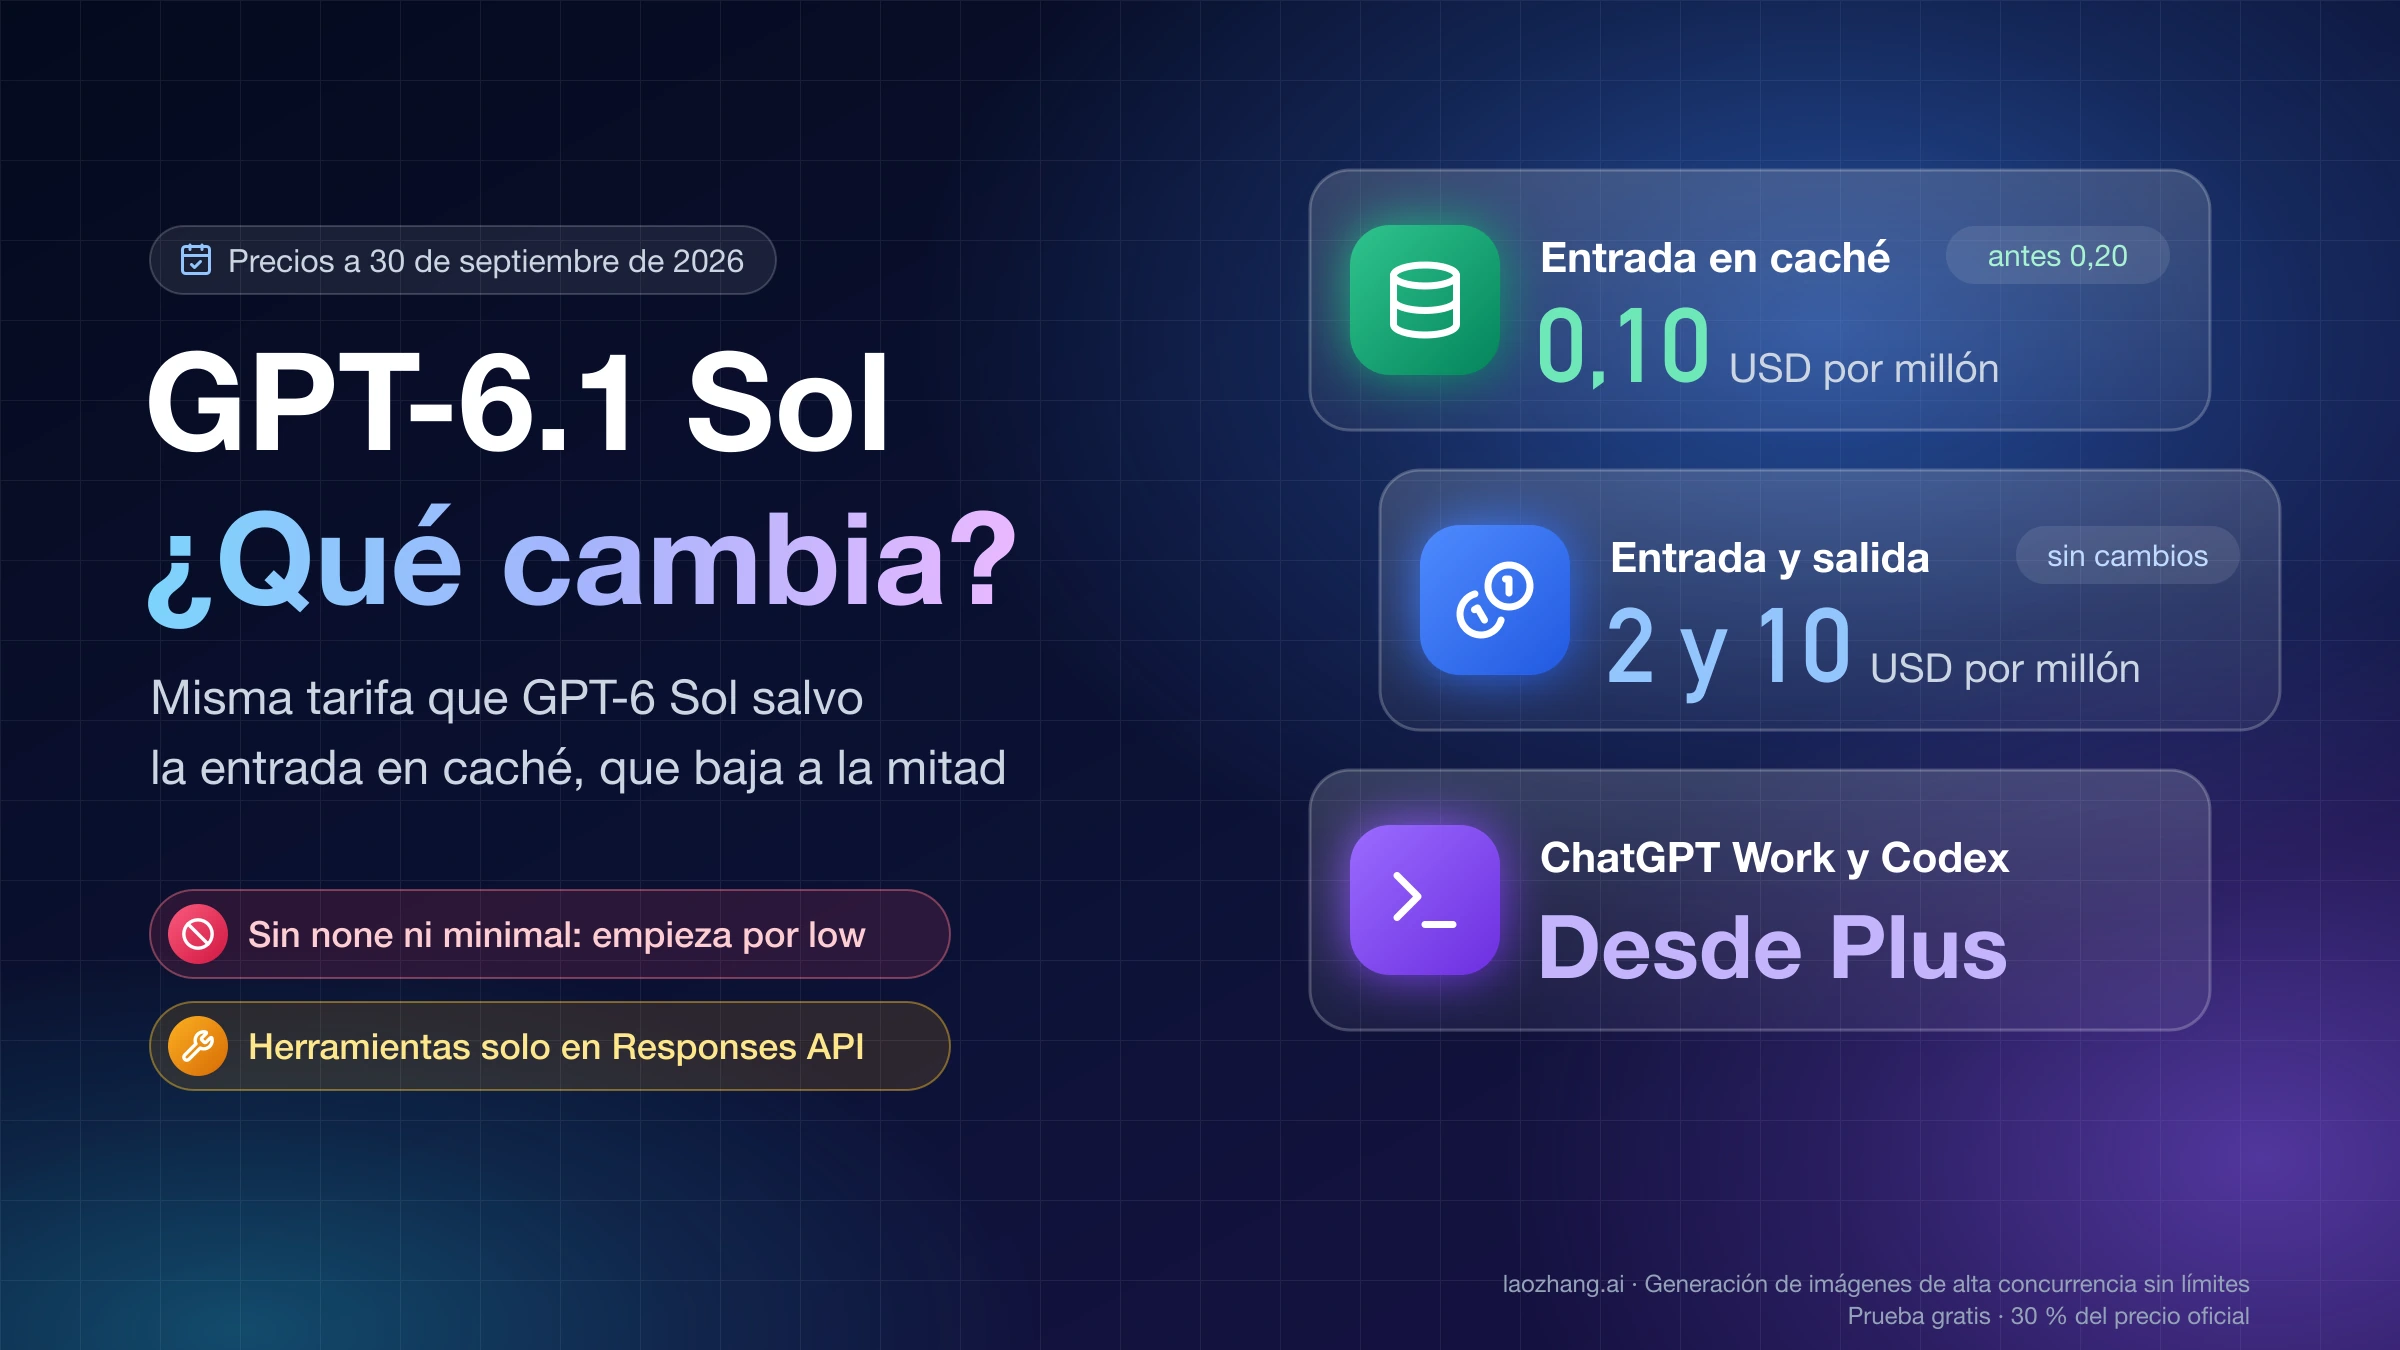
GPT-6.1 Sol (gpt-6.1-sol en la API) es la actualización de GPT-6 Sol que OpenAI publicó el 29 de septiembre de 2026, justo una semana después del modelo al que sustituye como Sol recomendado. Si ya pagas por gpt-6-sol, la tarifa es idéntica en todo salvo en una partida: la entrada en caché baja de 0,20 a 0,10 USD por millón de tokens. Con una carga que relee mucho contexto, la factura baja; sin caché, cada token cuesta lo mismo y la diferencia dependerá de cuántos tokens gaste cada modelo en la misma tarea.
Lo que sí puede fallar es la petición. GPT-6.1 Sol no admite none ni minimal en el esfuerzo de razonamiento y solo llama a herramientas desde Responses API; Chat Completions funciona, pero sin herramientas. Si tu integración con GPT-6 Sol usaba reasoning_effort: "none" para llamar funciones por Chat Completions, cambiar solo el ID no basta.
En ChatGPT, el modelo está en ChatGPT Work y en Codex para Plus, Pro, Business, Enterprise y Edu, no en el chat normal; Free y Go se quedan fuera. Los precios son los de la API directa de OpenAI, en USD, a 5 de octubre de 2026. Desde ese mismo día también puedes llamarlo por laozhang.ai con la misma tarifa de lista, pero allí los tokens que salen de caché se cobran como entrada normal: sale igual en llamadas sin caché y bastante más caro en bucles de agentes que releen contexto.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
GPT-6.1 Sol frente a GPT-6 Sol
OpenAI presenta GPT-6.1 Sol como «una mejora de GPT-6 Sol» orientada a programación con agentes, uso del ordenador (computer use) y trabajo profesional. En su guía de la familia GPT-6 quedan tres modelos: Astra, el de mayor capacidad; GPT-6.1 Sol, el equilibrio entre velocidad, coste e inteligencia; y Luna, el más rápido y barato. GPT-6 Sol ya no figura en ese reparto, y su propia ficha remite ahora a GPT-6.1 Sol como «el modelo Sol más reciente».
| Característica | GPT-6 Sol (gpt-6-sol) | GPT-6.1 Sol (gpt-6.1-sol) |
|---|---|---|
| Entrada, hasta 272K tokens (USD por millón) | 2 | 2 |
| Entrada en caché, hasta 272K | 0,20 | 0,10 |
| Escritura en caché de 30 minutos, hasta 272K | 2,50 | 2,50 |
| Escritura en caché de 12 horas (solo Responses API), hasta 272K | 5 | 5 |
| Salida (incluye razonamiento), hasta 272K | 10 | 10 |
Valores de reasoning.effort | none, low, medium (por defecto), high, xhigh, max | low, medium (por defecto), high, xhigh, max |
| Herramientas en Chat Completions | Solo con reasoning_effort: "none" | No; herramientas solo en Responses API |
| Ventana de contexto / salida máxima | 1.050.000 / 128.000 tokens | 1.050.000 / 128.000 tokens |
| Fecha de corte de conocimiento | 20 de abril de 2026 | 30 de abril de 2026 |
| Modo Fast con residencia de datos en la UE | No | No |
| Aparece en la tabla de precios de OpenAI | No | Sí |
Fuentes: fichas de GPT-6.1 Sol y GPT-6 Sol y página de precios de OpenAI, a 5 de octubre de 2026.
Las dos admiten entrada de texto e imagen y devuelven texto; ninguna procesa audio ni vídeo. GPT-6.1 Sol admite streaming, llamadas a funciones y Structured Outputs, pero no fine-tuning. En Responses API puede usar búsqueda web, búsqueda en archivos, generación de imágenes, intérprete de código, shell alojada, apply patch, skills, computer use, MCP y búsqueda de herramientas, además de multiagente en beta.
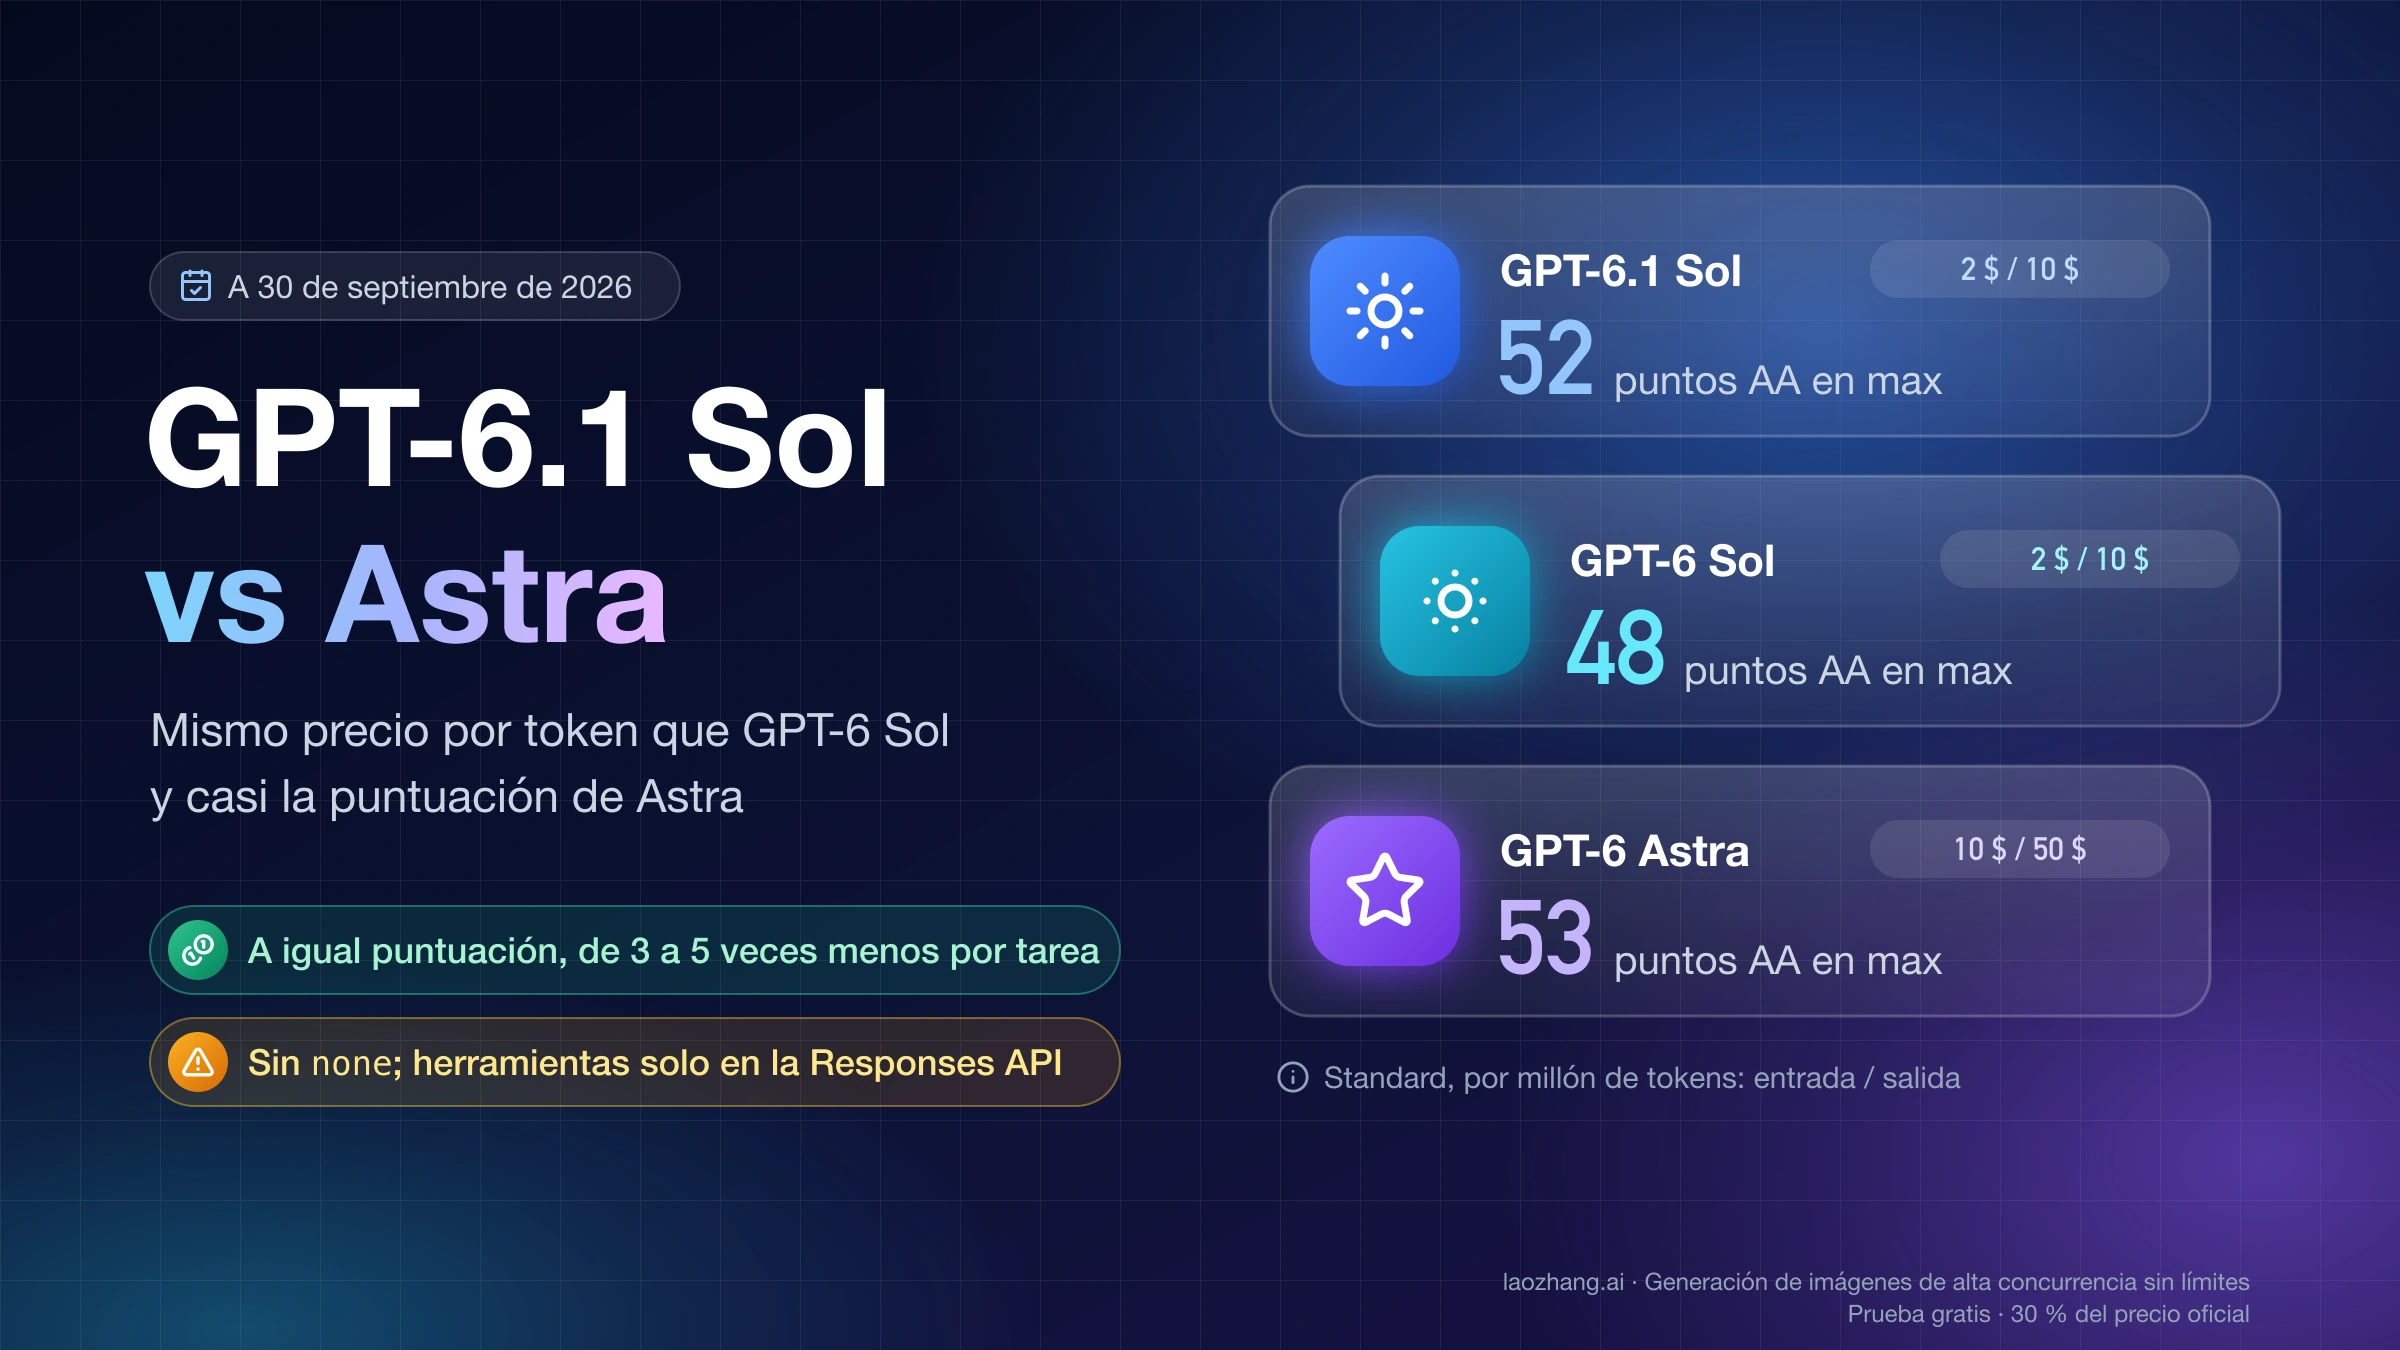
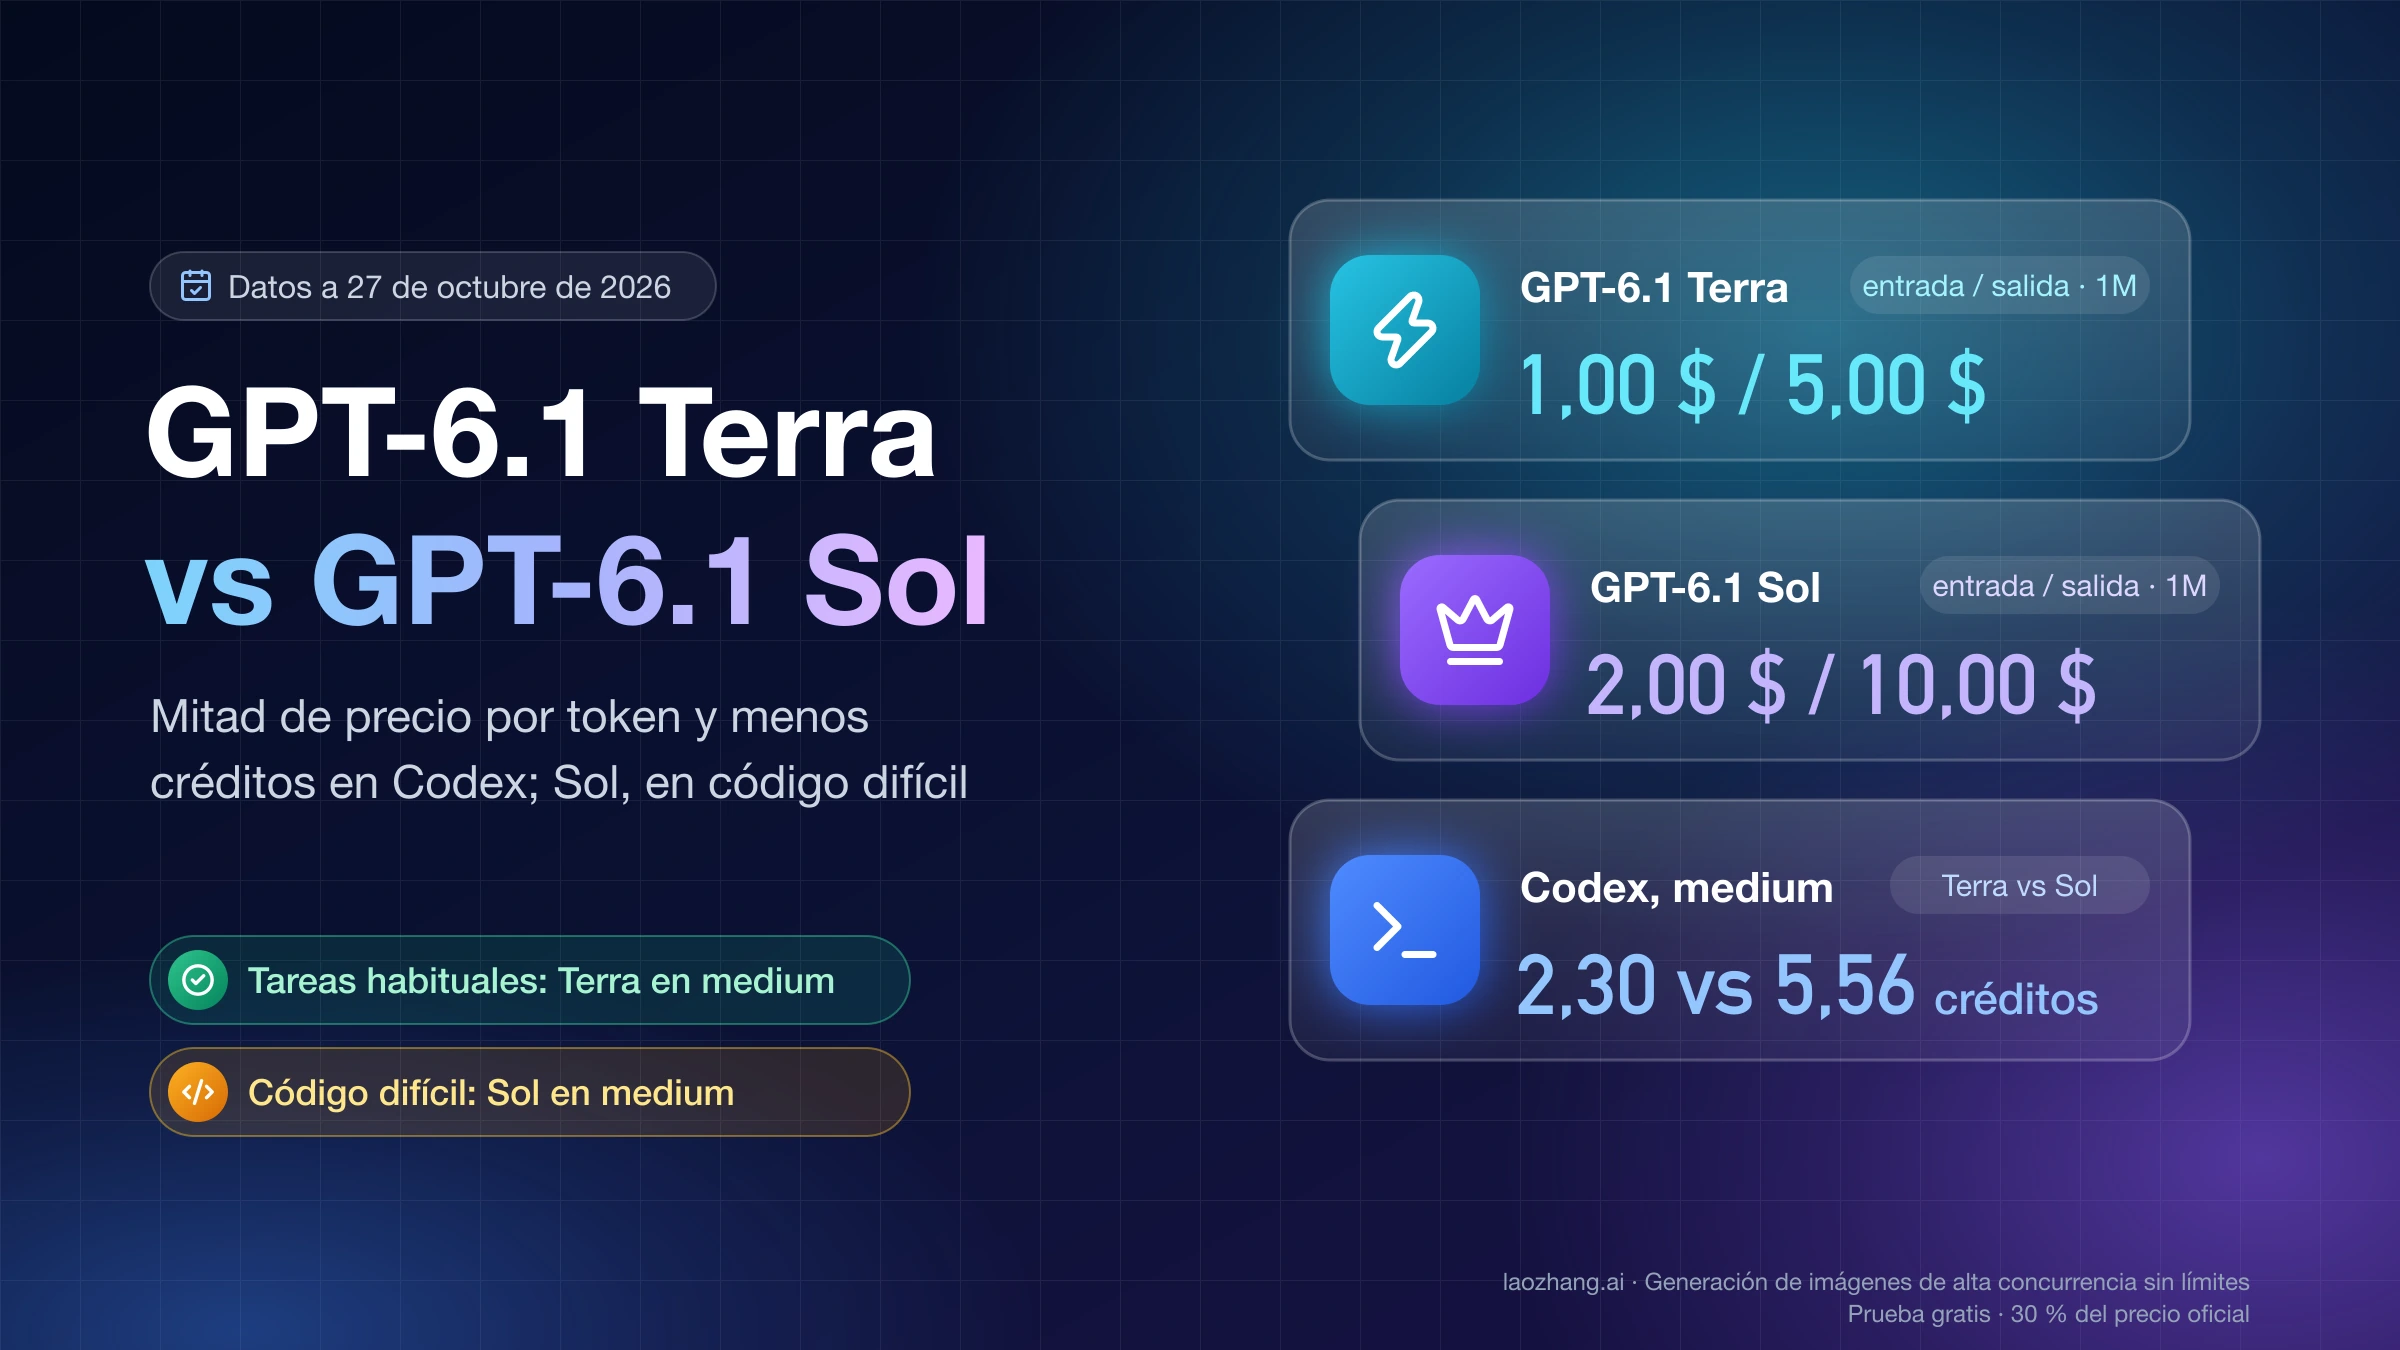
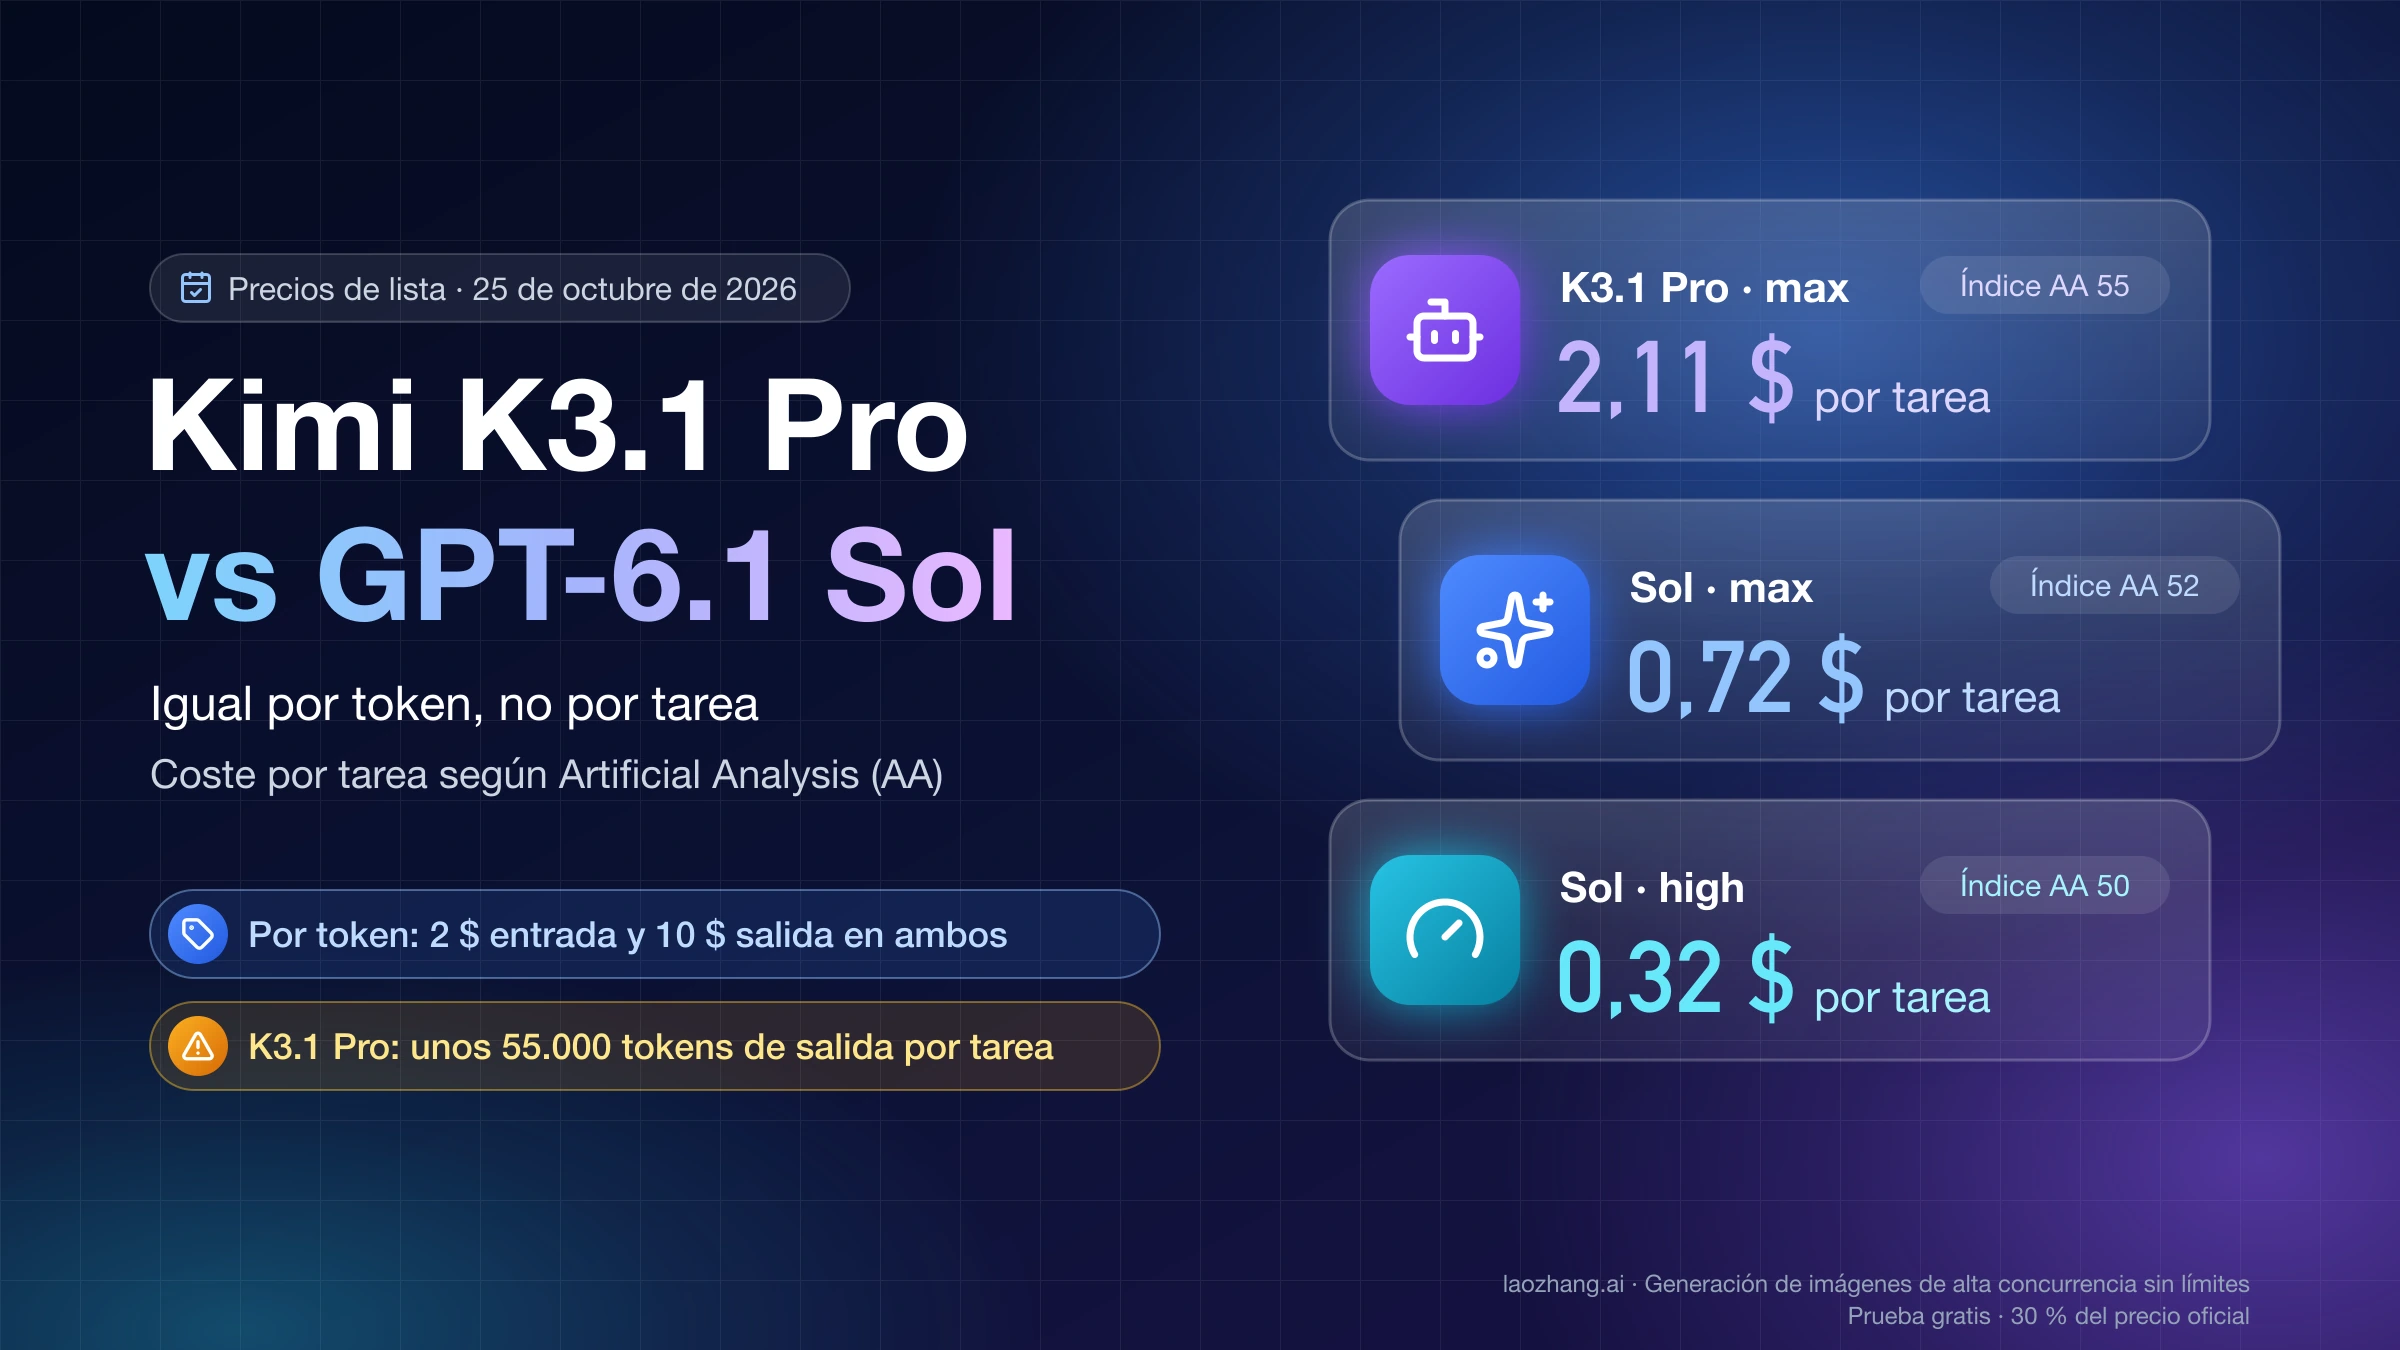
Frente a GPT-6 Astra, la relación de precios de lista es sencilla: Astra cuesta 5 veces más en entrada y salida (10 y 50 USD por millón) y 10 veces más en entrada en caché (1,00 frente a 0,10 USD). OpenAI sigue llamando a Astra «nuestro modelo de frontera más capaz». Si lo que dudas es si esa diferencia compensa, el detalle de tarifas y contexto largo está en Precio de la API de GPT-6 Astra: coste con caché y contexto largo. La gama anterior, antes de esta actualización, se compara en GPT-6 Sol, Luna y Astra frente a Terra 6.1: precios y cuál usar.
Las cifras de rendimiento son de OpenAI
El lema del lanzamiento, rendimiento «casi Astra» a un quinto del precio, es una afirmación de OpenAI sobre sus propias pruebas, hechas en su entorno de investigación o por API, no en ChatGPT. Los datos que más pesan para decidir, tal como aparecen en el anuncio de GPT-6.1 Sol:
- DeepSWE v1.1 (programación): resultado «comparable» al de GPT-6 Astra con un coste de alrededor de una quinta parte, y 6,4 puntos por encima de la mejor puntuación de GPT-6 Sol con menos esfuerzo y menos coste.
- OSWorld 2.0 (uso del ordenador, esfuerzo
max): 7 puntos por encima de GPT-6 Sol con menos de la mitad del coste, y a menos de 2,1 puntos de Astra con cerca de una séptima parte del coste por tarea. - Terminal-Bench Science 0.1 (esfuerzo
max): coste medio por tarea de 5,47 USD, frente a 23,80 USD de Astra y 23,21 USD de Claude Opus 5.5. Astra sigue primero con un 68,1 %, y OpenAI recomienda Astra para las tareas científicas más difíciles. - Errores factuales (esfuerzo
xhigh): 4,1 %, frente al 4,5 % de GPT-6 Sol y el 4,0 % de Astra, medido sobre conversaciones difíciles elegidas a propósito, no sobre uso típico.
Son evaluaciones seleccionadas por el propio fabricante, y las cifras de modelos de la competencia proceden, según OpenAI, de informes públicos. Sirven para decidir qué probar, no para saber cómo rendirá con tus tareas; eso lo mide la comparación del último apartado.
Cuánto cambia tu factura al pasar a GPT-6.1 Sol
La tarifa completa de gpt-6.1-sol en la API de OpenAI, en USD por millón de tokens y a 5 de octubre de 2026:
| Modalidad | Entrada | Entrada en caché | Escritura en caché | Salida |
|---|---|---|---|---|
| Standard, hasta 272K de entrada | 2,00 | 0,10 | 2,50 | 10,00 |
| Standard, más de 272K | 4,00 | 0,20 | 5,00 | 15,00 |
| Fast, hasta 272K | 4,00 | 0,20 | 5,00 | 20,00 |
| Fast, más de 272K | 8,00 | 0,40 | 10,00 | 30,00 |
| Batch y Flex, hasta 272K | 1,00 | 0,05 | 1,25 | 5,00 |
| Batch y Flex, más de 272K | 2,00 | 0,10 | 2,50 | 7,50 |
Fast (el antiguo procesamiento Priority, renombrado el 30 de julio de 2026) cuesta el doble que Standard; Batch y Flex, la mitad. La entrada en caché cuesta un 5 % de la entrada normal, y la escritura en caché de 30 minutos (la de la tabla), 1,25 veces. La escritura de 12 horas, añadida el 20 de octubre de 2026 y disponible solo en la Responses API, cuesta 2,5 veces: 5,00 USD en Standard hasta 272K, 10,00 USD por encima de 272K y en Fast hasta 272K, y 2,50 USD en Batch y Flex hasta 272K. Los tokens de razonamiento se facturan como salida. Las herramientas integradas, como la búsqueda web, pueden añadir cargos por llamada aparte de los tokens.
Para calcular una petición en Standard:
coste (USD) = (entrada sin caché × tarifa de entrada
             + entrada en caché × tarifa de caché
             + escritura en caché × tarifa de escritura
             + salida × tarifa de salida) / 1.000.000
Si tu carga vive de la caché, ahorras
Un turno típico de agente de programación que relee el repositorio: 150.000 tokens de entrada, de los que 140.000 salen de caché y 10.000 son nuevos, más 3.000 tokens de salida con el razonamiento incluido. Las escrituras en caché no se cuentan porque cuestan 2,50 USD en los dos modelos y no cambian la diferencia.
gpt-6-sol: 10.000 × 2 + 140.000 × 0,20 + 3.000 × 10 = 20.000 + 28.000 + 30.000 → 0,078 USDgpt-6.1-sol: 10.000 × 2 + 140.000 × 0,10 + 3.000 × 10 = 20.000 + 14.000 + 30.000 → 0,064 USD
(Los productos están en USD × tokens; divide entre 1.000.000.) Son 0,014 USD menos por turno, cerca de un 18 %; en 50 turnos, 3,20 USD frente a 3,90 USD. El cálculo supone que los dos modelos gastan los mismos tokens, y no tiene por qué ser así: si GPT-6.1 Sol razona más o menos para la misma tarea, la salida cambia y con ella el resultado. Y supone la API directa de OpenAI: por laozhang.ai, a 5 de octubre de 2026, ese mismo turno cuesta 0,330 USD con gpt-6.1-sol, porque la caché se cobra a precio de entrada (cálculo completo en el apartado sobre esa ruta).
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Si tu aplicación no reutiliza contexto y la entrada en caché es cero, las tarifas de los dos modelos son idénticas (2 / 2,50 / 10 USD hasta 272K; 4 / 5 / 15 USD por encima). En ese caso, cualquier diferencia en la factura sale solo del número de tokens por tarea.
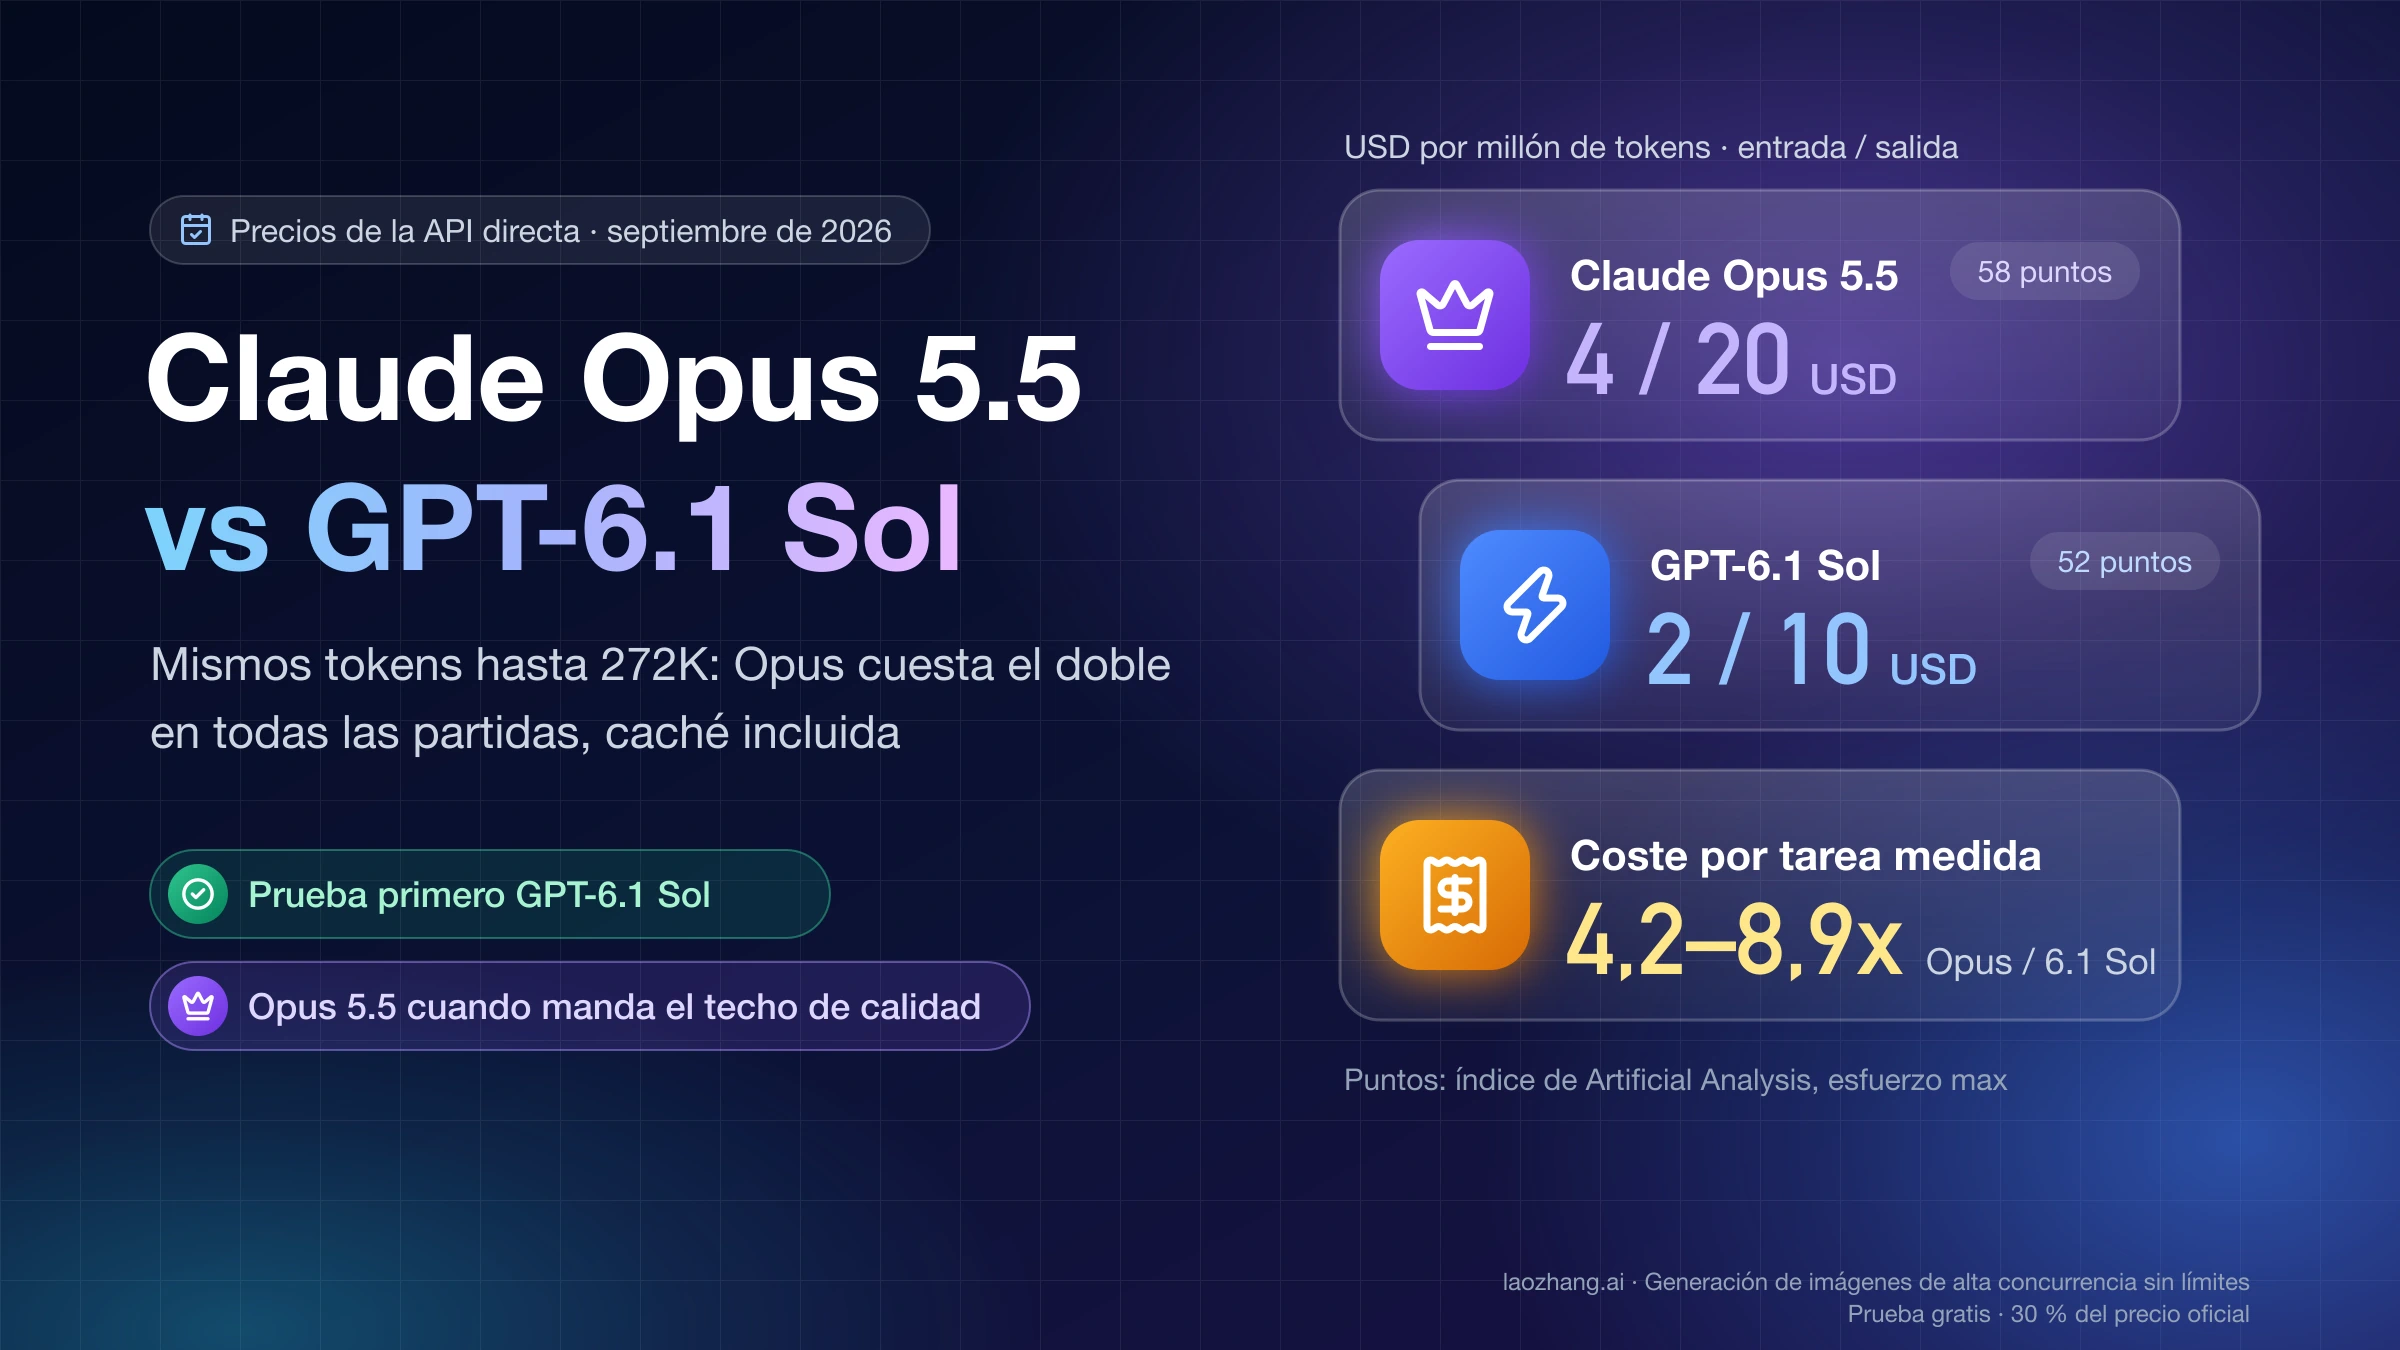
Si comparabas GPT-6 Sol con Claude Opus 5.5 a partir de que la lectura de caché costaba lo mismo en los dos, como en Claude Opus 5.5 vs GPT-6 Sol: cuál probar primero y qué pagas, ese punto ya no vale para GPT-6.1 Sol: su lectura de caché cuesta la mitad que la de GPT-6 Sol.
Por encima de 272K se encarece la petición entera
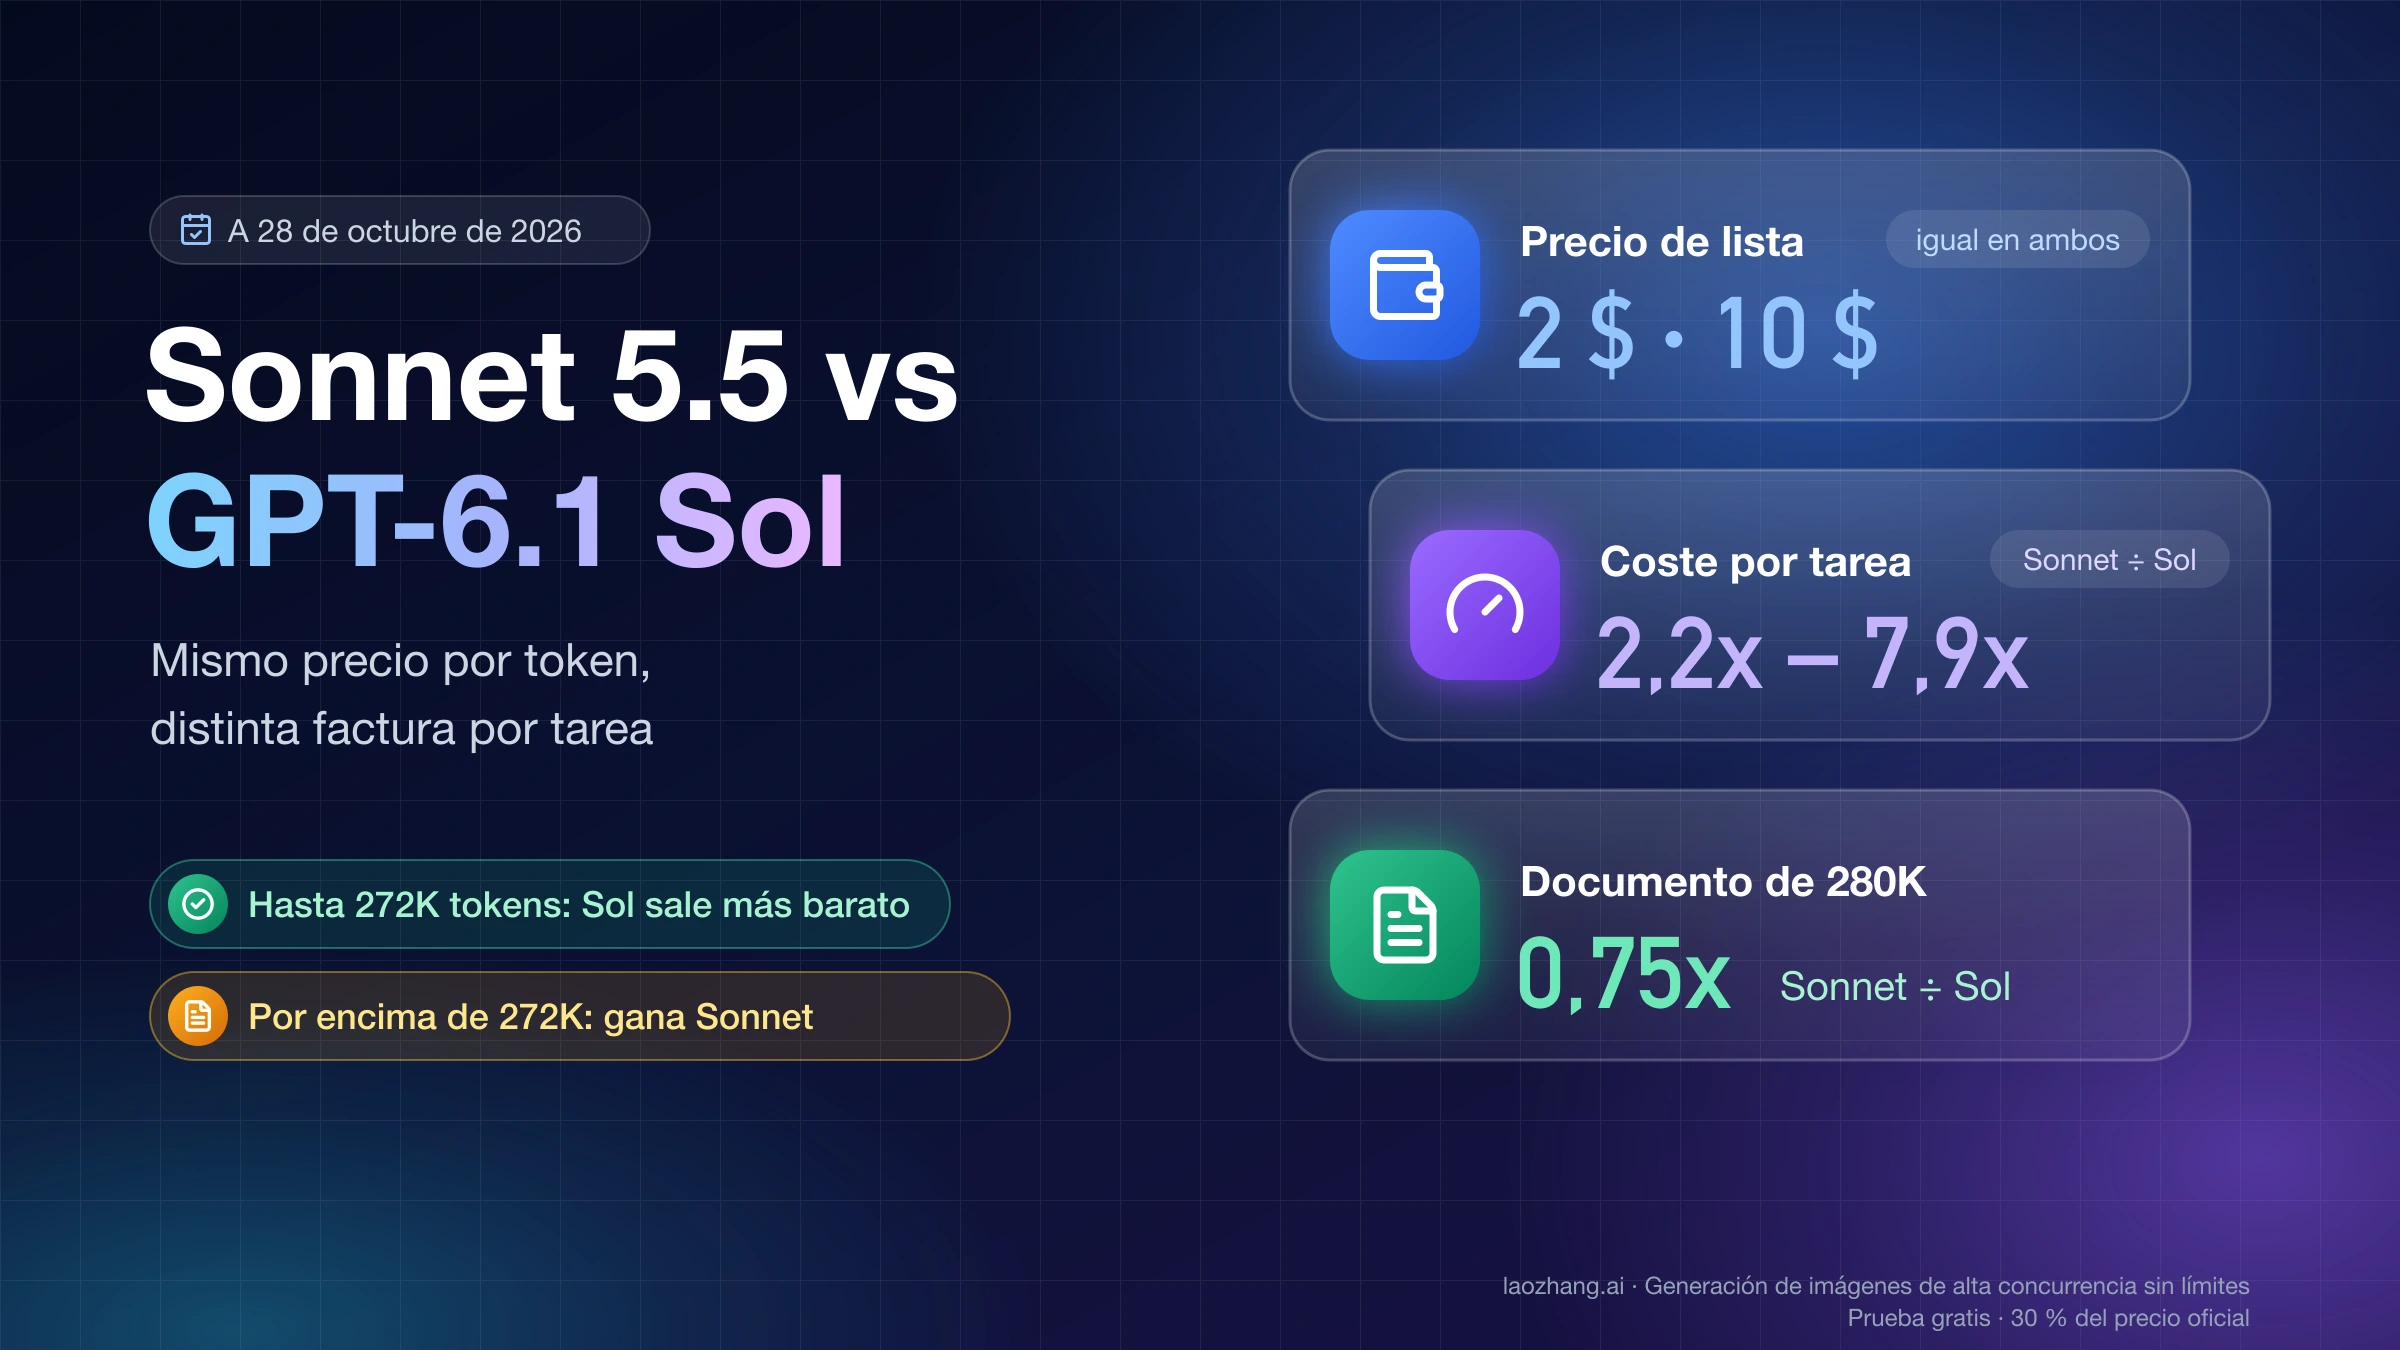
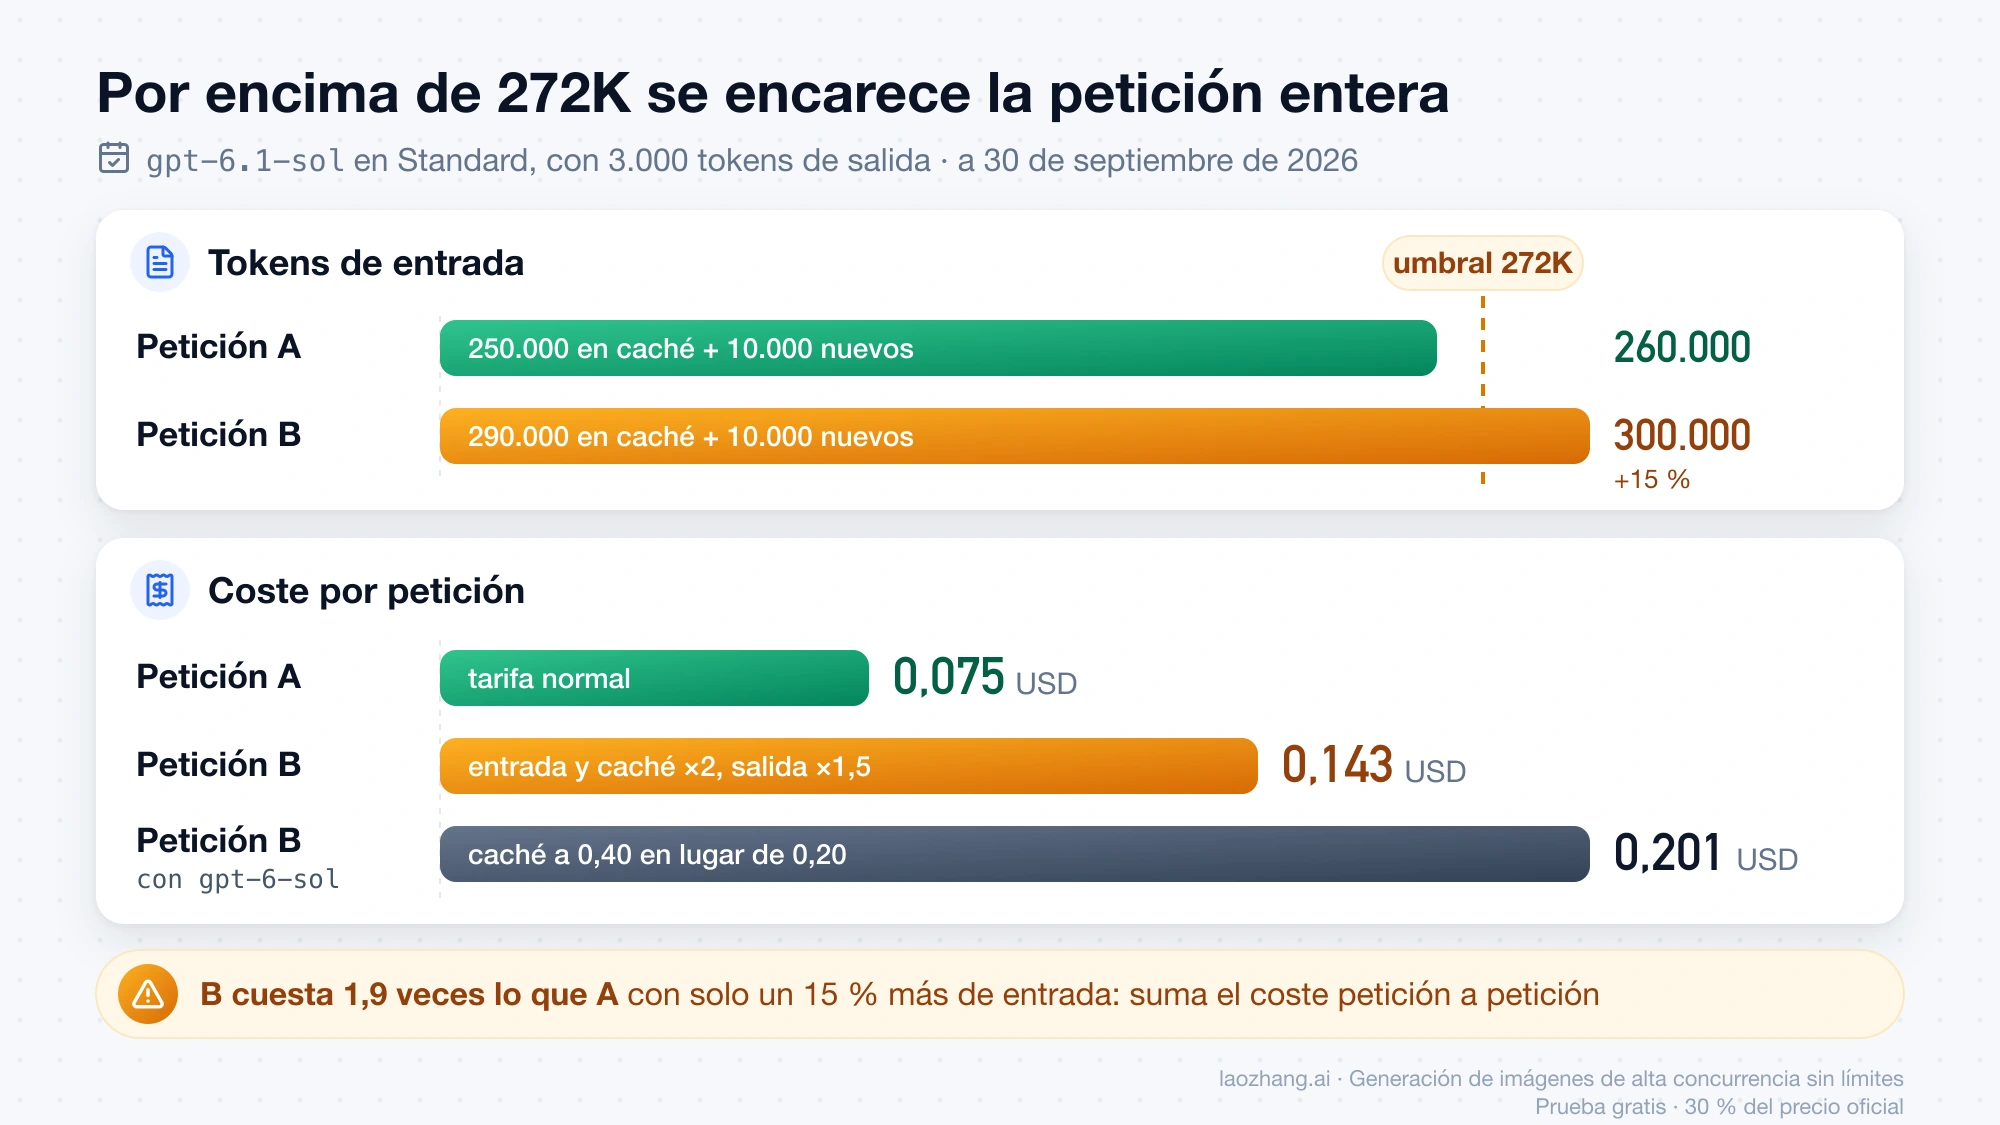
La ficha del modelo lo dice sin rodeos: las peticiones con más de 272K tokens de entrada se cobran al doble en entrada y caché y a 1,5 veces en salida para la petición completa, no solo para los tokens que pasan del umbral. Con gpt-6.1-sol, en Standard:
| Petición | Entrada (en caché + nueva) | Salida | Cálculo | Coste |
|---|---|---|---|---|
| A | 260.000 (250.000 + 10.000) | 3.000 | 10.000 × 2 + 250.000 × 0,10 + 3.000 × 10 | 0,075 USD |
| B | 300.000 (290.000 + 10.000) | 3.000 | 10.000 × 4 + 290.000 × 0,20 + 3.000 × 15 | 0,143 USD |
B con gpt-6-sol | 300.000 (290.000 + 10.000) | 3.000 | 10.000 × 4 + 290.000 × 0,40 + 3.000 × 15 | 0,201 USD |
Con un 15 % más de entrada, B cuesta 1,9 veces lo que A. El cálculo cuenta los tokens en caché dentro de los 272K, porque la regla habla de duplicar «input and cache rates» en las peticiones que superan el umbral; la ficha no lo desglosa más. Si un agente se queda casi siempre por debajo pero a veces carga más de 272K, esas llamadas sueltas pueden pesar más de lo que parece: suma el coste petición a petición, no con una media.
Fast, residencia en la UE y Ultrafast
- Residencia de datos: GPT-6.1 Sol admite residencia en EE. UU. y en la UE. El procesamiento regional añade un 10 % a los modelos publicados desde el 5 de marzo de 2026, así que se aplica a este. Si tu empresa usa residencia en la UE, Fast no está disponible; te quedan Standard, Batch y Flex.
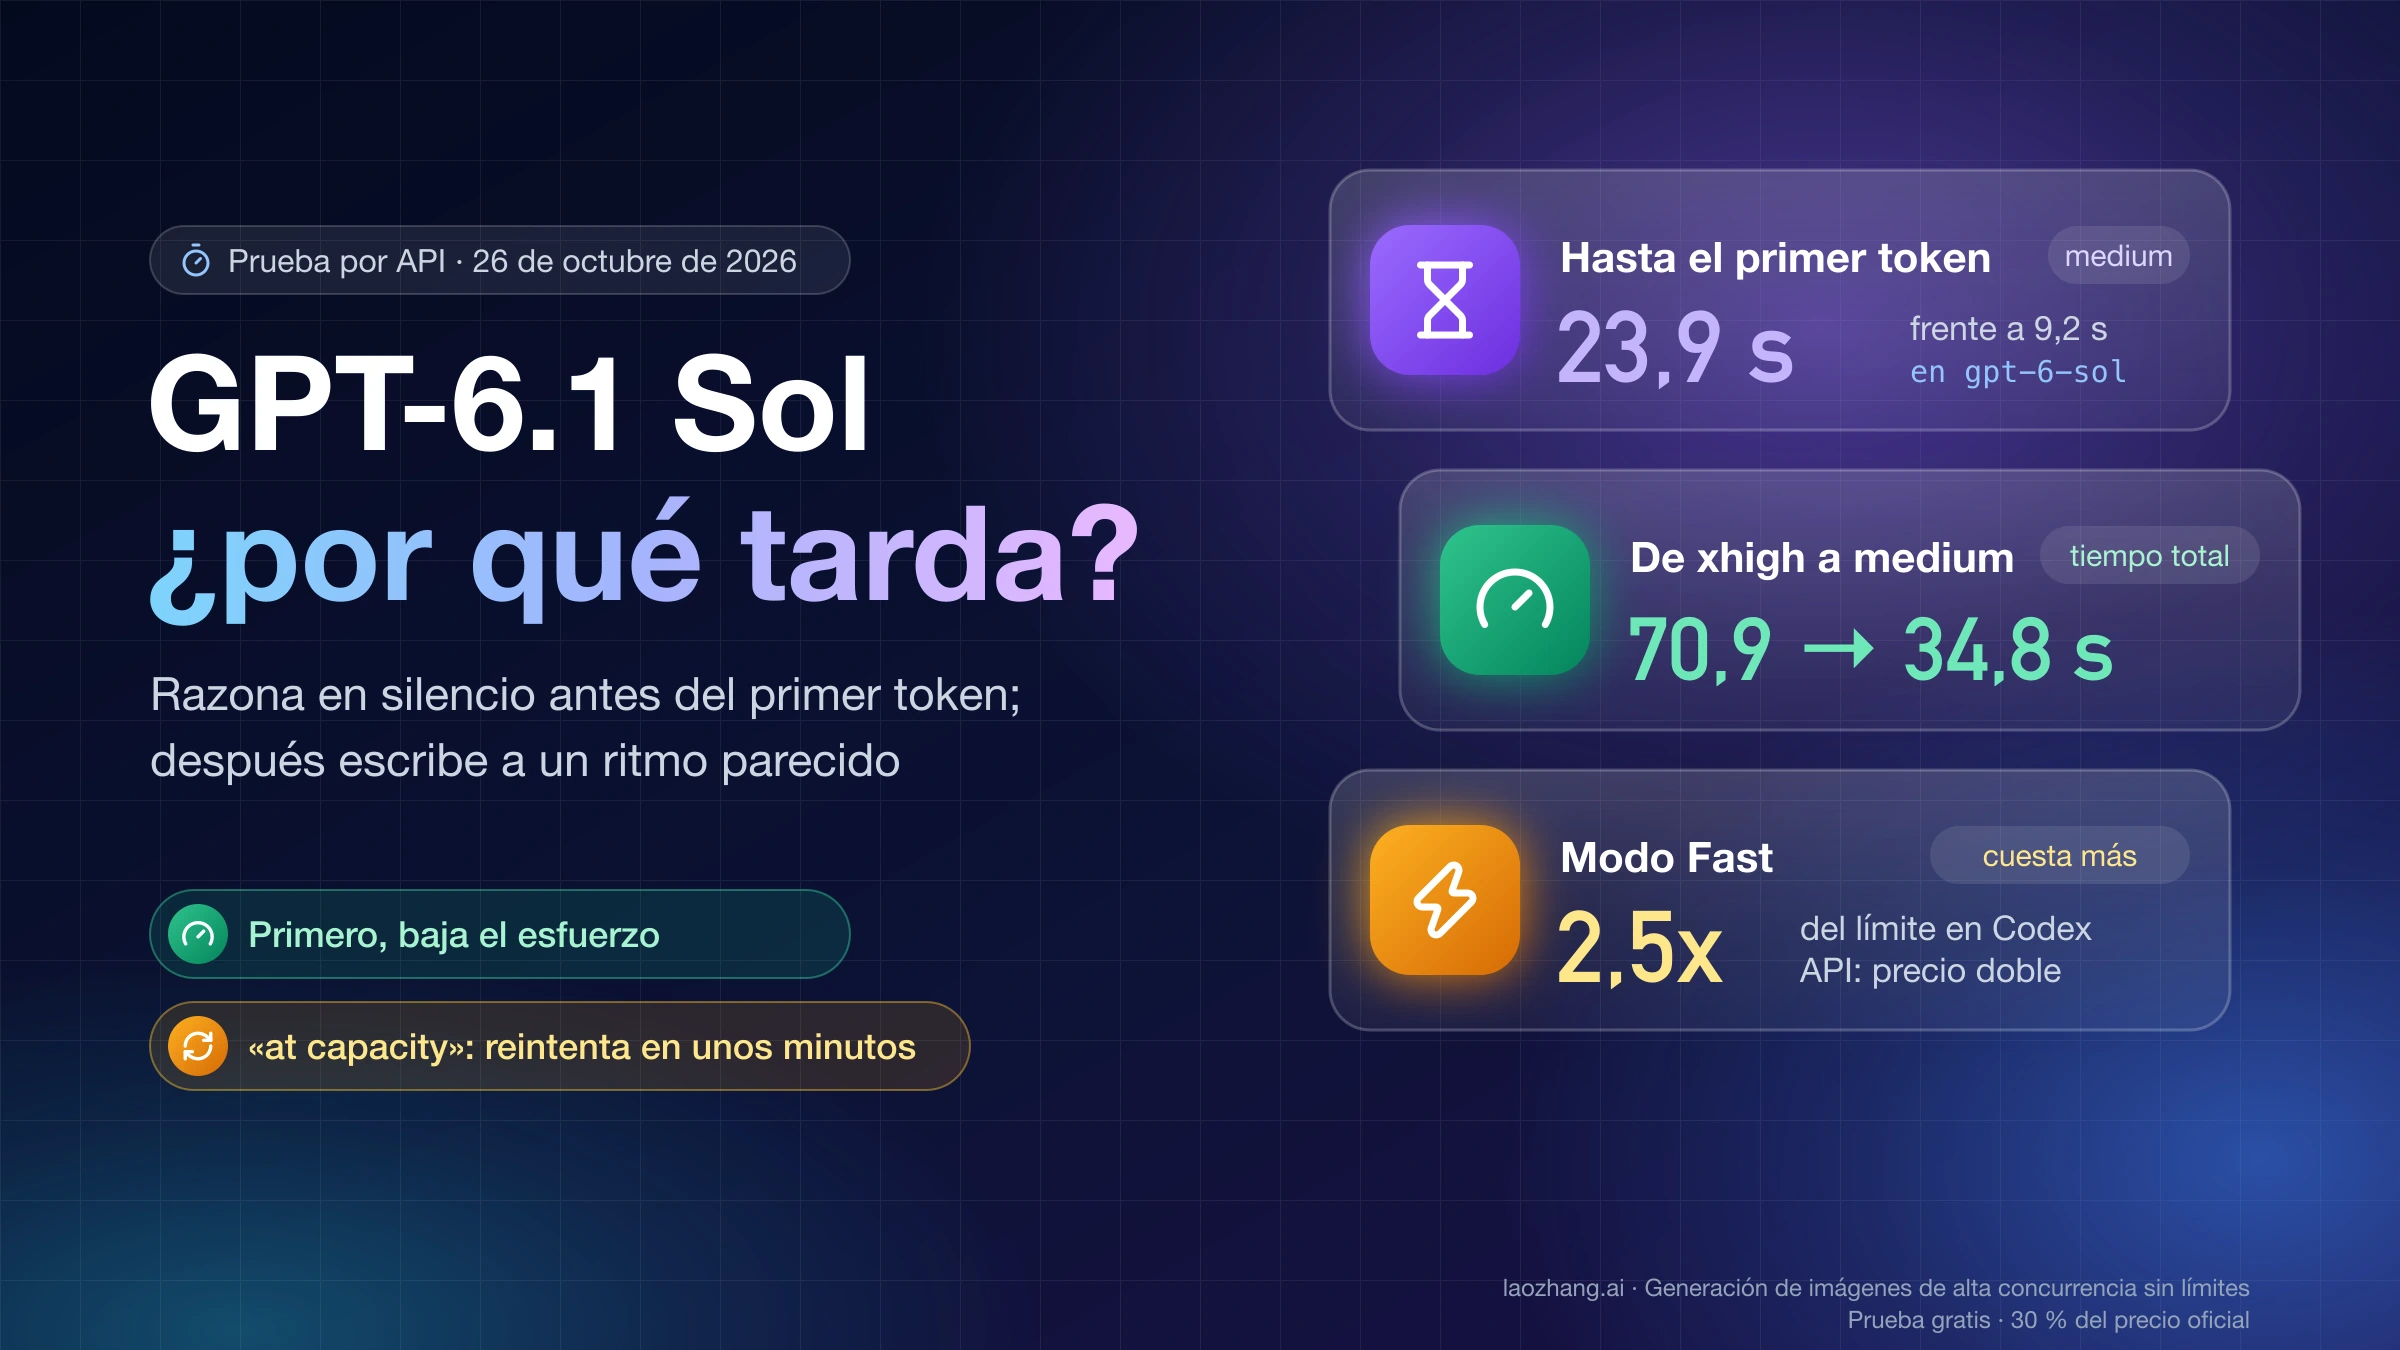
- Ultrafast: en el lanzamiento las fuentes de OpenAI se contradecían. El anuncio decía que GPT-6.1 Sol Ultrafast se lanzó junto a GPT-6 Astra Ultrafast y que se ofrecía por API, pero el resumen del DevDay lo daba como «próximamente», la página de modelos de ChatGPT indicaba que al lanzamiento solo había Standard y Fast y que Ultrafast llegaría más tarde, y el registro de cambios del 29 de septiembre y la pestaña Ultrafast de la página de precios solo recogían
gpt-6-astra. El 15 de octubre de 2026 el registro de cambios añadióservice_tier: "ultrafast"paragpt-6.1-solen la Responses API, para todos los usuarios de la API. Cuesta seis veces Standard: hasta 272K, 12 USD de entrada, 0,60 de entrada en caché, 15 de escritura de 30 minutos (30 la de 12 horas) y 60 de salida; por encima, 24 de entrada y 90 de salida. A diferencia de Astra Ultrafast (global o EE. UU.), con GPT-6.1 Sol funciona con procesamiento global y residencia en EE. UU. y en la UE.
Qué revisar en tu petición antes de cambiar el ID
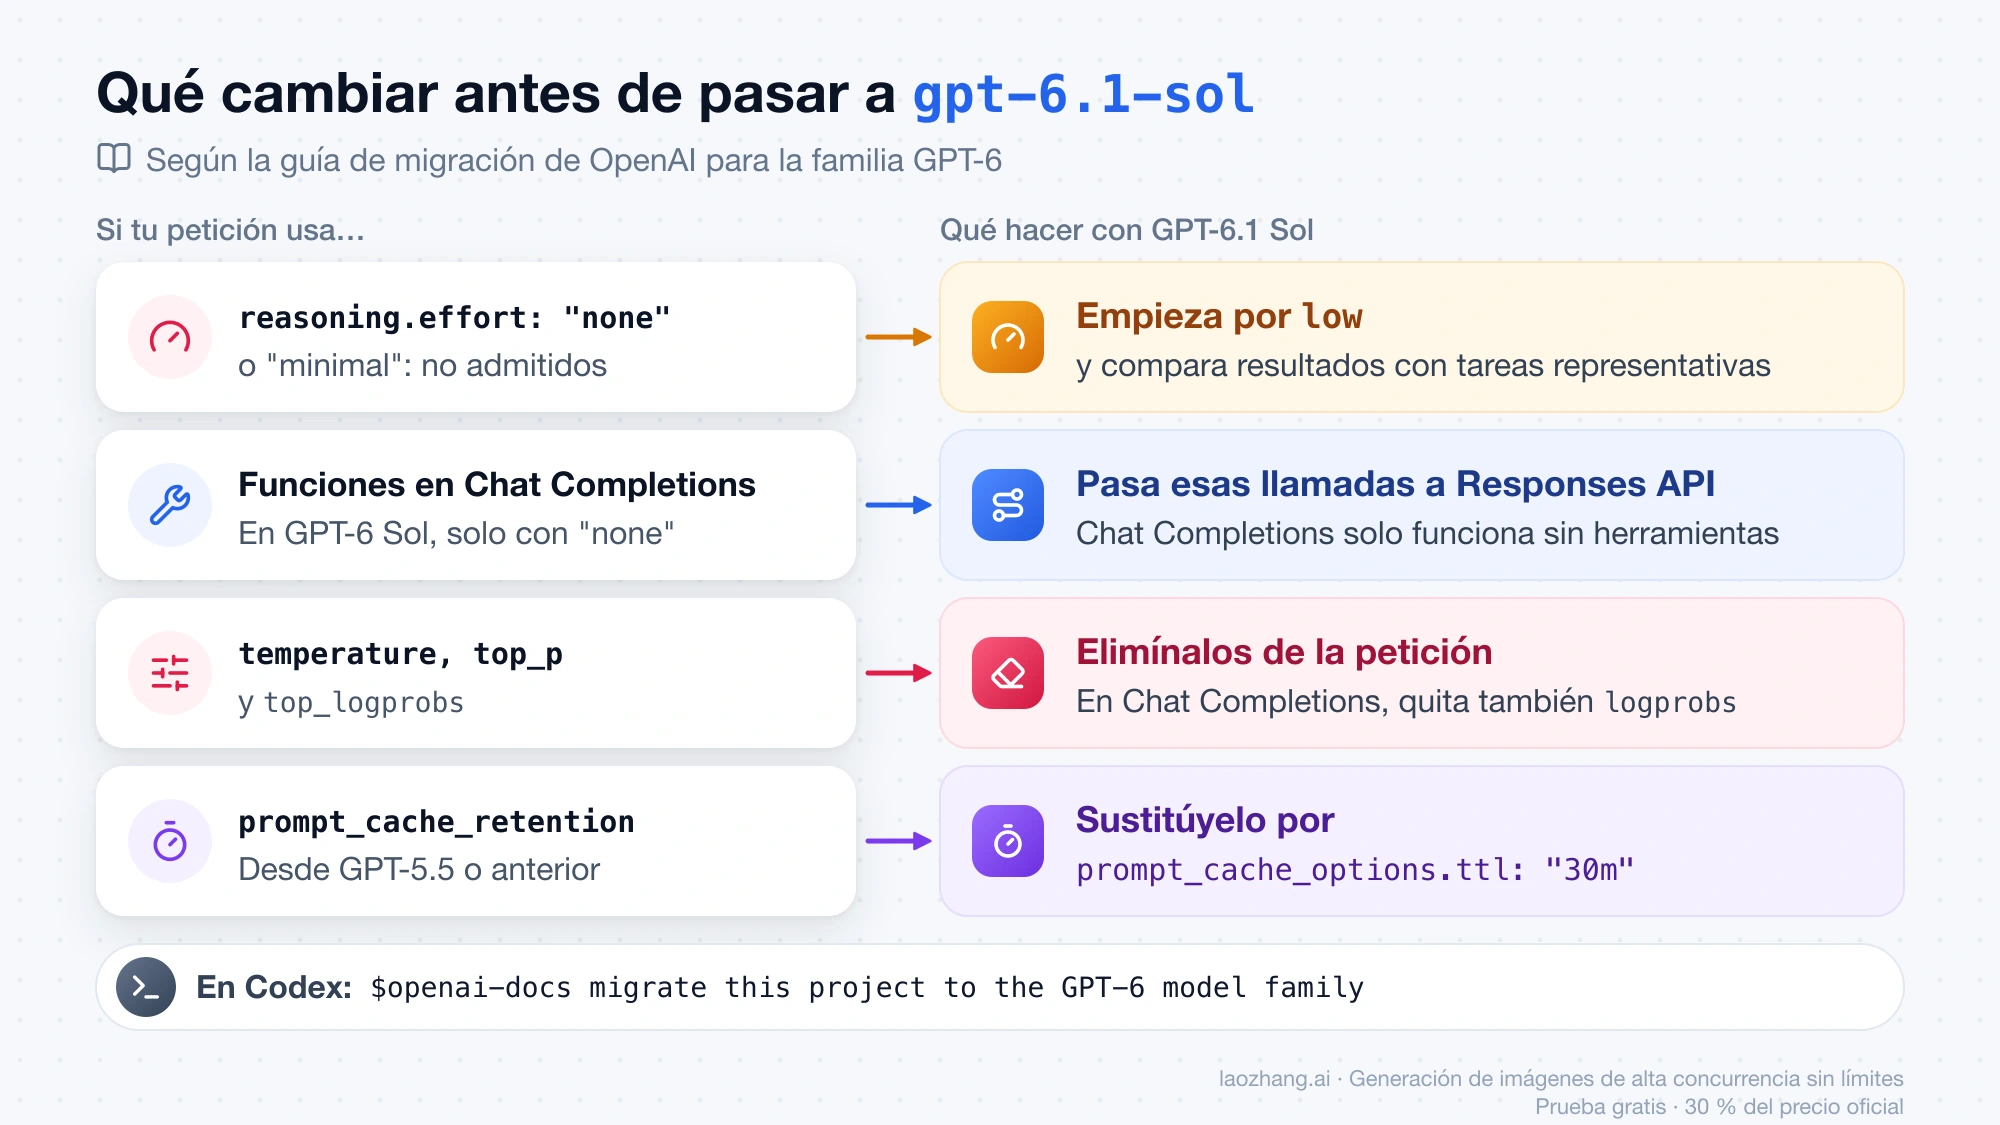
La guía de migración de OpenAI para la familia GPT-6 reduce el cambio a unas pocas comprobaciones. Estas son las que afectan a quien viene de gpt-6-sol o de un modelo GPT-5.x:
| Si tu petición actual usa… | Con gpt-6.1-sol | Qué cambiar |
|---|---|---|
reasoning.effort: "none" o reasoning_effort: "none" | No admitido | Usa low |
minimal | No admitido | Empieza por low y compara resultados con tareas representativas |
Llamadas a funciones o herramientas por Chat Completions (en GPT-6 Sol, solo posibles con none) | No admitido | Pasa esas llamadas a Responses API |
| Chat Completions sin herramientas | Admitido | Nada, salvo los parámetros de la fila siguiente |
temperature, top_p, top_logprobs | No admitidos con esfuerzo distinto de none, y aquí nunca es none | Elimínalos; en Chat Completions quita también logprobs |
include con message.output_text.logprobs en Responses | No admitido | Quítalo de include |
prompt_cache_retention (desde GPT-5.5 o anterior) | Sustituido | Usa prompt_cache_options.ttl con "30m" |
| Un modelo ajustado con fine-tuning | No hay fine-tuning para GPT-6.1 Sol | Mantén el modelo ajustado o prueba antes con prompts |
Dos matices de la guía de OpenAI:
- Los niveles de esfuerzo no equivalen exactamente de una generación a otra. Si usabas
mediumcon GPT-6 Sol, empieza con el mismo nivel y ajusta según los resultados, no según el nombre. - Para cambiar el esfuerzo a mitad de una conversación, OpenAI recomienda elementos de entrada
configuration_updatey dejar igual elreasoning.effortde la petición, porque así se conserva el prefijo del prompt y la caché sigue funcionando. Cambiar el esfuerzo de la petición entre turnos puede costarte justo la rebaja de la caché.
Si trabajas en Codex, la guía propone pedirle la migración al propio agente con la skill de documentación: $openai-docs migrate this project to the GPT-6 model family.
Petición con herramientas: Responses API
Este ejemplo en Python sustituye una llamada a función que antes iba por Chat Completions con none. El esfuerzo pasa a low y no hay temperature:
from openai import OpenAI

client = OpenAI()

tools = [{
    "type": "function",
    "name": "estado_pedido",
    "description": "Devuelve el estado de un pedido a partir de su número",
    "parameters": {
        "type": "object",
        "properties": {"pedido_id": {"type": "string"}},
        "required": ["pedido_id"],
        "additionalProperties": False,
    },
    "strict": True,
}]

resp = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},  # con gpt-6-sol quizá usabas "none"
    input="¿En qué estado está el pedido 48213?",
    tools=tools,
)

llamada = next(item for item in resp.output if item.type == "function_call")
print(llamada.name, llamada.arguments)

# Devuelve el resultado de tu función con el mismo call_id
resp2 = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},
    previous_response_id=resp.id,
    input=[{
        "type": "function_call_output",
        "call_id": llamada.call_id,
        "output": '{"estado": "enviado"}',
    }],
    tools=tools,
)
print(resp2.output_text)
print(resp2.usage)
Petición sin herramientas: Chat Completions
Si tu código solo genera texto por Chat Completions, basta con cambiar el modelo, el esfuerzo y quitar los parámetros de muestreo:
chat = client.chat.completions.create(
    model="gpt-6.1-sol",
    reasoning_effort="low",
    messages=[{"role": "user", "content": "Resume este registro de errores en tres puntos: ..."}],
    # sin temperature, top_p, logprobs ni top_logprobs
)
print(chat.choices[0].message.content)
print(chat.usage)
Antes de lanzar la primera petición, comprueba que tu proyecto tiene acceso al modelo y que la respuesta llega bien; el procedimiento es el mismo que en Cómo acceder a GPT-6 Astra por API y comprobar la primera respuesta, cambiando el ID.
Dónde seleccionar GPT-6.1 Sol
| Dónde trabajas | Cómo seleccionarlo | Condiciones a 5 de octubre de 2026 |
|---|---|---|
| API de OpenAI | model: "gpt-6.1-sol" (la ficha no publica snapshots con fecha) | No disponible en el nivel Free de la API; sí desde el nivel 1 |
| Codex CLI | codex --model gpt-6.1-sol o codex exec -m gpt-6.1-sol "Review the current changes"; dentro de la sesión, /model | Con sesión de ChatGPT, según tu plan; con clave de API propia, según el acceso de la API |
| Codex en la app de escritorio, CLI y extensión del IDE | model = "gpt-6.1-sol" en el config.toml compartido | El mismo archivo configura las tres superficies |
| ChatGPT Work (web y móvil) y Codex en la app de escritorio | Selector de modelo; en Advanced eliges modelo, esfuerzo y velocidad | Plus, Pro, Business, Enterprise y Edu; no está en el chat normal |
| Enterprise y Edu | Igual que arriba | Desactivado por defecto hasta que un administrador lo active |
| Free y Go | — | Sin acceso en el lanzamiento |
Fuentes: página de modelos de ChatGPT y ficha del modelo en la API.
En ChatGPT Work y en la app de escritorio, OpenAI recomienda empezar con el ajuste por defecto (Power) y moverte hacia Smarter para razonar más o hacia Faster para trabajos más rápidos y baratos. Los niveles de esfuerzo van de Light (equivale a Low en la CLI) a Extra High; Max y Ultra dependen de tu configuración y, en la CLI, aparecen en /model bajo «More reasoning…». Según la propia OpenAI, la mayoría de las tareas no necesitan Max ni Ultra. Elegir el modelo en el selector no cambia los permisos del espacio de trabajo: si tu administrador no lo ha habilitado, seguirás sin acceso.
La disponibilidad depende del despliegue, de cómo inicias sesión y del cliente, así que puede no aparecer todavía en tu cuenta aunque tu plan lo incluya. Mientras tanto, GPT-5.6 Sol, Terra y Luna siguen disponibles. Si en Codex sigues con GPT-5.5, ten en cuenta que se retira de ChatGPT, ChatGPT Work y Codex el 14 de octubre de 2026; la retirada no afecta a la API. El nuevo plan Pro de 500 USD al mes añade los límites de uso más altos y Ultrafast: primero Astra y ahora también GPT-6.1 Sol, que la documentación de ChatGPT incluye además en planes Enterprise y Edu elegibles. Para usar GPT-6.1 Sol en Standard o Fast basta con Plus.
Si usas Codex con un proveedor configurado por Chat Completions, OpenAI avisa de que ese soporte está obsoleto en Codex y desaparecerá en versiones futuras.
Límites de la API por nivel
| Nivel de uso | Peticiones por minuto | Tokens por minuto |
|---|---|---|
| Free | No admitido | No admitido |
| Nivel 1 | 500 | 500.000 |
| Nivel 2 | 5.000 | 1.000.000 |
| Nivel 3 | 5.000 | 2.000.000 |
| Nivel 4 | 10.000 | 4.000.000 |
| Nivel 5 | 15.000 | 40.000.000 |
El nivel sube solo a medida que aumenta tu gasto con OpenAI. Si tu organización está en el nivel 1 y lanza agentes con contextos de cientos de miles de tokens, el límite de tokens por minuto es el primero que conviene vigilar.
La lista de países admitidos de OpenAI para la API y ChatGPT incluye España. Microsoft Foundry, Amazon Bedrock y OpenRouter también listan GPT-6.1 Sol en sus catálogos; allí los precios, regiones y límites los fija cada plataforma, no la tabla de OpenAI. laozhang.ai lo ofrece desde el 5 de octubre de 2026; sus condiciones, comprobadas con llamadas reales, están en el apartado siguiente.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
GPT-6.1 Sol por laozhang.ai: misma tarifa, sin precio de caché
laozhang.ai cobra gpt-6.1-sol a la misma tarifa de lista que OpenAI en Standard: 2 USD por millón de tokens de entrada y 10 de salida hasta 272.000 tokens, y 4 / 15 USD por encima, aplicados a la petición entera. Lo que cambia es la caché: en su catálogo de modelos y precios, la columna de lectura de caché de este modelo muestra «—», es decir, sin precio de caché, y toda la entrada se cobra como entrada normal aunque acierte en caché. Con llamadas cortas o sin contexto repetido pagas lo mismo que en directo; en bucles de agentes que releen el repositorio, unas cinco veces más en el ejemplo de abajo. Son datos a 5 de octubre de 2026: el catálogo indica que lo que se te aplica es lo que muestra la consola, y el precio de caché puede configurarse más adelante.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Como España está en la lista de países admitidos de OpenAI, la API directa sigue siendo la vía normal. Esta ruta encaja si ya usas una clave de laozhang.ai para otros modelos y tu carga de GPT-6.1 Sol apenas tira de caché. Es una API: no da acceso a ChatGPT Work ni a un plan de Codex.
Qué parámetros acepta gpt-6.1-sol en laozhang.ai
La base URL es https://api.laozhang.ai/v1, con Chat Completions (/v1/chat/completions) y Responses (/v1/responses). La etiqueta «OpenAI-compatible» del catálogo se refiere al formato de Chat Completions, y el propio catálogo advierte que no significa que se acepte cualquier parámetro. Resultado de llamadas reales del 5 de octubre de 2026, con un token del grupo default y una llamada por caso:
Petición con gpt-6.1-sol | Chat Completions | Responses |
|---|---|---|
Texto con esfuerzo low | Funciona | Funciona |
Esfuerzo none | Error 400 | Error 400 |
Esfuerzo max | Error 400 | Funciona |
temperature: 0.2 | Error 400 | No probado |
| Llamada a función | Error 400 | Funciona: devuelve un function_call |
Búsqueda web integrada (web_search) | No probado | Funciona |
| Mismo prefijo de unos 42.000 tokens, segunda llamada | Acierta en caché (cached_tokens: 42.188) | Acierta en caché (cached_tokens: 42.188) |
Los errores llegan con este texto, útil para reconocerlos en tus registros:
Chat Completions, reasoning_effort "none" (con "max", igual pero con 'max'):
Unsupported value: 'reasoning_effort' does not support 'none' with this model. Supported values are: 'low', 'medium', 'high', and 'xhigh'.

Chat Completions, temperature 0.2:
Unsupported value: 'temperature' does not support 0.2 with this model. Only the default (1) value is supported.

Chat Completions, herramienta de función con esfuerzo "low":
Function tools with reasoning_effort are not supported for gpt-6.1-sol in /v1/chat/completions. To use function tools, use /v1/responses or set reasoning_effort to 'none'.
El último mensaje propone pasar a none, pero none también se rechaza, así que por Chat Completions no hay forma de llamar herramientas: llévalas a Responses, igual que con la API directa. El rechazo de max en Chat Completions se observó por esta ruta; si necesitas max, usa Responses. En Chat Completions, el campo model de la respuesta devuelve gpt-6.1-sol-2026-09-29, no el alias.
Para usar los ejemplos de Python de arriba basta con crear el cliente así:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.laozhang.ai/v1",
    api_key=os.environ["LAOZHANG_API_KEY"],
)
De esos ejemplos, por esta ruta se comprobó la primera llamada con herramienta, no la segunda que devuelve el resultado con previous_response_id. Tampoco se probaron el streaming, las modalidades Fast, Batch y Flex, las peticiones de más de 272.000 tokens ni los límites de peticiones y tokens por minuto. Para Codex CLI, la documentación de laozhang.ai propone un proveedor propio en ~/.codex/config.toml con wire_api = "responses"; su ejemplo usa gpt-6-sol:
model = "gpt-6-sol"
model_provider = "laozhang"

[model_providers.laozhang]
name = "LaoZhang API"
base_url = "https://api.laozhang.ai/v1"
env_key = "LAOZHANG_API_KEY"
wire_api = "responses"
Con model = "gpt-6.1-sol" esta configuración no se ha probado en Codex; lo comprobado es la API de Responses con llamadas a función, sin Codex de por medio.
Cuánto cuesta por laozhang.ai con caché: 0,330 USD frente a 0,064
La facturación medida el 5 de octubre de 2026 lo confirma: una llamada a gpt-6.1-sol con 42.191 tokens de entrada, 42.188 de ellos en caché, y 6 de salida costó 0,084442 USD, exactamente 42.191 × 2 + 6 × 10 dividido entre 1.000.000. Con la tarifa de lista de OpenAI en directo, la misma llamada sale por 3 × 2 + 42.188 × 0,10 + 6 × 10 → unos 0,0043 USD, casi 20 veces menos.
Aplicado al turno de agente de antes (150.000 tokens de entrada, 140.000 en caché, 3.000 de salida, sin escrituras en caché):
| Ruta y modelo | Cálculo (USD × tokens / 1.000.000) | Por turno | 50 turnos |
|---|---|---|---|
OpenAI directo, gpt-6.1-sol | 10.000 × 2 + 140.000 × 0,10 + 3.000 × 10 | 0,064 USD | 3,20 USD |
OpenAI directo, gpt-6-sol | 10.000 × 2 + 140.000 × 0,20 + 3.000 × 10 | 0,078 USD | 3,90 USD |
laozhang.ai, gpt-6.1-sol | 150.000 × 2 + 3.000 × 10 | 0,330 USD | 16,50 USD |
laozhang.ai, gpt-6-sol (caché a 0,20) | 10.000 × 2 + 140.000 × 0,20 + 3.000 × 10 | 0,078 USD | 3,90 USD |
Sin aciertos de caché, las dos rutas dan lo mismo: 20.000 tokens de entrada y 2.000 de salida son 20.000 × 2 + 2.000 × 10 → 0,060 USD en directo y por laozhang.ai.
De ahí sale la regla, a 5 de octubre de 2026:
- Llamadas cortas o sin contexto repetido:
gpt-6.1-solpor laozhang.ai cuesta lo mismo que en directo. - Agentes con mucho contexto en caché: usa la API directa de OpenAI, donde 6.1 Sol es la opción más barata, o
gpt-6-solen laozhang.ai, que sí tiene precio de caché y en este turno cuesta lo mismo que en directo.
El cálculo deja fuera las escrituras en caché de la primera llamada de cada sesión. Para ver lo que se cobró de verdad en cada llamada, escrituras incluidas, abre el registro de llamadas de la consola de laozhang.ai; para ver si hubo acierto, mira usage.input_tokens_details.cached_tokens en Responses o usage.prompt_tokens_details.cached_tokens en Chat Completions.
Error 503 «no available channels … [pay-per-request]»
Si la llamada a gpt-6.1-sol devuelve HTTP 503 con este mensaje, el problema es el modo de facturación del token, no el modelo:
Current group default has no available channels for model gpt-6.1-sol under billing mode [pay-per-request]Un token creado en modo de pago por llamada solo puede usar los modelos que se cobran por llamada, como los de imagen; los GPT-6 se cobran por tokens. Pasa lo mismo con gpt-6-sol y gpt-6-luna, y la llamada fallida no se cobra. En la página de tokens de la consola de laozhang.ai, edita el token o crea otro en el grupo default con el modo de facturación 按量优先 (prioridad al pago por uso), que es como aparece en la consola y permite llamar tanto a modelos por tokens como por llamada. Para comprobar que el token ya ve el modelo, pide GET https://api.laozhang.ai/v1/models con él: gpt-6.1-sol debe salir en la lista.
Cómo comparar antes y después con tus propias tareas
Las cifras de OpenAI no te dicen cuánto pagarás tú. Una prueba corta sí:
- Elige entre 5 y 10 tareas reales de tus registros: alguna corta, alguna con mucho contexto en caché y, si las tienes, alguna que supere los 272K de entrada.
- Lanza cada una con los dos modelos mientras
gpt-6-solsiga respondiendo, con el mismo prompt y el esfuerzo equivalente (nonepasa alow; el resto, igual para empezar). - Guarda el uso de cada respuesta. En Responses API:
usage.input_tokens,usage.input_tokens_details.cached_tokens,usage.output_tokensyusage.output_tokens_details.reasoning_tokens. En Chat Completions:usage.prompt_tokens,usage.prompt_tokens_details.cached_tokensyusage.completion_tokens. - Calcula el coste con la tarifa de cada modelo y la regla de los 272K. Esta función reproduce los ejemplos de arriba (Standard, sin escrituras en caché); la última entrada es
gpt-6.1-solpor laozhang.ai:
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
# USD por millón de tokens, Standard, a 5 de octubre de 2026
TARIFAS = {
    "gpt-6-sol":   {"corto": (2.00, 0.20, 10.00), "largo": (4.00, 0.40, 15.00)},
    "gpt-6.1-sol": {"corto": (2.00, 0.10, 10.00), "largo": (4.00, 0.20, 15.00)},
    # por laozhang.ai, sin precio de caché: lo que acierta en caché paga entrada normal
    "gpt-6.1-sol laozhang.ai": {"corto": (2.00, 2.00, 10.00), "largo": (4.00, 4.00, 15.00)},
}

def coste(modelo, entrada, en_cache, salida):
    tramo = "largo" if entrada > 272_000 else "corto"  # más de 272K: toda la petición
    p_entrada, p_cache, p_salida = TARIFAS[modelo][tramo]
    nueva = entrada - en_cache
    return (nueva * p_entrada + en_cache * p_cache + salida * p_salida) / 1_000_000

print(coste("gpt-6-sol", 150_000, 140_000, 3_000))    # 0.078
print(coste("gpt-6.1-sol", 150_000, 140_000, 3_000))  # 0.064
print(coste("gpt-6.1-sol laozhang.ai", 150_000, 140_000, 3_000)) # 0.33- Compara el coste por tarea aceptada, no por petición. Si GPT-6.1 Sol resuelve a la primera algo que GPT-6 Sol necesitaba en dos intentos, esa diferencia pesa más que la de la caché.
- Si una tarea sigue saliendo mal, pruébala con
gpt-6-astraantes de dar el cambio por cerrado: cuesta 5 veces más por token, y solo compensa si reduce los reintentos en esa proporción.
Preguntas frecuentes
¿Cuánto cuesta GPT-6.1 Sol en la API?
En Standard y con hasta 272K tokens de entrada, 2 USD por millón de entrada, 0,10 USD de entrada en caché, 2,50 USD de escritura en caché y 10 USD de salida. Por encima de 272K, toda la petición pasa a 4 / 0,20 / 5 / 15 USD. Fast cuesta el doble; Batch y Flex, la mitad. Es la misma tarifa que GPT-6 Sol salvo la entrada en caché, que cuesta la mitad.
¿Puedo usar GPT-6.1 Sol en ChatGPT?
Sí, en ChatGPT Work y en Codex si tienes Plus, Pro, Business, Enterprise o Edu; no en el chat normal. En Enterprise y Edu tiene que activarlo un administrador. Free y Go no lo tienen, y el nivel Free de la API tampoco.
¿Va a desaparecer GPT-6 Sol?
A 5 de octubre de 2026 no hay fecha de retirada. En la página de modelos retirados y obsoletos de OpenAI, gpt-6-sol solo aparece como sustituto: el aviso del 1 de octubre lo propone en lugar de gpt-5.1 y gpt-5.3-codex, que dejan la API el 1 de abril de 2027. Su ficha remite a GPT-6.1 Sol como el Sol más reciente y ya no figura en la tabla de precios, así que conviene planificar la migración sin esperar a un aviso.
¿Hay GPT-6.1 Sol Ultrafast?
Sí, desde el 15 de octubre de 2026. El anuncio lo daba por lanzado, pero al principio el resumen del DevDay, la documentación de ChatGPT, el registro de cambios y la página de precios solo recogían Ultrafast para GPT-6 Astra. Ahora la API lo ofrece para gpt-6.1-sol a 12 USD por millón de entrada y 60 USD de salida hasta 272K, seis veces Standard, y en ChatGPT y Codex está en Pro de 500 USD y en planes Enterprise y Edu elegibles.
¿Sale más barato GPT-6.1 Sol a través de laozhang.ai?
No. A 5 de octubre de 2026, la tarifa de lista es la misma que en OpenAI (2 / 10 USD por millón hasta 272K), pero laozhang.ai no aplica precio de caché a gpt-6.1-sol: lo que acierta en caché se cobra a 2 USD en vez de 0,10. Sin caché pagas lo mismo; en un turno de agente con 140.000 tokens en caché, 0,330 USD frente a 0,064 USD en directo. Si esa es tu carga, usa la API directa o gpt-6-sol en laozhang.ai. Las llamadas con herramientas, por cualquiera de las dos vías, van por Responses API.
¿Sigue compensando GPT-6 Astra?
Para las tareas en las que GPT-6.1 Sol falla y Astra no. Según OpenAI, Astra sigue por delante en las pruebas más difíciles, como Terminal-Bench Science; a cambio, cuesta 5 veces más en entrada y salida y 10 veces más en caché. Prueba primero GPT-6.1 Sol con tus tareas y reserva Astra para las que no supere. La comparación de benchmarks y coste por tarea está en GPT-6.1 Sol vs Astra vs GPT-6 Sol: cuál usar y si Astra compensa.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 26 oct 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 26 oct 2026.
- 1.GPT-6.1 Soldevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 2.GPT-6 Soldevelopers.openai.com/api/docs/models/gpt-6-sol
- 3.página de preciosdevelopers.openai.com/api/docs/pricing
- 4.anuncio de GPT-6.1 Solopenai.com/index/introducing-gpt-6-1-sol
- 5.resumen del DevDayopenai.com/index/devday-2026-recap
- 6.página de modelos de ChatGPTlearn.chatgpt.com/docs/models
- 7.guía de OpenAIdevelopers.openai.com/api/docs/guides/latest-model
- 8.página de modelos retirados y obsoletosdevelopers.openai.com/api/docs/deprecations