Opus 5.5とGPT-6 Sol・6.1 Sol比較:費用差
272K以下ならOpus 5.5の単価はGPT-6.1 Solのちょうど2倍で、長い依頼でも逆転しません。同じ推論設定の第三者計測では1課題の費用が4.2〜8.9倍です。
目次
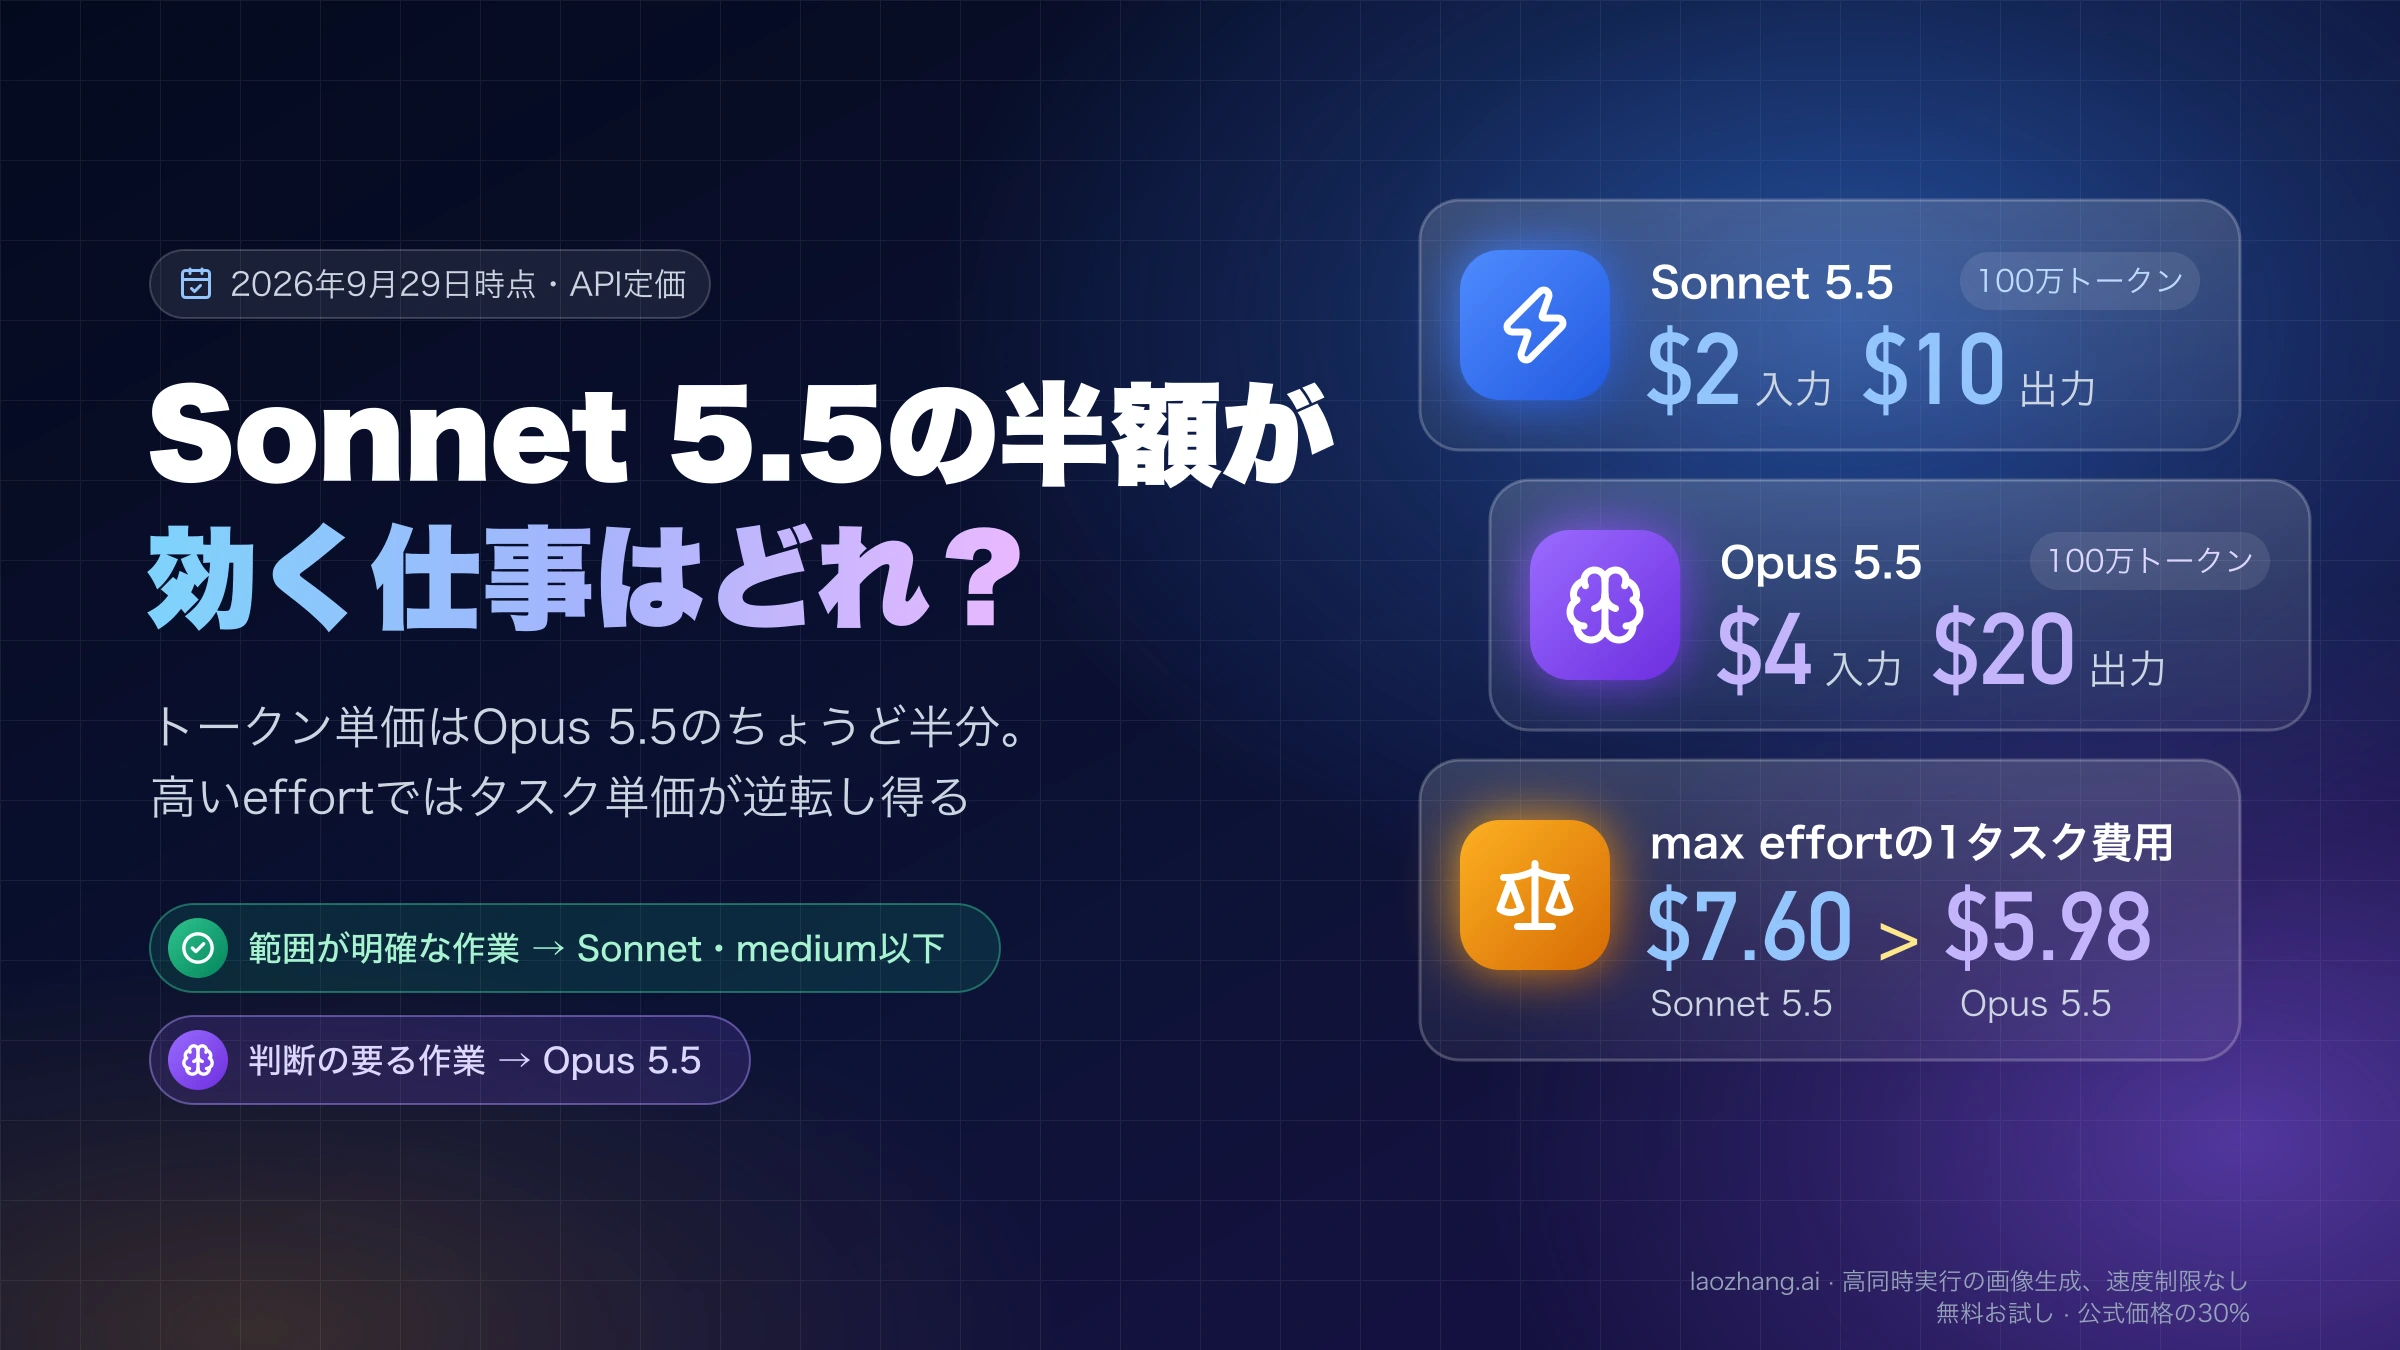
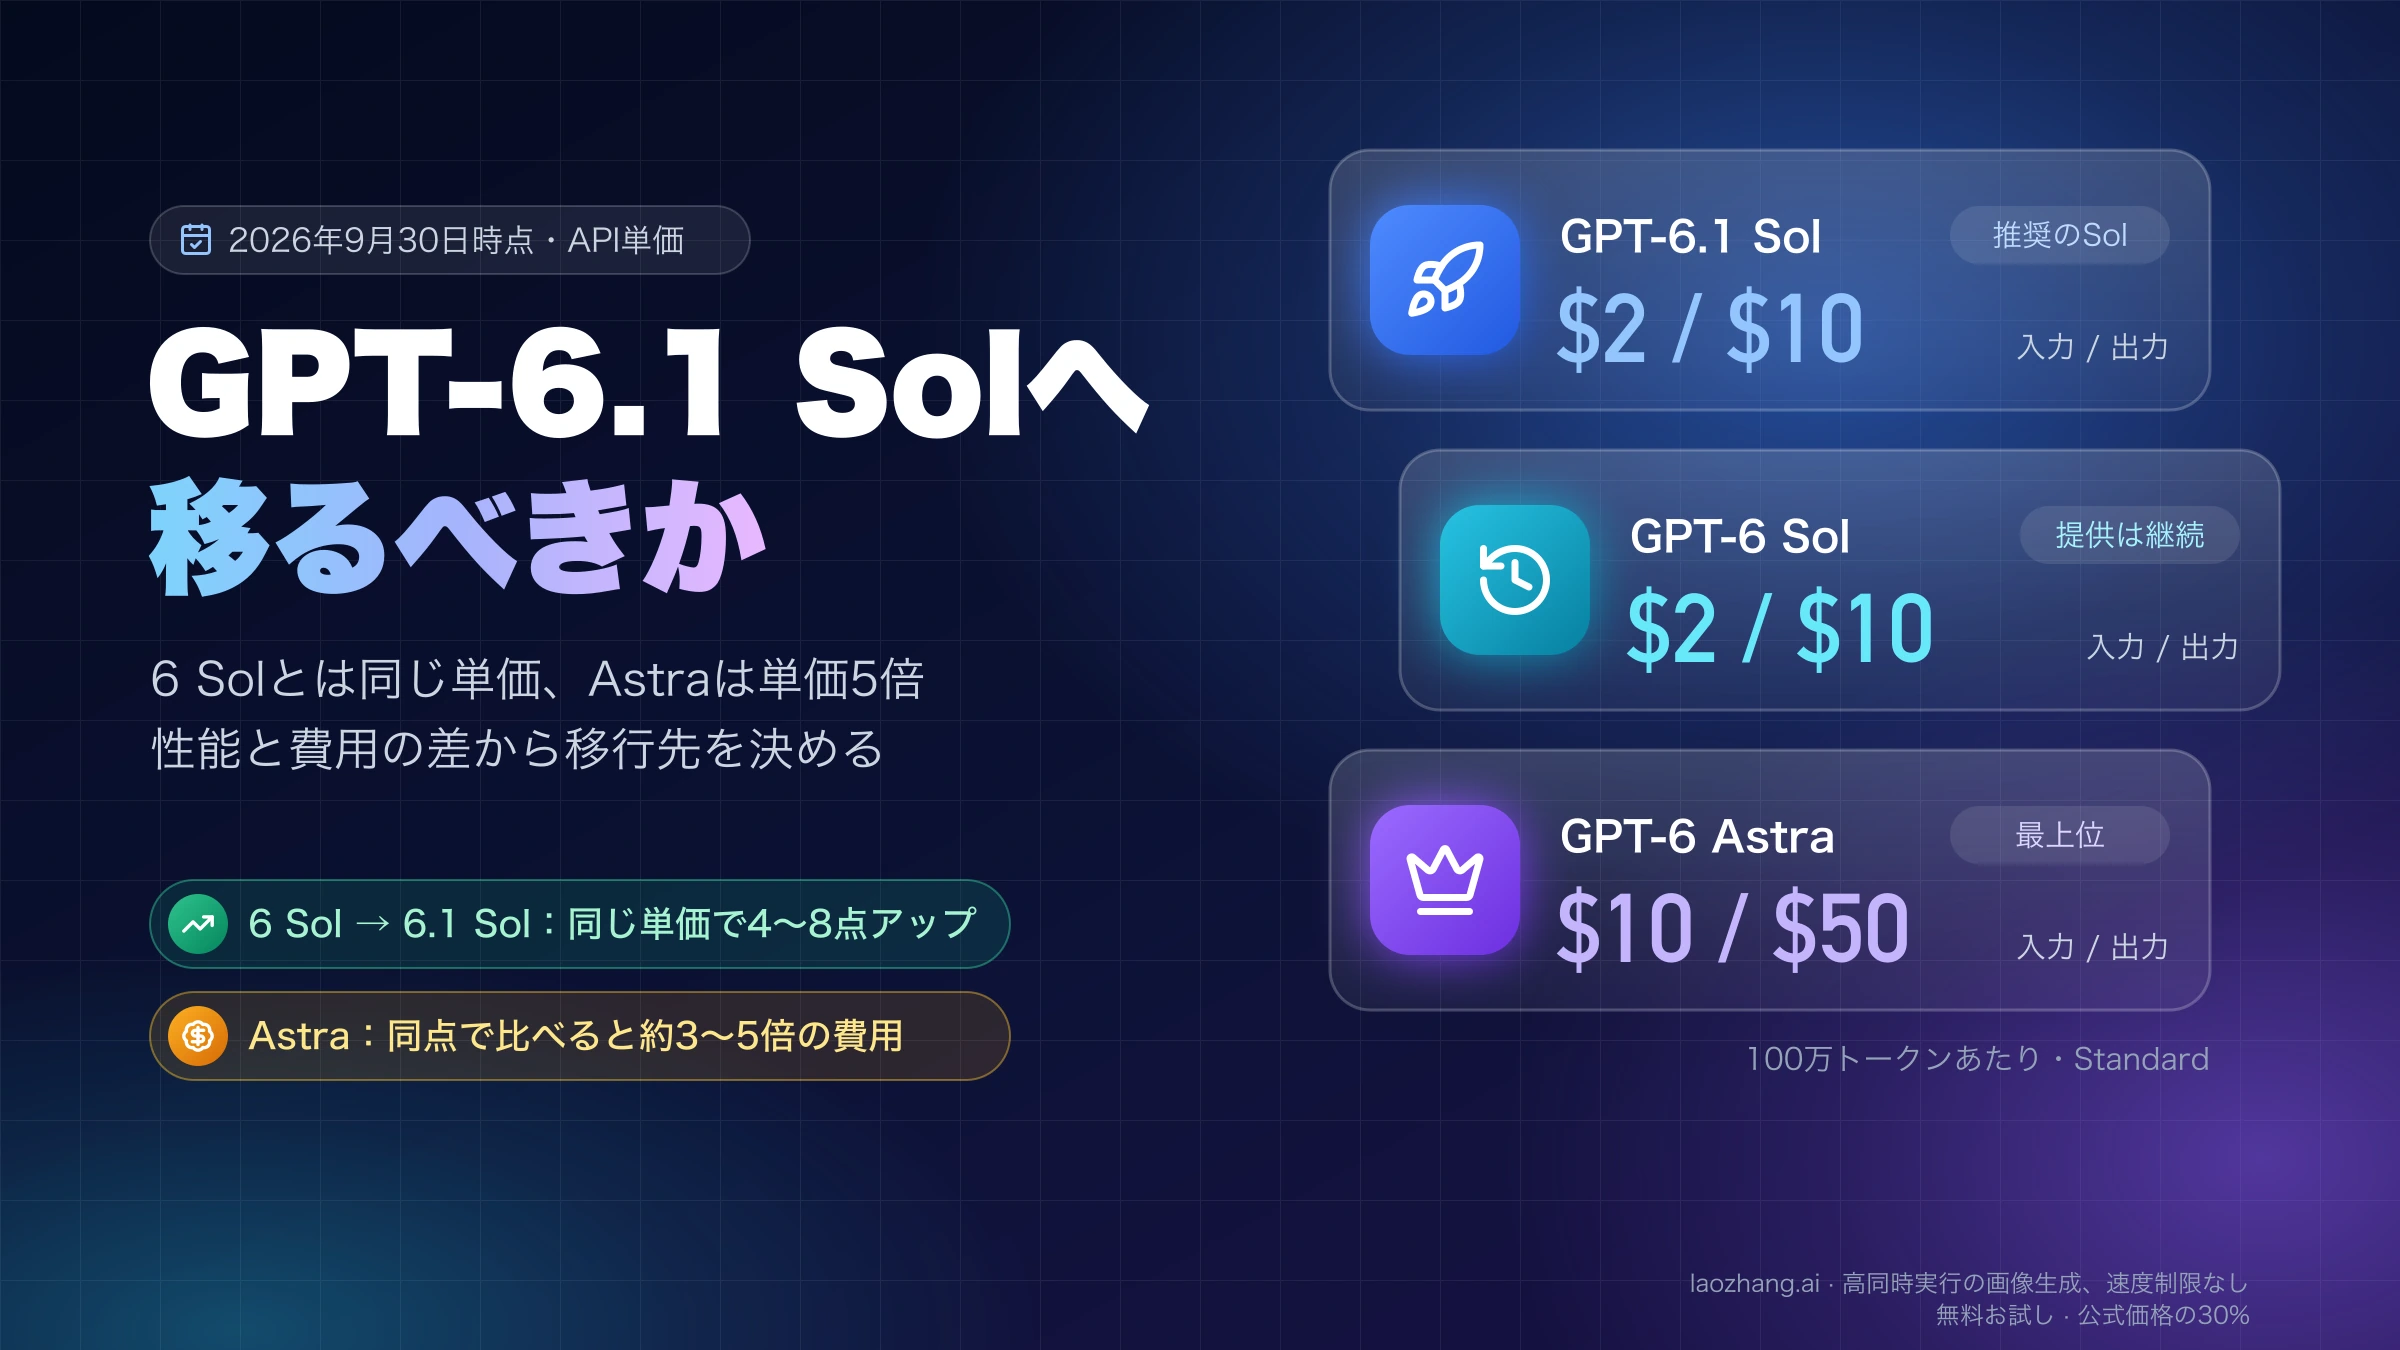
Claude Opus 5.5とGPT-6 Solは同じ2026年9月22日に発表され、OpenAIは9月29日にその後継のGPT-6.1 Sol(gpt-6.1-sol)を公開しました。いまOpus 5.5と比べるべきSolはGPT-6.1 Solです。APIの定価(100万トークンあたり。Anthropicは2026年9月25日、OpenAIは9月30日時点)は、Opus 5.5が入力$4・出力$20・キャッシュ読み出し$0.20、GPT-6.1 Solが入力$2・出力$10・キャッシュ読み出し$0.10です。1回の入力が272Kトークン以下の依頼なら、同じトークン数でOpus 5.5はどの項目でもちょうど2倍で、キャッシュを効かせても差は縮みません。272Kを超える依頼ではGPT-6.1 Solのリクエスト全体が長文料金になり、差は出力の分だけに縮みますが、それでもOpus 5.5のほうが安くなる組み合わせはありません。
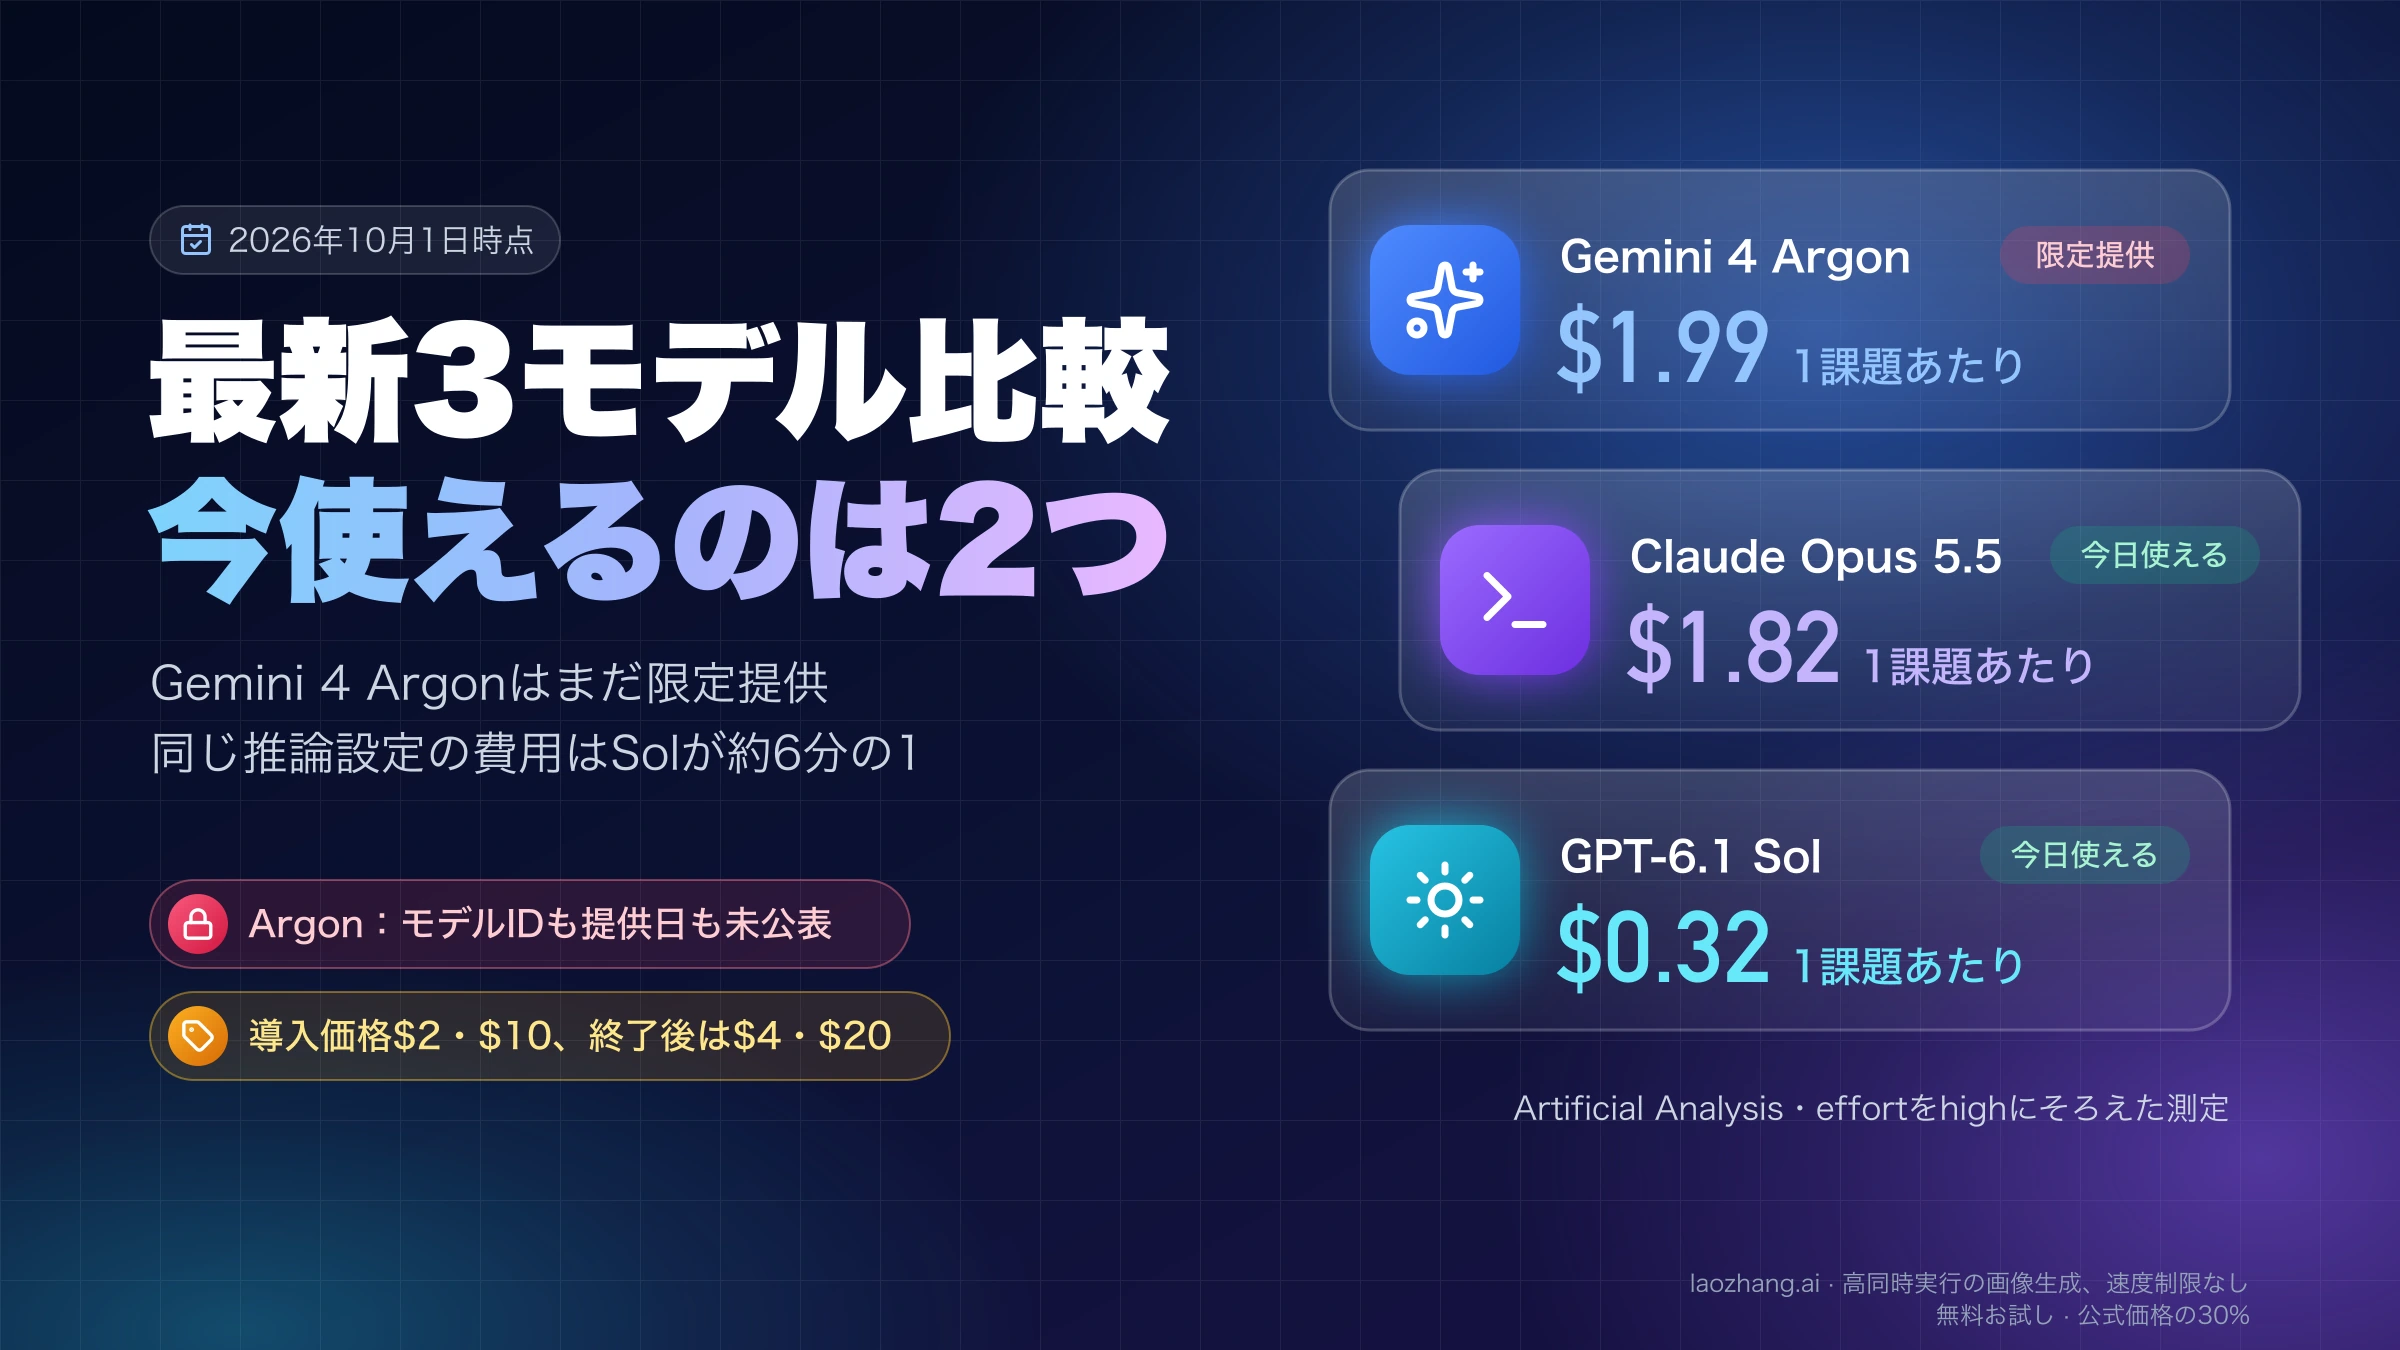
同じ課題を解かせた第三者の計測では、差は単価差よりずっと大きく開きます。Artificial Analysisの評価(2026年9月30日時点)では、推論の深さ(effort)をそろえた1課題あたりの費用はOpus 5.5がGPT-6.1 Solの4.2〜8.9倍(mediumで6.4倍)です。総合スコアはmedium以上でOpusが3〜6ポイント上、lowでは同点で、GPT-6.1 Solのmax(52)はOpus 5.5のmedium(51)を約半分の費用で上回ります。
使い分けの出発点は、既定をGPT-6.1 Solにして、まずeffortを上げて足りるかを確かめることです。maxでも合格しない長いコーディング作業や、1回の失敗や人のレビューが高くつく資料作業に限って、Opus 5.5を試します。最終的には、自分の課題で「合格した1件あたりの費用」(事前に決めた合格条件を満たした成果物1件を得るまでに払ったAPI費用とレビュー時間の合計)を出して決めます。
先に試すモデルの目安
| 仕事の性質 | 先に試す | 根拠 |
|---|---|---|
| 短い依頼を大量に回す分類・抽出・定型エージェント | GPT-6.1 Sol | 単価はOpusの半分、同じeffortでの1課題の費用は4分の1以下。effortは low から選べる(旧GPT-6 Solにあった none はない) |
| 1回の入力が272Kを超える長い依頼 | GPT-6.1 Sol | 272K超では入力とキャッシュの単価が並び、差は出力だけ。Opusが安くなる組み合わせはない |
| 何時間も続く自律的なコーディング、コードベース全体の移行や監査 | Claude Opus 5.5を試験 | Anthropicがこの用途を主眼に置き、第三者評価のスコアもmedium以上で上。ただしOpenAIは自社評価で逆の結果を出している |
| レビュー担当者の時間が高くつく資料・調査作業 | Claude Opus 5.5を試験 | API費用の差をレビュー時間や合格率の差で取り戻せるかで決まる |
| 最初の応答を早く返したい | GPT-6.1 Sol | Artificial Analysisの計測で最初の回答トークンまでmediumで5.72秒、Opus 5.5のmediumは22.95秒。生成が始まってからの出力速度はOpusが速い(毎秒72対59トークン) |
| ChatGPTの普段のチャット画面で使いたい | どちらも該当しない | GPT-6.1 SolもGPT-6 SolもChatGPTではWorkとCodexのみで、Chatでは選べない |
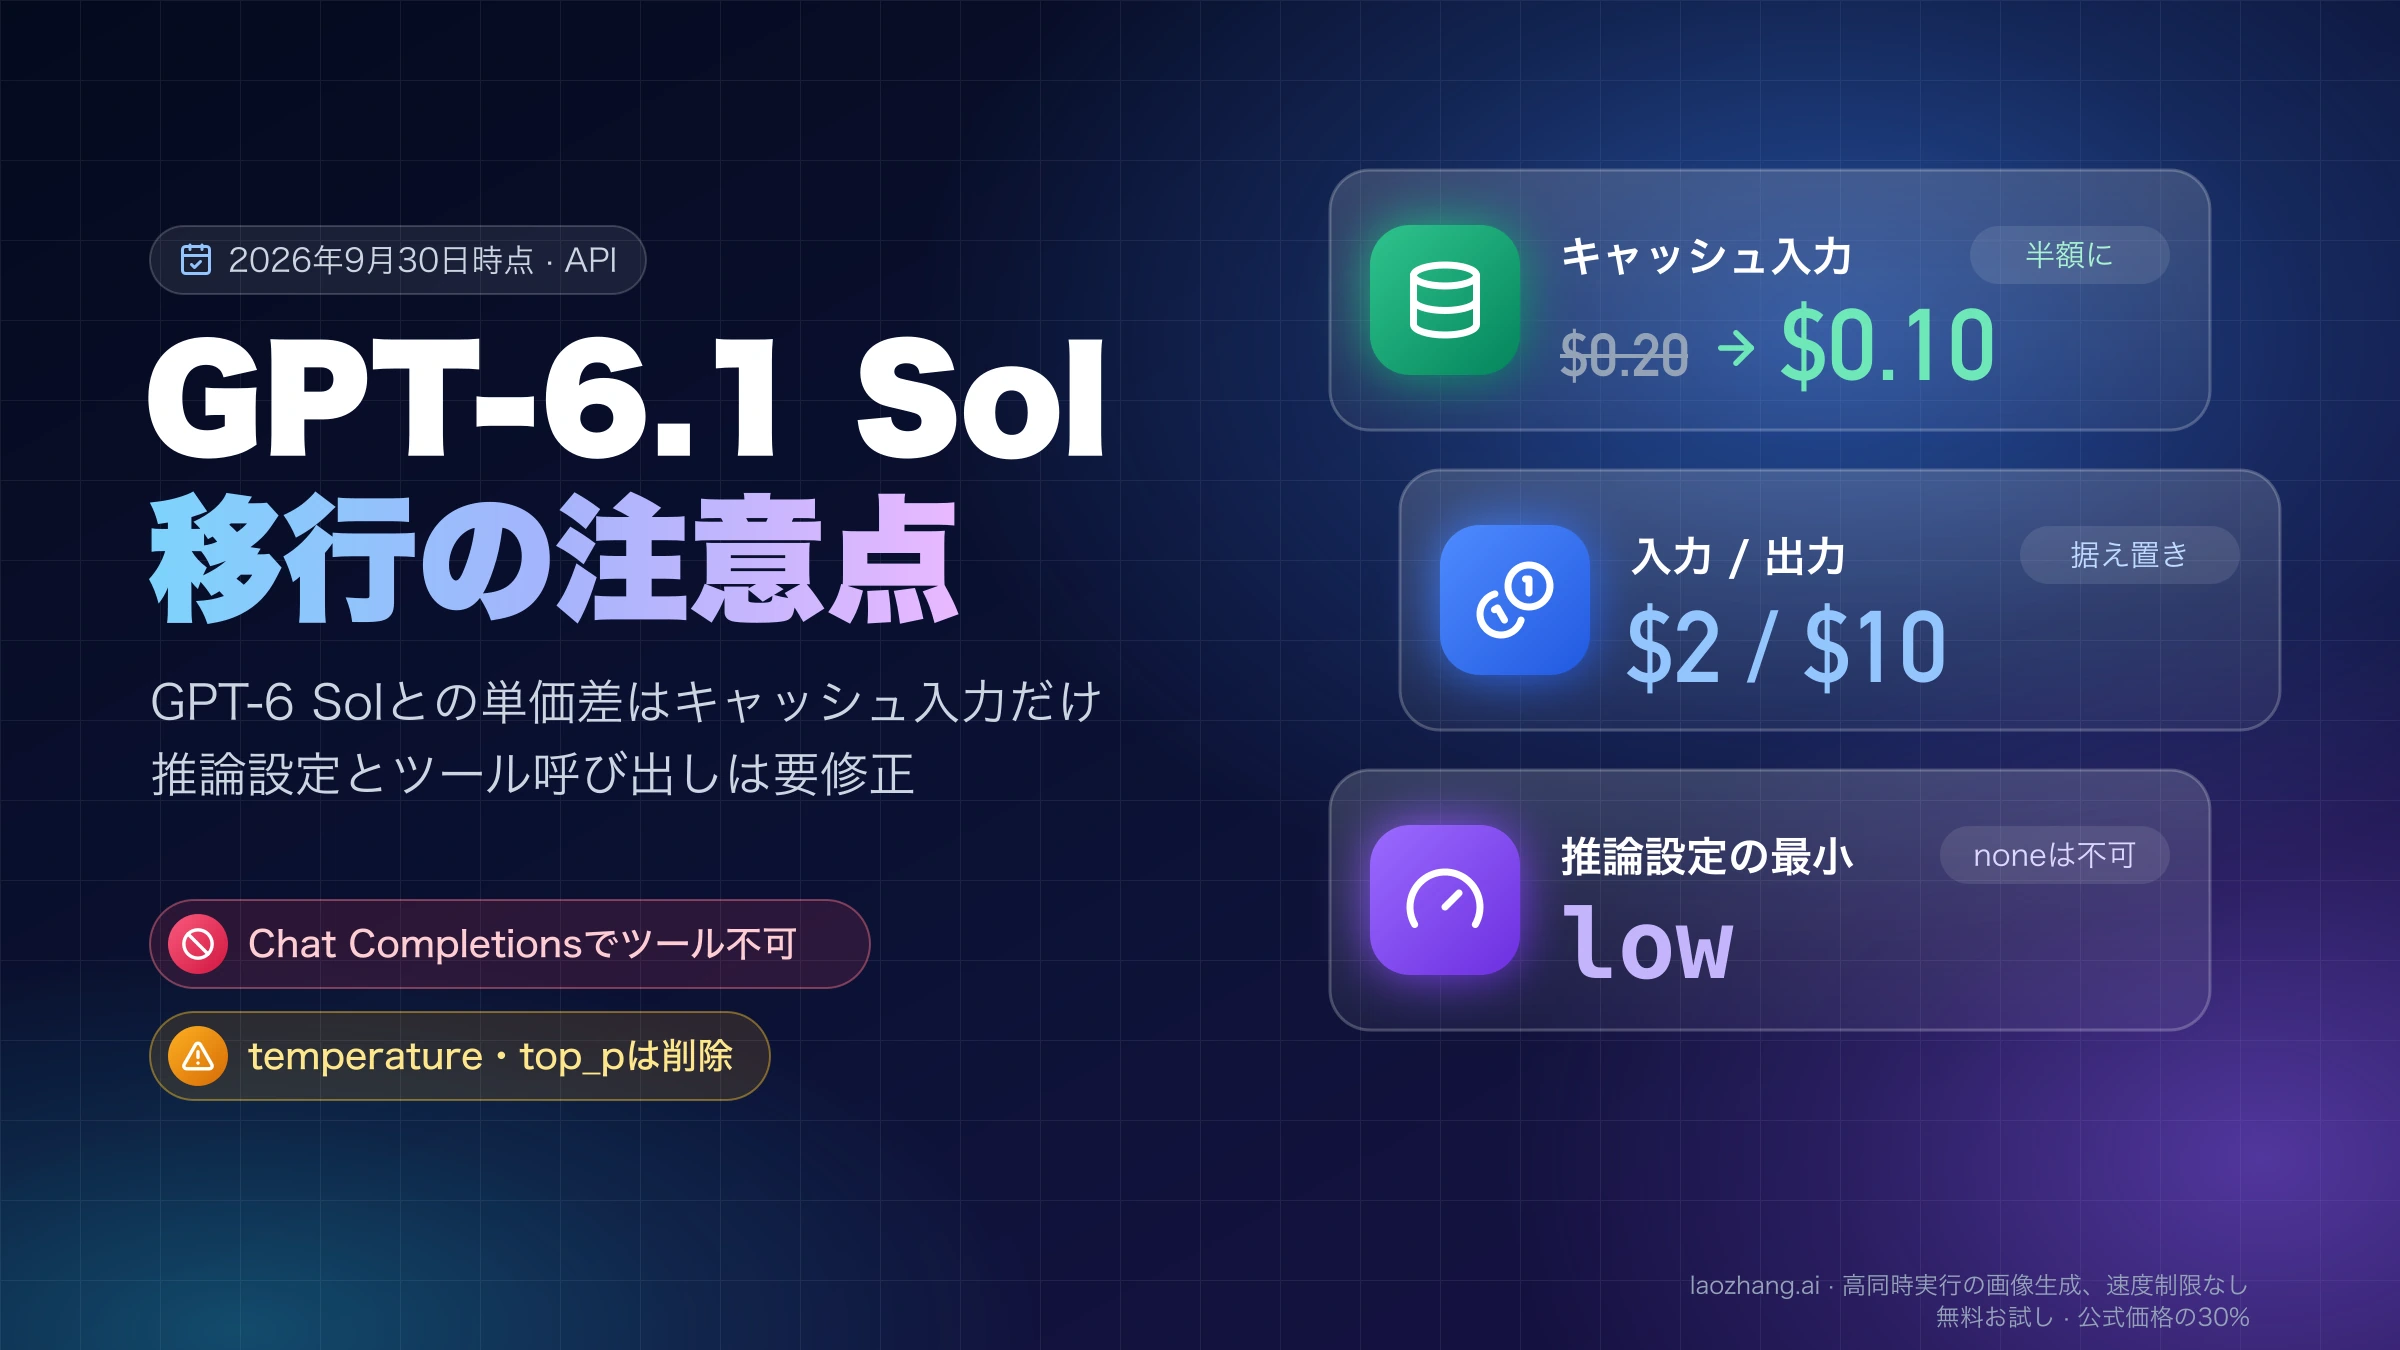
GPT-6.1 Solそのものの変更点(キャッシュ読み出しの値下げ、effortの none が使えないこと、ツール呼び出しはResponses APIが必要なこと)は「GPT-6.1 Sol:GPT-6 Solとの違いと移行の注意点」にまとめています。Opus 5.5でも品質が足りない仕事なら上位のFable 5.1が候補になり、判断の仕方は「Claude Fable 5.1とOpus 5.5を比較:普段はどっちを使うべき?」で扱っています。逆にSolより安いモデルで足りるかは「GPT-6 Sol・Luna・AstraとTerraの違い:API料金と用途から選ぶ」が参考になります。
料金の「2倍」が当てはまる項目と当てはまらない項目
両社の公式料金ページ(Anthropic、OpenAI)の標準料金を項目ごとに並べます。いずれも直接APIの標準料金で、100万トークンあたりの米ドルです(Anthropicは2026年9月25日、OpenAIは9月30日時点)。
| 項目 | Claude Opus 5.5 | GPT-6.1 Sol(入力272K以下) | GPT-6.1 Sol(入力272K超) |
|---|---|---|---|
| 未キャッシュ入力 | $4 | $2 | $4 |
| キャッシュ書き込み | $5(5分)、$8(1時間) | $2.50 | $5 |
| キャッシュ読み出し | $0.20 | $0.10 | $0.20 |
| 出力(推論トークンを含む) | $20 | $10 | $15 |
272K以下の依頼では、4項目すべてでOpus 5.5がちょうど2倍です。入力が272Kを超える依頼になると、未キャッシュ入力・書き込み(Opusの5分キャッシュと比べた場合)・キャッシュ読み出しが同額になり、出力だけOpusが約1.33倍高く残ります。
旧モデルのGPT-6 Solは、キャッシュ読み出しが$0.20(272K超は$0.40)である点を除けば、GPT-6.1 Solと同じ単価です。このためGPT-6 Solとの比較では「キャッシュ読み出しは同額」「272K超のキャッシュ中心の依頼ではOpusのほうが安い」ことがありましたが、GPT-6.1 Solではどちらも成り立ちません。GPT-6 Solは gpt-6-sol のまま呼び出せ、2026年9月30日時点で廃止の告知は出ていないものの、OpenAIの料金表からは外れ、モデルページも新しいSolとしてGPT-6.1 Solを案内しています。旧Solを使い続けるか移るかは「GPT-6.1 Sol・6 Sol・Astra比較:移行の判断」で扱っています。
272Kでの切り替わりには2つの前提があります。
- GPT-6.1 Solの長文料金はリクエスト単位で、入力が272Kトークンを超えた依頼は、272Kを超えた部分だけでなく全体が長文料金になります。OpenAIのモデルページは「入力が272Kトークンを超えるプロンプトは、リクエスト全体で入力とキャッシュの単価が2倍、出力が1.5倍」と書いているため、キャッシュ済みの部分も272Kに数えると読むのが自然ですが、その点は明記されていません。
- Opus 5.5には長文の割増がありません。Anthropicは100万トークンの枠全体を標準料金とし、90万トークンの依頼も9,000トークンの依頼と同じ単価だと説明しています。
コンテキスト長(Opus 5.5が100万、GPT-6.1 Solが105万トークン)と最大出力(どちらも12万8,000トークン)はほぼ同じなので、差を生むのは上の単価の組み合わせです。
自分の使用量で差を計算する
請求額を決めるのは、未キャッシュ入力(U)、キャッシュ書き込み(W)、キャッシュ読み出し(R)、出力(O)の量です。単位を100万トークン、金額を米ドルにすると、標準料金での計算式は次のとおりです(Opus 5.5の書き込みは5分キャッシュの単価)。
Opus 5.5                = 4U + 5W + 0.2R + 20O
GPT-6.1 Sol(272K以下) = 2U + 2.5W + 0.1R + 10O
GPT-6.1 Sol(272K超)   = 4U + 5W + 0.2R + 15O

参考:GPT-6 Sol(272K以下) = 2U + 2.5W + 0.2R + 10O
参考:GPT-6 Sol(272K超)   = 4U + 5W + 0.4R + 15O
式を並べると関係は単純です。272K以下では、Opus 5.5の料金はGPT-6.1 Solのちょうど2倍になります。272K超では、Opus 5.5からGPT-6.1 Solを引いた差が5Oで、出力が0でない限り必ずOpusのほうが高くなります。旧GPT-6 Solとの比較で使われていた「キャッシュ読み出しが出力の25倍を超えるとOpusが安い」という目安は、GPT-6 Solの272K超の読み出し単価が$0.40だったから成り立ったもので、GPT-6.1 Solには当てはまりません。
どちらのAPIもレスポンスの使用量(usage)欄に、入力・キャッシュ書き込み・キャッシュ読み出し・出力のトークン数を返します。数日分を集計して当てはめれば、自分の割高幅が出ます。キャッシュの当たり外れで1回の料金が大きく動く仕組みは「Claude Code のキャッシュミスと token コスト:1 回の turn が急に高く見える理由」で詳しく扱っています。
次の5例は、両モデルの課金トークン数がまったく同じだと仮定した計算です(書き込みは0とします)。右端は比較用の旧GPT-6 Solです。
| 例 | 使い方 | U / R / O(100万トークン) | Opus 5.5 | GPT-6.1 Sol | 比率 | 参考:GPT-6 Sol |
|---|---|---|---|---|---|---|
| A | キャッシュなしの短い依頼 | 0.1 / 0 / 0.02 | $0.80 | $0.40 | 2.00倍 | $0.40 |
| B | 短い呼び出しを何度も繰り返すエージェント | 0.1 / 2.0 / 0.05 | $1.80 | $0.90 | 2.00倍 | $1.10 |
| C | キャッシュ読み出しが大半のループ | 0.05 / 5.0 / 0.03 | $1.80 | $0.90 | 2.00倍 | $1.40 |
| D | 80万トークンの依頼1回、大半がキャッシュ済み | 0.05 / 0.75 / 0.02 | $0.75 | $0.65 | 1.15倍 | $0.80 |
| E | キャッシュなしの30万トークンの依頼1回 | 0.3 / 0 / 0.02 | $1.60 | $1.50 | 1.07倍 | $1.50 |
たとえばBは、Opus 5.5が4×0.1+0.2×2.0+20×0.05=$1.80、GPT-6.1 Solが2×0.1+0.1×2.0+10×0.05=$0.90です。GPT-6 Solでは読み出しの$0.40が両者で同じだったため比率が1.64倍まで下がっていましたが、GPT-6.1 Solでは読み出しも半額なのでちょうど2倍のままです。Dは依頼が272Kを超えるため、GPT-6.1 Solは4×0.05+0.2×0.75+15×0.02=$0.65になり、差は出力分の5×0.02=$0.10だけです。同じ条件でGPT-6 Solと比べた場合はOpus 5.5が$0.05安く(0.94倍)なっていましたが、GPT-6.1 Solに対しては逆転しません。
料金区分や付加料金でも差は動きます。
| 条件 | 差への影響 |
|---|---|
| Batch・Flex | GPT-6.1 SolはBatchとFlexで全項目が半額、Opus 5.5はBatchで入出力が半額。両方で使えば比率はほぼ変わらず、片方だけなら差が動く |
| Fast | Opus 5.5は入力$8・出力$40(Claude API直接利用のみ、研究プレビュー)、GPT-6.1 Solは全項目2倍。入出力の比率は2倍のまま |
| 地域指定の処理 | OpenAIの地域処理(データレジデンシー)は10%増し、AnthropicのUS限定推論(inference_geo: "us")は全項目1.1倍。片側だけに付くと比率が約10%動く |
| ツール呼び出し | OpenAIのWeb検索は1,000回あたり$10など、トークン以外の料金が別に加わる |
| effort | 推論トークンは出力として課金される。effortを上げると出力Oが増え、272K超の依頼では差(5O)がそのまま広がる |
実測では単価差より大きく開く理由
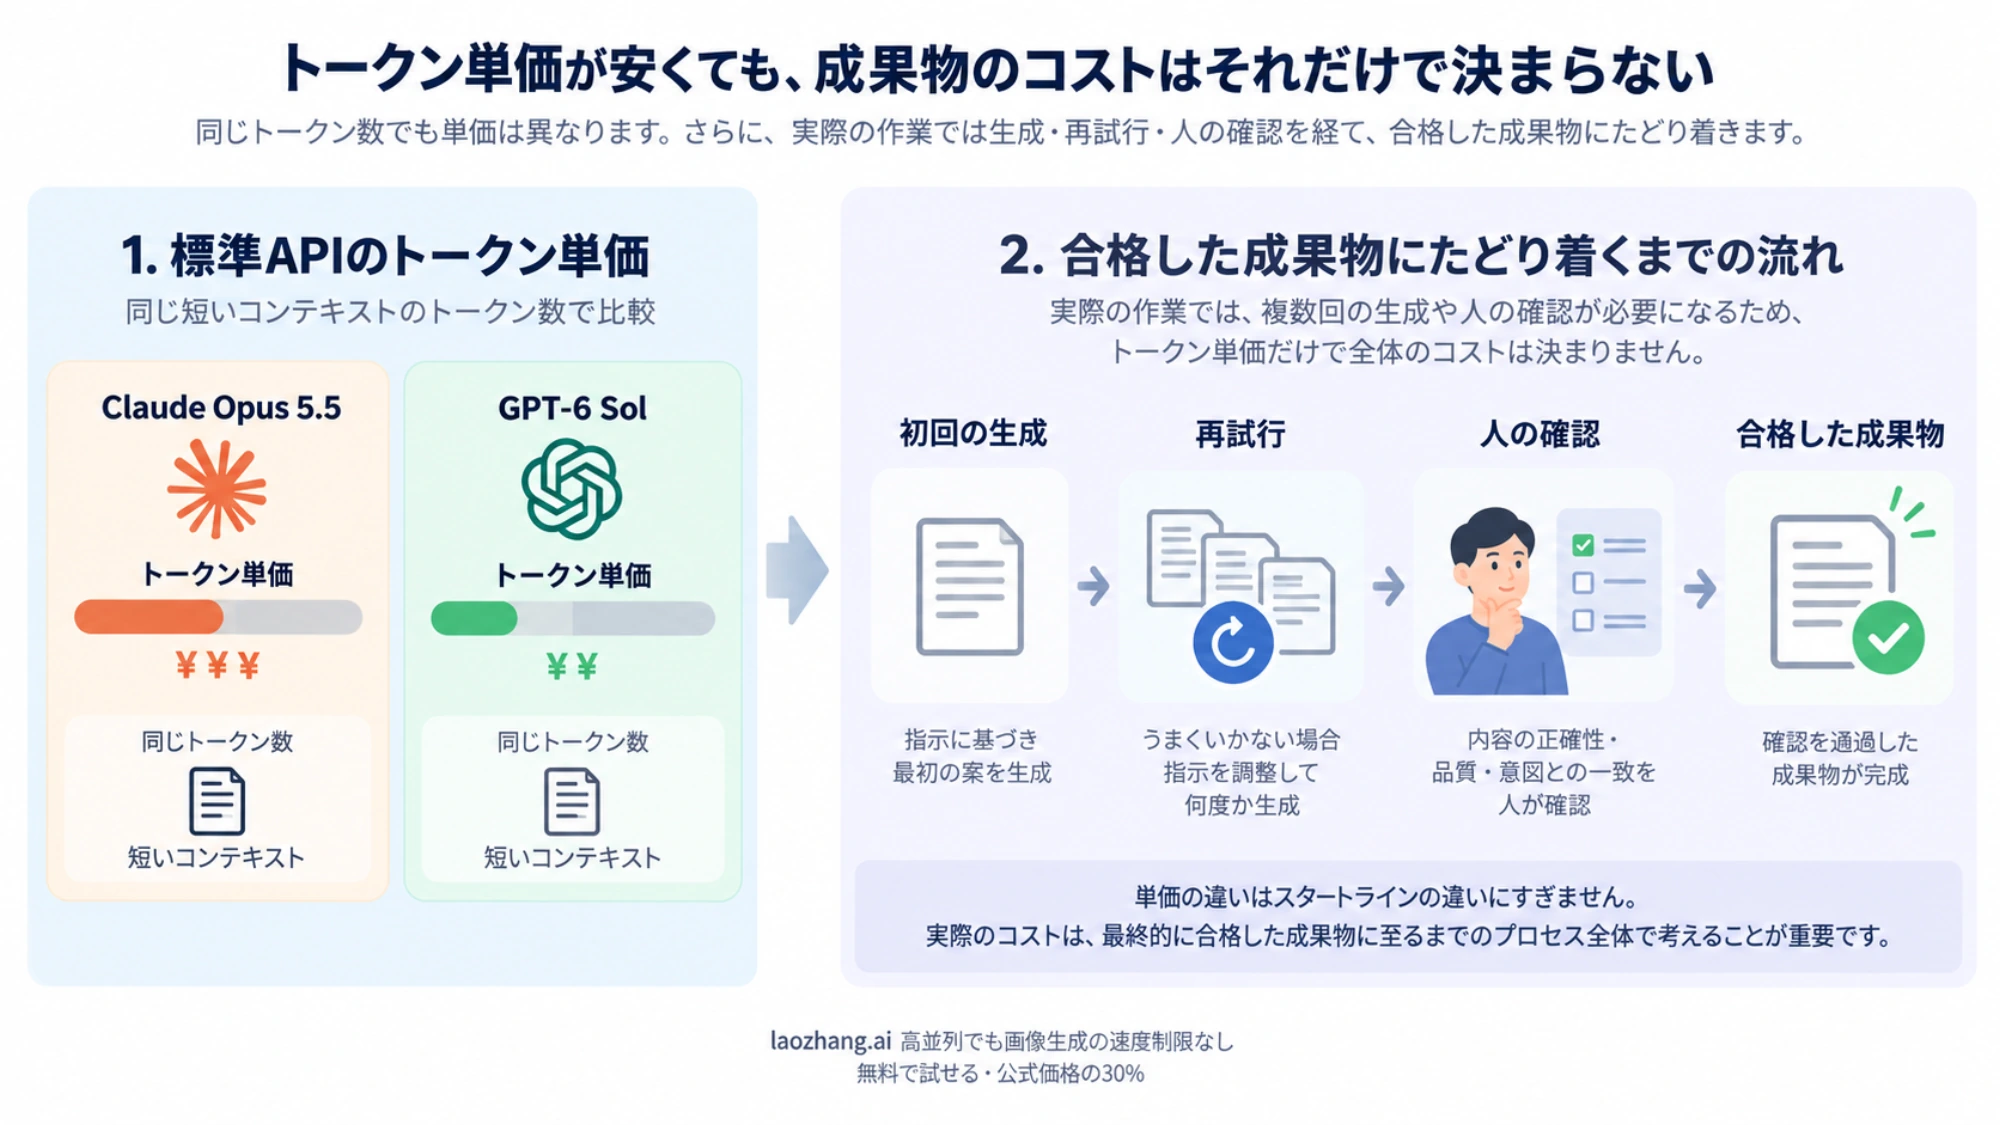
上の計算はトークン数が同じという前提に立っています。実際には、同じ課題でもモデルごとに考える量と出力の量が違い、トークナイザーも違います。Artificial Analysisの総合指標(Intelligence Index v4.3.2、10種類の評価)では、effortをそろえた1課題あたりの費用が次のように計測されています(2026年9月30日時点)。
| effort | Opus 5.5のスコア | Opus 5.5の1課題の費用 | GPT-6.1 Solのスコア | GPT-6.1 Solの1課題の費用 | 費用の比率 |
|---|---|---|---|---|---|
| max | 58 | $5.98 | 52 | $0.72 | 8.3倍 |
| xhigh | 56 | $3.46 | 51 | $0.39 | 8.9倍 |
| high | 54 | $1.82 | 50 | $0.32 | 5.7倍 |
| medium | 51 | $1.34 | 48 | $0.21 | 6.4倍 |
| low | 42 | $0.55 | 42 | $0.13 | 4.2倍 |
出典はArtificial AnalysisのGPT-6.1 SolとOpus 5.5の比較ページで、Opus 5.5はAdaptive Reasoning(フォールバックは既定)の各effortの値です。1課題の費用は入力・キャッシュ・推論・回答の各トークンを単価で重み付けした平均で、比率は1課題の費用を割った値です。
単価の差は最大でも2倍なので、残りは使うトークン量の差から来ています。同じ計測で1課題あたりの出力トークンは、mediumでOpus 5.5が26k、GPT-6.1 Solが8k、maxでは119k対38kと約3倍の開きがありました。単価の2倍に出力量の約3倍が掛け合わさると6倍前後になり、mediumの6.4倍とおおむね合います(トークンの内訳が違うため概算)。
旧GPT-6 Solと比べた場合、費用の比率は4.2〜6.5倍、スコア差はどのeffortでもOpusが8〜12ポイント上でした(2026年9月25日時点、GPT-6 Solのmaxは48)。GPT-6.1 Solでスコア差は縮み、費用の差はむしろ広がったことになります。
この表を読むときの注意が3つあります。
- effortをそろえて比べる。Opus 5.5のmediumとGPT-6.1 Solのxhighのように段階の違う結果を並べると、差を読み違えます。
- スコアは合格率ではない。指標のポイント差は、自分の課題で何件多く通るかを直接示しません。
- 1課題の費用は請求額ではない。評価用の課題セットでの平均で、自分の作業のキャッシュ比率や長さとは一致しません。
段階をまたぐと別の見方もできます。GPT-6.1 Solのmax(52、$0.72)は、Opus 5.5のmedium(51、$1.34)より高いスコアを約54%の費用で出しています。lowでは両者とも42で並び、Opusの費用は4.2倍です。Opus 5.5がGPT-6.1 Solのどの段階よりも高いスコアを出すのはhigh(54、$1.82)以上です。予算内で品質を上げたいならまずGPT-6.1 Solのeffortを上げ、maxでも届かない課題だけOpus 5.5のhigh以上を試す、という順序が妥当です。
速度は指標によって逆になります。同じ計測で、最初の回答トークンが出るまでの時間はGPT-6.1 Solのlowが2.12秒、Opus 5.5のlowが12.72秒と大きく差がありますが、生成が始まってからの出力速度はOpus 5.5のほうが速く、mediumで毎秒72トークン対59トークン、maxでは92対66です。これらの値は計測し直されるたびに変わります。
単発の実例としては、DataCampが2026年9月23日に公開した旧GPT-6 Solとのテスト(1ファイルのHTMLでテトリス風ゲームを作る課題、effortはhigh、各1回)があります。Opus 5.5はターン数も総トークン(107,958対120,226)もGPT-6 Solより少なかったのに、推論トークンが22,551対8,123と多く、費用は$0.87対$0.26でした。推論トークンは出力単価で課金されるため、手数が少ないモデルが安いとは限りません。採点はSolが5.0、Opusが4.3(5点満点)でしたが、1種類・各1回の結果で、GPT-6.1 Solでは試されていません。
ベンダーの数字を読むときの落とし穴
OpenAIの自社評価はOpus 5.5より上と主張しています。 GPT-6.1 Solの発表記事では、GDP.pdfでどの推論設定でもフォールバック付きのOpus 5.5より高いスコアを半分以下の1課題費用で出した、AutomationBench 1.0.6(medium)ではOpus 5.5より2.2ポイント高く費用は約3分の1、Terminal-Bench Science 0.1(max)の平均費用は1課題$5.47対Opusの$23.21、としています。Opus側の数字は公開報告から取ったもので、評価の選び方もOpenAIによるものです。Artificial Analysisの10種類をまとめた総合指標ではmedium以上でOpusが上なので、「Solが上」と「Opusが上」の両方の数字が同時に存在します。どちらも自分の課題で通るかを保証するものではありません。
「40%安い」はOpus 5との比較です。 AnthropicはClaude Opus 5.5の発表ページで、Opus 5.5は既定設定・一般的な作業でOpus 5より運用費が40%下がると述べています。入出力単価はOpus 5より20%、キャッシュ読み出しは60%安くなりました。Solに対する節約額ではありません。
Anthropicの比較表にあるSolはGPT-5.6 Solです。 同じ発表の表はOpus 5.5をFable 5.1、Opus 5、GPT-6 Astra、GPT-5.6 Solと比べています。Terminal-Bench 4.0の66.4%対37.3%、CursorBench 4.0の57.8%対41.7%などは、いずれも前の世代のGPT-5.6 Solとの比較で、GPT-6 SolやGPT-6.1 Solの数字ではありません。Opus側は注記がない限りmaxでの結果で、Anthropic自身も、このレベルではベンチマークの差が実際の差の目安として当てにしにくくなったと書いています。
トークン数は両社で換算できません。 Anthropicの料金ページは、Claude 4.7以降の新しいトークナイザーでは同じ文章のトークン数がClaude Sonnet 4.6以前より約30%増えると説明しています。これはClaudeの新旧の比較で、ClaudeとOpenAIの間の換算比ではありません。同じ文章が両社で何トークンになるかの公式な比率はどちらも公開していないため、実際の費用を比べるには、同じ課題を両方のAPIで流してusageの数字を見るしかありません。
合格した1件あたりの費用を出す小さな試験
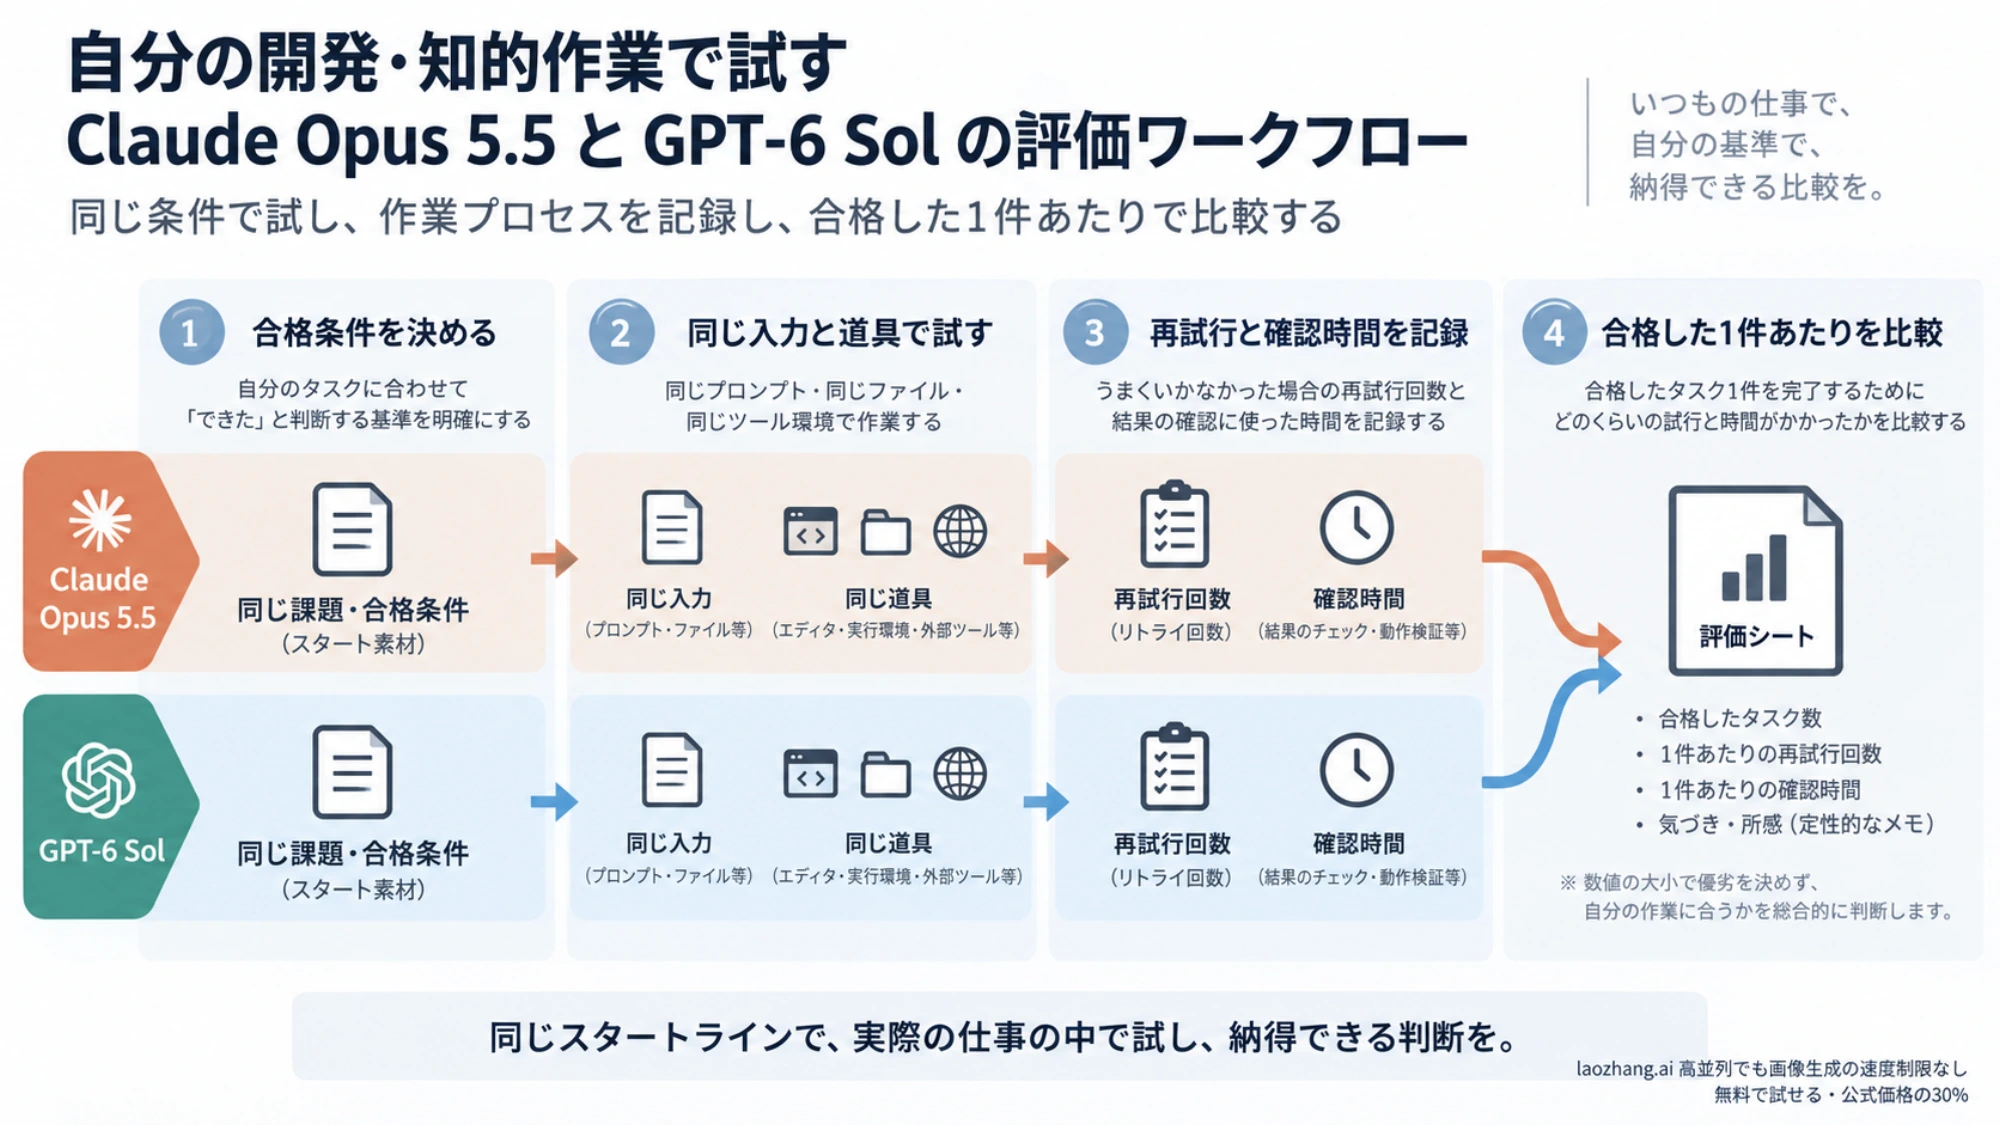
定価表と第三者の評価で候補を絞ったら、最後は自分の課題で決めます。計算の中心はこの式です。
合格1件あたりの費用 =(全試行のAPI費用 + ツール料金 + レビュー時間 × 時間単価)÷ 合格件数進め方は次のとおりです。
- 合格条件を先に書く。 テストが通る、指定の形式を満たす、事実誤りがないなど、合否を判定できる基準を試験前に決めます。後から決めると好みのモデルに甘くなります。
- 普段の課題を集め、条件をそろえて両方で回す。 実際のチケットや資料作業から難易度を混ぜて選び、プロンプト、リポジトリのスナップショット、ツール、effort、再試行の上限を同じにします。GPT-6 Solで
noneを使っていた処理は、GPT-6.1 Solではlowに置き換えて比べます。 - 1試行ごとに記録する。 モデルID、effort、キャッシュ設定、処理区分(Standard・Batch・Flex・Fast)、日付、usageの4種類のトークン数、ツール料金、再試行回数、レビューの分数、合否。
- 合格件数で割る。 不合格だった試行の費用も分子に入れます。
usageのトークン数は、両社で欄の名前が違います。
| 数えるもの | OpenAI(Responses API) | Anthropic(Claude API) |
|---|---|---|
| 入力 | input_tokens | input_tokens |
| キャッシュ読み出し | input_tokens_details.cached_tokens | cache_read_input_tokens |
| キャッシュ書き込み | input_tokens_details.cache_write_tokens | cache_creation_input_tokens |
| 出力(推論を含む) | output_tokens | output_tokens |
数字の読み方を、仮の数字で示します。
| GPT-6.1 Sol | Claude Opus 5.5 | |
|---|---|---|
| 課題数 | 10件 | 10件 |
| API費用の合計 | $3.00 | $12.00 |
| 合格件数 | 6件 | 9件 |
| レビュー時間の合計 | 150分 | 90分 |
| 合格1件あたりのAPI費用 | $0.50 | 約$1.33 |
| 合格1件あたりのレビュー時間 | 25分 | 10分 |
この仮定ではOpus 5.5のほうが合格1件あたり約$0.83高い一方、レビューが15分短く済みます。レビュー担当の時給が$3.3を超えるなら、Opus 5.5のほうが安くつきます。さらにGPT-6.1 Solで落ちた4件を誰かが仕上げる手間も残ります。反対に、合格件数もレビュー時間もほぼ同じなら、API費用の差がそのまま残り、GPT-6.1 Solを既定にするのが合理的です。
既定を変えるかどうかは、次のように決められます。
- Opus 5.5に切り替える:合格1件あたりの費用(API+レビュー)がGPT-6.1 Sol以下になる、またはGPT-6.1 Solがmaxでも合格条件に届かない課題が多い。
- GPT-6.1 Solのままにする:合格件数とレビュー時間に目立った差がない。
- 課題の種類で分ける:GPT-6.1 Solで通る課題はSolに任せ、落ちやすい種類だけOpus 5.5に回す。
- effortを見直す:Opus 5.5のlowやmediumで足りる課題なら費用差は縮みます。上の表のとおり、段階を変えるだけで1課題の費用は数倍変わります。
ChatGPT・Codex・Claude Codeで使う場合
サブスクリプションの利用枠は製品ごとに決められていて、API単価から逆算できません。OpenAIも、API料金はサブスクリプションの利用枠とは別で、含まれる作業量の見積もりに使わないよう案内しています。「APIで2倍だから枠も2倍の速さで減る」という関係はありません。
GPT-6.1 SolはChatGPTではWorkとCodexで使え、Chatでは選べません。Plus、Pro、Business、Enterprise、Eduが対象で、EnterpriseとEduは管理者が有効にするまで使えず、FreeとGoは対象外です。Codexでは codex --model gpt-6.1-sol で指定します。OpenAIは料金ページで、PlusとStandard Businessのローカルメッセージの目安を5時間あたりGPT-6.1 Solで15〜160件(GPT-6 Solは15〜150件)と公開しています。固定の上限ではなく、コンテキストや推論、キャッシュの使い方で変わり、週単位の制限もかかりえます。Proは月額$100・$200・$500の3段階になり、2026年9月30日時点で5時間ごとの制限はありません。ChatGPTクレジットで使う場合、GPT-6.1 Solは100万トークンあたり入力50・キャッシュ入力2.5・出力250クレジットです。枠を使い切ったときは「ChatGPT Plus の Codex 制限と利用枠:5時間の目安と credits」を参照してください。
Claude Opus 5.5はClaudeアプリ(Pro、Max、Team、Enterprise)とClaude Codeで使えます。Claude Codeはバージョン2.1.280以上が必要で、エイリアスの opus は接続先によって指すモデルが変わるため、フルIDの claude-opus-5-5 で指定するほうが確実です。Anthropicは5時間あたりの利用上限を引き上げましたが件数の目安は出していないので、月額$20前後のプランでCodexとClaude Codeのどちらの枠が長くもつかは公開情報からは比べられません。詳しくは「Claude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順」と「Claude Code と Codex の料金比較:月額、利用上限、API 実コスト」にまとめています。
APIでは、Opus 5.5はClaude APIのほかAmazon Bedrock、Google Cloud、Microsoft Foundryでも使えます。どの経路でも、アカウントや地域によって選べるモデルは異なります。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月1日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月1日。
- 1.Anthropicplatform.claude.com/docs/en/about-claude/pricing
- 2.OpenAIdevelopers.openai.com/api/docs/pricing
- 3.Artificial AnalysisのGPT-6.1 SolとOpus 5.5の比較ページartificialanalysis.ai/models/releases/comparisons/gpt-6-1-sol-vs-claude-opus-5-5
- 4.GPT-6.1 Solの発表記事openai.com/index/introducing-gpt-6-1-sol
- 5.Claude Opus 5.5の発表ページanthropic.com/claude-opus-5-5
- 6.料金ページlearn.chatgpt.com/docs/pricing