GPT-6.1 Sol:GPT-6 Solとの違いと移行の注意点
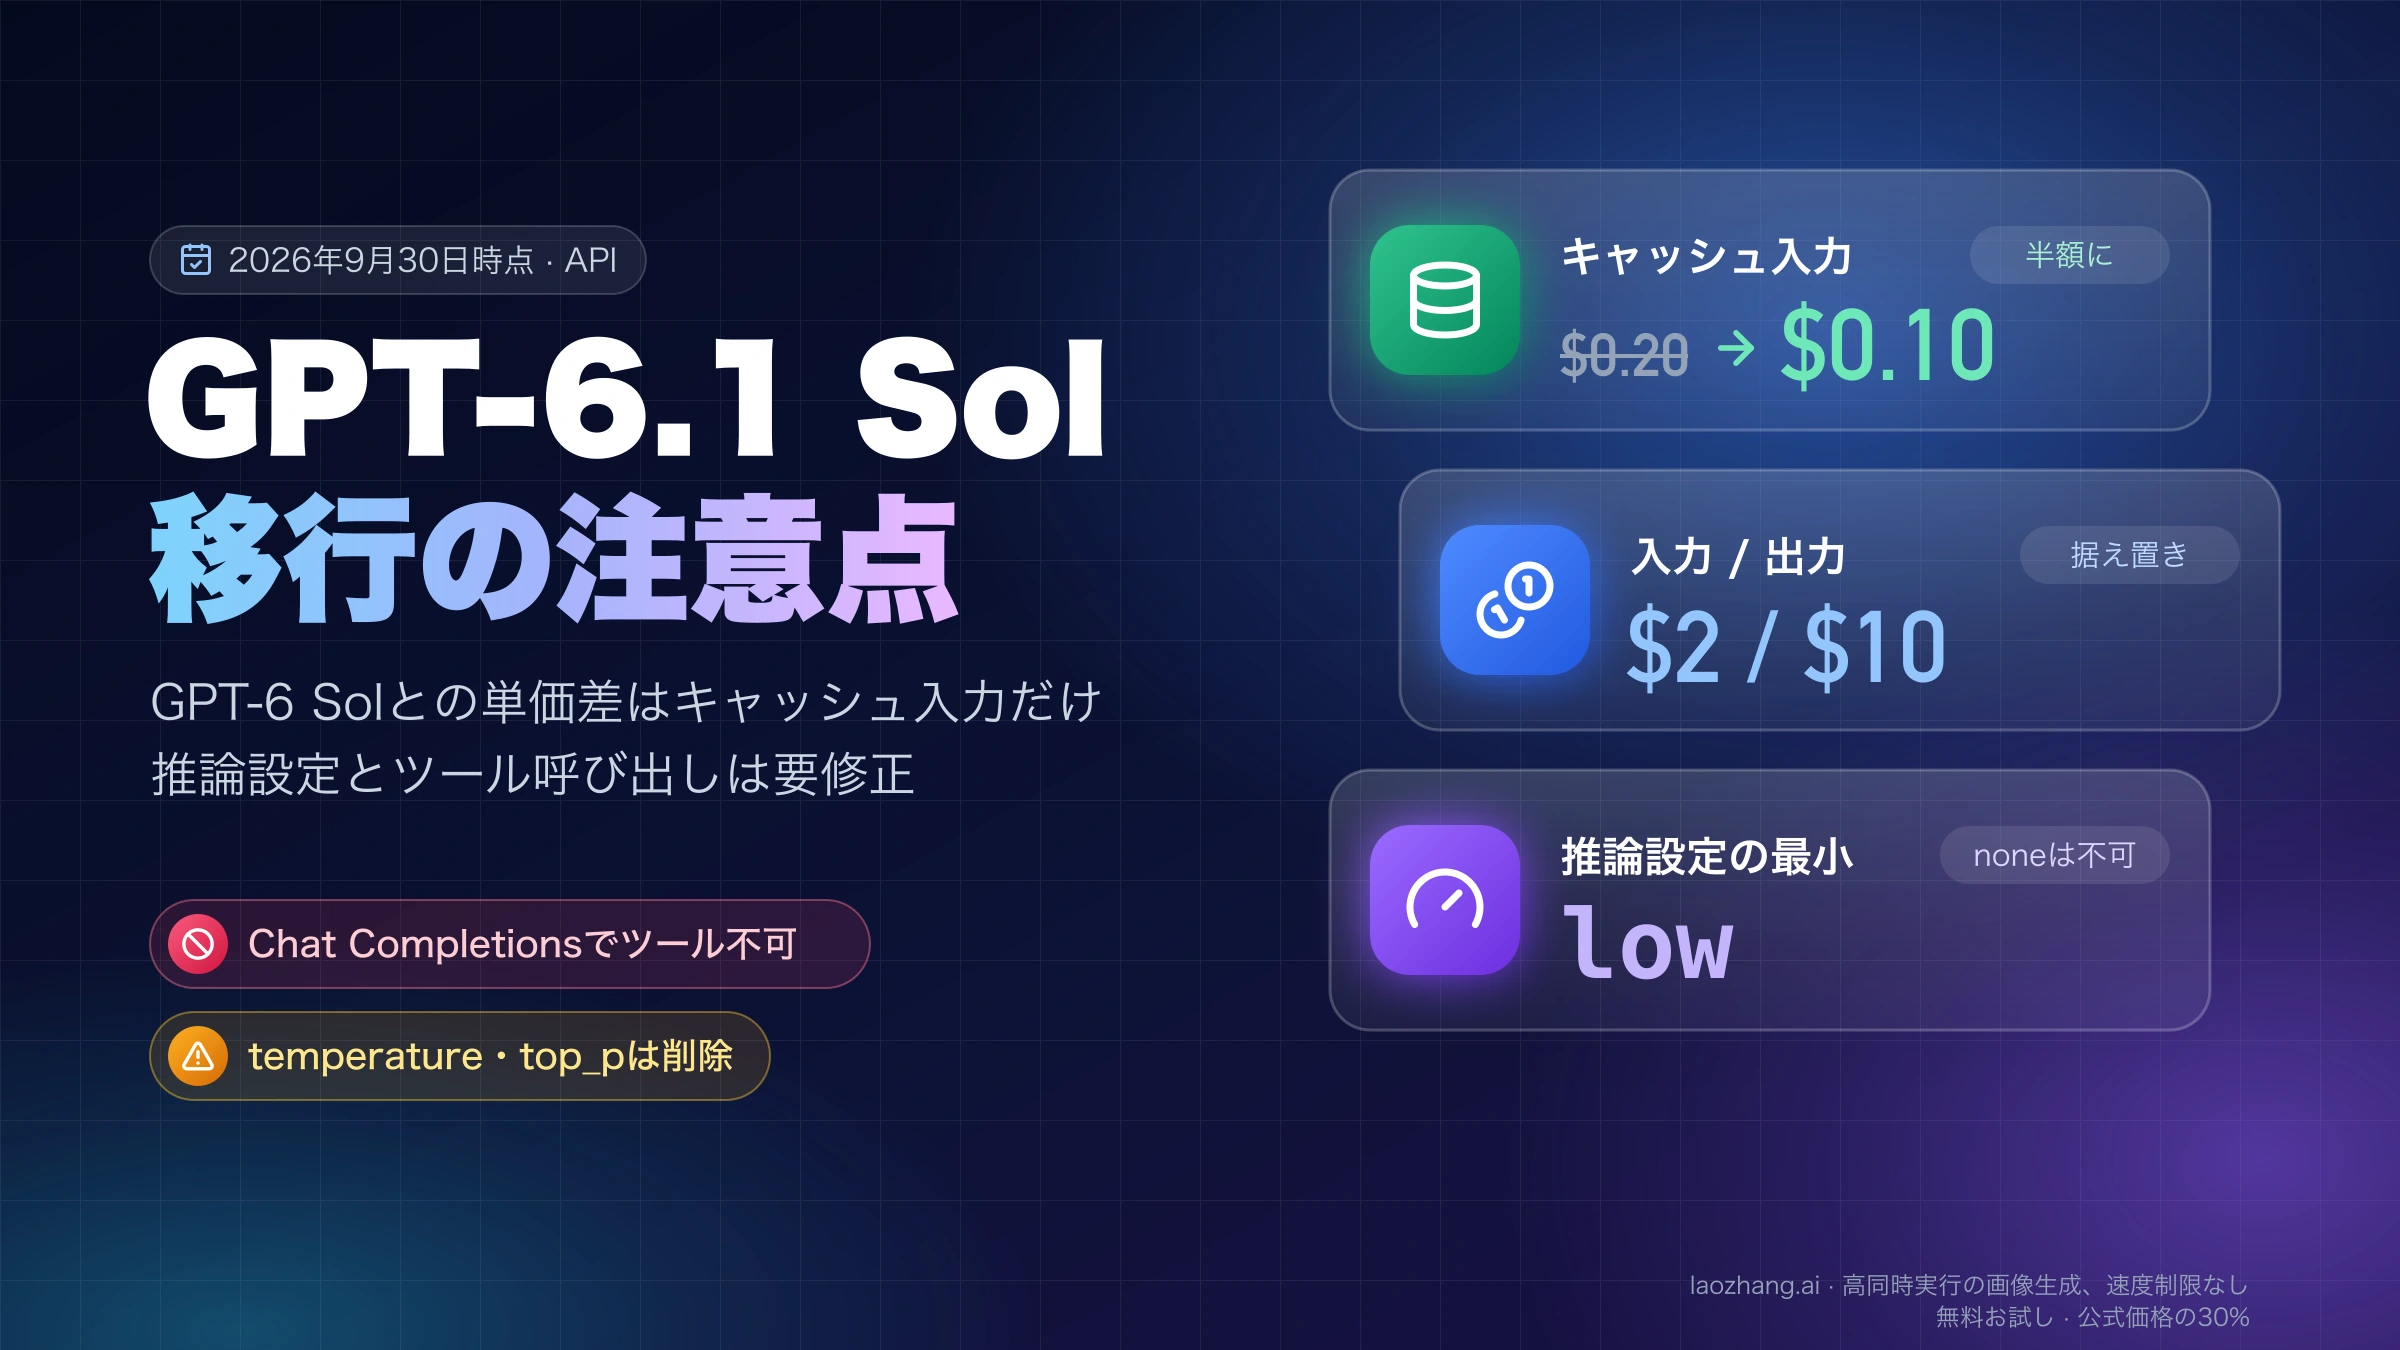
GPT-6.1 SolはGPT-6 Solの後継で、キャッシュ入力だけが半額です。APIではnoneの推論設定とChat Completionsでのツール呼び出しが使えません。
目次
GPT-6.1 Solは、OpenAIが2026年9月29日に公開したGPT-6 Solの改良版です。APIのモデルIDはgpt-6.1-solで、ChatGPTではChatGPT WorkとCodexで選べます。GPT-6系の最上位はこれまでどおりGPT-6 Astraで、6.1 SolはOpenAIが「Astraに近い性能を低いコストで」と位置づける中位のモデルです。GPT-6 Solの公開は9月22日だったので、わずか1週間での更新になります。
すでにgpt-6-solをAPIで使っている場合、切り替えの判断に関わるのは次の3点です。
- 料金表の単価は同じで、下がったのはキャッシュ入力だけです(100万トークンあたり$0.20から$0.10へ)。キャッシュの読み取りが多いエージェント処理ほど安くなり、キャッシュを使わない処理では定価の差がありません。
reasoning.effortのnoneとminimalは使えず、最小はlowです。Chat Completionsではツール呼び出しができないため、ツールを使うリクエストはResponses APIに移す必要があります。noneで運用していたリクエストにtemperatureやtop_pなどを付けている場合は、それらも削除しなければなりません。
以下の料金と仕様は、特に断りがない限り2026年10月5日時点のOpenAI公式ドキュメントに基づき、OpenAIのAPIを直接使う場合の話です。laozhang.ai経由で呼ぶ場合はキャッシュ入力の課金が異なり、上の「キャッシュが多いほど安くなる」は当てはまりません。その条件は後半の「laozhang.ai経由の6.1 Sol」の節にまとめています。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
GPT-6 SolやAstraとの関係
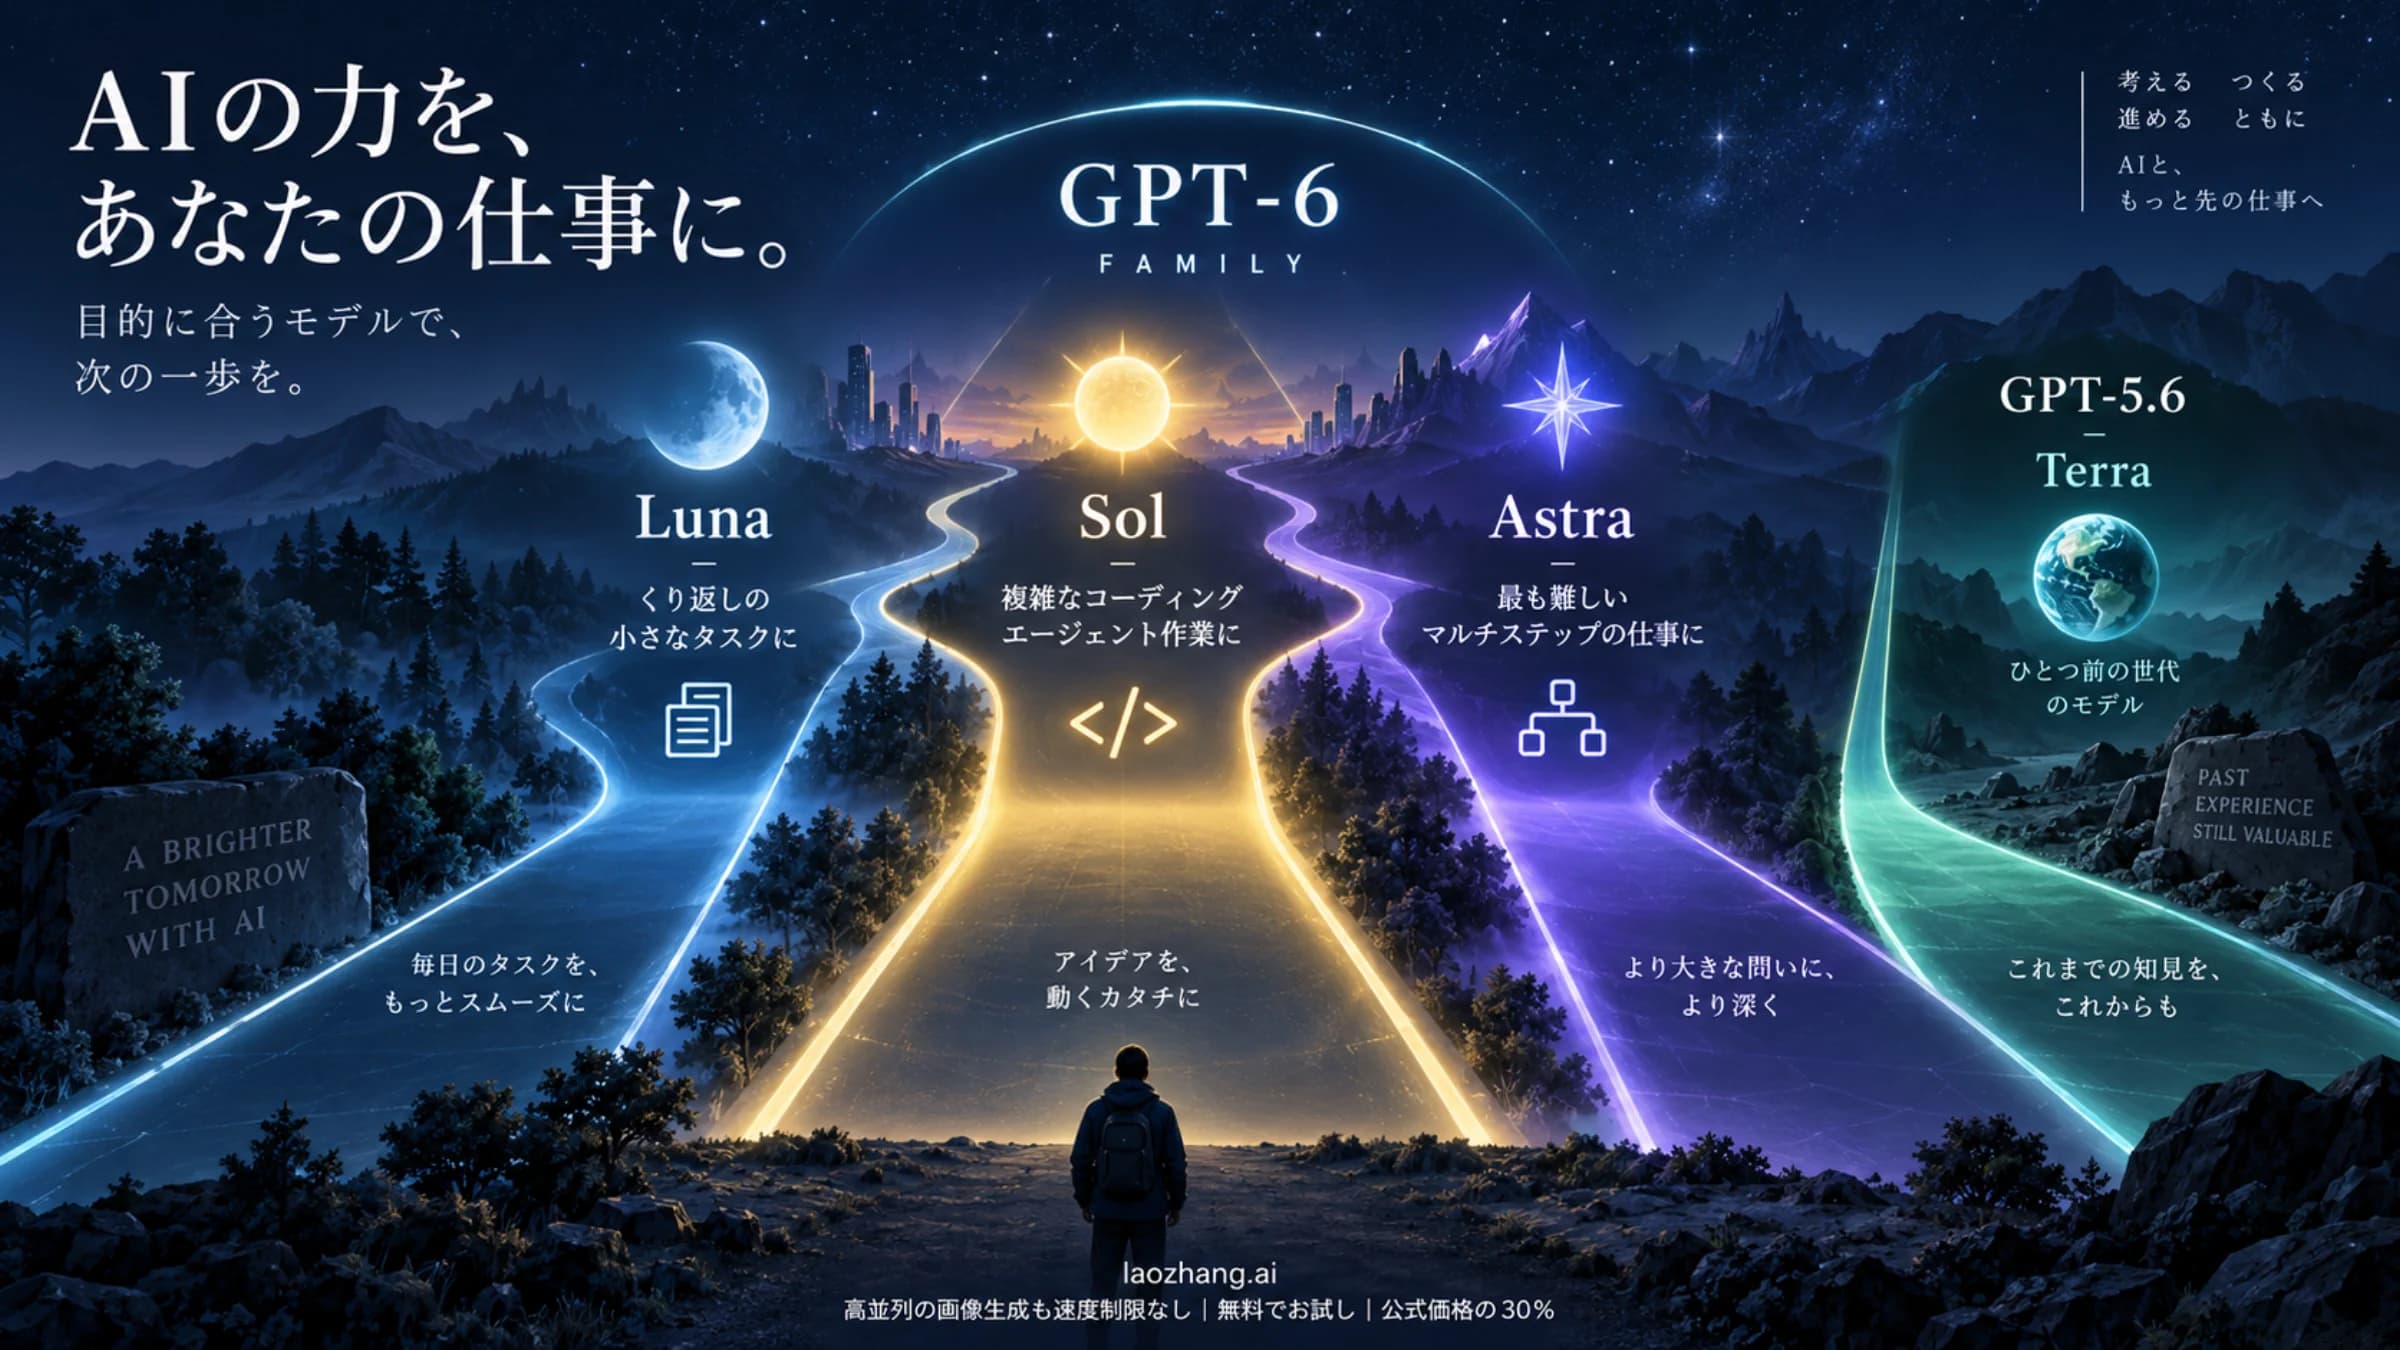
OpenAIのGPT-6ガイドでは、GPT-6系は次の3モデルで案内されています。GPT-6 Solはこの一覧から外れ、Sol枠は6.1 Solに置き換わりました。
| モデル | モデルID | OpenAIの説明 | 標準の入力 / 出力(100万トークン、272K以下) |
|---|---|---|---|
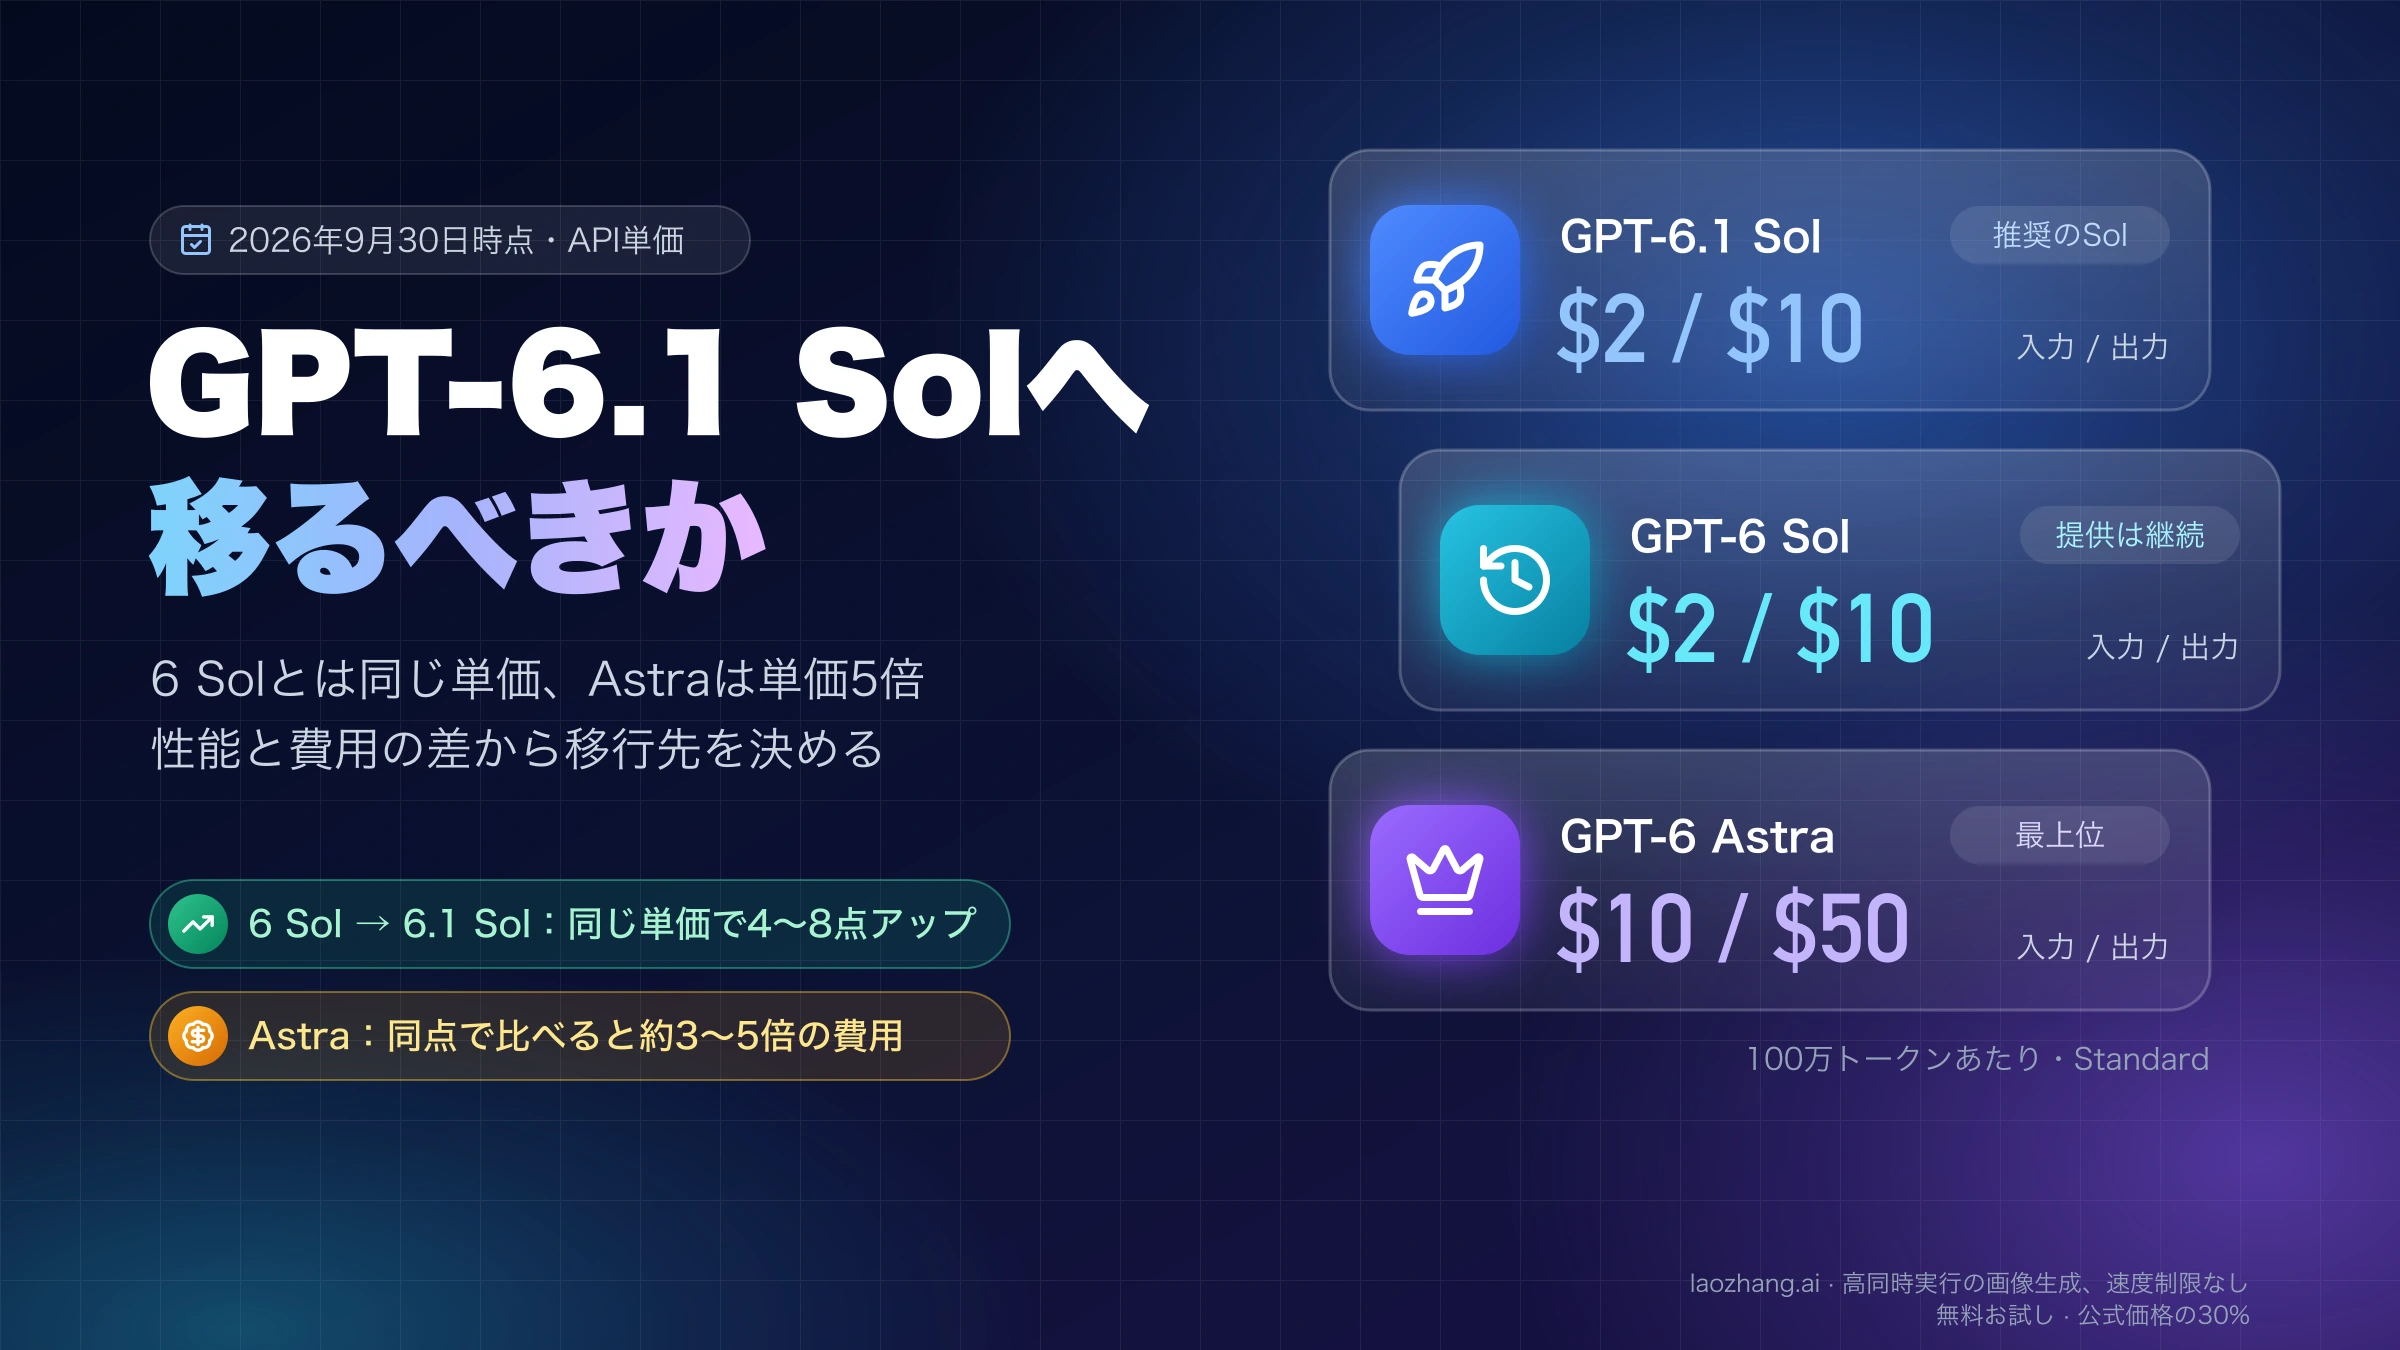
| GPT-6 Astra | gpt-6-astra | 最も高い知能 | $10 / $50 |
| GPT-6.1 Sol | gpt-6.1-sol | 速度・コスト・知能のバランス | $2 / $10 |
| GPT-6 Luna | gpt-6-luna | 最速で最も低コスト | $0.10 / $0.50 |
入力と出力の単価はAstraの5分の1、キャッシュ入力は10分の1です。「料金は5分の1」という言い方は、この入出力の定価比のことです。Astraの単価と長文時の計算は「GPT-6 Astra API料金:10種類の単価と長文・Batch・Fastの計算方法」で確認できます。
「Astraに迫る性能」はOpenAI自身の評価
性能の数字はすべてOpenAIの発表記事に載っている自社評価で、研究環境またはAPIで測ったものです。システムプロンプトや使えるツールが違うため、ChatGPTでの結果とは差が出る可能性があるとOpenAI自身が注記しています。主な主張は次のとおりです。
- DeepSWE v1.1:GPT-6 Astraと同等の水準を約5分の1のコストで達成し、GPT-6 Solの最高スコアを、より低い推論設定とコストで6.4ポイント上回る。
- OSWorld 2.0(最大の推論設定):GPT-6 Solより7ポイント高く、コストは半分以下。Astraとの差は2.1ポイント以内で、タスクあたりのコストは約7分の1。
- Terminal-Bench Science 0.1:首位は68.1%のGPT-6 Astraのまま。タスクあたりの平均コストは6.1 Solが$5.47、Astraが$23.80。
つまり「Astra並み」は一部の評価での話で、OpenAIも最も難しい研究タスクにはAstraを使うよう書いています。自分の用途でどちらが得かは、同じタスクを両方で流してみるまで分かりません。3モデルのベンチマークとタスクあたりコストの比較はGPT-6.1 Sol・6 Sol・Astra比較:移行の判断にまとめています。
GPT-6 Solはいつまで使えるか
gpt-6-solのモデルページには「新しいSolモデルはGPT-6.1 Solを参照」と案内が加わり、料金ページの主要モデル表からは消えました。一方で、廃止予定の一覧(Deprecations)には載っておらず、終了日は発表されていません。既存のリクエストがすぐ止まる状況ではありませんが、これから組む処理は6.1 Solを前提にしておくのが無難です。
料金:変わったのはキャッシュ入力の単価だけ
100万トークンあたりの標準料金(Standard、グローバル処理)を並べると、差はキャッシュ入力の行だけです。gpt-6-solの単価は、料金ページから外れる前の2026年9月25日時点の値です。
| 100万トークンあたり | gpt-6-sol 272K以下 | gpt-6.1-sol 272K以下 | gpt-6-sol 272K超 | gpt-6.1-sol 272K超 |
|---|---|---|---|---|
| 入力 | $2.00 | $2.00 | $4.00 | $4.00 |
| キャッシュ入力 | $0.20 | $0.10 | $0.40 | $0.20 |
| キャッシュ書き込み(30分、既定) | $2.50 | $2.50 | $5.00 | $5.00 |
| キャッシュ書き込み(12時間、Responses APIのみ) | $5.00 | $5.00 | $10.00 | $10.00 |
| 出力 | $10.00 | $10.00 | $15.00 | $15.00 |
6.1 Solのキャッシュ入力は通常入力の5%(95%引き)、30分のキャッシュ書き込みは通常入力の1.25倍、2026年10月20日に追加された12時間の書き込み(Responses APIのみ)は2.5倍です。推論トークンは出力トークンとして課金されます。Web検索などのツールは、呼び出しごとに別料金がかかる場合があります。
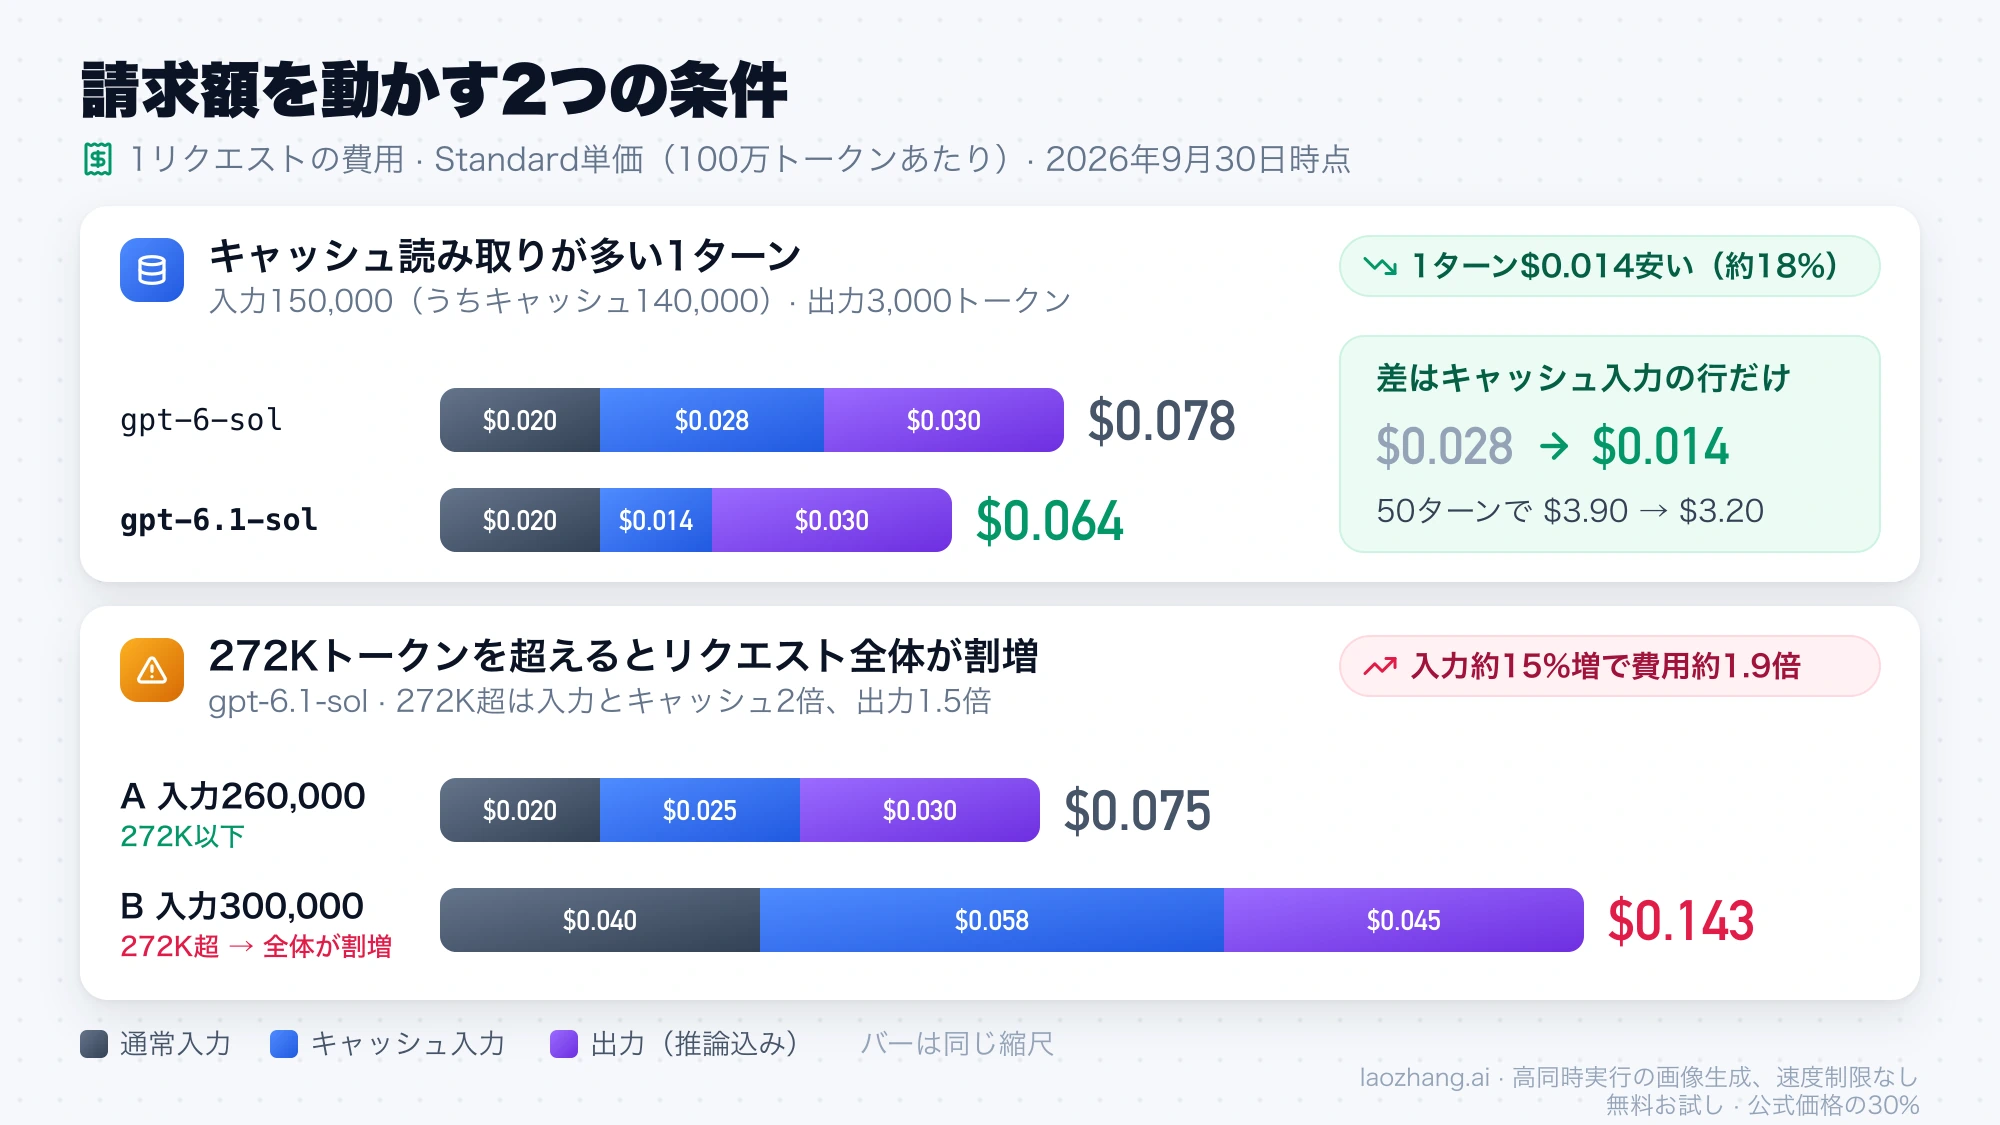
請求額が変わるかどうかは、ほぼ2つの条件で決まります。入力のうちキャッシュから読まれる割合と、1回のリクエストが272Kトークンを超えるかどうかです。以下の計算はどれも「費用 = トークン数 × 単価 ÷ 1,000,000」を項目ごとに足しただけなので、自分のログの数字に置き換えて再計算できます。
キャッシュが多いエージェント処理で比べる
同じ会話を何度も読み直すコーディングエージェントの1ターンを想定します。入力150,000トークンのうち140,000がキャッシュ読み取り、10,000が通常入力、出力は推論込みで3,000トークンです。キャッシュ書き込みの単価は両モデルで同じなので、差には影響しません。
| 項目 | gpt-6-sol | gpt-6.1-sol |
|---|---|---|
| 通常入力 10,000 | 10,000 × $2 ÷ 1M = $0.020 | $0.020 |
| キャッシュ入力 140,000 | 140,000 × $0.20 ÷ 1M = $0.028 | 140,000 × $0.10 ÷ 1M = $0.014 |
| 出力 3,000 | 3,000 × $10 ÷ 1M = $0.030 | $0.030 |
| 1ターンの合計 | $0.078 | $0.064 |
1ターンあたり$0.014、約18%の差で、同じターンを50回繰り返すと$3.90と$3.20になります。キャッシュ読み取りの割合が大きいほど差は広がります。逆にキャッシュを使わない処理では、残りの単価がすべて同じなので、定価上の差はありません。
ただし、この比較は両モデルが同じトークン数を使う前提です。実際には推論の長さややり直しの回数がモデルごとに違うため、請求額の差はトークン数の差にも左右されます。
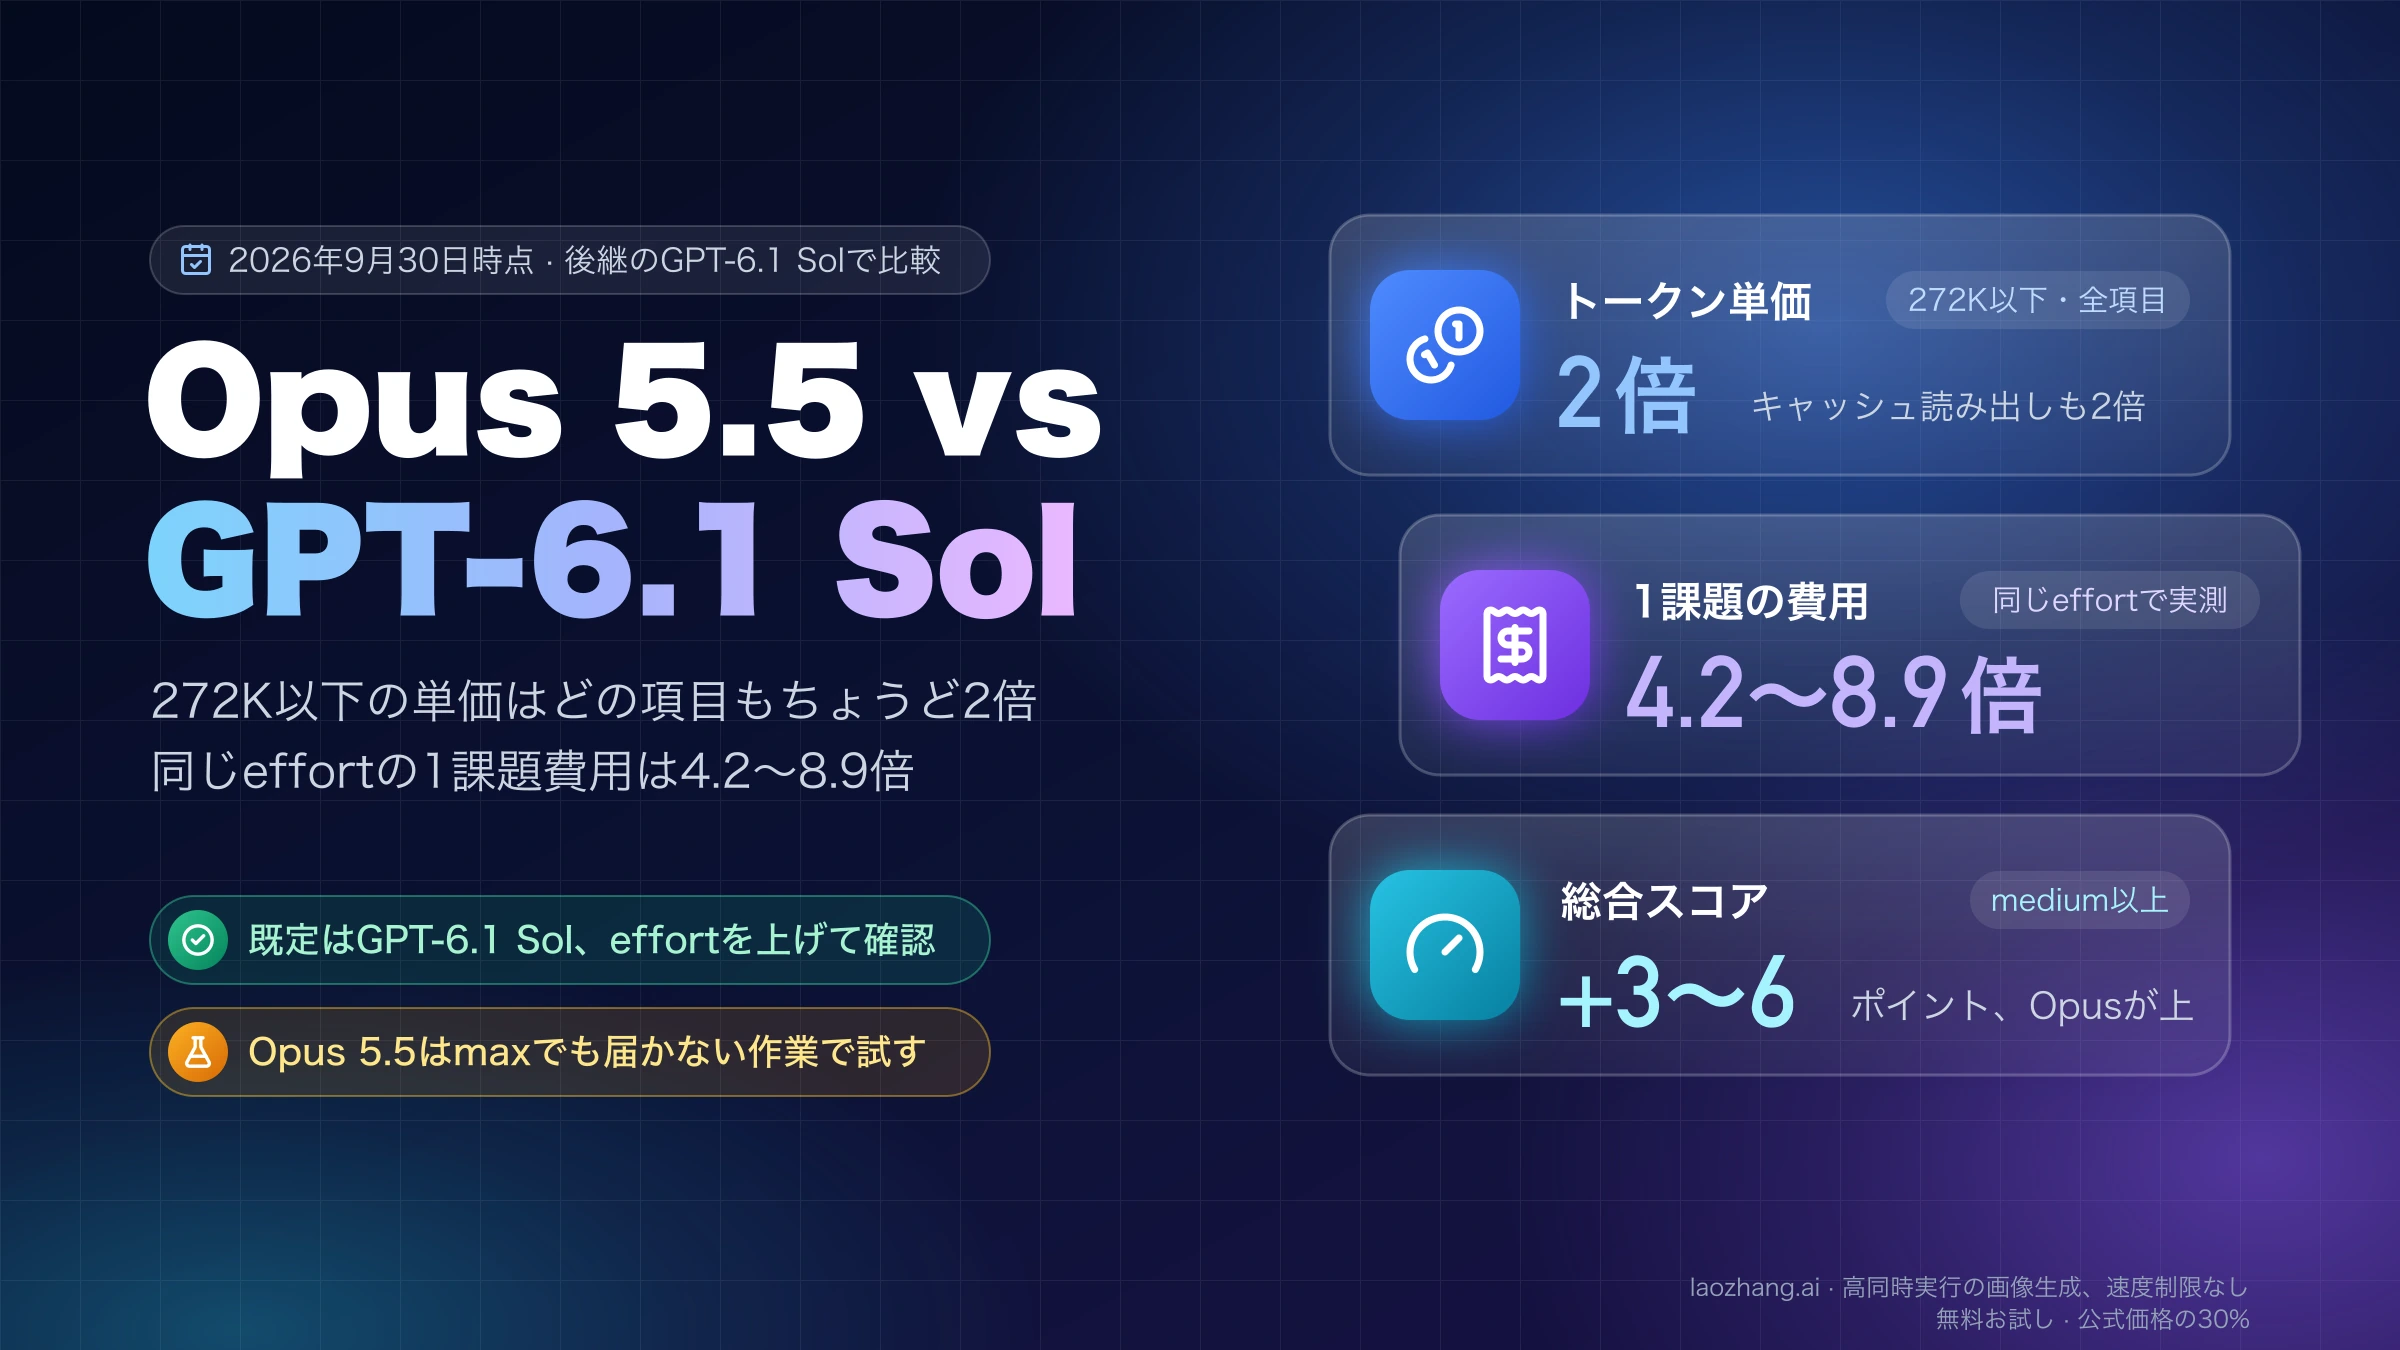
なお、「Opus 5.5とGPT-6 Sol比較:料金2倍はどこに効くか」はGPT-6 Solのキャッシュ入力単価($0.20)で計算しているので、6.1 Solで同じ比較をするならキャッシュの行を半額にして計算し直す必要があります。
272Kトークンを超えるとリクエスト全体が割増になる
入力が272Kトークンを超えると、超えた分だけでなくリクエスト全体に長文用の単価(入力とキャッシュが2倍、出力が1.5倍)が適用されます。これはGPT-6 Solと同じルールです。
- リクエストA(
gpt-6.1-sol、入力260,000=キャッシュ250,000+通常10,000、出力3,000):$0.020+$0.025+$0.030=$0.075 - リクエストB(
gpt-6.1-sol、入力300,000=キャッシュ290,000+通常10,000、出力3,000):10,000 × $4 ÷ 1M=$0.040、290,000 × $0.20 ÷ 1M=$0.058、3,000 × $15 ÷ 1M=$0.045、合計$0.143
入力が約15%増えただけで、費用は約1.9倍になります。同じリクエストBをgpt-6-solで送ると、キャッシュ部分が290,000 × $0.40 ÷ 1Mで$0.116になり、合計は$0.201です。長い履歴を抱えるエージェントは、1回の入力が272Kを超えないように履歴を圧縮するだけで、モデルを替えるより大きく費用が変わることがあります。
Fast・Batch・Flexの倍率
処理方式による倍率は6.1 Solでも次のとおりです(272K以下の単価)。
| 処理方式 | 入力 | キャッシュ入力 | キャッシュ書き込み | 出力 |
|---|---|---|---|---|
| Standard | $2.00 | $0.10 | $2.50 | $10.00 |
| Fast(Standardの2倍) | $4.00 | $0.20 | $5.00 | $20.00 |
| Batch・Flex(Standardの半額) | $1.00 | $0.05 | $1.25 | $5.00 |
表のキャッシュ書き込みは30分の単価で、12時間の書き込みはどの処理方式でもその2倍(Standard $5.00、Fast $10.00、Batch・Flex $2.50)です。データレジデンシー(地域処理)を使うと10%の上乗せがあり、EUのデータレジデンシーではFastを使えません。以前の「Priority processing」は、2026年7月30日にFast modeへ名称が変わっています。
APIでgpt-6-solから移すときに直す箇所
OpenAIの移行ガイドは「gpt-6-solを使っているなら、切り替える前に移行ガイダンスを確認すること」と明記しています。モデル名を書き換えるだけで済むかどうかは、今のリクエストが次のどれに当たるかで決まります。
| 今のリクエスト | gpt-6-sol | gpt-6.1-sol | 直し方 |
|---|---|---|---|
reasoning.effortがnone | 使える | 使えない | lowにする |
reasoning.effortがminimal | 一覧にない | 使えない | lowから始めて結果を比べる |
low〜max | 使える | 使える | そのまま(既定はmedium) |
| Chat Completionsでツール・関数呼び出し | noneのときだけ可 | 不可 | Responses APIに移す |
| Chat Completionsでツールなし | 使える | 使える | そのまま |
temperature・top_p・top_logprobs | noneのときだけ送れる | 送れない | 削除する |
Chat Completionsのlogprobs | noneのときだけ送れる | 送れない | 削除する |
Responsesのincludeにあるmessage.output_text.logprobs | noneのときだけ送れる | 送れない | includeから外す |
noneで動かしていたgpt-6-solの処理は、推論が必ず入るモデルに移ることになります。推論トークンは出力として課金されるため、lowに替えたあとの出力トークン数は必ず確認してください。OpenAIの移行ガイドでは、Codexに$openai-docs migrate this project to the GPT-6 model familyと指示して、プロジェクトの書き換えを任せる方法も紹介されています。
壊れやすい書き方と、直したあとのリクエスト
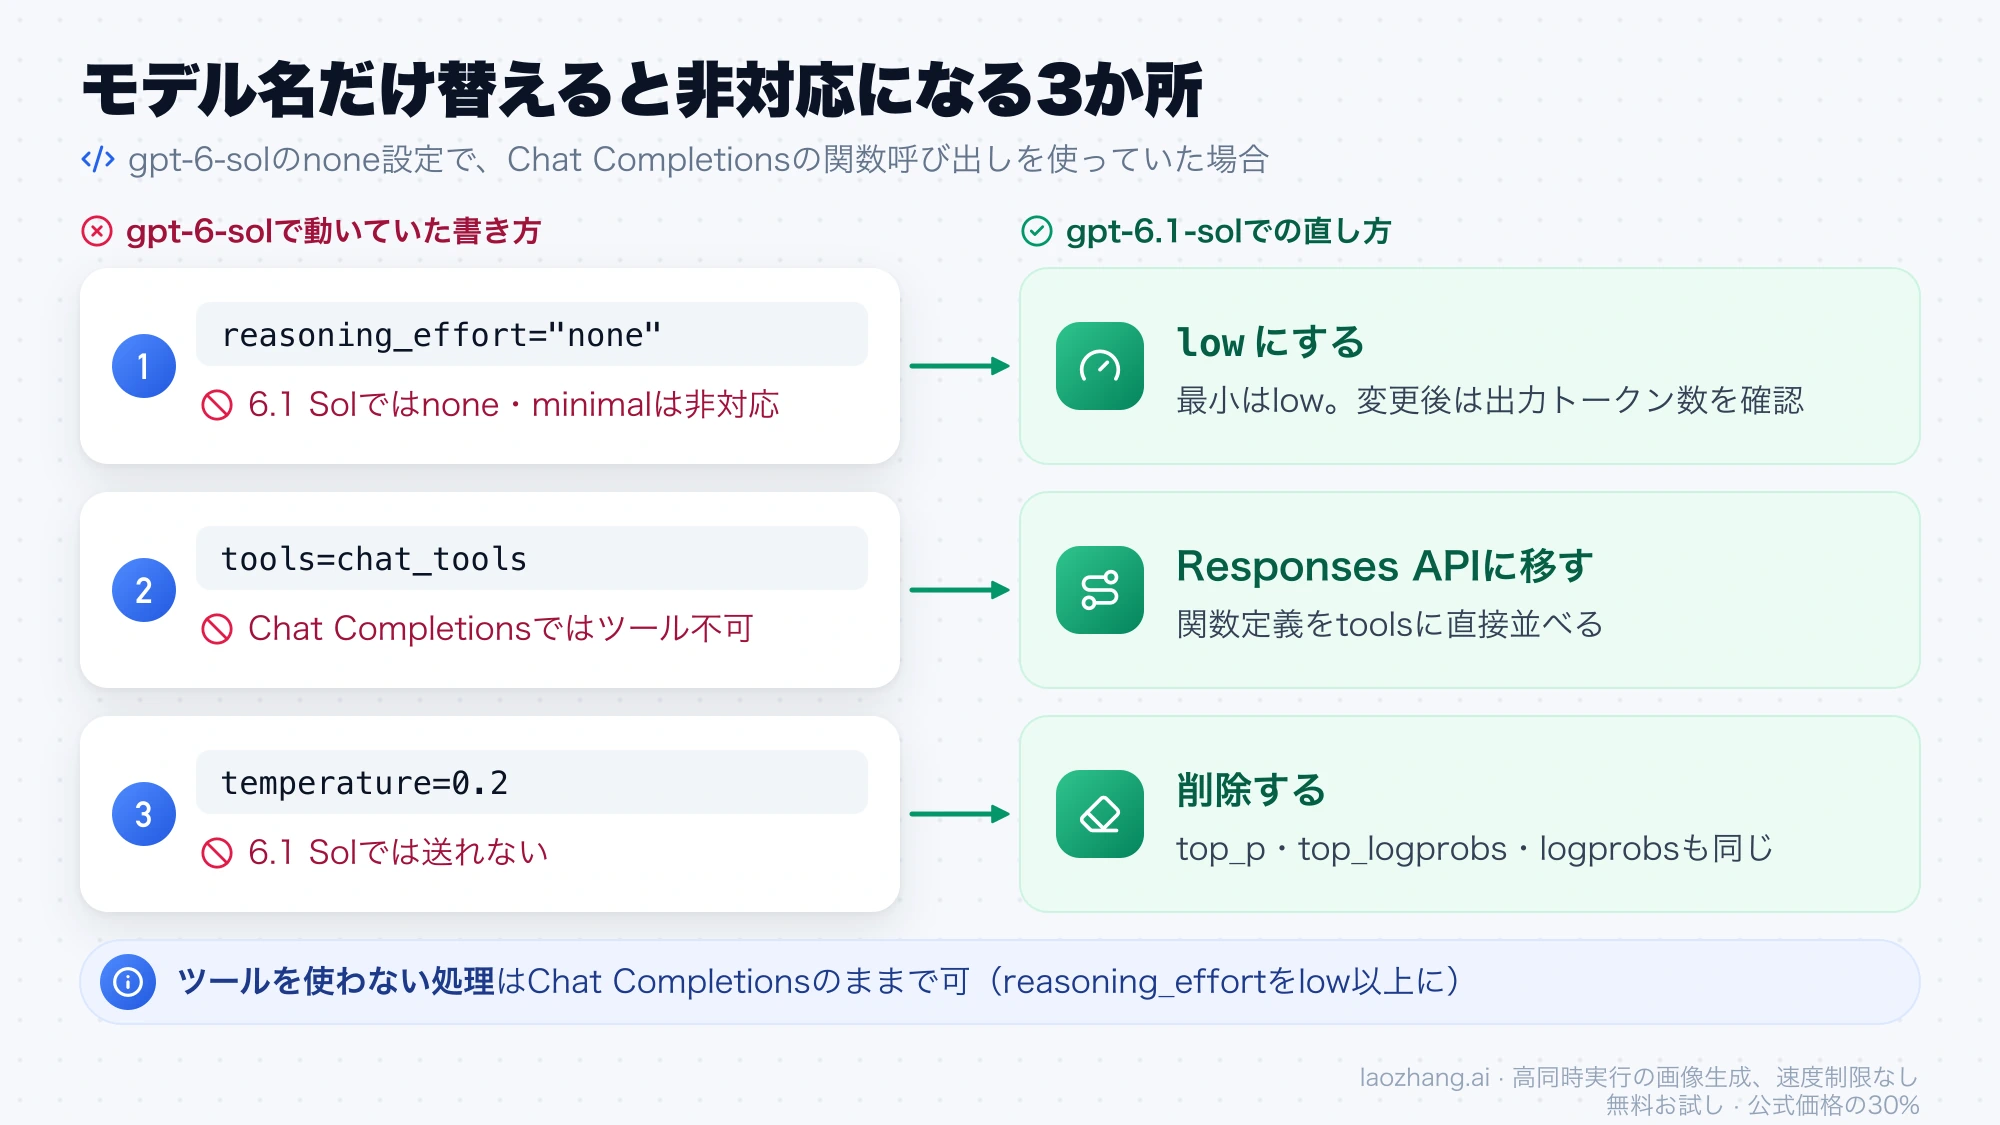
移行で最も引っかかりやすいのは、gpt-6-solのnone設定でChat Completionsの関数呼び出しとtemperatureを組み合わせていたケースです。次のリクエストは、モデル名だけ替えると3か所が非対応になります。
# gpt-6-sol では動いていた書き方
completion = client.chat.completions.create(
    model="gpt-6-sol",
    reasoning_effort="none",   # 6.1 Sol では非対応
    temperature=0.2,           # none 以外では削除が必要
    tools=chat_tools,          # 6.1 Sol の Chat Completions ではツール不可
    messages=messages,
)
ツールを使う処理はResponses APIに書き換えます。Responses APIでは関数定義をtoolsに直接並べます。
from openai import OpenAI

client = OpenAI()

tools = [
    {
        "type": "function",
        "name": "get_ticket",
        "description": "チケット番号から問い合わせ内容を取得する",
        "parameters": {
            "type": "object",
            "properties": {"ticket_id": {"type": "string"}},
            "required": ["ticket_id"],
        },
    }
]

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},  # 最小は low
    tools=tools,
    input="チケット A-1024 の問い合わせを要約してください",
)

for item in response.output:
    if item.type == "function_call":
        print(item.name, item.arguments, item.call_id)

print(response.usage)  # キャッシュ読み取りと推論のトークン数もここで確認
ツールを使わない処理なら、Chat Completionsのままでも動きます。reasoning_effortをlow以上にし、サンプリング系のパラメータを外すだけです。
completion = client.chat.completions.create(
    model="gpt-6.1-sol",
    reasoning_effort="low",
    messages=[{"role": "user", "content": "この仕様書の変更点を3行でまとめてください"}],
)
print(completion.choices[0].message.content)
会話の途中で推論設定を変える場合
同じ会話の途中で推論の深さを変えたいときは、リクエスト全体のreasoning.effortを書き換えるのではなく、入力にconfiguration_updateアイテムを入れます。リクエスト単位の設定を変えないことで、プロンプトの先頭部分がキャッシュに乗ったまま残ります。キャッシュ入力が半額になった6.1 Solでは、この差がそのまま請求額に出ます。
GPT-5.5以前から直接移る場合は、prompt_cache_retentionをprompt_cache_options.ttl(値は"30m")に置き換える必要もあります。
ChatGPTとCodexで使えるプラン
ChatGPTでは、GPT-6.1 SolはChatGPT WorkとCodexで選べますが、通常のチャットでは使えません。これはGPT-6 SolやGPT-6 Lunaも同じです。
| プラン | 2026年10月5日時点の扱い |
|---|---|
| Plus・Pro・Business | ChatGPT WorkとCodexで提供 |
| Enterprise・Edu | 提供対象だが、管理者が有効にするまでオフ |
| Free・Go | 公開時点では対象外 |
提供は段階的で、アカウントやクライアント(デスクトップアプリ、Web、モバイル、CLI、IDE拡張)によって表示されるまでに時間がかかる場合があります。モデルを選んでも、ワークスペースの権限が変わったり利用権が付与されたりはしません。ChatGPTのデスクトップアプリとWeb版のChatGPT Workでは、既定の「Power」から始め、深く考えさせたいときは「Smarter」、速さと低コストを優先するなら「Faster」に寄せます。モデル・推論の深さ・速度を個別に選ぶには「Advanced」を開きます。
Codexでモデルを指定する
Codex CLIでは、起動時にモデルを指定するか、セッション中に/modelで切り替えます。
codex --model gpt-6.1-sol
codex exec -m gpt-6.1-sol "Review the current changes"デスクトップアプリ、CLI、IDE拡張は同じconfig.tomlを読むので、既定のモデルをまとめて変えるなら次の1行で足ります。
model = "gpt-6.1-sol"推論の深さは、デスクトップアプリやIDE拡張の「Light」がCLIの「Low」に当たり、その上にMedium、High、Extra Highがあります。MaxとUltraは設定によって表示され、CLIでは/modelでモデルを選んだあと「More reasoning…」から選べます。OpenAIは、ほとんどのタスクにMaxやUltraは不要だとしています。世代が変わると推論設定の効き方も同じではないので、慣れたタスクを低めの設定で試してから上げていくのが確実です。
ChatGPTのサインインではなく自分のAPIキーでCodexを使っている場合は、APIの提供条件がそのまま当てはまります。CodexではChat Completions APIのサポートが非推奨になっており、将来のリリースで削除される予定です。
GPT-5.5をCodexやChatGPT Workで使っている人は、2026年10月14日にこれらの画面から外れる点にも注意してください(APIからは外れません)。OpenAIの案内では、複雑なコーディングとエージェント処理には、使えるようになっていればGPT-6.1 Solを勧めています。
APIで使うための条件
APIのFreeティアではgpt-6.1-solを使えません。有料の使用ティアごとの上限は次のとおりで、ティアは支払額に応じて自動で上がります。
| ティア | RPM | TPM |
|---|---|---|
| Tier 1 | 500 | 500,000 |
| Tier 2 | 5,000 | 1,000,000 |
| Tier 3 | 5,000 | 2,000,000 |
| Tier 4 | 10,000 | 4,000,000 |
| Tier 5 | 15,000 | 40,000,000 |
コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークン、知識の区切りは2026年4月30日です。入力はテキストと画像、出力はテキストのみで、音声と動画には対応していません。Responses APIでは、Web検索、ファイル検索、画像生成、Code Interpreter、Computer Use、MCPなどの組み込みツールと、マルチエージェント機能(ベータ)が使えます。ファインチューニングには対応していません。日付付きのスナップショットIDも用意されておらず、指定するのはgpt-6.1-solだけです。
OpenAIのAPIとChatGPTは提供国・地域が決まっていて、2026年9月25日時点の一覧には日本が含まれています。プロジェクトの権限やティアの確認手順は「GPT-6 Astra APIの始め方:利用権限の確認から最初の応答まで」と同じ流れで進められます。
2026年9月30日時点で、Microsoft Foundry、Amazon Bedrock、OpenRouterもGPT-6.1 Solを掲載しています。これらを経由する場合の料金、提供リージョン、上限は各プラットフォームが決めるので、上の数字はOpenAIのAPIを直接使う場合にだけ当てはまります。
laozhang.ai経由の6.1 Sol:キャッシュ入力も通常単価
日本はOpenAIの提供国・地域に含まれているので、APIで使うならここまでの直接契約がまず候補になります。もう一つの選択肢として、APIゲートウェイのlaozhang.aiが2026年10月5日からgpt-6.1-solを提供しています。OpenAIのアカウントとは別に、前払いの残高から使った分を差し引く契約です。上のティア別の上限はOpenAIと直接契約した場合の数字で、laozhang.ai経由には当てはまりません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
laozhang.aiのモデルと料金の一覧(英語)では、2026年10月5日時点のdefaultグループの単価は100万トークンあたり入力$2・出力$10(1リクエスト272,000トークン以下)、272,001トークン以上は$4・$15です。リクエスト全体が1つの段階で課金される点も含めて、OpenAIの定価と同じです。
違うのはキャッシュ読み取りです。一覧のキャッシュ読み取りの欄は「—」で、laozhang.aiのプロンプトキャッシュ課金の説明によると、この欄が「—」のモデルは入力をすべて通常の入力単価で課金します。キャッシュ自体は効いていて、約42Kトークンの同じ前置きで2回呼ぶと、2回目のusageにはcached_tokens: 42188が返りました。それでも割引はなく、入力42,191トークン(うちキャッシュ42,188)・出力6トークンの1回の請求は8.4442セントで、入力全体を$2で計算した額と一致しました。OpenAIの定価なら同じ呼び出しは約0.43セントです。
キャッシュ中心の1ターン:直接なら$0.064、laozhang.aiでは$0.330
料金の節と同じエージェントの1ターン(入力150,000=キャッシュ読み取り140,000+通常入力10,000、出力3,000、272K以下)を、定価で4通りに計算すると次のとおりです。単価は2026年10月5日時点のもので、OpenAI直接のgpt-6-solだけは料金ページから外れる前の値です。laozhang.ai上のgpt-6-solには、キャッシュ読み取り$0.20の単価が設定されています。
| 経路とモデル | 計算 | 1ターン | 50ターン |
|---|---|---|---|
OpenAI直接・gpt-6.1-sol | $0.020+$0.014+$0.030 | $0.064 | $3.20 |
OpenAI直接・gpt-6-sol | $0.020+$0.028+$0.030 | $0.078 | $3.90 |
laozhang.ai・gpt-6.1-sol | 150,000 × $2 ÷ 1M+3,000 × $10 ÷ 1M | $0.330 | $16.50 |
laozhang.ai・gpt-6-sol | $0.020+140,000 × $0.20 ÷ 1M+$0.030 | $0.078 | $3.90 |
キャッシュ中心の処理では、laozhang.ai経由の6.1 Solは直接契約の約5倍になり、同じlaozhang.ai上でもgpt-6-solのほうが安く済みます。直接契約との差額は「キャッシュ読み取りのトークン数 × $1.90 ÷ 1M」で、自分のログのcached_tokensを入れれば見積もれます。キャッシュ書き込み(セッションの最初の呼び出し)、やり直し、モデルごとのトークン数の違いはこの計算に入っていません。
逆に、キャッシュをほとんど使わない短い呼び出しなら差はありません。入力20,000・出力2,000のリクエストは、どちらの経路でも$0.040+$0.020=$0.060です。単価とキャッシュの設定は掲載直後のもので変わる可能性があり、一覧にも、実際に適用される価格はコンソールに表示されると書かれています。実際の課金は呼び出しログで確かめてください。
ツール呼び出しとmaxはResponsesで送る
ベースURLはhttps://api.laozhang.ai/v1で、Chat Completions(/v1/chat/completions)とResponses(/v1/responses)の両方を受け付けます。一覧の「OpenAI-compatible」はChat Completions形式の入口を指す表記で、一覧自身が「すべてのパラメータに対応するという意味ではない」と注記しています。2026年10月5日に、defaultグループの従量課金キーで各リクエストを1回ずつ送った結果(HTTPステータス)は次のとおりです。
| リクエスト | Chat Completions | Responses |
|---|---|---|
推論設定low | 200 | 200 |
推論設定max | 400 | 200 |
推論設定none | 400 | 400 |
temperature: 0.2 | 400 | 未実施 |
関数呼び出し(low) | 400 | 200(function_callが返る) |
組み込みのweb_search | 未実施 | 200(web_search_callが完了) |
| 約42Kトークンの同じ前置きを2回 | 2回目にcached_tokens 42,188 | 2回目にcached_tokens 42,188 |
Chat Completionsのエラーは次の3種類でした。
noneとmax:Unsupported value: 'reasoning_effort' does not support 'none' with this model. Supported values are: 'low', 'medium', 'high', and 'xhigh'.(maxでは'none'の部分が'max'になる)temperature:Unsupported value: 'temperature' does not support 0.2 with this model. Only the default (1) value is supported.- 関数呼び出し:
Function tools with reasoning_effort are not supported for gpt-6.1-sol in /v1/chat/completions. To use function tools, use /v1/responses or set reasoning_effort to 'none'.
エラー文はnoneにすればツールが使えると案内していますが、そのnone自体が拒否されるので、この経路のChat Completionsでツールを使う方法はありません。Responsesでnoneを送った場合はSupported values are: 'low', 'medium', 'high', 'xhigh', and 'max'.と返ります。関数呼び出しが通ったときのリクエストは次の形で、応答にはget_weatherのfunction_call(引数{"city":"Paris"})が入っていました。
curl https://api.laozhang.ai/v1/responses \
  -H "Authorization: Bearer $LAOZHANG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "low"},
    "input": "What is the weather in Paris? Use the tool.",
    "tools": [{
      "type": "function",
      "name": "get_weather",
      "description": "Get current weather for a city",
      "parameters": {
        "type": "object",
        "properties": {"city": {"type": "string"}},
        "required": ["city"]
      }
    }]
  }'
laozhang.aiのドキュメントには、Codex CLIをwire_api = "responses"のカスタムプロバイダーとしてつなぐ設定例もあります。ただし例のモデルはgpt-6-solで、gpt-6.1-solをCodex CLIから使う組み合わせは上の結果に含まれていません。ストリーミング、272Kトークンを超えるリクエスト、Fast・Batch・Flex、レート制限と同時実行数も同様です。laozhang.aiはAPIのゲートウェイなので、ChatGPT WorkやCodexのプランの代わりにはなりません。
503「no available channels」はキーの課金モード
laozhang.aiのキー(トークン)には課金モードがあり、回数課金のモードで作ったキーではgpt-6.1-solを呼べません。その場合はHTTP 503で次のエラーが返り、料金はかかりません。gpt-6-solとgpt-6-lunaでも同じでした。
Current group default has no available channels for model gpt-6.1-sol under billing mode [pay-per-request]laozhang.aiのトークン管理画面で、キーの課金モードを画面表示の按量优先(従量優先)に変えるか、このモードで新しいキーを作ります。従量課金のモデルと回数課金のモデルの両方を呼べます。グループはdefaultです。設定後、そのキーでGET https://api.laozhang.ai/v1/modelsを送ると、いま呼べるモデルの一覧にgpt-6.1-solが入っているかを確かめられます。
Ultrafastは2026年10月15日からAPIで提供
OpenAIの発表記事には「GPT-6 Astra UltrafastとGPT-6.1 Sol Ultrafastも投入し、APIで提供する」とありました。一方、同じ日のDevDayまとめでは6.1 SolのUltrafastは「近日提供」、ChatGPT Learnのモデル解説では「公開時点で使えるのはStandardとFast、6.1 SolのUltrafastは後日対応」と書かれ、APIの更新履歴(Changelog)と料金ページのUltrafastの表にもgpt-6-astraしかありませんでした。
この食い違いは2026年10月15日に解消しました。APIの更新履歴に、Responses APIのgpt-6.1-solでservice_tier: "ultrafast"を使えるようになったと載り、すべてのAPI利用者が対象です。料金はStandardの6倍で、100万トークンあたり入力$12、キャッシュ入力$0.60、キャッシュ書き込み$15(30分)/$30(12時間)、出力$60(272K以下)、272K超は入力$24、出力$90です。地域処理はグローバル、USとEUのデータレジデンシーに対応します(Astra UltrafastはグローバルとUSのみ)。Ultrafastには専用のレート制限があり、6.1 Solの既定値はBuild 100万、Launch 400万、Grow 4,000万TPMです(Ultrafastガイド)。ChatGPTとCodexでは、Pro $500と対象のEnterprise・Eduプランで6.1 SolのUltrafastを使えます。参考までに、GPT-6 AstraのUltrafastは入力$60、出力$300(272K以下)です。
切り替え前に自分のタスクで確かめる
公表された評価や定価の比較だけでは、自分の処理で安くなるか、品質が保てるかは決まりません。OpenAIのモデルページも、自分のタスクでAstraと比べて品質とコストのバランスを判断するよう勧めています。小さく比べるなら次の手順で足ります。
- 普段の処理から、成功と失敗がはっきり判定できるタスクを5〜10件選ぶ。
gpt-6-solは今の推論設定のまま、gpt-6.1-solは同じ設定(noneだった場合はlow)で流す。- 各リクエストの
usageから、通常入力・キャッシュ入力・出力(推論を含む)のトークン数を記録する。 - 上の単価表で費用を計算し(laozhang.ai経由ならキャッシュ入力も$2で計算)、1回の入力が272Kを超えたリクエストがないかも確認する。
- 結果の品質を同じ基準で比べ、足りなければ推論設定を1段上げて同じ比較を繰り返す。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
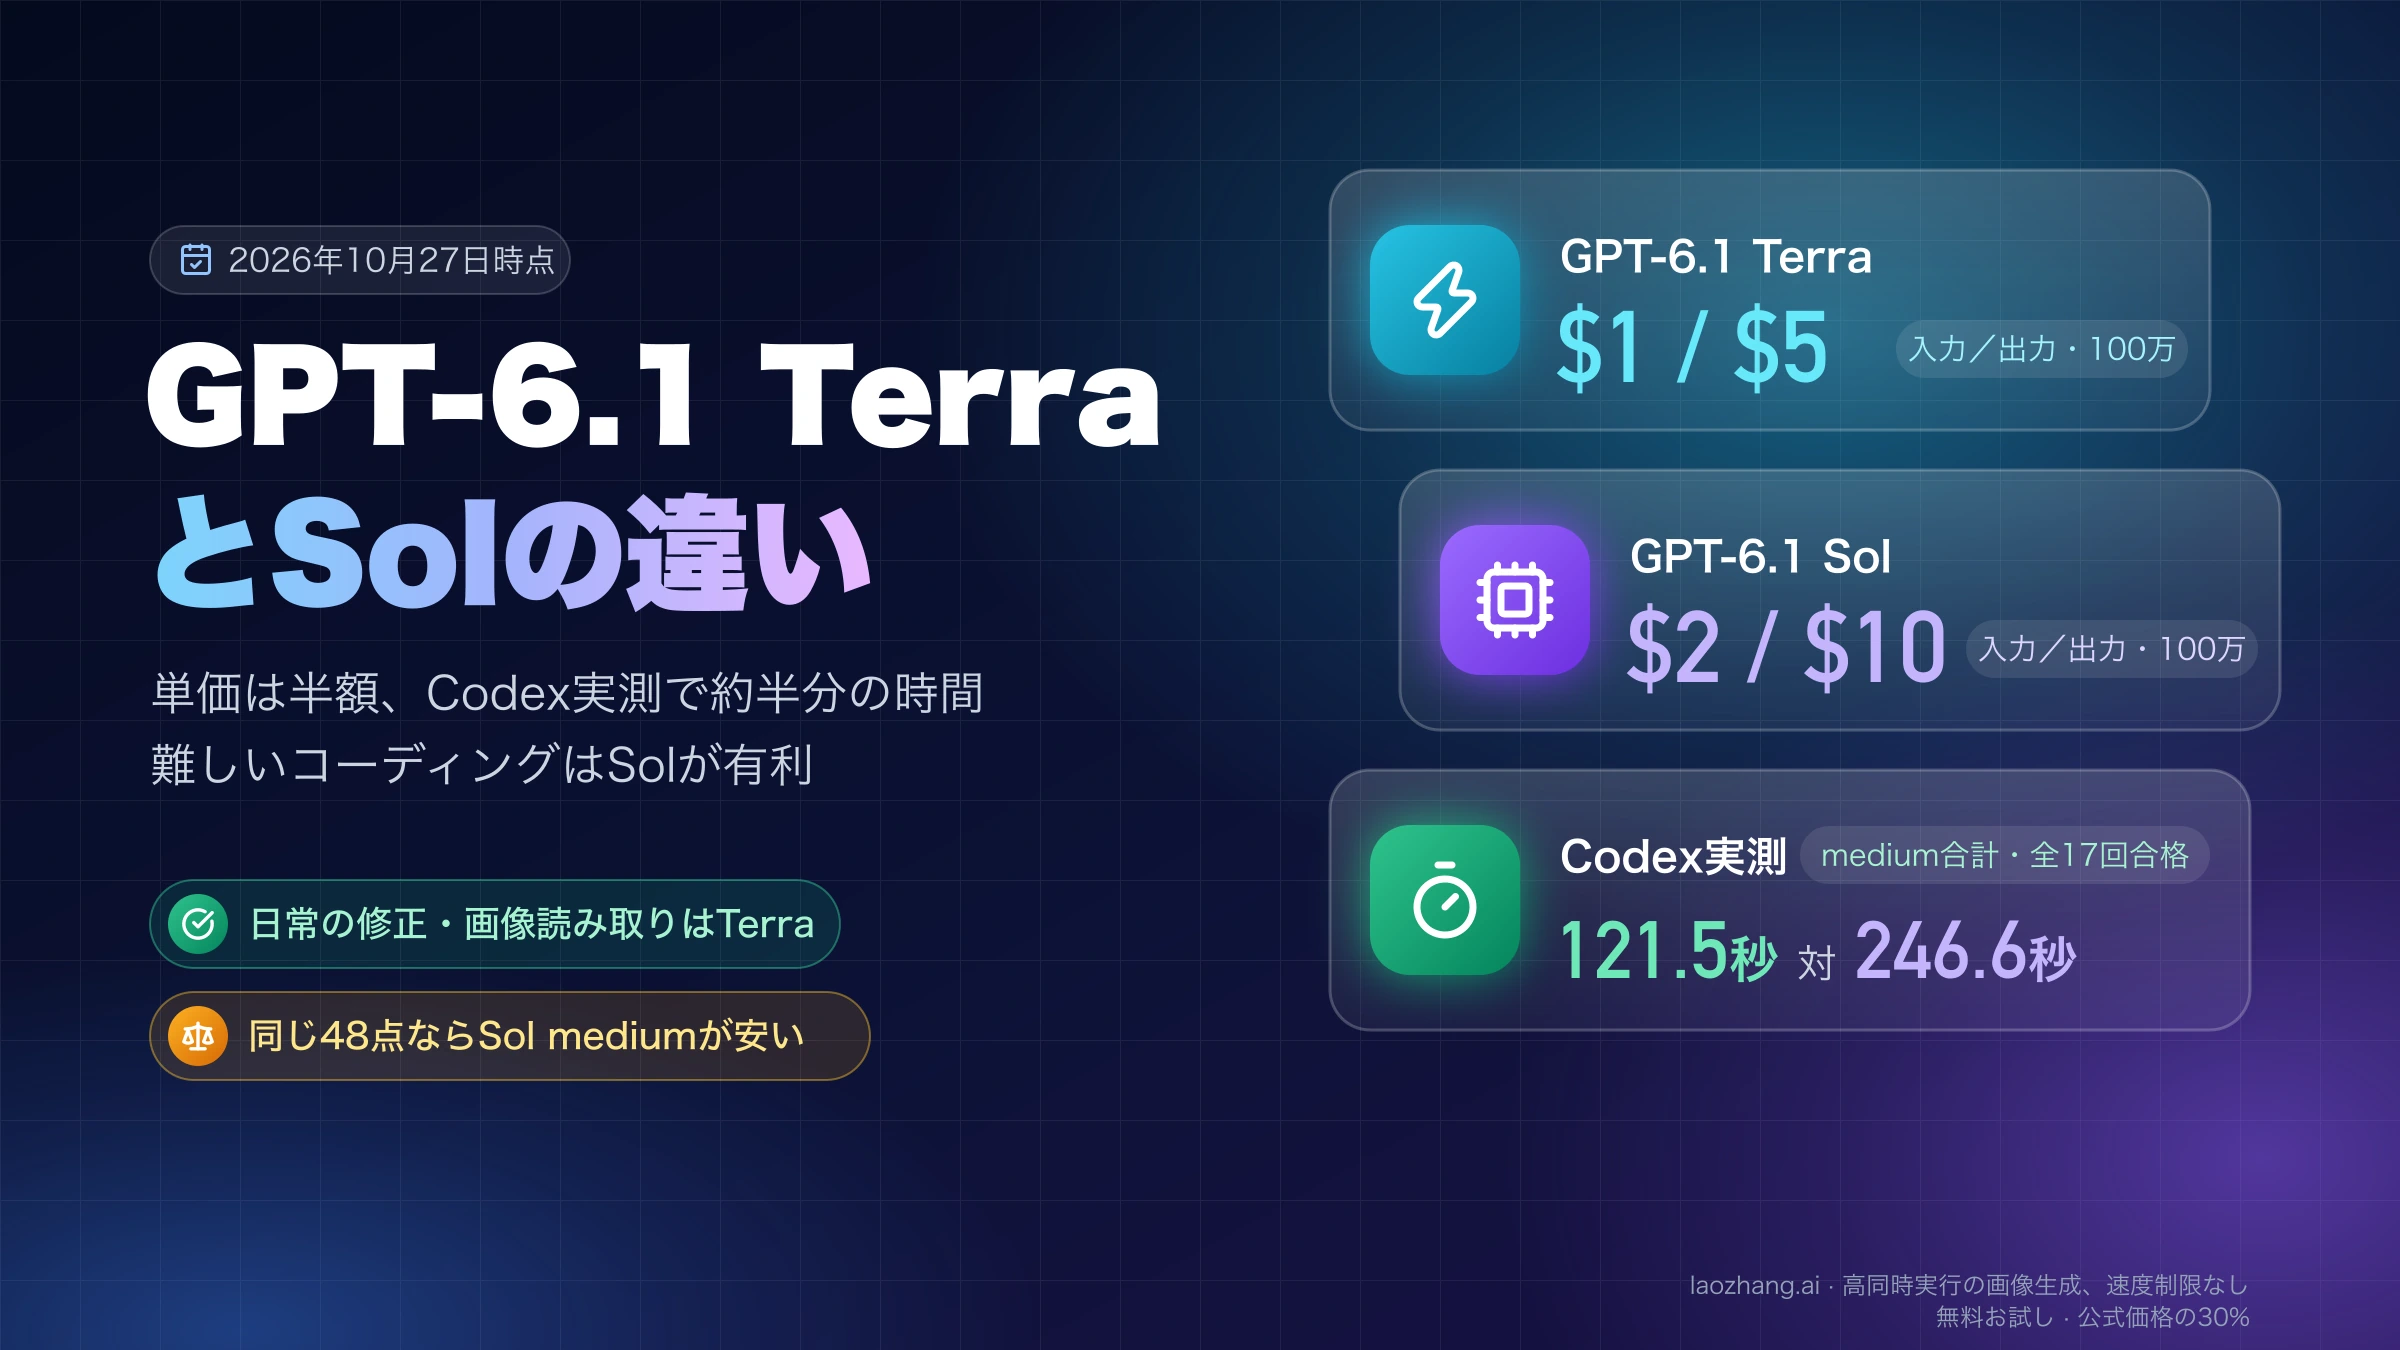
キャッシュ中心のエージェント処理で、品質が同等以上なら、切り替えでそのまま費用が下がります。キャッシュをほとんど使わない処理では、差を生むのはトークン数と品質だけです。より高い品質が必要なタスクだけをAstraに回す使い分けも考えられます。6.1 Sol公開前のラインアップとGPT-5.6 Terraとの違いは、「GPT-6 Sol・Luna・AstraとTerraの違い:API料金と用途から選ぶ」で比べられます。
参考資料1
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。
参考資料1
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。