GPT-6.1 Solが遅いのは解消した?10月26日の実測と速くする設定
公開直後の混雑は10月2日に解消。10月26日の実測では6.1 Solはlow・mediumで回答までGPT-6 Solの約2倍待ち、effortを下げるかFastで縮みます。
目次
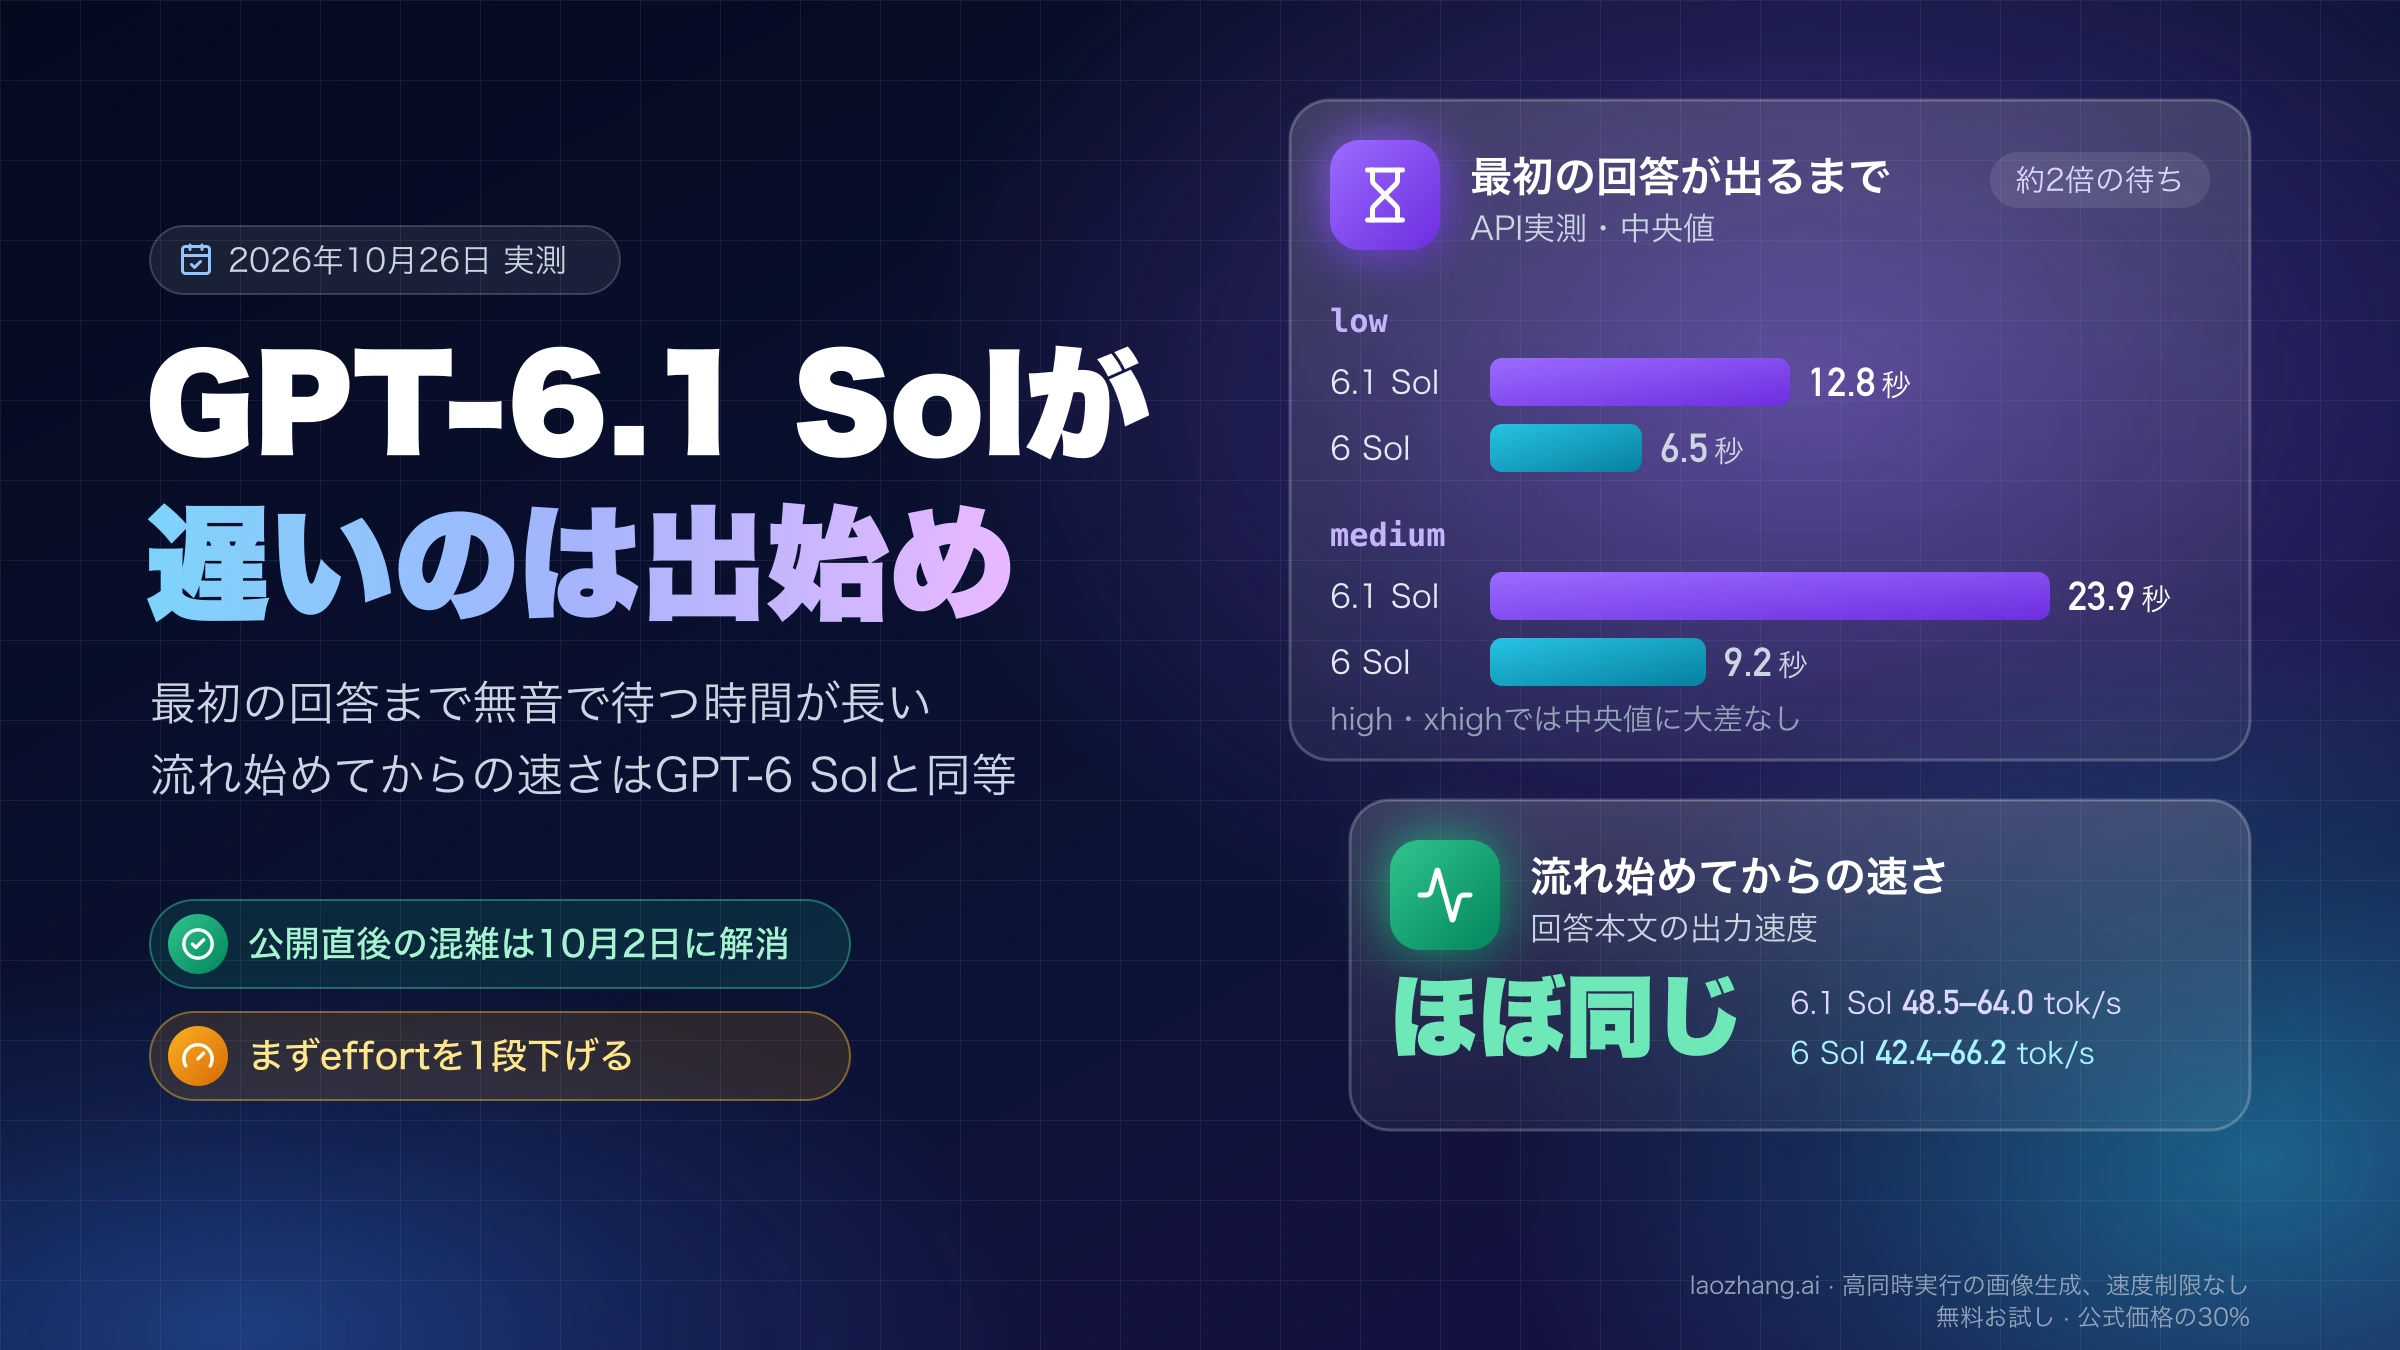
GPT-6.1 Solの公開直後(2026年9月29日〜10月1日ごろ)の遅さは、アクセス集中による高負荷が原因でした。OpenAIでCodexを率いるTibo氏は10月2日に「想定どおりの速度に戻った」と投稿しています。ただし、遅さがすべて消えたわけではありません。2026年10月26日の実測では、回答の文字が流れ始めてからの速さはGPT-6 Solとほぼ同じでしたが、low・mediumでは最初の回答が出るまでの無音の待ちがGPT-6 Solの約2倍でした。今の6.1 Solは、出力の前に長く考えるモデルです。
待ち時間を縮めるには、まずeffort(推論の深さ)を1段下げます。CodexならCLIの/modelかデスクトップアプリの「Advanced」、APIならreasoning.effort(Chat Completionsではreasoning_effort)をmediumかlowにします。同じ課題をAPIで解かせた実測では、xhighからmediumに下げると合計時間が70.9秒から34.8秒になり、正答は変わりませんでした。effortを下げられない作業なら、Codexの/fast(利用枠を2.5倍消費)かAPIのservice_tier: "fast"(単価2倍)で、お金を払って速くします。
例外は、特定の日時だけ極端に遅い場合と「Selected model is at capacity」が出る場合です。これはモデルの性質ではなく障害か一時的な容量不足なので、OpenAIのステータスページを確認し、数分おいて再試行します。なお、実測はOpenAI互換の中継APIと、ChatGPTでサインインしたCodex CLI(1アカウント、各設定1回)で行ったものです。OpenAI直結のAPI、APIでのFast、Ultrafastは測っていません。
GPT-6.1 Solの遅さは解消した?公開から10月26日までの経緯
公開直後の混雑による遅さは、OpenAIの説明では10月2日までに解消しています。9月29日の公開当日にはChatGPT・Codex・API全体でエラーが増える障害があり、翌30日にはAPIの一部リクエストでレイテンシが上がる障害も記録されました(OpenAIステータスページの障害履歴)。Tibo氏は10月1日に、6.1 Solは「ほぼ過去最高の需要」でChatGPTとCodexは高負荷だったと書き、翌日には「公開から2日間の負荷急増のあと、想定どおりの速度で動いている」とTibo氏の10月2日のX投稿で述べています。
10月5日(日本時間6日未明)には、別の変更が入りました。ChatGPTのサブスクリプション経由、つまりChatGPTでサインインするCodex、ChatGPT Work、OpenCodeなどの連携ツールで、GPT-6 AstraとGPT-6.1 Solの既定の速度を約50%引き上げたという告知です。返信では「30 TPSではなく50 TPSに達する」と補足しています(Tibo氏の10月5日のX投稿)。利用者側の設定変更は不要ですが、APIキーで呼ぶ場合は、APIキーで動かすCodexも含めてこの高速化の対象外です。この告知はOpenAIのドキュメントや更新履歴には載っていません。
効果を第三者が測った例として、Zennのoubakiouさんは、ChatGPTサブスクリプションで認証したCodex CLI 0.159.2で、9月30日と同じ課題を10月6日に測り直しています(Zennの記事「GPT-6.1 Solの遅さは解消したのか」)。3回平均の所要時間は、highが19.7分から7.4分、xhighが28.2分から10.3分、maxが35.1分から14.6分に縮み、出力トークン数はほぼ変わりませんでした。それでもgpt-6-solと比べると実働時間は1.2〜1.5倍長く、その差は出力トークンが1.1〜1.5倍多いことでほぼ説明できる、というのが筆者の見立てです。当初の遅さが混雑と高速化前の既定速度のどちらによるものかは切り分けられない、とも書いています。
その後も、障害で遅くなった時間帯はあります。日本時間で、10月8日2時21分〜3時23分(CodexとWorkモードの応答遅延)、10月13日17時10分〜14日1時36分(GPT-6.1 SolのCodexとWorkモードの性能低下)、10月14日16時05分〜18時53分(CodexとChatGPT Workのエラー増加)、10月21日11時26分〜12時28分(ChatGPT・Codex・APIの性能低下)です。この時間帯の遅さは設定を変えても直らないので、復旧を待つしかありません。
GPT-6 Sol・GPT-5.6 Solとの比較:effort別の待ち時間
OpenAI直結のAPIでは、6.1 Solの出力速度は同じeffortのGPT-6 Solの約半分です。Artificial AnalysisのGPT-6.1 Solのページ(以下AA)の2026年10月26日時点の計測では、6.1 Solは毎秒50.8〜62.3トークン、GPT-6 Solは毎秒112.1〜114.6トークンで、同じeffort同士の比は0.44倍(low)〜0.55倍(max)です。AAの「最初の回答トークンまで」は推論の時間を含みます。
GPT-5.6 Solとの比較では、AAの計測でGPT-5.6 Sol(max)は毎秒81.7トークン、最初の回答トークンまで103.65秒で、6.1 Sol(max)より速く出始めます。「GPT-5.6 Solより4.6倍遅い」といった数字もRedditなどで出回っていますが、条件を確かめられる測定ではありません。OpenAIコミュニティの「GPT-6.1 Sol MAXがGPT-5.6 Sol MAXより大幅に遅い」スレッドでは、Responses APIでmax、20万トークン超の入力、Web検索を使う分析が5.6 Solの373秒に対し6.1 Solで1,846秒かかったと報告されています。この1件では、6.1 Solは推論トークンを52,552と、5.6 Solの24,186の2倍以上使っていました。
API:最初の回答トークンまでの待ちが約2倍
2026年10月26日の日本時間16時07分〜18分に、laozhang.aiのOpenAI互換Chat Completions APIを経由して(Standard、ストリーミング)、同じコーディング課題(evalを使わずに数式を計算する関数を書く)を各設定2回ずつ解かせました。下の表の右2列がその中央値で、左2列はAAの計測です。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| モデル(effort) | AA:出力速度 | AA:最初の回答トークンまで | 実測:合計時間 | 実測:最初の回答トークンまで |
|---|---|---|---|---|
| GPT-6.1 Sol(low) | 50.8 tok/s | 2.64秒 | 23.2秒 | 12.8秒 |
| GPT-6.1 Sol(medium) | 53.5 tok/s | 4.20秒 | 34.8秒 | 23.9秒 |
| GPT-6.1 Sol(high) | 54.7 tok/s | 48.33秒 | 49.4秒 | 39.1秒 |
| GPT-6.1 Sol(xhigh) | 58.8 tok/s | 115.15秒 | 70.9秒 | 60.5秒 |
| GPT-6.1 Sol(max) | 62.3 tok/s | 246.63秒 | — | — |
| GPT-6 Sol(low) | 114.6 tok/s | 1.56秒 | 14.7秒 | 6.5秒 |
| GPT-6 Sol(medium) | — | — | 19.3秒 | 9.2秒 |
| GPT-6 Sol(high) | 112.1 tok/s | 13.66秒 | 52.1秒 | 42.5秒 |
| GPT-6 Sol(xhigh) | — | — | 75.4秒 | 65.3秒 |
| GPT-6 Sol(max) | 112.5 tok/s | 108.21秒 | — | — |
| GPT-5.6 Sol(max) | 81.7 tok/s | 103.65秒 | — | — |
中継経由の実測では、回答本文が流れ始めてからの速さは6.1 Solが毎秒48.5〜64.0トークン、GPT-6 Solが毎秒42.4〜66.2トークンで、差はありませんでした。差が出たのは最初の回答トークンまでの待ちで、この経路は推論の途中経過を流さないため、その間は何も表示されません。low・mediumでは6.1 Solの待ちがGPT-6 Solの約2倍で、mediumの推論トークンも590対317と多めでした。high・xhighでは中央値に大きな差がなく、GPT-6 Solはhighの待ちが12.9秒と72.0秒に割れるなど回ごとのばらつきが目立ちました。
16回の回答はすべて25件の隠しテストに合格しています。6.1 Solの1回答あたりの費用は定価換算でlowが$0.007〜0.009、mediumが$0.012〜0.014、highが$0.019〜0.020、xhighが$0.031でした。どのeffortでも正解できる易しい課題なので、難しい課題でもmediumで足りるとは限りません。AAの数字はOpenAI直結で、推論トークンの生成も含めた速度を別の課題で測ったものです。秒数は列をまたいで比べず、同じ列の中で6.1 SolとGPT-6 Solを比べてください。maxの実測がないのは、この中継のChat Completionsではgpt-6.1-solがmaxを受け付けないためです。
Codex CLI:highの1回は最初のメッセージまで159秒
同じ日の日本時間16時08分〜19分には、ChatGPTのmacOSアプリに同梱されたCodex CLI(0.164.0-alpha.11.1)をChatGPTサインインで使い、codex execで1つの修正課題(7項目の仕様に合わせてbilling.pyを直し、関数を2つ追加する)を各設定1回ずつ解かせました。完了した5回は、すべて36件の隠しテストに合格しています。
| 設定 | 完了までの時間 | 最初のメッセージまで |
|---|---|---|
| gpt-6.1-sol(low) | 72.6秒 | 11.8秒 |
| gpt-6.1-sol(medium) | 70.4秒 | 16.6秒 |
| gpt-6.1-sol(high) | 223.5秒 | 159.2秒 |
| gpt-6.1-sol(high、Fast) | 63.9秒 | 11.7秒 |
| gpt-6-sol(high) | 90.3秒 | 12.1秒 |
Standardのhighは、日本時間16時12分の容量エラーから約7分後に再実行した回です(その間にFastのhighとGPT-6 Solのhighを実行)。最初のメッセージが出るまでに159.2秒かかり、作業自体はそこから約58秒で終わって、プロセス終了までの合計が223.5秒でした。この待ちが混雑によるものか推論によるものかは、Codexのログからは区別できません。Fastを付けたhighは63.9秒でしたが、各設定1回の結果なので「Fastは何倍速い」とまでは言えません。この課題では、lowとmediumの差もほとんどありませんでした。
自分の遅さはどれ?症状別の原因と最初の確認
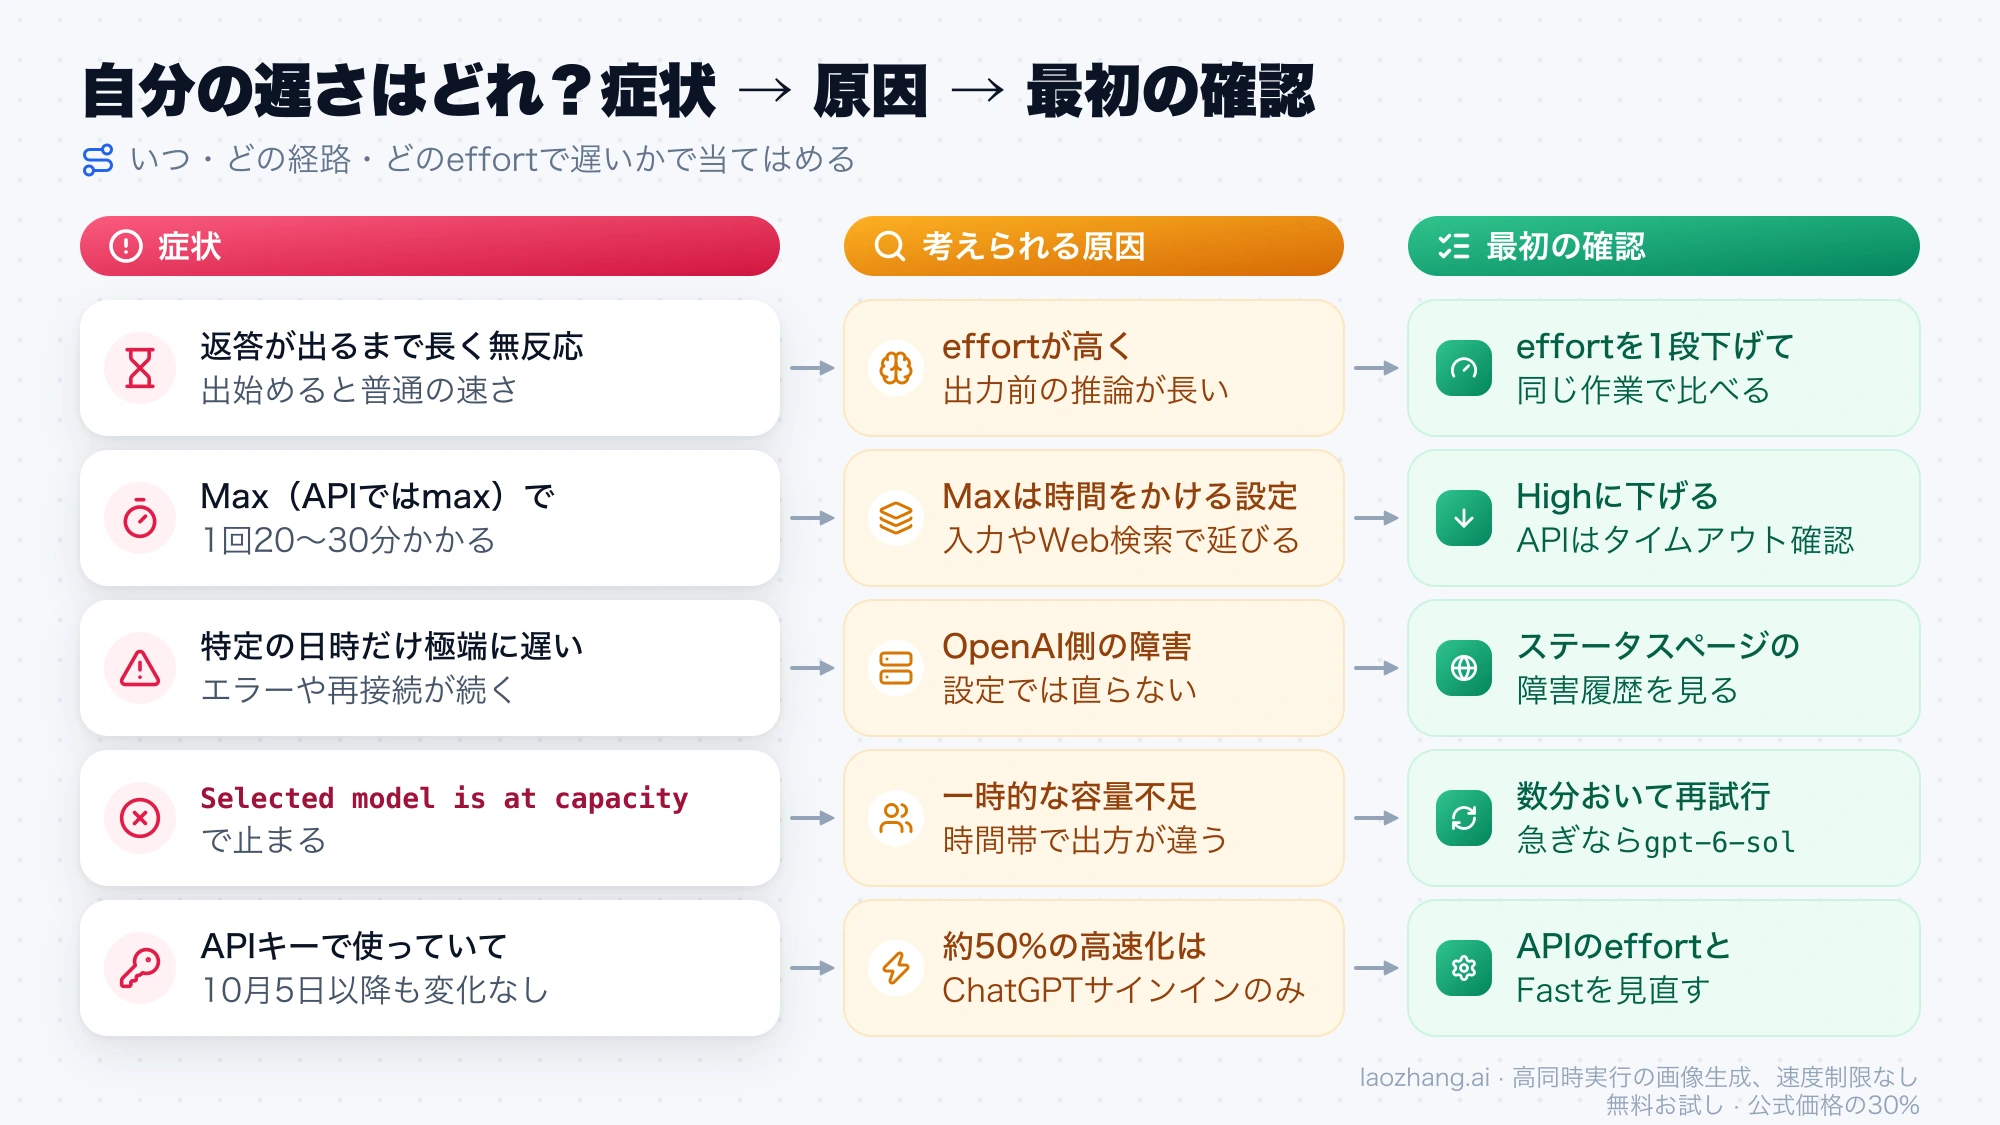
遅さの原因は、いつ、どの経路で、どのeffortで遅いのかで見分けます。日付が公開直後か障害の時間帯ならOpenAI側の問題、返答の前に長く黙っているならeffortの問題、APIキーで使っているなら10月5日の高速化が届かない経路、と当てはめてください。
| 症状 | 考えられる原因 | 最初の確認 |
|---|---|---|
| 9月29日〜10月1日ごろに特に遅かった、当時の計測記事を見て遅いと判断した | 公開直後の高負荷(10月2日に解消と説明) | 今の環境で同じ作業を測り直す |
| 返答が出始めるまで長く無反応で、出始めると普通の速さ | effortが高く、出力前の推論が長い | effortを1段下げて同じ作業で比べる |
| Max(APIではmax)で1回20〜30分かかる | Maxは1つの課題に時間をかける設定。長い入力やWeb検索が重なるとさらに延びる | Highに下げる。APIならタイムアウトとポーリングの設定 |
| 特定の日時だけ極端に遅い、エラーや再接続が続く | OpenAI側の障害 | OpenAIステータスページの履歴 |
| 「Selected model is at capacity」で止まる | 一時的な容量不足 | 数分おいて再試行(下の節) |
| APIキーで使っていて、10月5日以降も変化がない | 約50%の高速化はChatGPTサインイン経由だけ | APIのeffortとFastを見直す |
| Windowsのデスクトップアプリだけ遅く、どのモデルでも遅い | アプリ側の処理 | Codex Windows アプリが遅い時の CLI と Desktop の切り分け |
速くする方法と代償:effort・Fast・Ultrafast
最初に試すのは追加費用のかからないeffortの変更で、利用枠やお金を多く使うFast・Ultrafastはその後です。2026年10月26日時点のOpenAIのドキュメントでは、6.1 SolのFastとUltrafastが何倍速くなるかの数字は公表されていません。
| 方法 | 速さへの効果 | 代償 | 使える人 |
|---|---|---|---|
| effortを下げる | 実測(API、1課題)でxhighからmediumで合計時間が約半分。AAではMaxからHighで最初の回答トークンまでが約80%短縮 | 難しい課題で品質が落ちることがある | 全員 |
| CodexのFast | 6.1 Solの倍率は非公表(GPT-5.6では1.5倍) | 利用枠を2.5倍、購入クレジットは2倍で消費 | ChatGPTでサインインしたCodex |
APIのFast(service_tier: "fast") | 「最大2.5倍」(モデル共通の説明) | 単価2倍(100万トークンあたり入力$4、キャッシュ入力$0.20、出力$20) | APIの全ユーザー |
| CodexのUltrafast | 6.1 Solの倍率は非公表(GPT-6 Astraでは最大8倍) | 利用枠を8倍、購入クレジットは6倍で消費 | Pro $500と対象のEnterprise・Edu |
APIのUltrafast(service_tier: "ultrafast") | APIで最速の処理区分 | 単価6倍(入力$12、キャッシュ入力$0.60、出力$60)。レート制限は別枠 | APIの全ユーザー |
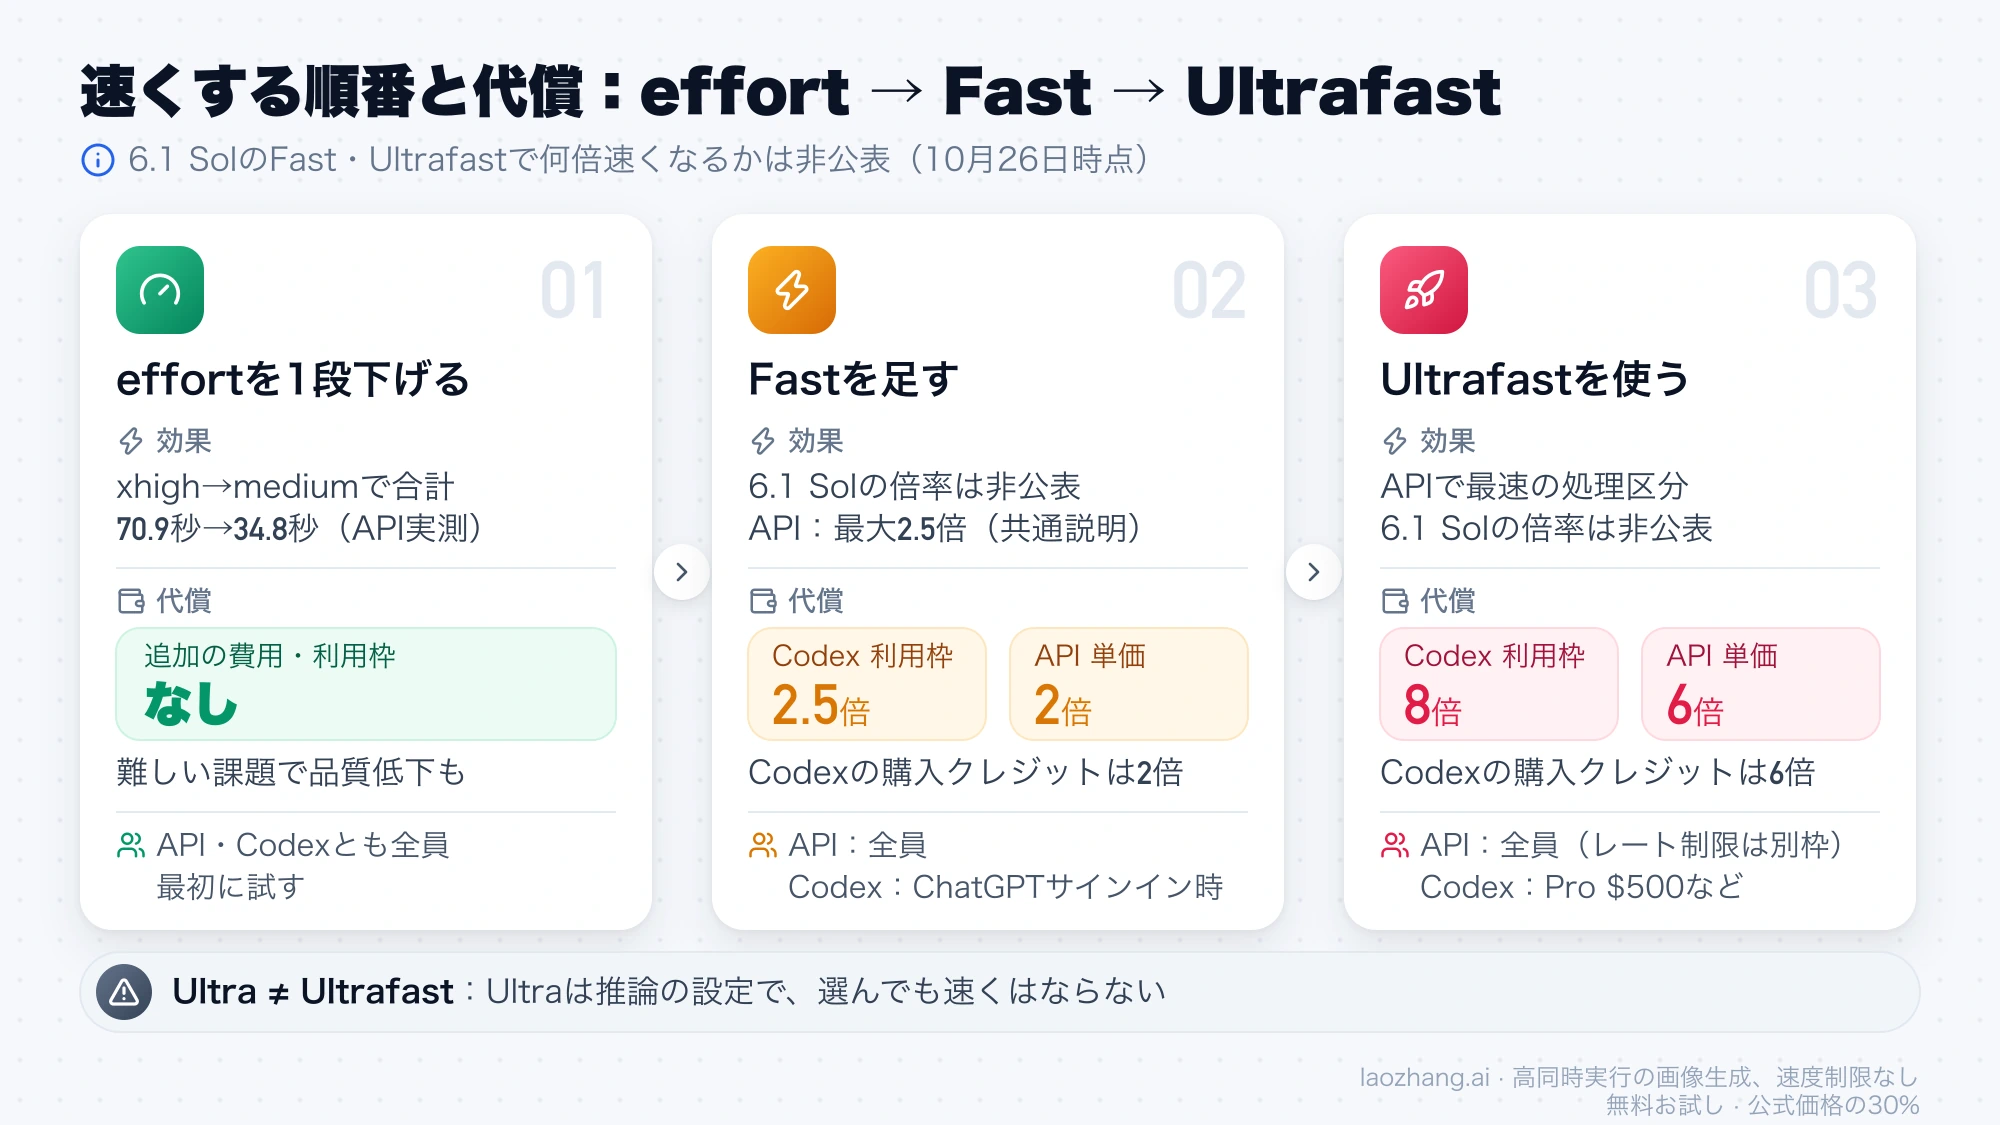
判断の目安は次のとおりです。対話しながら待っている作業なら、まずmediumに下げます。AAの知能指数では6.1 Solのmediumが48で、GPT-6 Solのmaxと同じ点数でした。Maxを使っているなら、Highに下げるとAAの計測で最初の回答トークンまでが246.63秒から48.33秒になり、指数は52から50への2点減です。それでも遅くて困るときにFastを足し、Ultrafastは待ち時間がそのままお金になる作業に絞ります。
名前が似ていますが、Ultra(サブエージェントで作業を並行させる推論の設定)とUltrafast(有料の速度モード)は別物です。Ultraを選んでも速くはならず、OpenAIも「ほとんどのタスクにMaxやUltraは不要」としています。Fastで利用枠がどれだけ早く減るかは「Codexの週次上限はいつリセット?Usageの見方と有料即時リセット」、Fast・Batch・Flexを含むAPI単価は「GPT-6.1 Sol:GPT-6 Solとの違いと移行の注意点」にまとめています。
Codexでeffortを下げ、Fastを有効にする手順
Codexでは、effortを先に下げ、それでも遅い場合だけFastを有効にします。FastはChatGPTでサインインしているときだけ使え、APIキーで動かすCodexはAPIの単価で課金されます(ChatGPT LearnのCodexの速度設定ページ)。
- effortを下げます。CLIでは
/modelでgpt-6.1-solを選び、LowかMediumを選びます。デスクトップアプリとChatGPT Workでは「Advanced」を開き、モデルを6.1 Solのまま推論の深さをLightかMediumにします。スライダーを「Faster」側に寄せる方法もありますが、プリセットによってはモデル自体が切り替わります。 - まだ遅ければFastを有効にします。CLIでは
/fastで切り替え、/statuslineで画面下部に表示できます。デスクトップアプリでは「Advanced」の速度で選びます。 - 同じ作業を1〜2回走らせて、完了までの時間と使用量を前と比べます。トークン数の見方は「Codexのトークン使用量を確認:/status、/usage、context、API費用」にあります。
毎回同じ設定で起動したい場合は、~/.codex/config.tomlに次のように書きます。
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
service_tier = "fast"

[features]
fast_mode = trueFastを常用しない場合は、service_tierの行と[features]以下を書かずに、必要なときだけ/fastで切り替えます。MaxとUltraは設定によって表示されず、CLIでは/modelでモデルを選んだあとの「More reasoning…」に出てきます。
APIでgpt-6.1-solを速くする・タイムアウトさせない設定
APIでは、reasoning.effort、ストリーミング、service_tier、タイムアウトの4つを見直します。gpt-6.1-solはreasoning.effortを省略するとmediumで動き、GPT-6 Solで使えたnoneは受け付けません。OpenAIの推論モデルのガイドは、xhighを「評価で明確な効果が出たときだけ」使うよう勧めています。
from openai import OpenAI

client = OpenAI(timeout=1800)  # 長い推論の途中で接続を切らない(秒)

stream = client.responses.create(
    model="gpt-6.1-sol",
    input="…",
    reasoning={"effort": "low"},  # 既定はmedium。速さ優先ならlow
    service_tier="fast",          # 単価2倍。不要なら削除
    stream=True,
)
for event in stream:
    if event.type == "response.output_text.delta":
        print(event.delta, end="", flush=True)
Chat Completionsではreasoning_effort="low"、service_tier="fast"、stream=Trueを同じように渡します。ストリーミングで縮むのは回答が出始めてからの体感で、最初の回答トークンまでの無音の待ちは変わりません。この待ちを短く見せたいなら、推論ガイドにあるとおり、深く考える前に短い前置きを書くよう指示する方法があります。
Fastを付けたときは応答のservice_tierを確認してください。100万入力TPMを超えてから15分ごとに50%を超えるペースで増やすと、一部のリクエストが"default"(Standard)に落とされ、通常料金になります(OpenAIのFast modeガイド)。Ultrafastを使う場合、ツール呼び出しの多いエージェントにはWebSocket接続が強く推奨されています。
maxで長い入力を扱うときは、タイムアウトを先に疑います。上のコミュニティの報告では、バックグラウンドモードで2秒ごとにポーリングしていた処理が1,800秒で打ち切られ、実際の応答は1,846秒で完了していました。待ち上限は想定より長めにとり、打ち切った後はリクエストを送り直さずにレスポンスIDで結果を取りに行けば、同じ処理にもう一度料金を払わずに済みます。この報告では最新の2回とも49,583トークンのキャッシュ書き込みがあったのにキャッシュヒットは0で、20万トークン超の入力をそのつど処理し直していました。
中継APIでは、service_tierの扱いが中継ごとに異なります。上の実測に使ったlaozhang.aiではgpt-6.1-solをOpenAIと同じ定価で呼べますが、応答にservice_tierが返らないため、Fastが適用されたかどうかは応答から判別できません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
「Selected model is at capacity」が出たときは数分おいて再試行
「Selected model is at capacity. Please try a different model.」は、6.1 Solの処理枠が一時的に埋まっているという表示です。2026年10月26日のCodex CLIの実測では、gpt-6.1-solの6回の実行のうち2回(日本時間16時08分のlowと16時12分のhigh)が開始から27秒と36秒でこのエラーで止まり、ファイルは書き換わっていませんでした。lowは約2分後、highは約7分後の再実行で完了しています。highの再実行は上の表の223.5秒の回で、完了はしたものの最初のメッセージまで長く待たされました。
OpenAIコミュニティのCodexの応答が極端に遅いというスレッドでも、10月12日〜13日にProユーザーから同じ容量エラーや再接続の報告が出ており、13日にはステータスページに6.1 Solの性能低下も載りました。同じ時期にPlusやEnterpriseで問題がないという声もあり、時間帯と利用者によって出方が違います。急ぎの作業ならgpt-6-solに一時的に切り替え、急がないなら数分おいて同じモデルで再試行します。
GPT-6 SolやAstraに戻すべき?待ち時間で選ぶ条件
短い対話やすぐ答えが欲しい作業をlow・mediumで回しているなら、GPT-6 Solに戻すと待ちは短くなる傾向があります。上の実測では、low・mediumでGPT-6 Solのほうが早く回答を出し始めました。ただし同じeffortならAAの知能指数は6.1 Solのほうが高く(highで50対42)、難しい作業では戻した分だけ出来が落ちることがあります。一方、GPT-6 Solのmaxで難しい作業をしていたなら、6.1 Solのmediumに切り替えるほうが速く、AAでは同じ指数48のまま、最初の回答トークンまでの時間が108.21秒から4.20秒に縮みます。
GPT-6 Astraは速さの解決策にはなりません。AAの計測でAstra(max)は毎秒66.7トークン、最初の回答トークンまで278.25秒で、6.1 Sol(max)より出始めが遅い数字です。性能や料金を含めたモデル選びは「GPT-6.1 Sol・6 Sol・Astra比較:移行の判断」で比べています。
参考資料10
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。
参考資料10
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月26日。
- 1.OpenAIステータスページの障害履歴status.openai.com/history
- 2.Tibo氏の10月2日のX投稿x.com/thsottiaux/status/2105843926221660585
- 3.Tibo氏の10月5日のX投稿x.com/thsottiaux/status/2107158998495748264
- 4.Zennの記事「GPT-6.1 Solの遅さは解消したのか」zenn.dev/oubakiou/articles/a39f4bde8c7e74
- 5.Artificial AnalysisのGPT-6.1 Solのページartificialanalysis.ai/models/gpt-6-1-sol
- 6.OpenAIコミュニティの「GPT-6.1 Sol MAXがGPT-5.6 Sol MAXより大幅に遅い」スレッドcommunity.openai.com/t/1406429
- 7.ChatGPT LearnのCodexの速度設定ページlearn.chatgpt.com/docs/agent-configuration/speed
- 8.推論モデルのガイドdevelopers.openai.com/api/docs/guides/reasoning
- 9.OpenAIのFast modeガイドdevelopers.openai.com/api/docs/guides/fast-mode
- 10.OpenAIコミュニティのCodexの応答が極端に遅いというスレッドcommunity.openai.com/t/1405880