Claude Sonnet 5.5移行ガイド:effort別の費用差と5つの破壊的変更
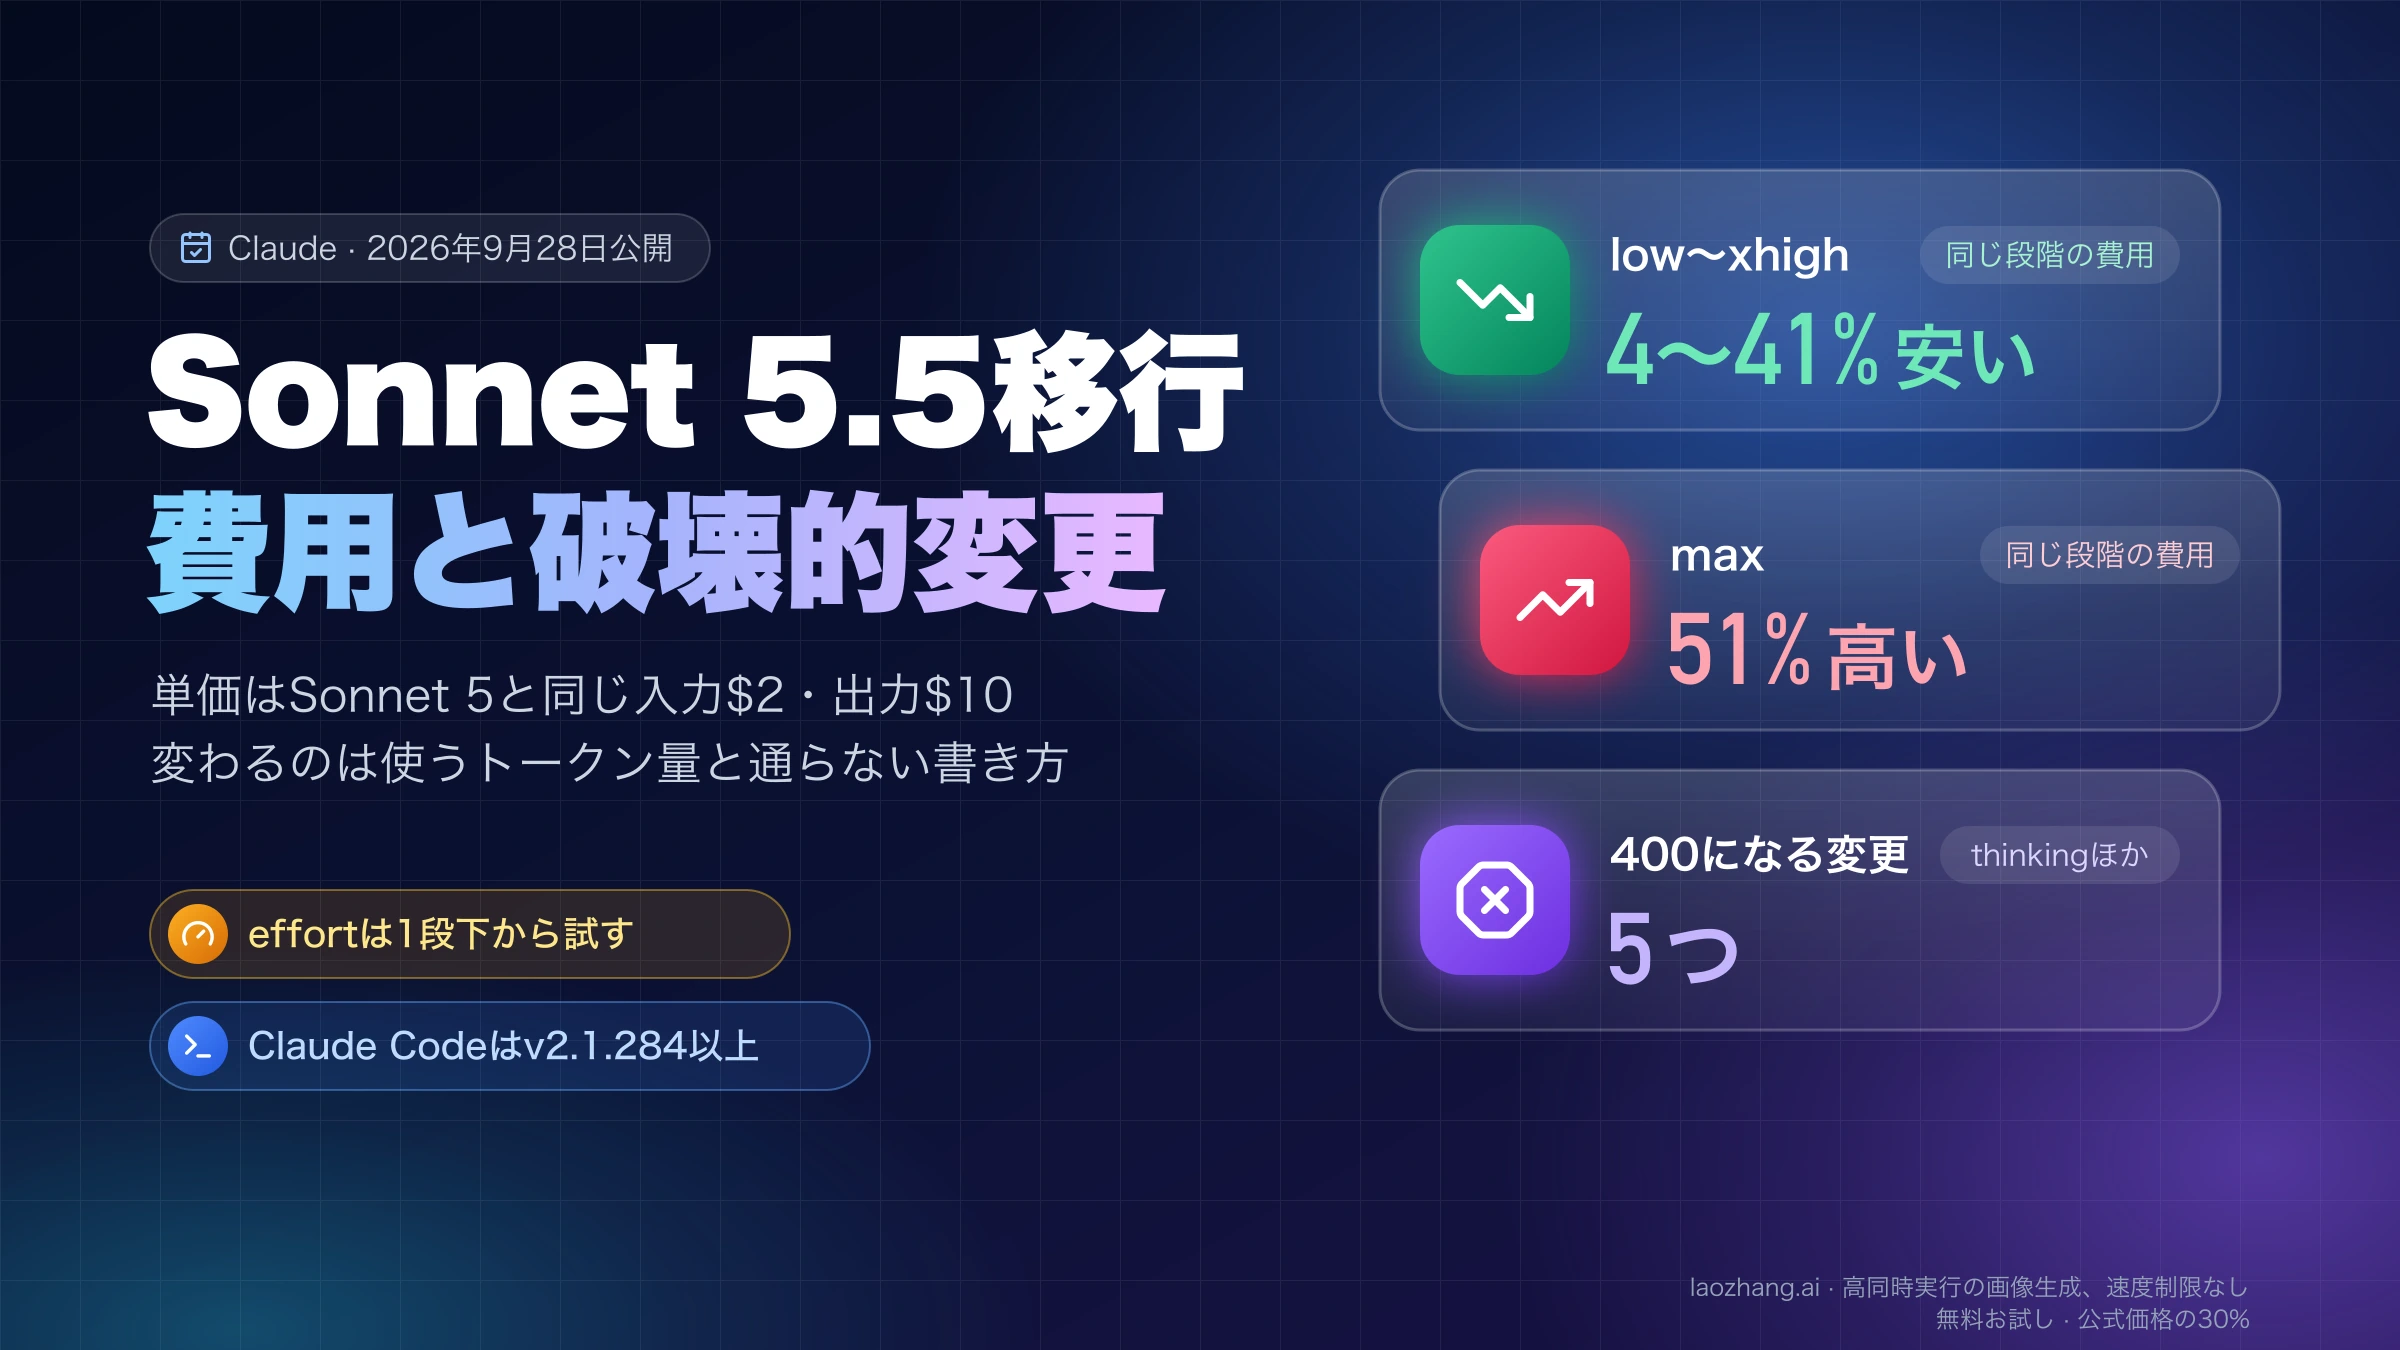
Claude Sonnet 5.5は単価がSonnet 5と同じで、AA測定の1課題の費用はlow〜xhighで下がりmaxだけ約5割増えます。effortは1段下から試します。
目次
Claude Sonnet 5.5(API ID claude-sonnet-5-5)は、2026年9月28日に公開されたSonnet 5の後継モデルです。100万トークンあたり入力$2・出力$10の単価も、トークナイザーもSonnet 5と同じです。移行で変わるのは「1つの作業に何トークン使うか」と「どのリクエストが通らなくなるか」の2点です。
- 費用:Artificial Analysis(以下AA)の2026年10月5日時点のデータでは、評価課題1件あたりの費用は同じeffort同士で
low〜xhighが4〜41%安く、maxだけ51%高くなります。Anthropicの「最大30%安い」とAAの「約50%高い」の食い違いは、この段階差から来ています。 - 設定:effortの各段階はSonnet 5と同じ量の思考をしません。Sonnet 5で使っていた段階の1段下(
lowならそのまま)から試すと、AAの指数ではどの段階でも点数が上がり、費用は下がります。 - 互換性:thinking(回答前の思考)を
disabledで切っているコードと、tool_choiceで特定のツールを強制しているコードは400エラーになります。ほかに3つの破壊的変更と、エラーを出さずに画面の表示が止まる変更が1つあります。
Sonnet 5は「レガシー」扱いになりましたが引き続き使え、提供終了は早くても2027年6月30日です。期限が迫っているのはSonnet 4.5(claude-sonnet-4-5-20250929)で、Claude APIでは2026年11月30日に提供が終わります。
Sonnet 5.5とSonnet 5の違い:単価は同じ、知識は2026年6月まで
料金と基本仕様はほぼそのまま引き継がれています。違いは知識のカットオフ、キャッシュできる最小サイズ、そして後述する動作の変化です。
| 項目 | Claude Sonnet 5.5 | Claude Sonnet 5 |
|---|---|---|
| Claude APIのモデルID | claude-sonnet-5-5(日付なし) | claude-sonnet-5 |
| Amazon BedrockのモデルID | anthropic.claude-sonnet-5-5 | anthropic.claude-sonnet-5 |
| 公開日 | 2026年9月28日 | 2026年6月30日 |
| 提供状況 | Active、終了は早くても2027年9月28日 | Legacy(利用可)、終了は早くても2027年6月30日 |
| 単価(100万トークン) | 入力$2、出力$10 | 同じ |
| キャッシュ・バッチ | 書き込み$2.50(5分)・$4(1時間)、読み込み$0.20、バッチ50%引き | 同じ |
| コンテキスト/最大出力 | 100万トークン/12.8万トークン(同期Messages API) | 同じ |
| 知識のカットオフ | 2026年6月 | 2026年1月 |
| キャッシュできる最小プロンプト | 512トークン | 1,024トークン |
| 思考 | adaptive thinkingが既定、effortの既定はAPIでhigh | 同じ |
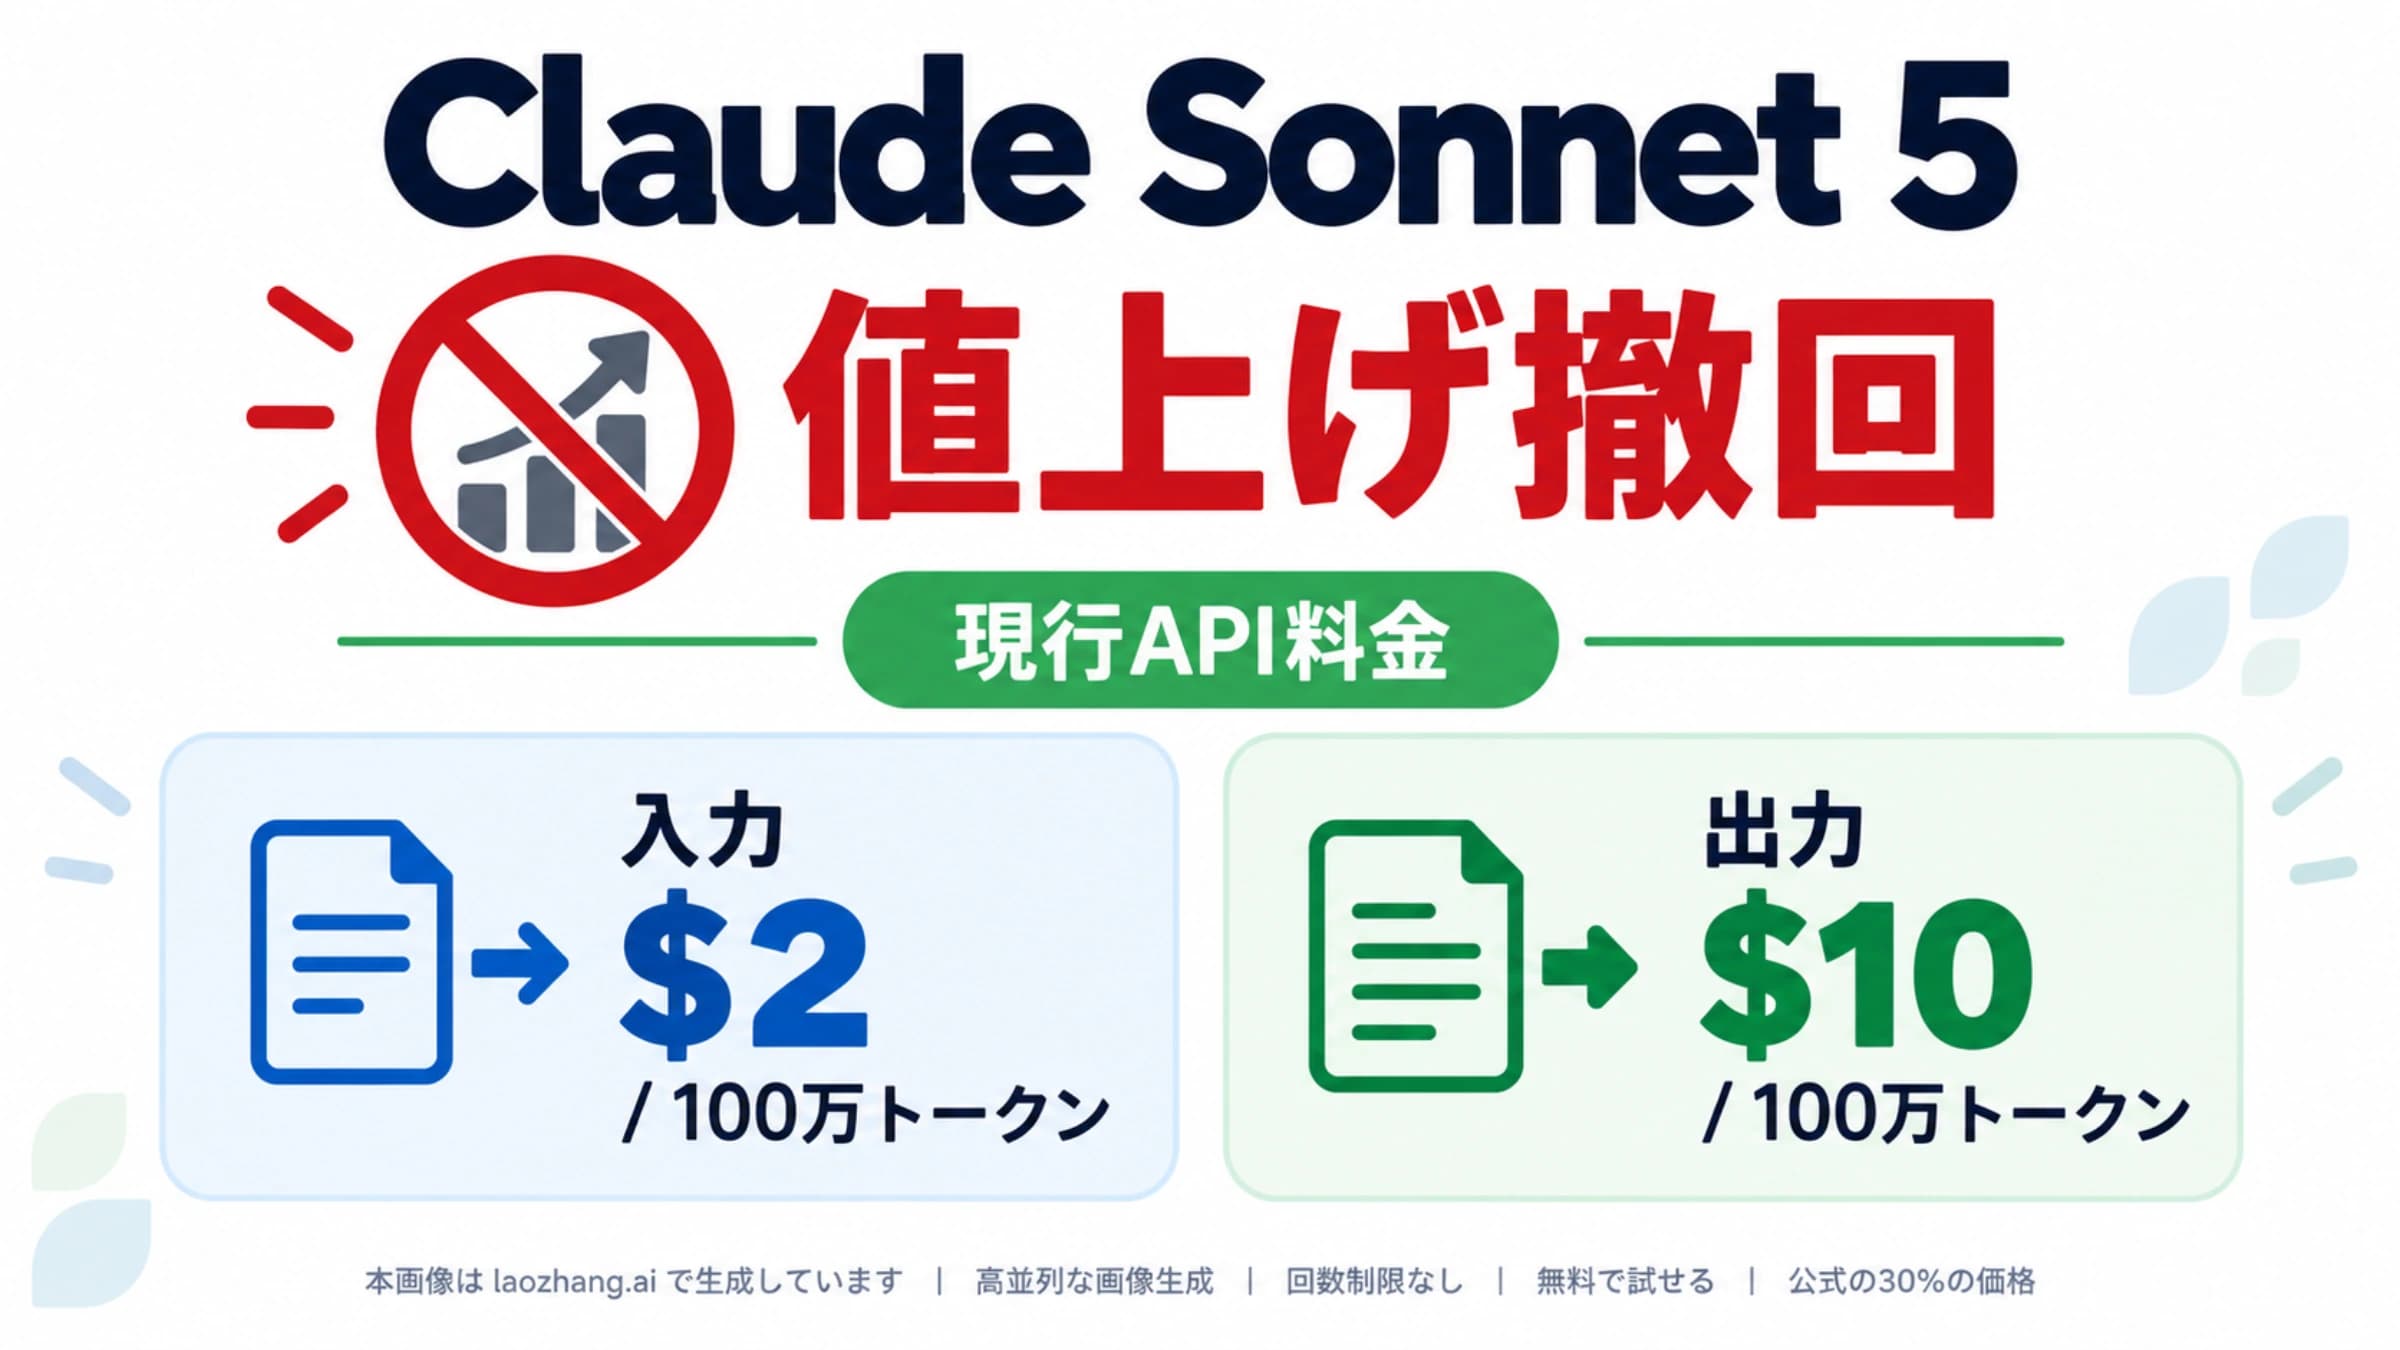
Anthropicは、トークナイザーがSonnet 5と同じで「同じテキストなら同じトークン数になる」と説明しています。単価とキャッシュ料金はClaude APIの料金ページで確認できます。Sonnet 5の単価が値上げ予定から$2/$10に据え置かれた経緯と、キャッシュ料金の照合方法は「Claude Sonnet 5の値上げは撤回。現在のAPI料金と予算の見直し方」にあります。
effortの既定値は使う場所で違います。Claude APIではhigh、Claude CodeとClaudeアプリではmediumです。同じ「Sonnet 5.5」でも、APIで指定なしに呼ぶ場合とClaude Codeで使う場合とでは、1回あたりの費用が変わります。
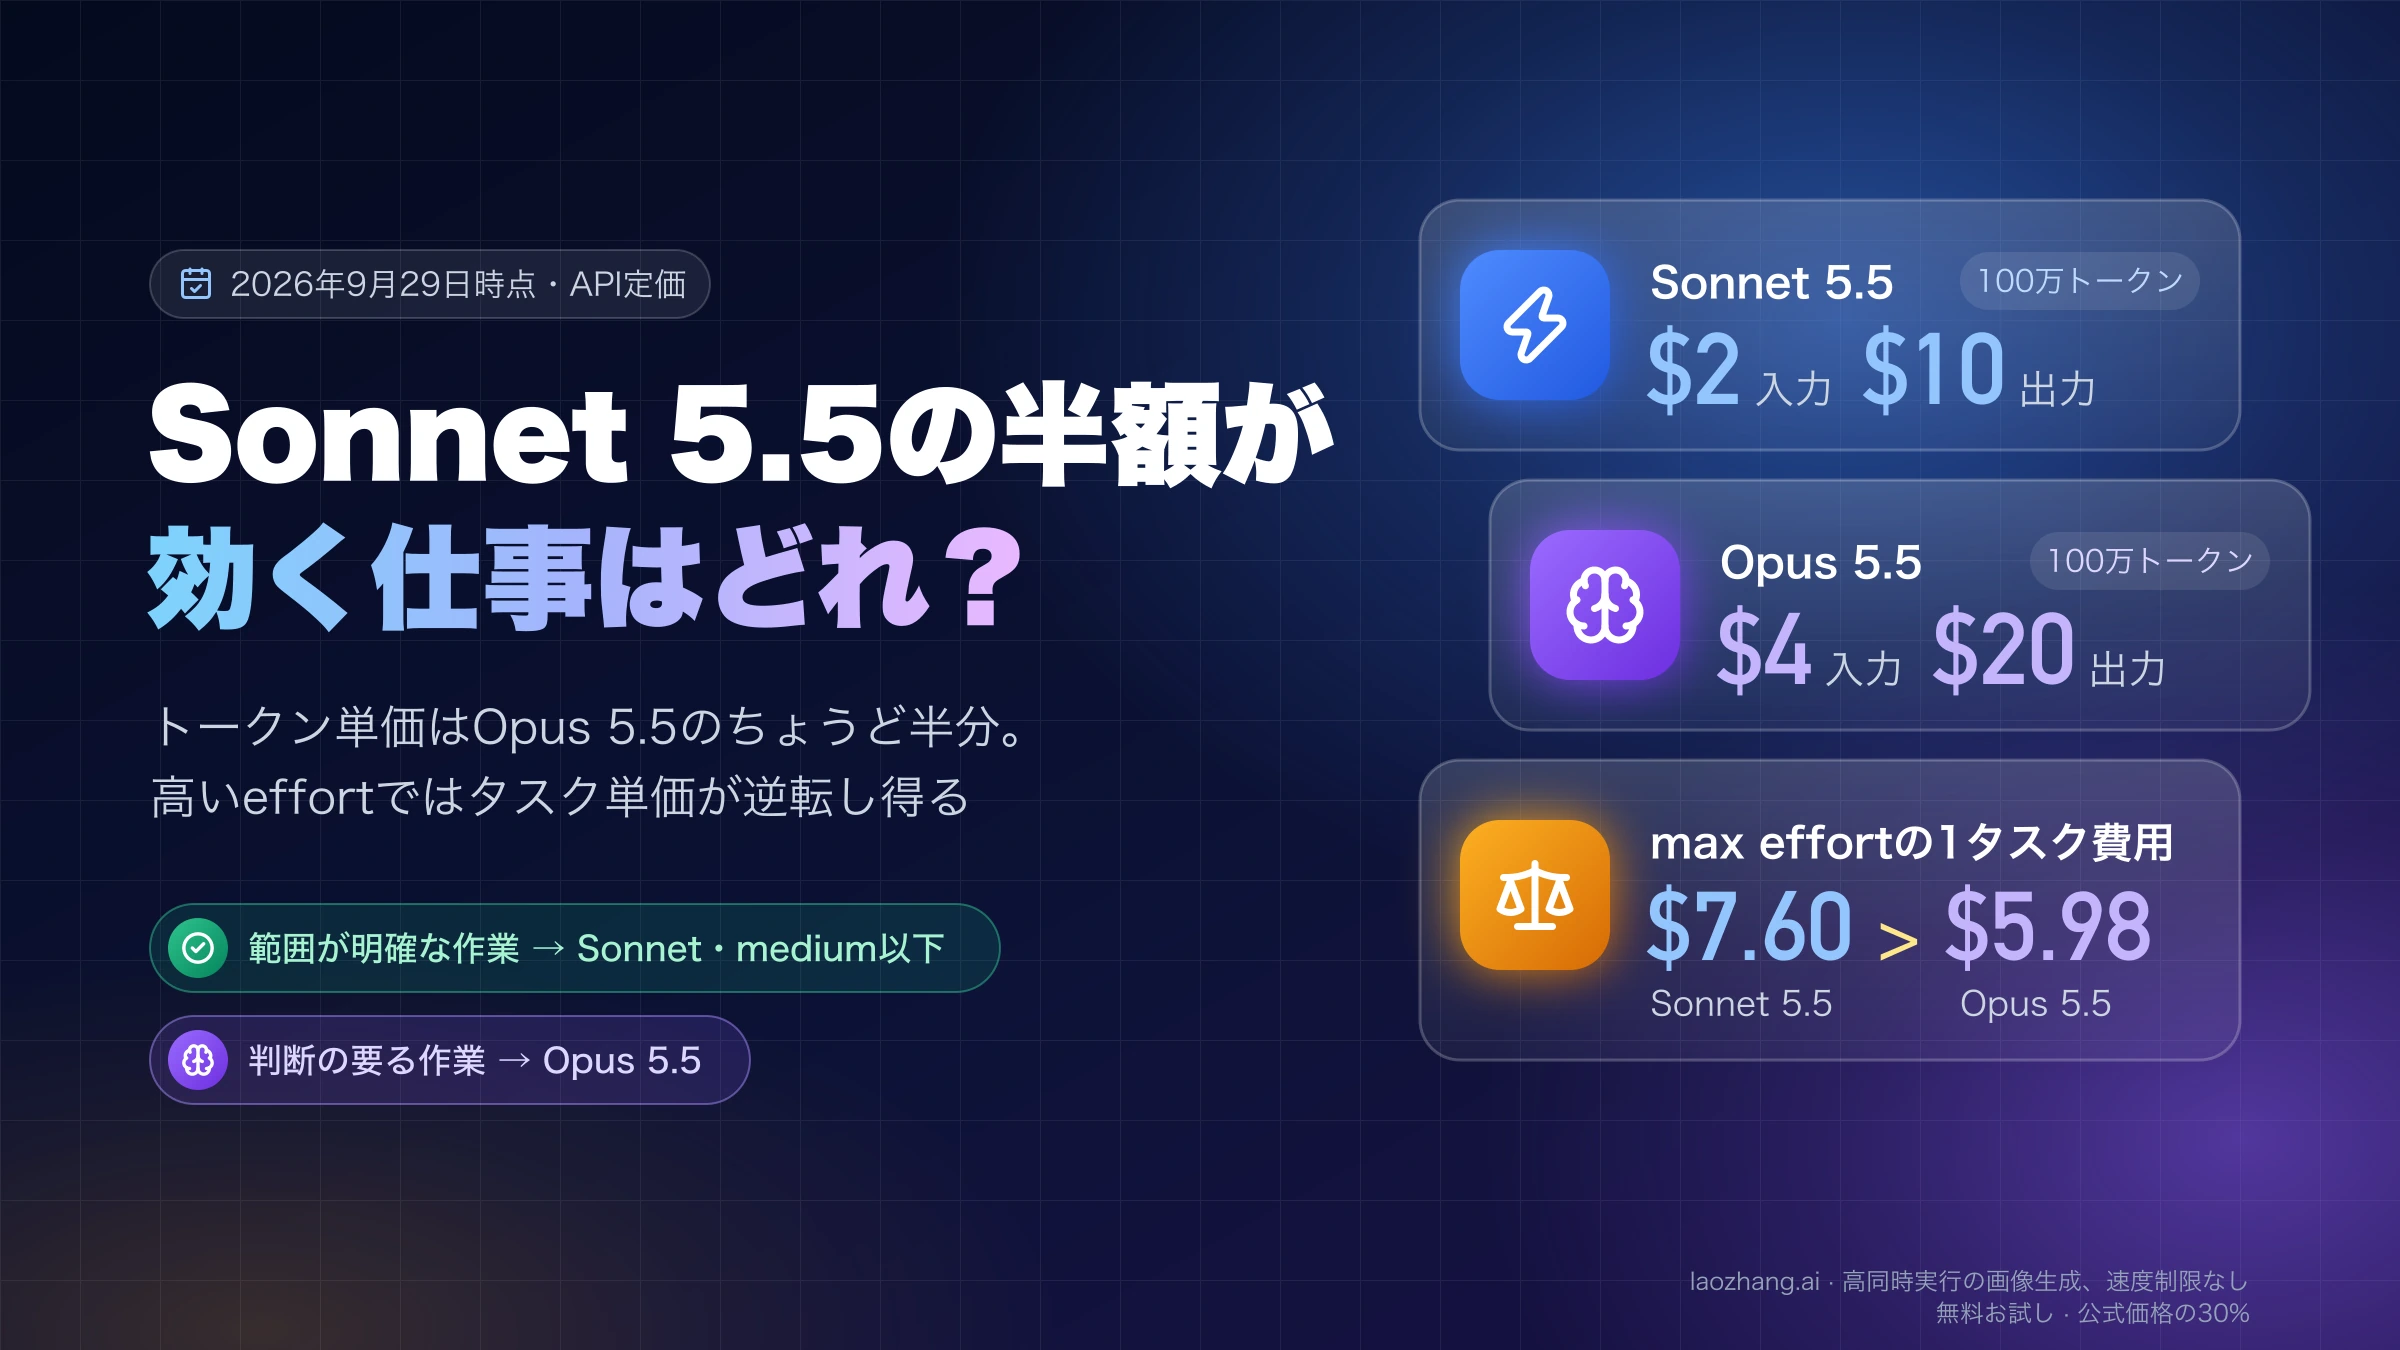
Sonnet 5.5はSonnetクラスのモデルで、Opus 5.5(入力$4・出力$20)の代わりにはなりません。AAの総合指数ではmax同士でOpus 5.5に2点差まで迫りますが、Anthropic自身も、判断を積み重ねる複雑で答えの決まっていない作業ではOpus 5.5がはっきり上だとしています。
Sonnet 5.5はSonnet 5より安いか:effort別の1課題あたり費用
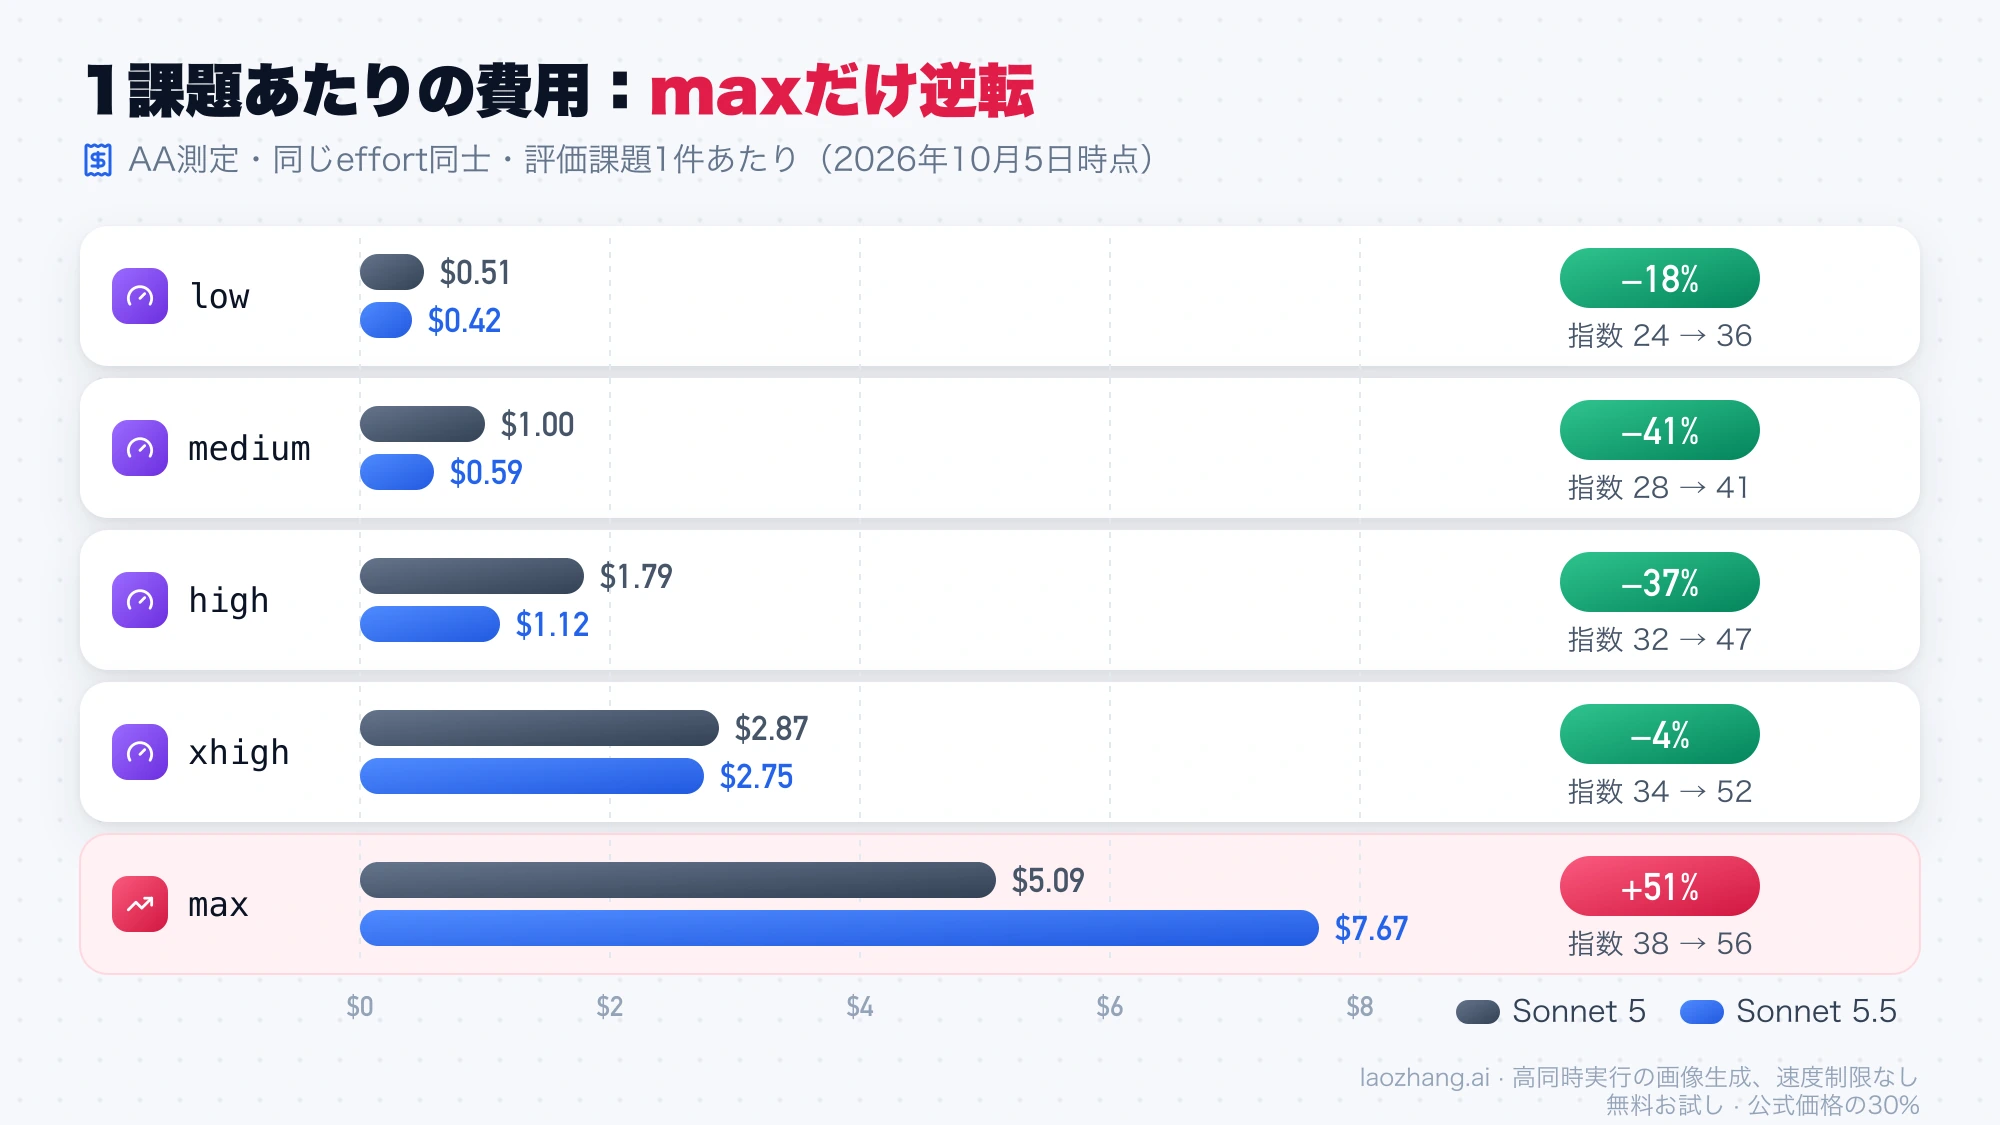
同じeffort同士なら、max以外ではSonnet 5.5のほうが安くなります。単価が同じなのに費用が下がるのは、同じ課題を少ないトークンと手数で終えるためです。逆にmaxでは出力トークンが約1.7倍に増え、費用も上がります。
下の表は、Artificial AnalysisのClaude Sonnet 5.5モデルページに載っている2026年10月5日時点のデータです。
| effort | Sonnet 5:指数/費用 | Sonnet 5.5:指数/費用 | 費用の差 | 出力トークン(5→5.5) | 所要時間(5→5.5) |
|---|---|---|---|---|---|
low | 24/$0.51 | 36/$0.42 | −18% | 1.5万→1.4万 | 138秒→95秒 |
medium | 28/$1.00 | 41/$0.59 | −41% | 2.7万→2.1万 | 245秒→138秒 |
high | 32/$1.79 | 47/$1.12 | −37% | 4.4万→3.7万 | 375秒→238秒 |
xhigh | 34/$2.87 | 52/$2.75 | −4% | 6.5万→7.5万 | 525秒→461秒 |
max | 38/$5.09 | 56/$7.67 | +51% | 11.8万→19.7万 | 852秒→968秒 |
- 指数はAA Intelligence Index v4.3.2(10種類の評価)の点数を整数に丸めたものです。費用・トークン・時間は、評価課題1件あたりの値です。
- 費用はAAの課題構成とキャッシュ条件での入出力の合計で、自分の請求額の予測ではありません。そのため、
xhighのように出力トークンが増えても費用がわずかに下がることがあります。 - 費用の差はAAの数字から「Sonnet 5.5の費用 ÷ Sonnet 5の費用 − 1」で求めた値です。たとえば
highは1.12 ÷ 1.79 − 1 ≒ −37%です。 - Sonnet 5.5はAnthropicの既定のフォールバックを有効にして測定されており、AAによると約0.1%の課題がSonnet 5で処理されています。
lowからhighまでは、費用が18〜41%下がり、点数は12〜15点上がり、時間も短くなります。xhighは費用がほぼ同じで点数が18点上がります。maxは点数が最も高い一方、費用は5割増、時間も延びます。AAも公開時の記事で、他社モデルと比べた費用対性能ではhighが最も競争力のある設定だと評価しています。
「最大30%安い」と「約50%高い」はどちらも正しい
2つの数字は比べている段階が違います。どちらかが誤りなのではありません。
AnthropicのClaude Sonnet 5.5発表ページは、Sonnet 5.5について「多くの作業で最大30%安い」「タスクあたり最大30%安い」と書いています。単価の値下げではなく、使うトークンが減ることによる1タスクあたりの費用の話で、しかも「最大」です。同じページは、いくつかのベンチマークで「LowやMediumのSonnet 5.5が、Sonnet 5の最高スコアを約10分の1の費用で上回る」とも書いています。
一方、Artificial AnalysisのSonnet 5.5公開時の記事(2026年9月28日)は、max同士で比べて1課題あたりの費用が「Sonnet 5より約50%高い」とし、出力トークン数はAAがこれまでに測った中で最も多いと書いています。AAはその後も再測定を続けていますが、10月5日時点の数字でもmax同士の差は+51%です。
段階をまたいで比べると、Anthropicの「約10分の1」に近い数字がAAのデータにも出てきます。
- Sonnet 5.5の
medium(41点、$0.59)は、Sonnet 5のmax(38点、$5.09)を上回り、費用は0.59 ÷ 5.09 ≒ 約9分の1です。 - Sonnet 5.5の
low(36点、$0.42)は、Sonnet 5のxhigh(34点、$2.87)を上回り、費用は約7分の1です。
つまり、Sonnet 5でmaxを使っていて、移行後もmaxのまま動かすと請求は増えます。段階を下げれば、点数を保ったまま費用を大きく下げられる余地があります。
Sonnet 5.5の性能:Anthropic発表値と第三者の測定
性能の伸びは大きいものの、発表値には前提の違いがあるので、第三者の測定と並べて読む必要があります。まずAnthropicの発表値です。多くは最高のeffortでの値で、Anthropicが実施した評価です。
| 評価 | Sonnet 5.5 | Sonnet 5 |
|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% |
| FrontierCode 1.1 Main | 52.1%(xhigh) | 42.4% |
| CursorBench 4.0 | 55.5% | 34.1% |
| OSWorld 2.1(partial) | 80.1% | 57.0% |
| Humanity's Last Exam(ツールあり) | 64.5% | 54.9% |
| GDPval-AA v2.1 | 1844 | 1449 |
| Chartography(ツールなし) | 61.6% | 15.6% |
読むときの注意が3つあります。
- Sonnet 5のTerminal-Bench 4.0の10.3%はかなり低い基準値です。AA自身の測定では、Sonnet 5が
maxで14.1%、Sonnet 5.5がmaxで63.6%でした。伸びは大きいものの、70.6%と10.3%の差をそのまま受け取らないほうが安全です。 - GDPval-AAはAAがプレリリース版で実施したもので、そのプレリリース版には構造化出力の不具合がありました(公開版では修正済み)。
- FrontierCodeはSonnet 5.5の
xhighの値で、maxでは46.2%に下がります。
速度について、Anthropicは出力の生成が30%以上速いとしています。上のAAの表でも、1課題あたりの所要時間はlow〜xhighで短くなっています。
第三者の例として、CodeRabbitのSonnet 5.5コードレビュー検証記事があります。既知のバグを含む難しい13件で、Sonnet 5.5は6件、Sonnet 5は4件を指摘でき、指摘の精度は41.2%と40.0%でほぼ同じでした。所要時間は約半分、定価で計算したレビュー1回あたりのClaude呼び出し費用は約60%少なかったとしています。ただし、Sonnet 5.5が新たに見つけたのが4件、Sonnet 5が見つけてSonnet 5.5が見逃したのが2件あり、CodeRabbit自身も13件は傾向を示すだけで証明にはならない規模だと書いています。
Sonnet 5のeffortをSonnet 5.5ではどこから始めるか
Sonnet 5で使っていた段階の1段下から始め、物足りなければ同じ段階に戻します。maxを使っていたなら、そのままmaxにせずxhighかhighから試します。Anthropicも「設定を持ち越さず、effortの比較をやり直す」よう求めています。
AAのデータで、同じ段階と1段下の段階を並べると次のようになります。
| Sonnet 5の段階(指数/費用) | Sonnet 5.5の同じ段階 | Sonnet 5.5の1段下 | 最初に試す段階 |
|---|---|---|---|
low(24/$0.51) | 36/$0.42 | なし | low |
medium(28/$1.00) | 41/$0.59 | low:36/$0.42(−58%) | lowかmedium |
high(32/$1.79) | 47/$1.12 | medium:41/$0.59(−67%) | medium |
xhigh(34/$2.87) | 52/$2.75 | high:47/$1.12(−61%) | high |
max(38/$5.09) | 56/$7.67 | xhigh:52/$2.75(−46%) | xhigh、費用優先ならhigh |
括弧内の%は、Sonnet 5の元の段階の費用に対する1段下の費用の差です(例:high→mediumは0.59 ÷ 1.79 − 1 ≒ −67%)。どの行でも、1段下げたSonnet 5.5のほうが点数は高く、費用は低くなっています。
ただしAAの指数は10種類の評価をまとめた数字で、自分の作業とは中身が違います。作業の種類ごとのAnthropicの推奨開始点と組み合わせて決めます。
- エージェント的なコーディングや複数ステップのツール利用:仕様がはっきりしたタスクは
medium、難しいタスクや長いタスクはhigh。 - チャットなど応答の速さが重要な用途:
mediumかlow。 - それ以外:
high。
最終的には、過去に失敗した例を含む自分の評価セットを候補の2〜3段階で回し、合格率と1件あたりの費用で決めます。Sonnet 5.5ではメッセージごとにeffortを変える機能(ベータ)も使えるので、普段は低めにして難しいターンだけ上げる運用もできます。
thinkingを切って使っていた場合は、もう1つ制約があります。思考オフの代わりになるbetween_toolsはlow・medium・highでしか受け付けられません。Sonnet 5でdisabledとxhighを組み合わせていたなら、思考をオンにしてxhighを保つか、high以下に下げてbetween_toolsを使うかを選びます。
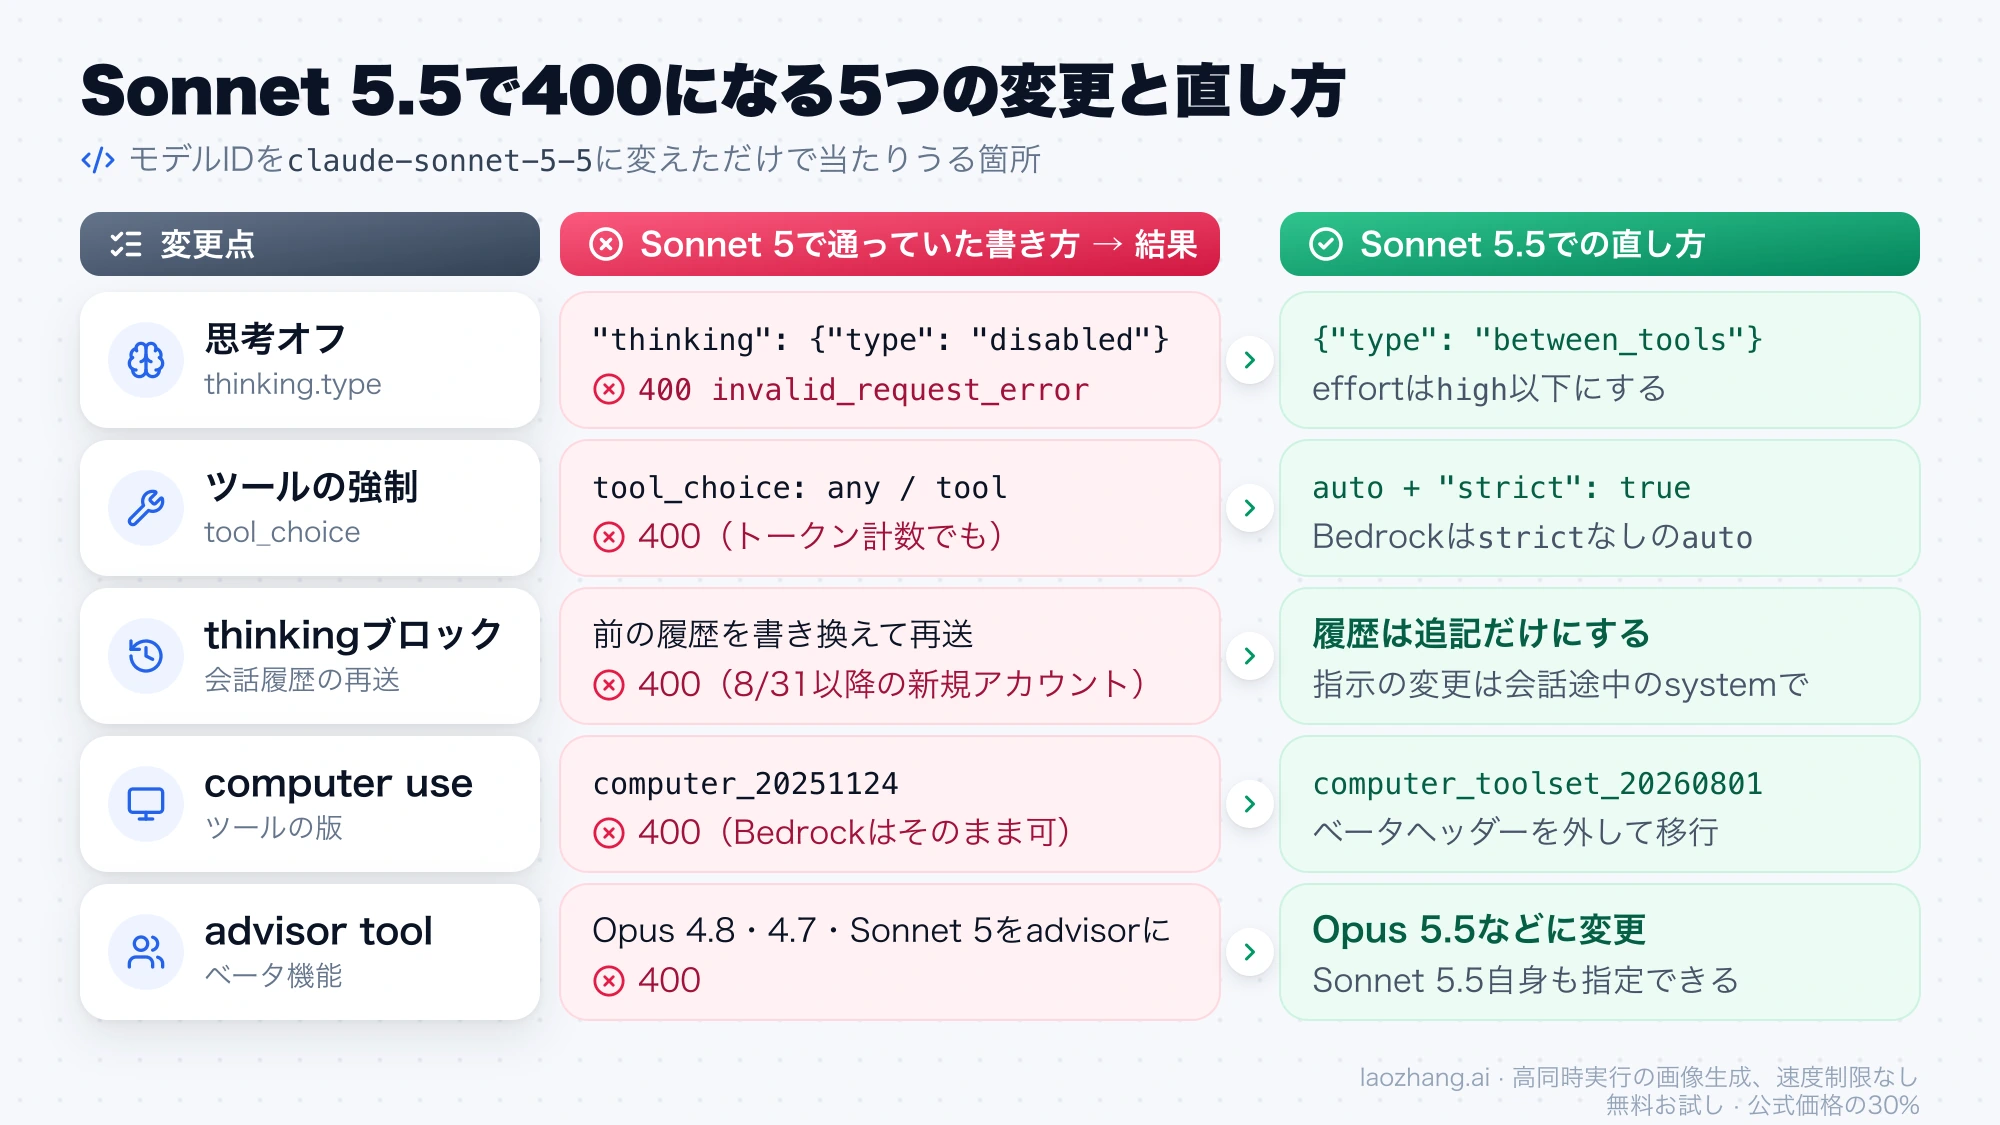
Sonnet 5.5で400エラーになる5つの破壊的変更
モデルIDをclaude-sonnet-5-5に変えただけでエラーになりうる変更は5つあります。自分のコードに当たるかどうかは、次の表で確認できます。
| 変更点 | Sonnet 5で通っていた書き方 | Sonnet 5.5での結果 | 直し方 | 対象 |
|---|---|---|---|---|
| 思考オフ | "thinking": {"type": "disabled"} | 400 invalid_request_error | {"type": "between_tools"}に置き換え、effortはhigh以下 | Sonnet 5.5を提供する全プラットフォーム |
| ツールの強制 | tool_choiceのanyまたはtool | 400(トークン計数エンドポイントでも) | autoにし、ツール定義にstrict: true | 全プラットフォーム(Bedrockはautoのみ) |
| thinkingブロック | 前の履歴を書き換えて再送 | 400(2026年8月31日以降に作成したアカウントの既定) | 履歴は追記だけにする | Claude API、Bedrock、Google Cloud |
| computer use | computer_20251124 | 400 | computer_toolset_20260801へ移行 | Claude API、Google Cloud |
| advisor tool(ベータ) | Opus 4.8、Opus 4.7、Sonnet 5をadvisorに指定 | 400 | Opus 5.5などSonnet 5.5が受け付けるadvisorに変更 | advisor toolの利用者 |
各項目の公式の説明と変更前後のリクエストは、Anthropicの「What's new in Claude Sonnet 5.5」とAnthropicのClaude Sonnet 5.5移行ガイドにあります。
thinkingのdisabledはbetween_toolsに置き換える
Sonnet 5.5にthinking: {"type": "disabled"}を送ると、2026年10月5日時点では次のメッセージで400が返ります。
To turn thinking off on this model, send "thinking": {"type": "between_tools"} instead of {"type": "disabled"}. The model does not think before responding. The short updates it writes between tool calls come back as thinking blocks.between_toolsは「回答前の思考を止める」設定で、Sonnet 5.5で最も軽い思考設定です。完全に思考をなくすわけではなく、ツール呼び出しの合間に書く短い進捗メモはthinkingブロックで返ります。このブロックは他のアシスタント出力と一緒に、そのまま送り返します。ツールを使わないリクエストなら、応答はテキストだけになり、Sonnet 5のdisabledと同じ形です。
変更前(Sonnet 5):
{
  "model": "claude-sonnet-5",
  "max_tokens": 16000,
  "thinking": {"type": "disabled"},
  "output_config": {"effort": "xhigh"},
  "messages": [{"role": "user", "content": "..."}]
}
変更後(Sonnet 5.5):
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": {"type": "between_tools"},
  "output_config": {"effort": "high"},
  "messages": [{"role": "user", "content": "..."}]
}between_toolsには次の制約があります。
xhighとmaxでは400になります。その段階で動かすならthinkingを省略するか{"type": "adaptive"}を送ります。display・budget_tokens・block_bindingを一緒に送ると400になります。手動の思考予算({"type": "enabled", "budget_tokens": N})もSonnet 5.5では400です。- 会話の途中でeffortを変えられません。メッセージごとのeffortで違う段階を送ると400になります。
- サーバー側フォールバックでSonnet 5に回ったリクエストは、Sonnet 5側では
disabledとして処理されます。
tool_choiceのanyとtoolはautoとstrict: trueに
Sonnet 5.5はツールの強制指定に対応していません。{"type": "any"}か{"type": "tool", "name": "..."}を送ると、次のエラーになります。トークン計数エンドポイントでも同じです。
tool_choice: type "tool" and "any" are not supported for this model.auto(既定)とnoneは使えます。入力をスキーマどおりにしたい場合は、tool_choiceをautoにしてツール定義にstrict: trueを付けます。autoではモデルがツールを呼ばずに答えることもあるため、どの場面でツールを使うかをプロンプトに書きます。
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 1024,
  "tools": [{
    "name": "get_weather",
    "description": "Get the current weather in a given location",
    "input_schema": {
      "type": "object",
      "properties": {"location": {"type": "string"}},
      "required": ["location"],
      "additionalProperties": false
    },
    "strict": true
  }],
  "tool_choice": {"type": "auto"},
  "messages": [{"role": "user", "content": "What's the weather in Paris? Use the get_weather tool."}]
}
strictモードはJSON Schemaの一部にしか対応しておらず、すべてのobjectにadditionalProperties: falseが必要です。Amazon BedrockではSonnet 5.5で構造化出力(strictモードを含む)が使えないので、strictなしのautoを送り、プロンプトで呼ぶ条件を伝え、受け取った入力を自分のコードで検証します。
thinkingブロックは作ったモデルと会話に結びつく
Sonnet 5.5のthinkingブロックは、それを作ったモデルと、それより前の会話内容に結びついています。影響が出るのは、会話の途中でモデルを切り替える場合と、過去の履歴を書き換えて再送する場合です。
- モデルの切り替え:Sonnet 5.5はSonnet 5、Opus 4.8、Haiku 4.5以前のブロックを読めますが、Opus 5、Opus 5.5、Fable・Mythosのブロックは読めません。Sonnet 5.5のブロックを読めるのは、Claude APIとGoogle Cloud上のOpus 5.5だけです。Sonnet 5からSonnet 5.5へ、またはSonnet 5.5からOpus 5.5(Claude API・Google Cloud)へ移るなら推論は引き継がれます。それ以外の移動では、読めないブロックはモデルに渡る前に削除されます。リクエストは成功し、削除分は課金されません。
- 履歴の書き換え:Sonnet 5.5のブロックより前にある
system、tools、過去のメッセージを変えてからそのブロックを再送すると、2026年8月31日0時(UTC)以降に作成したアカウントでは既定で400になります。対象はClaude API、Amazon Bedrock、Google Cloudです。エラーの代わりにブロックを捨てたい場合は、thinking-binding-controls-2026-08-01のベータヘッダーを付け、thinking.block_binding.prefix_mismatch_behaviorを"drop_block"にします(adaptive thinkingのときだけ使えます)。 - アカウント:Sonnet 5.5のブロックは、作ったアカウントか、それに紐づくアカウントでしか使えません。別のアカウントから送ったブロックは削除されます。
いちばん確実なのは、会話を追記だけにすることです。指示やツールを途中で変えたいときは、過去のsystemを書き換えず、会話途中のsystemメッセージを使います。
computer useはcomputer_toolset_20260801へ移す
Claude APIとGoogle Cloudでは、Sonnet 5.5のcomputer useはcomputer_toolset_20260801経由だけです。computer_20251124を宣言すると400になり、Claude APIでは次の文から始まるメッセージが返ります。
'claude-sonnet-5-5' does not support tool types: computer_20251124.移行では、ベータヘッダーを外し、toolsの項目を{"type": "computer_toolset_20260801"}に置き換えます。エージェントのループも、ツールセットのメンバーとして返るtool_useブロック、まとめて送られる操作、結果に付くtoolset_nameに対応させます。fine-grained-tool-streaming-2025-05-14のベータヘッダーはツールセットと一緒に送ると400になるので外し、必要なツールにeager_input_streaming: trueを設定します。
Amazon BedrockのSonnet 5.5はcomputer_20251124をそのまま受け付けます。古いcomputer_20250124はどのプラットフォームでも受け付けられません。すでにツールセットを使っている実装や、browser use toolは変更不要です。
advisor toolの組み合わせを見直す
advisor tool(ベータ)でSonnet 5.5を実行役にする場合、advisorにはMythos 5.1、Fable 5.1、Mythos 5、Fable 5、Opus 5.5、Opus 5、Sonnet 5.5自身のいずれかが必要です。Opus 4.8、Opus 4.7、Sonnet 5をadvisorにすると400になります。受け付けられるadvisorの助言はすべて暗号化されたadvisor_redacted_resultブロックで返るため、クライアント側では助言の本文を読めません。
エラーなしで変わる点:ツール呼び出しの合間の文章がthinkingブロックに
リクエストは失敗しないのに、ユーザー向けの画面が止まったように見える変更が1つあります。Sonnet 5.5では、ツール呼び出しの合間に書く1〜2文より長いメモが、進捗用のthinkingブロックで返ります。既定のdisplay: "omitted"ではこのブロックの本文が空なので、その文章をストリーミング表示しているアプリは、エラーもなくツール呼び出しの間だけ無言になります。Sonnet 5では、合間の文章はすべてtextブロックでした。
adaptive thinkingを使う場合は、thinking.displayを設定して本文を受け取ります。
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": {"type": "adaptive", "display": "updates"},
  "messages": [{"role": "user", "content": "..."}]
}"updates"はベータで、anthropic-beta: thinking-display-updates-2026-08-18ヘッダーが必要です。進捗メモだけが返ります。推論の要約と混ざってもよければ"summarized"を使います。本文が空でないthinkingブロックを、その後に続くtool_useブロックの前に表示するのが基本です。between_toolsを使っている場合は、displayなしで文章が返ります。
拒否のカテゴリーが増え、一部はSonnet 5で再実行される
Sonnet 5.5はSonnet 5より多くのカテゴリーで依頼を断ります。拒否はHTTP 200でstop_reason: "refusal"として返り、stop_detailsにcyber、bio、frontier_llm、reasoning_extraction、general_harmsのいずれかが入ります。general_harmsは無害な作業でも出ることがあります。
Claude APIのサーバー側フォールバック(fallbacks: "default"、ベータ)を有効にすると、cyberとfrontier_llmの拒否はSonnet 5で再実行されます。bio、reasoning_extraction、general_harmsは再実行されません。出力前の拒否が課金されるかはカテゴリーで変わり、レート制限にはどちらの場合も数えられます。通常のソフトウェア開発はこの安全対策の影響を受けないとAnthropicは説明していますが、セキュリティ関連のコードを多く扱うなら、拒否をログに残す処理を先に入れておきます。
そのほかの違い:キャッシュの下限と新機能
キャッシュできる最小プロンプトは、Sonnet 5の1,024トークンから512トークンに下がりました。短いプロンプトでもキャッシュが効くようになります。
Sonnet 5.5では、Sonnet 5にない機能として、メッセージごとのeffort(ベータ)、会話途中のsystemメッセージ、会話途中のツール変更(ベータ)が使えます。さらに、好きなタイミングで会話を要約するcompact-2026-09-04と、メッセージ内でツールを定義するinline-tools-2026-09-15の2つのベータがあります。
API・Claude Code・アプリでSonnet 5.5に切り替える手順
切り替え方と、実際に動いているモデルの確かめ方は、使っている場所ごとに違います。
Claude APIの移行チェックリスト
- モデルIDを
claude-sonnet-5-5に変えます(BedrockはAnthropic公式の一覧ではanthropic.claude-sonnet-5-5)。 output_config.effortを明示します。未指定だとhighで動きます。thinking: {"type": "disabled"}をbetween_toolsに置き換えます。tool_choiceのany・toolをautoとstrict: trueに変えます。- 会話履歴を追記だけにし、過去の
systemやtoolsを書き換えている箇所を直します。 - computer useの
computer_20251124(Claude API・Google Cloud)と、advisor toolの組み合わせを確認します。 - ツール呼び出しの合間の文章を表示しているなら、
thinking.displayを設定します。 stop_reason: "refusal"を処理し、必要ならフォールバックを設定します。- 自分の評価セットでeffortを比べ、費用の基準値を測り直します。
モデルIDの変更だけで済むかは、3〜7の項目に当たるかどうかで決まります。
Claude Code:v2.1.284以上とsonnetエイリアスの解決先
Claude CodeでSonnet 5.5を使うには、v2.1.284以上が必要です。古い場合はclaude updateで更新します。
claude update
claude --model claude-sonnet-5-5起動後なら/model claude-sonnet-5-5、環境変数ならANTHROPIC_MODELでも指定できます。/model sonnetのようにエイリアスを使う場合、どのモデルになるかは接続先で変わります。
| 接続先 | sonnetの解決先 |
|---|---|
| Anthropic API | Sonnet 5.5 |
| Claude Platform on AWS | Sonnet 4.6 |
| Amazon Bedrock、Google CloudのAgent Platform | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
BedrockやGoogle Cloud経由でsonnetを指定すると、Sonnet 5.5ではなくSonnet 4.5で動きます。クラウド経由でSonnet 5.5に固定するには、モデルのフルネームで指定するか、ANTHROPIC_DEFAULT_SONNET_MODELに接続先のSonnet 5.5のモデルIDを設定します。実際のモデルは/statusか、設定していればステータスラインで確認できます。
ほかに知っておきたい点は次のとおりです。
- effortの既定は
medium:Claude CodeではSonnet 5.5とOpus 5.5の既定がmediumで、ほかのモデルはhighです。/effort、--effort、CLAUDE_CODE_EFFORT_LEVELで変えられます。 defaultはSonnetではない:Pro・Max・Team・Enterprise・Anthropic APIでは、モデル設定のdefaultはv2.1.280以降Opus 5.5になります。それより前のバージョンでは、ProとTeam StandardでSonnet 5でした。- 途中の切り替えはキャッシュが切れる:セッションの途中で
/modelを切り替えるとプロンプトキャッシュが無効になり、それまでの文脈をキャッシュなしで読み直す費用がかかります。 - cyber判定はSonnet 5で再実行:セキュリティ関連と判定された依頼はSonnet 5で再実行され、生物学関連は拒否で終わります。Bedrock・Google Cloud・Foundryでは、Opusの解決先(
ANTHROPIC_DEFAULT_OPUS_MODELかOpus 4.8のモデル)と、Sonnet 5の解決先(ANTHROPIC_DEFAULT_SONNET_MODELかSonnet 5のモデル)がないと、再実行されずに拒否で終わります。
詳しい優先順位はClaude Codeのモデル設定ドキュメントにあります。
Claudeアプリ
ClaudeアプリでのSonnet 5.5の既定effortはMediumです。料金プランの表では、無料プランでも「Sonnet」が使えると書かれていますが、どのバージョンかは明記されていません。無料プランで現在選べるSonnetが5.5かどうかは、モデル選択の表示で確認してください。
当面Sonnet 5に残ってよいケース
Sonnet 5は非推奨や廃止の予定ではなく、「レガシー」として引き続き使えます。Anthropicは移行を勧めていますが、提供終了は早くても2027年6月30日です。急いで移すより、次のような場合は修正を済ませてから移るほうが安全です。
- 強制ツール指定に頼るパイプラインがあり、プロンプトと入力検証の書き直しが済んでいない。特にBedrockではstrictモードが使えません。
- Claude APIやGoogle Cloudで
computer_20251124のエージェントループを動かしていて、ツールセット対応がまだ。 - advisor toolでOpus 4.8やOpus 4.7をadvisorにしている。
- 過去の
systemやtoolsを書き換える会話管理をしていて、追記だけの形に直せていない。 - 常に
maxで動かしている。そのまま移すとAAの数字では1課題あたり5割増です。
また、cyberと判定された依頼のフォールバック先はSonnet 5です。フォールバックを使うなら、移行後もSonnet 5を呼べる状態にしておきます。
Sonnet 4.5は2026年11月30日までにSonnet 5.5へ
Sonnet 4.5(claude-sonnet-4-5-20250929)は2026年9月30日に非推奨となり、Claude APIでは2026年11月30日に提供が終わります。Anthropicが推奨する移行先はclaude-sonnet-5-5です。Sonnet 4.6はActiveのままで、提供終了は早くても2027年2月17日です。Bedrock・Google Cloud・Foundryの終了日は、それぞれの事業者が決めます。
Sonnet 4.5から移る場合は、上の5つの破壊的変更に加えて、次の違いにも対応が必要です。
- 思考が既定でオンになります。応答のブロックを
typeで読み分け、thinkingブロックを送り返し、max_tokensを見直します。 - 既定以外の
temperature・top_p・top_kは外します。 - 同じテキストでも、Sonnet 4.5よりトークン数が約30%増えます(Sonnet 5と同じトークナイザーのため)。
- アシスタントのプリフィルは400になります(
This model does not support assistant message prefill. The conversation must end with a user message.)。 output_config.effortを明示し、output_formatはoutput_config.formatへ移します。interleaved-thinking-2025-05-14とコンテキストウィンドウ関連のベータヘッダーを外し、fine-grained-tool-streaming-2025-05-14はeager_input_streamingに置き換えます。
モデルごとの完全な一覧はAnthropicのモデル提供終了スケジュールと移行ガイドにあります。
Claude Sonnet 5.5のよくある質問
Sonnet 5.5の「30%安い」は料金の値下げですか?
いいえ。トークン単価はSonnet 5と同じ入力$2・出力$10です。Anthropicが言う「最大30%」は、使うトークンが減ることによる1タスクあたりの費用で、上限の値です。AAのデータではlow〜xhighで4〜41%下がり、maxでは51%上がります。
Sonnet 5.5はOpus 5.5の代わりになりますか?
作業によります。Anthropicは、Sonnet 5.5が得意なのは範囲のはっきりした日常的な作業、バグ修正、資料作成で、単価はOpus 5.5の半分だとしています。一方でAnthropic自身が、判断を積み重ねる複雑で答えの決まっていない作業ではOpus 5.5のほうがはっきり強いとしており、AAの事実知識の評価でもSonnet 5.5の正答率はOpus 5.5より低くなっています(54%対66%)。
Sonnet 5.5とGPT-6 Astraはどちらを使うべきですか?
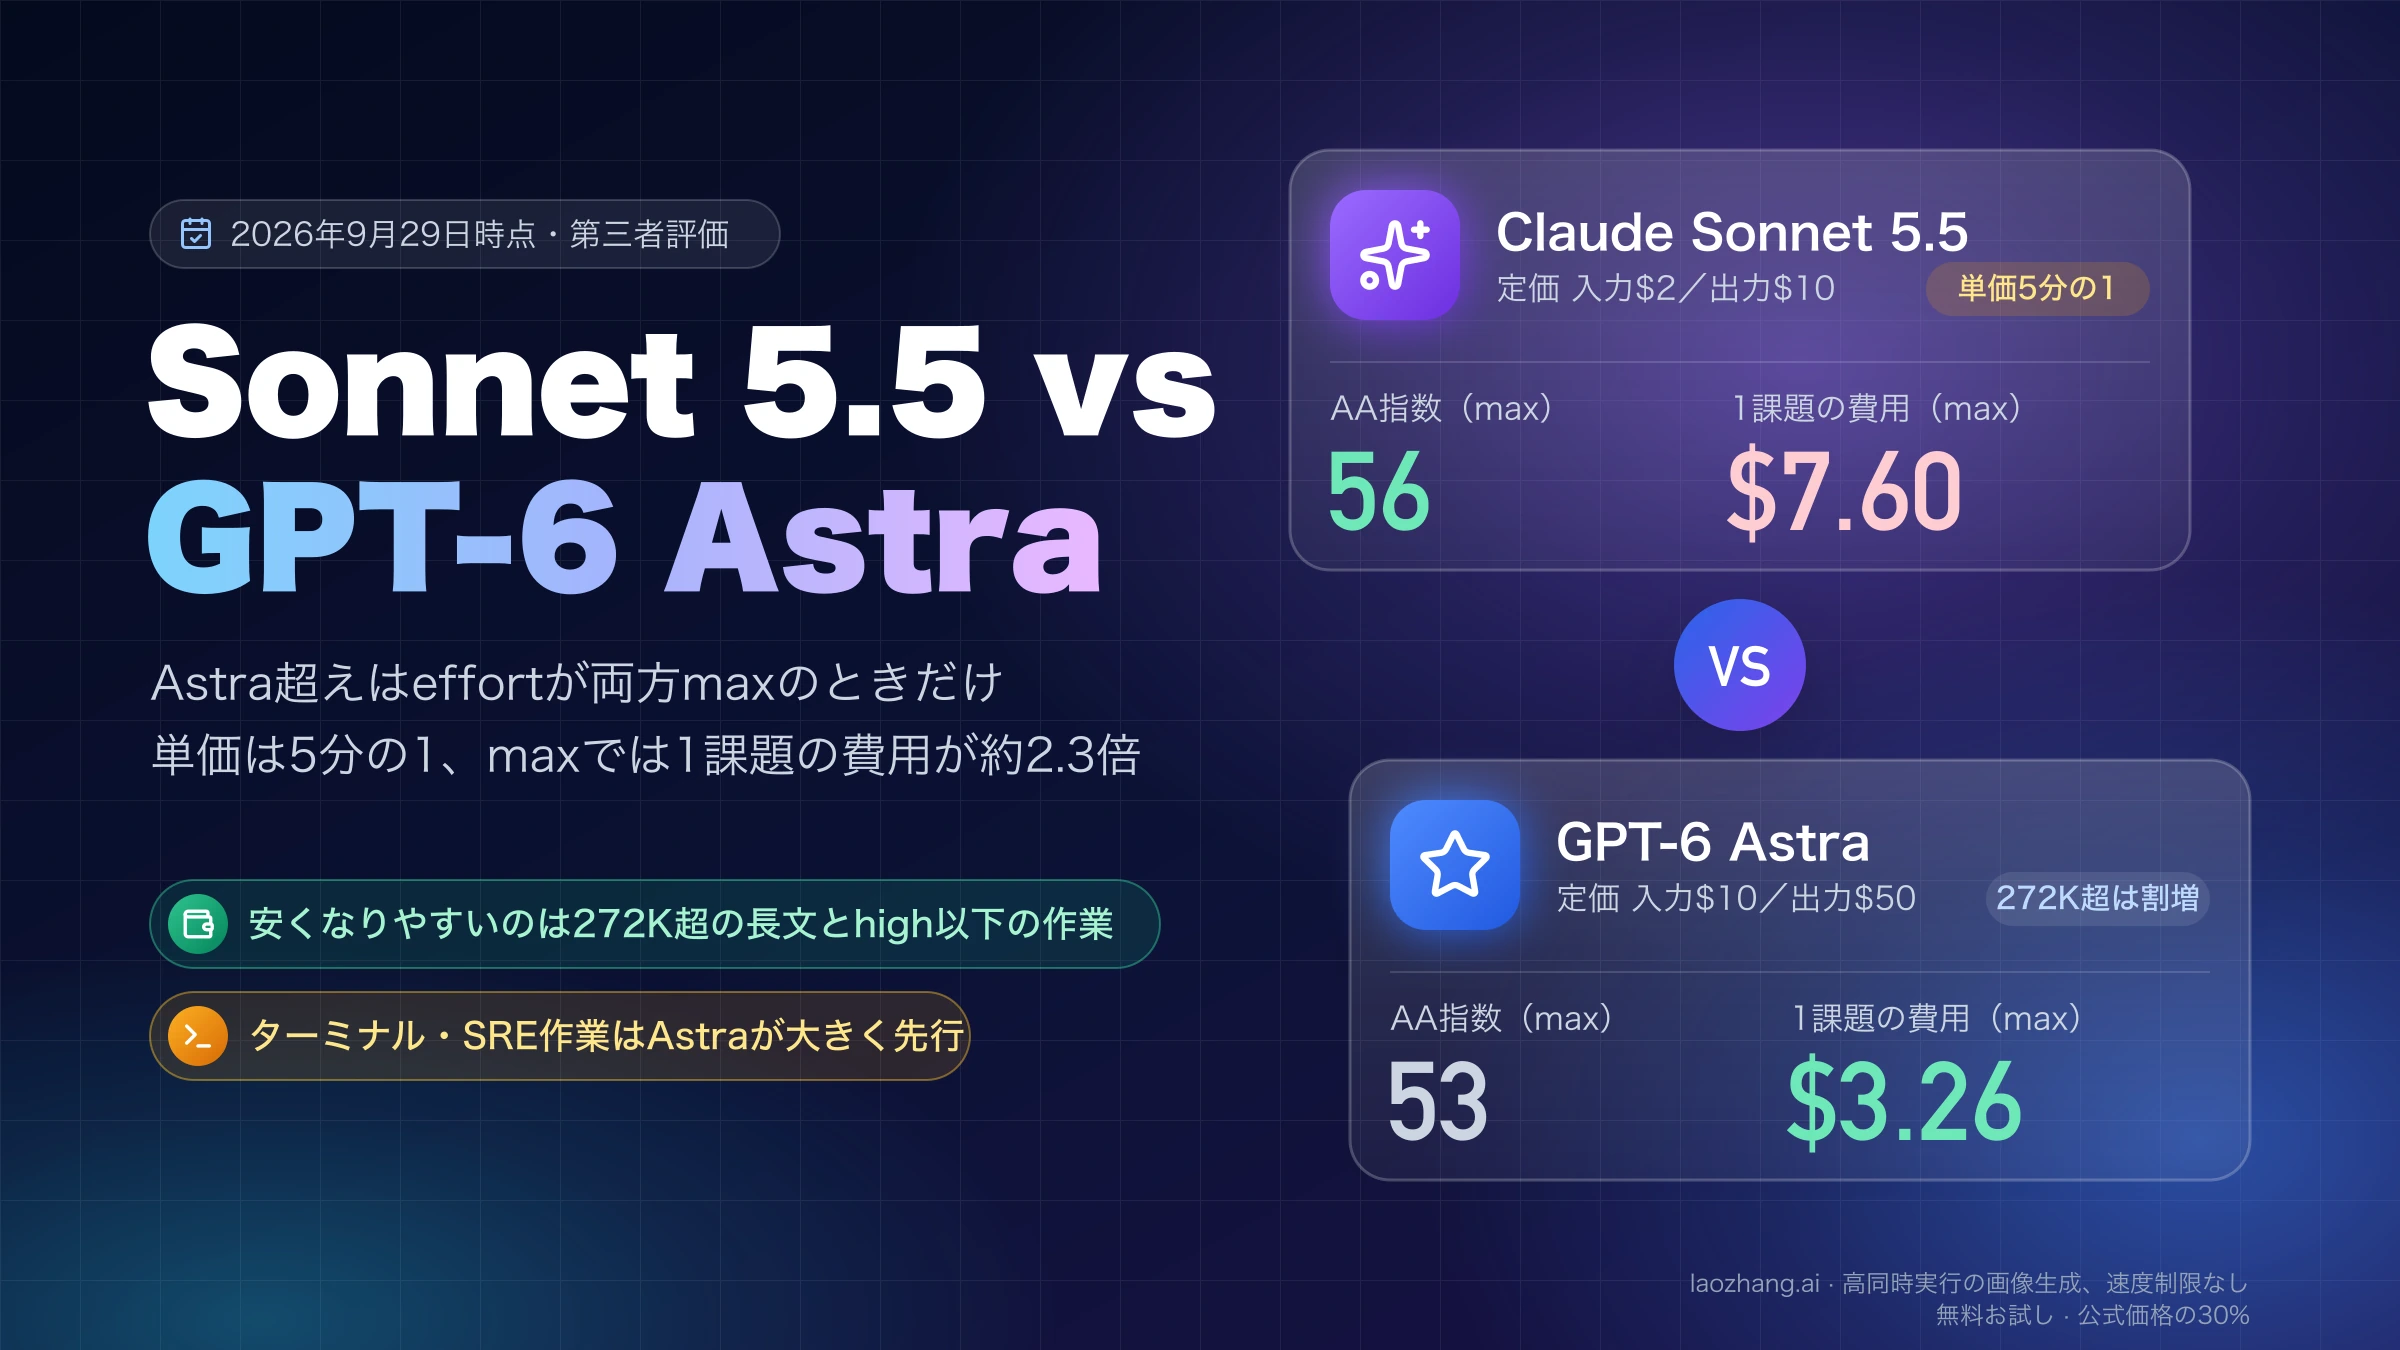
AAの公開時の記事では、Sonnet 5.5の低めの段階はGPT-6 AstraやGPT-6 Solの構成のほうが同等の性能をより安く出せるとされ、Sonnet 5.5が最も競争力を持つのはhighだと評価されています。段階別の費用と作業別の使い分けは「Sonnet 5.5とGPT-6 Astra比較:費用と使い分け」で扱っています。
APIでSonnet 5.5に変えたのに費用が下がりません。なぜですか?
まずeffortを確認します。指定しなければhighで動き、maxで動かしていればSonnet 5より高くなります。次に、会話途中でモデルを切り替えたり履歴を書き換えたりしてキャッシュが効いていないか、拒否されたリクエストがレート制限や課金に入っていないかを見ます。AAの数字は評価課題での値なので、自分の作業での費用は実際のログで測り直します。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月6日。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月6日。
- 1.Claude APIの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 2.Artificial AnalysisのClaude Sonnet 5.5モデルページartificialanalysis.ai/models/claude-sonnet-5-5
- 3.Claude Sonnet 5.5発表ページanthropic.com/claude-sonnet-5-5
- 4.Artificial AnalysisのSonnet 5.5公開時の記事artificialanalysis.ai/articles/claude-sonnet-5-5
- 5.CodeRabbitのSonnet 5.5コードレビュー検証記事coderabbit.ai/blog/sonnet-5-5-model-review
- 6.Anthropicの「What's new in Claude Sonnet 5.5」platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- 7.AnthropicのClaude Sonnet 5.5移行ガイドplatform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- 8.Claude Codeのモデル設定ドキュメントcode.claude.com/docs/en/model-config
- 9.Anthropicのモデル提供終了スケジュールplatform.claude.com/docs/en/about-claude/model-deprecations