Gemini 4 Argon APIのfinish_reason:途中で切れる回答の続け方
Argonの回答が切れたら、CONTINUATIONはトークン付きで再送、MAX_TOKENSは上限を上げて送り直します。OpenAI互換経路では続きを取れません。
目次
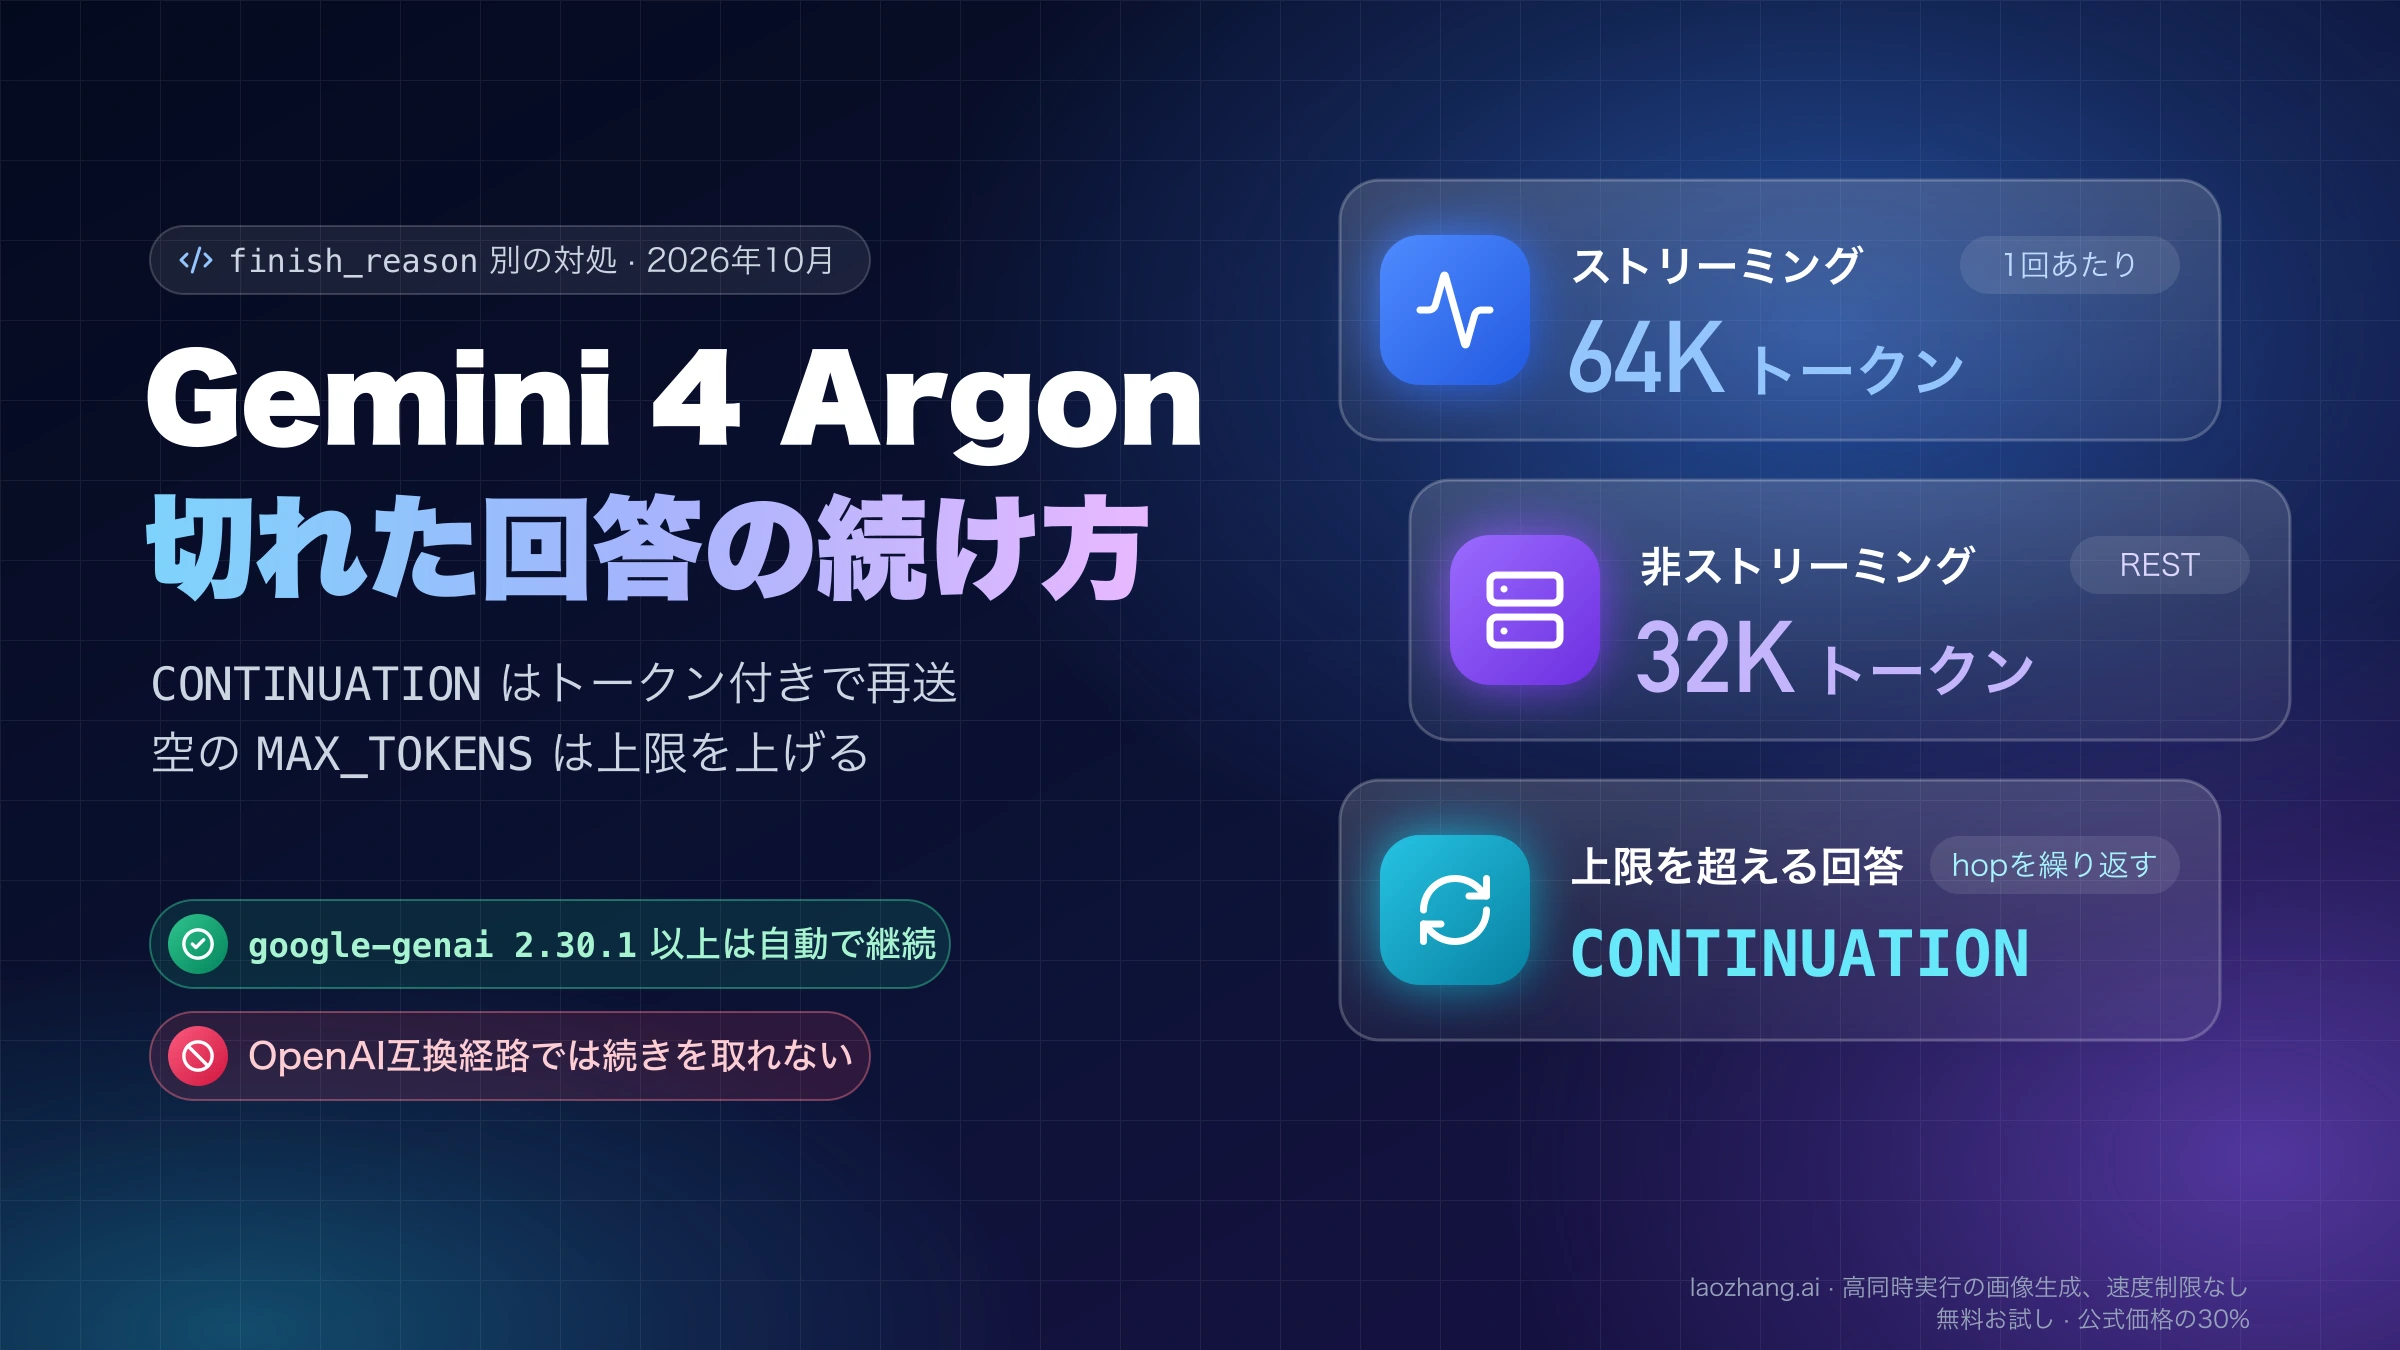
gemini-4-argonの回答が途中で切れたり空で返ってきたりしたら、最後のレスポンスのfinishReason(Python SDKとOpenAI形式ではfinish_reason)を見るのが最初の一歩です。CONTINUATIONなら、一緒に返ってきたcontinuationTokenを付けて同じリクエストを送り直せば続きが出ます。テキストが空のMAX_TOKENSは、maxOutputTokensをすべて思考に使い切ったという意味なので、上限を上げるか思考レベルを下げます。Googleのドキュメントによると、Argonが1回のリクエストで出すのはストリーミングで64K、非ストリーミングのRESTで32Kトークンまでで、それを超える回答はこの「続きの要求」を繰り返して受け取る仕組みです。
Googleの文書どおりに続きを受け取れるのは、有料枠のAPIキーでGemini APIのネイティブなgenerateContentを呼び、Pythonならgoogle-genai 2.30.1以上、JavaScriptなら@google/genai 2.29.1以上を使う構成です。この場合はSDKが自動で続きを取るので、max_output_tokensを65,536より大きく設定するだけで済みます。反対に、OpenAI互換エンドポイントでは続きの生成そのものが使えません。間に入ったAPI中継サービスがcontinuationTokenを落とすと、例外は出ずに空のテキストとCONTINUATIONだけが手元に残ります。
2026年10月28日に実際に動かしたのは、API中継サービス1社のネイティブ経路とOpenAI互換経路への計11回のリクエストと、google-genai 2.33.0と2.29.0をローカルの模擬サーバーにつないだ挙動テストです。Googleに直接つなぐAPIキーは使っておらず、テストした経路では本物のCONTINUATIONは一度も返ってきませんでした。Google直接の挙動として書いている部分は、Googleの公式ドキュメントに基づいています。
Gemini 4 Argon APIの始め方:有料枠のキー、モデルID、SDKの更新
ArgonはGemini APIの料金ページで無料枠の対象外とされており、課金を有効にしたプロジェクトのキーでなければ呼べません。長い回答を前提にするなら、キーを作った段階で次の5点まで済ませておくと、後から切れた回答の原因を探す手間が減ります。
- Google AI Studioで課金を有効にしたプロジェクトのAPIキーを作ります。Gemini APIの課金ページでは、お支払い情報の紐付けと$5以上の前払いでTier 1になり、前払い残高が0になるとキーはHTTP 402で止まります。日本は2026年10月22日更新のGemini APIの提供地域リストに含まれています。
- モデルIDに
gemini-4-argonを指定します。Gemini APIの変更履歴によると、2026年10月13日に一般提供(GA)になったStable版です。 - SDKを更新します。Pythonは
pip install -U "google-genai>=2.30.1"、JavaScriptはnpm install "@google/genai@>=2.29.1"です。Go 1.74.0、Java 1.77.0、.NET 1.26.0、Kotlin 1.6.0が同じ機能の最低バージョンです。 max_output_tokensを設定します。これは思考と回答を合わせた上限なので、Gemini 4 Argonの新機能ページの移行手順どおり少なくとも32,768にし、64Kを超える回答を受け取りたい場合は65,536より大きくします。temperature・top_p・top_kは無視されるので外し、思考の深さはthinking_level(low・medium・high、既定はmedium)で調整します。- HTTPクライアントの読み取りタイムアウトを20分にします。Pythonなら
genai.Client(http_options=types.HttpOptions(timeout=1_200_000))です。3分や5分のタイムアウトでは、難しい問題で思考している途中に切れます。
料金は入力100万トークンあたり$2.00、出力(思考トークンを含む)$10.00で、2026年12月1日からはそれぞれ$4.00と$20.00に上がります。Google AI ProやUltraの契約はGeminiアプリなどの利用権で、契約しているだけではプロジェクトからAPIを呼べるようにはなりません。429エラーやティアごとの上限はGemini APIのレート制限:確認場所、Tier別の支出上限、上げ方で扱っています。
finish_reason一覧:Gemini 4 Argonが返す値と次にやること
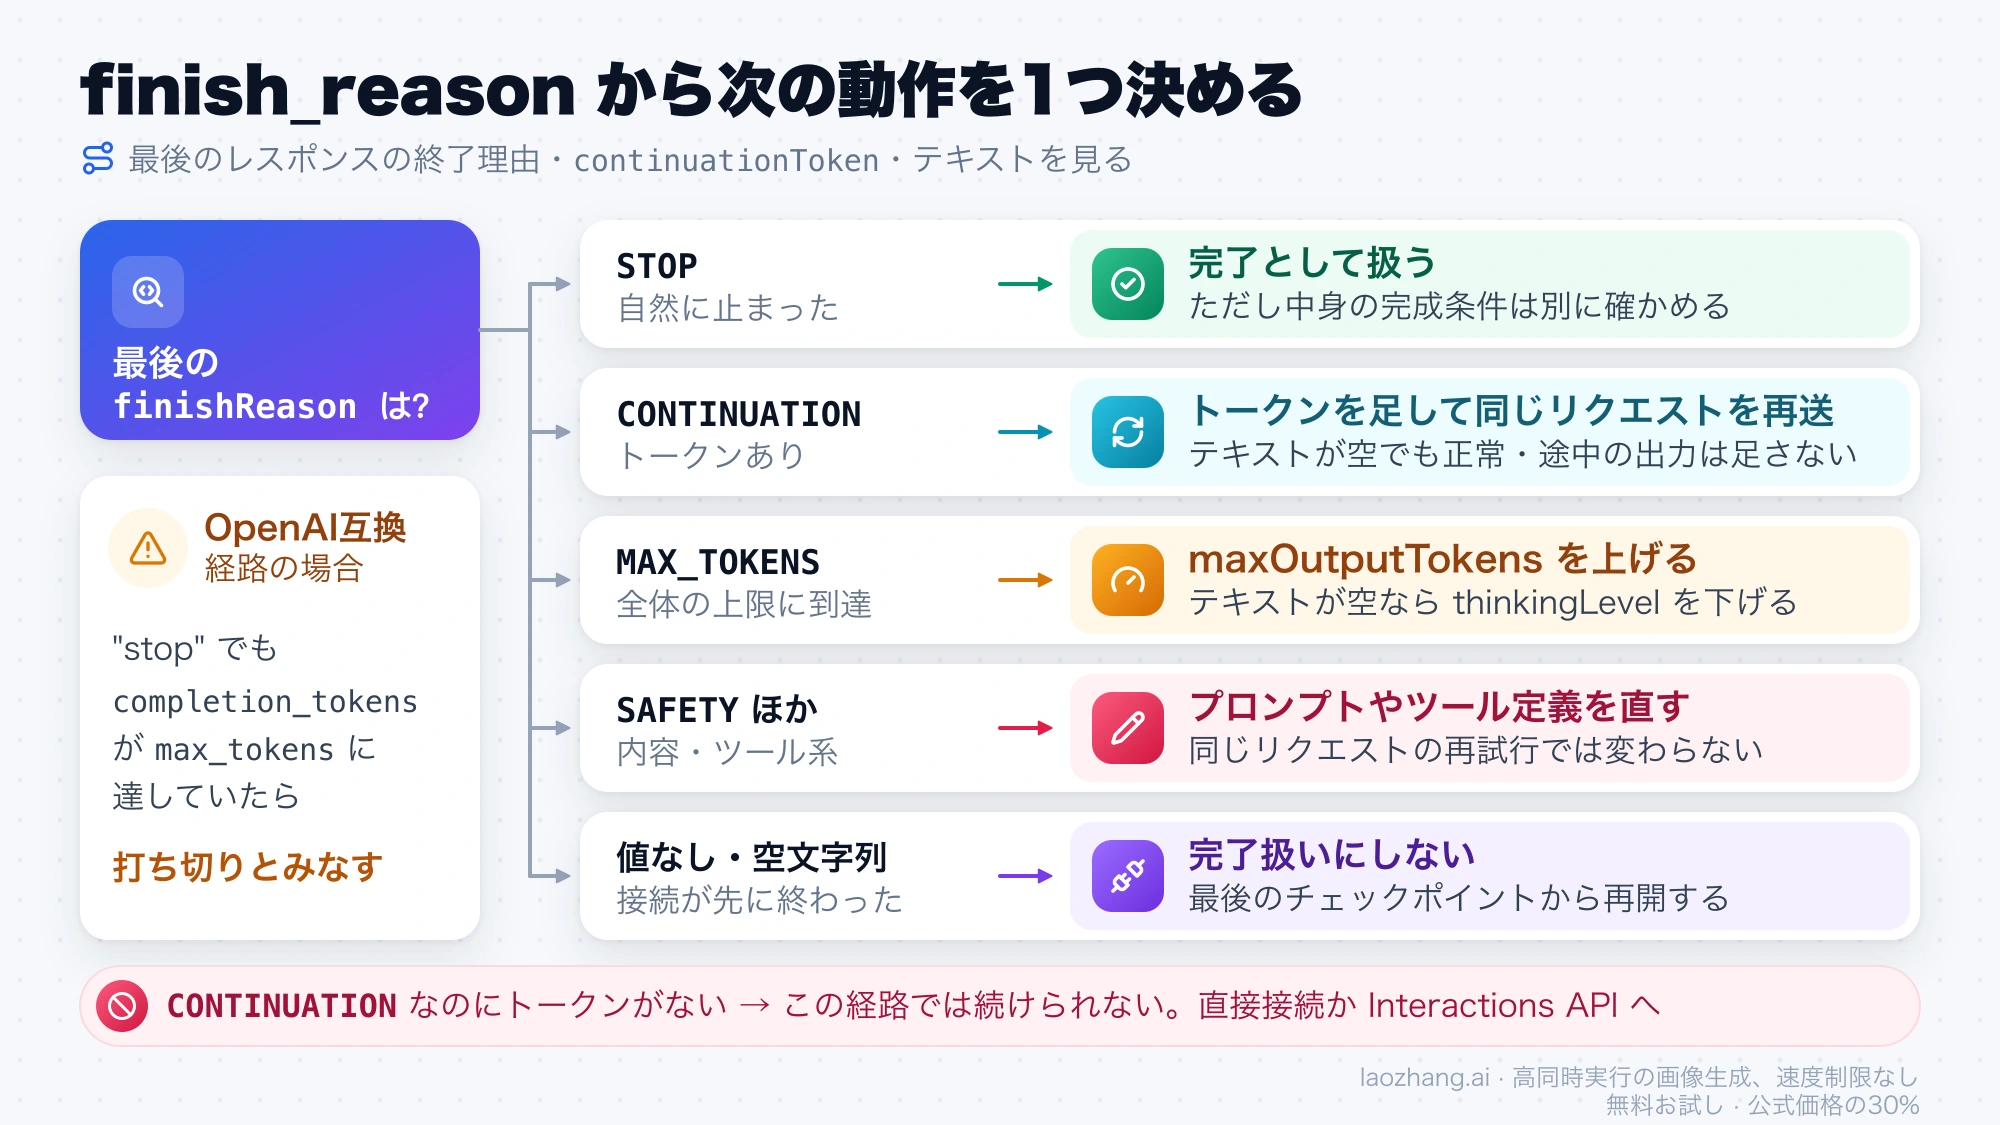
Argonのレスポンスに付く終了理由は、続きを取れば完成するもの(CONTINUATION)、上限を見直すもの(MAX_TOKENS)、内容やツール定義を直さない限り何度送っても同じになるもの、の3種類に分かれます。Gemini APIのGenerateContentリファレンスの列挙値のうち、画像生成専用の値(IMAGE_SAFETYなど)はテキストしか出力しないArgonには関係しないため除いています。
| finishReason | 意味 | コードが次にやること |
|---|---|---|
STOP | モデルが自然に止まった、または停止シーケンスに達した | 完了として扱う。ただし依頼どおりに仕上がったかは中身で確認する |
CONTINUATION(トークンあり) | 1回分の上限に達したが、maxOutputTokensはまだ残っている | 同じリクエストにcontinuationTokenを足して再送する。テキストが空でも正常 |
CONTINUATION(トークンなし) | 経路のどこかでトークンが削られた | この経路では続けられない。Googleに直接つなぐかInteractions APIに切り替える |
MAX_TOKENS(テキストあり) | 全体のmaxOutputTokensを使い切った | トークンがあれば上限を上げて続ける。なければ上限を上げて最初からやり直す |
MAX_TOKENS(テキストが空) | 上限をすべて思考に使い、回答を書く前に終わった | maxOutputTokensを上げるかthinkingLevelを下げる |
SAFETY・PROHIBITED_CONTENT・BLOCKLIST・SPII | 安全性、禁止コンテンツ、禁止語、個人を特定できる機微情報で停止した | プロンプトや入力を変える。同じリクエストの再試行では変わらない |
RECITATION・LANGUAGE | 既存の文章の再現、または未対応の言語と判定された | 同上。言い換えや出力言語の指定を見直す |
MALFORMED_FUNCTION_CALL・UNEXPECTED_TOOL_CALL・TOO_MANY_TOOL_CALLS | 関数呼び出しの形式が不正、ツール未設定なのに呼び出した、連続呼び出しが多すぎた | ツール宣言とツールの戻し方を直してから再試行する |
MISSING_THOUGHT_SIGNATURE・MALFORMED_RESPONSE | 履歴のthought signatureが欠けている、または応答の形式が壊れていた | 前のターンのモデル応答を加工せずに履歴へ戻してから再試行する |
ESCALATION・PUP_LIMITED_DISABLED | エスカレーションルールで除外された、または禁止使用ポリシー違反でアカウントが制限された | 再試行しない。アカウントと利用内容を確認する |
OTHER | 理由不明 | finishMessageを記録して1回だけ再試行する |
| 値がない、または空文字列 | 終了理由が届く前に接続が終わった | 完了扱いにしない。後述のストリームの節を参照 |
STOPは「モデルが自分で止まった」という意味でしかありません。2026年10月28日の中継経路のテストで、maxOutputTokens 33,000を指定して「1から7000までの整数をすべて1行ずつ出力して」と頼んだところ、Argonは142トークンで「1回の応答の出力上限を超えるため途中で切れてしまう」と断り、代わりにseq 1 7000などのコマンドを提案してSTOPで終わりました。長い出力を求めるパイプラインでは、STOPを見たうえで行数や必須項目など中身の完成条件も確かめる必要があります。
SDKがCONTINUATIONを見せない理由:自動継続とその条件
最新のGoogle GenAI SDKは、CONTINUATIONを受け取ると自分で次のリクエストを送り、全部つなげた1つの応答を返します。Googleのlong decodeガイドによると、この自動継続(automatic_continuation)はストリーミングでも非ストリーミングでも既定で有効です。そのため最新SDKを使っている限り、呼び出し側のコードにCONTINUATIONが届くことは基本的にありません。
この挙動を確かめるため、2026年10月28日に:generateContentを真似たローカルの模擬サーバーを立て、Googleの文書にある形のレスポンスを手書きで返して、PyPIの最新版google-genai 2.33.0と、最低バージョンを下回る2.29.0をつなぎました。1回目は思考だけで32,768トークンを使い、テキストが空のCONTINUATIONとトークンを返し、2回目でSTOPを返す設定です。
| シナリオ | 2.33.0の結果 | 2.29.0の結果 |
|---|---|---|
A:1回目CONTINUATION+トークン、2回目STOP | リクエスト2回。2回目は同じcontentsと同じmaxOutputTokens 262,144にトークンを付けて送信。呼び出し側に見えるのはSTOPと「Final answer.」 | リクエスト1回。空のテキストとCONTINUATION、トークンがそのまま返り、エラーにはならない |
B:Aと同じでautomatic_continuation=False | リクエスト1回。CONTINUATIONとトークンが呼び出し側に返る | 設定項目そのものが存在しない |
C:CONTINUATIONだがトークンなし | リクエスト1回。空のテキストとCONTINUATION、例外なし | 同じ |
D:MAX_TOKENS+トークン | リクエスト1回。SDKは続けず、途中までのテキストとトークンを返す | 同じ |
注意すべきなのはAの2.29.0とCです。どちらも例外が出ないので、response.textだけを見ていると「空の回答が返ってきた」としか見えません。2.33.0のソースコード(google/genai/_extra_utils.py)を読むと、続きを取りに行くのは終了理由がないかCONTINUATIONの場合だけで、ストリーミングでは新しいチェックポイントを得られないまま3回再接続すると諦めます。SDKの自動継続を使う場合でも、最後にfinish_reasonがSTOPかどうかを確認する1行は残しておくのが安全です。模擬サーバーの応答はGoogleの文書の形に合わせて手書きしたもので、実際のサーバーとは細部が異なる可能性があります。
継続ループを自分で書く:同じリクエストに最新のトークンだけ足す
SDKを使わずRESTで呼ぶ場合や、自分でループを管理したい場合は、finishReasonがCONTINUATIONの間だけ、最初とまったく同じリクエストに最新のcontinuationTokenを足して送り続けます。トークンにはモデルの思考を含む途中の状態が入っているので、途中までの出力をcontentsに足してはいけません。次のコードは標準ライブラリだけで書いた非ストリーミングの例で、2026年10月28日にローカルの模擬サーバー相手に動かし、3回のリクエストでSTOPまでつながること、トークンが落ちた応答では止まることを確かめています。
import json, os, urllib.request

URL = "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-argon:generateContent"
KEY = os.environ["GEMINI_API_KEY"]
BODY = {  # 毎回まったく同じものを送る
    "contents": [{"role": "user", "parts": [{"text": "素数定理の厳密な証明を書いてください。"}]}],
    "generationConfig": {"maxOutputTokens": 262144, "thinkingConfig": {"thinkingLevel": "high"}},
}

def call(body):
    req = urllib.request.Request(URL, data=json.dumps(body).encode(),
                                 headers={"x-goog-api-key": KEY, "Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=1200) as r:  # 20分
        return json.load(r)

parts, hops, token = [], [], None
while True:
    body = dict(BODY, continuationToken=token) if token else BODY
    resp = call(body)
    cand = resp["candidates"][0]
    parts += (cand.get("content") or {}).get("parts") or []
    hops.append(resp.get("usageMetadata", {}))
    reason, token = cand.get("finishReason"), cand.get("continuationToken")
    if reason != "CONTINUATION":
        break
    if not token:
        raise RuntimeError("CONTINUATION なのに continuationToken がない(途中で落とされている)")

text = "".join(p.get("text", "") for p in parts if not p.get("thought"))
print("finishReason:", reason, "/ hop数:", len(hops))
print("プロンプトの大きさ:", hops[0].get("promptTokenCount"))
print("入力トークン合計:", sum(h.get("promptTokenCount", 0) for h in hops))Googleのドキュメントは、1回のリクエストと応答を「hop」と呼び、ループの規則を次のように定めています。contents・system_instruction・tools・generation_configは毎回同じものを送り、max_output_tokensも変えません。送るトークンは最新の1つだけで、終了理由がCONTINUATION以外になったらループを抜け、最後に全hopのpartsを1つのモデルのターンとしてつなげて会話履歴に入れます。非ストリーミングのRESTでは1回あたり32,768トークンまでなので、同じ量でもストリーミングよりhop数が増えます。
MAX_TOKENSで終わった場合は事情が違います。Googleの説明では、ArgonのMAX_TOKENSにもトークンが付いていて、それまでに使った量より大きいmax_output_tokensにして同じリクエストを送れば続けられます。上限が使用済みの量以下だと、400エラー「Continuation token has already used output tokens…」が返ります。トークンを付けずに上限だけ上げて送り直すと最初からやり直しになり、両方の分を支払うことになります。
ストリーミングで自前のループを組む場合は、もう1つ規則が加わります。最初の32,768トークンを過ぎると、ストリームは5,000トークンごとにトークン付きのチャンク(チェックポイント)を送ってきます。受け取ったチャンクはいったん保留にしておき、トークン付きのチャンクが来た時点で確定させてトークンを保存します。途中で切れたら保留分を捨てて最後のトークンから再開し、最初のチェックポイントより前に切れた場合は元のリクエストを送り直します。
中継サービスとOpenAI互換経路のfinish_reason:2026年10月28日の実測
API中継サービスやOpenAI互換エンドポイントを経由すると、Googleの文書どおりの終了理由やトークンが返ってくるとは限りません。2026年10月28日に、laozhang.aiのGeminiネイティブ経路(/v1beta/models/gemini-4-argon:generateContent)とOpenAI互換経路(/v1/chat/completions)へ短いリクエストを送った結果が次の表です。費用は上限を$1と決めて動かし、後述の長いテストを含めて最悪見積もりで$0.59でした。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| リクエスト | 返ってきたもの | Googleの文書との違い |
|---|---|---|
ネイティブ、maxOutputTokens 64、thinkingLevel low、長い解説を依頼 | MAX_TOKENS、291文字、continuationTokenなし | 文書ではArgonのMAX_TOKENSにもトークンが付く |
| ネイティブ、200、high、難しい数学の問題 | MAX_TOKENS、テキスト0文字(思考197トークン) | 「全部思考に使った」パターン。ただしトークンなし |
| 1件目と同じリクエストをトークンなしで再送(上限64と600) | どちらも最初から書き直した別の回答 | トークンがなければ続きにはならない |
| ネイティブ非ストリーミング、40,000、「OKとだけ返して」 | STOP、「OK」 | 文書では直接のRESTで32,768超かつトークンなしは400 |
ネイティブ、thinkingLevel "minimal" | HTTP 500、中国語の「上游服务异常…」とコード"402" | 文書ではArgonはminimalを受け付けない。元のエラー文が置き換えられている |
OpenAI互換、max_tokens 64、長い解説を依頼 | completion_tokens 64、finish_reason "stop" | 上限まで使ったのに"length"ではない |
OpenAI互換、max_tokens 40,000、「OK」 | "stop"、5トークン | 正常な完了 |
この経路ではcontinuationTokenが一度も返ってこなかったので、ネイティブ経路でもArgonの長い回答を継続で受け取ることはできませんでした。OpenAIのChat Completions形式では上限で打ち切られた応答は"length"で終わるのが通例なので、OpenAI互換経路のこの"stop"は打ち切りを見逃す原因になります。GoogleのOpenAI互換エンドポイントのページにもfinish_reasonの対応表はないため、OpenAI形式で受ける場合はfinish_reasonだけを信じず、usage.completion_tokensがmax_tokensに達していたら打ち切りとみなすのが確実です。結果は1社の経路で1日に試したもので、ほかの中継サービスや同じ経路の今後の挙動を保証するものではありません。
Google自身のOpenAI互換エンドポイント(https://generativelanguage.googleapis.com/v1beta/openai/)でも、long decodeガイドの制限事項に「long decodeは使えず、出力は1回分の上限で止まる」と明記されています。reasoning_effortはlow・medium・highがそのままArgonの思考レベルに対応します。OpenAI SDKの向き先を変える設定そのものはOpenAIのbase_url変更:優先順位とパスの書き方を参照してください。
続きを受け取れない経路からの切り替え先:ネイティブSDKかInteractions
自分の経路で続きを受け取れるかどうかは、continuationTokenが手元まで届くかで決まります。OpenAI互換エンドポイント、トークンを返さない中継サービス、最低バージョン未満のSDKはいずれも、1回分の上限を超える回答を構造的に受け取れません。64Kや32Kを超える回答が必要なら、Gemini APIのネイティブgenerateContentを最新SDKか自前のループで呼ぶか、サーバー側で続きを処理してくれるInteractions APIに切り替えます。
Interactions APIのlong decodeガイドによると、background: trueとstore: trueを付け、max_output_tokensを65,536より大きく(最大で1,048,576から入力分を引いた値まで)指定すると、サーバーが64Kずつ生成してつなげ、最長24時間まで実行します。background: falseのまま65,536を超える値を送ると、400エラー「max_output_tokens greater than 65536 is not yet supported with background=false」になります。Interactions APIの結果はfinishReasonではなくstatusで返り、終わった状態はcompleted・requires_action・incomplete・failed・cancelledのいずれかです。incompleteはmax_output_tokensを使い切った状態で、テキストが空のこともあるので、MAX_TOKENSと同じく上限か思考レベルを見直します。
ストリームがfinishReasonなしで終わったら成功ではない
ストリームが最後のチャンクに終了理由を載せないまま閉じた場合は、完了ではなく接続の切断として扱います。google-genai 2.33.0のソースコードも、終了理由がない状態をCONTINUATIONと同じく「まだ続きがある途中の状態」とみなして再開を試みます。Googleのlong decodeガイドの手順どおり、最後に保存したチェックポイントトークンから再開し、チェックポイントがなければ元のリクエストを送り直します。
2026年10月28日の中継経路のテストでは、maxOutputTokens 33,000で3言語2,500行のCSVを頼むと、非ストリーミングでは300.9秒で接続が切れて本文が何も返らず、streamGenerateContent?alt=sseのストリーミングでは993件のイベントで74,760文字(1,065行目まで)を受け取ったところで302.5秒で終わりました。最後のチャンクのfinishReasonは空文字列で、最終的なトークン数もチェックポイントトークンもありませんでした。途中のチャンクのcandidatesTokenCountは0のままだったので、トークン数から進み具合を知ることもできません。約300秒という値はGoogleが文書化しているサーバー側の上限(非ストリーミング10分、ストリーミング20分)より短く、手元のHTTPプロキシと中継サービスのどちらで切れたのかはこの結果からは分かりません。
check_finish.py:finish_reasonから次の動作を1つ決める判定コード
ここまでの規則を、最後のレスポンスを渡すと次の動作を1つ返す関数にまとめました。依存ライブラリはなく、Python 3.9以上で動きます。2026年10月28日に、前の2節で触れた中継経路の保存済みレスポンス7件(ネイティブ4件、OpenAI互換2件、ストリーム最後のチャンク1件)と、模擬レスポンス4件に対して実行し、11件すべてが想定どおりに分類されました。
CONTENT = {"SAFETY", "PROHIBITED_CONTENT", "BLOCKLIST", "SPII", "RECITATION", "LANGUAGE"}
TOOLING = {"MALFORMED_FUNCTION_CALL", "UNEXPECTED_TOOL_CALL", "TOO_MANY_TOOL_CALLS",
           "MISSING_THOUGHT_SIGNATURE", "MALFORMED_RESPONSE"}

def next_action(resp: dict) -> str:
    """Gemini ネイティブ形式(REST JSON)の最後のレスポンスから次の動作を1つ返す"""
    cands = resp.get("candidates") or []
    if not cands:
        return "blocked_or_empty"            # promptFeedback を確認
    c = cands[0]
    reason = c.get("finishReason") or None   # 空文字列も「なし」として扱う
    token = c.get("continuationToken")
    parts = (c.get("content") or {}).get("parts") or []
    text = "".join(p.get("text", "") for p in parts if not p.get("thought"))
    if reason is None:
        return "transport_cut"               # 完了扱いにしない
    if reason == "STOP":
        return "done"
    if reason == "CONTINUATION":
        return "continue" if token else "continuation_without_token"
    if reason == "MAX_TOKENS":
        return ("raise_budget" + ("_empty_text" if not text else "")
                + ("_with_token" if token else "_start_over"))
    if reason in CONTENT:
        return "content_stop"                # 同じリクエストの再試行は無意味
    if reason in TOOLING:
        return "tool_or_format_stop"
    return "other"                           # finishMessage を記録して1回だけ再試行

def next_action_openai(resp, max_tokens):
    """OpenAI 互換形式:finish_reason より completion_tokens を信じる"""
    ch = (resp.get("choices") or [{}])[0]
    used = (resp.get("usage") or {}).get("completion_tokens", 0)
    if ch.get("finish_reason") == "length" or used >= max_tokens:
        return "truncated"                   # このエンドポイントでは続きを取れない
return "done" if ch.get("finish_reason") in ("stop", "tool_calls") else "check"実行結果は、64トークン上限の応答がraise_budget_start_over、テキスト0文字の応答がraise_budget_empty_text_start_over、OpenAI互換で"stop"だった64トークンの応答がtruncated、finishReasonなしで終わったストリームがtransport_cutでした。「1から7000まで」を断った応答はdoneに分類されます。STOPがタスクの完成を意味しないのはこの関数でも同じで、中身の確認は別に必要です。
long decode後のprompt_token_countが膨らむ理由と費用の読み方
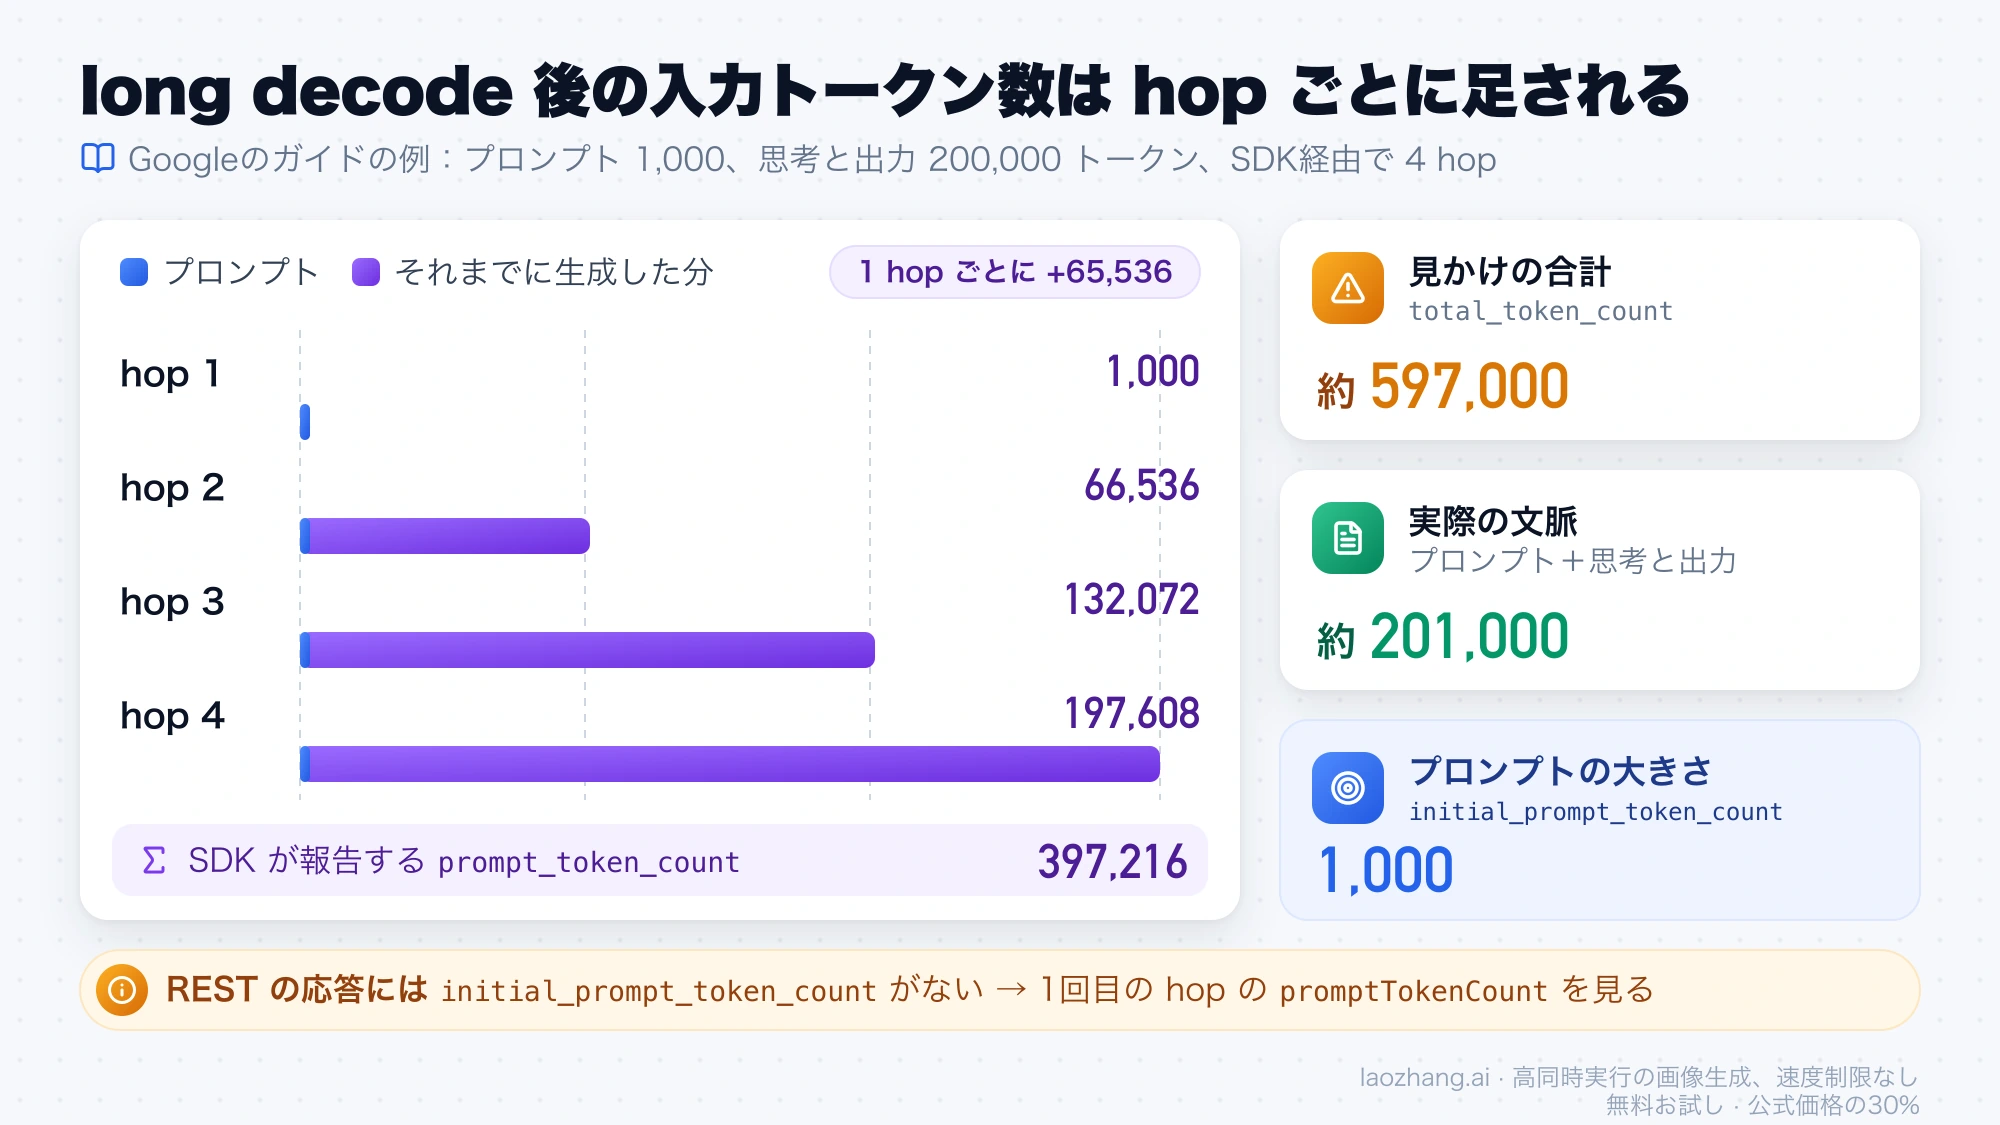
長い出力の生成(long decode)のあとにprompt_token_countが実際のプロンプトより何倍も大きく見えるのは、各hopの入力が足し算されているからです。2回目以降のhopでは、プロンプトにそれまで生成した分を加えたものがモデルの入力になり、SDKはその全hopの入力を合計して報告します。プロンプトの大きさを知りたいときは、Pythonならusage_metadata.initial_prompt_token_count、JavaScriptならusageMetadata.initialPromptTokenCountを読みます。
Googleのlong decodeガイドの例では、1,000トークンのプロンプトで思考と出力が200,000トークンになると、SDK経由で4回のhopになり、入力は1,000、66,536、132,072、197,608で合計397,216トークンと報告されます。実際の文脈は約201,000トークンなのに、total_token_countは約597,000になる計算です。非ストリーミングのRESTで32Kずつ回すと7回のhopになり、入力の合計は695,128トークンになります。前述の模擬サーバーのテストでも、2.33.0のprompt_token_countは2回分を足した33,008(120+32,888)で、initial_prompt_token_countは元の120でした。
この例を料金に直すと、思考を含む出力200,000トークンは2026年11月30日までの単価で200,000 ÷ 1,000,000 × $10.00 = $2.00です。入力397,216トークンは、キャッシュがまったく効かなかったとしても397,216 ÷ 1,000,000 × $2.00 ≈ $0.79が上限で、Googleの説明では2回目以降に繰り返される入力は暗黙的キャッシュで95%割り引かれ、100万トークンあたり$0.10になります。キャッシュは15〜20分使われないと消えるので、hopの間を空けると通常料金に戻ります。思考だけのhopも課金対象で、失敗したり切れたりした非ストリーミングのhopは$0、ストリームは32Kトークンより前に切れれば$0、それ以降は最後のチェックポイントまでが課金されます。
initial_prompt_token_countはSDKが手元で計算する値で、RESTのレスポンスにもmodel_dump()の出力にも含まれません。自前のループや中継サービスのようにRESTで呼ぶ場合は、各フィールドをhopごとに足して費用を出し、プロンプトの大きさには1回目のhopのpromptTokenCountを使います。会話履歴の要約や切り詰めの判断に合計値を使うと、まだ余裕があるのに早すぎるタイミングで圧縮が始まります。
Gemini 4 Argonのfinish_reasonに関するよくある質問
Gemini 4 Argonでtemperatureやtop_pを指定するとどうなりますか?
Googleのlong decodeガイドによると、Argonはtemperature・top_p・top_kを無視し、警告を返します。thinking_budgetも同様に警告の対象で、思考の量はthinking_levelで調整します。thinking_levelとthinking_budgetを両方指定するとエラーになるので、どちらか一方にします(2026年10月28日時点のドキュメント)。
max_output_tokensを小さくすれば、Argonの思考は短くなりますか?
なりません。max_output_tokensは思考と回答の合計の上限なので、下げてもモデルが簡潔に考えるようになるわけではなく、回答が早く切れるだけです。トークンの消費を抑えたい場合はthinking_levelをmediumからlowに下げるよう、Googleのlong decodeガイドは案内しています。
Argonに文字数を指定すれば、その分だけ出力されますか?
出力されるとは限りません。Googleのドキュメントは、Argonはトークン数や文字数の目標に従わず、max_output_tokensを大きくしても書く量はモデルが決めると説明しています。決まった分量の出力が必要なら、章や行の範囲ごとに分けて依頼し、受け取った側で完成条件を確かめるほうが確実です。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
- 1.Gemini APIの料金ページai.google.dev/gemini-api/docs/pricing
- 2.Gemini APIの課金ページai.google.dev/gemini-api/docs/billing
- 3.Gemini APIの提供地域リストai.google.dev/gemini-api/docs/available-regions
- 4.Gemini APIの変更履歴ai.google.dev/gemini-api/docs/changelog
- 5.Gemini 4 Argonの新機能ページai.google.dev/gemini-api/docs/latest-model
- 6.Gemini APIのGenerateContentリファレンスai.google.dev/api/generate-content
- 7.Googleのlong decodeガイドai.google.dev/gemini-api/docs/generate-content/long-decode
- 8.OpenAI互換エンドポイントのページai.google.dev/gemini-api/docs/openai
- 9.Interactions APIのlong decodeガイドai.google.dev/gemini-api/docs/long-decode